本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
点题:AS 不是创建即可用——大世界里的 AS 需要流式加载
回顾全系列前十篇的脉络:ep01 画了混合渲染的分界线——什么时候从光栅切到光线 [16];ep02/ep03 算了加速结构的工程账——BVH 怎么建、怎么压;ep04 绑了命中着色器和 SBT——trace 到了之后执行什么;ep05 编排了混合管线 Pass——RT 和光栅怎么在帧内交替;ep06–ep08 讲了降噪三连——从时域复用到神经降噪怎么把噪声画面变干净;ep09 分了光线预算——反射、阴影、GI 各分多少条 ray;ep10 讲了 AS 在单帧里的生命周期——四态流转、屏障、双缓冲、压缩、SBT、跨队列同步、池化。全系列的目录索引在 技术博客页。
前十篇有一个共同的隐含前提:AS 已经在显存里了,帧内只管 build、visible、trace、retire 的调度。但真实的大世界项目里,这个前提不成立。
一个 16 km × 16 km 的开放世界地图,地形加建筑加植被加道具,静态 mesh 可能超过几十万个。即便做了 HLOD 和 proxy mesh,全部 BLAS 的总量动辄超过 2 GB——RTX 3060 只有 12 GB 显存,除去帧缓冲、纹理、GBuffer、降噪历史帧,留给 AS 的预算可能只有 1–2 GB。把所有 BLAS 同时驻留,在消费级 GPU 上根本不现实。
AS 不是一个"场景加载时一次性构建"的静态资源,而是一个需要按需加载、按需卸载、在加载卸载过程中保持画面稳定的流式资源。这和纹理 streaming、几何 streaming 是同一类问题,但多了几个 RT 特有的约束——AS 的构建开销远大于纹理上传,AS 的热替换会造成 trace 结果跳变,AS 的序列化格式还是驱动相关的。
ep10 的四态模型在这里要扩展一个维度:从"单帧内的状态流转"扩展到"跨帧的加载/卸载流转"。AS 不再只是 build→visible→trace→retire,还要加上 unloaded→loading→ready→active→unloading 的流式生命周期。两条生命周期交叉在一起,才构成大世界 RT 管线的完整资源管理图景。
这里要做一个区分。ep10 的四态流转是"GPU 执行态"——描述的是 AS 在 GPU 命令队列中的状态变化,时间尺度是微秒到毫秒。本篇的流式生命周期是"资源管理态"——描述的是 AS 在整个资源管理系统中从磁盘到 VRAM 到 TLAS 再到淘汰的状态变化,时间尺度是帧到秒。一个 BLAS 可以同时处于 ep10 的"Trace"态(GPU 正在遍历它)和本篇的"Active"态(在 TLAS 中,可被 trace 引用)。两个状态模型正交——ep10 管 GPU 执行层的读写时序,本篇管资源层的加载/淘汰调度。
本篇聚焦四件事:BLAS 怎么序列化到磁盘和反序列化回来、怎么按 tile/cluster/LOD 组织流式加载、加载卸载时怎么不让画面闪、显存预算怎么分。把这四件事串起来,加上 UE5 和 NVIDIA RTX Kit 的工程参照,大家应该能看到 streaming AS 从"概念"到"落地"的完整链路。
边界声明:本篇不重复 ep10 的帧内四态流转和同步屏障细节(只在衔接处引用结论),不展开 BVH 构建算法与压缩算法的内部实现(ep02/ep03 已写),不涉及离线渲染的 AS 管理。本篇聚焦的是"大世界场景下,AS 资源怎么跨帧流式加载/卸载,怎么管理 VRAM 预算,怎么在热替换时保持画面稳定"。
一、序列化与反序列化:把 BLAS 变成可存储的格式
1.1 为什么需要序列化
在讲 streaming 之前,先解决一个前置问题:BLAS 构建完成后,怎么把它存下来?
ep10 讲了 BLAS 的 build 和 compaction——构建完成后,AS 数据驻留在 GPU 内存里,每一帧都被 trace 读取。如果场景不大,BLAS 可以在加载时构建一次然后一直驻留。但大世界场景里,BLAS 需要换入换出:当一个 tile 的 BLAS 不在显存里时,你是重新构建,还是从磁盘加载预构建好的序列化数据?
重新构建的代价不低。一个 5 万三角形的建筑 BLAS,在 RTX 4090 上构建约 1.5 ms,压缩约 0.5 ms。一个 tile 可能有 200 个这样的 BLAS,总构建时间约 300 ms——如果玩家走进这个 tile 时才开始构建,会看到明显的卡顿。而反序列化一个已经序列化好的 BLAS,开销通常只有构建的 1/5 到 1/10——同样的 BLAS,反序列化约 0.15 ms,200 个总共 30 ms,可以分摊到多帧完成。
序列化的另一个价值是跨帧缓存。动态植被、可破坏物、程序化生成的几何体,它们在场景运行期间可能多次进入/离开视锥。每次进入都重建 BLAS 是浪费——如果能把构建好的 BLAS 序列化到 host 内存或磁盘,下次进入时直接反序列化,就省掉了重复构建。
理解 BLAS 序列化的前提,是理解 BLAS 在 GPU 上的组织形式。BLAS 本质上是一棵 BVH 树的紧凑编码——内节点存储 bounding box 和子节点指针,叶子节点存储三角形引用。这棵树的深度和节点数量取决于三角形数量和 BVH 构建策略。一棵典型 BVH 的深度约 20–30 层,每层节点数翻倍,叶子层的三角形按空间位置排序后紧凑存储。序列化做的事情就是把这棵树的编码数据——节点数组、box 坐标数组、primitive index 数组——连同驱动内部的元数据,打包成一段连续的字节流。
这棵树在 GPU 内部可能还有厂商专有的优化布局——比如 NVIDIA 的 BVH 用量化节点(quantized nodes)压缩 bounding box 坐标,AMD 可能用不同的节点排列顺序。序列化时这些厂商专有布局被原封不动地写入字节流,反序列化时再原样还原。这也是序列化数据不能跨厂商兼容的根本原因——NVIDIA 量化节点的反序列化逻辑,AMD 驱动不一定有。
1.2 Vulkan 的序列化 API
Vulkan 通过 VK_KHR_ray_tracing_maintenance1 扩展提供了两个核心命令:vkCmdCopyAccelerationStructureToMemoryKHR 用于把 GPU 端的 AS 序列化到 host 可访问内存,vkCmdCopyMemoryToAccelerationStructureKHR 用于把序列化数据反序列化回 GPU 端的 AS [3]。
这里要区分两种复制语义。第一种是同一设备内部 AS 之间的复制、压缩或克隆,用 vkCmdCopyAccelerationStructureKHR,模式包括 SERIALIZE、DESERIALIZE、COMPACT、CLONE。第二种是 GPU 内存与 host 内存之间的序列化/反序列化,用的是上面两个 To/From Memory 命令。ep10 讲的 compaction 属于第一种(设备内部 COMPACT),本篇讲的序列化属于第二种(设备到主机)。
序列化的管线写法如下:
// === 1. 查询序列化所需 buffer 大小 ===
VkAccelerationStructureBuildSizesInfoKHR sizeInfo = {
    .sType = VK_STRUCTURE_TYPE_ACCELERATION_STRUCTURE_BUILD_SIZES_INFO_KHR
};
// 序列化大小通过 post-build info 获取
VkQueryPool queryPool;
VkQueryPoolCreateInfo queryInfo = {
    .sType = VK_STRUCTURE_TYPE_QUERY_POOL_CREATE_INFO,
    .queryType = VK_QUERY_TYPE_ACCELERATION_STRUCTURE_COMPACTED_SIZE_KHR,
    .queryCount = 1
};
vkCreateQueryPool(device, &queryInfo, nullptr, &queryPool);

// === 2. 提交 compaction size 查询 + 序列化命令 ===
vkCmdResetQueryPool(cmdBuf, queryPool, 0, 1);
vkCmdWriteAccelerationStructuresPropertiesKHR(
    cmdBuf, 1, &blas, VK_QUERY_TYPE_ACCELERATION_STRUCTURE_COMPACTED_SIZE_KHR,
    queryPool, 0);

// 屏障:确保 build 完成后再序列化
VkMemoryBarrier barrier = {
    .sType = VK_STRUCTURE_TYPE_MEMORY_BARRIER,
    .srcAccessMask = VK_ACCESS_ACCELERATION_STRUCTURE_WRITE_BIT_KHR,
    .dstAccessMask = VK_ACCESS_ACCELERATION_STRUCTURE_READ_BIT_KHR
};
vkCmdPipelineBarrier(cmdBuf,
    VK_PIPELINE_STAGE_ACCELERATION_STRUCTURE_BUILD_BIT_KHR,
    VK_PIPELINE_STAGE_ACCELERATION_STRUCTURE_BUILD_BIT_KHR,
    0, 1, &barrier, 0, nullptr, 0, nullptr);

// === 3. 执行序列化:BLAS → host visible buffer ===
VkCopyAccelerationStructureToMemoryInfoKHR serializeInfo = {
    .sType = VK_STRUCTURE_TYPE_COPY_ACCELERATION_STRUCTURE_TO_MEMORY_INFO_KHR,
    .src = blas,
    .dst = {hostBufferDeviceAddress},  // device address of host-visible buffer
    .mode = VK_COPY_ACCELERATION_STRUCTURE_MODE_SERIALIZE_KHR
};
vkCmdCopyAccelerationStructureToMemoryKHR(cmdBuf, &serializeInfo);
反序列化的写法是对称的——把 src 和 dst 对调,mode 改为 DESERIALIZE:
VkCopyMemoryToAccelerationStructureInfoKHR deserializeInfo = {
    .sType = VK_STRUCTURE_TYPE_COPY_MEMORY_TO_ACCELERATION_STRUCTURE_INFO_KHR,
    .src = {hostBufferDeviceAddress},
    .dst = blas,
    .mode = VK_COPY_ACCELERATION_STRUCTURE_MODE_DESERIALIZE_KHR
};
vkCmdCopyMemoryToAccelerationStructureKHR(cmdBuf, &deserializeInfo);

// 屏障:反序列化完成后对 trace 可见
VkMemoryBarrier postBarrier = {
    .sType = VK_STRUCTURE_TYPE_MEMORY_BARRIER,
    .srcAccessMask = VK_ACCESS_ACCELERATION_STRUCTURE_WRITE_BIT_KHR,
    .dstAccessMask = VK_ACCESS_SHADER_READ_BIT
};
vkCmdPipelineBarrier(cmdBuf,
    VK_PIPELINE_STAGE_ACCELERATION_STRUCTURE_BUILD_BIT_KHR,
    VK_PIPELINE_STAGE_RAY_TRACING_SHADER_BIT_KHR,
    0, 1, &postBarrier, 0, nullptr, 0, nullptr);
注意屏障的两个 access flag:序列化时 src 是 ACCELERATION_STRUCTURE_WRITE_BIT(build 写入),dst 是 ACCELERATION_STRUCTURE_READ_BIT(序列化读取);反序列化后,src 是 ACCELERATION_STRUCTURE_WRITE_BIT(反序列化写入),dst 是 SHADER_READ_BIT(trace 读取)。这两个屏障不能省——省了第一个,序列化可能读到未构建完成的 BLAS;省了第二个,trace 可能读到未反序列化完成的 AS。
1.3 序列化格式:block-based
Vulkan 的 AS 序列化数据在底层采用基于 block 的格式 [1][3]。这不是一个简单的二进制转储——它有结构化的头部和分块组织:
- Header:一个 64-bit 整数,高 32 bit 为
0xFFFFFFFF(magic number,标识 block-based format),低 32 bit 表示后续序列化 block 的数量。 - Block:每个 block 由 32-bit block type(
VkAccelerationStructureSerializedBlockTypeKHR枚举)、长度/数量字段、以及 payload 组成。
这个格式与 VK_KHR_opacity_micromap 提案中 micromap 的序列化 block 格式高度相似——两者都有 block header、长度字段、payload 内容 [1]。这种设计有其原因:Vulkan 的 AS 序列化需要同时支持普通 BLAS 和带 opacity micromap 的 BLAS,block-based 格式让不同类型的序列化数据可以混合在同一个 buffer 中。
序列化格式的设计目标是让驱动可以高效地写入和读取。block type 区分了不同类型的序列化数据——比如 BVH 节点 block、primitive index block、compacted data block、micromap data block。驱动在序列化时按内部数据组织写 block,反序列化时按 block type 还原。开发者不需要关心 block 的内部 payload 格式,只需要分配足够大的 buffer,调用 API,驱动自己处理。
这个 block-based 设计有一个容易被忽视的工程价值:它支持增量更新。如果只有 BVH 的叶子层发生了变化(比如几个三角形的顶点位置变了),理论上只需要重新序列化受影响的 block,而不是整个 AS。虽然 Vulkan 的当前 API 还不直接暴露"部分序列化"的能力——vkCmdCopyAccelerationStructureToMemoryKHR 总是序列化整个 AS——但 block-based 格式为此预留了可能。在工程实践中,这意味着未来的 streaming 优化可以做到"只传输变化的 block"而非整棵 BVH,大幅减少磁盘 IO 和 PCIe 传输量。
另一个格式细节是 header 中的 block count 字段。这个字段让反序列化端可以在读取 header 后就知道后面有多少个 block,从而预先计算需要多少 buffer 空间。这在 streaming 场景中很有用——加载线程可以先读 header,计算 buffer 大小,分配好内存后再读取后续 block payload。如果 block count 未知,就必须先读完全部数据才知道大小,无法预分配,需要动态扩容——效率低很多。
1.4 D3D12 的序列化 API
D3D12 侧的 API 思路与 Vulkan 基本一致 [2]。核心接口是 CopyRaytracingAccelerationStructure,配合 post-build info 获取序列化大小:
EmitRaytracingAccelerationStructurePostbuildInfo用于在 BLAS 构建完成后查询序列化相关信息。D3D12_RAYTRACING_ACCELERATION_STRUCTURE_POSTBUILD_INFO_SERIALIZATION_DESC描述序列化加速结构的大小与布局,包含SerializedSizeInBytes(包含 header 的总大小)和NumBottomLevelAccelerationStructurePointers(BLAS 指针数量)。D3D12_SERIALIZED_RAYTRACING_ACCELERATION_STRUCTURE_HEADER定义序列化头部,头部后跟随底层 BLAS 的 GPU 指针列表。
D3D12 的序列化思路是:先通过 post-build info 拿到序列化大小和布局,再调用 CopyRaytracingAccelerationStructure 执行实际的序列化/反序列化操作。和 Vulkan 一样,序列化数据是设备相关的——同一台机器上序列化的数据可以在同一台机器上反序列化,但跨设备不一定保证。
D3D12 的序列化 header 有一个 Vulkan 不太强调的字段:NumBottomLevelAccelerationStructurePointers。这个字段记录了序列化数据中包含多少个 BLAS 的 GPU 指针——它暗示 D3D12 的序列化支持把多个 BLAS 打包到一个序列化数据块中。这在 streaming 场景中很有用——一个 tile 的所有 BLAS 可以序列化为一个文件,反序列化时一次操作恢复整个 tile。Vulkan 的 vkCmdCopyAccelerationStructureToMemoryKHR 一次只序列化一个 AS,但多个 AS 可以序列化到同一个 buffer 的不同偏移——效果类似,只是 API 层面没有直接暴露"批量序列化"。
D3D12 还有一个 Vulkan 目前没有的能力:EmitRaytracingAccelerationStructurePostbuildInfo 可以同时查询多种 postbuild 信息——serialization size、compaction size、可视化工具需要的 TOOLS_VISUALIZATION 信息。Vulkan 需要为每种信息分别创建 query pool。对 streaming 工程来说,D3D12 的批量查询减少了 GPU 端的 query 提交开销。
1.5 序列化在 streaming 中的实际价值
序列化是 streaming 的底层基础设施,但它本身不等于 streaming。BLAS 序列化解决的是"把 GPU 内存里的 AS 变成可以存储和传输的字节流"这个问题。磁盘 streaming 还需要解决打包、压缩、IO 调度、版本管理这些上层问题。
实际工程中,序列化适合静态或低频变化的几何体。一个城市建筑模型在游戏运行期间不会变,它的 BLAS 可以在打包阶段构建并序列化,运行时直接 mmap 加载。但动态植被、可破坏物体这些每帧或每场景都变化的几何体,序列化的价值有限——还不如运行时构建。
一个典型的 streaming 链路是这样的:打包阶段按 tile 分组构建 BLAS → 序列化到磁盘(每个 tile 一个 .blas 文件)→ 运行时按 tile 加载需求 mmap 对应文件 → host→device 传输 → 反序列化到 GPU AS buffer → 屏障 → TLAS instance 更新 → trace。这条链路里,序列化只是其中一环,但它是把"构建"和"加载"解耦的关键。
打包阶段的细节需要展开。一个 tile 里的静态 mesh 可能来自不同的美术资源——建筑模型、地形 mesh、植被模型。打包时需要按 tile 重新组织这些 mesh,构建对应的 BLAS,然后序列化为一个 .blas 文件。这个过程通常在离线烘焙阶段完成,因为构建大 BLAS 很慢——一个包含 50 万三角形的 tile,构建加压缩可能需要 5–10 秒。打包阶段还应该做一件额外的事:压缩序列化数据。BLAS 序列化后的字节流通常没有压缩——它是 GPU 内部的紧凑编码,但仍有可压缩的冗余。用 zstd 或 LZ4 压缩后的 .blas 文件可以减小 30–50%,减少磁盘占用和 IO 时间。加载时先解压到 staging buffer,再反序列化。解压的开销远小于 IO 节省的时间——一个 5 MB 的 .blas 压缩后 2.5 MB,从 SSD 读取节省约 0.075 ms,zstd 解压约 0.02 ms,净节省 0.055 ms。
序列化解决了"存"的问题,接下来要看"怎么加载"——tile-based streaming 把世界切成地理单元,按需换入换出。
二、Tile-based AS Streaming:按地理单元加载 BLAS
2.1 从纹理 streaming 到 AS streaming
纹理 streaming 是光栅化管线的标配——只加载视锥体内可见的 mipmap 层级,远处用低精度贴图。AS streaming 的思路类似,但目标不是贴图像素,而是几何/加速结构资源。区别在于:纹理 streaming 的最小单位是 mipmap,AS streaming 的最小单位是 tile(或 cluster、object bucket)。
核心思路是把世界切成 tile,每个 tile 管理自己的 BLAS 集合、LOD 状态、加载优先级。相机移动时,新 tile 的 BLAS 换入、旧 tile 的 BLAS 换出,TLAS 的 instance list 动态更新——trace 永远只看到当前 active 的 BLAS。
纹理 streaming 和 AS streaming 还有一个关键区别:纹理的"缺页"只是低精度贴图,视觉上是模糊但可接受的;AS 的"缺 tile"是几何缺失,阴影有洞、反射里没东西、GI 计算跳变——视觉上非常刺眼。纹理 streaming 可以接受"先给低精度、后面再补高精度"的渐进策略,AS streaming 的渐进策略更复杂——不能简单地"先给低精度 BLAS",因为低精度 BLAS 的 trace 结果和高精度 BLAS 差异太大,降噪器无法处理这种跳变。
2.2 Tile 与 Cluster 的层级区分
在讲具体实现之前,先厘清两个容易混淆的层级概念。
Tile/Cell:由世界流送系统管理,按地理空间划分。比如 UE5 的 World Partition 把世界切成 256m × 256m 的网格,每个网格单元是一个 tile。Tile 管理的是"这块地面上有哪些物体"——包括建筑、地形、植被、道具。Tile 是 AS streaming 的主要调度单位。
Cluster/LOD Cluster:由 GPU 或 RTX Kit 工具链管理,按几何复杂度和三角形数量组织。一个 mesh 可以被切成多个 cluster,每个 cluster 最多 256 个三角形(这是 NVIDIA CLAS 的规格 [5][6])。Cluster 是 BLAS 内部的组织单位,不是 streaming 的调度单位。
本篇的 streaming 调度以 tile 为主,cluster/CLAS 作为 LOD 和 GPU-driven build 的进阶扩展放在第三章和第八章。
2.3 加载链路:disk → RAM → VRAM → TLAS instance
一个 tile 的 BLAS 从磁盘到被 trace 使用,经过四层:
- Disk → RAM:IO 线程读取 tile 的 .blas 文件到 host-visible staging buffer。SSD 的随机读取延迟约 0.1 ms,HDD 约 5–10 ms——差 50–100 倍。这就是为什么大世界 RT 游戏几乎要求 SSD。
- RAM → VRAM:
vkCmdCopyBuffer(或CopyBufferRegion)把 staging buffer 拷贝到 device-local AS buffer。这一步是 PCIe 传输,带宽约 16–32 GB/s(Gen4 x16),一个 5 MB 的 BLAS 约 0.15–0.3 ms。 - VRAM → AS:
vkCmdCopyMemoryToAccelerationStructureKHR反序列化,把字节流变成 GPU 可遍历的 AS 结构。开销约为构建的 1/5–1/10。 - TLAS instance 更新:在 TLAS 的 instance list 中加入(或替换)新 tile 的 BLAS 引用。TLAS 重建开销约 0.3–1 ms。
四步串行执行的话,一个 tile 的加载延迟约 0.5–12 ms(取决于 SSD/HDD)。如果一帧要加载 5 个 tile,串行执行可能 2.5–60 ms——在 60 fps 下严重超标。实际工程会把 IO 和反序列化放在独立线程/队列,与渲染并行。
并行化的典型做法是三条流水线:IO 线程负责从磁盘读取 .blas 文件到 staging buffer;传输线程负责 vkCmdCopyBuffer 和反序列化命令的提交(通过单独的 transfer queue);渲染线程负责 TLAS 更新和 trace。三条流水线通过 fence 或 timeline semaphore 同步——IO 线程读取完成后 signal,传输线程等待 signal 后提交 copy + deserialize 命令,传输完成后 signal,渲染线程在下一帧 TLAS 重建时使用新 ready 的 BLAS。整个加载延迟从串行的 0.5–12 ms 变为并行的 max(IO, transfer, 0) + 一帧延迟——通常 IO 是瓶颈,SSD 下约 0.1 ms per tile,5 个 tile 串行 IO 约 0.5 ms,可以藏在一帧的渲染时间里。
但并行化有一个隐藏的代价:staging buffer 的管理。每个正在加载的 tile 需要一个 staging buffer——如果 10 个 tile 同时在 IO 中,就需要 10 个 staging buffer,每个可能 1–10 MB,总共 10–100 MB 的 host-visible 内存。这些 buffer 不能立即回收——必须等 GPU 确认反序列化完成后才能复用。staging buffer 的管理通常用 ring buffer + fence——ring buffer 顺序分配,GPU 完成后标记对应 slot 可复用。如果 ring buffer 太小(比如只能容纳 5 个 tile 的 staging data),而一帧有 10 个 tile 需要加载,IO 线程就会 stall,等待 ring buffer 有空闲 slot。
2.4 Tile 生命周期状态机
每个 tile 在 streaming 系统中经历以下状态:
| 状态 | 含义 | 退出条件 |
|---|---|---|
| Distant | 在加载范围外,磁盘上 | 相机进入预加载范围 |
| Queued | 已进入加载队列,等待 IO | IO 线程开始读取 |
| Loading | IO 线程正在读取磁盘数据 | 读取完成 |
| Transferring | host→device 传输 + 反序列化 | GPU 完成反序列化 |
| Ready | BLAS 在 VRAM 中,但未进入 TLAS | TLAS instance 更新 |
| Active | 在 TLAS 中,trace 可见 | 相机离开加载范围 |
| Unloading | 等待从 TLAS 移除 + VRAM 释放 | TLAS 更新完成 + GPU 信号 |
| Evicted | VRAM 已释放,磁盘上仍有缓存 | 相机重新进入预加载范围或 LRU 淘汰 |
这套状态机的设计要点是 Ready 和 Active 的分离。一个 tile 的 BLAS 反序列化完成后,不立即加入 TLAS——而是在 TLAS 重建时机统一批量更新。这样做的原因是 TLAS 每帧只重建一次,如果每来一个 tile 就更新一次 TLAS,一帧可能更新几十次,开销不可接受。Ready 态的 tile 在下一帧 TLAS 重建时统一批量加入,一次重建搞定所有变化。
2.5 与虚拟内存分页的类比
AS streaming 的设计与操作系统的虚拟内存分页系统有很强的类比关系。操作系统把内存按 4 KB 分页,按需从磁盘加载到物理内存,用 LRU 淘汰不活跃的页。AS streaming 把 VRAM 按 tile 分页,按需从磁盘反序列化到 GPU 内存,用优先级队列淘汰不活跃的 tile。
差异在于:虚拟内存的页大小固定(4 KB),AS 的 tile 大小不固定(取决于 tile 内几何复杂度,可能 1 MB 到 50 MB);虚拟内存的缺页中断是同步的(CPU 必须等),AS 的缺 tile 可以异步(trace 用旧 BLAS 先渲染一帧,新 BLAS 下一帧再替换);虚拟内存的淘汰是透明的(程序不知道),AS 的淘汰必须处理画面稳定性(tile 卸载时画面可能闪)。
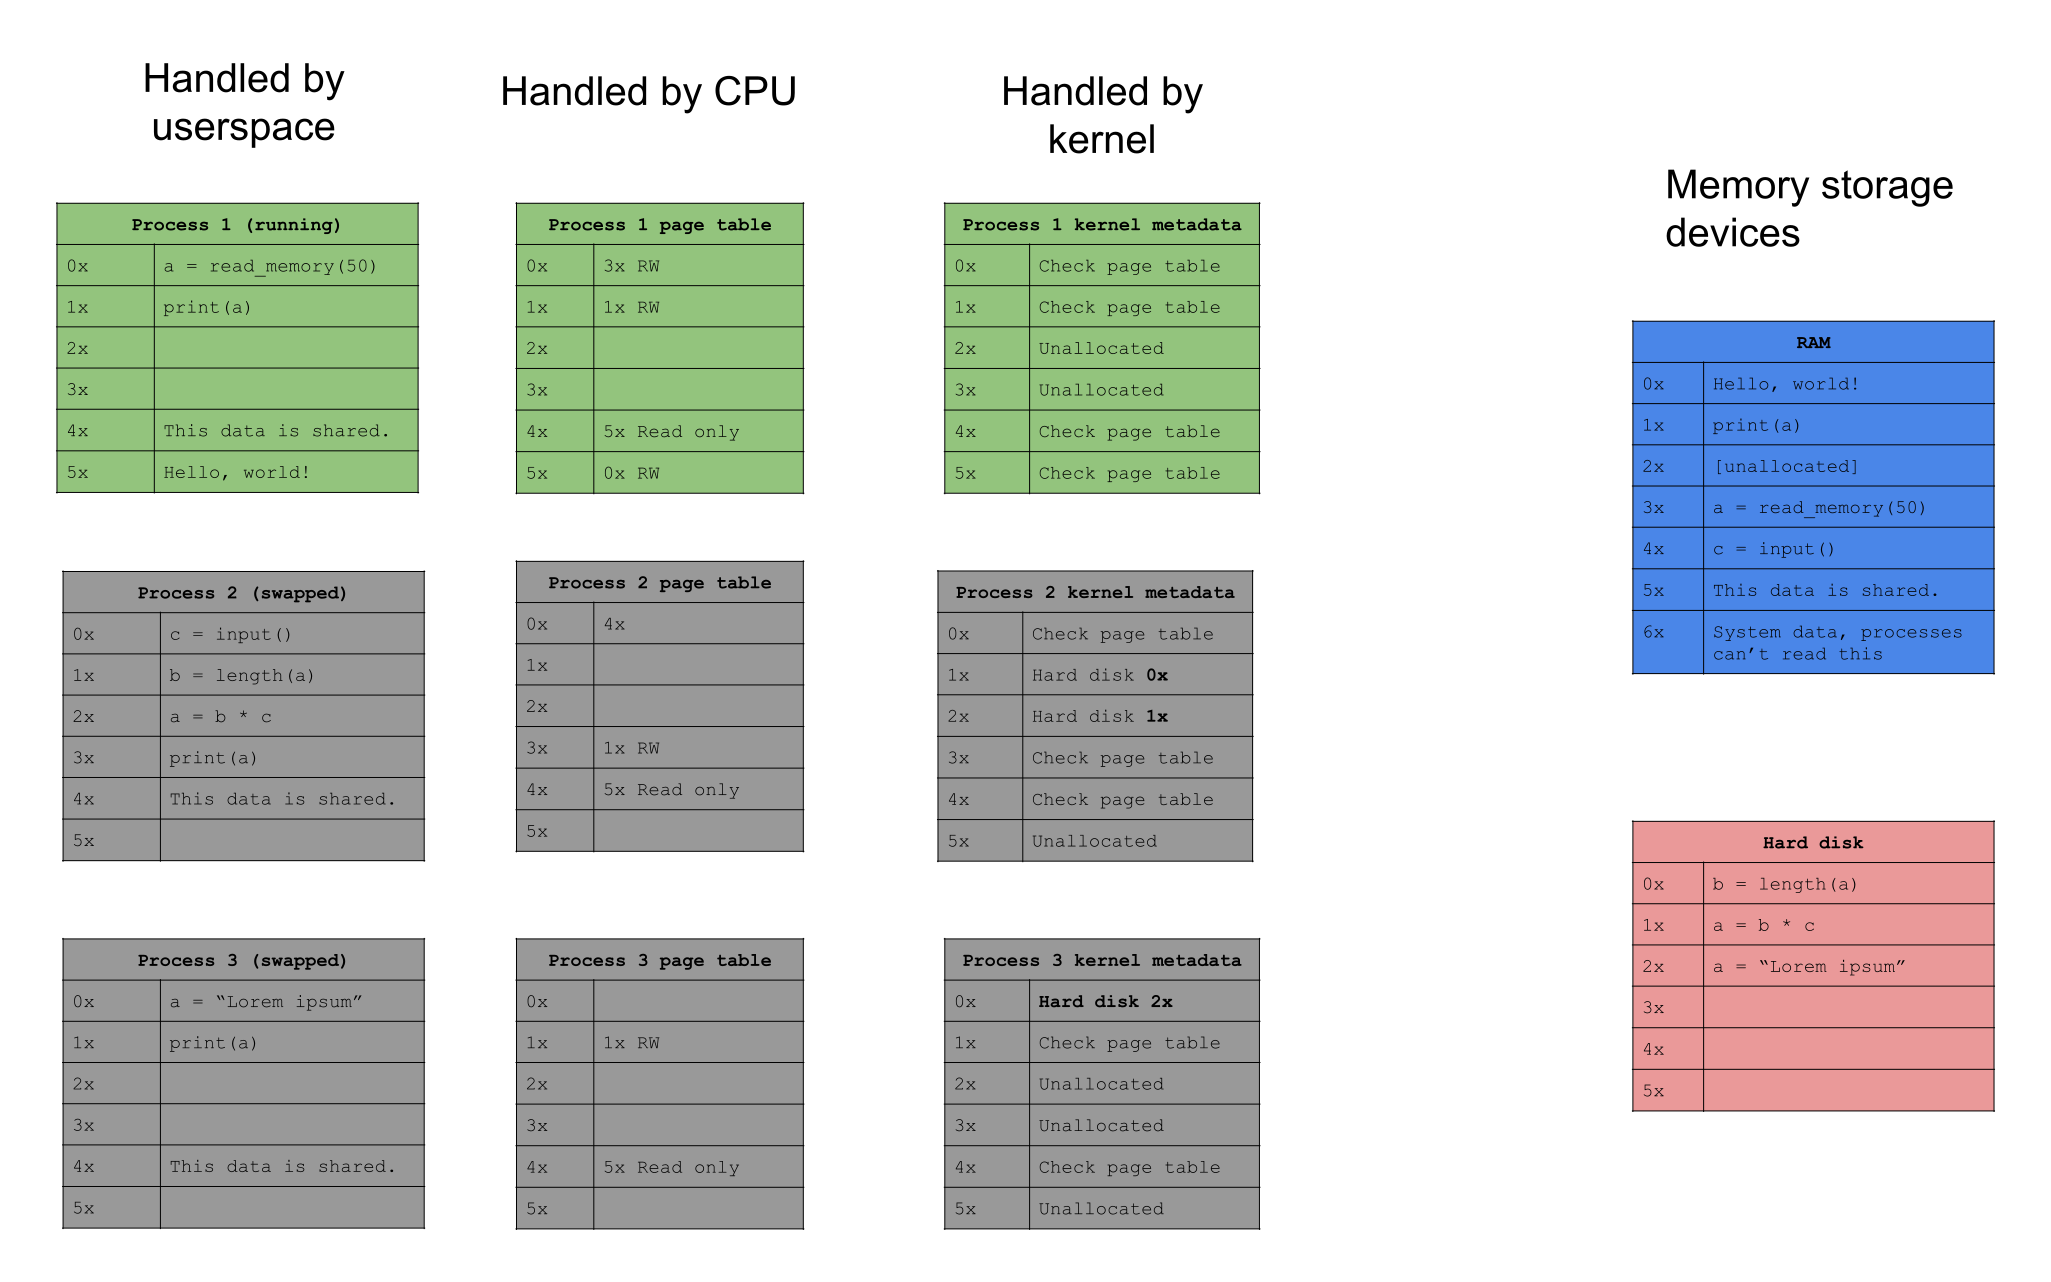
类比的价值在于:虚拟内存的很多工程经验可以直接迁移到 AS streaming——预读(speculative loading)、工作集(working set)、页面锁定(pinning tile for cutscene)、写入时复制(copy-on-write for instanced BLAS)。这些不是新发明,而是把成熟的 OS 工程经验应用到 RT 资源管理上。
再展开几个具体的工程对应。OS 的 working set 概念对应 AS streaming 的"活跃 tile 集合"——当前帧需要被 trace 的所有 tile 的 BLAS 集合。working set 大小决定了 VRAM 的最小需求——如果 working set 是 500 MB,VRAM 至少要留 500 MB 给 AS。OS 的 page fault 对应 AS 的"缺 tile"——当 trace 需要一个尚未加载的 tile 的 BLAS 时,需要回退到 proxy mesh 或上一帧结果。OS 的 swap 对应 AS 的"LRU 淘汰"——VRAM 不够时,最久未使用的 tile 被换出。OS 的 mmap 对应 AS 的"按需加载"——不预先加载整个场景,而是相机移动到哪里就加载到哪里。
这几个对应关系直接指导工程决策。比如 OS 的经验告诉我们:working set 不应该超过物理内存的 70%(留 30% 给突发需求),对应到 AS streaming 就是 active BLAS 不应该超过 RT geometry pool 的 70%。OS 还告诉我们:swap thrashing 是性能杀手——当 working set 频繁变化导致大量 page fault 时,系统会陷入"抖动",对应到 AS streaming 就是 tile 抖动(thrashing)——相机在 tile 边界附近来回移动导致 tile 反复加载/卸载,帧时间飙升。OS 的解决方案是适当增大 working set(多加载几圈 tile),AS streaming 的解决方案也类似——扩大加载范围、加保护期。
tile 的加载和卸载解决了"什么时候换"的问题,但还没回答"换什么精度"——同一个 mesh 在不同距离下需要不同精度的 BLAS,这就是 LOD 的职责。
三、BLAS LOD:同一个 mesh 的多级加速结构
3.1 为什么 BLAS 也需要 LOD
光栅化管线有 LOD——远处用低精度 mesh,近处用高精度 mesh,切换时机由屏幕占用面积决定。AS 也需要 LOD,但驱动因素不同:BLAS LOD 的目标不是减少光栅化的顶点处理开销,而是减少 ray traversal 成本和 BVH build/update 成本。
大世界中,同一个 mesh 在不同距离下需要不同版本的 BLAS。近景时,一个建筑可能 5 万三角形,BLAS 大小约 1.3 MB(按 26.5 bytes/triangle 估算 [12]),trace 时每条光线遍历约 15–25 个 BVH 节点。远景时,如果还是用同一个 5 万三角形的 BLAS,ray traversal 的开销并没有减少——BVH 节点数不变、trace 步数不变。但如果把远景的建筑换成 500 三角形的 proxy BLAS,BLAS 大小降到 13 KB,trace 步数降到 5–8 个,开销减少 60–70%。
LOD 切换的时机不是简单的"距离阈值"。光栅化 LOD 的切换依据是屏幕占用面积——物体在屏幕上占多少像素。AS LOD 的切换依据更复杂:不仅看屏幕占用面积,还要看这个 mesh 参与哪些 RT 效果。一个远景建筑如果只参与 Lumen Far Field 的 GI 计算,用 proxy BLAS 就够了;如果还参与 RT 反射(比如玩家用望远镜看远处建筑的镜面反射),需要更高精度的 BLAS。所以 AS LOD 的选择要和 RT 效果的类型挂钩。一个 mesh 同时可能有多个 RT 用途——GI trace 用近景 BLAS、反射 trace 用近景 BLAS、阴影 trace 可以用中景 BLAS、远场 GI 用远景 BLAS。如果引擎支持"按效果类型选 BLAS",同一个物体在同一个画面里可能同时被两个不同 LOD 的 BLAS 引用——GI trace 用高精度版,远场阴影用低精度版。这需要 TLAS 的 instance 带一个"用途标记",着色器在 hit 时检查标记决定用哪个 instance。UE5 的 RT 管线通过 r.RayTracing.GeometryType 类似机制区分近场/远场几何——不同 effect 使用不同精度的 AS。
3.2 近/中/远三级 BLAS
典型的 BLAS LOD 分三级:
- 近景 BLAS(0–50 m):保留完整三角形数量,适合高质量 GI、反射、阴影。构建时用
PREFER_FAST_TRACE,追求 BVH 遍历效率最优。 - 中景 BLAS(50–200 m):中等复杂度,约为近景的 1/10 三角形数。适合常规反射、中距离阴影。
- 远景 BLAS(200 m+):简化几何或 proxy mesh,约 100–500 三角形。适合远场照明、遮挡查询、Lumen Far Field。
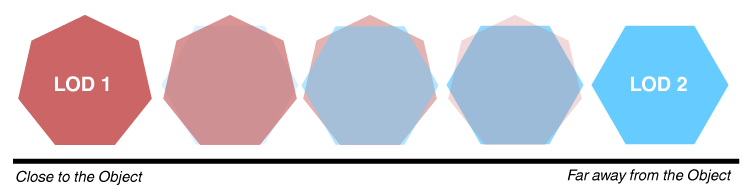
三级之间的切换不是瞬间的——瞬间切换会导致 trace 结果跳变(从一个精度突然变成另一个精度),表现为画面"闪"一下。第四章专门讲怎么处理这个过渡。
3.3 NVIDIA RTX Mega Geometry 与 CLAS
传统的 BLAS LOD 是离散的——近/中/远三档,切换时跳变。NVIDIA RTX Mega Geometry 提供了一条连续 LOD 的路径 [5]。
RTX Mega Geometry 的核心概念是 CLAS(Cluster-Level Acceleration Structure)。传统 BLAS 是一个 mesh 对应一个 BLAS,CLAS 把 mesh 切成多个 cluster(每个最多 256 个三角形 [5][6]),每个 cluster 构建一个 CLAS,多个 CLAS 组成一个 Cluster BLAS。这样,mesh 的 LOD 不是"整体替换",而是"按 cluster 增减"——近景时所有 cluster 的 CLAS 都在 TLAS 中,远景时只保留部分 cluster 的 CLAS,过渡可以是连续的。
RTX Mega Geometry 还提供了两个开源库:nv_cluster_builder 和 nv_lod_cluster_builder [5]。前者负责把 mesh 切成 cluster 并构建 CLAS,后者负责 continuous LOD 的 cluster 选择——根据距离动态决定哪些 cluster 需要加载、哪些可以卸载。这两个库在 Vulkan-Samples 的 vk_lod_clusters 示例中展示了从 RAM 到 VRAM 的按需流式系统 [5]。
对 Nanite 来说,RTX Mega Geometry 的意义在于:它让"使用 Nanite 完整细节的几何进入 ray tracing BVH"成为可能。之前 UE5 的 RT 管线对 Nanite mesh 只能用 fallback mesh(低精度代理),ray tracing 的反射和 GI 看到的不是 Nanite 的真实细节。RTX Mega Geometry 用 CLAS 把 Nanite 的 cluster 直接喂进 BVH,减少了自遮挡和反射误差。但代价是 BLAS 更大、trace 更慢——NVIDIA 的资料明确指出 r.RayTracing.Nanite.Mode 1(让 Nanite 为 RT 输出高 LOD mesh)的性能通常比 fallback mesh 更差 [8]。
3.4 UE5 的 Far Field 与 HLOD
UE5 走的是另一条路径——Lumen 的 Far Field 机制 [7]。
Lumen 默认的 GI 范围约 200 m(由 r.LumenScene.ViewDistance 控制)。超出这个距离的 GI 靠 Far Field 补充——r.LumenScene.FarField=1 启用后,Lumen 的 GI 和反射可以扩展到默认 1 km 范围 [7]。Far Field 依赖 World Partition 的 HLOD 系统:HLOD1 mesh(低精度合并 mesh)用于远场表示,每个 HLOD tile 的 BLAS 在 tile 加载时构建一次。
这套方案的特点是"分层":近景用 Nanite + 硬件 RT,中景用 Nanite fallback mesh + RT,远景用 HLOD1 + Lumen Far Field。三层之间各自管理各自的 BLAS,切换时机由 World Partition 的 loading range 控制。
UE5 方案的工程价值在于链路完整——World Partition 管世界分割、Nanite 管几何、Lumen 管 GI、RT geometry pool 管显存。但难点也很明显:各层之间互相牵制,调一个 CVar 可能影响三层。NVIDIA 的 RTX Mega Geometry 方案更偏"新增 AS 层级"——CLAS 作为中间加速结构,cluster-based BVH 构建、GPU-driven multi-indirect build、continuous LOD streaming、partial TLAS update,适合处理百万级三角形、密集植被、Nanite 完整几何 ray tracing [5][6]。
两条路径不是互斥的。UE5 的 RT geometry pool 可以和 RTXMU 的 compaction/suballocation 配合;RTX Mega Geometry 的 CLAS 可以在 UE5 的 Nanite 管线上层叠加。工程上的取舍是:UE5 方案成熟、链路完整、但有 UE5 绑定;RTX Kit 方案更底层、更灵活、但只在 NVIDIA GPU 上有硬件加速。
CLAS 的设计对 streaming 的影响需要单独展开。传统 BLAS 的 LOD 切换是"整体替换"——近景 BLAS 整个换成远景 BLAS,切换瞬间 trace 结果跳变。CLAS 把这个切换变成"增减 cluster"——近景时所有 cluster 都在 TLAS 中,拉远时逐个卸载不需要的 cluster,trace 结果的变化是渐进的而非跳变的。一个 5 万三角形的 mesh 被切成 200 个 cluster(每个 250 三角形),近景时 200 个 CLAS 全部 active,中景时只保留 100 个(50% 的三角形),远景时只保留 10 个(5% 的三角形)。每次卸载/加载只影响一个 cluster 的 CLAS,开销约 0.01 ms——可以平滑分摊到多帧完成,不会造成帧时间 spike。
NVIDIA 的 ACM 论文 [6] 进一步讨论了 GPU-driven multi-indirect build 的工程细节。传统 BLAS 构建需要 CPU 端逐个调用 vkCmdBuildAccelerationStructuresKHR——每个调用都有驱动开销(约 1–5 μs),1000 个 BLAS 的构建就有 1–5 ms 纯驱动开销。Multi-indirect build 允许 GPU 在一个 indirect 命令中批量提交多个 BLAS 的构建——CPU 只调用一次,GPU 内部遍历 indirect buffer 中的 build info 数组,批量构建。这对 streaming 的价值是:当一批 tile 同时 ready 时,不需要逐个反序列化,可以批量提交——CPU 端的开销从 N 次调用降到 1 次。
四、时域过渡:加载/卸载时怎么不闪
4.1 问题:几何突变
BLAS 热替换时,trace 结果会在帧间发生跳变。这不是 AS 的 bug,而是"几何可见性数据在帧间不连续"的必然结果。
具体来说,有四种典型的画面闪烁:
- 几何突然出现/消失:tile 加载时新 BLAS 加入 TLAS,远处的地面/建筑突然"冒"出来。玩家看到远处凭空出现一栋楼。
- 反射跳变:BLAS LOD 切换时,反射中的物体从一个精度突然变成另一个精度,表现为反射面"闪"一下。
- 漏影:远景的 proxy BLAS 精度不够,阳光阴影出现漏洞——远处地面上该有阴影的地方没有。
- 边界伪影:tile 边界处,两个 tile 的 BLAS 精度不同,接缝处出现几何断层或阴影断裂。
这些闪烁的根源是:trace 的结果依赖 AS 中的几何数据,AS 数据在帧间突变,trace 结果就跟着突变。降噪器(ep06–ep08 讲的 SVGF、ReSTIR 等)依赖时域复用——用上一帧的信息辅助当前帧。如果帧间几何突变太大,降噪器的时域假设失效,会导致更严重的伪影。
4.2 候选方案
| 方案 | 机制 | 代价 | 适用场景 |
|---|---|---|---|
| 过渡帧渲染 | 当前帧同时保留旧 BLAS 与新 BLAS,用 alpha blend 逐步替换 | CPU/GPU 同步复杂,TLAS instance 数翻倍 | LOD 切换 |
| 后处理融合 | 用上一帧 RT 结果与当前帧混合,旧几何的区域用历史帧填充 | 需要历史帧缓存,运动场景有 ghost | tile 加载 |
| 时间占位 | 旧几何卸载后,在下一帧仍保留低质量 proxy | 实现简单,但可能有 ghost | tile 卸载 |
| 渐进式采样 | 新 BLAS 的 ray tracing 结果逐步加入,每帧只采样部分像素 | 需要多帧复用,与降噪器耦合 | 大区域加载 |
过渡帧渲染是最直接的方案——在 TLAS 中同时放入新旧两个 LOD 的 instance,用 blend weight 控制每个 instance 的贡献。具体实现是:在着色器中,ray hit 后检查 instance ID,如果属于过渡中的 instance 对,按 blend weight 对两个 hit 结果做 alpha blend。这个方案的问题是 TLAS instance 数翻倍——如果一个场景有 500 个物体在过渡,TLAS instance 从 500 变成 1000,TLAS 构建和 trace 开销都会增加。实际工程通常只允许少量物体同时过渡,分批处理。
后处理融合不需要在 AS 层面做任何改动——它在 RT 结果上做。新 BLAS 加入后第一帧,trace 结果可能在某些区域出现跳变(新几何的阴影、反射等)。后处理阶段把上一帧的 RT 结果按运动矢量 warp 到当前帧,在有跳变的区域用上一帧结果填充,然后逐步混合。这个方案的缺点是运动场景下的 ghost——如果相机在过渡期间移动,warped 的上一帧结果会有错位。
4.3 双缓冲 streaming
ep10 讲了帧内双缓冲——当前帧 trace 用上一帧构建的 AS,当前帧构建的 AS 下一帧才用。在 streaming 场景中,双缓冲的含义更进一步:
- Buffer A(当前 active):TLAS 引用 A 中的 BLAS instance,trace 读 A。
- Buffer B(streaming target):新 tile 的 BLAS 正在反序列化到 B,TLAS 还没引用 B。
- 当 B 的所有 BLAS 都 ready 后,下一帧 TLAS 切换到引用 B,A 变成 retire 状态。
- A 的 BLAS 在确认 B 已被 trace 读取后,才能释放或用于下一批 streaming。
双缓冲 streaming 的关键收益是:trace 永远不会读到半加载状态的 BLAS。在 A 被 trace 的同时,B 可以安静地加载,两者互不干扰。代价是 VRAM 预算翻倍——需要同时容纳两套 BLAS。在 VRAM 紧张时,可以退化为单缓冲 + fence 同步:新 BLAS 加载完成后,fence 等待当前帧 trace 结束,然后 TLAS 更新引用新 BLAS——但这样会有一个"trace 等加载"的空窗期,帧时间可能 spike。
实际工程中的做法是 混合策略:近景 tile 用双缓冲(画质优先),远景 tile 用单缓冲 + 时间占位(内存优先)。近景 tile 的 LOD 切换用过渡帧渲染(质量优先),远景 tile 的 LOD 切换直接硬切(远处的跳变不明显)。
渐进式采样是另一种过渡方案。它的思路不是在 AS 层面做 blend,而是在像素层面做分批更新。新 BLAS 加入 TLAS 后,不是每个像素都在第一帧就对新几何做 trace——而是每帧只采样 1/4 的像素,用 4 帧的时间逐步覆盖所有像素。未被采样的像素继续用上一帧的 RT 结果。这样做的效果是:新几何的阴影、反射等效果"渐入"而非"闪入",玩家视觉上几乎感知不到。
渐进式采样的实现通常和降噪器耦合——降噪器本来就需要管理每像素的采样状态(哪些像素这帧采了、哪些没采),渐进式采样只是把"新 BLAS 区域"的采样优先级降低,让旧 BLAS 区域先完成收敛。这对 ReSTIR 类方案(ep08 讲过)特别自然——ReSTIR 的时域复用本来就需要处理帧间几何变化,渐进式采样给了它一个"优先级"的维度。
还有一种实践中效果不错的简化方案:dither 过渡。在 LOD 切换帧,对 trace 结果施加一个基于蓝噪声 dither 的 mask——mask 为 0 的像素用旧 LOD 的 trace 结果,mask 为 1 的像素用新 LOD。每帧 mask 的阈值逐渐变化(0.3→0.5→0.7→1.0),4 帧后完全切换到新 LOD。蓝噪声 dither 的空间分布比随机均匀,视觉上比硬切更平滑。这个方案的优势是开销极低——不需要双 BLAS,不需要 alpha blend,只需要在降噪阶段做一次 mask 混合。
LOD 和时域过渡解决了"精度切换怎么不闪"的问题,接下来要看工程上怎么落地——UE5 的 World Partition + Nanite + Lumen 三件套是目前最完整的大世界 RT streaming 方案。
五、UE5 的 RT 流式方案:World Partition + Nanite + Lumen
5.1 World Partition:大世界流送的基础
UE5 的 World Partition 是大世界流送系统的基础 [4][5]。它把世界划分为网格单元(Cell Size 可参考 12800–25600 Unreal 单位,约 128–256 米),运行时根据相机距离加载/卸载单元格。每个单元格独立管理自己的 actor、mesh、碰撞体。
World Partition 对 RT AS 的影响是:每个 cell 的静态 mesh 在 cell 加载时构建 BLAS,cell 卸载时回收 BLAS。BLAS 的构建和 TLAS instance 的加入/移除与 cell 的加载/卸载节奏同步。UE5 的 RT 管线通过 FRTGeometryManager 管理所有 RT 几何的注册/注销——当一个 cell 加载时,cell 内的 static mesh component 向 RT 管线注册自己的 BLAS;卸载时注销。
加载范围(Loading Range)通常设为 cell size 的 2–4 倍——这意味着在相机周围 2–4 圈的 cell 都是 loaded 状态,但只有最内圈的 cell 的 BLAS 是 active 的(在 TLAS 中),外圈的 cell 处于 Ready 状态(BLAS 在 VRAM 中但未加入 TLAS)。这样当相机移动到外圈 cell 时,BLAS 已经 ready,只需要做 TLAS instance 更新,不需要等 IO。
5.2 Nanite Streaming Pool
Nanite 是 UE5 的虚拟化几何系统 [9]。它的流式加载可以类比为 geometry streaming——自动 LOD、基于 cluster 的虚拟化、只加载/保留可见像素相关的数据。
Nanite 的 streaming pool size 由 r.Nanite.Streaming.StreamingPoolSize 控制。这个 pool 管理 Nanite 的 cluster 数据——哪些 cluster 的几何数据驻留在 VRAM 中。Streaming pool 过小会导致 streaming stalls(渲染等待数据加载),过大会挤占 Nanite/Lumen caches 和其他 RT 资源的 VRAM。
Nanite 对 RT 的影响有一个关键 CVar:r.RayTracing.Nanite.Mode [8]。Mode 0(默认)让 Nanite 为 RT 效果输出 fallback mesh(低精度代理),性能较好。Mode 1 让 Nanite 为 RT 输出高 LOD mesh——ray tracing 看到的是 Nanite 的真实细节,但性能开销显著增加。NVIDIA 的 UE5 Raytracing Guideline v5.4 明确指出 Mode 1 的性能通常比 fallback 更差 [8]——这不是一个"开了就更好"的选项,而是一个画质换性能的权衡。
5.3 Lumen Far Field + HLOD
Lumen 的硬件 ray tracing 与 World Partition 协同 [7]:
- 近场(默认约 200 m):Lumen 用硬件 RT 对场景内的 mesh 做 GI 和反射。Nanite mesh 用 fallback mesh 参与.trace。
- 远场(Far Field,默认扩展到 1 km):Lumen 依赖 HLOD1 mesh 做远场 GI。HLOD1 是 World Partition 自动生成的低精度合并 mesh,每个 HLOD tile 的 BLAS 在 tile 加载时构建一次。
- Surface Cache:Lumen 的 Surface Cache 依赖 Nanite 获取高效的 scene capture——Nanite 的 GPU driven rendering 让 scene capture 不需要光栅化所有三角形,只渲染可见 cluster。
这套方案的核心约束是 VRAM 预算。RT geometry pool、Nanite streaming pool、Lumen Surface Cache、HLOD BLAS、纹理——所有这些都在抢 VRAM。r.RayTracing.ResidentGeometryMemoryPoolSizeInMB 控制 RT geometry pool 大小,默认 400 MB [4]。如果场景的 BLAS 总量超过这个 pool,引擎会按 LRU 策略淘汰不活跃的 BLAS——被淘汰的 BLAS 下次需要时重新构建或反序列化。
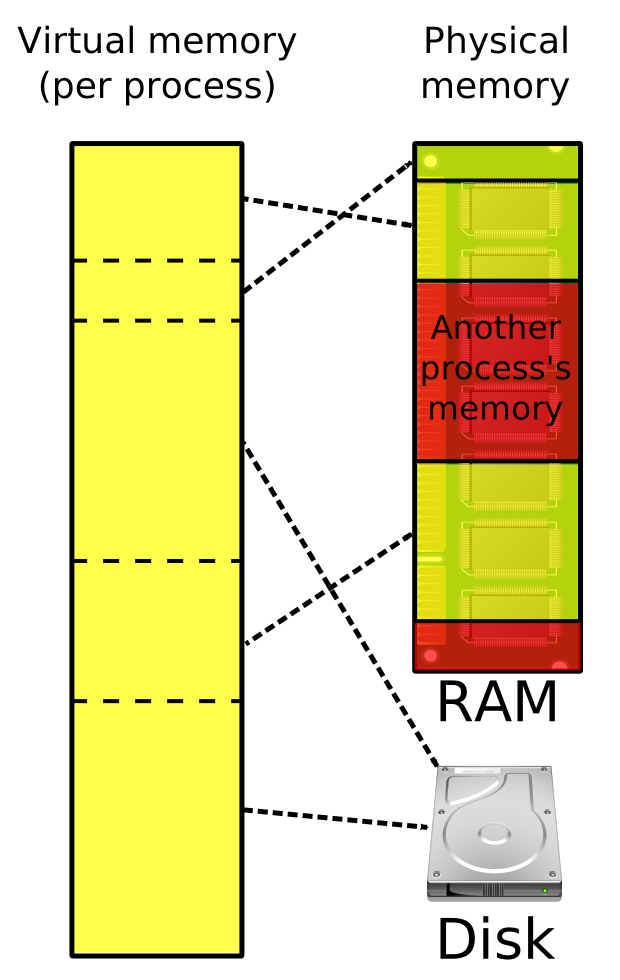
UE5 的 RT geometry pool 机制和虚拟内存非常像——pool 是"物理内存",BLAS 是"页",当 pool 满时按 LRU 淘汰。区别在于 OS 的 page eviction 是透明的,UE5 的 BLAS eviction 可能导致画面跳变(被淘汰的 BLAS 突然从 TLAS 中消失)。所以 UE5 的 RT geometry pool 通常会比实际需要的 BLAS 总量大 20–30%,留出缓冲空间。
5.4 实战调参的陷阱
UE5 的 RT streaming 调参有几个常见的陷阱。
第一个陷阱:RT geometry pool 设太小。默认 400 MB 在中等规模场景下够用,但大世界场景的 BLAS 总量可能远超这个数字。pool 满后引擎会按 LRU 淘汰 BLAS——被淘汰的 BLAS 下次需要时重新构建(或反序列化),导致帧时间 spike。调优方法是用 stat d3d12raytracing 命令查看 BLAS 总量和 pool 使用率——如果使用率持续在 90% 以上,说明 pool 太小,应该调到 r.RayTracing.ResidentGeometryMemoryPoolSizeInMB 为 BLAS 总量的 1.3 倍以上。
第二个陷阱:Nanite streaming pool 和 RT geometry pool 互相挤占。Nanite 的 cluster 数据和 RT 的 BLAS 数据共享 GPU 内存——两个 pool 都从同一块 VRAM 中分配。如果 Nanite streaming pool 设太大(比如 2 GB),RT geometry pool 的可用空间就被压缩。在 12 GB 显存的 RTX 3060 上,两个 pool 加起来不应该超过 4 GB——剩余要留给帧缓冲、纹理、GBuffer、降噪历史帧等。
第三个陷阱:Far Field 和近场 RT 的范围重叠。Lumen 的 Far Field 默认范围约 1 km,近场 RT 默认约 200 m。如果 Far Field 的 HLOD1 mesh 在 200 m 内就生效了(因为 World Partition 的 loading range 设得太大),近场 RT 会同时 trace 真实 mesh 和 HLOD1 mesh——几何重叠导致阴影和反射出现双重轮廓。解决方法是确保 World Partition 的 cell size 和 Lumen 的近场/远场切换距离对齐。具体来说,HLOD1 mesh 的生效距离应该大于近场 RT 的覆盖距离——这样近场 RT 结束后 Far Field 才接手,中间不会有重叠。UE5 的 r.LumenScene.ViewDistance(近场距离)和 r.LumenScene.FarFieldMaxDistance(远场距离)需要配合 World Partition 的 cell size 做联合调优——这不是一组独立 CVar,而是一个需要同时调整的参数组。
UE5 方案的调参陷阱说到底都是 VRAM 预算的争夺——AS 能占多少显存,决定了 streaming 策略的上限。
六、显存预算:AS 能占多少 VRAM
6.1 bytes/triangle 实测数据
要给 streaming 系统设计 VRAM 预算,先要知道 BLAS 到底占多少显存。公开的实测数据来自 zeux.io 的"Measuring acceleration structures"测试 [12]:
| GPU | BLAS 大小 | bytes/triangle | 相对 RTX 2080 |
|---|---|---|---|
| RTX 2080 | 46 MB | 26.5 | 100% |
| RTX 3050 | 45 MB | 25.7 | 97% |
| RTX 4090 | 45 MB | 25.7 | 97% |
| RTX 5070 | 33 MB | 18.8 | 71% |
| Intel Arc B580 | 79 MB | 45.0 | 170% |
这些数据来自同一组测试 mesh(约 174 万三角形),用 PREFER_FAST_TRACE 构建,未做 compaction [12]。几个关键点:
- RTX 2080 到 RTX 4090 三代之间,bytes/triangle 几乎没变(26.5→25.7)——NVIDIA 的 BVH 编码格式在这三代上没有大的变化。
- RTX 5070 显著降低到 18.8 bytes/triangle——Blackwell 架构引入了新的 BVH 编码格式,压缩率提升约 27%。
- Intel Arc B580 的 45.0 bytes/triangle 是 NVIDIA 的 1.7 倍——不同厂商的 BVH 编码效率差异很大,跨厂商的 AS 预算不能用同一套数字。
6.2 RTXMU Compaction 节省
RTXMU(RTX Memory Utility)是 NVIDIA 的 AS 内存优化工具 [10]。它的两个核心功能:
- Compaction:BLAS 构建完成后,通过
vkCmdCopyAccelerationStructureKHR(COMPACT 模式)把 AS 压缩到更小 footprint。Compaction 后的 AS 只能用于 trace,不能用于 refit update——因此只适合静态 BLAS。NVIDIA 的测试数据显示 compaction 平均减少 52% 的 AS 内存 [10]。 - Suballocation:把多个小 BLAS 打包到一个大 heap 中,用 256-byte alignment 替代标准的 64 KB buffer alignment。标准 alignment 下,一个 100 KB 的 BLAS 实际占 64 KB × 2 = 128 KB(向上对齐到 64 KB 边界),浪费 28 KB。Suballocation 把多个小 BLAS 紧密排列在同一个 heap 中,平均节省约 123 MB(取决于场景几何数量)[10]。
一个更具体的案例来自 Indiana Jones 的路径追踪优化 [13]。该项目对动态植被的 BLAS 做 compaction:compact 前总大小 1027 MB,compact 后降到 606 MB,减少约 41%。动态植被的特点是三角形数量大、单个 mesh 的三角形数少、BLAS 数量多——这种场景特别适合 compaction 和 suballocation。
Compaction 的工程注意事项:
- Compaction 后的 size 需要 CPU 端读取(通过 query pool 回读 compacted size),因此是异步的——构建完成后提交 compaction query,几帧后拿到结果,再执行实际的 compact copy。
- Compaction 只适合"构建一次"的 BLAS。每帧重建的动态 BLAS 做 compaction 的收益有限——compaction 本身有开销,且 compaction 后的 AS 不能 refit。
- Suballocation 适合包含数千个 small triangle-count BLAS 的场景。如果场景只有几十个大 BLAS,suballocation 的收益不大。
6.3 估算公式
基于实测数据,可以给出一个估算公式:
BLAS 大小 ≈ triangle_count × bytes_per_triangle × compression_ratio
bytes_per_triangle:从上面的实测表取值(NVIDIA 约 18.8–26.5,Intel 约 45.0)。compression_ratio:如果做 compaction,乘以 0.48(1 - 0.52);不做则为 1.0。- 实际大小以 post-build info 和 compaction 后的 size query 为准——估算公式只用于设计预算。
再用一个更完整的场景做一次端到端的预算演练。假设一个大世界开放世界游戏:场景面积 16 km × 16 km,静态 mesh 总量 8 万个(建筑 + 地形 + 道路 + 桥梁),平均每个 mesh 3000 三角形,总三角形 2.4 亿。动态 mesh(植被 + 角色 + 载具)约 5000 个,平均 5000 三角形,总三角形 2500 万。
在 RTX 4090 上(25.7 bytes/triangle,做 compaction,compression ratio = 0.48):
- 静态 BLAS(全量):2.4 亿 × 25.7 × 0.48 ≈ 2.96 GB——不可能全装进 VRAM。
- 但 streaming 只加载相机周围 ~2 km 范围的 tile,约占总场景的 1.5%(2/16)²,即约 44 MB——这只是理论下限。加上预加载圈(3–4 倍),实际 active + ready 的 BLAS 约 180–300 MB。
- 动态 BLAS(全量):2500 万 × 25.7 × 0.48 ≈ 310 MB——动态 BLAS 不能做 streaming(每帧或每场景变化),需要全量驻留或按视锥剔除后驻留。
- 如果动态 BLAS 做视锥剔除(只保留视锥内的 30%):310 × 0.3 ≈ 93 MB。
- 加上 TLAS(每帧重建,约 1–5 MB)、SBT(约 1–10 MB)。
- 总 AS VRAM 预算:约 280–400 MB。
这个数字和 UE5 默认的 RT geometry pool 400 MB 吻合——说明 UE5 的默认值是按"中等规模大世界场景 + RTX 40 级别 GPU"设计的。如果场景更大、GPU 更老(如 RTX 2060 的 6 GB 显存),400 MB 的占比就太高了——6 GB 显存留给帧缓冲和纹理可能只有 2 GB,400 MB 的 AS pool 占了 20%,需要调小。
不同游戏类型对 AS VRAM 预算的敏感度不同。线性叙事游戏(如《最后生还者》)的场景范围有限,相机运动可控,working set 变化小,AS pool 可以设小。开放世界游戏(如《赛博朋克 2077》)的相机自由度高,玩家可能快速移动导致 working set 剧变,AS pool 需要留更多余量。竞速游戏的相机沿赛道高速移动,tile 的加载/卸载频率远高于步行场景,对预测加载的精度要求更高。VR 游戏的帧率要求 90 fps 以上(帧预算 11 ms),留给 AS streaming 的时间窗口更短,需要更激进的预加载和更大的 Ready 池。
举个例子:一个 16 km × 16 km 的开放世界,5000 个静态 mesh,平均每个 2000 三角形。总三角形 1000 万。在 RTX 4090 上,不做 compaction 的 BLAS 总量 ≈ 1000 万 × 25.7 = 257 MB。做 compaction 后 ≈ 257 × 0.48 = 123 MB。这看起来不多,但加上动态 BLAS(角色、植被、可破坏物等可能再增加 200–500 MB),总量可能达到 350–620 MB——如果 UE5 的 RT geometry pool 默认只有 400 MB,就需要调大 pool 或减少 RT 几何。
6.4 内存池与空闲链表
streaming 系统需要一个高效的内存管理器来管理 AS buffer 的分配和释放。直接用 vkAllocateMemory 为每个 BLAS 分配一块内存是低效的——每次分配约 0.1–1 ms,且会产生碎片。生产引擎通常用一个大的 device-local buffer 配合 suballocation:
- Pool Allocator:预分配一个大 buffer(比如 1 GB),内部用 offset + size 管理子分配。BLAS 加载时从 pool 中分配一块,卸载时归还。
- Free List:维护一个按大小排序的空闲块链表。分配时找 best-fit 块,释放时合并相邻空闲块。
空闲链表的关键设计点是合并策略。当一个 BLAS 被释放时,如果它的前一个和后一个块都是空闲的,三者合并成一个更大的空闲块——这避免了碎片化。如果不做合并,连续的加载/卸载会把 pool 切碎成小块,最后虽然总空闲空间够,但找不到一个连续的大块来装新 BLAS。
RTXMU 内部就实现了类似的 suballocation + free list 管理 [10]。它用 256-byte alignment 替代 64 KB buffer alignment,让多个小 BLAS 紧密排列。这对包含大量小 BLAS 的场景(植被、小道具)特别有效——1000 个 50 KB 的 BLAS,用 64 KB 对齐需要 64 MB,用 256-byte 对齐只需要约 50 MB,节省 22%。
空闲链表的合并策略还有一个工程细节。当 BLAS 被释放时,链表需要检查前后相邻的空闲块并合并。如果链表按地址排序,合并只需检查 O(1) 个相邻块——但如果链表按大小排序(为了 best-fit 分配),合并需要从大小链表中移除被合并的块,开销变为 O(log n)。实际工程中,通常维护两个链表:一个按地址排序(用于合并),一个按大小排序(用于分配),两者通过指针互相关联。这样分配和合并都是 O(log n)。对 streaming 场景来说,BLAS 的加载/卸载频率可能是每帧 5–20 次,链表操作的开销可以忽略(< 0.01 ms per operation),但碎片化管理的效果会累积——如果不做合并,连续运行几小时后 pool 可能碎片化到无法分配一个大 BLAS,即使总空闲空间足够。
streaming 场景的内存池还有一个特殊需求:预分配预留。当 VRAM 使用率超过 85% 时,系统应该停止新 BLAS 的加载——留出 15% 的缓冲空间给突发需求(比如玩家瞬移到一个新区域,需要一次性加载大量 tile)。如果预留不足,VRAM 满了后新 BLAS 加载失败,TLAS 会引用到空指针——直接崩溃。实际做法是在 pool 的总容量中预留 10–15% 作为"安全余量",只有当主动触发卸载后空间释放,才允许新 BLAS 加载到安全余量区域。
有了预算数字和内存池管理,接下来要回答的是"谁先加载、谁先淘汰"——优先级队列把 tile 按重要程度排成队列。
七、优先级队列与预加载
7.1 P0–P4 五级队列
大世界的 AS streaming 不能用简单的 FIFO 队列——所有 tile 不是同等重要的。当 VRAM 紧张、IO 带宽有限时,需要按优先级决定谁先加载、谁先卸载。
| 优先级 | 内容 | 说明 | 典型延迟容忍 |
|---|---|---|---|
| P0 | 当前视锥中心 tile BLAS | 保证主视觉区域的 RT 质量 | 0 帧(立即需要) |
| P1 | 路径前方 tile BLAS | 相机运动预测,预加载即将进入视野的 tile | 1–3 帧 |
| P2 | 高复杂度 tile | 保证建筑、植被、大 mesh 不丢影/漏影 | 3–10 帧 |
| P3 | Far Field / HLOD 表示 | 远距离 Lumen 支持 | 10–30 帧 |
| P4 | 已缓存候选卸载 | VRAM 紧张时优先卸载这些 | — |
优先级的判断依据包括:
- 距离相机远近:越近优先级越高。
- tile 是否在视锥内:视锥内 > 视锥外。
- 相机朝向:相机朝向的 tile > 相机背后的 tile。
- 几何复杂度:复杂 foliage/建筑 > 简单地面。
- 是否正在被 ray 使用:正在被 trace 的 BLAS 不能卸载。
- 是否已被缓存:有磁盘缓存的 BLAS 优先卸载(重新加载快)。
- 是否刚被加载/卸载:刚加载的 tile 短时间内不卸载(避免抖动),刚卸载的 tile 短时间内不重新加载(避免抖动)。
最后一条特别重要——如果没有"刚加载/卸载保护期",相机在 tile 边界来回移动时会导致 tile 反复加载/卸载,称为 thrashing。保护期通常设为 1–3 秒——在这段时间内,即使 tile 不在加载范围内,也不立即卸载。
thrashing 的代价不仅是帧时间 spike——更严重的是它会触发 BLAS 的频繁构建/反序列化,加速 GPU 内存碎片化。每次分配和释放 AS buffer 都会在 pool 中产生碎片——如果 pool 被切碎成大量小空闲块,最终可能总空闲空间够但找不到一个连续大块来装新 BLAS。thrashing 场景下这个问题尤其严重,因为加载/卸载的频率比正常 streaming 高一个数量级。防 thrashing 的工程做法除了保护期,还有"滞后卸载"——不立即卸载离开加载范围的 tile,而是把它标记为"candidate for eviction",只有当 VRAM 使用率超过阈值(比如 85%)时才真正开始淘汰。这样在 VRAM 宽裕时,tile 会多留几帧,减少抖动风险。
7.2 相机运动预测
P1 的"路径前方 tile"需要预测相机未来 1–3 秒的运动方向。预测模型可以很简单——基于当前帧的速度向量和加速度,线性外推未来位置。也可以更复杂——基于路径规划(NPC 的巡逻路线、玩家可能的前进方向)、地形分析(上坡减速、转弯前减速)。
预测加载的设计窗口是这样的:
- 可见但不立即需要:tile 在视锥内但距离较远,可以保留在 hot cache(VRAM 中),不急着加入 TLAS。
- 即将可见:tile 在 1–3 秒内会进入视锥或加载范围,预加载 BLAS、更新 TLAS instance。
- 刚离开:tile 刚离开加载范围,保留短暂时间(保护期),避免抖动。
- 长时间不可见:超过保护期后,从 memory pool 释放。
预测加载的收益是减少 pop-in——如果等 tile 进入加载范围才开始 IO,玩家在快速移动时会看到大量几何 pop-in。预测加载让 IO 提前 1–3 秒开始,当 tile 进入加载范围时 BLAS 已经 ready,只需 TLAS 更新。代价是浪费 IO 带宽和 VRAM——预测不准时,加载了不需要的 tile,挤占了其他 tile 的资源。
实际工程中,预测加载通常只用于 P0 和 P1 级别的 tile——近景 tile 的预加载收益最大(pop-in 最明显),远景 tile 的预加载收益有限(反正都是 proxy mesh)。
预测加载的误差容忍设计也需要考虑。预测不可能 100% 准确——玩家可能突然转弯、跳跃、瞬移。预测加载了不需要的 tile,浪费的只是 IO 带宽和临时 VRAM——这些 tile 会在保护期后被淘汰,代价可控。但漏掉了该预加载的 tile,玩家就会看到 pop-in——代价是视觉体验下降。所以预测加载的策略应该偏向"宁可多加载不可少加载"——预测范围设大一点(比如 3 秒而不是 1 秒),让更多 tile 提前进入加载队列。多加载的 tile 如果不需要,只是多占几帧 VRAM;少加载的 tile 如果需要,就是可见的 pop-in。
一个更精细的预测策略是结合"运动方向加权"。相机正前方 120° 范围内的 tile 预测权重高(玩家大概率朝这个方向走),侧后方 240° 范围内的 tile 预测权重低(玩家不太可能倒着走)。按权重排序后,IO 线程优先加载高权重的 tile——如果 IO 带宽有限,低权重的 tile 可以推迟到下一轮。这种方向加权在开放世界赛车游戏中特别有效——车辆几乎总是朝前方运动,预加载前方 tile 的命中率接近 100%。
优先级队列解决了 CPU 端的调度问题,但 CPU 本身可能成为瓶颈——下一节看 GPU-driven BLAS 构建怎么把调度权交给 GPU。
八、GPU-driven BLAS 构建与 Mesh Shader
8.1 从 CPU-driven 到 GPU-driven
前面讲的 streaming 都是在 CPU 端调度的——CPU 决定加载哪些 tile、调用 vkCmdCopyMemoryToAccelerationStructureKHR 反序列化、更新 TLAS instance。这套模式的问题是 CPU→GPU 的往返开销:CPU 端分配 buffer、提交命令、等待 fence、读取 query 结果——每一步都有微秒级的驱动开销。一个场景如果有几千个 BLAS 在 streaming,CPU 端的开销可能达到 2–5 ms。
GPU-driven BLAS 构建把调度权交给 GPU。核心思路是:用 compute shader 在 GPU 上做剔除和 LOD 选择,然后通过 indirect draw(或 indirect build)命令直接在 GPU 上提交 AS 构建命令,不需要 CPU 介入。
NVIDIA RTX Mega Geometry 提供了 GPU-driven "multi-indirect" build functions [5][6]。这些函数让 GPU 可以在一个 indirect 命令中批量提交多个 BLAS 的构建——CPU 只需要提交一次 indirect 命令,GPU 内部完成所有构建。这在 streaming 场景下的价值是:当一组 tile 的 BLAS 需要构建(或从序列化数据反序列化)时,CPU 不需要逐个调用 API,GPU 自己就能批量处理。
8.2 VK_NV_cluster_acceleration_structure
VK_NV_cluster_acceleration_structure 是 NVIDIA 的扩展,提供了 CLAS 相关的 API [5]。它的核心命令包括:
- 构建 CLAS:把一个 cluster(最多 256 个三角形)构建为一个 CLAS。
- 构建 Cluster BLAS:把多个 CLAS 组合成一个 Cluster BLAS,替代传统的整体 BLAS。
- Partial TLAS update:TLAS 的 instance list 可以部分更新——不需要重建整个 TLAS,只更新变化的 instance。
Partial TLAS update 对 streaming 非常重要。传统 TLAS 每帧全量重建——即使只有一个 tile 的 BLAS 变化,也要重建整个 TLAS 的所有 instance。如果一个场景有 10000 个 instance,TLAS 重建约 1 ms。Partial update 允许只更新变化的 instance——如果一帧只有 5 个 tile 变化,partial update 只需要更新 5 个 instance,开销约 0.05 ms。
8.3 Mesh Shader 与 AS 构建的融合
Mesh Shader 引入了一种新的几何体提交方式——绕过传统的输入装配(IA)阶段,直接在 compute shader 中生成几何体。这影响了 AS streaming 的设计:
- 传统管线:CPU 上传 vertex buffer → IA → VS → BLAS 构建 → TLAS 构建 → trace
- Mesh Shader 管线:Mesh Shader(GPU 上生成几何体)→ BLAS 构建 → TLAS 构建 → trace
Mesh Shader 的优势是可以在 GPU 上做几何体剔除后再构建 BLAS——被剔除的几何体不进入 AS,减少了构建开销和 AS 内存。GPU-driven multi-indirect build + Mesh Shader 的组合,让 streaming 的触发点从"tile 加载完成"细化到"cluster/LOD 构建完成"——CPU 只管 tile 调度,GPU 自己处理 cluster 的构建和 AS 的更新。
这把 streaming 的瓶颈从 disk IO 扩展到 GPU compute。以前的问题是"等磁盘加载",现在是"等 GPU 构建"——GPU 构建的吞吐量远高于磁盘 IO,但如果一帧需要构建大量 CLAS,compute 队列可能成为新的瓶颈。NVIDIA RTX Best Practices 建议 AS build/update 时间控制在 2 ms 以内 [11],超过这个预算就需要异步 compute 队列重叠。
GPU-driven 的另一个优势是对 instance 数据的管理。传统 CPU-driven 管线中,每帧的 TLAS instance 数据需要 CPU 端写入——CPU 遍历场景中所有 active 的 BLAS,计算变换矩阵,写入 instance buffer,然后上传到 GPU,最后 TLAS build 读取这个 buffer。这个 CPU→GPU 传输每帧都需要做,数据量与 instance 数量成正比——10000 个 instance 约 640 KB(每个 instance 约 64 bytes),PCIe 传输约 0.04 ms,但 CPU 端遍历和写入的开销可能 0.5–1 ms。GPU-driven 方案让 instance 数据在 GPU 上直接生成——compute shader 做剔除后直接写 instance buffer,不需要 CPU 介入,同步从 semaphore 简化为屏障。
这个转变对 streaming 的影响很大。传统 streaming 中,新 tile 加载完成后需要 CPU 更新 TLAS instance list——CPU 需要知道新 tile 的 BLAS device address、变换矩阵、instance ID。GPU-driven 方案中,这些信息在 GPU 上维护——tile 加载状态、BLAS device address 都存在 GPU buffer 中,compute shader 读取这些 buffer 直接生成 instance list。CPU 只需要把 tile 加载命令提交到 GPU,后续的 TLAS 更新完全在 GPU 上完成——延迟更低,CPU 开销更小。
GPU-driven 方案把调度权交给了 GPU,但跨厂商的序列化兼容性仍然是一个未解的问题——下一节来看不同 GPU 之间能不能共享序列化数据。
九、跨厂商兼容性
9.1 序列化不等于跨设备兼容
前面讲的序列化/反序列化 API 是跨厂商的——Vulkan 和 D3D12 都提供了标准化的序列化接口。但"API 标准化"不等于"数据跨设备兼容"。一个 NVIDIA GPU 上序列化的 BLAS,拿去 AMD GPU 上反序列化,不保证能成功——因为各厂商的 BVH 编码格式、节点布局、compaction 算法都不一样。
Vulkan 提供了显式的兼容性检查 API:vkGetDeviceAccelerationStructureCompatibilityKHR。这个函数比较两个设备的 AS 序列化数据是否兼容——调用时传入序列化数据的 header(前面讲的 64-bit magic + block count),函数返回 VK_ACCELERATION_STRUCTURE_COMPATIBILITY_COMPATIBLE_KHR 或 INCOMPATIBLE_KHR。
对 micromap(Opacity Micromap),Vulkan 有对应的 vkGetDeviceMicromapCompatibilityEXT [1]。这两个兼容性检查 API 是 streaming asset 的必要环节——如果你在 NVIDIA GPU 上打包了序列化 BLAS,发到玩家的 AMD GPU 上运行,必须在加载前做兼容性检查,不兼容就回退到运行时构建。
兼容性检查的调用方式是这样的:从序列化数据的头部提取兼容性 UUID(一段驱动生成的标识符),然后调用 vkGetDeviceAccelerationStructureCompatibilityKHR 比较当前设备的 UUID 和序列化数据中的 UUID。如果 UUID 匹配,返回 COMPATIBLE,可以安全反序列化;如果不匹配,返回 INCOMPATIBLE,必须回退到运行时构建。UUID 是驱动生成的,包含厂商 ID、驱动版本、BVH 编码格式版本等信息——驱动升级可能导致 UUID 变化,之前序列化的 BLAS 在新驱动上可能变成 INCOMPATIBLE。这意味着序列化缓存需要带版本号,驱动升级后需要重新构建和序列化所有缓存——否则旧缓存在新驱动上无法使用。
9.2 AMD DGF 与 Intel RT 的差异
不同厂商的 AS 构建效率和内存占用差异很大。从前面的实测数据看 [12]:
- NVIDIA RTX 2080/3050/4090:约 25.7–26.5 bytes/triangle
- NVIDIA RTX 5070(Blackwell):约 18.8 bytes/triangle(新编码格式)
- Intel Arc B580:约 45.0 bytes/triangle(NVIDIA 的 1.7 倍)
AMD 的情况略有不同。AMD 有 DGF(Direct Geometry Format)和 DGF SuperCompression,用于几何数据压缩 [14]——但 DGF 压缩的是几何数据本身(vertex/index buffer),不是 BLAS。AMD 的 BLAS 构建走的是 DXR 标准 API(BuildRaytracingAccelerationStructure),构建质量和内存占用取决于驱动实现。AMD GPU 不支持 NVIDIA 的 RTXMU compaction——RTXMU 是 NVIDIA 专有的。
Intel 的 RT 实现指南 [15] 提到了 PREFER_FAST_TRACE / PREFER_FAST_BUILD 等 DXR 风格的构建 flag 建议,以及 r.RayTracing.Nanite.Mode 等引擎层面的优化。Intel Arc B580 的 45.0 bytes/triangle 意味着同样场景的 BLAS 在 Intel GPU 上占用的 VRAM 是 NVIDIA 的 1.7 倍——跨厂商的 VRAM 预算必须做适配。
Intel 的 RT 指南 [15] 还提到一个 NVIDIA 资料中不太强调的细节:Intel Arc GPU 对 PREFER_FAST_BUILD 和 PREFER_FAST_TRACE 的权衡与 NVIDIA 不完全一致。NVIDIA 上 PREFER_FAST_TRACE 构建慢约 50% 但 trace 快约 10–15%,而 Intel Arc 上 PREFER_FAST_TRACE 构建慢约 80% 但 trace 快约 5–8%——Intel 的 BVH 质量对 build flag 的敏感度更低。这意味着对 Intel GPU,PREFER_FAST_BUILD 可能是更合理的默认选择——构建快一倍,trace 慢不到 10%,对帧时间更友好。跨厂商项目如果只有一个默认 build flag,需要根据目标 GPU 的分布做权衡——如果 80% 的玩家用 NVIDIA,默认 PREFER_FAST_TRACE;如果 Intel/AMD 占比高,默认 PREFER_FAST_BUILD 更安全。
9.3 预算适配
跨厂商的 streaming 预算不能一刀切。一个场景在 RTX 4090(25.7 bytes/triangle)上 BLAS 总量 200 MB,在 Intel Arc B580(45.0 bytes/triangle)上变成 350 MB——如果 RT geometry pool 设为 400 MB,NVIDIA 够用,Intel 可能紧张。
工程做法是按 GPU 厂商动态调整 pool size 和 streaming 策略:
- 检测 GPU 厂商和型号(通过
vkGetPhysicalDeviceProperties的vendorID和deviceName)。 - 按厂商设不同的
bytes_per_triangle估算值。 - 按估算值调整 RT geometry pool size(NVIDIA 可以小一点,Intel/AMD 需要大一点)。
- 对 VRAM 较小的 GPU(如 RTX 3060 12 GB),减少远场 tile 的 BLAS 加载量,更多依赖 HLOD/proxy。
这比简单地设一个固定 pool size 更合理——不同 GPU 的 BVH 编码效率差异 1.7 倍,用一个统一的预算数字要么在 NVIDIA 上浪费,要么在 Intel 上不够。
跨厂商兼容性还有一个容易忽略的维度:序列化数据的版本管理。一个游戏可能在生命周期内多次更新——每次更新可能引入新的 mesh、修改现有 mesh 的几何。如果 BLAS 是在打包阶段构建并序列化的,每次更新就需要重新序列化受影响的 tile。但如果游戏需要在多个 GPU 厂商上运行(NVIDIA、AMD、Intel),同一个 tile 的 BLAS 需要为每个厂商各保存一份序列化数据——因为序列化格式不兼容。这意味着打包体积增大——一个 10 GB 的场景,BLAS 序列化数据可能占 500 MB,三个厂商各一份就是 1.5 GB。
工程上的折中方案是:对 VRAM 充裕的 GPU(RTX 4090 24 GB),不做序列化缓存,运行时构建。对 VRAM 紧张的 GPU(RTX 3050 8 GB),做序列化缓存但只保存当前厂商的格式——安装时检测 GPU 厂商,只保留对应的序列化数据,其他厂商的删除以节省磁盘空间。或者更简单:只对 NVIDIA GPU 做序列化缓存(因为 RTXMU 的 compaction + suballocation 让 NVIDIA 上的收益最大),AMD/Intel GPU 运行时构建(BLAS 较大但不做序列化缓存的复杂管理)。
跨厂商兼容性的困境指向一个方向——streaming AS 的标准化和 GPU-driven 的未来演进。
十、演进方向
10.1 Streaming AS 标准化
当前的 AS streaming 严重依赖厂商专有方案——RTXMU 只在 NVIDIA 上可用 [10],CLAS 只在 NVIDIA 上有硬件加速 [5],UE5 的 RT geometry pool 是引擎专有的 [4]。跨厂商的 streaming AS 标准化还在早期阶段。
Vulkan 的 VK_KHR_ray_tracing_maintenance1 扩展提供了标准的序列化/反序列化 API [3],这是标准化的第一步。但序列化格式的跨设备兼容性(vkGetDeviceAccelerationStructureCompatibilityKHR)目前只做检查、不做转换——不兼容就回退到运行时构建。未来的演进方向可能是标准化的中间表示(IR)——各厂商的 BLAS 序列化为统一的 IR 格式,运行时再由各厂商的驱动编译为硬件特定的 BVH 布局。这和 SPIR-V 的思路一致——统一的 shader IR,各厂商编译为硬件特定的 ISA。
10.2 神经降噪对流式加载的影响
ep06–ep08 讲了神经降噪(DLSS 3.5 Ray Reconstruction 等)让每像素的光线数降到 1 spp 以下。这对 streaming 有一个间接但重要的影响:trace 时间缩短了,但构建时间不变——AS 构建在帧时间中的占比上升。
用数字说明这个变化。假设一个场景的 AS 构建开销是 3.6 ms(动态 BLAS + TLAS),trace 开销从 4.1 ms(2 spp)降到 1.8 ms(0.5 spp + 神经降噪),帧时间从 7.7 ms(串行)降到 5.4 ms。但 AS 构建在帧时间中的占比从 47% 上升到 67%——构建变成了新的瓶颈。在 streaming 场景中,这个变化意味着"等 BLAS 加载"的等待时间(反序列化 + 传输)在帧时间中的占比也上升了——如果反序列化从 0.3 ms 变成帧时间的 5.5%(0.3/5.4),虽然绝对值不变,但相对占比更高,对帧时间波动的影响更大。
更激进的趋势是:神经降噪让 trace 的时间变得极短(< 2 ms),以至于"延迟一帧"的双缓冲收益变小——构建时间可能比 trace 还长,双缓冲的"藏在 trace 后面"策略不再有效。这时需要新的调度策略,比如分帧构建——把 AS 构建拆成多帧执行,每帧构建场景的一部分,trace 用不完整的 AS,通过概率性 ray tracing 补偿缺失部分。这个方向还在研究阶段。
对 streaming 来说,神经降噪的影响是双面的:一方面,trace 时间缩短意味着"缺 tile"的时间窗口更短——新 tile 加载完成前,trace 用旧 BLAS 多渲染几帧,因为每帧 trace 时间短,总延迟低。另一方面,降噪器的时域复用依赖帧间一致性——如果 BLAS 在帧间频繁切换,降噪器的历史帧积累失效,需要更多帧才能收敛。这意味着 streaming 的过渡帧数量不能太多——每多一个过渡帧,降噪器的收敛就慢一帧。dither 过渡(4 帧过渡)在 60 fps 下需要 67 ms 才能完成一个 LOD 切换的收敛,如果玩家快速移动导致 LOD 频繁切换,降噪器可能永远无法收敛——画面持续模糊。
这种矛盾在开放世界赛车游戏中尤其突出。赛车以 200 km/h 的速度移动,每秒前进约 56 米,如果 tile 边界间距 256 米,每 4.5 秒就有一批 tile 切换。60 fps 下 4.5 秒等于 270 帧,LOD 切换的 dither 过渡(4 帧)在其中占比不到 2%,看起来不是问题。但如果赛道穿过多个 LOD 边界(比如从城市到郊区到山区),每段边界的 LOD 切换都会触发一次 4 帧的 dither 收敛周期,多个周期叠加可能导致降噪器始终处于半收敛状态。解决这类问题的工程方向是让 LOD 切换频率和降噪器收敛速度协同——在高速运动场景中自动降低 LOD 切换频率(拉大 LOD 切换的距离阈值),优先保证降噪器的时域稳定性。这种协同设计目前还没有标准化的实现方案,各引擎需要根据自己的降噪器参数和场景特征做定制调优,这也是当前 streaming AS 工程化成熟度的一个重要标志和瓶颈所在。
10.3 Mesh Shader + GPU-driven 的未来
第八章讲了 GPU-driven multi-indirect build 和 Mesh Shader。这个方向的演进趋势是把 AS streaming 的调度权从 CPU 转移到 GPU:
- CPU 只管 tile/LOD 级别的粗粒度调度——"这个 tile 该加载了"。
- GPU 自己处理 cluster 级别的精细调度——"这个 cluster 用哪个 LOD、构建哪个 CLAS"。
- 反序列化/compaction 作为缓存环节,TLAS instance 动态更新。
- Streaming 的瓶颈从 disk IO 扩展到 GPU compute。
这四个变化合在一起,改变了 streaming 系统的工程重心。传统 streaming 的核心瓶颈是 IO 带宽——磁盘读取速度和 PCIe 传输速度决定了 tile 加载的吞吐量。GPU-driven 时代,IO 瓶颈让位于 compute 瓶颈——GPU 端的 BLAS 构建、CLAS 生成、TLAS 更新成为新的吞吐量限制。这意味着 streaming 系统的性能调优从"优化 IO 调度和缓冲管理"转向"优化 GPU 计算调度和内存访问模式"。
2025–2026 年的趋势是让 BLAS 构建也变成 GPU driven——Mesh Shader 输出的几何体直接流入 BLAS 构建管线,不需要 CPU 介入。AS 生命周期的 Build 状态将完全在 GPU 上完成,不需要 instance 数据的 CPU→GPU 上传——整个依赖链变成 Compute Shader(剔除+几何体生成)→ BLAS Build → TLAS Build → trace,全在 GPU 上,同步简化为屏障(不需要 semaphore)。这对 streaming 意味着:新 tile 的几何数据加载到 VRAM 后,BLAS 的构建可以完全在 GPU 上完成,不需要 CPU 提交 build 命令——延迟更低,吞吐量更高。
GPU-driven BLAS 构建还可能改变 tile 的定义。传统 tile 是一个地理单元——一平方公里内的所有 mesh 打包成一个 tile。GPU-driven 方案下,tile 可以变成一个"cluster 集合"——不是一个地理区域,而是一组按 LOD 和可见性动态组织的 cluster。这意味着 tile 的边界不再固定在地图网格上,而是随相机视角动态变化——视锥内的 cluster 组成一个"动态 tile",视锥外的 cluster 不属于任何 tile。这种动态 tile 的粒度更细,可以更精确地控制 VRAM 使用——只加载真正需要被 trace 的 cluster,而不是整块地理区域。但代价是 tile 管理的复杂度急剧上升——动态 tile 的生命周期更短、变化更频繁,对调度系统的要求更高。
10.4 系列互链
本篇承接 ep10 的 RT 资源生命周期,把视角从"单帧内 AS 的状态流转"扩展到"跨帧的流式加载/卸载"。ep10 讲的是 build→visible→trace→retire 四态流转和同步屏障,本篇讲的是这些机制在大世界场景下怎么扩展——序列化让 BLAS 可以存储和传输,tile streaming 让 AS 按地理单元加载,LOD 让远近精度有层次,时域过渡让加载卸载不闪,显存预算让 VRAM 分配有据可依。
回顾整个系列前十一篇的脉络:ep01 画了混合渲染的分界线 [16],ep02/ep03 算了加速结构的工程账,ep04 绑了命中着色器和 SBT,ep05 编排了混合管线,ep06–ep08 讲了降噪从时域复用到神经降噪,ep09 分了光线预算,ep10 和 ep11 一起构成了 RT 资源管理的上下篇——ep10 管帧内生命周期,ep11 管跨帧流式加载。
如果把这两篇放在一起看,一个完整的 RT 资源管理框架就浮现了。ep10 的四态流转(build→visible→trace→retire)管的是"单帧内 AS 的 GPU 状态"——什么时候能读、什么时候能写、谁在等谁。ep11 的 streaming 管的是"跨帧 AS 的 IO 和内存调度"——什么时候从磁盘加载、什么时候换入 VRAM、什么时候该淘汰、远近用什么 LOD、换的时候怎么不闪。两者交汇在 TLAS 的重建时机——每帧一次的 TLAS 重建是 streaming 的"提交点",所有加载/卸载的状态变化在 TLAS 重建时统一生效。理解了这个交汇点,就理解了大世界 RT 管线资源管理的骨架。
参考资料
以下资源涵盖了本文涉及的所有 API 规范、SDK 文档、最佳实践指南和实测数据,按主题分类排列。
- [1] Vulkan VK_KHR_opacity_micromap 提案(序列化 block format):docs.vulkan.org/features/latest/features/proposals/VK_KHR_opacity_micromap.html
- [2] D3D12 DXR 功能规范(serialize/deserialize、post-build info):microsoft.github.io/DirectX-Specs/d3d/Raytracing2.html
- [3] Vulkan vkCmdCopyAccelerationStructureToMemoryKHR 参考页(序列化 block-based format):docs.vulkan.org/refpages/latest
- [4] UE5 Ray Tracing 性能指南 5.5(RT geometry pool、Far Field、HLOD):dev.epicgames.com/documentation/tr-tr/unreal-engine/ray-tracing-performance-guide
- [5] NVIDIA RTX Mega Geometry 博客(CLAS、continuous LOD、Vulkan samples):developer.nvidia.com/blog/nvidia-rtx-mega-geometry-now-available-with-new-vulkan-samples/
- [6] ACM 论文:RTX Mega Geometry、CLAS、GPU-driven multi-indirect build:dl.acm.org/doi/pdf/10.1145/3721243.3735983
- [7] UE5 Lumen 技术细节 5.0(Far Field、World Partition、HLOD):dev.epicgames.com/documentation/en-us/unreal-engine/lumen-technical-details
- [8] UE5 Raytracing Guideline v5.4(Nanite streaming mode、Far Field):dlss.download.nvidia.com/uebinarypackages/Documentation/UE5+Raytracing+Guideline+v5.4.pdf
- [9] UE5 Nanite 技术细节(streaming pool、cluster 虚拟化):dev.epicgames.com/documentation/en-us/unreal-engine/nanite-technical-details
- [10] NVIDIA RTXMU 博客(compaction 52%、suballocation、内存管理):developer.nvidia.com/blog/reducing-acceleration-structure-memory-with-nvidia-rtxmu/
- [11] NVIDIA RTX Best Practices(AS build/update 预算、异步构建):developer.nvidia.com/blog/rtx-best-practices/
- [12] zeux.io 实测数据:Measuring acceleration structures(bytes/triangle 跨 GPU 对比):zeux.io/2025/03/31/measuring-acceleration-structures/
- [13] Indiana Jones 路径追踪优化(动态植被 BLAS compaction 1027→606 MB):developer.nvidia.com/blog/path-tracing-optimizations-in-indiana-jones
- [14] AMD DGF SuperCompression(几何数据压缩):gpuopen.com/learn/introducing-amd-dgf-supercompression/
- [15] Intel Arc 实时光线追踪开发者指南(构建 flag、best practices):intel.cn/developer/articles/guide/real-time-ray-tracing-in-games.html
- [16] Vulkan RT Tutorial(nvpro-samples,BLAS/TLAS/SBT 基础):nvpro-samples.github.io/vk_raytracing_tutorial_KHR/tutorial/
下篇预告
下一篇《透明、半透明与体积:光追里最难盈利的部分》会转向另一个工程难题——当光线遇到玻璃、烟雾、半透明物体时,RT 管线的代价会暴涨。透明物体让光线需要多段相交(每穿过一个透明面就多一次 hit),体积参与介质(participating media)让光线需要在介质中步进采样——这两类场景的 ray budget 和 AS 组织方式与不透明物体完全不同。我们会讲 RT 透明物体的排序与 blend、体积雾的 ray marching 与 AS 的关系、Opacity Micromap 在透明场景中的应用,以及为什么这些场景是"光追里最难盈利的部分"。这是本系列的第十二篇。
感谢大家读到这里。如果这篇对你有帮助,欢迎到个人站或知乎留言讨论——写这个系列的过程中,streaming AS 是我把 ep10 的帧内生命周期扩展到跨帧管理时踩坑最多的地方。序列化的跨设备兼容性、tile 边界的闪烁、VRAM 预算和各厂 BVH 编码效率的差异,每一个单独看都不复杂,叠在一起就是一整套资源管理系统的工程量。希望这篇整理能帮大家在大世界 RT 管线上少走弯路,找到属于自己的资源调度策略。
With Best Wishes.