本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
核心问题:上一篇结尾问的是"缓冲从哪来",这一篇要问的是那条队列自己是怎么记账的。
一个具体的问题就能把它逼出来:"三缓冲"到底指什么? 是指队列里有三个位置,还是指分配了三块内存,还是指这一时刻有三块在流转?——三个问题的答案不一样,而在同一台设备上,我这三处读到的数分别是 2、3、2。混着说,就会得出"三缓冲就是分配三块"这种听起来对、实际经不起核对的结论。
承接上一篇。ep03 讲的是缓冲怎么被申请、被画、被交出去——从渲染线程的视角看了一次 dequeue / queue。但那两次调用在队列内部到底改变了什么,ep03 一句话带过了。
这件事不是我临时起意补的。前两篇正文里各有两处明写"留给 ep04":
| 出处 | 原话 |
|---|---|
| ep02 §0.3 | 「BufferQueue 的四态迁移、队列深度与 slot 数组(ep04 展开)」 |
| ep02 §0.3 边界段 | 同上,列为 ep04 的正题 |
| ep03 §0.3 | 「BufferQueue 的四态迁移、队列深度与 slot 数组——也就是本篇只从渲染线程视角看了一次的那个 dequeue/queue,在队列内部到底改变了什么」 |
| ep03 §5.4 与 §6 结尾 | 两处指向同一句:「留给 ep04」 |
所以这一篇是来还债的:把四态、队列深度、slot 数组一次讲清。
三篇共用同一条链路,量的东西各不相同:
| 维度 | ep02《Choreographer》 | ep03《RenderThread》 | ep04(本篇) |
|---|---|---|---|
| 关心的对象 | 唤醒:节拍打在谁身上 | 交接:活与缓冲怎么交出去 | 记账:队列自己怎么记这一笔 |
| 量什么 | 订阅状态——枚举取值、连接条数 | 时间与占比——dequeue 耗时、帧余量 | 数量与状态——slot 状态、已分配块数、计数参数 |
| 主要命令 | dumpsys SurfaceFlinger 连接段 |
gfxinfo framestats + Perfetto 双线程轨 |
dumpsys SurfaceFlinger 的队列段与缓冲清单 |
| 典型结论 | 静止时没有一条连接处于周期订阅 | dequeueBuffer 是中位瞬时、尾部几十毫秒的双峰 |
公式值、实打 slot、已分配块数在设备上分别是 2 / 2 / 3 |
本篇也不涉及:应用/引擎能画多少与功耗带宽取舍(《移动端图形与功耗》已写)、渲染算法与画面技术(《实时渲染管线探析》《实时光线追踪与混合渲染》已写)、具体渲染器内部的光栅化实现(《2D 矢量引擎深挖》已写)、Perfetto 与 RenderDoc 自身的原理(《图形性能剖析工具链》已写)、合成决策与送屏(ep06 展开)、HWC 叠加层与合成模式(ep08 展开)、Vulkan 后端路径(ep05 展开)、以及厂商在队列之上加的私有改造(未公开,如实标注)。为什么不涉及:BufferQueue 是显示链路里唯一一个"契约+账本"俱全的组件——它有官方文档、有明确的状态机、还有能在设备上读到的账。这一篇的价值就在把这三样对齐讲完;掺进别的题域,这件事就讲不透了。完整边界见 §0.3。
系列文章写作风格说明(沿用前三篇,不再重复解释)
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、AOSP 源码怎么做、本机跑出来是什么——这三层分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(机型、Android 版本、命令、采样时刻);
- 实测优先:能用命令量出来的就不引用别人的结论;
- 模拟器与真机分开写:模拟器拿不到的东西(HWC overlay、自适应刷新率)如实标"需真机",绝不写成 Android 通例。
系列主要内容总览
- 【Android 图形显示系统】(一) 总览:从 App 到屏幕的图形管线
- 【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 【Android 图形显示系统】(三) RenderThread 与帧提交:从显示列表到一块缓冲
- 【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局(本篇)
- 【Android 图形显示系统】(五) Vulkan on Android:低开销渲染入口
- 【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么
- 【Android 图形显示系统】(七) ASurfaceControl:Android 10 的透明事务
- 【Android 图形显示系统】(八) HWC:GPU 合成之外的硬件叠加
- 【Android 图形显示系统】(九) HWC2:Vsync 回调和虚拟显示路径
- 【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞
- 【Android 图形显示系统】(十一) 三缓冲、多刷新率与 ARR
- 【Android 图形显示系统】(十二) 虚拟显示与屏幕录制
- 【Android 图形显示系统】(十三) 剖帧实战:Perfetto FrameTimeline 抓 jank
相关资源链接
- 官方一手来源:BufferQueue 和 Gralloc | 图形总览(三种工作模式) | Surface 与 SurfaceHolder(三缓冲口径) | 同步框架(栅栏) | 界面卡顿检测(缓冲计数判据)
- 下游与邻居:SurfaceFlinger 与 WindowManager | 硬件混合渲染器 HAL | SurfaceView 与 GLSurfaceView | Systrace 概览
- 源码入口:
BufferQueueCore.cpp|BufferQueueProducer.cpp|BufferQueueConsumer.cpp|BufferSlot.h|BufferQueueDefs.h - 与本文强绑定的前置:ep01《总览》| ep02《Choreographer:谁在召唤 Vsync》| ep03《RenderThread 与帧提交》
这一篇回答什么,不回答什么
OK,先把坐标系挪正。前三篇给了地图、给了一条叫醒链、给了一次交接;这一篇要给的是一本账——那条队列是怎么记下"哪块缓冲现在归谁、它能被谁碰"的。
0.0 内容总览:本篇知识地图
好了,先把十章各自回答的问题钉在一张表上。它同时也是本篇的目录总览。如果时间紧,第二章(队列的账本)与第七章(实测:本机这台设备的队列账本)是这篇最不可替代的两章——前者把状态机与三种数量讲清,后者把它变成这台设备上的实际读数。
| 章 | 回答的问题 | 关键结论 |
|---|---|---|
| 零 | 这一篇补哪一段 | 一条队列的四步循环,以及前两篇欠的三处账 |
| 一 | 为什么要有队列 | 使用方创建并拥有它;不复制内容,只传 handle |
| 二 | 队列怎么记账 | slot 数组 + 四态 + 四个索引集合;三种数量的分界线 |
| 三 | 四步循环各改哪一格 | 每一步只动一格状态;迁移是可枚举的 |
| 四 | 拿不到位置时发生什么 | 三种工作模式;背压是一条因果链,不是一句"阻塞" |
| 五 | "几缓冲"到底指什么 | 由计数公式决定;官方给了一个可读的 0/1/2 判据 |
| 六 | 队列里传的只是内存吗 | 还有栅栏;提交 ≠ 画完 ≠ 可取用 |
| 七 | 实测:本机这台设备的账 | 公式值 2、实打 slot 2、Launcher 层已分配 3 块 |
| 八 | BLAST 改变了什么 | 队列的归属与分配决策者变了;Gralloc 没变 |
| 九 | 四项可以立刻做的事 | 每条都给命令与判定阈值 |
0.1 一条队列的四步循环
OK,先看这条循环。它是整篇的主干,四步,每一轮都从"申请"回到"归还"。
第一步,申请(dequeueBuffer)。 生产方问队列要一个可用的位置。注意是"位置"——这一步拿到的是一个索引(slot),不是内存。
第二步,填进去。 生产方往这个位置上对应的缓冲里画。
第三步,交出去(queueBuffer)。 生产方说"这块我填好了",把它放回队列,等使用方来取。
第四步,被取走并归还。 使用方用 acquireBuffer() 取走,用完再 releaseBuffer() 还回来——这时那个位置才算重新可用。
好了,这四步的名字,官方文档给得很整齐(《BufferQueue 和 Gralloc》 原文):
使用方创建并拥有 BufferQueue 数据结构……当生产方需要缓冲区时,它会通过调用
dequeueBuffer()从 BufferQueue 请求一个可用的缓冲区……然后,生产方填充缓冲区并通过调用queueBuffer()将缓冲区返回到队列。接下来,使用方通过acquireBuffer()获取该缓冲区……它会通过调用releaseBuffer()将该缓冲区返回到队列。
言归正传,四步里有一个关键的不对称,值得先记下:申请时拿到的是"位置",归还时放回的也是"位置",中间那块内存从头到尾没换过主人。 这就是为什么队列能做到"不复制内容"(§1.2 展开)。
0.2 本篇与前两篇的分工
好了,三篇共用同一条链路,量的量纲完全不同。这张表同时划定了本篇的范围:
| 维度 | ep02 | ep03 | ep04(本篇) |
|---|---|---|---|
| 量什么 | 订阅状态(枚举与条数) | 时间与占比(耗时、余量) | 数量与状态(slot 状态、块数、参数) |
| 主要命令 | SurfaceFlinger 连接段 |
framestats + 双线程轨 |
SurfaceFlinger 队列段 + 缓冲清单 |
| 结论形态 | 静止时没有周期订阅 | dequeueBuffer 的双峰 |
公式值 2 / 实打 slot 2 / 已分配 3 块 |
ep02 讲透的东西(订阅的一次性、VSyncRequest 的枚举、五档回调)与 ep03 讲透的东西(握手、四个阶段、dequeueBuffer 的耗时分布),本篇一句都不重复。 本篇只补它们共同绕开的那一段:队列内部的状态与数量。
0.3 本文不涉及什么,为什么
本文不涉及:应用/引擎能画多少与功耗带宽取舍(《移动端图形与功耗》);渲染算法与画面技术(《实时渲染管线探析》《实时光线追踪与混合渲染》);具体渲染器内部的光栅化实现(《2D 矢量引擎深挖》);Perfetto 与 RenderDoc 自身的原理与用法(《图形性能剖析工具链》);合成决策与送屏(ep06);HWC 的叠加层与合成模式(ep08);Vulkan 后端路径(ep05);以及厂商在队列之上加的私有改造(未公开,如实标注"未公开")。
为什么不涉及:BufferQueue 最怕的就是"什么都往里塞"。它是显示链路里契约最清楚的一个组件——有官方文档、有明确的状态机、还有能在设备上读到的账。本篇要做的是把这三样对齐;一旦掺进合成决策或厂商私有逻辑,账本就成了一团。
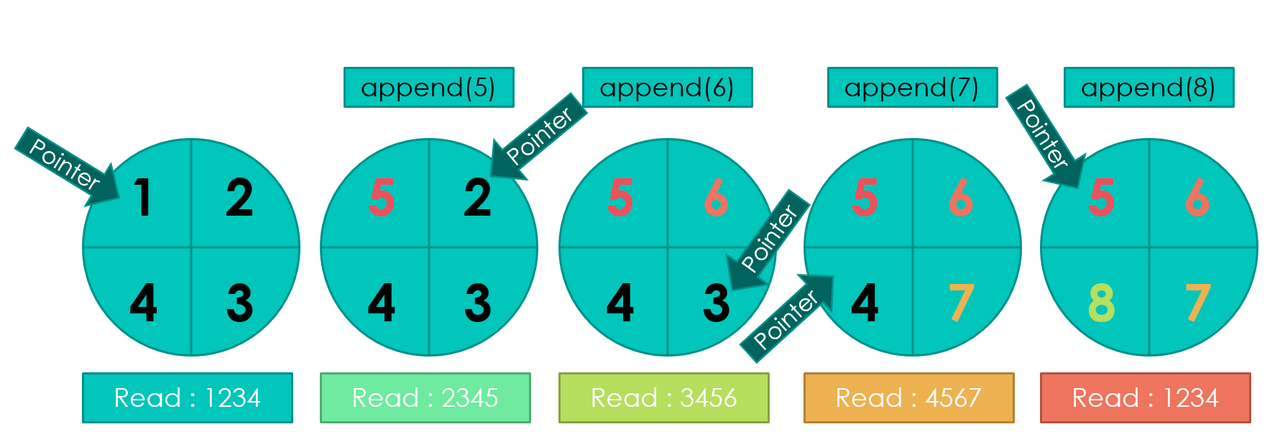
OK,还要提前声明一处类比边界:本篇题图与第五章的一处对照图用的是 Commons 上的通用缓冲数据结构示意(环形缓冲、FIFO)。它们是类比,不是 BufferQueue 的实际状态机。 BufferQueue 的 slot 不是一个环形读写的缓冲,而是一个带状态标记的索引数组——两者在"复用同一批位置"这一点上像,在"怎么判断哪个位置可用"这一点上完全不同。正文每次引用它们都会注明。
0.4 本文的读数从哪来
说白了,本篇所有真图都是本机实测,而这一篇的读数比前三篇都特殊:它读的不是耗时,而是队列自己写下的账。
| 项 | 取值 | 获取方式 |
|---|---|---|
| Android 版本 / API | Android 16 / API 36 | getprop |
| 层的总数 | 93 层 | dumpsys SurfaceFlinger 的 Active Layers 段 |
| 队列的计数参数 | mMaxAcquiredBufferCount=1、mMaxDequeuedBufferCount=1、mDequeueBufferCannotBlock=0、mAsyncMode=0 |
同上,BufferQueue … 行 |
| slot 账本 | >[01] state=ACQUIRED、[00] state=FREE |
同上,Slots: 段 |
| 层的当前缓冲与帧序号 | 6 层带 buffer=<id> frame=<n> |
同上,Active Layers 段 |
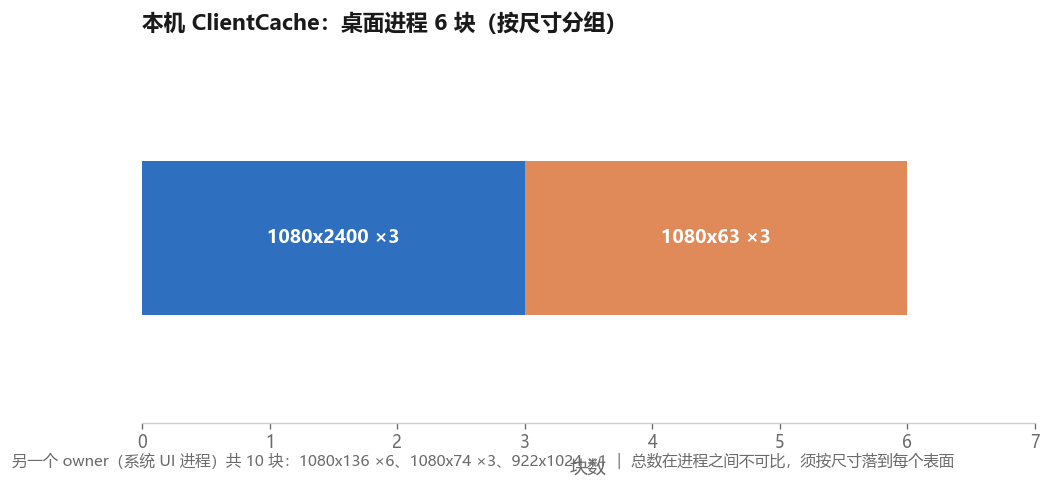
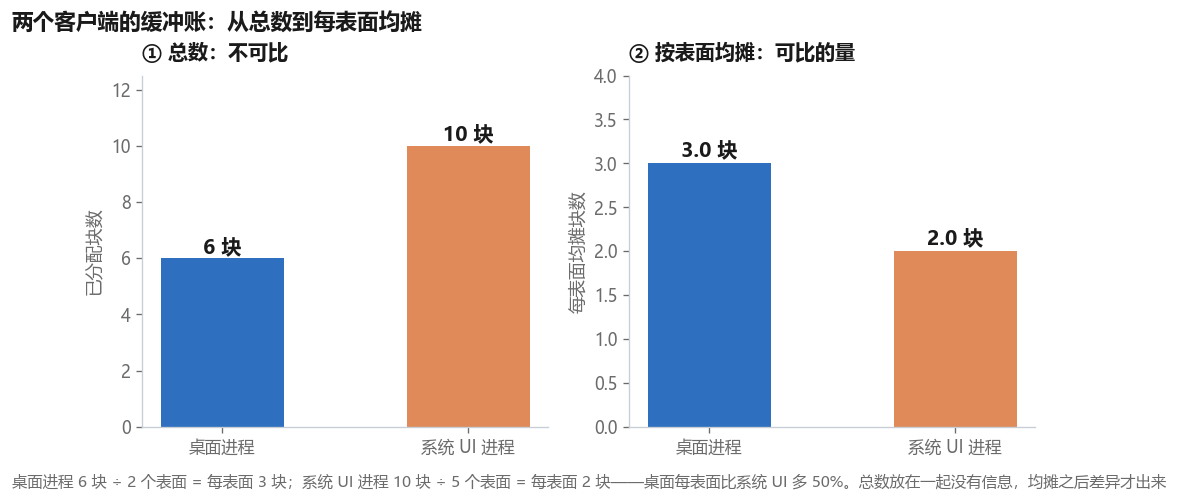
| 每个客户端的已分配缓冲清单 | 两个 owner:6 块(1080x2400 ×3 + 1080x63 ×3)与 10 块(1080x136 ×6 + 1080x74 ×3 + 922x1024 ×1) | 同上,ClientCache state: 段 |
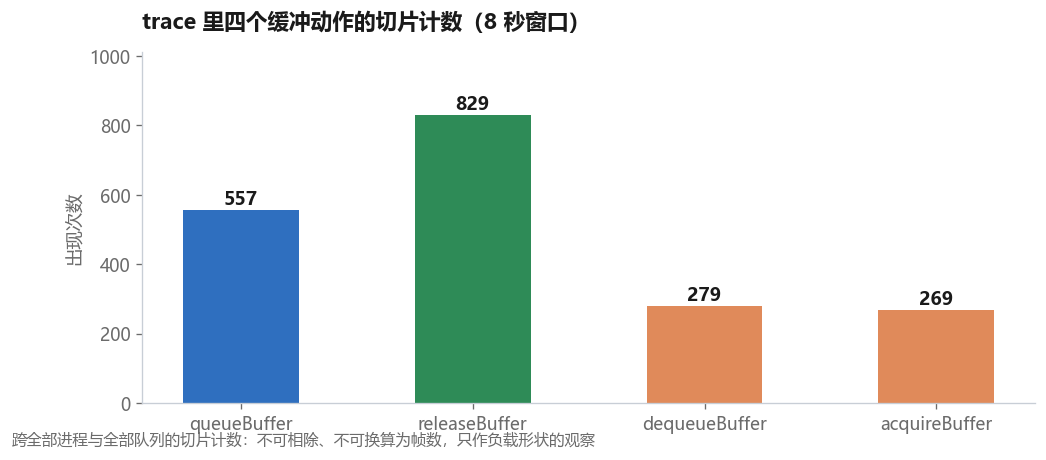
| 四个动作的切片计数 | dequeueBuffer ×279、queueBuffer ×557、acquireBuffer ×269、releaseBuffer ×829 |
perfetto(3,276,645 字节 trace) |
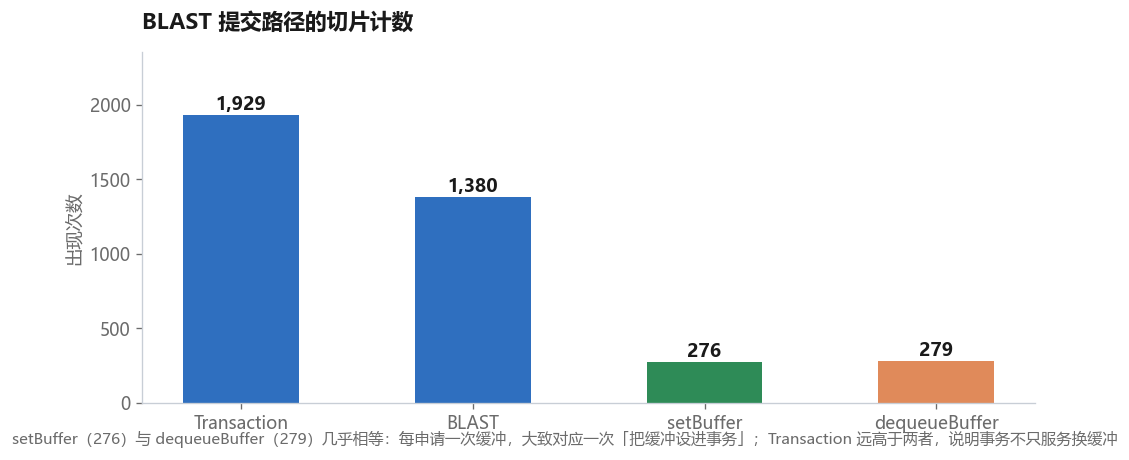
| BLAST / 事务路径 | BLAST ×1380、setBuffer ×276、Transaction ×1929 |
同上 |
| 被测应用 | com.google.android.apps.nexuslauncher |
系统桌面 + 任务栏,两个表面 |
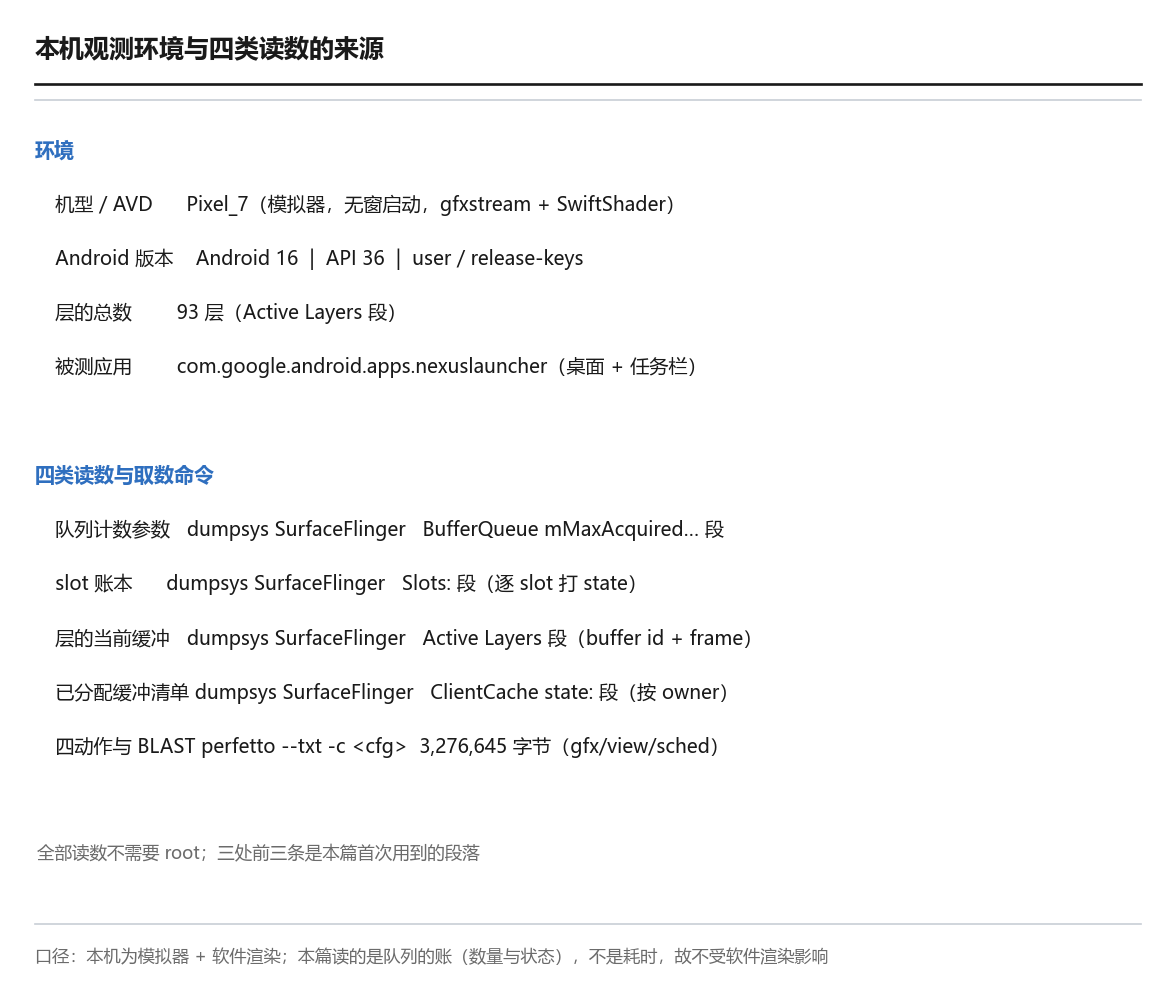
这张表要连着下面那张"读不到"的表一起看。 两边合起来才是本篇观测能力的完整边界:能读到的四类构成了全部真图,读不到的三处决定了哪些结论只能靠推断(§5.3)或侧面印证(§4.2)。只列能读到的,会让人以为账本是全透明的。
也要先把读不到的说清——这是本篇与前几篇不一样的地方,因为"账本"这个词会让人以为什么都读得到:
| 读不到的 | 实测证据 | 本篇怎么办 |
|---|---|---|
waitForFreeSlotThenRelock / mDequeueCondition |
trace 全文检索 0 次——它不是 trace 切片 | 背压的观测侧改用"四动作计数不对称 + slot 状态快照"(§7.2) |
| 每层的 BufferQueue 账本 | 默认 dump 与 --layer-name / --layers / --client-cache / --frame-stats 五种调用方式都只吐出 1 个 Slots: 段 |
如实写:本机只有 FramebufferSurface 那条队列的账本可读;每层能读到的是"当前缓冲 + 帧序号" |
--latency 帧延迟表 |
只返回 1 行 | 本篇不依赖该命令 |
| FrameTimeline 切片 | ep01/ep02 已两次实证取不到 | 本篇不依赖 |
这三行不是免责声明,是结论的一部分:它说明"能读到什么"本身取决于实现的 dump 设计,而不是取决于概念上有没有这件事。
一、为什么要有队列
1.1 一个反常识的设定:使用方创建并拥有它
言归正传,官方文档那句话里有一个词,绝大多数人第一次读都会自动略过——「使用方创建并拥有 BufferQueue 数据结构」。
好了,按照常识推断,队列是给生产者往里放东西的,那应该生产者建、生产者管才对。实际恰好相反。
| 角色 | 在本系列里是谁 | 对队列做了什么 |
|---|---|---|
| 使用方(consumer) | SurfaceFlinger、图像读取方、Camera 消费端 | 创建队列、拥有队列、取走缓冲、归还位置 |
| 生产方(producer) | 应用的渲染线程、Camera 采集端 | 申请位置、填充、交出缓冲 |
本机的 dump 里能直接看到这条关系:FramebufferSurface 那条队列的
producer=[535:/system/bin/surfaceflinger]、consumer=[535:/system/bin/surfaceflinger]——生产方与使用方在同一个进程里,这是系统合成路径上的特例;而应用侧那条队列的消费者在另一侧(§8 讲 BLAST 时会看到这个归属是怎么变的)。
为什么这么设计? 因为"谁决定何时取走"决定了整条链路的节奏。使用方要按自己的节拍(对 SurfaceFlinger 来说就是 Vsync)取用缓冲,它必须能掌控队列里有多少可用位置、以及能不能丢帧。把队列交给使用方,等于把"节拍权"交给使用方。 生产方只管往里面放,放不进去就等(§4 的背压)。
1.2 不复制内容,只传 handle
OK,第二条容易被略过的官方口径:缓冲区按需分配、不复制内容、只传 handle。
这条决定了队列的"轻"。一轮四步下来,被传递的不是那一整块几十兆的像素内存,而是:
- 一个索引(
slot,一个整数); - 一个 handle(指向那块内存的凭据);
- 加一个栅栏(§6 展开:什么时候可以安全地读写这块内存)。
所以 queueBuffer 的耗时与画面大小基本无关。 这一点在 ep03 的读数里已经侧面印证过:本机 queueBuffer 的中位只有 337–448 微秒,而同一批帧的画面是 1080×2400。如果它真在搬像素,这个数不可能是几百微秒。
这也解释了一个常见困惑:为什么"应用把画面交给系统"这一步看起来这么便宜。因为它交的不是画面,是画面的地址。
1.3 「粘合剂」:它在栈里的位置
图形总览页 给 BufferQueue 的定位是一句很形象的话:「BufferQueues 是 Android 图形组件之间的粘合剂」,生产方接口是 IGraphicBufferProducer。
好了,把它放到栈里看,两侧的接口是成对的:
| 侧 | 接口 | 谁实现 |
|---|---|---|
| 生产方 | IGraphicBufferProducer |
队列内部的 BufferQueueProducer |
| 使用方 | IGraphicBufferConsumer |
队列内部的 BufferQueueConsumer |
这两个接口的存在,正是"跨进程"这件事的落点。 应用进程通过生产方接口申请与交出;系统进程通过使用方接口取走与归还。当两者不在同一进程时,中间是 Binder——这也是 BLAST 改动所针对的那一段(§8)。
1.5 生产方这一侧的四步,长这样
OK,把 §0.1 那四步落到生产方的调用序列上,一共就四行:
//-----------------------------------【生产方一侧的四步】-----------------------------------
// 接口:frameworks/native/libs/gui/include/gui/IGraphicBufferProducer.h
// 说明:拿到的是"位置"(一个整数索引),不是内存
//----------------------------------------------------------------------------------------
// 【1】申请一个位置;这一步可能立刻返回,也可能阻塞等待(取决于工作模式,见第 4 章)
//      int slot; sp<Fence> fence;
//      status_t st = dequeueBuffer(&slot, &fence, w, h, format, usage);
//
// 【2】往这个位置上对应的缓冲里画(渲染线程在这里走完完整的一帧,见 ep03 第 4 章)
//
// 【3】填好之后交出去,并把"什么时候能读"的那张栅栏一起交出去
//      st = queueBuffer(slot, fence, ...);
//
// 【4】中途不想要了,可以不交出去、直接退回(这条路径不经过 QUEUED,见 §3.2)
//      st = cancelBuffer(slot, fence);
下面对其中三处特别说明。
第 1 步的返回值里就藏着第 4 章的三种命运。 同一个 dequeueBuffer,可以立刻返回、可以阻塞之后返回、也可以返回错误——决定权不在生产方手上,而在队列的参数与模式上。
第 3 步的 fence 参数是这套设计的精髓。 生产方交出的不是"我画完了"这句断言,而是一张能被等待的时间凭据。使用方拿到凭据就能知道"什么时候来读是安全的",而不必猜。
第 4 步是最容易被漏掉的一步。 它意味着生产方有权"反悔"——申请了位置但不交出。这条路径在丢帧场景里很常用,而它不经过 QUEUED,所以使用方从头到尾没看见过这块缓冲。
1.4 类比与边界:它像环形缓冲,但不是环形缓冲
好了,题图用的是一张环形缓冲的读写指针示意。这个类比有用,但必须马上划清边界,否则会带出一个错误的心智模型。
像的地方:两者都在"复用一批固定的位置",而且复用是循环的——用完了回到起点。
不像的地方,也正是 BufferQueue 的核心:
| 维度 | 通用环形缓冲 | BufferQueue |
|---|---|---|
| 判断"哪个位置可用" | 靠读写指针的位置关系(数学关系) | 靠每个位置自己的状态标记(FREE/DEQUEUED/QUEUED/ACQUIRED) |
| 位置的取出顺序 | 严格按指针推进 | 由状态与使用方的选择共同决定(不是简单的先进先出) |
| 能不能"跳着用" | 不能 | 能——只要有位置处于 FREE,任何一个都可以被申请 |
| 满载的含义 | 写指针追上读指针 | 没有任何一个位置处于 FREE |
为什么这个区别是本质的:环形缓冲只有一条"谁在前谁在后"的线索,而 BufferQueue 要同时回答三个不同的问题——哪块内存归谁(所有权)、哪块正处于什么阶段(状态)、谁在等(等待者)。一条指针线缆表达不了三件事,所以它必须给每个位置配一个状态标记。
下一章就来讲这本账。
二、队列的账本
2.1 每个位置有一个状态标记
OK,队列内部把位置叫 slot(槽位)。它不是一个"格子里放着一块缓冲",而是一个位置带着一个状态:
| 状态 | 含义 | 谁在用它 |
|---|---|---|
FREE |
空闲:可以被生产方申请 | 没人 |
DEQUEUED |
已被生产方申请走,正在填充 | 生产方 |
QUEUED |
已填好、已交回,等使用方来取 | 队列(等使用方) |
ACQUIRED |
已被使用方取走,正在被消费 | 使用方 |
这四个状态的所有权归属是清楚的:DEQUEUED 归生产方、ACQUIRED 归使用方、QUEUED 与 FREE 归队列。任何时刻,一个位置只可能处在其中一态,而且只属于一方。 这就是"不复制内容"能成立的原因——同一时刻只有一方在碰那块内存。
关于状态枚举的位置,有一处容易说错的地方:状态枚举在
BufferSlot上,不在GraphicBuffer上(frameworks/native/libs/gui/include/gui/BufferSlot.h)。GraphicBuffer管的是内存与句柄,状态机属于 slot。 口径声明:这条路径本轮只标到仓库位置,未取到源码正文(cs.android.com与android.googlesource.com本次抓取超时),所以这里写的是"路径可指",不是"逐行读过"。 另外,异步模式(mAsyncMode)下还会多一个标记用于表达共享情形——它是对核心四态的补充,不是第五个并列状态。主流资料只写四态是对的,把它当"五种并列状态"反而是过度解读。
2.2 实测:本机一条队列的账本
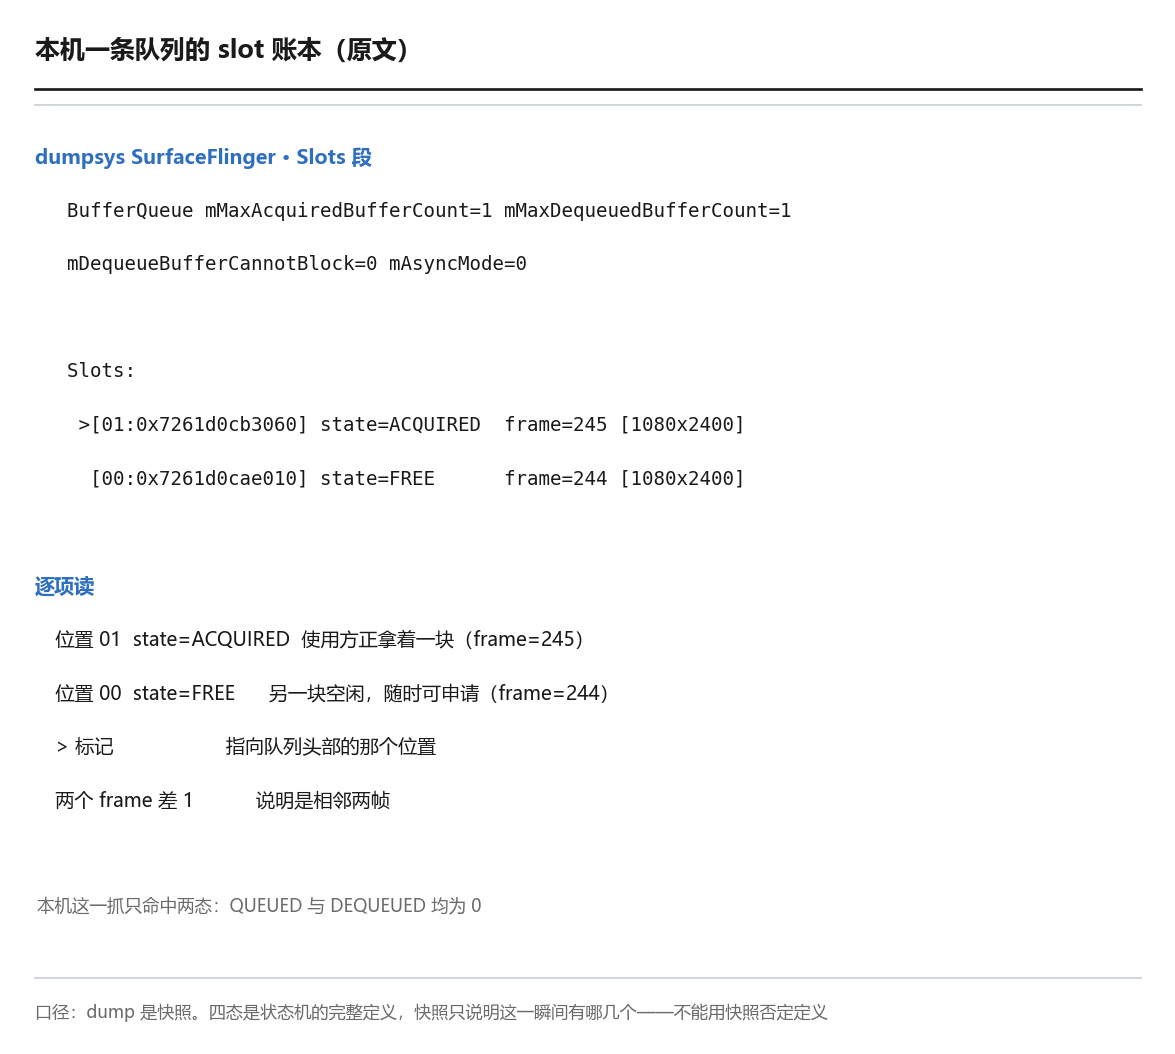
好了,理论说完,看真的。dumpsys SurfaceFlinger 里有一段能直接打出逐 slot 的状态——这是本轮实测发现的、官方文档没有明说的一处:
BufferQueue mMaxAcquiredBufferCount=1 mMaxDequeuedBufferCount=1
mDequeueBufferCannotBlock=0 mAsyncMode=0
mQueueBufferCanDrop=0 mLegacyBufferDrop=1
default-size=[1080x2400] default-format=1  transform-hint=00 frame-counter=199
…
Slots:
 >[01:0x7261d0cb3060] state=ACQUIRED 0x7262b0cab940 frame=245 [1080x2400:   0,  1]
  [00:0x7261d0cae010] state=FREE     0x7262b0cabb70 frame=244 [1080x2400:   0,  1]
逐项读一遍:
mMaxAcquiredBufferCount=1/mMaxDequeuedBufferCount=1:两个计数上限,第五章的公式要用它们;mDequeueBufferCannotBlock=0/mAsyncMode=0:两个模式开关,都关着(默认模式);Slots:段两行:位置01处于ACQUIRED(使用方正在消费)、位置00处于FREE(可被申请);>标记:指向队列头部的那个位置;frame=245/frame=244:这两块缓冲各自的帧序号,差 1,说明是相邻两帧。
这里有一件事必须点出来:本机这一抓只打到了两态。
OK,两行里没有 QUEUED,也没有 DEQUEUED。这不是因为它们不存在,而是因为 dump 拍的是一个瞬间——在这一刻,生产方(合成路径自身)没有正拿着缓冲在填。所以:
- 四态是状态机的完整定义;
- dump 里的两态是这个瞬间的快照。
把"我看到的"当成"全部存在的",是读这类 dump 最容易犯的错。 ep02 那条纪律在这里又用了一次:先问这个数是在什么时刻、什么窗口里量的,再谈它说明什么。
这一节的读数只来自一条命令:dumpsys SurfaceFlinger 的队列段。它的完整原文、逐字段释义与公式校验在第七章 §7.1–§7.3,那里还会把这套账目在设备上对一遍。
2.3 四个索引集合:队列怎么快速找到"能用的位置"
好了,如果每次申请都要把 64 个位置扫一遍,代价不小。所以队列额外维护了四个索引集合:
| 集合 | 里面装的是 | 用途 |
|---|---|---|
mFreeSlots |
被申请过、但还没有真正分配内存的位置 | 申请时优先从这里取(懒分配的入口) |
mFreeBuffers |
已经有内存、且处于空闲的位置 | 申请时优先拿它——不花分配代价 |
mUnusedSlots |
从未用过的位置 | 兜底 |
mActiveBuffers |
正在流转中的位置 | 用于统计与上限判断 |
这四张表就是"懒分配"的实现方式。 位置可以先占住、内存等真要用时再要;已经分配过的内存则尽量复用。这条设计直接解释了第五章那三种数量为什么会不一样——位置可以有很多,但真正分配过内存的只是其中一部分。
口径声明:这四个集合的名字与分工均来自已读全文的社区分析(尤其 《BufferQueueCore 详解》),本轮未能取到源码正文核对。它们在正文里的角色是解释性结构,不是逐行断言。
2.4 三种数量的分界线(本篇最重要的一节)
OK,到这里可以回答开头那个问题了:"三缓冲"到底指什么?
好了,它其实混着三个不同的量。这三个量在同一台设备上可以同时不一样,而我把它们都读到了:
| 数量 | 它回答什么 | 本机读数 | 怎么读到的 |
|---|---|---|---|
| 索引容量 | 队列能管理多少个位置 | 64(源码常量 NUM_BUFFER_SLOTS) |
路径可指,本轮未取到源码正文 |
| 有效参与数量 | 这一刻有多少块在参与流转(决定"是双缓冲还是三缓冲") | 2(FramebufferSurface) | 计数公式 1 + 1 + 0 = 2,且 dump 里恰好打 2 个位置 |
| 已分配内存 | 真正问 Gralloc 要过内存的块数(懒分配) | 3 块(Launcher 层,1080×2400) | ClientCache state: 段按 owner 列出的缓冲清单 |
三个数分别是 64、2、3——它们不是同一个东西的三个说法,而是三个不同的问题。
OK,而官方文档早就把这件事写清楚了(《Surface 与 SurfaceHolder》 原文):
用于显示 Surface 的 BufferQueue 通常配置为三重缓冲。缓冲区是在按需分配的基础上工作的……队列中可能只有两个分配的缓冲区。
两句话放在一起,就是本节的全部内容。 "通常配置为三重缓冲"说的是有效参与数量那一层;"队列中可能只有两个分配的缓冲区"说的是已分配内存那一层——官方自己在同一段里就把这两层分开了,只是中文侧常常只引前半句。
中文侧有三处典型混淆,逐条对照:
| 流传说法 | 错在哪 | 正确表述 |
|---|---|---|
| 「固定 3 个 slot,因为要三缓冲」 | 把索引容量与有效参与数量混为一谈 | 索引空间是 64;"3" 说的是某个时刻参与流转的块数 |
| 「BufferQueue 最多有 32 个 BufferSlot」 | 过时数字(早期版本的写法) | 现行常量是 64;早期版本曾是更小的数 |
| 「三缓冲 = 分配 3 块 HardwareBuffer」 | 把已分配内存直接等同有效参与数量 | 官方原文明说"可能只有两个分配的缓冲区";分配是懒的 |
第二处的口径要小心:我给的是"现行是 64、早期曾是更小的数",而不去复述那个过时数字——因为把错误值写进正文,等于替它传播一次。第三处则要用官方原文正面反驳,而不能只说"这个说法不对"。
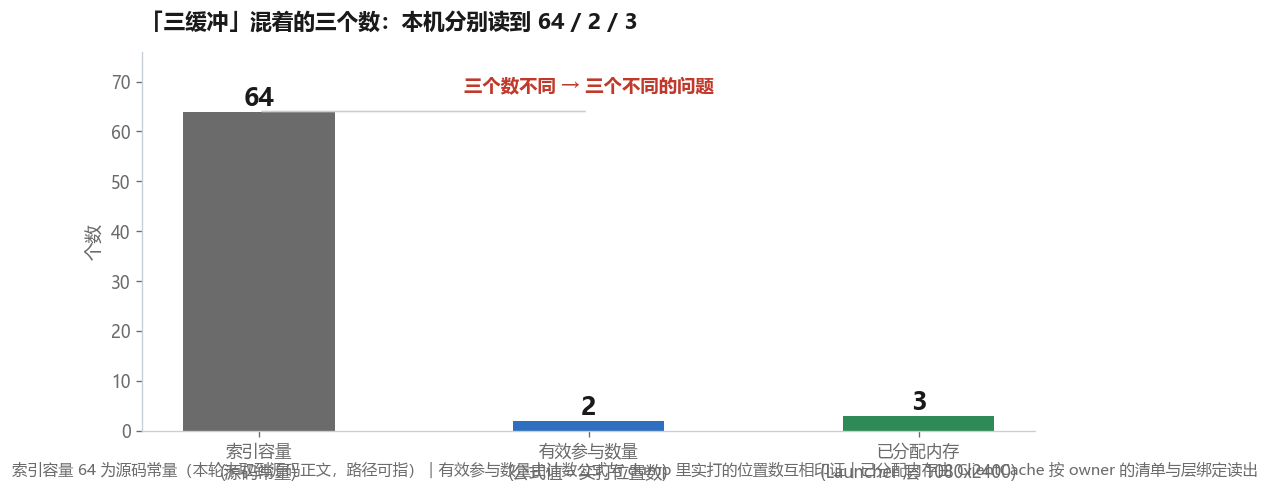
这一节的方法论值得单独记一句:遇到"某某是几个"这类问题时,先问这是哪一层的数量。索引容量、有效参与、已分配内存各有各的读法,混着问永远得不到稳定答案。
2.5 一次完整往返,账目怎么变
好了,把上面四样(状态、四个集合)放进一次完整的往返里走一遍,账目的变化就清楚了。设队列共有两个位置(00 与 01),初始时两个都空闲:
| 时刻 | 00 |
01 |
生产方能申请到几个 | 使用方能取走几个 | 发生了什么 |
|---|---|---|---|---|---|
| 初始 | FREE |
FREE |
2 | 0 | 两个位置都空着 |
| ① 生产方申请 | DEQUEUED |
FREE |
1 | 0 | 位置 00 归生产方了 |
| ② 生产方交出 | QUEUED |
FREE |
1 | 1 | 00 变成"待取",使用方可以来了 |
| ③ 使用方取走 | ACQUIRED |
FREE |
1 | 0 | 00 归使用方了 |
| ④ 使用方归还 | FREE |
FREE |
2 | 0 | 回到初始——这就是"循环"的含义 |
这张表有三处值得记住:
- 任何时候,"生产方能申请的数量 + 使用方能取走的数量 + 正在流转的数量"是一个常数(这里是 2)。这是守恒的;
- 第 ② 步之后,同一个位置同时"生产方不能碰、使用方能取"——所有权的转移就发生在这一格;
- 第 ④ 步回到初始状态,不需要任何额外操作。这就是 §3.1 那句"循环复用不需要额外操作"的账目依据。
再回到 §2.2 那两行 dump:位置 01 处于 ACQUIRED、位置 00 处于 FREE——对照上表,这正是第 ④ 步之前、第 ① 步之后的某个瞬间:一块已经还回来了,另一块还在使用方手里。两行 dump,正好落在这张表的一行上。
三、四步循环:每一步改动哪一格
3.1 四个动作,四条状态迁移
OK,其实这四步在接口上都只是一次调用,签名摆在一起就很清楚:
//-----------------------------------【四个动作的接口签名】-----------------------------------
// 生产方一侧(frameworks/native/libs/gui/include/gui/IGraphicBufferProducer.h)
//   申请:status_t dequeueBuffer(int* slot, sp<Fence>* fence, uint32_t w, uint32_t h, ...);
//   交出:status_t queueBuffer(int slot, const QueueBufferInput& input, QueueBufferOutput* output);
//   反悔:status_t cancelBuffer(int slot, const sp<Fence>& fence);
// 使用方一侧(同目录 IGraphicBufferConsumer.h)
//   取走:status_t acquireBuffer(BufferItem* buffer, nsecs_t presentWhen, uint64_t maxFrameNumber);
//   归还:status_t releaseBuffer(int slot, uint64_t frameNumber, ...);
//------------------------------------------------------------------------------------------
// 注意:四个动作都只操作「索引」,不搬内容
回到第零章那条循环。现在把每一步具体改动哪一格填上:
| 动作 | 谁发起 | 迁移 | 通俗说法 |
|---|---|---|---|
dequeueBuffer() |
生产方 | FREE → DEQUEUED |
"给我一个空的" |
queueBuffer() |
生产方 | DEQUEUED → QUEUED |
"这个填好了,拿去" |
acquireBuffer() |
使用方 | QUEUED → ACQUIRED |
"我取走一个" |
releaseBuffer() |
使用方 | ACQUIRED → FREE |
"我还回来了" |
四条迁移正好围成一个环。 这个环有几个性质值得记住:
- 每一步只能由特定的一方发起——生产方不能自己把
QUEUED改回DEQUEUED,使用方也不能把FREE直接改成ACQUIRED; - 环形意味着回到原点——
releaseBuffer之后那个位置又变成可申请的,循环复用不需要任何额外操作; - 环上任何一个位置停住,整条链就会在那一格积压——这正是下一章"背压"的机制。
3.2 完整迁移图:还有两个分支
好了,上面四条是主环。真实的状态机上还有两个分支,它们解释了两种"看起来像异常"的正常情况:
分支一:申请后不要了(cancelBuffer)。 生产方申请到一个位置、后来又不打算用了,可以不交出去,直接退回。迁移是 DEQUEUED → FREE——注意它不经过 QUEUED,也就是说这个缓冲从来没被使用方看见过。Camera 类应用在丢帧时常用这条路径。
分支二:异步模式下的额外标记。 当 mAsyncMode 打开时,队列允许生产方在旧缓冲还没被取走时就换新的("舍弃模式"的实现基础),此时会额外用到一个表达共享情形的标记。它是对四态的补充,不是第五个并列状态——这一点在 §2.1 已经说明过,这里补上它与主环的关系:它出现在 QUEUED 与 ACQUIRED 之间,用来标注"这一块正在被两边同时涉及"。
3.3 实测:四个动作在 trace 上各出现多少次
OK,理论给了迁移,trace 给的是这四个动作实际发生了多少次。本机抓的一段 8 秒窗口:
| 动作 | 出现次数 |
|---|---|
queueBuffer |
557 |
releaseBuffer |
829 |
dequeueBuffer |
279 |
acquireBuffer |
269 |
这张表第一个要讲的,是它不能怎么用。
不能相除。 一眼看去 releaseBuffer(829)比 queueBuffer(557)高出近一倍,很容易顺手得出"平均每块缓冲被归还 1.5 次"这种结论。这是错的:这四个数是跨全部进程、全部队列的切片计数,而且每个动作在实现里都有不止一个调用点会被记名。它们量的是"这些动作在这段时间里被记录了多少次",不是"经过了多少帧"。
这条纪律 ep03 已经用过一次(flush 的计数是 DrawFrames 的三倍多,不能读成"提交了三次")。同一族命名下面的计数往往不在同一个层面上,先看它们的归属,再谈比值。
那它有什么用? 它给出的是负载的形状:一段窗口里,四个动作各自有多活跃。比如"归还"明显比"申请"频繁,说明这段时间里缓冲的周转很快——这与本机同时在连续滑动的场景是相符的。它是一个相对量的观察,不是一个绝对量的换算。
四、拿不到位置时会发生什么
4.1 三种工作模式
好了,申请一个有三种结局(ep03 §5.1 从渲染线程视角讲过耗时)。从队列这一侧看,决定结局的是工作模式——图形总览页 给了三种,中英对照如下:
| 中文原文 | 英文原文 | 拿不到位置时 |
|---|---|---|
| 类同步模式(默认) | Synchronous-like mode | 阻塞等待,直到有位置空出来;入一出一,不丢 |
| 非阻塞模式 | Non-blocking mode | 不等待,返回错误;也不丢弃,避免死锁 |
| 舍弃模式 | Discard mode | 丢弃旧的,让新的先过去 |
三种模式在代码里其实是两个二进制开关的组合,其中:
| 模式 | mDequeueBufferCannotBlock |
mAsyncMode |
|---|---|---|
| 类同步模式(默认) | 0 | 0 |
| 非阻塞模式 | 1 | 0 |
| 舍弃模式 | 0 或 1 | 1 |
两个开关都与第五章那条计数公式直接相关——mAsyncMode || mDequeueBufferCannotBlock 为真时,上限要额外加一(§5.1)。
三种模式是一条"要不要丢"的谱系:默认模式宁可等也不丢;非阻塞模式既不丢也不等(把选择权交给调用方);舍弃模式选择丢旧留新。
这三种模式与"几缓冲"是两件事,但常常一起被调。 一句常被引用的话是"多一块缓冲能吸收抖动"——严格说,多一块缓冲改变的是"等的时候有没有备用的",而模式改变的是"要不要等"。两者的组合决定了这一帧的最终命运(§5.4 会把这笔账算一遍)。
4.2 背压:一条因果链,不是一句"阻塞"
说白了,"拿不到位置就等"这句话是结论,但它跳过了过程。把过程摊开,是一条五步的因果链:
- 某一轮里,某个已经交出去的位置没有被及时归还(使用方还没取走,或者取走了还没还);
- 于是处于
FREE的位置少了一个; - 生产方继续申请,
FREE继续减少; - 当
FREE归零,下一个申请者就必须等; - 等多久,取决于"最快被归还的那个位置还有多久回来"——而这又取决于第 1 步里是谁慢。
这条链子的关键在于第 5 步的"取决于"。 它意味着等待的时长不由申请方决定,而由队列下游的节奏决定。ep03 从渲染线程侧量到的那组数(dequeueBuffer 中位 26.9–158.6 微秒、90 分位 9.4–14.8 毫秒)就是这条链在时间轴上的样子:大多数时候有位置可拿(微秒级),偶尔等一次就是毫秒到几十毫秒。
换成队列侧的语言:那两组数字的差别,对应的是"FREE 里有没有货"。同一件事,两种量纲——这正是本系列相邻篇不重复的做法。
4.3 取出顺序:先进先出
好了,队列的名字里有"Queue",取出的顺序自然是先进先出:先交进去的先被取走。
这个顺序不是装饰性的,它有三个直接后果:
- 它保证了画面的先后关系——不会出现第 3 帧比第 2 帧先显示;
- 它决定了"丢哪一块"时的选择——舍弃模式下丢的是队首那块最旧的;
- 它让队列的深度有了意义——先进先出意味着深度越长,"最新交进去的那一块"离被取走的时刻越远,这就是延迟的来源。
下面这张图是通用 FIFO 队列的出队顺序示意——同样要说明:它是类比。BufferQueue 的取出并非严格的"按指针推进",而是由使用方从处于 QUEUED 的位置里选择(§1.4 已对照过两者差别)。先进先出在 BufferQueue 上是一条"通常成立"的顺序,不是一条数学上的硬规则。
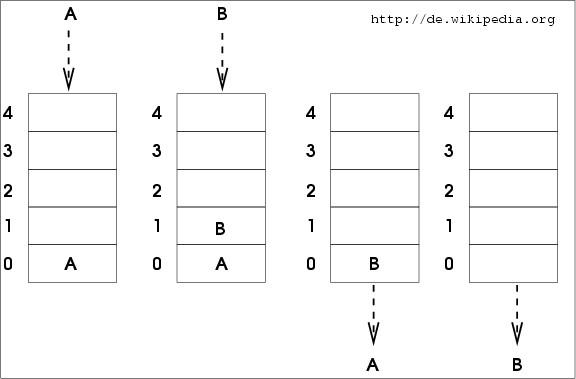
这是一张通用数据结构的类比图。 BufferQueue 的取出由使用方在处于 QUEUED 的位置中择取,不是按指针推进——§1.4 已把两者逐项对照过。
五、"几缓冲"到底指什么
5.1 计数公式
OK,第二章把三种数量分开了,这一章讲决定"有效参与数量"的那条公式。它长这样:
maxBufferCount = mMaxAcquiredBufferCount + mMaxDequeuedBufferCount
               + ((mAsyncMode || mDequeueBufferCannotBlock) ? 1 : 0)
用人话说:上限 = "使用方最多同时拿几块" + "生产方最多同时拿着几块" + "异步或不可阻塞时额外多留一块"。
好了,这条公式解释了为什么"几缓冲"不是一个固定答案——它由两个配置项与一个模式开关共同决定:
| 配置 | 计算结果 | 常见场景 |
|---|---|---|
| 默认(各 1,同步) | 1 + 1 + 0 = 2 | 常规 UI,双缓冲 |
| 异步模式打开(各 1) | 1 + 1 + 1 = 3 | 需要丢旧留新的场景 |
| 生产方可同时拿两块(各按配置) | 视配置而定 | 需要预填的渲染路径 |
| 使用方与生产方各留两块 | 2 + 2 + 0 = 4 | 更深的流水线 |
公式的来源与核对:公式本体来自已读全文的社区分析(《BufferQueue 多缓冲与背压》),而公式的分项在设备上被验证过——见 §7.3:本机
1 + 1 + 0 = 2,而 dump 里恰好打 2 个位置。
这张表是第五章的骨架。 顶上那条公式给出上限,下面的配置给出常见的四种取值。注意第三行写的是"视配置而定",而不是一个具体数字——因为当生产方可以同时拿两块时,上限要由两个配置项分别代入,没有一个通用默认值可套。把它写成具体数字,就成了一条看起来精确、实际不成立的"经验值"。
5.2 官方给了一个可以读出来的"几缓冲"判据
OK,到这里有一个好消息:"现在是几缓冲"这件事,官方给了一条可以直接读的判据。
界面卡顿检测 给出了 Surface BufferQueue 的实测缓冲计数 0 / 1 / 2 的解读,原文关键句是:值 2 表示应用当前处于三重缓冲状态,这会导致额外的输入延迟(对应 Android 9+ / API 28+)。
这条判据的价值在于它把三个概念接了起来:
- §2.4 的"有效参与数量"——本来要靠公式推算;
- 这里的"实测缓冲计数"——可以直接读到一个数;
- 以及"这个数变大意味着什么"——额外的输入延迟。
注意它同时给了一个代价:三缓冲让应用在迟到时有地方放,但代价是多了一帧的延迟。这和 §4.1 "多一块缓冲能吸收抖动"是同一件事的两面——收益是抗抖动,成本是延迟。
一处必须说清的边界:这条判据的取值是 0 / 1 / 2 三档,而 §5.1 的公式算出来的是上限。两者不是同一个量(一个是最多能有多少,一个是此刻读到多少)。把它们混起来,就会得出"上限 2 就是三缓冲"这种自相矛盾的结论。
5.3 实测:本机每层实际有几块缓冲
好了,公式给上限,官方的判据给此刻的计数,而"已分配内存"这一层在设备上也能读出来——ClientCache state: 段按客户端列出了已分配的缓冲清单。本机两个客户端的账:
| 客户端(owner) | 共几块 | 按尺寸分组 |
|---|---|---|
0x7263b0cb8600(桌面进程) |
6 | 1080x2400 ×3 / 1080x63 ×3 |
0x7263b0cbeb10(系统 UI 进程) |
10 | 1080x136 ×6 / 1080x74 ×3 / 922x1024 ×1 |
再把它与"层的当前缓冲"对上(Active Layers 段里,每个可见层都带着它此刻绑定的缓冲 id):桌面层绑定的缓冲落在第一个 owner 里,任务栏层绑定的也落在第一个 owner 里——而那个 owner 下正好是 3 块 1080x2400 加 3 块 1080x63。
于是得到一条很干净的结论:桌面进程的两个表面,各自 3 块缓冲。 尺寸也对得上——桌面层的 bounds 是 1080×2400,任务栏层的高度是 63。这是"逐层三缓冲"在这台设备上的实际形态。
一处推断链要写明:这个结论是两步推断得到的——先用"层当前缓冲 id"把层与 owner 绑起来,再用尺寸把 owner 下的块数分到各个表面。两步都可核对(id 与尺寸都在同一份 dump 里),但它毕竟不是 dump 直接给出的"某层有 3 块"这句话。本机没有一处 dump 直接打出"每层几块"(§0.4 的读不到表已经登记过这条)。
下面这张图是通用缓冲"满载"状态的示意——用它对照"没有任何一个位置处于 FREE"那个瞬间。同样要说明:它是类比。 通用环形缓冲的"满"由指针关系定义,BufferQueue 的"满"由所有位置都不处于 FREE 定义。
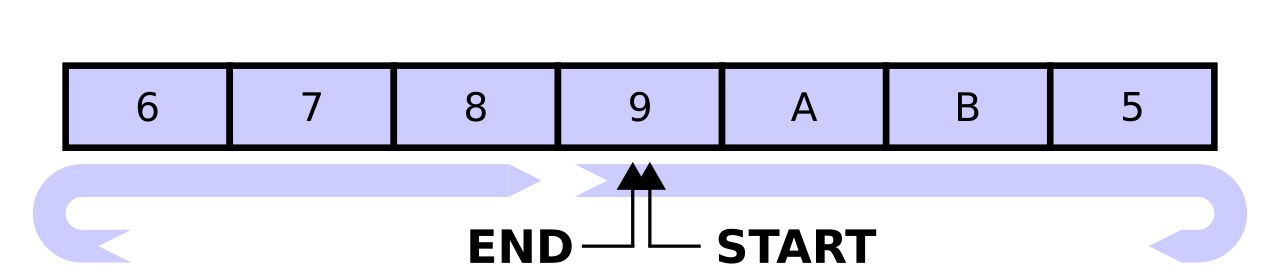
这是一张通用数据结构的类比图。 满的定义在两套体系里不同:环形缓冲看指针关系,BufferQueue 看有没有位置处于 FREE。
5.4 数量与延迟这笔账
OK,把 §5.1 的公式、§5.2 的代价、§5.3 的实况合起来,这笔账可以算得很具体:
- 多一块缓冲买到的是"抗抖动":生产方迟到时,队列里多一个空位可以让它先放着,不必阻塞等待;
- 多一块缓冲付出的是"延迟":先进先出意味着缓冲越多,最新交进去的那一块要等更久才被取走——官方那条判据把它说成"额外的输入延迟";
- 所以"加缓冲"从来不是免费的,它是一次时间上的借贷:把手上的等待换成后面的延迟。
这也解释了为什么 §4.1 的"舍弃模式"存在:当延迟比丢帧更不可接受时(比如实时性优先的场景),宁可丢掉旧的那一块,也不要让延迟累积。
这笔账的完整版(多刷新率、ARR、不同刷新率下的缓冲数)留给 ep11——那一篇会把"数量—延迟—刷新率"三者放在一起算。本篇只把公式与设备实况对齐。本篇到此为止不越界。
六、队列里传的不只是内存
6.1 三个不同的时刻
好了,回到 §1.2:队列传递的是"索引 + handle + 栅栏"。前两个好理解,栅栏(fence) 值得单独一章。
原因是有三个时刻经常被混成一个:
| 时刻 | 含义 | 谁在这时能碰这块内存 |
|---|---|---|
交出(queueBuffer 返回) |
生产方说"我填完了" | 还不能被读——GPU 可能还没画完 |
| 画完(GPU 执行完毕) | 像素真的落在了内存里 | 还不一定能读——要看栅栏 |
可取用(栅栏 signal、使用方 acquireBuffer) |
使用方拿到所有权 | 可以读了 |
"queueBuffer 很快"这件事在 §1.2 已经量化过(中位 337–448 微秒)。它快,是因为它在这一刻只做了一件事:把位置与凭据交出去,并附上一张"什么时候能读"的时间凭据。
同步框架 给出的机制是:sync_fence / sync_pt / sync_timeline;ANativeWindow 的 dequeueBuffer / queueBuffer / cancelBuffer 都带栅栏参数;使用侧还有 acquire / release / present 三种栅栏。
从调用侧看,「带栅栏」这件事就是多了一个参数:
//-----------------------------------【三个调用都带栅栏参数】---------------------------------
// 申请:产出栅栏(告诉生产方「这块什么时候能写」)
//   status_t dequeueBuffer(int* slot, sp<Fence>* fence, ...);
// 交出:传入栅栏(告诉使用方「这块什么时候能读」)
//   status_t queueBuffer(int slot, const QueueBufferInput& input, ...);  // input 内含 fence
// 反悔:传入栅栏(同样要说明这块什么时候可以重新用)
//   status_t cancelBuffer(int slot, const sp<Fence>& fence);
//------------------------------------------------------------------------------------------
// 栅栏的语义是「等这张凭据 signal 之后才安全」——它不是时间戳,是一张可等待的凭据
使用侧的三种栅栏各有分工,这是把"三个时刻"落到具体机制上的地方:
| 栅栏 | 谁等谁 | 干什么 |
|---|---|---|
| acquire 栅栏 | 使用方等生产方 | 生产方画完之前,使用方不能读 |
| release 栅栏 | 生产方等使用方 | 使用方读完之前,生产方不能往上写 |
| present 栅栏 | 系统等显示 | 这一帧真的到达屏幕的时刻(用于统计) |
三种栅栏合起来,构成了这块内存的"读写轮转锁"。 没有它们,就只能靠"猜一个足够长的等待时间"——而那会让整条链路要么过度保守(白等)、要么出错(读到半张图)。
一处很实用的细节:同一个栅栏每过一次队列会被重命名(官方原文举例 SurfaceView:0)。这意味着 trace 上同一个栅栏在不同阶段的显示名不同——顺着名字找它的完整生命周期,会找不到;要找它,得顺着时间而不是顺着名字。
6.2 实测:层的当前缓冲与帧序号
OK,栅栏本身在 dump 里读不到明细(§0.4 的读不到表登记过)。但有一处与它直接相邻的读数:每个可见层此刻绑定的缓冲 id 与帧序号。
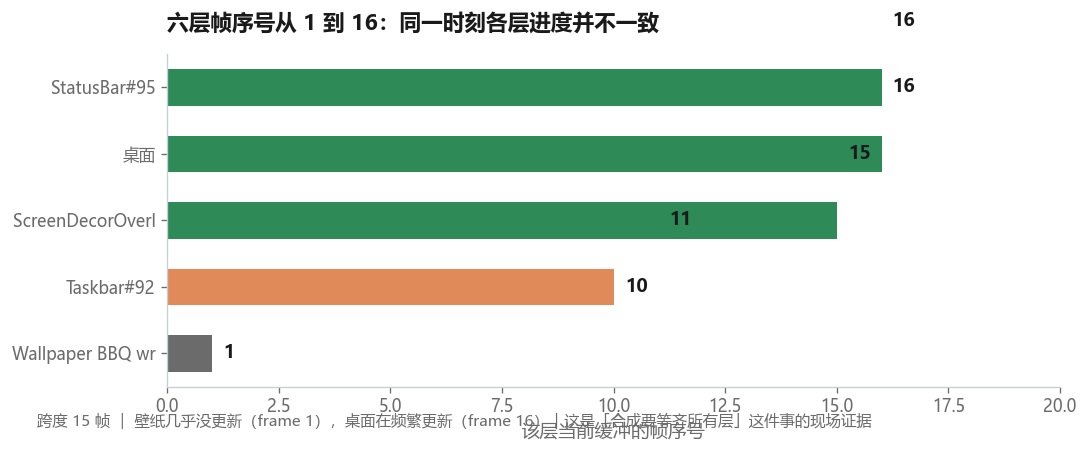
本机 Active Layers 段里 6 个层带这组信息:
| 层 | 帧序号 |
|---|---|
| Wallpaper BBQ wrapper | 1 |
| 桌面(NexusLauncherActivity) | 16 |
| StatusBar | 16 |
| Taskbar | 10 |
| ScreenDecorOverlay | 15 |
| ScreenDecorOverlayBottom | 11 |
这些帧序号差得很开(从 1 到 16)。这说明:同一时刻,不同层的"进度"并不一致——壁纸几乎没更新过(帧 1),而桌面在频繁更新(帧 16)。
这是"合成要等齐所有层"这件事的现场证据。 合成一帧时,它需要每个层都有一块可取用的缓冲;而各层的进度不同,意味着有的层可能正要换、有的早就好了。这一层不一致,正是合成侧要处理的核心问题——留给 ep06 展开,本篇只把"层与缓冲的绑定关系"这件事记下来。
七、实测:本机这台设备的队列账本
7.1 队列的计数参数,原文长这样
好了,这一章把本篇的读数摊开,它们都取自本机同一条 dumpsys SurfaceFlinger 的不同段落——先看队列的计数参数,它决定了公式的每一项:
BufferQueue mMaxAcquiredBufferCount=1 mMaxDequeuedBufferCount=1
mDequeueBufferCannotBlock=0 mAsyncMode=0
mQueueBufferCanDrop=0 mLegacyBufferDrop=1
default-size=[1080x2400] default-format=1  transform-hint=00 frame-counter=199
| 字段 | 本机值 | 在公式里的角色 |
|---|---|---|
mMaxAcquiredBufferCount |
1 | 加数一 |
mMaxDequeuedBufferCount |
1 | 加数二 |
mDequeueBufferCannotBlock |
0 | 决定额外项(不阻塞时为真) |
mAsyncMode |
0 | 决定额外项(异步时为真) |
mQueueBufferCanDrop / mLegacyBufferDrop |
0 / 1 | 与丢弃行为相关,本篇不展开 |
default-size |
1080x2400 | 这块队列服务的表面尺寸 |
frame-counter |
199 | 这条队列自建立以来交出的帧数 |
这张表本身就是一条判据:它把"用哪种模式、留几个位置"从文章里的定性描述,变成了几个可以直接读到的开关。
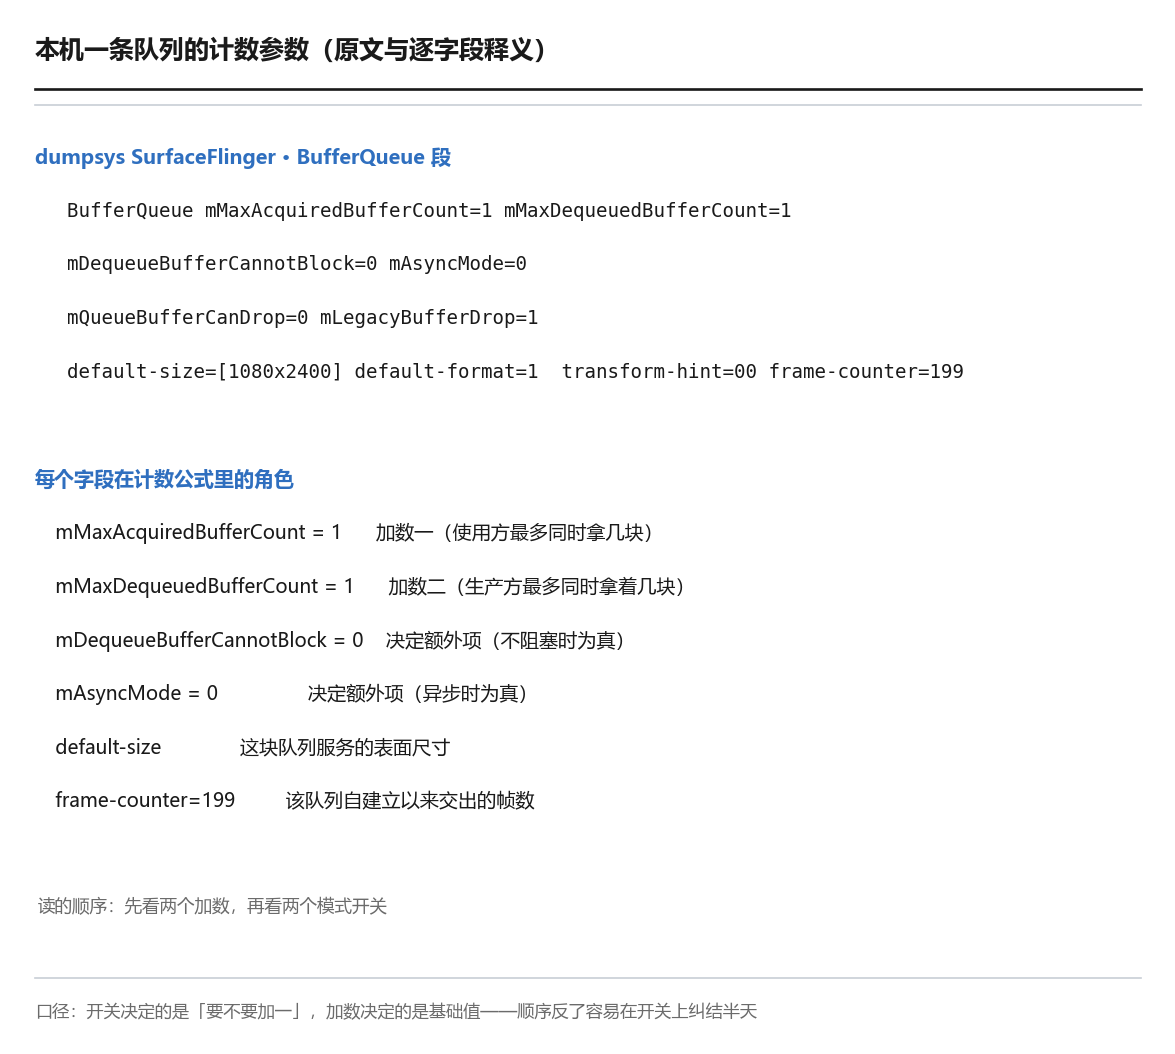
读这张表时有一个顺序上的讲究:先看两个加数,再看两个模式开关。因为开关决定的是"要不要加一",而加数决定的是基础值。 顺序反了,很容易在开关上纠结半天,最后发现基础值本身就是 2。
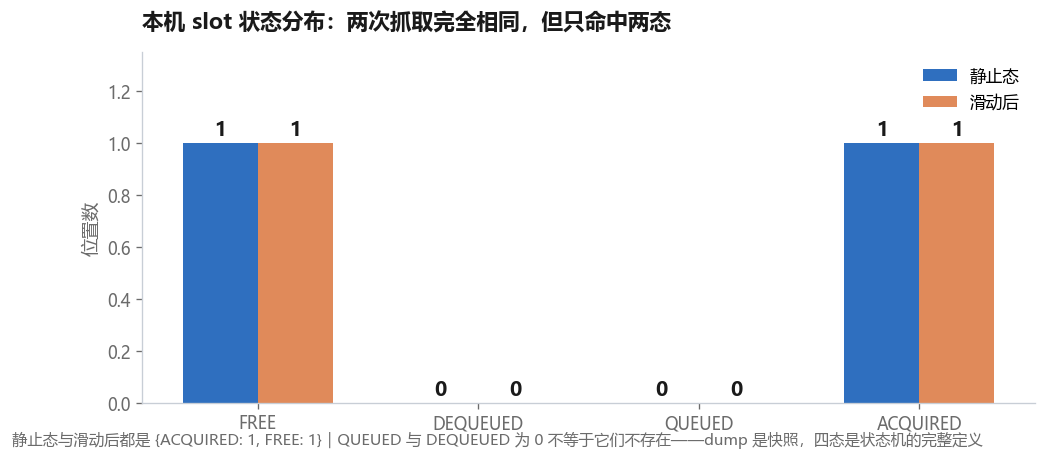
7.2 状态分布:两个位置,两种状态
OK,紧接着把 slot 账本汇总:
| 状态 | 位置数 | 本机在干什么 |
|---|---|---|
ACQUIRED |
1 | 使用方正拿着一块(frame=245) |
FREE |
1 | 另一块空闲,随时可申请(frame=244) |
QUEUED |
0 | 这一刻没有"填好待取"的 |
DEQUEUED |
0 | 这一刻没有"正在填"的 |
我把静止态与滑动后的态都抓了一遍,两次的分布完全相同——都是 {'ACQUIRED': 1, 'FREE': 1}。
这条读数是本篇"诚实清单"里的一项:四态里我只打到了两态。原因在 §2.2 说过——dump 拍的是瞬间,而在这条队列(系统合成路径)上,生产方与使用方在同一个进程里,交接往返极快,落进 QUEUED 或 DEQUEUED 的窗口很短。
要不要因此怀疑四态?不要。 状态机的定义与快照的命中是两件事:四态是"可能有哪些",快照是"这一瞬间有哪几个"。 用快照去否定定义,是读 dump 时最容易犯的错。
7.3 公式校验:在设备上对一次
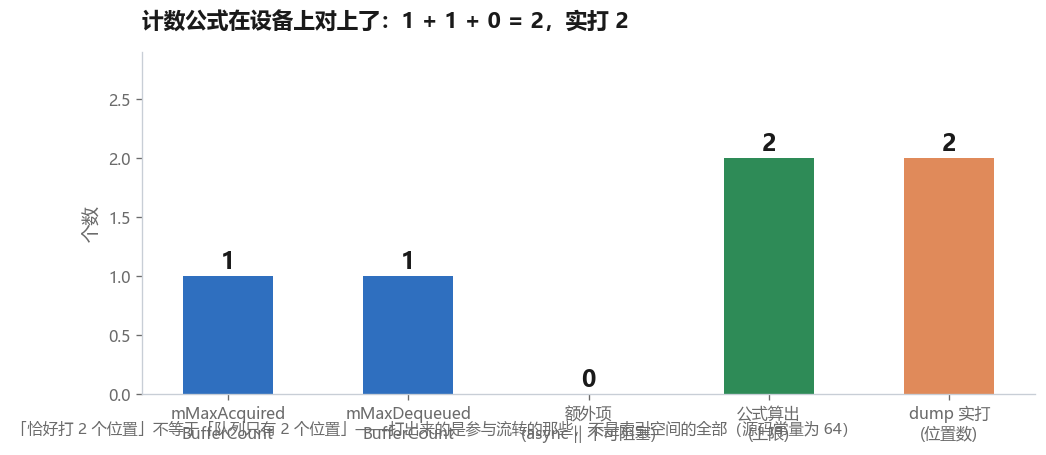
OK,现在把 §5.1 的公式和 §7.1 的参数合起来:
| 项 | 值 |
|---|---|
mMaxAcquiredBufferCount |
1 |
mMaxDequeuedBufferCount |
1 |
额外项(mAsyncMode \|\| mDequeueBufferCannotBlock) |
0(两个开关都关着) |
| 公式算出 | 2 |
| dump 里实打的位置数 | 2 |
| 是否一致 | 一致 |
这是本篇最硬的一处证据。 公式不是从文章里抄来的一个说法——它在这台设备上对上了:算出来是 2,打出来也是 2。
它同时顺手解决了 §2.4 那三种数量的第一层与第二层:
- 索引容量(64)是"最多能管理多少";
- 有效参与数量(2)由公式决定,并且 dump 里就打了这么多个位置——两者一致,说明公式的语义是"这一刻参与流转的位置数",而不是别的什么。
一处要小心的措辞:我写的是"恰好打 2 个位置",而不是"队列只有 2 个位置"。打出来的是参与流转的那些,不是索引空间的全部。 这两个说法差得很远。
7.4 两个客户端的缓冲账
OK,最后看已分配内存这一层。本机 ClientCache state: 段记了两个客户端的账(含缓冲 id 与尺寸):
Cache owner: 0x7263b0cb8600
  ID: 4492535791646, size: 1080x2400
  ID: 4492535791647, size: 1080x2400
  ID: 4492535791645, size: 1080x2400
  ID: 4492535791640, size: 1080x63
  ID: 4492535791639, size: 1080x63
  ID: 4492535791641, size: 1080x63
Cache owner: 0x7263b0cbeb10
  ID: 3874060501012, size: 1080x136
  …(共 10 块)
| 客户端 | 共几块 | 尺寸分布 |
|---|---|---|
| 桌面进程 | 6 | 1080x2400 ×3 / 1080x63 ×3 |
| 系统 UI 进程 | 10 | 1080x136 ×6 / 1080x74 ×3 / 922x1024 ×1 |
把这两个数放在一起看,有一处对比很有意思:桌面进程 6 块、系统 UI 进程 10 块,但它们服务的表面数量不同——前者 2 个表面(3+3),后者 5 个表面(1080x136 的 6 块要供两个同尺寸表面、1080x74 的 3 块、以及壁纸的 1 块)。所以"块数"这个数本身没有可比性,必须落到"每个表面几块"才有意义。
这也回到了 §2.4 那句提醒:先问这是哪一层的数量。 一个进程十块缓冲,可能意味着五个表面各两块;也可能意味着两个表面各五块。光看总数,什么都判断不出来。
7.5 本机读不到什么
这一节是本篇与前几篇最不一样的地方。因为"账本"这个词会让人以为什么都读得到,所以把读不到的三处单独列出来:
| 读不到的 | 实测证据 | 影响 |
|---|---|---|
| 等待的那个函数 | trace 全文检索 waitForFreeSlotThenRelock 0 次、mDequeueCondition 0 次 |
背压的"等待"这一环没有直接的 trace 切片。所以 §4.2 那条因果链的观测侧,改用"四动作计数不对称 + slot 状态快照"来侧面印证 |
| 每层的队列账本 | 默认 dump 与 --layer-name / --layers / --client-cache / --frame-stats 五种调用方式都只吐出 1 个 Slots: 段 |
本机只有一条队列(FramebufferSurface)的账本可读。所以 §5.3 那条"每个表面各 3 块"的结论是两步推断得来的,不是直接读到的 |
--latency 帧延迟表 |
只返回 1 行 | 帧延迟相关读数本篇不写 |
这三条不是"我们没找到方法",而是"这台设备的实现没有把这几样打出来"。 官方 《Surface 与 SurfaceHolder》 确实说 dumpsys SurfaceFlinger 可查看每层的缓冲区摘要——这句话是对的,但"缓冲区摘要"在本机的对应段落是 Active Layers 里的当前缓冲与帧序号,而不是 BufferQueue 的 slot 账本。 两件事,要分开说。
这条区分值得单独记一句:读 dump 时,"官方说这条命令能看某类信息"与"这条命令打出的正是我以为的那张表"是两件事。中间差一次核对。
7.6 三处读数怎么互相印证
本篇的四类读数不是各自独立的四组数字,它们之间有可核对的关系。这也是"实测"与"抄一遍"的分界:
| 印证关系 | 左边 | 右边 | 是否一致 |
|---|---|---|---|
| 公式 ↔ 实况 | 公式算出 2 | dump 里实打 2 个位置 | ✔ 一致 |
| 层 ↔ 缓冲归属 | 桌面层与任务栏层绑定的缓冲 id | 都落在同一个 owner 下(共 6 块) | ✔ 一致 |
| 块数 ↔ 表面数 | 桌面进程 6 块 ÷ 2 个表面 | 每表面 3 块;系统 UI 进程 10 块 ÷ 5 个表面=每表面 2 块 | ✔ 自洽 |
| 静 ↔ 动两态 | 静止时 {ACQUIRED: 1, FREE: 1} |
滑动后 {ACQUIRED: 1, FREE: 1} |
✔ 完全相同 |
| 帧序号 ↔ 层进度 | 壁纸帧 1 / 桌面帧 16 | 跨度 15 帧,各层进度不同 | ✔ 自洽 |
五组里有两组是可以被"独立复算"的(公式那一组、块数除以表面数那一组)——这两个是本篇结论的支点。其余三组是自洽性检查:它们不独立证明结论,但如果不一致,就说明某一步读错了。
一处要坦白的限制:这五组里,"每层几块"那一组是两步推断(先用缓冲 id 绑定层与 owner,再用尺寸分到各表面),不是 dump 直接给出的。§5.3 已经写明。把推断与直读分开标注,是这类结论能被核对的前提。
7.7 把这几组数折算成可比的量
原始读数不能直接横向比(§7.4),但折算之后就清楚了。三组折算:
第一组,按表面均摊的缓冲数。 桌面进程 6 块 ÷ 2 个表面 = 每表面 3 块;系统 UI 进程 10 块 ÷ 5 个表面 = 每表面 2 块。也就是桌面的每个表面比系统 UI 多出 50% 的缓冲——这与桌面的两个表面都在频繁重绘、而系统 UI 的表面多为静态装饰是相符的。
第二组,上限提高的代价可以换算成时间。 从上限 2 提到上限 3,多出来的那一块换来的是"生产方迟到时不必阻塞"。代价是一次先进先出的排队:多一帧 ≈ 多 16.7 毫秒(60 Hz 下)的延迟——官方那条判据说的"额外的输入延迟",量级就在这里。
第三组,各层进度的离散程度。 本机 6 个可见层的帧序号从 1 到 16,跨度 15 帧。跨度越大,说明同一时刻各层处在流水线的不同位置越远——合成要等齐它们,就需要更大的容忍窗口。
折算这一步是必要的,因为原始数在量纲上不可比。 "6 块"与"10 块"放在一起没有信息;"每表面 3 块"与"每表面 2 块"放在一起,立刻就能看出差异。
八、BLAST 改变了什么
8.1 队列归谁:从系统进程搬到应用进程
ep03 §6.2 讲过 BLAST 的事务语义(缓冲与图层属性一起提交)。这一节只讲另一面:队列的归属变了,而这一面直接改变了第二章那些数量由谁决定。
| 维度 | 旧方案 | BLAST 之后 |
|---|---|---|
| 队列在哪创建 | SurfaceFlinger 进程 | 应用进程 |
| 谁决定缓冲数量 | SurfaceFlinger | 应用侧 |
| 实际分配者 | Gralloc | Gralloc(没变) |
| 图层属性怎么走 | 与缓冲相关数据分头走 | 统一走事务(ep03 已讲) |
这次归属变化涉及的三个角色可以用一句「其中」说清:其中队列的创建者与缓冲数量的决策者变到了应用侧,而实际分配者仍是 Gralloc——三者不是同一个角色,改的只是前两个。
最容易出错的是第三行:BLAST 把队列搬到应用进程,很容易被推成"应用直接分配 HardwareBuffer"。这不是真的——《Android 12 BLASTBufferQueue 深度分析》 专门辟了一节澄清这一点:分配者始终是 Gralloc,变的是"谁来决策要不要分配、分配几块"。
关于归属变化本身,另有两处可对照的来源:《图像显示框架》 指出旧架构消费者在 SF 进程、新架构消费者在应用进程;《BLASTBufferQueue01 架构概述》 系统梳理了队列创建位置、缓冲传递方式与跨进程同步的差异。
一处纪律:同一篇深度分析里还出现过若干无出处的量化断言(例如 IPC 开销与负载的下降倍数)。本篇一律不引用这些数字——它们无法核对。同一篇文章可以有一处正确澄清(§8.1 第三行)与若干不可核对的断言,功过要分开记。
这条路是怎么演进过来的,值得按时间线说一遍。 队列归属前后有过三次形状变化:
| 阶段 | 队列在哪 | 图层属性怎么走 |
|---|---|---|
| 早期(Android 9 及以前) | SurfaceFlinger 进程 | 与缓冲相关数据分头走 |
| Android 10 起 | SurfaceFlinger 进程 | ASurfaceControl 把事务语义引入(ep03 §6.2 已讲) |
| BLAST 之后 | 应用进程 | 统一走事务 |
三次变化里,变的一直是"谁创建、谁决策、谁提交";没变的是"实际分配者是 Gralloc"。 把这条演进脉络记住,比背住某一个版本号有用——BLAST 默认启用的具体版本号本轮未核实,所以正文不写它(§0.3 的边界纪律)。
8.2 实测:BLAST 路径在 trace 上的痕迹
本机 trace 里这条路径的计数:
| 字符串 | 出现次数 |
|---|---|
Transaction |
1929 |
BLAST |
1380 |
setBuffer |
276 |
setBuffer(276)与 ep03 量到的 dequeueBuffer(287)几乎相等——这个数字关系在 ep03 已经解释过:每申请一次缓冲,大致对应一次"把缓冲设置进事务"。 两者是同一个动作的两头。
而 Transaction(1929)远高于它们,说明事务是一个被反复使用的机制,不只服务于换缓冲一件事(图层属性也走它)。这一点与 ep03 的读数一致——同一份量纲,两篇各自引用一次,不重复论证。
九、四项可以立刻做的事
9.1 四条命令与判据
前面八章的原理,落到操作上就是四条命令。每条都给判据。
第一件:看队列的计数参数。
adb shell dumpsys SurfaceFlinger | grep -A6 "BufferQueue mMaxAcquired"
判据:把两个加数代入公式,看与实打的位置数是否一致。 本机 1 + 1 + 0 = 2,打出来 2 个位置——一致。若不一致,说明你读的不是同一条队列的同一个时刻。
第二件:看 slot 账本的状态分布。
adb shell dumpsys SurfaceFlinger | grep -A4 "^Slots:"
判据:看有没有位置卡在 QUEUED 或 ACQUIRED 上不动。 本机是 {ACQUIRED: 1, FREE: 1}——没有积压。若某一态的数量长期偏高且不回落,那就是 §4.2 那条因果链上卡住的那一格。注意 dump 是快照:一次读数只能当一次证据,要看趋势得连抓几次。
第三件:看每个客户端已分配了几块。
adb shell dumpsys SurfaceFlinger | grep -A30 "ClientCache state:"
判据:按尺寸分组,落到"每个表面几块"。 本机桌面进程 6 块 = 两个表面各 3 块。不要用总数判断——总数在两个进程之间没有可比性(§7.4)。
第四件:核对"官方说的"与"实际打出来的"。
adb shell dumpsys SurfaceFlinger --layers # 与不带参数的结果对比
判据:同一条命令的几种调用方式,打出的段落是否如你所料。 本机五种调用方式都只吐出 1 个 Slots: 段——这说明"每层队列账本"在你这台设备上也读不到,别按"应该能看到"去找。
9.2 从「队列有问题」到定位结论:四步判读
如果手上只有一句"画面有点卡",而你想知道是不是这条队列的问题,按四步走。
第一步:先看有没有积压。 跑第二件命令,看 slot 状态分布。FREE 还有货 → 队列不是瓶颈,去查别的(ep03 的两个等待点);FREE 归零且 QUEUED/ACQUIRED 堆积 → 走第二步。
第二步:看是谁没还。 数一下堆在 QUEUED 上的多还是 ACQUIRED 上的多:QUEUED 多说明使用方没及时来取;ACQUIRED 多说明使用方取走了但没还。两种积压的责任方不同。
第三步:核一下数量配置是否合理。 跑第一件命令代入公式。上限过小(比如该给 3 的给了 2)会让生产方更容易撞上 FREE 归零;上限过大则要付 §5.4 那笔延迟账。
第四步:再看是不是"假积压"。 单次 dump 是快照。连抓三次,若分布始终一样,才是真积压;若三次都不一样,说明队列在正常周转,你抓到的是流动的瞬间。
这四步的顺序不能换。 先判有无、再判责任方、再看配置、最后才判连续性——反过来的话,一次快照就能把你带到错误结论上。
这四步里最容易省掉的是第四步。 前三步都能在一次 dump 里做完,看着很完整;但单次快照不足以支撑"积压"这个判断——积压是"长期不回落",而快照只说明"这一刻是什么"。省掉第四步,就会把正常的流动当成故障。
9.3 本篇留下的一句话,与下一篇
把全篇收成一句:
"几缓冲"不是一个问题,而是三个问题。 索引容量、有效参与数量、已分配内存各有各的读法与各自的数——在这台设备上它们分别是 64、2、3。混着问,就只能在"三缓冲=分配三块"这类结论上打转。
这句话也顺手回答了开头那个问题:为什么"三缓冲"这件事在中文侧会有那么多种说法。因为它本身就是一个需要先分层才能问的问题,而分层这件事,官方文档里其实已经写了——只是写在两句话里,中间隔了一个省略号。
下一篇讲的是画完之后那道关口:SurfaceFlinger 在 Vsync 之后做什么——合成怎么决定、合成列表怎么排、送屏怎么对齐。本篇讲的这条队列,在那一篇里会变成"被取走的那一端"。
相关链接
- 上一篇:【Android 图形显示系统】(三) RenderThread 与帧提交:从显示列表到一块缓冲
- 下一篇(预告):【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么
- 官方文档:BufferQueue 和 Gralloc(中文)| 同页英文版 | 图形总览(中文)| 同页英文版 | Surface 与 SurfaceHolder | 同步框架 | 界面卡顿检测
- 源码入口:
BufferQueueCore.cpp|BufferQueueProducer.cpp|BufferQueueConsumer.cpp|IGraphicBufferProducer.h|IGraphicBufferConsumer.h|BufferSlot.h|BufferQueueDefs.h - 社区实操:《BufferQueueCore 详解》 | 《Android Gfx Stack 中的 BufferQueue》 | 《BufferQueue 多缓冲与背压》 | 《Android14 显示系统剖析 5》 | 《BLASTBufferQueue01 架构概述》 | 《从 dequeueBuffer 卡顿看一次 GPU 丢帧》 | 《Android SurfaceFlinger 之 BufferQueue》 | 《浅谈 SurfaceFlinger 相关介绍(二)》 | 《Systrace Basics(11)三缓冲解读》
- 素材来源:Wikimedia Commons(图注逐张标作者与许可);本机实测图版权自有
With Best Wishes.