核心问题:光栅化把每个三角形变成了带插值 z 的像素流,屏幕上一个不透明物体怎么保证"后画的盖住先画的"?本篇把深度缓冲当作管线里的"第三张图像"来读——深度写、深度读、early-Z 什么时候能提前、什么时候必须退到 late-Z,再到 stencil 这个附在深度上的通道,最后落到 TBDR 把整条 hidden-surface 换成另一个算法。全篇收在"early-Z 省的是着色、HSR 省的是着色加纹理、Z 压缩省的是带宽"这笔可核对的账上。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
为什么光栅化出来还不能直接用(set-context)
上一篇的结尾,我们把三角形一路送进了屏幕:边函数判定覆盖、顶左规则分走共享边、重心坐标把属性插值到每个像素。看起来屏幕该有东西了——但还差最后一步,而且这步让所有"先画谁"的顺序都作废了。
先看矛盾从哪来。一个不透明的立方体,对着我们这一面,它背后的面、被自己挡住的面,最后都是不该显示的。问题在于:GPU 不像我们拍照,它是按提交顺序把物体一个接一个画进来的,它天然不知道"这个三角形是不是被前面画过的三角形挡住"。它只知道"我现在拿到一个像素,它带着插值出来的 z,我该不该把它写上去"。
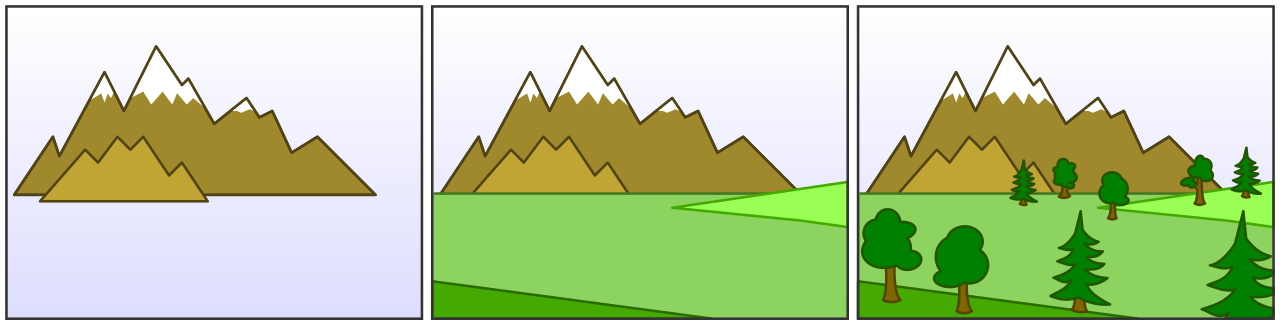
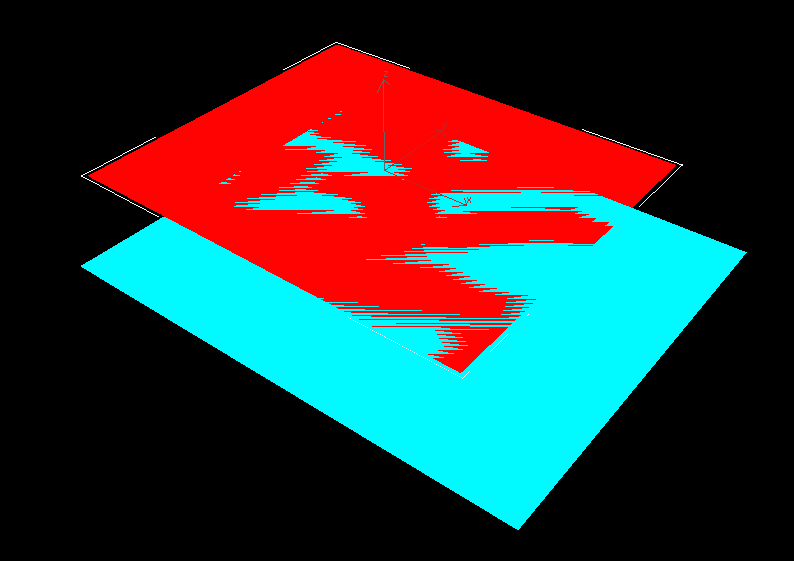
最直白的解法是画家算法(painter's algorithm):把不透明物体按到相机的距离从远到近排序,先画远的,再画近的,后画的自然盖住先画的。图 1 画的正是这种理想情形——一堆堆叠的物体按深度顺序一层层画上去。听着优雅,但它在数学上就不成立:不透明物体之间不存在一个对所有视角都稳定的全局排序。三块互相穿插的木板、一个"你挡住我、我又挡住你"的闭合几何,无论你怎么排,总有某处画错。更致命的是,深度排序是场景相关、逐帧变化的,把它交给 CPU 去做等于把绘制准备的时间拖到图形管线的前端里去。
排序这条路不是没人修补过,但每一条补救都败在同一件事上:问题的根源不在"排得不够好",而在"相交几何根本没有全局深度序"。 两个经典招数值得记住,因为它们后来都以不同形态活在软件管线里:
- Newell 算法(Newell's algorithm):画家算法的改进版——当两个多边形互相穿插时,不做全场景暴力排序,而是针对"当前这对"用切平面判断谁在前,必要时把其中一个沿交线切开再各自排序。它把"全局排序不存在"化解成"局部可切分",但代价是逐物体、逐三角形的平面点积与动态切线运算,付出的是 CPU 端的几何前处理时间——而这一步恰恰是硬件想从每帧绘制里省掉的。
- BSP 树(binary space partitioning):把场景预切割成一棵按平面分隔的空间树,绘制时从相机所在节点向远端逆序/向近端正序递归遍历,天然得到无穿插次序。它把问题一次性解决得很好,但树是静态场景的产物——物体一动、几何一变,这棵树就要重建,重建成本又被扔回了 CPU。
两条路线都在"绘制准备"这一端花钱,而硬件这一篇想解决的,正是把裁决从"绘制前排序"搬到"绘制中逐像素判断"。Z 缓冲之所以能赢,不是它排序更聪明,而是它把每帧的几何判断成本切碎、摊到了硅片每秒几十亿个像素级比较里,不额外占用 CPU 每帧的排序预算。
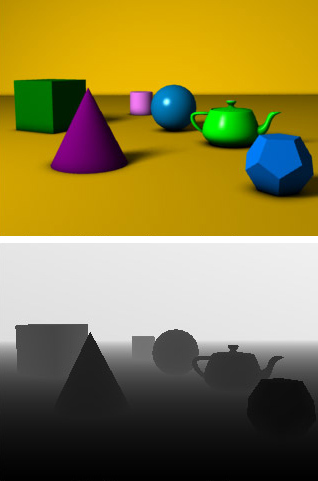
所以硬件换了思路:不给物体排序,给像素判断。给每个像素额外存一个"到相机的距离",画新像素时先比一比——新来的比存着的近,就写上;比存着的远,就丢进垃圾桶。这份"每个像素存着的距离",就是Z 缓冲(Z-buffer / depth buffer)。它不关心基元顺序,只关心一个判别式:这个位置,谁离相机更近。这一步,从 1974 年 Edwin Catmull 的论文一直用到现在,名字没变,变的只是它被插在管线哪个位置、以多细的粒度提前。
出处:Edwin Catmull《A Subdivision Algorithm for Computer Display of Curved Surfaces》1974(Z-buffer 概念的首个系统化描述)/ Wikipedia · Painter's algorithm(含 Newell 算法与局限) / Wikipedia · Binary space partitioning。
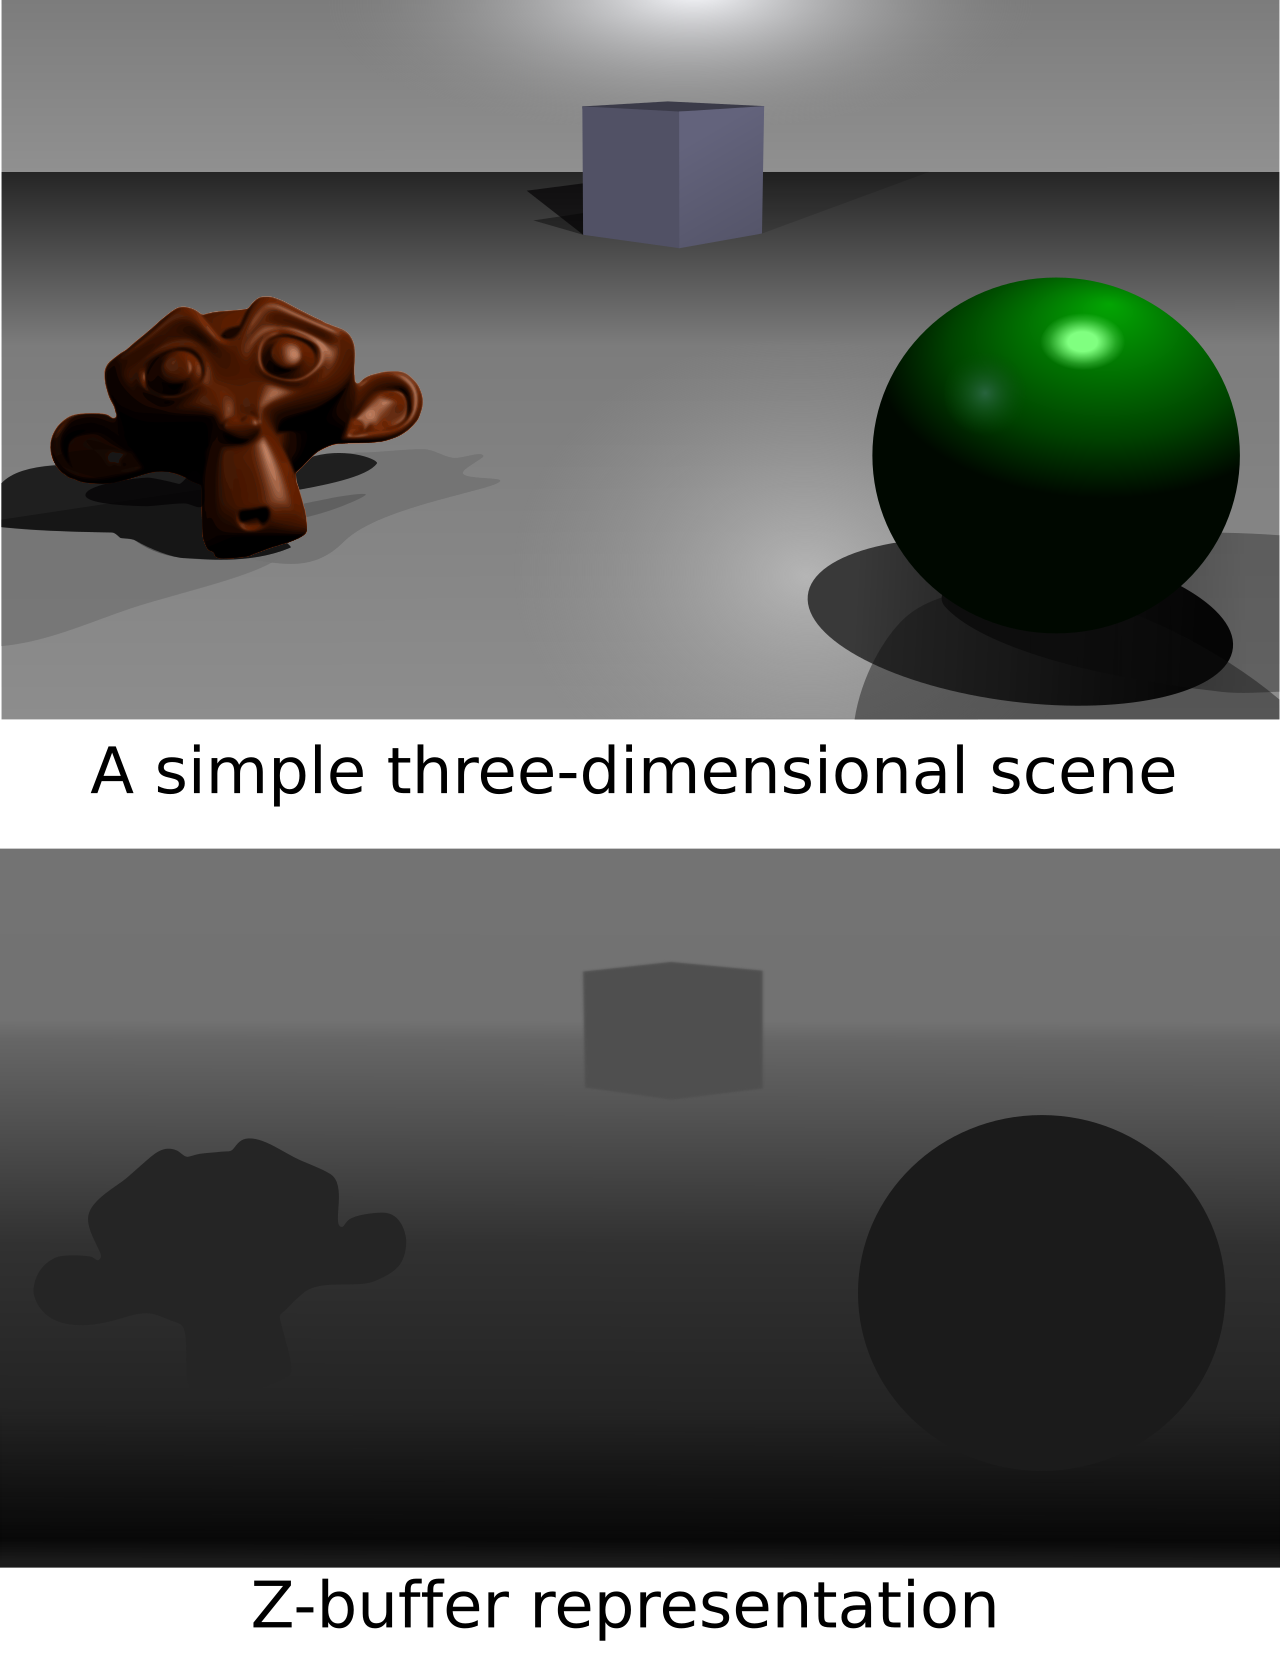
这一章我们要回答的,就是把这份"每像素的距离表"当作第三张图像,看它怎么被生产、怎么被消耗,以及——硬件最聪明的一步——它到底能不能提前到像素着色之前就起作用。后者是整个 early-Z 机制章的核心,也是本篇最容易被讲成"一个 API 开关"的地方。我们先从缓冲本身长什么样开始。
一、Z 缓冲:把"距离"当成第三张图像(explain-structure)
1.1 每个像素多一个数,和颜色并行读、并行写
我们说"第三张图像",意思是深度缓冲和颜色缓冲在物理上是两张平行的二维数组:颜色缓冲每个像素存 RGBA,深度缓冲每个像素存一个深度值 z。光栅化器填充完一整帧后,输出端同时维护这两张表——画新像素时,位置对齐的 z 值先被取出来比较,比较通过才写颜色。
这个"每个像素再存一个数"的代价,在分辨率账上一眼可见。以 1080p 为例,1920×1080≈207 万像素;如果深度是 24 位、加上 8 位模板凑成 32 位(D24S8 格式,后面 §7 会用到那 8 位),那么光这块缓冲就是 207 万 × 4 字节 ≈ 8.3 MB。4K 就翻到约 33 MB。这不仅是一块要常驻显存的空间,更关键的是——它每一次绘制都要被读出、被比较、还可能被写回。深度缓冲的读写流量,是像素后端带宽账里绕不开的一块。
1.2 深度测试与深度写入:一个比较,一次有条件的写回
深度缓冲的运作是两个动作的组合,必须分开记。
- 深度测试(Z test / depth test):拿新像素的 z,和缓冲里对应位置存的 z 比,按设定的深度函数(depth function)决定"要不要过"。最常用的是
less或less-equal——新 z 更近(或相等)才通过。 - 深度写入(Z write / depth write):通过测试的像素,可选地把自己这个 z 值写回深度缓冲,替换掉旧值。只有不透明、且希望靠深度隐藏后续物体时,才需要开深度写;如果这帧只画透明物体、或深度缓冲已经"被某次 pass 定死了不想再动",就该把深度写关掉。
两个动作一拆,就能看懂很多现实现象。为什么画半透明物体要"关闭深度写、只看深度测试"?因为半透明意味着前面的物体要透出后面——如果半透明物体把自己的 z 写进缓冲,后面本来合法的物体就被自己挡住了,透明就穿帮。所以常规做法是:先画不透明并把深度写死,再画透明时只做深度测试、不写深度,让透明的层次只靠排序(先远后近)去堆叠,深度只负责"别让透明物体盖过非透明主体"。
"测试"里的"函数"不是可选项,它一整张枚举就摆在那里。主流 API 的深度函数都是同一组八选一(direct3d 用 less/greater,符号随你的深度约定而变):
| 深度函数 | 新像素何时通过 | 典型用途 |
|---|---|---|
less |
新 z < 旧 z | 物体靠近平常(反向深度用 greater) |
less-equal |
新 z ≤ 旧 z | 多 pass 绘制避免同一深度被后续相等值顶掉 |
equal / not-equal |
新 z == 旧 z | 深度轮廓高亮、stencil 变体标记 |
greater / greater-equal |
新 z > 旧 z | 反向深度缓冲、深度纹理读取 |
always |
无条件过 | 清理/占位 pass,或只写、不靠深度裁决 |
never |
一律不过 | 配合纯 Stencil 场景 |
在配置层,这组状态和测试/写入开关通常聚成一个深度-模板状态对象,一次绑定管住整段绘制。以变体 B 的"配置清单 + 关键片段"口径,两端主流 API 各给一段最小形态:
/* D3D11:深度-模板状态(OM 阶段绑定) */
DepthStencilState g_dsLess = {};
g_dsLess.DepthEnable          = TRUE;
g_dsLess.DepthWriteMask       = D3D11_DEPTH_WRITE_MASK_ALL;  /* 是否写深度 */
g_dsLess.DepthFunc            = D3D11_COMPARISON_LESS;       /* 深度函数 */
g_dsLess.StencilEnable        = FALSE;
ctx->OMSetDepthStencilState(&g_dsLess, 0xFF);
/* Vulkan:pipeline 深度-模板状态(固定功能阶段) */
VkPipelineDepthStencilStateCreateInfo ds = {};
ds.sType            = VK_STRUCTURE_TYPE_PIPELINE_DEPTH_STENCIL_STATE_CREATE_INFO;
ds.depthTestEnable  = VK_TRUE;
ds.depthWriteEnable = VK_TRUE;
ds.depthCompareOp   = VK_COMPARE_OP_LESS;
ds.stencilTestEnable= VK_FALSE;
读这段配置时,心里要记得一件事:状态对象描述的是"逻辑语义",不决定早测晚测。你在 API 里能控制的只是"比不比较、写不写、用什么函数",至于硬件把这比较提前到着色前(early-Z)还是放在着色后(late-Z),那是硬件在逻辑一致约束下的启发式——这正是我们从 §2 开始要展开的分寸。
把这张"第三张图像"的字节数按常见分辨率列一张表,感受它跟着分辨率涨得多快(D24S8,每像素 4 字节):
| 分辨率 | 像素量 | 单张深度缓冲 |
|---|---|---|
| 1280×720 | ≈92 万 | 3.7 MB |
| 1920×1080 | ≈207 万 | 8.3 MB |
| 2560×1440 | ≈369 万 | 14.8 MB |
| 3840×2160 | ≈829 万 | 33.2 MB |
这还只是一张、一次读写。如果一帧里深度要被 prepass + 正式 pass 用到两轮,流量直接 ×2——这就是为什么"深度缓冲的带宽"会在 §6 成为专门一段,也是为什么移动像素后端打死不肯把它来回倒进显存(§8 见分晓)。记住 1080p 的 8.3 MB / 帧,它是后面所有带宽账的基准。
出处:Microsoft Learn · 深度测试原理 / Vulkan 规范 · Fragment Operations。
顺着这里,问题就来了:这两个动作,到底该坐在管线的哪一站?这就是下一章要较真的分寸。
二、规范里的它叫 OM:逻辑上测试排在像素着色之后(explain-why)
2.1 逻辑管线:你先算出像素颜色,再决定要不要写
观察一下图形 API 里深度测试被规定的位置。在 Direct3D 11 的逻辑管线里,它是输出合并(Output Merger, OM)阶段的一部分,位于像素着色器之后;Vulkan 里它属于片元操作(Fragment Operations),同样在着色器执行之后、写出片元颜色之前。语义上是:像素着色器先把颜色(和它自己的深度)算出来,然后 OM 这个固定功能阶段做深度测试、模板测试、混合,最后才把结果写进目标。
这不是随便放的。深度最初是可见性算法,它判断的是"这个像素最终该不该出现在屏幕上"——按冯诺依曼式的"先算后判"直觉,自然是先算完这个像素再说。而且像素着色器被允许自己改深度(后面 §3 会讲),这就决定了在逻辑语义上,深度值是"算出来的",没算之前没法可靠地测。
值得把 OM 这个"合并器"内部的动作顺序拉直看一眼,因为它决定了"谁能改谁"。规范里 OM 在收到着色器输出后,固定功能部分按固定先后做三件事:① 模板测试 → ② 深度测试 → ③ 混合,最后把产物写进目标缓冲(颜色与深度/模板分开的目标)。顺序不是巧合:深度/模板裁决在前,混合在后——因为只有先决定"这个像素是否存在",参与 alpha 混合的两个源才有意义;这也顺带解释了为什么"半透明要关深度写、只留测试"(§1.2)在规范结构上是走得通的:关闭写入不触碰裁决,只是让这张表不被后续透明颜色改掉。对 ROP(像素后端)而言,同样是这三步的体现,细节我们放到 ep08。
所以规范里,深度测试是后期测试(late-Z)。
2.2 但逻辑归逻辑,硬件只要求"可观测结果一致"
现在关键的张力出现了:逻辑上在最后,不代表硬件必须真的在最后跑。 规范定义的是逻辑管线(logical pipeline),它约束的是"最终可观测的结果必须一致",不是"内部每一步必须在哪一站发生"。硬件只要保证输出和逻辑管线一致,就可以把深度测试悄悄提到像素着色之前——如果它能确定,提早绝对安全的话。
举个对照就清楚了。一个被挡住、最终不写颜色的像素,在逻辑管线里它会:完整跑一遍像素着色器 → 走到 OM 深度测试 → 测试失败、整像素作废。可观测结果 = "这像素颜色没变"。如果硬件能确定该像素深度在着色前后不会变化(shader 不碰深度、不 discard),它完全可以把顺序颠倒:先测深度 → 失败 → 整个像素着色器调用直接跳过。两者可观测结果一模一样,但后者省掉了一整个着色器执行。这就是 early-Z 的"合法"真面目——它不是规范新增的开关,而是硬件在"逻辑一致"约束下偷出来的优化。也正因为它是优化而非语义,它才是"看条件"的启发式,§3 整章都在回答哪些条件会让它不敢偷这一步。
出处:Microsoft Learn · OM 阶段(深度/模板前、混合后的固定顺序) / Vulkan 规范 · Fragment Operations。fgiesen 在正文里明确把这是"硬件实现的推测性优化"定性,见 A trip through the Graphics Pipeline 2011 · Part 7。
三、Early-Z 到底什么时候生效(prove-claim)——本篇的核心
3.1 先破一个最常见的误解:它不是 API 开关
中文社区最常见的一句话是"把 early-Z 打开能省性能"——好像它是个 API 里能勾选的选项。技术上这是双重误解:
- 主流的深度测试提前,是驱动和硬件静默做的启发式,不是 API 暴露的可控开关。绝大多数时候你不开关它,它也在那里尝试。
- 即便有可干预它的机制(一会儿讲到 forced early-Z、ROV),那也是"告诉硬件我可以接受提前"的声明,而不是"命令硬件提前"的开关。
那 early-Z 到底是什么?它是硬件在回答一个选择题:"这个像素的深度测试结果,能不能不受像素着色器影响地提前算出来?" 能早算,就早算——被挡住的像素可以省掉整个像素着色器调用。答案的"能不能",取决于下面这几件事。
3.2 三个让硬件"不敢提前"的条件
硬件要提前深度测试,必须确认提早就安全。至少有三类情况会让它缩手:
第一,深度写必须能拆。 深度写会导致一个问题:像素着色器如果运行了,它最终写出的(或经它改动后写出的)深度值,其实就是缓冲里那两个值之一。硬件要提前测试,本质上是在赌"最终写进缓冲的 z 值,在测试那一刻就已知"。但 shader 可能自己导出深度(gl_FragDepth / SV_Depth),也可能用 discard 中途扔掉自己——这两种情况,最终的 z 是谁、这个像素还在不在,必须等 shader 跑完才知道,提前测就没法判断。
出处:Vulkan 规范 · Early Fragment Tests(EarlyFragmentTests 的适用条件)/ Microsoft Learn · 深度写入与 discard 的相互作用。
第二,只要编译后的指令流里存在 discard,运行期从不真的丢弃也一样"污染"。 这是最容易被踩的坑。hardware 没法在运行时看"这次到底丢不丢",它只能看编译产物——指令流里只要有一个 discard/clip,硬件就必须假定"最终谁活着要跑完 shader 才知道",于是整段退化成 late-Z。哪怕你只在最边角的分支里用了一次 discard,哪怕那分支从没执行,early-Z 也已经失效。
第三,SV_Coverage / gl_SampleMask 等价地破坏提前。 像素着色器读写覆盖掩码(coverage mask),本质和读写深度一样,是在"测试结果"上做文章——测试还没确定,shader 就在改测试结果,硬件只能把它放到测试之后。
3.3 深度写与 discard 其实可以拆:先早测剔除,再推迟写回
还有一层更细的分工,是本篇想让你记住的硬件机制:深度写不一定和像素着色绑定在一起。 硬件可以把"提前剔除被挡住的像素"和"把深度写推迟到着色之后"这两件事拆开干:
- 对于"这个像素铁定会被挡、且 shader 不会改它的 z"的情况——深度测试可以提前,被挡像素的着色器调用整个省掉;
- 但深度写本身,只要 shader 有可能改写 z,就得推迟到 shader 跑完,用 shader 算出的 z 去写缓冲。
一句话:早测剔除外壳,晚写保留深度。这么一拆,被挡住的像素省了着色,该写进缓冲的深度又一分不少。有实测为证:一个多 level 的深度 prepass 场景,用这条拆分路径后,像素着色器调用数从 582000 降到 440640——省掉的那 141360 次调用,正是早测剔除的功劳。方向反过来的对比尤其说明问题:明明有遮挡、却没做拆分时,被挡像素的 shader 每个都白跑一遍,overdraw(像素被重复着色)直接顶上去了。
出处:William Donnelly《To early-Z, or not to early-Z》(深度写与 discard 拆分的实测,PS invocation 582000 → 440640)/ NVIDIA · ShaderPrograms。
3.4 例外与强制:forced early-Z 与 ROV
那有没有"我就是想让深度测试提前、哪怕我的 shader 里有 discard"的场景?有,规范和硬件都给了出路,但都要你亲口声明"我接受了副作用":
- 强制 early-Z(forced early-Z):D3D11 里有
SV_InnerCoverage等配套的 early-depth 声明,HLSL 侧也有 "early-depth-stencil" 强制语义;Vulkan 用EarlyFragmentTestsextension(VK_EXT_early_fragment_tests/VK_AMD_early_fragment_tests)。声明之后,深度测试被确保在像素着色前发生——代价是,如果你 shader 里真写了SV_Depth,行为在关节处会和你预期不符(强制把 shader 的深度覆盖锁死),所以它是一种"我接受提前、愿意承担后果"的承诺,不是免费午餐。更细化的提案见 hlsl-specs 0053《allow early pixel culling》。 - ROP-only / 光栅化顺序视图(Rasterizer Ordered View, ROV):当像素顺序很重要(比如要做到像素级的前后一致、而不是碎片乱序)时,硬件用保守的 atomic 风格来保证顺序。这和 early-Z 是两条路:early-Z 是"早点剔除",ROV 是"保证顺序"——顺序一旦强制,能提前的部分又被收了回来,二者往往此消彼长。
出处:Microsoft Learn · 强制早深度测试的语义与不兼容性 / hlsl-specs 提案 0053 · allow early pixel culling / Vulkan · Early Fragment Tests。
规范 vs 实现的提醒:以上 early-Z 的"拆分/推迟/受指令流污染"是硬件实现层的启发式,不同厂商细节各异。规范层只定义了"逻辑管线与 early fragment test 的语义",不承诺你看到的那颗 GPU 会怎么提前。本系列把这层"硬件实际怎么做"讲清楚,但不在厂商之间对号入座。
3.5 小结:一句话判断 early-Z 能不能生效
用一张决策表收口这个核心问题:
| 条件 | 影响 |
|---|---|
像素着色器无 discard/clip |
可用 early-Z |
像素着色器无 SV_Depth/gl_FragDepth |
可用 early-Z |
无 SV_Coverage/gl_SampleMask |
可用 early-Z |
| 深度测试需要"写入缓冲且 shader 不改深度" | 测试可提前,写回推迟 |
| 任意一条被破坏(哪怕运行期从不触发) | 退化 late-Z |
| 用了 forced early-Z / ROV | 用户显式接受副作用后才提前 |
判断早不早,其实就一句话:深度测试的输入,是不是在测试那一刻就完全已知。 已知,就提前;凡是"shader 跑完才知道的",一律退到 late-Z。
3.6 实战里最可靠的一招:深度 prepass 故意让 early-Z 满血
如果 early-Z 这么容易被打断(一个 discard 就全废),那生产环境到底靠什么真正省钱?答案是深度 prepass(depth-only prepass)——一个看似绕路、实则是把 early-Z 主动权拿回自己手里的经典套路:
- 第一个 pass 只写深度、不着色:用一个极简的 shader(甚至不采样任何纹理、只输出
SV_Depth或不输出颜色)把全场景深度先画一遍。这个 pass 里没有discard、没有SV_Depth,early-Z 满血成立——被挡的背面、被挡的物体,全在这个只写深度的 pass 里被提前剔除。 - 第二个 pass 只测深度、开混合:正式着色时不打开深度写(深度已经被第一个 pass 定死了),只做深度测试。这样一来,正式 pass 里就算带
discard、带透明混合,也不影响深度——因为深度的最终裁决已经在第一个 pass 里安全地、按"输入已知"的方式完成了。
这笔账的量化很值:prepass 的 shader 只要没纹理、几乎不费带宽(只写深度),而它把正式 pass 里大量复杂着色负载(采样、光照、后处理前的运算)从"被挡像素"身上卸了下来。用 prepass 时,你让 damaged 的 early-Z 变成了确定能早——它从"硬件看你脸色"变成"你把硬件能早测的窗口主动造出来"。这就是为什么深度 prepass 在移动端几乎成了标配:它是在"early-Z 不可靠"的现实中,把省着色这件利益确定捞回来的工程手段。
把这笔账落到可核对的数字上,能直观看到 prepass 何时划算。设一个 1080p 场景,毛重度(total overdraw factor)2.5,即每帧每像素平均被画 2.5 次、其中约 40% 是整块被挡、可在 prepass 阶段被 early-Z 剔除:
- 正式 pass 的省:若无 prepass,那 40% 被挡像素要各自跑一遍完整着色(每像素 8 次纹理采样 + 光照);prepass 把它们全部提前剔除,正式 pass 里这些着色调用归零。仅此一项,就把正式 pass 的有效每像素着色次数从 2.5 压到约 1.5——省约 1.0 次/像素的复杂着色。
- prepass 的成本:第一个 pass 本身要画一遍全场景几何,但它的 shader 为零采样(只写深度),像素率高得多、带宽只跟深度写走(§6 的压缩还能再砍)。对带宽,它多写一遍深度;对着色,它几乎不花。
于是"prepass 划算"的条件就明朗:当被挡像素的着色成本 × 遮挡比,大于 prepass 的深度写带宽 + 几何重画成本 时,prepass 净省。这正是移动端深重度场景(草、树叶、密集建筑)几乎无条件走 prepass、而干净简单场景可以跳过它的度量依据——它是一个可以依赖 profile 计数器(如 per-pass pixel shader invocation、depth write 流量)做预算的取舍,不是玄学。
出处:NVIDIA · Depth Buffer 与 early-Z 最佳实践(prepass 建议) / Arm · Mali GPU 深度 prepass 指导(overdraw 与带宽权衡) / Microsoft · Depth prepass 与 early depth。
3.7 落入手:怎么验证 early-Z 真的在剔除
判断一个 pass 到底有没有吃到 early-Z,别靠"感觉我开了"——用 profile 计数器数 pixel shader invocation(这条线程到底真跑了多少次)。这一项是 GPU 硬件直接统计的读数,不经过 API 语义包装,是最可靠的证词。常用落点:
- Microsoft PIX / RenderDoc:直接给出每个 draw 的 "pixel shader invocation"(或 coverage),和屏幕像素数对照;
- NVIDIA NSight Graphics:按 draw 列 "pixels / overdraw / PS invocations",能单 draw 抽查;
- Arm Streamline 与 Mali 的 fragment shader invocation 计数器:移动端用它核对 depth prepass 是否把正式 pass 压下。
可核对的对照口径:一个 depth prepass 场景里,把"带 discard 的正式 pass"的 invocation 数和理论全屏数(宽×高,再乘该 pass 覆盖比例)对比。若 early-Z 满血,正式 pass 的 invocation 应显著低于全屏数×overdraw——因为被挡像素压根没跑 thread;若 invocation 仍旧约等于全屏数×overdraw,基本可以判断某条指令流污染(§3.2 的 discard/SV_Depth/SV_Coverage)把测试拖回了 late-Z,让你在"只是逻辑上开了要省"的位置空转。这个动作把"early-Z 到底生效没"从玄学变成可验收的工程检查点——它本身就是本节全部机制论的落地收尾。
出处:Microsoft PIX(GPU capture 与 invocation 统计) / NVIDIA NSight Graphics(像素着色调用计数)。
四、quad 粒度:early-Z 省的是调用,不是整个 quad(open)
early-Z 把被挡像素的着色器调用省掉了——但这里有一个别天真乐观的细节:省的不一定是整个"四方格"。
GPU 的像素着色器以 2×2 像素 quad 为最小执行单位。光栅化器一撮一撮地吐 quad,着色核一次处理一个 quad(里面 4 个像素的 SIMD lanes 天然齐步)。问题在于:一个三角形很少恰好铺满整个 quad。拿一个沿屏幕对角线扫过的三角形边来说,它在边缘处的 quad 往往是"1 个像素在三角形内、3 个在外"。这时 early-Z 只能判定"三角形外的 3 个像素本来就该丢",但硬件照样会为这个 quad 分配执行、让里边的 lane 干活、外边的 lane 空转——因为乱序/分离去逐像素剔除,在 SIMD 里比空转更贵。
为什么非要 quad,而不是"一个像素一个执行单元"?根子在导数(derivative):像素着色器里像 dFdx/dFdy(或采样器用的 LOD 计算)这类操作,需要在屏幕空间上对相邻像素做差分——ddx = f(x+1) − f(x) 的差分步长,天然要求这四个点在同一条"执行单位"里一起算,否则相邻值取不到。所以 quad 不只是执行粒度,它是着色语言的语义前提:textureLod 的自动 LOD、各向异性、以及 dFdx 族函数,全部建立在这个 2×2 栅格上。这也引出另一个概念——helper pixel(助手像素):落在三角形之外、但为了凑齐 quad 而被迫执行的 lane,它的计算结果不会被写进颜色缓冲(覆盖掩码为 0),只是拿来给导数差分提供邻居值,纯属为语义买单。
/* 一个会隐性迫使硬件保留 quad 的典型用法:纹理自动 LOD */
float4 c = tex.Sample(samp, uv);   /* 内部要算 ddx(uv)/ddy(uv) 求 LOD → 必须 quad */
/* 你若用 Level(0) 显式锁定 MIP 层级,才把这项导数依赖拿掉一部分 */
float4 c2 = tex.SampleLevel(samp, uv, 0.0f);
这就是 quad overshading(quad 过度着色):边缘 quad 即使 early-Z 开得再满,仍有 25%–75% 的着色量在被空转的脸贴门道里浪费掉。它和 ep06 里"小三角形毁掉 setup 效率"是同一类问题——几何越碎、每像素的碎片越多,quad 覆盖越差,超着色的比例越高。所以说 early-Z 解决的是"被整体遮挡的像素",解决不了"边缘被碎化浪费的 lane"。
这也顺带解释了为什么"early-Z 一开遮挡问题就没了"是错觉:它省的是着色器执行,而屏幕边缘的几何、微小的三角形,靠的其实是别的手段(更密的 LOD、更好的三角形粒度、或移动端的 HSR,见 §8)。
出处:fgiesen · A trip through the Graphics Pipeline 2011 · Part 8(helper pixels 与 quad 执行) / Stanford CS248 · 移动 GPU 硬件 / NVIDIA GPU Gems 2 · 像素四元组。
五、深度精度:24 位为什么在近处够、远处不够(formula)
说到深度值是"每个像素存一个数",就该问:这个数有多少位精度,够不够?答案是——格式定了位宽,投影定了精度分布,而分布才是坑。
5.1 深度不是线性分布的:近密远疏
深度缓冲里存的"距离",不是直观的到相机距离,而是经过投影后的量。在典型的透视投影下,深度从近裁剪面到远裁剪面映射到 [0,1],但映射是非线性的:靠近近裁剪面的那一小段,被塞进了 [0,1] 里极大的一段分辨率;离得越远,越往 1 靠,分辨率的步长越大。结果就是:近处的 z 值排得密、测得分得清;远处的 z 值排得稀、挨得太近的两个物体深度就分不开了。
这条规律可以写成一条可核对的式子,而不用停留在"非线性"这个形容词上。正交投影下深度随到相机距离线性增长,精度处处均匀;透视投影下却不是——常见的 D3D 深度约定把观察空间深度 z_view(范围 [n, f]:近远裁剪面距离)映射为:
z_buf = f·(z_view − n) / (z_view·(f − n)) (深度缓冲里实际存的那个数)
对它求导,就得到"每单位真实距离吃掉了多少深度分辨率":
d(z_buf)/d(z_view) = n·f / ( (f−n)·z_view² )
看到 1/z_view² 就明白了:深度分辨率随距离的平方衰减。 在近裁剪面 z_view ≈ n 处,这个导数 ≈ f/((f−n)·n),大得惊人;在远裁剪面 z_view ≈ f 处,导数 ≈ n/((f−n)·f),小到可怜。举个具体数字:设 n=0.1、f=1000,则在 z=1 处的深度分辨率密度,比在 z=700 处的高出约 (700/1)² ≈ 49 万倍——远处两个近距物体,深度差摊不开,于是 Z-fighting。
这也是"深度是 1/z 的化身"这句行话的来源:投影后的缓冲值在数学上与视图深度的倒数同源,近处密、远处疏根子上是 1/z_view 的形态决定的。
5.2 位宽与格式:D24S8、D32F 与 reverse-Z
常见深度格式:D24S8(24 位深度 + 8 位模板,32 位一存)、D32F(32 位浮点深度)、D16(16 位,老硬件/低要求)。位宽决定"每档距离能分的刻度数",但对精度分布起决定作用的还是上面那个非线性投影。
工程上解决"远处分不清"的经典招是 reverse-Z:把映射反转,让近处占的分辨率变少、把最多分辨率让给远处。配合浮点深度(浮点在 1 附近分辨率极高、在 0 附近极低),reverse 后把"近密疏远"翻成"远近都够用",在远距离 Z-fighting(两个很近的三角形互相闪)上效果立竿见影。这也是现代后端默认偏向 reverse-Z 的原因——它从数轴上买回精度,不花额外带宽。
出处:Matt Pettineo · A trip down the Graphics Pipeline · Reverse-Z 详解 / NVIDIA · 深度缓冲精度与 reverse-Z 最佳实践。
5.3 深度精度的一笔账
把格式、分辨率、位数串成可核对的一笔:
- D24 在 [0,1] 上足足 1670 万 个可表示步进;
- 但投影非线性后,靠近近裁剪面的 z 值把其中绝大部分分辨率吃掉,远处的步进被压到几十上百的数量级——这就是 Z-fighting 在远处爆发的根源;
- D32F + reverse-Z 是把它拉平的现代解法,代价是每像素 4 字节而不是 3 字节(若按 32 位存,和 D24S8 同为 4 字节,深度位宽从 24 提到 32)。
把深度格式、位宽、可表示步进与 reverse-Z 的价值串成一张对照表(§5.1 的图表 + 下表共同支撑 §5.3 的精度账):
| 格式 | 位宽 | [0,1] 可表示步进 | 近裁剪面步长 | 远处精度 | reverse-Z 效果 |
|---|---|---|---|---|---|
| D16 | 16 位定点 | 65,536 | 极细 | 差(远处易 Z-fighting) | 有限 |
| D24S8 | 24 位定点 + 8 位模板 | 16,777,216 | 细 | 中(远处步长变大) | 明显改善 |
| D32F | 32 位浮点 | 浮点(1 附近极密) | 随指数 | 好 | 显著(浮点在 1 附近密集) |
在 1/z 的锅里,还有一把局部的小勺子:深度偏移(depth bias / polygon offset)——不改投影、不换格式,而是对特定几何的深度在测试/写入时做一笔可配置的平移,让共面的"描边/地面贴花/阴影贴图比对"从"正好相撞"错开一档,直接缓解 Z-fighting。它和 reverse-Z 是两条不同作用面的工具:bias 是在单个几何层级把深度推开一点点,reverse-Z 是在整个缓冲层级重排精度分布——对照表就位,实操时是两种要一起留着的后手。
以 Vulkan 的固定功能深度偏移为例,形态是一个绑定在光栅化阶段的三个参数:
VkPipelineRasterizationStateCreateInfo rs = {};
rs.depthBiasEnable = VK_TRUE;                   // 打开深度偏移
rs.depthBiasConstantFactor = ...;               // 常数项:把深度整体推离
rs.depthBiasSlopeFactor     = ...;              // 斜率项:按面片斜率缩放,治"缓坡/陡坡"差异
rs.depthBiasClamp           = ...;              // 溢出收敛点
记住它的边界:bias 只能给"本来就该分开但靠得太近"的两个面一点错位,救不了远处精度整体见底——远处两个真正不同深度的物体会因为分辨率摊不开而被 bias 也无力分开,这时候换 reverse-Z、缩短 far 或换 D32F 才治本。
出处:Microsoft Learn · 深度格式与 polygon offset / Vulkan 规范 · 光栅化深度偏移(depthBias) / Khronos · GL polygon offset 手册 / Matt Pettineo · Reverse-Z 详解。
六、Z 压缩与 hierarchical Z:这层上还要挖带宽(the cost)
6.1 深度读写是带宽账里的大头
前面 §1.1 估过:1080p 的 D24S8 深度 = 每帧约 8.3 MB。一张深度缓冲要"读一次测、可能写一次"。但真正上量的不是"一张",而是一帧里反复用——一个深度 prepass 后再画实体、画半透明、画后处理,深度要被读写好几轮,每轮都是一次全屏级别的流量。在带宽稀缺的移动端,这就是为什么深度几乎从不在各个 pass 之间往返 main memory——它是 tile memory 里的常客(见 §8)。
6.2 Z 压缩:让大片"没变的深度"几乎免费
硬件没傻到老实写每一格。深度缓冲有大块可以用简单模式描述的区域:刚 clear 过的整屏(深度全是一个常数,tile 只存一个"我是常值"的标记)、场景里大片空背景(同样近乎常数)、以及斜面平缓的地面(深度沿一方向近似线性,可用一个斜率描述)。这些区域硬件用 深度压缩(depth compression) 通道处理:一块 8×8/16×16 的 tile,如果内部深度能用"一个常数 / 一个线性斜率"表达,就不逐像素写回,只存压缩标记 + 模式参数。
代价账的关键数字:clear 过的深度、大片空背景,几乎是零带宽。 真正花钱的是那些深度处处不同的复杂几何场景——那里的压缩比掉下来,读写流量才涨回去。
一个直观的压缩收益对比:同样一块 8×8 的深度 tile,如果内部深度是常数(clear 后、空背景),硬件只写"一个标记 + 一个值";如果内部是缓坡(一面平墙、一段地面),写"一个标记 + 斜率参数";只有当 tile 里深度乱跳(复杂几何交界、高密度 occluder 边缘),才退化成逐像素写满。实测上"常数/线性"型 tile 在普通场景能占到压倒多数,深度有效带宽往往被压到理论的四分之一甚至更低。反过来,如果你把深度缓冲每帧 clear 成充满噪声的复杂深度(比如拿某次 pass 的深度直接当下一帧的底),压缩会立刻失效,带宽账单就原形毕露。
出处:Arm · Mali GPU 深度缓冲压缩机制 / Imagination · PowerVR 深度与模板优化。
6.3 hierarchical Z:tlile 级别的"提前更提前"
early-Z 是像素级的提前,它还可以再升一层:hierarchical Z(hi-Z / HZ)。把深度缓冲逐级下采样成一座"深度 mipmap"式的金字塔——顶层每个格代表一片 tile 的"最远才能通过"的保守深度。于是画一个三角形时,先拿它的包围盒去问金字塔:一点这一片 tile 平均比它近、还是比它远?
- 若整个 tile 的三角形都比缓冲里这片近:整片 tile 一起通过,连 early 都不用逐像素等了;
- 若整个 tile 的三角形都比缓冲里这片远:整个 tile 整体剔除,一个三角形把一个方形区域一次性干掉,是像素级 early-Z 的上百倍放大;
- 只有 tile 内既有近又有远时,才下钻到像素级。
这一幕在移动/桌面后端里都常驻,且是许多硬件的隐藏面剔除主力。它给本系列留了一个钩子:hierarchical Z 是 遮挡剔除(occlusion culling) 的硬件基石,这一层在 ep12「2011 之后」还会爬上来。
把 HIZ 放到现代引擎里看,它已经不只是"绘制时顺手剔除",而是被当成一张可读的纹理主动喂给 GPU 驱动渲染(GPU-driven rendering):引擎把 HIZ 作为 depth_bounds/textureLod 的输入,在 compute shader 里对候选物体做一次粗粒度的"绕过光栅化的可见性预判"——透明度剥离、粒子发射、LOD 切换,全都靠"这一片有没有潜在可见者"来快速缩范围。它早期的经典形态是 occlusion query:把替补物体的包围盒画一遍、让 HIZ 判它是否完全不显,作为是否提交其正式绘制的门(NVIDIA 的软件式 HZB 方案、以及后来硬件化的 depth bounds 都是这一路)。这套机制把"每个三角形问一次像素"放大成"每个包围盒问一次 tile",正是它相对 early-Z 上百倍吞吐的来源。
需要强调的是,HIZ 的保守性写在名字里:金字塔每一层存的是该 tile 的最大值(最远),用来保证"整片通过/整片剔除"的判断绝对不误杀可见者——正因为它是保守的,它才敢整体剔除;一旦放弃保守(比如按平均值下采样),省下的带宽会换来不该消失的像素,得不偿失。
出处:NVIDIA · Hierarchical-Z Buffer Occlusion Culling / Microsoft · Depth bounds 与 HZB occlusion query / Arm · GPU-driven rendering on Mali(HIZ 输入 compute culling)。
七、Stencil:附在深度上的"另一个 8 位通道"(explain-structure + implementation)
7.1 它和深度挤在同一个 32 位槽里
stencil 缓冲与深度缓冲在 D24S8 这种格式里是物理上绑在一起的:同一个 32 位槽,24 位给深度,8 位给模板。模板不存距离,它存一个任意整数,本质上是"每个像素一个 8 位标记位"。
7.2 模板测试与三档更新
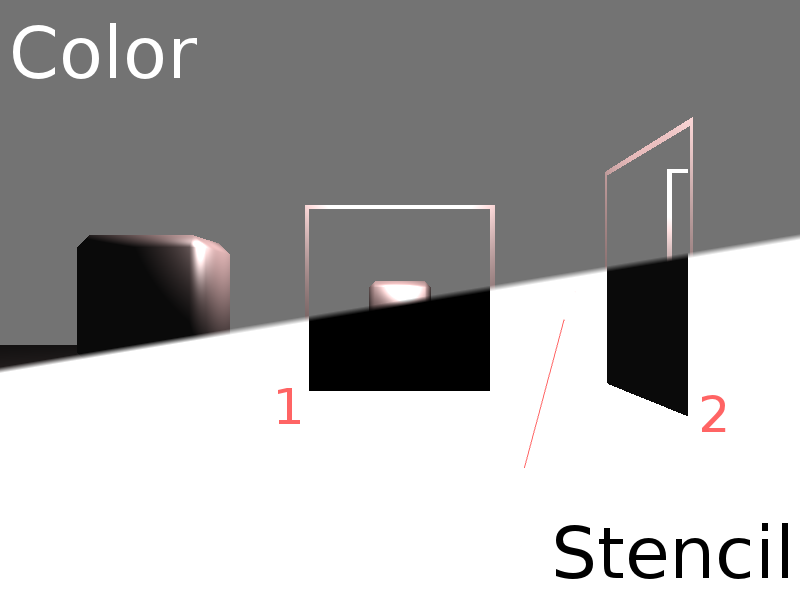
模板阶段像深度一样也是"测试 + 更新"两步,但它更细:一个像素可以通过/失败测试三种不同情形下的动作而不同——①stencil 失败时、②stencil 通过但深度失败(ZFAIL)时、③全通过(ZPASS)时,分别可以对该像素的模板位做不同操作(保持/清零/写值/翻转等)。
三个档位能设置的操作,也是硬件固定功能给的固定枚举——直接抄一遍就够记住全部可能性:
| 操作 | 行为 | 典型出处 |
|---|---|---|
keep |
保持当前值不变 | 默认档,多数情形只想"测不测人人" |
zero |
清成 0 | 轮廓末尾把标记抹掉 |
replace |
写成参考值(stencil ref) | 写入口播标、shadow 计数 |
incr / incr-wrap |
加 1(8 位,满则 0 或饱和) | shadow volume 的"被体积+1" |
decr / decr-wrap |
减 1 | shadow volume 的"出体积−1" |
invert |
按位取反 | 奇偶翻面的滑轮类玩法 |
这套测试/更新和深度一样可配置成正反面分离:D3D11 的 StencilOp 对 front/back face 各给一组,Vulkan 侧同样拆 front/back——为什么需要两面不同?因为"边缘轮廓"这类玩法,正面和背面在读模板时要用不同规则(见下)。配置形态(Vulkan 固定功能)大致是每个面一个 compareOp + fail/stencilFailOp/depthTestSucceedOp 三件套:
VkStencilOpState front = {};
front.compareOp  = VK_COMPARE_OP_EQUAL;   // 只对"模板值==参考值"的像素动手
front.failOp            = VK_STENCIL_OP_KEEP;    // stencil 失败时
front.depthFailOp       = VK_STENCIL_OP_KEEP;    // ZFAIL(模板过、深度失败)
front.depthPassOp       = VK_STENCIL_OP_INCREMENT_WRAP;  // ZPASS(全过)
rs.stencilTestEnable = VK_TRUE;
/* D3D11 同义形态:一面只差在 StencilFailOp/StencilDepthFailOp/StencilPassOp */
DepthStencilOpDescription op = {
    D3D11_STENCIL_OP_KEEP,   /* stencil fail */
    D3D11_STENCIL_OP_KEEP,   /* depth fail    */
    D3D11_STENCIL_OP_REPLACE /* pass          */
};
把枚举和结构记到手,再回头看用例就有落点。以轮廓为例:先画背面,把"模板==参考值"时 ZPASS → REPLACE 写 1;再画正面,只对"模板==1"的像素刷新、同时给它 ZFAIL → ZERO 抹标记,就得到一圈只沿着边缘的着色区域——三个档位、两套操作,就能拼出这种看似"很高级"的效果,模板的价值恰恰在它用最少的状态(每像素 1 字节)表达了一套复杂的"哪些像素要额外处理"的策略。
7.3 典型用法:轮廓、阴影体、portal、次数标记
8 位标记位可做的事很广,举几个真实用例收口它的价值:
- 边缘轮廓:一个 pass 里开模板、先画背面把模板位置写 1,再画正面只刷新模板为 1 的像素,就画出了面积轮廓线;
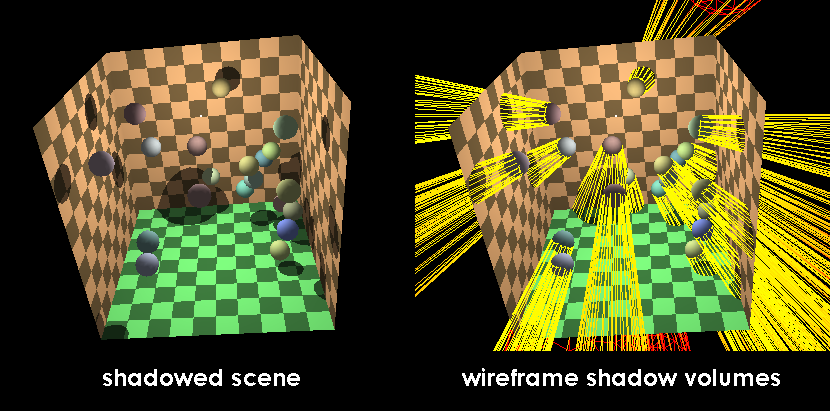
- 阴影体(stencil shadow volumes):把阴影体积画进模板,让可见性"困扰"深度之外再加一层模板——正是模板少有的"还能参与几何判断"的用途;
- portal / 房间遮挡:用模板记录"哪部分屏幕已经在某个开口里看过",控制后续绘制只落在开口区域;
- 次数标记 / shadow map pass 计数:给同一像素多次 pass 计数,做多光源叠加的可见性拆分。
7.4 hard boundary:本篇不写 hierarchical stencil 的算法细节
按系列边界声明,本篇到此为止——hierarchical stencil 的分层算法细节不在本篇范围。原因是原作者 fgiesen 明确说过,那部分掌握的公开可引用资料只到 NDA 文档,无干净授权来源;本系列遵守"只在机制层示范"的红线,不把没法追溯的算法细节写成定论。
出处:fgiesen · Part 7(Stencil processing) / Microsoft Learn · stencil 测试。
八、TBDR 与 HSR:移动端把 hidden-surface 整个换成另一个算法(compare-options)
8.1 两种展开方式的分水岭
到这里我们讲的都是立即模式渲染(Immediate-Mode Rendering, IMR):光栅化一有三角形就画,depth 是"每个像素在线比较"的裁决者。但移动端主流不是这个路数。
分块延迟渲染(Tile-Based Deferred Rendering, TBDR) 把屏幕切成小块,几何先全部分完箱(binning),一块 tile 内才真正光栅化和着色。深度/模板这些最终决定"谁露出来"的操作,在 tile 自己的片上高速内存里一次性跑完,不反复回显存。这就带出一个和 early-Z 平行的、但它更彻底的东西——隐藏面消除(Hidden-Surface Removal, HSR),Imagination PowerVR 的专有机制。
先把这个名词谱系拉直,避免"分块"即一切:移动/桌面渲染后端按"屏幕是否分块、分块后是否做延迟隐藏面消除"拆成三档——
- IMR(如传统桌面独显):无分块,光栅化即画,深度是"逐像素在线比较";优点是几何一进即出、延迟低,代价是深度读写频繁进出显存、overdraw 靠 early-Z 削一点、削不干净。
- TBR(Tile-Based Rendering):分块、但块内取色器照常立即执行,只把"最终哪个颜色写回显存"延迟到块末汇总;省的是深度/颜色进出的带宽,如何销掉 overdraw 仍是 pixel-by-pixel 的比较。多数移动 GPU 的默认形态属于"TBR 起步"。
- TBDR(Tile-Based Deferred Rendering):在前者之上把着色整个推迟到块内可见性排定之后——所有覆盖某像素的片段先做深度/模板裁决,只对"最终可见的那一个"跑着色,这才是 think 里"延迟"二字的分量。
对照硬件历史把名词对齐:Intel/AMD 桌面多为 IMR 或类 IMR;ARM 的 Mali 与高通 Adreno 属分块阵营但隐藏面消除策略各自不同;Imagination PowerVR 才是把 HSR(专有机制) 挂在 TBDR 上、把 once-per-pixel 写进卖点的典型。本篇的关键在于:early-Z 是"逐像素提前剔除"(IMR 的裁剪术),HSR 是"整 tile 排定后再 once-per-pixel"(TBDR 的替代算法)——两者名字都叫"隐藏面消除相关",但省的不是同一笔钱。
8.2 HSR 与 early-Z 的区别:是"排序"不是"剔除"
early-Z 是逐像素/逐 quad 的剔除——来了一个像素,尽早判断它是不是被挡,省掉它的着色。HSR 走的是另一条路:既然一个 tile 里的所有几何都齐了,那我先在全 tile 范围内排好"谁最靠前",再对着色的东西来一次只画一次。 每个像素真正被着色的次数,被压到 once-per-pixel——它不"省掉被挡的",而是"从根上让每个像素只被活着的那一个加工一遍"。
所以:
- early-Z 省的是"被遮挡像素的着色器调用",但 quad 边缘、过度几何仍会碎化浪费(§4);
- HSR 省的是"同一像素被多层几何重复着色",能顺带把 overdraw 的纹理/着色成本压掉,对那种"一堆物体叠穿"的场景(毛发粒子、草丛、密集几何)尤其强——这类场景 early-Z 只能挡住"整块挡住",挡不住"碎片层叠"。
这笔量化别再停留在感觉上。设一个"10 层几何层叠"的场景,比如一丛密集草叶:同一像素位置被 10 层覆盖。IMR + early-Z 下,如果草是碎片而非整块,early-Z 只能挡住"整层更靠后的块",层与层穿插的碎片仍可能让同一像素被着色三五次——因为碎片凑不成"能整体剔除的遮挡",quad 边缘还在空转(§4)。HSR 下,这一像素只在分箱结束后被最终可见的那一层着色一次。差别就是"每个像素 3–5 次着色 vs 1 次"——这正是 HSR 对粒子、草丛、密集植被这类"叠层碎片"场景碾压性优势的量化来源,也是移动端选渲染方案时"用不用 prepass"背后真正要掂量的经济账。
出处:Imagination PowerVR Graphics Architecture(HSR) / Arm · Vulkanised 2023 移动最佳实践 / 《移动端图形与功耗》ep02/ep03。
8.3 带宽的本质差异:IMR 让深度/颜色反复进出,TBDR 只汇总一次
把"省带宽"落到能核对的算式上,TBDR 的分量才显出来。设一个 1080p 场景:颜色缓冲 RGBA8 约 8.3 MB、D24S8 深度约 8.3 MB(§1.1 的基准),再设每帧平均 overdraw 系数 O(每个像素平均被画 O 次,比如 2.5):
- IMR:每有一个像素通过深度测试,它最终的颜色就要写一次主存。于是整帧颜色写流量 ≈ O × 8.3 MB——overdraw 直接变成外部带宽;深度要"读→测→可能写回",同样按命中率反复进出。overdraw 越狠、外部带宽越接近
O倍的量级,这就是桌面端死磕 prepass、early-Z、LOD 的原因。 - TBDR:颜色和深度不是逐像素写回的,而是先落在 tile 的片上 SRAM,一段 render pass 结束后每个 tile 把最终结果汇总写回一次。于是外部颜色写流量 ≈ 8.3 MB,与 overdraw O 无关——多画了几层几何,多出来的只是片上计算,不是外部带宽。
这一个系数——"overdraw 会不会乘进外部带宽"——就是 IMR 与 TBDR 在手账上的分水岭。IMR 的深度 prepass 是在"把遮挡提前剔掉、换取 O 变小";TBDR 干脆"不管 O,反正片上排完只提交一次"(§8.2 的 once-per-pixel)。这也是为什么移动端把 render pass 切得规整、让每个 pass 都在片上收尾,比堆 preass 手段更看重。
但这笔账有一个必须知道的上界:片上 SRAM 有限。tile 越小能容纳的每像素数据种类越多,但分箱(binning)开销越大;tile 越大、能同时驻留的 render target(多张 G-Buffer、MSAA 的多层采样)越有限,超限就只能把部分数据提前 spill 回主存,省下的带宽就要打折扣。所以"延迟"不是零成本,它是把外部带宽换成了片上面积与分箱延迟——这正是 TBDR 在带宽稀缺的移动端成为主流、而在大显存+高填充率的桌面独占端并不总是划算的根因。
出处:Imagination PowerVR Graphics Architecture(HSR / external bandwidth) / Arm · Vulkanised 2023 移动最佳实践(render pass 与 tile memory) / 《移动端图形与功耗》ep02/ep03。
8.4 Transaction Elimination:颜色侧的"没变就不写"
深度有压缩(§6,大片常数/线性近乎免费),颜色这边有一件对等的事——Transaction Elimination(TE),PowerVR 很早就引入的机制:一段 render pass 结束后,tile 先和它"此刻之前的内容"对比,如果完全没变(比如被不透明前景整个盖住、或是一整块保持不变的颜色区),就不把这块颜色写回主存。它和深度压缩是同一个思想——"没变的字节不该占用带宽"——只是作用在颜色缓冲侧,以逐 tile 逐帧比对的方式工作。
TE 的收益集中在"大片静止或被遮挡"的画面:静止的界面层、只画了单层的远景、动画里一块面积恒定不变的区域。难点在于对比本身也要花钱,所以它不是无脑每帧开,而是由启发式判断"比对省下的写回 vs 比对本身"哪个划算;写回与否在 tile 级决定,和 §6 深度压缩"能省则省、省不了老实写"是一个道理。这也是现代移动后端的带宽优化往往深度压缩、颜色压缩(如 Arm 的 AFBC 帧缓冲压缩,与 TE 同阶、机制不同的颜色侧方案)、TE 三件套并挂的原因——它们各自守住带宽账的一块,没有哪一招通吃。
出处:Imagination PowerVR Graphics Architecture(颜色 TE) / Arm · Mali 帧缓冲压缩(AFBC,颜色侧带宽优化) / 《移动端图形与功耗》ep03。
8.5 深度的移动端账:tile memory 内测完,只回写一次
TBDR 的深度妙处在于带宽:深度测试在 tile 片上内存里做完,最终只有存活的那个像素才需要把深度/颜色写回 main memory。这就是为什么移动端深度压缩(§6)和 TBDR 常常一起出现——两者都为了"把深度读写压到最低"。移动端 TBR/TBDR 与带宽的取舍,本系列在《移动端图形与功耗》ep02/ep03 已写透,本篇只在此引用结论、不重铺。
出处:Imagination PowerVR Graphics Architecture(HSR) / Arm · Vulkanised 2023 移动最佳实践 / 《移动端图形与功耗》ep02/ep03。
九、收尾:把三笔账对在一起(summarize + bridge-to-next)
一句话回答"early-Z 到底什么时候生效":深度测试的输入在同一时刻完全已知,它就提前;凡是 shader 跑完才知道的,一律退到 late-Z。 而整个 Z 阶段不是一个开关,而是一层"能提前多少、省多少、代价多少"的工程权衡。
把本篇的三笔账并排放:
| 手段 | 省的是什么 | 代价 |
|---|---|---|
| early-Z / 深度写拆分 | 被遮挡像素的着色器调用 | 受指令流(discard 等)污染,可能退化 late-Z |
| 深度压缩 / 常数斜率 | 深度读写带宽(大片恒定/线性区域近乎免费) | 复杂几何时压缩比下降 |
| hierarchical Z | 整片 tile 提前剔除(上百倍放大) | 有保守深度金字塔的开销 |
| TBDR + HSR | 每像素 once-per-pixel 的重复着色+纹理 | 依赖分块与片上内存,引入 binning 延迟 |
最后记得两个数字:1080p D24S8 = 约 8.3 MB / 帧,和 early-Z 拆分后的实测 PS invocation 582000 → 440640。前者是 Z 阶段的带宽底账,后者是"深度写与 discard 可以拆开"的实证锚点。
[next-step: Z 阶段结束,像素已经决定谁写、谁不写] 在下游,幸存下来的像素要真正落进颜色缓冲了。那一段同样不是一段平坦的路——fork/join、ROP 与那笔颜色带宽账在等着。深度的裁决、颜色的混合,将在像素后端里完成最后一次物理落地。Z 阶段的官方依据见 Vulkan 规范 · Fragment Operations 与 Microsoft Learn · OM 阶段。
(本篇完)
十、参考资料与可回溯出处
本篇的关键数字与机制全部来自规范、厂商文档与经典文献,正文中每一处引用都可回溯到出处。主要来源:
- Edwin Catmull《A Subdivision Algorithm for Computer Display of Curved Surfaces》1974(Z-buffer 概念首系统化描述)
- Fabian Giesen《A trip through the Graphics Pipeline 2011》· 深度/模板处理
- William Donnelly《To early-Z, or not to early-Z》· 深度写与 discard 拆分实测
- Microsoft Learn · 输出合并(OM)阶段
- Vulkan 规范 · Fragment Operations(含 Early Fragment Tests)
- hlsl-specs 提案 0053 · allow early pixel culling
- Matt Pettineo · Reverse-Z:为什么合理
- NVIDIA · Hierarchical-Z Buffer Occlusion Culling
- Imagination PowerVR · Graphics Architecture(HSR)
- Stanford CS248 · 移动 GPU 硬件(quad 执行)
- NVIDIA GPU Gems 2 · 像素四元组(pixel quad)
- Arm · Mali 帧缓冲压缩(AFBC,颜色侧带宽优化)
- Arm · Vulkanised 2023 移动最佳实践(render pass 与 tile memory)
- Microsoft PIX(GPU capture 与 invocation 统计)
- NVIDIA NSight Graphics(像素着色调用计数)
下篇预告:《GPU 架构剖析》系列进度:已完成【一】命令前端、【二】显存与地址空间、【三】着色器核、【四】纹理采样器、【五】图元装配、【六】光栅化与三角形建立、本篇【七】Z 缓冲与隐藏面消除,接下来是【八】像素后端与 ROP。Z 阶段的裁决在硅片与像素之间继续走下去。
With Best Wishes. 本文由@溯光 出品,转载请注明出处。我们在硅片到像素之间,继续挖下去。