本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
题图 四种把类型藏起来的办法:模板/虚函数/variant/类型擦除,以及各自的代价落点 @ 本系列绘制
本系列已发表篇目(全系列共 12 篇,分四波连载):
- ep01 对象布局、对齐与 padding:sizeof 的真相——第一波·布局与内存
- ep02 分配器解剖:malloc → jemalloc/mimalloc → pmr arena——第一波·布局与内存
- ep03 值语义的账:move/拷贝/SSO/emplace_back——第一波·布局与内存
- ep04 编译期账本:模板实例化与 -ftime-trace——第二波·编译器与链接器
- ep05 优化器的边界:UB、严格别名与向量化报告——第二波·编译器与链接器
- ep06 名字与符号:ABI、修饰、可见性、PLT 与 IAT——第二波·编译器与链接器
- ep07 链在一起:LTO 与 PGO 的收益从哪来——第二波·编译器与链接器
背景与边界
上一篇算的是构建期这笔账:LTO 拆翻译单元边界,PGO 拆类型与分支边界。这一篇把它反过来问。
把类型藏起来,要付多少运行时代价。
先来看看"把类型藏起来"是 C++ 里最常用的一类设计手法:写一个接受"任意可调用对象"的函数、写一个能装下多种形态的容器、写一个不暴露实现细节的接口。模板、虚函数、std::variant、类型擦除,四种办法都能做到这件事,而它们的代价不在同一个地方。
0.1 一句话结论先放这里
- 代价有四层:间接调用、分支预测、堆分配、类型检查。四种办法各踩其中几层,不是一条统一的账单。
- 同一档位的代价,取决于编译器能不能把它划掉。实测里最刺眼的一处:同一份单态虚调用的代码,GCC
-O2把它划成了 0(与直调同速),MSVC/O2没划掉(1.618 vs 0.766 ns/op)。 - 所以"哪个更快"这个问题,脱离编译器与标准库版本是无法回答的。本篇给出同一份代码在四组配置下的排序——它们互不相同。
0.2 实测环境
| 项 | 值 |
|---|---|
| MSVC | cl / link / dumpbin 19.44.35228(工具集 14.44.35207),/std:c++17 |
| GCC | MSYS2 ucrt64 g++ 16.2.0 + objdump |
| 计时 | 被测进程内 std::chrono::steady_clock,每档跑 5 次取中位 |
| 负载 | 4096 元素 × 20000 轮 ≈ 8,192 万次分发 |
| 平台 | Windows x64,PE/COFF |
0.3 本篇不涉及什么(边界声明)
- 不涉及微架构预测器的内部实现。分片预测、TAGE、gshare 这些分支预测器的具体结构不在本篇范围——本篇只说"这一层的代价存在,并且可以量"。
- 不涉及 C++ 入门教学:不解释什么是虚函数、什么是模板。需要前置的朋友请看本系列 ep01(对象布局)与 ep04(编译期账本)。
- 不做 Clang/LLVM 的本机实测:本机无 Clang、无 WSL。LLVM 的
WholeProgramDevirt、ThinLTO 只引官方原文。 - 不给"用 XX 替代虚函数"的通用建议。本篇给判据与读数;建议必须绑定具体场景。
0.5 按需跳读
本篇有 11 章,但不是每一章都对所有读者有用。三条路线:
- 只想知道"我该选哪个":读 §一(四种办法对照)、§四(阶梯表)、§九(判据与建议)——三章,约 2,500 字。
- 正在优化某段热路径:加读 §五(目标确定性)与 §六(多态分发)。这两章才是选型的真正依据。
- 想学方法(怎么自己量):读 §三(实测设计)、§七(分配与阈值怎么量)、§十(证据形态与复现)。
如果你这次只想知道"std::function 到底慢在哪",直接跳到 §7.1——那一节的结论可能会推翻你的预期。
0.6 这一篇与上一篇的接续
好了,上一篇(ep07)算的是构建期这笔账:LTO 把"看不见"变成"看得见",PGO 把"猜"变成"验",两者各自拆掉一条边界。
这一篇把镜头切到运行期,问一个更常见的问题:当你主动把类型藏起来时,代价从哪来?
两篇之间的接口在 §4.5:ep07 的靶子是"编译器看不见"(跨 TU),本篇的靶子是"编译器看得见但不敢定"(运行期多变)。两种靶子对应两种不同的优化——LTO 治前者,去虚拟化治后者——所以两篇的读数不会重复,也不该混着用。
0.7 为什么这一篇要用"阶梯"而不是"结论"
说白了,网上关于这个话题的文章,通常以一张排序表收尾:模板最快、虚函数次之、std::function 最慢。这张表在某个特定环境里是对的,但它把三个变量压成了一个数字:编译器版本、标准库实现版本、以及代码的具体形状。
本篇不这么做。本篇把被分发的操作故意做到极小(一条 x+1 之类的表达式),然后把 11 种分发办法放在同一份负载上跑,再把四组配置的结果并排摆开。这样做的结果是:排序表变成了阶梯表,而阶梯的形状会随列变化——那个变化本身才是本篇要讲的东西。
一、四种把类型藏起来的办法
四种办法的差别不在语法糖上,而在类型信息在什么时候被丢掉。模板根本不丢类型,它把类型编进代码;虚函数把类型压缩成一个 vptr,运行期再查回来;variant 把类型压缩成一个整数索引,就地存放;类型擦除最彻底,它连存的是什么都不保留,只留一个函数指针。下面这张对照表先把四者的形态摊开,后文所有读数都是它逐行展开的结果。
1.1 模板:把类型写进代码里
/* 模板 —— 类型在编译期完全确定 */
struct IncPolicy { int operator()(int x) const { return x + 1; } };
template <class P> long long run(P f, const int *p, int n) {
    long long s = 0;
    for (int i = 0; i < n; ++i) s = f((int)s + p[i]);   /* 目标已知 → 可直接内联 */
    return s;
}
言归正传,模板不"藏"类型,它把类型编进代码。每个 P 生成一份独立的函数,调用点看到的是完整定义,于是内联、常量传播、向量化都照常进行。代价转移到了别处:代码体积与编译时间(这是 ep04 的主题)。
1.2 虚函数:把类型藏进 vptr
/* 虚函数 —— 目标在运行时才知道 */
struct Op { virtual int apply(int x) const = 0; virtual ~Op() = default; };
struct A : Op { int apply(int x) const override { return x + 1; } };

long long run(const Op *op, const int *p, int n) {
    long long s = 0;
    for (int i = 0; i < n; ++i) s = op->apply((int)s + p[i]);   /* 取 vptr → 取槽位 → 间接调用 */
    return s;
}
好了,对象里多了一个 vptr,调用时多两步取值和一次间接跳转。这一层代价能不能被消掉,取决于编译器能不能证明 op 的动态类型——这是本篇最重的一处变量(§五)。
1.3 std::variant:把类型藏在索引里
std::variant<A, B, C, D> 就地存放其中一个备选,不碰堆;访问用 std::visit,实现上是一次基于 index() 的分支。它的语义由 WG21 提案 P0088R3与 工作草案的 variant 章定义——注意访问失败抛的是 std::bad_variant_access,而不是 bad_any_cast 那一套。它的代价落在分支而不是间接调用上——这是一个重要的区别,因为两者的优化路径完全不同。
1.4 类型擦除:把手写 vtable 包装起来
std::function、std::any、以及手写的 Erased 结构,本质是同一个手法:先擦掉类型,再通过一个函数指针把它调回来。
/* 手写类型擦除 —— std::function 的最小内核 */
struct Erased {
    const void *obj;
    int (*fn)(const void *, int);
    int call(int x) const { return fn(obj, x); }   /* 一次间接调用 */
};
template <class T> int erased_thunk(const void *o, int x) { return ((const T *)o)->operator()(x); }
这一层额外多出两个问题:对象要放在哪(栈上的本地缓冲,还是堆),以及类型对不对(any_cast 要检查)。
1.5 四种办法在一张表里
| 办法 | 类型确定时机 | 代价落点 | 能不能内联 |
|---|---|---|---|
| 模板 / CRTP | 编译期 | 代码体积、编译时间 | 能 |
| 虚函数 | 运行期(vptr) | 间接调用、分支预测 | 只在被去虚拟化时 |
std::variant |
运行期(索引) | 分支、代码体积 | 命中分支可内联 |
| 类型擦除 | 运行期(函数指针) | 间接调用 + 可能的堆分配 + 类型检查 | 只在被去虚拟化时 |
这四种办法可以按类型确定的时机归类:模板在编译期就把类型定死;另外三种都拖到运行期,各自靠 vptr、索引、函数指针来记类型。运行期这三种还能按代价落在哪一层再分一次——虚函数与类型擦除落在间接调用上,variant 落在分支预测上,而只有类型擦除额外背上堆分配与类型检查这两笔(§二会把这四层逐一拆开)。
1.6 同一段业务代码里的四种写法
上面四个片段是"最小形态"。放到一段真实业务里,选择会具体成这样:
假设要写一个"对一批数据做一次可配置的归一化"的函数。四种写法分别是:
- 模板:
template <class Norm> void normalize(Norm n, Batch &b)。调用方在编译期把Norm定下来;每种归一化生成一份代码。加一种归一化要重编,但当天就能上线。 - 虚函数:
void normalize(const Norm &n, Batch &b),Norm是抽象基类。加一种归一化只要实现一个子类、不用重编主程序——这正是插件与热更新的基础。 std::variant:void normalize(const NormVariant &n, Batch &b)。归一化的种类是有限且已知的(比如只有三种),那就不该为它开一条继承链。- 类型擦除:
void normalize(const Callable &n, Batch &b),Callable是std::function那类包装。调用方随手传个 lambda 就行,代价是 §七那一整套。
这段对照的真正用处,是把"选型"翻译成四个问题:归一化的种类会不会增长?增长时能不能停机?被归一化的数据量有多大(是不是热路径)?这段代码一年会被改几次?
本篇后面所有读数,都是为了回答第三个问题服务的。 前三个问题属于工程约束,不是性能问题——但它们决定了你是否需要关心性能。
1.7 术语约定
本篇反复用到几个词,先统一口径,避免后文歧义:
| 词 | 本篇口径 |
|---|---|
| 分发 | 从调用点到被调函数体之间的那一段"找目标并跳过去"的过程 |
| 目标确定性 | 编译器能否在编译期或链接期把被调目标定为唯一值 |
| 划掉 | 去虚拟化成功:间接调用被替换成直接调用并可被内联 |
| 账单 | 分发带来的可测代价,分四层(§二) |
| monostate | 全程只走一个实现的写法,用来测"目标唯一"这一支 |
| poll4 / 多态轮换 | 4 个实现轮流上场的写法(tab[i & 3]->apply(...)),用来模拟"目标真的会变" |
"划掉"这个词不是本文生造的——GCC 手册里对这个动作的表述是"把虚函数调用转换为直接调用",LLVM 那边的 pass 名字直译过来就是"整程序去虚拟化"。本篇用"划掉",只为在后文反复指代时更短。
二、代价的四层账单
把类型藏起来这件事,常被笼统地说成只有一次间接调用;但间接调用只是四层里最薄的那一层。实测里真正拉大差距的往往是另外三层,而且它们各有各的取证方式。这张图先把四层与各自的量法对应起来,后面每一章都会回到这四层上来对账。
2.1 第一层:间接调用本身
说白了,取 vptr、取槽位、call。这几条指令的开销是固定的、可数的——在一段几百条指令的循环体里几乎看不见。
所以只算这一层,会得出"虚函数几乎不花钱"的结论。 这个结论在"一次调用背后有几十上百条指令"的业务代码里是对的(控制反转的成本被摊薄),在本篇这种"被分发的操作只有一条 x+1"的极端情形里是错的。
2.2 第二层:分支预测
间接跳转的目标要到运行时才知道,CPU 只能用历史去猜。猜对了几乎免费,猜错了要冲刷流水线。
这一层的代价不体现在指令数上——两种写法可以生成完全相同的指令序列,只因为运行时目标是否稳定而差出成倍的时间。本篇 §6.3 的 monostate → poll4 就是这个变量:指令没变多,时间涨了 36%(MSVC)。
2.3 第三层:堆分配
std::function 与 std::any 都可能把被擦除的对象放到堆上。这一层有两笔账:
- 分配本身(
malloc/free的固定开销); - 缓存局部性(对象散落在堆上,每次调用都可能是一次 cache miss)。
本篇用重载全局 operator new 计数把第一笔账量出来(分配次数逐档可见),第二笔账则体现在时序上。
2.4 第四层:类型检查
std::any 的 any_cast 必须验证被擦除的类型是不是你要的那个;std::variant 的访问要处理索引不匹配。这一层在 std::any 上是主要成本——本篇实测它是整个阶梯最慢的一档。
2.5 为什么必须分层
因为一层快不代表整体快,一层慢也不代表整体慢。最典型的是 std::function:它的第 1 层(间接调用)与手写擦除完全一样,第 3 层(堆分配)在小捕获时可以完全避免,但它仍然比手写擦除慢——差别在第 1 层能不能被划掉。下面的实测会把这件事逐层拆开。
2.6 为什么"框架代码里的分发"通常不贵
有一个现象值得提前说清,否则本篇的读数会让人过度紧张:大多数业务代码里,虚函数或 std::function 的开销是可以忽略的。
原因是代价摊薄:
- 如果一次调用背后的函数体有 200 条指令,那 3 条分发指令的占比不到 2%——测不出来;
- 如果那个函数体本身还要访问内存、加锁、序列化,分发的 3 条指令更是完全淹没在访存延迟里。
反过来,本篇的用例把函数体压到一条 x+1,于是分发的占比接近 100%。这个极端设置是故意的:只有把业务逻辑剪掉,才能让分发的账单显形。
所以本篇的结论要这样用:
- 读到的倍率(2.9 倍、7 倍)是分发在总耗时里的占比上限,不是"换成虚函数就会慢 7 倍";
- 真正要问的是"我的这段热路径里,函数体有多重"——函数体越轻、调用越密,本篇的读数才越接近你的现实。
这也是本篇为什么不用"典型业务负载"做基准:用真实业务做基准,测出来的是"这个业务逻辑有多重",不是"分发有多贵"。要量工具的成本,就得把工具单独拿出来量。
2.7 四层账单的取证手段对照
四层里有两层可以"数",两层只能"测"。这张对照表是后面所有结论的取数依据:
| 层 | 能数吗 | 怎么取 |
|---|---|---|
| 一 · 间接调用 | 能数 | 反汇编里数 call qword ptr [..] / call *(%r..) |
| 二 · 分支预测 | 不能数 | 只能靠对照实验(同一份代码,换目标分布看时间差) |
| 三 · 堆分配 | 能数 | 重载全局 operator new 计数 |
| 四 · 类型检查 | 部分能数 | 看反汇编里有没有类型比较分支;失败路径只能靠异常验证 |
"不能数"的那一层才是最容易骗人的。 一份代码可以做到"指令数与直调完全相同、分配次数为 0",却因为间接跳转的目标分布而慢一倍——任何只看静态指标(指令数、分配数)的评估方法,都会漏掉这一层。
三、实测方法:把被分发的操作做到极小
下面进入要量分发本身的成本,必须先让它成为唯一变量。这一节交代三件事:被分发的操作被压到多小、负载为什么写成串行依赖链、以及每一档同时取哪三类数据。方法本身比读数重要——读数会随机器变,方法可以搬走。
3.1 三条设计原则
原则一:被分发的操作必须极小。如果每个 apply 里有 50 条指令,那 50 条会把 3 条的分发开销压成噪声。本篇四个实现的函数体都只有一条表达式。
原则二:负载必须一致。11 档共用同一份 4096 元素的伪随机数组、同样 20000 轮、同样的累加器形状(s = f(s + p[i]) —— 一条串行依赖链,这样编译器无法把循环并行化掉,分发就真的在关键路径上)。
原则三:不靠单一读数下结论。每档同时取三类数据:ns/op(时间)、g_allocs(堆分配次数)、以及反汇编里的间接调用条数(结构)。当时间读数互相矛盾时,以结构性证据为准——这是 ep07 学过的方法。
3.2 负载与口径
/* 统一负载:4096 元素 × 20000 轮 ≈ 8192 万次分发 */
for (int r = 0; r < rounds; ++r)
    for (int i = 0; i < n; ++i)
        s = dispatch(s + p[i]);        /* 串行依赖链:分发在关键路径上 */
/* 堆分配计数:重载全局 operator new */
long long g_allocs = 0;
void *operator new(std::size_t n) { ++g_allocs; void *p = std::malloc(n ? n : 1); if (!p) throw std::bad_alloc(); return p; }
void operator delete(void *p) noexcept { std::free(p); }
/* 反汇编计数:dumpbin /disasm(MSVC)与 objdump -d(GCC)里数间接 call */
/* 计数口径:call qword ptr [..] / call *(%r..) 记为间接;call ?name@@.. 记为直接 */
3.3 一个必须先说清的前提
好了,MSVC 默认是 C++14。<variant> 与 <any> 在 C++14 下会直接报 STL4038:
C:\...\include\any(12): warning STL4038: The contents of <any> are available only with C++17 or later.
加 /std:c++17 才能编。 本组实测的第一个"坑"就是它——不显眼,但会让整轮对照跑不起来。
3.4 为什么用"串行依赖链"而不是"独立求和"
负载写成了 s = f(s + p[i]) —— 每一步都依赖上一步。这不是随手写的,有两个理由:
- 挡住优化器的自动并行化。如果写成
s += f(p[i]),各次调用互相独立,编译器(或 CPU 的乱序执行)可以把多次迭代重叠起来,分发的延迟就被完全隐藏,测出来的是吞吐而不是延迟。串行链让每一次分发都落在关键路径上。 - 让"延迟"成为被测对象。本篇关心的是"跳过去要多久",这是延迟问题;独立写法测的是吞吐。两者都真实,但只有延迟能反映分发本身的成本——因为吞吐可以被流水线掩盖。
口径提醒:本篇所有 ns/op 都是串行链上的延迟口径。如果你的代码里分发彼此独立,实际影响会小于本篇读数——这是又一次"别把极端用例的倍率直接搬回家"。
3.5 顺带踩到的第二个坑:any_cast 的类型必须完全匹配
第一版用例里写了 std::any a = [k](int x){ ... };,然后用 std::any_cast<std::function<int(int)>>(a) 取回来。这在运行期直接抛 std::bad_any_cast,进程以 0xC0000409 退出(STATUS_STACK_BUFFER_OVERRUN,MSVC 下未捕获 C++ 异常的典型退出码)。
原因是 std::any 保存的是你给它的那个确切类型——它存的是 lambda 的闭包类型,不是 std::function。要按 std::function 取,就得先按 std::function 存:
/* 错:存的是 lambda 闭包类型,按 std::function 取会抛 bad_any_cast */
std::any a = [k](int x) { return x + k; };
s = std::any_cast<std::function<int(int)>>(a)(s + p[i]);

/* 对:存什么类型,就按什么类型取 */
std::any a = std::function<int(int)>([k](int x) { return x + k; });
顺手给每一档加了 try/catch,让一档失败不至于把整轮实测带走。这条坑的形态值得记:any 的"通用"是有条件的,它的运行时类型检查正是它的第四层代价——这次是它把程序打死的。
3.6 复现需要的最小材料
全部复现材料只有四件东西,可以整理进一个目录直接跑:
ep08recon/
├── iface.h       /* 四个虚函数实现 + 11 个入口声明 + 分配计数器 */
├── ops.cpp       /* 重载全局 operator new 做分配计数 */
├── bench.cpp     /* 11 档实现 + SBO 阈值探针 */
└── main.cpp      /* 统一负载与输出格式(ROW 行 + SBO 行) */
构建命令(两套工具链各一条,都必须 C++17):
MSVC :  cl /nologo /O2 /std:c++17 /EHsc /MD main.cpp ops.cpp bench.cpp /Fe:o2.exe
GCC  :  g++ -O2 -std=c++17 -o o2.exe ops.cpp bench.cpp main.cpp
输出是两段机读格式,可以直接用脚本解析取中位:
ROW <档位名> <毫秒> <ns/op> <分配次数> <累加和>
SBO <首次发生堆分配的捕获字节数>
"机读格式"这一点值得单说:如果只打印人类可读的表格,做 5 次取中位就得手工抄数;把每档输出写成一行固定格式、带 ROW 前缀,取中位、算比值、生成面板都可以脚本化。本篇那 44 个读数都是这么来的。
四、阶梯结果:四组列的排序互不相同
4.1 MSVC 的两列
MSVC 这一侧先给出两列:只开 /O2,以及再叠上 /GL + /LTCG。两列并排是为了回答一个很自然的问题——把链接期优化也开了,这一篇的阶梯会变样吗? 读数给出的答案是否定的(§4.5 会解释为什么),但只有并排看才敢下这个结论。
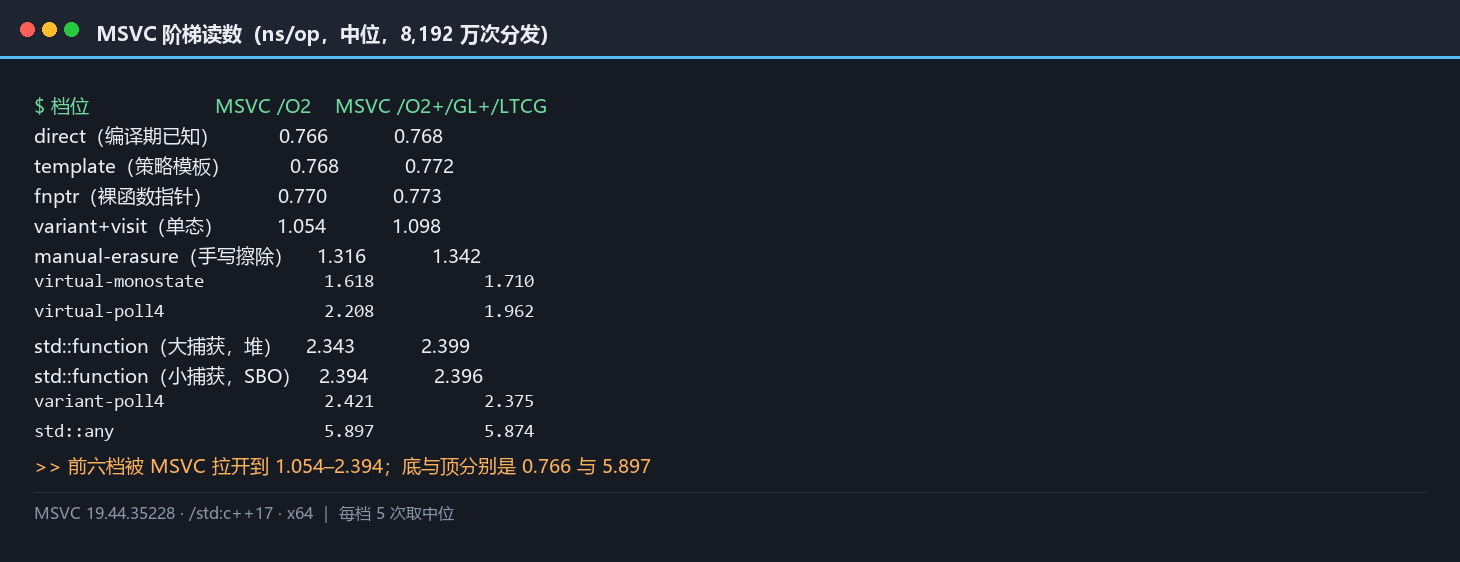
档位                        MSVC /O2    MSVC /O2+/GL+/LTCG
direct(编译期已知)           0.766           0.768
template(策略模板)           0.768           0.772
fnptr(裸函数指针)            0.770           0.773
variant+visit(单态)          1.054           1.098
manual-erasure(手写擦除)     1.316           1.342
virtual-monostate             1.618           1.710
virtual-poll4                 2.208           1.962
std::function(大捕获,堆)     2.343           2.399
std::function(小捕获,SBO)    2.394           2.396
variant-poll4                 2.421           2.375
std::any                      5.897           5.874
4.2 GCC 的两列
同样的 11 档,换到 GCC 的 -O2 与 -O2 -flto。这一列是本篇最反直觉的一列:前六个档位的读数几乎并排落在 0.77 附近——包括虚函数与类型擦除。看这一列时请特别留意 virtual-monostate 那一行。
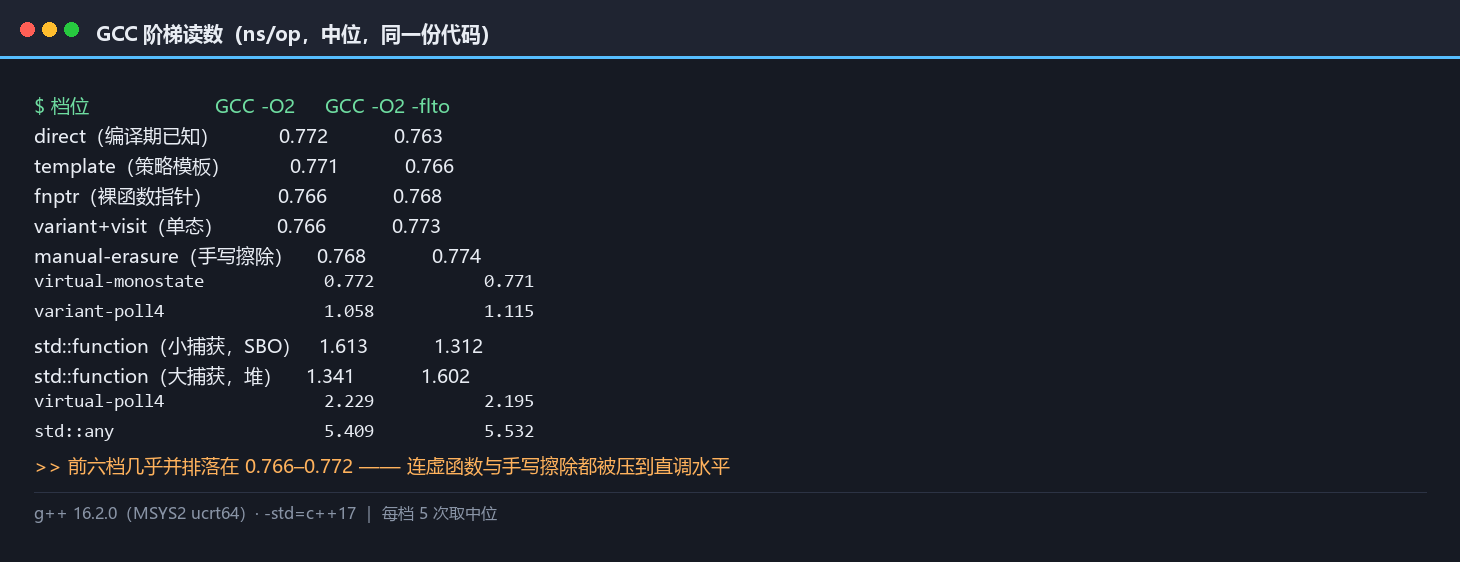
档位                        GCC -O2     GCC -O2 -flto
direct(编译期已知)           0.772           0.763
template(策略模板)           0.771           0.766
fnptr(裸函数指针)            0.766           0.768
variant+visit(单态)          0.766           0.773
manual-erasure(手写擦除)     0.768           0.774
virtual-monostate             0.772           0.771
variant-poll4                 1.058           1.115
std::function(小捕获,SBO)    1.613           1.312
std::function(大捕获,堆)     1.341           1.602
virtual-poll4                 2.229           2.195
std::any                      5.409           5.532
4.3 四列并排:排序真的会变
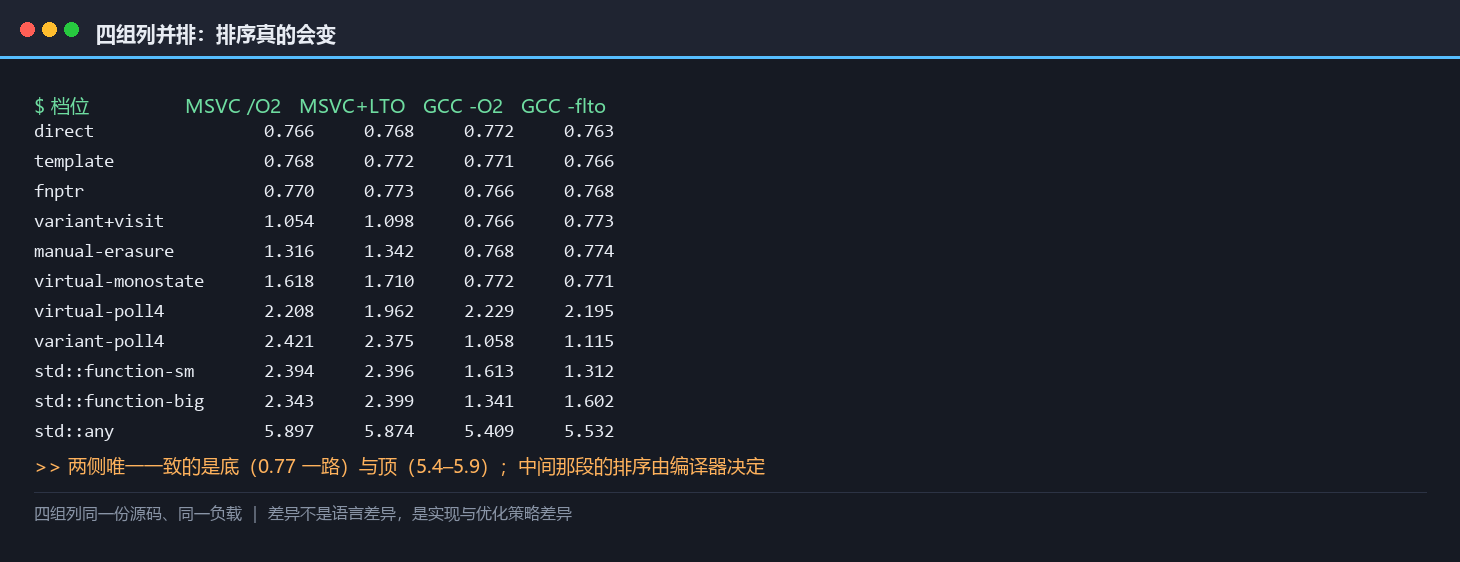
把它并成一张表可以看出三件事(数值见上面两张面板):
- GCC 侧的前六档几乎并列在 0.766–0.772:
direct、template、fnptr、variant+visit、manual-erasure、virtual-monostate全部被压到同一个数——它们在这份代码里被 GCC 划成了同一种东西。 - MSVC 侧同一批档位被拉开到 1.054–2.394,中间隔着
variant+visit(1.054)、manual-erasure(1.316)、virtual-monostate(1.618)。 - 两套工具链唯一一致的是"底"与"顶":
direct那一路都在 0.77 附近,std::any那一路都在 5.4–5.9——中间那一段的排序,是编译器决定的,不是语言决定的。
4.4 为什么排序会变:三个变量
- 编译器版本与优化策略:GCC 在
-O2就启用推测性去虚拟化;MSVC 的去虚拟化与final标注挂钩(§5.3)。 - 标准库实现版本:
std::visit在 libstdc++ 里走过一次实现换代(从跳转表改成"分支数少就用 switch"),公开实测显示这一改会让 variant 与虚函数的相对快慢翻转。 - 代码形状:本篇的对象是"编译单元里唯一且已知"的常量,所以 GCC 敢划掉;换成来自构造参数、跨编译单元的指针,结论就会变。
这三条加起来说明一件事:把"哪个更快"当成语言知识去背,是会背错的。该背的是判据(§5.5、§6.5),不是排序。
4.5 为什么 LTO 在这一篇几乎没帮上忙
第三列与第四列(/GL+/LTCG 与 -flto)的读数与基线相差很小,这与 ep07 里"LTO 让跨 TU 调用快 7 倍"形成了鲜明对比。为什么?
因为这一篇的用例里没有跨 TU 问题:
- 四个实现(
A/B/C/D)与三个run函数都在同一个编译单元里; - 没有"小函数被 TU 边界挡住"的情形;
- LTO 能做的跨模块内联,在这里本来就已经能做。
ep07 的靶子是"看不见"(编译 b.cpp 时看不见 a.cpp);本篇的靶子是"知道但不肯定"(看得见类型,但类型在运行期会变)。两种靶子对应两种优化:LTO 治前者,去虚拟化治后者。 LTO 对本篇无能为力,恰好反证了这一点。
4.6 一个附带结论:优化开关的组合不是"越多越好"
四列里唯一出现"LTO 反而更慢"的位置是 MSVC 的 virtual-monostate(1.618 → 1.710)与 std::function 两档(2.394→2.396、2.343→2.399)。差异都在 5% 以内,属于抖动范围。
但它提醒了一件事:本篇的阶梯表里,没有任何一档是因为"多开了一个优化开关"而变快 2 倍以上的。真正的差距来自代码形状(目标是否唯一)与实现路径(标准库怎么写 visit)。优化开关能拿的收益是有上限的;代码形状决定的那部分,开关拿不到。
五、决定性发现:同一份单态虚调用,GCC 划掉了、MSVC 没划掉
5.1 读数
先来看看这一处差异是本篇最值得细看的一组数字。表里四行分别是两套工具链各两个构建下的 direct、virtual-monostate 以及两者的比值。比值那一列才是重点——它把虚函数到底要不要付钱这个问题,变成了一个可比较的数。
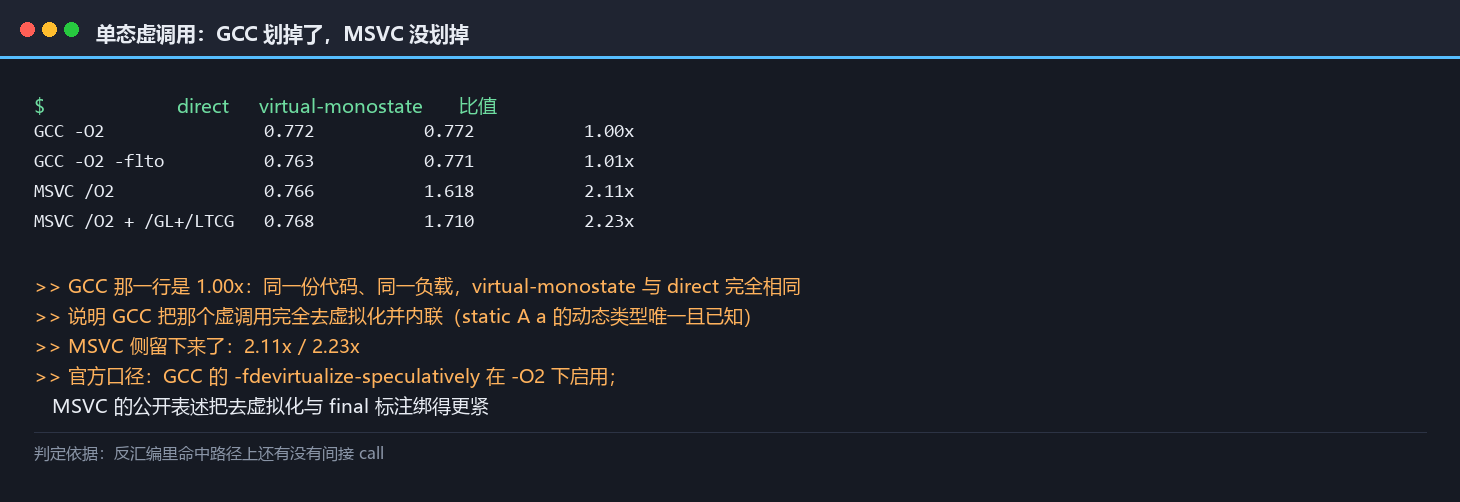
                             direct     virtual-monostate     比值
GCC -O2                       0.772           0.772           1.00×
GCC -O2 -flto                 0.763           0.771           1.01×
MSVC /O2                      0.766           1.618           2.11×
MSVC /O2 + /GL + /LTCG        0.768           1.710           2.23×
GCC 那一行是 1.00×。同一份代码、同一个负载,virtual-monostate 与 direct 的时间完全相同。
这说明 GCC 把那个虚调用完全去虚拟化并内联了:static A a; 的动态类型在编译单元内是唯一且已知的,op->apply 的目标可以静态确定。
5.2 反汇编证据
说白了,读数只能说明快了,不能说明被划掉了。要区分这两种情况,必须回到汇编上看调用点的形态:间接调用还在不在、被调函数体有没有被展开进循环。下面两张面板分别是 MSVC 与 GCC 在同一档上的反汇编片段,并排看它们,差异是可见的。
读数只是"更快了"。要看它是不是"划掉了",得看汇编。
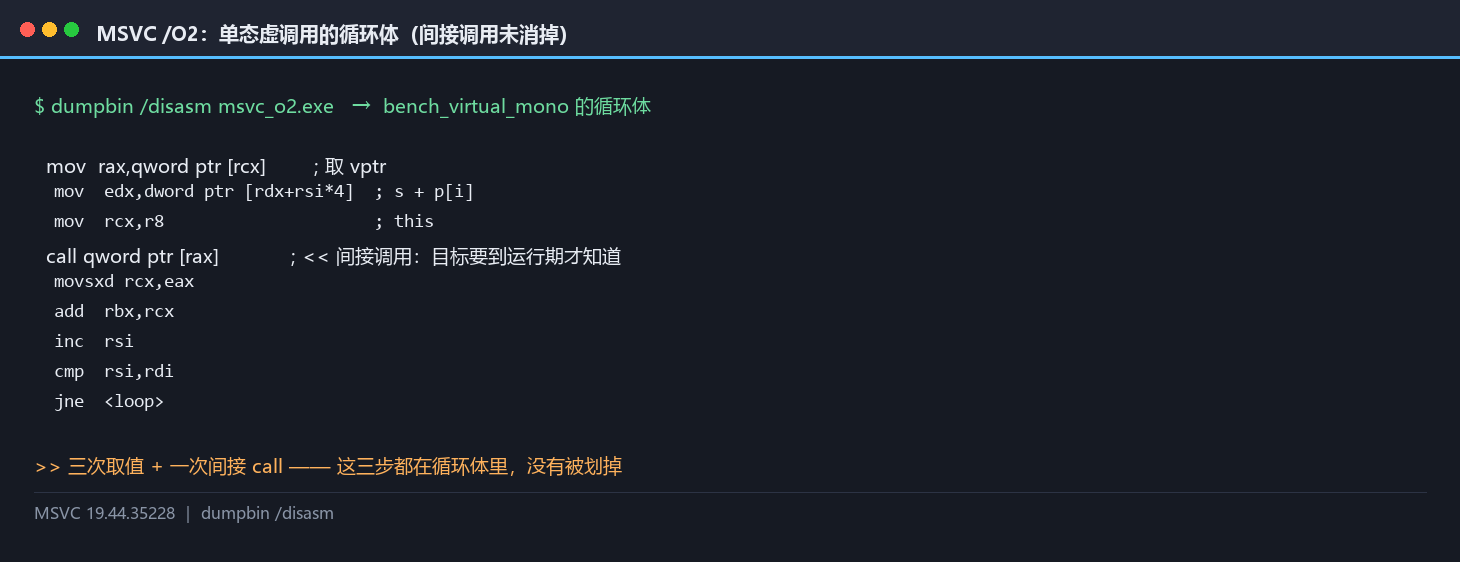
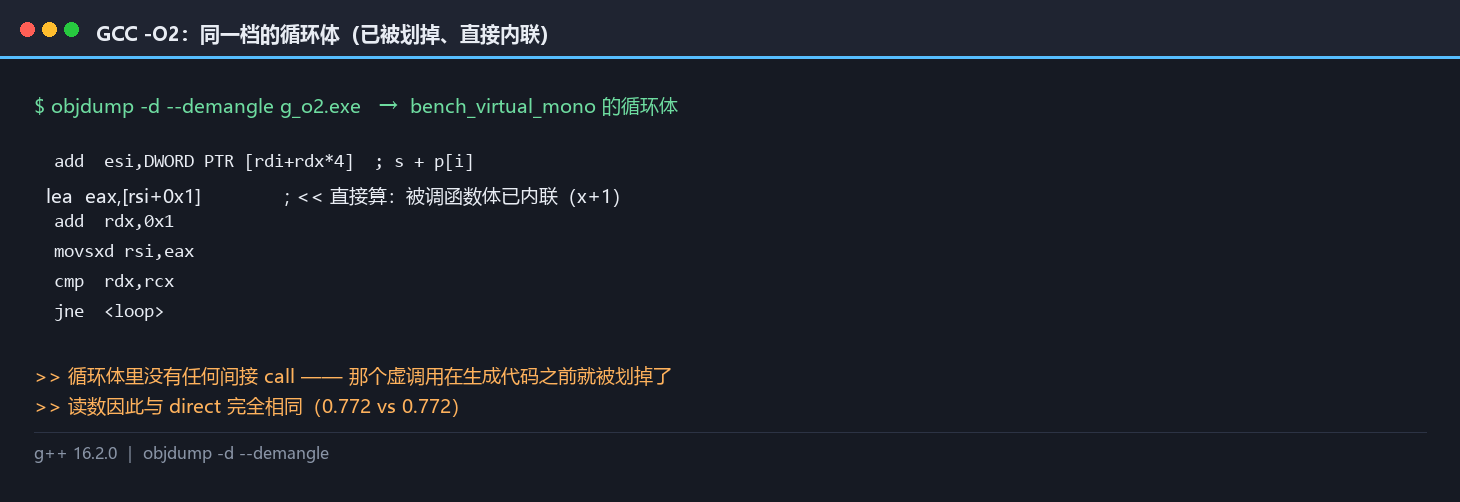
判定方式与 ep07 一致,看命中路径上还有没有间接 call:
| 构建 | 循环体里对 apply 的调用形态 |
|---|---|
MSVC /O2 |
取 vptr → 取槽位 → 间接 call(未消掉) |
GCC -O2 |
无间接 call(已内联进循环) |
5.3 官方口径对得上
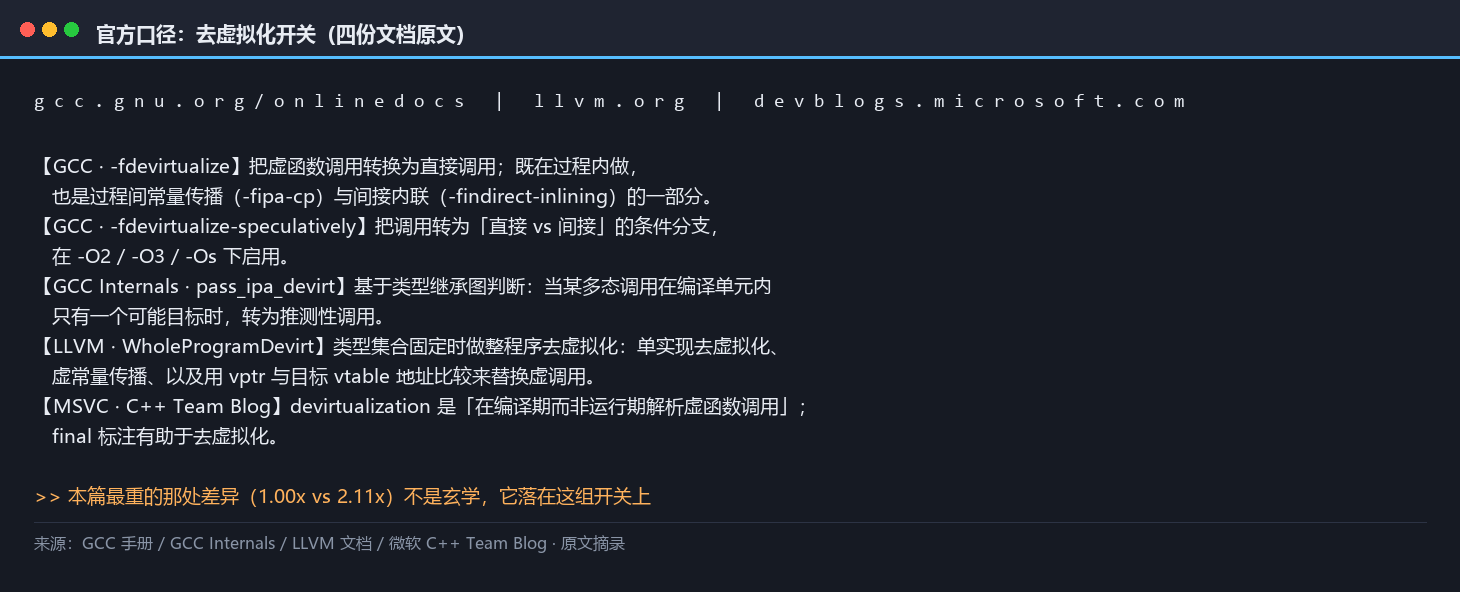
- GCC:
-fdevirtualize把虚调用转成直接调用,既在过程内做,也是过程间常量传播与间接内联的一部分;-fdevirtualize-speculatively把调用转成"直接 vs 间接"的条件分支,在-O2/-O3/-Os下启用。GCC Internals 还写明pass_ipa_devirt会基于类型继承图判断"某多态调用在编译单元内是否只有一个可能目标"——本篇的static A a恰好命中这个条件。 - LLVM:
WholeProgramDevirt在类型集合固定时做整程序去虚拟化,手段之一正是用 vptr 与目标 vtable 地址比较来替换虚调用;LLVM 开发者会议的讲稿给出了 profile 驱动的调用点形态if (get_class_id(receiver) == expected) call expected else deoptimize。 - MSVC:微软 C++ Team Blog明确 devirtualization 是"在编译期而非运行期解析虚函数调用",并指出
final标注有助于去虚拟化。
顺便一个量级参照:一份公开计时给出 virtual 28.86 ms / template 36.19 ms / std::function 150.56 ms(出处),量级关系与本篇一致。三条口径合起来解释了两边的差异:GCC 在 -O2 就默认启用推测性去虚拟化,而 MSVC 侧把去虚拟化的触发条件与 final 标注绑得更紧。同一份代码要 MSVC 划掉,通常需要给它一个更强的承诺。
5.4 一个同源现象:手写擦除与 variant 也被划掉了
GCC 侧被划掉的不止虚函数:
| 档位 | GCC -O2 | 与 direct 之比 |
|---|---|---|
manual-erasure |
0.768 | 0.99× |
variant+visit |
0.766 | 0.99× |
virtual-monostate |
0.772 | 1.00× |
三个"运行时分发"的档位全部被压到直调水平。原因相同:擦除本身不是开销,开销来自"编译器不知道目标是谁"。
manual-erasure里Erased::fn被初始化为&erased_thunk<IncT>,而IncT是个static常量对象——函数指针是编译期常量;variant里备选只有一个A,index()恒为 0——分支被折叠掉。
这就是本篇最值得记住的一条:类型擦除、虚函数、variant 都不是"天生慢",它们是"要求编译器在运行期做它本可以在编译期做完的决定"。能不能把这个决定收回去,是编译器的能力,也是代码形状给的线索。
5.5 判据(第一条)
把这一章收成一条可以在代码评审里直接问的判据。判据的形态刻意做成先问什么、再问什么,因为顺序反了很容易得出错误的结论——先怀疑分发、再去看目标是否确定,往往会把本来免费的东西优化一遍。
判据一:如果你在意分发开销,先问"编译器能不能确定目标"。能确定 → 三档(擦除/虚函数/variant)都可能是零成本;不能确定 → 再看下一节的图。
5.7 怎么把"目标确定性"变成代码事实
§5.1 的差异说明:"目标确定"这件事不是一个抽象概念,它有具体的代码写法。 想让编译器拿到确定性,有四种立即可用的手段:
| 手段 | 为什么有用 | 代价 |
|---|---|---|
给类加 final |
告诉编译器"这里不会再有第五个子类" | 放弃再继承(多数接口类本来就该如此) |
| 把对象放在编译单元局部的匿名命名空间 | 让"这个类型的实例只有这一处"成为可证事实 | 该类型不能被外部引用 |
| 用值语义而非指针 | 对象的动态类型就是静态类型 | 需要拷贝或移动(ep03 的账) |
密封继承层次(enum + switch,或 variant) |
把"候选集合"变成编译期可见的有限集 | 加一种形态要改中心代码 |
第一条是本篇性价比最高的建议:final 是零运行时成本的标注,而微软官方明确它有助于去虚拟化。"这个类会不会再被继承",本该在写它的时候就有答案 —— 如果答案是不会,就别把这个信息藏着。
第 2 条值得单独提一句:本篇 §5.1 那个被 GCC 划掉的用例,之所以能被划掉,正是因为 static A a; 让 A 的实例在编译单元里唯一。这是"代码形状给编译器线索"的最直白例子——把对象改成从构造参数传进来、或从另一个编译单元取的指针,GCC 也就划不掉了。
5.8 为什么 GCC 更敢划:一个设计取向的解释
言归正传,官方口径(§5.3)显示,GCC 把推测性去虚拟化的开关默认开在 -O2,并且由 pass_ipa_devirt 基于类型继承图自动判断;LLVM 的 WholeProgramDevirt 也走类似的"类型集合是否固定"的判断;而 MSVC 的公开表述把去虚拟化与 final 这类显式承诺绑得更近。
这三种取向没有绝对优劣,它们反映的是不同的风险偏好:
- 激进划掉:收益是免费的加速,风险是"如果判断错了会怎样"——所以这类优化都带一个"守卫"或"去优化"回退路径;
- 保守不划:收益少一点,但行为更好预测——"我写了虚调用,它就是虚调用"。
对使用者的意义是一致的:别假设编译器会替你把这一层划掉,也别假设它不会。想确认,就去看反汇编(§5.2);想争取,就给它承诺(§5.7 的四种手段)。
六、多态分发:去虚拟化救不了的那一档
6.1 读数
先来看看把目标从 1 个换成 4 个轮换,读数会怎么变?这一节的两行数字回答了这个问题。注意两套工具链的读数几乎一样——这是全篇唯一一处两边高度一致的档位,而它恰好也就是去虚拟化帮不上忙的那一档。
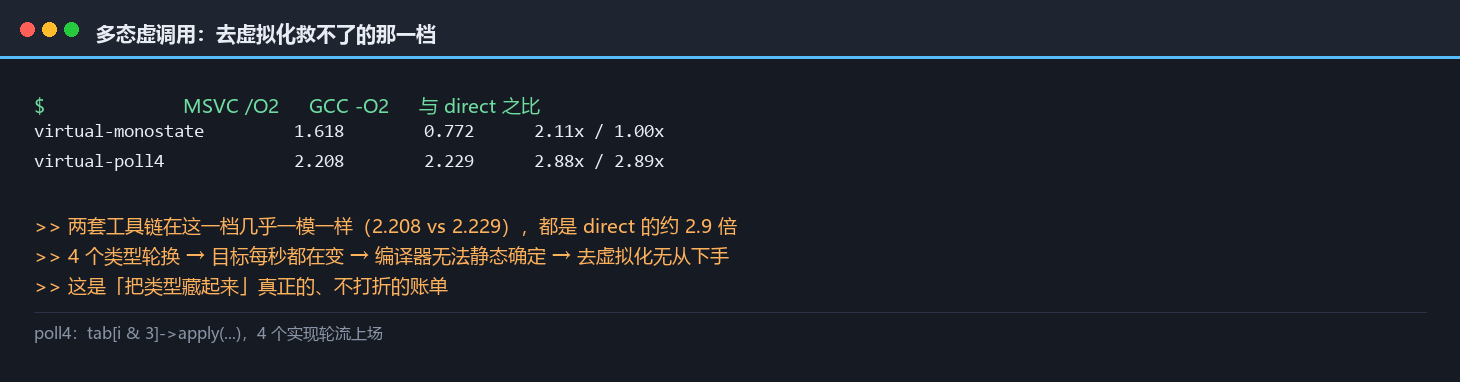
                             MSVC /O2     GCC -O2     与 direct 之比
virtual-monostate              1.618        0.772       2.11× / 1.00×
virtual-poll4                  2.208        2.229       2.88× / 2.89×
这一栏两套工具链几乎一模一样(2.208 vs 2.229),而且都是 direct 的 2.9 倍。
原因很直白:4 个类型轮换时,op->apply 的目标每秒都在变,编译器无法把它静态确定,去虚拟化无从下手。这一档是"把类型藏起来"真正的、不打折的账单。
6.2 variant 的两种命运
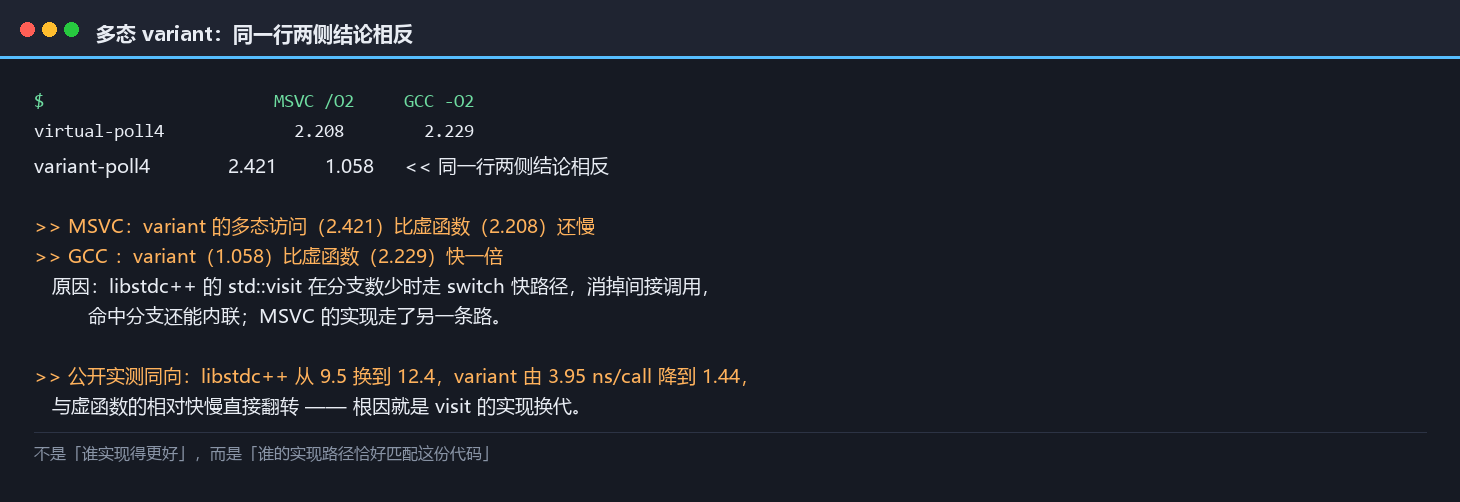
                             MSVC /O2     GCC -O2
virtual-poll4                  2.208        2.229
variant-poll4                  2.421        1.058     ← 同一行两侧结论相反
同一行两侧结论相反:
- MSVC:
variant的多态访问(2.421)比虚函数还慢。多了一次索引判定,却没换来更便宜的分发。 - GCC:
variant(1.058)比虚函数快一倍。libstdc++ 的std::visit在分支数少时走 switch 快路径,把间接调用消掉,命中分支还能内联。
这一处不是"谁实现得更好"的问题,而是"谁的实现路径恰好匹配这份代码"的问题(指针分发 vs variant 的另一份实测、以及 按数据分布讨论的俄文实测都指向同一结论)。公开实测里也有同向结论:一位作者的实测给出,同一份代码在 libstdc++ 从 9.5 换到 12.4 之后,variant 从 3.95 ns/call 降到 1.44 ns/call、直接翻转了与虚函数的相对快慢——根因就是 visit 的实现换代。另一份实测显示 visit 的跳转表与递归 switch 两种实现本身可以差约 4 倍。中文社区也有一句务实的总结:不存在普适的"variant 优于虚函数"结论。
6.3 单态 → 多态:分支预测那一层
| 单态 | 4 类型轮换 | 抬升 | |
|---|---|---|---|
| MSVC | 1.618 | 2.208 | +36% |
| GCC | 0.772 | 2.229 | +189% |
两边的抬升幅度差很多,但注意它们的方向一致:只要目标开始变化,时间就上去。
关于这一层,最经典的实证是 「处理有序数组为什么比无序数组快」那篇:可预测分支几乎零代价,不可预测分支触发流水线冲刷。Agner Fog 的优化手册则把预测依据讲到了 BTB(Branch Target Buffer)这一层。这一层的关键特征是"指令没变多"。把两种写法的反汇编并排看,多态版并没有多出一大段指令——变化的是间接跳转的目标分布。这也是为什么"数指令条数"这件事在分发代价上会失效:第一层可以数,第二层只能测。
6.4 裸函数指针为什么与直调同速
说白了,函数指针写起来像间接调用,但在这一档里它测出来与直调同速。这个结果初看反常识,实际上它把语法形态与运行期事实这两件事彻底分开了——这也是本篇第二个判据的来源。
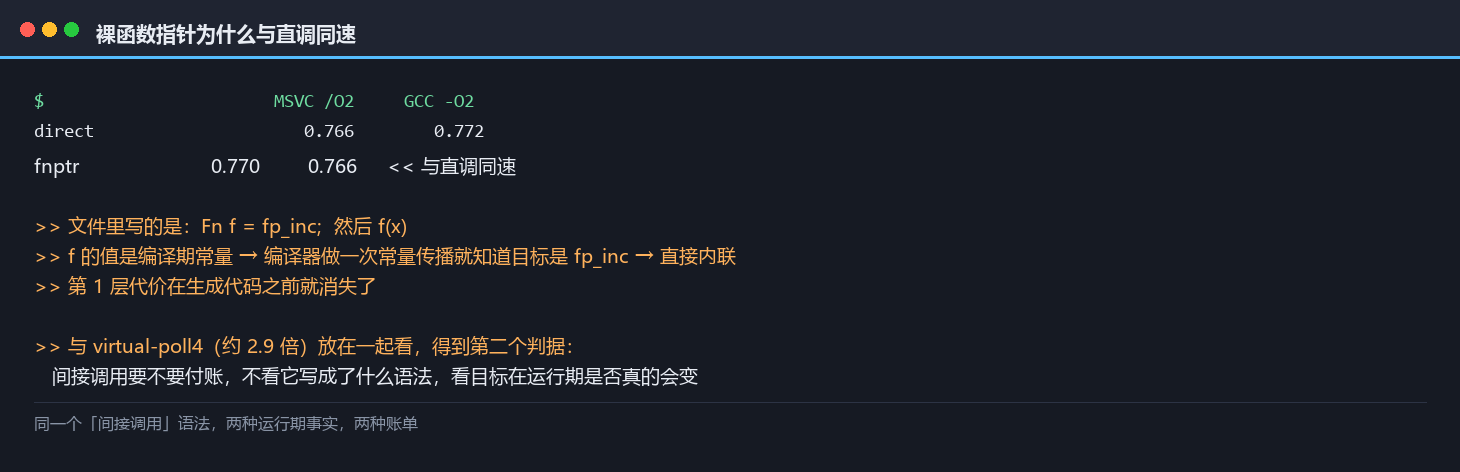
                             MSVC /O2     GCC -O2
direct                         0.766        0.772
fnptr                          0.770        0.766     ← 与直调同速
这个结果乍看反常识:函数指针不也是"间接调用"吗?
因为它在这里不是间接调用。 Fn f = fp_inc; 之后 f 的值是编译期常量,编译器做一次常量传播就知道目标是 fp_inc,于是直接内联——第 1 层代价在生成代码之前就消失了。
把它和 §6.1 的多态虚调用放在一起看,就得到了本篇的第二个判据。
6.5 判据(第二条)与本章小结
判据二:间接调用是否要付账,不看它写成了什么语法,看目标在运行期是否真的会变。
f是常量 → 免费;op->apply有 4 个候选 → 约 2.9 倍。
本章三件事合起来:
- 多态是不打折的那一档(两套工具链都是 ~2.2 ns/op);
variant与虚函数谁快,取决于标准库实现路径,实测里两侧结论相反;- 单态 → 多态的抬升来自分支预测层,量出来的(+36% / +189%)而不是数出来的。
6.6 一个可以自己做的对照(两类别轮换)
本篇只做了两组:单态(1 个实现)与 4 类型轮换。中间还可以插一档:2 个实现轮换。
把 §6.3 的思路延伸一下,这一档值得你自己在本地跑一次,因为它回答一个很实际的问题:"我的虚调用只有两个候选"是不是就已经要付全部账了?
做法与设计要点:
- 保持代码形状不变,只把
tab[i & 3]改成tab[i & 1]——只有一个字符的差别,保证"指令数"这一项几乎不变; - 同时观察两个读数:
ns/op与反汇编(间接调用条数)。如果间接调用条数没变而时间变了,你就又一次把"分支预测层"单独抓了出来; - 再补一组"伪随机选择":
tab[(i * 2654435761u) >> 31]之类,让选择器彻底不可预测。单态 → 两类别 → 4 类别 → 伪随机 这四档连起来看,就能看出"目标分布的熵"与耗时的关系曲线。
本篇没有跑这一档,原因是篇幅与预算;但方法是现成的,四档加起来不到 20 行改动。这属于"读完之后能自己接着做"的部分——比记住一个倍率有用得多。
6.7 把"分发"放回整条流水线
分发的代价必须放进流水线里看才有意义。一次"取数据 → 分发 → 计算 → 写回"的循环里,分发的占比取决于另外三步有多重:
| 循环形态 | 分发占比(估算) | 该关心分发吗 |
|---|---|---|
| 纯算术(本篇用例) | 接近 100% | 是,这是量工具成本的情形 |
| 算术 + 连续访存 | 10–30% | 看数据量:大数组下访存会成为新瓶颈 |
| 算术 + 随机访存 / 指针链 | < 10% | 先把访存改连续(缓存布局的账) |
| 算术 + 系统调用 / IO | < 1% | 不必:分发的账单已被完全淹没 |
这张表的用法是排除法:只有在最上面两行,本篇的判据才值得动用。如果在第四行还去纠结"该用虚函数还是 variant",那是在优化一个占比不到 1% 的项——这是性能工作里最常见的浪费。
七、类型擦除:SBO、堆分配与 std::any 的底
7.1 std::function 的两档
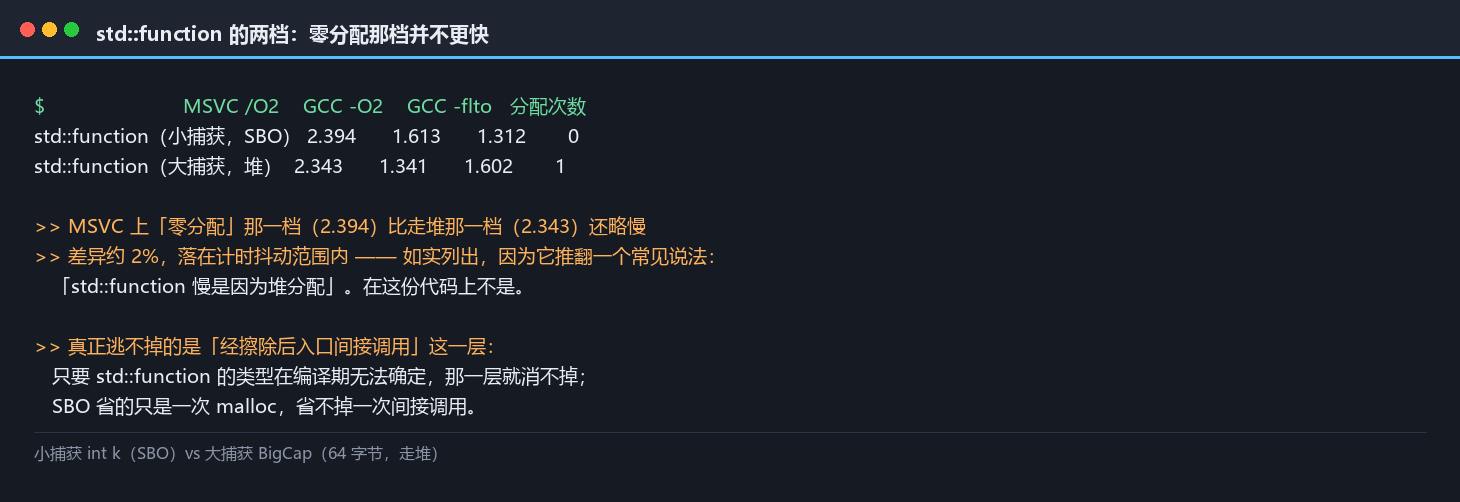
                             MSVC /O2     GCC -O2     GCC -flto
std::function(小捕获,SBO)    2.394        1.613       1.312
std::function(大捕获,堆)     2.343        1.341       1.602
堆分配次数                       0            0           0       ← 小捕获
                                1            1           1       ← 大捕获
这里有一个反直觉的结果:MSVC 上"零分配"的那一档(2.394)比走堆的那一档(2.343)还略慢。
原因不在 SBO 本身,而在被擦除的对象形状不同:
- 小捕获那档捕的是一个
int k,std::function把它放进了本地缓冲; - 大捕获那档捕的是 64 字节的
BigCap,走了堆。
两者都逃不掉"经擦除后入口间接调用"这一层——只要 std::function 的类型在编译期无法确定,那一层就消不掉,而 SBO 省的只是"一次 malloc",省不掉"一次间接调用"。当间接调用是主要成本时,省掉一次 malloc 换来的是 2% 的摆动。
口径提醒:这两档的差异(2.394 vs 2.343,约 2%)落在计时抖动范围内。本篇把它如实列出,是因为它推翻了一个更常见的说法——"
std::function慢是因为堆分配"。在这份代码上不是。
7.2 SBO 阈值:可以量的一个数
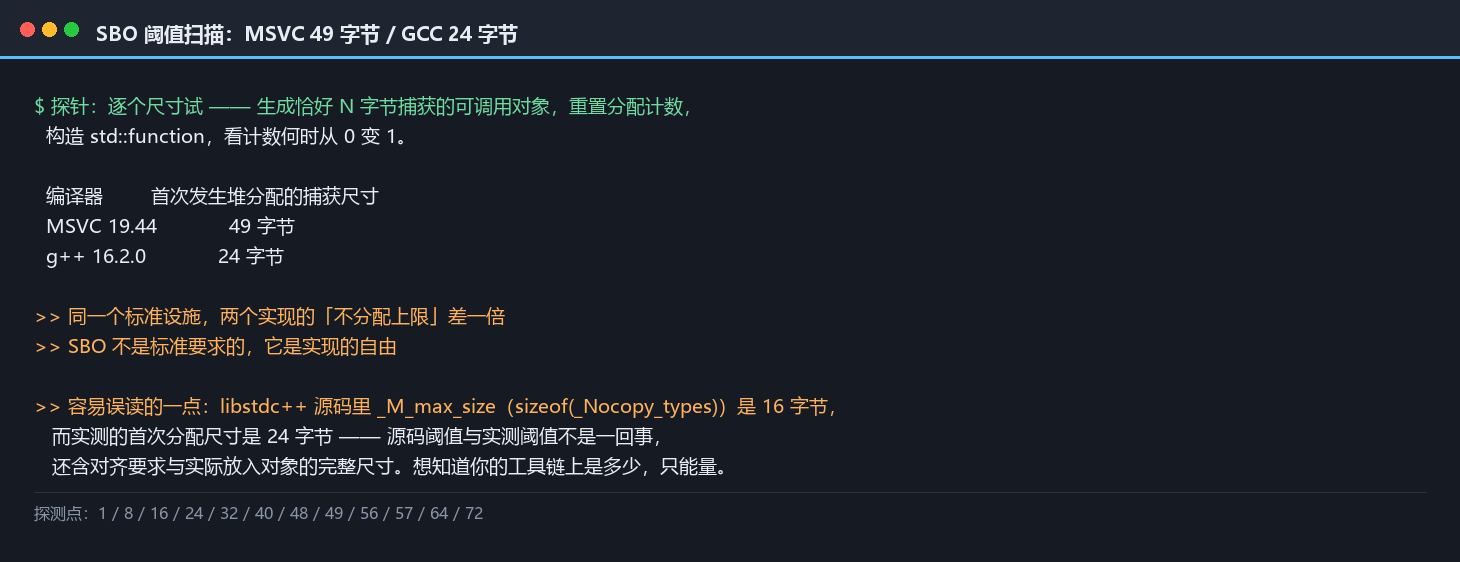
探针的做法是逐个尺寸试:生成一个恰好 N 字节捕获的可调用对象,重置分配计数,构造 std::function,看计数何时从 0 变 1。探测点取 1/8/16/24/32/40/48/49/56/57/64/72。
编译器          首次发生堆分配的捕获尺寸
MSVC 19.44            49 字节
g++ 16.2.0            24 字节
同一个标准设施,两个实现的"不分配上限"差一倍。这不是标准行为——SBO 从来不是标准要求的(cppreference 的 std::function 页只描述语义、不承诺缓冲尺寸),它是实现的自由。
而且注意一个容易误读的点:而 libstdc++ 的std_function.h 源码里那个 _M_max_size(sizeof(_Nocopy_types))在 64 位下是 16 字节,而实测的首次分配尺寸是 24 字节。源码阈值与实测阈值不是一回事:实测值还包含对齐要求与实际放入对象的完整尺寸。所以想知道你的工具链上是多少,只能量,不能推。
7.3 SBO 机制:省下的是哪一笔
好了,SBO 的收益很具体:省掉一次分配 + 省掉一次释放 + 换来对象与被调方在同一缓存行附近。
但它省不掉的是:类型已经擦掉了。std::function 的 operator() 仍然要跳到那个被擦除的入口。所以 SBO 有效的前提是——你的瓶颈在分配上,而不是在间接调用上。这句话在"被分发的操作本身很重"的业务代码里成立,在"操作只有一条 x+1"的极端用例里不成立。
7.4 std::any:这个阶梯的底
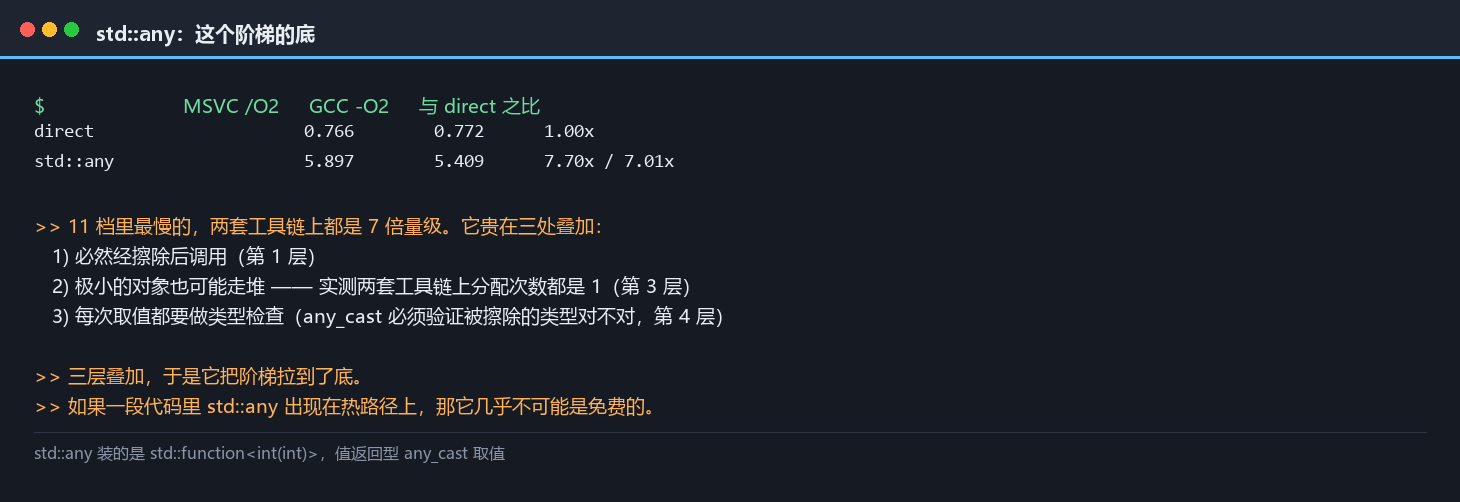
                             MSVC /O2     GCC -O2     与 direct 之比
direct                         0.766        0.772         1.00×
std::any                       5.897        5.409         7.70× / 7.01×
言归正传,std::any 是 11 档里最慢的,两套工具链上都是 7 倍量级。它贵在三处叠加:
- 必然经擦除后调用(第 1 层);
- 极小的对象也可能走堆——实测两套工具链上
std::any那一档的分配次数都是 1(第 3 层); - 每次取值都要做类型检查——
any_cast必须验证被擦除的类型对不对(第 4 层)——值返回型不匹配时抛std::bad_any_cast,而指针返回型只返回空指针、不抛。
三层叠加,于是它把阶梯拉到了底。如果一段代码里 std::any 出现在热路径上,那它几乎不可能是免费的。
7.5 any_cast 崩掉的现场
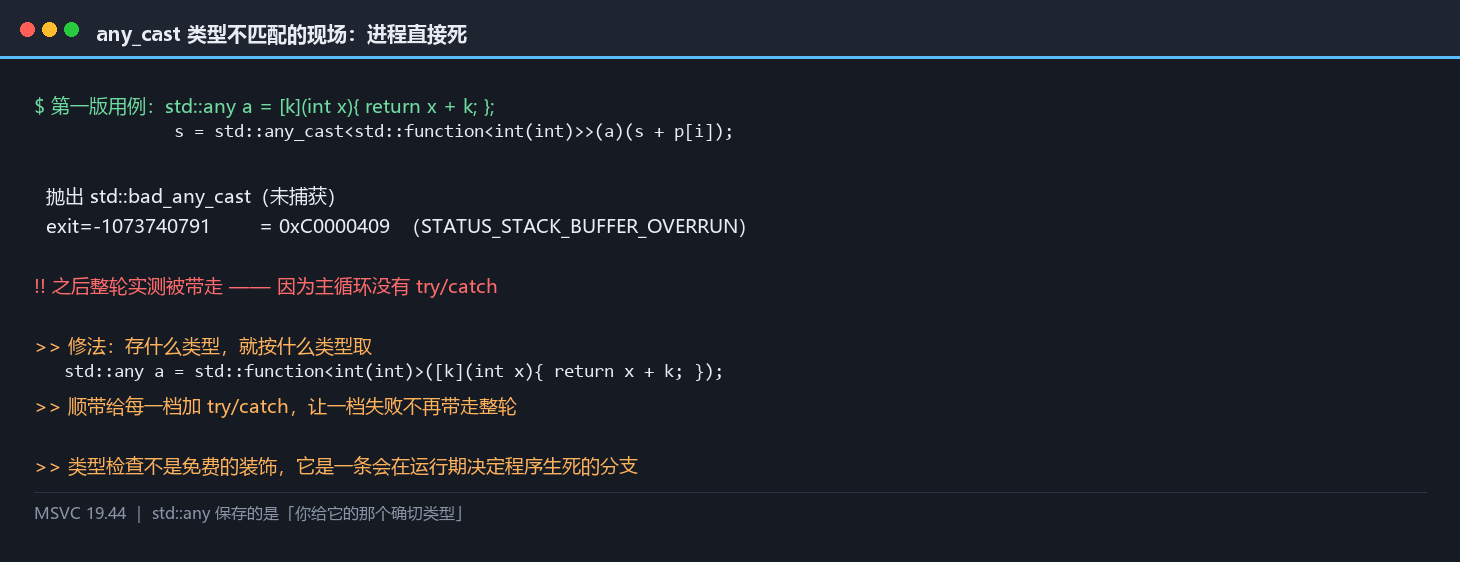
本篇的用例第一版就是这么崩的(§3.4 已交代修法)。这条现场值得单独留个图,因为它把"第 4 层代价"从抽象名词变成了一个退出码:
exit=-1073740791 (= 0xC0000409,MSVC 下未捕获 C++ 异常的典型退出码)
类型检查不是免费的装饰,它是一条会在运行期决定程序生死的分支。 也是因为这个原因,本篇给每一档都套了 try/catch —— 实测工作流里,"一档挂掉带走整轮"是很常见的浪费。
7.6 各档的堆分配次数
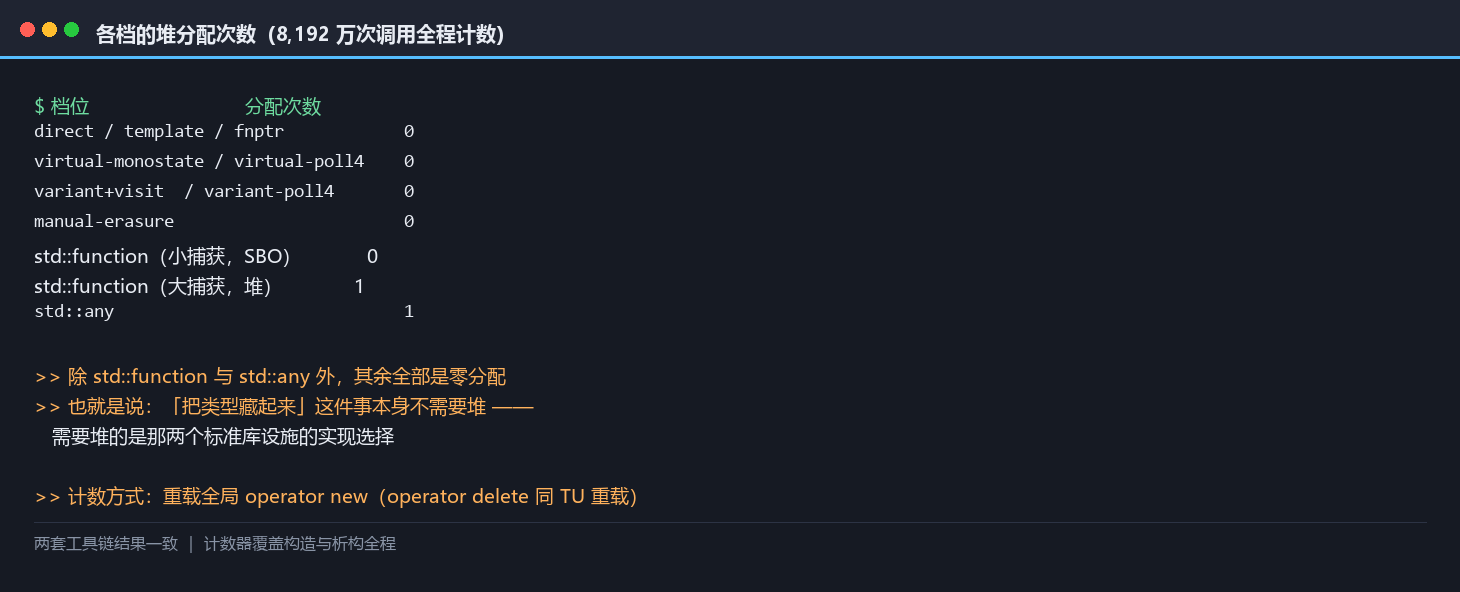
档位                        分配次数(8,192 万次调用)
direct / template / fnptr              0
virtual-monostate / virtual-poll4      0
variant+visit / variant-poll4          0
manual-erasure                         0
std::function(小捕获,SBO)             0
std::function(大捕获,堆)              1
std::any                               1
这张表有一个很干净的读法:除了 std::function 与 std::any,其余全部是零分配。"把类型藏起来"这件事本身不需要堆——需要堆的是那两个标准库设施的实现选择。
7.7 手写擦除:两种命运
先来看看手写擦除是理解这整件事最好的样本,因为它的代码只有五六行,却能同时演示"免费"和"付费"两种命运:
                             MSVC /O2     GCC -O2
direct                         0.766        0.772
manual-erasure                 1.316        0.768     ← 一侧 1.7×,一侧 1.0×
- GCC 侧 0.768 = 直调水平:
Erased::fn是编译期常量(&erased_thunk<IncT>),整条擦除被划掉。 - MSVC 侧 1.316:那一次间接调用留下来了,约等于直调的 1.7 倍。
同一份擦除代码、同一个用例,只在编译器不同时分开出两种结论。 这也是为什么 §4.4 说"排序是编译器决定的"——擦除这个动作本身,账单金额由编译器填。
7.8 SBO 阈值的工程含义
§7.2 量出的两个数(MSVC 49 字节、GCC 24 字节)不只是"一个有趣的差异",它有两个可操作的推论:
推论一:跨平台代码不能假设 SBO 行为一致。 一个捕 32 字节的可调用对象,在 MSVC 上完全不分配,在 GCC 上每次构造都要 malloc。如果你的代码要在热路径上构造 std::function,这个差别是实打实的——而且是那种"在开发机上测不出来、在另一套工具链上暴露"的差别。
推论二:把捕获压到阈值以下,是一个可以主动设计的动作。 阈值的窄口是 24 字节(本机 GCC),意味着:
- 捕获一个指针 + 一个整数(16 字节)通常还在缓冲里;
- 捕获两个指针 + 两个整数(24 字节)就危险了;
- 捕获一个
std::shared_ptr(16 字节)安全,捕获两个(32 字节)就会掉到堆上。
这些数字只有在量过之后才敢用。 本篇给出的 49 与 24 是本机实测值,换个标准库版本就会变——所以自检清单里那一条是"量一下本工具链的阈值",而不是"记住 24 这个数"。
八、机制层:vtable 布局、官方口径与代码膨胀
8.1 代码体积
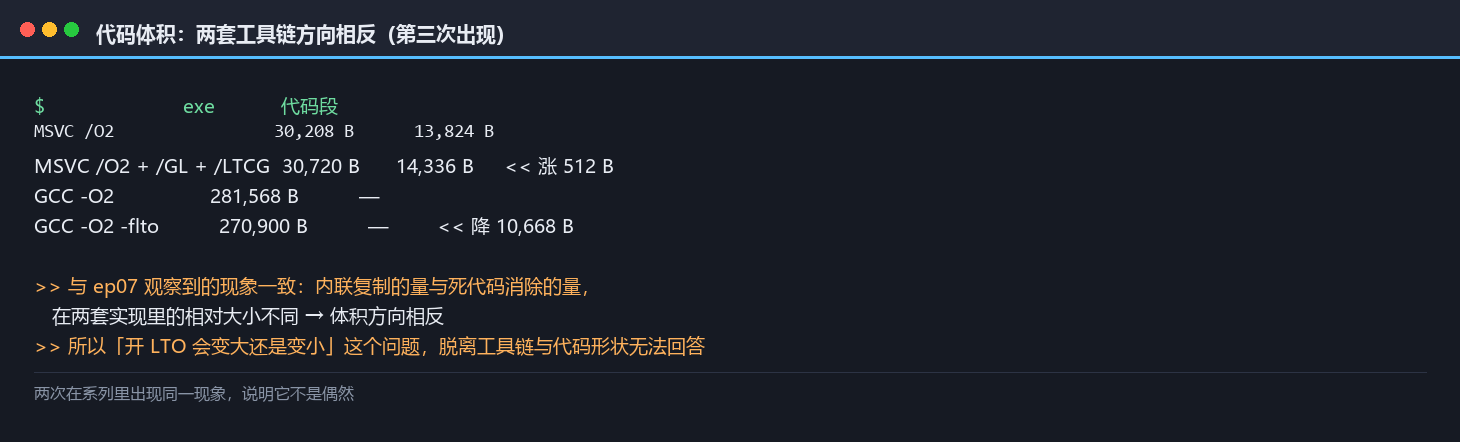
                        exe           代码段
MSVC /O2                30,208 B      13,824 B
MSVC /O2 + /GL + /LTCG  30,720 B      14,336 B     ← 涨 512 B
GCC -O2                281,568 B          —
GCC -O2 -flto          270,900 B          —        ← 降 10,668 B
两套工具链的体积方向又是相反的——与 ep07 观察到的现象一致。这一点在系列里第二次出现,说明它不是偶然:内联复制的量与死代码消除的量,在两套实现里的相对大小不同。
8.2 间接调用计数
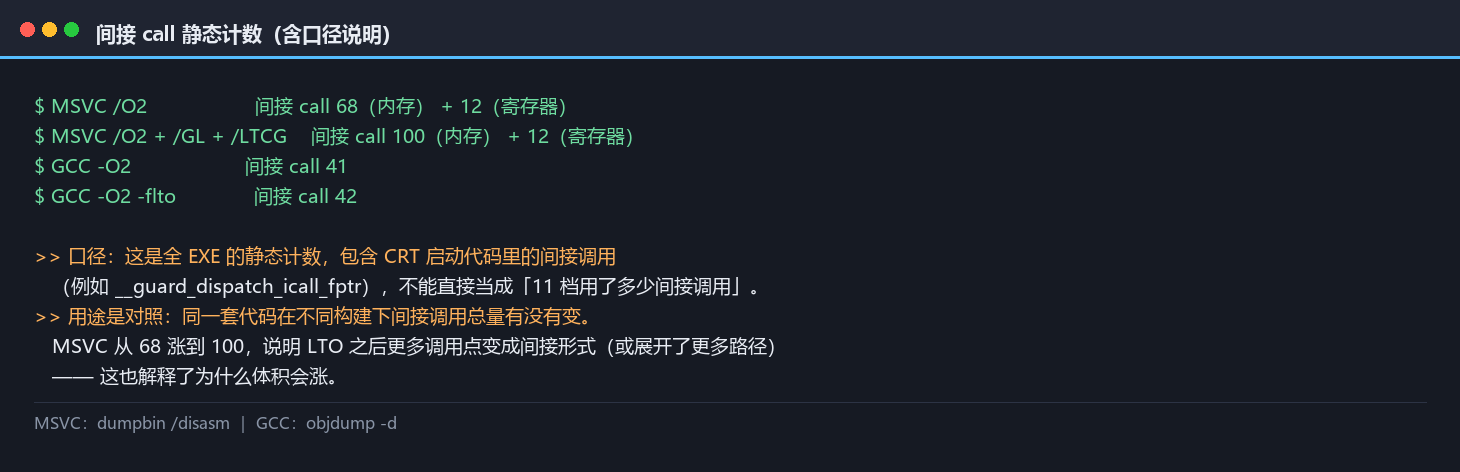
MSVC /O2                  间接 call 68(内存) + 12(寄存器)
MSVC /O2 + /GL + /LTCG    间接 call 100(内存) + 12(寄存器)
GCC -O2                   间接 call 41
GCC -O2 -flto             间接 call 42
这张表有一个必须交代的口径问题:这是全 EXE 的静态计数,包含 CRT 启动代码里的间接调用(__guard_dispatch_icall_fptr 等),所以它不能直接当成"你这 11 档用了多少间接调用"。
它的用途是对照:同一套代码在不同构建下,间接调用的总量有没有变。MSVC 从 68 涨到 100,说明 LTO 之后链接器把更多调用点变成了间接形式(或者展开了更多代码路径)——这也解释了为什么体积会涨。
8.3 类布局转储
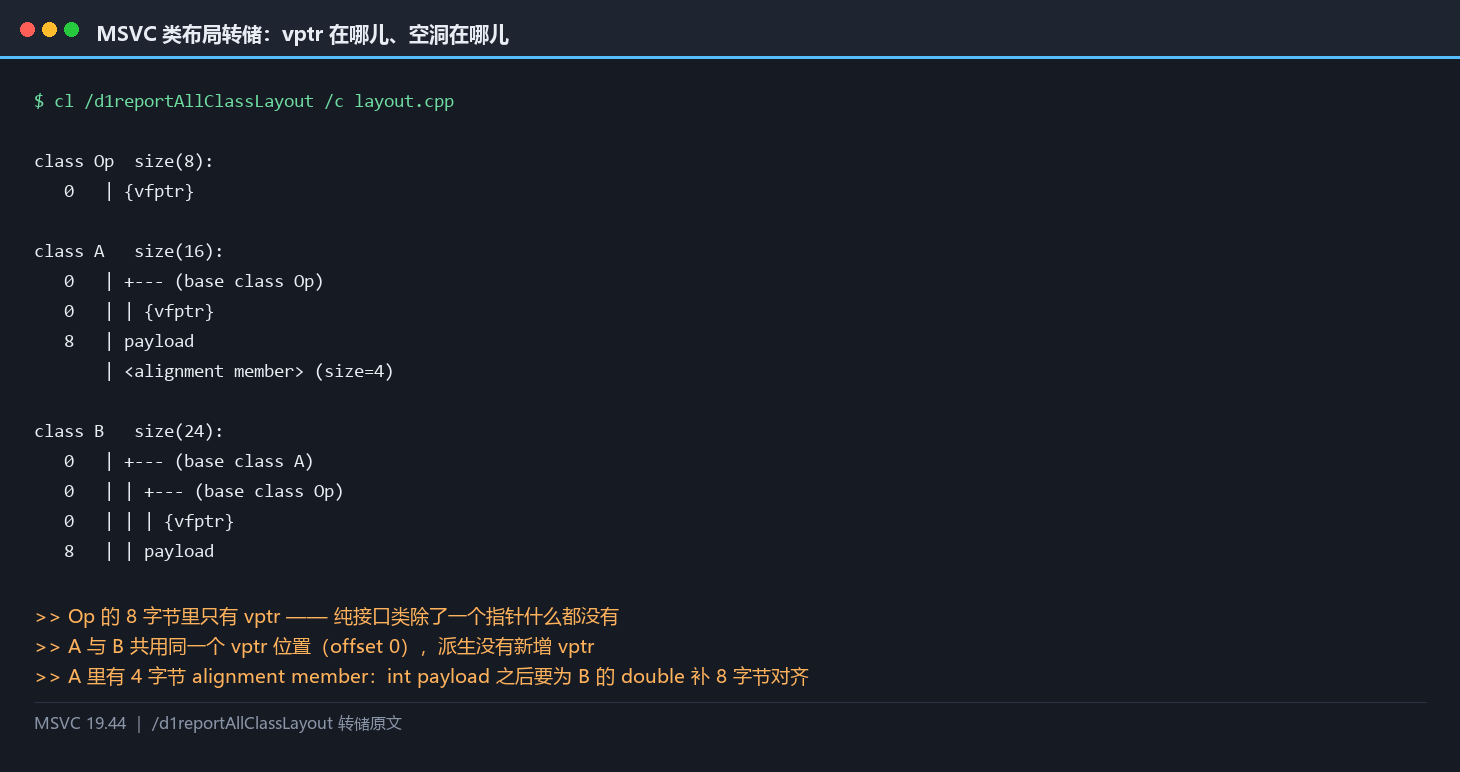
MSVC 有一个可以直接把类布局打出来的开关。给一个三层的类族:
struct Op { virtual int apply(int x) const = 0; virtual ~Op() = default; };
struct A : Op { int payload; int apply(int x) const override { return x + 1; } };
struct B : A { double extra; int apply(int x) const override { return x ^ 7; } };
class Op  size(8):
  0   | {vfptr}

class A   size(16):
  0   | +--- (base class Op)
  0   | | {vfptr}
  8   | payload
      | <alignment member> (size=4)

class B   size(24):
  0   | +--- (base class A)
  0   | | +--- (base class Op)
  0   | | | {vfptr}
  8   | | payload
三个可以直接读出来的结论:
Op的 8 字节里只有 vptr——纯接口类的对象里除了一个指针什么都没有;A与B共用同一个 vptr 位置(offset 0),派生没有新增 vptr——这就是"每类一份 vtable、每对象一个指针"在布局上的样子;A里有<alignment member> (size=4)——int payload之后要放B的double extra,为了 8 字节对齐补了 4 字节空洞。这是 ep01 那条"对齐与 padding"的账在本篇里又收了一次。
8.4 vptr 与 vtable 的结构
把布局与调用串起来:
- 每个对象在头部存一个 vptr(MSVC 调试器里叫
__vfptr); - 每个类有一份 vtable,槽位按声明顺序排列,基类的虚函数排在派生类新定义的之前;
- 一次虚调用 = 取 vptr → 取槽位 → 间接调用。
这三步里,"取"的两步是固定的、可数的;只有第三步的目标是不确定的。 所以四层账单里,第 1 层薄、第 2 层厚——这与 §6.3 的实测互相印证(指令没变多,但时间上去了)。
8.5 Itanium ABI 的原文
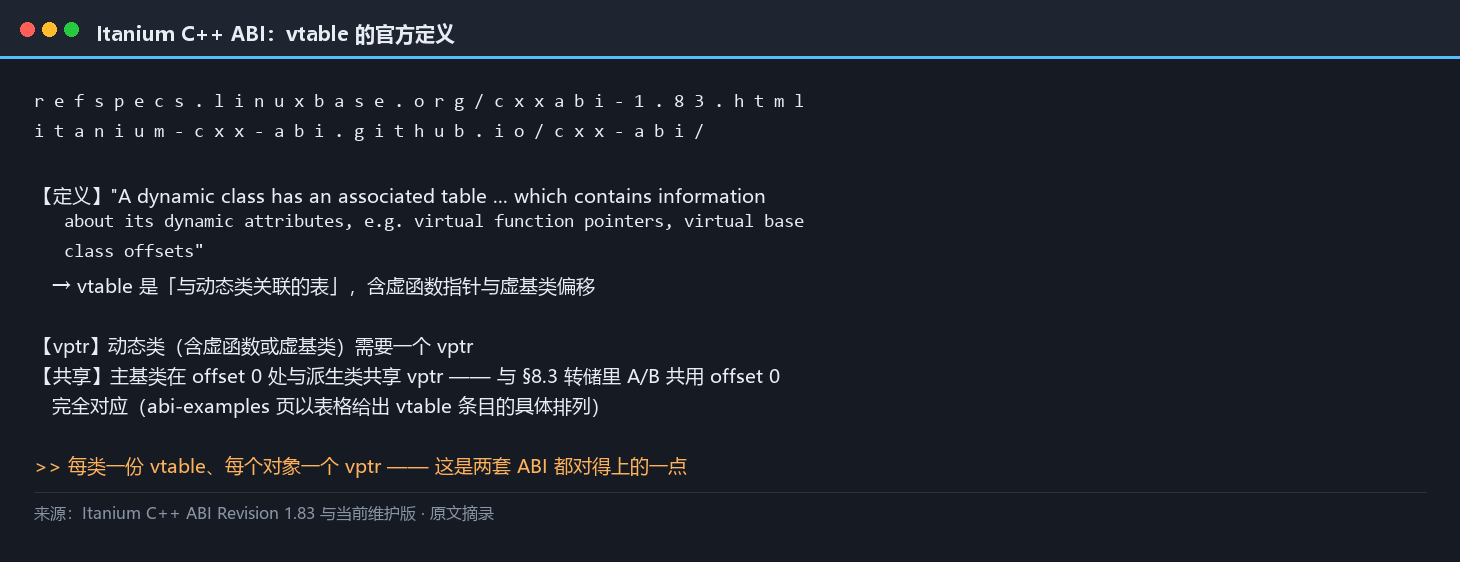
Itanium C++ ABI(GCC/Clang 在 Linux 侧遵循的那份规范)给了这套结构一个正式定义:
- "A dynamic class has an associated table ... which contains information about its dynamic attributes, e.g. virtual function pointers, virtual base class offsets"——vtable 是"与动态类关联的表",含虚函数指针与虚基类偏移;
- 动态类(含虚函数或虚基类)需要一个 vptr(Itanium C++ ABI 正文;Revision 1.83);
- 主基类在 offset 0 处与派生类共享 vptr——这与 §8.3 转储里
A/B共用 offset 0 完全对应,ABI 的示例页还以表格给出了 vtable 条目的具体排列。
8.6 MSVC 侧的对应口径
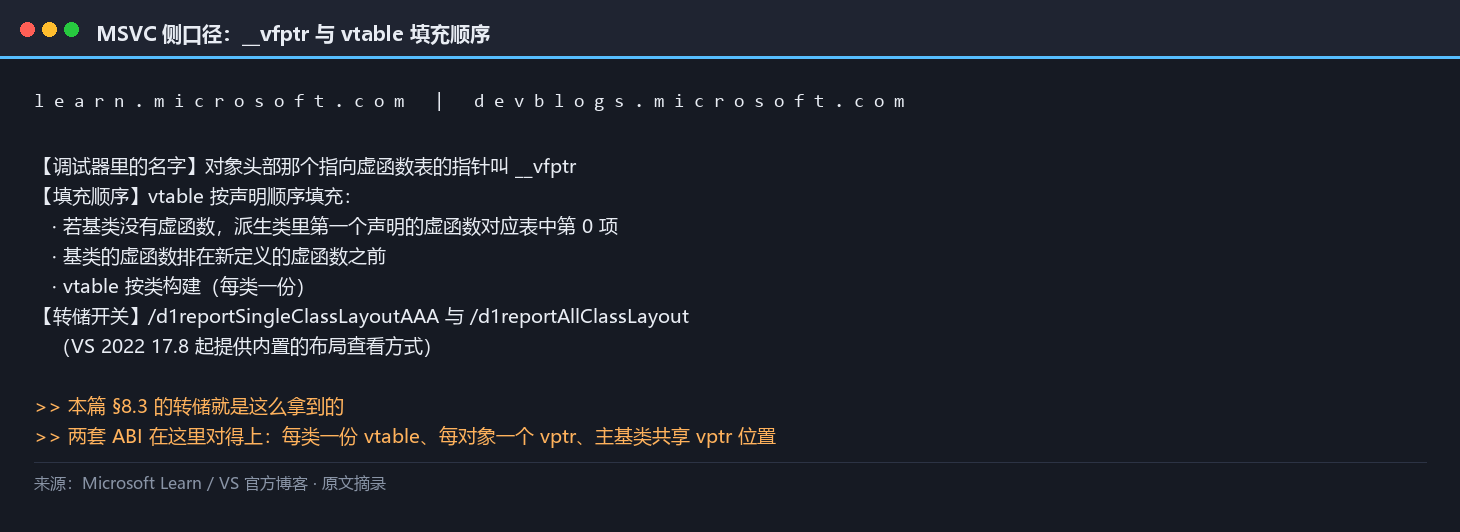
- 调试器里那个指针叫
__vfptr; - vtable 按声明顺序填充:微软的口径说明,若基类没有虚函数,派生类里第一个声明的虚函数对应表中第 0 项;基类的虚函数排在新定义的虚函数之前;vtable 按类构建;
- 类布局可以用
/d1reportSingleClassLayoutAAA与/d1reportAllClassLayout转出来(Visual Studio 官方博客确认了这两个开关的用法)——本篇 §8.3 的转储就是这么拿到的。
两套 ABI 在这里对得上(每类一份 vtable、每个对象一个 vptr、主基类共享 vptr 位置),这也是为什么本篇的实测能同时用两套工具链解释同一批读数。
8.7 去虚拟化的官方口径(已见 §5.3)
GCC 的 -fdevirtualize / -fdevirtualize-speculatively、pass_ipa_devirt 的类型继承图分析、LLVM 的 WholeProgramDevirt、MSVC 与 final 的关联——这四条在 §5.3 已引原文。放在这里是为了收口:本篇最重的一处差异(同一份单态虚调用,一侧划掉一侧没划掉)不是玄学,它落在四份官方文档都明确写着的那组开关上。
8.8 模板膨胀:实测的斜率
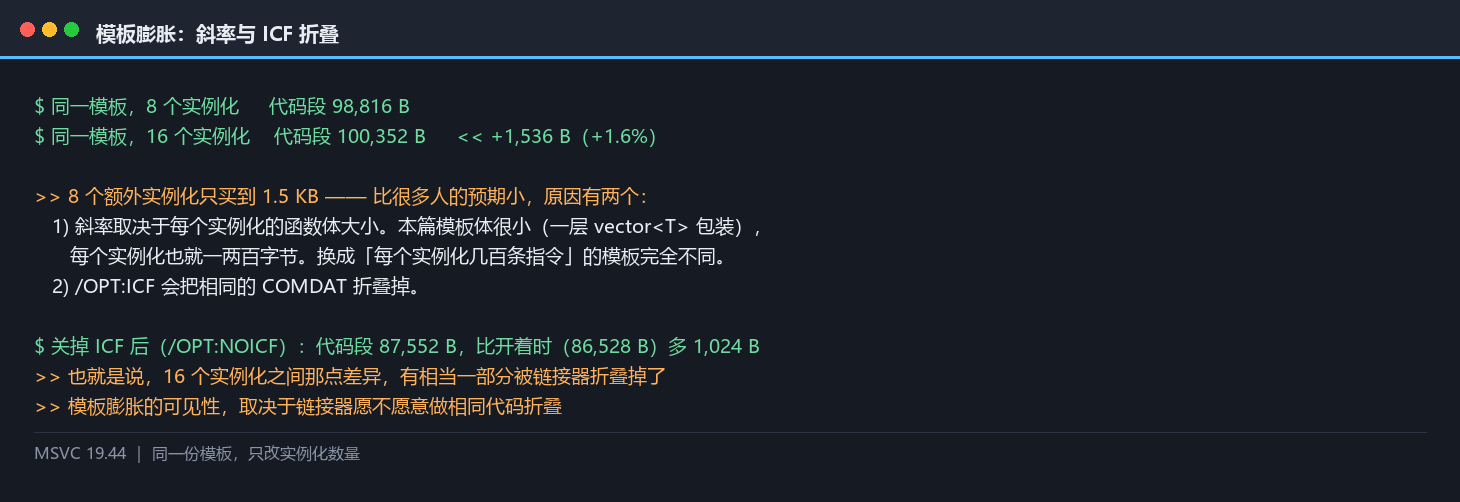
下面进入模板是"把类型编进代码",代价自然落在体积上。实测:
同一模板,8 个实例化     代码段 98,816 B
同一模板,16 个实例化    代码段 100,352 B     ← +1,536 B(+1.6%)
8 个额外实例化只买到 1.5 KB。 这个数字比很多人的预期小,原因有两个,都值得写清:
- 膨胀的斜率取决于每个实例化的函数体大小。Stroustrup 在访谈里就以
template<class T> class list举例说明过这件事。本篇的模板体很小(一层vector<T>的包装),所以每个实例化也就一两百字节。换成"每个实例化几百条指令"的模板,斜率会完全不同。 /OPT:ICF会把相同的 COMDAT 折叠掉。实测把 ICF 关掉后,代码段是 87,552 B,比开着时(86,528 B)多出 1,024 B——16 个实例化之间那点差异,有相当一部分被链接器折叠掉了。
第二条是本篇想强调的:模板膨胀的可见性,取决于链接器愿不愿意做相同代码折叠。所以"模板会带来多少体积"这个问题,同样不能脱离工具链回答。
8.9 膨胀的对策
好了,工程上的对策只有一条主线:把与类型无关的部分抽出去,让实例化只覆盖真正与类型相关的薄层。具体三种做法:
- 抽公共基:把不依赖
T的逻辑放进非模板函数或基类,模板里只留薄薄的转发层(工程侧的整理); - 编译期分支:用
if constexpr在同一实例里处理不同分支,而不是再生成一份; - 反向选择:用类型擦除换体积——把多变体收敛成一个擦除接口,代价是 §7 那一整套开支。这一条只在"非热路径"上划算。
第三条是对本篇前半部分的回收:膨胀与擦除是同一枚硬币的两面——一边省体积(擦除)、一边省间接调用(模板),选哪面取决于这段代码是否在热路径上。
8.10 vtable 里还有别的东西:RTTI 槽位
§8.3 的转储里,Op 的 vtable 旁边还多出一行 vftable 标签(以 Op:: 开头、带一个美元符号分隔的名字段)与 &Op_meta。这个 _meta 指向的是类型信息结构——vtable 不只存虚函数指针,它旁边还挂着 RTTI 的数据。
这带来两件本篇不展开、但要留个记号的事:
- 带虚函数的类天生带 RTTI 数据(除非禁用 RTTI),这部分成本不由你选择;
dynamic_cast与typeid走的就是这份数据——它们是另一条"运行时问类型"的路径,与any_cast(§7.5)不同但同类。
这正是下一篇 ep09 的入口:本篇讲"主动把类型藏起来要付什么",下一篇讲"语言机制替你留下了哪些痕迹"。RTTI 数据是其中最显眼的一处——它在你没写任何一行相关代码的情况下,已经躺在二进制里了。
九、选型判据与工程建议
说白了,前面所有章节都在量代价,这一章把它们收成一组可以在设计评审里直接用的判据。判据按顺序问,不按重要性排——因为前一条的答案会决定后一条要不要问。
9.1 四条判据,按顺序问
判据一(热路径):这段代码在热路径上吗?不在 → 选可读性最好的那个,本篇所有读数与它无关。
判据二(目标确定性):在热路径上,且目标在编译期或运行期唯一且已知 → 模板最稳;虚函数/variant/擦除可能被划掉(GCC 更积极,MSVC 更保守),别赌,量。
判据三(目标多变):在热路径上,且目标真的会在运行期变化 → 这是唯一必须付账的场合。此时:
- 候选集合小且封闭 → 优先
variant(无堆、可内联),但先在两套工具链上量一遍——本篇实测两侧结论相反; - 候选集合开放(插件、回调) → 虚函数或擦除二选一,选分配行为可控的那个;
- 把分配挪出热路径:对象预分配、用
pmr内存资源(ep02 的主题),别让热循环去malloc。
判据四(体积与编译时间):只有前三条都指向模板时,才去核对代码体积与编译时间(ep04 的账本)。顺序不能反——为了体积去选模板,通常会挑错。
9.2 三条可操作的工程建议
- 给编译器一个承诺:如果你的类不会再被继承,写上
final。微软官方明确final有助于去虚拟化——这是"零成本的性能标注"里最划算的一个。 - 别把
std::any放进热路径。它是本篇阶梯的底(7 倍量级),且三层代价叠加。需要"装任意类型"时,先问"类型集合是否真的开放"——封闭就换variant。 std::function的瓶颈通常不是堆。本篇实测零分配那一档并不更快。要优化它,就去减少它在热路径上的出现次数,而不是去调 SBO 阈值。
9.3 关于"用 variant 替代虚函数"的流行建议
本篇不支持把它当通用建议。实测是:
- MSVC 上
variant-poll4(2.421)比virtual-poll4(2.208)更慢; - GCC 上反过来(1.058 对 2.229);
- 公开实测里还有"随 libstdc++ 版本翻转"的记录。
另一份追踪 libstdc++ 实现演进的实测也印证了同一件事。所以正确说法是:"在封闭集合、且你的标准库 visit 实现走快路径的前提下,variant 有优势——这个前提必须自己验。"一句话的通用建议,会把三个变量全藏起来。
9.4 常见误用清单
把本篇实测能直接支持的五条误用列出来,每条都配一句"该怎么做":
| 误用 | 为什么是误用 | 该怎么做 |
|---|---|---|
在热循环里构造 std::function |
构造本身可能带一次分配(超过 SBO 阈值时) | 循环外构造一次,循环里只调用 |
用 std::any 传"可能多种类型"的参数 |
实测 7 倍量级,且极小对象也走堆 | 类型集合封闭就换 variant |
为了"少一次间接调用"给所有类加 final |
final 只有在编译器真去虚拟化时才有收益,它同时放弃了继承 |
只给出设计上确实不该被继承的类加 |
| 照抄"variant 比虚函数快"改架构 | 实测两侧结论相反 | 先在本工具链量一遍,再决定改不改 |
把 std::function 慢归因于堆分配 |
实测零分配那一档并不更快 | 先分清瓶颈在分配还是在间接调用 |
这五条有一个共同点:它们的错误都不是"性能直觉错了",而是"把一个带前提的结论当成了无条件结论"。本篇从头到尾在讲同一件事——性能结论的前提,就是它的适用边界。
十、收束与下一篇钩子
10.1 全篇读数汇总
好了,把本篇测出的全部读数集中在一张表里,便于对照与复核。每一档的原始输出都随篇留档在 evidence/ 下,表里任何一个数字都可以逐字回溯到某一行的日志。
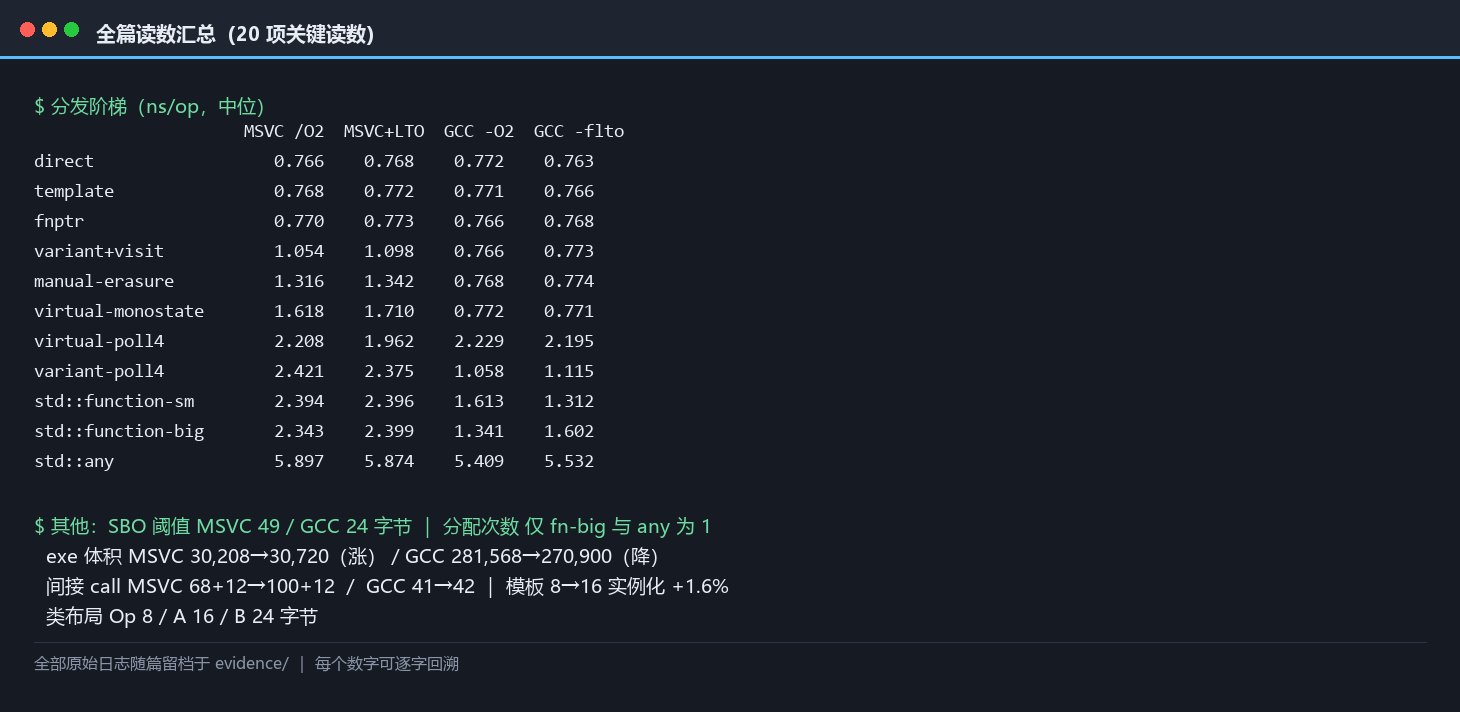
分发阶梯(ns/op,中位)
                               MSVC /O2   MSVC+LTO   GCC -O2   GCC -flto
direct                           0.766      0.768      0.772     0.763
template                         0.768      0.772      0.771     0.766
fnptr                            0.770      0.773      0.766     0.768
variant+visit(单态)            1.054      1.098      0.766     0.773
manual-erasure                   1.316      1.342      0.768     0.774
virtual-monostate                1.618      1.710      0.772     0.771
virtual-poll4                    2.208      1.962      2.229     2.195
variant-poll4                    2.421      2.375      1.058     1.115
std::function(小捕获,SBO)      2.394      2.396      1.613     1.312
std::function(大捕获,堆)       2.343      2.399      1.341     1.602
std::any                         5.897      5.874      5.409     5.532

其他关键读数
SBO 首次分配阈值                MSVC 49 字节 / GCC 24 字节
堆分配次数                      仅 std::function(大捕获)与 std::any 为 1,其余全 0
exe 体积                        MSVC 30,208→30,720 B(涨)| GCC 281,568→270,900 B(降)
间接 call 计数                  MSVC 68+12 → 100+12 | GCC 41 → 42
模板 8→16 实例化                代码段 98,816→100,352 B(+1.6%);关 ICF 后 87,552 B
类布局                          Op size 8(仅 {vfptr})| A size 16 | B size 24
10.2 两套工具链的证据形态
本篇的结论之所以敢写排序会变,是因为每一处判断都有不依赖时间的证据兜底。这一节把两套工具链各自能拿到哪些结构性证据列清楚——如果你的环境里只有其中一套,照这张表也能把同一批结论验一遍。
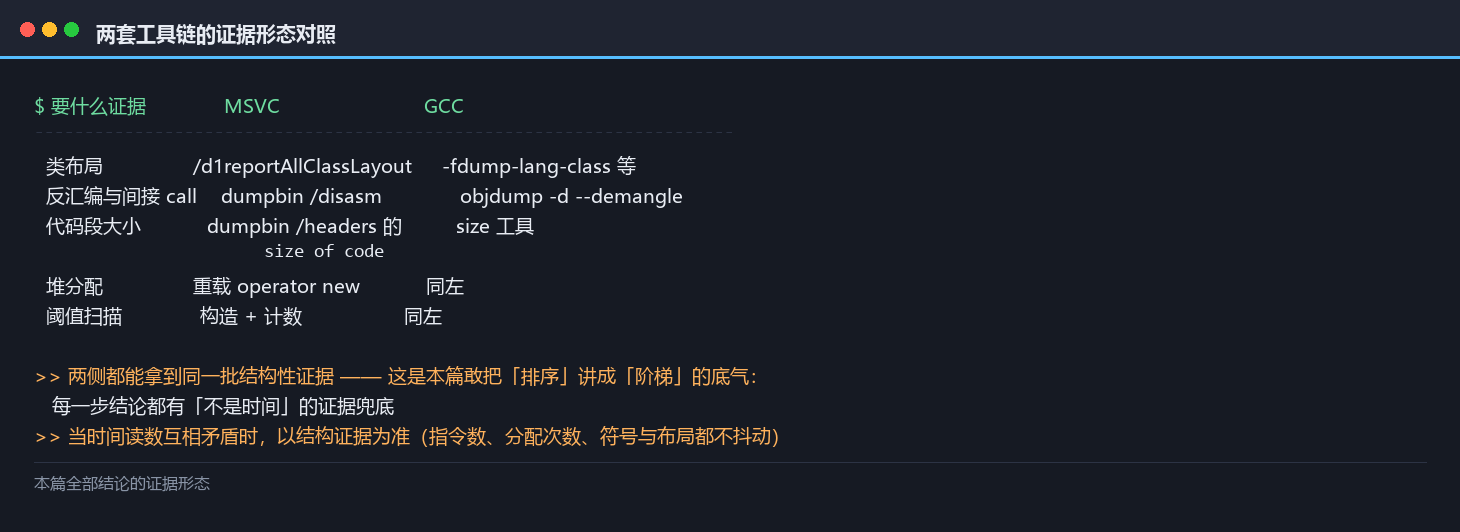
| 要什么证据 | MSVC | GCC |
|---|---|---|
| 类布局 | /d1reportAllClassLayout(§8.3) |
-fdump-lang-class 等 |
| 反汇编与间接 call 计数 | dumpbin /disasm |
objdump -d --demangle |
| 代码段大小 | dumpbin /headers 的 size of code |
size 工具 |
| 堆分配 | 重载 operator new |
同左 |
两侧都能拿到同一批结构性证据——这是本篇敢把"排序"讲成"阶梯"的底气:每一步结论都有不是时间的证据兜底。
10.3 复现流程
下面进入复现这一篇不需要任何私有环境:四个源文件、两套公开工具链、每套两档开关。下面这张图把完整流程串起来,包括编译器版本、必须的 C++17 开关、以及三类取数各自用什么命令。
复现需要:四个源文件、两套工具链(MSVC 19.44 / g++ 16.2,都要 C++17)、每套两档开关。全部原始日志与反汇编转储随篇留档于 evidence/。
10.4 自检清单
- [ ] 先确认这段代码在热路径上(不在,本篇所有读数与它无关)
- [ ] 再确认目标在运行期是否真的会变(不变 → 可能免费)
- [ ] 不会再被继承的类写上
final(有助于去虚拟化) - [ ] 把
std::any移出热路径(实测 7 倍量级) - [ ] 分清瓶颈是分配还是间接调用(本篇实测
std::function的瓶颈不是堆) - [ ] 需要 SBO 时量一下本工具链的阈值(MSVC 49 / GCC 24 字节)
- [ ]
variant与虚函数在你的编译器上量一遍(本篇两侧结论相反) - [ ] 用模板换性能时,核对代码体积与编译时间(ep04 的账本)
- [ ] 冻结工具链版本前重测一次(排序会随版本翻转)
- [ ] 全部原始输出留档(否则前面九条都只是"相信")
10.5 与系列其他篇目的交叉点
这篇不是孤立的,它与系列里四篇有直接接口:
- 与 ep01《对象布局、对齐与 padding》:
vptr是对象布局的一部分。§8.3 的转储里,Op的 8 字节全是 vptr,A的 16 字节里有 4 字节是对齐空洞——ep01 讲的是"字段怎么摆",本篇讲的是"摆进去的那一个指针带来什么"。 - 与 ep02《分配器解剖》:§7 那几个分配次数,最终都落在
operator new上。如果你在热路径上无法避免分配,下一步就是换分配器或改用pmr内存资源——那是 ep02 的内容。 - 与 ep04《编译期账本》:模板的代价不在运行期,在编译期与体积。本篇 §8.8 量出的膨胀斜率(8→16 实例化 +1.6%),要配合 ep04 的编译时间读数一起看,才能判断"用模板换性能"这笔交易是否划算。
- 与 ep07《链在一起》:两篇的靶子正好互补。ep07 的靶子是"编译器看不见"(TU 边界),本篇的靶子是"编译器看得见但不敢定"(运行期多变)。§4.5 那一段把两者的分工说清了:LTO 治看不见,去虚拟化治不敢定。
10.6 一条可以搬走的方法
言归正传,把本篇的做法抽象成三步:
- 把被测对象做到极小,让它的代价不被业务逻辑淹没——只有 3 条指令的成本,才能被 3 条指令的差异量出来;
- 让对照只差一个变量,并且这个变量要能"数出来"或"看出来"(目标是否唯一、捕获多少字节、实例化几个类型);
- 同时取时间与结构两类证据,冲突时以结构为准——指令数、分配次数、符号与 vtable 布局都不会抖动,时间会。
这三步与 ep07 的方法论是同一条,只是这一篇的"结构证据"多了一种:类布局转储(§8.3)。当你能把布局打出来时,"vptr 在哪、有没有空洞"这类问题就不再需要推理了。
10.7 资源清单
- 标准库与标准:
std::function、std::variant、std::any的语义(cppreference)|variant 提案 P0088R3 |libstdc++ 的std_function.h源码(SBO 判定)——见 https://en.cppreference.com/w/cpp/utility/variant - ABI 与类布局:Itanium C++ ABI(vtable 定义与示例)——见 https://itanium-cxx-abi.github.io/cxx-abi/abi.html|微软的类布局转储说明与 vtable 填充顺序
- 去虚拟化:GCC 手册
-fdevirtualize/-fdevirtualize-speculatively|GCC Internals 的 IPA devirtualization pass|LLVMWholeProgramDevirt|微软 C++ Team Blog 关于final与 devirtualization - 分支预测与微架构:Agner Fog 优化手册|"处理有序数组为什么更快"的经典实证
- 公开实测:stdlib 实现差异导致 variant/虚函数排序翻转的实测文、"variant 访问策略跳转表 vs switch"的实测、指针分发 vs variant 的实测
- 本篇证据:四个源文件 + 两套工具链全部原始日志、反汇编转储与读数 JSON,见本篇目录
evidence/
10.8 下一篇:异常与 RTTI
这一篇算的是"主动把类型藏起来"的账。下一篇算被动的那一笔:
ep09《异常与 RTTI:零成本到底成不成立》 异常处理常被称作"零成本"——不抛异常时不该有开销。这句话在多大程度上成立?这一篇会盯住三个位置:函数入口多出来的那段(如果有)、抛异常时的展开路径、以及 RTTI 在二进制里留下的那些数据结构(
type_info、vtable 里的 RTTI 槽位)。判据还是那两条:反汇编里多了什么、以及运行时真的走了哪条路。 会与本篇形成对照:本篇讲"把类型藏起来的主动代价",ep09 讲"语言机制替你留下的被动痕迹"。
本篇实测环境:MSVC 19.44.35228(VS 2022 Community,工具集 14.44.35207,
/std:c++17)|MSYS2 ucrt64 g++ 16.2.0(Rev3)|Windows x64 / PE-COFF。本机无 Clang、无 WSL,故 LLVM 侧的WholeProgramDevirt与 ThinLTO 只引官方原文、不做本机实测;计时为进程内steady_clock五次中位,非跨机器可比。本文由@溯光 出品 | 站点:https://yyy3d.online/blog/ | 本系列共 12 篇,本篇为第 8 篇
这一篇把四种"藏类型"的办法逐档量到了汇编一级,也把"排序会随编译器翻转"这件事摆到了台面上。如果它能帮你少一次"照着性能排序表选错方案"的返工,希望能对大家有所帮助。