站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:上一章留下一句话
上一篇我们跟着一条 Item 链走到实现层,看它怎么被收进定长数组、怎么按状态切成批,末尾留下一句结论:draw call 的数量取决于状态切换的次数,不取决于画了多少东西。那一篇把「批」当成一个已经存在的东西来用——它说了批是怎么被切出来的,没说的是:这批到底是谁、它凭什么能装下那么多东西、以及装不下了会怎样。
这一章要问的就是这三个问题。它们看着琐碎,但合起来正好是「2D 批处理」这件事的全貌;它们还有一个共同的历史背景——这条路在 Godot 4.4 才铺到所有渲染后端上,在那之前只有 Compatibility 后端走得到。
0.1 本系列的位置:这一篇落在第四层与第五层之间
好了,前面五篇把一次 2D 绘制的落点链走了一半:对象模型(第二篇)→ 服务层接口(第三篇)→ 画布剔除与排序(第四篇)→ 画布渲染抽象与中间表示(第五篇)。本篇接在第五篇后面,往同一层里再钻一步:第五篇讲「批是怎么切出来的」,本篇讲「批本身是什么、由谁管、代价在哪」。
整个系列按这条链路铺开,目录如下(本篇即第六行):
| # | 篇目 | 它回答的问题 | 状态 |
|---|---|---|---|
| 01 | 全景与边界 | 四层架构是什么、一次 2D 绘制要经过谁 | 已发布 |
| 02 | 对象模型 | 谁在什么时候把命令层下发 | 已发布 |
| 03 | 服务层接口 | 命令长什么样、怎么被排队 | 已发布 |
| 04 | 画布剔除与排序 | 画什么、按什么顺序 | 已发布 |
| 05 | 画布渲染抽象 | 绘制项里存了什么、怎么被提交 | 已发布 |
| 06 | 批处理(本篇) | 一批能装多少、按什么切、代价在哪 | 本篇 |
| 07 | RenderingDevice 抽象 |
命令列表怎么变成依赖图 | 待写 |
| 08 | 后端分叉 | 四条驱动怎么选、分叉在哪 | 待写 |
| 09 | 主循环与多线程 | 逻辑与渲染怎么错位 | 待写 |
| 10 | 资源侧 | 一张纹理从盘上到显存 | 待写 |
| 11 | 收官 | 这条链整体买到了什么 | 待写 |
好了,其中:这张表的用处是给出本篇与相邻两篇的接缝——上一篇交出「一批批的实例数据」,下一篇接手「这些实例怎么排进依赖图」。本篇要讲的,就是夹在这两句话中间的那一段。
0.2 沿用官方口径:三种渲染方法,四种驱动
口径先对齐,免得后面对不上。官方原句是「Godot 4 includes three renderers」——渲染方法是三种:Forward+、Mobile、Compatibility;驱动是四种:Vulkan、Direct3D 12、Metal、OpenGL(OpenGL 只能配 Compatibility)。可用组合一共 7 种。
本篇会反复用到「所有渲染方法」这个词,它指的就是 Forward+ / Mobile / Compatibility 这三种。
0.3 三个可检验命题
这一篇要留下三个能当场检验的命题,后文逐条兑现:
OK,1. 一批能装多少,是一个可配置的整数——它来自项目设置 rendering/2d/batching/item_buffer_size,默认 16384。改它,批的容量就变。
2. 切批有两层判据:项级看「裁剪主人」与「材质」,命令级看六条状态判据。两者都命中才叫一次真正的断批。
3. 攒批不是免费的:批不出来时成本照付——这句不是我们的判断,是官方在 4.6 的博客里自己写的。
0.4 先把三个词的边界划清
后面会反复用到三个词,它们常被混着说,先把边界划出来:
| 词 | 指的是什么 | 谁产的 | 本机怎么看 |
|---|---|---|---|
| 批(batch) | 一份状态快照+一段实例内存:状态决定用哪条管线,实例是这一批要画的东西 | 渲染实现层(_new_batch) |
无直接计数器,只能从 draw call 反推 |
| 实例(instance) | 一条命令在 GPU 侧的那 128 字节数据 | 渲染实现层(_add_to_batch) |
图元数 ÷ 图元每实例数 |
| draw call | 一次真正的提交 | 批落盘时发出 | Performance.get_monitor() 直接读得到 |
其中:三者的关系是一句话——一批里有若干实例,一批对应一次 draw call。所以「为什么 draw call 少了」这类问题,答案永远落在「批变少了」,而「批为什么变少」又要落到「判据有没有被触发」。
这张表还有一层用处:它解释了本篇的证据结构为什么长这样。批与实例都在内存里、没有现成计数器,能直接读到的只有 draw call 与图元数——所以我们所有的结论,都是从这两个可见的量反推出来的,再拿源码去解释这个反推。
0.5 边界声明:本篇不涉及什么
按系列约定,三条边界在本篇的落法如下:
OK,说白了,1. 不写矢量光栅算法(归《2D 矢量引擎深挖》)——本篇不写「一条曲线怎么变成像素」,只写「同一批里的命令为什么能一次提交」; 2. 不写渲染 API 教程(归《Vulkan/OpenGL 官方最佳实践》)——不写 Vulkan/D3D12 的接口用法,只写 Godot 怎么组织缓冲与管线; 3. 不写硬件微架构(归《GPU 架构剖析》)——只在「批处理为什么省 draw call」相接处点到为止:写 CPU 侧省下了什么、GPU 侧付了什么,不下探 ROP 与显存层级。
还有一条本篇自加的:4.6 那次「2D 渲染器大改」,官方只给了结论(1.1×–7×)与 PR 号。本篇不据 PR 号推测实现细节,只按其官方措辞如实转述;要展开,留待后续修订版。
0.6 本篇的读法:三层证据怎么配合
本篇的证据分三层,它们不是并列关系,而是互相钉住的关系:
| 层 | 它回答 | 它的局限 | 本篇用在哪 |
|---|---|---|---|
| 官方文档与文章 | 官方口径是什么、什么时候变的 | 只给结论,不给落点 | 一、二、十二章(版本转折与代价) |
| 官方源码原文 | 在哪一行发生 | 静态阅读,不知道跑起来是不是这样 | 三到十章(机制全貌) |
| 本机探针读数 | 跑起来对不对 | 只有一台机器、一种方法 | 十一章(容量与判据的行为) |
其中:三层配合的方式是「文档定口径 → 源码定落点 → 读数定行为」。少了任何一层都会留下缺口:只有文档会停在「官方说支持」;只有源码会停在「看起来是这样」;只有读数会停在「现象对上了,但不知道为什么」。这也是本系列一路以来固定下来的取证方式。
0.7 全量清单与归类:本篇要讲的十二个点
先把本篇会碰到的全部机制点列出来(宁全勿缺),再归一次类。清单来自三处:项目设置注册处、批处理的四个函数、以及官方两篇文章。
全量清单(12 项)
rendering/2d/batching/item_buffer_size(默认 16384,范围 128–1048576)rendering/2d/batching/uniform_set_cache_size(默认 4096,范围 256–1048576)rendering/gl_compatibility/item_buffer_size(Compatibility 的同名项)_render_batch_items()(唯一的批处理入口)- 「第一条项自成一派」
_new_batch() - 项级换批(
final_clip_owner/ 材质 / 画布组材质) - 命令级六条换批判据
_new_batch()的「拷贝上一批再改」_add_to_batch()与超限buffer_flush+ 强制切批new_instance_data()与中间实例数据(write-combined)ShaderSpecialization三位 + 四个着色器变体组(六变体) 言归正传,12.InstanceData(128 字节,编译期断言)
二次归类(按「它在整条链的哪一段起作用」)
| 类 | 包含 | 它决定什么 |
|---|---|---|
| 入口与容量 | 1、2、3、12 | 一批能装多少 |
| 切批判据 | 5、6、7 | 一批有几个 |
| 对象与写入 | 4、8、9、10 | 一批怎么写出来 |
| 管线与代价 | 11,以及第十二章的官方结论 | 一批贵在哪 |
其中:这张归类表就是本篇的结构骨架——三、四章讲「入口与容量」,五到七章讲「切批判据」,七到十章讲「对象与写入」,十到十二章讲「管线与代价」。清单是「面」,归类是「骨」;有了这张骨头,后面每一章都知道自己补在哪。
源码可在 renderer_canvas_render_rd.cpp 的在线页面上对照阅读(与本篇引用的 raw 文件同一份内容)。
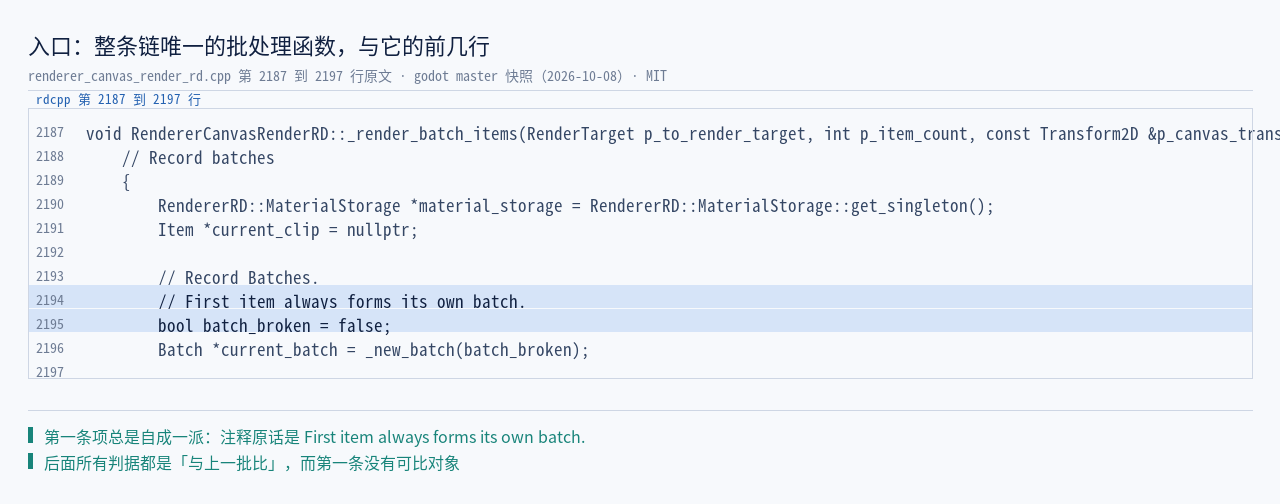
言归正传,上面的函数签名是本篇的入口。其中:p_item_count 是这一轮收进数组的项数,p_to_backbuffer 决定这一批落在主缓冲还是背缓冲上,r_sdf_used 是回传值——它出去时告诉上游「这一帧要不要生成遮挡距离场」。
它被调用的位置在剔除层的尾巴上,也就是上一篇反复提到的那一行:
// servers/rendering/renderer_canvas_cull.cpp:105(master 快照 2026-10-08;源文件该行本是一整行,此处按可读性换行)
RSG::canvas_render->canvas_render_items(p_to_render_target, list, p_modulate,
        p_lights, p_directional_lights, p_transform, p_default_filter,
        p_default_repeat, p_snap_2d_vertices_to_pixel, sdf_flag, r_render_info);
其中:list 就是剔除层一路串下来的那条链,sdf_flag 是那个回传位。这段代码的原理只有一句:上游做完「决定」,下游只负责「兑现」——剔除层决定画什么、按什么顺序,渲染层决定怎么把它们变成提交。本篇研究的全部内容,都发生在这条分界线之后。
把这一章的路线图先摊开:链表收进数组(第五章已讲)、状态一致者合成批(本篇第七章)、批里装着实例(第八章)、一批一次发出去(第七章末)。四个环节里,后三个都是新内容。
本章出处:上一篇的结论见第五篇;本文所有源码行号一律按 godot master 快照(2026-10-08),逐条回本机 clone 复核,不做算术平移。
一、官方口径的两版对照:同一句话,两个结论
说白了,这一章只做一件事:把两版官方文档里同一节、同一句位置的话摆在一起看。因为后面所有的源码读法都要对着一版口径来读,先把这个口径钉死。
1.1 4.3 的写法:只有 Compatibility 有
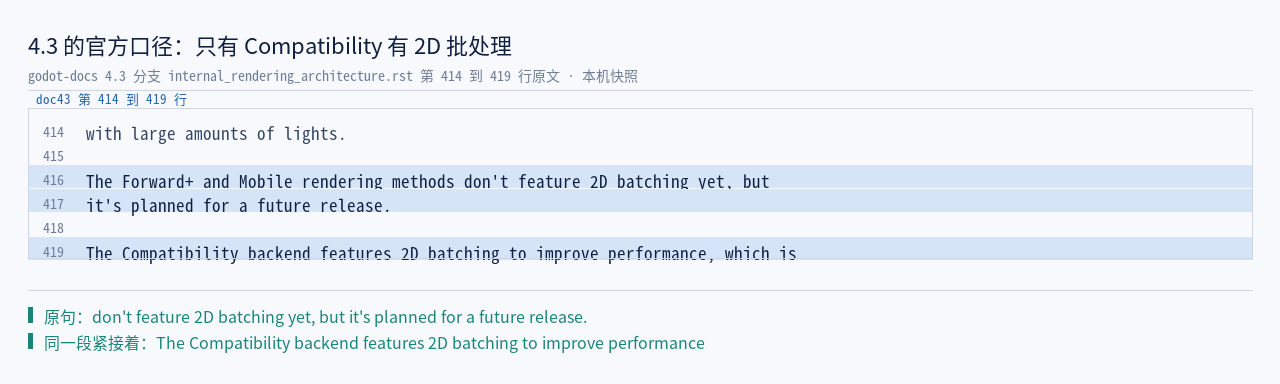
原文两句话连在一起:Forward+ 与 Mobile 还不支持 2D 批处理,但「计划在未来版本」(don't feature 2D batching yet, but it's planned for a future release.);紧接着一句:Compatibility 后端支持 2D 批处理以提升性能,在屏幕上有大量文字时尤其明显(The Compatibility backend features 2D batching to improve performance, which is especially noticeable with lots of text on screen.)。
先来看看,这里有个容易漏掉的细节:4.3 这句话把「benefit 的场景」也说清了——大量文字。为什么是文字?因为文字是「同一份纹理上重复很多次」的典型:一个字形的四边形与下一个字形的四边形,状态完全一致,天然该进同一批。
1.2 master 的写法:所有渲染方法都有
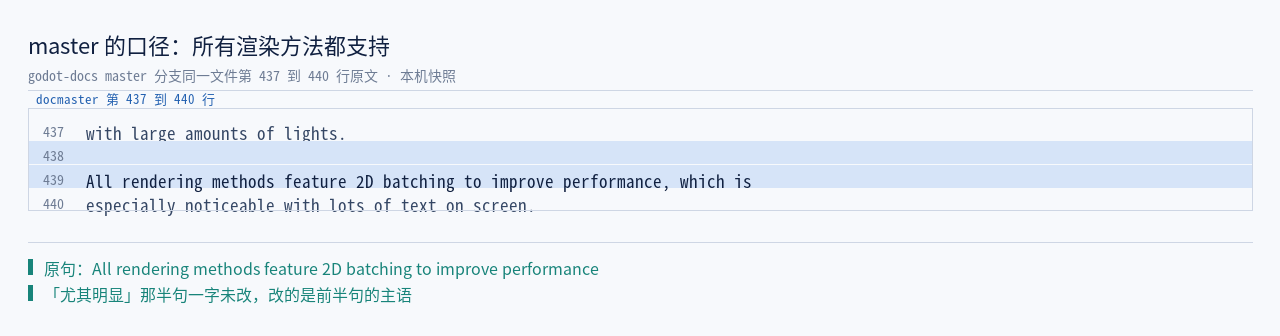
同一节、同一句位置,现在写的是:所有渲染方法都支持 2D 批处理以提升性能,同样在大量文字时尤其明显(All rendering methods feature 2D batching to improve performance, which is especially noticeable with lots of text on screen.)。
「尤其明显」这半句一字未改,改的是前半句的主语:从「Compatibility 一个后端」变成了「所有渲染方法」。
上图把两版并排。其中:左边一列是 4.3 分支,右边一列是 master 分支;两列的「受益场景」完全相同,只有「谁支持」这一项从「一个后端」扩到了「全部」。这就是那句话改口的全部内容。
1.3 为什么值得单开一章
因为这句话不是文档的措辞问题,而是实现事实的投影。文档改口之前,Forward+ 与 Mobile 上确实没有 2D 批处理这条路;改口之后才有的。而这条路的入口,就是本篇要讲的那些函数。
换句话说:看 4.3 时代的源码解读,和看现在的源码,看到的不是同一套东西。中文侧不少「Godot 2D 批处理」的文章至今仍按「Compatibility 才有」的旧口径在写——这就是我们在这一章要把两版摆在一起的原因。
1.4 这句话可以自己复核
这一段是可复现的:两个版本的同一路径文件都能直接取回,取回后只 diff 那一节即可。
把 <分支> 换成 4.3 或 master:
https://raw.githubusercontent.com/godotengine/godot-docs/<分支>/tutorials/contributing/development/core_and_modules/internal_rendering_architecture.rst

# 本机快照实测(2026-10-08 取回)
4.3   分支文件 40,772 字节 | 命中行为 L416–419
master 分支文件 43,622 字节 | 命中行为 L439
先来看看,换个角度看,其中:两个文件大小相差约 2.8 KB,但差异不止这一句——4.6 之后文档又新增了 SDF 一段等内容。所以「改口」这件事要按句核,不能按文件大小或行号差推;这也是本篇所有引用都标行号、并且不做算术平移的原因。
本章出处:两版原文均取自本机 godot-docs 快照(4.3 分支文件 40,772 字节 / master 分支文件 43,622 字节,2026-10-08 取回);官方 4.3 发布页与4.4 发布页可对照阅读。
二、转折发生在 4.4:官方的说法与署名
上一章看到了「改口」,这一章找「是谁改的、什么时候改的、后来为什么又要返工」。
2.1 4.4 发布说明里那张卡
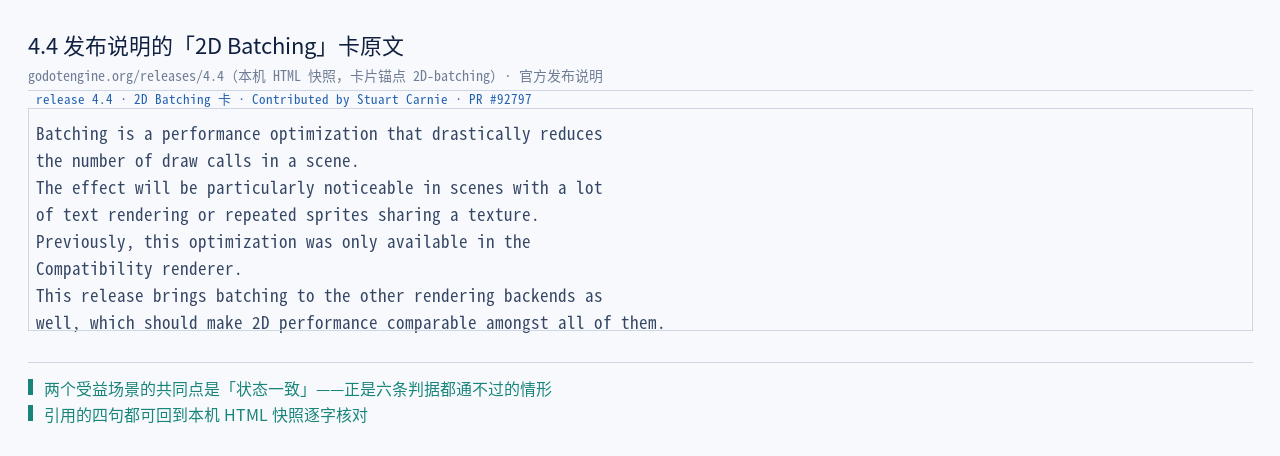
官方 4.4 发布说明里有一张专卡(页面内锚点 id="2D-batching"),原文四句:
- 批处理是一种性能优化,大幅减少场景中的 draw call 数量(
drastically reduces the number of draw calls); - 效果在大量文字渲染、或共享同一张纹理的重复精灵时尤其明显;
- 此前这个优化只在 Compatibility 渲染器里有(
Previously, this optimization was only available in the Compatibility renderer.); - 本次发布把批处理带给了其余渲染后端(
This release brings batching to the other rendering backends as well),使各后端的 2D 性能可比。
第 4 句就是上一章那句文档改口的发布说明侧版本。两处互相印证:转折在 4.4。
2.2 那张卡的原文
把卡上的四句按原样抄下来,便于逐句核对:
Batching is a performance optimization that drastically reduces the number of draw calls in a scene.
The effect will be particularly noticeable in scenes with a lot of text rendering or repeated sprites sharing a texture.
Previously, this optimization was only available in the Compatibility renderer.
This release brings batching to the other rendering backends as well, which should make 2D performance comparable amongst all of them.
其中:第 2 句给了两个受益场景——大量文字、以及共享同一张纹理的重复精灵。这两个场景的共同点是「状态一致」,正是第六章那六条判据都通不过的情形;换句话说,判据不触发的地方,就是批处理收钱的地方。这段文本的原理与上一章的文档改口是同一件事的两面:一面是「谁支持」,一面是「为什么值得支持」。
2.3 署名与 PR
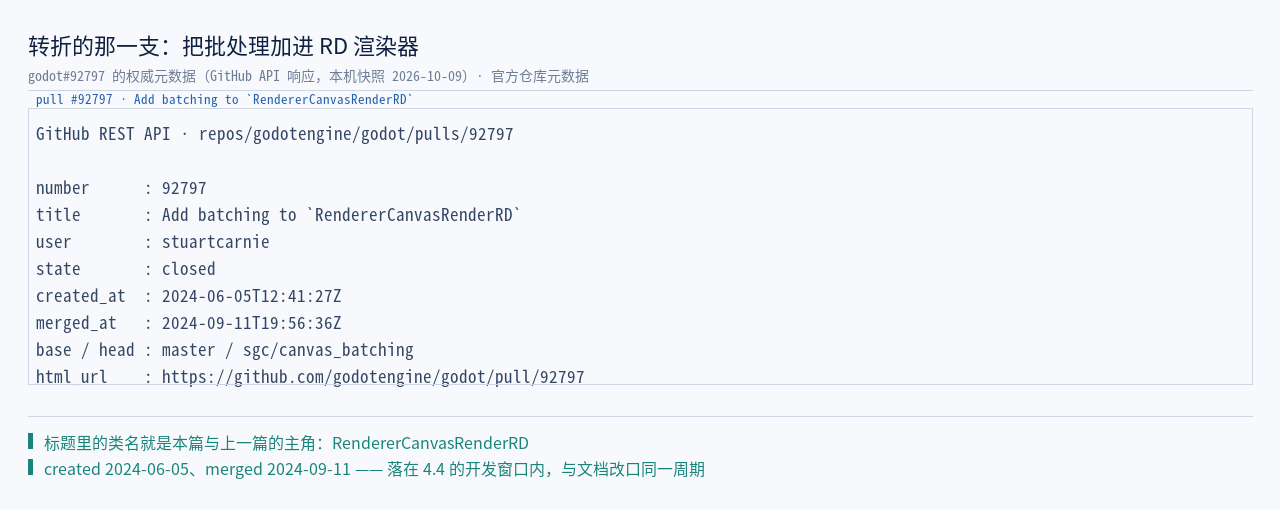
RendererCanvasRenderRD,created 2024-06-05、merged 2024-09-11@ GitHub API 响应(本机快照 2026-10-09)再说一遍,同一张卡上标着贡献者 Stuart Carnie(GitHub 用户名 startcarnie),对应的 PR 是 godot#92797。
这里要格外小心一件事:同一页相邻卡片还有别的贡献者署名,我们核对时是按卡内署名逐条对齐的,不是按页面顺序猜的。做技术引用时这一步不能省——「谁做的」写错,比不写更糟。
2.4 后来为什么又改了一次
下面我们开始,上图是这条路的三个节点。第三个节点值得先说结论:4.4 把批处理铺到所有后端之后,出现了「4.4 比 4.3 明显更慢」的报告,集中在老旧、低端的移动设备上——而这些设备恰好是受 GPU 限制(GPU-bottlenecked)的。于是 4.6 的开发期里,2D 渲染器被大改了一遍,目标是压低「批处理带来的 GPU 成本」。
这一节是本文「代价」那一章(第十二章)的引子:4.4 的收益与 4.6 的返工,是同一件事的两面。
本章出处:4.4 发布说明(本机 HTML 快照 259,905 字节,锚点 2D-batching)|4.6 dev 5 官方博客(本机 HTML 快照 41,369 字节)|godot#92797 与 godot#112481。
三、批的三行进口:两个旋钮与一个字节数
上一章讲的是「什么时候有的」。从这一章起进源码。第一站是:一批能装多少,这个数从哪来。
3.1 三行代码决定一批的容量
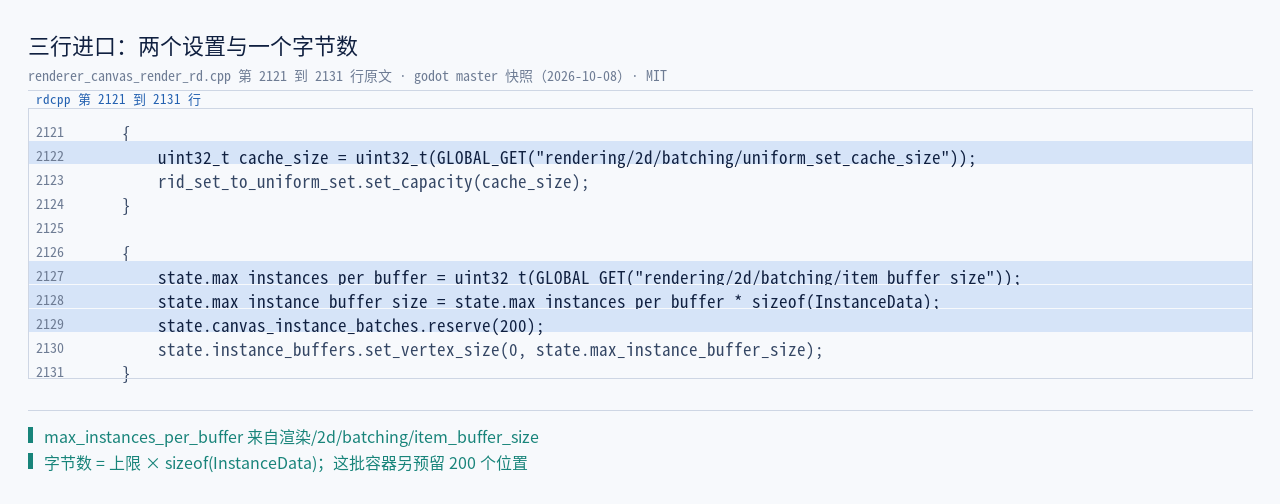
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:2121–2131(master 快照 2026-10-08)
{
        uint32_t cache_size = uint32_t(GLOBAL_GET("rendering/2d/batching/uniform_set_cache_size"));
        rid_set_to_uniform_set.set_capacity(cache_size);
}

{
        state.max_instances_per_buffer = uint32_t(GLOBAL_GET("rendering/2d/batching/item_buffer_size"));
        state.max_instance_buffer_size = state.max_instances_per_buffer * sizeof(InstanceData);
        state.canvas_instance_batches.reserve(200);
        state.instance_buffers.set_vertex_size(0, state.max_instance_buffer_size);
}
其中:第一段的 cache_size 是一个管线缓存的容量(谁和谁组合过的 uniform set 记下来,下次直接取);第二段的三个量才是批的容量本身——max_instances_per_buffer 是一批最多几条实例,max_instance_buffer_size 是把它换算成字节数,而 canvas_instance_batches.reserve(200) 是给「批的容器」预留 200 个位置。
话说回来,这段代码的原理一句话:批的容量不是写死的常数,而是从一个项目设置里读出来的整数,再乘一条实例的字节数。这也是为什么改设置能改行为——第七章到第十一章会把这句兑现。
3.2 那两个设置的默认值与范围
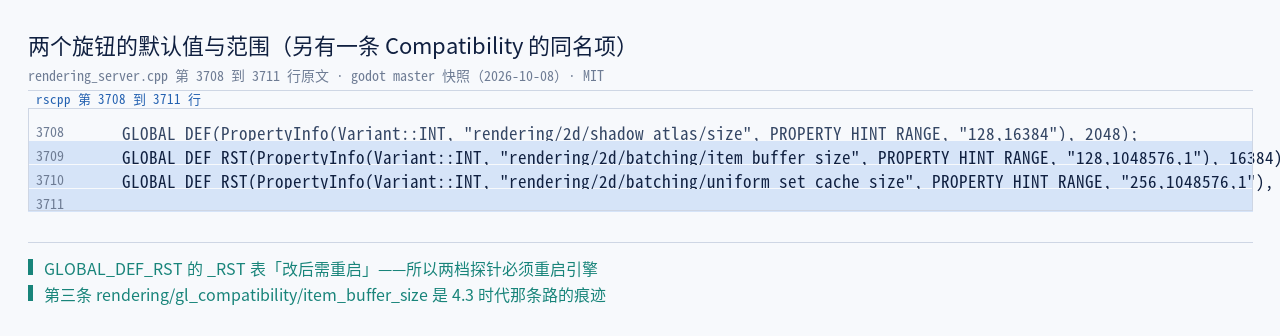
// servers/rendering/rendering_server.cpp:3708–3711(master 快照 2026-10-08)
GLOBAL_DEF(PropertyInfo(Variant::INT, "rendering/2d/shadow_atlas/size", PROPERTY_HINT_RANGE, "128,16384"), 2048);
GLOBAL_DEF_RST(PropertyInfo(Variant::INT, "rendering/2d/batching/item_buffer_size", PROPERTY_HINT_RANGE, "128,1048576,1"), 16384);
GLOBAL_DEF_RST(PropertyInfo(Variant::INT, "rendering/2d/batching/uniform_set_cache_size", PROPERTY_HINT_RANGE, "256,1048576,1"), 4096);
// Number of commands that can be drawn per frame.
GLOBAL_DEF_RST(PropertyInfo(Variant::INT, "rendering/gl_compatibility/item_buffer_size", PROPERTY_HINT_RANGE, "128,1048576,1"), 16384);
其中:GLOBAL_DEF_RST 的 _RST 意思是改后需重启(restart required)——这条对做实验的人很关键:运行期改它无效,必须写进项目配置再启动。取值范围 128,1048576,1 是「最小 128、最大 1048576、步长 1」。
两个默认值直接回答了本篇的第一个命题:item_buffer_size 默认 16384,uniform_set_cache_size 默认 4096。而第三个 GLOBAL_DEF_RST 是本文最值得留意的一处:它注册的是 rendering/gl_compatibility/item_buffer_size——Compatibility 后端有一条自己的、同名不同路径的实例缓冲上限,默认值也是 16384。
这条第三项就是第一章那句 4.3 文档的源码侧痕迹:在那个年代,只有 Compatibility 这条路有「一批装多少」这个概念,所以它需要自己的旋钮;2D 的通用批处理还没有。
3.3 一个整数怎么变成一批的容量
好了,上图把 §3.1 那三行的因果链摊开:设置里的 16384 → 实例上限 16384 条 → 乘一条实例的 128 字节 → 2,097,152 字节(2 MiB)的顶点缓冲 → 一批的容量。环环相扣,中间没有第二个来源。
这条链有两个值得记住的性质。一是它只有一次乘法——从「条数」到「字节数」只乘了 sizeof(InstanceData),没有别的系数、也没有对齐补白;二是它的两端性质不同:设置是可以改的,结构体大小是编译期钉死的。所以想改批的容量,唯一的入口就是那个设置,改别的都没用。
| 设置 | 默认 | 范围 | 作用 | 何时生效 |
|---|---|---|---|---|
rendering/2d/batching/item_buffer_size |
16384 | 128 – 1048576 | 一批最多几条实例 | 改后需重启 |
rendering/2d/batching/uniform_set_cache_size |
4096 | 256 – 1048576 | 管线 uniform set 缓存容量 | 改后需重启 |
rendering/gl_compatibility/item_buffer_size |
16384 | 128 – 1048576 | Compatibility 路线自己的实例上限 | 改后需重启 |
3.4 本机回读:与源码默认值逐条对上
好了,我们的探针在运行期把这两个值读回来(ProjectSettings.get_setting()),得到的是 item_buffer_size = 16384、uniform_set_cache_size = 4096——与源码里注册的默认值逐条一致。这一步不是形式主义:它证明我们后面改的那个设置,确实是引擎真正在用的那个,而不是同名的另一个键。
3.5 这两个旋钮各自护着什么
第三章开头把两个设置并列摆出来了,但它们的职责完全不同,值得分开说清楚——一个是「一批装多少」,一个是「同一条管线能复用多久」。
| 旋钮 | 护的东西 | 调大的好处 | 调大的代价 |
|---|---|---|---|
item_buffer_size |
一批的实例上限 | 同一批能装更多,批数更少 | 单条实例缓冲更大(16384 × 128 = 2 MiB);一次冲刷搬的数据更多 |
uniform_set_cache_size |
管线 uniform set 的缓存条数 | 反复出现的管线组合不用重建 uniform set | 常驻内存上升 |
其中:这两个量的调参方向是相反的诉求——item_buffer_size 想「少切批」,uniform_set_cache_size 想「少重建」。它们共同决定了批处理这条路走起来顺不顺。按本篇边界声明第 3 条,这里只到「谁护着什么」为止,不去算显存与带宽的细账。
本章出处:源码 renderer_canvas_render_rd.cpp(:2121–2131)|rendering_server.cpp(:3708–3711)|设置项说明见官方 ProjectSettings 类参考。
四、入口与第一批:为什么第一条项总是自成一派
批的三行进口讲完了,接下来看「进来之后怎么起头」。
4.1 入口只有一个
上一篇已经讲过:实现层在一次遍历里把链表收进定长数组,收满或走完就冲刷一次(_render_batch_items)。这一篇要补的是冲刷之后发生了什么。
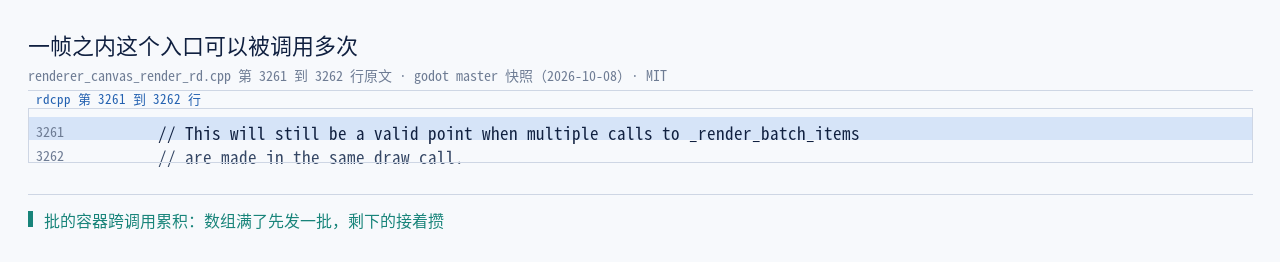
OK,OK,源码里有一句注释把它说清楚了:一帧之内,这个入口可以被调用多次(This will still be a valid point when multiple calls to _render_batch_items are made in the same draw call.)。也就是说,批的容器是跨调用累积的,不是每次都从头来。这解释了为什么「收满一批就冲刷」这种做法不会把批切碎——数组满了先发一批,剩下的接着攒。
4.2 第一条项自成一派
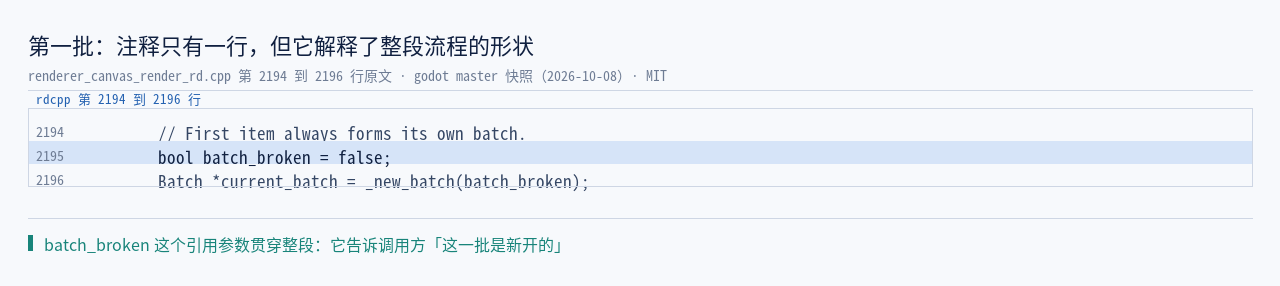
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:2194–2196(master 快照 2026-10-08)
// Record Batches.
// First item always forms its own batch.
bool batch_broken = false;
Batch *current_batch = _new_batch(batch_broken);
其中:注释只有一行,但信息量很大——第一条项总是自成一派。为什么?因为批的判据全都是「和上一批比」:光照有没有、命令类型变没变、纹理指针变没变……而第一条项前面没有上一批可比。既然没有比较对象,就只能先开一批,把它放进去,后面的项再和它比。
这句注释还有一个副作用值得我们记住:它意味着空场景不该产生批、而只要有项就至少有一个批。这跟本机读数完全吻合——200 条同型命令给 1 个 draw call,1 条命令也给 1 个。
4.3 上一章的三条读数在这里闭环
第四篇与第五篇各自给过一组读数,放在这里正好互相印证:
| 场景 | 命令条数 | draw call | 为什么 |
|---|---|---|---|
| 1 条矩形命令 | 1 | 1 | 第一条项自成一派,恰好一批 |
| 200 条同型同色命令 | 200 | 1 | 状态全同,一直留在同一批里 |
| 200 个节点各画 1 条 | 200 | 1 | 批跨项:项变了但状态没变,不切批 |
三行的共同点:draw call 跟着「状态变了没有」走,而不是跟着「项数或命令数」走。这也是上一篇留给我们的那句话。
本章出处:源码 renderer_canvas_render_rd.cpp(:2187–2196、:3261–3262)|本机读数 evidence/probe/E_batching_default.txt(A 组 / D 组)。
五、项级换批:裁剪与材质
第四章说了「起头」,这一章说「项这一层是怎么断批的」。
5.1 裁剪主人一变就换批
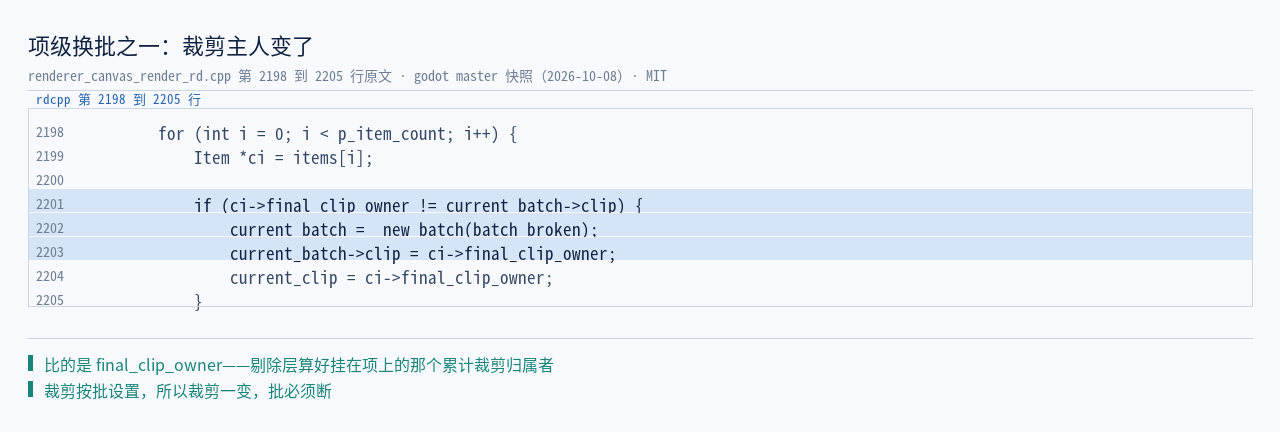
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:2198–2205(master 快照 2026-10-08)
for (int i = 0; i < p_item_count; i++) {
        Item *ci = items[i];

        if (ci->final_clip_owner != current_batch->clip) {
                current_batch = _new_batch(batch_broken);
                current_batch->clip = ci->final_clip_owner;
                current_clip = ci->final_clip_owner;
        }
说白了,其中:比的是 final_clip_owner——上一篇讲过,它是「累计裁剪的归属者」,在剔除层就已经算好挂在项上。为什么裁剪一变必须换批?因为同一批里的所有实例会共用同一份批级参数,而裁剪是按批设置的:如果两个项的裁剪区域不同,它们就不能共享这一次提交。
5.2 材质变了也换批
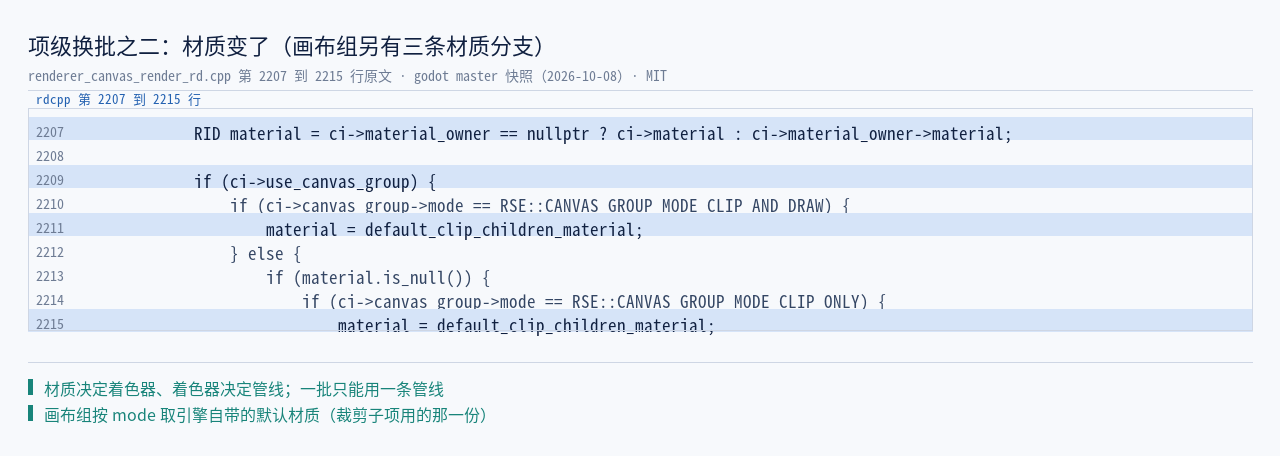
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:2207–2215(master 快照 2026-10-08)
RID material = ci->material_owner == nullptr ? ci->material : ci->material_owner->material;

if (ci->use_canvas_group) {
        if (ci->canvas_group->mode == RSE::CANVAS_GROUP_MODE_CLIP_AND_DRAW) {
                material = default_clip_children_material;
        } else {
                if (material.is_null()) {
                        if (ci->canvas_group->mode == RSE::CANVAS_GROUP_MODE_CLIP_ONLY) {
                                material = default_clip_children_material;
言归正传,其中:材质的取值有两条路——普通项取自己的 material(若挂在材质主人上则取主人那份),画布组则按 mode 取引擎自带的默认材质(裁剪子项用的那份)。原理:材质决定着色器,着色器决定管线;一批只能用一条管线,所以材质一变,批必须断。
5.3 两层判据的分工
上图把两层摆在一起。其中:项级判据(本章)管的是「这一项整体和上一项能不能同批」——看裁剪与材质;命令级判据(下一章)管的是「这一项里的某条命令和上一条能不能同批」——看光照、类型、混合、MSDF、纹理等。两层都过,才不换批。
上图归纳的是冲刷的三个触发面。前两个是「容量触发」与「项级状态触发」(第四、五章),第三个是「命令级状态触发」(第六章)。记住这三个面,「什么时候会多一个 draw call」这个问题就有了完整答案。
本章出处:源码 renderer_canvas_render_rd.cpp(:2198–2215)|画布组的三条模式见官方 CanvasGroup 类参考|「画布层」在用户侧的对应概念见 Canvas layers 教程。
5.4 谁先判:两层判据的先后
两层判据不是并列关系,而是有先后:先走项级(外层循环的每一项进来时判一次),再走命令级(这一项内部的每条命令再判)。
言归正传,这个顺序带来一个容易被忽略的推论:项级的判据只要命中一次,这一项剩下所有命令就都不用再判了。反过来则不成立——命令级判据命中,只会把这一项切成几批,不会影响下一项的判定结果(因为下一项要与「当前批」比,而当前批已经是切过之后的那一批)。
其中:顺序之所以重要,是因为它决定了代价的分布:项级判据是「每项一次」,命令级判据是「每条命令一次」。如果两种判据写反了位置,代价会差一个量级——这也是读这段代码时值得留意的一处工程细节。
说白了,顺带说一句:这个结构与上一篇验证过的读数是一致的——「200 个节点各画 1 条命令 ⇒ 1 个 draw call」说明项级的裁剪与材质都没变;「200 条命令交替类型 ⇒ 200 个 draw call」说明命令级判据确实做到了逐条检查。
六、六条换批判据:为什么是这六条
第五章讲了项级判据,这一章讲命令级判据。它是上一篇已经出现过的一段代码,但这次我们不再只列清单,而是问一句:为什么偏偏是这六条。
6.1 把那段代码再摆一次
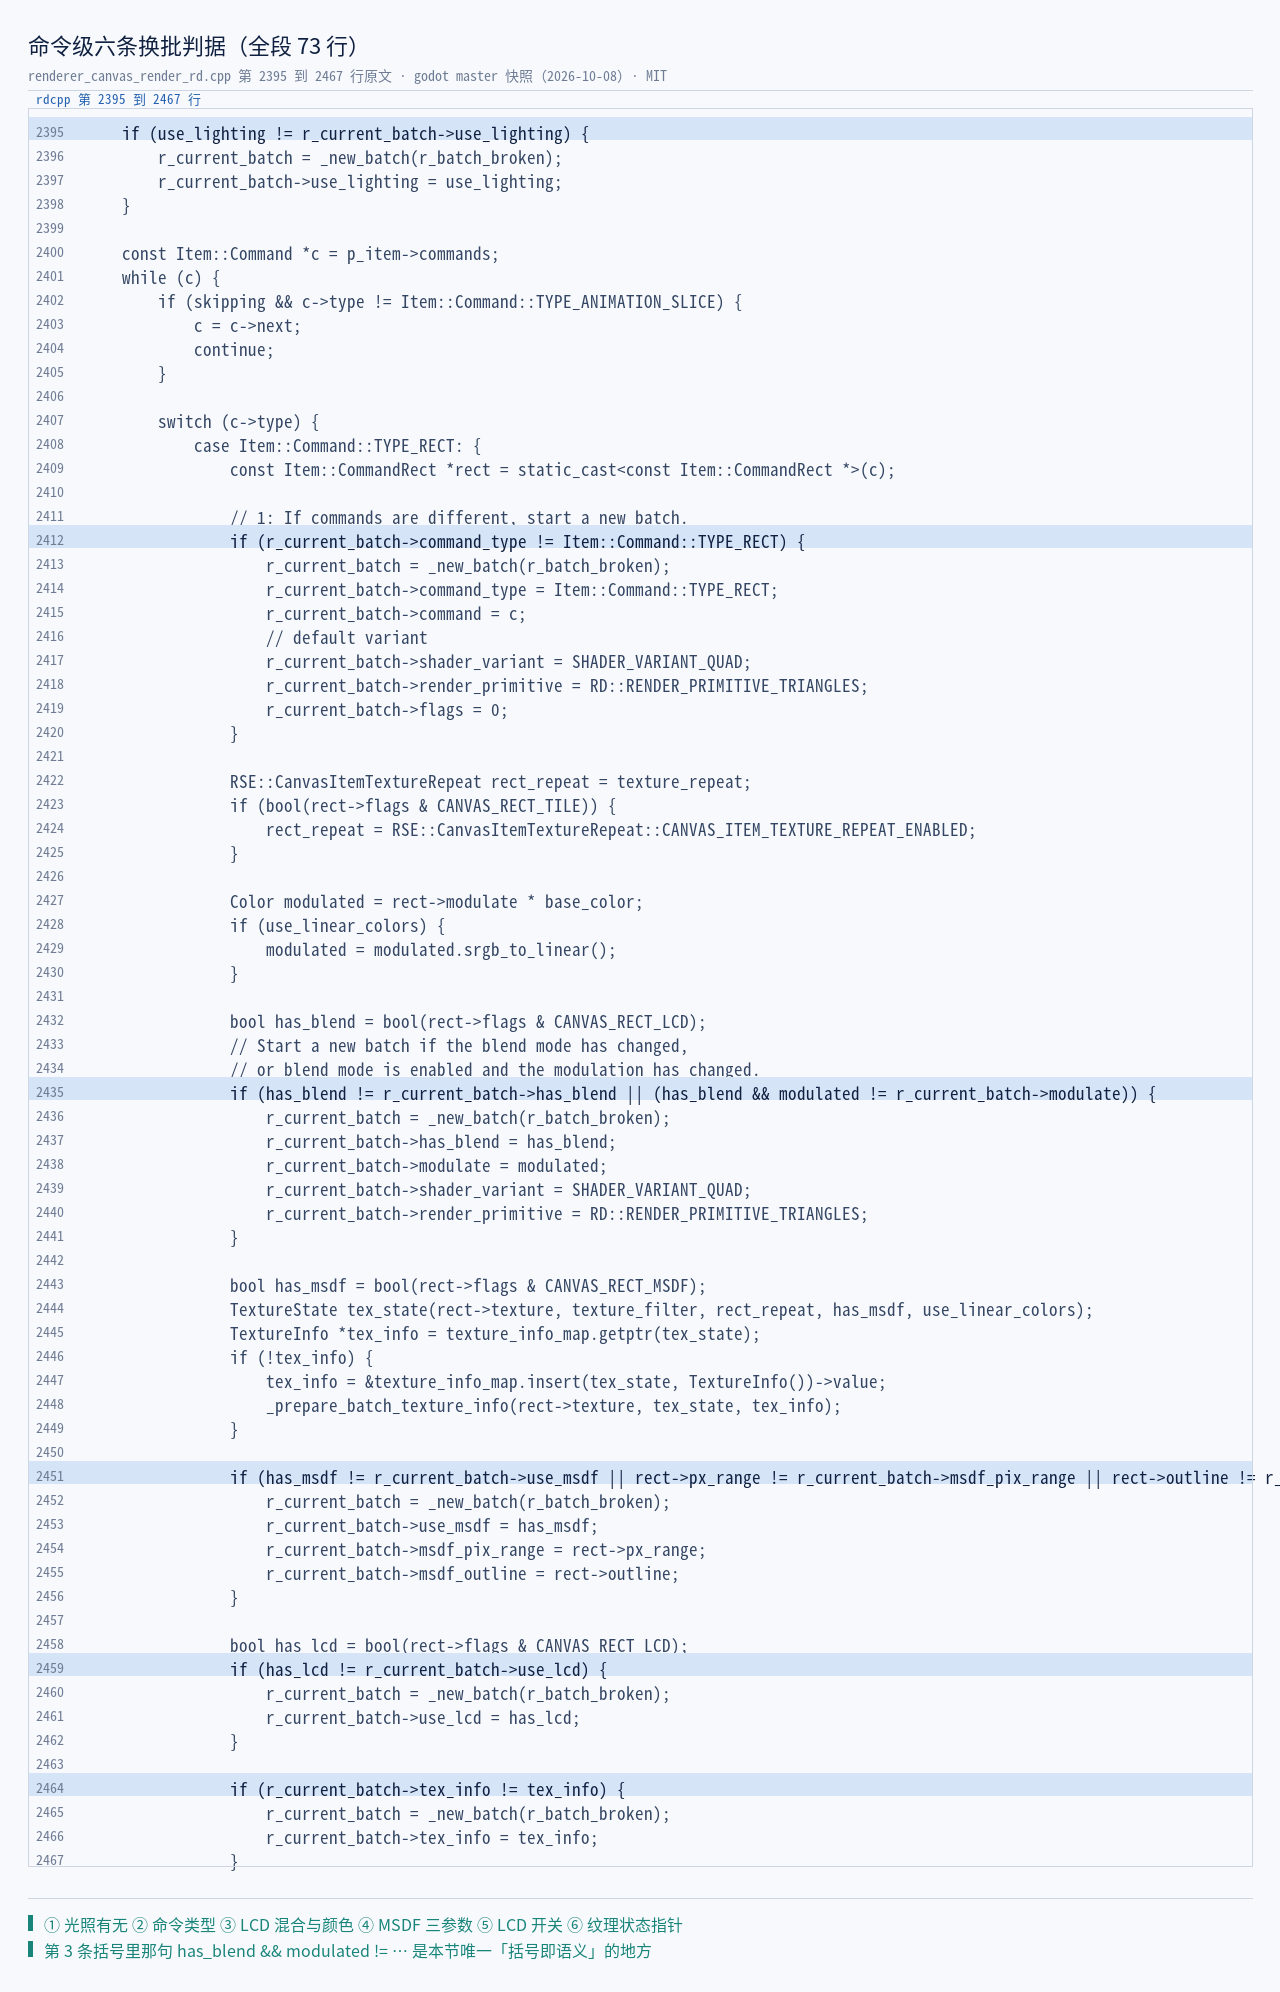
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:2395–2467(master 快照 2026-10-08,摘)
if (use_lighting != r_current_batch->use_lighting) {
        r_current_batch = _new_batch(r_batch_broken);
        r_current_batch->use_lighting = use_lighting;
}
...
// 1: If commands are different, start a new batch.
if (r_current_batch->command_type != Item::Command::TYPE_RECT) {
        r_current_batch = _new_batch(r_batch_broken);
        r_current_batch->command_type = Item::Command::TYPE_RECT;
        ...
        r_current_batch->shader_variant = SHADER_VARIANT_QUAD;
        r_current_batch->render_primitive = RD::RENDER_PRIMITIVE_TRIANGLES;
}
...
bool has_blend = bool(rect->flags & CANVAS_RECT_LCD);
if (has_blend != r_current_batch->has_blend || (has_blend && modulated != r_current_batch->modulate)) {
        ...
}
bool has_msdf = bool(rect->flags & CANVAS_RECT_MSDF);
...
if (has_msdf != r_current_batch->use_msdf || rect->px_range != r_current_batch->msdf_pix_range || rect->outline != r_current_batch->msdf_outline) {
        ...
}
bool has_lcd = bool(rect->flags & CANVAS_RECT_LCD);
if (has_lcd != r_current_batch->use_lcd) {
        ...
}
if (r_current_batch->tex_info != tex_info) {
        ...
}
其中:六条判据每条都落在同一个动作上——_new_batch()。判据之间互不覆盖:光照是光照、类型是类型、混合是混合。这段代码的原理可以概括成一句:「批与批不能共享的东西」,一项一项列出来。
6.2 为什么恰好是这六条
| # | 判据 | 它对应的是哪一类状态 | 为什么不能混 |
|---|---|---|---|
| 1 | use_lighting 变了 |
着色器特化的第一位 | 受光与不受光走不同的着色器分支 |
| 2 | 命令类型变了 | 着色器变体与图元类型 | 类型决定变体(quad / ninepatch / primitive / attributes) |
| 3 | 开了 LCD 混合且颜色变了 | 批级调制色 | 次像素混合要把调制色烘进批参数 |
| 4 | MSDF 三参数(开关 / px_range / outline)变了 |
字形渲染的像素范围 | 字形要每批固定的像素范围 |
| 5 | LCD 开关变了 | 批标志位 | 同上,进批标志位 |
| 6 | 纹理状态指针变了 | 纹理与采样状态 | 纹理与采样在批这一级绑定 |
好了,表读法:右边两列合起来就是答案——凡是「会被烘进批级参数」或「决定管线选择」的状态,都必须参与换批判据。不在这个集合里的东西(比如顶点位置、UV、颜色本身——除非开了 LCD)就不参与,这正是批能装下几百个矩形的原因。
6.3 第 3 条为什么带括号
第 3 条写的是 has_blend != r_current_batch->has_blend || (has_blend && modulated != r_current_batch->modulate)。括号是关键:颜色变了只有在「开了 LCD」时才换批。
于是有两种情形,结果完全不同:
| 情形 | 每两条换一次颜色 | draw call |
|---|---|---|
| 普通混合(没开 LCD) | 200 条矩形 | 1(颜色不参与判据) |
| 次像素混合(开了 LCD) | 200 条矩形 | 会按颜色切碎 |
好了,本篇的本机读数验的是第一种:同一项上 200 条矩形、每两条换一次色,draw call 仍然是 1。所以「颜色不影响合批」这句话只在普通混合下成立,讲的时候必须带上前提。
6.4 类型那条顺带定了管线
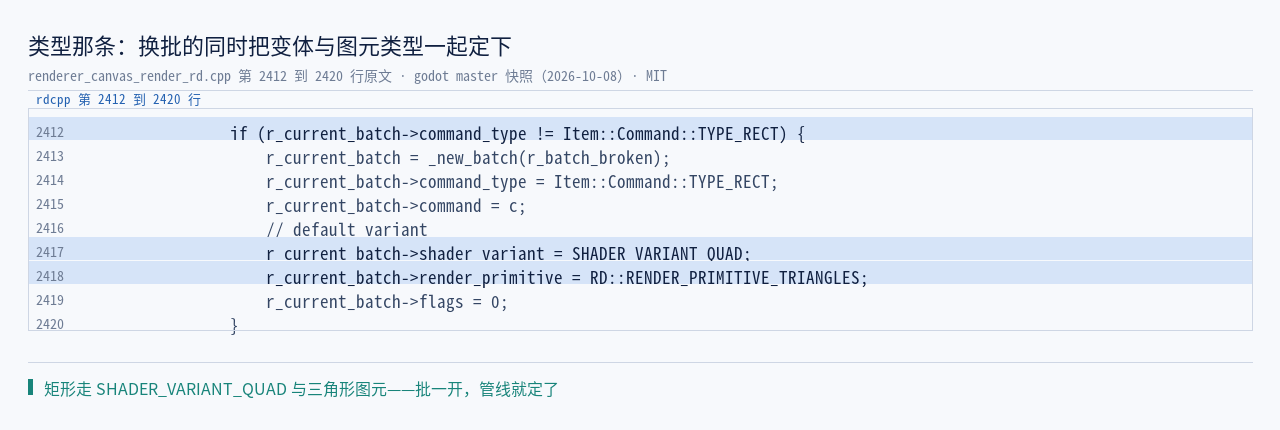
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:2412–2420(master 快照 2026-10-08)
if (r_current_batch->command_type != Item::Command::TYPE_RECT) {
        r_current_batch = _new_batch(r_batch_broken);
        r_current_batch->command_type = Item::Command::TYPE_RECT;
        r_current_batch->command = c;
        // default variant
        r_current_batch->shader_variant = SHADER_VARIANT_QUAD;
        r_current_batch->render_primitive = RD::RENDER_PRIMITIVE_TRIANGLES;
}
其中:换批的同时顺手把 shader_variant 与 render_primitive 定了下来——矩形走 SHADER_VARIANT_QUAD 与三角形图元。这就把第六章与第十章连起来了:批一开始,它要用的管线就已经确定了;后面再遇到不同类型,就必须另起一批。
本章出处:源码 renderer_canvas_render_rd.cpp(:2395–2467)|本篇与第五篇在六条判据这一段是同一处源码——第五篇用它证明「批按状态切」,本篇用它回答「为什么是这六条」|本机读数 evidence/probe/E_batching_default.txt(A4 组)。
6.5 六条判据的顺序能不能换
一个自然会问的问题是:这六条的顺序重要吗?答案是:对结果不重要,对可读性重要。
OK,理由是它们都作用在同一个动作上(_new_batch()),并且互相不覆盖——光照那条只比光照字段,类型那条只比类型字段;六条各自独立地把「新批的某个字段」设成当前值。所以无论先判哪条,最终「会不会换批」这个布尔结果都一样:只要有一条成立,就至少换一次批。
但顺序对切批的次数有影响吗?也没有——因为每次命中都会立刻换批并把该字段对齐,后续判据不会重复触发。换句话说,六条判据是幂等且可交换的。
其中:那为什么代码把它们排成现在这个顺序?看第八段的原文就能明白——光照在最前、类型紧随其后,是因为这两条决定了后面所有分支要不要走(着色器分支与图元类型);而 LCD、MSDF、纹理那几条只改批级参数,放在后面读起来更顺。这是可读性排序,不是语义排序,读代码时不必去找「顺序里的隐含条件」。
OK,反过来说,如果哪天有人把两条判据合并成一条(比如把 LCD 开关与 LCD 颜色合并),那就不再可交换了——合并会丢掉「开关没开时颜色不参与比较」这个条件,也就是 §6.3 那个括号。这是这段代码里唯一一处「括号即语义」的地方。
七、批对象是「继承上一批再改」
前两章讲的是「什么时候换批」。这一章讲一个更底层的问题:新批这个对象是怎么来的。
7.1 新批 = 上一批的副本
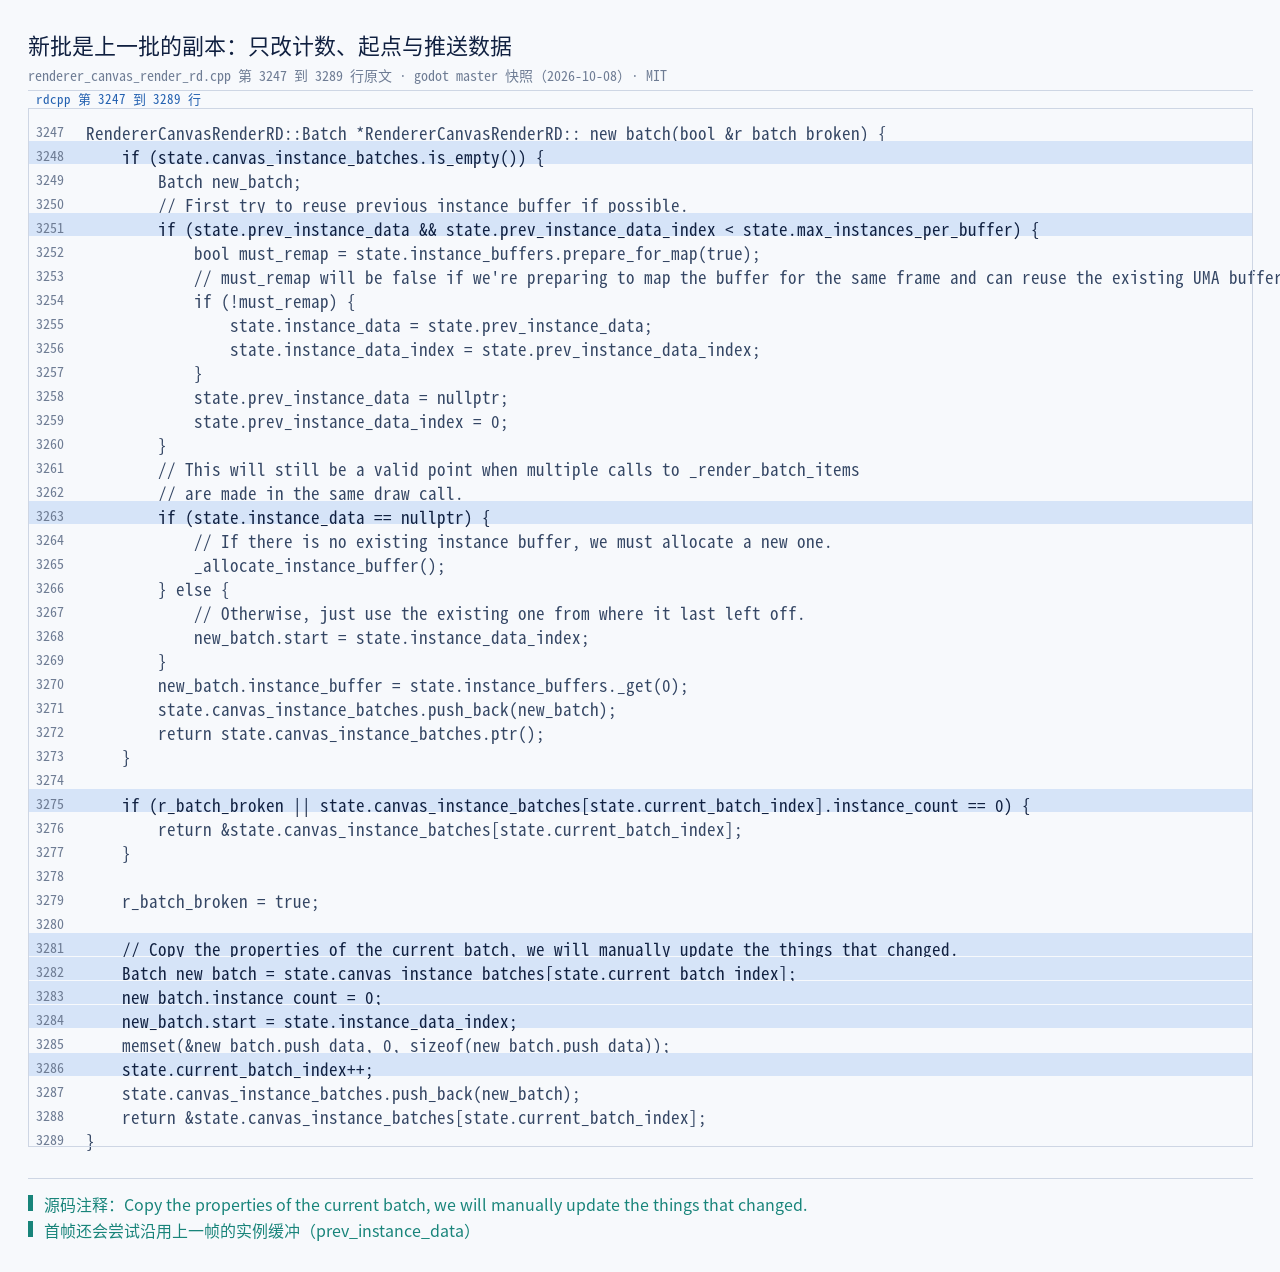
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:3279–3288(master 快照 2026-10-08,摘)
r_batch_broken = true;

// Copy the properties of the current batch, we will manually update the things that changed.
Batch new_batch = state.canvas_instance_batches[state.current_batch_index];
new_batch.instance_count = 0;
new_batch.start = state.instance_data_index;
memset(&new_batch.push_data, 0, sizeof(new_batch.push_data));
state.current_batch_index++;
state.canvas_instance_batches.push_back(new_batch);
return &state.canvas_instance_batches[state.current_batch_index];
其中:三处改动是 instance_count = 0(计数归零)、start = state.instance_data_index(起点接在上一批写到的位置)、推送数据清零。其余字段全部从上一批继承。源码注释也是这么说的:Copy the properties of the current batch, we will manually update the things that changed.
说白了,这个设计的原理是省下重复赋值:批有十几个字段(材质、裁剪、变体、图元、混合、MSDF 参数、纹理状态……),如果每开一批都从头构造,就得把上一批已知的信息再写一遍。而「延续 + 少量修改」正好对应它的语义——批只会在某一处状态上打断,其余状态是延续的。
7.2 Batch 里都记了什么
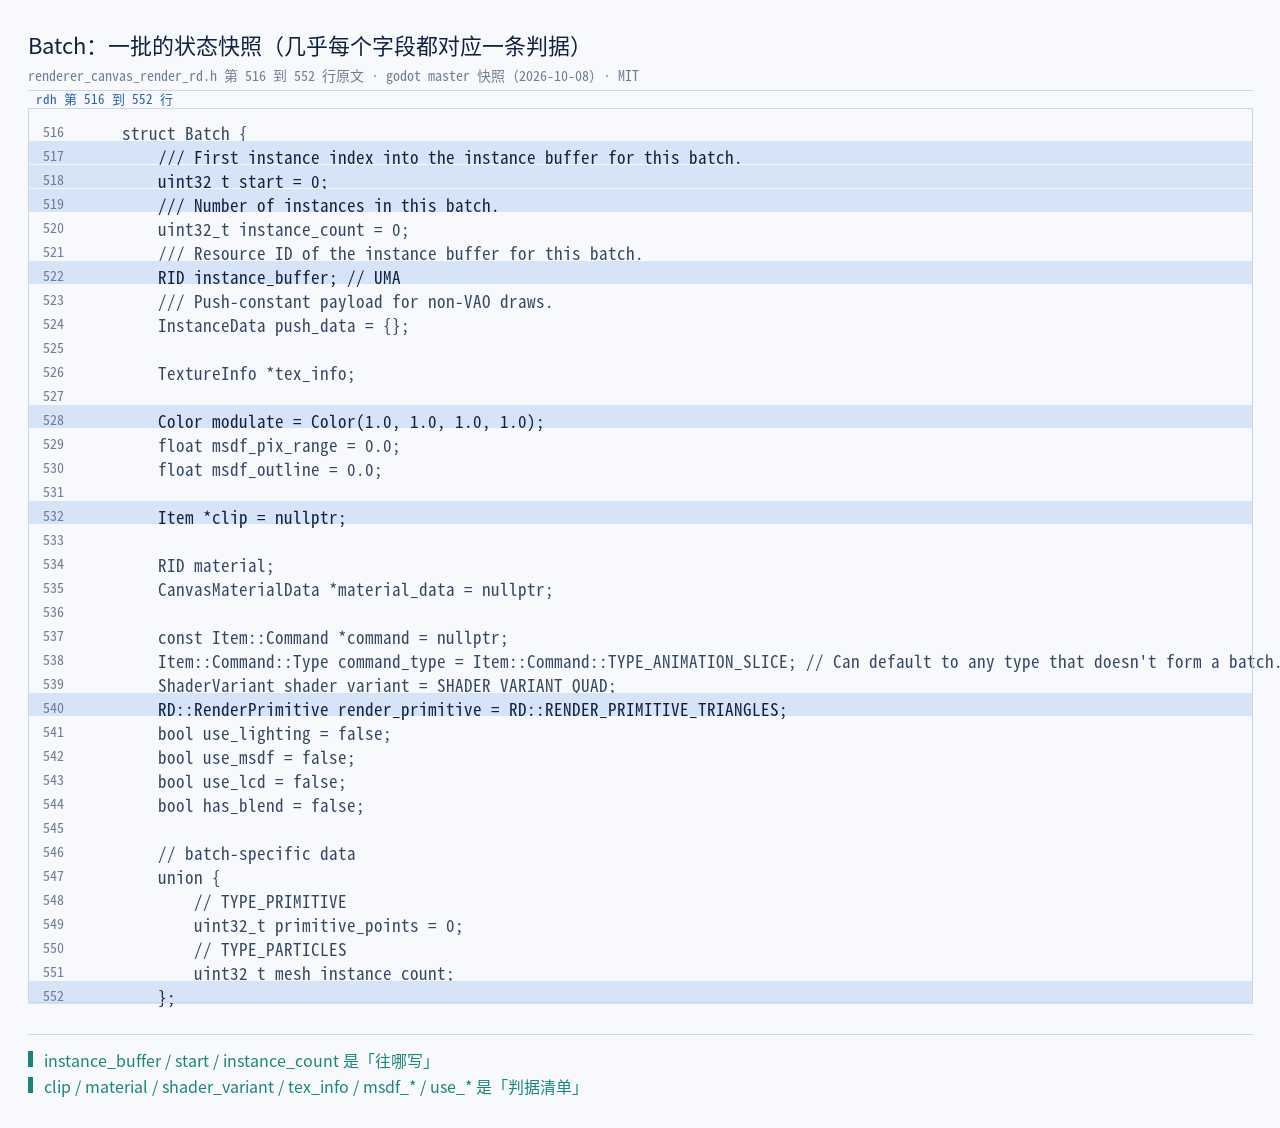
// servers/rendering/renderer_rd/renderer_canvas_render_rd.h(master 快照 2026-10-08,摘)
struct Batch {
        RID instance_buffer;
        uint32_t start = 0;
        uint32_t instance_count = 0;
        ShaderVariant shader_variant = SHADER_VARIANT_MAX;
        RD::RenderPrimitive render_primitive = RD::RENDER_PRIMITIVE_MAX;
        Item::CommandType command_type = Item::CommandType::TYPE_MAX;
        RID clip;
        RID material;
        TextureInfo *tex_info = nullptr;
        float msdf_pix_range = 0.0;
        float msdf_outline = 0.0;
        bool use_msdf = false;
        bool use_lcd = false;
        bool has_blend = false;
        bool use_lighting = false;
        Color modulate;
        InstanceData push_data;
        ...
};
其中:一眼能看出的对应关系是——这个结构里的每个字段,几乎都能在上一章的六条判据里找到自己的那一行(use_lighting / command_type / has_blend+modulate / use_msdf+msdf_pix_range+msdf_outline / use_lcd / tex_info),另外还有项级判据那两个(clip / material)与「往哪写」的三项(instance_buffer / start / instance_count)。
换句话说:Batch 这个结构就是「一批的状态快照」,六条判据就是「这份快照里有哪几项能被改写」。两者是同一件事的两面。
7.3 首帧还会沿用上一帧的实例缓冲
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:3251–3259(master 快照 2026-10-08)
if (state.prev_instance_data && state.prev_instance_data_index < state.max_instances_per_buffer) {
        bool must_remap = state.instance_buffers.prepare_for_map(true);
        // must_remap will be false if we're preparing to map the buffer for the same frame and can reuse the existing UMA buffer.
        if (!must_remap) {
                state.instance_data = state.prev_instance_data;
                state.instance_data_index = state.prev_instance_data_index;
        }
        state.prev_instance_data = nullptr;
        state.prev_instance_data_index = 0;
}
其中:prev_instance_data 是上一轮留下的写指针;如果它还合法(没写满),同一帧内就接着往下写,不必重新映射缓冲。注释里的 must_remap 说得很清楚:同一个帧内复用已有的 UMA(统一内存访问)缓冲时它就是 false。
这条细节与第八章的上限判据合起来,构成了「实例缓冲是按帧复用的一长条内存」这个图景:批只记「我从哪一段开始、占了多少条」,真正的内存是一整条被反复切分的缓冲。
7.4 另一个数字:为什么批的容器预留 200
言归正传,回到 §3.1 那三行,里面还有一个我们没解释的数:state.canvas_instance_batches.reserve(200)。它预留的是「批的容器」的空间,而不是实例的位置——也就是说,引擎预期一帧里的批数量量级是几百。
言归正传,这个数字与第六章的判据合起来读,意思就清楚了:reserve(200) 是一个经验值,反映的是「一帧里切换状态的次数」的常见量级。它不是一个硬上限(reserve 只影响容器是否会中途扩容),但它透露了作者的预期:批不会被切到几万个,也不会少到只有几个。
其中:这里要提醒一句读代码的常见误读——别把 reserve(200) 当成「一帧最多 200 批」。它与 item_buffer_size 的性质完全不同:后者是语义上限(写满就换缓冲、强制切批,真的会改变行为),前者只是容器容量提示(超了也能继续,只是容器要搬一次家)。
本章出处:源码 renderer_canvas_render_rd.cpp(:2129 的 reserve(200)、:3247–3289)与 renderer_canvas_render_rd.h(Batch 段)。
八、往批里加一条实例:上限一到就强制换批
第七章讲批对象怎么来,这一章讲一条命令怎么变成批里的一条实例。
8.1 加一条实例只有三步
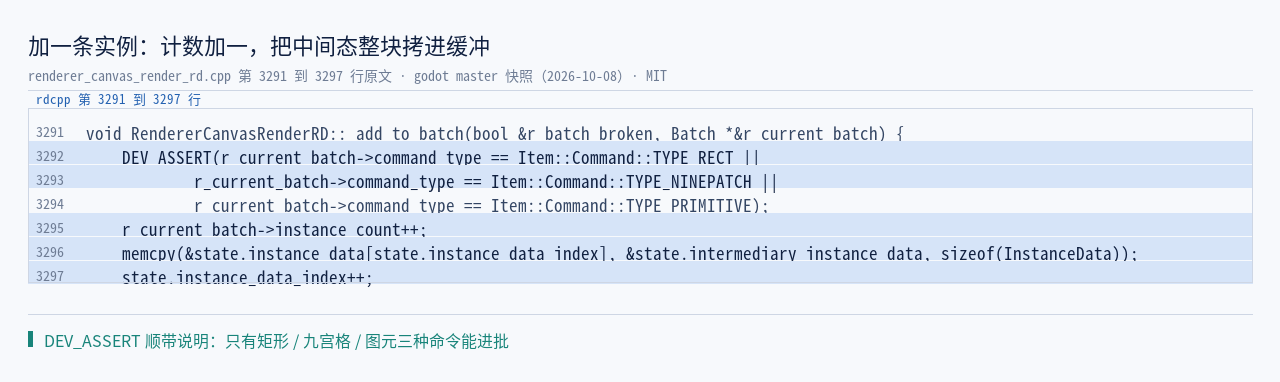
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:3291–3297(master 快照 2026-10-08)
void RendererCanvasRenderRD::_add_to_batch(bool &r_batch_broken, Batch *&r_current_batch) {
        DEV_ASSERT(r_current_batch->command_type == Item::Command::TYPE_RECT ||
                        r_current_batch->command_type == Item::Command::TYPE_NINEPATCH ||
                        r_current_batch->command_type == Item::Command::TYPE_PRIMITIVE);
        r_current_batch->instance_count++;
        memcpy(&state.instance_data[state.instance_data_index], &state.intermediary_instance_data, sizeof(InstanceData));
        state.instance_data_index++;
其中:三步——批的计数加一、把中间态 memcpy 进实例缓冲的当前位置、写指针加一。开头那条 DEV_ASSERT 还顺带说明了只有三种命令能进批(矩形、九宫格、图元),这与第十章「六个着色器变体」是对得上的。
8.2 上限一到会怎样
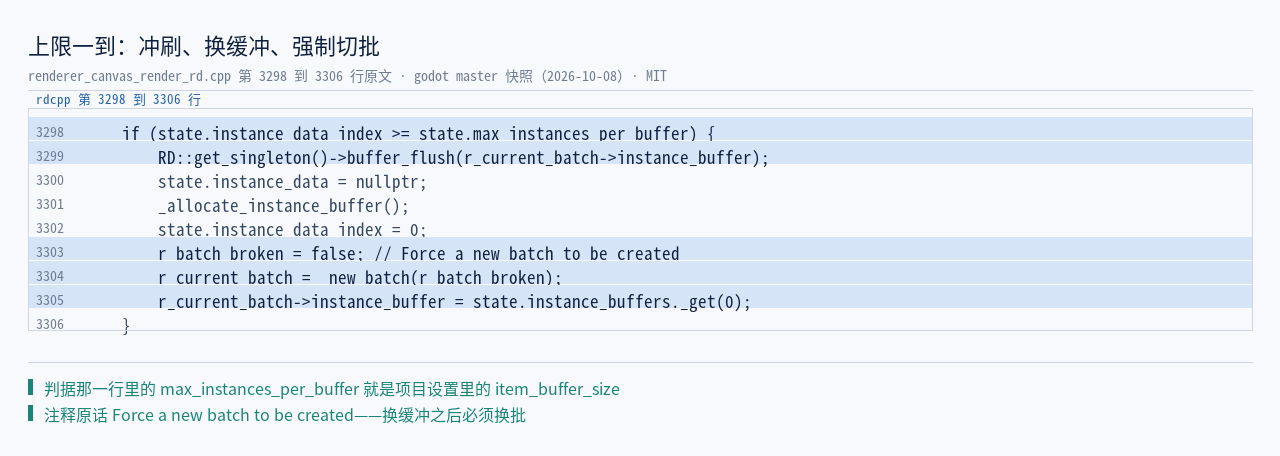
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:3298–3306(master 快照 2026-10-08)
        if (state.instance_data_index >= state.max_instances_per_buffer) {
                RD::get_singleton()->buffer_flush(r_current_batch->instance_buffer);
                state.instance_data = nullptr;
                _allocate_instance_buffer();
                state.instance_data_index = 0;
                r_batch_broken = false; // Force a new batch to be created
                r_current_batch = _new_batch(r_batch_broken);
                r_current_batch->instance_buffer = state.instance_buffers._get(0);
        }
}
其中:这五行是本文第一个命题的落点。state.instance_data_index >= state.max_instances_per_buffer 里的那个上限,就是第三章从项目设置里读出来的 item_buffer_size。一到它就做四件事:冲刷(把这一批已写的内容提交给驱动)、换一条新缓冲、写指针归零、强制切批(注释原文 Force a new batch to be created)。
为什么必须切批?因为缓冲换了——新的一批要用新的 instance_buffer,索引 0 对应新缓冲的第一格。
8.3 一条实例就是 128 字节
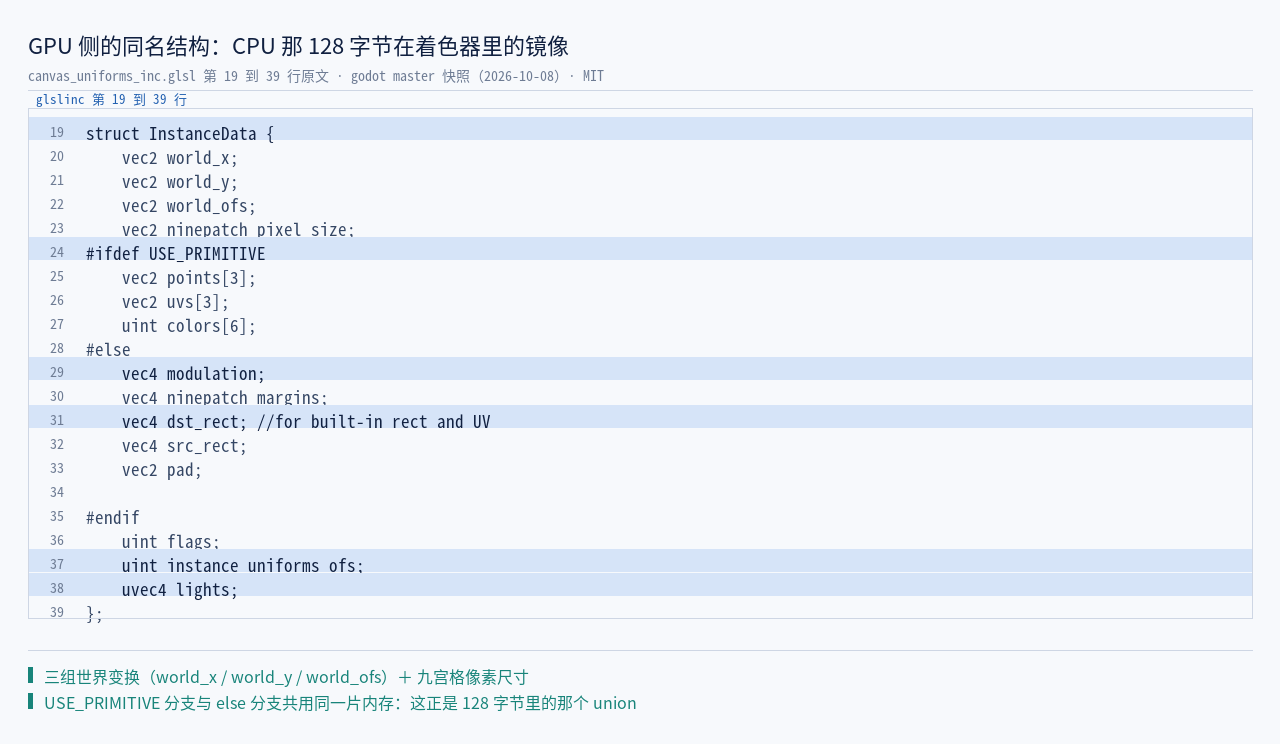
// servers/rendering/renderer_rd/renderer_canvas_render_rd.h:356–380(master 快照 2026-10-08,摘)
struct InstanceData {
        ...
        static_assert(sizeof(InstanceData) == 128, "2D instance data struct size must be 128 bytes");
};
先来看看,其中:memcpy 的长度就是这个 sizeof(InstanceData)——128 字节,由编译期断言钉死。于是第三章那个换算(16384 × 128 = 2,097,152 字节)在这里闭环:「一批装 16384 条」与「一条 128 字节」这两个数,一个来自项目设置,一个来自结构体大小。
8.4 上限一到,一条命令都不多画
上图把 §8.2 那五行画成流程。其中:注意「冲刷」与「换批」是两件事——冲刷是把当前这一批发出去,换批是给下一条命令准备新容器。顺序不能反:先发旧的,再开新的,否则那条命令就会掉进一个永远不会被发的批里。
本章出处:源码 renderer_canvas_render_rd.cpp(:3291–3306)与 renderer_canvas_render_rd.h(:356–380)、canvas_uniforms_inc.glsl(:19–39 的 GPU 侧同名结构)|本机读数 evidence/probe/E_batching_default.txt(A1/A2 组)。
九、为什么要有「中间实例数据」
第八章里出现过两次 state.intermediary_instance_data。这一章专门讲它——它藏着一条很实用的性能规则。
9.1 返回的是中间态,不是缓冲里的那一格
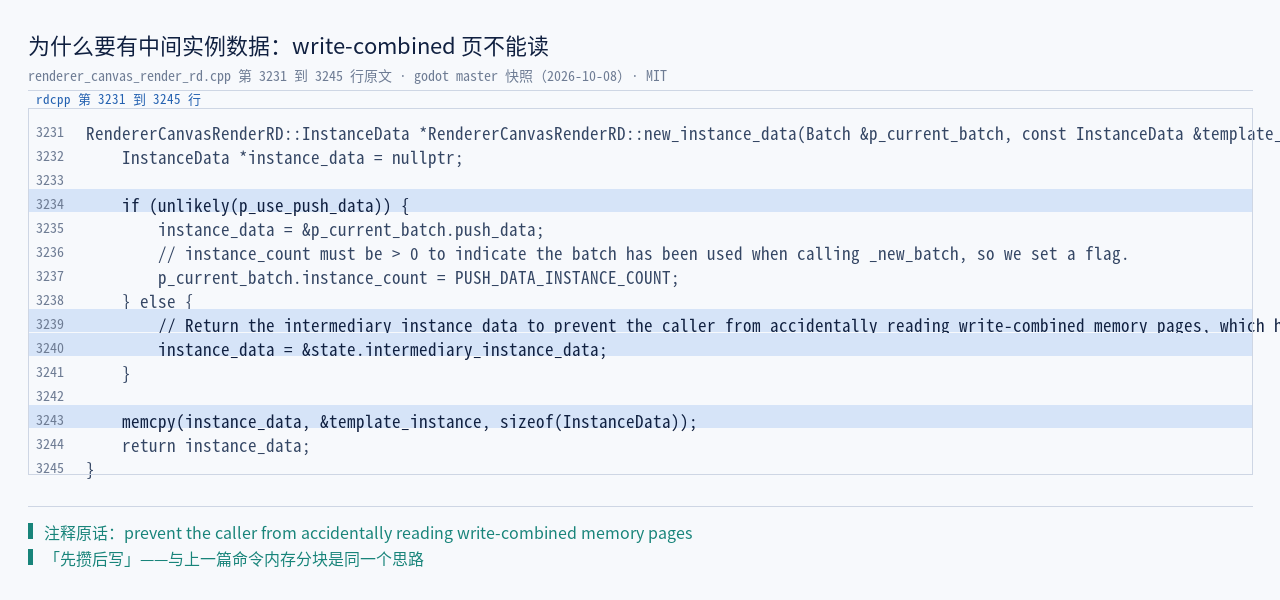
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:3231–3245(master 快照 2026-10-08)
RendererCanvasRenderRD::InstanceData *RendererCanvasRenderRD::new_instance_data(Batch &p_current_batch, const InstanceData &template_instance, bool p_use_push_data) {
        InstanceData *instance_data = nullptr;

        if (unlikely(p_use_push_data)) {
                instance_data = &p_current_batch.push_data;
                p_current_batch.instance_count = PUSH_DATA_INSTANCE_COUNT;
        } else {
                // Return the intermediary instance data to prevent the caller from accidentally reading write-combined memory pages, which has huge performance implications.
                instance_data = &state.intermediary_instance_data;
        }

        memcpy(instance_data, &template_instance, sizeof(InstanceData));
        return instance_data;
}
其中:正常路径返回的是中间实例数据(state.intermediary_instance_data,一份复用的小结构),而不是实例缓冲里的那一格。源码注释就是理由,原文是:返回中间态是为了防止调用方不小心去读 write-combined 内存页,那有巨大的性能影响(prevent the caller from accidentally reading write-combined memory pages, which has huge performance implications)。
9.2 一条实例的三段路
上图把一条实例的完整路径画出来:调用方先在栈上/结构体上拼出一个模板实例 → new_instance_data() 把它拷进中间态并返回指针 → 调用方只往中间态里补几个字段 → _add_to_batch() 再把中间态整块 memcpy 进实例缓冲。三步之后,调用方从来没有读过实例缓冲。
其中:write-combined(写合并)内存是 CPU 侧的一种映射策略:写操作会被攒起来成批下发到显存,读操作代价极高(要先把整个缓存行拉回来,还可能打断写合并)。上图把这条约定与它替下的做法对照:不做中间态,就得在写完一整批之后回头读缓冲里的内容去补字段——那正好踩在最贵的一类访问上。
先来看看,这条细节的价值不在「记住这个字段名」,而在它示范了一种引擎里常见的省法:把「读改写」拆成「先攒后写」。上一篇讲命令内存分块时,用的是同一个思路。
本章出处:源码 renderer_canvas_render_rd.cpp(:3231–3245)|关于写合并内存的一般性质,见 RenderingDevice 类参考中缓冲更新一族的说明。
十、批与管线变体:批一断就要重选管线
第八章的 DEV_ASSERT 提到「只有三种命令能进批」,这一章解释它背后的东西:批与管线是一对多的。
10.1 三个特化位
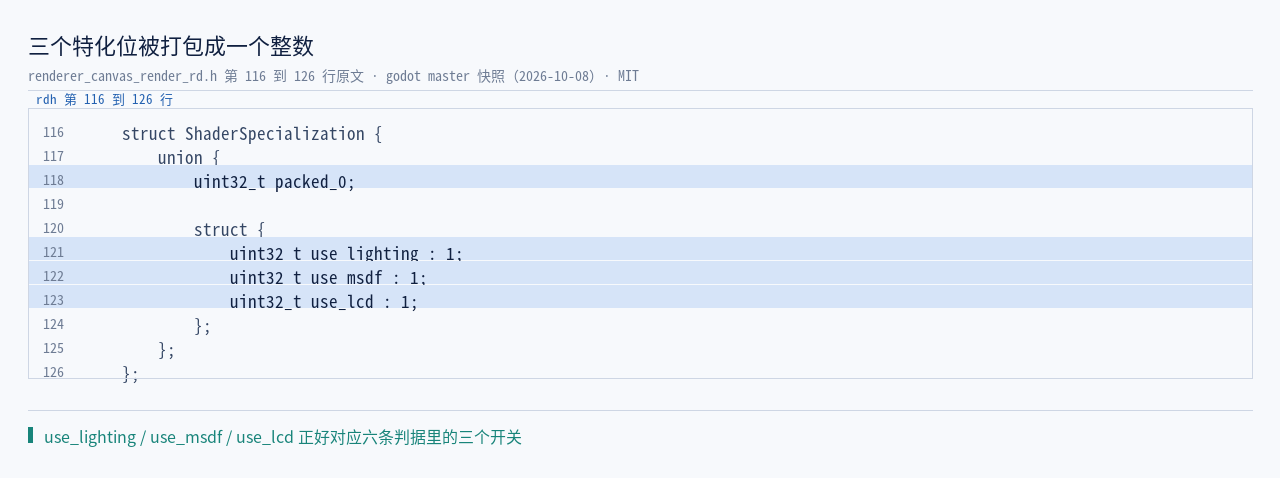
// servers/rendering/renderer_rd/renderer_canvas_render_rd.h:116–126(master 快照 2026-10-08)
struct ShaderSpecialization {
        union {
                uint32_t packed_0;

                struct {
                        uint32_t use_lighting : 1;
                        uint32_t use_msdf : 1;
                        uint32_t use_lcd : 1;
                };
        };
};
其中:三个 : 1 位正好对应第六章判据里的三个开关(受光、MSDF、LCD)。它们不是各判各的,而是被打包成一个 uint32_t——因为着色器特化参数是以「一个整数」的形态递进管线的。
10.2 六变体与四组 uniform set
// servers/rendering/renderer_rd/renderer_canvas_render_rd.h:45–64(master 快照 2026-10-08,摘)
enum {
        BASE_UNIFORM_SET = 0,
        MATERIAL_UNIFORM_SET = 1,
        TRANSFORMS_UNIFORM_SET = 2,
        BATCH_UNIFORM_SET = 3,
};

enum ShaderVariant {
        SHADER_VARIANT_QUAD,
        SHADER_VARIANT_NINEPATCH,
        SHADER_VARIANT_PRIMITIVE,
        SHADER_VARIANT_PRIMITIVE_POINTS,
        SHADER_VARIANT_ATTRIBUTES,
        SHADER_VARIANT_ATTRIBUTES_POINTS,
        SHADER_VARIANT_MAX
};
再说一遍,其中:四组 uniform set 的编号 0–3 是由粗到细的四级绑定(画布级、材质级、变换级、批级);六个变体则是着色器的六种写法。两者相乘再加上三个特化位,就构成「批要用的那条管线」的全部输入。
10.3 批与管线的对应关系
| 层面 | 取值 | 变不变 | 换批时要不要重选 |
|---|---|---|---|
| 着色器变体 | 六个(quad / ninepatch / primitive(+points) / attributes(+points)) | 按命令类型 | 要(第六章判据 2) |
| 特化位 | 三位(受光 / MSDF / LCD) | 按命令状态 | 要(判据 1、4、5) |
| 纹理与采样 | 纹理状态指针 | 按纹理 | 要(判据 6) |
| 批级 uniform | 批参数(特化位、批标志、MSDF 参数、像素尺寸) | 每批一次 | 要 |
| 材质 / 变换 / 画布级 uniform | 材质、画布变换、渲染目标 | 跨批共享 | 不必 |
表读法:前四行是每批都要重新确认的,后一行是跨批共享的。这也解释了「批一断为什么要重选管线」——因为管线键正是由前四行拼出来的,它们中任何一项变了,管线键就变了。
顺带说一句:这张表也解释了为什么批的收益与代价是绑在一起的——批越多,管线选择与资源绑定这两件「每批一次」的事就做得越多。
10.4 另一半进口:管线缓存是给谁用的
下面我们开始,第三章那两个旋钮里,item_buffer_size 讲了两章、还测了两档;另一个 uniform_set_cache_size 一直没展开。这一节补上,因为它正是「批变多」之后最先吃紧的那个东西。
话说回来,回到 §3.1 的第一段:rid_set_to_uniform_set 是一个从「管线 + 资源集合」到 uniform set 的映射,容量就是 uniform_set_cache_size(默认 4096)。它的存在理由很直白:同一套资源在同一帧里会被反复绑定——同一批画完之后,下一批往往还是同一条管线、同一份画布级与变换级资源;如果每次都重新创建 uniform set,代价会落在驱动层。
于是批处理与它的关系就是:批越多,批级的 uniform set 组合就越多(每批的批参数不同),缓存被翻动的次数也越多。4.4 把批处理铺到所有后端之后,Forward+ 与 Mobile 也走上了这条路——这就是为什么「批处理」这件事在实现侧从来不只是「把命令攒起来」那么简单。
其中:这一节只说清了「缓存护什么、为什么批多了会吃紧」;至于缓存的替换策略与具体开销,本篇不做推测——源码里那部分没有注释说明设计意图,按边界声明第 3 条,我们不据代码形状反推作者的考量。
本章出处:源码 renderer_canvas_render_rd.cpp(:2121–2124)与 renderer_canvas_render_rd.h(:45–64、:116–126)|着色器侧的实例属性布局见 canvas.glsl。
十一、两档探针:分界跟着设置移动
前十章讲的都是「读源码读到了什么」。这一章换证据类型:把那个设置真的改掉,看行为会不会跟着变。
11.1 实验怎么设计
要验的命题很具体:第三章那个 item_buffer_size,是不是真的就是批的容量。
做法是两档对照:第一档不动设置(用引擎默认值),第二档把 rendering/2d/batching/item_buffer_size 写成 512,各跑一次同样的用例。
这里有一个必须先交代的坎:这个设置是 GLOBAL_DEF_RST(改后需重启),运行期改它无效。所以我们的探针不是「一个进程里改设置」,而是改项目配置 → 重启引擎 → 再跑一遍,两档产出两份日志。每份日志开头都会把设置的实际值回读打印出来,这样事后核对时不会弄混哪份是哪档。
口径也一并写明:引擎是本机自建的 4.8.dev.custom_build.7177493c1(2026-07-03 构建,不是 stable),Vulkan 1.3.280 走 Forward+,设备是 RTX 3060 Laptop;探针必须带窗口运行(--headless 是 dummy 渲染器,计数器会失真),每例先跑若干帧稳定再读整帧计数。
判据本身只有两行:
# evidence/probe/ep06_probe.gd(摘)
_size_setting = int(ProjectSettings.get_setting("rendering/2d/batching/item_buffer_size", -1))
...
int(Performance.get_monitor(Performance.RENDER_TOTAL_DRAW_CALLS_IN_FRAME))
其中:第一行回读被测设置,第二行取整帧 draw call 计数。这组实验的原理是「单变量对照」:唯一的自变量是那个设置,唯一被读的因变量是 draw call 数,命令条数由我们给定——三个量都在我们手里,没有第四个变量在动。
11.2 默认档:16,384 与 16,385 之间
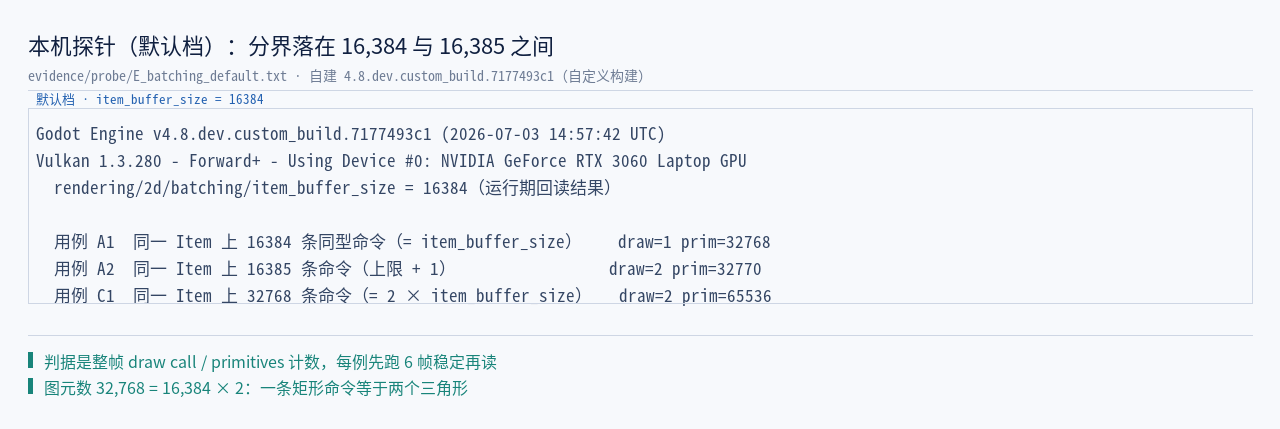
好了,默认档的结果是两条:同一项上 16,384 条命令 ⇒ 1 个 draw call(图元 32,768),16,385 条 ⇒ 2 个(图元 32,770)。分界正好落在源码那个默认值上。
这两条读数的意义不只是「对上了源码」,还在于它们排除了另一种解释:如果分界来自别的东西(比如某个固定的数组上限、或某种缓存阈值),那 16,384 与 16,385 之间不该正好翻倍。下一节把设置改掉,就能把「是不是这个设置」这件事问到底。
顺带一句:图元数 32,768 恰好是 16,384 的两倍——一条矩形命令等于两个三角形,换批并没有改变画了多少图元,只改变了它们被分几次提交。
11.3 512 档:分界跟着走了
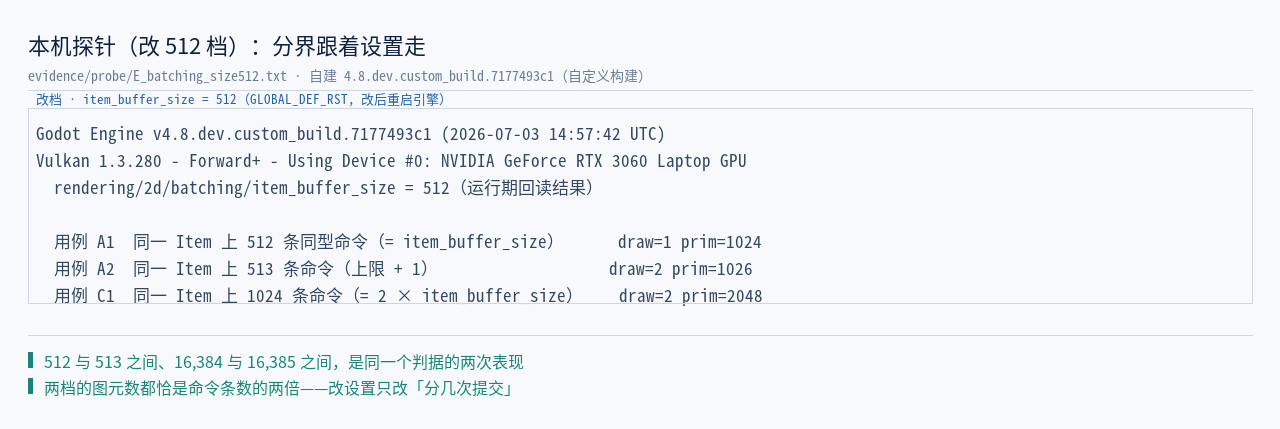
把设置改成 512 之后再跑,结果变成:512 条 ⇒ 1(图元 1,024),513 条 ⇒ 2(图元 1,026)。
两档并排看,结论就没有第二种解释了:分界不是代码里写死的 16384,而是那个设置的值。512 与 513 之间、16,384 与 16,385 之间,是同一个判据的两次表现。
这里还藏着一个容易被忽略的一致性:图元数始终是命令条数的两倍(512 → 1,024,513 → 1,026),与默认档的 16,384 → 32,768 完全同构。也就是说,改设置只改变了「分几次提交」,没有改变「画了多少东西」——两档的图元总数与命令总数是同一套换算,这本身就是一次交叉验证。
上图是两档的并排对照表。其中:除了上限两侧,我们还测了 2 × 设置值 的用例——默认档 32,768 条 ⇒ 2 个 draw call,512 档 1,024 条 ⇒ 2 个。正好两批,不多不少。
11.4 与设置无关的那些结论
同一批探针里还跑了三组不随设置变化的用例,用来确认「切批次数」这条线的独立性:
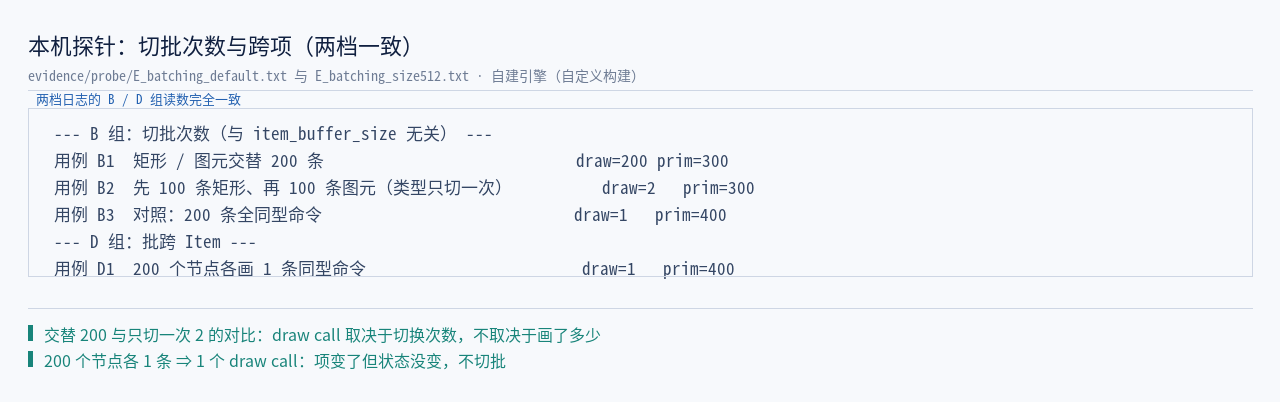
四条读数(两档一致):
| 用例 | 输入 | draw call |
|---|---|---|
| 矩形/图元交替 | 200 条 | 200 |
| 先 100 条矩形、再 100 条图元 | 200 条(只切一次) | 2 |
| 全同型 | 200 条 | 1 |
| 200 个节点各画 1 条 | 200 条 | 1 |
其中:前两行的对比说明「切批次数决定 draw call」;第四行说明「批跨项」(项变了但状态没变,不切批)。这四条与 item_buffer_size 无关——它们量的是判据,不是容量。把两类读数放在一章里,就是为了让人看清:容量决定一批装多少,判据决定一批有几个。
本章出处:本机探针两档日志 evidence/probe/E_batching_default.txt 与 evidence/probe/E_batching_size512.txt(装置:evidence/probe/ep06_probe.gd / ep06_probe.tscn / run_probes_ep06.ps1)|对照源码 renderer_canvas_render_rd.cpp(:3298–3306 的上限判据)与 rendering_server.cpp(:3709 的默认值注册)|计数器口径见官方 Performance 类参考(RENDER_TOTAL_DRAW_CALLS_IN_FRAME)与 Engine 类参考中的 Performance 一节。
11.5 这组探针没有测到的三件事
按本系列的规矩,实验的边界也要写明——这一节列的正是本篇没有证明的东西,避免读者把结论放大。
- 没测性能。 两组读数只证明「批的数量」与「容量/判据」的关系,没有任何耗时或帧率数据。性能那一侧本篇只引用官方结论,并写明其限定条件。
- 只测了一种渲染方法与一种驱动。 探针跑在 Forward+ × Vulkan 上;Mobile 与 Compatibility 在同机同场景下是否给出同样的批数,本篇没有测。4.4 之后四者共用同一条批处理路径,所以「大概率一致」是推测,不是结论;要下结论得各跑一遍。
- 没有触及图形 API 之后的事。 draw call 计数是引擎侧
Performance给的整帧计数;它在驱动与 GPU 侧怎么被合并、被排队,本篇不涉及(边界声明第 2、3 条)。
OK,其中:第 2 条尤其值得说明白。官方文档说的是「所有渲染方法支持 2D 批处理」,这句是关于能力的;而我们的读数只覆盖了其中一种方法的行为。两者不冲突,但也不能互相替代——这也是自跑通道的固有边界:机器只有一台,方法只有一种。
说白了,顺带说一句探针本身的局限:它是 _draw() 里画 N 条命令的合成场景,没有真实游戏的内容分布。真实的 2D 场景里,批往往是被「突然插入的一张不同纹理」或「突然切换的材质」打断的——那些情形本篇由判据表(第六章)解释,而读数只覆盖了合成出来的几种极端情形。
十二、代价:批不出来时成本照付
第二章埋了一句「4.6 的返工」。这一章把那笔账摊开——并且主要用官方自己的话摊。
12.1 官方怎么说收益
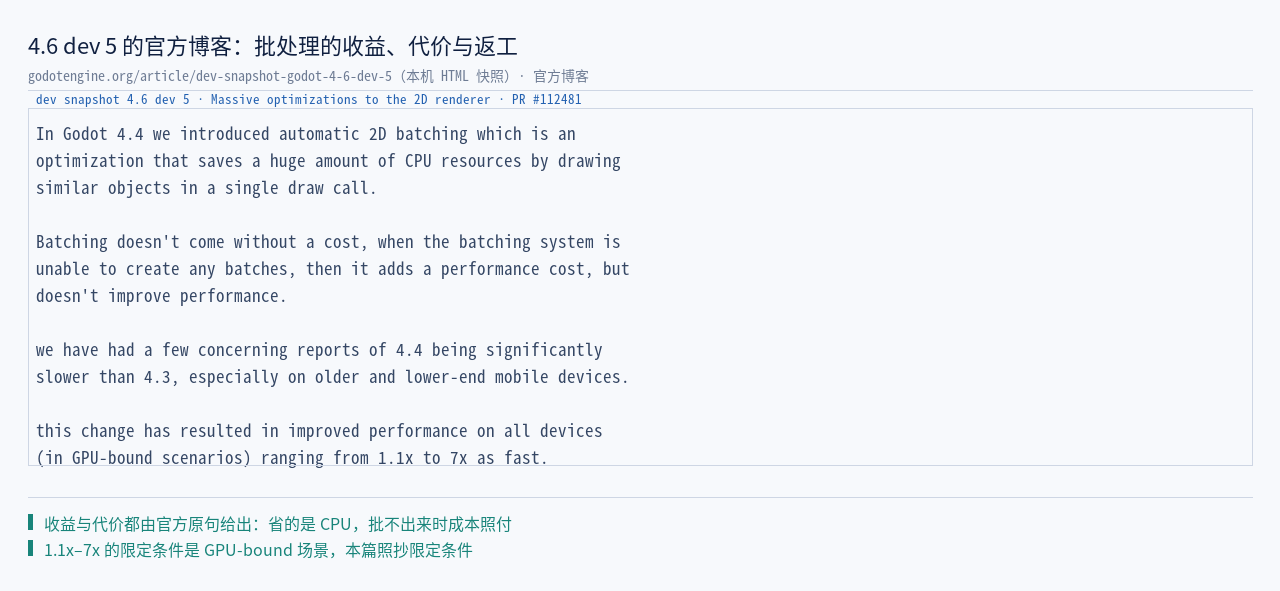
官方 4.6 dev 5 博客里有一节专讲 2D 渲染器。四段原文(按顺序):
- 收益侧:4.4 引入的自动 2D 批处理,「把相似对象画在一次 draw call 里,省下大量 CPU 资源」(
saves a huge amount of CPU resources by drawing similar objects in a single draw call);对容易批的内容收益巨大,比如文字密集的游戏或弹幕游戏。 - 代价侧:批处理不是没有代价——「当批处理系统无法创建任何批时,它增加了一份性能成本,却没有带来性能提升」(
adds a performance cost, but doesn't improve performance);它也让渲染对 GPU 稍微更贵一点。 - 现场反馈:实测中他们发现多数场景是 CPU 受限的,所以 GPU 成本上升没造成明显差别;但此后收到了一些「4.4 明显比 4.3 慢」的报告,尤其出现在老旧、低端的移动设备上——而这些设备往往是 GPU 受限 的,这让性能回退更值得担心。
- 返工结果:这一版对 2D 渲染器的设计做了大改以降低批处理的 GPU 成本;在 GPU 受限的场景里,各设备上的提升从 1.1 倍到 7 倍(
ranging from 1.1x to 7x as fast)。
第 2 段那句话值得单独抄下来:「批不出来时成本照付」不是我们的判断,是官方写的。它把「攒批」从「免费的优化」拉回到「一笔有条件的买卖」。
把最要紧的两句原文摘出来,方便逐句核对:
In Godot 4.4 we introduced automatic 2D batching which is an optimization that saves a huge amount
of CPU resources by drawing similar objects in a single draw call.

Batching doesn't come without a cost, when the batching system is unable to create any batches,
then it adds a performance cost, but doesn't improve performance.
言归正传,言归正传,其中:第一句给了收益的定义(省的是 CPU,靠的是「把相似对象画在一次 draw call 里」);第二句给了代价的定义(批不出来时「加了成本、没加性能」)。这条机制的原理可以概括成一句:批处理是把「许多次小提交」换成「少数次大提交」——它只在真能合并时才划算,合并不了就只剩开销。
12.2 两句话连起来读
上图把两笔账分开:CPU 侧省下的是提交次数(draw call 变少、状态切换变少、驱动调用变少);GPU 侧付出的是额外的数据与带宽(实例数据要上传、批级参数要绑定),而在「批不出来」的场景里,两边都不赚——GPU 那份成本照付。
把这条与第八章的上限判据合起来看,就能理解为什么「一批准装多少」这个旋钮是有意义的:批装得越多,摊在每一条命令上的固定成本越低;但装得越多,单条缓冲越大、越可能让批在不该断的时候断。
12.3 本篇的第三方立场
我们在这里加一句自己的话:11.x 那两组读数只证明了「容量与判据的行为」,没有测性能。性能那一侧本篇只引用官方结论(1.1×–7×),并明确它的限定条件——GPU 受限场景、对比对象是 4.6 改动前后。
按本篇边界声明第 3 条,我们不下探到 ROP 与显存层级去解释这 7 倍从哪来;也不据 PR 号推测实现细节。官方说了什么,本篇就写什么;官方没说的,本篇不补。
12.4 把 4.4 与 4.6 摆在一起看
这两次改动是一对:4.4 解决「有没有」,4.6 解决「划不划算」。
| 版本 | 要解决的问题 | 官方给出的结果 |
|---|---|---|
| 4.4 | 批处理只在 Compatibility 里,各后端 2D 性能不可比 | 批处理带给其余后端,「大幅减少 draw call」——解决「有没有」 |
| 4.6(dev 5) | 4.4 之后在 GPU 受限的旧设备上出现性能回退 | 2D 渲染器大改以降 GPU 成本,GPU 受限场景 1.1×–7×——解决「划不划算」 |
先来看看,其中:这张表把本篇前两章与本章串成一条线:文档改口(第一章)→ 发布说明(第二章)→ 代价与返工(本章),三处是同一件事的三个时间切片。而中间那些章节(三到十一章)讲的是这条路的机制——因为无论是 4.4 的「启用」还是 4.6 的「返工」,动的都是同一套判据与同一段实例写入。
说白了,顺带说一句:本节标题里的「今天」是有版本的今天。本篇所有关于 4.6 的表述都限定在 dev 5(开发快照) 这个时间点;4.6 正式发版之后是否还有调整,本篇不作预测。
本章出处:4.6 dev 5 官方博客(本机 HTML 快照)|对应 PR godot#112481|4.4 侧见 godot#92797与4.4 发布说明。
十三、收官:这条链还剩哪一层
十二章走下来,从文档改口一路走到两档探针。收尾一章把这条链收拢。
13.1 三个命题的兑现情况
回到第零章留下的三个命题,逐条对照:
| 命题 | 兑现 | 证据 |
|---|---|---|
| 一批能装多少是可配置的整数 | 已兑现:改设置,分界真的跟着走 | 第 11.2/11.3 节两档探针(512/513 与 16,384/16,385 同为 1→2) |
| 切批有两层判据 | 已兑现 | 第 5 章(项级:裁剪/材质)+ 第 6 章(命令级六条) |
| 攒批不是免费的 | 已兑现(官方原句) | 第 12 章(「批不出来时成本照付」+ 1.1×–7×) |
13.2 六条可以带走的结论
- 批的容量来自项目设置:
rendering/2d/batching/item_buffer_size,默认 16384,范围 128–1048576,改后需重启。 - Compatibility 另有一条同名项(
rendering/gl_compatibility/item_buffer_size)——这正是 4.3 时代「只有 Compatibility 有 2D 批处理」的源码痕迹。 - 第一条项总是自成一派(源码注释原话):批的判据全是「和上一批比」,第一条没有可比对象。
- 切批分两层:项级(
final_clip_owner/ 材质)与命令级(六条判据);Batch结构的字段几乎就是这两层判据的清单。 - 新批是上一批的副本改三处(计数归零 / 起点接上 / 推送数据清零)——「延续 + 少量修改」正好对应批的语义。
- 上限一到就冲刷、换缓冲、强制切批;一条实例是 128 字节,由编译期断言钉死。
13.3 全篇链条回看
上图把本篇插回系列那条链上。其中:剔除层交出链表(第四篇)→ 渲染层收进数组并切成批(第五篇)→ 本篇把「批本身」讲透(容量从哪来、判据怎么切、实例怎么写、代价在哪)→ 绘制列表与 RD(第七篇)。
先来看看,如果只记一件事,就记这条两段式:「容量」与「判据」是两个独立的东西——容量决定一批装多少条实例,判据决定会有几批。同一批里可以装下几百个矩形,是因为它们的判据全过;而 draw call 之所以能从 200 降到 1,正是因为判据一次都没被触发。
13.4 后面各篇各看哪一层
到此为止,本篇把「批」这一层讲完了,但它留下的问题还很具体:
- 这些批最终怎么变成
RenderingDevice上的命令、依赖图怎么排——第七篇; - Vulkan / D3D12 / Metal / OpenGL 四条路怎么分叉、RD 路径与 Compatibility 路径怎么共存——第八篇(这也直接呼应本篇第一、二章的历史:4.4 之后 Compatibility 那条「自己的 item_buffer_size」与通用批处理同时存在);
- 这一整套在什么时候被执行、逻辑与渲染怎么错位——第九篇;
- 一张纹理从盘上到实例数据里那个纹理句柄之间发生了什么——第十篇。
延伸阅读:想对照「用户侧怎么写出容易批的东西」,可看官方 CanvasItem 类参考与用服务器优化;它们讲的是接口与用法,本篇讲的是这套接口背后的容量与判据。
13.5 与前面几篇的对照
| 篇 | 入口 | 出口 | 它回答的问题 |
|---|---|---|---|
| 第四篇(剔除与排序) | 场景树 | 一条排好序的 Item 链 |
画什么、按什么顺序 |
| 第五篇(渲染抽象) | 一条 Item 链 |
一批批的实例数据 | 绘制项里存了什么、怎么被提交 |
| 第六篇(本篇) | 一批批的实例数据 | 批的容量与代价 | 批能装多少、按什么切、代价在哪 |
再说一遍,回头四篇连起来看,有一个共同的写法:每篇只讲清一层,接口两端是同一份数据的不同视角。第四篇里它是「排好序的项」,第五篇里它是「一条命令链上的节点」,本篇里它变成「批里的一格 128 字节」。对象没换,换的是谁在解释它。
下篇预告:下一篇顺着「批」往下走,问题换成这些批是怎么落到 RenderingDevice 上的——命令列表怎么变成依赖图、无环图解决了什么问题、以及 4.3 那次设备上下文的重构改了哪一层。
相关链接
源码落点:本篇共 221 处落点逐条实读(evidence/build/ep06_src_lines.txt,机器核对 0 FAIL),集中在
renderer_canvas_cull.cpp、
renderer_canvas_render_rd.cpp、
renderer_canvas_render_rd.h、
rendering_server.cpp、
renderer_canvas_render.h、
canvas.glsl、
canvas_uniforms_inc.glsl;
下面我们开始,其中:本篇特有的三处落点是 rendering_server.cpp:3709 的默认值注册、renderer_canvas_render_rd.cpp:3298 的上限判据、
以及 :3239 那条 write-combined 注释。行号一律按 master(2026-10-08 快照),不做算术平移。
资源清单
官方文档与文章(文档 CC BY 3.0 Unported,署名 “Juan Linietsky, Ariel Manzur and the Godot Engine community”,引用须标注改动): 4.4 发布说明、 4.6 dev 5 博客、 4.3 发布页、 内部渲染架构、 ProjectSettings 类参考、 CanvasItem 类参考、 CanvasGroup 类参考、 RenderingServer 类参考、 RenderingDevice 类参考、 画布项着色器参考、 用服务器优化。
对应 PR:godot#92797(4.4 把批处理带给其余后端)、 godot#112481(4.6 的 2D 渲染器大改)。
本机一手产物:evidence/probe/(两档探针日志 + 探针工程 + 一键复跑脚本)、
evidence/stage1/(4.3 与 master 两版文档原文、4.4 发布说明页、4.6 dev5 博客页)、
evidence/build/ep06_src_lines.txt(221 处落点核对)。
前作:第五篇 画布渲染抽象| 第四篇 画布剔除与排序| 第三篇 服务层接口| 第二篇 对象模型| 第一篇 全景与边界。
下篇预告:下一篇讲这些批怎么落到 RenderingDevice 上——命令列表怎么变成一张无环依赖图,以及设备上下文重构改了哪一层。
With Best Wishes.