核心问题:上一篇我们算完了加速结构的"静态账"——构建花多少、更新改什么、压缩省多少。但那笔账有个前提:场景基本不动,或者动得很温和。一旦场景里有大量动态物体、蒙皮角色、粒子特效、植被摇曳,那笔预付账的算法就完全不一样了。TLAS 每帧重建会不会成为瓶颈?BLAS 是 refit 还是 rebuild?三角形簇结构和 Opacity Micromap 这些新东西值不值得上?显存里到底多了哪些开销?这一篇就来算"动态场景"这本账——TLAS 的分区更新、BLAS 的动态策略、CLAS 的速度交换、OMM 的透明解放、内存账的拆解与预算,五件事合起来,才是"动态场景下加速结构到底亏不亏"的完整答案。
本篇不涉及 BVH 遍历的硬件实现(《GPU 架构剖析》已经写透,本篇只在"遍历是固定功能"这条结论上引用);不做建树算法的数学推导(只给"该选哪个策略"的判定口径);不写离线渲染的动态 BVH 优化(只关心实时预算下的取舍);也不写引擎编辑器的操作步骤。我们只把规范给的接口、厂商公布的数据、以及第三方实测的数字,摆成一本能算的账。
本系列(实时光线追踪与混合渲染,共 12 篇)的前置阅读:第一篇《分界线》给出了三类效果判据与三条成本模型;第二篇《加速结构工程账(上)》给出了构建/更新/压缩三科的静态账,本篇承接它的第三章(更新约束)与第五章(内存预算表),其余前置专题为算法层《实时渲染管线探析》5 篇、约束层《移动端图形与功耗》7 篇、硬件实现层《GPU 架构剖析》12 篇。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
点题:动态场景让预付账变活账
0.0 内容总览:本篇知识地图
先来看看一张总表,把八章各自回答的问题钉在这里。后面每一章都在展开其中的某一行。
| 章 | 回答的问题 | 核心结论 | 主要依据 |
|---|---|---|---|
| 一 | TLAS 在动态场景下怎么更省 | rebuild 是常态,分区更新适合"大部分不动、小部分动"的场景 | Vulkan 规范 · VK_NV_partitioned_acceleration_structure、NVIDIA Mega Geometry 样例 |
| 二 | BLAS 的动态策略怎么选 | refit 快但会退化、rebuild 慢但质量稳、混合策略看位移幅度 | SIGGRAPH 课程实测、Utah 大学 refit+rotation 论文 |
| 三 | CLAS 值不值得上 | 重建速度快一个数量级,但遍历略慢;适合高密度动态几何 | OptiX 9 官方口径、DXR 规范 CLAS 章节 |
| 四 | OMM 能省多少、代价是什么 | 透明几何的 TraceMain 可减半,阴影光线收益乘数效应;需要烘焙成本 | Indiana Jones 实测、VK_EXT_opacity_micromap 规范 |
| 五 | BLAS 的字节都花在哪 | 三角形节点 + 盒子节点 + 父链接 + 额外开销;主流厂商差 3x,含开源驱动最大 7x | zeux.io Bistro 实测、radv 开源驱动反推 |
| 六 | 动态场景的内存怎么算 | BLAS + TLAS + scratch + OMM + 多份副本;scratch 是容易漏算的大头 | 规范三类查询、RTX MU 内存优化实践 |
| 七 | 哪些技术还在实验阶段 | 四面体笼子、量化 BVH、混合 BVH;各有各的限制 | GPUOpen 论文、arXiv 量化 BVH 论文 |
| 八 | 五件事合起来是几句话 | 三句话判据 + 交棒 ep04(SBT) | 本篇归纳 |
读法建议:只想排查"TLAS 是不是瓶颈"的朋友,读第一章的决策树;要选 BLAS 更新策略的,读第二章的对比表;在考虑上 OMM 的,读第四章的收益与代价;要排显存预算的,直接翻第六章的预算表模板。
0.1 为什么动态场景是另一本账
先回顾一下上篇的结论:加速结构是一笔预付——花一次构建的钱,买下之后每一次遍历的便宜。这个模型在静态场景里工作得很好:构建一次,之后几百帧都在吃利息。
但动态场景把"一次"这个前提拿掉了。
想象一下这样的画面:一个开放世界场景,远处有山有水有城(静态),中景有 NPC 在走路、植被在摇曳(中量动态),近景有主角在跑酷、披风在飘、粒子特效满天飞(大量动态)。这样的场景里,加速结构的账该怎么算?
光追的本质,就是让每一条光线都和场景做一次"精确约会"。场景是静态的,这份约会名单可以提前排好;场景是动态的,名单每帧都得重排——加速结构就是这份名单。
至少有五件事会让静态账失效:
- TLAS 可能每帧都要重建——instance 变换每帧都变,TLAS 就每帧都得建一次。如果 instance 数很多,这笔开销可能从"可以忽略"变成"帧时间的几分之一"。
- BLAS 可能不能只 refit——蒙皮、形变、粒子这些拓扑变化的几何,refit 的禁止项直接命中,只能 rebuild。
- 新的结构出现了——三角形簇结构(CLAS)、Opacity Micromap(OMM),这些是为动态/高密度几何专门设计的,它们各自有一笔新账。
- 内存开销会变——动态场景需要 scratch buffer(可能很大)、可能需要多份 BLAS、OMM 还要额外内存。
- 策略选择变多了——静态场景只有"建一次就行",动态场景有 rebuild / update / refit / 分区 / 异步 / CLAS 等等一堆选择,选错了可能亏得更多。
这五件事,就是本篇的五章。
0.2 口径声明与边界
本篇所有数字按四档标注,正文里每次出现都会说明它属于哪一档:
| 口径 | 含义 | 本篇中的例子 |
|---|---|---|
| 规范事实 | 规范原文或由规范结构体布局直接推出的值 | update 的六条禁止项;OMM 细分层级;实例结构 64 B |
| 第三方实测 | 独立研究者在公开场景下的测量 | 跨厂商 BLAS 内存 18.8–137 B/tri(Bistro 场景) |
| 厂商官方口径 | 厂商官方文档、博客或样例给出的目标与收益 | OMM 将 TraceMain 从 7.9ms 降到 3.58ms(Indiana Jones · RTX 5080);CLAS 重建快一个数量级(OptiX 9) |
| 论文设定 | 论文在特定硬件与场景下的测量 | refit ≈ 10× 快于 full build;refit + rotation 接近 rebuild 质量 |
边界:不写 BVH 遍历的硬件实现;不写建树算法的数学推导;不写离线渲染的优化;CLAS、PTLAS、OMM 这些较新的扩展,明确标注其平台覆盖状态,不当成通用方案讲;四面体笼子、量化 BVH 等实验性技术只列名和现状,不给结论。
另有两条纪律跟上篇一样:"AS 占多少 MB"必须来自查询或实测,规范只给了可测量的接口、没给任何比例;论文里的绝对毫秒数不换算成项目结论,只取其中的相对关系与量级。
一、TLAS 的动态策略:从全重建到分区更新
1.0 TLAS 为什么会成为瓶颈
先从最顶层说起。在上篇里我们说过,TLAS 是"实例数组"——它装的是一个个 instance,每个 instance 指向一个 BLAS,带一个变换矩阵。遍历从 TLAS 开始,先找到哪个 instance 被击中,再钻进对应的 BLAS。
静态场景下,TLAS 建一次就够了。但只要 instance 的变换在变(位置、旋转、缩放),TLAS 就需要更新。而大多数游戏场景里,instance 变换每帧都在变——角色在动、载具在动、摄像机在动、可交互物体在动。
所以一个常见的做法是:TLAS 每帧重建。
这带来一个直接的问题:TLAS 重建的成本与什么成正比?
答案是:instance 数。TLAS 本质是对 instance 的包围体层次,instance 越多,建树的工作量越大。如果你的场景有几千个 instance,TLAS 重建可能不到 0.1 ms;但如果是开放世界、有几万甚至十几万 instance,这个成本就不能忽略了。
两个常见误解:
- "TLAS 用 update 不就行了吗?"——上篇说过,规范里 TLAS 的 update 只允许改变换矩阵,不允许增删 instance。如果你的场景 instance 数在变(比如流式加载、对象显隐),update 就用不了,只能 rebuild。
- "TLAS rebuild 一定比 update 慢很多"——不一定。对于 TLAS 这种 instance 级别的结构,rebuild 本身就不慢(instance 的 AABB 求交很便宜),而且 rebuild 保证树的质量最优,update 可能让盒子变松。NVIDIA 的最佳实践甚至建议 TLAS "prefer rebuild over update"。
所以对大多数项目来说,TLAS 每帧 rebuild 是默认选项。但当 instance 数特别多、且大部分不动的时候,就有更省的办法——分区 TLAS。
1.1 分区 TLAS:只重建变了的部分
分区加速结构(Partitioned TLAS,PTLAS) 是 NVIDIA 提出的一个扩展(VK_NV_partitioned_acceleration_structure),思路很直观:把 instance 按"动没动"分到不同的 partition 里,每帧只重建动了的那些 partition。
具体来说,PTLAS 把 instance 分成三类:
- 全局 partition——基本不动的静态物体,建一次就一直用;
- 分区 partition——中等频率变化的物体,按区域/类型分组,每组独立重建;
- 单 instance 更新——高频但少量的变化(比如主角、摄像机附近的物体),直接 update 单个 instance。
本质是缩小重建范围,而不是加快更新本身。如果场景里 90% 的物体是静态的,每帧只需要重建 10% 的 TLAS,成本理论上就是原来的 1/10。
NVIDIA 的样例用超过 10 万个物理对象做了演示——这些对象分布在不同区域,只有摄像机附近的分区需要每帧重建,远处的保持不动。结果是:TLAS 构建时间从"与全场景 instance 数成正比"变成"与视野内变化的 instance 数成正比"。
但 PTLAS 有几个前提条件:
- 你得能把 instance 按动静分组——如果所有 instance 都在动(比如满屏粒子),分区就没有意义了。
- 你得接受它是 NVIDIA 专有扩展——目前是
VK_NV_前缀,不是 KHR 级别的跨平台方案。 - 你需要跟踪"哪些 instance 动了"——这本身也有开销,如果跟踪错了还会导致错误。
所以它适合的场景很明确:开放世界 + 大量静态物体 + 动态物体集中在局部区域。如果你的场景是竞技场式的(所有东西都在动),或者是线性关卡(场景整体流式加载),PTLAS 的收益就很有限。
1.2 TLAS 动态策略决策树
说了这么多,到底该选哪种策略?在看决策树之前,先建立一个直观:TLAS 装的是一个个 instance,每个 instance 带自己的变换矩阵——场景里 instance 越多、越分散,TLAS 重建的工作量就越大。
我们把策略收成一棵决策树:
走一遍:
-
instance 数多不多? - 不多(几千以内)→ 直接每帧 rebuild。简单、可靠、质量最优。这点成本不值得花精力去优化。 - 很多(几万以上)→ 继续看。
-
每帧变动的 instance 比例高不高? - 很高(大部分都在动)→ 还是 rebuild。变动比例高的话,分区也省不了多少,反而增加复杂度。 - 不高(小部分在动)→ 继续看。
-
目标平台支持 PTLAS 吗? - 支持(NVIDIA 平台,且用 Vulkan)→ 考虑分区 TLAS。收益大致与"静态 instance 比例"成正比。 - 不支持 → rebuild + 优化 instance 数。比如把远处的静态物体合并成大 instance、用 LOD 减少 instance 数。
-
能不能接受专有扩展? - 能 → 上 PTLAS。 - 不能 → 还是 rebuild。或者考虑其他优化方向(比如减少 instance 数、合并静态物体)。
一条经验:优化 TLAS 之前,先确认它真的是瓶颈。用 Profiler 测一下 TLAS 构建占帧时间的比例,如果不到 1%,就不值得花精力在这上面——把时间花在 BLAS 优化或降噪器上,收益可能大得多。
1.3 TLAS 更新的带宽账
分区重建省的是构建时间,但每次更新都要把 instance 数据搬上显存——这笔带宽账常被漏算。
先看数据量。Vulkan 里一个 TLAS instance 的描述(VkAccelerationStructureInstanceKHR)是 64 字节:3×4 的变换矩阵 48 字节,instance custom index 与 mask 8 字节,SBT 记录偏移与 flag 8 字节。5000 个 instance 就是 320 KB,一万个是 640 KB。
这个数单独看很小——320 KB 走 PCIe 4.0 ×16(理论 32 GB/s)只要 10 微秒。问题在更新频率:如果每帧全量重建 TLAS,就等于每帧把这几百 KB 从 CPU 侧推一次;按 60 fps 算是每秒约 19 MB 的持续占用。听起来仍然不多,但这条路径上有两个放大器:
一是屏障与依赖链。 instance 数据上传只是第一步,后面还跟着 host write → 传输 → build → 屏障 → 光追读取四道同步。每帧都走一遍这条链,代价不在字节数上,在每次同步让谁等多久上(这一条在 ep05 讲队列重叠时会展开)。
二是 scratch 与双缓冲。 用异步构建(在计算队列上建结构、图形队列继续跑)时,动态部分的 BLAS 要准备两份;TLAS 的 scratch 也要按最大实例数预留。这两项不占上传带宽,但占显存——在 6.4 节那笔压测账里能看到它们随规模怎么长。
所以"每帧全量重建 TLAS"这种做法,在实例数少的时候看起来没问题,一旦实例数上万、同时又要异步构建,账就翻过来了。这也是分区方案真正的落点:它不是把单次构建变快,而是把每帧要碰的数据量按"动了多少"而不是"总共有多少"来算。
二、BLAS 的动态选择:refit、rebuild 还是混合
2.1 为什么 BLAS 的动态策略更复杂
TLAS 是 instance 级的,每个 instance 只是一个变换矩阵 + 一个指针,所以重建本身不慢。BLAS 就不一样了——它是三角形级的,一个 BLAS 可能有几万、几十万甚至上百万个三角形。BLAS 的重建成本要高得多。
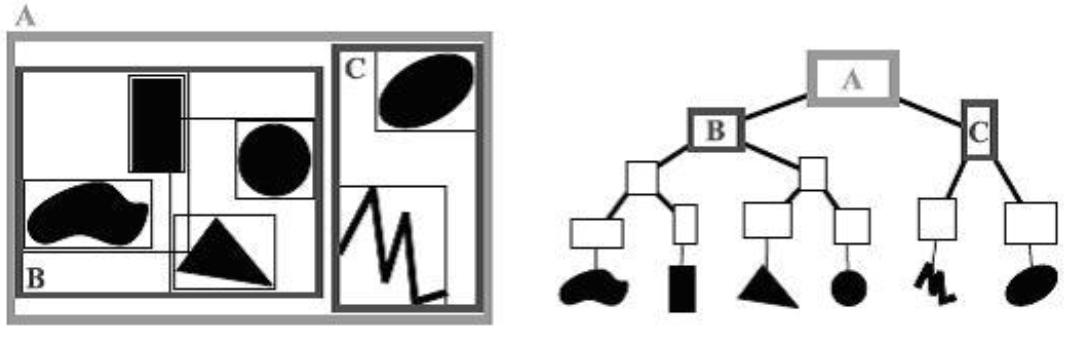
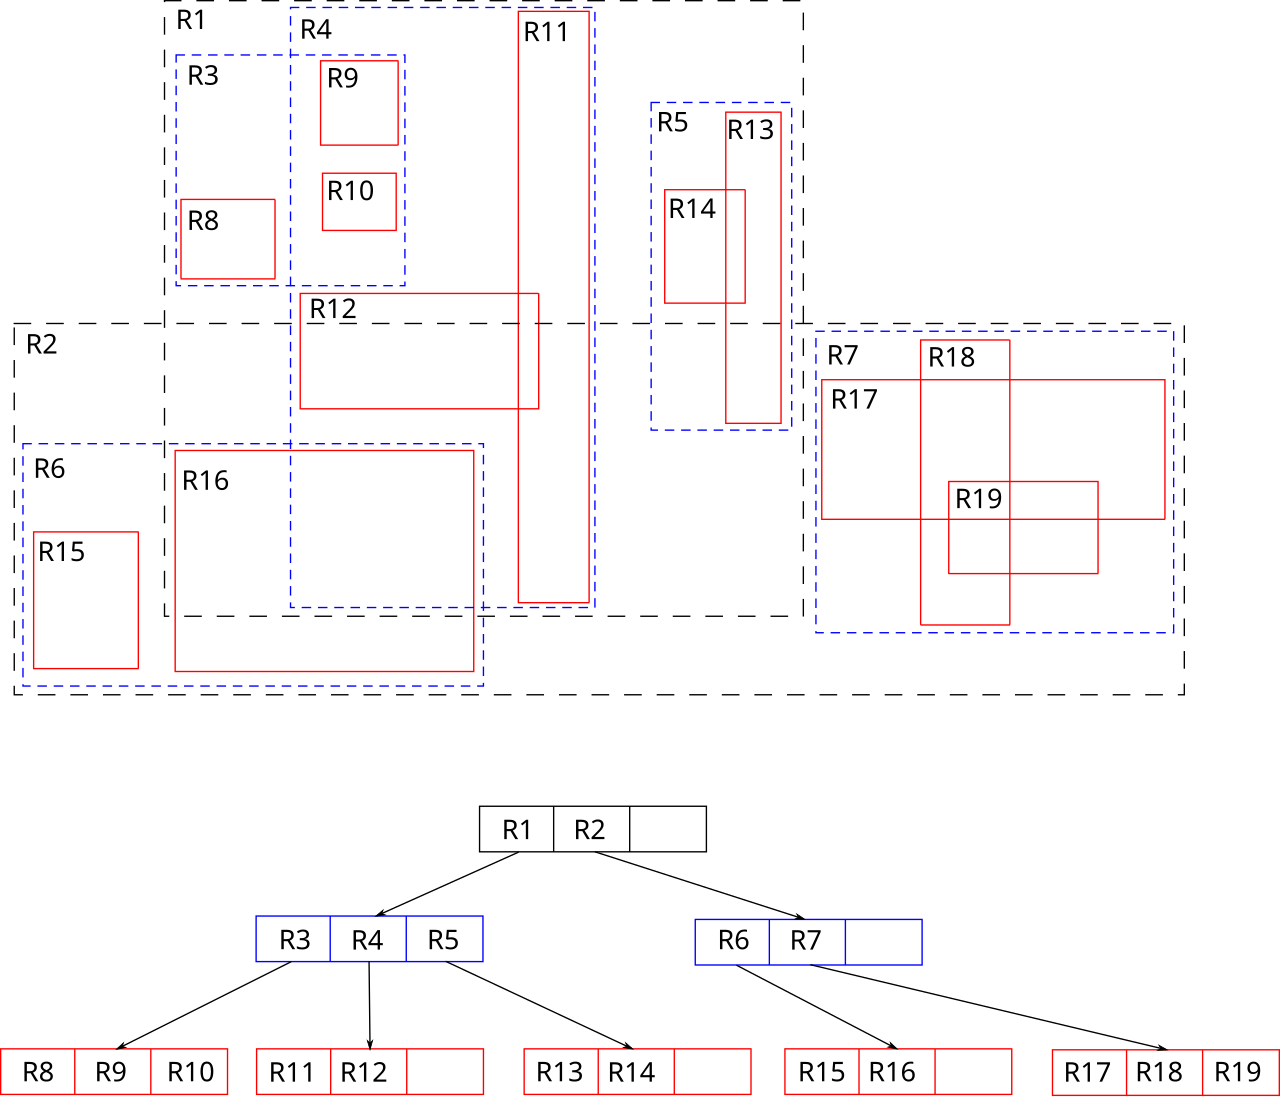
图 BVH 的基础结构:父节点用包围盒子节点,叶子节点里装三角形——BLAS 的内存账、更新策略、退化机理,都从这个结构长出来 @ Wikimedia Commons · Example of bounding volume hierarchy.JPG(Public domain)
所以 BLAS 的动态策略选择,是加速结构工程里最纠结的问题之一。
先回顾上篇结论: BLAS 的 update(即 refit)只允许改顶点位置,不允许增删三角形、不允许改顶点数、不允许改变几何身份。
那蒙皮网格算什么?蒙皮网格(skinned mesh)顶点位置每帧都在变,但三角形连接关系不变——从规范角度看,属于"顶点位置变化",理论上可以 refit。但实际上呢?
大多数引擎对蒙皮网格选择每帧 rebuild BLAS,而不是 refit。 原因有两个:
- 蒙皮位移幅度可能很大——角色挥一下手臂,顶点可能移动很远。refit 只是重新收紧盒子,不改变树的拓扑结构。位移大的话盒子会变得很松,遍历质量急剧下降。
- 蒙皮三角形数通常很多——一个角色就有几万到几十万三角形。refit 虽然快,但遍历退化的损失可能远大于 refit 省下的构建时间。
这就引出了 BLAS 动态策略的核心矛盾:构建速度和遍历质量的权衡。
2.2 refit 的退化曲线
refit 快不快?很快。经验值是 refit 大约比 full rebuild 快一个数量级(~1000 Mtris/s vs ~100 Mtris/s,论文设定口径)。如果你有 10 万三角形,rebuild 可能要 1 ms,refit 可能只要 0.1 ms。
但 refit 有个致命的问题:树的质量会退化。
想象一下:一棵树本来长得好好的,每个盒子都紧紧包住里面的三角形。然后三角形开始移动,你只是把盒子重新撑大来包住新位置,但不重新调整树的结构。结果是什么?盒子越来越松,重叠越来越多,空空间越来越大。
退化的程度取决于两个因素:
- 位移幅度:位移小(比如风吹草动、轻微抖动),退化很慢,可能几十帧才需要 rebuild 一次;位移大(比如角色动画、物体瞬移),几帧之内退化就很严重了。
- 位移的一致性:如果所有三角形朝同一个方向移动(比如整体平移),盒子只需要整体平移,退化很轻;如果三角形各奔东西(比如爆炸、撕裂),退化很快。
一个常见的误解:"refit 之后树的深度不变,所以遍历次数不变。"——不对。遍历的成本不只取决于树的深度,更取决于有多少盒子被射线击中。盒子越松,重叠越多,被击中的概率就越高,需要测试的节点就越多,遍历就越慢。
极端情况下,refit 后的遍历时间可能是 rebuild 的好几倍。上篇提到的粒子系统例子:rebuild 后遍历约 0.5 ms,每帧 refit 后退化到约 8 ms——省了 0.9 ms 的构建时间,亏了 7.5 ms 的遍历时间,净亏 6.6 ms。
这就是 refit 的"反向恶化":你以为省了构建时间,结果在遍历上亏得更多。
2.3 三种策略的对比
那到底该选 refit、rebuild,还是别的什么?我们把常见的策略放在一张表里对比。
在看表之前,先回顾一下上篇讲过的一对基本概念——空间划分 vs 对象划分。为什么要回顾这个?因为 refit 的退化机理、rebuild 的质量优势、甚至 CLAS 的思路,根子上都和"盒子是怎么包的"有关。
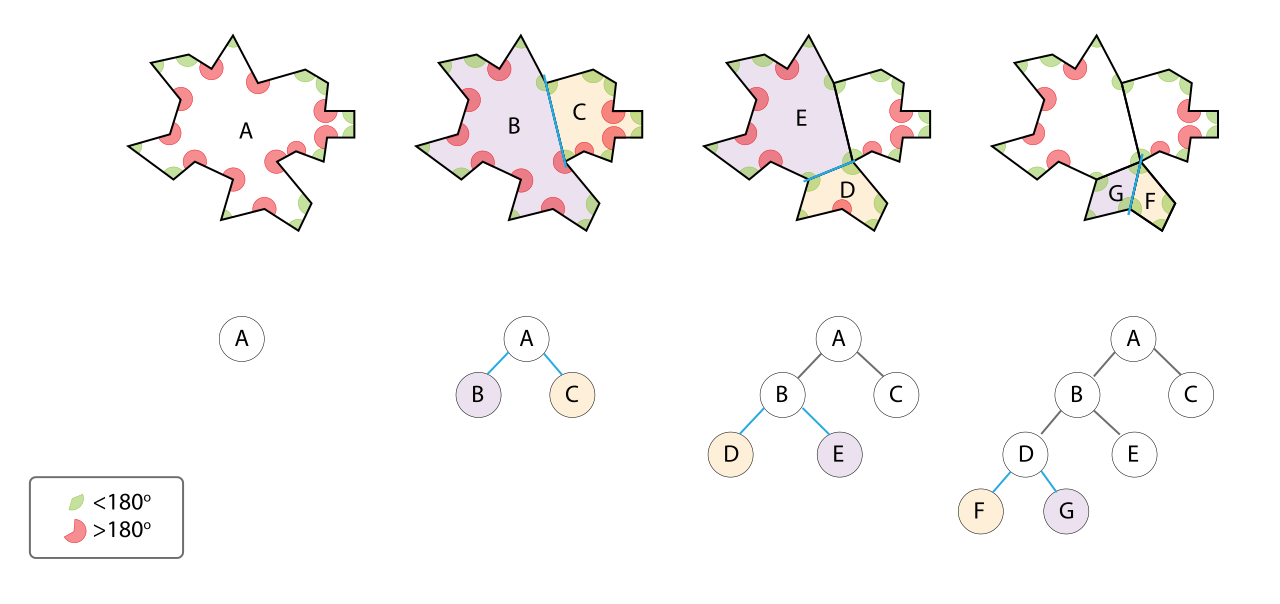
理解了这张图,再看三种策略的差异就有了坐标:refit 是"让盒子变形但不改结构",rebuild 是"重新算一遍最优结构",CLAS 是"先打包再建"。
| 策略 | 构建速度 | 遍历质量 | 内存开销 | 适用形变 | 拓扑变化 | 实现复杂度 |
|---|---|---|---|---|---|---|
| refit | 快(~10× rebuild) | 随形变退化 | 低(与原结构同) | 小位移、连续形变 | 不支持 | 低 |
| refit + rotation | 较快(略慢于 refit) | 接近 rebuild | 低 | 中等位移、旋转变形 | 不支持 | 中 |
| rebuild | 慢(基准) | 最优 | 高(需 scratch buffer) | 任意形变 | 支持 | 低 |
几个补充说明:
- refit + rotation 是学术论文里的方案(Utah 大学 2010 年左右的工作),在 refit 的基础上增加了"节点旋转"操作——当兄弟节点的子树交换后遍历效率更高时,就交换它们。论文说在 6 个测试场景里,有 5 个场景的帧时间接近或超过 rebuild 的性能,而额外开销很小。但这是软件 BVH 的方案,硬件加速光追里能不能用、驱动有没有做,要看具体实现。规范层面没有这个选项。
- 混合策略——不是一个独立的策略,而是"对不同的 BLAS 用不同的策略"。比如静态物体用 rebuild(一次就好),小位移的植被用 refit,大位移的角色每 2-3 帧 rebuild 一次。这才是真实项目里最常见的做法。
- 异步 rebuild——把 rebuild 放到计算队列或者另一帧执行,当前帧用旧的 BLAS。这样构建时间不占渲染帧,但会有一帧的延迟。对于背景物体、远处物体,延迟一帧没人会注意;但对于主角、近处的物体,一帧延迟可能导致穿模或阴影错位。
2.4 怎么选:三道判据
把上面的内容收成三道判据,判断一个 BLAS 该用什么策略:
-
几何的身份会不会变?(三角形数会不会变、会不会增删图元) - 会(粒子、破碎、生成式几何)→ 只能 rebuild。refit 的禁止项直接命中。 - 不会(蒙皮、变形、刚体运动)→ 继续看。
-
顶点位移幅度大不大?(相对于包围盒尺寸) - 很小(< 5%,比如风吹草动、轻微抖动)→ refit。退化很慢,构建省得多。 - 中等(5%–30%,比如角色动画、普通运动)→ 看情况:如果三角形少、refit 很快,退化后仍可接受 → refit + 定期 rebuild;如果三角形多、遍历成本高 → 直接 rebuild 或每 2-3 帧 rebuild。 - 很大(> 30%,比如爆炸、瞬移)→ 直接 rebuild。refit 的退化太严重,得不偿失。
-
这东西重不重要?(在不在视野里、占不占像素、光追采样多不多) - 不重要(远处的、小的、采样少的)→ 怎么便宜怎么来。refit 甚至跳过光追都行。 - 重要(主角、近处的、阴影采样多的)→ 质量优先。rebuild 或者高频率 rebuild。
一条纪律:选策略之前先测一下。 不要凭感觉选——建一个测试场景,分别测 refit 和 rebuild 的构建时间 + 遍历时间,看哪个加起来更小。不同几何、不同位移模式,最优策略可能完全不一样。
2.5 怎么知道该 rebuild 了:退化检测
refit 的退化曲线(2.2 节)是"事后"看到的。项目里更需要的是运行时的判据:这一帧的 refit 到底还值不值,什么时候必须重建。
工程上常用三类信号,它们各有各的盲区:
第一类是遍历步数(traversal step count)。 现代 GPU 的 RT Core 可以把每次遍历访问的 BVH 节点数报回来,把它除以光线数就是平均步数。refit 退化时,节点包围盒变大、重叠增多,平均步数会明显上升。这是最直接的信号,代价是要开一个额外的统计通道,且统计本身有开销——通常按帧抽样几个百分点的像素来估,而不是全屏统计。
第二类是结构质量指标。 在构建时算一个 SAH(Surface Area Heuristic)代价,重建时对比"当前结构与理想结构的代价比"。比值超过阈值就说明结构已经松了。这一类的优点是度量了"结构有多差"而不是"这帧有多慢",不受场景内容干扰;缺点是要额外跑一次代价评估。
第三类是最实在的:帧时间本身。 观察光追 pass 的 GPU 时间,在三角形数不变、光线数不变的前提下,如果它持续上升,那基本就是结构退化在拖。缺点是要先排除其他变量(纹理缓存、带宽竞争、时钟波动),而且它报得比前两类晚。
三类信号里,我建议用第一类做触发、第三类做兜底:遍历步数上升超过基线的一定比例就触发一次重建,同时给帧时间设一个硬上限,超过就无条件重建。第二类适合在离线工具里做结构质量审计,不适合放进每帧循环。
还有一个容易忽略的细节:退化的判据要和光线类型分开看。 阴影光线的遍历通常很短(找到第一个遮挡就停),对结构质量不敏感;而 GI 光线又长又散,对退化最敏感。如果只统计全屏平均,会被占比最大的阴影光线稀释掉。分开统计是个便宜但有效的改进。
三、三角形簇结构(CLAS):重建速度换遍历开销
3.1 为什么需要 CLAS
前面说了,动态高密度几何(比如细分曲面、粒子系统、高密植被)的 BLAS 重建可能很贵——三角形太多了。
有没有办法让重建更快?
一个思路是:不要从原始三角形开始建,先把三角形打包成"簇",再从簇开始建。这样做有两个好处:
- 簇的数量比三角形少得多——如果一个簇有 64 个三角形,那建树的工作量就从 N 变成了 N/64,快很多。
- 簇可以预计算——如果网格的拓扑不变(只是顶点在动),簇的划分可以离线算好,运行时只需要更新每个簇的包围盒。
这就是 Cluster Acceleration Structure(CLAS) 的核心思想。
3.2 CLAS 是什么
CLAS(Cluster Acceleration Structure) 是一种中间级的加速结构。它不是 BLAS,也不是 TLAS,而是介于三角形和 BLAS 之间的一层。
传统的 BLAS 是这样建的:三角形 → 建树器 → BVH。
有了 CLAS 之后是这样的:三角形 →(聚类)→ CLAS 簇 → 建树器 → Cluster BLAS。
关键细节:
- CLAS 是用户定义的——你决定怎么把三角形分组、分多少组。规范不会自动帮你聚类。
- CLAS 可以被多个 Cluster BLAS 引用——同一个簇模式可以用在不同的 LOD 级别,或者跨多个 mesh 共享。
- Cluster BLAS 的叶子节点是 CLAS 簇,不是三角形——遍历时,先找到击中了哪个簇,再在簇内找三角形。
这样做的收益是什么?
- 构建快很多——因为簇的数量远少于三角形。OptiX 9 的官方口径是"重建速度快一个数量级"。
- 簇可以复用——如果拓扑不变(只是顶点在动),簇的划分不需要重新计算,只需要更新每个簇的包围盒。
- 适合流式加载和 LOD——可以按簇为单位加载/卸载,或者不同 LOD 用不同密度的簇。
代价呢?
- 遍历可能略慢——多了一层间接性,而且簇内的三角形可能不是最优划分。
- 需要额外的工具链——你需要一个簇生成器(NVIDIA 提供了库),以及烘焙流程。
- 支持度有限——目前是 DXR 和 Vulkan 扩展级别,不是所有平台都支持。
3.3 性能权衡
我们把 CLAS 的性能权衡画成一张图:
怎么理解这张图:
- 如果你每帧都要重建(比如粒子系统、实时细分),CLAS 的收益最大——构建省了 90%,遍历只亏一点点,净赚很多。
- 如果你只建一次(静态场景),CLAS 就不划算——遍历还变慢了,完全没必要。
- 中间地带(比如每 5 帧 rebuild 一次)→ 要看具体比例,算一下构建省下的时间能不能覆盖遍历多花的时间。
一个量化的例子(假设数字,仅说明量级关系):
- flat BLAS:构建 1 ms,遍历 2 ms,合计 3 ms
- Cluster BLAS:构建 0.1 ms,遍历 2.2 ms,合计 2.3 ms
- 如果每帧都重建:CLAS 省了 0.7 ms(23%)
- 如果每 10 帧重建一次:flat 平均 (1 + 2×9)/10 = 1.9 ms;CLAS 平均 (0.1 + 2.2×9)/10 = 1.99 ms → flat 反而更快
所以 CLAS 什么时候值? → 重建频率越高、三角形越密,越值。
3.4 适用场景
那什么样的场景适合上 CLAS?
高收益区(推荐上):
- 细分曲面(Subdivision Surface)——Catmull-Clark 细分出来的三角形密度很高,而且簇模式可以预计算、跨帧复用。OptiX 9 专门提到了这个场景。
- 粒子系统——粒子数多、每帧都在动、每帧都要重建。
- 高密植被——草叶、树叶,三角形多、有动画、需要每帧或高频重建。
- 程序化生成几何——运行时生成的高密度几何,需要快速构建。
低收益区(不推荐):
- 普通静态网格——建一次就完事了,CLAS 的遍历开销纯亏。
- 低三角形数的动态物体——本来构建就很快,省不了多少,反而增加复杂度。
- 跨平台项目——如果目标平台不支持 CLAS,需要 fallback 方案,增加维护成本。
提醒:CLAS 目前还是比较新的技术,DXR 和 Vulkan 的支持情况、性能表现可能因厂商而异。上之前一定要在目标平台上实测——不要光看宣传数字,要用你自己的几何、你自己的场景测。
四、Opacity Micromaps:把透明从 any-hit 里解放出来
4.1 透明几何为什么贵
在光追里,透明物体(alpha test / alpha clip)特别贵。
想象一片草地:每根草都是一个透明的薄片,光线穿过草地的时候,可能要击中几十片草叶,每一片都要调 any-hit shader 来判断"这像素是草还是空"。如果是软阴影,每条阴影光线都要重复一遍这个过程——成本直接乘以采样数。
为什么?因为对于不透明物体,光线打到三角形之后就停了(closest hit),继续往下走就行。但对于透明物体,光线可能穿过去——你需要在 any-hit shader 里采样 alpha 贴图,判断这个像素是不是透明的,如果透明就忽略这次相交,继续找下一个。
问题在于:
- any-hit shader 执行频率很高——每击中一个透明三角形都要执行一次。如果是植被这种又多又透明的东西,any-hit 可能成为光追性能的最大瓶颈。
- any-hit 打断了硬件的遍历优化——RT Core 本来可以一口气遍历很多节点,遇到 any-hit 就得停下来等着色器执行,流水线被打断了。
- 透明物体的三角形通常很小很多——植被、头发、围栏,这些东西三角形密度很高,击中概率也高。
所以透明几何的光追成本,一直是个老大难问题。
Opacity Micromap(OMM) 就是为了解决这个问题而生的。
4.2 OMM 是什么
Opacity Micromap(微透明贴图) 的思路很直接:把透明度信息直接编码进加速结构里,让硬件在遍历的时候就知道哪些区域是透明的,不需要调用 any-hit shader。
具体来说:
- 每个大三角形被均匀细分为 4^N 个微三角形(micro-triangle)。
- 每个微三角形被标为三种状态之一:完全不透明、完全透明、未知(需要调 any-hit)。
- 遍历的时候,硬件直接跳过完全透明的微三角形,完全不透明的直接进入 closest hit,只有"未知"的才需要调 any-hit shader。
思路简单,收益直接。
为什么?因为 alpha test 的几何通常有一个特点:大部分区域要么全透明、要么全不透明,只有边缘那一圈是半透明的(也就是"未知"状态)。如果硬件能直接跳过完全透明的区域,any-hit shader 的调用次数就会大幅下降。
降多少? Indiana Jones 里的实测数据(厂商官方口径):
- 植被场景的 TraceMain pass:从 7.90 ms 降到 3.58 ms(RTX 5080)——省了 55%。
- 这还只是主光线。如果算上阴影光线,节省更多。
4.3 收益乘数效应:阴影越软,省得越多
OMM 有一个"收益乘数效应"——阴影光线越多,省得越多。
为什么?因为透明物体最常被什么光线击中?阴影光线。
想象一下:一片草,主光线可能只会击中一次(你看到草叶),但阴影光线呢?如果是点光源硬阴影,每个像素 1 条阴影光线;如果是软阴影,可能是 16 spp、32 spp 甚至更多。每条阴影光线穿过草叶的时候,都可能触发 any-hit。
所以 OMM 的节省大致与"穿过透明物体的光线数"成正比。
举个例子(仅说明量级关系):
- 主光线:透明物体贡献 2 ms → OMM 省 1 ms
- 阴影光线(8 spp):透明物体贡献 8 ms → OMM 省 4 ms
- 合计省 5 ms
如果阴影是 16 spp:
- 阴影光线贡献 16 ms → OMM 省 8 ms
- 合计省 9 ms
这就是为什么 OMM 在有软阴影的路径追踪管线里收益最大——阴影采样数越高,省得越多。
4.4 OMM 的代价
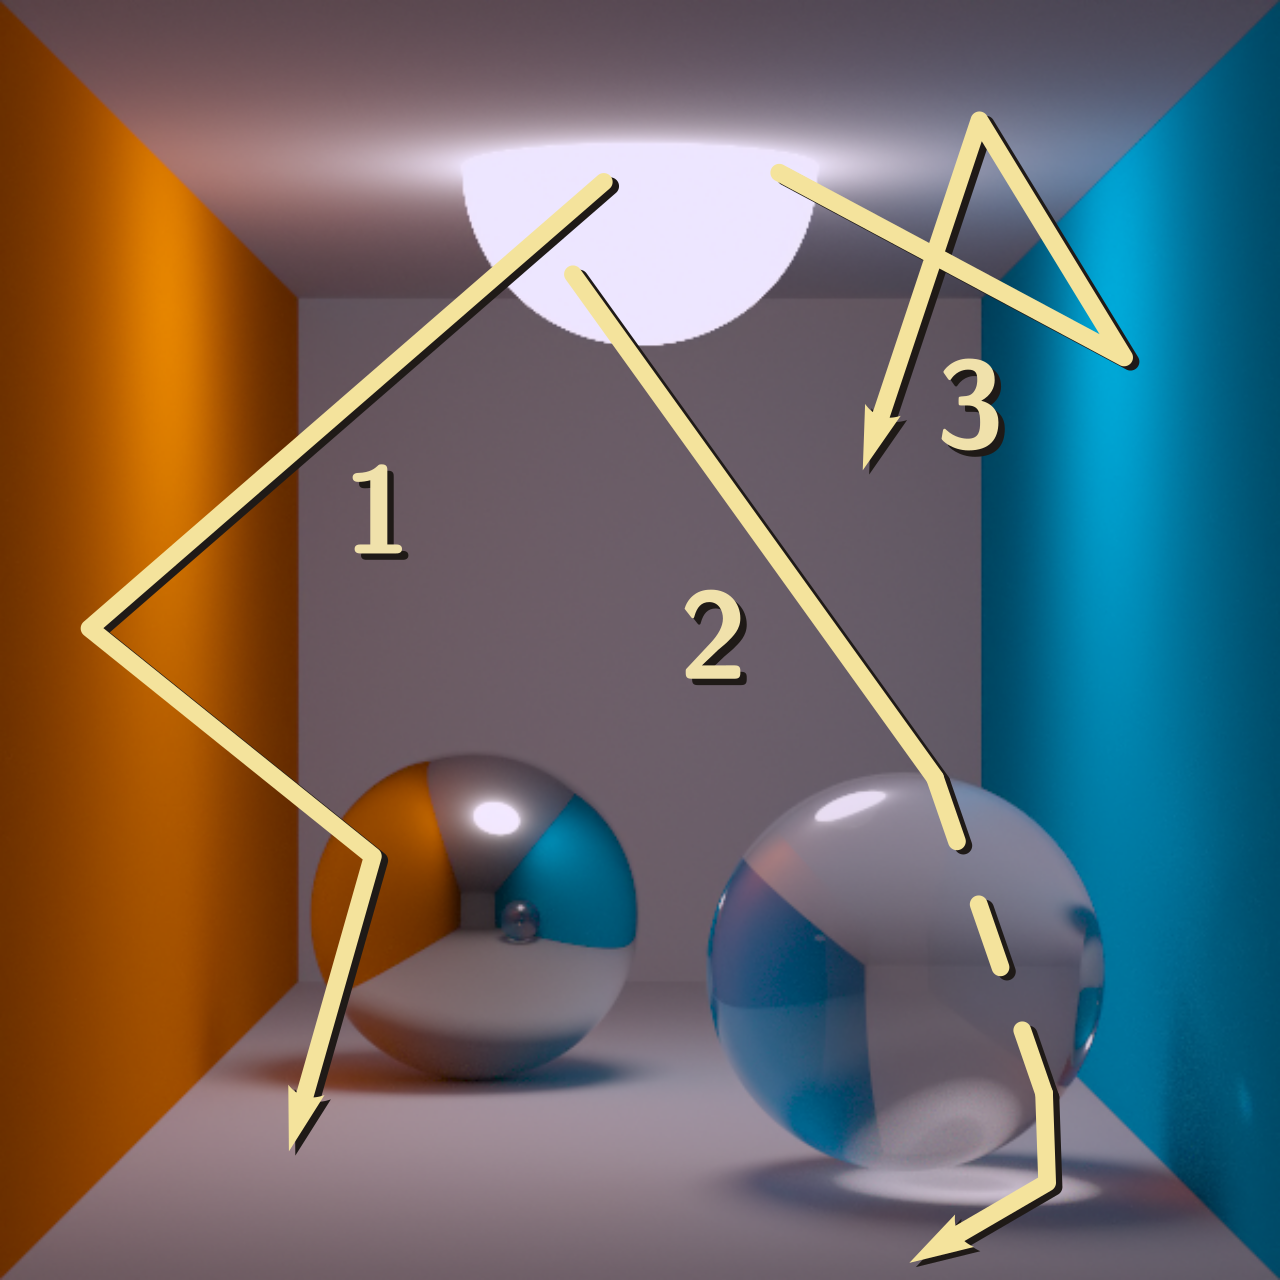
天下没有免费的午餐。OMM 省了遍历时间,但它有代价。在说代价之前,先看一张光线路径图——理解了"光线在透明物体里是怎么走的",才能理解 OMM 的价值和代价。
1. 额外的内存开销
每个 OMM 数据存在哪里?存在加速结构旁边(或者说,是加速结构的一部分)。大小取决于细分层级:
- 4^3 = 64 微三角/大三角 → 每大三角 64 × 2 bit = 16 字节
- 4^4 = 256 微三角 → 每大三角 64 字节
这个开销可大可小——如果透明几何很多,OMM 的内存可能不小。
2. 烘焙成本
OMM 不是自动生成的,你需要从 alpha 贴图烘焙出来。这个烘焙可以离线做(对于静态网格),也可以运行时做(对于动态 alpha)。离线烘焙是一次性成本,运行时烘焙就需要算到帧时间里。
3. 支持度
OMM 目前是扩展级别(VK_EXT_opacity_micromap),不是所有硬件都支持。移动端、集显可能不支持。项目需要 fallback 方案。
4. 质量损失(可选)
如果你用二态 OMM(只有透明/不透明,没有未知),边缘的过渡像素会变成硬边,没有抗锯齿效果。这是一个质量与性能的权衡——你可以用更高的细分层级来缓解,或者接受轻微的质量下降。
4.5 什么时候上 OMM
把上面的内容收成一个决策表:
| 条件 | 建议 |
|---|---|
| 透明几何很少(< 5% 三角形) | 不上。不值得花精力。 |
| 透明几何多,但都是简单形状(比如广告牌) | 可以上,用低细分(2-3 级)就行。 |
| 透明几何多且复杂(植被、头发、围栏) | 强烈推荐上,用 4-5 级细分,收益最大。 |
| 软阴影/路径追踪管线(阴影采样多) | 强烈推荐上,收益乘数效应突出。 |
| 移动端 / 不支持 OMM 的平台 | 不上。用其他方法优化(比如减少透明几何、用 impostor)。 |
| 运行时动态 alpha(不能预烘焙) | 看情况。如果运行时烘焙成本低于 OMM 节省的时间,就上。 |
一条经验:OMM 是那种"上了就回不去"的功能——一旦你看到植被场景从 16 ms 变成 7 ms,你就再也不想关掉它了。但上之前一定要在目标平台上测——不光测性能,还要测内存和质量。
五、内存账拆解:BLAS 的字节都花在哪
5.1 为什么要拆解内存
在上篇里我们说过,加速结构有多大,用 vkGetAccelerationStructureBuildSizesKHR 一查就知道了。这没错——但"知道多大"和"知道为什么这么大"是两回事。
如果你只是想排预算,查一下就够了。但如果你想优化内存、或者想理解"为什么不同厂商差这么多"、又或者想判断"这个数字合不合理",你就需要知道内存是怎么花出去的。
这一章,我们就把 BLAS 的内存拆开来看看。
先看一组来自第三方实测的数字(zeux.io,2025 年 3 月,Bistro 场景,1.754M 三角形,FAST_TRACE + 压缩):
| GPU / 驱动 | BLAS 大小 | 每三角字节 |
|---|---|---|
| NVIDIA RTX 5070 | 33 MB | 18.8 B/tri |
| NVIDIA RTX 4090 / 3050 / 2080 | 45–46 MB | 25.7–26.5 B/tri |
| AMD Radeon 9070 (RDNA4) | 84 MB | 47.9 B/tri |
| AMD Radeon 7900 GRE (RDNA3) | 100 MB | 57.0 B/tri |
| Intel Arc B580 | 79 MB | 45.0 B/tri |
| Apple M4 | 93 MB | 53.0 B/tri |
| radv (Mesa 25.0, RDNA3) | 241 MB | 137.4 B/tri |
主流厂商之间约 3 倍,算上开源驱动最大 7.3 倍。同硬件不同驱动也能差 2.4 倍。 这差距太大了,不可能只是"实现质量"的差异——肯定有结构上的不同。
接下来我们就来拆一拆:这些字节都花在哪了。
5.2 BVH 内存构成模型
BVH 是什么?是一棵树。树上有两种节点:盒子节点(内部节点,装包围盒和子节点指针)和三角形节点(叶子节点,装三角形顶点和 primitive ID)。
下面这张 K-D 树的结构图可以帮你建立直观——虽然 K-D 树是空间划分、BVH 是对象划分,但"内部节点 + 叶子节点"的两层结构是一样的,内存账的算法也类似。
所以最粗略的内存模型是:
总内存 ≈ 盒子节点数 × 每盒大小 + 三角形节点数 × 每三角大小
但实际上不止这些。还有:
- 父链接(parent links)——用于遍历的时候回退(当栈不够深的时候)。
- 对齐开销——硬件喜欢对齐到 64 字节或 128 字节,会有一些 padding。
- 树不平衡的开销——不是所有节点都能被充分利用,不平衡的树会有更多空槽。
我们一个一个来看。
三角形节点
一个三角形节点存什么?至少要存: - 3 个顶点的位置(3 × 3 = 9 个 float → 36 字节,如果是 fp32) - primitive ID(4 字节) - geometry ID + flags(4 字节)
所以 fp32 的话,一个三角形节点至少 44 字节。但由于硬件对齐,通常是 64 字节。
有些硬件支持三角形对压缩(pair compression)——一个叶子节点存 2 个三角形。这样叶子节点数减少了一半,对应的盒子节点数也减少了一半。节省很可观。
盒子节点
一个盒子节点存什么?对于 4 叉树(业界常见): - 4 个子节点的包围盒(4 × 2 × 3 floats = 24 floats → 96 字节,fp32) - 4 个子节点指针(4 × 4 字节 = 16 字节)
所以 fp32 的 4 叉盒子节点大约 112 字节。如果是 fp16,就是 64 字节(4×2×3×2 = 48 字节坐标 + 16 字节指针)。
节点数比例
对于一棵比较平衡的 4 叉树: - 叶子节点数 ≈ 三角形数(如果没有对压缩) - 盒子节点数 ≈ 三角形数 / 3(因为 1 + 1/4 + 1/16 + ... = 4/3,减去叶子就是 1/3)
所以,如果三角形节点 64 字节、盒子节点 64 字节(fp16),理想情况是: 64 + 64/3 ≈ 85.3 字节/三角形
如果有三角形对压缩(叶子减半): 32 + 32/3 ≈ 42.7 字节/三角形
这和 AMD 的实测值(47–57 B/tri)很接近——多出来的是父链接、对齐和不平衡开销。
那 NVIDIA 为什么能做到 18.8–26.5 B/tri?这说明 NVIDIA 有更激进的压缩方案——可能是更高效的节点格式、可能是量化的包围盒、也可能是其他我们不知道的优化。具体是什么,NVIDIA 没有公开。
5.3 父链接:额外的 6%
父链接(parent links)是什么?为什么需要它?
BVH 遍历通常用一个栈来记录"接下来要访问哪些节点"。栈的大小是有限的——如果树特别深,栈可能不够用。这时候怎么办?
有两种办法: 1. 把栈做大一点——但占用更多寄存器或内存。 2. 用父链接实现栈式遍历——当你需要回退的时候,顺着父链接爬回去。
父链接就是每个节点存一个"我爸是谁"的指针。这样即使栈很小,也能遍历任意深度的树。
代价是每个节点额外 4 字节。如果 BVH 总大小是 64 字节为单位的节点,那父链接就是 4/64 = 6.25% 的额外开销。
不多,但也不是零。radv 的代码里就明确分配了这部分内存。
5.4 为什么不同厂商差这么多
回到开头的问题:为什么不同厂商的 BLAS 大小能差 3 倍甚至更多?
根据 zeux.io 的分析和开源驱动的反推,主要原因有:
- fp16 vs fp32 盒子节点——fp16 的盒子节点比 fp32 小一半。如果某家只用 fp32,光这一项就差很多。radv 就是这样——它还不支持 fp16 盒子节点,所以体积大。
- 三角形对压缩——支持的话,叶子节点少一半,盒子节点也少一半,总内存减少约 40%。
- 更激进的量化/压缩——NVIDIA 的数字低于理论下限,说明有更激进的方案。具体是什么,外人不知道。
- 驱动优化程度——AMD 官方驱动 9 个月内从 88.4 B/tri 优化到 57.0 B/tri(1.5x),说明驱动优化空间很大。radv 和官方驱动差 2.4x,也说明实现质量的影响很大。
这对我们有什么意义?
- "加速结构占多少内存"没有统一答案——不同硬件、不同驱动,可能差 2-3 倍。排预算的时候要按目标平台的实测值来,不能拿一个数字到处用。
- 驱动更新可能改变预算——如果驱动优化了 AS 内存,你的显存预算可能突然就松了。反过来也成立。
- 压缩很重要——上篇说的 compaction 是一方面,fp16、三角形压缩这些硬件级别的优化是另一方面。能用就用。
5.5 BLAS 内存的压缩选项
5.2 节把 BLAS 的字节拆开了,这一节说哪些部分可以被压。
第一是顶点数据。 位置精度从 fp32 降到 fp16 能把顶点缓冲砍一半,代价是精度——世界坐标尺度大的场景(几公里的开放世界)在远处会出现可见的抖动,需要配合"相对坐标 + 分块原点"来用。索引从 32 位降到 16 位只在单块几何不超过 65536 个顶点时成立,对大网格要先切块。
第二是结构本身。 主流的做法是对节点包围盒做量化:用整型代替浮点存包围盒的上下界,再配一张每节点的变换参数去还原。压缩率通常在 20% 到 40% 之间,取决于几何的分布——分布集中(比如一整片植被)压得多,分布散(比如一整座城市)压得少。
第三是对压缩——三角对合并。 把共享一条边的两个三角形作为一个单元去建层次,节点数能明显下降。它对规则网格(地形、扫描件)效果好,对退化三角形多的模型(美术手工做的低模)收益有限。
压缩不是免费的,代价主要落在三处:
- 构建时间变长——压缩要在构建时算量化参数,构建时间可能增加百分之几十;
- 更新变贵——refit 时量化参数要跟着变,更新路径比未压缩结构长;
- 运行时多一步还原——每次访问节点都要解压,这笔开销在 RT Core 里通常已经被吸收,但在软件遍历路径上要自己算。
所以选择顺序通常是:先看几何能不能接受 fp16,再看要不要对压缩,最后才考虑结构量化。 前两项的实现复杂度低、可逆;结构量化一旦上了,构建与更新的复杂度都会跟着上一个台阶,而它在总内存里能省下的那部分(节点本身的字节)往往不是最大头。
六、动态场景的内存预算表
6.1 动态场景多了哪些内存开销
上篇的内存账是"静态账"——BLAS + TLAS + 两种 scratch buffer。动态场景下,这笔账会变。
多了哪些开销?
- scratch buffer 常驻——静态场景下,scratch buffer 用完就可以释放。但动态场景每帧都要重建/更新,scratch buffer 就得一直留着。而且如果你同时在构建多个 BLAS,scratch 还得够最大的那个用。
- OMM 内存——如果你用了 Opacity Micromap,每个带 OMM 的 BLAS 都要额外存 OMM 数据。
- 多份 BLAS——如果你用异步构建,可能需要双缓冲(当前帧用的 + 正在构建的)。如果有多个 LOD 级别,每个级别一个 BLAS。
- 更新相关的临时数据——比如 instance transform 数组、instance index 数组。
- 更多的 BLAS——静态场景可能把很多静态物体合并成一个大 BLAS,动态场景可能需要拆成更多小 BLAS(方便单独更新)。
这些加起来可能有多少? 我们来算一笔粗账。
6.2 一笔动态场景的粗账
假设一个中等规模的开放世界场景:
- 三角形总数:500 万(静态 400 万 + 动态 100 万)
- BLAS 数:200 个(静态 50 个大的 + 动态 150 个小的)
- TLAS instance 数:5000 个
- OMM:植被用,约 50 万三角形
我们一项一项算:
BLAS 本体: - 静态:400 万三角 × 25 B/tri(中端 GPU)= 100 MB - 动态:100 万三角 × 30 B/tri(动态可能不压缩或压缩率低)= 30 MB - 合计:130 MB
TLAS: - 5000 instance × 64 B = 0.32 MB(可以忽略) - TLAS 本体:大约 1–2 MB(可以忽略) - 合计:~2 MB
Scratch buffer: - 最大的 BLAS(假设 50 万三角)的 build scratch:大约 50 万 × 20 B = 10 MB(量级估计) - TLAS build scratch:可以忽略 - 如果并行构建多个,可能需要更大的 scratch - 合计:~10–20 MB(取决于最大 BLAS 和并行度)
OMM: - 50 万三角 × 4 级细分(256 微三角/大三角)× 2 bit = 50 万 × 64 字节 = 32 MB - (如果是 3 级细分就是 8 MB) - 合计:8–32 MB(取决于细分层级)
多份 BLAS(双缓冲): - 动态 BLAS 的第二份:30 MB - 合计:30 MB(如果用异步构建)
其他杂项: - instance 数据、临时 buffer 等:~5–10 MB
总计:130 + 2 + 15 + 20 + 30 + 7 ≈ 204 MB
注意:这只是一个粗略的估算。实际数字取决于: - 三角形总数和分布 - 目标硬件(不同厂商差 2-3 倍) - 是否用压缩、fp16、对压缩 - OMM 的使用量和细分层级 - 是否用异步构建(双缓冲) - 有多少动态 BLAS
但这个估算告诉我们几件事:
- BLAS 本体是大头——占 60-70%。优化内存首先要优化 BLAS。
- OMM 的开销不容小觑——如果用了高细分,OMM 可能占总内存的 10-15%。
- scratch buffer 容易漏算——很多人排预算的时候只算结构本体,忘了 scratch。虽然通常不大,但如果 BLAS 很大,scratch 也不小。
- 双缓冲可能增加 15-20%——如果用异步构建,动态 BLAS 的双缓冲是一笔额外开销。
6.3 预算表模板
把上面的内容整理成一个预算表模板,你可以把自己项目的数字填进去。在填表之前,记住一个原则:加速结构的内存是"为场景复杂度买单"——场景越复杂、几何越多、动态性越强,这笔开销就越大。下面这张经典的 Cornell Box 路径追踪图,可以帮你建立"光追场景需要多少结构支撑"的直观。
| 项目 | 计算方式 | 估算值(示例) | 备注 |
|---|---|---|---|
| 静态 BLAS | 静态三角数 × 每三角字节 | 100 MB | 用 compaction 后的值;按目标平台实测 |
| 动态 BLAS | 动态三角数 × 每三角字节 | 30 MB | 动态可能压缩率低,取稍高的值 |
| TLAS | ~1–2 MB(通常可忽略) | 2 MB | instance 很多的话另算 |
| Scratch buffer | 最大 BLAS 的 build scratch | 15 MB | 并行构建可能需要更多 |
| OMM | OMM 三角数 × 每三角字节 | 20 MB | 取决于细分层级(3级约8B/三角,4级约32B/三角) |
| 双缓冲(异步) | 动态 BLAS 大小 × 1 | 30 MB | 异步构建才需要 |
| 其他杂项 | ~5–10 MB | 7 MB | instance 数据、临时 buffer 等 |
| 合计 | ~204 MB |
排预算的三条建议:
- 按目标平台的实测值排——不要拿别人的数字直接用,自己的目标硬件上测一下。
- 留 20-30% 的余量——驱动更新、内容增加、功能迭代都会让内存增长。
- 动态增长的项目,定期重测——每加一批新内容,都重测一下 AS 内存,不要等爆了才发现。
6.4 从 10 万到 100 万 instance:一笔压测账
6.2 节算的是 500 万三角形、5000 instance 的中等场景。规模上去以后,各项开销不是等比例长的,这一节把放大关系摊开。
实例数从 5000 涨到 10 万(20 倍): - TLAS instance 数据:320 KB → 6.4 MB(线性) - TLAS 本体:1–2 MB → 20–40 MB(超过线性:层次深度增加,节点数增长快于叶节点数) - TLAS build scratch:可忽略 → 几十 MB(新出现的大项,scratch 按最大构建规模预留)
实例数再涨到 100 万(再 10 倍): - TLAS instance 数据:64 MB(线性) - TLAS 本体:200–400 MB(继续超线性) - 每帧全量重建的时间:从几十微秒涨到毫秒级——这时候"每帧重建 TLAS"就已经不可能了,必须上分区或增量更新
三条结论值得记下来:
第一,TLAS 的开销随实例数是超线性的。 常见误解是"instance 只有 64 字节,可以随便加"。本体和 scratch 的增长都比 instance 数据快,到百万级时它们才是大头。
第二,scratch 是按"最大一次构建"预留的。 它和场景平均规模无关,只和最大的那个 BLAS / 最大的那次 TLAS 构建有关。所以把一个大网格切成几块小的,既能把 scratch 峰值压下来,也更容易并行——代价是实例数变多(回到第一条)。
第三,规模到一定量级之后,"策略"比"压缩"重要。 100 万 instance 的场景里,靠压缩省下的那几十个百分点,抵不过"每帧只重建 1% 的分区"这一个策略决定。先定策略、再抠格式,顺序反了会在错误的地方花力气。
七、高级方向与边界:哪些是实验性的
7.1 技术地图
前面讲的 TLAS 分区更新、BLAS refit/rebuild、CLAS、OMM,这些都是已经可用或接近可用的技术。但动态加速结构这个领域还在快速发展,还有一些更前沿的方向。
我们把这些技术按"成熟度"和"收益"排一张地图:
图上呈对角线分布:越成熟的技术,收益越保守;收益越高的技术,成熟度越低。工程上的选择,本质上是在这条对角线上找一个适合自己项目的落点。
| 技术 | 成熟度 | 收益 | 状态 |
|---|---|---|---|
| BLAS refit / rebuild | 生产可用 | 中 | 规范标准功能,所有平台都支持 |
| TLAS 每帧重建 | 生产可用 | 中 | 标准做法 |
| Compaction | 生产可用 | 中-高 | 规范标准功能 |
| Opacity Micromap | 扩展级 | 高 | VK_EXT / DXR,桌面端支持较好 |
| 分区 TLAS (PTLAS) | 扩展级 | 中-高 | VK_NV,仅 NVIDIA |
| 三角形簇 (CLAS) | 扩展级 | 高(动态高密几何) | DXR / Vulkan 扩展,支持有限 |
| 四面体笼子 | 实验性 | 高(复杂动画) | 研究论文,未进入硬件/规范 |
| 量化 BVH | 实验性 | 中(内存受限) | 研究论文,需硬件支持 |
| 混合 BVH | 实验性 | 中(大场景) | 研究论文,实现复杂 |
下面挑两个讲一讲——它们是什么、现在是什么状态、离生产可用还有多远。
7.2 四面体笼子:把动画从 BVH 里解耦出来
四面体笼子(Tetrahedral Cages) 是 AMD GPUOpen 提出的一种技术,思路很有意思:
问题:动画几何的 BLAS 更新很贵,因为三角形太多了,每帧都要 refit 或 rebuild。
思路:用一个稀疏的四面体笼子把密网格包起来。笼子的四面体很少(比如几十个到几百个),而笼子里面的密网格是静态的、不变的。
动画的时候,只更新四面体笼子的顶点——笼子变形,带动里面的密网格一起变形。BVH 是建在笼子上的,因为笼子很简单(只有几十个四面体),所以每帧重建也很快。
遍历的时候,光线先和笼子的 BVH 相交,找到击中了哪个四面体,然后把光线变换到四面体的局部坐标系,再和里面的静态密网格求交。
核心价值:动画复杂度与三角形数解耦——不管网格有多密,动画的代价只取决于笼子的复杂度。一个一万面的角色和一个十万面的角色,动画更新的代价可能差不多。
代价呢?
- 实现复杂——需要笼子生成工具、需要动画重定向、需要特殊的遍历代码。
- 遍历可能略慢——多了一层变换,而且四面体内部的插值有精度问题。
- 控制受限——不是所有动画都能用四面体笼子表达,复杂的面部动画可能就不行。
- 没有硬件支持——目前是纯软件方案,需要在 shader 里自己实现遍历。
状态:研究论文 + GPUOpen 开源实现,还没有进入硬件/规范。适合技术预研和特定场景(比如大量重复的动画物体),离通用生产可用还有距离。
7.3 其他值得关注的方向
再简单列几个,了解一下就行:
这些实验性方向虽然路线不同,但有一个共同点:都在"精度、速度、内存"三角里找新的平衡点。有的牺牲一点精度换内存(量化 BVH),有的加一层结构换构建速度(混合 BVH),有的换一种射线形态换测试次数(光束追踪)。下面这张体素八叉树的图,可以帮你直观感受"空间切细了是什么样子"——量化和混合的思路,本质上都是在做类似的事情。
有了这个直观感受,再来看三个具体方向就不抽象了。
1. 量化 BVH(Quantized BVH)
把包围盒坐标从 fp32 降到 8-bit 或 16-bit 定点数,大幅减少内存。论文说可以降到 9 B/tri 级别。但需要硬件支持定点数求交,而且精度是个问题。目前是研究阶段。
2. 混合 BVH(Hybrid BVH)
把 BVH 和其他结构(比如 uniform grid)混合起来,取长补短。论文说在某些场景下可以省 40% 内存、更新快 3 倍。但实现复杂,通用性待验证。
3. 光束追踪(Beam Tracing)
不是 BVH,但也算加速结构的一种替代思路。用光束代替射线,减少相交测试次数。目前更多用于离线或特定场景。
7.4 边界声明
本篇不展开、不给结论的技术:
- 四面体笼子——有开源实现,但无硬件支持,通用性待验证
- 量化 BVH——论文阶段,需硬件支持
- 混合 BVH——论文阶段,实现复杂
- BIH(Bounding Interval Hierarchy)——已基本被 BVH 取代
- SBVH(Spatial BVH)——建树质量更高,但构建更慢,离线烘焙可用
- 所有 GPU 上的具体实现细节——各厂商不公开,反推的结果不一定准
为什么不列结论? 因为这些技术要么太新、要么太偏、要么没有硬件支持,在真实项目里落地的条件还不成熟。列在这里是让大家知道有这么个方向,但不要急着上——等支持度更高、有更多实测数据了再说。
7.5 边界之外:什么时候干脆不要动态加速结构
前面七章讲的都是"怎么让加速结构跟上场景"。但项目里还有一类更彻底的选择:不追。
做法一:全静态结构 + 实例变换。 把可以预建的几何全部烘成静态 BLAS,只在 TLAS 层更新实例矩阵。角色、载具、可交互物件各自是一个实例,它们动的是矩阵,不是三角形。这样 BLAS 一次建好永不重建,每帧只更新几十到几千个 instance——大多数开放世界项目最后都收敛到这条路上。它的代价是几何一旦需要变形(骨骼动画、破碎、地形雕刻)就得单独处理,所以通常是"静态 + 少量动态 BLAS"的混合。
做法二:用别的表示替掉三角形。 体素、SDF、高度场这些表示天然支持快速的局部更新,代价是渲染路径完全不同(要走专门的求交或体积积分),且和现有光栅管线、材质系统、美术工具链的对接成本很高。它适合从零开始、且场景本身适合这种表示的题材,不适合往存量引擎里塞。
做法三:把动态性从几何层挪到着色层。 风、草、布这些"看起来在动、其实拓扑不变"的东西,用顶点着色器或位移去演出效果,几何本身保持静态。这一招几乎是免费的——加速结构完全不用更新,动态感由着色器提供。判断标准很朴素:观众能不能分辨"这是真的几何在动"和"这是顶点在动"? 大多数情况下分不出。
这三条的共同点是:都绕开了"每帧重建 BVH"这个问题,而不是去解决它。 工程上这没有错——加速结构是手段不是目的。真正需要警惕的是反过来:为了保留"全动态 BVH"的架构,付出远超收益的内存与帧时间,最后画面上看不出区别。
8.3 本篇留下的问题
这一篇把"动态场景的加速结构怎么配"讲完了,但有几个问题刻意留着没答——它们要么属于别的篇目,要么还没有稳定答案。
第一个是压缩与更新能不能兼得。 5.5 节说了结构量化的收益与代价,但"既要压缩率高、又要 refit 快"目前还没有两全的方案:量化参数一变,更新路径就得跟着重算。厂商在推进的方向是把量化做成"可分块独立"的——某一块重建时只影响自己的参数。这块进展值得盯。
第二个是分区的粒度由谁定。 1.1 节的 PTLAS 把 instance 分成三类,但"按什么分"(空间区域?材质?更新频率?)会直接决定收益。目前是交给实现方按场景自己划,没有通用的判据。这更像一个场景分析问题而不是管线问题——谁先把场景的动静结构自动识别出来,谁就能把这一块的收益吃满。
第三个是光线的预算怎么和结构质量联动。 本篇讲的是"结构怎么跟得上场景",而 ep06 会讲"光线怎么分配"。这两件事其实是耦合的:结构退化时,同样的光线数会换到更差的画面。把两者放进同一个反馈环(结构质量差就降低光线数、或反过来)目前还没有成熟的工程做法。
这些问题的共同点是:它们都要求把"场景"和"管线"当成一个系统来优化,而不是各自调参。 这也是本系列选择把工程取舍层单独写一个专题的原因——算法与硬件的知识在别处已经有了,缺的是这类跨层的账。
最后补一句实操上的提醒:本篇给出的所有数字都是量级,不是可以直接抄进设计文档的定值。同一份场景在两家卡上,BLAS 的每三角形字节数能差两三倍;同一家卡在两个驱动版本之间,构建时间的差距也可能超过百分之几十。所以第 6 章那张预算表模板的正确用法是先按量级排出一版、再在目标平台上逐项实测回填,而不是把示例值当成目标值去卡。加速结构这笔账最忌讳的就是「照别人的数字估自己的场景」——几何分布、动态比例、材质复杂度这三项一变,账就重写。 下一篇换一个视角:加速结构解决的是「光线往哪儿走」,而光线停下来之后调用哪段代码,是另一套完全不同的账。
八、收束与交棒
8.1 三句话判据
本篇讲了五件事——TLAS 的分区更新、BLAS 的动态策略、CLAS 的速度交换、OMM 的透明解放、内存账的拆解与预算。收成三句话:
第一句:动态策略的选择看两个维度——变动比例和位移幅度。 变动比例低 → TLAS 用分区更新;位移幅度小 → BLAS 用 refit;两个都高 → 老老实实 rebuild,别折腾。
第二句:新技术(CLAS / OMM)的收益很大,但不是免费的。 CLAS 让构建快 10x 但遍历略慢——只适合高频重建的高密度几何;OMM 让透明几何的 TraceMain 减半甚至更多——但要吃内存、要烘焙、不是所有平台都有。上之前先在目标平台测。
第三句:加速结构的内存没有统一数字,跨厂商能差 3x。 排预算按目标平台实测值来,留 20-30% 余量。fp16、三角形压缩、compaction 这些优化能用就用,能省不少。
8.2 交棒:命中着色器与 SBT
到这里,加速结构的上下两册就讲完了——上册讲了静态账(构建/更新/压缩),下册讲了动态账(TLAS 策略 / BLAS 策略 / CLAS / OMM / 内存拆解)。
但加速结构只是光追管线的第一段。光线穿过加速结构之后,会做什么?它会找到最近的相交点,然后调用命中着色器(closest-hit shader)。命中着色器怎么组织?不同的几何体怎么对应不同的着色器?着色器的数据存在哪?——这些问题,就是 SBT(Shader Binding Table,着色器绑定表) 要回答的。
SBT 是光追管线里最容易出错的部分之一——表的布局不对、偏移算错、miss shader 找不到,这类问题调试起来特别痛苦。下一篇,我们就来拆 SBT——它是什么、为什么需要它、怎么组织、常见的坑有哪些,以及怎么验证你的表是不是对的。
下一篇(预告):【实时光线追踪与混合渲染】(四) 命中着色器与 SBT:别被自己的表绊倒
参考资料: 1. Vulkan 规范 · Acceleration Structures 章 — Khronos Group 2. VK_NV_partitioned_acceleration_structure 扩展 — Khronos Group 3. VK_EXT_opacity_micromap 扩展 — Khronos Group 4. DirectX Raytracing Functional Spec, Part 2 (CLAS) — Microsoft 5. NVIDIA RTX Mega Geometry 技术博客 — NVIDIA Developer 6. Path Tracing Optimizations in Indiana Jones(OMM + 动态 BLAS 压缩) — NVIDIA Developer 7. Fast Ray Tracing of Dynamic Scenes Using OptiX 9 — NVIDIA Developer 8. Measuring acceleration structures(跨厂商 BLAS 内存实测) — zeux.io, 2025 9. Fast, Effective BVH Updates for Animated Scenes — Utah 大学, 2008 10. Reducing Acceleration Structure Memory with RTXMU — NVIDIA Developer 11. Ray Tracing Massive Amounts of Animated Geometry(四面体笼子) — GPUOpen 12. Minimizing Ray Tracing Memory Traffic through Quantized Structures — arXiv 2025 13. A Hybrid BVH Structure for Interactive GPU Ray Tracing — yiningkarlli.com 14. NVIDIA RTX Best Practices — NVIDIA Developer 15. Vulkan-Samples · ray_tracing_extended — Khronos Group
本篇作者:溯光 本系列(实时光线追踪与混合渲染,共 12 篇):分界线 → 加速结构工程账(上)→ 加速结构工程账(下)→ SBT → 降噪(上)→ 降噪(下)→ ReSTIR → 光线预算表 → RT 资源生命周期 → 透明与体积 → 反射与阴影混合 → 跨平台差异 前置专题:《实时渲染管线探析》5 篇 · 《移动端图形与功耗》7 篇 · 《GPU 架构剖析》12 篇 下一篇预告:【实时光线追踪与混合渲染】(四) 命中着色器与 SBT:别被自己的表绊倒
希望能对大家有所帮助。