站点链接:技术博客页 | 公众号:溯光的图形笔记
入口:把「三层」当标签容易,问「谁在下命令」才难
这一章要回答一句话:把 Node、SceneTree、CanvasItem 分成三层,除了方便贴标签,还能换来什么可被检验的东西。
0.1 三条线各管一件事
这一节要回答:这三个对象各自守着哪条线,为什么它们压不成一句「都在场景层里」。
官方 Optimization using Servers 给了这套分工一个动机。原文写着 "One of the most interesting design decisions for Godot is the fact that the whole scene system is optional. While it is not possible to compile it out, it can be completely bypassed.",紧接着又说 "At the core, Godot uses the concept of Servers. They are low-level APIs to control rendering, physics, sound, etc. The scene system is built on top of them and uses them directly."(官方文档,CC BY 3.0,署名 Juan Linietsky、Ariel Manzur 与 Godot 社区;本次仅节选,未改动文字)。两句把场景层与服务层(server layer)的上下关系钉住了:服务层是地基,场景层建在地基上,也可以整层绕开。
把镜头收进场景层,三件不同的事落在三个对象上。Node 管树,谁是谁的子节点、入树出树的顺序、就绪与处理的传播,都由它维护。SceneTree 管节奏,每一帧分几段跑、物理帧与 idle 帧各走哪条入口,由它决定。CanvasItem 管脏,一个 2D 可绘制对象这一帧要不要重画、画布归属落在哪里,由它记着。三件事的周期并不一样:树的改动随时发生,帧的推进按固定周期,脏标记只在有变化时才置位。把三件事塞进一个「场景层」的筐里,筐能装下,周期装不下。
OK,读这张图:三条横线并排,Node 那条连着节点与父子箭头,SceneTree 那条连着帧与时钟,CanvasItem 那条连着一段画布与一枚脏标记。三条线共用同一批对象,却各自维护一份状态。把这三条线记住,后面每一次「谁在什么时候下发」都能落回其中一条;落不回去,多半是问题被问混了。
分层标签还有一个副作用,会让读代码的人默认三层是并列的兄弟。实际从属并不平齐:CanvasItem 在继承上属于 Node 这一支,SceneTree 管的是整棵树的推进,三者在继承图上的位置并不对称。把三条线当成三个并列的框,遇到「谁调用谁」时就会卡住。名字是静态的,推进是动态的,读者最容易记住三层各叫什么,最不容易记住每一层在什么时候被推。本篇把落点逐行指出来,正是为了让动态的那一半也能被复述。
为什么挑一次绘制命令当主线,而不是把三层平铺着各讲一遍。三条线里,只有与画有关的那条会走出场景层、落到服务层;树的推进与帧的推进都留在场景层内部。追一次绘制命令,正好能把两条留在层内的线接到一条跨层的线上,前者解释它什么时候被推,后者解释推出来的东西交给了谁。这条跨层线是本篇的主线,三章各负责其中一段。
0.2 本篇的边界与三层证据口径
这一节要回答:本篇把边界划在哪里,取证分几层,又按哪个版本与哪份快照读。
OK,边界先划清。本篇只走对象模型与一次绘制命令下发这一段:Node 入树、CanvasItem 挂画布、SceneTree 分帧推进,以及命令出门面之前的那一跳。句柄(RID)自身的编码与生命周期、剔除与排序、渲染抽象与渲染设备、主循环的完整骨架,都不在本篇展开,留给后续各篇。
这一篇也不是孤立的一篇。本系列的第一篇把四层落点链先走通了一遍,把这条链上的层按职责做了归类,本篇接着把镜头压到场景层这一侧。全系列的目录按层摊开大致是这样:前两篇给全景与对象模型,第三篇起进服务层,讲门面与句柄;再往后是剔除与排序、渲染抽象、命令录制与后端分叉;最后两篇收在主循环的多线程与资源侧。本篇对应其中第二格,只把场景层与命令出门面之前的那一跳讲透。
取证分三层,口径分开陈述。第一层是官方文档,落在 docs.godotengine.org 与 godot-docs 仓库,回答官方想让引擎怎么工作。第二层是官方源码原文,落在 godot 仓库的 master 分支,回答代码实际上怎么组织;本篇引用的行号一律按 master 快照(2026-10-08),共 86 处逐条实读,机器核对 0 处失配。第三层是本机实测,落在工程里的 evidence/probe/ 四个探针,回答这台机器上实际跑了什么。三层各说各的,正文里不混写。
三层证据的强弱不同,用法也跟着变。官方文档给得出设计意图与命名约定,对实现细节常只给概述;源码原文给得出确切行号与确切写法,它不解释作者为什么这样写;本机读数给得出这台机器上的实况,它只是一个样本。机制拿源码原文作证,意图拿官方文档作证,实况拿本机读数作证,这条分工本篇一直执行。
四个探针覆盖三种不同粒度,能回答的问题也不同。一款按帧计数,量的是连续调用与 _draw() 实际次数;一款按像素比对,量的是重绘区域的包围盒;一款按句柄取值,量的是 get_canvas() 随父级链的变化;还有一款读性能计数器。粒度不同,能证的事情也不同,正文引用它们时都会注明属于哪一种粒度。
OK,版本口径两版并存,别写混。官方稳定版是 4.7.2(2026-08-18),开发版是 4.8-dev7(2026-09-29)。本机实测全部跑在 4.8.dev.custom_build.7177493c1(2026-07-03 构建),这是自定义构建,不属于官方稳定版。正文引用本机读数时会写明版本串与「自定义构建」字样,不把它当成官方 stable 的行为,也不跨机器外推。
行号还有一条纪律要交代。本机编辑器所据的提交是 7177493(2026-07-03),与 master 快照已经漂移,而且漂移量逐文件、逐段都不同。canvas_item.cpp 从 +0 漂到 +5,main/main.cpp 从 +31 漂到 +35,同一份文件内部漂移量都不一样,所以拿旧行号做算术平移这条路走不通,必须逐条按字面量重新定位。
源码落点:分层动机与「场景系统可绕过」见官方 用服务器优化,服务层定位见 RenderingServer 类参考,许可与商标见 引擎许可。其中: using_servers 给出「服务层是地基、场景层建在其上」的原句,class_renderingserver 给出「整个场景系统挂在渲染服务器上显示」的定位,两者都属官方文档口径;本机四个探针与版本串属本机口径,两类在正文里不混写。
一、两棵树:Node 的父子树与画面项树
这一章要回答:Node 的父子树与画布项树什么时候是同一棵,什么时候分岔,分岔处又是谁说了算。
1.1 两棵树的对照
这一节要回答:两棵树各由谁维护,又在什么条件下重合、什么条件下分岔。
Node 的父子树由 add_child 与 remove_child 维护,它决定 _ready、_process、输入事件这些沿树推进的顺序。画布项树由画布项(canvas item)之间的挂接关系维护,它决定一个 2D 对象这一帧挂在哪张画布下、跟谁一起被遍历。两棵树都由同一批对象参与,却不是同一份结构:父子树看的是节点父子,画布项树看的是挂接归属。
两棵树在一种情况下重合:参与的两个节点都是画布项,而且子节点的最近画布项祖先恰好就是它的 Node 父节点。这时父子树的每一层,在画布项树上都能找到一条对应的挂接。分岔也常见:中间夹了非画布项的节点,挂接会跳过它直连到更上一层的画布项;出现 CanvasLayer 或子视口时,画布归属会另起一支。官方在 RenderingServer 类参考里把 2D 可见的前提写成一句话:"In 2D, all visible objects are some form of canvas item.",又说 "In order to be visible, a canvas item needs to be the child of a canvas attached to a viewport, or it needs to be the child of another canvas item that is eventually attached to the canvas. 2D-specific RenderingServer methods generally start with canvas_*."(官方文档,CC BY 3.0,本次仅节选)。前半句确认了可见单位,后半句给出两条挂接可能。
OK,读这张图:左边一棵按父子缩进的树,右边一棵按挂接连线的树,中间几条虚线把两边的同一对象连起来。重合处虚线短,分岔处虚线跨过若干层。图里最值得记住的是那道「跳过」动作:非画布项的中间节点在左树里占一层,在右树里被跨过去,挂接直接连到更上一层的画布项。
用一个具体例子把这道跳过说清。父节点是一个 Sprite2D,它下面挂一个普通 Node,再下面挂一个 Sprite2D。父子树上是三层,画布项树上中间那层被跳过,两个 Sprite2D 直接成挂接关系。这个例子里「最近画布项祖先」是上层的 Sprite2D,挂接判定按它算,中间那层 Node 在画布项树上不占位。遍历画布项树时,服务层见到的就是这棵压缩过的树,压缩掉的正是那些不参与绘制的中间节点。
把这条性质记牢,能解释一个常见观感:父子树上相邻的两个画布项,在画布项树上可能隔着若干层。挂接判定的依据是「最近的画布项祖先」,与这道跳过讲的是同一件事的两面。
1.2 编辑器场景树实拍
这一节要回答:编辑器面板上那棵可展开的树,对应的是两棵里的哪一棵。
对应的是 Node 的父子树。编辑器场景树面板按父子层级缩进显示节点,add_child 之后面板上多一行缩进,remove_child 之后少一行。面板读的与运行时维护的是同一份父子数据,它是这份数据的一个视图。这条同源关系让面板能直接当证据用:面板上看到的结构,就是父子树的结构。
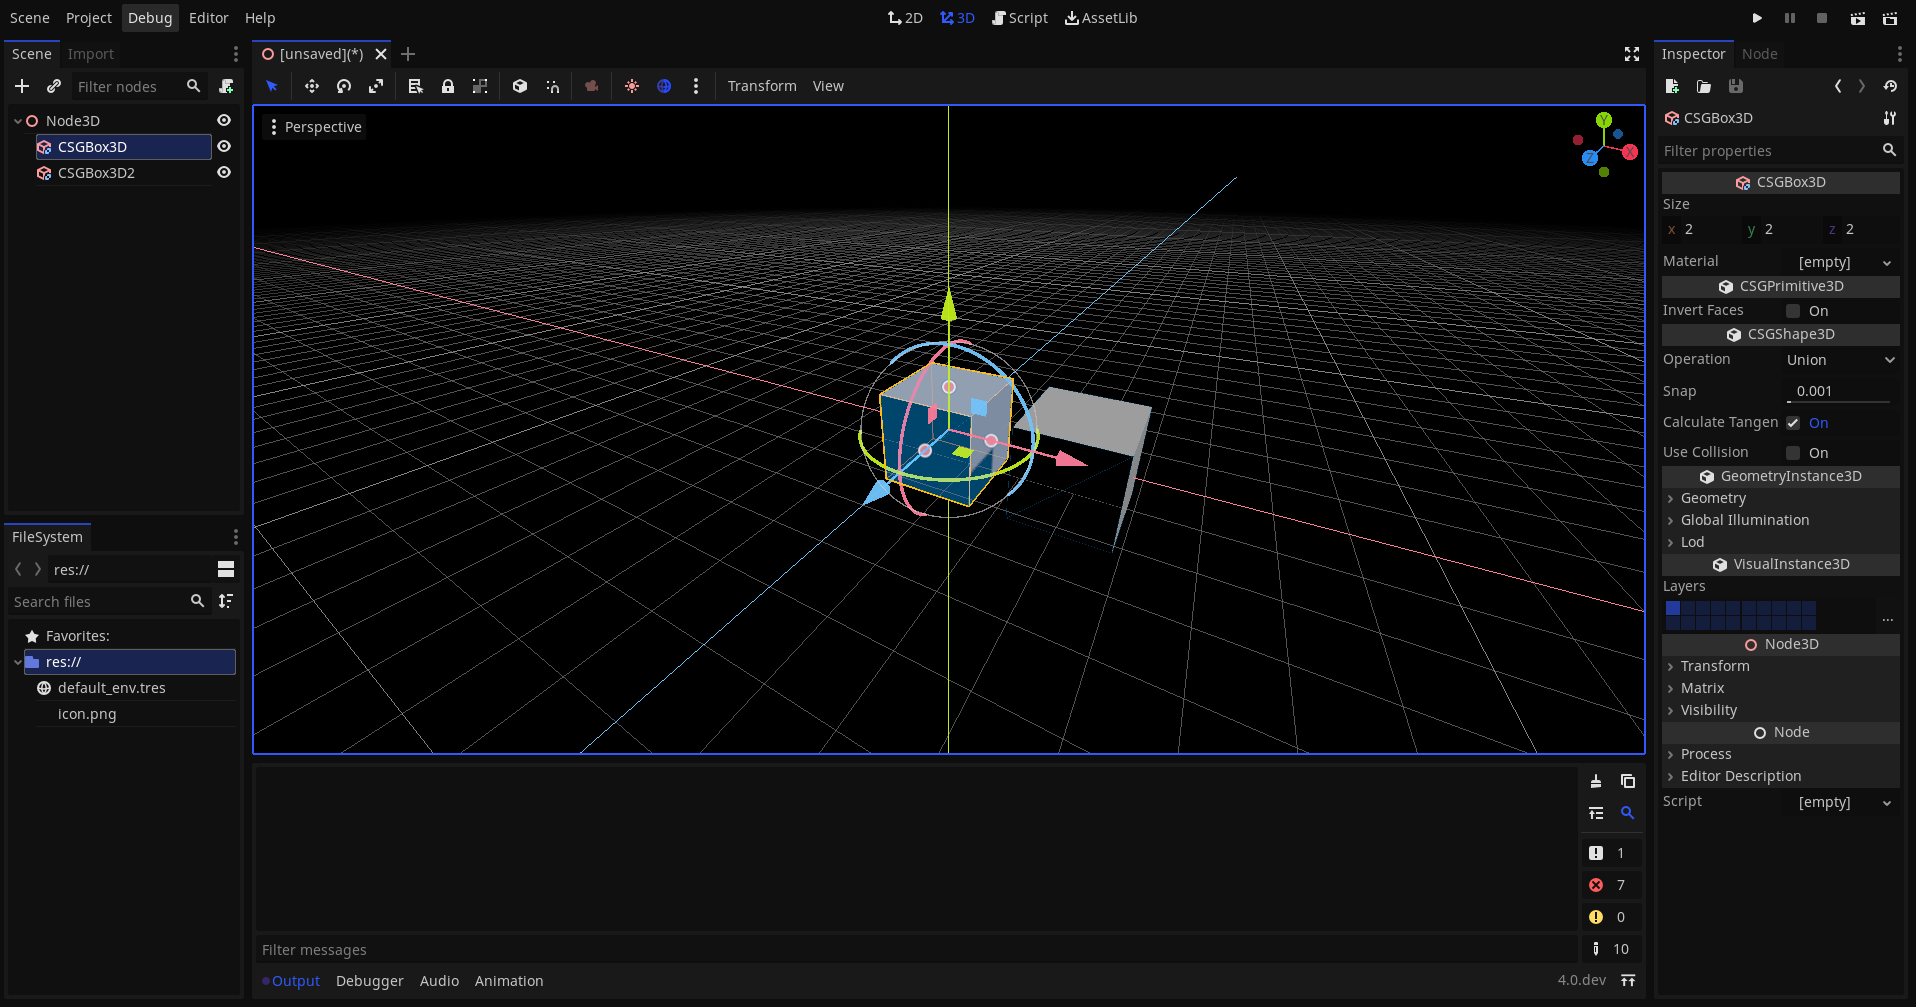
好了,读这张实拍:左侧一栏是场景树面板,节点按缩进排成层级;右侧是检查器,列出选中节点的属性。把左栏的缩进记下来,它就是父子树;但这棵树里哪些节点是画布项、哪些不是,面板不会标出来,需要另按 1.1 的规则去算画布项树。把两处对起来看,一只节点的两种身份才分得开。
顺带记一条边界:面板只呈现节点父子,不呈现服务层里的挂接。想让面板上的结构与画布项树对上,得自己按「最近画布项祖先」的规则再算一遍。这条差距在嵌套 CanvasLayer 或子视口时最明显。
1.3 _enter_canvas 的两条挂接路径
这一节要回答:一个画布项入树时,挂接这件事具体落到哪几行。
挂接发生在入树通知里。scene/main/canvas_item.cpp 第 259 行是 _enter_canvas() 的定义,第 269 行写着 canvas_item_set_parent(canvas_item, parent_item->get_canvas_item());,这是第一条路径,把当前画布项挂到最近画布项祖先的画布项上。第 289 行写着 canvas = canvas_layer->get_canvas();,第 291 行写着 canvas = get_viewport()->find_world_2d()->get_canvas();,这两行是第二条路径的取数,前者从 CanvasLayer 取画布,后者从视口的 World2D 取画布,最终在第 294 行用 canvas_item_set_parent(canvas_item, canvas); 挂到画布上。两条路径,一条挂到父画布项,一条挂到画布本身。
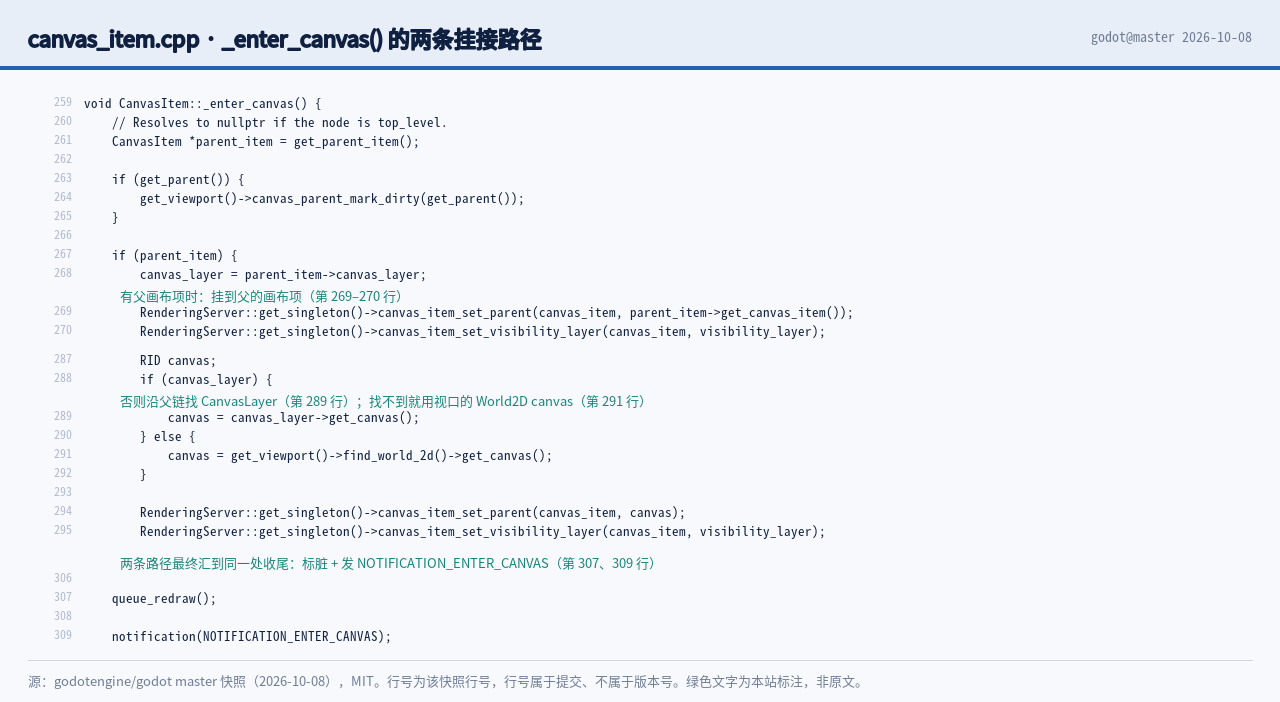
读这四处原文:259 行是入口,269 行是「有父画布项」时走的那一跳,289 与 291 行是「没有父画布项」时从 CanvasLayer 或 World2D 取画布的两种来源。四行合起来说明一件事:挂接目标由入树那一刻按父级链算出,与节点上的任何属性都无关。把这句话记住,改挂会改变画布归属这件事就不意外了。
好了,入树挂接之外,还有一对反向动作值得摆在一起看。canvas_item.cpp 第 312 行是 _exit_canvas(),第 313 行发出退出通知,第 314 行用空 RID 调用 canvas_item_set_parent,把挂接脱开。第 1223 行的 get_canvas() 与第 289、291 行同源,读的也是父级链算出来的那两张画布之一。构造期还留了一处落点:第 1897 行在 CanvasItem 的构造函数里就调了 canvas_item_create(),画布项句柄在对象一落地时就申请好了,等到入树才谈挂接。一条命令的起点因此比很多人想的更早。
1.4 画布项的挂接判定
这一节要回答:没有父画布项时,判定按什么顺序往下走。
判定是一条链。先看有没有父画布项:有,就挂到父项,这是第 269 行那一跳。没有,就看从当前节点往上有没有 CanvasLayer:有,用该层的画布,取数在第 289 行。再没有,就退到视口的 World2D 画布,取数在第 291 行。三步走完一定落在一张画布上,因为根视口总带着一份 World2D。
读这条判定链:最上面一格问「有没有父画布项」,答是就走左出口挂父项;答否就往下问「有没有 CanvasLayer」,答是就取该层画布,答否就退到视口 World2D 的画布。三个出口汇到同一步挂接。这条链的次序决定了一件常被问起的事:同一个节点换个父级,画布归属会跟着变。本机用 4.8.dev.custom_build.7177493c1(自定义构建)的探针把同一节点依次挂到四种位置,get_canvas() 每次都随父级链变化,落到哪张画布由这条链当场算出。
把这条链与官方那句「2D 里可见对象都是画布项」接起来,能得出一条判据:一只画布项能否出现在屏幕上,取决于它是否经父级链接到了某张挂在视口下的画布。接不到画布的画布项,即便在父子树上活着,也不进入绘制。这条判据解释了一个常见困惑:节点明明在场景树里,画面里却看不到它。
1.5 编辑器 2D 工作区实拍
好了,这一节要回答:画布项树在编辑器里露不露面,从哪个界面能看。
2D 工作区给的是画布项的视图。在这里,画布项以可选中、可拖动、可设可见性的对象出现,变换与层级在视口里叠加显示。它与场景树面板看的是同一批对象,侧重不同:场景树面板按父子缩进,2D 工作区按画布位置与变换摆放。两处对起来看,一只画布项的归属与层级才能对齐。
读这张实拍:居中一块画布,上面摆着若干个带手柄的可选对象,右侧那栏给出选中对象的位置与可见性。工作区里看到的是画布项按变换铺开的样子;它没画出来的,是这些对象在服务层里被挂到了哪张画布。那张画布要回到 1.4 的判定链去算。
把 1.2 与 1.5 两张实拍并排看,两种视图的边界就清楚了:一个按结构缩进,一个按位置摆放,谁都不完整。画布项树是第三种视图,它只在服务层里存在,编辑器不直接给,要靠 1.4 的判定链推出来。
源码落点:挂接实现见 canvas_item.cpp。其中: 第 259 行是 _enter_canvas() 的定义,第 269 行把画布项挂到最近画布项祖先,第 289 行从 CanvasLayer 取画布,第 291 行从视口 World2D 取画布,第 294 行完成挂接,第 312 至 314 行是脱钩,第 1223 行是 get_canvas(),第 1897 行在构造期申请画布项句柄,行号均按 master 快照(2026-10-08)实读;2D 可见前提的官方原句见 RenderingServer 类参考。
二、Node 管树:入树与就绪是传播,处理模式是继承
这一章要回答:Node 为什么把入树与就绪做成沿树传播,处理模式又是怎么一层层继承下来的。
2.1 两个通知分支
这一节要回答:每一帧推给节点的那两个通知,在 Node 侧各自落到哪一行。
Node 侧的通知在 scene/main/node.cpp 第 68 行的 _notification() 里分发。第 99 行是 case NOTIFICATION_PROCESS:,第 100 行是 GDVIRTUAL_CALL(_process, get_process_delta_time());;第 103 行是 case NOTIFICATION_PHYSICS_PROCESS:,第 104 行是 GDVIRTUAL_CALL(_physics_process, ...);。两个分支结构对称,一个走 idle 帧,一个走物理帧。官方对两个回调的定位分别是:_process() "Called on each idle frame, prior to rendering, and after physics ticks have been processed.",_physics_process() "Called once on each physics tick"(官方文档,CC BY 3.0,本次仅节选)。
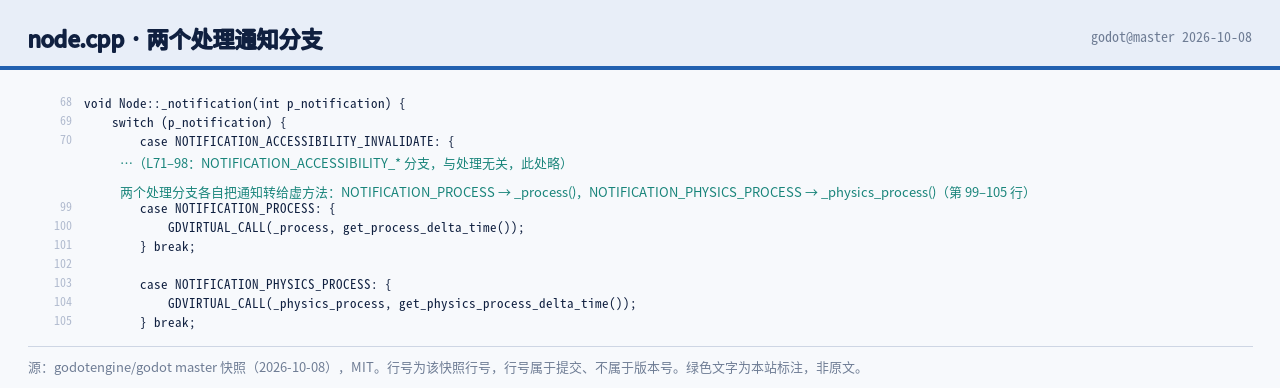
说白了,读这五处原文:68 行是分发入口,99 与 100 行是一对,103 与 104 行是一对。两对里各有一种 GDVIRTUAL_CALL,把通知转成脚本侧的回调调用。两个分支对称铺开,说明每帧推一次这件事在 Node 侧由两个独立入口承担,各自带着自己的时间增量。
两个分支虽然对称,触发来源并不在一处:NOTIFICATION_PROCESS 由 idle 那条入口推进来,NOTIFICATION_PHYSICS_PROCESS 由物理那条入口推进来。来源不同,到达 Node 侧的次序也就跟着两条节奏走,这一点会在第三章的 ProcessGroup 派发里补齐。
2.2 入树与就绪是传播
这一节要回答:为什么入树与就绪沿树推进,而不对每个节点单独发一次。
node.cpp 第 341 行是 _propagate_enter_tree(),第 323 行是 _propagate_ready()。两个函数都从当前节点出发,一路往子节点推进。官方教程在讲节点入树时也按这个次序描述:父节点先收到,子节点随后。这条做法带来一个可预期的顺序,深度优先、父先子后;_ready 的推进方向相反,子先父后。顺序一旦固定,初始化代码里「谁已经准备好」这件事就有了稳定答案。
读这条推进:根在最上,箭头往下层层展开,_propagate_enter_tree 自上而下,_propagate_ready 自下而上。图里两串箭头方向相对,正好对上「就绪等子节点先稳」这条约定。传播的代价是顺序被引擎固定,收益是每个节点不必自己去等别人。
传播这种做法的收益还体现在另外两条通知上。除了入树与就绪,退树与暂停也按树推进,父节点先收到、子节点后收到。把一批节点整体移进移出时,逐节点通知的顺序会变得难预测,沿树传播则给了一个固定次序。把这条次序记住,后面碰到「父节点初始化没完成,子节点就绪里为什么读不到」,答案就在两种方向里。
2.3 处理模式与两道判据
这一节要回答:处理模式(process mode)在哪里设,暂停判据又落在哪两行。
node.cpp 第 669 行是 void Node::set_process_mode(ProcessMode p_mode),处理模式从这里设入。第 758 行是 _propagate_process_owner(...),负责把模式沿树推开。判据有两道:第 892 行是 bool Node::can_process_notification(int p_what) const,按通知类型分三档放行;第 907 行是 bool Node::can_process() const,给出暂停状态的总判据。两道判据配合,通知级开关管「这一档要不要发」,节点级判据管「这棵树此刻是不是停着」。
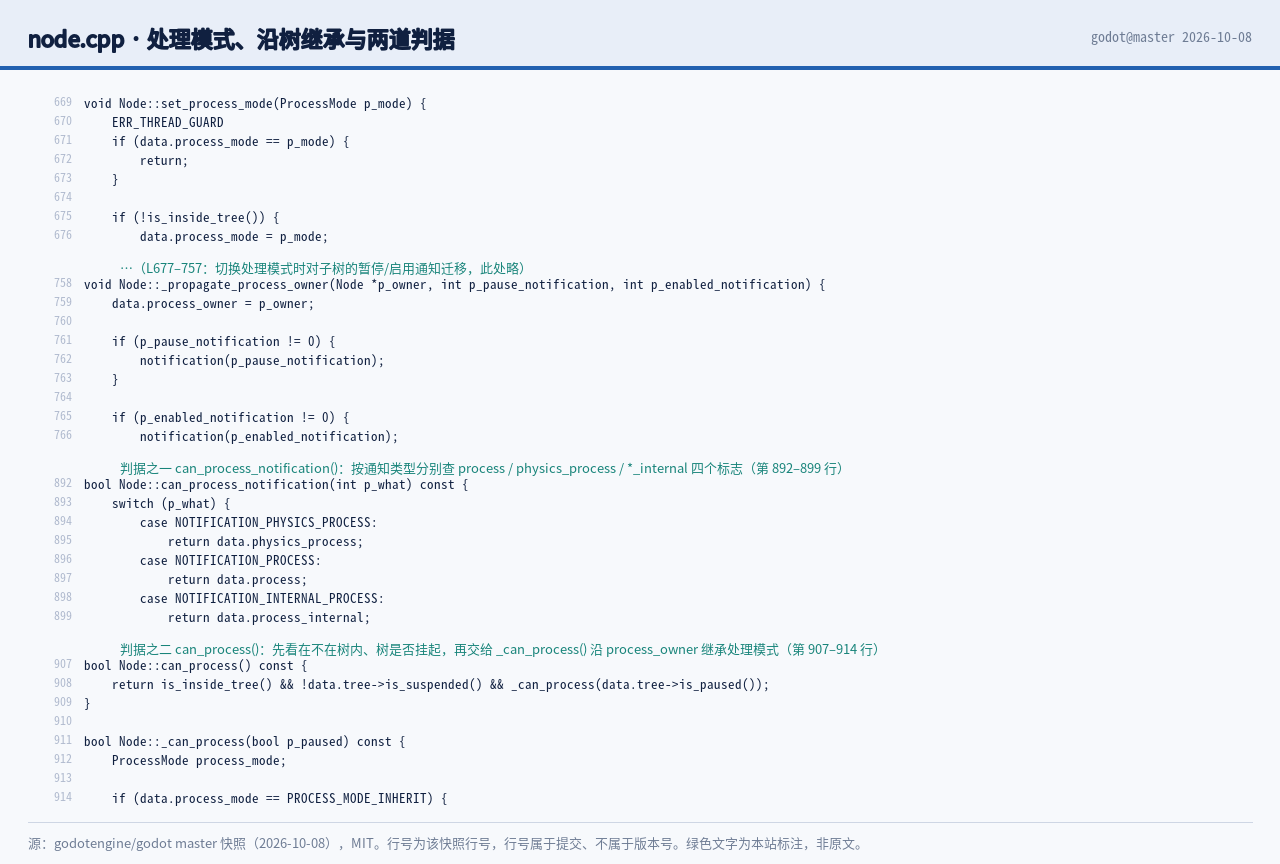
说白了,读这四处原文:669 行是写入点,758 行是传播点,892 与 907 行是两道读取判据。四处分工清楚,写入一次,沿树传播,读的时候按档位与暂停状态分别判。把这几行记住,后面遇到「父节点一停,子节点为什么也停」时,答案就在 758 与 907 两行之间。
三档放行的取值落在 PROCESS、PHYSICS_PROCESS、INTERNAL 上:前两档分别对应两条入口,INTERNAL 留给引擎内部通知。两道判据里,通知级判据先筛类型,节点级判据再判暂停状态,两道都过,通知才真正下发。把两道判据分开,好处是暂停整棵树这件事不必改动每一条通知的类型。
2.4 处理模式沿树继承
这一节要回答:一个节点暂停,为什么会让整支子树一起停,继承又停在谁那里。
处理模式是逐节点的一个枚举,取值里有「继承」这一档:一个节点不自己表态时,就听最近那个有主张的祖先。树干上某个节点一停,它下面的整支子树跟着下沉,直到某一层自己改成另一个值为止。这条继承由 _propagate_process_owner 在设值时推开,落到每个节点的 process_owner 上。子节点不必各自设一遍,跟着树走即可。
读这张图:一棵竖直的树,中间某一层的节点被标成暂停,它以下的整支都染成同一色,旁边标出 process_owner 落在这个节点上。图里还想说明继承的边界:某个子节点自己改成「总是处理」之后,它那一支就从下沉里脱出来。继承沿树走,主张落在最近那个改过值的祖先身上。
process_owner 这个落点解释了继承为什么能便宜地实现:子节点不用各自复制一份模式,只要记住最近那个改过值的祖先即可。代价是链一长,判断「谁在负责这一支」要沿父级往上找;收益是一个节点改一次,整支跟着变,不必逐节点写。
源码落点:通知分发与模式继承见 node.cpp。其中: 第 68 行是 _notification(),第 99 与 100 行是 NOTIFICATION_PROCESS 分支,第 103 与 104 行是 NOTIFICATION_PHYSICS_PROCESS 分支,第 341 行是 _propagate_enter_tree(),第 323 行是 _propagate_ready(),第 669 行是 set_process_mode(),第 758 行是 _propagate_process_owner(),第 892 与 907 行是两道 can_process* 判据,行号均按 master 快照(2026-10-08)实读;两个回调的官方定位见 Node 类参考。
三、SceneTree 管节奏:两条入口与 ProcessGroup 这个派发单位
这一章要回答:每帧的推进为什么要有两条入口,逐节点发通知又为什么落在 ProcessGroup 这个单位上。
3.1 两条入口
说白了,这一节要回答:处理这件事在 SceneTree 侧由哪两个函数领进来。
官方把 SceneTree 的定位写成 "[SceneTree] is the default [MainLoop] implementation used by the engine, and is thus in charge of the game loop."(官方文档,CC BY 3.0,本次仅节选)。两条入口就在这份职责里:scene/main/scene_tree.cpp 第 689 行是 bool SceneTree::process(double p_time),第 714 行 emit_signal(SNAME("process_frame"));,第 720 行 _process(false);;第 640 行是 bool SceneTree::physics_process(double p_time),第 650 行 emit_signal(SNAME("physics_frame"));,第 656 行 _process(true);。两条入口结构对称,都是先发信号,再把一个布尔值交给同一个 _process。
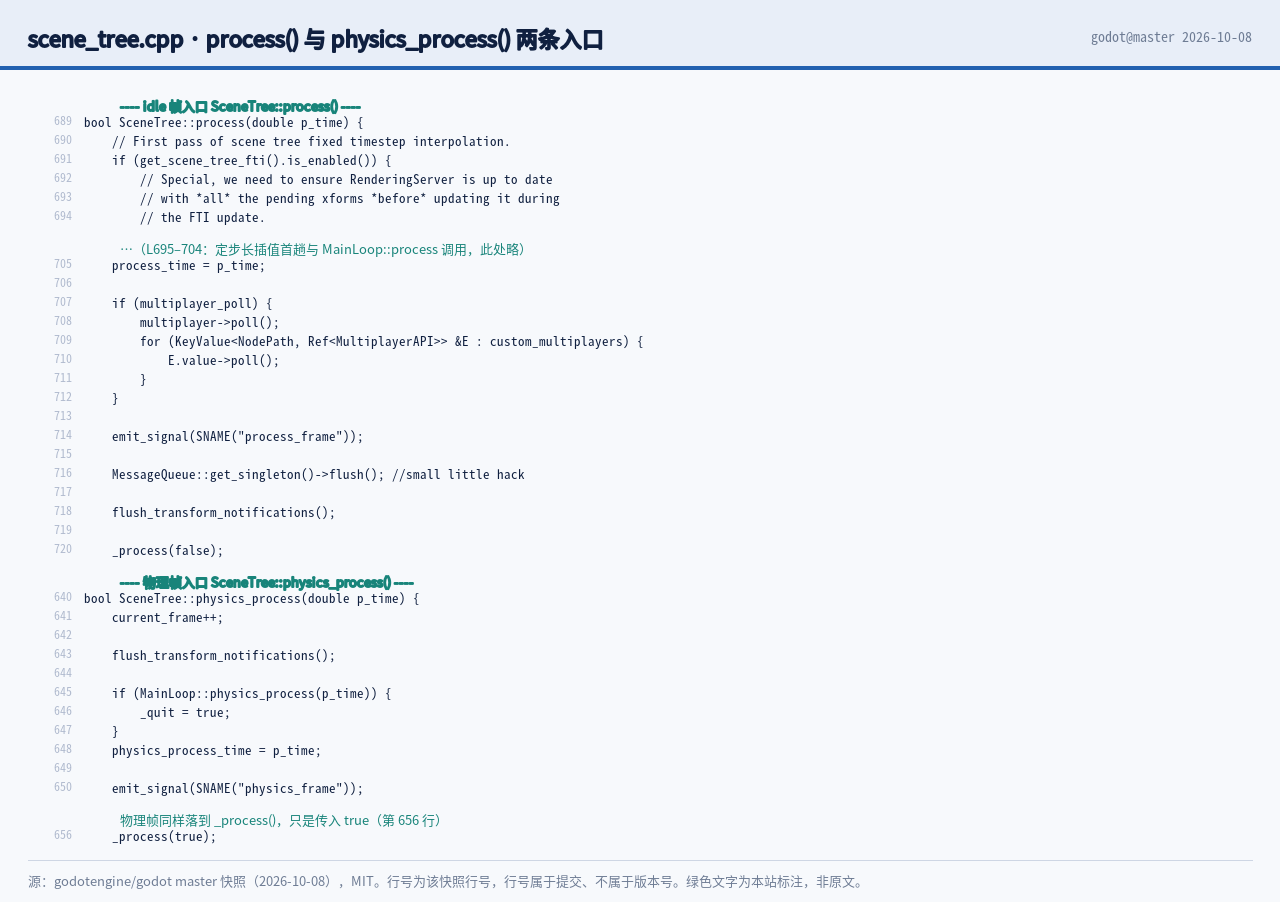
读这六处原文:689、714、720 三个是 idle 那条,640、650、656 三个是物理那条。两条里各自「先发信号再派发」的次序一致,区别只在末尾那个布尔值。信号先到,脚本里挂在 process_frame 或 physics_frame 上的回调先跑;通知后到,节点上的 _process 或 _physics_process 接着跑。官方对两个帧信号的描述也一致,physics_frame 的原句是 "Emitted immediately before [Node._physics_process()] is called on every node in this tree.",process_frame 同构。
把信号放在派发之前,是一个次序上的选择。信号里挂的回调属于「帧刚开始」这一类,通知里跑的 _process 属于「这一帧的逐节点处理」。两者分开,脚本可以在整棵树被推之前先做一次全局准备。
3.2 两条节奏
这一节要回答:两条入口背后的节奏差在哪里,为什么物理帧一帧可能跑多次。
物理帧按固定步长走,idle 帧一帧一次。官方在讲 idle 与物理处理时把两者的关系写成:_process() "is not synchronized with physics. Its rate depends on hardware and game optimization. It also runs after the physics step in single-threaded games."(官方文档,CC BY 3.0,本次仅节选)。固定步长带来一种常见现象:某一帧花的时间超过一个物理步长时,引擎会在这一帧里多跑几次物理,把欠下的步数补上;idle 帧不补,一帧就一次。
言归正传,读这条时间线:上下两条轨道,上轨是物理帧,按等距刻度推进,某一段里连着出现两次;下轨是 idle 帧,每个大刻度只出现一次。两条轨道端点对齐在帧末,说明它们在同一帧里跑,次数可以不一样。这条差决定了 _physics_process 适合放与物理同步的逻辑,_process 适合放与画面同步的逻辑。
两条节奏合起来给出每帧的次数结构:物理可能跑零次、一次或多次,idle 必跑一次。这个结构是后面理解「一次绘制命令落在帧末」的底座,因为绘制排在两条节奏之后,等两边都跑完才轮到服务层。把物理量放进 _process,跨机器时会读出不一样的步长,这也是官方把两者分成两条入口的一条实际理由。
3.3 ProcessGroup 是派发单位
这一节要回答:逐节点发通知这一步,为什么用一个分组作单位。
派发落在 ProcessGroup 上。scene_tree.cpp 第 1193 行是 void SceneTree::_process_group(ProcessGroup *p_group, bool p_physics),第 1260 行是 void SceneTree::_process(bool p_physics),后者按分组把前者叫起来。真正逐节点发通知的语句在循环体里:第 1246 行是 n->notification(Node::NOTIFICATION_PROCESS);,第 1239 行是物理那一支的同构语句。分组把节点按优先级归堆,派发按堆走。
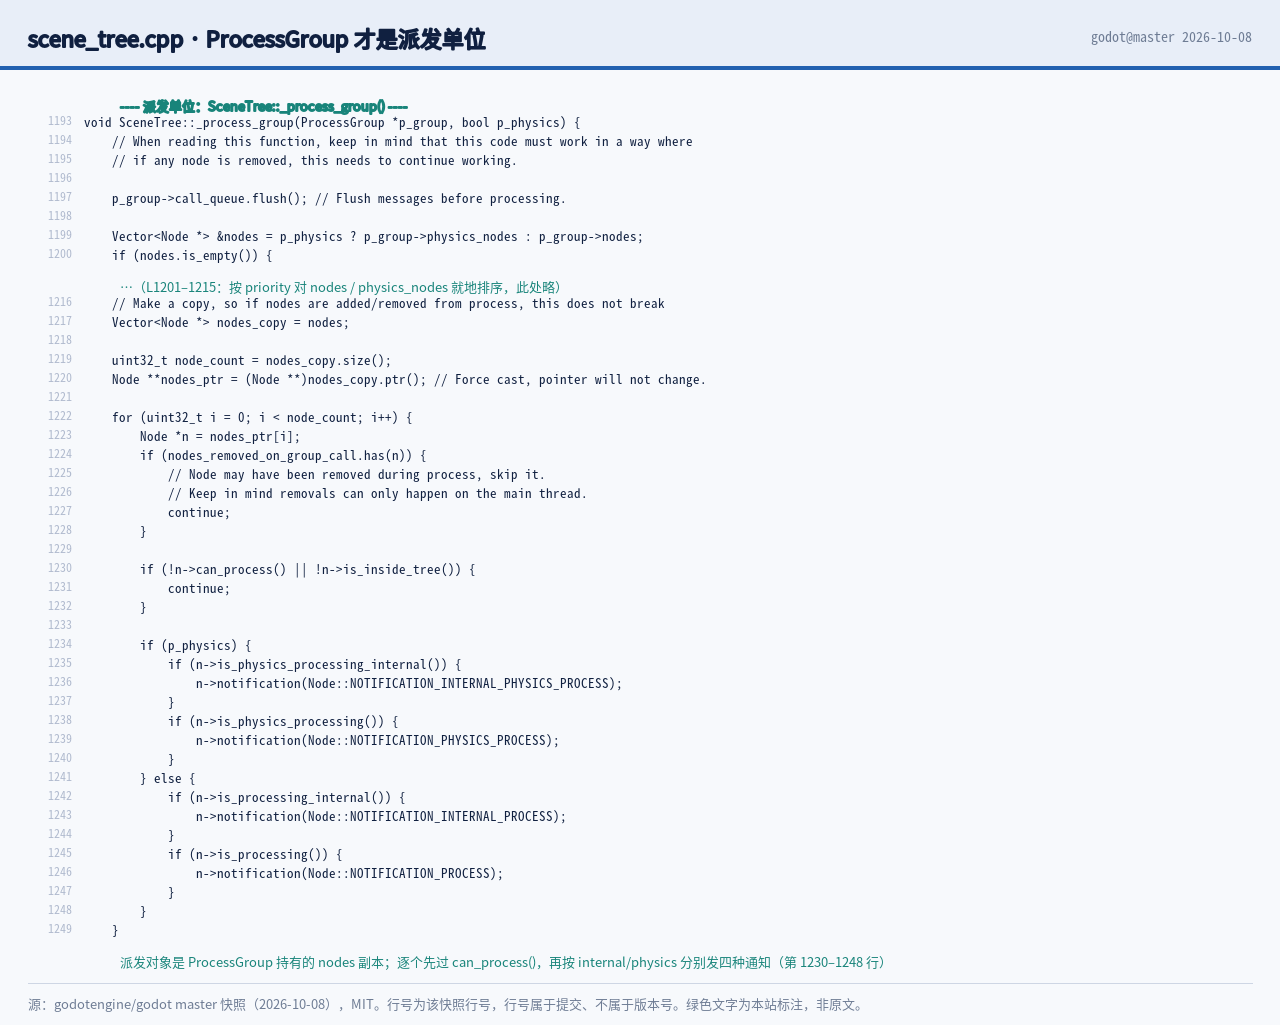
读这四处原文:1193 行是分组派发的定义,1260 行是分档入口,1246 与 1239 行是循环体里那两条发通知的语句。四行摆在一起能看出一条分界:分档入口只决定这一轮走物理还是走 idle,真正一个个通知下去的动作在分组函数里。谁来派发这个问题,答案落在分组这一层。
言归正传,分组的意义在优先级上。节点带着一个处理优先级,分组把这批节点按优先级归堆,派发时先跑高优先的一堆。把优先级做成一个可分堆的量,派发的顺序就有了可配置的余地,同时又不必为每个节点单独排一次序。
3.4 ProcessGroup 的派发流程
这一节要回答:一个分组内,派发按什么步骤把节点走一遍。
分组派发有四步。先把待办队列冲一遍,把这一轮要处理的节点冲进分组;再按优先级给节点排序;排序之后复制一份节点向量,再拿这份副本去遍历。复制这一步是为处理过程中被移除的节点留出余地:遍历时用的是快照,某个节点在自己被处理时把另一个节点移出树,遍历那份快照不会因此乱掉。
读这条流程:四个方框从左到右,冲队列、排序、复制、遍历,最后一步才连着「发通知」那根箭头。第三步的复制是整条流程里最容易被忽略的一环,它换来的是遍历期间的结构安全。把这条流程与 3.1 的两条入口接起来看,一帧里 idle 与物理各走一遍这条流程,次数按 3.2 的节奏定。
四步里前两步是准备,后两步是执行。冲队列这一步把这一轮真正要处理的节点定下来,后面三步都基于这份集合。复制这一步在这份集合上再加一层保护,让遍历期间的结构改动不至于打断循环。
说白了,这四步的顺序也不是随意的。冲队列放在最前,是为了把这一帧新增的待处理节点也算进来;排序放在遍历之前,是为了让优先级在整堆范围内生效;复制放在遍历之前,是为了让遍历拿到一份不会中途变形的名单。三步都排在遍历前面,遍历本身只负责把通知一个个发下去。
源码落点:两条入口与分组派发见 scene_tree.cpp。其中: 第 689 行是 process(),第 714 与 720 行是它发信号与派发两步,第 640 行是 physics_process(),第 650 与 656 行是同构两步,第 1193 行是 _process_group(),第 1260 行是 _process(),第 1246 与 1239 行是循环体里的两条发通知语句,行号均按 master 快照(2026-10-08)实读;SceneTree 定位与两个帧信号的官方原句见 SceneTree 类参考。
四、CanvasItem 管脏:queue_redraw 的幂等闸与帧末合并
4.1 一次标脏只留一个延迟回调
这一节回答 queue_redraw() 在同一帧里被反复调用时,引擎凭哪一道判据只留下一份重绘请求。画布项(canvas item)的重绘被拆成两段:调用方负责把这一项登记成「脏」,引擎在帧末统一处理脏项。判据落在 CanvasItem::queue_redraw() 上,函数体的有效代码只有几行,先做树内判定,再看脏标记,最后排一个延迟回调(deferred call,延迟到消息队列冲刷时才执行的调用)。
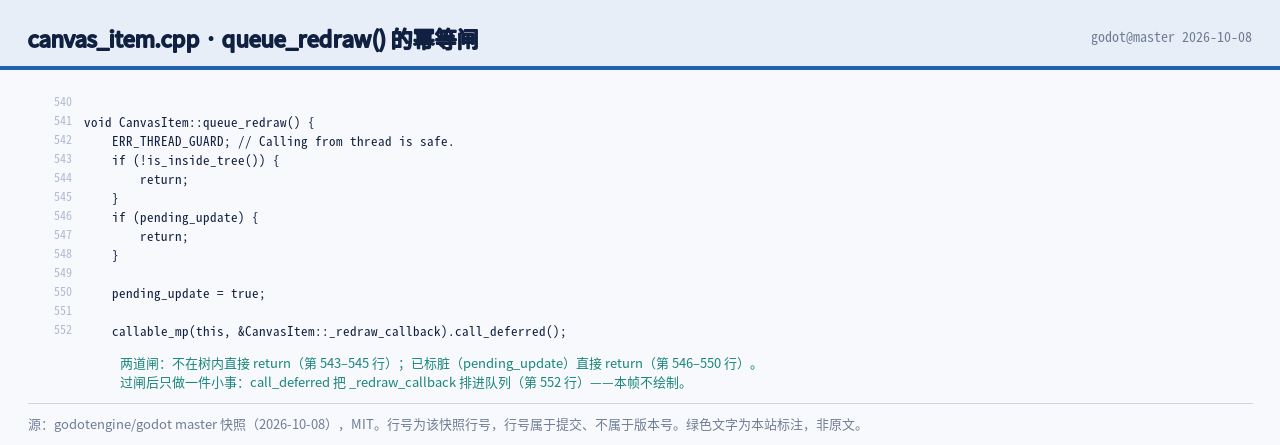
代码里三道并列:if (!is_inside_tree()) 先挡掉不在树上的项,:546 的 if (pending_update) { 是第二道闸,已经脏过就直接 return,:550 的 pending_update = true; 落脏,:552 用 callable_mp(this, &CanvasItem::_redraw_callback).call_deferred(); 把回调挂进延迟队列。这道闸的效果叫幂等(idempotent):同一帧里调十次与调一次,落到相同的状态,队列里始终只多出一个待执行回调。重绘请求因此有两条线,一条是「谁把项标脏」,一条是「谁把回调取走执行」,两条线之间隔着一次延迟队列的冲刷。
这段实现要强调一处:call_deferred 把执行时机推到当前这一批消息处理完之后,与立即重绘不同。把重绘推迟,换来的是同一帧内的多次标脏自然合并,代价是画面更新延后到本帧收尾。
好了,函数开头还有一处线程口径:canvas_item.cpp:542 的 ERR_THREAD_GUARD; 后面跟着注释 // Calling from thread is safe.,标脏这一步允许从别的线程发起,真正执行绘制的那一段则留到帧末的主线程里。标脏与执行被拆到不同时点、不同线程,重绘队列因此有了存在的理由。第一道闸 is_inside_tree() 挡的是不在树上的项:不在树就没有视口,也没有父级链可以推算 canvas,标脏没有落点。
标脏入口对上层是公开 API,引擎内部也会走到它:可见性变化时 _propagate_visibility_changed()(canvas_item.cpp:77)在 :107 调 queue_redraw(),可见性翻转因此复用同一道闸,不必另开一条重绘通道。多个来源汇到同一个入口,是这道闸值得单独讲一遍的原因。
源码落点:queue_redraw() 全文见 canvas_item.cpp,成员声明见 canvas_item.h。其中:queue_redraw() 在 canvas_item.cpp:541,幂等闸 if (pending_update) 在 :546,置脏在 :550,call_deferred 在 :552,脏标记 bool pending_update = false; 声明在 canvas_item.h:119,行号口径为 master(2026-10-08 快照)。
4.2 幂等闸的时序:同帧 N 次只排一个回调
这一节回答同一帧内连续 N 次调用在时间上被压成了什么形状。第一次进入时 pending_update 为 false,闸放开,状态被置为 true,延迟队列里落进一个 _redraw_callback;从第二次起 pending_update 已是 true,函数在 :546 处原样返回,队列不再增长。帧内所有调用结束后,消息队列(message queue)冲刷,那个唯一的回调被取出来执行,执行完在 :181 把 pending_update 复位为 false,下一帧的闸重新可用。
这条时序里有三个时点要对上:标脏时点(调用方每调一次都落在这里)、排队时点(只有第一次调用会产生回调)、执行时点(帧末冲刷时)。合并发生在排队时点,判据就是那一个布尔量。回调执行前把 draw_commands_dirty 判一次,回调结束才复位 pending_update,复位放在末尾是为了防住递归重绘,源码注释在 canvas_item.cpp:181 写着 // Don't change to false until finished drawing。
说白了,把两态放在一起看,这道闸管住的只是同一帧内的重复。跨帧的重复要等 canvas_item.cpp:181 复位之后才会重新产生回调,复位时点落在绘制完成之后,下一次标脏因此一定发生在上一轮绘制之后。draw_commands_dirty 与 pending_update 分别管两件事,前者记「有没有命令要清」,后者记「有没有回调在排队」,两者都在 canvas_item.h 里声明为布尔量(:120 与 :119),没有任何计数参与。
有一个边界要说清:本机四组构造都没能把「回调跨帧尚未执行」的窗口测出来,_draw() 落点与该批调用落在同一帧(相差 0 帧)。本节陈述的是同帧合并这一可观测事实,pending_update 这道闸是它的机制解释,不能据此写成「跨帧再调也不会新增回调」。
源码落点:时序两端的函数见 canvas_item.cpp。其中:排回调在 canvas_item.cpp:552,回调体 _redraw_callback() 在 :144,末尾复位在 :181,闸判定在 :546,三处共同决定同一帧只留一个回调。
4.3 本机探针:23 次调用与 4 次绘制
这一节给出本机探针把「同帧合并」测出来的那组读数。探针工程里放一个画布项节点,按不同相位在同一帧内连调 queue_redraw(),用计数器分别记下调用次数与 _draw() 实际执行次数。整场跑下来,调用共 23 次,_draw() 只执行 4 次,每次执行的帧号与它那一批调用的帧号相同。
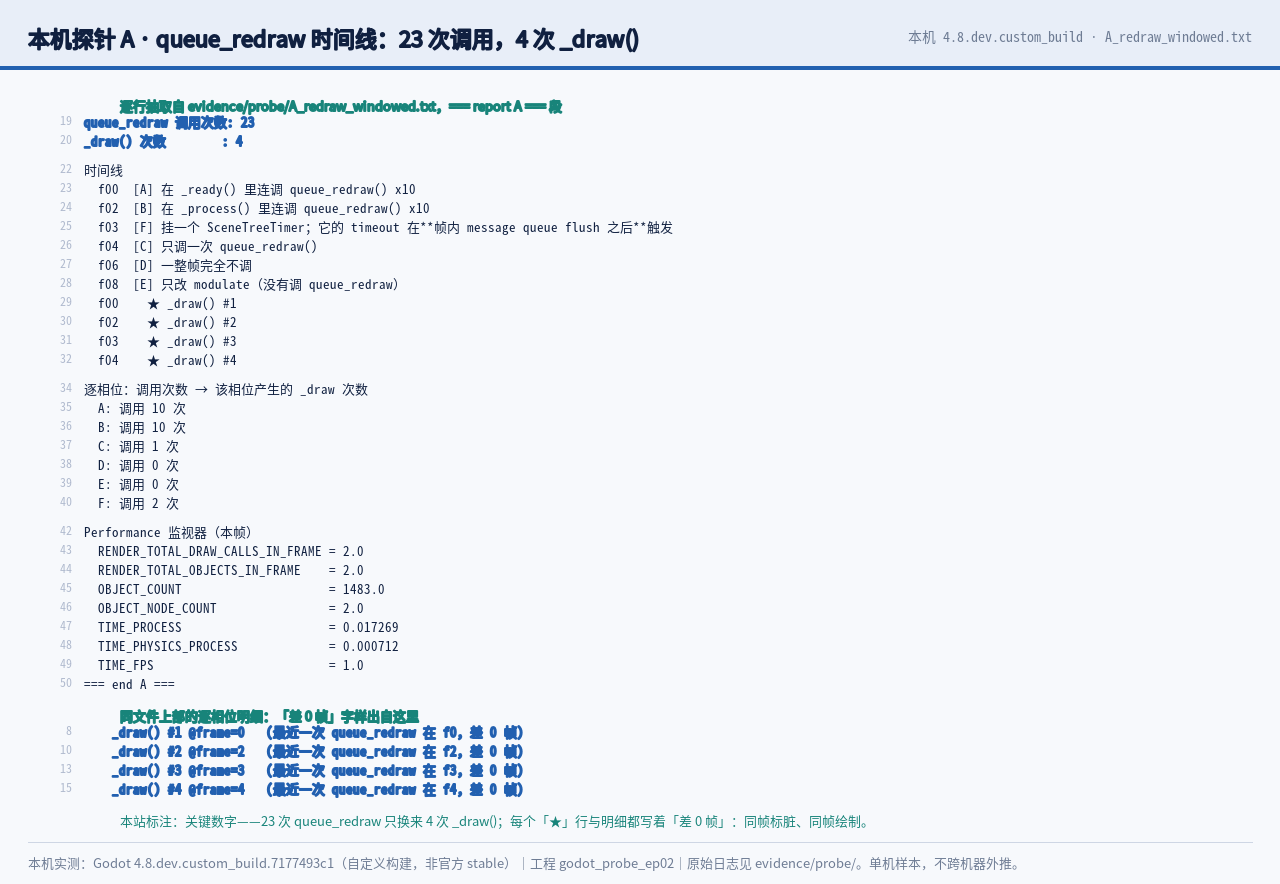
读数口径要先交代:本次实测跑在本机 4.8.dev.custom_build.7177493c1(2026-07-03 构建),这是一个自定义构建,不等于官方稳定版 4.7.2,本节只陈述本机现场,不跨机器比,也不给绝对性能承诺。逐相位的账是:相位 A 在 _ready() 里连调 10 次落到 1 次 _draw(),相位 B 在 _process() 里连调 10 次落到 1 次,相位 F 在定时器回调里连调 2 次落到 1 次,相位 C 只调 1 次落到 1 次,相位 D 整帧不调落到 0 次,相位 E 只改 modulate 落到 0 次。headless 与窗口两种模式跑出来的这份账一致。
OK,headless 与窗口两种模式读数一致这一点与第 8 章的 draw call 计数要分开看:合并发生在场景层的标脏阶段,与渲染后端无关,所以 dummy 渲染器下这份账照样成立;draw call 计数则依赖后端,headless 下恒为 0,把那个 0 读成「没有绘制」会出错。
源码落点:探针脚本与日志见本机归档 evidence/probe/。其中:调用入口 queue_redraw() 在 canvas_item.cpp:541,一次绘制的派发在 _redraw_callback()(canvas_item.cpp:144),版本串 4.8.dev.custom_build.7177493c1 取自探针日志首行。
4.4 逐相位对照
这一节把六个相位的「调用数到绘制数」逐条排开,看每一相的压缩比落在哪里。相位 A、B、F 都属于多次调用压成一次,相位 C 属于一次调用对应一次,相位 D、E 属于零次调用对应零次绘制。
表里最该停一下的是 D 与 E 两行。相位 D 一整帧完全不调 queue_redraw(),该帧 _draw() 为 0,说明重绘按需发生,没有帧计数在背后无条件推动。相位 E 只改 modulate,_draw() 同样为 0,这一行回答了一个常见疑问:视觉上的变化并不都汇进重绘队列。改 modulate 走的是属性直通服务层(server layer)的旁路,canvas_item.cpp:563 的 set_modulate() 里调的是 RenderingServer::get_singleton()->canvas_item_set_modulate(...)(:570),没有碰 pending_update。也就是说「改 modulate 会触发重绘」这个说法在本机读数下不成立。
相位 F 的构造刻意多绕了一层:它的 queue_redraw() 由 SceneTreeTimer 的 timeout 触发,而该 timeout 落在帧内消息队列冲刷之后。即便排在这么靠后的位置,它产生的 _draw() 仍落在同一个帧号上(f03)。这说明延迟队列的冲刷时点足够靠后,帧内较晚发起的标脏也能被本帧回收。
源码落点:set_modulate() 与属性旁路见 canvas_item.cpp。其中:set_modulate() 在 canvas_item.cpp:563,直通调用在 :570,与重绘入口 queue_redraw()(:541)是两条互不相交的路径,本机逐相位读数见 evidence/probe/A_redraw_headless.txt。
4.5 两帧逐像素比对:重绘按块标记
这一节回答重绘在画面上按什么粒度被标记。本机用同一个小场景开关 --debug-canvas-item-redraw 各抓一帧,再把两张图逐像素比对,看调试痕迹出现在哪块区域。
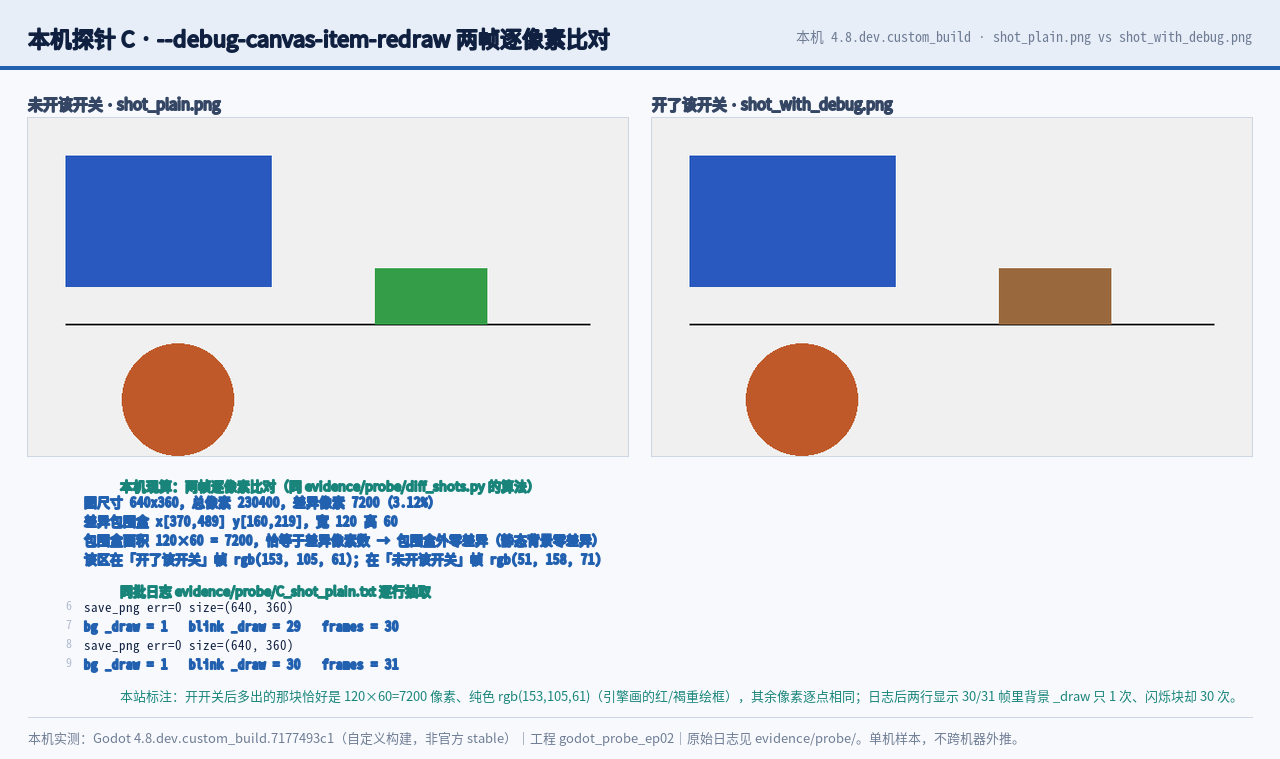
OK,比对结果是差异 7200 像素,恰等于 120 乘 60;包围盒为 x[370,489]、y[160,219],正好是场景里每帧请求重绘那一块的矩形。开启调试层那张在该区域读到 rgb(153,105,61),未开启那张读到 rgb(51,158,71),静态背景那块两帧零差异。同一场景 30 帧里,背景的 _draw() 只发生 1 次,每帧请求重绘的小块发生了 30 次。口径仍要写明:读数来自本机 4.8.dev.custom_build.7177493c1 自定义构建;这条命令的开关说明取自本机 --help 原文,--debug-canvas-item-redraw 的用途是「Display a rectangle each time a canvas item requests a redraw」。两个读数合起来给出一个可检验的命题:重绘登记以画布项为单位逐块进行,痕迹范围与该块矩形逐像素吻合,没被请求的静态块不受牵动。
这条开关本身的定位在 --help 里写着 useful to troubleshoot low processor mode,用途是排查低处理器模式下画面是否按需更新。把它当成一次可视化实验,得到的是「哪一块被登记为脏」的图,静态区域完全不出现痕迹,这一条与第 4.4 节相位 D 的零次绘制互相印证。
源码落点:比对脚本与两张截图见本机归档 evidence/probe/(diff_shots.py / shot_plain.png / shot_with_debug.png)。其中:重绘登记入口 queue_redraw() 在 canvas_item.cpp:541,请求到的重绘由 _redraw_callback()(:144)在帧末执行,屏幕上的矩形痕迹来自本机自定义构建的调试开关,不构成官方 stable 行为。
4.6 官方文档那句话与实现那道闸
这一节把官方文档的表述与实现里的判据并排放,说明两者各处在链条的哪一端。queue_redraw() 的类参考原文写的是「This only occurs once per frame, even if this method has been called multiple times.」,CanvasItem 类描述另有一句「canvas items don't need to be redrawn on every frame, improving the performance significantly.」。这两句描述的是现象:一帧至多画一次。实现里的判据是 pending_update 那道闸:已经脏过就不再排队。
OK,把两端对接起来看,「每帧至多一次」是结果,「已脏则不再排队」是判据,结果由判据推出,判据在源码里能读到具体行号。官方 CanvasItem 类描述里还有一句前置:「Any CanvasItem can draw.」,接着才是重绘流程的说明,两者合起来界定了重绘的适用范围。中文侧对这一句的转述多停在现象层,把发生次数讲成引擎在按帧计数去重,本机读数与之不符:相位 D 整帧不调就是 0 次绘制,计数式去重不会给出这个结果。这里只做机制层对照,不对引擎行为下判断。另有一处与读者相关的历史要交代:CanvasItem 的 update() 在 4.0 改名为 queue_redraw(),三版时代留下的大量教程仍写作 update(),迁移文档的原句是「CanvasItem's update() is now queue_redraw().」,读到旧代码时按新名对照即可。把文档与实现对读,得到的是一条可复核的命题链:文档说一帧至多一次,实现用一道布尔闸把它落到具体的行号上,本机探针再用计数把结果测出来,三份材料各自独立,结论方向一致。
源码落点:官方表述见 class_canvasitem 与 从 Godot 3 升级到 4,实现判据见 canvas_item.cpp。其中:文档那句「This only occurs once per frame」在 class_canvasitem 的 queue_redraw() 条目下,对应的实现判据在 canvas_item.cpp:546,置脏与排回调在 :550 与 :552。
五、_draw 的边界:命令是重建不是增量
5.1 帧末回调的四步
这一节回答延迟回调真正执行时按什么顺序做完了四件事。_redraw_callback() 是帧末唯一处理重绘的函数,它的动作可以拆成四步:清上一轮命令、派发绘制通知、记下本轮已有命令、复位脏标记。
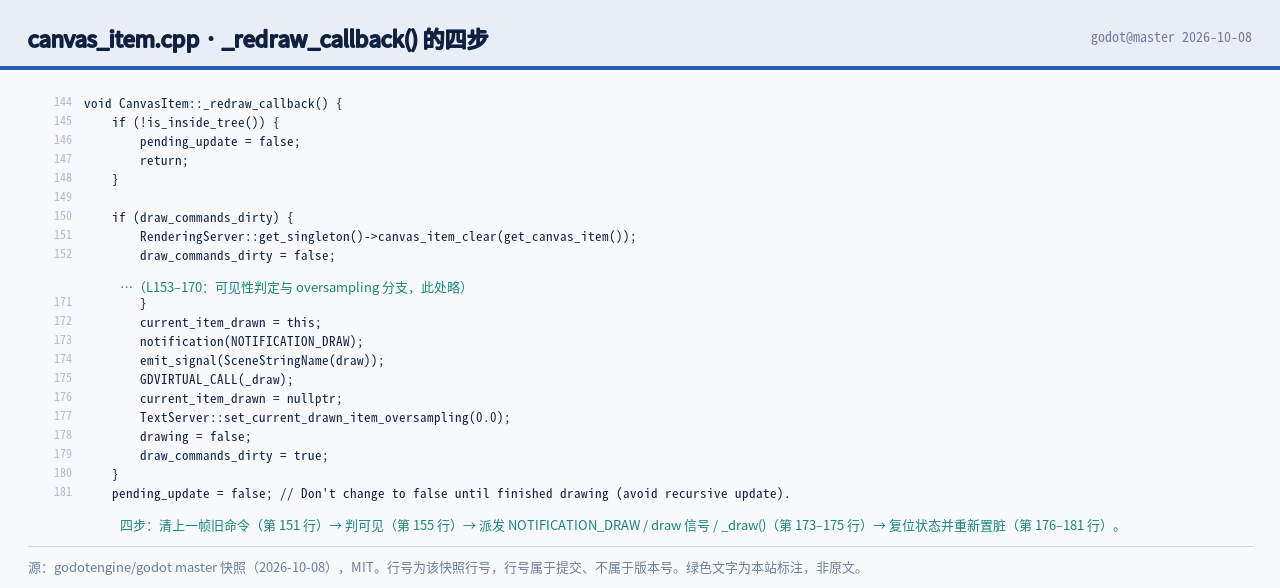
四步分别落在这些行::150 判 if (draw_commands_dirty),:151 调 RenderingServer::get_singleton()->canvas_item_clear(get_canvas_item()); 把上一轮的绘制命令成批清掉;:173 到 :175 依次是 notification(NOTIFICATION_DRAW);、emit_signal(SceneStringName(draw));、GDVIRTUAL_CALL(_draw);,通知、信号、虚调用三条通道都指向用户的绘制代码;:179 的 draw_commands_dirty = true; 记下本轮产生了命令;:181 在收尾处复位 pending_update。顺序不可调换,清必须发生在派发之前,否则上一轮的命令会与本轮叠加;复位必须发生在结尾,否则回调执行过程中若再触发标脏会形成递归。
三条通道面向不同写法:NOTIFICATION_DRAW 面向覆写 _notification() 的旧式写法,draw 信号面向用连接方式挂回调的写法,GDVIRTUAL_CALL(_draw) 面向脚本里覆写 _draw() 的写法。三条都落在同一个绘制窗口内,窗口由 drawing 布尔量圈定。清命令与派发之间没有别的动作,上一轮的命令不会活到本轮派发之后,这就是「重建」在时序上的样子。
源码落点:回调全文见 canvas_item.cpp。其中:回调入口在 canvas_item.cpp:144,清旧命令在 :151,绘制派发在 :173 到 :175,标记命令与复位在 :179 与 :181,行号口径为 master(2026-10-08 快照)。
5.2 命令是重建不是增量
这一节回答「清旧命令」这一步为什么必须是整批清掉。每次重绘开始时,画布项身上挂着的命令队列先被 canvas_item_clear() 一次性清空,_draw() 再按这一帧的现场从头把命令写一遍。清掉的是上一轮的全部命令,重建的是本轮的全部命令,两轮之间不做差分。
OK,驱动这一步的是 draw_commands_dirty 这个布尔量,它在 canvas_item.h:120 声明为 bool draw_commands_dirty = false;。状态只有两态:false 表示没有待清的旧命令,true 表示上一轮写过命令、需要在本轮开头清一次。清完立刻在 canvas_item.cpp:151 之后置 false,本轮结束再在 :179 置回 true,于是每轮开头都恰好清一次。把两态与两处置位对齐:初值是 false,第一次重绘时 :150 的判据不成立,跳过清命令一步,:179 把它置为 true;此后每一轮开头都先清一次,再重建一次。命令队列挂在画布项对象上,不在场景层的节点结构里,清与建都通过服务层的 canvas_item_clear 与 draw_* 系列完成。官方教程给的是同一件事的说明:「The _draw function is only called once, and then the draw commands are cached and remembered, so further calls are unnecessary.」,命令被缓存下来,只在需要变化时重来一次。重建式更新的直接收益是逻辑简单,绘制内容与当前状态保持一致;代价是每轮都要把整项重画一遍,命令量大的项重绘成本随之上升。
源码落点:脏标记声明见 canvas_item.h,清命令与置位见 canvas_item.cpp,官方说明见 2D 自定义绘制。其中:draw_commands_dirty 在 canvas_item.h:120,清命令在 canvas_item.cpp:151,标记在 :179,缓存的表述出自官方教程 Custom drawing in 2D。
5.3 drawing 闸挡的是什么
这一节回答 draw_* 系列函数为什么只能在特定时机调用。画布项上有一个名为 drawing 的布尔量,它在 canvas_item.h:122 声明为 bool drawing = false;。只有进入绘制窗口时它才被置 true,退出时立刻置回 false,绘制函数开头的守卫宏据此判定是否放行。
守卫宏在 canvas_item.cpp:55 定义,宏体是 ERR_FAIL_COND_MSG(!drawing, "Drawing is only allowed inside this node's_draw(), functions connected to itsdrawsignal, or when it receives NOTIFICATION_DRAW.")。窗口的开合在 _redraw_callback() 里::156 置 drawing = true;,:178 置 drawing = false;,两者之间正好包住 notification(NOTIFICATION_DRAW)、emit_signal(draw)、GDVIRTUAL_CALL(_draw) 三次派发。current_item_drawn 在派发期间指向当前正在绘制的项,绘制函数据此知道命令该写进哪一项的队列。官方 CanvasItem 类描述把这三种时机写全了:「However, they can only be used inside _draw, its corresponding _notification or methods connected to the draw signal.」。这道闸挡的是在没有绘制上下文时下命令:命令要写进当前这一项的命令队列,队列的归属由 current_item_drawn 在派发期间指向决定,窗口之外它没有确定指向,放行只会让命令落到错误的项上。
守卫宏 ERR_DRAW_GUARD 被套在 draw_* 系列与 canvas_item_add_* 系列的命令函数上,凡是往命令队列写内容的入口都要走它。窗口一旦关闭,这些入口在调试构建下直接报错并返回,命令不会写进任何项。闸的开合粒度是单项的,每个画布项在各自被派发时才打开自己的窗口,项与项之间互不影响。
源码落点:守卫宏与窗口开合见 canvas_item.cpp,成员声明见 canvas_item.h,官方表述见 class_canvasitem。其中:drawing 在 canvas_item.h:122,守卫宏在 canvas_item.cpp:55,置位与复位在 :156 与 :178,三者共同界定绘制窗口。
六、三张 RID:viewport、canvas 与 canvas_item 各归谁
6.1 三张句柄的四个持有者
好了,这一节回答 viewport、canvas、canvas_item 三张句柄(RID,指向远程对象的不透明指针)分别由谁申请、谁持有。三张句柄都由场景层的不同对象在构造期向 RenderingServer 申请,申请点分散在四个构造函数里,拿到后各自持有。
四个持有者与申请点对得上:Viewport 在构造期调 viewport_create()(viewport.cpp:5598)持有视口(viewport)句柄,对外通过 get_viewport_rid()(:1093)给出;World2D 在构造期调 canvas_create()(world_2d.cpp:109)持有 canvas 句柄,通过 get_canvas()(:46)给出;CanvasLayer 自建 canvas,构造期调 canvas_create()(canvas_layer.cpp:360),通过 get_canvas()(:272)给出;CanvasItem 在构造期调 canvas_item_create()(canvas_item.cpp:1897)持有画布项句柄,通过 get_canvas_item() 给出。挂接关系是一条链:视口挂 canvas,canvas 下挂若干 canvas_item。官方对这条链的必要性写得很直白:「In order to be visible, a canvas item needs to be the child of a canvas attached to a viewport, or it needs to be the child of another canvas item that is eventually attached to the canvas.」。
官方对句柄的性质另有一条原句:「These functions return RIDs which are not references to the objects themselves, but opaque pointers towards these objects.」,句柄是不透明指针,场景层拿着它并不能解引用去看实现。配套还有一条使用纪律:「Try to never request any information from RenderingServer」,因为服务层可能异步运行,任何带返回值的调用都会逼它把待办处理完。把画布项挂到 canvas 的命令是 canvas_item_set_parent,它在门面上声明为一条 RID 型纯虚接口(rendering_server.h:815),第 7 章会拆它的转发路径。把这两条放在本章开头,三张句柄的用法就有了边界:场景层只下发命令,不向服务层要数据。
源码落点:四个申请点见 viewport.cpp、world_2d.cpp、canvas_layer.cpp 与 canvas_item.cpp。其中:viewport_create() 在 viewport.cpp:5598,canvas_create() 在 world_2d.cpp:109 与 canvas_layer.cpp:360,canvas_item_create() 在 canvas_item.cpp:1897,取用入口分别在 viewport.cpp:1093、world_2d.cpp:46、canvas_layer.cpp:272。
6.2 本机探针:四种情形下的 get_canvas
这一节给出本机探针把三张句柄的取值测出来的那组读数。探针把同一个画布项节点依次挂到四种父级下,逐次打印它的 get_canvas(),看这个值随挂接位置如何变化。
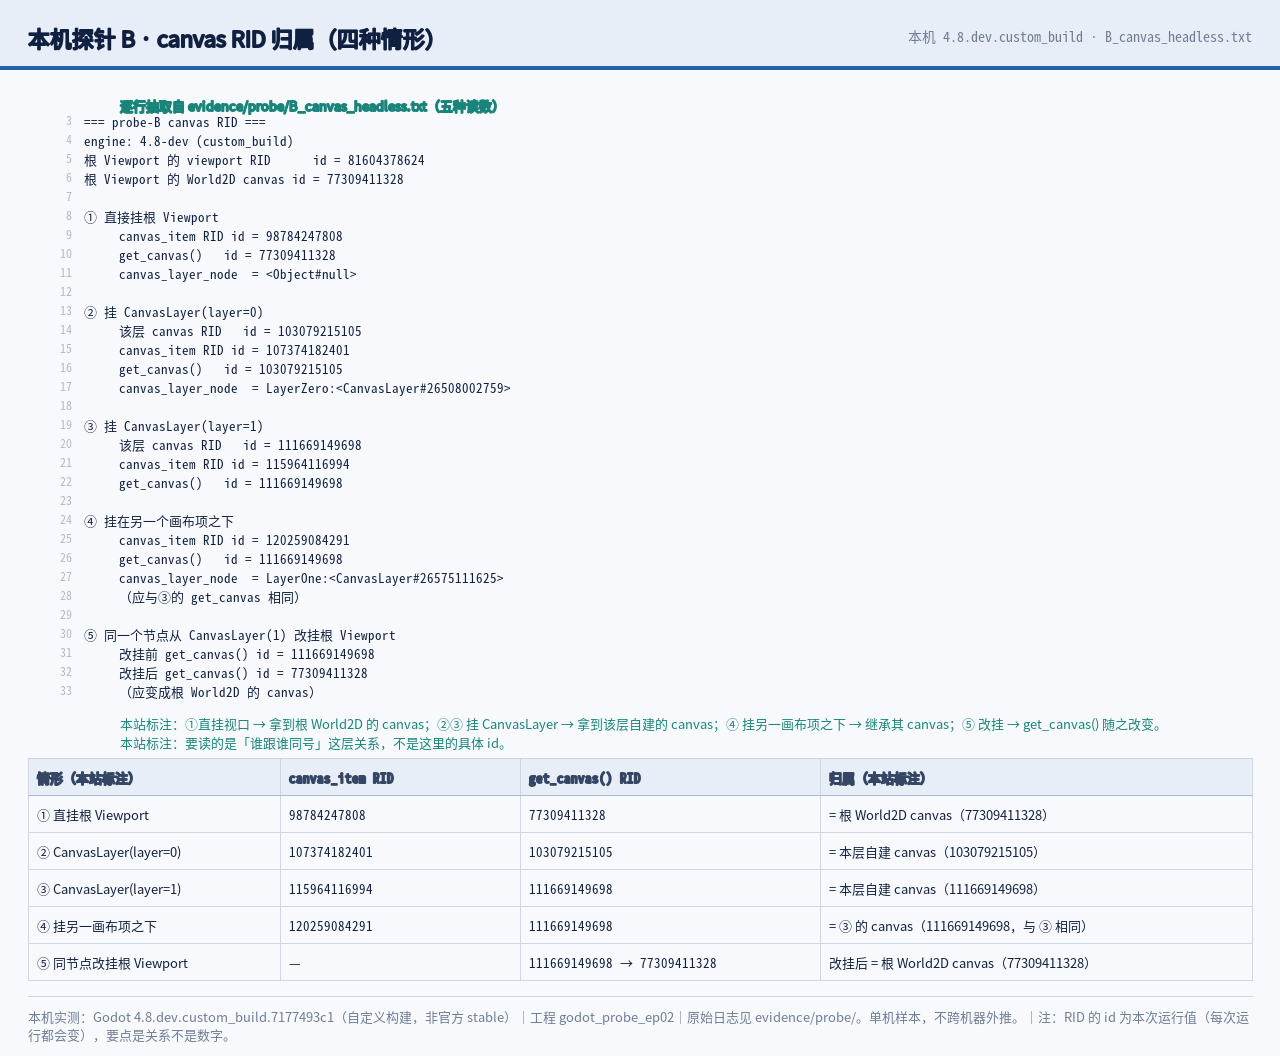
好了,读数是:根视口的 viewport 句柄为 81604378624,根 World2D 的 canvas 句柄为 77309411328;① 直接挂根视口,get_canvas() 得到 77309411328;② 挂 CanvasLayer(layer=0),该层 canvas 为 103079215105,get_canvas() 得到该值;③ 挂 CanvasLayer(layer=1),该层 canvas 为 111669149698,get_canvas() 得到该值;④ 挂另一个画布项之下,get_canvas() 得到 111669149698,与它的父项同号;⑤ 把 ③ 的节点改挂到根视口,get_canvas() 从 111669149698 变为 77309411328。其中数字是本次运行的句柄值,运行之间会不同,可复现的是关系:canvas 归属跟着父级链走。四种情形的取值也对得上本章开头那条挂接链:直挂视口拿到的是 World2D 的 canvas,挂层拿到的是层的 canvas,挂画布项下拿到的是父项的 canvas。headless 模式下句柄照样申请、照样可取,这一组读数与渲染后端无关。口径照旧:读数来自本机 4.8.dev.custom_build.7177493c1 自定义构建,只作本机样本。
源码落点:探针脚本与日志见本机归档 evidence/probe/(canvas_probe.gd / B_canvas_headless.txt)。其中:取值函数 get_canvas() 在 canvas_item.cpp:1223,挂接实现 _enter_canvas() 在 :259,本机四种情形的输出见 B_canvas_headless.txt。
6.3 视口从哪来、canvas 又由谁建
这一节回答视口句柄与 canvas 句柄各自的来处。视口在 Viewport 构造期申请,入树时把 canvas 挂到自己名下;canvas 由 World2D 与 CanvasLayer 分别自建,前者挂在视口上,后者在入树时再挂。
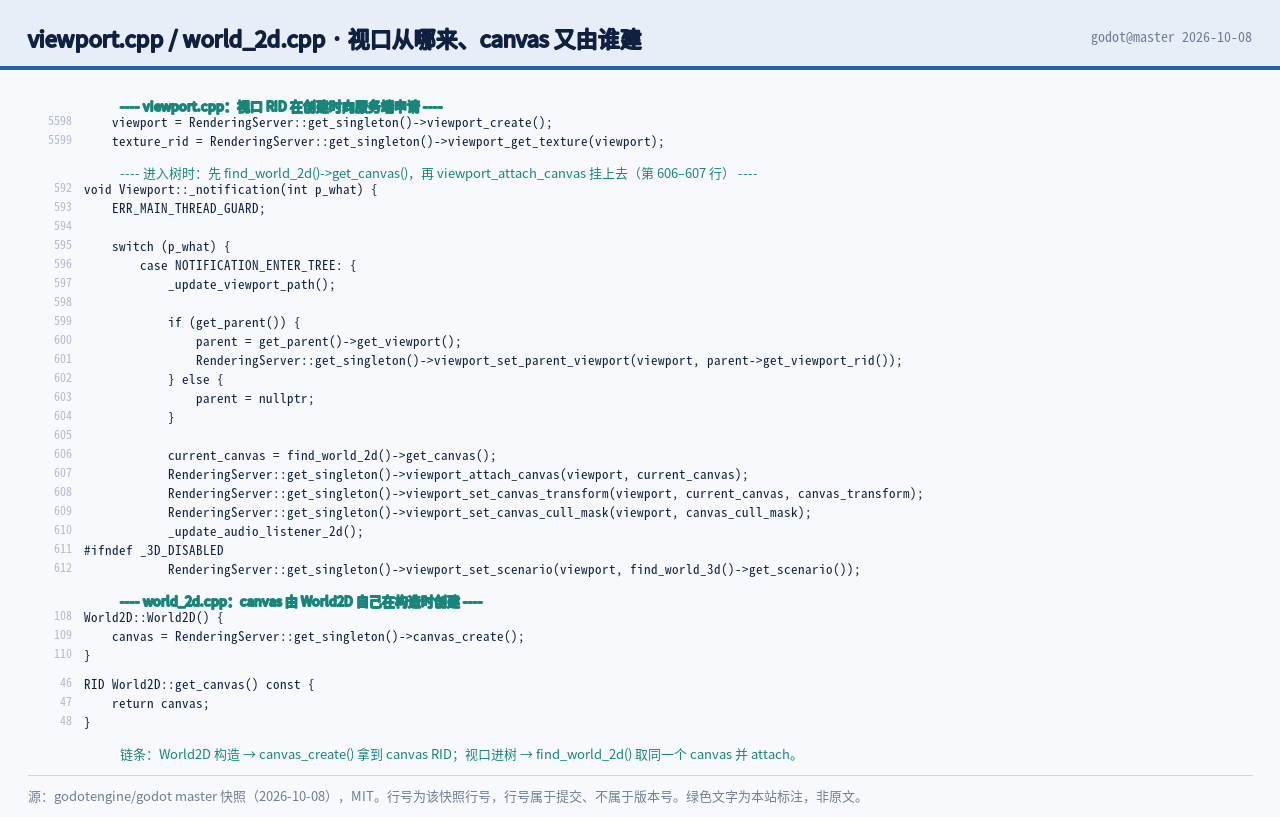
链条在这些行上接齐:viewport.cpp:5598 的 viewport_create() 是视口句柄的来源;:592 的 Viewport::_notification() 处理入树;:607 的 RenderingServer::get_singleton()->viewport_attach_canvas(viewport, current_canvas); 把 canvas 挂到视口,而 current_canvas 在 :606 取自 find_world_2d()->get_canvas();:1093 的 get_viewport_rid() 是视口句柄的对外出口。另一头,world_2d.cpp:109 的 canvas_create() 建出 World2D 的 canvas,:46 的 get_canvas() 把它交出去。CanvasLayer 走同一套:canvas_layer.cpp:360 建 canvas,:272 给出,:185 在入树时调 viewport_attach_canvas(viewport, canvas); 把它挂到所属视口。于是「canvas 归谁」有了准确答案:视口自己不带 canvas,它挂的是别人建好的 canvas,默认那份来自 World2D,层的那些来自各个 CanvasLayer。官方把视口描述成「A Viewport creates a different view into the screen, or a sub-view inside another viewport.」,get_viewport_rid() 是「Returns the viewport's RID from the RenderingServer.」。落到源码上,视口句柄与它挂的 canvas 是两份东西,前者来自 viewport_create(),后者来自 World2D 或 CanvasLayer 的 canvas_create()。
源码落点:视口侧见 viewport.cpp,世界侧见 world_2d.cpp,层侧见 canvas_layer.cpp。其中:viewport_create() 在 viewport.cpp:5598,viewport_attach_canvas() 在 :607,get_viewport_rid() 在 :1093,canvas_create() 在 world_2d.cpp:109,get_canvas() 在 :46,层的挂接在 canvas_layer.cpp:185。
6.4 层是一个节点
这一节回答 CanvasLayer 在对象模型里的位置:它是一类节点,不是一个属性。在编辑器里它出现在场景树上,与其它节点并列,可以展开、可以加子节点;挂在它下面的画布项会被画在这一层,层的顺序由一个数字索引决定。
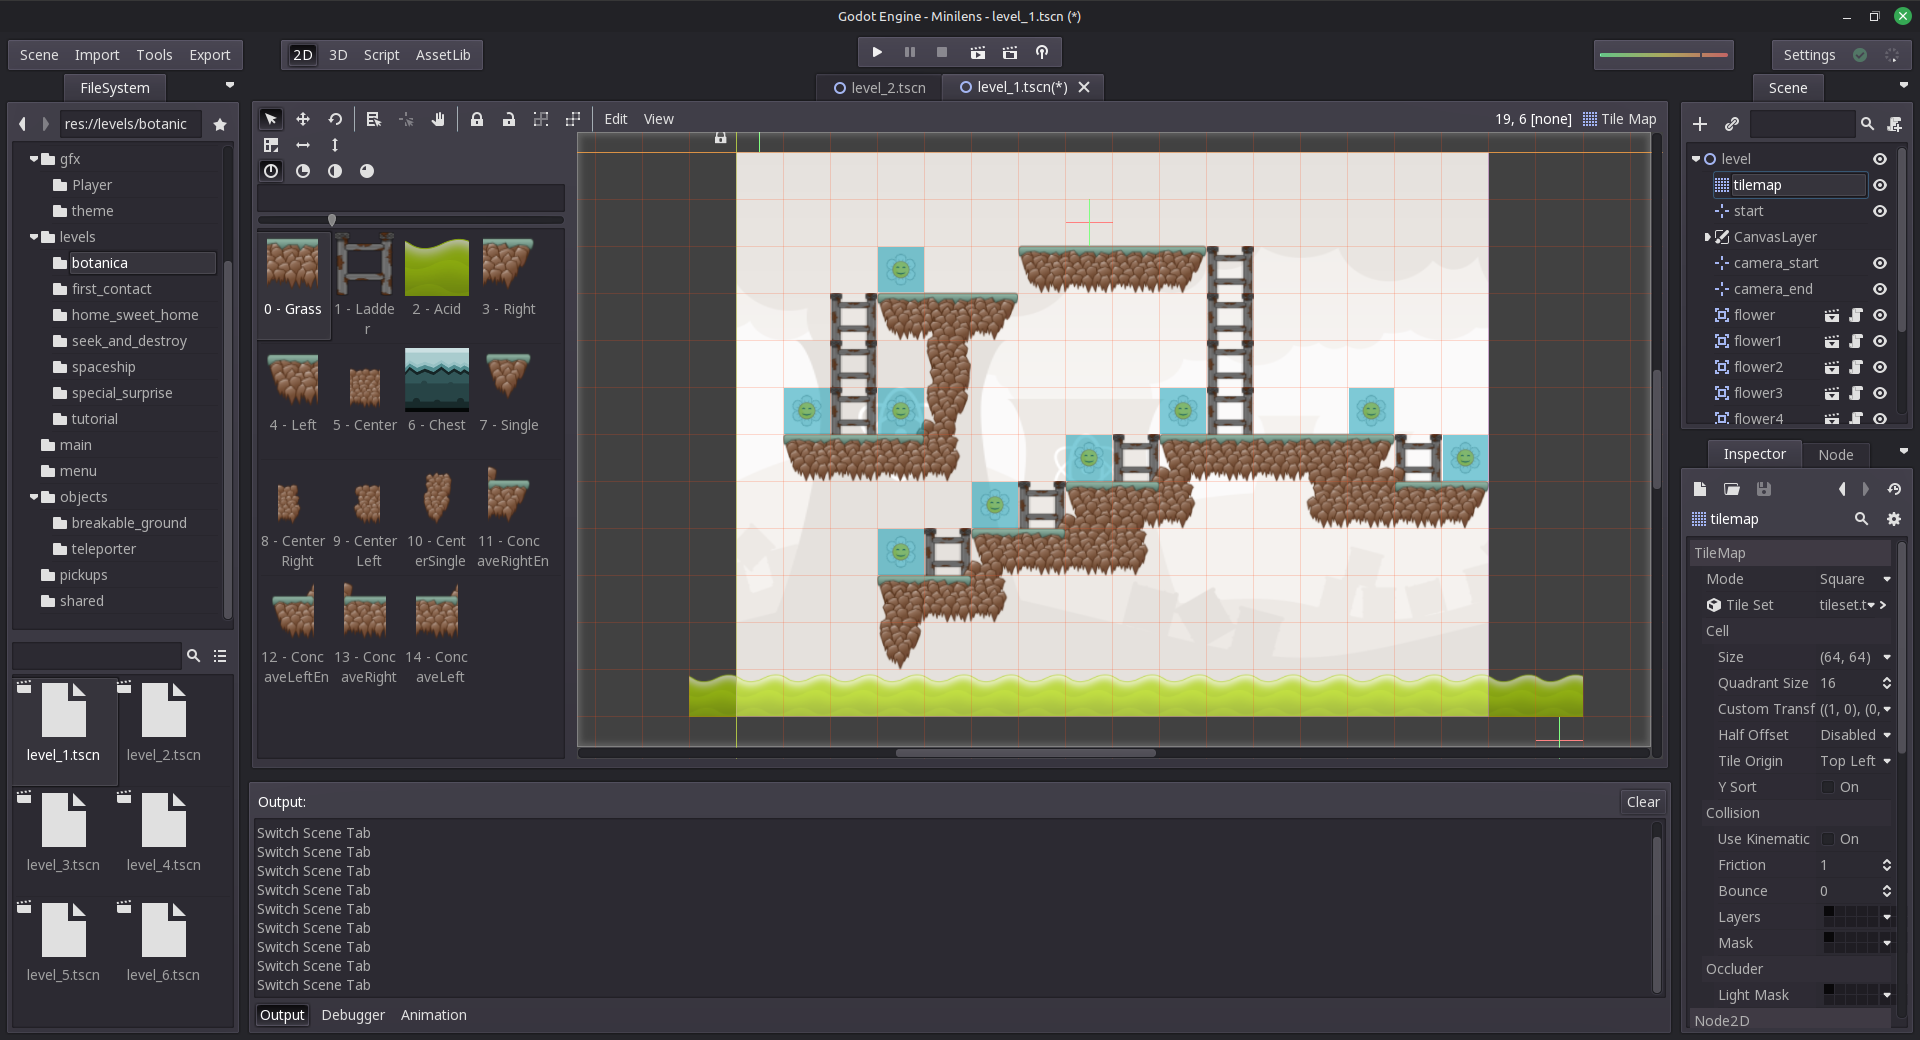
好了,官方 CanvasLayer 类参考把两件事写清楚了:顺序上「The layer is a numeric index that defines the draw order.」且「This order will hold regardless of the z_index of the nodes within each layer.」;归属上「Each CanvasLayer is drawn on one specific Viewport and cannot be shared between multiple Viewports.」,取 canvas 的接口 get_canvas() 是「Returns the RID of the canvas used by this layer.」。「cannot be shared between multiple Viewports」这一句约束的是层的归属:一个层只画在一个视口上,跨视口复用不被支持。层序由一个数字索引决定,且这个顺序不受层内节点的 z_index 影响,两者管的是不同尺度上的先后。这一节配的外部实拍取自 Wikimedia Commons 的 Category:Screenshots of Godot (game engine),该池以 CC BY-SA 4.0 为主,引用时须写明原图许可与本处改动,且 Godot 名称与标志是商标,图注不得暗示官方背书。这里的取舍也说得明白:把层做成节点,层就能用上入树传播、处理模式一类既有机制;代价是每层多出一个节点与一份自建 canvas。
源码落点:类参考见 class_canvaslayer,实现见 canvas_layer.cpp。其中:层自建 canvas 在 canvas_layer.cpp:360,get_canvas() 在 :272,入树挂接在 :185;外部实拍候选与许可说明见本篇 material-inventory.md 的候选短名单。
6.5 改挂时画布跟着变
这一节回答同一个画布项改变父级之后,它的 canvas 归属会如何变化。父级链一变,_enter_canvas() 会按新的父级重新算一遍 canvas,旧挂接先摘除,新挂接再写入,get_canvas() 随之给出新值。
挂接实现的三条路径在 _enter_canvas()(canvas_item.cpp:259)里:有父画布项时走 :269 的 canvas_item_set_parent(canvas_item, parent_item->get_canvas_item()); 挂到父项;否则有 CanvasLayer 时走 :289 的 canvas = canvas_layer->get_canvas();;再否则走 :291 的 canvas = get_viewport()->find_world_2d()->get_canvas();,最后在 :294 用 canvas_item_set_parent(canvas_item, canvas); 挂到 canvas。换父级时旧挂接由 _exit_canvas()(:312)摘除,它在 :313 发反向通知,在 :314 用 canvas_item_set_parent(canvas_item, RID()); 挂一个空句柄脱钩。脱钩与挂接是一对反向动作:入树按父级链算出 canvas 并写进去,出树或换父级时先发反向通知再挂空句柄,空句柄是「没有父级」的表达,不是一个特殊 canvas。本机探针的第 ⑤ 组正好走到这条路径:节点从层的 canvas(111669149698)改挂到根视口的 canvas(77309411328)。由此可以确认,canvas 归属是入树时按父级链算出来的结果,不随节点本身固定。本机读数仍限定在 4.8.dev.custom_build.7177493c1 自定义构建口径,只作样本,不跨机器外推。
源码落点:挂接与脱钩见 canvas_item.cpp。其中:_enter_canvas() 在 canvas_item.cpp:259,三条挂接路径在 :269、:289、:291,写入在 :294,_exit_canvas() 在 :312,空句柄脱钩在 :314,get_canvas() 在 :1223。
七、门面那一跳:canvas_item_create 为什么在实现层查不到
本节要回答的是:门面上那条 canvas_item_create() 落到实现层为什么换成了两个方法名,以及这一跳为什么不只是一次改名。
7.1 门面上仍是 RID 型纯虚接口
说白了,先给门面(facade)这一层的定义:它是场景层看得见的那个头文件,servers/rendering/rendering_server.h 里画布项一族命令一律以纯虚接口(pure virtual interface)出现,谁来实现由运行时决定。打开这三行,virtual RID canvas_item_create() = 0;(master 快照 2026-10-08,rendering_server.h:814)、virtual void canvas_item_set_parent(RID p_item, RID p_parent) = 0;(:815)、virtual void canvas_item_clear(RID p_item) = 0;(:864),返回值与参数都是 RID。官方文档把 RID 的性质写成一句:这些函数返回的 RID 不是对象本身的引用,只是指向这些对象的不透明指针(opaque pointer)。场景层从 create 拿到的因此只是一个号码,不能解引用去看实现。
门面这一层还压着一条硬边界:官方口径是不主动向服务层要数据,任何有返回值的调用都会让服务层把待办处理完,打断它的异步。这条边界解释了这一段链上的命令为什么几乎全是「交号码」与「收回号码」,场景层只下发、不查询。落到 canvas_item_create() 上,门面给出的形态只能是一个纯虚接口加一个 RID,既不给对象,也不给结构体。
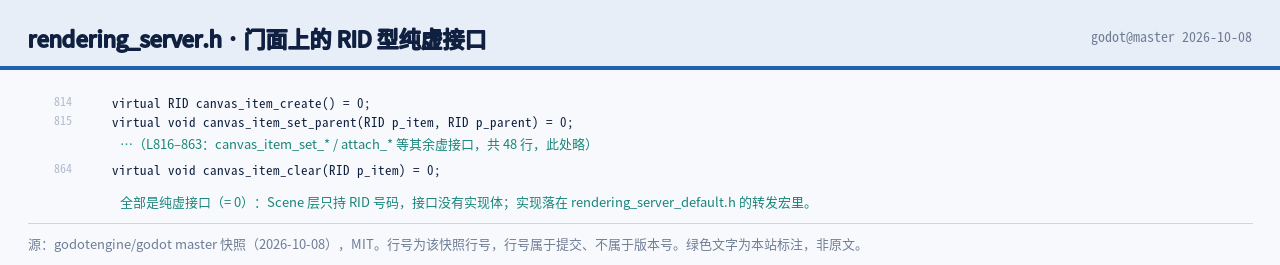
把这块面板读给读者听,三行分别是申请、挂父、清命令。第一行 canvas_item_create() 交出一个 RID,第三行 canvas_item_clear() 收回一个 RID,中间一行 canvas_item_set_parent() 同时收两个 RID。门面这一层的形态很单纯:每条命令要么交出一个号码,要么收回一个号码,场景层与实现层之间只走号码,不走指针。
7.2 宏定义与它的展开体
门面上写着 create,渲染服务头文件里却找不到它的函数体。rendering_server_default.h:1016 那一行 FUNCRIDSPLIT(canvas_item) 把这条命令转给画布实现,:1017 那一行 FUNC2(canvas_item_set_parent, RID, RID) 把挂父命令转出去,这两行是转发点。真正给出形态的是宏(macro)定义本身,servers/server_wrap_mt_common.h:58 的 #define FUNCRIDSPLIT(m_type) 就是它。
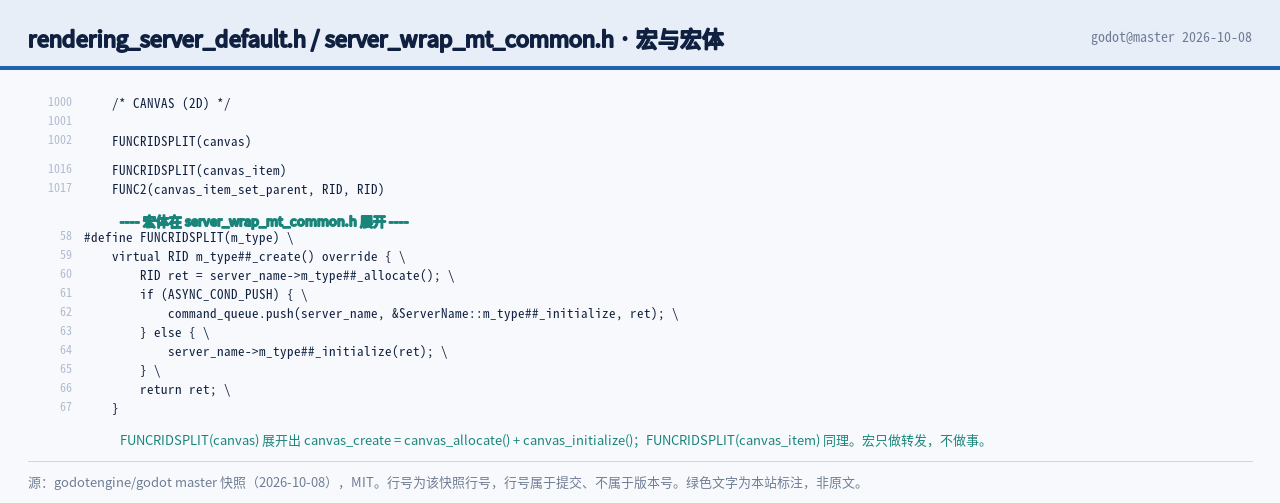
这块面板里两个文件分工清楚,一份是转发点,一份是定义点。转发点告诉读者 canvas_item 这条命令走的是 RSG::canvas 这条通道,定义点给出它被展开成什么样。这里先落一句结论:门面上那条 create 的实体不写在渲染服务头文件里,它由宏在编译期生成,按方法名去实现层翻,必然翻不到。
7.3 FUNCRIDSPLIT 的一次展开
说白了,把宏按 m_type = canvas_item 展开(expansion),落在四步之内。server_wrap_mt_common.h:60 的宏体先写下 RID ret = server_name->m_type##_allocate();,拿到一个号码;随后 :64 调它的 _initialize;两拍之间还有一条异步分支 ASYNC_COND_PUSH(:61),多线程包装器把命令压进队列再让渲染线程消费,命令就在这一步换手。
这张展开图只有三条:宏定义在上,展开后的 allocate 与 initialize 在中,那条异步分支贴在两拍之间。它的用处是把「一条命令」拆成「先占位、再填内容」两拍,两拍之间允许换线程。读完这一节,create 在门面上就不再是「一步造出一个对象」,它是一段展开后的两拍流程。两拍为什么必须分开,答案在线程那一侧。官方博文把服务器的定位写成「单通道命令 API 加 RID 作为远程对象句柄」,多线程包装器据此让命令先入队、再被渲染线程消费;allocate 在这一侧先把号码占下来,initialize 可以放到换手之后补,两拍之间那条 ASYNC_COND_PUSH 就是换手的开关。
7.4 实现层只有 allocate 与 initialize
落到实现层,renderer_canvas_cull.cpp:567 是 RID RendererCanvasCull::canvas_item_allocate(),:570 是 void RendererCanvasCull::canvas_item_initialize(RID p_rid),全文件没有 canvas_item_create 这个方法名。二手内容里常见「RenderingServer::canvas_item_create() 直接创建并返回一个画布项」的说法,对着 master 快照读,这句话只对了一半:create 只存在于门面,且是宏生成的。
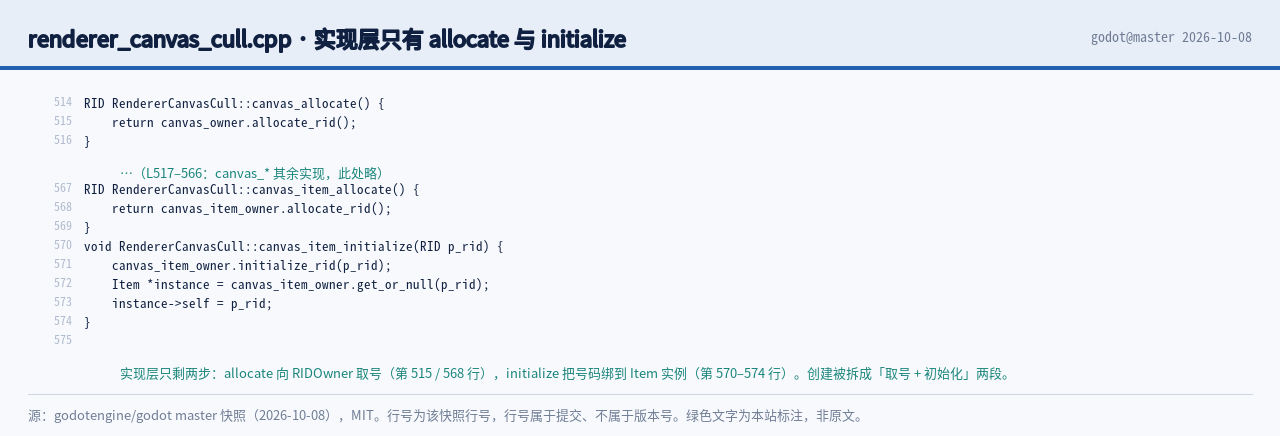
说白了,面板里两行贴在一起,前者交号码,后者把号码变成可用对象。两拍之间为什么值得单列,官方把边界写在类参考里:渲染服务的实际逻辑可能跑在另一条线程上,从主线程或其他线程去碰它的内部会出错。这两拍之间正是线程切换的窗口,那条 ASYNC_COND_PUSH 分支就是它的落点。这里只陈述「门面写 A、实现层读到 B」这一层事实,不替引擎下结论。号码先到手、内容后补齐,这条次序在实现层看得最清楚:canvas_item_allocate() 返回的 RID 当场就能当句柄用,canvas_item_initialize() 才把这份句柄背后的状态填上,线程边界正卡在这两拍之间。二手内容把这一跳读成一步,是因为只看了门面上的方法名,没看宏展开后的落点。
源码落点:门面的纯虚接口见 rendering_server.h,宏转发见 rendering_server_default.h,宏定义与宏体见 server_wrap_mt_common.h,实现层的 allocate 与 initialize 见 renderer_canvas_cull.cpp,RID 与线程边界的官方口径见 RenderingServer 类参考;其中: 门面 :814 的 canvas_item_create() 是纯虚接口、返回 RID,rendering_server_default.h:1016 用 FUNCRIDSPLIT(canvas_item) 把它转出去,宏体 server_wrap_mt_common.h:60 展开成 allocate 加 initialize 两拍并带 ASYNC_COND_PUSH 异步分支,实现层 renderer_canvas_cull.cpp:567/570 只有 canvas_item_allocate 与 canvas_item_initialize,全文没有 create 这个方法名,行号一律按 master(2026-10-08 快照)。
八、次序:绘制为什么必然落在帧末
本节要回答的是:一帧里物理帧、空闲帧、服务层同步与提交的排布是什么次序,绘制为什么必然被推到帧末。
8.1 主循环里的四段排布
先给主循环(main loop)这一层的定义:main/main.cpp:4948 的 bool Main::iteration() 是每帧走一遍的入口,帧内先跑物理、再跑空闲、然后与服务层同步、末了提交。四段的落点依次是 :5028 的 get_main_loop()->physics_process(physics_step * time_scale)、:5089 的 get_main_loop()->process(process_step * time_scale)、:5104 的 RenderingServer::get_singleton()->sync();、:5120 的 RenderingServer::get_singleton()->draw(wants_present, scaled_step);。
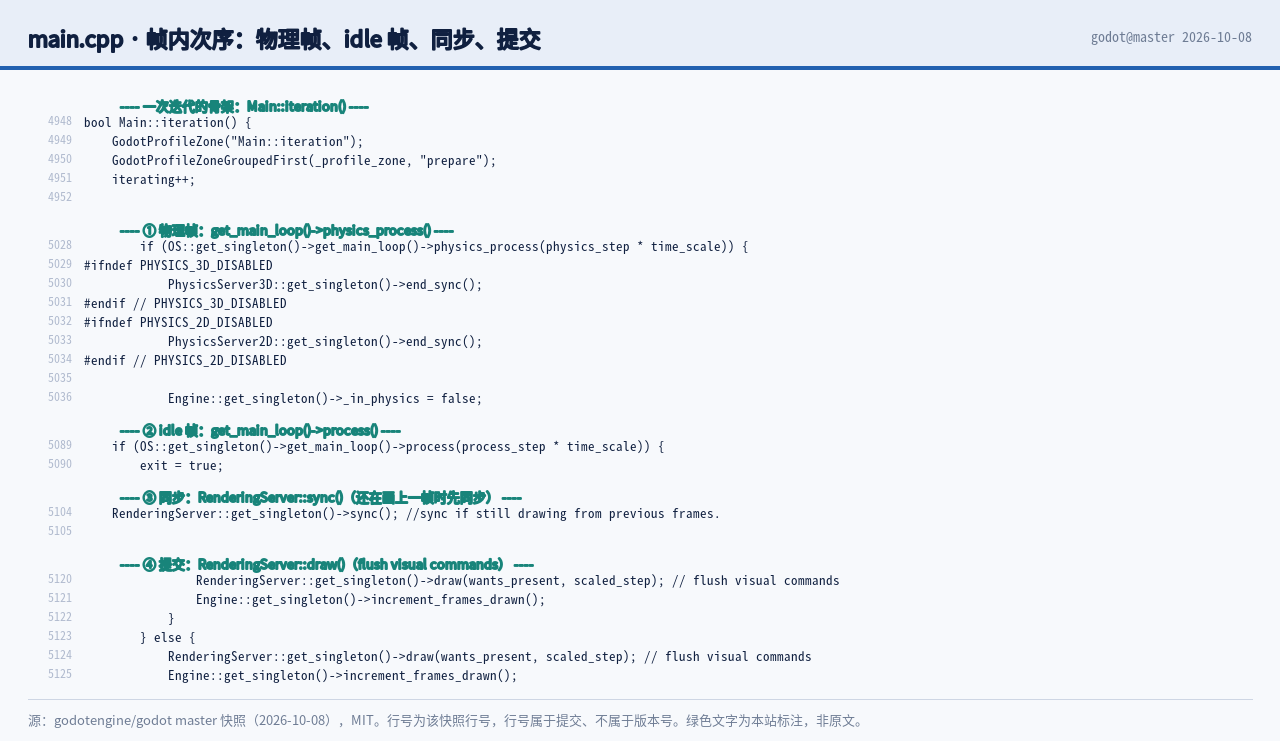
这块面板给出五行,第一行是总入口,后四行是它内部的四个落点。前面几章讲的 SceneTree::process() 与 SceneTree::physics_process() 就是在这里被调起来的两个宿主,物理与空闲两条节奏在 Main::iteration() 里合成一条时间轴。官方把两条节奏的不同步写得直白:_process() 与物理不同步,它的速率取决于硬件与游戏优化,单线程下还排在物理步之后。这句给的是「一帧里物理可能多次、空闲只一次」的另一面,也解释了次序条为什么把物理段画成一串、把空闲段画成一个。
8.2 帧内次序条
把四段排成一条次序条,两边的时间量并不相同。物理帧(physics frame)按固定步长推进,一帧里可能跑多次;空闲帧(idle frame)一帧一次。官方把空闲帧的时点写成一句:_process() 在每个空闲帧被调用,早于渲染、晚于物理步。SceneTree 侧对应的两条信号写得更直白,physics_frame 在树上每个节点收到 _physics_process() 之前发出,process_frame 与它同构。次序条因此是「物理帧若干次、空闲帧一次、再同步、再提交」。
言归正传,读这条次序条只要抓住分段:左端是一串物理脉冲,中间一个空闲脉冲,右端是服务层的同步与提交两点。绘制命令要落到屏幕上,必须等右端那两点发生,这一条把「绘制为什么在帧末」的时序先钉住,下一小节给读数。
8.3 本机性能读数
本机跑探针时读的是 Performance 监视器,窗口模式下三项读数是:RENDER_TOTAL_DRAW_CALLS_IN_FRAME 2.0、RENDER_TOTAL_OBJECTS_IN_FRAME 2.0、TIME_PROCESS 0.017269 毫秒,另有 OBJECT_COUNT 1483 与 TIME_PHYSICS_PROCESS 0.000712 毫秒。这组读数出自本机二进制 4.8.dev.custom_build.7177493c1(2026-07-03 构建),是一个自定义构建,与官方稳定版 4.7.2(2026-08-18)和开发版 4.8-dev7(2026-09-29)都不等同。
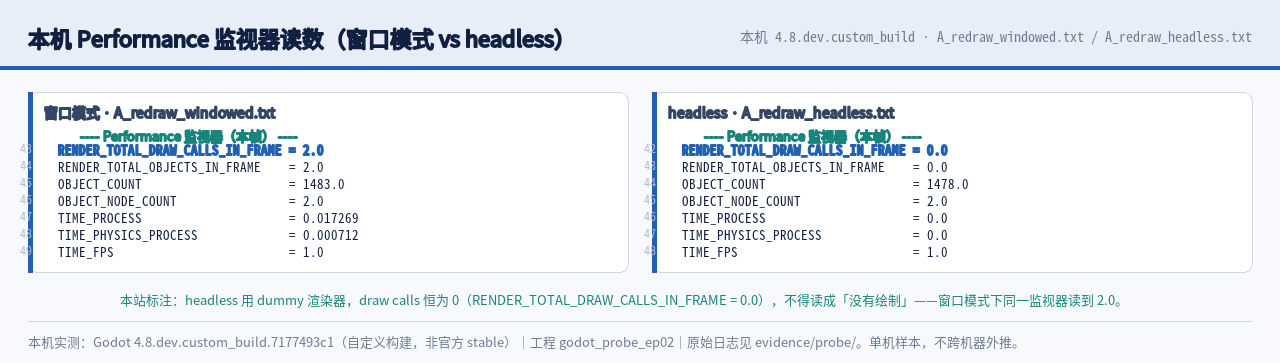
面板里的 draw calls 是 2、objects in frame 是 2、TIME_PROCESS 是 0.017 毫秒。这里有一条口径要贴住:同一探针在 --headless 下 RENDER_TOTAL_DRAW_CALLS_IN_FRAME 恒为 0,因为 headless 走 dummy 渲染器,那个 0 不能读成「没有绘制」。读数只取窗口模式那一份,且只在本机口径下成立,不跨机器外推。面板另给 OBJECT_COUNT 1483 与 TIME_PHYSICS_PROCESS 0.000712 毫秒,前者说明帧里对象总数与 draw call 是两个量,后者说明这份样本里物理侧开销比空闲侧低两个数量级,两者同属一次采样,只作本机样本。
8.4 绘制为什么必然落在帧末
回到 queue_redraw() 那一跳。它在 canvas_item.cpp:552 排的是一个延迟回调(deferred call),回调先进消息队列,等这一帧的空闲段被冲队列时才跑;冲队列的时点落在空闲帧之内,绘制落点因此必然被推到帧末。官方把结果写成一句:空闲时若画布项可见,NOTIFICATION_DRAW 被发出、_draw() 被调用,这件事每帧至多发生一次。
言归正传,这张图把这条链画成一段:调用标脏、延迟回调入队、帧末冲队列、跑到 _draw()、命令下发、再同步与提交。本机探针给的是同一条链的读数,23 次 queue_redraw() 只出 4 次 _draw(),且每次 _draw() 落点与该批调用同帧,差 0 帧。同帧合并是实测到的事实,pending_update 幂等闸是它的机制解释;本机四组构造都没有复现出「回调跨帧尚未执行」的窗口,这一层就不写成跨帧结论。把这条链与本机读数对上,能确认两件事:合并发生在延迟队列被冲的那一刻,命令的下发与提交都排在其后,由 Main::iteration() 在帧末收口。次序条给机制,本机探针给落点,两条证据互相印证。
源码落点:主循环四段的落点见 main.cpp,空闲帧与物理帧的官方时点见 Node 类参考 与 SceneTree 类参考,重绘与空闲时点的官方口径见 CanvasItem 类参考,延迟回调的落点见 canvas_item.cpp,用服务器下发的动机见 用服务器优化;其中: Main::iteration()(main.cpp:4948)内部依次调 physics_process(:5028)、process(:5089)、sync(:5104)与 draw(:5120),绘制命令的合并时点落在空闲段的延迟队列冲队列处,本机读数(4.8.dev.custom_build.7177493c1 自定义构建)给出 23 次调用对 4 次 _draw()、落点同帧差 0 帧,headless 下 draw call 计数恒为 0 不作「没有绘制」解读。
九、收官:这套分工买到什么,代价是什么
本节要回答两件事:从入树到一次绘制下发的这条链合起来是什么形状、这套分层换来什么又付出什么,以及后面各篇各看哪一层。
9.1 一条链的十个落点
把前面七章串成一条链,每一跳都指得到源码落点。起点在 Node 入树的传播 _propagate_enter_tree()(node.cpp:341),它让 CanvasItem 在 canvas_item.cpp:417 收到 NOTIFICATION_ENTER_TREE;挂接在 _enter_canvas()(:259),有父画布项就挂父项(:269),否则挂 World2D 的 canvas(:294)。标脏走到 queue_redraw()(:541),幂等闸在 :546,延迟回调排在 :552。帧末 _redraw_callback()(:144)先清旧命令(:151),再派发 NOTIFICATION_DRAW(:173),随后 GDVIRTUAL_CALL(_draw)(:175)。_draw() 里的 canvas_item_add_* 命令经门面宏转发(rendering_server_default.h:1016/1017)进入实现层 RendererCanvasCull(renderer_canvas_cull.cpp:567/570),帧末由 render_canvas()(:495)消费,整条链由 Main::iteration()(main.cpp:4948)驱动、在 :5120 提交。
这张总图把十章压成一列:入树、挂画布、标脏、合并、重建命令、门面转发、实现层两拍、帧末消费、提交。取舍可以分两面说。换来的是解耦,Node 管树、SceneTree 管节奏、CanvasItem 管脏各守一段,服务层可以整体绕开场景层使用;付出的是间接,一次绘制要穿入树、标脏、延迟回调、门面宏、实现层两拍这么多跳,中间隔着 RID 号码与多条线程边界。这条链的账单可以算得具体:一次绘制要穿九到十跳,横跨场景层与服务层两条线,每一跳都有 master 落点可复核。分层把「可替换」放在「最短路径」之前,第三到第十篇拆的正是这九到十跳。
9.2 后面各篇各看哪一层
先来看看这张表的定义很窄,只回答每篇看哪一层,各篇的标题不在本篇给出。本篇停在对象模型,第三到第十篇各拆一层。
| 篇 | 看哪一层 | 这一层在本篇这条链上的位置 |
|---|---|---|
| 第三篇 | Core 层·句柄 | RID 句柄与服务层接口,门面那一跳的载体 |
| 第四篇 | Server 层·剔除 | RendererCanvasCull 决定画什么、按什么顺序 |
| 第五篇 | Server 层·抽象 | 绘制命令的中间表示与命令家族 |
| 第六篇 | Server 层·攒批 | 从画布项到一次 draw call 的攒批规则与后端演进 |
| 第七篇 | Server 层·RD | RenderingDevice 抽象与渲染依赖图 |
| 第八篇 | Drivers 层 | 后端分叉与运行时选择 |
| 第九篇 | Main | 主循环与多线程命令队列,驱动整条链 |
| 第十篇 | 全链收官 | 这套分层分工的取舍 |
这张表把本篇与后续各篇接成一条链:本篇把对象模型讲到源码落点,第三到第八篇从门面往下逐层拆,第九篇回到驱动整条链的主循环,第十篇收口。分层给了可替换与可绕开,链上的每一跳就是它的账单。表里第三到第八篇一路往下,从 RID 句柄走到后端驱动;第九篇回到驱动整条链的主循环;第十篇把这套分工重新收成一句取舍。本篇的任务到这里完成:对象模型的三个对象各守一段,一次绘制命令的下发路径已经指到每一跳的源码落点。
源码落点:链条各跳依次见 node.cpp、canvas_item.cpp、rendering_server_default.h、server_wrap_mt_common.h、renderer_canvas_cull.cpp 与 main.cpp,服务层定位见 RenderingServer 类参考,行号一律按 master(2026-10-08 快照);其中: 链从 _propagate_enter_tree(node.cpp:341)经 _enter_canvas(canvas_item.cpp:259)、queue_redraw(:541)、_redraw_callback(:144)到 _draw() 里的 canvas_item_add_*,再经门面宏(rendering_server_default.h:1016/1017)进 RendererCanvasCull(renderer_canvas_cull.cpp:567/570),由 Main::iteration()(main.cpp:4948)驱动、:5120 提交,每一跳都有 master 落点,分层换来可替换与可绕开,代价是多跳的间接与线程边界。
资源清单
官方文档(CC BY 3.0 Unported,署名 “Juan Linietsky, Ariel Manzur and the Godot Engine community”,引用须标注改动):RenderingServer 类参考、CanvasItem 类参考、Node 类参考、SceneTree 类参考、Viewport 类参考、CanvasLayer 类参考、用服务器优化、2D 自定义绘制、idle 与物理处理、内部渲染架构、从 Godot 3 升级到 4。文档许可见 godot-docs 仓库的 LICENSE。
官方源码(godot 仓库 master raw;MIT,行号按 2026-10-08 快照):canvas_item.cpp、canvas_item.h、node.cpp、scene_tree.cpp、viewport.cpp、canvas_layer.cpp、world_2d.cpp、rendering_server.h、rendering_server_default.h、server_wrap_mt_common.h、renderer_canvas_cull.cpp、main.cpp。
官方发布与设计文章:为什么 Godot 用服务器与 RID、核心重构进展报告 #2、设计哲学、节点与场景。许可与商标:官方许可、官方美术与商标。Godot 名称与 Logo 属商标,配图与说明不得暗示官方背书。
官方素材(编辑器截图):Godot 截图类目、Godot 主类目。该池以 CC BY-SA 4.0 为主,对截图做裁切或标注须写明「原图许可 + 本处改动」。
相关链接(社区与竞品口径):caimouse《Godot 源码分析》专栏、caimouse《RID + RID_Owner》。
说白了,本机一手产物:evidence/probe/ 下 A_redraw_headless.txt 与 A_redraw_windowed.txt(queue_redraw 探针与 Performance 读数)、B_canvas_headless.txt(canvas RID 归属)、C_shot_debugredraw.txt 与 C_shot_plain.txt(--debug-canvas-item-redraw 两帧比对),另有 evidence/ep02_src_lines.txt(86 处落点,机器核对 0 FAIL)。本机读数用的引擎版本为 4.8.dev.custom_build.7177493c1(2026-07-03 构建),与官方稳定版 4.7.2(2026-08-18)、开发版 4.8-dev7(2026-09-29)都不等同,只在本机口径下成立。
本清单的原则与前几章一致:每条结论都指到它那一层的原始出处,官方文档与源码里查不到对应命名的说法,本清单不收。
下篇预告
下一篇把镜头压到服务层,专讲 RenderingServer 为什么是一组 RID 型命令:第三篇。
With Best Wishes.