站点链接:技术博客页
系列文章前言
系列定位
这个系列只回答一个问题:同样是「把矢量变成像素」,为什么市面上会同时活着五套做法完全不同的引擎,而它们各自还都活得挺好?
本篇是第二篇,也是钻入主线引擎的第一篇。上一篇立起了坐标系——用「几何在哪算」与「谁管场景」两根轴,给 Skia、Vello、Cairo、Godot-2D、Rive 排了格子;这一篇起,我们沿着 Skia 这条最主流的路,把「一次 draw」这件事拆到骨头。所以这一篇的门槛不在概念,而在层级: 很多人天天调 canvas.drawPath,却说不清这条命令从 API 面往下走了几层、在哪一层变成像素、CPU 与 GPU 两条路又是在哪里分岔。这正是我们要补的那一段。
系列文章写作风格说明
- 篇幅规划:每篇约 16,000 汉字、10 章左右,每章 1,400 到 2,300 字。
- 写作顺序:先立坐标系(ep01),再沿 Skia 主线走机制(ep02 到 ep06),中间穿插三次自跑(ep07、ep08、ep10),最后与 Vello 前沿和三个对照项合流(ep09、ep11)。
- 每篇都给可核对的量化结论与出处;用「本机实测」与「官方原文」两条腿站住,凡是二手转述一律标注口径。
- 本系列不搬运厂商官方配图(Skia 官方的架构图、Graphite 博客配图、Chromium 设计文档里的流程图都受项目方版权约束)。需要图示时,我们用自己跑、自己算、自己画的图;外部示意图只取自 Wikimedia Commons 的通用概念图。
- 凡是前序系列已经占领的题域,本篇只引用、不复述——边界见 0.3 节。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(上一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 本篇最常用的两个官方在线工具:Skia Fiddle | Skia WASM Debugger
- 本篇本机自跑用的绑定:skia-python 发行页
本篇总览与边界:只回答三件事,不复述什么
先说说这一篇要干什么。它不是 API 手册,也不是源码导览,而是一次 draw 的旅程。 上一篇的坐标系告诉我们 Skia 站在「通用 2D 图形库」那一格;这一篇要把脚迈进去,看清楚这一格由哪几层撑起来、哪一层在 CPU 上、哪一层在 GPU 上。顺序很重要: 先看清有哪几层,才谈得上「谁持状态」;先分清「几何与样式」,才谈得上「谁把矢量变像素」。
0.1 全篇知识地图:十章的顺序与产出
先来看看这张表。它不是并列的知识点,而是一条从 API 面往像素走的动线——顺序不能颠倒:先知道有几层,才谈得上每层管什么;先分清 Canvas 与 Paint 的分工,才谈得上「参数怎么下沉」;先看 CPU 这一侧,才有一个可比对的基准去看 GPU 那一侧。
| 章节 | 在回答什么 | 你会拿到什么 |
|---|---|---|
| 零、总览与边界 | 本篇只回答哪三件事、不复述什么? | 三件题域 + 五块让出去的题域 + 术语双语对照 |
| 一、一次 draw 的旅程 | 从 API 到像素,中间有哪几步? | 官方分层骨架 + SkDevice 抽象 + 三后端路由 |
| 二、SkCanvas 持什么状态 | Canvas 持有的是状态还是样式? | 矩阵与裁剪栈 + 状态栈语义 + saveLayer 语义 |
| 三、SkPaint 参数包 | 样式怎么随 draw 下沉? | Paint 字段到后端参数的映射 + 混合模式对照 |
| 四、几何的构造与存储 | 路径为什么拆成两半? | SkPathBuilder、SkPath、SkPathData 三分 |
| 五、先记后放 | 绘制为什么不是立刻落像素? | 记录态 Device + 不可变回放 + 线程解耦 |
| 六、CPU Raster 造像素 | CPU 凭什么把矢量变像素? | 扫描线加阶段链两段式 + 外部覆盖图解 |
| 七、GPU Ganesh | GPU 后端的 op 与上下文长什么样? | Edge 实测像素 + op 列表 + 产线现场 |
| 八、CPU 与 GPU 同场景 | 两条真实路径到底差在哪? | 像素并置与差分 + GPU 栈读数 + 分界线 |
| 九、回指与预告 | 本篇交给 ep03 什么? | 像素坐标回指锚点 + 下篇口径 |
这张表里最该先记住的是第一章。 多数中文资料讲 Skia 直接从 SkCanvas 的成员函数开始列,读者记住了 API,却说不清「光栅化」具体落在哪一层。本篇把它拆到能一眼看出「后续哪一篇展开哪一段」为止。
0.2 本篇只回答三件事
第一件:一次 draw 从 API 面到像素,经过哪几层。 官方的分层骨架是 Client API 层、核心图元层、GPU 后端层、平台接口层四段,而把它们串起来的是 SkDevice 这道抽象——SkCanvas 把命令交给它,由它决定这条命令最终落到哪个后端。这是本篇的骨架。
第二件:SkCanvas 与 SkPaint 的分工到底是什么。 一句话:Canvas 持状态,Paint 持样式。 这里的「状态」特指矩阵与裁剪栈,不包含颜色与线宽;颜色、线宽、抗锯齿开关、混合模式这一整套,装在 SkPaint 里,随每一次 draw 一起往下传。这个分工不是某篇文章的总结,而是跨语言绑定逐字同义的官方口径。
第三件:CPU(Raster) 后端与 GPU 后端的分界在哪。 这一件要克制的是「比性能」的冲动:本篇会给出 Raster 侧的现场读数与 GPU 侧的栈读数,但这两条读数不在同一条调用栈上,任何拿它们直接比大小的结论都是假的。本机 skia-python 走的是 Raster,Edge 走的是 Skia GPU,两者只是同一台机器上的两条真实光栅路径。
0.3 本篇不复述什么:五块已经占领的题域
既然三件事说清了,边界也得说清。机制篇最容易翻的车,就是把前序系列的题域重新讲一遍。 所以下面这张表把五块题域显式让出去:
| 已被占领的题域 | 属哪个系列 | 本篇只用它做什么 |
|---|---|---|
| 抓帧、回放、Event Browser、Perfetto trace 与 FrameTimeline | T01 性能剖析工具链(已完结 13 篇) | 只在讲「实测」时引用其方法论,不重讲任何工具用法 |
| Godot 引擎整体架构(场景树、服务器架构、渲染器组织) | T02 Godot 4 引擎架构 | 本系列只把 Godot-2D 当对照项,不展开其内部 |
| App 到 Choreographer 到 SurfaceFlinger 到 HWC 的上屏系统栈 | T05 Android 图形显示系统 | 本篇讲引擎内部如何把矢量变像素,sink 侧只引用不展开 |
| 粒子、程序化特效、后处理 | T16 实时 GPU VFX | 本篇讲引擎架构与光栅化分工,不是特效 |
| GLSL、HLSL、WGSL 写法与 SPIR-V、DXIL、DXC 编译链 | T14 与 T15 着色器语言与 IR | 只在 Graphite 需要时引用 compute shader 概念,不教程化着色器语言 |
还有一块要说清:本篇不复述 ep01 的五引擎象限。 上一篇已钉死坐标系与词汇表,本篇只回指它。一句话说清关系:前序系列讲「怎么验」「引擎整体长什么样」「像素怎么上屏」,上一篇讲「五款引擎各在哪一格」,本篇讲「Skia 这一格里面,一次 draw 怎么走」。
0.4 边界声明与量化锚点
边界在开篇说一次,九章 9.3 节再确认一次:
- 不涉及曲线细分与覆盖率的算法本体:贝塞尔怎么拆、覆盖怎么解析式地算,这些属 ep03,本篇只说「这一步在 Raster 里由
SkScan承担,在 GPU 里由 path renderer 承担」; - 不涉及字形光栅化:文本走的是另一条与 path 不同的链路,属 ep04;
- 不涉及 GPU 后端的覆盖策略:instanced tessellation 与覆盖 approach 属 ep05;
- 不展开 Graphite:本篇只立它与 Ganesh 的分界线一句话,深度属 ep06;
- 不做跨栈耗时对比:本机 Raster 读数与 Edge 的 GPU 读数不是同一条调用栈,任何跨栈比大小都不成立;
- 不把本机绑定当主线源码:本机读的是
skia-python绑定的 Skia m144 二进制,凡断言「Skia 现在怎么做」都会同时给实测与源码或文档两条依据。
本篇要拿下的可核对数字有八个,全部来自本轮实测或官方原文:本机 Skia 为 m144(skia-python 144.0.post2);Raster 侧同场景 drawPath 跑 50 次共 254.02 ms,折合 5.0803 ms 每帧,非白像素 88,771;PictureRecorder 记录 128 见方得到 cullRect 为 Rect(0,0,128,128)、op 计数 1,回放到 256 成功;Edge 侧 canvas 的 UA 为 Edg/153.0.0.0,GPU 栈读数为 ANGLE 加 D3D11 下的 RTX 3060 Laptop;同场景像素对比的通道均差 0.083、最大差 3、差异超 24 的像素 0 个。
先来看看本篇与四个已占领系列、以及 ep01 的题域切分。它决定了后面每一章能讲多深:
图上被划掉的那几块都不是本篇。 本篇占的是最里面那条细线——Skia 内部,一次 draw 从 API 面到像素的那条链路。正因为它是「链路」,它才可以不带任何算法细节、也不带任何生态判断独立成篇。
0.5 术语双语对照(先备着)
后面几章会密集出现官方术语原名,中文侧译法并不统一,这里一次钉死:
| 中文 | English | 一句话 |
|---|---|---|
| 画布 | SkCanvas |
客户端 API 的入口,所有 draw 都发到它身上;只持矩阵与裁剪栈 |
| 画笔 | SkPaint |
样式与颜色的参数包,随每次 draw 下沉 |
| 设备 | SkDevice |
后端抽象的落点,决定命令走 CPU 还是 GPU |
| 光栅化 | rasterization | 把几何变成像素覆盖的过程 |
| 覆盖 | coverage | 一个像素被几何盖住的比例,取 0 到 1 之间 |
| 扫描线 | scanline | CPU 光栅器逐行处理像素的工作方式 |
| 光栅管线 | SkRasterPipeline |
CPU 侧的模块化像素处理阶段链,据源码与文档 |
| 即时模式 | immediate mode | Ganesh 的提交方式:draw 立刻转成后端命令 |
| 延迟模式 | deferred | Graphite 的提交方式:先记进 DrawList 再成批提交 |
| 记录器 | SkPictureRecorder |
把一批绘制记成不可变 SkPicture 的入口 |
| 图层 | layer | saveLayer 开出的一层离屏目标,最后再合成回来 |
| 后端 | backend | 真正把像素写出去的那一层:Raster、Ganesh、Graphite 等 |
一句话记住本篇的方法:先问「这条命令现在在哪一层」,再问「持状态的是谁、背样式的又是谁」;这两问的答案组合起来,一次 draw 的旅程就唯一确定了。
一、一次 draw 的旅程:从 SkCanvas 到像素要过几层
下面我们开始第一阶段。 这一章要回答的问题看起来最基础,却恰恰是中文资料最含糊的一段:一句 canvas.drawPath(path, paint) 从 API 面走下去,中间到底经过了哪几步?把这几个环节钉住,后面八章才有共同的坐标系。
1.1 一次 draw 的三个要素:命令、状态、目标面
先来看看这条链路最上面那一层。任何一个 2D 矢量引擎,它对外暴露的最小动作都可以写成一句话:一次绘制调用,等于「一个命令」加「一组状态」,落到「一个目标面」上。
命令(draw call)指的是「画什么」:在 Skia 里通常是路径、矩形、图像或文本。状态(state)分两部分:一部分是几何与裁剪类的状态,比如当前变换矩阵、当前裁剪区;另一部分是样式类的状态,比如颜色、线宽、抗锯齿开关、混合模式。目标面(target)则是像素最终落在哪里——内存里的位图、窗口的绘图表面,或者一张 GPU 纹理。三者当中,只有命令描述的那份几何是矢量的,另外两个都是光栅世界的概念。
先把整条链路画出来,它就是本篇的骨架:
这张图要盯住的是中间那道竖线。 SkCanvas 并不自己画东西,它只负责接住命令与状态、维护状态栈,然后把活转交出去。这条「转交」就是 Skia 分层的核心:API 面与实现面被一道抽象隔开。
1.2 官方口径的分层骨架:从 Client API 到 Platform APIs
既然中间隔了一道抽象,那两边的层要怎么数? 官方源码结构把 Skia 图示成四段:客户端 API 层(SkCanvas、SkPaint、SkPath 这些天天在用的名字)、核心图元层(以 SkPathBuilder 到 SkPath 到 SkPathData 这条路径链为代表)、GPU 后端层(Graphite 与 Ganesh 两个后端)、以及平台接口层(真正调用系统图形栈的那一段)。四段的顺序不能颠倒:越靠上越抽象,越靠下越接近像素。
同一种「一次绘制经过若干阶段」的组织方式,在图形学里是通用形态。下面这张外部示意图给的就是这种通用形态的一条实例——把阶段摆成一列、标出数据怎么往下流:
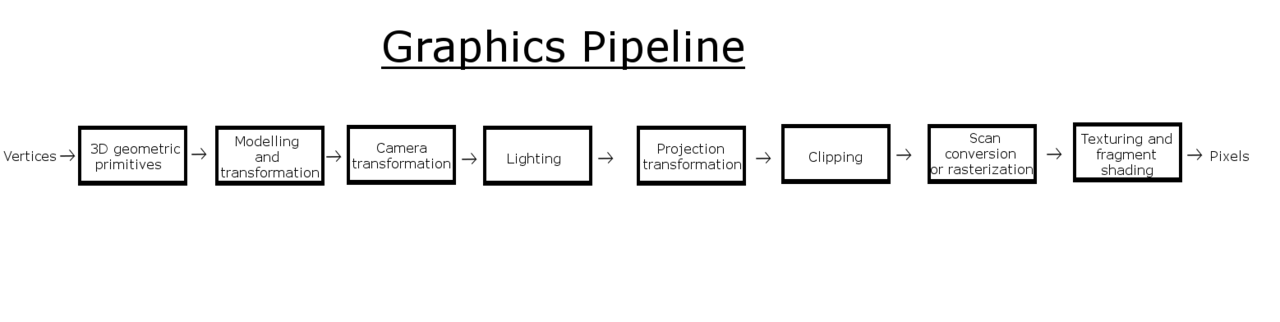
这张图的价值在于「阶段序」这三个字。 Skia 的四段与图形学的通用管线不是一回事——前者的分层解决的是「API 与实现解耦」,后者的阶段解决的是「几何到像素的加工顺序」。两件事都叫「管线」,但一个讲分层、一个讲流程,本篇要分开说,免得混成一团。
1.3 SkDevice 是那道抽象:谁能接住这次 draw
分层骨架落在代码上,就是 SkDevice 这一个名字。 官方对它的定义很短:SkDevice 是「渲染后端之上的一层抽象」,SkCanvas 把命令路由给它,由它实现真正的渲染行为——CPU、Ganesh GPU,或 Graphite GPU。这句话信息量很大:它一次把「三层」和「三后端」都点出来了。
SkCanvas是客户端 API 的入口,负责发命令、维护状态栈;SkDevice是后端的抽象,负责把命令落到某个具体后端;- 底下三个后端分别是 CPU 的 Raster、GPU 的 Ganesh 与 Graphite,按构建开关选择、可以共存。
先把这棵分叉画出来:
图上这三条路就是本篇下半场的分工。 第六章走左支(CPU Raster),第七章走中间支(Ganesh),第八章把左右两支的像素放在一起看,而右支(Graphite)本篇只立一条分界线。大家后面看到任何一句「Skia 用 GPU 加速」,都可以回到这张图来问:它说的是哪一支?
1.4 本章收在哪里
第一章走完,手里该有四件东西:一句「一次 draw 等于命令加状态加目标面」的共同词汇、一条四段的官方分层骨架、一道名为 SkDevice 的抽象、一棵三后端路由树。下一章要回答的是:在这条链路的 API 面上,SkCanvas 到底持有什么。
把本章的链路压成一段伪代码,它长这样:
-----------------------------------【一次 draw 的四段旅程】----------------------------------------
# 描述:从 API 面到像素的四段,对应 1.2 节官方分层骨架与 1.3 节三后端路由
# 说明:本段是结构示意,不是任何一版 Skia 的真实实现;括号里标出本篇的展开章
#------------------------------------------------------------------------------------------------
1. canvas.drawPath(path, paint)   # 客户端 API 层:命令 + 状态(第二章 / 第三章)
2. device = canvas.getDevice()    # 后端抽象层:SkDevice 决定这条命令去哪
3. route  <- device  落在 {Raster, Ganesh, Graphite}   # 第六章 / 第七章 / 第八章
4. pixels <- backend 真正写出去   # 第八张:CPU 与 GPU 的像素并置
其中:
- 第 1 步的「状态」只在
SkCanvas手里(矩阵与裁剪栈),样式则在SkPaint手里——这是第二章与第三章的分工; - 第 2 步的
SkDevice是唯一的岔路口,本篇后面所有「CPU 还是 GPU」的讨论都从它分出去; - 第 4 步的产物是像素,而「怎么把几何变成像素」这一步在 CPU 与 GPU 上走了两套完全不同的实现。
本章对应的官方依据:分层骨架与
SkDevice的定义见 DeepWiki 的 Skia 源码结构页;SkCanvas作为入口的表述见 Skia 官方 API 总览;本机实测环境见 skia-python 发行页。
二、SkCanvas 到底持有什么状态
下面我们开始第二阶段。 上一章把链路摊开了,这一章往下走一层,专门回答一个问题:SkCanvas 这个名字里,到底装了什么? 答案比直觉小得多——它不装颜色、不装线宽,只装矩阵与裁剪,外加维护这一对的状态栈。
2.1 Canvas 持状态、Paint 持样式:跨绑定一致的官方原句
先来看看官方怎么描述它。SkiaSharp 的官方文档对 SKCanvas 的定义是:一块画布把「绘制到某个设备」所需要的状态封装起来,这里包括对设备本身的一个引用,以及一个矩阵与裁剪值的栈。紧接着一句把 SKPaint 的职责也点明了:用 SKPaint 对象来缓存样式与颜色信息。两句话放在一起,分工就清楚了:栈归 Canvas,样式归 Paint。
这个分工不是某一家绑定的口味,而是跨绑定逐字同义的官方口径——Rust 侧的 skia-safe 对同一批类型(SkCanvas、SkSurface、SkPicture、GrDirectContext)的封装说明与之对齐。多语言绑定说同一件事,说明这是底层语义,不是封装习惯。
本机用 skia-python(Skia m144)现场画了一组四态对照,把「状态栈」这件事从文字变成像素:
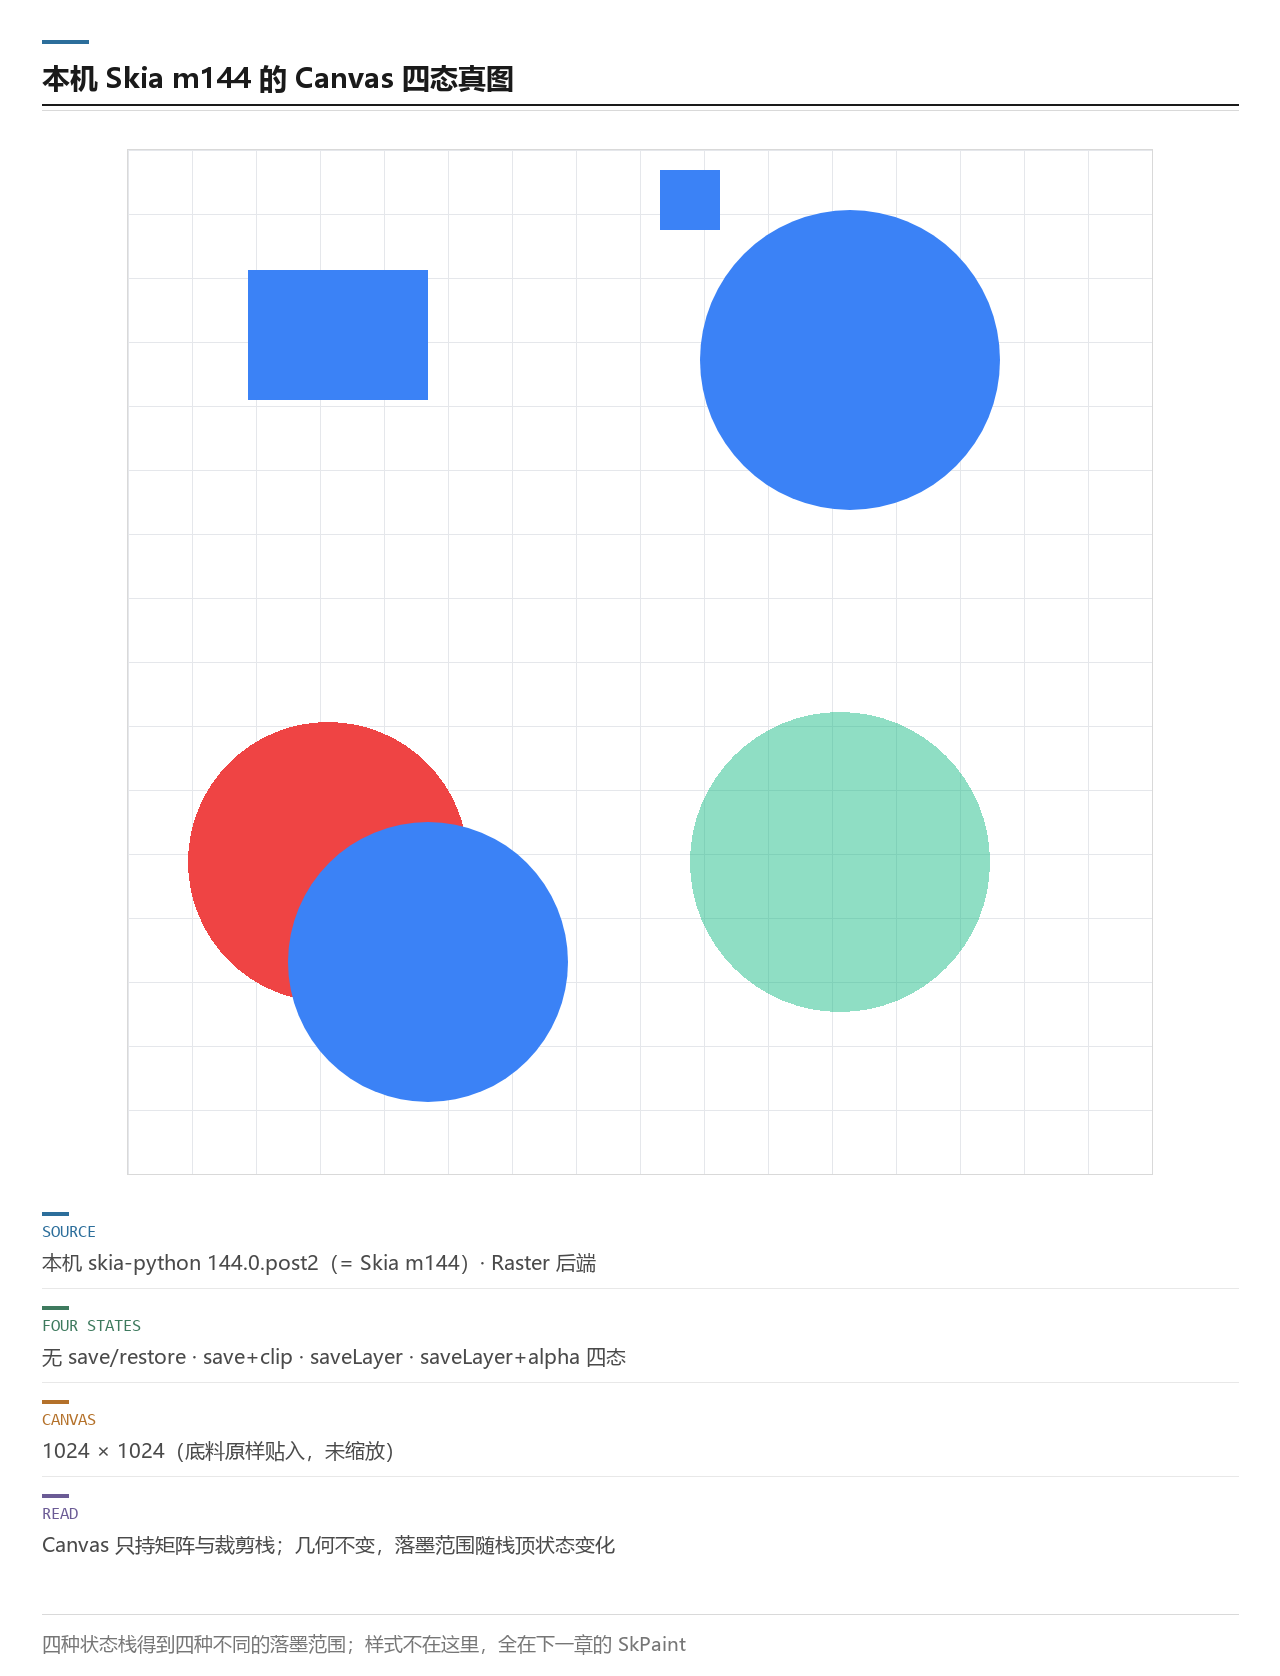
这张图要读的是「同一份几何、不同落墨范围」。 四格画的都是同一条路径,差别只在状态栈——裁剪改变了允许落墨的区域,开图层改变了合成的中间层。这就是「Canvas 持状态」的实证:命令没变,状态变了,像素就变了。
2.2 状态栈的语义:save、restore 与 restoreToCount
既然 Canvas 持的是一个栈,那就得说清它是怎么进出的。 栈语义只有三条:save 把当前的矩阵与裁剪值压入一份副本并留在栈顶;restore 弹出栈顶、恢复到上一份;restoreToCount 一次弹到指定的深度。关键在「压的是副本」——压栈之后你继续修改矩阵或裁剪,改的是栈顶那一份,栈里更早的那几份不受影响。
-----------------------------------【状态栈的进出与继承】------------------------------------------
# 描述:save 压入当前状态的副本,restore 弹出并恢复;draw 只用栈顶那一份
# 口径:本段是语义示意;save 与 restore 的官方原句见 SkiaSharp 的 SKCanvas 文档
#------------------------------------------------------------------------------------------------
初始        栈 = [S0]
save()      栈 = [S0, S0']       # 压入副本,之后改 S0' 不影响 S0
translate()  栈顶 = S0' 被改      # 只动栈顶
draw()       用栈顶 S0' 画        # 命令永远只看栈顶
restore()   栈 = [S0]            # 弹出,恢复
restoreToCount(n)                 # 一次弹到深度 n
其中:
save与restore必须配对,这是最容易被漏掉的一条:忘记restore会让后续所有 draw 都继承一个不该存在的状态;restoreToCount是为「一次退出多层嵌套」准备的,它在框架封装里很常见;- 这一整套只动「矩阵与裁剪」,不涉及颜色与线宽——样式不在这条栈上。
先把这条栈画成一张卡,方便后面回看:
这张卡的用处是防止混淆: 很多人把 save 与「开一个图层」当成一回事,其实前者只是压一份状态副本,后者才是真的开一块离屏目标——这正是下一节要拆开讲的那件事。
2.3 saveLayer 开的不是状态,是一层离屏目标
既然 save 已经能压状态了,为什么还要一个 saveLayer? 因为两者的目的完全不同:save 解决的是「我改完要还回去」,saveLayer 解决的是「我要把一批绘制先画到别处、再整体合成回来」。它开出的是一个新的离屏目标(图层),而栈只负责记住这一层的边界,等 restore 时把它按指定的混合方式合成回上一层。
这层差别在像素上很直观:同一批半透明绘制,分多次直接画到目标上,与先合成到图层再一次性合成回去,结果并不相同——前者每次都参与底色混合,后者只在最后参与一次。这不是视觉误差,而是混合算术的结果差异。
这里补一条方法上的诚实说明。 「离屏与图层」这个概念本该找一张外部真实对照图,但本轮把 Commons 的图层类目枚举完了也没有合格对位件(Layers (digital image editing) 只有两个文件且长边都不足 1280,邻近唯一尺寸达标的合成算子图已被他篇落位三次)——该位按脚本登记为落空,本节不再补图,改由上面这张本机四态实测图(2.1 节)承担「图层会改变结果」的实证。这是「用真实素材兜底、不拿自绘图顶替落空位」的处置,不是此处无话可配图。
2.4 本章收在哪里
第二章走完,该记住三件事:Canvas 持的是矩阵与裁剪栈,不是样式;save 与 restore 管的是这份栈的进出与继承;saveLayer 开的是一层离屏目标,与压状态不是一回事。下一章接着往上走一层,看样式那个参数包——SkPaint——怎么随 draw 下沉。
-----------------------------------【Canvas 状态面与样式面的分工】--------------------------------
# 描述:把第二章的三件事压成一张责任表;与本段对照的官方原句见 SkiaSharp 的 SKCanvas 文档
# 口径:左侧三项属 Canvas 的状态;右侧三项属 Paint 的样式,下一章展开
#------------------------------------------------------------------------------------------------
Canvas 持有:变换矩阵 matrix     | Paint 持有:颜色与着色器 color 与 shader
Canvas 持有:裁剪区 clip         | Paint 持有:线宽与端点 strokeWidth 与 cap
Canvas 持有:二者的栈 stack      | Paint 持有:抗锯齿与混合模式 AA 与 blendMode
其中:
- 左列三项合起来构成「状态」,它们随
save与restore进出栈; - 右列三项合起来构成「样式」,它们不随状态栈变化,而是随每一次 draw 一起传下去;
saveLayer是唯一同时触碰两侧的动作:它既进栈(记住边界),又开一块离屏目标(影响样式怎么合成)。
本章对应的官方依据:
SKCanvas持有「矩阵与裁剪值栈」、SKPaint缓存「样式与颜色」的原句见 SkiaSharp 的 SKCanvas 文档;Rust 侧同一批类型的封装见 skia-safe 文档;saveLayer的语义见 Chromium 的图形与 Skia 设计文档。
三、SkPaint 怎么作为「参数包」随 draw 下沉
下面我们开始第三阶段。 上一章把 Canvas 的状态面钉住了,这一章补上另一面:样式去哪了? 答案是装进 SkPaint,作为一个参数包,跟着每一次 draw 一起往下走。
3.1 Paint 是「缓存样式与颜色」的那个参数包
先来看看官方对它的定位。官方对「SkPaint 缓存样式与颜色信息」这句话已经定死了它的角色——它不是一个绘制对象,而是一组参数的集合。你在一次 draw 前把颜色、线宽、抗锯齿、混合模式一次性设置好,Skia 在真正落像素时读它,而不必在每一层重新推导样式。
这个「参数包」的定位解释了它为什么可以复用。 同一个 SkPaint 可以服务成千上万次 draw,因为它是只读的输入;而画布那侧的矩阵与裁剪则是随命令一起变化的。一个变、一个不变,这就是两者被拆开的原因。
本机用 skia-python(Skia m144)把四种常见样式画在同一张图上,好让「参数包」这件事看得见:
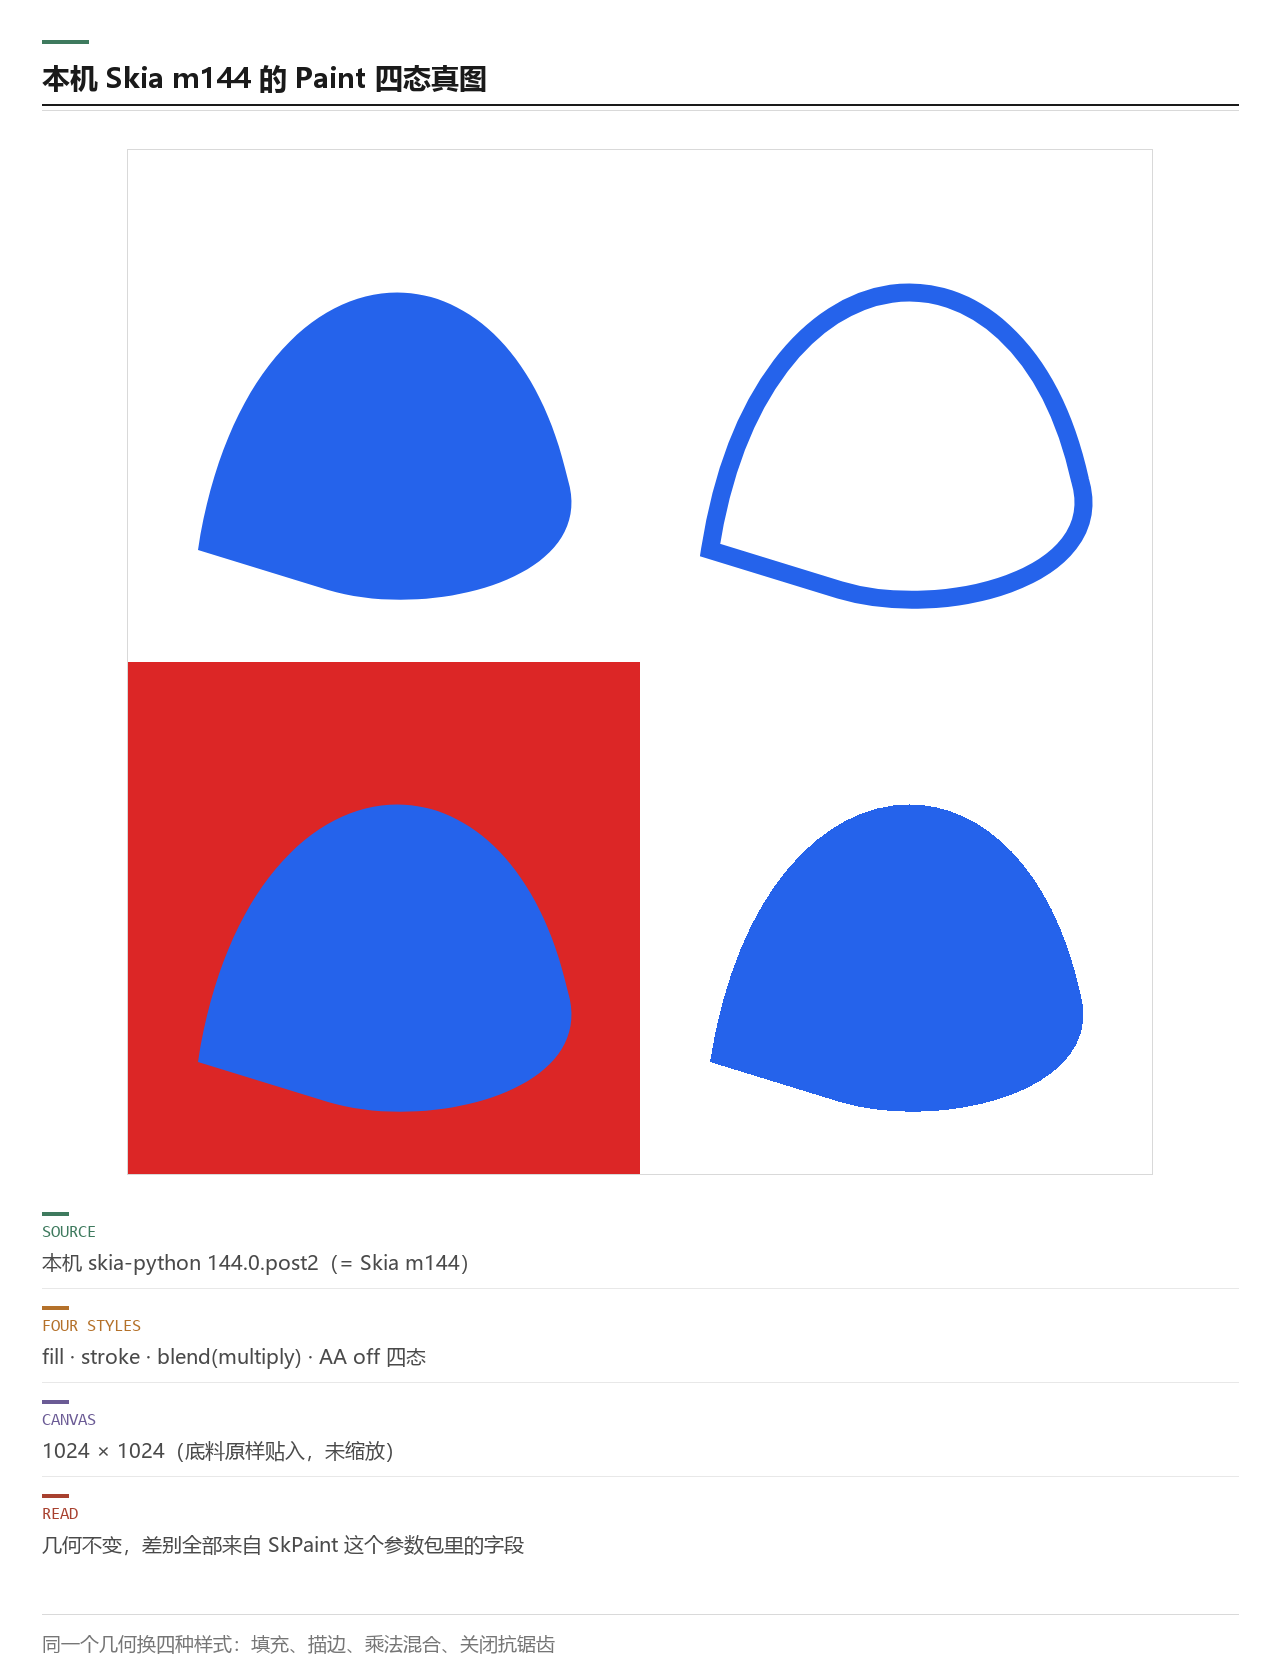
这张图要读的是「几何一律相同、样式一律不同」。 四格的路径完全一样,变的只有 SkPaint 的字段。这就是「样式随 draw 下沉」的实证:几何在上游定死,样式在参数包里定死,两者在落像素时才相遇。
3.2 字段到后端参数的映射
参数包要下沉,就得在某个地方被翻译。 这一步的翻译方向是:SkPaint 的字段被读出来,转成后端能理解的绘制参数。在 CPU 后端,它决定扫描线阶段链要加载什么;在 GPU 后端,它要先被转成后端的绘制参数(这一层转换是社区资料里被反复提到的一环),再进入后端的 op 列表。同一份 SkPaint,在两条路上被翻译成两组不同的东西——这正是后端抽象存在的意义。
先把这张映射表摆出来,它是第三章的中枢:
这张表里最该留意的是最后一列。 「几何怎么被填充」与「颜色怎么合成」是两组完全不同的参数,它们在后端也走两条不同的路径:前者影响覆盖,后者影响混合。ep05 讲 GPU 覆盖策略时,会回到这张表的左半部分。
3.3 混合模式的外部真实效果对照
既然参数包里有一项叫混合模式,那它到底改变什么? 混合模式(blend mode)决定了「新画的颜色」与「底下已有的颜色」按什么算子合成。它不是滤镜,也不改变几何,只改最后那次颜色合成。为了不空口描述,下面用一张外部的真实效果对照图来看:
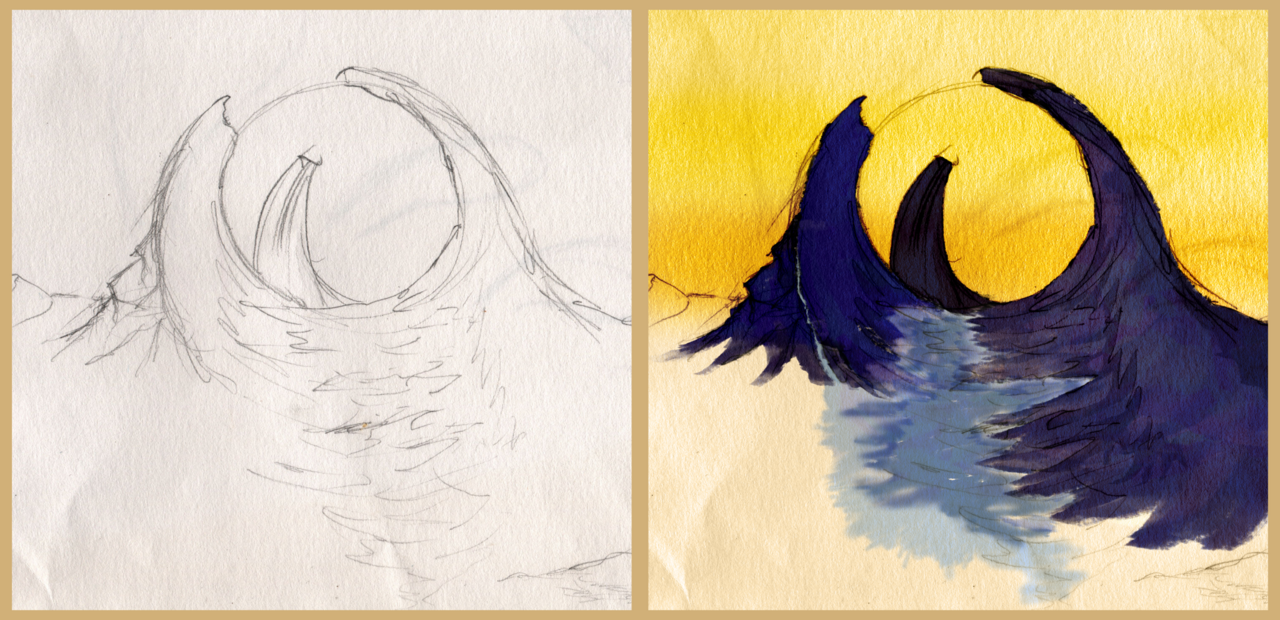
这张图给出的是「算子不同、结果不同」这条直感。 需说明:它演示的是图像处理软件里的混合模式,与 Skia 的 blendMode 枚举不是同一套命名表——两者同属「颜色合成算子」这一层,本篇只借它说明「这项参数确实显著改变像素」,具体枚举以 Skia 官方为准。
3.4 本章收在哪里
第三章走完,该记住三件事:SkPaint 是样式与颜色的参数包;它在落像素前要被翻译成后端参数,两条后端翻译成两组东西;混合模式只改颜色合成,不改几何。下一章换个方向:从「画什么」的样式侧,转到「画的东西本身」——几何。
-----------------------------------【参数包下沉的四个时点】----------------------------------------
# 描述:SkPaint 从被设置到被消费的四个时点,对应本章的映射表与两条后端路径
# 口径:本段是结构示意;GPU 侧的 paint 转后端参数一句话来自社区资料,深度留 ep05
#------------------------------------------------------------------------------------------------
设置    paint.setColor(...)          # 参数包成形,此后可被多次 draw 复用
提交    canvas.drawPath(path, paint) # 参数包随命令下沉到 SkDevice
翻译    paint -> 后端绘制参数         # CPU 读进阶段链;GPU 转成后端参数进 op 列表
消费    在覆盖与混合两步被读           # 覆盖读 style 与 AA;混合读 blend 与 colorFilter
其中:
- 「设置」与「消费」之间可以隔任意多次 draw,这正是参数包可复用的原因;
- 翻译发生在后端边界上,即
SkDevice之下、真正落像素之前; - 消费分两步:先按覆盖算形状,再按混合算颜色——这两步是第四章之后与第五章之前的分水岭。
本章对应的官方依据:
SkPaint承载样式与颜色的原句见 SkiaSharp 的 SKCanvas 文档;SkPaint与后端绘制参数之间的转换见 Skia 官方 API 总览;混合模式的外部效果图见 Wikimedia Commons 的混合模式演示图页。

四、几何为什么拆成「构造」与「存储」两半
下面我们开始第四阶段。 样式说完了,这一章回到几何本身。一条路径在 Skia 里不是一个对象,而是三个:一个用来构造的可变接口,一个不可变的句柄,以及一份真实存储。
4.1 SkPathBuilder、SkPath 与 SkPathData:可变接口、不可变句柄、真实存储
先来看看这条三分链。SkPathBuilder 是可变接口——你在它身上 moveTo、lineTo、cubicTo,把一条路径拼出来;SkPath 是不可变的句柄,它引用到底层那份数据,本身不改;SkPathData 才是真实存储,段与动词(verbs)都住在这里。官方源码结构对这三者的描述就是这条链。
为什么要拆成两半——可变与不可变? 因为路径在 Skia 里要同时满足两个互相拉扯的需求:构造时需要一个方便改的中间物,消费时需要一份可以安全共享的成品。 把两者分开,就能让「构造」只在 builder 上发生,而「消费」永远面对一份不会被别人改动的数据。这不是设计洁癖,而是为线程安全与缓存复用铺的路。
这张图的关键是「句柄」这两个字。 SkPath 之所以能做到不可变还能被到处传,是因为它只是个引用;真正占空间的是它指向的那份数据,而那份数据在构造结束后就不再变。
4.2 贝塞尔的控制点决定了什么
路径里除了直线段还有曲线段,而曲线段几乎都用贝塞尔表达。 原因是工程上只有它能同时满足两件事:用固定数量的控制点表达任意光滑曲线,且求值稳定;并且可以被任意精度地拆成直线段——后者正是光栅化的前置条件。控制点决定曲率:端点决定曲线经过哪里,控制点决定曲线往哪弯。
下面这张外部示意图给的是贝塞尔曲线的几何构造过程:
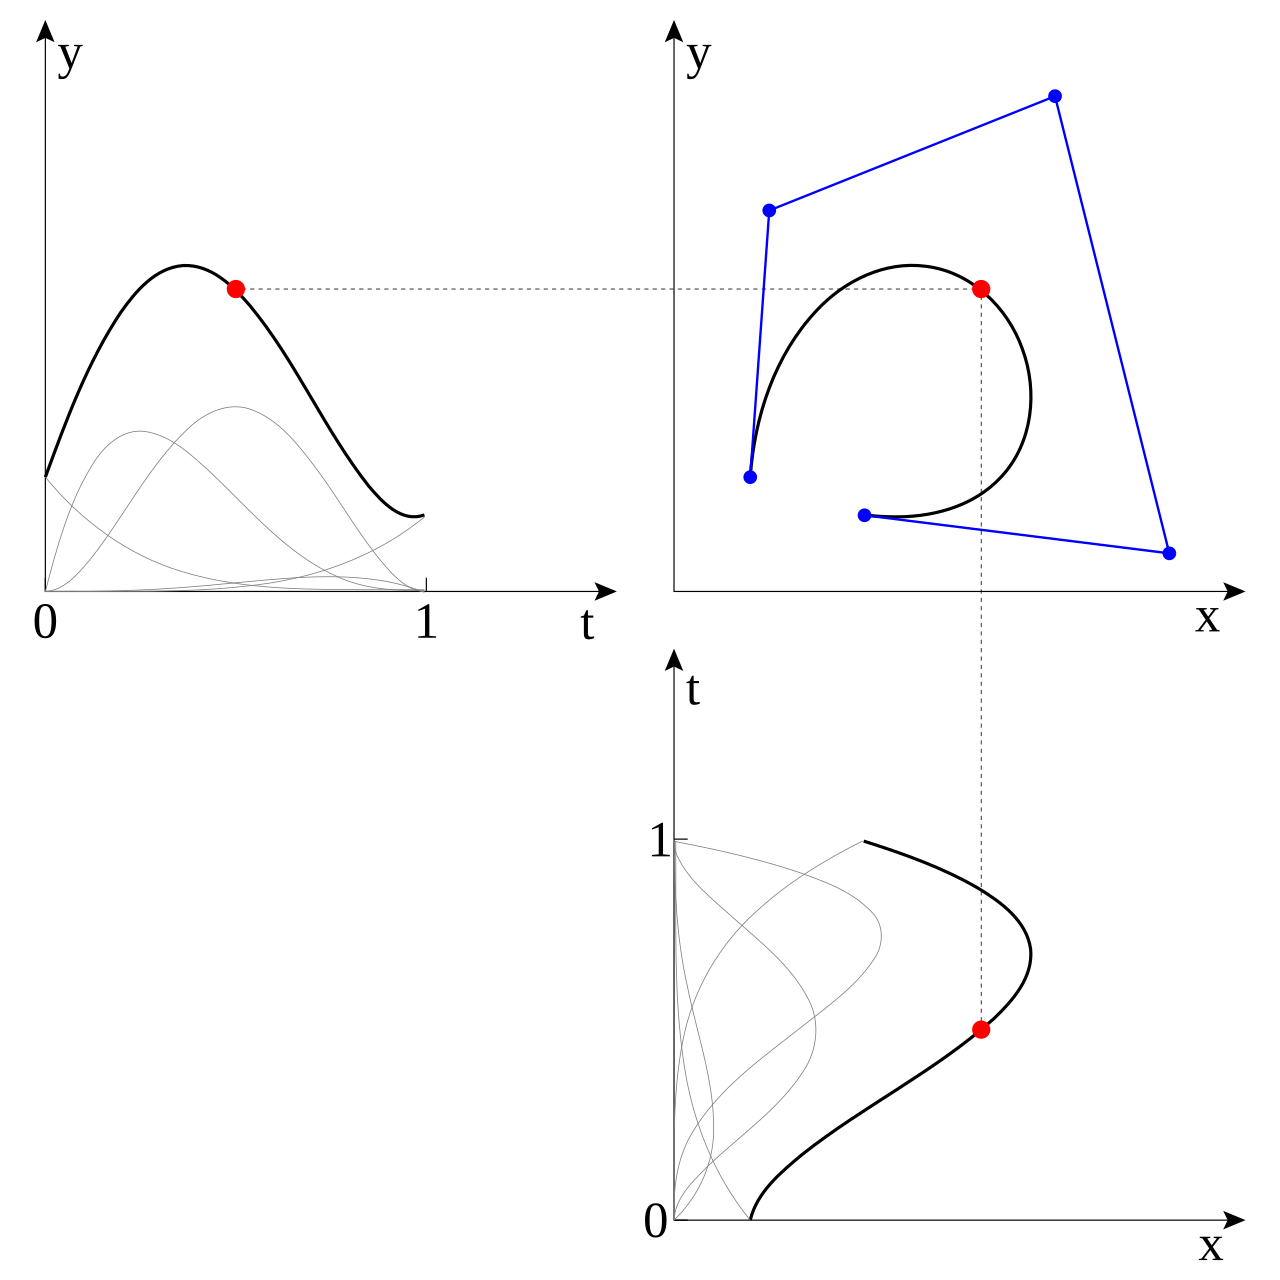
这张图只用来立几何,不展开算法。 曲线不能直接光栅化,必须先被拆成足够短的直线段;而拆多细、按什么误差控,是 ep03 的核心权衡。本篇到这里为止:只钉死「控制点决定曲率、曲线落在控制多边形内」这两条几何事实。
4.3 本章收在哪里
第四章走完,该记住三件事:路径被拆成构造接口、不可变句柄、真实存储三层;拆开的理由是让构造可变、消费可共享;贝塞尔的控制点决定曲率,曲线落在控制多边形内。下一章换个时间维度:一次 draw 为什么不是「立刻落像素」,而是先记再放。
-----------------------------------【一条路径的三层与一次转换】------------------------------------
# 描述:从构造到消费,路径要经过三层;本段是结构示意,不是任何一版 Skia 的真实实现
# 口径:三层结构据官方源码结构描述;细分容差 tol 与误差控制归 ep03
#------------------------------------------------------------------------------------------------
builder = SkPathBuilder()      # 可变接口:moveTo 与 lineTo 与 cubicTo 在这里发生
builder.moveTo(...) ; builder.cubicTo(...)
path    = builder.detach()     # 不可变句柄:此后 path 不再变,可被安全共享
data    = path 引用的 SkPathData  # 真实存储:segments 与 verbs 住在这里
tess    = tessellate(data, tol)  # 细分:按容差 tol 拆成折线(ep03 展开)
其中:
detach()这一步是「可变到不可变」的关门动作,关门前随便改、关门后不许改;- 真实存储只此一份,多个不可变句柄可以指向它;
tol(细分容差)是唯一由使用者决定的质量旋钮,它直接决定后续覆盖判定要处理多少段——这条线交给 ep03。
本章对应的官方依据:路径三层链见 DeepWiki 的 Skia 源码结构页;贝塞尔曲线构造图见 Wikimedia Commons 的贝塞尔构造图页;细分与覆盖算法见 arXiv 上关于 2D 光栅化语义的论文。

五、绘制为什么先「记」再「放」
下面我们开始第五阶段。 前四章讲的是「一条命令怎么被描述」,这一章开始讲「一批命令怎么被组织」。Skia 给了一个很反直觉的答案:它先把这批绘制记下来,之后再放出去。
5.1 PictureRecorder 记的是什么
先来看看这个记录器在做什么。SkPictureRecorder 发给你一块画布,但这块画布不产像素——它把每一次 draw 序列化成命令。 官方与社区对它的一致描述是:SkPictureRecorder 交出的那块画布,不是产出像素,而是把每一次绘制调用序列化进一份记录;由此得到的 SkPicture 不可变,并且可以在别的线程、别的尺寸上被重放很多次。记录态与落像素态,是两种不同的状态。
OK,先来看看本机实测。本机用 skia-python(Skia m144)跑了一遍这条记录与回放链,读数如下:
-----------------------------------【PictureRecorder 记录与回放实测】-------------------------------
# 描述:128 见方记录一条绘制,再把同一份记录回放到 256 见方,验证记录与落像素解耦
# 环境:skia-python 144.0.post2(= Skia m144);命令为 beginRecording 加 drawCircle 加 finish
#------------------------------------------------------------------------------------------------
cullRect          = Rect(0, 0, 128, 128)   # 记录时给出的可见范围
approximateOpCount = 1                     # 记录下来的绘制 op 数
replay -> 256      : makeImageSnapshot().width() == 256   # 同一份记录回放到更大尺寸成功
其中:
cullRect是记录时声明的可见范围,它可以与最终回放的尺寸无关;approximateOpCount给出的是记录下的 op 数,这份记录只有 1 条;- 回放到 256 见方成功,且记录本身在回放前后都没变——这就是「记录与落像素解耦」的直接证据。
把这份记录与它的两种落点并置,结论比文字更直观:
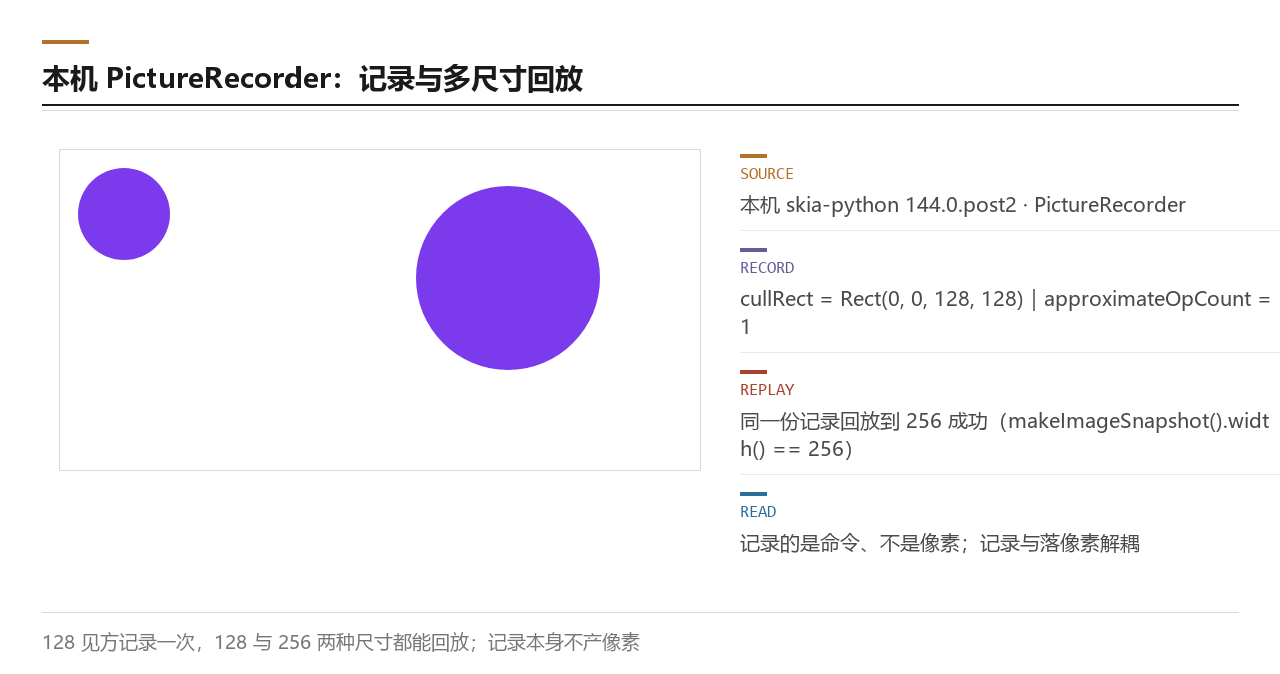
这张图的意义是「一份记录、多次落点」。 记录一旦完成就成了不可变的中间物,它既可以在不同尺寸上重放,也可以被交给别的线程去重放——这正是 Skia 把「绘制」与「光栅化」解耦的手段。
5.2 记录态用的是不落像素的 Device
既然记录态不产像素,那它的 SkDevice 到底是什么? 这就回到了第一章那道抽象:SkCanvas 把命令交给 SkDevice,而记录态用的是一台不落像素的设备——它不会往任何位图上写,只是把命令追加进记录。社区对 RecordingCanvas 的说法很直接:它背后是「一个不会绘制成像素点的设备」,所以它「只是把绘制命令记录到二进制数组」。
这一点值得单独强调:记录与落像素不是同一件事,它们甚至用的是不同的设备。 换句话说,SkDevice 这道抽象不仅决定「用哪个后端」,还决定「这次究竟是不是要落像素」。
这张图把「记什么」讲完了。 记的是命令与状态的变化,不是像素;所以同一份记录才能被拿去重放成不同尺寸。下面接着看「放什么」。
5.3 回放:不可变、线程安全、可在别处重放
放的时候会发生什么? 一份已完成的 SkPicture 是不可变的,因此它可以被多处安全共享;回放时,记录里的命令被重新逐条喂给一台真正落像素的设备——这台设备可能是 CPU 的 Raster,也可能是 GPU 后端。记录侧与回放侧因此被彻底解耦:内容在一处产生,像素可以在别处、别的线程、别的尺寸产生。
这条解耦带来的收益是结构性的。 一份被反复使用的内容(比如界面里不变的背景)只需记录一次,之后每次重画都是回放;而回放的代价与记录侧的构造代价不必叠加。代价则落在别处:记录本身要占内存,回放仍要按目标后端重新跑一遍光栅化——记录省的是构造,不是光栅。
这里同样补一条诚实说明。 「显示列表与绘制命令」这个概念,本轮在 Commons 上把 Display lists、Scene graphs、Abstraction layers、Rendering software 四个类目逐个枚举,四个类目全部不存在,另外两组关键词检索也没有可用结果——该位按脚本登记为落空,本节不再补图,改由上面这张自绘结构图与 5.1 节的本机实测共同承担说明。这是「落空位不拿自绘图顶替」的处置:自绘图画的是本篇据文档建立的结构示意,不是拿来冒充那张不存在的外部对照。
5.4 本章收在哪里
第五章走完,该记住三件事:记录态不产像素,它把命令追加进记录;记录态用的是不落像素的设备,落像素发生在回放时;回放可以跨线程、跨尺寸,代价是记录占内存且光栅仍要重跑。下一章进入本篇下半场:CPU 后端凭什么把矢量变成像素。
-----------------------------------【记录与回放的两侧分工】----------------------------------------
# 描述:把记录侧与回放侧的职责分开;本段是结构示意,记录态设备的说法来自社区资料
# 口径:SkPicture 的不可变与线程安全是官方与社区的一致口径;本机回放 256 实测见 5.1 节
#------------------------------------------------------------------------------------------------
记录侧   recorder.beginRecording(128,128) -> canvas 不落像素 -> 追加命令 -> picture
         picture 一旦完成即不可变,可安全共享
回放侧   picture.replay(真后端设备) -> 逐条重喂命令 -> 覆盖与混合 -> 像素
         目标尺寸与记录时的 cullRect 无关;目标线程与记录线程也无关
其中:
- 两侧共用同一份
SkPicture,记录侧不必知道将来画到哪,回放侧也不必知道记录怎么来的; - 记录态设备与回放态设备是两台不同的设备,这是解耦的物理落点;
- 本机实测只覆盖记录与多尺寸回放,多线程重放本轮未做实验,故正文只作定性引用,不编造本机数据。
本章对应的官方依据:记录与回放、不可变与线程安全的表述见 DeepWiki 的 Skia 源码结构页;不落像素设备的社区说法见 掘金上关于 SkCanvas 与 RecordingCanvas 的文章;Chromium 侧 paint recording 与
SkPicture的对应见 grida 的 Chromium paint recording 文档。
六、CPU(Raster) 凭什么把矢量变像素
下面我们开始第六阶段。 从这里起,本篇进入下半场:前面讲的都是「命令怎么被描述与组织」,这一章起讲「几何怎么真的变成像素」。先走 CPU 这一侧,因为它是不依赖图形硬件、可逐行解释的那条路。
6.1 两段式:几何覆盖与像素着色分工
先来看看 CPU 光栅化的整体结构。它是一条两段式的流水线:前一段把几何变成「哪些像素被盖住、盖住多少」,后一段按样式把这些覆盖变成颜色并写出去。 前者是扫描线光栅化,后者是光栅管线。分工是理解它的钥匙:几何侧只关心边界与覆盖,像素侧只关心颜色与混合,两者用一个覆盖值对接。
本机 skia-python(Skia m144)现场跑了一次 Raster 出图并记下读数:
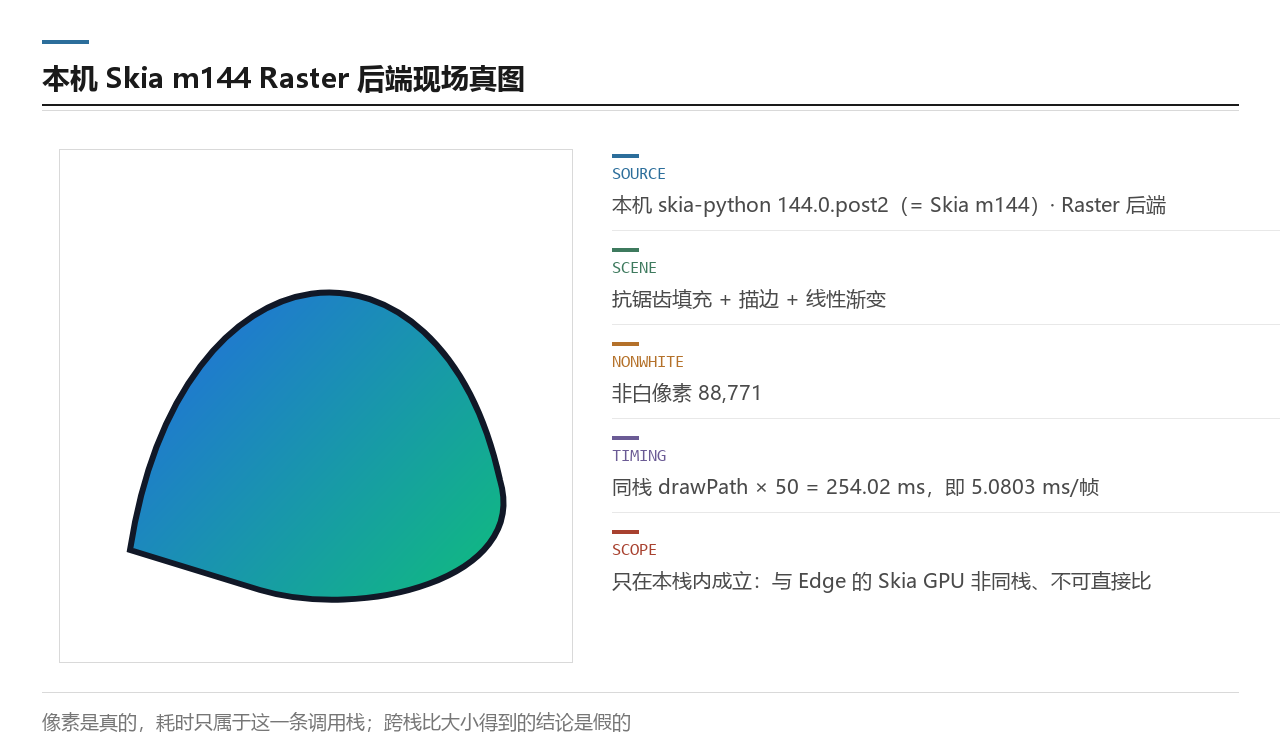
这张图要读两件事:一是它确实出了一张真图,二是它旁边的耗时读数只能在它自己的栈里解释。 5.0803 ms 每帧来自 skia-python 绑定这一条调用栈,它和第七章 Edge 侧的 GPU 读数不是同一条栈,两者放一起比大小得到的结论是假的——这条纪律后面第八章还会再钉一次。
6.2 SkScan 扫描线加 SkBlitter:几何怎么变成覆盖
第一段具体是怎么做的?据源码与文档,它的入口是 SkScan。 这一段按官方源码结构的描述是扫描线光栅化:把路径的边按上端纵坐标排序(SkEdgeBuilder 负责),维护一张活动边表,对每一条扫描线求出交点区间(span),交给 SkBlitter 去写像素。SkBlitter 是一个像素写入的抽象——几何侧算出的覆盖最终要通过它落到目标上。
SkScan是几何侧入口,对外是HairLine、AntiHairLine、FillPath这一类名字;- 边的表示有两种:普通边与解析式边,后者用于直接算出覆盖,而不是靠超采样逼近;
- 调用方向是
SkDraw到SkScan到SkBlitter,最后由 blitter 把覆盖写进像素。
必须标清口径:以上关于 SkScan 与 SkBlitter 的叙述据源码/文档(取自官方源码结构页对 CPU 光栅管线的描述),不是本机绑定实测——本机 skia-python 并未暴露这两个内部类,凡本节结论都不得当成「本机跑过」。
6.3 SkRasterPipeline:为了躲开组合爆炸的阶段链
第二段就是光栅管线。据源码与文档,SkRasterPipeline 的设计动机是躲开「组合爆炸」。 它的头文件注释写得很直白:这条管线是为「潜在管线极度组合化」的场景设计的——目标格式数乘源格式数乘遮罩格式数乘传递模式数,没有人愿意为这些组合逐一写专用例程。于是它把处理拆成一条由「阶段」组成的线性链,每个阶段处理一批像素,组合由拼装阶段来表达。
同一条注释还给了执行模型的几个事实:它是一条对 SIMD 像素向量逐阶段运行的函数链;每一轮处理 8 到 16 个像素;阶段名如加载 8888、存储 565、源覆盖等。 SIMD 向量本身是自定义的,运行期可在标量、NEON、SSE41、AVX、AVX2 之间选择。
先把这条「几何到像素」的两段式画出来:
这张图的左半是几何、右半是像素,中间那个覆盖值是唯一的接口。 需要再说一次口径:关于 SkRasterPipeline、SkScan、SkBlitter 的三段叙述均据源码/文档,本机 skia-python 并未暴露这条管线(本机对绑定做成员枚举时,光栅管线与 Graphite 两项均为空),因此本篇不声称在本机跑过它,图也只是按源码结构画的示意。
6.4 光栅化的外部真实对照
覆盖到底长什么样? 外部真实素材里最适合回答这个问题的是扫描转换图——它把「几何边界如何被判定覆盖到像素格」画了出来:
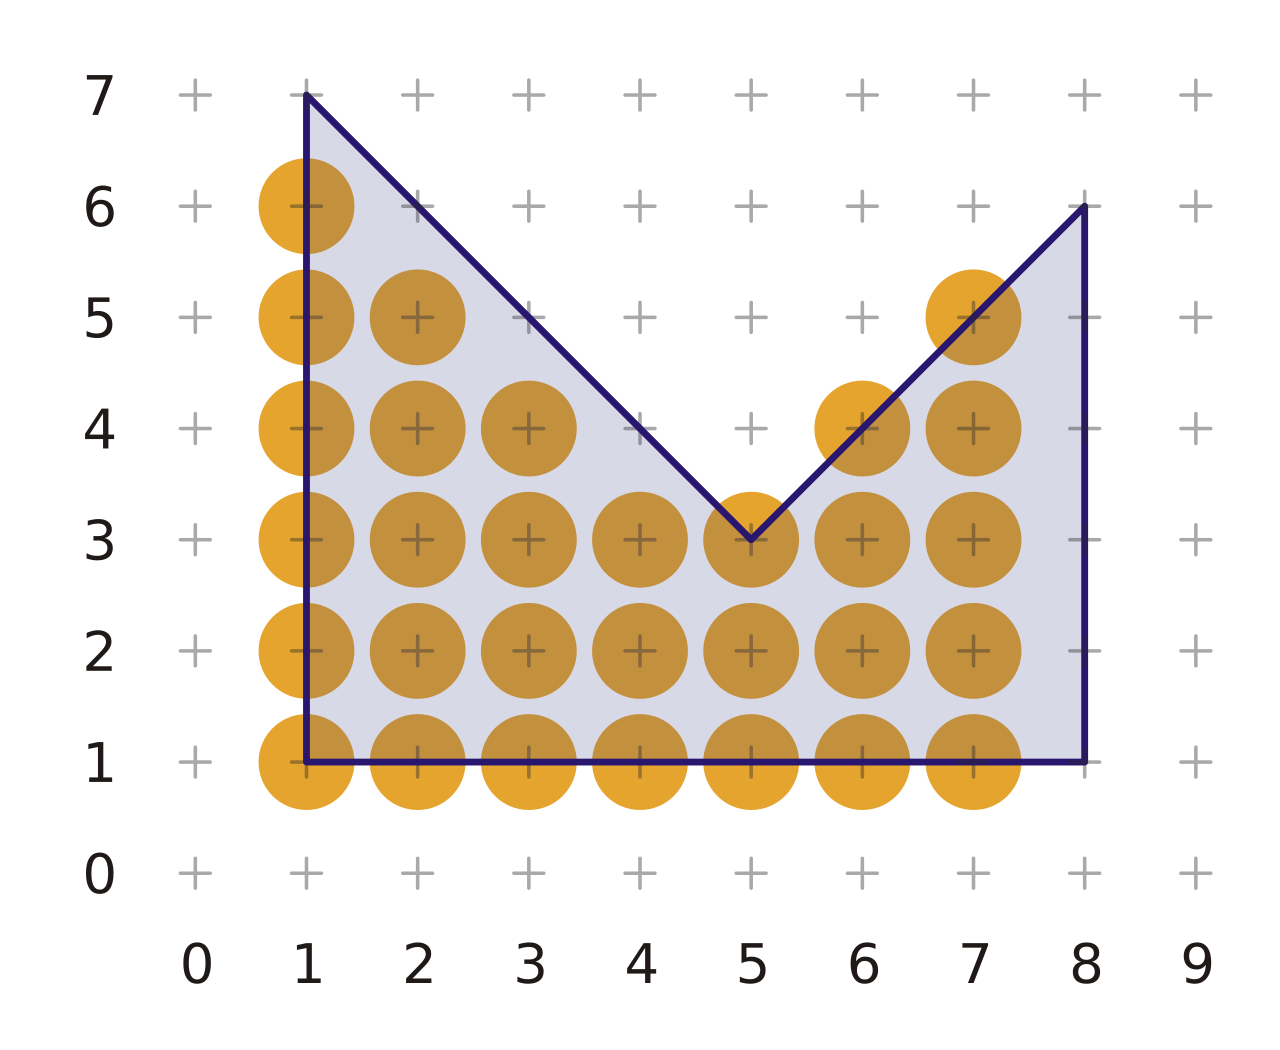
这张图与 6.2 节是同一件事的两面:前者讲「代码在哪一段做」,后者画「做出来是什么样」。覆盖值是连续几何与离散像素之间唯一的桥梁——抗锯齿在 CPU 与 GPU 上都会回到「覆盖怎么算」这一步。
6.5 本章收在哪里
第六章走完,该记住四件事:CPU 光栅是两段式,几何覆盖与像素着色分工;几何侧据源码是扫描线加活动边表,覆盖经 blitter 写入;像素侧据源码是 SIMD 阶段链,动机是躲开组合爆炸;本机只出了 Raster 真图与同栈读数,未跑过那两段内部实现。下一章走向另一条真实路径:GPU。
-----------------------------------【CPU 光栅的两段与接口】----------------------------------------
# 描述:几何侧与像素侧各做什么,接口只有覆盖值;本段据源码结构示意,非本机实测
# 口径:SkScan 与 SkBlitter 与 SkRasterPipeline 三段叙述均据源码/文档
#------------------------------------------------------------------------------------------------
几何侧  SkScan:边排序 -> 活动边表 -> 逐条扫描线求 span -> 覆盖值
接口    coverage  in [0, 1]        # 连续几何与离散像素之间唯一的桥梁
像素侧  SkRasterPipeline:拼装阶段链 -> 每轮 8 到 16 像素 -> 着色与混合 -> 写目标
其中:
- 接口只有「覆盖」这一个量,两侧因此可以各自演进而不互相绑架;
- 每轮 8 到 16 像素是据源码注释的执行粒度,不是性能承诺;
- 本机未跑过这两段内部实现,凡引用其结构一律标「据源码/文档」,不与 Raster 出图的实测读数混为一谈。
本章对应的官方依据:CPU 光栅两段式与
SkScan、SkBlitter、SkRasterPipeline的结构见 DeepWiki 的 CPU 光栅化管线页;本机 Raster 现场与读数见 skia-python 发行页;覆盖判定的示意图见 Wikimedia Commons 的多边形扫描转换图页。

七、GPU(Ganesh) 的 op 与 GrDirectContext
下面我们开始第七阶段。 上一章走的是 CPU。这一章换到 GPU,但方法不变:还是先在本机取一条真实像素,再看官方口径的结构。
7.1 同一台机器上的另一条真实光栅路径:Edge 与 Skia-GPU
先来看看 GPU 侧的像素怎么取。本机没有一条能直连 Skia GPU 后端的绑定通道(对绑定做 GPU 上下文初始化返回空),所以要取 GPU 侧的真实像素,我们换用浏览器:Chromium 系浏览器的 2D canvas 就是 Skia 在跑,且默认走 GPU 光栅。 本机用 Playwright 驱动 Edge,把与第六章同一个几何画进 512 见方的 canvas:
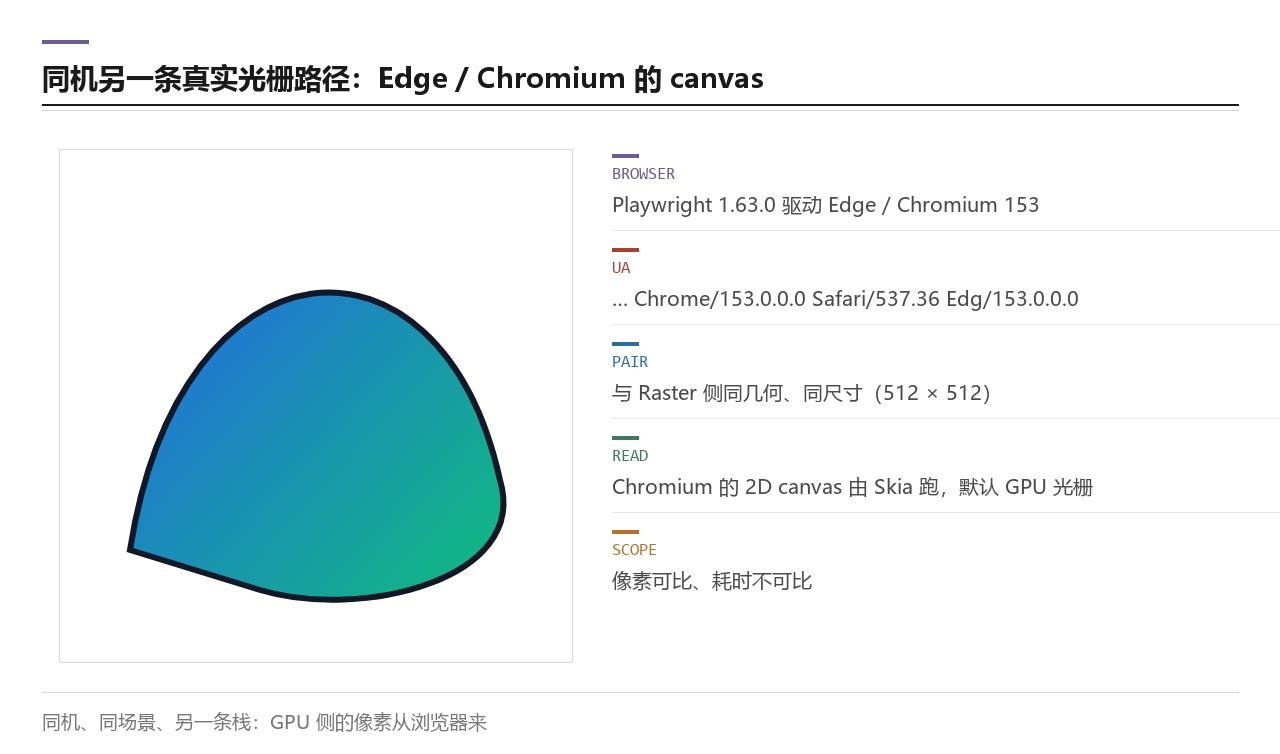
这张图的价值在于「同机、同场景、另一条栈」。 它和第六章那张 Raster 真图出自同一台机器、画的几何也一样,但两者背后的调用栈完全不同——这一点第八章会专门处理,这里先记住「GPU 侧的像素从浏览器来」这个取数路径。
7.2 Ganesh 的结构:op 列表加有状态的 GrDirectContext
先来看看它的两个标签。据源码与文档,Ganesh 是 Skia 的即时模式 GPU 后端。 这句话可以拆成两半来读:其一是「即时模式」——draw 提交时就被转成后端命令,不存在先攒一批再成批提交的阶段;其二是「有状态」——它用一个叫 GrDirectContext 的上下文对象承载 GPU 侧的全局状态,draw 与资源的生命周期都挂在它身上。后端子类按图形 API 分:GL、Vulkan、Metal 各有一个 GrGpu 子类。
「即时」这两个字是理解 Ganesh 的钥匙,也是它后来遇到麻烦的根:它起于 OpenGL ES 时代,那套 API 对多线程与计算着色器的支持很有限;等到现代图形 API(Vulkan、Metal、D3D12)普及,这种即时、有状态的形态就积累了技术债,难以吃满多线程与 GPU 通用计算。后来才引出 Graphite——这一段留给 8.3 节与 ep06。
这张图的三个层次要分清: 最上面是被转成 op 的绘制命令,中间是有状态的上下文,最下面是按图形 API 分的后端实现。从 SkPaint 到 GPU 绘制参数的转换就发生在这一层——第三章那张映射表的右半部分,落点正是在这里。
7.3 Skia 在产线上跑:Chrome 窗口实截
结构图之外,还该有一条「它在真实产品里跑」的证据。 Skia 最主要的产线之一就是浏览器,本机在用的 Edge 与它同源。下面这张外部实截图给的是 Chrome 在桌面系统上的窗口形态:
这张图只用来证明「它在产线上跑」,不承担任何机制说明。 它的版本信息(Chrome 75、桌面系统)是截图当时的快照,与本机实测的 Edge 153 不是同一个版本——两张证据的时间坐标不同,这一点要分开说,不能混成一句「浏览器里都是这样」。
7.4 本章收在哪里
第七章走完,该记住三件事:GPU 侧的像素本机从浏览器取,走的是与 Raster 完全不同的调用栈;Ganesh 是即时模式加有状态上下文的 GPU 后端,后端子类按图形 API 分;它在产线上跑,其形态与所依赖的图形 API 时代强相关。下一章把两条路径的像素放在一起,回答最后一个问题:它们到底差在哪。
-----------------------------------【Ganesh 的三层与一次转换】--------------------------------------
# 描述:从 draw 到后端实现的三个层次;本段据源码与文档示意,非本机实测
# 口径:即时模式与有状态上下文、后端子类命名均据源码与文档;GPU 像素取自 Edge 实测
#------------------------------------------------------------------------------------------------
op     <- draw 提交即转成后端 op     # 即时模式:不攒批
ctx    <- GrDirectContext 承载全局状态  # 有状态:draw 与资源生命周期挂在它身上
gpu    <- GrGpu 子类 {GL, Vulkan, Metal}  # 后端子类按图形 API 分
其中:
- 「即时」与「有状态」是 Ganesh 的两个标签,也是它与「延迟模式」后端的分水岭;
- 后端子类的划分依据是图形 API,不是平台,所以同一平台可能有多个子类;
- 本节全部结构叙述据源码与文档,本机只提供了 7.1 节那张 GPU 侧像素。
本章对应的官方依据:Ganesh 的即时模式与
GrDirectContext、后端子类见 DeepWiki 的 GPU 后端页;Ganesh 起于 OpenGL ES 且对多线程支持有限的说法见 Chrome 官方博客的 Graphite 介绍;GPU 侧像素取自本机 Playwright 驱动 Edge 的实测截图。
八、CPU 与 GPU 同场景到底差在哪
下面我们开始第八阶段。 这是本篇的技术收口章。前七章分别讲了 CPU 与 GPU 两条路,这一章把它们放在同一台机器上对照——但要先说清:能比的只有像素,不能比的是耗时。
8.1 同场景像素并置与差分:能比什么、不能比什么
先来看看怎么比才成立。两条栈唯一的公共坐标系是「同一份几何、同一个尺寸」,所以能比的只有这个条件下的像素结果:把 Raster 侧与 Skia-GPU 侧的两张图并排,再算一次逐像素差分,看它们差多少。
本机实测的结果是:通道均差 0.083、最大差 3、差异超过 24 的像素为 0 个。 也就是说,两条完全不同的实现路径,对同一份几何给出了几乎一致的像素——三处差异都在量化误差量级,没有一处结构性偏差。
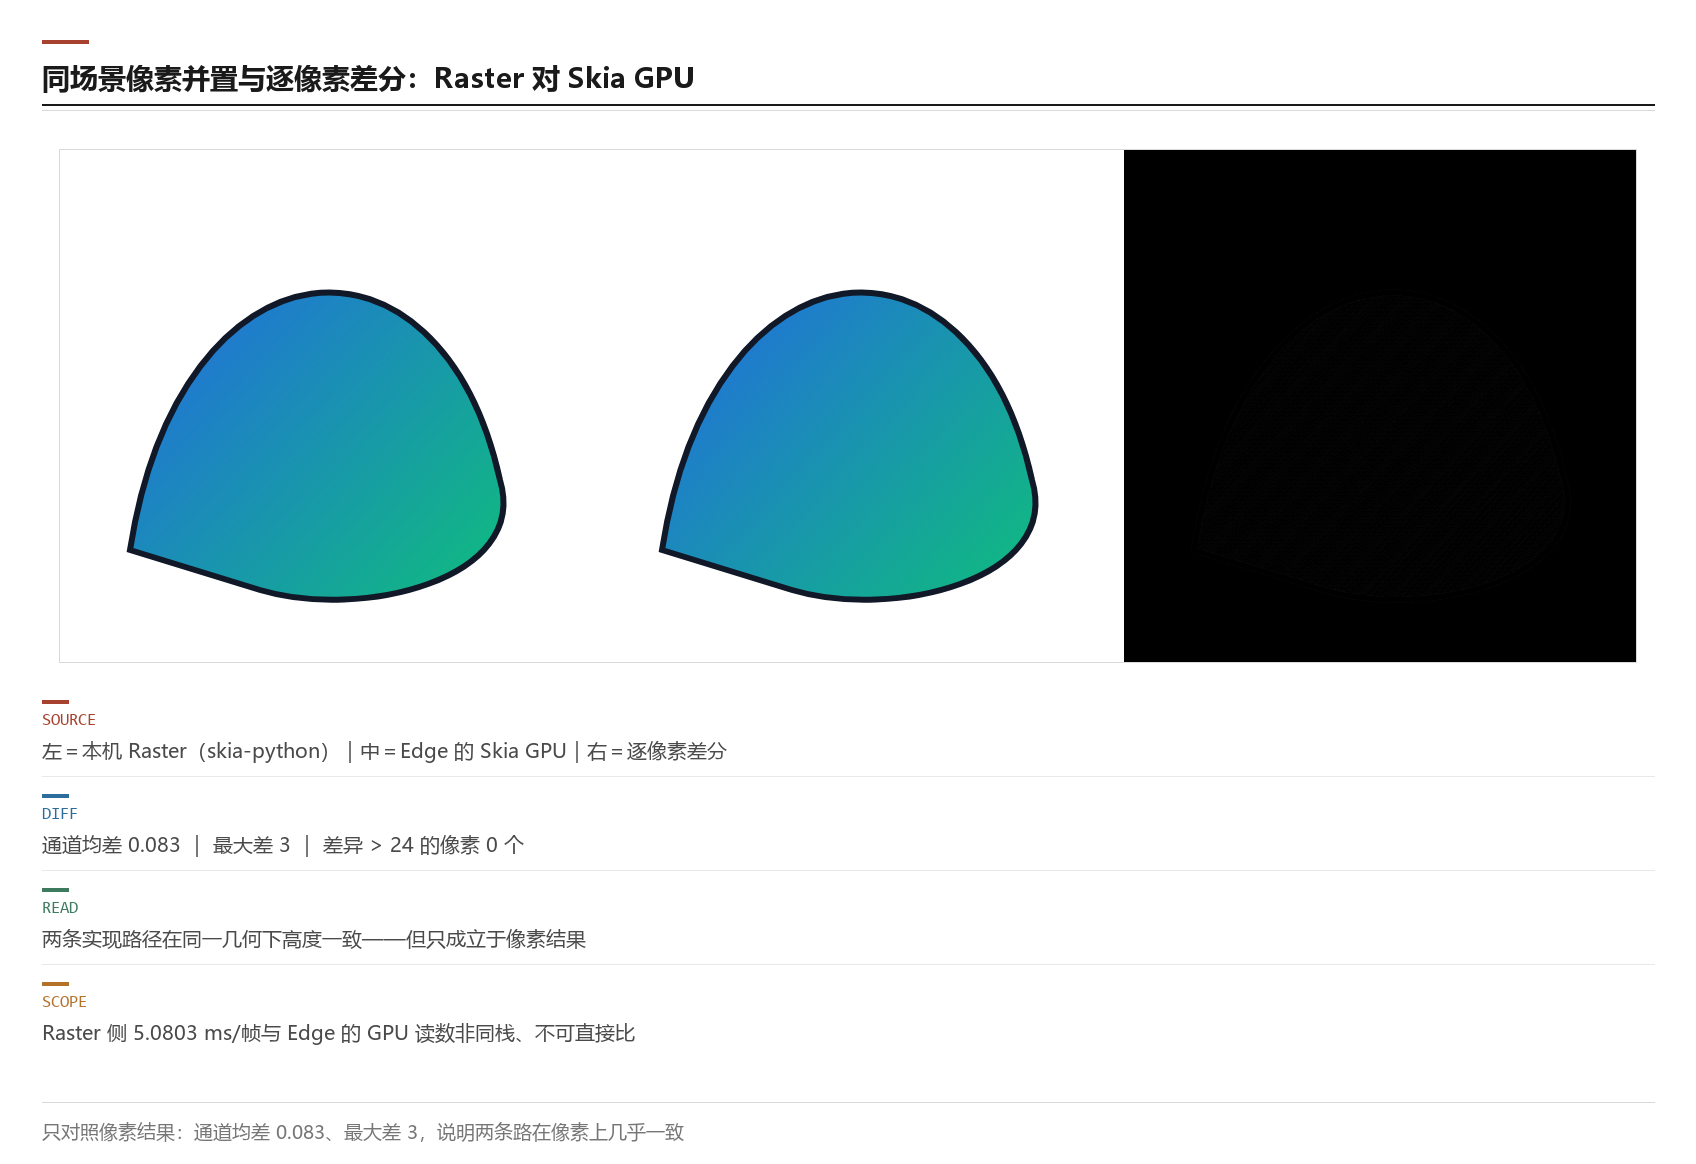
这张图是本篇最硬的一块证据。 它把「CPU 与 GPU 只是同一件事的两种做法」从说法变成了数字。同时它也标出了边界:这张图比的是像素,不是速度——两边的耗时读数来自不同的调用栈、不同的进程、不同的进程模型,非同栈、不可直接比,任何「GPU 比 CPU 快几倍」的结论都不能从本篇这两条读数里推出来。
8.2 本机 GPU 栈的客观读数
既然 GPU 侧的像素从浏览器来,那「它在本机到底走哪条栈」就该有个客观读数。 本机用 Playwright 从浏览器的调试信息里读出了渲染器字符串:
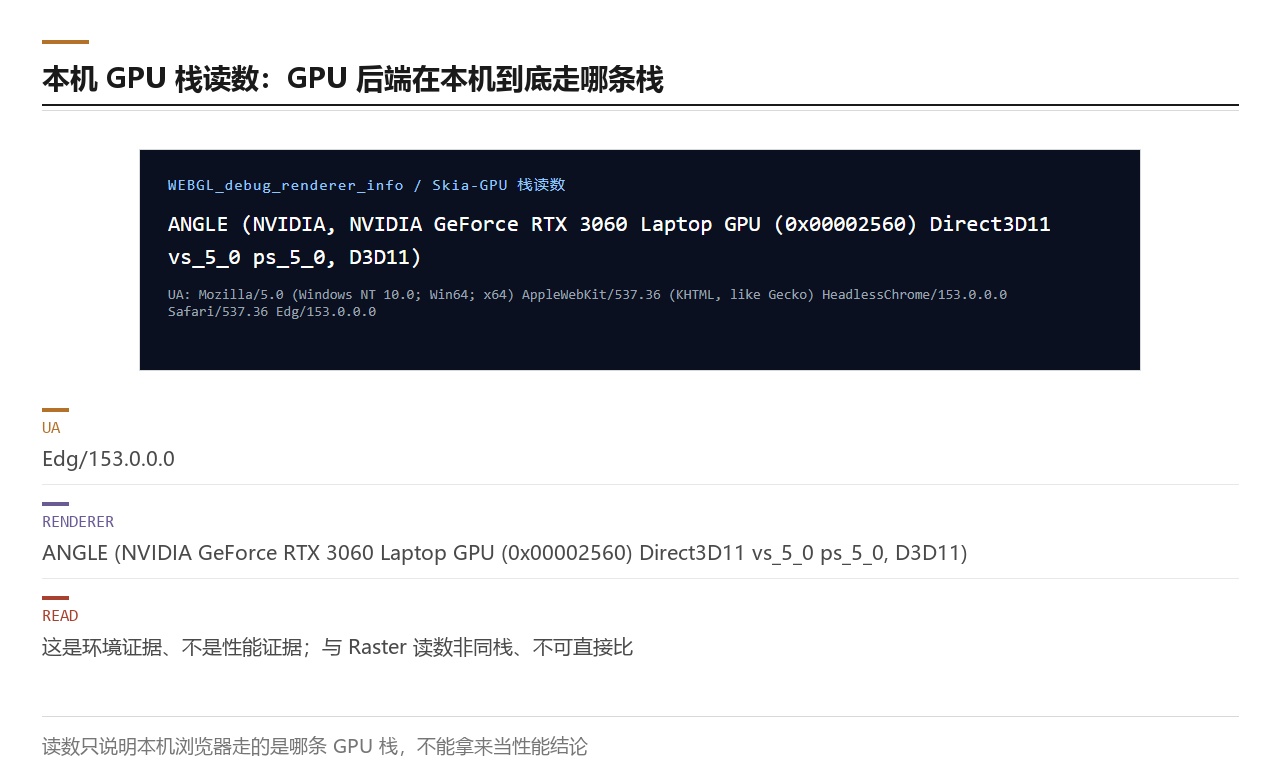
读数的完整原文是「ANGLE (NVIDIA, NVIDIA GeForce RTX 3060 Laptop GPU (0x00002560) Direct3D11 vs_5_0 ps_5_0, D3D11)」,浏览器 UA 为 Edg/153.0.0.0。要分清两件事:这条读数证明的是「本机的 GPU 与驱动条件在位,走的是 ANGLE 加 D3D11 这条栈」;它不能证明的是「所以 Skia 在 GPU 上一定更快」——那是性能问题,不是环境问题。 而且它与 6.1 节那条 5.0803 ms 每帧的 Raster 读数非同栈、不可直接比。
8.3 Ganesh 与 Graphite 的分界线
最后一件事,把 GPU 这两个后端的关系钉死一句话。据源码/文档:Ganesh 是即时模式,用一个有状态的 GrDirectContext 提交;Graphite 是延迟模式,把绘制命令先记进 DrawList,最后成批提交成 CommandBuffer。 这条分界线就是本篇对 GPU 后端能讲到的尽头——再往下的 Graphite 内部机制(计算光栅化、用 z 值降 overdraw、多线程)属 ep06,本篇不展开。
这条线的意义在于「提交时机」。 即时模式把「什么时候转成后端命令」定死在 draw 那一刻,延迟模式把它推迟到成批提交那一刻。后者能做的优化(合批、去重、跨线程)都来自这段被推迟出来的时间窗口——这也解释了为什么现代图形 API 普及之后,Skia 要再长出一个延迟模式后端。
8.4 本章收在哪里
第八章走完,该记住四件事:两条栈能比的只有同几何同尺寸下的像素结果;本机实测的像素高度一致,差异在量化误差量级;GPU 栈读数是环境证据,不是性能证据;Ganesh 与 Graphite 的分界线是「即时与延迟」,其内部机制属 ep06。
-----------------------------------【两条栈的对照边界】--------------------------------------------
# 描述:把「能比什么、不能比什么」写死;本段是口径声明,不是性能数据
# 口径:像素对照为本机实测(通道均差 0.083);耗时读数各自成立,非同栈不可直接比
#------------------------------------------------------------------------------------------------
可比    同几何 + 同尺寸 + 同目标像素格式  ->  像素结果(本机实测通道均差 0.083)
不可比  Raster 的 5.0803 ms 每帧  vs  Edge 的 GPU 读数   # 非同栈、不可直接比
不可比  裸 GPU 型号  写成  「Skia 在 GPU 上更快」        # 环境证据不等于性能结论
其中:
- 「可比」的三个条件缺一不可,缺了同尺寸或同像素格式,像素对照就不成立;
- 耗时读数只在各自栈内有效,本篇不给出任何跨栈倍数;
- 三处注明(6.1、8.1、8.2)反复写这条纪律,是因为它最容易被读者自行「合并」成一个假结论。
本章对应的官方依据:Ganesh 与 Graphite 的即时与延迟模式见 DeepWiki 的 GPU 后端页;Graphite 的动因见 Chrome 官方博客的 Graphite 介绍;本机两条栈的像素与读数分别见 skia-python 发行页 与 Playwright 官网。
九、边界回指与预告 ep03
下面我们开始第九阶段。 这是本篇的收口章。它只做两件事:把「像素坐标」这件事回指给下一篇,再把本篇的边界确认一遍。
9.1 像素坐标的回指锚点
先钉一个坐标事实,它是下一篇的地基。 本篇反复说「覆盖」与「像素格」,但一直没把「像素坐标到底怎么数」这件事摆出来——因为它是 ep03 的起点,不是本篇的终点。下面这张外部图示给的是像素绘图里的坐标约定:
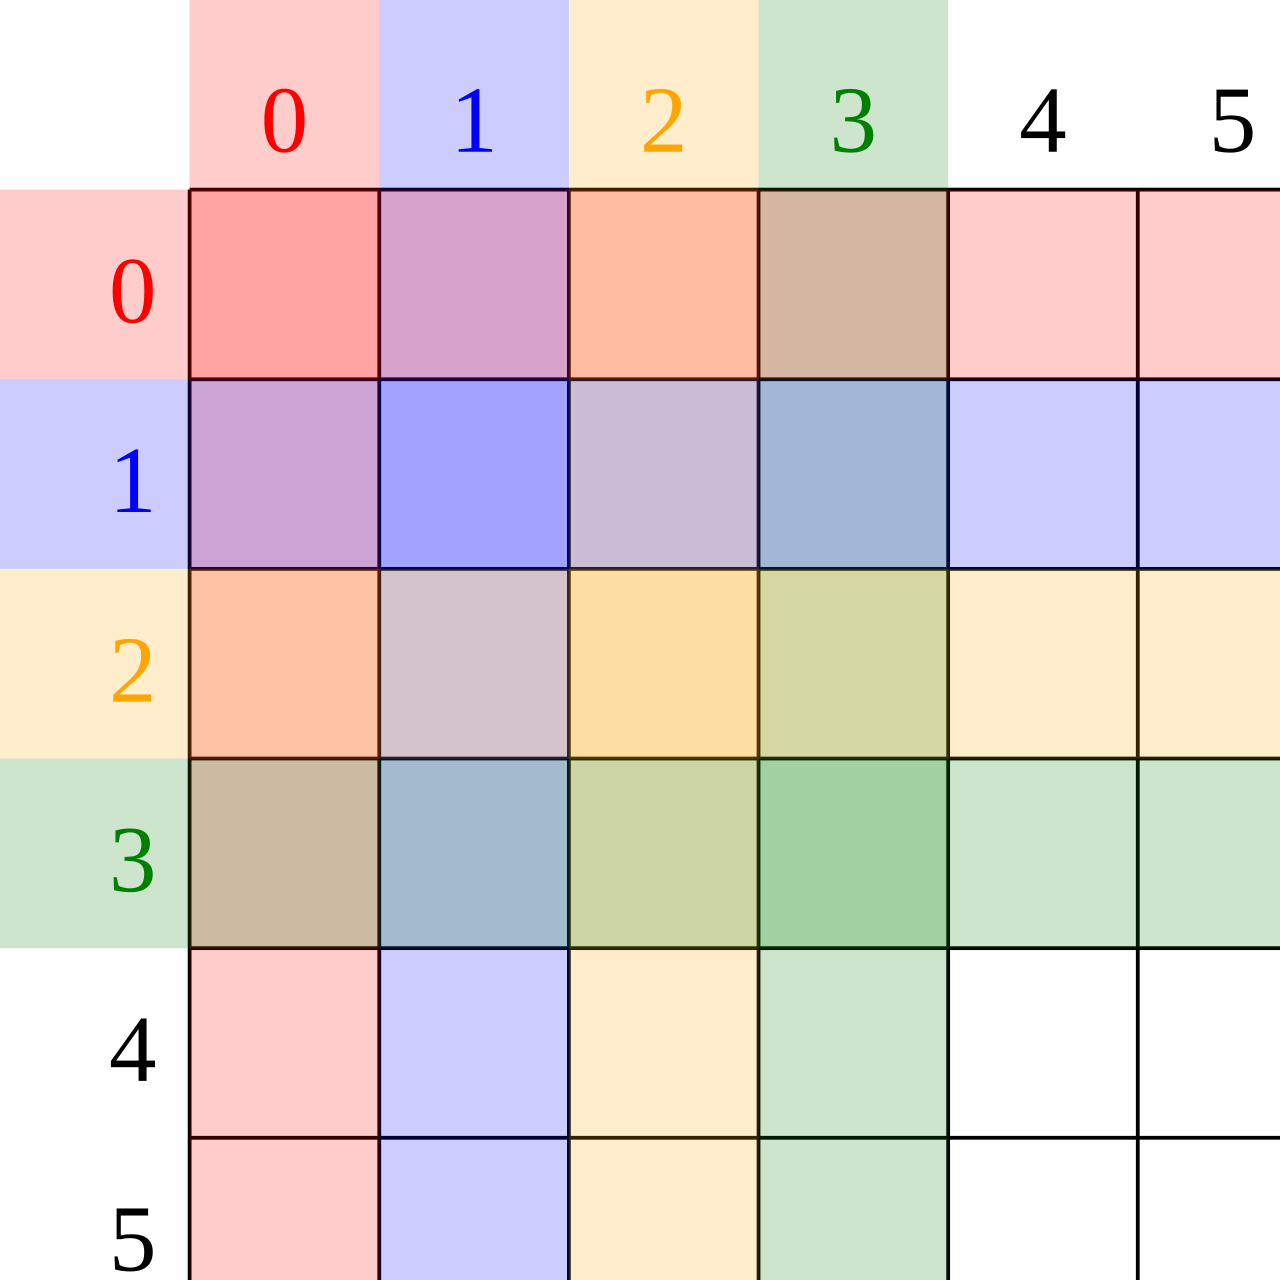
这张图上的每一个格子,就是下一篇要反复处理的对象。 本篇讲了「覆盖值是连续几何与离散像素之间唯一的桥梁」,但没讲这个覆盖值具体怎么算——算它得先把坐标约定钉死,再谈采样还是解析式。这正好是 ep03 的入口。
9.2 本篇交给 ep03 的几件事
先说本系列在 Skia 主线上的编排。 本篇是 Skia 机制的开篇,后面几篇按「几何到像素」的顺序往下挖,这条顺序排期时就定下:
| 篇 | 接走本篇的哪一段 | 展开什么 |
|---|---|---|
| ep03 | 4.2 节的控制点几何 + 6.1 节的覆盖值 | 曲线细分、tessellation、analytic AA 与 coverage |
| ep04 | 2.4 节的「文本是另一条链路」 | 字形数据组织、blob 与 CJK |
| ep05 | 3.2 节的字段映射左半 + 7.2 节的 op 层 | GPU 覆盖 approach 与 instanced tessellation |
| ep06 | 8.3 节的分界线 | Graphite 的 compute 光栅化与降 overdraw |
这张表里最该先记住的是第一行。 本篇在 6.2 与 6.3 两节只说了「几何在哪算、覆盖经谁写出去」,没有推一条覆盖公式;ep03 要补的正是这一段:细分按什么容差、覆盖按采样还是按解析式、解析式那一族怎么在 CPU 与 GPU 上分别落地。
还有一条演进脉络要交代。 本篇的两个 GPU 后端不是同时出现的:Ganesh 起于早期的 OpenGL ES 生态,随着 Vulkan、Metal、D3D12 这些现代图形 API 演进,才长出延迟模式的 Graphite。这条从「即时」到「延迟」的演进,本篇只立分界线,纵深留给 ep06。
9.3 本篇的边界再确认
好了,最后把边界再确认一遍,与 0.4 节首尾呼应。 先把三个后端按归属归类:Raster 归 CPU 一类,Ganesh 与 Graphite 归 GPU 一类。本篇不涉及曲线细分与覆盖率的算法本体,不涉及字形光栅化,不展开 GPU 覆盖策略与 Graphite 内部机制,不做跨栈耗时对比,不把本机绑定当作主线源码。
-----------------------------------【本篇与 ep03 的交接点】----------------------------------------
# 描述:本篇交出去什么、留下什么;本段是口径声明,不是算法
# 口径:本篇只给「分层链路 + 分工 + 分界线」三条,算法与覆盖公式全部留给 ep03
#------------------------------------------------------------------------------------------------
交出去  4.2 控制点几何        -> ep03 细分与容差
交出去  6.2 覆盖经 blitter 写  -> ep03 覆盖怎么算
交出去  6.3 阶段链的动机       -> ep03 与 ep05 的覆盖落地
留下来  一次 draw 的四段链路   # 本系列后续各篇共用
留下来  三后端路由与 Ganesh 与 Graphite 分界  # 后续各篇回指
其中:
- 交出去的三项都是「算法本体」,本篇只给它们在链路里的位置;
- 留下来的两项是「结构」,它们不再变,后续各篇只回指、不重述;
- 凡后续篇目与本篇结论冲突,以「有源码或文档依据、或有本机实测」的一方为准,并回写本篇。
本篇交付的是一条链路,不是一个性能结论。 它的正确性取决于那条从 API 面到像素的链路——「有哪几层」「谁持状态」「CPU 与 GPU 在哪分岔」——是否足以把一次 draw 讲清楚。 若后续某篇发现这条链路少了哪一环,说明本篇需要一次订正。
本章对应的官方依据:本篇引用的官方页面已在各章末逐条列出;源码结构(含 GPU 后端与 CPU 光栅)见 DeepWiki 的 Skia 源码结构页;像素坐标图示见 Wikimedia Commons 的位图坐标图页;下篇口径与全系列骨架见 Skia 官方 API 总览。

相关链接
- 下一篇(预告):【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 相关系列(方法底座):T01 性能剖析工具链,13 篇已完结
- 相关系列(硬件侧):GPU 架构剖析
- 本系列使用的自跑工具链:skia-python 发行页 | Skia Fiddle | Skia WASM Debugger
参考资料
- Skia 官方 API 总览
- SkCanvas 概览
- SkPaint 概览
- SkPicture 概览
- Skia 官方构建文档
- DeepWiki 的 Skia 源码结构页
- DeepWiki 的 CPU 光栅化管线页
- DeepWiki 的 GPU 后端页
- Chrome 官方博客:Graphite 介绍
- Chromium 的图形与 Skia 设计文档
- SkiaSharp 的 SKCanvas 文档
- skia-safe 文档
- skia-discuss:GPU 抗锯齿实现讨论
- Skia Fiddle 在线工具
- Skia WASM Debugger 在线工具
- grida 的 Chromium paint recording 文档
- 掘金:SkCanvas 与 RecordingCanvas
- CSDN:Skia 渲染架构的旧版分析
- CSDN:Skia 的延迟渲染与显示列表
- CSDN:Skia 图形库核心组件解析
- CSDN:SkGpuDevice 与 GrContext 的一处记述
- vectree 的 Skia 图形引擎视觉解释
- arXiv:2D 光栅化语义论文
- skia-python 发行页
- pycairo 发行页
- Playwright 官网
- Wikimedia Commons 的混合模式演示图页
- Wikimedia Commons 的贝塞尔构造图页
- Wikimedia Commons 的多边形扫描转换图页
- Wikimedia Commons 的位图坐标图页
- Wikimedia Commons 的渲染管线图页
- Wikimedia Commons 的 Chrome 窗口截图页


外部示意图出处
- Graphic Pipeline.png | Digital colouring blend modes demonstration.png | Bezier2D construct.svg
- Polygon scan-conversion.svg | Google Chrome 75 screenshot.png | Bitmap Coordinates.svg
With Best Wishes.