站点链接:技术博客页
系列文章前言
这个系列写到这里要收尾了。
前四篇的路子是这样的:第一篇拆延迟渲染,讲"几何信息怎么存进 G-Buffer、光照怎么被推迟到屏幕空间";第二篇拆阴影贴图,讲"怎么判断一个点有没有被挡住";第三篇拆后处理链,讲"算完之后怎么把它变成一张能看的图";第四篇拆 PBR 与 IBL,讲"光打在表面上之后该怎么算"。
这四篇有一个共同的隐含前提:假设我们已经知道该画哪些东西。 G-Buffer 要为每个像素填通道,阴影贴图要为每个投射体算深度,后处理要处理整屏像素,PBR 要为每个可见片元算 BRDF——但"哪些东西该进入这些环节",四篇里都没回答。
这篇要补的就是这块。而它的难度和前面四篇不太一样:前面四篇回答的是"怎么画",这篇回答的是"画什么"。
为什么要为"画什么"单独写一篇。 初看这问题很朴素——不在视野里就不画。但真做起来会发现:几乎所有能让帧率翻倍的优化,都出在这一环;而几乎所有"物体莫名消失""边缘闪烁""拖动相机时鬼影"的诡异 bug,也出在这一环。它是实时渲染里收益最高、也最容易出错的一环。
读完能得到什么:一条从最基本的"视锥判定"一路走到"把判定整个搬进 GPU"的完整链条;每一层剔除付出的代价;以及一组来自官方样例与社区实测的性能数据。
不涉及什么(这条边界先声明,免得读到一半发现不是想要的):本文不涉及光栅化与着色本身的实现(那是前四篇的领域);不展开光追管线的加速结构(BVH 在光追里的用法只作对照);不讲具体引擎的编辑器操作步骤;不给特定项目的剔除参数调优建议。原因很清楚:这些每一项都够写一篇同体量的文章,塞进来会让主线失焦。
几个关键数值也先摆在这里,后文逐个展开:NVIDIA Turing 的 meshlet 定义为不超过 64 个顶点、126 个图元;Hi-Z 的降采样每一级取下层 2×2 中最远的那个值;深度金字塔必须用 R32f 这类高精度格式,Rgba8 做不了遮挡深度。
目录总览
本篇的主线其实只有一句话:从"保守判定"这条铁律出发,沿着视锥与包围体、空间划分、遮挡剔除、时序代价逐层更换判定的依据与粒度,终点是把这套判定整个搬进 GPU。
五篇的关系可以这样摆:前四篇沿着"拿到可见集合之后怎么画"展开,本篇负责产生这个集合。
背景铺垫
0.1 从一次"物体莫名消失"说起
先说一个具体的故障,因为它比任何定义都更能说明问题的性质。
假设场景里有几百个物体,帧率还算稳。某天你发现:某些物体在特定角度下会突然消失,稍转一下相机又回来了。 距离相机二十到三十米的地方最容易出现,近处的物体都正常。
这类故障有个专门的归类——假阴性(false negative):一个本来可见的物体被判定为不可见,于是被剔掉了。
它与"假阳性(false positive)"正好相反:假阳性是把不可见的东西留下来多画了,代价是性能;假阴性是漏画了自己该画的东西,代价是画面出错。
这两者的代价完全不对等。 多画一点,最多帧率掉一些,玩家看不出来;漏画一点,画面直接缺东西,玩家立刻发现。所以实时渲染里有一条铁律:宁可多画,不可漏画。
本文后续所有技术,本质上都在做同一件事:在守住"不可漏画"的前提下,尽可能减少"多画"。
0.2 这门手艺的难点在哪
好了,先说说难在哪。如果只看定义,剔除并不复杂——判断一个东西在不在视野里、有没有被挡住,不在就跳过。真正的难点在三处。
第一,精确判定太贵。 要判断"这个物体到底有没有被挡住",严格做法是拿它的每一个三角形去和场景求交。
这在实时渲染里完全不可能。所以只能退而求其次,用包围体(bounding volume)这种粗略的形状去近似,用深度缓冲这种已经算出来的副产品去近似。近似就意味着有误差,误差就意味着有假阳性。
第二,判定结果有生命周期。 遮挡剔除需要知道"当前帧的深度长什么样",可深度是渲染过程中才产生的——等深度算完再剔除,这一帧已经画完了。
于是工业界普遍用上一帧的深度来做这一帧的剔除。这带来一个根本性的时序依赖:当物体运动、相机旋转、或者上一帧本身有问题时,判定就会出错。
第三,判定本身的成本不能超过收益。 剔除是为了省时间,如果判定花的比省下来的还多,那它就是负优化。
硬件遮挡查询是最典型的例子——它的判定很精确,但会引入 CPU 与 GPU 之间的同步等待,在简单场景里反而拖慢帧率。
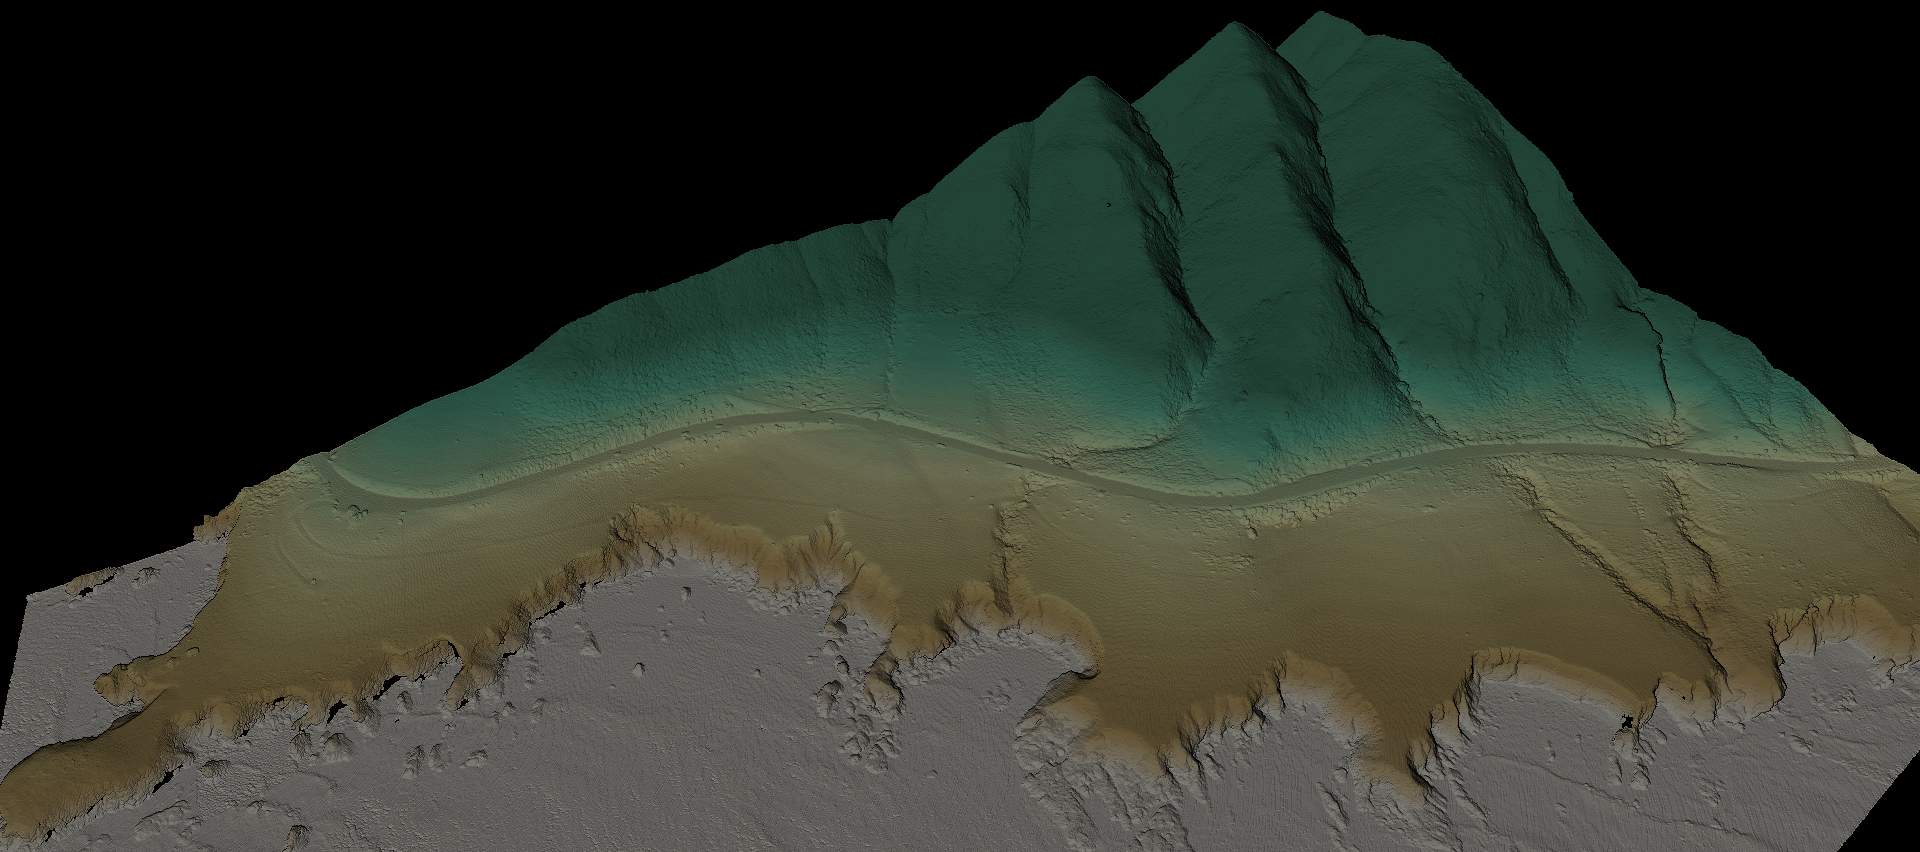
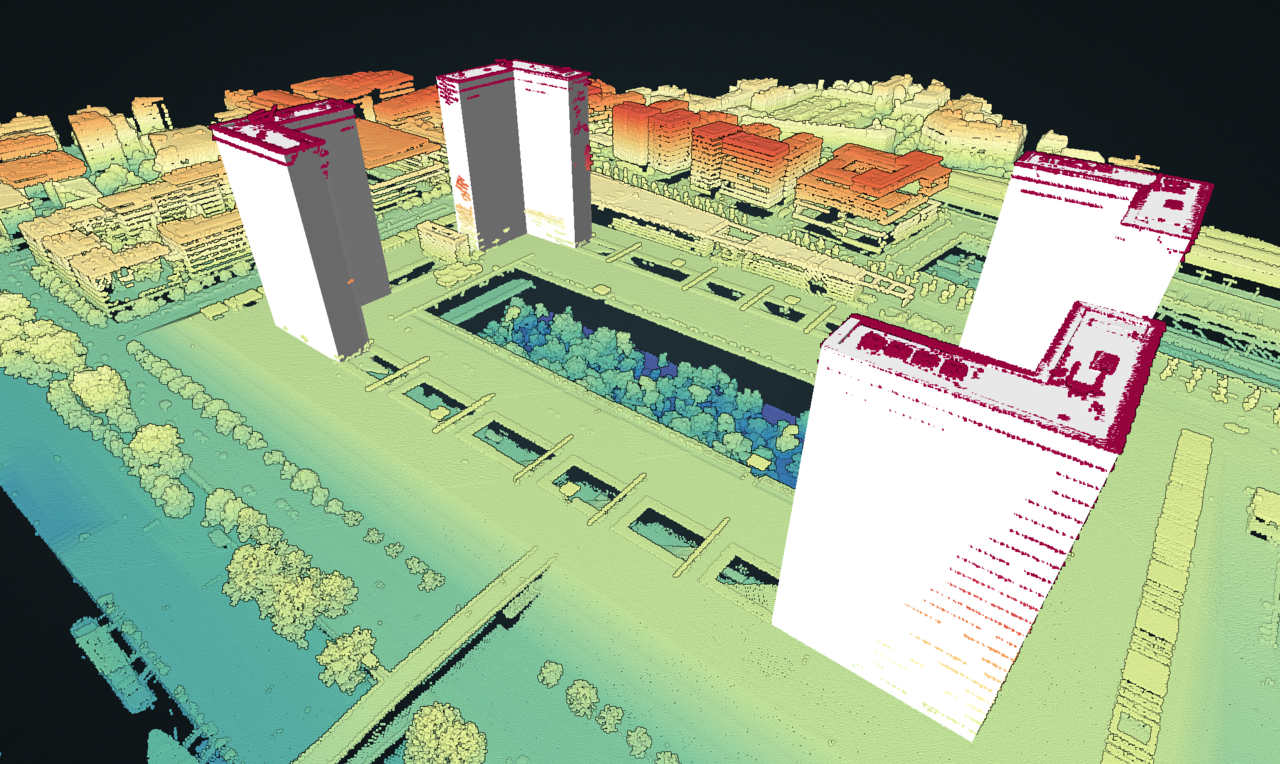
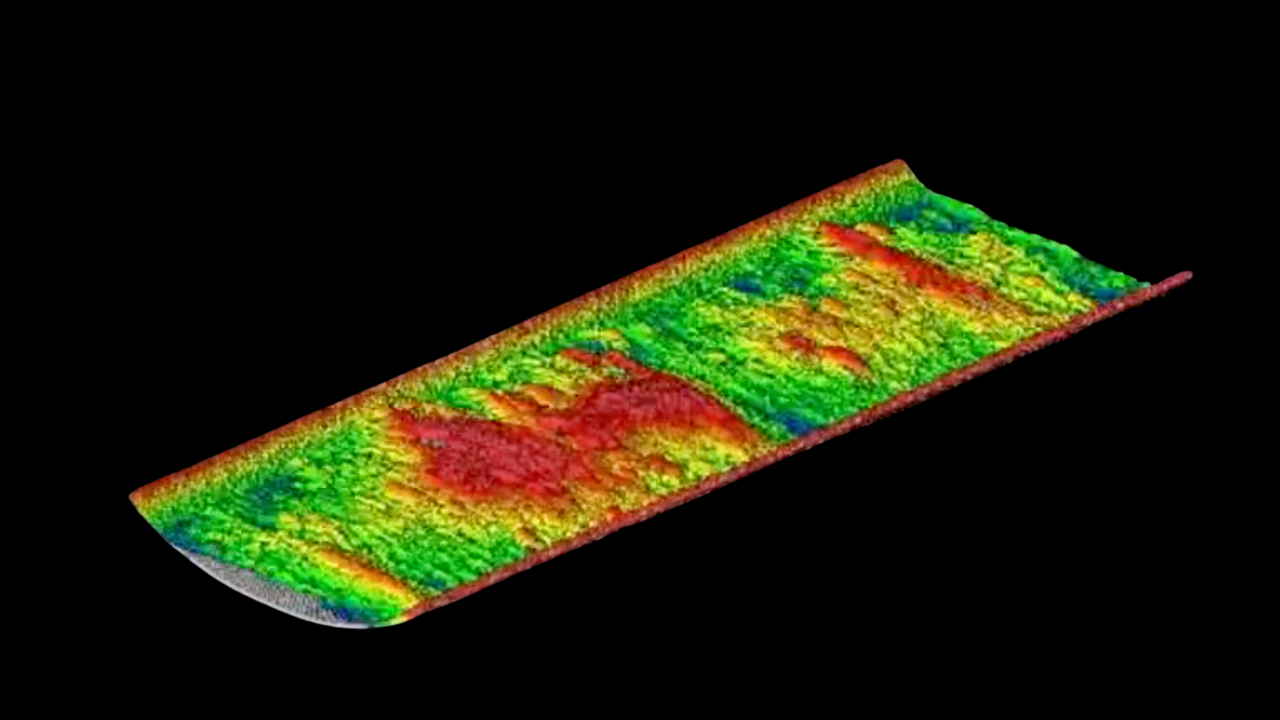
难点首先来自数据规模——这是机载激光雷达扫出的一条道路:
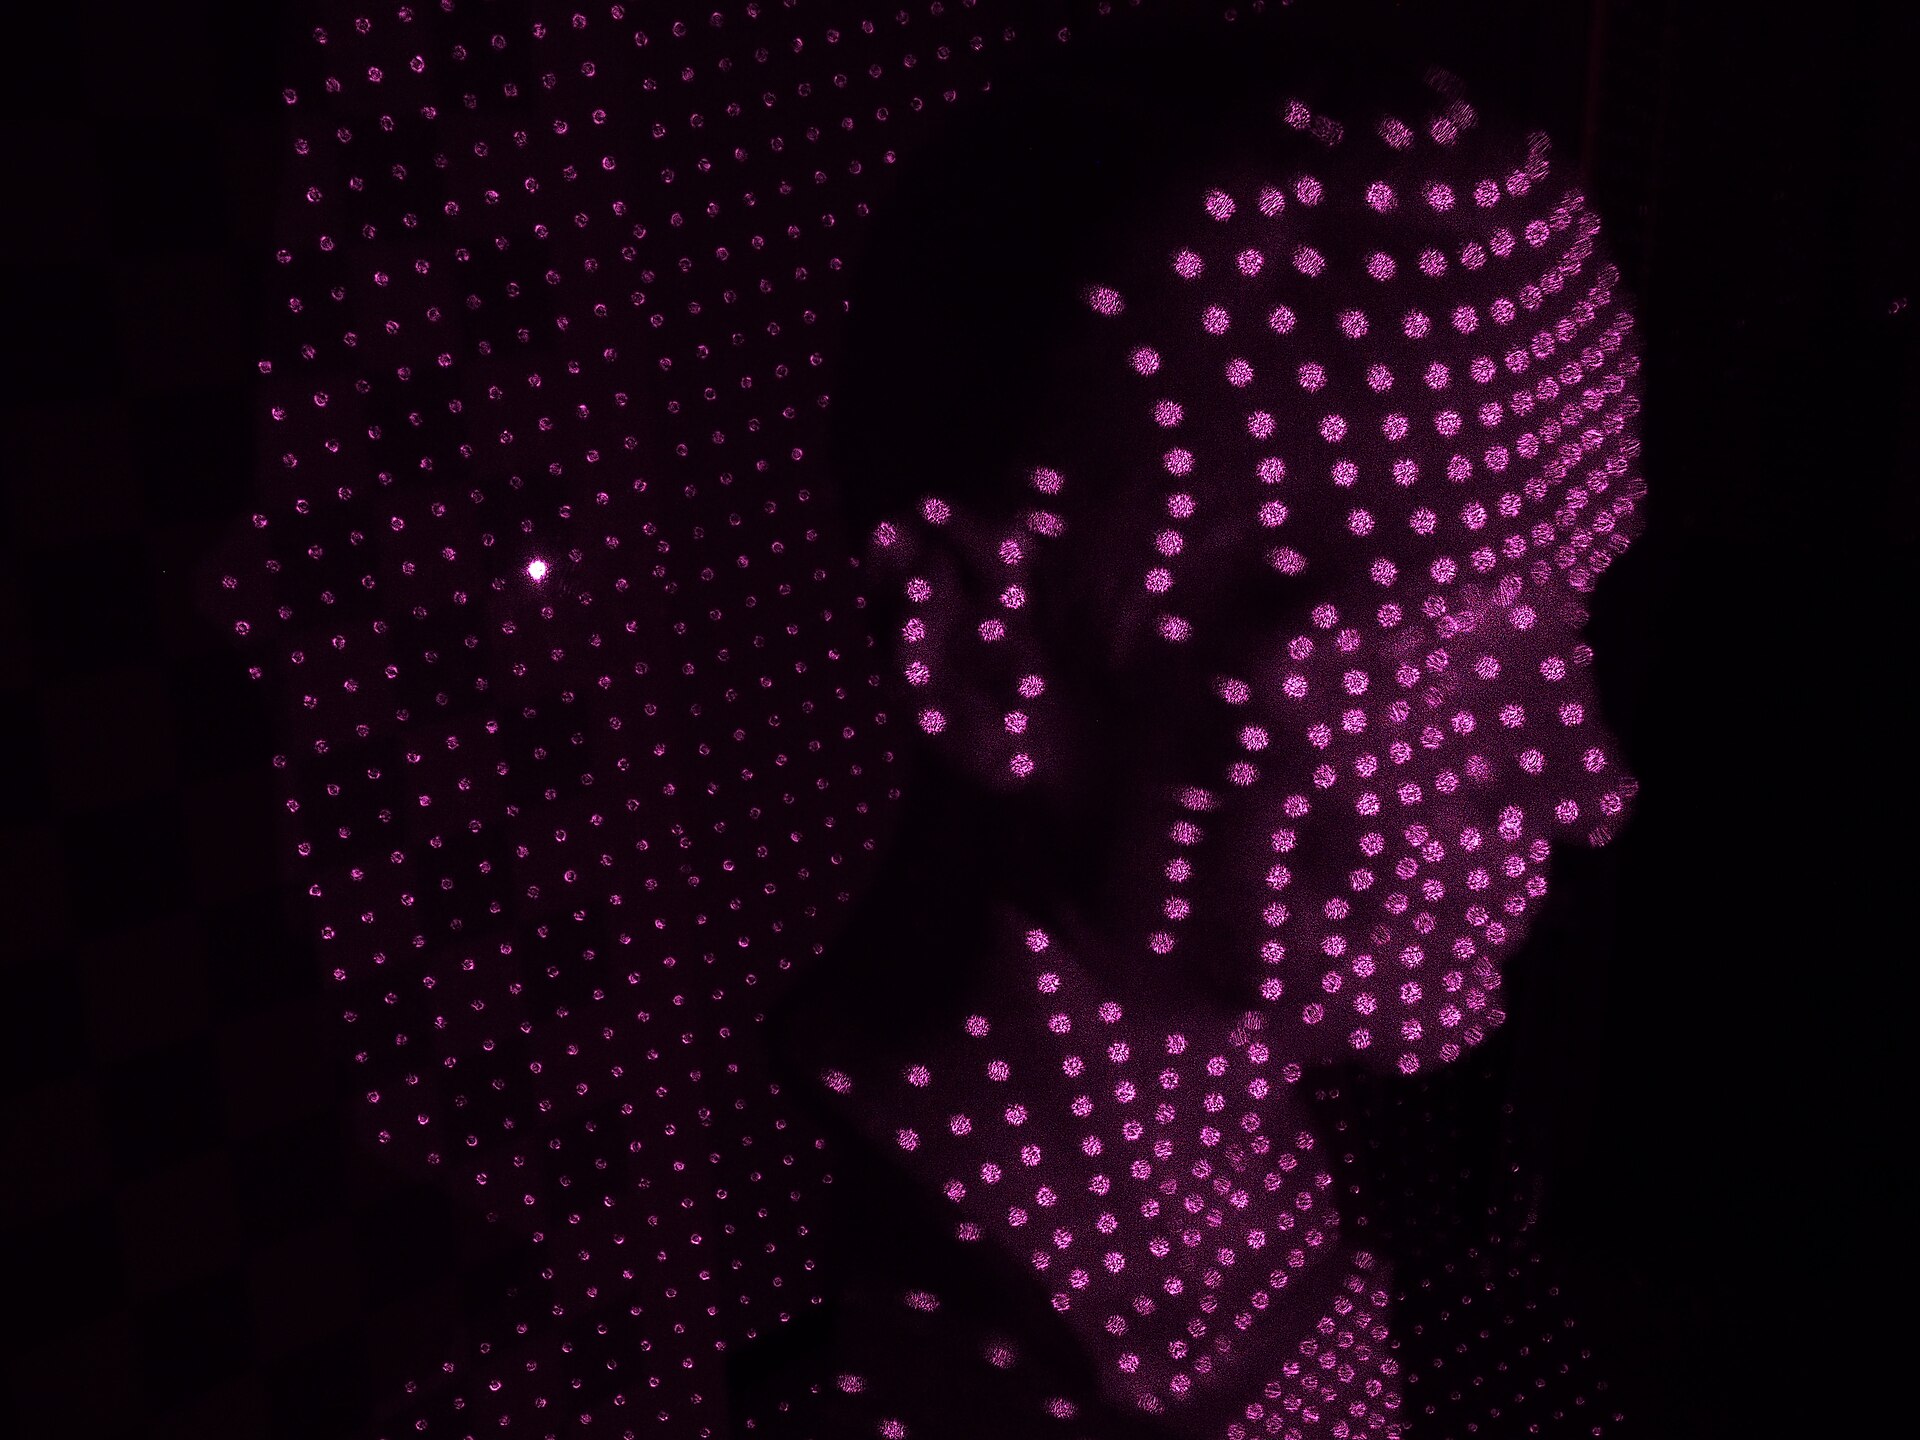
雕像扫描出来的点云是另一个量级的例子:
工业场景里的点云同样如此:
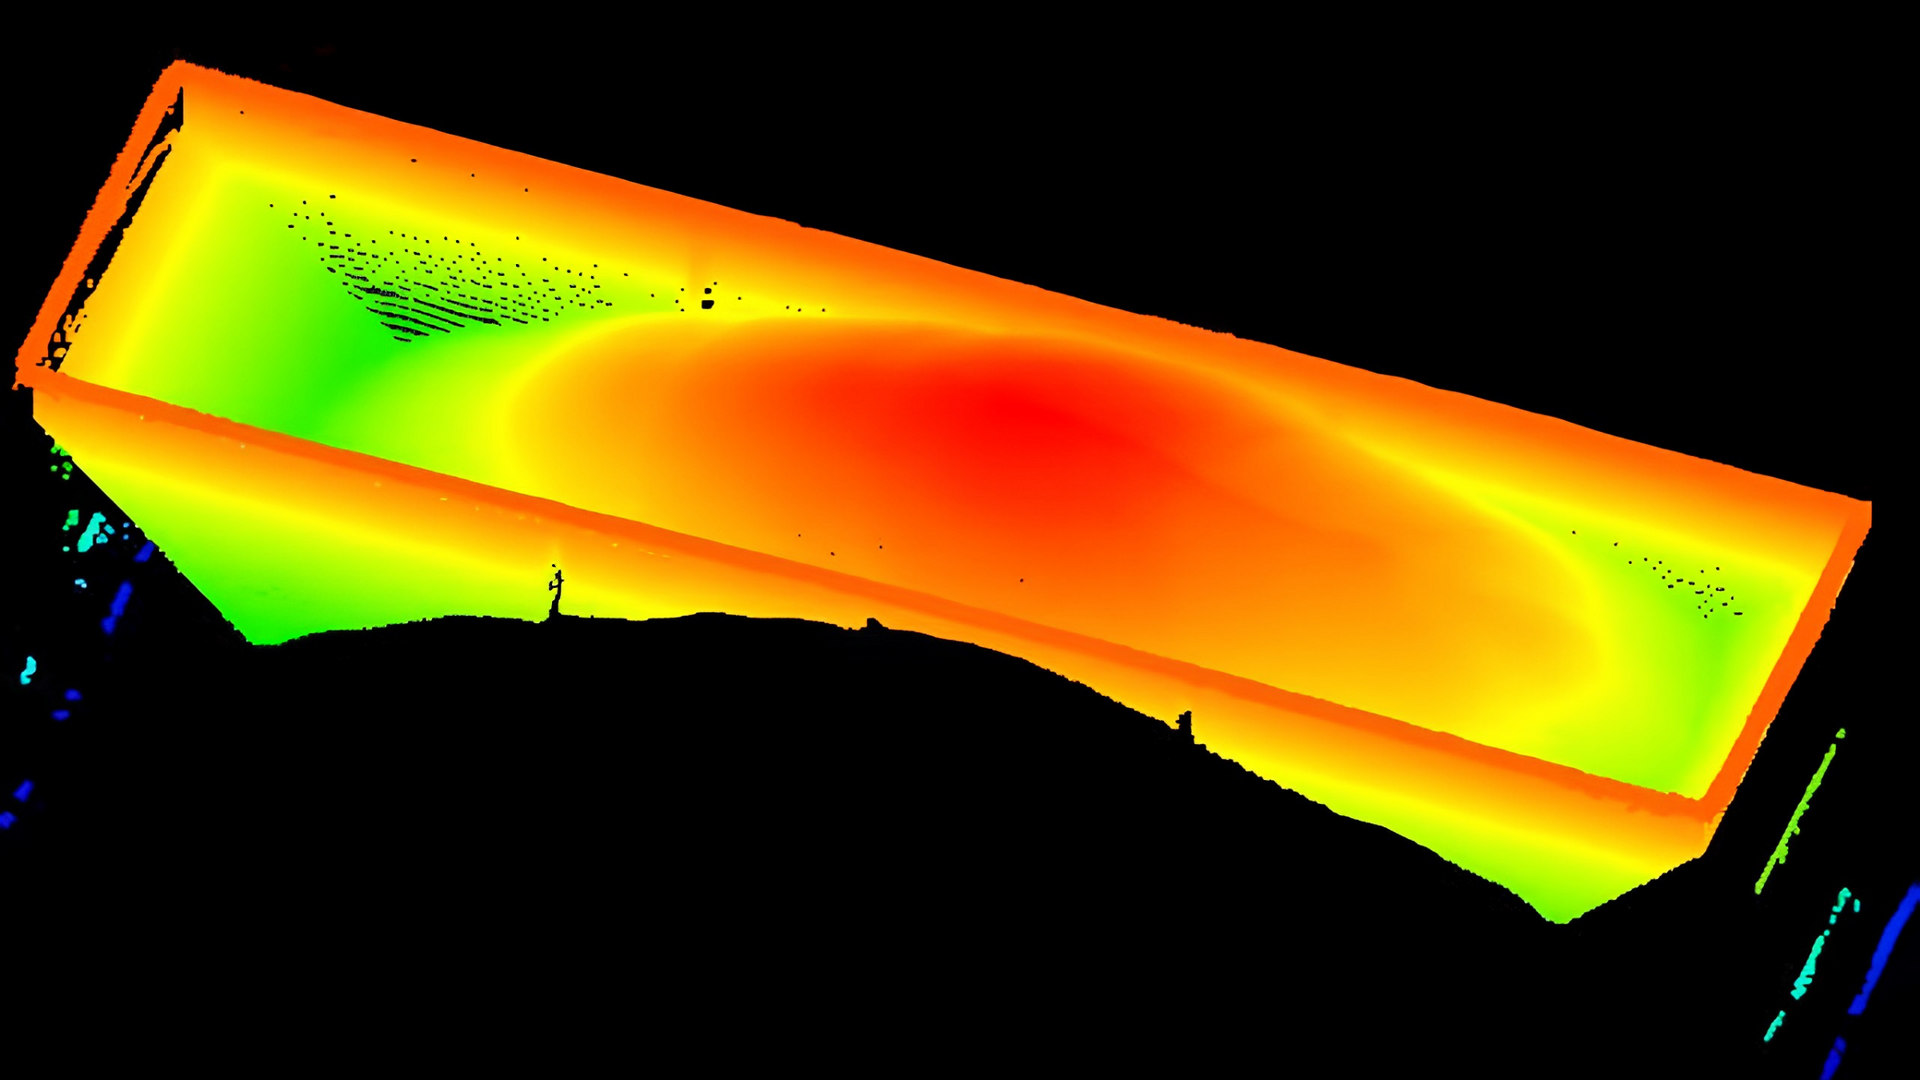
0.3 术语先对齐
下面我们先对齐术语。中文社区在这个领域的译名不太统一,先把本文的用法固定下来。括号里是本文同时使用的英文原名,第一次出现时双语并写。
0.4 一个贯穿全篇的问题
这里把这篇要回答的核心问题摆出来,后文每一章都在回答它的一个侧面:
既然"不画不需要的东西"收益这么大,为什么这件事必须一层一层往下推?每一层的判定能剔掉什么、又付出什么代价?
带着这个问题往下读,比记住任何单个算法都有用。
0.5 全量清单:可见性判定的所有手段
OK,言归正传。在展开细节之前,先把这个话题的全部手段列一遍。这份清单按"判定的依据"分组,宁全勿缺——有些手段本文不展开,但读者应当知道它们存在。
按视野范围判定:
| 手段 | 依据 | 本文处理 |
|---|---|---|
| 视锥剔除 | 六个视锥平面 | 第二章展开 |
| 近远平面剔除 | 近、远裁剪面 | 并入视锥剔除 |
| 屏幕占比剔除 | 投影后的屏幕尺寸 | 第五章提及 |
| 背面剔除 | 三角形朝向 | 光栅化阶段自动 |
按遮挡关系判定:
| 手段 | 依据 | 本文处理 |
|---|---|---|
| 硬件遮挡查询 | GPU 统计通过深度测试的像素数 | 第六章展开 |
| 层次 Z 缓冲(HZB) | 深度金字塔的保守比较 | 第七章展开 |
| 软件遮挡剔除 | CPU/GPU 软光栅化的低分辨率深度 | 第九章展开 |
| 门户剔除 | 门户(portal)与房间的连通关系 | 第九章提及 |
| 背面遮挡体剔除 | 遮挡体的背面不参与遮挡 | 不展开 |
按空间组织判定:
| 手段 | 依据 | 本文处理 |
|---|---|---|
| BVH | 层次包围体 | 第四、五章展开 |
| 八叉树 / 松散八叉树 | 空间均分 | 第四章展开 |
| k-d tree / BSP | 轴对齐/任意平面切分 | 第四章对照 |
| 潜在可见集(PVS) | 离线预计算的房间可见关系 | 不展开 |
按几何组织判定:
| 手段 | 依据 | 本文处理 |
|---|---|---|
| LOD 剔除 | 屏幕尺寸决定细节层级 | 第五章提及 |
| 簇级剔除(meshlet) | 小簇的包围球 | 第十章展开 |
| 三角形级剔除 | SV_CullPrimitive 等 |
第十一章展开 |
| 细粒度剔除(per-triangle) | 逐三角形判定 | 第十一章提及 |
先说最朴素的一条:面朝哪边决定画不画。
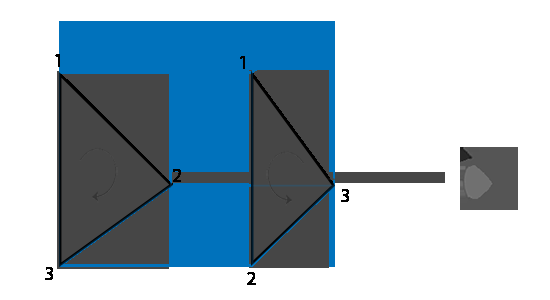
判定依据是顶点绕序:
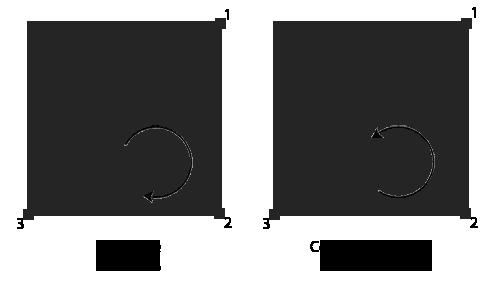
绕序搞反,剔除的就会是正面:
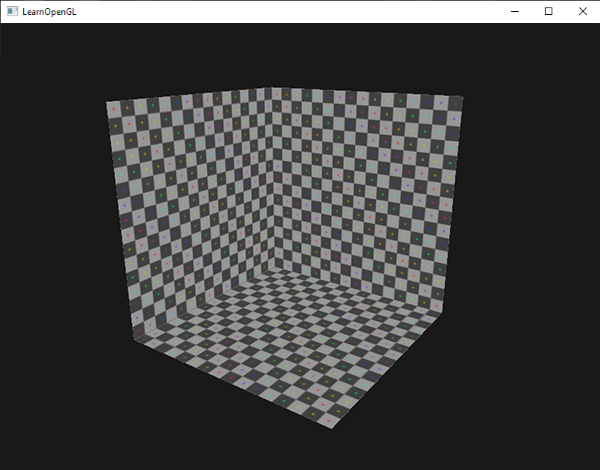
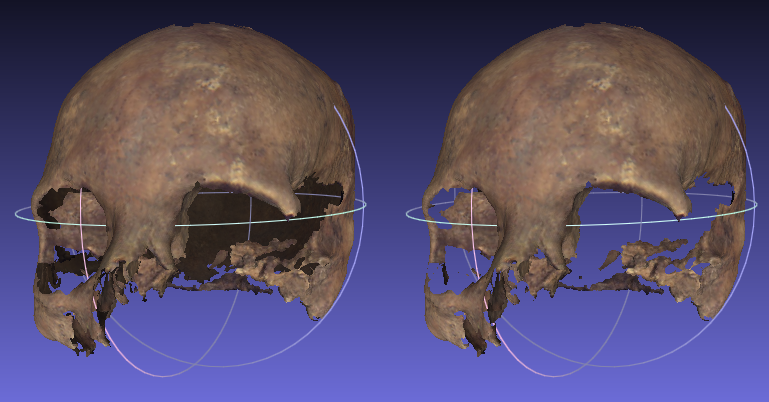
一个直观的例子——只给可见面着色:
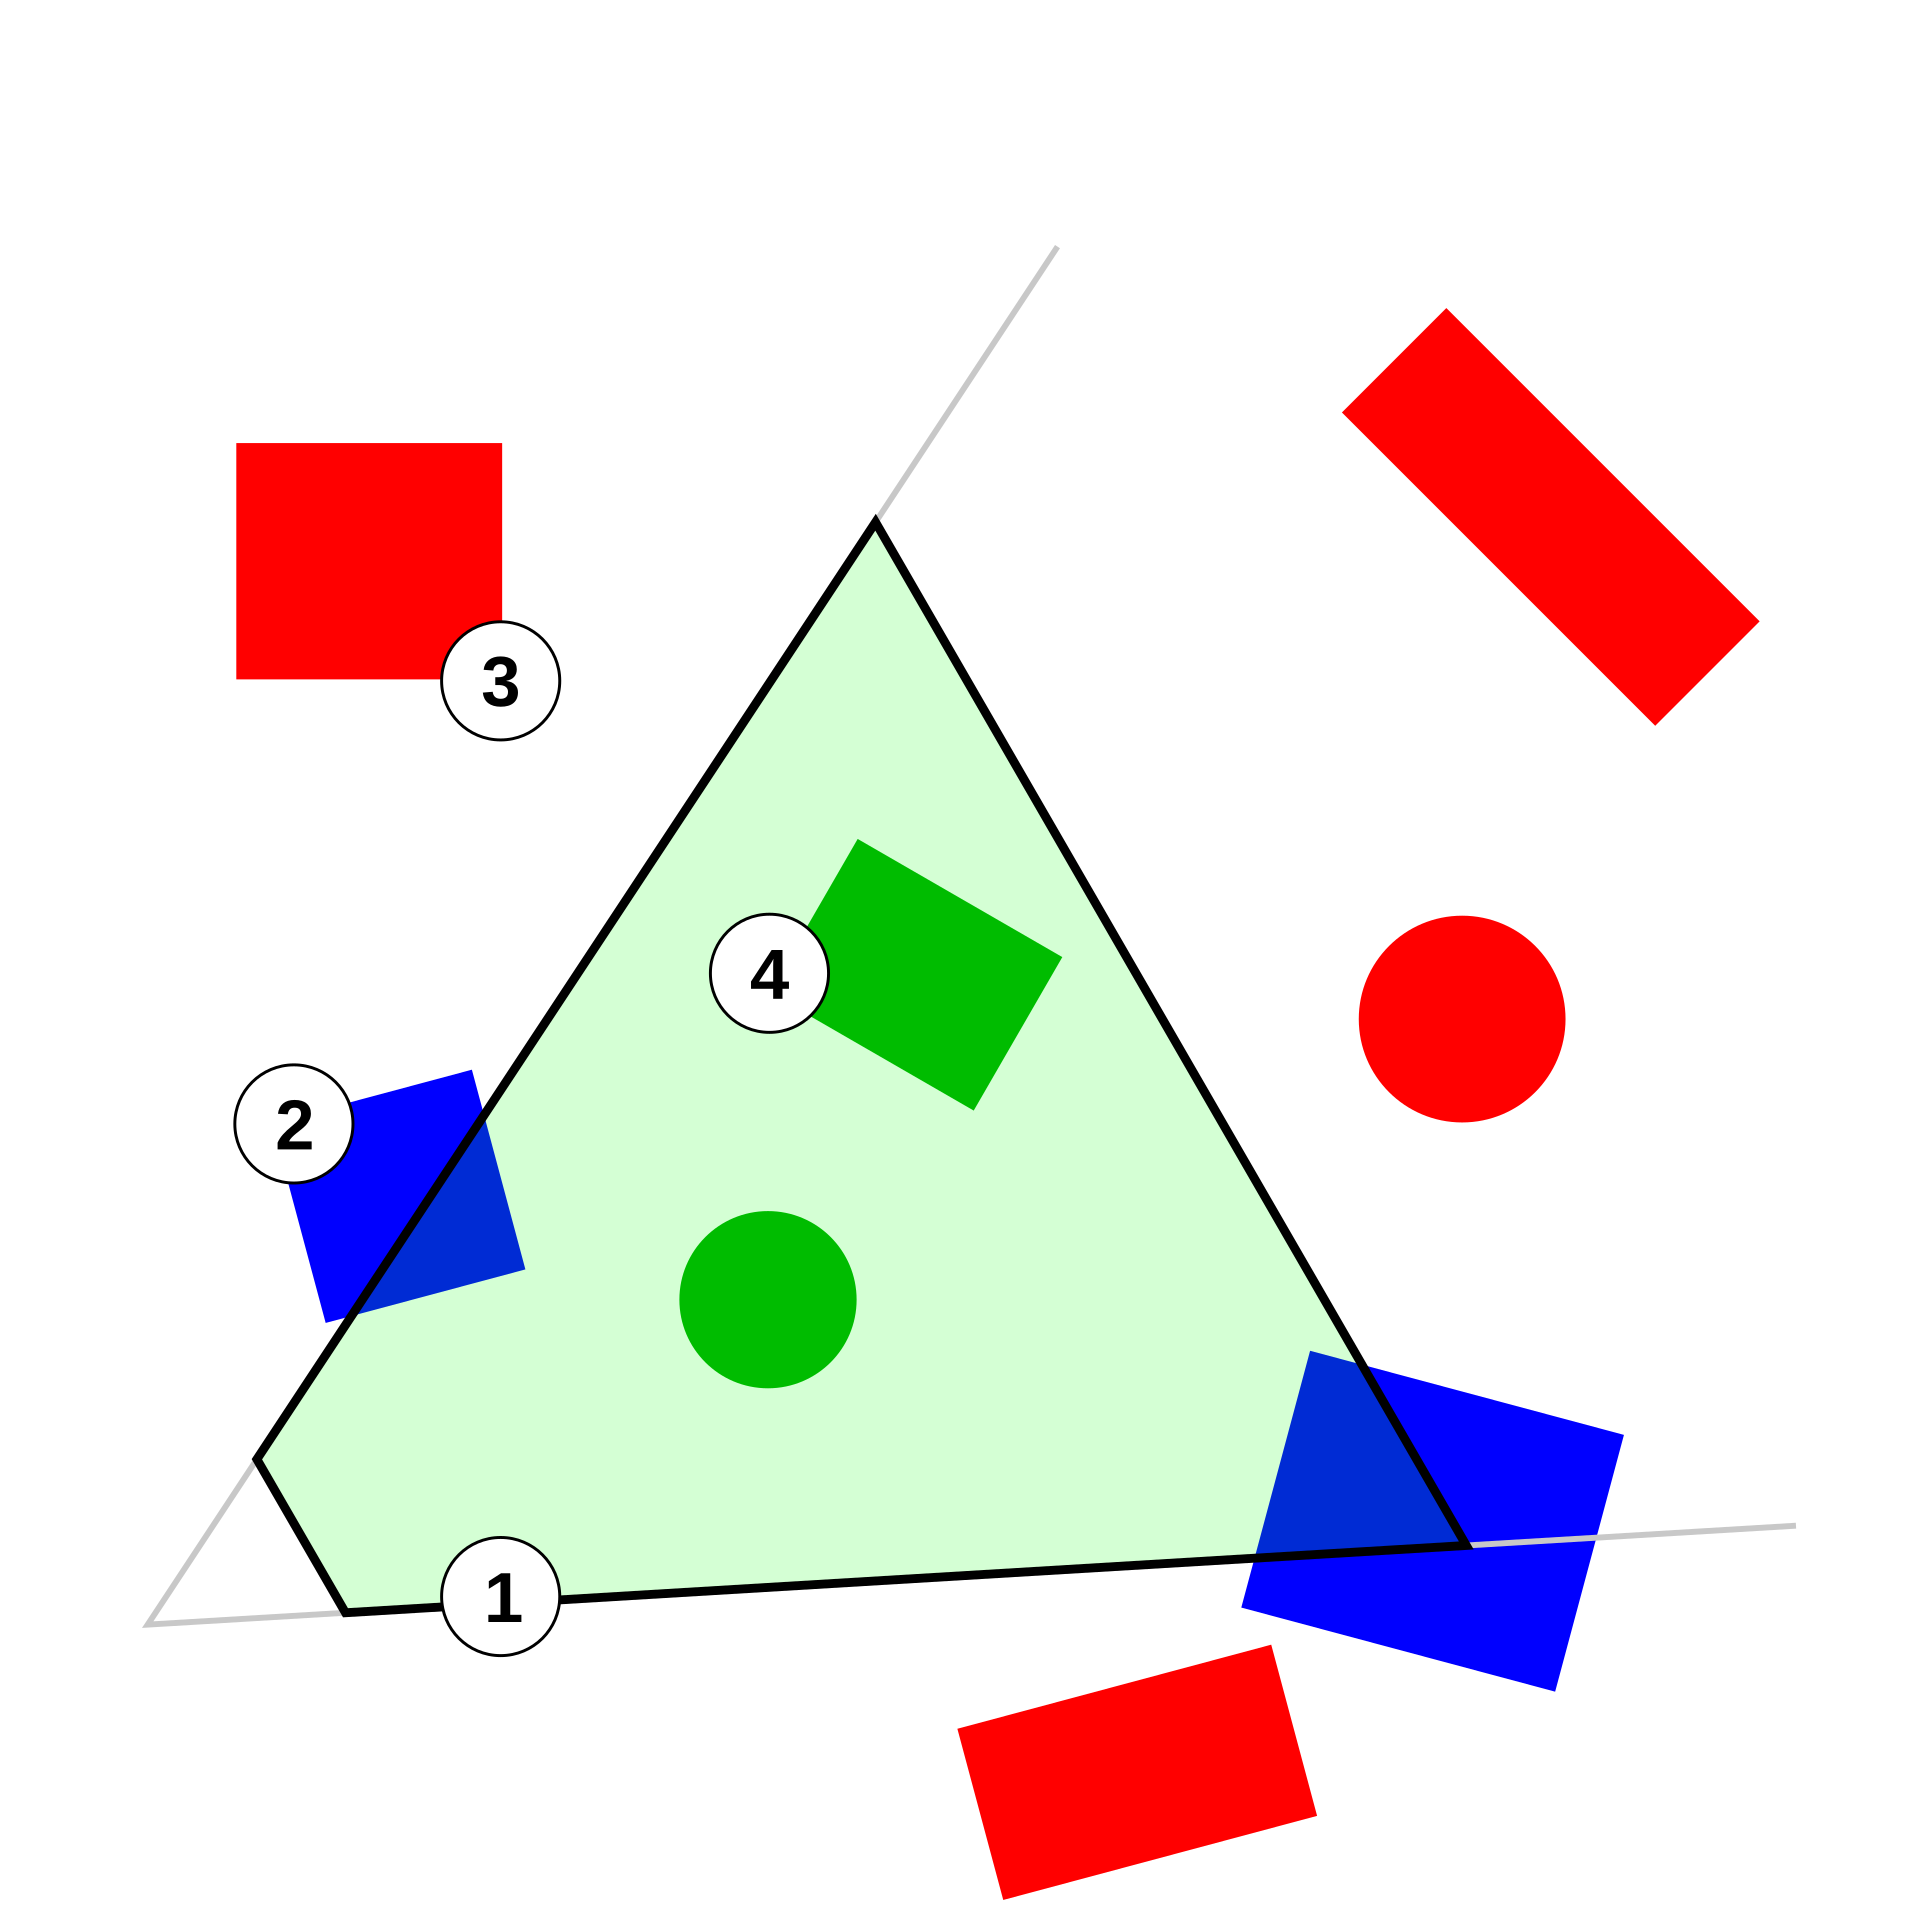
清单里的另一条是视锥剔除,思路是这样的:
0.6 二次归类:四代技术的分野
清单是"面",归类才是"骨"。把上面这些手段按"什么时候做出判定"重新归类,会看清四个世代。
这个归类最有价值的地方在于它揭示了一个规律:每一代的跨越,都不是"判定更准了",而是"判定者变了"——从 CPU 单人做,到 CPU/GPU 分工,到 GPU 全员并行,再到 GPU 自己决定还要产生什么工作。精度提升是副产品,吞吐量的提升才是主线。
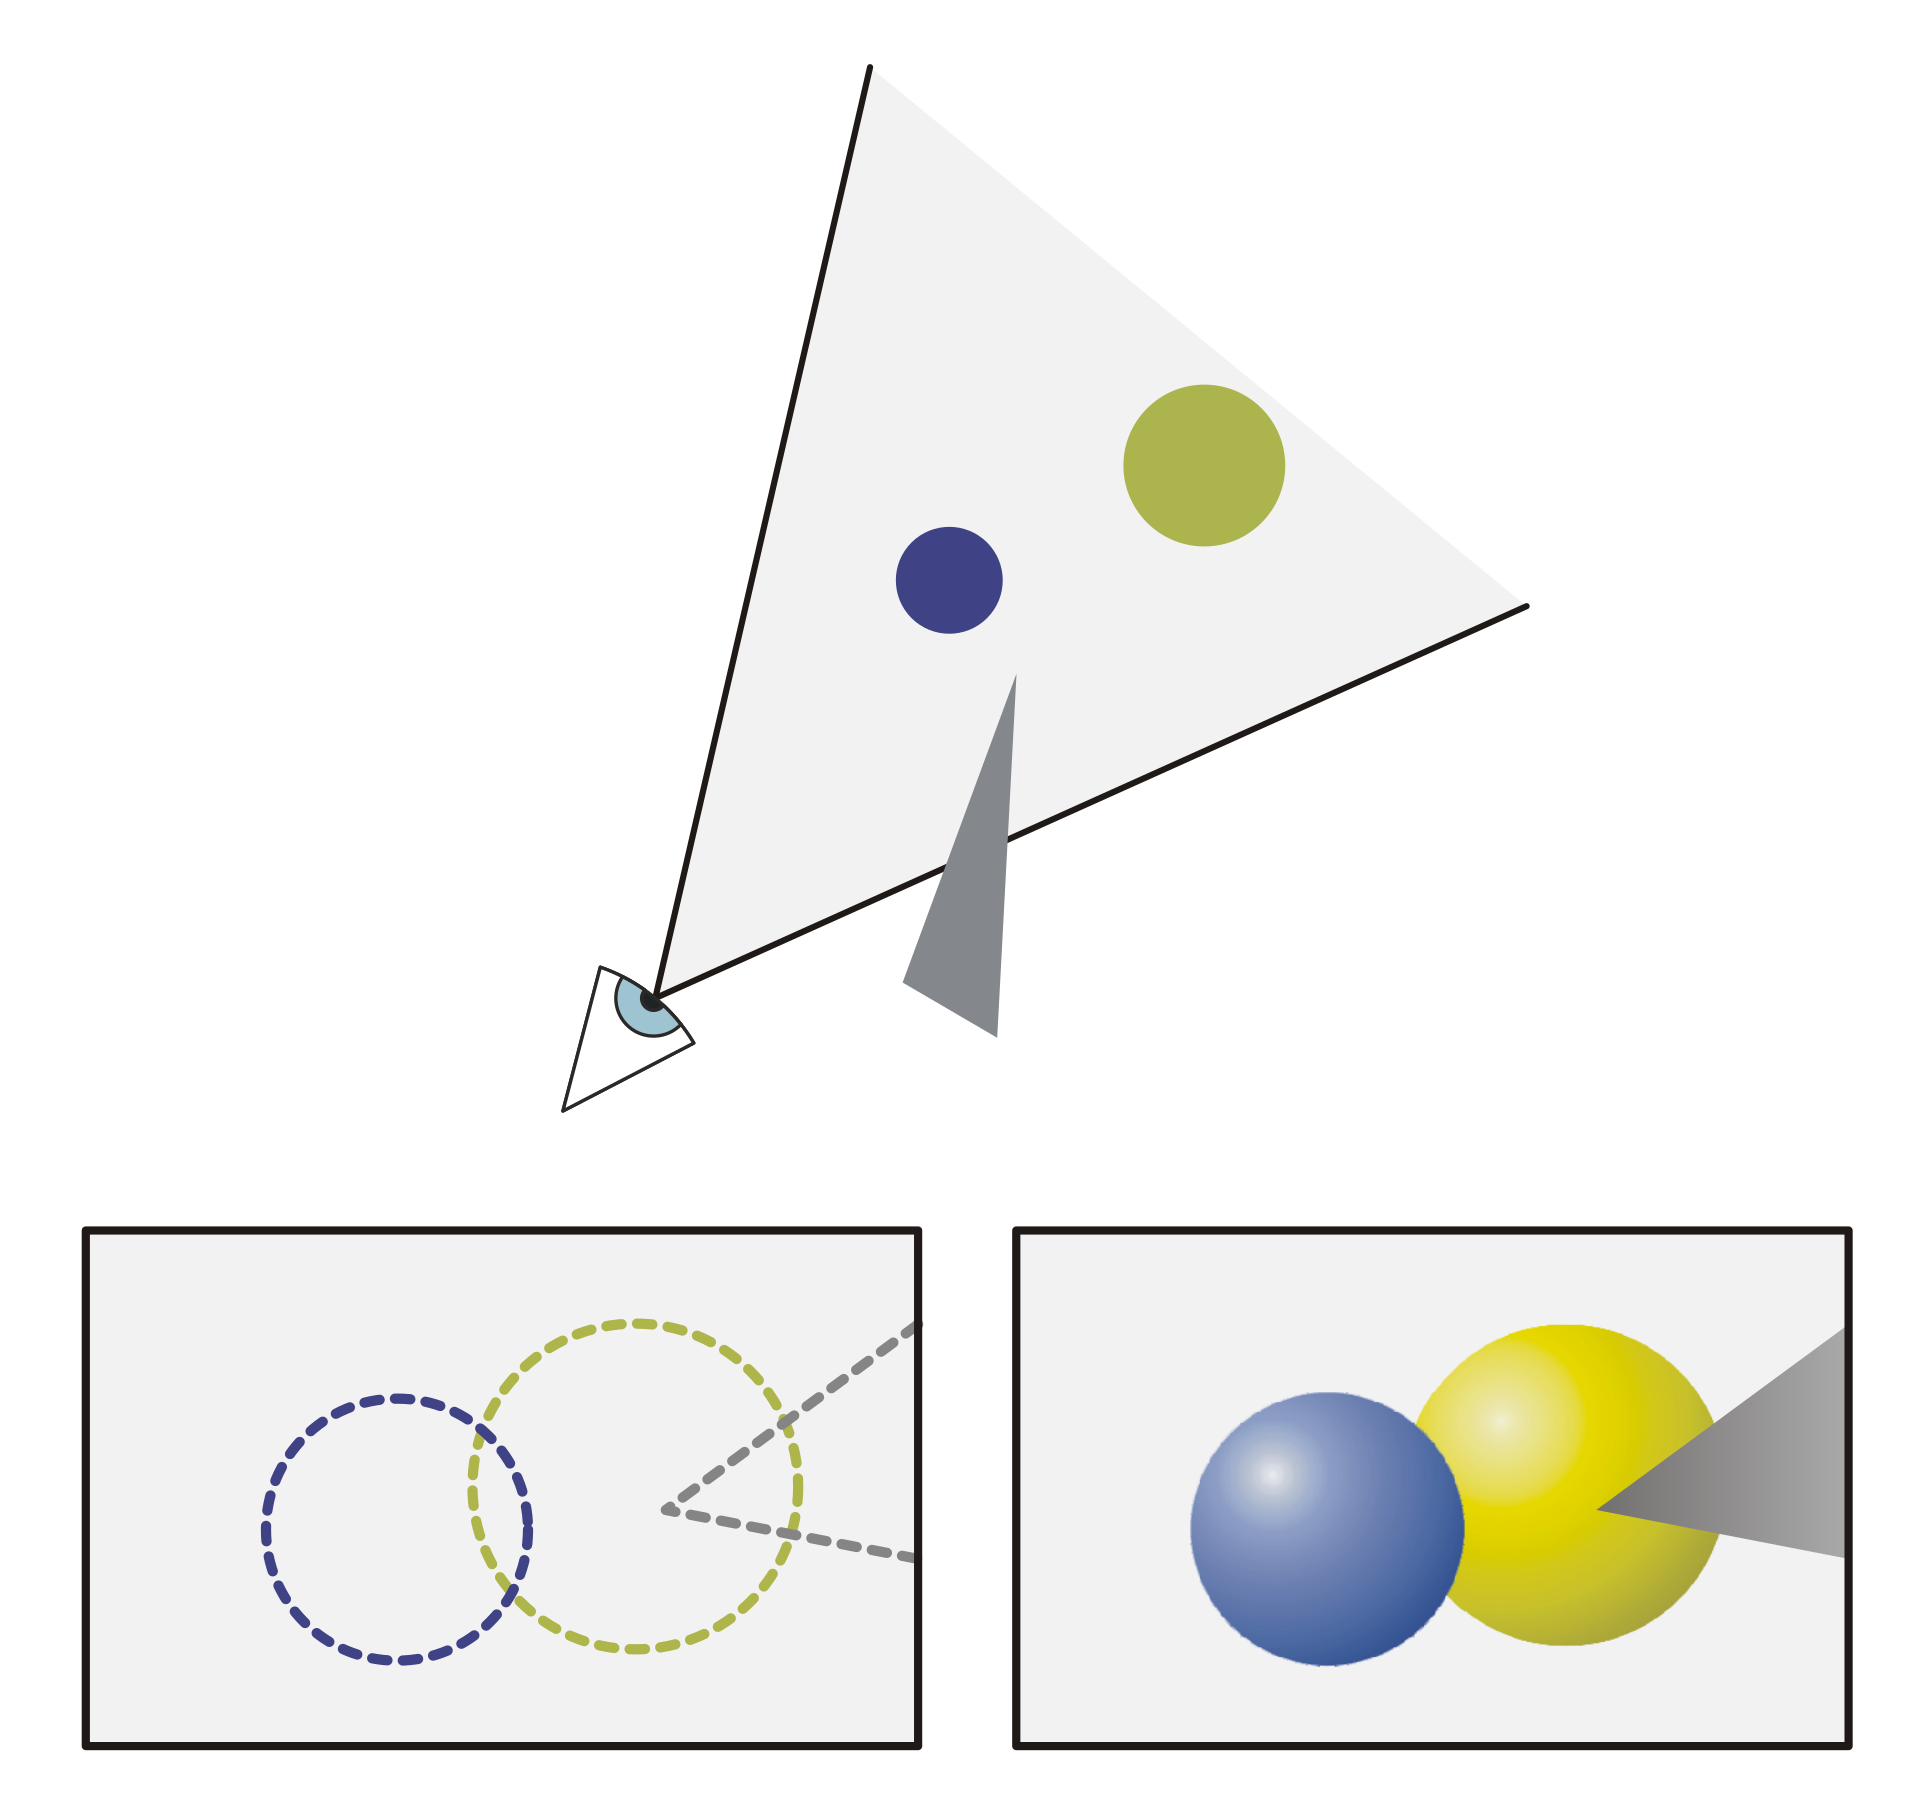
消隐这个问题的全貌,可以这样概括:
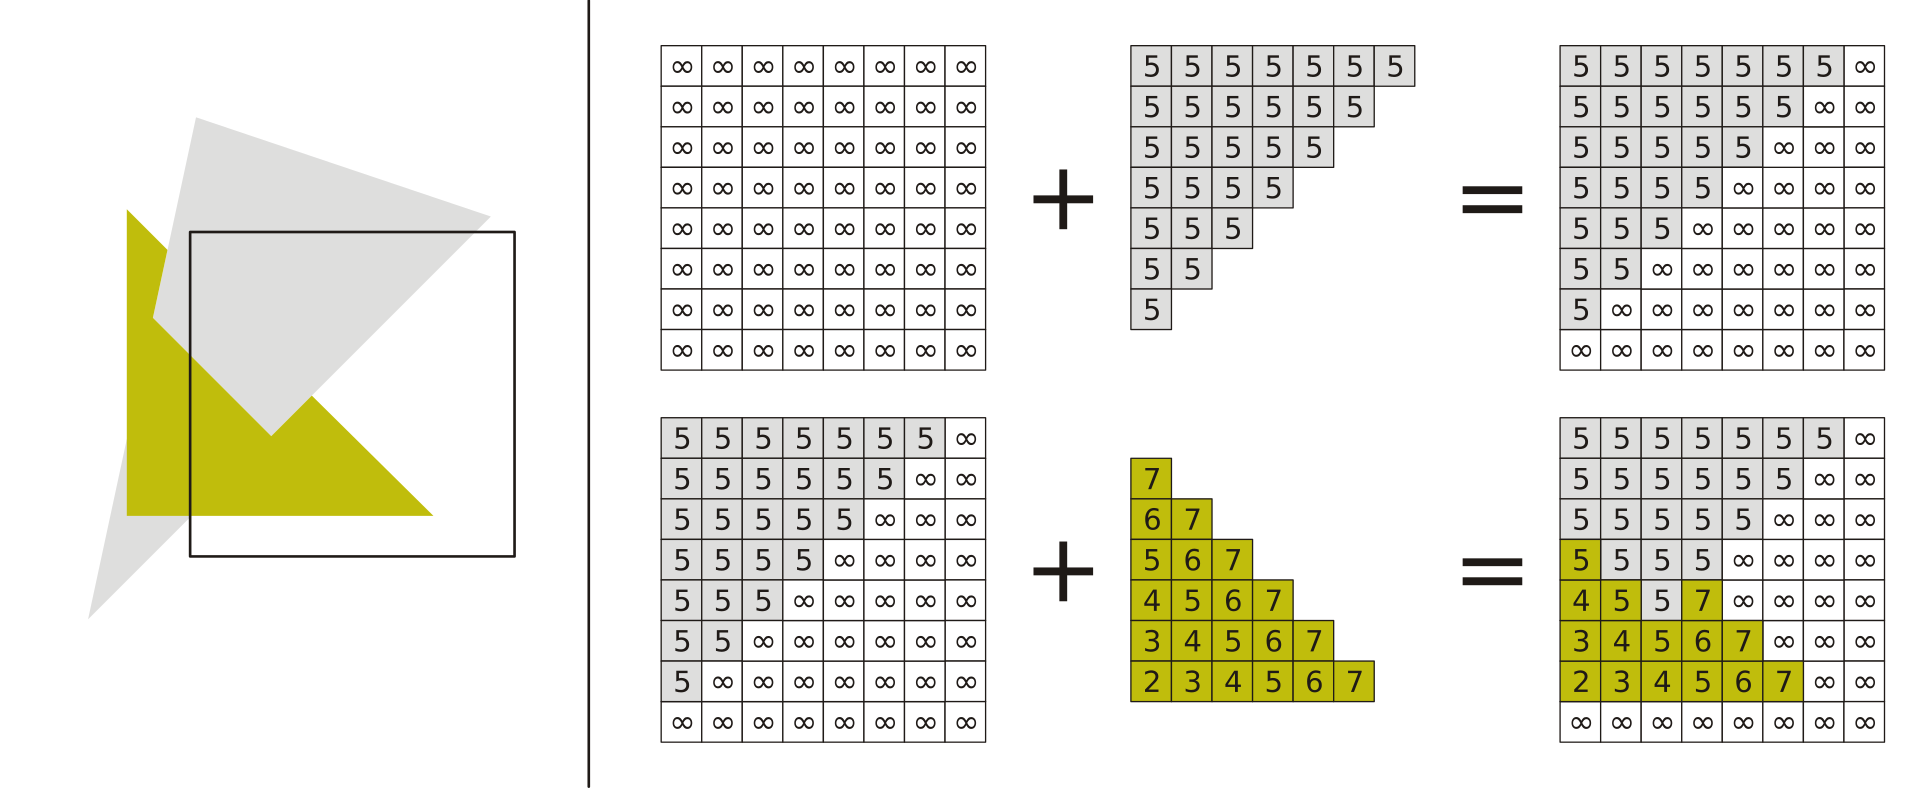
最早的一代思路是从远到近逐层覆盖:
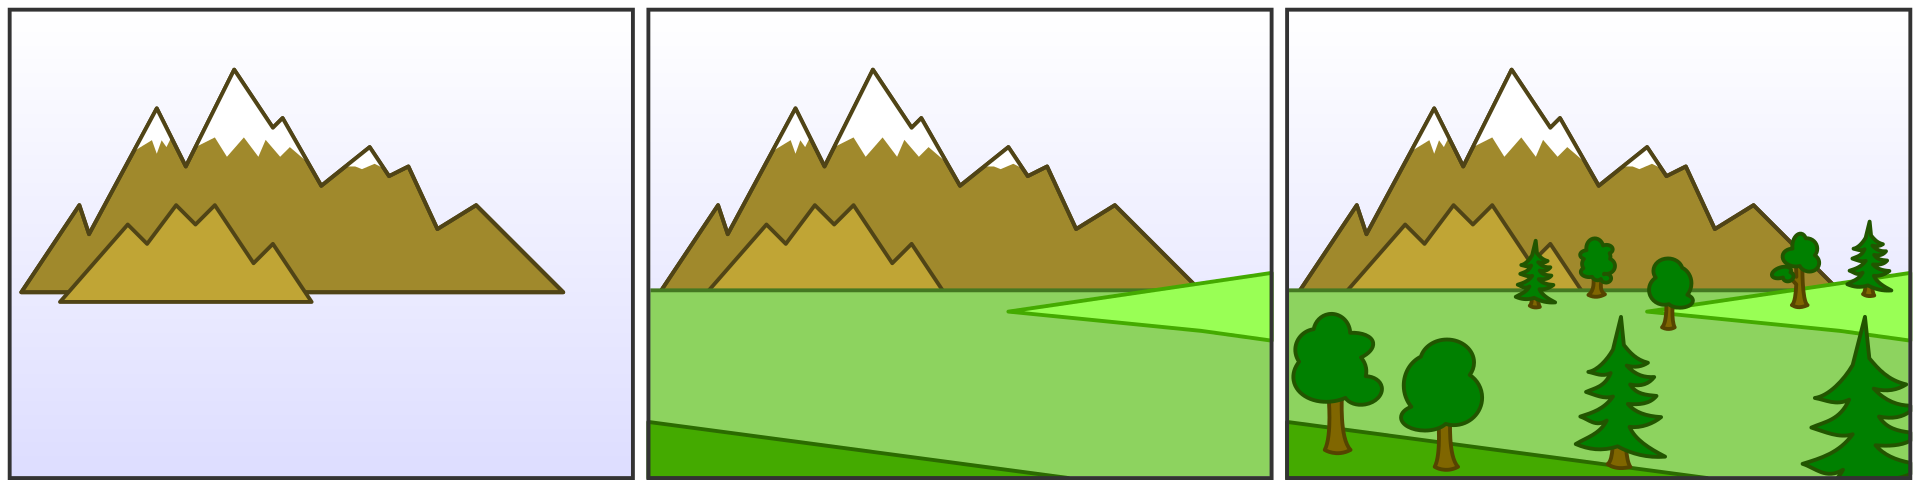
但它有解决不了的情况:
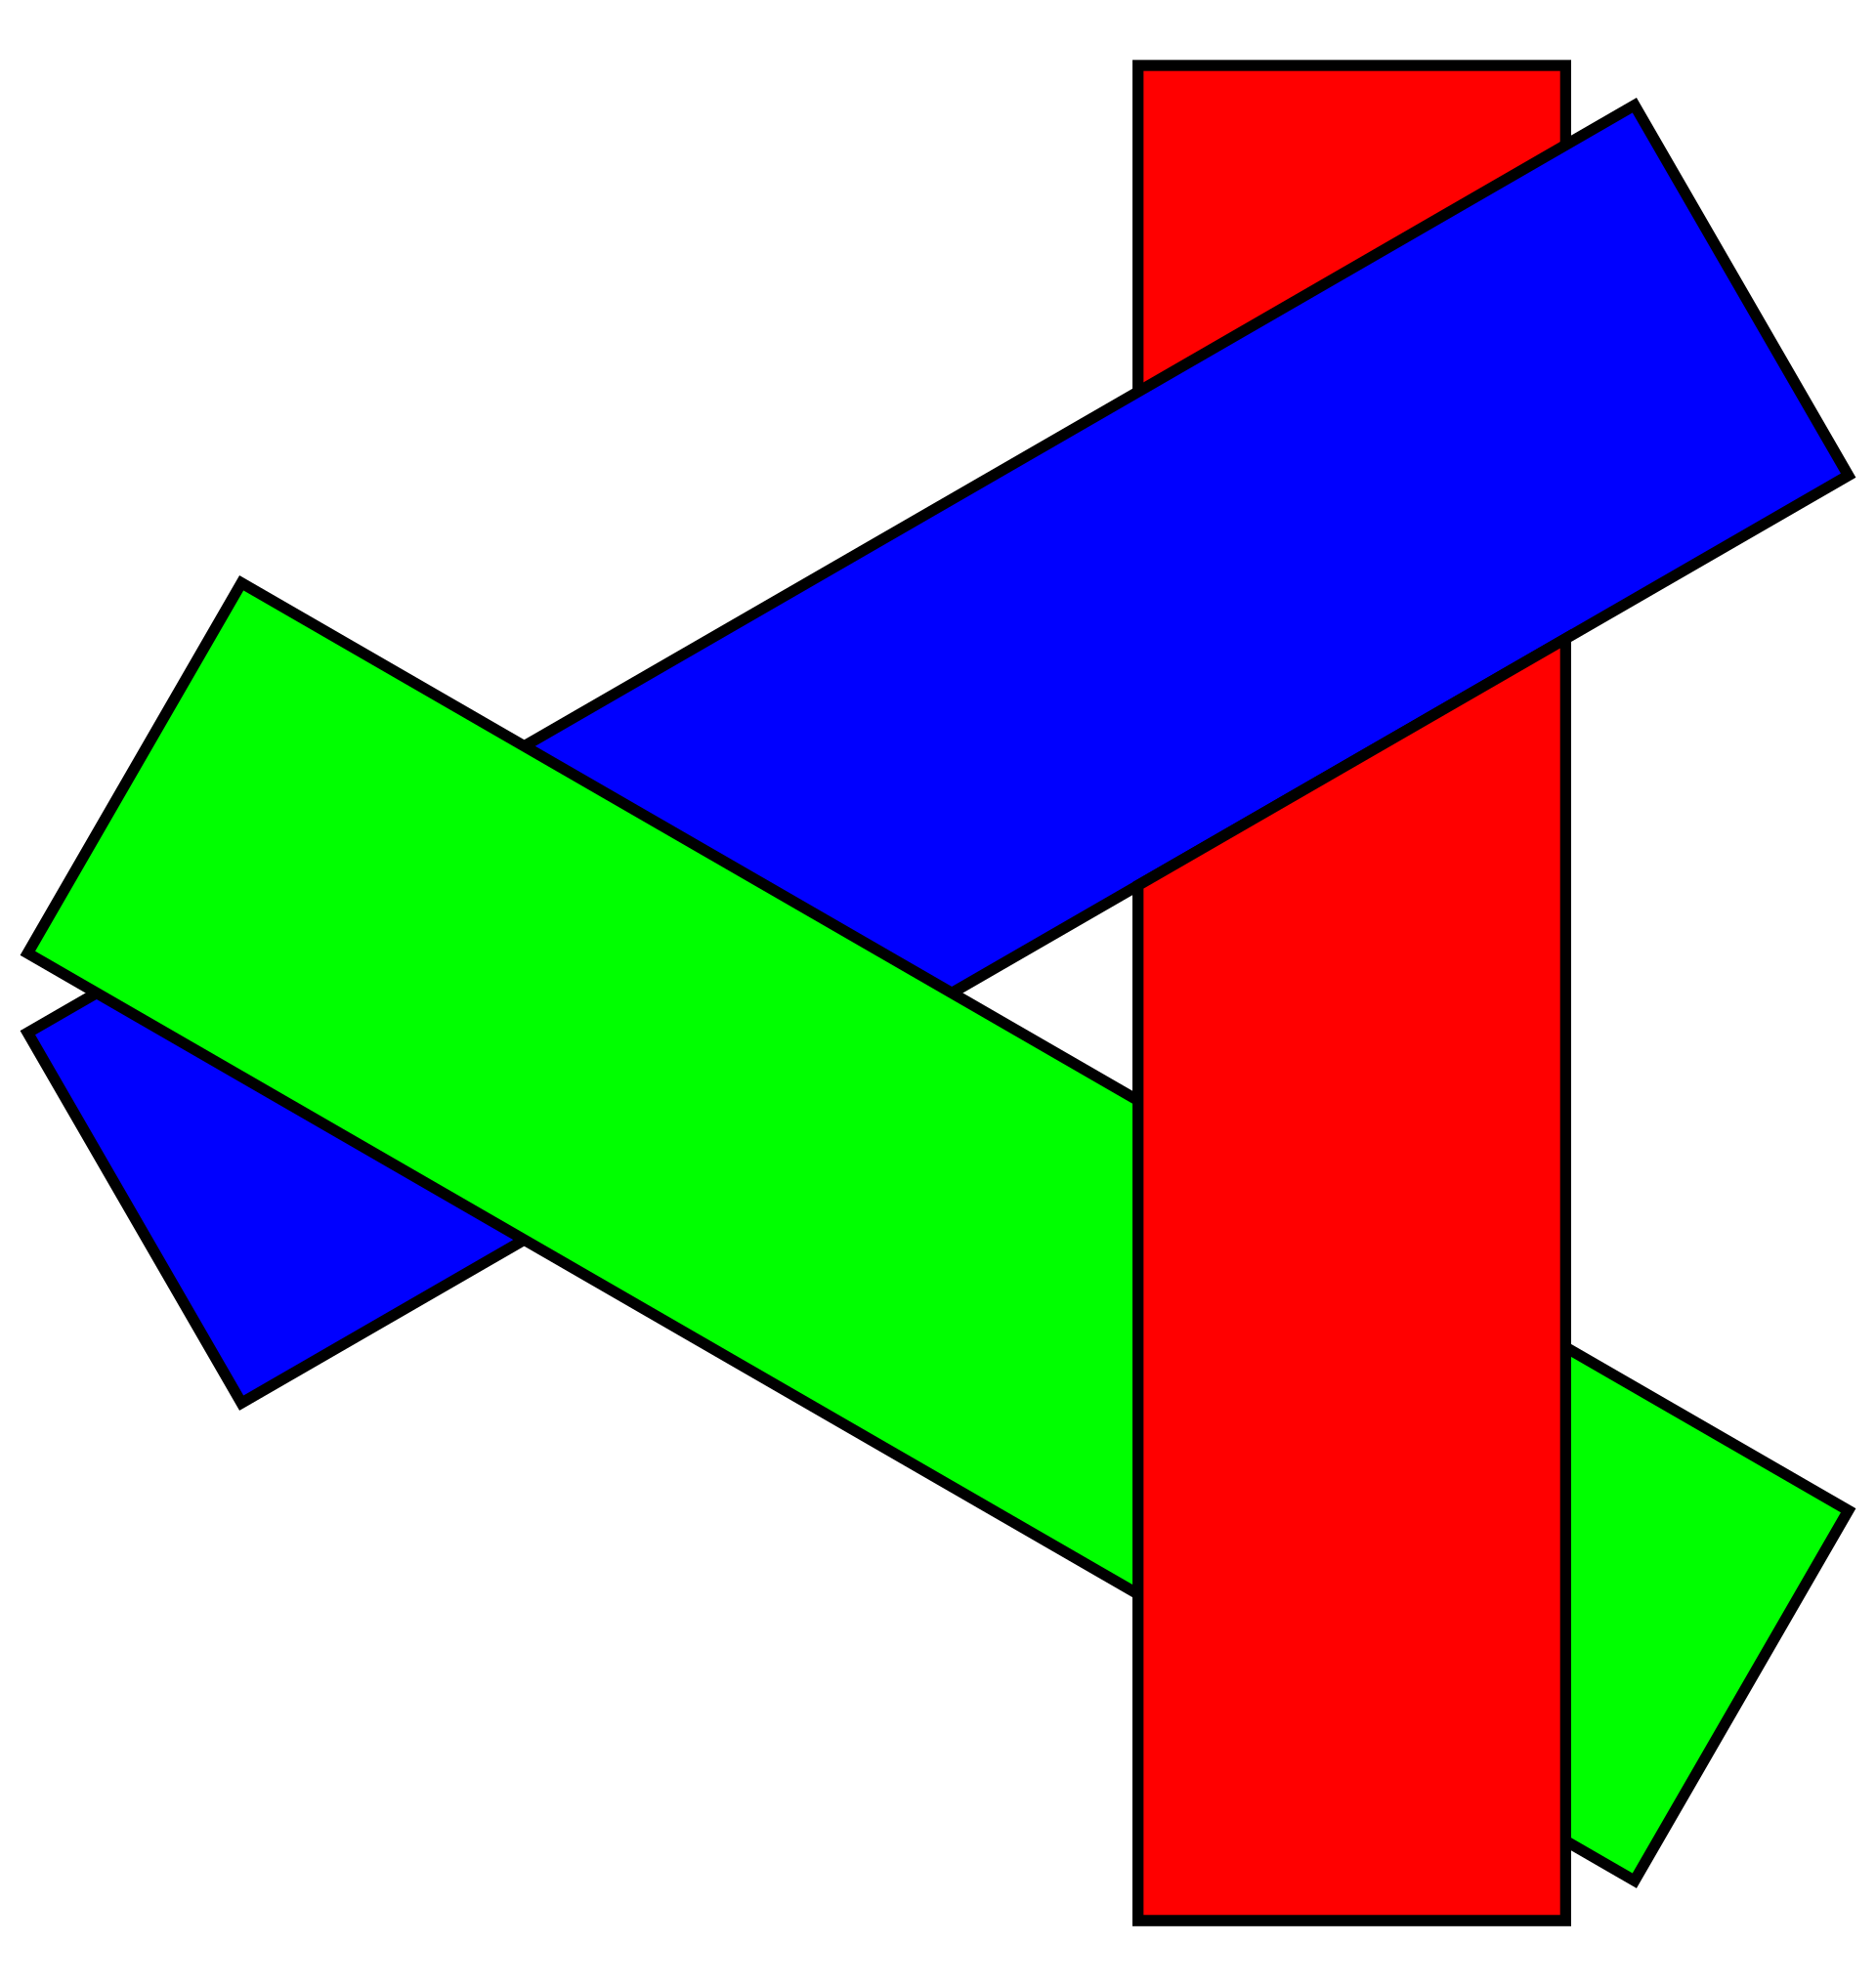
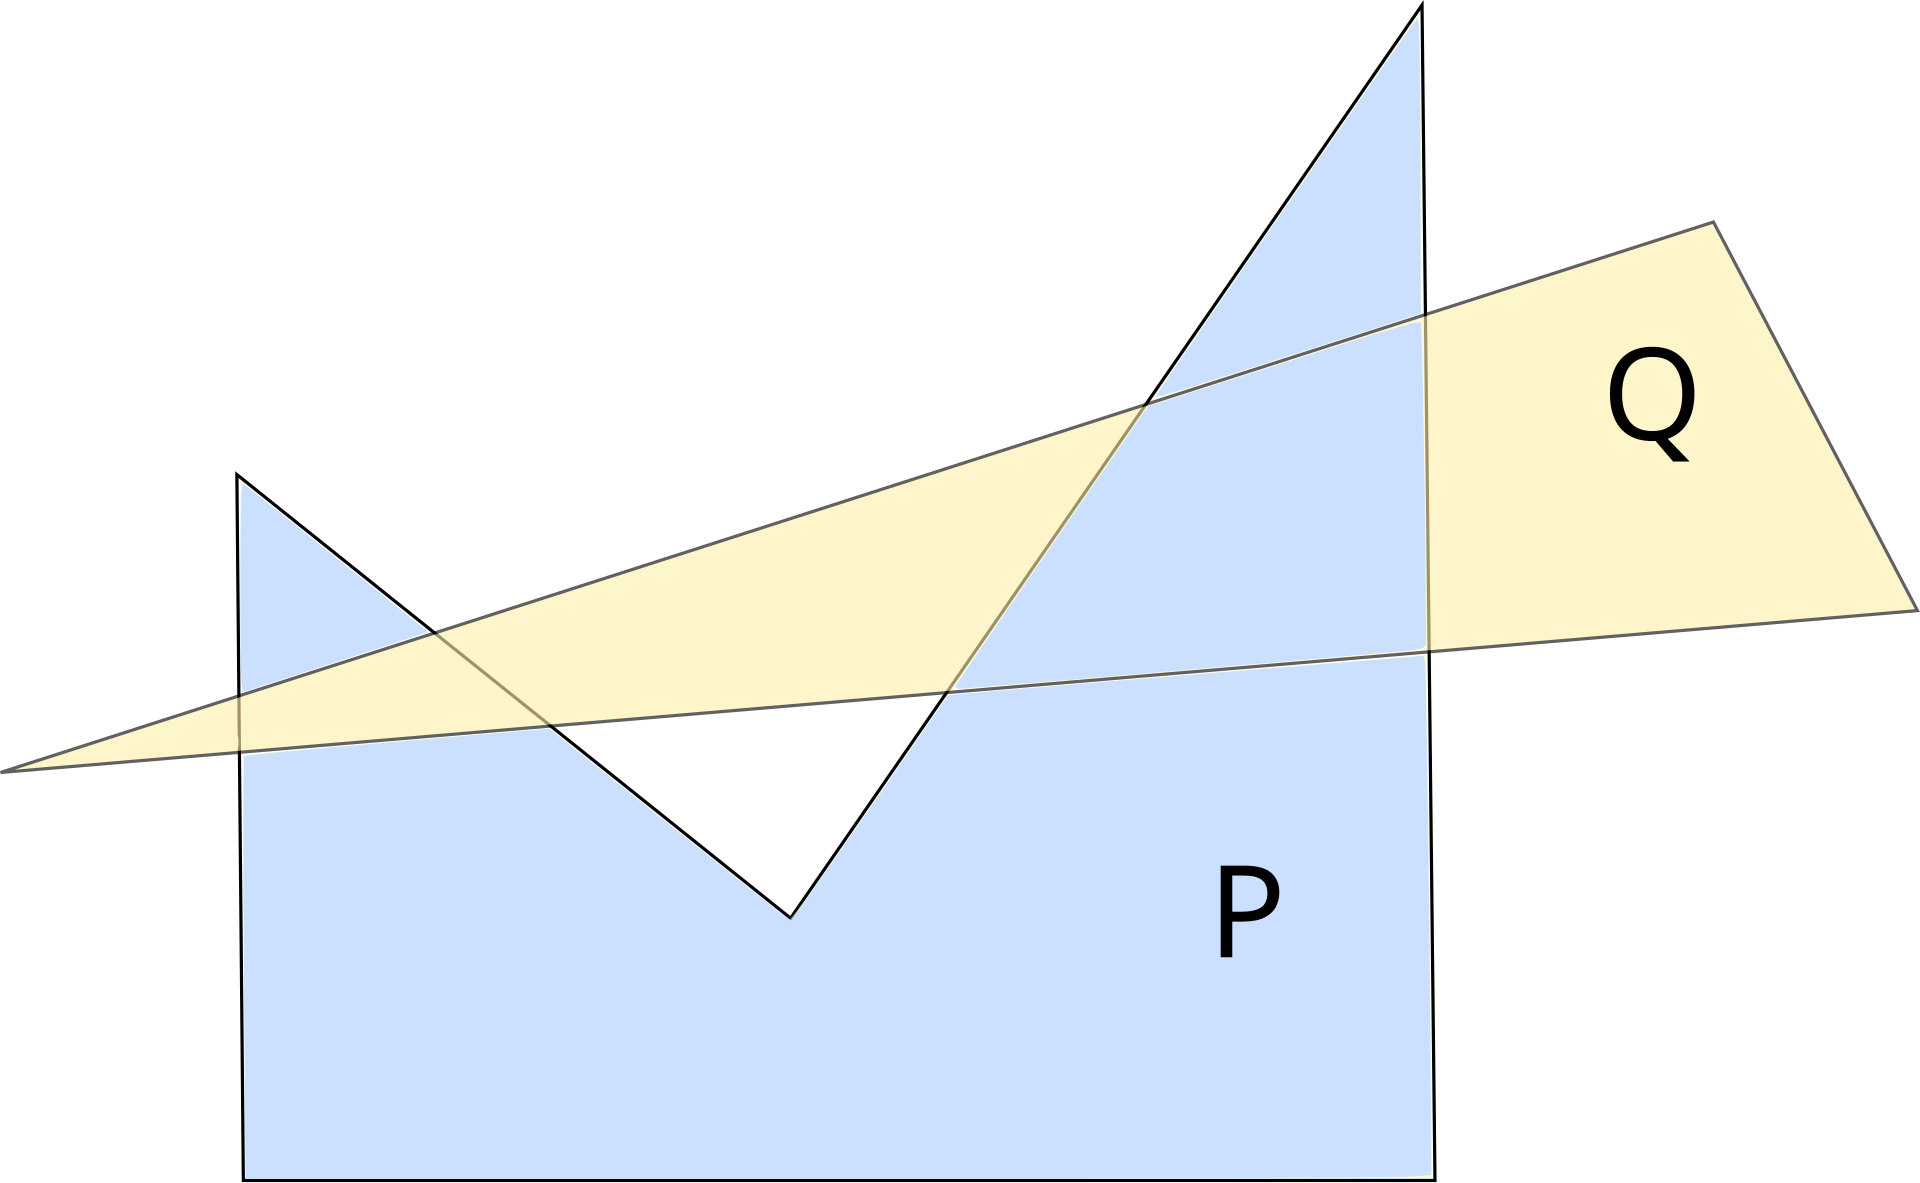
互相穿插的多边形就是它的死结:
0.7 演进时间线
下面我们开始捋时间线。把技术史按年份排一遍,能看到每一步的驱动力。年份口径说明:以公开论文或产品发布为准,工程实践中的广泛采用通常滞后两到三年。
| 年份 | 事件 | 提出者 / 产品 |
|---|---|---|
| 1980s | BSP 树用于室内可见性 | 建筑与飞行模拟领域 |
| 1993 | 层次 Z 缓冲可见性(Hi-Z 源头) | Greene 等 [31] |
| 1996 | 从矩阵提取视锥平面 | Gribb & Hartmann [25] |
| 2000s | 硬件遮挡查询进入 GPU | NVIDIA 等 |
| 2005 | 相干层次剔除(用上一帧隐藏延迟) | Wimmer & Bittner,GPU Gems 2 [17] |
| 2000s | Umbra 类软件遮挡剔除 | Aila & Miettinen 的 dPVS [20] |
| 2010s | HZB 在引擎中普及 | Unreal / Unity |
| 2013 | 可见性缓冲提出 | Burns [24] |
| 2015 | 当帧深度重测的剔除方案 | Haar & Aaltonen,Eidos 采用 [59] |
| 2016 | 掩码软光栅软件剔除 | Hasselgren 等,HPG [20] |
| 2018 | Meshlet 与 Task/Mesh Shader | NVIDIA Turing [38] |
| 2021 | 虚拟几何(Nanite) | Epic Games [41] |
| 2023 | Work Graphs 公开预览 | Microsoft [5] |
| 2024 | 移动端簇化虚拟几何 | NanoMesh,SIGGRAPH [42] |
| 2025 | 商业引擎 meshlet 管线公开 | Capcom RE Engine [44] |
这条线有三段明显的加速期:2005 年之前是算法驱动(提出各种判定思路);2013 年之后是硬件驱动(GPU 可编程性带来的并行空间);2018 年之后是几何组织驱动(meshlet 与虚拟几何改变了"判定单位"本身)。
把前面列的清单按"判定依据"重排一遍,四代技术的分野就清楚了。
判定次数随粒度收窄而指数上升,这是后面所有工程取舍的根源。
这条演进线的起点是数据从哪来——真实几何靠扫描获得:
实物扫描的现场是这样:
一、一个必须先立的规矩:宁可多画,不可漏画
1.1 保守性:所有剔除的共同前提
OK,言归正传。把保守性(conservativeness)说清楚,后面所有的取舍就都能理解了。
一个剔除算法的判定有三种可能结果:确定不可见(可以安全剔除)、确定可见(必须画)、不确定。保守性要求的是:只有在"确定不可见"时才允许剔除;"不确定"一律按可见处理。
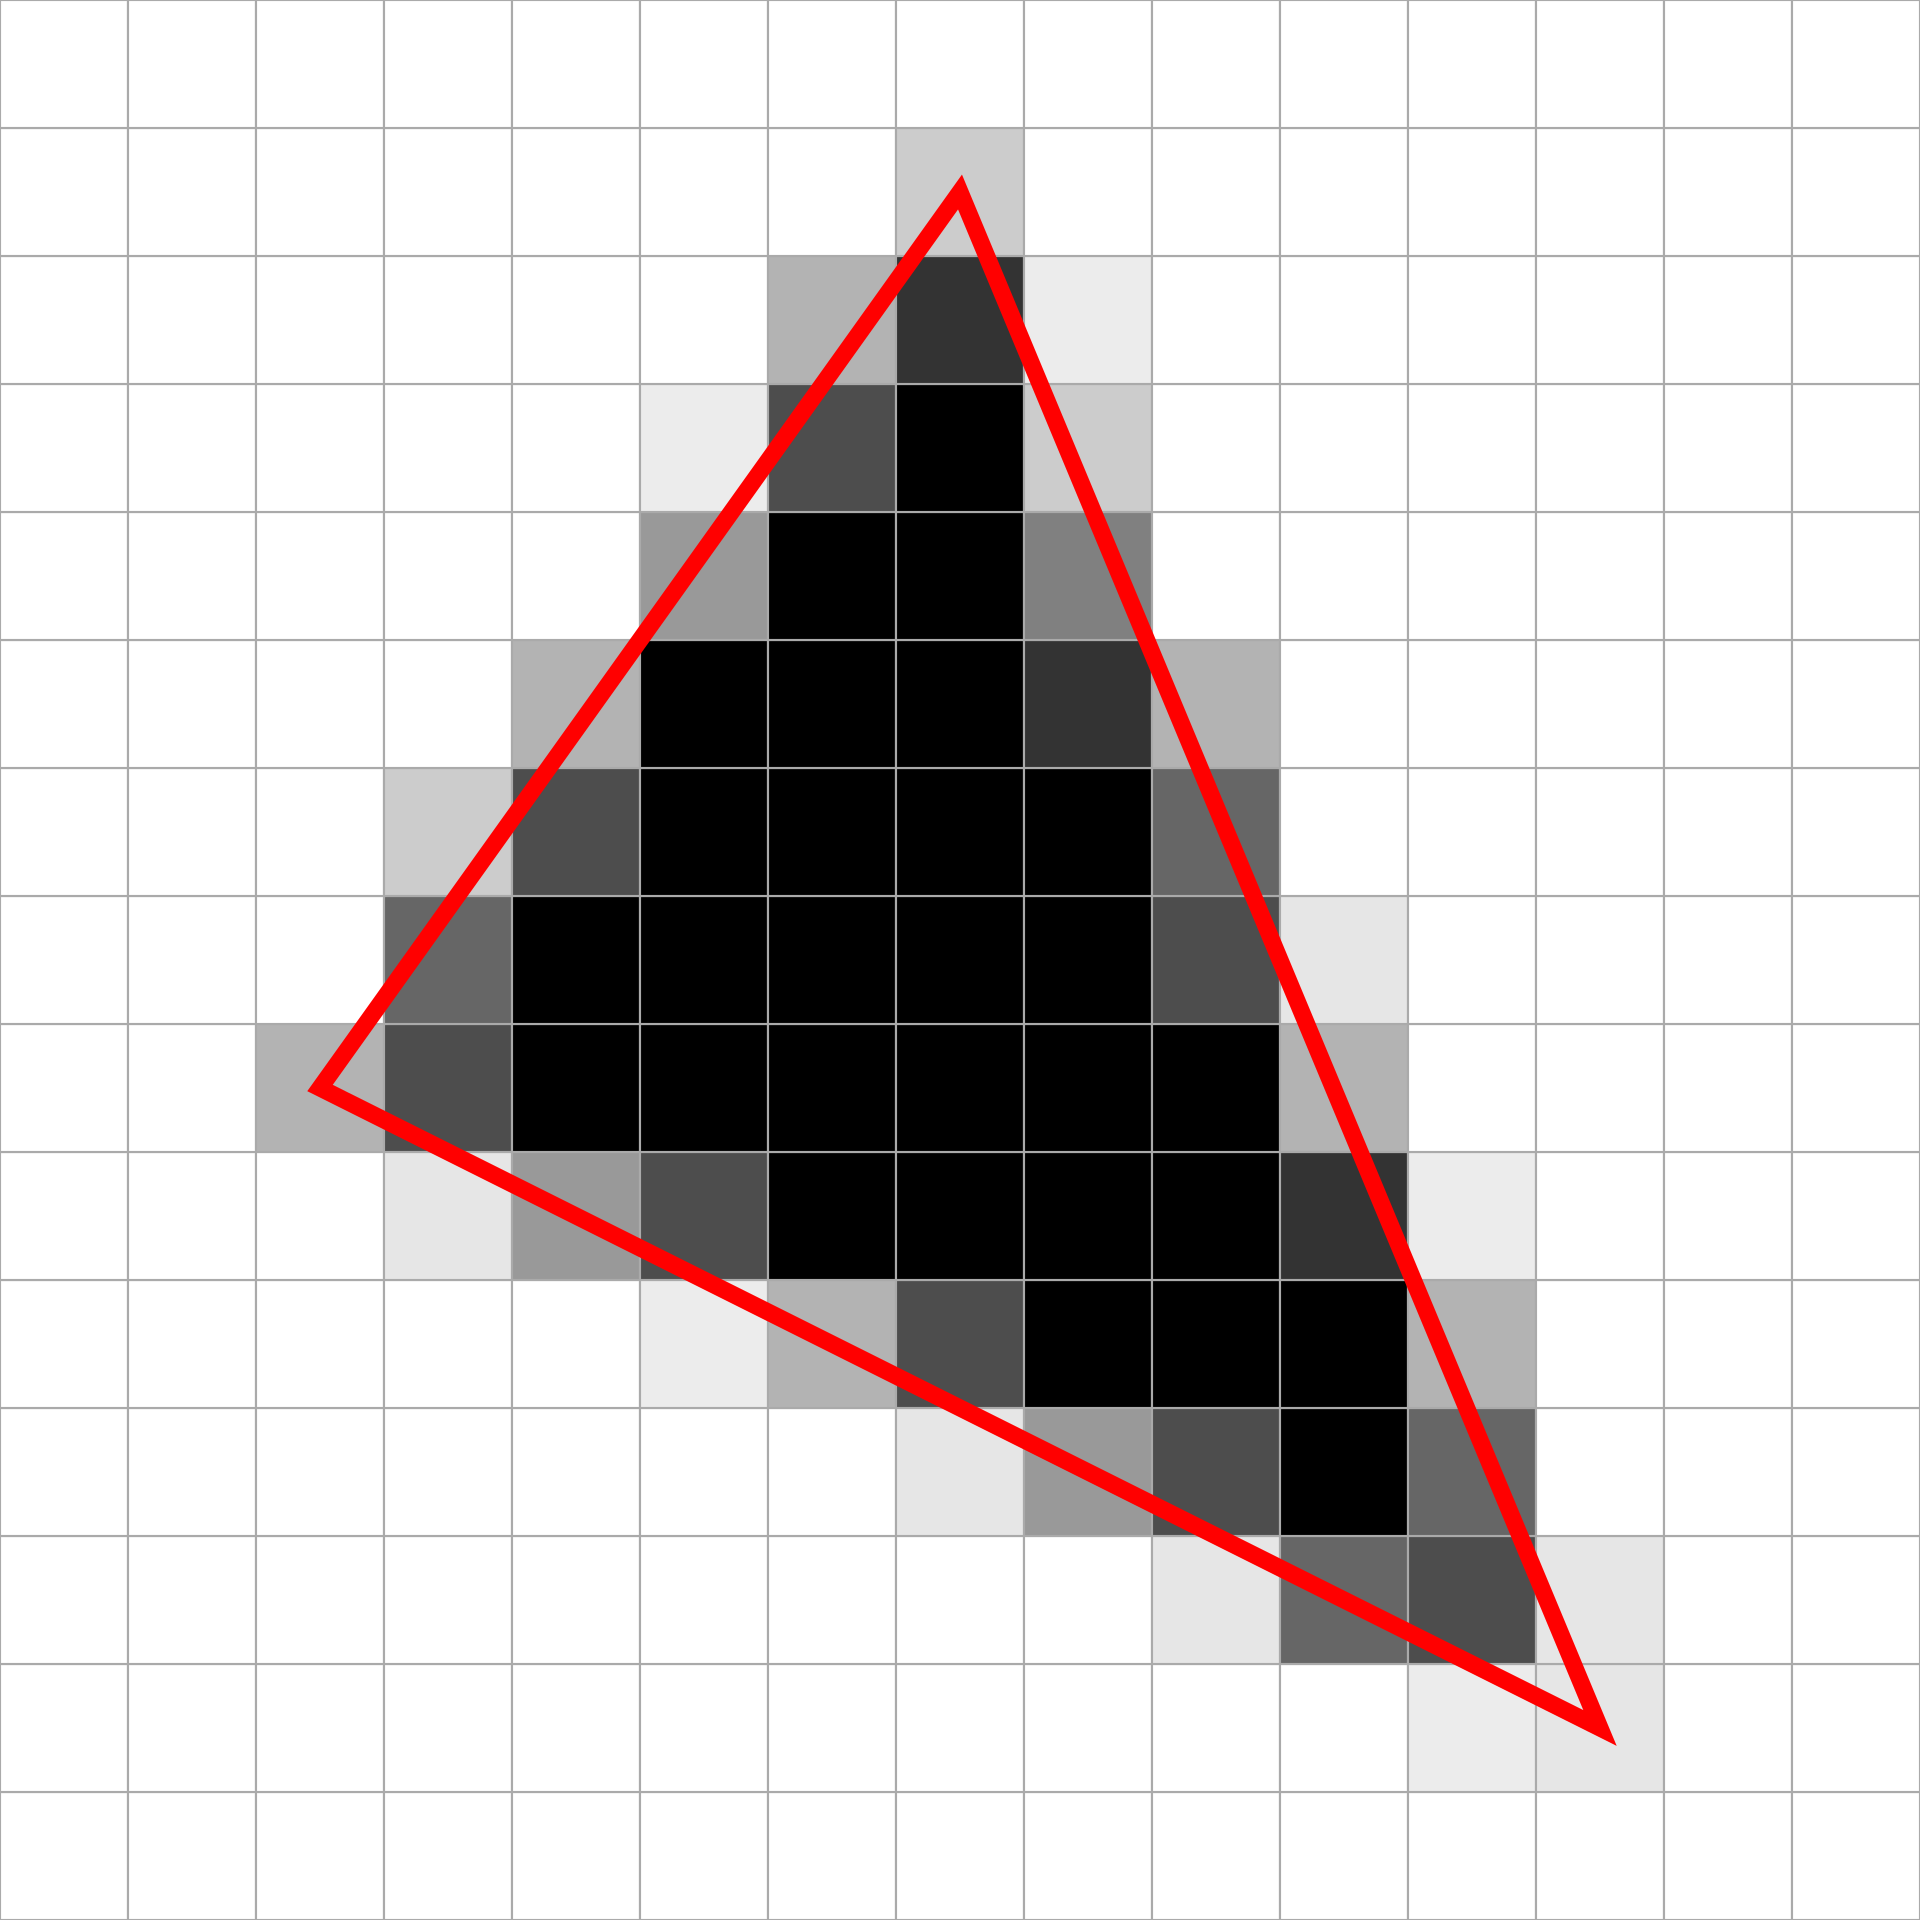
保守性最终体现在三角形的覆盖判定上:
这条规矩的直接后果是:剔除算法的输出永远是一组"可能可见"的集合,而不是"确实可见"的集合。 它做的事是排除掉那些肯定不用画的,剩下的交给后续环节。
1.2 三层次的剔除:从粗到细
先来看看怎么拆。既然一次判定不够准,工业界就把判定拆成多层,粗的便宜、细的贵,用粗的先把大部分东西排除掉,只对剩下的做精细判定。
这个漏斗结构是理解整篇的关键。 后面会看到:视锥剔除的假阳性多,所以需要遮挡剔除来消化;遮挡剔除在对象粒度上仍然不够细,所以需要把网格切碎(meshlet)继续筛;碎到一定程度 CPU 处理不过来了,于是把整件事搬到 GPU。
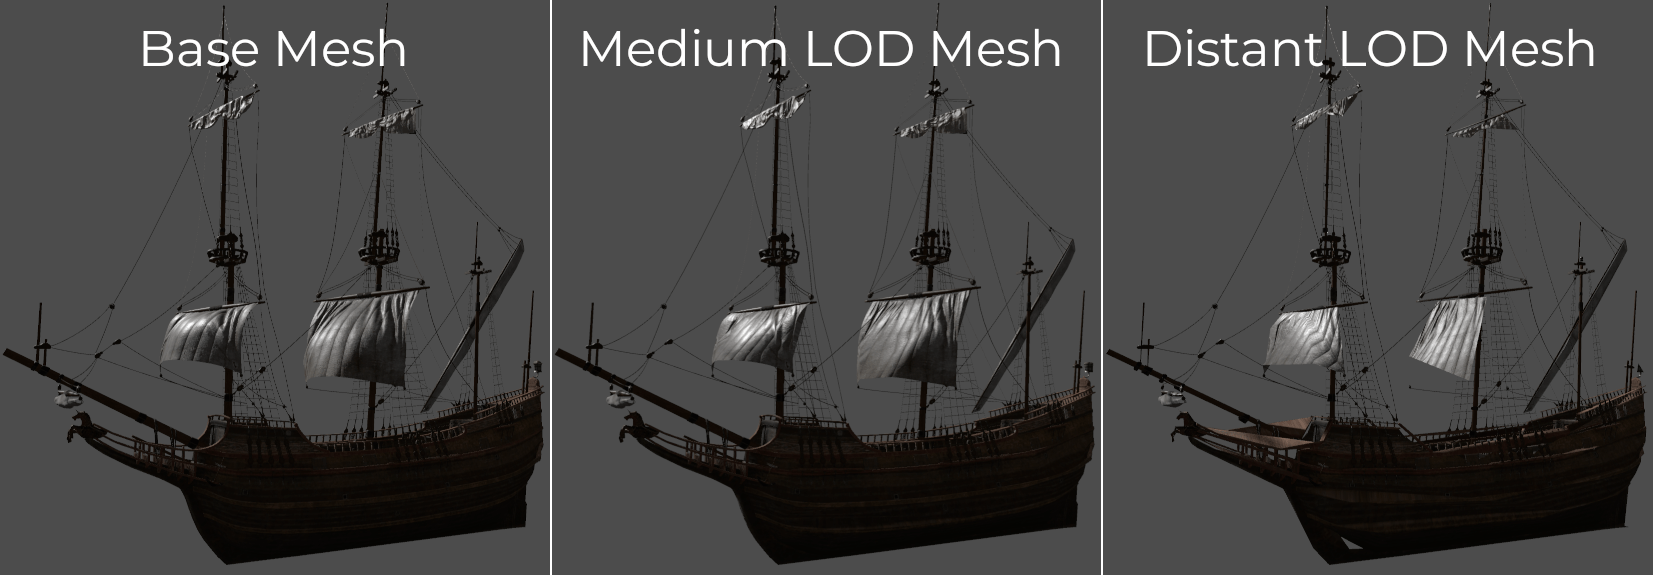
剔除的另一个维度是细节层次——同一模型的不同 LOD:
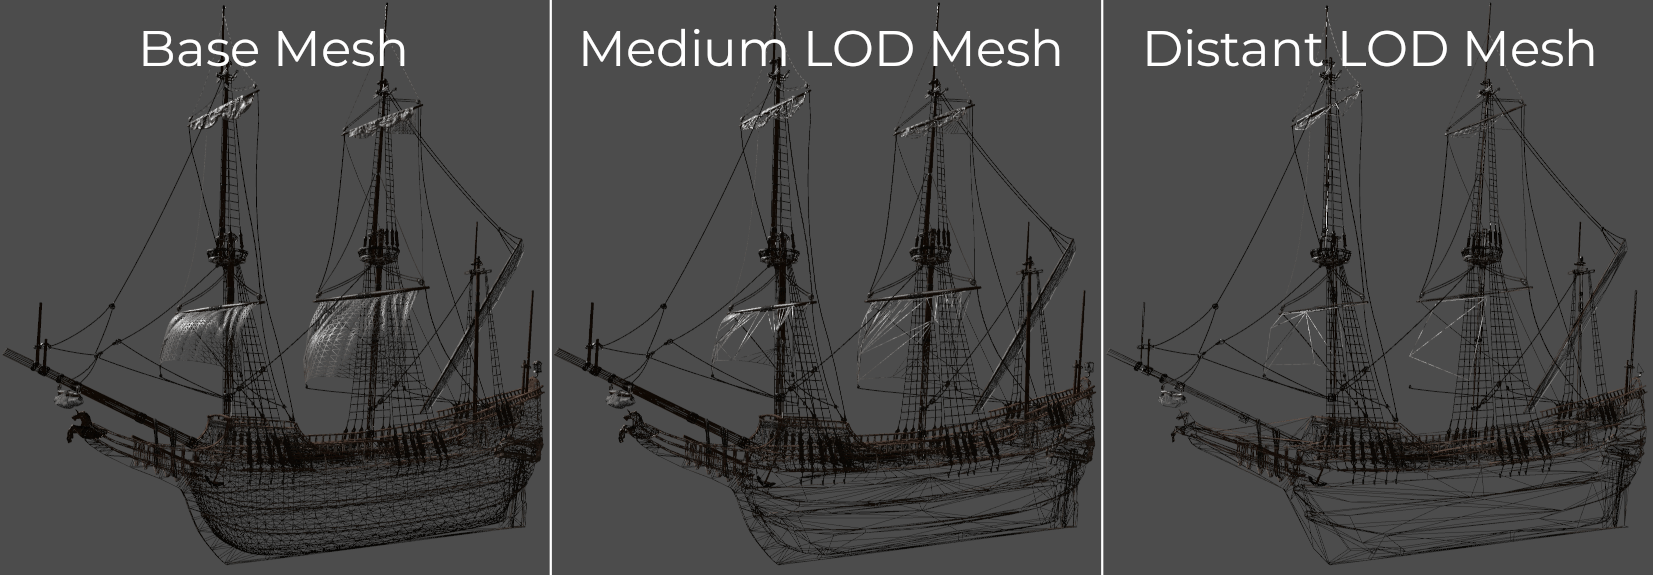
换成线框,三角形数量的差异一目了然:
关掉 LOD 之后,远景也在用全精度模型:
1.3 参数逐项释义:判定的粒度与代价
下面进入参数部分。"粒度"是这一章最需要记住的参数,因为它同时决定了两个东西:能剔掉多少,以及判定本身要花多少。
这张表解释了 GPU-Driven 为什么必然出现:当粒度细到 meshlet 一级时,判定次数是十万量级——CPU 单线程逐个处理完全来不及,只能交给 GPU 并行。
1.4 一个量化的问题:假阳性剩多少
好了,那假阳性到底剩多少?保守性意味着假阳性一定存在,那到底剩多少?这取决于两个因素:包围体有多紧,以及遮挡信息有多准。
一个粗略的量级感:对象级的视锥剔除通常能剔掉场景里 50%–90% 的对象(取决于相机朝向与场景布局);加上遮挡剔除之后,室内场景常常还能再剔掉一半以上。而到了簇一级,能剔掉的比例往往超过 90%——因为大量簇是模型内部或背面朝外的细节。
这几个数字不是精确值,是量级感——真实比例取决于场景。之所以要给出量级,是因为它决定了后面每一层的性价比:如果一个场景里视锥剔除已经能筛掉 90%,那再上复杂的遮挡剔除收益就有限;反之如果相机常常朝向场景中心,视锥剔除几乎筛不掉东西,遮挡剔除就是必需的。
1.5 源码链接
各引擎的可见性文档都把这套分层讲得比较清楚:Unreal 的《Visibility and Occlusion Culling》区分了视锥与各类遮挡方法 [91];Unity 的手册明确说明"即使启用了遮挡剔除,常规视锥剔除仍然自动且始终发生" [100][101];Godot 的文档给出一个很好的保守性例子——它把遮蔽体几何光栅化到一张低分辨率缓冲上,再拿这张图去测被遮挡物的 AABB,并要求"AABB 必须被完全遮挡才会被剔除" [97][104]。
1.6 剔除的收益上限:一个 Amdahl 视角
说白了,先算账再动手。在投入做剔除之前,值得先算一笔账:剔除最多能带来多少收益?
用 Amdahl 定律的视角看,如果渲染总时间是 100 份,其中"确实需要绘制的部分"占 40 份,那即使剔除做到完美(把所有不该画的都剔掉),上限也只有 2.5 倍——因为那 40 份永远省不掉。
| 场景 | 可剔除比例 | 理论最大加速 |
|---|---|---|
| 相机朝向空旷方向(大部分物体在视野外) | 90% | 约 10 倍 |
| 室内场景(大量物体被墙挡住) | 70% | 约 3.3 倍 |
| 相机朝向场景中心(几乎都在视野内) | 20% | 约 1.25 倍 |
这张表解释了一个常见困惑:为什么同样的剔除实现在不同项目里效果差那么多。不是实现好坏的问题,是场景的"可剔除比例"本来就不同。
所以在做剔除之前,先测一下你场景的可剔除比例,再决定投入多少。
保守判定有三种出口,把它们画出来,后面每一章都只是在换判定依据。
判定成本与命中收益之间存在平衡点,粒度不可能无限细分。
1.7 这一章留下的问题
规矩立好了:必须保守。但保守到什么程度,取决于我们用什么形状去近似物体。下一章先讲最基础的一层——怎么算出"视野范围"这个东西。
二、视锥剔除:从矩阵里取出六个平面
2.1 视锥是什么
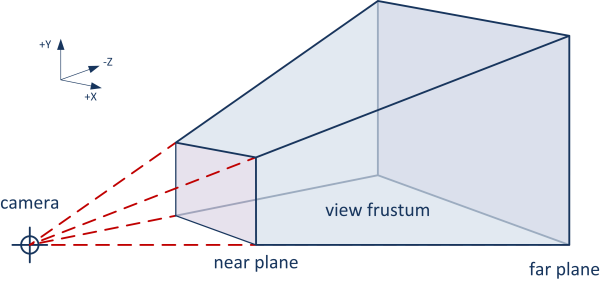
先来看看视锥体的形状。相机能看到的空间是一个视锥体(view frustum):以相机为顶点,向视野方向张开的一个四棱台。它由六个平面围成——左、右、上、下四个侧面,加上近裁剪面与远裁剪面。
视锥的几何形状,一张图就能交代清楚:
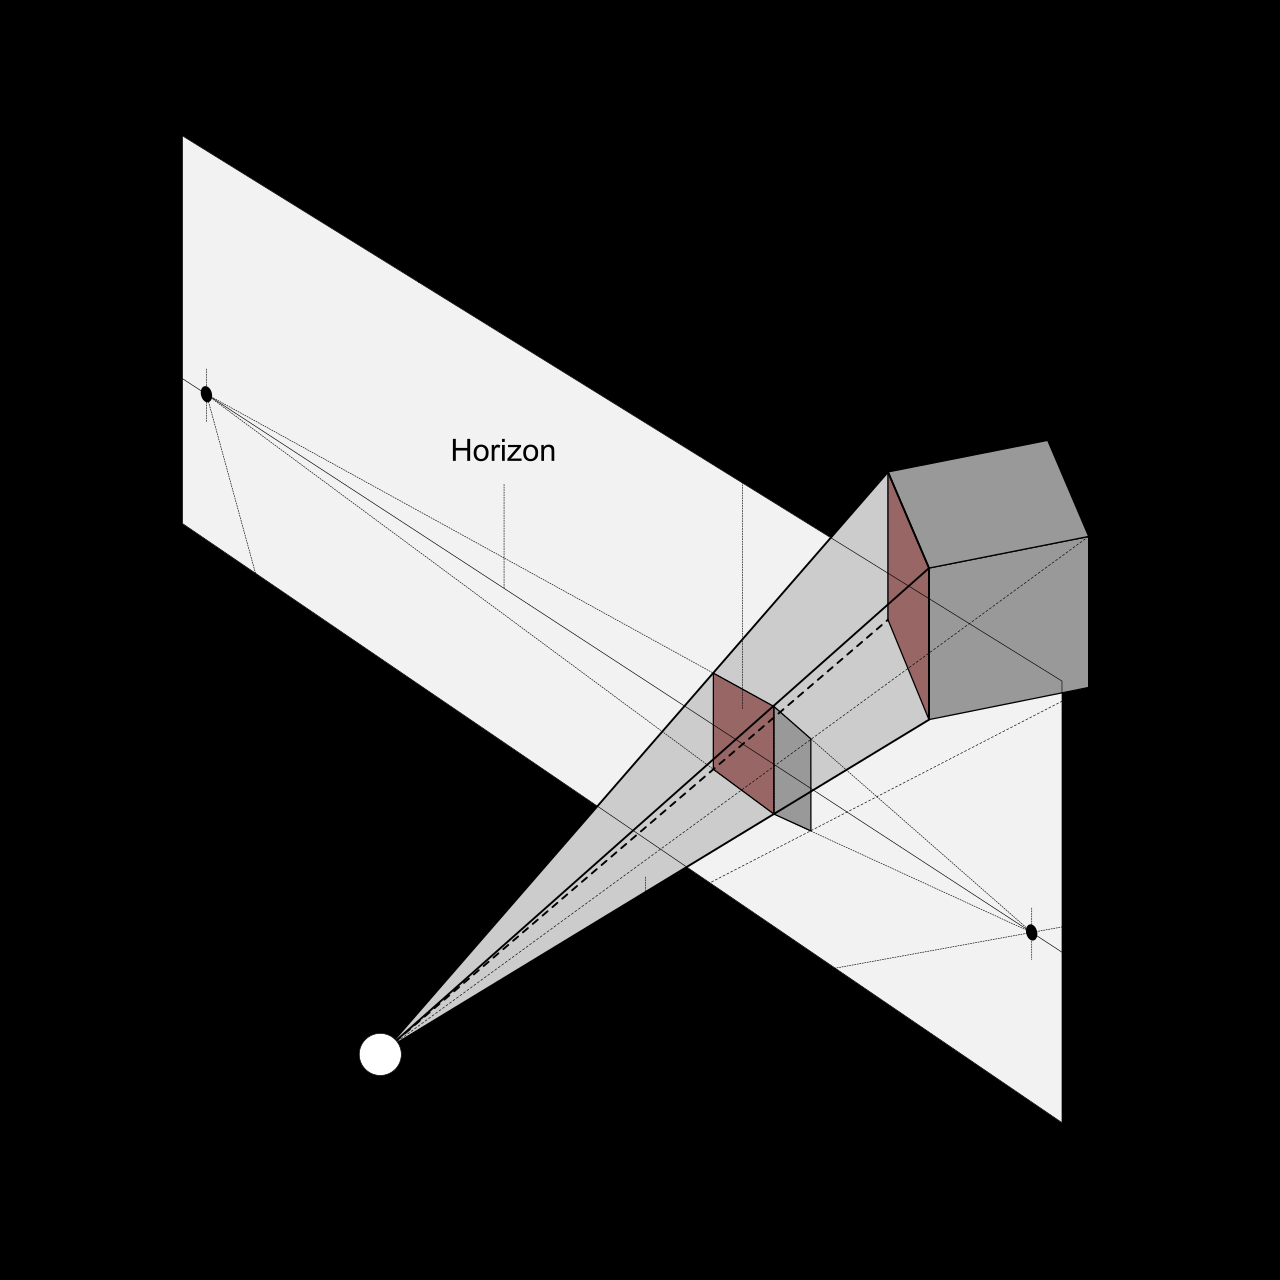
换一个更早的叫法——“视锥”其实就是视觉金字塔:
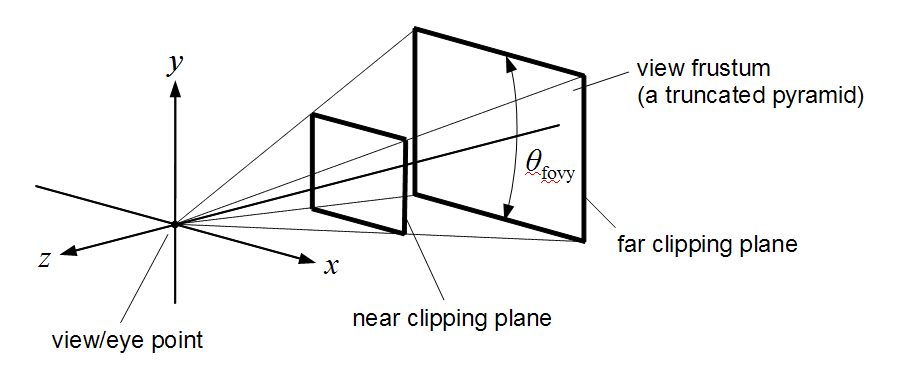
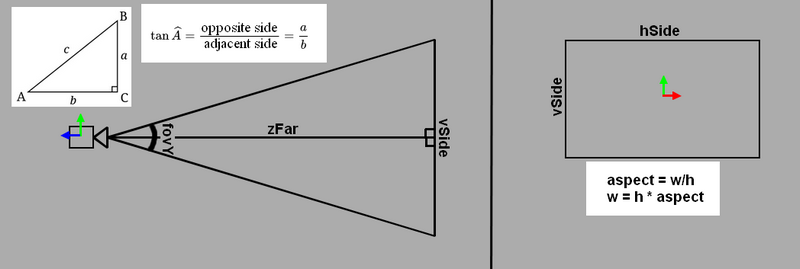
它的开口大小由视场角决定:
任何完全落在这个四棱台外面的物体,一定不可见。这就是视锥剔除的全部依据。
2.2 六个平面从哪来:Gribb-Hartmann 提取
OK,言归正传。问题来了:那六个平面怎么得到?
最朴素的做法是手工算——从相机位置、朝向、视场角、宽高比推导出八个角点,再由角点构造平面。但这很繁琐,而且要处理各种退化情况。
1996 年,Gribb 和 Hartmann 给了一个更漂亮的办法:直接从一个矩阵里提取六个平面。
具体做法是:把 World-View-Projection 矩阵的行进行加减组合。对投影后的空间来说,"在视锥内"等价于四个不等式全部成立:
$$ -w \le x \le w, \qquad -w \le y \le w, \qquad -w \le z \le w $$
把每个不等式展开成 $ax + by + cz + d \ge 0$ 的形式,就得到了六个平面的方程——每一条不等式对应一个平面,系数直接来自矩阵的相应行。
这个推导的价值不在于省了几行代码,而在于它把"视锥"从几何概念变成了代数对象。 平面提取出来之后,所有的可见性判定都变成了"点积和符号"的问题,可以批量、可以并行。
六个面在空间中的位置关系是这样的:
换到侧视图,上下与远近面更清楚:
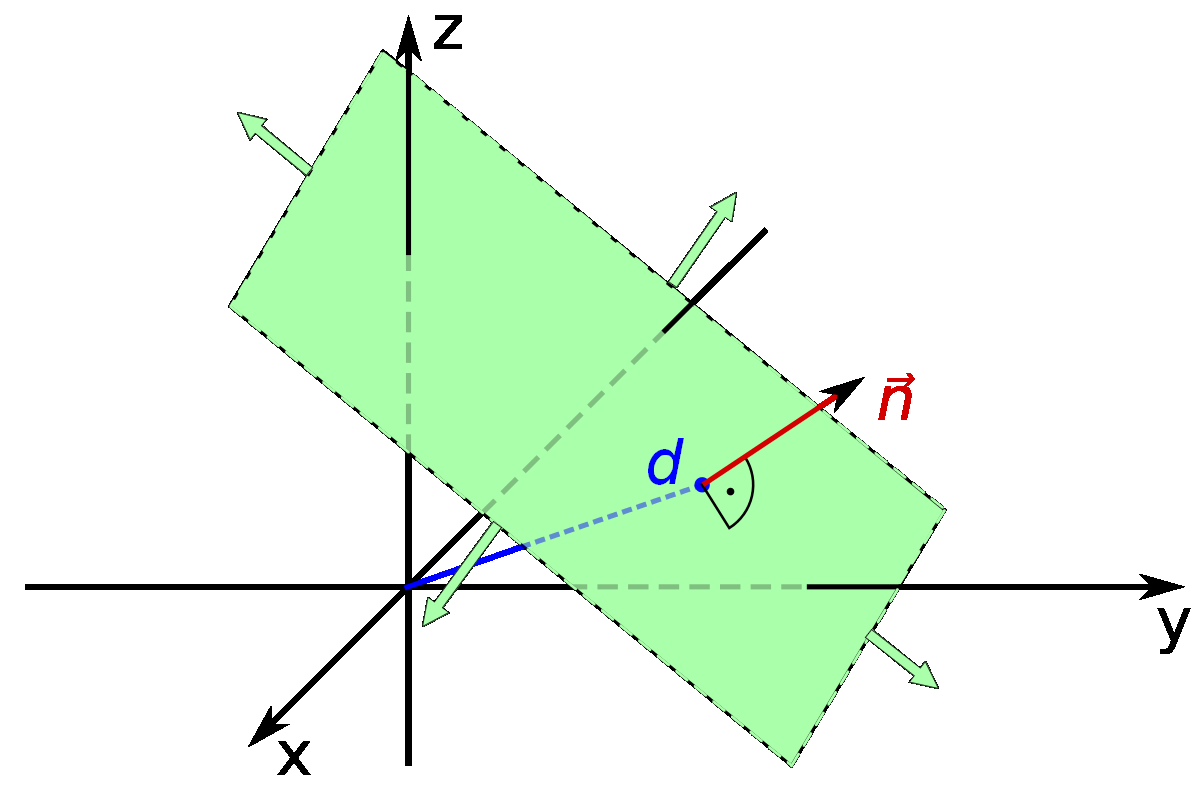
判定要用到平面的法线方向:
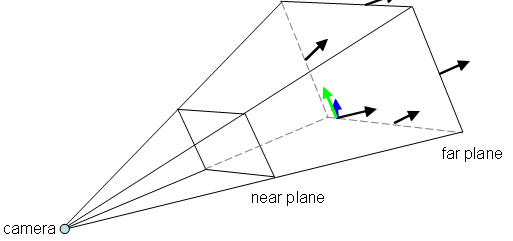
视锥裁剪的几何关系,也有现成的图解可对照:
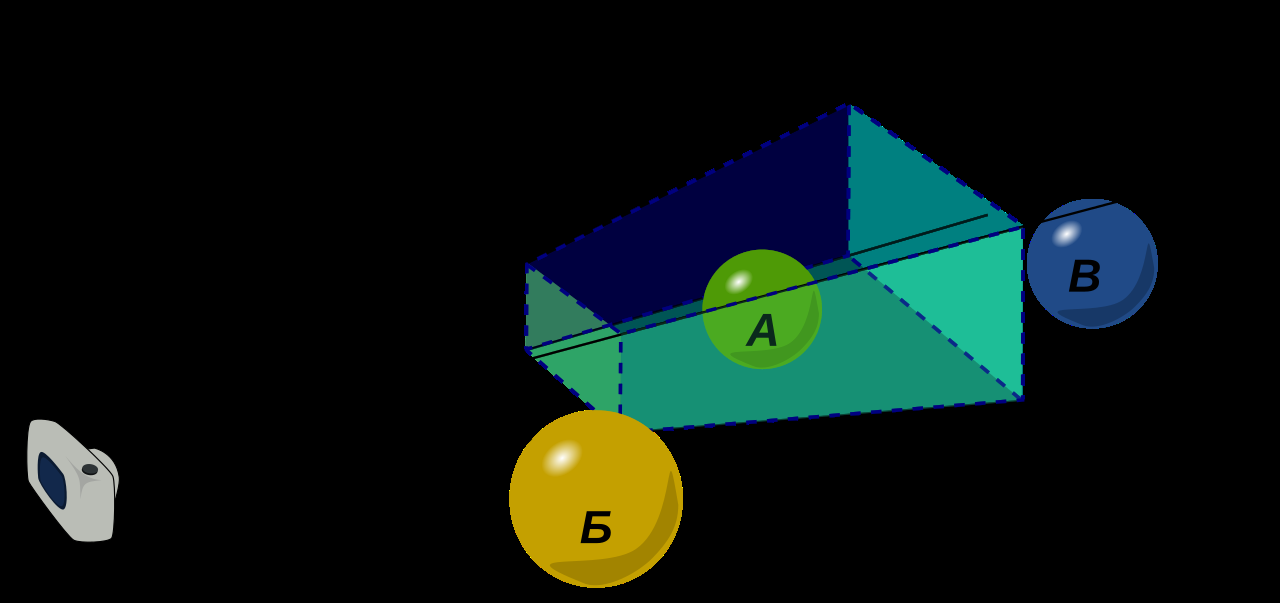
Chalmers 的相交测试讲义对这套流程有完整的教学讲解 [25];Möller 的实时渲染加速讲义则把视锥剔除放进了"多级剔除体系"里讨论 [26]。
2.3 用球体做测试
平面有了,接下来是判定物体与平面的关系。
最省事的做法是用包围球(bounding sphere):因为球体到平面的距离可以直接算,不需要考虑方向。
$$ \text{dist} = \vec{n} \cdot \vec{c} + d $$
其中 $\vec{n}$ 是平面法线、$\vec{c}$ 是球心、$r$ 是半径。判据是:
| 条件 | 含义 | 动作 |
|---|---|---|
| $\text{dist} < -r$ | 球完全在平面外侧 | 确定不可见,可剔除 |
| $\text{dist} > r$ | 球完全在平面内侧 | 该平面判定通过 |
| 其他 | 球跨越平面 | 保守:按可见处理 |
六个平面逐个测,只要有一个判定"完全在外"就可以剔除;全部都不判定"在外"才保留。
先看包围球这一路——它是判定最简单的一种包围体:
球与平面的判定,本质上是一次点到平面的距离比较:
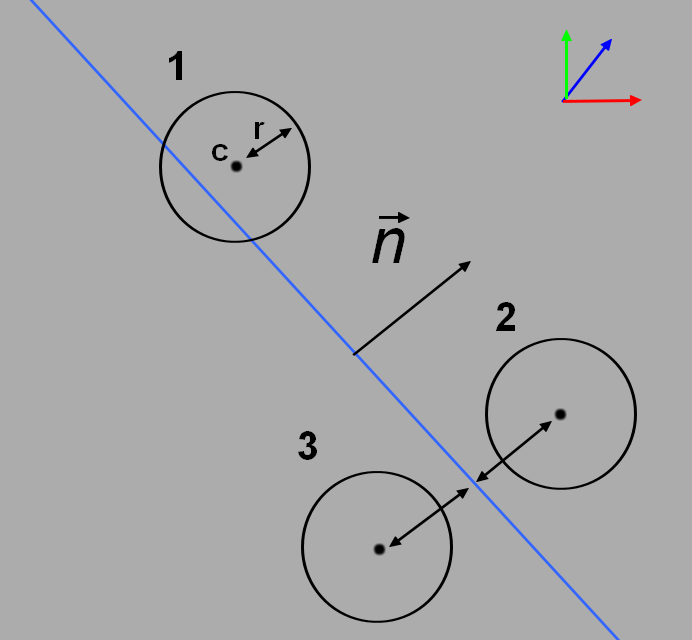
有符号距离决定了球在平面的哪一侧:
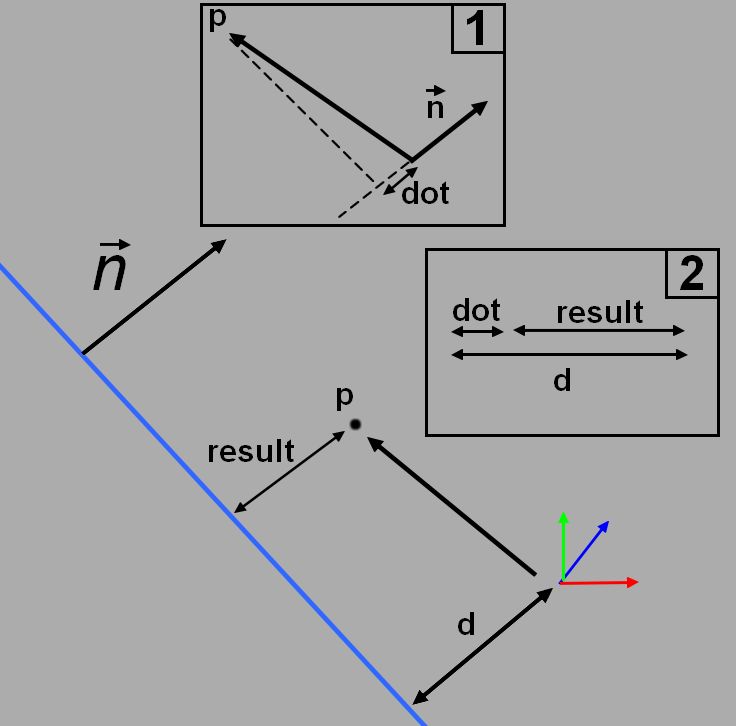
这里要特别指出平面的朝向。 平面法线必须指向视锥体外侧——也就是说,条件 $\text{dist} < -r$ 里的负号,含义是"球心在平面的外侧且距离超过半径"。
如果法线朝向搞反了,程序不会报错,但剔除逻辑会完全颠倒——可见的物体被剔掉,不可见的留下,表现就是那类"物体莫名消失"的故障。
社区里有一份对剔除代码的逐行分析专门强调了这一点,并把"外向朝视锥平面"列为很多假阴性 bug 的根源 [63]。
2.4 参数逐项释义:为什么先算包围球
先来看看包围球的缺点。包围球有一个明显缺点:它比物体"松"得多。一个细长的物体(比如一根管子),用包围球包住会多出大量空白区域,导致假阳性。
那为什么还要先算球?因为它快:
| 判据 | 需要的运算 | 说明 |
|---|---|---|
| 球体 | 一次点积 + 一次比较 | 最省 |
| AABB(轴对齐包围盒) | 8 个顶点 × 6 个平面 = 48 次点积 | 精确得多,成本高一个量级 |
| OBB(有向包围盒) | AABB 基础上加坐标变换 | 更紧,但变换本身有成本 |
实用的做法是两级:先用球体做一次快速排除(能剔掉的直接剔掉),剩下的再用 AABB 精确判定。这就是"粗筛 + 细筛"在最小尺度上的应用。
2.5 实现
实现里更常用的是 AABB——轴对齐包围盒:
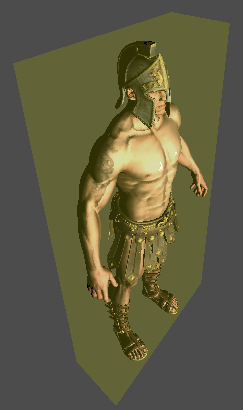
AABB 的表示方式,关键在“轴对齐”这个约束:
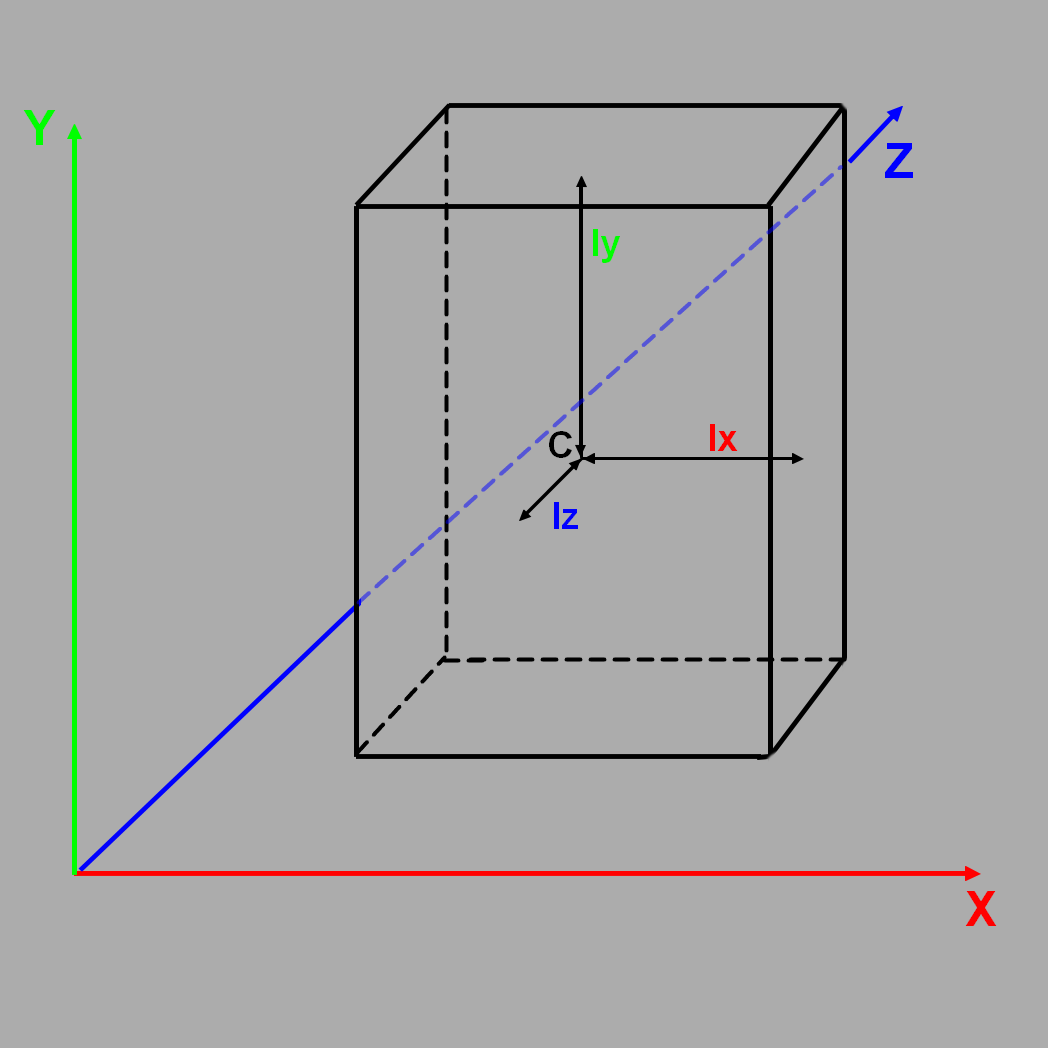
下面这段代码是视锥剔除的核心循环,用 AABB 做判定:
// 【视锥剔除】AABB 的 8 个顶点逐个与 6 个平面做点积
bool IsAABBVisible(float3 boxMin, float3 boxMax, float4 planes[6]) {
    // 【1】枚举 AABB 的 8 个角点
    float3 corners[8];
    for (int i = 0; i < 8; ++i) {
        corners[i] = float3((i & 1) ? boxMax.x : boxMin.x,
                            (i & 2) ? boxMax.y : boxMin.y,
                            (i & 4) ? boxMax.z : boxMin.z);
    }
    // 【2】逐个平面测试
    for (int p = 0; p < 6; ++p) {
        bool allOutside = true;
        for (int i = 0; i < 8; ++i) {
            float d = dot(planes[p].xyz, corners[i]) + planes[p].w;
            if (d >= 0.0) { allOutside = false; break; }  // 【3】只要有一个点在内侧,就判定该平面不排除
        }
        if (allOutside) return false;   // 【4】某个平面判定完全在外 → 确定不可见
    }
    return true;                        // 【5】六个平面都不排除 → 保守地视为可见
}
上面这段特别说明四处。
【1】处的角点枚举用了位运算技巧:索引的第 0、1、2 位分别表示 x、y、z 取 min 还是 max。这样八个角点用三行解决,比手写八个 float3 清楚得多。
【3】处是这个实现的关键——只要有一个顶点在平面内侧,就立刻跳出,判定"该平面不排除"。因为判定"完全在外"要求"所有点都在外侧",所以遇到反例就该停止。这也让常见情况下(物体跨越平面)的循环提前结束。
【4】处是唯一允许返回"不可见"的地方。注意它是六个平面里任意一个判定在外就成立。
【5】处的默认返回是 true(可见)。这个默认值的朝向不能写反——它体现的正是第 1 章那条铁律:默认动作永远是"画"。
社区的教程里有一份同类实现,把"8 顶点 × 6 平面"的判据写得很清楚,并特别强调"只要有一个点不满足外侧条件就提交渲染" [35]。
2.6 效果与源码链接
剔除实际生效后的画面是这样的:
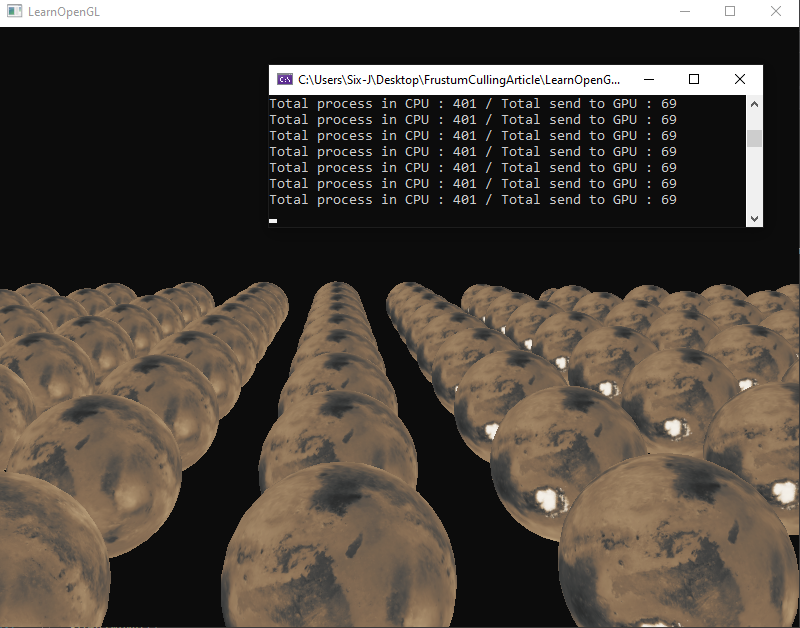
ktstephano 的实现笔记给出了一份可直接对照的版本 [35];bruop 的文章则从"减少提交命令与 CPU/GPU 浪费"的角度切入,配了图示 [36]。两者的差别正好是两种讲法——一个从代码讲,一个从收益讲。
2.7 视锥剔除的五个常见实现错误
下面进入踩坑清单。视锥剔除的代码很短,但出错的地方很集中。把常见的五个错误列出来,比讲十遍原理更有用。
其中第一、第三、第四个错误在第三章还会展开——因为它们都会造成假阴性。
Gribb-Hartmann 方法的关键在于:平面方程不需要显式构造几何,直接从矩阵的行组合里读出来。
球体测试便宜但偏保守,AABB 测试紧一些但更贵。
2.8 这一章留下的问题
视锥剔除的判定本身很干净,但它依赖一个前提:包围体要包得住物体。而包围体是近似的,这个近似会带来假阳性。更麻烦的是,它偶尔也会带来假阴性——下一章就讲这个。
三、包围体的代价:为什么剔不干净
3.1 包围体越松,假阳性越多
好了,说回包围体。包围体的作用是"包住物体",但它包得越松,判定就越不准。
拿一根斜放的细长管子举例:AABB 会把它包在一个大盒子里,盒子里大部分是空的。从某个角度看,盒子进入了视野,于是整根管子被保留——但实际那根管子可能只有很小一段露在视野里。
包围体的松紧程度,直接决定剔除的干净程度:
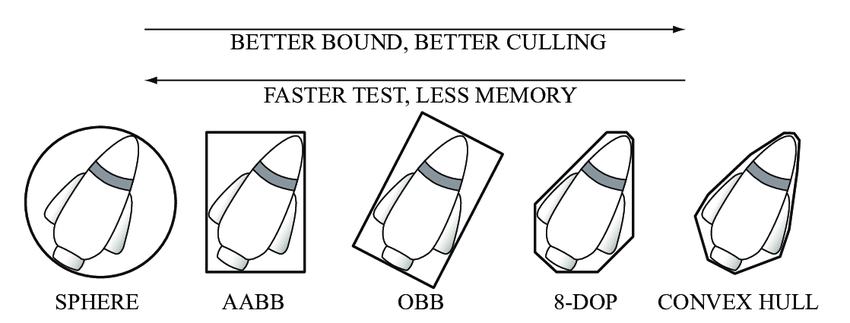
这是保守性的必然代价:包围体是物体的上界,判定结果就是真实可见性的上界。松一点,假阳性就多一点。
3.2 假阳性的两个来源
把假阳性的来源拆开,可以看到它有两类:
| 来源 | 原因 | 能否消除 |
|---|---|---|
| 包围体松弛 | 包围体比物体大,物体外的空白区域进入了视野 | 只能减小,不能消除(要精确就得用三角形本身) |
| 判定粒度太粗 | 一个对象被当作整体判定,其中一部分可见就整体保留 | 可以通过细分粒度减小(对象 → 子网格 → 簇) |
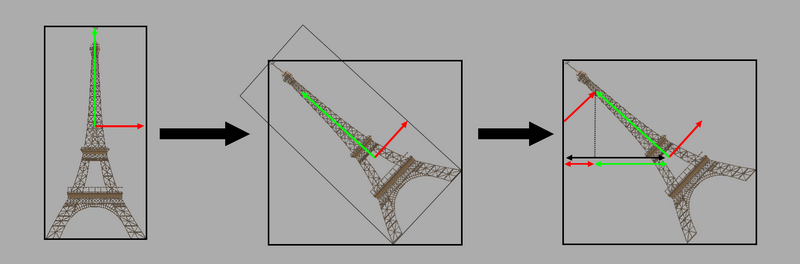
轴对齐带来便利,也带来代价——物体一转,盒子就不贴了:
同一物体在不同朝向下,AABB 的松散程度差别很大:
第二类是整篇后半段的驱动力。 从对象级到子网格级再到 meshlet 级,本质都是在减小"判定粒度太粗"带来的假阳性。
3.3 假阴性从哪来:三个真实案例
先来看看假阴性。假阳性只是浪费性能,假阴性才是真事故。而假阴性几乎总是实现细节出错,而不是算法本身的缺陷。三个真实的案例能说明这一点。
案例一:距离导致的误剔。 某渲染器的一个 issue 里记着:距离相机约 20–30 米时,明显在屏内的角色会被判定为"在外"而误剔,近处正常——结果是物体突然 pop out。
这是假阴性最典型的形态:近处对、远处错,指向的是数值精度或半径计算的问题 [61]。
案例二:边界处的不稳定。 某引擎的公开 issue 记录了一种更诡异的现象:相机在包围盒外且背对时,粒子仍被渲染(应剔未剔);而改变相机角度会出现 flickering——判定在阈值附近来回跳变 [62]。这属于包围体与判定条件配合不当。
案例三:法线方向搞反。 前面提过的那份逐行分析显示,代码本身是正确的,问题出在很多人会写反平面法线的朝向 [63]。这类 bug 的表现是"剔除逻辑完全颠倒",但程序不报错——排查起来最费时间。
从这三个案例能提炼出一条实用经验:假阴性几乎不来自"算法想错了",而来自"数值和方向写错了"。所以排查时优先查三件事——法线朝向、半径与容差、以及变换矩阵是否更新。
社区里有一份中文问答把"模型缺失"的首位原因归给了"视锥体裁剪误剔除——包围盒不精确或未更新变换矩阵" [90],与上面的结论一致。
3.4 参数逐项释义:容差要给多少
既然阈值附近会跳变,那就要给判定留容差(epsilon)。做法是在判定时把包围体略微放大:
$$ r_{eff} = r \times (1 + \epsilon) $$
$\epsilon$ 的取值是个经验问题:
还有一个经常被忽略的项:容差不仅要吸收浮点误差,还要吸收动画与蒙皮带来的包围体变化。如果一个角色的骨骼动画把手臂伸出了原本的 AABB,而包围体没有同步更新,那手臂就会被误剔。
3.5 实现:把包围体放大再判定
容差在代码里就是一次缩放。
// 【容差放大】判定前把包围体略微放大,吸收浮点误差与变换误差
float4x4 GetConservativeTransform(float4x4 objTransform, float epsilon) {
    float4x4 t = objTransform;
    // 【1】把旋转缩放部分的三个基向量各自放大
    t[0].xyz *= (1.0 + epsilon);
    t[1].xyz *= (1.0 + epsilon);
    t[2].xyz *= (1.0 + epsilon);
    return t;                            // 【2】平移部分不动,只放大尺寸
}
上面这段特别说明两处。
【1】处只放大矩阵的旋转缩放部分——平移不能动,否则物体会整体偏移,那是比剔除错误更明显的问题。
【2】处这个放大的方向是"变大",不会让物体缩小。方向写反(用 1.0 - epsilon)会直接造成假阴性。
3.6 包围体更新的时机
说白了,更新时机也是成本。包围体不是算一次就完事的。什么时候更新它,直接影响判定正确性与成本。
第二行那个"需要准确追踪"是个陷阱:如果一个物体的父节点动了,它的世界矩阵会变,但物体本身的局部变换没变——只看局部变换就会漏更新。
稳妥的做法是在每次世界矩阵被写入的地方打标记,而不是去猜哪些物体动了。
包围体越松,假阳性越多——这是纯粹的几何事实。
3.7 这一章留下的问题
包围体是逐个物体测的,如果场景里有十万个物体,逐个测就是十万次判定。要减少判定次数,就得先把物体组织起来——下一章讲空间划分。
四、空间划分:BVH、八叉树与它们的取舍
4.1 为什么需要层次结构
OK,言归正传。逐个测十万个物体太贵,但如果能先排除掉一大片区域,剩下要测的就少了。空间划分就是干这个的:把空间切成层次化的块,整块不可见就整块跳过。
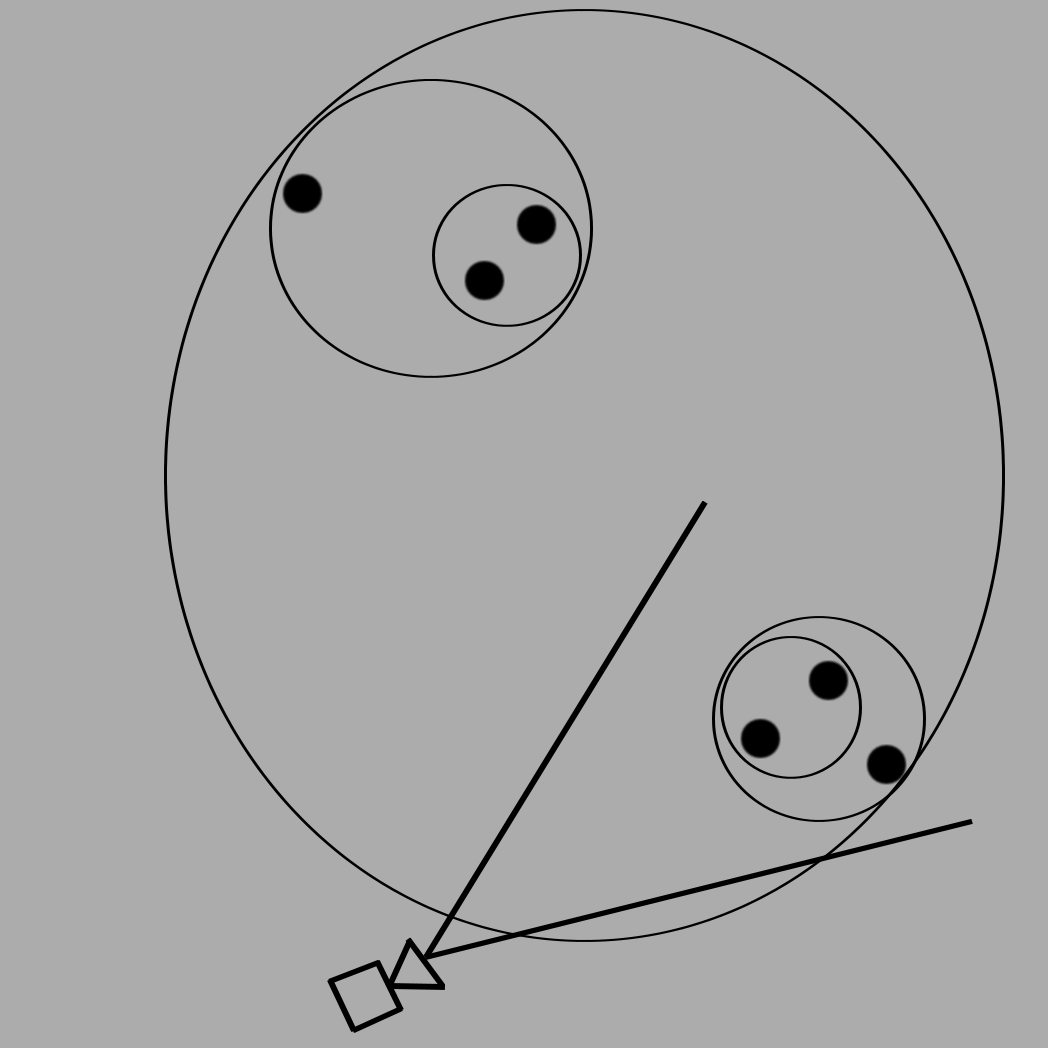
层次结构的组织方式,可以用包围体的嵌套来表示:
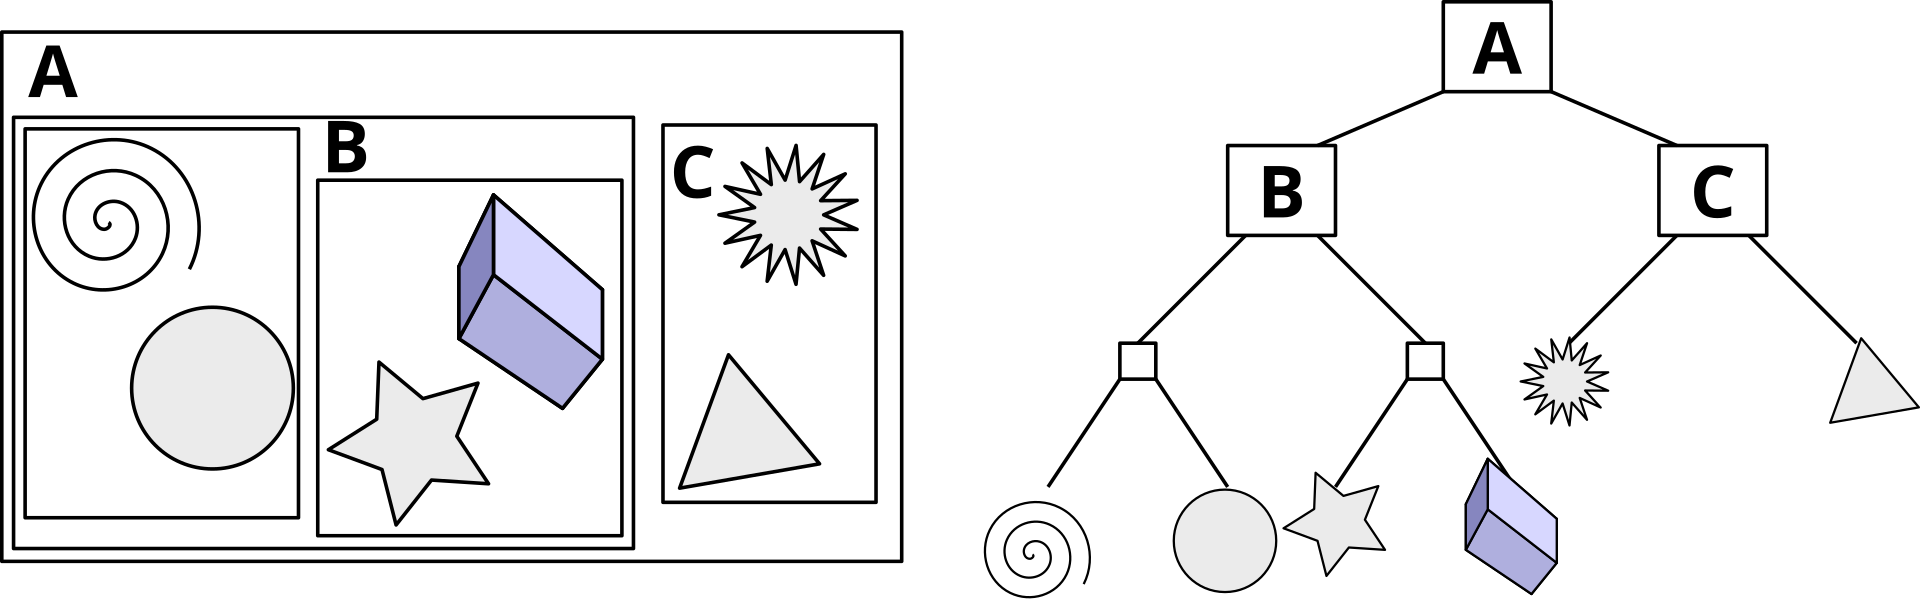
关键在于树的结构:如果一棵子树被判定不可见,那么子树下所有物体都不必再测。判定次数从"物体数"降到了"树节点数"的量级,而好的层次结构让树高只有 $O(\log n)$。
层次结构的本质是“先排除一整块”——下面是同一块地图按包围盒逐层切分的结果:
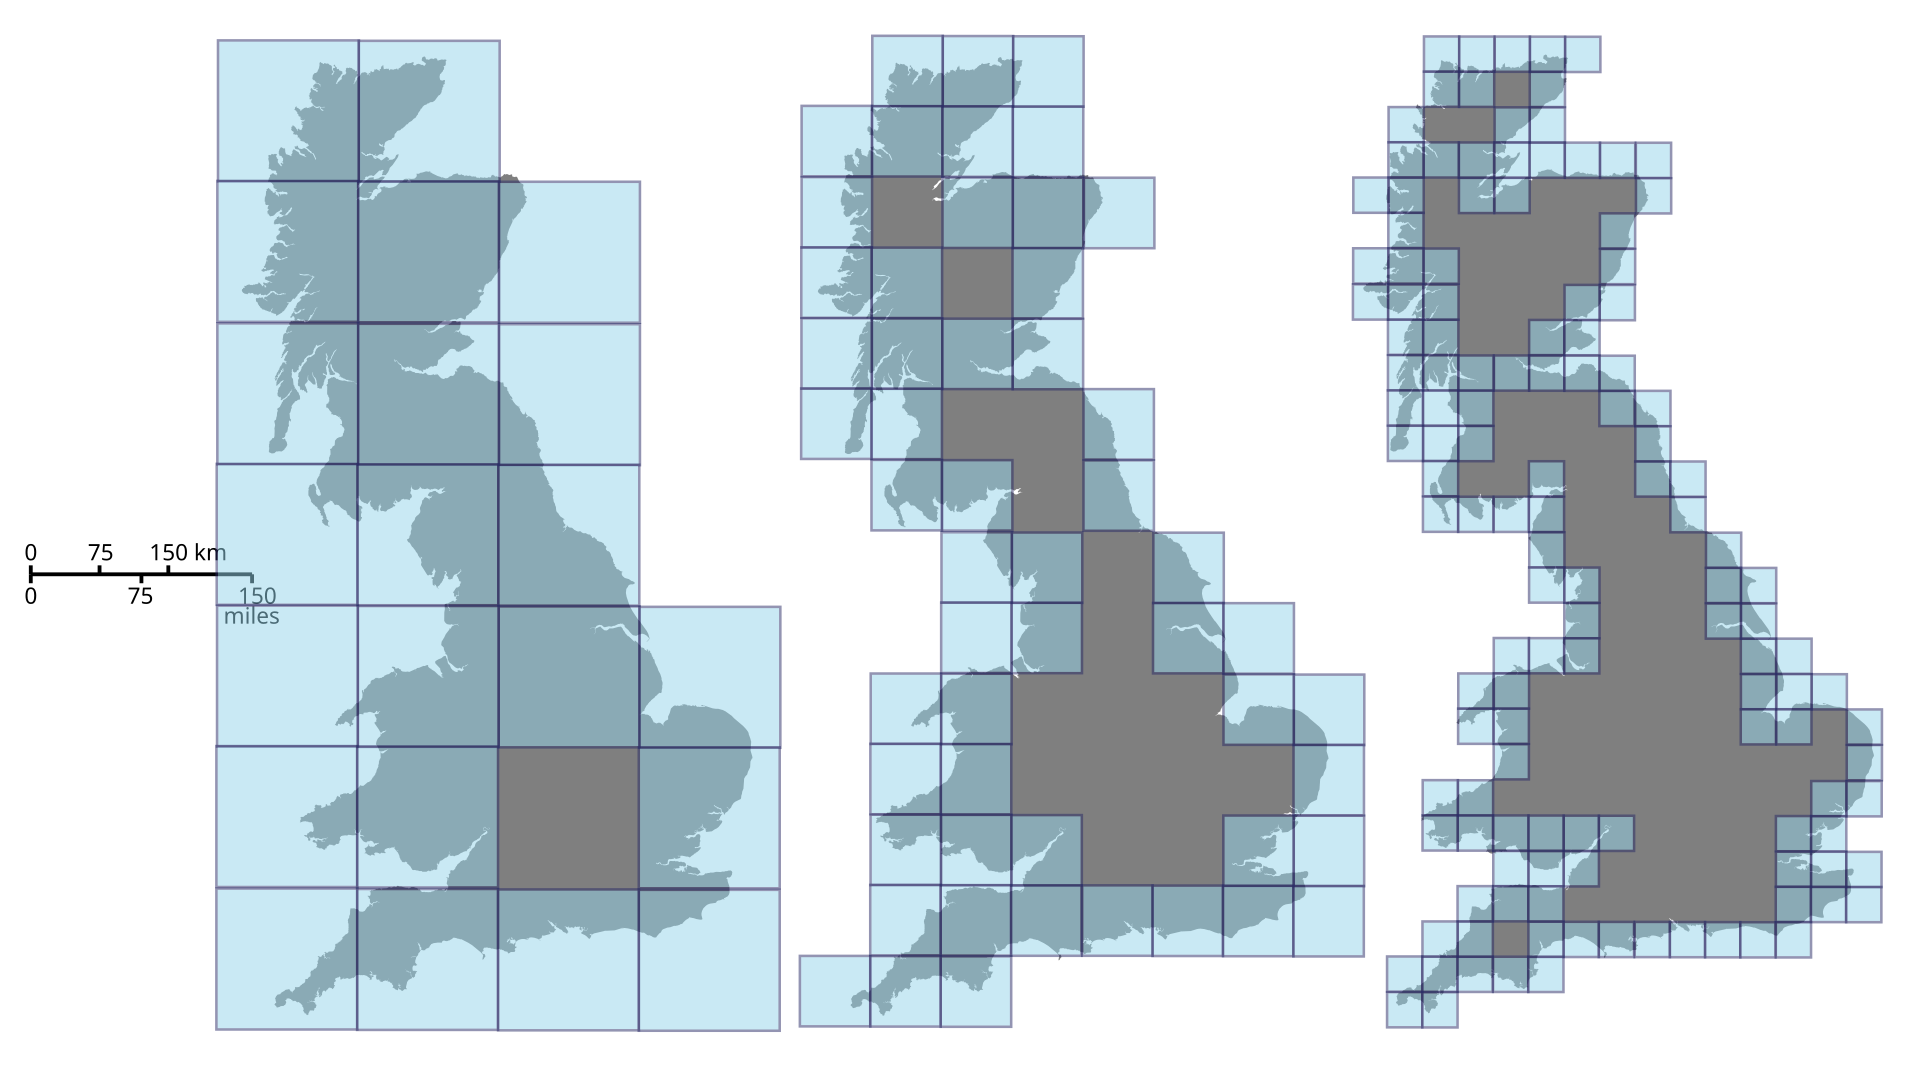
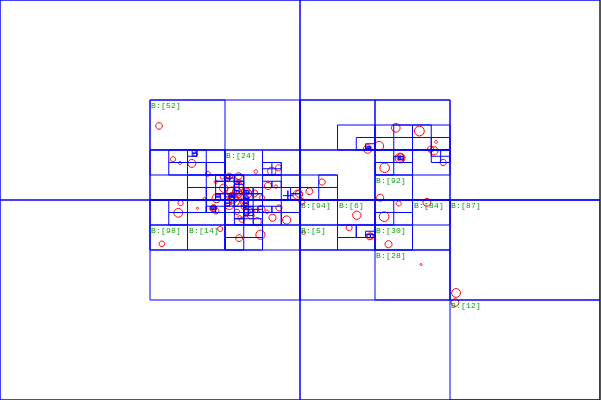
四叉树对二维空间的递归划分是这样:
4.2 五种结构的取舍
| 结构 | 构建成本 | 查询成本 | 动态更新 | 适用场景 |
|---|---|---|---|---|
| BVH | 中等(SAH 构建较贵) | 低 | 差,常需重建 | 通用默认、光追、静态为主 |
| 八叉树 | 低 | 低 | 好,局部更新 | 动态场景、地形 |
| 松散八叉树 | 低 | 低 | 最好,物体跨格不必重插 | 大量运动物体 |
| k-d tree | 中等 | 最低(最近邻剪枝最优) | 差,数据点变化易触发重建 | 静态点集 |
| BSP tree | 高 | 低 | 差 | 室内建筑场景 |
这份对照里有两条结论值得单独说。
一是 BVH 为什么成了通用默认。 它不挑场景——不像 BSP 需要室内几何、不像八叉树要求分布均匀。而且它同时适用于剔除、光追、碰撞检测,一套结构多处复用 [32]。
社区的对比文章把这一点讲得比较直接:BVH 是光追与通用空间查询的现代默认;SAH 构建质量高、LBVH 以质量换构建速度;k-d tree 最适合最近邻查询 [32]。
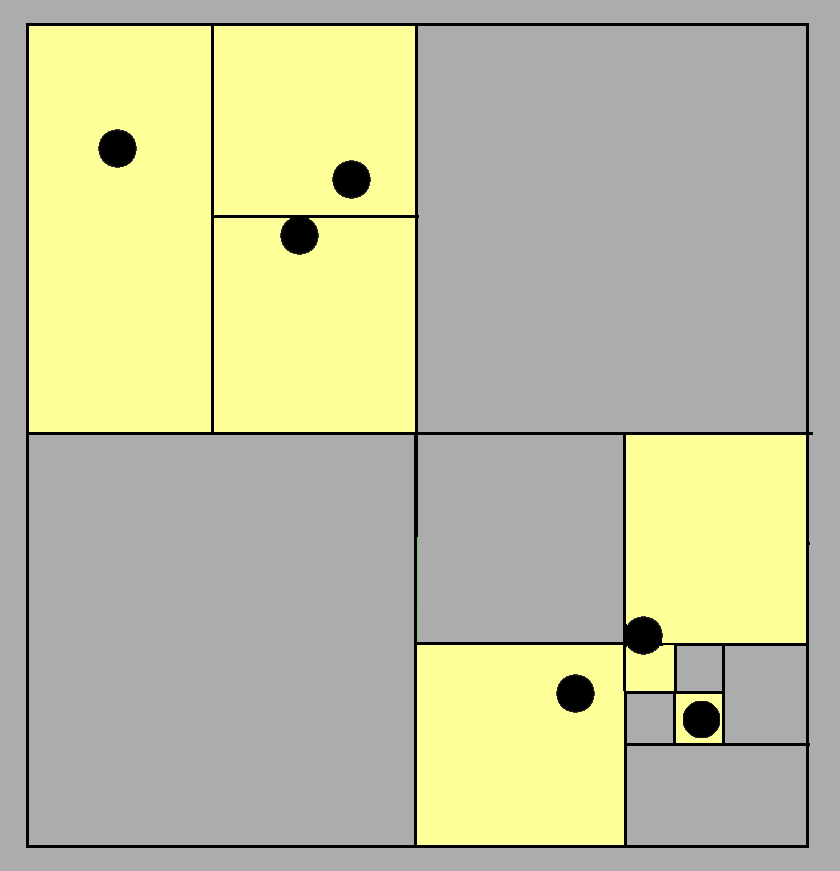
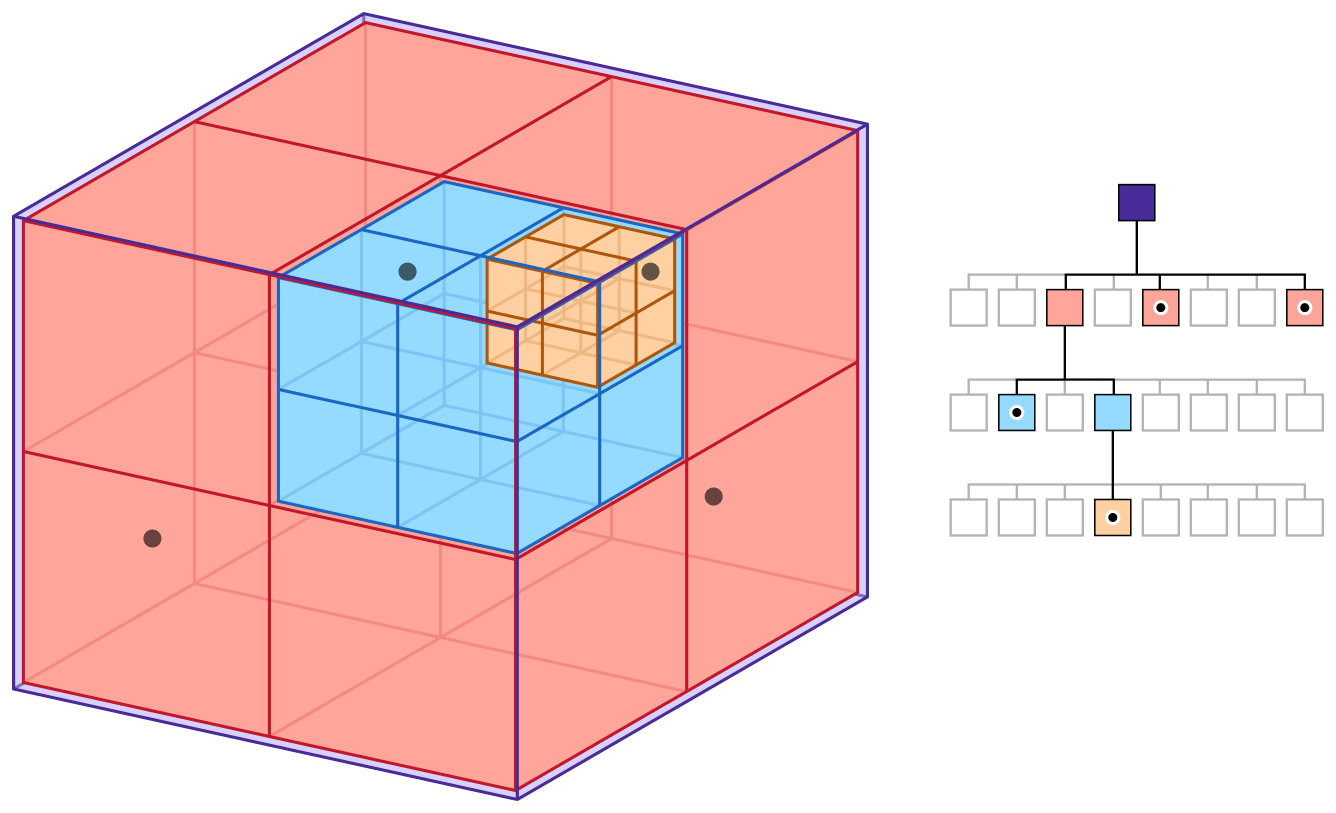
二是八叉树的动态优势来自哪里。 八叉树把空间按固定规则切成八份,物体落在哪一格是算出来的,不需要重新构建树。
物体移动时只需要把它从一格挪到另一格——这就是"局部更新"。而 BVH 的切分是基于物体分布算出来的,物体一动,原本最优的切分可能就失效了,往往要重建。
层次结构的第一种形态是包围球层次:
四叉树把空间按二维递归四分:
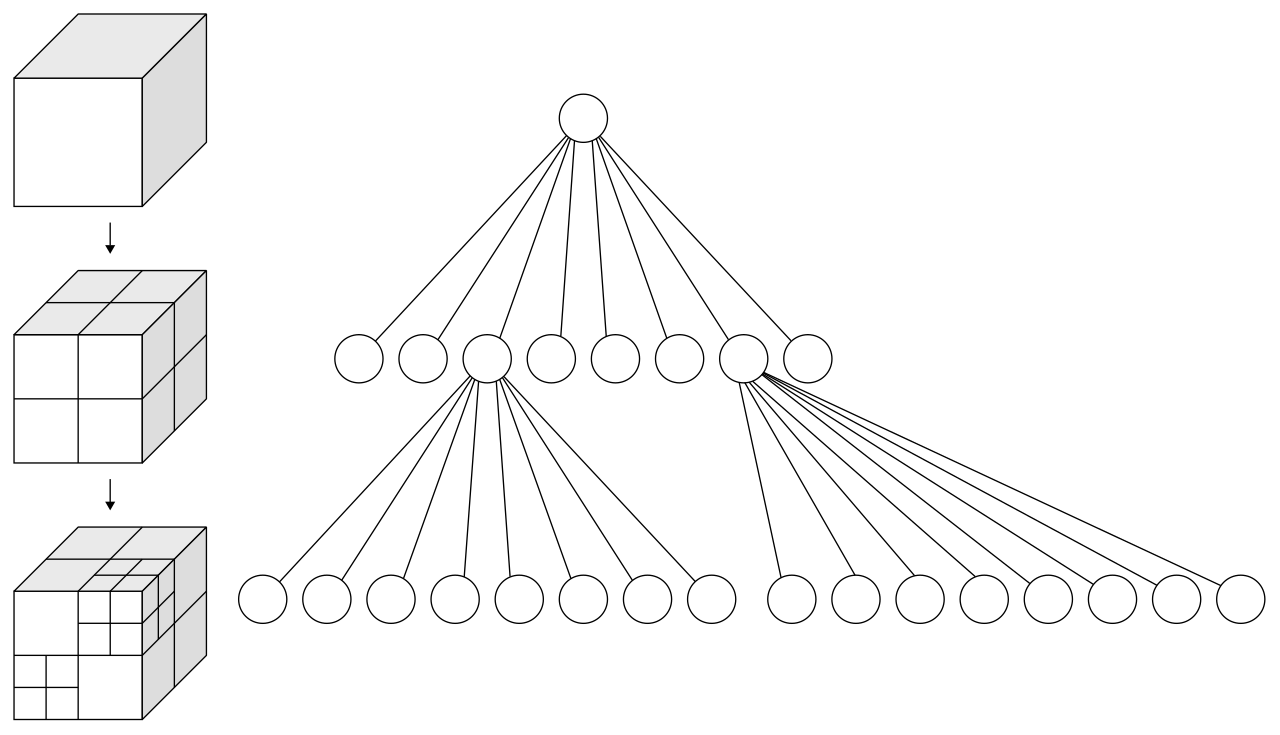
三维场景对应的是八叉树:
BSP 走的是另一条路——用平面切分而不是格子:
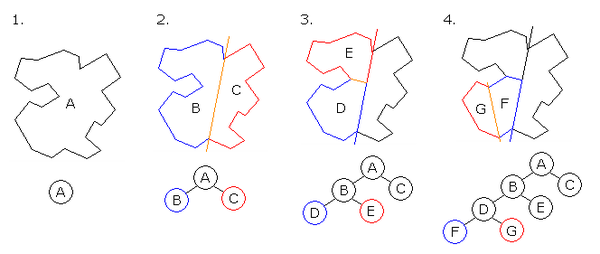
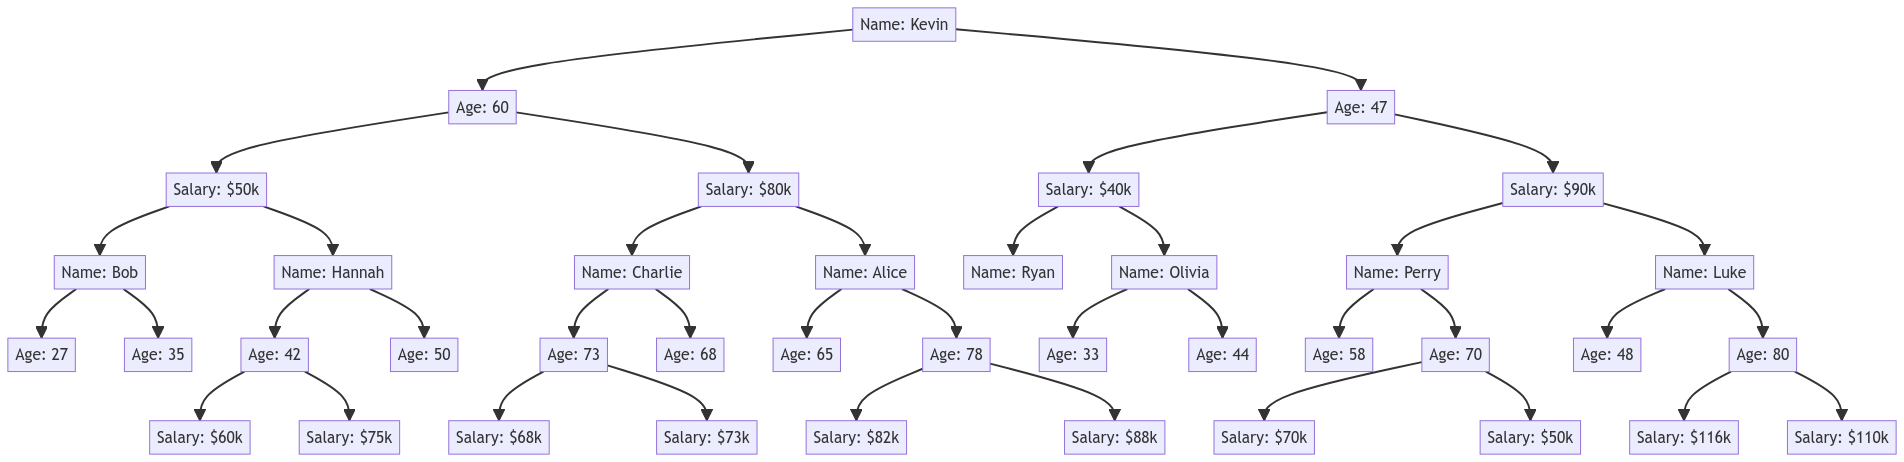
k-d 树是第五种结构——按维度轮流切分:
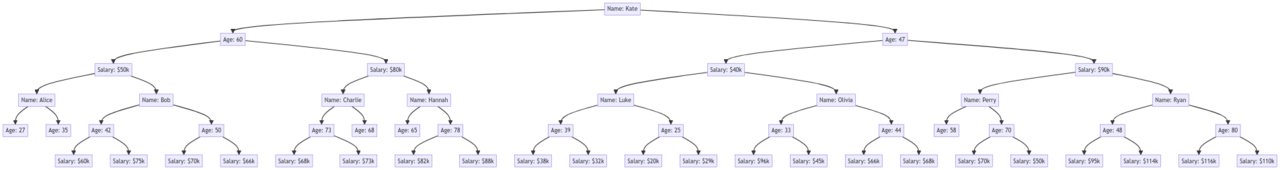
它的叶节点才存实际对象,中间节点只做划分:
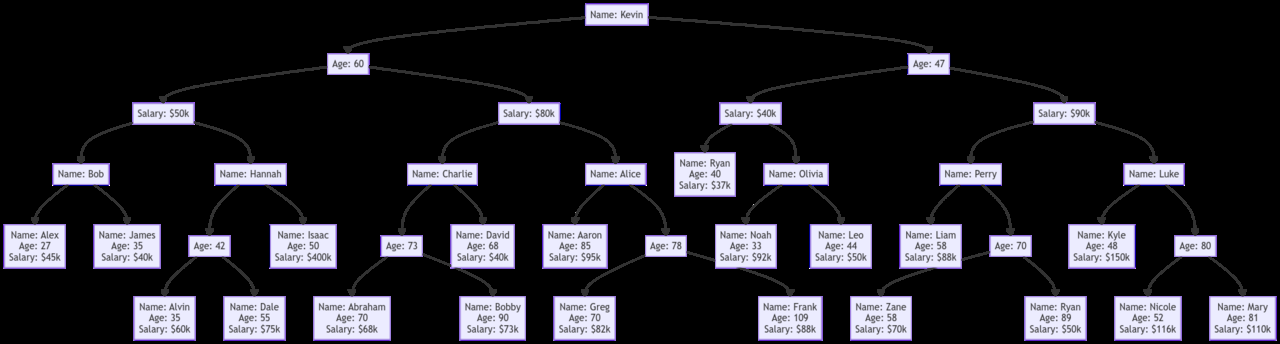
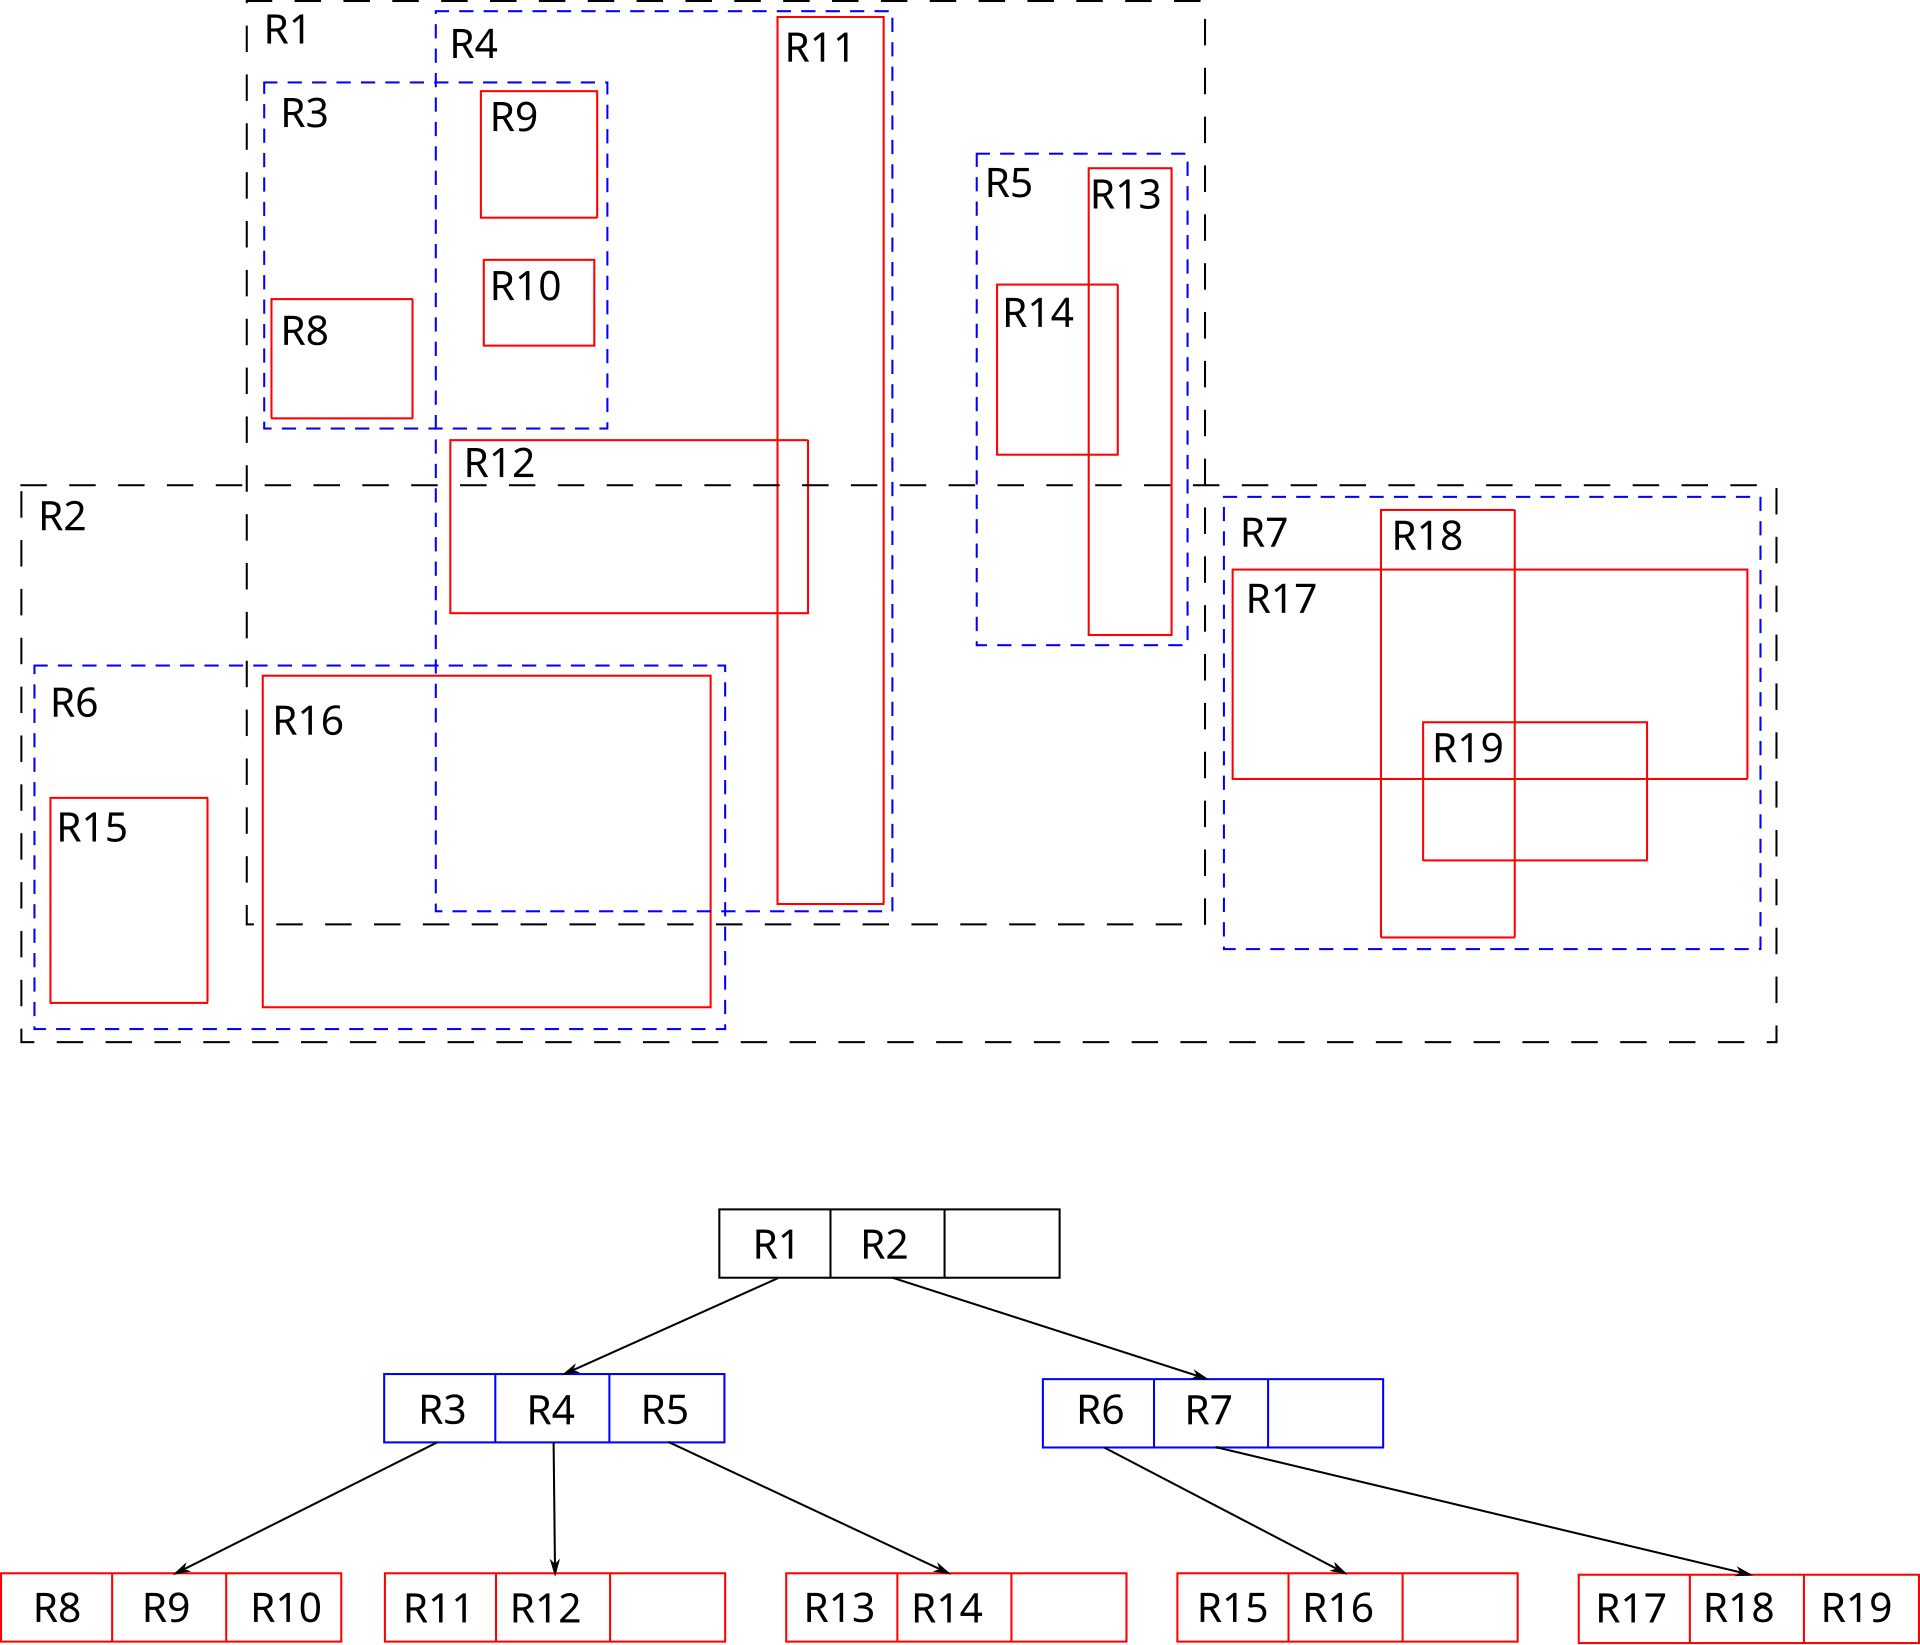
空间索引不止树形一种,R-tree 用最小外接矩形组织对象:
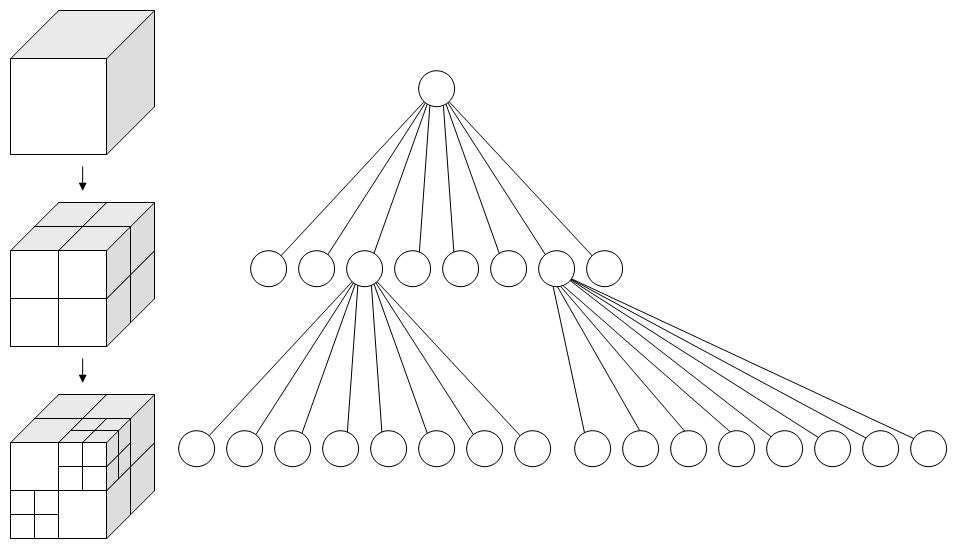
八叉树的划分过程是这样:
k-d 树每层只沿一个轴切分,空间划分与节点树一一对应:
4.3 松散八叉树:用一点冗余换免重建
先来看看松散八叉树。普通八叉树有个麻烦:物体如果正好跨在两格的边界上,就得决定"算哪一格"。算一格会让包围体不准(假阳性多),算两格会让物体被重复记录。
松散八叉树(loose octree) 的办法是:把每一格的实际判定范围向外扩一圈(通常扩到相邻格的中心),这样跨边界的物体总能落进唯一一格。
八叉树在可视化工具里的实际形态是这样:
代价是每格覆盖的空间变大了,包围体更松、假阳性更多。但换来的是物体移动时不必重插——这对大量运动物体的场景是划算的。
TU Clausthal 的比较研究进一步提出"向初始树的不同层级插入数据(而不是只插到叶层)",保留八叉树顺序的同时降低内存占用,适合动态场景 [27]。
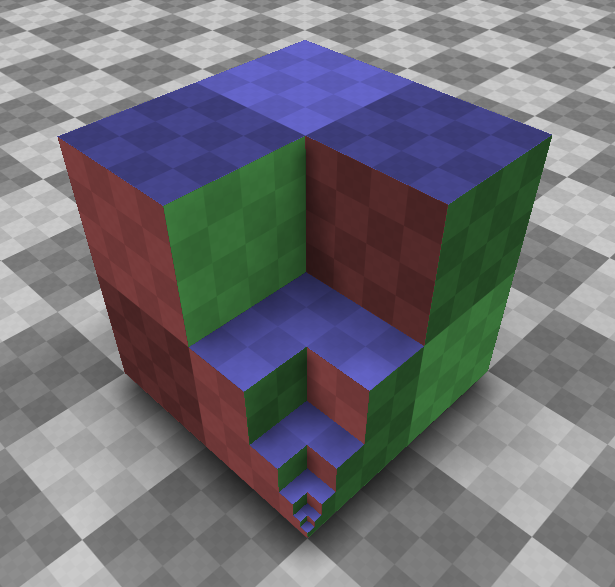
八叉树在真实引擎里是可见的——这是开源引擎的关卡编辑器,世界本身就是一棵八叉树:
4.4 参数逐项释义:树的分支度与深度
下面进入参数部分。树的分支度(每个节点几个子节点)决定了树的形状,也决定了判定次数与内存的平衡。
高分支度在 GPU 上有额外好处:一次可以取一整批子节点做判定,容易向量化。这也是 BVH 在 GPU 光追实现里常用高分支度的原因。
4.5 实现:BVH 的剔除遍历
层次结构的剔除是一段典型的递归——但为了在 GPU 上跑,通常改成显式栈的迭代形式。
// 【BVH 剔除遍历】用显式栈替代递归,便于在 GPU 上展开
void TraverseBVH(uint rootIndex, float4 planes[6], inout uint visibleList[], inout uint count) {
    uint stack[64];                       // 【1】固定深度栈,避免动态分配
    int  top = 0;
    stack[top++] = rootIndex;

    while (top > 0) {
        uint node = stack[--top];
        // 【2】先做视锥测试——最便宜的一层
        if (!IsAABBVisible(nodes[node].boundsMin, nodes[node].boundsMax, planes))
            continue;                     // 整棵子树跳过

        if (nodes[node].isLeaf) {
            visibleList[count++] = nodes[node].objectId;   // 【3】叶子:加入可见列表
        } else {
            stack[top++] = nodes[node].left;               // 【4】内部节点:压入两个子节点
            stack[top++] = nodes[node].right;
        }
    }
}
上面这段特别说明四处。
【1】处的固定深度栈有两个理由:GPU 上不支持动态大小的局部数组(必须编译期确定),而且固定深度天然避免了栈溢出。64 层的深度对二叉树来说足以容纳 $2^{64}$ 个物体。
【2】处是剔除发生的地方。注意这里用的是 continue 而不是 return——它跳过的是当前节点及其整棵子树,而不是整个遍历。
【3】处把叶子节点加入可见列表。在实际实现里这一步通常配合一个原子计数器,因为多个线程会同时写这个列表。
【4】处是遍历顺序。压栈顺序会影响缓存命中率——先压右再压左,弹出时就会先处理左子树,这对空间上连续的节点更友好。
社区里有几个真实的实现可以参考这份遍历的形状:一个引擎用四个 compute dispatch 在渲染之前运行,其中剔除那一步就是用 compute 把每个实体的 AABB 与相机六平面测试 [58];另一个则把视锥剔除构建在可复用的 fat-AABB BVH 上,同一套核心被物理 broadphase 与静态网格三角索引复用 [52]。
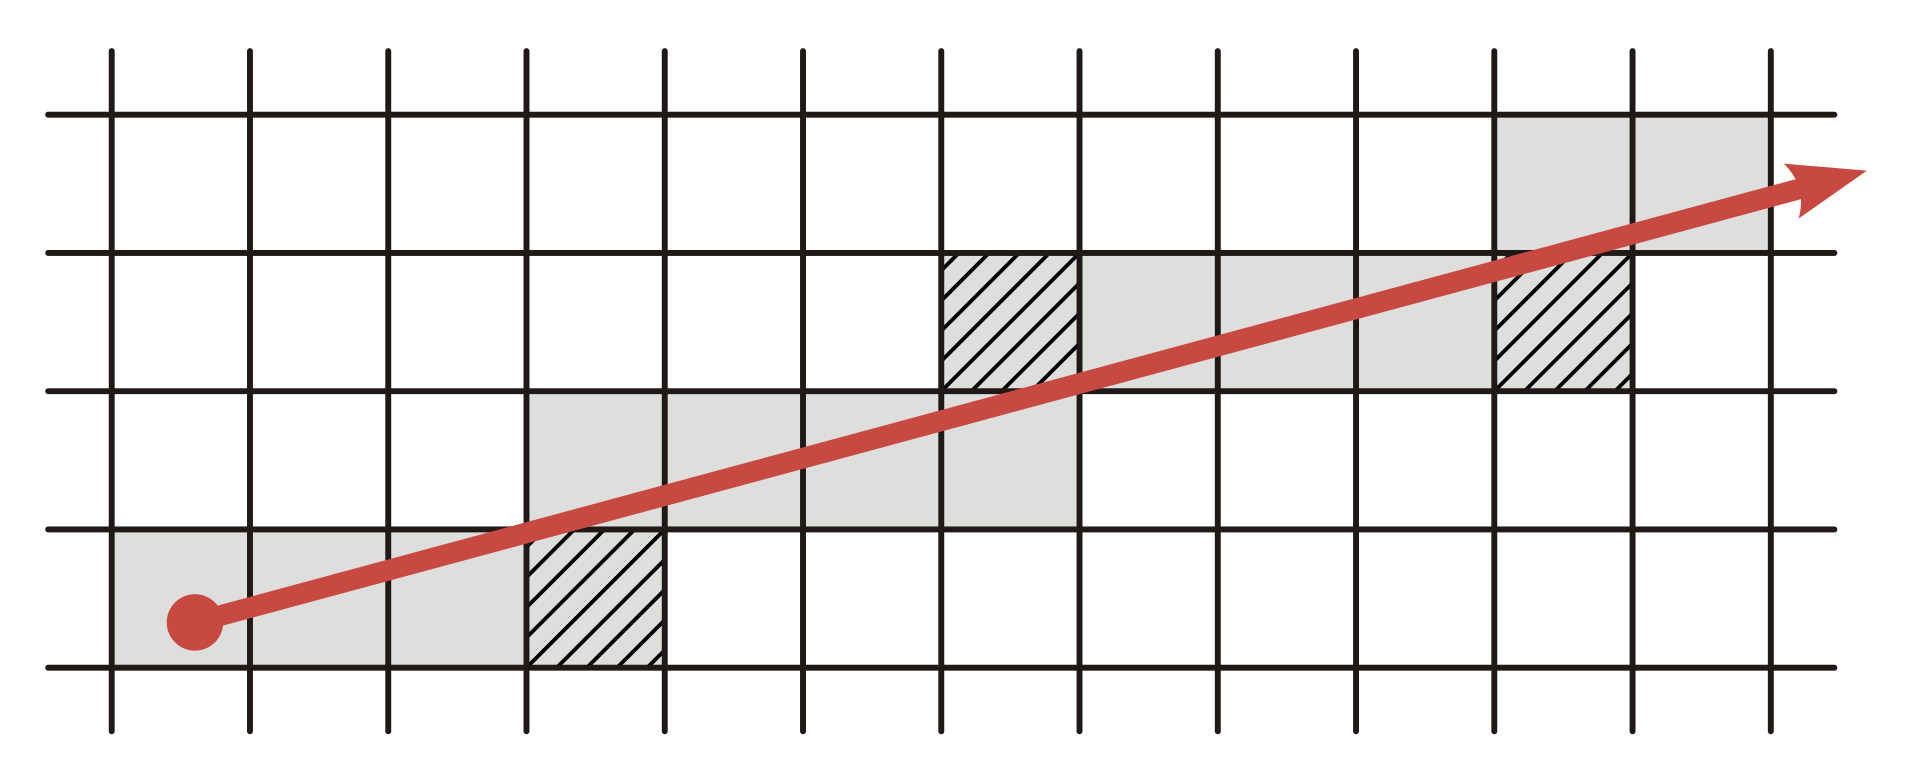
遍历要逐格推进,均匀网格中的光线遍历是最直观的一种:
4.6 五种结构在同一场景下的表现
好了,看看真实场景里的差距。结构选择如果只看理论,容易得出"BVH 最好"的结论。但真实场景里差距没那么绝对。
| 结构 | 构建时间 | 每帧判定次数 | 动态更新成本 | 综合 |
|---|---|---|---|---|
| 均匀网格 | 极低 | 高(分布不均时退化) | 极低 | 简单场景够用 |
| 八叉树 | 低 | 中 | 低 | 均衡 |
| 松散八叉树 | 低 | 中(假阳性略多) | 极低 | 动态物体多时最优 |
| 静态 BVH | 高 | 低 | 需重建 | 静态场景最优 |
| k-d tree | 中 | 低 | 高 | 最近邻查询专用 |
结论是"没有全面最优的结构"——这跟前面说的"先测再上"是同一件事。社区的中文对比也给出了类似的取舍判断:k-d tree 在数据点位置变化时可能需要重建、成本更高,而四叉树允许局部更新 [88]。
松散因子是这一族结构里唯一需要手调的参数,它同时影响内存和测试量。
同一套四叉树结构叠在场景上是这样:
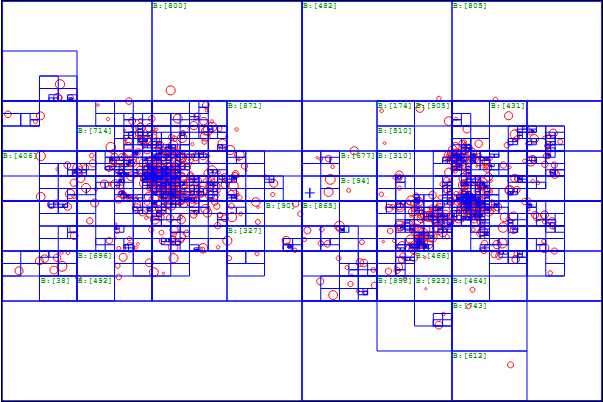
4.7 这一章留下的问题
结构选好了,但树怎么建?在哪个位置切分,直接决定了这棵树好不好用。 这就是下一章的问题。
五、构建期的问题:SAH 与动态场景
5.1 切分位置决定树的质量
OK,言归正传。对 BVH 来说,最核心的构建决策是:在当前节点的空间里,从哪个位置、沿哪个轴切开?
切得好,两个子节点的包围体都紧、重叠少;切得差,两侧包围体大量重叠,剔除时两条分支都得走——层次结构的收益就没了。
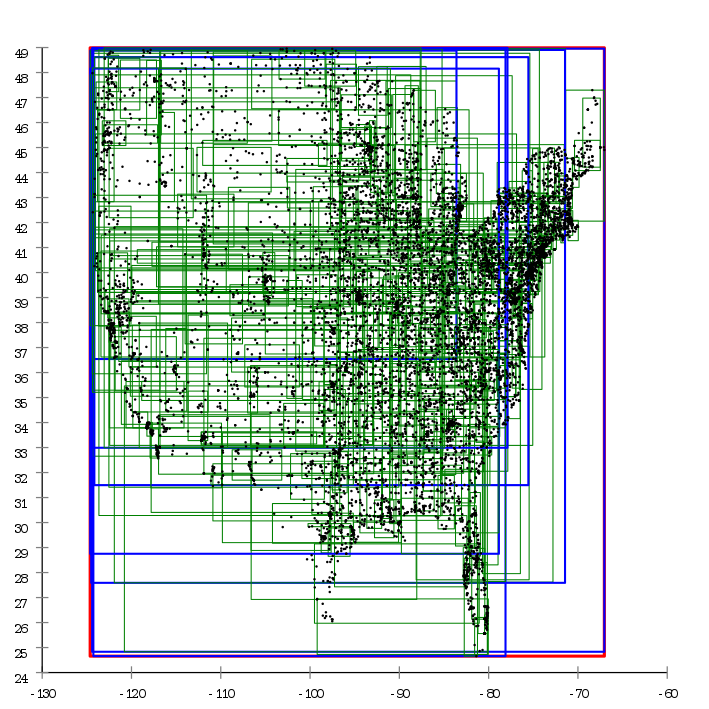
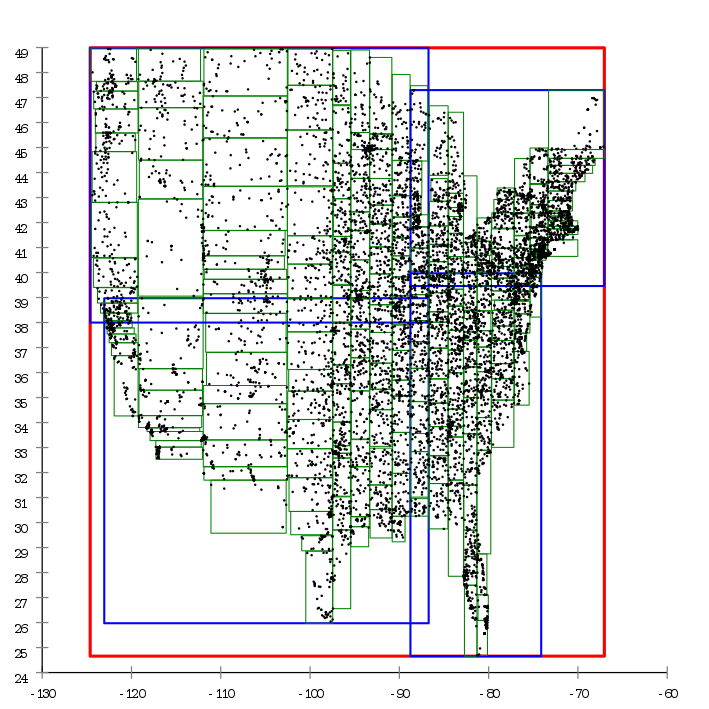
切分位置决定树的质量,这一点在空间索引领域早有量化研究——下面是 R-tree 的二次切分:
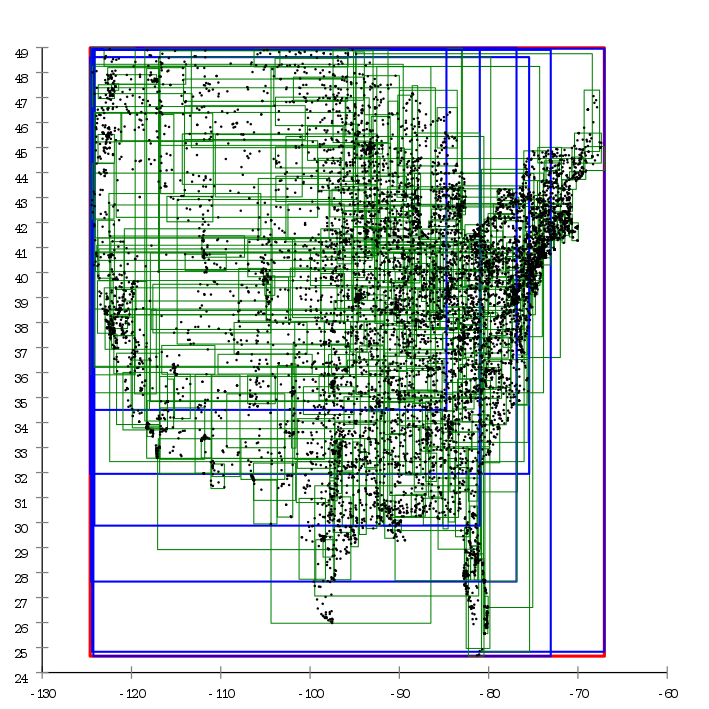
同一批数据换一种更便宜的切分策略,结果是这样:
5.2 表面面积启发式
下面我们开始讲 SAH。SAH(Surface Area Heuristic,表面面积启发式)是目前最常用的切分评价标准。它的几何直觉很干净:随机一条射线命中凸体的概率,正比于它的表面积。
把它用到判定成本上,就得到一个代价模型:
$$ C = C_{trav} + \frac{SA(L)}{SA(P)} N_L C_{isct} + \frac{SA(R)}{SA(P)} N_R C_{isct} $$
各项的含义:
| 符号 | 含义 |
|---|---|
| $C_{trav}$ | 遍历一次内部节点的固定成本 |
| $SA(P)$ | 父节点包围体的表面积 |
| $SA(L)$、$SA(R)$ | 左、右子节点包围体的表面积 |
| $N_L$、$N_R$ | 两侧的图元数量 |
| $C_{isct}$ | 一次相交测试的成本 |
这个模型最值得琢磨的地方是那个面积比值。 它说的是:父节点的表面积越大,随机射线落在子节点上的相对概率就越小。
所以面积小的子节点更"便宜"——把物体尽量分到包围体紧凑的一侧,总的判定成本就下降了。
社区的推导文章把它写成了更直观的形式,并说明构建策略是"沿轴扫描、在每个物体边界处评估代价、取最小" [64];一份真实源码里可以看到分箱(binning)实现——把轴分成若干箱、只在箱边界处评估 SAH 代价,把 $O(n^2)$ 的暴力扫描降到 $O(n \log n)$ 量级 [57]。
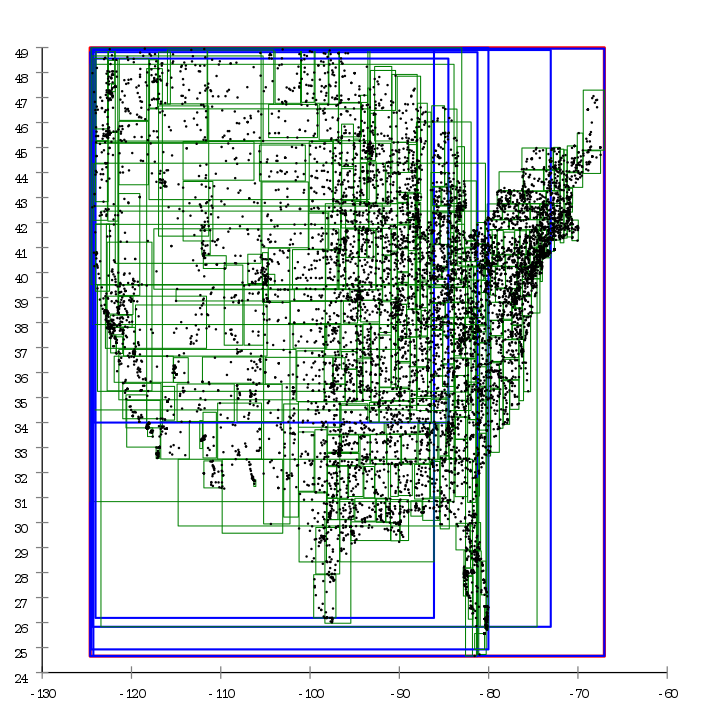
按面积代价优化到极致,就是 R-star 树的拓扑切分:
5.3 参数逐项释义:构建质量与构建速度的取舍
SAH 质量最好,但构建最慢。工业界有几个档位:
LBVH 值得单独提一句:它用 Morton 码(把三维坐标按位交织成一个整数)直接决定切分,几乎不需要全局评估——每一步都能独立计算,因此可以完全并行。
代价是质量不如 SAH,但对于"每帧都要重建"的动态场景,快就是一切。
5.4 动态场景:重建还是复用
先来看看动态场景怎么办。这是工程上最实际的一个问题。物体在动,树就旧了。三种应对:
| 策略 | 做法 | 代价 |
|---|---|---|
| 整树重建 | 每帧重新构建 | 构建成本随物体数增长,但实现最简单 |
| 增量更新 | 只更新受影响的子树 | 需要追踪"哪些物体动过" |
| 放弃层次 | 退回逐个物体判定 | 判定次数回到 $O(n)$,但省下构建成本 |
选择依据是"运动物体的比例":如果只有少数物体在动,增量更新最划算;如果几乎所有物体都在动(比如粒子、群集),整树重建反而更简单直接,甚至不如退回逐个判定。
社区的一个实现给出了工程上的做法:用循环轮转(Round-Robin)的方式分批更新,避免每帧都在重建上花掉大量时间。
5.5 一个容易被忽略的复用点
空间结构不只为剔除服务。同一个 BVH 可以同时被用于:
- 剔除(本文主题)
- 光追的加速结构
- 物理的 broad phase(粗筛)
- 拾取(鼠标点击选物体)
社区的一个引擎实现就把视锥剔除构建在可复用的 fat-AABB BVH 上,同一套核心被物理 broad phase 与静态网格三角索引共用 [52]。
"一套结构多处复用"是这类基础设施最重要的设计目标——因为构建成本只付一次,收益却摊在多个系统里。
5.6 构建成本要摊销到多少帧
说白了,这是一笔摊销账。构建一棵 BVH 的代价,必须摊到多帧才划算?这里有个简单的判断方法。
假设构建一次耗时 $T_{build}$(毫秒),每帧剔除能省 $T_{save}$(毫秒),那么:
$$ N_{break} = rac{T_{build}}{T_{save}} $$
回本帧数是 $N_{break}$。 如果一个场景的构建要 20 ms、每帧省 2 ms,那就需要 10 帧回本——对静态场景完全划算(构建一次用几千帧),对每帧重建的方案则是纯亏损。
这也解释了为什么分箱 SAH 成为默认:它的构建时间处在"一次构建、长期使用"的合理区间——比暴力 SAH 快得多,质量又明显好于中点切分。
分箱构建把 SAH 的代价从"每个候选位置都算一遍"降到"每个箱算一遍"。
批量装载是另一条路——一次性把整批数据构造成树,而不是逐个插入:
5.7 这一章留下的问题
到这里,第一层(视锥)的完整链条走完了:平面提取、包围体测试、空间划分、构建策略。
但视锥剔除只能回答"在不在视野里"。一个物体在视野正中央、却被一堵墙完全挡住——视锥剔除对它无能为力。要处理这种情况,必须知道"深度长什么样"。下一章开始讲这件事。
六、遮挡剔除:从硬件查询到层次 Z
6.1 遮挡剔除在解决什么
下面进入第二层判定。视锥剔除的假阳性里,有一大类特别可惜:物体在视野内,但完全被别的东西挡住了。 在城市街道、室内场景、丛林里,这类物体占比常常过半。
要判定"有没有被挡住",就需要深度信息——物体投影到屏幕上之后,如果它的所有像素处都已经有更近的东西,那它必然不可见。
遮挡剔除要处理的场景,引擎里长这样:
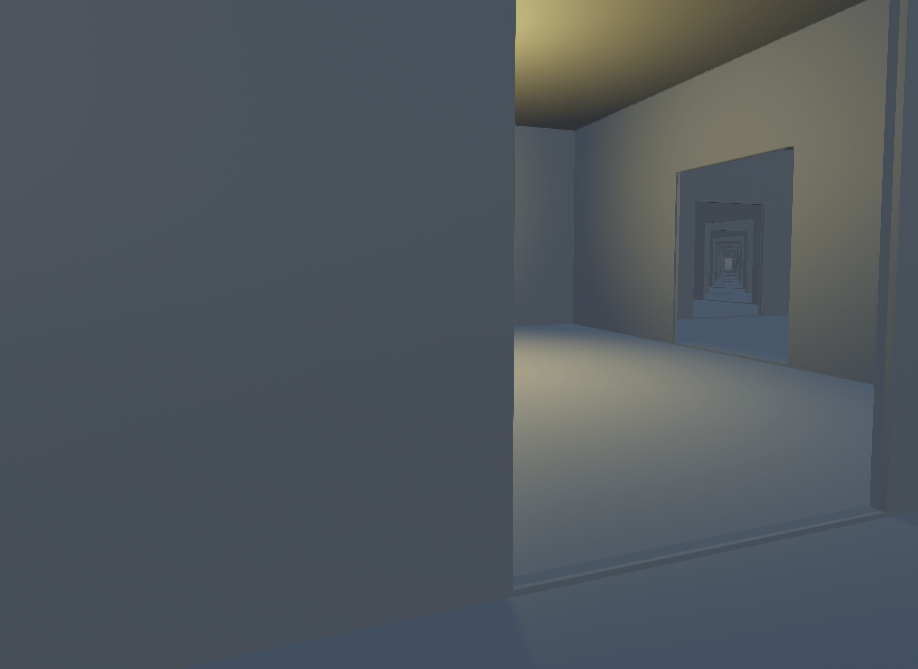
关闭遮挡剔除时,被挡住的物体照样进入绘制:
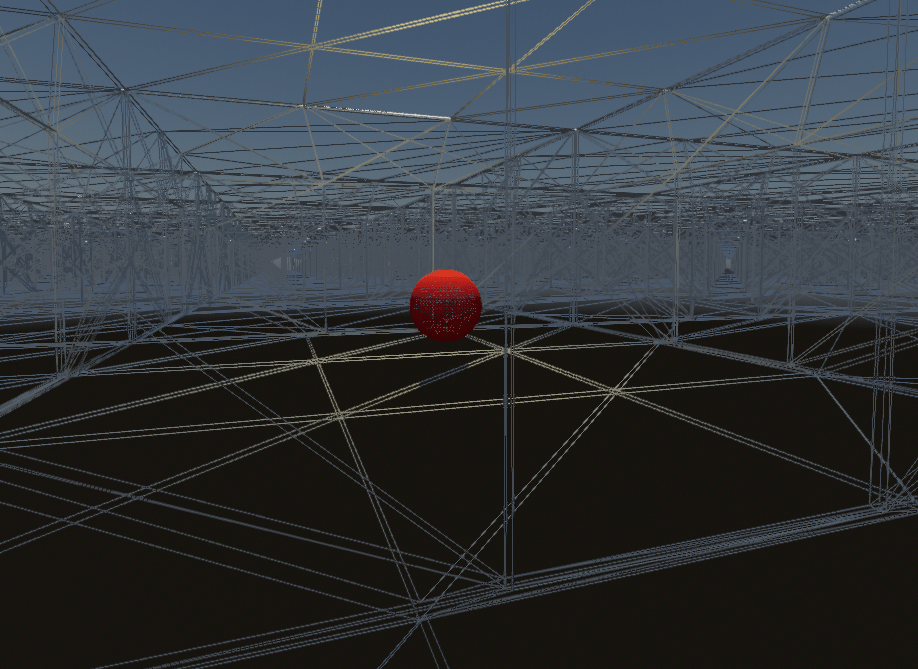
开启之后,这部分开销被消掉了:
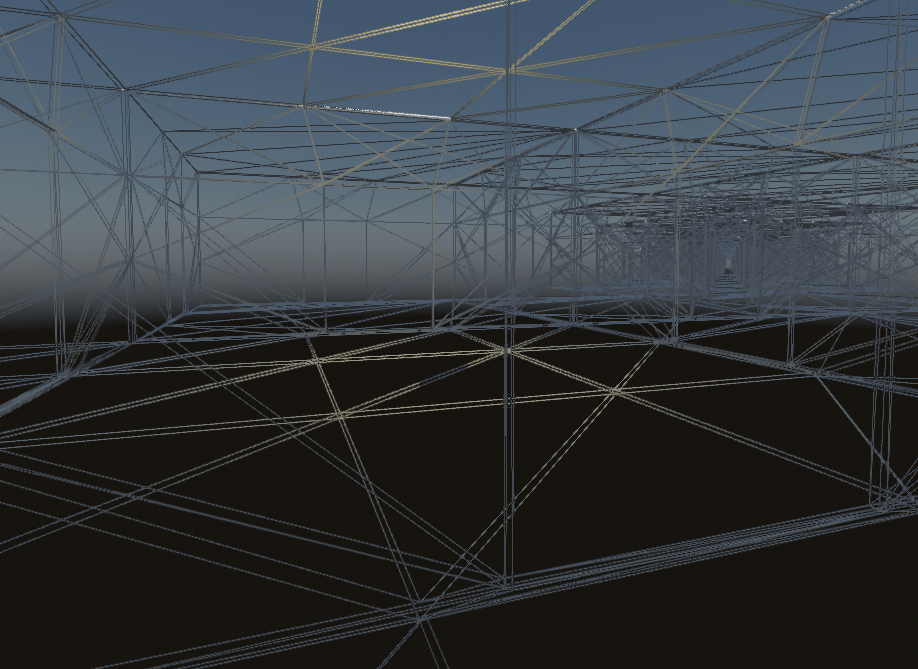
遮挡剔除要处理的是这类情形:
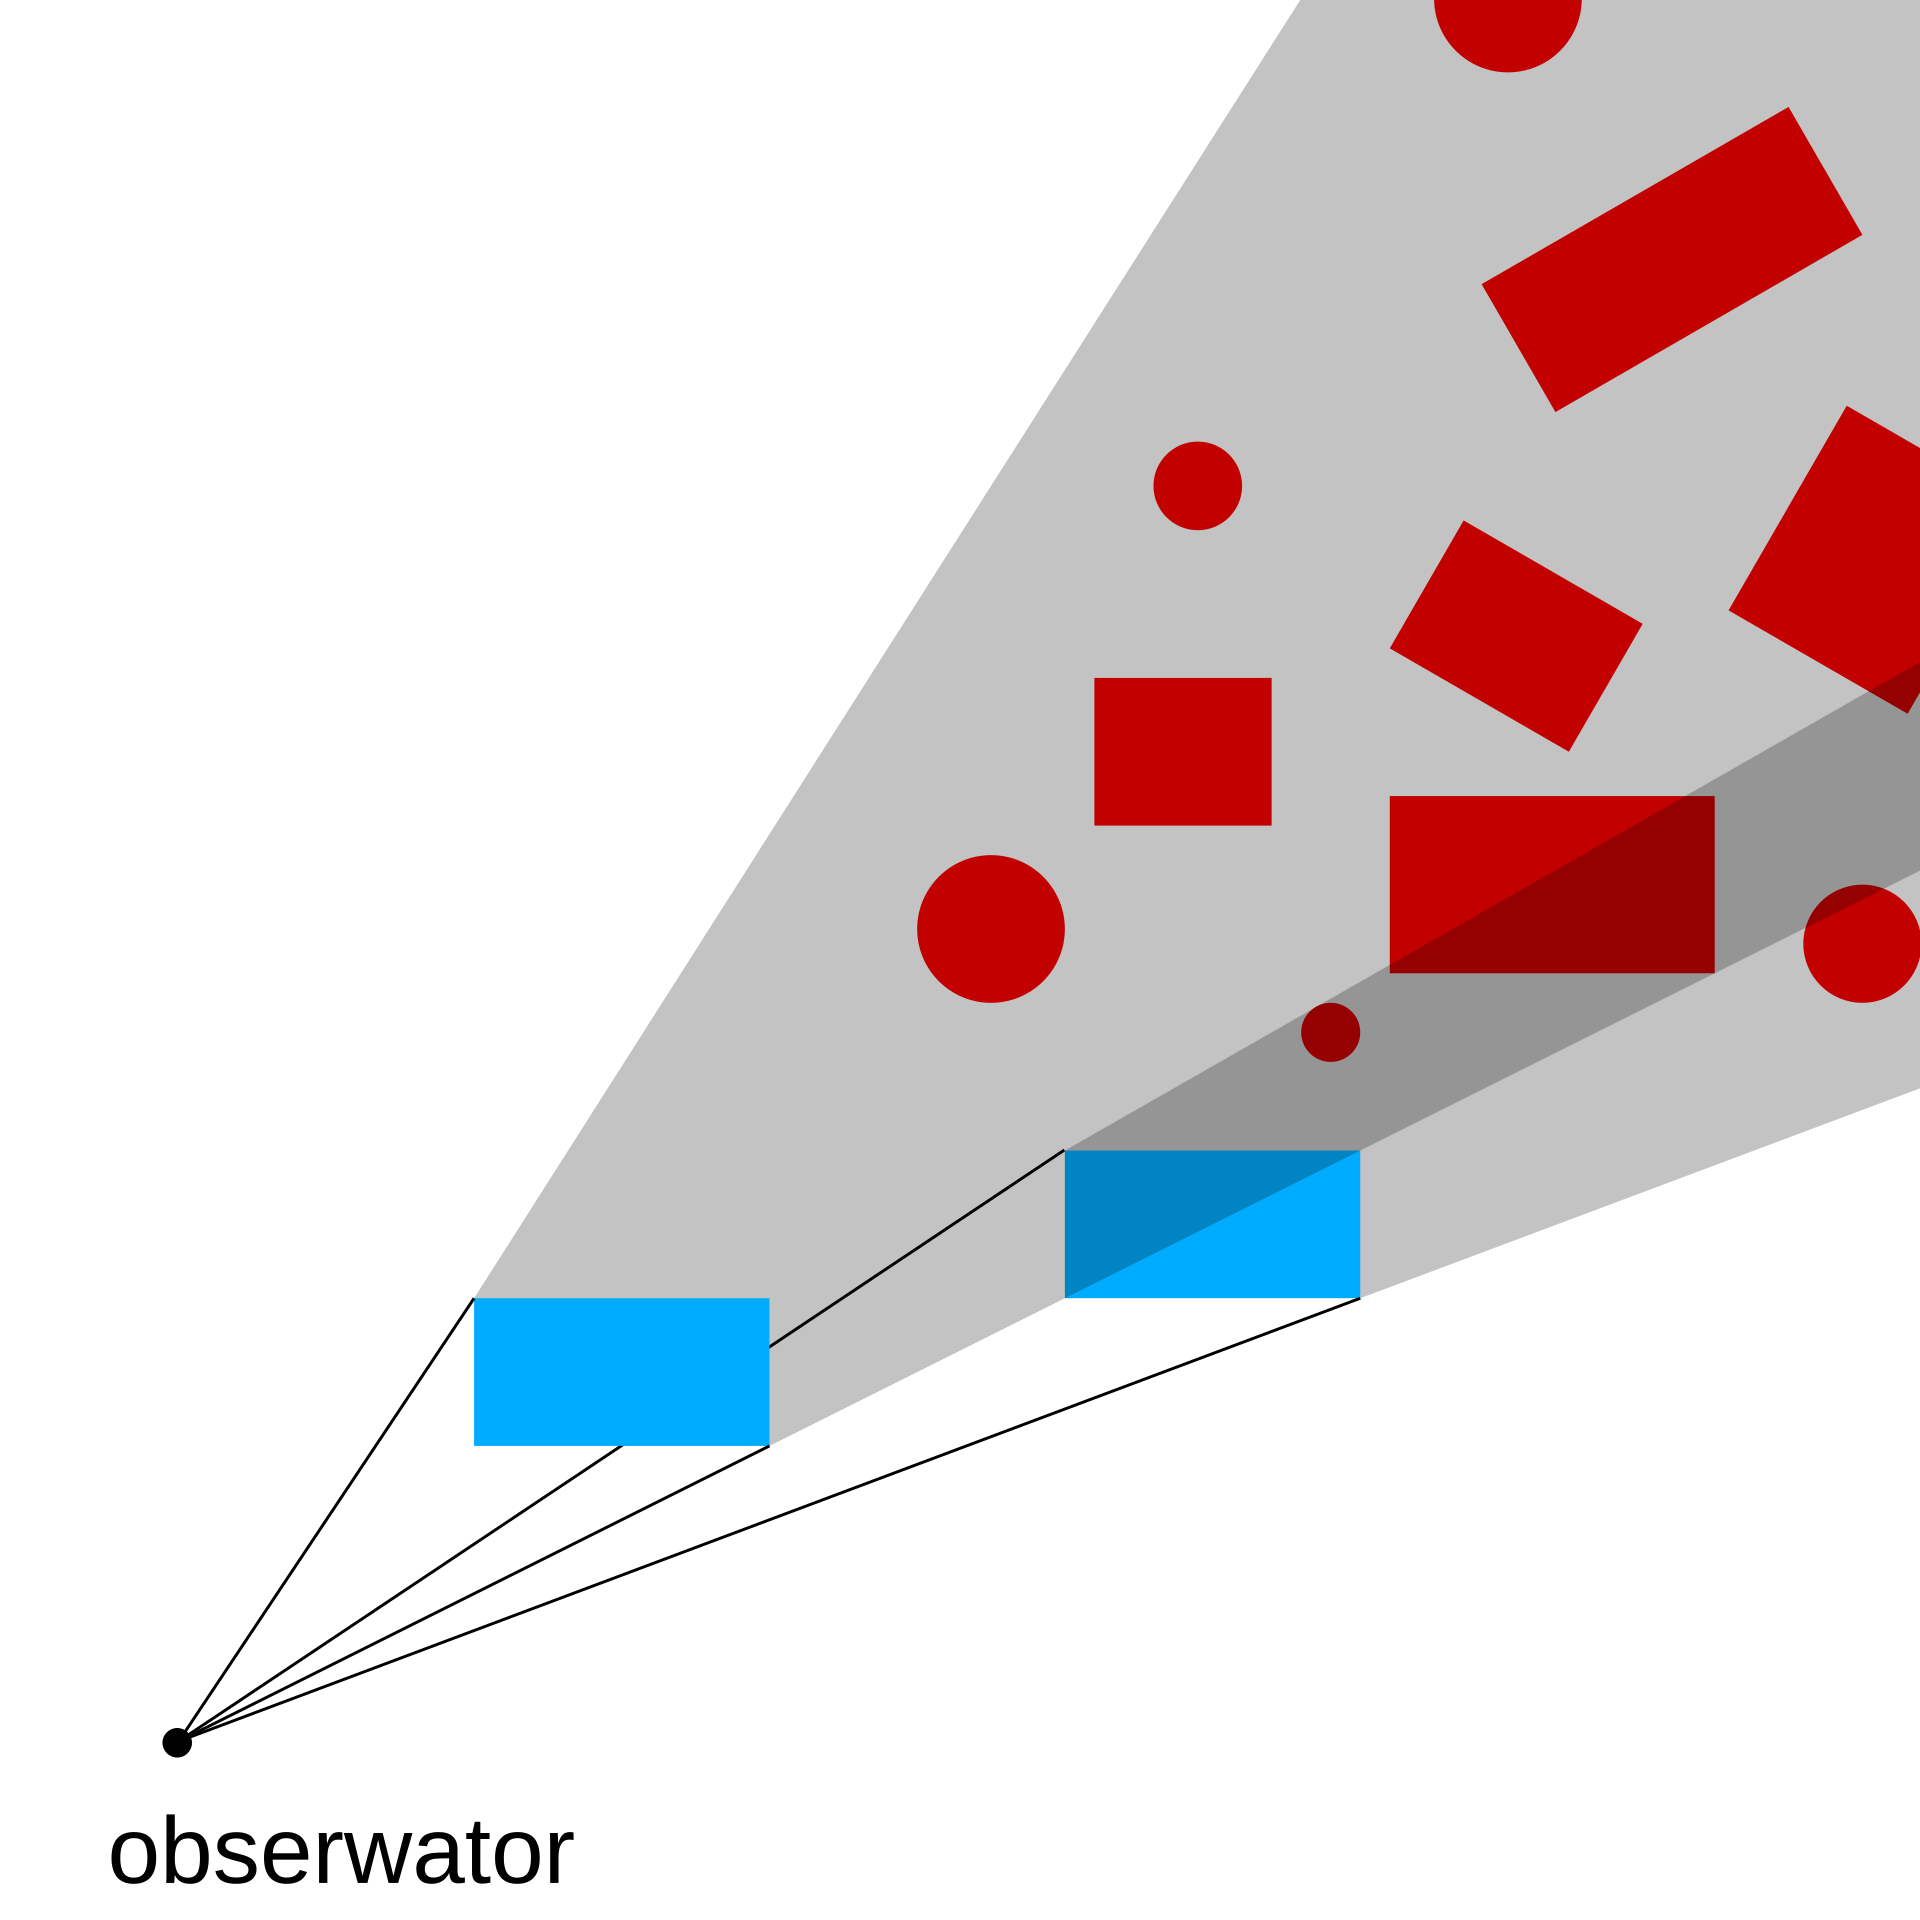
难点立刻出现:深度信息是渲染的产物,而要画的物体又依赖于剔除结果。 这是个循环依赖。
6.2 硬件遮挡查询:最直接的方案
硬件这条路最直接。最直接的破环办法是让硬件来回答这个问题。GPU 提供遮挡查询(occlusion query)机制:提交一批几何,硬件渲染时统计"有多少像素通过了深度测试",然后把这个数字告诉你。
判定规则很干净:通过测试的像素数为零,就说明这批几何完全被挡住。
6.3 stop-and-wait 的两个缺陷
好了,问题出在等待上。看起来很美,但朴素的用法有致命问题。
最朴素的用法叫 stop-and-wait:提交查询、等结果、根据结果决定画不画。它的两个缺陷在 GPU Gems 2 第 6 章里讲得很清楚 [17]:
缺陷一:CPU stall。 读回查询结果要求 CPU 等待 GPU 完成——这是同步等待。在这段时间里 CPU 什么都干不了,GPU 也可能因为等不到后续命令而空转。
缺陷二:查询本身有开销。 每个对象一个查询,查询数量一多,光是查询的开销就够可观了。
这个缺陷在实践中是真实存在的。 有开发者在论坛里记录了硬件查询的同步点拖累简单场景性能的情况,并说改用 HZB(走 compute、不用硬件查询)后缓解——但同时提醒,HZB 更保守、可能多画,反而抵消收益 [60]。
6.4 相干层次剔除:用上一帧隐藏延迟
GPU Gems 2 那一章给出的解法是本文认为最值得学的一个思路:既然等不了,那就别等——用上一帧的结果做猜测,然后延迟验证。
具体做法:
- 用上一次查询的结果决定这一帧"大概"要不要画
- 照常提交绘制
- 如果上一帧的结果很旧或置信度低,再补发一次查询去验证
这个方法利用的是时间相干性(temporal coherence)——相邻两帧之间,视角和场景的变化通常很小,所以"上一帧可见"是"这一帧可见"的一个很好的预测器。
代价是引入了时序依赖。 一旦用上一帧的信息,就必然接受"上一帧错了,这一帧也跟着错"的可能。这个代价在第八章会展开讲。
6.5 Umbra 的两阶段:工业界的另一条路
除了硬件查询这条路,还有一条纯软件的路。Unity 用的 Umbra 就是后者的代表,而它的流程有官方的一手说明——由 Umbra 自己的开发者撰写 [47]。
那个官方说明里有一句话值得记住:查询永远保守——绝不产生假阴性,但可能产生假阳性。 这正是第一章那条铁律在工业产品里的直接体现。
三个烘焙参数决定了数据大小与精度的平衡:Smallest Hole(最小的洞)、Smallest Occluder(最小的遮挡体)、Backface Threshold(背面阈值)[47]。它们的含义都很直观:场景里小于某个尺寸的缝隙与遮挡体被忽略——因为处理它们不划算。
社区里有一份中文整理复述了这个流程 [84];中文学术界也有一份基于分块遮挡图、仅在需要时更新、保守剔除并用 OpenMP 并行化的图像空间软件遮挡引擎 [29]。
6.6 参数逐项释义:软硬两条路的取舍
这张表也解释了为什么两条路都存在至今:它们各自擅长不同的场景,谁也没能取代谁。
6.7 遮挡查询的粒度选择
先来看看粒度怎么选。硬件遮挡查询的粒度选择有一个反直觉之处:不是越细越好。
GPU Gems 2 那一章的建议是把邻近物体成组,当作单个对象做查询 [17]——它同时列举了空间层次结构的几种形式(k-d tree、BSP tree、标准 BVH),并指出通用的做法是递归划分直到 cell 足够小。
这里的"足够小"就是查询粒度选择的准则:小到能剔掉不少东西,但还没小到查询开销成为主角。
GPU Gems 3 的一章补充了另一个实用细节:最简单的层次结构就是 AABB 的二叉 BVH,它生成极快、适合动画场景每帧重建,而节点的可见性测试顺序是"先做视锥相交,再做遮挡查询" [19]——先便宜后贵,与第十章那段 GPU 剔除代码的顺序一致。
CHC 的核心是让查询结果延迟一帧可用,中间用绘制填满等待。
Bittner 在 ShaderX7 里强调过一点:CHC 本身不限定空间结构,BVH、k-d tree、八叉树都能承载它 [96];而工业界把这条路线做成产品的 Umbra,走的却是另一套——离线体素化加 portal 建图,运行时只做 cell 与 portal 的遍历 [94][93]。
6.8 这一章留下的问题
两条路都提到了"深度缓冲"——一个用硬件渲染出来的深度、一个用软件光栅化出来的深度。
到了现代 GPU 管线里,这件事换了个做法:不单独为遮挡算深度,而是直接复用场景的深度缓冲,做成金字塔。 下一章讲这个。
七、层次 Z 缓冲:深度金字塔怎么做
7.1 逐像素测试太贵
下面进入 Hi-Z。遮挡剔除的核心是"物体的投影范围内,深度是否都已被更近的东西占住"。最直接的做法是逐像素查深度缓冲——一个物体的屏幕投影可能覆盖几万个像素,逐像素测太贵。
层次 Z 缓冲(HZB / Hi-Z) 的思路是:把深度缓冲做成 mip 金字塔,用较粗的层级一次性覆盖一大片区域。
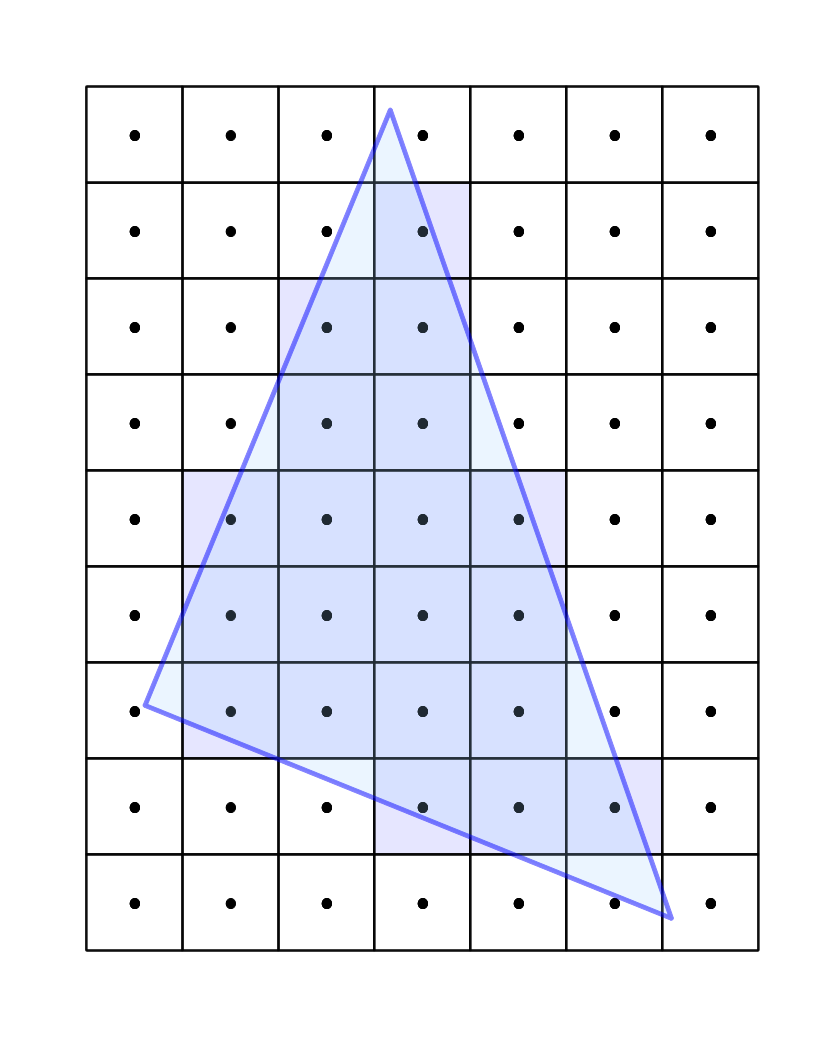
“逐像素”到底有多贵,看一个三角形覆盖多少像素就明白:
遮挡判定最终要落到逐像素的深度比较上:
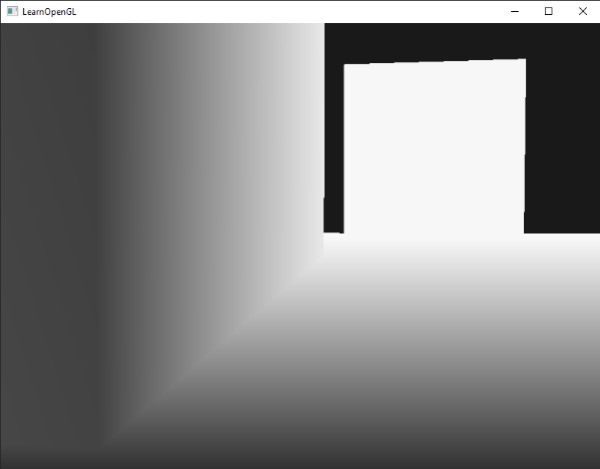
更直白地说,深度缓冲就是画面与它逐像素的深度记录:
深度缓冲(Z 缓冲)的原理是这样的:
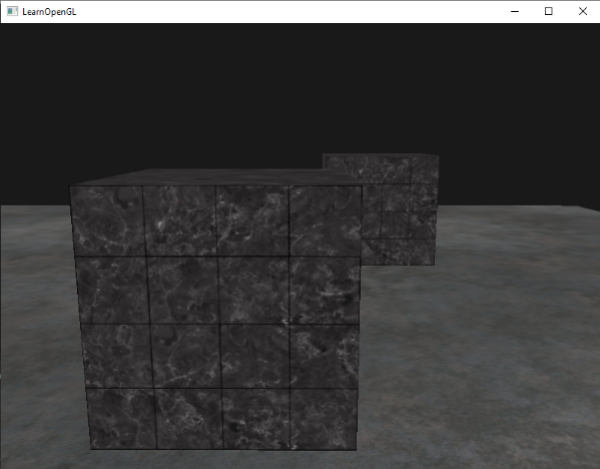
这个逐像素判定用的就是深度测试——正常情形是“更近才通过”:
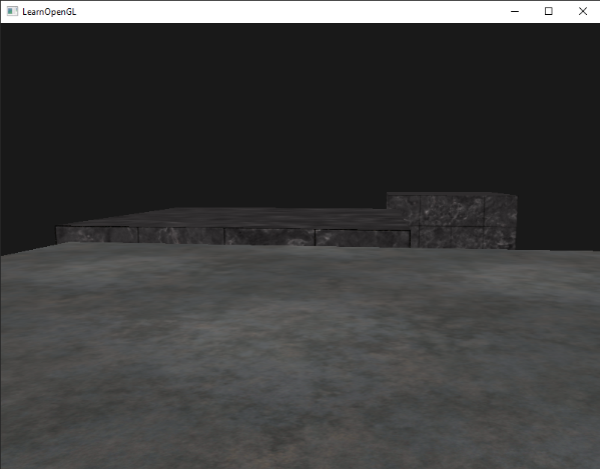
如果这个判定干脆不比较深度:
逐像素比较还有一个精度上的软肋:
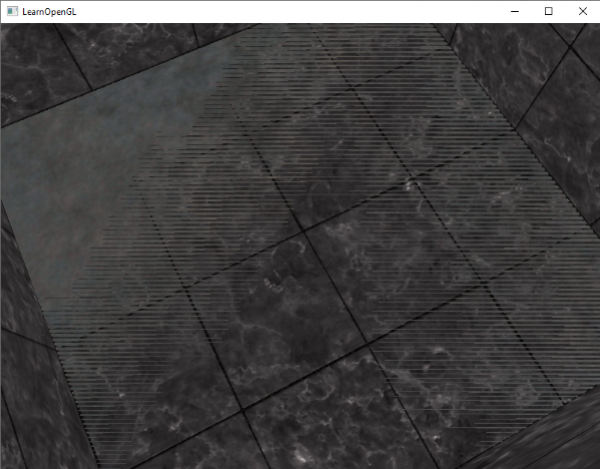
这和 mipmap 的思路一样,只是内容换成了深度。判定时从较粗的层级开始,粗层级能排除就直接跳过,不能排除再往细里走。
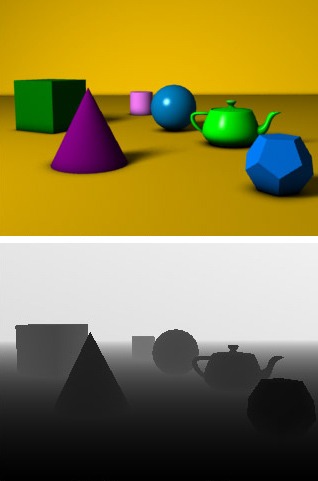
Hi-Z 要处理的就是这样一张深度图——左边是场景,右边是它对应的深度:
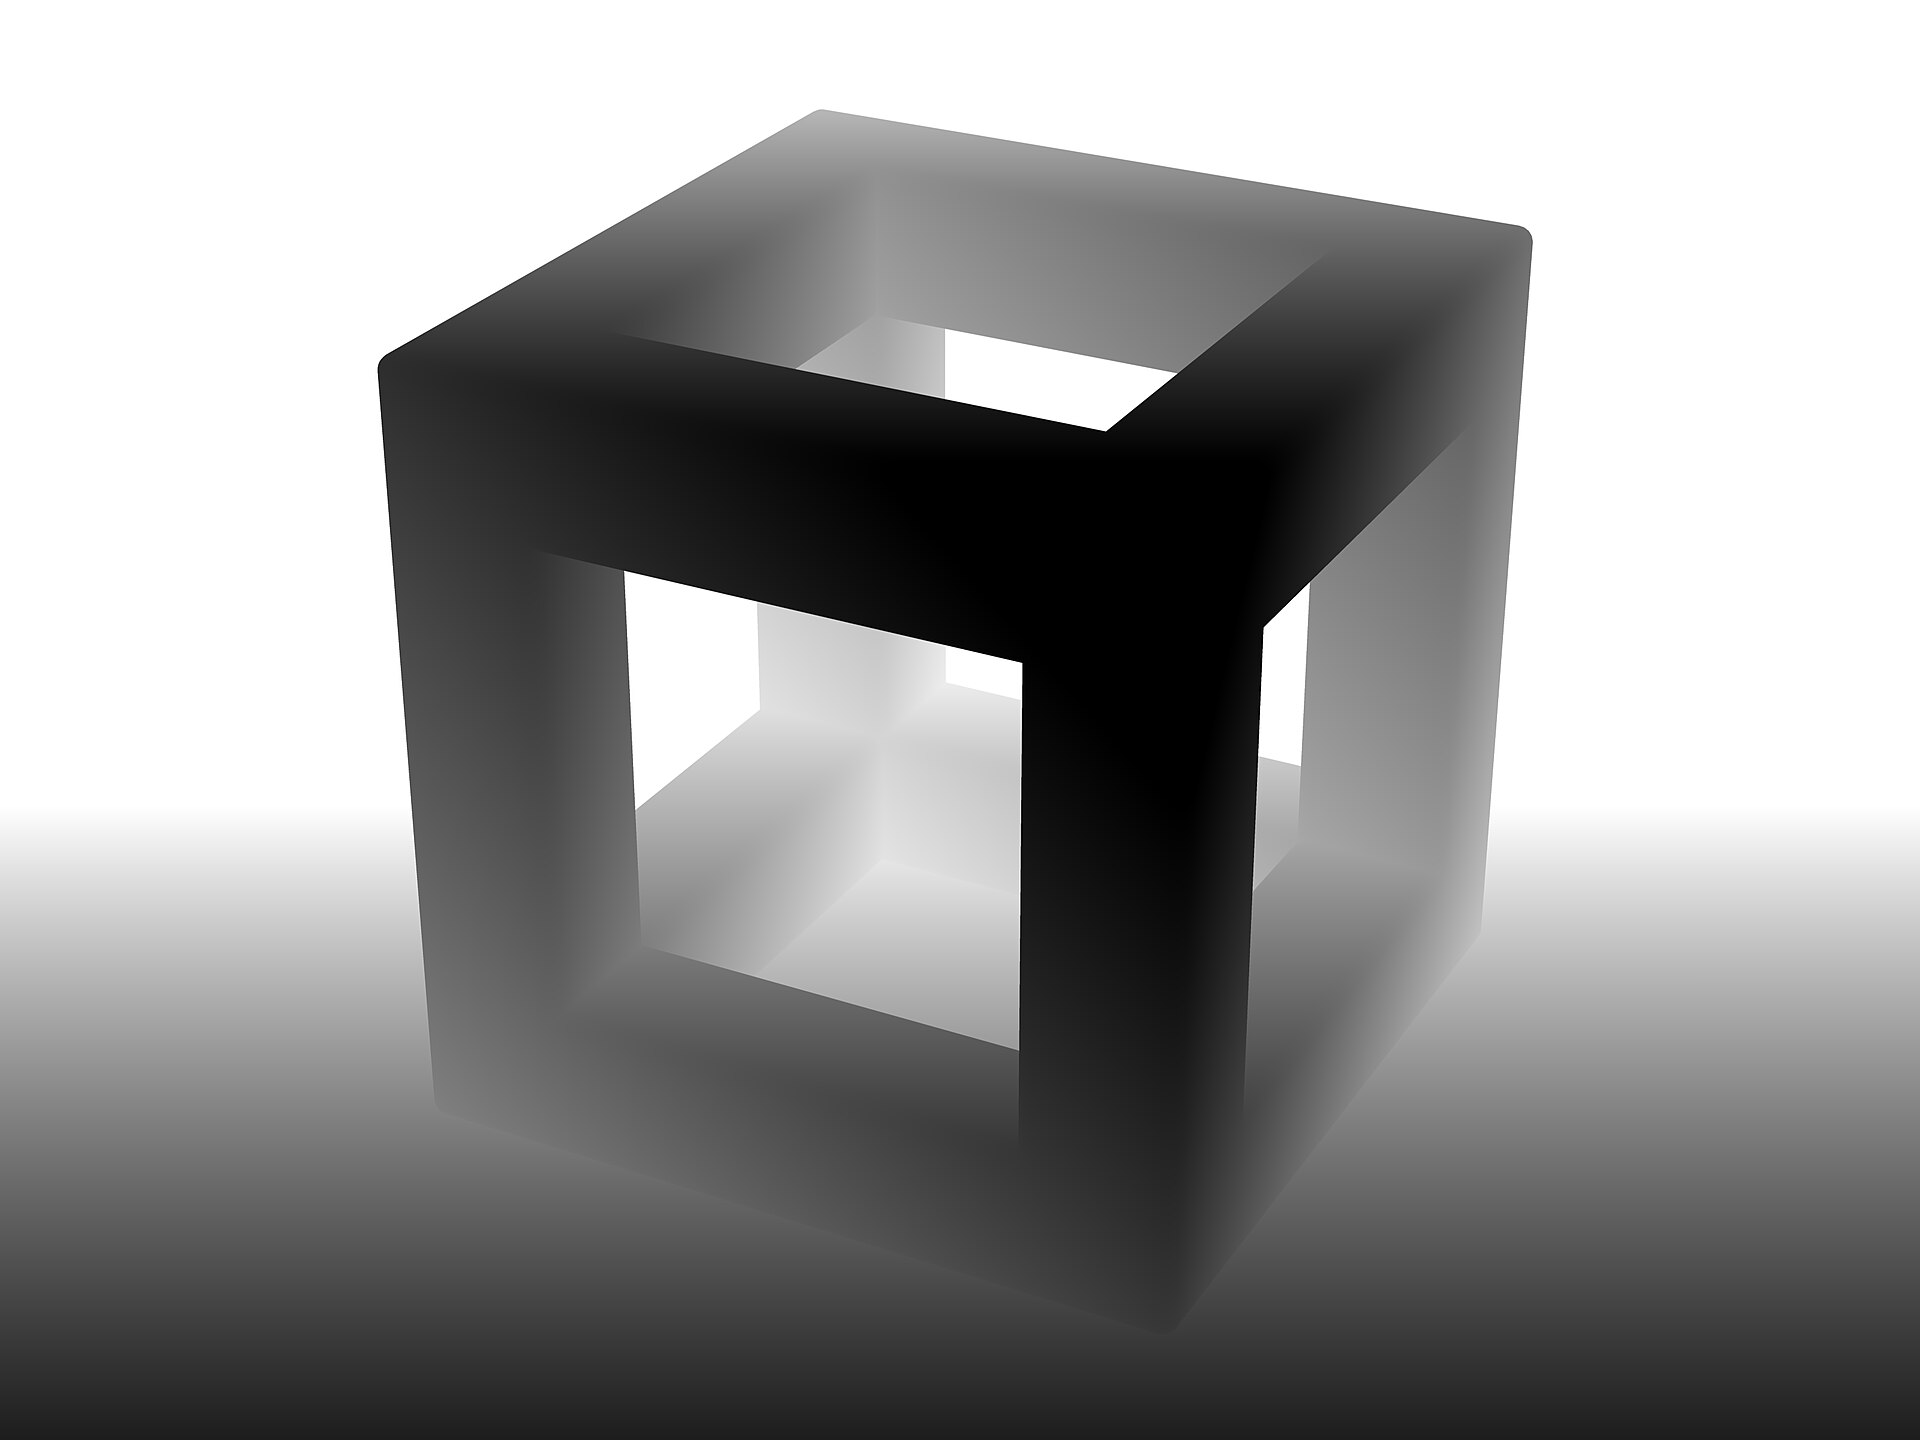
7.2 关键细节:降采样要取最远
下面进入最关键的一步。这是 Hi-Z 里最容易写错、也最不能写错的一点。
构建金字塔时,每一级的一个纹素由下一级 2×2 的四个纹素归约而来。归约用哪个算子?取最远(max 深度)的那个。
深度的分布方式直接影响金字塔是否好用——线性分布是这样:
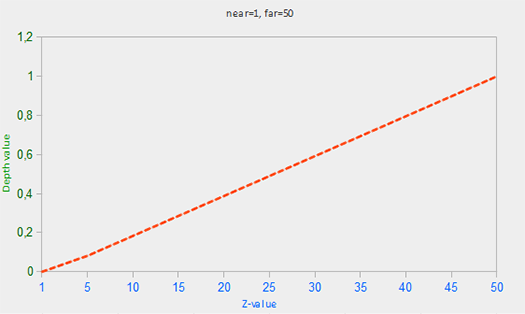
而实际投影得到的深度是非线性的:
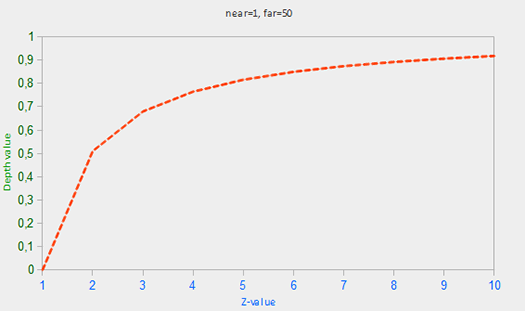
把同一场景的深度缓冲线性化后,远处的精度被摊平:
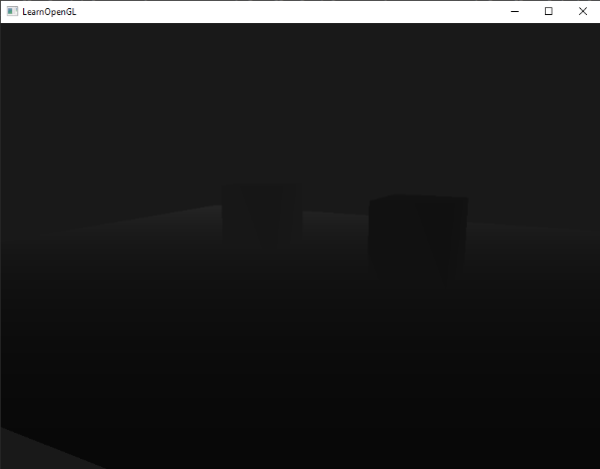
道理在于保守性:粗层级的深度代表"这一小片区域里最远的东西有多远"。如果用最远值,那么"物体比这个值还远"就一定真的被挡住了;如果用最近值,就可能把一个可见物体判成被挡住——直接造成假阴性。
一份实现笔记把这个细节写得很明确:先用遮挡物 depth pre-pass 写入 HZB 的 mip0,再max 降采样(每层取下层四纹素中最远者)[34]。
另一份入门资料也强调同样的做法,并补充了直观的验证——最高级只剩 1×1 时,它代表的就是全屏最远距离 [50]。
格式也必须注意:深度金字塔需要 R32f 这类高精度格式,Rgba8 不能用来做遮挡深度 [34]。原因是遮挡判定要比较精确的深度值,8 位精度会导致大量误判。
降采样前的原始深度图是这样:
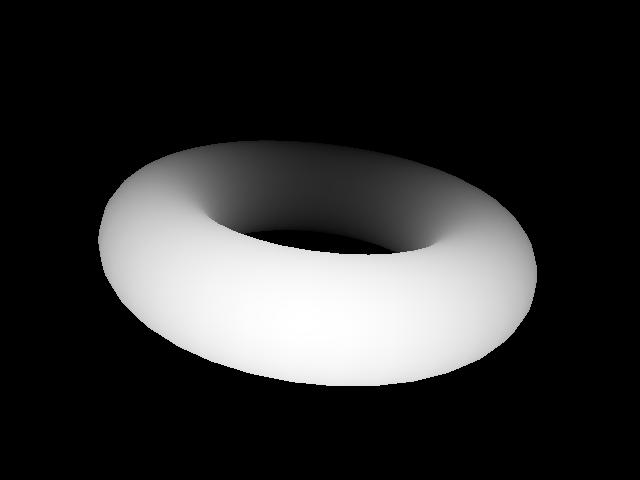
7.3 保守测试:怎么判定一个包围盒被挡住
下面我们开始做保守测试。有了金字塔,判定一个 AABB 是否被遮挡的做法是:
- 把 AABB 投影到屏幕,得到一个矩形范围
- 选一个合适的 mip 层级,使该矩形大致对应 2×2 个纹素
- 取这四个纹素里最近的那个深度值(对应第 2 步的保守方向)
- 比较:如果 AABB 的最近深度都比这个值远,那它一定被挡住
第 3 步取最近值、第 4 步要求 AABB 的最近点更远——两个方向都要偏保守,才能保证不漏画。
7.4 量化:遮挡剔除到底能省多少
NVIDIA 的官方样例 gl_occlusion_culling 给了一组很有说服力的实测数据(Quadro K5000 + i7-860)[48]:
从 26.1 ms 降到 11.1 ms(HiZ 方案),再降到 4.9 ms(低分辨率软光栅方案)——最快的一档比完全不剔除快了 5 倍多。 这就是为什么遮挡剔除值得做,它的收益在所有剔除技术里最高。
同一份样例还对比了三种结果处理方式:Current Frame(当帧算、当帧用)、Last Frame(用上一帧结果)、Temporal Current Frame(两阶段)。它明确指出:Last Frame 在低帧率或大运动时会产生物体 popping 的伪影;而 Temporal 方案"先画上一帧可见集 → 再测 → 再补画",把每个物体的绘制次数限制为 1 次 [48]。
7.5 参数逐项释义:为什么要有两种遮挡测试
上面那张表里 HiZ 和 Raster 是两种不同的实现——一个用金字塔做层级测试,一个用低分辨率光栅化。它们的差别值得说清:
两者在现代实现里常常是同一套系统的两部分——用低分辨率光栅化产生遮挡信息,再用金字塔加速查询。Umbra 的 "portal 光栅化到深度缓冲"本质上就是 Raster 路线。
7.6 一个反直觉的取舍:低分辨率反而更好
有一份实现笔记给了一条反直觉但很实用的建议:用上一帧深度时,最好不要用全分辨率——相机移动会导致剔除不正确,用低分辨率做粗剔反而能缓解 [50]。
原因不难理解:全分辨率的深度图对上一帧的视角是精确的,但这一帧视角已经变了,越精确反而越容易"精确地错"。低分辨率把细节抹掉之后,判定变得更保守,漏画的风险反而下降。
这又一次印证了保守性的优先级:宁可用一张模糊但安全的图,也不用一张精确但会漏画的图。
7.7 Hi-Z 的几种变体
好了,说说变体。深度金字塔不止一种做法,不同变体适合不同场景。
反向 Z 值得单独提醒一句:因为用法线化的深度反转存储,降采样的方向也跟着反过来——要取最小值而不是最大值。
方向搞反就是典型的假阴性来源。这也说明前面反复强调的那条经验是对的:换方案时最容易出错的地方,永远是方向。
一份学术资料讨论了分辨率的选择:用 1/4 分辨率的单层遮挡图,是"纹理获取次数"与"保守性"之间一个良好的折中 [28];另一份则给出了 Hi-Z 构建的完整流程——先用可见 patch 生成遮挡信息、再构建金字塔做保守测试 [21]。
金字塔构建是自底向上的取最远,测试则是自顶向下的逐级下钻。
7.8 这一章留下的问题
到这里,遮挡剔除的技术手段讲完了。但前面反复出现一个关键词——"上一帧"。用上一帧的深度、上一帧的可见集,到底要付出什么代价?下一章专门讲这件事。
八、时序的代价:上一帧深度与 popping
8.1 为什么非要看上一帧
OK,言归正传。遮挡剔除需要深度,而深度是渲染的产物。如果等当前帧的深度算完再剔除,这一帧就已经画完了——剔除结果只能用于下一帧。
常见的三种规避办法,每一种都在某处让步:
工业界最常用的是第二条——用上一帧的深度。 因为它零额外成本,而时序错误在多数情况下不明显。
8.2 popping 是怎么产生的
先来看看 popping 是怎么来的。用上一帧深度会出错的典型场景是这样的:
某个物体在上一帧被完全挡住(不可见),这一帧相机移动了,它露出了一角。但剔除用的是上一帧的深度,判定结果仍然是"被挡住"——于是这一帧它没被画出来。等到下一帧才补上。
表现就是物体突然出现(pop out),而不是平滑地露出来。
反过来的情况也存在:物体上一帧可见、这一帧被挡住了,会多画一帧。但多画一帧没人看得出来——所以 popping 专指前一种,也就是迟画导致的突然出现。
8.3 三种缓解手段
NVIDIA 的官方样例对第一条给了明确评价:Temporal 方案"用上一帧可见集先画、再测、再补画",把每个物体的绘制次数限制为 1 次——这是它的关键性质,因为如果只做朴素的两遍,物体可能被画两次 [48]。
Eidos Montreal 在《Deferred+》里描述的则是第二条路线,且做法很务实:用上一帧深度获得初判,对可能的假阴性用当前帧深度重测。
他们还做了一个值得注意的取舍——不用专门的遮挡几何(这样对自然场景更友好),并且没有采用层级深度缓冲,而是用细分网格 [59]。
8.4 参数逐项释义:深度信息的生命周期
有一个容易被忽略的工程细节,GPU Gems 第 29 章专门提过:SwapBuffers 之后,深度缓冲的内容不保证被保留 [18]。
这意味着"跨帧复用深度"不能依赖交换链的缓冲区,必须由引擎自己管理一份深度拷贝。这是"用上一帧深度"这个方案的隐藏成本。
8.5 实现:两阶段剔除的骨架
下面这段是两阶段(Temporal)剔除的骨架,也是当前主流的做法:
// 【两阶段遮挡剔除】用上帧可见集先画,再用当前帧 HZB 补画
// —— 阶段一:用上一帧 HZB 判定,只画"上帧可见"的对象
for (uint i = 0; i < instanceCount; ++i) {
    if (prevVisible[i] && TestHZB(instances[i].bounds, prevHZB)) {
        DrawInstance(i);                          // 【1】这些对象必然被画一次
        currentDepthBuffer.MarkRegion(instances[i].bounds);   // 【2】顺手写当前帧深度
    }
}
BuildHZB(currentDepthBuffer, currentHZB);         // 【3】构建当前帧金字塔

// —— 阶段二:用当前帧 HZB 判定,补画阶段一没画的对象
for (uint i = 0; i < instanceCount; ++i) {
    if (!prevVisible[i] && TestHZB(instances[i].bounds, currentHZB)) {
        DrawInstance(i);                          // 【4】每个对象最多再画一次
    }
    prevVisible[i] = /* 本帧的可见性结果 */;        // 【5】更新跨帧状态,供下一帧使用
}
上面这段特别说明四处。
【1】处是"先画上帧可见集"——这一步保证了即使判定出错,上一帧见过的东西这一帧一定会再画一次,不会因为剔除而消失。
【2】处那一步是关键:画的同时顺手标记它覆盖的深度区域,这样就为阶段二构建出了当前帧的深度信息,不需要单独做一遍深度预渲染。
【3】处的 BuildHZB 就是第 7 章讲的 max 降采样金字塔。
【4】处的条件 !prevVisible[i] 保证了每个对象在两个阶段里最多被画一次——这正是 NVIDIA 样例强调的性质。
【5】处把本帧结果存下来供下一帧使用。这一行是整个方案时序特性的来源:它既是收益(省下当帧判定),也是风险(错了会传播一帧)。
8.6 时序错误怎么检测
下面进入检测手段。时序错误(迟画一帧)不像崩溃那样会报错,需要主动统计。有三种可行的检测手段。
第一种最可靠但最贵——它需要额外跑一遍"不做剔除"的渲染作为基准。实用的折中是只在开发版开启,并且只对一部分帧做。
注意第一行和第二行的性质完全不同:假阴性率是一个"正确性指标",必须为零;假阳性率是一个"性能指标",只需要观察趋势。把两者混在一个仪表盘上看,会导致错误的优化方向。
两阶段剔除的骨架其实很短:先拿上一帧的深度判一遍,再用本帧结果修正。
8.7 这一章留下的问题
时序代价讲清了:所有用上一帧的方案,都要接受"错了会晚一帧"这个性质。 那么有没有第三条路——不依赖上一帧,也不依赖硬件查询?
下一章讲软件遮挡剔除,它走的就是这条路。
九、软硬之间:Umbra 与掩码软光栅
9.1 第三条路:纯软件
下面进入第三条路。第 6 章讲了硬件遮挡查询,第 7、8 章讲了基于深度金字塔的 GPU 侧方案。还有第三条路:完全在软件里做遮挡剔除,不依赖硬件查询,也不依赖上一帧。
它的代表是 Umbra(Unity 用的就是它),而它的技术源头可以追溯到 Aila 与 Miettinen 的 dPVS 系统 —— 这是 Lund 大学那篇《Masked Software Occlusion Culling》里明确指出的沿革关系 [20]。同一篇资料还记录了一个有意思的事实:Umbra 曾经同时支持 GPU 与 CPU 两条路径,后来转为纯软件。
9.2 掩码软光栅:用位运算代替逐像素
软件方案的核心是掩码软光栅(masked software occlusion culling)。它的做法是:
- 用一个低分辨率的深度缓冲(比如 1/4 分辨率)
- 遮挡体用软光栅化画进这个缓冲
- 判定被遮挡物时,把它投影成一个矩形,用掩码(mask)表示覆盖到哪些像素
- 一次位运算就能判断"这个掩码覆盖区域内,深度是否都更近"
用位运算替代逐个像素访问,是它能在 CPU 上跑得快的原因。 一份学术资料讨论了分辨率的选择:用 1/4 分辨率的单层遮挡图,是"纹理获取次数"与"保守性"之间的一个良好折中 [28]。
9.3 参数逐项释义:Umbra 的三个烘焙参数
Umbra 是烘焙式的——它在编辑器里预计算场景的可见性数据。三个参数决定了数据的粒度与体积 [47]:
注意这里的方向:这三个参数调大都是"忽略更多细节",也就是让判定更保守(因为忽略遮挡体意味着少剔东西)。它们的调节本质上是"数据体积换保守度"。
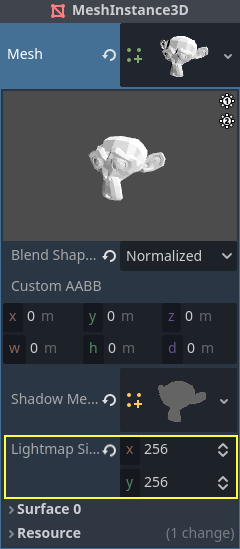
烘焙参数里最直接影响质量的一项是分辨率:
9.4 软硬两条路的深层差别
第 6 章给过一张软硬对照表,这里要补上更深的一层差别:它们对"动态性"的态度完全不同。
这解释了为什么 Umbra 需要"动态物体"的特殊处理:烘焙好的可见性数据描述的是静态场景,运动的物体不在其中,只能单独处理。
9.5 实现:软件遮挡剔除的并行化
好了,讲讲并行。软件方案要跑得快,并行是必须的。一个可行的做法是利用多核并行处理不同的候选对象——一份学术实现就是用 OpenMP 并行化的图像空间软件遮挡引擎,配合分块遮挡图、仅在需要时更新 [29]。
// 【软件遮挡剔除的并行骨架】(伪代码,示意结构)
// 阶段一:构建低分辨率深度图(可用多线程分块)
parallel for each visibleOccluder:
    rasterizeSoftware(occluder, lowResDepth)

// 阶段二:并行判定每个候选对象
parallel for each candidate:
    mask = projectToMask(candidate.bounds, lowResDepth)   // 【1】求掩码
    if (allMaskedByCloserDepth(mask, lowResDepth))        // 【2】一次比较
        markInvisible(candidate)
上面这段特别说明两处。
【1】处把物体的屏幕投影转成掩码——这是软件方案的核心技巧,把"逐个像素比较"压缩成"一次位运算"。
【2】处的判定必须保守:只要掩码里有任何一个像素的深度比物体近,就不能判它不可见。这与第 7 章 HZB 判定的方向一致。
9.6 烘焙流程的工程细节
烘焙式方案(Umbra 类)的成本主要不在运行时,而在流程。有几个工程细节决定了它能不能用起来。
最后一行最容易被低估。 因为烘焙数据与场景几何强耦合,任何几何改动都会让烘焙数据失效——这在开发期意味着频繁重烘焙,是流程上的真实负担。这也是很多团队最终选择 HZB 类方案的原因:它没有烘焙这一步。
掩码软光栅的省法在数据表示上:一格不用 64 个字节,而用一个 64 位整数。
Godot 走的是另一条:用 Embree 在 CPU 上把遮蔽体几何光栅化到低分辨率缓冲,再拿它测 AABB,并要求完全遮挡才剔除 [97]。
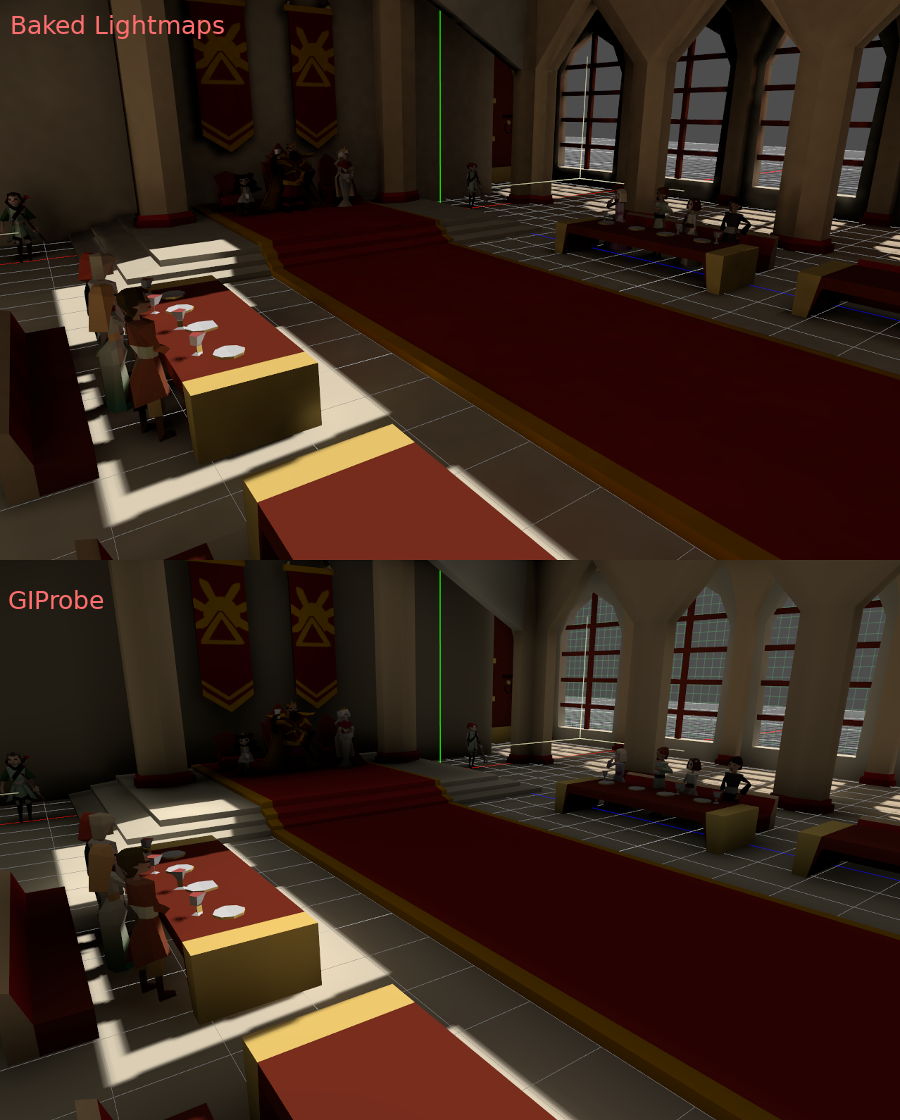
烘焙与实时的差别,最直观的对照是这样:
烘焙在编辑器里是一次可观察的过程:
烘进去的信息包含直接光与间接光两部分:
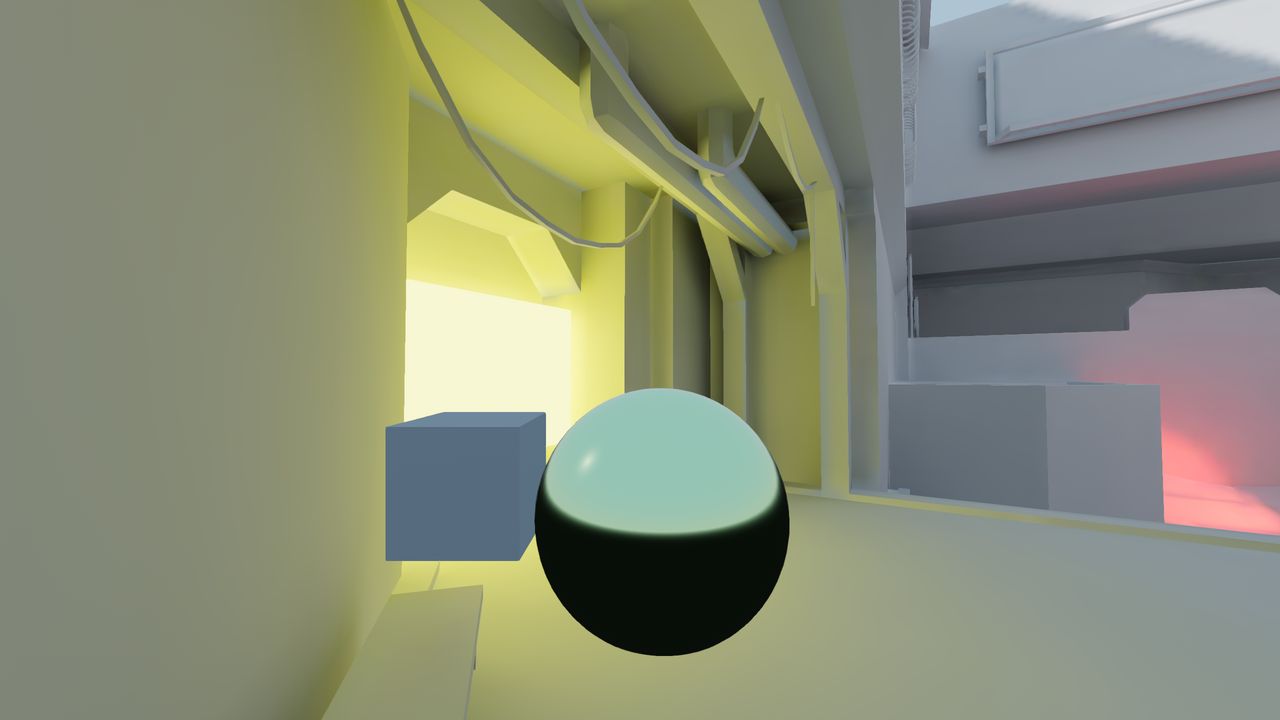
阴影遮罩是烘焙里常被忽略的一路输出:
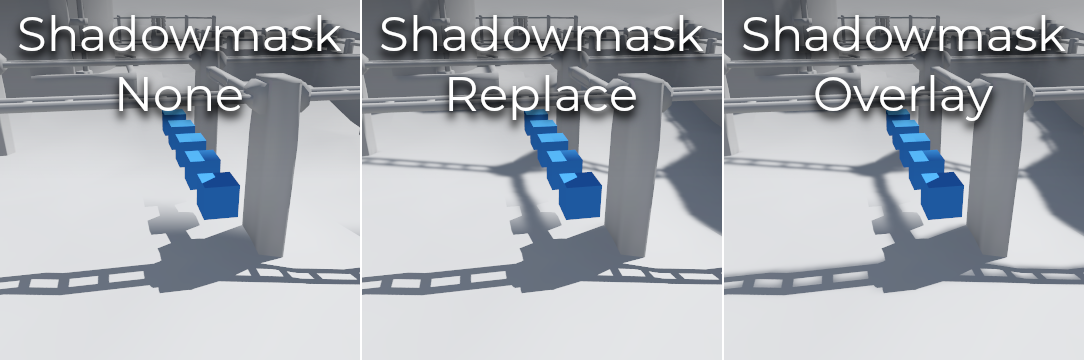
降噪是烘焙流程里绕不开的一步:
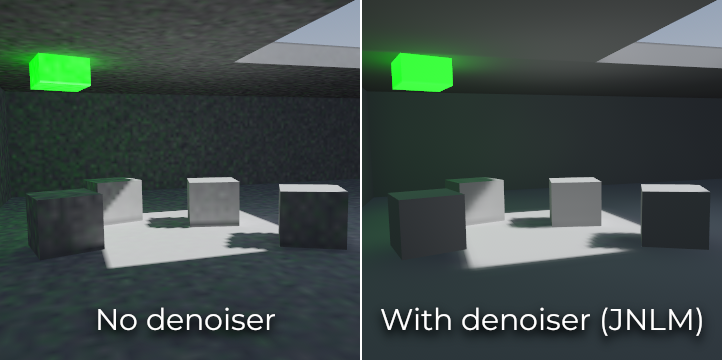
9.7 这一章留下的问题
到这里三章讲了三条遮挡剔除的路线。它们有一个共同点:判定都在"对象"或"子网格"粒度上做。 而第 3 章分析过,假阳性的第二个来源是"判定粒度太粗"。
要真正把假阳性压下去,得把网格切碎到簇一级——而碎到这个程度,CPU 就处理不过来了。这就是下一章的事。
十、GPU-Driven:把判定搬进 GPU
10.1 动机:判定次数涨到 CPU 扛不住
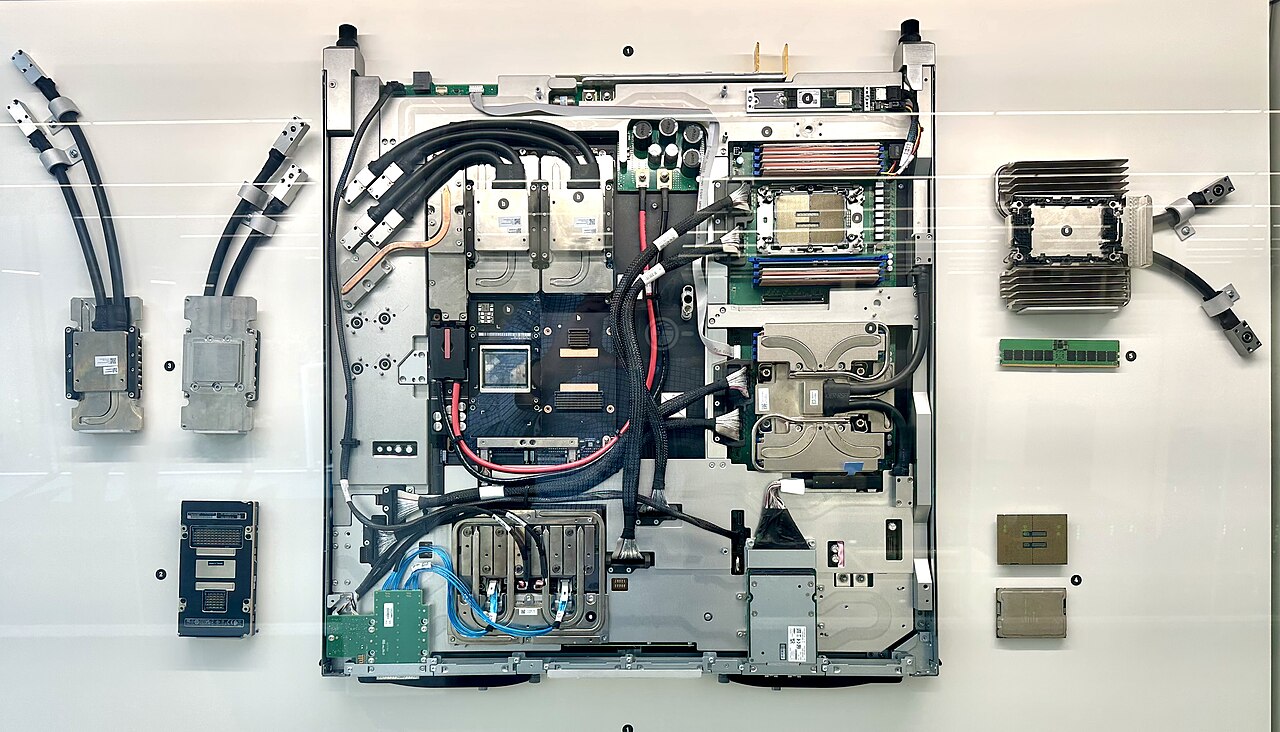
回过头看第 1 章那张粒度成本表:
| 粒度 | 判定次数(10 万三角形场景) |
|---|---|
| 对象级 | 1000 次 |
| 子网格级 | 10000 次 |
| 簇级(meshlet) | 约 80000 次 |
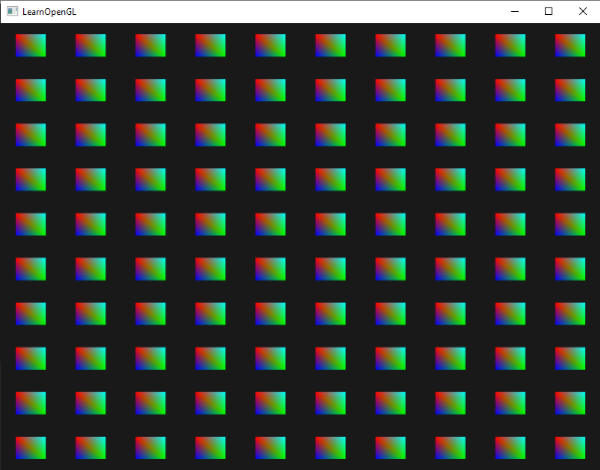
GPU-Driven 的起点是实例化——同一批几何一次提交:
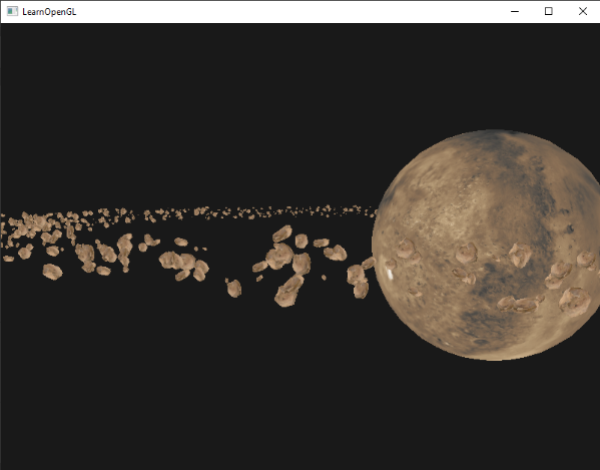
实例数量一上去,CPU 逐个提交就不现实了:
八万次判定,每次还要做投影、层次遍历、深度比较——CPU 单线程完全来不及。而且就算来得及,CPU 逐个提交 draw 也是瓶颈。
GPU-Driven 要解决的就是这个:把剔除和提交这两件事一起搬到 GPU 上。
10.2 核心机制:三步
下面我们开始拆这三步。GPU-Driven 的骨架可以拆成三步:
- 并行剔除:每个簇(或实例)由一个 GPU 线程负责,做视锥与遮挡判定
- 压缩成列表:把通过判定的对象用前缀和(prefix sum)+ 原子操作压成紧凑列表
- 间接绘制:GPU 把 draw 参数写进缓冲区,由一次间接绘制命令消费
第 2 步的"压缩"是必要的,因为剔除的输出是稀疏的——判定结果是"可见/不可见"的布尔数组,如果直接按原顺序绘制,就等于没有剔除。必须先把它压缩成连续的列表,后面的绘制才能一次画完。
10.3 间接绘制的谱系
下面进入 API 这条线。这一步依赖 API 层面的支持。这条演进线索很清晰:
这里要澄清一个常见的误解。 单次 indirect draw 仍然只是一个 mesh——如果场景里有 500 个不同的 mesh,仍然需要 500 次绘制调用,只是参数不再由 CPU 逐个填写而已。
真正把绘制次数降下来的是 multi-draw indirect——它让参数指向同一个大顶点缓冲区的不同切片 [14]。
Vulkan 的官方教程把这条思路的目标写得很清楚:单 pass 内完成剔除与绘制、CPU 不等待剔除结果、并且成本与场景规模无关 [15]。
10.4 参数逐项释义:为什么"成本与场景规模无关"这么重要
上面那句"成本与场景规模无关"值得单独拆开讲,因为它是 GPU-Driven 最核心的性质。
有一份社区工程实现给出了很直观的实测数据 [49]:
在 50 万实例时,CPU 路径的剔除开销是 9.4 ms/帧,而 GPU 路径是 CPU 0 ms + GPU 20 µs [49]。
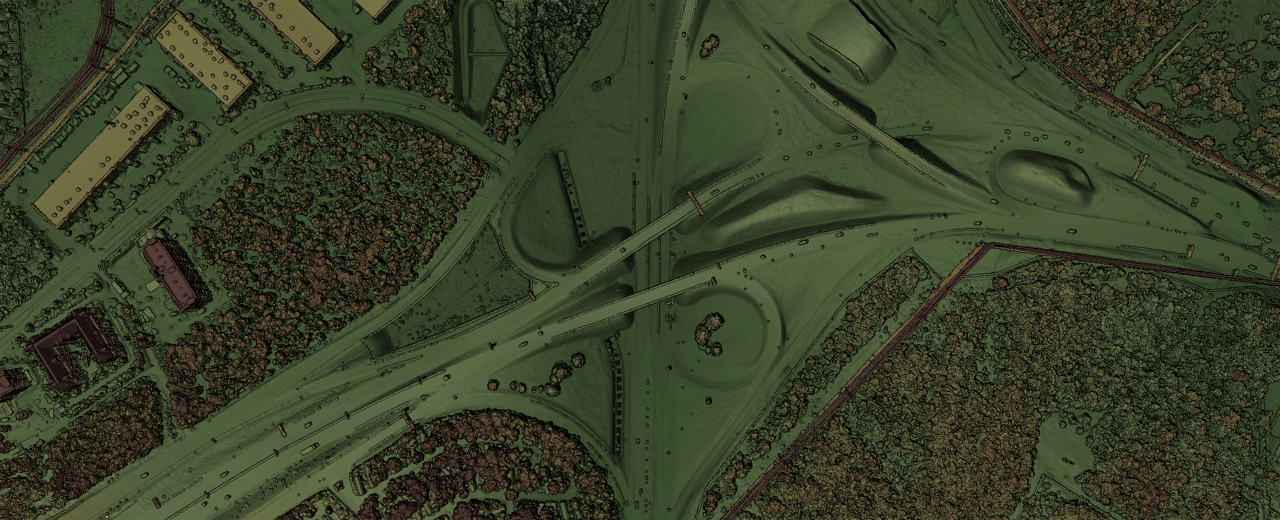
场景规模的极端形态是点云——这里的几何量以亿计:
从 9.4 毫秒到 20 微秒,差了三个数量级。 这个对比是 GPU-Driven 存在的最好理由。
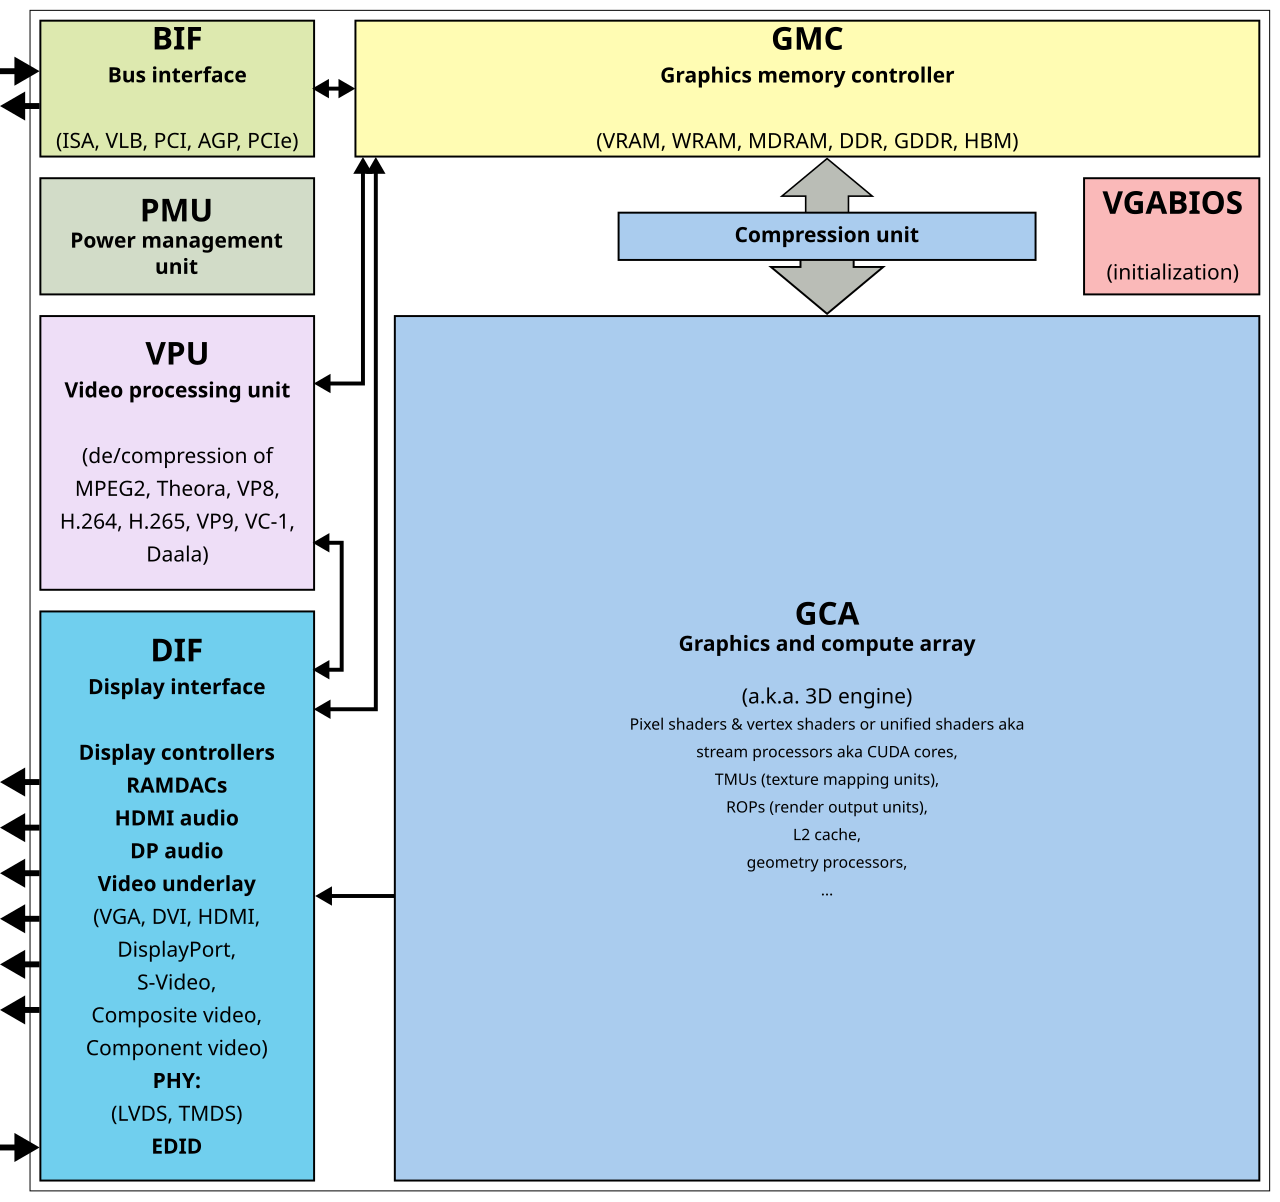
10.5 实现:一个 compute 剔除的骨架
// 【GPU 剔除 + 压缩】每个线程处理一个实例
[numthreads(64, 1, 1)]
void CullAndCompact(uint3 dtid : SV_DispatchThreadID) {
    uint i = dtid.x;
    if (i >= instanceCount) return;

    bool visible = IsAABBVisible(instances[i].min, instances[i].max, frustumPlanes);
    if (visible) visible = TestHZB(instances[i].bounds, hzb);   // 【1】视锥过了再测遮挡

    visibilityFlags[i] = visible ? 1u : 0u;                     // 【2】写入布尔数组
    GroupMemoryBarrierWithGroupSync();

    // 【3】组内前缀和求偏移,再原子累加到全局计数器
    uint localOffset = PrefixSumInGroup(visibilityFlags, i);
    uint groupCount  = CountInGroup(visibilityFlags);
    uint base = 0;
    if (WaveGetLaneIndex() == 0)
        InterlockedAdd(visibleCount, groupCount, base);

    if (visibilityFlags[i]) {
        uint slot = base + localOffset;
        visibleIndices[slot] = i;                               // 【4】压成紧凑列表
        // 【5】同时用槽位号写 draw 参数(instanceCount / startInstanceLocation)
        drawArgs[slot]    = instances[i].drawArgs;
        drawArgs[slot].startInstanceLocation = slot;
    }
}
上面这段特别说明五处。
【1】处的顺序很重要——先用视锥剔除(便宜)再测遮挡(贵)。反过来会让所有不可见物体都去做一次 HZB 测试,白白浪费。
【2】处先写布尔数组再压缩,是因为前缀和需要先知道每个线程的结果。也可以直接用 vote 类指令,但两步写更清晰。
【3】处用的是组内前缀和 + 全局原子累加的两级结构——这避免了每个线程都对全局计数器做原子操作(那会成为瓶颈)。
【4】处把实例索引写进紧凑列表。这里用的是槽位号作为写位置,因此写入是唯一的、无冲突的——不需要原子操作。
【5】处是 GPU-Driven 的关键一步:draw 参数也由 GPU 生成。CPU 只提交一次 dispatch,剩下的全在 GPU 上完成。
社区里有几个完整的实现可以参考这个形状:一个引擎用 persist-thread compute shader 遍历 DAG 选簇、再做两阶段剔除 [53];另一个用 mesh → cluster → triangle 三级剔除写进可见性缓冲,只需可见性 ID,因此不需要深度预渲染 [54]。
10.6 GPU-Driven 的适用边界
好了,说说它的边界。GPU-Driven 的收益很惊人(第 10.4 节那三个数量级),但它不是所有场景的答案。有那么几种情况反而不划算。
第二行是一个容易被忽略的坑:如果游戏逻辑需要知道"某个物体本帧可见吗"(比如为了触发音频或 AI 感知),而判定发生在 GPU 上,那就要把结果回读到 CPU——回读意味着同步等待,第 6 章讲过的 stall 问题又回来了。
实践中的做法是把这类需求拆分:视觉可见性交给 GPU 判定,游戏逻辑用另一套更粗的近似(比如距离与视锥的快速判断),避免回读。
GPU 剔除的三步里,中间那步"压缩"最容易被忽略,但它决定了间接绘制能不能一次提交完。
引擎侧已经把这条链路产品化了:Unity 的 BatchRendererGroup 把剔除交给 OnPerformCulling 回调,输出直接是绘制命令 [98][99];团结引擎的 GPU Resident Drawer 则把这套机制对中文开发者做了落地 [103]。
中间那步"压缩"在 API 侧也有对应做法——Vulkan 的多重间接绘制(MDI)把可见对象的绘制参数写进一张间接缓冲,再用一个原子计数器给出数量 [105];而要把判定的结果真正压实成连续数组,靠的是并行前缀和(scan),这套算法在 GPU Gems 3 的 Part VI 里有完整交代 [107]。
10.7 这一章留下的问题
判定搬进 GPU 了,那"被判定"的几何本身要不要也跟着变?十万个簇逐个提交判断,簇的尺寸、边界、复用方式都会影响结果。下一章讲几何怎么组织。
十一、从 meshlet 到 Work Graphs:提交方式的下一步
11.1 meshlet:把网格切碎
下面我们开始拆簇。第 10 章讲了判定搬到 GPU,但没说判定单位是什么。答案是把网格切成小簇——meshlet(也叫 cluster)。
簇的尺寸有一个明确的上限,来自 NVIDIA 的 Turing 架构定义:不超过 64 个顶点、126 个图元 [38]。这不是随便定的——64 个顶点刚好能让整个簇的顶点索引放进一个 64 位的位掩码里做顶点复用,126 个图元则保证一次线程组调用能处理完。
Nanite 走的是另一条口径:它的虚拟几何把簇按 128 个三角形划分 [3]。数量级与 Turing 的定义接近,区别在于 Nanite 要的不是"刚好塞满一次线程组调用",而是足够规整的簇尺寸——这样离线构建出的层级结构才能被稳定地流式调度。
这个"≤126 图元"的数字有个来历:簇内的三角形由顶点索引组成,如果顶点数不超过 64,那么每个顶点可以用 6 位表示,三个顶点就是 18 位——这样簇的索引数据可以被紧凑打包。NVIDIA 的技术博客详细讲了这个设计与其带来的带宽收益 [38]。
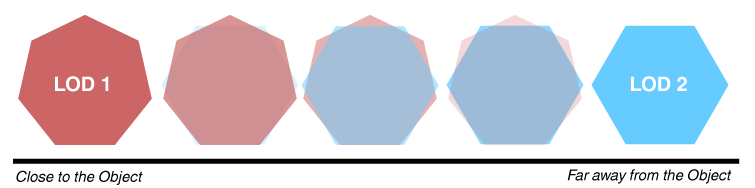
LOD 切换要在两级之间过渡,抖动混合是最轻的一种做法:
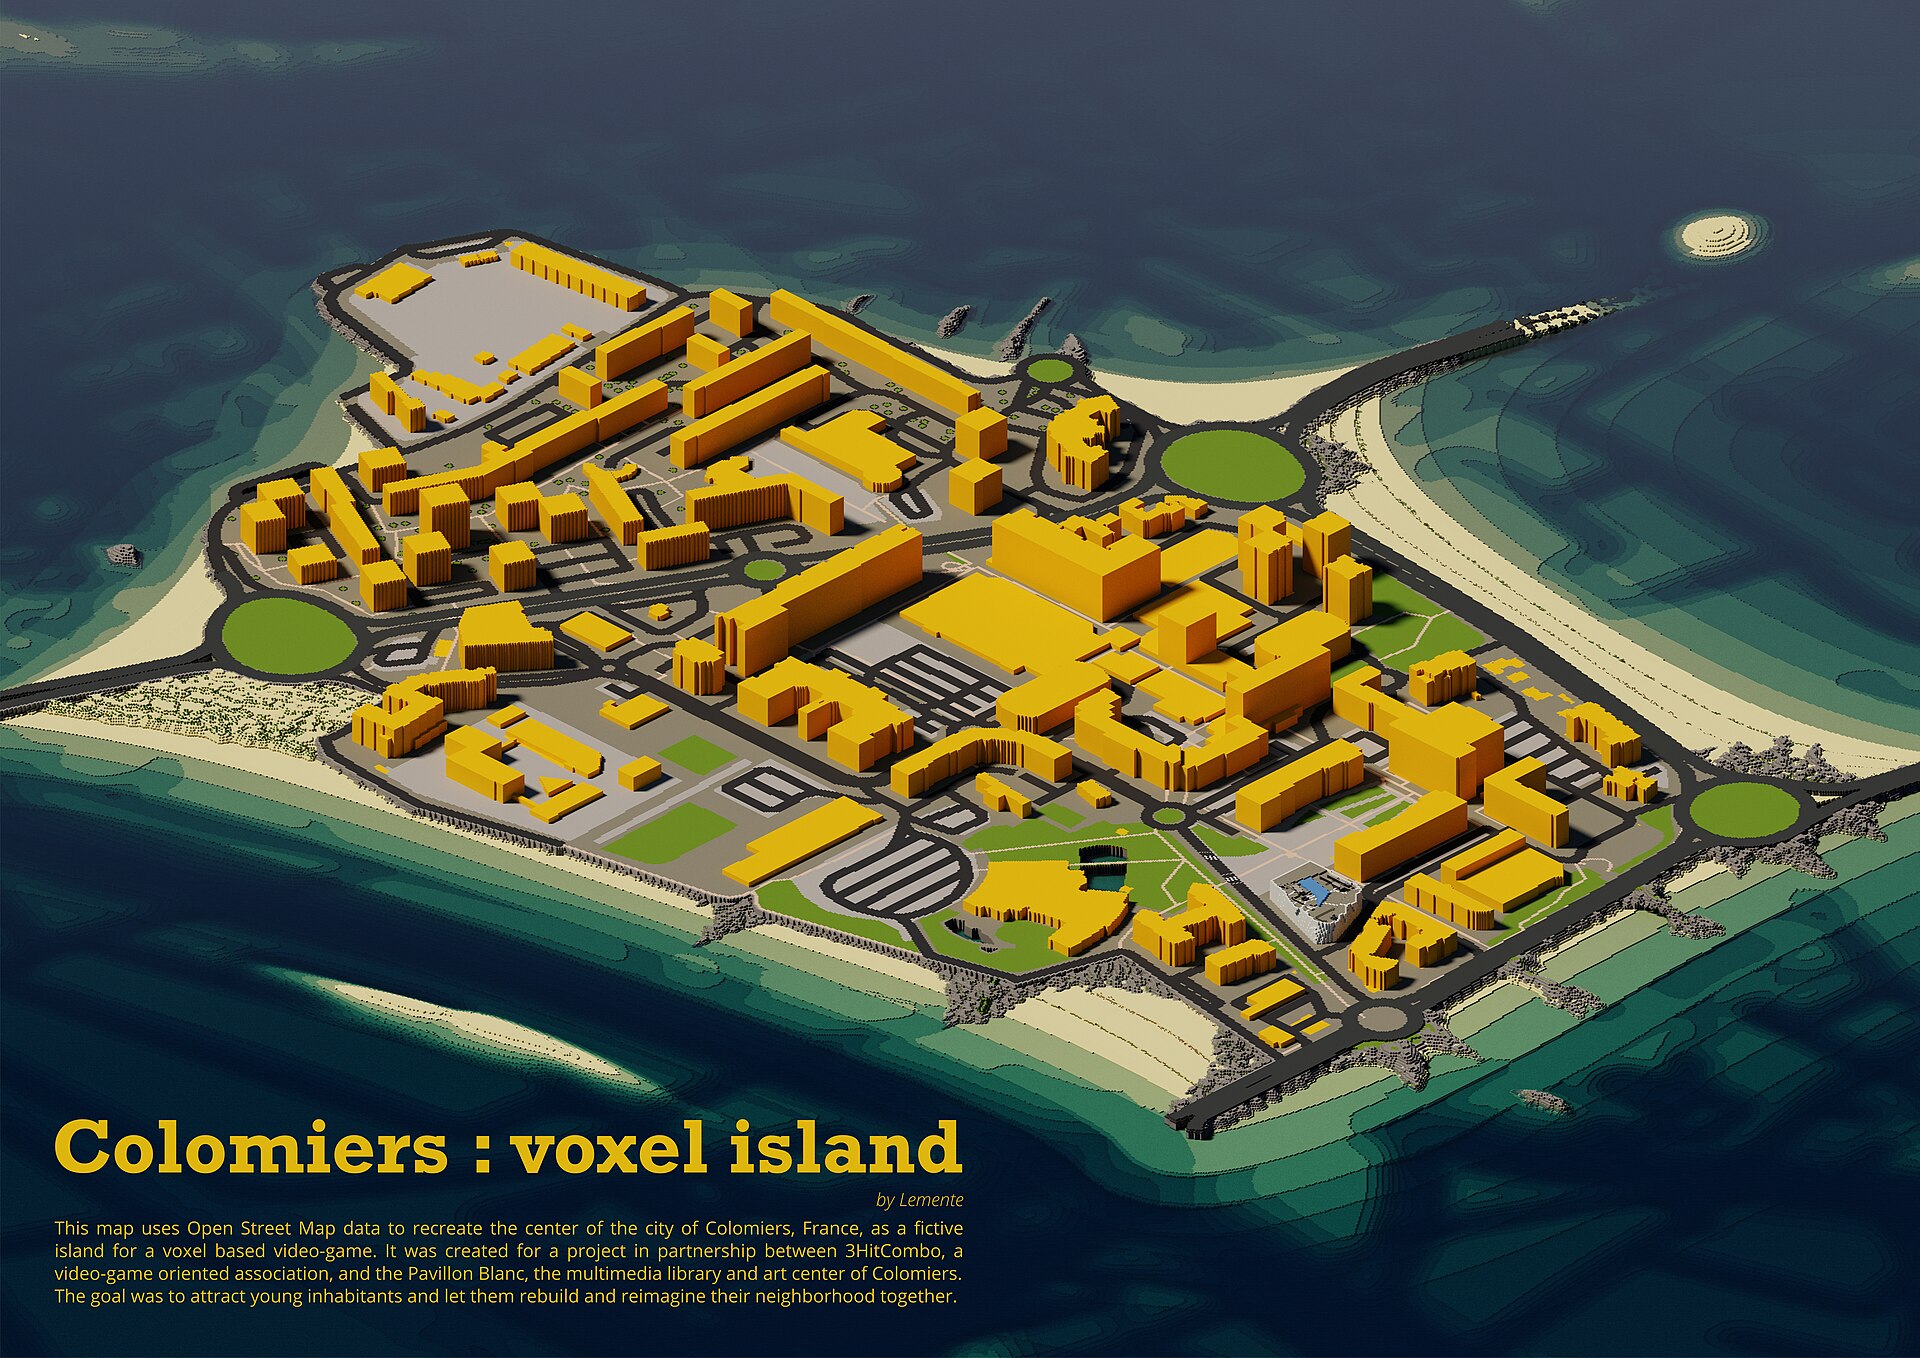
把几何切成规整的体素,是另一种“切碎”的思路:
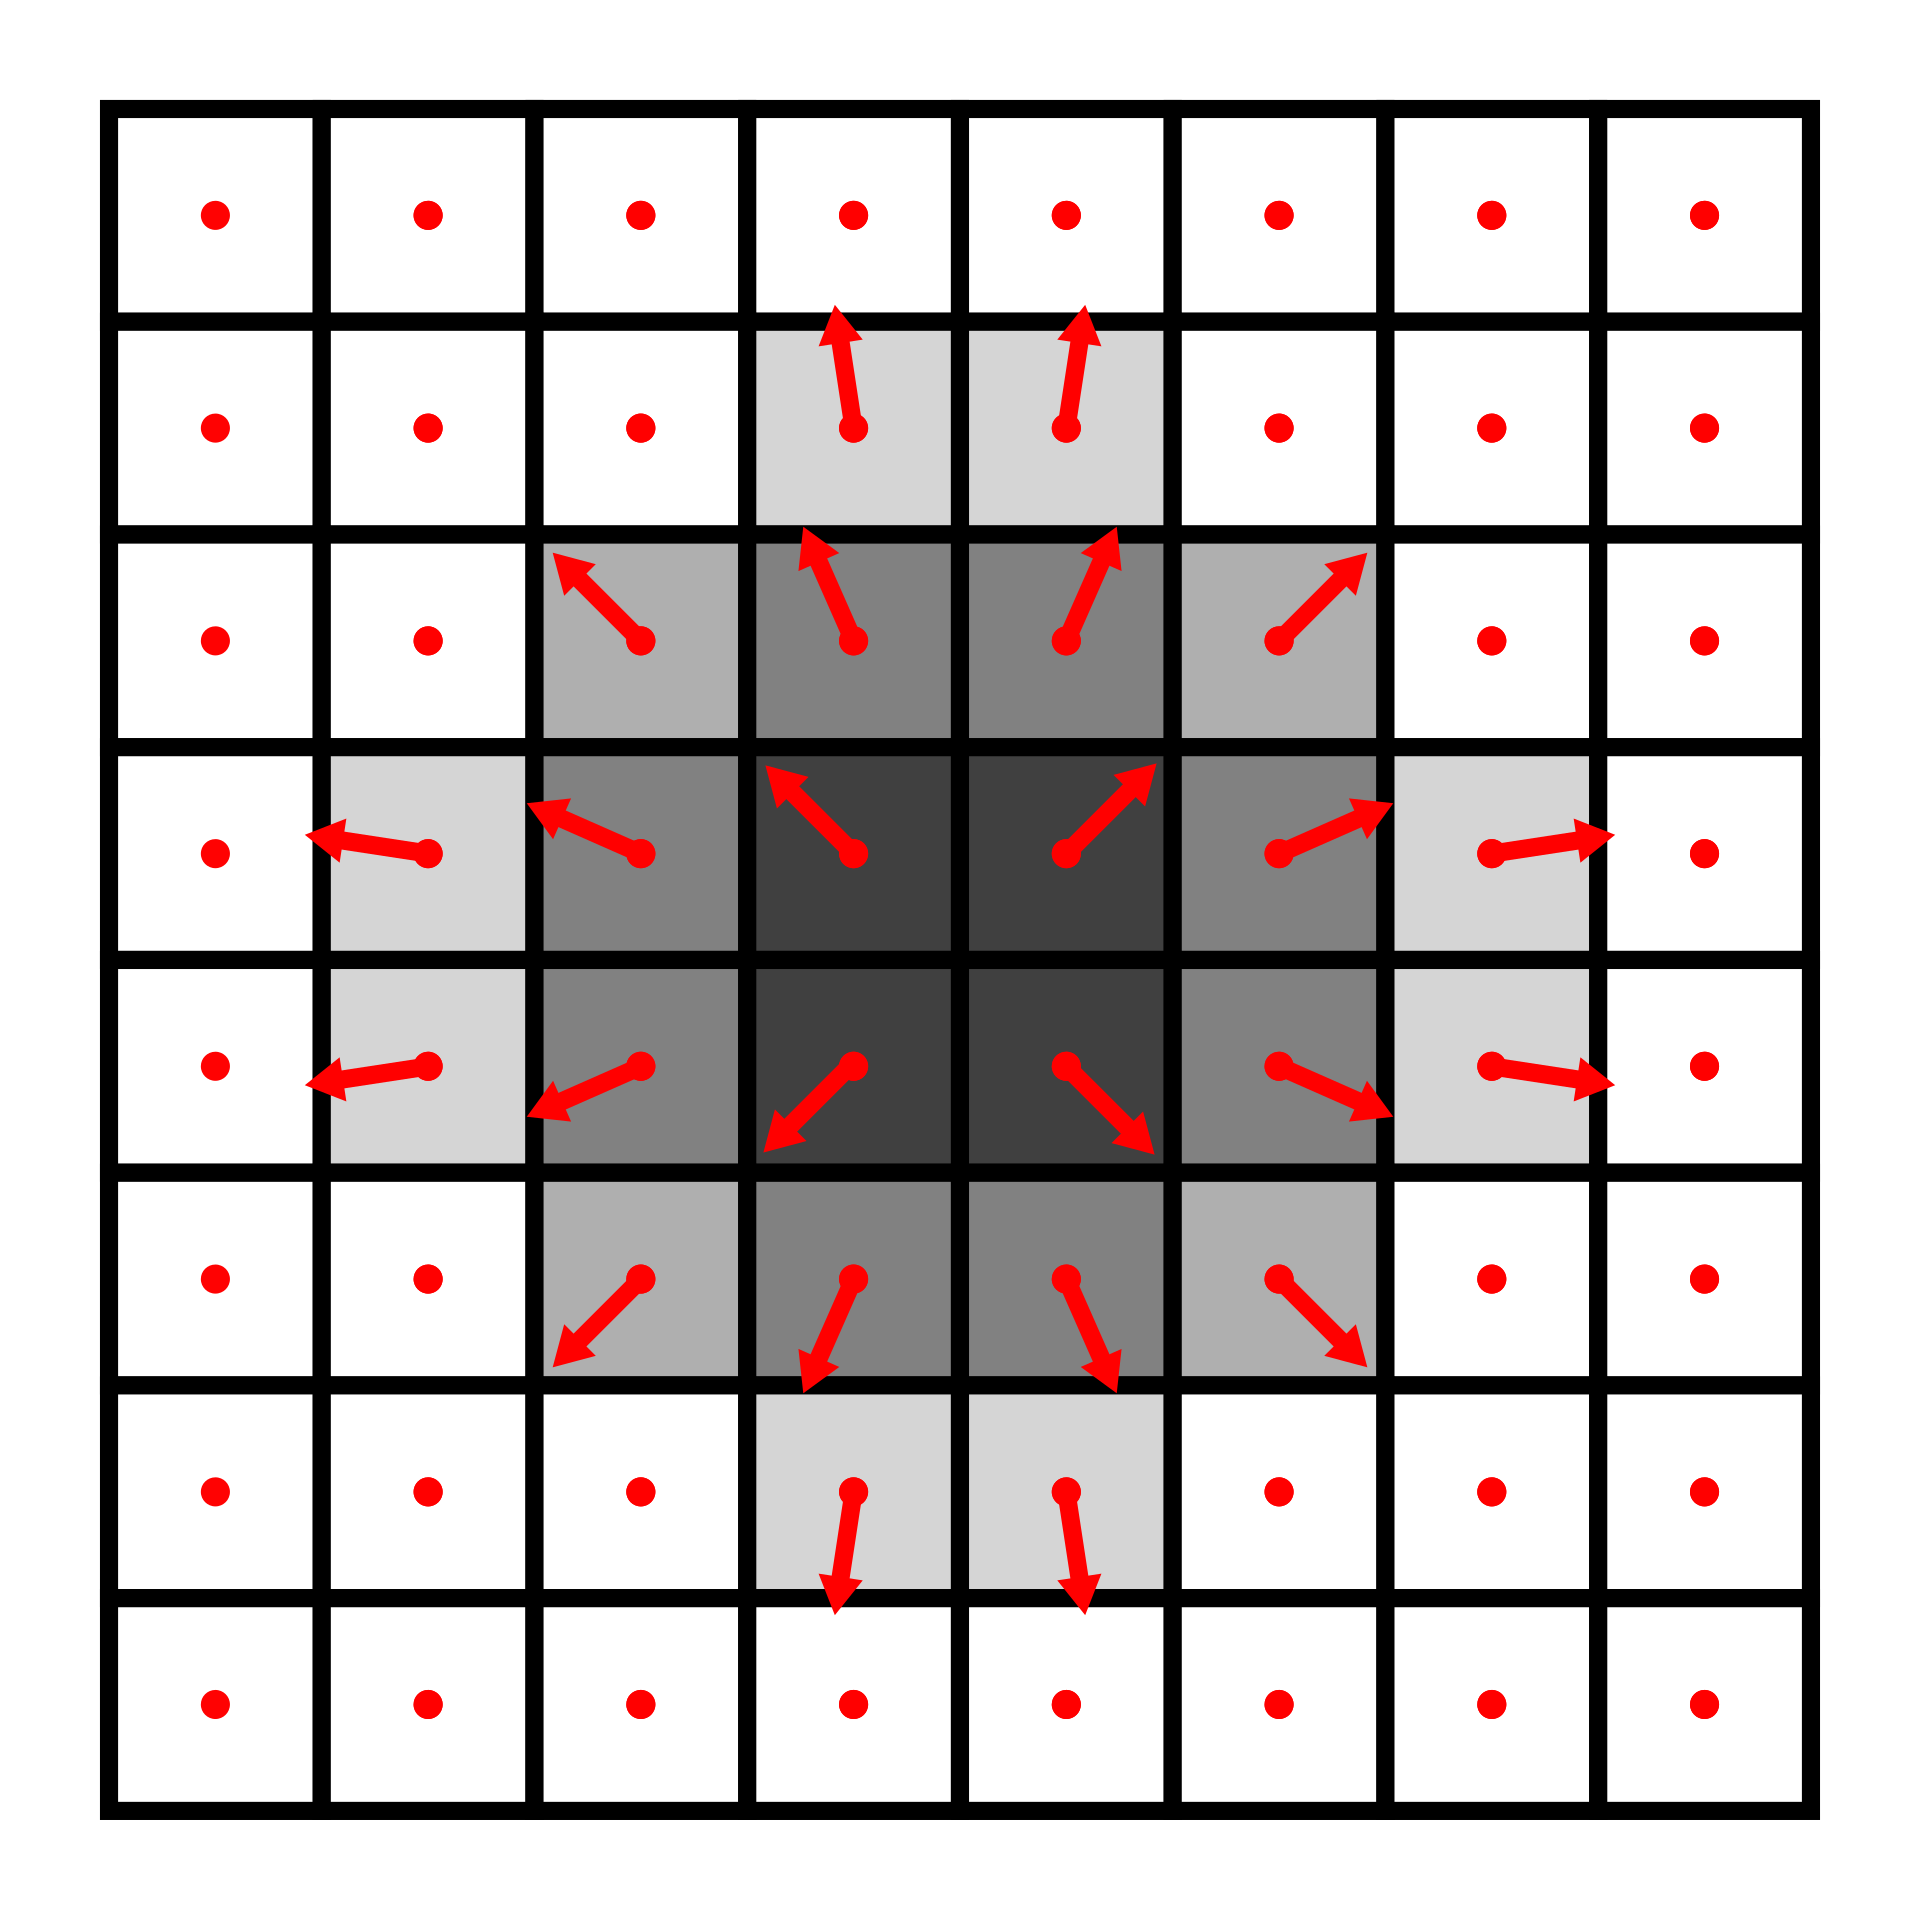
体素的法线也是逐单元存储的:
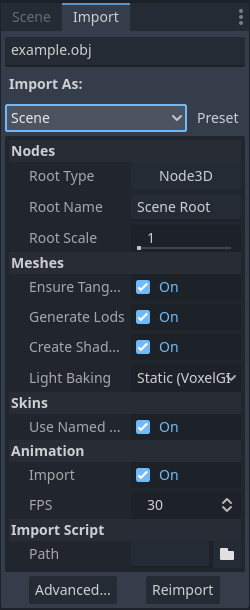
引擎里的 LOD 是在导入阶段生成的:
11.2 Task Shader 与 Mesh Shader
簇切好之后,剔除该在哪做?答案是在管线的更前端。
传统管线是"顶点着色 → 图元装配 → 裁剪",剔除只能在这些之前用 CPU 或 compute 做。Turing 之后多了一条任务着色器(task shader)与网格着色器(mesh shader) 的路径:task shader 决定"这个簇要不要画",mesh shader 负责生成这个簇的顶点。
Mesh shader 还提供一个内置的剔除手段:SV_CullPrimitive ——可以直接标记某个图元不输出,省掉后续的光栅化开销。AMD 的 RDNA 3 架构演讲专门讨论了它"内置剔除"与"手动移除导出"两种做法的差别 [39]。
但 task shader 不是免费的。 AMD 的优化指南给了两条重要的工程提醒:amplification shader 的线程组必须按序执行,会引入额外延迟;因此需要足够高的 amplification rate(平均每个 task 线程组能启动的 mesh 线程组数量)才能收回开销 [40]。
11.3 可见性缓冲:只存 ID
OK,言归正传。把几何切碎之后,还有一个问题:着色阶段要拿什么信息?
传统做法是延迟渲染——把所有着色需要的数据写进 G-Buffer(这一系列第一篇讲过的)。但 G-Buffer 很占带宽,而簇级剔除已经把可见图元压得很小,再为每个像素写一堆属性就浪费了。
可见性缓冲(visibility buffer) 的做法是只存一个 ID:每个像素记录"是哪个图元的哪个三角形" [24]。着色时用这个 ID 反查几何与材质数据。
这与第一篇讲的延迟渲染是同一思路的两个实例:都把"几何阶段"与"着色阶段"解耦,只是一个解耦在"属性"层面,一个解耦在"标识"层面。
可见性缓冲把解耦推得更彻底——延迟渲染省的是重复着色,可见性缓冲省的是带宽。
一份实现给出了紧凑的位域设计:只需要可见性 ID(26 位 meshlet 实例 + 6 位三角形序号),因此完全不需要深度预渲染 [54]。
11.4 Nanite:这套思路的完整形态
把上面这些拼起来,就是 Nanite 的形态。GDC 2024 的《Nanite GPU Driven Materials》给出了一组关键实现数据 [41]:
"大走硬件、小走软件"这个分流是很有意思的一个工程决策:硬件光栅化对单个大三角形效率高,但对微小的三角形(一个像素都盖不住)效率急剧下降;软件光栅化(在 compute 里做)反而能批量处理这些小三角形。两者的分界线是按屏幕上的尺寸定的。
两阶段剔除在 Nanite 里的具体形式,伊利诺伊的课程章节讲得比较清楚 [31]:
- Pass 1:渲染上一帧可见的簇并读其深度 → 生成当前帧 HZB
- Pass 2:用当前帧 HZB 处理 Pass 1 未画的簇
这正是第 8 章那套两阶段骨架在大规模场景下的落地——机制完全相同,只是规模从几千个对象变成了百万级簇。
这里要再提一次第 4 篇末尾用过的判断准则:来源要分级。检索 Nanite 内容时会遇到一些覆盖面极广但质量可疑的资料,本文只采用 Epic 官方文档 [3]、GDC 官方演讲 [41] 与课程资料 [31] 的说法。
11.5 参数逐项释义:工业界怎么配这套东西
Capcom 在 REAC 2025 上公开了 RE Engine 的 meshlet 管线,配置是:Meshlets + 两阶段遮挡剔除 + 可见性缓冲 + 软件光栅器 [44]。这份资料里有一句很诚实的评价——"Nanite 是渲染工程师的梦想实现",但它的自动 LOD 难以在 RE 引擎里复刻。
这个对比说明了"这套技术"与"这套技术加上自动 LOD"是两件事。 前者已经可以工程落地,后者需要整套虚拟几何的构建、流式与简化工具链。
11.6 Work Graphs:把"谁产生工作"也交给 GPU
间接绘制有一条限制:它的层级是平的——GPU 生成一批 draw 参数,然后画完。如果某个阶段想根据中间结果决定"再产生一批新工作",就必须回到 CPU 或写多轮 dispatch。
Vulkan 阵营把"设备端生成命令"这一步单独标准化过一版,它在能力谱系上正好落在间接绘制与工作图之间 [106]。
Work Graphs 解决的就是这个。它让 GPU 上的 shader 节点可以动态产生新的工作,形成一个有向图。D3D12 的规范与官方博客都已公开 [3][4]。
其中一个特别有用的特性是 mesh node:它可以直接作为工作图的叶节点,把 mesh launch 所需的着色器与管线状态打包在一起——这意味着图形工作本身可以由 GPU 动态产生 [5]。
一个工程上要注意的约束:Work Graphs 的线程组上限是 16,777,215 [9]。这个数字够大,但说明它仍有边界。
11.7 移动端:同一套思路的另一种取舍
移动端是另一套取舍。移动端也走了这条路,但取舍不同。SIGGRAPH 2024 的 NanoMesh 给出了实测数据 [42]:
六倍多的差距说明这套方案的性能对硬件非常敏感。这与桌面端不同——桌面端 GPU 的算力相对宽裕,而移动端的功耗与带宽约束要严得多。
Epic 在 GDC 2024 的移动渲染演讲里给了另一组数据:移动端 UE5 经过聚簇延迟着色优化后,FPS 从 13.8 提升到 17.8 [43],同时给出了一条实用的预算参考——每视图 700 次绘制调用以内。
移动端还有一个硬件层面的机制值得一提:Adreno GPU 在 binning 阶段用 LRZ(低分辨率深度缓冲) 先于 Early-Z 拒绝三角形 [46]。这与第 7 章的 HZB 是同一个思路——只不过一个在硬件里自动做,一个由引擎显式构建。
11.8 三种管线形态的横向对比
把前面讲的拼装方式归成三种形态,对比一下各自的取舍。
| 维度 | 传统管线 | GPU 剔除 + 间接绘制 | Mesh Shader 管线 |
|---|---|---|---|
| 剔除位置 | CPU | GPU compute | Task Shader |
| 提交方式 | 逐个 draw | indirect / multi-draw | DispatchMesh |
| 几何单位 | 整个 mesh | 实例 / 子网格 | meshlet |
| 硬件要求 | 无 | 支持 indirect 即可 | Turing 及之后 |
| 移植成本 | — | 中 | 高(需管线重构) |
| 调试难度 | 低 | 中 | 高 |
这张表里最该看的是最后一列:Mesh Shader 管线的移植成本最高——它不是加一个 pass,而是替换掉顶点装配那一段管线。
所以很多引擎采取的策略是多形态共存:高端走 Mesh Shader,中端走 GPU 剔除 + 间接绘制,低端退回传统管线。这种"按能力降级"的分层设计,比单选一种要现实得多。
11.9 这一章留下的问题
技术链条到这里就完整了。最后一章不再引入新东西,而是回头看看这条路走下来,哪些问题被解决了、哪些还悬着。
十二、结语:五篇的收口与三个未解问题
12.1 五篇讲了同一件事
先回到整个系列的坐标。五篇的主题分别是:
| 篇 | 主题 | 回答的问题 |
|---|---|---|
| 一 | 延迟渲染 | 几何信息怎么存、光照怎么推迟 |
| 二 | 阴影贴图 | 一个点有没有被挡住 |
| 三 | 后处理链 | 算完之后怎么变成一张能看的图 |
| 四 | PBR 与 IBL | 光打在表面上之后怎么算 |
| 五 | 可见性与剔除 | 哪些东西需要算 |
写到这里会发现,这五篇讲的其实是同一件事:在有限预算下决定"算什么、不算什么"。 延迟渲染决定"先算几何后算光照",是为了不重复着色;阴影贴图决定"哪些点要算阴影",是为了不浪费解析计算;后处理的每一档画质取舍,都是在决定"哪些效果值得算";PBR 的多散射补偿,是在决定"哪些物理项可以近似掉"。
而这一篇是这条主线上最直白的一环——因为它连"画不画"这个决定本身都变成了优化对象。
12.2 三条贯穿全篇的结论
好了,说三条结论。第一,保守性优先于精确性。 从视锥的六个平面,到 HZB 的 max 降采样,到 Umbra 的烘焙参数,到两阶段剔除的"先画上帧可见集"——所有设计都在同一个方向让步:宁可多算,不可漏算。 这条铁律解释了几乎所有看起来"不合理"的设计。
第二,精度是靠粒度换来的,而粒度的成本要靠并行消化。 假阳性的两个来源里,包围体松弛无法消除,粒度太粗可以减小。
所以技术一路从对象级细化到簇级——而细化带来的十万级判定次数,只能靠 GPU 并行解决。这就是 GPU-Driven 必然出现的原因,它不是潮流,是算术结果。
第三,时序依赖是这个领域最深的坑。 所有用上一帧的方案都更便宜,也都更容易出错,而且错误会以"晚一帧"的形式传播。
popping 只是最明显的一种表现。Eidos 那条"当帧重测"的路之所以被记录,正是因为它在这个权衡上选择了另一侧。
12.3 三个还没解决的问题
问题一:动态场景的层次结构仍然昂贵。 静态场景的 BVH 可以离线构建,效果很好;但物体一动,最优切分就可能失效。
增量更新与整树重建之间没有一个通用解——选择依据是"运动物体的比例",而这个比例会随游戏进程变化。 目前的做法都是静态配置,没有自适应的方案。
问题二:时序伪影无法根除。 第 8 章讲的三种缓解手段都是"减轻"而不是"消除"。只要用上一帧的信息,就有对应的失败模式。
Eidos 的做法需要当前帧深度,那就回到了"必须先渲染一遍"的成本。真正的自适应方案——根据内容动态决定用哪种判定——目前还没有成熟实践。
问题三:粒度的选择仍然是手工的。 meshlet 切多大、切成多少簇、LOD 层级怎么分——这些参数目前主要靠经验与离线工具。
Capcom 明确说 Nanite 的自动 LOD 难以复刻,正说明这一层的自动化是最难的。它需要同时考虑几何简化质量、簇的边界对齐、以及运行时的剔除效率。
三个未解问题各自卡在不同的地方,把它们摆在一起能看出下一步大概往哪走。
12.4 选型建议
如果要给一个可操作的判断顺序,大概是这样的:
最重要的一条建议是:先测再上。 第 7 章那组数据(26.1 ms → 4.9 ms)很动人,但那是特定场景的结果。在简单场景里,硬件查询的同步开销甚至可能是负优化——有开发者就记录了这种情况 [60]。剔除是收益最高的优化,也是最容易做了不划算的优化。
12.5 结语
这篇写完,系列就收尾了。
回头看,这个系列一直在做的事是"拆"——把一条渲染管线拆成几何、阴影、成像、表面、可见性五块,每块再拆到算法、参数、代码、数据四个层次。
拆的过程里最能说明问题的,往往不是"这个算法是怎么设计的",而是"设计者被迫放弃了什么"。
剔除这一环把这件事暴露得最彻底:它几乎不关乎美学,几乎全是取舍——多画一点还是少画一点、准一点还是快一点、信这一帧还是信上一帧。实时渲染的工程量,大半都在这种地方。
12.6 一张覆盖全篇的对照表
把全文涉及的主要技术拉到一起,给一张可以贴在显示器旁的速查表。
| 技术 | 判定依据 | 粒度 | 保守性手段 | 主要代价 |
|---|---|---|---|---|
| 视锥剔除 | 六个平面 | 对象 | 相交测试的容差 | 假阳性多 |
| 空间划分 | 层次结构 | 节点 | 包围体只作上界 | 构建成本 |
| 硬件遮挡查询 | 通过像素数 | 批次 | 无(硬件精确) | 同步 stall |
| HZB | 深度金字塔 | 对象 / 簇 | max 降采样 | 时序依赖 |
| 软件遮挡剔除 | 低分辨率软光栅 | 对象 | 掩码判定 | 需烘焙 |
| 簇级剔除 | 簇包围球 | meshlet | 保守比较 | GPU 并行成本 |
| GPU-Driven | 综合 | 实例 / 簇 | — | 结果在 GPU,难回读 |
12.7 术语速查
这里把术语再收一遍,方便回查。
| 术语 | 英文 | 一句话 |
|---|---|---|
| 保守性 | conservativeness | 不确定就按可见处理,绝不漏画 |
| 假阴性 | false negative | 可见却被剔除——唯一的红线 |
| 层次 Z 缓冲 | HZB / Hi-Z | 深度金字塔,用粗层级加速遮挡判定 |
| 遮挡查询 | occlusion query | 硬件统计通过深度测试的像素数 |
| 间接绘制 | indirect draw | draw 参数来自缓冲区 |
| 网格片 | meshlet / cluster | 剔除与提交的几何单位 |
| 可见性缓冲 | visibility buffer | 每像素只存图元 ID,省带宽 |
| 保留模式 | retained-mode | 几何驻留 GPU 跨帧复用 |
资源清单
| 资源 | 说明 |
|---|---|
| 系列仓库 | 含五篇的 Markdown 与全部配图 |
| 本篇配图 | 93 张外部素材(CC0 / PD / CC BY / CC BY-SA)+ 137 张自绘示意图 |
| 复现脚本 | stage-gate.py / palette-audit.py / svg-gen.py 等,见系列仓库 |
| 数据来源 | 文末参考文献 1–107;图片版权见"图片版权"一节 |
后续方向
系列到此收尾,但这条主线上还有东西可写。若之后继续,优先考虑三个方向:一是光追管线里的 BVH——本文只把它当对照,但它自己的构建、压缩与更新是一整块内容;二是几何处理的完整链条,从网格简化到虚拟几何;三是移动端渲染的独立剖析——它的约束与桌面端差别大到值得单独写。
落款
本篇是《实时渲染管线探析》系列的第五篇,也是最后一篇。五篇写完,感谢每一位读到这里的同学。
文中数据均标注了出处,若发现任何数字或表述有误,欢迎指出——尤其欢迎能给出反例的指出,因为这篇讨论的正是"什么情况下会出错"。
参考文献
- NVIDIA. Introduction to Turing Mesh Shaders. https://developer.nvidia.com/blog/introduction-turing-mesh-shaders/
- AMD GPUOpen. Mesh Shaders in AMD RDNA 3 Architecture (GDC 2024). https://gpuopen.com/download/GDC2024_Mesh_Shaders_in_AMD_RDNA_3_Architecture.pdf
- Epic Games. Nanite Virtualized Geometry Overview. https://dev.epicgames.com/documentation/unreal-engine/nanite-virtualized-geometry-in-unreal-engine
- Microsoft. D3D12 Work Graphs Specification. https://microsoft.github.io/DirectX-Specs/d3d/WorkGraphs.html
- Microsoft DirectX Blog. D3D12 Work Graphs. https://devblogs.microsoft.com/directx/d3d12-work-graphs/
- Microsoft DirectX Blog. Mesh Nodes in Work Graphs. https://devblogs.microsoft.com/directx/d3d12-mesh-nodes-in-work-graphs/
- Microsoft Learn. Work Graphs DDI. https://learn.microsoft.com/en-us/windows-hardware/drivers/display/work-graphs
- Microsoft. D3D12 Mesh Shader Specification. https://microsoft.github.io/DirectX-Specs/d3d/MeshShader.html
- Microsoft. D3D12 Increased 1D Dispatch Dimensions. http://microsoft.github.io/DirectX-Specs/d3d/D3D12IncreasedDispatchDimension.html
- Microsoft. D3D12 Indirect Drawing. https://github.com/pineoc/DirectX-Specs/blob/master/d3d/IndirectDrawing.md
- Khronos. Vulkan Samples: Multi-Draw Indirect. https://docs.vulkan.org/samples/latest/samples/performance/multi_draw_indirect/README.html
- Khronos. GPU-Side Command Generation. https://docs.vulkan.org/tutorial/latest/Advanced_Vulkan_Compute/07_GPU_Driven_Pipelines/03_gpu_side_command_generation.html
- Khronos. GLSL_EXT_mesh_shader. https://docs.vulkan.org/glslext/latest/glslext/ext/GLSL_EXT_mesh_shader.html
- tigerabrodi. Indirect draws in WebGPU and why they're so powerful. https://tigerabrodi.blog/indirect-draws-in-webgpu-and-why-they-re-so-powerful
- Khronos. GPU-Side Command Generation (Advanced Vulkan Compute). https://docs.vulkan.org/tutorial/latest/Advanced_Vulkan_Compute/07_GPU_Driven_Pipelines/03_gpu_side_command_generation.html
- AMD GPUOpen. Mesh Shaders Optimization and Best Practices. https://gpuopen.com/learn/mesh_shaders/mesh_shaders-optimization_and_best_practices/
- NVIDIA. GPU Gems 2, Chapter 6: Hardware Occlusion Queries Made Useful. https://developer.nvidia.com/gpugems/gpugems2/part-i-geometric-complexity/chapter-6-hardware-occlusion-queries-made-useful
- NVIDIA. GPU Gems, Chapter 29: Efficient Occlusion Culling. https://developer.nvidia.com/gpugems/gpugems/part-v-performance-and-practicalities/chapter-29-efficient-occlusion-culling
- NVIDIA. GPU Gems 3, Chapter 11: Efficient and Robust Shadow Volumes. https://developer.nvidia.cn/gpugems/gpugems3/part-ii-light-and-shadows/chapter-11-efficient-and-robust-shadow-volumes-using
- Hasselgren et al. Masked Software Occlusion Culling (HPG 2016). https://fileadmin.cs.lth.se/graphics/research/papers/2016/culling/culling.pdf
- Nießner et al. Patch-Based Occlusion Culling for Hardware Tessellation. https://graphics.stanford.edu/~niessner/papers/2012/2occlusion/niessner2012patch.pdf
- Remedy. Occlusion Culling in Alan Wake. https://dl.acm.org/doi/pdf/10.1145/2037826.2037889
- Aokana Voxel Rendering Framework. https://arxiv.org/pdf/2505.02017v1.pdf
- Burns. The Visibility Buffer: A Cache-Friendly Approach to Deferred Shading. https://github.com/ConfettiFX/The-Forge
- Chalmers. Intersection Testing Tutorial. https://www.cse.chalmers.se/edu/course.2014/TDA361/isect.pdf
- Möller. Real-Time Rendering Acceleration (CS248). http://www-graphics.stanford.edu/courses/cs248-05/real-time-programming/moller-cs248-01-lecture.pdf
- Gu et al. Fast and Dynamic Construction of BVHs based on Loose Octrees. https://www2.in.tu-clausthal.de/~cgstore/publications/2018_Gu_VMV_AuthorsVersion.pdf
- UNLP. Vertex Discard Occlusion Culling. https://sedici.unlp.edu.ar/bitstream/handle/10915/31657/Documento_completo.pdf
- Techniques for an Image Space Occlusion Culling Engine. https://scispace.com/pdf/techniques-for-an-image-space-occlusion-culling-engine-421xmqidor.pdf
- Potentially Visible Set Generation with the Disocclusion Buffer. https://dl.acm.org/doi/pdf/10.1145/3757377.3763981
- UIUC CS418. Streaming, LOD, and Occlusion. https://courses.grainger.illinois.edu/CS418/fa2025/text/nanite.html
- 100x Computer Graphics Guide, Ch.47 Spatial Data Structures. https://github.com/cemergin/100x-computer-graphics-guide/blob/main/part-9-geometry-curves/47-spatial-data-structures.md
- rastergrid. Hierarchical Z Map based Occlusion Culling. http://rastergrid.com/blog/2010/10/hierarchical-z-map-based-occlusion-culling/
- borisbat. dasVulkan Tutorial 12: GPU-Driven Rendering. https://borisbat.github.io/dasVulkan/tutorials/12_gpu_driven.html
- ktstephano. View Frustum Culling Using AABBs. https://ktstephano.github.io/rendering/stratusgfx/aabbs
- bruop. Frustum Culling. https://bruop.github.io/frustum_culling/
- Ubisoft. GPU-Driven Rendering Pipelines (Wihlidal). https://blog.csdn.net/liran2019/article/details/115618046
- NVIDIA. Introduction to Turing Mesh Shaders(中文版). https://developer.nvidia.cn/blog/introduction-turing-mesh-shaders
- AMD. Mesh Shaders in AMD RDNA 3(GDC 2024). https://gpuopen.com/download/GDC2024_Mesh_Shaders_in_AMD_RDNA_3_Architecture.pdf
- AMD. Mesh Shaders Optimization and Best Practices. https://gpuopen.com/learn/mesh_shaders/mesh_shaders-optimization_and_best_practices/
- Epic Games. Nanite GPU Driven Materials (GDC 2024). https://media.gdcvault.com/gdc2024/Slides/GDC+slide+presentations/Nanite+GPU+Driven+Materials.pdf
- SIGGRAPH 2024 Advances. Seamless Rendering on Mobile (NanoMesh). https://advances.realtimerendering.com/s2024/content/Cao-NanoMesh/AdavanceRealtimeRendering_NanoMesh0810.pdf
- GDC 2024. Innovation Unleashed: High-Performance UE5 Mobile Rendering. https://media.gdcvault.com/gdc2024/Slides/GDC+slide+presentations/Li_Bo_Gong_Jing_etc.+Innovation+Unleashed+High-Performance.pdf
- Capcom. RE ENGINE Meshlet Rendering Pipeline (REAC 2025). https://enginearchitecture.org/downloads/REAC_2025_Capcom.pdf
- Epic Games. A first look at Unreal Engine 5. https://www.unrealengine.com/en-US/blog/a-first-look-at-unreal-engine-5
- Vulkanised 2026. GPU-Driven Rendering in the Quest 2 and 3. https://vulkan.org/user/pages/09.events/vulkanised-2026/1415-Lucas-Silva-DevshGraphicsProgramming.pptx.pdf
- Unity. Occlusion culling in Unity 4.3: The basics. https://blog.unity.com/engine-platform/occlusion-culling-basics-unity-4-3
- NVIDIA. nvpro-samples: gl_occlusion_culling. https://github.com/nvpro-samples/gl_occlusion_culling/
- whlee503. ue5-gpu-driven-culling. https://github.com/whlee503/ue5-gpu-driven-culling
- SuperSheep1021. GPUDrivenTerrainLearn. https://github.com/SuperSheep1021/GPUDrivenTerrainLearn/blob/master/README.md
- SynapseEngine. https://github.com/TamasPetii/SynapseEngine
- fireEngine. https://github.com/nnewson/fireEngine
- Nyx. https://github.com/moonlovelj/Nyx/
- foundation. https://github.com/lukasino1214/foundation
- JamWils. gpu-driven. https://github.com/JamWils/gpu-driven
- nanite-webgpu_dev. https://github.com/RussPalms/nanite-webgpu_dev
- jbikker. bvh_article/bvh.cpp. https://github.com/jbikker/bvh_article/blob/main/bvh.cpp
- UntoldEngine. RenderingSystem. https://untoldengine.github.io/UntoldEngine/Architecture/renderingSystem/
- Eidos Montreal. Deferred+: Next-Gen Culling and Rendering for Dawn Engine. https://www.eidosmontreal.com/news/deferred-next-gen-culling-and-rendering-for-dawn-engine/
- Unreal Forums. Occlusion Culling Sync Points cause poor performance. https://forums.unrealengine.com/t/occlusion-culling-sync-points-cause-poor-performance-in-even-simple-scenes/750084
- VRMMetalKit Issue #301. https://github.com/arkavo-org/VRMMetalKit/issues/301
- Unreal Issue UE-229617. https://issues.unrealengine.com/issue/UE-229617
- quetoo. FRUSTUM_CULLING_ANALYSIS.md. https://github.com/Eclipse1982/quetoo/blob/main/doc/copilot/FRUSTUM_CULLING_ANALYSIS.md
- BVH for Collision Detection: From AABB to Optimal Hierarchies. https://dev.to/mayank_mayam03/bvh-for-collision-detection-from-aabb-to-optimal-hierarchies-21k6
- BVH: Bounding Volume Hierarchy. https://www.mysimulator.uk/content/articles/bvh-acceleration.html
- Instanced Rendering & LOD. https://mysimulator.uk/content/articles/instanced-rendering-lod.html
- Pictor rendering pipeline plan. https://github.com/LUDIARS/Pictor/blob/main/plan.md
- Game Programming Gems index. https://github.com/Gforcex/GPU-Book/blob/master/README.md
- Iterative Depth Warping (ACM 2018). https://dl.acm.org/doi/fullHtml/10.1145/3190859
- Level of Detail, Culling, and Draw Call Optimization. https://kindatechnical.com/game-development/level-of-detail-culling-and-draw-call-optimization.html
- Unity 渲染管线(三)LOD 判据. https://soo-bak.github.io/dev/unity/UnityPipeline-3/
- CSDN. Camera 视锥体剔除技术详解. https://blog.csdn.net/qq_33060405/article/details/151263491
- CSDN. RTR3 第十四章 渲染加速算法总结. https://blog.csdn.net/sinat_31849633/article/details/79402333
- gitcode. RTR 第四版·第十九章 加速算法. https://gitcode.csdn.net/6a236ff210ee7a33f2783b6d.html
- CSDN. Acceleration Algorithms (Bounding Volume 类型). https://blog.csdn.net/qq_41940565/article/details/128864968
- CSDN. UE GPU Driven Pipeline & Mesh Shader(meshlet). https://blog.csdn.net/qq_35312463/article/details/122648769
- CSDN. A Deep Dive into Nanite Virtualized Geometry. https://blog.csdn.net/qq_41940565/article/details/162691879
- CSDN. Nanite 系统 GPU 驱动材质. https://blog.csdn.net/qq_33060405/article/details/144014684
- SegmentFault. UE5 渲染技术简介:Nanite 篇. https://segmentfault.com/a/1190000040251406
- 风中追风. UE5 Nanite 原理. http://neozheng.cn/2023/08/24/UE5%20Nanite%20%E5%8E%9F%E7%90%86/
- NaniteTree(中文). https://github.com/NaniteTree/NaniteTree.github.io/blob/main/index_cn.html
- CSDN. Hierarchical Z-Buffer Visibility (Hi-Z). https://blog.csdn.net/wolf96/article/details/100851090
- CSDN. GPU Driven Occlusion Culling (Hi-Z). https://blog.csdn.net/qq_35312463/article/details/124072312
- 掘金. early-z、z-culling、hi-z、z-prepass 到底是什么. https://juejin.cn/post/6844904132852072462
- CSDN. Unity 中的遮挡剔除. https://blog.csdn.net/f980511/article/details/146773889
- 现代渲染剔除技术. https://c13n.club/blog/2026-04-20/index.pdf
- realherschel. From Draw Calls to Meshlets. https://realherschel.com/from-draw-calls-to-meshlets-why-gpu-driven-rendering-is-reshaping-real-time-graphics/
- CSDN. 游戏空间划分技术. https://blog.csdn.net/enternalstar/article/details/149932397
- CSDN 问答. 3D 显示全部模型时为何出现模型缺失. https://ask.csdn.net/questions/9355559
- jooh3444. Nanite Basepass 分析. https://jooh3444.tistory.com/35
- Unreal Engine. Visibility and Occlusion Culling. https://dev.epicgames.com/documentation/en-us/unreal-engine/visibility-and-occlusion-culling-in-unreal-engine
- Unreal Engine. Visibility and Occlusion Culling Reference. https://dev.epicgames.com/documentation/en-us/unreal-engine/visibility-and-occlusion-culling-reference-in-unreal-engine
- Umbra 3D. Support & Release Notes. https://support.umbra3d.com/
- Bushnaief. Solving Visibility and Streaming in The Witcher 3: Wild Hunt with Umbra 3 (GDC 2014). https://ubm-twvideo01.s3.amazonaws.com/o1/vault/GDC2014/Presentations/Bushnaief_Jasin_Solving_Visibility_In.pdf
- Unity Manual. Umbra(com.unity.modules.umbra). https://docs.unity3d.com/2022.3/Documentation/Manual/com.unity.modules.umbra.html
- Bittner. Game-Engine-Friendly Occlusion Culling (ShaderX7, 8.4). https://dcgi-wp.felk.cvut.cz/wp-content/wpallimport-dist/publications/pdf/publications-2009-.bittner-shaderx7-gefoc-paper.pdf
- Godot Engine Docs. Occlusion culling. https://github.com/godotengine/godot-docs/blob/master/tutorials/3d/occlusion_culling.rst
- Unity Manual. Create draw commands with the BatchRendererGroup API. https://docs.unity3d.com/6/Documentation/Manual/batch-renderer-group-creating-draw-commands.html
- Unity Blog. BatchRendererGroup sample: Achieve high frame rate even on budget devices. https://blog.unity.com/engine-platform/batchrenderergroup-sample-high-frame-rate-on-budget-devices
- Unity Manual (5.1). Occlusion Culling. https://docs.unity3d.com/510/Documentation/Manual/OcclusionCulling.html
- Unity 手册(中文). Occlusion Culling. https://docs.unity.cn/cn/2018.2/Manual/OcclusionCulling.html
- Unity Learn. GPU Driven Rendering. https://learn.unity.com/tutorial/gpu-driven-rendering
- Unity 官方开发者社区. 团结引擎新增 GPU Resident Drawer. https://developer.unity.cn/projects/686b447dedbc2a6b14c2915c
- Godot Engine Docs. Occlusion culling(English, stable). https://docs.godotengine.org/en/stable/tutorials/3d/occlusion_culling.html
- Khronos. Vulkan Tutorial: Multi-Draw Indirect (MDI). https://docs.vulkan.org/tutorial/latest/Advanced_Vulkan_Compute/07_GPU_Driven_Pipelines/04_multi_draw_indirect_mdi.html
- Vulkanised 2025. Device-Generated Commands in Vulkan. https://www.vulkan.org/user/pages/09.events/vulkanised-2025/T10-Ricardo-Garcia-Igalia.pdf
- NVIDIA. GPU Gems 3, Part VI: GPU Computing(含 Chapter 39 Parallel Prefix Sum). https://developer.nvidia.com/gpugems/gpugems3/part-vi-gpu-computing
图片版权
本文使用的 93 张外部素材来自 Wikimedia Commons、LearnOpenGL(CC BY 4.0)与 Godot 官方文档(CC BY 4.0),许可均为 CC0 / Public domain / CC BY / CC BY-SA(无 NC、无 ND)。逐张登记如下。
| 用途 | 素材 | 作者 | 许可 | 来源 |
|---|---|---|---|---|
| 题图 | Ouster OS1-64 城市街道激光雷达点云 | Daniel L. Lu | CC BY 4.0 | Commons |
| 图 | 传送带上散料的激光雷达高度图(红高蓝低) | Mweaver89 | CC BY-SA 4.0 | Commons |
| 图 | 拆下的镜头出瞳(光圈在镜后成的像,视锥口径的实际来源) | BenFrantzDale | CC BY-SA 3.0 | Commons |
| 图 | 八叉树的层级切分结构 | WhiteTimberwolf | CC BY-SA 3.0 | Commons |
| 图 | Stanford Armadillo 测试模型 | Mille-dt | CC BY-SA 4.0 | Commons |
| 图 | 建筑尺度的 LiDAR HD 点云 | FuzzyGeo | CC BY 4.0 | Commons |
| 图 | 现代 GPU 刀片(MareNostrum 5 液冷刀片) | Steve Jurvetson | CC BY 4.0 | Commons |
| 图 | NVIDIA G70 裸片 | Martijn Boer | Public domain | Commons |
| 图 | 现代 GPU 结构框图 | ScotXW | CC0 | Commons |
| 图 | LandSat 9 线框模型 | NASA GSFC | Public domain | Commons |
| 图 | VisualCameraFrustum.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | plan.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | hAndVSide.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | RightNormal.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | boundingSphere.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | SpherePlanDetection.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | SignedDistanceDraw.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | boundingAABB.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | AABBRepresentation.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | result.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | boundingVolumeQuality.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | AABBProblem.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | AABB%20orientation.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | BSH.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | quadtree.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | octree.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | BSP.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | occlusion_culling_scene_example.png | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | occlusion_culling_disabled.png | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | occlusion_culling_enabled.png | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | mesh_lod_comparison_shaded.png | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | mesh_lod_comparison_wireframe.png | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | mesh_lod_disable_lod.png | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | instancing_quads.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | instancing_asteroids.png | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | lightmap_gi_comparison.png | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | lightmap_gi_bake.webp | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | gi_lightmap_gi_direct_and_indirect.webp | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | lightmap_gi_shadowmask.webp | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | lightmap_gi_denoiser_comparison.webp | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | lightmap_gi_lmsize.webp | Godot Engine documentation | CC BY 4.0 | Godot |
| 图 | Frustum clipping.svg | Tetromino | CC BY 3.0 | Commons |
| 图 | Pyramid of vision.svg | Konrad Conrad | CC BY-SA 3.0 | Commons |
| 图 | Kd-tree-example.png | Jarfuls of Tweed | CC BY-SA 4.0 | Commons |
| 图 | Kd-tree-example-with records as leaf nodes.png | Jarfuls of Tweed | CC BY-SA 4.0 | Commons |
| 图 | 17 Octree 9 10.png | Eshipley | CC BY-SA 3.0 | Commons |
| 图 | Austin Texas LiDAR Point Cloud (Highway 183).png | Rebecca equator | CC BY-SA 4.0 | Commons |
| 图 | Pixels covered by a triangle.png | Martin Kraus | CC BY-SA 3.0 | Commons |
| 图 | 正/背面判定:只有朝向观察者的三角形才需要绘制 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | 顶点绕序(winding order):顺时针与逆时针区分正背面 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | 绕序反了的后果:剔除了本该可见的面,模型出现内外翻转 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | 背面剔除实例(颅骨):剔除背面后仍保留完整的体积感 | Claudio Rocchini | CC BY-SA 4.0 | Commons |
| 图 | 视锥剔除:只保留落在相机可见棱台内的物体 | Wojciech Muła | CC BY-SA 3.0 | Commons |
| 图 | 消隐(hidden surface determination):判定哪些面最终可见的全过程 | Vierge Marie | CC BY-SA 4.0 | Commons |
| 图 | 画家算法:按深度从远到近绘制,后画的覆盖先画的 | Zapyon | CC BY-SA 3.0 | Commons |
| 图 | 画家算法的失效情形:多边形互相穿插时不存在正确的整体排序 | Wojciech Muła | Public domain | Commons |
| 图 | 交叉多边形:无法用单一的先后顺序表达遮挡关系 | Vlasenko D | CC BY-SA 3.0 | Commons |
| 图 | 三角形光栅化的覆盖规则:像素中心是否落在三角形内决定是否覆盖 | Wojciech mula at Polish Wikipedia | Public domain | Commons |
| 图 | 视场角与视锥:FOV 决定棱台的张角,进而决定剔除范围 | Martin Kraus | CC BY-SA 3.0 | Commons |
| 图 | 包围体层次(BVH):大包围体套小包围体,逐层排除 | Schreiberx | CC BY-SA 3.0 | Commons |
| 图 | 遮挡剔除示意:被前景完全挡住的对象可以被整块跳过 | Wojciech mula at Polish Wikipedia | CC BY-SA 3.0 | Commons |
| 图 | 深度缓冲可视化:每个像素记录最浅深度,近处亮、远处暗 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | 画面与它对应的 Z 缓冲:每个像素对应一个深度值 | en:User:T-tus | CC BY 2.0 | Commons |
| 图 | Z 缓冲原理:逐像素保留最近深度,作为可见性判定的依据 | Vierge Marie | Public domain | Commons |
| 图 | 深度测试(LESS):只有更近的片元才覆盖,这就是要被查询无数遍的那个判定 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | 深度测试(ALWAYS):所有片元都通过,遮挡关系完全丢失 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | Z-fighting:两个面深度过于接近时,判定结果随像素抖动 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | 线性深度分布:深度值与距离成正比 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | 非线性深度分布:精度集中在近处,远处迅速逼近上限 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | 深度缓冲(线性化后):远处的精度被摊平,金字塔层级才均匀可用 | Joey de Vries | CC BY 4.0 | LearnOpenGL |
| 图 | 包围盒层次:大盒套小盒逐层排除,与 BVH 用大包围体套小包围体是同一个思路 | Prokofiev | CC BY-SA 3.0 | Commons |
| 图 | 四叉树划分:空间递归切成四份,直到每块内的物体数量足够少 | Lucidation | CC BY-SA 3.0 | Commons |
| 图 | R-tree:以最小外接矩形做层次组织,与 BVH 同属“包围体套包围体”的索引结构 | Skinkie , w:en:Radim Baca | Public domain | Commons |
| 图 | 八叉树细分:空间递归切成八份,节点内的物体集合随之收缩 | Nü at German Wikipedia | CC BY-SA 3.0 | Commons |
| 图 | k-d 树:每层只沿一个坐标轴切分,左为空间划分、右为对应的节点树 | Jarfuls of Tweed | CC BY-SA 4.0 | Commons |
| 图 | 编辑器中的八叉树世界:整个场景按八叉树组织,编辑与剔除共用同一套结构 | Calinou1 | CC BY-SA 3.0 | Commons |
| 图 | 网格内光线遍历:沿光线逐格步进、每格只做一次判定——BVH 遍历是同一思路的层次版本 | Phrood~commonswiki | CC BY-SA 3.0 | Commons |
| 图 | 四叉树叠加层:结构划分与物体一一对应,结构质量直接决定遍历效率 | Lucidation | CC BY-SA 3.0 | Commons |
| 图 | R-tree 二次切分:按最小面积增量挑选分裂点,与 SAH 的目标完全一致 | Chire | CC BY-SA 4.0 | Commons |
| 图 | R-tree 线性切分:牺牲一点树质量换构建速度,是构建期最典型的一组取舍 | Chire | CC BY-SA 4.0 | Commons |
| 图 | R-star 树拓扑切分:以面积与重叠为代价函数重新分配条目,与 SAH 同源 | Chire | CC BY-SA 4.0 | Commons |
| 图 | R-star 树批量装载:按空间排序后自底向上构造,构建成本可以一次性摊销 | Chire | CC BY-SA 4.0 | Commons |
| 图 | 场景与其深度图:深度图里每个像素只是一个距离值,金字塔就是对它逐级降采样 | Dominicos | CC BY-SA 3.0 | Commons |
| 图 | 深度图示例:近处亮、远处暗,降采样时必须取最远值才能保持保守性 | IzE_Design | Public domain | Commons |
| 图 | LOD 混合:两级网格按屏幕覆盖率抖动插值,避免切换时出现跳变 | Sirotk | CC BY-SA 3.0 | Commons |
| 图 | 体素场景:几何被切成规整单元,可见性判定的粒度随之改变 | Mérédith Nolot | CC BY-SA 4.0 | Commons |
| 图 | 体素法线:每个体素单元携带自己的法线,与 meshlet 的属性打包是同类做法 | Roland Rytz (draemmli) | CC BY-SA 4.0 | Commons |
| 图 | LOD 导入面板:网格简化在导入时完成,运行时只负责选用哪一级 | Godot Engine documentation | CC BY 4.0 | Godot 文档 |
| 图 | 三维扫描设备:真实物体的几何与颜色由此进入管线,规模从此只受存储限制 | Alange6373 | CC BY-SA 3.0 | Commons |
| 图 | 实物扫描过程:逐面采集并拼接,产出的是高密度网格 | Kelly No.715 | CC BY-SA 4.0 | Commons |
| 图 | 机载 LiDAR 道路点云:单次采集即千万级点,可见性判定必须在这样的规模上做 | Rebecca equator | CC BY-SA 4.0 | Commons |
| 图 | 雕像点云:扫描精度带来极高点密度,任何逐点判定都不现实 | Jorma Palmén | CC BY-SA 4.0 | Commons |
| 图 | 料堆 LiDAR 点云:红高蓝低的高度着色,数据规模与几何复杂度同步增长 | Mweaver89 | CC BY-SA 4.0 | Commons |


另有 137 张示意图(图中标注"本系列绘制")由本系列自行绘制,采用统一色板,不涉及第三方版权。CC BY 与 CC BY-SA 类素材均在上表给出作者与许可链接,符合署名与相同方式共享要求。
检索到但未采用的素材(如实记录)
阶段 2 的候选池里有 2 张分形 zbuffer 渲染图(Mandelbulb 20190828 zbuffer.png、Mengerbulb zbuffer 20190902.png,均 CC BY-SA 4.0),原计划用作"深度缓冲的真实形态"。下载后经客观特征评估判为低——曝光 1.000、明暗层次 σ 仅 0.007/0.003、边缘密度约 0.0001,即画面接近纯白、无可辨识信息。按规范不采用,且不以自绘图顶替该位置,第七章的深度可视化改由激光雷达高度图承担。
另有 1 张建筑点云(Point cloud data of the David W. Dyer Federal Building...,CC BY-SA 4.0)因 Commons 页面未标注作者、无法满足署名要求而未采用,改用有明确作者的 BNF Lidar HD(CC BY 4.0)。
本轮逐张对照正文主体所做的替换(旧→新):
- 第 2 章"拆下的镜头出瞳"原误用 Sony Alpha 7R IV ... lens.jpg(白底索尼机身整机),官方描述不含出瞳;已换为真正显示镜头出瞳(光圈在镜后的像)的 Camera lens exit pupil.jpg(BenFrantzDale, CC BY-SA 3.0)。
- 第 10.1 节原用 1990 年代 HP HCRX24 老显卡作 GPU 算力示意,已换为 MareNostrum 5 的现代 GPU blade with glycol cooling(Steve Jurvetson, CC BY 4.0)。
- 第 10.5 节原用 Intel Core i9-13900K CPU 裸片配 GPU compute 剔除——CPU 裸片与"把剔除搬进 GPU"主体相悖,已换为 Generic block diagram of a GPU.svg(GPU 内部结构框图,ScotXW, CC0)。
- 第 10.3 节 LHC 机架、第 11.3 节倒角线框两张弱素材(需靠隐喻才沾边)按规范移除,对应小节摄影像改由本系列自绘示意与正文承担,不另配无关真图。
本轮计数更正与未采用记录:
- 计数更正:第 10.5 节的 ep05_gpu_blocks.svg 经核验实为 Wikimedia Commons Generic block diagram of a GPU.svg(ScotXW, CC0)的渲染件(文件本体即 PNG),此前误计入自绘,现更名为 src_gpu_blocks.png 并按外部素材登记。
- 未采用 Frustum_clipping.svg(Tetromino, CC BY 3.0):与第 2.2 节已用的 src_frustum_clipping.png 为同一图形的更高分辨率渲染件,同源重复,不另占图位。
- 未采用 Z-fighting.png(Mhoskins, Public domain):794×561、文件仅 7.8 KB,画面信息量过低;且第 7.1 节已用 LearnOpenGL 的 Z-fighting 实例,不重复采用。
- 未采用四叉树图(Quadtree, graphical and tree representation.png):第 4.2 节已用 LearnOpenGL 的四叉树图示,同节重复,不另插入。
以下备选检索源(未在正文使用,仅作可追溯记录):
- https://commons.wikimedia.org/wiki/Category:Integrated_circuit_dies
- https://commons.wikimedia.org/wiki/Category:Graphic_chips
- https://commons.wikimedia.org/wiki/Category:Video_cards
- https://commons.wikimedia.org/wiki/Category:Data_centers
- https://commons.wikimedia.org/wiki/Category:3D_models
- https://commons.wikimedia.org/wiki/Category:Aerial_photography
- https://commons.wikimedia.org/wiki/Category:Photographic_lenses
- https://commons.wikimedia.org/wiki/Category:Octrees
- https://commons.wikimedia.org/wiki/File:Esfera_octree.png
- https://commons.wikimedia.org/wiki/File:Octree.png
- https://commons.wikimedia.org/wiki/File:Z-depth2.png
- https://commons.wikimedia.org/wiki/File:Point_cloud_torus.gif
- https://commons.wikimedia.org/wiki/File:%22Punktewolke%22_Berlin_Vertikale_Vermessung_des_Hauptbahnhofs_(7499499824)_(2).jpg
- https://commons.wikimedia.org/wiki/File:AMD_Am95C60_die.jpg
- https://commons.wikimedia.org/wiki/File:ST90E40ZL1_(2).png
- https://commons.wikimedia.org/wiki/File:CERN_data_centre.jpg
- https://commons.wikimedia.org/wiki/File:ADR1FT_gameplay_screenshot.png
- https://commons.wikimedia.org/wiki/File:Nvidia_G71_die_shot_-_28205145199.jpg
- https://commons.wikimedia.org/wiki/File:Nvidia_NV43_die_shot_-_25186619957.jpg
- https://commons.wikimedia.org/wiki/File:Hitachi_HD61700_microprocessor_top_metal_die_shot.jpg
- https://commons.wikimedia.org/wiki/File:Worldwide_LHC_Computing_Grid.jpg
- https://commons.wikimedia.org/wiki/File:Cube_wireframe.stl
- https://commons.wikimedia.org/wiki/File:Lidar_forestry.png
- https://commons.wikimedia.org/wiki/File:Austin_Texas_LiDAR_Point_Cloud_(Highway_183).png
- https://commons.wikimedia.org/wiki/File:Quaternionsche_Mandelbrotmenge_20190830_zbuffer.png
- https://commons.wikimedia.org/wiki/File:LiDAR_visualization_of_bulk_material.png
相关链接 - 上一篇:【实时渲染管线探析】(四) PBR 与 IBL:从渲染方程到工业实践 - 下一篇(预告):本篇为系列收尾篇,暂无下一篇;本条留作后续续篇的更新位 - 本文全部参考文献(107 条)见上一节,图片版权见「图片版权」表
以上。 如果这篇帮你把"画什么"这一环从视锥一路串到了 GPU-Driven,或者让你下次遇到"物体莫名消失"时能更快定位到是哪一层出的问题,那它就达到了目的。感谢大家读到这里。
With Best Wishes.