CSDN 版文章链接:待发布 知乎专栏版文章链接:待发布
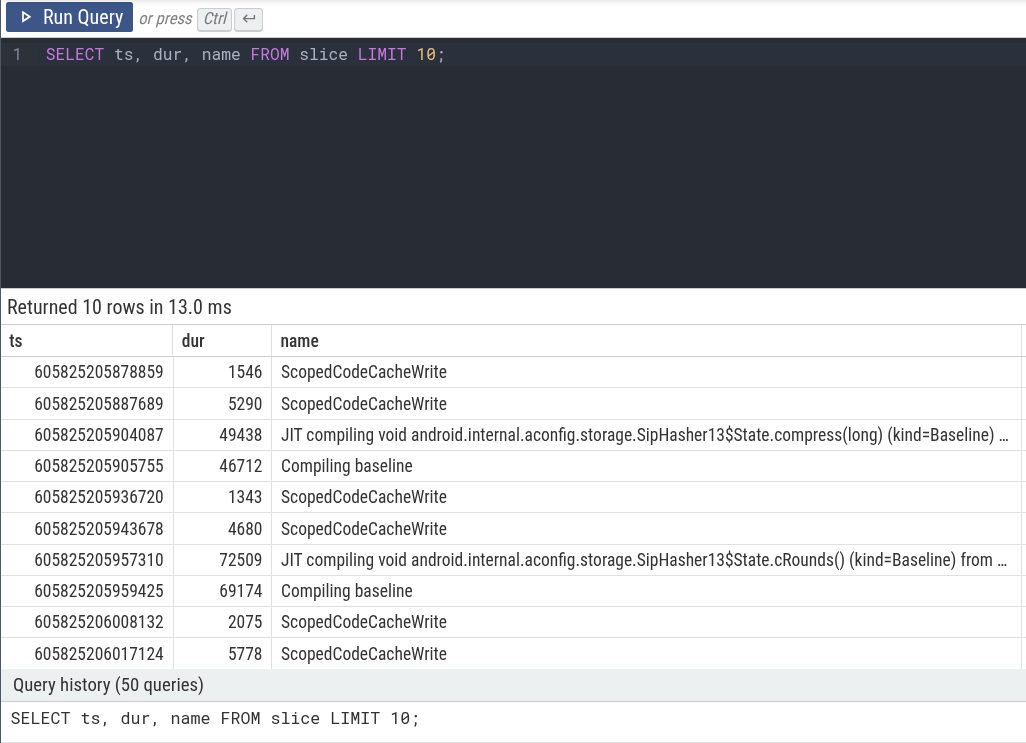
SELECT ts, dur, name FROM slice LIMIT 10 的三列输出,ts 是纳秒时间戳、dur 是纳秒时长、name 是切片名——这三个字段就是本篇所有口径与性能讨论的原子@ Perfetto 官方文档(Google,Apache-2.0)[^ext1]点题与总览:能查只是起点
先说清一件事:采集与数据源不在本篇范围内(那是本系列 ep08 的地盘),jank 判据与 FrameTimeline 的归因公式也不在这里(留给 ep10)。至于 SQL 语法入门,SELECT、GROUP BY、窗口函数这些基础,随便一本教材都比本文讲得细,本篇同样不复述。这里只有一件事:同一份 trace、同一个业务问题,为什么有人三秒出答案,有人跑十分钟还跑错了。
从 ep07 到 ep09,这条链路是这样接上的:ep07 讲"文件里有什么",把 .pftrace 拆到 SQL 表;ep08 讲"这些内容谁写进去的",把表对回 data source;到本篇,数据已经躺在库里了,问题变成怎么把它们问对、问快。所以本篇的位置很明确——它是这条链路的第三块,也是第一块"由你亲手写、写错就自己承担"的部分。
0.1 能查 ≠ 查得快、算得对
先来看看三个几乎人人都踩过的场景。 它们分属三件不同的事,但症状长得很像,都是"结果出来了,但结果是错的或者慢得离谱"。
第一种是算错。你把 dur 当普通数字求和,得到"总耗时 3 小时",可这份 trace 只录了 30 秒——里面混着 dur = -1 的"未结束切片",数值上一乘就是负数。你把 slice 直接 JOIN args ON arg_set_id,20 万行的结果变成 60 万行,因为一个 arg_set_id 对应多条 args 记录,"一对一"实际是"一对多"。共同点:SQL 一声不吭,结果长得跟真的似的——你写下的语义,和引擎执行的语义不是一回事。
第二种是查慢。你在一个视图上再套视图,每次执行都从原始表重算;你在封装里先 ORDER BY … LIMIT、又把过滤留在了外面,两份"看起来一样"的报表给出两个行数;你用三张表做 JOIN 却忘了过滤那个取值 -1 的键——引擎老老实实给你算出百万行中间结果,然后内存爆了。问题就出在这里:写法看起来完全合法,官方文档也没说不能这么写。
第三种是不可复现。你在 Perfetto UI 的 Query 标签页里敲了七分钟,调出一个漂亮数字,复制到群里,然后自己再也复现不出来——既没保存那段 SQL,也没记录 trace 的版本与当时开了哪些模块。这个场景最容易被当成"不是技术问题",恰恰是调优工作的最大漏损点。
先把全篇最易踩的五个口径坑摆在这里。 它们分属后面不同章节,但有一个共同特征——SQL 一声不吭,你还以为结果是对的:
- 把
dur = -1当普通时长求和:那是"未结束"的哨兵值,一进SUM就把总时长算小甚至算成负数(第一章); JOIN args时只写arg_set_id而漏了key:arg_set_id是分组号、不是坐标,漏写key会让行数按参数条数成倍膨胀(第一章);- 把纳秒当毫秒,或在两个时钟域之间直接做减法:基础表的时间单位是纳秒,跨时钟域必须先换算(第一章);
- 把
WHERE落在封装哪一侧当成纯性能问题:写在视图、CTE 或子查询的外面,有时计划一字不差,有时却会让LIMIT的截断跑在过滤之前——结果行数悄悄变了,SQL 一句提醒都没有(第四章); - 让
frame_id = -1这类哨兵值参与等值连接:-1与-1恒相等,三表 JOIN 会退化成笛卡尔积,百万行直接 OOM(第五章)。
好了,把这三件事并成一句题眼:调优不是"把 SQL 写漂亮",而是把"能查"推进到"查得快、算得对",并且可复现。 本篇九章就是顺着这三件事排的:一、二、三章管"算得对",四、五章管"查得快",六章管"可复现",七章把前六章收成一张可执行的处方表。
0.2 全篇知识地图
下面这张表是后面九章的顺序与产出。它不是并列的九个知识点,而是一条从"先修口径"到"再修性能"的坡道——顺序不能颠倒,因为一个算错的查询再快也没有价值。
| 章节 | 在回答什么 | 你会拿到什么 |
|---|---|---|
| 零、点题与总览 | 能查、算对、查快是三件不同的事 | 知识地图 + 口径演进 + 术语双语表 + 边界声明 |
| 一、先算对 | 什么样的查询"看起来对、其实算错"? | 纳秒单位、dur 三态、depth/parent_id、arg_set_id → args 与 EXTRACT_ARG |
| 二、该物化就物化 | 什么时候落表、什么时候保持视图? | CREATE PERFETTO TABLE 的判据、CREATE PERFETTO INDEX 的适用面与代价、重物化流程 |
| 三、别重写标准库 | 官方已经写好的东西在哪? | INCLUDE PERFETTO MODULE 的语义 + slices.* 家族五个成员各自解决什么 |
| 四、过滤下推与连接语义 | 换个位置写 WHERE,差的是口径还是量级? |
filter early、EXPLAIN 计划对照、SPAN_JOIN 与分区语义 |
| 五、长 trace 上的内存与时间 | 多大算大?内存账怎么算? | 2 × S × N 内存公式、原生 server、-m metatracing、笛卡尔积 OOM 复盘 |
| 六、批处理与可复现 | 怎么把一次调优变成一条命令? | CLI 四种模式、export 三格式、可重放的批处理脚本 |
| 七、调优清单 | 下次遇到同类问题怎么办? | 症状 → 诊断 → 处方 三列矩阵 + 与 ep08 的反向咬合 |
| 八、边界与结语 | 本篇讲到哪、下篇讲什么? | 边界再确认表 + ep10 预告 + 资源清单 |
这九章里,第一章的位置最要紧。 大多数人的直觉是"先优化慢查询",可一路讲下来你会发现:所谓慢查询里,相当一部分是错查询——它们慢,是因为语义写错导致中间结果规模失控。第五章那个笛卡尔积案例就是标本:表面是性能问题,根因是"没过滤 -1"这个正确性问题。所以先钉口径,再谈速度。
0.3 口径体系的演进:从 v1 指标到三页权威文档
把这套查询体系放进时间线,你会发现"怎么算"这件事一直在搬家——搬的不是语法,而是官方希望你从哪个入口进入。
| 阶段 | 时间 | 关键变化 | 留下的痕迹 |
|---|---|---|---|
| trace 变成可查的库 | 2018 年前后(Perfetto 从 systrace 分家) | TraceProcessor 内置 SQL 查询,trace 从"看的"变成"问的" | 今天的 slice / counter 基础表 |
| v1 指标体系(legacy metrics) | Android 10 同期(2019 年前后) | RUN_METRIC 组合 SQL 文件,配 .load-metrics-sql 与 .run-metrics 做热重载 |
今天仍在维护,官方已标 legacy |
| PerfettoSQL 方言与标准库 | 2020 年以后 | CREATE PERFETTO TABLE/VIEW/FUNCTION/MACRO 与 INCLUDE PERFETTO MODULE 成型 |
手写 JOIN 的时代结束 |
| v2 摘要系统 | 近年 | TraceSummary 与 summarize 子命令,官方明确它是 RUN_METRIC 的正统继任者 |
新工作流的默认入口 |
| analysis 分区文档重构 | 2025–2026 | 概念、语法、CLI 拆成三页权威文档 | 旧的分析分区路径陆续失效,照抄老博客会一路 404 |
最后一行尤其值得单独说一句:如果你按两年前的博客去查官方文档,很可能一路 404。 本篇所有引用一律用重构后的新路径——概念与最佳实践走 PerfettoSQL 入门,语法与 CREATE PERFETTO … 走 PerfettoSQL 语法,命令行参数走 Trace Processor 命令行参考。这三页是本篇的事实底座。
上面这条时间线还藏着一个实用判断:v1 与 v2 不是"旧的要扔、新的要用",而是两套口径并存——v1 的 RUN_METRIC 至今能用,-q 这类经典扁平参数也仍在支持,而 v2 的 summarize --metrics-v2 才是新工作流的推荐入口。搞清楚手上的工具属于哪一代,比记住某个参数名重要得多。这一点第六章还会回来。
0.4 术语双语对照(先备着)
先来看看这套术语的双语对照。 后面几章会密集出现官方术语原名,先放一张表,遇到不确定回来查:
| 中文 | English | 一句话 |
|---|---|---|
| 切片 | slice | 一段有起止时间的时间区间,带一个名字 |
| 计数器 | counter | 随时间连续变化的数值,如 CPU 频率、内存 |
| 轨道 | track | 事件的归属分区,UI 上的一行 |
| 物化 | materialization | 把查询结果落成一张真实存储的表 |
| 过滤下推 | filter pushdown | 把过滤条件尽早施加,减少扫描行数 |
| 元追踪 | metatracing(-m) |
用 Perfetto 追踪 trace_processor 自己 |
一句话记住本篇的方法:先问口径对不对,再问计划快不快,最后问这条命令能不能重放。
0.5 边界声明与量化锚点
边界在本篇开篇就说一次,第八章会再确认一次:
- 不涉及采集与数据源。 哪个源、怎么配、谁写的,这些是 ep08 的全部内容。本篇假设你要的数据已经在库里了。
- 不涉及 jank 判据。
AppDeadlineMissed、SurfaceFlingerGpuDeadlineMissed这类帧级结论怎么算、怎么归因,属于 ep10。本篇只讲"怎么把帧相关的表查对、查快"。 - 不复述 SQL 语法入门。
JOIN、GROUP BY、子查询、窗口函数的基本写法不在这里讲;本篇只讲 PerfettoSQL 相对 SQLite 多出来的那部分,以及它们在性能与正确性上的后果。 - 不涉及 trace_processor 的 C++/Python 嵌入整篇。 只用到与命令行、批处理直接相关的部分。
本篇要拿下的量化锚点有五个,先给出来,后文逐一对上:时间单位 1 ns(纳秒);dur = -1 表示切片未结束;批处理内存约 2 × S × N;笛卡尔积轻易到 10⁶ 量级(约 100 万行)就足以让 WASM 环境 OOM;CREATE PERFETTO TABLE 被官方明确描述为比普通 SQLite 表更快、更省内存。记住这五个数,你对"代价"就有了量感。
一、先算对:时间、区间与附加键值
下面我们开始拆第一层。 这一章不讲任何优化技巧,只做一件事:把你写的每条查询从"看起来对"推到"可以证明对"。因为后面所有的"快"都建立在这个前提上。
1.1 时间单位是纳秒,这是所有换算错误的源头
PerfettoSQL 的基础表里,ts(timestamp,时间戳)与 dur(duration,时长)的单位都是纳秒(nanosecond),官方在 PerfettoSQL 入门 的 Best Practices 里把这一条单列为一项,可见踩它的人有多少。1 毫秒等于 10⁶ 纳秒,1 秒等于 10⁹ 纳秒——所以你在结果里看到 dur = 16000000,那是 16 毫秒,不是 16 秒,更不是 16000 秒。
更麻烦的是时钟域。ts 的绝对值取决于采集时 TraceConfig 里选的主时钟,常见的是一台设备开机以来的单调计数器——跨 trace 直接比较 ts 是没有意义的;需要换算时,依据是 clock sync 与 clock_snapshot 表。官方为此提供了 time.conversion 模块,把换算写成函数,省掉自己乘除:
-------------------------------------【时间换算:把纳秒换成人类可读】-----------------------------------
-- 描述:用 time.conversion 模块做单位换算,而不是在 SQL 里手写 *1e-6
-- 依据:perfetto.dev/docs/analysis/perfetto-sql-getting-started 的 Best Practices
----------------------------------------------------------------------------------------------------
INCLUDE PERFETTO MODULE time.conversion;             --【1】引入换算函数,而不是自己乘除

SELECT
  name,
  time_to_ms(dur) AS dur_ms,                          --【2】纳秒 → 毫秒,避免手写 *1e-6
  time_to_s(dur)  AS dur_s
FROM slice
WHERE dur > time_from_ms(10)                          --【3】阈值同样用函数写,避免量级笔误
ORDER BY dur DESC
LIMIT 20;
下面对【3】特别说明。 把阈值写成 time_from_ms(10) 而不是 10000000 不只是好看:手写数字时多写或少写一个零,是这类查询最常见的事故,函数写法把"量级"交还给引擎。另外注意【1】里那个 INCLUDE PERFETTO MODULE 的行为更接近 C++ 的 #include 而不是 import——引入的对象直接进全局命名空间,所以你要避免自己的表名和标准库撞名。
1.2 dur 的三种状态:正常、瞬时、以及"还没结束"
有了单位概念,我们来看 dur 这个字段本身。 它看起来是个普通整数列,实际有三种语义状态,官方在 SQL 表参考 里对 slice 表的定义是"时长(纳秒)",但落到数据上,你必须自己处理三态:
dur 取值 |
语义 | 你该怎么做 |
|---|---|---|
| 正常正整数 | 这是一段有始有终的区间 | 直接参与求和、排序、区间判断 |
0 |
瞬时事件:起止同一时刻 | 求和会漏掉它,做区间相交时要单独考虑 |
-1 |
未结束(trace 结束时它还没关) | 求和会算出负数;必须先过滤或按"到 trace 末尾"补齐 |
第三行是本篇最想钉住的一条。dur = -1 不是"时长为负",而是"这个切片的结束时间未知"。为什么未知?因为 trace 录制结束时,这个切片还没关闭——比如一个 measure 切片跨越了录制边界,或者某个异步事件的 end 消息丢包了。引擎不会替你补,它老老实实把 -1 放在那里。于是:
- 你对它做
SUM(dur),总和会莫名其妙变小甚至变成负数; - 你对它做
WHERE dur > 1000000的过滤,它会被静默排除,于是"长耗时切片"的统计里永远看不到那些真正跨了录制边界的长时间任务——这正是性能分析里最不该漏掉的那一类; - 你对它做区间相交(第四章的
SPAN_JOIN),它会参与计算出诡异的结果。
上面这张三段对照图建议和第五章的笛卡尔积案例对着看:它们讲的是同一件事的两面——一个字段的语义没吃透,代价可以是一个算错的结论,也可以是一次 OOM。 官方标准库对此有现成处理,slices.hierarchy 与 slices.self_dur 都内置了对 -1 的处置逻辑,这也是第三章劝你"别重写标准库"的第一条理由。
1.3 嵌套怎么变成 depth 与 parent_id
言归正传,接着看层级。 同一根轨道上,切片是可以嵌套的:函数 A 里调用 B,B 里调用 C,三者在时间轴上是一条套一条的矩形。trace 里记录的是它们的起止时间,但存储时已经被展平——slice 表是一个扁平表,没有父子字段的天然分组。
引擎用两列把这份嵌套关系表达出来:
depth:切片在当前嵌套栈里的深度,最外层是 0;parent_id:直接父切片的id,没有父就是NULL(更准确地说,是无效值)。
这两列是可推导的——理论上你有 ts/dur/track_id 就能自己算出嵌套,但那要写一段不短的区间比较逻辑,很容易写错。官方的选择是解析阶段直接算好并落在表上,你只需 JOIN slice ON child.parent_id = parent.id 就能拿到父切片。反过来,"拿到某个切片的所有后代"官方提供了 descendant_slice(id) 操作表,以及无需引入模块即可用的 slice_is_ancestor(ancestor_id, descendant_id) 函数。
这张映射图里真正要留意的,是"深度逐 track 独立计数"这一点。 同一个 depth 值在不同轨道上毫无关系;你按 depth = 1 去捞数据,捞到的是"每条轨道各自的第一层子切片",而不是"所有第二层"。要做跨轨道的层级分析,得先把 track_id 带进来。
1.4 计数器与轨道:counter 不是 slice 的另一种写法
切片是"有起止的区间",计数器是"某个时刻的一个值"。两者在表结构上彻底分开:slice 有 dur,counter 没有——它只有 ts、track_id、value 三个核心列,所以"把计数器当切片求和"本身就不成立。要让 counter 变成可比较的区间只有一条路:自己在时间轴上把相邻样本连起来,也就是用 lead(ts) 造出 dur——官方讲区间连接的示例就是这么干的。

至于"轨道"(track),它是事件的归属分区:线程轨道挂 utid,进程轨道挂 upid,CPU 计数器轨道挂 cpu。官方特意提醒:UI 上的"轨道"与 trace_processor 里的 track 不是一一对应的——UI 轨道属于展示层,可能被分组与折叠;按 UI 上看到的一行去找表很可能对不上,此时回到 track 表按 type 与 name 查。
1.5 arg_set_id → args:唯一通道,也是最大的坑
下面我们进入本章最容易出错的一节。 基础表的列是强类型的:slice 有 name、ts、dur,但不可能为每种切片预定义列——ATrace 事件带的 prev_comm、TrackEvent 的 key=value、GPU 事件的 vendor 字段,都不在固定 schema 里。这些"自由键值"统一走一条通道:
任何带附加信息的行,都会有一个 arg_set_id 列;这个 id 指向 args 表里的一到多行键值记录。 官方给了两个取法,一个省事、一个直白:
-------------------------------------【取附加参数的两种写法】-----------------------------------
-- 描述:EXTRACT_ARG 是官方助手函数;下面同时给出它的"脱糖"形态,看清 join 关系
-- 依据:perfetto.dev/docs/analysis/perfetto-sql-getting-started 的 Helper functions
------------------------------------------------------------------------------------------------
-- 写法 A:用 EXTRACT_ARG,官方推荐写法,语义清楚且不必自己拼 join
SELECT ts, name,
       EXTRACT_ARG(arg_set_id, 'prev_comm') AS prev_comm   --【1】按 key 直接取值
FROM ftrace_event
WHERE name = 'sched_switch'
LIMIT 10;

-- 写法 B:写法 A 在引擎内部的展开形态,看清它其实是一次"一对多"的关联
SELECT
  ts, name,
  (SELECT string_value                                  --【2】只取 string_value 这一列
     FROM args
    WHERE key = 'prev_comm'                             --【3】key 相等是第二重条件
      AND args.arg_set_id = ftrace_event.arg_set_id     --【4】arg_set_id 相等是第一重条件
  ) AS prev_comm
FROM ftrace_event
WHERE name = 'sched_switch'
LIMIT 10;
还有两处得单独拎出来:【1】与【4】。 【1】是官方文档给出的标准用法:EXTRACT_ARG 接收 arg_set_id 与 key,返回 args 里的值,你不必关心类型分支(int_value / string_value / real_value 三者只有一个非空)。【4】才是坑的所在——arg_set_id 相等只保证"属于同一组参数",不保证唯一:一个 arg_set_id 下可以挂十几条 key/value,忘写 key 条件,行数就按参数条数成倍膨胀,这就是 0.1 节里"20 万行变 60 万行"的成因。
说白了,这条血缘链只有一句话要记:arg_set_id 是分组号,key 才是坐标。 只给分组号不给坐标,你取到的是"这一组参数里的某一条",在多数引擎里它会与 key 相等的行一一相乘,于是你以为在查一个字段,实际在做一次多对多连接。
1.6 一次真实查询长什么样
下面我们进入本章最后一步:把上面的口径放进一次真实查询里。 官方入门文档给的最短示例是 SELECT ts, dur, name FROM slice LIMIT 10——短到不像"查询语言",却是理解这一切的起点。官方 slice 概念图给得很直白:切片就是一段带名字的时间区间。

回到引擎里执行同一条语句,你看到的是三列:ts 是一个绝对纳秒数(比如 814321000000)、dur 是一个纳秒时长(比如 16000000)、name 是切片名。这三列就是后面所有分析的原子,它们并排的样子就是本文题图那张官方截图。 养一个习惯:拿到任何一份 trace,先跑一次这条语句——ts 的量级告诉你时钟基准,dur 的形态告诉你有没有 -1,name 的风格告诉你数据来自哪个源(接上 ep08 的"从 key 反推源")。
这一章先收在这里。 走完第一章,你手里应该有三个动作:换算用函数(别手写零的个数)、求和前问 dur 是不是 -1、取参数时给全 (arg_set_id, key) 两个条件。这三条都是"便宜的正确性"——成本几乎为零,但能挡掉性能分析里最难看的一类错误:结论错了,还没人怀疑。
二、该物化就物化:表、视图与索引
好了,从这一章起我们开始谈速度。 第一件要破的,是一个几乎所有人都有过的直觉:"视图不占空间、随用随算,所以视图比表省。" 这句话在传统数据库语境里有一半是对的,在 trace 分析语境里却常常是反的。
2.1 视图是"每次现算",表是"算一次"
先说清两种东西的定义,再说它们的代价。视图(view) 是一段被存下来的 SQL 定义,你每次查它,引擎就按定义从头跑一遍;表(table) 是真正落下来的数据,一次写好,之后查询读的是存储而不是定义。
于是代价模型完全不同:
- 视图的代价是每次乘积——
SELECT一次付一次,SELECT一百次就付一百次; - 表的代价是一次性建设 + 每次读取——建表那一刻把重活干完,之后每次查询只读存储,但你要为这份存储付内存。
把这两种存法写成代码,差别其实只有两个关键字:
-------------------------------------【同一口径的两种存法:视图 vs 物化表】------------------------
-- 描述:两条语句的 SELECT 完全一致,唯一区别是"只留定义"还是"把数据落下来"
-- 依据:perfetto.dev/docs/analysis/perfetto-sql-syntax 的 Creating efficient tables
-- ---------------------------------------------------------------------------------------------
CREATE VIEW v_join AS                                    --【1】只留定义:每次查都重跑这段三表 JOIN
SELECT s.id, s.dur, s.name, t.name AS thread_name
FROM slice AS s
JOIN thread_track AS tt ON s.track_id = tt.id
JOIN thread AS t USING (utid);

CREATE PERFETTO TABLE t_join AS                          --【2】把数据落下来:这段 JOIN 只做一次
SELECT s.id, s.dur, s.name, t.name AS thread_name
FROM slice AS s
JOIN thread_track AS tt ON s.track_id = tt.id
JOIN thread AS t USING (utid);
下面对【1】与【2】特别说明。 两条语句的 SELECT 一字不差,差别只在"定义留下来"还是"数据落下来":前者每查一次就重跑一次三表 JOIN,后者在定义那一刻把结果按列存好,之后读的是存储。这就是"视图一定省"失效的地方——省的是存储,费的是每一次查询。
在 trace 分析里,这个差别被两件事放大。第一,底层表的规模很大:一份 30 秒的系统 trace,slice 表几万到几十万行很正常,thread_state、sched 动辄百万行,多表 JOIN 的中间结果很容易比输入大一个量级。第二,交互式分析是反复查询——你在 UI 里改一版 SQL、看一眼、再改一版,同一个中间结果会被重算几十次。这时候"视图省"的直觉就反过来了:省的是磁盘,费的是每次查询的时间。
2.2 CREATE PERFETTO TABLE:官方明说更快更省
PerfettoSQL 相对 SQLite 的一大扩展,就是能建"面向分析的"表。官方 PerfettoSQL 语法 对它的定性非常直接:CREATE PERFETTO TABLE 定义的表,比用 SQLite 原生 CREATE TABLE 建的表既更快(more performant)也更省内存(more memory efficient)。原因是存储形态不同——Perfetto 表是列式存储(columnar storage),分析型查询只读需要的列,而传统行存要按行搬运。
同时官方也把限制写清楚了,这两条必须记住:
- Perfetto 表创建后是只读的,不能
INSERT,不能改; - 它必须由
SELECT定义并填充,不能只声明列名与类型。
-------------------------------------【物化:把重活落成一张表】-----------------------------------
-- 描述:CREATE PERFETTO TABLE 建的是列存分析表,连接与过滤在定义时只做一次
-- 依据:perfetto.dev/docs/analysis/perfetto-sql-syntax 的 Creating efficient tables
------------------------------------------------------------------------------------------------
CREATE PERFETTO TABLE long_slices AS                      --【1】必须用 SELECT 定义并填充
SELECT s.id, s.ts, s.dur, s.name, s.track_id,
       t.name AS thread_name
FROM slice AS s
JOIN thread_track AS tt ON s.track_id = tt.id             --【2】重活在定义时干一次
JOIN thread AS t USING (utid)
WHERE s.dur > 1000000;                                    --【3】过滤同时生效,落下来就是小表

SELECT * FROM long_slices
WHERE thread_name = 'RenderThread'                         --【4】后续查询只读列存,不再重算连接
LIMIT 20;
【1】与【2】各管一头。 【1】这条限制看似啰嗦,其实是个保护:它逼你把"数据从哪来"写清楚。【2】才是本章的落点——那两行 JOIN 是这份查询里唯一的重活,物化之后只发生一次;你在 UI 里再改十版 WHERE,引擎都不必重做那两次连接。
这张对照图其实只想说五个字:"重活只做一次"。 判断要不要物化,问一个很朴素的问题就够了:这份中间结果,我接下来还会查几次? 只查一次,留在视图里就好;要反复查、或者它前面挂着昂贵的多表连接,那就该落表。第七章的处方矩阵会把这条判据写成一个具体动作。
2.3 CREATE PERFETTO INDEX:适用面、内存代价与两条禁令
言归正传,接着看索引。 机制很好理解:官方在语法页里说,CREATE PERFETTO INDEX 建索引时,Perfetto 会把被索引的列在内部维护成有序(sorted order),于是等值过滤、范围过滤、连接这些"需要排序能力"的操作就能走二分查找而不是线性扫描。官方给的对照很直观:同一句 WHERE track_id = 10 AND name > "b",裸表要线性扫整列,带索引的表可以二分查找;而差异最大的是连接。
但官方的三条 NOTE 比优点更值得背下来:
| 官方提示 | 含义 | 你该怎么做 |
|---|---|---|
| 索引有不可忽略的内存代价 | 索引本身是额外的一份结构,要占内存 | 只在确实有性能收益时才建,用完可以 DROP |
| 索引不会被子表继承 | 在带索引的表上建视图能用索引,但基于它再建的表用不上 | 别指望"父表建了索引、子表自动受益" |
过滤或连接 id 列无需索引 |
id 是主键,Perfetto 表对它已有专门优化 |
见到 id/slice_id 这类列,不要多此一举 |
-------------------------------------【索引:只在该加的时候加】-----------------------------------
-- 描述:建索引让过滤与连接走二分;同时演示复合索引的"等值优先"规则与显式删除
-- 依据:perfetto.dev/docs/analysis/perfetto-sql-syntax 的 Index 小节
------------------------------------------------------------------------------------------------
CREATE PERFETTO TABLE sl AS SELECT * FROM slice;                    --【1】先物化成表,视图上建不了索引

CREATE PERFETTO INDEX sl_track ON sl(track_id);                     --【2】单列索引
CREATE OR REPLACE PERFETTO INDEX sl_track_name ON sl(track_id, name);  --【3】复合索引:等值列在前

SELECT * FROM sl WHERE track_id = 10 AND name > 'b';                --【4】两列都能受益(有等值约束)
SELECT * FROM slice WHERE track_id = 10 AND name > 'b';             --【5】对照:裸表只能线性扫描

DROP PERFETTO INDEX sl_track ON sl;                                 --【6】不用就删,别白占内存
这两处要看的东西不一样。 【3】的顺序不是随便排的:官方明确说,复合索引 (track_id, name) 对 name 的操作只有在同时存在 track_id 等值约束时才可用——把复合索引写成 (name, track_id),那句"先按 track_id 等值、再按 name 比大小"的查询就白建了,这跟传统数据库的"最左前缀"是一个道理。【5】是对照组:差别不在"哪张表",而在"这张表有没有被索引"。
2.4 增量物化:不是"建完就一劳永逸"
下面我们进入物化的第二层,也是官方设计文档里最有意思的一层。 你可能担心:物化一次就把数据钉死了,换个过滤条件怎么办?答案是——PerfettoSQL 的物化不是"快照式"的,官方 Data Explorer 架构 描述的核心机制是查询链(query chains)与按需计算(lazy computation):引擎把一连串查询组织成依赖链,只在真正需要结果时才计算,并复用链条上已算出的中间结果。
这套机制带来一个反直觉但非常有用的结论:"增量物化"和"重物化"是两个不同的动作,触发条件也不同。
- 增量物化:当上游依赖变了、而下游查询仍然成立时,只重算受影响的那一段,链上其他结果继续复用;
- 重物化:当表定义本身变了(你改了
CREATE PERFETTO TABLE的SELECT),整张表需要重新构建。
这张数据流图的价值在于解释一个常见困惑:为什么我改了外层的 WHERE,整体耗时几乎没变。 因为你改的那一层在链的下游,上游的重活(连接、物化)被复用了。好消息是下游改动便宜;提醒是真正的优化要动链条上游,在下游反复改条件,属于"在伤口上贴创可贴"。
2.5 物化决策:三个问题定方案
把这一章收成一张可查的表。三种形态——纯视图、物化表、物化表加索引——各有明确的适用面:
| 形态 | 什么场景用 | 代价 | 什么时候换成别的 |
|---|---|---|---|
纯视图(CREATE VIEW / CREATE PERFETTO VIEW) |
中间结果只查一两次;定义简单、不含大表连接 | 每次查询重算定义 | 同一视图被反复查、或定义里有昂贵 JOIN |
物化表(CREATE PERFETTO TABLE) |
中间结果要反复查;定义里有多表连接或重过滤 | 一次性建设 + 存储占用 | 上游表会频繁变化、且下游只查一次 |
物化表 + 索引(CREATE PERFETTO INDEX) |
物化表上还要按非 id 列做等值/范围过滤或连接 |
建设成本 + 索引的额外内存 | 该列被删掉、或查询模式变了 |
注意表里最后一行的"换成别的"那一格。 它提醒的是:索引不是一次性投资,而是跟查询模式绑定的——查询从"按 track 过滤"改成"按 name 前缀过滤",那个 (track_id, name) 索引就只剩一半用处,留着只会白占内存。能删的索引就该删,这就是官方那条"内存代价"警告的实操含义;第五章第二组自跑对照还会给这条结论一个更硬的注脚:一句等值加范围过滤只跑一次,在只有两万行的表上建索引,耗时反而从 4 ms 涨到 7 ms——索引值不值,取决于这个查询模式会不会被重复。
三、别重写标准库:slices.* 家族早替你想过了
下面我们进入本篇最省时间的一章。 前两章讲"怎么自己写对写快",这一章讲"大部分你打算自己写的东西,官方已经写好了"。官方 PerfettoSQL 标准库 是一份由领域专家贡献的表、视图、函数与宏的集合,灵感来自编程语言的标准库,目标很清楚:不必复制粘贴大段 SQL,并把低层概念(切片、轨道)抬升到开发者熟悉的概念(启动、binder 事务)上。
3.1 INCLUDE PERFETTO MODULE 的语义:像 #include,不像 import
引入方式只有一条语句:INCLUDE PERFETTO MODULE 模块名。官方在语法页里特意用了一句话点明它的行为——它更接近 C++ 的 #include,而不是 Java/Python 的 import:模块里的所有对象直接进入全局命名空间,不带模块名限定。
这句话有两个直接后果:
- 优点是写起来短——引入
slices.with_context之后,你可以直接SELECT ... FROM thread_slice,不必写slices.with_context.thread_slice; - 代价是可能撞名——你自己建的表如果和标准库里的对象重名,会覆盖或者互相当成对方,报错信息往往很难读。
-------------------------------------【引入标准库:on-demand 加载,不是全量载入】---------------------
-- 描述:模块按需引入;交互式开发可用通配符,但标准库内不允许通配符
-- 依据:perfetto.dev/docs/analysis/perfetto-sql-syntax 与 stdlib-docs
------------------------------------------------------------------------------------------------
INCLUDE PERFETTO MODULE slices.with_context;      --【1】切片 + 线程/进程上下文,最常用的一支
INCLUDE PERFETTO MODULE slices.self_dur;          --【2】自耗时长(扣除子切片)
INCLUDE PERFETTO MODULE slices.hierarchy;         --【3】层级相关的表与视图
INCLUDE PERFETTO MODULE time.conversion;          --【4】单位换算

SELECT ts, dur, name, thread_name, process_name    --【5】引入后对象在全局命名空间,直接用
FROM thread_slice
WHERE name = 'measure'
LIMIT 10;
【1】与【5】各有一层意思。 【1】之所以最常用,是因为它解决了切片查询里最高频的问题——"这条切片属于哪个线程、哪个进程",官方把它做成了预连接好的视图,不必再手写三次 JOIN。【5】体现的正是"全局命名空间":thread_slice 就是视图本身的名字。官方对通配符(INCLUDE PERFETTO MODULE android.*)的态度也值得记一笔:交互式探索允许用,标准库内部不允许——标准库要保持依赖显式。
还要补一句:模块是按需加载的,不是把整份标准库塞进内存。 官方标准库按域分了二十多个模块目录,从 slices/、sched/ 到 android/、viz/,在 stdlib 源码目录 里一眼就能看到这个划分——需要哪一支引哪一支。
3.2 slices.* 家族:五个成员,各管一件事
先来看看家族成员。 slices/ 目录下的几个模块不是"同一件事的多种写法",而是五个不同的分析问题各自的标准答案:
| 模块 | 它解决的原始问题 | 手工做要写什么 | 你直接拿到什么 |
|---|---|---|---|
slices.with_context |
这条切片属于哪个线程/进程? | 三次 JOIN:slice → thread_track → thread → process |
thread_slice / process_slice / thread_or_process_slice |
slices.flat_slices |
嵌套切片怎么拉平、切片与线程怎么摊平? | 自己处理 depth/parent_id 的递归与展开 |
扁平化后的切片视图 |
slices.hierarchy |
父子关系怎么稳定地查? | 手写 parent_id 递归、处理 -1 与空值 |
层级相关的表与函数 |
slices.self_dur |
这个函数自己花了多少时间(不含子调用)? | 从 dur 里减去子切片时长,还要处理重叠与未结束 |
自耗时长的现成计算 |
slices.cpu_time |
这段切片实际占了多少 CPU 时间? | 与 sched 做区间相交、处理跨核与抢占 |
切片粒度的 CPU 时间 |
这张表里真正值得盯的是"手工做要写什么"那一列:这几件事没有一件是"写一行 JOIN 就完事"的——self_dur 要处理子切片重叠、cpu_time 要与调度表做区间相交、hierarchy 要处理 dur = -1 的边界。官方把这些坑踩过并封成了模块。
3.3 用源码为证:官方那几段 JOIN 到底写对了什么
下面我们走到最硬的一层证据:源码。 说"官方已经写对了",最有力的证明不是文档里那句推荐,而是它的 stdlib/slices 目录 里那几个文件本身:
with_context.sql——thread_slice与process_slice的 JOIN 写法,是你手写三次JOIN的官方版本,条件与列选择都被官方回归测试覆盖过。flat_slices.sql—— 扁平化的官方口径:何时按depth展开、展开后id与parent_id怎么处理。hierarchy.sql—— 层级关系的标准处理,含手写递归最容易漏掉的"无父"与"未结束"分支。self_dur.sql—— 自耗时长计算。这一个文件顶得上一篇小品文:它要处理子切片重叠造成的重复扣减。cpu_time.sql—— 切片与调度表的区间换算,也就是"墙钟时间"到"CPU 时间"的转换。
为什么"官方写的"这三个字有分量? 因为这个仓库的测试是有回归基线的——test/trace_processor 目录下是海量 .sql 输入与 .out 期望输出对照(官方 测试约定 讲得很细)。标准库里的每一段 SQL 都跑在这套基线上,写错就会在 CI 里炸出来;而你手写的那段没有这层保护——它只跑在你手上那份 trace 上,跑对一次不等于对。
3.4 官方视图 vs 手写 JOIN:一张对照表
言归正传,把"该不该自己写"变成可判断的标准。 下面这张表的左边是"手动 JOIN"路线,右边是"标准库视图"路线,中间那一列是决策依据:
| 维度 | 手写 JOIN | 标准库视图 | 怎么选 |
|---|---|---|---|
| 代码量 | 三次 JOIN 加列选择,通常几十行 | 一行 INCLUDE 加一次查询 |
除非要标准库没暴露的列,否则用标准库 |
| JOIN 条件正确性 | 全靠自己核对 | 由官方维护并被回归测试覆盖 | 有疑虑时先读标准库源码,再决定 |
| 性能 | 取决于你的写法,下推成没成功要看计划 | 官方写法已考虑过滤顺序 | 手写版务必对照第四章的 filter early |
| 可维护性 | trace 结构或表名变化时要自己跟进 | 跟随版本更新 | 长期脚本用标准库 |
重点在最后一行。 如果你还在想"我自己写一遍也就十分钟",请记住:你的 SQL 一旦变成团队固定脚本或进了 CI 做回归,它就不再是"一次性十分钟",而是一份要跟着 Perfetto 版本走的资产。 用标准库,就是把这份维护成本转给上游。
3.5 这一屏就是你的工作台
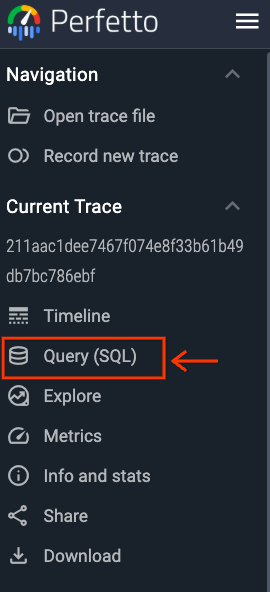
最后把镜头拉回界面。 前面讲的 INCLUDE、物化、索引,落到日常操作上就是官方查询界面的那一屏:左边是 SQL 编辑器与查询历史,右边是结果表。入口在 Perfetto UI 顶部的 Query (SQL) 标签页,写完按 Ctrl + Enter 执行。
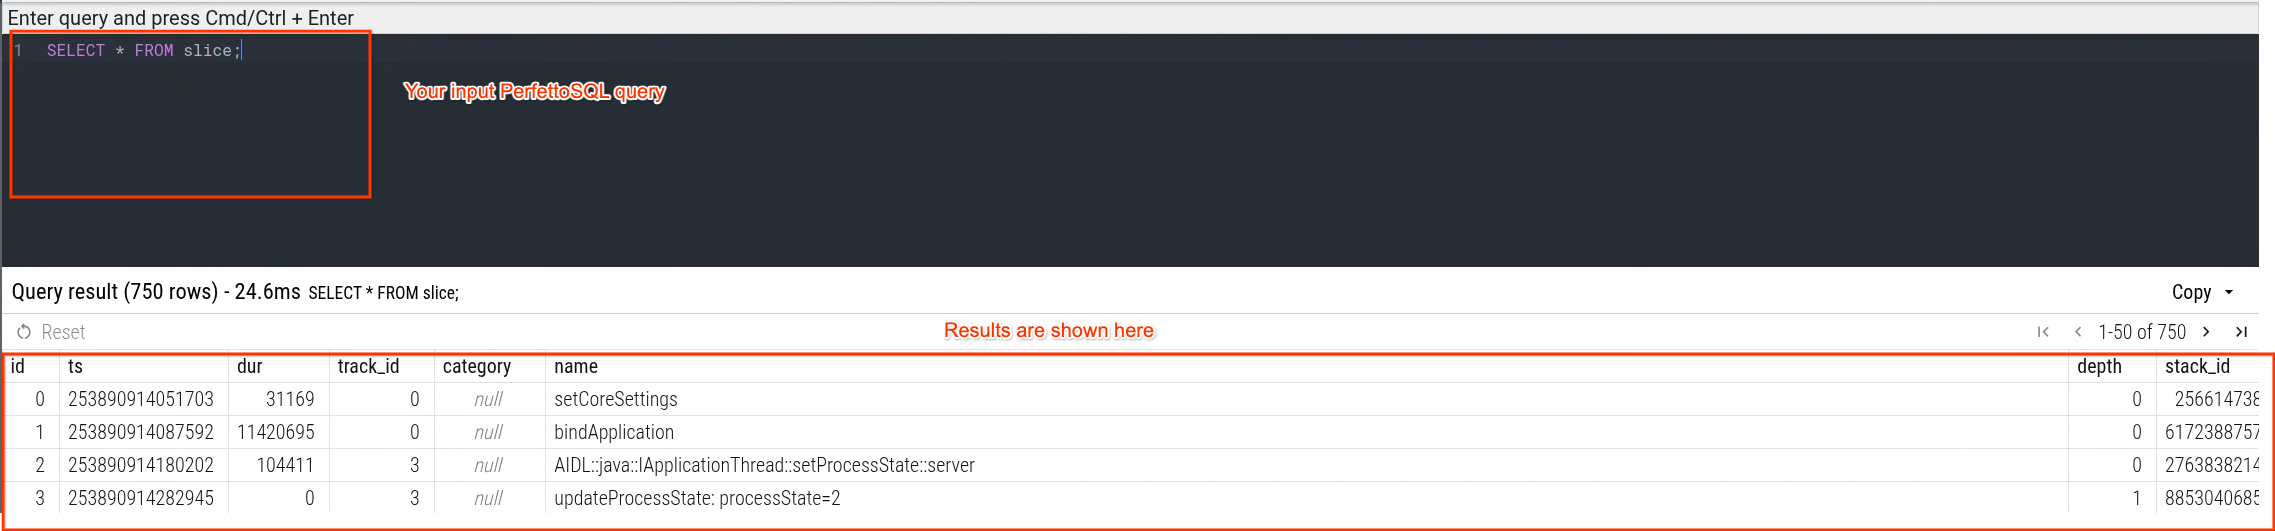
这一屏有个习惯值得养成:把查询历史当资产看。 官方文档特意提到这个界面会保留查询历史——试出那条"既对又快"的语句时,别再靠记忆复现它,直接抄进文件;第六章会讲怎么把它变成一条可重放的命令。
这一章也到站了。 工具箱里应该有三件东西:一个 INCLUDE PERFETTO MODULE 的入口、一份 slices.* 家族的分工表、一条"先读官方源码再决定要不要自己写"的习惯。下一章我们换个方向,去看那些"写法完全合法、位置一挪就可能换口径、也可能换量级"的地方。
四、过滤下推与连接语义:差的是口径还是量级
下面我们开始讲本篇最"有手感"的一章。 前三章讲的是对与错,这一章讲的是两种写法都合法、位置一挪就不一样的地方。但先别急着给它贴价签:有些位置差的是口径,有些位置差的才是量级——而哪一种,只能由计划告诉你。这类差别最讨厌的地方在于:语法检查过、结果有时还长得一模一样,你完全没有理由怀疑它——直到某天 trace 变大十倍,或者某天你发现两份报表明明问的是同一个问题,数字却对不上。
4.1 filter early:官方最佳实践的第一条
官方在 PerfettoSQL 入门 的 Best Practices 里专门列了一条 filter early(尽早过滤),原话是"总是把 WHERE 子句——尤其是对 name 的过滤——放在尽可能早的位置,这样 trace processor 就能跳过不会出现在结果里的行"。注意措辞:它说的是"跳过扫描",也就是让扫描行数下降,这是引擎层面唯一真正有效的优化方向。
但官方给的是建议,不是保证。 官方说的是让引擎跳过扫描,而跳过没跳过、下推成没成功,必须看计划——这句话是本节与 4.2 节的接口。先把几组对照的结果摆出来(同一份 30 秒官方示例 trace):
| 对照 | 结果 |
|---|---|
平面三表连接封进视图,WHERE 在视图外 vs 在视图内 |
EXPLAIN 输出逐条相同(均 27 条指令),耗时均 0 ms,两侧结果一致 |
封装内含 ORDER BY … LIMIT,WHERE 在外 vs 在内 |
计划 54 条 vs 40 条,耗时 14 ms vs 0 ms,结果行数 627 vs 656 |
| 普通视图 vs 物化表(第五章自跑) | 两版汇总值完全一致,视图 13 ms、落表 7 ms |
| 建索引前 vs 建索引后(第五章自跑) | 无索引 4 ms vs 建索引后 7 ms,两侧都是同一批 703 行 |
第一行与第二行的差别,就是本节的全部内容。 第一行说明:把中间结果封进视图,并不自动等于"先算全量再筛"——普通 CREATE VIEW 会被计划器展平,外层 WHERE 照样被下推,两版计划逐条相同:你以为的差别,计划说没有。 第二行说明:一旦封装里含 ORDER BY … LIMIT,位置就真的开始起作用了——LIMIT 会在过滤之前先截断:外侧写法筛的是"时长 top 5000 里名字命中的 627 条",内侧写法给的是"名字命中的 top 5000 = 656 条"。这是口径差异,不只是性能差异。
那"早"到底该到哪一层?关键分野在这里:
- 在一条扁平查询里,
WHERE写在JOIN之前还是之后语义等价,优化器通常也能自行把它推下去——这一层不必纠结; - 一旦你把中间结果封进子查询、视图或 CTE,
WHERE的位置就开始有后果,但后果分两种:平面连接这类写法,两版计划逐条相同——下推成功,白操心;含ORDER BY … LIMIT的封装,位置会连结果一起改掉。是哪一种,只能看计划。
-------------------------------------【过滤下推对照:写在外层 vs 写在内层】--------------------------
-- 描述:四版写法成组对照,用来验证位置会不会改变计划与结果
-- 依据:perfetto.dev/docs/analysis/perfetto-sql-getting-started 的 Best Practices
------------------------------------------------------------------------------------------------
-- 版本 A:平面三表连接封进视图,过滤写在最外层
CREATE VIEW v_all_slices AS                               --【1】视图的定义里没有任何过滤
SELECT s.ts, s.dur, s.name, t.name AS thread_name
FROM slice AS s
JOIN thread_track AS tt ON s.track_id = tt.id
JOIN thread AS t USING (utid);

SELECT * FROM v_all_slices
WHERE thread_name = 'RenderThread'                        --【2】外侧写法:与内层写法的计划逐条相同
  AND dur > 1000000;

-- 版本 B:同一个封装,过滤封进内层
CREATE VIEW v_long_thread_slices AS
SELECT s.ts, s.dur, s.name, t.name AS thread_name
FROM slice AS s
JOIN thread_track AS tt ON s.track_id = tt.id
JOIN thread AS t USING (utid)
WHERE t.name = 'RenderThread'                             --【3】线程名先收窄
  AND s.dur > 1000000;                                    --【4】时长再收窄,两处都在封装内

SELECT * FROM v_long_thread_slices LIMIT 20;

-- 版本 C:封装里多了 ORDER BY … LIMIT,位置才真的开始起作用
CREATE VIEW v_top_slices AS
SELECT s.dur, s.name, t.name AS thread_name
FROM slice AS s
JOIN thread_track AS tt ON s.track_id = tt.id
JOIN thread AS t USING (utid)
ORDER BY s.dur DESC LIMIT 5000;                           --【5】先截断时长 top 5000,再交给外层筛

SELECT * FROM v_top_slices
WHERE thread_name = 'RenderThread';                       --【6】外侧写法:627 行、14 ms

-- 版本 D:把过滤也收进封装,让它在截断之前生效
CREATE VIEW v_top_thread_slices AS
SELECT s.dur, s.name, t.name AS thread_name
FROM slice AS s
JOIN thread_track AS tt ON s.track_id = tt.id
JOIN thread AS t USING (utid)
WHERE t.name = 'RenderThread'                             --【7】过滤先于排序截断
ORDER BY s.dur DESC LIMIT 5000;

SELECT * FROM v_top_thread_slices;                        --【8】内侧写法:656 行、0 ms
下面对【2】与【6】特别说明。 【2】是本节最容易搞错的一条:那句 WHERE 语法完全正确,读起来也符合直觉——"先备好数据,再筛出我要的"。把它和【3】【4】的版本一起送进 EXPLAIN 会发现:两版计划逐条相同,耗时也都在 0 ms 这一档。普通视图被计划器展平了,外层过滤照样下推,你担心的"先物化一遍全量结果"并没有发生。【6】才是位置真正生效的地方:ORDER BY … LIMIT 是个"必须先算出结果才能截断"的算子,它把过滤挡在了后面,于是外侧与内侧两版变成 54 条计划对 40 条、14 ms 对 0 ms,结果行数也从 627 变成 656——外侧筛的是"时长 top 5000 里名字命中的那一部分",内侧给的是"名字命中的 top 5000"。同一个业务问题,两种口径;而这件事,只有计划会告诉你。
上面这张对照图里的"封装边界"仍是本节的题眼,但它标记的不再是"谁扫得多",而是"计划会不会被改写":你每建一层视图、每写一个 CTE,就等于划一条边界;WHERE 落在边界的哪一侧会不会有后果,取决于封装里有没有排序、截断这类不可交换的算子。 边界在扁平连接上形同虚设(两版计划逐条相同),在带 LIMIT 的封装上却是分水岭(口径与耗时一起变)——所以本章给出的动作是"写完去看计划",别指望"永远往内层写"这条口诀。
4.2 看计划,而不是猜计划
光讲道理不够,我们得能看见。 位置挪一下到底差多少,有两类证据可以拿:一是查询计划(query plan),二是真实耗时。前者用 EXPLAIN 拿到,后者只能本机实测。
先看计划。EXPLAIN 会把引擎准备怎么执行这条语句吐出来——扫描顺序、用了哪张表、有没有走索引:
-------------------------------------【看计划:EXPLAIN 输出】-------------------------------------
-- 描述:四版写法各看一次计划,让引擎自己说出扫描顺序与算子
-- 用法:在 Perfetto UI 的 Query 标签页或 trace_processor 的交互式 shell 里执行
------------------------------------------------------------------------------------------------
EXPLAIN
SELECT * FROM v_all_slices
WHERE thread_name = 'RenderThread' AND dur > 1000000;     --【1】平面连接的外侧写法:27 条指令

EXPLAIN
SELECT * FROM v_long_thread_slices;                       --【2】同一封装的内侧写法:也是 27 条

EXPLAIN
SELECT * FROM slice WHERE track_id = 10 AND name > 'b';   --【3】对照:无索引,线性扫描

EXPLAIN
SELECT * FROM v_top_slices
WHERE thread_name = 'RenderThread';                       --【4】含 LIMIT 的封装,外侧写法:54 条

EXPLAIN
SELECT * FROM v_top_thread_slices;                        --【5】同一封装改成内侧:40 条
看【1】与【3】,重点不在同一个地方。 看计划不要只看"有没有用索引",更要看两版之间的差别。【1】与【2】这一对,EXPLAIN 的输出逐条相同、各 27 条指令——你以为的差别,计划说没有:普通视图被展平,外层过滤照样下推。真正拉开差距的是【4】与【5】这一对,带 ORDER BY … LIMIT 的封装,外侧 54 条、内侧 40 条——外侧多出来的正是 InitCoroutine 与 OpenEphemeral 这一对排序物化指令,它们就是"过滤被挡在截断之后"在计划里的样子。【3】正好和第二章的索引小节对上:同一句查询换到带索引的物化表上,扫描方式就变了。计划是唯一不需要相信任何人的证据。
再看耗时。性能主张不能靠转述,只能靠自己跑。 本节末尾给出的是本机实测对照——同一份官方示例 trace、同一台机器,只改过滤位置:
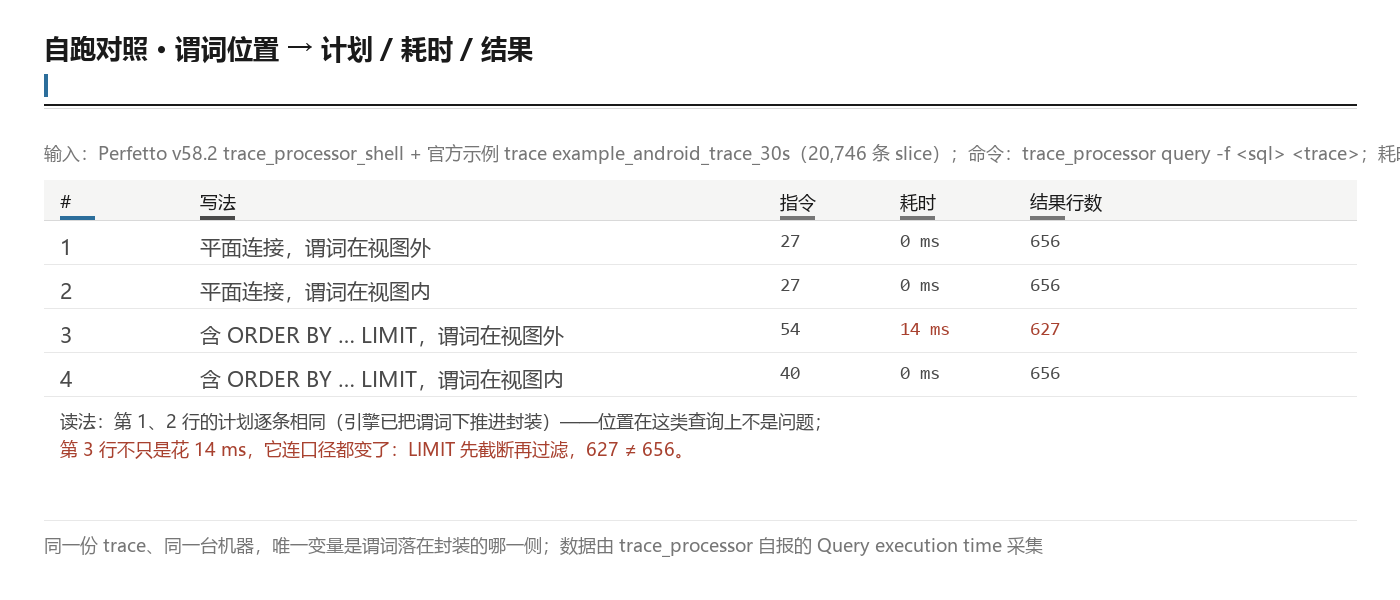
上面一张是耗时与结果的对照,下面一张是同一批查询的查询计划:前者回答"位置一挪到底有没有代价、代价是落在耗时上还是落在结果上",后者回答"引擎那边到底发生了什么"——两张图合起来,才算一份完整的证据。
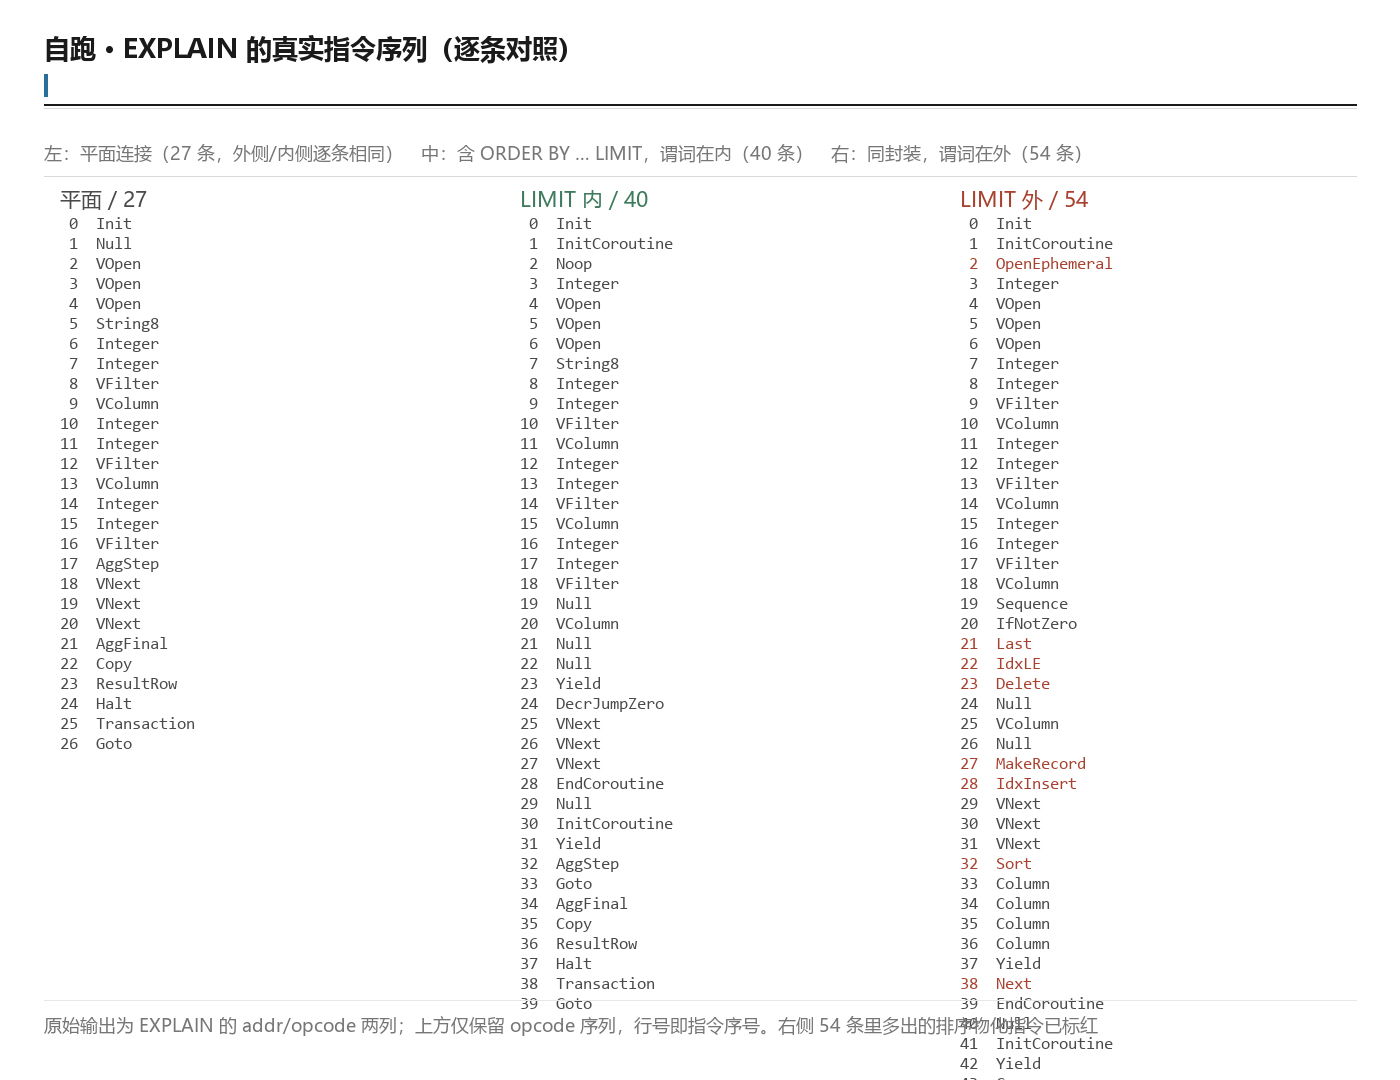
这两张实测图放在一起看才完整。 计划图回答"引擎打算怎么干",耗时图回答"这么干花了多少"。你手上有 trace 的话,完全可以按 4.1 的四版 SQL 复刻一遍——实验的输入、命令与口径本篇都给全,唯一的变量是你那份 trace 的规模:官方示例 trace 证明的是"这事成立",你的 trace 证明的是"它对你有多重要"。
4.3 SPAN_JOIN:区间连接的语义与那条静默的坑
言归正传,接着看连接。 普通 JOIN 按列的等值关系连接,而 trace 里大量问题是按时间区间连接——"这段切片落在哪个调度区间里""这个函数执行时 CPU 频率是多少"。官方为此提供一组区间连接操作表:SPAN_JOIN(内连接)、SPAN_LEFT_JOIN(左连接)、SPAN_OUTER_JOIN(外连接)。它们的输入必须含 ts 与 dur 两列——这也是第一节要你把 dur 三态搞清楚的原因:-1 会破坏区间语义。
用法是这样的:先把两侧整理成"带 ts/dur 的区间表",再用 SPAN_JOIN 声明成一张虚拟表:
-------------------------------------【区间连接:把频率贴到调度切片上】-----------------------------
-- 描述:SPAN_JOIN 按时间区间求交;分区列用 PARTITIONED 声明,两侧同名才能对上
-- 依据:perfetto.dev/docs/analysis/perfetto-sql-getting-started 的 Operator tables
------------------------------------------------------------------------------------------------
-- 左侧:调度切片(天然带 ts/dur)
CREATE VIEW sp_sched AS
SELECT ts, dur, cpu, utid FROM sched;                      --【1】sched 本身就是区间表

-- 右侧:频率计数器不是区间表,要先用窗口函数造出 dur
CREATE VIEW sp_frequency AS
SELECT ts,
       lead(ts) OVER (PARTITION BY track_id ORDER BY ts) - ts AS dur,  --【2】PARTITION BY 是窗口分区
       cpu,
       value AS freq
FROM counter
JOIN cpu_counter_track ON counter.track_id = cpu_counter_track.id
WHERE cpu_counter_track.name = 'cpufreq';

-- 声明区间连接:两侧都按 cpu 分区
CREATE VIRTUAL TABLE sched_with_frequency
USING SPAN_JOIN(sp_sched PARTITIONED cpu,
                sp_frequency PARTITIONED cpu);             --【3】PARTITIONED 才是区间连接的分区

SELECT ts, dur, cpu, utid, freq FROM sched_with_frequency LIMIT 20;  --【4】结果同时含两侧的列
两处都写"分区",说的却是两码事:【2】的 PARTITION BY track_id 是窗口函数分区,决定"上一条记录找谁";【3】的 PARTITIONED cpu 是区间连接分区,决定"哪两条区间允许相交"——只有同分区的区间才会去求交。官方对分区的要求很硬:分区列必须是整数;分区键是线程名这类字符串时,得先用 HASH 转成整数。
4.4 静默多算:区间连接最危险的一条规则
下面我们进入这一章最该背下来的一条。 官方在区间连接的说明里给了一条警告,措辞比一般的 NOTE 重得多:同一张表在同一分区内的区间不允许重叠;而为了性能,区间连接不会去检测并报错——它只会静默地产生错误的行。
把这句话翻译成工程语言:如果你喂进去的区间表本身有重叠(或者含有 dur = -1 的未结束区间),SPAN_JOIN 不会告诉你,它会给你一份看起来很正常、但数值全部偏大的结果。 这是本篇里第二个"性能与正确性是同一件事"的坐标——第一个是第五章的笛卡尔积。
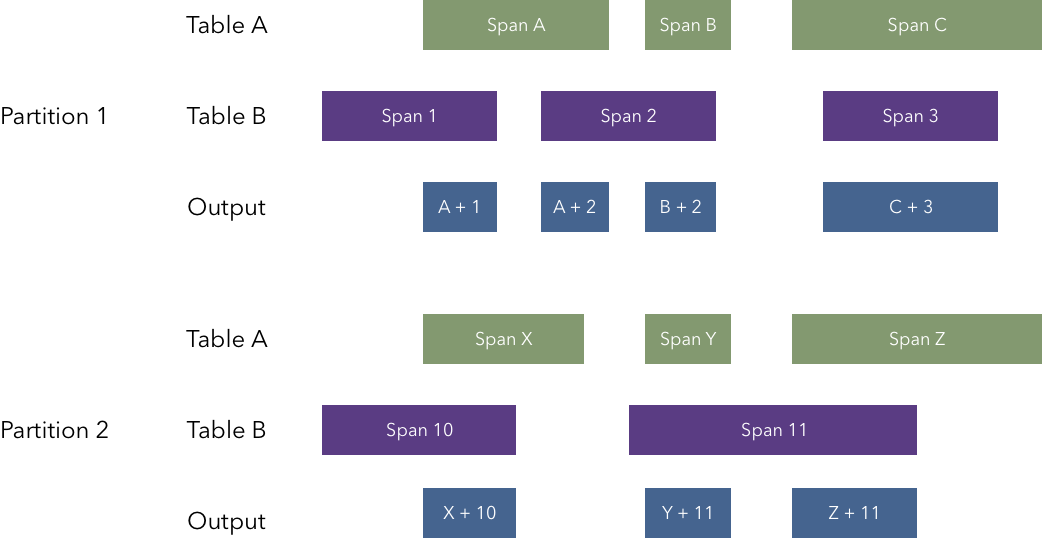
同一条说明里还有两个容易被忽略的细节,也一并记下:
- 一侧为空的边界(要看分区加在哪一侧):官方 NOTE 说的"不会产生任何行",只在只对一侧声明
PARTITIONED时成立——两侧都分区(SPAN_LEFT_JOIN(n PARTITIONED cpu, e PARTITIONED cpu),e为空)会输出 1 行:保留另一侧、右列填NULL;单侧分区(SPAN_LEFT_JOIN(n3, e4 PARTITIONED cpu),e4为空)才是 0 行。同一个SPAN_LEFT_JOIN,分区声明的位置不同,空侧的行为就不同——读那条 NOTE 时要连着"分区声明在哪一侧"一起读,别当成无条件结论; - 分区可以只加在一侧:官方允许"两侧都分区、只一侧分区、两侧都不分区"三种形态;两侧都分区时,列名必须一致。
第四章到此。 三条纪律应该已经拿到手:位置先看计划,别照习惯挪、分清改的是口径还是代价,再下结论、区间连接前先确认没有重叠与 -1。这三条不需要你更聪明,只需要写完 SQL 后多问一句"引擎到底打算怎么干"。
五、长 trace 上的内存与时间
下面我们进入"长大之后怎么办"这一章。 前面四章都在单份 trace 的尺度内讨论,这一章换两个尺度:一份大到让浏览器标签页喘不过气的 trace,以及一批要批处理的 trace 集合。先说结论:这两件事的瓶颈完全不在同一个地方——前者的瓶颈是单进程内存,后者的瓶颈是并发条数。
5.1 内存公式:2 × S × N
官方在 Batch Trace Processor 的记忆占用小节里给了一个非常好用的经验公式:若平均每份 trace 的大小是 S、你要同时加载 N 份,那么内存占用约为 2 × S × N。 官方同时说明了这个数字为什么这么"整"——每份 trace 完整地驻留在内存里,这正是它能在成百上千份 trace 上做到"交互式查询(<1 秒)"的原因:用内存换掉了磁盘随机读。
这个公式最大的价值,是把"能不能跑"变成一个可预算的问题:若 S = 200 MB、N = 8,按公式就是 2 × 200 MB × 8 ≈ 3.2 GB——还没算索引与中间结果。这解释了为什么批处理的条数上限是硬的:官方自己也提醒"加载太多 trace 会导致内存不足"。
把这张图贴进批处理脚本的注释里,是个好习惯。 每次调并发参数前先按它估一遍,比跑起来被 OOM 打断要便宜得多。注意公式里的 2 × 不是保守估计而是经验值——官方说"这会因 trace 内容与大小的不同而显著变化",所以把它当量级参考,不当承诺。
5.2 单份大 trace:GB 级该换路线
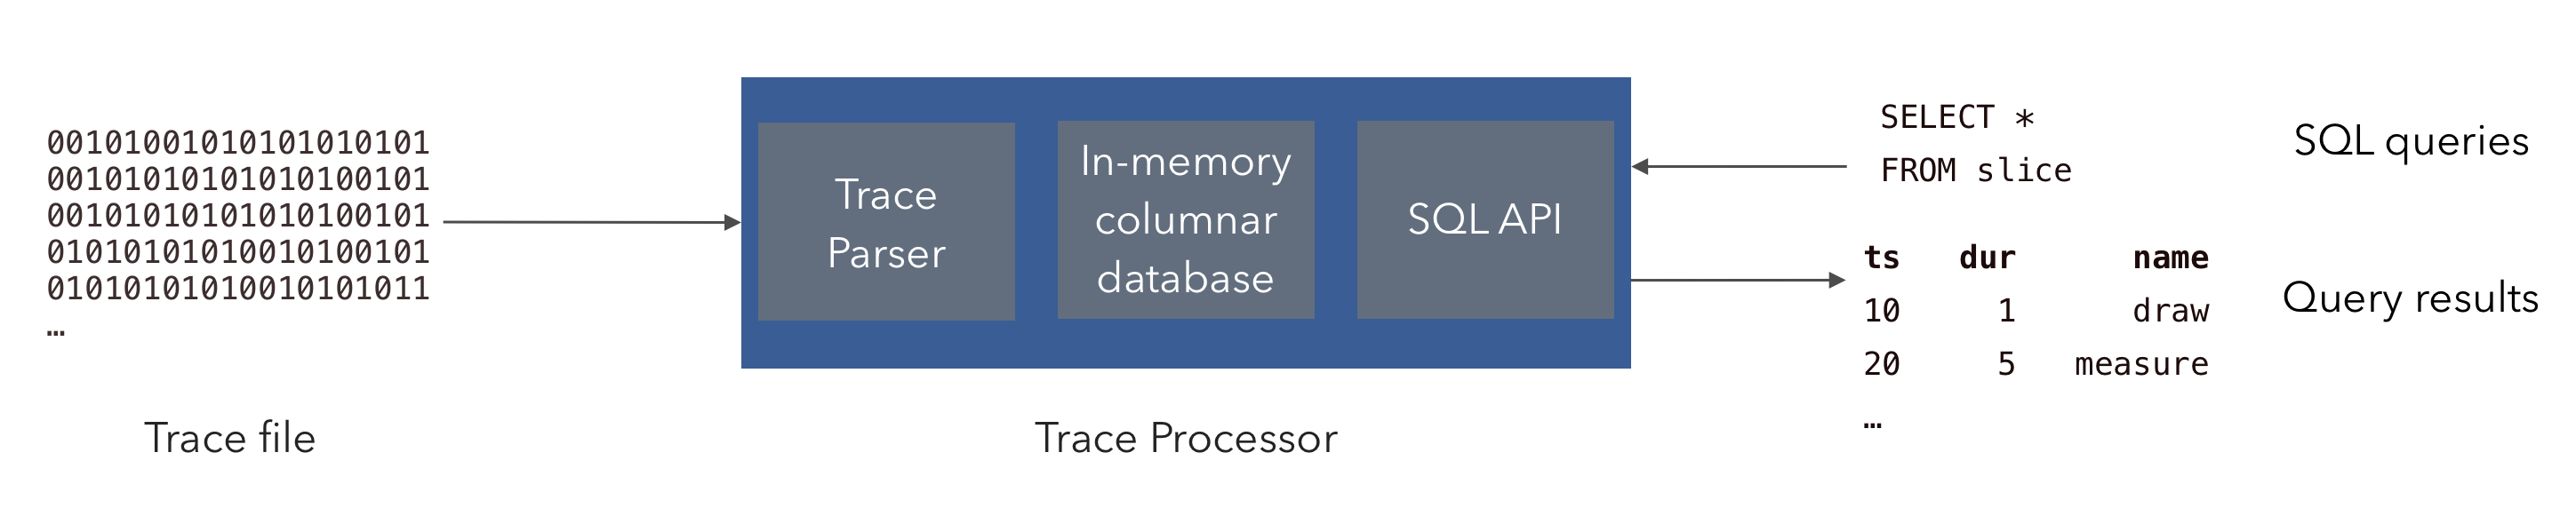
批处理是"多份小 trace"的问题,单份大 trace 是另一个极端。官方在 大型 trace 可视化 里给出的实践路线很明确:当 trace 到了 GB 级(超过 2 GB 这个量级),浏览器内嵌的 WASM 解析会先撞上内存天花板,此时应该改用原生 trace_processor 进程来解析,让 UI 通过 RPC 把查询卸给它。
这就是 CLI 里 server 模式存在的理由——它把 trace 解析搬到一个独立进程里,界面只负责显示结果:
# ---------------------------------【原生 server:让大 trace 离开浏览器】---------------------------
# 描述:把解析搬到本地原生进程,UI 通过 RPC 复用这份已解析的会话
# 依据:perfetto.dev/docs/reference/trace-processor-cli 的 server 子命令
# ------------------------------------------------------------------------------------------------
trace_processor server http trace.pftrace                                  #【1】HTTP 模式,默认 9001
trace_processor server unix --name big --daemonize trace.pftrace           #【2】命名会话后台常驻(仅 POSIX)
trace_processor query --remote big "SELECT count() FROM slice"             #【3】复用热会话查询
trace_processor server kill big                                            #【4】用完清掉会话
【2】与【3】这两个坑不一样。 【2】的 --daemonize 让会话在后台常驻,好处是解析只做一次——2 GB 以上的 trace,解析常是整条链路上最贵的一步;但要先看一眼平台:--daemonize 仅 POSIX 可用,Windows 版会直接回你一句"这个平台还不支持",此时改用另开一个终端让会话前台常驻,或改走【1】的 server http(【4】的 server kill <name> 不受影响,各平台都能用)。【3】的 --remote 让后续查询接到这个热会话上,不必每次重新加载 trace。这套"常驻会话 + 远程查询"是长 trace 上唯一称得上"提速"的手段,其余都是在省扫描行数。
5.3 用 -m 让工具剖析自己
下面我们进入定位手段这一节。 当一条查询就是慢,你想知道慢在哪一步,最直接的办法是让 trace_processor 追踪它自己。CLI 里提供了 -m(--metatrace)参数:它会产出一份追踪 trace_processor 自身的 Perfetto trace,官方对它的描述是"你可以把它加载回 UI 做性能调试"。
# ---------------------------------【元追踪:让 TP 剖析它自己】-----------------------------------
# 描述:-m 产出一份"trace_processor 自己的 trace",直接拖进 UI 看算子耗时
# 依据:perfetto.dev/docs/reference/trace-processor-cli 的 Global flags
# ------------------------------------------------------------------------------------------------
trace_processor -m tp_self.pftrace -Q "SELECT count() FROM slice" trace.pftrace     #【1】边跑边记
trace_processor -m tp_self.pftrace --metatrace-buffer-capacity 65536 trace.pftrace  #【2】加大缓冲
【1】值得单独拎出来看。 元追踪的价值在于:它把"查询慢"从主观感受变成了可查看的时间线——你能看到引擎在哪个算子、哪一步连接上花了多久。这与 ep07/ep08 强调的"可自证"是同一件事:当一个结论无法通过读文档得到时,就换一个能观测它的工具;官方还有 --metatrace-categories 可按类别过滤,行为相当克制。
顺带记一处经典扁平参数的坑:-q 是 --query-file,它读的是 SQL 文件,不是 SQL 字符串;命令行里直接给一句 SQL 要用 -Q——【1】用的是后者,第六章那份批处理模板同理。这类"参数名长得像、语义差一截"的地方,与其背,不如 --help-classic 自查一次。
5.4 笛卡尔积复盘:一次"性能问题其实是正确性问题"
下面我们进入本篇的题眼案例。 社区里有一个流传很广的 OOM 复盘,主角是本系列反复碰到的 android.frames.timeline 模块。故事骨架是这样:
某次分析里,有人把帧相关的三张表做了连接,条件是"帧标识相等",于是写成 a.frame_id = b.frame_id。问题出在那批 frame_id 取值上——当帧数据不可用时,frame_id 会被写成 -1。对 -1 来说"相等"依然成立:所有 -1 与所有 -1 互相匹配,于是三张表里那些 -1 的行两两相乘:
- 每张表约 100 个
-1行,三表连接后约100 × 100 × 100 = 10⁶行; - 这 10⁶ 行不是"真实数据",而是一个无效键值造成的组合爆炸;在 WASM 环境里(可用内存有限),这一步直接把会话打爆,报 OOM。
-------------------------------------【笛卡尔积复盘:一个无效键值如何炸掉一次连接】------------------
-- 描述:坏版把 -1 也当成有效键参与连接;好版先在每一层把无效帧剔掉
-- 依据:github.com/google/perfetto 的 android/frames/timeline 模块与社区 OOM 复盘
------------------------------------------------------------------------------------------------
INCLUDE PERFETTO MODULE android.frames.timeline;        --【1】三份帧数据来自官方 timeline 模块

-- 坏版:三份帧数据自连接,只写了"帧标识相等"
SELECT a.ts, b.dur, c.process_name
FROM android_frames AS a
JOIN android_frames AS b ON a.frame_id = b.frame_id      --【2】-1 与 -1 也相等,于是全乘起来
JOIN android_frames AS c ON b.frame_id = c.frame_id
WHERE a.frame_id != 0;

-- 好版:把无效帧挡在连接之前
SELECT a.ts, b.dur, c.process_name
FROM android_frames AS a
JOIN android_frames AS b ON a.frame_id = b.frame_id
JOIN android_frames AS c ON b.frame_id = c.frame_id
WHERE a.frame_id NOT IN (0, -1)                          --【3】在最早的位置剔掉 0 与 -1
  AND b.frame_id NOT IN (0, -1)
  AND c.frame_id NOT IN (0, -1);

-- 更好的做法:别自己拼这三份数据,模块已经把无效帧处理好了
SELECT * FROM android_frames LIMIT 20;                   --【4】官方视图直接可用
【1】与【3】各有分工。 【1】先把来源钉清楚:故事里那"三张帧表"就是官方 android.frames.timeline 模块提供的 android_frames——它其实是同一张表的三次自连接(复盘时习惯起 a / b / c 三个别名,是为了把三份帧数据区分开),而这个视图没有 name 列,进程名要取 process_name。【3】才是这次事故的全部技术含量:它不是"引擎慢"的故事,而是"无效键值参与了等值连接"的故事——-1 在设计上是"无值",在 = 两侧却是"相等的值",这类哨兵值(sentinel value)在连接语义上永远是雷。【4】的修法很朴素,但它交代了定位过程:先把自连接逐层缩小到单条 SQL,再用 -m 元追踪确认耗时集中在哪一步。性能问题的根因,往往是正确性问题。
5.5 自跑对照:物化 vs 视图、有索引 vs 无索引
下面我们用实测把第二章的三张表验一遍。 第二章讲了"该物化就物化""索引只在该加的时候加",但那两张表本身是判据,不是证据。证据得自己跑:同一份官方示例 trace、同一台机器、只改一个变量。
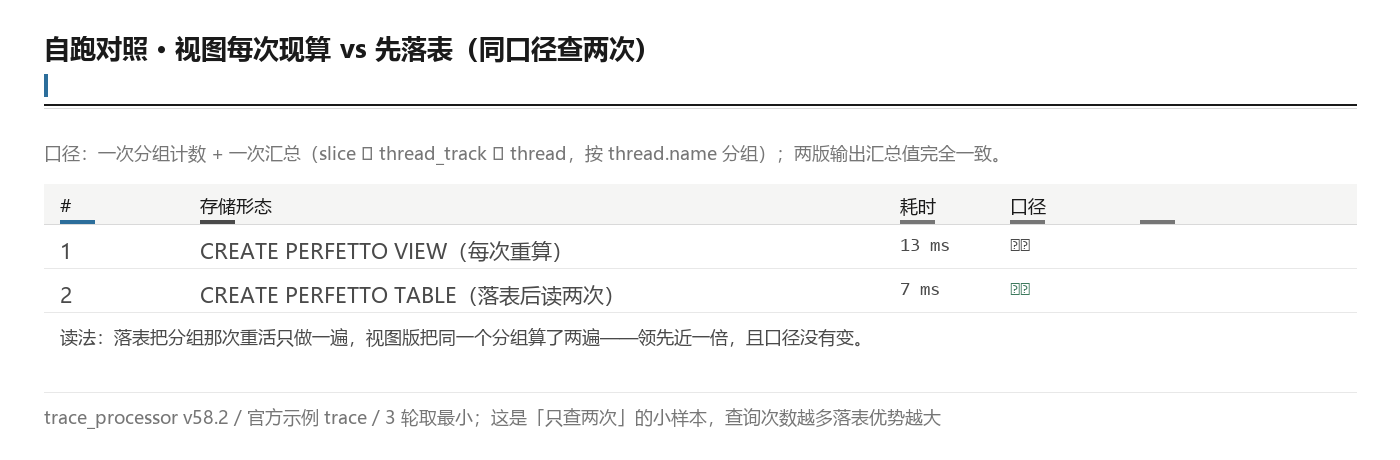
第一组对照是"先落表"与"每次现算":同一个查询口径(一次分组计数 + 一次汇总),一版建 CREATE PERFETTO TABLE 再查,一版留在视图里每次重算。两版输出的汇总值完全一致——口径没变,只改了存储形态;耗时上留在视图的一版 13 ms、先落表的一版 7 ms:在这份 30 秒示例 trace 上,落表领先了将近一倍——它把分组那次重活只做一遍,而视图版把同一个分组算了两遍。这也正好印证 2.1 节那句"视图的代价是每次乘积":查询次数越多、口径越重,落表的优势越明显。
第二组对照是"有索引"与"无索引":在物化表上建一个按非 id 列的索引,再跑同一句等值加范围过滤的查询(name = 'mprotect code' AND dur > 1000,命中 703 行),比较建索引前后的耗时。结果是无索引 4 ms、建索引后 7 ms——索引没让它变快:这张表只有两万行、这句查询又只跑一次,建索引的成本比省下来的扫描还贵。这不是"索引没用",而是第二章那两条判据的现场复现:索引是跟查询模式绑定的投资,换到"小表 + 只查一次"的场景里,它就不值。
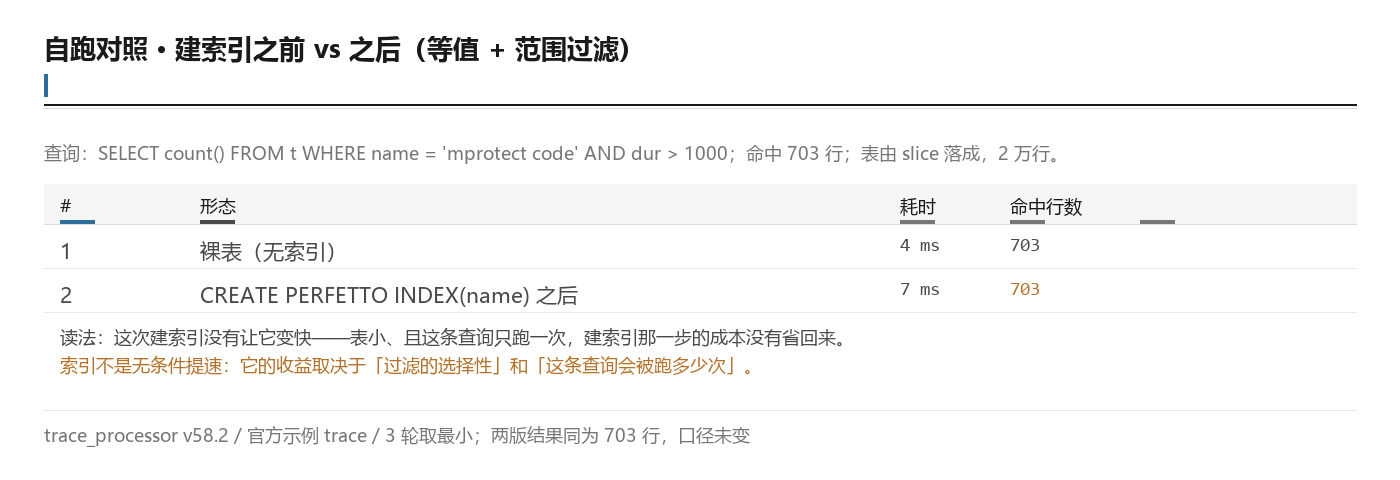
这两组实测最该注意的是"口径完全一致"这一点。 我们刻意让每组对照里的两条路径输出相同的行数——输出不同就不是性能对照,而是正确性对照了(第四章那对 627 与 656 就是后者)。先保证口径一致,再比速度,这是本篇所有实测的唯一规矩。另外说一句诚实的话:具体毫秒数依赖你的 trace 大小与机器,图上给的是本机实测值;实验的输入、SQL 与命令本篇都给全,你可以复刻。
第五章收尾。 手里的工具又多三件:一个可预算的内存公式、一条 GB 级 trace 的换路线、一套"逐层缩小 + 元追踪"的定位法。再加上第四章的三条纪律,剩下的问题只剩一个:怎么让这一次调优,变成下一次可一键复现的东西。
六、批处理与可复现:把调优固化成一条命令
下面我们进入本篇最短但最实用的一章。 前面五章的知识都发生在"你坐在屏幕前敲 SQL"这个场景里,而工程上的真实需求是:明天、下个月、在别人的机器上,同一条口径要能再跑一次,并给出同一个数字。 达不成这一条的调优,在原理上就是一次性的。
6.1 CLI 的四种模式
官方 Trace Processor 命令行参考 把命令收敛成 trace_processor <命令> 结构,同时保留经典扁平参数(-q、-Q、--httpd、--summary、--run-metrics 等),用 --help-classic 查看。与日常分析最相关的是四个模式:
| 模式 | 一句话用途 | 适合谁 | 关键点 |
|---|---|---|---|
query |
跑一段 SQL、打印结果、退出 | 脚本与 CI | SQL 可做参数、可读文件(-f)、可从 stdin 进;结果按 CSV 打印 |
interactive |
打开 SQL 提示符 | 交互式探索 | 它是默认子命令——trace_processor trace.pftrace 就等价于它 |
server |
把解析与查询做成常驻服务 | 大 trace、UI 联合分析 | 支持 http / stdio / unix 三种形态;UI 会自动探测本地 server |
summarize |
计算 trace 摘要(v2 指标) | 批量回归、口径统一 | --metrics-v2 all 跑全部 v2 指标;可接 spec 文件 |
除这四个之外,还有一个和本篇关系极大的命令:export。它把解析后的数据写成三种格式,三者的定位差别必须分清:
| 格式 | 写成什么 | 能不能回灌 | 适用场景 |
|---|---|---|---|
perfetto |
非空静态表的版本相关归档 | 可以(同版本回灌,跨版本不保证) | 想把"解析结果"当 trace 再用一次 |
arrow_tar |
标准 Apache Arrow 文件的 tar,一表一文件 | 不行 | 给 pandas / Polars / pyarrow 等外部生态 |
sqlite |
静态表 加 会话中的视图,一个 SQLite 库 | 不行 | 用任意 SQLite 工具继续查 |
这三种格式有一个共同前提,必须单独强调:导出的都是"静态注册表"。 官方原话是——会话中创建的表(例如你用 CREATE PERFETTO TABLE 物化的那张)不会被导出。这条看似冷门却非常关键:你顺手物化的中间结果只属于"这一次会话",算不上资产;想让下次复现,要保留的不是那张表,而是建表的那段 SQL。
6.2 一条命令跑完一轮口径
先来看看把上面这些拼起来是什么样子。 下面这段是本篇的"批处理模板":把 SQL 存成文件、用命令行跑、把耗时与指标一并落盘——它同时满足"跑得快"和"可复现"两个要求。
# ---------------------------------【trace_processor 批处理模板】---------------------------------
# 描述:把一次调优固化成可重放的命令:SQL 存文件 → 计时执行 → 结果与耗时双落盘
# 依据:perfetto.dev/docs/reference/trace-processor-cli 与 analysis/batch-trace-processor
# ------------------------------------------------------------------------------------------------
trace_processor query -f q_slices.sql example.pftrace > slices.csv             #【1】子命令形态:SQL 存文件
trace_processor -Q "SELECT count() FROM slice" example.pftrace                 #【2】经典扁平形态:一行 SQL
trace_processor query --perf-file timing.txt \
    -f q_slices.sql example.pftrace                                            #【3】把加载与查询耗时写进文件
trace_processor summarize --metrics-v2 all example.pftrace                     #【4】v2 摘要:推荐入口
trace_processor metrics --run trace_metadata --output text example.pftrace > metrics.txt  #【5】legacy v1 指标(必须带 --run)
trace_processor export sqlite -o trace.db example.pftrace                      #【6】导出带视图的 SQLite 库
下面对【3】与【5】特别说明。 【3】是"可复现"里最容易被忽略的一环:把耗时也当成结果的一部分记下来——没有它,你下次说"这次好像快了点"时手里没有任何凭据,而 --perf-file 会给出一份可对比的基线。【5】有三件事要交代清楚:一是这个子命令必须带 --run,裸跑会直接失败(它会明确告诉你 --run 是必需的),--run 后面跟的才是指标名,示例给的是 trace_metadata,--output text 把结果按文本交给 stdout,方便你重定向落盘;二是 legacy v1 指标属于经典扁平参数那一代,官方文档只说"metrics 子命令跑 v1 指标、新流程请改用 summarize --metrics-v2",具体有哪些指标名、参数怎么拼,要 trace_processor help metrics 在手上的二进制上自查——文档告诉你方向,只有 help 告诉你事实;三是新工作流优先用【4】的 --metrics-v2,官方已明确它是 v1 的正统继任者。
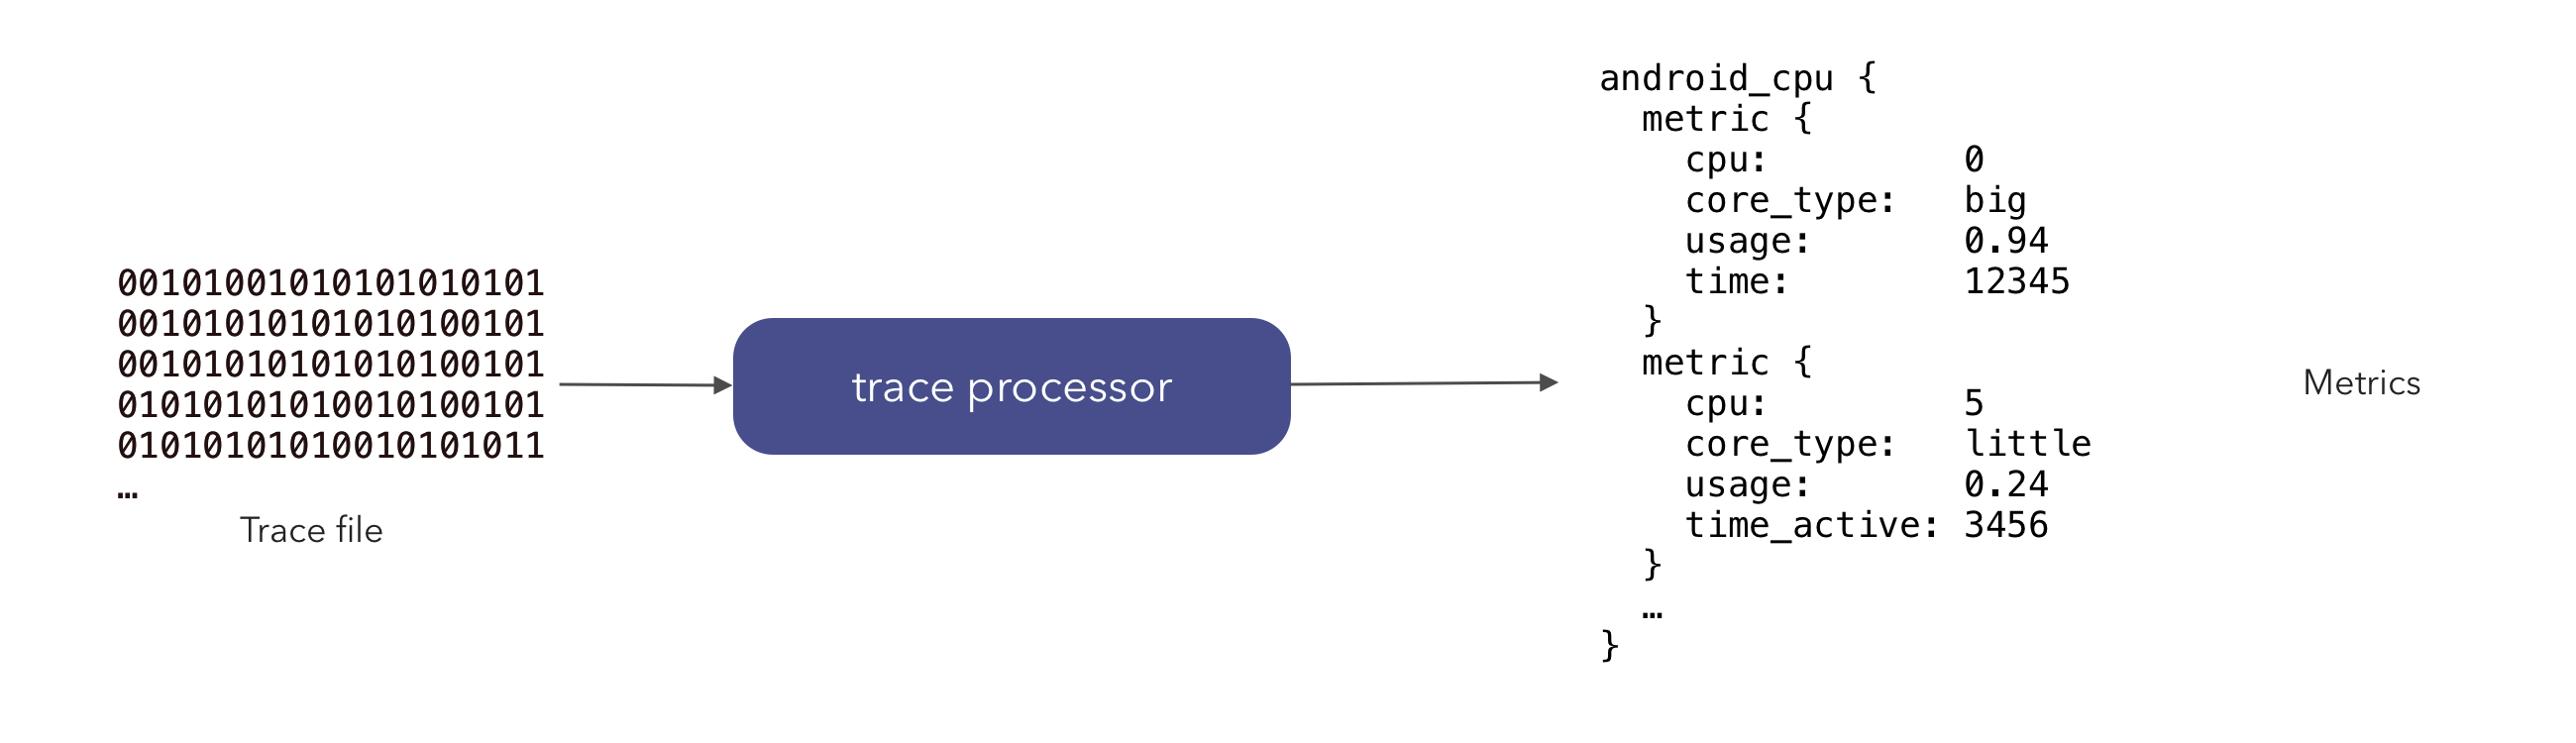
顺带说批处理的另一条路:如果对象是一批 trace 而不是一份,官方提供了 Batch Trace Processor(Python 库,pip install perfetto 装,需 pandas 前置),允许跨 trace 跑同一条 SQL 并把结果拼成一张表(query_and_flatten),也支持把"云上/HTTP"这类位置写成 trace URI。批处理的内存账,就是 5.1 节那个 2 × S × N。
6.3 UI 入口与脚本入口是一件事
言归正传,最后把两个入口连起来。 很多人把"在 UI 里查"和"写脚本查"当成两件事,其实它们是同一条 SQL 的两个执行位置:UI 的入口是顶部的 Query 标签页,脚本的入口是 query 子命令——在 UI 里调通的那段 SQL,复制出来就是脚本的第一版。
这一章只有一句要带走:调优的交付物不是"我查出来了",而是"这条命令谁跑都一样"。 下一章我们把这六章的结论压成一张表——症状进,处方出。
七、调优清单:症状 → 诊断 → 处方
下面我们进入全篇的收口。 前面六章按"概念"组织,这一章按"症状"组织——真实场景里,你先看到的正是症状。下面这张三列矩阵是本篇的核心交付物:
| 症状 | 诊断(先查什么) | 处方(怎么改) |
|---|---|---|
| 求和结果明显偏小或为负 | SELECT count() FROM slice WHERE dur = -1,看有多少未结束切片 |
先过滤 dur = -1,或按"到 trace 末尾"补齐;改用 slices.self_dur 等标准库口径 |
| 行数比预期多好几倍 | 检查 JOIN args 时有没有 key 条件;检查复合索引列序 |
取值一律用 EXTRACT_ARG(arg_set_id, key);复合索引把等值列放前 |
| 同一条查询第二次还是慢 | 看中间结果被封进了视图还是落了表;用 EXPLAIN 看两版计划条数与每步的输入规模 |
反复查的中间结果用 CREATE PERFETTO TABLE 落列存;WHERE 落在哪一侧要照计划定,别顺手挪 |
| 加了索引但没变快 | 检查过滤列是不是 id;检查物化表是不是子表 |
id 列不要建索引;子表不继承索引,索引要建在真正被查的那张表上 |
| 内存被打爆 / 报 OOM | 按 2 × S × N 估批处理总量;检查连接键有没有 -1、0 这类哨兵值 |
降并发条数;把无效键挡在连接之前;单份大 trace 改用原生 server |
| 区间连接的数值全部偏大 | 检查喂进去的区间表在同一分区内有没有重叠;有没有 dur = -1 |
先去重/裁齐区间再连接;注意分区列必须是整数(字符串用 HASH) |
| 换台机器/换个人就复现不出来 | 检查 SQL 是否只存在于查询历史里;检查有没有记录耗时基线 | SQL 存文件 + query -f + --perf-file,把口径与耗时一起纳入版本管理 |
| 口径与新版本对不上 | 检查用的是 v1 指标还是 v2 摘要;检查引用的文档路径是否已失效 | 新工作流用 summarize --metrics-v2;引用一律走语法页/命令行页这类现行路径 |
把这张表再做一次归类,八行处方其实只有四类手段:改口径(dur = -1、key 坐标、纳秒与时钟域)、换存储形态(落列存、加索引、删无用索引)、挪执行位置(按计划决定 WHERE 落在哪一侧、解析搬进原生 server)、做工程化(SQL 存文件、耗时基线入版本管理)。四类的优先级从上到下,先修口径,再动结构,最后才谈工程化。顺序不能倒:口径错了,后面三步都是在错误的结论上加速。各条的官方依据都在上文各章,现行入口是 Trace Processor 命令行参考。
这张表可以截图存一份:它的每一行都能对回前面某一章,遇到症状先来这里定位,再回去看那一章的推导。
7.1 与 ep08 反向咬合:从表问回源
下面我们把两篇接起来。 ep08 讲的是"每个源最后落到哪张表",它给的是源 → 表的方向。本篇讲的是"怎么把表问对问快",方向正好相反,是表 → 结论。把两个方向叠起来,你就得到一条完整的追责链:
- 从结论出发:我算出某个进程的 CPU 时间偏高;
- 问表:这个数字来自
sched还是thread_state?(第一章的口径问题) - 问源:这两个表分别由谁写进去的?(ep08 的"源 ↔ 表"对照)
- 问配置:那次采集真的打开那个源了吗,丢包了吗?(ep08 的丢包标记与
stats表) - 回到本篇:源与表都没问题,那问题就落在我的 SQL 上——回第七章找症状。
这条链的价值在于它消灭了最常见的甩锅方式:"这是 trace 采得不好"。 你确实有时能把锅甩给采集,但那需要证据:源没开、buffer 满了、丢包计数非零——这些都写在表里。本篇教你把表问对,ep08 教你认出表是谁写的,合起来才能把"数字不对"一路问到底。
八、边界再确认与结语
好了,最后我们把边界再钉一遍。 0.5 节开篇时给过一次边界,走完全篇之后再确认一次,你会更清楚"这篇到哪为止"。
8.1 边界再确认表
| 本篇讲了 | 本篇没讲(→ 对应篇目) |
|---|---|
口径正确性:纳秒单位、dur 三态、depth/parent_id、args 血缘 |
采集侧的时间精度与丢包成因 → 属 ep08 数据源与配置 |
存储形态选择:CREATE PERFETTO TABLE 与 CREATE PERFETTO INDEX 的判据 |
源名、配置块字段、TraceConfig 分发 → 属 ep08 |
标准库复用:INCLUDE PERFETTO MODULE 与 slices.* 家族分工 |
SQL 语法入门(JOIN/窗口函数基础写法)→ 本篇不复述 |
执行层优化:filter early、EXPLAIN、区间连接语义 |
帧级判据与归因(AppDeadlineMissed 等)→ 属 ep10 |
长 trace 与批处理:2 × S × N、原生 server、metatracing |
vsync / BufferQueue / SurfaceFlinger 系统流水线 → 属 ep10 |
可复现:CLI 四模式、export 三格式、批处理模板 |
trace_processor 的 C++/Python 嵌入整篇 → 只用到与命令行相关的部分 |
这张表里,第三行与第四行最该留意。 第三行是"故意不讲基础语法"——那部分内容任何一本 SQL 教材都讲得比这里细,塞进来只会稀释方法论;第四行是"帧级结论留给 ep10"——本篇只负责让你把帧相关的表查对、查快,至于"这一帧算不算掉帧、掉在谁身上",那是下一篇的主题。
8.2 下篇预告:一帧到底有没有掉
本篇第七章那张矩阵的最后一行讲的是"口径漂移",而下一篇(ep10)要做的恰恰是把一套口径钉死:FrameTimeline——系统给出的"期望时间线"与"实际时间线"怎么读,AppDeadlineMissed、SurfaceFlingerGpuDeadlineMissed 这类判据怎么算,为什么"掉帧"在 App 侧与 SF 侧会有两个不同的答案,以及在 SQL 里怎么把"这一帧有没有按时上屏"问成确定的事实。
ep08 让你知道表是从哪来的,ep09 让你知道表该怎么问,ep10 拿这套问法去回答一个具体问题:这一帧,到底掉没掉。 到那里你会发现,本篇讲的口径纪律与自证习惯,全都要用上。
8.3 资源清单与参考资料来源
- PerfettoSQL 入门(概念、最佳实践、filter early、
EXTRACT_ARG、SPAN_JOIN)—— https://perfetto.dev/docs/analysis/perfetto-sql-getting-started - PerfettoSQL 语法(
CREATE PERFETTO TABLE/VIEW/INDEX、INCLUDE、MACRO)—— https://perfetto.dev/docs/analysis/perfetto-sql-syntax - PerfettoSQL Prelude 与表语义(
slice、counter、args列定义)—— https://perfetto.dev/docs/analysis/sql-tables - PerfettoSQL 标准库索引(模块、视图、函数的权威清单)—— https://perfetto.dev/docs/analysis/stdlib-docs
- 向后兼容说明(版本升级时哪些写法会变)—— https://perfetto.dev/docs/analysis/perfetto-sql-backcompat
- 标准库与查询风格指南 —— https://perfetto.dev/docs/analysis/style-guide
- 内建表、函数与操作表清单 —— https://perfetto.dev/docs/analysis/builtin
- 分析入口(从 UI 到命令行的第一站)—— https://perfetto.dev/docs/analysis/getting-started
- Trace Processor(会话、预热、嵌入、
RegisterSqlPackage)—— https://perfetto.dev/docs/analysis/trace-processor - Trace Processor Python API(脚本化查询)—— https://perfetto.dev/docs/analysis/trace-processor-python
- Batch Trace Processor(
2 × S × N内存公式、trace URI、query_and_flatten)—— https://perfetto.dev/docs/analysis/batch-trace-processor - legacy v1 指标(
RUN_METRIC与热重载工作流)—— https://perfetto.dev/docs/analysis/metrics - v2 摘要系统(
RUN_METRIC的正统继任者)—— https://perfetto.dev/docs/analysis/trace-summary - Debug Tracks(把查询结果画回时间轴)—— https://perfetto.dev/docs/analysis/debug-tracks
- Trace Processor 命令行参考(
query/server/summarize/export/-m)—— https://perfetto.dev/docs/reference/trace-processor-cli - 命令行分析入门(导出与配方)—— https://perfetto.dev/docs/getting-started/command-line-analysis
- 时钟同步概念(跨时钟换算的依据)—— https://perfetto.dev/docs/concepts/clock-sync
- Trace Processor 架构设计(列式存储与表/视图实现位置)—— https://perfetto.dev/docs/design-docs/trace-processor-architecture
- Data Explorer 架构(查询链与增量物化)—— https://perfetto.dev/docs/design-docs/data-explorer-architecture
- 大型 trace 可视化(GB 级走原生 server)—— https://perfetto.dev/docs/visualization/large-traces
- 测试约定(
.sql与.out回归基线)—— https://perfetto.dev/docs/contributing/testing - 源码:PerfettoSQL 标准库根目录 —— https://github.com/google/perfetto/tree/main/src/trace_processor/perfetto_sql/stdlib
- 源码:
stdlib/slices模块目录 —— https://github.com/google/perfetto/tree/main/src/trace_processor/perfetto_sql/stdlib/slices - 源码:
slices/with_context.sql—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/slices/with_context.sql - 源码:
slices/flat_slices.sql—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/slices/flat_slices.sql - 源码:
slices/hierarchy.sql—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/slices/hierarchy.sql - 源码:
slices/self_dur.sql—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/slices/self_dur.sql - 源码:
slices/cpu_time.sql—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/slices/cpu_time.sql - 源码:
android/frames/timeline.sql(第五章 OOM 复盘的主角模块)—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/android/frames/timeline.sql - 源码:
test/trace_processor回归基线 —— https://github.com/google/perfetto/tree/main/test/trace_processor - 工具:
trace_processor下载入口 —— https://get.perfetto.dev/trace_processor - 数据:官方 Android 示例 trace(自跑实验的输入)—— https://storage.googleapis.com/perfetto-misc/example_android_trace_30s_1
- 社区:
frame_id = -1笛卡尔积 OOM 复盘 —— https://blog.gitcode.com/dddd62e7aab1db931d61151814b9c006.html - 社区:GB 级 trace 的命令行打开实践 —— https://blog-146fea-1251724055.tcloudbaseapp.com/2025/02/08/Android-Perfetto-04-Open-Big-Trace-With-Command-Line/
- 第三方使用建议(建表用
CREATE PERFETTO TABLE)—— https://precice.org/tooling-performance-analysis
参考资料来源:本篇所有语法、机制与默认值均以 Perfetto 官方现行文档(概念页、语法页、表语义页、标准库页、批处理页与命令行页)与 google/perfetto 仓库源码为一手依据;配图为官方文档配图(Google,Apache-2.0),出处见图注与脚注;社区材料仅作旁证,正文已逐条标注。官方 analysis 分区 2026 年重构后旧的分析页路径已失效,本篇引用一律使用现行路径。
下篇预告:(十)FrameTimeline:一帧到底有没有掉。
开篇快捷键:想快速上手,记住四句话——单位是纳秒(换算用 time.conversion);求和前先问 dur 是不是 -1;反复查的中间结果用 CREATE PERFETTO TABLE 落列存;写完先看 EXPLAIN,别猜计划。
以上。 希望这一路"从能查到查得对、查得快"的梳理,能让你下次在面对一份百万行的 trace 时不再靠试错——而是能一路问下去:我的口径对吗、引擎要在多大规模上干活、这条命令下个月还跑得出来吗。
本文由@溯光 出品,让"查得快、算得对"成为可复现的两笔账。
With Best Wishes.
[^ext1]: 题图「基础查询实例结果」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/perfetto-sql-basic-query.png,配套 https://perfetto.dev/docs/analysis/perfetto-sql-getting-started),作者:Google,Apache-2.0 许可。
[^ext2]: 图「counter 的呈现形态」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/counters.png,配套 https://perfetto.dev/docs/analysis/perfetto-sql-getting-started),作者:Google,Apache-2.0 许可。
[^ext3]: 图「切片概念示意」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/slices.png,配套 https://perfetto.dev/docs/analysis/perfetto-sql-getting-started),作者:Google,Apache-2.0 许可。
[^ext4]: 图「查询界面全貌」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/perfetto-sql-cli-description.png,配套 https://perfetto.dev/docs/analysis/perfetto-sql-getting-started),作者:Google,Apache-2.0 许可。
[^ext5]: 图「区间连接语义」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/span-join.png,配套 https://perfetto.dev/docs/analysis/perfetto-sql-getting-started),作者:Google,Apache-2.0 许可。
[^ext6]: 图「Trace Processor 架构」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/trace-processor.png,配套 https://perfetto.dev/docs/analysis/trace-processor),作者:Google,Apache-2.0 许可。
[^ext7]: 图「v2 指标摘要输出」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/metrics-summary.png,配套 https://perfetto.dev/docs/analysis/metrics),作者:Google,Apache-2.0 许可。
[^ext8]: 图「UI 的 Query (SQL) 标签页」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/perfettosql_query_tab.png,配套 https://perfetto.dev/docs/analysis/perfetto-sql-getting-started),作者:Google,Apache-2.0 许可。