站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:同一套东西,凭什么盖住六种图形 API
好了,前四篇把"它怎么进来""它用什么写""它每帧怎么跑"都讲完了。到这里,一个做过实际工作的人多半会冒出一个很朴素的问题:
D3D9 和 Vulkan 之间,差得有多远?
远到什么程度呢——远到几乎没有可比性。D3D9 是 2002 年的东西:设备对象上挂着一大堆全局状态,你设一次就一直在,改一次就全局生效;Vulkan 是 2016 年的东西:没有全局状态,什么都要显式写进命令缓冲,连"这张纹理要从什么状态转到什么状态"都得你自己声明。前者像一个共用的操作台,后者像一沓要自己填的表格。
而 ReShade 的 add-on 接口,同一行代码要在这两者上都跑。它做到这件事的办法,中文技术圈里最省事的说法是"抽象层把差异抹平了"。这句话不算错,但它把最要紧的那一步糊过去了:差异抹平之后,被抹掉的东西去哪了?
这一篇要回答的,就是那三个字背后的三件事,而答案比"抹平"这个说法要具体得多:
- 坐标系是怎么选的——抽象层不是从零发明一套中立术语,而是先选了 D3D12 与 Vulkan 当蓝本,再把另外四个后端翻译进来。所以差异没被消灭,而是被约定收走了(第一、二章)。
- 最硬的差异落在哪——落在"命令列表是隐式的还是显式的"这一条上。它有可以逐字数出来的痕迹:四个后端各有一份"状态块",另外两个根本没有这个文件(第三章)。
- 抽象不住的是什么——有些差异被抽象层吃掉了(描述符堆的归属),有些只是被"翻译"了(present 有九个入口),还有一类压根没被抽象(多队列语义)。分清这三类,才谈得上"这套抽象够不够用"(第七、八章)。
第四到六章按"一次调用从入口到落地"的顺序走:present 有几个入口、格式怎么对上、管线怎么创建。这三章是把第一、二章的"坐标系"落到具体调用上的三处。
这一篇的地图就在这张边界图里:十一篇各占一层,本篇只占中间那一层。左边三篇讲"怎么进来、用什么写、跑起来什么样",本篇讲"跑起来之后,怎么在六种不同的图上都显得一样",右边几篇才轮到 add-on、深度与生态。
读这张图的正确姿势是从下往上看:先看最底下那句红线——本篇不涉及 add-on 的 C++ 回调面(那是第六篇)、不涉及后处理算法的实现(那是后处理篇)、不涉及深度缓冲的工程问题(第七篇)。把边界先钉死,后面三章才敢往深里钻;不钉死的话,写到"描述符"就会滑进第六篇,写到"深度格式"就会滑进第七篇。
0.1 全系列目录总览(十一篇)
依然是惯例,先给系列地图。本系列沿"一个外部注入的运行时"从入口一路拆到效果生态,十一篇的落点如下(本篇即第五行):
| # | 篇目 | 这一篇要回答的那一问 |
|---|---|---|
| 一 | 总论:注入式后处理与管线内后处理的边界 | 它到底动的是哪一段?和引擎自带的后处理差在哪? |
| 二 | 代理 DLL、加载顺序与导出表挂钩 | 它凭什么进得来?进来之后怎么把调用接过去? |
| 三 | ReShade FX:语言血统、独立编译器与纹理语义 | 效果是拿什么写的?编译器为什么能单独拿出去用? |
| 四 | effect runtime:technique / pass 图、render state 与运行时数据源 | 一个 effect 从源码到画面,中间过了几道? |
| 五 | 本篇:跨 API 抽象——D3D9/10/11/12、OpenGL、Vulkan 的差异与统一 | 同一套东西怎么盖住六种图形 API? |
| 六 | Add-on API:事件模型、跨 API 资源交换与两种构建的分野 | 想在运行时插手更深的事,接口长什么样? |
| 七 | 深度缓冲的工程学:自动关闭、MSAA、UI 缺失与子矩形错位 | 为什么深度类效果时灵时不灵? |
| 八 | 效果生态与许可地图:同一份清单里的 MIT 与"禁止再分发" | 那些效果到底能不能用、能不能转? |
| 九 | 自跑一:注入本地 D3D11 demo——逐效果前后对比 | 真跑一遍是什么样子? |
| 十 | 自跑二:效果栈与帧耗账,外加自写一个小 .fx | 代价是多少?自己写一个要几步? |
| 十一 | 合规与工程取舍的合集:把十一篇的账并到一处 | 这条路线值不值得用、边界在哪? |
阅读路径:只想知道"为什么一套接口能通吃"的朋友,读第零章与第一章就够;要搞明白"差异到底被谁吃掉了"的,第三章是核心;现在就在写 add-on、被某个 API 卡住的,第四、五、七章各有一处直接答案。
0.2 本篇要讲清的一件事
好了,先把结论放这儿:跨 API 抽象层的做法不是"抹平差异",而是"选一个坐标系,把另外几个后端翻译进来"——蓝本是 D3D12 与 Vulkan,D3D9/10/11 与 OpenGL 是被翻译的一方。
这个说法不是我推的,是官方文档自己的措辞。REFERENCE.md 第 70 行(逐字):
The [graphics API abstraction] is modeled after the Direct3D 12 and Vulkan APIs, so much of the terminology used should be familiar to developers that have used those before.
"modeled after"这两个词是整篇的题眼。 它意味着这套抽象里的 command_list、pipeline、descriptor_table 这些概念,本来就是 D3D12 与 Vulkan 的词,不是某个中立第三方的词。选谁当蓝本,决定了另外四个后端要付出什么样的翻译代价。
这一篇要看的就是那个代价落在哪。
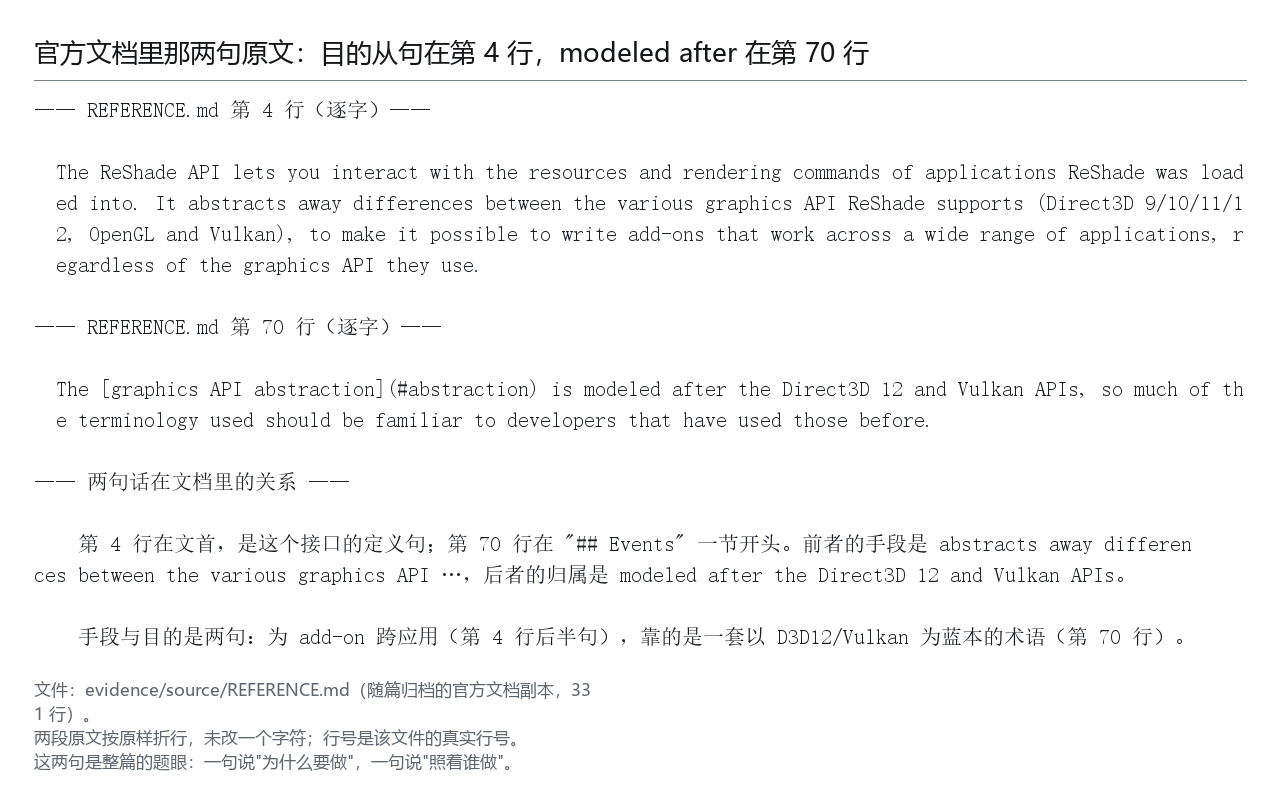
这张面板把这句话的出处、以及它紧挨着的另一句一起摊开了。第二句是 REFERENCE.md 第 4 行的目的从句——抽象层的存在理由是"让 add-on 能在各种应用上都能用",而不是"让 ReShade 内部好写"。这个区别很重要:它决定了抽象层的边界画在哪——凡是 add-on 碰不到的东西,抽象层就不管。
0.3 本篇不涉及什么(边界声明)
依然是惯例,先把边界摆在前面:
| 不涉及 | 为什么 |
|---|---|
| add-on 的 C++ 回调面——怎么注册事件、回调签名长什么样、怎么在回调里拿到资源 | 那是第六篇的题域;本篇只讲"抽象出来的对象长什么样",不讲"你怎么写代码去用它" |
| 后处理算法在某个具体 API 上的实现差异——比如某个效果在 D3D9 上要绕什么路 | 算法实现是《实时渲染管线探析》那条线的题域,本系列只引用、不复述 |
| 驱动内部——Mesa 的 GLSL IR 怎么优化、厂商驱动怎么编译着色器 | 本篇引用 Mesa 的分层图只为说明"翻译发生在哪一层",不追进驱动内部 |
| 深度缓冲的跨 API 差异——为什么 D3D9 的深度特别难拿、MSAA 下深度怎么错位 | 这是第七篇的题域,本篇只在"格式枚举"那一处提到 D3D9 的 INTZ |
| 任何绕过做法——绕过深度限制、绕过网络检测、绕过反作弊 | 红线。本系列全部实验都在自有开源 demo 上做,商业游戏一次都不碰 |
参数口径也说一句:系列里所有"本机读数"都来自同一台机器——Windows 11(build 26200)、RTX 3060 Laptop(6144 MiB 显存、驱动 560.70)、.NET 运行时 4.8 以上;帧耗类读数一律关垂直同步、不锁帧。第五篇不新做实验,全部读数分两类:一类是对随篇归档的官方源码原件做离线解析,一类是本机文件系统的只读清单。
0.4 四条读法约定(沿用本系列体例)
好了,写这个系列的过程中,有四条约定帮我们避开了四类常见误读,先摊在这里:
- 官方文字优先,二手转述只作线索。 凡涉及版本、行为与立场的说法,一律追到官网、发布说明或代码仓库原文;二手内容明标为二手。本篇特别要守这一条——"抽象层"这个话题上,转述与原文的偏差最大,有些流传很广的说法在源码里根本找不到对应,第三章会点出一处。
- "抽象住了"与"翻译了"必须分开说。 差异有两种命运:一种是被抽象层吃掉(调用方再也不用管),一种只是被翻译(调用方仍然看得见,只是不用自己换算)。两者常被混成"抽象层都处理了",但含义完全不同——第四、五章各有一处对照。
- "没复现"就是"没复现"。 本机做不到的,一律写"测不了",不拿别人的结论替自己作证。这一条在本篇尤其重要:本机只有 D3D11 一条路径,Vulkan 与 D3D12 的运行时行为本篇一律不写"实测"。
- 读数的口径必须写在读数旁边。 本篇会出现很多"多少个成员""多少行"——这些数全部由脚本从归档原件现读,不是估算、不是转述。凡是引用别人的数字,一律注明转述。
这四条在后面六篇里都会再用到。
一、"统一"是什么意思:先把坐标系定下来
先来看看标题里那个最含混的词:"统一"到底统一了什么?
在"抽象层"这个话题上,"统一"有三种常见的理解,而这三种里只有一种是官方做的:
- 统一了语义——把六个 API 里说法不同的东西归纳成一套中立术语。听起来最漂亮,但做不成:D3D9 里那张全局状态表和 Vulkan 里的命令缓冲,找不出一个共同的"中立词"。
- 统一了调用方式——选一个 API 的术语体系当模板,别的都往上靠。这才是官方做的。
- 统一了行为——同一份 add-on 代码在六个 API 上跑出一样的结果。这个官方没有承诺,也不可能承诺:底层的语义差别摆在那里。
把第 2 和第 3 混起来,是"抽象层"讨论里最常见的错位。 官方文档说的始终是第 2 种("modeled after"),而第 3 种要 case by case 地处理——本篇第三章到第七章都在处理第 3 种留下的坑。
1.1 蓝本是谁,为什么是它们
device_api 这个枚举会回答"支持几个 API",但它回答不了"以谁为蓝本"。后者在文档里,而枚举里的赋值顺序其实也透出一点信息。
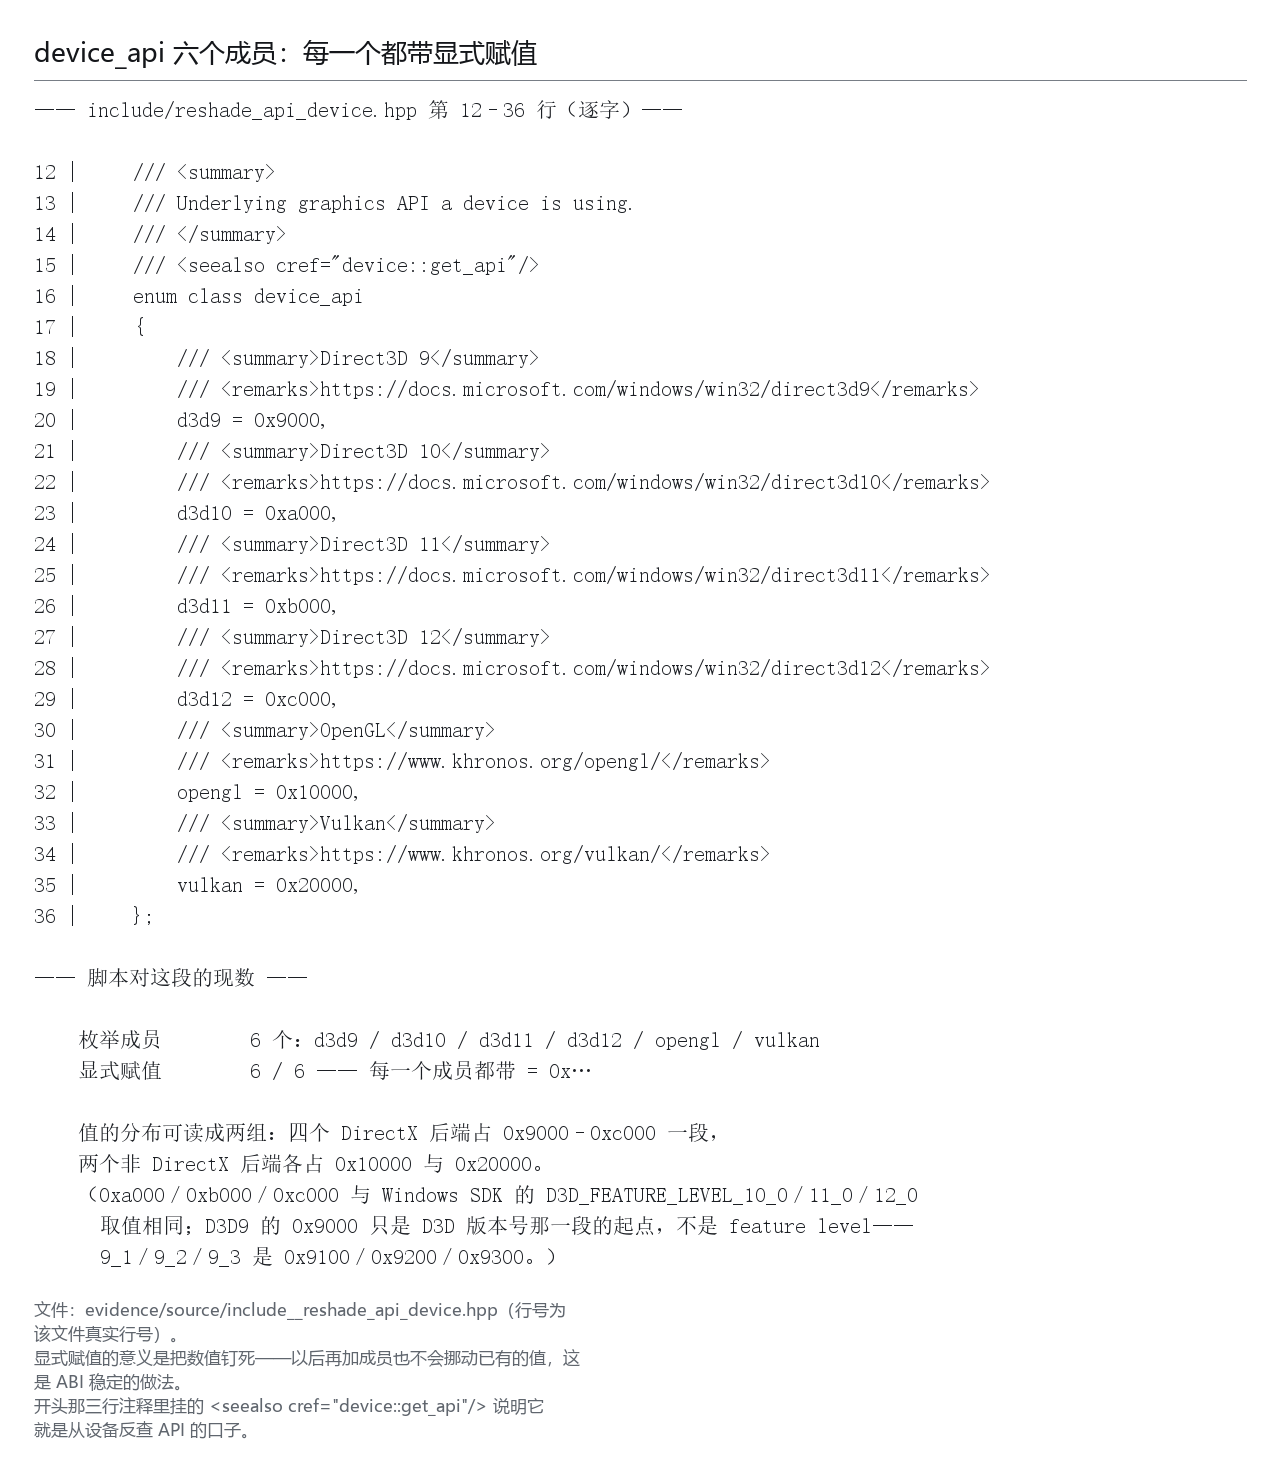
这张面板是 include/reshade_api_device.hpp 第 12 到 36 行的原样——六个成员,每一个都带显式赋值:
d3d9   = 0x9000,
d3d10  = 0xa000,
d3d11  = 0xb000,
d3d12  = 0xc000,
opengl = 0x10000,
vulkan = 0x20000,
这几个数不是随手写的:0x9000/0xa000/0xb000/0xc000 连着排,正是把 Direct3D 的代数编进了高位——9 落在 0x9000、10 落在 0xa000、11 落在 0xb000、12 落在 0xc000。其中后三个还与 Windows SDK 里 D3D_FEATURE_LEVEL_10_0/11_0/12_0 的取值逐个相同;但 D3D9 的 0x9000 只是这条编号规律里的那一格,不是它对应的 feature level——D3D_FEATURE_LEVEL_9_1/9_2/9_3 的取值是 0x9100/0x9200/0x9300,官方枚举里没有 0x9000 这个值(阶段 4 对着 Windows SDK 文档核过这一处,顺手记在这里)。0x10000/0x20000 则是给两个非 DirectX 后端留的位。显式赋值这个动作本身也有意义:它把数值钉死,以后再加成员也不会挪动已有的值——这是 ABI 稳定的做法(这个习惯在本篇后面还会出现两次)。
为什么蓝本是 D3D12 与 Vulkan 而不是 D3D11? 官方只给了结果没给理由,但理由是能推的,而且推出来只有一条:
翻译的方向是"从显式翻译到隐式"比反过来容易。
- D3D12/Vulkan 的世界里,"要做什么"全写在命令列表上,信息是完整的;
- D3D9 的世界里,"当前状态是什么"需要去问设备,而"我刚才做了什么"这种历史信息根本没有。
如果拿 D3D9 当蓝本,那么为了支持 D3D12,抽象层必须凭空补出一大堆"全局状态",而其中很多在 D3D12 上不存在也不该存在;反过来拿 D3D12 当蓝本,D3D9 那边要补的是"把全局状态记下来再还原"——这件事 D3D9 自己有现成机制(第三章会给出证据:那份 83 行的状态块里,用的正是 CreateStateBlock(D3DSBT_ALL))。
还有一条更硬的理由:信息量。 显式世界里的命令列表,"要做什么、按什么顺序、资源在什么状态"全都写在上面,信息是完整的;隐式世界里,"当前状态"要去问设备,而"我刚才做过什么"这种历史信息根本没地方存。从信息多的那一侧往信息少的那一侧翻译,最坏情况是丢东西——丢了之后仍然是自洽的;反过来,你得发明信息,而发明出来的东西一旦和真实语义不符,就会变成那种"在某个游戏上偶发"的毛病。选蓝本这件事,本质上是在选"往哪边丢东西"。
这次选择在这张图上被画成了一次"分边":蓝本侧是 D3D12 与 Vulkan,被翻译侧是 D3D9/10/11 与 OpenGL。 注意分界不是"新 vs 旧"——D3D11 和 D3D12 是同一年代的东西,但它在"状态要不要显式声明"这件事上站在了旧的那一边,所以归入被翻译侧。
1.2 一个容易被跳过的前提:这套抽象是给谁用的
好了,这一节很短,但它决定了后面所有章节的取舍。
REFERENCE.md 第 4 行那句完整的话是这样的(逐字):
The ReShade API lets you interact with the resources and rendering commands of applications ReShade was loaded into. It abstracts away differences between the various graphics API ReShade supports (Direct3D 9/10/11/12, OpenGL and Vulkan), to make it possible to write add-ons that work across a wide range of applications, regardless of the graphics API they use.
加粗的前半句是手段,后半句才是目的。 目的从句里那个 "that work across a wide range of applications" 划定了抽象的深度:
- 凡是 add-on 需要碰的东西,必须抽象(资源、视图、管线、描述符、命令列表);
- 凡是 add-on 碰不到的,可以完全不抽象——ReShade 内部为了完成注入而做的一大堆事(挂钩管理、模块转发、状态保存),在
reshade::api里找不到对应的抽象对象。
这条前提解释了一个初学者常见的困惑:为什么这套 API 看起来"不全"?——因为它本来就不是一个通用的图形 API,它是一个给"寄生者"用的接口面。它的完整度不是按"能不能写一个渲染器"衡量的,而是按"add-on 想插手的事情够不够用"衡量的。
这一层认识,在第七章会变成一个具体判据:拿"它抽不抽象某个东西"去质疑它,得先问"add-on 需不需要这个东西"。
二、抽象出来的是什么东西:一半是类,一半是句柄
坐标系定完之后,下一个问题是:在这个坐标系里,东西都长什么样? 先给一个抽象层(abstraction layer)的粗定义:它是"把六个后端收在同一组类型与方法背后"的那一层。
翻一遍 include/ 下的四个头文件,会发现一件有点反直觉的事:这套抽象里的成员不是同一种东西。有一半是类,有方法可以调;另一半是句柄,里面只有一个 64 位整数。这不是随手设计的,它对应一条很清楚的界线。
2.1 两种形态:会被"调用"的,和会被"传递"的
说白了,判据只有一条:这个东西有没有行为?
- 有行为的 → 做成类。
device(能创建资源)、command_list(能记录命令)、command_queue(能提交)、swapchain(能呈现)。它们的方法定义在include/reshade_api_device.hpp第 320、691、1216、1341 行附近。 - 没有行为的 → 做成不透明句柄(opaque handle)。
resource、resource_view、pipeline、pipeline_layout、descriptor_table、sampler。它们从头到尾只被传来传去:创建的时候产出一个,用的时候递给某个方法。
句柄的定义是一个宏,在 include/reshade_api_resource.hpp 第 8 行到第 14 行(逐字):
#define RESHADE_DEFINE_HANDLE(name) \
        typedef struct { uint64_t handle; } name; \
一个 uint64_t,就这么多。 官方对这条分工的说明在 REFERENCE.md 第 148 行(逐字):
In contrast to the described basic API abstraction objects, any buffers, textures, pipelines, etc. are referenced via handles.
这条界线在这张图上摆得很清楚:左边一列是"会被调用的",右边一列是"会被传递的"。注意 command_queue 在两列之间——它有 execute_command_lists 这样的方法,所以在左列;但它在 D3D12/Vulkan 上其实也常被当句柄传递。这个位置本身说明了另一件事:这条界线是"有没有行为"划的,不是"重不重要"划的。
2.2 句柄的注释里,写满了它没抹掉的差异
这是本篇第一个"硬发现":抽象层没有把差异藏起来——它把差异写在了注释里。
看 sampler 这个句柄的完整注释(include/reshade_api_resource.hpp 第 132 行到第 146 行,逐字):
/// <summary>
/// An opaque handle to a sampler state object.
/// <para>
/// Depending on the graphics API this can be:
/// <list type="bullet">
/// <item>Direct3D 9: An opaque value.</item>
/// <item>Direct3D 10: A pointer to a 'ID3D10SamplerState' object.</item>
/// <item>Direct3D 11: A pointer to a 'ID3D11SamplerState' object.</item>
/// <item>Direct3D 12: A 'D3D12_CPU_DESCRIPTOR_HANDLE' (to a sampler descriptor).</item>
/// <item>OpenGL: An OpenGL sampler object name.</item>
/// <item>Vulkan: A 'VkSampler' handle.</item>
/// </list>
/// </para>
/// </summary>
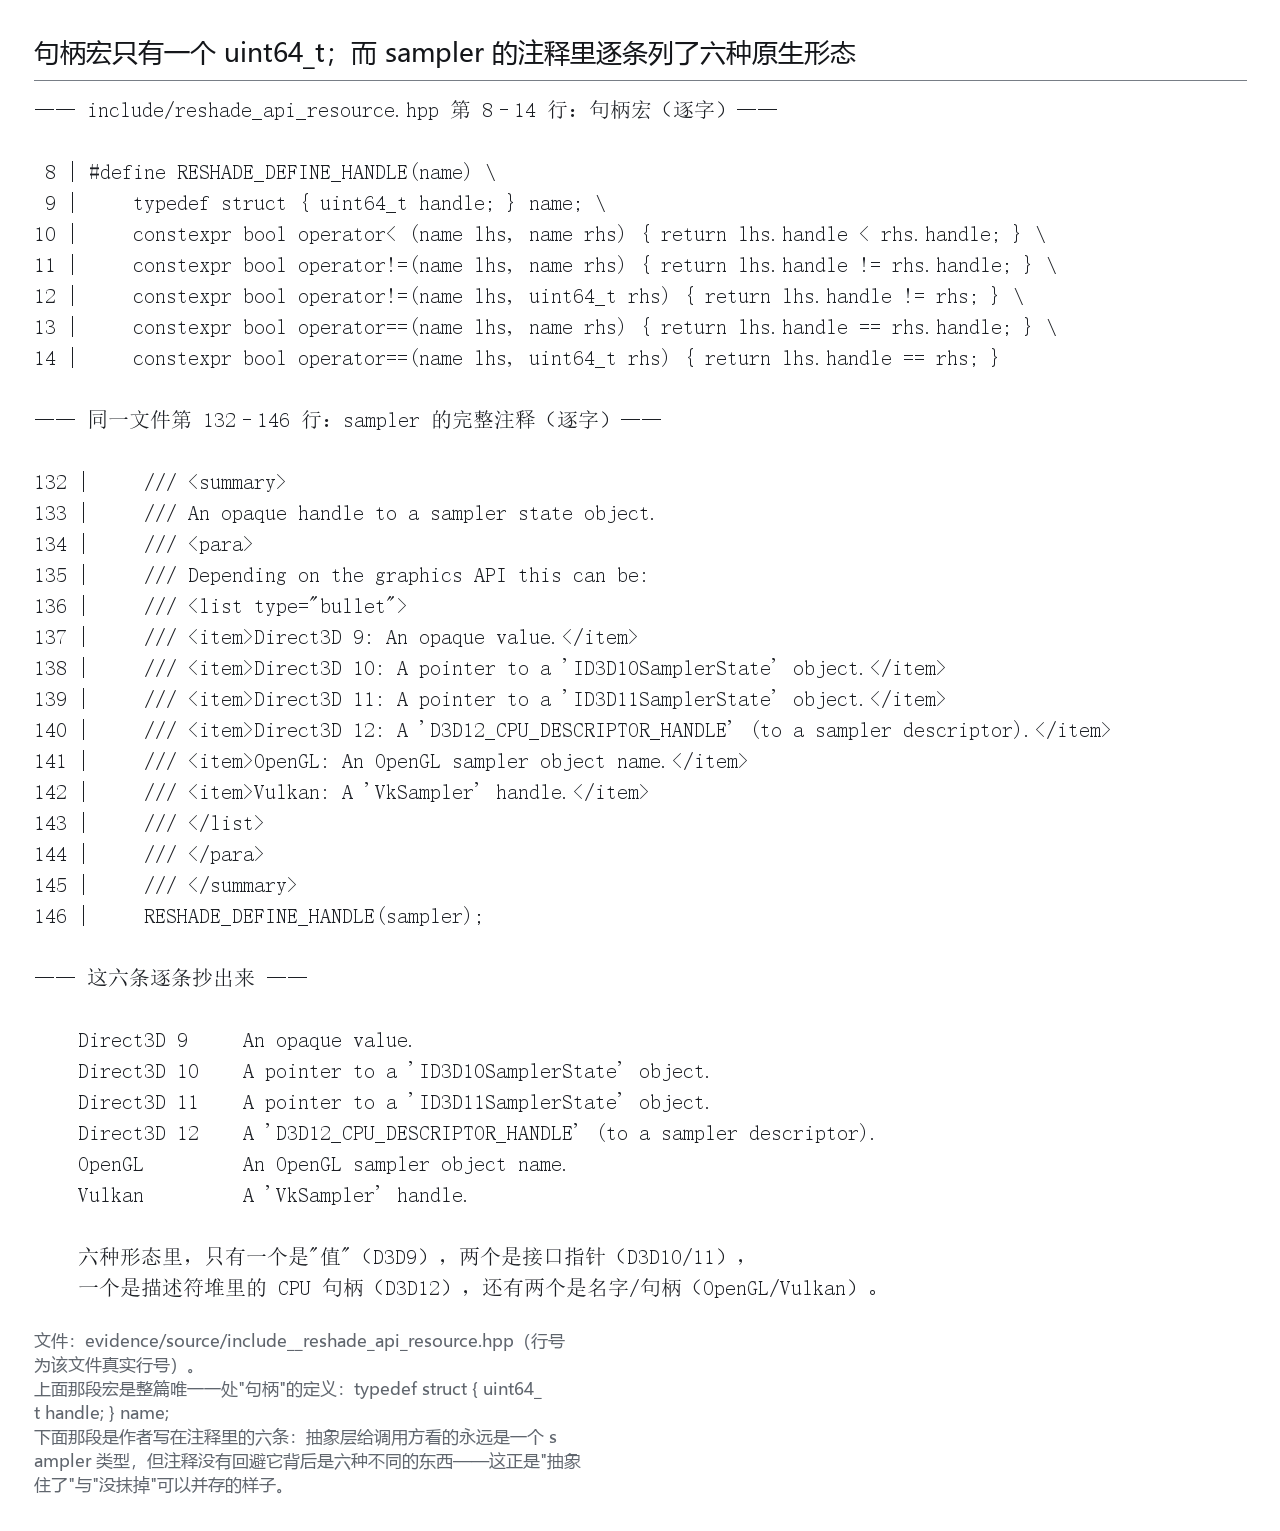
这六行是整个抽象层最诚实的一处。 同一个"采样器",在六个 API 上是六种完全不同的东西:D3D9 里是个不透明的值(连指针都不是)、D3D10/11 里是接口指针、D3D12 里是描述符堆里的一个 CPU 句柄、OpenGL 里是个整数名字、Vulkan 里是个句柄。而抽象层给调用方看到的是同一个 sampler 类型。
读懂这段注释,就懂了这个抽象层的设计姿态:
- 调用方拿到
sampler之后不需要知道它底层是哪种东西——这是"抽象住了"; - 但如果调用方想知道,注释会告诉你——这是"没抹掉"。
这两句不矛盾,它们是同一件事的两面:抽象层把差异收进了句柄的内部,而在接口的文档上把它标出来。所以判断"这套抽象靠不靠谱",不该看它"声称统一了什么",而该看它的注释在不在回避差异。这一处的答案是:没有回避,一条一条列了六个。
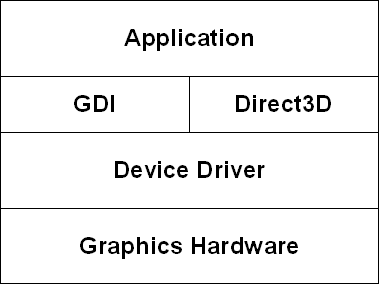
这是外面找的一张真图(Wikimedia Commons,CC BY 2.5):Direct3D 抽象层的四层结构——最上面是 GDI 应用,中间的方块写着 Direct3D,往下是 Device Driver(设备驱动),最下面是 Graphics Hardware。图上只有五个英文词(GDI/Application/Direct3D/Device Driver/Graphics Hardware,本机 OCR 逐词核过)。
把它和上一张面板并排看,就是"抽象"这两个字的两层含义:这是一种——横向的、进程之间的抽象,让应用不必知道显卡是什么;ReShade 那套是另一种——纵向的、同一层之内的抽象,让 add-on 不必知道上面跑的是哪个 API。两张图讲的不是一回事,但它们解释了同一个动机:把"上面不需要知道"的东西收下去。
2.3 "功能等价于"这五个字
device 的 class 注释里有一句和 sampler 同型的话(include/reshade_api_device.hpp 第 320 行到 327 行,逐字):
/// <summary>
/// A device, used for resource creation and global operations.
/// <para>Functionally equivalent to a 'IDirect3DDevice9', 'ID3D10Device', 'ID3D11Device', 'ID3D12Device', 'HGLRC' or 'VkDevice'.</para>
/// </summary>
/// <remarks>
/// This class is safe to use concurrently from multiple threads in D3D10+ and Vulkan.
/// </remarks>
"Functionally equivalent to"后面又是六个东西,而且这六个里有三个是接口(COM 风格),两个是句柄(HGLRC、VkDevice),一个是上下文。这一段还有一条 <remarks> 值得停一下:"在 D3D10+ 与 Vulkan 上可以从多线程安全使用"——注意它只说了 D3D10+ 与 Vulkan,没提 D3D9 与 OpenGL。
这句"没提"不是遗漏。D3D9 的设备对象有全局状态、OpenGL 的上下文要绑定到线程,它们的线程语义和 D3D11 之后的东西根本不一样。抽象层没有假装一样:它在注释里把适用范围明说了。
2.4 一套句柄 = 一个"差异的容器"
前四节有一个共同点,可以收拢成一句:这套抽象里真正装差异的地方,是那六个句柄。
类(device/command_list/command_queue/swapchain)负责的是统一:
它们的方法名、参数、返回类型,六个后端共用一个签名。句柄负责的是容纳:每个句柄背后是什么,六个后端各是各的。
这个分工带来一个很实际的后果,第四、五章会各用一次:
- 只要一句代码不关心句柄背后是什么,它就真的与 API 无关——这是 add-on 能跨 API 的根本原因;
- 一旦某句代码需要拆开句柄(比如要拿到底层的
ID3D11Resource*才能做某件事),它就必须先问"现在跑在哪个 API 上"——device::get_api()就是为这个准备的。
换句话说:抽象层保证的是"不拆句柄的代码"跨 API,"拆了句柄的代码"从来就是 API 相关的。 这条界线,是后面所有"某某功能在某个 API 上不生效"的根源。
2.5 什么时候不得不拆句柄
上面那条界线值得举一个具体场景,因为它就是"add-on 到底能不能跨 API"这个问题的实际边界。
第一种:只传不拆。 比如"在 present 事件里把当前背缓冲当成一张纹理递给自己的着色器"——拿到 resource_view 句柄,递给 bind_descriptor_table,完事。这段代码在六个 API 上完全一样。
第二种:必须拆。 比如"我要在这张纹理上加一个 D3D11 专有的调试标记",或者"我要用 D3D12 的某个特性"。这段代码必须先 device::get_api() 判断后端,再用 get_native() 拿到底层对象。从此它与 API 绑定。
第三种最微妙:不拆也能跑,但语义不一样。 比如"资源的初始状态"——在显式世界里你必须声明它,在隐式世界里这个概念几乎不存在。同一句 create_resource 传同样的参数,在六个后端上得到的"初始可用性"并不完全一致。
所以官方那句"写一次、到处能跑",准确的说法是三句:不拆句柄的代码跨 API;拆了句柄的代码得自己处理;第三种情况接口一样但语义有差别,要按场景办。这三条不是文档里的原话,是本章证据推出来的——但它们解释了为什么实践中同一个功能经常要写好几份后端分支。
2.6 把三篇接起来看:从效果源码到原生对象,一共三跳
这一节把前三篇连成一条线,因为"抽象"在这个项目里不是一层,是两层。
第一跳:效果源码(第三篇)→ 语言层对象。 用 ReShade FX 写的效果,手里是一个 texture/sampler,它调 tex2D。它完全不知道 api:: 那一层的存在。
第二跳:语言层(第四篇)→ reshade::api 句柄(本篇)。 效果声明的语义纹理(texture BackBuffer : COLOR;)由运行时翻译成一个 resource_view 句柄,语义名到句柄的对应关系在第四篇讲过的那张注册表里。
第三跳:reshade::api 句柄 → 原生对象(各后端)。 就是本章讲的六个句柄的六种形态。
这三跳有本机读数可以对照:在第四篇对同一批 69 个效果源的只读解析里,ReShade::BackBuffer 出现了 67 次、ReShade::GetLinearizedDepth() 出现了 20 次、include "ReShade.fxh" 出现在 69 个中的 58 个里。效果作者写的是"背缓冲"和"取线性化深度"这种概念,而不是 ID3D11ShaderResourceView* 或 VkImageView。
这条链的意义在于:从效果作者的角度看,"六种 API 的差异"根本不存在——因为他站在第一跳,连第二跳都看不见。而本篇讲的抽象层是第二跳到第三跳之间的那一层,它服务的对象其实是写 add-on 的人(在 C++ 里直接碰句柄),而不是写效果的人。
换句话说:同一个项目里,"跨 API"这件事被处理了两次——一次在语言层(效果看不见 API),一次在抽象层(add-on 不必知道 API)。 本章讲的是后一次;前一次的机制在第三篇与第四篇里。
三、最硬的差异:命令列表是隐式的还是显式的
OK,这一章是整篇的核心。前面两章讲的是"抽象长什么样",从这一章开始讲"抽象吃力的地方在哪"。
而最吃力的地方,可以从一个非常小的观察开始:六个后端里,有四个有一份叫状态块(state block)的文件,另外两个没有。
3.1 两个世界
先说清这两个世界差在哪,再给证据。先给一个状态块(state block)的说法:它是"把设备当前的整套状态存下来、稍后原样装回去"的那份记录。
- 隐式世界(D3D9/D3D10/D3D11/OpenGL):设备上有一份全局的当前状态。你设一次混合模式,它就一直有效;你在别处改了,全局都变。还有一类 API 更是只有一条立即执行的命令流,命令写下去就生效,没有命令列表(command list)这个对象可以攒着。
- 显式世界(D3D12/Vulkan):没有全局状态。要做什么,全部录进命令列表;什么时候执行,由你提交到队列时决定。资源在什么状态、要不要转换,也得自己用屏障声明。
两个世界的时间线,在这张图上并排摆着。注意第三行那个动作:在隐式世界里,ReShade 要在 present 前后把应用的状态存下来再装回去(否则效果跑完,应用的渲染就乱了);在显式世界里,这一步不需要——因为"应用的命令"和"效果的命令"分别在各自的命令列表里,互不干扰。
这一个差别,直接决定了那份文件存不存在。
3.2 四份状态块,和一份不存在的
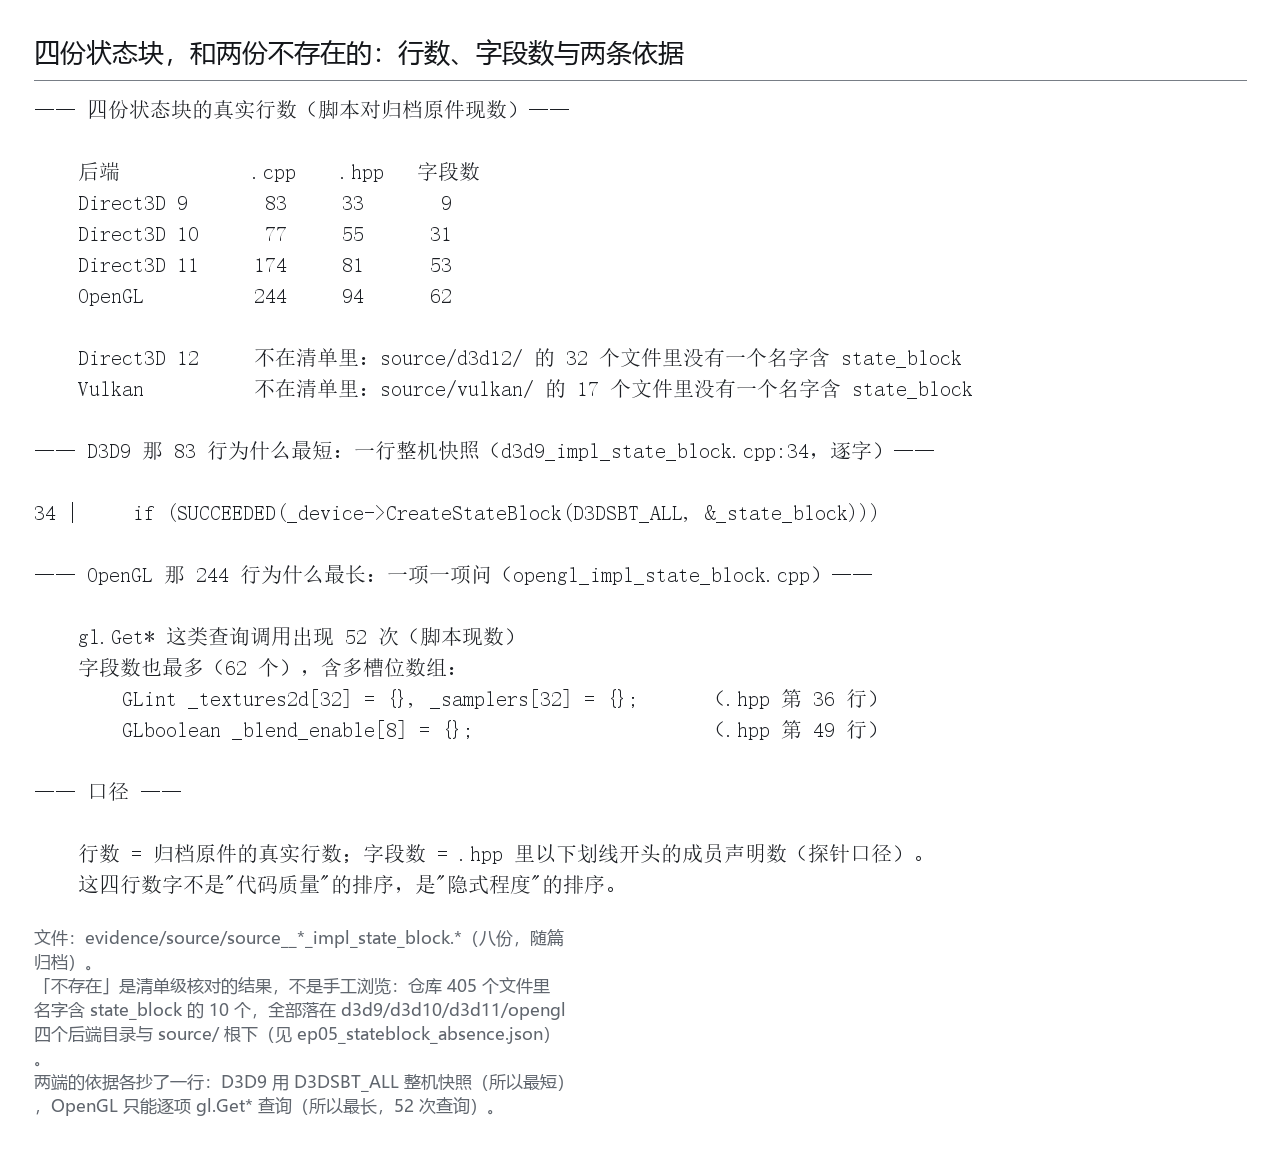
上面这张面板是本篇最硬的一处读数。四份状态块的真实行数与字段数(脚本对随篇归档的原件现数):
| 后端 | .cpp |
.hpp |
字段数 |
|---|---|---|---|
| Direct3D 9 | 83 | 33 | 9 |
| Direct3D 10 | 77 | 55 | 31 |
| Direct3D 11 | 174 | 81 | 53 |
| OpenGL | 244 | 94 | 62 |
| Direct3D 12 | 无此文件 | — | — |
| Vulkan | 无此文件 | — | — |
先看"没有"那两个:D3D12 与 Vulkan 的后端目录里,根本没有 *_impl_state_block.* 这个文件。这不是遗漏——它们的实现里确实不需要状态块。
这句话不是"我翻了两个目录没看到"。 它是对着仓库清单核的:405 个文件里,名字含 state_block 的只有 10 个,全部落在 D3D9/D3D10/D3D11/OpenGL 四个后端目录与 source/ 根下;而 d3d12 那 32 个文件与 vulkan 那 17 个文件里,一个都没有(清单级证据留在随篇归档里,可复核)。"不存在"这件事本身,也是能给出出处的。
再看"有"那四个的行数,这里有个反直觉的地方:写得最短的 D3D9(83 行),其实是最省事的那个。 为什么?因为 D3D9 有现成的机制可以整机快照——d3d9_impl_state_block.cpp 里那一行是这么写的:
if (SUCCEEDED(_device->CreateStateBlock(D3DSBT_ALL, &_state_block)))
D3DSBT_ALL 意思是"全部状态"——D3D9 自己就能把设备的整份状态打成一个包,ReShade 只要 Capture 和 Apply 各调一次,83 行就写完了。
反过来,写得最长的 OpenGL(244 行)是最费事的那个:GL 没有"整机快照"这种接口,只能一项一项去问。归档的 opengl_impl_state_block.cpp 里,gl.Get* 这类查询调用出现了 52 次——52 次询问换一份状态快照,字段数也因此最多(62 个,含 _textures2d[32]/_samplers[32]/_blend_enable[8] 这类多槽位数组)。
所以这四行数字不是"代码质量"的排序,是"隐式程度"的排序:越"全局"的世界,快照的成本越高、要记的东西越多。
3.3 为什么只有四个后端需要它
这张图把上一节的结论推完:状态块的存在与否,只取决于"状态归谁管"。
- 状态归设备管(隐式世界)→ 效果跑之前必须先"接管现场",跑完再"恢复现场"→ 需要状态块;
- 状态归命令列表管(显式世界)→ 效果和应用各录各的 → 不需要状态块。
这里有一处需要说清"抽象住了"与"翻译了"的区别(第 0.4 节第 2 条约定):
- 对于 add-on,两种情况一模一样——它只管在事件回调里做自己的事,不需要知道底层有没有全局状态。这是"抽象住了"。
- 对于后端实现,两种情况差 244 行代码。抽象层没有把这件事统一掉,它只是把差异关在了各自的
*_impl_state_block文件里。这是"翻译了"。
"抽象住了"是说给调用方的,"翻译了"是说给实现者的。 分清这两句话,才不会得出"抽象层没干活"或者"抽象层什么都干了"这种过头结论。
3.4 翻译发生在哪一层:一张外部真图
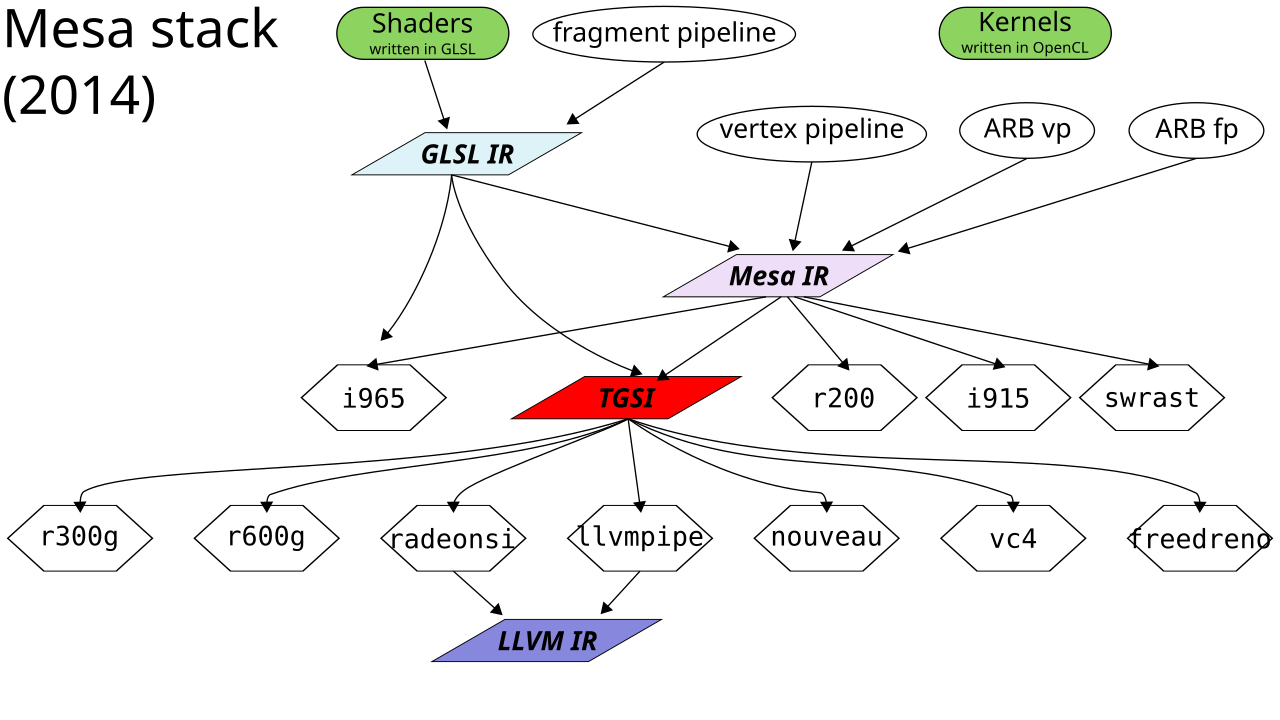
这是外面找的真图(Wikimedia Commons,CC0,960×540):Mesa 图形栈的分层。图上那串词是一条完整的翻译链——Shaders written in GLSL(用 GLSL 写的着色器)→ GLSL IR → Mesa IR → TGSI → LLVM IR → 机器的最终码;旁边还标了 i965 这类具体驱动后端(图上文字本机用 SVG 源码逐节点核过,全为英文)。
说白了,把它放在这里是为了回答一个容易混的问题::我们说"抽象层把差异收走了",收走之后呢?
收走不等于消失,而是下移。 ReShade 的抽象层把"六个 API 的差异"收进了 *_impl_type_convert.cpp 和 *_impl_state_block.cpp;再往下一层,Mesa 这种驱动栈把"GLSL 到机器码"的差异收进了它自己的四五层中间表示里。每一层都在做同一件事:让上面那一层不必知道下面发生了什么。
这条"分层收起差异"的规律,也解释了为什么本篇的读数要按后端分开数——如果抽象层真的把差异消灭了,我们就不会看到 83 与 244 这种差三倍的数字。
3.5 顺手纠一处流传很广的说法
这一节是本篇最该守"官方文字优先"这条约定的地方。
中文技术圈讲 ReShade 的 D3D9 路径时,常见一种说法:"它是挂在 IDirect3DDevice9::EndScene 上的"。这个说法听起来很合理——老一点的注入工具确实爱挂 EndScene,因为那是"这一帧画完了"的信号。
但源码里对不上。 我把归档的 d3d9_device.cpp 翻到第 1338 行,那个函数是这样的(逐字):
HRESULT STDMETHODCALLTYPE Direct3DDevice9::EndScene()
{
#if RESHADE_ADDON
    reshade::invoke_addon_event<reshade::addon_event::execute_command_list>(this, this);
#endif

    return _orig->EndScene();
}
EndScene 里确实有 ReShade 的挂钩,但它发的是 execute_command_list 这个事件——那是"有一串命令要执行了",不是"要呈现了"。 真正的呈现接管点,是同一文件里另外三处(第 368、2314 行)与交换链那一处(d3d9_swapchain.cpp 第 139 行),它们调用的才是 on_present(...)。
所以那个说法错在哪:它把两个不同的挂钩当成了一个。EndScene 确实被接管过,但它负责的不是 present。这一处的教训是通用的:"某处有挂钩"和"某处是 present 入口"是两件事,不能因为一个函数名眼熟就把它当入口。 下一章会把九个真正的入口逐条列出来。
四、一次 present 要接几个入口
4.1 九个
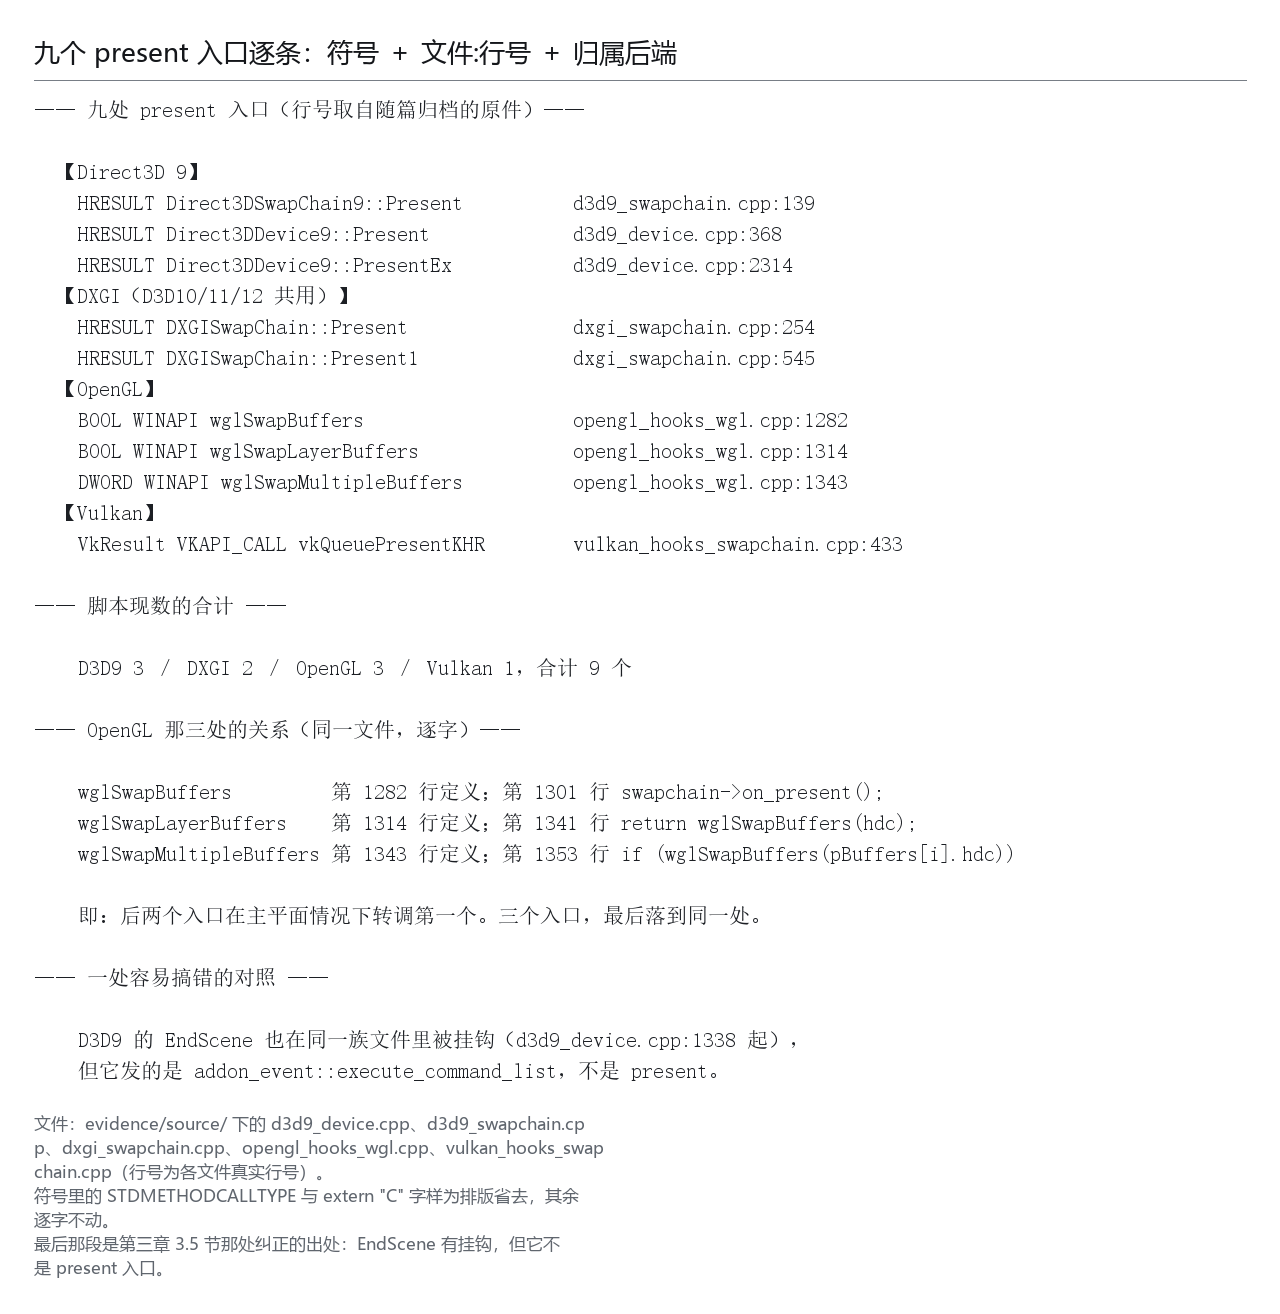
本章的核心读数就在这张面板上:六个图形 API,一共有九个 present 入口(逐条核过,符号与 文件:行号 都在面板上):
| # | 符号 | 位置 | 属 |
|---|---|---|---|
| 1 | Direct3DDevice9::Present |
source/d3d9/d3d9_device.cpp:368 |
D3D9 |
| 2 | Direct3DDevice9::PresentEx |
source/d3d9/d3d9_device.cpp:2314 |
D3D9 |
| 3 | Direct3DSwapChain9::Present |
source/d3d9/d3d9_swapchain.cpp:139 |
D3D9 |
| 4 | DXGISwapChain::Present |
source/dxgi/dxgi_swapchain.cpp:254 |
DXGI |
| 5 | DXGISwapChain::Present1 |
source/dxgi/dxgi_swapchain.cpp:545 |
DXGI |
| 6 | wglSwapBuffers |
source/opengl/opengl_hooks_wgl.cpp:1282 |
OpenGL |
| 7 | wglSwapLayerBuffers |
source/opengl/opengl_hooks_wgl.cpp:1314 |
OpenGL |
| 8 | wglSwapMultipleBuffers |
source/opengl/opengl_hooks_wgl.cpp:1343 |
OpenGL |
| 9 | vkQueuePresentKHR |
source/vulkan/vulkan_hooks_swapchain.cpp:433 |
Vulkan |
这张表里有三处值得停一下:
第一,D3D9 自己就有三个入口。 不只是设备上的那两个(Present 与 PresentEx,后者是 D3D9Ex 才有的扩展接口),还有交换链上的一个(Direct3DSwapChain9::Present)。多交换链的程序走的是第三个,如果只接前两个就会漏掉。所以面板上那三行不是"重复",是三条都要接。
第二,DXGI 只有两条,但服务三个 API。 D3D10、D3D11、D3D12 都不新增 present 入口——它们的交换链实现在各自的 *_impl_swapchain.hpp 里,但类型参数都是 IDXGISwapChain*(D3D12 是 IDXGISwapChain3*)。present 这件事统一落在 source/dxgi/dxgi_swapchain.cpp。这就是"被翻译的一方"在入口层的表现:不是六个入口,也不是九个,而是九处入口汇报给同一个事件。
第三,OpenGL 那三条是"一层套一层"的。 wglSwapLayerBuffers 的实现体里只有一句 return wglSwapBuffers(hdc);,wglSwapMultipleBuffers 也是转调——但两条都做了独立挂钩,因为老程序可能直接调它们而绕开 wglSwapBuffers。这是一处"看着冗余、其实必要"的写法。
4.2 九个入口,一个函数
上面这张图画的是收敛:九个入口最终都走到 on_present(...)。这件事在架构上的意义比字面大——它意味着:不管程序用哪种 API、从哪个入口进来,ReShade 看到的是同一个事件、拿到的是同一组参数(背缓冲、"上一帧用了多久"、有没有要截屏)。
注意这里又是"翻译了"而不是"抽象住了"。 对 add-on 来说,reshade::addon_event::present 就是一个事件;但对 ReShade 后端来说,九处挂钩逻辑各是各的——要适配 D3D9 的 RECT* 参数、DXGI 的 DXGI_PRESENT_PARAMETERS、WGL 的 WGLSWAP 数组。抽象层把这些收进了各自的后端文件,没有统一成一套参数解析。
4.3 管线对照:两张不同世界的图
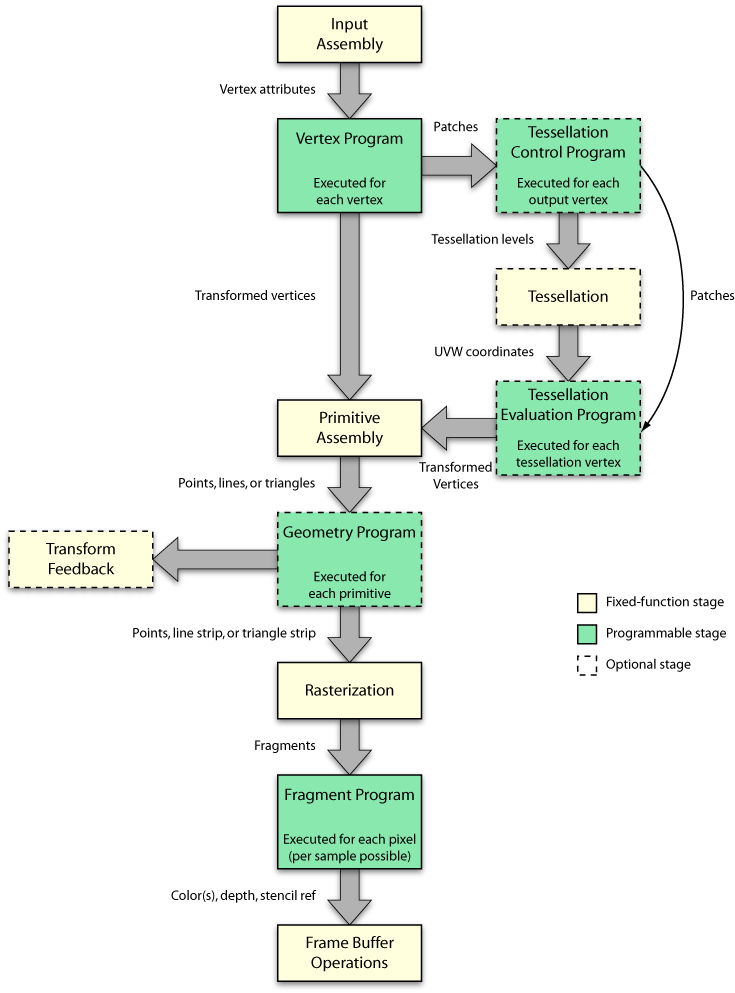
下面进入第四处证据。这仍是外面找的真图(Wikimedia Commons,CC BY-SA 3.0,735×993):OpenGL 与 DirectX 的图形管线阶段并列。图上是一串英文阶段名(Input Assembly/Vertex Program/Primitive Assembly/Geometry Program/Transform Feedback/Rasterization/Fragment Program/Frame Buffer,本机 OCR 逐行核过)。
为什么这张图要放在第四章? 因为它回答了一个接口层看不见的问题:ReShade 的效果插在哪个阶段?
看这张图的右侧:Transform Feedback 与 Frame Buffer 之间,有很长一段没有阶段名——那就是"帧已经算完,还没送出去"的那段空档,也就是第一篇讲的"注入器唯一的立足点"。抽象层里的九个 present 入口,接的都是这一段。
把三张图连起来看,结论是:抽象层统一的是接口,不是管线;它让你的代码不必知道自己在哪个 API 上,但它不改变效果实际落在管线的哪个位置。
4.4 顺带回答:D3D10 为什么能"蹭"
第四个入口那一行会引出一个问题:为什么 D3D10 和 D3D11、D3D12 一起挤在 DXGI 那两条上,而不是各有各的 present?
答案在各自的交换链实现声明里。三个后端的 *_impl_swapchain.hpp 里,那个类模板的第一个类型参数是这样的:
- D3D10:
api::api_object_impl<IDXGISwapChain *, api::swapchain> - D3D11:
api::api_object_impl<IDXGISwapChain *, api::swapchain> - D3D12:
api::api_object_impl<IDXGISwapChain3 *, api::swapchain>
三个是用同一个东西(IDXGISwapChain 及其继任接口)实现的——D3D10 与 D3D11 从诞生之初就走 DXGI 做交换链,D3D12 延续了这个安排。所以 present 这件事在 DXGI 那一层就已经统一了,三个后端只是各自把 IDXGISwapChain* 包成自己的交换链对象。
这一处很能说明"哪里该做统一、哪里不该":D3D10/11/12 的渲染命令完全不同(三套设备接口、三套状态模型),但呈现这件事从 D3D10 起就是共享的。抽象层跟着这个事实走——呈现只做一处,渲染各做各的。
反过来说,这也是 D3D9 要单独接三个入口的原因:它的呈现路径压根不属于 DXGI 那一族,Direct3DSwapChain9 是另一套东西。"新旧"在这里又切了一刀,但切的位置和第一章那条分界线不一样——第一章的分界是"状态该不该显式",这里是"呈现归谁管"。同一个 API 集合,在不同维度上会被切成不同的组,这一点是后面几章反复出现的。
五、格式与状态怎么统一:一个枚举,六份转换器
5.1 一个枚举,六份转换器
第五章的题眼就是这张图。格式这件事在抽象层里的结构是这样的:
- 一个集中的枚举:
format,定义在include/reshade_api_format.hpp第 17 行,脚本现数 131 个成员; - 六份分散的转换器:每个后端各有一对双向
convert_format,在各自的*_impl_type_convert.cpp里。
这就是"统一坐标系 + 各自翻译"在代码结构上的样本——枚举是那个统一的坐标系,六个转换器是翻译动作。抽象层从来没有一张"总换算表":因为 format 的语义本身随 API 变,硬做一张表反而会给每一处都加上条件和例外。
format 这个枚举还有一句话值得抄下来(include/reshade_api_format.hpp 第 13 行到第 15 行的注释,逐字):
/// Available data and texture formats.
/// This is mostly compatible with 'DXGI_FORMAT'.
"mostly compatible with DXGI_FORMAT"——又是蓝本侧的措辞。 大部分格式直接沿用 DXGI 的编号习惯(枚举成员全部显式赋值),而 D3D9 那套 D3DFORMAT 就完全不是一回事了。
5.2 六份转换器的位置,以及一处必须写死的四字码
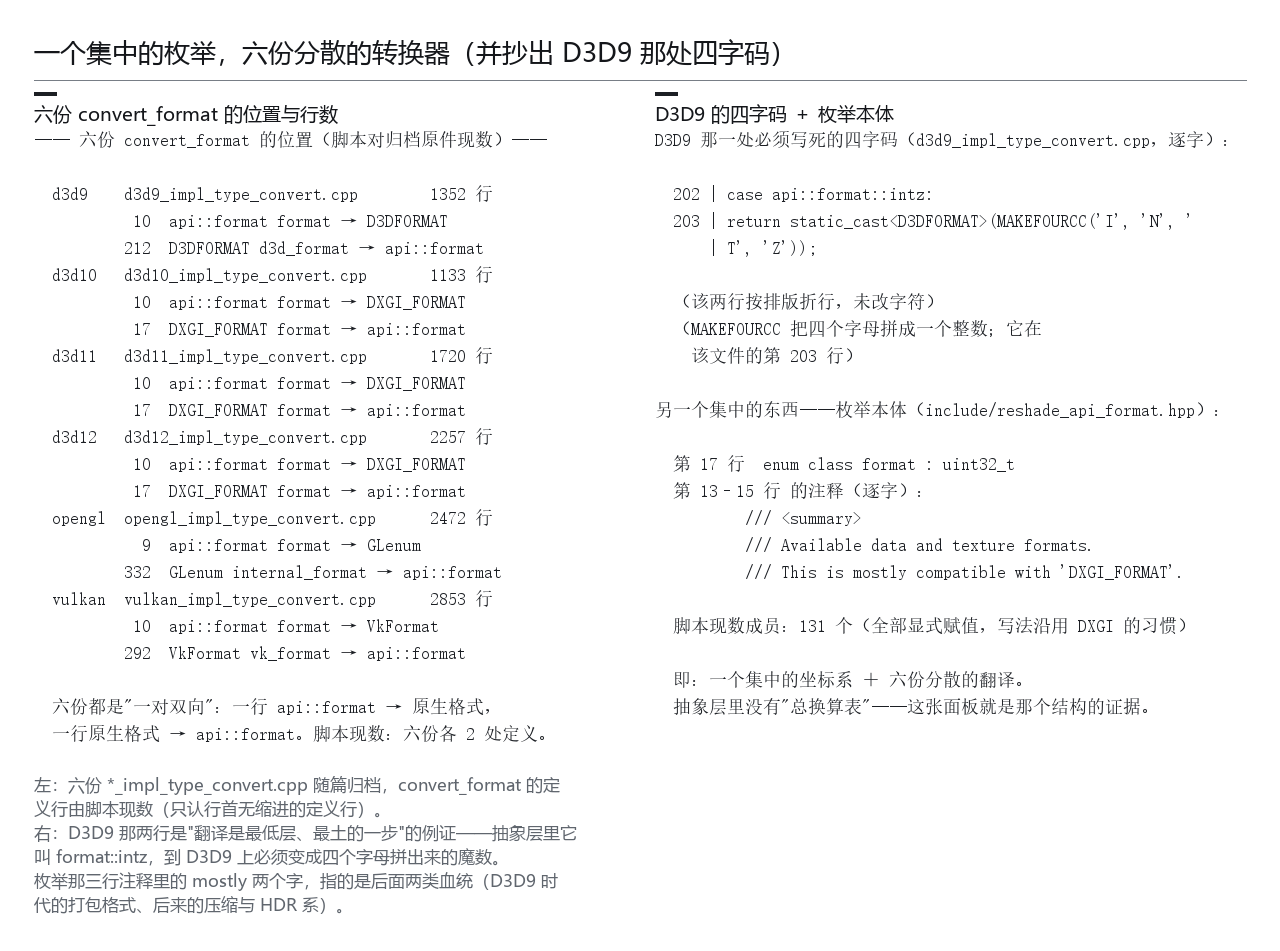
六处转换器的位置在这张面板上逐条列着。其中 D3D9 那一处有一行不太一样:
case api::format::intz:
    return static_cast<D3DFORMAT>(MAKEFOURCC('I', 'N', 'T', 'Z'));
MAKEFOURCC 是"把四个字母拼成一个整数"——'I','N','T','Z' 拼出来就是 D3D9 时代那个有名的 INTZ 格式。这是一个典型的"翻译不完全"的例子:抽象层里它叫 format::intz(一个干净的枚举成员),而到 D3D9 上,它必须变成四个字母拼出来的魔数。
这一处的工程含义在第七篇会展开(那是深度缓冲的题域):INTZ 这类格式之所以存在,是为了让深度缓冲变成"可采样的纹理",而它在 D3D9 上有格式替换、单 z-buffer 之类的限制。本篇只用到它作为"翻译是最低层、最土的一步"的例证。
5.3 被翻译的那一侧长什么样
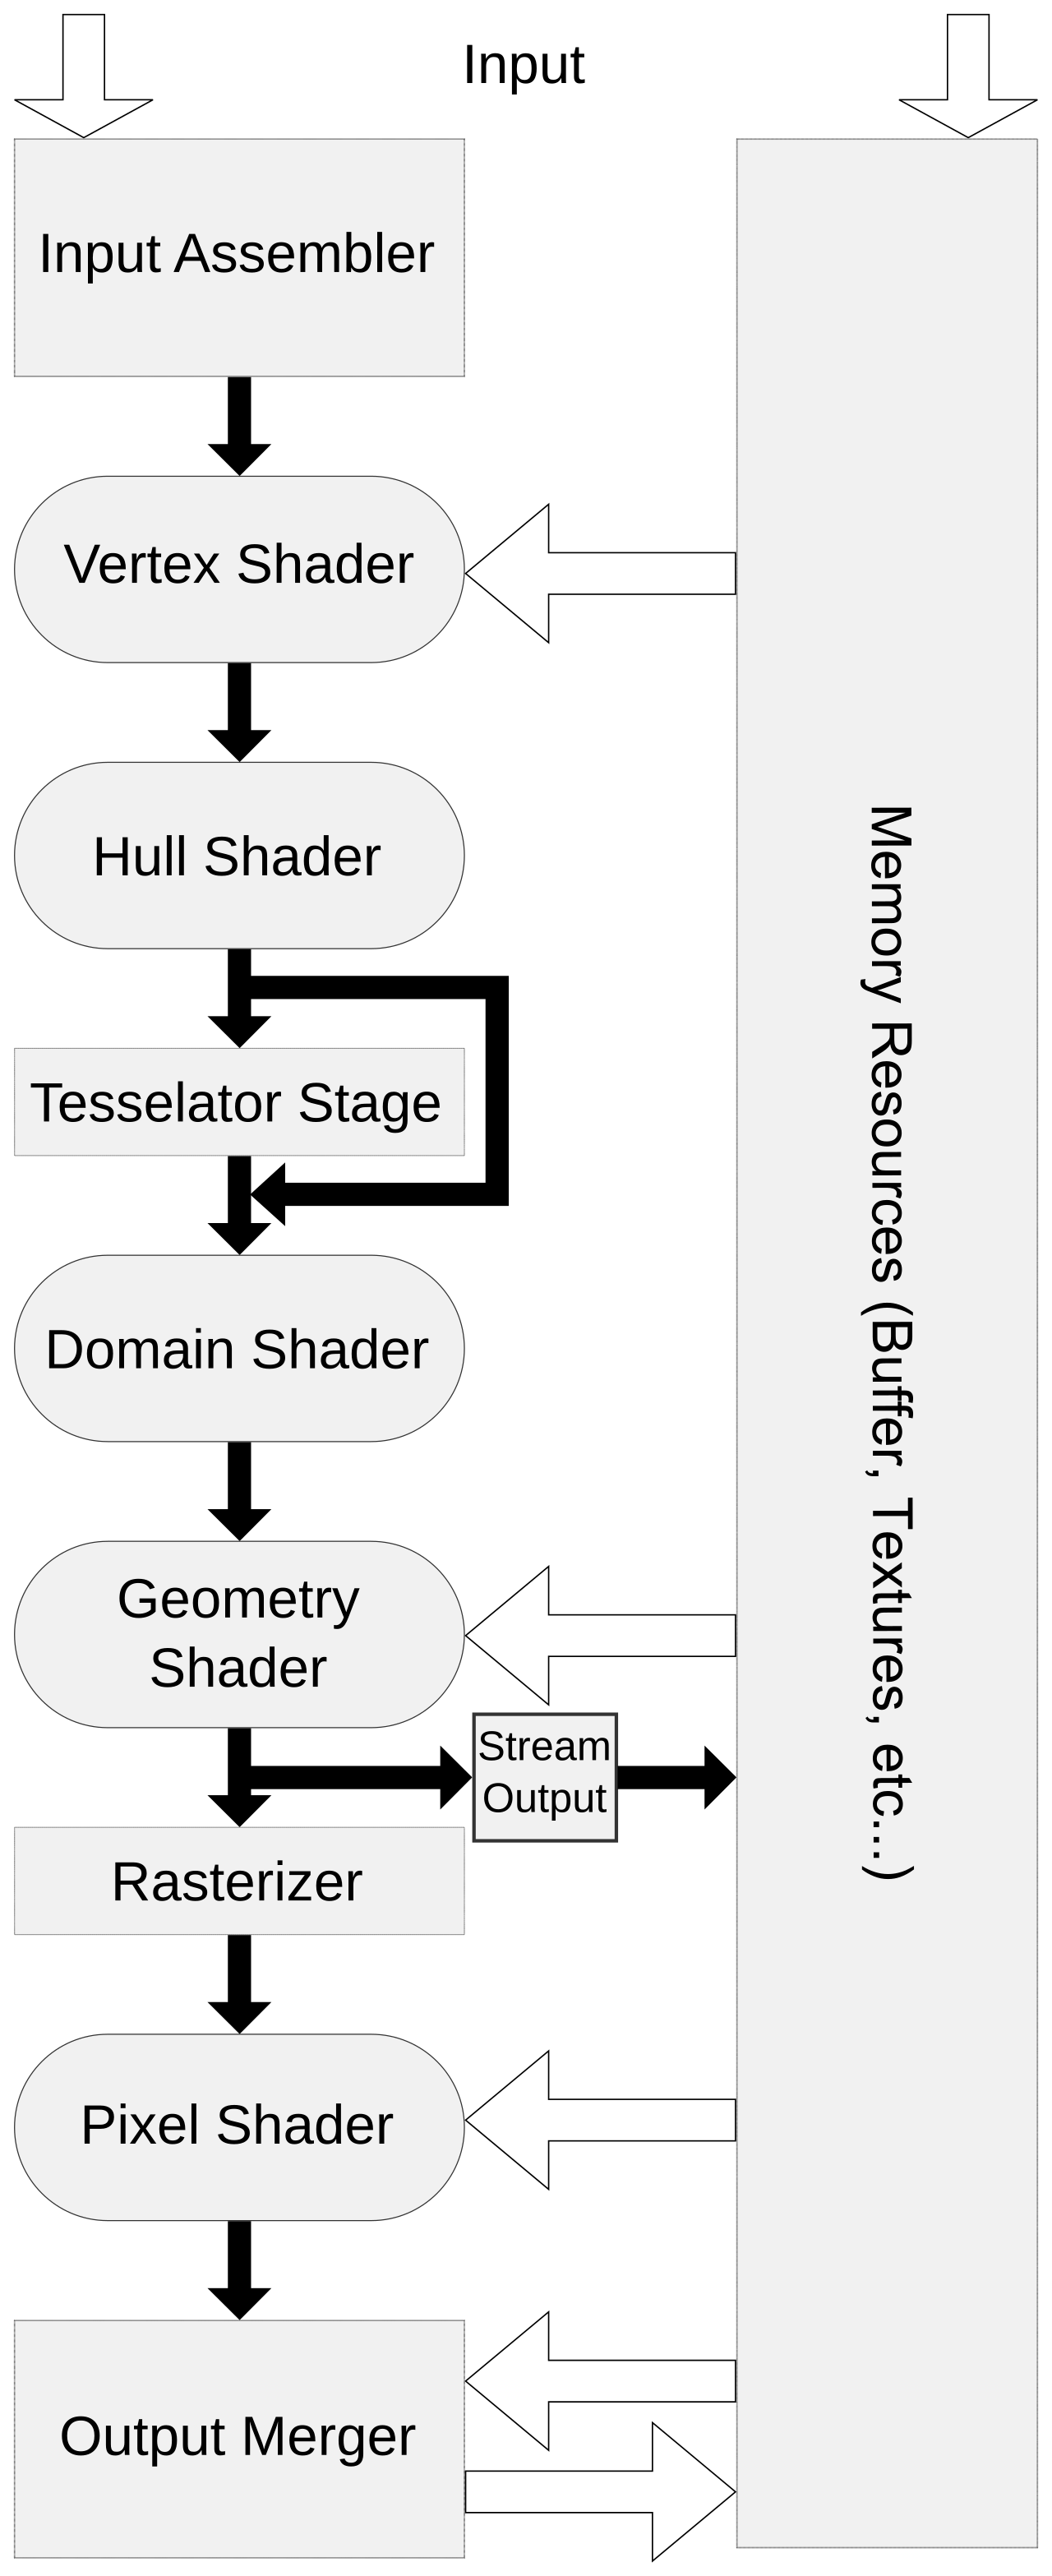
这是外面找的真图(Wikimedia Commons,CC BY-SA 3.0,760×1861):D3D11 的管线全貌。图上是一串英文阶段名——Input Assembler/Vertex Shader/Rasterizer/Pixel Shader/Output Merger,另外标了 Stream Output 与各类资源(本机用 SVG 源码逐节点核过,全为英文)。
这张图为什么放在"被翻译的一方"这一节:D3D11 的状态模型正好卡在中间——它有设备上下文这类"当前状态"的概念(像旧世界),也有 ID3D11CommandList 这种可延后执行的列表(像新世界)。所以它的状态块最"厚"(174 行/53 字段),既不如 D3D9 那样能整机快照,也没有 D3D12 那样不需要快照。
这就是"过渡年代 API"的代价:它两边都沾一点,翻译起来两边都得管。
5.4 一件本机测不了的事
好了,按第 0.4 节第 3 条约定,这一节要如实登记一处测不了。
上面那些转换函数的正确性,需要真机上跑六个 API 才能验证——而本机只有 D3D11 一条路径(本机 ReShade 装在各游戏目录里,E:\GameData\ReShade 顶层没有任何后端 DLL,所以连"逐个后端的实物对照"也做不了)。
本篇的处理是:只陈述"转换器在哪个文件、它做了什么",不写"六个 API 上的换算结果都正确"。 这一条也写进了配图盘点的"候选缺位"里——该论点不做图,正文也不写"我们对照了 DLL"。
补一句能核的:把 131 个成员按来源分一下,会发现这个枚举里混着三种血统的东西。一类是 DXGI 原生的(r8g8b8a8_unorm 这类,占大多数);一类是 D3D9 时代才有的(intz 这种四字码格式、以及 r8g8_b8g8_unorm/g8r8_g8b8_unorm 这对做 YUV 转换用的打包格式);还有一类是后来加的压缩与 HDR 系(bc7_unorm_srgb 这类)。"mostly compatible with DXGI_FORMAT"那句注释里的那个 mostly,指的就是后两类。 一个枚举里同时装着三个时代的东西,也不得不分散出六份转换器——这两件事是同一个原因的两个结果。
六、管线怎么创建:一次"打包"
6.1 为什么管线要"打包"
言归正传,在旧世界里,设置渲染状态是一连串独立的动作:设混合、设深度测试、设光栅化、绑着色器……每一条都是一次调用,改一条就生效一条。
在新世界里,这一串动作被捆成一个对象:你把所有状态写成一份描述,交给 create_pipeline 一次创建,以后每次用它只要绑一下。这个对象的创建成本很高、使用成本很低,而且创建之后改不了——想改就得重建一个。
抽象层跟的是后者的做法。第四篇已经讲过这条设计取向在 effect runtime 里的后果(pass 的状态在装载期就被折进管线对象),这一章讲它在抽象层接口上长什么样。
上面这张图是"打包"的形态:一串子对象 → 一次创建 → 之后只剩绑定。
6.2 打包的"清单":34 个格子
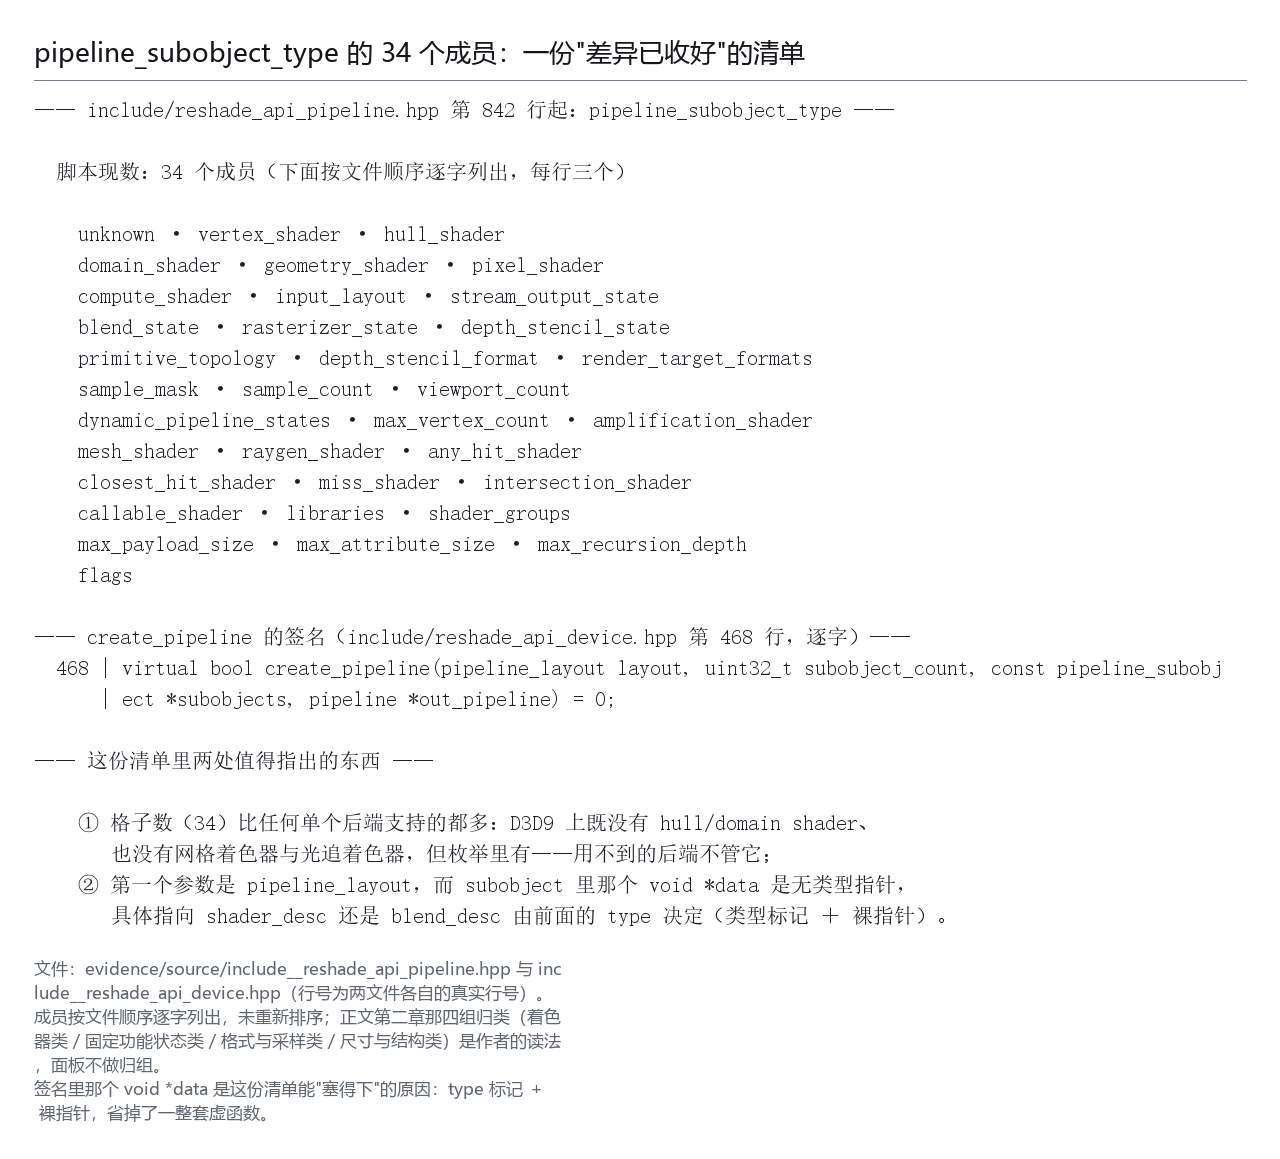
这份"清单"的原样就在面板上——pipeline_subobject_type 枚举,脚本现数 34 个成员,粗看可以分成四组:
- 着色器类:
vertex_shader/hull_shader/domain_shader/geometry_shader/pixel_shader/compute_shader,以及后来加的网格着色器(amplification_shader/mesh_shader)与光追着色器(raygen_shader/any_hit_shader/closest_hit_shader/miss_shader/intersection_shader/callable_shader); - 固定功能状态类:
blend_state/rasterizer_state/depth_stencil_state/input_layout/primitive_topology/stream_output_state; - 格式与采样类:
depth_stencil_format/render_target_formats/sample_count/sample_mask/viewport_count; - 光追的尺寸与结构类:
libraries/shader_groups/max_payload_size/max_attribute_size/max_recursion_depth/dynamic_pipeline_states/flags。
这份清单本身就是一个"差异已收好"的证据:D3D9 上没有 hull/domain shader、没有网格着色器、也没有光追着色器——但枚举里有。抽象层的做法是:格子全都留着,用不到的后端不管它。这比"按后端裁剪枚举"要省事得多,代价是调用方可能传进一个后端不支持的格子(那就创建失败)。
create_pipeline 的签名还透出另一件事(include/reshade_api_device.hpp 第 468 行,逐字):
virtual bool create_pipeline(pipeline_layout layout, uint32_t subobject_count, const pipeline_subobject *subobjects, pipeline *out_pipeline) = 0;
注意第一个参数是 pipeline_layout,还有第五个参数 void *data——pipeline_subobject 里那个 void *data 是关键:它是个无类型指针,具体指向 shader_desc 还是 blend_desc,由前面的 type 字段决定。这是一个不用虚函数的"联合体":类型标记 + 裸指针。
6.3 两个"新世界专属"的概念,被提到了抽象层
说白了,这一节要说的是本篇第二处"抽象方向的证据":描述符表与管线布局。
这两个概念在旧世界里根本不存在:
descriptor_table(描述符表)——D3D12 里它是一个描述符堆上的区间,Vulkan 里它是VkDescriptorSet;pipeline_layout(管线布局)——D3D12 里是ID3D12RootSignature,Vulkan 里是VkPipelineLayout。
它们被做成了抽象层的类型(两个都是句柄)——描述符表(descriptor table)与管线布局(pipeline layout),注释里也逐条写明映射(include/reshade_api_pipeline.hpp 第 285 行与第 1117 行附近,逐字):
/// <item>Direct3D 12: A pointer to a 'ID3D12RootSignature' object.</item>
/// <item>Vulkan: A 'VkPipelineLayout' handle.</item>
被翻译的一方要付的代价,就在这一处:D3D9/10/11 与 OpenGL 上并没有这两种东西,但抽象层里必须有,因为它们出现在 create_pipeline 的签名里。所以这四个后端的实现得造出对应的对象来(哪怕只是个空壳),才能满足接口。
这就是"先选坐标系"的代价:蓝本侧的每个概念,被翻译侧都得提供一个"能顶上的东西"。概念越多、这个代价越大——而 34 个格子说明它不少。
6.4 打包这件事本身的代价
好了,这一节把第六章的账算清。"打包创建"换来的好处是运行期便宜——绑一个对象比设十几条状态快,这是它在现代 API 里取代逐条设置的核心理由。但代价有两笔,两笔都能指到具体位置:
第一笔:创建期贵,而且贵在你不想创建的时候。 一个管线对象要把着色器编译结果、混合模式、写掩码、采样状态全折进去再提交给驱动。第四篇讲过它折进去之后运行期改不了——所以"临时改一个混合模式"这件事,在打包模式下等于重建一个管线对象。对后处理这种"全套参数一帧变一次"的场景,这个代价是可以接受的;对一个要频繁改状态的渲染器,它是不能接受的。
第二笔:void *data 这个裸指针把类型检查推给了调用方。 看 pipeline_subobject 的定义(include/reshade_api_pipeline.hpp 第 1048 行附近):
struct pipeline_subobject
{
    pipeline_subobject_type type = pipeline_subobject_type::unknown;
    uint32_t count = 0;
    void *data = nullptr;
};
type 与 data 之间靠约定对齐:type 是 blend_state,data 就必须指向一个 blend_desc;指错了,编译器不会报错。这是 C++ 里为"无虚函数的变体"付的常规代价——换来的是创建接口只有一个(无论后端怎么变,签名不变)。
把这两笔代价合起来看,就能回答一个常见疑问:"为什么 ReShade 的效果能在运行期调参数,却调不了混合模式?"——因为参数是 uniform(数据,可以每帧填),混合模式是管线状态(结构,折进对象之后就固定了)。这两件事在抽象层的设计里就分开了,不是实现偷懒。
七、抽象也有套娃,也有漏项
7.1 六条路径,不是一个整数
先来看看本章的第一个发现——上面这张图:抽象层要处理的路径数,比 device_api 枚举的成员数多。
device_api 是六个成员,但 source/ 目录里还躺着这些:
d3d11/d3d11on12.cpp与d3d11on12_device.hpp—— D3D11 跑在 D3D12 之上(游戏为了用 D3D12 的特性又懒得重写 D3D11 代码时会这么干);d3d9/d3d9on12.cpp与d3d9on12_device.hpp—— 同理,D3D9 跑在 D3D12 上;d3d12/d3d12_device_downlevel.cpp与d3d12_command_queue_downlevel.{hpp,cpp}—— D3D12 的 downlevel 路径(D3D12On7,让 D3D12 能在老系统上跑);dxgi/dxgi_d3d10.cpp—— D3D10 场景下 DXGI 工厂的代理。
所以真实的路径不是六条,而是六条主路 + 至少四条"套娃"支路。 这不是设计花哨,而是注入器必须面对的现实:它要进的是别人的进程,别人用了什么组合它管不了。
为什么这件事在"抽象层"这个话题里很重要:套娃意味着同一份命令会经过两层翻译——游戏按 D3D11 写,被翻译成 D3D12,再翻回抽象层。抽象层在中间既不能假设"底层一定是 D3D12",也不能假设"上层一定是 D3D11"。这几处代码就是这两个假设都不成立时留下的补丁。
7.2 事件的规模:100 与 23
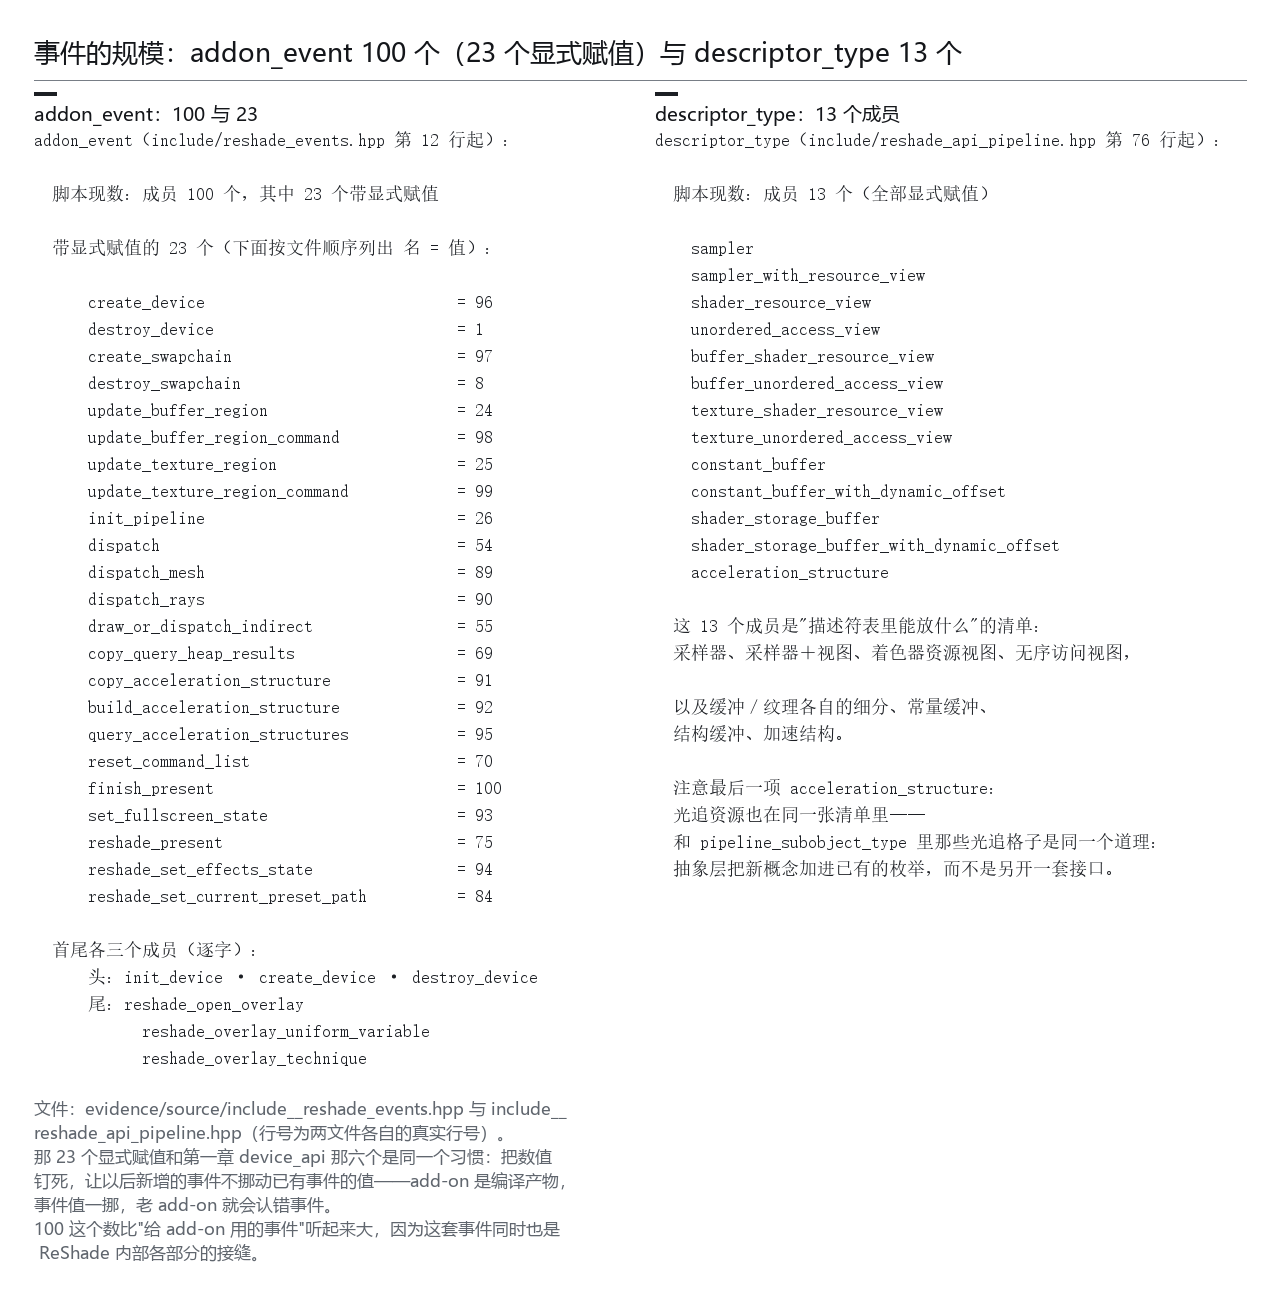
面板上并置着两处读数:addon_event 一共 100 个事件(其中 23 个带显式赋值),以及 descriptor_type 的 13 个成员。
先看那 23 个显式赋值。 这和第一章 device_api 那六个显式赋值是同一个习惯:把数值钉死,让以后新增的事件不会挪动已有事件的值。 对一套要给第三方编译的接口来说,这不是洁癖——add-on 是编译产物,事件值一挪,老 add-on 就会把事件认错。
再看 100 这个数。 它比"给 add-on 用的事件"听起来多,原因在于这套事件同时也是 ReShade 内部各部分的接缝:除了 reshade_present 这种明显给 add-on 的,还有大量 init_*/create_*/destroy_*/bind_* 的细粒度事件。粒度细是为了让 add-on 能在足够早的时机插手——比如想在资源创建时改描述,就必须有 create_resource 这类"创建之前"的事件(而不是等 init_resource)。
7.3 另一张驱动栈分层图
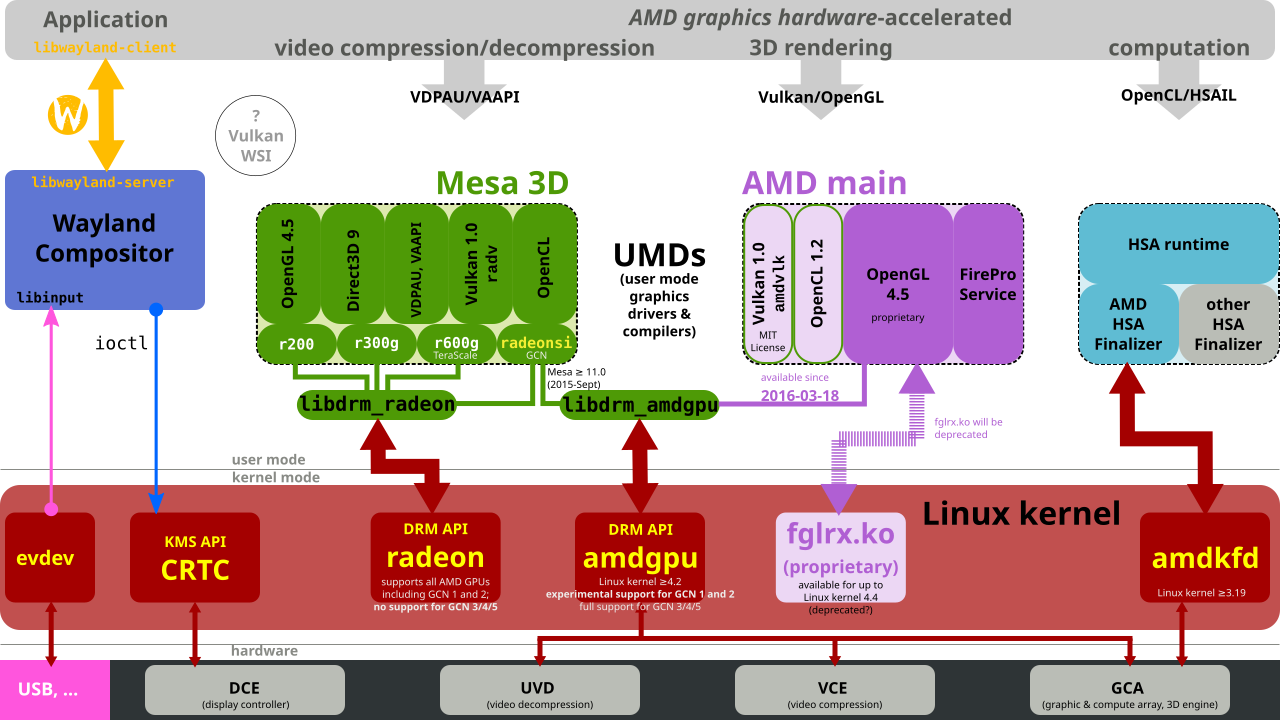
这是外面找的真图(Wikimedia Commons,CC BY-SA 4.0,1280×720):Linux 上的 AMD 图形栈。这张图的文字节点多达 96 个,是本篇所有外部素材里信息量最大的一张——从内核里的 ioctl/evdev/设备节点,到 OpenGL 4.5/OpenCL 1.2 这些上层接口,都在图上(本机用 SVG 源码逐节点核过,全为英文)。
它和第三章那张 Mesa 图是一对:那张讲"着色器在这一栈里被翻译了几道",这张讲"这一栈本身有几层、每层的接口是什么"。两张合起来说明一件事:所谓"图形 API",从来不是一层,而是一串;ReShade 的抽象层插在最上面那一道缝里,它下面的整串东西它都不管。
7.4 没被抽象住的东西:一类"漏"和一类"没打算抽"
OK,最后一节按第 0.4 节第 2 条的约定,把"抽象住了"和"翻译了"之外剩下的第三类——压根没抽——清一清。
第一处:描述符堆的归属(属于"翻译了"但翻了不够)。 这是本机唯一能拿到的官方口径,来自官方论坛一条 2026 年的问答(crosire 本人的回答):在 D3D12 上,CBV/SRV/UAV 与 Sampler 分属两个不同的描述符堆,而游戏自己的表与 ReShade 分配的表来自不同堆,绑定时必须同源——所以 ReShade 在 command_list::bind_descriptor_tables 内部自动切换堆。
这是"抽象层替调用方吃掉一层差异"最干净的一个例子:add-on 只管传表,堆的切换被藏在了绑定动作里。但同时它也说明抽象层不可能完全藏住:堆是有限的资源,切换有成本,当 add-on 自己要创建描述符表时,这个成本就会重新浮出来。
第二处:多队列语义(属于"没打算抽")。 D3D12 与 Vulkan 都支持一个设备上有多条队列(图形队列、计算队列、拷贝队列),抽象里有 command_queue 这个类型,但没有"队列优先级""队列族""队列之间的同步"这一整套语义。按第一章那条前提,这不奇怪——add-on 的典型用法不需要它。但如果你想让 add-on 自己在计算队列上跑点什么,就会碰到这一片空白。
第三处:present 的九处入口(属于"翻译了")。 第四章已经讲过:对 add-on 是一个事件,对后端是九处挂钩。
把这三处摆在一起,就得到了本章的结论:问"这套抽象全不全",先得说清问的是哪一层。 对 add-on 而言它相当完整;对后端实现者而言它只是把差异分了工;对"想用它当通用图形 API"的人而言它从来不是为这个设计的。
7.5 这套抽象层是什么时候出现的:5.0 的沿革
依然是惯例,这一节补一个"时间坐标",因为本篇讲的所有结构都不是一开始就有的。
本篇引用最多的那两句官方原话,出处其实是 5.0 的发布帖。原文第一段(逐字):
ReShade 5.0 is a major rewrite of the underlying architecture (again, yay), for improved performance, easier maintenance and future feature additions and most importantly, an all new, extremely powerful add-on API.
紧接着那段(逐字)——它和 REFERENCE.md 第 4 行是同一句话:
The add-on API makes it possible to modify/extend both ReShade and the games it is loaded into. It abstracts away differences between the various graphics API ReShade supports (Direct3D 9/10/11/12, OpenGL and Vulkan), to make it possible to write add-ons that work across a wide range of applications, regardless of the graphics API they use.
所以 REFERENCE.md 里那句"抽象层"的定义,最先出现在 5.0 的发布说明里。 而 5.0 变更日志里那一条则把"沿革"说死了(逐字):
Reworked internals and effect rendering to use an API abstraction layer rather than separate implementations for D3D9/10/11/12/OpenGL/Vulkan — This makes future feature additions much easier to implement
"rather than separate implementations"——在 5.0 之前,是每个 API 一套独立实现。 这句话回答了一个自然的疑问:"为什么不一开始就这么做?"——因为为六个 API 各写一套,在当时是更省事的做法;只有当"以后还要往里加特性"这件事变得频繁,抽象层的收益才压过它的成本。
这条沿革也解释了本篇第三章那处读数的意义:四份状态块之所以还在、还被写成四个文件,是因为它们是 5.0 之前那套独立实现的遗留物——抽象层做的是把"接口"统一掉,而不是把"实现"合并掉。真要把四份状态块合成一份,需要 D3D9 的设备查询和 OpenGL 的 gl.Get* 有一个共同的模型,而这个共性并不存在。
附带说一处边界:同样是这一篇发布说明,还交代了 add-on 与两种构建的关系——签名版"add-on 支持大部分被关掉",另外单独有一个不参与反作弊白名单的完整 add-on 版。这是第六篇的题域,本篇只在"抽象层是谁在用"这个意义上提一句。
八、代价与收益
8.1 两侧清单
第八章的任务,是把前面七章讲过的东西收成一张两栏对照表。左边一栏是抽象层真正处理掉的差异——对象模型、资源与视图的形态、全局状态、呈现入口、格式、管线状态、描述符堆;右边一栏是它没有处理的——队列族与多队列语义、驱动内部的实现细节、真实的性能特征,以及还在继续长出来的套娃路径。
好了,这张图就是本篇的账本。左边每条都能在正文里找到一处读数或一段官方原文作依据,右边每条则对应一次"没抽住"的指认。下面把两边的做法与出处逐条摆开。
| 抽象层处理了 | 怎么处理的 | 依据 |
|---|---|---|
| 对象模型 | 选 D3D12/Vulkan 当蓝本,其余四个往上靠 | REFERENCE.md:70(modeled after) |
| 资源与视图的形态 | 不透明句柄 + 注释里逐条列六种原生形态 | sampler 六条(第二章) |
| 全局状态 | 四个后端各自快照,两个不需要 | 83/77/174/244 行(第三章) |
| 呈现入口 | 九处挂钩汇报给一个事件 | 九个入口(第四章) |
| 格式 | 一个 131 成员的枚举 + 六份转换器 | 第五章 |
| 管线状态 | 34 个格子的打包创建 | 第六章 |
| 描述符堆归属 | 绑定时自动切换堆 | 官方论坛答复(7.4) |
| 抽象层没管 | 为什么 |
|---|---|
| 队列族/优先级/队列间同步 | add-on 的典型用法用不到(第一章那条前提) |
| 驱动内部的翻译链 | 在抽象层的下一层(第三章 Mesa 图、7.3 的 AMD 栈图) |
| 各 API 的性能特征 | 统一接口,但不统一开销——同一行代码在 D3D9 与 D3D12 上的代价不同 |
| 套娃路径 | 没有抽象成"路径"概念,而是各写了补丁文件(7.1) |
8.2 四条能复核的收益
收益不写"更优雅"这种没法验的话,只写能复核的:
- 一处接口面,覆盖六种 API 与至少四条套娃支路。 依据:
device_api六个成员 +source/下四个套娃文件; - 第三方不需要读六个后端就能写 add-on。 依据:
include/只有 8 个头文件,其中真正要读的是 4 个(reshade.hpp/reshade_api*.hpp/reshade_events.hpp);总行数在第四章那批读数里(reshade_events.hpp最大,1,966 行); - 差异不会"消失",只会下沉,而且下沉到哪是可定位的。 依据:六个
*_impl_type_convert.cpp与四份状态块,位置全部可在面板上查到; - 接口的稳定性是被主动维护的。 依据:
device_api六处显式赋值 +addon_event23 处显式赋值。
8.3 代价
三条,也都是能指到具体位置的:
- 被翻译侧要造出自己本来没有的概念。 依据:
pipeline_layout与descriptor_table在 D3D9/10/11 与 OpenGL 上并不存在,但必须提供(6.3); - 蓝本侧的啰嗦会传染给所有人。 34 个管线格子、100 个事件——哪怕你只想在 present 时改个颜色,接口面也摊在那里;
- 同一行代码,六个后端六种开销。 依据:状态块的 83 与 244、
gl.Get*的 52 次查询——"统一接口"从来不等于"统一成本"。
本篇与第八、九、十篇的分工也要说一句:本篇讲的是"抽象层怎么把差异收起来",第八篇讲的是"效果能不能用"、第九、十篇讲的是"跑起来要付多少"——三件事的判据完全不同,所以分三处讲。
8.4 和别的"跨 API 抽象"比一比
下面进入横向对照。"跨 API 抽象"不是 ReShade 独有的问题。这一节拿四个同类项目做横向对照——但先说清差异:这四个都掌控整条渲染管线,ReShade 寄生在别人的进程里。 这个差别决定了它们要处理的问题只有一部分重叠。
| 项目 | 它是什么 | 与 ReShade 的关键差别 |
|---|---|---|
| bgfx | API 无关的渲染库(BSD-2) | 给引擎作者用,不注入他人进程 |
| Diligent Engine | 为次世代 API 从零设计的图形框架 | 同上;官方自述"之于 bgfx ≈ D3D12 之于 D3D11" |
| wgpu | 基于 WebGPU 标准的跨平台图形 API,内含底层 hal 层 | 目标是应用直接调用的原生 API |
| The Forge | 跨平台引擎/中间件框架,自研着色语言 | 面向"写引擎/移植游戏",且已移除 DX11 支持 |
它们和 ReShade 有三处共同的问题,和三处只有 ReShade 才有的问题。
共同的三个:① 都要选一个坐标系统一六个 API(它们也大多以 D3D12/Vulkan 为蓝本);② 都要处理"隐式状态机怎么翻译成显式状态";③ 都要维护一份格式映射表。
只有 ReShade 才有的三个:
- 它不能要求应用改一行代码。 上面四个项目里,应用是在它们的接口上写的,所以它们可以规定"你必须用我的命令列表抽象"。ReShade 面对的是已经编译好、按原生 API 写死的程序——它只能去观察与拦截,不能要求对方配合。
- 它必须接住别人怎么写,而不是规定别人怎么写。 第四、七章那九处 present 入口、四个套娃文件,全部是这个约束的产物。上面四个项目里没有一个需要为"宿主程序可能用 D3D11On12 跑 D3D11"准备分支。
- 它的抽象层必须承认自己会漏。 因为它无法控制宿主的用法,所以像"多队列语义"这类东西,它只能不抽(7.4);而上面四个项目可以干脆不提供这个能力,从而不需要承认漏洞。
这一节想说的结论是:同样叫"跨 API 抽象",寄生式的比掌控式的难。 前者要在一个它控制不了的环境里维持一致性,后者只需要在自己的世界里自洽。所以拿 bgfx 之类项目的优雅程度去衡量 ReShade 的抽象层,比错了对象——它们处理的是同一类问题的子集,而 ReShade 多出来的那部分恰恰是最乱的。
九、三条结论与路线图
9.1 本篇三条结论
- "统一"的意思是"选一个坐标系",不是"抹平差异"。 官方文档的措辞是
modeled after the Direct3D 12 and Vulkan APIs——蓝本选定之后,另外四个后端是被翻译的一方。差异没有被消灭,而是被约定收走,收走的位置可以在代码里逐一定位(六个转换器、四份状态块、九处入口)。 - 最硬的差异落在"状态归谁管"上,而且有可以逐字数出来的痕迹。 四个后端有状态块(83/77/174/244 行),D3D12 与 Vulkan 没有这个文件;行数的排序就是"隐式程度"的排序。同一行 add-on 代码两边都跑得通,但后端实现差三倍代码量——这就是"抽象住了"与"翻译了"的分野。
- "抽象全不全"取决于问的是哪一层。 对 add-on:相当完整(描述符堆的切换都被藏进了绑定动作);对想当通用图形 API 的人:它从来不是为这个设计的(按
REFERENCE.md:4的目的从句,它只为"add-on 能跨应用工作"服务)。
9.2 从这一篇往后怎么走
好了,本篇把"抽象层"这一层拆完了。接下来按"从接口到实测"的顺序走完剩下六篇:
- 接口层(第六篇):想在运行时插手更深的事——add-on 的事件模型、跨 API 的资源交换、两种官方构建的分野;
- 约束层(第七篇):深度为什么时有时无。这一篇会用到本篇第五章那处 INTZ 的伏笔;
- 生态与实测层(第八、九、十篇):效果能不能用、能不能转,以及真跑一遍的账;
- 收束篇(第十一篇):把十一篇的账并到一处。
9.3 三类读者的最短路径
- 只想知道"能不能用、会不会出事":本篇第零章与第九章,加第八篇的许可地图;
- 想搞清楚它怎么实现:第一、二章立坐标系,第三章看最硬的差异,第四到七章按"从入口到落地"的顺序读;
- 现在就在写 add-on:第二章(对象形态)+ 第七章(哪里会卡)是必读;第六篇接着讲事件怎么用。
9.4 本篇与后面六篇的接口
最后交代一下这一篇给后续留了什么,免得读第六篇时觉得"前面讲过了怎么又讲":
- 本篇讲接口面,第六篇讲怎么用:本篇只说清
device/command_list/句柄长什么样,至于"怎么注册回调、在哪个事件里拿到它们"是第六篇的题域; - 本篇讲抽象,第七篇讲约束:本篇第五章点到 D3D9 的 INTZ 就收住了,深度为什么时有时无是第七篇的题域;
- 本篇讲结构,第九、十篇讲开销:本篇给出了"同一行代码六种成本"的结构性原因,具体多少毫秒要等自跑那两篇。
一句话:本篇把"差异去哪了"回答完,从第六篇开始讲"拿这套接口能做什么"。
资源清单
官方一手来源
- ReShade 官网(版本、签名指纹、分发政策原文)
- ReShade API 文档(add-on 接口与抽象层说明)
- ReShade API 参考(Doxygen:事件全量列表,含每个事件在各原生 API 的触发点)
- ReShade 代码仓库(许可、源码文件清单)
- 仓库内 REFERENCE.md(本篇多处逐字引文的出处)
- add-on 示例目录(官方 examples)
- ReShade 发布说明(历代版本变更)
- D3D_FEATURE_LEVEL 枚举(Microsoft Learn:
0xa000/0xb000/0xc000与9_x那三个取值的出处,第一章那处辨析即据此) - source/runtime_manager.cpp(
present_effect_runtime的定义处——九处 present 入口的收敛点)
官方论坛(含 crosire 本人的答复)
- 5.0 发布说明(统一抽象层取代各 API 独立实现)
- 描述符表与堆归属的问答(§7.4 那处官方口径)
- add-on 讨论版块
- 6.5 发布说明(
create_device事件用于 API 版本升级)
横向参照(目标与 ReShade 不同,仅作对照)
- bgfx | Diligent Engine | wgpu | The Forge(均为"掌控整条管线"的框架,非注入器)
图片素材(Wikimedia Commons,逐张核过许可与图内文字语言)
- File:D3D Abstract Layer (en).png(CC BY 2.5,380×286)
- File:The OpenGL - DirectX graphics pipeline.png(CC BY-SA 3.0,735×993)
- File:Mesa layers of crap 2014.svg(CC0,960×540)
- File:D3D11 Pipeline.svg(CC BY-SA 3.0,760×1861)
- File:Linux AMD graphics stack.svg(CC BY-SA 4.0,1280×720)


下篇预告
下一篇是《Add-on API:事件模型、跨 API 资源交换与两种构建的分野》。本篇只讲到"抽象出来的对象长什么样"这一层,下一篇要往下追三件事:那 100 个事件是怎么注册与分发的;add-on 拿到的资源句柄在跨 API 时怎么换手;以及官方那两种构建为什么在 add-on 上分了岔。
落款
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号「溯光的图形笔记」与个人博客 yyy3d.online。
这一篇是系列里最"结构"的一篇,把差异的去向画完就收;希望能对大家有所帮助——尤其是那句"统一的意思是选一个坐标系,不是抹平差异",后面讲 add-on 与深度时都会回到这同一个判断上来。