站点链接:技术博客页 | 公众号:溯光的图形笔记
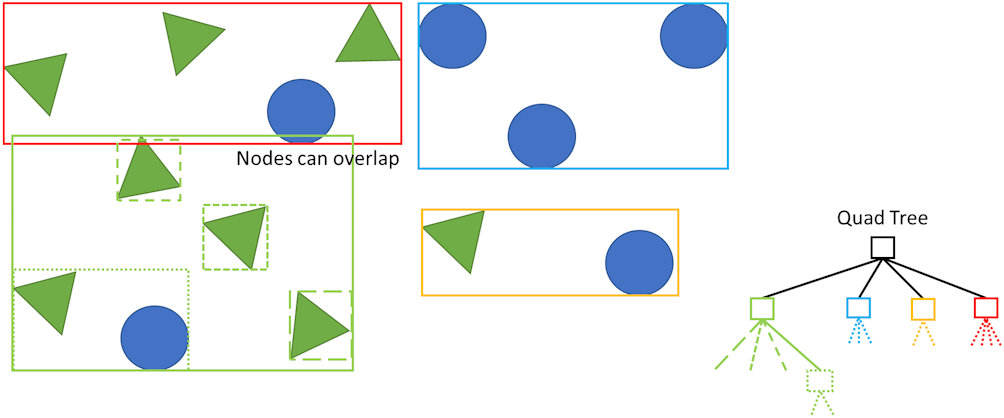
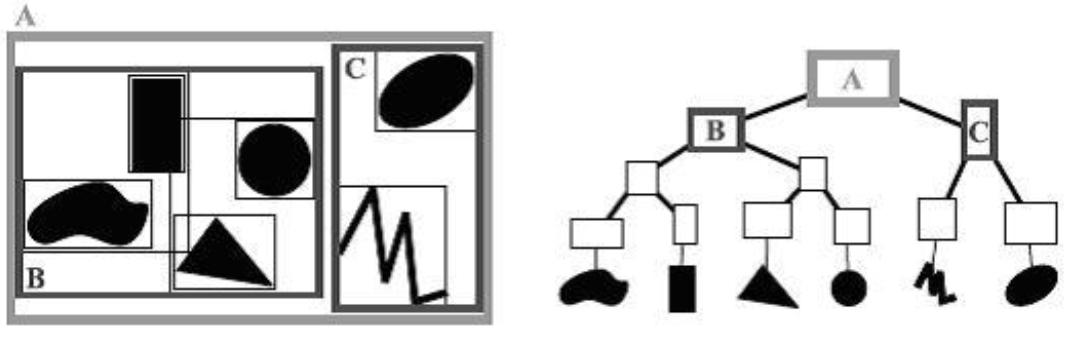
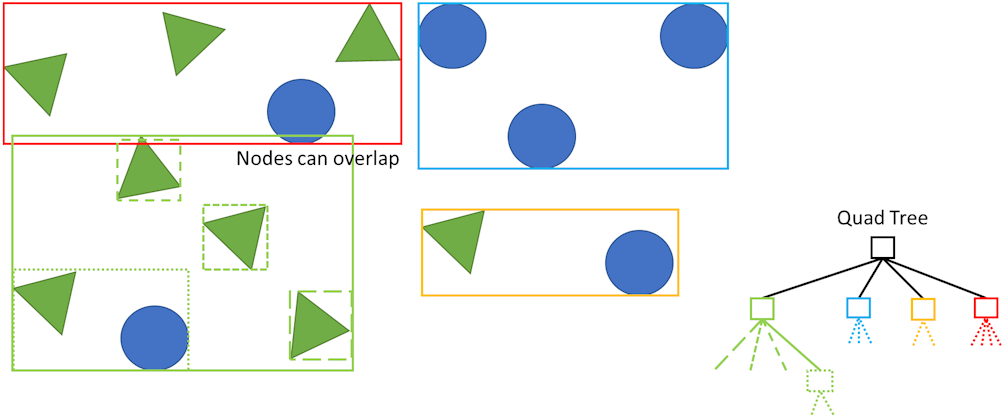
Docs/Images/QuadTreeExample.png(MIT)上一篇把刚体这个「对象」讲完了:三态与半个对象、BodyID 的位布局、四步生命周期、两副面孔的接口。
但对象只是躺在那儿。要让它们真正撞起来,第一件事是先扔掉绝大部分不可能相撞的配对,还轮不到算接触。
物理世界里,一万个刚体两两组合是四千九百九十九万对。逐对去算接触,一帧都跑不完。 所以每个物理引擎都有这么一层:用最便宜的几何判断,把候选配对砍到只剩极少数。 它叫宽相(broad phase),与真正精算接触的窄相(narrow phase)相对。
Jolt 把这一层做成了四叉 AABB 树,而且做了两件不太常见的事:树是无锁的, 以及同一时刻存在两棵树。这一篇就来拆这两件事,并回答一个官方只给了定性警告、没给数字的问题: 逐个添加刚体到底会把宽相搞坏到什么程度。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、源码怎么实现、本机跑出来是什么,这三层在文中分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(版本、场景、规模、编译选项、日期);
- 自跑优先:本专题的图以本机编译运行 Jolt 得到的真图与官方一手图为主,自绘为辅;
- 不写没有落点的说法:凡是官方文档与源码里找不到对应命名的说法,文中会明确指出查无落点;
- 本篇的知识地图:三条主线贯穿全篇,粗筛的代价(一颗 AABB 树怎么把配对砍掉)、 无锁的代价(放宽与重建的交易)、退化的代价(逐个添加为什么把树撑成一条链);
- 本篇不涉及:三层过滤器的具体配置(第五篇)、窄相怎么算接触(第六篇)、 形状与质量属性(Shape 篇)、约束求解(第九篇)、GPU 宽相(Jolt 没有这条路)。
入口:一次 AABB 粗筛
0.1 宽相在做什么
好了,先看官方怎么定义这一层。Docs/Architecture.md 的 Wide Phase 一节开篇是一句话:
When bodies are added to the PhysicsSystem, they are inserted in the broad phase (
BroadPhaseQuadTree). This provides quick coarse collision detection based on the axis aligned bounding box (AABB) of a body.(第 579 行)
翻译过来:刚体一进物理系统,就先被塞进一棵叫 BroadPhaseQuadTree 的树里。
这棵树的唯一职责,是拿每个刚体的轴对齐包围盒(AABB)做一次廉价的粗筛。
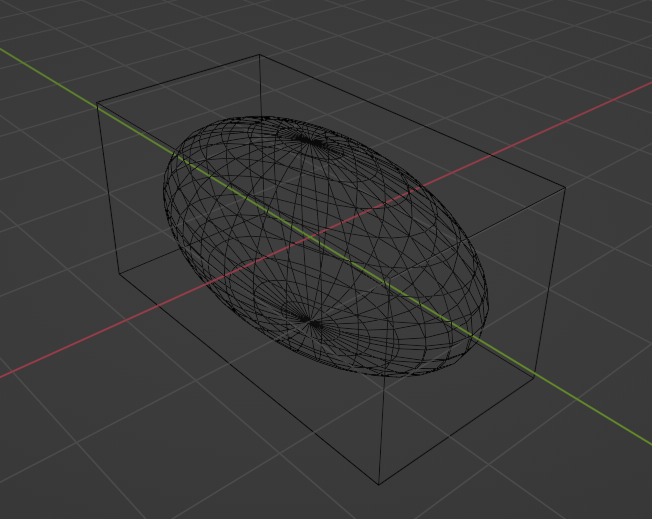
官方的配图把这件事说得很清楚:
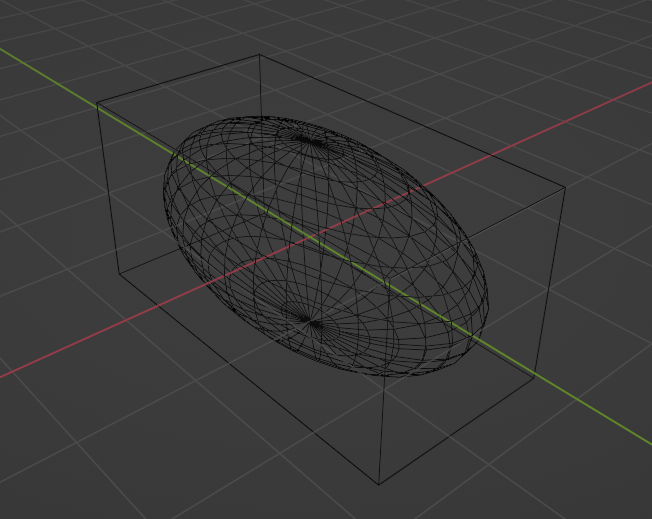
Docs/Images/EllipsoidAABB.png(MIT)OK,为什么 AABB 便宜:轴对齐意味着盒的六个面都平行于坐标轴,判断两个盒是否重叠只需要比较六对数字, 不需要任何三角函数、不需要算分离轴,连乘法都不用几次。 代价是它很松,一个斜着放的细长物体,外接 AABB 可能比它本身大好几倍。但粗筛本来就不需要精确, 它只需要不放过任何一个可能相撞的配对(不能漏),至于多报一些(误报),交给窄相去筛掉。
粗筛的两条硬性要求是不漏报与足够便宜。误报率可以高,漏报率必须为零: 漏掉一对接触,物体就会穿模;而多报一对,只是窄相多做一次无用功。
在这条管线上,宽相位处最前面:
0.2 本篇的边界(本篇不涉及什么、为什么)
好了,边界说三条。
讲什么:宽相为什么是四叉树、四个孩子的理由、无锁是怎么做到的、为什么同时有两棵树、 「重建」为什么不是全量重建、一个节点里装了什么、为什么要分层、 以及逐个添加刚体为什么会让树退化、退化的代价有多大。
只给指针、不展开什么:三层过滤器的配置(ObjectLayer / BroadPhaseLayer / 碰撞组,
第五篇)、窄相怎么算接触(第六篇)、形状本身(Shape 篇)、约束求解(第九篇)、岛与睡眠(第十篇)。
本篇提到分层只讲官方给的那一句理由:为什么要把静态与动态分家,不讲怎么配。
为什么不写 GPU 宽相:Jolt 没有这条路。v5.6 的 compute 通路只服务发束头发仿真, 刚体求解与宽相全在 CPU 的 job-system 上。拿 PhysX 或 Havok 的 GPU 实现来填 Jolt 的机制位, 是这一系列明确划掉的做法。
0.3 本机环境与读数口径
最后交代读数的来源。本篇有三类本机数据:源码与文档原文截取(行号可复核)、 原创基准实测(自写程序)、官方调试设施导出(打开官方宏后由引擎自己吐出)。
| 项 | 值 |
|---|---|
| 机型 | 16 逻辑核(8 物理核 + 超线程)x86-64 |
| 系统 / 编译器 | Windows · MSVC 14.44(VS 2022 BuildTools) |
| Jolt 版本 | v5.6.0(源码在 E:\AI\project\JoltPhysics_new) |
| 精度 | 单精度(JPH_DOUBLE_PRECISION 关) |
| 库构建 | Release · 静态运行时(/MT) · 开了 JPH_PROFILE_ENABLED |
| 基准编译 | 与库同宏 + /Zc:__cplusplus + /utf-8 |
| 两道特制宏 | JPH_TRACK_BROADPHASE_STATS(官方宽相计数)、JPH_DUMP_BROADPHASE_TREE(官方导出树结构) |
| 基准场景 | 1 块静态地面 + N 个动态立方体按 2 米间距铺成立方体网格(半长 0.5 米、mAllowSleeping = false) |
| 基准程序 | ep04_bench/bench_broadphase.cpp 与 dump_tree.cpp(均原创,随本篇存档) |
这些参数在本文开头那张题图里已经集中呈现过,这里不再重复贴一遍。
三点口径要说明,其中每一条都影响到读数的可比性:
第一,mAllowSleeping = false 是有意的。 睡眠会让静止刚体退出仿真,把宽相代价掩盖掉;
本篇要量宽相,所以让它们全程活跃。这个开关的默认值其实是 true
(见 PhysicsSettings.h 第 123 行)。
第二,两道特制宏只影响「能不能量」,不影响「量到多少」。 JPH_TRACK_BROADPHASE_STATS
只是打开官方的计数器;JPH_DUMP_BROADPHASE_TREE 只是让引擎在维护前后各导出一份树结构的 DOT 文件。
两者都不改变宽相算法本身。其中:ReportBroadphaseStats() 只在第一个宏打开时才存在
(见 PhysicsSystem.h 第 259 行)。
第三,官方 instrumentation 有一条边界要说清:它统计的是六类显式查询
(射线、AABB、球、点、有向盒、盒扫掠),不包含每步内部那个找配对的 FindCollidingPairs。
所以本篇用它量「查询代价」,不拿它冒充「整步宽相耗时」。
0.4 本篇的知识地图:三条主线
在进入正文之前,先把三条主线摆出来,大家读的时候可以对照着看。
主线一,粗筛的代价:一颗四叉 AABB 树把候选配对砍到多少。 宽相唯一的产出是「可能相撞的配对」。它做得越准,窄相越省。 这条线解释了 §1 为什么是四叉、§4 一个节点里装了什么,以及 §7 那个「同一个查询访问了多少节点」的计数。
主线二,无锁的代价:放宽与重建的交易。 为了不改结构就能被多线程同时改,Jolt 让刚体一动就把「根到它」这条路径上的包围盒放宽; 贴合的树留到下一步在后台重建,而且同时存在两棵。 这条线解释了 §2 与 §3,一笔花在「浪费的遍历」上的钱,换回了不用加锁。
其中三条主线的分工是:一、二两条管「一棵树怎么工作」,第三条管「这棵树会被用坏成什么样」。
主线三,退化的代价:逐个添加为什么把树撑成一条链。 同样是添加十万个刚体,批量添加得到的是一棵深 7 层的四叉树,逐个添加得到的却是 一条 667 层的链(本机实测,§6 给证据)。这条线解释了 §6 的全部读数,也是本篇最实用的一节。
0.5 本机实验设计:四组实验与两道宏
言归正传,这一节交代后面所有「本机实测」是怎么来的。不先看这一节,后面的数字就没有口径。
| 实验 | 问的问题 | 做法 | 产出 |
|---|---|---|---|
| E1 | 同一查询打在「坏树」与「好树」上差多少 | 10 万体场景,逐个/批量/逐个+重建三种树,各打一个 ±5 米的探针盒,读官方计数 | §7.1、§7.2 |
| E2 | 一次重建要花多少、能收回多少 | 四种插入组合各跑一遍,分别计插入、重建、首次 Update、稳态 20 步 | §3.3、§3.4、§3.5 |
| E3 | 退化树长什么样 | 打开官方导出宏,把维护前后的真实树写成 DOT 再解析 | §6.4、§6.5 |
| E4 | 宽相查询会不会报出一个「已经搬走」的刚体 | 批量插入后把一个刚体搬走 200 米,在原位查询并分两种口径计数 | §7.3 |
两道宏的作用要说清:JPH_TRACK_BROADPHASE_STATS 打开官方计数器(E1 用),
JPH_DUMP_BROADPHASE_TREE 让引擎导出真实树结构(E3 用)。
两道宏都只影响「能不能量」,不改变宽相算法本身。其中:JPH_DUMP_BROADPHASE_TREE
在官方 cmake 里没有对应的配置项,本机是用编译选项传给库的;
JPH_TRACK_BROADPHASE_STATS 则有官方选项,见
Build/README.md。
一、为什么是四叉树
1.1 四个孩子是为了一条指令
好了,宽相树的形状不是几何决定的,是指令集决定的。官方原文:
Our broad phase is a quad tree, which means each node has 4 children. … The reason why we pick 4 children is that modern CPUs support doing 4 math operations in a single instruction, so when we walk the tree from top to bottom during a collision query, we can handle 4 children at the same time and quickly get to a minimal set of colliding objects.(第 583、587 行)
这句话把「为什么是 4 而不是 2」讲透了,而且它把结论落在指令集上,而不是落在几何上。原理上,树的每一个孩子的判定都要花一次比较,把「四个孩子」与「一条 SIMD 指令」对齐,等于让每层的固定开销被摊到四个分支上。:四个 float 刚好凑满一条 SSE 寄存器,
一次 AABox4VsBox 就能同时判定「查询盒与四个孩子的包围盒」是否相交。
源码里的实现正是这么写的(QuadTree.cpp 第 1169 行):
//【宽相查询:一次比四个孩子的包围盒】,摘自 QuadTree.cpp 的 CollideAABox visitor
JPH_INLINE int VisitNodes(Vec4Arg inBoundsMinX, Vec4Arg inBoundsMinY, Vec4Arg inBoundsMinZ,
                          Vec4Arg inBoundsMaxX, Vec4Arg inBoundsMaxY, Vec4Arg inBoundsMaxZ,
                          UVec4 &ioChildNodeIDs, int inStackTop) const
{
    //【1】查询盒 vs 四个孩子的盒:一条 SIMD 指令出四个结果
    UVec4 hitting = AABox4VsBox(mBox, inBoundsMinX, inBoundsMinY, inBoundsMinZ,
                                inBoundsMaxX, inBoundsMaxY, inBoundsMaxZ);
    //【2】把命中的孩子搬到前面,决定这一层要往哪几个孩子里走
    return CountAndSortTrues(hitting, ioChildNodeIDs);
}
下面对这段代码特别说明两处。
第一,四个孩子是一组,不是四个独立判断。 参数 inBoundsMinX 等是 Vec4Arg,
即四个 float 打包成一个 SIMD 值;四个孩子的最小/最大 X 各占一个分量。
所以「判定四个孩子」在指令层面是一次比较,不是四次。
第二,CountAndSortTrues 决定的是「往哪走」,不是「撞到了谁」。 它把命中的孩子排到数组前面并返回命中个数,
遍历循环据此只处理前几个,这一步决定了树访问的规模。
二叉树的对照也很清楚:
1.2 一堆刚体被切开是什么样
先来看看树的结构落到刚体上是什么样。它本身是抽象的,落到刚体上才看得见。Jolt 官方的示意图画的就是这件事: 左边是一堆球与三角形,右边是把它切成四块之后对应的树。那张就是本文开头的题图,这里不再重复贴一遍。
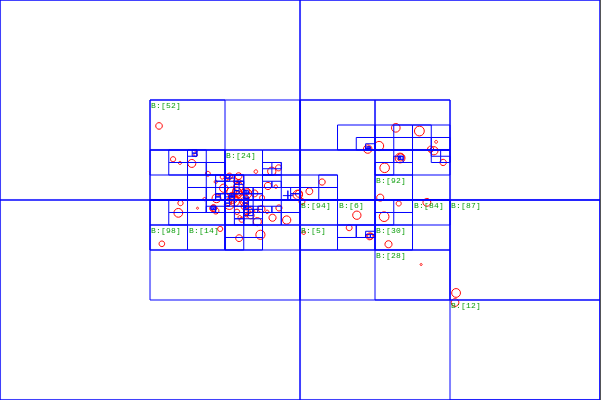
Commons 上还有一张用 100 个刚体做的四叉划分图,效果更直观:
1.3 节点里几个形状才分裂
说白了,划分规则本身很简单,官方原文给出了三种情况:
At the highest level we split all objects in 4 mostly disjoint sets. Note that nodes are allowed to overlap, but for efficiency reasons we want the amount of overlap to be minimal. … Three out of four nodes … have 4 or less shapes in them, so the tree can directly point at the shapes rather than at a next node. One node … has more than 4 shapes in it so needs a further split.(第 587 行)
读法:一个节点有四个位置(槽),每个位置要么指向一个形状,要么指向一个子节点。 所以一个节点最多直接容纳 4 个形状;超过 4 个,就得分一层。
这条规则有一个副作用值得点出来:树是「一节点挂四体」,不是「一叶四体」。 一个节点可以同时挂着「形状」和「子节点」,上面那张官方例子里, 绿色那块就是「三个形状 + 一个子节点」混在同一个节点下。
其中:cStackSize = 128 是遍历时栈深的上限(源码 QuadTree.h 第 142 行),
这条常量在 §6 会变成主角,它就是「树太深」的判定线。
1.4 节点之间允许重叠
OK,官方那句「nodes are allowed to overlap」容易被跳过,但它解释了一个常见困惑: 划分做的是把物体分成四组、每组给一个包围盒,不追求精确的空间等分;这四个盒可以互相压着。
为什么允许重叠:如果强行要求四个盒子不相交,就得把跨界的物体切开或复制, 代价远大于「偶尔多走一个分支」。这是一次典型的工程取舍:让结构松一点,换实现简单。
1.5 官方原文与源码落点
这一段的两句话都出自官方文档,源码层的落点在 QuadTree.h(完整类文档见 QuadTree 类页):
Internal tree structure in broadphase, is essentially a quad AABB tree. Tree is lockless (except for UpdatePrepare/Finalize() function) …(第 17、18 行)
翻到源码对应位置(本机核对):
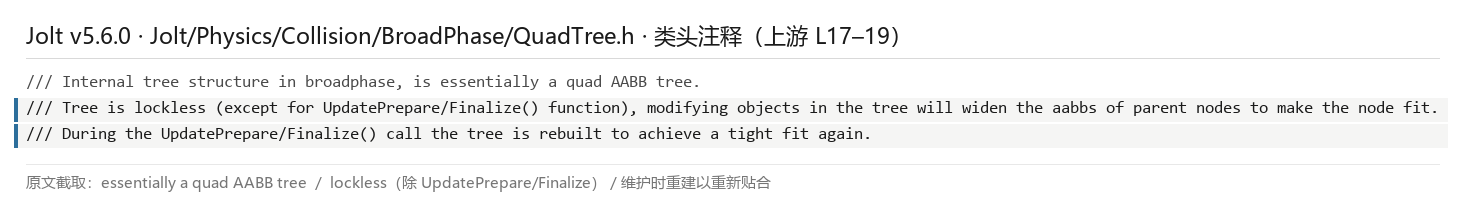
这张截图值得逐句读。它把整棵树的性格写在了最上面三行:第一句说它是一棵四叉 AABB 树,第二句说它是无锁的。第三句说只有维护那两个函数例外,其余时刻靠放宽父节点来容纳改动。把这三点连起来,就是本篇第 二 节与第 三 节要展开的全部内容。
其中:类头注释的第二句是「lockless(除 UpdatePrepare/Finalize 之外)」, 第三句是「During the UpdatePrepare/Finalize() call the tree is rebuilt to achieve a tight fit again」。 这两句就是 §2 与 §3 的全部提纲,无锁靠放宽,贴合靠重建。
1.6 宽相不只有「内部配对」,它还对外提供六种查询
到这里为止讲的都是宽相在引擎内部干的活:给每一步找出候选配对。
但它还有另一副用途:对外提供查询,这是很多人第一次读 PhysicsSystem 时容易忽略的一块。
官方文档把这件事列在碰撞检测一节的头部:
Coarse collision detection against the world, using only the bounding box of each body is done through the
BroadPhaseQueryinterface (seePhysicsSystem::GetBroadPhaseQuery).(Architecture.md第 563 行)
源码里这六类查询被逐条列出(BroadPhaseQuery.h 第 35 至 53 行,本机核对):
| 查询 | 语义 | 典型用途 |
|---|---|---|
CastRay |
射线打到的盒子 | 视线、拾取 |
CollideAABox |
与 AABB 相交的刚体 | 区域查询、本篇的探针 |
CollideSphere |
与球相交的刚体 | 「附近有什么」 |
CollidePoint |
包含某点的刚体 | 点选、地形高度 |
CollideOrientedBox |
与有向盒相交的刚体 | 跟随角色的检测盒 |
CastAABox |
盒扫掠(带运动的盒) | 移动物体的连续检测 |
这六类查询都只测包围盒,不测形状本身,官方在 BroadPhaseQuery 的类注释里写得很清楚:
「These queries will only test the bounding box of the body … The shapes of the bodies are not tested,
if you want this then you should use the NarrowPhaseQuery interface.」
所以如果你要的是「精确命中」,宽相查询只能当前置粗筛用。
这里用的是本系列一贯的读法:先给全量清单,再做二次归类,清单是「面」,归类是「骨」。 上面那张表是「面」(六类查询一个不漏),按「测什么几何」再归一次类就是「骨」: 前两类测直线与盒(一维与三维的相交),中间三类测更具体的形状(球、点、有向盒), 最后一类测运动过程(盒扫掠)。只有最后一类测的是「一段时间内的相交」,而不是「某时刻的相交」, 这也解释了它为什么要单列,它内部要沿运动方向做多次判断。
其中:这六类查询正好是 §0.3 里官方 instrumentation 的统计口径,
也是 §7.1 那个探针实验用的那一类(CollideAABox)。
换句话说,本篇的实测数字与官方计数表是同一个口径,中间没有我自己的插桩。
二、无锁双树
2.1 刚体一动,只放宽父节点
好了,先说无锁的那一半。官方原文:
When a body moves, all nodes in the AABB tree from root to the node where the body resides will be expanded using a lock-free approach. This way multiple threads can move bodies at the same time without requiring a lock on the broad phase. Nodes that have been expanded are marked …(第 589 行)
关键动作是「expand」,源码里叫 widen(放宽)。它由两个函数完成
(QuadTree.h 第 290、293 行声明,本机核对):
//【放宽:把新包围盒并进节点槽的存值】,摘自 QuadTree.cpp 的 EncapsulateChildBounds
bool QuadTree::Node::EncapsulateChildBounds(int inChildIndex, const AABox &inBounds)
{
    //【1】六个方向各自做一次原子 min / max,只会越并越大,不会越并越小
    bool changed = AtomicMin(mBoundsMinX[inChildIndex], inBounds.mMin.GetX());
    changed |= AtomicMin(mBoundsMinY[inChildIndex], inBounds.mMin.GetY());
    changed |= AtomicMin(mBoundsMinZ[inChildIndex], inBounds.mMin.GetZ());
    changed |= AtomicMax(mBoundsMaxX[inChildIndex], inBounds.mMax.GetX());
    changed |= AtomicMax(mBoundsMaxY[inChildIndex], inBounds.mMax.GetY());
    changed |= AtomicMax(mBoundsMaxZ[inChildIndex], inBounds.mMax.GetZ());
    //【2】返回值表示「这次有没有真的变大」,调用方据此决定要不要往上传
    return changed;
}
下面对这段代码特别说明三处。
第一,放宽是单调操作。 只会把盒撑大,永远不会缩小。正因为单调, 两个线程同时放宽同一个节点时,谁先谁后都不影响最终结果,这就是它不需要锁的原因。 (这一句是本文对源码语义的解读,官方文档只说了「用无锁方式 expand」。)
第二,一次动体会影响一整条路径。 刚体所在的叶子上挂着的盒要改,
它的父节点、祖父节点一直到根,全部要跟着放宽并标脏(MarkNodeAndParentsChanged)。
第三,标脏是为了下一步重建。 只看「脏没脏」这一位,就能决定下一步要不要重算这个子树。
放宽与贴合是两种状态,差得很远:
2.2 双根怎么交替
先来看看,只有放宽还不够,盒越撑越大,剪枝就会失效。所以还得有人负责把树重新贴合。 官方说这一步是在后台建一棵新树替换旧的:
Nodes that have been expanded are marked and during the next physics step a new tight-fitting tree will be built in the background while the physics step is running. This new tree will replace the old tree before the end of the simulation step. This is possible since no bodies can be added/removed during the physics step.(第 589 行)
源码里这件事的载体是两个根(QuadTree.h 第 267、340、341 行,本机核对):
We alternate between two trees in order to let collision queries complete in parallel to adding/removing objects to the tree
RootNode mRootNode[2];/atomic<uint32> mRootNodeIndex { 0 };
为什么不能建完就丢旧的:如果有别的线程正在遍历旧树,节点一释放,它的栈里就全是悬垂索引。
Jolt 的解法是给查询配一把「旧查询锁」,把释放动作推到 FrameSync()。
2.3 怎么保证「没有线程还在查旧树」
OK,这段代码是整篇里最能说明「双树为什么必须配锁」的一段(BroadPhaseQuadTree.cpp 第 58 至 70 行,本机核对):
//【帧同步:旧树在这里才被释放】,摘自 BroadPhaseQuadTree.cpp
void BroadPhaseQuadTree::FrameSync()
{
    JPH_PROFILE_FUNCTION();

    //【1】对「旧查询锁」取独占锁:拿到它就说明没人还在遍历旧树
    UniqueLock root_lock(mQueryLocks[mQueryLockIdx ^ 1] JPH_IF_ENABLE_ASSERTS(, mLockContext, EPhysicsLockTypes::BroadPhaseQuery));

    //【2】逐层丢弃旧树(每层一棵,见 §5)
    for (BroadPhaseLayer::Type l = 0; l < mNumLayers; ++l)
        mLayers[l].DiscardOldTree();
}
下面对这段代码特别说明两处。
第一,注意锁的是 mQueryLockIdx ^ 1。 异或 1 得到的是「上一棵树」对应的那把锁,
而不是当前树的,查询走当前树的锁,释放等旧树的锁,两者互不阻塞。
第二,DiscardOldTree 是整棵丢。 它不做增量清理,因为旧树已经没有任何引用了。
其中:OptimizeBroadPhase() 的实现就是先 FrameSync() 再全量重建
(BroadPhaseQuadTree.cpp 第 72 行起),所以「手动重建」和「每步的自动维护」共用同一套机制。
2.4 代价:节点内存要备双份
说白了,双树不是白拿的。节点分配器的容量在初始化时就按两棵树算好
(BroadPhaseQuadTree.cpp 第 39 至 43 行,本机核对):
//【节点预算:按最大刚体数倒推,并乘以 2】,摘自 BroadPhaseQuadTree.cpp 的 Init
uint32 num_leaves = (uint32)(mMaxBodies + 1) / 2;                          // Assume 50% fill
uint32 num_leaves_plus_internal_nodes = num_leaves + (num_leaves + 2) / 3;  // = Sum(num_leaves * 4^-i), i = [0, Inf].
mAllocator.Init(2 * num_leaves_plus_internal_nodes, 256);                   // double the amount while rebuilding the tree
这里有两个隐含假设写在注释里:一组装填率 50%(叶子数取刚体数的一半)、
内部节点按四叉树的几何级数求和(每个内部节点摊到约 1/3 个叶子)。
最后一个参数 256 是分配器的页大小,不是节点数
(FixedSizeFreeList::Init(inMaxObjects, inPageSize),见
FixedSizeFreeList.h 第 84 行)。
节点大小是 128 字节(§4 拆开看),于是三档规模的内存账可以直接算出来:1 万体 13334 个节点,折合约 1.6 MiB;10 万体 133334 个,约 16.3 MiB;100 万体 1333334 个,约 162.8 MiB。
注意这张表的口径:它是按源码公式推算的,不是官方给的数字,也不是本机实测的分配量。 它说明的是一件事:双树策略把宽相的固定内存抬高了一倍,而这个代价与刚体数同阶。
三、重建不是全量重建
3.1 脏路径之外,整块搬
好了,标题这句是本节的主论点。官方把重建说得轻描淡写(「a new tight-fitting tree will be built」),
但源码里的重建不是把所有节点重算一遍。原理上,它只重算「被标脏的那条路径」,其余子树整块搬走。关键判断在 QuadTree.cpp 第 333 行(本机核对):
//【重建时的取舍:没脏的子树整块搬过去】,摘自 QuadTree.cpp 的 UpdatePrepare
if (!node.mIsChanged && !inFullRebuild)
{
    // Node is unchanged, treat it as a whole
    *cur_node_id = node_id;
}
读法:遍历旧树收集节点时,遇到一个「自己没被标脏」的节点, 就直接把它当作一个整体放进新树,不再往下拆。§2.1 里那次「从刚体到根全部标脏」的操作, 到这里变成了收益:只有被触碰过的那些路径需要重算。
3.2 深度 5 这条线是作者手调的
OK,「整块搬」听上去只有好处,其实有害处:搬过去的子树内部还是老结构,新树的质量会变差。
源码里为此留了一个常数(QuadTree.cpp 第 363 至 370 行,本机核对;整份实现见 QuadTree.cpp):
// those nodes get recreated every time when we rebuild the tree. This balances the amount of
// time we spend on rebuilding the tree ('unchanged' nodes will be put in the new tree as a whole)
// vs the quality of the built tree.
constexpr uint cMaxDepthMarkChanged = 5;

AABox root_bounds;
root_node_id = BuildTree(inBodies, ioTracking, node_ids, num_node_ids, cMaxDepthMarkChanged, root_bounds);
官方的注释把交易写得很直白:重建耗时与树的质量之间取平衡,脏标记只往下降到第 5 层。 再深的节点即使被标记,也保持原样搬过去。
这张图把那个常数画成了两条方向相反的箭头:往下重算得越多,新树越贴合、但重建越贵;重算得越少,重建越快、但树里会留下越来越松的盒子。作者选了 5,说明他量过这两条线的交点大概在哪。
其中:cMaxDepthMarkChanged = 5 是一个编译期常数,不是可配参数。
也就是说这是作者测出来、写死在代码里的经验值,不是使用者能调的旋钮。
3.3 本机实测:一次重建要花多少
言归正传,上面都是机制,现在换到实测。第一件要量的事是一次全量重建的耗时随规模怎么变。
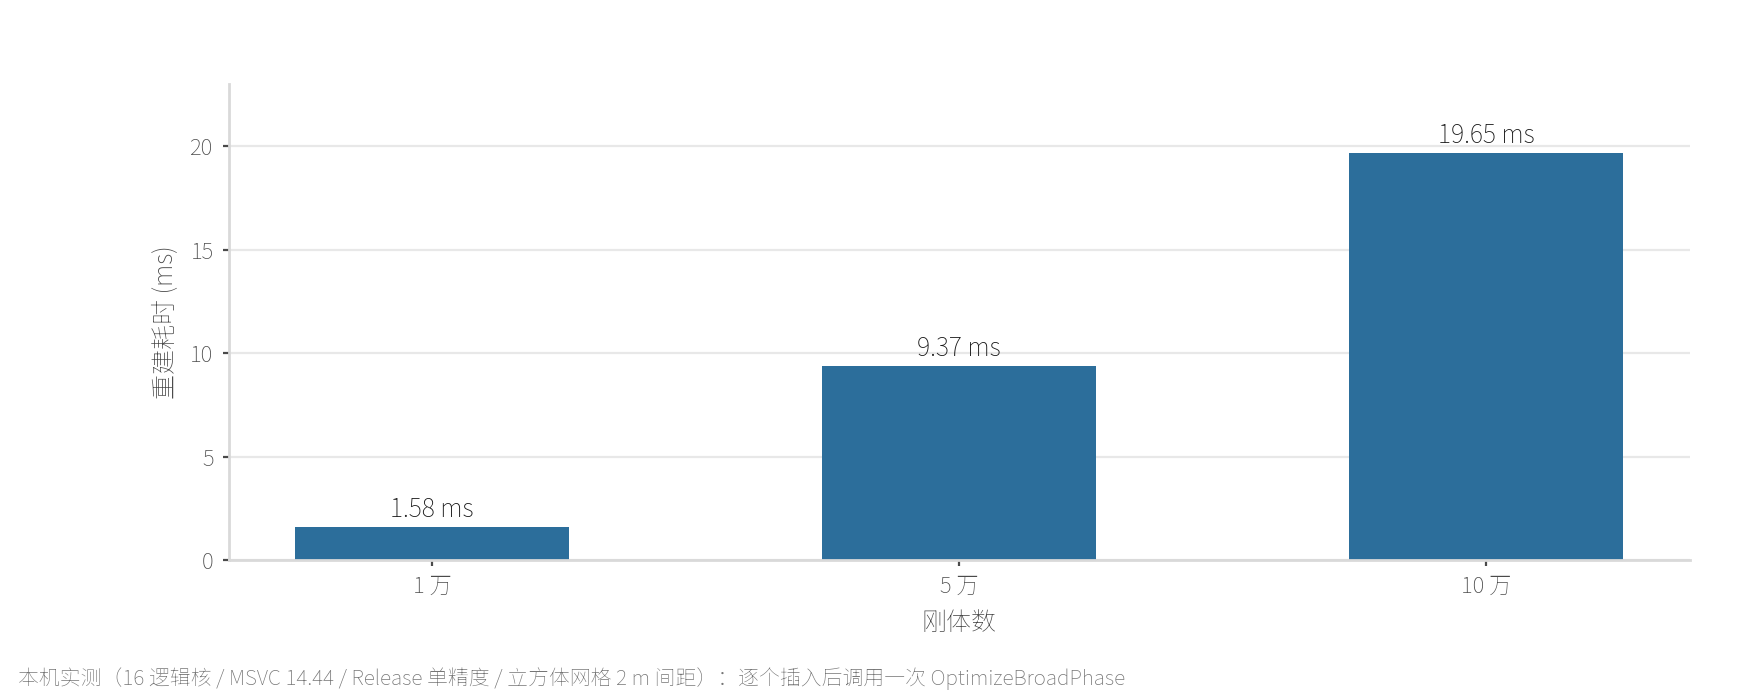
口径:本机 16 逻辑核 / MSVC 14.44 / Release 单精度 / 立方体网格 2 米间距;
每档先逐个插入 N 个刚体,然后调用 OptimizeBroadPhase() 计时,重复一次取单次值。
三档耗时近似线性:1 万体 1.58 毫秒、5 万体 9.37 毫秒、10 万体 19.65 毫秒。 按节点数算也合理,10 万体的树约 6.7 万个节点,19.65 毫秒意味着单个节点约 0.29 微秒, 与「遍历 + 四叉划分 + 原子写」的量级相符。
3.4 本机实测:插入方式 × 是否重建
先来看看第二件要量的事:四种组合下,插入、重建、首次 Update、稳态各花多少。
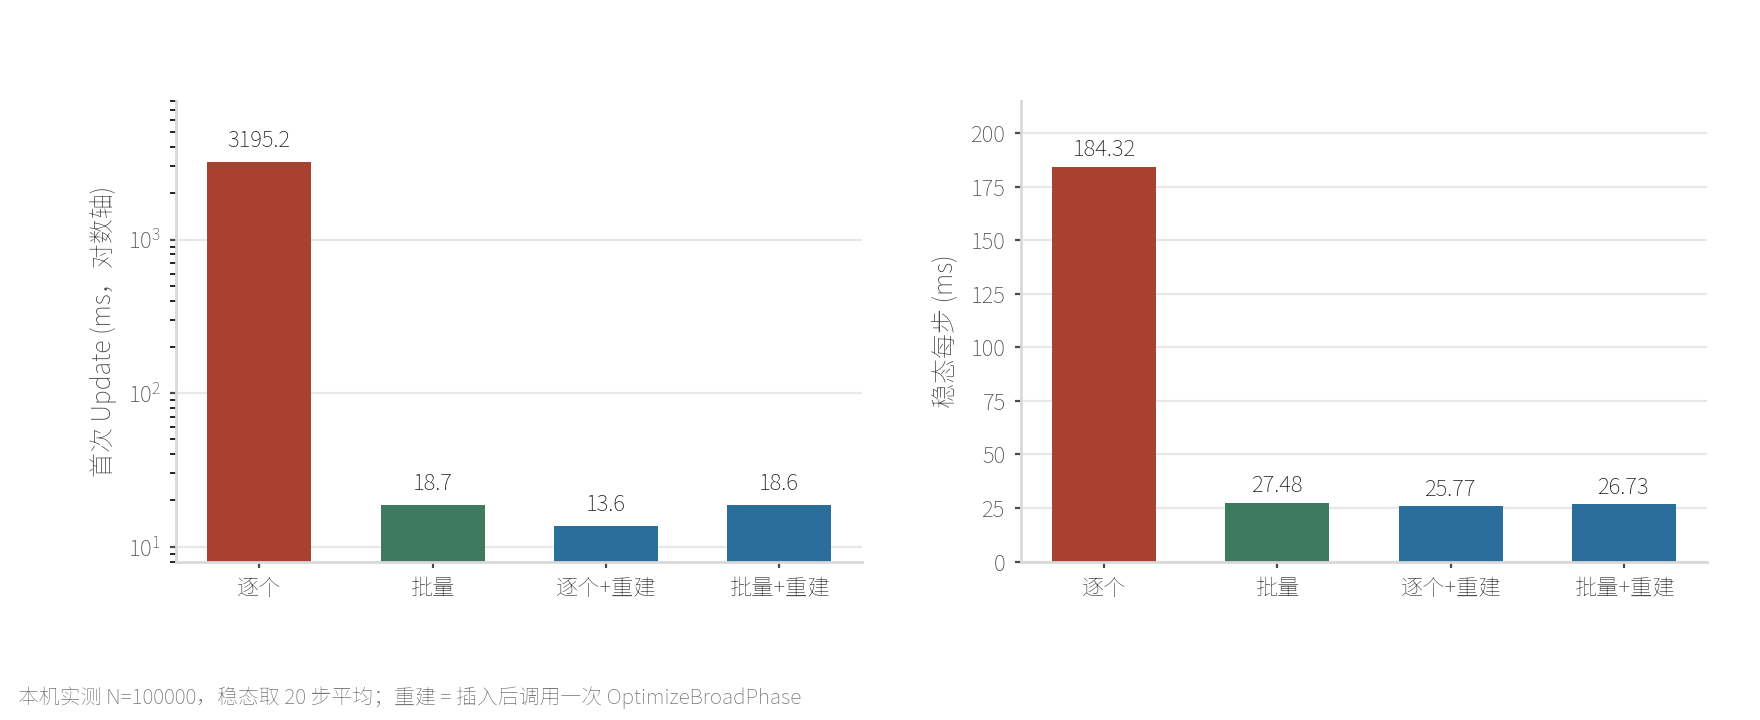
口径同上,N = 100,000,稳态取 20 步的平均值:
| setup | 插入(ms) | 重建(ms) | 首次 Update(ms) | 稳态(ms/步) |
|---|---|---|---|---|
| 逐个 AddBody | 28.6 | — | 3195.2 | 184.32 |
| 批量 Prepare/Finalize | 36.5 | — | 18.7 | 27.48 |
| 逐个 + Optimize | 27.2 | 18.24 | 13.6 | 25.77 |
| 批量 + Optimize | 34.0 | 17.71 | 18.6 | 26.73 |
这张表里有三件事值得说。
第一,逐个插入的插入本身并不慢(28.6 毫秒,甚至比批量还快一点),慢的是它留下的烂摊子。 这与 ep03 测到的结论一致:批量接口的代价不在插入那一瞬,而在插入之后。
第二,一次重建把首次 Update 从 3195 毫秒拉回 13.6 毫秒,差 235 倍; 稳态从 184.32 降到 25.77 毫秒每步,差 7.2 倍。
第三,批量插入之后再重建几乎没有收益(18.7 → 18.6 毫秒,稳态 27.48 → 26.73)。
官方在 PhysicsSystem::OptimizeBroadPhase() 的注释里正好写了这一条:
If you add many bodies through
BodyInterface::AddBodiesPrepare/AddBodiesFinalizeand if the bodies in a batch are in a roughly unoccupied space (e.g. a new level section) then a call toOptimizeBroadPhaseis also not needed as batch adding creates an efficient bounding volume hierarchy.(PhysicsSystem.h第 145 至 148 行)
本机读数与这句官方说明对得上:批量插入本身就建出了好树,所以重建无事可做。
3.5 本机实测:稳态会自己收敛吗
好了,第三个问题:如果不重建,光靠每步的自动维护,稳态能追平批量吗。
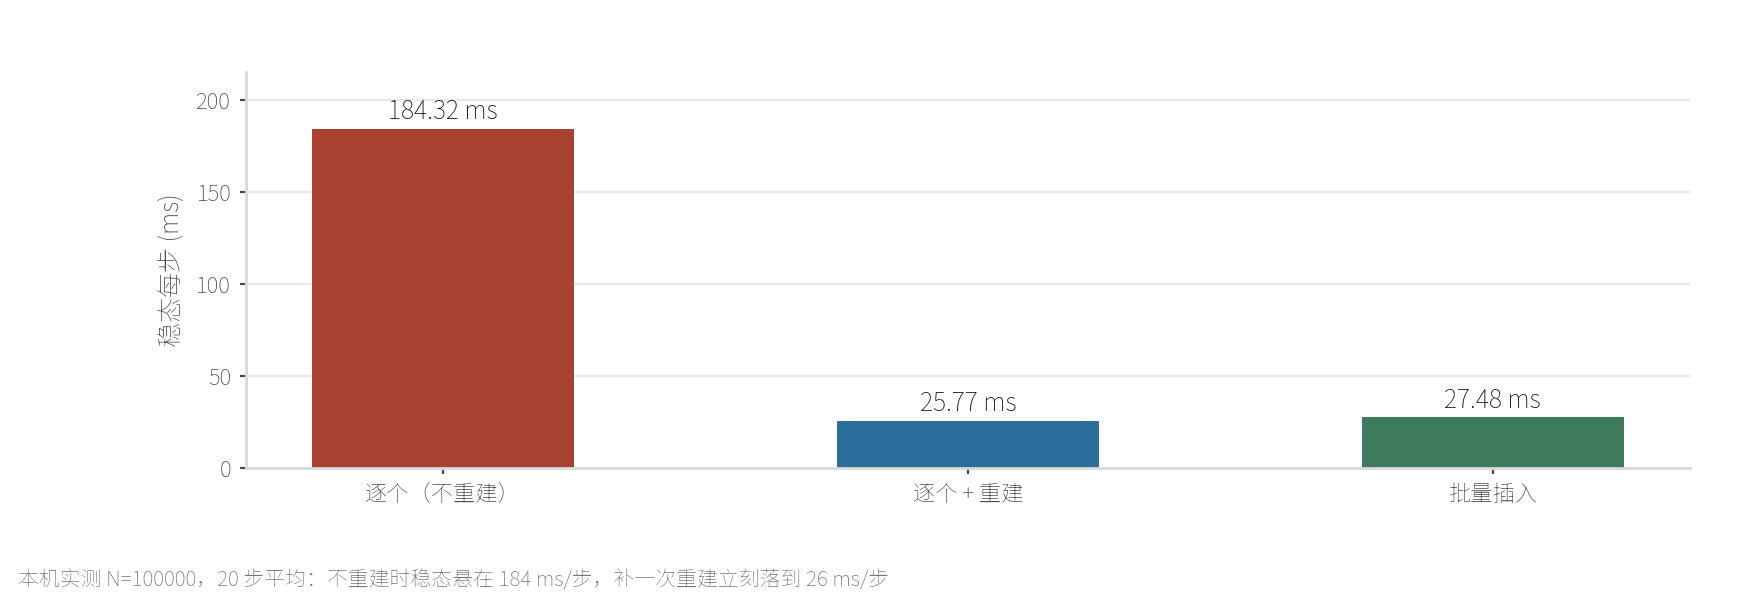
结论:逐个插入后不重建时,稳态一直悬在 184 毫秒左右;补一次重建立刻落到 26 毫秒附近, 与批量档的 27 毫秒基本齐平。也就是说维护重建能收敛,但收敛得很慢, 而一次手动重建是「立刻到位」。本篇不量它到底要多少步才收敛,那需要几百步的长跑, 留作 §8 的一条可检验命题。
3.6 这笔账:18 毫秒换回 3.2 秒
OK,把上面的数字并起来看,一次重建的性价比高得有点不真实:
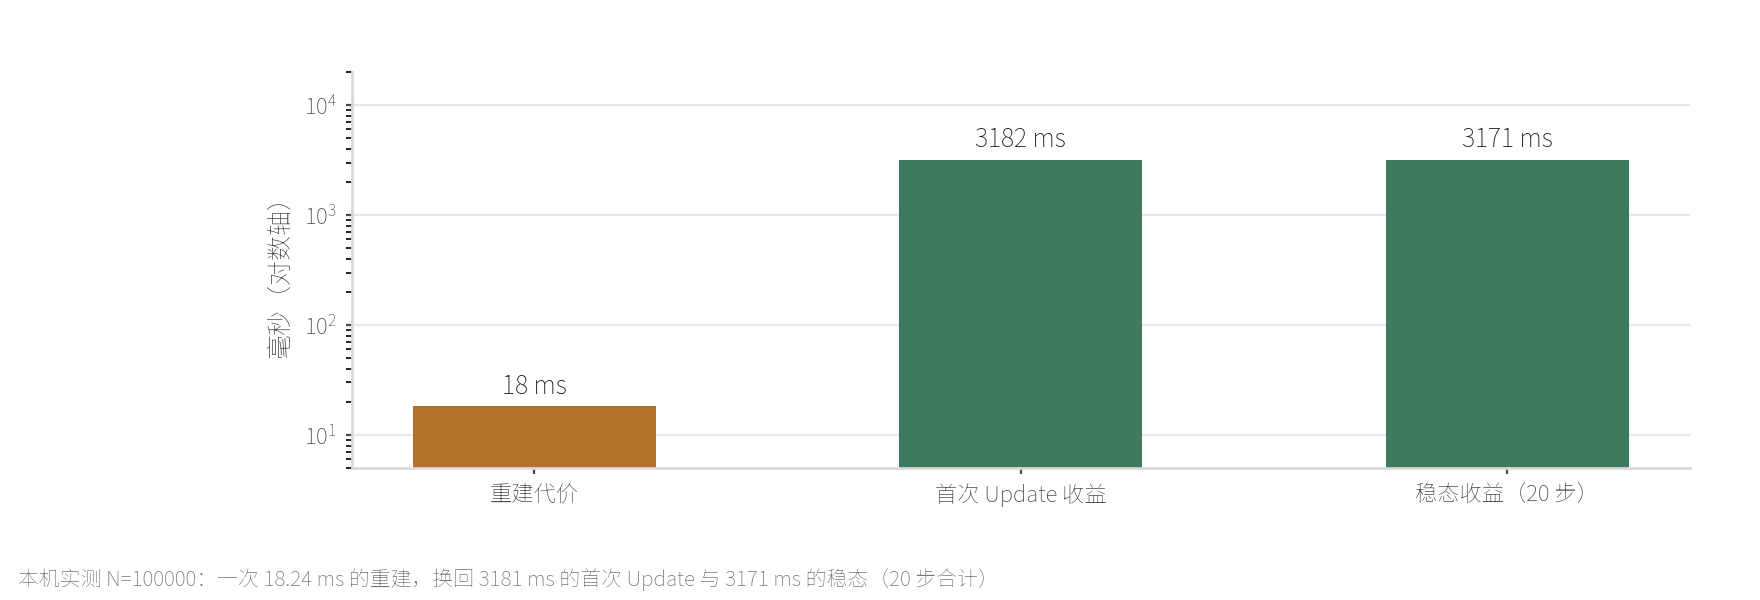
这张图只做一件事:把「付出去的那一笔」和「收回来的一大笔」放在同一张图上。凡是能被一次操作收回两个数量级的地方,都值得在工程里专门做一次,这也是 §8.4 那条处方的由来。
这正是官方那句「use PhysicsSystem::OptimizeBroadPhase to rebuild the tree」的量化版本:
官方只说了「用它重建」,没说重建要花多少、能收回多少。本机给出的答案是18.24 毫秒换 3.2 秒。
其中:这里的 3.2 秒是 3195.2 − 13.6 毫秒(3181 毫秒),只算首次 Update 这一项; 稳态那一档每步少花 158 毫秒(184.32 − 25.77),按 20 步摊开又是约 3171 毫秒。
四、一个节点 128 字节
4.1 字段布局
好了,上一节反复提到「节点」,现在把它拆开。源码里的 Node 有六个字段组
(QuadTree.h 第 119 至 139 行,本机核对):
这张图按字节把节点铺开:上半是四个孩子各自的包围盒(每个孩子六个 float),下半是四个孩子 ID 与两个 32 位标记。注意它是「四个孩子共用一个节点」,而不是「一个孩子一个节点」,这个结构直接决定了 §1.3 的分裂规则。
| 字段 | 类型 | 字节 | 说明 |
|---|---|---|---|
mBoundsMinX/Y/Z、mBoundsMaxX/Y/Z |
atomic<float>[4] × 6 组 |
96 | 四个孩子各自的 AABB,每个孩子 6 个 float |
mChildNodeID[4] |
AtomicNodeID × 4 |
16 | 每个孩子要么是刚体 ID、要么是子节点索引 |
mParentNodeIndex |
atomic<uint32> |
4 | 父节点索引(重建期间不可靠,源码有注明) |
mIsChanged |
atomic<uint32> |
4 | 这一支变过没有;没变就在重建时整块搬走 |
| padding | uint32 |
4 | 补齐到 124 字节 |
为什么刚好是 128:字段本身加起来 124 字节,源码再补 4 字节 padding。 这个数不是随手定的,源码里有一句编译期断言钉着它:
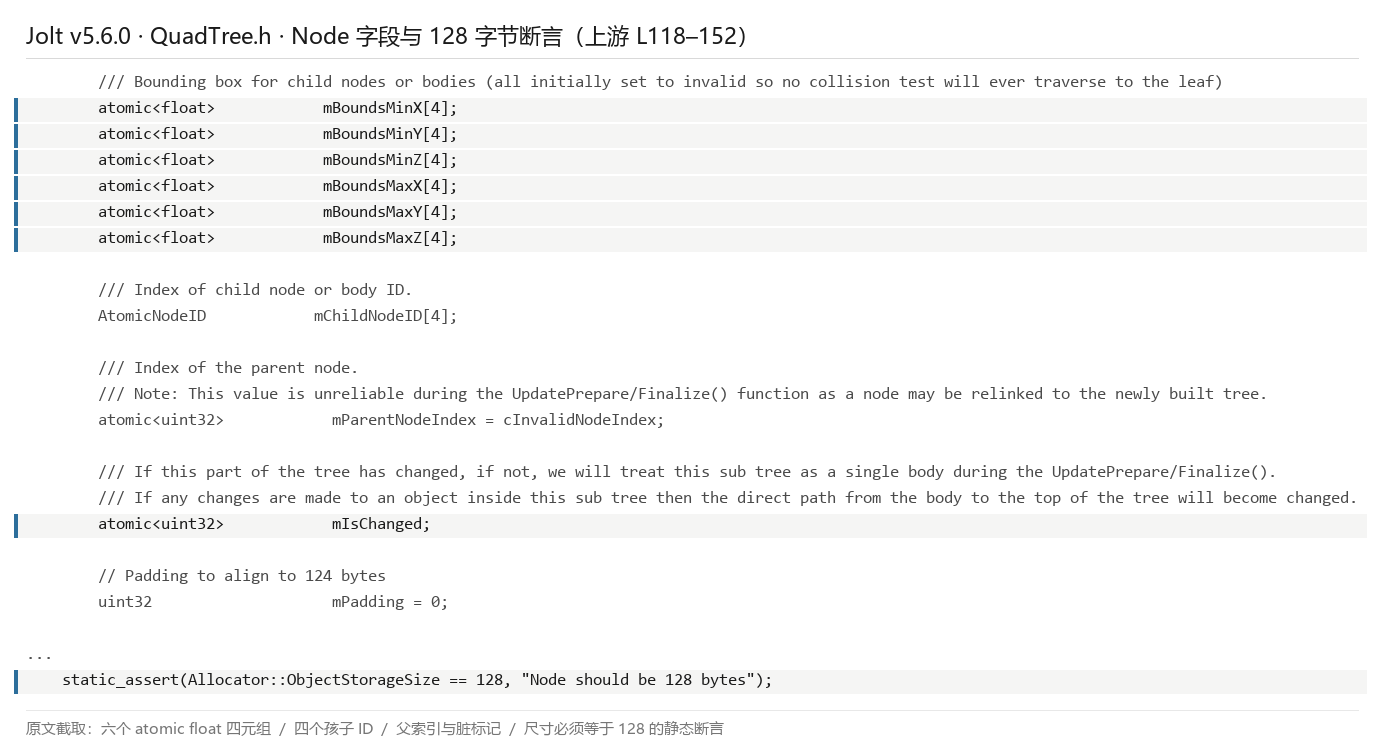
对照着上表读这张截图,能看到三件事:包围盒字段一律是 atomic(供多线程放宽)、孩子 ID 用 32 位 ID 而不是指针,以及一句把尺寸钉死在 128 字节的编译期断言。最后那句断言是本节的主证据。
其中:static_assert(Allocator::ObjectStorageSize == 128, "Node should be 128 bytes")
是一句编译期的守门人。谁改字段改出了别的尺寸,编译就会失败。
4.2 为什么死死盯着对齐
OK,128 这个数还有第二层含义:它是伪共享(false sharing)的边界。
节点分配器 FixedSizeFreeList 会把节点按这个尺寸排布;如果一个节点跨了两条缓存行,
两个线程改相邻节点就会互相把对方的缓存行踢掉。
官方 release notes 里有一条正是这件事(Docs/ReleaseNotes.md 第 251 行,v5.1.0):
QuadTree / FixedSizeFreeList: Reorder variable layout to reduce false sharing & thread syncs to reduce simulation time by approximately 5%.
这条版本记录的价值在于口径:它说明「宽相的性能」不只是算法问题, 内存布局也在账上,而且这个改动是官方实测过、给了数字的(约 5%)。
4.3 一个本机踩过的坑:空槽持有「无效包围盒」
说白了,这一段是本篇唯一的「工具坑」,写出来是因为它差点让本篇的核心指标算错。
我最早想用「树的包围盒体积 ÷ 所有刚体真实包围盒的体积」当膨胀比,
结果量出来是 1.0e40 量级的数,毫无意义。查源码才明白原因(QuadTree.cpp 第 123 行):
//【无效包围盒:min 用极大值、max 用极小值,因此「跟谁都不相交」】
const AABox QuadTree::cInvalidBounds(Vec3::sReplicate(cLargeFloat), Vec3::sReplicate(-cLargeFloat));
节点里未使用的槽并不空着:它持有一个 min 用「极大 float」、max 用「极小 float」的盒。
它的语义是「无效」,作用是让碰撞测试永远不会走进这个槽。
但 GetBounds() 会把根节点的所有槽封起来,包括这些无效盒,
于是根包围盒变成了一个天文数字大小的盒子。
处置:放弃体积比这个指标,改用官方节点计数与真实树结构来量退化(§6 与 §7)。 这条教训也值得写进正文:一个「看起来很自然」的指标,可能因为源码里的哨兵值而彻底失真。
4.4 节点 ID 也是 32 位
节点里那四个孩子槽存的是 32 位的 ID,不是指针(QuadTree.h 第 61 行,本机核对):
//【一个 uint32 同时表示「是刚体还是节点」】,摘自 QuadTree.h 的 NodeID
static const uint32 cIsNode = BodyID::cBroadPhaseBit;   ///< If this bit is set it means that the ID refers to a node, otherwise it refers to a body
这一行把两个设计缝在了一起:宽相节点 ID 复用了 BodyID 的最高位当「这是节点」的标志。
ep03 讲过 BodyID 是「低 23 位索引 + 8 位序号」;而在宽相这边,
同一个 32 位空间被用来表示「要么是刚体、要么是节点」。
源码里还有一行编译期断言钉着两者尺寸相等:
static_assert(sizeof(NodeID) == sizeof(BodyID), "Body id's should have the same size as NodeIDs");(第 66 行)
这个复用有一个可见的历史后果:v5.3.0 之前这个「是不是节点」的标志位不在最高位, 于是当刚体数量极大、又调用重建时,节点 ID 会不够用。 官方 release notes 第 168 行记的正是这次修改(把宽相位标志移到最高位)。 也就是说,这一位的摆放位置曾是宽相的一个真实瓶颈。
其中:mParentNodeIndex 这一格在源码注释里被特别标注为「重建期间不可靠」
(QuadTree.h 第 130 行),因为节点可能被重新挂到新树上。读宽相源码时,这个字段不能当权威。
五、分层:一棵树不够,也不该多
5.1 为什么静态与动态要分家
好了,到目前为止都是「一棵树」。实际上 Jolt 的宽相是一层一棵树(BroadPhaseQuadTree.h 第 81 行,
QuadTree *mLayers)。原理上,这一层要解决的是「不同更新频率的数据能不能共处一棵树」。官方给的分层理由很短,但信息量很足(Architecture.md 第 591 行):
The broad phase is divided in layers (
BroadPhaseLayer), each broad phase layer has an AABB quad tree associated with it. A standard setup would be to have at least 2 broad phase layers: One for all static bodies (which is infrequently updated but is expensive to update since it usually contains most bodies) and one for all dynamic bodies (which is updated every simulation step but cheaper to update since it contains fewer objects). In general you should only have a few broad phase layers …
把两个括号里的说法读出来,这就是一句「不同的数据有不同的更新频率」: 静态体占绝大多数、但几乎不动;动态体少、但每步都在动。 把它们放进同一棵树,就意味着每步都要为了那少数几个动的东西去碰一棵装着几万个静态体的树。
5.2 每步只维护一层
先来看看分层引出的新问题:如果每层都要维护,一步里要重建好几棵树吗。
源码的答案是「不」,见 BroadPhaseQuadTree.cpp 第 115 至 131 行(本机核对):BroadPhaseQuadTree::UpdatePrepare() 每步只挑一层:
//【每步只维护一层:轮询找到一棵「有体 + 脏 + 可更新」的树就立刻返回】,摘自 BroadPhaseQuadTree.cpp
for (uint iteration = 0; iteration < mNumLayers; ++iteration)
{
    //【1】按轮转游标取一层,游标前进一格
    QuadTree &tree = mLayers[mNextLayerToUpdate];
    mNextLayerToUpdate = (mNextLayerToUpdate + 1) % mNumLayers;

    //【2】三层条件都满足才维护它,且维护完立即返回
    if (tree.HasBodies() && tree.IsDirty() && tree.CanBeUpdated())
    {
        update_state_impl->mTree = &tree;
        tree.UpdatePrepare(mBodyManager->GetBodies(), mTracking, update_state_impl->mUpdateState, false);
        return update_state;
    }
}
下面对这段代码特别说明两处。
第一,这就是「同一时刻存在两棵树」的调度来源。 层与层之间轮转维护, 而每一层自己又是双根交替,两套机制叠在一起,才是完整图景。
第二,「脏」是维护的唯一入口。 一个层如果没有体、或者没脏、或者不可更新, 这步就跳过它。所以分层的收益不只是「少碰静态树」,还有「不脏就不碰」。
这张图把上面对应的循环画成了一条轮转路径:每步从游标位置开始找,找到第一棵「有体、脏、可更新」的树就停下来维护它;找不到就整步不做维护。它解释了为什么静态层的维护是间断的,也解释了 §6.4 那个「只导出一层」的坑。
其中:这个循环最多跑「层数」次,也就是说一步最多更新一层。
mNextLayerToUpdate 是那个轮转游标,它保证不会永远同一层被跳过。
5.3 层多了会怎样
OK,官方那句「only have a few broad phase layers」是有代价背景的:
两条代价方向相反,这是分层的取舍点:层多了,查询要按层过滤(每次查询可能要走多棵树); 层少了,维护要在一棵大树上做。官方给的建议是 2 层起步,一条静态、一条动态, 和本机基准里的配置一致。
六、退化:逐个添加为什么把树撑成一条链
6.1 一条链是怎么长出来的
好了,这是本篇最实用的一节。现象在 ep03 已经量过:逐个添加会让首次 Update 慢两个数量级。
但「慢」只是结果,根因在宽相树的形状上,而源码把这个根因写在了一段注释里
(QuadTree.cpp 第 211 行起,本机核对):
// If you're running out of nodes, you're most likely adding too many individual bodies to the tree. // Because of the lock free nature of this tree, any individual body is added to the root of the tree. // This means that if you add a lot of bodies individually, you will end up with a very deep tree and you'll be // using a lot more nodes than you would if you added them in batches.
读懂这句「any individual body is added to the root」是关键。 批量添加时,引擎拿到一整批刚体,可以像 §1.3 那样一次性把它们四叉划分好,从根往下有组织地放。 而逐个添加时,engine 只知道「现在来了一个」,为了不加锁、不重排已有结构, 它把这个刚体直接挂到根节点上。
一个刚体挂到根上之后会发生什么:根节点的四条槽会被逐渐占满。 满了之后,为了容纳更多,只能再造一层新的根,把旧的整棵树当作它的一个孩子。 于是每来一个「装不下」的刚体,树就往上长一层,这才是「一条链」的形成机制。
6.2 节点预算:为什么会「耗尽节点」
说白了,上一个问题自然引出下一个:树长成这样,会耗尽什么。答案是节点。 节点分配器的容量是初始化时按最大刚体数算死的(§2.4 那个公式), 而链式退化会远远超出「50% 装填」这个假设:
按 inMaxBodies = 100000 算,分配器给了 133,334 个节点(约 16.3 MiB)。
四叉树形态下 10 万体只需要约 6.7 万个节点,余量充足;
但链式退化时,每个节点只挂几个刚体,实际需求可以逼近甚至超过刚体数本身。
余量会被吃光。吃不光的时候,源码会走到这一行(QuadTree.cpp 第 231 行):
//【节点耗尽:打印提示后直接 abort】,摘自 QuadTree.cpp 的 AllocateNode
Trace("QuadTree: Out of nodes!");
std::abort();
这就是官方文档里那句「in extreme cases may lead to the broadphase running out of internal nodes
(std::abort will be called in that case)」的源码落点。
它不是「性能下降」,是进程直接终止。
6.3 官方那两条 Trace 长什么样
OK,官方文档说「a trace will notify when this happens」,源码里确实有两条 Trace,位置在
QuadTree.cpp 第 128 至 134 行与第 231 行:
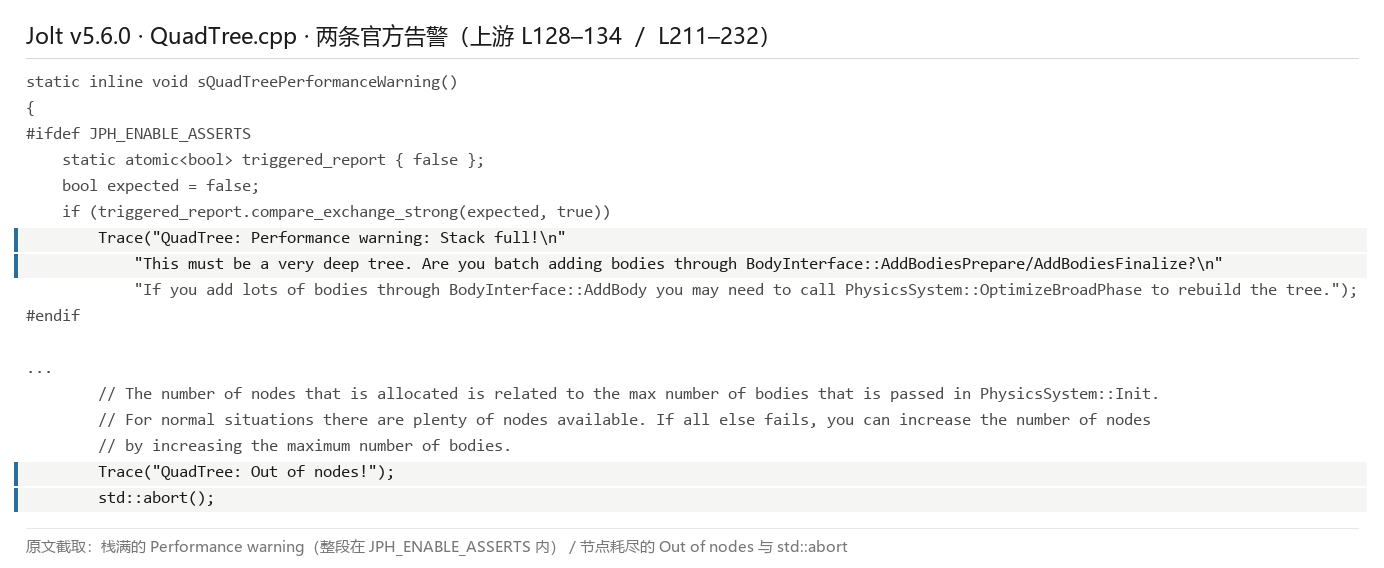
其中:第一条 Trace 的原文里有一句很直白的自问:
「This must be a very deep tree. Are you batch adding bodies through BodyInterface::AddBodiesPrepare/AddBodiesFinalize?」
引擎在运行期主动问使用者「你是不是在用批量接口」。这是本篇最值得记住的一行提示。
不过这里有一条口径必须说清:
栈满那条 Trace 只在带断言的构建里存在(sQuadTreePerformanceWarning() 整段在
#ifdef JPH_ENABLE_ASSERTS 内)。所以 Release 版跑出病态树时,不会打印那句提示,
只有在带上断言时才看得见。节点耗尽那条没有这个限制,它是真的会 abort。
6.4 本机取证:把真实树导出来看
先来看看证据。上面全是源码里的说法。要把它变成「证据」,最好的办法是让引擎自己把树导出来。
官方留了一个调试设施 JPH_DUMP_BROADPHASE_TREE,打开它之后,
每次维护的前后都会各导一份 DOT 文件(QuadTree.cpp 第 290 与 412 行):
//【维护前导出当前树】,摘自 QuadTree.cpp 的 UpdatePrepare
#ifdef JPH_DUMP_BROADPHASE_TREE
    DumpTree(root_node.GetNodeID(), StringFormat("%s_PRE", mName).c_str());
#endif
//【维护后导出新树】,摘自 QuadTree.cpp 的 UpdateFinalize
#ifdef JPH_DUMP_BROADPHASE_TREE
    DumpTree(new_root_node.GetNodeID(), StringFormat("%s_POST", mName).c_str());
#endif
下面对这段代码特别说明两处。
第一,mName 是层名(本机基准里是 MOVING 与 NON_MOVING),文件因此按层分开。
第二,这份导出是官方的,不是我在外面自己画的,DumpTree 还顺手调用了 Graphviz
把 DOT 渲染成 SVG(第 1696 行 dot %s.dot -Tsvg -o %s.svg)。
但这里踩了一个坑:我第一次只跑了 1 次 Update,只拿到 NON_MOVING 的导出,MOVING 那份没出现。
原因是 §5.2 那条轮转:每步只维护一层,第 1 步维护的多半是静态层,
要跑到第 2 步才轮到动态层,它的 PRE/POST 才会落盘。
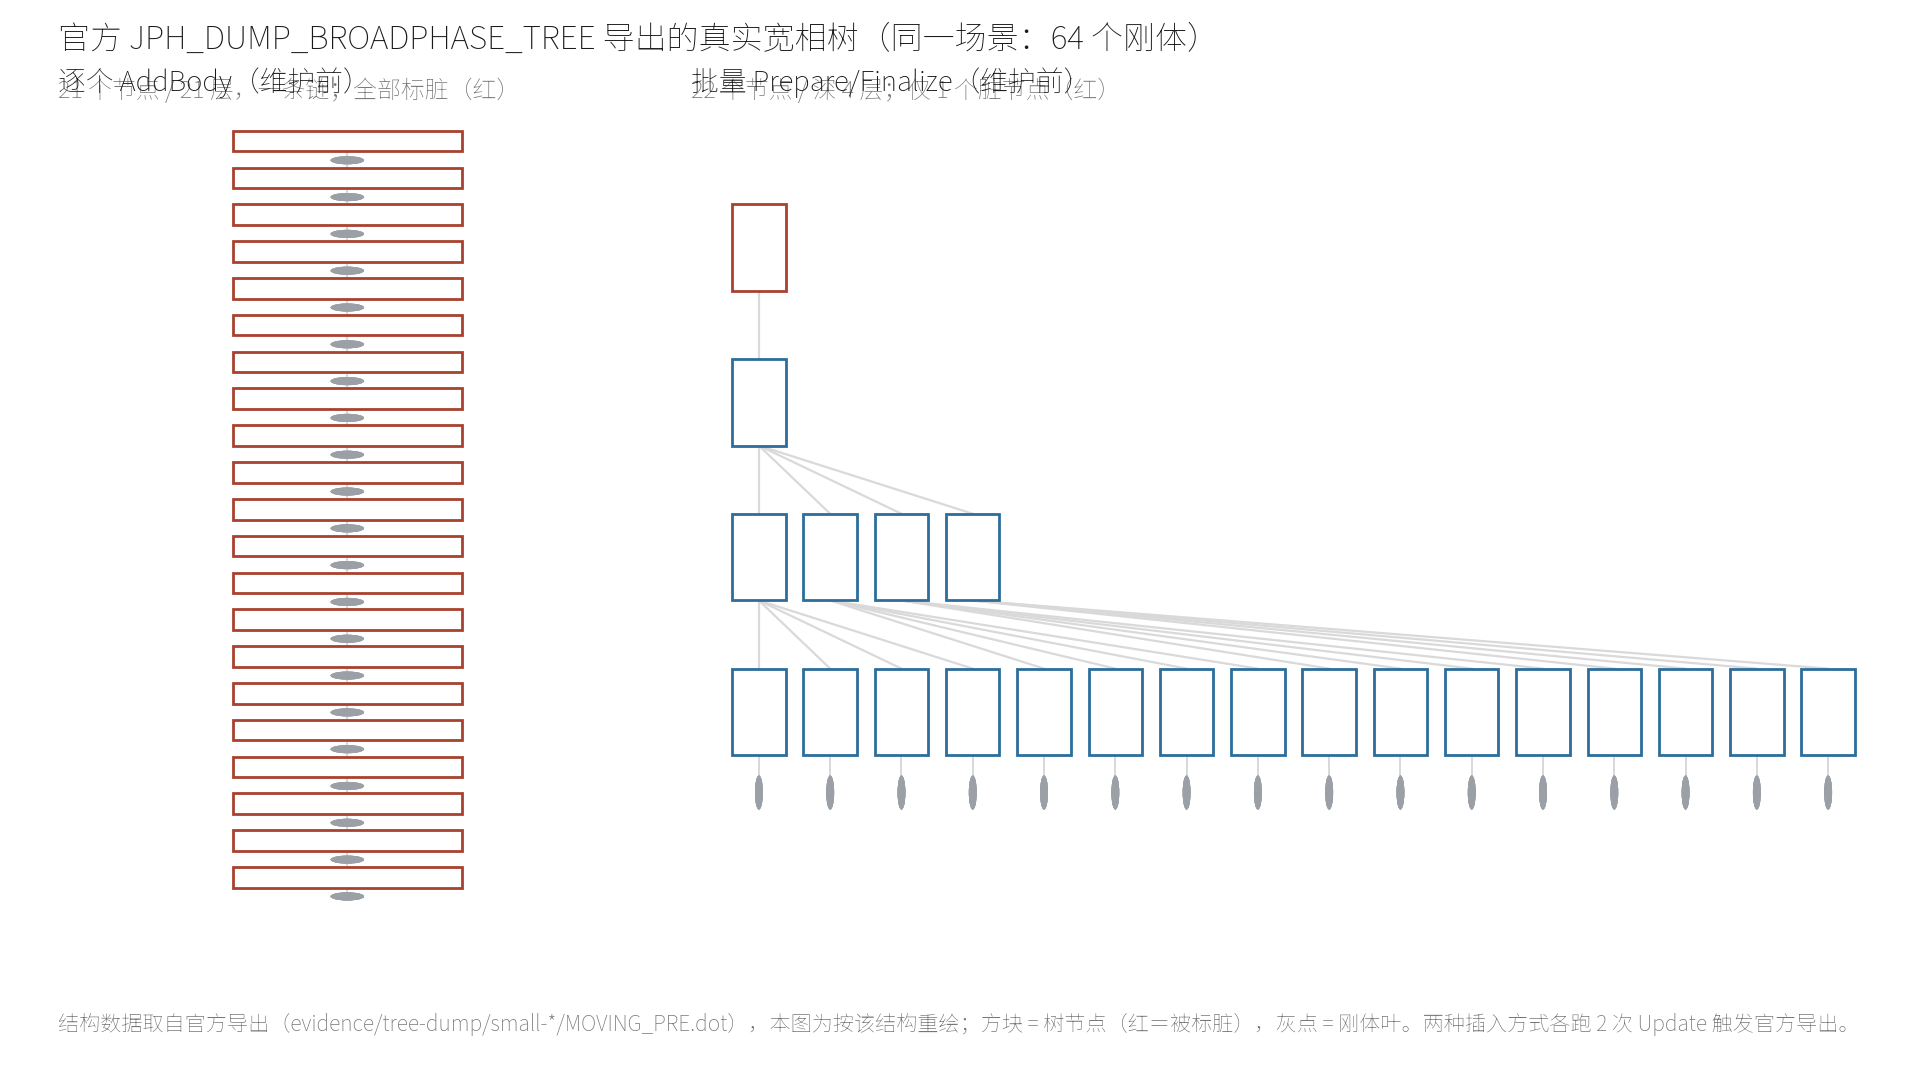
这是同一个 2000 体场景、两种插入方式导出的真实树(PRE 是维护前,POST 是维护后):
6.5 本机实测:667 层对 6 层
好了,图看得见形状,数字更硬。把导出的 DOT 解析成节点数与树深:
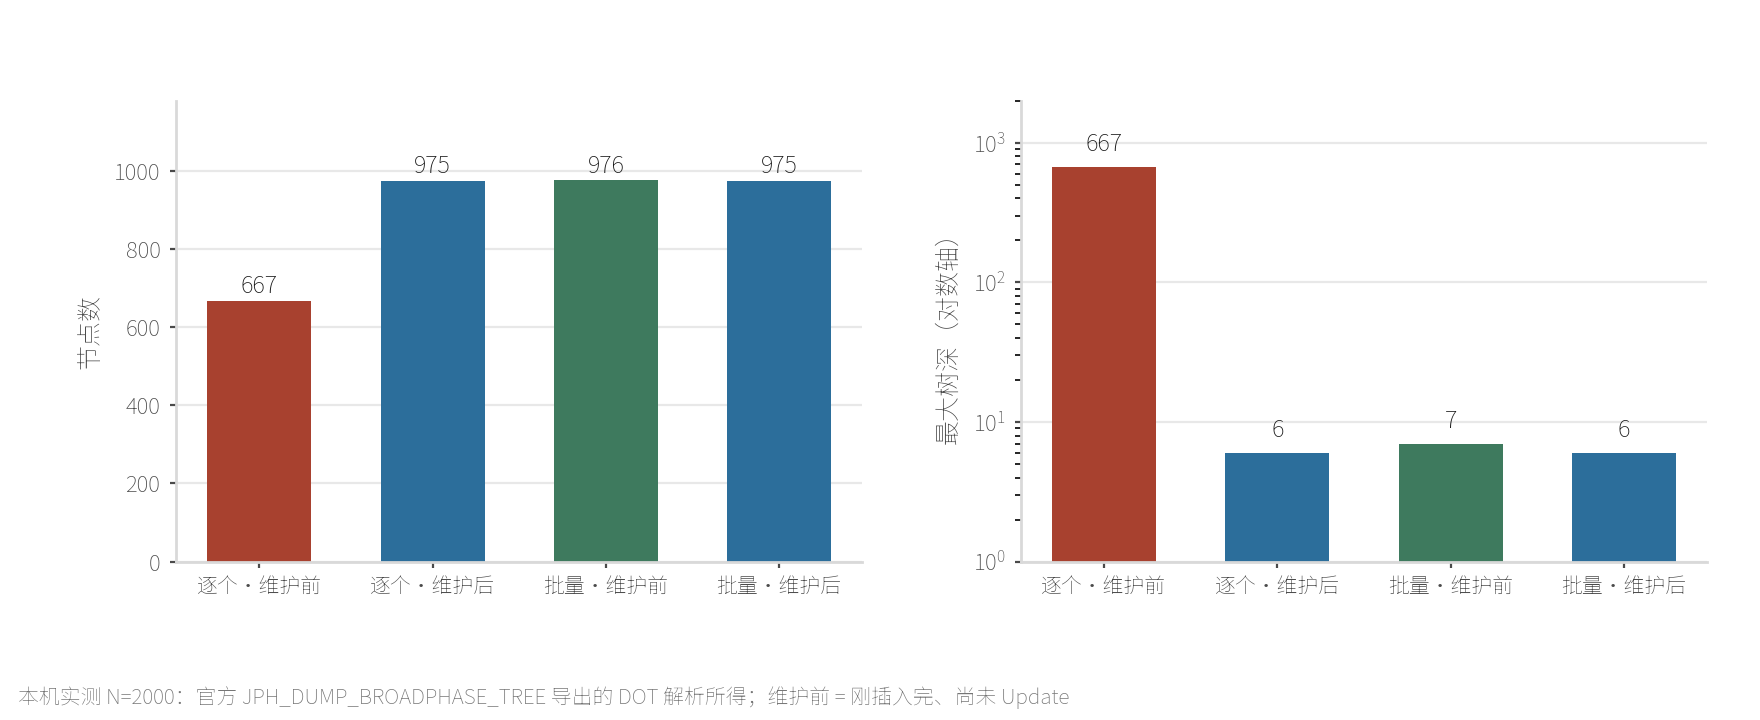
口径:N = 2000 体立方体网格,PRE = 维护前(刚插入完、还没跑 Update),
POST = 该次维护之后;节点数与树深由 DOT 文件解析得出,脏节点是 DOT 里被标成红色的节点。
| 场景 | 节点数 | 最大树深 | 脏节点 | 按深度的节点数 |
|---|---|---|---|---|
| 逐个插入 · 维护前 | 667 | 667 | 667 | 每层 1 个,一条链 |
| 逐个插入 · 维护后 | 975 | 6 | 341 | 1 / 4 / 16 / 64 / 256 / 634 |
| 批量插入 · 维护前 | 976 | 7 | 1 | 1 / 1 / 4 / 16 / 64 / 256 / 634 |
| 批量插入 · 维护后 | 975 | 6 | 0 | 1 / 4 / 16 / 64 / 256 / 634 |
这张表里有三件事。
第一,逐个插入的树真的是一条链:667 个节点分布在 667 层, 平均每层 1 个节点,而且全部 667 个节点都被标脏。这与 §6.1 的机制完全对上。
第二,批量插入的树深度只有 7,各层节点数是标准的四叉树几何级数(1/4/16/64/256…)。
第三,维护能把两者拉回同一形状:都收敛到 975 个节点、深 6 层。 一次维护就够了,这是 §3.6 那笔账的另一种呈现。
换成小场景,结论一样。 同一套程序跑 64 个刚体(数字小到可以逐节点看清): 逐个插入维护前是 21 个节点、21 层的链(层分布 1/1/1/…),维护后塌成 21 个节点、深 3 层 (层分布 1/4/16);批量插入维护前就是 22 个节点、深 4 层(1/1/4/16),维护后 21 个节点、深 3 层。 规模缩小三十倍,形状关系不变,链式退化是机制问题,不是规模问题。 这也正是 §6.4 那张真实树图用的是 64 体版本的原因:2000 体的导出有两兆字节,看不清;64 体的能看清,而结论相同。
6.6 667 层意味着什么
667 这个数本身还不算什么,把它与源码里的 cStackSize = 128 摆在一起才吓人:
两条线摆在一起差距很直观:一条是链式退化带来的 667 层,一条是源码里写死的 128 层栈上限。超过上限会怎样,源码的历史给出了两个答案,v5.3.0 之前是崩,之后是退到堆上继续跑。
遍历宽相树用的是固定栈(QuadTree.h 第 142 行 static constexpr int cStackSize = 128),
667 层远超这个上限。这正是 v5.3.0 那条版本记录的事故现场(Docs/ReleaseNotes.md 第 168 行):
When inserting lots of bodies without using batching, a broad phase tree of depth > 128 can be created. If the
PhysicsSystemwas destructed in this situation, a stack overflow would cause a crash.
而 v5.4.0 给了一个更温和的处置(同文件第 93 行):
QuadTreewill now fall back to the heap when running out of stack space during collision queries. Previously this would trigger an assert and some collisions would not be detected.
「some collisions would not be detected」这半句特别值得停一下:在这条修复之前, 树太深不只是慢,还会漏检碰撞。也就是说宽相的性能问题,是可以升级成正确性问题的。
七、宽相查询的不确定与横向对照
7.1 同一个查询,两种树,529 倍代价
OK,§6 讲的是树被撑坏,这一节讲撑坏之后查询要付多少。 本机的做法很简单:在 10 万体的场景里放一个半径 5 米的探针查询盒,用同一次查询分别打在三种树上。
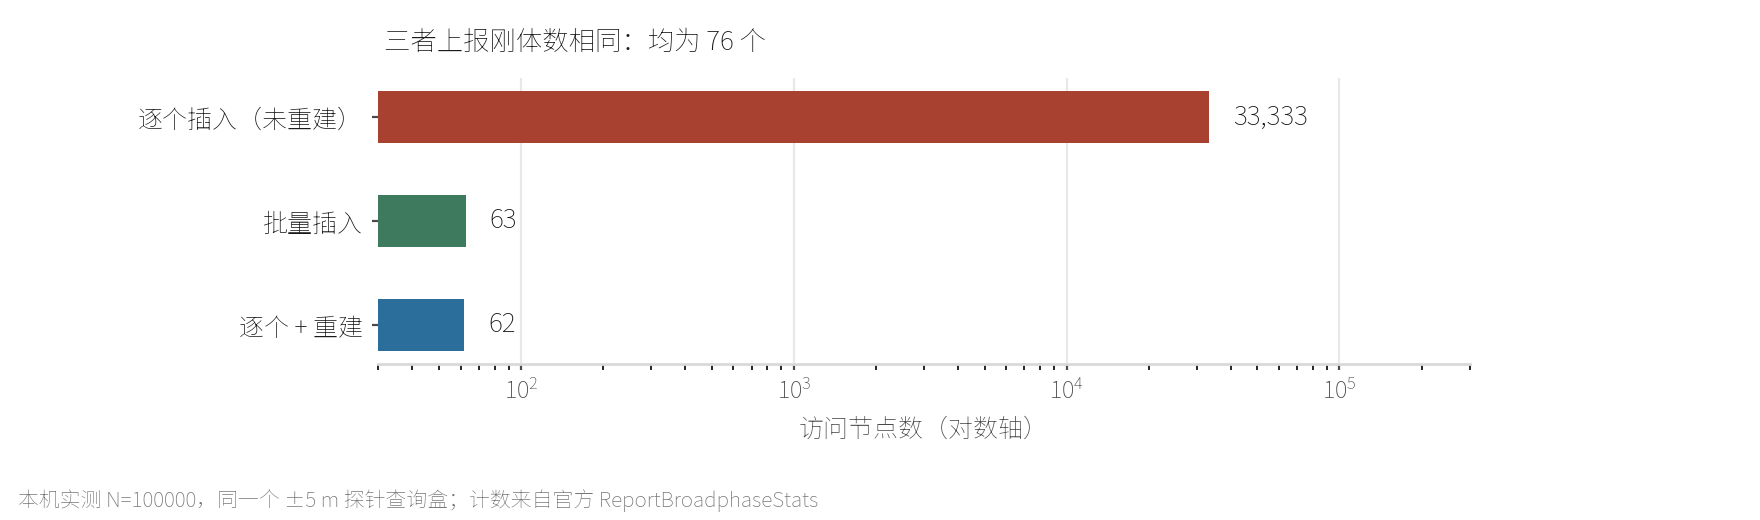
口径:N = 100,000 体网格,查询盒为中心 ±5 米,三种树分别是「逐个插入未 Update」
「批量插入未 Update」与「逐个插入后重建」;计数来自官方的 ReportBroadphaseStats()。
| 树 | 上报刚体 | 访问节点数 | 查询耗时 |
|---|---|---|---|
| 逐个 AddBody(未 Update) | 76 | 33,333 | 0.494 ms |
| 批量 Prepare/Finalize(未 Update) | 76 | 63 | 0.022 ms |
逐个 + OptimizeBroadPhase |
76 | 62 | 0.021 ms |
三者上报的刚体数完全一样(76 个),访问节点数却差了 529 倍。 这就是「病态宽相」最干净的定义:结果是对的,代价是错的。 §0.1 说过宽相的两条硬性要求是「不漏报」与「足够便宜」。 链式退化破坏的是第二条,第一条始终没坏。这一点很重要:它意味着 宽相退化不会让物理结果变错,只会让帧率崩掉(要等到栈溢出那条才轮到最后正确性)。
7.2 官方 instrumentation 的原始输出
说白了,上面那张表的数字是打开官方宏之后引擎自己打出来的,不是我插的桩:
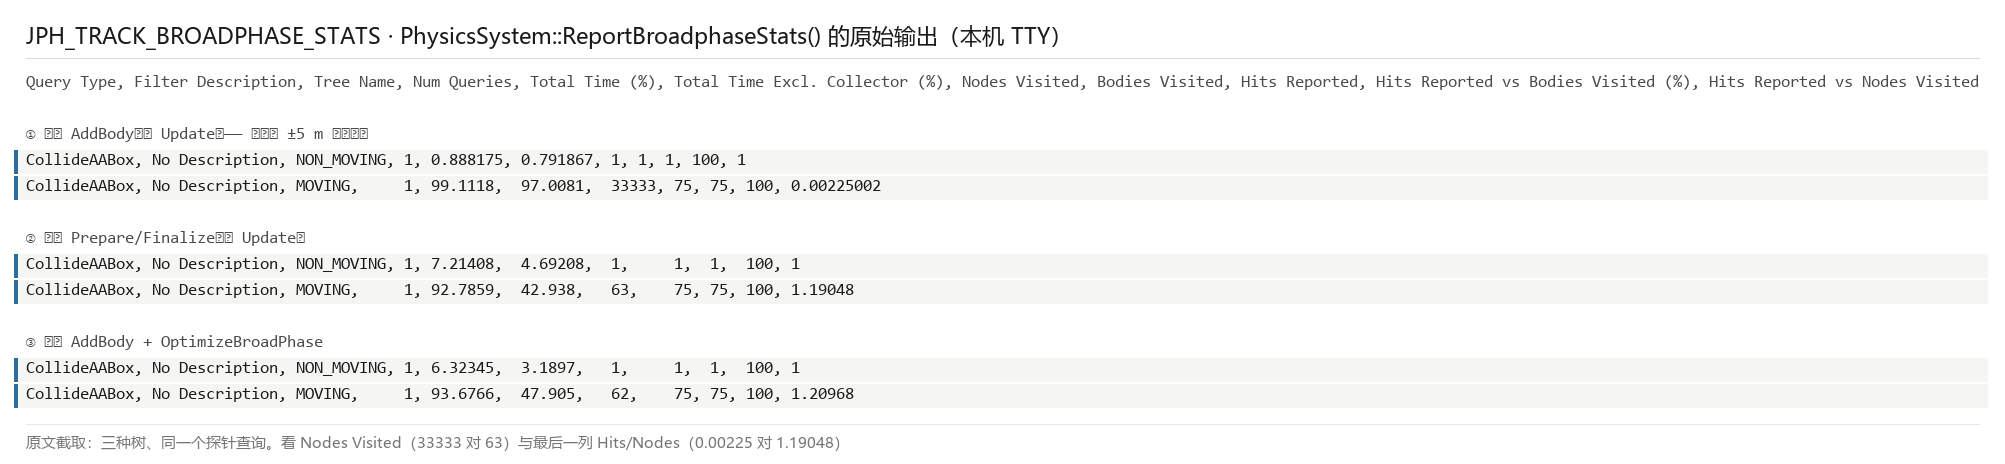
原文的一行长这样(MOVING 层,逐个插入未 Update 的那一次查询):
CollideAABox, No Description, MOVING, 1, 99.1118, 97.0081, 33333, 75, 75, 100, 0.00225002
按官方表头对照着读:查询类型 CollideAABox、层名 MOVING、查询次数 1、
总耗时占比 99.11%、去掉收集器后占比 97.01%、访问节点 33,333、
访问刚体 75、上报命中 75、命中/访问刚体 100%、命中/访问节点 0.00225。
最后那个比值是这张表里最有信息量的数:0.00225,即每访问 445 个节点才命中 1 个。
批量那棵树同一列是 1.19048,每访问不到 1 个节点就有 1 个命中。
其中:ReportBroadphaseStats() 的统计口径只覆盖六类显式查询
(射线、AABB、球、点、有向盒、盒扫掠),不含每步内部那个找配对的 FindCollidingPairs
(源码第 1739 至 1748 行逐条列出,本机核对)。所以这张表用来量「查询」,
不能拿来当「整步宽相耗时」。
7.3 一个可数的「不确定」
§7.1 说结果是对的。但官方文档里有一条相反的提醒(Architecture.md 第 804 行):
Broadphase queries (
BroadPhaseQuery) are NOT deterministic because the broad phase can be modified from multiple threads. As bodies are modified, their bounding boxes get widened until the next maintenance update. … If you want to do a broadphase query deterministically then create a customCollisionCollectorthat in itsAddHitfunction repeats the query against the actual bounding box of the body (Body::GetWorldSpaceBounds) and accept only hits that collide with this bounding box.
「包围盒会被放宽、并保持到下一次维护更新」,这正是 §2.1 那个放宽机制的副作用。
问题在于:它是怎么变成一次「不确定」的查询结果的。源码给了答案
(QuadTree.cpp 第 1167 至 1178 行):
//【查询时用节点里存的盒判定,命中就直接上报】,摘自 QuadTree.cpp 的 CollideAABox visitor
JPH_INLINE int VisitNodes(Vec4Arg inBoundsMinX, ...) const
{
    //【1】用「槽里存的」四个孩子的盒做相交判定
    UVec4 hitting = AABox4VsBox(mBox, inBoundsMinX, inBoundsMinY, inBoundsMinZ, ...);
    return CountAndSortTrues(hitting, ioChildNodeIDs);
}
JPH_INLINE void VisitBody(const BodyID &inBodyID, int inStackTop)
{
    //【2】判定通过就直接上报,不再用刚体当前的 AABB 复核
    mCollector.AddHit(inBodyID);
}
下面对这段代码特别说明两处。
第一,判定用的是「槽里存的盒」。 那个盒可能是被放宽过的旧值, 不等于刚体当前的 AABB。刚体可以从这里搬走,槽里却还盖着原位。
第二,上报之后没有复核。 VisitBody 直接把 ID 丢给收集器。
所以宽相确实可能上报一个「真实包围盒已经不在查询盒里」的刚体。
本机把这件事做成了一个可数的实验(单线程、期间不调 Update):
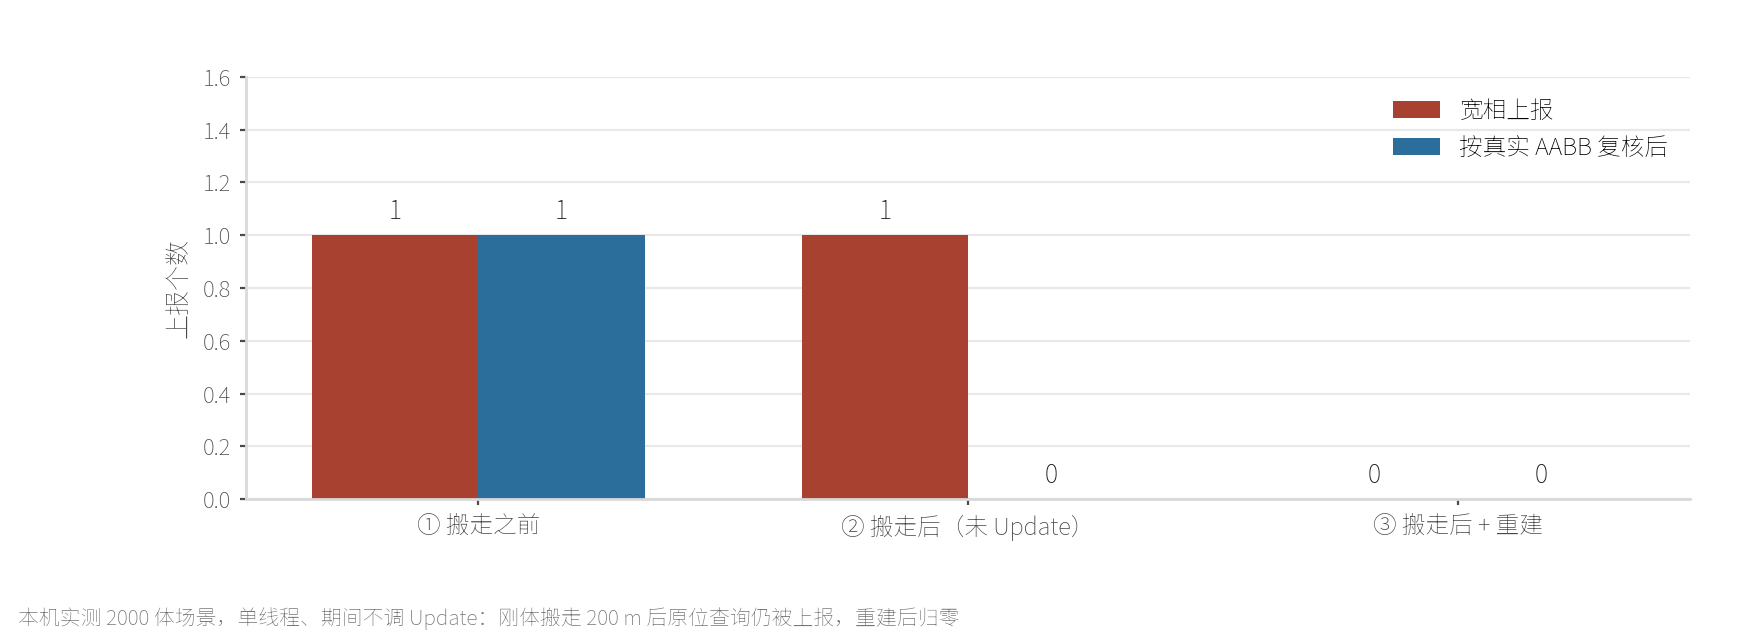
口径:2000 体场景,先批量插入(得到紧致树);取一个刚体 B 记下原位 P;
把 B 搬到 P + 200 米(SetPosition,不激活、不跑 Update);然后在 P 处查一个 ±0.6 米的盒子。
| 时点 | 宽相上报 | 按真实 AABB 复核后 |
|---|---|---|
| ① 搬走之前 | 1 | 1 |
| ② 搬走之后(未 Update) | 1 | 0 |
③ 搬走之后 + OptimizeBroadPhase |
0 | 0 |
官方那句抽象的「不确定」,在这里变成了一个可数的数:假阳性 1 个。
而且三次读数把因果链闭合了:② 的假阳性来自「槽里存的旧盒」,
调用一次重建(③)让树重新贴合,宽相自己也不报了。
官方建议的「在收集器里用 GetWorldSpaceBounds() 复核」是绕过它,重建是修复它。
7.4 横向对照:五家引擎的宽相设计
OK,「宽相怎么做」是个每家一个答案的题。把主流做法并排放一下,本篇的位置会更清楚:
| 引擎 | 宽相数据结构 | 并发策略 | 平衡手段 |
|---|---|---|---|
| Jolt | 四叉 AABB 树(一层一棵) | 无锁放宽 + 双根交替 + 后台重建 | 每次维护重建出贴合树 |
| Bullet | btDbvtBroadphase:动态 AABB 树(DBVT) |
单线程为主,内部维护动态/静态两棵树 | 树的旋转 |
| PhysX | PxBroadPhaseType:SAP / MBP 可选 |
多线程分区 | 视算法而定 |
| Rapier | Hierarchical-SAP(分层网格 + 扫描剪枝) | 多线程 | 分层网格 |
| Box2D | 动态 AABB 树(二叉) | 单线程 | 树的旋转(可处理退化输入) |
Box2D 那一列是本节最值得对照的一格。 官方文档写得很清楚:
The dynamic tree is a hierarchical AABB tree. Each internal node in the tree has two children. A leaf node is a single user AABB. The tree uses rotations to keep the tree balanced, even in the case of degenerate input.
两条路线的分歧点就在这里:Box2D 用旋转换平衡,代价是改结构必须加锁(或者干脆单线程); Jolt 用放宽 + 后台重建换无锁,代价是放宽期间剪枝会失效、以及节点内存要备双份。 这不是谁更先进,是两种取舍。
PhysX 官方对 SAP 的软肋说得也很直白:
eSAP… Performance can degrade significantly though, when all objects are moving, or when large numbers of objects are added to or removed from the broad phase.
7.5 别家阵营的同类读数
言归正传,公开渠道里唯一一份「大规模增删把宽相搞坏」的实测数据来自 PhysX 阵营 (wessam.dev 的《The Case of a Million Collision Bodies》):
For a 33 ms spike, most of the cost came from
BroadPhaseSap::batchRemove… the large number of boxes (930,479) … 10 Players — SAP: Min 40 ms, Max 215 ms, Avg 138 ms;MBP: Min 2.29 ms, Max 9 ms, Avg 3.4 ms.
这份数据要标清楚口径:它量的是 PhysX 的 SAP 与 MBP 两档,不是 Jolt。 本篇引用它只为说明一件事:「大规模增删把宽相搞坏」是这一层的通病,不是 Jolt 独有的问题。 Jolt 的数字,必须由本篇自己的实测给出(§6 与 §7.1)。
读这类横向数据时,最容易被忽略的是场景差异。 上面那份数据是「一万个玩家各自带着大量刚体」的游戏场景, 而本篇的场景是「一次插入十万个静态铺开的立方体」,两者的绝对值不可直接比。
八、边界、版本与处方
8.1 六条可被检验的命题
OK,照例把本篇结论写成可被检验的命题,每条给出检验入口。
| # | 命题 | 检验入口 |
|---|---|---|
| 1 | 四叉的理由是 SIMD:一层一次指令判定 4 个孩子 | 读 Architecture.md L587,或看 QuadTree.cpp 的 AABox4VsBox |
| 2 | 宽相是无锁的,靠「放宽父节点路径」实现 | 读 QuadTree.h L17–19,或看 EncapsulateChildBounds 的原子 min/max |
| 3 | 重建不是全量重建:没脏的子树整块搬走,脏标记只下探 5 层 | 读 QuadTree.cpp L333 与 cMaxDepthMarkChanged = 5 |
| 4 | 每步只维护一层,按轮转游标挑选 | 读 BroadPhaseQuadTree.cpp L115–131 |
| 5 | 逐个插入会把树撑成一条链(本机实测 667 层),批量插入是深 7 层的四叉树 | 打开 JPH_DUMP_BROADPHASE_TREE 跑 dump_tree 自己导一份 |
| 6 | 同一个查询打在两种树上,上报结果相同但访问节点数差 529 倍(33,333 vs 63) | 打开 JPH_TRACK_BROADPHASE_STATS 跑 ep04_bench 自己看 |
这六条覆盖了本篇的三层证据:第 1 到第 4 条是源码层的,读文件即可验证; 第 5、6 条是实测层的,需要按 §6.4 与 §3.3 跑一遍本机程序。 没有一条需要相信本文,这是本系列从 ep01 起就定下的规矩。
其中:第 5、6 两条都需要打开非默认的编译宏(JPH_DUMP_BROADPHASE_TREE 与
JPH_TRACK_BROADPHASE_STATS),这也是为什么本篇的复现说明里把两道宏单列出来。
8.2 本篇不涉及什么(边界声明)
| 本篇给出的 | 不展开的部分 | 归属篇目 |
|---|---|---|
| 宽相为什么是四叉、为什么无锁、为什么双树 | 三层过滤器的具体配置(ObjectLayer / 碰撞组 / 各种 Filter) |
第五篇 |
| 静态层与动态层「为什么要分开」这一句理由 | 层数怎么定、BroadPhaseLayerInterface 的三种实现 |
第五篇 |
| 宽相产出的是「候选配对」 | 候选怎么变成接触点(GJK / EPA / 流形裁剪) | 第六篇 |
| 一次插入的代价与树的退化 | 每个形状自身的质量属性与包围盒怎么算 | Shape 篇 |
| 「树太深会漏检碰撞」这一条版本记录 | 求解器怎么迭代、岛怎么切分、睡眠判据 | 第九、十篇 |
| 宽相完全在 CPU 上(本系列边界) | GPU compute 通路(只服务发束头发,不是 GPU 刚体) | 收官篇(反误区) |
这张表的作用是把「本篇的承诺」写清楚:左边是已经给出的结论,中间是明确不展开的机制,右边指向它们各自的篇目。读到后面几篇时,如果发现某个机制在这里被跳过,先查这张表。
8.3 演进:与宽相有关的版本变更
OK,原理上,这一层的每一次修复都指向同一件事:树的结构与节点的寿命。宽相这条线的版本记录不多,但每一条都指向一个具体的坑(完整清单见 Docs/ReleaseNotes.md):
其中:这五条里有三条(v5.3 两条、v5.4 两条中的一条)都与「树太深」或「节点没释放」有关,
说明「逐个添加」这个用法在真实项目里踩得很频繁,作者才会为它连出两版修复。
前四条在 Docs/ReleaseNotes.md 的对应行号是 322、251、168、90 与 93;
最后一条 v5.5 是给宽相查询补上 BroadPhaseQuery::GetBounds(),属补漏而非修复。
8.4 三条处方
好了,把本篇的结论收成三条可以直接落地的做法:
处方一,新场景一律走批量接口。 官方那句「Always use the batch adding functions」在本机读数下站得住:
逐个插入的首次 Update 比批量慢 171 倍(3195.2 vs 18.7 毫秒)。
处方二,老路径补一次 OptimizeBroadPhase()。 很多项目的逐个添加藏在不好动的地方
(动态生成的关卡、玩家建造的系统、网络同步的增量物体)。
不必重写整套流程,在插入完成后补一次重建:18.24 毫秒换回 3.2 秒。
处方三,做宽相查询时按真实包围盒复核。 这是官方 L804 给的办法, 本机实测里它把假阳性从 1 个降到 0 个。对依赖查询结果做逻辑的代码(比如「附近有什么」), 这一步是必须的,否则你会拿到一个「刚才在这里、现在已经搬走」的刚体。
三条处方的适用边界不同:处方一与二是性能问题,处方三是正确性问题。 前两条可以晚一点做,第三条最好一开始就做对。
补两条官方的使用注意,都写在 OptimizeBroadPhase() 的注释里(PhysicsSystem.h 第 145 至 149 行):
Don't call this every frame as
PhysicsSystem::Updatespreads out the same work over multiple frames. … Don't call this function while bodies are being modified from another thread or use the lockingBodyInterfaceto modify bodies.
下面对这两条各说明一处。
第一条是「别把它当每帧的例行公事」。Update 本来就会把同样的维护工作摊到多帧里做,
每帧额外再调一次全量重建,等于把这件事做了两遍。它与本机的读数并不矛盾。
本机那次 18.24 毫秒是一次性的插入后重建,不是每帧开销。
第二条是线程安全:重建期间不要在别的线程改刚体,或者改用加锁版的 BodyInterface。
这一条与本篇 §2 的双树机制是同一件事的两面:重建会换掉根,正在改动的线程必须被挡住。
还有一个使用建议:如果本来就用批量接口添加,而且这批刚体落在一片基本空着的区域 (比如新加载的关卡区块),官方认为连重建都不需要,因为批量添加已经建出了高效的层次结构。 本机读数支持这条建议:§3.4 里「批量 + Optimize」相对「批量」几乎没有变化。
8.5 本篇的三层证据,与它们的分工
OK,最后交代一下本篇的证据结构。
这张图把本篇用到的材料按来源分了三层:官方文档说设计意图,源码说实现方式,本机实测说真实代价。三层分开说的好处是,任何一句结论都能被单独反驳,而不必推翻整篇。
这套分工也是本系列的写作纪律:每一句结论都要能指到它出自哪一层。 如果一句话既像官方口径又像实测结论,那它通常两边都不牢。
8.6 下篇预告
下一篇我们回到「谁能撞谁」这个问题:三层过滤器。
ObjectLayer 怎么映射到 BroadPhaseLayer、碰撞组怎么配、
以及为什么「同一层的对象进同一棵子树」这件事会同时影响性能与行为。
配错一个映射,轻则白跑一堆查询,重则该撞的不撞。
资源清单
官方源码与文档(Jolt 仓库,MIT;以下均给出 v5.6.0 的 raw 地址,行号已从本机源码逐条核对)
Docs/Architecture.md, 宽相一节(L577–593)/确定性一节(L804)/精度限制(L770)/批量警告(L42)Jolt/Physics/Collision/BroadPhase/QuadTree.h, 类头无锁注释(L17–19)/节点字段与 128 字节断言(L119–152)/cStackSize(L142)/ 双根(L267、L340–341)/mIsChanged(L135)Jolt/Physics/Collision/BroadPhase/QuadTree.cpp, 两条官方告警(L128–134、L211–232)/部分重建(L333)/cMaxDepthMarkChanged(L366)/ 无效包围盒(L123)/查询 visitor(L1141–1193)/DOT 导出(L1632–1697)/统计口径(L1739–1748)Jolt/Physics/Collision/BroadPhase/BroadPhaseQuadTree.h, 接口全貌(Optimize/UpdatePrepare/UpdateFinalize/AddBodies*)Jolt/Physics/Collision/BroadPhase/BroadPhaseQuadTree.cpp, 节点预算公式(L39–43)/FrameSync(L58–70)/Optimize(L72 起)/每步只维护一层(L115–131)/ 统计打印(L615–625)Jolt/Physics/PhysicsSystem.h,OptimizeBroadPhase的注释(L145–148)/GetBroadPhaseQuery(L121)/ReportBroadphaseStats(L259)Jolt/Core/FixedSizeFreeList.h,Init(inMaxObjects, inPageSize)(L84–85)Docs/ReleaseNotes.md, v5.0(L322)/v5.1(L251)/v5.3(L168)/v5.4(L90、L93)Build/README.md,JPH_TRACK_BROADPHASE_STATS的官方说明- 官方宽相图两张:
QuadTreeExample.png/EllipsoidAABB.png Jolt/Physics/Collision/BroadPhase/BroadPhaseQuery.h, 六类查询与GetBounds的接口定义Jolt/Physics/Collision/BroadPhase/BroadPhaseLayer.h, 分层与过滤接口(第五篇展开)Docs/APIChanges.md,BroadPhaseQuery::GetBounds取代PhysicsSystem::GetBounds的变更记录Docs/PerformanceTest.md, 官方压测入口(本篇核对:全文无 broadphase 字样)- 官方 Doxygen 类索引与关键类页(可核验类名与接口):
类索引 /
BroadPhase/BroadPhaseQuadTree/QuadTree/BroadPhaseQuery/BroadPhaseLayerInterface/ObjectVsBroadPhaseLayerFilter - 官方仓库文件清单(核图与文档存在性):
Docs/列表 /Docs/Images/列表 - 作者官方多核扩展性实测(本篇只作背景):
JoltPhysicsMulticoreScaling.pdf - 作者 GDC 2022 演讲笔记(官方 PDF):
ArchitectingJoltPhysics_Rouwe_Jorrit_Notes.pdf
社区与对照(用于判断本篇的差异化空间)
- Jolt v5.3.0 release notes,逐个插入树深 >128 与宽相位标志上移
- Jolt README,批量插入在后台线程准备、查询可见前/后一致状态
- 官方文档镜像站,
Broad Phase Update Prepare/Finalize建新树并交换 - Box2D 碰撞检测文档,动态 AABB 树用旋转保持平衡
- PhysX
PxBroadPhaseType,eSAP与eMBP的取舍原句 - Rapier
BroadPhase,Hierarchical-SAP - The Case of a Million Collision Bodies,PhysX SAP vs MBP 的百万级实测
- 中文:UE4 物理模块(三)SAP/MBP/BVH 算法简介,中文侧的宽相综述
本机产物(原创)
evidence/bench_broadphase.cpp+evidence/build_bench.ps1,宽相四组实验的源码与编译脚本evidence/dump_tree.cpp+evidence/build_dump.ps1,树结构取证的源码与编译脚本evidence/bench_bp_run_20261001.txt,四组实验的原始输出evidence/tree-dump/**,官方导出的 DOT/SVG(逐个与批量各一组,含 2000 体与 64 体两个规模)evidence/tree-dump/tree-stats.json,解析出的节点数与树深
下一篇:《三层过滤:谁能撞谁》,ObjectLayer 怎么映射到 BroadPhaseLayer、碰撞组怎么配、以及配错一个映射为什么会同时破坏性能与行为。
With Best Wishes.