本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
核心问题:前面十二篇,每一篇都是取快照——一个时刻一个值。
dumpsys给的是"现在是什么样",而"掉帧""晚了""卡了"这些说法,本质上都是过程:某一帧从应用画完到上屏花了多少、错过 deadline 的是哪一帧、错过多少毫秒。这一篇第一次取过程,而且一上来就撞见两个数:
Legacy stats are as follows:
totalFrames = 6755
missedFrames = 396                      ← 5.9%

Global aggregated jank payload (Timeline stats):
totalTimelineFrames = 7753
jankyFrames = 6020                      ← 77.6%
同一台设备、同一段窗口,两个口径给出的 jank 率差 13 倍。 更麻烦的是,同一个包里还有第三个数:
Total frames rendered: 183
Janky frames: 130 (71.04%)
Janky frames (legacy): 178 (97.27%)
应用侧这一对,方向是反的。 所以这一篇要回答的不是"jank 率是多少",而是"你读的是谁的账,用哪一对口径"。
承接上一篇。ep12 结尾明写:dumpsys 给的是快照,而 jank 是过程——这一篇就是把那个过程打开。同时这也是 T05 系列的收官篇:前面十二篇铺完了从应用到屏幕的整条链路,这一篇把"怎么证明它真的没有卡"这件事补上。
这件事在前面几篇里挂过账。ep09 讲节拍、ep10 讲相位差,两篇反复出现"帧就绪 → 上屏"的时间量;ep11 见过"掉帧计数不可相加"的坑;ep12 见过"有变化才有帧"。前面这些读数全是"某一刻的累计值",它们能告诉你"有帧晚了",但说不出晚在哪一段。这一篇来还这笔账。
四篇共用同一条链路,各篇量的东西仍然不同:
| 维度 | ep10《Vsync 偏移》 | ep11《三缓冲与 ARR》 | ep12《虚拟显示》 | ep13(本篇) |
|---|---|---|---|---|
| 关心的对象 | 三路节拍错开多少 | 队列有多深 × 屏幕有几个档 | 一块不存在的屏 | 哪一帧晚了、晚了多少、算谁的 |
| 量什么 | 相位与时长 | 槽位数、区间、投票 | display 数、六行档案 | 两族 jank 计数、逐层 payload、14 列时间戳 |
| 取值形态 | 快照 | 快照 | 快照 | 过程(两段窗口 + 逐帧) |
| 主要命令 | Scheduler 相位段 |
Slots: + --timestats |
--display-id + screenrecord |
--timestats -dump + gfxinfo framestats + perfetto |
| 典型结论 | 就绪→上屏 6.17 / 15.96 ms | 槽位只有两格;refreshRateSwitches=0 |
14 秒只录到 2 帧 | 同一窗口两族口径差 13 倍;应用侧还反向 |
本篇也不涉及:Perfetto 自身的架构与 PerfettoSQL 引擎原理(已在 T01《图形性能剖析工具链》)、trace_processor 的表结构与 stdlib 细节(只给一条指针 + 一组 SQL 示例)、应用层具体优化手法(列表复用、避免过度绘制等)、厂商私有调度策略(LTPO 面板调参、厂商白名单)、编解码与媒体链路的 jank。为什么不涉及:这一篇的价值集中在"把一次 jank 读到帧上、并且把口径摆清楚"这一件事上,掺进工具原理与应用优化清单就讲不透。完整边界见 §0.3。
系列文章写作风格说明(沿用前十二篇,不再重复解释)
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、AOSP 源码怎么做、设备上读出来是什么,这三层分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(机型、Android 版本、命令、窗口、采样时刻)——本篇尤其要紧,因为这一篇的主题就是口径本身;
- "报数先报口径":凡出现 jank 率,一律连"哪一处(平台侧/应用侧)、哪一对(新口径/legacy)、哪一段窗口"一起写出来。只写数字不写口径,在这一篇里等于没说;
- 模拟器结论不外推:本篇所有读数来自一台 Android 16 模拟器。凡是"真机上会怎样"的话,本篇一律标为转述官方或标为待验证。
系列主要内容总览
- 【Android 图形显示系统】(一) 总览:从 App 到屏幕的图形管线
- 【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 【Android 图形显示系统】(三) RenderThread 与帧提交:从显示模块到一块缓冲
- 【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局
- 【Android 图形显示系统】(五) Vulkan on Android:低开销渲染入口
- 【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么
- 【Android 图形显示系统】(七) ASurfaceControl:Android 10 的透明事务
- 【Android 图形显示系统】(八) HWC:GPU 合成之外的硬件叠加
- 【Android 图形显示系统】(九) HWC2:Vsync 回调和虚拟显示路径
- 【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞
- 【Android 图形显示系统】(十一) 三缓冲、多刷新率与 ARR
- 【Android 图形显示系统】(十二) 虚拟显示与屏幕录制
- 【Android 图形显示系统】(十三) 剖帧实战:Perfetto FrameTimeline 抓 jank(本篇 · 收官)
相关资源链接
- 官方文档:Android Jank detection with FrameTimeline(Perfetto) | Perfetto CLI 参考 | Trace Processor
- 应用侧:测试界面性能(Android Developers) | 界面卡顿检测 |
dumpsys用法 - 平台侧:Understand systrace(AOSP) | 用 adb 捕获 Winscope 轨迹(AOSP)
- 源码:
frameworks/native/libs/gui/include/gui/JankInfo.h(jank 类型的枚举定义)
这一篇回答什么,不回答什么
好了,先把坐标系挪正。前面十二篇给了管线、叫醒链、交接、邮局、入口、关口、改动、归属、节拍、错开、队列深度、虚拟屏;这一篇要还的是"过程"这笔账——前面所有读数都是"某一刻的累计值",从来没有人问过"这一帧到底晚在哪一段"。
OK,先说清它跟前一篇的关系:ep12 结尾我写过一句话——dumpsys 给的是快照,而 jank 是过程。ep12 的最强读数(14 秒 2 帧)本身就是一个过程性的发现,但它能得出那个结论,靠的还是"两个快照相减"。这一篇换成一次真正的过程采样:两段受控窗口 + 一次逐帧读列 + 一条真实 trace。
0.0 内容总览:本篇知识地图
好了,先把十一章各自回答的问题钉在一张表上。它同时也是本篇的目录总览。如果时间紧,第三章(八类归因)、第六章(framestats 的 14 列)、第七章(两个口径)是这篇最不可替代的三章:第三章给"算谁的账",第六章给"另一条证据链长什么样",第七章给"为什么两个数到处打架"。
| 章 | 本章问句 | 关键读数或原文 |
|---|---|---|
| 零 | 这一篇回答什么、不回答什么 | missedFrames 396 / jankyFrames 6020 |
| 一 | jank 到底是怎么判定的 | "presented 时间与预测时间不匹配" |
| 二 | 两条轨道各是什么 | Expected 给预算、Actual 给实况,靠 token 配对 |
| 三 | 八类归因怎么分工 | 应用侧两类 / SF 侧四类;本机八类计数 |
| 四 | 两段窗口差多少 | 静止窗口 0 帧;负载窗口 93.8% |
| 五 | 整屏 jank 来自哪一层 | StatusBar#104 2840/2411;launcher 层 2003/1251 |
| 六 | 另一条链怎么读 | FRAME_COMPLETED − INTENDED_VSYNC |
| 七 | 两个口径为什么差 | 平台侧 13 倍;应用侧反向 |
| 八 | 怎么采一条 trace | perfetto -c - --txt;Wrote 6637061 bytes |
| 九 | 采到了就能剖开吗 | 三条获取路径全部受阻 |
| 十 | 哪些只能上真机 + 系列回望 | 缺口分档;13 篇一句话一串 |
0.1 本篇那个"反直觉的对照"
好了,先把这个对照摆出来,因为它撑住了整篇的骨架。
第一件事:同一个窗口,平台侧两个口径差 13 倍。
Legacy stats are as follows:
totalFrames = 6755
missedFrames = 396                      ← 5.9%

Global aggregated jank payload (Timeline stats):
totalTimelineFrames = 7753
jankyFrames = 6020                      ← 77.6%
这两行印在同一份 dump 里,相隔不过几十行。 一个说"6% 的帧有问题",一个说"78% 的帧有问题"。
第二件事:到了应用侧,同一对名字的方向反过来了。
Total frames rendered: 183
Janky frames: 130 (71.04%)
Janky frames (legacy): 178 (97.27%)
launcher 这个包里,legacy 口径给出的 jank 率比新口径更高。而平台侧是相反的。 所以"legacy 比新口径更松"这句话本身就是错的——它没有"松"或"严"这个属性,它只有"哪一处、哪一对"这个前提。
第三件事:本机 jank 的大头不是"应用画得慢"。
负载窗口的增量里,八类归因的前三名是 appBufferStuffingJankyFrames(+323)、appUnattributedJankyFrames(+287)、sfPredictionErrorJankyFrames(+273)——而sfLongCpuJankyFrames(+46)与 sfLongGpuJankyFrames(+19)很小。"合成超时"不是主角,"预测错误"和"缓冲堆积"才是。
说白了,这三件事合起来就是本篇的主轴:"jank 了"不是一个结论,它是一组带前提的判定。
0.2 与相邻篇目的分工
| 篇 | 量什么 | 留给本篇什么 |
|---|---|---|
| ep10 | 三路节拍错开多少 | 给了"就绪 → 上屏"的时间量,但那是平均值 |
| ep11 | 队列与档位 | 给了"掉帧计数不可相加"的坑;本篇在同一族计数上再踩一次并写进口径提醒 |
| ep12 | 虚拟屏与录制 | 明写"dumpsys 是快照、jank 是过程",本篇兑现 |
| T01《图形性能剖析工具链》 | 工具自身的方法论 | 本篇不重复工具原理,只讲"这一个判决怎么读" |
0.3 边界声明:本篇不涉及什么,以及关键参数
下面进入边界声明。本篇不涉及(只给指针、不配图):
| 不涉及的内容 | 为什么不写 | 去哪看 |
|---|---|---|
| Perfetto 自身的架构与 PerfettoSQL 引擎 | 已由 T01 覆盖 | T01《图形性能剖析工具链》 |
trace_processor 的表结构与 stdlib |
只给一条指针 + 一组 SQL 示例 | PerfettoSQL 表文档 |
| 应用层优化手法(列表复用、过度绘制…) | 属工程实践,不是本篇的判决问题 | 《移动端图形与功耗》与工程实践资料 |
| 厂商私有调度策略 | 未公开 | — |
| 编解码 / 媒体链路的 jank | 属媒体专题 | T0x 媒体专题 |
关键参数与观测条件(凡引用本篇读数,条件一律照此):
| 项 | 值 |
|---|---|
| 设备 | emulator-5554(Pixel_7 AVD · Android 16 / API 36 · goldfish_x86_64 · user 构建 · ro.debuggable=0) |
| root | 没有——但本篇不需要(见 §1.3) |
| Perfetto | /system/bin/perfetto,v49.0;init.svc.traced = running |
| 窗口形态 | 两段受控窗口(A 静止 15 s / B 负载:连续手势 + 三次页面切换 + 4 个 CPU 争用进程),窗口对比一律用差分(§4.3) |
| trace | perfetto -c - --txt -o …,6 s,含 android.surfaceflinger.frametimeline + linux.ftrace(sched/sched_switch + atrace gfx/view) |
| 本机台账 | ep13_raw/(36 份,含 6.6 MB trace),正文所有读数以此为准 |
0.4 本篇怎么读:三条判据贯穿全篇
- "jank 了"不是一个结论,"哪一帧、哪一类、算谁的"才是。 平台侧 77.6% 的
jankyFrames里,sfPredictionError与appBufferStuffing占大头,而sfLongCpu/sfLongGpu很小(§3.2);逐层看,两层的成因还完全不同(§5.2)。先问是哪一类,再问该谁改。 - 两族口径不能混用,也不能相加。 Legacy 与 Timeline 在同一窗口里差 13 倍(§7.1);同一帧可命中多个 jank 类型,各类之和远大于
jankyFrames(§3.2)。报数之前先报口径。 - 采到 trace 不等于剖得开 trace。 采集侧一条命令就能跑通(§8),分析侧需要
trace_processor;拿不到它时,设备上仍有两族可读的账。"我采到了"和"我读出来了"是两件事。
外加一条跨篇复用:工具在"输入不合法"时退化成"回一个默认值"——ep09 上线后修正过这条(--latency 认不出来的名字只回一个周期值),ep11 复现过,ep12 用三个名字第三次复现并识别出那个数就是 60 Hz 周期。本篇是第四次遇到同族现象,只不过这次退化的不是命令,而是我自己:窗口对比时如果照抄"先 reset 再看",拿到的会是一个根本没被重置的累计值(§4.3)。
本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | 测试界面性能(Android Developers)。这一章的定义可以收成一句:jank 是一组带前提的判定,读它之前必须先问"这是哪一处、哪一对口径、哪一段窗口"。其中:坐标系是输入,三条判据是量尺,而后面十一章是逐条兑现。
一、jank 的官方定义:一次"预测落空"
OK,第一章先把"jank"这个词的定义钉死。注意这一章的证据分三层:官方文档怎么写、设备上读出来是什么、以及"这台设备到底能不能采"。
1.1 官方那句定义
先来看看官方那句话,它短得出奇,而且把判据写成了"比较":
"A frame is said to be janky if the time the frame was presented on screen does not match the predicted present time given by the scheduler."
——perfetto.dev《Android Jank detection with FrameTimeline》
注意这句话的构造:它没有说"耗时超过 16.7 ms 就是 jank",而是说实际送上屏的时间与调度器给出的预测时间不匹配。这两个判据是不同的东西——一帧完全可以很慢但"不 jank"(预测本身就给了宽限),也可以很快但"jank"(预测说它该更早到)。
同页还给了一句模块定位:
"FrameTimeline is a module within SurfaceFlinger that detects janks and reports the source of the jank."
——同上
"reports the source" 是这一篇的题眼:这根轨道不只报"卡了",它报"卡在谁身上"。而版本门槛也很清楚:
"FrameTimeline requires Android 12(S) or higher"
——同上
最后是一条已知限制,写正文里免得读者踩:
"SurfaceViews are currently not supported, but will be, in future."
——同上
本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | frameworks/native/libs/gui/include/gui/JankInfo.h。这一章的定义可以收成一句:一帧被判定为 jank,是因为它实际上屏的时刻与调度器预测的时刻不匹配。其中:判据是输入(两个时刻),比较是手段,而"jank / 不 jank"是输出。
1.2 本机八类 jank 的账
好了,定义讲完了,上设备看。本机的设备侧 surfaceflinger 时间统计里,直接印着 FrameTimeline 的八类归因计数(ep13_raw/b2_load_timestats.txt,负载窗口后的累计值):
Global aggregated jank payload (Timeline stats):
displayRefreshRate = 60 fps
renderRate = 60 fps
totalTimelineFrames = 7753
jankyFrames = 6020
sfLongCpuJankyFrames = 1007
sfLongGpuJankyFrames = 564
sfUnattributedJankyFrames = 6
appUnattributedJankyFrames = 1773
sfSchedulingJankyFrames = 3
sfPredictionErrorJankyFrames = 4044
appBufferStuffingJankyFrames = 3332
逐个数读:7753 帧里有 6020 帧被记成 janky(77.6%),而八类里最大的是 sfPredictionErrorJankyFrames(4044)与 appBufferStuffingJankyFrames(3332),而 sfLongCpu(1007)与 sfLongGpu(564)小得多。
这里必须插一条口径提醒(ep11 在同一族计数上踩过):这八类不可相加。1007 + 564 + 6 + 1773 + 3 + 4044 + 3332 = 10729,远大于 jankyFrames 的 6020——因为同一帧可以同时命中多个 jank 类型。把八类加起来当"总 jank 数"是最常见的读错方式。
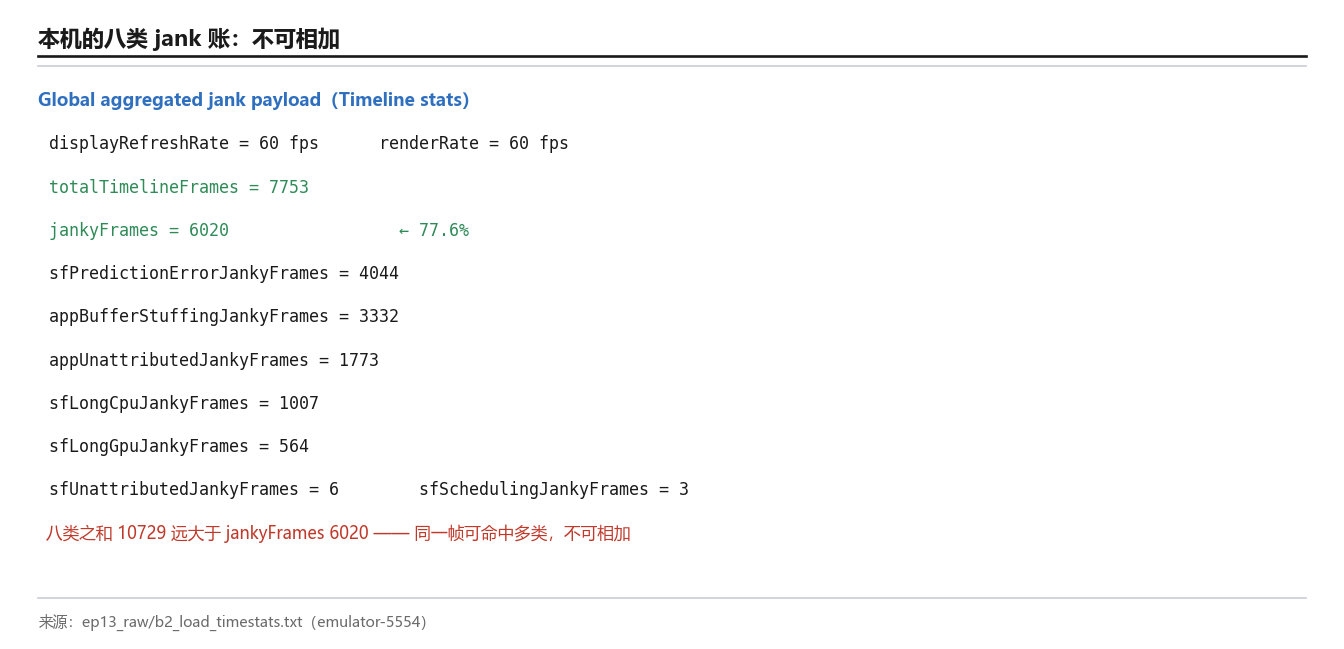
totalTimelineFrames 7753 里 jankyFrames 6020(77.6%),最大两项是预测错误与缓冲堆积——而八类之和 10729 大于 6020,说明同一帧可命中多类,不可相加@ 本机 dumpsys SurfaceFlinger --timestats -dump 实测(emulator-5554)1.3 环境与"能不能采":无 root 也能采
说白了,这一节要修正一条流传很广的说法。 系列规划里把这一篇标为「需真机 + root」。上设备一探,实际情况不是这样(ep13_raw/a_still_env_identity.txt 与 c_trace_query.txt):
| 项 | 值 | 含义 |
|---|---|---|
ro.build.version.sdk |
36 | Android 16 |
ro.build.type / ro.debuggable |
user / 0 |
没有 root 可拿 |
/system/bin/perfetto --version |
v49.0 | 设备自带 |
init.svc.traced |
running |
跟踪服务在跑 |
| shell 身份 | uid=2000(shell),组内含 readtracefs(3012) |
有读 tracefs 的权限 |
| 数据源 | android.surfaceflinger.frametimeline(由 pid 541 的 surfaceflinger 提供) |
FrameTimeline 数据源已注册 |
结论很清楚:采一条含 FrameTimeline 的 trace,不需要 root。 真机与 root 能扩的是"更真实的负载与更全的数据源",不是"能不能采"。这一条要写成口径修正——它同时解释了为什么下面九章全部能在模拟器上做完。
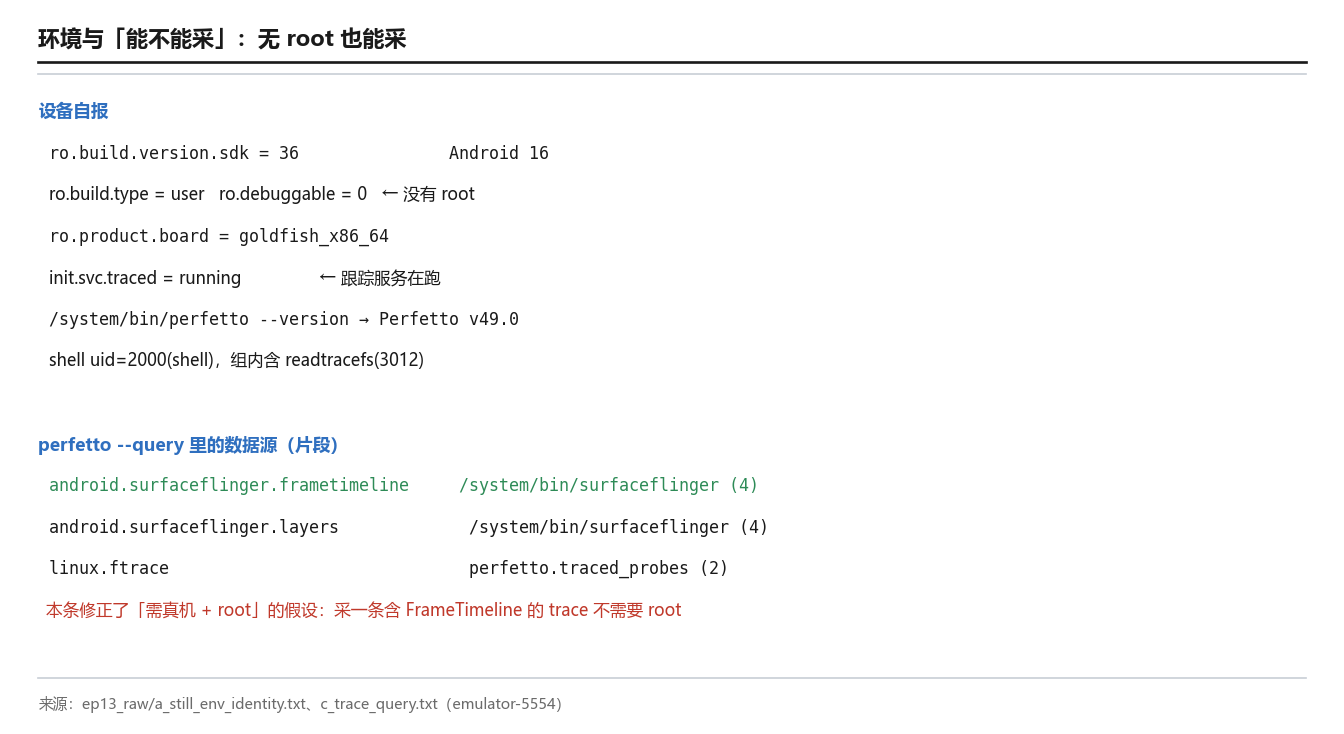
user 构建、无 root,但 traced 在跑、frametimeline 数据源已注册、shell 有 readtracefs 权限——采一条含 FrameTimeline 的 trace 不需要 root@ 本机 getprop + perfetto --query 实测(emulator-5554)本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | Perfetto CLI 参考。这一章的结论可以收成一句:jank 的判据是两次时刻的"不匹配",而本机在无 root 的条件下就能拿到这套判定。其中:官方管"判据是什么",本机管"我能不能拿到它"。
二、两条轨道:Expected 给预算、Actual 给实况
好了,第一章立了判据。这一章就展开那个判据的两端:"预测的时刻"和"实际的时刻"分别是怎么来的。
2.1 两条切片各是什么
OK,官方把两条轨道分开定义,读起来像两句话,但各自的分量不同:
"Each slice represents the time given to the app for rendering the frame."
"These slices represent the actual time an app took to complete the frame (including GPU work) and send it to SurfaceFlinger for composition."
——perfetto.dev《Android Jank detection with FrameTimeline》
第一句是"预算",第二句是"实况"。 而两条轨道的起点也被官方点明了:
| 轨道 | 起点 | 官方原话 |
|---|---|---|
| Expected | Choreographer 回调被安排运行的时刻 | "the time the Choreographer callback was scheduled to run." |
| Actual | Choreographer 回调真正开始运行的时刻 | "Choreographer#doFrame or AChoreographer_vsyncCallback started to run" |
注意这一对起点的差别:一个是"被安排",一个是"真开始"。ep02 讲过 Choreographer 是"谁在召唤 Vsync",ep10 讲过三路节拍错开多少——到这里,那两件事汇成了一个可判定的差额。
Actual 的结束时刻同样值得单列,因为它把 GPU 也算进去了:
"the time the app's frame was posted to SurfaceFlinger" 与 GPU 时间取
max(gpu time, post time)——同上
"取 max"这件事有含义:一帧的"完成"不是"画完了",也不是"送上去了",而是两者里更晚的那个。所以一帧里 GPU 排队排得久,它就算"完成得晚",不管 CPU 侧多早交差。
这张图怎么读:先看两条轨道的起点——上面那条从"被安排运行"起算,下面那条从"真开始运行"起算,差额就是这一帧"没赶上节拍"的那一段。再看 Actual 的结束端:它不是"画完",而是 GPU 时间与上屏时间取更大值。一句话:这条图能回答"帧去了哪",而"为什么去得慢"要靠后面的归因。
2.2 靠什么把两条切片配成一对
两条轨道分属不同进程、不同上下文,怎么知道哪一条 Expected 对应哪一条 Actual? 官方给了那个"钥匙":
切片名 = "the token received from choreographer"
——同上
切片名就是 choreographer 发下来的 token。 于是同一帧的两条切片可以用 token 一一对照——这条设计直接决定了下面那个 SQL 怎么写(§9.1 会给示例):两张表各取一次,用 token 连接。
顺带把官方列的可读字段一次列全(选中一条 actual 切片后能看到什么):
| 字段 | 取值 | 读它做什么 |
|---|---|---|
| Present Type | early / on time / late | 这帧是早到、准点还是迟到 |
| On time finish | 布尔 | 应用是否按时完成(只看应用那一侧) |
| Jank Type | 八类之一,无则 None |
算谁的账(本篇第三章专讲) |
| Prediction type | Expired Prediction / Valid Prediction | 这条预测是否已过期 |
| GPU Composition | 布尔 | 这帧是否走了 GPU 合成 |
| Layer Name | 层名 | 落到哪一个层上(比"整屏 jank"可执行得多) |
| Is Buffer? | buffer / animation | 这一帧是应用缓冲还是动画 |
这张图怎么读:左边两条轨道上各画了几条切片,其中一条 Expected 与一条 Actual 的名字是同一个 token——右侧那条连线就是配对。配对之后才有那七个字段可读,而七个字段里最要紧的是 Jank Type 与 Layer Name 两个:一个告诉你"算谁的账",一个告诉你"落在哪一层"。
2.3 采集侧的数据源清单里就有它
好了,机制讲完了,看设备上它长什么样。perfetto --query 会把已注册的生产者与数据源列出来(ep13_raw/c_trace_query.txt):
Service: Perfetto v49.0
PRODUCER PROCESSES CONNECTED:
4      541      1000            /system/bin/surfaceflinger
DATA SOURCES REGISTERED:
android.surfaceflinger.frame             /system/bin/surfaceflinger (4)
android.surfaceflinger.frametimeline     /system/bin/surfaceflinger (4)
android.surfaceflinger.layers            /system/bin/surfaceflinger (4)
linux.ftrace                             perfetto.traced_probes (2)
track_event                              /system/bin/surfaceflinger (10)
三件事一眼可见:① surfaceflinger 作为一个生产者连着;② 它注册的名字里有 android.surfaceflinger.frametimeline——就是本篇要采的那个;③ 同一份清单里还有 linux.ftrace(提供 sched/gfx 等)与 track_event。
一处措辞纪律:候选材料里偶尔出现
android.surfaceflinger.frame被当作"帧事件数据源"来写。它在官方文档里查不到对应条目,本篇不为它下定义,只把设备上印出来的这一行如实列出;本篇要采的是android.surfaceflinger.frametimeline。
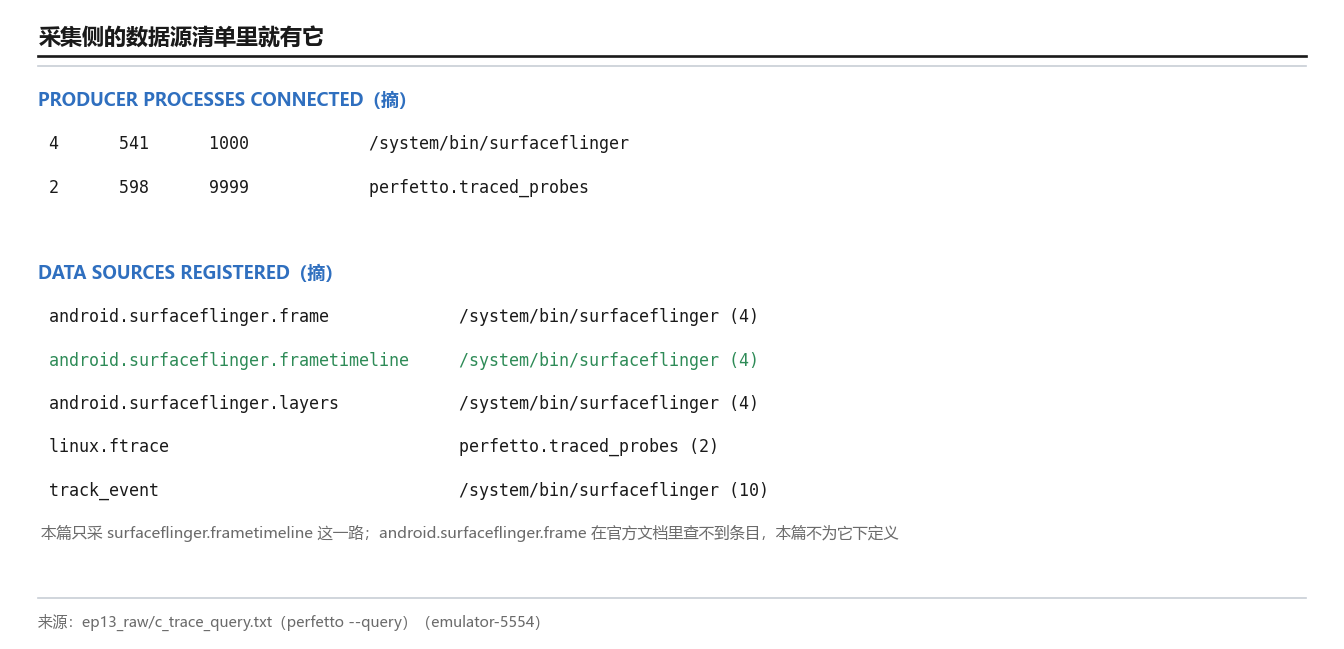
android.surfaceflinger.frametimeline 由 surfaceflinger 自己注册——要采的东西本来就在那儿,问题只在怎么采、以及采完怎么读@ 本机 perfetto --query 实测(emulator-5554)本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | Perfetto CLI 参考。这一章的定义可以收成一句:Expected 轨道给出预算、Actual 轨道给出实况,两条切片靠 choreographer 的 token 配成一对。其中:官方管"两条轨道各是什么、字段怎么读",本机管"这条数据源确实注册着、随时可采"。
三、八类归因:谁在拖后腿
好了,前两章把"怎么判定"和"两条轨道"讲完了。这一章才是 FrameTimeline 真正值钱的地方:它不只说"卡了",它说"卡在谁身上"。
3.1 八类的分工
先来看看官方列的全集。官方把 jank 类型列全了,一共八类(None 之外七类归因,另有 Unknown):
| 侧别 | jank 类型 | 字面意思 | 谁该动手 |
|---|---|---|---|
| 应用侧 | AppDeadlineMissed |
应用错过了自己的 deadline | 应用 |
| 应用侧 | BufferStuffing |
缓冲区堆起来了 | 应用(产帧太快或队列太浅) |
| SF 侧 | SurfaceFlingerCpuDeadlineMissed |
SF 的 CPU 侧错过 deadline | 平台 / 合成负载 |
| SF 侧 | SurfaceFlingerGpuDeadlineMissed |
SF 的 GPU 侧错过 deadline | 平台 / GPU 负载 |
| SF 侧 | DisplayHAL |
显示硬件抽象层这一环 | 屏幕侧(不在应用或 SF 手里) |
| SF 侧 | PredictionError |
预测本身错了 | 看情况——预测错不等于画得慢 |
| — | Unknown |
不知道算谁的 | 需要进一步取证 |
| — | None |
不是 jank(正常帧) | — |
原文并注明这些类型定义在 JankInfo.h:
"The jank types are defined in JankInfo.h"
——perfetto.dev《Android Jank detection with FrameTimeline》
这张表里最容易被忽略的是 PredictionError。 它说的不是"谁画慢了",而是"预测这件事本身没算准"——一帧可能画得挺准时,却因为预测给的时刻偏了而被判 jank。这就是为什么第一章那句定义要单独拎出来讲:如果按"耗时有没有超 16.7 ms"去读,这一类会被整类误判成"没问题"。
顺带把官方给的五色码也记下(读图用):Green = 好帧;Light Green = 高延迟状态(流畅但迟到,输入延迟增大);Red = 卡顿且该进程是主因;Yellow = 仅应用轨道,卡顿但主因是 SurfaceFlinger;Blue = Dropped frame。
PredictionError 说的是"预测没算准",不是"谁画慢了"@ 本系列绘制(依据 perfetto.dev 原文与 JankInfo.h 的枚举)3.2 本机的八类账
OK,把本机负载窗口的增量单独拎出来看(ep13_raw/a2_still_timestats.txt 与 b2_load_timestats.txt 两次数值相减):
| jank 类型 | 累计值 | 窗口增量 | 占窗口 jankyFrames(396)的比例 |
|---|---|---|---|
appBufferStuffingJankyFrames |
3332 | +323 | 81.6% |
appUnattributedJankyFrames |
1773 | +287 | 72.5% |
sfPredictionErrorJankyFrames |
4044 | +273 | 68.9% |
sfLongCpuJankyFrames |
1007 | +46 | 11.6% |
sfLongGpuJankyFrames |
564 | +19 | 4.8% |
sfUnattributedJankyFrames |
6 | +2 | 0.5% |
sfSchedulingJankyFrames |
3 | +1 | 0.3% |
这张表要竖着读,不要横着加。 四个读数:① 最大的是"缓冲堆积"与"预测错误",不是"合成超时";② sfLongCpu(+46)与 sfLongGpu(+19)加起来只占窗口 jankyFrames 的 16%——"SF 合成太慢"在这种负载下不是主因;③ 比例一列全都小于 100%,因为同一帧可以同时命中多类(§1.2 已经说过不可相加);④ sfUnattributedJankyFrames 只有 2 帧、sfSchedulingJankyFrames 只有 1 帧——这两类在本机几乎不出现。
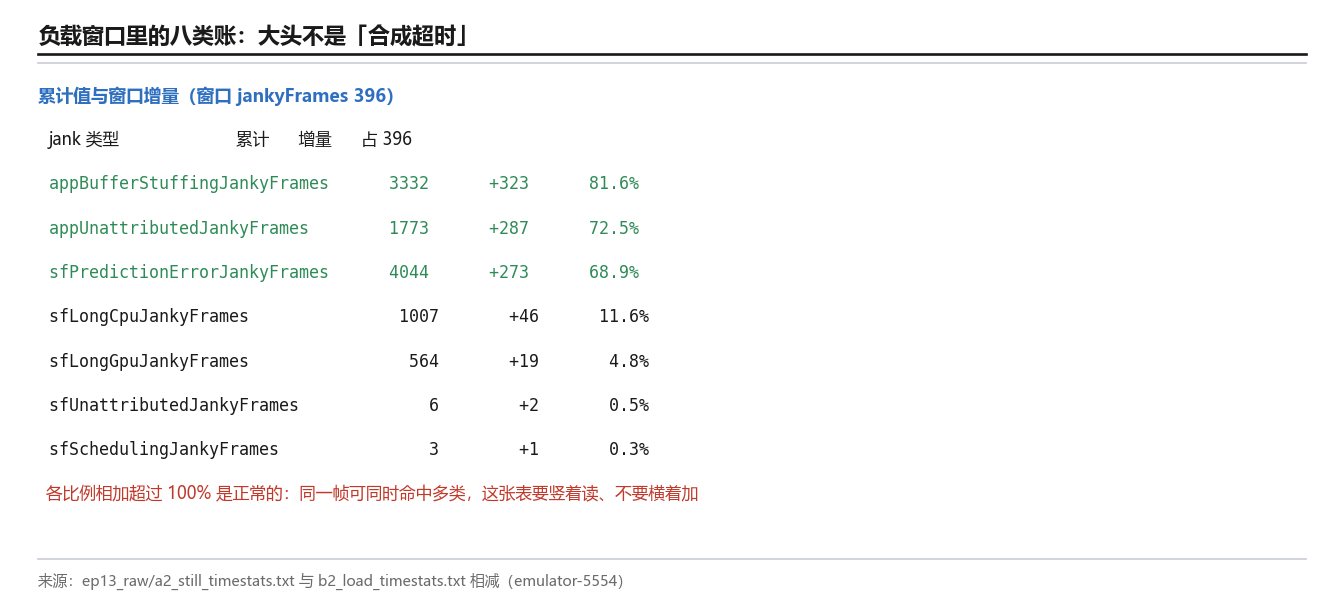
sfLongCpu 与 sfLongGpu 加起来只有 16%——"合成太慢"在这种负载下不是主因@ 本机两窗口差分(emulator-5554)3.3 落到层上:四层 × 八类
说白了,整屏一个 jank 率不是可执行的结论——它没告诉你改哪里。它的原理是:判定与归因都是按层记的,所以"整屏"只是一个聚合视图,真正的证据在层上。
adb shell dumpsys SurfaceFlinger --timestats -dump
# 在输出里找 "Jank payload for this layer" 那一段,逐层读
本机的 payload 是按层印的,每层带 uid、层名、包名、四种帧计数,以及同一套八类归因(ep13_raw/zz_layer_payloads.txt):
| 层 | totalFrames |
jankyFrames |
sfPredictionError |
sfLongCpu |
appBufferStuffing |
|---|---|---|---|---|---|
StatusBar#104 |
2840 | 2411(84.9%) | 2092 | 162 | 184 |
…NexusLauncherActivity#329 |
2003 | 1251(62.5%) | 783 | 329 | 1152 |
NotificationShade#370 |
389 | 354(91.0%) | 315 | 13 | 377 |
Taskbar#137 |
202 | 157(77.7%) | 89 | 34 | 118 |
四层的 jank 率在 62.5%–91.0% 之间,看起来"整屏都很糟"。但成因一列一列看下去就分化了——这正是下一章要展开的。
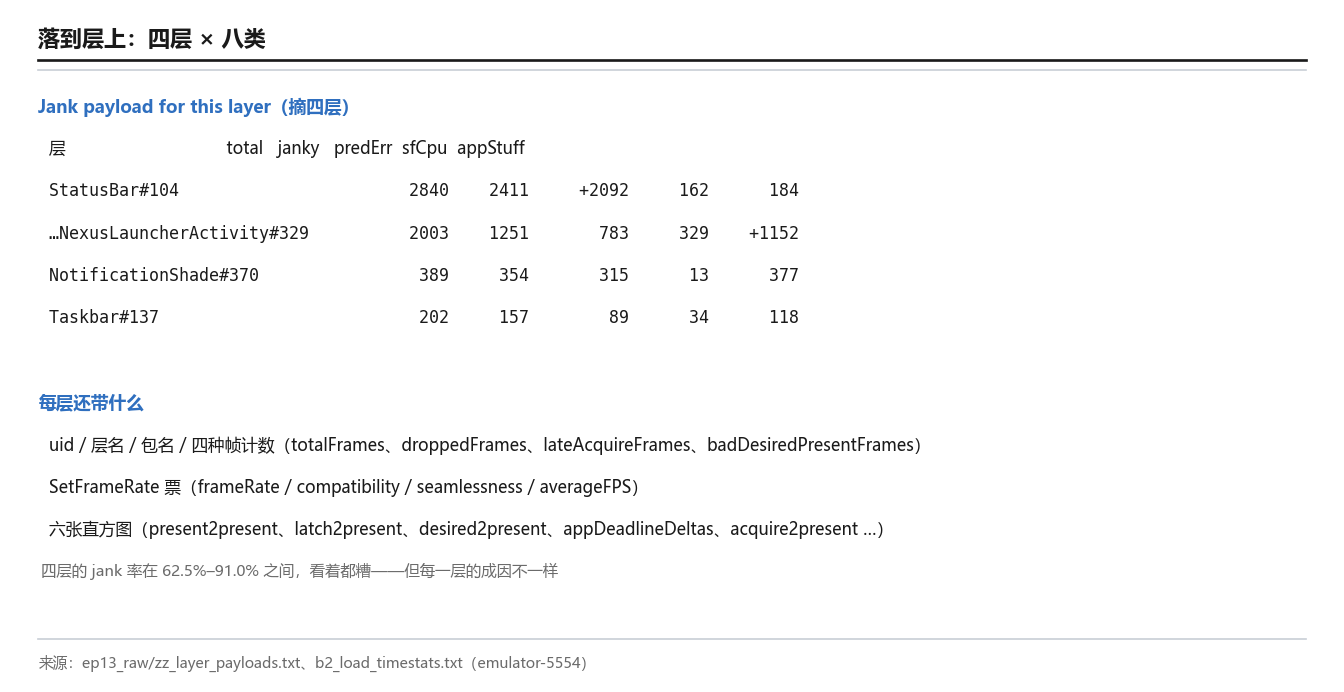
dumpsys SurfaceFlinger --timestats -dump 的逐层 payload 实测(emulator-5554)本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | frameworks/native/libs/gui/include/gui/JankInfo.h。这一章的定义可以收成一句:jank 不是一个"卡/不卡"的布尔量,而是八类归因里的一条(同一帧可命中多类)。其中:官方管"有哪八类、各由谁动手",本机管"这一次的账主要落在哪几类、哪几层上"。
四、本机的账:静止窗口 0 帧、负载窗口 93.8%
好了,第三章读的是"累计值"。这一章换成两段受控窗口——因为"累计 77.6%"里混着开机、待机与各种历史负载,它说明不了任何一次具体操作有多糟。
4.1 两段受控窗口
先来看看窗口是这么造的(ep13_raw 里两段各一套台账):
| 窗口 | 怎么造 | 持续 |
|---|---|---|
| A 静止 | 不动屏幕、不起负载 | 15 s |
| B 负载 | 连续手势(上下各 14 次滑动)+ 三次"打开设置再返回"+ 4 个 CPU 争用进程 | 到操作结束 |
两窗口的读法:取窗口前后的两次全量 dump,做差(为什么必须做差,见 §4.3)。结果如下:
| 指标 | 基线 | A 静止窗口后 | B 负载窗口后 | B 窗口增量 |
|---|---|---|---|---|
Legacy totalFrames |
5673 | 6349 | 6755 | +406 |
Legacy missedFrames |
341 | 364 | 396 | +32 |
Timeline totalTimelineFrames |
6562 | 7331 | 7753 | +422 |
Timeline jankyFrames |
4961 | 5624 | 6020 | +396 |
于是窗口内的两个 jank 率是:
- Timeline 侧:
396 / 422 = 93.8% - Legacy 侧:
32 / 406 = 7.9%
同一个窗口、同一段操作,两个口径差 11.9 倍。 而累计口径下这个差是 77.6% 对 5.9%,13.2 倍(题图就是这两个数)。这一章先把这个差摆出来,第七章再逐条拆它为什么差。
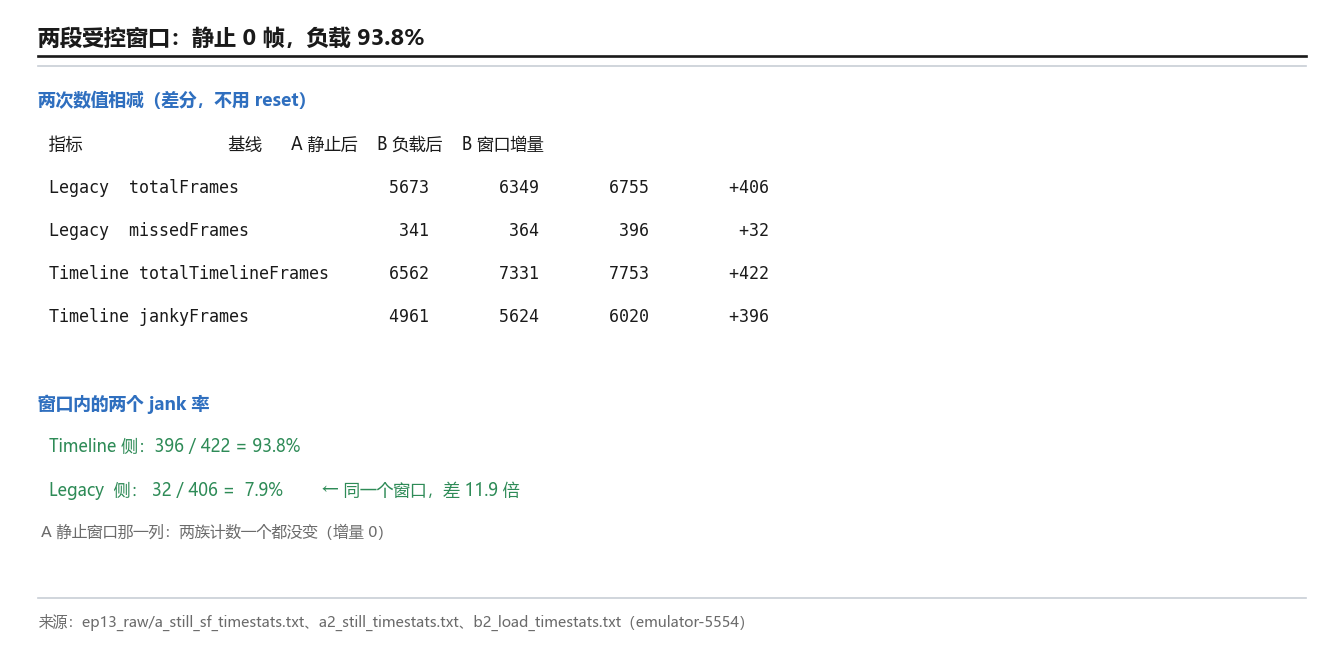
这张面板怎么读:四行指标各有一列"B 窗口增量"——那一列才是窗口内的数,前几列都是累计值。两次 dump 相减得到增量,再拿增量除以同族的帧数,才得到窗口内的 jank 率(右侧那两个 93.8% 与 7.9%)。如果只看累计列,你读到的是"这台设备开机以来",不是"刚才那几次滑动"。
4.2 静止窗口里,两族计数一个都没动
好了,上一张表里有一格最值得单独拎出来:A 静止窗口后的那一列,两族计数一个都没变。
Legacy totalFrames6349 → A 窗口后仍是 6349;Timeline totalTimelineFrames7331 → A 窗口后仍是 7331。
A 窗口里增量是 0——一段"没有变化"的窗口里,一帧都没有产出,自然也没有一帧 jank。
换个角度看同一件事,用应用侧的账来验(ep13_raw/a2_still_gfx_launcher.txt):
Total frames rendered: 0
Janky frames: 0 (0.00%)
Janky frames (legacy): 0 (0.00%)
0 帧。 而负载窗口同一条命令给出的是 183 帧(§7.2)。两条独立证据链(平台侧计数与应用侧计数)在这里指向同一件事。
这是本篇与 ep12 的一处跨篇呼应:ep12 用"14 秒只录到 2 帧"证明了"有变化才有帧";这一篇在另一个工具上又量到一次——静止 15 秒,零帧。两个工具、两个视角、同一条事实。
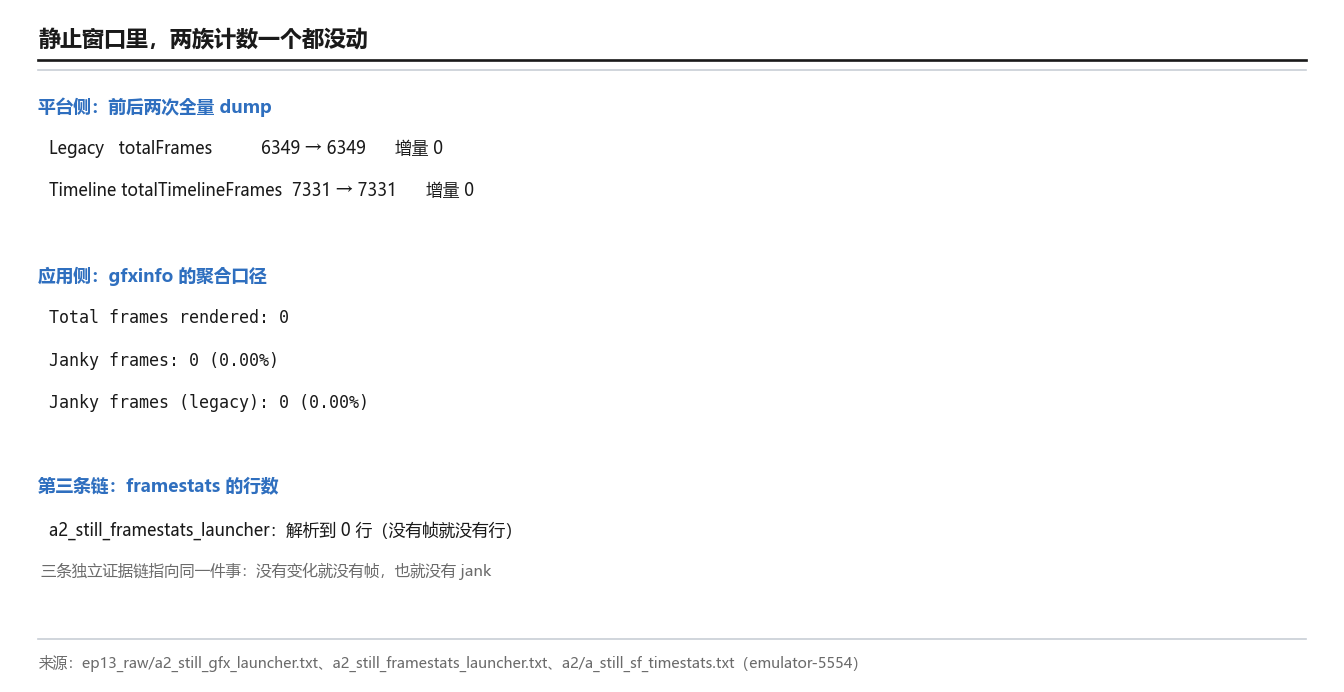
Total frames rendered: 0——没有变化就没有帧,也就没有 jank(与 ep12 的"有变化才有帧"是同一件事在两个工具上的两次落地)@ 本机两窗口差分(emulator-5554)4.3 一处工具事实:reset 是空操作
OK,这一节讲一个我踩到的坑,不踩它整章的窗口对比都是错的。
按直觉,做窗口对比的标准做法是"先 --timestats -reset,跑一段,再看"。于是我先按这个做了,紧接着又做了一次核对:reset 之后连取两次,间隔 6 s(ep13_raw/z_reset_semantics.txt):
reset 后 6s #1: Timeline total=7331 janky=5624 predictErr=3771 ...
再等 6s   #2: Timeline total=7331 janky=5624 predictErr=3771 ...
一字不差。 两次读数完全相同,连"6 秒里长出来的新帧"都没有——而 6 秒静止窗口本来就该 0 帧(§4.2),所以问题不能靠"有没有新帧"来判。换个判法:reset 前后的那一对读数(reset 之前刚取过一次)也是同一个数。
结论:dumpsys SurfaceFlinger --timestats -reset 在本机是空操作——计数没有被清零,仍是自 statsStart 起的累计值。因此本机的窗口对比只能靠"前后两次全量 dump 相减"。 这也意味着:照抄"先 reset 再看"的人,拿到的会是一个没被重置的累计值,而他会以为那是窗口内的数。
这条属于本篇第四条判据的一个实例(§0.4 跨篇复用那条):工具在"输入不合法"时退化成"回一个默认值"——ep09 那次退化的是一条命令(--latency 对认不出的名字回一个周期值),这次退化的是一条语义:-reset 接受了、不退错、但什么也没做。
一处成因未明,如实登记:为什么
-reset在本机是空操作(是这一族计数本来就不支持重置,还是某个版本的行为),本篇没有查源码,故不解释。写作上只把它当成一条必须绕开的操作事实:用差分,不用 reset。
--timestats -reset 在本机是空操作:reset 后连取两次数值一字不差——窗口对比只能靠"前后两次全量 dump 相减"@ 本机 z_reset_semantics 实测(emulator-5554)本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | 测试界面性能(Android Developers)。这一章的结论可以收成一句:窗口内的 jank 率要靠差分算(本机 Timeline 93.8% 对 Legacy 7.9%),而窗口本身要么有变化要么零帧。其中:官方管"判据与字段",本机管"这段窗口里到底产出了几帧、以及 reset 靠不靠得住"。
五、逐层的账:整屏 jank 主要来自哪一层
好了,第四章把两段窗口的账算清了。这一章往里再走一层——因为"这块屏在 jank"不是可执行的结论,"哪一层的哪一类 jank"才是。
5.1 哪一层在 jank
把 §3.3 那张表按 totalFrames 降序排一遍——下面进入逐层,并补上每一层的占比(ep13_raw/zz_layer_payloads.txt):
| 层 | uid / 包名 | totalFrames |
jankyFrames |
jank 率 | 最大成因 |
|---|---|---|---|---|---|
StatusBar#104 |
10185(packageName 为空) |
2840 | 2411 | 84.9% | 预测错误 2092 |
…NexusLauncherActivity#329 |
10180 | 2003 | 1251 | 62.5% | 缓冲堆积 1152 |
NotificationShade#370 |
— | 389 | 354 | 91.0% | 缓冲堆积 377 |
Taskbar#137 |
— | 202 | 157 | 77.7% | 缓冲堆积 118 |
两件事值得停一下。
第一件:帧最多的是状态栏,而不是 launcher。 StatusBar#104 有 2840 帧,比 launcher 层(2003)还多——averageFPS 一栏也印证了(状态栏这一层在持续产帧)。这与"重负载都在应用上"的直觉相反:在这台模拟器上,产帧最多的是系统 UI 自己。
第二件:packageName 是空的。 状态栏那一层的 packageName =(空)——同一次 dump 里,有的层印了包名、有的没印。这与 ep12 §7 那条纪律同族:读之前先问这是谁的账本;一个字段印不出来,不等于这一层没有归属,只等于这个字段在这里是空的。
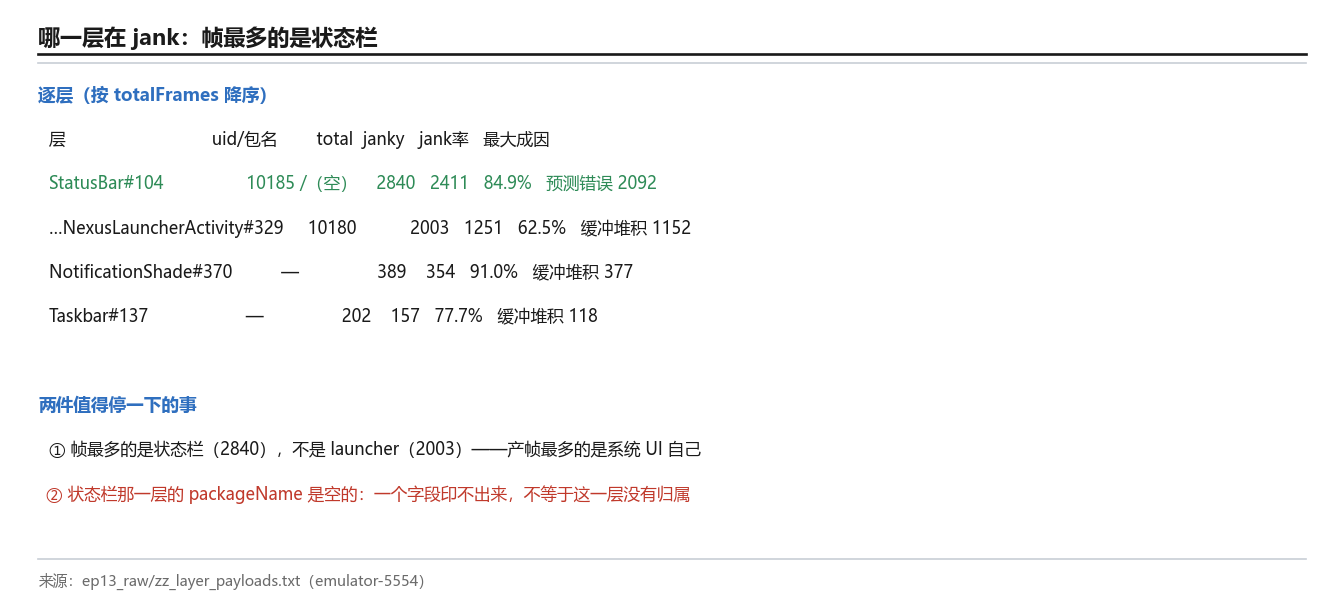
packageName 一栏是空的@ 本机 dumpsys SurfaceFlinger --timestats -dump 逐层 payload 实测(emulator-5554)5.2 两层成因完全不同
说白了,把 §3.3 那张表换个读法,只看两层的成因结构:
| 层 | jankyFrames |
预测错误 | 缓冲堆积 | CPU 超时 | GPU 超时 | 主因占比 |
|---|---|---|---|---|---|---|
StatusBar#104 |
2411 | 2092 | 184 | 162 | — | 预测错误 86.8% |
…NexusLauncherActivity#329 |
1251 | 783 | 1152 | 329 | — | 缓冲堆积 92.1% |
同一块屏、同一段时间,两层的主因是反过来的。
- 状态栏那一层:86.8% 是"预测错误"——它画得不慢,是预测给它的时刻不准;
- launcher 那一层:92.1% 是"缓冲堆积"——这是应用侧的账,产帧与消费的节奏没对上(ep11 专章讲过 stuffing 是一种"状态")。
这两条指向的动手方向完全相反:前者该看的是平台的预测与调度,后者该看的是应用侧的产帧节奏。如果只报一个"整屏 77.6%",这两条信息会一起被抹平。
本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | Understand systrace(AOSP)。这一章的结论可以收成一句:jank 的账要落到层上读,而不同层的主因可能相反。其中:官方管"归因有哪些类、层名怎么读",本机管"这一次哪一层在 jank、算谁的账"。
六、另一条链:gfxinfo framestats 的 14 列
好了,前五章用的都是平台侧的账。这一章换到应用侧——那里有另一条独立的时间证据链,而且它的粒度比"每帧一条归因"更细:一帧内部被切成 14 个时刻。
6.1 官方写 14 列,设备印了 24 列
先来看看官方把这条链的每一列都定义了(《测试界面性能》),命令是:
adb shell dumpsys gfxinfo <PACKAGE_NAME> framestats
它输出一段 CSV,时间戳单位是纳秒。 官方文档把它列成 14 个字段,而"总帧时间"的官方定义只有一行:
"总时间 = FRAME_COMPLETED − INTENDED_VSYNC"
——developer.android.com《测试界面性能》
这一行是整条链的地基:一帧花多久,等于"它该开始的时刻"到"它彻底完成的时刻"之间的差——注意起点是"该开始"(INTENDED_VSYNC)而不是"真开始",这与 §2.1 那条 Expected/Actual 的分野是同一个思路。
但设备上印出来的不是 14 列。 本机(Android 16)的实际表头是 24 列——官方文档列的那批字段有 11 个仍在(只是命名从 SNAKE_CASE 变成了 camelCase),OLDEST_INPUT_EVENT 与 NEWEST_INPUT_EVENT 两个被一个 InputEventId 取代,另有 12 个新字段。先按官方文档把 14 个字段列出来(这一层是"文档怎么写"):
| 序 | 列 | 官方定义(摘) | 它回答什么 |
|---|---|---|---|
| 1 | FLAGS |
非 0 的行应忽略 | 这一行能不能用 |
| 2 | INTENDED_VSYNC |
「帧的预期起点」 | 这一帧该从何时起算 |
| 3 | VSYNC |
「所有 Vsync 监听器中使用的时间值」 | 实际对齐到了哪一拍 |
| 4 | OLDEST_INPUT_EVENT |
输入队列最早事件(无则 Long.MAX_VALUE) |
有多少输入积压 |
| 5 | NEWEST_INPUT_EVENT |
输入队列最新事件(无则 0) |
输入到上屏增加了多少延迟 |
| 6 | HANDLE_INPUT_START |
把输入派发给应用 | 处理输入花了多久 |
| 7 | ANIMATION_START |
Choreographer 中动画运行 | 动画评估花了多久 |
| 8 | PERFORM_TRAVERSALS_START |
遍历开始 | layout / measure 花了多久 |
| 9 | DRAW_START |
绘制阶段开始 | 对所有失效视图调 View.draw() 花了多久 |
| 10 | SYNC_QUEUED |
向 RenderThread 发同步请求 | 交棒给渲染线程的时刻 |
| 11 | SYNC_START |
绘制同步阶段开始 | 有多少新位图要上传 GPU |
| 12 | ISSUE_DRAW_COMMANDS_START |
硬件渲染器开始下发绘制命令 | 命令下发开始 |
| 13 | SWAP_BUFFERS |
调用 eglSwapBuffers |
交出去的时刻 |
| 14 | FRAME_COMPLETED |
— | 彻底完成的时刻 |
这张表的价值在"相邻两列相减":官方明确点出几处——FRAME_COMPLETED − NEWEST_INPUT_EVENT ≈ 应用增加的延迟;HANDLE_INPUT_START 与 ANIMATION_START 相差 >2 ms 就算偏大;SYNC_START 与 ISSUE_DRAW_COMMANDS_START 相差大 ⇒ 大量新位图需上传 GPU。
再看设备实际印出来的那 24 列(本机表头原文,逐字照抄):
Flags,FrameTimelineVsyncId,IntendedVsync,Vsync,InputEventId,
HandleInputStart,AnimationStart,PerformTraversalsStart,DrawStart,
FrameDeadline,FrameStartTime,FrameInterval,WorkloadTarget,
SyncQueued,SyncStart,IssueDrawCommandsStart,SwapBuffers,FrameCompleted,
DequeueBufferDuration,QueueBufferDuration,GpuCompleted,SwapBuffersCompleted,
DisplayPresentTime,CommandSubmissionCompleted,
12 个新字段里,有三个直接改变了本篇的结构:
| 新字段 | 它是什么 | 对本篇的意义 |
|---|---|---|
FrameTimelineVsyncId |
这一帧在 FrameTimeline 里的 vsync id | 两条证据链的接口就在这里——它把 framestats 的这行与 §2 那条 Actual 切片对上了号(原以为要靠 trace 才能连,其实设备上本来就接着) |
FrameDeadline |
这一帧该完成的时刻 | 与 FrameCompleted 一比,就知道超没超、超多少——不用再拿 16.7 ms 去猜 |
DisplayPresentTime |
这一帧实际上屏的时刻 | 这正是 §1.1 那句判据里的 presented time——与预测时刻一比,jank 的判据在应用侧就地可算 |
另外九个同样有用:FrameStartTime / FrameInterval / WorkloadTarget(帧预算与 workload 目标)、DequeueBufferDuration 与 QueueBufferDuration(队列两端的耗时,直接接上 ep04 与 ep11 那条 BufferQueue)、GpuCompleted / SwapBuffersCompleted / CommandSubmissionCompleted(GPU 侧三个完成时刻——正对上 §2.1 那句"取 max(gpu time, post time)")。
这一节的结论要写清:官方文档的 14 列是低版本的形态;如果照文档的字段名去解析本机的 CSV,第一列就会错位(真实的第二列是 FrameTimelineVsyncId,不是 IntendedVsync)。读之前先打一次表头,别照文档硬写。
FrameTimelineVsyncId 把两条证据链接了起来,FrameDeadline 与 DisplayPresentTime 让 jank 的判据在应用侧就地可算@ 本系列绘制(依据官方逐列定义与本机表头原文)6.2 哪些列能推断出什么
把"哪两列相减、能得到什么结论"OK,单独收成一张对照表(同样是官方原话的整理):
| 算式(或字段) | 得到的量 | 偏大的含义 |
|---|---|---|
FrameCompleted − IntendedVsync |
总帧时间 | 这一帧整体慢了 |
FrameCompleted − FrameDeadline |
超了多少(负数=提前完成) | 直接就是"晚了多少毫秒" |
DisplayPresentTime 与预测时刻比 |
jank 判据本身 | 不匹配 → 判 jank(§1.1 那句话) |
Vsync − IntendedVsync |
UI 线程有没有及时响应 Vsync | 不为零就说明 UI 线程被占住了 |
HandleInputStart − AnimationStart |
处理输入耗时 | 官方给的参考阈值是 2 ms |
AnimationStart − PerformTraversalsStart |
动画评估耗时 | 动画本身太贵 |
PerformTraversalsStart − DrawStart |
layout / measure 耗时 | 布局太深或太频繁 |
DrawStart − SyncStart |
对失效视图调 draw() 的耗时 |
重绘范围过大 |
SyncStart − IssueDrawCommandsStart |
绘制同步阶段 | 偏大 ⇒ 大量新位图要上传 GPU |
QueueBufferDuration / DequeueBufferDuration |
队列两端的耗时 | 接 ep04/ep11 那条 BufferQueue |
GpuCompleted − SwapBuffersCompleted |
GPU 侧完成的先后 | 对上 §2.1 的 max(gpu time, post time) |
读法:这张表把"帧耗时长"这一个模糊结论拆成了八个可归因的段落——这正是竞品材料里 gfxinfo 那一拨停在"帧耗时长不长"、没有再往下走的地方。
这张表怎么读:每一行的"算式"是两列的差,而"偏大的含义"是这一段的诊断结论。八行里最常被误判的是 HANDLE_INPUT_START − ANIMATION_START(>2 ms 就算大,但它常常只是输入密集)与 SYNC_START − ISSUE_DRAW_COMMANDS_START(偏大意味着大量新位图要上传 GPU)。先定位到段,再回去找帧。
6.3 FLAGS 过滤:判据不是经验
好了,第一列 FLAGS 不是数据,是可用性标记:官方要求 FLAGS 非 0 的行应忽略(窗口布局变化、旋转、首帧等)。
本机确实用得上这一步——两段台账里都数出了 FLAGS≠0 的行。按设备表头逐列解析后:
| 台账 | CSV 数据行 | FLAGS = 0(可用) |
FLAGS ≠ 0(须剔除) |
同份摘要的 Total frames rendered |
|---|---|---|---|---|
b2_load_framestats_launcher(负载) |
163 | 161 | 2 | 183 |
b2_load_framestats_sysui(负载) |
65 | 63 | 2 | 87 |
a2_still_framestats_launcher(静止) |
0 | 0 | 0 | 0 |
三段台账里都出现了 FLAGS≠0 的行(各 2 行),剔掉之后可用行是 161 与 63。
还有两个数必须分开报:CSV 的数据行数(163 / 65)与同份摘要里的 Total frames rendered(183 / 87)并不是同一个数——前者是这份 CSV 里实际带着的行,后者是这一窗口内渲染过的帧数。把两者混为一谈,会得出"我统计了 183 帧"这种对不上账的结论。
所以这一节的判据是三条:① 先打表头、按设备真实列名解析;② FLAGS≠0 的行一律剔,过滤前后都要报;③ CSV 行数与摘要里的 Total frames rendered 是两个数,分开报。
顺带一个与 §4.2 互证的细节:静止窗口那一份 0 行——framestats 给的是最近的一批帧,没有帧就没有行。这是"静止窗口零帧"在第三条证据链上的第三次落地。
这里还有一处文档与设备的差:官方文档说它输出"最近 120 帧",而本机两份台账分别拿到 163 行与 65 行——这个上限也不是照文档走的。所以本篇一律用"CSV 数据行数"这个词,不写"120 帧"这种带默认值的说法。
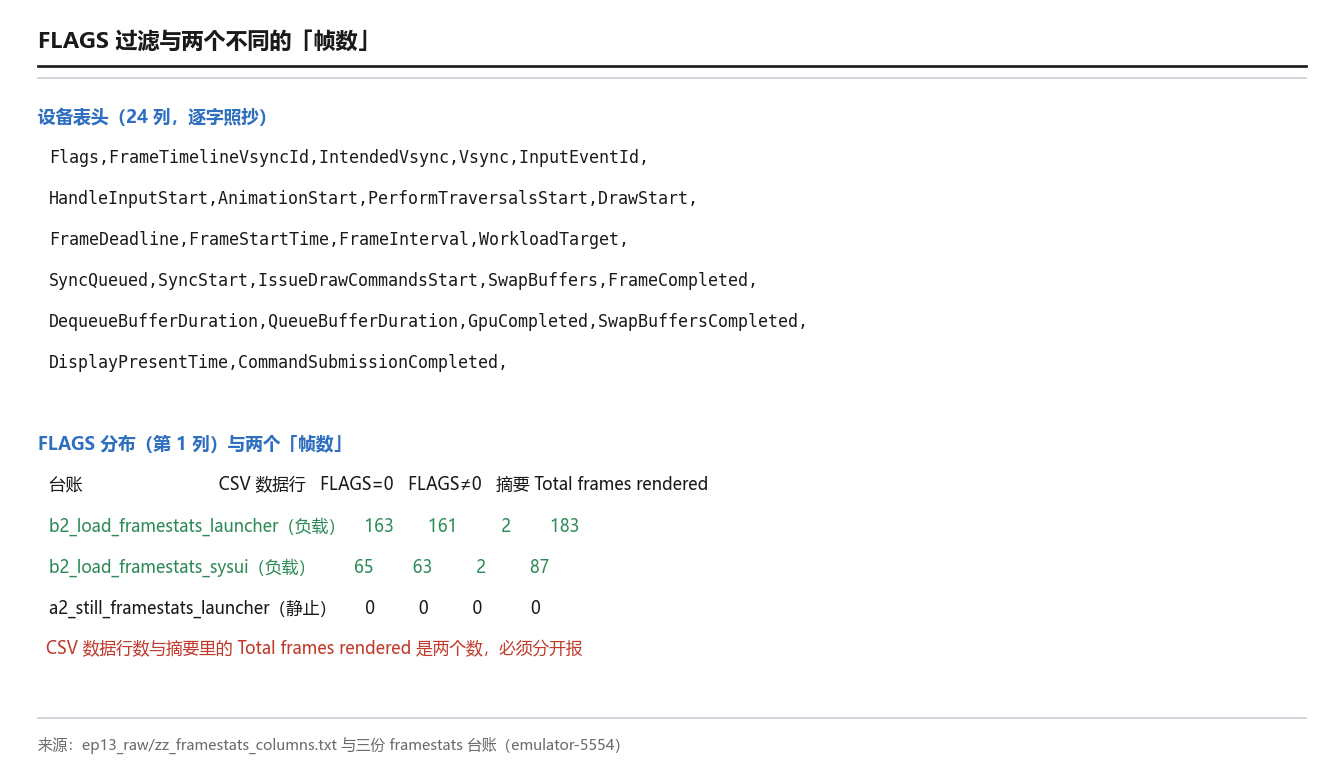
FLAGS 过滤与两个不同的"帧数":三段台账里都出现了 FLAGS≠0 的行(各 2 行),剔后可用 161 与 63;而 CSV 数据行数(163 / 65)与同份摘要里的 Total frames rendered(183 / 87)不是同一个数,必须分开报@ 本机 dumpsys gfxinfo … framestats 实测(emulator-5554)6.4 聚合口径:两个 Janky + 百分位 + 五个成因
同一份 gfxinfo 说白了,同一份 gfxinfo 还给出聚合后的摘要(ep13_raw/b2_load_gfx_launcher.txt):
Total frames rendered: 183
Janky frames: 130 (71.04%)
Janky frames (legacy): 178 (97.27%)
50th percentile: 57ms
90th percentile: 105ms
95th percentile: 150ms
99th percentile: 200ms
Number Missed Vsync: 80
Number High input latency: 95
Number Slow UI thread: 93
Number Slow bitmap uploads: 34
Number Slow issue draw commands: 120
这个包里有三个数:183 帧、71.04%(新口径)、97.27%(legacy 口径)。而它们出现在同一个摘要块里,相隔两行。
另外五个成因计数同样直接可读:Missed Vsync 80(没赶上 Vsync)、High input latency 95(输入延迟高)、Slow UI thread 93(UI 线程慢)、Slow bitmap uploads 34(位图上传慢)、Slow issue draw commands 120(下发绘制命令慢,是这五项里最大的一项)。这五个数与 §6.2 的八条算式是同一套东西的聚合版——先看聚合定位到哪一段,再回到逐列去找是哪一帧。
百分位一列也要读:50th 57 ms / 90th 105 ms / 95th 150 ms / 99th 200 ms——连中位数都是 57 ms,远高于 60 Hz 的 16.7 ms。这组数说明负载窗口里几乎每帧都慢,与"71%"这类的比例读数是两种互补的信息。
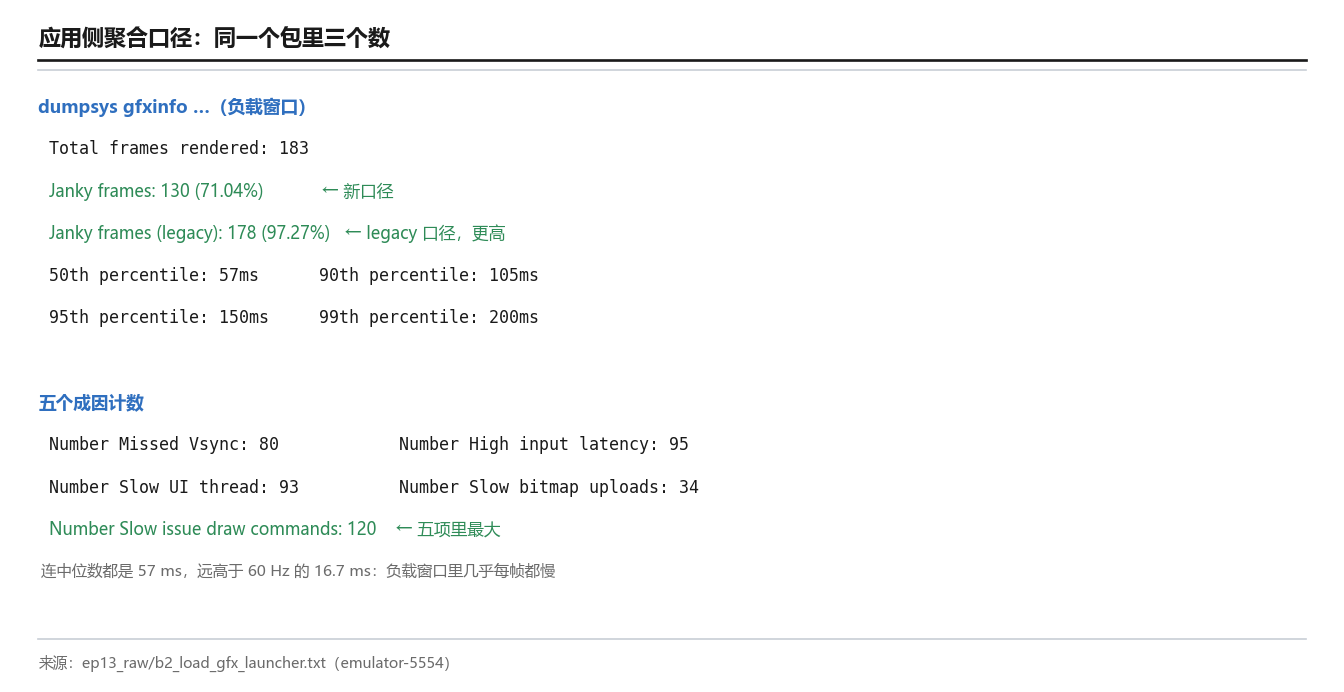
Slow issue draw commands 120 最大,而百分位显示连中位数都是 57 ms@ 本机 dumpsys gfxinfo 实测(emulator-5554)本章的源码与文档:测试界面性能(Android Developers) | dumpsys 用法(Android Developers)。这一章的定义可以收成一句:framestats 把一帧切成 14 个时刻,靠相邻两列相减得到各段耗时。其中:官方管"每一列是什么、总帧时间怎么算",本机管"这一次的 14 列与聚合读数长什么样、以及 FLAGS 要不要剔"。
七、两个口径:同一窗口差 11.9 倍,应用侧还反向
好了,前六章把两条证据链各自立住了。这一章把它们摆在一起——因为整篇的题眼就落在这里。
7.1 平台侧:Legacy 段 vs Timeline payload
同一份 --timestats -dump 里,两族账是分开两段印的——先来看看这两段(ep13_raw/b2_load_timestats.txt):
| 族 | 字段 | 累计值 | B 窗口增量 |
|---|---|---|---|
| Legacy 段 | totalFrames / missedFrames |
6755 / 396(5.9%) | +406 / +32(7.9%) |
| Legacy 段 | averageFrameDuration |
6.321 ms | — |
| Legacy 段 | averageRenderEngineTiming |
12.513 ms | — |
| Legacy 段 | refreshRateSwitches |
0 | 0 |
| Legacy 段 | clientCompositionFrames / ReusedFrames |
392 / 8 | +21 / 0 |
| Legacy 段 | compositionStrategyPredicted / Succeeded / Failed |
218 / 215 / 3 | +11 / +11 / 0 |
| Timeline payload | totalTimelineFrames / jankyFrames |
7753 / 6020(77.6%) | +422 / +396(93.8%) |
| Timeline payload | 八类归因计数 | 见 §3.2 | 见 §3.2 |
两族相距几十行,数字差 11.9 倍(窗口)/13.2 倍(累计)。 而 Legacy 段 里还有几个只有它才有的读数值得单列:
averageFrameDuration = 6.321 ms——平均每 6.32 ms 就有一帧?这个数与"60 Hz 每 16.7 ms 一拍"对不上,也与averageRenderEngineTiming = 12.513 ms对不上。两个"平均值"在同一段里给出两个数(一处 6.32、一处 12.51),它们量的不是同一件事——本篇只记下这两个数并标出它们不同源,不为它们下定义;compositionStrategyFailed = 3——组合策略预测一共试了 218 次、成功 215 次、失败 3 次。3 次失败本身很小,但它说明这套"预测"机制在本机确实在跑、也确实会失手(这与 §3.2 里sfPredictionError占大头是同一族线索);refreshRateSwitches = 0——ep11 量过同一件事,这一篇的窗口里依然是 0(补充了新证据,结论没变)。
本篇只主张到这里:两族的口径不同、量级差一个数量级以上;而 Legacy 侧的精确判据,官方文档没有给——JANK_TYPE_NAMES[] 里同时有 Frame deadline missed 与 Frame deadline missed (legacy) 两串,说明它是另一套判法,但本篇只取到了源码片段,不据片段造句(§1.6 已登记)。本篇据实测量出这条差,并给出"读哪一族、为什么读它"的判据,但不替 Legacy 口径下定义。
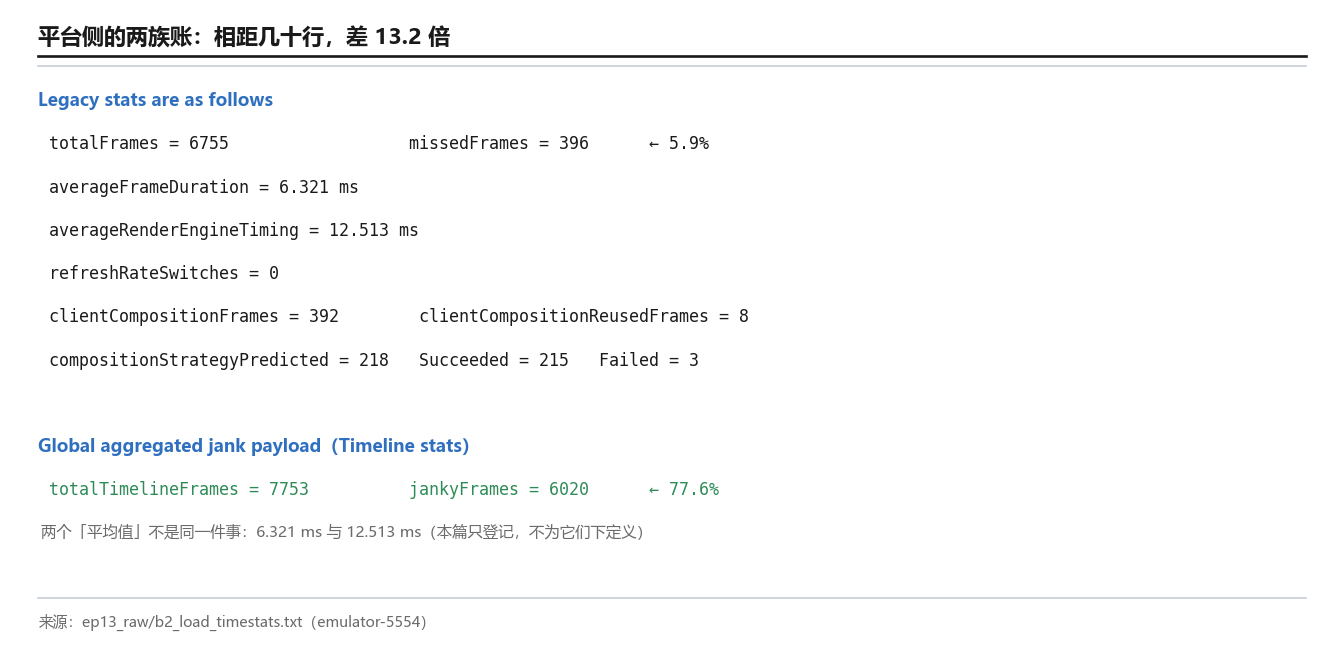
missedFrames 396(5.9%)与 jankyFrames 6020(77.6%)相距几十行——而 Legacy 段里两个"平均值"(6.321 ms 与 12.513 ms)也不是同一件事@ 本机 dumpsys SurfaceFlinger --timestats -dump 实测(emulator-5554)7.2 应用侧:另一对,方向相反
OK,平台侧那一对是"legacy 少、Timeline 多"。到了应用侧,同一对名字给出的方向是相反的(ep13_raw/b2_load_gfx_launcher.txt 与 b2_load_gfx_sysui.txt,都是 B 负载窗口):
| 包 | Total frames rendered |
Janky frames |
Janky frames (legacy) |
方向 |
|---|---|---|---|---|
…NexusLauncherActivity |
183 | 130(71.04%) | 178(97.27%) | legacy 更多 |
com.android.systemui |
87 | 79(90.80%) | 87(100.00%) | legacy 更多 |
launcher 这个包里,legacy 口径判出的 jank 比新口径多 48 帧(97.27% 对 71.04%);systemui 里 legacy 把 87 帧全判成了 jank(100.00%)。
所以正确的读法是:"Legacy 比新口径更松"这句话是错的。 平台侧那一对(--timestats 的 Legacy 段 vs Timeline payload)是 legacy 少、Timeline 多;应用侧那一对(gfxinfo 的 Janky frames vs Janky frames (legacy))反过来。两处各自成对,但方向相反,而且统计对象根本不同——平台侧数的是 SF 侧的帧与 timeline 帧;应用侧数的是这个包里应用画的帧。
这也解释了为什么公开材料里两个数字到处打架:它们往往来自不同的一处、不同的一对,却都被写成了"jank 率"。
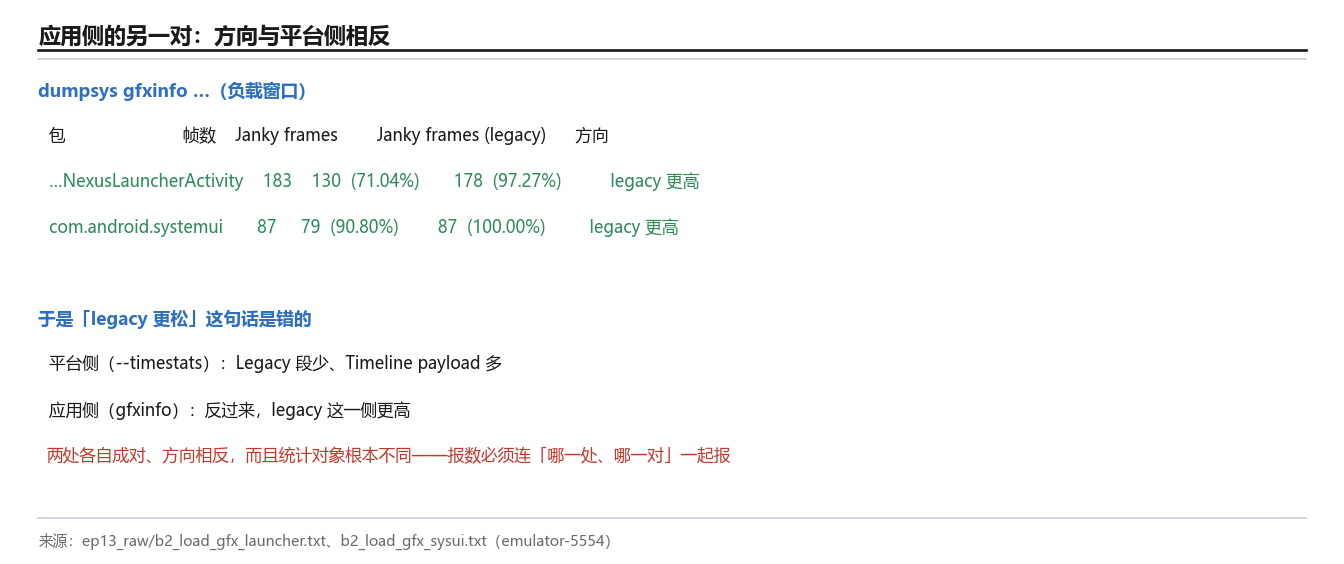
dumpsys gfxinfo 实测(emulator-5554)7.3 口径四象限:报数必须连"哪一处、哪一对"一起报
好了,把前两节合成一张定位图,就是本篇给出的硬判据:
| 新口径 | legacy 口径 | 谁更高 | |
|---|---|---|---|
平台侧(--timestats) |
Timeline payload 77.6% | Legacy 段 5.9% | 新口径高(13.2 倍) |
应用侧(gfxinfo) |
Janky frames 71.04% |
Janky frames (legacy) 97.27% |
legacy 高 |
四个格子,两个方向。 所以本篇给出一条判据:报 jank 率必须连"是哪一处、哪一对口径、哪一段窗口"一起报。
- 只写"jank 率 71%"——不成立(没说是哪一处;也没说窗口);
- 只写"legacy 更严"——不成立(平台侧相反);
- 只写"平台侧 77.6%"——部分成立,补上"累计口径、Timeline payload、这一台模拟器"才算完整。
这条判据比"差多少倍"更有用:倍数会随负载变,而"报数先报口径"是一条永远成立的操作纪律。
还有一句要补:本篇一开始以为"两条证据链要连起来,得先把 trace 剖开";读完 §6.1 那张表头才发现——设备上本来就接着:framestats 的第二列 FrameTimelineVsyncId 就是 FrameTimeline 给这一帧发的 vsync id。一边是逐列时间戳、一边是归因判定,接口一直都在那里。
本章的源码与文档:测试界面性能(Android Developers) | Android Jank detection with FrameTimeline(Perfetto)。这一章的结论可以收成一句:同一个"jank 率"名字下至少有四组互不相同的数,且方向可能相反。其中:官方管"两边各自的判据是什么",本机管"这次它们各是多少、方向为何相反"。
八、采一条 trace:一条命令,四处踩坑
好了,前七章读的都是设备上现成的账。这一章换成"自己采一条"——因为 FrameTimeline 最有价值的形态其实在 trace 里(§2 那两条轨道、每条切片的七字段,都在 trace 里,不在 dump 里)。
8.1 配置走 stdin:一次成功的采集
先来看看官方 CLI 的语法很简单,-c 支持从 stdin 读配置:
"
adb shell perfetto [ --txt ] --config CONFIG_FILE";-c, --config支持-表示从 stdin 读——perfetto.dev《Perfetto CLI 参考》
实际用的配置(ep13_raw/c2_cfg.txt):
buffers { size_kb: 32768 fill_policy: RING_BUFFER }
data_sources { config { name: "android.surfaceflinger.frametimeline" } }
data_sources { config { name: "linux.ftrace" ftrace_config {
  ftrace_events: "sched/sched_switch"
  atrace_categories: "gfx"
  atrace_categories: "view"
  atrace_apps: "*"
} } }
duration_ms: 6000
flush_period_ms: 2000
跑起来之后的日志(ep13_raw/c2_trace_run.txt):
[103.737]    perfetto_cmd.cc:1047 Connected to the Perfetto traced service, TTL: 6s
[109.965]    perfetto_cmd.cc:1210 Wrote 6637061 bytes into /data/misc/perfetto-traces/ep13_trace.perfetto-trace
两行日志,两个信息点:Connected … TTL: 6s(连上了跟踪服务、本次会话最长 6 秒);Wrote 6637061 bytes(6.6 MB 落盘)。文件随后 adb pull 回本机台账,头部字节是 0a 61——一段合法的 TracePacket 流(字段 1、长度 97)。
注意这个配置里三样东西的搭配:frametimeline 给帧的判定与归因,linux.ftrace 的 sched/sched_switch 给"这段时间 CPU 在跑谁",atrace 的 gfx/view 给图形与视图系统的锚点。三样合起来才够回答"这一帧晚的时候,机器在忙什么"。
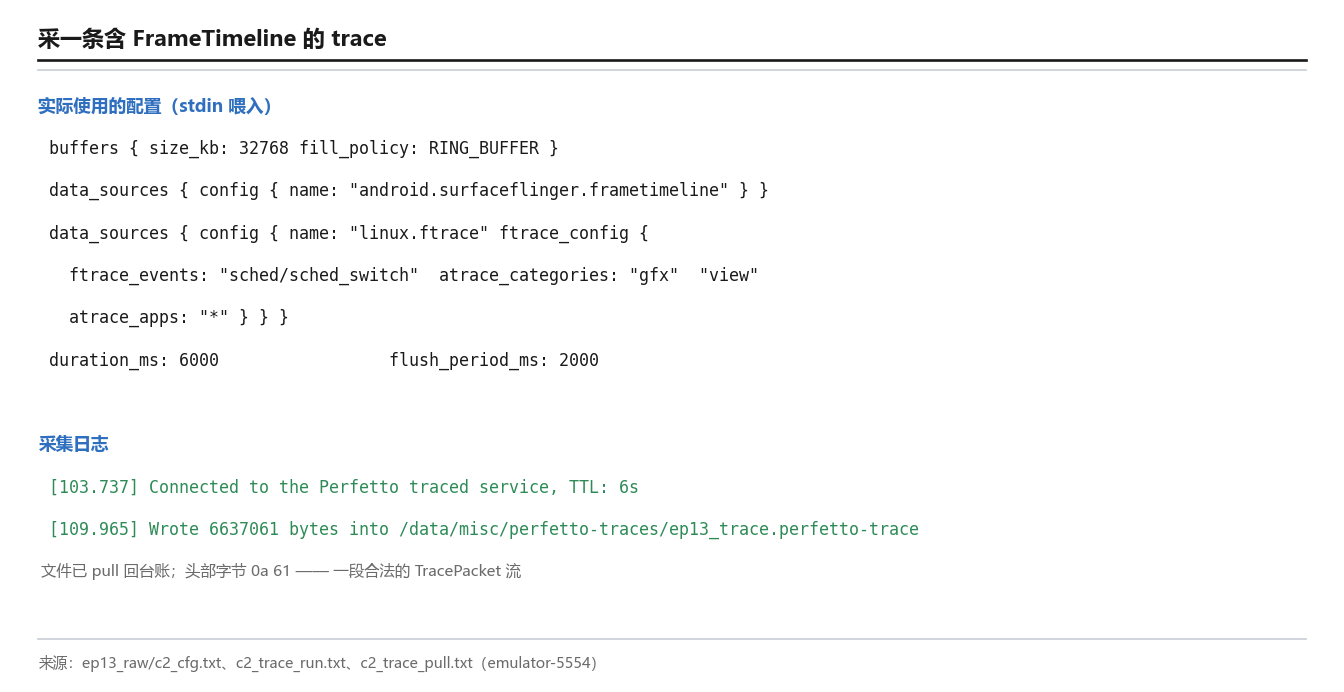
frametimeline + sched/sched_switch + atrace gfx/view,6 秒采出 6,637,061 字节@ 本机 perfetto -c - --txt 实测(emulator-5554)8.2 失败那次与成功那次
说白了,这一次成功之前还有一次失败,而失败的原因值得记下来(ep13_raw/c_trace_run.txt):
[034.591]  perfetto_cmd.cc:328 Could not open /data/local/tmp/ep13_cfg.txt.
           ... (errno: 13, Permission denied)
exit=1
当时我把配置文件写到了 /data/local/tmp/——那是 adb 侧很方便的一个目录,但 shell 身份运行的 perfetto 读不到它。Perfetto 自己在那句报错里给了提示:可以把配置放进 /data/misc/perfetto-configs。
处置:不换目录,改用 stdin——perfetto -c - --txt 把配置直接喂给命令,绕开"文件放在哪"这整个问题。这也是官方 Winscope 采集页给出的模板写法。
| 轮次 | 配置怎么给 | 结果 |
|---|---|---|
| 第一次 | push 到 /data/local/tmp/ep13_cfg.txt |
Permission denied(errno 13),退出码 1 |
| 第二次 | -c - --txt(stdin) |
成功:Wrote 6637061 bytes |
这条踩坑的一般化写法是:"能读到文件"与"文件在那儿"是两件事——/data/local/tmp 对 adb 侧的 shell 命令友好,但对设备上以另一个身份运行的进程不友好。同一族现象 ep12 §7 也见过(同一次 dump 里有的层印包名、有的印空)——读之前先问:这个动作是谁在替我执行。
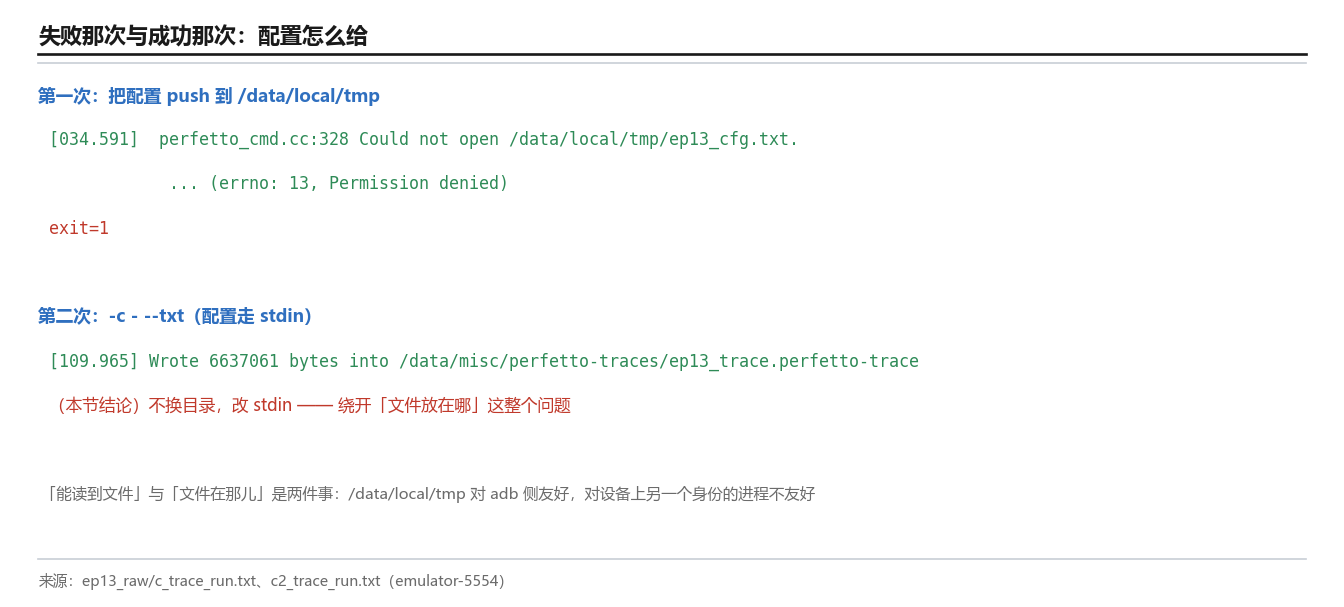
/data/local/tmp → Permission denied(errno 13);改成 stdin 后一次成功——"能读到文件"与"文件在那儿"是两件事@ 本机两次 perfetto 采集(emulator-5554)本章的源码与文档:Perfetto CLI 参考 | 用 adb 捕获 Winscope 轨迹(AOSP)。这一章的定义可以收成一句:采一条含 FrameTimeline 的 trace,是一条命令、一份 pbtxt 配置、两行日志的事。其中:官方管"配置怎么写、--txt 与 stdin 怎么用",本机管"这条命令在我这儿跑通没有、以及第一次为什么没跑通"。
九、采到 ≠ 剖开:trace_processor 这一环
好了,第八章把 trace 采到了。这一章讲一件很多人会跳过的事:采到之后怎么读。 而本篇在这一环上卡住了——卡住这件事本身值得写一章。
9.1 三条获取路径全部受阻
先来看看一个前提。FrameTimeline 的切片级信息(§2 那两条轨道、每条切片的七个字段)只在 trace 里,不在 dump 里。要把 trace 剖成可查询的表,官方给的工具是 trace_processor:
curl -LO https://get.perfetto.dev/trace_processor—— > "This is a thin Python wrapper that fetches and caches the right native binary for your platform on first use (Windows and other options: reference)."——perfetto.dev《Cookbook: Analyzing Traces from the Command Line》
"thin Python wrapper"是关键字:它本身不是工具,它去下载一个原生二进制。于是链路上出现了三个依赖点。本机逐一试过,三条全断:
| 路径 | 试了什么 | 结果 |
|---|---|---|
| ① 官方 wrapper | 下载 https://get.perfetto.dev/trace_processor |
wrapper 拿到(10,698 字节),但它去拉 commondatastorage.googleapis.com 上的二进制——该域不可达(Failed to connect … after 21292 ms) |
| ② GitHub Releases | api.github.com 列资产可通(v58.2 有 windows-amd64.zip,13.5 MB),再下 github.com/…/releases/download/… |
api.github.com 可达但 github.com 直连超时(curl 退出码 28),文件没下下来 |
| ③ PyPI | pip install perfetto protobuf |
包装上了(perfetto 0.58.2),但它是纯 Python 轮子(py3-none-any):既不含原生二进制,也不含 .proto 生成的 perfetto.protos.*——实测 proto 模块数 = 0,因此无法用它替代 trace_processor 解析 trace |
所以本篇的处理是"分档登记"而不是"假装做到了":
- 逐帧的证据链不依赖
trace_processor——改用设备上直接可读的两族账(§3–§7)。这一点很重要:本篇的全部结论在采不到trace_processor的情况下依然成立。 - trace 本身作为"采集侧已跑通"的证据:配置、日志、字节数、文件头(§8.1)。"我采到了"是真的,"我读出来了"不是。
- SQL 示例照写——因为"如果有它,该怎么问"本身就是读者需要的东西(官方文档给了两张表与示例列):
-- 期望轨道:每一帧拿到了多少预算
SELECT ts, dur, surface_frame_token AS app_token, process.name
FROM expected_frame_timeline_slice;

-- 实际轨道:每帧实际花了多久,以及 jank 归因
SELECT ts, dur, display_frame_token AS sf_token,
       jank_type, present_type, on_time_finish, layer_name
FROM actual_frame_timeline_slice
WHERE jank_type != 'None'
ORDER BY dur DESC
LIMIT 20;
这两条 SQL 要连起来读:surface_frame_token 与 display_frame_token 就是 §2.2 说的那个 token——用它把两条轨道接上,才能回答"这一帧的预算给了多少、实际花了多少、算谁头上"。
一条判据:"采到"和"剖开"是两件事,中间隔着一个"能不能拿到分析器"。 如实登记这条缺口,比假装剖开更有用——因为读者多半也会撞上同一堵墙。
trace_processor 的路径全部受阻——而本篇的全部结论在拿不到它的情况下依然成立(替代路径是设备上直接可读的两族账)@ 本机三次获取尝试实测9.2 剖析输出的两种形态
OK,剖不开自己的 trace,不妨退一步问:"剖析输出"这种形态本身长什么样? 本篇在 Commons 上筛到最后,只留下两张真正对位的图——它们分别代表两种形态:
framestats 那一条证据链的形态(原图 1938×1570,未做重采样放大)@ Wikimedia Commons · Timo Tijhof(MIT)边界声明(两张都要写):这两张图是通用剖析输出的形态示意——一张来自 PHP 剖析器的火焰图,一张来自 Web 请求剖析器的表格。它们不是 Android 的实现图,也与 FrameTimeline 没有任何实现关系。 本篇只借它们说明一件事:剖析输出只有两种基本形态——"按层次摊开"与"排成表";而本篇 §3 的归因树属于前者、§6 的 14 列属于后者。
本章的源码与文档:Trace Processor | Cookbook: Analyzing Traces from the Command Line | Android Jank detection with FrameTimeline。这一章的结论可以收成一句:帧级剖开需要 trace_processor,而本环境取不到它——于是本篇用设备上可读的两族账兜住结论,并把这条缺口写成一节。其中:官方管"这个工具是什么、表叫什么、SQL 怎么写",本机管"我这儿拿得到拿不到"。
十、真机才能做的四件事 + 系列回望
好了,最后一章。前面九章能测的都测了,这一章把测不了的摆清楚,给出可以照着做的动作,然后给整个系列收个尾。
10.1 缺口分档
"做不到"好了,这件事要分档,因为它们的原因不一样、补救方式也不一样:
| 项 | 分档 | 依据 |
|---|---|---|
用 trace_processor 把 trace 剖成 actual_frame_timeline_slice |
工具链缺口(三条获取路径受阻) | §9.1 |
expected_frame_timeline_slice 的切片级读数 |
同上(只能在 Perfetto UI 里看) | §9.1 |
| 真机负载下的 jank 结构 | 需真机 | 模拟器不在真实 CPU / GPU / 喂帧节奏上 |
SurfaceView 的帧时间线 |
官方明确不支持 | §1.1 |
| Legacy 口径的精确判据 | 官方网页未定义、源码只取到片段 | §7.1、§1.6 |
--timestats -reset 为何是空操作 |
读数留存、成因未明 | §4.3,未查源码故不解释 |
| 厂商调度策略对 jank 的影响 | 未公开 | 越界,只给指针 |
| 应用层具体优化手法 | 越界 | 属工程实践与另一专题 |
各档的补救路径完全不同:第一、二档告诉你"换个网络环境就能做";第三档告诉你"换台真机";第四、五档告诉你"这是文档与源码的边界,别硬找";第六档告诉你"这是留存下来的现象,先别急着解释";最后两档告诉你"明确不写"。
10.2 四组可执行动作与判据
下面进入可执行部分。如果你手上有一台真机(或者一个能上外网的机器),这四组动作可以直接照做。每组都给出判据——做完之后怎么算"看对了"。
动作一:先看这台设备能不能采。
adb shell getprop init.svc.traced
adb shell perfetto --query
判据:traced 应是 running;--query 的输出里应能找到 android.surfaceflinger.frametimeline。找不到它就说明这台设备的 FrameTimeline 数据源没注册(而不是命令写错了)。
动作二:采一条含 FrameTimeline 的 trace。
adb shell perfetto -c - --txt -o /data/misc/perfetto-traces/probe.perfetto-trace
配置从 stdin 喂进去(见 §8.1 那六行)。判据:日志应出现 Connected to the Perfetto traced service 与 Wrote N bytes;N 不应是 0。
动作三:读两族账(这一步不需要任何额外工具)。
adb shell dumpsys SurfaceFlinger --timestats -dump
adb shell dumpsys gfxinfo <你的包名>
判据:第一份应同时印出 Legacy stats are as follows: 与 Global aggregated jank payload (Timeline stats): 两段;第二份应同时印出 Janky frames 与 Janky frames (legacy) 两行。两处各记下"哪一对高"——若与本文方向相反,那就是一条新读数。
动作四:验一次"静止窗口零帧"。
adb shell dumpsys SurfaceFlinger --timestats -dump   # 记下 totalTimelineFrames
# 不动屏幕,静置 15 秒
adb shell dumpsys SurfaceFlinger --timestats -dump   # 再看 totalTimelineFrames
判据:两次的 totalTimelineFrames 应当相同(本机差值为 0)。若不同,说明有东西在持续产帧——那就先找出它在哪一层(用逐层 payload 找 averageFPS 最高的那一层)。
10.3 三句结论
第一句:"jank 了"不是一个结论,"哪一帧、哪一类、算谁的"才是。 平台侧 77.6% 的 jankyFrames 里,sfPredictionError 与 appBufferStuffing 占大头,而 sfLongCpu/sfLongGpu 很小(§3.2);逐层看,状态栏的主因是预测错误(86.8%)、launcher 层的主因是缓冲堆积(92.1%)(§5.2)。先问是哪一类,再问该谁改。
第二句:同一个"jank 率"名字下至少有四组数,方向还可能相反。 平台侧新口径 77.6% 对 legacy 5.9%(差 13.2 倍),应用侧却是 71.04% 对 97.27%(legacy 高)(§7.3)。所以报数必须连"哪一处、哪一对、哪一段窗口"一起报——只写一个百分比,等于没说。
第三句:采到 trace 不等于剖得开 trace。 采集侧一条命令就能跑通(§8.1),分析侧需要 trace_processor;拿不到它时,设备上仍有两族可读的账,而这两族账足以支撑本篇的全部结论(§9.1)。分清"我采到了"与"我读出来了",是这一篇最想留下的一条纪律。
10.4 系列十三篇回望
好了,这一篇是 T05《Android 图形显示系统》的收官篇。 十三篇连起来,其实是在回答一个问题:一帧画面,从应用的代码走到屏幕上的像素,中间经过谁的手、每一步凭什么。
| 段 | 篇目 | 一句话 |
|---|---|---|
| 起点 | ep01 总览 | 整条链路先画出来:从 App 到屏幕,谁在谁后面 |
| 应用侧 | ep02 Choreographer | 谁在召唤 Vsync:节拍的源头 |
| 应用侧 | ep03 RenderThread | 帧怎么被交出去:从显示模块到一块缓冲 |
| 交接 | ep04 BufferQueue | 缓冲区的邮局:四态流转与 fence 语义 |
| 入口 | ep05 Vulkan on Android | 另一条低开销的渲染入口 |
| 平台侧 | ep06 SurfaceFlinger | 收到帧之后做什么 |
| 平台侧 | ep07 ASurfaceControl | 事务化的图层控制(Android 10) |
| 硬件侧 | ep08 HWC | 合成归属:GPU 之外的硬件叠加 |
| 节拍 | ep09 HWC2 | Vsync 回调与虚拟显示路径 |
| 节拍 | ep10 Vsync 偏移 | 三路节拍错开多少:应用、SF、屏幕的三步舞 |
| 资源 | ep11 三缓冲与 ARR | 队列有多深、屏幕有几个档 |
| 特例 | ep12 虚拟显示与录制 | 一块不存在的屏,凭什么也算一块屏 |
| 收官 | ep13 剖帧实战(本篇) | 逐帧读:哪一帧晚了、晚了多少、算谁的 |
前十二篇是"地图与机理",这一篇是"测量"。 没有前面十二篇,读不懂那些字段名;没有这一篇,前面十二篇的结论都无法被验证。
系列的边界(收官处一并写清):本系列只写显示链路层——一帧画完之后,缓冲怎么传、合成怎么决定、刷新率怎么选、上屏怎么对齐、以及怎么证明它真的没错过 deadline。不写:应用/引擎能画多少与功耗取舍(《移动端图形与功耗》)、渲染算法与画面技术(《实时渲染管线探析》与《实时光线追踪与混合渲染》)、具体渲染器的光栅化实现(《2D 矢量引擎深挖》)、Perfetto / RenderDoc 自身的原理(T01《图形性能剖析工具链》)、厂商私有的调度与合成逻辑(只写 AOSP 通用链路,厂商部分如实标注"未公开")。
10.5 收官
说白了,这一篇写完,T05 十三篇就齐了。回头看,它做的事其实很朴素:把"卡了"这三个字拆成可核对的东西——拆成八类归因、拆成 14 个时刻、拆成四个口径格子、拆成"哪一层、哪一段窗口"。
最后说一句实在话:本篇最重要的一条读数不是 77.6%,也不是 13.2 倍,而是那个"采到了 6,637,061 字节,却没能剖开"。因为它把一件常被跳过的事摆到了台面上——工具链的最后一环也是有前提的。把这条写出来,比再找一个漂亮的数字有用。
落幕之前,把三次踩坑一并留给后来的人:--timestats -reset 在本机是空操作(用差分,别用 reset);配置别放 /data/local/tmp(用 stdin);两张剖析输出图只说明形态、不是 Android 的实现图。希望能对大家有所帮助。
本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | Perfetto CLI 参考 | Trace Processor。这一章的定义可以收成一句:测不到的东西要按档记,测得到的东西要给出判据,而系列要有收口。其中:缺口是输入,四组动作是手段,三句结论与回望是输出。
10.6 收官之后:预告这一栏为什么是空的
本系列到这一篇为止:T05 一共十三篇,本篇是最后一篇——所以这一栏里没有"下一篇预告"。
但往下读的路还在。 想接着往下走,有三条:
- 想补工具方法论:去 T01《图形性能剖析工具链》——那 13 篇讲的是 Perfetto / RenderDoc 自身怎么用,本篇刻意没重复(§0.3 已声明);
- 想补约束层:去《移动端图形与功耗》——"能画多少、该省多少"是另一条轴,与本篇的"有没有按时上屏"互补;
- 想补链路细节:回到本系列 ep01 按顺序读一遍——本篇的每个字段名,前面十二篇里都有它的出处。
同一个站点上后续还会有别的专题,届时新篇目的"下篇预告"会重新出现;而这一篇留下的,是十三篇里唯一一次完整的"测量"。
参考资料
官方文档(已取正文)
- Android Jank detection with FrameTimeline(Perfetto) —— jank 定义 / 两条轨道 / 八类 jank_type / 五色码 / 两张 SQL 表
- Perfetto CLI 参考 ——
-c/--config、--txt、simple 与 normal 两种模式 - Trace Processor ——
trace_processor的下载与运行(含 Windows) - Cookbook: Analyzing Traces from the Command Line ——
get.perfetto.dev/trace_processor、query / session / export - 测试界面性能(Android Developers · 中文镜像) ——
framestats逐列定义与聚合口径 dumpsys用法(Android Developers · 中文镜像) ——gfxinfo与gfxinfo … framestats- 界面卡顿检测(Android Developers · 中文镜像) —— Android 12 / 11 / 10 的卡顿检测分层与"指向 Perfetto"
- Understand systrace(AOSP) —— atrace / ftrace、
gfx类别、FrameMissed 与 HWC2 - 用 adb 捕获 Winscope 轨迹(AOSP · 中文镜像) —— 自 Android 15 起 Winscope 并入 Perfetto、数据源名、
-c - --txt模板
只有 URL / 仅取到片段(正文不得据其造句)
- PerfettoSQL 表文档 —— 帧时间线与 SurfaceFlinger 相关表
- Trace Processor CLI 参考
- trace_processor 下载入口
- FrameTimelineEvent Proto 定义页
- AOSP
JankInfo.h(jank 类型的枚举定义) —— 本环境只取到搜索片段 - AOSP
ProfileData.cpp(JANK_TYPE_NAMES[]) —— 含Frame deadline missed (legacy),仅取到片段 - Winscope 概览(AOSP)
同类文章 / 第三方(背景,不作官方依据)
- 读者点单·06|你的 App 为什么「掉帧」?从 VSync 信号到屏幕亮像素的 16ms 全链路拆解(腾讯云) —— 陆业聪
- Android FPS 帧率采集入门:从渲染管线到数据源(掘金) —— gfxinfo 逐列对照与手算帧耗时
- Android Perfetto 系列 8:深入理解 Vsync 机制与性能分析(掘金) —— Gracker
- Android Perfetto 系列 4:使用命令行在本地打开超大 Trace(掘金) —— Gracker
- 【Android 性能优化实战 60 讲】03:Perfetto 现代分析利器:SQL 查询 Trace 数据(CSDN)
- Android Systrace 流畅性实战 3:卡顿分析过程中的一些疑问(掘金) —— 绿 / 黄 / 红帧的旧口径
- Perfetto 笔记(官方文档翻译·博客园)
- 在 Jetpack Compose 中解决性能问题的实用方法(Android Developers Codelab) —— 用 Expected / Actual 定位长帧
- AndroidX benchmark
JankCollectionHelper.java源码 —— 同时解析两个 Janky 口径的旁证 - Fairphone 社区:真机 dump 里两个口径并列
视觉资源(Wikimedia Commons)
- Wikimedia Commons|
Flame-graphs-with-excimer-and-speedscope.png(CC0) —— 入选(图 13-25) - Wikimedia Commons|
XHGui profile for Wikipedia web request.png(MIT) —— 入选(图 13-26) - Wikimedia Commons|Category:Gantt charts(98 个文件,本篇未取)
- Wikimedia Commons|Category:Computer performance(替代类目,34 个文件)
- Wikimedia Commons|Category:Benchmarks (computing)(替代类目,31 个文件)
- Wikimedia Commons|Category:Frame rate(仅 2 个文件,均不对位)


本机台账(ep13_raw/,36 份,正文所有读数以此为准):a_still_* 7 份 / b_stress_* 7 份 / a2_still_* 3 份 / b2_load_* 6 份 / z_reset_semantics、zz_key_readings、zz_layer_payloads / c_trace_* 5 份(第一次失败)/ c2_* 5 份(成功)/ ep13_trace.perfetto-trace(6,637,061 字节)。