核心问题:ep05 讲了混合管线的整体编排——光栅化与光追怎么接力、G-buffer 怎么当数据接口、性能预算怎么分。其中第五章给了 SVGF 三步骤的概览(时间累积→方差估计→A-Trous 滤波),但没展开。
降噪器里最关键、也最容易出问题的一环是时域复用——用上一帧的结果来提升当前帧的质量。听起来很美好:不用多花光线、不用多算采样,只要把历史数据搬过来就行。但一旦搬错了,画面就会出现鬼影、拖影、闪烁——这些问题在项目里调试起来极其折磨人。
本篇来回答——时域累积的数学机制是什么、运动矢量怎么算、重投影什么时候失败、鬼影从哪来、除了鬼影还有哪些失效模式、工业降噪器怎么处理这些问题、时域稳定性和空间质量怎么权衡。八件事合起来,才是"时域复用为什么能用、什么时候会坏"的完整答案。
本篇不涉及神经降噪算法原理(ep07 专讲);不写 ReSTIR 的采样策略(ep08 专篇);不写 A-Trous 空间滤波的数学推导(ep05 已给概览,ep07 从 SVGF 到神经降噪会展开);也不写具体引擎的编辑器操作。我们只把论文给的公式、厂商公布的数据、以及第三方实测的数字,摆成一本能算的账。
本系列(实时光线追踪与混合渲染,共 12 篇)的前置阅读:第一篇《分界线》给出了三类效果判据与三条成本模型;第二篇《加速结构工程账(上)》给出了构建/更新/压缩三科的静态账;第三篇《加速结构工程账(下)》给出了动态场景的 TLAS/BLAS 策略;第四篇《命中着色器与 SBT》讲了找到三角形之后该调用哪段着色器;第五篇《混合管线编排》讲了光栅化与光追的接力赛和性能预算。本篇承接 ep05 的结尾——"降噪占的预算可能比光追还多,但降噪器本身我们只讲了个大概"。其余前置专题为算法层《实时渲染管线探析》5 篇、约束层《移动端图形与功耗》7 篇、硬件实现层《GPU 架构剖析》12 篇。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
点题:为什么时域复用是降噪的基石
0.0 内容总览:本篇知识地图
先来看一张总表,把八章各自回答的问题钉在这里。后面每一章都在展开其中的某一行。读者可以先从这张表里找到自己最关心的问题,然后跳到对应章节去看。
这张总览表横向覆盖了全篇的八个章节,纵向给出了每章的核心问题、结论和主要依据。其中第一到三章讲"是什么"——时域累积的数学、运动矢量与重投影、disocclusion 检测;第四到五章讲"哪里会坏"——鬼影和其他四种失效模式;第六到七章讲"怎么处理"——工业降噪器的策略和参数权衡;第八章总结交棒。
| 章 | 回答的问题 | 核心结论 | 主要依据 |
|---|---|---|---|
| 一 | 时域累积的数学是什么 | EMA 混合,α 控制历史贡献,history length 决定有效采样数 | SVGF 论文 (Schied et al., HPG 2017) |
| 二 | 运动矢量怎么算 | Back projection:当前像素 → 世界坐标 → 上一帧 VP → 上一帧屏幕坐标 | Vulkan RT 优化教程 · TRMV 论文 |
| 三 | Disocclusion 是什么 | 遮挡物移开后新表面出现,历史缓冲指向错误颜色,必须检测并丢弃 | AMD FidelityFX Denoiser 文档 |
| 四 | 鬼影从哪来 | 运动矢量不准 + 历史颜色被错误复用,六种典型触发场景 | TAA 综述 (Yang et al., EG 2020) |
| 五 | 除了鬼影还有哪些失效 | 时域滞后、闪烁/沸腾、模糊、动画伪影,四种额外失效模式 | NVIDIA GTC 2020 REBLUR 演讲 |
| 六 | 工业降噪器怎么处理 | REBLUR 自稳定递归模糊、SVGF 方差驱动、TSR History Resurrection | NRD GitHub · UE5 TSR 文档 |
| 七 | 时域稳定 vs 空间质量怎么权衡 | "denoising is a tradeoff between temporal lag and blurriness" | NVIDIA GTC 2020 |
| 八 | 三句话判据 + 交棒 | 时域复用是基石 / 运动矢量是命门 / 失效模式是调试指南 | 全篇总结 |
0.1 1 spp 的噪声问题
光追管线每帧发射的光线数量是有限的。在 1080p 分辨率下,每像素发射 1 条光线(1 spp),全屏约 200 万条光线——听起来不少,但对路径追踪来说远远不够。
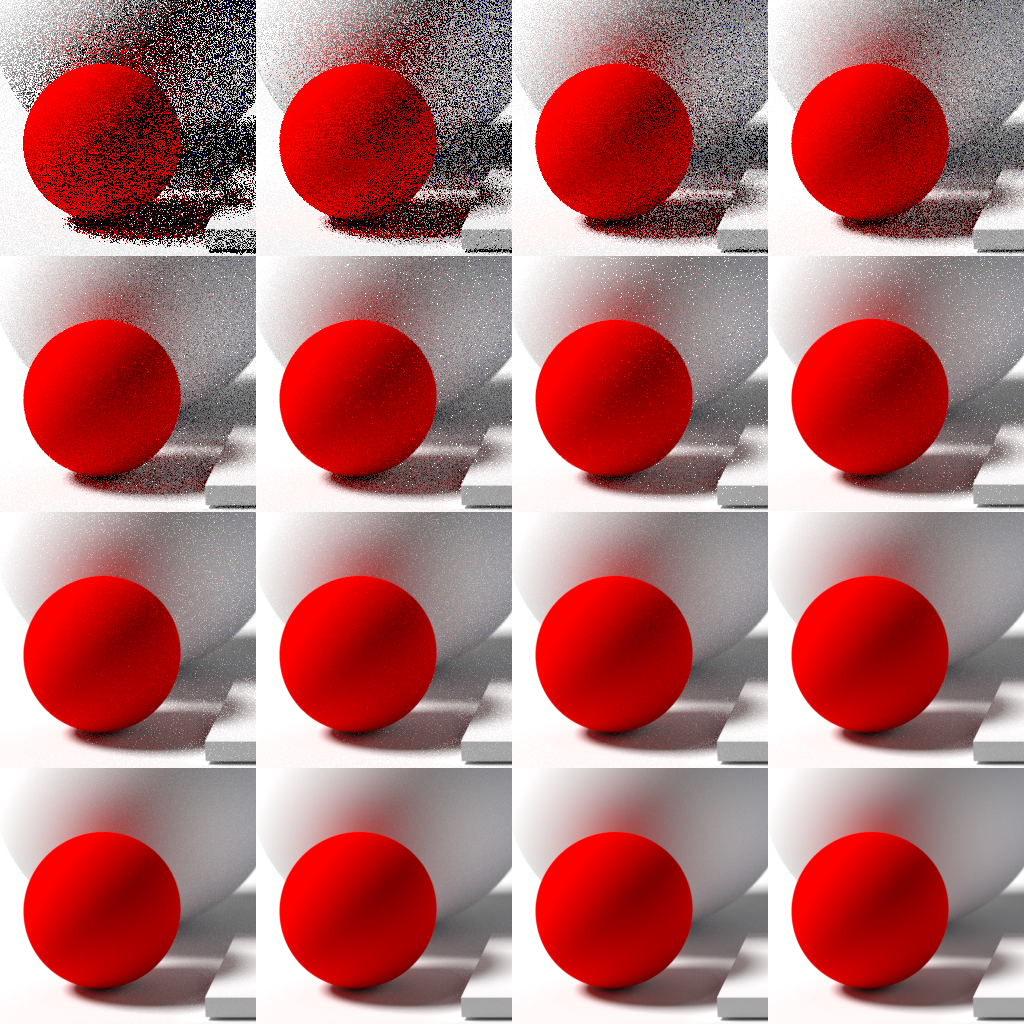
1 spp 的路径追踪输出几乎全是噪声。原因很简单:每条光线在场景里弹射时,每次 bounce 只随机选一个方向、随机选一个光源采样点。单条光线的辐射度估计方差极大——就像掷一次骰子来估计平均值,结果几乎不可用。
来量化一下这个噪声有多严重。路径追踪的噪声方差与采样数成反比:Var ≈ σ² / N,其中 N 是采样数。N=1 时方差最大,信噪比最低。要把噪声降到视觉可接受的水平,通常需要 N ≥ 64;要达到"干净"的程度,需要 N ≥ 1024。离线路径追踪通常用 1024-4096 spp,但在实时渲染里,16 ms 帧预算只能给光追分配 2-3 ms,1-2 spp 就是上限。
那怎么办?空间滤波能去噪,但会模糊边缘和细节。增加光线数量?预算不允许。说白了,答案就是时域复用——用上一帧(以及上上帧、上上上帧……)的结果来提升当前帧的有效采样数。
0.2 时域复用:用时间换采样
时域复用的核心思想:如果场景在帧间变化不大(相机没怎么动、物体没怎么动、光照没怎么变),那么上一帧的降噪结果对当前帧仍然有效。把上一帧的结果"搬"到当前帧来,相当于多了一倍的采样。搬 N 帧,就相当于 N+1 倍采样。
当然,场景不可能完全不变。相机一动、物体一动、光照一变,上一帧的数据就不再准确。所以时域复用不是简单地把上一帧的图叠上去——它需要一套精密的机制来判断历史数据是否有效、混合多少历史数据、在历史失效时怎么办。
这套机制的每一个环节都可能出问题。而这些问题在画面上的表现,就是各种伪影——鬼影、拖影、闪烁、模糊。OK,言归正传,本篇的主线就是"哪里会坏、为什么坏、怎么防"。
先用一个直觉性的例子来说明时域复用的价值。假设有一个完全静止的场景,相机不动、光源不动、物体不动。每帧 1 spp 的光追输出都是独立同分布的噪声。如果做时域累积,第一帧 1 spp,第二帧等效 2 spp,第三帧等效 3 spp……第 N 帧等效 N spp。30 帧后(0.5 秒),等效采样数就到了 30 spp——虽然还比不上离线渲染的 1024 spp,但已经足以把噪声压到可接受水平。
这就是时域复用为什么是降噪基石的原因:它用时间维度上的冗余来弥补采样数的不足,代价是假设帧间有连续性。一旦连续性被打破(运动、遮挡变化、光照突变),时域复用就会失效,产生各种伪影。
0.3 口径声明
本文的性能数字基于以下口径: - 硬件:以 RTX 3080/4070 级别为参考(主流高端桌面 GPU) - 分辨率:1080p / 1440p(游戏常用分辨率) - 帧率目标:60 fps(16.67 ms 帧预算) - 光追效果:以 1-2 spp 路径追踪为基准(最低有效采样率) - 参考实现:SVGF (Schied et al., 2017)、NRD REBLUR (NVIDIA, 2020)、UE5 TSR
一、时域累积的数学
1.1 EMA:指数移动平均
时域累积的数学基础是指数移动平均(Exponential Moving Average, EMA)。公式很简洁:
result_t = α · current_t + (1 - α) · result_{t-1}
其中 α 是混合因子,current_t 是当前帧的输入(光追的 1 spp 噪声图),result_{t-1} 是上一帧的累积结果。α = 1 表示完全用当前帧(不累积),α = 0 表示完全用历史(当前帧被忽略)。
公式的好处在于:不需要存储所有历史帧,只要存上一帧的结果就行。而且每帧的权重按指数衰减——越老的数据贡献越小,但不会突然消失。
来展开算几步看看。设 α = 0.1,当前帧输入为 C₁, C₂, C₃, …:
- 第 1 帧:R₁ = 0.1·C₁ + 0.9·R₀ (R₀ 是初始值,一般为 0 或第一帧输入)
- 第 2 帧:R₂ = 0.1·C₂ + 0.9·R₁ = 0.1·C₂ + 0.09·C₁ + 0.81·R₀
- 第 3 帧:R₃ = 0.1·C₃ + 0.9·R₂ = 0.1·C₃ + 0.09·C₂ + 0.081·C₁ + …
可以看到,第 N 帧的权重是 0.1 × 0.9^(N-1)。10 帧前的数据权重只有 0.1 × 0.9^9 ≈ 0.039——已经很小了,但非零。这就是"指数衰减"的含义:旧数据不会突然消失,但贡献越来越小。
1.2 α 参数的含义与取值
α 直接决定了时域累积的激进程度:
- α 小(如 0.05-0.1):历史贡献大,累积帧数多,等效采样数高。但收敛慢——画面变化后需要很多帧才能更新到新值。容易产生滞后和鬼影。
- α 大(如 0.3-0.5):当前帧贡献大,响应快。但等效采样数低,噪声压不住。
- α = 1:不累积,等于纯空间滤波。
等效采样数与 α 的关系很简洁:当累积帧数足够多时,N_eff ≈ 1/α。α=0.1 对应约 10 倍等效采样,α=0.05 对应约 20 倍。等于把 1 spp 提升到等效 10 spp,只需要把 α 设为 0.1 并让像素连续累积约 30 帧(3 倍时间常数后基本收敛)。
SVGF 论文中使用的是自适应 α:在方差低的区域(噪声小)用较小的 α(多累积),在方差高的区域(噪声大)用较大的 α(少累积,靠空间滤波来补)SVGF (Schied et al., HPG 2017)。具体做法是用上一帧的方差估计来调整当前帧的 α——方差低意味着该区域噪声已经收敛,可以放心累积;方差高意味着噪声仍然很大,历史本身也不可靠,不如少累积。
NRD REBLUR 的做法更激进——它不用固定 α 的 EMA,而是用"自稳定递归模糊"来控制历史贡献,最多可积累 32 帧 NVIDIA GTC 2020。REBLUR 的设计哲学是"时间稳定≠时间积累"——简单的 EMA 堆叠会引入滞后,而递归模糊通过自适应半径在稳定性和响应速度之间找到更好的平衡。
1.3 History Length 与有效采样数
时域累积的等效采样数不是简单的帧数叠加。由于 EMA 的指数衰减特性,N 帧后的等效采样数为:
N_eff ≈ 1 / α (当 N 足够大时)
例如 α = 0.1,等效采样数约 10;α = 0.05,等效采样数约 20。也就是从 1 spp 提升到等效 10 spp,只需要把 α 设为 0.1 并累积足够帧数。
但有个关键变量:history length——像素被连续累积的帧数。每当发生 disocclusion(遮挡物移开露出新表面)或运动矢量不可靠时,history length 会被 reset 归零。reset 后,该像素的等效采样数从 1 重新开始累积。
所以时域降噪在静态场景表现好(history length 不断增长,噪声持续收敛),但在动态场景表现差(频繁 reset 导致等效采样数上不去)。
来算一笔账。假设场景中有 30% 的像素在每帧都发生 disocclusion(动态场景的典型值),这些像素的 history length 平均只有 3-5 帧,等效采样数只有 3-5 spp——远低于静态区域的 20-30 spp。结果是动态区域的噪声会比静态区域明显高出一个量级,而人眼恰好对运动区域的噪声更敏感。这是时域降噪的根本困境:最需要降噪的地方(动态区域)恰恰是时域复用最帮不上忙的地方。
1.4 SVGF 的时域部分
SVGF 的时域部分只做三件事:
- 重投影:用运动矢量把上一帧的累积结果"搬"到当前帧的像素位置
- 有效性检测:检查搬过来的历史是否还可靠(深度/法线是否一致)
- EMA 混合:可靠就混合,不可靠就丢弃(α 设为 1,等于纯用当前帧)
空间滤波(A-Trous 小波滤波器)在时域累积之后执行,用方差估计来驱动滤波强度。ep05 已经给了 SVGF 三步骤的概览,这里不重复。本篇聚焦时域部分——重投影和有效性检测,以及它们什么时候会坏。
A-Trous 滤波器是空间滤波部分的核心。5 级 5 抽头,每级步长翻倍(2^0, 2^1, 2^2, 2^3, 2^4),等效卷积半径约 65 像素。它用 G-buffer 的法线和深度来指导滤波——法线相似且深度接近的邻居才参与滤波,跨过边缘不滤。这部分是空间域的,ep07 会展开讲。
SVGF 论文给出的完整运行时间约 10 ms(1080p,包含时域累积和空间滤波),其中时域部分约 1-2 ms,空间滤波占大头 SVGF 论文。JCGT 2025 的优化论文将 A-Trous 滤波器的 GPU 实现优化了 1.3-2.5 倍 JCGT 2025,意味着在现代 GPU 上 SVGF 的总运行时间可以压到 4-6 ms。关于 G-buffer 的布局和 光栅化 pass 的编排,ep05 已经详细讲过,这里不重复。
1.5 EMA 的频域视角
理解 EMA 的另一个角度是频域分析。EMA 就是一个一阶低通滤波器,其传递函数为 H(ω) = α / (1 - (1-α)·e^(-jω))。这个传递函数告诉我们:低频成分(场景中缓慢变化的部分,如漫反射颜色)能顺利通过,高频成分(噪声、锐利边缘)被衰减。
截止频率(-3dB 点)约为 f_c ≈ α / (2π) 帧^-1。α=0.1 时,截止频率约 0.016 帧^-1——意味着周期超过 63 帧的变化才能被完整保留,更快的变化会被衰减。α 小时画面「稳」(高频噪声被滤掉)却「滞后」(快速变化也被滤掉),根源就在这条衰减曲线上。
从频域的角度看,时域降噪的矛盾就摆得很清楚:噪声是高频的,我们想滤掉它;但细节也是高频的,我们想保留它。EMA 无法区分"高频噪声"和"高频细节"——它一刀切地衰减所有高频成分。空间滤波的优势在于能用 G-buffer 引导(法线、深度)来区分边缘和噪声,但时域累积没有这种引导——它只能靠运动矢量来"对齐"帧间数据,对齐了就等效于低通滤波,对不齐就产生伪影。
工业降噪器普遍用「时域 + 空间」组合而不是纯时域,原因也在这里——时域负责低频降噪(大尺度平滑),空间负责高频降噪(边缘保持滤波),两者互补才能在不牺牲细节的前提下降噪。关于冲激响应和阶跃响应的详细推导,信号处理的教科书里有完整的数学分析,这里只给工程上需要知道的结论。
二、运动矢量与重投影
2.1 Back Projection:把当前像素映射回上一帧
时域累积的第一步是把上一帧的结果"搬"到当前帧。但上一帧和当前帧的像素位置不一定对应——相机动了、物体动了,同一个场景点在两帧中的屏幕坐标不同。
"搬"的方法叫 back projection(反向投影):
映射链分四步:
- 当前像素 (x, y) 从 G-buffer 读到世界坐标
world_pos - 用上一帧的 view-projection 矩阵
VP_prev变换到上一帧的裁剪空间 - 透视除法 + 视口变换,得到上一帧的屏幕坐标
(u_prev, v_prev) - 用
(u_prev, v_prev)采样上一帧的历史缓冲
运动矢量(motion vector)就是这两步屏幕坐标的差值:
motion_vector = (u_current, v_current) - (u_prev, v_prev)
这个差值一般在 G-buffer 生成阶段就预算好了,存在一个专门的运动矢量缓冲区里。光追 pass 和降噪 pass 都可以直接读取,不需要临时计算。
2.2 运动矢量怎么算
运动矢量的计算路径取决于物体类型,这直接影响 back projection 的精度:
静态物体 + 相机移动:最简单的情况。只需用上一帧和当前帧的 view-projection 矩阵。world_pos 不变(物体没动),但 VP 变了(相机动了),所以屏幕坐标会变。运动矢量 = project(VP_prev, world_pos) - project(VP_current, world_pos)。这种情况下运动矢量非常精确——因为 world_pos 来自 G-buffer 的深度重建,精度取决于深度缓冲的位数。
动态物体 + 相机移动:需要物体的 model 矩阵变化。world_pos 本身变了(物体动了),加上 VP 也变了。这时需要用当前帧的 model 矩阵 × 上一帧的 VP 来做 back projection。关键是要在 G-buffer pass 中同时记录"当前帧 world_pos"和"上一帧 world_pos"——后者需要把上一帧的 model 矩阵传到当前帧的着色器里。
顶点形变(骨骼动画):最麻烦的情况。每个顶点的位置都可能不同,而光栅化生成的 G-buffer 只存了当前帧的 world_pos。要做准确的 back projection,需要额外的"上一帧 world_pos"缓冲——也就是每顶点运动矢量。具体做法是在顶点着色器中同时用当前帧和上一帧的骨骼矩阵变换顶点位置,得到两个屏幕坐标,差值就是运动矢量。这一步的额外开销约 0.3-0.5 ms(取决于角色数量和骨骼数量),但能显著减少动画伪影。
Vulkan 的 G-buffer 一般有一个专门的运动矢量通道(VK_KHR_ray_tracing_pipeline + motion vector extension),由光栅化 pass 在写入 G-buffer 时一并生成 Vulkan Ray Tracing Optimization。
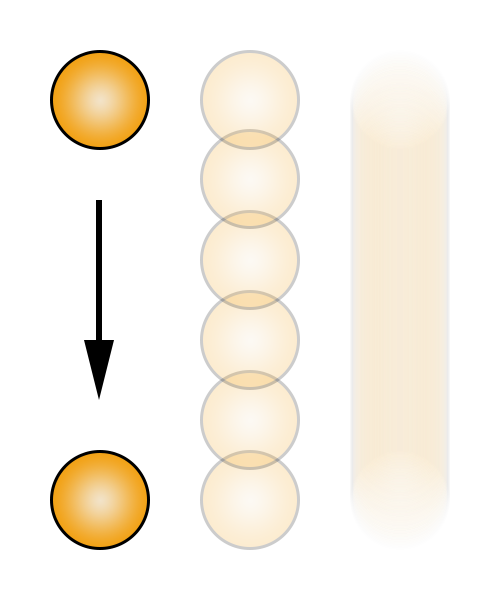
2.3 运动矢量精度对降噪的影响
运动矢量的精度直接决定时域累积的质量。来分析几个影响精度的因素:
深度缓冲位数:world_pos 是从深度值重建的。16 位深度缓冲的精度远低于 32 位浮点深度缓冲。在远距离场景中,深度精度不足会导致 world_pos 偏差,进而导致 back projection 偏差。这也是为什么光追管线通常用 32 位浮点深度——不是为了 Z-fighting,而是为了运动矢量精度。
运动矢量缓冲的精度:运动矢量本身也存在缓冲区里。8 位精度不够——亚像素运动的矢量值可能小于 1 哪个,8 位量化后误差太大。多用 16 位浮点(R16G16_FLOAT)存储运动矢量。
视口偏移(jitter):TAA 和时域降噪通常会对视口施加子像素抖动来增加采样位置多样性。抖动量需要在运动矢量计算中扣除——否则抖动会被当作"相机运动"计入运动矢量,导致 back projection 偏差。
2.4 重投影失败的典型场景
Back projection 的前提是"同一个场景点在两帧中都可见"。这个前提在很多情况下不成立:
- Disocclusion(遮挡消除):物体移开后露出新表面,新表面在上一帧不可见
- 屏幕外:物体移出屏幕边缘,或从屏幕外移入
- 镜面反射:反射内容随视角剧烈变化,反射面的运动矢量不等于反射内容的运动矢量
- 阴影:阴影接收面的运动矢量不等于阴影本身的运动矢量——阴影会随光源移动,但接收面可能完全静止
Zeng et al. (EG 2021) 专门研究了这个问题,提出了时间可靠运动矢量(Temporally Reliable Motion Vectors, TRMV),针对阴影、反射和遮挡场景生成更可靠的运动矢量 TRMV 论文。TRMV 的核心思路是:对每种光追效果(阴影、反射、GI),单独追踪其"成因"(遮挡物、反射体、光源),并用成因的运动来生成效果的运动矢量,而不是用接收面的运动矢量。
2.5 运动矢量不准的后果
运动矢量算错了,back projection 就会把上一帧的错误像素搬到当前帧——说白了,历史颜色和当前帧的实际颜色不匹配。EMA 混合后,画面上会出现:
- 旧颜色"涂抹"到新位置(鬼影)
- 边缘处颜色泄漏(颜色渗透)
- 动态光照下残影拖尾(滞后)
这些问题在第四章和第五章会展开讲。这里先记住一个关键点:运动矢量是时域复用的命门。运动矢量准,时域累积就稳;运动矢量不准,所有后续处理都在错误的基础上做。在项目里调试降噪器时,第一步永远是检查运动矢量——而不是调 α 或滤波参数。
2.6 运动矢量精度量化
前面定性地讲了运动矢量精度对降噪的影响,这里给一组量化数据,帮助理解不同精度等级下的误差量级。
| 精度配置 | world_pos 误差 | MV 误差 (像素) | 降噪影响 |
|---|---|---|---|
| 16 位深度 + 8 位 MV | ~0.5-1.0 cm @ 10m | 0.5-2.0 | 严重鬼影,边缘拖影 |
| 32 位深度 + 8 位 MV | ~0.01-0.05 cm @ 10m | 0.5-2.0 | MV 精度瓶颈,仍有鬼影 |
| 32 位深度 + 16 位 MV (FP16) | ~0.01-0.05 cm @ 10m | 0.01-0.1 | 基本可接受,轻微模糊 |
| 32 位深度 + 32 位 MV (FP32) | ~0.01-0.05 cm @ 10m | <0.01 | 精度充足,非 MV 限制 |
从表中可以清楚看到:深度缓冲位数和 MV 缓冲精度是两个独立的瓶颈。只提升深度位数而不提升 MV 精度,world_pos 算准了但 MV 量化误差仍在。两者都要到位才能消除精度瓶颈。实际项目中,32 位浮点深度 + FP16 MV 是性价比最高的组合——FP16 的精度足够表示亚像素运动,且内存开销只有 FP32 的一半。
还有一个容易被忽略的精度问题:视口抖动(jitter)扣除。TAA 和时域降噪一般用 Halton 序列 对视口施加子像素抖动来增加采样位置多样性。抖动量需要在 MV 计算中精确扣除——否则抖动会被当作"相机运动"计入 MV,导致 back projection 偏差。抖动量一般在 ±0.5 像素以内,如果扣除不干净,残余误差就在亚像素级别——肉眼不一定看得出来,但会让 EMA 混合后的边缘发虚。
三、Disocclusion:时域复用的第一道坎
3.1 什么是 Disocclusion
Disocclusion(遮挡消除)是时域复用遇到的最基本的失效场景。想象一个简单场景:物体 A 在物体 B 前面,A 向右移动,B 逐渐露出来。
当前帧中 B 的像素是新可见的——上一帧这些像素位置存的是 A 的颜色。如果直接复用历史,B 的像素就会被"A 的旧颜色"污染。这就是鬼影的基本成因之一。
Disocclusion 在动态场景中无处不在。角色走过走廊、车辆驶过路标、门打开露出房间——每一次遮挡关系变化都会产生 disocclusion 区域。这些区域的像素没有有效历史,直接复用必然出错。
3.2 深度一致性检测
检测 disocclusion 最直接的方法是深度比较:
- 取当前像素的深度
depth_current - 用 back projection 找到上一帧对应的屏幕位置
- 读取上一帧的历史深度
depth_prev - 比较两者:如果
|depth_current - depth_prev| > threshold,标记为 disocclusion
阈值的选择是工程问题——太小会导致很多像素被误判为 disocclusion(丢失有效历史,噪声增大),太大又会漏检(鬼影残留)。实践中通常用相对深度差而非绝对深度差,因为远距离场景的深度精度本身较低。一个常见的阈值是 1% 的相对深度差——|depth_current - depth_prev| / depth_current > 0.01。
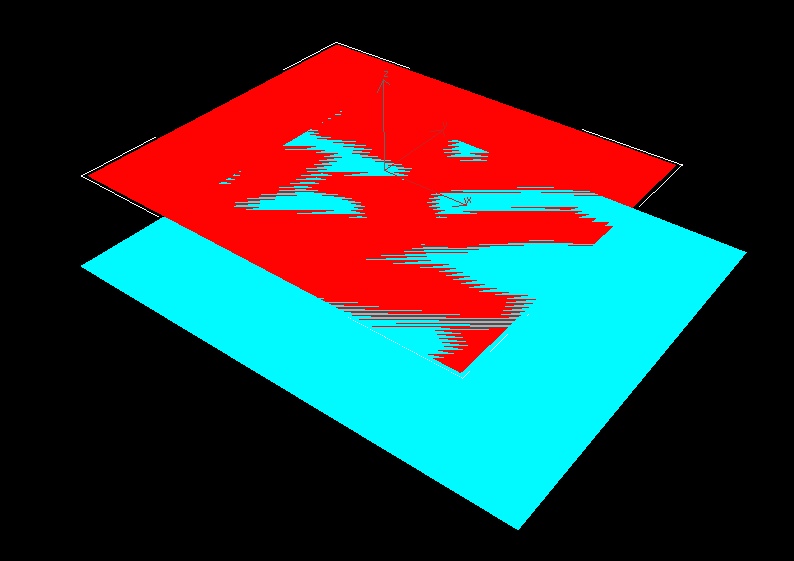
深度检测的可靠性最终受限于深度缓冲本身的精度。在 32 位浮点深度下,近处的可分辨步长远小于远处——上图的 z-fighting 就是两个表面的深度差小到缓冲分辨不出来时出现的结果。把比较做成相对量,正是为了让同一个阈值在远近处都能用。
AMD FidelityFX Denoiser 1.3 给出了具体的 disocclusion mask 生成流程 AMD FidelityFX Denoiser,将上一帧深度重新投影到当前帧并与当前深度比较,若不匹配则标记为 disocclusion。这个 mask 后续用于控制历史混合权重——disocclusion 区域的 α 被拉高到 1(纯用当前帧),非 disocclusion 区域正常累积。
3.3 法线一致性检测
深度检测能抓住大部分 disocclusion,但有些情况下深度差异不大、颜色却完全不同。比如两面墙成锐角相交,深度接近但法线相反。这时需要法线一致性检测作为补充:
if (dot(normal_current, normal_prev) < threshold) {
    // 法线差异过大,标记为 disocclusion
}
法线检测的阈值通常用点积——dot > 0.9 表示法线接近(同一表面),dot < 0.9 表示法线差异大(不同表面或边缘)。有些实现用更严格的 dot > 0.95 来减少漏检。法线检测和深度检测是互补的——深度检测擅长抓大尺度遮挡变化,法线检测擅长抓小尺度几何边缘。
3.4 Disocclusion 时怎么办
检测到 disocclusion 后,有几种处理策略:
策略一:Reset history。把 history length 归零,α 设为 1。等于放弃历史,纯用当前帧。代价是该像素的噪声突然增大——从等效 20 spp 一下子掉回 1 spp,需要多帧才能重新收敛。在快速运动的场景中,频繁的 reset 会导致噪声"闪烁"——时好时坏,视觉上很不舒服。
策略二:降低 α。不完全丢弃历史,但减少历史贡献。比如从 α=0.1 临时提到 α=0.5。折中方案——牺牲一些等效采样数来换取更快的响应。NRD REBLUR 用的是类似策略,但通过递归模糊的自适应半径来实现,比简单的 α 调整更平滑。
策略三:空间补洞。从当前帧的邻居像素借用信息来填补 disocclusion 区域。NRD REBLUR 的"历史重建"就包含这一步——它不是简单地把 disocclusion 像素的 α 拉到 1,而是用邻居的有效历史来"猜测"该像素的历史值。这能显著减少 reset 后的噪声跳变。
策略四:颜色裁剪(Color Clamping)。不丢弃历史,但把历史颜色裁剪到当前帧邻居的颜色范围内。这是 TAA 的经典做法——计算当前像素周围 3×3 邻居的颜色均值和方差,把历史颜色裁剪到 [mean - k·std, mean + k·std] 范围内(k 一般取 0.5-1.0)。颜色裁剪能减轻鬼影但不能完全消除——如果历史颜色完全错误,裁剪后的结果仍然有偏差。
实践中,工业降噪器往往组合使用多种策略。NRD REBLUR 的做法是:先检测 disocclusion,对 disocclusion 像素用空间补洞重建历史,然后用自适应 α 混合,最后对结果做颜色裁剪。这种多层级处理比单一策略的鲁棒性高得多。
3.5 颜色裁剪的数学
颜色裁剪(color clamping) 是 TAA 和时域降噪中减轻鬼影的核心手段。原理是:不丢弃历史,但把历史颜色限制在当前帧邻居的颜色统计范围内。具体做法分两步。
第一步:统计邻居颜色范围。取当前像素周围 3×3 邻居的颜色,计算均值 μ 和标准差 σ。这给出了当前帧该区域的颜色分布范围。
第二步:裁剪历史颜色。把历史颜色 C_hist 裁剪到 [μ - k·σ, μ + k·σ] 范围内:
C_clamped = clamp(C_hist, μ - k·σ, μ + k·σ)
其中 k 是裁剪强度系数,一般取 0.5-1.0。k=0.5 最激进(紧紧限制在半标准差范围内),k=1.0 最保守(允许一个标准差的偏差)。激进的裁剪能有效消除鬼影,但也会过度修正合法的历史颜色——导致细节丢失和颜色偏移。
NRD 和 AMD FSR 用的是 AABB(轴对齐包围盒)裁剪而非高斯统计——对非正态分布的颜色更鲁棒。AABB 的做法是取邻居颜色的最小/最大值作为裁剪边界:C_clamped = clamp(C_hist, min(neighbor), max(neighbor))。AABB 的优点是不假设颜色分布形态,缺点是对异常值敏感——一个噪声像素就能把 max 拉得很高,导致裁剪不够。
UE5 TSR 用的是更精细的"shading rejection"——不仅检查颜色范围,还检查亮度和色度的一致性。TSR 将颜色转到 YCoCg 空间,分别检查亮度和色度通道,对每个通道独立做裁剪。这比 RGB 空间的裁剪更合理——人眼对亮度变化比对色度变化更敏感,分开处理能更好地保住视觉上更敏感的那部分信息。
颜色裁剪能减轻鬼影但不能完全消除——如果历史颜色完全错误(比如 disocclusion 区域的历史指向了完全不同的表面),裁剪后的结果仍然有偏差。所以颜色裁剪一般和 disocclusion 检测配合使用:先检测 disocclusion,对 disocclusion 像素用更激进的裁剪(k=0.5)或直接 reset,对非 disocclusion 像素用温和的裁剪(k=1.0)。
四、Ghosting:最典型的时域伪影
4.1 Ghosting 的视觉表现
Ghosting(鬼影)是时域降噪最臭名昭著的伪影。它的视觉表现很直观:快速移动的物体后面拖着一条半透明的"尾巴",物体离开后旧位置仍有残留颜色。在暗背景上移动亮物体时尤为明显——残影可以持续 5-10 帧才完全消散。
在 UE5 Lumen 的实际使用中,ghosting 问题被频繁反馈——移动高亮物体时,亮色在暗背景上留下残影,需要数帧才能消散 UE5 Lumen ghosting 讨论。这个问题的根因是 Lumen 的 Screen Probe Gather temporal history 在物体快速移动时没有及时丢弃历史。
4.2 六种触发场景
鬼影不是单一原因造成的。根据触发条件的不同,可以分成六种典型场景:
场景一:物体移动 最常见的鬼影。物体 A 移动后,A 原来位置的像素现在应该显示背景 B,但历史缓冲里存的是 A 的颜色。如果 disocclusion 检测没抓住(深度差异在阈值内),A 的颜色就会残留在 B 上。表现:物体边缘有"颜色拖尾",物体离开后残影逐渐淡出。
场景二:相机转动 相机快速转动时,运动矢量可能不够精确(特别是使用低精度运动矢量缓冲时),导致 back projection 的位置偏差。偏差不大时表现为轻微模糊——历史和当前帧错位了 1-2 像素,混合后边缘变虚。偏差大时表现为鬼影——错位超过 3-4 像素时,历史颜色完全来自错误位置,形成明显的残影。
场景三:光照变化 光源强度或颜色突然变化时(比如灯泡闪烁、爆炸闪光),历史缓冲里的旧光照颜色会被混合到新光照中。这不是几何问题——深度和法线都没变,但颜色变了。表现:光源切换后,旧光照的残影需要数帧才能消散。颜色裁剪是主要缓解手段。
场景四:阴影移动 阴影本身没有几何体,它的运动矢量不等于阴影接收面的运动矢量。当光源移动导致阴影移动时,接收面的运动矢量仍然是零(接收面没动),但阴影已经移走了。旧阴影位置的历史颜色会被错误复用,形成"阴影残影"——阴影已经移走,但原位置还有一层淡淡的黑影。这是 TRMV 论文专门解决的问题之一。
场景五:镜面反射 反射内容随视角变化剧烈。反射面的运动矢量不等于反射内容的运动矢量——反射面可能静止(比如一面镜子),但反射内容已经完全变了(因为观察角度变了)。如果用反射面的运动矢量来做 back projection,历史中存的是旧的反射内容,混合后会出现"反射拖影"。
场景六:透明物体 透明物体后面的颜色是混合的,运动矢量一般只对应前面一层。半透明边缘的时域累积特别容易出错——边缘像素的前景和背景比例在帧间变化,但运动矢量只能描述其中一层的运动。表现:半透明边缘出现"色彩抖动"或"边缘拖影"。
4.3 根因分析
六种场景的根因可以归结为两类:
第一类:运动矢量不可靠(场景一、二、四、五、六) back projection 依赖运动矢量。运动矢量错了,历史就从错误的位置搬过来。EMA 混合后,错误的颜色被"印"在当前帧上,而且后续帧还会继续累积这个错误——因为下一帧的 back projection 又会指向这个已经被污染的历史。这形成了一个错误累积循环:第一帧混入 10% 的错误颜色,第二帧又混入 10% 的(已被污染的)历史,错误浓度逐渐升高,直到 history reset 才能清除。
第二类:颜色突变(场景三、四)
即使运动矢量完全正确,像素对应的场景点也确实是同一个,但如果该点的光照条件在帧间发生了剧变,历史颜色就不再代表当前状态。EMA 的低通滤波特性会"拖住"颜色变化——数学上,EMA 对阶跃信号的响应需要约 1/α 帧才能收敛到新值的 63%。α=0.1 时,需要约 10 帧才能消除 63% 的颜色差异,约 30 帧才能消除 95%。
第一类问题的解法是改进运动矢量(TRMV 方法)或加强 disocclusion 检测。第二类问题的解法是颜色裁剪——把历史颜色限制在当前帧邻居的颜色统计范围内,超出范围就裁掉。
五、其他失效模式
鬼影是最显眼的,但不是唯一的。下面来看看时域复用还有四种常见的失效模式,它们不如鬼影那么容易发现,但在实际项目中同样折磨人。
5.1 Temporal Lag(时间滞后)
时间滞后是 EMA 的本质特性——它是低通滤波器,会让输出"慢半拍"。NVIDIA 在 GTC 2020 的 REBLUR 演讲中明确说:"denoising is a tradeoff between temporal lag and blurriness"——降噪就是滞后和模糊之间的权衡 NVIDIA GTC 2020。
滞后的数学根源:EMA 对阶跃变化的响应时间约为 τ = -1/ln(1-α) 帧。α=0.1 时 τ ≈ 9.5 帧,α=0.05 时 τ ≈ 19.5 帧。也就是说画面变化后,降噪输出需要约 τ 帧才能更新到新值的 63%。
表现:快速移动物体的降噪结果"追不上"实际位置,阴影变化需要数帧才能稳定,光照切换有明显的过渡期。UE5 Lumen 的社区反馈中,降低 MaxFramesAccumulated 可以减轻滞后,但代价是噪声增加 UE5 TSR FAQ。
5.2 Flickering / Boiling(闪烁/沸腾)
闪烁表现为画面中细粒度的明暗跳动,尤其在纹理细节区域、半透明边缘或高噪声区域。噪声在帧间来回跳动,形成"沸腾"效果——像水烧开时气泡翻滚那样。
根因是时域累积和空间滤波的参数不匹配——累积因子过高(历史贡献大)但空间滤波强度不足(噪声没压住),噪声在时间域中无法被充分平滑。同时空间域又未能有效压制噪声。具体来说,当 α 很小时,每帧只有 5-10% 的当前帧噪声进入累积,但这个噪声的方差没有被空间滤波充分压低,就会在帧间反复出现,形成闪烁。
UE5 TSR 专门提供了 Flickering Temporal Analysis 模块来稳定帧间噪声。NRD REBLUR 的做法是用递归模糊在每帧做轻度空间滤波,即使累积因子很低也不会让噪声"裸奔"。
5.3 Blurring(模糊)
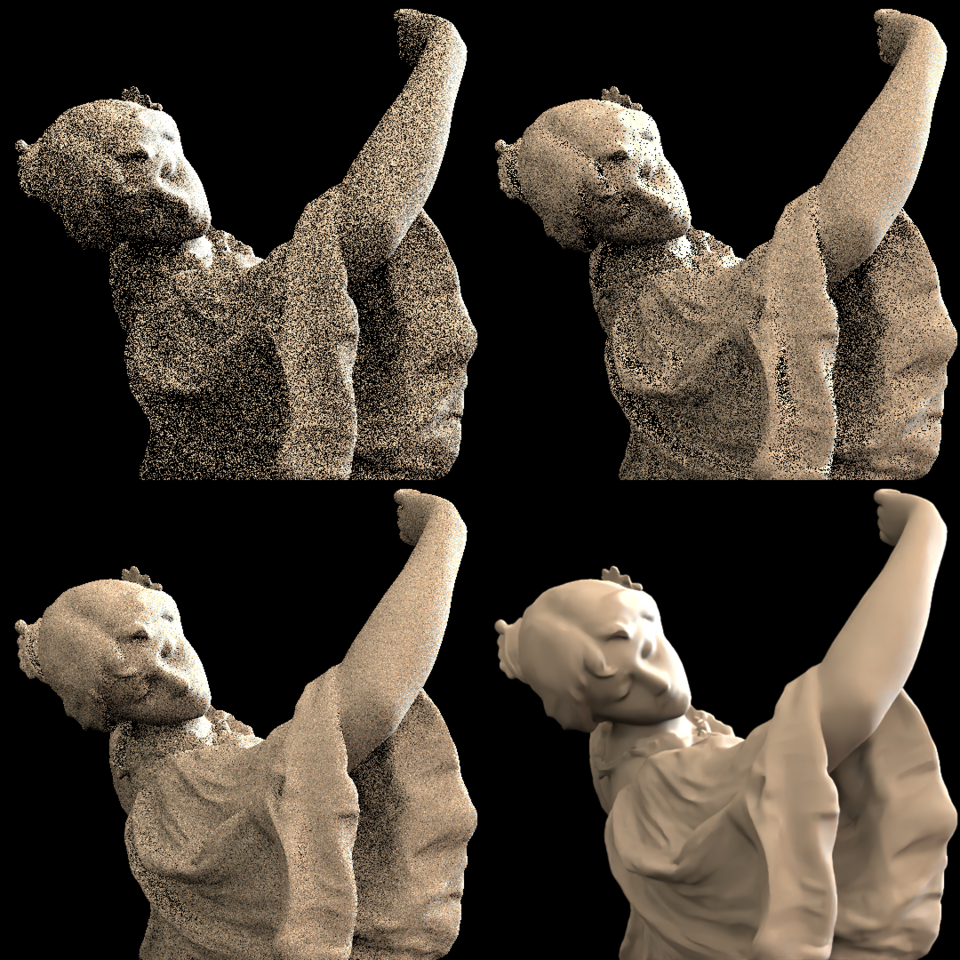
模糊是过度累积的直接后果。当 α 太小、历史贡献太大时,EMA 会持续平滑当前帧的细节。这有两层含义:一是历史和当前帧的运动矢量有微小偏差(亚像素级),混合后边缘变虚;二是 EMA 本身就是低通滤波器,高频细节(锐利边缘、细密纹理)会被衰减。
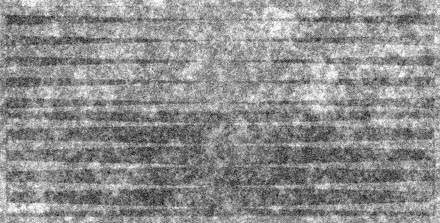
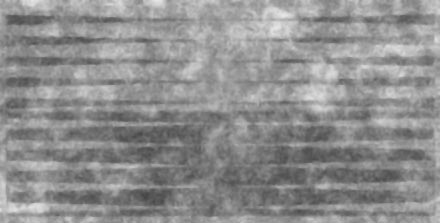
这一对图把「去噪的代价」摆在了明面上:噪声被压下去的同时,纹理和边缘也一起被磨平了。时域降噪的相对优势正在这里——它用多帧信息替代单帧邻域,能在压低噪声的同时留住更多高频细节,代价则是引入滞后与鬼影这类只属于时间维度的问题。
A-SVGF 的研究表明,固定 5 级 A-Trous 滤波器在任何情况下都运行,会对锐利区域造成过度模糊;而基于时空方差估计的自适应迭代次数(1-5 级)可减少这种问题 A-SVGF。A-SVGF 的做法是:在低噪声区域跳过深层小波级(只做 1-2 级),在高噪声区域用全部 5 级。这样锐利区域不被过度平滑,噪声区域得到充分滤波。
5.4 Animation Artifacts(动画伪影)
骨骼动画和形变网格在帧间产生非刚性形变,但运动矢量一般基于顶点变换计算,可能无法准确反映形变后的表面运动。角色肢体的边缘可能出现半透明残影,或形变后的网格在时域累积中出现不连贯的闪烁。
根因是形变前后的表面点不是同一个 3D 位置——骨骼旋转后,同一个顶点的 world_pos 变了,但它仍然是"同一个点的运动"。如果运动矢量只记录了刚体位移而忽略了形变分量,back projection 就会指向错误的位置。
解法是在骨骼动画中计算每个顶点的实际位移作为运动矢量(形变感知运动矢量),或在形变剧烈的区域临时提高 α。前者增加约 0.3-0.5 ms 的 G-buffer pass 开销,但效果显著。
5.5 失效模式总览
把前面讲过的鬼影和四种额外失效模式汇总成一张表,方便在项目调试时当检查清单用。看到什么伪影就查表找根因,再对应策略去调参数,比盲目调 α 高效得多。这张表覆盖了时域复用最常见的六种失效场景,给出了每种模式的根因、视觉表现、检测方法和缓解策略。
| 失效模式 | 根因 | 视觉表现 | 检测方法 | 缓解策略 |
|---|---|---|---|---|
| 鬼影 | 运动矢量不准/颜色突变 | 移动物体后拖尾 | 深度/法线一致性检测 | 改进 MV + 颜色裁剪 |
| 时间滞后 | EMA 低通特性 | 降噪结果慢半拍 | 帧间差异监测 | 降低累积帧数/自适应 α |
| 闪烁/沸腾 | 累积与滤波参数不匹配 | 细粒度明暗跳动 | 方差监测 | 加强空间滤波/Flickering Analysis |
| 模糊 | 过度累积 | 整体发虚 | 空间频率分析 | 自适应滤波级数/降低 α |
| 消隐伪影 | Disocclusion 未检测到 | 边缘颜色泄漏 | 深度/法线检测 | Reset history/空间补洞 |
| 动画伪影 | 形变运动矢量不准 | 关节处残影 | 顶点位移检测 | 形变感知 MV/提高 α |
这张表在项目调试时可以当检查清单用:看到什么伪影 → 查表找根因 → 对应策略去调。比盲目调参数高效得多。
六、工业降噪器的应对策略
在看具体降噪器之前,先拉一条时间线。从 SVGF 到 REBLUR 再到 TSR,每一步都是在前一代的失效模式上打补丁——SVGF 给光追加了方差驱动的空间滤波,但时域累积本身还停留在固定 α 的水平;REBLUR 用递归模糊把时域稳定性推到了新的高度;TSR 则专门去补历史不可用时的重建问题。理解这条演进线,才能理解为什么每个降噪器做了那些选择。
6.1 NRD REBLUR:自稳定递归模糊
NVIDIA 的 NRD(Noise Removal Denoiser)是目前最成熟的工业级实时降噪库,包含三种降噪器:REBLUR(漫反射/镜面)、SIGMA(阴影)、RELAX(RTXDI 光照)NRD GitHub。NRD 是 API 无关的——它可以用于 Vulkan、DX12 或任何能提供 G-buffer 引导信号的管线。
REBLUR 的核心创新是"自稳定递归模糊"。它不用固定 α 的 EMA,而是用递归模糊来控制历史贡献:
- 自适应模糊半径:模糊半径随累积帧数变化——刚开始累积时用大半径(强力去噪),累积稳定后用小半径(保留细节)。具体来说,前几帧用接近全分辨率的大半径滤波,随着 history length 增长,半径逐渐缩小到正常水平。
- 分层历史重建:disocclusion 区域不是简单丢弃历史,而是从邻居像素重建历史。REBLUR 用多级 MIP 来加速这个重建过程——第一级 MIP 用于快速搜索有效邻居,后续级别用于精细重建。
- 最多 32 帧积累:在稳定区域可达 32 帧等效采样,等效 α 约 0.03——非常激进的历史复用。
- 时间稳定≠时间积累:REBLUR 的设计哲学是"稳定性来自递归模糊的自适应性,不是来自简单的历史堆叠"。这句话的含义是:简单的 EMA 会引入与累积深度成正比的滞后,而递归模糊通过自适应半径把滞后控制在可接受范围内。
6.2 SVGF:方差驱动的累积因子
SVGF 的时域策略比 REBLUR 简单,但也不失巧妙。它的 α 不是固定的,而是由方差估计驱动:
- 当前像素的方差低(噪声小)→ α 小(多累积历史)
- 当前像素的方差高(噪声大)→ α 大(少累积,靠空间滤波来补)
方差估计来自时域累积本身——比较上一帧的累积结果和当前帧的输入,差异大的区域方差高。好处是自适应——噪声大的区域不会被历史"拖住"(因为历史本身也是噪声大的),噪声小的区域能充分利用历史来进一步降噪。代价是方差估计本身需要时间收敛,在前几帧可能不准确。
6.3 UE5 Lumen / TSR:History Resurrection
UE5 的 TSR(Temporal Super Resolution)提供了几种独特的时域处理机制 UE5 TSR 文档:
- Parallax Heuristics:通过运动矢量重投影历史数据,在 disocclusion 区域保持图像质量。TSR 的 parallax 判据比简单的深度比较更鲁棒——它考虑了视差效应,能区分"真正的遮挡变化"和"视角变化导致的深度偏移"。
- Shading Rejection:检测颜色变化和半透明性,防止不正确的历史数据被累积。这是颜色层面的检测——即使几何(深度/法线)一致,如果颜色变化超过阈值也会拒绝历史。
- History Resurrection:当之前被丢弃的历史数据在当前帧重新出现时,将其"召回"。这个机制解决了一个 TAA 的经典问题:物体被短暂遮挡后重新出现时,history 已经被 reset 了,需要从头累积。History Resurrection 缓存被丢弃的历史,在 re-disocclusion 时恢复。
- Subpixel Geometry:0/1/2 三种模式来平衡细节保留与时间稳定性。模式 0 最保守(最强稳定性),模式 2 最激进(最多细节)。
Lumen 的 ghosting 问题往往出在 Screen Probe Gather 的 temporal history 上。社区测试发现,设置 r.Lumen.ScreenProbeGather.Temporal.ClearHistoryEveryFrame = 1 可消除某些测试场景中的 ghosting,但代价是稳定性下降 UE5 Lumen ghosting。
6.4 AMD FSR:深度不连续检测
AMD 的 FSR 2/3 时域管线使用了几种经典的 disocclusion 处理技术 AMD GDC 2023:
- 深度不连续检测:将当前深度与重投影深度比较,标记 disocclusion 区域。FSR 的实现用分 tile 的深度比较来加速,避免逐像素比较的开销。
- 颜色矩形修正(Color Rect):对旧样本进行颜色修正,限制在当前帧邻居的颜色范围内。与 TAA 的 color clamping 类似,但 FSR 用 AABB(轴对齐包围盒)而非高斯统计来限定颜色范围——对非正态分布的颜色更鲁棒。
- 保守 disocclusion 掩码:确保边缘稳定。保守的含义是——宁可误判为 disocclusion(多丢一些历史),也不漏判(导致鬼影)。误判的代价是噪声略增,漏判的代价是鬼影——后者视觉影响更大。
- FSR 3.1 改进:减少运动物体上的 ghosting,消除 disocclusion 表面伪影。FSR 3.1 还实现了上采样与帧生成的解耦,允许 DLSS 上采样搭配 FSR 3 的帧生成 AMD GDC 2024。
6.5 性能与内存开销
时域降噪的内存开销主要来自历史缓冲区。以 1080p 为例:
| 缓冲区 | 通道数 | FP16 占用 | FP32 占用 | 说明 |
|---|---|---|---|---|
| 历史颜色 | 3-4 | 12-16 MB | 24-32 MB | 累积结果 |
| 运动矢量 | 2 | 8 MB | 16 MB | XY 分量 |
| 深度 | 1 | 4 MB | 8 MB | 线性深度 |
| 法线 | 3 | 12 MB | 24 MB | 世界空间 |
| 方差 | 1 | 4 MB | 8 MB | SVGF 用 |
| 合计 | — | 40-44 MB | 80-88 MB | — |
4K 分辨率下各项 ×4,FP16 约 160-176 MB,FP32 约 320-352 MB。所以很多降噪器默认用 FP16——在画质几乎无损的前提下把内存和带宽开销减半。
帧时间方面,SVGF 在 1080p 上的完整运行时间约 10 ms(含时域累积+空间滤波,Schied et al. 2017 论文数据)。单独时域部分通常占 1-2 ms,空间滤波占大头。NRD 在 RTX 4080 @ 1440p 上的示例配置未给出统一 ms 级数据——因为性能高度依赖场景复杂度和降噪器配置 NRD GitHub。AMD FSR Ray Regeneration 在 1440p 下的总工作集约 447 MB(内存工作集,非帧时间)AMD FSR Ray Regeneration。NVIDIA DLSS 的 Ray Reconstruction 模式用神经网络替代传统降噪器,在画面质量和性能之间提供了新的权衡选项,但原理层面的分析留到 ep07。
6.6 降噪器横向对比
把前面讲的四种工业降噪器放在一起对比,方便选型时参考。下表从时域处理、空间处理、disocclusion 策略、适用场景等维度做了横向归纳。每种降噪器的时域处理策略差异很大——REBLUR 用递归模糊,SVGF 用方差驱动,TSR 用 parallax heuristics,FSR 用深度不连续检测——这些差异直接决定了它们在不同场景下的表现。
| 维度 | NRD REBLUR | SVGF | UE5 TSR | AMD FSR |
|---|---|---|---|---|
| 时域处理 | 自稳定递归模糊 | EMA + 方差驱动 α | Parallax heuristics + History Resurrection | 深度不连续检测 + 颜色矩形修正 |
| 最大累积帧数 | 32 帧 | ~20 帧(α=0.05) | 可配置(MaxFramesAccumulated) | 可配置 |
| Disocclusion 策略 | 多级 MIP 空间补洞 | 深度/法线检测 + reset | Parallax + Shading Rejection | 保守 disocclusion 掩码 |
| 颜色裁剪 | 内置 | 可选 | YCoCg shading rejection | AABB 颜色矩形修正 |
| 空间滤波 | 内置递归模糊 | A-Trous 5 级 | 内置 | RCAS 锐化 |
| API 无关 | 是 | 是 | 仅 UE5 | 是 |
| 适用场景 | RTX 光追降噪 | 学术研究/原型 | UE5 项目内 | 跨平台上采样+降噪 |
| 开源 | 是 (GitHub) | 论文+参考实现 | UE5 引擎内置 | 是 (GitHub) |
选型建议:如果项目用 Vulkan/DX12 且需要独立降噪器,NRD 是首选——它的递归模糊在时域稳定性上目前没有对手。如果项目用 UE5,TSR 是默认选择,配合 Lumen 的 Screen Probe Gather temporal history。如果需要跨平台(包括 AMD/Intel GPU),FSR 的开源许可和硬件无关性是优势。SVGF 更适合学术研究和原型验证——它的代码结构清晰,方便理解每个模块的作用,但工业项目一般直接用 NRD。
关于 NVIDIA OptiX 和 NVIDIA Falcor 中集成的降噪器,底层也调用了 NRD 的 REBLUR。而 Intel XeSS 的内部 history texture 机制在原理上和 TSR 的 History Resurrection 类似——缓存被丢弃的历史,在 re-disocclusion 时恢复。
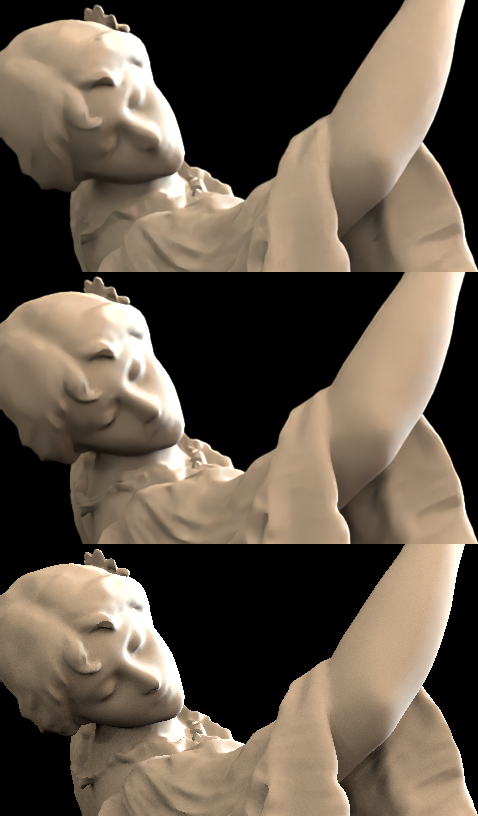
上图是一份时域降噪的实际输出。采样阶段的噪声被压掉之后,画面才具备可看性——这也是为什么说降噪器在整条管线里不是「锦上添花的后处理」,而是把不可用的原始输出变成可用画面的必要一环。
七、时域稳定性 vs 空间质量的权衡
7.1 根本权衡:lag vs blur
NVIDIA 在 GTC 2020 的 REBLUR 演讲中用一句话总结了时域降噪的核心权衡:
"Denoising is a tradeoff between temporal lag and blurriness." —— 降噪就是滞后和模糊之间的权衡。
这个权衡的两端是:
- 多累积(小 α)→ 时间稳定 + 收敛快 → 但滞后严重 + 容易鬼影
- 少累积(大 α) → 响应快 + 无鬼影 → 但噪声大 + 闪烁
没有完美的 α 值。说白了,最佳选择取决于场景类型、运动速度和画质目标。因此工业降噪器都不用固定 α——SVGF 用方差驱动,REBLUR 用递归模糊,TSR 用 parallax heuristics。自适应是唯一出路。
7.2 参数调优空间
时域降噪的可调参数主要集中在三个维度:
α(混合因子) - 静态场景:α = 0.05-0.1(多累积,利用时间提升采样) - 动态场景:α = 0.1-0.2(适度累积,平衡稳定性和响应) - 极端动态:α = 0.3-0.5(少累积,快速响应)
注意这些范围是"等效固定 α"的参考值。实际降噪器用的是自适应 α,这些范围只是帮助理解不同场景下的 α 倾向。
Disocclusion 阈值 - 深度阈值:通常 0.5%-5% 的相对深度差(场景相关,需要调)。室内场景用较小阈值(1%),因为遮挡变化幅度小;室外场景用较大阈值(3-5%),因为远距离深度精度低。 - 法线阈值:dot product > 0.8-0.95(越严格越不容易漏检,但越多误判)。通常 0.9 是一个合理的起点。
History reset 策略 - 硬 reset:history length 归零,α = 1。最激进,噪声跳变最大。 - 软 reset:history length 减半,α 临时提高。折中方案。 - 不 reset + 颜色裁剪:保留历史但限制颜色范围。最保守,可能残留鬼影。
7.3 不同场景的推荐配置
先用一组对照说明一件事:降噪的难度和场景里间接光的比重直接相关。同一个 Cornell Box,在「全组件 GI」「仅直接光 + 阴影」「关闭全局光照」三种设置下,需要降噪的像素比例完全不同。
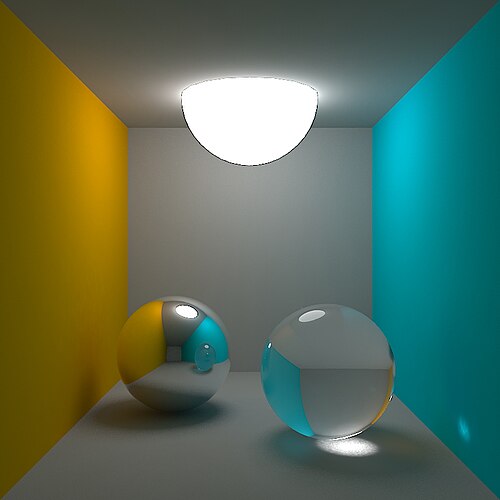
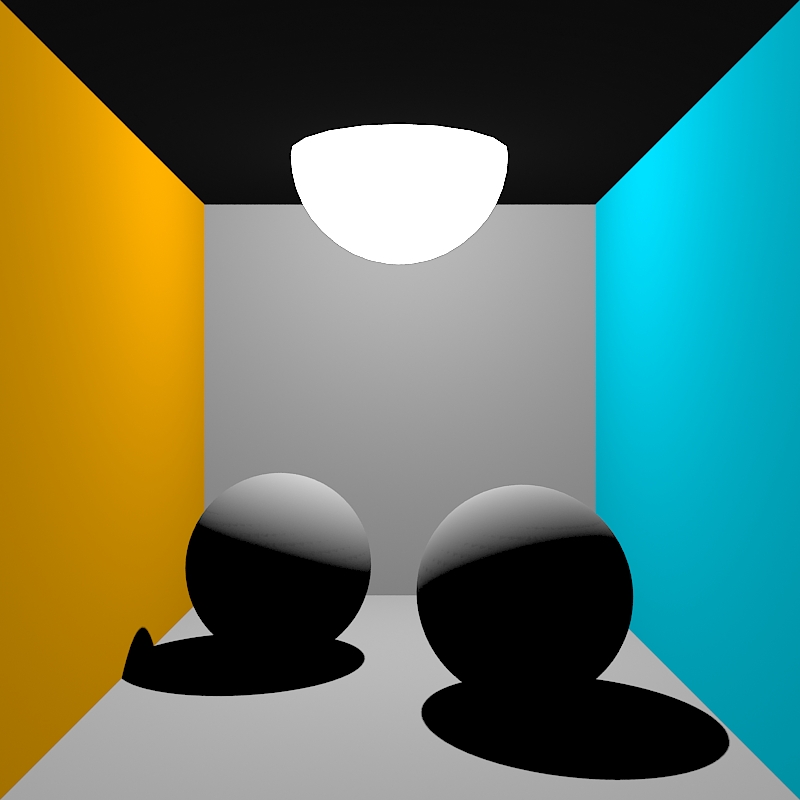
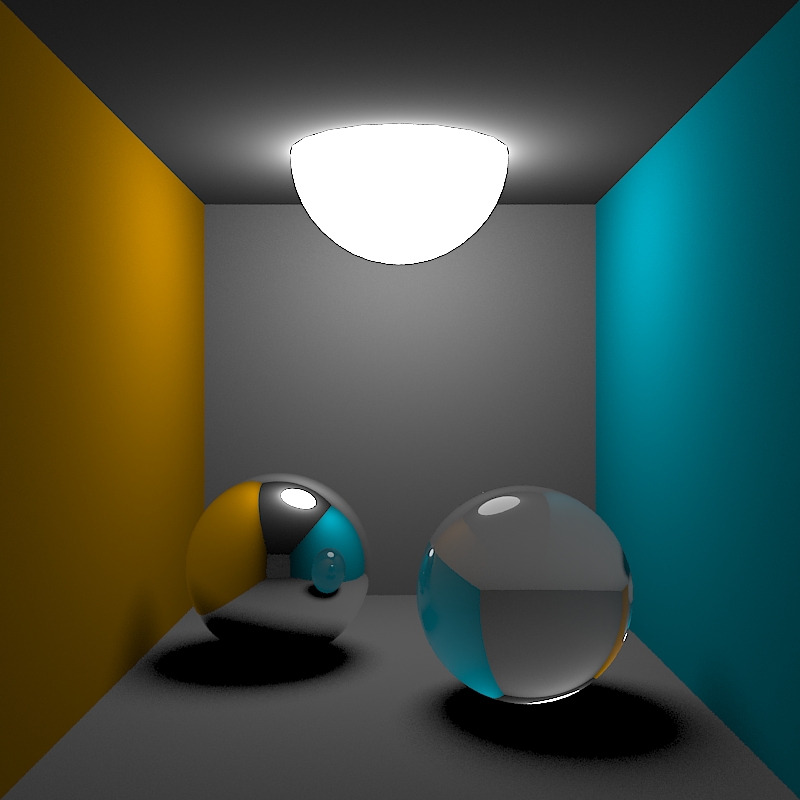
三张图之间的差别都来自间接光:全组件 GI 里墙面之间的颜色渗透、天花板下方的柔和过渡,在另外两张里都不存在。而间接光恰恰是路径追踪里方差最大、最依赖时域降噪的那一部分。
| 场景类型 | α 范围 | 累积帧数 | 空间滤波 | 特殊处理 |
|---|---|---|---|---|
| 静态室内 | 0.05-0.1 | 20-32 | 弱(保留细节) | 无需特殊处理 |
| 动态室外 | 0.1-0.2 | 10-15 | 中等 | 阴影单独降噪 |
| 快速运动 | 0.2-0.3 | 5-8 | 强(补时域不足) | TRMV 运动矢量 |
| 角色近景 | 0.15-0.25 | 8-12 | 中等 | 骨骼动画形变感知 |
| 远景 | 0.05-0.1 | 20+ | 弱 | 低分辨率累积 |
注意这些只是参考范围。实际项目中,α 和其他参数需要根据场景实测调优——不同引擎、不同降噪器的参数语义不完全一致。NRD REBLUR 的"累积帧数"和 SVGF 的"α"不是简单换算关系,因为 REBLUR 的递归模糊比简单 EMA 复杂得多。
一个实用的调优流程:先用较高 α(0.2-0.3)确认没有鬼影和严重噪声,然后逐步降低 α 直到出现可接受的伪影——那就是该场景的 α 下限。再根据动态程度选择比下限高 20-50% 的值作为日常配置。
7.4 实战调优清单
把前面讲的参数和策略整理成一份可操作的调优清单。在项目里调试降噪器时,按这个顺序排查比盲调参数高效得多。
第一步:验证运动矢量
运动矢量是时域复用的命门。在调任何降噪参数之前,先确认运动矢量是否正确。方法是把运动矢量可视化——用 RG 通道分别编码 XY 分量,把矢量长度映射到亮度。静态场景下,静止物体的运动矢量应该为黑色(零矢量);只有移动物体和相机移动导致的区域应该有颜色。如果静止区域出现非零矢量,说明 jitter 没有正确扣除或运动矢量计算有误。
第二步:验证 disocclusion 检测
把 disocclusion mask 可视化——被标记为 disocclusion 的像素显示为红色。移动物体经过背景时,物体边缘后方应该出现红色条纹(新暴露的背景)。如果红色区域过大,说明阈值太严(太多像素被误判);如果红色区域过小或没有,说明阈值太松(漏检会导致鬼影)。
第三步:确认基础参数
确认 深度缓冲 位数(32 位浮点)、运动矢量缓冲精度(FP16)、jitter 周期(一般 8 帧或 16 帧 Halton 序列)。这些基础设置不对,调 α 怎么调都救不回来。
第四步:按伪影类型调参数
参照 5.5 节的失效模式总览表,先看伪影类型再调对应参数。鬼影→检查运动矢量和 disocclusion 检测;滞后→降低累积帧数或提高 α;闪烁→加强空间滤波;模糊→降低 α 或减少滤波级数。
第五步:场景遍历测试
在不同场景类型下测试:静态室内、动态室外、快速运动、角色近景、远景。每种场景的最佳参数可能不同——考虑是否需要做 per-scene 或 per-region 的参数自适应。
这份清单不能替代实际调试中的反复试错,但能给一个系统化的排查方向。记住一个原则:先排基础(运动矢量、深度精度),再调策略(disocclusion 阈值、颜色裁剪),最后调数值(α、滤波强度)。反过来调的话,就是在错误的基础上优化,怎么调都不对。
7.5 调试案例:三种典型伪影的排查实录
清单给了步骤,但实际项目里的伪影不会按教科书分类出现。下面三个案例都是混合渲染管线调试中真实遇到的场景,记录排查过程供参考。
案例一:角色走过后墙壁上的彩色拖尾
现象:第三人称场景中,角色快速跑过一面浅色墙壁后,墙面上留下一抹淡蓝色的残影,持续约 0.5 秒后消失。静止观察时完全不可见,只在运动中闪现。
排查过程:第一步看运动矢量可视化——角色和墙壁都正确,排除运动矢量错误。第二步看 disocclusion mask——角色遮挡区域后方有红色条纹,但条纹宽度只有 2-3 像素,而残影宽度约 10 像素。这说明 disocclusion 检测只覆盖了紧贴角色边缘的区域,但残影来自更深层的颜色泄露。根因是颜色裁剪的 AABB 比较窗口太小——窗口只取 3×3 邻域,在角色边缘处历史颜色和当前颜色差异较大,AABB 未能有效约束。把裁剪窗口从 3×3 扩大到 5×5 后残影消失。代价是边缘略有模糊,但比残影可接受。
这个案例的教训是:disocclusion 检测管的是"该不该用历史",颜色裁剪管的是"历史能偏多远"。两者解决的问题不同,不能只调一个。
案例二:暗角处的高频闪烁
现象:室内场景的墙角和天花板交界处,在相机静止时出现持续的微小闪烁,像水在沸腾。闪烁只在暗部区域可见,亮部完全稳定。
排查过程:这种情况典型的原因是方差估计不足导致空间滤波强度不够。SVGF 的方差估计依赖局部邻域的统计量,暗部区域的像素值本身很小,信噪比极低,方差估计的相对误差大。检查发现方差缓冲精度用的是 FP16,在暗部(像素值 < 0.01)时精度不够。解决方案不是直接提高缓冲精度(那会翻倍内存),而是在方差估计前加一个亮度感知的权重——暗部区域用更大的邻域(7×7 替代默认的 5×5)来稳定统计量。改完后闪烁消失,帧时间增加约 0.3ms。
这个案例说明:暗部是时域降噪的盲区。噪声在亮部是相对误差,在暗部是绝对误差——同一个 α 值在亮部和暗部的效果天差地别。
案例三:反射表面的时域错位
现象:地板反射中,移动物体的倒影和本体之间有一帧的延迟,导致反射"跟不上"本体。快速移动时反射看起来在拖拽。
排查过程:这是运动矢量未覆盖反射通道的典型表现。管线里反射是单独一路光追算的,但运动矢量只算了主视图的 G-buffer 通道。反射视图的运动矢量缺失,导致重投影时直接用了主视图的运动矢量——这个矢量描述的是屏幕空间运动,不是反射空间运动。解决方案是参照 TRMV 方法为反射通道单独计算运动矢量,或者在反射区域降低时域累积权重(把 α 从 0.1 提高到 0.3),用空间滤波补偿。前者更正确但实现复杂,后者更简单但反射会更模糊。
这个案例的教训是:任何不经过主 G-buffer 的渲染通道都是时域复用的危险区——反射、折射、透明、体积雾,都可能有这个问题。在管线设计阶段就要为这些通道规划运动矢量的来源,否则到调试阶段再补会非常痛苦。
三个案例放在一起,能看出些共同的东西。伪影的根因几乎都不在降噪器本身——运动矢量不准、缓冲精度不够、通道覆盖缺失,这些都是管线层面的问题,降噪器只是受害者。而修一个伪影往往要拿另一个维度去换:扩大裁剪窗口换来边缘模糊,加大邻域换来帧时间增加,降低累积权重换来反射模糊。不存在免费的修复,只存在你能接受的代价。还有一条更实用的:排查的第一步永远是把中间缓冲可视化——运动矢量、disocclusion mask、方差图、history length 图。肉眼看到的伪影是最终结果,中间缓冲才是病因所在。养成「先看缓冲再调参数」的习惯,比记住任何具体参数值都管用。
八、收束与交棒
8.1 三句话总结
第一句:时域复用是降噪的基石。 1 spp 的光追输出几乎全是噪声,空间滤波能去噪但会模糊。时域累积通过复用历史帧来提升有效采样数,在不增加光线的前提下把 1 spp 变成等效 10-30 spp。没有时域复用,实时光追的画面根本没法看。EMA 的数学很简单——一行公式——但它背后的运动矢量、disocclusion 检测、history 管理才是真正的工程难点。
第二句:运动矢量是时域复用的命门。 时域累积的前提是"上一帧的像素和当前帧的像素对应同一个场景点"。运动矢量算错了,历史就从错误的位置搬过来,后续所有处理都在错误的基础上做。阴影、反射、透明——这些场景的运动矢量特别难算对,也是鬼影的高发区。TRMV 方法是针对这些困难场景的专门解法,值得深入研究。
第三句:失效模式是调试指南。 鬼影、滞后、闪烁、模糊、消隐伪影、动画伪影——六种失效模式各有各的根因和对策。在项目里调试降噪器时,先看伪影类型,再追根因,最后调参数。别一上来就盲调 α——先确认运动矢量是否可靠、disocclusion 检测是否有效、颜色裁剪是否在工作。
8.2 交棒:降噪(下)
ep06 讲了时域复用的原理和失效模式——EMA 数学、运动矢量、disocclusion、鬼影、其他五种失效模式、工业降噪器的应对策略、时域稳定性和空间质量的权衡。三个调试案例展示了这些理论在实际项目里怎么用:运动矢量可视化是排查起点,颜色裁剪和 disocclusion 各管各的事,暗部和反射通道是高危区域。
但降噪还有另一半没讲——空间滤波和神经降噪。SVGF 的 A-Trous 小波滤波器怎么在保持边缘的同时去除噪声?从 SVGF 到 A-SVGF 的自适应迭代做了什么改进?DLSS Ray Reconstruction 用神经网络替换传统降噪器,效果和代价各是什么?NRD 的 REBLUR 和 RELAX 有什么本质区别?时域和空间怎么协同——时域先还是空间先,为什么大多数管线选时域在前?这些问题,ep07 来回答。好了,本篇到此收束。
参考与引用
| 类型 | 资料 | 用途 |
|---|---|---|
| 论文 | SVGF (Schied et al., HPG 2017) | 时域累积+方差估计+A-Trous 滤波奠基论文 |
| 论文 | ATAA (Marrs et al., HPG 2018) | TAA 自适应超采样改进 |
| 论文 | TRMV (Zeng et al., EG 2021) | 阴影/反射/遮挡场景的可靠运动矢量 |
| 论文 | A-SVGF (Frey et al.) | 自适应滤波器迭代次数 |
| 论文 | JCGT 2025 SVGF 优化 | A-Trous GPU 架构优化 1.3-2.5× |
| 综述 | TAA Survey (Yang et al., EG 2020) | TAA 原理与伪影全景 |
| 白皮书 | NVIDIA NRD GitHub | REBLUR/SIGMA/RELAX 工业降噪器 |
| 演讲 | NVIDIA GTC 2020 REBLUR | 自稳定递归模糊原理与性能数据 |
| 文档 | Vulkan Ray Tracing Optimization | Reprojection 失败场景说明 |
| 文档 | AMD FidelityFX Denoiser | Disocclusion mask 生成流程 |
| 文档 | UE5 TSR | Parallax Heuristics, History Resurrection |
| 文档 | UE5 TSR FAQ | 时域超分常见问题 |
| 文档 | Intel XeSS | 内部 history texture 机制 |
| 文档 | AMD FSR Ray Regeneration | ML 去噪器内存工作集数据 |
| 演讲 | AMD GDC 2023 Temporal Upscaling | 深度不连续检测、颜色矩形修正 |
| 演讲 | AMD GDC 2024 FSR 3 | 上采样与帧生成解耦 |
| 社区 | UE5 Lumen ghosting 讨论 | 实际 ghosting 案例与修复 |
延伸阅读与参考资源
以下资源按主题分类,供读者深入扩展阅读。
基础数学与信号处理
- 指数移动平均(EMA)— Wikipedia:EMA 的数学定义、衰减特性与频域解释
- 低通滤波器 — Wikipedia:EMA 作为一阶低通滤波器的频域分析
- 方差 — Wikipedia:路径追踪噪声方差的数学定义
- 信噪比 — Wikipedia:采样数与信噪比的关系
- 阶跃响应 — Wikipedia:EMA 对阶跃信号的响应特性
- 指数衰减 — Wikipedia:历史权重的指数衰减机制
- 混叠 — Wikipedia:时域锯齿与采样定理
- 采样(信号处理)— Wikipedia:采样定理与 Nyquist 频率
- Nyquist 频率 — Wikipedia:采样定理的关键概念
- 小波 — Wikipedia:A-Trous 小波滤波器的数学基础
- 双边滤波 — Wikipedia:边缘保持滤波原理
- 高斯模糊 — Wikipedia:高斯滤波与噪声压制
- 中值滤波 — Wikipedia:非线性滤波去噪方法
- 冲激响应 — Wikipedia:线性时不变系统特性
- 傅里叶变换 — Wikipedia:频域分析基础
- 图像噪声 — Wikipedia:图像噪声分类与模型
- 信号处理 — Wikipedia:信号处理基础
核心论文与研究
- NVIDIA Real-Time Ray Tracing Research:NVIDIA 实时光追研究实验室,包含 SVGF、NRD 等全部论文
- UCSB Lingqi Yan Publications:TRMV 作者的研究主页,含多篇光追降噪论文
- KIT Computer Graphics Group:A-SVGF 作者的研究组,含自适应滤波论文
- HPG (High Performance Graphics):高性能图形学会议,SVGF/ATAA 的发表会议
- Eurographics Digital Library:欧洲图形学会议论文库
- SIGGRAPH:计算机图形学顶会
- Physically Based Rendering: From Theory to Implementation:PBRT 书在线版,路径追踪的数学基础
- Real-Time Rendering Book:实时渲染圣经,含 TAA 与降噪章节
工业实现与开源项目
- NVIDIA Falcor (GitHub):NVIDIA 渲染框架,含 SVGF/NRD 集成示例
- NVIDIA OptiX:NVIDIA 光追引擎,包含去噪 API
- AMD FidelityFX SDK (GitHub):AMD FSR/Denoiser 完整源码
- AMD FSR:AMD FidelityFX Super Resolution 官方页面
- AMD FSR 3:FSR 3 帧生成与上采样
- AMD FidelityFX SDK:AMD 渲染技术 SDK 全集
- pbrt-v4 (GitHub):PBRT 第四版源码,含路径追踪参考实现
- Blender Cycles Renderer:开源路径追踪渲染器
- Pixar RenderMan:电影级路径追踪渲染器
引擎文档与规范
- UE5 Lumen GI:UE5 Lumen 全局光照文档
- DirectX Raytracing Spec:DXR 官方规范
- Vulkan Ray Tracing Pipeline Extension:Vulkan 光追管线扩展规范
- Khronos Group:Vulkan/OpenGL 标准
- Vulkan Tutorial:Vulkan 入门教程
- NVIDIA DLSS:DLSS Ray Reconstruction 官方页面
- NVIDIA GTC On-Demand:GTC 演讲视频库
- AMD GPUOpen:AMD GPU 开发者资源
- AMD RDNA Architecture:AMD GPU 架构白皮书
- NVIDIA Ada Architecture:NVIDIA Ada GPU 架构白皮书
- NVIDIA Reflex:低延迟渲染技术
教程与学习资源
- Scratchapixel:从零开始的计算机图形学教程
- Ray Tracing in One Weekend:Peter Shirley 的光追入门书
- LearnOpenGL:OpenGL 实时渲染教程
相关概念百科
- 路径追踪 — Wikipedia:路径追踪原理与蒙特卡洛积分
- Cornell Box — Wikipedia:经典渲染测试场景
- 蒙特卡洛积分 — Wikipedia:随机采样积分方法
- 运动补偿 — Wikipedia:视频编码中的运动矢量概念
- Z 缓冲 — Wikipedia:深度缓冲原理
- 延迟着色 — Wikipedia:延迟渲染与 G-buffer
- 时域抗锯齿 — Wikipedia:TAA 原理概述
- 抗锯齿 — Wikipedia:抗锯齿技术全景
- 超采样 — Wikipedia:超采样抗锯齿方法
- 镜面反射 — Wikipedia:镜面反射光学原理
- 阴影映射 — Wikipedia:阴影映射算法
- 光追(图形学)— Wikipedia:光线追踪算法概述
- 渲染方程 — Wikipedia:全局光照的数学基础
- 全局光照 — Wikipedia:GI 技术全景
- 半精度浮点数 — Wikipedia:FP16 格式与精度
- Mipmap — Wikipedia:多级渐远纹理
- 骨骼动画 — Wikipedia:骨骼动画与蒙皮
- 包围体层次 — Wikipedia:BVH 加速结构
- 光栅化 — Wikipedia:光栅化原理
- 帧率 — Wikipedia:帧率与流畅度
- 色彩空间 — Wikipedia:色彩空间与转换
- 色彩深度 — Wikipedia:色彩位数与精度
- 纹理过滤 — Wikipedia:纹理采样与过滤
- 法线贴图 — Wikipedia:法线贴图原理
- 边缘检测 — Wikipedia:边缘检测算法
- 计算机图形学 — Wikipedia:计算机图形学概述
- 渲染(计算机图形学)— Wikipedia:渲染技术全景
- 数字图像处理 — Wikipedia:数字图像处理基础
- 图形管线 — Wikipedia:图形渲染管线
- 视锥体 — Wikipedia:视锥体与裁剪
- 3D 投影 — Wikipedia:3D 投影变换
本篇作者:溯光 本系列(实时光线追踪与混合渲染,共 12 篇):分界线 → 加速结构工程账(上)→ 加速结构工程账(下)→ SBT → 混合管线编排 → 降噪(上)→ 降噪(下)→ ReSTIR → 光线预算表 → RT 资源生命周期 → 透明与体积 → 反射与阴影混合 → 跨平台差异 前置专题:《实时渲染管线探析》5 篇 · 《移动端图形与功耗》7 篇 · 《GPU 架构剖析》12 篇
相关链接 - 上一篇:【实时光线追踪与混合渲染】(五) 混合管线编排:光栅化与光追的接力赛 - 下一篇(预告):【实时光线追踪与混合渲染】(七) 降噪(下):从 SVGF 到神经降噪的取舍 - 参考资源:SVGF 论文 NVIDIA Research · NRD GitHub · UE5 TSR 文档
With Best Wishes.