核心问题:上一篇(ep07)把降噪讲到了"参数怎么定"这一层,但降噪链上有一个前提被我们一直当成既定事实——它只能修,不能造。一个像素在一帧里只发了 1 到 2 条阴影光线,降噪器再怎么聪明,也只能把这寥寥几个样本修得好看些;如果这几个样本本身就挑错了地方(比如把光线花在了一个远处看不见的灯上),任何后处理都救不回来。
所以信噪比的上限在采样这一侧就已经定下了:不是发了多少条光线,而是发在哪。ReSTIR(reservoir-based spatiotemporal importance resampling,基于蓄水池的时空重要性重采样)的全部本事,就是把"挑哪条光线"这件事,从"每个像素各自为战"变成"像素之间互相帮忙",从而让一条光线干出几百条光线的活。
这一篇来回答——重采样为什么能用便宜的分布逼近好分布、蓄水池为什么必须"可合并"、时域与空间复用各自在解决什么、复用引入的偏到底从哪来、路径复用为什么要乘一个雅可比行列式、这套东西在生产里要花多少内存与带宽、以及 2025 到 2026 年人们还在修它的哪些边界。十件事合起来,才算把"采样侧"这本账翻完。
本篇承接 ep07 的交棒,只讲采样与重采样;降噪器内部机制(SVGF/A-SVGF/NRD/TSR/DLSS 光线重建)已在 ep06 与 ep07 讲透,本篇只在"与降噪侧怎么分工"的地方引用结论,不再展开。本篇也不涉及:体积渲染的 ReSTIR(体积的时空重采样有独立的一套数学)、逆渲染与可微渲染中的 ReSTIR、神经采样与神经可见性缓存的具体建模、离线渲染里多重重要性采样(multiple importance sampling, MIS)与重要性采样的系统推导(只讲 ReSTIR 用到的那部分)、以及具体引擎的编辑器操作与蓝图配置。这么切是因为前四类问题的约束条件与实时渲染完全不同——体积与逆渲染各有自己的定义域,神经方法关心的是模型训练与泛化,离线渲染不关心 16 ms 的预算,硬凑在一起只会把"预算下怎么挑样本"讲糊。
本系列(实时光线追踪与混合渲染,共 12 篇)的前置阅读:第一篇《分界线》给出了三类效果判据与三条成本模型;第二、三篇《加速结构工程账》上下给出了构建/更新/压缩与动态场景的账;第四篇《命中着色器与 SBT》讲了找到三角形之后该调用哪段着色器;第五篇《混合管线编排》讲了光栅化与光追怎么接力、性能预算怎么分;第六篇《降噪(上)》给出了时域复用的数学、运动矢量与重投影、六类失效模式;第七篇《降噪(下)》讲了空间滤波、方差驱动与学习型重建。其余前置专题为算法层《实时渲染管线探析》5 篇、约束层《移动端图形与功耗》7 篇、硬件实现层《GPU 架构剖析》12 篇。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
点题:不是发更多光线,而是让每条光线更值钱
0.0 内容总览:本篇知识地图
先把十章各自回答的问题钉在一张表上,后面每一章都在展开其中的某一行。大家可以从这张表里找到自己最关心的那一行,再跳到对应章节去看;如果时间紧,第四章(偏从哪来)与第七章(工程账)是两处最容易被略过、也最容易在项目里吃亏的地方,建议至少读到那两章。
| 章 | 回答的问题 | 关键结论 |
|---|---|---|
| 零 | 为什么"挑对光线"比"多发光线"更重要 | 一个像素能分辨的独立阴影只有几条,但积分要对全部光源成立 |
| 一 | 重采样(RIS)凭什么用便宜的分布逼近好分布 | 源分布只要"好采且处处非零",质量由后续重采样放大 |
| 二 | 蓄水池(WRS)为什么必须是常数内存且可合并 | "可合并"是复用成立的前提,否则复用比重新采样还贵 |
| 三 | 时域与空间复用各自在解决什么 | 时域解决帧间稳定,空间解决帧内相关;两者用同一套权重 |
| 四 | 复用引入的偏从哪来、代价是什么 | 随机数共享、支持集不匹配、条件概率是三条主要来源 |
| 五 | 复用的对象怎么从"光源"变成"路径" | 偏移映射改变积分变量的测度,必须乘雅可比行列式 |
| 六 | 把复用推到整条路径要付什么代价 | 成对 MIS 压方差,但空间 pass 仍有偏(官方文档自认) |
| 七 | 这套东西在生产里花多少内存与带宽 | 每像素一份蓄水池不大,多轮复用的中间缓冲与访存才是成本 |
| 八 | 三款作品分别把它用到了哪一层 | Cyberpunk 2077 用在 GI,Portal RTX 用在重制,Lumen 用在 Gather |
| 九 | 2025–2026 还在修什么 | 运动下的回投影失效、disocclusion、LOD 与邻居选择 |
| 十 | 本篇不涉及什么、下一步去哪 | 交棒给"光线预算怎么分" |
0.1 从 ep07 的交棒说起:降噪的上限由采样决定
言归正传,ep07 的结论里有一句是全篇的落脚点:降噪是一个"质量放大器",它放大的是上游已经存在的信息。如果上游一个像素只采到一条阴影光线,而降噪器要用 30 个邻居去平均它,那它平均的其实是"一个样本在 30 个像素上的不同投影",而不是"30 个独立样本"。这两者在数学上完全不同:前者的误差是相关的,平均不会让它抵消。
SIGGRAPH 2023《A Gentle Introduction to ReSTIR》课程笔记
官方课程笔记把这件事说得很直白:后处理降噪器通常完全忽略"支持集"(support)的问题,这正是它们常常掉能量(以及引入其他偏)的原因。而重采样算法能在信息被丢掉之前就介入——它拿到的是概率、分布与样本,不只是颜色加点 G-buffer 引导。这是 ReSTIR 这条路线最根本的立足点。
到这里,问题就从"怎么把噪声修掉"变成了"怎么让每个样本更值钱"。这两种思路的差别,可以先用一张分层图摆清楚。
上面这张图想说明的其实是时间顺序:复用站在降噪的上游。同一个像素,先由采样侧决定"追哪条光线",再由降噪侧决定"这个结果和邻居怎么平均"。顺序颠倒过来(先降噪再挑样本)在工程上做不到,因为降噪之后就只剩颜色了。
0.2 现实约束:万千小光源与"只看得见几条阴影"
先来看看现实里的规模。要让这件事的必要性变得具体,最好的入口是一张真实的照片。现实里的复杂光照场景——比如一片灯饰——看起来光源密到数不清,但任何一个像素上能分辨出的独立阴影只有寥寥几个;与此同时,光照积分(rendering equation,渲染方程)却要求对这个像素可见的全部光源成立。
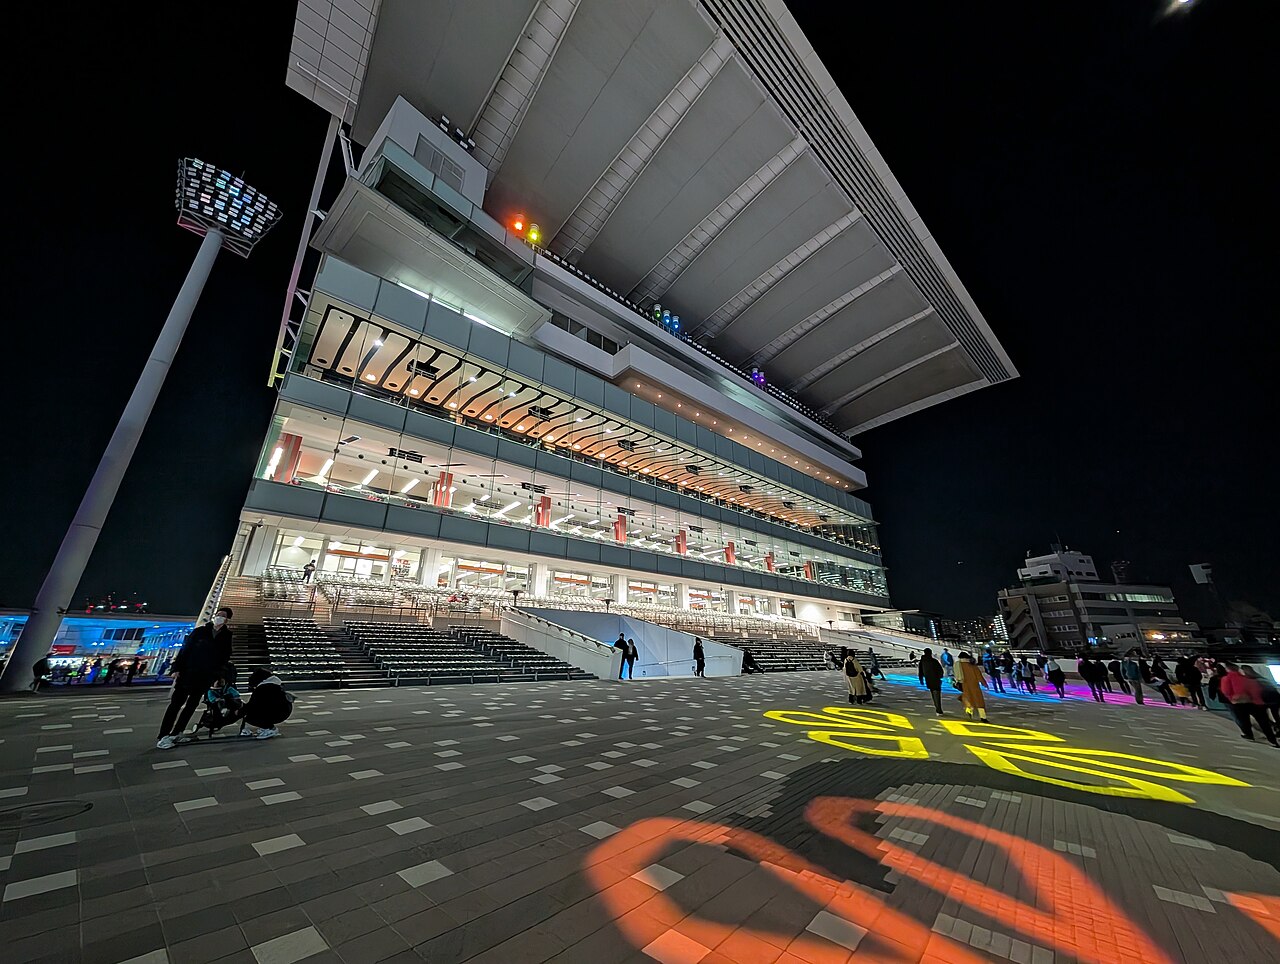
这两个事实的落差就是全部机会:既然一个像素只需要几条光线,那问题就不是"怎么给上万个光源各算一遍",而是"怎么挑出最值得追的那几条"。传统做法是给每个光源建阴影图、再逐像素剔除,成本随光源数线性上升;而在光源数进入千级之后,这条路就没有余地了。一张间接光的成品对照,可以先让大家建立起"目标画质"的直觉——直接光与全局光打开之后,画面差别主要集中在暗部与接触处,而那正是采样数最吃紧的地方。
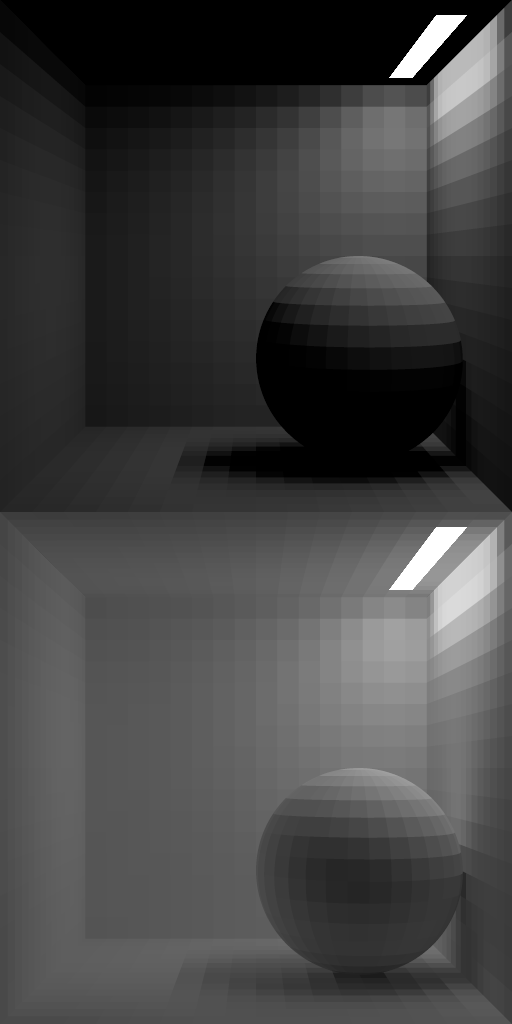
说白了,"只需要几条阴影"这个判断是感知层面的,不是数学层面的:全图各处都可能有重要的阴影,只是它们不在同一个像素上。这正是"哪个光源重要"会逐像素变化、因而无法用一个全局结构解决的原因——也是为什么这套方法最终走的是统计与概率,而不是空间数据结构。
0.3 边界声明与关键参数范围
按本系列的惯例,先把本篇的边界钉住:这篇文章只讨论实时渲染里直接光与(部分)间接光的样本复用;不讨论体积渲染、逆渲染、神经采样建模、离线渲染的 MIS 系统推导,也不重复降噪器内部。参数取值上,本篇涉及的量级大致落在:光源数从一到百万级、每像素每帧的初始候选数在个位数到 16 之间、蓄水池大小是常数、复用轮次在个位数。凡是引用到具体设备的绝对值(内存、带宽、耗时),都会同时给出分辨率与口径——本系列在 ep07 里已经吃过"混用口径"的亏,这里保持同样的纪律。
一、RIS:把"采样"换成"重采样"
1.1 为什么需要重采样
要从一个理想的目标分布 $p$ 里取样本,标准答案是重要性采样(importance sampling)。但理想分布常常不能直接采样:它可能是某个 BSDF 与光源项之积归一化后的形状,也可能只在解析上可写、采样却要解一个方程的逆。工程上的常见妥协是"用一个简单的近似分布去采",代价是样本质量下降、方差上升。
重采样重要性采样(resampled importance sampling, RIS)换了个角度:既然好分布难采,那就用便宜分布多采几个,再按分数筛。它由 Talbot 等人 2005 年提出,原本用于全局光照,长期没什么人用——直到 ReSTIR 把它变成了实时的主力工具。
Talbot 等 2005《Importance Resampling for Global Illumination》
这个"先多采几个再筛"的想法并不新鲜,真正值得注意的是它的代价结构:候选的生成很便宜(用简单分布),筛的成本几乎为零(只是几次乘加),而昂贵的操作(追一条光线)只在最后发生一次。把贵操作往后推,是 RIS 的全部工程价值。
1.2 RIS 的三步与估计量
RIS 的流程可以拆成三步,顺序不能换:
- 抽候选:从源分布 $p_{src}$ 里独立抽取 $N$ 个候选样本 $x_1 \dots x_N$;
- 打分:对每个候选计算权重 $\hat{w}(x_i) = \dfrac{\hat{p}(x_i)}{p_{src}(x_i)}$,其中 $\hat{p}$ 是未归一化的目标分布;
- 抽规范样本:按权重比例从 $N$ 个候选里抽出一个,称为规范样本(canonical sample),并给它一个无偏贡献权重:
$$\hat{w}_{ris} = \frac{1}{N}\sum_{i=1}^{N}\hat{w}(x_i) \times \frac{\hat{p}(x_{k})}{p_{src}(x_{k}) \cdot \hat{w}(x_k)}$$
这个式子里最需要看懂的是两部分的分工:前半段的求和是"这批候选整体有多好"的度量,后半段的比值是"被选中的那个样本自身有多好"。两者相乘,才构成了一个无偏的估计——单独用后半段(只算被选样本的权重)会引入偏,因为它忽略了"其他候选也参与了选择"这件事。这是后面所有复用能保持无偏的地基,也是复用出偏时最先被破坏的一环。
1.3 源分布的选择:只要好采,质量由重采样放大
说白了,一个很自然的疑问是:如果源分布质量差,重采样还能救回来吗?答案是能,但有条件。条件有两条:
- 处处非零:源分布在被积区域上不能为零——否则那个区域的样本永远抽不到,重采样也就无从筛起(这是"重要性采样支持集必须覆盖被积函数支持集"的老规矩);
- 便于采样且成本低:这正是选择它的唯一理由。
只要满足这两条,源分布的形状好坏并不重要——它只是候选的来源,最终的样本质量由打分环节决定。这个性质与 ep07 里"降噪器是质量放大器"的说法是同一件事的两种表述:便宜的输入 + 正确的加权 = 高质量的输出。
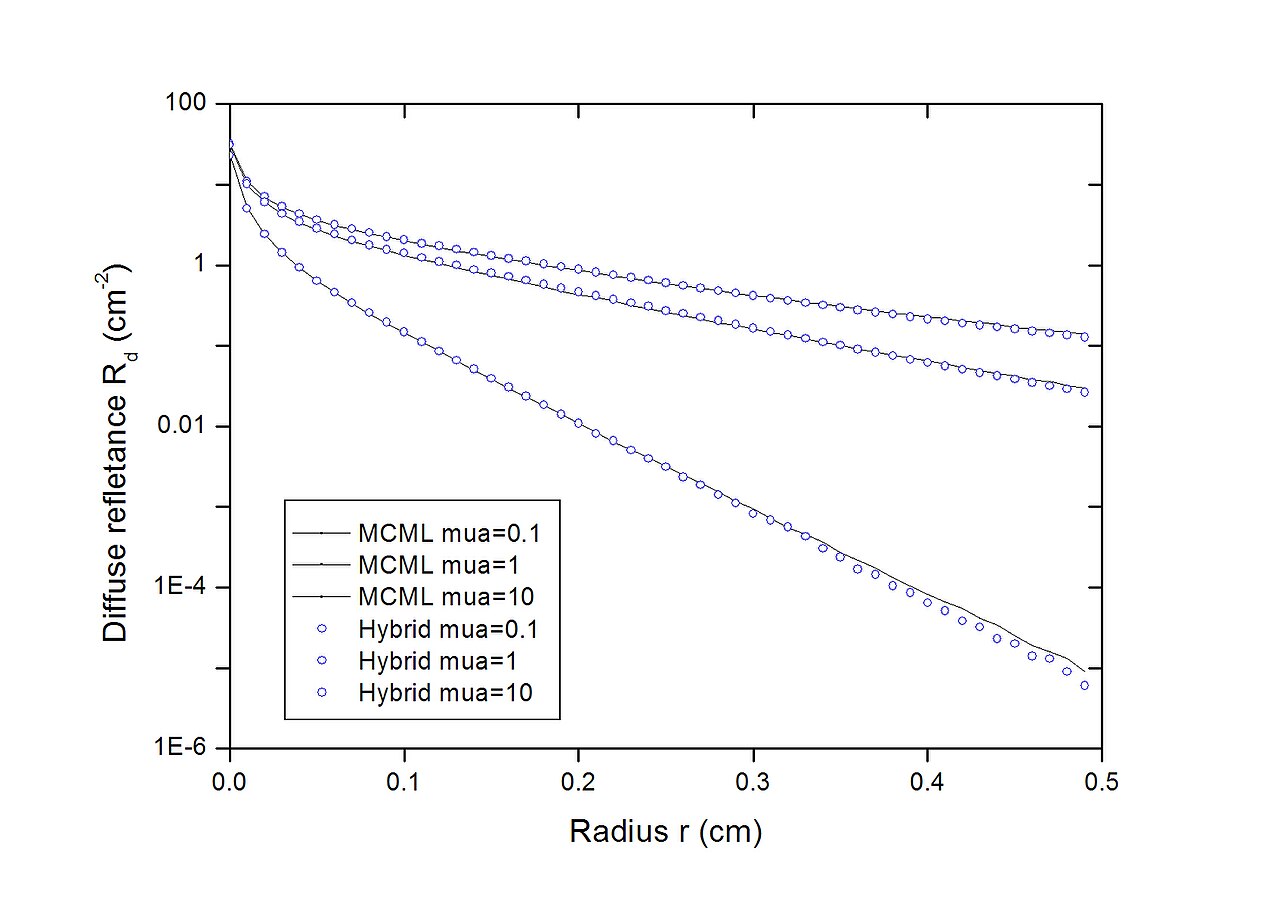
先放一张最朴素的蒙特卡洛估计与解析解的对照,让大家看看"估计质量差"到底长什么样——它不是偏色,而是误差随样本位置随机起伏。
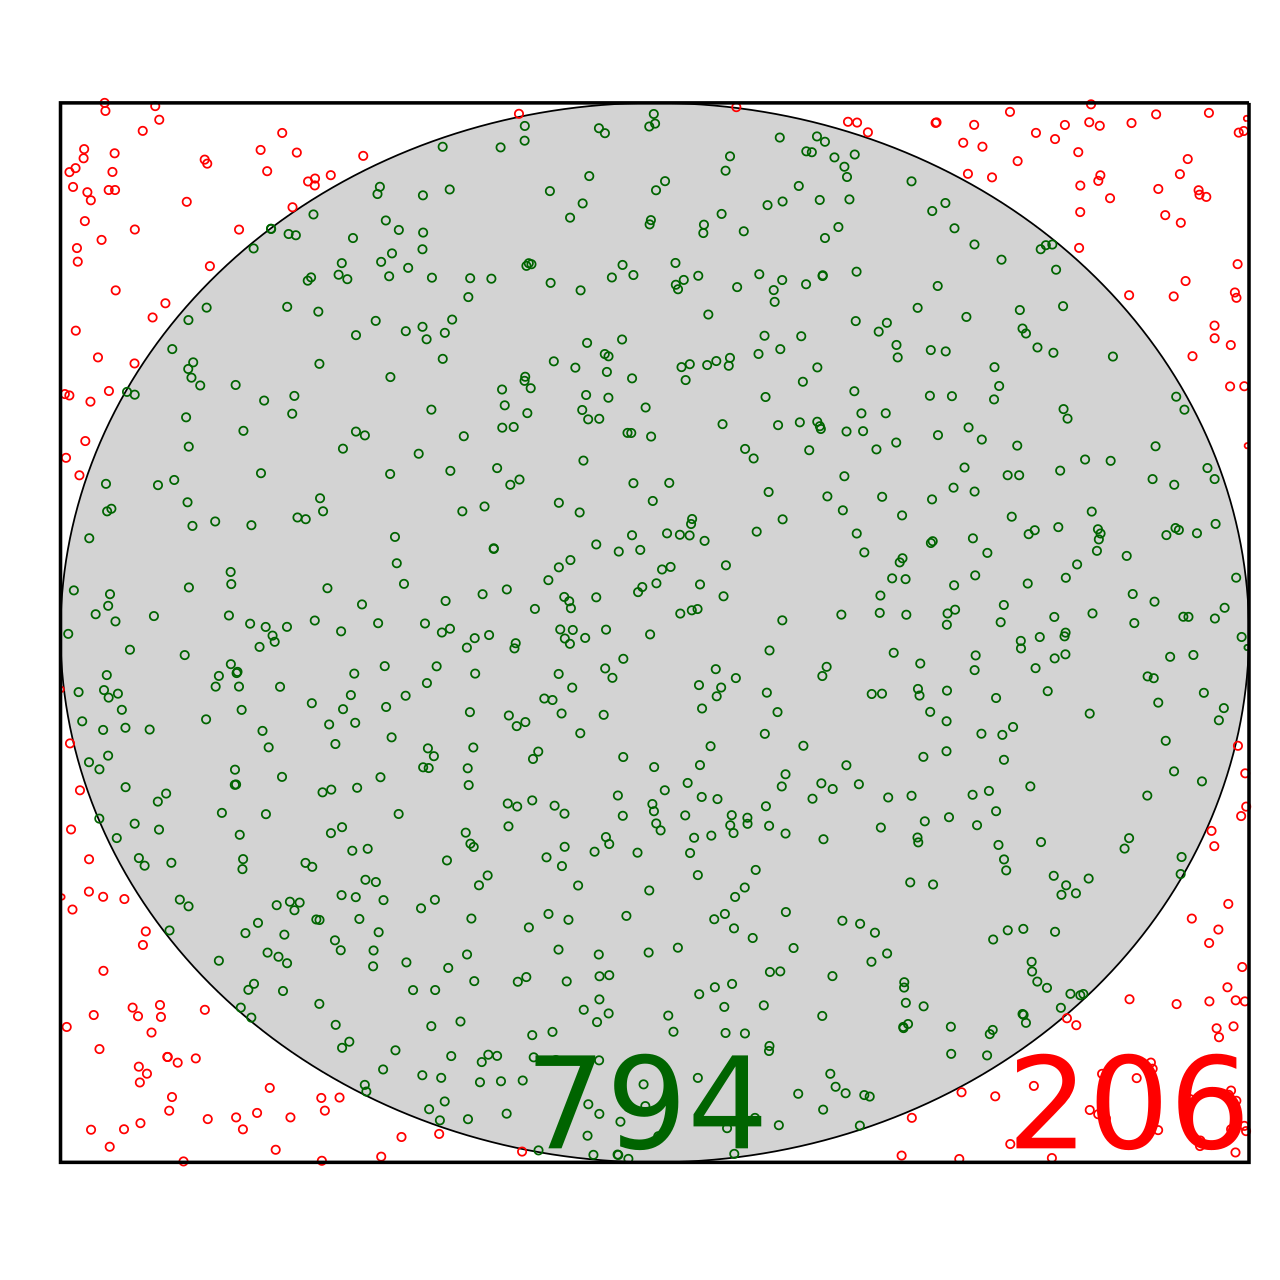
再用一张图把"积分"这件事的几何含义摆出来。蒙特卡洛积分的经典图示是用随机落点估计一块面积:落在区域内的比例乘以总面积。这张图之所以值得放在这里,是因为它同时说明了 RIS 在做什么——它不是在改进单次落点,而是在改进"落点从哪个分布里来"。
1.4 N 的作用与代价
下面我们进入这个旋钮的讨论。候选数 $N$ 是 RIS 里最直接的旋钮。$N$ 越大,选出来的样本越接近目标分布,方差下降;但同时候选的生成成本线性上升。在实时渲染里这个旋钮通常给得很小——因为候选生成本身就是采样,真正的成本在后面的光线追踪。
这里有个容易搞反的地方:RIS 的 $N$ 与"采了多少条光线"不是一回事。RIS 的 $N$ 个候选可以是不追光线就生成的(比如直接在光源集合里随机取点),只有当规范样本被选中之后才追一条阴影光线验证可见性。所以"$N = 8$"并不代表 8 条光线,而是8 次光源采样的代价 + 1 条光线。这个区分是后面"复用把一条光线放大成几百条"的前提。
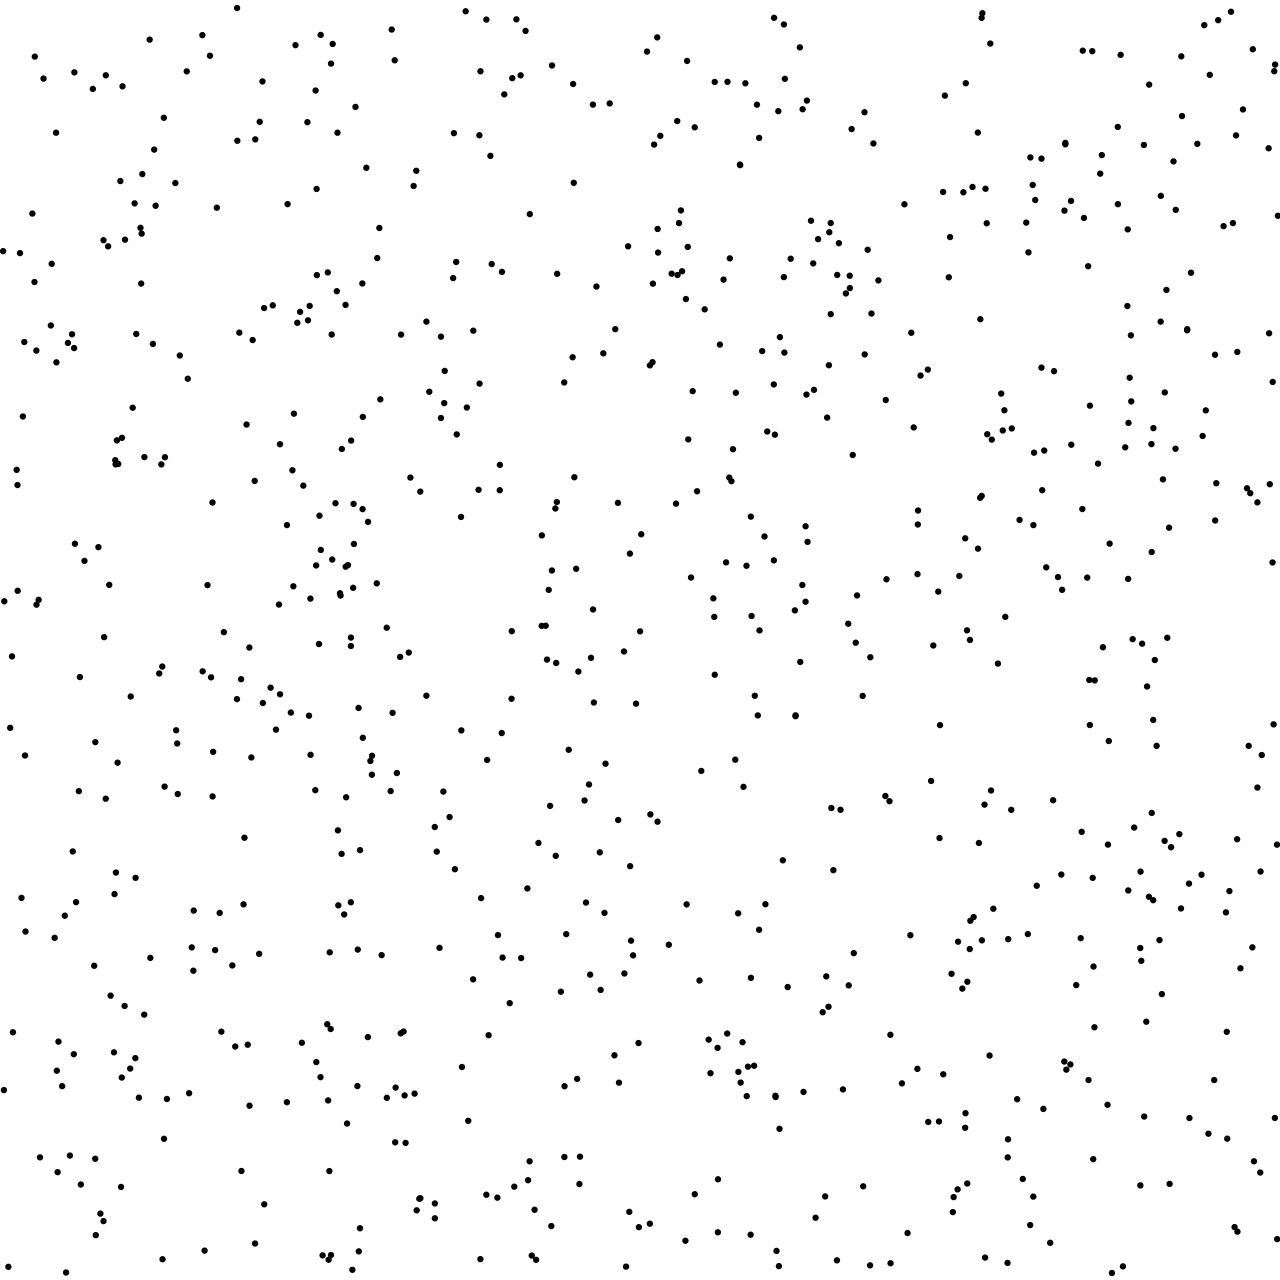
纯随机落点的一个固有缺陷值得单独看一次:随机分布必然出现成簇与空洞。这不是随机数质量的问题,而是随机性的定义——方差的来源正是在这里。
1.5 对照物:为什么不是马尔可夫链
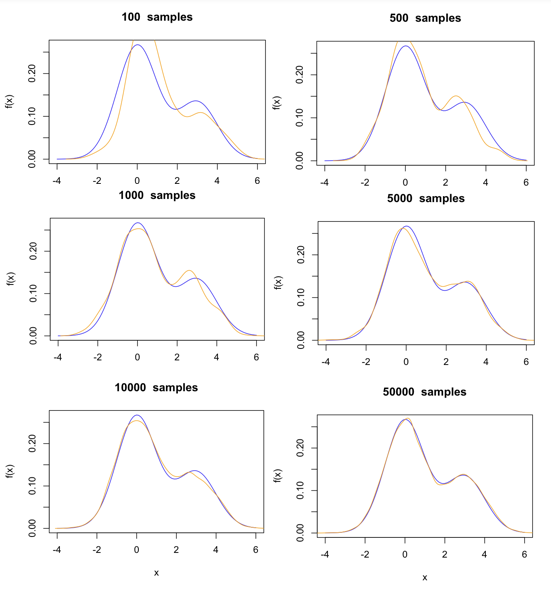
做过采样的同学可能会想到另一条成熟路线:马尔可夫链蒙特卡洛(Markov chain Monte Carlo, MCMC),比如 Metropolis-Hastings。它同样能在只能"评价"不能"采样"的分布上工作,而且收敛后样本质量很好。为什么实时渲染没有走这条路?
原因有两个,都在实时约束上:
- 顺序依赖:MCMC 的样本是链式的,后一个样本依赖前一个,这天然不适合 GPU 的宽并行;每条链都要顺序推进,与"每像素一个线程"的执行模型冲突;
- 预热成本:链需要预热(burn-in)才进入稳态,而预热的帧是没有用的——在一帧只有 16 ms 的预算里,这笔开销无法摊销。
放一张 MCMC 收敛过程的曲线在这里,作为对照而不是主角:它展示的是"链式采样需要时间才能进入稳态"这件事,正好解释了为什么实时侧选择了另一条"无状态、可并行、逐帧独立累加"的路线。
1.6 估计量长什么样:把权重写清楚
把 1.2 的公式展开成"实现里真正要存的东西",就是下面这个样子。这段不是可运行代码,而是伪代码级别的结构说明,目的是让大家看清"哪些量必须一路带着走"——后面的复用之所以要额外存辅助信息,根子就在这里。
【RIS 估计量 · 结构】
输入:目标分布 p̂(·)(未归一化)、源分布 p_src(·)(可采样)
      N:候选数
【1】候选生成
      for i in 1..N:
          x_i ~ p_src(·)
          w_hat_i = p̂(x_i) / p_src(x_i)        // 候选的权重
【2】累积(这一步的结果就是后面"蓄水池"里要存的和)
          W_sum = Σ w_hat_i
【3】按权重抽取规范样本 k(Pr[k=i] = w_hat_i / W_sum)
【4】无偏贡献权重
          w_ris = W_sum / N × p̂(x_k) / (p_src(x_k) · w_hat_k)
      估计值 = w_ris × f(x_k)                  // f 为该样本上被积函数的值
下面对这段里两个容易写错的点特别说明。
第一,【1】里的除数是源分布,不是目标分布。写成 p̂(x_i) / p̂(x_i) 就恒等于 1,整套重采样会退化成"均匀随机挑一个候选"——这是实现中最常见的一处笔误,而且它不会报错,只会让画质莫名地差。
第二,【4】的分母里有被选概率。w_hat_k 与 W_sum 的比值正是"这个候选被选中的概率",把它放进分母,是对"按分数抽取"这个随机步骤的补偿。凡是"先评分、再随机选"的流程,都要在估计量里显式补偿这一步——这条规则在后面讲复用出偏时会反复出现,因为复用本质上也是一次"先判定、再接受"的随机步骤。
把式子里四个量的来龙去脉画成一张关系图,可以省掉反复回看公式的麻烦:候选权重决定累积和,累积和与计数决定归一化,被选样本的目标/源之比决定最后一项。
1.7 RIS 在采样谱系里的位置
把 RIS 放进采样方法的谱系里看,它的位置会更清楚。采样方法大致可以按两个问题分类:能不能直接采(目标分布是否有闭式采样器)、有没有状态(样本之间是否独立)。
- 闭式采样 + 无状态:逆变换采样、拒绝采样。它们要求目标分布可解析、可求逆或可包络。优点是样本独立、无偏;缺点是遇到"BSDF × 光源"这类乘积分布就无能为力——那个分布通常既不可逆也不可包络。
- 无闭式 + 无状态:RIS。它不要求目标分布可采,只要求可以评价(能算未归一化的密度),再加上一个可采的源分布。样本之间仍保持独立,这是它比 MCMC 更适合并行的根本原因。
- 无闭式 + 有状态:MCMC、序列重要性采样。样本之间存在依赖链,换来的是"可以沿着难采分布慢慢游走"的能力。代价就是 1.5 里说的两条:顺序依赖与预热成本。
用一句话概括 RIS 的定位:它是"可评价但不可采"这一类分布上,唯一同时保住无状态与无偏的方案族。实时渲染选它不是因为它的方差最低(在候选数趋近无穷时它才趋近理想重要性采样),而是因为它把"贵操作的次数"压到了 1 次——这在 16 ms 的预算下才是决定性的。
顺带说清一个常见混淆:RIS 与"重要性采样"不是替代关系,而是嵌套关系。源分布本身就是一次重要性采样(用 $p_{src}$ 采),RIS 在它之上再做一次"按目标分布重新加权选择"。所以源分布选得好,RIS 的起点就高;源分布选得差,RIS 还能把它拉回来一些——但拉不回无限多,这也解释了为什么 §1.3 里要强调"处处非零"这条硬条件。
1.8 源码与规范外链
RIS 本身的实现很短,难的是在正确的地方用它。可查证的一手材料:
- Talbot 等 2005《Importance Resampling for Global Illumination》:http://justintalbot.com/publication/importance-resampling/
- SIGGRAPH 2023 课程笔记第 3 章(RIS 的完整推导,含 MIS 权重):https://intro-to-restir.cwyman.org/presentations/2023ReSTIR_Course_Notes.pdf
- 课程 RIS 单节幻灯片:https://intro-to-restir.cwyman.org/presentations/2023ReSTIR_Course_RIS.pdf
二、WRS:一个常数内存的"擂台"
2.1 从 N 个候选中按权重挑一个
RIS 的第三步要求"按权重比例从 $N$ 个候选里抽一个"。最直白的做法是把 $N$ 个候选全存下来、算总和、再抽一次——但这要求内存与 $N$ 成正比,而且要求候选全部到齐。在实时渲染里这两个要求都很麻烦:内存要在每像素的预算里再切一块,而"到齐"意味着没法流式处理。
加权蓄水池抽样(weighted reservoir sampling, WRS)解决的正是这个问题。它维护一个固定大小的蓄水池(reservoir),候选一个一个到来,每个候选按权重决定是否替换池中样本。流过全部 $N$ 个候选之后,池中的样本就等价于"按权重比例抽出的那一个"。
它的价值不只是省内存,而是把"抽取"从一次性操作变成了可增量、可中断、可合并的过程——这三条恰好是复用的前提。
2.2 蓄水池的数据布局
一个蓄水池实际要存什么,决定了后面所有的内存账。最小可用的字段如下:
【蓄水池 · 数据布局】
struct Reservoir {
    sample   y;        // 【1】选中的样本(直接光:光源上的一个点;路径复用:一条路径)
    float    w_sum;    // 【2】候选权重之和 Σ w_hat_i(用于计算 w_ris)
    float    w;        // 【3】当前样本的权重(可选,便于增量更新)
    uint     M;        // 【4】已流入的候选数(用于 1/M 的归一化)
    float    W;        // 【5】当前样本的无偏贡献权重(复用时要随着一起搬)
};
下面对其中两个字段特别说明。
【4】的计数 M 不是调试信息。它直接参与估计量的归一化(公式里的 $1/N$),而且复用的时候它要跟着合并——如果两个蓄水池合并后把 $M$ 简单相加,那相当于宣称"两批候选是独立采样的",这在跨像素复用时并不成立(邻居的候选来自另一个目标分布)。合并规则写错,是偏的第一大来源。
【5】的贡献权重 W 必须一路带着走。它是"这个样本相对于当前像素应该算多少"的唯一凭据;丢了它,复用得来的样本就只能当普通样本用,无偏性随之丢失。
2.3 可合并性:复用能成立的前提
WRS 最关键的性质是可合并:两个蓄水池 $R_a$、$R_b$ 可以按各自权重和的比例,合成一个与"把两批候选按顺序全流过一遍"等价的蓄水池。合并后的权重和是两者之和,计数也是两者之和,而样本按权重比例从两者中挑一个。
这条性质把"复用"的成本降到了常数:复用邻居的样本,不需要重新采样,只需要一次合并。可以这样理解——如果蓄水池不可合并,那么空间复用就等于"把邻居的候选再采一遍",成本立刻回到原点,整套算法也就没有意义了。"可合并"不是 WRS 的一个便利特性,它是 ReSTIR 能存在的前提。
合并的伪代码如下,注意权重和与计数的处理:
【蓄水池合并】
合并 R_a, R_b → R_new:
    W_sum_new = R_a.w_sum + R_b.w_sum
    M_new     = R_a.M + R_b.M                       // 【1】计数相加
    with probability R_a.w_sum / W_sum_new:
        R_new.y = R_a.y
    else:
        R_new.y = R_b.y
    R_new.w_sum = W_sum_new
    // 【2】贡献权重在新样本上重新计算(不能把两个 W 直接相加)
    R_new.W = W_sum_new / M_new × (p̂(y_new) / (p_src(y_new) · w_hat(y_new)))
下面对这段里一处反直觉的地方特别说明:【1】里计数相加是"形式上"的,而【2】里权重必须重算。很多人第一直觉是把两个蓄水池的贡献权重加起来,这是错的——权重是"相对某个目标分布"的量,合并后半数的样本只属于其中一个来源,把它对应的 $W$ 与另一个来源的 $W$ 相加,等于凭空把能量加了一倍。凡是合并,都要在新样本上重算,而不是把旧权重相加。
2.4 蓄水池给复用留的接口
下面我们进入复用的部分,先把第二章的结论压成一句话:蓄水池是一个"可增量、可中断、可合并"的加权抽取器。它把 RIS 的第三步变成了一个几乎免费的算子,于是"复用"这个动作在成本上变得可行。
到这里,RIS 与 WRS 两块地基就铺好了。接下来把它们装进一帧的流程里,就是 ReSTIR 的直接光版本。
三、ReSTIR DI:时空复用怎么把 1 条光线放大成几百条
3.1 一帧的四段
先看看这一帧里发生的四件事。一帧的直接光重采样可以拆成四段,顺序不能换:
- 初始采样:每个像素从光源集合里抽若干候选,写进自己的蓄水池。这一步便宜,因为候选生成不需要追光线;
- 时域复用:把上一帧的蓄水池重投影到当前帧,与本帧的蓄水池合并;
- 空间复用:与邻域像素的蓄水池合并,通常重复若干轮;
- 着色:用最终选出的样本追一条光线、验证可见性,并乘上贡献权重。
这四段里,只有第 4 段是"贵"的——追光线。前三段都是权重与计数的算术。所以"一条光线干出几百条光线的活"这句话的准确含义是:第 4 段仍然只追一条光线,但它追的那一条,是经过 2、3 两段从几百个候选里筛出来的。算力没有被省掉,被省掉的是试错。
官方博客对此的表述是"用便宜、易定义的采样分布做输入,让 RIS 与 ReSTIR 去放大质量"——放大的是候选的质量,不是光线的数量。这句话里的因果关系值得记住,因为后面所有的性能与画质取舍都从它推出来。
3.2 时域复用:重投影与 history length
时域复用的动作很直观:用运动矢量把上一帧的蓄水池重投影到当前像素位置,与本帧的蓄水池合并。它解决的问题是帧间稳定——同一个像素在时间轴上的样本可以互相累积,等效于把采样数乘上帧数。
真正需要工程判断的是 history length,也就是"这个蓄水池里积累了多少帧的信息"。它由合并时的计数 M 隐式表达:每合并一次,计数增加,历史越长。
- 历史越长越稳:样本多、方差低,静态画面很快收敛;
- 历史越长越钝:光照突变、物体运动、遮挡变化时,旧样本已经不代表当前的情况,继续给它权重就会拖出鬼影与残影。
这与 ep06 里讲的时域失效模式是同一类问题,区别在于:ep06 的时域滤波是对颜色做累积,而这里是对候选做累积。前者出错表现为颜色涂开,后者出错表现为"光线一直追向一个已经不重要的光源"——前者是图像问题,后者是采样问题,后者更难从画面上倒推原因。
3.3 空间复用:邻居选择与支持集
空间复用把邻居像素的蓄水池合并进来,解决的是帧内相关——一个像素挑不出好样本时,它的邻居可能刚好挑到了好的。这一段的难点全部集中在"邻居选择"上。
课程笔记里有一句话点得很准:有人问"你怎么保证邻居的样本对当前像素有意义",作者的回答是"非常、非常小心地"。原因在于目标分布是不同的:每个像素有自己的 BSDF、自己的可见集合、自己的几何法线。邻居的样本是相对邻居的目标分布挑出来的,搬到当前像素时,它在数学上属于另一个积分问题的解。
SIGGRAPH 2023《A Gentle Introduction to ReSTIR》课程笔记
于是空间复用必须做三件事:限制邻居范围(几何/法线/材质差异过大的邻居直接排除)、重新计算贡献权重(把样本放到当前像素的目标分布下重新评分)、以及对"复用与否"这一判定做概率补偿(否则引入条件概率)。第三件事最容易被漏掉,也最难自查——它不会报错,只会让结果慢慢偏向某个方向。
3.4 MIS 权重:为什么必须有
说白了,一个蓄水池里合并了多个来源的样本:本帧初始采样、上一帧的重投影、若干邻居。它们各自来自不同的分布,直接相加等于假设它们同分布,这是错的。多重重要性采样(MIS)的作用就是给每个来源一个与"它有多可能生成这个样本"相关的权重。
这正是"看起来显然的优化会引入不可控偏"的典型现场:如果为了省钱,把 MIS 权重简化成"按贡献权重硬拼",在多数帧上看不出问题——直到某个光源刚好在某个角度变得重要,画面才出现一块不该有的亮斑。这类 bug 的排查成本极高,因为它依赖特定的视角与光照组合才复现。
3.5 采样分布的三个旁证
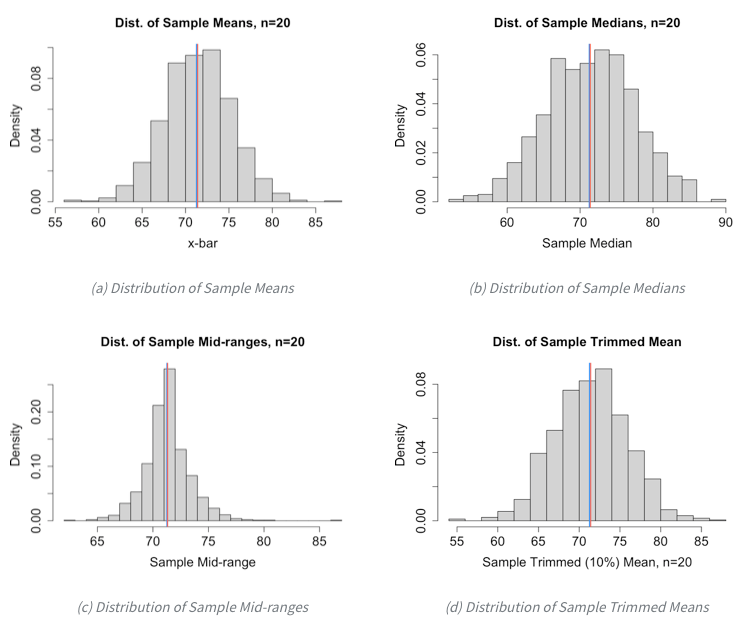
先看看样本分布质量的旁证。这一节放三张外部图,从统计与信号两个角度给"样本分布质量"提供旁证,帮大家建立"为什么值得为分布的形状花成本"的直觉。
第一张是估计量的抽样分布:同一批参数、不同的源分布,估计量的分布形状不同——分布越窄,同等样本数下的方差越小。这说明"用什么分布采"直接决定了估计的稳定性,而不是只影响均值。
第二张从频域看采样不足的后果。样本数不够时,高频信息并不是"变糊",而是折叠到低频上去(混叠)。这解释了为什么实时渲染里"少发一点采样、交给降噪"这种做法在结构化的高频内容(细栏杆、栅格、头发)上特别容易翻车:混叠是结构化的误差,而降噪器倾向于把它当成真实结构保留下来。
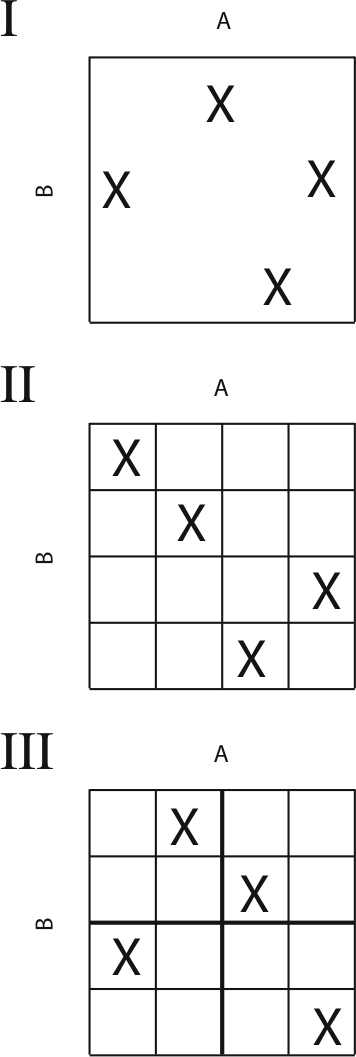
第三张是分层采样的样本分布:把采样区域先划分再在每格内取点,样本被"铺开"而不是撞在一起。它的收益与 RIS 是叠加的——分层改善候选的分布,重采样改善最终样本的分布。
3.6 复用方法的全量清单与二次归类
好了,值得把"复用"这件事的全部变体摊开列一遍——因为它们常被混为一谈,而实际上一份完整清单里有十几个不同的东西。下面这份清单按"复用什么对象"枚举,再按"沿哪个维度复用"做二次归类。
| 方法 | 复用对象 | 复用维度 | 代价/限制 |
|---|---|---|---|
| 时域抗锯齿(TAA) | 颜色 | 时域 | 只对颜色做累积,对采样分布无影响 |
| 时域降噪(ep06) | 颜色 | 时域 | 对帧内空间相关无效;鬼影 |
| 空间降噪(ep07) | 颜色 | 空间 | 忽略支持集,常掉能量 |
| 上采样(DLSS 等) | 颜色 | 空间 | 只解决分辨率,不解决采样质量 |
| 时域蓄水池复用 | 光源样本 | 时域 | 运动/光照突变下失效 |
| 空间蓄水池复用 | 光源样本 | 空间 | 支持集不匹配,须重算权重 |
| 时空联合复用(ReSTIR DI) | 光源样本 | 时域 + 空间 | 需要 MIS 权重补偿 |
| 路径复用(ReSTIR GI) | 路径样本 | 时域 + 空间 | 需偏移映射与雅可比 |
| 全路径复用(ReSTIR PT) | 任意路径 | 时域 + 空间 | 窄分布下雅可比敏感;已知仍有偏 |
| 蓄水池投递(splatting,2025) | 路径样本 | 时域(反向) | 需置信度上限防过度信任 |
| 多层投递(2026) | 路径样本 | 时域 + 深度层 | 需维护多层屏幕空间数据 |
| 体渲染复用(本系列不展开) | 体积散射路径 | 时域 + 空间 | 定义域不同,需独立推导 |
把这份清单二次归类后,脉络会清晰很多:
- 按"复用的是什么"分两类:颜色复用(TAA、降噪、上采样)与样本复用(RIS/ReSTIR 这一族)。前者发生在信息已经丢掉之后,只能拿颜色加点引导缓冲;后者发生在丢掉之前,手里有概率与分布。本篇讲的整条线都属于后者——这也是它能在数学上保持无偏、而颜色复用做不到的根本原因。
- 按"沿哪个维度"分三类:只时域、只空间、时空联合。有趣的是时空联合不是简单叠加,它带来了新的失败模式:时域的历史在空间上传播后,误差会跨像素"抱团",于是鬼影的区域会比单纯时域复用更大、更结构化。这解释了为什么空间复用必须带 MIS 权重与邻居约束,而不能只是"多平均几个邻居"。
- 按"边界在哪年被修"分两类:已收敛的(DI 这一层,2019–2021 年基本定型)与仍在被修的(路径复用与它的失效边界,2025–2026 年还在出最佳论文)。第九章会专门讲后者。
这张清单还有一个用法:它是排查"复用类 bug"的索引。当你看到画面出现特定形态的伪影(成片的结构化斑块、运动边缘的闪烁、暗部的能量缺口),可以先在上表里定位"这个现象属于哪一行",再去查那一行的已知失效模式——比从头读代码快得多。
3.7 小结
到这里,ReSTIR DI 的骨架就完整了:四段流程 + 一个可合并的蓄水池 + 一套 MIS 权重。接下来要谈的是它最容易被忽略的一面——复用不是免费的午餐。
四、复用的代价:偏从哪来
4.1 「无偏」到底在保证什么
OK,先把"无偏"这个词的严格含义摆清楚,因为工程讨论里它经常被当成"画质好"的同义词,而这两件事并不等价。
无偏(unbiased)说的是:估计量的期望等于真值。它不保证单帧画面好看——一个方差极大的无偏估计,单帧可能比一个有偏但稳定的估计难看得多。正因为如此,工程上"用一点偏换很多方差"是有吸引力的交易,ReSTIR 的很多实践做法本质上是这笔交易的具体形式。
要看清这笔交易,得先看清误差的两个来源。均方误差(mean squared error, MSE)可以精确分解成偏差的平方 + 方差——这是理解整章的地基。
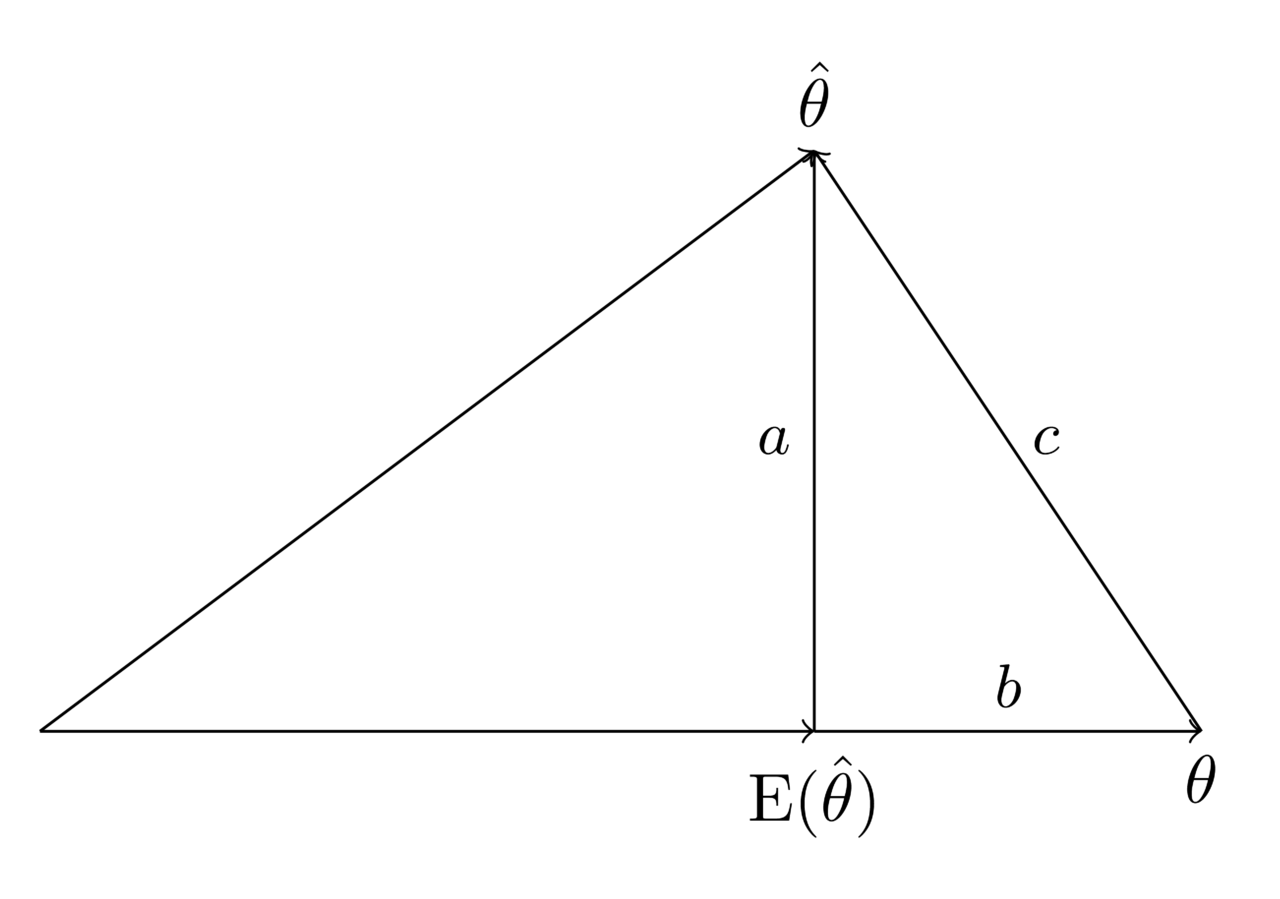
这张图要引出的判断是:"无偏"把第一项钉死为零,代价往往落在第二项上。于是无偏版本比"看起来对"的版本更贵——多出来的成本不是白花的,它买的是"误差不会系统性地偏向一边"。而系统性偏差在实时渲染里特别讨厌,因为它不会随帧数收敛:多跑几帧只能压方差,压不掉偏。
4.2 偏的三条来源
好了,复用的偏有三个独立来源,值得逐条讲清,因为它们的修法完全不同。
来源一:随机数共享。 相邻像素如果共用同一个随机数序列去做空间复用,样本之间就不再独立。相关性会让画面看起来"干净"——噪声被相关化之后,眼睛看到的颗粒密度下降。但这不是降噪,是把误差藏起来了:真实的误差没有减少,只是分布形态变了。更麻烦的是,相关性会随复用半径传播,形成大尺度结构。
来源二:支持集与定义域不匹配。说白了, 邻居的样本是在邻居的目标分布下产生的,而当前像素的目标分布不同。表现包括:邻居的样本在当前像素上被积函数为零(本该丢弃)、或者当前像素的重要区域邻居根本没采到(复用了也没用)。后处理降噪器完全忽略这件事,所以它们"常常掉能量",这是课程笔记里的原话。重采样能在信息丢弃前介入,但并不是自动免疫——它必须在权重里显式处理支持集。
来源三:条件概率。 这是最隐蔽的一条。当某个量既参与"是否复用"的判定、又参与权重计算时,这个量就成了一个条件,权重必须按条件概率重新推。举个具体的例子:如果实现里先判断"邻居样本可见性是否通过"再决定要不要合并,那"通过"这个事件本身就携带信息,不补回来就会系统性地高估亮区。
4.3 样本分布的好与坏,是可以直接看的
来源二里"支持集不匹配"听起来抽象,但它的底层直觉很简单:样本在空间里的分布形状,直接决定了它的代表性。同一种采样预算下,分布得均匀的那一份能覆盖更多区域、更少成簇。
先看"好"的那一侧:二维填充均匀、没有明显空洞——这种分布下,任何一个局部区域的覆盖概率都接近它的面积占比。
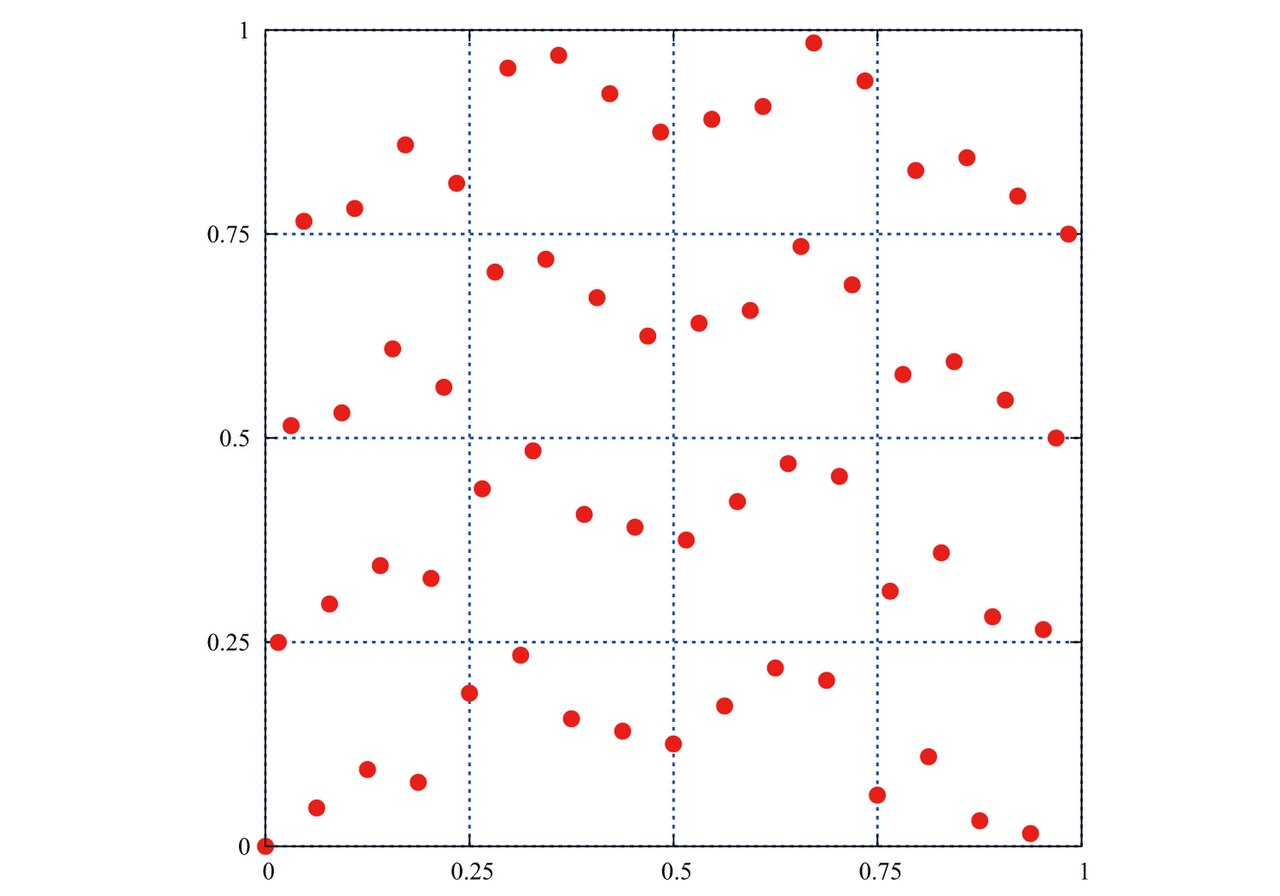
再看"差"的那一侧:同一口径下,填充的均匀性差一档,成簇与空洞明显变多。两张图是同一坐标系、同一评价标准下的对照,因此可以直接比较。
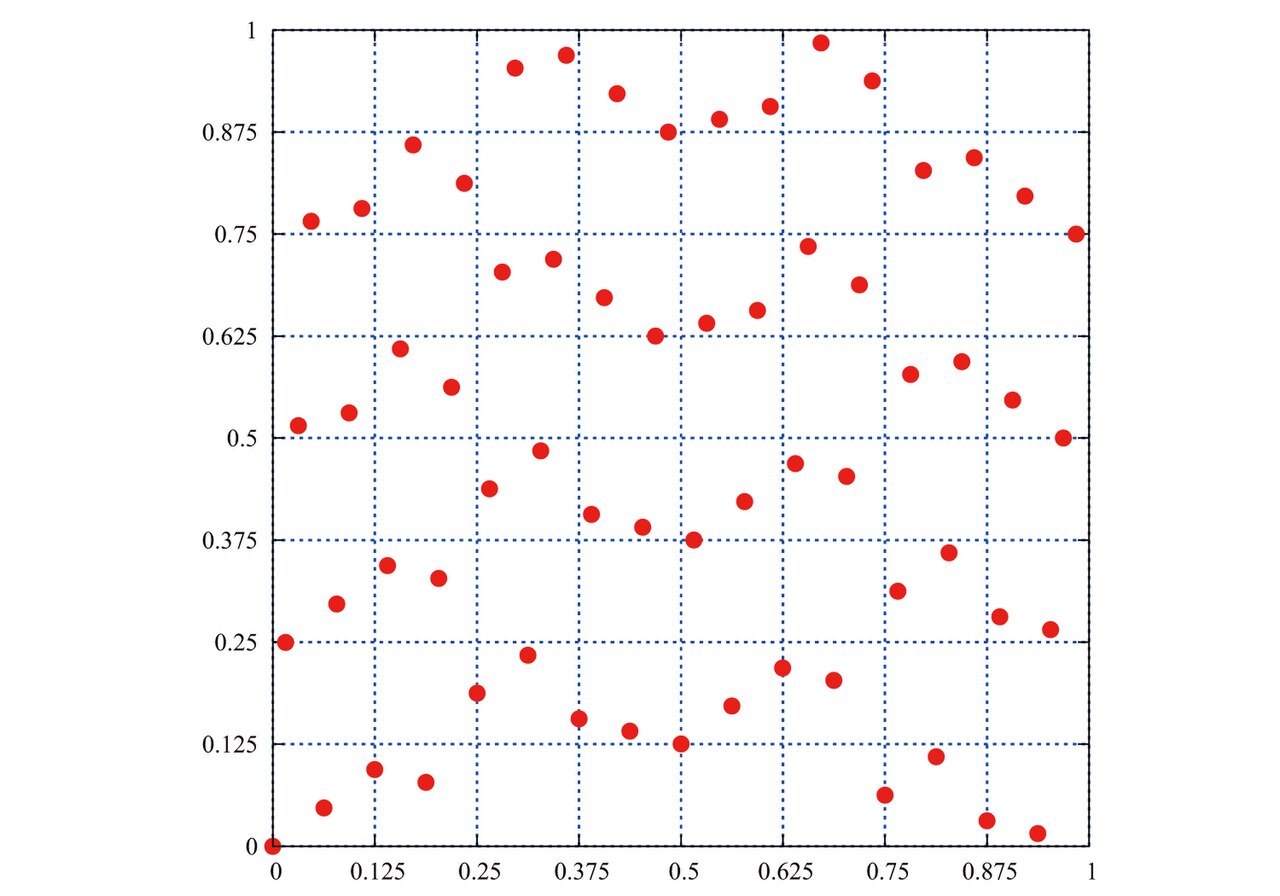
这两张图放在同一个章节里,是为了说明一件事:"样本分布质量"不是玄学,它是可以在二维图上直接看出来的。工程上判断一个采样器的好坏,先看它的样本分布形状,比看画面噪声有效得多。
4.4 无偏版本贵在哪
把三条来源合起来看,无偏版本的成本结构就很清楚了。社区里流传的几种做法——邻域拒绝(把不合格的邻居样本按概率拒绝)、贡献权重(用贡献大小当权重)、成对 MIS(对每一对来源分别算 MIS 权重)——都是在"补偿上述三条"这件事上做不同强度的近似:
| 做法 | 补偿了什么 | 代价 |
|---|---|---|
| 邻域拒绝(近似 MIS 权重) | 近似处理来源差异 | 便宜,但只是近似,仍有小偏 |
| 贡献 MIS 权重 | 支持集差异 | 中等,需要额外的目标分布评估 |
| 成对 MIS 权重 | 来源两两之间的权重分配 | 贵,复杂度随来源数上升 |
| 有偏(省略补偿) | 不补偿 | 最便宜,偏不可控、且不随帧收敛 |
课程笔记把这些做法整理在同一章(第 7 章"让它变快")里,作者的告诫值得原文转述:集成过程中那些看起来显然的"优化",会悄悄引入条件概率与依赖关系,一旦被忽略,就会给结果加上不可控的偏。
SIGGRAPH 2023《A Gentle Introduction to ReSTIR》课程笔记
4.5 一个诚实的旁证:官方自认还有偏
好了,如果上面的讨论听起来像"理论上要小心,实践里应该都处理好了",那有一条来自生产 SDK 的反例值得记住:RTXDI 的已知问题列表里明写——"ReSTIR PT 的空间 pass 有一些偏(has some bias to it)"。
这句话的含义比它看起来重要:它说明在把复用推到全路径(第六章)之后,偏不是理论上的可能性,而是这一代实现的既成事实。工程上正确的态度不是"有偏就不能用",而是"知道它偏在哪、偏多少、在什么内容上看得出来"——这也正是本篇把它单列一章的原因。
到这里,直接光与偏的来源都讲完了。接下来的问题是:同样的思路能不能用在间接光上——那里的"样本"不再是一个光源上的点,而是一整条路径。
4.6 怎么在自己项目里把偏找出来
OK,理论说完,回到最实际的问题:偏看不见,怎么知道自己的实现有没有?
偏之所以难查,是因为它在单帧、单视角下常常看不出异常——有偏的结果依然"像一张图",只是能量整体偏了 5%。等到美术反馈"暗部有点怪"时,往往已经过去几周。下面这组对照实验是本篇建议的最小排查流程,成本很低,但能覆盖三条来源里的大部分情况。
实验一:关掉复用,看两条曲线的走向。 分别在"只初始采样"与"全复用"两种配置下,让相机完全静止,记录连续 300 帧的图像均值与方差。正确的结果是:两者的均值在收敛后趋于一致,只有方差不同(复用让方差更快下降)。如果均值稳定停在两个不同的位置,说明复用引入了系统性偏差——这就是偏的定义本身。
实验二:只开时域,再只开空间。 把复用拆开单独跑。时域单独跑出的偏通常来自 M 计数的处理(2.3 里那条"计数相加但权重必须重算"的规则);空间单独跑出的偏通常来自支持集与 MIS 权重(3.3 与 3.4)。分开跑能迅速把问题缩小到其中一侧。
实验三:随机数共享的自查。 把空间复用的随机数种子从"每像素独立"临时改成"全局共享",再改回来,比较两版画面。如果共享版明显更"干净",说明存在相关性被误当成降噪——注意这里不是 bug,而是设计取舍;但如果共享版看起来更干净却与参考解(长时间离线渲染)差得更远,那这个"干净"就是假象。
实验四:运动与去遮挡压力测试。 前三个实验都在静止场景下做,它们抓不到与运动相关的失效。用一段相机快速平移、频繁穿过遮挡边界的相机路径,把结果与"关闭复用"的结果做差值图。第九章讲的回投影失效与 disocclusion 都会在这张差值图上留下清晰的痕迹。
这四个实验共用一句判据:复用不该改变期望,只该改变方差。 一旦发现"复用之后画面看起来更好,但和参考解离得更远",那多半就是偏——比任何代码审查都快。
五、从光照到路径:ReSTIR GI 与 GRIS
5.1 复用的对象从光源变成路径
好了,直接光的样本很具体:一个光源上的一个点,加上它的贡献权重。间接光的样本要复杂一档:它是一条路径——从可见点出发、经过若干次弹射、最终接到某个光源上的整条链路。要让复用"搬得动",先得把路径折成一个可以存储、可以评分、可以再抽样的东西。
ReSTIR GI 的做法是引入虚拟点光源(virtual point light, VPL)的视角:与其把路径看成"一串顶点",不如把它看成"一个虚拟的光源"——它落在路径的第一个弹射点上,携带一个出射方向上的辐照度。这样一来,间接光的样本在形式上与直接光的样本同构了,复用的框架可以直接搬过来。
这个"换个视角就复用同一套机器"的思路,是整条 ReSTIR 路线里最漂亮的一处设计。它带来的直接好处是:蓄水池、合并规则、MIS 权重这些基础设施一次都不用改。
5.2 偏移映射:搬过来的样本必须"平移"
但路径复用有一个直接光没有的麻烦:邻居的路径不能原样搬过来。一条路径的第一个顶点落在邻居的可见点上,而当前像素的可见点位置不同;如果只是把样本数据复制过来,几何位置就错了,路径会从空气里开始。
解决办法叫偏移映射(shift mapping):把邻居的路径顶点按一种几何上合理的方式"平移"到当前像素的上下文里。常见的偏移方式包括:把首个顶点重投影到当前像素的可见点、保持方向只改起点、或保持角分布只改距离。偏移映射的选择是 ReSTIR GI 里最需要工程判断的地方。
偏移映射带来一个必须付的账:它改变了积分变量的测度。样本从"相对于邻居像素的积分"搬到了"相对于当前像素的积分",同一个方向在两者下对应的立体角/面积不同,于是权重里必须乘上一个雅可比行列式(Jacobian determinant)来修正。漏掉它,能量就会系统性错位——这是路径复用最经典的一类 bug。
5.3 什么样的偏移映射算是"好"的
先看看判据。课程笔记把"什么是好的偏移映射"单列成一小节(第 6.4 节),判据可以归纳成三条:
- 几何上成立:偏移后的路径顶点要落在合法的表面上,不能穿模、不能落进几何体内;
- 测度变化可控:雅可比行列式既不能趋近于零(否则权重爆炸),也不能大到让少数样本主导结果;
- 样本相关性低:偏移后的样本不能与原来过于相似,否则等于没复用(变相的自相关)。
第三条经常被忽略:复用一批"几乎一样"的样本,方差看起来下降了,但那只是把同一个信息数了两遍。这与 4.2 里"随机数共享"是同一类错误的另一种表现。
5.4 GRIS:把路径复用一般化
ReSTIR GI 处理的是漫反射多跳;更复杂的路径(含镜面链、含体积散射)需要更一般的框架。GRIS(generalized resampled importance sampling,广义重采样重要性采样)把偏移映射与雅可比行列式这套工具一般化,给出了跨不同积分定义域复用的统一数学。
它的价值不只是"覆盖更多情况",还在于把"什么情况下复用是无偏的"变成了可以判定的命题——判据就是"偏移映射与雅可比是否把样本正确地搬运到了新的定义域"。RTXDI 的第三版(ReSTIR PT)正是建立在这套框架上。
六、ReSTIR PT:把复用推到整条路径
6.1 从 GI 到 PT:多出来的是什么
OK,ReSTIR GI 已经能复用间接光了,为什么还需要 PT?差别在路径的形态:
- GI 的复用主要针对漫反射路径,顶点的方向分布是宽而平滑的,偏移映射的雅可比变化温和;
- PT 要处理任意形态的路径,包括含镜面反射、含高光泽的材料——这类路径的方向分布极窄,偏移一点点落在测度上就是巨大的变化,雅可比会非常敏感。
所以 PT 的额外难度几乎全部来自"偏移映射在窄分布下的稳定性"。这也是为什么 RTXDI 的 PT 实现要在文档里单独说明它的算法细节。
6.2 成对 MIS:压掉复用带来的额外方差
好了,复用会引入一个新的方差来源:来源之间的权重分配。当蓄水池里同时有"本帧新采的样本"和"从若干邻居搬来的样本"时,如果权重分配不当,画面会出现空间上的斑块——同一片区域里,有的像素信了邻居的样本,有的信了自己的,两者不一致。
成对 MIS(pairwise MIS)的做法是:对每一对来源,分别计算"如果只用这两个来源,最优的权重是多少",再把这些权重组合起来。它比"一个全局权重"更精细,代价是复杂度随来源数上升——这是典型的"用算力换方差"。
6.3 空间结构与已知偏差
邻居从哪里找?直接的做法是在屏幕空间取一个邻域窗口,但窗口内的几何差异可能很大。生产实现往往引入空间结构辅助:空间哈希(把相似几何的像素分到同一桶里)或按其组织方式命名的格栅结构。它们的共同目标是让"有资格当邻居"的判定变便宜。
这一章的最后要回到 4.5 那条诚实的旁证:RTXDI 文档明写"ReSTIR PT 的空间 pass 有一些偏"。把本章的讨论合起来看,这句话其实可以预测——空间复用要处理任意路径形态、要在窄分布下算雅可比、还要在性能预算内做邻居判定,任何一处近似都会留下偏。这一代实现的偏不是疏忽,而是取舍的结果;2025 到 2026 年的工作(第九章)正是在这个边界上继续推进。
七、工程账:内存、带宽、复用半径与调度
7.1 每个像素一份蓄水池,到底多大
先看看这个数字是怎么来的。按 2.2 的布局,一个蓄水池至少要存:样本、权重和、计数、贡献权重。直接光场景下"样本"就是光源索引 + 光源上的一个点(可以用重心坐标或极坐标紧凑存储),所以一个蓄水池的实际大小落在十几个到几十字节的量级。
这个量级听上去无害,但要做两次乘法:
- 乘以像素数:1080p 约 207 万像素、1440p 约 368 万像素、4K 约 830 万像素;
- 乘以份数:至少需要"当前帧一份 + 上一帧一份"(时域复用要读历史),若空间复用分多轮、每轮需要独立的读写缓冲,还要再翻倍。
以 1080p、32 字节/蓄水池、双缓冲计算:207 万 × 32 B × 2 ≈ 132 MB。这个数字在现代显卡上不算大,但它必须常驻且每帧全量读写,于是真正的成本转移到了下一节。
7.2 带宽与访存模式
复用的每一轮都要读邻居的蓄水池。这与 ep07 里 à-trous 的问题同构:算术量很小,访存是大头。区别在于访存模式更不友好——à-trous 读的是固定偏移的若干邻居(空间局部性好),而空间复用的邻居集合是随机化的(为了避免固定的复用模式带来结构性伪影),因此缓存命中率明显更低。
官方博客在讲 RTXDI 时也点出了这一层:光照成本会随"光源数据落在 L1、L2 还是全局内存"而变化,所以他们又加了一层重采样来重排计算,目的是让光照成本在不同场景下保持接近常数。这句话听起来绕,实际说的就是"访存局部性值得为它多花一次重采样的代价"。
7.3 复用半径与调度
复用半径(邻域窗口大小、空间结构的影响范围)是另一个旋钮:
- 半径越大,可复用的样本越多、方差越低,但访存越分散、分支分歧越严重(同一 warp 内的像素指向不同的邻居集合);
- 半径越小,访存局部性好,但复用不充分,噪声回升。
分歧这件事在 GPU 上特别贵:同一个 warp 里的线程如果走了不同的分支,两条路都要执行。空间复用天然带分歧,所以生产实现倾向于把邻居集合按 tile 组织,让同一 tile 内的像素共享访问模式。
【空间复用 pass · 结构】
for each pixel p (并行):
    R = 本帧初始蓄水池(p)
    【1】时域:把上一帧重投影到 p
    if 重投影有效(运动矢量/几何/材质一致):
        R = merge(R, 上一帧蓄水池的重投影结果)
    【2】空间:邻居集合在 tile 内选取,保证访存局部性
    for round in 1..K:
        q = 采样邻居(p, round)              // 随机化,避免固定模式的结构性伪影
        if 兼容(p, q):                      // 几何/法线/材质约束
            R = merge(R, 蓄水池(q))
    【3】MIS 权重:对每个来源按"它有多可能生成这个样本"加权
    R.W = MIS_combine(...)
    着色(p, R.y, R.W)                       // 只有这一步追光线
下面对这段里一处最容易漏的地方特别说明:【2】里的 兼容(p, q) 判定本身就是一次随机事件。如果它在不同轮次、不同像素上的通过率不同,那么"通过"这个事件就与像素位置相关,MIS 权重必须把它补回来——这正是 4.2 里的来源三。实践中这类漏补偿往往在静态场景里完全看不出来,只有相机开始运动、遮挡关系频繁变化时才浮现。
7.4 与降噪侧的分工
最后一个问题:采样侧做到这一步,还需要降噪器吗?答案是需要,而且两者是配套的。RTXDI 的仓库里同时带了 NRD(降噪)与 DLSS(超分)两个子模块,这个依赖关系本身就是答案。
分工的界线可以这样划:采样侧负责把噪声降到"降噪器能吃下去"的水平,它保证每个像素的样本在期望上正确、且残差是零均值的随机噪声;降噪侧负责把这层零均值噪声抹平。如果采样侧的偏没处理干净,残差就不是零均值——那正是降噪器最不擅长处理的情况(它会把这层系统性偏差当成真实结构保留下来,ep07 已经讲过这一点)。
7.5 一个可复算的带宽估算
下面我们进入最关键的一步。把 7.1 与 7.2 合起来,可以算出一个数量级,而不是停在"访存是大头"这种说法上。取一组明确假设:
- 分辨率 1080p,约 207 万像素;
- 每个蓄水池 32 字节;
- 空间复用 2 轮,每轮读 5 个邻居的蓄水池;
- 时域复用额外读 1 份历史缓冲。
读出量 ≈ 207 万 × 5 × 2 × 32 B ≈ 663 MB/帧,加上时域与写入,一帧的总访存约 800 MB 量级。按 60 Hz 换算就是约 48 GB/s 的持续带宽需求。
这个数字的有意思之处在于它跟谁比:
- 对一块 256 bit、GDDR6 的中高端独显(理论带宽约 400–500 GB/s 量级),这占 约 10%——可以接受,但要与其他系统(纹理、渲染目标、降噪器)分享;
- 对显存带宽低一个数量级的平台(集成显卡、移动端),同样的配置会直接吃掉过半带宽。这也解释了为什么 ReSTIR 类方法在移动端至今不是常规选项——限制它的是带宽,不是算力(与 ep07 里 NRD 内存账的结论同源)。
这组数字是按假设推算的量级,不是任何具体实现的实测值;改变轮次、邻居数或蓄水池布局,结果按比例变化。给出它的目的不是让人记住 48 GB/s,而是给出一条可复算的算式——做方案评估时,先用这条算式看带宽是否落在可分享的范围内,再去谈画质。
八、生产落地:三款作品三种取舍
8.1 Cyberpunk 2077:把 GI 交给复用
先看看第一款作品。Cyberpunk 2077 的 2.1 版本更新把路径追踪的光照质量又推进了一档,官方补丁说明里明确写了两件事:引入基于蓄水池的时空重要性重采样(ReSTIR)的全局光照,以及它的收益点——在最小化鬼影的同时改善暗部光照。
它挑的落点是"暗部"与"鬼影"这两个词。这不是随机选的:暗部正是间接光样本最少、方差最高的区域;鬼影正是复用(尤其时域复用)最容易出的问题。这份补丁说明的两端,恰好对应了本篇第三章与第四章的两个主题。
8.2 Portal RTX:经典场景的重制
OK,Portal RTX 是另一条路线的代表:把复用类的技术带进经典场景的重制。它的内容特点(几何相对简单、材质以漫反射为主、场景规模小)与"重制"这个目标(画质优先、可以接受更高的采样开销)组合起来,正好落在 ReSTIR 类方法最擅长的区间。
8.3 UE5 Lumen:进了主流引擎的常规管线
好了,第三条路线最有分量,因为它不再是"某个游戏的技术选型",而是主流引擎把它当成了常规管线的一部分:UE5.4 的 Lumen 在其 Gather 阶段已经实现了基于 ReSTIR 的做法。
把三者放在一起对照,能看出同一套算法在不同约束下的三种形态:
到这里,生产的图景就清楚了:这套方法已经不是实验室里的技巧,而是进入了"内容作者随手就会用到"的基础设施层。也正因为如此,2025 到 2026 年它在边界上被反复修补,就格外值得单列一章。
九、2025–2026:复用还在被修
9.1 先看它坏在哪:运动下的回投影
先看看它坏在哪。复用最脆的一环是回投影:把上一帧的样本按运动矢量搬到当前帧。这个动作隐含一个假设——"上一帧的那个样本,在当前帧仍然描述同一个表面点"。静态场景下这个假设成立;一旦相机移动、物体运动、或者出现亚像素级别的几何变化,假设就开始失效。
2025 年的工作把这个失效讲得更细:回投影会因为移动相机、亚像素几何的运动差异而找不到相关路径。注意这里的措辞——不是"找错了",而是"找不到"。这比找错更麻烦,因为它意味着复用链条会断:一旦断掉,像素就退回"只有本帧初始采样"的状态,方差骤升。表现出来就是运动边缘上的闪烁与噪点回升。
SIGGRAPH 2025 会议论文(路径蓄水池覆盖像素足迹)
9.2 2025:从"回投影"改成"投递"
OK,针对这个失效,2025 年出现了蓄水池投递(reservoir splatting)的思路:与其把当前像素"拉到上一帧去找"自己的历史样本(回投影),不如让上一帧的样本主动投递到当前帧该去的位置。这个方向的代表工作是 Reservoir Splatting for Temporal Path Resampling and Motion Blur,它同时处理了一个更棘手的问题——运动模糊下的时间采样。
Liu 等 2025《Reservoir Splatting for Temporal Path Resampling and Motion Blur》
这个方法里有一个设计值得说:置信度权重与置信度上限。投递过来的样本不是无条件相信的,它带一个"我有多可信"的权重;而这个权重有一个上限,防止单个样本在反复投递中被无限放大(那会变成另一种形式的偏)。给复用加一个"信任上限",是这一代修补的共同思路——因为复用出错时最典型的形态就是"某个样本被过度信任"。
9.3 2026:多层投递与 disocclusion
好了,投递思路解决了运动下的失效,但还有一类更顽固的情况:disocclusion(去遮挡)——某个区域之前被遮住、现在露出来了。这个区域在上一帧可能根本不可见,于是它在上一帧没有任何样本可投递,复用链条同样断裂。这类失效在相机平移、开门、镜头摇过墙角时高频出现。
2026 年 SIGGRAPH 的 Multi-Layer Reservoir Splatting for Temporal Reuse under Disocclusion 针对的正是它:用多个屏幕空间层记录"曾经可见、现在被遮挡"与"曾经被遮挡、现在可见"的样本,通过层间投递把去遮挡区域的历史样本重新用起来。它还有两个工程性设计:
- 用深度范围重定义积分域,从而省掉大量光线查询——这相当于把"可见性判定"的一部分成本换成了"定义域限制"的成本;
- 只跟踪从前一帧传播过来的活跃定义域,避免为全屏维护多层数据的开销。
SIGGRAPH 2026《Multi-Layer Reservoir Splatting for Temporal Reuse under Disocclusion》
9.4 同年的另两条线:LOD 与邻居选择
OK,2026 年还有两条与"复用边界"直接相关的工作:
- Real-time Level-of-Detail Rendering with ReSTIR(SIGGRAPH 2026 最佳论文):把复用用到细节层级(LOD)渲染上。它的意义在于把复用从"光照采样的工具"扩展成"几何细节预算分配的工具"——两者共享同一个问题:有限的预算该花在哪。
- Compatibility-Guided Neighbor Selection for ReSTIR(HPG 2026 最佳论文):直接针对第 3.3 节那个核心难题——"谁有资格给谁当邻居"。它把"兼容性"从几条硬性阈值(法线夹角、深度差、材质一致)升级成一个更有指导性的判定,减少无效复用与错误复用两边的浪费。
把这一章压成一句话:复用这件事在 2026 年仍未收敛。它坏在三个地方——运动、去遮挡、邻居选择;而 2025 到 2026 年的工作恰好是逐个去修这三个地方。一篇 2020 年的算法在六年之后还有两份最佳论文在围着它做,这个事实本身就是"它值得学"的最好理由。
十、边界与交棒
10.1 量化结论与口径汇总
本篇引用到的量化结论集中在这里,每条都标了口径——本系列从 ep07 起就守这条纪律,因为同一个算法流传着好几个不同的倍数。
| 结论 | 数值 | 口径 | 出处 |
|---|---|---|---|
| ReSTIR 相比当时最好方法的加速 | 最高 65× | 官方博客的 "up to" 口径,2020 | NVIDIA 开发者博客 |
| 等误差条件下的加速 | 6×–60× | 论文摘要口径(equal-error) | 论文页 / 语义学者 |
| 高度优化变体的效率提升 | 100× | 课程笔记表述,对照传统光线/路径追踪 | SIGGRAPH 2023 课程笔记 |
| 早期 RTXDI 原型的场景规模 | 1,100 万字面 / 11,000 自发光三角形 / 8 ms 内 | 单 GPU、原型阶段 | RTXDI 博客 |
| 交互式路径追踪场景的动态光源数 | 7,000 个 | 短片场景,非通用上限 | NVIDIA 开发者页 |
| 蓄水池内存(1080p、32 B/池、双缓冲) | ≈132 MB | 本篇按 §2.2 布局推算,随布局与份数变化 | 本篇推算 |
| ReSTIR PT 空间 pass 的偏 | 存在 | 官方已知问题列表 | RTXDI 仓库 |
三条口径提醒,值得单独记一下:
- "最高"不是"通常"。65× 与 100× 都是上界式的表述,落在什么位置取决于场景的光源复杂度与基准方法;论文的 6×–60× 区间才是更接近"实际区间"的说法。
- 等误差口径与等时间口径不同。6×–60× 是"在相同误差下更快",而工程里最常问的其实是反过来:在相同的帧时间预算下,谁的误差更低——两者的数值并不相等。
- 算例不能当上限。1,100 万字面 / 11,000 自发光三角形 / 8 ms 是特定场景、特定硬件上的原型数据,把它当成"这就是 ReSTIR 的能力边界"会误判。
10.2 三句话收束
好了,三句话收束全篇:
- 复用的本质是把"挑样本"这件事从像素内搬到像素之间——便宜的候选 + 正确的加权,让一条光线承担了几百个候选的信息;
- 复用的代价是偏,而偏有三条来源——随机数共享造成相关性、支持集不匹配造成能量错配、条件概率造成系统性偏移,三条都得显式补偿,否则误差不会随帧收敛;
- 这套方法仍在被修——2025 年修运动下的投递与置信度上限,2026 年修去遮挡、LOD 与邻居选择;官方文档自己也承认这一代还有偏。
交棒方向:采样侧把"每条光线更值钱"做到了复用的极限之后,剩下的问题是光线预算怎么分——一帧里反射、阴影、全局光、体积各自给几条光线,按什么比例分,超预算时先砍谁。那正是【实时光线追踪与混合渲染】(九)《光线预算表:反射、阴影、全局光怎么分钱》要回答的。
本篇作者:溯光 本系列(实时光线追踪与混合渲染,共 12 篇):分界线 → 加速结构工程账(上)→ 加速结构工程账(下)→ SBT → 混合管线编排 → 降噪(上)→ 降噪(下)→ ReSTIR → 光线预算表 → RT 资源生命周期 → 透明与体积 → 反射与阴影混合 → 跨平台差异 前置专题:《实时渲染管线探析》5 篇 · 《移动端图形与功耗》7 篇 · 《GPU 架构剖析》12 篇
相关链接 - 上一篇:【实时光线追踪与混合渲染】(七) 降噪(下):从 SVGF 到神经降噪的取舍 - 下一篇(预告):【实时光线追踪与混合渲染】(九) 光线预算表:反射、阴影、全局光怎么分钱 - 参考资源:ReSTIR 论文 NVIDIA Research · SIGGRAPH 2023 课程 A Gentle Introduction to ReSTIR · RTXDI GitHub · 课程笔记 PDF
With Best Wishes.