本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-vulkan-best-practices
题图 本篇要量的那件事与三条主线:官方判据、本机 13 条路径的同机对照、以及一个可精确验证的等价性输出 @ 本系列绘制
全系列篇目总览(共 10 篇,本篇为第 3 篇):
- ep01 官方最佳实践到底在哪:四套体系的边界与本机能力实勘——地图与本机能力基线
- ep02 2026 新范式:Vulkan 1.4 基线、Dynamic Rendering 与 Shader Objects——新范式
- 本篇 · ep03 同步最佳实践:barrier 精细化、sync2 与时间线信号量——同步
- ep04 管线缓存:绝不在 draw time 建管线——管线缓存
- ep05 Render Pass 与 Subpass:attachment 策略与 tile 内存——render pass / subpass
- ep06 命令缓冲与多线程录制:secondary CB 与 false sharing——命令缓冲
- ep07 描述符与内存分配:从 256 字节的告警说起——描述符
- ep08 Layout Transition:barrier 的代价落在哪——layout transition
- ep09 Swapchain 与 Present:image 数量、旋转与 waitIdle→fence——swapchain
- ep10 验证层 Best Practices:从 warn 到修复的真图闭环(收束篇)——验证层闭环
除以上三篇外的七篇尚在排期,发布后回填链接。本系列的写作边界(前五条承 ep01/ep02、第六条本篇新增)见 §0.3,汇总在 §12.1。
先说清楚这一篇要干什么
好了,ep02 把「同步基元选哪个」量完了——时间线信号量(timeline semaphore)能替代栅栏(fence),但替代之后并没有更快。那一篇结尾留了一句:下一篇要回答的是「一次布局转换(layout transition)到底花多少、什么时候该合并、什么时候必须分开」。
说白了,这篇按那句话交作业,但范围比那句话更宽一点。因为要回答「什么时候该合并」,就得先回答一个更基础的问题:一次屏障(barrier)写下去,到底值多少。
0.1 这一篇要量的一件事
OK,一篇只回答一个问题:同一份用例、同一台机器,只改屏障的写法,读数会不会变。
OK,这个问法看着朴素,但它是官方材料里唯一没有的东西。Guide 的同步示例页给的是逐条可抄的判据——哪些依赖只需要执行依赖、哪些必须有内存依赖、什么情况下屏障可以整条删掉;Tutorial 讲的是 sync2(VK_KHR_synchronization2)为什么能避免「log jam」;Samples 里有一个样本报出了 13% 的帧时间改善。三处加起来,判据齐、方向明,唯独没有一条给出代价数字。这不是疏漏,是体裁决定的:跨驱动的绝对值给不出来。
那就自己量。我们搭了一个最小用例,把屏障写法当成唯一变量,在同一台机器上写了十三条路径,每条路径跑五次、报区间不报单次,并且每条路径都必须产出一个可精确验证的输出——帧末把一块缓冲读回主机,算哈希。理由很简单:「删掉一条屏障」只有在结果不变的证据在场时才是结论。
三条主线摊开来说:
第一条:官方那九条判据,原样摆出来。 Guide 的同步示例页给了九条可以逐条照抄的写法判据,其中六条直接构成本篇的章节骨架。它们是本篇的差异化基础——全是官方明写,但一条数字都不给。
第二条:同一个依赖,五种写法,同机各量一次。 这是本篇最硬的部分。我们让十三条路径做完全相同的事——两次缓冲填充、两次缓冲拷贝、256 次 draw、一次布局转换——只允许屏障的写法不同。
第三条:写错的那部分,验证层抓不抓得住。 三条路径是故意写错的。它们在计时上毫无异常,结果也完全正确,而验证层默认一条错都不报。这条是本篇全文里最值得记住的一句。
0.2 与 ep02 的接缝:一次布局转换到底花多少
先来看看 ep02 留下的那笔债。
言归正传,ep02 的用例里其实已经有两次布局转换——UNDEFINED → COLOR_ATTACHMENT_OPTIMAL 与 COLOR_ATTACHMENT_OPTIMAL → PRESENT_SRC_KHR——但它们当时只是被画进时序图,没有被单独量过。本篇把这两次转换拆出来,逐次量。
还有两处接缝要说明。一是时间线信号量:ep02 用一条故意失败的探针撞实了「交换链的 acquire/present 仍要二元信号量」这道墙,本篇在第九章复跑那次探针并把结论并置。二是能力口径:ep02 已经把 synchronization2 / timelineSemaphore / hostQueryReset / presentWait 四项核过一遍,本篇沿用同一份 vulkaninfo 快照,不再重复实勘——同一台机器、同一份驱动,读数可比。
0.3 边界声明:本篇不涉及什么
说白了,第一,不做跨厂商对照。 本机只有一块 NVIDIA 独显。所有厂商材料(AMD 的 RDNA 性能指南、Intel 的 Gen11 优化指南、Arm 与 Roblox 的 GDC 报告)只引原文,不冒充实测;凡是我们自己量不到的,正文会写明「这一条只引官方或厂商口径」。
第二,不给驱动内部 JIT 的结论。 Vulkan 没有任何官方接口能看到驱动编译器内部的中间表示或 JIT 决策,屏障在驱动里被怎么合并、怎么提升(hoist),我们只能观测外部行为。
第三,不给指令集规范的断言。 NVIDIA 没有公开 SASS 的官方 ISA 文档。
第四,时间戳有同步域边界。 vkCmdWriteTimestamp 只保证同一次提交内 happens-after 的时间戳不递减。本篇的 GPU 时间全部来自同一队列、同一次提交内成对写入的时间戳,跨队列相减一律不做;VK_EXT_calibrated_timestamps 在本机只在位、不校准——这一条承 ep01/ep02,本篇不改口径。
第五,不做移动端实测。 手上没有 Android 设备。而移动端的屏障代价恰恰是这一篇绕不开的对照:Mali 这类分块渲染(tile-based rendering)GPU 有顶点/计算与片段两个独立调度槽,BOTTOM_OF_PIPE → TOP_OF_PIPE 在它上面的代价特别大。这条我们只引官方样本与 Arm/Roblox 的材料,一次都不会说成「本机实测」。
第六,本篇新增:不配移动端专图。 既然正文声明不涉及移动端的屏障细节,就不该拿一张 tiled GPU 的架构图来凑版面。这条边界同时管着配图:本篇 36 个图位里没有一张是移动端专用件。
0.4 本机环境与同步能力快照
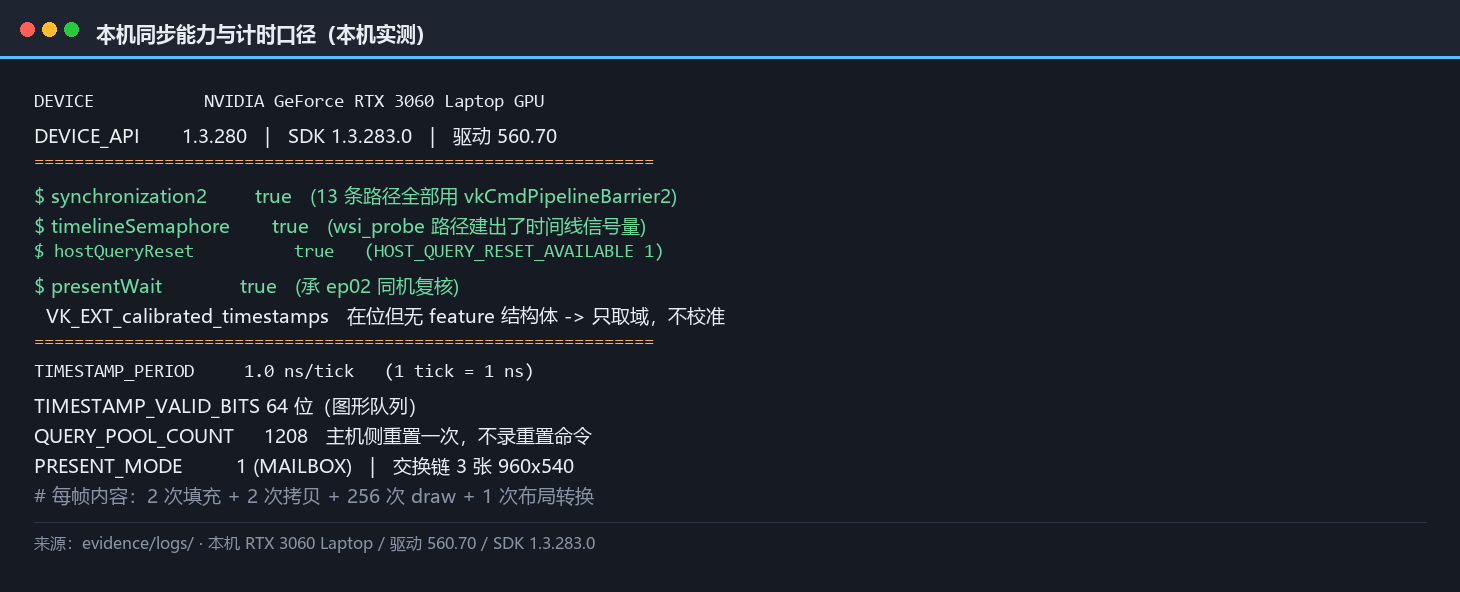
好了,老规矩先上环境。ep02 已经量过一遍这台机器,这里只补本篇新用到的那几项——同步能力与计时口径。
| 项 | 读数 | 对本文的含义 |
|---|---|---|
| GPU / 驱动 | NVIDIA GeForce RTX 3060 Laptop GPU|驱动 560.70 | 与 ep01/ep02 同一台机,读数可比 |
| 设备 API 版本 | 1.3.280 | 够到 Vulkan 1.3 核心,所以 sync2 可按核心用 |
synchronization2 |
true | 全篇的屏障都用 vkCmdPipelineBarrier2 + VkDependencyInfo |
timelineSemaphore |
true | 第九章可用(承 ep02) |
hostQueryReset |
true | 时间戳查询池可在主机侧重置一次,不必录一条重置命令 |
presentWait |
true | 显示侧同步可测 |
maxTimelineSemaphoreValueDifference |
2147483647 | 计数差值容差近乎无限,适合大规模计数测试 |
timestampPeriod |
1.0 ns/tick | GPU 时间戳可直接按微秒相减 |
timestampValidBits(主队列) |
64 位 | 跨帧相减不会回绕;计时必须选 64 位队列 |
VK_EXT_calibrated_timestamps |
扩展在位,无 feature 结构体 | 只能取到时钟域,不做校准实测(承 ep01/ep02) |
这张表有两行要停一下。
好了,第一行是 timestampValidBits 是 64 位。这一条决定了本篇所有 GPU 读数的合法性:时间戳一旦回绕,跨帧相减出来的数就是垃圾。本机的图形队列报 64 位,所以从第 61 帧到第 600 帧的差值可以直接相减——但这不是普遍成立的,同一台机器的部分队列就只报 32 位。
第二行是 timestampPeriod 是 1.0 ns/tick。这是最省事的一种——刻度就是纳秒,读出来的 tick 数除以 1000 就是微秒,不需要乘任何系数。后面正文里出现的每一个「µs」,都是这样算出来的。
好了,环境交代完,下面进正文。
一、官方那份「同步说法」说了什么
OK,这一章只干一件事:把官方四个体系里关于同步的材料原样摆出来,不带我们的评价。评价从第三章开始。
1.1 官方对同步的定位:最强,也最易错
Vulkan Guide 的同步页开头就把定性写死了:
"Synchronization is one of the most powerful but also most complex parts of using Vulkan. The application developer is now responsible for managing synchronization using the various Vulkan synchronization primitives. Improper use of synchronization can lead to hard-to-find bugs as well as poor performance in cases where the GPU is unnecessarily idle."
这一句就是本篇的题眼,因为它把「同步写错」的后果说成了两样东西:一个是难查的 bug,另一个是 GPU 空转。前半句被验证层管着,后半句没人管——而本篇只量后半句。
同页对管道屏障(pipeline barrier)的定义很短:
"Pipeline Barriers give control over which pipeline stages need to wait on previous pipeline stages when a command buffer is executed."
「哪些阶段要等哪些阶段」——这是全部判据的来源。
1.2 官方示例页:九条可以逐条照抄的判据
docs.vulkan.org/guide/latest/synchronization_examples.html 这一页是三处材料里最实用的一份,因为它给的是逐条可执行的写法判据。九条里,六条直接构成本篇的章节骨架:
| # | 官方原文(节录) | 意译 | 落到本文章节 |
|---|---|---|---|
| 1 | "WAR hazards don't need availability or visibility operations between them - execution dependencies are sufficient. A pipeline barrier or event without any access flags is an execution dependency." | 读后写只需执行依赖,不必给 access 掩码 | §五 |
| 2 | "Generally considered more efficient to do a global memory barrier than per-resource barriers, per-resource barriers should usually be used for queue ownership transfers and image layout transitions - otherwise use global barriers." | 全局内存屏障一般比逐资源更高效 | §六 |
| 3 | "Batch barriers where possible if it doesn't change how synchronization takes place" | 不改变同步语义时尽量批量 | §六 |
| 4 | "interactions with graphics should ideally be performed by using subpass dependencies (external or otherwise) rather than pipeline barriers" | 图形依赖优先用 subpass dependency | §七(与 ep02 的 dynamic rendering 衔接) |
| 5 | "Signalling a semaphore waits for all stages to complete, and all memory accesses are made available automatically … semaphore alone is sufficient. No additional synchronization required - remove those barriers." | 已被信号量覆盖且无布局变化时,屏障可整条删掉 | §六 |
| 6 | "you still need a memory barrier to do a layout transition though, but you don't need any access types in the src access mask" | 只做布局转换时保留屏障,但源侧 access 可以为空 | §七 |
| 7 | "This is an example of a WAW (Write-After-Write) hazard, which always require a memory dependency." | 写后写必须有内存依赖 | §五 |
| 8 | "You should ONLY USE THIS FOR DEBUGGING - this is not something that should ever ship in real code, this will flush and invalidate all caches and stall everything" | 全屏障禁止进发布代码 | §三、§四 |
| 9 | "The stages used in srcAccessMask must be equal to (or logically later than) the values in VkSubmitInfo::pWaitDstStageMask … otherwise the barrier is not guaranteed to occur after the semaphore wait." |
屏障源阶段须不早于信号量等待的目标阶段 | §九 |
这九条有一个共同点值得留意:它们全是「该怎么写」,没有一条是「这么写值多少」。 第 8 条最典型——官方用了「ONLY」「never」「stall everything」三个重词,却没有给一个数。三条流行说法(第十章)里的第一条,正是从这种「重词多、数字少」的缝隙里长出来的。
1.3 sync2 到底改了什么:六条会改写法的地方
再看 Tutorial 的 sync2 专页。从 VK_KHR_synchronization2 到 Vulkan 1.3 核心,有六处直接改变代码形态:
| 项 | 旧接口 | sync2 |
|---|---|---|
| stage 与 access 的关系 | 分开传(两个参数) | 成对出现在同一个 barrier 结构体里 |
| 位宽 | 32 位——官方原话「running out of the 32 bits」 | 64 位,为光追/网格/视频阶段腾出空间 |
| 阶段粒度 | VERTEX_INPUT / TRANSFER / SHADER_READ 等粗粒度 |
拆细:INDEX_INPUT + VERTEX_ATTRIBUTE_INPUT;COPY/RESOLVE/BLIT/CLEAR;UNIFORM_READ/SHADER_SAMPLED_READ/SHADER_STORAGE_READ |
TOP/BOTTOM_OF_PIPE |
语义模糊、常被误用 | 废弃,并给出明确映射表(src=TOP→NONE;dst=TOP→ALL_COMMANDS;src=BOTTOM→ALL_COMMANDS;dst=BOTTOM→NONE) |
| 图像布局 | 逐格式选 COLOR_ATTACHMENT_OPTIMAL 等 |
新增 ATTACHMENT_OPTIMAL / READ_ONLY_OPTIMAL,按格式上下文自动映射 |
| 提交流 | vkQueueSubmit + VkSubmitInfo |
vkQueueSubmit2 + VkSubmitInfo2,信号阶段可以指定 |
第三条(阶段粒度拆细)是本篇最意外的收获。 官方把这条列成「更细的控制」,听起来是纯粹的收益;但本篇实测发现它同时带出一个新的坑:老的 TRANSFER 阶段被拆成 COPY / RESOLVE / BLIT / CLEAR 之后,把源阶段写成 COPY 就管不到 vkCmdFillBuffer——因为填充属于 CLEAR。这一条没有任何一份官方判据提到,而它有一个非常干净的复现路径(§八)。
另外有一条唯一不能逐处替换的增量迁移例外:同一个 VkEvent 不得混用 vkCmdSetEvent2KHR() 与 vkCmdWaitEvents()。LunarG 的迁移材料把它标成 sync2 迁移的唯一例外,其余改动都可逐处替换。这一条落到第十一章的迁移判据表。
1.4 「合并屏障」:官方给了一个很关键的区分
Khronos Tutorial 的 The Synchronization 2 Advantage 一节里有一句原话,它能直接纠正一条流行说法:
"By merging the stages at the function level, you were inadvertently telling the GPU to wait for all the source stages to finish before any of the destination stages could start. You were creating a bottleneck where one didn't need to exist."
这句话把「合并」劈成了两件不同的事:
- 合并函数调用——把几条屏障塞进一次
vkCmdPipelineBarrier调用。官方第 3 条判据鼓励这么干,AMD 也建议这么干,理由是「减少进入驱动的次数,让驱动有机会去掉冗余操作」; - 合并 stage 掩码——把几个互不相干的依赖揉成一个宽掩码。这一件是官方说的 bottleneck。
能分开讲这两件事的文章很少,能分开量的更少。 本篇第六章专门做这个区分,并且把它写成了两条只有一处差异的路径。
1.5 验证层的同步校验:官方给了定位,也给了局限
VK_LAYER_KHRONOS_validation 的同步校验(syncval)是这样的:
"It identifies resource access conflicts caused by missing or incorrect synchronization between commands that read or write the same regions of memory."
Tutorial 把同步 bug 归成三类——RAW(read-after-write)/ WAR(write-after-read)/ WAW(write-after-write)——并点明 RAW 是「读到垃圾数据」最常见的根因。同时官方也写清了两件事:同步校验是验证层的一个功能开关(不是跟着层一起打开的东西),以及 "the sync validation layer has a non-trivial performance overhead. It is not meant to be left on in your production or release builds."
LunarG 在 Vulkanised 2024 的演讲里还补了一条已知局限:它按 stage/access 对记录「首次/最近」访问并做依赖链跟踪,但「Any hazard reported earlier may mask detection of subsequent hazard with same memory」——先报出的那一处会掩盖同一块内存上的后续 hazard。这一点要如实写:工具可信,但不是全覆盖。
1.6 三处材料的分工
好了,把这一章的内容收一下:Guide 给判据,Tutorial 给动机,Samples 给方向,Validation 给工具。四者缺的那一样是共同的——数字。
| 材料 | 给什么 | 缺什么 |
|---|---|---|
| Guide · Synchronization + Examples | 九条可执行的 Do/Don't | 每条的代价 |
| Tutorial · sync2 与依赖解剖 | 为什么会有 bottleneck、64 位掩码的动因 | 无实测;不区分两种「合并」的代价 |
| Samples · pipeline_barriers | 一个 13% 的帧时间改善 | 单点、单一用例、无同机多方案对照 |
| Validation · 同步校验 | 三类 hazard 的检出与工具定位 | 无「该写多少屏障」的判据 |
四个空档里,本篇挑两个来补:同一台机器、同一份用例、多种屏障写法的对照表,以及「哪些屏障可以整条删掉」的可核判据。
这张图的作用是把后面十一章的站位先说清:凡是我们自己量到的,图注会写「本系列绘制」并给出归档路径;凡是只引来的,图注会写清出处与机型。 读到「13%」或「56%」这样的数字时,请大家先看一眼它是哪台机器给的——本篇不会把别人的数字说成自己的。
这一章到此为止,只摆了官方的原话与它们的缺口。从第二章开始,逐条拿到本机上来。
二、sync2 改了什么:六条会改写法的地方
好了,上一章把官方四套材料摊开了,判据、动机、方向、工具都在场,缺的只有数字。这一章先不急着找数字,我们把镜头对准一个更底层的东西:VK_KHR_synchronization2(下称 sync2)到底动了接口的哪些地方。它从扩展升成 Vulkan 1.3 的核心之后,同一段同步逻辑的写法就换了模样——要是你脑子里装的还是旧写法,后面几章的判据你会抄不下去。官方 Tutorial 把改动列了六处,我们一条一条过。
说白了,先说为什么要为这个单独开一章。官方那九条判据,几乎全是用新语法写出来的;你要是拿旧接口的脑子去读,很容易把「阶段」和「访问」错位——读起来是同一句话,落到代码里却是另一个东西。所以这一章不是接口百科,而是给后面几章铺语法地基。
2.1 六处会改写法的地方
OK,第一处,阶段(stage)与访问类型(access)的关系变了。旧接口里,阶段和访问是分开传的两个参数,写的时候容易对不上;sync2 把它们成对塞进同一个屏障(barrier)结构体里,「谁在等谁、等的是读还是写」必须一次想清。这一改看着像排版,实际是逼你在写的当下就把依赖方向交代明白。
第二处,位宽。官方原话是位快不够用了——「running out of the 32 bits」。光线追踪(ray tracing)、网格着色(mesh shader)、视频编解码这些新阶段都要占位,旧掩码(mask)装不下,于是整个加宽。
第三处,阶段粒度被拆细。旧的粗粒度 TRANSFER 被拆成 COPY / RESOLVE / BLIT / CLEAR;SHADER_READ 被拆成 UNIFORM_READ / SHADER_SAMPLED_READ / SHADER_STORAGE_READ;连 VERTEX_INPUT 都拆成了 INDEX_INPUT 与 VERTEX_ATTRIBUTE_INPUT。官方把这说成「更细的控制」,听上去纯是收益。
第四处,TOP_OF_PIPE 与 BOTTOM_OF_PIPE 被废弃。这两个老阶段语义模糊、常被误用,sync2 给了明确映射表:源写 TOP 映射成 NONE、目的写 TOP 映射成 ALL_COMMANDS;源写 BOTTOM 映射成 ALL_COMMANDS、目的写 BOTTOM 映射成 NONE。以前靠经验猜的东西,现在有了对照。
第五处,图像布局(image layout)多了两个枚举。ATTACHMENT_OPTIMAL 与 READ_ONLY_OPTIMAL 会按格式上下文自动映射到具体布局,不必再为每种格式手挑 COLOR_ATTACHMENT_OPTIMAL 之类。
第六处,提交流换了。vkQueueSubmit 搭档 VkSubmitInfo 换成 vkQueueSubmit2 搭档 VkSubmitInfo2,信号阶段可以显式指定。
六处改动分散在六个不同的地方,动机却是同一个:让「你想表达的依赖」和「你写下的代码」更接近。 旧接口里不少语义是隐含的、靠约定俗成;sync2 把该显式的都显式出来,代价就是你不能再靠感觉写了。
六处摊完,你会发现五处是便利,一处是陷阱。前几处改的是「怎么写」和「写什么」,最后那处改的是「在哪写」;分开看都不大,合起来就是一套新写法。而陷阱,就藏在第三条里。
2.2 拆细带来的那个坑:一个词的偏差
好了,先看拆细前后的差别。老的 TRANSFER 一刀切下去,覆盖所有传输类操作;拆细之后,你给源阶段写 COPY,它就只认拷贝这一件事。
这里要停一下:填充(fill)走的是 CLEAR 阶段,不是 COPY。 所以当你把「填充 → 拷贝」这条依赖的源阶段写成 COPY,vkCmdFillBuffer 的那次写根本没被覆盖。access 掩码可以完全正确,可这条依赖就是不成立。
要特别说明的是,这类错误不会以任何显眼的方式跳出来。没有崩溃,没有画面异常,计时也照常——它只在你怀疑「这里是不是该有同步」并且主动打开校验工具时才会露面。这和我们后面要讲的「写宽」是两码事:写宽是性能问题,写错是正确性问题,而正确性问题偏偏最难发现。
看两个只差一个词的屏障。先是写对的那条:
//-------------------【屏障:填充 -> 拷贝 的 RAW】-------------------
// 描述:填充走 CLEAR 阶段,拷贝走 COPY 阶段,源阶段必须写 CLEAR
//------------------------------------------------------------------
//【1】源:CLEAR + TRANSFER_WRITE,目的:COPY + TRANSFER_READ
VkMemoryBarrier2 m_precise = buf_bar(VK_PIPELINE_STAGE_2_CLEAR_BIT,
                                     VK_ACCESS_2_TRANSFER_WRITE_BIT,
                                     VK_PIPELINE_STAGE_2_COPY_BIT,
                                     VK_ACCESS_2_TRANSFER_READ_BIT);
VkDependencyInfo di = { 0 };
di.sType = VK_STRUCTURE_TYPE_DEPENDENCY_INFO;
di.memoryBarrierCount = 1;
di.pMemoryBarriers = &m_precise;
vkCmdPipelineBarrier2(cb, &di);
再看写错的那条,它只把源阶段从 CLEAR 换成了 COPY:
//-------------------【屏障:源阶段写错一格】-------------------
//【2】同样的 access 掩码,源阶段却写成 COPY —— CLEAR 的写不再被覆盖
VkMemoryBarrier2 m_stagemiss = buf_bar(VK_PIPELINE_STAGE_2_COPY_BIT,
                                       VK_ACCESS_2_TRANSFER_WRITE_BIT,
                                       VK_PIPELINE_STAGE_2_COPY_BIT,
                                       VK_ACCESS_2_TRANSFER_READ_BIT);
我们把这个偏差做成了实验里的一条路径 stage_miss。它在计时上看不出任何异常,结果也完全正确——可依赖其实已经断了。这条路径的原始日志长什么样,第八章会原样贴出来。
2.3 掩码圈的是管线上的格子
说白了,阶段掩码写的就是「这张图上的哪些格子」。
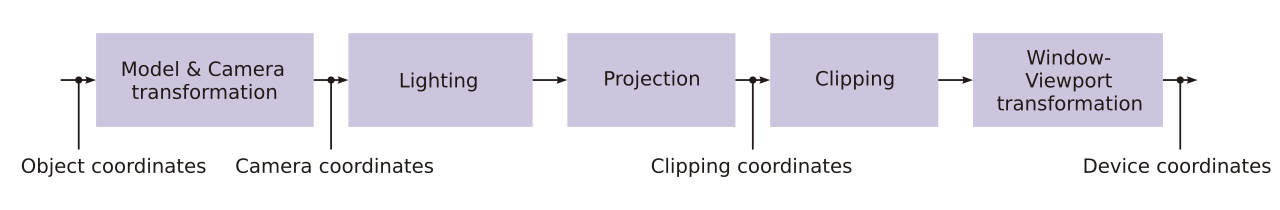
说白了,写对掩码的前提,是脑子里先有这张全流程图:填充落在哪儿、拷贝落在哪儿、写和读各归哪个阶段。sync2 拆细的本意是让你圈得更准,可一旦你脑子里那张图还是旧的粗粒度版本,圈出来的格子就会错位。
所以真正要练的不是背枚举名字,而是先把管线在脑子里走一遍。你写下一个源阶段,就得能指着流程图上的一格说「就是它」。指着说不出来的时候,多半就是写错的开始。
还有一点常被忽略:这张流程图不是静止的。同一段依赖写在不同位置——比如队列提交的边界两侧——它实际覆盖的阶段格子并不一样。所以「这条屏障管到哪儿」这个问题,只有在具体位置上问才有意义。精度本身是收益,精度带来的「多一个词可选」才是陷阱。 下一章,我们把「一次屏障写下去,硬件上究竟发生了什么」拆开看。
三、barrier 是什么操作:一次 flush 加一次 invalidate
好了,很多人写屏障时把它当成「记账」——好像它只是给命令流插个标记,告诉 GPU「这条命令得在那条后面跑」。这一章要把这件事说清楚:屏障不是记账,它是一次真会落到硬件上的内存操作。
3.1 屏障不是记账:可用性与可见性
Vulkan 的同步分两层语义。一层叫可用性(availability),说的是某次写的结果已经离开执行单元、可以被别人拿到;另一层叫可见性(visibility),说的是读的一方终于能看见这份新数据。落到缓存(cache)上,可用性对应把脏行刷到 L2(flush),可见性对应把 L1 里的陈旧副本作废(invalidate)。
所以,一条管内存的屏障,本质就是一次 flush 加一次 invalidate。
这里要补一句很多人会混的地方:执行依赖和内存依赖不是一回事。 执行依赖只管「命令 A 要排在命令 B 之前」,它不保证 A 写的数据对 B 可见;内存依赖才同时管住「先后」与「可见」。一条不带任何 access 掩码的屏障,只给执行依赖;一条写满 access 的屏障,才把两次缓存动作都做实。后面讲三类依赖时会反复用到这条区分。
换句话讲,你写的每一个 access 掩码,最后都要落到这两次缓存动作上——掩码写多宽,flush 与 invalidate 的范围就有多大。
把这两层分开看,很多老问题一下就顺了:为什么有的屏障只写阶段、不写 access 也照样有效?因为它只需要执行依赖。为什么有的屏障 access 写满了却还是不安全?因为它的源阶段写错了,flush 根本没把该刷的东西刷出去。
3.2 一趟缓存往返
有人会想:刷一次、废一次,不就是一条指令吗,能有多贵。问题在于缓存不是一整块,它分层、分域,flush 与 invalidate 都得真跑一趟。zolotukhin.ai 在 2026 年 7 月那篇里把这句话讲得很直:
"A pipeline barrier is not free bookkeeping. It is a memory operation with real hardware cost … a full cache round trip"
「一趟完整的缓存往返」——这就是屏障的物理含义。这句是外部口径,不是本机实测;本机只负责量它落在这个用例上到底有多大,那部分留到第四章。
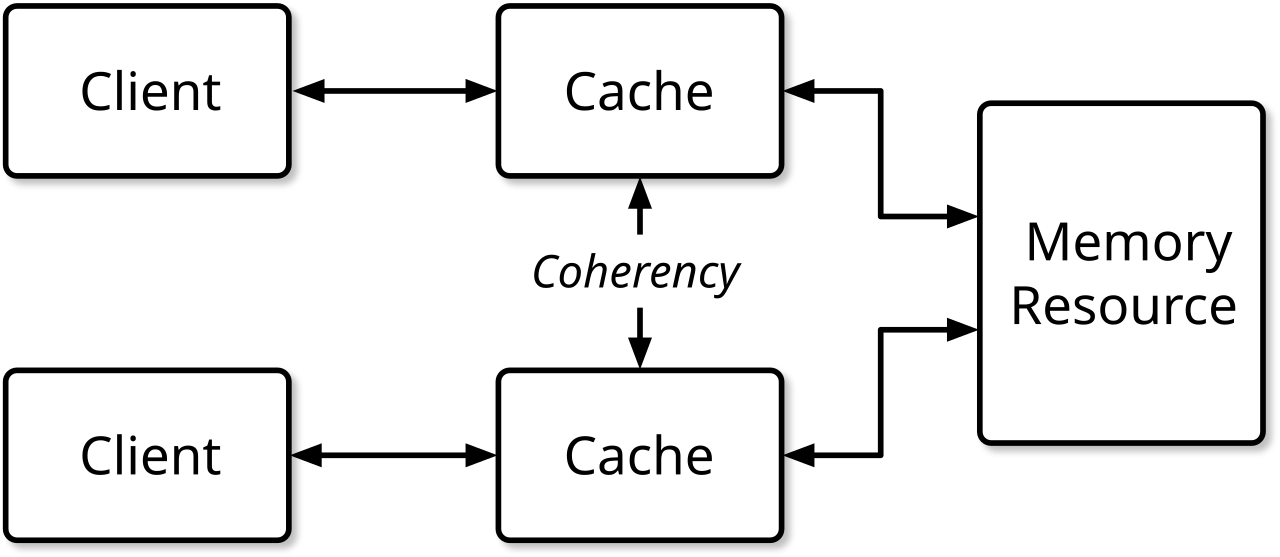
把它放到分层缓存上看,代价就不在「记了一笔账」,而在「数据真的走了一趟」。也正因为如此,屏障的代价可以被「范围」调制:范围窄,往返的只是少数几行缓存;范围宽,往返的就是整个缓存域。这正是后面「精确掩码」与「全掩码」能拉开差距的物理原因。
3.3 最贵的那一档:全屏障
那最贵的一种长什么样?就是源、目的阶段都写 ALL_COMMANDS、access 写满的那条「全屏障」。官方同步示例页第 8 条给了它一句判词:
"You should ONLY USE THIS FOR DEBUGGING - this is not something that should ever ship in real code, this will flush and invalidate all caches and stall everything"
三个重词:ONLY、never、stall everything。它一次把所有缓存都 flush 掉、再全 invalidate,还要把整条流水线(pipeline)拦住等——这已经不是局部依赖,而是全局停下。
我们照这条判词建了一条路径叫 conservative:源与目的阶段都写 ALL_COMMANDS_BIT,access 写 MEMORY_WRITE 与 MEMORY_READ | MEMORY_WRITE。
这里还要说明一点:官方把它说成调试专用,意思是「不值得为它冒风险」,而不是「它会让你慢上几倍」。 这两句话的差别,恰恰是后面要逐条对的三条流行说法之一。它到底慢多少,得用读数说话。
所以「全屏障」的问题不在于它多做了几次缓存动作,而在于它把本该局部的一次依赖,扩大成了全局的等待——流水线里其他互不相干的活儿,也得停下来陪它一起等。范围放大,才是它贵的地方。
OK,这一章回答的是「屏障是什么」:一次 flush 加一次 invalidate,最贵的那档是全局停下。但请记住一句话——「写错」和「写宽」是两回事。 写错(源阶段少写一个词)会让依赖整条失效,代价是正确性;写宽(全掩码)只是让 GPU 多等一会儿,代价才是性能。下一章,我们去量后者。
四、本机实验台:十三条路径同机对照
好了,铺垫到这儿,该上机器了。这一章把实验台整个摆出来:台子是什么、纪律是什么、读数是多少、结果对不对得上。数字全部来自本机,一条外部口径都不会混进来。
4.1 台子:一个二进制,13 条路径
整个实验就是一个二进制(vk_ep03.c)、13 条路径,每帧要做的事完全相同:2 次 vkCmdFillBuffer、2 次 vkCmdCopyBuffer、256 次 vkCmdDraw,再加 1 次布局转换(layout transition)。唯一允许变的,是屏障怎么写。
台子的规格也一并交代:交换链(swapchain)3 张 960×540、呈现模式(present mode)MAILBOX、被读回的缓冲 256 字节、GPU 时间戳 1.0 ns/tick、主队列 64 位有效位。这几项决定了读数的精度——时间戳是 64 位,跨帧相减才不会回绕。
为什么要把「每帧做的事」钉死成完全一样?因为只有用例不变,读数的差才只能归给屏障写法。如果每帧的 draw 次数或拷贝次数也跟着变,你就分不清差异是屏障造成的、还是负载造成的。所以我们宁可把用例做得单调,也要保证变量只有一个。说白了,我们搭的不是一个「渲染器」,而是一把只测屏障的尺子——它故意做得没有花样,正是为了让读数的解释空间尽可能小。
比规格更要紧的是测量纪律:每条路径 ×5 次复跑,每次 600 帧、其中 60 帧预热,只报区间、不报单次。 这一条是后面所有对照能不能成立的前提。
4.2 唯一分开了的那一对
计时总表(同步校验关闭)先摆出来。
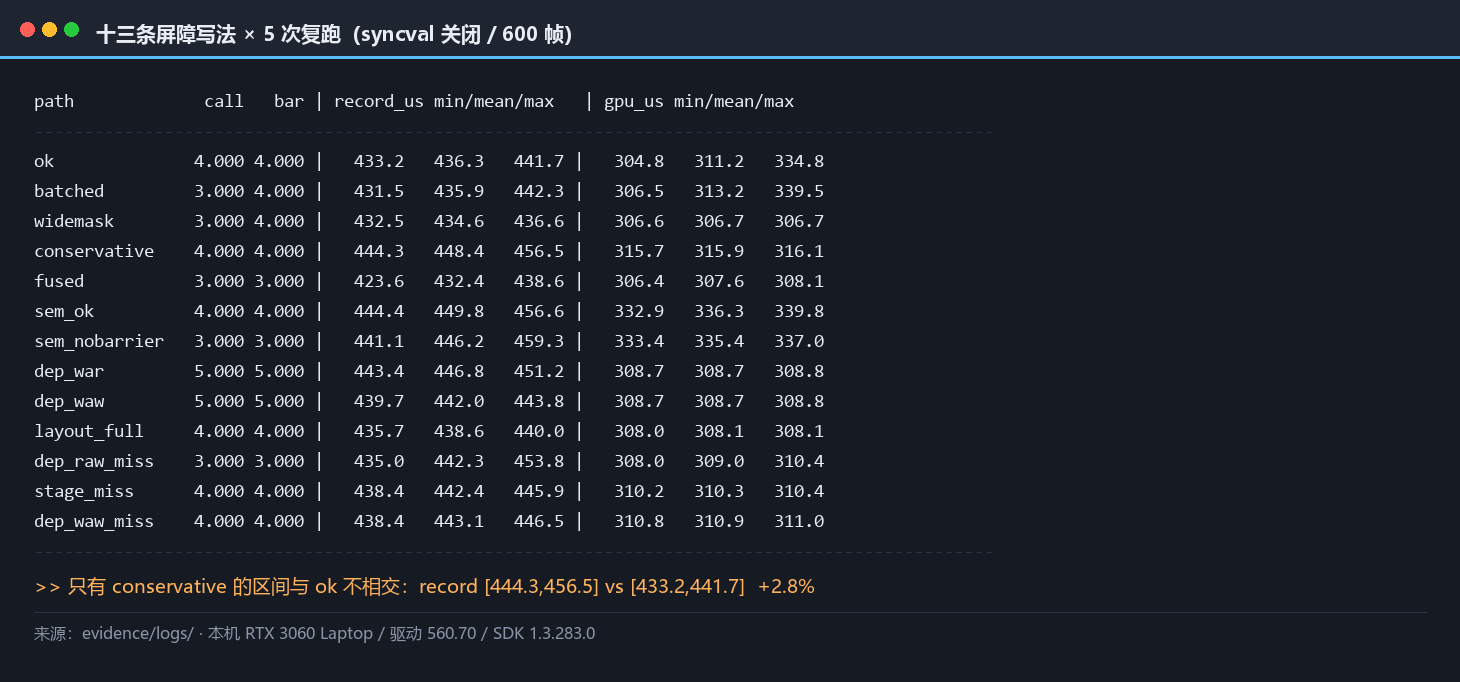
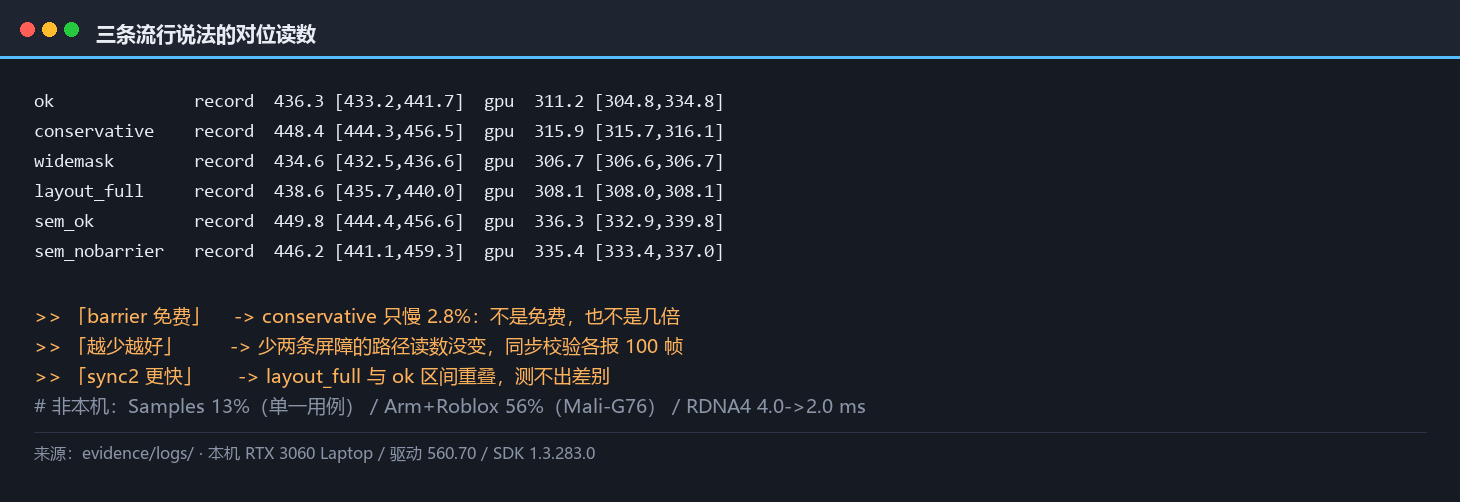
这张表里,唯一一个区间不相交的对照是 conservative(全掩码)。它录制 448.4 µs,对上精确掩码路径 ok 的 436.3 µs,是 +2.8%;GPU 315.9 对 311.2,是 +1.5%;整帧 1.088 ms 对 1.059 ms,是 +2.7%。而且它的区间 [444.3, 456.5] 与 ok 的 [433.2, 441.7] 不相交——13 条里只有这一对,配得上「确实分开了」这句话。
这里要停一下:只慢 2.8%,不是几倍。 官方那句「stall everything」措辞很重,但它是定性描述,不能当成量级来引。全屏障在这个用例上确实更慢、也慢得稳定,可差别是百分之几的量级。
剩下的差异呢?全部落在复跑噪声里。 batched 把两条屏障合成一次调用,驱动调用数从 4 降到 3,可录制 435.9 µs 对 ok 的 436.3 µs,几乎没动;widemask(合并成一条宽掩码)的 GPU 均值 306.7 µs,反而低于 ok 的 311.2 µs;fused 与 dep_raw_miss 各自少一条屏障,也没有更快。说白了,官方「合并掩码会造瓶颈」这条,在本机这个用例上量不到。(细节留到第六章。)
还有一组要如实讲:两次提交接近可辨,但没有分开。 sem_ok(两次提交、屏障保留)的 GPU 是 336.3 µs,对 ok 的 311.2 µs,是 +8.1%;整帧 1.108 ms 对 1.059 ms,是 +4.6%。单看均值差得不小,可两者区间仍然相交(332.9–339.8 与 304.8–334.8),所以只能说「接近但未分离」。
把这几组放在一起读,会得到一个不太「爽」、但很重要的结论:在这台机器、这个用例上,屏障怎么写的代价往往小于直觉。 官方的判词、社区的经验都指向「不要写宽、不要过度同步」,方向没错;可方向对不等于幅度大——幅度是要在本机上量出来的。
4.3 结果等价:65 次运行一个哈希
然后是这一章最能立住的一件事:结果等价。
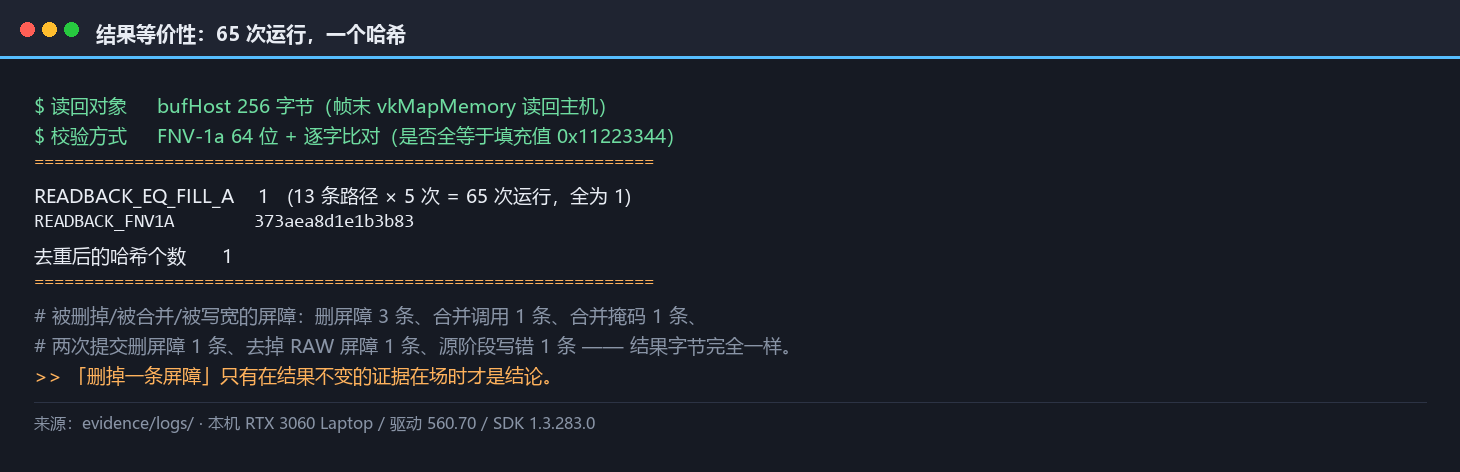
13 条路径 × 5 次 = 65 次运行,读回 256 字节算 FNV-1a 哈希(hash),65 次全部是同一个值 373aea8d1e1b3b83,回读校验位 READBACK_EQ_FILL_A 也全为 1。
这一步看着只是「确认没写崩」,其实是整篇方法论的支点。没有等价性,前面所有读数就只是「跑得快」,而不是「跑得对」。 这条哈希也是全篇最「硬」的一个证据:它不依赖我们对性能的理解对不对,只要读数一致,就说明十三条路径在语义上是同一件事,前面那些计时差异才有比较的意义。
也正因为结果一致,我们才敢让三条故意写错的路径混在里面(dep_raw_miss、stage_miss、dep_waw_miss)。在同步校验(synchronization validation,syncval)关闭时,它们计时正常、结果正确,连验证层(validation layer)都一条错都不报。换句话说,计时和结果都可能正常,坏的只是那条看不见的依赖——这正是验证层要补的地方。这件事有多要命,第八章单独讲。
4.4 测量纪律与两条不是本机的读数
回到纪律。为什么只报区间、不报单次?
因为复跑之间的抖动,常常比我们要找的那点差异还大。 上面那张表里,除了 conservative 那一对,其余路径的最小值与最大值都互相交叠,交叠就意味着「按本机噪声分不开」。这也是为什么 batched 少一次驱动调用、widemask 的 GPU 均值反而更低——它们不是「更快」,是差异淹没在抖动里。
说白了,我们要报告的不是「某个数」,而是「某个区间的位移」。只有当一组区间整体移开、和另一组不再交叠,我们才敢说「这里真的有差别」。这也是为什么下面两条外部读数必须把机器说清楚:同一句结论换到别的机器上,迁移性是不一样的。
这里还要分清两种「没差别」:一种是真没差别,差异确实落在噪声里;另一种是我们这台机器的精度不足以分辨。这两者的措辞必须分开——把「分不出来」写成「就是没差别」,那是另一种形式的夸大。
最后必须标清两条不是本机的读数:Samples 的 pipeline_barriers 样本报过放宽阶段后帧时间改善 13%,那是 PC 台式机上的读数,不是本机;Arm 与 Roblox 在 GDC 2020 报过同一条改动在 Mali-G76 上帧时间最高下降 56%。两台机器都和我们这台不一样,只引原文、不冒充实测。
OK,台子、纪律、读数、等价性都摆完了,也把「哪些差异算数、哪些不算数」划清了。下一章开始,我们拆三类依赖:RAW、WAR、WAW,各自到底需要什么。
五、三类依赖各需要什么:RAW / WAR / WAW
先来看看这一章要解决的第一个真问题。第四章把实验台摆好了:一个二进制、十三条路径,每帧做的事一模一样——两次填充、两次拷贝、256 次绘制、一次布局转换,唯一变量是屏障怎么写。而「怎么写」的第一层,就是先搞清楚你面对的是哪一类依赖:给多了是浪费,给少了是错——这是这三章所有读数的主线。
5.1 三类依赖要的强度不一样
OK,官方 Tutorial 把同步错误归成三类,用的都是很朴素的词:
- 读后写(read-after-write,RAW):先有人写、后有人读,读的人必须等到写完成、而且能看到写的结果。这是「读到垃圾数据」最常见的根因。
- 写后读(write-after-read,WAR):先有人读、后有人写,写的人必须等到读完成——但不需要等读的结果可见,因为此时还没有新数据要给别人看。
- 写后写(write-after-write,WAW):两次写落在同一块内存,后写必须等前写,否则结果取决于谁先到。
三类的差别,说白了就是要保证的东西不一样。RAW 要「你写的我看得见」,是一整套可用性(availability)加可见性(visibility)的活儿;WAR 只要「你读完我再动手」,一堵时序墙就够,不动缓存;WAW 不管「读得对不对」,只认「写的顺序不能乱」,所以需要一次内存依赖(memory dependency)把两次写排好。
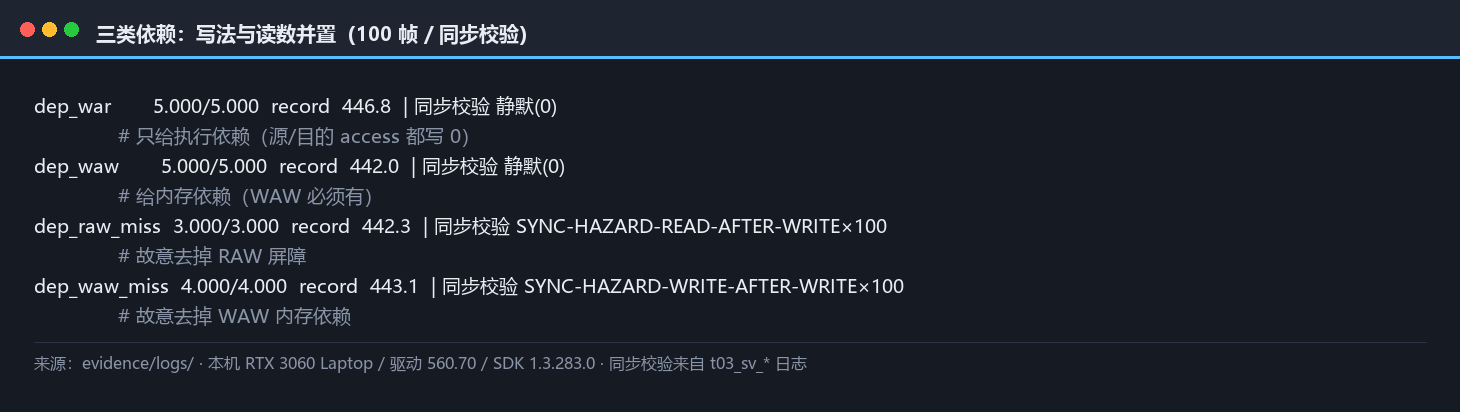
我们把这三种依赖各做成了一条路径,参数对齐到最小必要:dep_war 只给执行依赖,dep_waw 给内存依赖,dep_raw_miss 与 dep_waw_miss 把该给的故意抽掉。这么多条落在这一章,正是因为它最容易写错,也最容易把写错的代价看清楚。
这里要停一下。请注意上面这张图里的一个不对称:三类依赖里,只有 RAW 那一栏要「保证你写的东西我看得见」,另外两类都与此无关。 后面会出现「写得不一样、读数却一样」,根子就在这个不对称上——很多被顺手写进去的访问掩码(access mask),其实是在替 WAR 和 WAW 办一件它们根本不需要的事。
5.2 WAR 不需要 access mask
官方示例页第 1 条判据,关于 WAR 写得非常干脆:
"WAR hazards don't need availability or visibility operations between them - execution dependencies are sufficient. A pipeline barrier or event without any access flags is an execution dependency."
好了,「一条不带任何 access flag 的屏障就是执行依赖」——这句话直接把写法定死了。我们的 dep_war 路径照这条写:源、目的两侧的 access 掩码全部写 0,只留 stage。它不是「忘了写」掩码,是本来就不该写。
读数这边:dep_war 一共 5 次屏障调用 / 5 条屏障(5 / 5),GPU 时间 308.7 / 308.7 / 308.8 µs(最小/均值/最大)。拿它去比基准 ok 的 311.2 µs——把掩码全清空的这条反而略低一点。这点差值落在复跑区间里,不能当结论,但它至少说明:给 WAR 省掉掩码,代价上不会更差。
省掉的到底是什么?接到第三章:屏障在硬件上是一次「脏行写到 L2、L1 失效」的内存往返。WAR 不涉及可见性,掩码写空等于告诉驱动这里不产生缓存操作——省下的不是代码长度,是一次缓存动作。
5.3 WAW 必须有内存依赖
官方示例页第 7 条,关于 WAW 同样不留余地:
"This is an example of a WAW (Write-After-Write) hazard, which always require a memory dependency."
说白了,一个「always」,把话讲死了:WAW 不能只给执行依赖,必须有内存依赖。我们的 dep_waw 路径照此写——两次写之间给上内存依赖,5 / 5 条屏障,GPU 308.7 / 308.7 / 308.8 µs,和 dep_war 几乎一模一样。
然后是对照组 dep_waw_miss:同样的两次写,但把内存依赖去掉。它的 GPU 均值是 310.9 µs,和给了内存依赖的 dep_waw(308.7)也差不出结论。这就是本章最要命的地方——写对和写错,在这台机器的计时上完全看不出区别。
区别在哪?在验证层。打开同步校验(syncval),dep_waw_miss 报 SYNC-HAZARD-WRITE-AFTER-WRITE × 100,100 帧、每帧 1 条、三次复跑一致;而 dep_waw 静默通过。同一份代码结构,只差一个内存依赖,一边报满、一边一条不报。
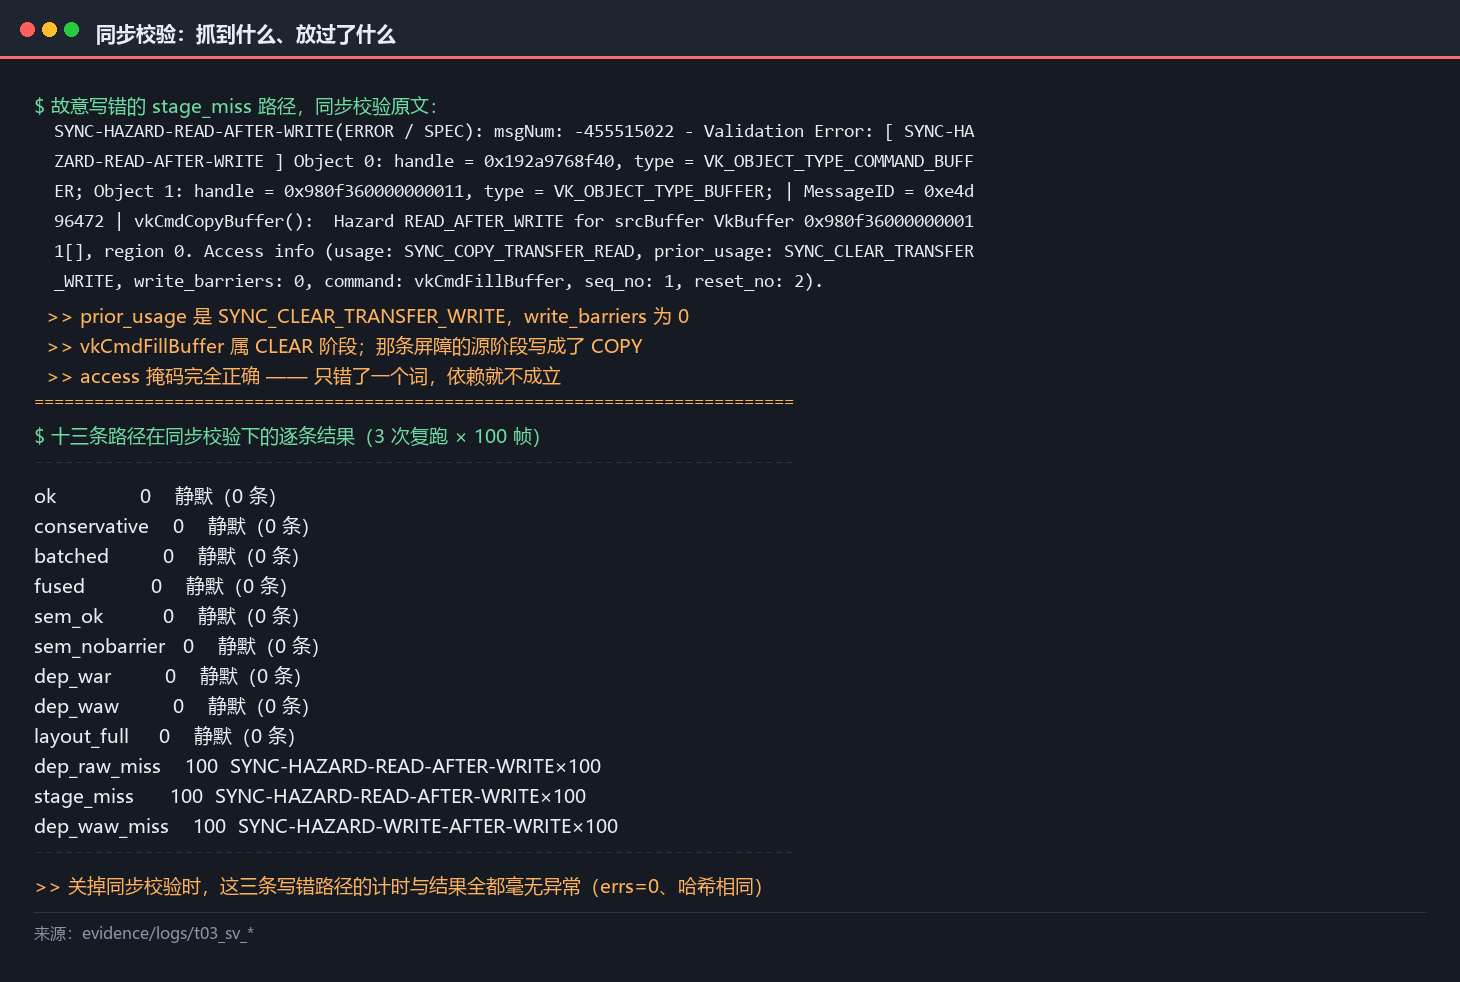
这里提前撂一句实话(完整的账记在第八章):凡是「写错」的路径——dep_raw_miss、dep_waw_miss、stage_miss——在 syncval 关闭时,计时正常、结果正确(哈希和 ok 一模一样)、验证层一条错都不报。也就是说,「不报错」和「没写错」是两件事。
5.4 三类同机对照:执行依赖与内存依赖的分界
OK,把这一章的四条路径摆到一张表上,分界就清楚了。
| 路径 | 依赖类型 | 给了什么 | 屏障条数 | GPU µs(最小/均值/最大) |
|---|---|---|---|---|
dep_war |
WAR | 只给执行依赖(access 全 0) | 5 / 5 | 308.7 / 308.7 / 308.8 |
dep_waw |
WAW | 给内存依赖 | 5 / 5 | 308.7 / 308.7 / 308.8 |
dep_waw_miss |
WAW | 抽掉内存依赖 | 4 / 4 | 310.8 / 310.9 / 311.0 |
dep_raw_miss |
RAW | 抽掉屏障 | 3 / 3 | 308.0 / 309.0 / 310.4 |
OK,看了这张表大家会发现一件反直觉的事:四行的 GPU 均值几乎贴着,全落在复跑区间以内。 从 308.7 到 310.9,最「大方」的和最「抠门」的写法,机器根本分不出来——计时这把尺子在这一章彻底失灵。 想区分它们只能靠结果和验证层:十三条路径、65 次运行,FNV-1a 全是同一个值 373aea8d1e1b3b83,写错的那几条连哈希都一样。
本机这条分界就是:执行依赖管「顺序」,内存依赖管「可见性」。 WAR 只要顺序,WAW 还要内存排布,RAW 两样都要——而这三件事在读数上都藏得住,只在验证层里现形。
好了,三类依赖讲完,本章可以收成一句:先判断是哪一类依赖,再决定给多少。 下一章要处理的是一个更狡猾的问题——「合并」这个词,本身就有两个意思。
六、「合并」的两义性:合并调用好,合并掩码坏
说说这一章为什么单独立出来。十三条路径里有两条只差一处:batched 和 widemask。它们做的是同一件事——把两条原本分开的依赖合并成一次 vkCmdPipelineBarrier2 调用,区别只在合并之后那两条依赖是原样保留,还是被揉成一条更宽的掩码。这么小的差别,却对应着官方材料里一句分量很重的话。
6.1 官方原话里的那个 bottleneck
Khronos Tutorial 的 The Synchronization 2 Advantage 一节里有一句原话,直接纠正了一条流行说法:
"By merging the stages at the function level, you were inadvertently telling the GPU to wait for all the source stages to finish before any of the destination stages could start. You were creating a bottleneck where one didn't need to exist."
这句话的厉害之处,是它把中文里含混的「合并」劈成了两件不同的事:
- 合并函数调用——把几条屏障塞进一次
vkCmdPipelineBarrier2调用。目的是少进几次驱动,让驱动有机会去掉冗余操作。 - 合并 stage 掩码——把几个互不相干的依赖揉成一个宽掩码。这件才是官方说的 bottleneck,因为它等于告诉 GPU「所有源阶段都结束之前,任何一个目的阶段都不许开始」。
前一件是省事,后一件是加锁。 两件事共用「合并」两个字,才会被人混着说。我们把它们做成了两条只有一处差异的路径,就为了分开量。
6.2 合并调用:两条依赖原样保留
先看 batched。它还是那个「两条依赖」的场景,但这次用一个 VkMemoryBarrier2 加一个 VkImageMemoryBarrier2 装进一次调用:
//-------------------【合并调用:依赖原样保留】-------------------
// 描述:两条依赖塞进一次 vkCmdPipelineBarrier2,各自掩码不变
//--------------------------------------------------------------
//【3】合并调用:一次 vkCmdPipelineBarrier2,两条依赖原样保留
VkMemoryBarrier2 mb[1] = { m_precise };
VkImageMemoryBarrier2 ib[1] = { i1_precise };
dep2(cb, mb, 1, ib, 1);
注意 mb[0] 和 ib[0] 用的还是 m_precise 与 i1_precise——也就是 ok 路径里那两条精确屏障,一字未改。合并的只是调用次数,同步语义一点没动。
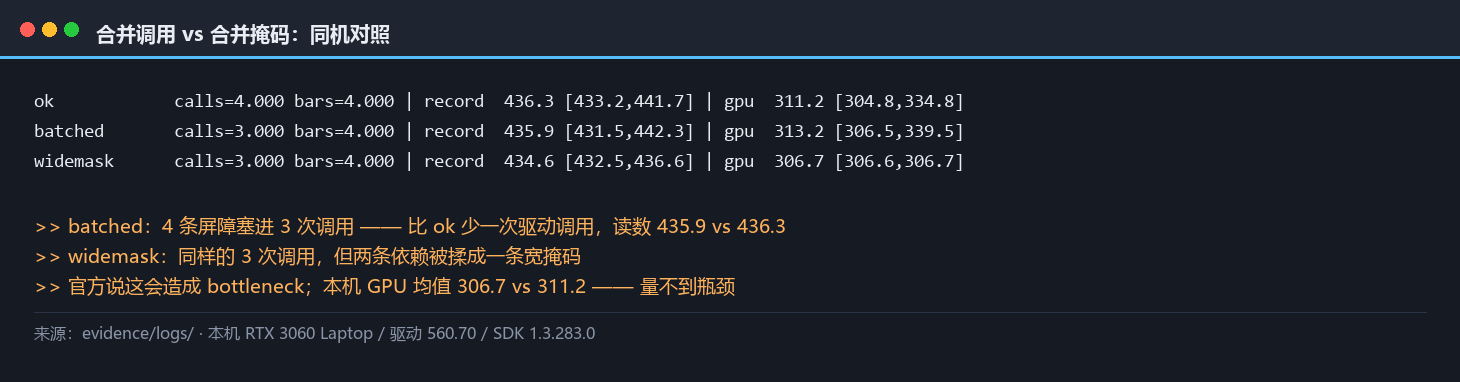
读数也印证了这一点:batched 是 3 次调用 / 4 条屏障(3 / 4),比 ok 的 4 / 4 少进一次驱动;录制时间 435.9 µs 对上 ok 的 436.3 µs——少了那次调用,读数没变(这点差值在复跑区间里,不能当结论)。
三方口径在这件事上是统一的。官方示例页第 3 条:「Batch barriers where possible if it doesn't change how synchronization takes place」——只要不改变同步语义就尽量批量;AMD 的 RDNA 性能指南建议「Batch groups of barriers into a single call」;Intel 的 Gen11 指南给了驱动侧动机——每次屏障一般对应一次缓存刷写或 GPU 停顿,批量提交能让驱动把屏障推迟、合并到 render pass 边界。说白了,合并调用就是把决定权交给驱动——你少敲几次门,驱动自己知道哪些能省。
6.3 合并掩码:官方说会造瓶颈,本机量不到
再看 widemask。它和 batched 唯一的差别,是那两条依赖不再原样保留,而是被揉成一条更宽的依赖:
//-------------------【合并掩码:依赖被揉宽】-------------------
// 描述:还是一次调用,但两条依赖合成一条更宽的掩码
//------------------------------------------------------------
//【4】合并掩码:还是一次调用,但两条依赖被揉成一条更宽的依赖
VkMemoryBarrier2 m_wide = buf_bar(VK_PIPELINE_STAGE_2_CLEAR_BIT,
                                  VK_ACCESS_2_TRANSFER_WRITE_BIT,
                                  VK_PIPELINE_STAGE_2_COPY_BIT
                                  | VK_PIPELINE_STAGE_2_COLOR_ATTACHMENT_OUTPUT_BIT,
                                  VK_ACCESS_2_TRANSFER_READ_BIT
                                  | VK_ACCESS_2_COLOR_ATTACHMENT_WRITE_BIT);
请大家盯一眼目的阶段:COPY 和 COLOR_ATTACHMENT_OUTPUT 被 | 到了一起,目的 access 也是两个拼起来——这就是官方那句 bottleneck 说的写法:本来只有一条依赖需要等 COLOR_ATTACHMENT_OUTPUT,现在这条更宽的依赖会让两边互相等。
按官方的判据,这一条应该更慢。本机量的结果呢?widemask 是 3 次调用 / 4 条屏障(3 / 4),和 batched 一样;但它的 GPU 均值是 306.7 µs,不但没比基准 ok 的 311.2 µs 慢,反而略低一点。
这里要停一下,把话说清楚:官方「合并掩码会造瓶颈」这条判据,在本机这个用例上量不到。 我们量到的是「没有变得更慢」,不是「验证了官方说法」,也不能反过来写成「官方说错了」——它只说明:在这台机器、这个用例的规模下,宽掩码带来的额外等待还没到能被读数分辨的量级。 官方讲的是机制,本机量的是量级(这点等待淹在复跑噪声里)。
那本机唯一量出来的、区间不相交的对照是谁?是 conservative——每条屏障都用 ALL_COMMANDS 加全套内存掩码的那条。它的录制是 448.4 µs 对 ok 的 436.3(+2.8%),GPU 315.9 对 311.2(+1.5%),整帧 1.088 对 1.059 ms(+2.7%);区间 [444.3, 456.5] 与 ok 的 [433.2, 441.7] 不相交。这是十三条路径里唯一一条把「差异」坐实的。
但请注意量级:最保守的写法只慢了 2.8%,不是几倍。 官方那句「stall everything」措辞很重,可在这里它对应的实测代价是个位数百分比——重词不能当成量级来引。所以本机的结论是:把掩码写宽的代价真实存在,但小到需要「全掩码」这种极端写法才量得出来;温和的宽掩码(widemask)在这个用例里藏进了噪声。
6.4 驱动视角:屏障位置与 hoist 空间
那为什么温和的宽掩码在本机量不到?一个不在我们观测范围内的解释是:驱动把这些屏障挪了位置。
这里要接第三章那句:「有成本」不等于「成本按你写的位置发生」。Intel 的 Gen11 指南说得很直白:驱动「allow the driver to defer and hoist barriers to render pass edges」,把屏障推迟、提升(hoist)到 render pass 边界;AMD 也建议把屏障成组折叠进一次调用,图的就是给驱动留出这种搬移的空间。
一旦屏障被驱动挪了位置,你在源码里把两条依赖写成一条宽掩码,落到硬件上可能还是被拆回两个位置执行。 这就是本机「量不到」最可能是怎么回事——不是没有瓶颈,是这个用例里的瓶颈被驱动的调度盖住了。
必须说清楚:这条只是解释,不是实测。 边界声明第三条(§0.3)讲过,Vulkan 没有任何官方接口能看到驱动内部的中间表示或 JIT 决策,屏障怎么合并、怎么提升,只能观测外部行为——所以我们只写「驱动有这个空间,读数与『被搬移』不矛盾」。
好了,这一章收一下:「合并」要当两个词用。 合并函数调用,官方、AMD 都鼓励,本机读数支持它不更差(batched 435.9 对 436.3);合并 stage 掩码,官方点名为 bottleneck,本机这个用例量不到额外代价,唯一坐实的是极端写法 conservative 的 +2.8%。下一章换一个变量:把「布局转换」单独量。
七、layout transition 单独量
先来看看这一章要还的债。ep02 的用例里其实已经有两次布局转换(layout transition)——UNDEFINED → COLOR_ATTACHMENT_OPTIMAL 与 COLOR_ATTACHMENT_OPTIMAL → PRESENT_SRC_KHR——但它们当时只是被画进时序图,没有被单独量过。ep02 结尾留了一句「下一篇要回答一次布局转换到底花多少」,这一章来兑现。
7.1 ep02 留下的那笔债:一次布局转换在帧里的位置
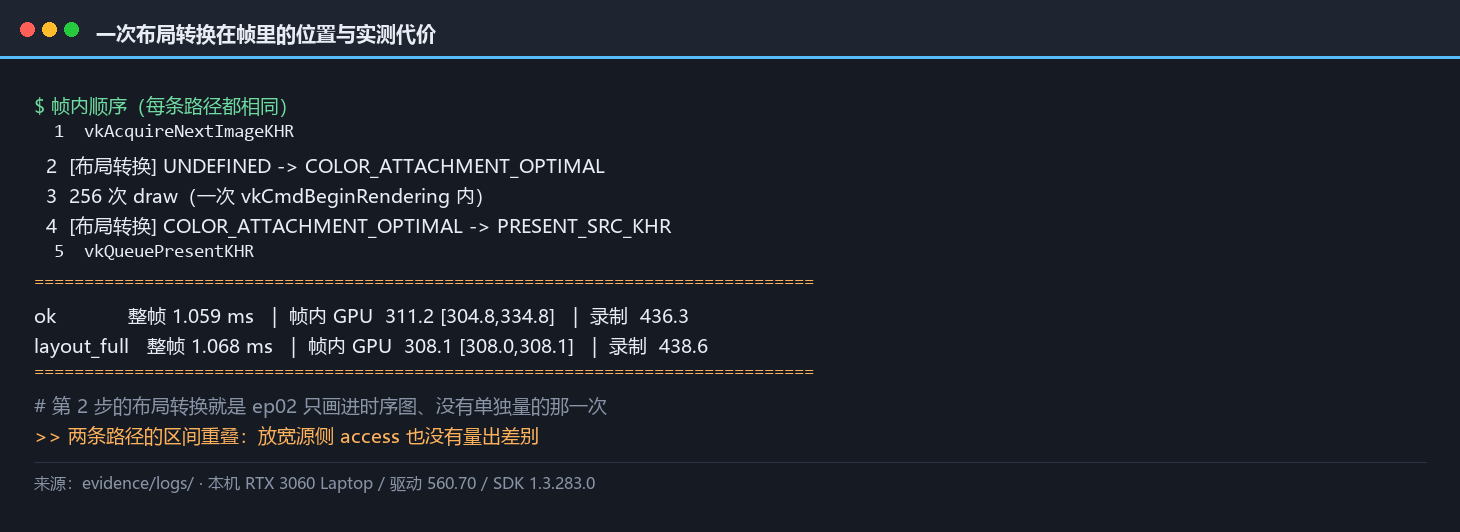
先说清楚布局转换在实验台里的位置。十三条路径每帧都包含 1 次布局转换,它是「每帧内容完全相同」的固定成分之一——和两次填充、两次拷贝、256 次绘制并列。我们没给它单开一条路径,而是把它放在每帧都会发生的那个位置上,再看它的写法变化会不会被读数分辨出来。
这一点决定了本章能回答什么:我们不报「一次布局转换值多少微秒」——实验台没把它单独摘出来测。本章量的是写法从精确变宽松时,读数会不会变。
7.2 只做布局转换时可以空着 src access
官方示例页第 6 条,关于布局转换给了唯一一条能改写法的地方:
"you still need a memory barrier to do a layout transition though, but you don't need any access types in the src access mask"
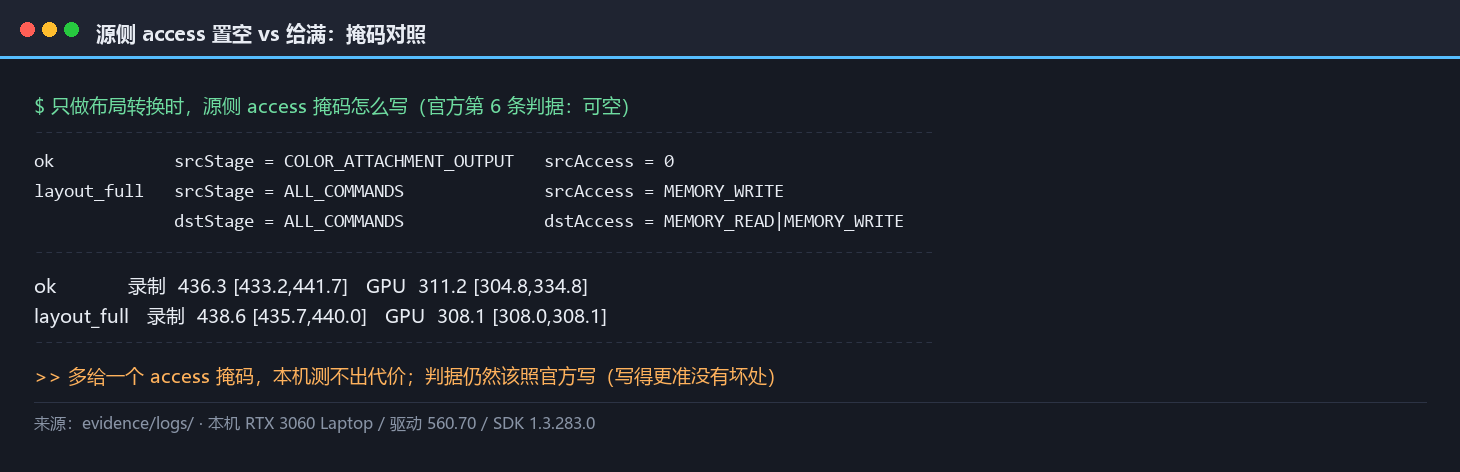
这句话有两半。前半是底线:布局转换仍然需要一条内存屏障——不能像第六章里那些被信号量覆盖的屏障整条删掉,因为转换本身要动缓存。后半才是省法:源侧 access 掩码(src access mask)不必给任何 access 类型。
为什么源侧可以空?回到第三章那个模型——布局转换本质上是一次缓存操作,它要保证「转换前对这张图的写已经落到能被安全重排的状态」,而这一步不依赖具体的源 access 类型。多数写法在这里会顺手补一个 COLOR_ATTACHMENT_WRITE 之类的掩码,其实多给了一个。
layout_full 这条路就是照着「多给」来写的:布局转换的源侧给一个宽 access 掩码。它和 ok 的差别,恰好就在这半边。
7.3 layout_full 同机对照:宽 access 也没量出差别
读数摆出来。layout_full 是 4 次调用 / 4 条屏障(4 / 4),录制 435.7 / 438.6 / 440.0 µs(最小/均值/最大),GPU 308.0 / 308.1 / 308.1 µs,整帧 1.068 ms。
拿它去比基准 ok:GPU 均值 308.1 对 311.2,整帧 1.068 对 1.059 ms。又是「差不出结论」。 给源侧多补了一个宽 access 掩码的 layout_full,读数落在 ok 的复跑区间里,甚至 GPU 均值还略低一点。
于是本章的结论,和第六章是同一个教训的第二次出现:「源侧 access 掩码能不能空着」这条判据,语义上是确定的(官方明写可以空),读数上却量不出差别。 空着是对的、省掉了一条冗余掩码,但那点开销在这台机器、这个用例上量不出来。
这跟「删掉屏障不会更快」是同一类结论——sem_nobarrier 的 GPU 均值 335.4 µs 对上 sem_ok 的 336.3 µs,删掉那条官方点名的屏障,同样测不出快慢。
还需不需要再提醒一句边界?要。本章量的是「写法的代价差」,不是「布局转换本身的绝对代价」。 有朋友会问:布局转换本身到底贵不贵?诚实回答是:本篇实验台答不了,因为它没把布局转换单独摘出来做一条路径。ep02 用逐像素比对确认了两次转换结果正确,本篇又用 FNV-1a(65 次运行同一个值 373aea8d1e1b3b83)确认了一次——但「转换本身值多少」,本机这一轮没测。 想拿到它得另设「有转换 vs 无转换」的对照,那是补测的事。
7.4 三章合起来:能分辨对错的是验证层
把这三章收成一句不太好听、却很实在的话:在这台机器、这个用例上,屏障「怎么写」的代价差别大多藏在复跑噪声里;真正能分辨对错的不是帧时间,是验证层。 下一章就把验证层那把尺子端上来——它开了会涨多少开销,以及它自己有什么盲区。
八、同步校验:能抓三类 hazard,也有盲区
好了,前面七章一路在量「写法的差别」。这一章换个方向:写错的差别。
8.1 它不是一个「跟着验证层一起打开」的东西
先来看看这件事最容易踩的地方。同步校验(synchronization validation,syncval)是 VK_LAYER_KHRONOS_validation 里的一个功能开关,必须用 VkValidationFeaturesEXT 明确打开。启用了验证层、但没写这个开关,验证层会照常检查 API 用法,却对依赖关系一言不发。
言归正传,本篇第一次跑就踩进去了:三条故意写错的路径跑完,验证层一条错都没报,读数还挺好看。当时差点把「本机没有 hazard」写进正文。后来才反应过来——是没打开。
//-------------------【打开同步校验】-------------------
// 描述:syncval 是验证层的功能开关,不写它等于没开
//------------------------------------------------------
//【1】最佳实践与同步校验是两个独立的启用量
VkValidationFeatureEnableEXT bp_en[2] = {
    VK_VALIDATION_FEATURE_ENABLE_BEST_PRACTICES_EXT,
    VK_VALIDATION_FEATURE_ENABLE_SYNCHRONIZATION_VALIDATION_EXT
};
vf.enabledValidationFeatureCount = syncval_on ? 2u : 1u;
vf.pEnabledValidationFeatures = bp_en;
这段代码里的 syncval_on 来自环境变量,所以同一个二进制可以带着它跑、也可以不带它跑——两条读数才可比。
8.2 三条写错的路径,只有它抓得住
说白了,我们把三条故意写错的路径和另外十条正确的路径放在一起看,结论是这样:
| 观察项 | 同步校验关闭 | 同步校验打开 |
|---|---|---|
| 计时 | 13 条路径的读数全部落在各自的复跑区间内,看不出异常 | 保留(本篇不在打开状态下取性能读数) |
| 结果 | 65 次运行的读回哈希全部是同一个值 373aea8d1e1b3b83 |
同 |
| 验证层报错 | 0 条 | dep_raw_miss 与 stage_miss 各报 SYNC-HAZARD-READ-AFTER-WRITE 100/100 帧;dep_waw_miss 报 SYNC-HAZARD-WRITE-AFTER-WRITE 100/100 帧 |
这就是本篇最想让大家记住的一句:写错的路径,在正确的计时和正确的结果里,可以安静地活很久。「不报错」与「没写错」是两件不同的事,中间隔着的是一个必须手动打开的开关。
三条错例覆盖两类 hazard:
- RAW(read-after-write,读后写):填充写完之后没有让这次写对后续的读可见,读到的可能还是旧字节。两条错例都属于这一类,但原因不同——一条是屏障整条没了,另一条是屏障在、掩码写错。
- WAW(write-after-write,写后写):连续两次写同一块内存,中间没有内存依赖。官方第 7 条判据写得很硬——「always require a memory dependency」——本机把这条撞实了:去掉那条依赖,同步校验立刻报满 100 帧。
- WAR(write-after-read) 本篇只造了对例(
dep_war,用只带执行依赖的屏障,同步校验静默、结果不变),没有造错例。这一条如实登记,不假装三类都测全了。
8.3 stage 掩码错一个词,依赖就不成立
好了,这一节是整篇里最值得单独拎出来的一处。stage_miss 路径的那条屏障,access 掩码完全正确,只是源阶段写成了 COPY。同步校验的原始输出是这样的:
Hazard READ_AFTER_WRITE for srcBuffer ..., region 0.
Access info (usage: SYNC_COPY_TRANSFER_READ, prior_usage: SYNC_CLEAR_TRANSFER_WRITE,
write_barriers: 0, command: vkCmdFillBuffer, seq_no: 1, ...)
请留意 prior_usage 是 SYNC_CLEAR_TRANSFER_WRITE,以及那个刺眼的 write_barriers: 0——意思是「这条写没有任何屏障作用在它上面」。
原因在 sync2 的第二条改动里:老的 TRANSFER 阶段被拆成了 COPY / RESOLVE / BLIT / CLEAR 四个细粒度阶段,而 vkCmdFillBuffer 属于 CLEAR。把源阶段写成 COPY,覆盖的是拷贝,覆盖不到填充。
对的那一条和错的那一条只差一个词:
//-------------------【屏障:填充 -> 拷贝 的 RAW】-------------------
// 描述:填充走 CLEAR 阶段、拷贝走 COPY 阶段,源阶段必须写 CLEAR
//------------------------------------------------------------------
//【1】对:源阶段 CLEAR
VkMemoryBarrier2 m_precise = buf_bar(VK_PIPELINE_STAGE_2_CLEAR_BIT,
                                     VK_ACCESS_2_TRANSFER_WRITE_BIT,
                                     VK_PIPELINE_STAGE_2_COPY_BIT,
                                     VK_ACCESS_2_TRANSFER_READ_BIT);

//【2】错:同样的 access 掩码,源阶段写成 COPY
VkMemoryBarrier2 m_stagemiss = buf_bar(VK_PIPELINE_STAGE_2_COPY_BIT,
                                       VK_ACCESS_2_TRANSFER_WRITE_BIT,
                                       VK_PIPELINE_STAGE_2_COPY_BIT,
                                       VK_ACCESS_2_TRANSFER_READ_BIT);
为什么这条值得单独讲? 因为常见的屏障自查清单几乎全都盯着 access 掩码——「源 access 有没有写」「目的 access 有没有漏」。这一条错法,那些清单一条都抓不到:access 两边都没问题,只有在阶段这一层才能看出来。而它恰恰是 sync2 新增的坑:粒度越细,越容易漏。
8.4 它的代价,以及它的盲区
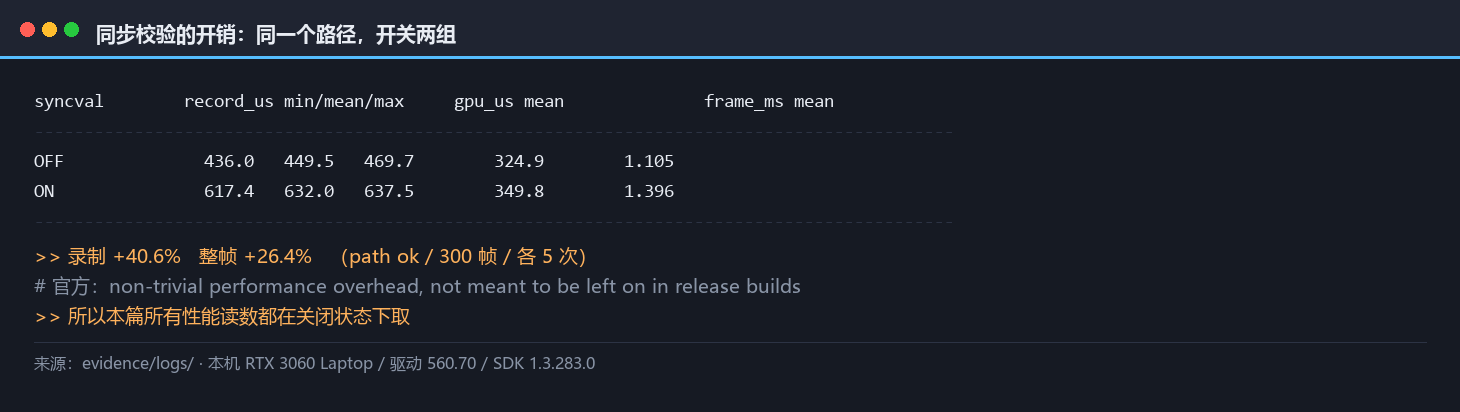
说白了,官方把同步校验的开销写成 "non-trivial performance overhead … not meant to be left on in your production or release builds"。本机把「non-trivial」量成了一个数——同一个 ok 路径、同样 300 帧,只切换那个环境变量:
| 模式 | 录制 µs(均值,区间) | GPU µs 均值 | 整帧 ms 均值 |
|---|---|---|---|
| 同步校验关闭 | 449.5(436.0–469.7) | 324.9 | 1.105 |
| 同步校验打开 | 632.0(617.4–637.4) | 349.8 | 1.396 |
| 差 | +40.6% | +7.7% | +26.4% |
录制时间涨了四成、整帧涨了四分之一。这就是为什么本篇所有性能读数都在关闭状态下取——不是嫌麻烦,是打开之后的数就不是原来那个数了。
再看它的盲区。LunarG 在 Vulkanised 2024 的演讲里自己写了一条:先报出的 hazard 会掩盖同一块内存上的后续 hazard。 这句话的分量在于它来自工具作者:工具可信,但不是全覆盖。所以正确的用法是把它当成「把这类 bug 从'看不见'变成'看得见'」的第一步,而不是「跑一遍干净就等于写对了」。本篇 stage_miss 那条错误的发现顺序也是一个例子——我们先是自己读出了 prior_usage 里的 CLEAR,才回头确认工具报的是这个原因。
九、与 ep02 的接缝:时间线信号量解决不了的事
9.1 交换链那道墙:驱动不拦你,验证层拦你
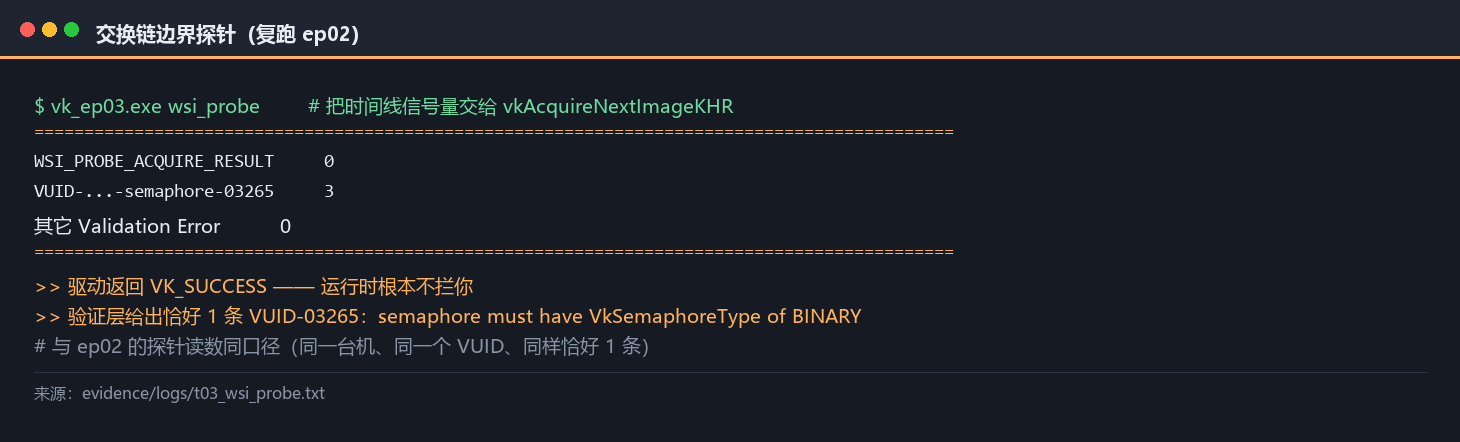
这一节先把 ep02 的探针复跑一遍。那是一次故意失败的探测:把一个时间线信号量交给 vkAcquireNextImageKHR。官方的说法是硬边界——
"swapchain acquire and present operations still require legacy binary semaphores and cannot yet wait on or signal timeline semaphores directly."
本机复跑的结果与 ep02 完全一致,两条都记下来:
WSI_PROBE_ACQUIRE_RESULT 0          ← 驱动返回 VK_SUCCESS,不报错
VUID-vkAcquireNextImageKHR-semaphore-03265   ← 验证层给出恰好 1 条
驱动不拦,验证层拦。 这条读数的用法不是「证明时间线信号量不能用在交换链上」,而是提醒一件事:同一个 API 调用,运行时与验证层可能给你完全不同的答复。 这类边界只靠跑是发现不了的,必须让验证层在跑的时候开着。
9.2 屏障源阶段不得早于等待的目标阶段
第二条接缝是官方九条判据里的第 9 条:
"The stages used in srcAccessMask must be equal to (or logically later than) the values in
VkSubmitInfo::pWaitDstStageMask… otherwise the barrier is not guaranteed to occur after the semaphore wait."
说白了,信号量的等待只对「不早于等待阶段」的那些阶段起作用。等待阶段写得越窄,被它约束的命令越少;写得太窄,屏障就可能跑在它前面。
本篇 sem_ok 与 sem_nobarrier 这两条路径正好把这条判据用上了。它们把一帧拆成两次提交:第一次只做填充、信号一个二元信号量;第二次做其余的全部工作,等待阶段设成 TRANSFER,而第二次提交里读那块缓冲的拷贝属于 COPY。由于 TRANSFER 是 COPY / RESOLVE / BLIT / CLEAR 的合集,它覆盖了 COPY——所以 sem_nobarrier 把屏障整条删掉之后,同步校验是静默的。
这里藏着一个很实用的不对称:等待阶段可以用粗的(TRANSFER),屏障的源阶段必须用细的(CLEAR)。 前者粗一点只是多等一会儿,后者粗一点、错一点就是漏掉依赖。
9.3 它解决的是提交之间的排序
把 ep02 与本篇的结论并在一起看,时间线信号量的边界就清楚了:它解决的是队列提交之间的排序,用一种比栅栏更轻的方式表达「这一批等那一批」。
而命令缓冲内部的排序——布局转换(layout transition)、源 access 的脏行写进 L2(cache flush)、目的 access 在 L1 失效(invalidate)——全都是屏障的活,信号量一件都代不了。所以第七章量过的那两次布局转换,一次都省不掉。
这也正是 ep02 那句「可替代 ≠ 更快」在本篇的续写:可删 ≠ 删了更快。 sem_nobarrier 比 sem_ok 少一条屏障,GPU 均值 335.4 vs 336.3 µs——测不出差别。屏障确实可以删(同步校验静默、结果不变),但删掉它不会带来收益。省下来的是一条指令,不是一段时间。
十、三条流行说法逐条对
10.1 第一条:「barrier 是免费的记账」
这条说法把屏障当成一次纯语法操作——写下去只影响编译器排命令的顺序,本身不花钱。反证来自社区的一手材料,那段描述把屏障还原成一次真实的内存往返:
"A pipeline barrier is not free bookkeeping. It is a memory operation with real hardware cost … on RDNA4 that barrier is a full cache round trip the batch of one has no way to hide."
那次实测里,用 kernel fusion 消掉中间写之后,barrier 造成的气泡从 4.0 ms 降到 2.0 ms。注意这是 RDNA4 上、LLM 推理场景里的读数,不是本机读数。
那本机呢?本篇能测到的最大差别,就是把每条屏障都写成全掩码的 conservative 路径:录制 +2.8%、GPU +1.5%、整帧 +2.7%。这不是「免费」,但也远不是「几倍」。 两个数字放在一起看才有意思:一边是「不是免费的」这句话完全成立,另一边是它的量级取决于工作负载——本机这个用例每帧只有两次填充、两次拷贝、256 次 draw,屏障造成的等待有大量空闲可以吞掉。
10.2 第二条:「barrier 越少越好」
这条说法比第一条更能打动人,因为它听起来像个优化原则。它错在把数量当成了目标。
本机有两组直接的反证。dep_raw_miss 与 stage_miss 各比 ok 少一条生效的屏障,fused 连中间那次拷贝带屏障一起少了;三条路径的读数全部落在复跑区间内,看不出更快。而它们的同步校验结果分别是报满 100 帧、报满 100 帧、静默——前两条少写的那一条,恰恰是不能少的。
正确的说法应该是「把不必要的等待去掉」,而不是「把屏障写少」。官方示例页第 8 条把话说得很重("ONLY USE THIS FOR DEBUGGING"),正是因为它去掉的不是等待,是全部的并行机会——方向刚好相反。
那「该少写」的那一半在哪里?官方第 5 条判据给了条件:已经被信号量覆盖、且没有布局变化时,屏障可以整条删掉。本篇的 sem_nobarrier 就是这个条件的一次本机构造:同步校验静默、结果不变、读数测不出差别——判据成立,收益为零。
10.3 第三条:「sync2 更快」
这条说法把一次写法换代读成了一次性能升级。本机读数不支持它。
sync2 带来的直接可比项只有一处:layout_full 与 ok 的差别——前者给布局转换一个宽的源 access,后者按官方第 6 条判据把源 access 留空。两条路径的 GPU 均值分别是 308.1 与 311.2 µs,区间重叠,测不出差别。而本篇唯一能稳定测出的差别,来自那个被判据明确禁止的写法(全掩码),不是来自 sync2 本身。
sync2 真正的收益不在速度上,在两处写法上:stage 与 access 成对出现,让「哪个阶段配哪个访问」这件事一眼可查;以及阶段粒度拆细,让依赖能写得更准。前者省的是人读代码的时间,后者省的是 GPU 等待——而后者有代价,就是 §8.3 那个坑。
三条说法对完,共同的错误是同一个:把「少写」当成了目标。 真实的判据永远是那三条关于依赖本身的问题——这块内存谁写谁读、要不要跨队列、有没有布局转换——写出来的屏障条数是这三问的结果,不是原因。
十一、迁移判据:从旧接口增量迁 sync2
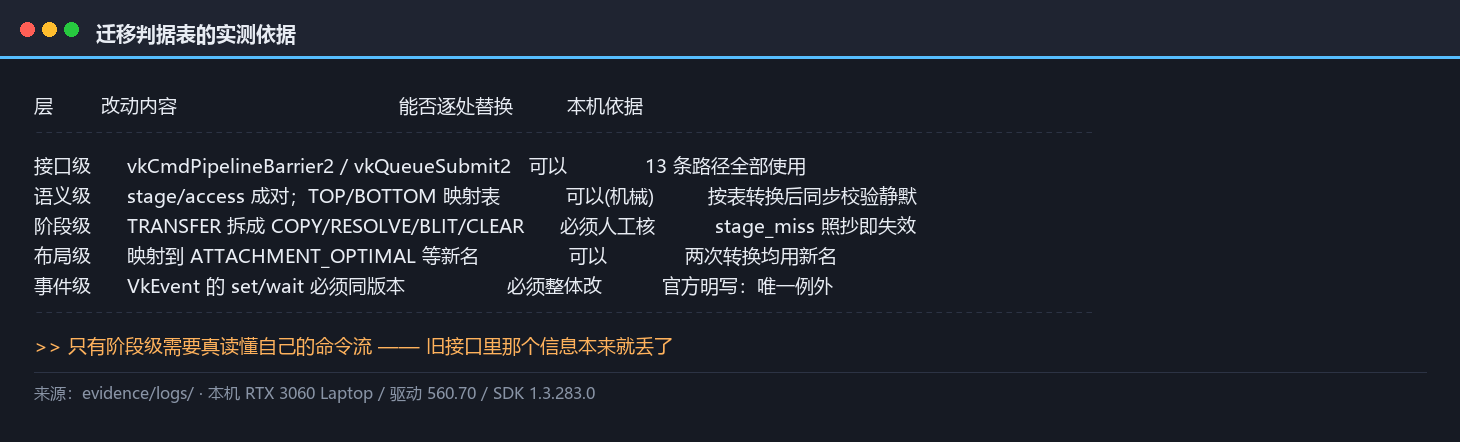
11.1 五层判据
LunarG 的迁移材料给了最实用的一句结论:sync2 "largely backward compatible"、可以增量采用。但「增量」到什么程度,要逐层看。
| 层 | 改动内容 | 能否逐处替换 | 本机依据 |
|---|---|---|---|
| 接口级 | vkCmdPipelineBarrier → vkCmdPipelineBarrier2;vkQueueSubmit → vkQueueSubmit2 |
✅ 可逐处替换 | 本篇 13 条路径全部使用 sync2 接口,编译与运行无异常 |
| 语义级 | stage/access 成对进结构体;TOP/BOTTOM_OF_PIPE 按映射表转换(src=TOP→NONE;dst=TOP→ALL_COMMANDS;src=BOTTOM→ALL_COMMANDS;dst=BOTTOM→NONE) |
✅ 可机械替换 | 映射表是官方给的,本机按表转换后同步校验静默 |
| 阶段级 | 老的 TRANSFER 拆成 COPY/RESOLVE/BLIT/CLEAR 等 |
⚠ 必须人工核 | stage_miss:掩码照抄旧写法后依赖失效,同步校验报满 100 帧 |
| 布局级 | COLOR_ATTACHMENT_OPTIMAL → ATTACHMENT_OPTIMAL;SHADER_READ_ONLY_OPTIMAL → READ_ONLY_OPTIMAL |
✅ 可按格式上下文映射 | 本篇两次布局转换均用新名,同步校验静默 |
| 事件级 | VkEvent 的 set/wait 必须同版本配对 |
❌ 必须整体改 | 官方明写:不得混用 vkCmdSetEvent2KHR() 与 vkCmdWaitEvents(),这是唯一的例外 |
五层里,只有第三层需要人真正读懂自己的命令流:哪条命令落在 COPY、哪条落在 CLEAR。这一层没有机械替换的办法,因为旧接口只有一个粗的 TRANSFER,信息本来就丢了。第五层的处理最简单——找出所有 VkEvent 的 set/wait 配对,一起换版本。
11.2 这张表的用法
这张表的使用顺序建议是从下往上:先扫一遍事件级(改动面最小但必须整体改,先排掉最硬的),再核阶段级(唯一需要读懂命令流的一层),最后三层可以放心地逐处替换。
阶段级那一层有一条自查办法,本篇实测有效:把屏障里出现的每一个阶段名,在命令流里各找一条属于它的命令。 找不到的,多半是写错了;能全找到的,再交给同步校验跑一遍。这个方法不依赖工具,但它要求写代码的人先知道 vkCmdFillBuffer 属于 CLEAR——也就是 §8.3 那条。
十二、边界、自检清单与下一篇
12.1 边界六条
开篇声明的六条,这里收成一处。前五条承 ep01/ep02,第六条本篇新增。
第一,不做跨厂商对照。 本机只有一块 NVIDIA 独显。AMD 的 RDNA 指南、Intel 的 Gen11 指南、Arm 与 Roblox 的 GDC 报告,本篇只引原文,一处都没有写成实测。
第二,不给驱动内部 JIT 的结论。 屏障在驱动里怎么被合并、怎么被提升到渲染通道边界,我们只能从外部行为观测——Intel 的指南里那句「给驱动留出 hoist 的空间」在本篇只作定性引用。
第三,不给指令集规范的断言。 NVIDIA 没有公开 SASS 的官方 ISA 文档。
第四,时间戳有同步域边界。 本篇所有 GPU 读数都来自同一队列、同一次提交内成对写入的时间戳;VK_EXT_calibrated_timestamps 在本机只在位、不校准。
第五,不做移动端实测。 没有 Android 设备。而移动端恰恰是这一篇绕不开的对照——Mali 这类分块渲染 GPU 有顶点/计算与片段两个独立调度槽,BOTTOM_OF_PIPE → TOP_OF_PIPE 在它上面代价特别大。这一条只引官方样本与 Arm/Roblox 的材料。
第六,本篇新增:不配移动端专图。 正文既然声明不涉及移动端的屏障细节,就不拿一张 tiled GPU 架构图来凑版面。本篇 36 个图位里没有一张移动端专用件。
12.2 十条自检清单
清单分两组:环境五条管「这个读数能不能信」,屏障五条管「这条屏障写对了没有」。两组都要在提交前各过一遍——只过一组是最常见的失守方式,本篇自己就先后各踩过一次。
上面这十条里,第八条(阶段与访问配对之后,再逐条核对命令落在哪个细粒度阶段)和第二条(同步校验是否真的打开了)是本篇新增的两条,也是本篇两次踩坑换来的:前者来自 §8.3 那个 CLEAR/COPY 的陷阱,后者来自三条错例在关闭状态下全部静默的那次经历。
12.3 下一篇:管线缓存
ep04 是《管线缓存:绝不在 draw time 建管线》。
这一篇从同步出发,最后落在「哪些等待是真的」;下一篇换一个方向,量的是创建期的代价:管线对象什么时候建、缓存怎么命中、为什么「在 draw time 建管线」这件事在真项目里会变成一次卡顿。同步与创建看着是两件事,但两篇用的是同一套测量纪律——一个变量、多次复跑、每条路径都要有一个可精确验证的输出。
资源清单
- 本机实测产物:
evidence/src/vk_ep03.c(13 条路径 + 1 条探针)、build_ep03.ps1、run_ep03_campaign.ps1、summarize_ep03.py|evidence/logs/(112 个原始日志)|evidence/lab-summary.md与evidence/stage3/lab-summary.json - 官方材料入口:Vulkan Guide(
docs.vulkan.org/guide/latest/)|Vulkan Tutorial(/tutorial/latest/)|Vulkan Samples(/samples/latest/)|Vulkan 规范 refpage(docs.vulkan.org/refpages/latest/)|Vulkan Docs 仓库 wiki 的 Synchronization Examples - 工具:
vulkaninfo|glslangValidator(Vulkan SDK 1.3.283.0)|MSVC 与 CMake|VK_LAYER_KHRONOS_validation(含同步校验与最佳实践)|RenderDoc
参考资料
Vulkan Guide 与 Tutorial(官方)
- Synchronization|Synchronization Examples|Vulkan-Docs wiki:Synchronization Examples|(旧接口版)
- VK_KHR_synchronization2|The Synchronization 2 Advantage
- Synchronization Validation:介绍|验证层用法
- Timeline Semaphores|Rendering and Presentation
规范与 refpage(官方)
Samples(官方)
验证层与工具(LunarG)
- Synchronization Usage|Vulkan Sync2 Validation 材料|Vulkanised 2024:Enabling Synchronization Validation
厂商与社区(对照与反例,均非本机实测)
- AMD:RDNA Performance Guide|Intel Gen11 优化指南:本篇只引原文(该文档未记录可公开访问的稳定链接,故不给链接,读者可在官方渠道检索其原文措辞)
- zolotukhin.ai:Decode kernel fusion on RDNA4|Render graphs and Vulkan(TheMaister/Granite)
- Arm + Roblox(GDC 2020)|Roblox(Reboot 2019)|Vulkanised 2026:Timeline Semaphores(Devsh)
- Versions & Porting|vulkan-tutorial:Frames in flight
下篇预告
第四篇《管线缓存:绝不在 draw time 建管线》——本篇把「一次屏障值多少」量完了,结论是:写法的差别大多落在噪声里,而写错与没写错的差别全在验证层里。下一篇换一个方向,量创建期的代价:管线对象什么时候建、缓存怎么命中、为什么「在 draw time 建管线」在真项目里会变成一次卡顿。同一套测量纪律会继续用下去——一个变量、多次复跑、每条路径都要有一个可精确验证的输出。
落款
希望能对大家有所帮助。 本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。