站点链接:技术博客页
系列文章前言
系列定位
这个系列只回答一个问题:当渲染管线里的某一环,它的先验从"人手写的启发式"换成"训练出来的网络",代价到底转移到了哪里?
它面向的是已经能读懂渲染管线、也大致知道神经网络是什么,但没亲手把学习式环节接进过真实管线的图形程序员。所以我们不推导反向传播,也不复述算法综述——我们要算的是那笔账:算力、带宽、显存、训练成本、以及最容易被忽略的"泛化边界"。
系列文章写作风格说明
- 每条结论都落到"代价换到了哪里":显存、算力、训练成本,还是画质与稳定性。
- 把"论文里的设定"与"项目里的现实"分开写——尤其训练数据规模与泛化范围。
- 对厂商宣传的倍数标注口径,不转述为定论,也不搬运其配图。
- 明确写出"这一环换成网络不划算"的反例场景,不写成推销。
全系列内容总览
本篇是已发布篇目之一。至此为止本系列共发布五篇,后续规划暂缓,以系列现状为准。全系列目录(仅列已发布篇目):
| 序号 | 篇目 | 主题 |
|---|---|---|
| 一 | 神经渲染的分界线 | 哪一环该换成网络 |
| 二 | 神经降噪(上) | 当先验从人手写变成学出来 |
| 三 | 神经降噪(下) | 数据从哪来,以及它在哪里失效 |
| 四 | 神经纹理压缩 | 把纹理解码交给网络(本篇) |
| 五 | 神经外观 | 从解析 BRDF 到学习式材质 |
系列结构
本系列目前已发布到第五篇(判据、降噪上/下、纹理压缩、外观),后续篇目因需要真实硬件/训练环境而暂缓,不再续写尚不能真实实验的篇目。
本篇在系列里的位置
前三篇都在讲降噪。降噪替换掉的是一条时域链路:重投影、历史累积、方差估计,一环扣一环。而本篇要换的东西性质完全不同——它替换的是"纹理在显存里长什么样"。
这件事的门槛不在算法,而在一条硬约束上:纹理采样必须能随机访问(random access)。你想采哪个纹素,就得能直接算出它在内存里的位置。图片压缩里那些效果最好的方案(AVIF、JPEG XL、超先验那一脉)全都不满足这一条,所以它们进不了实时渲染——不是不好,是不能用。
于是本篇要回答三个问题:
- 它省的是哪一笔?官方给了三种模式,直觉上以为是三档画质,其实是三笔不同的账,其中一种一分显存都不省。
- 为什么不能像图片那样压?随机访问这条约束具体卡住了什么,以及为了绕开它,过滤这一环付出了什么代价。
- 什么时候不值得换?从业界唯一一份公开的出货记录里,能读出比"省了 8 倍"重要得多的东西。
本篇不涉及什么
按惯例,先把边界划出来,也顺便说明为什么:
- 不涉及着色器内推理的 API 细节(cooperative vector 的指令形态、data graph、算子融合)——这一侧面未在当前已发布篇目里展开。
- 不涉及神经外观与 BRDF 的神经化——第五篇。
- 不涉及实时去噪(第二、三篇已讲透)与采样/路径引导(这一侧面未在当前已发布篇目里展开)。
- 不涉及硬件代际与显存带宽的底层机制——那属第三专题《GPU 架构剖析》的题域,这里只用到"哪条路径能出货"这一层结论。
- 不涉及图形 API 扩展的规范条文——Vulkan 与 DX 的差异,本篇只讲到"哪一条现在不许出货"。
- 不涉及训练侧的完整工程(数据集构建、损失函数设计)——这一侧面未在当前已发布篇目里展开。
前两篇留下的那本账
好了,降噪那两篇算完,账本上留下这样一个形状:收益真实,代价是"你必须拥有对得上内容的训练数据",而且验收时得看得见时间维度上的失效。
纹理这一环的账本形状不一样,而且更容易被误读——因为它表面上是纯粹的显存问题,"省 8 倍"听起来不需要权衡。但只要你把三种模式摊开看一眼,就会发现权衡一直都在,只是藏在一个不显眼的地方:省的是什么存储器。
把这两本账并排放,先来看看会发现什么:一个共同点:换掉的都是先验,而不是换掉了管线。降噪换掉的是滤波核的先验;纹理压缩换掉的是"块内怎么用两个端点插值出 16 个像素"这一手先验。管线该有的环节一个没少,只是每一环里的"人写的规则"变成了"训出来的规则"。
这就是为什么本篇的标题落在"解码"两个字上——被换掉的正是解码这一手。至于为什么这件事拖到 2023 年才有论文、2024 年才有 SDK,答案在第二章:不是没人想到,是随机访问这条约束把绝大部分现成的压缩方案挡在门外了。
顺便把这篇的读法说一下。前三章是立约束:先看清数字的口径(第一章),再搞清纹理为什么不能照图片那套压(第二章),然后才看新方法长什么样(第三章)。中间两章是算账:三笔账(第四章)与最贵的那一环(第五章)。后四章是算现实:真实项目怎么用的(第六章)、它做不到什么(第七章)、门槛与许可(第八章)、以及什么时候不该换(第九章)。
如果你时间只够读两节,读 4.1 和 6.2。 前者是那张"on-Load 不省显存"的官方表,后者是唯一一份公开出货记录的做法——这两节合起来,比任何倍数宣传都更能决定你项目里该不该上。
一、先把五个数字摆在一张桌上
先说结论:同一件事,公开材料里有五个不同的数字,从 4 倍到 96% 都有。 如果你是从新闻标题认识这项技术的,那么你记住的那个数字,大概率不是官方口径。
1.1 官方自己的两个口径
先来看看官方口径。NVIDIA 在 2025 年 1 月的 CES 官方博客 里写的是 7 倍,原文限定词是:
The neurally compressed textures save up to 7x more VRAM or system memory than traditional block compressed textures at the same visual quality.
而同一家公司的 RTX Kit 开发者页 与 上手教程 里写的是 8 倍:
Use AI to compress textures with up to 8x disk memory improvement at similar visual fidelity.
7 与 8 不是笔误,是限定词不同。 前者的限定是"VRAM 或系统内存",后者的限定是"磁盘内存"。引用这类倍数必须带着限定词——把它们混成一句"最多省 8 倍显存",是这一章后面所有误读的源头。
1.2 论文给的是另一套数
下面我们看论文那一套。原创论文(SIGGRAPH 2023,《Random-Access Neural Compression of Material Textures》)报的是质量与分辨率,不是倍数:
| 项 | 分辨率 | 体积 | PSNR | FLIP |
|---|---|---|---|---|
| BC high 基线 | 1024×1024 | 5.3 MB | 19.4 dB | 0.224 |
| NTC | 4096×4096 | 3.8 MB | 22.0 dB | 0.177 |
| 未压缩参考 | 4096×4096 | 256 MB | — | — |
换成一句话:分辨率高 4 倍(纹素多 16 倍),内存反而少 30%。 注意这里比的不是"同分辨率下的倍数",而是"同内存预算下能换到多高的分辨率"——这是两种不同的比较方式,论文选了后者,因为它更能说明问题。
1.3 厂商演示与单一场景实测
言归正传,再往下是演示与实测,各有一个流传很广的数字:
- 厂商演示:官方讲师在 Vulkanised 2025 的幻灯片 里给出 Tuscan Villa 场景 BCn 6.5 GB → NTC 970 MB,约 6.7 倍。
- 单一场景实测:一份第三方在 Intel Sponza 标准场景上的测试(原始测试页,经二手转述取得)给出无损参考 6830 MB → on-Load 转 BCn 2041 MB → on-Sample 303 MB。最后那一档相对无损是 95.6% 的降幅。
这两个数都真实存在,但口径完全不同:前者是厂商自己搭的场景,后者是一份针对特定场景、特定设置的测试——而且它是二手转述(原始测试页本次未直接取得,数字经两条独立二手来源交叉核对)。
1.4 于是就有了那个 96%
中文媒体在 2025 年 2 月出现了这样一类标题(例):《RTX 神经纹理压缩,显存用量狂减 96%》。
官方从未给出 96%。 我把它和上面几个数字对了一遍:96% 与 Sponza 场景 on-Sample 那一档的 95.6% 吻合。所以我的判断是——这个数字很可能来自一个场景的实测,被当成通用结论转述了出去。 需要说明的是,这是我的推断,原文并未说明它的来源。
这张表就是本篇的起点。同一个技术的五个数字,没有一个错——错的是把它们当同一个数用。
1.5 把限定词丢掉,账会错到哪里
好了,举一个具体例子,说明为什么这不是文字游戏。
假设你的项目有 40 GB 的 BCn 纹理,你希望它降到 10 GB 以内。你读到"省 8 倍",按这个数字做预算:40 ÷ 8 = 5 GB,于是很有把握地把 10 GB 的目标写进了排期。
然后你发现选的是 on-Load 模式,显存占用一点没变——因为 8× 那个数字的限定词是 disk memory,它对应的是安装包与流读带宽。磁盘确实从 40 GB 降到了 5 GB(这是真的,而且很有价值),但显存账面上一格没动。
要拿到显存那 8×,你得走 on-Sample:代价是每帧几百万到几千万次纹素级推理,以及第五章那一整套"过滤必须换成随机采样"的改造。
同一份宣传数字,两种选型,差的是整个排期。 这就是为什么第一篇就要把口径摆在最前面——在这一环上,口径不是"注释",是"结论的一部分"。
1.6 那到底该记住哪个数
说白了,给一个可以直接用的判断法:
- 关心安装包体积与流式加载带宽 → 记 8×(限定词 disk),走 on-Load 就能拿到,门槛最低。
- 关心运行时显存占用 → 看 on-Sample 那一档。官方表里是 12 MB → 2.5 MB,接近 5×,而不是 8×。注意这里说的是官方那张 2K 材质包表,不是场景级的总账——场景级的数字要看具体资产构成。
- 关心同内存下的画质 → 看论文那套:分辨率高 4 倍、内存少 30%。
三个问题对应三个不同的数字,没有一个可以说"就是 8 倍"。
二、纹理为什么不能像图片那样压
好了,要理解这项技术为什么长成现在这个样子,得先接受一条不讨喜的事实:纹理这一行,压缩比的竞争者从来不是"更好的压缩算法",而是"能不能随机访问"。
2.1 一条二十年没松过的约束
纹理采样的基本动作是:拿到纹理坐标 (u, v),算出它落在第几个纹素上,然后把那个纹素取出来。这一步在像素着色器里每帧要发生几亿到几十亿次,所以它必须满足两件事:
- 能直接定位:给定坐标,直接用算术算出内存地址,不能先顺序解压一大段再查表;
- 能并行:同一个 wave 里 32 个线程各取各的纹素,互不依赖。
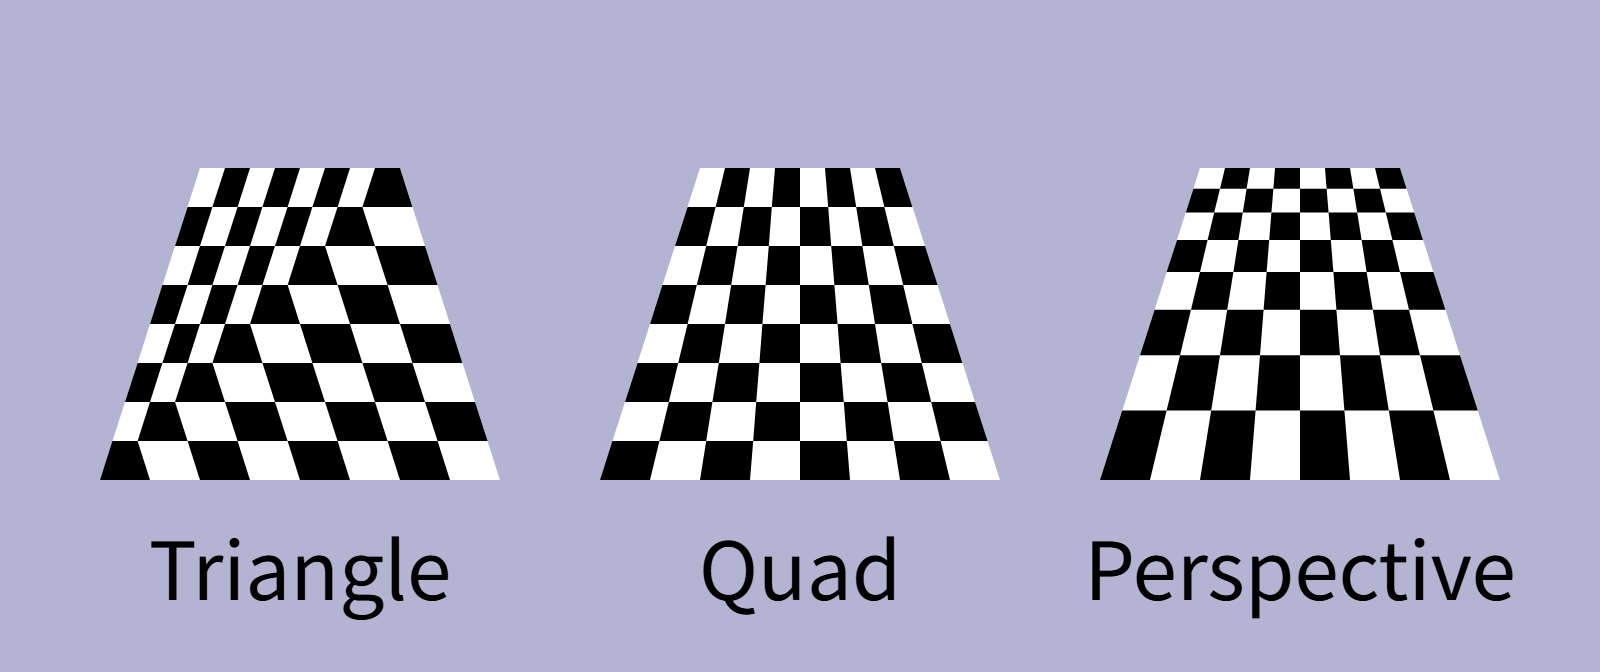
这就是块压缩(block compression)必须把图像切成 4×4 小块、每块用固定比特数的原因:固定比特 ⇒ 地址可以用乘法算出来。 BC1 每块 8 字节(4 bpt)、BC7 每块 16 字节(8 bpt)、ASTC 从 0.89 到 8 bpt 可调——不管质量档怎么换,每块的字节数是常数,这一点从 1999 年的 S3TC 到现在没变过。
2.2 图片压缩为什么进不来
反过来看图片压缩。JPEG 的熵编码是顺序的:想解出后面一个像素,得先解完前面的码流。JPEG XL、AVIF 那一脉质量更高,但同样不提供块级随机定位。
它们不是不够好——在"整张图一次性解出来"这个前提下的确更好。超先验(hyperprior)一脉把图像的隐变量分布建模得非常精细,所以在极低码率下的感知质量远超块压缩。但渲染要的不是"整张图更好",而是"第 3792 个纹素,现在就要"。
原创论文在这件事上说得很直白:这类方法"因缺少随机访问、且无法压缩非颜色材质属性,不适合实时渲染"。
那为什么不给 JPEG 配一张索引表? 这个想法其实有人试过,而且在离线渲染里能用:维护一份"每个最小编码单元(MCU)在压缩数据里的偏移表",就能跳到需要的那一段。问题出在渲染的访问模式上——
- 索引表本身要占内存。按 16×16 像素一个 MCU 算,一张 4K 贴图有 65,536 个 MCU;每个偏移量按 4 字节算是 256 KB。而这张表本身还得支持随机访问,于是它又变成了一份"未压缩的侧数据"——省下来的比特被索引吃掉了一部分。
- 解压要付出算术代价。JPEG 是频域的:想取一个像素,得先做逆离散余弦变换——一次要几十次乘加。块压缩取一个像素是什么代价?两次端点的线性插值,几次加减乘而已。这个差距在每帧几亿次采样的规模上不可接受。
- 熵编码天生串行。霍夫曼码是变长的,想找到第 N 个码字必须从头扫;这让"同一个 wave 里 32 个线程各取各的"这件事变得很难。
所以真正的结论不是"图片压缩不好",而是:它优化的目标(整张图的总比特数)和实时渲染要的目标(单个纹素的访问代价)不是同一个。 这个区分是本篇后面所有权衡的源头——每次有人问"为什么不用更先进的压缩算法",答案都是这一条。
2.3 但纹理不是一张图
说白了,真正让这个问题变得有意思的是下一件事:纹理从来不是一张图。
一个再普通不过的 PBR 材质至少包含基础色、法线、粗糙度、金属度、环境光遮蔽——9 到 10 个通道。它们在磁盘上通常是分开的几张图,各自独立压缩;而它们在物理上却是同一块表面的不同描写:基础色里有条缝的地方,法线里通常也有条缝,粗糙度也往往跟着变。
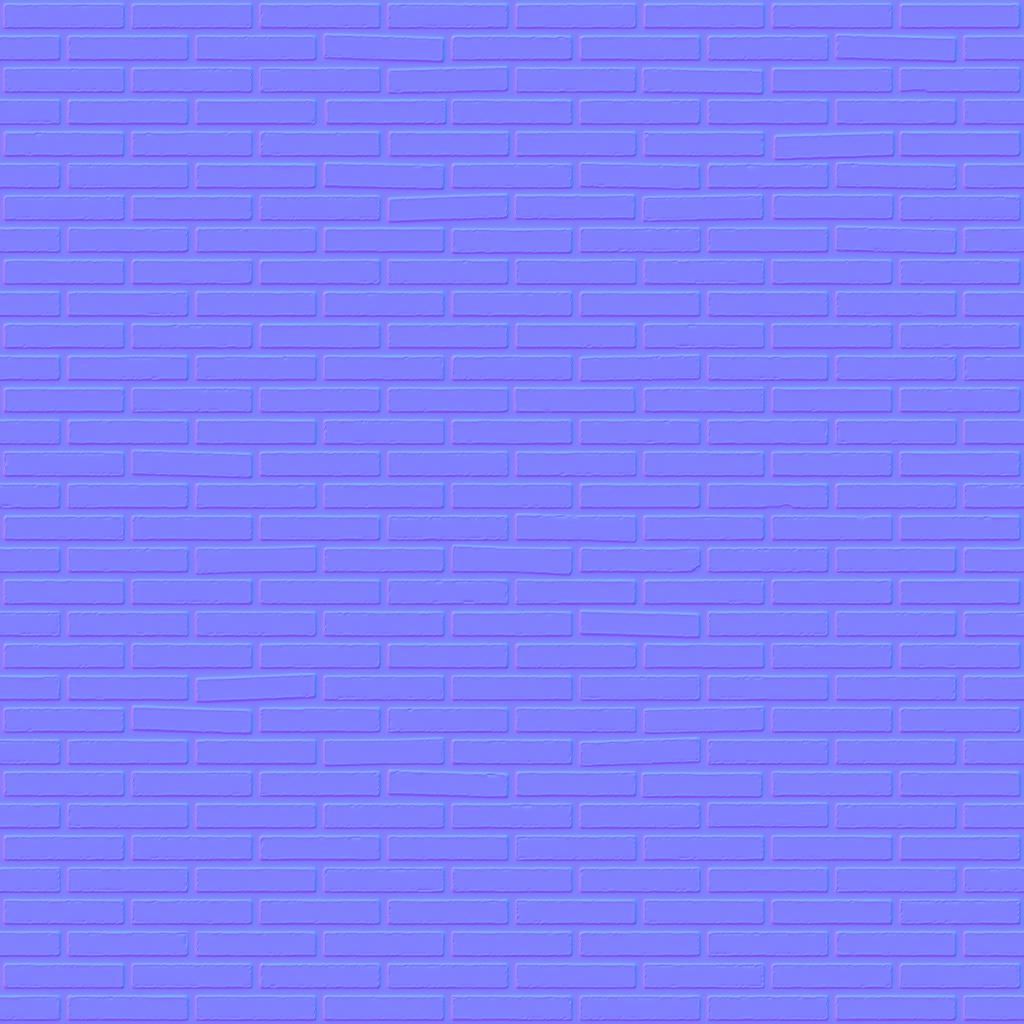
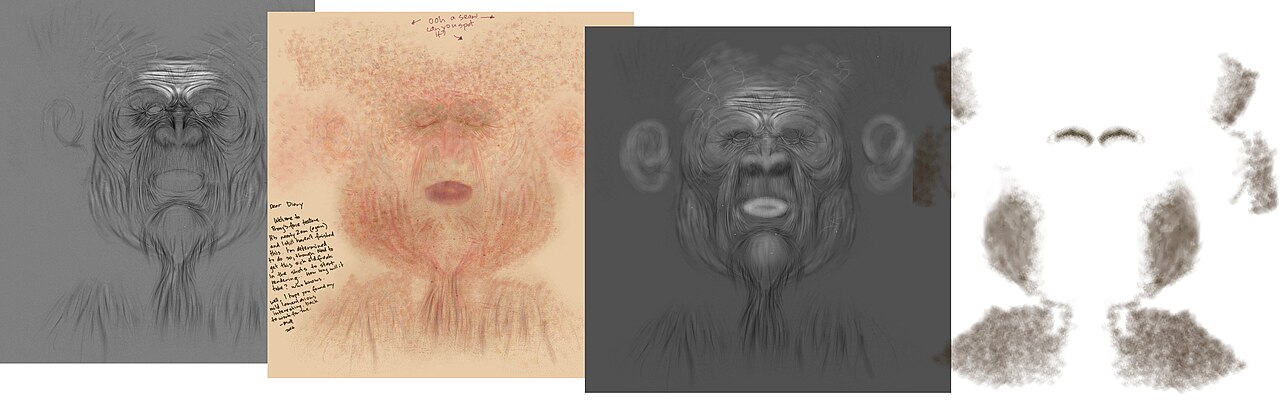
"通道之间相关"这件事,正是神经压缩的收益前提。 分开压,每一张图都要自己承担一份压缩损失;合起来压,网络可以只在"这些通道共同变化的地方"花比特。用 TU Wien 那篇 2025 年变码率论文的原话说,NTC 这类方法"在有多个强相关通道的场景下表现最好"——因为它的设计出发点就是把多个通道和它们的 mip 链一起压。
2.4 那"四个 4×4 块"里到底发生了什么
顺手把一个常见误解说清:块压缩不是"把图缩小",而是在每个 4×4 块里用少量参数重新描述这 16 个像素。BC1 给每块两个端点色,块内每个像素用一个 2 比特的权重在两个端点之间插值;BC7 则允许更复杂的端点与权重组合模式。
所以块压缩是有损的,而且在某些内容上损失很明显。这也不是什么边角问题——它是后面第七章要说清"基线到底长什么样"的原因。
2.5 一张图值多少比特
说白了,把账算细一点。一块 256×256 的基础色贴图,未压缩是 256 KB;按 BC7 的 8 bpt 压完是 64 KB,按 BC1 的 4 bpt 是 32 KB。听起来不多——但一个 4K 材质集动辄 9 个通道、还要带完整的 mip 链(约多 33% 体积),再乘上场景里成百上千个材质,账就完全不同了。
这就是为什么"再省 2 到 4 倍"值得为它写一篇论文。 在块压缩已经把 8:1 到 4:1 拿到手之后,想把倍数再往上推一档,靠调块大小和端点模式已经很难——得换掉"用什么描述这一块"这件事本身。
2.6 顺带说清一件事:块压缩为什么有好几套格式
好了,大家在项目里一定见过这种麻烦:同一张图要按平台编成不同格式。这不是历史包袱没清理干净,而是固定比特 + 硬件解码这个设计带来的必然结果。
- BC 系列(BC1 到 BC7)是 PC 与主机的通用答案,其中 BC1 是 4 bpt、BC7 是 8 bpt;
- ASTC 把块大小做成可调的,比特率从 0.89 到 8 bpt 都能走,质量与压缩比更灵活,主要落地在移动端;
- ETC1/ETC2 复杂度更低,面向的是低端与移动设备。
它们共享的正是同一条约束:块大小固定、比特率固定,所以地址可以直接算出来,解码可以交给固定功能硬件。代价是每条平台线各有一张表,跨平台项目得为同一份资产准备多份编码。
这件事对神经压缩其实是好消息:因为 NTC 那类方法也走"块内固定比特"这条路(隐向量按固定尺寸组织),所以它天然能嵌进现有格式——第六章会看到,出货的做法正是把隐向量写进标准 BC。换掉的只是块里存的东西,不是块这套机制。
三、神经压缩怎么做的
好了,先把结论给出来:它把"每块两个端点色"换成了"每块一小段隐向量,加一个每个材质单独训练的小网络"。 骨架是三层:特征金字塔、跨 mip 共享、每材质一个小解码器。
3.1 先看被描写的东西是什么
好了,在讲结构之前,得先看清"材质"到底是什么——因为这个结构的设计出发点就是通道之间的相关性。
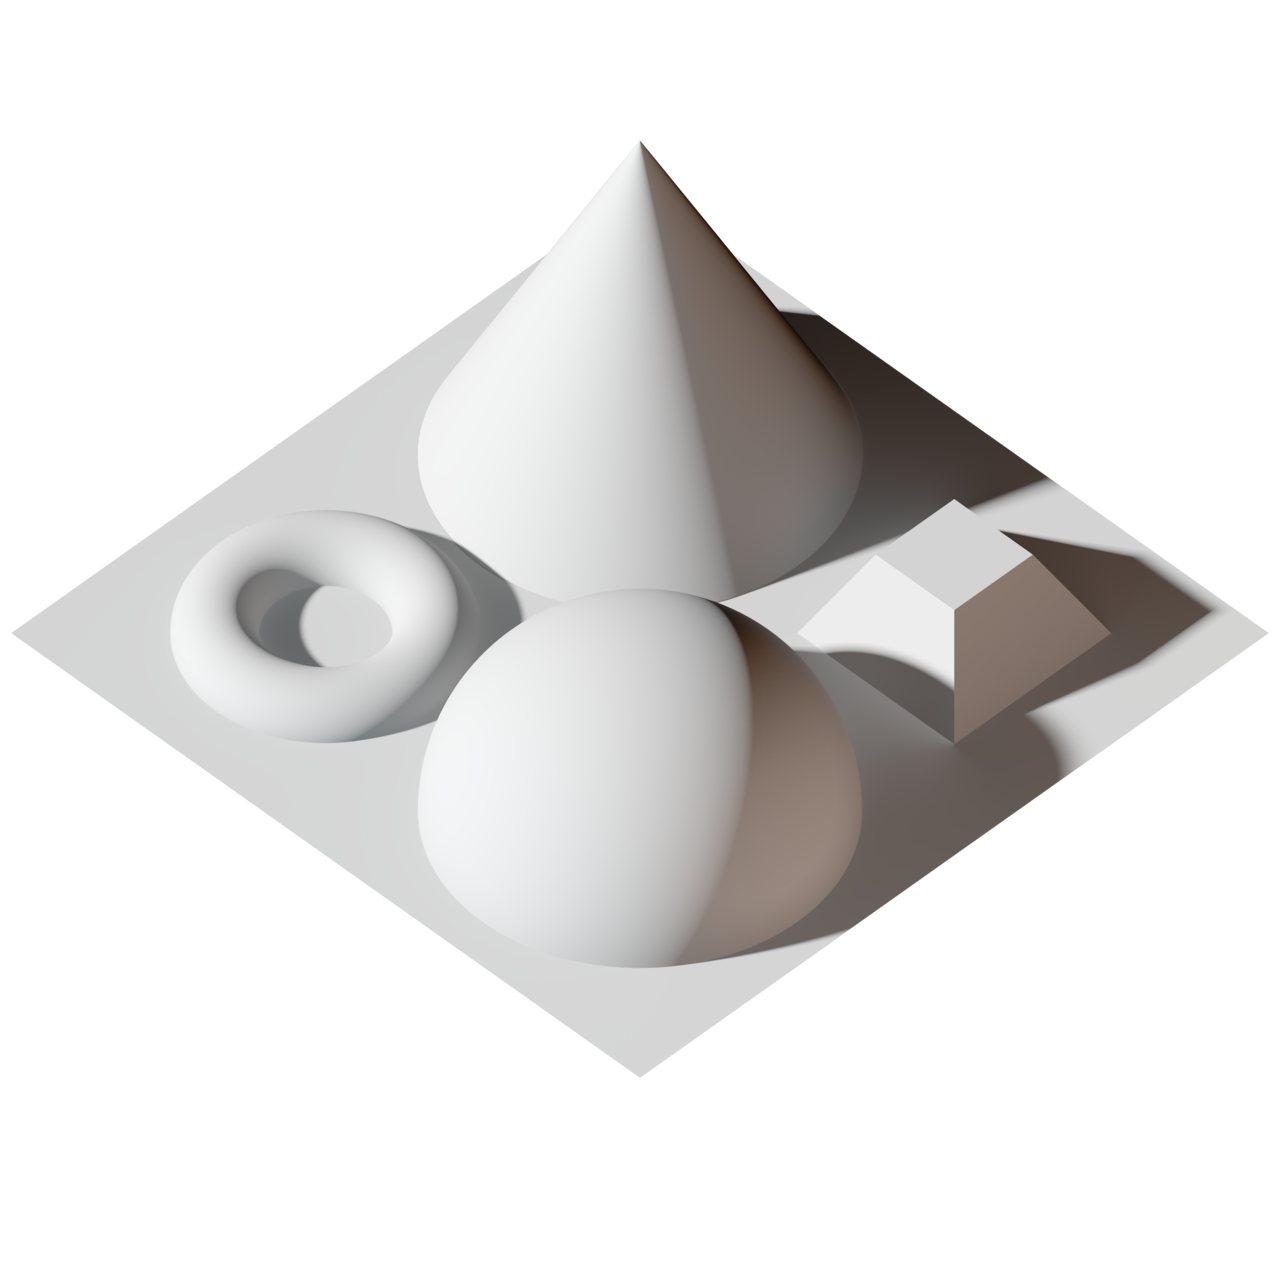
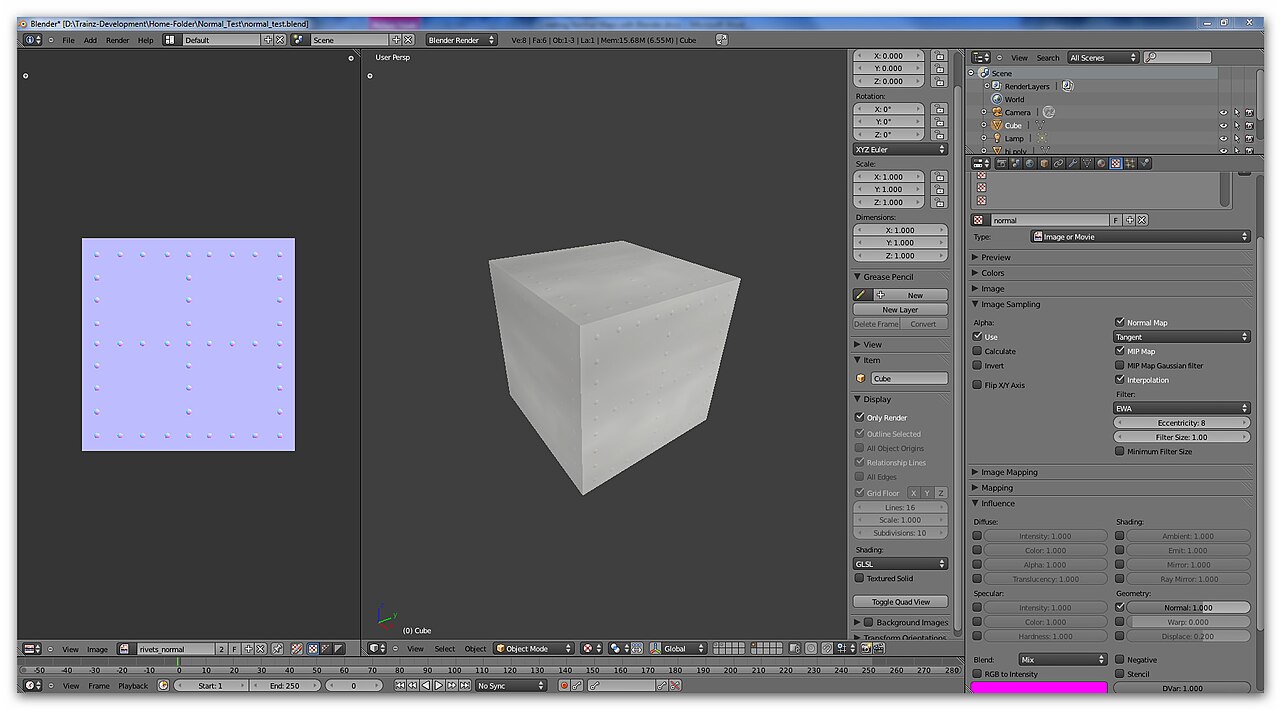
上面这张是没有纹理的版本:几何、光照、投影都在,唯独表面看起来像一块块塑胶。下面这张是其中的一个通道——法线贴图本身。
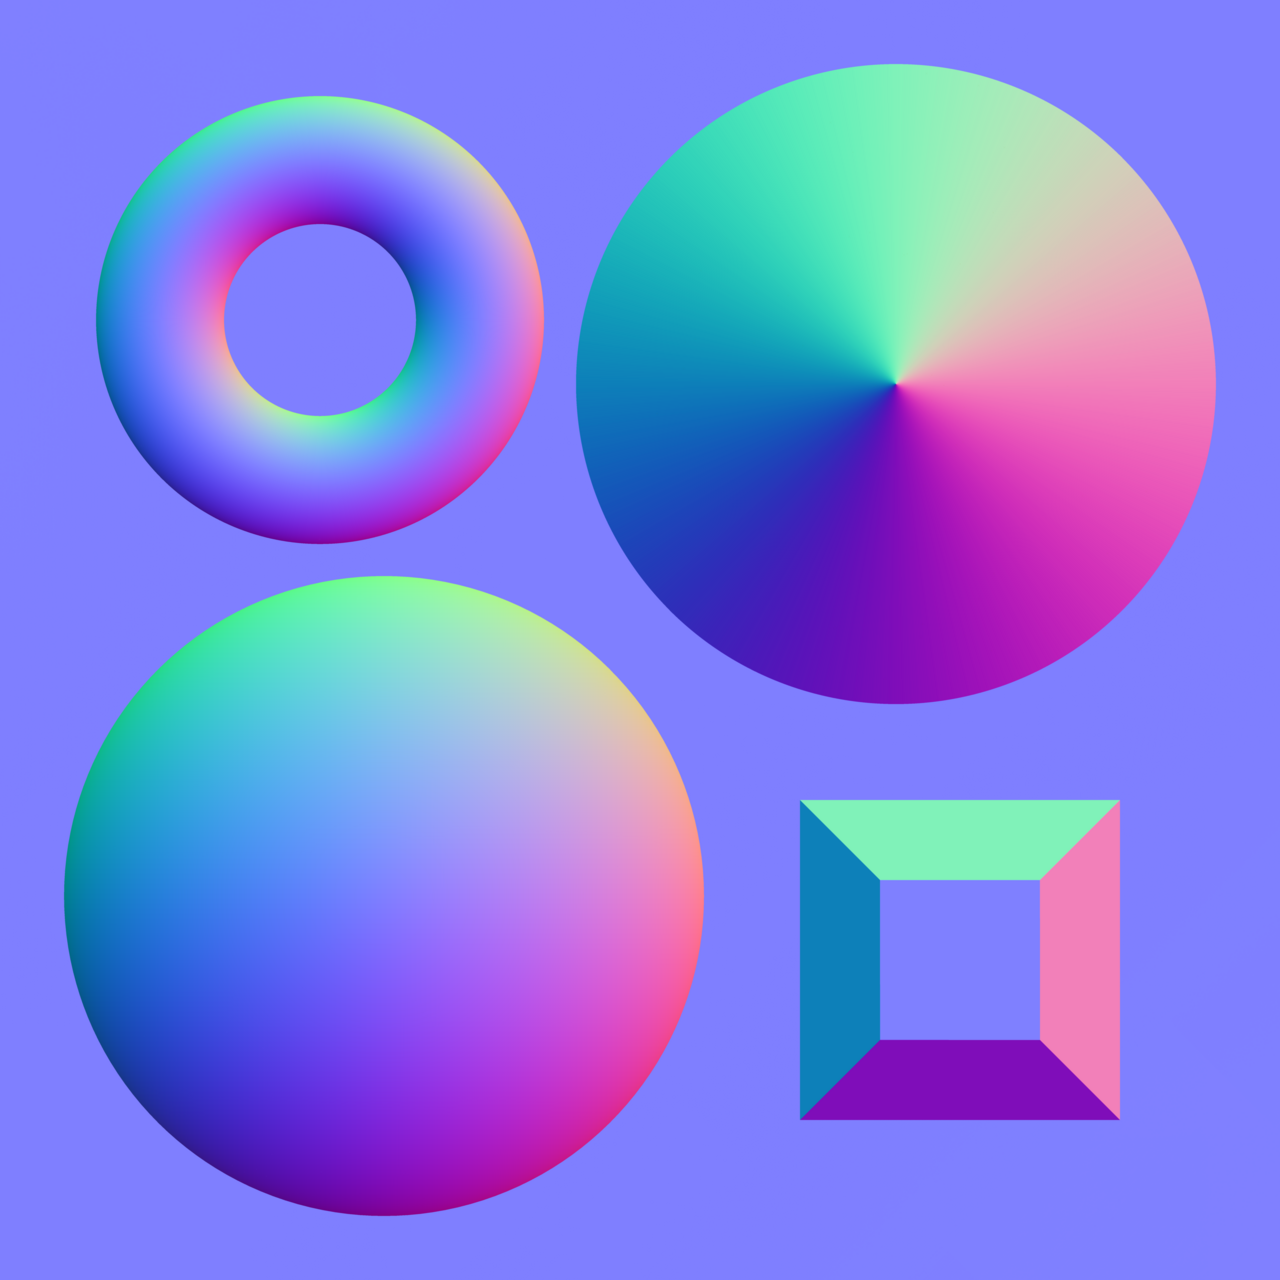
而本篇的题图,就是这两个通道加上其余通道合成之后的着色结果。三张放在一起看,通道相关这件事就变得非常直白:法线图里那些凸起的位置,和合成结果里高光的位置是逐像素对应的——网络的收益正是从这种对应里省出差额。
为什么法线通道"看起来像一张彩色图,其实是数据":它把表面法线在切线空间下的三个分量分别塞进 R、G、B 三个通道。因为法线是单位向量,三个分量被约束在 -1 到 1 之间,正好能映射到 0 到 255。这意味着它是三个"有物理约束的数值",不是三个独立的颜色——压缩时对它的量化误差会直接变成光照方向的偏差,这也是后面第七章要单独说精度的原因。
反过来想一件事:既然一个材质是多张贴图,而它们描述的是同一块表面,那么分开压就等于让每张图各自承担一份量化损失,而且它们之间的冗余完全没被利用。基础色里有条缝的地方,法线里也有条缝——这份对应关系,分开压的那套办法是看不见的。神经压缩的全部收益,就建立在这份"看得见"上。
3.2 结构一:特征金字塔
下面我们把它拆成实体来看。NTC 的压缩表示不是一张图,而是多层级特征金字塔(feature pyramid):第 j 层包含一对二维网格,网格的每个单元里存着一个量化后的隐向量(latent)。
采样一个纹素要做的动作是:按纹理坐标在金字塔里取相邻单元、双线性插值出隐向量,再送进小网络。注意这一步和块压缩的相似之处——都是"先定位、再取数",区别只在于取出来的东西不是颜色,而是网络的输入。
把这一步的参数逐项摆出来,就更容易看清比特花在哪:
| 参数 | 作用 | 影响 |
|---|---|---|
| 金字塔层数 | 特征网格的层级数 | 层数越少、共享越多,比特越省,但表达能力下降 |
| 每层网格分辨率 | 每层网格有多少个单元 | 决定"空间上多细的差别能被描述" |
| 每格隐向量维数与比特数 | 单个隐向量的表示精度 | 论文的码率范围上限是 20 bits per pixel per channel,可调到 1/32 那一档 |
| 输出通道数 | 一次解几个通道的值 | 官方称一次最多 16 个通道,典型 PBR 材质是 9–10 个 |
最后一行那个"16 通道上限"值得记住:它不是随意设的,而是"这些通道必须相关"这个前提在工程上的边界。 通道越多、越不相关,共享特征能省的比例就越低。
3.3 结构二:一个特征层服务多个 mip
说白了,这是整套设计里最省的一手,也是最容易被忽略的一手:一个特征层同时预测两个或更多 mip 层。
为什么省?因为 mip 链本身是重复信息——mip 1 是 mip 0 降采样来的,它和 mip 0 有大量共同结构。分开压,每一级都要独立付一份损失;共享特征层,网络只需要存"这一级比上一级少了什么"。
从信号的角度看更清楚:mip 级数越高,图像的有效频率越低,需要描述的信息量越少。 所以"一层特征服务两级 mip"并没有让网络工作量翻倍——粗级别本来就更容易被同一套特征描述。作者选"两层共享"这个粒度,是压缩率与质量之间的折中。
这一点直接解释了为什么"只压最高级、其余靠降采样"行不通。 看下面这张 mip 链与走样的对照:
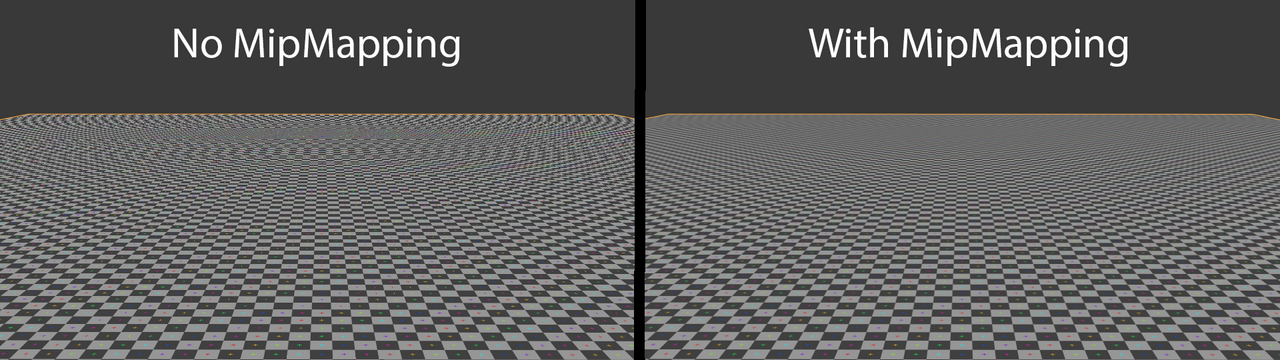
图中显示的是同一份内容在不同 mip 级别上的表现差异。如果压缩只保证最高级质量,粗级别的走样会直接出现在远处表面和掠射角表面上——而远景恰恰占了屏幕像素的多数。
3.4 结构三:每个材质一个网络
好了,第三层是解码器:每个材质单独优化一个小网络,网络的权重直接嵌进材质着色函数。官方在 Vulkanised 2025 的幻灯片里给了一张空间分配表:压缩数据里 99% 是隐向量,网络权重只占约 12 KB。
"每材质一个"这个选择值得停一下。 共享一个大网络听起来更省,但它会把不同材质的统计特性混在一起——石头的隐向量和皮肤的隐向量被迫用同一套解码规则。分开练,每个材质的网络只用管自己那一小片分布,代价是权重不能跨材质共享,收益是每个材质的比特都花在自己身上。
3.5 还有两类通道,形状不太一样
言归正传,前面讲的都是颜色与法线这类通道。材质里还有两类通道值得单独看一眼,因为它们在网络里的行为并不一致。
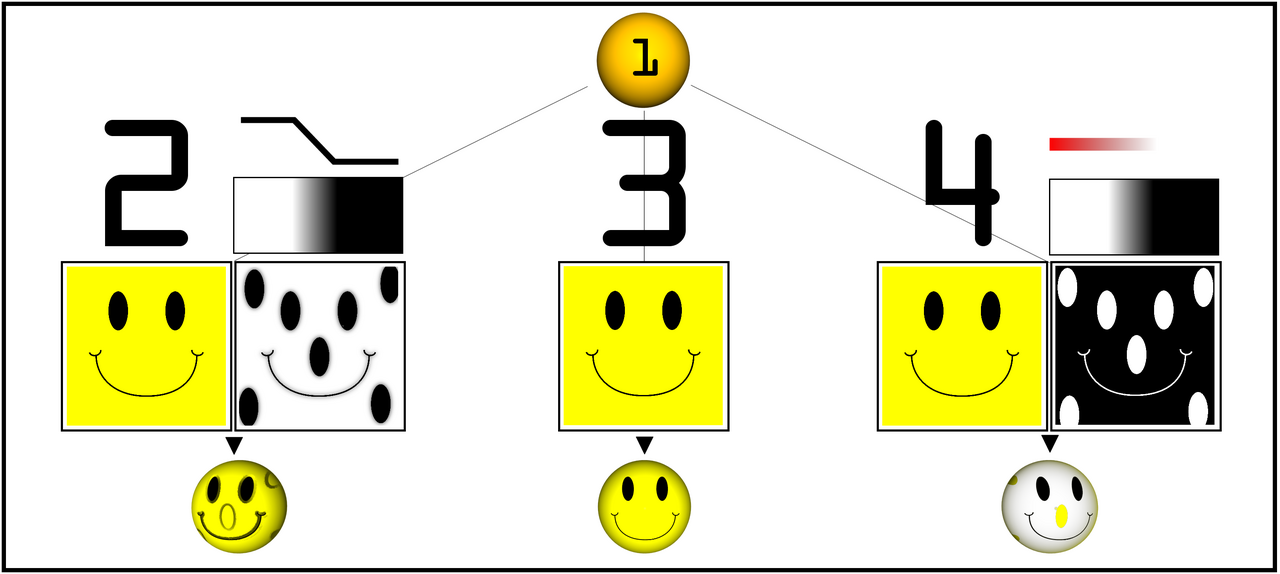
法线这类通道的难点在于精度:它编码的是方向向量,不是颜色,量化误差会直接变成着色上的方向偏差。bump 与 opacity 又是另一回事——它们不描述"表面长什么样",而描述"表面在几何上如何被扰动""这一块是否可见"。
这也是通道相关性这个前提的边界:基础色与法线高度相关,所以一起压很划算;但如果某个材质的通道之间没什么关系(比如一张纯噪点的遮罩和一张干净的基础色),NTC 的收益就会明显缩水。它不是无条件的赢。
3.6 小结:三句话记住这套结构
- 表示:多层级特征金字塔,格子里是量化隐向量;
- 共享:一个特征层覆盖多个 mip,整条链一起压;
- 解码:每个材质一个约 12 KB 的小网络,99% 的体积是隐向量。
3.7 压缩端:训练要花多少时间
好了,前面讲的都是运行时。但这条链还有一半在离线:隐向量和那个小网络是训练出来的,这笔时间得算进资产管线。
论文给的口径是:一个 9 通道的 4K 材质集,在 RTX 4090 上需要 1 到 15 分钟,看质量档。听起来可以接受——但它和"改一张贴图要等一分钟"完全是两件事。
官方讲师在 Vulkanised 2025 上更新了产品化后的数字:压缩实现比论文版快了 25 到 30 倍,100k 步就能得到不错的压缩质量,在 4090 上远不到一分钟。
这一条对流程的影响值得单独说:它决定了压缩能不能放进日常迭代。15 分钟一次的方案只能用在版本末期;一分钟以内,才谈得上"改完美术资源顺手重压一遍"。如果你的项目有几千个材质,按前者算就是几百小时的机器时间——这也是为什么"能不能并行、能不能走分布式缓存"会成为工程问题,而不是调参问题。
3.8 那训练数据从哪来:一笔上篇欠的账
好了,上篇(降噪)的结尾留了一句话:纹理压缩这一环的"训练数据来自贴图本身,不来自渲染帧——数据这一关的难度会低很多"。现在到了该兑现的地方。
先说为什么确实低。 降噪要的是成对数据:一张带噪的、一张干净的,而且这一对必须来自同一条管线、同一套光照。这类数据要么靠离线渲染自产(成本极高),要么用公开数据集(许可条款本身就是选型约束,还常常与项目内容对不上)。而纹理压缩要的是重建:输入就是那张贴图,监督信号就是它自己。没有第二份数据源,也就没有"数据集许可"这道关。
但代价换了地方,换成三件新事:
- 训练任务的个数等于材质的个数。 每个材质单独练一个小网络(§3.4),所以有三千个材质就是三千次训练。数据关轻了,资产关重了——这是它和降噪最大的形状差异:降噪是"一次训练、到处推理",这里是"一个材质、一次训练"。
- 迭代时间变成了美术流程的一部分(§3.7)。降噪的训练在项目早期一次性完成;纹理压缩的压缩步骤每次贴图改动都要重来,所以它必须快。
- 监督信号必须模拟运行时(§6.4)。这是最容易被忽略的一条:训练时如果不把 BC 量化与过滤算进去,训出来的解码器与运行时就对不上。
所以准确的说法是:这一环的"数据从哪来"确实比降噪轻松得多——但省下来的难度没有消失,它转移到了"数量"(几千个材质)、"速度"(能不能进日常迭代)与"训练与运行时的一致性"这三件事上。 这也是这个系列一直在讲的那件事:代价从不消失,只会换地方。
到这里,"它怎么做到的"就清楚了。但真正决定它能不能落地的,是下一章——这三种模式各自省的是哪一笔。
四、三笔账:on-Load / on-Sample / on-Feedback
好了,这一章是整篇里最该逐字读的一章。原因很简单:三个模式看起来像三档画质,实际是三笔不同的账,其中一笔根本不省显存。
4.1 官方那张表,逐行看清楚
好了,先看官方 SDK README 给的 2K 材质包对照表(Albedo + Normal + Roughness + Metalness + AO,约 5 bits/texel,PSNR 40–50 dB):
| 方案 | 磁盘 | PCIe 流量 | VRAM |
|---|---|---|---|
| 原始 | 32.00 MB | 32.00 MB | 32.00 MB |
| BCn | 12.00 MB | 12.00 MB | 12.00 MB |
| NTC-on-Load | 2.50 MB | 2.50 MB | 12.00 MB |
| NTC-on-Sample | 2.50 MB | 2.50 MB | 2.50 MB |
on-Load 那行的显存是 12 MB,和 BCn 一模一样。 官方文档解释了原因:这个模式是"在游戏或地图加载时解压,并同时转码成一种块压缩格式(BCn)"。也就是说——它解压完又压回去了。
4.2 三种模式分别是什么
把官方的三个定义摊开写:
- Inference on Load:加载时解压 + 转码回 BCn。省的是磁盘与 PCIe 流量,显存一分不省。适合低端硬件与"安装包太大"这个具体问题。
- Inference on Sample:采样时逐纹素跑网络。省的是显存(官方表 2.5 MB 对 12 MB)。代价最大,第五章整章都在讲这个代价。
- Inference on Feedback:用 Sampler Feedback 找出当前视角真正会用到的那些 tile,只解压它们,存进稀疏纹理。介于两者之间——省显存,但只省"这一帧真的用到"的那部分。
4.3 为什么这个区别重要
因为它决定了一件很实际的事:如果你的目的是降运行时显存,那么选 on-Load 等于白干。
这个误判的代价不是性能,是项目排期——团队花几周接入 on-Load 模式,装包小了、加载快了,然后发现显存占用一点没降,于是不得不回头改 on-Sample,而 on-Sample 要面对的正是下一章那些麻烦。
反过来也有实际价值:如果你的瓶颈真的是包体与安装时间,on-Load 就是那条又便宜又稳的路。 它门槛最低(推荐配置只要 Turing 及以上),也不要求任何过滤侧的改造。
4.4 拿一个 4K 材质集,把三笔账算一遍
官方那张表是 2K 的。我们按面积把它外推到 4K(这是本篇自己的算术,不是官方给出的 4K 数字——外推时只按纹素数量线性缩放,忽略了 mip 链与填充开销):
| 未压缩 | BCn | on-Load | on-Sample | |
|---|---|---|---|---|
| 磁盘(单个 4K 材质集) | 128 MB | 48 MB | 10 MB | 10 MB |
| 运行时显存(单个) | 128 MB | 48 MB | 48 MB | 10 MB |
| 300 个材质的显存合计 | 37.5 GB | 14.4 GB | 14.4 GB | 3.0 GB |
这张表把三件事一次说清:
- on-Load 在显存这一列与 BCn 完全相同(48 MB)——磁盘省了 38 MB,显存省 0 MB。这就是 §1.5 那个例子里排期出错的根源。
- on-Sample 才是显存那一栏:48 → 10 MB,接近 5 倍;300 个材质上是 14.4 GB → 3.0 GB,省出 11.4 GB。11 GB 在现代管线里足以决定"能不能上更高分辨率的资产",或者"能不能把目标卡从 16 GB 降到 10 GB"。
- "8 倍"从来没有出现在显存这一列。它出现在磁盘那一列(128 → 10,约 12 倍——注意这里连 8 倍都不止,因为官方给的是"最高 8×"的保守说法,且不同资产构成差别很大)。这正说明为什么必须带着限定词引用。
再补一句这套账的用法:第 3 行的差别不是"性能",而是资产预算。省下来的 11 GB 可以换成更高分辨率的贴图、更大的虚拟纹理缓存、或者更宽的硬件支持面——第六章里 Ubisoft 的选择,正是按这条账做出的。
五、最硬的一环:过滤
好了,现在讲全篇技术上讲得最深、也最容易被跳过的一环。
5.1 解码器一次只吐一个纹素
官方文档里有一句关键的话,原文是这样:
the decoder produces unfiltered data for only one texel, and in order to get filtered textures, we suggest using NTC in combination with Stochastic Texture Filtering (STF).
拆开看:解码器一次只产出单个未经过滤的纹素。
这句话为什么是问题?因为硬件纹理过滤从来不是取一个纹素。双线性要 4 个、三线性要 8 个、各向异性在 16× 档位上可能要 16 个甚至更多——它们都要经过插值才能得到最终颜色。
5.2 为什么不能硬算
说白了,把上面那张图的账算一遍就明白了:如果每个纹素都要跑一次网络推理,那么一次双线性采样 = 4 次推理,一次三线性 = 8 次。官方讲师在 Vulkanised 2025 的幻灯片上把结论写得很直接:
Direct evaluation of trilinear/aniso would be way too slow.(直接算三线性/各向异性会慢得离谱。)
同一份材料里还有一句更重的定性判断:on-Sample 模式的性能开销"可能吃掉整帧 20–30% 的性能"。
官方幻灯片还给了两条更具体的原因,值得单独说:
- "MLP evaluation needs a lot of registers"——小网络的推理要占用大量寄存器。而寄存器是像素着色器里最紧的资源之一,占用一多,能同时驻留的线程数就下降,延迟就藏不住了。
- "Cooperative Vectors and SER only help to a degree"——综合向量能加速矩阵乘、着色器执行重排序(SER)能缓解发散,但两者都只是缓解,不是消除。
这两条合起来解释了一个常见的误判:大家容易以为"网络小 = 开销小"。 实际上小网络的麻烦不在算力总量,而在它挤占的是寄存器与占用率——这两样东西在已经有复杂着色逻辑的管线里本来就不宽裕。这才是"过滤那一章"要单独占一整章的根本原因。
5.3 于是只能换一种过滤方式
OK,绕开的办法是把硬件过滤换成随机采样——这就是 STF(随机纹理过滤)。它的做法是:每个像素随机抽一个纹素,不做插值,用大量像素上的随机性换来"平均意义上正确的过滤结果"。
官方原文对此的定位是 "STF is a requirement"——是硬要求,不是可选优化。
配套的官方组件是 RTX Texture Filtering,专为 AI 压缩纹理的过滤质量而做。顺便说一句它的一个副产品:随机采样天然支持更高阶的滤波核(三次、高斯都可以),这在硬件三线性里是做不到的——因为它不需要把 16 个纹素都取出来。
5.4 各向异性过滤为什么是争议现场
好了,各向异性过滤(anisotropic filtering)是这场讨论里最微妙的一格:它需要在沿纹理被压缩的方向上取更多次采样,而每次采样在神经路径里都是一次推理——代价随各向异性档位线性上升。
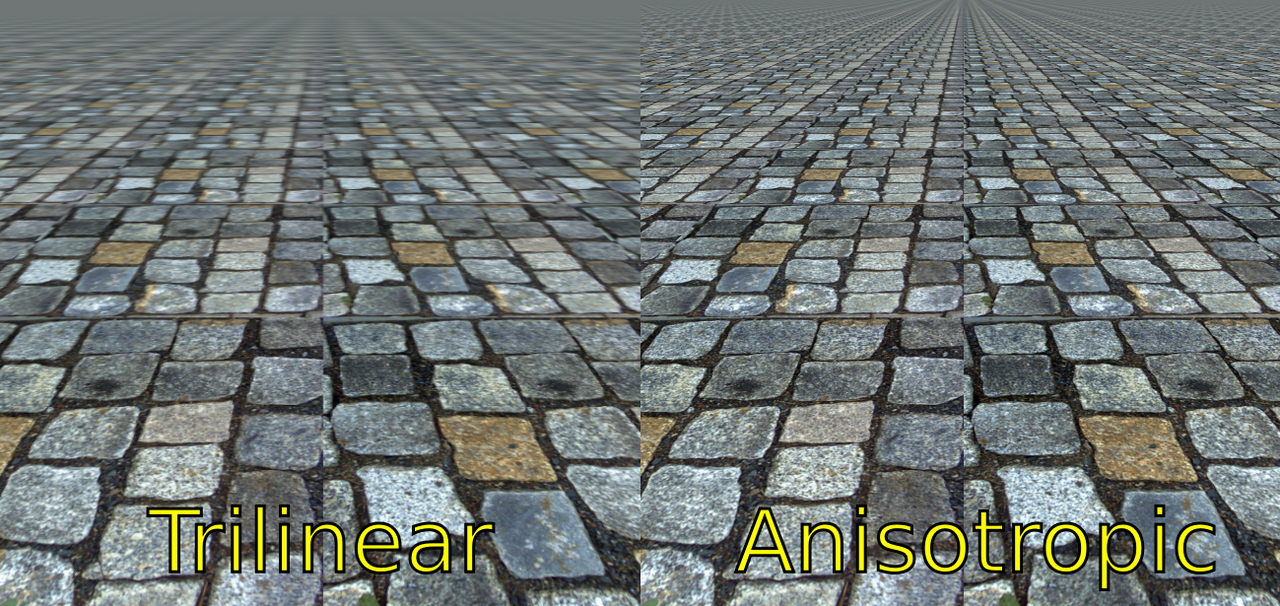
关于它,公开材料里有三种互相矛盾的说法:
| 说法 | 来源 | 性质 |
|---|---|---|
| 各向异性过滤、mipmap、随机访问全部保留 | Ubisoft 的出货工程记录(第六章) | 一线工程记录 |
| 各向异性下视觉正确 | Intel Labs 的 HPG 2025 论文 | 论文声明 |
| NTC 只支持三线性,不支持各向异性,某引擎实现把它限死在 1× | 一篇商业教程博客 | 低可信度,未证实 |
我的处理是把三者并列摆出来,而不是挑一个当结论。 第三条的来源在本篇的调研里被判定为低可信度——它把官方口径写成"60–80% 降幅"(官方是 7×/8×,即约 85–87%),平台矩阵与驱动版本也与官方 README 多处不一致,且页面同时推销自家工具。但它提出的这个问题本身是真的:各向异性确实是神经过滤里最贵的一环。所以正确做法是把它当成待验证的工程问题看待,而不是当成已知结论。
5.5 随机采样带来的新问题:它把过滤变成了管线级依赖
OK,STF 不是免费的午餐,它有明确的代价,而且这个代价会溢出到渲染管线的其他部分。
代价一:单帧是带噪的。 用随机性换无偏,意味着每个像素单独看都是"抽了一个样",多个像素平均才收敛到正确的过滤结果。所以它必须靠时域累积把噪声压下去。
代价二:于是它和抗锯齿/超分设施绑在了一起。 公开实测里的观察很一致:
- 关掉抗锯齿:噪点直接可见;
- 纯时域抗锯齿(TAA):能清掉大部分,但不是全部;
- 超分(如 DLSS):能完全消除。
代价三:与超分同开会争用同一批硬件单元。 公开实测注意到,超分开着的时候这项技术的开销会上升——两边抢的是同一类算力。
把三条合起来看,得到一个比"过滤是个优化点"重要得多的结论:
上 on-Sample 模式,等于同时要求你的项目已经有了随机采样、历史帧累积、运动矢量这几样设施。 如果你的管线里这几样都还没有,那你要评估的就不是一个纹理压缩方案,而是一整套时域重建的改造——这才是第五章真正的结论。
反过来说:如果你的管线里已经有成熟的时域超分,这一环的边际成本就低得多——这也解释了为什么这条技术路线天然更适合已经上过超分的项目。
六、出货路径:把 BC 当载体
言归正传,前面所有的技术讨论到这里都收束到一个问题上:它进过真实项目吗? 答案是进过,而且进的方式很值得学。
6.1 一份公开的出货记录
Ubisoft 的 La Forge 团队写过一篇工程博客《Shipping Neural Texture Compression in Assassin's Creed Mirage》,把做法和边界都讲清楚了。要点有四条:
- 做法:隐向量用标准 BC 纹理承载,加一个单隐层 MLP,在像素/G-Buffer 着色阶段解码。
- 效果:相对传统逐层压缩,有效压缩率提升约 30%。
- 关键工程结论:因为隐向量导出成了标准 BC,所以随机访问、mipmap、各向异性过滤全部保留,并且沿用引擎原有的 streaming 与常驻规则——集成代价相当直接。
- 关键限制:受运行时代价约束,只对"实例数多、显存压力大"的部分资产选择性启用,并没有全量替换。
6.2 这条路径为什么聪明
把 §2.1 那条约束翻回来看就明白了:随机访问的问题不在"怎么解压",而在"怎么定位"。
Ubisoft 这条路线的取舍是:放弃"隐向量必须按自己的最优格式存储"这件事,改成把它塞进 BC 纹理里。 代价是隐向量要多占一点比特(BC 的量化并不精细),收益是整套纹理基础设施原封不动——mip 链、各向异性过滤、tile 化的流式加载、显存驻留策略,一行都不用改。
这就是本篇最想传达的一句话:这项技术不消灭块压缩,它把块压缩当载体。 新闻标题里"取代 BC"的说法,与唯一一份公开出货记录的实际做法是反的。
6.3 "选择性启用"这四个字值多少
第 4 条要点容易被当成附注,但它其实是最有信息量的一条。
它说明的是:在一款商业 3A 项目里,团队算完账后选择的不是"全量替换",而是"只在高收益资产上用"。 哪些是高收益资产?实例数多、显存压力大的那些——同一份贴图在场景里出现很多次、或者本身分辨率很高、占用显存可观。
反过来说,实例少、贴图小的资产不划算:省下来的显存微不足道,却要付一份解码开销。这就是第六章给读者的实用结论:不要按"材质类型"决定用不用,要按"这个材质的显存占用 × 解码次数"决定。
6.4 一个容易被忽略的细节:训练时就得模拟 BC
好了,还有一条工程细节值得记下来,因为它解释了"为什么这条路径画质能稳住"。
既然隐向量最终要存进标准 BC 纹理,那么它在运行时一定会被 BC 的量化影响。所以如果训练时不考虑这件事,训练出来的解码器就是在"理想数值"上优化的,上线后面对的是"被 BC 量化过的数值"——分布对不上。
Ubisoft 的做法是:训练阶段就显式模拟 BC 解码,并且监督信号用 GPU 上同样的三线性/双三次过滤生成。这样解码器在训练中就把"数值会被量化""最终要经过过滤"这两件事隐式学进去了,上线后不需要额外的后处理 pass。
这一条把前面几章的隐含假设补上了:第四章说"隐向量写进 BC",第五章说"过滤交给随机采样"——而这一节说的是,这两件事必须在训练时就一起考虑,不能等运行时有偏差了再修。 这是这类"表示即资产"的技术共同的工程量:你训练的不是一个算法,是一个要长期住在显存里的数据结构。
七、反证与边界
好了,前面几章讲的都是它能做什么。这一章讲它做不到什么——包括它自己的论文写出来的那部分。
7.1 论文自己的反证
好了,NTC 论文的补充材料里做了一件很诚实的事:等存储量对比。因为两种方法的存储成本差着 16 倍,直接比"同分辨率下的画质"不公平;作者的做法是在 BC 侧去掉前两个 mip 层,让两边占用接近后再比每一级的质量。
结论是:NTC 在多数 mip 层上"持平或更高",但 mip 2、3 层的 PSNR 略差。
这一条比任何宣传数字都更值得记住。 它说明"整条链一起压"是一个全局优化,它换来的是总体最优,而不是每一级都最优。如果你项目的观感瓶颈恰好卡在中等距离的表面上(mip 2–3 对应的正是这个距离段),这个细节就可能变成真问题。
7.2 基线到底长什么样
言归正传——反过来,也得说清被替换的东西是什么水平——否则"省了多少"没有参照物。块压缩本身是有损的,而且损失在特定内容上相当明显:
看得出什么、看不出什么,要说明白:这两张都是单张图,不是同场景的对照对,而且原始长边都不足 1280——它们只能说明"有损压缩的输入与观感长什么样",不能用来做任何质量对比的结论。 这也是本篇反复强调的一件事:图注不能比图更敢说。
7.3 两个流传很广,但都不准确的说法
说法一:这个技术必须新一代旗舰卡。 不准确。官方 README 给的门槛是分模式的:
| 用途 | 最低 | 推荐 |
|---|---|---|
| on-Load 解压 + 转码 BCn | SM6 任意 GPU | NVIDIA Turing(RTX 20)及以上 |
| on-Sample 推理 | SM6("能跑但很慢") | NVIDIA Ada(RTX 40)及以上 |
| 压缩(训练侧) | NVIDIA Turing | NVIDIA Ada 及以上 |
而且官方明确列出了已验证过的最老硬件:GTX 1000 系、AMD Radeon RX 6000 系、Intel Arc A 系。所以准确的表述是:"on-Sample 在 Ada 以下不实用"是对的,"必须是新一代旗舰"是错的。
说法二:综合向量(cooperative vector)需要某个固定的着色器模型版本。 官方材料自己就前后不一致——RTX Kit 开发者页写的是"现在可用的 Shader Model 6.9",而当前 SDK README 针对 DX12 的路径指向的是 Shader Model 6.10 / LinAlg(Agility SDK 预览)。两者并存,官方未给出兼容矩阵。 引用时必须注明版本差异,不能挑一个当定论。
7.4 同一条路上的其他走法,以及为什么比不了
这项技术不是孤例。2023 到 2025 年之间有若干条平行路线,各自换了不同的零件。把它们列出来是有必要的——因为只有把"哪条是真出货的"和"哪条只是论文"分开,才能看懂这个领域当前的真实水位。
| 路线 | 换了什么零件 | 论文/材料报了什么 | 没报什么 |
|---|---|---|---|
| NTC(SIGGRAPH 2023) | 特征金字塔 + 每材质小网络 | 4× 分辨率少 30% 内存;逐 mip 等存储量对比 | 单纹素解码的绝对耗时 |
| ECCV 2024(随机访问神经图形纹理压缩) | 分块量化隐向量 + 位置条件解码器 | 宣称压缩率更高 | 论文没给任何解码效率数据——TU Wien 那篇在综述里直接点出了这一点 |
| HPG 2025(Intel Labs,协同向量加速的神经块压缩) | 把神经表示放进 BC 块,复用硬件过滤 | 4K 九通道材质集在 1080p + 各向异性下:28 MB / 0.55 ms(Intel B580) | 跨厂商的一致口径 |
| TU Wien(CGF 2025) | 干脆不走神经,用变码率 JPEG | 额外约 0.17 bpp 开销,RTX 4090 上开销不到 0.3 ms | 与神经路线的正面对比 |
从这张表能读出一件比结论更重要的事:在解码效率这一栏,几条路线根本没法放在一起比,因为口径、硬件、场景都不一样,而且有的论文压根不报这项。所以看到"某方法压缩率更高"时,正确的追问是:它的解码效率呢?在什么硬件上?
顺带说一句 NTC 论文自己怎么看待"图片压缩那条路":它承认那一脉在极低码率下的感知质量改善显著,但畸变指标提升有限、需要大规模数据与昂贵训练,而且因为缺少随机访问、也无法压缩非颜色材质属性,不适合实时渲染。这是作者的定位判断,不是第三方评测——但它与 TU Wien 那篇独立论文 的评述是一致的。
7.5 如果不用神经解码,还有哪几条路
下面我们把备选项摆出来。这个问题值得单独答,因为它决定了"要不要上"这个决策的备选项集合。除了"继续用 BC",公开材料里至少还有三条:
- 改编码器、不改解码器。 最典型的是神经块压缩——用网络去学一个更好的 BC1 编码器,输出仍然是标准 BC1。这条路的解码代价一点不变(还是硬件那套插值),收益全部来自"同一份格式下画质更好"。如果你只想拿画质不想动管线,这条路的风险远小于换解码器。
- 变码率 JPEG 路线。 TU Wien 那篇做的就是这件事:用延迟渲染管线识别当前帧真正需要的块、只解压这些,再加上块缓存;在 RTX 4090 上额外开销不到 0.3 ms,质量优于 BC1、与 ASTC 互有胜负。代价是引入了一套新的解压与缓存机制,而且它的"随机访问"靠的是索引表 + 缓存,不是硬件原生。
- 降低需求侧,而不是提高压缩率。 虚拟纹理与流式加载只解决"同一时刻需要多少 texel",不改变"每个字节能承载多少信息"。它和压缩是正交的两件事,可以叠加——第六章里出货的做法就同时用上了(隐向量随原有 streaming 走)。
四条路的共同点值得记一下:第 1 条只动编码端,第 2 与第 3 条动的是访问模式,只有神经解码这一条是把解码本身换掉。所以它的收益最大——而它的风险也最大,风险不在压缩率上,在第五章那一整章的过滤链上。
八、能不能用:门槛与许可
好了,技术上的账算完,还剩两道非技术的门。
8.1 门槛这张表,要连着"能不能出货"一起看
SDK 的推理接口有三种走法,这一点在代码层面就能看出来:
【推理接口选择】
  --dx12         → Microsoft LinAlg(Shader Model 6.10,Agility SDK 预览)  【1】
  --vk           → VK_NV_cooperative_vector                               【2】
  --no-coopVec   → DP4a / 整数回退,任何 Shader Model 6 GPU 都能跑          【3】
下面对这三行特别说明:第【1】行是预览路径,官方 README 的原话是"The DX12 LinAlg support is for testing purposes only. DO NOT SHIP ANY PRODUCTS USING IT."——明确不许出货,而且它还要求 Windows 处于开发者模式。第【2】行与第【3】行可以出货,其中第【3】行的回退路径在计算上要慢一截,但兼容面最广。
官方还列了两条已知问题:DX12 LinAlg 推理与当时的 AMD 预览驱动不兼容;on-Feedback 模式在 AMD GPU 的示例里是坏的。这两条对跨厂商项目是实打实的排期风险。
8.2 许可不是开源的
好了,最后一道门最容易被忽略。SDK 的许可是 NVIDIA RTX SDKs LICENSE(版本日期 2024-02-23),要点:
- 非开源,不是 Apache / MIT 那一类;
- 可以修改并创建样例源码的衍生作品,可以以目标码形式随应用分发;
- 不得反向工程;
- 不得以任何方式让它变成受开源许可约束的作品;
- 累计责任上限 US$10.00。
"改样例 + 目标码随应用分发"这个范围,与工程上的常见用法是吻合的;但它不是"随便用"的素材。如果你的项目有开源计划,或者法务对 SDK 许可有额外要求,这一条要在评估阶段就过一遍,而不是等接完再问。
8.3 还有两件"没有公开数字"的事
好了,按前几篇的惯例,把查不到的事情也列出来——它们比错数字更值得知道:
- 单个纹素解码的绝对耗时:官方只给了"显著高于普通像素着色器"的定性描述、综合向量带来的 2–4 倍相对提升、以及"可能吃掉整帧 20–30%"这个区间。没有任何官方绝对数字(周期数 / 纳秒 / 毫秒)。
- 已出货使用这项技术的作品清单:官方未公布。本次调研只找到一家(《刺客信条:幻景》),而且它是团队自己的工程博客,不是厂商名单。
8.4 一份最小评估清单
把前面八章压成一张可以照着走的清单。顺序不能换——每一步都在决定后面还有没有必要往下走:
| 步 | 要确认的事 | 不通过的后果 |
|---|---|---|
| 1 | 瓶颈是不是显存?(不是包体、不是加载时间) | 若瓶颈是包体 → 只做 on-Load 就够了,不要动过滤链 |
| 2 | 目标平台上 on-Sample 的算力余量够不够 | 低端卡 + 高分辨率是最差组合(§9 第 2 条) |
| 3 | 管线里有没有随机采样 + 时域累积的设施 | 没有 → 你评估的是一整套时域重建改造(§5.5) |
| 4 | 能不能接受只在高收益资产上启用 | 不能 → 全量替换的收益/成本比在现有记录里是负的(§6.3) |
| 5 | 走哪条 API 路径、这条路径现在能不能出货 | DX12 + 综合向量当前不许出货(§8.1) |
| 6 | 许可能不能过你项目的法务口径 | 非开源许可 + 目标码分发(§8.2) |
| 7 | 压缩时间能不能塞进日常迭代 | 若一轮要 15 分钟量级,只能用在版本末期(§3.7) |
这份清单的用法,和前面几篇的判据表一样:按序自查,遇到第一条不通过就停下。 不要在第一步没确认的情况下去优化第六步——这是这类技术最容易踩的坑:把工程问题当成了调参问题。
九、结论:什么情况下不值得换
依然是惯例,收尾不复述,把全篇压成一张可查的表。
用法和前面几篇一样:按行自查,任何一条对上号就先停下重新评估,不要跳步。
- 只想降运行时显存 → on-Load 模式显存一分不省(§4.1),要么改 on-Sample,要么这件事本身就不是它该解决的问题。
- 低端卡跑高分辨率 → on-Sample 的代价随采样纹素量上升。公开实测里,同代旗舰在 4K 上的增量不到 0.1 ms,而中端卡在 4K 上到了约 1.2 ms 量级——越低端、分辨率越高,代价越陡。
- 管线已经吃满张量单元 → 与超分类技术争用同样的硬件资源,开销会上升。
- 拿不到随机纹理过滤或时域超分 → on-Sample 需要随机采样;关掉抗锯齿会出噪点,纯时域抗锯齿只能清掉大部分。这一条是硬依赖。
- 想做全量替换,但引擎改造预算有限 → 唯一一份公开出货记录的做法是选择性启用,不是全量替换(§6.3)。
- 必须走 DX12 + 依赖综合向量加速 → 当前这条路径不许出货(§8.1)。要么改走 Vulkan,要么用回退路径吃性能损失。
六条里有三条是"非技术"的(第 3、5、6 条:资源争用、全量替换的预算、出货红线),三条是"技术"的(第 1、2、4 条:省的是哪一笔、低端卡的代价陡增、过滤的硬依赖)。这个分布本身值得记一下:一项看起来纯的是显存优化的技术,真正卡住落地的一半以上是非技术因素——这与前两篇降噪的结论形状不同(那一环的难点主要在数据与验收方法上)。
反过来,一张正向的自查表:当你的瓶颈确实是显存、目标平台是 PC 为主、管线里已经有随机采样或时域超分的设施、而且你能接受"只在高收益资产上启用"时,这笔账才算成立。
到这一步,"省了 8 倍"这个数字才终于有资格被引用——因为它已经带着三笔账、一道随机访问约束、一条过滤硬依赖和一张许可清单了。
相关链接
- RTX Neural Texture Compression SDK(README 含系统要求、三种模式与 DX12 出货警告)
- NVIDIA RTX Kit 开发者页(含 8× disk memory 口径与 SDK 入口)
- Get Started with Neural Rendering Using NVIDIA RTX Kit(含需求表)
- RTX Neural Rendering 发布博客(含 7× VRAM or system memory 口径)
- Random-Access Neural Compression of Material Textures(SIGGRAPH 2023 论文与补充材料)
- Practical Neural Texture Compression(Vulkanised 2025 官方演讲幻灯片:三笔账、STF 要求、整帧开销区间)
- Ubisoft La Forge:Shipping Neural Texture Compression in Assassin's Creed Mirage
- Hardware Accelerated Neural Block Texture Compression with Cooperative Vectors(HPG 2025,Intel Labs)|Neural Graphics Texture Compression Supporting Random Access(ECCV 2024)
- Variable-Rate Texture Compression: Real-Time Rendering with JPEG(TU Wien,含对 NTC 通道相关性的评述)
- NVIDIA RTX SDKs LICENSE(非开源许可原文)
- RTX Texture Filtering 仓库(随机纹理过滤的官方组件)
下篇预告
下一篇换到材质本身:神经外观——从解析 BRDF 到学习式材质。
它和本篇是对着来的。本篇替换的是"纹理在显存里怎么存",而下一篇替换的是"光打到表面上该怎么算"——前者动的是存储与带宽的账,后者动的是着色方程本身。好处同样是质量与体积,但代价的形状会变:这次的难题不是随机访问,而是一个网络能不能覆盖一整类材质的光学行为,以及它在没见过的参数上会不会给出物理上不成立的结果。
再往后两篇会讲清楚那个所有神经着色都绕不开的工程问题:怎么在着色器里把网络跑起来。
With Best Wishes.