站点链接:技术博客页
【移动端图形与功耗】第 3 篇 | 系列共 7 篇
- 上一篇:【移动端图形与功耗】(二)分块渲染:binning、片上内存与它的代价
- 下一篇(预告):【移动端图形与功耗】(四)功耗与热:帧率为什么会掉下去
系列文章前言
1.1 系列定位
上一篇把分块渲染的机制拆完了:几何先分桶、逐块着色、附件尽量留在片上。那是机制层的答案。
这一篇问一个更原始的问题:一帧到底有多少字节必须跨芯片搬运? 机制决定了"能不能不搬",账本决定了"搬多少才够"。两件事必须分开算,否则优化会变成拍脑袋。
1.2 本篇要回答的三个问题
把这一篇要立的东西压缩成一句话:在 5 GB/s 量级的预算里,哪些搬运是架构决定的、哪些是工程可以拿掉的,各自能拿掉多少。
拆开就是三个问题:一帧的字节从哪来;移动内存的物理边界在哪;四类降带宽手段各自能省下多少。这三个问题有先后依赖:不算清账本,就不知道哪个手段值得动。
1.3 全系列内容总览
先看看整个系列怎么排。本系列共七篇,按"约束 → 机制 → 账本 → 代价 → 取舍 → 新特性 → 测量"推进:
| 篇 | 主题 | 回答的问题 |
|---|---|---|
| 一 | 两台不同的机器:移动 GPU 的物理约束 | 为什么移动端不能照搬桌面做法 |
| 二 | 分块渲染:binning、片上内存与它的代价 | 机制上怎么少搬 |
| 三(本篇) | 带宽:移动端最硬的那道墙 | 一帧搬多少、怎么搬得更少 |
| 四 | 功耗与热:帧率为什么会掉下去 | 为什么持续运行会降频 |
| 五 | 延迟着色在移动端:能做什么、不能做什么 | 哪些高级效果值得做 |
| 六 | 现代特性落地:VRS、网格着色与移动光追 | 新特性在移动端的真实收益 |
| 七 | 测量与调优:怎么证明你真的优化了 | 怎么把结论做成可复现的证据 |
这张表把七篇的先后关系摆清楚了:约束、机制、账本、代价、取舍、新特性、测量。读的时候可以只挑当前需要的两篇,但建议至少把第 1 篇和第 7 篇一起看——前者给前提,后者给验证方法,缺了任何一头,中间的取舍都站不稳。
整条系列线从「约束」起、到「测量」收,本篇立在第三格「账本」上:前两篇把机制与约束摆清楚,接下来的四篇都在这条账本线上各自算一遍,本篇先做其中字节的那半边。
1.4 与已有中文资料的差异
中文资料在这个题目上有两个极端。一端是厂商文档的翻译片段,讲清了某一项技术却说不清它在总账里的位置;另一端是经验帖,给了一堆"要开 mipmap、要压缩纹理"的结论,却几乎不给可核对的数字。
中间那层——把一帧的账真算一遍,再用厂商官方数字核每一项收益——基本没人做。这一篇补的就是这一层。凡是量化收益,一律标注出处与测量条件;凡是社区转述、无法溯源的数字,宁可不用。
1.5 阅读建议与边界声明
本篇按变体 B 呈现:移动端图形以硬件约束与工程取舍为主线,代码密度天然偏低,硬凑长代码段只会稀释信息密度;因此关键做法以配置清单 + 伪代码给出,凡涉及具体实现仍给可复现的做法。
本篇不涉及:分块机制的实现细节(第 2 篇已讲,本篇只引用)、DVFS 与温度墙(第 4 篇)、延迟着色等具体效果的取舍(第 5 篇)、完整的测量协议(第 7 篇)。本篇涉及的分辨率与格式基准统一取 1080p、RGBA32 颜色附件、D24S8 深度模板、60fps;换基准会改变绝对数值,但不改变各项的相对量级。
背景铺垫:为什么带宽是墙,而不是资源
2.1 一句话点题
好了,这一章先把坐标系立起来。桌面端把带宽当资源,移动端只能把它当预算。这一章把坐标系立起来,不展开机制。
2.2 原理与概念:两种做法的分岔
先看看桌面端是怎么做的。桌面 GPU 面对带宽压力时,有一个非常直接的解法:把总线加宽、把显存提速。这是用面积和功耗换带宽——显卡有独立的供电与散热,多出来的引脚和 I/O 功耗由整机承担。
移动端没有这个选项。SoC 的引脚数、封装尺寸、散热能力都被机身锁死,而内存往往还是与 SoC 叠在一起封装的。带宽因此不是"可以买更多"的资源,而是一份固定预算。
Arm 给出过一组对比:典型嵌入式设备能处理约 5.0 GB/s 的带宽,而典型桌面 GPU 可以超过 100 GB/s[1][2]。差了一个数量级以上。这就是本篇的全部前提。
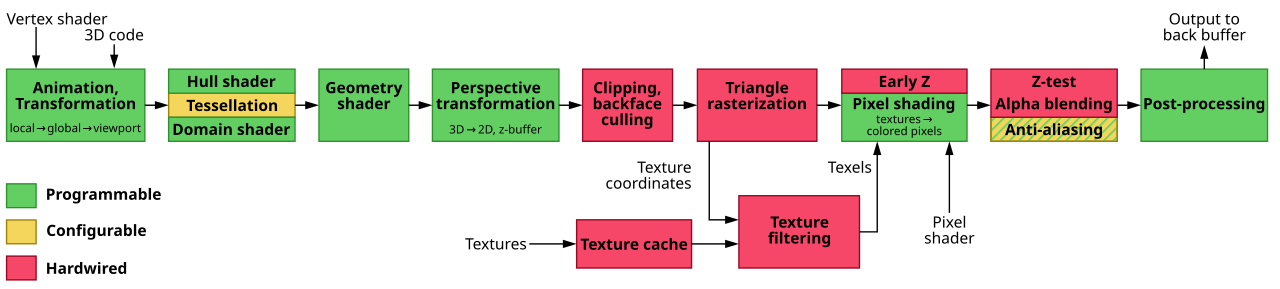
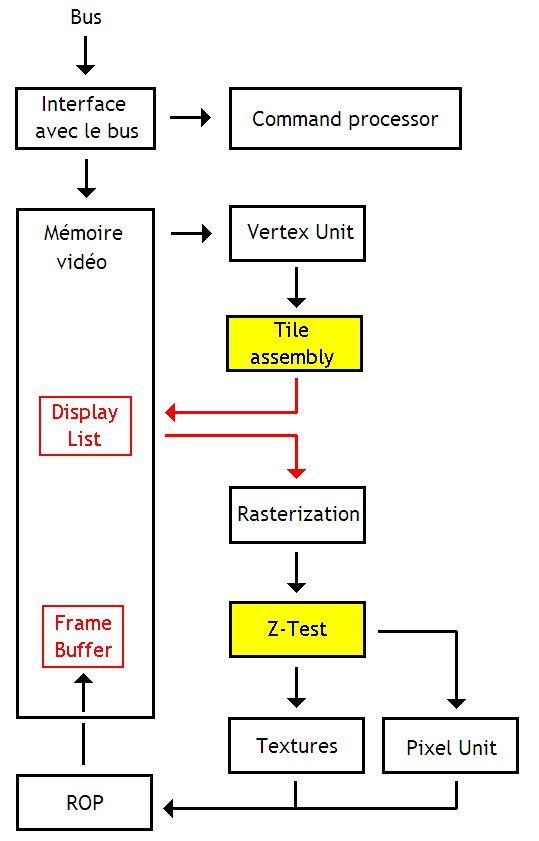
带宽的算法口径本身很简单:实际搬运的字节数 =(外部总线读节拍数 + 外部总线写节拍数)× 总线宽度[2]。注意这里数的是实际发生的搬运,不是理论峰值——后者只是上限。
2.3 原理与概念:为什么搬运字节等于耗电
说白了,移动端真正在意的不是"搬得慢",而是"搬得贵"。DDR 访问的能耗有一个常用的经验值:约 100 pJ/byte[4]。这个数字把带宽问题直接换算成了功耗问题。
举一个能算的账:如果某项优化每帧省下 60 MB 的搬运,在 30fps 下就是每秒 1.8 GB,按 100 pJ/byte 折算约 180 mW 的系统级功耗[4]。对一台整机功耗预算只有几瓦的手机来说,这不是零头。
这一跳——字节 → 功耗——是理解移动端图形取舍的钥匙。它解释了为什么"带宽优化"在这个平台上是第一优先级,而在桌面上往往排在算力之后。
把带宽换算成功耗,这一步在很多资料里被跳过了。跳过之后,"省带宽"就只是一个性能话题;算上之后,它才变成一个续航话题——而续航才是移动端真正被卡住的地方。这也是本篇与桌面视角最大的分歧点。
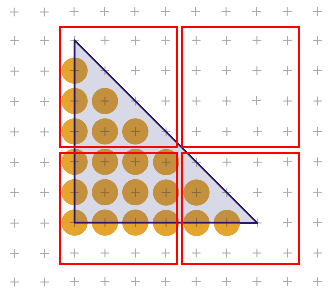
2.4 公式或参数逐项释义:本篇会用到的三个换算
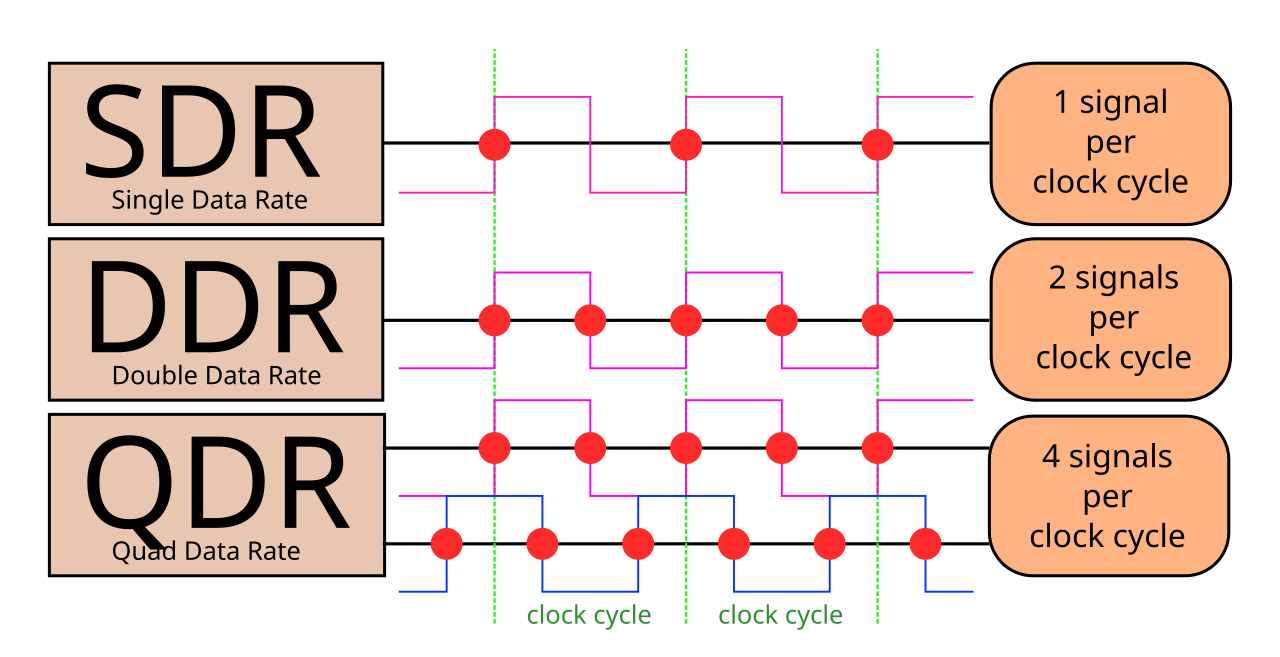
换算一 · 名忆带宽:名义带宽 = 数据率 × 位宽 ÷ 8。以 LPDDR5X-8533 的单个 16-bit 通道为例:8533 MT/s × 16 bit ÷ 8 = 17.1 GB/s[69][73]。注意这是每通道——整机带宽要把通道数乘上去。
换算二 · 附件流量:附件字节 = 像素数 × 每像素字节数 × 覆盖次数。1080p 的 RGBA32 颜色附件是 2,073,600 × 4 = 8.29 MB;深度模板 D24S8 是每像素 4 字节,再加 8.29 MB。两者相加约 16.6 MB/帧,仅"各写一次"。
换算三 · 字节到功耗:功耗 = 字节数 × 频率 × 100 pJ/byte[4]。三个换算在后面每一章都会用到。
这三个式子在后面的每一章都会用到。式一量的是内存能给的上限,式二量的是这一帧要搬多少,式三把两者之间的差额折算成功耗。任何一项优化,最终都可以落到这三个式子的某一项上,反过来也说明:落不到任何一项的改动,多半不是带宽优化。
2.5 全量清单:降带宽的手段有哪些
依然是惯例,把能查到的做法尽量列全,宁全勿缺:
| 类别 | 手段 |
|---|---|
| 数据格式 | 纹理压缩(ASTC / ETC2 / PVRTC / BC)、帧缓冲压缩(AFBC / AFRC / UBWC / PVRIC)、几何压缩(PVRGC) |
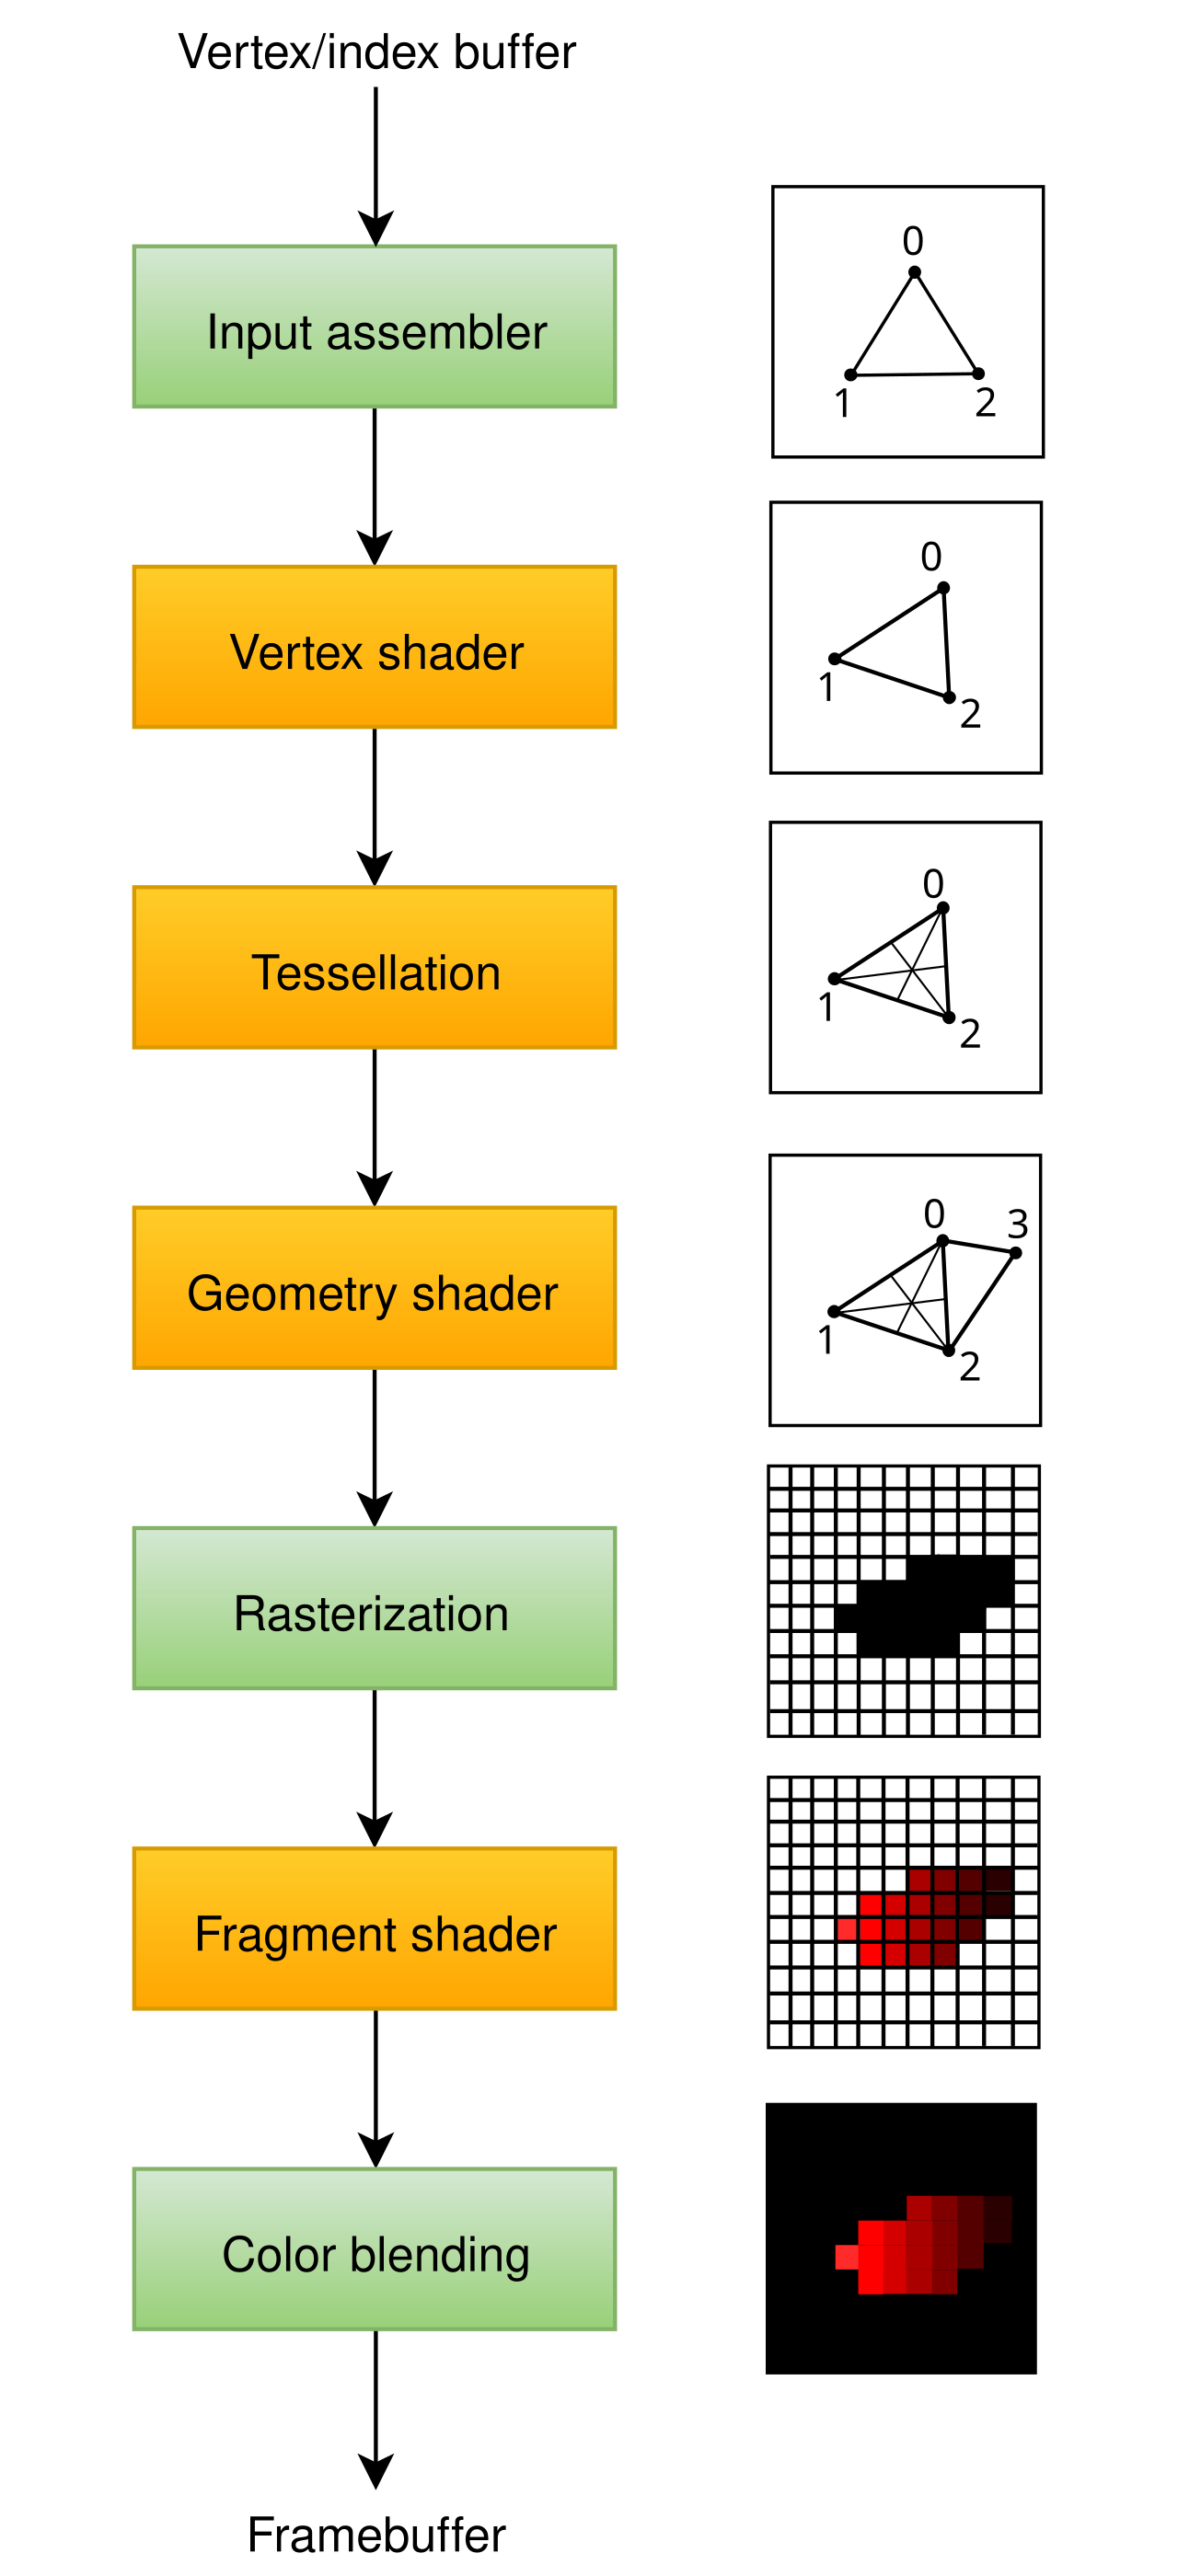
| Pass 结构 | transient attachment、lazily-allocated memory、STORE_OP_DONT_CARE、subpass 合并、pixel local storage、单 pass 化 |
| 采样策略 | mipmap 链与 LOD 偏置、各向异性过滤的档位、纹理串流的内存预算、纹理缓存友好布局 |
| 几何与顶点 | 顶点格式瘦身、索引化、顶点缓存顺序、几何压缩、减少重复着色 |
| 资产侧 | 分辨率与位深的降档、图集合并、UI 层与场景层分离 |
| 目标侧 | 分辨率缩放、帧率与画质档位、可变速率着色 |
2.6 全量清单的二次归类
说白了,上面这张清单如果只是罗列,读者记不住。归成四类之后就有骨头了:
① 改数据格式——同样的信息用更少的字节表示。收益取决于内容,通常有明确的压缩比上限。 ② 改 Pass 结构——让数据根本不需要离开片上。收益最大,因为省下的是整笔流量而不是一个比例。 ③ 改采样策略——同样一次采样,少读几个纹素。收益中等,但配置最轻。 ④ 改资产与目标——降低要处理的总量。收益直接,但代价是画质或分辨率,属于产品决策而非技术优化。
后面第 3 到第 6 章按这个顺序逐类展开,并在第 8 章把四类的收益放在同一把尺子上排序。
2.7 演进脉络:约束是怎么被逐步认识到的
| 年份 | 事件 | 意义 |
|---|---|---|
| 1990s 末 | PowerVR 系列把分块延迟渲染带进消费级 | 从架构上先减少外部访问[16] |
| 2000s | ETC1/ETC2 成为 OpenGL ES 的标准纹理压缩 | 纹理压缩从可选变为标配 |
| 2010 | Arm 提出 AFBC,帧缓冲也开始压缩 | 压缩对象从纹理扩展到附件[11] |
| 2012 | ASTC 由 Arm 与 AMD 联合开发并进入 OpenGL ES 扩展 | 块尺寸可调,画质与位宽解耦[13] |
| 2013 起 | Qualcomm 在 A5x 之后的 GPU 上引入 UBWC | 压缩从 GPU 内部扩展到 SoC 全局[18] |
| 2016 起 | Vulkan 的 subpass 与 transient attachment 进入规范 | 附件"不落主存"从厂商技巧变成标准能力[27] |
| 2020 年代 | Arm 推出 AFRC 定比特率压缩;Adreno 推出 Tile Memory Heap | 压缩比与片上内存开始由应用可控[17][20] |
口径说明:年份取公开资料中的首次发布或标准化时间,不是产品大规模出货时间。
这条时间线里有两个转折点值得留意:一是 2010 年前后压缩的对象从纹理扩展到帧缓冲,二是 2016 年前后"附件不落主存"从厂商技巧变成了 Vulkan 的标准能力。后者意味着这类优化不再依赖特定硬件的私有扩展,跨设备复用的可能性才真正出现。
2.8 术语对齐:三家厂商的四套缩写
说白了,同一个目标——把跨芯片搬运的字节压下去——三家厂商各有一套名字。先把这张对照表立起来,后面全篇只用一类叫法,别名括注一次。
| 目标 | Arm | Qualcomm | Imagination |
|---|---|---|---|
| 帧缓冲 / 中间结果压缩 | AFBC(无损)、AFRC(定比特率有损)[11][17] | UBWC[18] | PVRIC[22] |
| 纹理压缩 | ASTC、ETC2[13] | ASTC、ETC2 | PVRTC、ASTC[23] |
| 几何压缩 | — | — | PVRGC[22] |
Imagination 把三者合称 PVR3C(Triple Compression)[22]。记住一件事就够了:这三家的帧缓冲压缩格式互不兼容,跨厂商发布时只能回退到标准纹理压缩,帧缓冲压缩则交给各自的驱动。
这张表建议反复回看。中文资料里最常见的混乱,是把 AFBC 说成"纹理压缩"、把 UBWC 说成"Arm 的压缩"。记住一条就够:帧缓冲压缩与纹理压缩解决的是两类完全不同的数据,混用会导致对收益的错误预期,也会让方案评审时的估算整体偏掉。
2.9 三个常见误判
好了,先看三个容易搞混的地方。误判一:带宽就是显存容量。 两者是不同维度。移动端卡的从来不是"装不下",而是"每秒搬不了那么多"。容量不够会闪退,带宽不够会掉帧——症状完全不同。
误判二:开了压缩就省带宽。 压缩的实际效果取决于数据模式。AFBC 是无损压缩,遇到某些"坏"数据模式可能完全不压缩[11];把压缩当成必然收益,会在实时渲染的画面(大量噪声与高频细节)上落空。
误判三:subpass 合并一定更快。 Arm 官方专门写过一篇来纠正:合并几乎总能省带宽,但不一定省时间——除非确实受带宽限制;在较老的 GPU 上性能甚至可能略降[15]。
边界声明:本篇讨论的是外部内存(DRAM)流量,不涉及片上 SRAM 的访问开销;讨论的是渲染管线产生的流量,不涉及相机、视频编解码等其他 SoC 模块,虽然它们共享同一条内存总线。
2.10 贯穿全篇的问题
言归正传。这一篇始终围绕一个问题展开:在一帧的账本里,哪一笔最值得动?
问题会在每一章被细化一次——第 1 章把账本摊开,第 2 章给出内存侧的物理上限,第 3 到第 6 章分别量四类手段的收益,第 8 章给出排序。最后在第 10 章交出去,因为账算完之后,还有一个现象没有解释:为什么同样的帧,跑二十分钟就掉下来。
一、账本:一帧的字节从哪来
3.1 一句话点题
好了,这一章把一帧的账摊开。不先算清总量,后面的"省了多少"都无从谈起。
这一章把一帧的账摊开。先说结论:在 1080p 的基准场景下,一帧约需搬运 35 MB,其中附件读写占了接近三分之二。不先算清这个总量与结构,后面每一章说的"省了多少"都无从谈起,甚至看不出哪一笔才是最值得动的。
3.2 原理与概念:四类流量的来源
先看看这些字节从哪来。一帧里跨芯片搬运的字节,可以归成四类。
第一类是附件读写。颜色、深度、模板这些"附件"(attachment)在着色过程中被反复读写。在即时渲染(IMR, Immediate Mode Rendering)架构里,每一次混合、每一次深度测试都可能触发一次外部读写;在分块架构里,附件先留在片上,只有进出时各搬一次——这正是第 2 篇讲的机制价值[16]。
第二类是纹理解析。每次纹理采样都可能触发一次外部读取,具体读多少取决于 LOD、过滤模式与缓存命中率。
第三类是几何与缓冲。顶点数据、索引、常量缓冲、各种 storage buffer。这一类的绝对量通常不大,但它是"每帧都要搬一次"的固定成本。
第四类是隐式流量。应用没有显式声明、但硬件仍然会产生的搬运:压缩格式的元数据、瓦片表、mipmap 链里未被访问的层级、以及缓存行对齐带来的过读。这一类最容易被忽略,也最难优化,因为它不在任何 API 调用里。
分清四类之后,一个重要的划分就出来了:哪些是架构决定的刚性开销,哪些是工程可以动的。
刚性开销的典型例子是几何数据与必需纹理的最低读取量——只要你要渲染这个场景,这些字节就必须搬。可压缩开销的典型例子是 overdraw 带来的重复附件写入、以及未被访问却被整块读入的数据。优化的空间几乎全在后者。
3.3 公式或参数逐项释义:算清一笔账的三个式子
式一 · 名义带宽
名义带宽 (B/s) = 数据率 (MT/s) × 位宽 (bit) ÷ 8
以 LPDDR5X 的单个 16-bit 通道为例:8533 × 16 ÷ 8 = 17.1 GB/s[69][73]。这个数字是上限,不是承诺。
式二 · 附件字节
附件字节 = 像素数 × 每像素字节数 × 覆盖次数
1080p 的 RGBA32 颜色附件:2,073,600 × 4 = 8.29 MB;D24S8 深度模板每像素 4 字节,再加 8.29 MB。两者合计约 16.6 MB/帧。
式三 · 字节到功耗
功耗 = 字节数 × 频率 × 100 pJ/byte
这个 100 pJ/byte 是 DDR 访问的能耗经验值[4],它是本篇把带宽收益翻译成功耗收益的唯一桥梁。
三式的关系是层层递进的:式一给上限,式二算需求,式三把差额折算成代价。实际工作里可以只记住式二和式三——它们直接决定优化能省下多少毫瓦,而式一决定的是你能走多远;前者关系到能不能交差,后者关系到天花板在哪。
3.4 原理或概念:被 overdraw 放大的那一笔
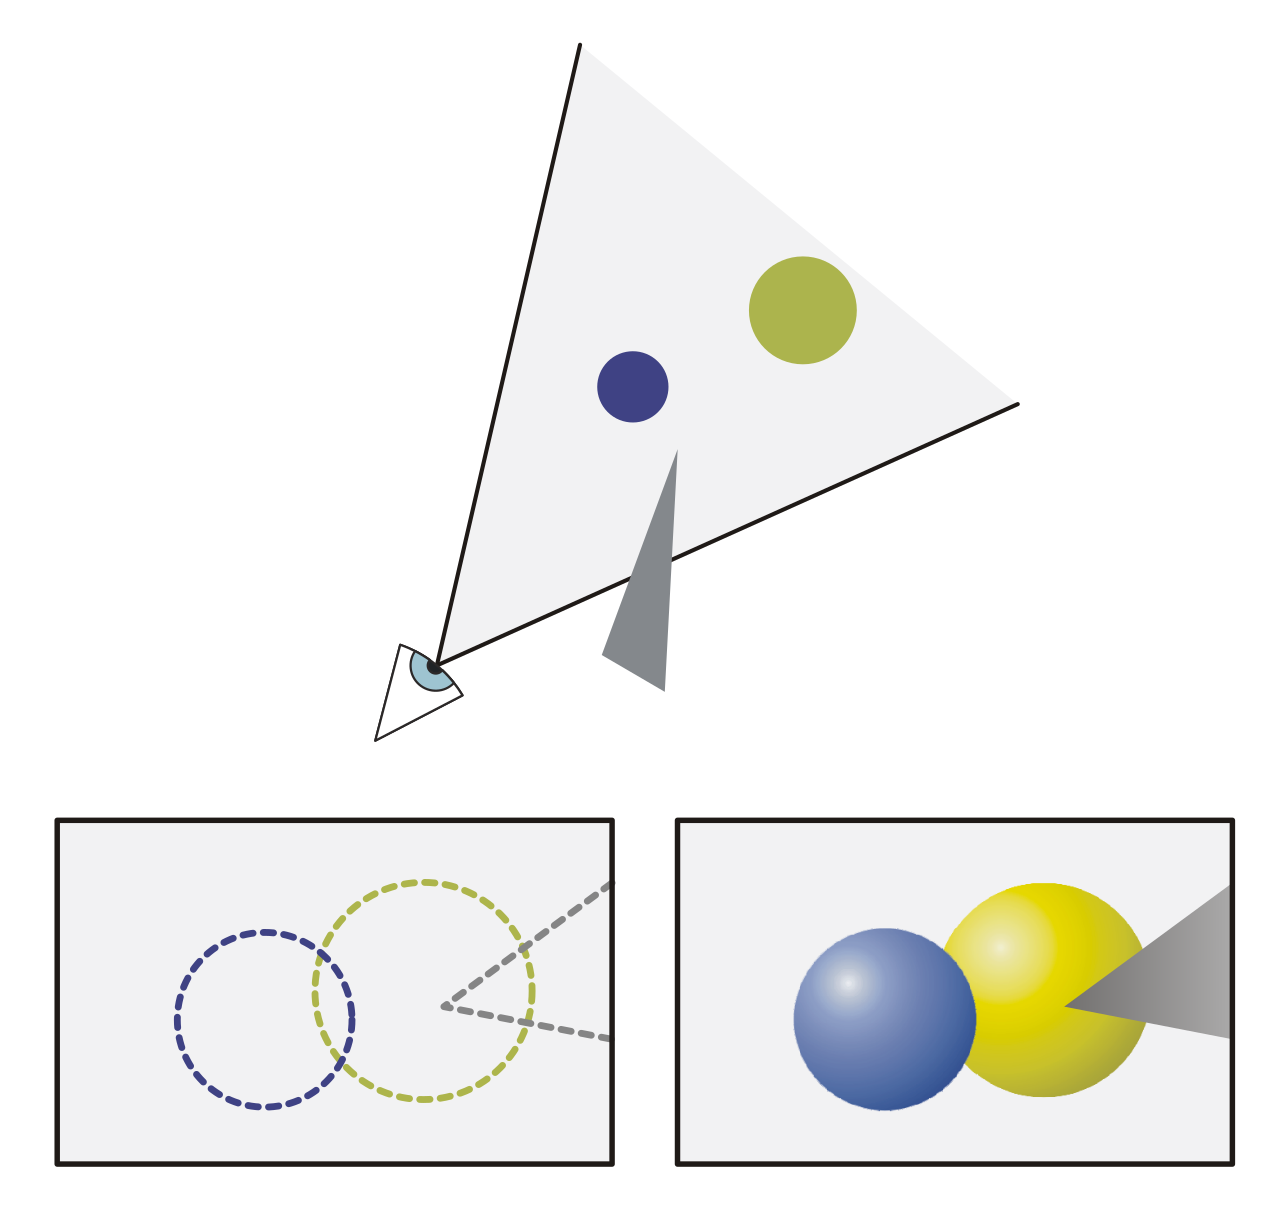
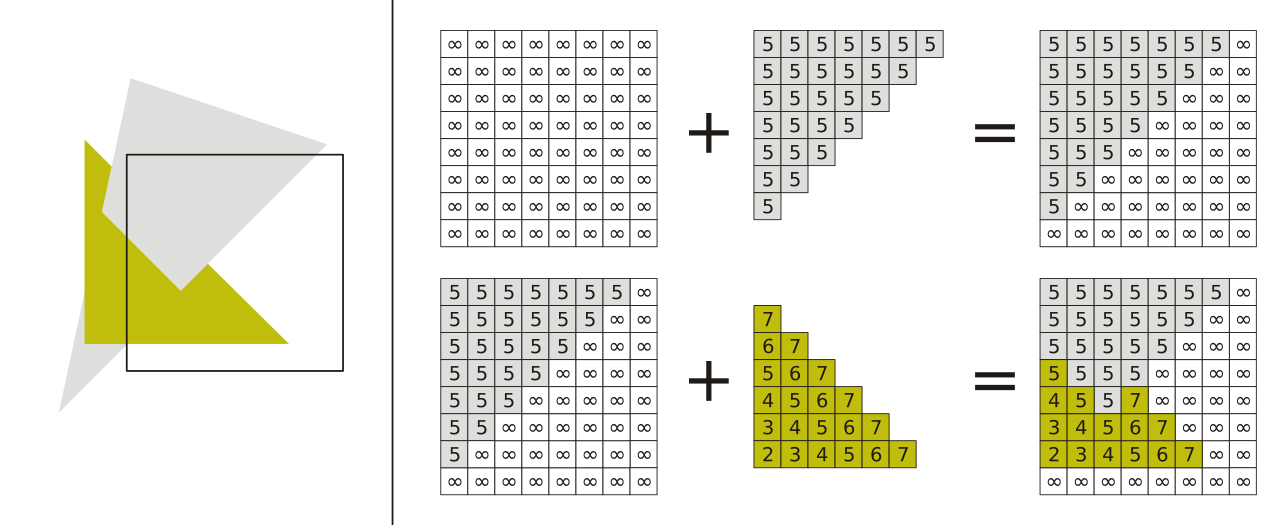
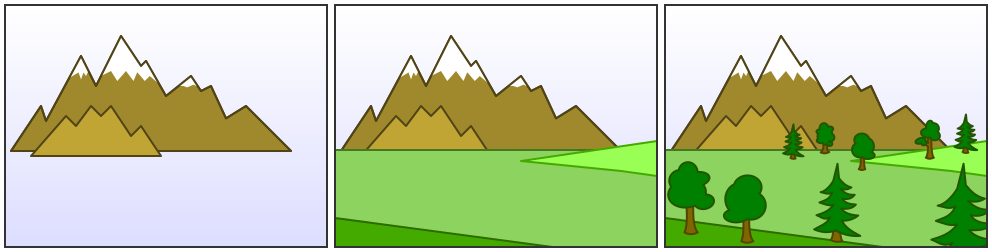
先看看这个容易被读漏的乘数:覆盖次数。一个像素如果被着色 3 次,附件写入就是 3 份。
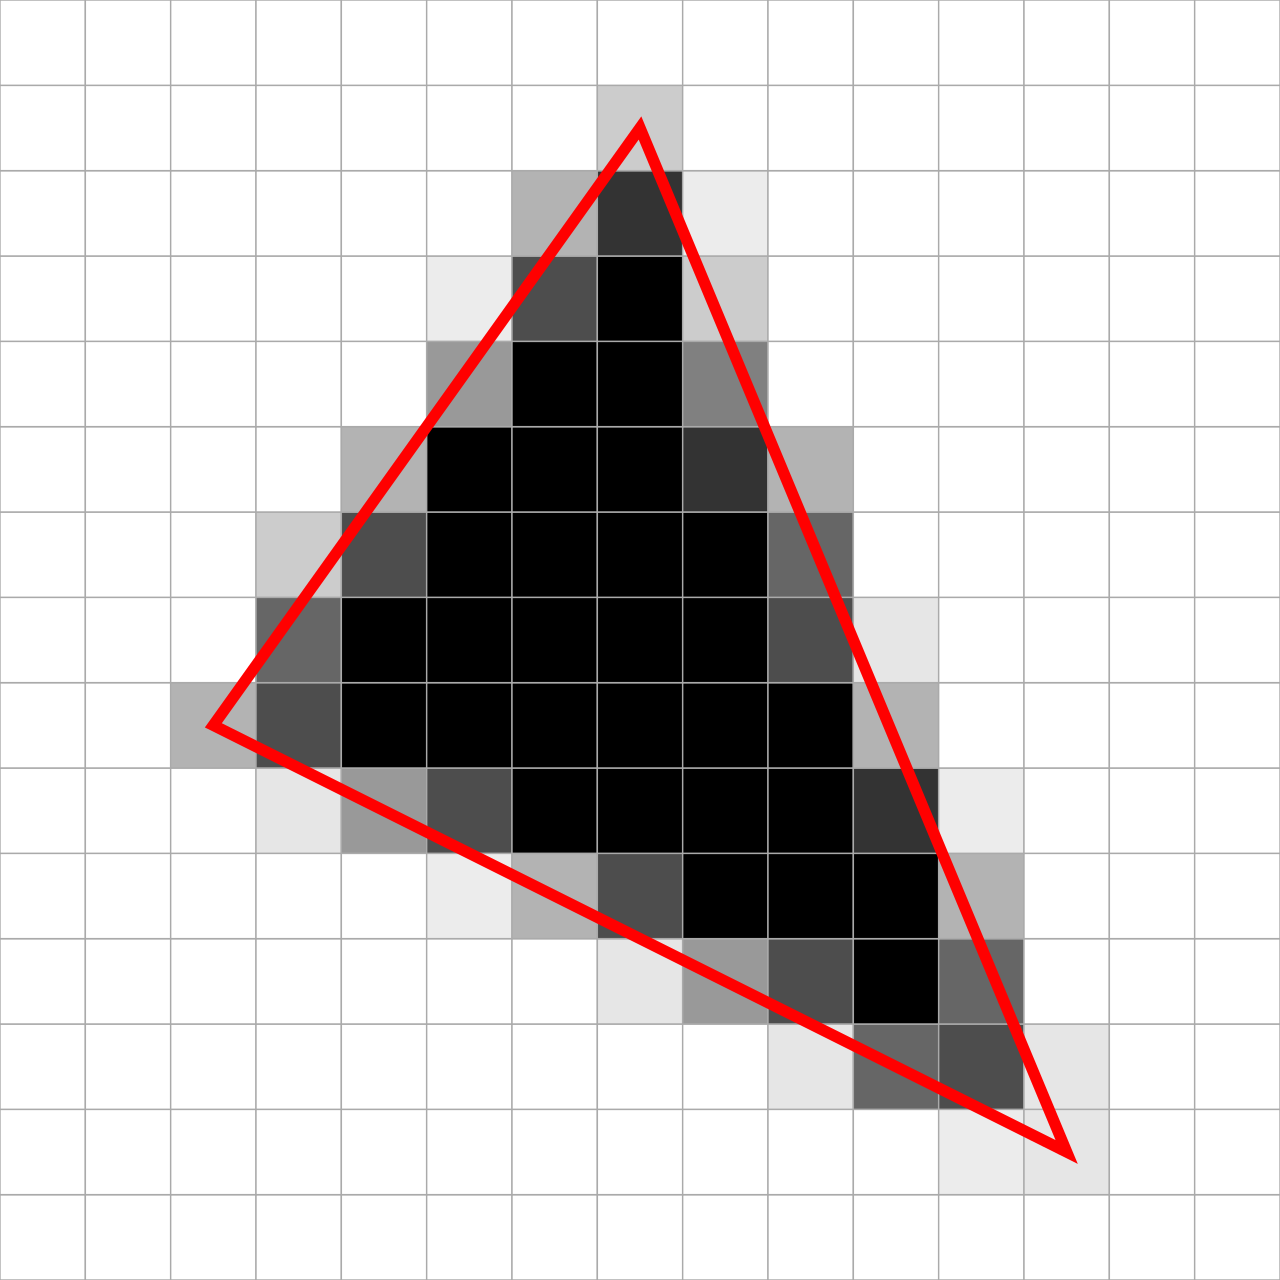
overdraw 的定义很朴素:片段着色器调用次数 ÷ 实际存储的像素数[41]。比值大于 1 的部分,就是白做的功。
这就是为什么移动端对 overdraw 格外敏感。桌面端多画两遍,代价是几毫秒;移动端多画两遍,代价是带宽被打满,然后转化成热量。
纹理那一侧也有类似的放大。一张 1024×1024 的纹理,如果远处物体在屏幕上只占 8×8 像素,而没有 mipmap,GPU 仍会按原分辨率去读,还要为各向异性过滤做多次采样。读取量与实际需要的信息量严重不匹配,这是第 6 章要处理的问题。
3.5 效果与量化:1080p 基准场景的账本
好了,把上面的式子套进一个具体场景:1080p、RGBA32 颜色附件、D24S8 深度模板、平均 overdraw 2.5、60fps。
| 项目 | 每帧字节 | 每秒字节 | 说明 |
|---|---|---|---|
| 颜色附件写入 | 8.29 MB × 2.5 | 1.24 GB/s | 含 overdraw 放大 |
| 深度模板读写 | 8.29 MB × 2 | 0.99 GB/s | 深度测试与写回 |
| 纹理解析 | 约 12 MB | 0.72 GB/s | 取决于 LOD 与缓存命中 |
| 几何与常量缓冲 | 约 2 MB | 0.12 GB/s | 顶点 + 索引 + UBO |
| 隐式流量 | 约 3 MB | 0.18 GB/s | 元数据、对齐过读 |
| 合计 | 约 35 MB/帧 | 约 2.1 GB/s | — |
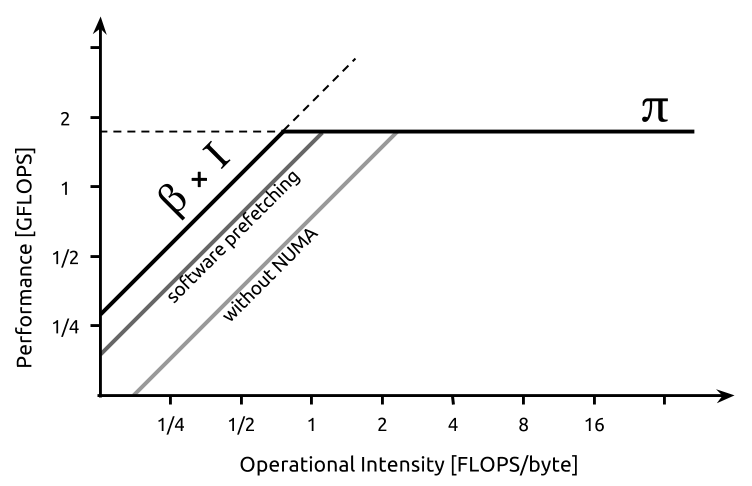
对照 Arm 给出的 5.0 GB/s 量级[1],这个场景已经用掉了四成预算,而这还只是一个不含后处理的裸场景。加上两三个全屏后处理 pass,很容易冲到 3 GB/s 以上。
这张表是全文所有百分比的基数。换任何一项前提——分辨率、颜色格式、overdraw 倍数、帧率——都会改变绝对数值,但各项的相对量级不会翻转。附件那一行占了一半以上,这正是第 5 章"结构与附件"收益最大的原因所在。
附件那一笔显然是最大的一项,占比接近三分之二。这是后面第 5 章(结构与附件)收益最大的原因——它动的就是这一笔。
3.6 实现与配置:名义值与实际值的差距
好了,这里要提醒一句:账本里所有的数字都是名义值。实际能拿到多少,还要看内存子系统的调度效率。经验上持续吞吐只能达到名义值的一部分,差额来自 bank 冲突、刷新开销、读写切换与总线仲裁[66]。
这一点在下一章展开。这里只需记住一件事:账本给的是下限,不是保证。
3.7 源码与数据链接
- 带宽与能耗口径:Arm《Analyzing Performance of Mobile Games》[1]、《Performance Analysis & Debugging with Mali》[2]
- 100 pJ/byte 与 PLS 省量:Arm GDC2017《Achieving Console Quality Games on Mobile》[4]
- 显示带宽账本体例:TI OMAP4470 白皮书[49]
- overdraw 的测量定义:Apple WWDC 2020《Optimize Metal apps and games with GPU counters》[41]
3.8 这一章留下的问题
账本算出来了,但里面每一个数都依赖一个前提:内存侧到底能给多少。这个前提如果不成立,账本上所有的"占比"都会变形。下一章去内存那一端把上限量出来。
二、内存侧事实:LPDDR 的物理边界
4.1 一句话点题
带宽的上限不由 GPU 决定,由内存接口决定。这一章量出这个上限,并解释为什么它总也拿不满。
好了,带宽的上限不由 GPU 决定,而由内存接口决定。这一章要量出这个上限,并解释为什么实际能拿到的总是明显低于名义值。不理解这个差额,后面很容易把"没达到预期"误判成优化本身无效——那会导致方向性的错误。
4.2 原理与概念:LPDDR 的通道组织
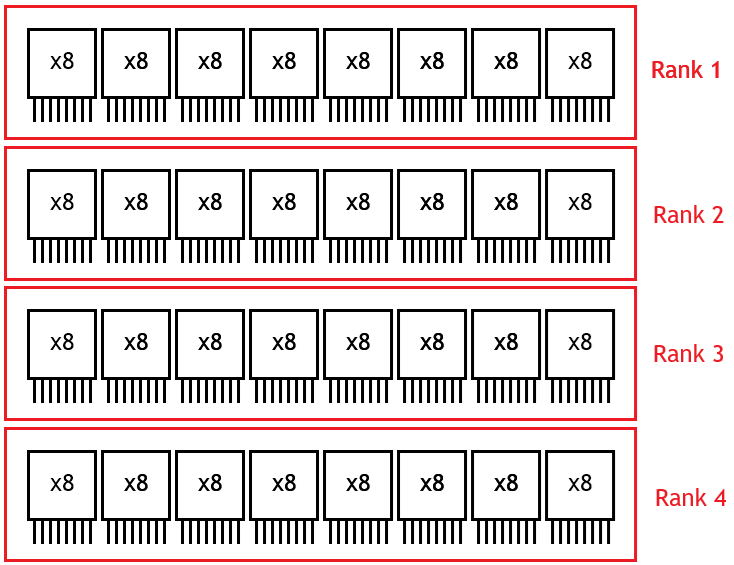
先看看内存是怎么组织的。LPDDR 的内存不是一整块,而是被组织成若干条独立的 16-bit 通道。器件位宽常见三种:x16(1 通道)、x32(2 通道)、x64(4 通道),每条通道有自己的命令/地址(CA)与数据(DQ)引脚[60]。
这个设计直接决定了带宽的算法:通道数 × 每通道带宽 = 整机名义带宽。所以手机上的"位宽"通常不是指单条 64-bit 总线,而是多条窄通道并行。
LPDDR5-6400 的单通道带宽是 12.8 GB/s,LPDDR5X-8533 是 17.1 GB/s[69][73]。一颗用 x64(4 通道)LPDDR5X 的器件,名义带宽就是 17.1 × 4 ≈ 68 GB/s。
把内存理解成"若干条窄通道并行"而不是"一条宽总线",是读懂移动端带宽的第一道门槛。这个理解会直接影响后面所有换算:位宽不再是一个数,而是每通道位宽与通道数的乘积,漏乘通道数会让估算差出好几倍。
4.3 公式或参数逐项释义:代际参数与换算
| 代际 | 最高数据率 | 每 16-bit 通道带宽 | 备注 |
|---|---|---|---|
| LPDDR4 | 4266 MT/s | 8.5 GB/s | 双通道成为主流 |
| LPDDR4X | 4266 MT/s | 8.5 GB/s | 降低 I/O 电压 |
| LPDDR5 | 6400 MT/s | 12.8 GB/s | 引入 bank group |
| LPDDR5X | 8533 MT/s | 17.1 GB/s | 当前旗舰主流[69][73] |
注意这张表只列单通道带宽。厂商宣传里的"整机带宽"通常已经乘过通道数,两者相差数倍,比较时务必对齐口径。
这张表只列单通道带宽,因为厂商宣传里的"整机带宽"通常已经乘过通道数。两者相差数倍,比较时务必先对齐口径——这是跨厂商规格对比里最容易出错的一处,也是最容易被误读成"某家更快"的一处。
4.4 原理与概念:为什么持续吞吐追不上名义值
先看看为什么拿不满。名义带宽是理想条件下的上限。实际跑起来,有三件事会把它吃掉。
第一件是 bank 冲突。LPDDR5 的不同 bank 模式(16B / BG / 8B)与 burst 长度(BL16 / BL32)会改变并行度;访问模式与 bank 组织不匹配时,吞吐明显下降[66]。
第二件是刷新。DRAM 需要周期性刷新以保持数据,刷新期间该 bank 无法服务请求。容量越大、刷新开销越显著。
第三件是读写切换。总线在读写之间切换需要周转时间,渲染负载恰恰是读写交替的典型模式。
三件损耗的来源不同,但对应用的影响是叠加的:bank 冲突来自访问模式与组织形式不匹配,刷新是 DRAM 的物理必需,读写切换则是渲染负载的固有特征。好消息是它们都能通过访问模式调整部分缓解;坏消息是任何一项都无法完全消除。
4.5 实现与配置:PoP 封装的物理意义
说白了,移动端常见的做法是把 LPDDR 直接堆叠封装在 SoC 上方(Package on Package, PoP)[73]。这样做省掉了长距离 PCB 走线,缩短了信号路径。
对带宽的影响是双向的:好处是延迟更低、信号完整性更好;代价是散热相互耦合——内存的发热会直接传到 SoC 上,这也是第 4 篇要处理的问题之一。
封装形式听起来与带宽无关,但它同时决定了信号路径长度与散热耦合方式。移动端之所以愿意接受散热耦合这个代价,看中的正是毫米级走线距离带来的延迟收益——这是一次用热换取时间的交换,后面第 4 篇会看到它的后果。
4.6 公式或参数逐项释义:三个必须记住的量级
量级一 · 5 GB/s:典型嵌入式设备的可用带宽[1]。这是本篇所有账本的预算上限。
量级二 · 100 GB/s:典型桌面 GPU 的带宽[1]。记住它是为了理解"为什么桌面做法不能照搬"。
量级三 · 100 pJ/byte:DDR 访问能耗[4]。记住它是为了把字节换算成毫瓦。
| 对照 | 移动内存模组 | 桌面内存模组 |
|---|---|---|
| 形态 | 颗粒直贴或 PoP 堆叠 | 独立模组插槽 |
| 每通道位宽 | 16-bit | 64-bit |
| 典型整机带宽 | 数十 GB/s | 数十至上百 GB/s |
| 功耗归属 | 与 SoC 共享散热 | 有独立供电与风道 |
5、100、100 这三个数字建议直接记住:第一个是预算,第二个是对照,第三个是换算系数。本篇后面所有的估算,都可以只用这三个数加上基本的乘除完成——不需要记住任何具体芯片的参数,也能判断一个方案的量级是否合理。
4.7 效果与量化:延迟与带宽是两个约束
这两个概念经常被混为一谈,但它们的解法完全不同。
带宽不够的表现是吞吐上不去:单元数量够、每次都能拿到数据,只是单位时间拿得太少。解法是减少总搬运量——这就是本篇后面四章在做的事。
延迟太高的表现是等待:每次访问都要等很久,但总吞吐可能并不饱和。解法是提高并行度(更多在途请求)或改善局部性。
移动端的问题是两者同时紧:带宽预算小,而延迟又因为内存子系统相对简单而偏高[66]。这意味着"用更多在途请求掩盖延迟"这条桌面上的常用手段,在移动端会先撞到带宽墙。
4.8 源码与数据链接
- LPDDR5 物理结构与通道定义:systemverilog.io 教程[60]
- LPDDR5/5X 参数与每通道带宽:techyorker 对比表[69][73]
- LPDDR5 实际性能(bank 模式与 burst 长度的影响):arXiv 2209.14756[66]
- 嵌入式与桌面带宽量级:Arm 会议材料[1][2]
4.9 这一章留下的问题
内存给的上限量出来了,账本也摊开了。接下来的四章要把四类手段逐一算清:每一类到底能从那 2.1 GB/s 里拿掉多少。 先从最轻的一类——改数据格式——开始。
三、手段甲:纹理压缩
5.1 一句话点题
下面我们开始看第一类手段。纹理压缩是降读带宽最直接的一招,但它不是"选个格式"那么简单——块尺寸、位宽、画质、平台兼容性四件事互相牵制。
纹理压缩是降读带宽最直接的一招,但它不是"选个格式"那么简单。块尺寸、位宽、画质、平台兼容性四件事互相牵制,任何一个选择都会在另外三个上留下代价,所以判断标准不是"哪个压缩率最高",而是"在我的内容上哪一档的代价可以接受"。
5.2 原理与概念:块压缩在做什么
先看看基本思路。纹理压缩的核心是分块编码:把纹理切成固定大小的块(例如 4×4 或 6×6 个纹素),每块用固定字节数编码。这样做有三个好处:解码不需要查表所以硬件可以并行;每个纹素的字节数固定所以带宽可预测;块独立所以随机访问不需要额外的依赖。
代价是画质。块越小,块内纹素的相似性要求越低,画质越好,但每纹素字节数越高。块尺寸就是画质与带宽之间的旋钮。
未压缩的 RGBA8888 纹理是 32 bpp(每像素 4 字节)。Arm 给出的压缩链是:24 bpp 的原图 → ASTC 8 bpp → ASTC 3.56 bpp[9]。位宽降了一个数量级,读取时搬运的字节数随之下降。
5.3 公式或参数逐项释义:块尺寸与位宽的对应
先看看这张表。ASTC 的块尺寸谱系很宽,位宽随块尺寸下降:
| 块尺寸 | 每纹素位宽 (bpp) |
|---|---|
| 4×4 | 8.00 |
| 5×4 | 6.40 |
| 5×5 | 5.12 |
| 6×5 | 4.27 |
| 6×6 | 3.56 |
| 8×5 | 3.20 |
| 8×6 | 2.67 |
| 10×5 | 2.56 |
数据来自 NVIDIA 的 ASTC 说明[47]。这张表是本篇最实用的一张——它把"我要省多少带宽"直接翻译成"我该选哪个块尺寸"。
选择原则很简单:主体材质(角色、近景、UI)用 4×4 到 6×6;远景地形与道具用 8×6 或更低。ASTC 的灵活性正在于此——同一张图集里可以按感知重要性混用不同块尺寸。
和 ETC2 对比时,收益是可量化的:ASTC 5×5 相比 ETC2+EAC(RGBA) 在同等画质下,纹理占用小约 24%、读带宽少约 11%、每帧能耗低约 10%[10]。
这张表是本篇最实用的一张:它把"我要省多少带宽"直接翻译成"我该选哪个块尺寸"。实际项目里的做法通常是按材质重要性分档,而不是整包统一成一个尺寸——主体材质保留高精度,远景与道具才压到低档,这样画质损失集中在观众不会细看的地方。
5.4 实现与配置:格式选型与回退链
下面我们开始谈选型。跨平台发布时的格式选择,本质上是一张兼容性矩阵:
| 平台 | 首选 | 回退 |
|---|---|---|
| iOS | ASTC | PVRTC(旧设备)[23] |
| Android | ASTC | ETC2 → ETC1(无透明通道时) |
| 桌面 / 主机 | BC7 / BC1-5 | — |
判断逻辑是:先看目标设备是否全覆盖 ASTC,是则统一用 ASTC;否则按设备能力分档打包。 注意 ETC2 在 OpenGL ES 3.0 上是强制支持的,所以它是最安全的兜底档。
除了静态打包,还有一条路是运行时压缩。天美在 GDC 讲《三角洲行动》时提到一个具体做法:移动端虚拟纹理为降带宽与发热,在运行时用像素着色器把数据压成 ASTC 4×4 或 6×6,压缩结果写入 128-bit 的整数纹理后再转成压缩纹理[85]。
这条路的价值在于自适应——同一份资产可以按设备档位选择压缩比。代价是压缩本身要花算力和一次额外的读写,所以它只在"资产体积远大于算力余量"的场景划算。
5.5 效果与量化:能耗与收益
纹理压缩的收益不止带宽,还有能耗。Arm 给出过一组每帧能耗对照:未压缩 3D 纹理 4.17 mJ/帧,ASTC 4×4 降到 1.00 mJ/帧,ASTC 5×5 进一步降到 0.93 mJ/帧;对应的内存占用下降约 90%、带宽下降约 38%[9]。
| 方案 | 每帧能耗 (mJ) | 相对未压缩 |
|---|---|---|
| 未压缩 | 4.17 | — |
| ASTC 4×4 | 1.00 | −76% |
| ASTC 5×5 | 0.93 | −78% |
按 100 pJ/byte 的换算口径[4],带宽每降 1 GB/s,在 60fps 下相当于每秒省下 6 × 10¹⁰ 字节的搬运,折合约 6 W·s/s 的等价能耗量级——这个数字看起来很大,是因为它把"减少的字节数"全部按 DDR 访问计了价;实际收益要按真实流量占比打折。
预算估算的方法很直接:先把场景里所有纹理的日均可见面积与 LOD 分布列出来,再乘上各自格式的 bpp,就能得到纹理读带宽的量级。 麻烦的不是算法,而是"日均可见面积"这个数——它需要跑起来才知道,这也是第 9 章讲测量的原因。
纹理压缩与 mipmap 是配合关系而非替代关系:压缩降低单次读取的字节数,mipmap 降低读取的次数与层级。两者叠加才能拿到数量级的改善。
5.6 源码与数据链接
- ASTC 块尺寸与位宽表:NVIDIA《Using ASTC Texture Compression for Game Assets》[47]
- ASTC 压缩链与能耗:Arm《What Makes ASTC Special》[9]
- ASTC 与 ETC2 的量化对比:Arm《Getting the Most Out of OpenGL ES》[10]
- PVRTC 的最低 2 bpp 与缓存效率:Imagination 文档[23]
- 运行时 ASTC 压缩的真实案例:GDC《三角洲行动》跨平台技术分享[85]
5.7 这一章留下的问题
纹理压缩动的是"读的数据格式"。但账本里最大的一笔是附件,而附件的读写模式与纹理完全不同——它是整块全分辨率写、再整块全分辨率读。有没有针对附件的压缩方案? 下一章看厂商给出的三套答案。
四、手段乙:帧缓冲压缩
6.1 一句话点题
下面我们开始看第二类手段。帧缓冲压缩和纹理压缩是两条独立的路径:它压的是渲染过程中生成的图像,而不是预先打包的资产。
帧缓冲压缩与纹理压缩是两条独立的路径:它压的是渲染过程中生成的图像,而不是预先打包好的资产。这一点决定了它的启用条件与失效模式都与纹理压缩完全不同,也决定了它不能被写进资产管线,只能在运行时由驱动与配置共同决定。
6.2 原理与概念:AFBC 与 AFRC
先看看 Arm 这一路。AFBC(Arm Frame Buffer Compression)是无损压缩,针对帧缓冲与中间渲染结果,在内容合适时平均可降低 50% 以上的带宽[11][12]。它是无损的,所以压缩率完全取决于数据模式:某些规整的数据模式能压到 20% 以下,而遇到高频噪声这类"坏"模式,压缩率可能接近 1(即完全不压)[11]。
Arm 后来补了一个有损版本 AFRC(Arm Fixed-Rate Compression):视觉无损、比特率固定,应用可以通过 VK_EXT_image_compression_control 选择压缩比,档位从 3:2 到 4:1[17]。
两者的取舍很清楚:AFBC 压缩率上限更高但不保证;AFRC 保证压缩率且带宽可预测,代价是引入不可逆的画质损失。选哪一个取决于这一帧的画质余量:带宽已经紧张到必须精确控制时,AFRC 的定比特率更好用;内容本身规整、压缩率能跑高时,AFBC 的无损路径更划算。两种方案在同一台设备上可以按附件分别选择。做带宽预算时,AFRC 更好算账。
6.3 原理与概念:UBWC 与 PVRIC
UBWC(Universal Bandwidth Compression)是 Qualcomm 的方案,A5x 之后的 GPU 全系支持[18]。它的特点是跨模块:不只服务 GPU,还覆盖显示、视频、相机等模块。这个覆盖面是它的关键价值——一个 SoC 里,GPU 只是内存的几个大户之一,如果压缩格式不统一,模块之间的数据交接就要走未压缩路径。
PVRIC 是 Imagination 的图像压缩方案,与 PVRTC(纹理)和 PVRGC(几何)合成 PVR3C 三重压缩体系[22]。三家厂商的方案在目标上完全一致,但格式互不兼容——这是跨厂商发布时的硬约束。
6.4 公式或参数逐项释义:压缩比对有效带宽的影响
有效带宽的换算式很直接:
有效带宽 = 名义带宽 × 压缩比
假设整机名义带宽 68 GB/s,附件流量占总量的 60%:
| 附件压缩比 | 附件部分有效带宽 | 整机等效带宽 |
|---|---|---|
| 1:1(不压) | 40.8 GB/s | 68 GB/s |
| 2:1 | 81.6 GB/s | 108.8 GB/s |
| 3:1 | 122.4 GB/s | 149.6 GB/s |
也就是说,2:1 的附件压缩,等于把整机带宽提高了 60%。 这解释了为什么厂商愿意为压缩投入专门的硬件面积。
换算式看起来过于简单,但它的用途很明确:把"压缩比"这个技术参数翻译成"等效带宽"这个工程结论。做方案评审时,后者才是能与预算对话的语言——没有人会为"压缩比 2:1"批预算,但"等效带宽提升 60%"能直接对上资源。
6.5 实现与配置:启用条件与失效模式
说白了,帧缓冲压缩不是"打开就好",它有明确的前提条件。
条件一 · 附件不能被 CPU 读取。 压缩格式是 GPU 私有的,一旦 CPU 需要映射读取该附件,驱动就必须先解压或回退到未压缩路径。
条件二 · 图像必须按照驱动期望的方式创建。 部分平台需要显式标注用途与内存属性,否则驱动不会启用压缩。
条件三 · 数据模式不能太"坏"。 大量高频噪声的画面(粒子、抖动、屏幕空间噪声)会让无损压缩率趋近于 1。
| 数据模式 | 无损压缩表现 |
|---|---|
| 大面积纯色 / 渐变 | 压缩率高(可到 80% 以上)[11] |
| 常规 3D 场景 | 平均 50% 以上[11][12] |
| 高频噪声 / 抖动 | 可能完全不压缩[11] |
启用帧缓冲压缩有三条硬前提,任何一条不满足,收益都会归零。其中最容易踩的是第一条:只要有一段调试代码去映射读取了颜色附件,整条压缩路径就会静默退回未压缩——不报错、不警告,只是白改一场。
6.6 效果与量化:收益量级
把这一章的收益落到账本上:以第 1 章的 1080p 基准场景为例,附件流量约 22 MB/帧,占总量 35 MB 的 63%。
| 情形 | 附件流量 | 总流量 | 相对基准 |
|---|---|---|---|
| 无压缩 | 22 MB | 35 MB | — |
| AFBC 平均 50% | 11 MB | 24 MB | −31% |
| AFRC 3:1 | 7.3 MB | 20.3 MB | −42% |
按 60fps 折算,AFBC 一项就能把总流量从 2.1 GB/s 压到约 1.44 GB/s,省下约 0.66 GB/s;再按 100 pJ/byte 换算,相当于约 40 mW 的系统级功耗[4]。
把压缩收益落到具体账本上,才能判断它值不值得做。附件占总量六成以上,所以附件压缩对总流量的杠杆明显高于纹理压缩——这是四类手段排序里的关键一手,也是本篇反复强调"先看账本再选手段"的原因。
6.7 源码与数据链接
- AFBC 的 50% 平均降幅与数据模式依赖:Arm《ARM's New Mali》[11]、arm.com AFBC 页面[12]
- AFRC 压缩比档位与扩展名:Arm @ Vulkanised 2023[17]
- UBWC 的跨模块覆盖:Qualcomm 文档[18]
- PVR3C 三重压缩体系:Imagination 文档[22]
6.8 这一章留下的问题
压缩的收益是可预期的"按比例打折"。但还有一类手段,它不改数据格式,而是让数据根本不需要被搬运——这一类省下的不是比例,而是整笔流量。下一章看它。
五、手段丙:结构与附件
7.1 一句话点题
下面我们开始看第三类手段,也是收益最大的一类。它省下的不是比例,因为省下的不是比例,而是整笔流量。它不改数据格式,改的是数据需不需要被搬。
这一类手段收益最大,因为它省下的不是比例,而是整笔流量。代价是它对通道结构的改动最深,通常需要重排渲染流程,而不是加几行配置就能生效——所以它往往要等到项目中期、管线稳定之后才做得动。
7.2 原理与概念:附件的生命周期
先看看附件的寿命。一个附件的生命周期有三段:被创建、在渲染中被读写、结束时是否需要保留。
绝大多数附件属于"用完即弃":深度缓冲在通道结束后就没用了;G-Buffer 在光照算完之后也没用了;MSAA 的多重采样附件在 resolve 之后就没用了。但在传统的做法里,它们每一段都要经过主存。
Vulkan 给了两个明确的工具来避免这件事[27]:
工具一 · 瞬态附件。给图像加上 VK_IMAGE_USAGE_TRANSIENT_ATTACHMENT_BIT,并把它分配到带 VK_MEMORY_PROPERTY_LAZILY_ALLOCATED_BIT 属性的内存上。这样GPU 可以完全不为它分配系统内存——数据只存在于片上[27]。
工具二 · 存储操作。给附件指定 STORE_OP_DONT_CARE,表示通道结束后不需要把内容写回主存[27]。
两者配合起来,一个深度附件可以从"写一次、可能读一次、再写回一次"变成"只在片上存在"。省下的不是某个百分比,而是整整两次跨芯片搬运——这也是本篇五类手段里收益最直接的一处。
7.3 公式或参数逐项释义:存储与加载操作的组合
attach 的加载与存储操作一共四种组合,代价差别很大:
| loadOp | storeOp | 外部流量 | 适用 |
|---|---|---|---|
CLEAR |
DONT_CARE |
几乎为零 | 每帧重画的附件(深度、瞬态颜色) |
CLEAR |
STORE |
仅写 | 需要保留的结果(最终颜色) |
LOAD |
DONT_CARE |
仅读 | 需要上一帧内容但结果不保留 |
LOAD |
STORE |
读 + 写 | 需要累积的附件(如后处理链中间结果) |
选错组合会白搬一整份附件。以 1080p RGBA32 为例,多一次不必要的读写就是 16.6 MB/帧,60fps 下约 1 GB/s[27]。
四种组合的差别不在功能,而在流量。选错组合不会报错、不会画错,只会白搬一整份附件——这类"静默浪费"正是账本要解决的问题:它不会以 bug 的形式出现,只会以功耗与发热的形式慢慢显形。
7.4 原理与概念:subpass 合并的条件与反直觉结论
好了,当多个 subpass 之间只有帧缓冲局部依赖时,驱动可以把它们合并成一个硬件通道,中间数据全程留在片上,不落到外部内存[27][29]。
判定的方法是:如果两个 subpass 之间的数据传递是"同一个像素位置、同一个 tile 内"的,就具备合并条件。Vulkan 提供了 VK_EXT_subpass_merge_feedback 扩展,应用可以查询驱动是否真的合并了——这一点很重要,因为合并不保证发生,它是实现相关的[27]。
Qualcomm 侧的数据是:正确配置后 subpass 链合并,frametime 可提升 10% 以上,具体取决于链的复杂度[19]。
Arm 在 GDC2017 上给过一个更夸张的实测:在 Galaxy S7(Exynos)上,4096×2048 分辨率,把 G-Buffer 与光照融合后,帧率提升约 30%、带宽下降约 80%[5]。
但这里有一个反直觉结论,值得单独记住。 Arm 专门写过一篇来纠正它:合并几乎总能省带宽,但不一定更快——除非应用确实受带宽限制。在受算力限制、或较老的 GPU 上,合并后的性能甚至可能略降[15]。
优化的是带宽,不是时间。 如果不先确认瓶颈在带宽,这个改动可能白做。
7.5 实现与配置:resolve 时机与像素本地存储
MSAA 的 resolve 时机是一个典型例子。Arm 的实测结论是:让 MSAA 在写回时 resolve,带宽影响很小;一旦改用 vkCmdResolveImage 单独做一次 resolve,就引入了一个独立的通道,带宽显著上升[7]。
同一件事,两种写法,流量差一整份附件。
Pixel Local Storage(PLS) 是另一种结构性手段。它让片元着色器把中间数据留在片上,避免 G-Buffer 走主存。Arm 给出的量化是:平均每帧省下 60 MB 带宽[4]。按 100 pJ/byte、30fps 折算,系统级省 约 180 mW[4]——这是本篇最硬的一条"字节 → 功耗"因果链。
7.6 效果与量化:结构性收益的排序
把这一章的收益放在一起:
| 手段 | 官方量化 | 来源 |
|---|---|---|
| G-Buffer 与光照融合(subpass) | 帧率 +30%、带宽 −80%(Galaxy S7, 4096×2048) | Arm GDC2017[5] |
| subpass 链合并 | frametime 提升 >10% | Qualcomm[19] |
| PLS 避免 G-Buffer 走主存 | 省 60 MB/帧 ≈ 180 mW @30fps | Arm GDC2017[4] |
| MSAA 写回时 resolve(对比独立 resolve) | 带宽影响很小 vs 显著上升 | Arm @ SIGGRAPH 2020[7] |
这一类的收益量级明显高于压缩类,原因在于它把整笔流量变成了零,而不是把一笔流量打折。
把这一章的四个手段放在一起看,量级都在"几十个百分点"这个级别,明显高于压缩类。但它们的前提也最严格:必须先把渲染流程排对,否则配置写了也不生效;这也是为什么把它排在压缩类之前讲,而不是之后。
7.7 源码与数据链接
- 瞬态附件、惰性分配与存储操作:Vulkan《Tile Based Rendering (TBR) Best Practices》[27]
- subpass 合并的条件与
VK_EXT_subpass_merge_feedback:同上[27];Vulkan subpasses 样例[29] - 合并的反直觉结论:Arm《Vulkan subpasses: the good, the bad, and the ugly》[15]
- Qualcomm 侧的 frametime 数据:Qualcomm Adreno Best Practices[19]
- G-Buffer 融合与 PLS 量化:Arm GDC2017《Vulkan Multipass》[5]、《Achieving Console Quality Games on Mobile》[4]
- MSAA resolve 时机:Arm @ SIGGRAPH 2020[7]
7.8 这一章留下的问题
四类手段讲完了三类。最后一类不动数据、也不动结构,它改的是采样方式——同样一张纹理,怎么采样决定实际读多少字节。它的收益不如结构性手段,但配置最轻。
六、手段丁:采样侧
8.1 一句话点题
这一类是唯一"改配置就见效"的:同一份资产,采样策略不同,实际搬运量可能差一个数量级。
先看看最后一类手段。它是唯一"改配置就见效"的:同一份资产,采样策略不同,实际搬运量可能差一个数量级。它的收益不如前面两类,但上手成本也最低,适合作为优化流程的第一步——先用它把明显的浪费挤掉,再投入改造结构的成本。
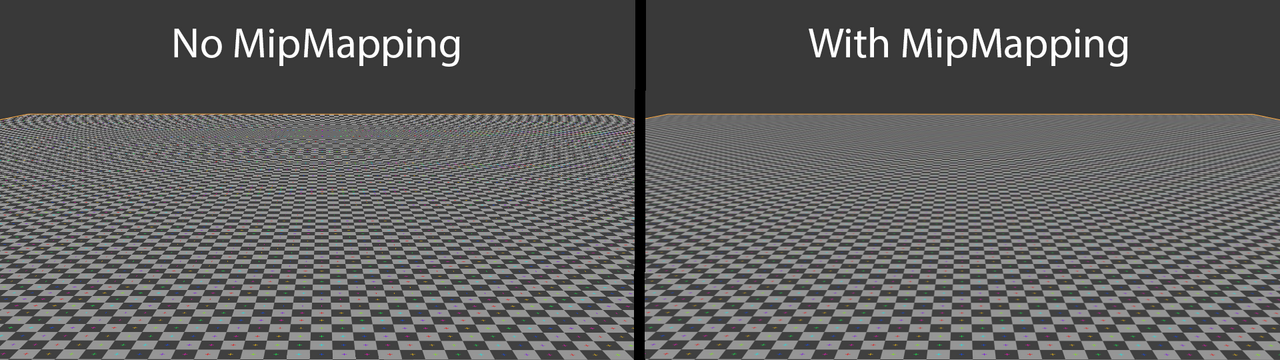
8.2 原理与概念:mipmap 与 LOD 选择
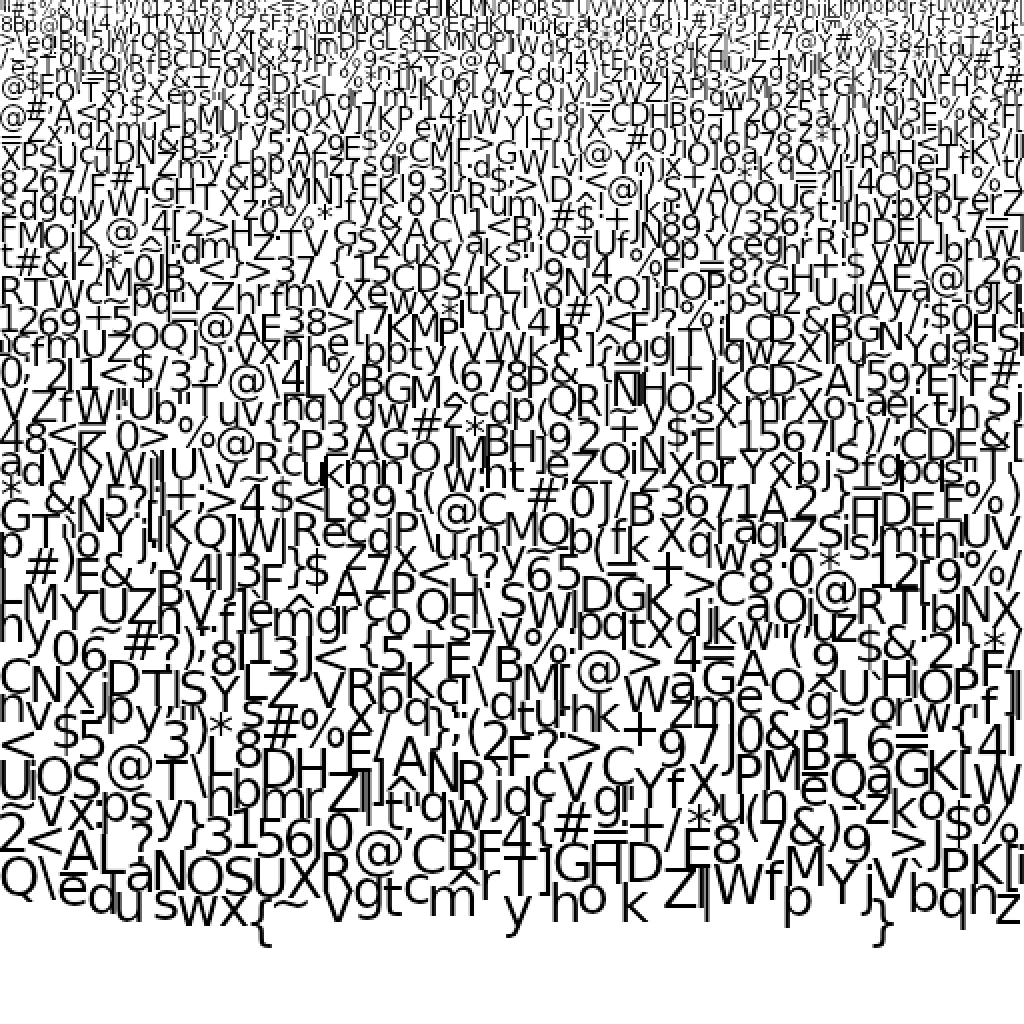
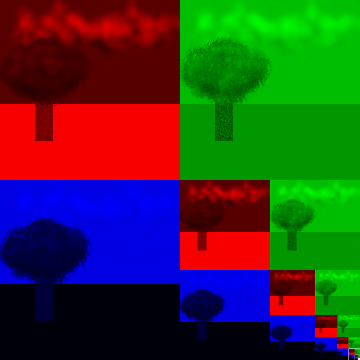
先看看 mipmap 是什么。它是一系列逐级降分辨率的纹理副本,合起来叫 mipmap 链[38]。渲染时硬件根据片元在屏幕上的纹理空间占用,从链里挑一个合适的层级(LOD)来采样。
作用在带宽上非常直接:远处物体在屏幕上只占几个像素时,不需要读原分辨率的数据。 一张 1024×1024 的纹理,若物体只占 8×8 像素,直接从 mipmap 链里取 8×8 那一级,读取量下降两个数量级[38]。
LOD 偏置(LOD bias)是一个容易上手的调试旋钮:往正方向偏会让硬件选更小的层级,带宽下降但画质变软。它的实际取值需要按场景内容调,不是常数。需要注意的是,偏置施加在硬件选择层级之前,因此它会同时影响画质与读取量——调它等于在两者之间快速移动,而不是免费地降低开销。
8.3 公式或参数逐项释义:各向异性过滤的代价
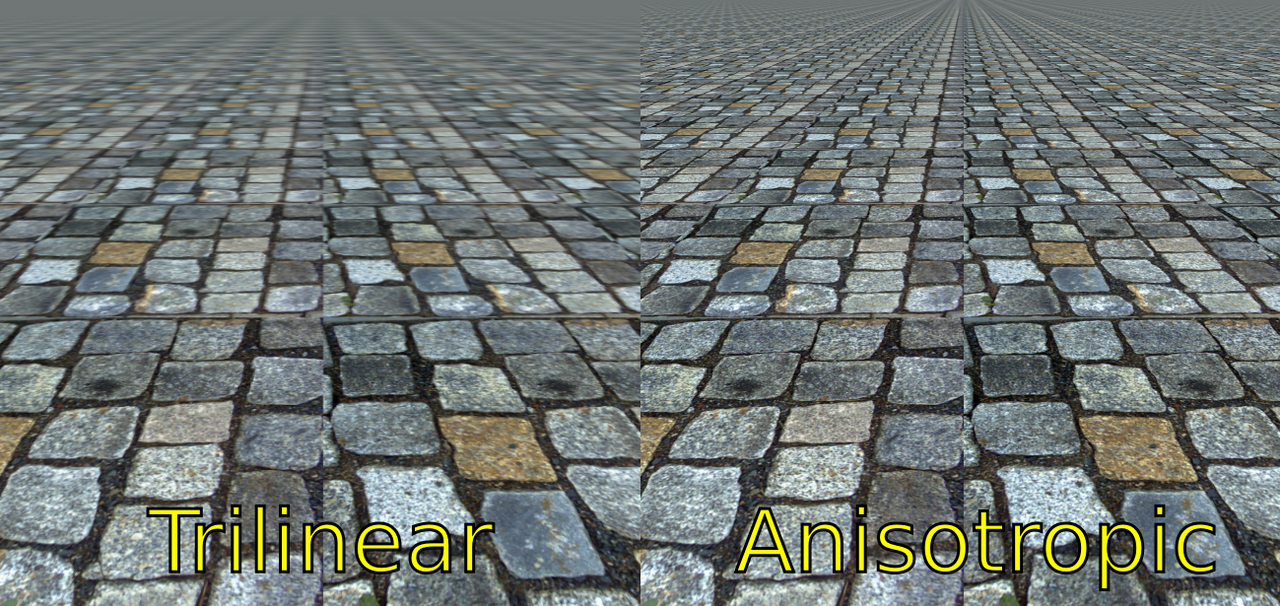
各向异性过滤(anisotropic filtering)解决的是斜视角下纹理模糊的问题:沿主方向做多次采样再混合,档位表示采样次数。
代价直接与档位成正比:AF4x 是 4 次采样,AF16x 是 16 次。在被过滤的纹素上,读取量按档位放大。
这里必须提醒一句:中文社区里流传的"8x 各向异性性能损耗 15%、锐度提升 300%"之类的数字,找不到任何厂商数据支撑,本篇不予引用。 能确认的只有方向性结论:档位越高、读取越多、斜视角画质越好;具体数值必须在目标设备上实测。
8.4 实现与配置:纹理串流的内存预算
引擎层的做法是把"读多少"变成一个由预算反推的问题。Unity 的纹理串流系统用一个内存预算控制所有纹理的总占用,超出时自动降低 mipmap 级别[42];Unreal 的纹理串流同样按池大小(PoolSize)与优先级决定哪些纹理降级、降几级[44]。
这个机制对带宽的意义是间接但真实的:降低 mip 级别既减少常驻内存,也减少采样时的读取量。两边收益同向,所以它是引擎默认开启的功能。
配置时的检查清单:
- 是否所有 3D 场景纹理都启用了 mipmap(UI 与 2D 精灵通常不需要)[38]
- 各向异性档位是否与目标设备档位匹配(低端机不要给 AF16x)
- 纹理串流的内存预算是否与实际设备内存档位对应
- 是否存在 mipmap 链被截断的情况(只生成到某一级)
8.5 效果与量化:可观测的四个指标
这一类的好处是完全可观测。Android GPU Inspector 的纹理带宽视图直接给出四个计数器[36]:
| 计数器 | 含义 | 用途 |
|---|---|---|
| 纹理内存读取带宽 | 从外部内存读取的纹理数据量 | 账本里"纹理解析"那一项的真实值 |
| 纹理 L1 遗漏百分比 | 采样时的 L1 缓存未命中率 | 判断访问是否局部性友好 |
| 非基础级别纹理百分比 | 采样落在非 base level 的比例 | 确认 mipmap 是否真的在起作用 |
| 各向异性过滤百分比 | 经过各向异性过滤的纹素占比 | 量化 AF 带来的额外读取 |
"非基础级别百分比"是这里面最有信息量的一个:如果它接近 0,说明几乎所有采样都落在最高分辨率那一级——mipmap 形同虚设,前面所有的降带宽努力在这一项上都没兑现。
Arm 的 Mali 计数器体系同样覆盖外部内存带宽、缓存效率与内存系统停顿[43],L2 缓存读查找与外部内存读的比例可以直接反映缓存效率。
采样侧手段的收益量级不好给单一数字——它高度依赖内容。可以确定的排序是:它低于结构性手段与压缩类,但配置成本也最低,而且是唯一不需要改资产管线就能拿到的收益。
8.6 源码与数据链接
- mipmap 与 LOD:Android 官方《纹理》文档[38]
- 纹理串流的内存预算:Unity 纹理串流文档[42]、Unreal 纹理串流文档[44]
- 纹理带宽计数器:Android GPU Inspector《分析纹理内存带宽用量》[36]
- Mali 计数器体系:Unity Mali GPU 计数器参考[43]
8.7 这一章留下的问题
四类手段的量级都出来了,但前面每一章都在讲"能省多少",没有讲"怎么配"。下一章把 Vulkan 与 Metal 两侧的具体配置项列成清单,并标注每一项对应账本里的哪一笔。
七、实现与配置
9.1 一句话点题
前面六章讲的是"能省多少",这一章讲"怎么配"。每个配置项都标注它对应账本里的哪一笔。
好了,前面八章讲的是"能省多少",这一章讲"怎么配"。每个配置项都会标注它对应账本里的哪一笔——先确认瓶颈落在哪一笔,再改对应那几项;否则很容易改了一堆配置而账本纹丝不动,最后既浪费了时间,也动摇了对方法本身的信心。
9.2 原理与概念:配置项与账本的对应关系
说白了,配置不是清单式地"全开就好",每一项都有它要解决的那一笔账。对应关系是这样的:
| 账本条目 | 对应的配置手段 |
|---|---|
| 颜色附件写入 | 帧缓冲压缩、避免多余写回、控制 overdraw |
| 深度模板读写 | 深度附件的存储操作、HSR 前置 |
| 纹理解析 | 压缩格式选型、mipmap 与 LOD、各向异性档位 |
| 几何与缓冲 | 顶点格式瘦身、几何压缩 |
| 隐式流量 | 附件对齐、避免不必要的格式转换 |
先确认瓶颈落在哪一笔,再改对应那几项——否则很容易改了一堆配置,账本纹丝不动。
这张对应表是本篇从"原理"过渡到"工程"的关键。它把前六章的机制结论压缩成一句可执行的话:账本上的哪一笔出问题,就去查对应的那几项配置。有了这张表,配置项就不再是一份需要背下来的清单。
9.3 公式或参数逐项释义:Vulkan 侧配置清单
先看看 Vulkan 这一侧。以下是与本篇主题直接相关的配置项:
| 配置项 | 作用 | 对应账本 |
|---|---|---|
VK_IMAGE_USAGE_TRANSIENT_ATTACHMENT_BIT + LAZILY_ALLOCATED |
附件不落系统内存[27] | 深度模板读写 |
storeOp = VK_ATTACHMENT_STORE_OP_DONT_CARE |
通道结束不写回[27] | 颜色/深度写入 |
loadOp = VK_ATTACHMENT_LOAD_OP_CLEAR |
避免读入上一帧内容 | 附件读取 |
subpass 依赖声明为 VK_DEPENDENCY_BY_REGION |
允许合并[27] | 附件读写 |
VK_EXT_subpass_merge_feedback |
查询合并是否真的发生[27] | 验证手段 |
MSAA 在写回时 resolve(避免 vkCmdResolveImage) |
避免独立 resolve 通道[7] | 附件写入 |
VK_EXT_image_compression_control(AFRC,Arm) |
选择帧缓冲压缩比[17] | 颜色附件写入 |
伪代码骨架:
// 附件创建时标注瞬态与惰性分配
VkImageCreateInfo color = {
  .usage = COLOR_ATTACHMENT | TRANSIENT_ATTACHMENT_BIT,   // 【1】不落主存
  .format = FORMAT_R8G8B8A8_UNORM,
};
allocate(color, { LAZILY_ALLOCATED_BIT });                // 【2】惰性分配

// 深度附件:清空 + 不保留
depth.loadOp  = CLEAR;                                     // 【3】不读上一帧
depth.storeOp = DONT_CARE;                                 // 【4】不写回

// 通道依赖按区域声明,给驱动合并的机会
dependency.srcSubpass = 0; dependency.dstSubpass = 1;
dependency.srcStageMask = COLOR_ATTACHMENT_OUTPUT;
dependency.srcAccessMask = COLOR_ATTACHMENT_WRITE;
dependency.dependencyFlags = BY_REGION;                    // 【5】可合并

// 提交后验证是否真的合并
submit();
getSubpassMergeStatusEXT(...);                             // 【6】不是猜的
下面对【2】特别说明:LAZILY_ALLOCATED 需要与 TRANSIENT_ATTACHMENT_BIT 同时使用才生效——单独声明惰性分配,驱动会忽略。这一点在规范里有明确要求[27]。
这份清单只收录与本篇主题直接相关的配置项,不追求完整。每一项都给了对应的账本条目与规范出处,读者可以按自己的瓶颈逐项核对,而不必通读规范——这也是本篇用变体 B 呈现的原因:给出可核对的具体做法,而不是堆砌代码。
9.4 实现与配置:Metal 侧配置清单
Metal 侧的对应能力分散在附件描述与纹理创建上:
| 配置项 | 对应 Vulkan | 作用 |
|---|---|---|
MTLLoadActionClear / MTLStoreActionDontCare |
loadOp / storeOp | 控制附件进出流量 |
MTLStoreActionMultisampleResolve |
写回时 resolve | 避免独立 resolve[7] |
MTLStorageModeMemoryless |
LAZILY_ALLOCATED |
附件只存在片上 |
| 纹理创建时的 compression 相关属性 | AFRC | 帧缓冲压缩 |
MTLHeap 与纹理别名 |
— | 复用内存、减少常驻 |
Apple 在 WWDC 2020 给过一个与本篇直接相关的测量方法:用 GPU 计数器测光栅化像素数、片段着色器调用数、实际存储的像素数、Pre-Z 测试失败数,并由此算出 overdraw[41]。这条路径把"账本里的 overdraw 那一笔"变成可读的数。
9.5 实现与配置:生效前提与失效模式
配置写了不等于生效。四个常见前提:
前提一 · 附件不能被 CPU 读取。一旦 CPU 需要映射读取压缩或瞬态附件,驱动会回退到普通路径。
前提二 · 附件的用途与内存属性要匹配。TRANSIENT_ATTACHMENT_BIT 不能与 SAMPLED 或 STORAGE 同时声明。
前提三 · subpass 合并不保证。必须用 VK_EXT_subpass_merge_feedback 查,或者用计数器间接验证[27]。
前提四 · 旧设备会静默忽略。扩展不在时,配置被忽略而不会报错——这类"静默失效"是排查中最费时间的。
验证步骤建议固定下来:先查扩展支持 → 再查运行时是否真的合并/压缩 → 最后用带宽计数器确认外部流量下降。三步都过,才算配置生效。
配置写了不等于生效,这是移动端图形调试里最耗时的一类问题。更麻烦的是失效往往是静默的:不报错、不警告,只是收益没有出现。所以验证步骤必须固定下来,把"查到扩展支持"与"确认运行时真的生效"当成两个独立动作。
上面这四条前提里,前两条是硬性约束、改不了,后两条可以通过扩展查询与计数器间接确认。把这四条当成一张检查清单,可以在动手之前先判断某项配置在这台设备上是否可能生效——省掉一轮注定拿不到收益的验证。这一步花的时间,通常比事后排查静默失效要少得多。
9.6 效果与量化:逐项收益的归属
把配置清单回填到账本上,可以估出各项的收益区间:
| 配置组 | 影响账本条目 | 预期收益区间 |
|---|---|---|
| 瞬态附件 + 存储操作 | 深度模板 + 部分颜色 | 附件流量的 30%–50% |
| subpass 合并 | 中间结果附件 | 相关流量的 60%–80%[5] |
| MSAA 写回时 resolve | 颜色附件 | 避免一整份 resolve 流量[7] |
| 纹理压缩 + mipmap | 纹理解析 | 读流量 −11% 到 −38%[9][10] |
| 各向异性档位下调 | 纹理解析 | 被过滤纹素的读取量按档位比例下降 |
这张表把配置组回填到账本上,给出的是区间而不是确定值。原因是每一项的实际收益都取决于内容与驱动实现,区间比点估计更接近工程现实——汇报时给出区间并说明依据,比给一个精确但无法复现的数字更可信。
9.7 源码与数据链接
- 附件与 subpass 配置:Vulkan TBR Best Practices[27]
- AFRC 与
VK_EXT_image_compression_control:Arm @ Vulkanised 2023[17] - Metal 侧计数器方法:Apple WWDC 2020[41]
- MSAA resolve 时机:Arm @ SIGGRAPH 2020[7]
9.8 这一章留下的问题
配置清单有了,各项收益区间也有了。但这些区间能直接相加吗?把四类手段全开,总收益是四者之和,还是远小于之和?下一章算这笔总账。
八、效果与量化:四类手段的收益排序
10.1 一句话点题
好了,四类手段的收益不在一个量级上。这一章把它们放在同一把尺子上排序,并完成字节到功耗的换算。
四类手段的收益不在一个量级上。这一章把它们放在同一把尺子上排序,并完成一次换算——把省下的字节折算成毫瓦。这才是本篇与系列主题真正接上的地方:账本解释的是数字,毫瓦解释的是为什么要为这些数字付出工程成本。
10.2 效果与量化:收益量级排序
按第 1 章的 1080p 基准场景(总流量约 2.1 GB/s),四类手段的收益量级如下:
| 排序 | 手段 | 典型收益 | 依据 |
|---|---|---|---|
| 1 | 结构与附件 | 相关流量 −60% 到 −80% | Arm GDC2017 实测[5] |
| 2 | 帧缓冲压缩 | 附件流量 −50%,总流量约 −31% | Arm AFBC[11][12] |
| 3 | 纹理压缩 | 读带宽 −11%(ASTC 5×5 vs ETC2);能耗 −76%[9][10] | Arm / NVIDIA[47] |
| 4 | 采样侧 | 高度依赖内容,无单一数字 | Android AGI 计数器[36] |
排序的规律很清晰:改结构 > 改格式 > 改采样。原因是结构性手段省的是整笔流量,格式类省的是按比例打折,采样类省的是部分访问。
投入产出上,采样侧的门槛最低(改配置即可),结构性手段的门槛最高(要重排通道结构)。但从量级上看,结构性手段的收益是采样侧的数倍——先做结构,再做格式,最后调采样,是收益递减但成本也递减的合理顺序。
10.3 公式或参数逐项释义:字节到功耗的换算链
先看看这条换算链。它只有三步,但每一步都要写清口径:
① 省下的字节数 ΔB  = 优化前流量 − 优化后流量     (单位:字节/帧)
② 每秒省下的字节   = ΔB × 帧率                  (单位:字节/秒)
③ 省下的功耗       = 每秒字节数 × 100 pJ/byte    (单位:瓦)
以本场景为例:假设优化后总流量从 35 MB/帧降到 20 MB/帧,ΔB = 15 MB/帧,60fps 下每秒省 900 MB,折合 90 mW。
90 mW 看起来不多,但要放到正确的参照系里看:一台手机的整机功耗预算通常只有几瓦,而 DRAM 部分的预算常在数百毫瓦量级。省 90 mW 等于把这部分预算砍掉了一大块。
10.4 效果与量化:叠加效应与边界
好了,这里要泼一点冷水:四类手段的收益不能简单相加,因为它们作用在同一笔流量上:
- 附件压缩先把附件流量减半,再对附件做瞬态化,"再省 30%" 是基于已经减半后的基数;
- 纹理解析做压缩后,采样侧 LOD 优化的绝对收益也随之缩小;
- overdraw 降低会同时减少附件写入与纹理解析两边。
正确的算法是按顺序逐级施加,每一级基于上一级的结果:
| 步骤 | 施加手段 | 总流量 | 相对基准 |
|---|---|---|---|
| 基准 | — | 35 MB/帧 | — |
| ① | 结构与附件 | 24 MB/帧 | −31% |
| ② | 帧缓冲压缩 | 17 MB/帧 | −51% |
| ③ | 纹理压缩 + mipmap | 14 MB/帧 | −60% |
| ④ | 采样侧调优 | 12.5 MB/帧 | −64% |
最终约 −64%,而不是把四类的百分比相加得到的 −90% 以上。这个差距是很多优化汇报出错的根源。
再往下的边界是功耗与帧率的权衡:流量继续降,画质和功能的代价开始上升。这条曲线的拐点必须按产品定位来定,不是技术问题。
10.5 实现与配置:验证手段
账本上的数字必须能被测量验证,否则只是一份推演。三个层次的手段:
硬件仪器:功耗分析仪给整机功耗的绝对口径,是最终的裁判。示波器用来看瞬时的电流波动,判断是否存在峰值超标。
GPU 计数器:Android GPU Inspector 的纹理带宽视图[36]、Mali 计数器体系[43]、Apple 的 GPU counters[41],给出各项流量的分解值。
红外热像:把功耗代价可视化。它不给出精确数字,但能快速定位热区,也能在汇报时说明问题。
账本上的数字必须能被测量验证,否则只是一份推演。三个层次的验证手段各有分工:仪器给绝对口径,计数器给分解值,热像给可视化——缺一项都不足以支撑结论,而三者方向不一致时,首先要怀疑的是测量方法。
10.6 效果与量化:本篇量化结论汇总
把全篇可核对的结论集中列在这里。凡标"机制上如此"的是厂商文档层面的必然结论,凡给数字区间的都标注了出处与测量条件。
| 结论 | 数值 | 来源类型 |
|---|---|---|
| 嵌入式设备可用带宽 | ≈5.0 GB/s | Arm 官方材料[1] |
| 桌面 GPU 带宽 | >100 GB/s | Arm 官方材料[1] |
| DDR 访问能耗 | ≈100 pJ/byte | Arm GDC2017[4] |
| AFBC 平均降幅 | >50%(无损,内容相关) | Arm 官方[11][12] |
| AFRC 压缩比档位 | 3:2 ~ 4:1 | Arm @ Vulkanised 2023[17] |
| ASTC 5×5 vs ETC2+EAC | 读带宽 −11%、能耗 −10%、占用 −24% | Arm[10] |
| ASTC 3D 纹理能耗 | 4.17 → 1.00 mJ/帧(4×4) | Arm[9] |
| PLS 省量 | 60 MB/帧 ≈ 180 mW @30fps | Arm GDC2017[4] |
| G-Buffer 与光照融合 | 帧率 +30%、带宽 −80%(Galaxy S7, 4096×2048) | Arm GDC2017[5] |
| subpass 链合并 | frametime +10% 以上 | Qualcomm 官方[19] |
| MSAA resolve 时机 | 写回时 resolve 影响很小;独立 resolve 显著上升 | Arm SIGGRAPH 2020[7] |
这张表是全篇可核对结论的汇总,每一条都标注了来源类型。凡是给区间的,都说明了测量条件;凡是标"机制上如此"的,是厂商文档层面的必然结论,不依赖具体设备。读者可以只取其中与自己场景接近的几条使用。
10.7 源码与数据链接
- 全部量化来源见上方表格的编号引用,完整清单见文末"参考文献"
- 可复现的算例:本篇第 1 章的账本算式与第 10.3 节的换算链,均可按文中给出的公式重算
10.8 这一章留下的问题
账算完了,四类手段的收益也排出了序。但有一个现象从头到尾没有解释:同一台手机,跑分能到高帧率,持续运行十几分钟却掉下来。 那个问题的答案不在带宽,在功耗与散热——下一章交出去。
九、测量与验证
11.1 一句话点题
账本上的每一个数都要能被量出来。这一章给出可复现的验证方法,完整的测量协议留给第 7 篇。
好了,账本上的每一个数都要能被量出来,否则优化就只是推测。这一章给出可复现的验证方法,并把三种最容易误判的情形单独点出来——完整的测量协议留给第 7 篇,本篇只解决"怎么证明带宽真的省了"这一个子问题。
11.2 原理与概念:计数器与账本的对应
测量不是"打开 profiler 看哪个数字大",而是每个账本条目都要找到对应的计数器:
| 账本条目 | 对应计数器 | 平台 |
|---|---|---|
| 纹理解析流量 | 纹理内存读取带宽 | Android AGI[36] |
| 纹理解析效率 | 纹理 L1 遗漏百分比、非基础级别纹理百分比 | Android AGI[36] |
| 附件流量 | 外部内存读写带宽 | AGI / Mali 计数器[36][43] |
| overdraw | 片段着色器调用数 ÷ 实际存储像素数 | Apple GPU counters[41] |
| HSR 效率 | Pre-Z 测试失败数 | Apple GPU counters[41] |
| 缓存效率 | L2 缓存读查找 / 外部内存读 | Mali 计数器[43] |
没有对应计数器的条目,说明它量不出来——那就不要在结论里给它数字。
测量不是"打开 profiler 看哪个数字大",而是每个账本条目都要找到对应的计数器。找不到对应计数器的条目,就不该在结论里给它数字——这是把推演与证据分开的关键,也是本篇坚持标注出处的延伸。
11.3 实现与配置:测量流程四步
下面我们开始走流程。第一步 · 固定基准场景。 分辨率、格式、内容、帧率、设备温度状态全部锁定。任何一项变了,前后数据就不可比。
第二步 · 采基线。 关掉所有待验证的配置,跑够时间采一组稳定的数据(不是一次采样)。
第三步 · 单变量改动。 一次只改一项配置,重采。同时改多项就分不清哪项起了作用。
第四步 · 交叉验证。 计数器给出的流量下降,要和仪器测到的功耗下降方向一致。两者矛盾时,先怀疑测量方法。
这四步中最容易被跳过的是第三步。一次改多项配置看起来省时间,实际上会让所有数据都失去归因能力:最后得到的只是一个"好像变快了"的印象,而无法回答"是哪一项带来的、还能不能再往前推一步"。
11.4 公式或参数逐项释义:基准场景的固定条件
本篇所有算例的基准条件如下,读者复现时应对齐:
| 参数 | 取值 | 说明 |
|---|---|---|
| 分辨率 | 1920×1080 | 像素数 2,073,600 |
| 颜色附件 | RGBA8(每像素 4 字节) | 8.29 MB |
| 深度模板 | D24S8(每像素 4 字节) | 8.29 MB |
| 平均 overdraw | 2.5 | 决定附件写入的乘数 |
| 帧率 | 60fps | 换算成每秒流量 |
| 后处理 | 不含 | 加入后总量会显著上升 |
| 压缩 | 关闭 | 作为基线 |
换任一条件都会改变绝对数值。换基准不改变各项的相对量级排序——这是本篇结论可以跨场景使用的原因。
把基准条件写成表,是为了让读者能复现。换任一条件都会改变绝对数值,但不会改变各项的相对量级排序——这也是本篇结论可以跨场景使用的原因:你可以用自己的分辨率与格式重算一遍,排序仍然成立。
11.5 效果与量化:对照实验设计
先看看实验怎么设计。一个能说明问题的对照实验,至少要包含下面四组:
| 组 | 配置 | 观察项 | 预期 |
|---|---|---|---|
| A · 基线 | 全部关闭 | 总流量 | 35 MB/帧 |
| B · 仅结构 | 瞬态附件 + DONT_CARE + subpass 合并 | 附件流量 | 显著下降 |
| C · 仅压缩 | 帧缓冲压缩 + 纹理压缩 | 分类流量 | 按比例下降 |
| D · 全开 | B + C + 采样侧 | 总流量与功耗 | 约 −60% 以上 |
关键是 B 与 C 必须分开测,否则无法验证第 10.4 节的"叠加不可相加"。D 组用来验证逐级施加的模型是否成立。
关键在 B 组与 C 组必须分开测。把结构类与压缩类放在一起改,就无法验证第 10.4 节说的"叠加不可相加",也就无法建立一个可用于预测的模型——而模型的价值正在于:还没动手,就能估出大概能拿到多少收益。
11.6 实现与配置:容易误判的三种情形
误判一 · 把降频率当优化成功。 带宽降了,帧率也降了——很可能只是 GPU 降频了,流量并没有真正减少。必须同时看频率。
误判二 · 采样时间窗口太短。 移动 GPU 的功耗与频率状态变化很快,一两秒的采样很容易采到瞬态。至少要覆盖完整的稳态区间。
误判三 · 忽略热状态。 冷机与热机的数据不可比。同一组实验应在相同的热状态下进行,或者在报告中注明热状态。
这三种误判有一个共同点:数据都是真的,结论是错的。避免的方法不是更仔细地看数字,而是同时记录那些能解释数字的旁证——频率、热状态、采样窗口长度。测量记录里少了这几项,事后几乎无法复盘。
11.7 源码与数据链接
- 纹理带宽计数器:Android GPU Inspector[36]
- Mali 计数器:Unity Mali GPU 计数器参考[43]
- overdraw 与 HSR:Apple WWDC 2020[41]
11.8 这一章留下的问题
测量方法有了。但这一篇只解决了"怎么证明省了带宽",还有一个更大的问题没有回答:为什么省了带宽,持续运行仍然会掉帧? 那个问题的答案在功耗与散热,下一篇处理。
十、结语:账算完了,帧率为什么还会掉
12.1 一句话点题
OK,这一篇把带宽的账从头算到尾。结语回到系列主线,并把下一个问题交出去。
这一篇把带宽的账从头算到尾。结语回到系列主线,并把这个账本解释不了的那个现象交出去——账算得再准,也只能说明"搬得少",说明不了"为什么不掉帧"。
12.2 效果与量化:全篇账本回收
回到开篇那三个问题,逐条对答案:
一帧的字节从哪来? 四类:附件读写、纹理解析、几何与缓冲、隐式流量。在 1080p 基准场景下约 35 MB/帧、2.1 GB/s,其中附件一项占 63%。
移动内存的物理边界在哪? 由 LPDDR 的通道数与每通道位宽决定,名义带宽可由数据率乘以位宽算出;但持续吞吐因为 bank 冲突、刷新与读写切换,拿不到名义值。
四类手段各自能省多少? 结构与附件 > 帧缓冲压缩 > 纹理压缩 > 采样侧。逐级施加后总流量约降 60%,而不是四者相加。
回看系列进度:前两篇「约束」「机制」已交付,本篇「账本」完成;剩下的第 4 篇《功耗与热》把字节账接到「每秒能分多少焦耳」这条线上,第 5~7 篇再分别讲取舍、新特性与测量。
12.3 三个还没解决的问题
问题一 · 带宽降了,帧率没涨。 这说明瓶颈不在带宽。判断瓶颈归属需要一套更系统的流程,本篇只给了带宽那一支。
问题二 · 帧率在持续运行中下降。 冷机跑得动、热机跑不动,与带宽关系不大——这是 DVFS 与温度墙的作用。
问题三 · 不同设备的收益不一致。 同一套优化在不同 SoC 上的收益差异很大,原因是压缩格式与内存子系统的实现各不相同。跨设备结论需要分别验证。
12.4 实现与配置:本篇结论的适用边界
本篇所有量化结论都有前提,离开这些前提就不成立:
- 基准场景是 1080p、RGBA8、overdraw 2.5、不含后处理;换场景数值会变
- 压缩收益取厂商官方数字,其测量条件未必与本场景一致
- 结构性手段的收益依赖驱动是否真的合并或启用压缩,必须实测验证
- 厂商缩写对应的能力互不兼容,跨厂商发布不能假设收益可迁移
12.5 下一篇预告与系列进度
本篇是《移动端图形与功耗》的第 3 篇。账算完了,但"省了带宽"并不等于"不掉帧"——同一台手机,跑分能到高帧率,玩二十分钟却只有较低帧率,这个现象带宽解释不了。
那是第 4 篇《功耗与热:帧率为什么会掉下去》要回答的:DVFS 怎么工作、温度墙在哪里、持续性能该怎么当成设计目标。下一篇的入口就开在这儿——把这本字节账交到「功耗与热」手上。
12.6 结语与落款
写这篇时最费劲的地方,是把账对上。
机制很好找——四家厂商的文档把每条路径都写清楚了。但收益量级散落在几十份会议材料里,每份的测量条件都不一样:有的跑在 1440p,有的用 Exynos,有的只给百分比不给基数。把它们放在同一把尺子上之前,必须先把条件对齐。
所以这一篇里凡是给数字的地方,都尽量给出处与条件;社区里那些没法溯源的数字,宁可留白。一份能被复算的账,比一堆看起来精确的数字更有用。
With Best Wishes.
参考文献
官方文档与权威资料
- Arm《Analyzing Performance of Mobile Games》,https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/Analyzing-Performance-of-Mobile-Games.pdf
- Arm《Performance Analysis & Debugging with Mali》,https://community.arm.com/cfs-file/__key/telligent-evolution-components-attachments/01-2066-00-00-00-00-47-97/Performance-Analysis-and-Debugging-with-Mali.pdf
- Arm《Mali GPU OpenGL ES 应用程序优化指南》,https://community.arm.com/cfs-file/__key/telligent-evolution-components-attachments/01-2057-00-00-00-00-49-90/mali_5F00_optimization_5F00_guide.pdf
- Arm GDC2017《Achieving Console Quality Games on Mobile》,https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/GDC2017/Achieving-Console-Quality-Games-on-Mobile.pdf
- Arm GDC2017《Vulkan Multipass: mobile deferred done right》,https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/GDC2017/Vulkan-Multipass-Final.pdf
- Arm SIGGRAPH 2015《Mobile HW and Bandwidth》,https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/siggraph2015_2D00_mmg_2D00_andy_2D00_notes.pdf
- Arm @ SIGGRAPH 2020《Vulkan samples》,https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2_2D00_mmg2020_2D00_vulkan_2D00_emilio.pdf
- Arm《Modern Mobile GPU Architecture》(2026),https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2026_2D00_mmg_2D00_ralph_2D00_mobile_2D00_arch.pdf
- Arm GDC2013《ASTC: The Future of Texture Compression》,https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/ASTC-GDC2013.pdf
- Arm《What Makes ASTC Special》,https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/Get_the_most_out_of_ASTC.pdf
- Arm《Getting the Most Out of OpenGL ES》,https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/Sponsored%20Session%20-%20OPEN%20GL%20ES%203-x.pdf
- Arm《ARM's New Mali: An Integrated Multimedia Platform》,https://community.arm.com/cfs-file/__key/telligent-evolution-components-attachments/01-2066-00-00-00-00-58-55/New-Mali-Multimedia-System_5F00_final_5F00_rev2.pdf
- Arm《Performance Optimization and Debugging Mobile Games》,https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/Performance%20Optimization%20and%20Debugging%20Mobile%20Games.pdf
- Arm《Arm Frame Buffer Compression》,https://www.arm.com/technologies/graphics-technologies/arm-frame-buffer-compression
- Arm《自适应可扩展纹理压缩(ASTC)》,https://www.arm.com/zh-cn/technologies/graphics-technologies/adaptive-scalable-texture-compression
- Arm Community《Vulkan samples: Bandwidth and throughput optimizations for mobile》,https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/vulkan-samples
- Arm Community《Vulkan subpasses: the good, the bad, and the ugly》,https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/vulkan-subpasses-the-good-the-bad-and-the-ugly
- Arm Community《The Mali GPU: An Abstract Machine, Part 2 - Tile-based Rendering》,https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/the-mali-gpu-an-abstract-machine-part-2---tile-based-rendering
- Arm Community《Mali Bifrost Family Performance Counters》,https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/mali-bifrost-family-performance-counters
- Arm Community《Arm-powered Xiaomi Mi 5c features the entire Arm Mali Multimedia Suite》,https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/arm-powered-xiaomi-mi-5c-smartphone-features-the-entire-arm-mali-multimedia-suite-of-graphics-video-and-display
- Arm @ Vulkanised 2023《Getting started on mobile and Best practices for Arm GPUs》,https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_2023_getting_started_on_mobile_and_best_practices_for_arm_gpus.pdf
- Arm Learn《GPU metrics》(Unity Profiler 中的 Arm GPU 计数器),https://learn.arm.com/learning-paths/mobile-graphics-and-gaming/unity_packages/mali_metrics
- Mali Texture Compression Tool v4.3.0 User Guide,https://raw.githubusercontent.com/Alexkaer/png2pkm/refs/heads/master/Mali%20Texture%20Compression%20Tool%20v4.3.0%20User%20Guide.pdf
- Qualcomm《Universal Bandwidth Compression (UBWC)》,https://docs.qualcomm.com/bundle/publicresource/topics/80-78185-2/overview.html
- Qualcomm《Adreno GPU on Mobile: Best Practices》,https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- Qualcomm《Android OS on Snapdragon》,https://docs.qualcomm.com/doc/80-78185-2/topic/android_os.html
- Qualcomm《Remove unused render targets》(GMEM Store),https://docs.qualcomm.com/bundle/publicresource/80-71528-1/topics/remove_unused_render_targets.md
- Qualcomm Developer Blog《Tile Memory Heap extension for Vulkan》,https://www.qualcomm.com/developer/blog/2026/05/high-performance-memory-extension-optimize-memory
- Qualcomm Developer Blog《Optimize performance and graphics for Adreno GPU for low power gaming》,https://www.qualcomm.com/developer/blog/2025/08/optimize-performance-and-graphics-for-adreno-gpu-low-power-gaming
- Qualcomm QCM6490/QCS6490 SoC Product Brief,https://www.qualcomm.com/content/dam/qcomm-martech/dm-assets/documents/qcs-qcm6490-soc-product-brief_87-28733-1-b.pdf
- Qualcomm《Snapdragon Profiler User Guide》,https://developer.qualcomm.com/qfile/71530/snapdragon_profiler_user_guide.pdf
- Imagination《PowerVR Graphics Architecture》(PVR3C),https://www.imaginationtech.com/products/gpu/graphics-architecture/
- Imagination《Introduction to PowerVR for Developers》,https://imagination-technologies-cloudfront-assets.s3.eu-west-1.amazonaws.com/website-files/documents/Introduction_to_PowerVR_for_Developers.pdf
- Imagination《Texture Compression using PVRTC》,https://docs.imgtec.com/performance-guides/graphics-recommendations/html/topics/pvrtc/texture-compression-using-pvrtc.html
- Imagination《PowerVR Performance Recommendations》,http://powervr-graphics.github.io/WebGL_SDK/WebGL_SDK/Documentation/Architecture%20Guides/PowerVR.Performance%20Recommendations.pdf
- Imagination《PVRTC & Texture Compression User Guide》,https://imgtec.eetrend.com/sites/imgtec.eetrend.com/files/download/201712/10872-31543-pvrtc-and-texture-compression-user-guide.pdf
- Vulkan Docs《Tile Based Rendering (TBR) Best Practices》,https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- Vulkan Docs,MSAA 样例,https://docs.vulkan.org/samples/latest/samples/performance/msaa/README.html
- Vulkan Docs,Subpasses 样例,https://docs.vulkan.org/samples/latest/samples/performance/subpasses/README.html
- Vulkan Docs,AFBC 样例,https://docs.vulkan.org/samples/latest/samples/performance/afbc/README.html
- Vulkan Docs,Render pass attachments 样例,https://docs.vulkan.org/samples/latest/samples/performance/render_passes/README.html
- Vulkan Docs《Mobile Development: Rendering Approaches》,https://docs.vulkan.org/tutorial/latest/Building_a_Simple_Engine/Mobile_Development/04_rendering_approaches.html
- Vulkan 规范《Render Pass》章节,https://vulkan.lunarg.com/doc/view/1.4.321.1/linux/antora/spec/latest/chapters/renderpass.html
- Vulkan 扩展提案《VK_KHR_dynamic_rendering》,https://docs.vulkan.org/features/latest/features/proposals/VK_KHR_dynamic_rendering.html
- Vulkan 扩展提案《VK_EXT_multisampled_render_to_single_sampled》,https://docs.vulkan.org/features/latest/features/proposals/VK_EXT_multisampled_render_to_single_sampled.html
- Android《分析纹理内存带宽用量》(AGI),https://developer.android.com/agi/sys-trace/texture-memory-bw?hl=zh-cn
- Android《GPU performance counters》,https://developer.android.google.cn/agi/sys-trace/counters
- Android《AGI 快速入门》,https://developer.android.google.cn/agi/start
- Android《系统性能分析概览》,https://developer.android.google.cn/agi/sys-trace/system-profiler
- Android《纹理》(游戏优化),https://developer.android.com/games/optimize/textures?hl=zh-cn
- Android《减少过度绘制》,https://developer.android.com/topic/performance/rendering/overdraw?hl=zh-cn
- Android《检查 GPU 渲染速度》,https://developer.android.google.cn/topic/performance/rendering/inspect-gpu-rendering.html
- Android《CPU 和 GPU 优化提示》,https://developer.android.com/games/optimize/optimization-tips
- Samsung GameDev《OpenGL ES Usage Recommendations》,https://developer.samsung.com/galaxy-gamedev/resources/articles/opengl.html
- Samsung GameDev《GPU Framebuffer Memory: Understanding Tiling》,https://developer.samsung.com/galaxy-gamedev/resources/articles/gpu-framebuffer.html
- Apple WWDC 2020《Optimize Metal apps and games with GPU counters》,https://developer.apple.com/videos/play/wwdc2020/10603
- Unity 手册《纹理串流》,https://docs.unity3d.com/cn/2019.4/Manual/TextureStreaming.html
- Unity 手册《优化》(移动端),https://docs.unity.cn/cn/2018.1/Manual/MobileOptimisation.html
- Unity《Mali GPU counters reference》,https://docs.unity3d.com/Packages/com.unity.profiling.systemmetrics.mali@1.1/manual/metrics-guide.html
- Unity《Recommended, default, and supported texture compression formats》,https://docs.unity.cn/2021.1/Documentation/Manual/class-TextureImporterOverride.html
- Unity Blog《Tackling profiling for mobile games with Unity and Arm》,https://blog.unity.com/games/tackling-profiling-for-mobile-games-with-unity-and-arm
- Unreal Engine《Texture Streaming Metrics》,https://dev.epicgames.com/documentation/en-us/unreal-engine/texture-streaming-metrics-in-unreal-engine
- Unreal Engine《Texture Streaming Configuration》,https://dev.epicgames.com/documentation/en-us/unreal-engine/texture-streaming-configuration-in-unreal-engine
- Unreal Engine《Optimization and Development Best Practices for Mobile Projects》,https://dev.epicgames.com/documentation/en-us/unreal-engine/optimization-and-development-best-practices-for-mobile-projects-in-unreal-engine
- NVIDIA《Memory Bandwidth》(Tegra),https://docs.nvidia.com/gameworks/content/technologies/mobile/gles2_perf_mem_bandwidth.htm
- NVIDIA《Using ASTC Texture Compression for Game Assets》,https://developer.nvidia.com/astc-texture-compression-for-game-assets
- TI《Super high resolution displays empowered by the OMAP4470》,https://www.ti.com/lit/wp/swpy028/swpy028.pdf
- JEDEC JESD209-5《Low Power Double Data Rate 5 (LPDDR5)》,https://standards.globalspec.com/std/14222463/jedec-jesd209-5
- JEDEC 发布 JESD209-5B 新闻稿,https://itbusinessnet.com/2021/07/jedec-publishes-new-and-updated-standards-for-low-power-memory-devices-used-in-5g-and-ai-applications/
内存器件与产业资料
- Micron LPDDR5 产品页,https://www.micron.cn/products/memory/lpddr-components/lpddr5
- Micron LPDDR5X 产品页,https://my.micron.com/products/memory/dram-components/lpddr5x
- Micron《LPDDR5X memory pushes the limits》,https://www.micron.com/about/blog/memory/dram/lpddr5x-memory-performance-pushes-the-limits-of-whats-possible
- Samsung LPDDR5X 产品页,https://semiconductor.samsung.com/dram/lpddr/lpddr5x/
- Samsung Semiconductor 应用页(LPDDR5/5X 规格),https://semiconductor.samsung.com/applications/automotive/
- TechYorker《LPDDR5 and LPDDR5X Explained》,https://techyorker.com/lpddr5-and-lpddr5x-explained-understanding-their-differences-and-benefits/
- Ecrionix《LPDDR Memory Guide》,https://ecrionix.org/digital-electronics/lpddr/
学术研究与量化材料
- 《Unveiling the Real Performance of LPDDR5 Memories》,arXiv:2209.14756,https://arxiv.org/pdf/2209.14756
- 《Rendering Elimination: Early Discard of Redundant Tiles in the Graphics Pipeline》,arXiv:1807.09449,https://arxiv.org/pdf/1807.09449v1
- 《3-D WiRED: A Novel WIDE I/O DRAM With Energy-Efficient 3-D Bank Organization》,https://www.engr.colostate.edu/~sudeep/wp-content/uploads/j27.pdf
- 《Muchisim: A Simulation Framework for Design Exploration of Multi-Chip Manycore Systems》,https://arxiv.org/html/2312.10244v1/
- 《A Reconfigurable and Accurate Circuit-Level Substrate for DRAM Design and Analysis》,https://portal.acm.org/doi/10.1145/3716368.3735231
- 《Thermodynamic Constraints in Dynamic Random-Access Memory Cells》,https://arxiv.org/html/2505.23087v2
- 《Charge-Margin-Oriented Write-Energy Optimization for Low-Power DRAM Array》,https://www.mdpi.com/2079-9292/15/16/3539
- SystemVerilog.io《LPDDR5 Tutorial: Deep dive into its physical structure》,https://www.systemverilog.io/design/lpddr5-tutorial-physical-structure/
- soo:bak《GPU 아키텍처 (2) - 모바일 GPU와 TBDR》,https://soo-bak.github.io/dev/unity/GPUArchitecture-2/
- Procedural Pixels《VRAM bandwidth and its big role in optimization》,https://www.proceduralpixels.com/blog/vram-bandwidth-and-its-big-role-in-optimization
- GPU Memory Bandwidth Calculator,https://codingace.net/physics/gpu_memory_bandwidth.html
- Mobile optimization guide for VR games made in Unity,http://sanna.ekneling.se/Mobileoptimizationguide.pdf
工程实践与社区讨论
- 《带宽:GPU 的粮道在哪里堵住了》,https://blog.csdn.net/qq_45370022/article/details/164295496
- 《Mali 系列 GPU 里的 AFBC + ASTC 到底是什么》,https://blog.csdn.net/weixin_43644245/article/details/120424094
- 《移动端 Overdraw 优化实战》,https://blog.csdn.net/weixin_29313239/article/details/164890756
- 《Arm Mali GPU 纹理采样性能瓶颈如何优化?》,https://ask.csdn.net/questions/8996902
- 《LPDDR5 和 DDR5 谁更快?带宽、延迟、功耗对比》,https://ask.csdn.net/questions/9402915
- 《GPU 性能优化全指南:从诊断到实战》,https://blog.csdn.net/qq_33060405/article/details/148148889
- 《压缩纹理:游戏性能优化的关键基石》,https://blog.csdn.net/qq_33060405/article/details/150983912
- 《渲染的纹理带宽瓶颈如何破?纹理压缩格式选择之道》,https://blog.csdn.net/LiteTrans/article/details/155634618
- 《移动端 GPU 发热优化:纹理与后处理的带宽降载实战》,https://blog.csdn.net/weixin_30972263/article/details/165081156
- 《WebGPU 移动端性能优化:适配低功耗移动 GPU 架构》,https://blog.csdn.net/gitblog_00930/article/details/151947522
- 《纹理采样、Mipmap 与各向异性过滤全解析》,https://blog.csdn.net/VarLens/article/details/155931999
- 《GPU 纹理映射核心算法与优化策略》,https://blog.csdn.net/ProceSeed/article/details/155633959
- 《基于移动端渲染 Tile-Based Rendering》,https://blog.csdn.net/Kaitiren/article/details/140371914
- 《adreno 源码系列(三)dts 配置与 gpu 列表》,https://blog.csdn.net/weixin_44901612/article/details/128179612
- 《Flutter GPU 纹理压缩支持深度技术分析报告》,https://juejin.cn/post/7577313637951881225
- 《Unity 渲染实战宝典:突破平台限制的优化策略》,https://juejin.cn/post/7573523709300310051
- Unity 官方开发者社区《PNG 转 ETC2 的底层逻辑与跨平台实践指南》,https://developer.unity.cn/projects/692ef50aedbc2a001d3c786e
- 《跨平台游戏纹理压缩策略:ASTC/BC7/ETC2 选型与最佳实践》,https://beefed.ai/zh/texture-compression-multi-platform
- 《Unity Texture Compression Comparison》,https://gamedevcheatsheet.com/texture-compression
- 《mobile-shader-optimization》,https://lobehub.com/skills/neversight-learn-skills.dev-mobile-shader-optimization
- 《Advanced Android 04.1 Part B: Debug GPU Overdraw》,https://myweb114889891.wordpress.com/wp-content/uploads/2021/04/4.1b-gpu-rendering_dark-1.pdf
- 天美工作室《三角洲行动》跨平台技术解密(GDC 演讲转述),https://m.10100.com/article/1070430
图片版权
本篇共使用 38 张外部图片,全部来自 Wikimedia Commons,遵循各文件标注的开放许可使用,逐张署名如下:
| 文件 | 作者 | 许可 |
|---|---|---|
src_dram_xoom.jpg |
Raimond Spekking | CC BY-SA 4.0 |
ext_tbr_architecture.jpg |
Mewtow | CC BY-SA 4.0 |
ext_imr_pipeline.png |
Original: Martin Wantke Vector: AntiCompositeNumber | CC0 |
ext_tiled_traversal.png |
Mewtow | CC0 |
ext_memory_wall.png |
Oğuz Ergin | CC BY-SA 4.0 |
ext_roofline.png |
Giu.natale | CC BY-SA 4.0 |
ext_word_addressable.png |
Debabrattaj | CC BY-SA 4.0 |
ext_geometry_pipeline.png |
PaterMcFly / User:Vierge Marie | CC0 |
ext_unified_shader.png |
ScotXW | CC BY-SA 4.0 |
ext_alpha_blending.jpg |
Lukáš Buričin | Public domain |
ext_raster_triangle.png |
Wojciech mula at Polish Wikipedia | Public domain |
ext_painter_algorithm.svg |
Zapyon | CC BY-SA 3.0 |
ext_color_attachment.jpg |
astrofra | CC BY-SA 4.0 |
ext_normal_attachment.jpg |
astrofra | CC BY-SA 4.0 |
ext_memory_cost.png |
Our World In Data | CC BY 4.0 |
ext_lpddr.png |
RusPlot | CC BY-SA 3.0 |
ext_sdr_ddr_qdr.png |
MisterSanderson | CC BY-SA 3.0 |
ext_sdram_ranks.png |
Mewtow | CC0 |
ext_mem_hierarchy.png |
ComputerMemoryHierarchy.png: User:Danlash at en.wikipedia.or | Public domain |
ext_hbm_schematic.png |
ScotXW | CC BY-SA 4.0 |
ext_mem_hierarchy_latency.jpg |
Kerrick Staley | CC BY-SA 3.0 |
ext_mipmap.png |
Phorgan1 (talk) 00:34, 5 February 2012 (UTC) Illustration by | CC BY-SA 3.0 |
ext_arith_encoding.png |
Dcoetzee | Public domain |
ext_astc_detail.png |
Seantellis | CC BY-SA 3.0 |
ext_mrt.png |
Faldrian | CC BY-SA 4.0 |
ext_fbo_stack.jpg |
McMalloc | CC BY-SA 3.0 |
ext_zbuffer.png |
Vierge Marie | Public domain |
ext_hsr.png |
Vierge Marie | CC BY-SA 4.0 |
ext_mipmap_alias.png |
BillyBob CornCob | CC0 |
ext_aniso.png |
Cobblestones.JPG: THOMAS derivative work: Lampak (talk) | CC BY-SA 3.0 |
ext_msaa_quincunx.png |
Vierge Marie | Public domain |
ext_fxaa.png |
Drummyfish | CC0 |
ext_minmax.png |
Metoc | CC BY-SA 2.5 |
ext_vulkan_pipeline.png |
Alexander Overvoorde | CC BY-SA 4.0 |
ext_webgl_pipeline.png |
Scriptor universalis | CC BY-SA 4.0 |
ext_texture_atlas.png |
Nicolas P. Rougier | CC BY-SA 4.0 |
ext_cache_hitrate.png |
Oğuz Ergin | CC BY-SA 4.0 |
src_scope_2.jpg |
Unnerving duck | CC0 |


资源与延伸:本篇的账本算式与换算链均可按正文公式复算;系列仓库(含源码与原始数据)随第 7 篇一并整理,相关链接见文末「参考文献」。
系列导航:本系列《移动端图形与功耗》共 7 篇。
- 上一篇:(二)分块渲染:binning、片上内存与它的代价
- 本篇:(三)带宽:移动端最硬的那道墙
- 下一篇预告:(四)功耗与热:帧率为什么会掉下去 —— 账算完了,帧率为什么还会掉
With Best Wishes.