核心问题:前面十一期,我们手里握着一张 2011 年的硬件地图——命令队列、显存与地址空间、SM 与波前、纹理采样器、装配裁剪、光栅化与早深度、像素后端、几何前端与细分、计算着色器的共享内存、以及最后那张横跨 CPU 与 GPU 的同步账。这一期要回答的是收官问题:从 2011 年到 2026 年,这张地图上哪些位置被改写了,哪些位置一动没动? 我们不走"哪一年发布了什么"的编年史,而是给一套判定式:看到一个"新特性",先问它替代了 2011 年的哪个环节、代价转移到了哪一侧(应用侧还是驱动侧)、哪条原本由硬件兜底的保证被降级了。全篇按"变的三处 + 三条横向演化 / 没变的四处"两条线展开,所有数字都标注口径——规范事实、厂商宣传、第三方实测,三档分开写。
本篇不涉及移动端 TBDR 的取舍、性能测量方法论,以及 mesh shader / work graphs 的完整实现代码;理由是这三块分别属于《移动端图形与功耗》与本系列 ep10、ep11 的题内,本篇只做"变了/没变"的判定与依据(详见 §0.3 与 §0.5)。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
点题:十二年后,地图还剩几笔没改
0.0 内容总览:本篇知识地图(先看这张表,再决定读哪几章)
| 章 | 环节 | 2011 年的形态 | 2026 年的判定 | 主依据 |
|---|---|---|---|---|
| 一 | 几何输入 | IA 固定功能:索引解压 + 顶点重用 | 变了:搬进可编程阶段 | Mesh Shader 规范 |
| 二 | 资源绑定 | 每 draw 绑定一组槽位 | 变了:bindless + 运行期索引 | VK_EXT_descriptor_indexing 等 |
| 三 | 工作发起 | CPU 生成命令、GPU 顺序遍历 | 变了:节点图按需发起 | Work Graphs 规范 |
| 四 | 求交 | 着色器自己算 | 新增专用单元:BVH 遍历与求交硬件化 | DXR 规范、Turing 白皮书 |
| 五 | 着色速率 | 一律按最高速率 | 降级可调:VRS / FDM / SER | VK_KHR_fragment_shading_rate |
| 六 | 渲染目标与片上内存 | 管线创建时定死、片上归硬件管 | 显式化:命令期指定 + transient 声明 | Vulkan 1.3、Vulkan Guide |
| 七 | 存储与封装 | GDDR 颗粒围一圈 | 形态大变:chiplet + HBM + 压缩 | NVIDIA / Samsung / Arm |
| 八 | 光栅、ROP、纹理、同步职责 | 固定功能 + 应用侧同步 | 未变(同步反而更显式) | Mesh Shader 规范、Vulkan 同步章节 |
| 九 | 判据与总表 | — | 三问判据 + 时间线 + 变/不变矩阵 | 本篇归纳 |
| 十 | 收束 | — | 把读法迁移到后续白皮书的阅读上 | 本篇归纳 |
读法建议:只关心"我手上的老知识还能不能用"的朋友,可以直接读第八章与第九章;关心新机制怎么落地的,按一到六章顺序读;只想知道"这十二年到底改了什么"的,读第零章的 0.1–0.2 两节加第九章的矩阵即可。第十章的收尾三件事,任何一条都够一次技术评审用。
0.1 先把 2011 的基线摆出来
要把"变了什么"讲清楚,得先有一张可对照的底图。按 fgiesen 那套描述(CC0,本系列的立论底本),2011 年的图形管线可以压成五句话:
- 几何输入是固定功能:索引解压、顶点重用(post-transform cache)、按索引拉起顶点属性,全部由硬件完成;应用只负责给出 index buffer 与 input layout;
- 着色阶段顺序执行:VS →(HS/DS 细分)→ GS,GS 之后仍有固定功能的图元装配与裁剪;
- 光栅化与 ROP 是固定功能:三角形建立、属性插值、深度测试、混合、写入,都不由应用控制;
- 资源绑定是 per-draw 的:每个 draw 之前绑定一组常量/资源/采样器槽位;
- 命令由 CPU 生成、GPU 顺序消费:命令缓冲里的内容被逐条遍历执行。
到 2026 年,这五句里有三句被改写了、两句原样保留,另外还有三条不属于"环节改写"、但同样深刻的横向演化(固定功能的按需降级、管线与渲染目标模型的显式化、硬件形态本身)。我们先把总表摆在这里,后面逐条展开。
0.2 两条对照线
变了的三处,每一处都伴随一次"责任上移":
- 几何前端被搬进可编程阶段:输入装配器(Input Assembler,IA)被关掉,顶点重用不再由硬件兜底,责任上移到应用侧的 meshlet 划分;
- 资源绑定模型换了:从"每 draw 重绑一组槽位"变成"一次绑定巨量描述符 + 运行期索引"(bindless),绑定的固定成本消失,代价是资源生命期与可见性要自己管;
- 工作发起方式换了:从"CPU 生成命令、GPU 顺序遍历"变成"GPU 侧按需请求工作"(work graphs),串行遍历那一步被去掉,代价是调度正确性更难推理。
没变的四处,是这套地图真正的骨架,也是本篇与"新特性罗列文"的分界线:SIMT 波前执行模型、固定功能光栅化与 ROP、纹理采样器这条固定流水、以及"同步职责留在应用侧"这件事——最后一条不但没变,还更显式了。
0.3 口径声明与边界
本篇所有性能数字分三档,正文里每次出现都会标注:
| 口径 | 含义 | 例 |
|---|---|---|
| 规范事实 | 规范/文档原文,可逐字核对 | mesh shader 输出顶点 ≤256 |
| 厂商宣传 | 厂商官方材料给出的收益,场景特定 | Lucy 场景 mesh 0.9 ms vs 1.8 ms |
| 第三方实测 | 独立作者在公开文章里量到的结果 | Niagara 20.7B vs 7.4B 三角形/秒 |
边界:不重复前十一期的机制细节(只做"变了/没变"的判定与依据);不写移动端 TBR/TBDR 的取舍与带宽账(《移动端图形与功耗》ep02/ep03 已写透);不写性能测量方法论(同系列 ep07);不展开 mesh shader / work graphs 的完整实现代码(ep10 已把计算模型交棒到本篇,本篇给机制与判据)。此外,凡是没取到官方原文的数字一律不写——比如 RDNA 3 的 MCD/GCD 划分与片间带宽,本轮检索只取到技术讲义、没取到白皮书原文,因此本篇不提这些具体数值。
出处:fgiesen · A trip through the Graphics Pipeline 2011(索引)/DirectX-Specs · Mesh Shader/DirectX-Specs · Work Graphs。
0.4 术语速查(中英对照)
本篇的机制名几乎都来自两套 API 的官方命名,先把中英对照钉在这里,后面每一章不再重复解释:
| 中文 | 英文 | 出现在 |
|---|---|---|
| 输入装配器 | Input Assembler(IA) | 第一章 |
| 网格着色器 / 任务着色器 / 放大着色器 | Mesh / Task / Amplification Shader | 第一章 |
| 顶点重用 | post-transform cache | 第一章 |
| 小网格 | meshlet | 第一章 |
| 光栅化顺序 | rasterization order | 第一章 |
| 无绑定(描述符索引) | bindless / descriptor indexing | 第二章 |
| 描述符堆 | descriptor heap | 第二章 |
| 命令签名 | command signature | 第三章 |
| 间接绘制 | indirect drawing | 第三章 |
| 工作图 | work graphs | 第三章 |
| 加速结构(底层 / 顶层) | acceleration structure(BLAS / TLAS) | 第四章 |
| 着色器绑定表 | shader binding table(SBT) | 第四章 |
| 内联光线查询 | inline ray query | 第四章 |
| 可变速率着色 | Variable Rate Shading(VRS) | 第五章 |
| 片元密度图 | fragment density map | 第五章 |
| 着色器执行重排 | Shader Execution Reordering(SER) | 第五章 |
| 动态渲染 | dynamic rendering | 第六章 |
| 片上内存 / 瞬态附件 | tile memory / transient attachment | 第六章 |
| 管线库 / 着色器对象 | pipeline library / shader object | 第六章 |
| 稀疏资源 | sparse / tiled resources | 第六章 |
| 小芯片 | chiplet | 第七章 |
| 高带宽内存 | High Bandwidth Memory(HBM) | 第七章 |
| 帧缓冲压缩 | frame buffer compression | 第七章 |
| 波前 | wavefront / warp | 第八章 |
| 像素后端 | render output unit(ROP) | 第八章 |
0.5 为什么用判定式,而不是编年史
把 2011 到 2026 的特性排成年表,是最省事也最没用的写法。原因有三个:
- 特性不是均匀分布的:2018–2024 这六年里塞进了 DXR、mesh shader、DirectX 12 Ultimate、work graphs 四件大事,而 2011–2017 的显式 API 期(Vulkan 与 D3D12)主要是在把 2011 年就存在的硬件能力"暴露得更充分";
- 同一件事会被包装成不同名字:
ExecuteIndirect、mesh shader 的间接绘制、work graphs 的 draw 节点,说的都是"让 GPU 自己决定画什么";按名字背年表,会以为它们互不相干; - 年表不回答"我该改什么":读者真正要的是"我手里的老代码/老知识,哪些还能用、哪些必须重写"。
判定式的写法把这三个问题一次解决:每条机制都归位到"它替代了哪个环节",于是同名的合并、异名的分家;每条机制都标出"责任转移到哪",于是"我该改什么"有了答案;每条机制都点出"哪条保证被降级",于是排查阶段有据可依。
举个具体例子。看到"mesh shader 关闭了 IA"这条信息,按年表只能记下"2019 年 11 月发布的特性";按判定式则能立刻推出三件对工程有影响的事:① 顶点重用不再由硬件兜底(要自己切 meshlet);② 依赖绘制顺序的效果要重新核对(有 AS 时顺序保证变弱);③ 原来的顶点缓冲布局可以保留、但 input layout 声明会作废(PSO 要改)。 这三条才是能直接落到代码里的东西。
一、几何前端被搬走了:IA 关闭之后,谁来补上顶点重用
1.1 概念:2011 的几何前端,一半功劳在固定功能
2011 年的几何输入是"半自动"的:应用给出 index buffer,硬件做索引解压;顶点被多个三角形复用时,post-transform cache 会把它缓存下来,避免重复执行顶点着色器;顶点属性的拉取格式(input layout)也在管线状态里声明好。也就是说,"一个顶点只算一次"这件事曾经是硬件替你保证的。
这一层在 2018 年之后被整体取消。DirectX 的 Mesh Shader 规范写得很直接:
Inputs to the Mesh shader don't have IA enabled.(mesh shader 的输入不启用输入装配器) With Mesh shaders, index buffers and input layouts can not be specified in the PipelineState description.(PSO 里不能再指定 index buffer 与 input layout)
规范同时给出了动机的原话:目标是"remove the need for the index processing part of the IA and allow GPUs to be more parallel"——把 IA 里那段索引处理拿掉,让 GPU 更并行。
1.2 原理:task/mesh 两阶段替换了一个流水段
替代品是两个新增的可编程阶段:
- task shader(amplification shader):先跑一小批线程,决定"要不要发射工作、发射多少",用
OpEmitMeshTasksEXT发射 mesh 工作组并传一个 payload; - mesh shader:直接产出顶点与图元(
OpSetMeshOutputsEXT声明实际输出数量,因此数量是动态的),然后交给同一个固定功能光栅化器。
这条替换路线的野心写进了规范:amplification shader 的意图是"eventually replace hardware tessellators"(最终取代硬件细分器)。不过这一条目前仍是意图而非既成事实——第三方实测里,保守的 meshlet 包围体方案与"用 mesh shader 换掉细分"之间的账并没有一边倒,这一点在 §1.5 的量化里会看到。
两个阶段的对照可以用五句话概括:
| 环节 | 2011 | 现在(mesh/task 路径) |
|---|---|---|
| 索引解压 | 固定功能硬件 | 不存在(应用自己组织顶点) |
| 顶点重用 | post-transform cache 兜底 | 应用侧靠 meshlet 共享顶点 |
| 属性拉取 | input layout 声明 + IA 拉取 | 着色器里自己按索引读数据 |
| 顶点/图元数量 | 由 index buffer 静态决定 | OpSetMeshOutputsEXT 动态声明 |
| 输出拓扑 | 支持 strip/fan | 仅支持 list(要自己展开) |
代价转移到了应用侧,落到工程里就是 meshlet。 硬件不再保证"一个顶点只算一次",应用就得自己把这件事安排出来:把模型切成顶点数受控的小簇(meshlet),簇内顶点共享一份数据,再给每簇配一个包围体做剔除。这套做法不是"新玩具",而是把 2011 年 post-transform cache 的活接过来自己干——省下的重复着色变成应用侧的数据组织成本。
顺带说一句,这一章里"责任上移"这四个字会反复出现,而且每次都长得很像,但移上去的东西并不一样:这里移上去的是顶点重用,第二章移上去的是资源生命期,第三章移上去的是工作调度。分清楚"移的是什么",比记住"又上移了"有用得多。
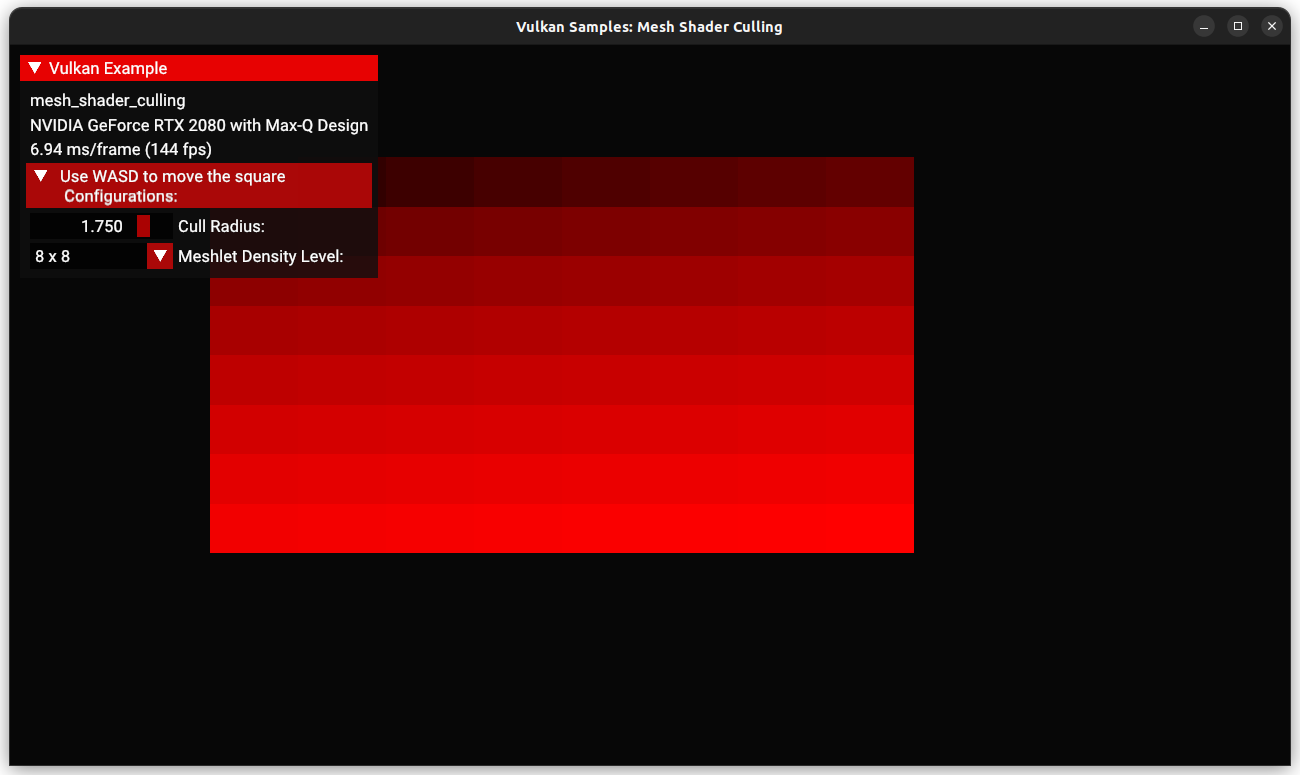
上面这张官方样例图与本系列的示意图放在一起看,能对上三件事:簇级剔除确实能跑(官方样例)、剔除粒度确实更细(对照 2011 的整批提交)、代价确实在应用侧(meshlet 要自己切)。图注里那句"从整批顶点细化到簇",就是第一章结论的最好注脚。
那 GS 与细分去哪了? 这一层在 mesh 路径里没有一对一的替代阶段:
- 细分的定位:官方说 amplification shader 的意图是"最终取代硬件细分器"——即用 task shader 决定"要发射多少工作"、mesh shader 生成三角形,逼近原来 HS/DS 的效果;
- GS 的能力被拆成两半:几何放大这一类(用少量输入生成大量图元)被 mesh shader 直接吸收;而流输出(stream out)那部分没有对应物——在 mesh 路径里要把数据写到缓冲,得显式走 UAV 写;
- 但"取代"并非一边倒:第三方实测里(§1.6 那张表最后一行),用保守包围体的 meshlet 方案去替代硬件细分器,收益并不稳定。所以现状是两条路并存,而不是后者取代前者。
一句判据:几何放大如果是"规则的、可预知的"(地形、曲面参数化),固定细分器依然省事;如果是"依数据而变的"(每帧 LOD 分布不均、需要按可见性决定生成量),task/mesh 更合适。
1.3 参数逐项:硬限制是怎么定死的
这些上限不是工程惯例,是规范条款,可以直接拿来评估"一个模型能不能塞进一个 mesh 工作组":
[numthreads]满足X × Y × Z ≤ 128;- 每个 mesh 工作组最多输出 256 个顶点、最多 256 个图元;
- amplification shader 的 payload ≤ 16 KB/实例;
- mesh shader 输出 ≤ 32 KB;两者合计 ≤ 47 KB;
- mesh shader 可用的 groupshared 上限是 28K(比计算着色器的 32K 更小)。
Vulkan 侧的对应物是 VK_EXT_mesh_shader:新增 VK_SHADER_STAGE_TASK_BIT 与 VK_SHADER_STAGE_MESH_BIT,并新增了对应的 pipeline stage,让应用可以显式地同步这两个阶段。命令方面有个容易记错的细节:Vulkan 侧的命令是 vkCmdDrawMeshTasksEXT 系列——是 draw 而不是 dispatch。
1.3.1 一个 meshlet 的顶点预算怎么估
规范只给上限,不给推荐值,所以这个预算得自己估。步骤可以固定成四步:
- 统计模型的重用率:闭合三角网格的平均关系是"三角形数 ≈ 顶点数 × 2",也就是说一个 meshlet 若装 N 个顶点,大约对应 2N 个三角形(这是统计规律,不是规范约束);
- 先定三角形数、再反推顶点数:以"输出图元 ≤256"为界,一个 meshlet 的三角形数最多 256,对应顶点约 128 个——离 256 的顶点上限还有一半余量,这个余量要留给边界顶点(相邻 meshlet 共享、必须重复携带的那部分);
- 检查两个上限都不越界:顶点 ≤256、图元 ≤256,两者同时满足才合法;
- 给 AS payload 留预算:如果有 amplification shader,payload ≤16 KB/实例、mesh 输出 ≤32 KB,合计 ≤47 KB——这是"一个工作组能带多少数据"的硬顶,超了只能拆两级。
至于取多大合适,规范里没有答案,因为它取决于你自己的模型分布:meshlet 越大,剔除粒度越粗(一个簇要么全画要么全不画),簇内顶点复用的边界收益也越小;越小,簇数量爆炸、包围体与调度开销上升。 唯一靠谱的做法是拿你的场景统计一遍顶点复用率,再用剔除命中率去校准——这也是为什么这一节先讲"责任上移":参数没有标准值,只有你自己的统计值。
1.4 被降级的保证:光栅顺序
搬走 IA 顺带改掉了一条隐含保证。规范里专门有一段"Rasterization order":
- 没有 amplification shader 时:同一次
DispatchMesh()内的 thread group 按 (x, y, z) 顺序退场,图元的写入顺序有保证; - 有 amplification shader 时:只保证父级 AS 工作组之间的顺序,子 mesh 工作组之间不保证顺序。
这条差别在写"依赖写入顺序"的效果时很致命(比如不用 ROV 就用 UAV 累加、或者靠绘制顺序做覆盖)。判断口径很简单:你要的顺序保证,是不是被 AS 拆散了? 如果拆散了,就得用原子操作、ROV,或者自己把顺序约束写回图里。
1.5 可核对的做法(变体 B)
本篇按系列约定不贴长代码,但给一份可核对的最小清单,照着改就知道自己有没有踩到:
【mesh 管线的 PSO 清单】
1. 不再提供:input layout、index buffer、primitive topology(拓扑由 mesh 自己声明)
2. 需要提供:task / mesh 的 [numthreads]、output signature(顶点属性 + 图元类型)
3. 同步:把 VK_PIPELINE_STAGE_TASK_SHADER_BIT / MESH_SHADER_BIT 加进 barrier 的 stage mask
4. 间接:vkCmdDrawMeshTasksIndirectEXT / ...IndirectCountEXT(数量可由 GPU 决定)
5. 顺序依赖:若依赖绘制/写入顺序,先确认有没有 AS 把顺序拆散(§1.4)
第 5 条是最容易被跳过、也最容易在"偶发花屏"里找回来的那条。
1.6 效果与量化(分口径)
| 数据 | 口径 | 出处 |
|---|---|---|
| Lucy 雕像(27M 三角形,RTX 3090):mesh shader 0.9 ms vs 传统顶点着色 + 32 位索引 1.8 ms | 厂商宣传(场景特定) | NVIDIA 官方开发者博客 |
| 同场景配 16 位索引拆分:mesh 0.8 ms vs VS 1.1 ms | 厂商宣传 | 同上 |
| AMD 侧:顶点着色调用从 143.9k(重复因子 4.13)降到 48.9k(1.40),顶点数 34.8k 不变 | 厂商宣传 | GPUOpen |
| Niagara 粒子:mesh 20.7B 三角形/秒 vs vertex shading 7.4B 三角形/秒 | 第三方实测 | 第三方博客(经 meshlet 综述转述) |
| meshlet 遮挡剔除(GBuffer 单视图):2.75 ms → 1.86 ms,加视锥剔除后 1.64 ms(约 −40%) | 第三方实测(单一场景) | Interplay of Light |
| task shader 是否真能取代硬件细分器 | 尚无定论 | 两方实测汇总(Unterguggenberger) |
读这张表的正确方式是看重复因子那一行:从 4.13 降到 1.40 说明"顶点重用"这件事确实从硬件手里交到了应用手里——省下来的不是算术,是索引处理与重复顶点着色。
出处:DirectX-Specs · Mesh Shader 规范/Microsoft DirectX 博客 · Mesh 与 Amplification Shader 发布/Vulkan · VK_EXT_mesh_shader 提案/NVIDIA · Using Mesh Shaders for Professional Graphics/GPUOpen · Mesh Shaders on RDNA/Sebastian Aaltonen · No Graphics API。
二、绑定模型换了:从"每 draw 重绑"到"一次绑定 + 运行期索引"
2.1 概念:绑定曾经是 draw 的固定成本
2011 年的模型是"槽位制":每个 draw 之前,把常量缓冲、纹理、采样器按槽位绑好;切换材质意味着重新绑定一批资源。这个模型的代价不在 GPU 侧算得多慢,而在提交侧的动作数量——绘制对象越多,绑定调用越多,CPU 侧越先撑不住。
现在的模型把这笔账反过来了:绑定一次巨量描述符,之后靠运行期整数索引去取。Vulkan 生态里这件事的通用名字就叫 bindless:
Descriptor indexing is also known by the term bindless ... we can bind a huge descriptor set once and just index into a large number of descriptors.
2.2 原理:三块砖叠起来才成立
bindless 不是单个扩展,而是三件事叠出来的:
- update-after-bind:描述符在被绑定之后仍可更新——这是"一次绑定、长期复用"的前提,否则每换一次纹理还得重绑;
- 非 uniform 索引:同一个波前(wavefront)内,不同线程可以索引到不同的描述符。这一条是 2011 年模型完全做不到的:当年一个 draw 只有一套绑定;
- GPU 指针:
VK_KHR_buffer_device_address(Vulkan 1.3 起进入核心)让着色器直接持有地址,进一步把"表驱动"变成"指针驱动"。
再往后一步,Vulkan 侧已经出现 VK_EXT_descriptor_heap 这类提案:不再需要 VkDescriptorSetLayout / VkPipelineLayout,而且"no shaders have to be modified to use it"——描述符模型的这几层封装,正在被一层层剥掉。
上一节讲几何前端时提到"责任上移",绑定侧同样如此:绑定成本消失了,但资源生命期与可见性责任上移了。 描述符堆里的一个槽位什么时候指向有效资源、什么时候能被覆写,API 不再替你盯——这正是 ep11 那套同步与生命期规则变得更重要的一部分原因。
2.3 可核对的做法
【bindless 的最小落地顺序】
1. 建一个规模足够大的描述符堆/数组(按纹理数预估上限,留 20% 余量)
2. 打开 update-after-bind(绑定后仍可写)
3. 打开非 uniform 索引(否则同一波前只能走同一个描述符)
4. 索引来源统一:材质表 → 索引 → 描述符堆;或直接存 GPU 指针
5. 生命期:被索引到的资源在"最后一个可能使用它的帧"完成前不得释放(回看 ep11 §4.4 的多帧在飞)
第 5 条是 bindless 最常见的翻车点——它把 ep11 讲的那本"帧内资源账"从"每帧一套 UBO"扩展成了"每帧一套纹理索引"。
2.4 效果与量化
bindless 的收益几乎全部体现在提交侧,而不是 GPU 侧:
- 绑定调用从"每 draw 一次"降到"每帧一次"级,CPU 侧提交开销随之下降;
- 非 uniform 索引让"一次 draw 里用多种材质"成为可能,间接绘制与 GPU-driven 渲染因此才成立(见第三章);
- 代价是驱动要维护更多约束——本轮检索里,官方样例明确演示了"绑定后更新"这一能力,但没有任何官方材料声称它"无成本"。
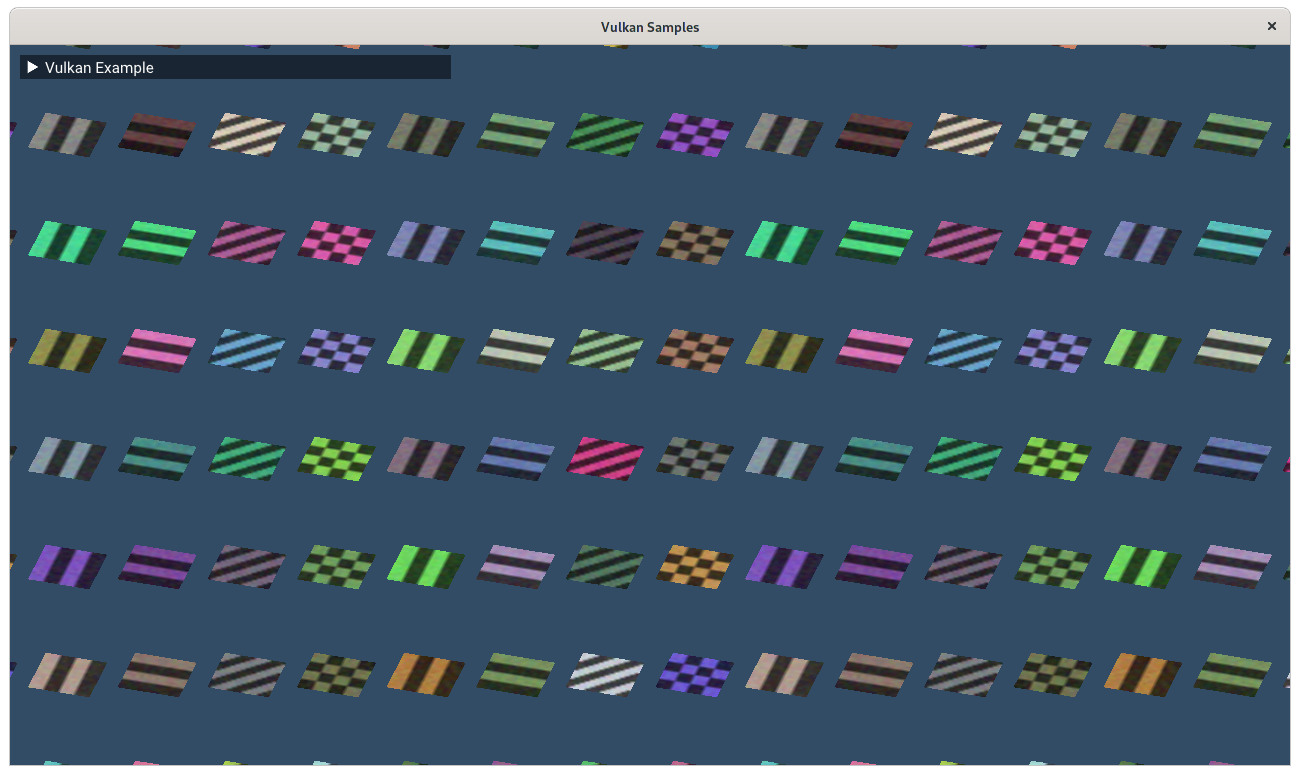
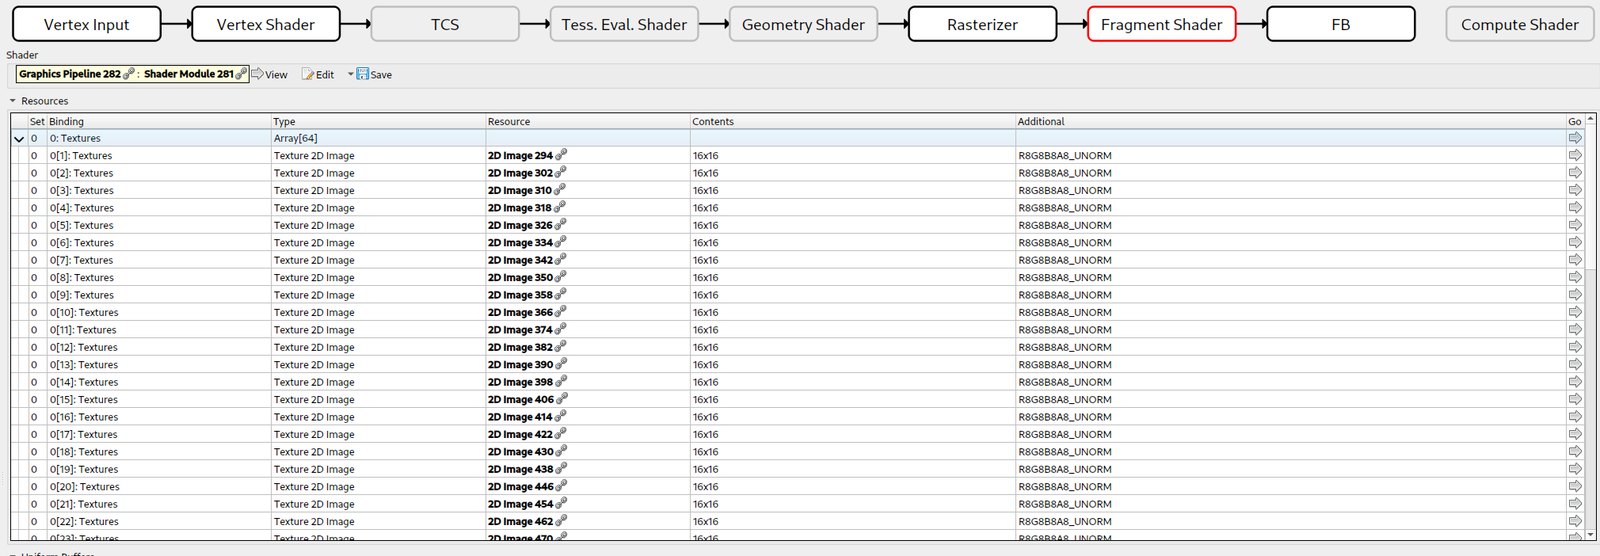
上面两张官方样例图放在一起看,就明白"绑定"这件事的性质变了:左边证明描述符可以在绑定后更新,右边证明同一个波次里的线程可以走不同资源。把两件事合起来,2011 年的"每 draw 一套绑定"这个前提就没了——而 GPU-driven 渲染(下一章)正是建立在这个前提消失之上。
2.5 描述符堆的容量规划与两种索引方式
bindless 落地时有两个必须自己拍的决定,规范不会替你拍。
第一是容量。 堆要按"峰值纹理数 + 余量"建:纹理数组与 mip 链是各占一个槽还是共享一个槽、动态资源(每个 resize 换一批 RT)要不要动态扩张,都直接影响堆大小。留余量的理由很实际——堆一旦用满,回退路径通常是最难写的那个(要么重建堆、要么退回逐 draw 绑定,两条路都要改代码)。
第二是索引方式,这是 bindless 内部真正的技术分岔:
| 方式 | 怎么取资源 | 优势 | 代价 |
|---|---|---|---|
| 整数索引 | 材质表里存索引 → 查描述符堆 | 有边界信息、便于调试与工具观察;换资源只改一个槽 | 多一层间接;索引越界的行为依赖实现 |
| GPU 指针 | 描述符里直接存设备地址(VK_KHR_buffer_device_address) |
少一层间接、组合灵活(可以在着色器里算偏移) | 失去边界检查:越界读会安静地读到别的资源,而不是被拦下 |
选法可以按数据性质分:表驱动的数据(材质、实例、光源)用整数索引,因为它们天然是"一堆同类资源";紧耦合的数据(顶点缓冲、临时缓冲、连续的结构数组)用指针,因为它们是"一段内存里的连续布局"。混用的项目里最常见的翻车是:把指针当索引用、又在指针上做了错误的偏移算术——这类 bug 的表现与 ep11 §8.5 那类"读到旧数据"极其相似,但根因完全不同。
2.6 这一章留下的问题
绑定成本消失之后,下一个瓶颈会前移到哪里?答案是索引数据的生成——材质表、实例表、剔除结果表都由 GPU 侧写出来,而"谁来写、什么时候写完、写完给谁看"就变成了第三章(工作发起)与 ep11(同步)的交界处。这也解释了为什么 GPU-driven 渲染的教科书里,同步与生命期的篇幅往往比绘制本身还长。
出处:Vulkan-Samples · Descriptor Indexing(bindless)/Khronos Vulkan Guide · Descriptor Heap/DirectX-Specs · Indirect Drawing。
三、谁发起工作:ExecuteIndirect 的两条约束,与 work graphs 的节点图
3.1 概念:从"CPU 生成命令"到"GPU 自己请求工作"
2011 年的模型里,命令是 CPU 生成的:CPU 知道要画哪些对象,把命令写进命令缓冲,GPU 顺序消费。GPU-driven 渲染要打破的正是这一条——让 GPU 自己决定"要画什么"。
第一步是间接绘制(indirect drawing):把要画的参数(顶点数、实例数等)放进一块 GPU 可写的缓冲,CPU 只发一条"按这块缓冲画"的命令。DirectX 12 为此引入了 command signature(命令签名)对象,用来描述间接参数缓冲的格式与命令类型;mesh 管线也有对应的 DISPATCH_MESH 类型。Vulkan 侧就是 vkCmdDrawIndirect* 与 vkCmdDrawMeshTasksIndirect* 系列。
但这只是第一步。间接绘制解决了"参数从哪来",没解决"要不要发起、发起几次、用哪套状态"。
3.2 原理:ExecuteIndirect 的两条硬约束
第一条约束写在 Work Graphs 规范里,是官方对旧模型的直接批评:
ExecuteIndirect... forces a serial processing step for the GPU — walking through a GPU generated command list to determine a sequence of commands to issue.
也就是说:GPU 生成的那份"命令列表",仍然要被串行遍历一遍才能确定接下来发哪些命令。并行度在这里被卡住了。
第二条约束由 NVIDIA 在官方博客里点明:
ExecuteIndirectis confined to work under the state it was launched with, most notably the shader specified by the pipeline state object.
间接命令受发起时的管线状态约束。如果你的 GPU 侧数据说"这批对象要用另一个着色器",那就只能反复"改状态 → 再发起间接绘制",一次状态切换一次提交——这又回到了 CPU 侧的记账。
两条约束合起来,划出了 2011 之后"工作发起"这件事的天花板:参数可以来自 GPU,但发起序列与状态仍然由 CPU 侧预先组织。
3.3 原理:work graphs 把"命令列表"换成"节点图"
work graphs 换掉了那份列表。规范的定义是:
a graph of nodes where shader code at each node can request invocations of other nodes, without waiting for them to launch.
三个要点:节点可以请求调用下游(生产者-消费者关系写进图里)、请求之后不必等待下游启动、调度方式交给系统:
Scheduling of work requests can be done by the system with whatever underlying hardware tools are at its disposal ... Less capable architectures might revert to a single processor on the GPU scheduling work requests. More advanced architectures might use distributed scheduling techniques.
这句话的含金量在于它承认了实现分层:能力弱的架构可以退化成"一个处理器统一调度",强的架构可以分布式调度。对读者来说,这意味着"work graphs 的收益因架构而异"是规范自己写着的,不是厂商在找借口。
结构上的硬限制与新增语义单元:
- 图是 DAG,允许节点输出给自己(自递归),递归深度上限 32(含递归);
- 节点类型除了广播 / 合并 / 线程启动三种,还包含 mesh 节点、draw 节点、drawindexed 节点——也就是说,光栅化节点已经被纳入图里,这是第四章"专用单元"与第三章衔接的地方;
- 官方也明确它不是银弹:对某些负载,"continue to use
ExecuteIndirect"仍是更好的选择。
3.4 可核对的做法(变体 B)
把一条典型的"剔除 → 绘制"间接管线改写成节点图,对照关系如下:
【改写对照】
1. ① 剔除 pass(compute)→ 写成 broadcasting/coalescing 节点(按需展开数量)
2. ② 写间接参数缓冲      → 取消:参数直接作为下游节点的输入记录
3. ③ ExecuteIndirect     → 换成 draw / drawindexed 节点(图内部发起,不经 CPU)
4. ④ 材质/着色器切换      → 换成 graph 内的节点分支(不再受"发起时 PSO"约束)
5. ⑤ 依赖与顺序          → 由图的边表达;需要顺序时用 ROV 或原子操作兜住
第 5 条与第一章"光栅顺序被降级"是同一类问题:把顺序保证从硬件隐式承诺,变成你要显式表达的东西。
3.5 效果与量化
| 数据 | 口径 | 出处 |
|---|---|---|
| 延迟着色案例(RTX 4090 / 1920×1080):work graph 0.8–0.95 ms vs uber shader dispatch 0.98 ms | 厂商实测(单案例) | NVIDIA 官方博客 |
| "Work graph execution is not free"——图记录管理与调度本身有开销 | 官方定性 | 同上 |
对某些负载 ExecuteIndirect 仍更优 |
官方定性 | Work Graphs 规范 |
这三行放在一起看,才是这一节该有的结论:work graphs 换掉的是"串行遍历 + 状态预绑定"这两笔固定成本,不是把所有调度都变成免费的。 什么时候值得换?当你的图里存在运行时才知道展开数量的生产者-消费者链时——这正是 Nanite 一类几何管线的最典型形状。
3.6 三种节点类型,与"递归上限 32"的工程含义
work graphs 的节点类型决定了"一个请求如何展开成一批工作",需要逐项分清楚:
| 节点类型 | 语义 | 典型用途 |
|---|---|---|
| broadcasting launch | 请求里带一个数量,展开成该数量的调用 | 剔除节点说"这批 37 个 meshlet 可见",下游展开 37 次 |
| coalescing launch | 多个请求被合并成固定数量的调用 | 大量小请求需要合并处理(如汇总计数、批量分配) |
| thread launch | 一个线程一个调用,粒度最细 | 逐元素处理(如逐光源裁剪) |
在它们之上还有 mesh / draw / drawindexed 节点——这是"光栅化进图"的具体形式:几何处理与绘制不再由 CPU 侧的间接命令触发,而是图的节点。
"递归深度上限 32"这条限制比它看起来重要。 它意味着图的深度是预算:如果你的算法想在图上做层次化的多级展开(剔除 → LOD 选择 → 簇生成 → 绘制),每一级都要吃深度。深度用完就得改结构——把"继续往下递归"改成"写一个中间列表、下一帧或下一阶段再展开"。换句话说:
work graphs 把"命令的串行遍历"换成了"图的深度预算"——省下的是遍历时间,付出的是"深挖只能到 32 层"这个结构性约束。
这一点在调试上同样成立:图越深,"一次绘制到底是被谁请求的"越难追。实践建议是把深度控制在个位数级,把复杂逻辑放进节点内部而不是堆层级。
3.7 这一章留下的问题
work graphs 把"谁发起工作"交回给 GPU 之后,CPU 的角色去哪了?官方博客给的答案很直接:CPU 的重心正在从"生成命令"转向"资源管理与依赖追踪"("the role of the CPU is trending towards primarily resource management and hazard tracking")。也就是说,本篇第二、三章的变化合起来,把应用侧的工作从"逐 draw 组织提交"改成了"组织数据与保证正确性"——这也是为什么 ep11 那套同步与生命期知识,在 2026 年比在 2011 年更重要。
出处:DirectX-Specs · Work Graphs 规范/Microsoft DirectX 博客 · D3D12 Work Graphs/NVIDIA · Work Graphs: A Case Study of Deferred Shading/NVIDIA · Advancing GPU-Driven Rendering with Work Graphs/DirectX-Specs · Indirect Drawing。
四、专用单元进来了:求交被做成硬件
4.1 概念:一条与"可编程化"相反的路
第一章到第三章讲的都是同一个方向:把固定功能拿掉,交给可编程阶段。光追硬件是反着来的——它把一件事做成固定的专用单元。
2011 年的 GPU 里没有"求交"这种单元,射线与三角形求交只能由着色器程序自己做,遍历一棵包围体层次(BVH)也全靠指令。2018 年之后,BVH 遍历与光线-三角形求交被搬进了 SM 里的专用硬件。NVIDIA 图灵白皮书的原话是:RT Core 代表 SM 中的线程做可见性测试("RT Cores perform visibility testing on behalf of threads running in the SM")。
这个方向的转变值得单独标一笔:"更可编程"不是唯一的技术演进方向。当一件事足够常用、足够规则、又足够贵时,把它做成专用单元的收益会超过灵活性。
4.2 原理:两级加速结构与两种调用方式
DXR 规范给出的两级结构是:
two levels of acceleration structures: Bottom-level acceleration structures each consist of a set of geometries ... A top-level acceleration structure represents a set of instances of bottom-level acceleration structures.
- BLAS(底层加速结构):装几何——可以是三角形网格,也可以是用 AABB 描述的过程图元;
- TLAS(顶层加速结构):装实例——每个实例引用一个 BLAS 并带自己的变换。
两级拆开的价值在更新频率:静态几何的 BLAS 建一次长期可用,而每帧变化的实例变换只更新 TLAS 那层。这是加速结构的工程账,也是为什么"动态物体多"的场景更吃 TLAS 更新。
调用方式有两代:
- SBT 派发模型(DXR 1.0 /
VK_KHR_ray_tracing_pipeline):命中后走 shader binding table 找对应的命中着色器,好处是结构清晰,代价是组织复杂; - inline ray query(
VK_KHR_ray_query,规范里的OpRayQueryProceedKHR):在任意着色器里内联发起求交,不进入 SBT 派发模型。这一条让光追从"独立管线"变成了"着色器里的一种操作"。
4.3 参数与新增资源类型
- RT Core 的吞吐:Ada 第三代 RT Core 的 ray-triangle 相交吞吐相对上代为 2×(厂商宣传口径);
- 不透明微图(Opacity Micro-Map):Ada 引入,规范侧有
VkAccelerationStructureTrianglesOpacityMicromapKHR/EXT——用来快速判断"这次命中是不是真的命中",省掉为透明度走一遍着色; - 专用层级的代价:专用单元带来的是新的资源类型与新的同步需求——加速结构要构建(build)、要更新(update)、要在使用前完成可见性交接。ep11 那套"资源生命期"的规则,在这里多了一类对象。
4.4 代价:发散是固有成本
RT Core 替线程做遍历与求交,但着色仍然是线程的事。光追的经典形态是"相邻线程打到完全不同的材质/几何",于是同一个波前里线程走不同的分支、访问不同的数据——发散(divergence)。这不是 RT Core 的缺陷,而是它的固有形态,也直接催生了下一章那个机制:把发散的工作重排回来。
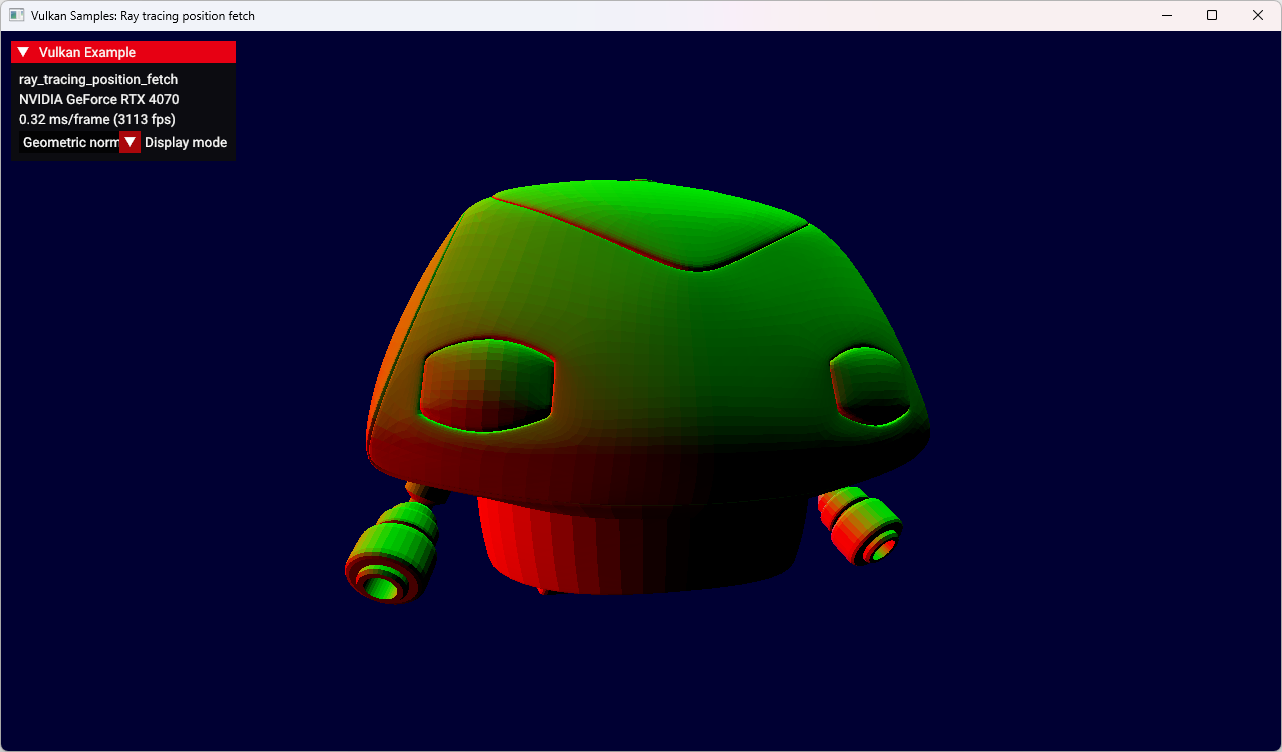
4.5 效果与量化
| 数据 | 口径 | 出处 |
|---|---|---|
| Ada 第三代 RT Core:ray-triangle 相交吞吐 2× | 厂商宣传 | NVIDIA 产品页 |
| 加速结构仍是"新资源类型"(构建/更新/可见性) | 规范事实 | DXR 规范、Vulkan 光追章节 |
| inline ray query 可绕过 SBT 派发 | 规范事实 | VK_KHR_ray_query / 规范 OpRayQueryProceedKHR |
出处:DirectX-Specs · Raytracing 规范/Microsoft DirectX 博客 · 发布 DXR/NVIDIA Turing 架构白皮书/Vulkan 规范 · Ray Tracing 章节。
4.6 加速结构的三种操作与 SBT 的组织
专用单元带来的不只是一次求交调用,还有一套资源生命周期操作。加速结构上最常见的三种操作,代价与用途完全不同:
| 操作 | 做什么 | 何时用 | 代价特征 |
|---|---|---|---|
| build(构建) | 从几何数据从头建一棵 BVH | 静态几何首次建、拓扑变化 | 最贵,通常配合异步计算或专用队列 |
| update(更新) | 复用已有拓扑、只更新顶点位置 | 每帧形变(蒙皮、布料、植被摆动) | 比 build 便宜,但频繁 update 会让树质量下降 |
| compact(压缩) | 把构建期的临时空间压成紧凑块 | 构建完成后一次性做 | 换来显存占用下降,之后不能再 update |
三者之间的取舍就是加速结构最实用的一条工程规则:需要每帧 update 的地理/角色几何走 update;不需要动的静态几何走 build + compact(省显存、遍历也更快);而长期只 update 不重建,遍历效率会持续退化——所以要留一条"周期性重建"的策略。
SBT(shader binding table)的组织方式则是另一类坑。它本质是一张表,把"哪个实例 × 哪个几何 × 哪种命中"映射到一段着色器记录上。三件容易写错的事:
- 索引偏移:命中组、几何索引、实例偏移三者叠加算出来的位置,任何一项写错都会让你落到另一段着色器上(表现是"画面莫名其妙用了别的材质逻辑",而不是崩溃);
- 记录对齐:记录大小与对齐要求由硬件能力决定,跨平台时不能假定一个固定值;
- 与内联求交的分工:
VK_KHR_ray_query那一路不走 SBT,所以项目里常常两种方式并存——能用内联的地方别硬塞进 SBT,省下一层间接与一张表的维护。
最后把这一章挂回 ep11 的那本账:加速结构也是资源,构建/更新之后要使用它,同样需要一次可见性交接(写端 make available、读端 make visible)。这不是可有可无的礼节——它是"专用单元"给应用新增的那部分同步责任。
五、固定功能的按需降级:VRS、fragment density map 与 SER
5.1 概念:不是砍掉固定功能,而是让它可调
第四章的专用单元是"加东西",这一章是第三种变化形态:固定功能还在,但它从"一律按最高速率执行"变成了"按区域、按图元、按需调低"。
官方对这个方向的动机写得很直白:分辨率从 4K 到 8K 让性能需求涨 4 倍,而"this extra pixel fidelity is not necessarily perceptible"(这些额外的像素保真度并不一定被感知到)。于是在"必须渲染"和"不必那么认真地渲染"之间,硬件开出了一个可调旋钮。
5.2 原理:VRS 的三档控制点
Vulkan 的 VK_KHR_fragment_shading_rate 给了三档控制粒度,理解这三档就理解了这一类机制的全貌:
| 档位 | 控制方式 | 典型用途 |
|---|---|---|
| per-draw | VkPipelineFragmentShadingRateStateCreateInfoKHR 或动态 vkCmdSetFragmentShadingRateKHR |
整批对象统一降速率(如远处水面、半透明雾) |
| per-triangle | provoking vertex 上写出 PrimitiveShadingRateKHR |
同一个模型里近处 1×1、远处 2×2 |
| per-region | VkFragmentShadingRateAttachmentInfoKHR + 一张 shading rate attachment(texel 尺寸受 min/max 与长宽比限制) |
按屏幕区域分配速率——VR 的中心清晰 / 边缘降速最典型的用法 |
三档不是互斥的,它们通过 combiner ops(KEEP / REPLACE / MIN / MAX / MUL)合成,最终速率还受 maxFragmentSize 与 maxFragmentSizeAspectRatio 上限约束。
这里有一处工程细节值得记下来,因为它是跨 API 移植的真实坑:Vulkan 用线性值做 MUL,而 D3D 的 VRS 用 log2 位标志相加,语义并不一致,于是规范里专门引入了一个限制项 fragmentShadingRateStrictMultiplyCombiner 来对齐——同一套想法,两套 API 的乘法不在同一个数域里。
5.3 原理:fragment density map 与 SER
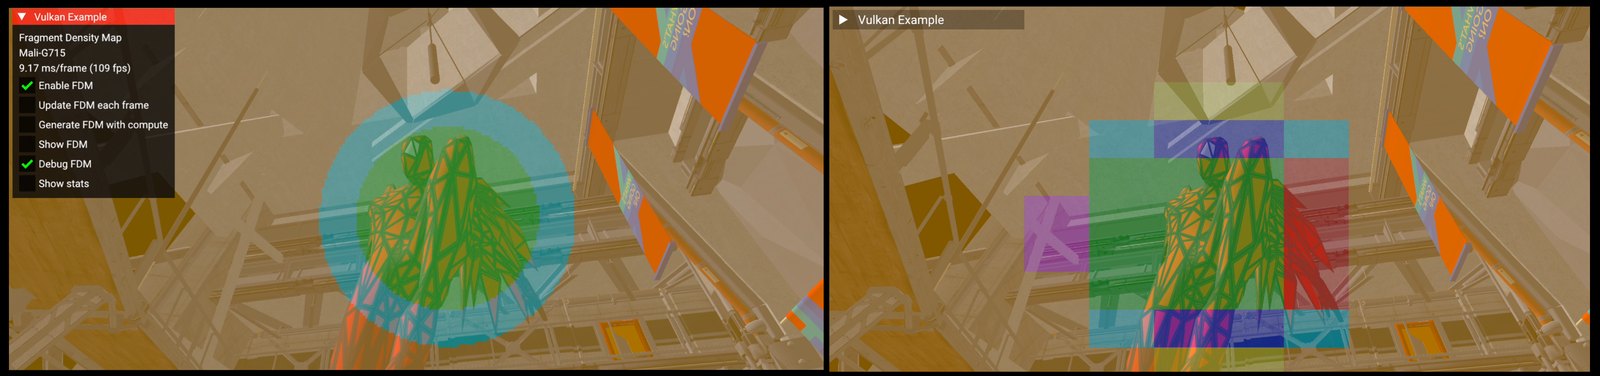
fragment density map(FDM) 是 per-region 那一档的移动/VR 变体:用一张"密度图"告诉硬件屏幕上每个区域该按什么密度着色。它解决的是同一个问题——视野边缘不值得按中心的分辨率着色。
shader execution reordering(SER) 解决的是第四章留下的那个代价。Ada 白皮书的定义是:SER 是一套新的调度系统,可以在飞行中重排着色工作("reorders shading work on-the-fly"),以改善执行与数据局部性。翻成大白话:把发散的线程攒成同质的批次再执行,让同一个波前里的线程尽量干同一件事。
5.4 效果与量化(分口径)
| 数据 | 口径 | 出处 |
|---|---|---|
| VRS + NAS 组合:FPS 最高 +15% | 厂商宣传 | NVIDIA Adaptive Shading |
| VRS 的官方定性:"essentially free of charge" 的性能提升 | 官方定性(无倍数) | Microsoft VRS 文档 |
| Gears 的 VRS Tier 2 落地(跨 Xbox Series 与 PC) | 第一方落地案例 | Microsoft DirectX 博客 |
| SER:RT shading 最高 3×、游戏帧率最高 +25% | 厂商宣传 | NVIDIA Ada 产品页 |
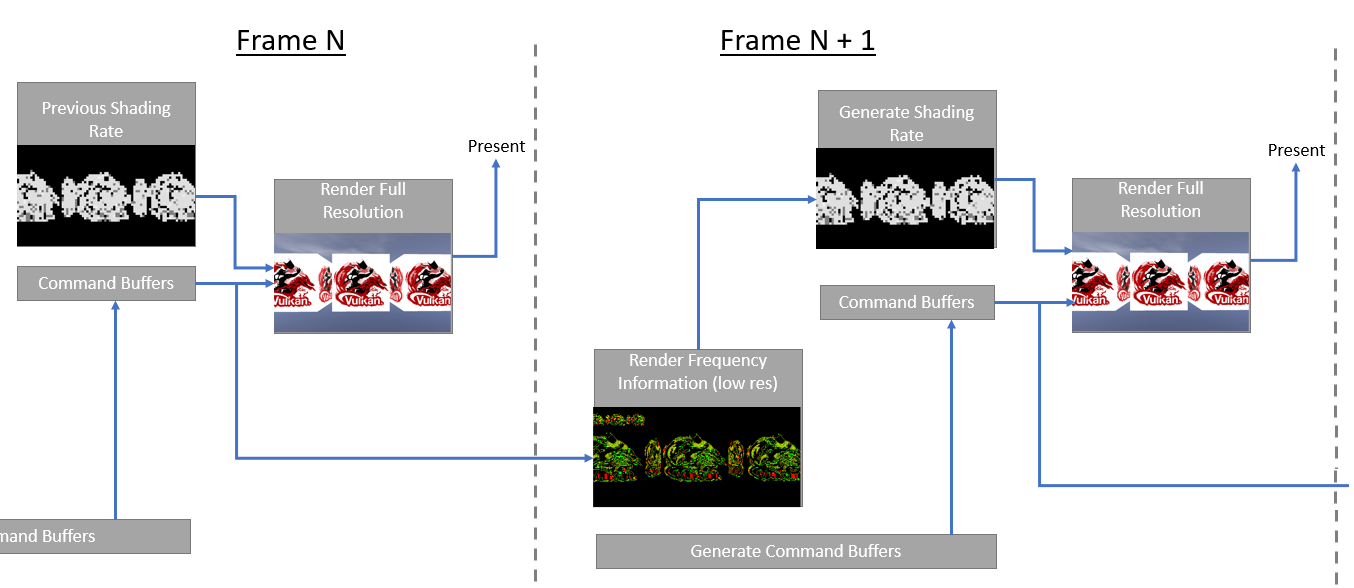
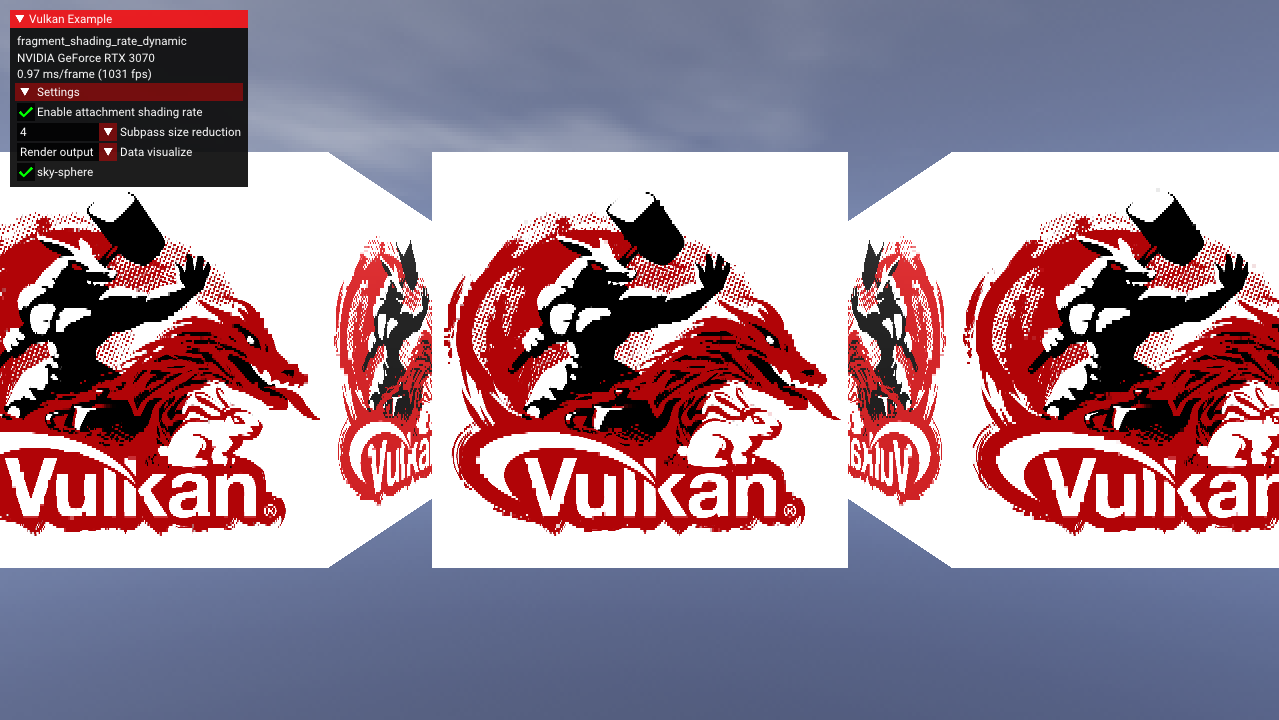
上面两张官方样例图连起来看,就是一个完整的"这一类变化"的样本:原理图说明旋钮在哪,效果图说明旋钮拧下去画面长什么样。它们与第一章的 mesh shader 图、第二章的 bindless 图属于同一类证据——真实素材来自官方样例仓库,而不是我们的示意图。
出处:Vulkan · VK_KHR_fragment_shading_rate 提案/Microsoft Learn · Variable Rate Shading/Microsoft DirectX 博客 · Gears 的 VRS Tier 2/NVIDIA · Adaptive Shading 深度解读/NVIDIA Ada 架构白皮书。
5.5 三档冲突时怎么合成:一个必须算清楚的例子
VRS 的三档可以同时生效,于是"最终速率是谁说了算"必须算清楚——这也是 combiner 存在的意义。假设同一批像素上同时有以下三个来源:
| 来源 | 声明的速率 | 谁提的 |
|---|---|---|
| per-draw | 2×2 | 材质说"这批是半透明雾,降一档" |
| per-triangle | 1×1(远景三角形声明"我精算") | 顶点着色器在 provoking vertex 上写出 |
| per-region | 4×4(屏幕边缘区域) | shading rate attachment 提的 |
三档的合成不是取最小值,也不是简单相乘,而是按 combiner 的声明逐对合成:MIN 会取最精细的(1×1)、MAX 取最粗的(4×4)、MUL 把两个方向的倍率乘起来(2×2 与 4×4 相乘会撞上 maxFragmentSize 上限)。所以同一份数据,换一个 combiner,最终画质与性能可以差好几倍。
这里还埋着 §5.2 提过的那个坑:Vulkan 的 MUL 在线性值上做、D3D 的 VRS 在 log2 位标志上相加,同一套"相乘"的直觉在两套 API 里落到的数域不同。写成代码就是:
【合成顺序与注意事项】
1. 先算 per-draw × per-triangle(同一批内部)
2. 再与 per-region 合成(屏幕级)
3. 每步后检查是否越过 maxFragmentSize / maxFragmentSizeAspectRatio
4. 要"最精细者胜"就声明 MIN;要"最粗者胜"用 MAX;跨 API 时先确认 MUL 的数域
5. 降速率后务必复核依赖像素精度的效果(自定义插值、某些后处理)
第 5 条是实践中最容易漏的一步:VRS 不改变你的着色器逻辑,只改变它被执行的密度——所以任何"按像素做微积分"的效果(导数、邻域采样、逐像素抖动)都要重新验证一遍。
六、管线与渲染目标模型显式化:把硬件内部的约定搬到 API 表面
6.1 概念:2011 的"预先声明"模型
2011 年的模型里有两条"预先声明"的约定:渲染目标集合在管线创建时确定(render pass 与 attachment 要提前声明),以及片上内存(tile memory)是硬件内部的事——应用不需要知道数据待在片上还是落到显存里。
第六章这一类变化,方向都是把这两条约定从硬件内部搬到 API 表面。它不改硬件能力,改的是暴露方式。
6.2 原理:dynamic rendering
VK_KHR_dynamic_rendering 对应的核心入口是 Vulkan 1.3 的 vkCmdBeginRendering:attachment 在命令期指定,而不必在管线创建时定死。配套的 VkPipelineRenderingCreateInfo 也进入了 1.3 核心,管线只需要知道格式,不必与某一个 render pass 对象绑定。
这件事的直接收益在工程侧:render pass 与 pipeline 的排列组合爆炸被消掉了。以前"同一个管线配不同 attachment 组合"要各建一份兼容对象,现在只要格式兼容就能复用。
6.3 原理:片上内存显式化(transient 与 input attachment)
Vulkan Guide 关于 TBR 最佳实践给出一条很实在的建议:只在一个 render pass 内存活的数据,应标记为 transient attachment(VK_IMAGE_USAGE_TRANSIENT_ATTACHMENT_BIT)并配 VK_MEMORY_PROPERTY_LAZILY_ALLOCATED_BIT——"某些 GPU 可以完全不分配物理系统内存",数据"只存在于片上内存"。
官方样例(subpasses)把反面也演示清楚了:没有设 transient / lazily allocated 时,fragment job 会增加,因为数据必须写回外部内存。也就是说,这一节讲的"显式化"不是学术问题,它直接决定 tile 架构省不省带宽。
6.4 原理:管线模型的两端——GPL 与 shader object
管线抽象本身也在被拆。VK_EXT_graphics_pipeline_library 的官方动机是"monolithic compilation very slow":把图形管线拆成可以独立编译、独立链接的部件,先把贵的部分编好,剩下的运行期链接。它的 prior art 是给光追管线用的 VK_KHR_pipeline_library——同一个想法先在光追侧验证,再搬到图形侧。
反方向则是 shader object:连"预先整体创建 PSO"这个前提都取消,着色器按需指定。GPL 是把大对象拆小,shader object 是把固定对象变活。 这两条路都不改变硬件的执行方式,改的都是"什么时候编译、什么时候确定状态"的时序。
此外还有一类更彻底的显式化:sparse / tiled resources——物理页按需挂接,虚拟地址连续、物理页可以稀疏。它把"内存是否真的分配了"这件事也交到了应用手里(虚拟纹理、流式加载的基础)。
6.5 可核对的做法(变体 B)
【从 render pass 迁到 dynamic rendering 的检查清单】
1. 管线创建:换成 VkPipelineRenderingCreateInfo(只声明格式)
2. 命令录制:vkCmdBeginRendering / vkCmdEndRendering 包住绘制
3. layout:自己负责在 begin 之前把 image 切到 COLOR_ATTACHMENT_OPTIMAL(回看 ep11 §4.1)
4. 片上数据:标记 TRANSIENT + LAZILY_ALLOCATED,否则等于放弃 tile 省带宽
5. 兼容性:多线程录制时确认 attachment 的 layout 转换不跨线程冲突
第 3、4 两条是迁移中最常见的回归点:dynamic rendering 把"谁负责 layout"从驱动挪到了应用,而 transient 标记一漏,省下来的带宽会原样还回去。
6.6 效果与量化
| 数据 | 口径 | 出处 |
|---|---|---|
| transient + lazily-allocated:某些 GPU 可完全不分配物理系统内存,数据只存在于片上 | 官方文档 | Vulkan Guide · TBR Best Practices |
| 不设 transient:fragment job 数量增加(数据要写回外部内存) | 官方样例说明 | Vulkan-Samples · subpasses |
| GPL 的动机是"单体编译太慢" | 官方动机 | VK_EXT_graphics_pipeline_library 提案 |
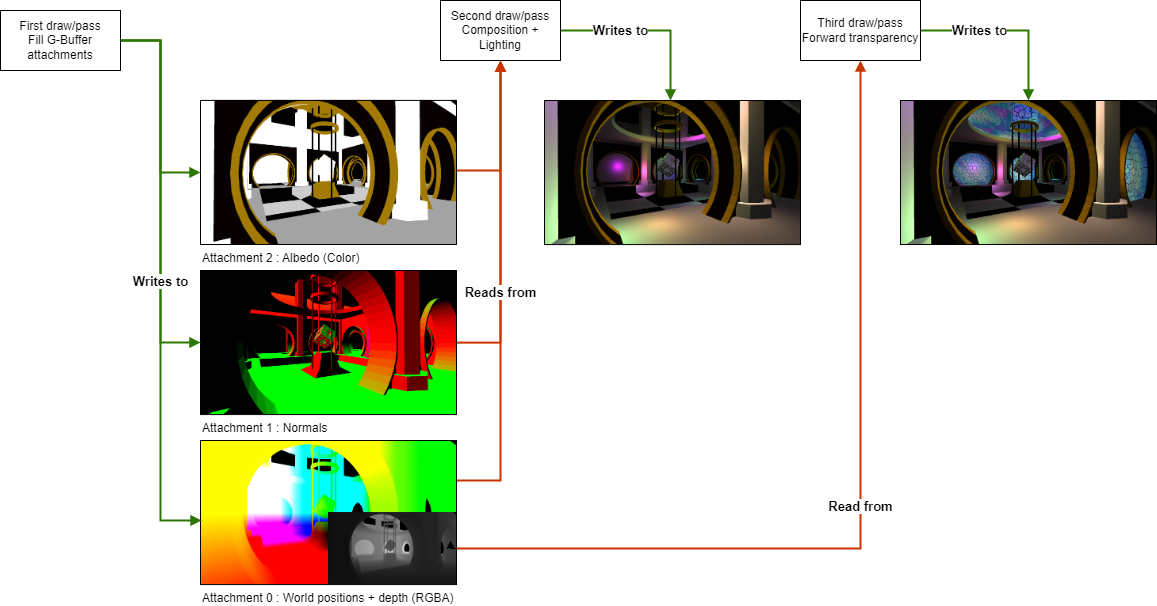
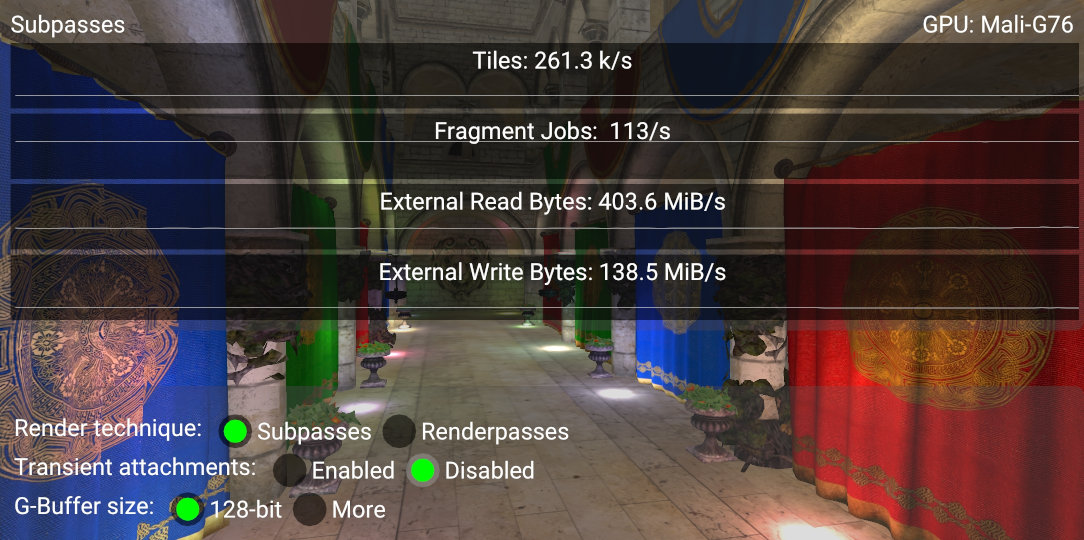
上面两张图对应 6.2 与 6.3 两条原理:第一张是"attachment 什么时候确定",第二张是"数据待在哪一级存储"。把这两件事都显式化之后,2011 年那句"渲染目标集合在管线创建时确定"就正式作废了。
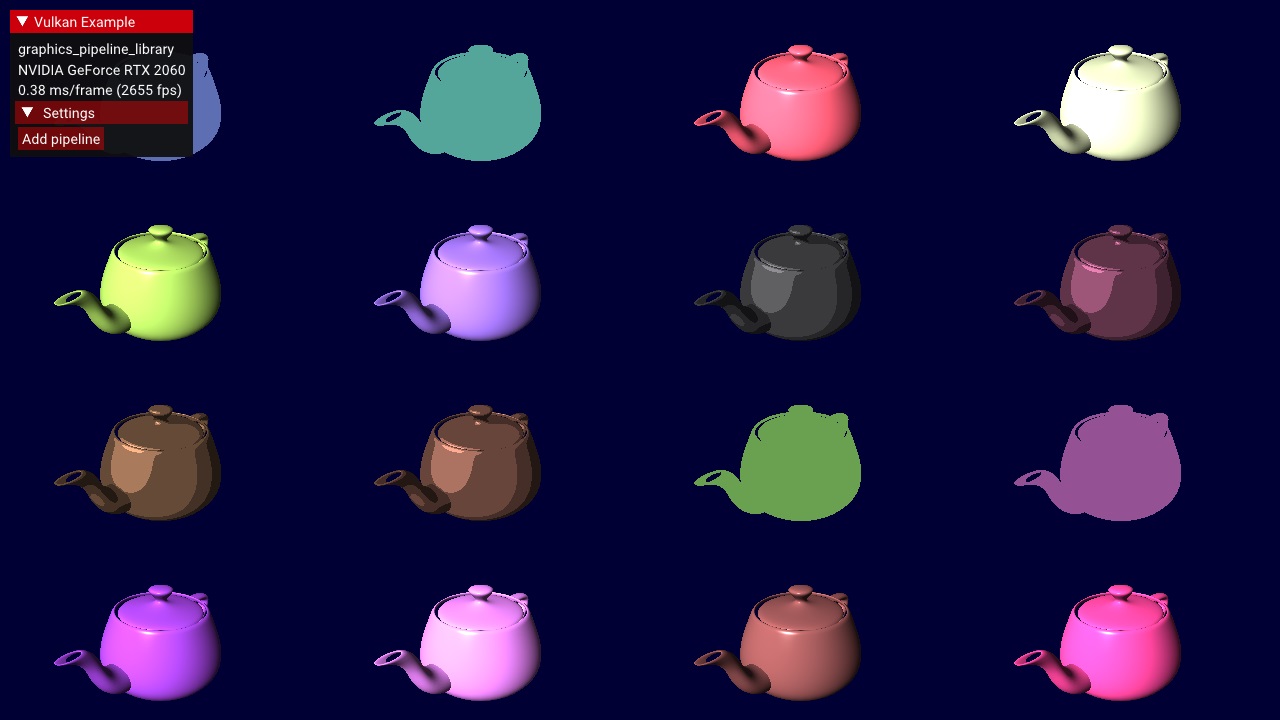
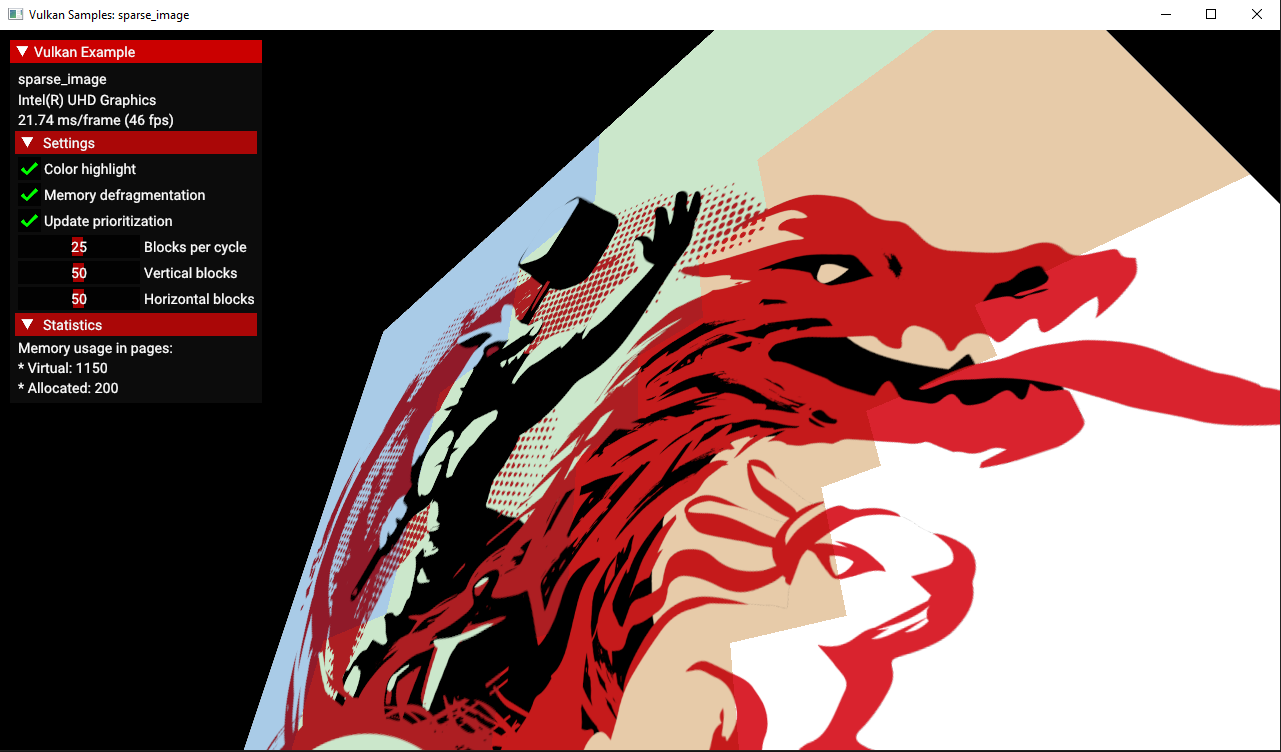
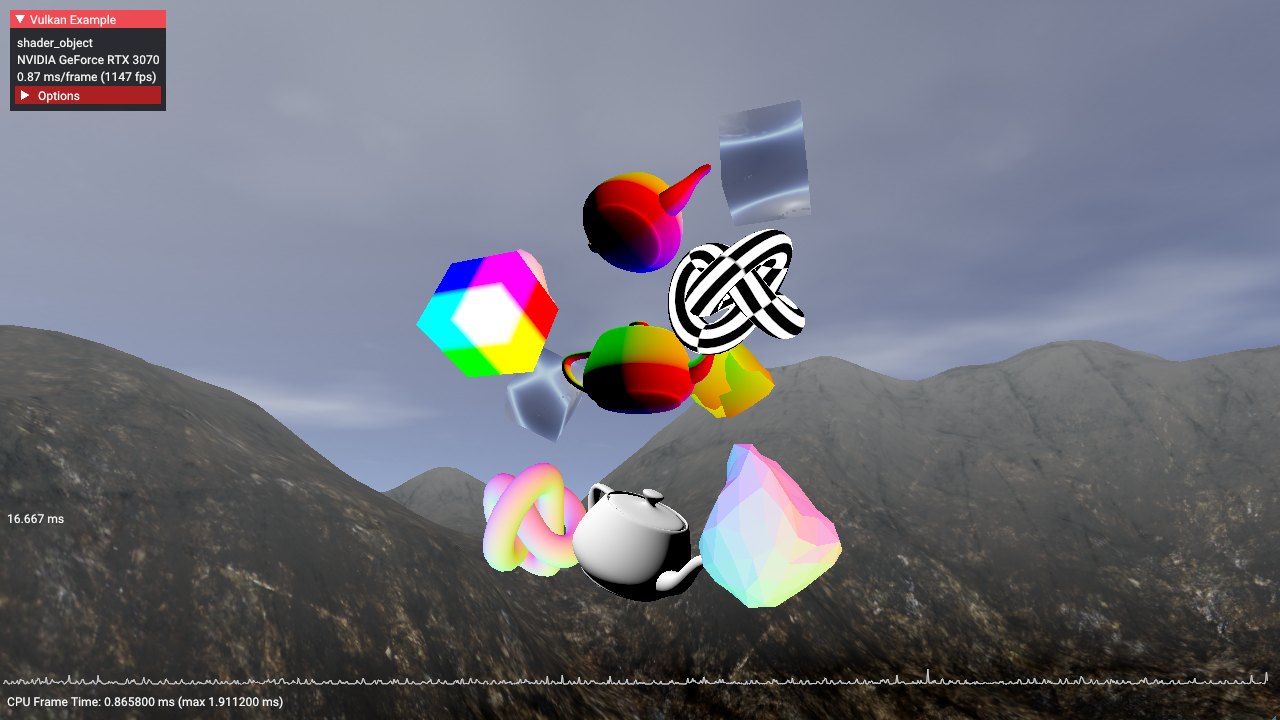
上面三张图放在一起,是"管线与资源控制权上移"这条线的三种强度:拆开编译(GPL)、按页挂接(sparse)、取消预创建(shader object)。它们的共同点是把原本由驱动做主的时序决定权交还应用——这与第一章"IA 关闭后顶点重用上移"是同一件事的不同侧面。
出处:Vulkan · VK_KHR_dynamic_rendering 提案/Vulkan 规范 · Render Pass 章节/Vulkan refpage · VK_VERSION_1_3/Vulkan Guide · Tile-Based Rendering 最佳实践/Vulkan-Samples · Subpasses/Vulkan · VK_EXT_graphics_pipeline_library 提案。
七、硬件形态本身变了,但编程模型没变
7.1 概念:这一章讲的是"另一类变化"
前面六章的变化都能被应用看见:多了一个阶段、换了一种绑定方式、多了一类资源。这一章讲的变化应用看不见——它发生在封装、互连与存储介质层面。
这一节之所以必须单独成章,是因为它最容易被写成"参数罗列",而它真正的价值恰恰相反:硬件形态大改,编程模型却没动。这本身就是"哪些没变"的最强证据。
7.2 chiplet:两颗 reticle 尺寸 die,对外仍是一颗设备
Blackwell 的官方描述是:由两颗 reticle 尺寸的 die 组成,通过自研互连 NV-HBI 连接,带宽 10 TB/s,TSMC 4NP 工艺,2080 亿晶体管(约为 Hopper 的 2.6 倍)。官方同时强调它"functioning as a single, NVIDIA CUDA-programmed accelerator"、"one fully coherent, unified GPU"。
对应用侧来说,这段描述里最关键的词是"single"与"unified":die 之间的边界不暴露给编程模型。跨 die 的通信由互连硬件承担,着色器里没有"这是远端 L2"这种概念。
上面这张图想说的是:在过去十几年里,最激进的一次硬件形态变化,恰好是对编程模型最透明的一次。 如果哪天你的着色器里开始出现"跨 die 的访问要比本地慢"这类概念,那才说明形态变化终于渗进了编程模型——截至本篇写作时,它还没有。
7.3 HBM:显存形态的变化
显存是这十几年里变化最直观的一处。三星的官方数据:HBM4 已量产,传输速率 11.7 Gbps(可达 13 Gbps),采用 4nm 逻辑 base die;官方 infographic 给出 I/O 引脚 2048(HBM3E 为 1024 的两倍)、单 stack 带宽约 3.3 TB/s(约为 HBM3E 的 2.7 倍)。
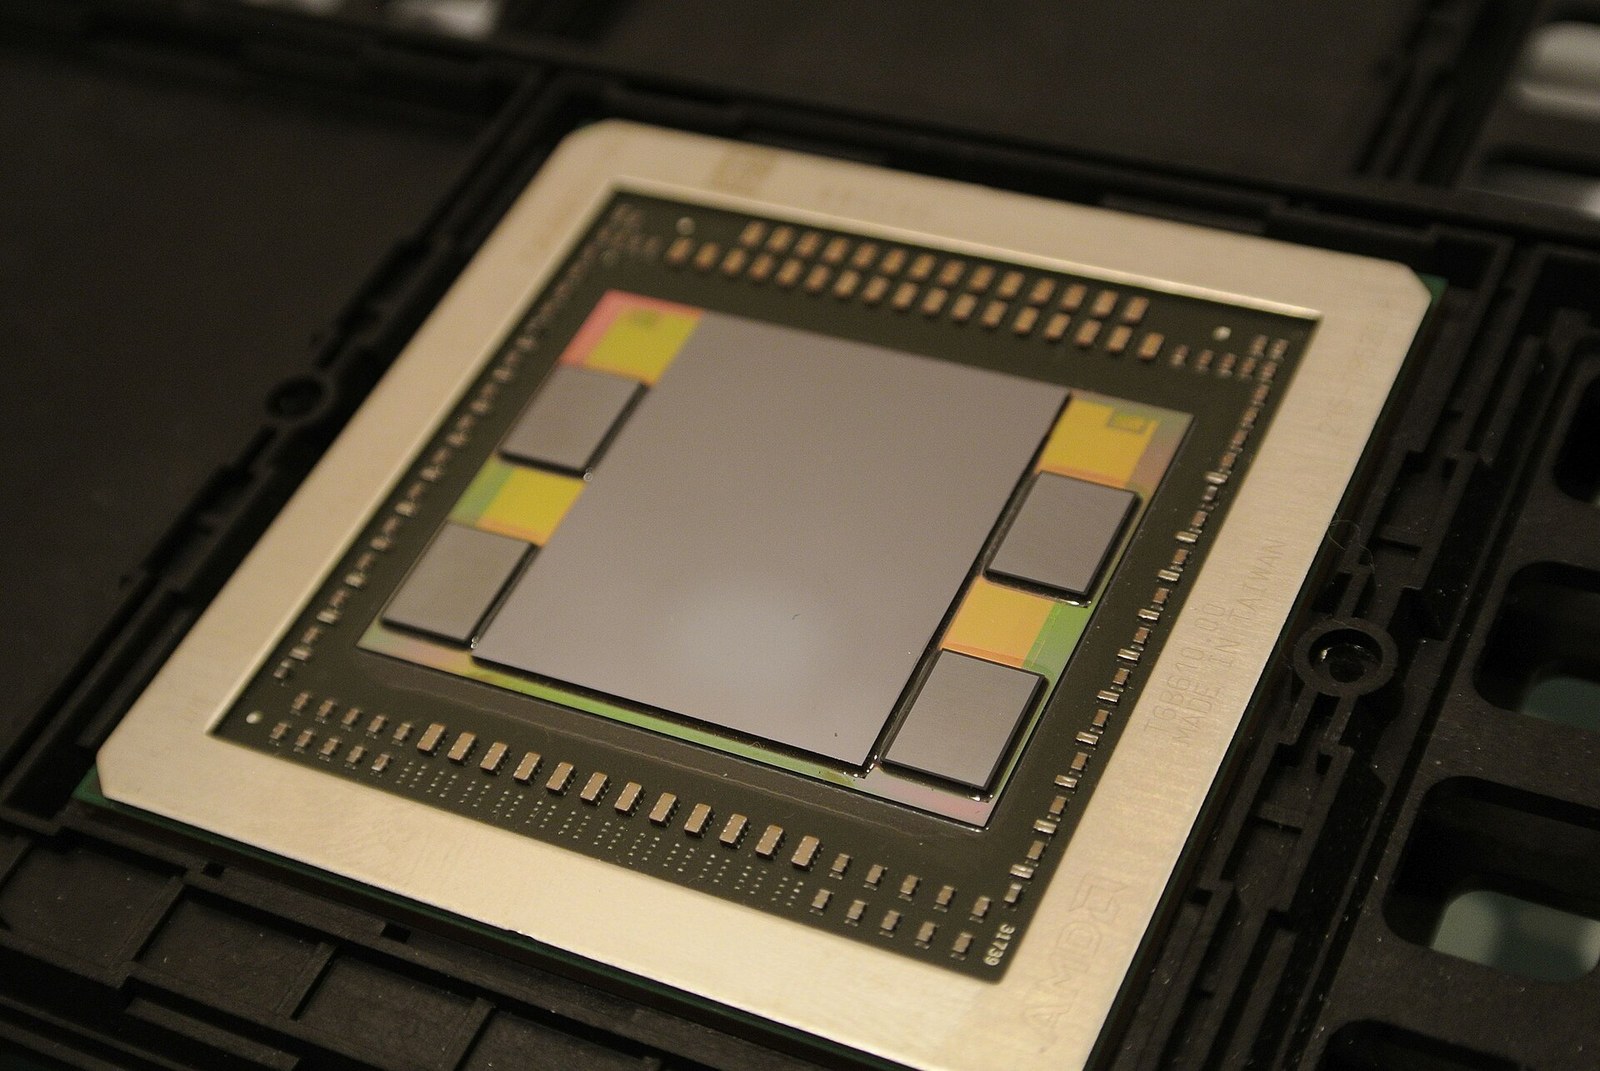
这张实物值得对着 §7.5 那几行数字一起看:引脚数与堆栈数决定了带宽量级,中介层决定了"这些堆栈能离 GPU 多近"。 而对应用来说,这一整套变化的结果只是"VkDeviceMemory 那一侧变快了",接口一个字没改。
7.4 缓存与压缩:带宽缺口的两条路
带宽需求涨得比带宽快,业界的两条解法都在这一层:
- 更深的缓存层次:AMD 从 RDNA 2 起引入 Infinity Cache 一级(官方材料把"Memory Bandwidth is scarce"作为前提,用 Compression + Caches 两条路径降低带宽需求);
- 更省的表示:帧缓冲压缩。Arm 的 AFBC 官方口径是无损压缩、可把系统级带宽与功耗成本降低最多 50%;Linux 内核文档给的定义更工程化——"a proprietary lossless image compression protocol and format",并提供细粒度随机访问。AMD 侧的 DCC(Delta Color Compression)同样是无损、块级压缩:块内只存一个全精度值,其余存 delta。
7.5 效果与量化(分口径)
| 数据 | 口径 | 出处 |
|---|---|---|
| Blackwell:双 reticle die、NV-HBI 10 TB/s、2080 亿晶体管、"one fully coherent, unified GPU" | 厂商宣传 | NVIDIA 官方 |
| HBM4:11.7 Gbps(可达 13)、2048 引脚、单 stack 约 3.3 TB/s(≈2.7× HBM3E) | 厂商宣传 | Samsung 官方 |
| AFBC:系统级带宽与功耗成本最多降 50%(无损) | 厂商宣传 | Arm 官方技术页 |
| DCC:无损、块级、delta 存储 | 厂商文档 | GPUOpen |
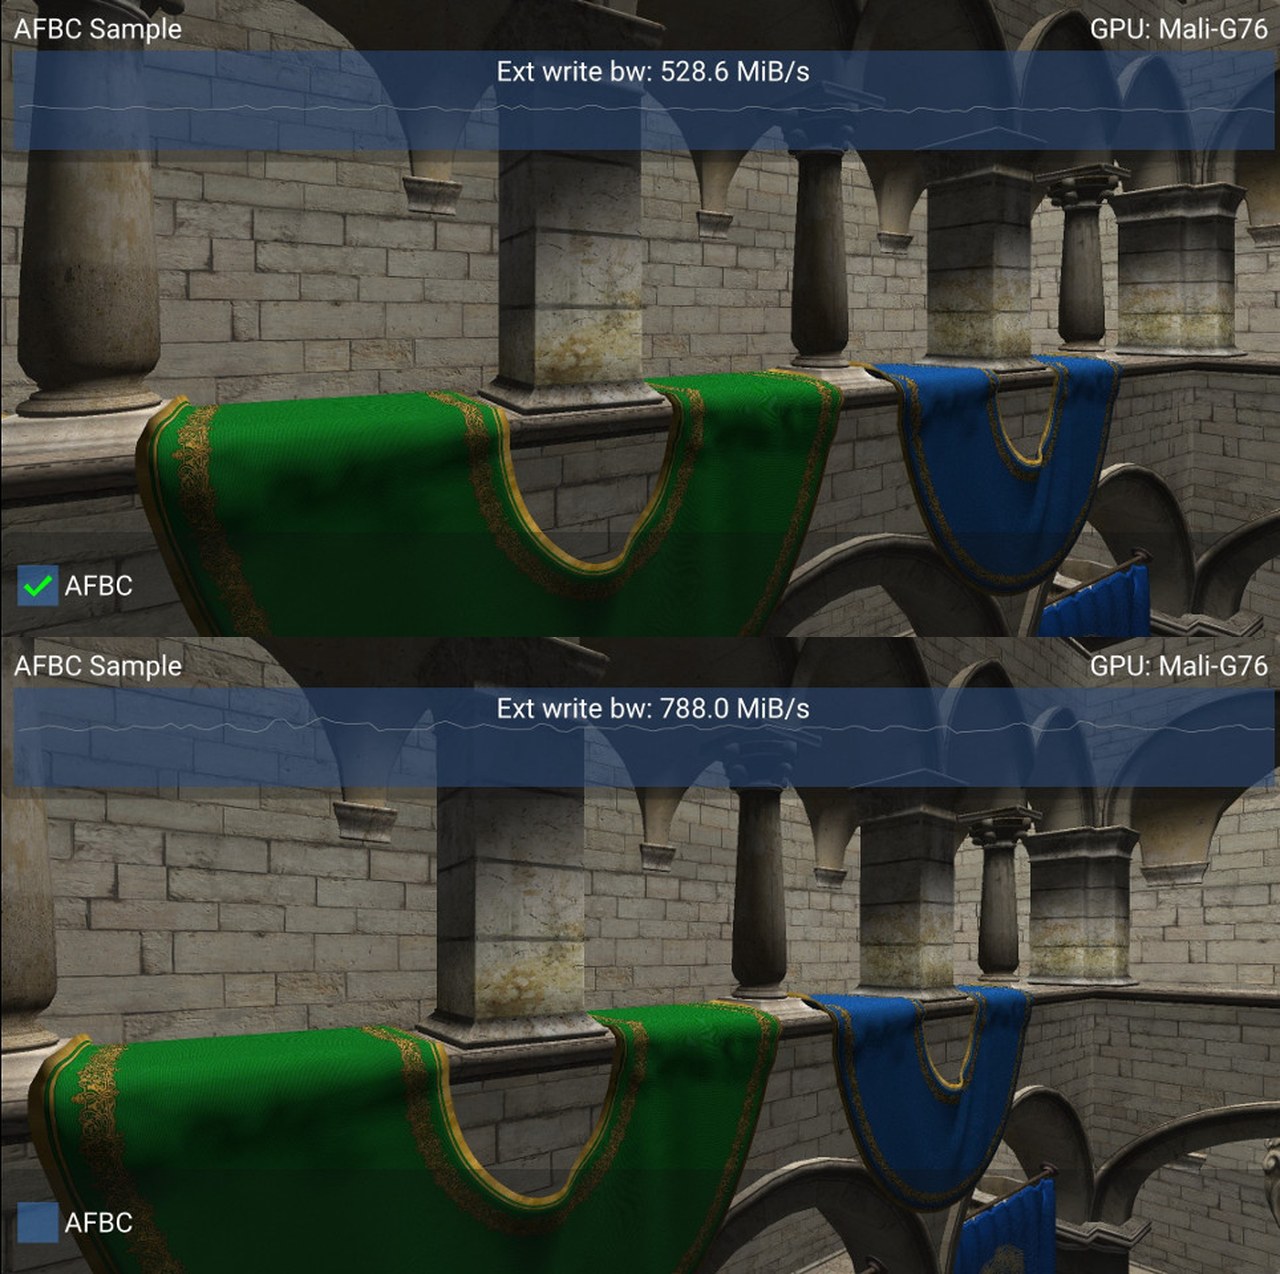
这张对照图值得单独看一眼:它把"压缩"从纸面参数变成了同一场景下开关一次的实测差异。这一类素材正是本篇要强调的——能拿实测图证明的,就不要只给数字。
7.6 一个量级算例:一帧的带宽账长什么样
硬件形态变了这么多,最终都要落到一个问题上:一帧到底要搬多少数据? 这里做一个纯算术的量级估算(推导,不是实测,只为建立数量级感觉):
【1920×1080、单目标 32 位色、60 fps 的最粗估算】
1. 单张目标:1920 × 1080 × 4 B ≈ 8.3 MB
2. 若一帧依次写/读同一张目标 4 次(渲染 → 后处理 A → 后处理 B → 呈现)
   → 8.3 MB × 4 ≈ 33 MB/帧
3. 乘 60 fps → ≈ 2 GB/s
4. 每多一个中间目标(G-Buffer、AO、反射)就再加一份同样量级
5. 若同时上采样到 4K,第 1 步直接变成 33 MB/帧 → 上述数字整体 ×4
这张账里能看出三件事,也就解释了第七章这两条路为什么重要:
- 中间目标的个数比分辨率更敏感:把 4 个 pass 合成 2 个(或用 input attachment 让数据留在片上),省下的是整份 8.3 MB 级的读写;
- 压缩的收益直接乘在这条账上:AFBC/DCC 那 30%–50% 的带宽节省,乘的是一个已经在 GB/s 量级上的数字;
- "留在片上"是最彻底的优化:§6.3 的 transient attachment 之所以值得单独配一张图,就因为它能把这项从"省一部分"变成"完全不发生"。
当然,真实项目里还有纹理采样、顶点与索引、加速结构遍历、UAV 读写等一大堆流量,这条算例只覆盖了"渲染目标读写"这一项。但量级感比精确值重要:知道自己在 GB/s 量级上花钱,就不会对"少一个 pass 能省多少"抱错误期待。
出处:NVIDIA · Blackwell Ultra/NVIDIA · Blackwell 架构页/Samsung · HBM4 量产公告/Samsung Semiconductor · HBM4 infographic/Arm · Frame Buffer Compression/Linux 内核文档 · AFBC/GPUOpen · DCC 概览/GPUOpen · RDNA3 技术讲义。
八、没变的那几件:这套硬件地图的骨架
8.1 概念:为什么"没变"要单独成章
新特性文写多了,容易产生一个错觉:GPU 好像每年都在重写。把"没变"的部分列清楚,才知道哪些知识是长期资产、哪些只是当下的接口形状。
判定"没变"不能凭印象,得有官方依据。这一章的每一条都配出处。
8.2 SIMT 波前:执行模型没变,打包方式变了
变的是构成,没变的是模型:
- Turing 的 SM:每个 TPC 含 2 个 SM,每个 SM 共 64 个 FP32 + 64 个 INT32 核心;对照 Pascal 的 GP10x——每个 TPC 一个 SM、每个 SM 128 个 FP32。SM 内部的算术单元配比大改,但"SM 之上还是 TPC、SM 之内是一批并行执行槽"这一级层次没变;
- RDNA 的 CU:引入 WGP(work group processor)= 两个紧耦合 CU,每个 CU 有 2 个 32-wide SIMD,主执行模式是 Wave32。也就是"CU 的包装方式与波前宽度变了,CU + SIMD 的构成逻辑没变"。
一个指令译码器驱动一组 ALU 同执行——这条 SIMT 的基本形态,从 2011 年到 2026 年没有动摇。变的是打包:波前宽度(Wave32/Wave64)、每 SM 的 ALU 配比、以及调度粒度。
8.3 固定功能光栅化与 ROP:没有被可编程化取代
第一章讲 mesh shader 时有一条容易读漏的结论:mesh shader 的输出仍然交给同一个固定功能光栅化器。规范不仅保留了光栅器,还专门定义了 thread group 之间的光栅退场顺序(§1.4),并保留 ROV(rasterizer-ordered views)作为"要顺序就自己声明"的手段。
也就是说:几何前端可编程化了,光栅化与像素后端没有。 三角形建立、属性插值、深度测试、混合、ROP 写入,仍然是固定功能——它们只是多了一些可调旋钮(第五章的 VRS/FDM)。
8.4 纹理采样器:这条固定流水没动
纹理采样器从 2011 年至今仍是固定功能流水:寻址、过滤、各向异性、LOD 计算都由硬件完成。这一层的变化是"加功能"(如更精细的过滤、稀疏纹理、采样器反馈),而不是"改性质"。
8.5 同步职责:没变,而且更显式
ep11 讲过的那套账(when/where、范围与对象)在 2026 年没有变化,反而更重:
- Vulkan 仍然要求应用显式管理 barrier 与同步范围;
- mesh/task 的出现只是新增了两个 pipeline stage(
TASK_SHADER_BIT/MESH_SHADER_BIT),让应用能够显式地同步它们; - work graphs 把依赖写进图的边,但谁来声明这些边、谁来兜住顺序,仍然是应用的事。
"硬件不替你猜" 这条原则从 2011 年延续到现在。区别只是:当年你要声明的是"这次 draw 之后切纹理",现在你要声明的是"这批描述符索引有效、那棵加速结构已就绪、这张图的边可以从这里展开"。
8.6 未变四项与官方依据
| 未变的机制 | 官方依据 |
|---|---|
| SIMT 波前执行模型 | Turing 白皮书(SM 构成);ROCm 文档(CU/Wave32) |
| 固定功能光栅化与 ROP | Mesh Shader 规范的"Rasterization order"与 ROV 条款 |
| 纹理采样器固定流水 | 样品与规范中的采样路径(VRS 的可用遮蔽率、mesh 的属性插值) |
| 同步职责在应用侧 | Vulkan 同步章节;mesh/task 的新增 stage 位 |
这张表建议随手截图存下来。它的用法很直白:当你听到"GPU 架构整个变了、以前的经验没用了"这类说法时,把这张表拿出来对一对——你会发现变的那几层都集中在"数据怎么进来、谁来决定",而真正决定像素怎么落地的那些机制,十二年没动过。
出处:NVIDIA Turing 架构白皮书/AMD ROCm 文档 · GPU 硬件实现/DirectX-Specs · Mesh Shader(Rasterization order)/Vulkan 规范 · Synchronization。
九、判据与总表:看到一个"新特性"该怎么判断
9.1 三问判据
前面八章讲的每个机制,都可以用同样三个问题拆开。这套判据就是本篇最想留下的东西——它不依赖你记住任何具体扩展名:
- 它替代了 2011 年的哪个环节? 找不到被替代的环节,说明它多半是"加功能"而不是"改模型";
- 代价转移到哪一侧? 应用侧(自己补顶点重用、自己管生命期、自己声明顺序)还是驱动侧(驱动做翻译与合并)?责任转移的方向,决定你未来项目的复杂度上限;
- 哪条原本由硬件兜底的保证被降级了? 这一问最容易被跳过,却最容易在后期变成"偶发花屏"。
9.2 用判据拆一个具体机制
拿第五章的 VRS 走一遍,三个问题都有明确答案:
| 判据 | VRS 的答案 |
|---|---|
| 替代了哪个环节? | 没有替代——它是给固定功能光栅化加了一个"可调速率"的旋钮 |
| 代价转移到哪? | 一部分到应用侧:速率怎么定、降速率后画面能不能接受,要应用自己判断与调参 |
| 哪条保证被降级? | 像素级着色的一致性(同一像素在不同区域可能按不同速率着色),因此依赖像素精度的效果(自定义插值、某些后处理)要重新评估 |
三问走完,你会得到一个很实用的结论:VRS 是"省钱不省事"的机制——它省下的是着色开销,多出来的是画质判断与兼容性核对的工作量。用同一套流程去看 work graphs,答案就完全相反:它替代的是"命令缓冲串行遍历 + 状态预绑定"两个环节,代价转移到调度正确性上,被降级的保证是"命令顺序即执行顺序"这条直觉。
再用同一套流程拆第一章的 mesh shader,把三问练成肌肉记忆:
| 判据 | mesh shader 的答案 |
|---|---|
| 替代了哪个环节? | 输入装配器整段(索引解压 + 顶点重用 + 属性拉取),以及 GS 的几何放大能力 |
| 代价转移到哪? | 应用侧:meshlet 划分、顶点去重、包围体、LOD 决策,全都要自己实现 |
| 哪条保证被降级? | 光栅顺序(有 AS 时只保父级之间)与顶点重用的隐式保证(硬件不再兜底) |
把 VRS、work graphs、mesh shader 三个答案并排看,会发现一个共同形状:每一次"责任上移",都会在应用侧多出两项工作——一项是数据组织(meshlet、材质表、加速结构),另一项是正确性声明(顺序、生命期、可见性)。 前者是工程量的增加,后者是 ep11 那套知识的用武之地;而"哪条保证被降级"之所以必须每次单独确认,是因为它既不会在编译期报错,也不一定在测试里稳定复现。
9.3 时间线(2011 → 2026)
这条时间线上值得注意的不是年份,而是节奏:执行模型的两次大改(几何前端、工作发起)都发生在 2019–2024 这五年里,而"没变"的四项在这段时间里一次也没有被重写。硬件的演化是分层的——上层接口换得快,下层执行模型换得慢。
9.4 变 / 降级 / 未变矩阵
把矩阵竖着读,会看到三条规律:
- 输入侧几乎全变了(几何输入、绑定、工作发起、求交),输出侧基本没变(光栅化、ROP、纹理采样)——变化集中在"数据怎么进来、谁来决定";
- 所有"变了"的环节都伴随责任上移:顶点重用、描述符生命期、工作调度、同步声明,全都要应用自己兜;
- "没变"的恰恰是最靠近像素的固定功能——这也是为什么前十一期讲的那些机制(ROP 的读写、纹理采样的过滤、early-Z 的判定)今天依然要懂。
出处:DirectX-Specs · Mesh Shader/DirectX-Specs · Work Graphs/Vulkan refpage · VK_VERSION_1_3/Microsoft DirectX 博客 · DirectX 12 Ultimate。
十、收束:十二期地图之外的读法
10.1 十二期合起来是什么
这套系列从一开始的目标就很窄:讲清同一个管线在硅片上由哪些单元、按什么顺序、付什么代价完成。十一期拆完硬件环节,这一期把它放进十二年里去对照。
10.2 该带走的三样东西
比记住扩展名更要紧的是这三样:
- 规范语言与硬件语言的对照习惯:规范说"layout transition",硬件做的是 flush/invalidate/drain(ep11 第五章);规范说"mesh shader 不启用 IA",硬件事实是"索引处理与顶点重用不再由固定功能承担"。每次看到规范词汇,问一句"对应的硬件动作是什么";
- 口径标注习惯:本篇所有数字分三档写。这套习惯迁移到读白皮书时格外有用——"最高 3×"与"3×"是两种东西;
- 判定式而不是罗列式:看到新特性先问三问(替代了谁、代价转移到哪、哪条保证被降级)。这比背一张特性表耐用得多。
10.3 收尾
系列到这里就结束了。十二期下来,我们其实只做了一件事:把"图形管线"这个黑盒,逐层拆成有名字的硬件单元、可核对的规范条款,以及可以量出来的代价。 如果这些期里有一句话能被记住,我希望是 ep11 那句的推广版——
API 是遥控器,硬件才是动作;而"谁欠谁一个保证",永远是这套系统里最需要你自己算清楚的事。
这一章留下的问题:本篇刻意没有展开的,是"这些机制在移动端 SoC 上的形态差异"——TBDR 架构下 VRS、动态渲染、片上内存显式的收益曲线与桌面完全不同,而移动端的带宽约束会把本卷第 7 章的两条路(更深缓存、更省表示)放大成第一优先级。这个题目留待后续专题。
本系列到此收官(共十二期)。若后续开新专题,会在个人博客与公众号同步预告;想按技术主题回看的读者,可以用下面这份资源清单当索引。
参考资料与技术资源清单(按来源归类)
规范与官方规范文档
- DirectX-Specs · Mesh Shader(IA 关闭、输出上限、光栅顺序)
- DirectX-Specs · Work Graphs(节点图语义、递归上限、节点类型)
- DirectX-Specs · Indirect Drawing(command signature)
- DirectX-Specs · Raytracing(两级加速结构)
- Vulkan 规范 · Ray Tracing 章节/Render Pass 章节/Synchronization
- Vulkan refpage ·
VK_VERSION_1_3
Vulkan 扩展提案(机制的原话都在这里)
VK_EXT_mesh_shader/VK_KHR_fragment_shading_rate/VK_KHR_dynamic_rendering/VK_EXT_graphics_pipeline_library
厂商架构材料(配图不转载,文字引用)
- NVIDIA Turing 架构白皮书/Ada 架构白皮书/Blackwell Ultra
- Ampere 之后的 GPU-driven 与 work graphs 系列博客/延迟着色案例
- GPUOpen · DCC 概览/RDNA3 技术讲义/Mesh Shaders on RDNA/RGP Manual
- AMD ROCm 文档 · GPU 硬件实现(CU / Wave32)
- Arm · AFBC 技术页/Linux 内核文档 · AFBC
- Samsung · HBM4 量产公告/HBM4 infographic/SK hynix · HBM 产品页
实测样例与第三方实测(本篇真图来源)
- Khronos Vulkan-Samples · 样例总览(Apache-2.0,本篇 13 张真图来源:mesh_shader_culling / descriptor_indexing / fragment_shading_rate_dynamic / fragment_density_map / ray_tracing_position_fetch / dynamic_rendering_local_read / graphics_pipeline_library / sparse_image / shader_object / subpasses / afbc)
- Interplay of Light · Meshlets and Mesh Shaders(第三方 meshlet 剔除实测)
- Sebastian Aaltonen · No Graphics API(固定功能顶点提取消失这条线)
- Johannes Unterguggenberger · Mesh Shaders as Replacement for Hardware Tessellation?(两方实测汇总)
- SIGGRAPH Blog · Mesh Shaders Release the Intrinsic Power of a GPU(落地时间线)
本系列的立论底本
With Best Wishes.