本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
十篇下来,我们把「2D 矢量引擎怎么把矢量变成像素」这件事,从 Skia 的 SkCanvas 分层一路挖到 Vello 的 Sparse Strips,中间还夹了三篇自跑:第七篇量两条后端的像素差与 overdraw,第八篇拆 SKP 与字体开关,第十篇把 Vello 的三条路线在同一台机器上跑了一遍。
这一篇是收官。收官篇有一个很实际的诱惑:把前面十篇的结论再复述一遍,配上几张漂亮的对比表,就算完成。这一篇不做这件事。 它要处理一个前面十篇一直没空处理的问题——这些引擎根本不在同一层,凭什么放在一起比。
先把坐标挪一下。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 结论带读数:凡是「更快/更省/更大」的说法,绑定官方原文或本系列已交付篇目的读数并写明口径;
- 凡引必注:官方定义给链接与逐字原句,本系列读数标明来自哪一篇;
- 本篇不涉及(边界见 0.3):Android 图形栈内部(HWUI / SurfaceFlinger / HWC 的实现)、VFX 与粒子系统的实现、Godot 引擎整体架构、各引擎的性能横向对比;
- 篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,400 到 2,300 字。
本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真图复用自本系列已交付篇目(图注标明来源篇);自绘图为本系列绘制,走 styles/qianmo/palette.json 色板单源。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 收官:与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(第一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 上一篇(Vello 三路自跑):【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 本篇的五个对照对象:Skia 官方文档 | Cairo 官网 | Godot 官方文档 | Rive 官网 | Vello 仓库
- 与本文交叉的两个专题:T05 Android 图形显示 | T16 VFX 特效(见 §8.1 的指针清单)
- 素材来源:Wikimedia Commons(图注逐张标作者与许可)
十篇之后,这一篇只补一件事
OK,收官篇不重新做实验,先补一张坐标系。十篇讲的是「某个引擎怎么把矢量变成像素」。这一篇要补的是坐标系:这十个字里的五款引擎,谁和谁其实不能直接比。
0.1 十一篇的坐标系
先看看前九篇都干了什么。
机制深挖五篇:第二篇拆 Skia 的 SkCanvas 分层(Canvas → Paint/Surface → backend);第三篇拆矢量语义层(贝塞尔细分、tessellation、analytic AA 与 coverage);第四篇拆字形光栅化(glyph 数据组织、blob 与 CJK);第五篇拆 Skia 的 GPU backend(覆盖 approach 与 instanced tessellation);第六篇拆 Graphite(深度 z 降 overdraw 的 compute 光栅化)。这五篇的共同点:主语都是「源码与文档怎么写的」。
自跑三篇:第七篇量 Skia 两条后端的像素差与 overdraw;第八篇拆 SKP 回放与字体开关;第十篇把 Vello 的三条路线跑成四路并给出完整的单帧耗时分解。这三篇的共同点:主语是「本机真跑出来的数与图」。
前沿一篇:第九篇讲 Vello 的 Sparse Strips 与 prefix-scan,并当场纠正了一处流传的说法(「Vello = compute + prefix-scan + sparse strips」在 2026 年 9 月的重构后不成立)。
收官一篇:就是这一篇。
这十一篇的坐标一旦摆出来,就能看出这一篇为什么必须存在:前九篇每一篇内部都自洽,但篇与篇之间没有共同的度量。 第十篇结尾那条「8000 图元时 compute 比 hybrid 快 4.85 倍」,说的是 Vello 内部的四条路线;而第一篇里那句「Skia / Vello / Cairo / Godot-2D / Rive 各在哪个生态」,说的是五个产品之间的定位关系。这两句话不能相乘,因为它们不在同一层。
0.2 本篇只回答三件事
OK,先把三件事摆出来。第一件:这五款引擎到底分几层? 这是整篇的骨架。「引擎」这个词在中文技术写作里被用得太宽了:Skia 是图形库,Godot 2D 是游戏引擎里的一个子系统,Rive 是矢量动画运行时,Vello 是渲染器实现,Impeller 是 Flutter 的渲染运行时。把它们排成一行做表格,看着整齐,其实是错的。
第二件:像素到底从哪来? 五款引擎最后都要回答同一个问题:给定一条路径,谁在什么时候把它变成像素。答案只有三种:CPU 光栅化、GPU 光栅化、GPU 计算。三种来路决定了引擎的硬件门槛、单帧延迟特征与失败模式——这一件是把第二到第六篇的结论接到同一张图上。
第三件:这篇的边界在哪? 这一篇要引用 Android 图形栈与 VFX,而这两块是别的专题的题域。越界是这一篇最大的风险,所以边界声明单独成节(§0.3),写得比前三问还细。
0.3 边界声明:这一篇不涉及什么
好了,这一节不是客套。写边界声明是为了让这一篇可以被证伪——读者拿到这份清单,就能检验我有没有偷偷越界。
不涉及 Android 图形栈内部。 HWUI 怎么组织 RenderNode 与 DisplayList、SurfaceFlinger 怎么合成图层、HWC 怎么送屏——全部不在本篇。本篇只讲一个接缝:Android 的 2D 绘制最终会落到 Skia 上,以及这条接缝意味着什么(§8.3)。那些内部机制属于另一个专题的题域。
不涉及 VFX 与粒子系统的实现。 本篇只用一个粗判据区分「同一屏幕像素的两种来路」:解析式(几何 + 覆盖率)与程序化(粒子 + 噪声 + 时间)。粒子系统怎么调度、GPU 粒子怎么与物理交互,全部不在本篇(§8.2)。
不涉及 Godot 引擎整体架构。 本篇只讲 Godot 的 2D 子系统这一小段:CanvasItem 与 _draw() 的语义、RenderingDevice 在三层里的位置。Godot 的场景树、节点系统、3D 渲染管线不在本篇。
不做性能横向对比。 这是本篇最硬的一条自我约束。理由是基准口径不可比:WebKitGTK 的 2.46 公告用的是 MotionMark、Godot 官方 benchmark 用的是「每帧绘制 10000 个 shape 的 Canvas Item」、Flutter 侧的对照表用的是首帧卡顿与掉帧率——这三套数放在一张表里,得到的不是结论,是错觉。所以本篇一个跨引擎的性能数字都不引。
边界说完了,回到第一章要回答的问题。
0.4 本篇的证据分两类,出处逐条标
OK,回过头说证据从哪来。收官篇不产生新证据,所以这件事必须写得更细,否则它就容易变成一篇靠印象写成的综述。
第一类是官方一手材料,用来定义身份、机制与边界。这一篇的官方来源横跨五家:Skia 官网与 Google 官方博客、cairographics.org(含 news 页、后端页、手册与邮件列表)、Godot 官方文档、rive.app(含官网、Renderer 页、运行时页、状态机文档与两篇博客)、docs.flutter.dev 与 Flutter engine README。凡涉及「某个引擎怎么做」的断言,一律引原句并给链接。
第二类是本系列已交付篇目的读数,用来在需要数字时给出处。这一篇引用的每一个数字都标明来自哪一篇:第十篇的四路单帧耗时、第九篇的双族划分、第六篇的 Graphite 官方定位、第三篇的 analytic AA、第五篇的覆盖 approach。不引任何第三方的跨引擎基准(§0.3 已说明理由)。
还有一条负向纪律:本篇不做「我印象里 Skia 更快」这类断言。 收官篇最容易翻车的地方,是把十篇读下来的感觉直接当成结论——算错反倒少见。所以凡是没有出处的比较句,一律删掉——这也是本篇最终没有性能横向对比表的直接原因。
一、五个对象先摆到一张表上
这一章先把五款引擎的「身份信息」列齐,然后立刻暴露一个问题:其中三个在公共素材库里连 logo 都没有。
1.1 五路 logos,以及缺掉的三格
先看看这一节要做的事,它有点反常:先展示能拿到的素材,再把拿不到的摆出来。 因为后者才是这一章真正的发现。
检索时我按惯例先枚举类目。有 logo 的这三个先摆出来:
三个 logo 摆在一起,本身已经说明了一件事:它们都是「用户会直接说出口的名字」——Godot 是一个你下载来用的引擎,Cairo 是一个你写在依赖清单里的库,Flutter 是一个你用来开发 App 的框架。下面说缺的三格。
做素材检索时我先按惯例跑类目枚举,结果出现了三次「类目不存在」:
Category:Skia (graphics library)—— 不存在。全域检索 “Skia”,命中的全是同名的西文字体字形样本,与图形库无关。Category:Rive (software)—— 不存在。检索 “Rive”,返回的是法国的地名与车站。Category:Impeller—— 不存在。检索 “Impeller rendering engine”,出来的全是蒸汽机相关的旧文献。
而同一批检索里,Godot 与 Cairo、Flutter、Vulkan、OpenGL 都有官方 logo,许可清楚、尺寸达标。
这不是巧合,是生态位的证据(这一条会在 §2.3 展开)。Skia 是被打包进 Chrome / Android / Flutter 里的库——用户看到的是宿主,不是它;Impeller 是 Flutter 内部的后端;Rive 是商业 SaaS 的运行时。它们不拥有自己的公共形象。而 Godot 与 Cairo 有 logo,是因为它们是「用户会直接说出口的名字」。
所以本章的 logo 矩阵只能凑出前三格,后三格是文字。这一篇不为了凑图去找近似图——找不到就是找不到,写清楚比硬补一张更有价值。
1.2 五路定位矩阵
好了,矩阵摆完了,把最关键的一行单独拎出来:类型。
| 对象 | 类型 | 宿主 | 许可 | 最新版本(截至 2026-09) |
|---|---|---|---|---|
| Skia | 2D 图形库 | Chrome / ChromeOS / Android / Flutter / Firefox | 见官方仓库 LICENSE(本轮未取到原文) | 见 Graphite 相关公告(2025-07) |
| Cairo | 2D 图形库 | GTK / 各类 Unix 桌面工具链 | 见官方仓库 LICENSE(本轮未取到原文) | 1.18.6(2026-09-20) |
| Godot 2D | 游戏引擎的 2D 子系统 | Godot 引擎自身 | 见官方仓库 LICENSE(本轮未取到原文) | 随引擎版本走 |
| Rive | 矢量动画运行时 | 13+ 平台(含 Unity / Unreal / Flutter) | 运行时 MIT(官方原文) | 持续更新,Renderer 已开源 |
| Vello | 渲染器实现(三路) | Xilem / Bevy 等 Rust 生态 | Apache-2.0 OR MIT(官方仓库) | vello 0.10.0(2026-08-14) |
这张表有两处值得停一下。
第一处是 Cairo 那一行的粗体。 网上有一种流行的说法是「Cairo 已经死了,大家都换 Skia 了」。但 Cairo 在 2026-09-20 还在发稳定版(1.18.6),上一个稳定版是 2025-03-08 的 1.18.4。它确实节奏慢、确实被 WebKitGTK 换掉了,但「慢」和「死」是两件事——这一条在第六章会展开。
第二处是 Rive 那一行的「13+ 平台」。 一个矢量动画运行时要同时出现在 Unity、Unreal、Defold、Flutter、React Native 与原生 C++ 里,这本身说明它把自己定位成跨宿主的资产格式 + 运行时,而不是某个平台专用的渲染功能。这一点会在 §2.2 展开。
矩阵摆完了。但「类型」这一列只是标签,它背后的实质差别在下一章。
1.3 矩阵里最容易看错的一格:许可
OK,接着看矩阵里最容易看错的一格。上面那张表里,「许可」这一列最容易被当作法务问题跳过,但它其实是一条技术约束。
先说一条有原文可引的。Rive 的运行时页写着:「Our runtimes are MIT-licensed, giving you the ability to evaluate, contribute, and modify them.」一个商业 SaaS 把运行时开源成 MIT,这件事本身就在说明它的商业模型在哪一层——编辑器与协作,而不是运行时的许可费。它也解释了为什么 Rive 的运行时能铺到 13 个以上平台(Web / iOS / Android / Flutter / React / Unity / Unreal / Defold / C++ …):MIT 许可让每一个宿主都能放心把它编进去。
Vello 的仓库许可是 Apache-2.0 OR MIT(Rust 生态的标准双许可),同样允许闭源使用。
剩下的三个我做了保守处理。 Skia、Cairo、Godot 的许可条款我在本轮检索里没有取到可逐字引用的官方原文(Skia 的许可页与仓库 LICENSE 两次抓取都超时;Cairo 的许可散在源码头部与发行说明里)。按本系列的纪律,没取到原文就不写具体条款——所以矩阵里那三格只标了「见官方仓库 LICENSE」,不填具体许可名。
不写具体条款,但那条通用约束背后的原理仍然成立:库的许可会直接改变工程结构。 带 copyleft 成分的库,闭源产品通常只能动态链接(核心要求是「允许用户替换掉这个库」),你不能把它静态编进一个不提供替换途径的二进制里;而宽松许可(MIT / BSD 类 / Apache)允许静态链接,这正是「被嵌入」的前提。
这条约束的实用价值在于:当你要把某个渲染器嵌进自己的产品时,「它的许可允不允许我这样打包」的优先级,可能高于「它快不快」。 一个性能达标但你没法合法打包进去的库,等于没有。这也是为什么 Skia 这类库能同时出现在 Chrome、Android、Flutter、Firefox 里——能不能被编进去,是它的第一道门槛。
二、三类东西不是一回事
这一章是整篇的骨架。它要证明的是:五款引擎可以分成三层,跨层的比较必须换判据。
2.1 谁调谁:三层的判据
先看看判据。只有一条:它自己决定要画什么吗?
图形库(Skia、Cairo):不决定。 它们是被调用方。Skia 官方的自我定位是「an open source 2D graphics library which provides common APIs that work across a variety of hardware and software platforms. It serves as the graphics engine for Google Chrome and ChromeOS, Android, Flutter, Mozilla Firefox and Firefox OS, and many other products.」——注意这句里它是被谁用,而不是做什么产品。Cairo 同样:它的定位是把绘制命令翻译到十来个后端上。
游戏引擎的 2D 子系统(Godot 2D):决定一部分。 它自己拿着场景树与节点,知道哪个节点在什么位置、什么时候需要重绘。但它不生成美术资源——美术是编辑器的输入。
矢量动画运行时(Rive):决定「画什么」与「怎么变」。 它吃的是一份 .riv 文件加一组状态机输入值,场景树不在它的输入里;输出是每一帧的绘制命令。
这三层的关系不是「高低」,而是信息流向:运行时 → 引擎 → 库。跨层比较会立刻出错,比如拿 Cairo 的「一次 fill 的耗时」去比 Rive 的「一个状态机切换的耗时」——前者是一次函数调用,后者可能牵动几十条绘制命令。这不是谁快谁慢的问题,是量纲不对。
有一篇博客把这件事说得比官方文档更直白:「Skia 不是游戏引擎(无 3D、无场景图、无物理);Skia 也不是 UI 框架(只画图元,UI 层要自己搭)」。这句话的价值在于它同时划出了下面与上面两条边界。
一个具体的错位例子。 假设你要做一个「页面上有 500 个可点击图标、需要平滑动画」的功能,然后你拿三份文档来比较:
- 你查 Cairo 的性能,找到的是「一次
fill在多大数据量下的耗时」——这是单次绘制命令的粒度。 - 你查 Godot 2D 的性能,找到的是「每帧能画多少个 CanvasItem」——这是每帧绘制批的粒度。
- 你查 Rive 的性能,找到的是「一个状态机切换的耗时」与「120fps」——这是一次状态迁移的粒度。
三个数字放在一起,你会得出「Rive 最快、Cairo 最慢」——而这个结论毫无意义。因为它们的分子分母完全不同:Cairo 的数除以 500 才是你要的量级,Godot 的数本身就是你要的量级,而 Rive 的数根本不包含「500 个图标」这件事——在 Rive 的模型里,500 个图标是 500 个图形资产,状态机切换的耗时与资产数量关系不大。
正确的做法是先确定你的粒度在哪一层,再只比同层的东西。 如果你的问题真的是「500 个图标每帧重画」,那你要比的是「同层里谁能一次性提交 500 个绘制命令」——这是图形库与引擎的 2D 子系统之间的问题,运行时那一层不参与。
这也是本篇把「三层」放在第二章(而不是放在最后当总结)的原因:先分层,后面的每一章才有意义。
2.2 Rive 的「运行时」二字
好了,说回 Rive。「运行时(runtime)」这个词在它这里不是修辞。官方对状态机的定义是:
State Machines are a visual way to connect animations together and define the logic that drives the transitions. They allow you to build interactive motion graphics that are ready to be implemented in your product, app, game, or website.
关键在最后半句:「ready to be implemented」——状态机的逻辑被构建进动画文件里,而不是写在应用代码里。这一点与传统的矢量动画格式(如 Lottie)构成了根本区别。Rive 官方在两篇文章里把这条差别说得很清楚:
Lottie 交付轻量线性动画;Rive 的 State Machine 是基石特性,可让图形实时响应输入/数据。
Lottie 给播放文件加逻辑,Rive 把逻辑构建进动画本身。
翻译成一句话:一个是播放器,一个是响应式系统。 这也解释了为什么 Rive 的文件会更小——它不需要把每一帧的状态都烘焙出来,只需要存状态机与曲线;而 Lottie 存的是关键帧序列。
顺带记一条检索落空:.riv 的格式规范页(https://rive.app/docs/runtimes/rive-file)返回 404。官方只在运行时页说明「Rive files are a fraction of the size of videos, GIFs, image sequences, or JSON-based formats.」。所以本篇不写「.riv 规范公开」这类话——公开的是运行时源码(MIT),不是格式规范文档。
2.3 公共素材库里的痕迹,也是一份证据
OK,回到第一章那个「缺掉的三格」。把检索结果整理成一张账:
| 对象 | Commons 类目 | 官方 logo | 说明 |
|---|---|---|---|
| Godot | ✔ 16 文件 | ✔ CC BY 4.0 | 有名字的独立产品 |
| Cairo | ✔ 20 文件 | ✔ Public domain | 有名字的独立库 |
| Flutter | ✔ 4 文件 | ✔ Public domain | 有名字的产品 |
| Vulkan / OpenGL / EGL | ✔ | ✔ Public domain | 有名字的行业标准 |
| Skia | ✘ | ✘ | 被嵌入的库 |
| Rive | ✘ | ✘ | 商业 SaaS 的运行时 |
| Impeller | ✘ | ✘ | 框架的内部后端 |
这条观察为什么值得写进正文?因为它给出了一个可检验的推论:一个技术如果没有自己的公共形象,那么它的用户大概率也不直接与它打交道。Skia 的用户是浏览器与框架的开发者,不是 App 的开发者;Impeller 的用户是 Flutter 引擎团队;Rive 的用户通过编辑器与 SDK 与它打交道。
推论反过来也成立:当我们要判断「某个引擎是不是我要直接面对的东西」时,问「它在公共素材库里有没有痕迹」是一条便宜且有效的启发式。 当然这只是一条启发式,不是判据——Arm 有 logo,但它也只是被嵌入的 IP。
这一章把三层的边界划完了。下一章换一个更硬的角度:不管在哪一层,最后都要把像素做出来——那么像素从哪来。
三、像素从哪来:三条路
3.1 三条来路
先看看这三条路。把前九篇的结论压缩一下,任何一款 2D 渲染实现,像素只可能从三条路里来:
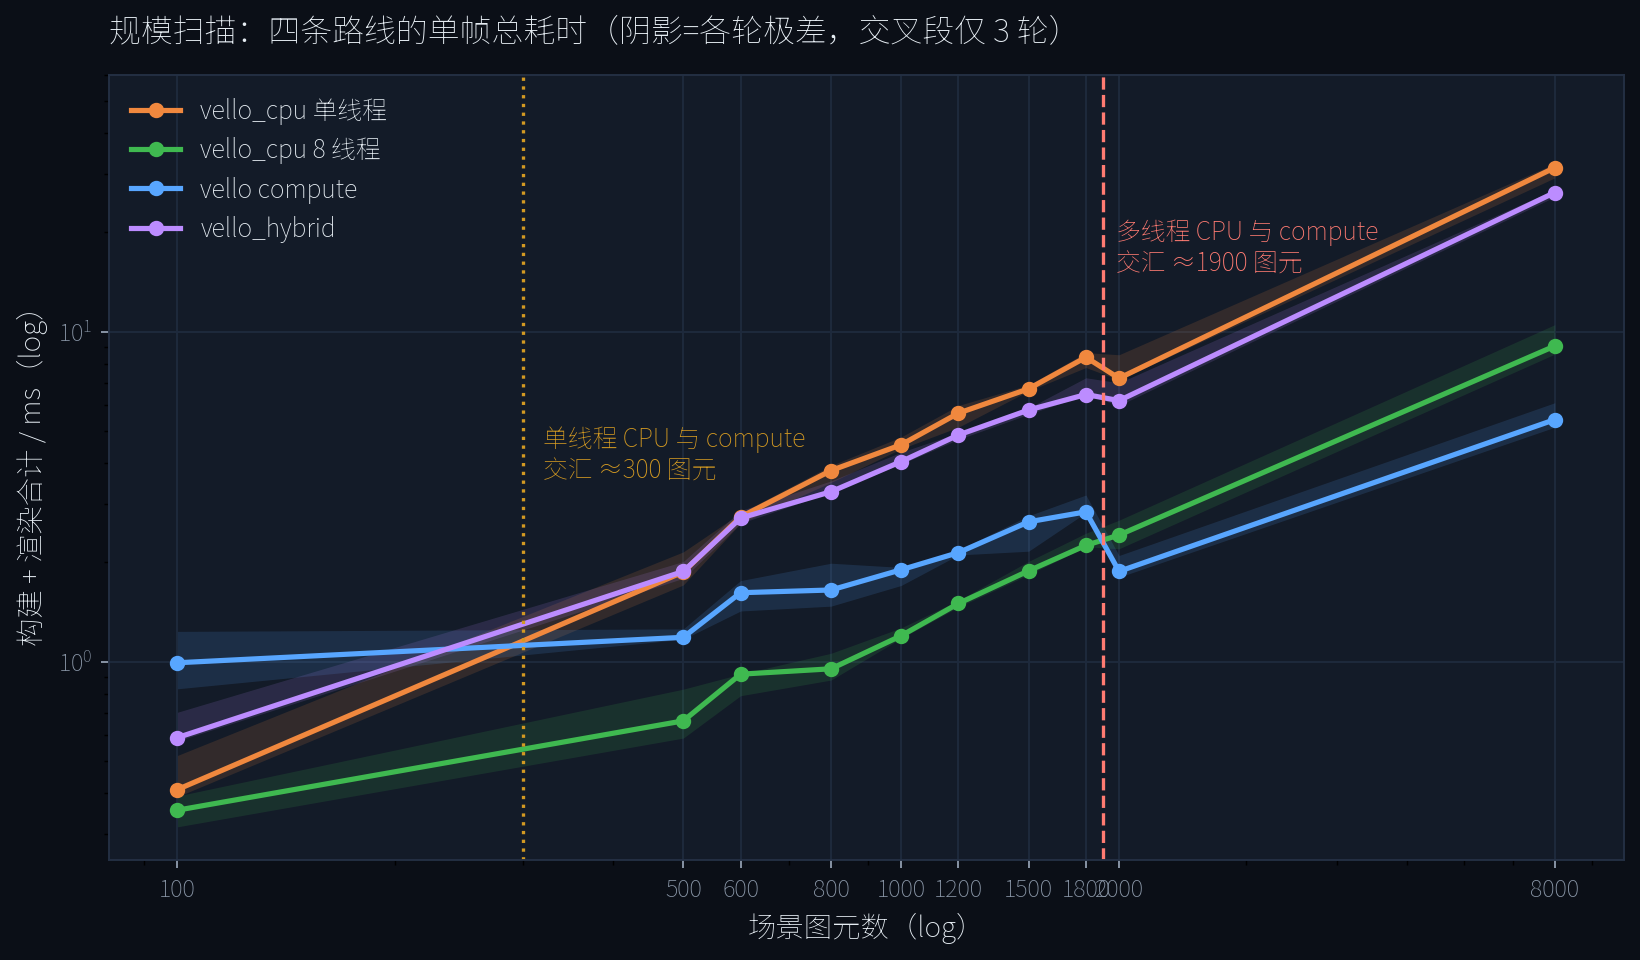
第一条是 CPU 光栅化。 覆盖率与颜色都在 CPU 上算,写进一块内存缓冲。代表性实现是 Skia 的 Raster 后端与 Cairo 的 image 后端。它的优点是不依赖 GPU、单帧延迟最确定;缺点是斜率最陡——第十篇实测过,从 100 图元到 8000 图元,vello_cpu 单线程的合计耗时涨了 73.59 倍。
第二条是 GPU 光栅化。 几何处理仍在 CPU,但像素的活交给 GPU 的图形管线(vertex / fragment)。Vello 的第三条路线(vello_hybrid)就是这一条,官方描述是「The CPU processes paths, tiles, and schedules sparse strips. The GPU rasterizes those strips and performs compositing.」。Skia 的 Ganesh 与 Godot 的 2D 渲染也属于这一路。它的关键是不需要计算着色器——一块支持 WebGL2 的设备就能跑。
第三条是 GPU 计算。 分格、排序、裁剪、覆盖率全部做成 compute shader 的多趟 dispatch。Vello 的 compute 路线与 Skia 的 Graphite 都是这一路。Graphite 的官方介绍写得很明确:「take advantage of modern graphics APIs like Metal, Vulkan and D3D12 and paradigms like compute based path rasterization, and is multithreaded by default」。它的斜率最平(第十篇实测 5.37 倍),但固定开销最高。三条路的完整机制,可以对着 Vello 仓库 与 Skia 官方文档 复核。
三条路没有优劣,只有配比:CPU 路线固定开销最低、斜率最陡;GPU 计算路线固定开销最高、斜率最平。选型就是选你落在斜率还在平的那一段,还是固定开销已经摊薄的那一段。
3.2 CPU 与 GPU 的分工
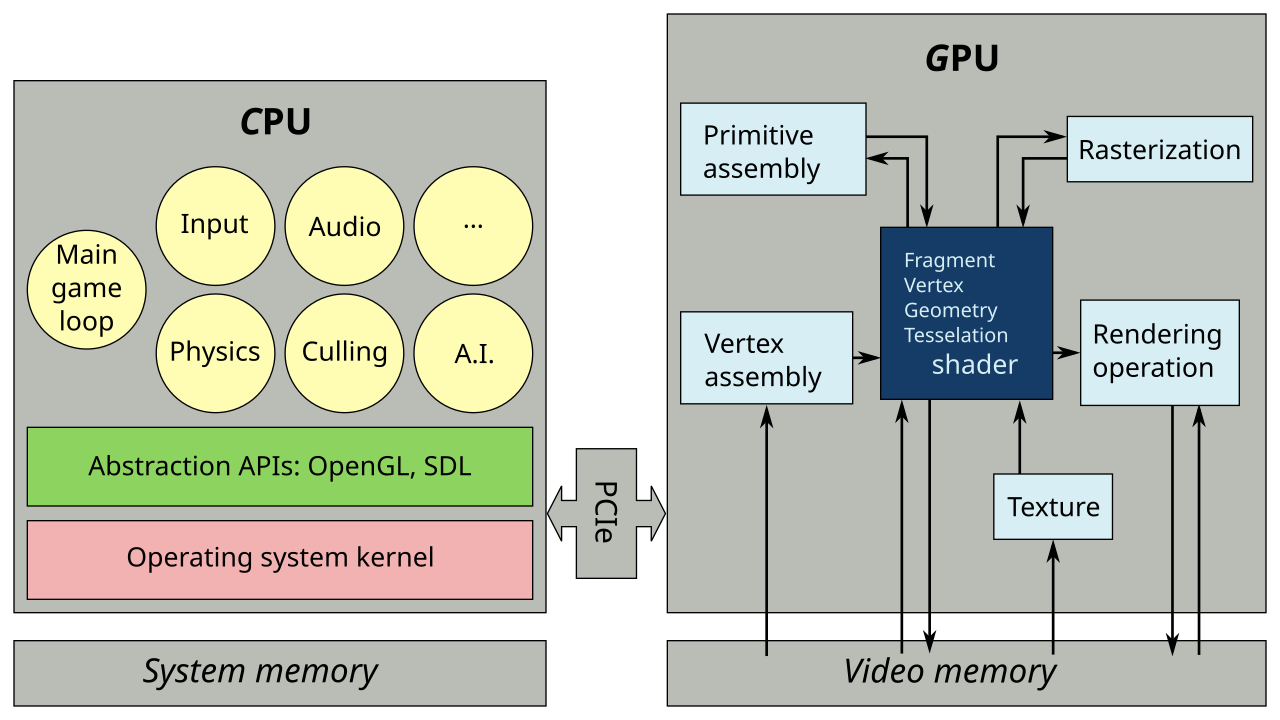
下面进入 CPU 与 GPU 的分工。这张图的价值在那句官方描述里:「Illustrates the division of labor between the CPU and the GPU. In fact only shaders are executed by the GPU.」
GPU 不是「更快的 CPU」。 它只执行着色器——也就是说,你要它干活,就必须把你的问题表达成「对一大片数据并行执行同一个函数」的形式。这一条约束解释了前面所有的现象:
- 为什么 CPU 路线的图元数与耗时的关系接近直线?因为扁平化与分条本质上是串行依赖较强的活,很难完全并行。
- 为什么 GPU 计算路线的构建几乎免费?因为它把展平、分格、排序全部编码成「对一大片数据并行执行」的形式,交给 GPU 去做。
- 为什么 GPU 路线的固定开销高?因为每次都要把数据搬过去、把管线准备好——「让 GPU 开始干活」本身要花钱。
3.3 立即模式与保留模式
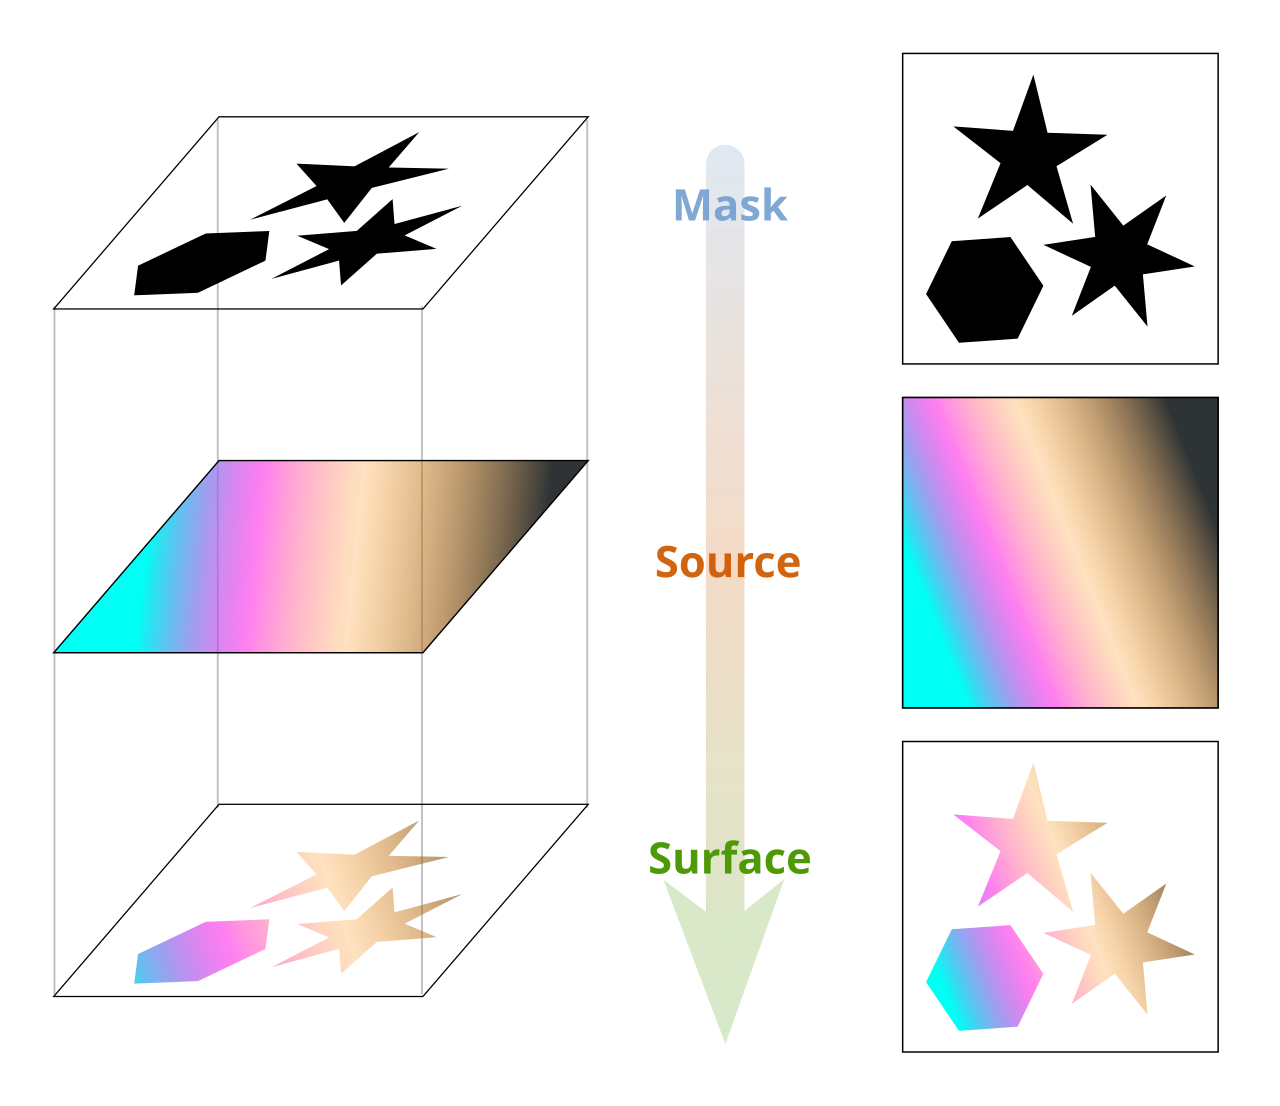
好了,换一个角度。三层划分之外,还有一条正交的差别值得记:立即模式(immediate mode)与保留模式(retained mode)。
Cairo 与 Skia 是立即模式:一次 stroke / fill 调用立刻作用于目标表面,画完即忘。上面这张图就是 Cairo 的绘制模型——source、destination、mask、clip 四个概念在一次操作里完成合成。
Godot 的 2D 绘制是保留模式加缓存。官方文档的原话是:
Any CanvasItem can draw. For this,
queue_redraw()is called by the engine, thenNOTIFICATION_DRAWwill be received on idle time to request a redraw. Because of this, canvas items don't need to be redrawn on every frame, improving the performance significantly.
而 _draw() 本身「is only called once, and then the draw commands are cached and remembered」。
这条差别决定了两类完全不同的性能问题。 立即模式下,瓶颈在「每帧要做多少次绘制命令」;保留模式下,瓶颈在「什么时候触发重绘、缓存什么时候失效」。所以拿「一帧画 1 万个图元」这种立即模式的场景去比较 Godot 的 2D 性能,会得到一个偏低的数字——因为那个场景在 Godot 里本来就不该每帧重画。
像素的来源讲完了。下一章换一个角度:这些像素是由什么输入产生的。
四、一条 path 在五个系统里是什么
4.1 语义对照
先看看这一章要解决的问题。前面三章讲的是「东西怎么变成像素」,这一章往回退一步:被变成像素的那个东西,在五个系统里各叫什么、各是什么。 这件事看着像术语考据,但它决定了一件很实际的事——你能不能让一个系统的经验直接搬到另一个系统上。
下面这张表把五个系统的「路径」逐个对上。注意看最后一列——「谁消费它」比「它叫什么」更能说明身份,因为名字可以重名,而消费者决定了它属于哪一层。表里 Godot 那一行最反直觉,下一节单独讲。
| 系统 | 「路径」对应的概念 | 是绘制对象吗 | 谁消费它 |
|---|---|---|---|
| Skia | SkPath |
是 | 立即被 rasterize 或记录进 DisplayList |
| Cairo | cairo_path_t |
是 | 立即作用于目标表面 |
| Godot | Path2D + Curve2D |
不是 | 给 PathFollow2D 节点沿路移动 |
| Rive | 图形(artboard 里的 shape) | 是,但由状态机驱动 | 运行时按状态机输出每一帧 |
| Vello | Scene 里的路径命令 |
是(编码进场景缓冲) | 由渲染器在渲染阶段消费 |
这张表里最反直觉的是 Godot 那一行。
4.2 Path2D 不是「可绘制的路径」
OK,Godot 那一行为什么反直觉,看官方定义。Godot 官方文档对 Path2D 的定义是:
Inherits:
Node2D<CanvasItem<Node<ObjectContains aCurve2Dpath forPathFollow2Dnodes to follow.
注意这句话的两个部分:它继承自 Node2D(所以它在场景树里),而它的用途是「给 PathFollow2D 节点沿着走」。
也就是说:在 Godot 里,Path2D 不是「一条可以 fill 的路径」,而是「一条轨道」。 你要把一条路径画出来,得在某个 CanvasItem 的 _draw() 里调用 draw_polyline() 之类的绘制函数——Path2D 本身不负责画自己。
这个例子很能说明本篇为什么要单独讲「语义」这一层:同一个词(path)在五个系统里指的不是同一件事。Skia 的 SkPath 与 Cairo 的 cairo_path_t 是绘制对象,Godot 的 Path2D 是运动轨道,Rive 的图形是被状态机驱动的资产。文档里的词一样,代码里的角色完全不同。
一个可操作的推论:读一个引擎的文档时,先确认它的名词指的是「数据」还是「行为」。 Godot 的 Path2D 名字里带 Path,但它是行为(让节点跟着走)的载体;Skia 的 SkPath 名字里也带 Path,它是数据(一组几何)。
4.3 名词与行为:一份判读清单
好了,把这条推论用到底。把它展开成一份可以照着用的清单,是这一章对读者最直接的价值。
第一步:看它继承自什么。 Godot 的 Path2D 继承自 Node2D,而 Node2D 继承自 CanvasItem——在场景树里。一个东西只要在场景树里,它就同时是「绘制对象」与「结构节点」;而 SkPath 是一个纯数据对象,不在任何树里。继承链往往比名字更能说明身份。
第二步:看谁创建它、谁消费它。 SkPath 由你创建,交给 canvas->drawPath() 消费;Path2D 由你在编辑器里放一个节点创建,交给 PathFollow2D 消费。「谁消费」这一问能直接决定它属于哪一层:如果消费方是图形库的绘制入口,它是数据;如果消费方是引擎的运行时节点,它是结构。
第三步:看它有没有「行为」的字段。 Path2D 里有 curve(几何)也有节点自己的 transform、visible、z_index——一个纯粹的数据对象不会有「可见性」。字段表里出现可见性、层级、父子关系这些词,就说明它已经进入场景语义了。
第四步:反查一遍文档里的例子。 官方文档的示例代码是最不容易骗人的地方:Path2D 的示例都在讲「怎么让一个 Sprite 沿着路径移动」,而 SkPath 的示例都在讲「怎么把这条路径画出来」。用例是语义的指纹。
这四步对五款引擎都适用。它们的价值不在于「知道了 Path2D 是什么」,而在于下次读一个陌生引擎的文档时,你能在五分钟内判断一个名词属于哪一层——这也是收官篇该留下的一种可迁移的能力。
输入形态讲完了。下一章看这些输入最终要交给谁去执行。
五、后端与设备门槛
5.1 后端 × 平台矩阵
先看看 Godot 官方文档 怎么拆这一层。它把渲染相关的三层拆得很清楚,这套拆分值得借来当通用框架:
The renderer, or rendering method, determines which features are available. The rendering driver tells the GPU what to do, using a graphics API. RenderingDevice is a rendering backend, an abstraction layer between the renderer and the rendering driver. It is used by the Forward+ and Mobile renderers…
翻译一下:渲染方法(有什么能力)→ 渲染后端(抽象层)→ 渲染驱动(具体图形 API)。Godot 4 的三个渲染方法是 Forward+、Mobile、Compatibility;它们的驱动分别是 Vulkan/D3D12/Metal(前两个,走 RenderingDevice)与 OpenGL(Compatibility,不走 RenderingDevice)。
这套分层的价值在于它能回答一个具体的选型问题:2D 该选哪个渲染方法? Godot 官方给的答案是「Compatibility is usually good enough for 2D」。但这里有一个容易被忽略的代价——官方在同一份文档的比较表里注明,MSAA 2D 只在 Forward+ 与 Mobile 里可用,Compatibility 不支持。也就是说,2D 选 Compatibility 省了硬件门槛,但丢掉了 2D 抗锯齿。这就是「后端门槛」在 2D 语境下的具体面貌:它不是一个抽象的性能问题,而是一个「你要不要这个特性」的取舍。
5.2 两条驱动路线
下面进入两条驱动路线。这三个 logo 放在一起,说明了「后端」这一层为什么难统一:同一个引擎要覆盖的设备,横跨了三代图形 API。 Vulkan 与 D3D12 是「现代显式 API」,OpenGL / OpenGL ES 是「上一代隐式 API」,而 Metal 是 Apple 自家的封闭路线。
Godot 的处理方式是把它变成配置项(rendering/renderer/rendering_method 有 forward_plus / mobile / gl_compatibility 三个取值),代价是特性集不齐(见 §5.1 的 MSAA 2D)。Skia 的处理方式是同时维护 Ganesh 与 Graphite 两代后端。Vello 的处理方式是把路线本身分成两条:vello_hybrid 只要 vertex/fragment(可在 WebGL2 上跑),compute 路线要求计算着色器。
三种处理方式背后是同一个原理:现代图形 API 的能力提升,是靠放弃旧设备换来的。2D 引擎的困境在于,它的用户里有大量旧设备(老手机、车载屏、嵌入式面板)。
5.3 桥接层:EGL / GLX / WGL
cairo-gl 后端官方说明是「supports GLX, WGL, and EGL」@ Wikimedia Commons · Khronos Group(Public domain)OK,这一格容易被跳过,但它解释了一个常见困惑:为什么同一个引擎在不同桌面系统上表现不一样?
Cairo 官方的 cairo-gl 后端说明是:「Draws hardware-accelerated graphics with OpenGL. Supercedes the previous glitz based backend. This backend supports GLX, WGL, and EGL.」GLX(X11)、WGL(Windows)、EGL(跨平台,含嵌入式)是窗口系统与 GL 之间的桥。桥不同,上下文的创建方式、共享方式、同步方式就不同——这就是「同一个 OpenGL 后端在不同平台表现不同」的一部分原因。
顺带说一句 Cairo 的后端清单为什么重要:它有 image / ps / pdf / xlib / xcb / quartz / win32 / svg / beos 这一长串后端,而 cairo-gl 只是其中之一。这是「图形库」这个类别的典型形态:输出目标是可插拔的——同样的绘制命令可以落在屏幕上、落进 PDF、落成 SVG。Skia 也有类似的设计(Raster / Ganesh / Graphite / PDF / SVG)。而游戏引擎的 2D 子系统没有这一层,因为它的输出目标只有一个:屏幕。
5.4 现代 GPU 管线的形态
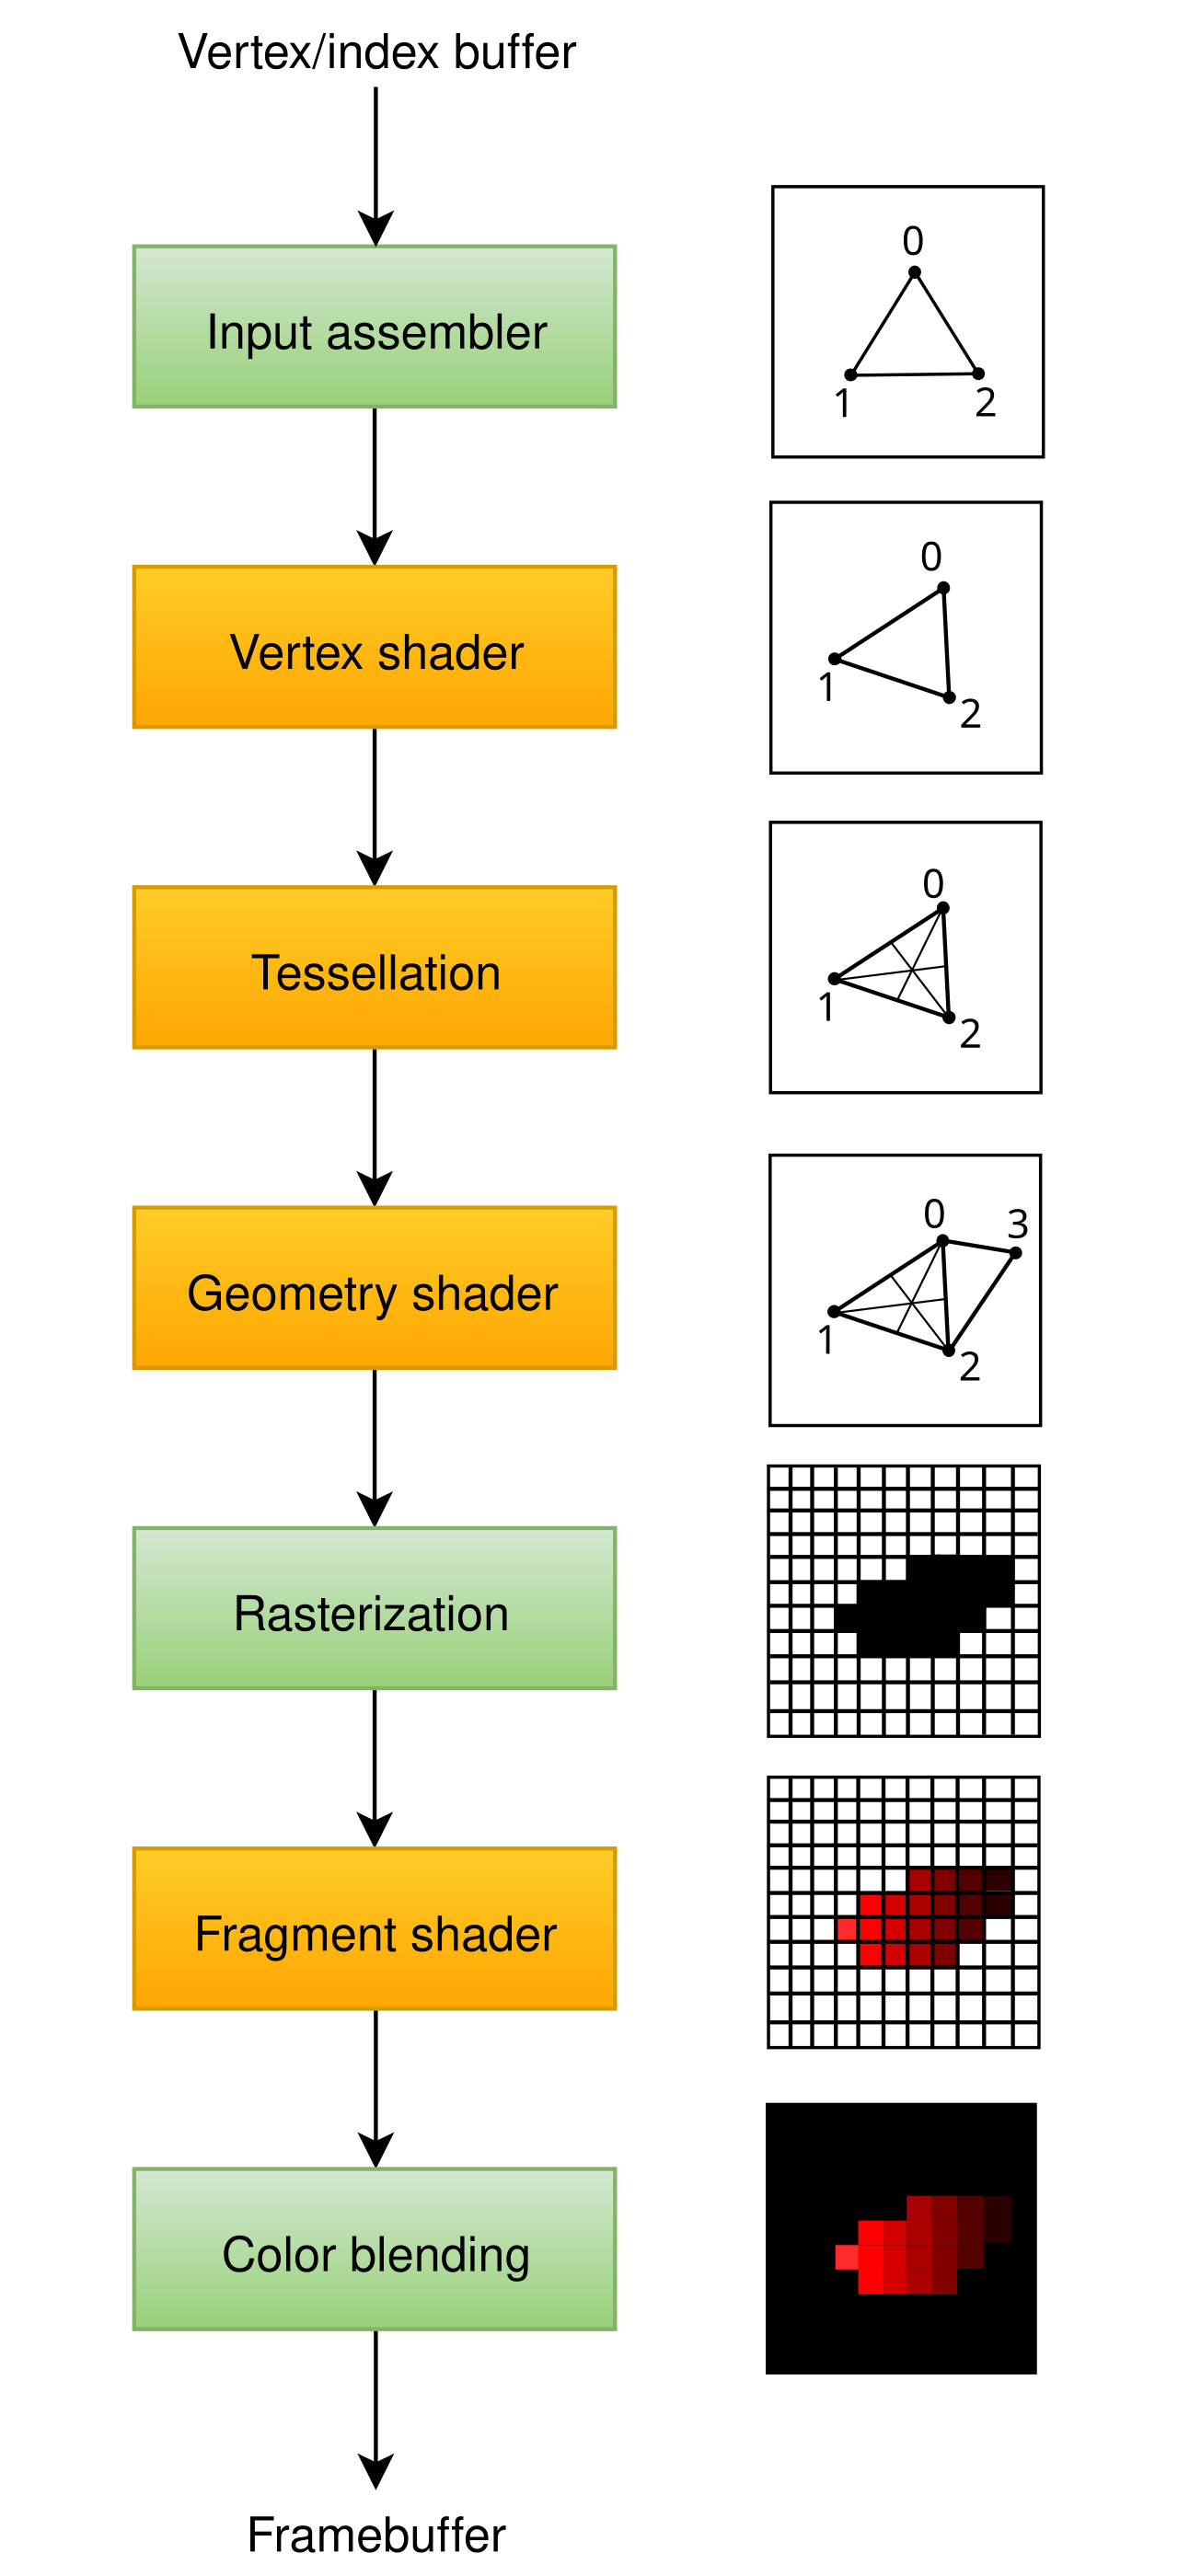
好了,看现代 GPU 管线的形态。这张图很窄很长,正好说明一件事:现代图形管线的阶段很多,而 2D 渲染只用到其中一部分。 传统 2D 引擎(Skia 的 Ganesh 路线、Vello 的 hybrid 路线)走的是「顶点/片元」这一段;而 2D 引擎真正需要的「按几何求覆盖率」这一步,图形管线里没有直接对应——所以要么在 CPU 侧算完再送进去(hybrid),要么用计算着色器自己写一遍(compute / Graphite)。
这就是第三条路(GPU 计算)存在的根本原因:不是「compute 更快」,而是「图形管线里没有 2D 矢量光栅化需要的那个阶段」。
5.5 后端门槛的三条实际后果
言归正传,「后端门槛」听起来抽象,但它在工程上只表现为三件很具体的事。
第一件:你的特性集会被最低设备决定。 Godot 的 MSAA 2D 在 Compatibility 下不可用、只在 Forward+ 与 Mobile 下可用——这就是典型形态:你为了兼容旧设备选了低门槛后端,代价是某些特性直接在配置里消失,而不是「慢一点」。这类损失最容易被低估,因为它不会在开发机上出现(开发机一定是高配),只会在用户的老设备上出现。
第二件:同一个后端在不同平台上不是同一个东西。 前面 EGL / GLX / WGL 那一节讲的就是这件事。跨平台的图形代码里,真正容易出问题的是「上下文怎么建、什么时候同步、共享纹理怎么传」,而「画什么」反而最不容易出错——这些都属于桥接层的职责范围。
第三件:升级后端会变成一次重写而不是一次优化。 从 Ganesh 到 Graphite、从 OpenGL 到 Vulkan、从「CPU 分条 + GPU 光栅」到「GPU 计算」,每一次都不是把参数调一下,而是把数据流重新组织一遍。第九篇讲的 Vello 双族划分就是活生生的例子:同一个仓库里,compute 渲染器与 Sparse Strips 家族是两套实现,不是同一个实现的两种配置。
这三条合起来,给出一条选型时的提醒:后端选择不是性能调优的最后一步,而是架构设计的第一步。 它决定了你能用什么特性、在多少设备上能跑、以及未来换代的成本。
5.6 三条路各自怎么坏
好了,最后看三条路各自怎么坏。选型时真正起作用的往往不是「谁更快」,而是「它会以什么方式坏掉」。三条路的失败模式完全不同:
CPU 光栅化的典型失败是延迟尖刺。 它的单帧耗时最确定(第十篇实测四路里 hybrid 的极差最小、CPU 单线程次之),但代价是斜率最陡——图元数翻一倍,耗时几乎就翻一倍。所以它在真实产品里的坏法是「平时很稳,某个页面图元一多就卡住」,而且卡住时没有任何回退手段:CPU 路线没有「换个后端」的选项。
GPU 光栅化的典型失败是固定开销摊不平。 场景太轻时,它的单帧耗时被「让 GPU 开始干活」这件事主导。第十篇实测:100 图元时 vello_hybrid 的渲染段是 8 线程 CPU 的 2.618 倍。所以它在真实产品里的坏法是「小页面反而不如 CPU 快」——这也是 Vello 仓库 issue #1380 里那个页面的情形(同一页面 Hybrid 约 110 毫秒、Vello CPU 约 36 毫秒)。
GPU 计算路线的典型失败是单帧延迟不可复现。 第十篇实测:同一个配置 5 轮独立运行,2048² 的渲染中位出现 3.822 与 26.648 毫秒两种模式,相差近 7 倍;而且它有极强的外部干扰敏感性——在 CPU 那条路径里多写一次 PNG,它的单帧耗时就被抬高 2.30 倍,另外三路同口径变动都在 1.10 倍以内。所以它在真实产品里的坏法是「平均帧率没问题,但偶尔掉一帧掉得很深」——对交互式应用,这比平均慢更难受。
把三种失败模式并排放,就能看懂为什么同一个项目里常有「两条路线并存」的做法:这是在对冲不同种类的风险,而不是在追求同一个指标。
后端这一章讲完了。下一章把时间轴拉开,看这五款引擎各自处在什么代际。
六、维护状态与代际
6.1 代际时间线
先看看时间轴。把五款引擎在 2025–2026 年发生的事按时间排开,能看到一个共同的方向:大家都在往「现代图形 API + 并行」这一侧移动,而且动作都集中在 2025 年下半年到 2026 年上半年。这不是巧合——那一轮 API 换代(Vulkan 成熟、Metal 迭代、D3D12 普及)刚好到了能被 2D 引擎吃下的阶段。
把事件按时间铺成一张表,三个方向会更清楚:Skia 在换代后端、Vello 在拆分家族、Cairo 在低速发版但被下游更换。 这张表里最值得讲的是同一个 Cairo 的两条时间线——一条来自它自己,一条来自换掉它的人。
| 时间 | 事件 | 意义 |
|---|---|---|
| 2025-07-08 | Skia 的 Graphite 在 Chrome(Apple Silicon Mac)上线 | Skia 自己也在换代:从 Ganesh 到 compute 光栅化 |
| 2025-10 | Vello Hybrid 首发(0.0.4) | Sparse Strips 家族分出第三条路线 |
| 2024-10-04 | WebKitGTK 2.46 用 Skia 取代 Cairo | 「库与库之间」的一次公开替换 |
| 2025-03-08 | Cairo 1.18.4 | 上一个稳定版 |
| 2026-09-20 | Cairo 1.18.6 | Cairo 仍在发稳定版 |
| 2026-08-07 | vello_cpu / vello_hybrid 0.2.0 | Sparse Strips 家族的第一个 0.2 系列 |
| 2026-08-14 | vello 0.10.0 | compute 渲染器的最后一版 |
| 2026-09 | Vello 仓库重构:两族拆开,compute 移入 research/ |
两族正式分开 |
这张表里最值得讲的是同一个 Cairo 的两条时间线。
6.2 两句话的对照
好了,关于 Cairo 的现状,有两句常被引用的话。
第一句来自 Cairo 官方:2026-09-20 发布了 1.18.6,官方 news 页的原话是「Release 1.18.6 (2026-09-20 Emmanuele Bassi)」「A new stable release.」
第二句来自 WebKitGTK 官方:2024-10-04 的 2.46 公告里说明 Skia 取代 Cairo 作为渲染后端,并称 Cairo 渲染器「不再接受积极开发,计划不久后移除支持」,同时给出 MotionMark 最高 4× 的提升数据。
两句都是真的。但它们说的不是同一件事:第一句说的是「Cairo 这个项目还在维护」,第二句说的是「WebKitGTK 这个下游不打算再等它了」。
这里的纪律是:不要把下游的决定读成上游的死刑判决。 一个库可以被某些下游放弃而继续活着;反过来,一个库在发新版也不等于它被广泛采用。区分「项目活跃度」与「生态采用度」是两件事——这一条在选型时尤其重要。
Cairo 自己的位置也不是没有变化。它在 1.17 开发周期做过一次「精简遗留代码」的清理(官方原话:「In a continuing effort to reduce the amount of legacy code, and increase the long-term maintainability of cairo, the following backends have been removed」),并把构建系统统一到 Meson。而它与 Skia 的那段关系早就有结论——Cairo 官方手册里写着:
CAIRO_SURFACE_TYPE_SKIA | The surface is of type Skia, since 1.10, deprecated 1.18 (Skia support have been removed, this surface type will never be set by cairo)
维护者当年给出的理由很有信息量:
skia is not API stable and is not available packaged, versioned forms … which means in practice that Cairo's skia backend will always work only with a specific snapshot and lacking a high degree of maintenance activity will always be badly out of date.
「把不稳定的 API 包进自己的后端」是一笔长期负债。 这条经验对本系列的读者有直接价值:如果你想在自己的项目里包一层别人的渲染器,先问它的 API 稳不稳、有没有版本化的发行包——否则你会得到一个「只能配某个快照」的后端。
6.3 一个可迁移的判断:项目活跃度 ≠ 生态采用度
OK,这个例子值得再抽一层,因为它给出了一个可以反复用的判断框架。
两个指标容易被混为一谈:项目自身的活跃度(有没有发版、提交频率、issue 响应)与生态采用度(有多少下游在用、新旧下游的迁移方向)。Cairo 在这两个指标上给出了相反的读数:它以数月到一年的节奏仍在发稳定版(活跃度不低到零),同时它被 WebKitGTK 这类重要下游换掉了(采用度在上游收缩)。
混用这两个指标,会得到两个都错的结论:
- 只看采用度 → 「Cairo 死了」——但它还在发版,说它死了会误伤仍在用它的项目。
- 只看活跃度 → 「Cairo 很好」——但重要下游正在离开,新项目选它要评估这条风险。
正确的读法是分开问两个问题:这个项目自己在动吗?它周围在动吗?这条判据的原理在于——项目自身的节奏与它周围的生态节奏,驱动因素完全不同。两个答案可能不一致,而不一致本身就是一条重要信息——它通常意味着这个项目的定位正在变化(对一个成熟的库,这常常是「转入维护模式」的信号)。
把这条框架放回本篇的五个对象,会发现它们分布在不同的位置:Skia 与 Godot 在两个指标上都在动;Vello 活跃度高但采用度还在早期(官方自己说 compute 那条是 experimental);Rive 活跃度高、采用度在扩张(13+ 平台);Cairo 则是一个「自己在动、周围在收缩」的样本。这四种位置对应四种完全不同的选型建议,而任何单一指标的排名做不到这件事。
代际讲完了。下一章把这一篇与前面十篇接起来。
七、十一篇的知识地图
7.1 哪几篇讲机制、哪几篇自跑
先看看怎么分类。把这个系列的十篇按「证据类型」分一次类,是收官篇最该做的事:
机制篇(二、三、四、五、六) 的证据是源码与官方文档的逐字引用。它们的结论长这样:「ARCHITECTURE.md 说 flatten 之后分箱进 tile」。 自跑篇(七、八、十) 的证据是本机实测的读数。它们的结论长这样:「8000 图元时 compute 的合计是 5.327 毫秒」。 前沿篇(九) 两类都有:机制靠源码,代价靠自写的算法级实现。 收官篇(本篇) 不产生新证据,只做归类与交叉。
这个分类的意义在于:两类篇目互为校验。 第十篇实测出「hybrid 的构建段占其合计的 81.4%」,这个数字要能被第九篇讲的「Sparse Strips 的 CPU 侧分条」解释;如果不能解释,那就是有一边说错了。一句「实测数据支持机制描述」,需要两边同时存在才能说。
7.2 前九篇的结论回填
把十篇里可以直接被后续引用的结论各提一条,附上它的口径:
| 篇 | 可复用的结论 | 口径 |
|---|---|---|
| 二 | Skia 的分层是 Canvas → Paint/Surface → backend,与具体图形 API 解耦 | 官方文档与仓库结构 |
| 三 | analytic AA 的覆盖率是解析式算出来的,不是采样估计 | 源码 |
| 四 | 字形光栅化的产物是 blob,CJK 的字形量与缓存策略是它特有的约束 | 源码与实测 |
| 五 | Skia 的 GPU backend 走「覆盖 approach + instanced tessellation」 | 源码 |
| 六 | Graphite 用深度 z 值降 overdraw,且默认多线程 | 官方公告 |
| 七 | 两条后端在同一路径上的像素差与 overdraw 可被量化可视化 | 本机真跑 |
| 八 | SKP 回放的字节与渲染结果可逐字节核对;字体开关会改变结果 | 本机真跑 |
| 九 | Vello 的排序/裁剪/分配靠 prefix-scan;双族划分在 2026-09 成立 | 源码 + 算法级自写实现 |
| 十 | 四路单帧的构建/渲染分解;compute 的单帧延迟不可复现(×2.30 干扰实验) | 本机真跑(5 轮取中位) |
这张表有一个刻意的取舍:每篇只提一条。理由是要让「可复用」这件事真的可复用——如果一篇列出五条,读者还是不知道该带走哪条。而挑出来的这一条,都是各篇里被验证过、且不依赖该篇上下文就能理解的那一条。
7.3 两条主线为什么必须同时存在
OK,还有一个问题值得回答:把这十篇按证据类型分成两类之后,为什么不能只写一类?
如果只写机制篇,会得到一套自洽但无法证伪的描述(Vello 仓库 的 ARCHITECTURE.md 就是这个类型:它说得都对,但不给代价)。比如第九篇可以完整地讲清「Sparse Strips 的 CPU 侧要展平与分条」,而这句话在任何实现上都成立——它不告诉你这件事要花多少时间,也不告诉你在什么规模下它会成为瓶颈。第十篇那句「hybrid 的构建段占其合计的 81.4%」才是让机制描述变得可用的东西。
如果只写自跑篇,会得到一堆没有解释力的数字。第十篇的四路耗时表单独看,只能得出「compute 最快」——而 compute 为什么最快、它在什么条件下会变慢,全部要靠第九篇的机制描述才能解释。没有机制的读数,连「这个数是不是测错了」都判断不了。
两条主线同时存在的第三个好处,是它们能互相抓住错误——这条原理也可以反过来用:任何一边单独出现,都该被怀疑。第十篇第一版探针把单线程 CPU 当成 CPU 路线,测出「慢 6 倍」——这个数字在读数侧看完全自洽(5 轮一致、方差很小),它错在机制侧:官方文档写了 multithreading 是可选的,而当时没读那一行。一个孤立的读数无法自证;只有把它拿回机制描述里对照,才能发现「比错了对象」。
这也是本系列给后续篇目留下的一条工作流建议:自跑篇的读数和机制篇的原文,必须能互相索引。本篇 §7.2 那张表就是这条建议的产物——九行里每一行都同时写着「结论」与「口径来源」。
十一篇的自洽性讲完了。下一章向外看:这一篇引用了两个别的专题,边界在哪。
八、跨专题交叉索引
8.1 三个专题的索引
先看看这一节的位置:它是一张地图,不是一段讲解。 地图的作用是让你知道「往哪个方向走能看到什么」,而不是把目的地的风景搬过来。这一节之所以值得单独成章,是因为本系列有四篇的结论其实要靠相邻专题才能闭合。
有了地图,再给指针清单。注意第三列写的是「在何处相接」,不是「内容是什么」——这一列才是这张表真正有用的部分:它把两个专题的交点定位到了一节甚至一段。
| 想了解 | 去哪读 | 本系列在何处与它相接 |
|---|---|---|
| Android 的 2D 绘制怎么落到 Skia | Android 图形显示专题(HWUI / RenderNode / DisplayList) | 本篇 §8.3;第一、二篇的 Skia 分层 |
| Android 的图层合成与送屏 | 同上(SurfaceFlinger / HWC) | 不在本系列(本篇明确不涉及) |
| GPU 粒子与程序化特效 | VFX 专题 | 本篇 §8.2 的粗判据 |
| Skia 的 compute 后端 | 本系列第六篇(Graphite) | 直接可读 |
| Vello 的三路与实测 | 本系列第九、十篇 | 直接可读 |
索引是要有方向的。 一张只说「这两个主题相关」的图没有用;有用的是「从这里往那边看,你会看到 X;从那边往这边看,你会看到 Y」。
8.2 同一像素的两种来路
本系列讲的是解析式来路:一个像素的颜色来自「哪些几何覆盖了它、覆盖了多少」。第三篇讲的 analytic AA、第五篇讲的覆盖 approach,都是这条路。 VFX 专题讲的是程序化来路:一个像素的颜色来自「一个程序在这个位置、这个时刻算出了什么」。粒子、噪声、体积雾都属于这条。
两条路的输入不同(几何 vs 程序与随机种子)、可复现性不同(解析式天然可复现,程序化依赖随机数与时间)、失败模式不同(解析式的典型失败是边缘锯齿与覆盖错误,程序化的典型失败是闪烁与密度不均)。
这是一条粗判据,不是一条理论。 检索时我没有找到任何公开材料系统论述过「VFX 与矢量图形引擎」的分工边界——这一条如实登记为落空。所以本篇只给判据,不展开论证,也就不给这条判据配 VFX 的图(越界风险)。
8.3 Android 侧只讲接缝
本篇唯一涉及 Android 的地方是一句关系:Android 的 2D 绘制最终会落到 Skia 上。 这条接缝为什么值得在收官篇里点一次?
因为它解释了 Skia 的定位里最容易被忽略的一半。Skia 官方文档 那句话里列了一串宿主:「Google Chrome and ChromeOS, Android, Flutter, Mozilla Firefox and Firefox OS, and many other products.」——Android 是其中之一。 也就是说,你在 Android 上看到的每一个 2D 界面,走过的一条路是:应用的绘制命令 → Android 的绘制框架 → Skia → 某个图形 API → 屏幕。
但这条路中间那一段(Android 的绘制框架)不在本系列。 它在另一个专题里。这就是收官篇要划的那条线:本系列讲的是「Skia 收到命令之后怎么变像素」,不是「Android 怎么把命令交给 Skia」。 前者是图形库内部,后者是平台框架——两者的知识几乎不重叠,混讲会让两边都讲不清。
8.4 交叉索引的三条纪律
好了,划完边界,顺手记三条做交叉索引的纪律。它们是这一篇写下来之后最想留给后续篇目的东西。
第一条:索引要给方向,不给关联。 「A 与 B 相关」这句话的信息量是零——任何两个技术话题都能说相关。有用的是方向与内容:「想在 A 里挖深,会走到 B 的哪一段;反过来在 B 里挖深,会走到 A 的哪一段。」本篇 §8.1 那张表就是这样写的:每一行都有「想了解什么」「去哪读」「在何处相接」三列。
第二条:越界的技术不配图。 这是素材侧的一条硬约束(M13)。本篇 §8.2 给了 VFX 的判据,但没有给它配图——不是因为找不到,而是因为一旦配了 VFX 的图,读者会以为本篇要讲粒子系统。图比文字更容易被误读为「这里在讲这个」。 ep03 实测踩过这个坑:把一张延迟着色的图插进了明写「不涉及延迟着色」的正文。
第三条:把「找不到」也写下来。 本篇在 §8.2 明确写了「检索时没有找到任何公开材料系统论述过 VFX 与矢量引擎的分工边界」。这类负向结论有两个作用:一是阻止后来的自己重复检索;二是给读者一个准确的地图——他会知道这个空白是真实的,而不是作者偷懒没查。
三条都不属于「技术内容」,但它们决定了这一篇的交叉索引部分是不是可信。收官篇最容易在这里失守:因为写到这里已经很熟了,随手就会越界。
交叉索引讲完了。最后一章收边界与建议。
九、选型建议与系列收官
9.1 一张选型表
先看看怎么选。把这一篇的所有判据压成一张表,其中:行是「你的处境」,列是「建议」与「判据来自哪一节」——每条判据的官方依据,都能在 Skia 官方文档 与 Godot 官方文档 里逐条核对。前提固定在「2D 应用、单帧延迟敏感」这个场景里。
| 你的处境 | 建议 | 判据来自 |
|---|---|---|
| 要做 UI 框架 / 浏览器 / 排版系统,自己管场景与重绘 | 图形库(Skia 这一层) | §2.1 三层划分:库不决定画什么,所以你要自己决定 |
| 要做游戏,2D 内容只是其中一层 | 游戏引擎的 2D 子系统 | 同上:引擎已经替你管了场景树与重绘时机 |
| 要做交互动效,且动效逻辑应该由设计师交付 | 矢量动画运行时(Rive 这一类) | §2.2:逻辑进文件,不进应用代码 |
| 没有可用的 GPU | CPU 光栅化路线 | §3.1 第一条路;第十篇实测其斜率最陡 |
| 有 GPU 但可能只有 WebGL2 级别 | GPU 光栅化路线(不做 compute 的那一支) | §5.2:hybrid 这类路线 "without requiring compute shaders" |
| 有现代 GPU,且图元数会长期增长 | GPU 计算路线 | §3.1 第三条路;第十篇实测其斜率最平(5.37 倍 vs 73.59 倍) |
| 需要确定性单帧延迟 | 避开 compute 路线 | 第十篇:同一配置 5 轮内出现 3.8 与 26.6 毫秒两种模式 |
| 需要 2D 抗锯齿,且用的是 Godot | 别选 Compatibility | §5.1:官方注明 MSAA 2D 只在 Forward+ / Mobile 可用 |
这张表里没有一行是「哪个引擎更快」。 这是刻意的:本篇在 §0.3 就声明不做性能横向对比,因为基准口径不可比。能给的是判据,不是排名。
9.2 系列收官
十一篇到这里结束。回顾一下这条线的形状。
第一篇立坐标系,把五款引擎摆进各自的生态;第二到第六篇把 Skia 从 API 分层挖到 compute 后端;第七、八、十篇三次把工具搬出来,量真数;第九篇换到 Vello,把一个前沿引擎的机制讲完;第十一篇(本篇)回到坐标系,把机制与读数接到同一张图上。
如果这一篇只留下一句话,我希望是这一句:「引擎」不是一个层次的概念,跨层比较先要换量纲。 库里没有场景,引擎里没有 PDF 后端,运行时里没有节点树——它们的「快」不是同一种快。
第二个希望留下的是方法:机制篇的证据是原文,自跑篇的证据是读数,两类必须互为校验。 这一系列里唯一一次真正翻车的错误(第十篇第一版探针把单线程 CPU 当成 CPU 路线),就发生在「读数没有回来校验机制描述」的地方——官方文档写了 multithreading 是可选项,而我当时没去读那一行。
第三个是本篇自己踩到的:素材检索的结果可以反哺正文。 「Skia / Rive / Impeller 在公共素材库里没有 logo」这条观察,最后变成了 §2.3 里论证三层划分的一条证据。它本来只是一次失败的图位检索。
9.3 三条可以立刻照做的判断
OK,最后把判据落成三个动作,都不需要读源码。
第一,先用一句话问清「你要的是哪一层」。 动笔(或动手)之前先回答:我是在选一个图形库(我要自己管场景与重绘时机),还是在选一个引擎的 2D 子系统(我只要告诉它画什么),还是在选一个动画运行时(我希望动效逻辑由设计师交付)?这一个问题能排除掉大部分错配——把库当引擎用,你会自己写一遍场景树;把运行时当库用,你会把状态机逻辑写在应用代码里,两件事的返工量都不小。
第二,拿「斜率还是固定开销」去判路线,而不是拿「谁更快」。 具体做法是问两个问题:图元数会不会长期增长?单帧延迟要不要可复现?会增长 → 站到斜率平的那一侧(GPU 计算);要可复现 → 站到固定开销低、斜率陡的那一侧(CPU 或 GPU 光栅化)。 两个都要,就得接受两条路线并存——这也是很多项目最后的选择。
第三,把「它会怎么坏」写进选型文档。 三条路的失败模式分别是延迟尖刺、小场景固定开销、单帧不可复现(§3.4)。把这三条写下来,比写一句「性能可接受」有用得多——因为一年后你会需要知道「当时是接受哪一种坏法才选了它」。
三条合起来,其实就是这一篇想说的事:选型不是排名,是把你的约束翻译成别人的取舍。
9.4 边界回指
这一篇的边界声明写在最前面(§0.3),这里回指一次,并交代它守住了没有:
- Android 图形栈内部:只在 §8.3 讲了一条接缝,没有展开 HWUI / SurfaceFlinger / HWC;
- VFX 与粒子:只在 §8.2 给了一条粗判据,并且没有为它配图(避免越界);
- Godot 引擎整体架构:只用了它的渲染三层与
CanvasItem/Path2D两个类,没讲场景树与 3D; - 性能横向对比:一个跨引擎的性能数字都没引,§9.1 给的是判据不是排名。
四条都守住了。
参考资料
- Skia 官方文档(定位一句话)— https://skia.org/docs/
- Google 官方博客 · Introducing Skia Graphite(2025-07-08)— https://blog.google/chromium/introducing-skia-graphite-chromes/
- Cairo 官网首页 — https://cairographics.org/
- Cairo 1.18.6 发布公告(2026-09-20)— https://cairographics.org/news/cairo-1.18.6/
- Cairo 后端清单(含 cairo-gl)— https://cairographics.org/backends/
- Cairo 1.17.8(精简遗留代码与 Meson 化)— https://cairographics.org/news/cairo-1.17.8/
- Cairo 手册 · cairo_surface_type_t(Skia 后端已移除)— https://www.cairographics.org/manual/cairo-cairo-surface-t.html
- Cairo 邮件列表 · Drop the experimental skia backend(移除理由原文)— https://lists.freedesktop.org/archives/cairo/2017-August/028296.html
- WebKitGTK 2.46 公告(Skia 取代 Cairo)— https://www.webkitgtk.org/2024/10/04/webkitgtk-2.46.html
- Godot 官方文档 · CanvasItem(
_draw与右queue_redraw语义)— https://docs.godotengine.org/en/stable/classes/class_canvasitem.html - Godot 官方文档 · Path2D(继承链与用途)— https://docs.godotengine.org/en/stable/classes/class_path2d.html
- Godot 官方教程 · Custom drawing in 2D(
_draw只调用一次)— https://docs.godotengine.org/en/stable/tutorials/2d/custom_drawing_in_2d.html - Godot 官方文档 · Renderers(三层拆分与三个渲染方法)— https://docs.godotengine.org/en/stable/tutorials/rendering/renderers.html
- Godot 官方文档 · Internal rendering architecture(2D batching)— https://docs.godotengine.org/en/stable/engine_details/architecture/internal_rendering_architecture.html
- Godot 官方文档 · 2D antialiasing(MSAA 2D 的可用范围)— https://docs.godotengine.org/en/stable/tutorials/2d/2d_antialiasing.html
- Godot 官方 benchmark(只登记,不引用其数字)— https://benchmarks.godotengine.org/benchmark/2025-03-11_30bb49ec1/
- Rive 官网(Interactive experience engine)— https://rive.app/
- Rive Renderer 介绍页(自研 GPU 矢量引擎,已开源)— https://rive.app/renderer/
- Rive 运行时页(MIT 许可与平台清单)— https://rive.app/runtimes/
- Rive 官方文档 · State Machine 定义 — https://rive.app/docs/editor/state-machine/state-machine
- Rive 官方博客 · Rive as a Lottie alternative — https://rive.app/blog/rive-as-a-lottie-alternative
- Rive 官方博客 · Why importing Lotties isn't what Rive was built for — https://rive.app/blog/why-importing-lotties-isn-t-the-workflow-rive-was-built-for
- Flutter 官方文档 · Impeller(布局、边界与 Web 仍用 Skia)— https://docs.flutter.dev/perf/impeller
- Flutter engine README · Impeller 目标清单 — https://github.com/flutter/flutter/blob/main/engine/src/flutter/impeller/README.md
- Vello 仓库(两族划分与三路分工)— https://github.com/linebender/vello
- 素材来源:Wikimedia Commons 十张外部素材(见各图图注署名与许可)
- 本系列已交付篇目:ep01–ep10(本机真图仅复用 ep10 的规模扫描图一张)
本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真图复用自本系列已交付篇目(图注标明来源篇); 自绘图为本系列绘制,走
styles/qianmo/palette.json色板单源。站点链接:技术博客页
下篇预告:本系列十一篇到此收官。下一批会把这条方法(机制靠原文、代价靠自跑、两类互为校验)搬到相邻的题域上继续用——先补上本篇只给了接缝的那一段:Android 的 2D 绘制框架怎么把命令交给图形库。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。
With Best Wishes.