本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
前面四篇都发生在 CPU 一侧。第二篇把「一次 draw」从 API 面拆到后端门口,第三篇走完了「曲线→线段→覆盖率→灰度」这条 CPU 光栅的动线,第四篇换了输入,讲字形怎么被取出来。四篇下来有一个默认前提一直没被检验:这些工作都由 CPU 干。这一篇把那个前提拿掉。同一条路径、同一个字形,交到 GPU 手上之后,引擎需要做的第一件事不再是「怎么算准覆盖率」,而是怎么把一次 draw 变成一串 GPU 愿意接受的指令:组织成哪些 op、能不能合并成一个 render pass、几何要拆成多少个实例、每个实例里塞几个控制点、抗锯齿的覆盖率从哪来。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 结论带读数:凡是「更快/更准」的说法,绑定官方原文常量或本机实测数字;
- 凡引必注:源码常量给文件与版本,官方文档给链接,本机实测给环境与命令;
- 本篇不涉及(边界见 0.3):Graphite 的 Recorder/Recording 内部机制与 Dawn 抽象层、Vello 的 sparse strips 与 4×4 tile 流水线、Pathfinder 的 GPU tiling-dicing、Loop-Blinn 隐式曲线那条「曲线直接交互像素」的路线、CPU 光栅与字形缓存(前两篇已讲透);
- 篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,400 到 2,300 字。本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机自跑实截由
skia-python 144.0.post2生成;自绘图为本系列绘制,走styles/qianmo/palette.json色板单源。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(第一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 上一篇(字形光栅化):【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 本篇引用最密的两个源码文件:Tessellation.h | WangsFormula.h
- 本篇本机自跑用的绑定:skia-python 发行页
本篇只回答三件事
先来看看这一篇要回答的三个问题。它们不是并列的知识点,而是一条从「一次调用」到「一条 GPU 指令」的动线,顺序不能颠倒:先明白 op 是怎么被组织与合并的,才谈得上「为什么有些路径必须走细分」;先看清覆盖 approach 怎么把灰度算出来,才谈得上「为什么还要有一条实例化细分的路」。
0.1 全篇知识地图:三个问题,一条动线
第一件:一次 draw 在 GPU 侧要穿几层。我们在 API 面写的是 canvas->drawPath(path, paint);到了 GPU 侧,它先被记成一条 op(操作),若干条 op 被收进一张 render pass(渲染通道),最后才被翻译成命令缓冲里的 draw call(绘制调用)。这条链上每一层都在做筛选与合并,读者的第一印象应该是「GPU 侧的工作量大头不在算术,在组织」。第二件:GPU 侧有哪几条画路径的路。 CPU 侧只有一条路(扫描转换 + 覆盖率),GPU 侧却有一串候选:模板缓冲两步法(stencil-then-cover, StC)、覆盖式抗锯齿(coverage AA,给几何套一层裙边并沿裙边插值)、固定次数实例化细分(fixed-count instanced tessellation),以及更晚加入的 CCPR(覆盖计数,两个 pass 一个 R 通道缓冲)[3]。四条路各自适用不同内容,引擎必须有一套判据在其中选。第三件:一条曲线怎么变成一个 patch。这是本篇篇幅最多的一段。答案为:先用 Wang 公式算出这条曲线需要多少段,再把控制点打进实例属性——每个实例的基座是四个控制点,曲线类型要么靠 p3.y 是不是无穷来推断,要么单独用一个 float 说明;段数不够就自增,超过上限就先把曲线切小。我们要看清的三件事说完了。
0.2 一句话说清 GPU 侧换了什么
CPU 侧的问题是「怎么把覆盖率算准」,GPU 侧的问题是「怎么把路径翻译成 GPU 喜欢的形状」。这句话不是修辞。CPU 侧的扫描转换器面对的是像素,它的核心矛盾是精度与开销;GPU 侧面对的是图元(三角形与实例),它的核心矛盾是批处理效率:GPU 不爱画小东西,也不爱频繁换状态。所以 GPU 侧的所有设计——模板、裙边、实例、段数上限——都可以被同一句话解释:把「很多条大小不一、弯曲不同的曲线」压成「少数几次形状统一的绘制」。顺便说清一件事:GPU 侧并不比 CPU 侧准。它换来的东西是吞吐与并行,代价是复杂度。谁在什么时候更快,取决于内容与驱动,而不是取决于「GPU」这个字。
0.3 边界:本篇不涉及什么
把话说在前面,避免把精力花在别处:
- Graphite 的内部机制:Recorder / Recording 的生命周期、多线程录制的同步细节、Dawn 抽象层、Recording 的重放与滚动复用——属下一篇(ep06)。本篇只用到 Graphite 的两条已经公开的设计结论(z 值与 depth 裁剪);
- Vello / piet-gpu:sparse strips、flatten/binning/coarse/fine 四阶段、prefix-scan 与 GPU 排序、4×4 tile——属 ep09/ep10;
- Pathfinder 与 NV_path_rendering:作为「另一条范式」只在坐标系里出现,不展开;
- Loop-Blinn 与 GPU Gems 3 的隐式曲线渲染:那是「曲线直接与像素交互」,与 Skia 的「先实例化再栅格」是两条路,本篇只做背景对照;
- CPU 光栅与字形:扫描转换、analytic AA、字形数据组织、缓存与 CJK——前三篇已讲透,本篇只引用不复述。
关键参数取值范围(本篇反复用到的三个数,先立在这里):精度 1/4 像素;单曲线段数上限 32 段;单曲线段数切分阈值 1024 段。
0.4 证据来源与可复现方式
本篇的证据分两类,各有各的边界,其中第二类的边界必须说在最前面。第一类:官方源码常量与官方文档原文。格式为「文件路径 + 常量名或注释原文」。本篇 GPU 侧的全部数字都出自这一路,逐条标了出处文件与版本(快照口径见参考资料第 5 条),没有一个是本机测出来的。第二类:本机自跑,但只在 CPU 侧成立。环境是 skia-python 144.0.post2(Skia m144),代码在 pixel-raster-dev 仓 exp/gpu/ 下。这里有一条必须坦白的限制:本机没有 GPU 抓帧环境(RenderDoc、AGI、chrome://tracing 的 Skia 轨迹都不可用),所以本篇不写任何「本机 GPU 实测」。标「本机自跑」的图测的都是两侧同样成立的量:覆盖率分布、弦高误差、曲线类型占比、段数分布、join 几何。只能由 GPU 回答的(实例数、draw call 数、命令缓冲大小)一律引源码常量,绝不估算。另有一条检索结论:Commons 上没有对位「GPU 引擎内部机制」的示意图(Skia、Path rendering、Instanced rendering、Tessellation、Stencil buffer、Z-buffer、Depth buffer、Framebuffer 八个类目全部返回 0 个文件),所以机制示意全部是本机自绘或本机实截,外部示意图只用在「通用原理」那几个位置。
0.5 本章收在哪里
下面我们进入第一阶段。本篇的线索是「组织」:一次调用是一个 op,一批 op 是一个 pass,一条曲线是一个实例。
官方依据:图形管线的阶段定义见 The OpenGL - DirectX graphics pipeline 与 Vulkan 规范的管线章节;Skia 的两条后端线见 Skia Graphite 官方博客。

一、一次 draw 在 GPU 侧要走几层
下面我们进入第一阶段:一次 drawPath 到底被拆成什么。这一章不讲算术,只讲分层与合并——因为 GPU 侧的效率天花板通常不落在算术上,而落在「有多少次绘制、每次切换了多少状态」上。
1.1 从 SkCanvas 到命令缓冲
我们在 API 面写下的每一个绘制动作,在 GPU 侧都要经过四层:
- 第一层:意图记录。
SkCanvas收下命令、矩阵与裁剪栈,转给设备层。设备层不再关心「用户想画什么」,只产出「要执行什么」; - 第二层:op 列表。每个绘制动作被记成一条 op,带上它需要的全部状态:几何、画笔、混合模式、目标表面、以及这条 op 能不能和别的 op 合并的信息;
- 第三层:render pass。 op 被筛进渲染通道。这一层发生的是合并:落在同一张表面、状态兼容的 op 会被塞进同一个 pass,于是命令缓冲里的绘制次数显著少于 op 条数;
- 第四层:命令缓冲。到这一层已经没有「路径」这个概念了,只剩顶点缓冲、索引缓冲、实例缓冲与一次
drawIndexedInstanced。这条链上「路径」的形态每过一层就变一次:从几何变成记录,从记录变成批次,从批次变成指令。越往下,越不像我们写的那行代码。这条链还解释了一个常见困惑:为什么同一个画面在 CPU 侧和 GPU 侧的「画了多少东西」永远对不上。CPU 侧我们数的是路径条数,GPU 侧数的是绘制次数与实例数,两者之间隔着上面这四层——本篇后面所有的「上限」「拆分」「批次」,都是这四层带来的。
1.2 本篇在图形管线里的位置
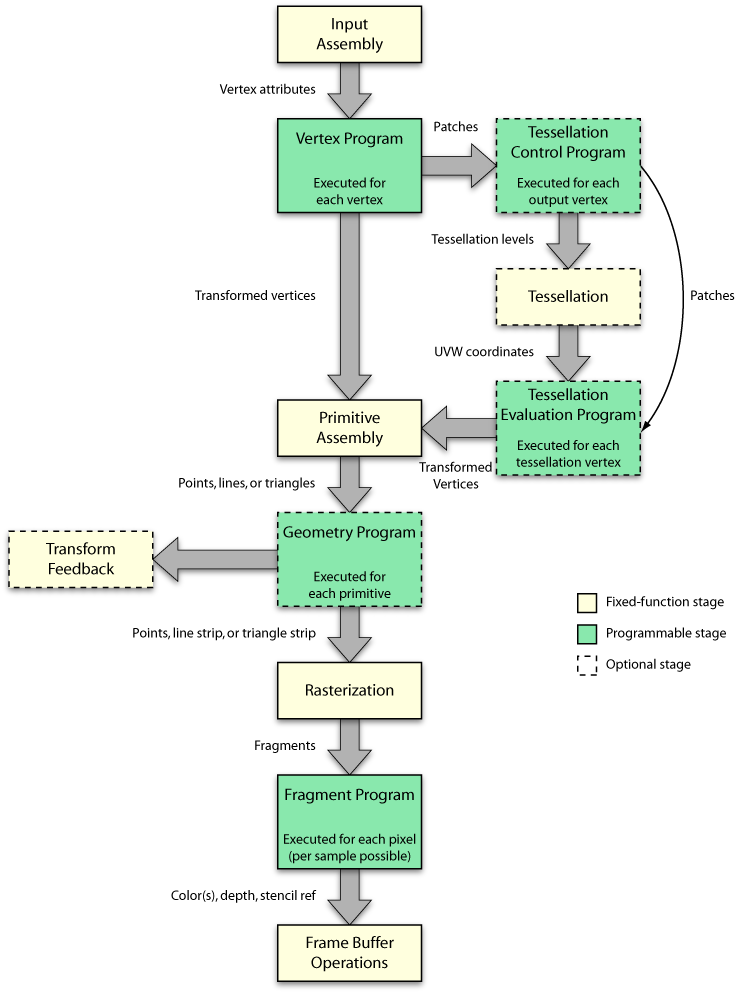
上面这张图把 GPU 管线的阶段摆开了。本篇的位置在几何阶段的尾部到光栅化的入口:我们关心的不是片元着色器怎么写,而是进去的是曲线、出来的是三角形这一段的翻译过程。这一段在术语上有个总称——曲面细分(tessellation)。这里要拆开一个容易混淆的词。tessellation 在不同上下文里指两件不同的事:
- 在 GPU 硬件规范里,它指的是一组可编程的细分阶段(外壳着色器与域着色器),由硬件按 patch 控制点计算新顶点,patch 控制点上限由设备限制给出;
- 在 Skia 的实现里,它指的是「固定次数实例化细分」(fixed-count instanced tessellation)——不用硬件细分阶段,而是把每条曲线当成一个实例,用一个预先写好的顶点/索引缓冲配合实例属性,在着色器里把曲线展成三角形。这两条路都叫 tessellation,但实现完全不同。本篇讲的是第二条,理由在 §3.2:硬件细分阶段在移动端缺席、且控制点上限与批处理配合不佳,Skia 选择了「用实例化自己模拟细分」。
1.3 一次画面的 op 记录条数
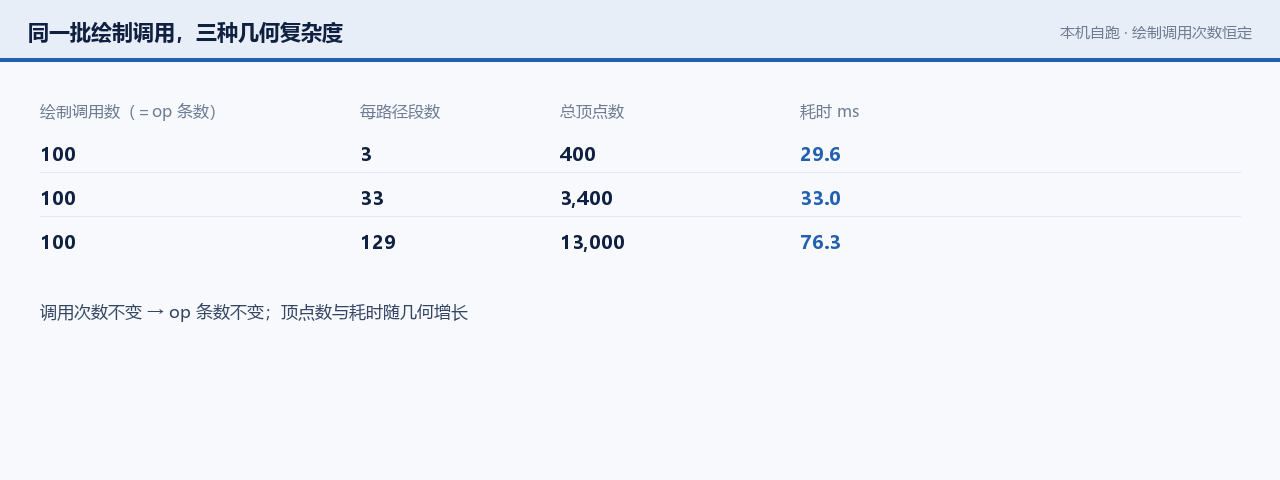
本机自跑口径:这一张量的是
SkPicture记录下来的显示列表条目,属 CPU 侧的记录层,不是 GPU 的 op 列表。之所以先量它,是因为两者形状一致(都是「一个绘制动作一条记录」),而 CPU 侧这一层本机能真跑。顺手记一个反例,用来说明「批处理」这件事有多贵:2014 年 Chromium 的图形开发组里有人直接点名当时的 Skia:「Current skia ganesh is not good at batching gl drawing calls. e.g. if you draws 1k rects, skia issues 1k glDrawArray/Element」[13]。这句话的年份很重要——它是 tessellation 路径渲染器成熟之前的语境,但结论至今成立:批处理不是自动的,是引擎主动设计出来的。
1.4 Ganesh 与 Graphite:两代录制模型的差别
先来看看官方怎么描述这两代的差别,因为它决定了「op 在哪里被记下来」这件事有没有第二种答案。
Ganesh 的瓶口在单线程:
"Due to the single threaded nature of Ganesh and OpenGL, only a limited set of work could be moved to other threads, making it easy to overload the main thread..." —— [1]
这句话的因果值得读两遍:不是「Ganesh 不想多线程」,而是它的底座(OpenGL 的上下文模型)决定了它只能这么干。op 的录制、排序、提交都挤在主线程上,主线程一忙整条链就等。
Graphite 换的正是一层底座:
"Graphite's new core API is centered around independent Recorders that can produce Recordings on multiple threads, with minimal need to synchronize between them." —— [1]
关键词是 independent(互相独立):多了「录制」这个可独立进行的阶段之后,op 的产出可以并行,消费(回放)再统一进行。「录制」与「回放」拆成两阶段是下一篇的机制,也是本篇要先交代的边界:本篇讲 Ganesh 这一代的答案。
1.5 本章收在哪里
这一章只讲了一件事:GPU 侧的第一性问题是组织,不是算术。一次 draw 要穿过记录、op、pass、命令缓冲四层,每一层都在筛与合。理解了这条链,后面「为什么上限是这个数」「为什么要拆 chunk」才有落点。
官方依据:Ganesh 的单线程瓶口与 Graphite 的录制模型见 Skia Graphite 官方博客;两代 backend 的官方定性见 skia-discuss 讨论帖。
二、op 是怎么被排序与合并的
下面我们进入第二阶段。上一章说 op 会被合并,这一章回答按什么规则合并、以及哪些东西不能被合并改掉。这是 GPU 侧效率的来源,也是正确性的边界所在。
2.1 op 列表与 render pass 合并
合并的判据可以压成三点:同一张目标表面、兼容的混合与采样状态、没有互相遮挡的依赖。三点都满足,相邻的 op 就能进同一个 pass。这里有一个反直觉的事实:合并的收益不在算术上,在切换上。把两次绘制并成一次,省掉的不是那几十个三角形的计算,而是两次流水线状态切换——包括着色器程序切换、常量缓冲重绑、纹理绑定。GPU 从「画」切到「换状态」再切回「画」,这中间的空转是纯粹的损耗。所以 GPU 侧的效率指标不是「画了多少像素」,而是「切换了多少次状态」。明白了这一点,才能理解为什么下一篇的 Graphite 要把「画家顺序」编码成一个 z 值交给深度测试——只有让顺序由硬件自动保证,op 才有重新排列的自由。
2.2 排序目标与不变量
排序有一个目标和一条不变量,两者直接对抗:
- 目标:最小化状态切换。把用同一套管线的 op 排到一起,把绑定同一张纹理的 op 排到一起;
- 不变量:画家顺序(painter's order)。后画的必须压住先画的,否则半透明与叠加的语义就错了。这对矛盾的解法取决于 op 有没有遮挡关系。官方博客把 Graphite 的做法说得很直白:「opaque objects in the foreground can now automatically eliminate overdraw. This means opaque draws can be re-ordered to minimize expensive GPU state changes while relying on the depth buffer to produce correct output.」[1]——不透明的 op 因为有深度缓冲兜底,可以任意重排;半透明的 op 必须维持顺序,因为没有「谁挡住谁」的确定答案。这一节还顺手解释了 depth 在这里的角色:它不是给 3D 用的,它是给 2D 的排序自由用的。
2.3 一个批处理的算例
下面我们用一个算例把前面三条判据串一遍。假设一幅画面里有一千条曲线路径,它们分散在三个不同的图层上,全部不透明,目标表面相同:
【批处理算例:1,000 条曲线路径,三个图层,全部不透明】
op 条数        = 1,000            # 每个绘制动作一条 op
可合并的邻居   = 同图层内相邻     # 判据:同表面 + 兼容状态 + 无遮挡依赖
render pass 数 = 3                # 三个图层各自成一段,图层之间必须保序
draw 次数      = 分块数 × (1 + 是否开 AA)
其中:
- op 条数由「画了多少次」决定,与几何复杂度无关——一条一万段的路径与一条两段的路径都是一条 op;
- render pass 数由「能合并的邻居有多少」决定,本例被图层切断成三段;
- draw 次数由「上限与 AA」决定(第九章算全),它才是随 GPU 变化的量。下面对这个算例特别说明:它把「批处理率」变成可算的比值——op 条数与 draw 次数之比。换一次纹理、插一层半透明、加一次裁剪,比值就被切一段。GPU 侧的性能问题多数就是在这个比值上做文章。
2.4 本章收在哪里
这一章讲「op 按什么合并、什么不能动」。判据是表面、状态与依赖三条;收益在少切换而不在少算术;代价是只能重排不透明 op。从这一章起,「画家顺序」这个词会一直跟着我们。
官方依据:不透明 op 的重排与深度兜底见 Skia Graphite 官方博客;绘制批处理的历史语境见 chromium graphics-dev 讨论。
三、GPU 侧有哪几条画路径的路
下面我们进入第三阶段:既然 op 已经组织好了,具体到「一条路径」该怎么画,引擎手里有几张牌。这一章先把牌摊开,后面三章逐条展开其中最重要的两张。
3.1 四条路:一份全量清单与它的二次归类
先给全量清单,再归类——这是本系列的习惯(先摊开「面」,再给「骨」):
| 路线 | 一句话机制 | 抗锯齿从哪来 | 典型适用 |
|---|---|---|---|
| 模板两步法 | 先用「模板」步骤把覆盖区域标进模板缓冲,再用一个覆盖全区域的四边形做「着色」步骤 | 由模板的次像素精度或后续滤波提供 | 自相交、复杂填充规则、需要精确非零环绕的场景 |
| 覆盖式 AA | 给几何套一层三角形裙边(skirt),沿裙边插值覆盖率 | 几何自带的覆盖率 | 凸路径、直线与二次曲线为主的形状 |
| 固定次数实例化细分 | 每条曲线一个实例,在着色器里按段数展成三角形 | 同覆盖式:裙边插值 | 曲线多、需要一次批处理大量路径 |
| CCPR | 两个 pass,用一个 R 通道缓冲记录每个像素被覆盖的次数 | 覆盖计数本身 | 硬件够新(见下)时替代模板两步法 |
归类方式有三种,对这四条路都成立:
- 按「覆盖怎么算」分:前三条都依赖「几何 + 插值」,第四条靠「计数」。这是最本质的分法;
- 按「要不要额外缓冲」分:模板两步法要模板缓冲,CCPR 要一张 R 通道缓冲,另外两条不要;
- 按「硬件门槛」分:模板两步法门槛最低(几乎任何 API 都有模板),CCPR 要求最低 ES 3.0,且需要半精度浮点 alpha 可作为颜色渲染目标,覆盖式与实例化细分居中。
「覆盖怎么算」这一维是本文的主线,因为另外两维都是它的后果。
3.2 为什么 Skia 不直接用硬件细分阶段
这里要说清一个选择。GPU 硬件规范里本来就有可编程细分阶段:喂一组 patch 控制点,硬件自己算出新顶点。既然现成,为什么 Skia 要自己用实例化模拟一遍?三个理由,都来自规范与实现本身的形状:
- 控制点上限不保证。规范里 patch 控制点上限由设备限制给出,只保证「支持细分的 GPU 至少能给到 32」;换句话说,引擎不能假设一个 patch 能装下任意形状的路径,必须自己做拆分;
- 移动端缺席。移动平台历史上对细分阶段的支持并不可靠,而 Chrome 的 GPU 光栅化要覆盖移动端;
- 批处理更差。硬件细分阶段要为每个 patch 走一遍外壳与域着色器,与实例化相比,「把多条曲线用同一套顶点/索引模板批量展成三角形」更符合 GPU 的偏好。所以 Skia 的 tessellation 是「用实例化模拟细分」,它的顶点与索引缓冲是预先算好的固定模板,配合实例属性里的控制点,在着色器里算出每条曲线的实际顶点位置。这也是本篇标题写「instanced tessellation」的原因——这四个字指的就是这个实现选择。
3.3 stencil-then-cover 的状态推进
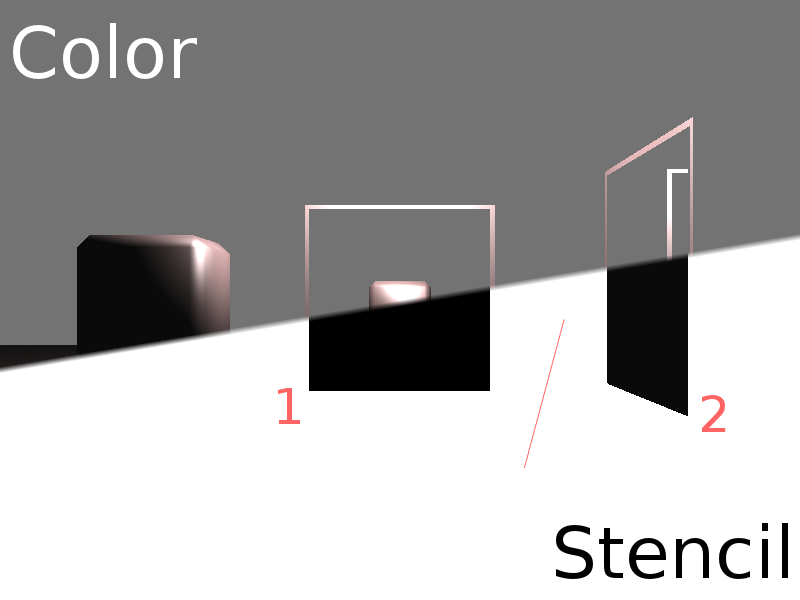
模板两步法的细节在两篇经典文献里讲透了:Kilgard & Bolz 在 SIGGRAPH Asia 2012 提出「Stencil, then Cover」的两步接口,把「算覆盖」与「着色」显式解耦——原文的说法是「we explicitly decouple in our programming interface the stencil step to determine a path's filled or stroked coverage from the subsequent cover step」[19]。这套接口后来以 NV_path_rendering 扩展的形式产品化。它是 GPU 路径渲染坐标系里的另一种范式:覆盖精度来自模板缓冲的位数与规则,不来自几何。优势是能干净处理自相交与非零环绕;劣势是每个像素要写两遍,且模板缓冲占内存。顺便说一段历史对照:同一篇论文在 2012 年评价当时的 Skia,说它的 CPU 光栅器把覆盖率掩码算成纹理、每次绘制都当纹理加载,「often bottlenecked by the dynamic texture updates required for every rendered path」[19]。这话今天已不成立——Skia 的 GPU 路径渲染后来走了几何路线。引用它只为说明:同一个引擎在不同阶段可以有完全不同的答案。
3.4 本章收在哪里
这一章摊开了四条路并给了三种分法。本篇余下篇幅只展开两条:覆盖式 AA(第四章)与固定次数实例化细分(第五至九章)——因为它们是 Skia 在实际启用 tessellation 时用的那两条,也是「几何路线」这句话的具体内容。
官方依据:GPU 侧 AA 的两大桶与「裙边插值覆盖率」这句话见 skia-discuss 官方讨论;CCPR 的硬件门槛同帖;模板两步法的接口定义见 Kilgard & Bolz, GPU-accelerated Path Rendering。
四、覆盖 approach:AA 的 skirt 是怎么插值的
下面我们进入第四阶段,本篇两条主线的第一条。这一章回答一个很具体的问题:三角形的边缘是硬的,抗锯齿的灰度是从哪冒出来的?先来看看官方的说法。Skia 的维护者在官方讨论组里对 GPU 侧的抗锯齿有一句概括:
"For more complex paths, the different path renderers use a variety of approaches, but one common idea is to inflate the path geometry with a skirt of triangles, and interpolate coverage across that skirt." —— Brian Osman, skia-discuss [3]
一句话就是全文的答案:给几何套一圈三角形裙边,沿裙边把覆盖率插出来。
4.1 覆盖式 AA 的像素选择
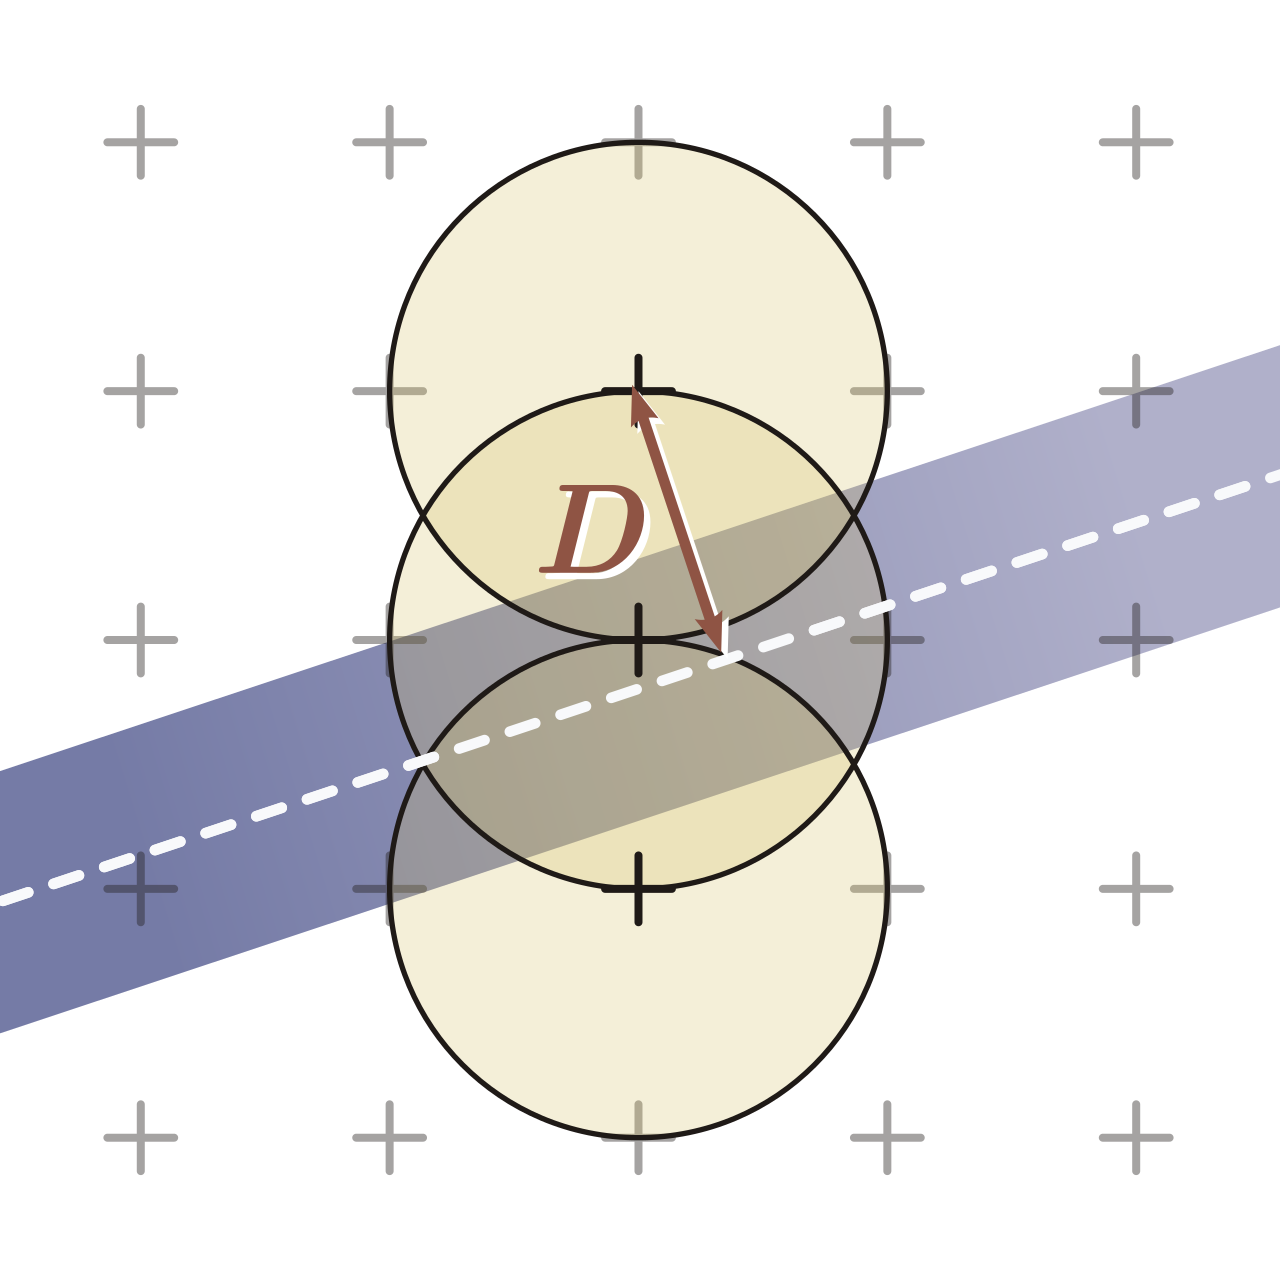
先看最经典的那张图:解析式覆盖(analytic coverage)怎么决定一个像素拿多少灰度。做法是算像素中心到线段的距离,再按距离映射到覆盖档位——这也叫 Gupta-Sproull 滤波。它的特点是不需要多个采样点,一次算术就给出一档覆盖率。把它与 MSAA(多重采样抗锯齿)/ 超采样摆在一起看,差别就清楚了:
| 维度 | 覆盖式 / 解析式 | 超采样 / MSAA |
|---|---|---|
| 覆盖率怎么来 | 几何位置插值出连续值 | 有限个采样点投票,档位受采样数限制 |
| 需要额外内存吗 | 不需要 | MSAA 需要每采样存储,超采样需要更大缓冲 |
| 档位上限 | 理论上连续(受位深限制) | 采样数决定(4 采样 → 5 档) |
| 代价落在哪 | 几何与着色器算术 | 内存与带宽 |
这张表是理解 GPU 侧 AA 全部分歧的钥匙:走左边就要处理「几何膨胀」,走右边就要处理「内存与采样数上限」。
4.2 skirt 插值:4 顶点 hull
覆盖式 AA 在 Skia 里的落地形状是这样的:曲线本身用中间向外拓扑展成三角形,另外用一次固定四顶点的实例化绘制把「裙边」贴上。裙边的顶点沿着曲线法向向外撑开一定距离,其中一个顶点带覆盖率 1、另一个带覆盖率 0,于是光栅化在两者之间做线性插值——灰阶就是在这一步产生的。这里有一个很容易被忽略的工程细节:裙边是「按需要」贴的。也就是说,同一条路径在抗锯齿开与关时,走的是不同的绘制次数,不是「同一批几何换一个着色器」。这一点在 §4.3 会看到源代码级的证据。
4.3 两次 draw 的结构
好了,下面来看本篇第一个「源码级」的结构证据。 Skia 的 tessellation 路径渲染器在提交绘制时,主线与裙边是分开两次交出去的:
/* 【PathTessellator.cpp】填充/描边主线与 AA 裙边的提交 */
flushState->bindBuffers(fFixedIndexBuffer, chunk.fBuffer, fFixedVertexBuffer);
flushState->drawIndexedInstanced(fMaxVertexCount, 0, chunk.fCount, chunk.fBase, 0);
// 注释原文:The max vertex count is the logical number of vertices that the GPU needs to emit,
//          so since we're using drawIndexedInstanced, it's provided as the "index count" parameter.

flushState->drawInstanced(chunk.fCount, chunk.fBase, 4, /* vertexCount */ 0);
// 裙边:固定 4 个顶点,实例数 = 本 chunk 的 patch 数
其中:
fFixedIndexBuffer、chunk.fBuffer、fFixedVertexBuffer分别是索引缓冲、实例缓冲、顶点缓冲——三个缓冲配合,索引与顶点是全局预计算的固定模板,只有实例缓冲随内容变化;chunk.fCount是本 chunk 的 patch 数量,也就是实例数;fMaxVertexCount被当作索引个数传给drawIndexedInstanced——原文注释专门解释了这一点,因为「顶点数」与「索引数」在实例化绘制里容易混;- 裙边那次用
drawInstanced,顶点数固定 4,不传索引。下面对这一段特别说明:它把本篇的核心结论摆在代码上了——一条路径在 GPU 侧不是「一次绘制」,而是「一次主绘制 + 一次裙边绘制」,且这两次的形状完全不同(一次是索引化的实例绘制,一次是无索引的固定顶点实例绘制)。读者如果只记一句话,记这个。
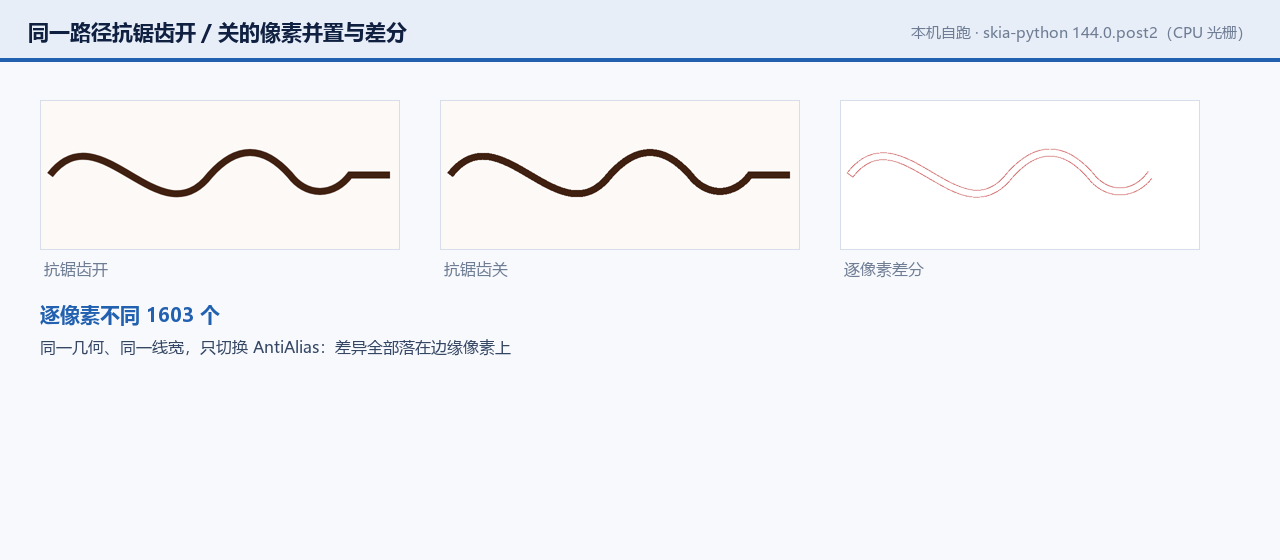
4.4 覆盖率的实测分布
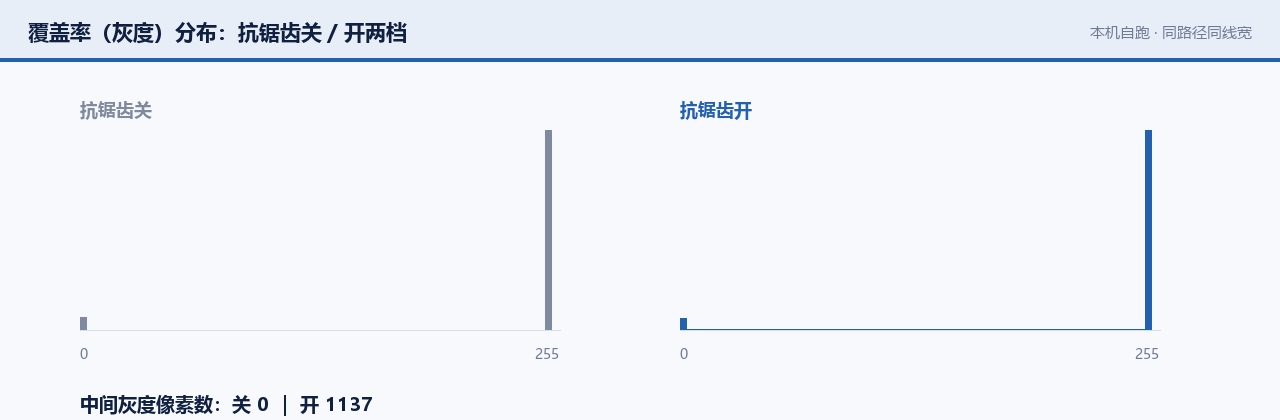
本机自跑口径:这一张量的是覆盖率分布的形态,属 CPU 与 GPU 两侧同样成立的量。它不是 GPU 抓帧。实测出来的形状与理论一致:关闭抗锯齿时,像素值只有两级(全透明或全不透明,中间灰度为 0 个);开启之后出现大量中间灰度。这个「中间灰度的个数」很能说明问题——它就是覆盖率档位的直观计数。这条读数还有一个用法:它可以用来说明为什么 MSAA 的采样数与视觉档位直接绑定。采样数 4 的 MSAA 只能给出 5 档(0/4 到 4/4),而解析式覆盖的档位由位深决定,通常是 256 级。两者的视觉差距在斜线与小字号上最明显。
4.5 MSAA 与超采样的采样位置
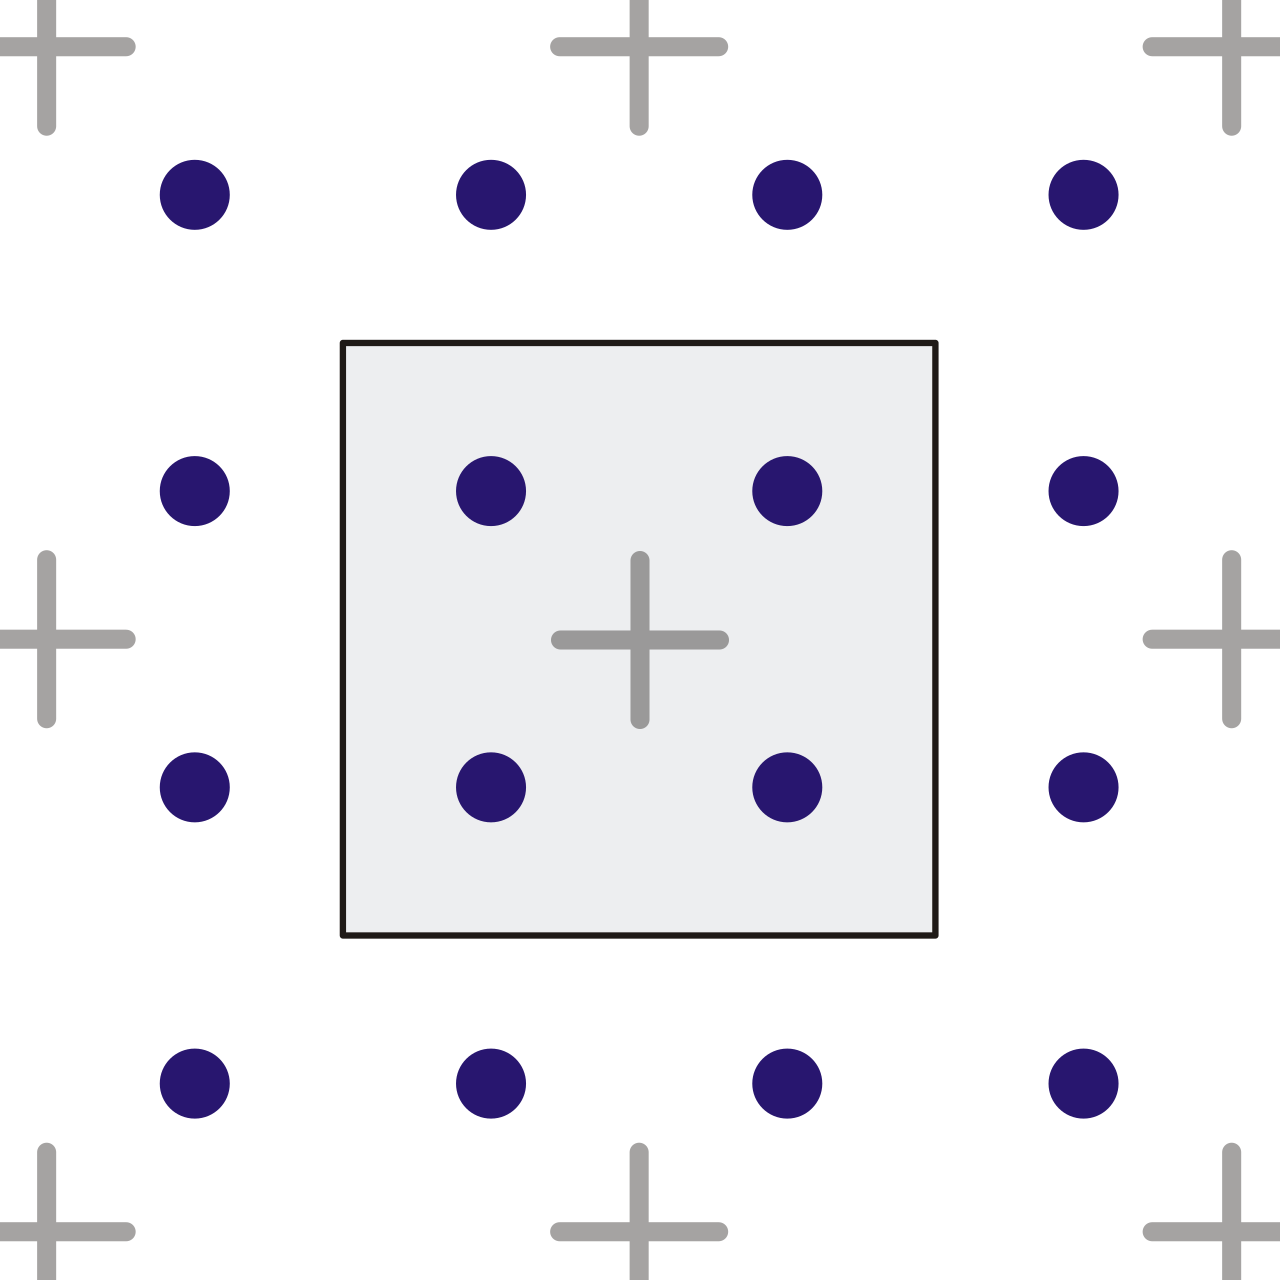
超采样这一类路线的关键变量不是「采几个点」,而是「采在哪里」:
- 均匀网格(uniform grid):把像素切成 n×n 个格子各取一个样本,最容易实现,但边缘容易出现规律性的台阶;
- Quincunx(梅花形):五个样本按梅花形排布,用更少的样本换更好的边缘,代价是垂直与水平方向的响应不对称;
- 旋转网格:把采样格旋转一个角度,把规律性伪影变成更难察觉的高频噪声;
- 抖动(jitter):把采样位置随机化,配合时间上的变化可以让闪烁变成噪点。这四个选项在 GPU 侧不由引擎决定,而由 API 与驱动决定——引擎能选的只是「用不用 MSAA」。这也是为什么覆盖式 AA 对引擎更有吸引力:它的档位与采样排布都在引擎自己手里。
4.6 为什么覆盖式 AA 在小字号上占优
先来看看这个差别在什么场景下最要命——答案是小字号的中文与斜线。原因回到档位:MSAA 取 4 个采样只有 5 档覆盖率,而覆盖式 AA 的档位由位深决定,通常 256 级——两者档位数量差约 50 倍。在笔画宽度只有一到两个像素的字形上,差别不是「细腻一点」,而是笔画会不会跳档:
- MSAA 下,一个宽度约 1.5 像素的竖笔,覆盖率只在 5 档里选,相邻笔画的灰度容易出现整档跳变,看上去是「有的笔画深有的浅」;
- 覆盖式下,同一条竖笔的覆盖率可以在 256 级里取值,灰度过渡连续。这条读数与 ep04 接得上,但要分清层次:hinting 改的是轮廓坐标,覆盖率只决定轮廓如何变成灰度——互不替代(ep04 §6.8「先分清调的是哪一层」在这里同样适用)。
4.7 本章收在哪里
这一章讲的是「灰度从哪来」。答案是几何:给路径套一层裙边三角形,沿裙边插值覆盖率。源码级证据是「一次主绘制 + 一次四顶点裙边绘制」这个两段结构。这条路的档位由位深决定,比 MSAA 的采样数档位细得多——这是它存在的理由。
官方依据:裙边插值与 GPU 侧 AA 分类见 skia-discuss 官方讨论;解析式覆盖面选择与超采样排布的对照图见 Gupta-Sproull pixel selection 与 Supersampling - Uniform。


五、instanced tessellation:一条曲线怎么变成一个实例
下面我们进入第五阶段,本篇第二条主线的起点。这一章回答:一次绘制里有几百条曲线,GPU 怎么知道每条曲线长什么样?答案是「实例」:每条曲线是一个实例,控制点放在实例属性里,顶点与索引模板是所有实例共用的。
5.1 每实例四个控制点
先来看看布局。Skia 在 Tessellation.h 里把实例的步长写成了一个表达式:
/* 【Tessellation.h】patch 的步长 */
constexpr size_t PatchStride(PatchAttribs attribs) {
    return 4 * sizeof(SkPoint) + PatchAttribsStride(attribs);
}
其中:
4 * sizeof(SkPoint)是基座——四个控制点,在着色器里习惯写成p01与p23两个float4;-
PatchAttribsStride(attribs)是可选属性区的长度,由位掩码决定(见 §5.2)。四个控制点,这是一个必须记住的数。它带来两个后果: -
二次曲线用不满。一条二次贝塞尔(quadratic)只需要 3 个控制点,第四个位置被借去放别的东西(或空着);
- 三次曲线刚好。一条三次贝塞尔(cubic)正好四个控制点,一个实例装一条,不多不少。同一份源码里还有一处断言把这个布局钉死了——描边着色器构造时逐字校验:
SkASSERT(this->instanceStride() == sizeof(SkPoint) * 4 + PatchAttribsStride(fPatchAttribs));
下面对这句断言特别说明:它不仅在说「是 4 个点」,还在说「实例步长是按属性位掩码动态算的」——同一个绘制批次里,如果有些属性用不上,就不占空间。这是「固定模板 + 情况增减」这个设计取向的直接体现。顺手纠一个流传的说法:有二手资料写「Skia 每个实例能装 5 条二次曲线 / 10 个控制点」——源码不支持。我们逐字核过三处独立证据(PatchStride 与两处 instanceStride() 断言),每实例基座都是 4 个控制点;那个「5」是 MiddleOutShader::kMaxInstanceAttribCount,指属性条数。本篇不沿用该说法。
5.2 PatchAttribs 位域
可选属性用一个位掩码表达。Skia 的枚举逐字如下(注释即为原文):
/* 【Tessellation.h】PatchAttribs:可选实例属性 */
kJoinControlPoint  = 1 << 0,  // [float2] Used by strokes. This defines tangent direction.
kFanPoint          = 1 << 1,  // [float2] Used by wedges. This is the center point the wedges fan around.
kStrokeParams      = 1 << 2,  // [float2] Used when strokes have different widths or join types.
kColor             = 1 << 3,  // [ubyte4 or float4] Used when patches have different colors.
kPaintDepth        = 1 << 4,  // [float] Used in Graphite to specify depth attachment value for draw.
kExplicitCurveType = 1 << 5,  // [float] Used when GPU can't infer curve type based on infinity.
kWideColorIfEnabled= 1 << 6,
kSsboIndex         = 1 << 7,  // [int] Used to index into a shared storage buffer for this patch's uniform values.
这张表值得逐位读一遍,因为它把「实例里还能塞什么」摊开了:上一个控制点(描边要用它的切线)、扇心(楔形填充要用)、描边参数(线宽与 join 类型)、颜色、深度值(Graphite 用)、显式曲线类型、共享存储索引。其中三位与本章两条主线直接相关:
kJoinControlPoint解释了 §8.2:描边必须多带一个控制点,否则接缝处的切线方向无从得知;kFanPoint解释了 §8.1 的楔形模式:扇心是楔形三角形共用的那个顶点;kPaintDepth是 §10.2 那条线的接口——Graphite 把 z 值放在实例属性里,塞进深度缓冲。
5.3 曲线类型怎么编码
三类曲线要能在一个实例结构里共存,编码方式就得统一。Skia 的描边着色器注释把规则写得很省字:
// pts 0..3 define the stroke as a cubic bezier. If p3.y is infinity, then it's a conic with w=p3.x.
翻译过来:默认按三次贝塞尔解释;如果 p3.y 是无穷大,那这条是 conic(圆锥曲线),权重 w 放在 p3.x 里。用「一个不可能出现的坐标值」当类型标记,好处是类型信息不占额外空间——只有当 GPU 不支持浮点无穷时才退到 kExplicitCurveType 那一支(逐字注释:// We should use explicit curve type when, and only when, there isn't infinity support.)。同一段注释里还写了一个特例:// An empty stroke (p0==p1==p2==p3) is a special case that denotes a circle, or 180-degree point stroke.——四个控制点全相等 = 一个整圆或一个点状描边。这个特例很有工程味:它让「圆点」这种最常见的小图形不需要走任何通用路径。
5.4 三类曲线的实际占比
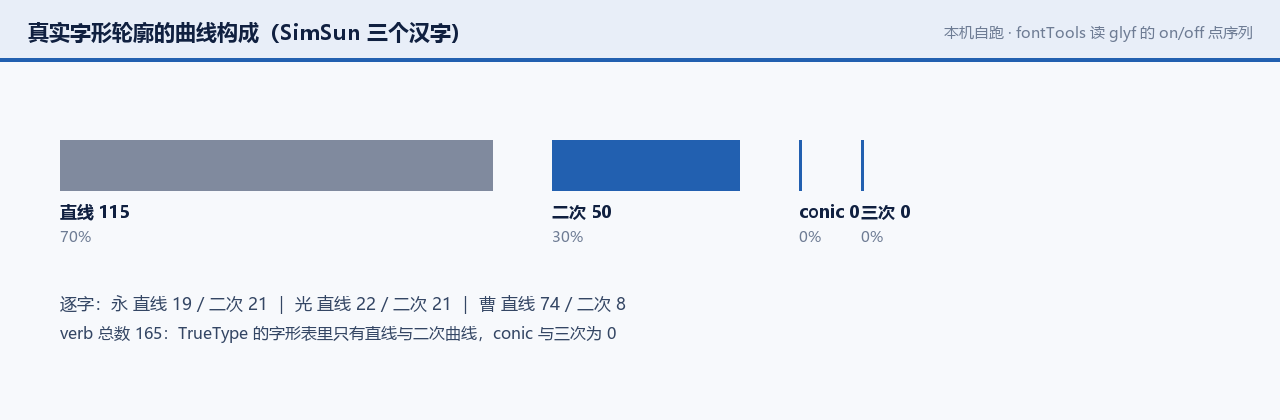
本机自跑口径:遍历路径的 verb 序列统计三类曲线占比,属 CPU 侧可直接做的量。实测三个汉字里,
曹的直线段占该字轮廓的 90%(74 条直线对 8 条二次),而永是 19 对 21。同一个字体里,不同字的曲线构成差得很远——这决定了「为哪类曲线做特例」不能只看平均值。这个统计的用处是判「值不值得为某类曲线做特例」。如果 conic 占比很高,那么 §5.3 里「用p3.y是无穷来标记 conic」这种省空间的技巧就不只是聪明,而是高频路径上的必需;反过来,如果某类曲线几乎不出现,那么为它做专门分支的收益就有限。
5.5 实例缓冲的生命周期
好了,回头看一眼这些缓冲是怎么被组织的——因为「实例」这个办法能不能省成本,取决于缓冲活多久。从 §4.3 那段代码能看出分工:
- 索引缓冲与顶点缓冲是固定的:它们是按
resolve level预计算的模板,与内容无关,只有若干档,可以长期留着; - 实例缓冲是按内容生成的:控制点来自当前这批路径,换了内容就得重填,所以它跟着 op 的生命周期走(§4.3 里的
chunk.fBuffer就是「本块的实例缓冲」)。这个分工解释了「固定次数」为什么划算:省下的不是顶点数,而是「每条曲线各自准备一份缓冲」这件事本身——一份模板加一段实例数据,替掉上千次独立的小缓冲分配。顺带说清:本节只从代码形状推断分工,不对缓冲回收策略下任何断言(那需要抓帧或读分配器实现,本篇两条都不具备)。
5.6 本章收在哪里
这一章讲「一条曲线怎么变成一个实例」。基座是四个控制点,可选属性由 PatchAttribs 位掩码决定,曲线类型靠 p3.y 是否为无穷来区分。「四个控制点」是本篇最该记住的单个数——后面所有的段数上限、拆分、chunk 边界,都是从它推出来的。
官方依据:实例步长、位域与曲线类型编码见 Tessellation.h;实例步长断言见 GrStrokeTessellationShader.cpp。
六、段数是谁算的
下面我们进入第六阶段。上一章解决了「实例里装什么」,这一章解决「要画多少段」——因为一条曲线在 GPU 上不是曲线,是一串直线段,段数少了看得出棱角,段数多了白算。先来看看答案的来源:不是猜的,是公式算的。
6.1 Wang 公式
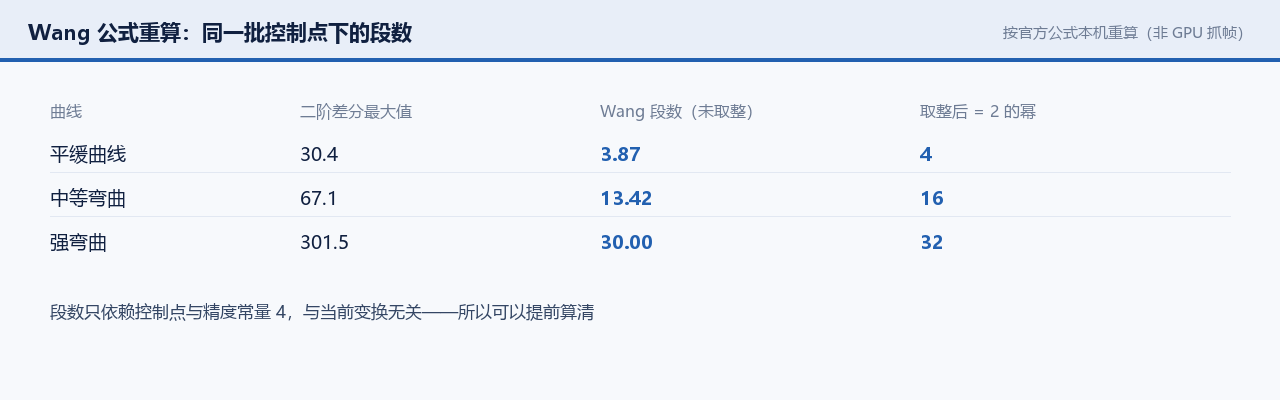
Skia 的 WangsFormula.h 把公式与出处一起写在文件头,逐字如下:
// Wang's formula gives the minimum number of evenly spaced (in the parametric sense) line segments
// that a bezier curve must be chopped into in order to guarantee all lines stay within a distance
// of "1/precision" pixels from the true curve.
//
// maxLength = max([length(p[i+2] - 2p[i+1] + p[i]) for (0 <= i <= n-2)])
// numParametricSegments = sqrt(maxLength * precision * n*(n - 1)/8)
//
// (Goldman, Ron. (2003). 5.6.3 Wang's Formula. "Pyramid Algorithms: A Dynamic Programming Approach
// to Curves and Surfaces for Geometric Modeling". Morgan Kaufmann Publishers.)
这段话里有三个信息点值得停下来看:
- 它给的是「最小段数」,不是「推荐段数」——原话是 "the minimum number of evenly spaced (in the parametric sense) line segments",保证所有折线离真实曲线的距离不超过
1/precision像素; maxLength的算法是二阶差分:p[i+2] - 2p[i+1] + p[i],这是曲线在参数方向上的「弯曲程度」指标。曲线越弯,这个值越大,段数越多——这符合直觉,但它是从公式里来,不是从经验里来;-
n*(n-1)/8是次数因子:二次曲线n = 2给2*1/8 = 0.25,三次曲线n = 3给3*2/8 = 0.75。三次曲线的因子是二次的三倍——也就是说同样的弯曲程度,三次曲线要的段数更多。同一个文件里还有两处署名,说明这套公式不是只有一版: -
二次与三次用的是 Goldman 教材里的 Wang 公式(上面那段);
- conic(圆锥曲线)用的是另一篇:逐字注释写
// This is not actually due to Wang, but is an analogue from (Theorem 3, corollary 1): J. Zheng, T. Sederberg. "Estimating Tessellation Parameter Intervals for Rational Curves and Surfaces." ACM Transactions on Graphics 19(1). 2000.
所以 Skia 的段数公式有两个来源:有理曲线(conic)要用 Zheng-Sederberg 的有理版本,因为 Wang 公式本身只对多项式曲线成立。这是一个容易在二手资料里被抹掉的细节。
6.2 公式的三个参数
把公式里的参数逐项拆开:
precision:精度。Skia 取常量 4,也就是1/4像素——Tessellation.h的注释原文是// Don't allow linearized segments to be off by more than 1/4th of a pixel from the true curve.;maxLength:曲线控制点的二阶差分长度的最大值。它只依赖控制点,不依赖当前的变换——所以段数可以在一遍预处理里算完,不必等到着色器里;n:曲线次数。二次为 2,三次为 3,conic 走有理版本。这三个参数合起来决定了段数,而段数决定了这次绘制的顶点数与索引数——于是「画一条曲线要多少三角形」这件事变成了一道可提前算出的算术题。这正是批处理的前提:先算清楚总规模,再决定怎么分组。
6.3 弦高误差 vs 段数
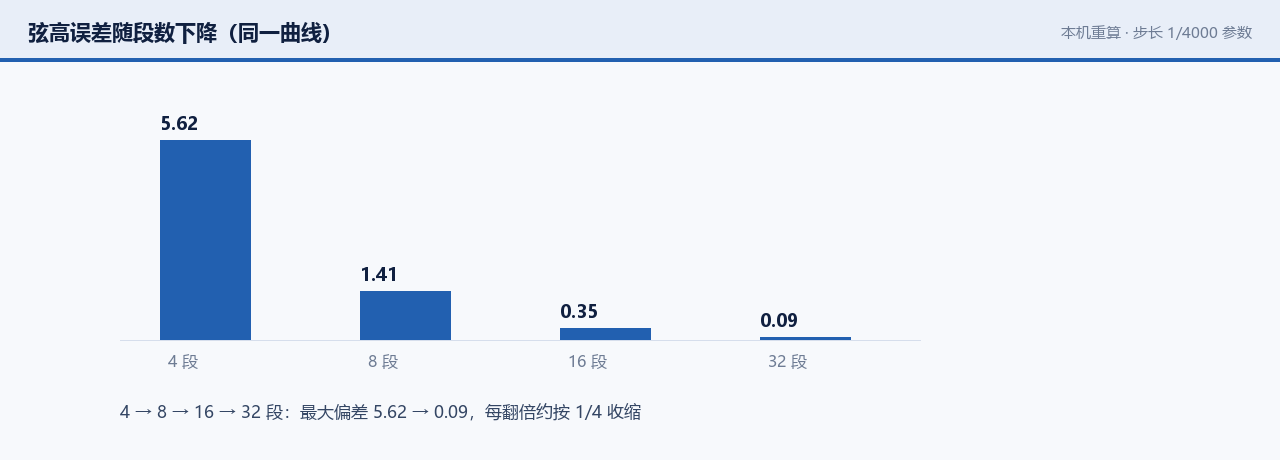
本机自跑口径:把同一条曲线按 4 / 8 / 16 / 32 段折线化,量折线到真实曲线的最大弦高偏差。实测出来的趋势与公式的预期一致:段数每翻一倍,误差大致按四分之一收缩(因为在同样的曲率下,弦高误差与段长的平方成正比)——4 段到 8 段从 5.63 降到 1.41 像素,降幅 75%。这条读数的用处是解释为什么精度常量的量级是「像素的分数」而不是「整数像素」——因为误差是二次收缩的,想要再准一档,代价只是段数翻倍。
6.4 精度链:4 → 1/4 px → 32 段 → 1024 先切
把本篇用到的那几个常量串成一条链,读者一眼就能记住它们在彼此什么位置:
【精度链】
kPrecision = 4
  → 目标:折线与真实曲线的偏差 ≤ 1/4 像素
  → Wang 公式按此精度算出「最小段数」
kMaxResolveLevel = 5 → kMaxParametricSegments = 1 << 5 = 32
  → 固定次数的顶点/索引缓冲最多表达 32 段;超出的曲线必须被 chop(切分)
kMaxSegmentsPerCurve = 1024
  → 单条曲线若需超过 1024 段,先调 PreChopPathCurves 预切
其中:
kPrecision = 4是精度,注释原文强调它管的是「折线与曲线的偏差」;kMaxParametricSegments = 32是表达上限,注释原文说明它是「固定次数顶点与索引缓冲能表示的最大细分级数」,超出就得 chop;kMaxSegmentsPerCurve = 1024是预切阈值,注释原文说「不要细分那些单条曲线可能需要超过 1024 段的路径」,这种情况先调PreChopPathCurves。下面对这条链特别说明:三个数不是同一类东西——32 是「装不下」,1024 是「先切再装」。前者是形状限制,后者是工程阈值。混淆这两个数会读不懂源码里为什么两处都在「限制段数」却给了不同的量级。
6.5 本章收在哪里
这一章讲「段数是算出来的」。用 Wang 公式(conic 用 Zheng-Sederberg 的有理版本),精度常量取 1/4 像素,次数因子 n(n-1)/8 让三次曲线要求的段数三倍于二次。段数一旦可提前算清,批处理才有可能——这就是下一章「一个实例里怎么排三角形」的前提。
官方依据:公式全文、出处署名与精度常量见 WangsFormula.h;段数上界与预切阈值见 Tessellation.h。
七、一个实例里怎么排出三角形
下面我们进入第七阶段。段数算清了,接下来的问题是这些段按什么顺序变成三角形。Skia 给的答案叫「中间向外」——它不是唯一的选择,但它的选择理由很值得看。
7.1 middle-out 拓扑
Skia 的填充着色器把这个拓扑写在注释里了,逐字如下:
// Uses instanced draws to triangulate standalone closed curves with a "middle-out" topology.
// Middle-out draws a triangle with vertices at T=[0, 1/2, 1] and then recurses breadth first:
//   depth=0: T=[0, 1/2, 1]
//   depth=1: T=[0, 1/4, 2/4], T=[2/4, 3/4, 1]
//   depth=2: T=[0, 1/8, 2/8], T=[2/8, 3/8, 4/8], T=[4/8, 5/8, 6/8], T=[6/8, 7/8, 1]
// The shader determines how many segments are required to render each individual curve smoothly,
// and emits empty triangles at any vertices whose sk_VertexIDs are higher than necessary. It is the
// caller's responsibility to draw enough vertices per instance for the most complex curve in the
// batch to render smoothly (i.e., NumTrianglesAtResolveLevel() * 3).
为什么是「中间向外」而不是「从头到尾」?有三个工程理由:
- 三角形的形状更均匀。顺序细分(0→1/8→2/8→…)会产生细长的三角形;中间向外每层都把最长的三角形对半分,长宽比更接近 1,光栅化效率更高;
- 层次结构天然对应段数。深度 0 是 1 个三角形(2 段),深度 1 是 3 个,深度 2 是 7 个——段数就是 2 的幂,于是「需要几段」可以映射成「画到第几层」;
- 同一套顶点缓冲能服务不同精度的曲线。因为它是「先画粗的,再逐层补细」,所以简单曲线提前停下也不会有洞。第三点最重要,它直接决定了下面那个「空三角形」技巧。
7.2 空三角形怎么被丢掉
上面注释里那句 emits empty triangles at any vertices whose sk_VertexIDs are higher than necessary 是这套设计的精髓。
做法:一个批次里的所有实例共用一份顶点/索引模板,模板按「最复杂的那条曲线」所需的最大层数准备好。每条曲线在着色器里算出自己只需要到第几层,超出部分的顶点就被丢到退化位置(面积为 0 的三角形)——GPU 照常提交它们,但它们不产生任何像素。
代价与收益:代价是每次绘制都要按最坏情况提交顶点数(注释里那句 "It is the caller's responsibility to draw enough vertices per instance for the most complex curve in the batch" 就在交代这件事);收益是整批曲线一次实例化绘制交出去,不必为每条曲线单独备缓冲。这就是「固定次数」(fixed-count)这个说法的来源:绘制次数固定,不受曲线复杂度影响。
7.3 resolve level → 三角形数
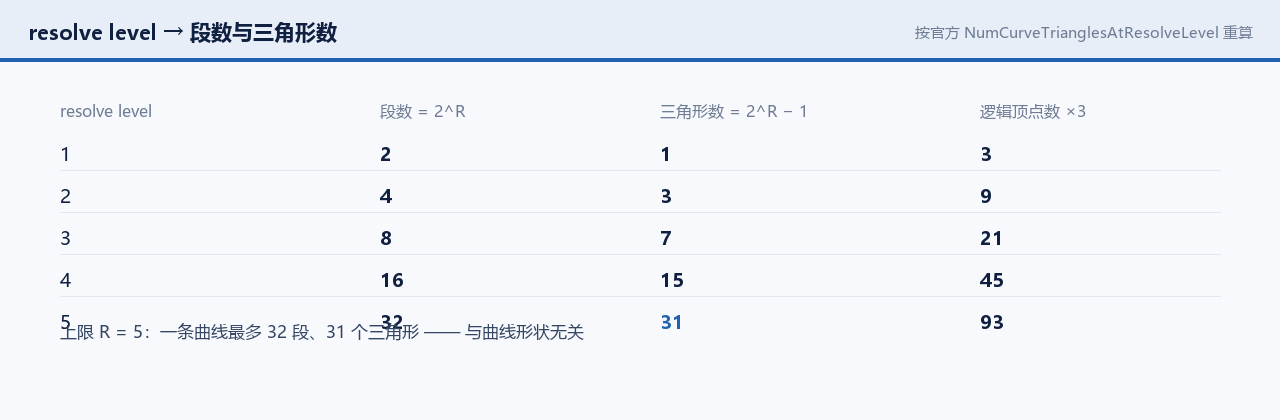
先来看看三角形数与层次的关系,源码里有一个函数直接给出:
/* 【Tessellation.h】每层三角形数 */
constexpr static int NumCurveTrianglesAtResolveLevel(int resolveLevel) {
    return (1 << resolveLevel) - 1;
}
注释里把前几层逐行列了出来(原文):resolveLevel=0 -> 0 line segments -> 0 triangles、resolveLevel=1 -> 2 line segments -> 1 triangle、resolveLevel=2 -> 4 line segments -> 3 triangles、resolveLevel=3 -> 8 line segments -> 7 triangles。把这条式子与上一节的两个常量接起来,就得到一张完整的账:
| resolve level | 段数(= 2ᴿ) | 三角形数(= 2ᴿ − 1) | 说明 |
|---|---|---|---|
| 0 | 1 | 0 | 退化,不出图 |
| 1 | 2 | 1 | 最简曲线 |
| 2 | 4 | 3 | |
| 3 | 8 | 7 | |
| 4 | 16 | 15 | |
| 5 | 32 | 31 | 上限:kMaxResolveLevel = 5 |
下面对这张表特别说明:它把 §6.4 的精度链落到了顶点数量上——一条曲线最多 31 个三角形,且这个数不随曲线形状变化。于是「一个批次要提交多少顶点」变成「批内最复杂曲线的层数 × 该层三角形数 × 3」,完全是可提前算清的。这就是「固定次数」名下的所有含义。
7.4 本章收在哪里
这一章讲「三角形怎么排」。中间向外拓扑让每层都把最长三角形对半分,层次与段数通过 2 的幂对齐;简单曲线靠退化三角形提前停下,于是整批共用一个模板。「用浪费换统一」是这一章的一句话。
官方依据:middle-out 注释与
NumCurveTrianglesAtResolveLevel见 GrPathTessellationShader.cpp 与 Tessellation.h。
八、三条 fixed-count 路线各管什么
下面我们进入第八阶段。前面几章讲的是「填充一条曲线」,可路径不止填充一种画法。这一章回答:固定次数实例化一共分几种模式,各自的模板长什么样。
8.1 三种模式
Skia 把这个枚举写在 FixedCountBufferUtils.h 里,注释逐字如下:
// Fixed-count tessellation operates in three modes, two for filling paths, and one for stroking.
// - FixedCountCurves: for filling paths where just the curves are tessellated.
// - FixedCountWedges: for filling paths by tessellating the curves and adding an additional inline
//   triangle with a shared vertex that all verbs connect to. Works with PatchAttribs::kFanPoint.
// - FixedCountStrokes: for stroking a path. Likely paired with PatchAttribs::kJoinControlPoint and
//   PatchAttribs::kStrokeParams.
三种模式的差别,用一张表说清:
| 模式 | 用来干什么 | 额外几何 | 依赖的实例属性 |
|---|---|---|---|
| FixedCountCurves | 填充:只把曲线展成三角形 | 无 | 无(基座四个控制点够用) |
| FixedCountWedges | 填充:曲线 + 一个共用的扇心,所有 verb 连到它 | 每个 verb 一个内联三角形 | kFanPoint |
| FixedCountStrokes | 描边:把曲线按线宽撑成带状 | 径向量、join 与 cap 的额外顶点 | kJoinControlPoint、kStrokeParams |
这两种填充模式为什么要并存?因为它们处理「封闭区域内部」的方式不同:Curves 只把边界曲线三角化,内部空着,需要另一套「内部扇」来补(Skia 的实现里配了一个内扇三角化器);Wedges 则把内部直接用楔形三角形填掉——每条曲线加一个连向扇心的三角形,简单但三角形更窄。其中一句注释很值得单独看,它解释了一个看似多余的转换:// Explicitly convert the line to an equivalent cubic w/ four distinct control points because it fans better and avoids double-hitting pixels.——楔形模式会把直线段也转成三次曲线。理由是「扇得更好,且避免像素被重复命中」。这是「为了批处理统一而故意多算一点」的又一个例子,与 §7.2 的退化三角形是同一个思路。
8.2 描边为什么要多带一个控制点
填充只需要「曲线本身」,描边不行——描边要知道曲线的切线方向,因为线的宽度是沿法向撑开的,而法向要靠切线求。这就是 kJoinControlPoint 的用途(逐字注释:// [float2] Used by strokes. This defines tangent direction.)。它是上一段曲线的最后一个控制点,有了它,当前段的起始切线方向就能算出来。描边还依赖另一个属性 kStrokeParams(// [float2] Used when strokes have different widths or join types.)——线宽与 join 类型。于是「同一批里可以有不同的线宽和不同的接缝样式」这件事,是靠实例属性承载的,而不是靠拆分批次。
8.3 描边 join 的额外顶点
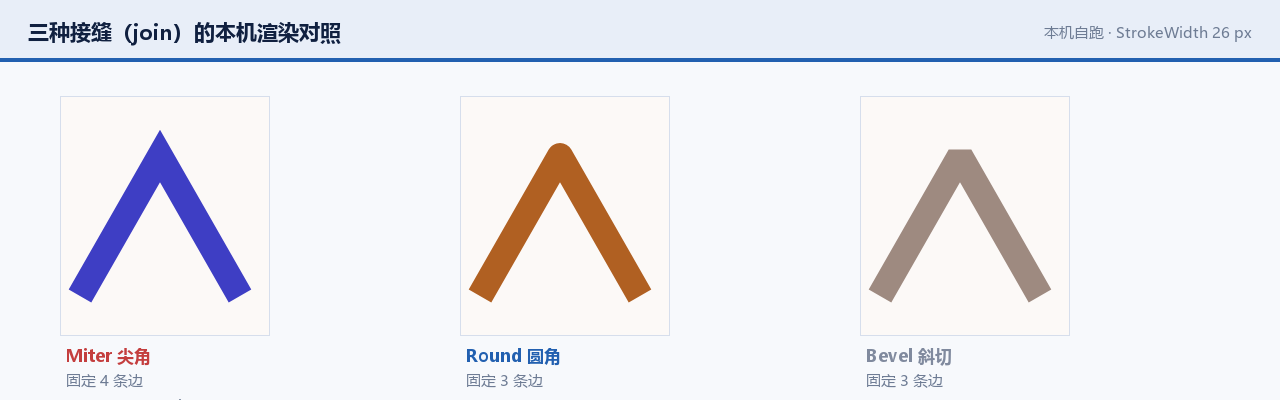
下面我们看接缝本身怎么被编码。Skia 的做法又一次体现了「用不可能的值当类型标记」这个习惯:
/* 【Tessellation.h】join 类型的编码 */
// Negative => Round Join
// Zero     => Bevel Join
// Positive => Miter join, and the value is also the miter limit
负数是圆角、零是斜切、正数是尖角且数值兼作尖角限制——一个 float 同时承载了类型与参数。接缝的几何量由另一个函数给出,逐字如下:
/* 【Tessellation.h】不同 join 的固定边数 */
NumFixedEdgesInJoin(...) {
    // miter 分支
    return 4;
    // round / bevel 分支
    return 3;
}
所以一次 join 的代价是固定的 3 条或 4 条边,不随角度变化。这条读数有用:它说明接缝不是「按角度算」的,而是「按类型查表」的——又往「可提前算清」的方向走了一步。顺带补一个与之配套的常量:圆角部分的径向量条数由 CalcNumRadialSegmentsPerRadian(approxDevStrokeRadius) 给出,逐字实现是 return .5f / acosf(std::max(cosTheta, -1.f));——它按「设备空间下的描边半径」换算出每弧度要几段。也就是说,描边的圆弧精度同样是把半径换算成像素后才定的,与前文的「1/4 像素」是同一套思路。
8.4 本章收在哪里
这一章讲「三条路线各管什么」。填充有两条(只展曲线的、以及带扇心的),描边一条;描边靠多带一个控制点换切线,接缝靠类型编码换固定 3 或 4 条边。同一个「固定次数」框架把填充与描边都装进去了——代价是属性位掩码越来越长(回看 §5.2 那张表)。
官方依据:三种模式的定义见 FixedCountBufferUtils.h;join 编码与边数见 Tessellation.h;直线转三次的理由见 PathTessellator.cpp。
九、上限在哪里,撞上会怎样
下面我们进入第九阶段。任何「固定」的设计都要回答一个问题:固定到多大为止。这一章讲两个上限数,以及撞上之后引擎做什么。
9.1 边数上限的两个数字
描边能画多少条边,源码里给了两个数,逐字注释如下:
/* 【FixedCountBufferUtils.h】描边的边数上限 */
static constexpr int kMaxEdges = (1 << 14) - 1;      // = 16383
// 注释原文:Don't draw more vertices than can be indexed by a signed short.
//          We just have to draw the line somewhere and this seems reasonable enough.
//          (There are two vertices per edge, so 2^14 edges make 2^15 vertices.)
static constexpr int kMaxEdgesNoVertexIDs = 1024;
两个数的分工是这样的:
- 16383 = 2¹⁴ − 1:有顶点 ID 支持时的上限。注释把推导讲全了——每条边两个顶点,2¹⁴ 条边正好是 2¹⁵ 个顶点,刚好是可被 16 位有符号索引覆盖的极限。也就是说,这个上限不是来自 GPU 的算力,而是来自索引位宽;
- 1024:没有顶点 ID时的上限。这时不能靠内建的顶点序号,只能用一段回退顶点缓冲(源码里
FixedCountStrokes::VertexBufferSize()就是按这个数算的),于是上限被缓冲尺寸压下来。这两个数差 16 倍,而差别只来自「GPU 给不给顶点 ID」。这是本篇最能说明「引擎常量常常是平台能力的结果而非算法结果」的一个例子。
9.2 上限与 chunk 拆分
撞上上限时,引擎不会报错,只会分批。这就是 §4.3 那段代码里 chunk 的来历——它是「一块不超过上限的 patch 组」。于是 GPU 侧一次绘制的完整结构可以写全了:
【一次裁剪后的绘制结构】
for chunk in chunks:                       # 每块 patch 数不超过上限
    bindBuffer(indexBuffer, chunk.instanceBuffer, vertexBuffer)
    drawIndexedInstanced(maxVertexCount, 0, chunk.count, chunk.base, 0)   # 主线
    if AA: drawInstanced(chunk.count, chunk.base, 4, 0)                  # 裙边,固定 4 顶点
其中:
chunks是按上限切出来的分块,块内共享同一套索引与顶点模板;chunk.count是本块的实例数,也就是 patch 数;- 抗锯齿开启时每块多一次裙边绘制——所以「开 AA」这件事在 GPU 侧的代价是绘制次数翻倍,不是「多算一点覆盖率」。下面对这一段特别说明:这段伪代码是全文结构上的落点。它把前面所有常量串成了一个可执行形状:上限决定分块,分块决定绘制次数,AA 决定是否翻倍。读者若要估算一次复杂路径绘制的 GPU 提交量,照着这三个变量算就够了。
9.3 一次复杂路径的提交量算例
下面我们把这几个数代进一个具体算例,看看「按常量推算」能算出什么。假设一批一千条三次曲线,其中最复杂的一条需要 32 段(也就是打满 kMaxParametricSegments):
【提交量算例:1,000 条三次曲线,批内最复杂一条需 32 段】
resolve level              = 5                    # 2^5 = 32 段
每实例三角形数             = (1 << 5) - 1 = 31
每实例逻辑顶点数           = 31 × 3 = 93
本批逻辑顶点数             = 1,000 × 93 = 93,000
每条边两个顶点 → 边数      = 93,000 / 2 = 46,500
是否超过 kMaxEdges=16383   → 超过 → 必须分块
最少分块数                 = ceil(46,500 / 16,383) = 3
那么 draw 次数(开 AA)    = 3 × 2 = 6            # 主线 3 次 + 裙边 3 次
其中:
resolve level = 5是按kMaxResolveLevel取满,因为批内存在一条需要 32 段的曲线——这正是 §7.2 说的「按最坏情况准备模板」;- 每实例的 93 个逻辑顶点里,大部分曲线用不到(简单曲线早就被丢进退化三角形了);
- 分块数是「按上限反算」出来的,本例是 3 块,于是绘制次数是 6 次。下面对这个算例特别说明:这张账全部按官方常量推算,不是抓帧结果。两个用处:说明「一批一千条曲线要提交多少东西」可以提前算清,以及「上限 → 分块」为何直接决定绘制次数。替换输入(曲线条数、最复杂曲线所需段数)即可照同一张账估自己的内容。
9.4 本章收在哪里
这一章讲「固定设计的边界」。描边的两个上限(16383 / 1024)只差「GPU 给不给顶点 ID」,说明常量出自平台能力;撞上上限不是失败而是分块,于是「绘制次数」成了最终的可调量。「上限 → 分块 → 绘制次数」这条链,是 GPU 侧效率问题真正的形状。
官方依据:两个边数上限与推导注释见 FixedCountBufferUtils.h;分块与两次绘制的提交见 PathTessellator.cpp。
十、这条路线的代价与最新动向
下面我们进入第十阶段。前面九章讲的都是「机制如何自洽」,这一章要问的是它在真实世界里付了什么代价、以及官方接下来打算怎么办。
10.1 回归与修复:一条时间线
先把时间线摆出来,因为它解释了「为什么现在看到的是 fixed-count 版本」:
| 时间 | 事件 | 来源 |
|---|---|---|
| 2012 | Kilgard & Bolz 提出模板两步法接口;同文评价当时的 Skia 「CPU 光栅器把覆盖率掩码当纹理上传,常被动态纹理更新卡住」 | [19] |
| 2014 | Chromium 图形组指出当时的 Ganesh 批处理能力差:「1k rects → 1k glDrawArray/Element」 | [13] |
| 2021 | Skia 官方缺陷跟踪记录:启用 tessellation 路径渲染器后,某些内容明显变慢 | [11] |
| 2021 之后 | 作者记「Regressions fixed after fixed count tessellators」——回归在改成固定次数细分器后修掉 | [11] |
| 2023-08 | 官方帖:backend 分 Ganesh(稳定)与 Graphite(开发中);GrContext 只服务 Ganesh |
[2] |
| 2025-07 | 官方博客:Graphite 在 Apple Silicon Mac 的 Chrome 上首发,MotionMark 1.3 提升近 15% | [1] |
| 2026(当前) | 官方帖:Graphite「stable enough to start testing」,Mac 默认启用,Windows/Android 推进中 | [2] |
2021 那条缺陷记录是本章最该读的一条,因为它把「机制优雅」与「实测更快」之间的距离摆出来了。当时的原话是:「It appears that certain kinds of content runs quite a bit slower once the tessellation path renderer is available.」——新渲染器上线,某些内容反而更慢;紧接着作者问的是「我们能不能在 onCanDrawPath 阶段更好地识别出哪些内容不会受益」,也就是说,引擎最终采取的办法是「挑内容走这条路」,而不是「让所有内容都走这条路」。
这对读者的意义是:判断一条 GPU 路线好不好,不能只看它的机制,还要看引擎有没有一套判据决定什么时候不用它。
10.2 Graphite 的 z 值与 depth 裁剪
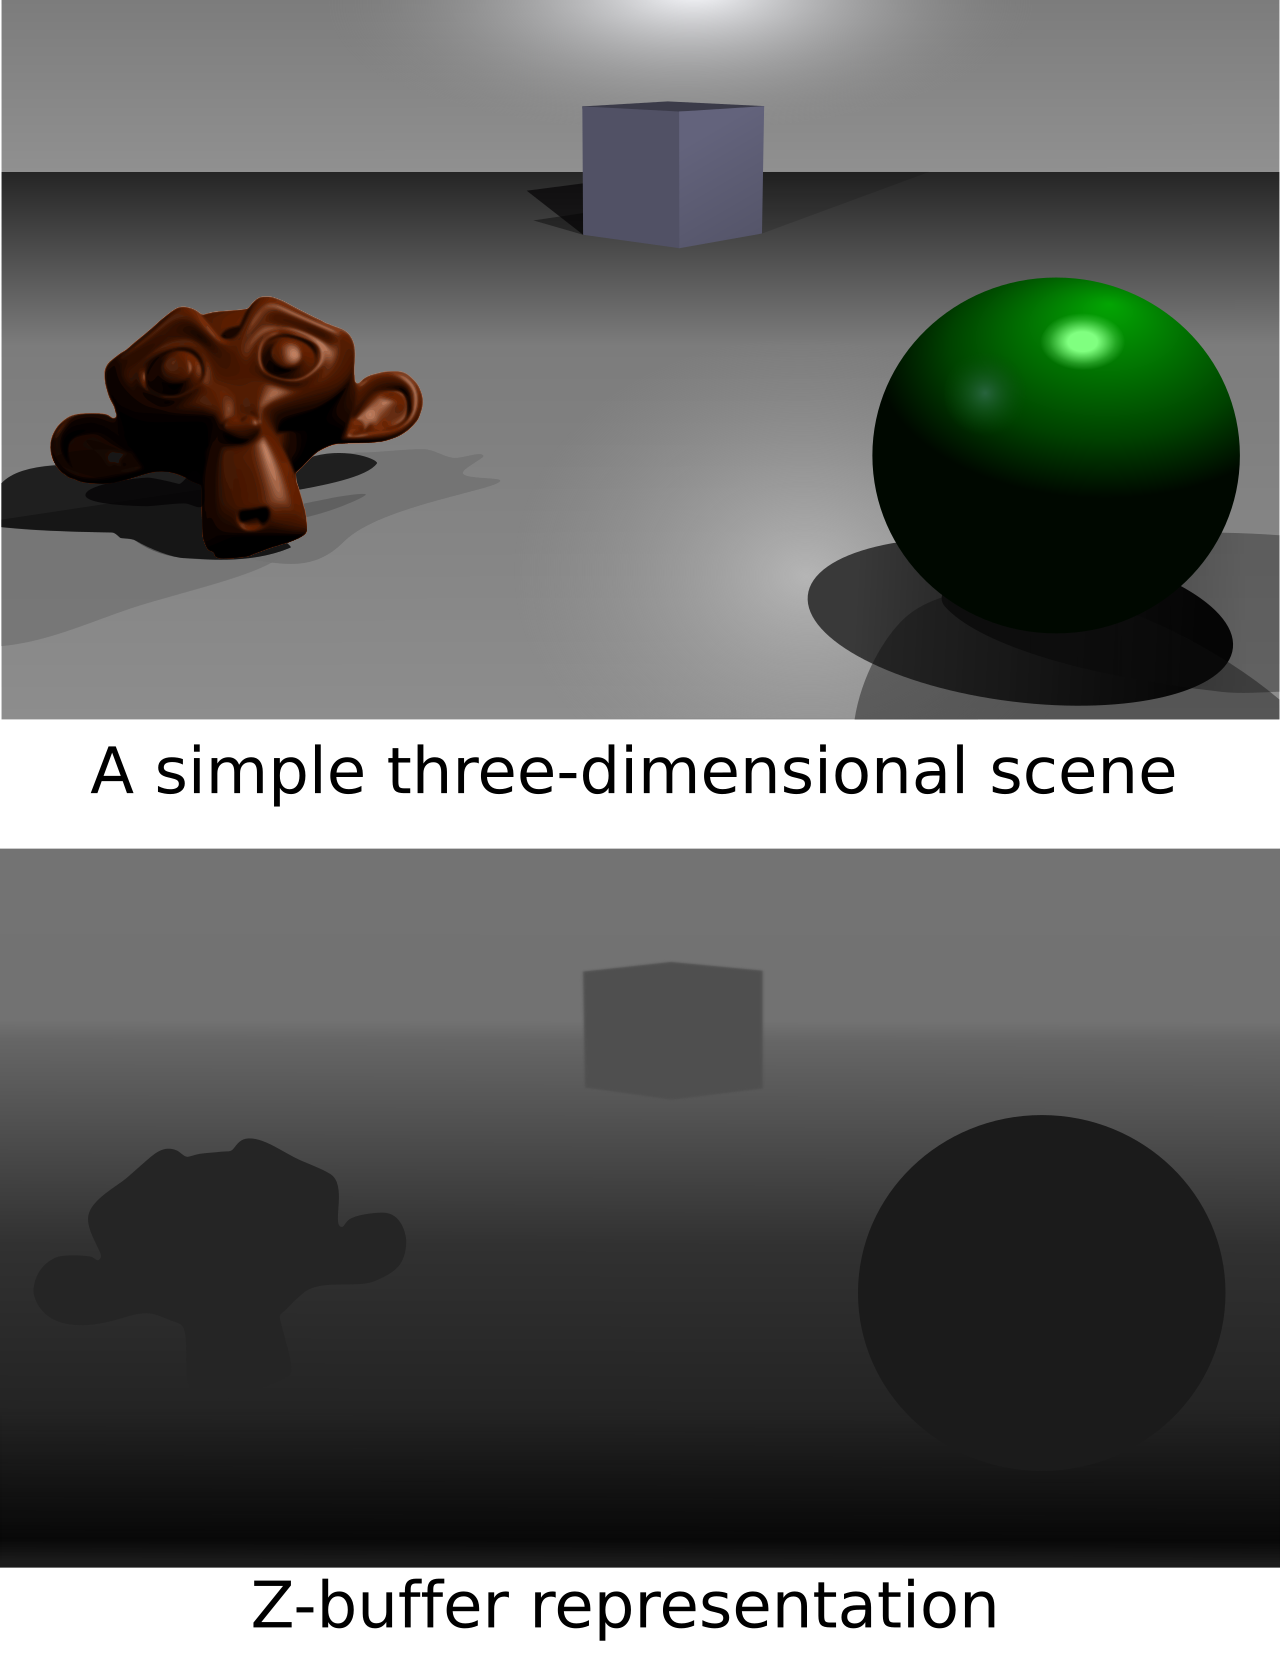
回到第二章留下的那条线。Graphite 把「画家顺序」变成了一个可以交给硬件的数:
"Graphite extends Skia's GPU rendering to take advantage of the depth test by assigning each 'draw' a z value defining its painter's ordering index." —— [1]
每次绘制一个 z 值,值就是它在画家顺序里的位置。上了深度测试之后,前景的不透明绘制会自动淘汰被它挡住的像素——这就是官方说的 「automatically eliminate overdraw」。同一条思路还用在裁剪上:
"Depth testing is also used to implement clipping in Graphite by treating clip shapes as depth only draws as opposed to maintaining a clip stack like in Ganesh." —— [1]
裁剪形状被当作「只写深度的绘制」,而不再像 Ganesh 那样维护一个裁剪栈。这是本篇的主题(op 组织)在 Graphite 上的直接后果:裁剪栈是一种 CPU 侧的累积状态,它天然妨碍 op 重排;把它变成深度值之后,裁剪也成了 op 的一种,可以被排序、被合并。硬件的对应物就是深度缓冲本身——一个能比较、能淘汰的额外通道。它原本是给 3D 用的,在 2D 里被借来当排序器。
10.3 官方承认的缺口:MSAA 被限到 4 采样
最后一节说清官方自己承认的短板,因为它直接决定了本篇讲的两条路线谁在什么时候上场:
"Currently, Graphite relies on MSAA where it can, but in many cases we can't due to poor performance on older integrated GPUs or high memory overhead on non-tiling GPUs, and we have to fallback to CPU path rasterization using an atlas for caching. GPU compute based path rasterization would allow us to improve over both the visual quality of MSAA which is often limited to 4 samples per pixel and over the performance of CPU rasterization." —— [1]
这段话里有四个可以直接用的信息:
- Graphite 当前主要靠 MSAA,不是覆盖式几何;
- 很多场合用不了 MSAA:老集成显卡性能不够、非 tiling GPU 内存开销过大;
- 回退是 CPU 光栅化 + 图集缓存——又回到 ep03/ep04 那条路上;
- 官方下一步是 GPU compute 路径光栅化,目标同时超过 MSAA 画质(常被限到每像素 4 采样)与 CPU 光栅性能。所以「覆盖 approach」的位置要说准:它是几何路线里产出灰度的手段(§4),而 Graphite 这一代的默认是 MSAA,覆盖式几何与 CPU 回退各守一段。把「Skia 用覆盖式 AA」当全局结论是错的。
10.4 流水线合并:为什么要把管线数量压到最少
先来看看官方对流水线数量的说法,因为它解释了「op 重排」的收益最终落在哪里:
"Graphite's design philosophy is instead to consolidate the number of rendering pipelines as much as possible ... This reduces the number of pipelines that have to be compiled, and makes it possible for Chrome to ensure they are compiled at startup..." —— [1]
这段话把「批处理」的目标从「少几次绘制」推进到了「少几套管线」。原因是 GPU 侧的一次管线切换远比一次绘制昂贵:切换意味着着色器程序、混合状态、采样状态一整套重新绑定;而如果管线组合的数量本身很少,编译它们的时间就可以提前到启动期,运行期不再因为「遇到一套没编译过的组合」而卡顿。这给读者一个可操作的判断:看批处理能力不要只数 draw call,要看管线组合空间有多大。组合空间小,重排自由度才大;组合空间爆炸,再好的排序也只能少切几次。
下面对这张图特别说明:它的横轴是「同一套管线能覆盖多少 op」,纵轴是「排序能省下多少切换」。曲线在组合空间小的时候陡、在组合空间大的时候平——这解释了为什么 Graphite 的官方表述是「consolidate the number of rendering pipelines」,而不是「sort the draws better」:先让管线种类变少,排序才有东西可排。
10.5 本章收在哪里
这一章讲「机制的代价与官方动向」。 2021 年的回归说明新路线需要一套「何时不用」的判据;Graphite 把画家顺序与裁剪都交给了深度缓冲;而官方自己承认 MSAA 被限到 4 采样、并留有 CPU 回退。一句话:GPU 侧的答案不是一条路走到黑,而是一套按内容与硬件切换的组合。
官方依据:回归记录与作者结论见 Skia Issue 12010;z 值、depth 裁剪与 MSAA 缺口见 Skia Graphite 官方博客;深度缓冲的通用原理图见 Z buffer。

十一、边界回指与预告
好了,最后一章来做收束。
11.1 三条路线的选型判断
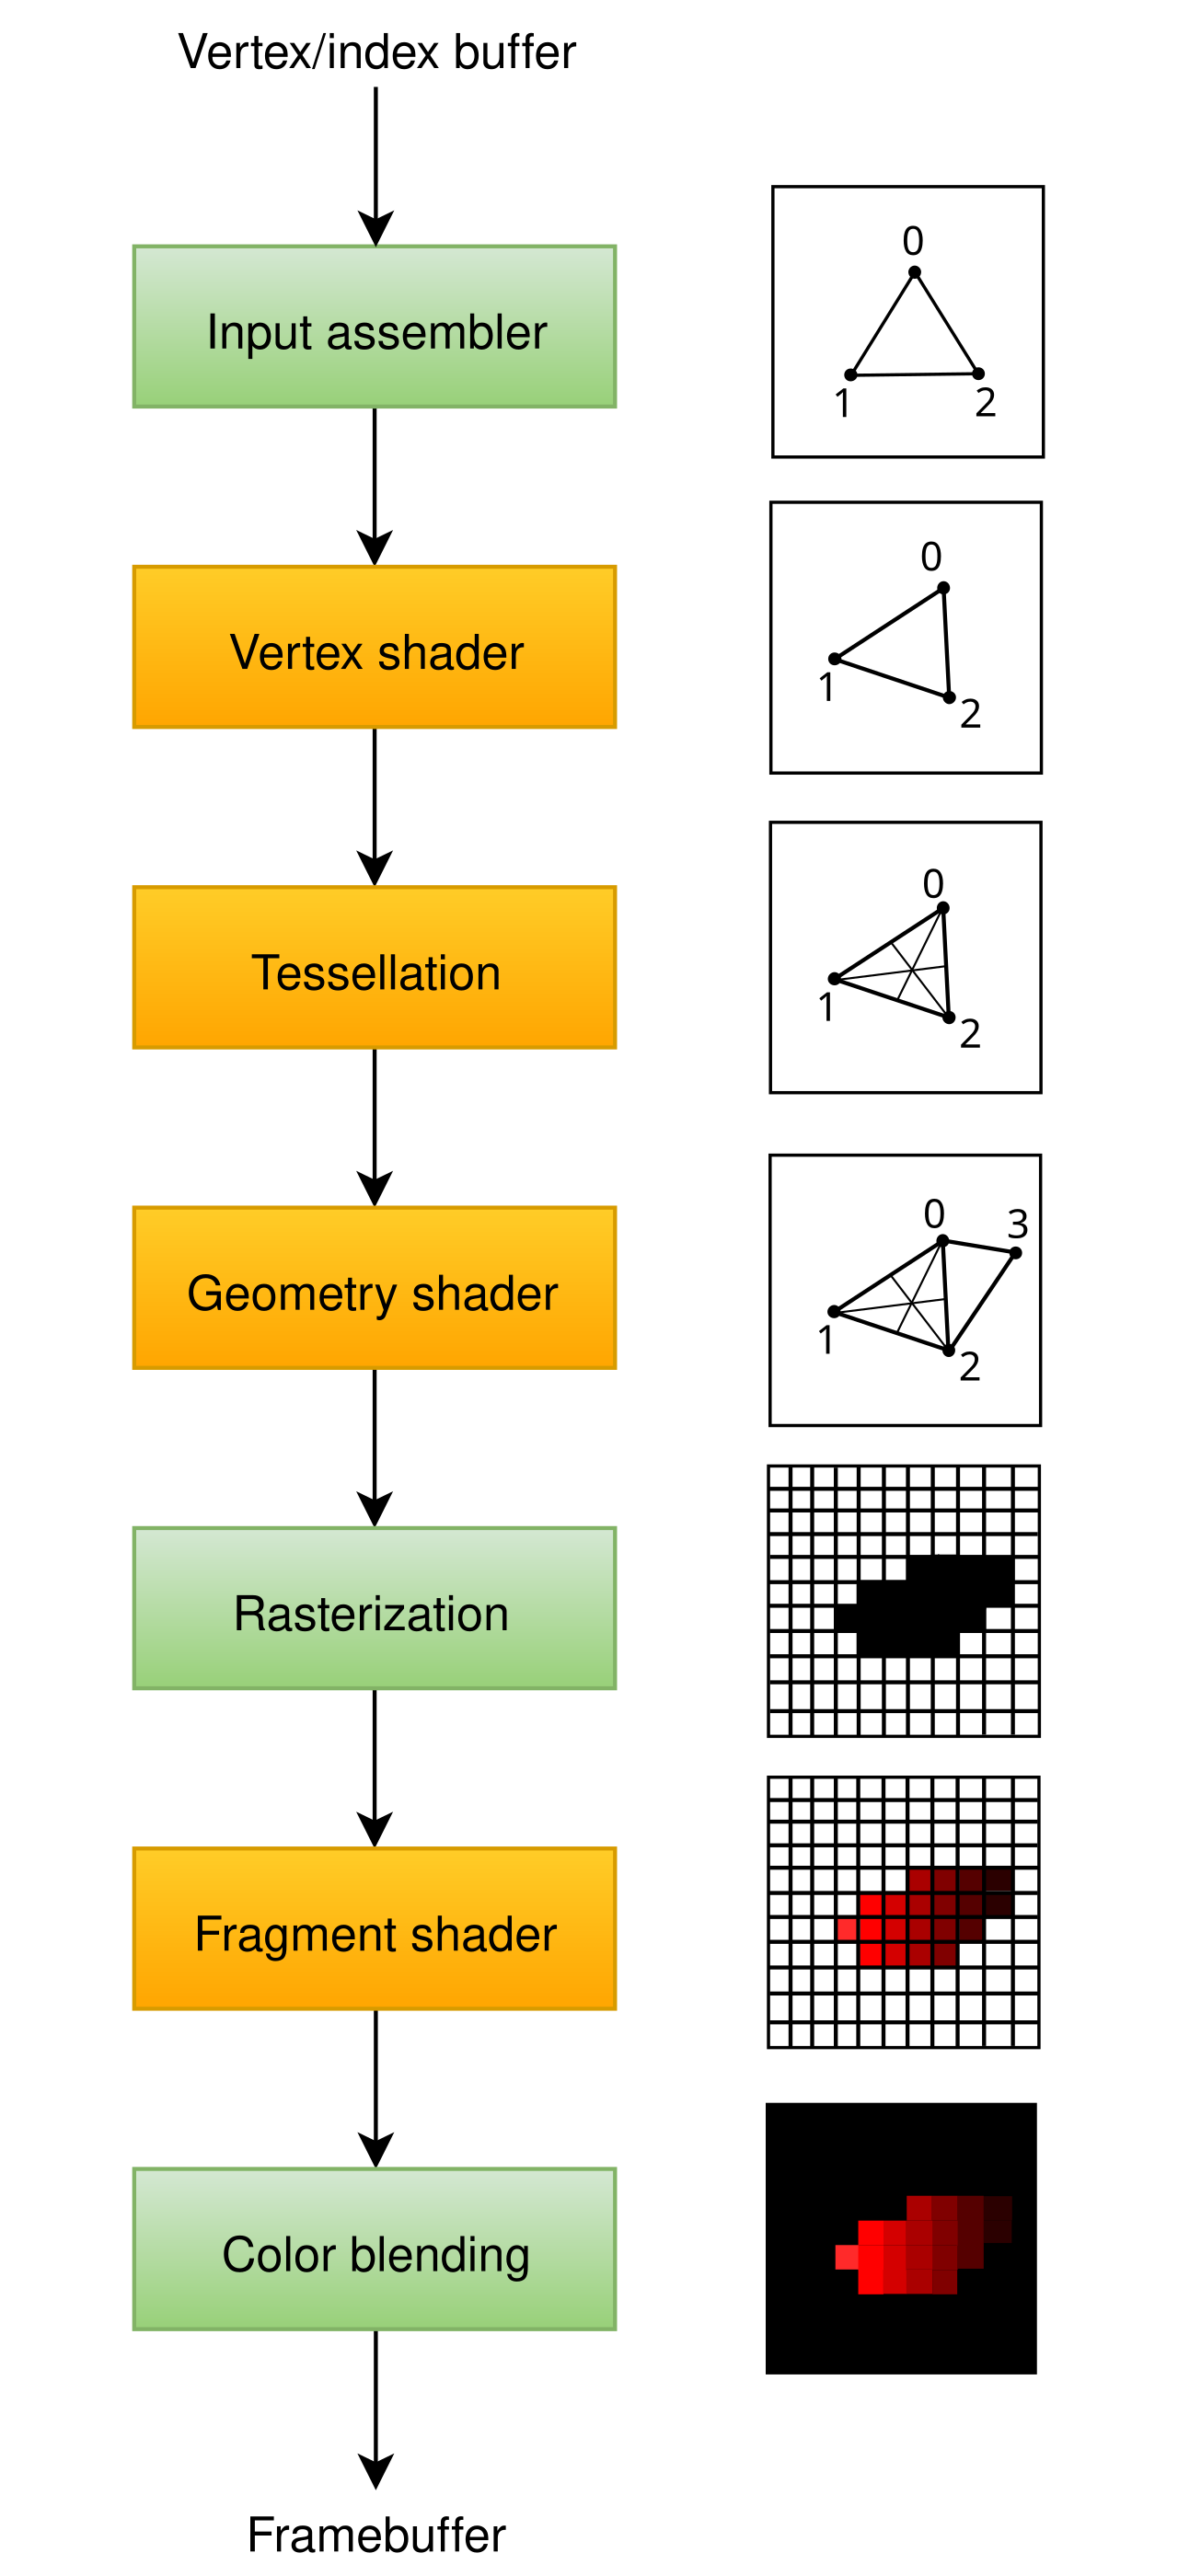
先来看看把开头那条动线说到底是什么意思。一次 draw 被记成 op,op 被合并进 render pass,路径被翻译成实例,实例被展成三角形,三角形由硬件管线画成像素。本篇讲的五个常量、三条路线、两次绘制,全都挂在这句话上。选型判断可以压成三句:
- 要批处理大量曲线 → 固定次数实例化细分(本篇主体);
- 要干净的填充规则与自相交 → 模板两步法或 CCPR;
-
硬件支持且内容简单 → MSAA 就够,不要为它付几何膨胀的代价。这三句判断背后其实是三个可核对的量,其中:
-
曲线条数与批内最复杂曲线所需段数→ 决定分块数与绘制次数(§9.3 的算例);
- 填充规则与是否自相交→ 决定要不要模板缓冲或覆盖计数;
- 目标硬件的采样上限(MSAA 常被限到 4 采样)与显存条件→ 决定能不能走采样路线。
11.2 让出去的题域
按本系列的习惯,把不在本篇的题域显式让出去:
- Graphite 内部机制(Recorder/Recording、Dawn 抽象层、Recording 重放)→ 下一篇;
- Vello / piet-gpu(sparse strips、四阶段流水线、prefix-scan)→ ep09/ep10;
- Pathfinder 的 tiling-dicing 与 NV_path_rendering 的完整接口 → 只作坐标系,不展开;
- Loop-Blinn 与 GPU Gems 3 的隐式曲线渲染 → 另一条路线,只做背景;
- CPU 光栅与字形 → 前三篇已讲透。
11.3 下篇预告
本篇到此为止。下一篇(ep06)进入 Graphite:同样画一条路径,Graphite 换了一套完全不同的组织方式——它把「录制」与「回放」拆开,让多个线程各自录制、再统一回放;它把画家顺序交给深度值;它试图把流水线数量压到最少,好在启动期就能编译完。换句话说,本篇讲的是 Ganesh 这一代的答案,下一篇讲 Skia 为什么决定把这一代整体换掉。官方那句话可以当作两篇之间的接缝:「The long-term goal for Skia is to deprecate Ganesh and move forward with Graphite only.」[2]
官方依据:Skia 抽象层与原生 API 管线的位置见 Vulkan simplified pipeline 与 Skia API 参考;Ganesh 的终局见 skia-discuss 讨论帖。

参考资料
- Skia Graphite 官方博客 — Introducing Skia Graphite
- skia-discuss — Suggested/status of GPU backends
- skia-discuss — Anti-aliasing techniques used in Skia GPU Implementation
- Skia API Reference and Overview
- Tessellation.h(常量、位域、join 与补丁步长)
- WangsFormula.h(Wang 公式与 Zheng-Sederberg 有理版本)
- FixedCountBufferUtils.h(三种模式与边数上限)
- GrStrokeTessellationShader.cpp(描边实例布局与步长断言)
- PathTessellator.cpp(主线与裙边的两次提交)
- GrPathTessellationShader.cpp(middle-out 拓扑与 stencil-only 管线)
- Skia Issue 12010 — Enabling GrTessellationPathRenderer causes some performance regressions
- Skia RELEASE_NOTES chrome/m130
- chromium graphics-dev — The c1k problem in canvas 2D
- Vulkan 规范 — Tessellation 章节(patch 控制点上限)
- GPU Gems 3 第 25 章 — Rendering Vector Art on the GPU
- Raph Levien — Fast 2D rendering on GPU
- μSkia — Semantics for 2D Rasterization(含 Graphite 第三方定位)
- DeepWiki — Ganesh: Legacy GPU Backend
- Kilgard & Bolz — GPU-accelerated Path Rendering(SIGGRAPH Asia 2012)
- NVIDIA — GPU-Accelerated Path Rendering(NV_path_rendering 介绍页)
- Commons — The OpenGL - DirectX graphics pipeline
- Commons — Stencil.png(模板缓冲状态推进)
- Commons — Gupta-Sproull pixel selection
- Commons — Supersampling - Uniform
- Commons — Z buffer.svg
- Commons — Vulkan simplified pipeline
- Commons — Triangle Strip In OpenGL(图元拓扑,备选)
- skia-python 发行页(本篇本机自跑用的绑定)


本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机自跑实截由
skia-python 144.0.post2生成;自绘图为本系列绘制,走styles/qianmo/palette.json色板单源。站点链接:技术博客页
下篇预告:下一篇进入 Graphite——Skia 决定把 Ganesh 整个换掉的那个新后端,看它怎么用多线程录制、深度裁剪与更少的流水线,重做一次本篇讲过的这些事。本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。
With Best Wishes.