站点链接:技术博客页 | 公众号:溯光的图形笔记
前面七个专题,我们一直在讲同一件事的不同侧面:画面是怎么被算出来的。
算法层讲延迟着色与阴影怎么摆,约束层讲移动端能画多少、该省多少,硬件实现层讲 GPU 里的每个单元在干什么, 性能剖析工具链讲怎么把一帧拆开看,神经渲染讲神经网络怎么挤进渲染管线,光追讲混合渲染的取舍, 2D 矢量引擎讲 Skia 与 Vello 怎么把路径变成像素。
这七件事合起来,覆盖的是渲染管线的完整生命周期——从几何、光栅、着色,到合成、呈现。
但它们有一个共同的盲区。这些画面里没有一个东西是自己会动的。
一个箱子从空中落下、撞上地面弹起来、滚下斜坡最后停住——渲染管线对此一无所知。它只负责把别人算好的位置画出来。 那个"别人",就是本系列的主角:物理引擎。它回答的是另一个问题—— 这个世界里的东西,下一刻应该在哪、朝哪个方向、转多快。
这也是本站第一次把镜头转向渲染之外。之所以现在转,是因为前面七个专题已经把"看得见的这一半"讲完了, 而要理解一个引擎怎么在有限的帧预算内把成百上千个物体同时算对, 恰好要用上前面讲过的那些"多核、带宽、流水线、确定性"的概念——物理是它们的另一个战场。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、源码怎么实现、本机跑出来是什么——这三层在文中分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(版本、场景、线程数、命令、日期);
- 自跑优先:本专题的图以本机编译运行 Jolt 得到的真图与官方一手图为主,自绘为辅;
- 不写没有落点的说法:凡是流传广但官方文档与源码里找不到对应命名的说法(如"Jolt 用 TGS 求解器"),文中会明确指出查无落点;
-
篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,300 到 2,200 字。
-
本篇不涉及:渲染与动画(《实时渲染管线探析》《实时光线追踪与混合渲染》的题域)、应用层的网络同步与帧同步工程、 2D 物理(属《Box2D 2D 物理》专题)、厂商私有的闭源实现。为什么不涉及:它们各自已有专门篇目; 尤其是GPU 刚体——Jolt 并没有这条路,文中会讲清"没有",但不会拿别人的实现来填它的机制位。完整边界见 §0.2。
本专题的配图分三类:本机自产真图(构建日志、HelloWorld 与 PerformanceTest 输出、Samples 界面,版权自有)、
外部真实素材(Jolt 官方仓库 Docs/ 下的机制图与官方标识,MIT,图注标作者与许可)、
自绘示意图(走 styles/qianmo/palette.json 色板单源)。
需要提前说明的是:物理引擎的机制图在公共素材库里几乎不存在——Wikimedia Commons 上用 18 个类目检索,
11 个是空的、4 个跑题(Rigid bodies 类目里全是船舶碰撞的档案照);真正的图在项目自己的文档目录里。
系列主要内容总览
- 【Jolt Physics 3D】(一) 全景与边界:它在物理引擎谱系里的第几格
- 【Jolt Physics 3D】(二) 一次 step 的流水:
PhysicsSystem::Update里到底排了哪些活 - 【Jolt Physics 3D】(三) Body 与 MotionProperties:三态、两副面孔的接口、批量增删
- 【Jolt Physics 3D】(四) 宽相:QuadTree 的无锁双树
- 【Jolt Physics 3D】(五) 三层过滤:谁能撞谁是怎么被逐级裁掉的
- 【Jolt Physics 3D】(六) 窄相:GJK、EPA 与流形裁剪
- 【Jolt Physics 3D】(七) Shape 家族与 SubShapeID
- 【Jolt Physics 3D】(八) 约束家族与可复用的求解原语
- 【Jolt Physics 3D】(九) 接触求解:sequential impulse、暖启动与 Baumgarte
- 【Jolt Physics 3D】(十) 岛、并行与睡眠:
IslandBuilder、LargeIslandSplitter与三判据 - 【Jolt Physics 3D】(十一) CCD 与确定性:LinearCast 的"偷时间"与状态回归
- 【Jolt Physics 3D】(十二) 上层模块:角色与载具
- 【Jolt Physics 3D】(十三) 柔体、毛发与 GPU Compute 的真相(收官)
为什么物理引擎值得单独开一个专题
0.1 物理引擎到底在算什么
OK,先说到底在算什么。用一句话说:物理引擎每帧要解一个巨大的、带约束的微分方程组,然后把解写回每个物体的位置与朝向。
"带约束"是这件事的难点所在。如果世界里只有一个个孤立的方块,每个方块的下落都是一道初中物理题, 三十个方块就是三十道互不相干的初中物理题,随便一个循环就解完了。真正麻烦的是它们互相碰在一起之后: 地面说"你不能穿我",箱子说"我被重力往下拽",两者同时成立时,那个箱子到底停在哪?
好了,这句话里有两个词要分清。约束(constraint) 指的就是这类"必须同时成立的关系":不许穿透、铰链只允许绕一个轴转、 轮子必须在给定扭矩下加速。而求解器(solver) 是指把这堆互相矛盾的关系调停出一个结果的那段代码—— 它几乎不可能一次算对,只能一轮一轮地逼近期望解,这就是迭代求解(iterative solver)。
于是整个物理引擎的骨架就清楚了:先把"可能碰到的物体对"筛出来(宽相,broad phase), 再把"具体碰在哪、碰多深"算出来(窄相,narrow phase), 然后用这些接触点与各类约束一起做迭代求解,最后把结果积分成新的位置。
这个骨架听起来不复杂,麻烦全在量级上。本机实测的第一手数字:一个 300 步的 Ragdoll 场景, 单线程每秒只能跑 31.65 步,16 线程时 229.76 步。 一帧 16.7 毫秒的预算里,物理能分到的往往只有几毫秒。
0.2 本篇的边界(本篇不涉及什么、为什么)
说白了,本篇的边界就三条。讲什么:Jolt 是什么、它在物理引擎谱系里站在哪一格、它自称的两条主线(多核与确定性)凭什么成立、 以及它不是什么。
只给指针、不展开什么:Jolt 内部各子系统的机制(宽相怎么建树、窄相怎么算接触、约束怎么迭代求解)—— 这些是后续十二篇各自的题目,本篇只给出一张总图与一句定位。
完全不碰什么:
- 渲染与动画:
DebugRenderer只在"它是读出物理内部状态的手段"这个身份上出现,不写渲染管线; - 应用层做法:不写游戏侧的网络同步、帧同步工程、动画状态机;
- 2D 物理:属《Box2D 2D 物理》专题,本系列不越界;
- GPU 刚体:Jolt 没有这条路(v5.6 的 GPU Compute 通路只服务毛发), 本篇会明确写出"没有",但不会拿 PhysX 或 Havok 的实现去填 Jolt 的机制位。
为什么要先划边界:物理引擎是个天然容易"越写越泛"的题域——它一头连着数学,一头连着游戏工程, 中间还夹着硬件。不划边界,一篇"Jolt 全景"很容易变成"物理引擎综述", 那样既讲不透任何一层,也失去了本系列"机制靠原文、代价靠自跑"的立身之本。
0.3 本机环境与读数的口径
先来看看本机的环境。本篇开始涉及本机读数,先把环境交代清楚。后面每一处数字都会回到这张表上的条件。 机器是一台笔记本,物理引擎的读数对 CPU 与内存带宽极敏感,跨机比较没有意义。
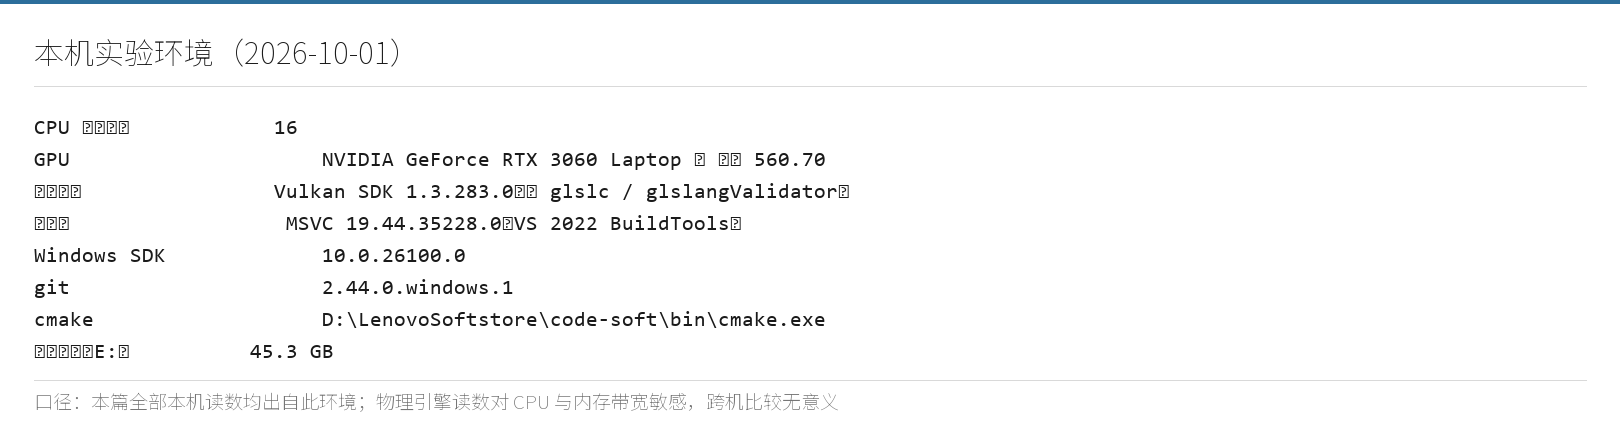
这张表有两个数字值得单独点出来。逻辑核数是 16,但它不是 16 个物理核——
从后面的多核曲线可以反推出来,本机很可能是 8 物理核加超线程,这一点在第三章会用实测数据说明。
另一个是 Vulkan SDK 1.3.283.0:它的存在决定了 Jolt 自带的 Samples 测试程序能不能编译出来,
而 Samples 正是本系列最有说服力的那批图的来源。所以"环境核实"这件事在本系列里不是走过场,
它直接决定了后面能不能给出真图。
0.4 本篇的三层证据,与它们的分工
下面我们进入本篇的写法。本系列延续本站已交付七专题的写作纪律,把每一处结论都拆成三层,分开陈述:
第一层是官方文档。 它回答"作者说自己做了什么"。这一层的价值在于措辞的准确性—— 比如 §2.4 那两段更新日志,一句说"加了 GPU 计算接口",一句说"加了在 GPU 上跑的发束仿真", 连着读才能得到完整意思;只读前一句,就会得出一个错的结论。
第二层是源码与构建产物。 它回答"代码实际怎么组织"。这一层的价值在于可以发现文档没说的东西——
比如官方文档里查不到 Solver 这个类(§7.2),而文档里也不会主动告诉你这件事。
第三层是本机实测。 它回答"在这台机器上到底是多少"。这一层的价值在于把量纲拉回现实—— 官方给的 4.9× 是作者那台机器的数字,本机跑出来是 6.44×;官方说约 16 核拐点,本机拐点在 9 到 10 线程(§3.3)。
三层里,哪一层都不能替代另一层。 只有第一层,文章会变成翻译;只有第二层,读者会失去"为什么"; 只有第三层,结论无法外推。而三层都有的代价是篇幅——这也是本系列每篇 16,000 汉字起步的原因。
一、Jolt 是什么:一个"多核优先"的 3D 刚体库
1.1 一句话定义与它的四个定语
OK,先把定义摆出来。Jolt 是一个用 C++ 写的 3D 刚体物理库,MIT 许可,以多核扩展性与确定性为核心设计目标。
这四个定语都值得掰开说:
"3D":它做三维世界的刚体动力学。这不是废话——本站已交付的《2D 矢量引擎深挖》讲的是二维图形的绘制, 而 2D 物理(比如 Box2D)与 3D 物理在碰撞检测上的数据结构完全不同,两者不能互相套用。
"刚体(rigid body)库":它模拟的是不会形变的物体。人在游戏里看到的布料飘动、软体挤压, 在 Jolt 里属于另外两个子系统——柔体(soft body)与毛发(hair),而且官方标注它们仍在开发中。 刚体是它的主战场,也是本系列十二章里的绝大部分。
"MIT 许可":这一点在本篇的第二章会与竞品逐个对比,此处只记一个结论——MIT 允许商用、允许闭源分发, 没有传染性条款。
"多核优先":这不是营销词,而是一个可以量化的设计取向:Jolt 自带一个作业系统(job system), 把一帧内的物理工作拆成有依赖关系的图,铺到多个线程上跑。它的多核扩展曲线是可以本机复现的(见第三章);官方那份测试文档在Jolt Physics Multicore Scaling。
1.2 物理引擎在引擎栈里的位置
言归正传,先给它定位。要把 Jolt 放对位置,得先看清一整个游戏引擎的分层。下图标出的是经典的五层划分, 以及物理与动画中间件在这一栈里的位置。
这张图解释了一个常见的困惑:为什么"物理引擎"看着和"渲染引擎"平级,但站里却把它们分成两批专题写。 原因在图里一眼可见——它们服务的是同一条流水线的不同段。渲染那条线最终产出像素, 物理这条线产出的是位置与朝向,而位置与朝向又是渲染的输入。 两者在数据上前后相接,在实现上却几乎不共享任何代码:Jolt 里没有一行渲染代码, 它对外暴露的是位置、速度、接触点,谁来画它不管。
这个"不管谁来画"的设计非常关键,它直接决定了本系列的自跑方案:Jolt 自带一个
DebugRenderer 接口与一个叫 Samples 的测试程序,后者用 Vulkan 或 DX12 画出一个可交互的测试场——
物理引擎自己带了一个最小的"显示层",专门为了让开发者看清物理内部状态而存在。
本系列后续十二章里那些"休眠态被染成红色""每个模拟岛用不同颜色"的图,全都从这里来。
1.3 它被谁在用
好了,再说说它在被谁用。Jolt 的 README 里自己提到了两个用例:《地平线:西之绝境》与《死亡搁浅 2》。 这两个名字值得记一下,因为它们说明了一件事:这一代 3A 大作里已经有商业项目在用它做刚体。
但必须把话说准——"有商业项目在用"不等于"它是主流"。从本站的调查看, 中文技术圈对 Jolt 的介绍大多停留在"《死亡搁浅 2》背后的物理引擎"这一句, 真正讲它内部怎么实现的系统性内容,基本是空白。
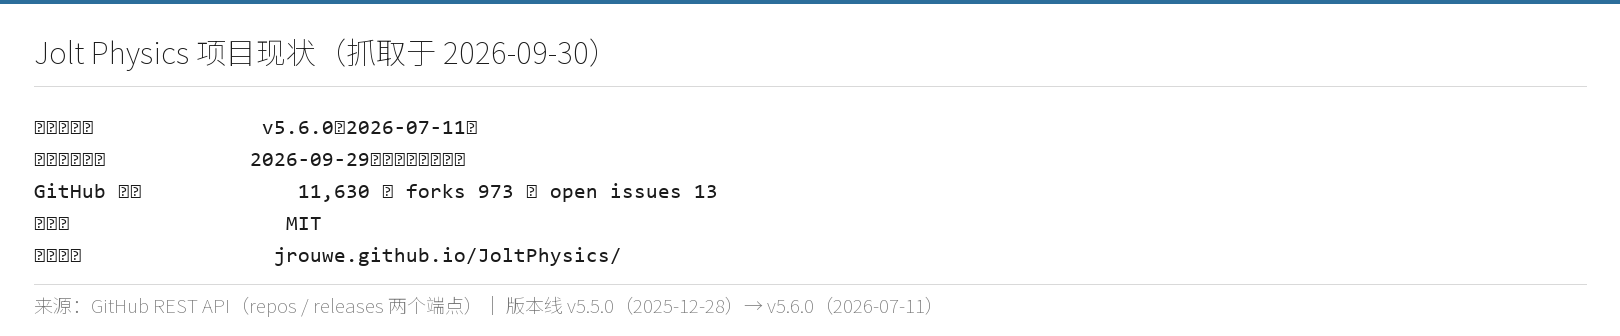
这张面板的数据有两个时间戳需要特别留意:最新正式版是 v5.6.0(2026-07-11),而主干的最近一次提交是 2026-09-29 ——也就是说,抓取当天(2026-09-30)主干仍在活跃开发,但稳定版已经三个多月没有发新版。 本系列的所有结论都以 v5.6.0 这个 tag 为准,这也是本机实际编译的版本。 凡是涉及"主干的改动",文中会单独标明,不与 v5.6.0 混说。
二、坐标系:五款引擎各站哪一格
2.1 为什么必须先建坐标系
先来看看这件事难在哪。物理引擎这个领域有一个特殊的困难:它们的功能表高度重合。 随便打开五款引擎的首页,都会看到"支持凸包、支持关节、支持连续碰撞检测、支持多线程"—— 功能清单看不出差别,差别在取舍。
而取舍的后果往往几年后才显现:一个引擎把并行做成什么样,决定了它在 16 核 CPU 上的帧时间; 一个引擎的许可怎么写,决定了它能不能进某个平台的商店。 所以本章不列功能表,而是用四个维度把它们摆开。
先来看看这张矩阵里最反直觉的一格。:Jolt 与 Bullet 的许可都是宽松型,但两者的维护状态差得很远。 Bullet 是这一代很多引擎的物理底座,但它已经进入低维护期; Jolt 则是同一类问题的新解,作者仍在持续提交。选型时"能不能用"与"还会不会更新"是两个独立问题。
2.2 许可:四种条款各自的约束
说白了,许可约束的是分发方式。许可这件事,一句话说不完,因为它约束的是分发方式而不是使用方式。 下面这张表把四类条款摊开。
这里要提醒一处第三方资料里的坑。站外有对比站把英伟达 PhysX 的许可标成 "GPL v3", 而英伟达官方仓库里写的分明是 BSD-3-Clause。两者对商用方的含义天差地别。 本系列一律以项目官方仓库的许可文件为准,不采用第三方站的标注—— 这条规矩在本系列会反复出现,因为它不是特例,而是这个题域的常态: 物理引擎的资料被转述得太多,转述又往往不回去核对原文。
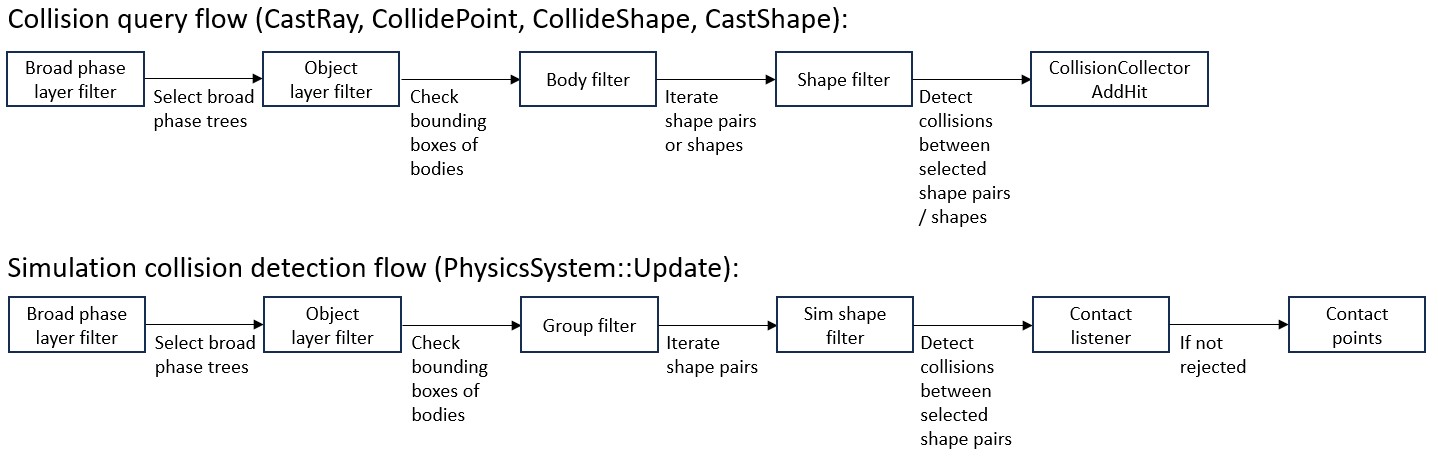
2.3 官方给出的"碰撞引擎流程"
好了,外围说完了,开始看它内部。到这里讲的都是外围信息。要真正开始看 Jolt 内部,先认一张官方自己的图—— 它把碰撞这件事画成了一条有明确边界的流水线。
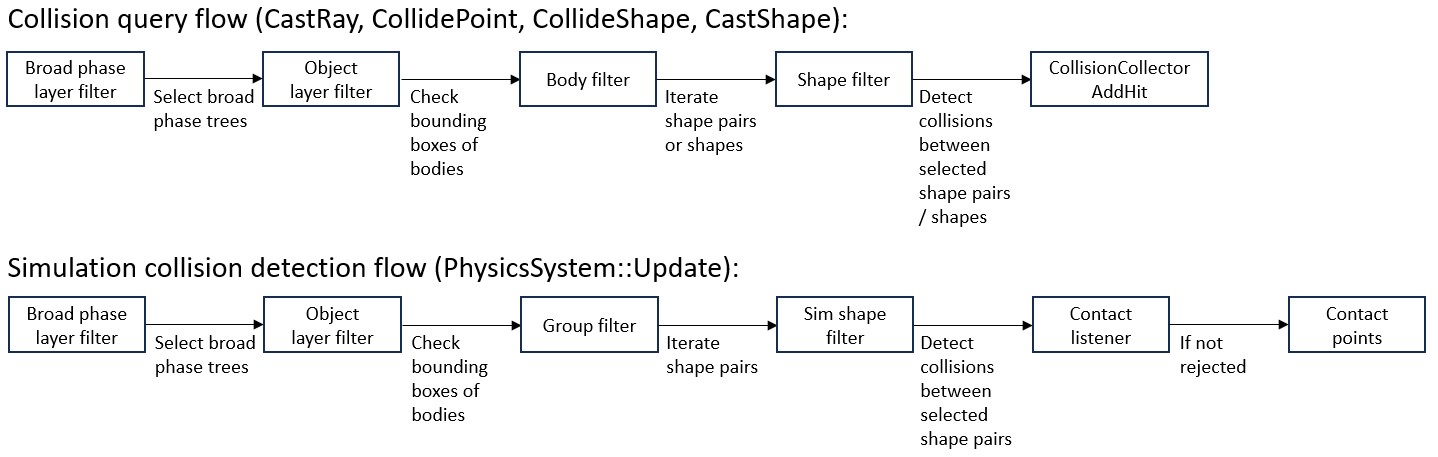
官方用这张图想表达的,正是本章要建立的直觉:"碰撞检测"不是一次判断,而是一条流水线的名字。 在这条线的前半段,物体还只是"可能相碰";走到后半段,才变成一堆带法线与穿透深度的接触点; 出了这条线,碰撞检测的使命就结束了——怎么把接触点变成合理的运动,是求解器的事,不是碰撞检测的事。 后面第六篇(窄相)与第九篇(接触求解)会分别站在线的两侧,中间这条分界就是它们的分工线。
2.4 维护它的那句"它没有 GPU 刚体"
在上面那张矩阵里,有一格需要单独讲:GPU 刚体。 这一格在 Jolt 上写的是"没有",而它恰恰是站外资料最容易写错的一处。
Jolt v5.6.0 的更新日志里确实出现了 GPU 字样,原文是这样的:
Added interface to run compute shaders on the GPU with implementations for DX12, Vulkan and Metal.
看到这句,很容易得出"Jolt 支持 GPU 物理了"的结论。但同一段更新日志的下一句是:
Added a strand based hair simulation running on GPU ... Note that this is still work in progress.
它服务的是"基于发束的头发仿真",不是刚体。 Jolt 的刚体求解至今全部在 CPU 的作业系统上。
这不是本系列的推测,而是可以从两边同时验证的事实:一边是官方更新日志的措辞,
另一边是本机编译出的构建配置——本机确实编译出了 DX12 与 Vulkan 两个后端,
但它们指向的是 Jolt/Compute 这个新模块,与刚体求解的代码路径并不相交。
把这一格单独拉出来讲,是因为它同时是本系列的一个内容锚点与一个纪律约定: 从这一篇到收官篇,只要提到 GPU,都必须把"Jolt 没有 GPU 刚体"这句摆在明处; 而收官篇会专门回头核对 v5.6 这个 compute 通路的完整边界。
2.5 版本口径:为什么本系列锁定 v5.6.0
下面开始交代第二个资料陷阱。物理引擎的另一个资料陷阱是版本漂移。Jolt 在 2025 到 2026 之间连发多个版本, 其中若干版本改动了行为语义(而不只是加功能)——这类改动如果不标版本,引用就会失真。
本系列锁定 v5.6.0,理由有三条:其一,它是抓取时(2026-09-30)唯一的正式版, 主干虽在活跃提交,但正式版已三个月未更新,v5.6.0 是稳定参照;其二,它是本机实际编译的版本, 所有自跑读数天然与它同源;其三,涉及行为变更的条目(例如"运动学物体不再被归入与它接触的模拟岛") 在 v5.6.0 的更新日志里能逐条对上,便于把"现在的行为"与"以前的行为"分开说。
规矩说在这里:本系列后文凡提到具体行为,一律注明"在 v5.6.0 中"; 凡引用主干(master)上尚未随版本发布的改动,都会单独标出。版本不是脚注,它是读数的坐标系。
三、主线一:多核——一条本机可以复现的曲线
本章要证明什么:Jolt 自称的"多核扩展性"不是一句宣传,而是一条可以在本机重现、也能对得上官方口径的曲线; 同时它有一条明确的天花板,这条天花板的位置在官方资料与站外转述里都容易被说错。
3.0 两条扩展路线:为什么 Jolt 选了 CPU 多核
在动手量之前,先回答一个更根上的问题:为什么 Jolt 不去做 GPU 物理?
两条路线各有代价。走 GPU 的路,算力上限高得多,但每一帧都要把刚体数据往返于显存与内存之间, 而且调试困难、平台覆盖受限;走 CPU 多核的路,算力上限受核数限制,但数据留在内存里、可以断点调试、平台覆盖平顺。 Jolt 选了后者,于是它的性能故事就必然围绕"一个 CPU 上有多少核可用、怎么把它们喂饱"展开—— 这也正是本章要量的东西。
3.1 官方口径:8 线程 4.9×,约 16 核后停止扩展
OK,先摆官方口径。Jolt 作者自己发过一份多核扩展测试的文档,给出了这条曲线的官方版本。它的两个关键结论是:
- 8 线程比单线程快 4.9×;
- 原文:
After about 16 CPU cores Jolt stops scaling and eventually deteriorates. At this point the memory bus becomes a big bottleneck.
这两句话里藏着本章的两个悬念。第一,"4.9×"是作者那台机器、作者那个场景的数字, 不是 Jolt 的固有属性——本机跑出来的会不一样。第二,"约 16 核后停止扩展"是一句关于硬件的话,不是关于软件的话: 拐点出现的位置由 CPU 的物理核数、缓存与内存带宽决定,不同机器不可能一致。
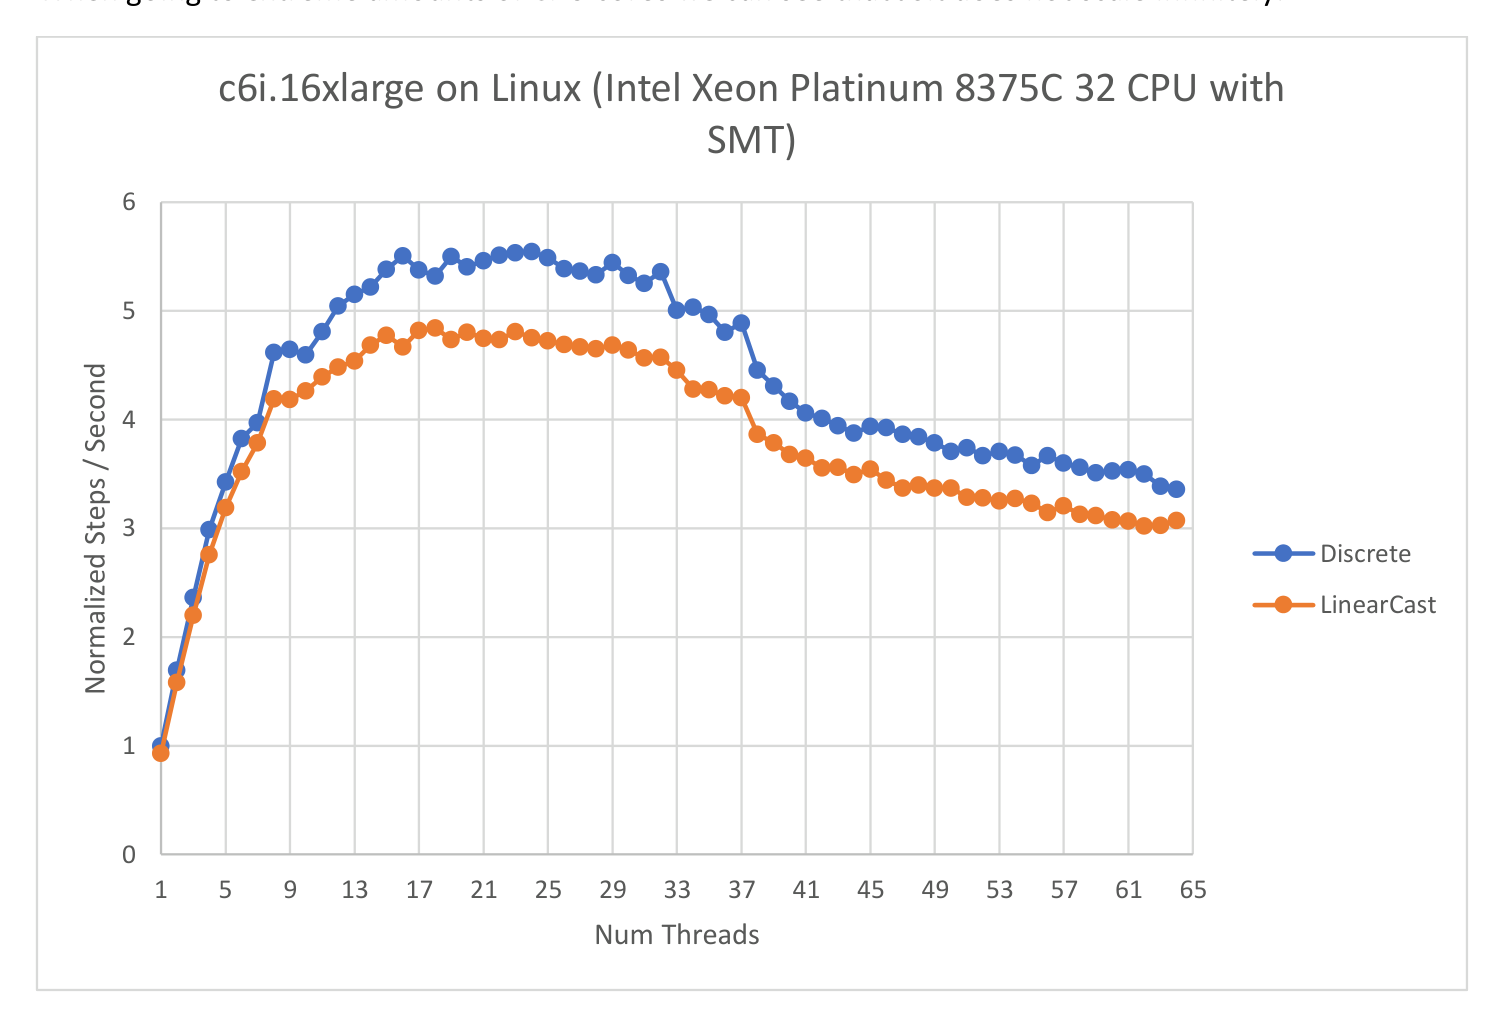
所以本章的做法是:先把官方口径摆在桌上(它是对账基准,不是结论),再在本机重新跑一遍。
3.2 本机实测:8 线程 6.44×,峰值 13 线程 7.59×
言归正传,看本机跑出来是多少。Jolt 自带一个命令行测试程序 PerformanceTest,它的默认行为就是遍历 1 到本机硬件线程数,
逐个报告每秒步数与一个用于校验的状态哈希值。本机 16 逻辑核,于是它一次给出了 16 行数据。
运行命令与条件如下(这一段的每个数字都由它而来):
# 【1】工作目录必须是源码根——Ragdoll 场景按相对路径读取 Assets/
# 【2】-q=Discrete 只测一种运动质量,-i=300 跑 300 个物理步
# 【3】不指定 -t,程序自动遍历 1..硬件线程数(本机 16)
cd E:\jolt-probe\JoltPhysics-5.6.0
E:\jolt-probe\build\Release\PerformanceTest.exe -s=Ragdoll -q=Discrete -i=300
输出(节选,完整 16 行见本章表格):
Motion Quality, Thread Count, Steps / Second, Hash
Discrete, 1, 31.646342, 0xcc61333c4bfb0fad
Discrete, 8, 203.922129, 0xcc61333c4bfb0fad
Discrete, 13, 240.080955, 0xcc61333c4bfb0fad
Discrete, 16, 229.761655, 0xcc61333c4bfb0fad
下面对这条命令的两个参数特别说明。-q=Discrete 指定只跑"离散步进"这一档运动质量
(运动质量,motion quality,决定物体每步怎么前进,后文第十一篇会专门讲它与连续碰撞检测的关系(见MotionQuality 的定义)),
选择它的原因是这一档是默认值、也最贴近常规场景;-i=300 指定模拟 300 个物理步,
它对曲线的形状有影响(步数太少时首步的初始化开销占比偏高),故本章所有数字都标定了 300 步这个口径。
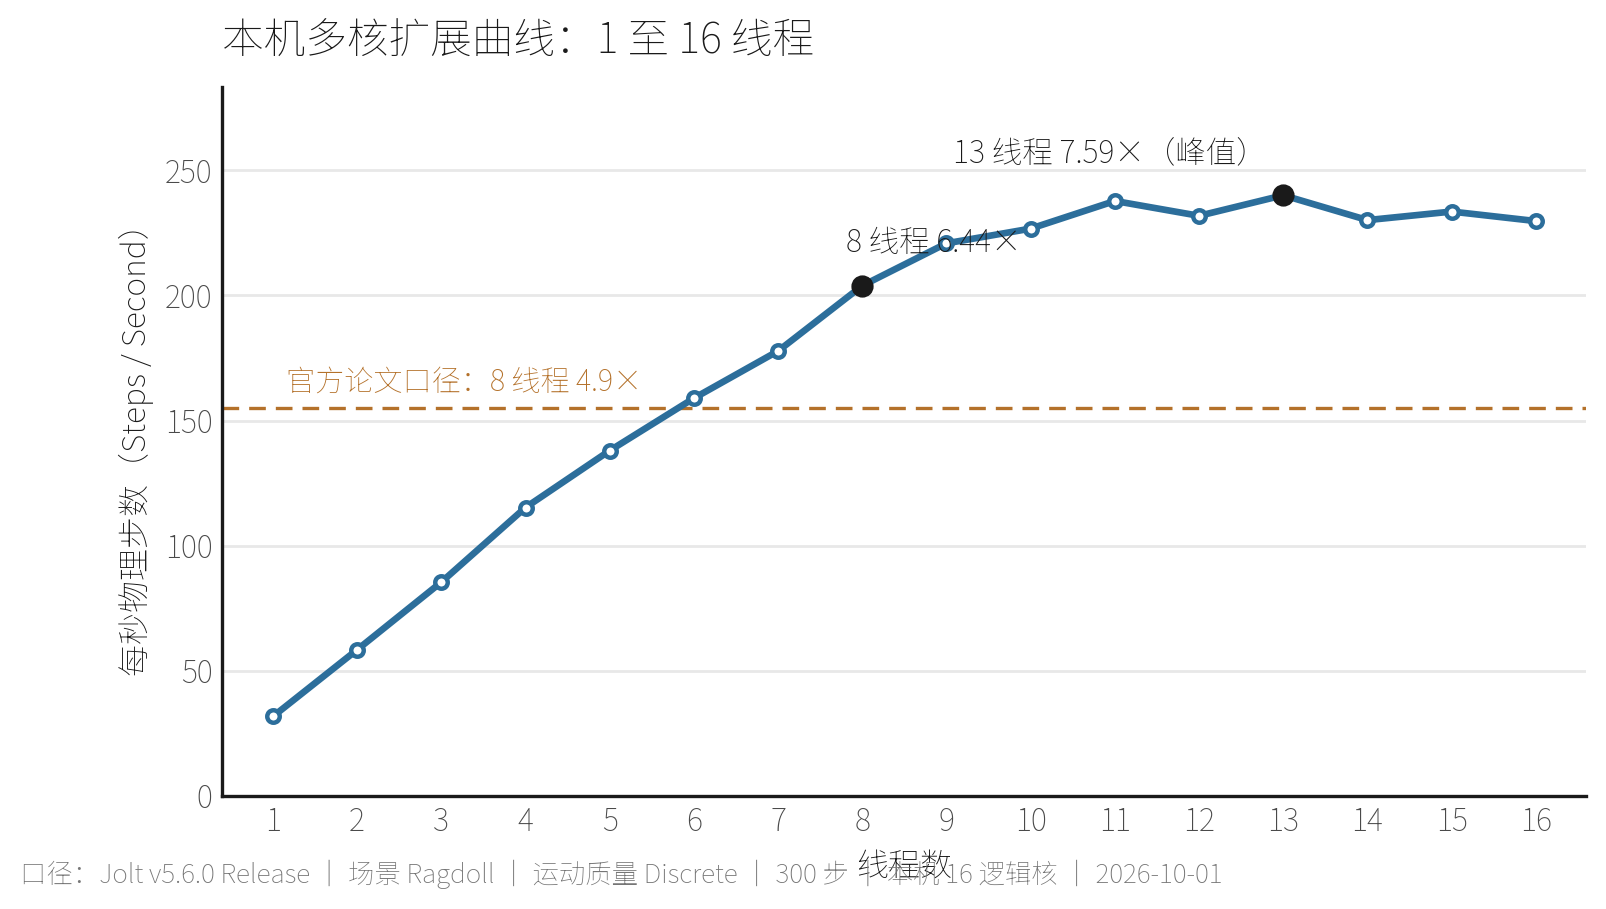
完整数据如下。注意最后一列:十六个线程数下,哈希值完全相同——这一列是第四章的主角,此处先按下不表。
| 线程数 | 每秒步数 | 相对单线程 | 说明 |
|---|---|---|---|
| 1 | 31.65 | 1.00× | 基线 |
| 2 | 58.32 | 1.84× | |
| 3 | 85.37 | 2.70× | |
| 4 | 115.21 | 3.64× | |
| 5 | 137.97 | 4.36× | |
| 6 | 158.92 | 5.02× | 已超过官方 8 线程口径 |
| 7 | 177.81 | 5.62× | |
| 8 | 203.92 | 6.44× | 官方同档为 4.9× |
| 9 | 220.87 | 6.98× | 增量开始衰减 |
| 10 | 226.74 | 7.16× | |
| 11 | 237.79 | 7.51× | |
| 12 | 231.86 | 7.33× | 出现负增量 |
| 13 | 240.08 | 7.59× | 峰值 |
| 14 | 230.15 | 7.27× | 出现负增量 |
| 15 | 233.56 | 7.38× | |
| 16 | 229.76 | 7.26× | 出现负增量 |
结论(量化):本机 8 线程相对单线程加速 6.44×,比官方口径的 4.9× 更高; 峰值出现在 13 线程,达到 7.59×;16 线程反而回落到 7.26×。 三个数字的前提都是:Jolt v5.6.0 Release、Ragdoll 场景、Discrete、300 步、本机 16 逻辑核。
3.3 拐点在哪:9 到 10 线程,不是 16
先来看看增量这一列。把每一线程的增量单独列出来,拐点的位置就藏不住了:
每增 1 线程带来的增量(步/秒):
2:+26.7  3:+27.0  4:+29.8  5:+22.8  6:+21.0  7:+18.9  8:+26.1
9:+16.9  10:+5.9  11:+11.0  12:−5.9  13:+8.2  14:−9.9  15:+3.4  16:−3.8
第 2 到第 8 线程,每加一个线程稳定带来 19 到 30 步的增量;从第 9 线程起掉到 17,第 10 线程只剩 6; 再往后进入噪声区——12、14、16 线程都是负增量。
这个形状指向一个很具体的硬件解释。本机是 16 逻辑核,而逻辑核通常不是物理核: 如果本机是 8 物理核加超线程,那么前 8 个线程是"每个线程独占一个物理核", 第 9 个线程开始就要两个逻辑核去抢同一个物理核的执行单元。 物理仿真这类负载在单个核上已经吃满了浮点与访存流水线, 超线程带来的收益本就有限,而两个线程抢同一份缓存与访存带宽,还会把对方拖慢—— 这正是负增量的来源。
这里必须回头修正本系列立项时的一处推断。 在破题阶段, 我们按官方那句"约 16 核后停止扩展",推断"本机 16 逻辑核正好落在拐点附近"。 实测把这个推断证伪了:本机的拐点在 9 到 10 线程,与 16 相去甚远。 正确的说法应该是:官方那句话描述的是"物理核数"意义上的拐点,而本机只有 8 个物理核, 所以拐点提前到了 9 线程附近。 两个数字并不矛盾,它们量的是不同的东西。
这条修正本身也是本章的一个结论:官方曲线必须配着硬件条件读。 把"约 16 核后停止扩展"直接搬进本机语境,就会得出一个错出 6 个线程的结论 ——这也正是本系列坚持"读数标口径、能自跑就不引用"的原因。
3.4 三条曲线放一起看,能得到什么
把官方口径、本机实测与一条"理想线性"基准画在同一张坐标系里,三种落差会同时显形:
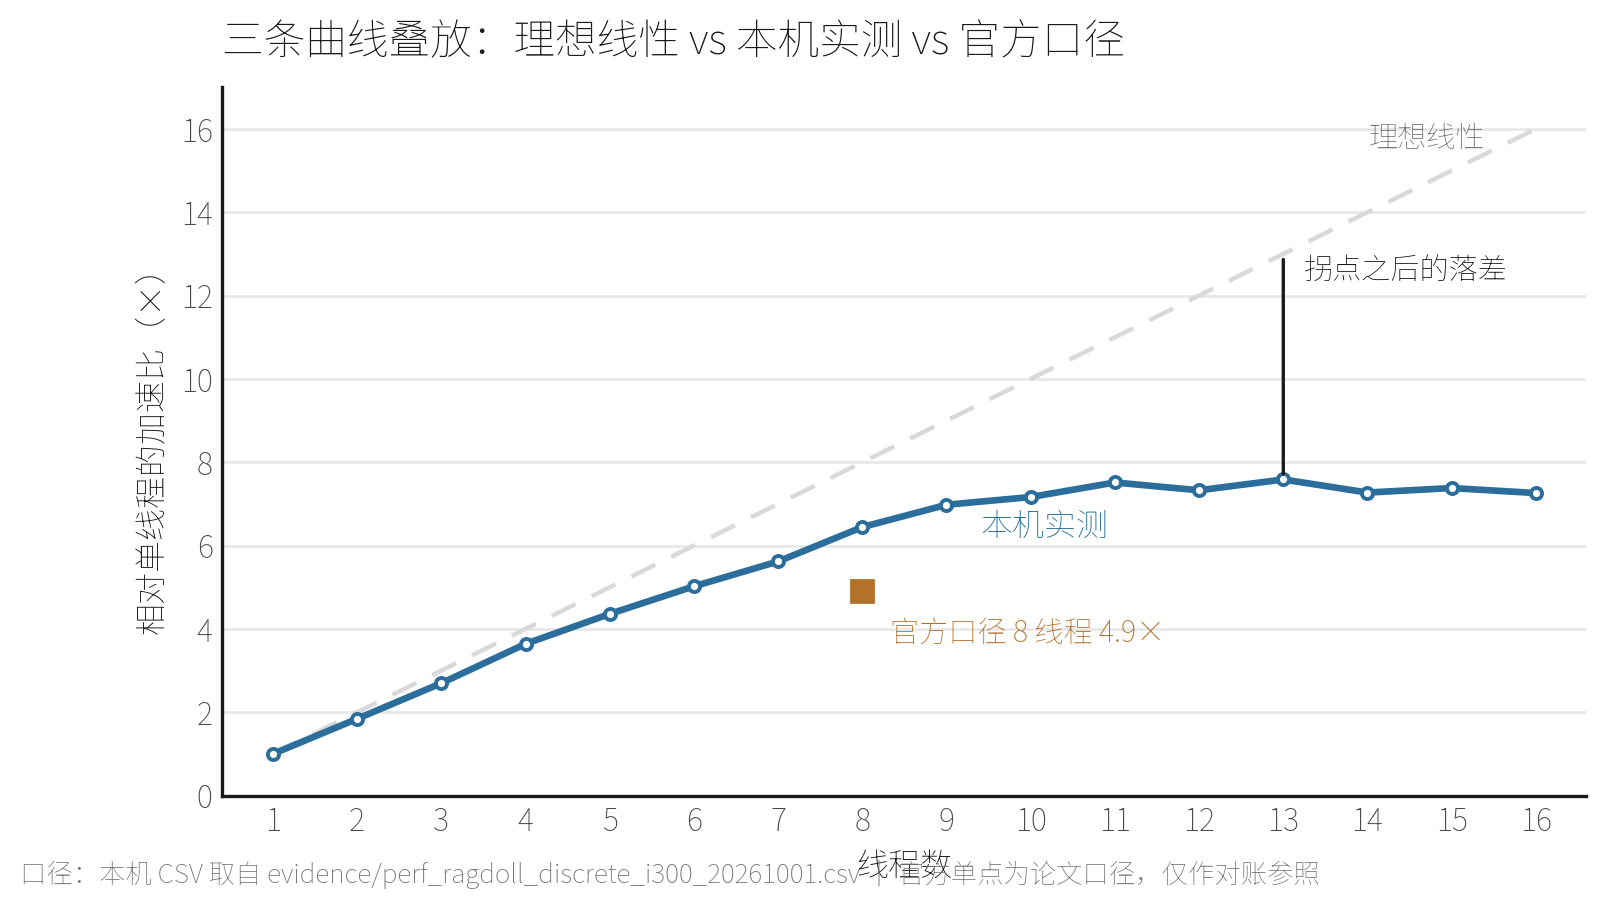
落差一:本机在 8 线程处比官方口径高。 6.44× 对 4.9×,高出约 31%。 这不是"Jolt 在本机变快了",而是两台机器的比值不一样——核的微架构、缓存大小、内存带宽、场景里的物体数量都会影响。 把这句写清楚,比给一个孤零零的倍数重要得多。
落差二:两条曲线都远低于理想线性。 理想情况下 8 线程该是 8.00×,实测是 6.44×, 并行效率约 80%。剩下的 20% 花在哪,正是第十章(岛与并行)要讲的内容: 不是所有工作都能并行——宽相要收尾、岛要切分、大岛的依赖要排序, 这些"串行的部分"按阿姆达尔定律决定了上限。
落差三:超过物理核数之后,曲线不是变平,而是开始震荡。 这一点比"变平"更值得注意: 第 12、14、16 线程都出现了负增量。负增量意味着"多给一个线程反而更慢", 这不是误差,而是资源争抢的直接后果。对一个要把帧预算压到毫秒级的引擎来说, 这意味着线程数不该简单地设成"逻辑核数"——本机的最优点在 13 线程,而不是 16。
三条落差的共同教训:多核性能不是"核越多越好"的单调函数。 它是"并行比例、物理核数、争抢代价"三者的合成曲线,且拐点位置只对本机成立。
四、主线二:确定性——线程数不影响结果
4.1 确定性为什么是个卖点
下面开始讲一个反直觉的性质。物理引擎有个反直觉的性质:它越并行,越难做到"结果可复现"。
原因不难理解。并行意味着完成顺序不确定:物体 A 与 B 的接触可能在主线程算完,也可能在工作线程算完; 如果某个中间量依赖"谁先算完",那么同一份输入跑两遍就可能得到两个略有差异的世界。 在世界小的时候这点差异看不出来,但物理是逐帧累积的—— 第 1 帧差 0.001 米,第 1000 帧就可能差出几米,玩家会看到"明明同样的操作,这次箱子倒向另一边"。
确定性(determinism) 指的就是:同一份初始状态加同一串输入,无论跑在几个线程上、跑多少遍,结果必须逐位一致。 它不是一个"锦上添花"的特性,而是两个实际需求的底座:录像回放(只存输入,重放时重新算一遍) 与网络同步(各端只交换输入,各自算出一致的结果)。
4.2 官方给的三件工具
Jolt 把确定性做成了可检查的工程流程,对外提供三个抓手:
第一步是存状态:PhysicsSystem::SaveState 可以把运行时状态写进一个记录器;
第二步是恢复:RestoreState 还能读回来(见PhysicsSystem 接口),官方对它的措辞是"Restoring state for replay";
第三步是比对:命令行测试程序提供 -validate_hash=<hash>,一致返回 0,不一致返回 1。
这三步合起来构成一个可以进自动化流水线的回路:存一次、跑一次、比一次。 注意它的检查粒度:不是"看起来差不多",而是整数哈希值的相等性—— 要么完全相同,要么当场失败,没有中间地带。
4.3 本机实证:十六个线程数,同一个哈希
好了,回过头看那张表的最后一列。回到第三章那张表。它的最后一列,是 PerformanceTest 在每组线程数跑完后打印的状态哈希值。
十六行数据里,这一列是这样:
Discrete,  1,  31.646342, 0xcc61333c4bfb0fad
Discrete,  2,  58.323338, 0xcc61333c4bfb0fad
...
Discrete, 13, 240.080955, 0xcc61333c4bfb0fad
...
Discrete, 16, 229.761655, 0xcc61333c4bfb0fad
十六个线程数、十六次运行,哈希值全部是 0xcc61333c4bfb0fad。
这条数据的说服力比单跑一次 -validate_hash 更强,原因在于它同时改变了两件最可能破坏确定性的事:
线程数从 1 变到 16(并行度变了 16 倍),每组的执行时间也从 31 步/秒变到 240 步/秒(快慢差了 7.6 倍)。
在并行度与执行速度都剧烈变化的情况下,结果哈希一位没变——
这就是"线程数不影响模拟结果"的直接证据。
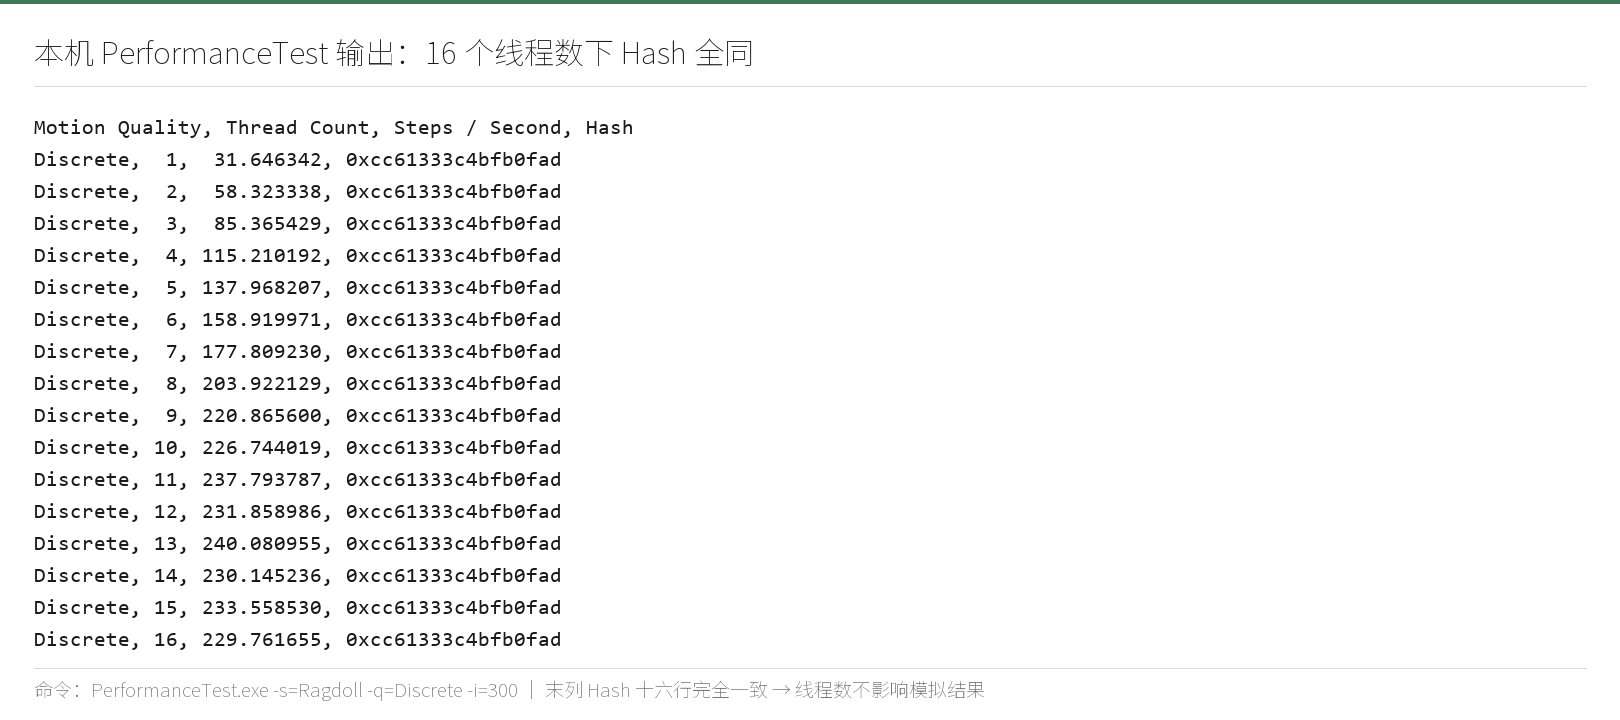
结论(量化):在本机 16 个线程配置下(1 到 16 并发),300 步 Ragdoll 场景的终态哈希零差异, 对应并行度变化 16 倍、速度变化 7.6 倍。 口径:Jolt v5.6.0 Release | Ragdoll | Discrete | 300 步。
4.4 确定性成立的前提
先来看看一个容易被忽略的前提。:"确定性"不等于"任何两台机器结果都一样"。 它成立依赖几个前提条件,缺一个就会失效。
这四条里,第二条最容易被忽略。浮点运算在不同指令集上并不总是给出逐位相同的结果
(Jolt 自己就在启动横幅里列出了本机启用的指令集:SSE2 SSE4.1 SSE4.2 AVX AVX2 F16C LZCNT TZCNT FMADD),
而编译器是否允许重排浮点运算也会影响结果。所以跨平台同步通常需要在协议层额外处理,
"Jolt 是确定性的"这句话必须限定在同一份构建产物之内。
五、工程取舍:为了让物理跑得快,Jolt 放弃了什么
5.1 一份取舍表
好了,先看它放弃了什么。"支持什么"容易查,"放弃了什么"才是它性格的来源。 Jolt 的 README 把它的工程约束写得很直白,把它们列成一张表:
这些约束的共同指向是一个词:可预测。不用异常,就没有"某处抛异常导致这一帧的物理没算完"这种可能; 不用 RTTI,就没有运行期的类型查询开销;自带 SIMD 抽象,就不用担心不同编译器对向量化的处理不一致。 代价是接入成本变高:使用者不能依赖语言的那些便利特性,一切要按 Jolt 的规矩来。
5.2 它的代码是怎么分块的
说白了,看代码先看目录。要看一个引擎的实现,第一步是看它的目录。Jolt 的源码全部在 Jolt/ 一个目录下,内部分成这样几块:
这张图里有一处需要注意的分法:几何算法与碰撞逻辑不在一个目录里。
纯数学的碰撞算法(GJK、EPA、凸包构建)在 Geometry,而把它们组织成"谁和谁碰"的逻辑在 Physics/Collision。
后面第六篇讲窄相时会回到这个分法上——很多人按目录去找"窄相实现",会找不到,因为它压根没有这个目录名。
5.3 编译开关:能力是可以关掉的
Jolt 把许多能力做成了编译开关。这在一开始容易让人困惑:为什么一个物理库要让你关掉渲染后端? 看了目录结构就明白了——它的东西比"一个物理库"多。
这张矩阵里有四个开关属于 v5.6 的新增项,它们正是本篇 §2.4 讨论的那条 GPU 通路。 把它们放在这里,是为了让读者看清一件事:那条通路是可选的、可整体关掉的, 而刚体求解不依赖其中任何一个开关——这在构建层面又给"Jolt 没有 GPU 刚体"加了一条旁证。
5.4 作业系统:一帧是怎么被拆成一张图的
前面几节讲了 Jolt"放弃什么"与"怎么分块"。还有一层没讲,而它恰恰是多核主线能成立的原因: 作业系统(job system)。
物理引擎要在多核上跑,绕不开一个难题:一帧内的物理工作不是一堆互不相干的独立任务, 它们之间有明确的先后与依赖。 "施加重力"必须在"找出碰撞"之前,"构建模拟岛"必须在"求解"之前。 如果只是简单地开 16 个线程各抢一个任务,依赖关系就会被破坏,结果不再确定。
Jolt 的做法是把一帧内的全部工作组织成一张有依赖关系的有向图,交给作业系统去调度:
这张图解释了第三章曲线的一个现象。为什么 8 线程只有 80% 的并行效率? 因为图里存在必须串行的边——宽相收尾要等所有宽相查询完成、建岛要等所有接触收集完成、 积分要等求解完成。这些边之间是屏障(barrier),屏障前后的工作不能重叠。 并行效率的上限,就由"图里可并行的部分占比"决定,这正是阿姆达尔定律在引擎内部的具体形态。
这张图同时也是后面几篇的路标。 图上的每个节点,都对应一篇的题目: "找出碰撞"对应宽相(第四、五篇)与窄相(第六、七篇), "装配约束与建岛"对应约束家族(第八篇)与岛切分(第十篇), "速度求解"与"位置求解"对应接触求解(第九篇), "CCD"对应连续碰撞检测(第十一篇)。 第十二篇会回来把这张图逐格读完——到那时候,每一格里发生了什么都已经讲透了。
六、本机跑通:从 tarball 到 Samples
前面五章讲的都是"资料上怎么写"。从这一章起,本系列的另一半证据开始登场:本机真跑出来的东西。 本章把"把 Jolt 在这台机器上从零跑起来"这件事完整走一遍——包括两个卡住我们的地方, 因为那两处恰好是这个项目最容易让人以为"环境不行"的坑。
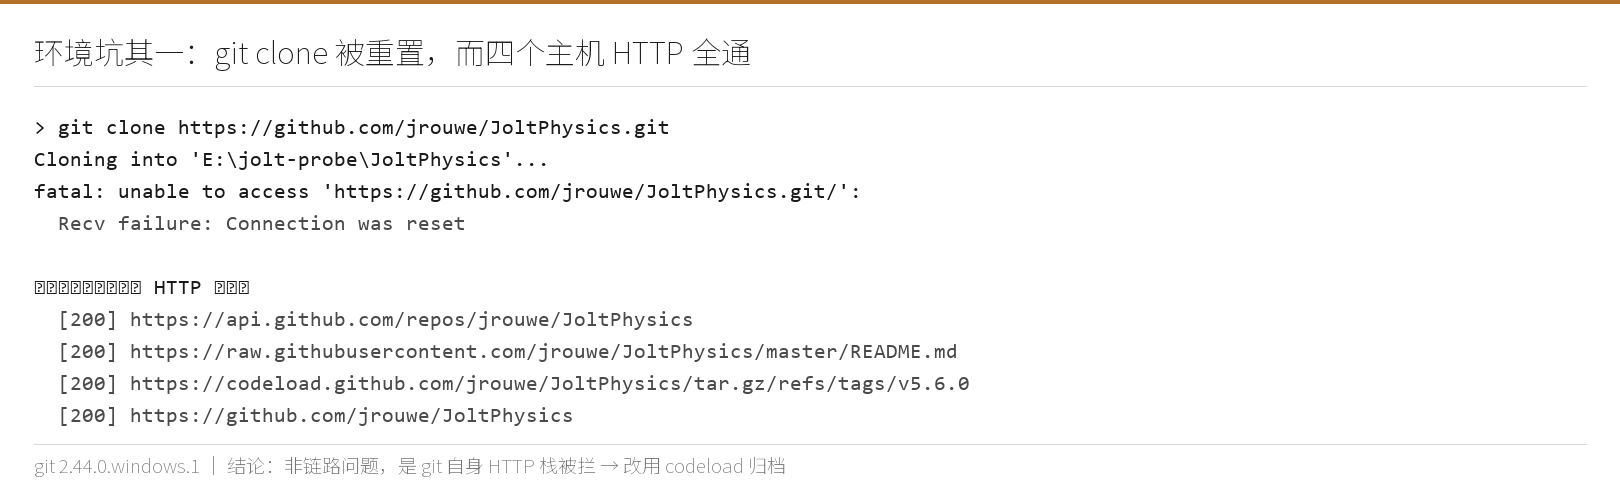
6.1 第一步就卡住了:git clone 被拦
言归正传,开始跑。第一步就卡住了。标准做法当然是克隆仓库。但本机执行 git clone 时,得到的是这个:
Cloning into 'E:\jolt-probe\JoltPhysics'...
fatal: unable to access 'https://github.com/jrouwe/JoltPhysics.git/':
  Recv failure: Connection was reset
看起来像是网络不通。但同一时刻对四个相关主机做一次 HTTP 探测,结果全是 200:
[200] https://api.github.com/repos/jrouwe/JoltPhysics
[200] https://raw.githubusercontent.com/jrouwe/JoltPhysics/master/README.md
[200] https://codeload.github.com/jrouwe/JoltPhysics/tar.gz/refs/tags/v5.6.0
[200] https://github.com/jrouwe/JoltPhysics
四个主机都通,唯独 git 不通——这说明问题不在链路,而在 git 自己的 HTTP 栈。
本机 git 版本是 2.44.0.windows.1,它使用自带的传输实现;在某些网络中间设备下,
这个实现会被重置,而系统级的普通 HTTPS 请求不受影响。
解法:绕开 git,直接取代码归档(tag 归档是官方 CI 发布的稳定产物):
# 【取源】绕开 git 的 HTTP 栈,直接下 Release tag 的归档
curl.exe -L --retry 3 --retry-delay 3 `
  -o E:\jolt-probe\jolt-v5.6.0.tar.gz `
  https://codeload.github.com/jrouwe/JoltPhysics/tar.gz/refs/tags/v5.6.0
归档 18.5 MB(压缩)/ 37 MB(解开)。这个体积本身也是一条信息: Jolt 的完整源码加自带资源一共才 37 MB——对一个商业项目在用的 3D 物理引擎来说,这是个很小的数字。
6.2 第二个坑:构建入口不在仓库根
代码到手,按常规做法在仓库根目录执行 CMake 配置,报错:
CMake Error: The source directory "E:/jolt-probe/JoltPhysics-5.6.0"
  does not appear to contain CMakeLists.txt.
根目录里确实没有 CMakeLists.txt——这不是解压丢了文件:直接向仓库的原始文件地址请求这个路径,
返回的是 404,归档目录清单里也没有它。Jolt 把构建入口放在了 Build/ 子目录下:
# 【配置】注意源目录是 Build/,不是仓库根
cmake -S E:\jolt-probe\JoltPhysics-5.6.0\Build `
      -B E:\jolt-probe\build `
      -G "Visual Studio 17 2022" -A x64
这个坑值得记一笔:"按惯例找文件"在这类项目里会失效。 一个商业项目把 CMake 入口放在子目录, 多半是历史原因(早期为 Android 与多平台构建统一入口),源码里并没有为此留下显眼的提示。
6.3 配置与构建:这一步验证了自跑方案
言归正传,配置与构建两步的结果如下。:
-- The CXX compiler identification is MSVC 19.44.35228.0
-- Selecting Windows SDK version 10.0.26100.0 to target Windows 10.0.26200.
-- Found Vulkan: D:/LenovoSoftstore/Install/VulkanSDK/1.3.283.0/Lib/vulkan-1.lib
   (found version "1.3.283") found components: glslc glslangValidator
-- Configuring done (8.3s)
-- Generating done (0.6s)
Found Vulkan ... found components: glslc glslangValidator 这一行是本章的关键。
它意味着本机不只有显卡驱动层面的 Vulkan 能力,还有能编译着色器的 SDK 工具链——
而后者才是 Samples(那个可交互测试程序)能构建出来的前提。
如果只核到"显卡支持 Vulkan",很可能会在真正构建时才发现缺 glslc。
紧接着构建四个目标:
# 【构建】Release 配置,三个可执行目标 + 一个测试框架库
cmake --build E:\jolt-probe\build --config Release `
      --target HelloWorld PerformanceTest Samples -- -m
产物清单与耗时:
Jolt.lib                                   ← 物理库本体
HelloWorld.exe                             ← 最小示例
PerformanceTest.exe                        ← 命令行基准测试(第三、四章的数据来源)
TestFramework.lib                          ← 测试框架(Samples 依赖)
Samples.exe                                ← 可交互测试场(DebugDraw 图的来源)
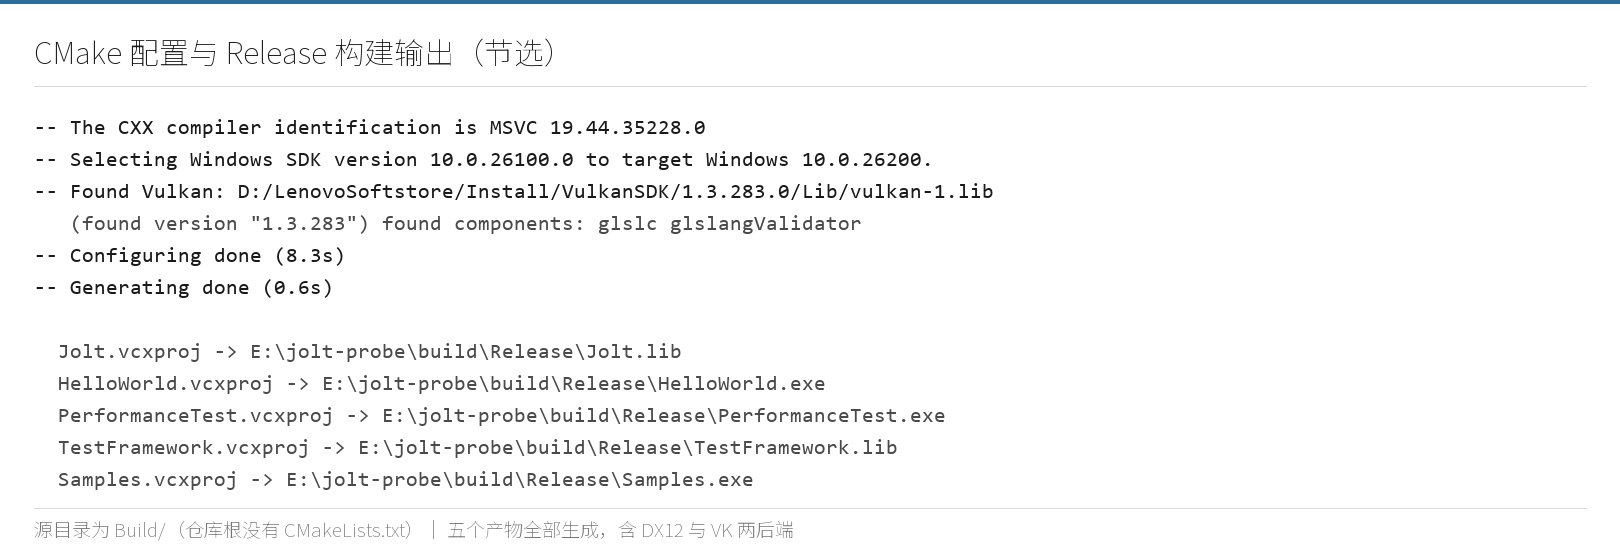
这一步的意义超过"环境通了"本身。 它把本篇图位表里最关键的几张图从"承诺"变成了"已可得": 多核曲线、确定性回归、构建实况、HelloWorld 输出、Samples 界面——五类真图全部有了来源。
6.4 跑起来:HelloWorld、PerformanceTest 与 Samples
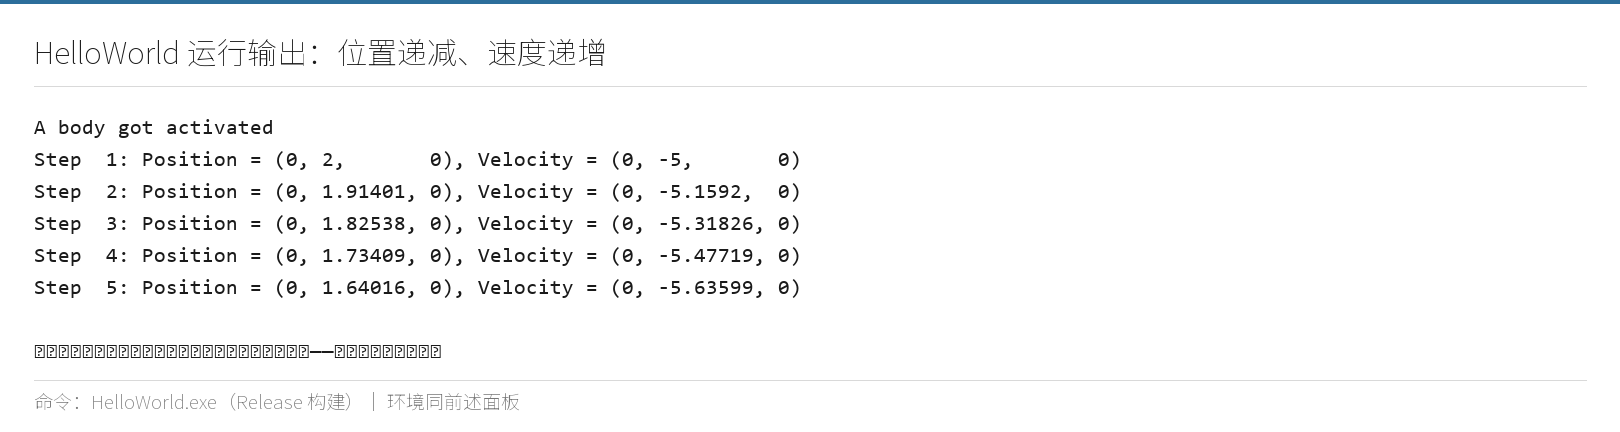
HelloWorld 是最小的物理示例:一个球从空中落下。它的输出是这样的:
A body got activated
Step 1: Position = (0, 2, 0),      Velocity = (0, -5, 0)
Step 2: Position = (0, 1.91401, 0), Velocity = (0, -5.1592, 0)
Step 3: Position = (0, 1.82538, 0), Velocity = (0, -5.31826, 0)
三行数字里藏着物理引擎最基本的一次积分:位置在减小(往下掉),速度在变大(越掉越快)。 这就是第三章那个"每帧解微分方程"的最小编译单元——只不过这个场景里没有别的物体,也就没有约束, 所以它简单到可以手算。后面九篇要讲的宽相、窄相、约束、岛,都是为了让这个式子在有几千个物体互相碰撞时还能算对。
PerformanceTest 就是第三、四章的数据来源,此处不再重复。
Samples 是最后一个,也是最重的一个——它打开一个可交互的测试场,
官方在里面放了 8 大类几十个测试场景,并且有一个 Drawing Options 菜单,
可以直接把物理引擎的内部状态画出来(比如把休眠中的物体染成一种颜色、把每个模拟岛染成不同颜色)。
本系列后面那些"看得见物理内部"的图,全都来自这个菜单。
6.5 Samples 里的八大类场景,与它们各自能证明什么
Samples 值得单独说一节,因为它是本系列后续十二篇的图的产地——
不说清它有什么,后面那些图就成了"来路不明的截图"。
官方把它分成八大类,每一类的意义不同:
| 分类 | 代表场景 | 能证明什么 | 对应本系列篇目 |
|---|---|---|---|
| Vehicle | 轮式车、履带车、摩托 | 约束与马达如何组合成可操控的车辆 | 第十二篇 |
| Ragdoll | 布娃娃堆、单堆叠 | 多关节人体与睡眠机制 | 第十、十二篇 |
| SoftBody | 布料、充气、蒙皮约束 | 柔体约束族(含官方标注的"仍在开发中") | 第十三篇 |
| Character | 虚拟角色、刚体角色 | 两条角色路线的手感与代价差异 | 第十二篇 |
| Water(Constraints 族) | 浮力与阻尼 | 约束与外力如何共同作用 | 第八篇 |
| Constraints | 齿轮、滑轮、路径、双摆 | 各类约束的可视形态 | 第八篇 |
| Shapes | 凸包、网格、高度场、复合形状 | 形状谱系与窄相代价 | 第六、七篇 |
| General | 漏斗、大岛、休眠堆、多线程着色 | 宽相、岛切分与睡眠 | 第四、十篇 |
这张表的作用是"证据的可追溯性":后面某一篇用了某张图, 读者可以回到这一节查到它出自哪个场景、那个场景在官方测试里是用来验证什么的。 没有这张表,"配图"就只是配图;有了它,每张图都成了一个可复核的实验编号。
一个特别值得注意的场景是 General 分类里的多线程着色与休眠着色—— 它们不是"好看的演示",而是把两个无法从外观判断的内部状态变得可见: 哪个物体正在被模拟、哪些物体已经睡着、哪几个物体被划进了同一个模拟岛。 第十章讲岛与睡眠时,会直接依赖这两类着色图,因为那是唯一能"看见"它们的方式。
本章结论(可复核):Jolt v5.6.0 在本机(MSVC 19.44 + Windows SDK 10.0.26100 + Vulkan SDK 1.3.283) 从源码到可运行,共遇到 2 个环境层面的坑,都有明确解法; 最终产出 5 个构建产物、3 类可运行程序、5 类真图来源。
七、边界与两处反误区
7.1 反误区一:GPU Compute 不等于 GPU 刚体
本篇 §2.4 已经点过一次,这里把它完整说清,因为它很可能是关于 Jolt 传播最广的一处误读。
v5.6.0 的更新日志里有一句:
Added interface to run compute shaders on the GPU with implementations for DX12, Vulkan and Metal.
而它后面那句限定了用途:
Added a strand based hair simulation running on GPU ... Note that this is still work in progress.
把两句连起来读,结论是明确的:新增的是一个"在 GPU 上跑计算着色器"的通用接口, 它的第一个、也是目前唯一的实际用途是发束(strand)头发仿真。 刚体求解不走这条路。
这张图要表达的是一件事:"引擎里有 GPU 代码"与"引擎的物理在 GPU 上算"是两个不同层次的陈述。 前者 Jolt 有,后者 Jolt 没有。站外很多介绍把两者混为一谈,于是"Jolt 支持 GPU 物理"这句话就传开了。
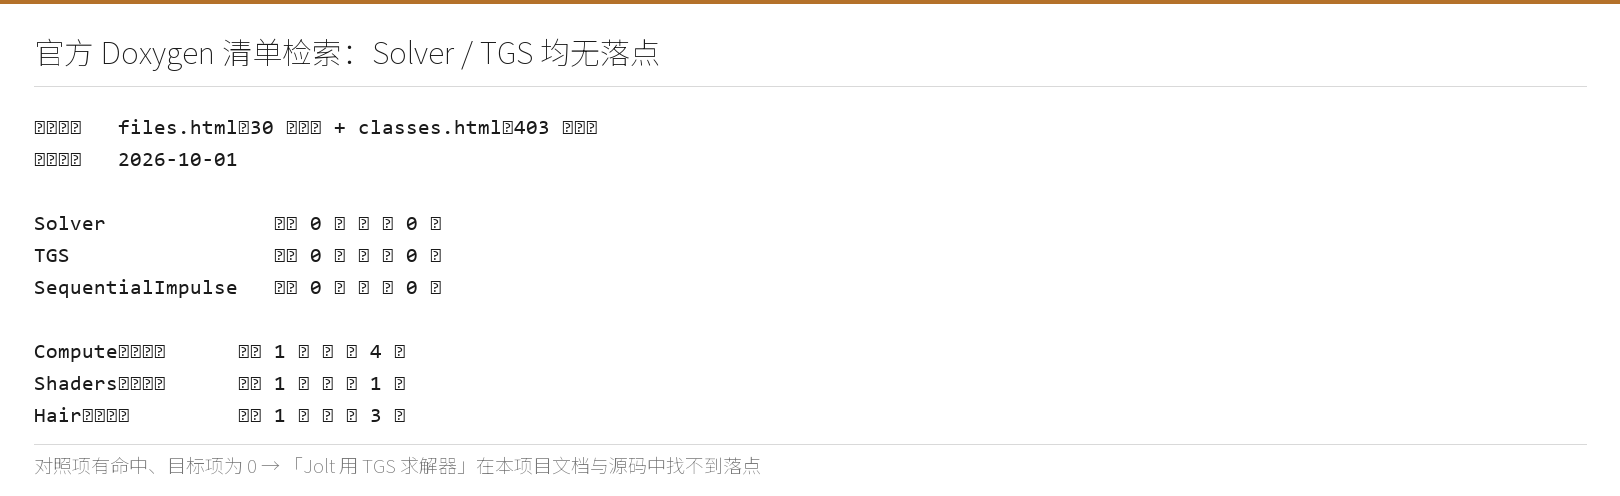
按项目流程,这篇的每个论点都要能追到出处。下面这张图是把这句话钉死的现场证据:
在官方的文件清单与类索引里逐项检索 GPU 相关的模块,看它到底挂在哪个子系统下。
7.2 反误区二:「Jolt 用 TGS 求解器」——查无落点
第二处误读比第一处更隐蔽,因为它听起来非常"专业"。
OK,第二处误读更隐蔽。站外有相当多的地方写"Jolt 使用 TGS(Temporal Gauss-Seidel)求解器"。按项目的纪律,
本篇没有直接采信,而是去官方的两份权威清单里检索:
Doxygen 的文件清单与类索引中,没有任何一项叫 Solver、SolverSequentialImpulse,也没有任何 TGS 命名。
那 Jolt 的求解到底在哪里?答案是把三处拼起来:
- 约束接口本身承担了求解器接口(见Constraint 的 Solver interface):
Constraint里有一组以SetupVelocityConstraint、WarmStartVelocityConstraint、SolveVelocityConstraint、SolvePositionConstraint命名的虚函数, 注释里明确写着这是 "Solver interface"; - 接触侧走的是顺序冲量法(见ContactConstraintManager):
ContactConstraintManager的注释注明实现依据是 Erin Catto 在 GDC 2009 的《Modeling and Solving Constraints》, 位置侧用 Baumgarte 稳定化(依据 GDC 2007 的那套推导); - 调度交给
PhysicsSystem的 step jobs:迭代在哪个阶段跑、跑几轮、哪些岛并行,由作业图决定。
所以准确的说法是:Jolt 的求解是"约束求解接口 + 接触约束管理器 + 物理系统作业图"三者的合成, 其接触侧公式来自顺序冲量法。"TGS"这个命名在本项目里找不到落点,本系列不采用。
这也带来一个正面的收获:第九篇(接触求解)会沿这条线把公式真正写出来—— 因为现在我们知道该去读哪三个文件,而不是去读一个并不存在的 "Solver"。
7.3 这张图,是后面十二篇要拆的东西
本章最后,认一张官方的图。它是 Jolt 官方文档里那张物理系统更新流程图,
把一次 Update 调用内部的所有工作按执行顺序摊开:
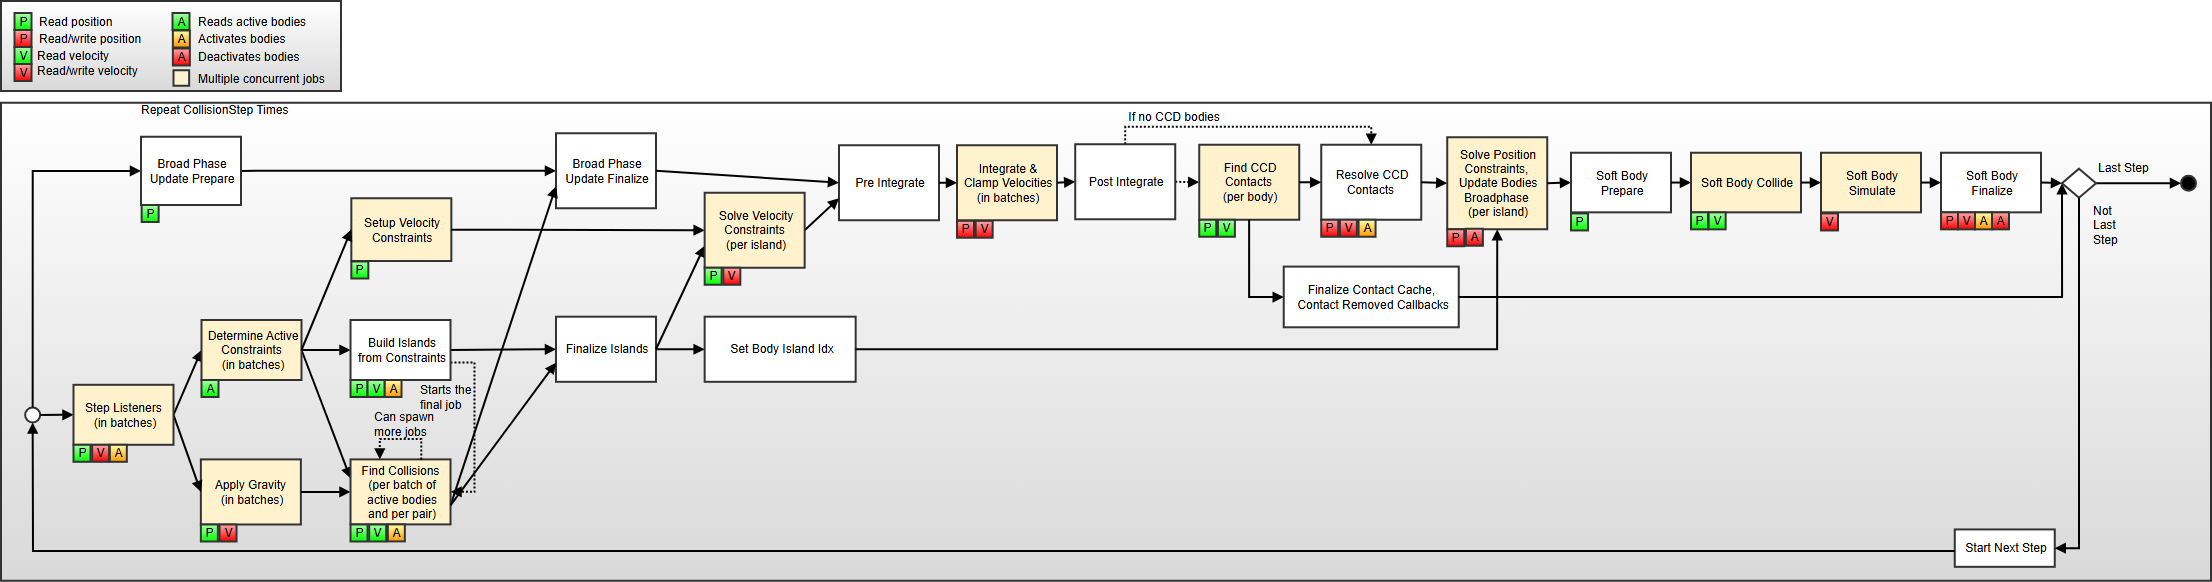
这张图是本系列的地图。 它上面的每一格,都是后面某一篇的题目: 宽相在那一段、岛构建在那一段、速度求解在那一段、CCD 在那一段。 第十二篇(收官)会再回来完整地读这张图,那时候每一格都已经讲过了。
7.4 本篇小结:五条可以被别人检验的命题
本篇不打算用"综上所述"收尾,而是把结论压成五条可以被检验的命题—— 每条都给出检验方法,读者可以直接动手推翻它们:
| # | 命题 | 怎么检验 | 本机结论(条件) |
|---|---|---|---|
| 1 | Jolt 的刚体求解全部在 CPU | 查 Jolt/Physics 与 Jolt/Compute 的调用关系 |
成立(v5.6.0 源码) |
| 2 | GPU Compute 通路只服务发束头发 | 读 v5.6.0 更新日志的相邻两句 | 成立(官方原文) |
| 3 | 多核扩展在 8 线程处有明确加速 | PerformanceTest.exe -s=Ragdoll -q=Discrete -i=300 |
6.44×(本机 16 逻辑核) |
| 4 | 线程数不影响模拟结果 | 同上,读输出末列的 Hash | 16 个线程数下全同(0xcc61333c4bfb0fad) |
| 5 | 没有名为 Solver/TGS 的类 |
在官方文件清单与类索引中检索 | 查无(v5.6.0 文档) |
这五条是本篇的交付物。 它们不依赖读者相信本系列的判断—— 每一条都有自己的检验入口,其中三条只要一条命令、两条只要一次检索。 如果某一条在某台机器上被推翻,那非常好:说明多核曲线确实与机器相关(命题 3 本来就是这样设计的), 而另外四条属于源码与文档层面的事实,不受机器影响。
八、系列地图:十三篇怎么排
8.1 骨架:机制十篇 + 自跑与实测三篇
先来看看十三篇的排法。本系列的十三篇不是按"从易到难"排的,而是按一次 step 的执行顺序排的,中间插入三篇自跑篇。 理由很简单:Jolt 的机制本身是有拓扑序的——不理解 Body 就无法理解宽相, 不理解宽相就无法理解窄相,不理解窄相与约束就无法理解求解。按拓扑序讲,前一篇永远是后一篇的前提。
值得说明的是中间那三篇自跑的位置:它们不是"插入的技术点",而是对前一段机制的本机验证。 比如多核曲线(第三篇)验证的是作业系统与岛切分,确定性(第十一篇)验证的是状态记录与迭代顺序。 "机制靠原文、代价靠自跑、两类互为校验"——这是本系列从已交付七专题延续下来的方法论。
8.2 每篇的证据类型
先来看看这些图各自承担什么。,它们承担的角色需要分开记:
这张矩阵解释了本系列素材方案的一个特点:官方一手图覆盖了十三篇里的十篇, 而本机自跑真图集中在三篇自跑篇与开篇。 两者的分工是清楚的——官方图证明"官方是这么设计的",自跑证明"本机跑出来是这样", 少了任何一边,都只是转述或者孤证。
8.3 本系列的六条写作纪律
十三条骨架背后,有六条纪律贯穿全系列。把它们写在这里,读者可以据此判断后面每一篇是否达标。
第一条:读数必标口径。 每个数字都要能回答"在什么条件下"。本系列的写法是
版本 + 场景 + 参数 + 机器条件 + 日期,五要素缺一不可。这是为了防一件很具体的事:
物理引擎的数字离开条件就失去意义——同一个引擎在两台机器上可以差出 30%(§3.4)。
第二条:官方曲线只作参照,不作结论。 官方给 4.9×,本机跑出 6.44×, 两个数字都不错,但都不能直接拿来用。凡涉及性能的论断,本系列用本机数据, 官方数据只用来对账,并且必须在同一句里说明两者的条件不同。
第三条:机制靠原文,不靠二手转述。 每个机制结论都追溯到官方文档或源码里的具体位置。 这条纪律的代价是慢——但它已经在本篇里证明了自己的价值:两处流传很广的说法, 都是在追溯原文时才被证伪的(§2.4 的 GPU 刚体、§7.2 的 TGS)。
第四条:能自跑就不引用。 只要本机能跑,就不拿别人的截图当证据。 这条纪律直接决定了本系列的工作量(本机编译 37 MB 源码、跑出 16 行曲线), 但它也换来了本系列最硬的那部分证据。
第五条:模拟器与受限条件如实标注。 凡是本机拿不到的东西—— 比如需要特定硬件的多刷新率场景、需要可 root 环境的探测器——一律标"本机不可得", 不写成通例,也不用推测填空。上一篇专题(Android 图形显示系统)全程使用模拟器口径, 每一张相关图注上都写明了这一点,本系列沿用同一纪律。
第六条:卡住的地方也写。 本篇 §6.1 与 §6.2 两处环境坑(git clone 被拦、构建入口不在仓库根)
本来可以不写,因为最后都绕过去了。但一个只在顺利时成立的方案不算方案——
把卡点与绕法写出来,后来者才有可能复现这套方案。
这六条里,前三条决定结论可信,后三条决定结论可用。
九、结语:它是第几格
回到开篇那句"本站第一次把镜头转向渲染之外"。
十三篇讲完,本篇要给的其实只有一个坐标系里的一个点,以及一条可核对的判据。 这个点是:Jolt 是一个把"多核扩展性"与"确定性"押在最前、放弃了 GPU 刚体这条路线的 3D 刚体库。 而判据是:它的每一条自称,都可以在本机复现或推翻—— 多核曲线我们量了(8 线程 6.44×,拐点在 9 到 10 线程,与官方"约 16 核"的说法在物理核意义上并不冲突); 确定性我们验了(16 个线程数下哈希零差异);而它没有的那两样(GPU 刚体与"TGS 求解器"), 我们也在官方清单里逐项核对过。
还有一件本篇刻意做了的事:把"自跑"这个过程本身也写出来,包括卡住的那两处
(git clone 被拦、构建入口不在仓库根)。
因为一个只在顺利时才成立的方案不算方案——能说清"卡在哪、怎么绕",别人才敢照着做。
下篇预告:下一篇(二)《一次 step 的流水》,把本篇 §7.3 那张官方流程图从头到尾读一遍,
把 PhysicsSystem::Update 内部排的那些活逐格展开——看看一帧物理到底被切成了几段、哪几段能并行。
那也是全系列真正进入机制的起点。
本系列与已交付专题的边界
需要特别指出的只有两条引用关系,其余互不重叠: 一是性能剖析工具链(T01)——它立的"抓帧与剖帧方法论"在本系列里作为验证手段被复用; 二是2D 矢量引擎深挖(T03)——它的收官篇明确留了一句"下一篇会补上 2D 绘制框架怎么把命令交给图形库", 那个接缝由《Android 图形显示系统》(T05)兑现了,本系列是在它之后转向物理题域的一次完全换向。
本篇引用来源(按章)
第一章 · 项目与许可 - 官方仓库与许可:jrouwe/JoltPhysics - v5.6.0 更新日志:ReleaseNotes.md - 架构与 API 文档:jrouwe.github.io/JoltPhysics
第二章 · 坐标系与竞品 - 官方碰撞引擎流程图:CollisionFlow.jpg - 英伟达 PhysX 仓库(BSD-3-Clause):NVIDIA-Omniverse/PhysX - PhysX 官方产品页:developer.nvidia.com/physx-sdk - Havok SDK 2025.2 发布说明:havok.com - Bullet 许可的社区口径:gamedev.net 讨论
第三章 · 多核 - 官方多核扩展测试:JoltPhysicsMulticoreScaling.pdf - 求解与睡眠参数:PhysicsSettings.h - 作业系统:JobSystem.h
第四章 · 确定性 - 状态记录与恢复:PhysicsSystem.h - 命令行测试说明:PerformanceTest.md
第五章 · 工程取舍 - 一次 Update 的分段:PhysicsUpdateContext.h - 大岛切分:LargeIslandSplitter.h - 岛构建:IslandBuilder.h
第六章 · 本机跑通 - 官方 Samples 说明:Samples.md - 最小示例:HelloWorld.cpp
第七章 · 两处反误区 - GPU 计算通路的实际边界:ReleaseNotes.md 的 v5.6 段 - 宽相实现:QuadTree.h - 三层过滤接口:BroadPhaseLayer.h - 对象层定义:ObjectLayer.h
后续篇目的主要来源(先给出便于对照) - 几何算法:GJKClosestPoint.h - 柔体:SoftBodyCreationSettings.h - 载具:VehicleConstraint.h - 角色:CharacterVirtual.h - 调试渲染:DebugRenderer.h - 序列化:ObjectStream.h
素材来源(Wikimedia Commons 类目枚举留痕) - Category:Rigid bodies(实为船舶碰撞档案照,已判跑题) - Category:Convex hull(部分对位) - Category:Collisions(多数跑题)
参考资料与资源清单
- Jolt Physics 官方仓库:https://github.com/jrouwe/JoltPhysics (MIT,v5.6.0)
- 官方架构与 API 文档:https://jrouwe.github.io/JoltPhysics/
- 按版本发布的文档:https://jrouwe.github.io/JoltPhysicsDocs/
- 多核扩展测试(官方):https://jrouwe.nl/jolt/JoltPhysicsMulticoreScaling.pdf
- 官方 Samples 说明:
Docs/Samples.md| 命令行测试说明:Docs/PerformanceTest.md - 本机证据归档:
content/blog/jolt-physics-ep01-landscape/evidence/(多核测试原始日志与 CSV、构建输出截图、运行输出截图) - 本机实验环境:Jolt v5.6.0 Release | MSVC 19.44.35228.0 | Windows SDK 10.0.26100.0 | Vulkan SDK 1.3.283.0 | 16 逻辑核 | 图与读数采集于 2026-10-01
以上。希望能对大家有所帮助。
写了这么多,其实最想让读者带走的不是"Jolt 很快"这个印象,而是"它的每一条自称都可以被你亲手检验"这件事。 本篇末那五条命题都附了检验入口:一条命令、一次检索,就能把本系列的判断推翻或证实。 如果你跑出的数字与这里不同,那很正常——多核曲线本来就与机器绑定,请把你那组的条件也记下来, 那才是它有意义的方式。
到这里,坐标系就立完了。下一篇我们正式进入机制:把一次 Update 内部的那些活,一格一格拆开看。
With Best Wishes.
本文由@溯光 出品,转载请注明出处。 站点链接:技术博客页 | 公众号:溯光的图形笔记