站点链接:技术博客页
本文是《实时光线追踪与混合渲染》系列的第十三篇,也是收官篇。全系列目录:ep01 画出光栅与光追的分界线,ep02–03 算加速结构的工程账,ep04 拆解命中着色器与 SBT,ep05 编排混合管线,ep06–07 讲透降噪的时域与空间两半,ep08 是 ReSTIR 类采样,ep09 做光线预算分配,ep10–11 管 RT 资源的生命周期与流式加载,ep12 收在透明、体积与次表面散射这三个"最难盈利"的场景。十二篇合计约 20.9 万汉字、352 张图。本篇不再新增机制,而是把十二篇的结论合成一张可查的决策地图,再回答一个问题:下一代硬件会改写其中哪几条。本文不涉及离线渲染与路径追踪的教学式推导。也不做未发布硬件的规格推测:厂商倍数一律标注口径,不与第三方实测并列。
点题:十二篇的账,该合成一张图了
十二篇写下来,最容易被忽略的一件事是:这些篇章从来不是并列的技术点,而是一笔账被反复翻开的不同页。ep01 立了三条判据(屏幕空间近似在什么硬条件下直接错、光追成本与什么成正比、代价被转移到了哪里),后面十一篇都在往这三条判据里填数字——加速结构的构建与更新成本、SBT 的表大小、降噪器的毫秒数、光线预算的分配比例、加速结构的显存占用、透明与体积的每像素光线数。
本篇要解决什么。前面每一篇都是纵向深入,读者拿到的是十二份局部最优解;但真实项目里,这十二份结论必须同时成立,而它们会互相抢资源。一帧 16.67 毫秒的预算里,加速结构构建多占 1 毫秒,降噪器就少 1 毫秒;透明多要 8 条光线,阴影就只剩 1 条。所以收官篇的任务不是复述,而是把十二份局部最优解摆到同一张预算表上,标出它们彼此的冲突点与各自的失效边界。
它在系列里的位置。ep01 画了一条线——什么时候该从光栅切到光线。经过十二篇的填充,这条线已经不再是"能/不能"的二分,而是一张多维权衡图。本篇就是给这张图配上坐标轴与刻度。
先看看本篇的读法。第二至四章是决策地图的主体,按"几何与加速结构 / 着色与采样 / 降噪与合成"三段展开,每一段给出一棵决策树,并标出每个分支的结论出自哪一篇、在什么条件下成立。第五章是十二篇的量化总账——一张把所有数字、口径、成立条件摊开的表。第六章用四个真实场景走查验证这张地图能不能用。第七章之后转向未来:下一代硬件会改写什么、标准化落地到哪一步、以及哪几条判据不会随硬件改变。
边界声明。本篇不涉及 BVH 遍历与 RT Core 的硬件内部实现(《GPU 架构剖析》已写透,此处只引用结论);不涉及光栅管线自身的算法与硬件细节;不涉及离线渲染与路径追踪的教学式推导;不涉及具体引擎的编辑器操作与蓝图配置;不涉及未发布硬件的规格推测——AMD RDNA 5 / Intel Xe3 的光追单元内部结构两家官方均未公开,本篇只写到"官方尚未公开"为止。
好了,边界划清楚,下面先把十二篇归一下位——它们其实只回答三个问题。
一、三条主线:这一系列到底在算什么
1.1 一句话概括十二篇
如果把十二篇压成一句话:用可核对的数字,回答"光线该在什么时候、以什么代价、被用在哪里"。拆开就是三条主线。
主线一:分界线(ep01)。哪些效果必须走光线、哪些继续用光栅与屏幕空间近似。判据不是"哪个更先进",而是屏幕空间近似在什么硬条件下会失效——不是质量差一点,而是直接错:屏幕外没有几何信息、背面没有信息、低频光照没有收敛依据。
主线二:成本结构(ep02–ep05)。走光追要花多少钱,钱花在哪几项上。加速结构的构建/更新/压缩是预付(ep02–ep03),命中着色与 SBT 组织决定每次命中的固定开销(ep04),而管线编排决定这些开销能否与光栅工作重叠(ep05)。
主线三:代价转移(ep06–ep12)。切换之后代价并没有消失,它被转移了。转移到降噪器的时空稳定性预算(ep06–ep07),转移到采样器的方差控制(ep08),转移到光线预算的分配(ep09),转移到资源管理的显存与同步(ep10–ep11),最后在透明、体积与次表面散射上转移到"每像素光线数暴涨而视觉收益非线性递减"这个死结(ep12)。
先说清楚这条主线的逻辑。三条主线不是并列的三个话题,而是同一条分析链的三个环节:先判断该不该切(一),再算切换到什么成本(二),最后追问钱去哪了(三)。ep01 那句"每条结论都要落到代价换到了哪里",就是这条链的收口。
1.2 十二篇的归属与量化锚点
依然按老规矩,先把账摆出来。 下表是十二篇的体量与本篇将反复引用的核心锚点,第五章会把它们全部展开成总账。
| 篇 | 主题 | 汉字 | 图 | 三主线归属 | 核心锚点 |
|---|---|---|---|---|---|
| ep01 | 混合渲染的分界线 | 18,842 | 30 | 一 | 三道判据;十条不成立的"光追=更快更真" |
| ep02 | 加速结构工程账(上) | 16,655 | 26 | 二 | 三个尺寸 + 五个标志;更新三问;压缩收益三档 |
| ep03 | 加速结构工程账(下) | 16,088 | 34 | 二 | TLAS 动态策略;CLAS;Opacity Micromap |
| ep04 | 命中着色器与 SBT | 16,016 | 26 | 二 | hit group 三种组合;any-hit 是最贵的"可选" |
| ep05 | 混合管线编排 | 15,884 | 29 | 二 | G-buffer 接口与带宽;两种混合模式;16.67 ms 分账 |
| ep06 | 降噪(上):时域复用 | 16,576 | 31 | 三 | EMA 的 α 取值带;disocclusion 与 ghosting |
| ep07 | 降噪(下):空间与学习型 | 16,923 | 28 | 三 | 联合双边四因子;à-trous 五级换 32 px 半径 |
| ep08 | ReSTIR 与光照采样 | 17,623 | 27 | 三 | RIS + WRS 两个地基;DI 的偏从哪来 |
| ep09 | 光线预算表 | 17,953 | 29 | 三 | 反射 8–22 条 vs 阴影 1–2 条;偏差型 vs 方差型后果 |
| ep10 | RT 资源的生命周期 | 16,662 | 25 | 三 | 四态流转;Build→Trace 屏障;双缓冲 |
| ep11 | RT 资源的流式加载 | 16,663 | 26 | 三 | BLAS 序列化;tile 流式;BLAS LOD |
| ep12 | 透明、半透明与体积 | 18,818 | 41 | 三 | OIT 谱系;2-state OMM;三家引擎的跳过/降级/统一 |
| 合计 | — | 208,703 | 352 | — | — |
先看看这张表怎么读。它不是篇幅统计,而是"哪一篇在管哪一块预算"。当项目里出现一个具体问题时,先定位它落在哪条主线,再翻对应的篇——这就是决策地图的入口。
1.3 本篇用到的判据与口径约定
言归正传,先立两条解读规则,否则后面的数字会被误读。
规则一:厂商倍数与第三方实测不并列。本系列反复强调这一点,本篇执行得最严格。厂商口径的典型例子:NVIDIA 称 RTX Mega Geometry 支持 "up to 100x more ray-traced triangles" NVIDIA RTX Kit;AMD 称 RDNA 4 的第 3 代光线追踪加速器"每 CU 光追吞吐 2x" AMD RDNA 4 新闻稿;Intel 称 Xe2 的 RT 单元有 3 条遍历管线(1.5x)、18 个 box 求交(1.5x)、2 个三角形求交(2x)、16 KB BVH cache(2x)Intel Arc B-Series 简报。这些都是厂商内测口径,不可与第三方实测直接比较。
规则二:优先引用带 pass 级证据的数据。同一批材料里,唯一同时具备官方身份与 profiler 级证据的是 Indiana Jones 的 OMM 实测——TraceMain 从 7.90 ms 降到 3.58 ms(−55%),SharcUpdate 从 1.99 ms 降到 0.89 ms(−55%),动态 BLAS 压缩让显存从 1027 MB 降到 606 MB(−41%)NVIDIA Indiana Jones OMM。这类数据才是决策地图的承重墙。
参数清单(本篇的口径标注约定):
口径标注规则(贯穿全篇)
  [A] 规范/白皮书级    Khronos 规范、DXR 版本页、Blackwell 白皮书
  [O] 官方宣传口径      厂商博客的倍数表述,未给 profiler 证据
  [P] 官方 profiler     官方博客的 pass 级耗时/内存数据
  [T] 第三方实测        独立媒体或社区,方法论需可查
  [C] 社区转述          仅作线索,不作数据依据(本篇不采用为论据)
先说清楚为什么这么严。因为下一代硬件的宣传数字正在快速变大(100x、2x、1.5x),而它们的分母各不相同——"100x 更多三角形"量的是几何容量,"2x 每 CU 吞吐"量的是单元吞吐,"1.5x 遍历管线"量的是管线条数。把它们放进同一句话里比较,等于把三种不同的量纲相加。
好了,规则立完,下面进入决策地图的第一段——几何与加速结构。
二、决策地图(上):几何与加速结构
2.1 这一段在管什么
这一段的边界很明确:几何数据进入光追管线之后,从"三角形"变成"可被光线高效命中的结构",再到"这堆结构在显存里怎么活、怎么换"的全部开销。ep02 管静态账,ep03 管动态账,ep10 管帧内生命周期,ep11 管跨帧流式。四篇合起来是一件事:几何的代价是预付的,而预付额随场景规模超线性增长。
先看代价的形状。这个超线性来自哪里?来自构建算法本身:BVH 构建的复杂度大致是 $O(n \log n)$,但随着几何复杂度上升,逐帧重建的成本会指数式增长到无法维持实时帧率——这不是本篇的推断,是 NVIDIA 在 CES 2025 官方承认的判断:场景几何复杂度爆炸使逐帧 BVH 构建成本无法维持实时帧率,这才有了 Mega Geometry 这条路 NVIDIA Neural Rendering。
这一段的核心公式(内存账的第一层):
$$M_{\text{accel}} = M_{\text{BLAS}} + M_{\text{TLAS}} + M_{\text{scratch}} + M_{\text{compressed}}$$
其中:
- $M_{\text{BLAS}}$ 与几何三角形数近似线性,但常数项由构建标志决定(ep02 的"三个尺寸 + 五个标志");
- $M_{\text{TLAS}}$ 与实例数成正比,与三角形数无关——这是 ep03 与 ep10 的分界;
- $M_{\text{scratch}}$ 是构建期的临时占用,每帧都要还回去(ep10 的 scratch buffer 回收);
- $M_{\text{compressed}}$ 是压缩后的稳态占用,Indiana Jones 的实测把它从 1027 MB 拉到 606 MB。
2.2 决策点一:加速结构该建多大、更新到什么程度
先看第一个分叉。这是 ep02 与 ep03 共同回答的问题,决策树如下。
判据一:几何动不动。全静态或极轻微动(只做整体位移)→ 构建一次、靠实例变换复用 BLAS;有蒙皮角色与形变 → 必须在 refit 与 rebuild 之间选;有植被风摆这类顶点级动画 → 传统 BLAS 的 refit/rebuild 二选一都不划算,必须换结构(CLAS 或 LSS)。
判据二:改完之后遍历会变成什么样。refit 便宜但会把 BVH 质量拉低——节点包围盒在多次 refit 后逐渐松垮,遍历时无效访问变多;rebuild 保质量但每帧成本高。ep02 给出的是"更新三问"决策树,核心是三问:改的是顶点位置还是拓扑、改的比例是多少、改完之后还能不能接受遍历变慢。
判据三:显存够不够。压缩能省多少,ep02 给了三档口径;要不要把省下来的钱还回去(重建成本换显存),取决于场景是带宽受限还是容量受限。
参数清单(加速结构选型的可核对项):
BLAS 构建标志(Vulkan 侧,ep02 详述)
  PREFER_FAST_TRACE       保遍历性能,构建更慢、占用更大
  PREFER_FAST_BUILD       保构建速度,遍历性能下降
  ALLOW_COMPACTION        允许压缩,需二次构建(先拿压缩后尺寸再重建)
  ALLOW_UPDATE            允许 refit(否则只能 rebuild)
  LOW_MEMORY              低内存构建,代价是遍历性能

判据取值带(ep03 实测归纳)
  动的是顶点位置、且比例 < 30%   → refit 优先
  动的是拓扑(增减三角形)        → 只能 rebuild
  顶点级动画(植被/布料)         → CLAS / LSS,不走传统 BLAS
  实例数 > 100,000(UE5 口径)    → 必须做 RT Scene 剔除,否则 TLAS 成瓶颈
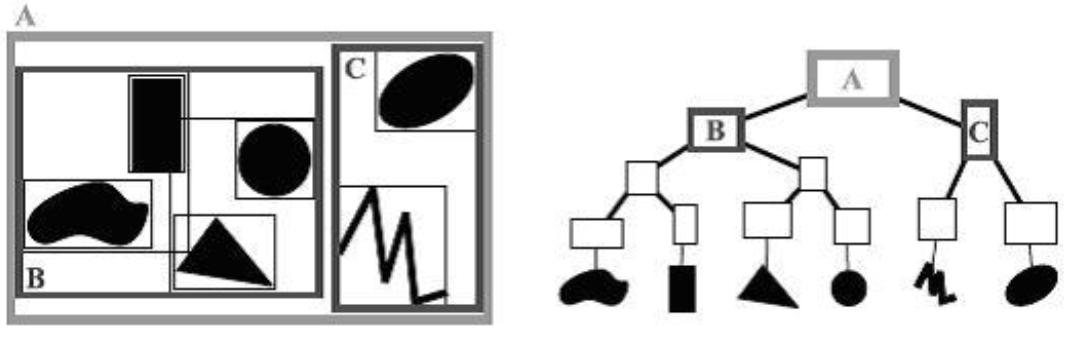
先来看看动态场景那本账的关键数字。ep03 的结论里最值得记的是:TLAS 的策略不是"全重建 vs 不重建",而是分区更新——把 TLAS 拆成静态区与动态区,每帧只重建动态区。UE5 的 Lumen 把它量化成了硬约束:硬件光追下,RT Scene 剔除后实例数需要低于 100,000,否则 TLAS 每帧重建本身就成为瓶颈 UE5 Lumen Performance Guide。
再说一句代价转移。这一段所有优化最终都会转移到两个地方:要么转移到构建期的 CPU/GPU 时间,要么转移到遍历期的带宽与缓存命中率。Frostbite 的 GIBS 系统把这个权衡量化过:对静态几何做离线预计算 BLAS 带来 +15% 的射线遍历性能,在阈值下做选择性 rebraiding 再叠加 +5% Frostbite GIBS, SIGGRAPH 2024。离线预计算换实时遍历——这就是"预付"二字最直白的形态。
决策树(几何与加速结构):
Q1 几何是否逐帧变化?
  ├─ 否 ────────────────► 构建一次 + 压缩 + ALLOW_COMPACTION
  └─ 是
     Q2 变化的是顶点位置还是拓扑?
       ├─ 顶点位置,且比例低 ──► REFIT(ALLOW_UPDATE),监控 BVH 质量衰减
       ├─ 拓扑 ─────────────► REBUILD,并把 TLAS 拆成静态区/动态区
       └─ 顶点级动画 ────────► 换结构:CLAS(集群)或 LSS(头发)
     Q3 实例数是否 > 100,000?
       ├─ 是 ───────────────► 先做 RT Scene 剔除,再谈 TLAS 策略
       └─ 否 ───────────────► 常规分区更新
好了,几何账算到这里。下面把时间轴拉长——单帧内的账算清楚了,跨帧的流式加载是另一回事。
2.3 决策点二:RT 资源在帧内与跨帧怎么活
这一段把 ep10 与 ep11 合起来看。ep10 管的是帧内生命周期,ep11 管的是跨帧流式加载;两篇的结论拼在一起,才是"RT 资源管理"的完整答案。
帧内的四态流转(ep10):加速结构在每一帧里经历 build → visible → trace → retire 四个状态。容易被忽略的是第二步——加速结构不是"创建即可见",从构建完成到可以被着色器读取之间必须插一道屏障;漏掉它不会报错,只会偶尔读到上一帧的结构。Vulkan 与 D3D12 的写法不同但语义一致,双缓冲与"延迟一帧"是两种常见的规避方式。
跨帧的流式加载(ep11):当世界大到加速结构装不进显存时,BLAS 需要能被序列化到磁盘、按地理单元(tile)加载、按 LOD 控制远近精度、并在加载/卸载时做时域过渡避免闪烁。ep11 给出的类比是操作系统的虚拟内存分页,但两者的关键差异必须记住:虚拟内存的淘汰对程序透明,加速结构的淘汰会导致画面跳变。所以 UE5 的 RT geometry pool 通常会比实际需要大 20–30% 留缓冲。
参数清单(RT 资源管理的可核对项):
帧内(ep10)
  屏障位置        : AS build → AS build(完成)→ shader 读取(Vulkan: 两个 barrier)
  双缓冲          : 帧 N 构建、帧 N+1 使用,代价是延迟一帧的 AS 新鲜度
  scratch 回收    : 每帧归还,否则显存按帧数线性增长
  内存池          : AS 池化复用,避免每帧 alloc/free

跨帧(ep11)
  序列化          : VK_KHR_acceleration_structure 的 serialization 特性
  tile 粒度       : 按地理单元切(如 64 m 网格),过大则加载卡顿、过小则调度开销高
  LOD 级数        : 同 mesh 多级 BLAS;远处用低精度结构
  预算缓冲        : pool 比理论需求大 20–30%(UE5 实践)
  过渡            : tile 卸载时的时域 blend,避免画面闪
先看看这一段的冲突点。几何账与资源账会在同一个地方打架:显存。ep02 的压缩、ep10 的池化、ep11 的 LOD 与流式,争的是同一块 VRAM。Frostbite 的 GIBS 给出过一个极紧凑的预算形态:最多 100k 探针、存储上限 100 MB,算下来每探针约 1 KB(其中方差深度用 14×14、辐照度用 6×6 图集,剩余约 96 B 留给滤波)Frostbite GIBS。当预算被压到"每探针 1 KB"这个量级时,几何侧的每一兆显存都要有说法。
决策树(RT 资源管理):
Q1 单帧内 AS 是否被重建?
  ├─ 是 ──► 必须双缓冲或延迟一帧;scratch 每帧回收;build→trace 加屏障
  └─ 否 ──► 仅需一次同步,注意 retire 时机(着色器可能仍在读)

Q2 全部 BLAS 能否常驻显存?
  ├─ 能 ────► 池化 + 压缩,预留 20–30% 缓冲
  └─ 不能 ──► 序列化 + tile 流式
              ├─ tile 粒度按地理单元(过细 → 调度开销,过粗 → 卡顿)
              ├─ LOD 分级(远处降精度)
              └─ 卸载必做时域过渡,否则画面闪
决策地图的第一段到此收口。几何与加速结构的全部账可以压成一句:预付换遍历,预付额随规模超线性增长,而超线性部分要靠结构创新(CLAS / LSS / PTLAS)而不是调参来消化。先看看第二段——着色与采样。
三、决策地图(中):着色与采样
3.1 这一段在管什么
光线已经打到三角形了,接下来花的是另一种钱。2.1–2.3 管的是"几何怎么被高效地找到",这一段管的是"找到之后算什么、以及为了少算而怎么采样"。对应 ep04(命中着色与 SBT)、ep08(ReSTIR 类采样)、ep09(光线预算分配)三篇。三篇的共同点是:它们处理的都是"每次命中"的边际成本。
先看边际成本的构成(ep04 与 ep09 共同给出的分解):
$$C_{\text{ray}} = C_{\text{traverse}} + C_{\text{hit-shading}} + C_{\text{denoise-amortized}}$$
三项的性质完全不同:$C_{\text{traverse}}$ 由结构与场景决定,$C_{\text{hit-shading}}$ 由材质与 SBT 组织决定,$C_{\text{denoise-amortized}}$ 是把降噪器的总耗时摊到每条光线上。ep09 的贡献正是把这条式子从"光追很贵"变成"一条光线拆成三类账单"。
先说清楚为什么必须拆。因为三者的优化手段互不通用:降 $C_{\text{traverse}}$ 要靠加速结构与遍历效率,降 $C_{\text{hit-shading}}$ 要靠 SBT 与材质系统组织,降 $C_{\text{denoise-amortized}}$ 要靠采样质量与复用。把它们混成一个"光追耗时"数字,等于放弃了三条独立的优化路径。
3.2 决策点三:命中着色器怎么组织、any-hit 要不要用
先看 ep04 的结论。SBT(Shader Binding Table)是着色器的"电话簿":光线命中一个三角形后,运行时靠命中记录里的索引去查该执行哪段代码。每个 hit group 由三种着色器组成——closest-hit、any-hit、intersection。
这里有一个反直觉的结论:三者里最贵的不是 closest-hit,而是 any-hit。原因是 any-hit 的语义是"每次相交都要执行一次,直到某次让它停下来",它在硬件上无法像 closest-hit 那样只保留最近一次命中——每条光线可能在同一个 BVH 节点上触发几十次 any-hit 调用。这就是 alpha test 类几何(植被、铁丝网)在光追里格外昂贵的原因。
量化证据来自 ep12 引用的同一组数据:Indiana Jones 中,用 OMM 替代着色器 alpha 测试后,AHS(any-hit shader)采样次数在 TraceMain 上下降 67%、在 SharcUpdate 上下降 59% NVIDIA Indiana Jones OMM。这不是"优化了一点",而是把一类几何的开销从"贵得没法上"变成"可以上"。
参数清单(SBT 组织的可核对项):
hit group 组成(Vulkan / DXR 语义一致)
  closest-hit    : 必选,算材质
  any-hit         : 可选,alpha test / 阴影遮挡判定;最贵
  intersection    : 可选,自定义几何(非三角形)

SBT 组织要点(ep04)
  - SBT 记录按 shader group 索引,命中记录里存的是 index
  - 材质数量 ↑ → 记录数 ↑ → 查表开销 ↑:用"材质族 + 参数表"压缩记录数
  - ray payload 大小直接影响寄存器压力 → 控制在 32–48 B 量级
  - 阴影光线专用 miss/hit group 与主光路分开,避免 payload 冗余

替代 any-hit 的两条路
  1) 2-state Opacity Micromap:把 alpha 信息预烘焙进结构,硬件直接判不透明/透明
  2) 强制 2-state 遍历:gl_RayFlagsForceOpacityMicromap2StateEXT
     (阴影射线用 4-state 保守判定,间接光照射线用 2-state 近似)
先看看这一段最容易被低估的一环。ep04 里"别被自己的表绊倒"这个标题不是修辞:SBT 组织不当会带来两个隐性成本,一是记录数膨胀导致的查表开销,二是 payload 过大导致的寄存器溢出——后者会在 occupancy 上直接反映为并行度下降,而 profiler 里看不到"因为 payload 大了 8 字节所以掉了 12% 占用率"这样的归因。
好了,说完命中侧,下面转向另一个方向——少发光线,也就是采样。
3.3 决策点四:样本从哪来、怎么复用
ep08 的结论可以压成一句话:不是把光线发得更多,而是让每条光线更值钱。ReSTIR 这条线的两个地基是 RIS(重采样重要性采样)与 WRS(加权蓄水池采样)。
先把两个地基讲清楚。RIS 的思路是:用一个便宜分布抽出 $M$ 个候选,按分数筛出其中一个,从而把"追光线"这个贵操作从 $M$ 次压到 1 次。WRS 解决的是"如何在常数内存下做加权筛选并让结果可合并"——这是时空复用能成立的前提,因为复用本质上就是把邻域的样本合并进来重新加权。
复用带来的偏从哪来(ep08 单列了一章讲这件事):目标分布随帧变化、邻域与当前像素的可见性不一致、以及历史样本的权重随时间衰减不当。这三条决定了 ReSTIR 不能"开了就灵",必须配合可见性检验与权重上限。
官方实现侧的现状(可作为可核对的事实):NVIDIA RTXDI 的版本演进是 v2.0 引入 ReSTIR GI(Ouyang 等)、v3.0 引入 ReSTIR PT(Lin 等,"Generalized Resampled Importance Sampling")NVIDIA RTXDI。其仓库的已知问题里明确注明 ReSTIR PT 的空间 pass 存在一定偏差(bias)——这是一个少见的、由官方开源自陈的局限,值得在选型时记住。
参数清单(采样与复用):
ReSTIR 一帧四段(ep08)
  1) 初始采样      : 每像素 M 个候选(M 常取 8–32)
  2) 时域复用      : 与上一帧 reservoir 合并
  3) 空间复用      : 与邻域 reservoir 合并(PT 的空间 pass 有已知 bias)
  4) 着色          : 用最终 reservoir 的样本着色

光线预算档位(NVIDIA NRD 官方建议,ep09 引用)
  1    rpp   全分辨率      : 最佳画质
  0.5  rpp   checkerboard  : 平衡
  0.25 rpp   半分辨率降噪  : 偏性能
  0.25 rpp   1/4 分辨率降噪: 最佳性能
  ※ 1 rpp 下建议用概率式 lobe 选择,而非固定 0.5 漫反射 + 0.5 镜面分配
先看看预算怎么分。ep09 的核心贡献是把光线预算变成一张可填的表:反射凭什么敢要 8–22 条、阴影凭什么只要 1–2 条。答案不在于"反射更重要",而在于两类问题的数学性质不同——阴影是"问一个是非题"(这个点是否被遮挡),反射是"重建一个函数"(这个点的 BRDF 在整个半球上的积分)。是非题一枚样本就有意义,函数重建则需要多枚样本才能成形。
决策树(着色与采样):
Q1 场景里是否有 alpha-test 类几何(植被/铁丝网/栅栏)?
  ├─ 有 ──► 优先 OMM(2-state);否则 any-hit 开销会成为主项
  └─ 无 ──► 常规 closest-hit + miss shader

Q2 材质种类数是否很大(>100)?
  ├─ 是 ──► SBT 用"材质族 + 参数表"压缩记录数,控制 payload ≤48 B
  └─ 否 ──► 直接一一对应

Q3 光线预算是多少 rpp?
  ├─ ≥1.0 ──► 可用更高采样质量,降噪器以时域为主
  ├─ 0.5  ──► checkerboard 追踪
  └─ 0.25 ──► 降采样 + 空间复用(ReSTIR 类)成为必选项
               └─ 注意:ReSTIR PT 空间 pass 有已知 bias,需可见性检验兜底
决策地图的第二段收口:着色与采样的全部账可以压成一句:边际成本分三项,三项各有独立优化路径;而"少发光线"这条路上,复用的收益与偏的风险永远同源。先看看第三段——降噪与合成。
四、决策地图(下):降噪与合成
4.1 这一段在管什么
降到每像素 0.25 条光线之后,剩下的画面靠什么补出来。这是 ep06、ep07、ep12 三篇共同回答的问题。ep06 管时域复用,ep07 管空间滤波与学习型重建,ep12 管最麻烦的一类——透明、体积与次表面散射,因为它们的合成顺序本身就是个难题。
先看降噪的真实分量。这一点在本系列里出现过三次,每次都指向同一个结论:降噪已经不是一个"后处理小项",而是与光照 pass 同量级的主项。可核对的数字来自 NVIDIA NRD 官方在 RTX 4080 @1440p 原生默认设置下的自测:REBLUR_DIFFUSE_SPECULAR 2.55 ms(SH 模式 3.40 ms)、RELAX_DIFFUSE_SPECULAR 3.25 ms(SH 模式 4.80 ms)、SIGMA_SHADOW 0.40 ms(阴影专用,只处理阴影)NVIDIA NRD。
把这个数字放进 16.67 ms 的账里看。漫反射加镜面反射的降噪要 2.55–3.25 ms,占掉一帧的 15–20%;而主光照 pass 在很多场景里也就这个量级。ep09 的表述是"降噪按吃掉约 1 毫秒处理"——那是当时的保守估计;NRD 的官方数据说明,在最重的配置下这个数字要往上修。
这一段的核心权衡式(ep06 给出的时域累积本质):
$$\hat{L}_t = \alpha \cdot L_t + (1 - \alpha) \cdot \hat{L}_{t-1}, \qquad \alpha \in [\alpha_{\min}, \alpha_{\max}]$$
其中:
- $L_t$ 是当前帧采样结果,$\hat{L}_{t-1}$ 是历史累积;
- $\alpha$ 越小,历史权重越大,等效采样数越高、噪声越低,但运动物体的跟随越慢;
- $\alpha$ 的取值带由像素的运动量、深度/法线一致性与 disocclusion 判定共同决定——固定 α 是时域复用最常见的错误做法。
4.2 决策点五:降噪链怎么配
ep06 与 ep07 合起来是一条三段的链:时域复用负责压掉同一像素在时间轴上的抖动,空间滤波负责处理单帧内部的空间相关性,学习型重建负责把"手调参数"换成"学出来的权重"。三段不是替代关系,而是串联——因为它们处理的是不同维度的噪声。
先看时域那一段的失效模式(ep06 的重点)。时域复用的两道坎是 disocclusion 与 ghosting:前者是新暴露区域没有历史可用,后者是错误的历史把"鬼影"拖进画面。修补手段是深度与法线一致性检验、邻域裁剪(clamping)与可变 α。这三者都是"宁可少用历史,也不要拖影"的保守化措施——这就是时域复用的代价:它在压噪的同时牺牲了一部分运动响应。
再看空间那一段的数学(ep07 的重点)。联合双边滤波的权重由四个因子相乘:空间距离、深度差、法线夹角、亮度差。四者缺一不可——去掉深度差会有边缘渗色,去掉法线差会让折角糊掉,去掉亮度差会把高频细节抹平。à-trous 的价值在于用"打洞"结构把采样点摊开到更大半径:五级步长翻倍,用 125 次采样换到 32 像素的等效半径。
最后是学习型那一段的取舍(ep07 的收口)。ep07 给这笔账的结论是"值不值取决于你的迭代预算":神经降噪在质量上确实拉开了距离,但它把"调参数"换成了"训模型",团队需要具备训练与版本管理的工程能力。可核对的一手参照来自 AMD 的路线:FSR Radiance Caching 以 technical preview 上线,正式版排期 2026,配套的 ML 光追去噪是 FSR Ray Regeneration AMD FSR Redstone。这说明连 AMD 也把 ML 光照缓存当作路径追踪的必选项,而不是可选项。
参数清单(降噪链配置项):
时域复用(ep06)
  α 基准            : 静态区可取 ~0.05–0.1;运动区应上调
  history length    : 白噪声下历史长度可安全提到 60 帧(NRD 口径,需提供 History Confidence)
  disocclusion 判定 : 深度差 + 法线夹角双阈值,阈值过松 → 鬼影,过紧 → 降噪失效
  邻域裁剪          : 用当前帧邻域分布对历史做 clamping,抑制鬼影
  输入质量          : NVIDIA 建议基线用 32 spp 蓝噪声序列

空间滤波(ep07)
  联合双边四因子    : 空间距离 / 深度差 / 法线夹角 / 亮度差(缺一不可)
  à-trous 五级      : 步长 1,2,4,8,16;125 采样 ≈ 32 px 半径
  σ 三根            : 三组 σ 分别控三个因子;调错的表现各不相同(渗色/糊角/抹细节)
  方差驱动(SVGF)  : 用逐像素方差估计替代固定 σ

学习型(ep07 收口)
  代价              : 从"调参"变为"训练 + 版本管理"
  官方状态(可核对): AMD FSR Radiance Caching = technical preview,正式版 2026
4.3 决策点六:合成顺序与"最难盈利"的三个场景
先看合成顺序为什么会成为问题。不透明几何的合成顺序由深度缓冲天然决定(谁近谁赢),但透明、体积与次表面散射都不遵守这个规则。ep12 把这个问题拆成了三层:透明层之间需要顺序无关透明(OIT),体积与透明层之间需要正确的积分顺序,次表面散射则把"表面反射"变成了"表面下方的输运"。
这一步的代价有多大,ep12 给了最完整的账。光栅化时代的 OIT 方案谱系从硬件 alpha blending(1.00x)到精确 OIT(约 10x),中间是 WBOIT(1.17x)、MLAB 2 层(2.78x)、Moment-based 4 矩(2.64x)这些近似方案。而到了光追侧,代价的形式变了:透明不再需要多层合成,但要为折射递归追踪;体积需要 ray marching 的 128 步采样;次表面散射需要 16–64 次采样。
"最难盈利"的判定不是感觉,是两条曲线:代价随每像素光线数线性增长(8 条光线就是 8 倍遍历),而视觉收益随采样数非线性递减(第 128 步采样贡献的画质提升远小于第 1 步)。两条曲线的夹角就是利润区。
三家引擎的答案高度一致(这是 ep12 最值得记下的结论):UE5 Lumen 选择跳过/降级——透明按距离分档,近处高品质、远处直接回退;Frostbite 选择统一介质——把雾、体积与粒子放进同一个积分框架;Unity HDRP 选择全部交给路径追踪——但代价是它的 Path Tracing 是累积式的,本质上是离线质量/录制用途,并非实时方案 Unity HDRP Path tracing。
参数清单(合成与"亏损区"配置):
透明(ep12)
  OIT 选型        : WBOIT(1.17x,近似)→ 精确 OIT(~10x,顺序无关)
  光追侧          : any-hit alpha test → 2-state OMM(−55% pass 耗时)
  深度限制        : 限制折射递归深度(9 层是离线质量,实时通常 1–2 层)

体积(ep12)
  ray marching    : 步数 64–128;步长自适应(靠近介质边界收细)
  froxel grid     : 视锥对齐体素,近处高分辨率、远处低分辨率
  阴影            : 逐样本阴影射线成本高(IO Interactive 在 007 First Light 中放弃朴素做法)

次表面散射(ep12)
  方案三档        : BSSRDF 扩散剖面 → 屏幕空间 blur 近似 → ReSTIR 混合路径追踪
  采样数          : 屏幕空间近似 16–64 次;路径追踪方案需样本复用兜底

跳过/降级的工程判据
  近景(<5 m)    : 高精度方案
  中景(5–30 m)  : 半精度近似(MLAB-2 等)
  远景(>30 m)   : 回退光栅 alpha blending / 直接跳过
这边要提的是这一段的冲突点。三段的资源争抢比前两段更直接:降噪器要毫秒,透明与体积也要毫秒;而 ep12 的结论是这两类需求在预算表上正面对撞。UE5 的 Lumen 官方文档把这个权衡写得很直白:Lumen 的目标预算是主机 30fps 给 8 毫秒、60fps 给 4 毫秒(1080p 内部渲染分辨率,GI + 反射 + 体积雾三项共用)UE5 Lumen Performance Guide。4 毫秒里再切出一份给降噪器,剩下的才是光照本身——这就是为什么"跳过"和"降级"不是偷懒,而是预算约束下的必然。
决策树(降噪与合成):
Q1 时域复用是否可用(有运动矢量且历史有效)?
  ├─ 可用 ──► EMA + 邻域裁剪;注意 disocclusion 与 ghosting 的判定阈值
  └─ 不可用 ► 退到纯空间滤波(质量换稳定性)

Q2 是否上学习型重建?
  ├─ 有训练与版本管理能力 ► 神经降噪 / ML 光照缓存(AMD 官方状态:2026 转正式)
  └─ 无 ─────────────────► 手调参数 + 方差驱动(SVGF 路线)

Q3 画面里有透明 / 体积 / SSS 吗?
  ├─ 无 ──► 标准光栅合成顺序
  └─ 有 ──► 按距离分档:
              近景高精度(光追折射 / 完整 BSSRDF)
              中景近似(WBOIT / 屏幕空间 SSS)
              远景跳过(光栅 alpha blending)
决策地图的第三段收口:降噪与合成的全部账可以压成一句:降噪已经与光照同量级,而透明/体积/SSS 是唯一"收益非线性递减、代价线性增长"的死结,唯一解是按距离分档降级。好了,三段地图画完,下面把十二篇的数字全部摊到一张表上。
五、十二篇的量化总账
5.1 先说清楚这张表怎么用
这张表不是"数字集合",而是"决策依据的索引"。它的每一行都回答同一个句式:这个数字量的是什么、口径是什么、在什么条件下成立。前面四章是地图,这一章是把地图上的刻度标上具体数值。
读表规则有三条。第一条:口径列里的 [O] 与 [T] 不可直接比较(厂商内测 vs 第三方实测);第二条:条件列里写明的边界是硬约束,越界后数字失效;第三条:凡是标 [C] 的数据一律不进入本表作为论据。
5.2 总账:加速结构与资源管理
第一组账是几何侧的。它包含四篇的产出,量的是同一件事的不同侧面:构建一次要花多少、更新能改什么、压缩能省多少、以及这堆结构在显存里怎么活。下表的每一行都标了口径与成立条件——注意"离线预计算 +15%"这类数字有明确前提(仅静态几何),越界后不成立。
先看看这四行里最容易被误用的一条:RT Scene 实例数上限 < 100,000 是 UE5 硬件光追路径下的工程约束,它量的是"TLAS 每帧重建会不会成为瓶颈",而不是"硬件最多支持多少实例"。后者在规范里远高于此。
| 指标 | 数值 | 口径 | 条件/边界 | 出处 |
|---|---|---|---|---|
| BVH 构建复杂度 | $O(n\log n)$,逐帧重建会指数式恶化 | [A] | 几何复杂度爆炸时无法维持实时帧率 | NVIDIA Neural Rendering |
| 离线 BLAS 预计算收益 | 射线遍历 +15% | [P] | 静态几何;Frostbite GIBS | Frostbite GIBS |
| 选择性 rebraiding | 再 +5% | [P] | 需设阈值,超阈值不重编 | 同上 |
| 动态 BLAS 压缩 | 显存 1027 → 606 MB(−41%) | [P] | RTX 5080 / 26.9M 三角场景 | NVIDIA Indiana Jones OMM |
| RT Scene 实例数上限 | < 100,000 | [A] | UE5 硬件光追,超出则 TLAS 成瓶颈 | UE5 Lumen Performance |
| AS 池化缓冲 | 比理论需求大 20–30% | [A] | UE5 RT geometry pool 实践 | ep11 |
| AS 网络类比差异 | 淘汰不透明(OS)vs 淘汰导致跳变(AS) | — | 二者不可等同 | ep11 |
5.3 总账:着色、采样与光线预算
| 指标 | 数值 | 口径 | 条件/边界 | 出处 |
|---|---|---|---|---|
| any-hit 替代后 AHS 采样 | TraceMain −67% / SharcUpdate −59% |
[P] | 用 OMM 替代着色器 alpha 测试 | NVIDIA Indiana Jones OMM |
TraceMain pass 耗时 |
7.90 → 3.58 ms(−55%) | [P] | RTX 5080 / 4K + DLSS-RR Perf | 同上 |
SharcUpdate pass 耗时 |
1.99 → 0.89 ms(−55%) | [P] | 同上 | 同上 |
| 光线预算档位 | 1 / 0.5 / 0.25 / 0.25+降采样 rpp | [A] | NRD 官方建议;1 rpp 建议概率式 lobe 选择 | NVIDIA NRD |
| 反射光线数 | 8–22 条 | — | 镜面/光泽面;低粗糙度像素优先 | ep09 |
| 阴影光线数 | 1–2 条 | — | 是非题型问题,一枚样本即有信息 | ep09 |
| ReSTIR 版本演进 | v2.0 ReSTIR GI / v3.0 ReSTIR PT | [A] | 仓库自陈:PT 空间 pass 有已知 bias | NVIDIA RTXDI |
| 探针射线预算 | 100k rays/frame,每帧仅重追 ~6k 探针 | [P] | 需八面体辐照度内联卷积(≥16 条/探针) | Frostbite GIBS |
| 探针存储 | 100k 探针 / 100 MB ≈ 1 KB/探针 | [P] | 方差深度 14×14、辐照度 6×6 图集 | 同上 |
5.4 总账:降噪、合成与引擎侧默认值
| 指标 | 数值 | 口径 | 条件/边界 | 出处 |
|---|---|---|---|---|
| REBLUR 漫反射+镜面降噪 | 2.55 ms(SH 模式 3.40 ms) | [P] | RTX 4080 @1440p 原生,默认设置 | NVIDIA NRD |
| RELAX 漫反射+镜面降噪 | 3.25 ms(SH 模式 4.80 ms) | [P] | 同上 | 同上 |
| SIGMA 阴影降噪 | 0.40 ms | [P] | 仅阴影,不含漫反射/镜面 | 同上 |
| 安全历史长度 | 60 帧 | [P] | 白噪声输入;蓝噪声基线 32 spp | 同上 |
| 降噪器采用度 | 15+ AAA 游戏 | [A] | 含 Autodesk Aurora / Enscape / Lumion | 同上 |
| Lumen 目标预算 | 30fps 8 ms / 60fps 4 ms | [A] | 1080p 内部;GI+反射+体积雾共用 | UE5 Lumen Performance |
| Lumen 反射粗糙度门限 | 粗糙度 < 0.4 才追反射 | [A] | 植被可设 0 完全不追 | 同上 |
| SSR 替代 Lumen 反射 | 省 1 ms | [A] | Xbox Series S 官方示例 | 同上 |
| MegaLights 阴影方式 | 默认 Ray Tracing | [A] | 代价模型:性能恒定、质量随复杂度下降 | UE5 MegaLights |
| HDRP 光追状态 | 自 2019.3 起一直是 preview | [A] | 仅支持 DirectX 12;不支持 MSAA/体积雾/顶点动画/正交 | Unity HDRP |
| HDRP GI 光线档 | 1 ray/px 或 1 ray/4 px | [A] | Performance 模式全分辨率开关 | Unity HDRP RTGI |
| APV 探针间距 | 1 / 3 / 9 / 27 m | [A] | 每像素取最近 8 个探针插值 | Unity APV |
5.5 总账:离线参照与"不可能三角"
最后一组数字用来校准量级感。前面所有实时数字都需要一个参照系,否则"2.55 毫秒"到底算快还是算慢没有意义。
这个参照系是离线渲染。可核对的一手数据来自 AC Shadows 的公开演讲:如果用传统的均匀探针烘焙方案覆盖 256 km² 的世界,外推结果是 44 帧光照数据、624 天烘焙时间、约 1.9 TB 存储;而改用全动态光追 GI 之后的实际数据是 5 天、10 GB(11 个时段关键帧 × 3–4 个季节 = 33 帧)AC Shadows, SIGGRAPH 2025。624 天对 5 天——这是光追对离线工作流的真实价值,它不在运行时帧率上,而在制作管线的时间上。
再说"不可能三角"。把上面四张表合起来看,会浮现一个结构性约束:画质、帧预算、场景规模三者不能同时取满。
| 组合 | 取满的两项 | 被牺牲的 | 真实案例 |
|---|---|---|---|
| 画质 + 帧预算 | 全动态 GI + 60fps | 场景规模(探针上限 100k / 实例上限 100k) | Frostbite GIBS(130+ 体育场,单场规模有限) |
| 画质 + 场景规模 | 256 km² 全动态 GI | 帧预算(依赖超分兜底,2.5x–3x 放大) | AC Shadows / PSSR 路线 |
| 帧预算 + 场景规模 | 60fps + 开放世界 | 画质(跳过硬阴影、体积、SSS) | UE5 Lumen 跳过策略 / 移动端回退 |
先来看看这张三角表的用法。它不能替你选,但能帮你判断"某个项目宣称同时做到了三件事"时,唯一可能成立的原因是它偷偷换掉了量纲——比如把"全动态 GI"换成"部分烘焙 + 运行时插值",或者把"60fps"换成"60fps + 帧生成"。
总账到此摊完。数字很多,但它们的组织方式只有一条:每一项都是某个取舍的价格标签。下面用四个真实场景走一遍,看这张地图能不能用。
六、决策地图怎么用:四个场景走查
6.1 走查规则
这一段是验收环节。如果决策地图只能在抽象层面自洽,它就只是纸面产物。所以下面挑四个有公开数据的真实项目形态,按"预算 → 约束 → 选型 → 牺牲"的顺序走一遍,看每一步是否能从地图上查到依据。
走查的四个场景分别代表四种典型约束:主机 60fps(帧预算最紧)、高端 PC 路径追踪常开(画质优先)、大世界开放世界(规模优先)、移动与低端回退(约束最硬)。
走查背后的原理是一致的:先确定这一档硬件的硬约束(它定义了问题的可行域),再从地图上查该约束对应的分支,最后确认这个分支的代价落在哪里。下面把四个场景的速查表先摆出来,再逐个展开。
四场景走查速查(预算 → 硬约束 → 选型 → 代价落点)
  场景一 主机 60fps 全动态 GI
    预算 16.67 ms | 约束:无硬件光追单元、探针/实例数量级上限
    选型:compute 侧探针 + 优先级队列分帧摊销(100k rays/frame,每帧重追 ~6k 探针)
    代价:时域收敛速度(快移相机会滞后)
  场景二 高端 PC 路径追踪常开
    预算 16.67 ms(或 8.33 ms 冲 120fps)| 约束:需 DXR 1.2 级硬件
    选型:SER + ReSTIR GI + ML 重建
    代价:强依赖硬件代际;ReSTIR PT 空间 pass 有已知 bias,需可见性检验兜底
  场景三 大世界开放世界
    预算 16.67 ms | 约束:256 km² 数据装不进显存、需任意时段/季节
    选型:ray march 优先 + BVH 兜底 + 粗糙表示 + 探针体补间接光
    代价:BVH 内几何非全量(低 LOD、无蒙皮),细节靠屏幕空间补
  场景四 移动与低端回退
    预算 受带宽/功耗/显存三重挤压 | 约束:引擎侧"不支持清单"
    选型:APV 探针 + 反射探针 + 按距离降级
    代价:多层透明与离屏反射处理不好,且常以超分为前提
6.2 场景一:主机 60fps,全动态 GI
约束:主机 CPU/GPU 固定,60fps 意味着 16.67 ms,且必须留出余量给渲染之外的工作。已知答案:Frostbite 的 GIBS 系统。
走查过程。第一步查预算(ep05 的 16.67 ms 分账 + ep09 的光线预算表):无硬件光追单元时,只能用 compute 侧的探针方案。第二步查射线预算(5.3 节):100k rays/frame 是上限,而每个探针的八面体辐照度内联卷积至少要 16 条射线,所以每帧只能重追约 6k 个探针——占探针总量的 6%。第三步查怎么摊销(ep09 的分配策略):靠优先级排队 + 逐层分帧摊销,把 6% 的更新率铺到时间轴上。第四步查代价转移(第三章的结论):代价转移到了时域收敛速度——画面里的间接光需要多帧才能稳定,快速移动相机时会出现滞后。
走查结论:这条路能成立的关键不是"算法多先进",而是把不足 1 ray/探针的预算变成可摊销的队列。而它的量化收益先例在 ep12 也出现过:GIBS 首版总 GPU 时间 6–7 ms,而 Frostbite 游戏通常 60fps 负担不起,经过三年增量优化才在主机上解锁 60Hz 全动态 GI Frostbite GIBS。"三年优化"本身就是这个场景最诚实的成本标注。
6.3 场景二:高端 PC,路径追踪常开
约束:高端独显,可以吃满硬件光追单元,但仍然只有 16.67 ms(或 8.33 ms 冲 120fps)。已知答案:Capcom 的 RE ENGINE。
走查过程。第一步查能力边界(ep01 的判据 + 5.2 节的硬件数据):硬件支持 SER 与 OMM,可以把 alpha-test 几何与发散着色的开销压下来。第二步查采样与复用(3.3 节):路径追踪常开意味着直接光与间接光都走光追,方差管理必须靠 ReSTIR 类复用。第三步查降噪(4.2 节):必须上 ML 重建才能收敛。这三步对应 Capcom 公开的技术栈:SER + ReSTIR GI + DLSS Ray Reconstruction——其中 ReSTIR GI 被专门用于稳定 DLSS RR 的质量、降低间接光噪声,并且刻意从上一帧略偏移的位置采样,以避免与 RR 高度相关 NVIDIA × Capcom Q&A。
走查结论:这条路的地图依据最完整——每一项选型都能在 ep04(SER 解决发散)、ep08(ReSTIR GI 降低方差)、ep07(学习型重建)里找到对应。但要记住两件事:一是这套组合强依赖硬件代际(SER 与 OMM 需要 DXR 1.2 级的支持,见第八章);二是 Capcom 的公开口径里提到此前光追只用于间接光照,PRAGMATA 与 RE Requiem 把直接光也交给路径追踪,角色光照因此获得更立体的阴影与间接照明——这是"画质优先"场景的典型形态。

6.4 场景三:大世界开放世界
约束:256 km² 级别的世界,几何与光照数据装不进显存,且必须支持任意时段/季节。已知答案:AC Shadows(Anvil Pipeline)。
走查过程。第一步查几何与资源(第二章):加速结构必须做流式加载与 LOD。第二步查场景规模的硬上限(5.2 节):实例数与探针数都有量级上限,直接推全量不可行。第三步查混合策略(ep05 的编排):AC Shadows 的公开做法是先屏幕空间 Ray Marching,未命中再进 BVH——因为主机上 raymarch 比 raytrace 更快。第四步查代价(ep03/ep10 的结论):RT/BVH 场景是粗糙表示——低 LOD、无顶点动画与蒙皮、大量小几何被剔除,因此必须靠屏幕空间补细节并避免自交。
走查结论:开放世界场景的地图入口是"规模"这一维,而它把前两段的结论全部改写了:硬件光追不再是首选(ray march 优先),BVH 里的几何不再是全量(粗糙表示),二级命中处的间接漫反射由相机周围的探针体提供,每点取最近 8 个探针插值,探针光照与上一帧值迭代得到多弹射 GI AC Shadows。这正是决策地图的价值:它让你在"信号优先"与"规模优先"之间做出有依据的选择,而不是把高端 PC 的方案照搬到开放世界。
6.5 场景四:移动与低端回退
约束:带宽、功耗与显存同时收紧,光追往往是可选项甚至不可选项。已知形态:Unity HDRP 的光追定位与 Intel 的 XeSS 绑定叙事。
走查过程。第一步查"能不能开"(5.4 节的引擎侧默认值):HDRP 的光线追踪自 Unity 2019.3 起至今一直标注 preview,且仅支持 DirectX 12,同时明确不支持顶点动画(植被风摆)、MSAA、体积雾、Tessellation、正交投影与 Terrain 的 detail mesh/tree Unity HDRP。这份"不支持清单"本身就是最有价值的走查依据——它把"开光追"这件事的隐性代价列全了。第二步查降级策略(4.3 节):按距离分档,远景直接回退光栅。第三步查替代方案(ep01 的判据):用 APV 探针体系(间距 1/3/9/27 m,每像素取最近 8 个探针)承担间接光,用反射探针承担反射。
走查结论:低端场景的地图入口是"不支持清单",而不是"性能倍率"。而 Intel 的官方叙事提供了一个旁证:其 Arc B 系列页面把"开光追"与"必须开 XeSS"绑定为同一个动作,并以 1440p Ultra + XeSS Performance 作为对比基准 Intel Arc B-Series。当一家厂商把超分写进光追的默认前提时,它实际上是在说:这个档位的硬件的绝对光追能力还不足以独立支撑。
四个场景走完,一个共性浮现:无论是主机、高端 PC、开放世界还是移动端,它们的第一步都不是"选算法",而是"确定这一档硬件的硬约束在哪里"。约束一旦确定,后面的选型几乎是被推出来的——这就是决策地图相对于"最佳实践清单"的价值:清单会过时,约束不会。
七、下一代硬件会改写什么
7.1 先划一条线:哪些是已发布事实,哪些是宣传口径
这一章最容易写坏,因为硬件展望天然偏向厂商叙事。所以先划一条硬线:只写官方已发布材料里能核对的规格与时间点,对未公开的部分明确写"官方未公开"。
已知的未公开项(本篇不推测):AMD 官方尚未公开 RDNA 5 / UDNA 的光追单元与 BVH 遍历改进细节;Intel 在 CES 2026 的 Core Ultra Series 3 简报中只给出 GPU tile 为 Xe3、含 4 个 Xe-core 与 4 个光线追踪单元,单元内部结构未展开 Intel CES 2026。另外,三家厂商都没有给出"硬件加速路径追踪将于某年实现实时"的年度承诺——可核实的只有两种立场:NVIDIA 主张靠几何压缩加神经渲染在当下旗舰上实现全保真路径追踪,AMD 与 Intel 主张靠 ML 超分、去噪与光照缓存让高画质光追变得可玩。
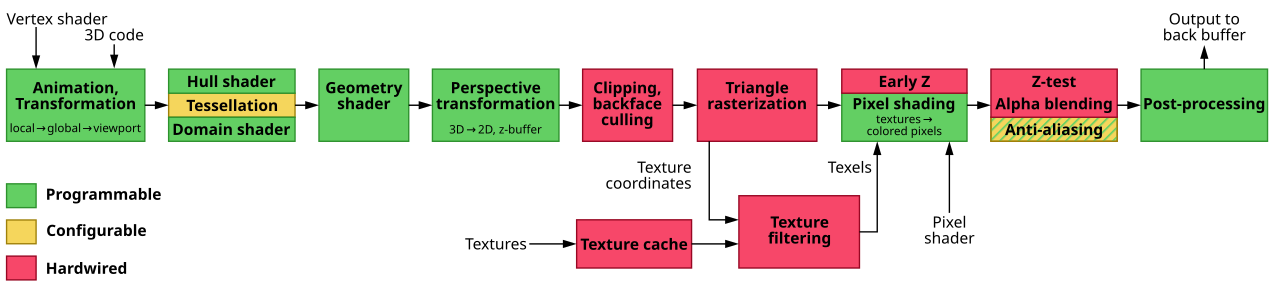
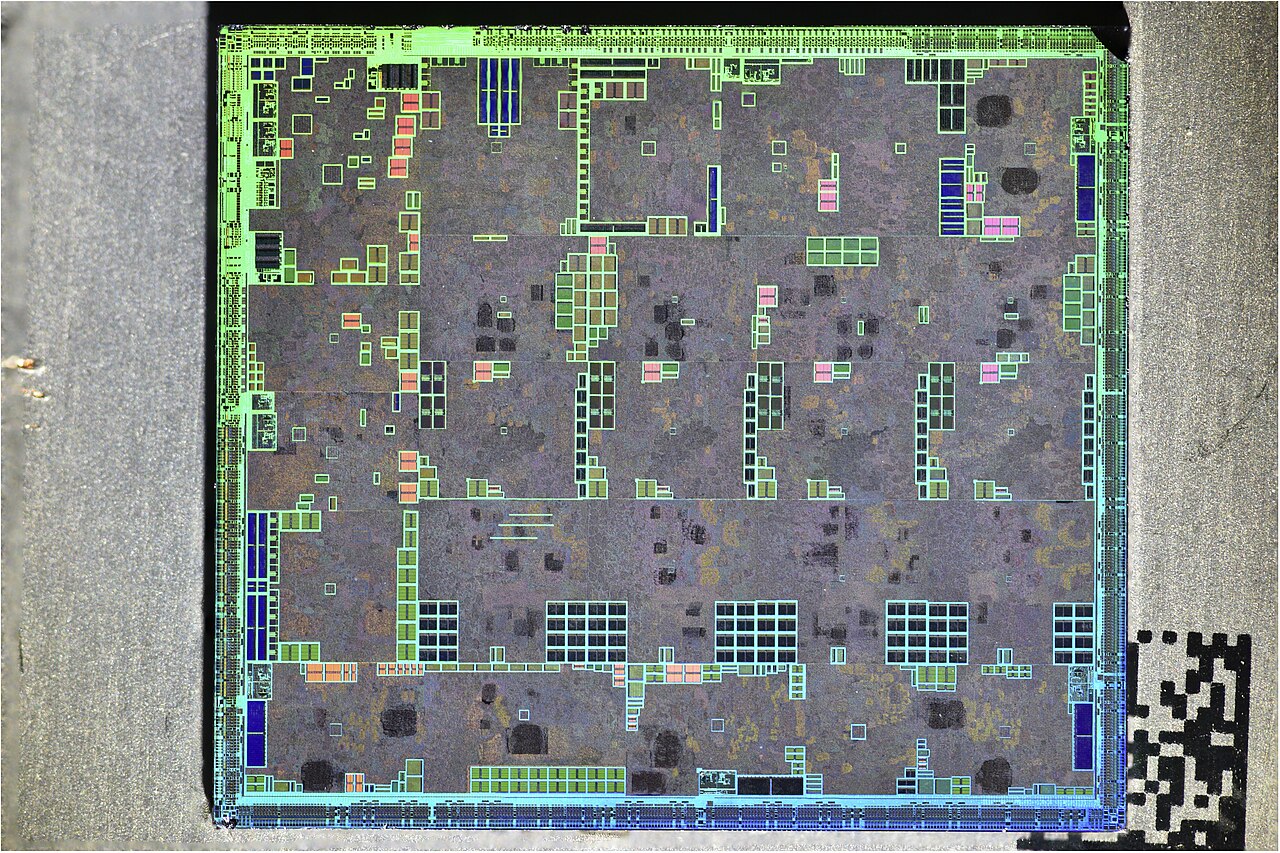
先看这段演进的起点形状。下面这张芯片照来自 2004 年的 NV40(GeForce 6800 世代)。它代表的是"固定功能单元 + 可编程着色器"的时代——那时的 GPU 里没有任何专用光线求交单元,光线追踪只能在通用着色器里软件实现。
7.2 改写项一:几何容量——从"优化三角形数"到"换结构"
这是下一代硬件改动最大的一项。RTX Mega Geometry 的官方表述是支持 "up to 100x more ray-traced triangles",并让构建光追结构比传统方法快 100 倍 NVIDIA RTX KitGeForce GDC 2026 公告。注意这是 [O] 官方宣传口径,且"100x"量的是几何容量而不是帧率——两者不可混用。
改写地图上的哪一格:第二章的"几何账"。原来的决策树里,动态几何只有 refit / rebuild / 换结构三条路,且换结构的选项只有 CLAS 与 LSS。新的硬件层面提供了两个额外支柱:
VK_NV_cluster_acceleration_structure:提供动画集群(animated clusters)、动态细分(dynamic tessellation)与集群 LOD 三组能力;配套开源库nv_cluster_builder做递归节点切分式聚类、nv_lod_cluster_builder做连续 LOD 并支持 RAM→VRAM 流式 NVIDIA Mega Geometry Vulkan Samples。VK_NV_partitioned_acceleration_structure(Partitioned TLAS):只重建 TLAS 中发生变化的部分,而不是整体重建。这正是第二章"分区更新"思路的硬件化——区别在于以前要手动切静态区与动态区,现在有了结构级的支持。PTLAS 的公开样例演示了超过 100,000 个物理对象的仿真。
量化收益的两种口径必须并列呈现:官方称在 Alan Wake 2 上获得 +5–20% FPS、−300 MB VRAM GeForce GDC 2026;而社区在 RTX 4090 上的对照测试给出约 +13% 性能、约 −1 GB VRAM,但该数据只有二手聚合页可访问,原文未定位到,故按 [C] 社区转述处理,不作为本篇论据。显存节省口径差异明显(−300 MB vs −1 GB),在原文核实之前不应采信。
第二个可核对的硬件事实来自 Blackwell 白皮书:第 4 代 RT Core 的光线—三角形求交吞吐相对 Ada 翻倍 NVIDIA Blackwell 白皮书。这是少见的、写进官方硬件文档的吞吐规格,比场景级帧率更接近"硬件能力"本身。
先看看这一项对决策地图的实际影响。它消解的是第二章里最贵的那一格:"顶点级动画几何"。以前这类几何在光追里几乎无解(refit 会松垮、rebuild 太贵),现在有了集群与分区结构,它从"跳过硬阴影、只做近似"变成"可以进光追"。GDC 2026 的公告里提到新的植被系统采用分区 TLAS 首次实现对数百万株独立动画植被的路径追踪,并称该技术将用于 The Witcher 4 GeForce GDC 2026——这是一个可以核对的落地信号。
7.3 改写项二:并发效率——SER 从"扩展"变成"标配"
这一项改写的是第三章。ep04 讲 any-hit 与 SBT 时,隐含前提是着色器在光线之间是发散的——同一个 warp 里的 32 条光线可能命中完全不同的材质,导致指令级并行度崩掉。SER(Shader Execution Reordering,也称 invocation reordering)的思路是让硬件按相干性重新排序光线,把命中相似材质的光线聚到一起执行。
标准化状态是可核对的:Vulkan 侧是 VK_EXT_ray_tracing_invocation_reorder,其规范页末次修改日期为 2026-04-02,依赖 SPV_EXT_shader_invocation_reorder 与 GL_EXT_shader_invocation_reorder VK_EXT_ray_tracing_invocation_reorder。更早的 Vulkanised 2025 演讲把动机量化得很清楚:执行发散按发散因子削减指令吞吐,数据发散削弱访存路径与缓存效率 Vulkanised 2025。D3D 侧的口径是 DXR 1.2 包含 SER,于 GDC 2025 宣布 Microsoft D3D12 SER。
对决策地图的影响:第三章的决策树里原本有一条"材质种类数 > 100 时用材质族 + 参数表压缩 SBT 记录数"。SER 并不取消这条优化,但它降低了发散带来的惩罚——也就是说,SBT 组织的容错空间变大了,材质系统的设计不必再为"记录数膨胀导致查表开销"过度让路。
7.4 改写项三:透明几何——2-state OMM 成为标准路径
这一项改写的是 ep12 与第三章的交叉点。先把一个容易混淆的命名澄清掉:不存在官方命名为 "Opacity Micromap 2" 的硬件特性。可核实的等价物有三个:
- 2-state OMM 的光追标志:
gl_RayFlagsForceOpacityMicromap2StateEXT。Indiana Jones 的官方实测中,阴影射线用 4-state OMM 做完全保守判定,间接光照射线则用该标志让 RT Core 以 two-state 近似遍历 OMM,从而在带 OMM 的结构上完全避免着色器 alpha 测试 NVIDIA Indiana Jones OMM。 - DXR 1.2 的 OMM:微软官方口径为 GDC 2025 宣布、随 SM 6.9 正式落地,并引用 Remedy 案例称光追成本降低 1/3 Microsoft D3D12 OMM。
- Vulkan 的 lossy micromaps 与 force2state:
VK_KHR_opacity_micromap新增 lossy micromaps(允许把 level 5 的应用数据构建为 level 4*),force2state 可把 4-state 值降为 2-state 且可复用同一份 4-state 数据、无需单独编码 Vulkanised 2026。
对决策地图的影响:第三章里"alpha-test 类几何是主开销项"这个结论要改写成"在有 OMM 的硬件上,alpha-test 类几何的主开销项被移除了"。这是一次结论级的改写,不是参数级微调——因为 any-hit 从"最贵的可选着色器"变成了"可以被完全绕过的路径"。
参数清单(OMM 相关的可核对项):
OMM 三条路径的取舍(本篇汇总)
  4-state OMM   : 完全保守,适合阴影射线(正确性优先)
  2-state 近似  : 通过 ForceOpacityMicromap2StateEXT 启用,适合间接光照射线
                  —— 可复用 4-state 数据,无需单独编码
  lossy OMM     : VK_KHR 新增;允许 level 5 应用数据构建为 level 4*
                  驱动暴露 maxOpacityLossy4StateSubdivisionLevel >= 5
7.5 改写项四:光照求解——ML 从"后处理"变成"管线的一环"
这一项改写的是第四、五章。三家的动作方向一致但路径不同,且都能在官方材料里核对:
- NVIDIA:RTX Kit 2026.2 为 RTXDI 增加 ReSTIR PT(任意弹射路径复用,面向镜面与光泽面)NVIDIA RTX Innovations。
- AMD:FSR Radiance Caching 以 technical preview 上线,正式版排期 2026,定位是与 Monte Carlo 路径追踪协同的在线 ML 光照缓存,设备端实时持续训练多弹射 GI、无需预计算或烘焙;配套 ML 光追去噪为 FSR Ray Regeneration AMD FSR RedstoneAMD FSR Radiance Caching。
- 引擎侧:UE5 的 MegaLights 把
Shadow Method默认值设为 Ray Tracing,并用"性能恒定、质量随光照复杂度下降"这个不同于传统 Deferred 的代价模型来描述它 UE5 MegaLights。
先看看这一项最值得记住的一点。MegaLights 的代价模型翻转很有信息量:传统延迟着色的成本随灯光数线性增长而质量恒定,MegaLights 则是成本恒定、质量随复杂度下降。这意味着它把"灯多了帧率会掉"这个可预测的风险,换成了"灯多了降噪器先模糊、后鬼影"这个需要在画面侧监控的风险。UE5 官方文档给出的应对建议也印证了这一点:把多个小灯合并为大面光、收紧衰减范围与面光边界——这是把成本压力重新从降噪器转移回灯光布置。
决策地图的改写汇总:
| 原结论(ep01–ep12) | 下一代硬件的改写 | 改写程度 |
|---|---|---|
| 顶点级动画几何在光追里无解 | CLAS + PTLAS 使其可进光追 | 结论级 |
| any-hit 是最贵的可选着色器 | 2-state OMM 使其可被完全绕过 | 结论级 |
| SER 是可选优化 | DXR 1.2 / VK_EXT 纳入,成为默认路径 | 结论级 |
| 逐帧 BVH 重建成本指数增长 | Mega Geometry 换结构而非调参 | 结论级 |
| 降噪是后处理小项 | ML 光照缓存成为管线一环(AMD 官方路线) | 量级级 |
| 光栅与光追的边界在哪 | 边界未移动,但几何容量侧的门槛被抬高 | 量级级 |
注意最后一行:边界没有消失,只是移动了。第二章的"预付换遍历"、第三章的"边际成本分三项"、第四章的"收益非线性递减"——这些账的结构不变,变的只是某些格子里的数字。这正是第九章要展开的内容。
八、标准化时间线:两条线各自的落地节点
8.1 为什么要单列一章
因为"硬件支持"与"你能用"之间隔着标准化。前面所有关于 SER、OMM、Mega Geometry 的讨论都建立在一个隐含前提上:这些能力在你的目标平台上是可用且可移植的。而实际情况是——同一个能力在 Microsoft 与 Khronos 两条线上的落地时间可能相差一年以上,且 API 形态完全不同。
先给出结论,再展开证据:Microsoft 线的节奏是"宣布即随 SDK 落地",Khronos 线的节奏是"批准早、发布晚"。两条线的这一差异,直接决定了跨平台项目该按哪条线做技术选型。
两条线的差异不是"快慢",而是两种不同的推进定义。下面这张可用性矩阵把定义差异摆清楚——同一项能力在两条线上的"可用"含义并不相同。
能力可用性矩阵("可用"的定义在两条线上不同)
  能力              Microsoft 线                          Khronos 线
  ------------------------------------------------------------------------------
  SER(光线重排序)  DXR 1.2;2026-02 随 SM 6.9 正式版    VK_EXT_ray_tracing_invocation_reorder 已可用
  OMM(不透明度微图)DXR 1.2;2025-05 进入正式版          SPV_KHR_ 已批准;VK_KHR_ 尚未发布
  Work Graphs        SM 6.8;2024-04 首发                无对位扩展
  host 侧 AS 构建   保留                                  已弃用(今后无 host 命令等价物)

  注:Khronos 线的"可用"以扩展发布为准;从 EXT 提升到 KHR 时 API 可变(OMM 已发生)
先说清楚这条矩阵怎么用。跨平台项目最常见的误判是"既然 DXR 1.2 有了 OMM,Vulkan 侧应该也差不多"。矩阵里 OMM 那一行说明事实并非如此:D3D 侧已进入正式版,Khronos 侧对应的 VK_KHR_opacity_micromap 在 Vulkanised 2026 上仍是"尚未发布"的状态,且从 EXT 提升时 API 形态发生了实质变化。
8.2 Microsoft 线:DXR 1.2 的落地节奏
这条线的时间点可以从 Agility SDK 版本页逐一核对:
| 时间 | Agility SDK 版本 | 关键内容 |
|---|---|---|
| 2024-03/04 | 1.613.x | Work Graphs + Shader Model 6.8(含 generic programs in state objects、GPU Upload Heaps) |
| 2025-01-30 | 1.615.0 | shader hash bypass 正式支持 |
| 2025-05-30 | 1.616.0 | Opacity Micromap 进入正式版(RayQuery + OMM 需 SM 6.9,当时仍在 1.717.0 预览);Tier 4 Tiled Resource |
| 2025-09-25 | 1.618.1 | Advanced Shader Delivery、Application Specific Driver States |
| 2026-02-26 | 1.619.0 | Shader Model 6.9 正式版,明确包含 SER(DXR 1.2)与 Opacity Micromaps(DXR 1.2) |
| 2026-07-30 | 1.619.5 | 补丁:OMM array 对齐校验修复(128 B 对齐、PerOmmDescs 4 字节对齐) |
| 2026-07-30 | 1.721.3-preview | Shader Model 6.10 预览(LinAlg VectorAccumulate、Partial Programs、UAVs of Depth) |
来源:DirectX 12 Agility SDK 版本页。
先看看这条线怎么读。关键节点只有两个:2025-03 的 GDC 宣布(SER 与 OMM 同时进入 DXR 1.2)与 2026-02 的 SM 6.9 正式版(能力真正可发布)。中间近一年是预览期。而 Work Graphs 比它们早了整整一年(2024-04 随 SM 6.8),且 2026 年的 SM 6.10 预览方向已经偏向"泛 AI/图编译器"(LinAlg、Partial Programs),而不是光追本身——光追标准化的重心正在从"增加新能力"转向"让已有能力落地稳定"。
8.3 Khronos 线:批准早、发布晚
这条线的节奏明显更慢,且可以逐条核对:
| 能力 | 关键节点 | 状态 |
|---|---|---|
VK_EXT_ray_tracing_invocation_reorder(Vulkan 版 SER) |
Vulkanised 2025 时"即将完成";规范页末次修改 2026-04-02 | 扩展已可用 |
SPV_KHR_opacity_micromap |
SPIR-V 工作组批准 2026-01-07;Khronos 董事会 ratified 2026-02-20;Rev 4 末次修改 2026-07-10 | SPIR-V 侧已批准 |
VK_KHR_opacity_micromap |
Vulkanised 2026(2026-02-09~11)首次公开,尚未发布 | 未发布 |
| host 侧加速结构构建 | Khronos 官方论坛公告弃用(非移除);新扩展今后不再提供 host 命令等价物 | 已弃用 |
来源:SPV_KHR_opacity_micromap、Vulkanised 2026、Khronos 论坛公告。
这里有一个值得细看的差异。VK_KHR_opacity_micromap 从 VK_EXT_ 提升为 KHR 时,API 发生了重大变化:VkMicromapEXT 对象不提升、host 命令被废弃、ray query 默认禁用 micromap、新增 lossy micromaps Vulkanised 2026。这对跨平台项目的含义很直接:基于 VK_EXT_ 写好的 OMM 代码,在 VK_KHR_ 落地时需要重新适配,而不是换个扩展名即可。
两条线的对比表:
| 维度 | Microsoft 线 | Khronos 线 |
|---|---|---|
| 推进节奏 | 宣布 → 预览版 → 正式版(约 1 年) | 工作组批准 → 董事会批准 → 扩展发布(更慢,且可能更名/改形态) |
| SER 可用性 | DXR 1.2,2026-02 随 SM 6.9 正式版 | VK_EXT_ray_tracing_invocation_reorder 已可用 |
| OMM 可用性 | DXR 1.2,2025-05 进入正式版 | SPV_KHR_ 已批准;VK_KHR_opacity_micromap 尚未发布 |
| API 稳定性 | 随 SDK 版本演进,向后兼容 | 从 EXT 提升到 KHR 时 API 可变(OMM 已发生) |
| 方向 | 从新增能力转向稳定与工具链(SM 6.10 偏泛 AI) | 弃用 host 侧 AS 构建,向现代引擎架构收敛 |
先说清楚这条对比的实用价值。它回答的是跨平台项目最常见的一个误判:"既然 DXR 1.2 有了 OMM,Vulkan 侧应该也差不多"。实际时间差接近一年,且 API 形态不同。技术选型必须以两条线各自的落地节点为准,而不是以硬件能力为准。
九、不会变的那几条判据
9.1 为什么这一章最重要
前八章讲的都是会变的:会变的是几何容量、是标准化节点、是某个 pass 的毫秒数、是某家引擎的默认值。而这一章要挑出不随硬件改变的那几条——它们才是这本系列真正的产出。因为硬件三年一换代,判据不会。
先给出这四条,再逐条解释:
- 代价必转移——没有免费的优化,只有转移方向的差异。
- 偏差与方差是两类不同的敌人——一个靠更多样本救,一个靠更多样本反而固化。
- 屏幕空间先跑、光追兜底——这是三家厂商一致收敛出的工程范式。
- 收益非线性 —— 所有"画质换预算"的账都要按递减曲线算,不能按线性外推。
9.2 判据一:代价必转移
这是整个系列的收口命题。ep01 就把它立为写作纪律:"每条结论都落到'代价换到了哪里':显存、带宽、CPU、还是画质"。十二篇验证下来,它没有被推翻过一次,只是转移的目的地一直在换。
四个阶段的转移目的地:切到光追的代价转移到降噪器的时空稳定性预算(ep06–ep07);降采样到 0.25 rpp 的代价转移到采样器的方差控制(ep08);集群化几何的代价转移到构建期与结构复杂度(ep03 + Mega Geometry);学习型重建的代价转移到训练与版本管理(ep07)。
先看看这条判据怎么用。它的实用形态是一个反问句:当有人提出一个"零成本优化"时,问一句"代价转移到哪里了"。如果答不出来,通常意味着代价被转移到了尚未被监控的指标上——比如把成本从帧时间转移到了 latency,或者从 GPU 转移到了 VRAM,而这两项在很多项目的监控面板里都缺席。
9.3 判据二:偏差与方差是两类不同的敌人
这一条是 ep09 立下的,也是本系列里最不直观的一条。ep09 单列一章讲"预算不够时会怎样",并把后果严格分成两类:偏差型后果(比如过遮蔽——光线不够导致该被照亮的地方被错误遮蔽,画面结构性错误)与方差型后果(噪声——画面统计上正确但看起来脏)。
为什么这个区分不会过时:因为两者的补救手段相反。方差可以靠更多样本、更好的复用或更强的降噪器压下去;而偏差加样本只会更稳定地固化错误——再加一百万条光线,过遮蔽的地方依然过遮蔽。这条判据在 ReSTIR 上尤其要记住:RTXDI 仓库自陈 ReSTIR PT 的空间 pass 存在 bias NVIDIA RTXDI——这不是 bug,是方法固有的取舍,所以必须配可见性检验兜底,而不是靠增加样本解决。
9.4 判据三:屏幕空间先跑、光追兜底
这一条是跨厂商收敛出的工程范式,也是本系列里被外部证据支持得最充分的一条。
- Epic:MegaLights 的追踪策略是先做短距离屏幕空间保守射线拾取细节,超出屏幕或被遮挡后再续接硬件或软件光追,从最后一个有效点继续 UE5 MegaLights。
- Ubisoft:AC Shadows 明确"先屏幕空间 Ray Marching,未命中再进 BVH",原因很直白——主机上 raymarch 比 raytrace 更快 AC Shadows。
- Frostbite / Anvil:两者的光追场景都是粗糙表示(低 LOD、无蒙皮、剔除小几何、简化 albedo),细节一律靠屏幕空间补 Frostbite GIBSAC Shadows。
为什么这条判据不会变:因为屏幕空间查询本质上是在"已有像素数据"里做低成本近似,而光追本质上是在"几何与材质数据"里做高成本精确查询。只要这两类数据的可得性差异存在(屏幕空间数据每帧都已经有了,几何数据需要遍历结构),这个成本差就不会消失。硬件能缩小差距,但不能消除它——因为屏幕空间那条路也会跟着变便宜。
9.5 判据四:收益非线性
这一条是"最难盈利"的数学基础。ep12 把它写成两条曲线的夹角:代价随每像素光线数线性增长,而视觉收益随采样数非线性递减。
为什么它不会随硬件改变:因为这两个函数的形状来自数学,不来自硬件。蒙特卡洛积分的误差按样本数的平方根倒数下降——想把噪声再降一半,样本数要翻四倍。这个关系式与 RT Core 有几代、有没有 Mega Geometry 无关。硬件能改变的是每个样本的价格(遍历吞吐翻倍、OMM 移除 alpha test 开销),改变不了样本数与噪声之间的平方根关系。
先来看看这一条的实用形态。它意味着一件事:性能翻倍不等于画质翻倍。如果一款新硬件让光追吞吐翻倍,把多出来的预算全部投入"更多样本"只能换来约 $\sqrt{2} \approx 1.41$ 倍的噪声改善(在方差主导的阶段);而把同样的预算投入"更高的分辨率"或"更大的场景规模",收益曲线完全不同。所以硬件越强,"该把预算花在哪"这个问题反而越尖锐,而不是越不重要。
四条判据到此说完。它们的共同特征是:都关于结构,不关于数值。下面收尾。
十、结语:这条线还会继续移动
十二篇之前,问题是一条线。ep01 开篇问的是"什么时候该从光栅切到光线",答案是一组判据:屏幕空间在什么硬条件下会直接错、光追成本与什么成正比、代价被转移到了哪里。
十二篇之后,问题是一张网。因为每一个判据背后都长出了一片决策空间:光追成本与什么成正比,答案变成了遍历、命中着色、降噪三项的分解(ep02–ep05、ep09);代价转移到哪里,答案变成了降噪器的时空稳定性、采样器的方差、资源管理的显存与同步、以及透明体积这些"收益递减"的死结(ep06–ep12)。
本篇做的事,是把这张网画出来。三棵决策树(几何与加速结构、着色与采样、降噪与合成)、一张量化总账、四个场景走查、一张标准化的双线时间线。它们的作用不是给出"标准答案"——真实项目里没有标准答案——而是在有人提出方案时,让你能迅速定位它是哪一格、代价在哪、边界在哪。
往下还会移动的部分:几何容量侧的集群化与分区结构(Mega Geometry / PTLAS)、并发效率侧的 SER 常态化、透明几何侧的 2-state OMM、光照求解侧的 ML 缓存(AMD 已排期 2026 转正式)。不会移动的部分:代价必转移、偏差与方差是两类敌人、屏幕空间先跑光追兜底、收益非线性。
最后一句话留给"这条线本身"。它是一个移动的边界,而不是一个固定的答案。三十多年前,光线追踪只能渲染一张静态图;今天它在 16 毫秒里跑完整条路径;而这条线还在动。对工程师来说,重要的不是记住线现在在哪,而是记住它是靠什么在移动——靠的是把每一笔不得不付的代价,找到更划算的转移方向。
相关链接 - 上一篇:透明、半透明与体积:光追里最难盈利的部分 - 系列总览:实时光线追踪与混合渲染(全十三篇) - 参考资源:NVIDIA RTX Kit · NVIDIA RTXDI · NVIDIA NRD · NVIDIA Blackwell GPU 架构白皮书 · DirectX 12 Agility SDK 版本页 · VK_EXT_ray_tracing_invocation_reorder · SPV_KHR_opacity_micromap · UE5 Lumen Performance Guide · AMD FSR Radiance Caching · Khronos Vulkan-Samples(RT 样例) - 素材来源:Wikimedia Commons(CC0 / Public domain / CC BY-SA,逐图署名见图注)
With Best Wishes.