系列配套:GitHub 源码仓库(demo 代码与生成本文全部示意图的工具)|在线阅读入口(本站发布)
上一篇我们拆完了纹理采样器:一条采样指令进了硬件,坐标归一化、LOD 计算、缓存取数、滤波插值,一条几百级的流水线把颜色读了出来。颜色读出来了,但它往屏幕的哪个位置写、超出屏幕的部分怎么处理、怎么保证它真的落在食指所在的像素上——这些是采样器之后、光栅化之前那一大段固定功能的活。这一站叫图元装配、裁剪与视口变换(Primitive Assembly, Clipping and Viewport Transform)。
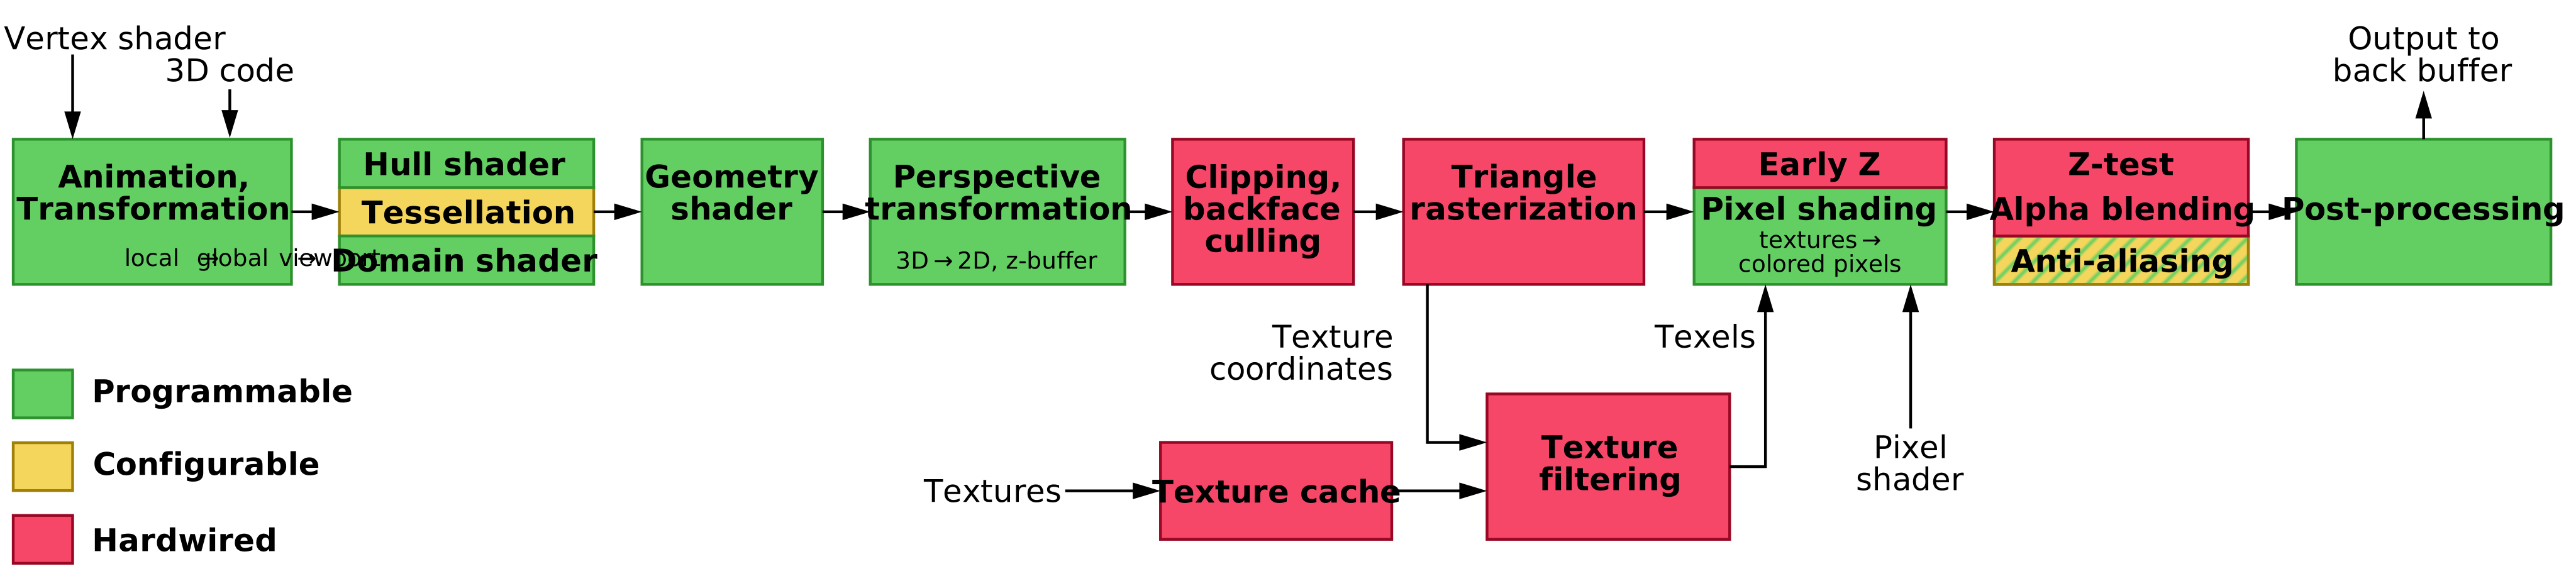
这一篇在系列里的位置,可以再看一眼全系列知识地图:命令前端、显存、着色器核、纹理采样器都到了,下一站是光栅化。本篇是第五站,它回答一个问题——顶点着色器算完那堆 clip 坐标之后,GPU 是怎么把它们变成屏幕上具体的像素位置的。老实说,很多人会觉得「顶点算完坐标,三角形就该'啪'地出现在屏幕上了」,其实根本没那么简单——在这两者之间,藏着整段硬件固定功能。
先来看看这一篇那句会被反复引用的结论:「画一个三角形」在硬件里不是一件事,而是装配、变换、裁剪三段固定功能。 装配把离散的顶点按拓扑捆成图元;变换把 clip 坐标逐级映射到屏幕像素;裁剪决定三角形哪些部分真正进入光栅化。而硬件的反直觉之处在于——它不在像素级逐元裁剪,而是用一块比屏幕大得多的 guard band(护栏区)兜底,让绝大多数三角形直接逃过最昂贵的裁剪。这话很多人第一次听都愣一下,别急,我们这一篇慢慢把它捋顺。
一句话点题:顶点算完 clip 坐标,接下来是固定功能的活
先把这一篇要回答的问题串起来,一共四件。跟前面几篇一样,我们在动手之前,先把「这一篇到底要干什么」的边界码清楚,这样读到一半不至于迷路。
第一,离散的顶点怎么变成图元。 shader 输出的是一堆没有次序感的顶点,硬件要按拓扑(topology,triangle list/strip/fan、line list、point list)把它们重新捆成有意义的三角形。这一步在驱动眼里是「一次 draw 到底画了几笔」,在硬件眼里则是「把一串顶点按规则拆成一组三角形」。出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》Part 5。
第二,clip 坐标怎么变成屏幕坐标。 从齐次裁剪空间到窗口空间,中间是透视除法(除以 w)+ 视口变换(offset 加 scale)两步,每一步都是固定功能。顶点着色器输出的是四个分量、w 不一定为 1 的齐次坐标,而光栅器只吃得下两个维度的窗口坐标,这段「压缩」必须由硬件精确完成。出处:Vulkan Specification · Fixed-Function Vertex Post-Processing。
第三,相机看不见的部分怎么办。 三角形超出视锥(frustum)或卡到 w ≤ 0 时,不能直接扔进光栅化——会除法翻转。这里硬件有一个反直觉的策略:先扩大可见范围(guard band),把逐元裁剪省掉,只在极端情况下才真正裁剪。出处:Themaister《PS2 GS emulation》。
第四,谁被直接扔掉。 背面朝向相机的三角形(backface)、面积退化成零的三角形,在进光栅化之前就被剔除了,根本不会浪费一个像素周期。这一步的成本低到只剩一个符号位,却能在场景里省下近一半不该画的像素。出处:NVIDIA《Life of a Triangle》。
这一问里,环绕方向(winding)的符号位(sign bit)是整个判断的钥匙——顶点给出的先后顺序定义了三角形的「正反面」,硬件只看这个低成本的位就能决定要不要画。把它和下面这张四问总览里的其他三问放在一起看,从顶点到屏幕坐标的整条链路就串起来了。
这四问不是四个孤立话题,它们其实是同一条「从顶点到像素位置」链路上的四个检查点。硬件一次 draw 走完这四个点,几何才算被真正安置到屏幕坐标上。下面这张图把四问在管线上的各自着落点再叠在一张图上,方便我们带着「哪一问对应哪一段」的框架往后读。
好了,四个问题串起来了,动手之前先把边界声明码清楚:本篇不涉及光栅化本身——三角形覆盖哪些像素、边函数怎么算、深度怎么写,那是下一篇(光栅化)的活。本篇只到「把 clip 坐标变成一组待光栅化的屏幕空间三角形」为止:装配、透视除法与视口、guardband 与裁剪、背面与退化剔除。也不涉及细分几何着色与 mesh shader(那是系列后面几篇)。出处:Vulkan Specification · Rasterization。
为什么要啃这一篇:因为「顶点算完坐标就直接画上去了」大概是图形里最常见的想当然之一。它默认 clip 坐标到屏幕像素是「一步到位」,默认裁不裁都无所谓。这两个默认都不对——中间隔着一整段固定功能的管道,装配的顺序、视口的坐标、guardband 开的范围,任何一个出问题,三角形就会画偏、画翻、或画错屏。这三段是驱动与硬件之间藏得最深、又最决定「画对没画对」的一环。这张「想当然 vs 现实」的对照图,把那段被默认跳过的管道可视化出来,是理解本篇价值的第一步。
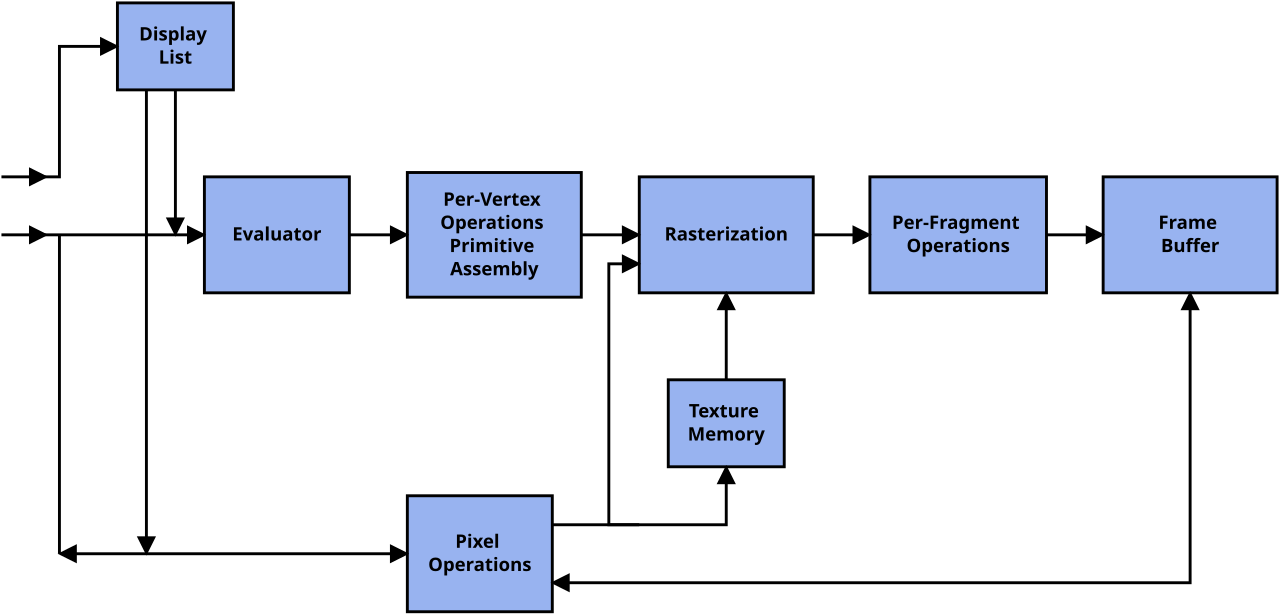
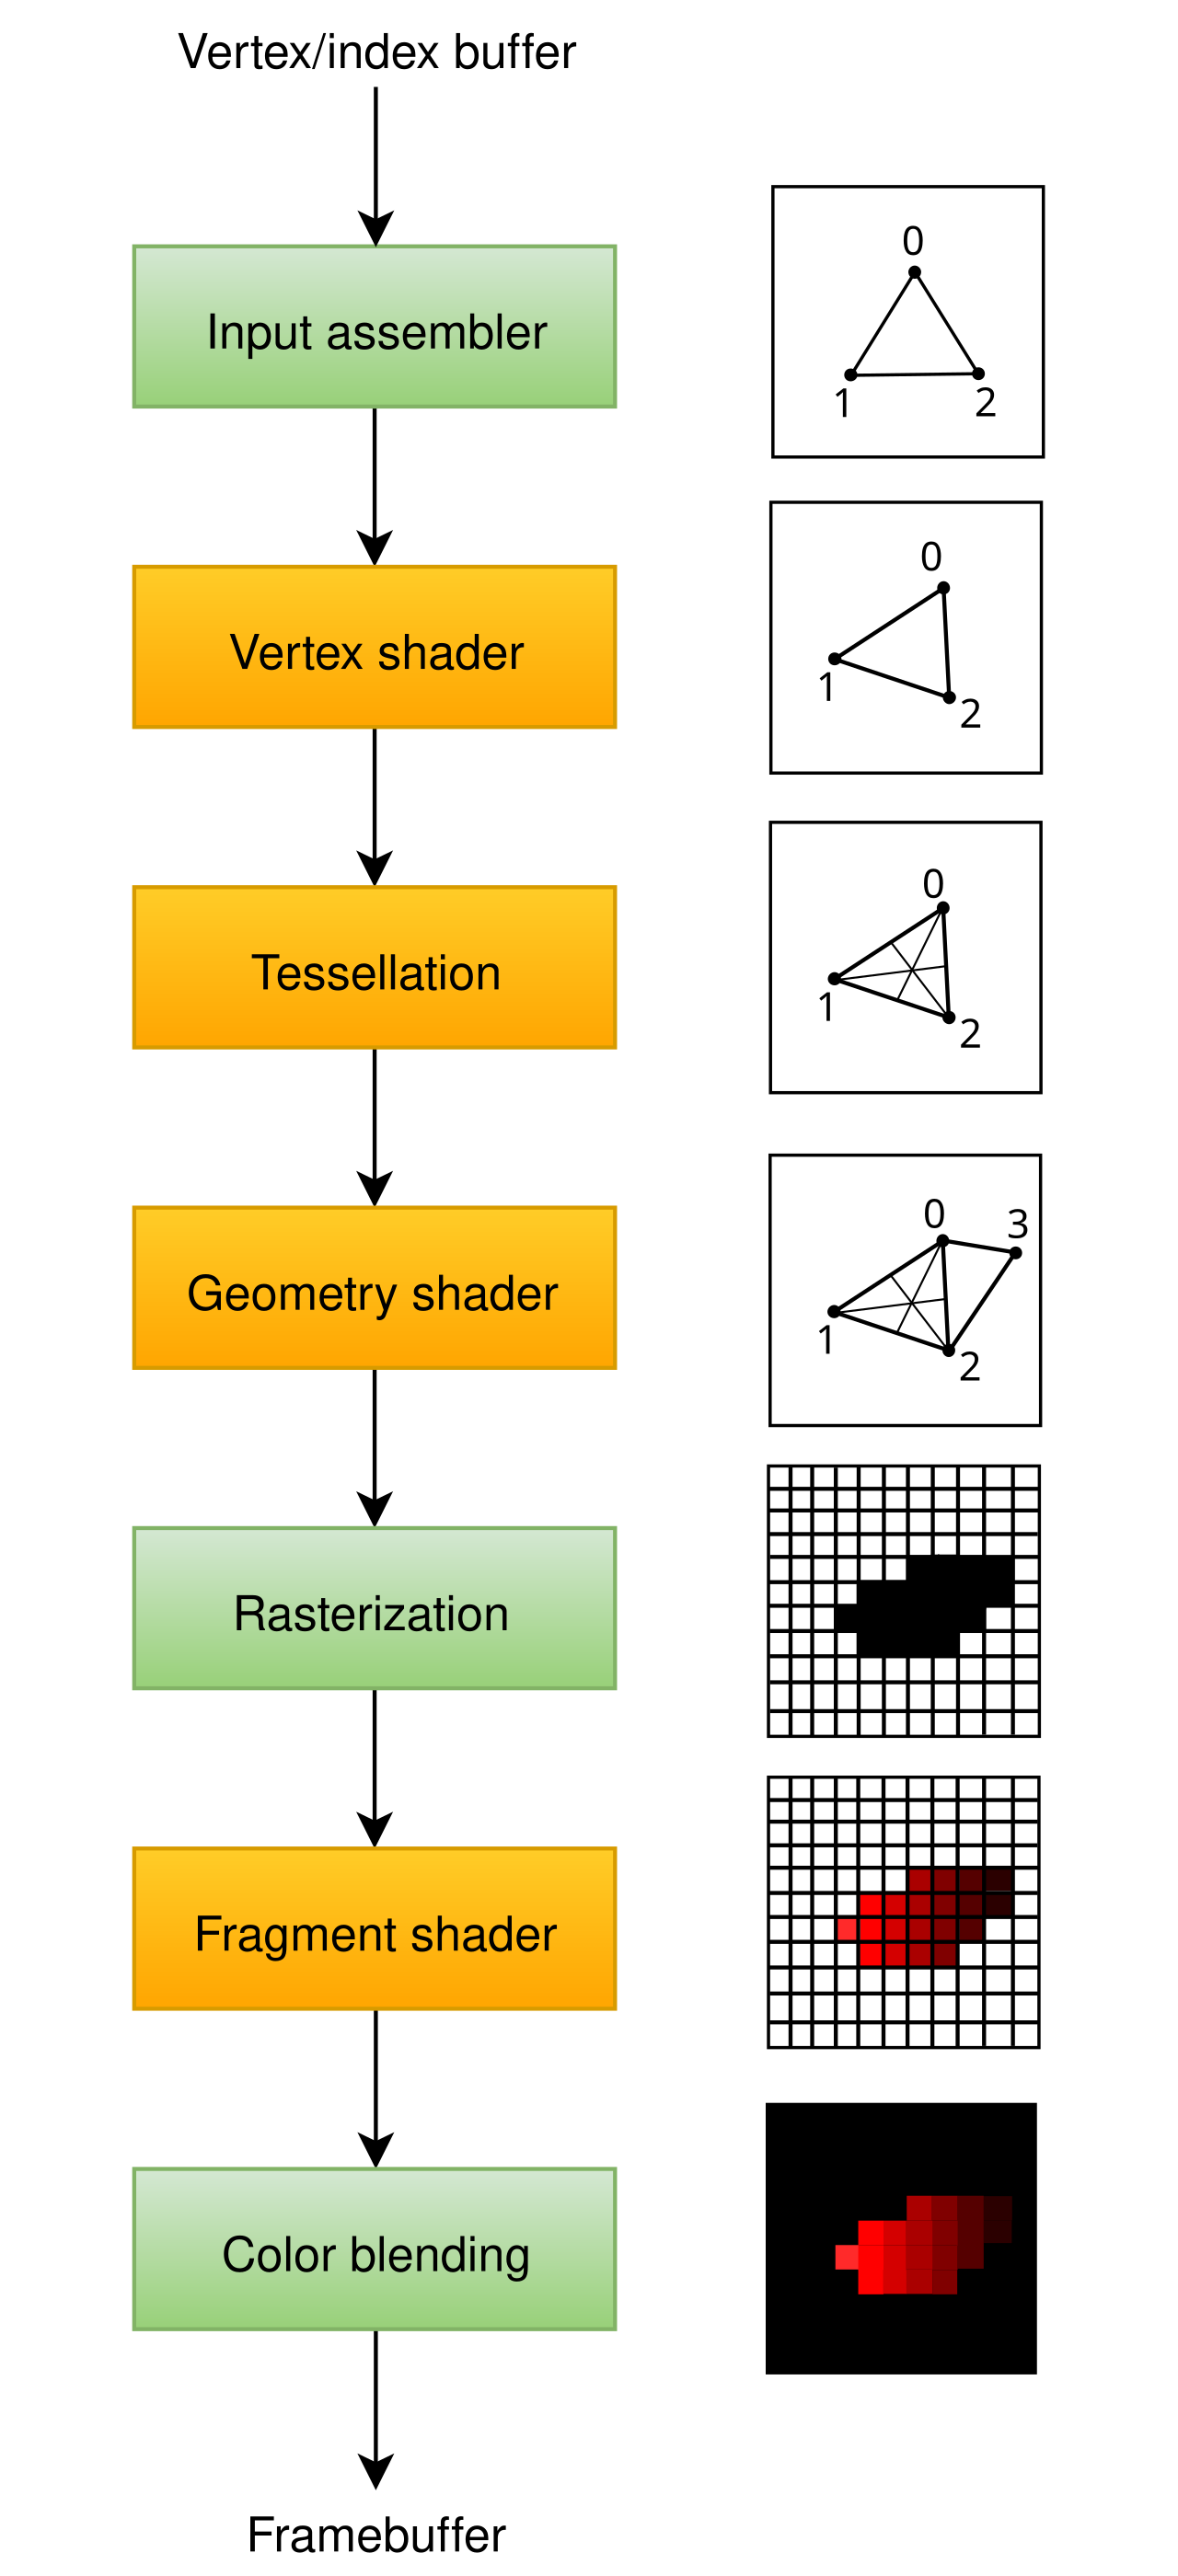
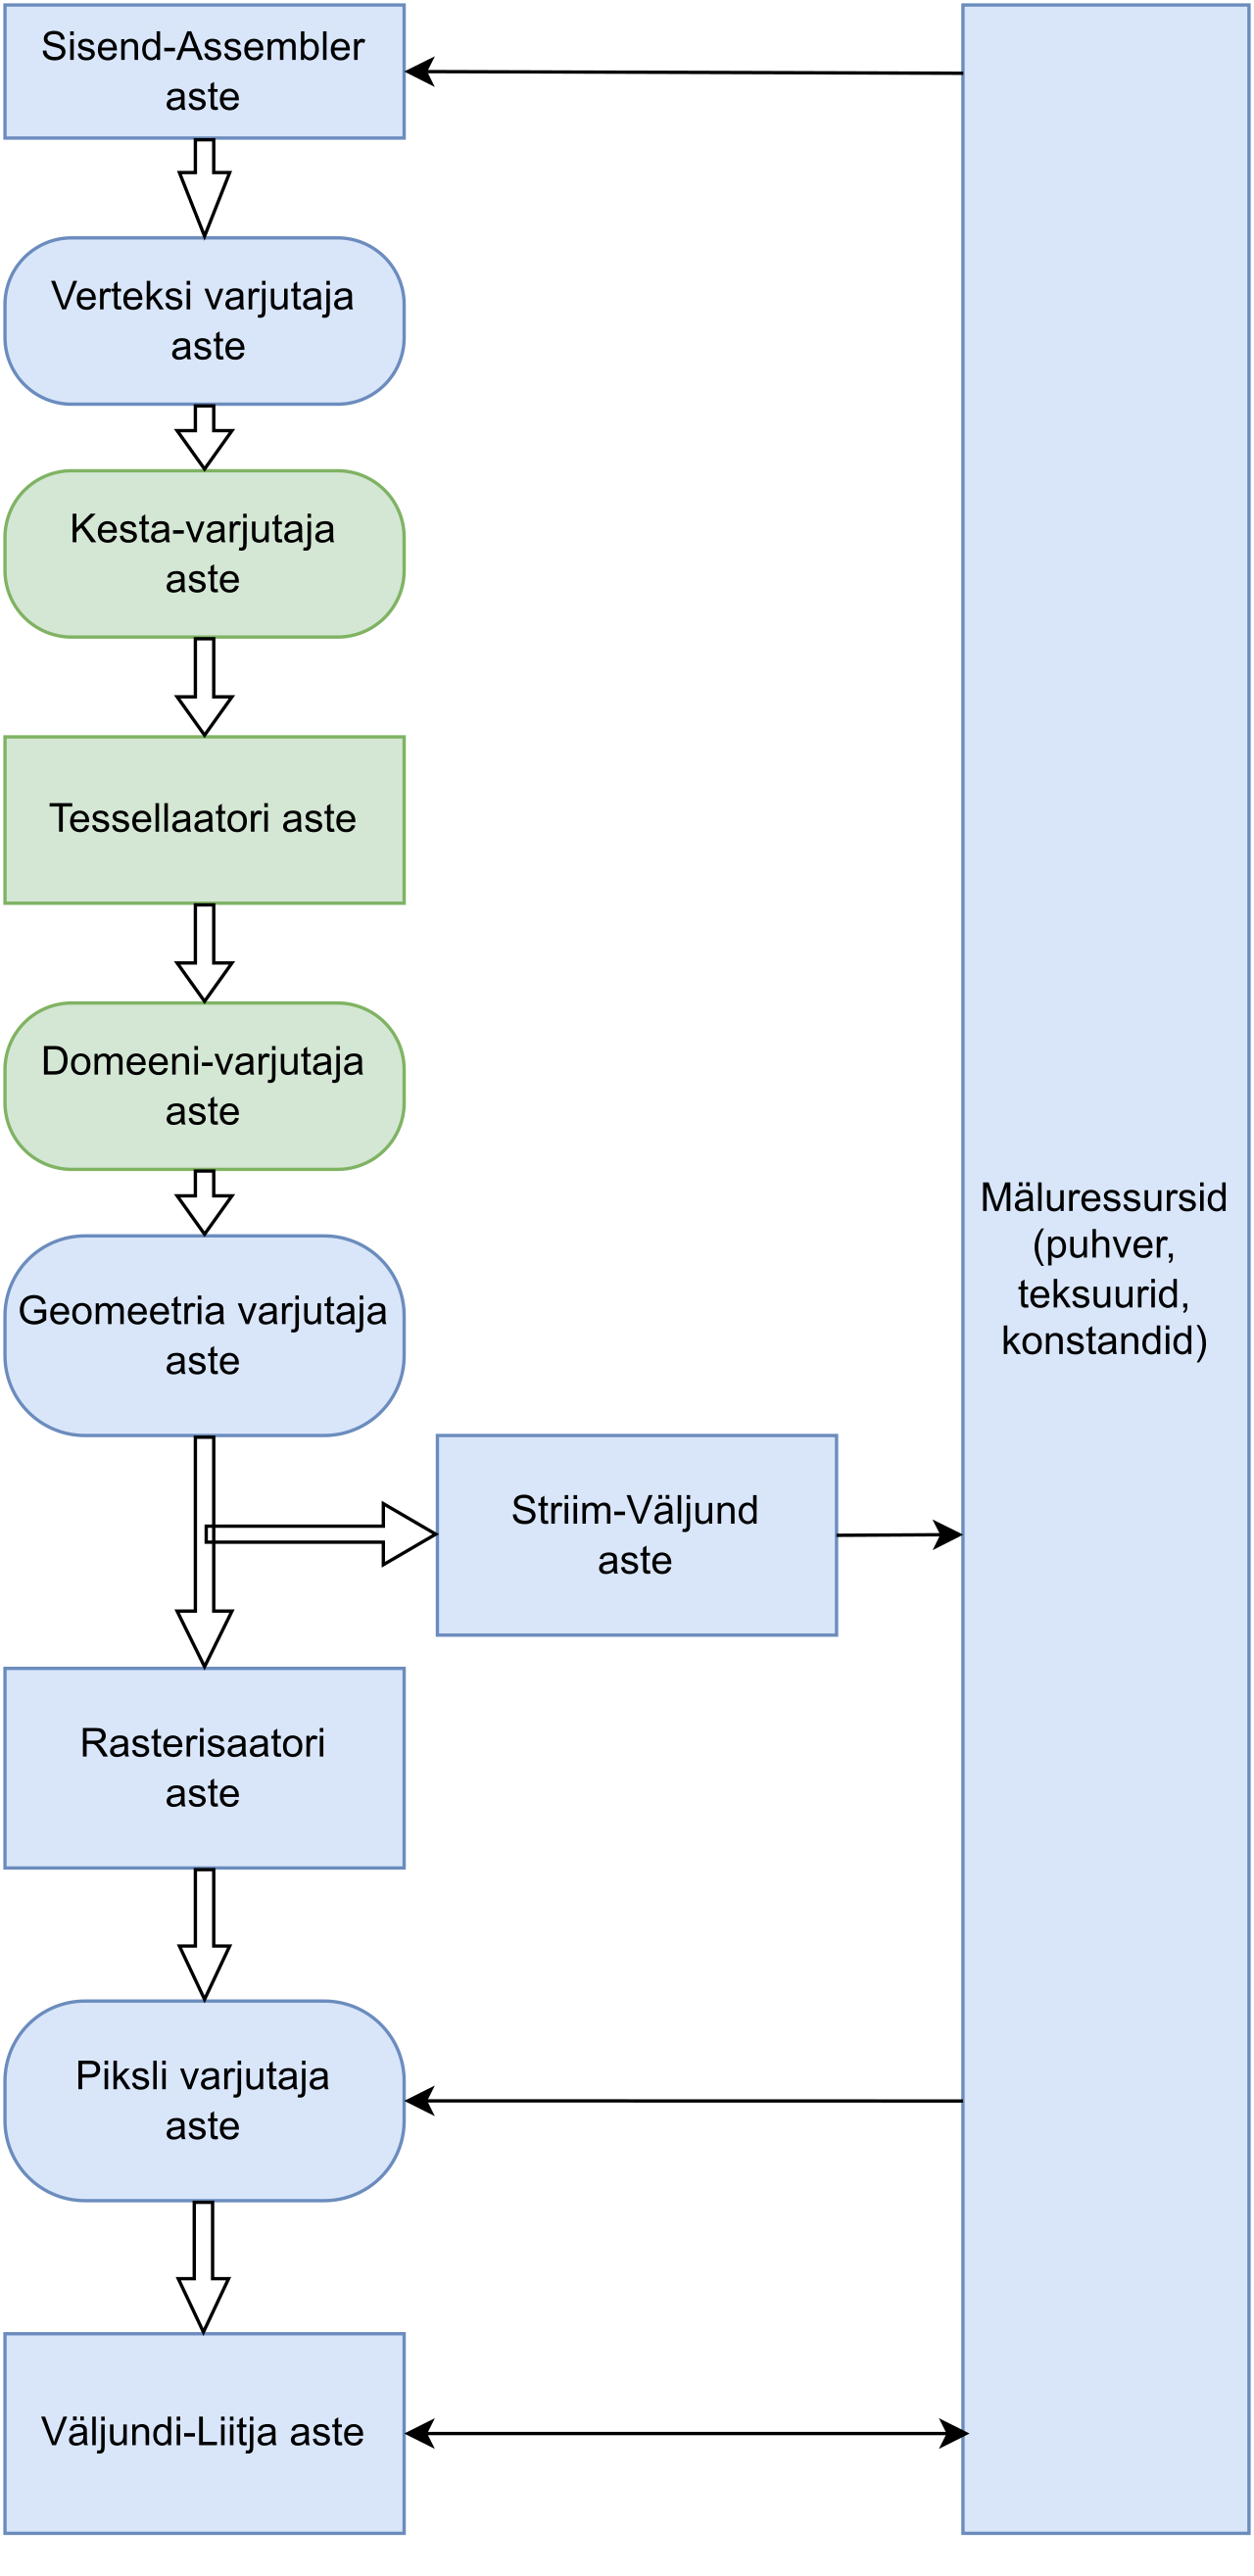
「中间隔着一整段固定功能」这件事在真实 API 的管线图上看最直白——下面三张分别是 OpenGL、Vulkan、Direct3D 的完整渲染管线,图元装配、裁剪、光栅化、输出合并这些阶段在各自的链条里都有明确的落点,和上面的抽象分法一一对应:装配总在顶点之后,光栅与裁剪在片元之前,谁先谁后一眼可见。出处:Wikimedia Commons 三张管线图(Public domain / CC BY-SA,见文末台账)。
所谓「画错屏」,最典型的信号就是三角形出现在了它不该出现的那一面——这往往不是坐标或滤波的问题,而是最前面的装配、视口或裁剪环节某一处翻了车。抱着这张对照图往后读,你在排查类似 bug 时就有了「先在哪个环节定位」的次序感。简单讲,这一篇是你理解「为什么我的三角形没画出来」「为什么边缘有条缝」「为什么越界就没了」这三个经典 bug 的钥匙。
下面依「装配 → 透视除法与视口 → guardband 裁剪 → 剔除」的路线往下展开。
一、图元装配:把离散顶点捆成三角形
我们正式开始。要讲清「三角形怎么被画出来」,先得从它的「出生」讲起——顶点不是出生就是一堆三角形,它需要一步叫装配(Assembly)的动作。这一节我们把装配讲透:一次 draw 带了多少顶点、装配器在管线里站哪、拓扑家族几张脸、以及带宽账怎么算。
1.1 一次 Draw 命令带了多少顶点
软件侧先看。vkCmdDraw(count, first) 或 DrawIndexed 里,我们只给了顶点数(和可选索引)。硬件并不知道这些顶点该组成什么形状,它靠绘制模式(拓扑,topology)来解读。一次 draw 除了顶点数,其实还带着「起始顶点偏移」和「实例数」这么一圈参数,它们共同决定了顶点流怎么被取、怎么被分组。
//-----------------------------------【图元装配·拓扑解读】---------------------------------------
// 描述:同一批顶点,按不同拓扑解释成不同形状
//------------------------------------------------------------------------------------------
//【1】PointList:每个点一个图元
//【2】LineList:每两个点一条线
//【3】TriangleList:每三个点一个三角形
//【4】TriangleStrip:复用前两点,每来一点新三角
vkCmdDraw(cmd, vertexCount, 1, 0, 0);   // 顶点流 → 按 topology 组装
上面代码里,同一个顶点流,topology 变了,画出来的是点、线还是三角形就完全不同。出处:DirectX-Specs · D3D11 Functional Specification。除了顶点数,一次 draw 还带着顶点起始偏移与实例数这几笔参数,它们共同决定顶点流从哪里开始取、取几份。下面这张图把它们拆开看,方便我们理解「一个 draw 到底占用了哪些输入窗口」。
既然是固定功能,这些参数最终会落到装配器能读的三个来源:顶点缓冲、索引缓冲(可选)、以及随参数带来的起始偏移。搞清楚这些口径,是我们在「同一个 mesh 换参数复用」或「实例化绘制」时不出错的前提。
这张图先给了装配器的位置感,接下来我们要看它上游到底接的是什么样的数据。顶点流和索引流是两条不同的内存窗口,装配器按 baseVertex/indexOffset 从这两条流里取数,再按拓扑把它们组织起来。这决定了「一次 draw 有几份内存要读」——顶点流一份、索引流一份(用了索引时)。
1.2 顶点流与索引流:装配器上的两道数据口
在硬件里,这一步由图元装配器(Primitive Assembler)完成。它是前端几何处理的一块固定功能,上游接顶点着色器的输出流,下游把「按拓扑捆好的图元」交给后面的裁剪/视口/光栅化。AMD 的 RDNA 架构里,图元装配器与几何引擎(Geometry Engine)同属前端;NVIDIA 则把它划在几何处理段。装配器真正读的是两条数据:顶点缓冲(vertex buffer)里装的属性,以及可选的一张索引缓冲(index buffer)。
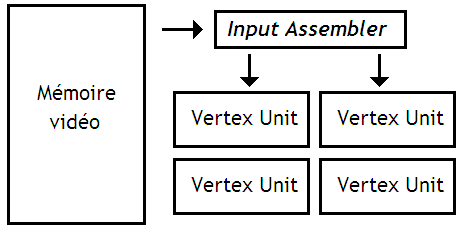
下面这张图为装配器在完整管线里的「位置感」提供了实锤:它的上游是顶点缓冲/索引缓冲的取数,下游接顶点着色,再往后才到几何着色、平滑着色、光栅化——装配就站在「决定连接性」这一档,而不是「算数据」。出处:Wikimedia Commons · File:Input assembler.png(CC0)。
//-----------------------------------【顶点流/索引流输入】---------------------------------------
// 描述:索引如何把顶点缓冲里的顶点重新排序成图元
//------------------------------------------------------------------------------------------
//【1】索引数组:0,4,2 → 取顶点缓冲里的第 0、4、2 号顶点
//【2】非索引:直接按 0,1,2,… 连续取
//【3】IndexedDraw 让相邻三角形可以共享顶点,省内存
vkCmdDrawIndexed(cmd, indexCount, 1, 0, 0, 0);
下面对索引流做一点特别说明:DrawIndexed 多传了一个索引缓冲,装配器先读索引、再去顶点缓冲里按索引取号。这正是 strip 有趣的地方——它允许同一顶点被多个三角形引用,而不用重复存储,是我们的带宽账最关心的来源。
不同厂商给了不同的名字:AMD 叫 Primitive Assembler,几何引擎负责知道 points/lines/triangles 的连接性;NVIDIA 在 Life of a Triangle 里把这段叫图元装配与光栅化管理。但机制一致:装配器拿到的是顶点流,交出去的是连接好边的图元。 出处:AMD GPUOpen《All the Pipelines》。
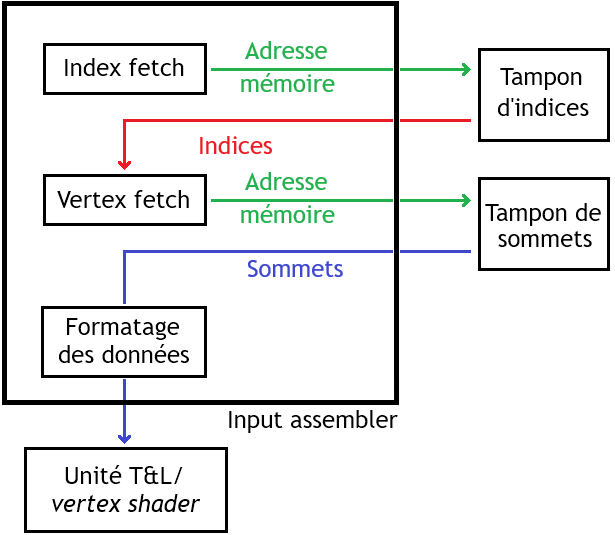
下面这张图把装配器在硬件里的「并排放置」关系画出来了:顶点着色与片元着色两段可编程单元之间,装配器作为固定功能块参与,它读顶点流、产出图元,是两段着色之间的「传送带」中转。这印证了上文那句「装配是连接性的活,不是算数的活」——它和两侧的着色器是并列而非嵌套的关系。出处:Wikimedia Commons · File:Implémentation matérielle de l'input assembler.png(CC0)。
这里有一个值得注意的点:装配是按拓扑重新解释顶点,不改变顶点数据本身。 顶点着色已经算完了,装配只是把它们按 list/strip 的规则串联起来,并告诉下一级「这三个是三角形」或「这两个是线」。它在硬件里的成本主要是带宽——连接信息本身也是要读的(尤其 IndexedDraw 时读索引缓冲)。说白了,装配阶段硬件的开销大头是「搬运数据」,而不是「算」。
这么说吧,装配器并不是一个「聪明」的单元,它只是一台照拓扑规则机械分组的机器。它读进来的顶点即便排布毫无规律,它也能照着拓扑把「每三个一组」或「每两个一组」分对——它自己并不理解内容,只是按索引和步长办事。这正体现了「固定功能」的本质:不做任何判断,只按规则执行。
下面我们要把 topology 家族摆出来看看——同样是「每几个一组」,list 和 strip 在顶点数量需求上差别很大,而这直接决定了一次 draw 的带宽账。
1.3 topology 家族:list 与 strip 与 fan
拓扑不是任意的,硬件只认少数几种。核心就两类:list(列出式)和strip(条带式),再加上极少数场景会用到的 fan(扇式)。无论哪种,都要让装配器知道「几个点算一个图元、相邻图元之间怎么共享点」。
- TriangleList:每三个连续顶点一个三角形。两个相邻三角形不相干,各要 3 个顶点。
- TriangleStrip:第 N 个三角形复用前两个顶点,每来一个新顶点就多一个三角形。两个相邻三角形只多画 1 个顶点。
- TriangleFan:一个公共圆心顶点 + 一圈外围顶点,所有三角形共享圆心那个顶点。
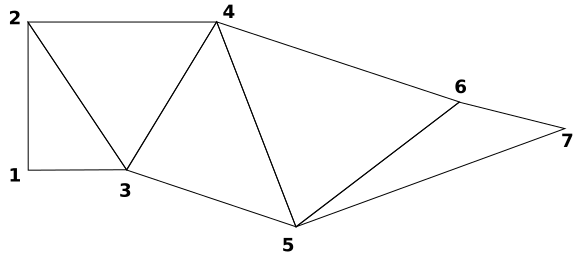
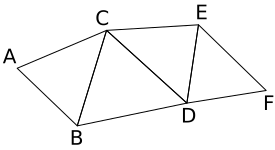
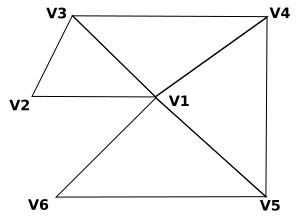
既然提到纹丝不动,我们说清楚一件重要的事:strip 与 fan 省的是「顶点缓冲的读取量」,而不是「图元数量」。 同样画 N 个三角形,list 要读 3N 个顶点,strip 只读 N+2 个,fan 只读 N+2 个(一个公共点 + N+1 个外围点)。这是装配阶段最直观的一笔带宽账。
这个差异在 IndexedDraw 下尤其明显:用 strip 的顶点复用,带宽账直接减半以上;但 strip 的缺点是三角形极性会交替翻转(第 2、4、6…个三角形环绕方向反了),需要奇偶补丁(vkCmdSetPrimitiveTopology 时代先到先得,或用 primitivesGenerated 之类计数对齐)。
为什么说「极性翻转」会影响我们?因为strip 的环绕方向每两个三角形就反一次,如果你在后处理或 tesselation 里对「正面」有方向性假设,就得靠奇偶规则补回来。这个我们第五节在剔除里还会碰到,先埋个扣。
1.4 索引与非索引:一次 draw 的两份账
聊完拓扑,我们把「非索引」和「索引」两种 draw 放一起看。非索引 draw(vkCmdDraw)直接从顶点缓冲按序号连续取顶点;索引 draw(vkCmdDrawIndexed)则多读一张索引缓冲,用索引去重排取号。两者都能表示同一个三角形网格,但内存布局和缓存行为完全不同。
| 维度 | 非索引 Draw | 索引 Draw(Indexed) |
|---|---|---|
| 顶点缓冲读取 | 连续按序取,无重复 | 按索引取,同一顶点可被多次引用 |
| 顶点是否需要重复存 | 相邻面共享点也要重复存 | 共享点只存一份 |
| 带宽账 | 3N 顶点的属性全读 | 索引读 + 命中顶点缓存后省属性读 |
| 典型用途 | 逐三角形无共享的粒子/线条 | 大多数封闭网格 |
图里那条「索引命中顶点缓存」的路径是索引 draw 省带宽的关键:因为同一顶点可以被多个三角形显式引用,只要索引顺序让附近的三角形引用附近的地图顶点,缓存命中了,一个顶点只需真正着色一次。反之,如果索引顺序乱得像洗过牌,缓存命中率暴跌,读带宽和着色计算都会成倍上涨。
下面对索引 draw 的收益做点特别说明:当三角形网格里大量顶点被共享时(比如一个细分网格一个角点连接 6 个三角形),索引 draw 配合后顶点缓存(post-transform vertex cache),能让同一个顶点的着色结果被复用,而不是每被引用一次就重算一遍。这正是现代 GPU 前端非常依赖的优化——我们下一小节专门讲讲这个缓存。
1.5 顶点缓存:为什么会「上面快、下面慢」
GPU 前端普遍有一个后变换顶点缓存(post-transform vertex cache):顶点着色算完一个顶点的 clip 坐标和属性后,结果按顶点索引缓存一段时间。装配器再次需要同一个索引时,如果命中缓存,就直接用缓存的着色结果,而不再重新跑一遍顶点着色器。索引顺序排得好不好,直接决定这个缓存的命中率。
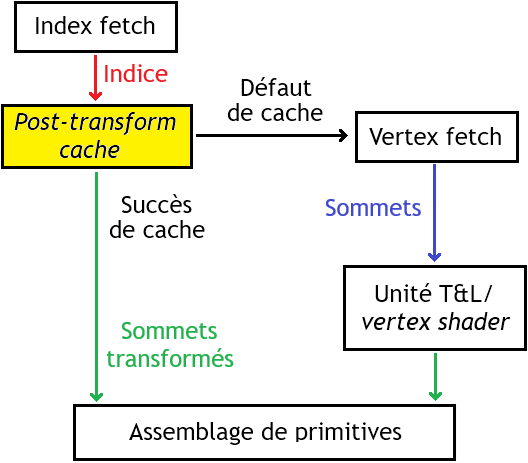
//-----------------------------------【顶点缓存命中】---------------------------------------
// 描述:缓存最近算过的顶点着色结果,避免重复着色
//------------------------------------------------------------------------------------------
//【1】顶点 T 第一次遇到 → 跑顶点着色,结果入缓存
//【2】再次遇到同一索引 T → 命中缓存,直接取结果
//【3】缓存满 → FIFO 淘汰最旧顶点
uint tri[];   // 三角形顶点索引序列
下面对顶点缓存再做一句补充:这种缓存对手工排列顶点的网格尤其重要,合理分块(cache-friendly ordering)能把顶点着色次数从「每被引用一次算一次」压低到接近「每个唯一顶点算一次」,差距可达数倍。这里也提醒大家:不要一张 draw 里把毫无空间邻接的顶点塞一起,那样缓存形同虚设。
缓存命中率的高低,直接受索引的顺序相关度影响:如果让相邻三角形尽可能引用相邻索引,缓存里一堆近邻顶点互相复用,命中率能冲到九成以上;若索引乱序,则每次都像「重新认识一个陌生人」,命中率暴跌。这也是为什么引擎里常常专门做一步「cache-optimized index ordering」对顶点加以重排。
缓存再进一步,还有一个与装配相关的推论:同一段顶点缓冲如果被多个 draw 引用,缓存无法跨 draw 保证命中——每个 draw 的缓存窗口是独立的。所以频繁把大网格拆成很多很小、顶点毫无重叠的 draw,反而会错过缓存红利。
1.6 Primitive Restart:在 strip 里切一刀
Strip 太长时,我们需要在中间「断开」。硬件提供 Primitive Restart(图元重启)——用一个保留的索引值(如 0xFFFF 或 0xFFFFFFFF)标记边界,装配器遇到它就从下一个紧后顶点重新开一条 strip。这样一来,一条很长的三角形条带可以被切成很多段互不相连的独立 strip,而不必一个个单独发 draw。
//-----------------------------------【Primitive Restart】---------------------------------------
// 描述:在一个 index buffer 里切换多个不相连的 strip
//------------------------------------------------------------------------------------------
//【1】索引流:0,1,2,3, 0xFFFF, 0,1,2...
//【2】装配器遇到 restart index,从其后重新起一条 strip
uint indices[] = {0,1,2,3, 0xFFFF, 0,1,2};
// 效果:一个 draw 画出两条不相连的 strip
上面代码里,0xFFFF 就是 restart 记号。装配器顺着索引流扫到它时,不会把它当成普通顶点去取号,而是当作一个「此处断开」的分隔符——它只负责复位条带的状态,自身并不产生任何图元。这样一来,一条长 strip 就能被切成两段互不相连的 strip,全程只发一个 draw 就搞定。出处:Vulkan Specification · Primitive Restart。
一件容易忽略的细节:restart 记号到底取哪个值,与索引的位宽强相关。16 位索引常见用 0xFFFF,32 位索引用 0xFFFFFFFF——它把「索引计数范围」整个挤出一个保留号。如果你们引擎里既需要满范围的索引地址、又想要 restart,就会遇到「该不该牺牲 0xFFFF 这个地址」的取舍,往往通过换 32 位索引 + 自定义 restart 值来两全。
另外,restart 行为对 list 拓扑无效——list 的每个图元本来各占一段连续索引,不需要「断开」的记号,只有 strip / line-strip 这类连续复用的拓扑才吃 restart。装配器对不支持的拓扑会直接忽略 restart 标记,别指望它当「万能分隔符」用。
要特别提醒大家:restart index 是「保留索引」,它不能当普通顶点用。如果在装配里把它误当成一个真实顶点,就会在 mesh 的某个角落画出一堆翻转、穿帮的错误三角形——这是我们第六节陷阱里会再提的一个高频 bug。同时,restart 只在 strip/line-strip 这类「连续复用」拓扑里才有意义,list 拓扑本来每段独立,就不需要 restart。
1.7 Primitive ID:给每个图元一个户口
每个装配出来的图元还打上了一个序号,叫 Primitive ID——从每个 draw 开始从 0 递增,每多一个图元 +1。这个 ID 在旧式管线(几何/片元着色器可读)和 primitiveID() 里都有用处:它让几何着色能知道自己在处理第几个图元,也让片元着色能据 ID 做逐图元的差异化(如图元级随机)。
特别说明:Primitive ID 的「户口」是装配时打的,但不同 API 对重新启动(restart)后是否复位、以及 GS 存在时如何分发的规定略不同,正式语义见规范。出处:Vulkan Specification · Shader Execution。
Primitive ID 最常见的用途之一,是几何着色器(Geometry Shader)里按图元做差异化处理,例如给每个图元一个随机的颜色、或是把图元 ID 传下去做批量动画。虽然现代管线里 GS 用得少了(更多换成 compute + mesh shader),但理解 Primitive ID 在装配时怎么打,是读懂后面所有「按图元逐项处理」功能的地基。
一个与之类似、常被混为一谈的概念是 Primitive/Instance Index:与 Primitive ID 不同,Instance Index 在每个实例(instance)递增一次,而 Primitive ID 在每个图元递增一次。两类索引解决的是不同粒度的问题——前者用于「这个实例改了没」的批量区分,后者用于「这个图元排在哪个位置」的逐图元区分。装配器通常同时维护两路计数。
另一个值得留意的点是 ID 的复轮(wrap):Primitive ID 的数据位宽有限,超出范围后会回绕(wrap)归零。如果某个小技巧依赖「ID 永不重复」,就必须考虑 wrap 到 0 的那一刻是否会被误判为「第 0 个图元」。多数正规用法不依赖 ID 的全局唯一性,所以这条缝隙很少有人踩到,但也别想当然。
1.8 顶点数不足与余数图元
现实中有时候顶点数并不正好是三的倍数——比如 TriangleList 传了 10 个顶点,最后一组只剩 1 个顶点凑不成三角形。遇到这种情况,硬件的行为有严格规定:不完整的尾段图元(incomplete primitive)默认被丢弃,不参与渲染,但仍会计入 primitivesGenerated 计数。这种细节看似无关紧要,却是驱动魔改、流式输出时对不上的常见原因。
| 拓扑 | 顶点总数 | 尾段 | 是否被装配 |
|---|---|---|---|
| TriangleList | 10 | 剩 1 顶点 | 丢弃尾段,装配 3 个三角形 |
| LineList | 5 | 剩 1 顶点 | 丢弃尾段,装配 2 条线 |
| TriangleStrip | 8 | 无需对齐 | 完整装配 |
为什么「被丢弃」还要「计入计数」?因为这两笔属于不同用途:丢弃是为了不让残缺图元制造垃圾三角形,计数是为了让上层能对「打算画多少」与「实际画了多少」的落差有感知。尤其在做统计、调试、或依赖 stream output 的管线里,口径对不上往往是「画得对但数不对」的根源。
顺带一提,不完整图元被丢弃并不影响前面完整图元的装配顺序——硬件从头到尾按序装配,只是到了缺顶点的那组直接跳过。所以「计数相同、顺序不变」是它的两个稳定特性,理解这两点,我们就不会在流式输出时把顺序想岔了。
下面对 primitivesGenerated 做点补充:这个计数与真正被装配的图元并不总是相等——被 restart 隔断、被丢弃的尾段都会有它自己的口径。当我们用 transform feedback 或做流式统计时,必须以规范定义的口径去对号,别拿「我数了三的倍数」就当结论。
1.9 装配不产生新数据,它决定连接性
最后用一句话把第一节收束:装配是「分类与连接」,不是「计算」。 它把顶点流按拓扑重排、打上 Primitive ID、过滤掉不完整的图元,但从头到尾不改变顶点坐标、不进行插值、不产生新顶点。真正会「产生新顶点」的是后面的裁剪(逐元裁剪会生成交点),所以在硬件里,装配被归为「廉价的前端固定功能」。
回到装配这个名词本身:它只负责把几何「组织好」,至于这些几何长成什么样、颜色怎么算,装配器一概不管。能理解这一「只管组织、不算内容」的分工,后面读视口变换、读光栅化时的每一步才能对号入座。接着,我们进入第二阶段——那些组装好的图元,坐标要怎么从抽象的齐次空间「翻译」成屏幕上的具体位置。
顺带说一句,这一节的整段都能在规范的前端部分找到对应:从「如何从顶点缓冲与索引流取数」到「incomplete primitive 的处置」,都是固定功能语义的一部分。我们把它从政文细节里拎出来讲,是为了让大家在「画不全/画错/计数对不上」这类问题上有个抓手。出处:Vulkan Specification · Vertex Buffers and Attribute Fetch。
二、透视除法与视口变换:clip 坐标变成屏幕坐标
好了,装配那关过了。下面我们进入坐标的下一站:顶点着色输出的是齐次裁剪坐标(clip space),这四个分量里 w 不是 1。要把它们变成屏幕上的 2D 像素位置,硬件要做两步:先除以 w(透视除法),再映射到窗口(视口变换)。这一节我们把这两步的数学、像素中心约定、以及视口的可配旋钮一项项拆开。
2.1 透视除法:为什么要除以 w
先别急着背公式,先弄懂这一步在干嘛。clip 坐标 $(x_c, y_c, z_c, w_c)$ 里的 w 携带透视信息——除完 w 之后,近处的物体在 NDC 里比远处的大,才有了「近大远小」的透视投影。这一步叫透视除法(perspective divide):
$$ x_{ndc} = x_c / w_c, \quad y_{ndc} = y_c / w_c, \quad z_{ndc} = z_c / w_c $$
其中: - $x_c, y_c, z_c$ 是裁剪坐标(clip coordinates),顶点着色器输出的原始值。 - $w_c$ 是齐次坐标的第四分量,通常等于视角(view)空间到裁剪空间的深度距离,透视投影下 $w_c > 0$ 才有意义。 - $x_{ndc}, y_{ndc} \in [-1, 1]$,$z_{ndc} \in [0, 1]$(NDC,规范化设备坐标)。
为什么「除以 w」会产生近大远小?我们把它想成一根伸向屏幕的柱子:柱子越远,其实它的 w 就越大,同样一条屏幕上的高度,除以一个更大的 w 之后,在 NDC 里就变短了。w 就是那个「把你压远」的分母,透视投影的缩放感全在这一除里。
把「w 是压远分母」再换成一组具体数字体会一下:同一根边长,它的 w 从 1 涨到 8,NDC 里的边长就缩到原来的八分之一。这组缩放是完全线性的、也是完全可逆的——只要保留 w 的信息,光栅阶段就能在屏幕空间里做正确的透视校正插值(perspective-correct interpolation)。这正是为什么除法之后 w 不会简单地「丢进垃圾筒」,而是被当成每顶点的「深度权重」继续传递下去。除法前的齐次坐标含义与除法本身可参 Wikipedia · 齐次坐标 和 Wikipedia · 透视除法。
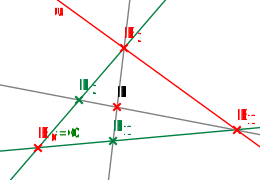
顺带看一张「同一段线段在不同 w 下的屏幕投影」示意,把上面的数字具象成几何:线段贴着镜头(w 小)时在屏幕上划出长长的投影,略微后退(w 大)投影就急遽变短。这种「w 每增大一点、投影按反比收缩」的关系,正是透视投影一切视觉结果的数学根源,也是后面理解透视校正插值必须抓住的手感。
这就引出一个硬约束:如果 $w_c \le 0$,除法会翻转或产生无穷,NDC 全乱。 所以凡是 $w_c \le 0$ 或落到视锥之外的图元,必须先裁剪——这正是下一节讲 guardband 的动机。出处:Fabian Giesen Part 5。换句话说,透视除法不是「随便除」,它要求 w 恒正且计算顺序在裁剪之后,这是硬件固定功能里一整套有序约定。
把 NDC 的意义再夯实一层:NDC 的三个分量其实是一个「归一立方体」里的坐标。任何落在立方体内的顶点,透视除法后都在「镜头前且可见」;落在立方体外,就落在视锥外——这也为我们第三节从「立方体边界」理解裁剪埋好了伏笔。这份直觉在排查「顶点为什么没了」时特别管用。
2.2 视口变换:offset 加 scale
NDC 坐标 $[-1,1]^2$ 是抽象的归一化空间,得映射到具体的像素范围,这一步是视口变换(viewport transform)。它的本质是一个 offset 加 scale 的仿射映射:先把 NDC 区间缩放到视口的宽高对应的像素数,再把原点对齐到视口左上角的起点 topLeft,于是三角形在 NDC 里多大、落在哪,就换算成屏幕上要画在几号像素:
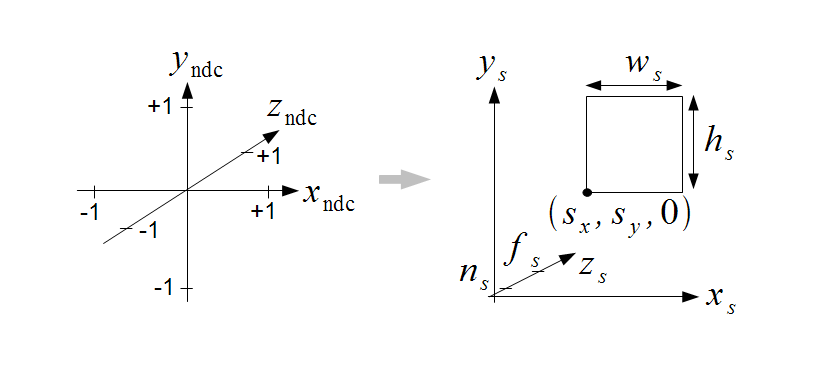
$$ x_w = \left( \frac{x_{ndc} + 1}{2} \right) \cdot W + topLeftX, \quad y_w = \left( \frac{y_{ndc} + 1}{2} \right) \cdot H + topLeftY $$
其中: - $W, H$ 是视口的宽高(viewport width/height)。 - $topLeftX, topLeftY$ 是视口左上角在窗口里的起点。 - 深度维度再映射一次 $z_w = z_{ndc} \cdot (maxDepth - minDepth) + minDepth$。
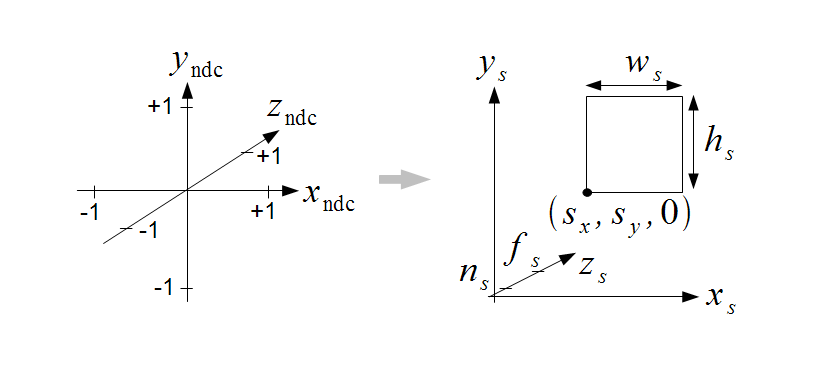
注意这两个公式的极值语义:当 $x_{ndc}=-1$ 时对应视口左边界,$x_{ndc}=+1$ 对应右边界,中间是线性铺开。也就是说,视口变换不会「丢」任何 NDC 信息,只是把无限区间换成一个有限但精确的像素区间——这也是为什么视口可以任意小,甚至允许把 NDC 的整幅画面压进视口的某一小块,用来做棋盘分屏或小地图。
这是「offset 加 scale」两类操作,硬件里各是一组常数乘加。出处:CS418 · Fixed Functionality。视口变换可以写成一整个矩阵,把 $x_{ndc}$、$y_{ndc}$、$z_{ndc}$ 三点同时映射到 $(x_w, y_w, z_w)$,硬件只要维护这一组系数,倍率与偏移就被「一锅端」了。
2.3 深度 z 的映射
视口变换不只是 X/Y 两维,深度维 $z$ 也要过一次映射——把 NDC 的 $z_{ndc} \in [0,1]$ 映射到视口声明的深度区间 $[minDepth, maxDepth]$。这一步决定了当顶点落到深度缓冲时,它的 z 值落在哪个区间。
$$ z_w = z_{ndc} \cdot (maxDepth - minDepth) + minDepth $$
其中 $minDepth$、$maxDepth$ 默认分别是 0 和 1,此时深度映射就是恒等;如果驱动改写它(比如做反向深度 Reverse-Z),近处细节的深度精度会显著提升,因为深度值在 $z_{ndc}$ 靠近 0 时精度更高。这是现代引擎经常用的一份「免费的精度糖」。
下面对深度映射做点特别说明:这部分纯是固定功能的一次线性映射,不会因为 mapping 不同而改变插值方式,也不会影响 X/Y 的覆盖判断——它只影响最终写入深度缓冲的数值。正因为它如此简单、位置又深,反向深度这种优化常常被当成「配置项」直接调,但引擎层若没同步处理,就会出现深度裁剪/平面聚常规格的怪问题。
2.4 像素中心约定:半像素偏差从哪来
同样是映射到像素,OpenGL 和 D3D/Vulkan 的原点与像素中心约定不同,这是无数「画偏半个像素」bug 的根源。差别看似只是一点点约定,却能左右每个片元的覆盖判定:同一套 NDC 坐标,在两种约定下会被映射进不同的像素格,多抽帧、多分辨率缩放、多 Pass 渲染时,边缘就会错开一条缝。
- D3D / Vulkan:视口原点在 render target 左上角,y 向下;像素中心在整数位置偏 +0.5(pixel center 相对 lattice 偏移 (0.5, 0.5))。
- OpenGL:原点在左下角,y 向上;视口变换也有它自己的 half-texel 惯例。
这一半像素偏差,会直接改变边缘像素的覆盖判断,进而在多 Pass 或多分辨率缩放时产生接缝。出处:Microsoft Learn · D3D Coordinate System。写渲染器时,「用哪种坐标系」必须在开头就敲定,并贯穿顶点方向、纹理坐标、光栅覆盖的全过程——半途换约定,最典型的现象就是「上一帧正常下一帧偏半个像素」这种玄学 bug。
屏幕边缘这条错缝,根子就在两套坐标系的轴向与像素中心约定上。D3D/Vulkan 让 y 向下、原点落在 render target 左上角,纹理坐标与片元覆盖都顺着这个方向走;OpenGL 则从下往上画,y 轴方向正好反过来,两者的差异不只在坐标取值,还会一路波及背面剔除里的环绕方向判断(见后文 2.4)。下面把它抽象成一张简图,把两套坐标并排对照。像素中心偏移 +0.5 的规范细节可对比 Microsoft Learn · D3D 坐标约定 与 OpenGL Wiki · 视口变换。
2.5 视口状态:哪些是可配的旋钮
视口不是写死的,它是一组可配置的状态。Vulkan/D3D 里我们每次设置:
//-----------------------------------【视口配置】---------------------------------------
// 描述:一套视口状态 = 位置 + 尺寸 + 深度范围
//------------------------------------------------------------------------------------------
//【1】TopLeftX / TopLeftY:左上角
//【2】Width / Height:宽高
//【3】MinDepth / MaxDepth:深度范围(决定 z 怎么落)
vkCmdSetViewport(cmd, 0, 1, {0, 0, w, h, 0.0f, 1.0f});
上面代码里,最后两个数 0.0f / 1.0f 是深度范围,把 NDC 的 z 线性映射到深度缓冲的区间。动的自由度不大,但都影响「画在哪、深度怎么算」。 出处:Vulkan Tutorial · Fixed functions。Vulkan 还允许你传负数高度的视口实现 Y 翻转,这在做某些后处理或兼容 OpenGL 语义时很常用。
2.6 多视口与视口数组
先来看看不够用的时候。单个视口只服务一种画面,而 Vulkan 支持多个视口(multiple viewports)同时存在,并用 viewportIndex 把图元分布到不同视口。层级哈希(multiview)、立体渲染(stereo)都靠它把一套几何同时画到左眼/右眼的两张图。每个视口有自己独立的 offset/scale/depth 范围,互不干扰。
//-----------------------------------【多视口】---------------------------------------
// 描述:一套几何按 viewportIndex 分布到不同视口
//------------------------------------------------------------------------------------------
//【1】设定 2 个视口:左眼、右眼各自一张 pixel 范围
//【2】顶点着色器根据 instance 或 gl_ViewportIndex 选择落到哪个视口
vkCmdSetViewport(cmd, 0, 2, viewports);  // 同时激活两个视口
下面对多视口做一句特别说明:视口是「状态」,而 scissor 也是另一个独立状态,两套状态可以自由组合。很多人画立体时只改了视口没同步 scissor,结果边缘出现半幅不画的怪像——这正是我们陷阱一节会点名的经典坑。
2.7 clip → NDC → window 的总览
把这一节串起来,其实是一条有序的固定功能流水:clip 空间 →(透视除法)→ NDC →(视口变换 scale)→(加 offset)→ 窗口坐标。四步一字排开,每步的输入输出都有明确空间;硬件只要顺着走,就能把齐次坐标压成像素坐标。
这张总览图就是你调「三角形画到哪了」的坐标字典:顶点着色器算完的顶点落在哪一步、硬件在哪一步截断(裁剪)、在哪一步取整(光栅),一条线上的三个环节彻底对上了。出处:CS418 · Fixed Functionality。
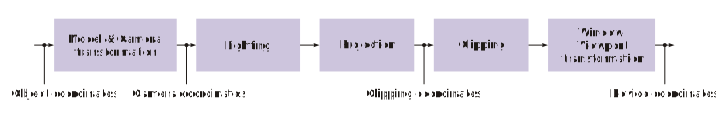
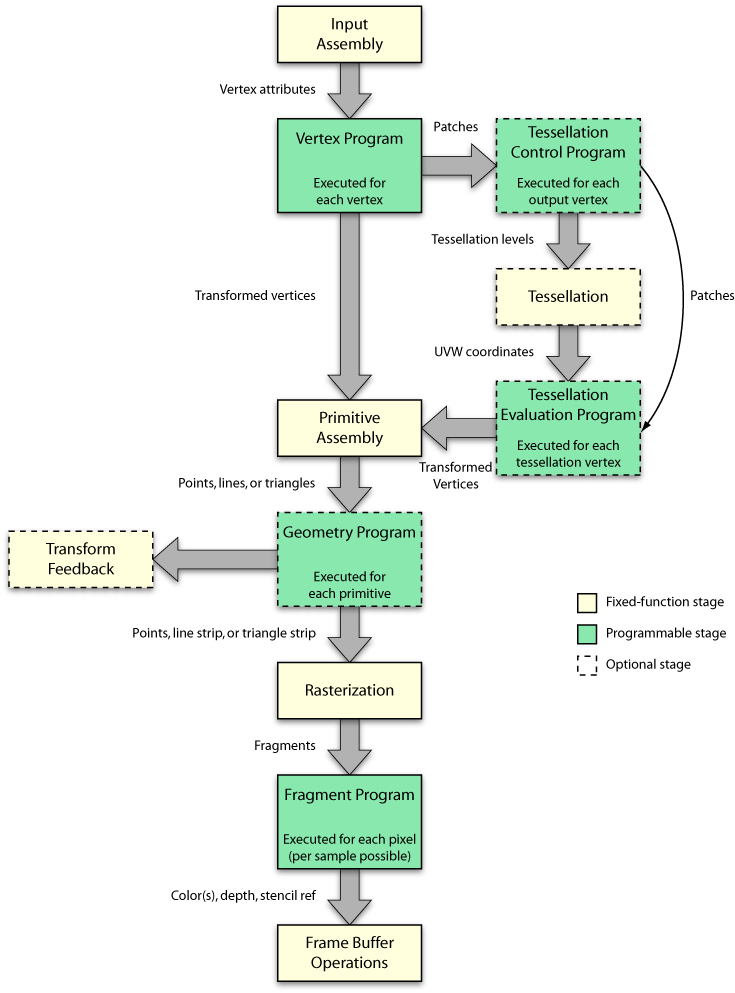
下面这张图把这一整段「顶点后处理」放到 OpenGL 与 DirectX 两套管线的约定里对照:输入装配 → 顶点着色 →(细分/几何)→ 裁剪与光栅化,装配与后面这段固定功能在两套 API 里是共同的骨架,区别只在各阶段的措辞与细分/几何着色是否启用。这幅管线横截面对应本节的「固定功能流水」结论——它从 CLIP 坐标一路走到光栅器,正是我们要算清的坐标变换在整条管线里的落点。出处:Wikimedia Commons · File:The OpenGL - DirectX graphics pipeline.png(CC BY-SA 3.0,作者 Eric Lengyel)。
三、裁剪与 guard band:为什么硬件不逐元裁剪
先来看看:一个三角形可能横跨整个屏幕,也可能绝大部分在屏幕外、只露出一个小角。对后者,最朴素的做法是「把三角形切到屏幕范围内再用」,这就是逐元裁剪(per-vertex clipping)。但硬件几乎不做这件事——这就是本篇最反直觉的一段。
3.1 视锥与裁剪体:你能看到的只有这些
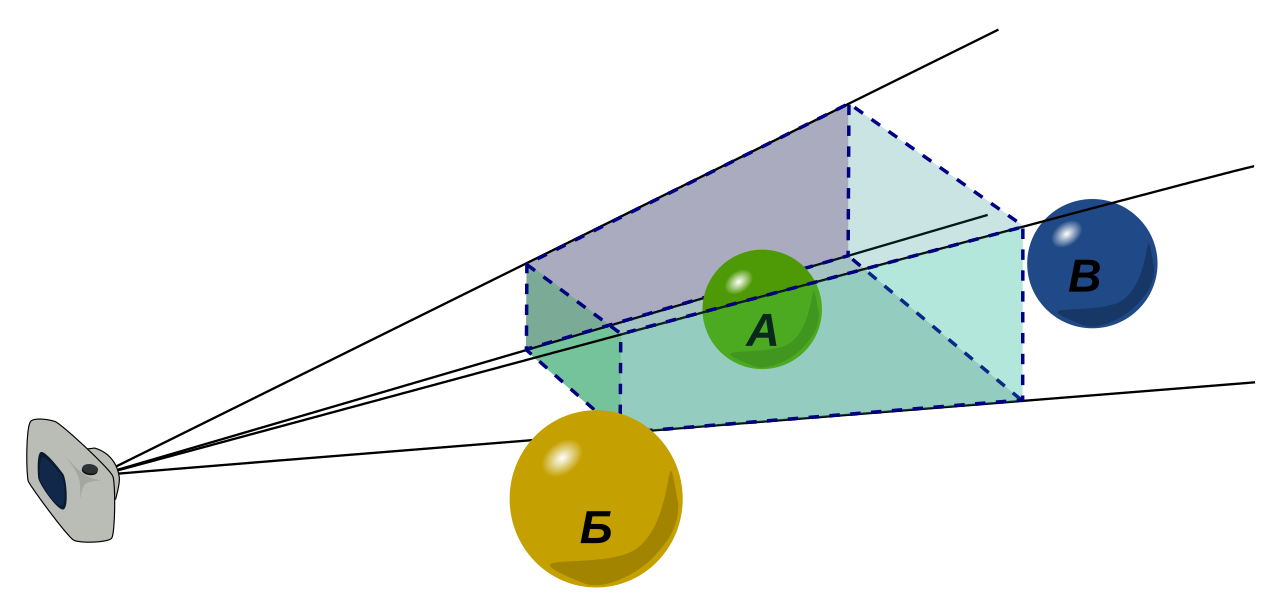
先弄明白「该裁界在哪」。相机能够看到的区域,是一个被视锥(viewing frustum)包围的四棱台——上下左右四斜面、外加近平面(near plane)与远平面(far plane)。落在这个六面体外面的顶点,相机根本看不见,必须在进光栅化之前被处理掉。这个六面体同时也是透视除法后 NDC 坐标的合法范围。
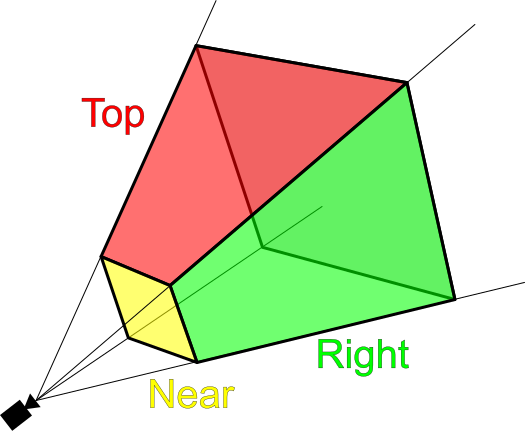
这张视锥图是「裁剪为什么要有边界」的直接来源:顶点一旦超出这套范围,要么在屏幕外、要么在相机背后,硬画只会画出一堆奇怪的翻转或失却深度意义的东西。硬件把这六面体化为 NDC 的若干不等式,裁剪就是检验这些不等式。每面对应 NDC 里的一个边界条件,合起来就是「顶点能被看见」的充分必要条件。
下面这张图把同样的「视锥=裁剪边界」用另一种风格画出来:frustum 作为可见范围,其近/远平面的取舍直接决定哪些点被裁剪。它和上文那张六面体图互为印证,把「frustum 的边界就是裁剪的边界」这个概念用两种图示钉死。出处:Wikimedia Commons · File:Frustum clipping.svg(CC BY 3.0,作者 Tetromino)。
3.2 朴素方案:Sutherland–Hodgman 逐元裁剪
先来说说「如果真的逐元裁」会长什么样。经典的裁剪是Sutherland–Hodgman 算法:三角形与六面视锥(左右上下近远)逐面求交,每过一个平面就切一次,还可能冒出新顶点。它精确、通用,但成本高——裁剪不是删除,而是要计算新顶点的交点、重算插值属性。
| 右边界的交点记为 E |
| 逐面裁剪:每次引入最多 1 个新顶点,至多切出多边形 |
| NDC[-1,1]³ 六面体:left/right/bottom/top/near/far |
来源:本系列依据 Microsoft D3D11 Functional Spec 的自绘示意。逐元裁剪在数学上无懈可击,但它在硬件里是慢路径——交点计算与属性重插值都不便宜。
更麻烦的是,逐元裁剪的结果不一定是三角形——一个三角形被近平面切掉顶角后,剩下的可能是个四边形甚至多边形,需要再拆回三角形才能进入光栅化。这带来额外的「三角化(triangulation)」开销,也是硬件想尽办法避开逐元裁剪的另一个原因。
这也是为什么裁剪在硬件里的别名是「慢路径」:每一步都是「求交点、断边、再三角化」的序列,任何一环都要用到相当于几十次乘加的浮点运算,远贵于装配与剔除那种一次符号判断。理解了这套「慢」的本质,guard band 的价值才真正凸显。逐多边求交的经典框架与代价可参 Wikipedia · Sutherland–Hodgman 多边形裁剪 及原始论文 Sutherland & Hodgman《Reentrant Polygon Clipping》(1974)。
这一段的「多边形裁剪」到底长什么样,可以用一套经典的四情形样例来钉死——Sutherland–Hodgman 多边形裁剪正好覆盖了「顶点在窗内/外、交点穿入/穿出」的全部组合,每一情形输出边数如何变化、什么时候冒出交点,这张样例图一套讲清。出处:Wikimedia Commons · File:Sutherland-Hodgman clipping sample.svg(Public domain,作者 Wojciech Muła)。
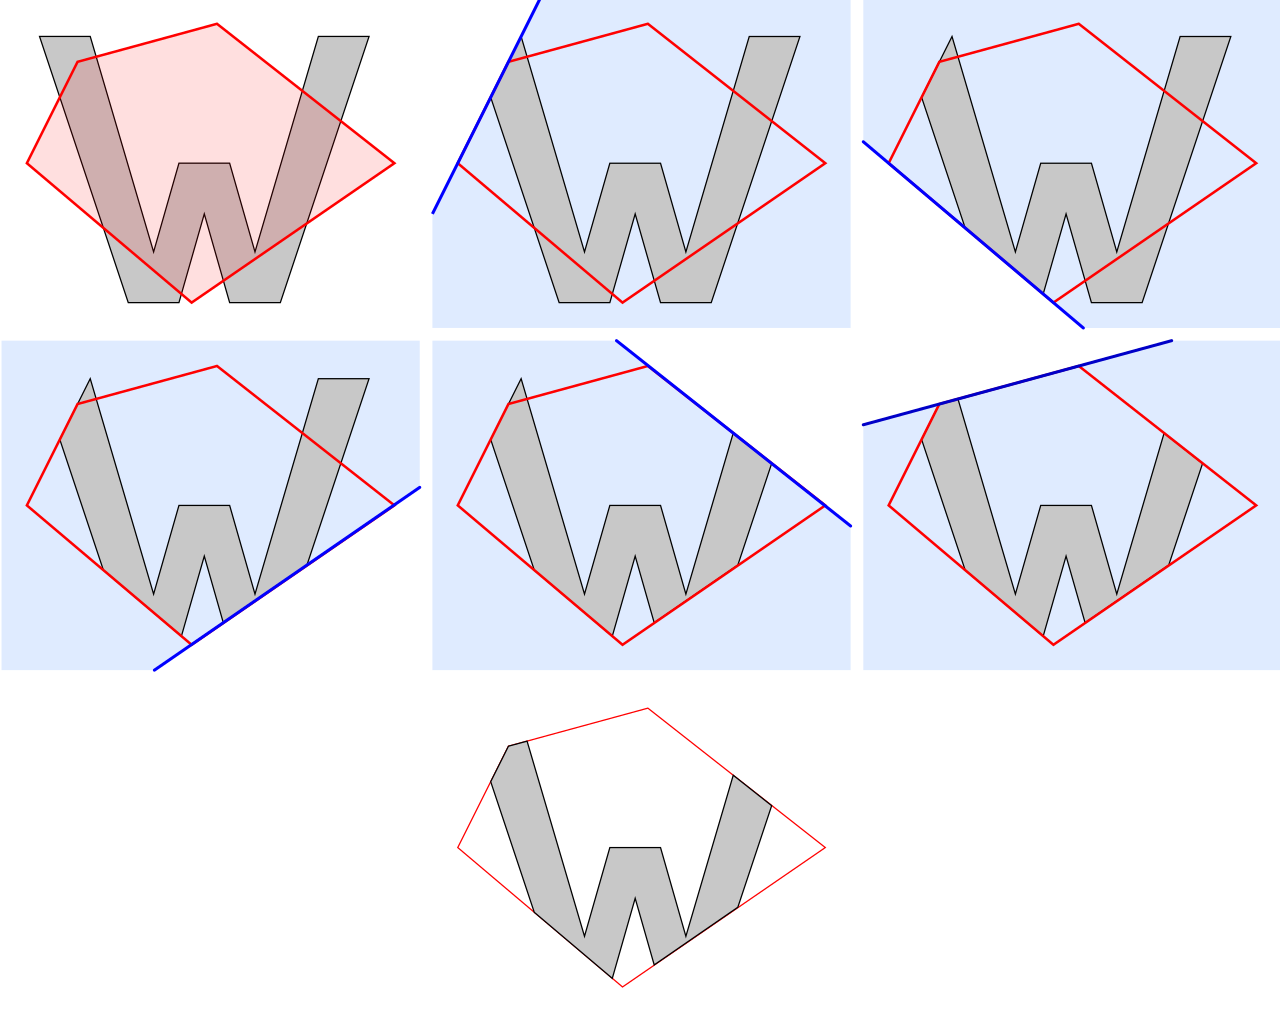
同一个交点处理逻辑分四种情形:顶点在裁剪窗内/外的四种组合,决定了是直接保留、还是先求交点再收边。下面四张小图把 case A—D 逐张拆开,正好对应「顶点在窗内(A)、交点入窗(B)、穿入穿出(C、D)」这几条路径——读图时记住「每次只处理一条边 + 当前顶点」,四种情形就不会混。出处:Wikimedia Commons · File:Sutherland-Hodgman caseA–D.svg(Public domain,作者 Wojciech Muła)。
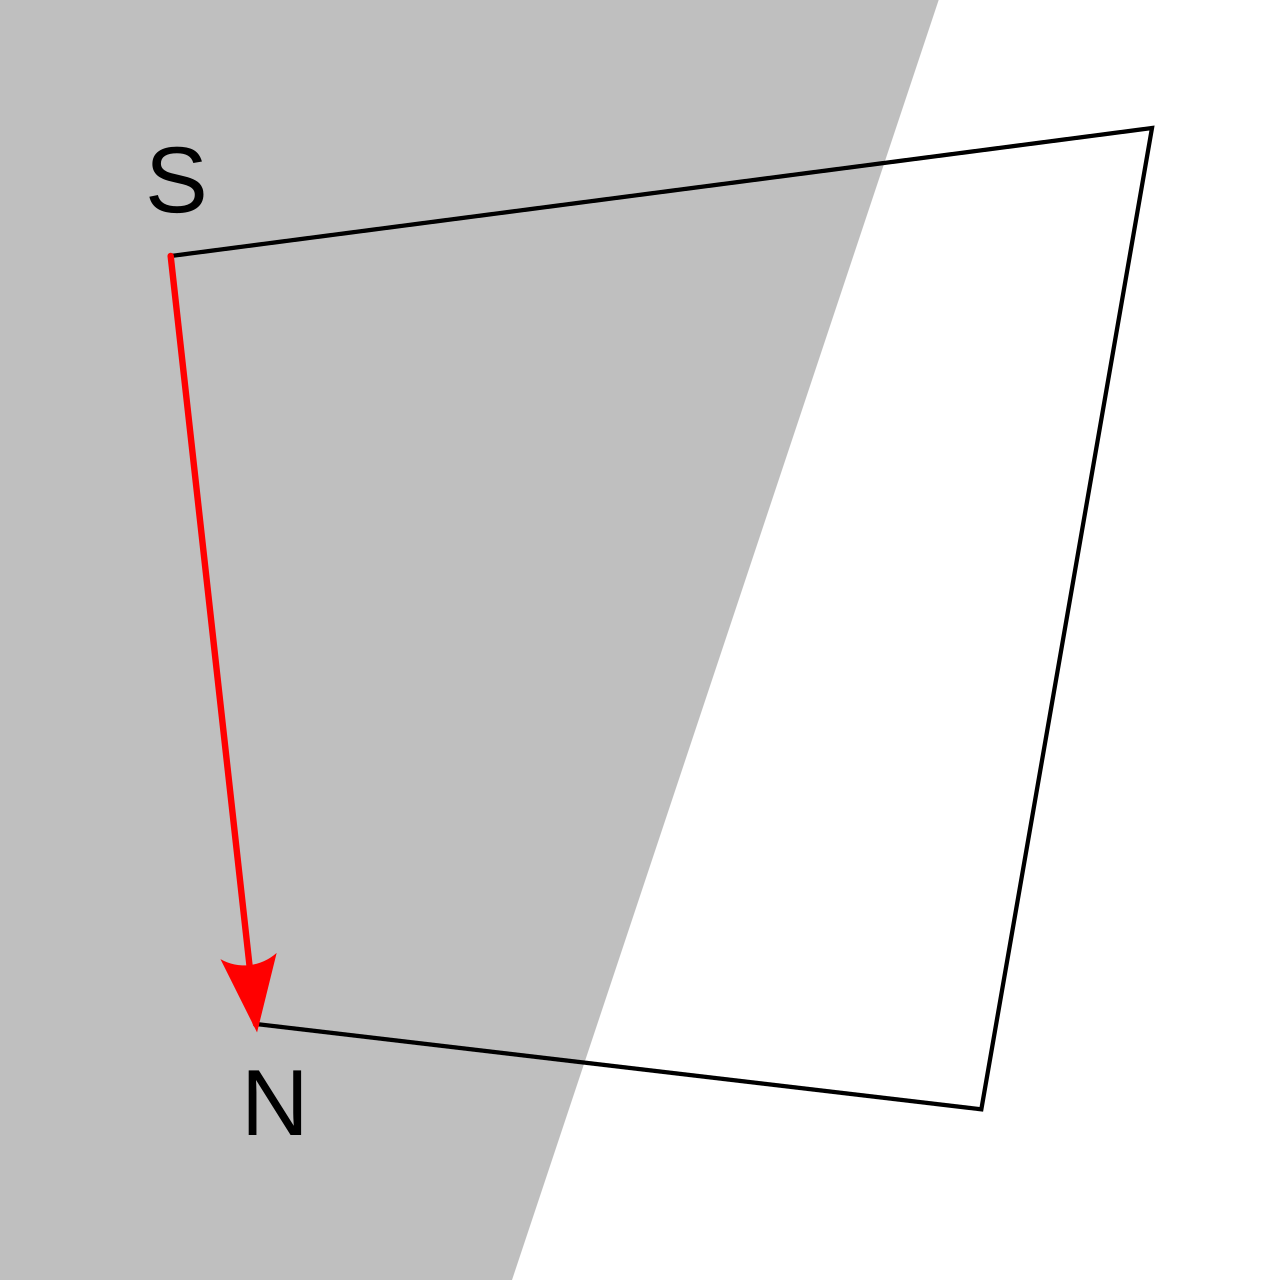
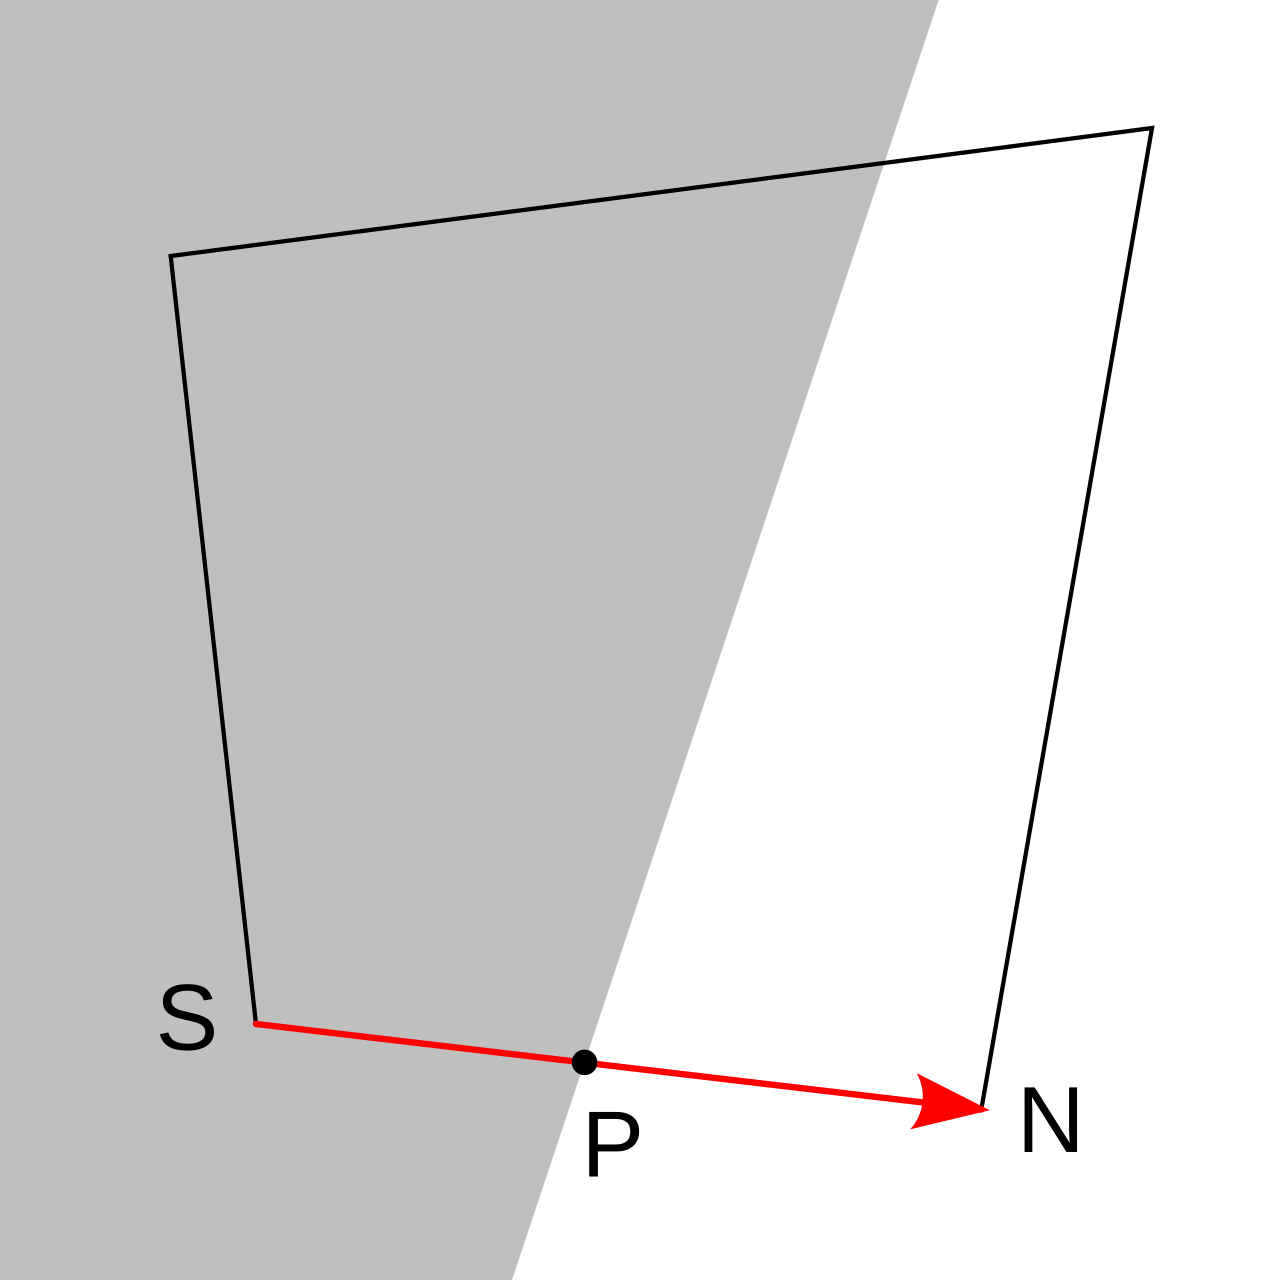
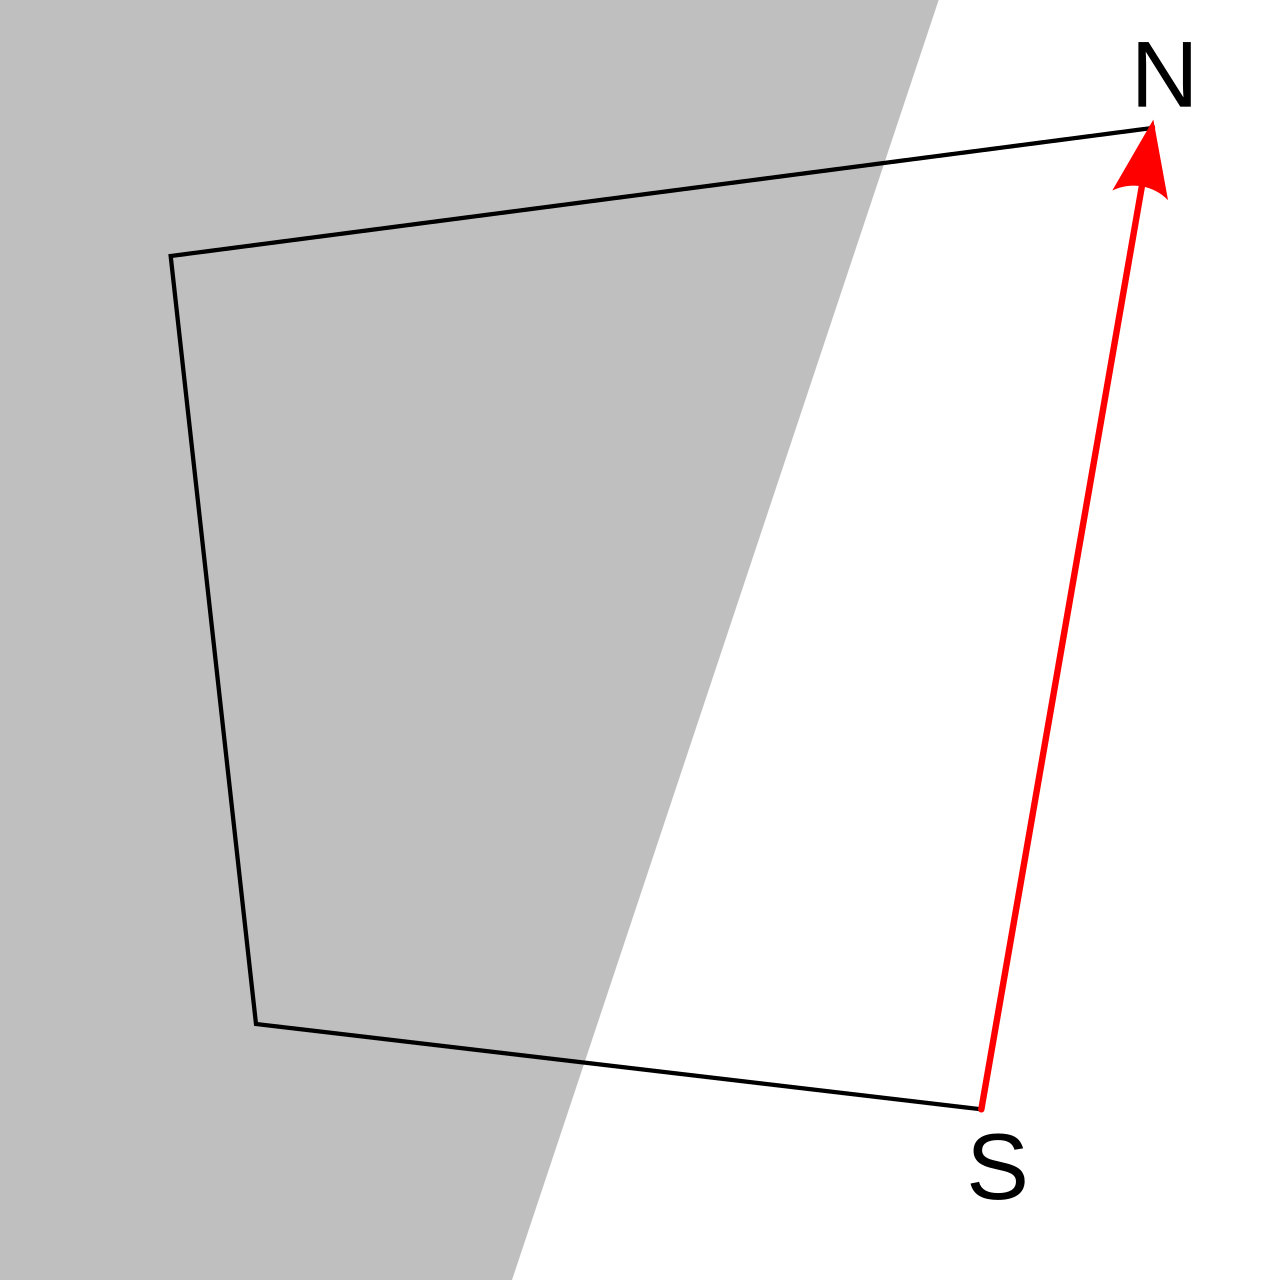
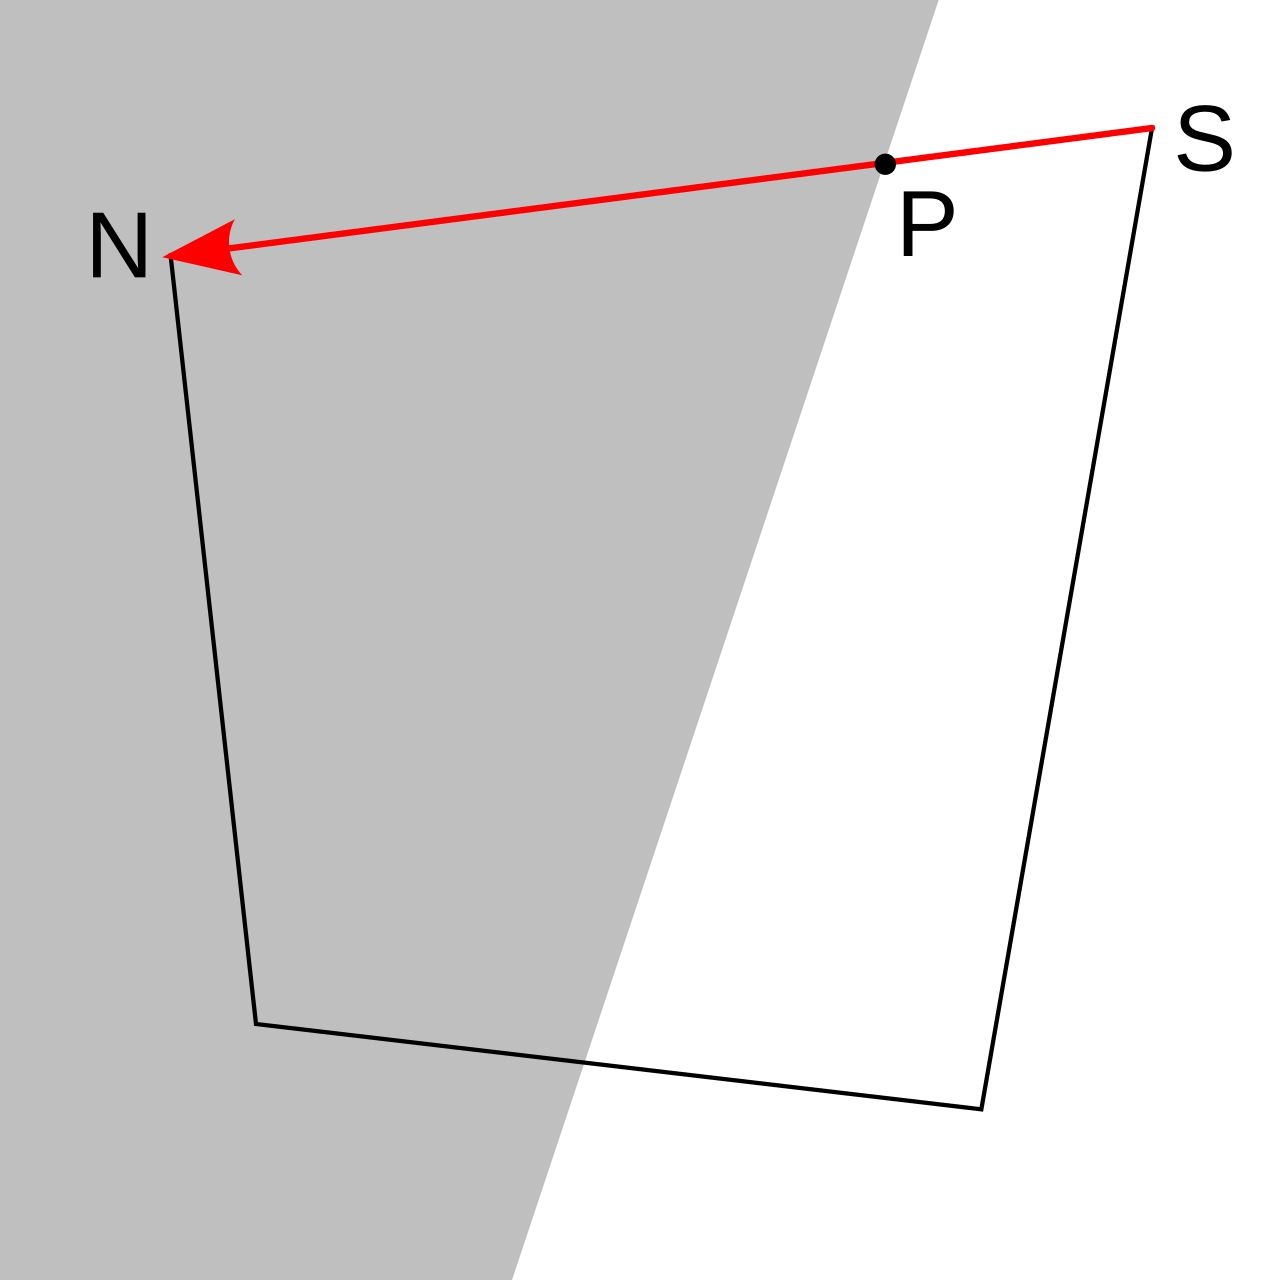
看到这套 case A—D,再回看上文那句「裁剪要算交点、重插值、再三角化」就有了直观:case B/C 都会引入一个「出/入交点」,这正是硬件在慢路径上要为每个交点重算属性插值的地方;而 case A/D 不产出交点,是「白走一趟」或「直接被忽略」。四种情形兜在一起,就是硬件逐元裁剪全部分支的真实面貌。
3.3 被切出来的新顶点:属性也要重插值
逐元裁剪真正贵的地方,在于裁出来的新顶点(交点)并不是「随便一个点」——它要重算所有顶点插值属性。位置、法线、UV、颜色、切线,这些原本由顶点着色器输出的属性,在裁剪出的交点上要靠线性插值重新得到:
$$ \mathbf{p}_{new} = \alpha \, \mathbf{p}_A + (1-\alpha) \, \mathbf{p}_B, \quad \alpha = \frac{d_B}{d_A + d_B} $$
其中 $d_A$、$d_B$ 是两个原顶点到裁剪平面的有符号距离,$\alpha$ 是插值权重。每一个属性都要按这个权重重插一遍——一裁五六条边、每条边一个交点、每个交点十几个属性,这笔账叠加起来相当可观。
正因为这笔「重建属性」的账太重,硬件在绝大多数路径上想要避开它——这就是下面 guard band 出场的原因。
3.4 guard band:把可见范围放大,让裁剪变罕见
好了,说回硬件的主路径吧。硬件真正的做法是 guard band(护栏区):先不裁,而是把「有效范围」放大到比屏幕大得多的一块区域,只要三角形落在这块区域里,就直接放行进光栅化,一个交点都不算。只有极端逃出 guard band 的极少三角形,才走慢路径的逐元裁剪。
这是 hardware 权衡的经典:裁剪的成本是「每个越界三角形都要算交点」,而 guard band 的成本只是「多光栅化几个屏幕外的像素」——后者多半被像素覆盖测试挡掉,或干脆不产生 fragment。 对绝大多数视口内的场景,越界三角形很少,guard band 让它完全没裁剪成本。
3.5 guard band 把区域分成三档
好了,guard band 到底把屏幕外分成了几档,值得单独拎出来看。理解 guard band,最有用的是把它画成三层同心区域:最里面是屏幕(真正会输出像素的可视区);外面一圈是 guard band(可见范围大得多,三角形落在这里只是「多光栅化几个屏幕外像素」);最外面才是真正必须逐元裁剪的逃逸区。
| 区域 | 范围 | 行为 |
|---|---|---|
| 屏幕区(可视) | 真正的 render target | 光栅化并输出 |
| 护栏区(guardband) | 屏幕外一大圈 | 直接放行,仅多算几个屏幕外像素 |
| 逃逸区 | 超出护栏区 | 必须逐元裁剪 |
这张分档图是「为什么大多数三角形零裁剪成本」的直观答案:绝大多数视口内的三角形,顶多撑到护栏区,根本不到逃逸区,所以主路径上裁剪交点一个都不用算。硬件把这个「撑到哪里就算哪」的判定做成极廉价的边界比较,几乎零开销就把绝大多数三角形放行了。
3.6 guard band 的真实大小
guard band 不是无限大,它有具体尺寸。限制它的通常是硬件光栅器的子像素坐标系(subpixel coordinates)能表示的范围,以及视口变换后的数值精度。
- 传统主路径:guard band 大小约等于光栅器 subpixel 网格能表达的 NDC 范围。用固定点表示时,太远就溢出。
- 实例:PlayStation 2 的 GS 坐标系视口 X/Y 偏移能形成约 ±4096 的有效范围,这被 Themaister 称作「健康的大小」(a healthy guard band)。出处:Themaister · PS2 GS emulation。
下面对这个「±4096」数字做一点说明:PS2 GS 的有效坐标范围正是被它光栅器的固定点子像素坐标系顶上去的天花板——mobile 一点的定点数、老一点的固定点宽度,都会直接收窄这个「健康大小」。所以说 guard band 的尺寸不是拍脑袋定的,它取决于光栅坐标定点数的表示范围,这是我们第五节「子像素精度」的关键前提。guard band 在光栅化中的定位可参 Wikipedia · Guard band。
3.7 什么时候必须真正裁剪
guard band 只对「轻微越界」的三角形免裁。那么,什么时候必须动真格逐元裁剪?有几种情况无论如何都躲不掉:
- 近平面(near plane)与 w ≤ 0:透视除法在 w=0 处是奇点,必须裁到 $w > 0$ 一侧,否则除法翻转,guard band 兜不住。
- 极端逃逸:三角形完全冲出 guard band 范围(例如相机极近时,三角形撑满整个裁剪空间)。
- depth clamp 关闭:depth clamp 关闭时不会钳走深度,近平面必须精确裁剪(否则近处几何会穿越或翻转)。
特别说明:规范层面,Vulkan/D3D 对"是否裁剪近平面"是可配的(
depthClampEnable就允许不改深度直接放行)。硬件是否仍实际裁剪,取决于厂商。出处:Vulkan Specification · Primitive Clipping。
3.8 w ≤ 0:为什么它连 guard band 都兜不住
guard band 对付的是「位置越界」,但面对 w ≤ 0 它就无能为力了。原因在于,透视除法在 w=0 处是数学奇点:除以趋近于 0 的分母,坐标会被送到无穷远处,正面顶点会被翻到背面。这样的三角形不裁剪直接画,会出现「近处物体穿过你、几何翻转」的经典穿帮。所以规范强制在透视除法前去处理 w ≤ 0 的图元。
处理 w ≤ 0 的标准做法就是近平面裁剪:把落在相机背后、w ≤ 0 的那部分图元,沿着近平面切掉,只保留 w > 0 的有效部分。这一步有没有 guard band 都躲不掉,是硬件里少数「非裁不可」的路径。
3.9 近平面裁剪:从三角形切出背面的部分
近平面裁剪的原理其实还是逐元裁剪那一套——把 near 平面当成一个裁剪面,三角形与其求交。交会处生成的新顶点同样要重插值属性。唯一特殊的是:这条路径因为跨过透视奇点,结果再被三角化时要注意顶点环绕方向不能乱,否则切出来的小三角形方向就反了。
//-----------------------------------【近平面裁剪】---------------------------------------
// 描述:把 w<=0 的图元沿近平面切掉,保留有效部分
//------------------------------------------------------------------------------------------
//【1】对每个三角形顶点,检验其在近平面内侧/外侧
//【2】跨过近平面的边 → 求交点生成新顶点(含属性插值)
//【3】仅输出 w>0 的有效部分
下面对近平面裁剪做一句特别说明:它是「被迫逐元裁剪」的代表,因为透视奇点决定了它无法被 guard band 覆盖。所以硬件里近平面裁剪永远是保留路径,哪怕 guard band 把其它裁剪都省了,这条仍然在。
3.10 depth clamp:可以关掉的近平面裁剪
为了在某些特效(比如把贴近相机的物体「放行」)下不裁近平面,硬件提供了 depth clamp(深度钳制):开启后,顶点深度不再被近平面裁剪,而是被钳到合法深度范围内直接放行。代价是那些本该被裁掉的近处几何会挤压在近平面上,但省掉了一次真正的逐元裁剪。depth clamp 的可配开关(如 Vulkan 的 depthClampEnable)与语义可参 Vulkan Guide · 深度与图元裁剪 和 WebGPU · 深度钳制。
使用 depth clamp 时要清醒:它不是免费的免费——被钳掉的区域深度精度会非常稀薄,且三角形之间可能因为深度全压在一起而出现排序混乱。引擎里常把它用于阴影贴图的特写、体积雾等场景,属于「明确知道在做什么」的高级开关。
3.11 裁剪的成本模型与总结
我们把第三节的成本账收一下。逐元裁剪慢,因为它要「求交点 + 重插属性 + 三角化」三件事;guard band 快,因为它把这些统统省掉,只多花一点点「光栅化屏幕外像素」。一份粗略的成本对比:
| 手段 | 每越界三角形的成本 | 触发频率 | 总结 |
|---|---|---|---|
| 逐元裁剪 | 求交点 + 重插属性 + 三角化 | 仅逃逸区 | 最贵,慢路径 |
| guard band | 只多光栅化屏幕外像素 | 护栏区内 | 最省,主路径 |
| depth clamp | 深度钳位一次 | 开启时全走 | 跳过裁剪但降深度精度 |
这台账解释了一个现象:为什么现代 GPU 敢把 guard band 开那么大、却几乎不担心性能——因为护栏区里的三角形本来也不会产生多少有效像素,早被覆盖测试挡掉了。裁剪在这里被「前移 + 稀释」成了几乎免费的一步。
四、剔除:谁在光栅化之前就被扔掉
说白了,guard band 管的是「屏幕外的三角形」,还有一类三角形是「不该存在的」,在进光栅化之前就该被扔掉——这类动作叫剔除(culling)。这一节我们把剔除讲全:背面剔除、退化剔除,以及它们和裁剪、guard band 到底怎么区分。
4.1 backface culling:背向相机的脸直接扔掉
先来看看剔除里最大的一笔——背面剔除。三角形的顶点按逆时针或顺时针环绕,这个环绕方向(winding)决定了它的正面朝向。当三角形背面朝向相机时,它对面外的像素没有任何贡献,可以安全地扔掉。
- 正面/背面定义:由环绕方向 + 视口 y 方向约定决定。D3D/Vulkan 左上角系里,顺时针(CW)默认正面;OpenGL 左下落系默认逆时针(CCW)。
- 代价:一个三角形的环绕方向判断只需一个符号位——几乎零成本。
//-----------------------------------【背面剔除】---------------------------------------
// 描述:按环绕方向决定是否剔除背面三角形
//------------------------------------------------------------------------------------------
//【1】算三角形法线与视线方向的关系(符号判断)
//【2】背面(<=0)或正面,视 cullMode 决定扔不扔
vkCmdSetCullMode(cmd, VK_CULL_MODE_BACK_BIT);  // 剔除背面
上面代码里,cullMode 只留一个 bit,硬件在光栅化前对着这个符号位做判断:是背面就直接丢弃。这么做换来的收益很直观——省掉的是一整个背面三角形的像素着色成本,而这个三角形本来在屏幕上露的是「外面」那面,画它纯属白费。出处:NVIDIA Life of a Triangle。
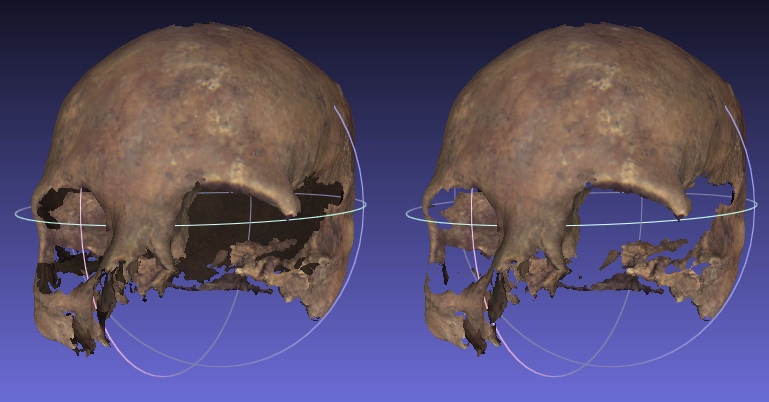
「背向相机的脸」落到真实对象上长什么样,下面这张骷髅示例很直观:两侧朝向相反的面,背向相机的那一侧(轮廓内侧、颜色更深的面)在 cull 开启后根本不送进光栅化,只有朝前的一半被画出来。出处:Wikimedia Commons · File:Back face culling skull example.png(作者 Dgwolf)。
4.2 正面/背面:一个符号位怎么定
那么「正面还是背面」到底怎么做判断?硬件在屏幕空间里对三角形三条边做叉积(signed area),得到一个带符号的面积值——符号为正就是正面(或背面,取决于约定)。这几乎就是一次整数/定点乘减,成本可以忽略。它是整套「封闭网格 + 背面剔除」管线的核心判据。环绕方向判别与剔除语义可参 OpenGL Wiki · Back Face Culling、LearnOpenGL · 面剔除 与 Apple Metal · MTL CullMode。
$$ area = (x_1 - x_0)(y_2 - y_0) - (y_1 - y_0)(x_2 - x_0) $$
其中 $(x_i, y_i)$ 是屏幕空间顶点坐标,$area$ 的符号即环绕方向,其绝对值还顺带暴露了三角形是否退化(见下节)。这个式子很便宜,因为它是冗繁叉积却只取符号:
值得反复提醒大家的是:正面的判定依赖 y 轴的约定。同一套几何,在 D3D/Vulkan「y 向下」和 OpenGL「y 向上」两套约定下,同一个三角形的环绕方向可能被判定为相反——这就是换 API 忘了翻转 winding,结果「三角形全被剔除」「只有背面着色」这种著名 bug 的根源。
4.3 环绕方向与两套坐标系
把「环绕方向随坐标系翻转」这件事再具象一次。设三角形顶点顺序给定,在 D3D/Vulkan 左上角系里它是顺时针(CW)正面;但同一顶点顺序放进 OpenGL 左下角系,y 方向反了,读出来就是逆时针(CCW)。所以照搬顶点顺序过去,正反面就反了。
规避方法无非两句:要么在导模型时统一 voxel 坐标系并重排索引,要么在 setCullMode 时按约定翻转 cull 面。多数引擎走后者——因为只改一个状态,成本最低。但提醒一下,如果模型是用工具在 OpenGL 坐标系里烘焙的,转换时必须记得翻转索引绕序,否则背面剔除会把半边三角形全剔光。
4.4 退化三角形与零宽线
先来看看同样「不该存在」的第二类:面积为零的三角形(三点共线)和零宽的线。它们经过光栅化也产生不了任何有效 fragment,纯粹浪费。硬件在装配/光栅化阶段就检测并丢弃。
检测的成本一样低:面积信号(叉积)接近零就丢弃。出处:Microsoft Learn · D3D Rasterizer Rules。正因为检测如此廉价,硬件几乎总是在光栅化前就把退化图元解决掉,根本不把它们送进像素着色。
4.5 退化如何来:闪烁网格的根源
退化三角形往往不是「天生」的,而是顶点分布坍缩的结果——细分曲面在消失某一角时、LOD 切换时、或顶点正好落在同一扫描线上时,都会产生三点共线。这类退化若没被剔除,就会在旋转/缩放时产生整片像素的闪烁(边缘处一小撮三角形疯狂上下跳动)。
这也是为什么要做退化剔除而非仅规范裁剪的原因:裁剪裁的是「在范围外」,退化是「在范围内但没面积」——它不被规范裁剪处理,只能靠面积判据去剔。两者分工清晰,缺一不可。
4.6 永不剔除:双面与 cull 关闭
既然是可选开关,背面剔除当然也可以「关闭」——cullMode = NONE 时,正反两面的三角形都会保留。这在画双面叶子、半透明墙面、以及对象内部可见的特效里很常见。代价是三角形的面数翻倍没有得到剔除减免,Pixel Shader 的负载相应升高。
这里也顺带更正一个常见误解:关闭清除(cull off)不等于「两面都要正确着色」——如果模型是封闭网格,「漏画」的背面其实长在外部看不到,关不关 cull 都无所谓;真正需要关 cull 的是那些「必须看到里面」的开放对象。所以默认开着背面剔除,是最稳的保守策略。
4.7 剔除能省多少:半面像素的账
下面算一笔很现实的账:先来看看背面剔除到底能省多少像素?假设一个封闭场景里相机朝一个方向看,大约一半的三角形背面朝自己。如果没有剔除,这半个场景的像素要被完整着色一遍;开了剔除,它们连一个像素周期都不占。这是「不花智商、白捡一半」的经典优化。
| 场景 | 无背面剔除 | 有背面剔除 |
|---|---|---|
| 封闭网格、单侧可见 | 一半三角形白画 | 背面三角形零开销 |
| 开放对象 | 两面都画(依需) | 可能漏背面 |
这张表把两种场景分清爽了,下面再用一张图盯一遍主线:在封闭、只看单面的场景里,背对相机的三角形大约占全部三角形的一半。开了剔除,它们完全进不了光栅化,这半面像素直接零开销;不开剔除,就要原原本本把每一个像素都着一遍色——这笔账就是第六节量化对比里的重中之重。
4.8 剔除、裁剪、guard band:三者别混
把这一篇讲的三件「预处理」放一起就不容易混了:
| 手段 | 判定依据 | 做什么 | 进不进光栅化 |
|---|---|---|---|
| 背面剔除 culling | 环绕方向符号 | 直接扔掉背面三角形 | 不进 |
| 退化剔除 | 面积≈0 | 扔掉零面积/零宽 | 不进 |
| guard band | 是否在护栏区内 | 护栏内免裁直接进;超出才裁 | 进(护栏内) |
| 逐元裁剪 clipping | 是否冲出有效范围 | 算交点重生成新顶点 | 进(裁完后) |
上面表格里,剔除是「不要」,裁剪是「修剪」——剔除不进光栅化,裁剪裁完还要进。这一区分是读懂硬件行为的钥匙。(本系列自绘整理,依据 FGiesen Part 5 与 NVIDIA 文档。)
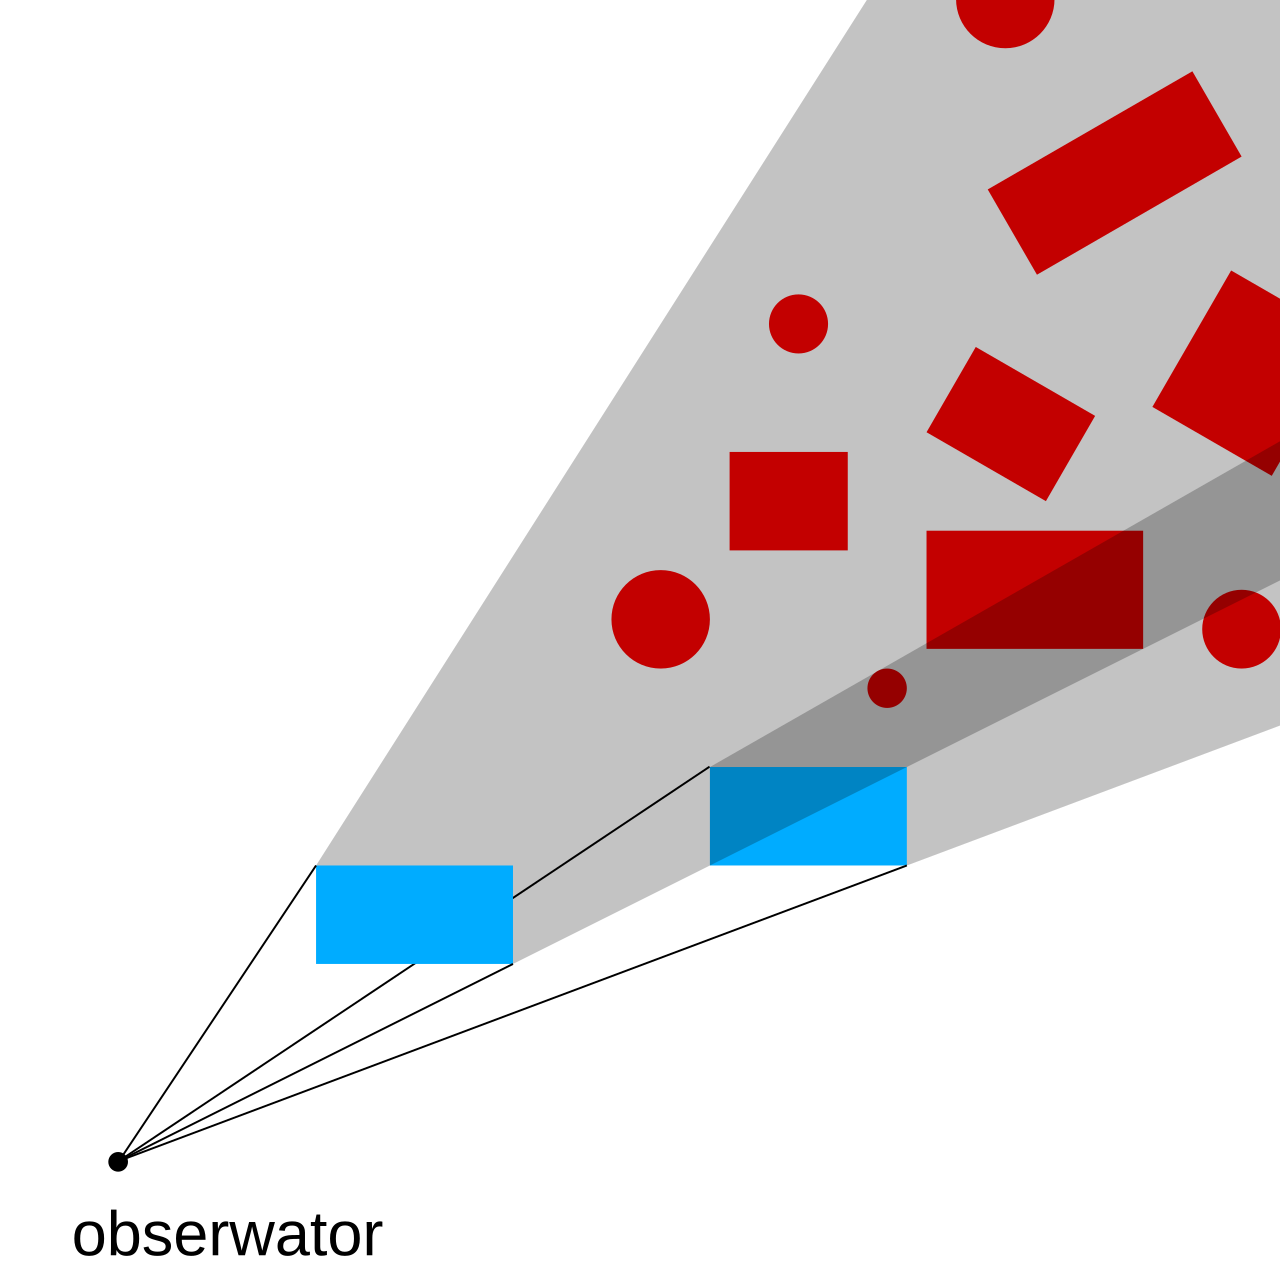
背面剔除并不是剔除家族的全部。广义的 culling 还包括基于可见性的预判,在进光栅化之前先把「极可能看不到」的三角形处理掉——视锥剔除(frustum culling)在 CPU 侧就排掉视锥外的整体对象,遮挡剔除(occlusion culling)用已有深度/可见信息去弃掉被挡住的图元,隐藏面判定则是这些判定的总称。它们和背面剔除共用同一原则:凡对最终像素零贡献的图元,越早扔越好。下面四张来自 Wikimedia Commons 的示意图把这条家族谱系铺开,和上表「剔除=不要」的语义逐一对应:
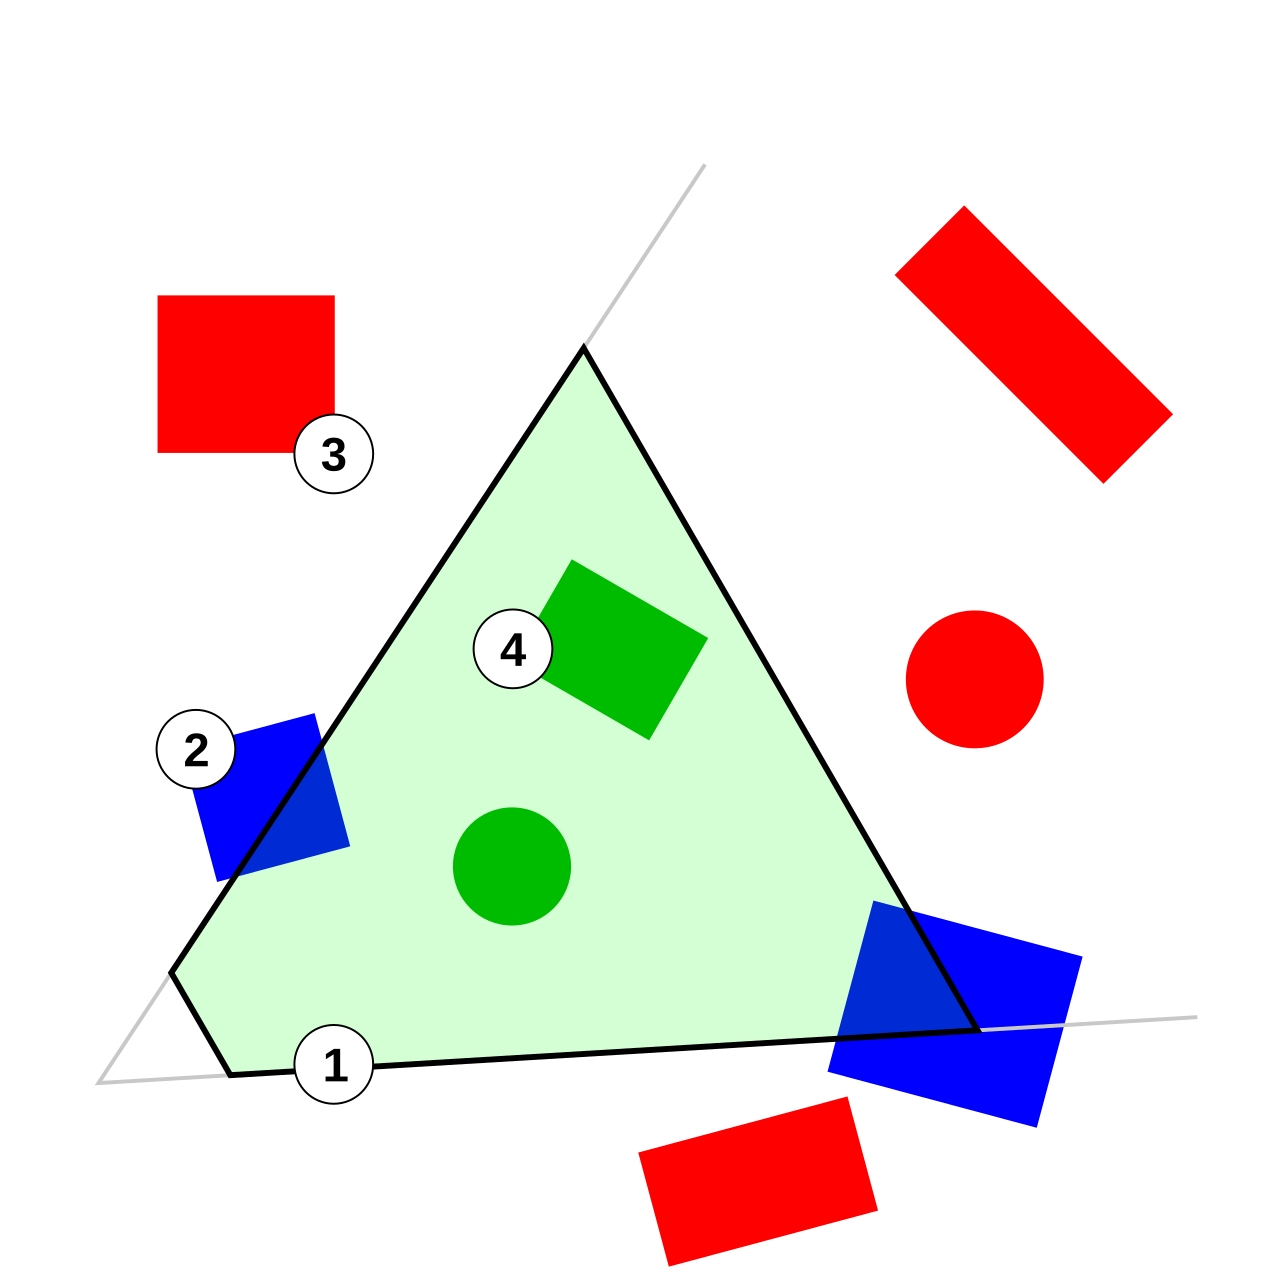
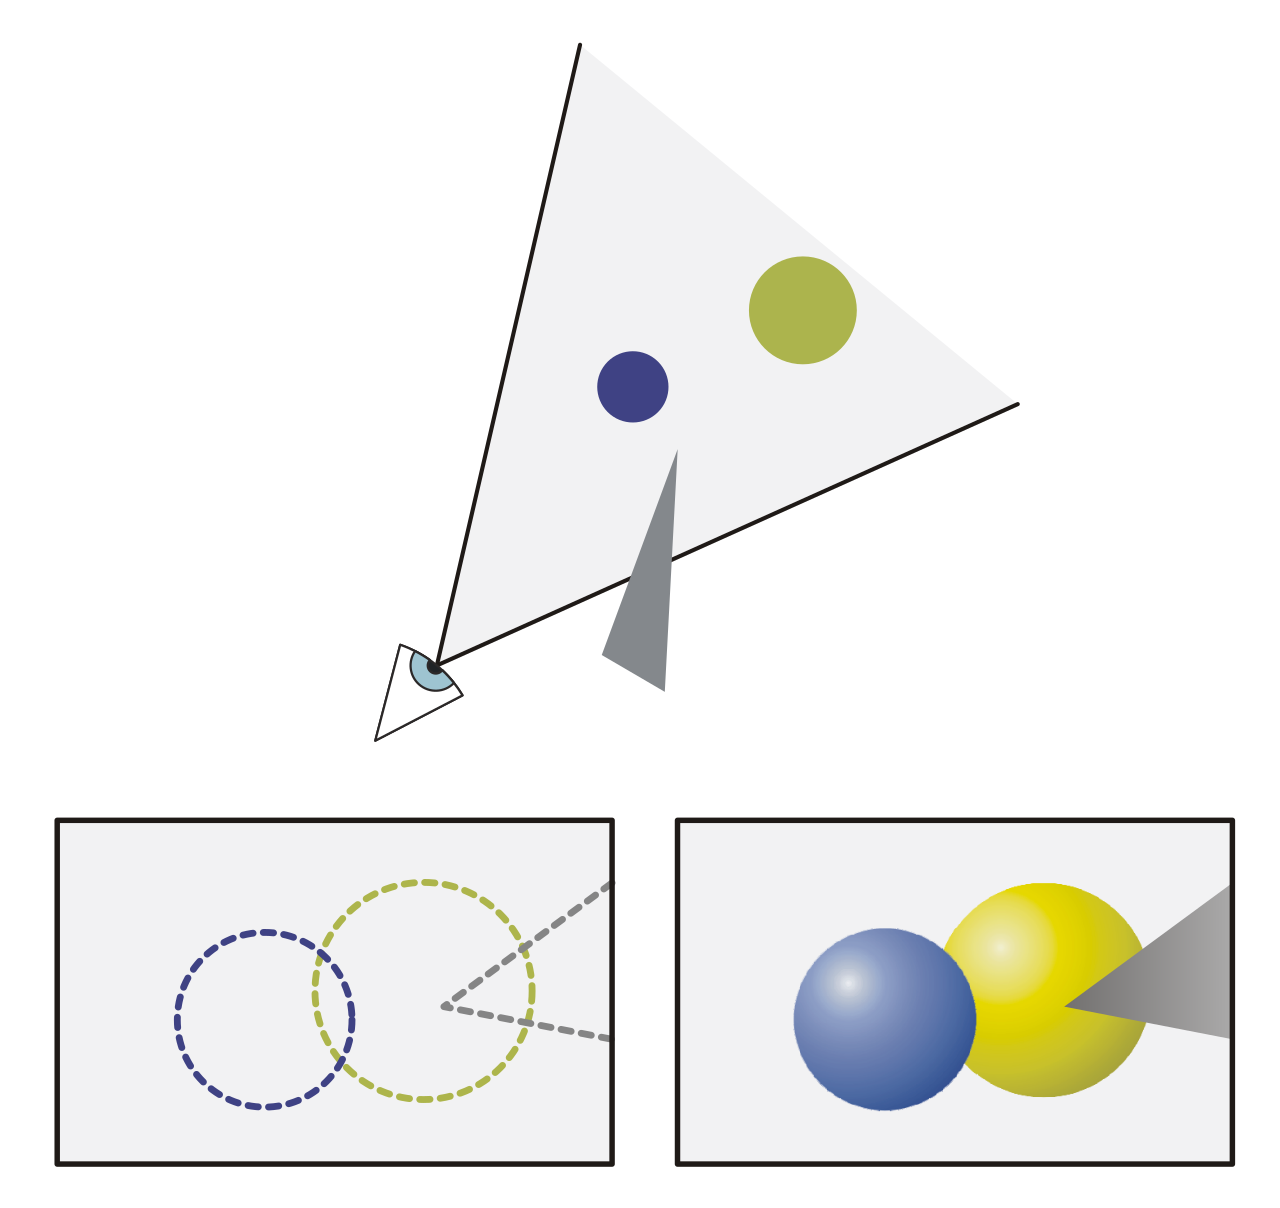
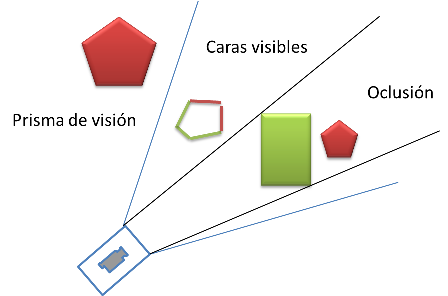
最后再用几何直觉总结一次:剔除处理「方向不对」的三角形,guard band 处理「轻微越界」的三角形,逐元裁剪处理「必须切」的三角形。 三类问题、三个手段,正好把光栅化之前能省的全省了、该切的切完了。这张图就是这三者关系的最终地图。
五、硬件实现:谁在硅片上干这些活
言归正传,机制都讲清了。下面我们真正落到硅片上看:这些活在芯片上由哪些单元、按什么顺序干,成本又体现在哪。这是本系列的落点。
5.1 前端几何引擎:装配与分块的常驻设施
GPU 不会给每个 draw 单独建一条装配管线。装配、剔除、guardband 判断是常驻的前端固定功能,跟着色器程序无关,也不能被编程。AMD 把它们集中在几何引擎(Geometry Engine),NVIDIA 则在光栅前段(rasterization frontend)处理。
这一段的本质是「知道连接性 + 知道剔除规则」的硬线逻辑,不是着色器。出处:AMD GPUOpen《All the Pipelines》。就算你的 draw 连一个着色器都没写,只要画图,这段固定功能也必须存在——它跟「谁去运算」无关,是「怎么把几何喂给光栅器」的地基。
5.2 装配到光栅的队列:前端是一条有节奏的流水
下面看看节奏这件事。前端既然常驻,就存在吞吐节奏。顶点着色结果从着色器核批量返回后,装配器按拓扑把它们组好,再送入后面的变换/剔除/光栅。这中间通常有缓冲队列(queue)与流控(flow control),避免某一块卡住整条管线。前端固定功能的吞吐是「每周期处理几个图元」这种硬指标,往往是厂商做营销比较的点。
理解了这一点,就能解释为什么「很多小三角形」比「少数大三角形」更吃前端吞吐压力——每个三角形都要在前端走一遍固定的装配/剔除开销,三角形数量直接乘上前端单图元成本。前端是「按图元计费」的,这是第六节量化账的重要前提。
5.3 三角形的旅程:bounding box 与分块
NVIDIA 对三角形有一个经典描述:三角形经过视口变换后,硬件会算出它的包围盒(bounding box),据此决定把它交给哪个光栅引擎(raster engine)处理。一个三角形可能被拆分分配到多个 GPC(图形处理簇),让不同引擎并行光栅化它的不同部分。
光栅引擎并不是随机挑活的——硬件先给三角形算一个 2D 包围盒(bounding box),看它的屏幕覆盖落在哪些引擎负责的区块上,再据此把图元分派过去。这样一来每个引擎只处理自己负责的那一块屏幕,彼此不抢任务,天然并行。下图就把「包围盒 → 选引擎」这条分配关系单独画出来,好对应后面的 GPC 协调问题。
这张图能直接回答「为什么三角形大的场景反而可能卡」:一个大三角形的 bounding box 横跨多个 GPC,光栅化的负载要跨单元协调。 出处:NVIDIA Life of a Triangle。相反,一堆小三角形因为各自 bounded 在单个 GPC 内,并行很干净——所以现代 GPU 更偏爱「小而多」的网格。
5.4 分块(binning):按包围盒分配
先来看看分块怎么分。「分配」不是随便分的,硬件普遍用分块(binning/tile-based)思想:把 render target 切成若干 tile,按三角形的 bounding box 跟哪些 tile 相交,把它放进对应 tile 的图元列表。Tile-Based 架构(如手机 GPU)常常在前端就做这种 binning,把图元按屏幕区块归好类,光栅时逐 tile 处理,从而局部性好、带宽省。
下面对 binning 做一句特别说明:binning 是「几何前处理」,它天然与 bounding box 强绑定,所以 bounding box 算不对、算早了,会直接导致图元被分错 tile。这解释了为什么硬件对 bounding box 的计算如此敏感——它是前端能否把负载合理摊到各 tile 的第一步。
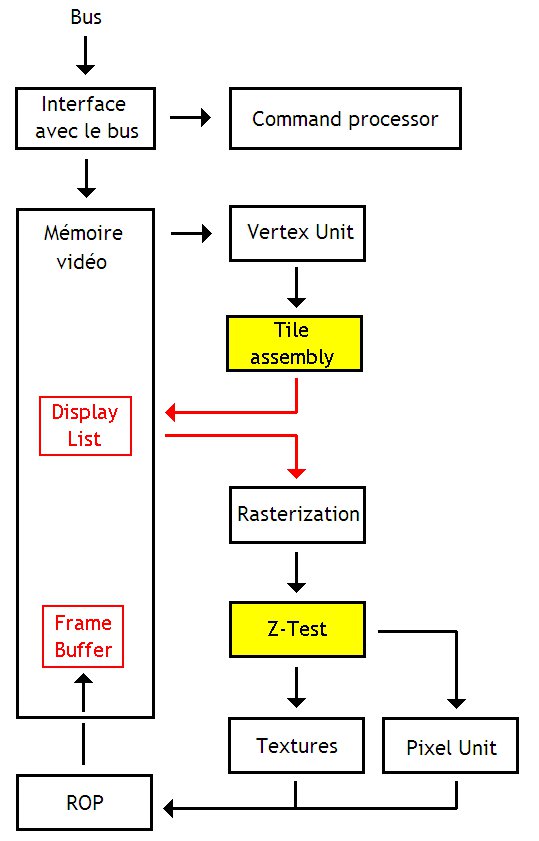
分块(tile-based)这条思路在真实手机 GPU 上尤其核心:渲染目标被切成一个一个小 tile,几何按包围盒归到对应 tile 的图元列表,光栅时逐 tile 处理,屏幕外的像素几乎不被碰。下图是一套典型的分块渲染架构——tile 化、逐 tile 光栅与隐藏面消除互为配套,把「局部性好、带宽省」落实成可复用的硬件结构,也印证了上文「tile/分块与 bounding box 强绑定」的判断。出处:Wikimedia Commons · File:Tiled rendering architecture.jpg(CC BY-SA 4.0,作者 Mewtow)。
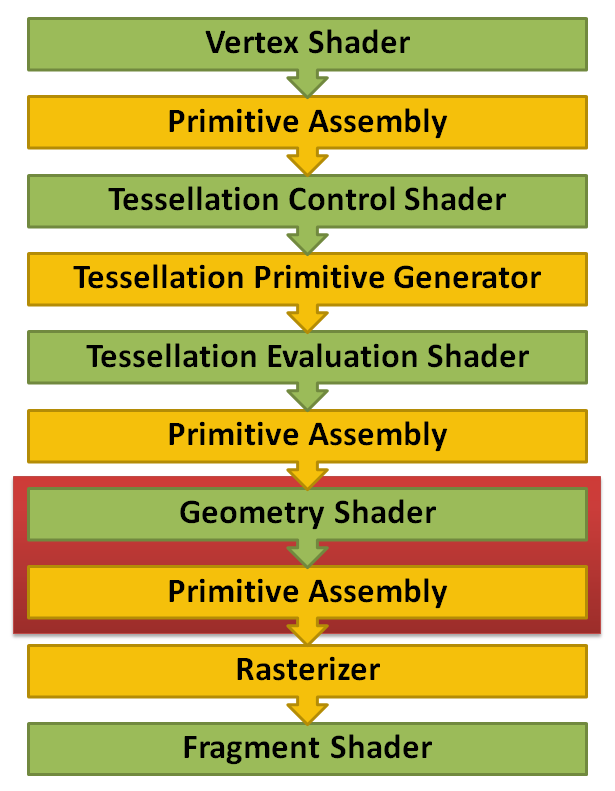
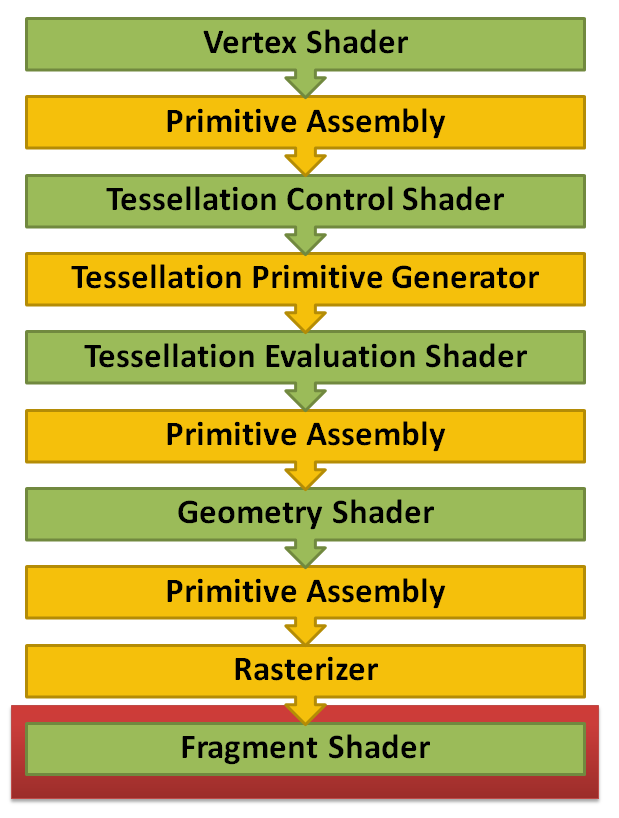
「谁在硅片上干这些活」还可以从着色阶段的角度看:几何着色器与片元着色器各是管线里可编程的一环,前端装配/剔除的固定功能与它们串行、互为前后级。下面两张是这两类着色阶段在完整管线中的官方示意,和 5.1 的「前端常驻固定功能」对照着读,就能看清「可编程部分」与「固定功能部分」各自在哪一层。出处:Wikimedia Commons · Geometry-shader-pipeline-simple、Fragment-shader-pipeline-simple(CC BY-SA 4.0,作者 Davi.trip)。
5.5 scissor:裁剪在光栅器里执行
先来看看另一档限制。guard band 是「软」的可见范围,还有一档硬限制叫 scissor(剪刀)。scissor 是一个矩形的像素范围,落在它外的 fragment 一律不写入。硬件做这步的位置很讲究——它在光栅器里执行,比在 fragment 处理器之后执行高效得多,因为它让无关 fragment 根本不被生成。出处:NVIDIA GPUGems2 Chapter 30。
┌────────────── 视口 ─────────────┐
│  ┌────────scissor──────────┐    │
│  │ 只有这里产生并写入fragment │    │
│  └─────────────────────────┘    │
└─────────────────────────────────┘
上面 ASCII 示意里,scissor 比视口小或相等,scissor 之外已经不生成 fragment,也就不浪费像素着色和带宽。这正是「把剔除尽量前移」原则的一个缩影——凡是在光栅化之前就能判定不必画的东西,宁可让前端多做一次范围比较,也别让像素管线往下白跑一路。
5.6 scissor vs 视口:两套独立状态
很多人容易把 scissor 和视口混成一回事,其实它们是两套独立的状态。视口决定「NDC 怎么映射到像素范围」,scissor 决定「哪些像素允许被写」;两者可以不同心、不同大小、甚至毫无交集。视口你设多大多小都只是映射,scissor 才是真正卡住「哪块能画」的闸门。
因此,只要改视口,几乎总得同步检查 scissor。多 Pass 后处理里经常只改了视口没动 scissor,导致画面边缘一块永远不画——这是第六节陷阱一的高发源。
5.7 子像素坐标与数值精度
光栅化的坐标不是整数像素,而是子像素(subpixel)固定点坐标——通常每个像素拆成若干子位(如 4×4 或 8×8),用来做更稳的覆盖判断和插值。子像素位宽决定了坐标上限:三角形顶点一旦超出这个定点数能表达的范围就会溢出,这正是上一节那个超大 guard band 被顶上去的天花板。
出处:Microsoft Learn · D3D Rasterizer Rules(矢量数据映射到 raster data 时先 snap 到整数位置再处理)。
5.8 子像素的定点数:几位小数、上限多少
子像素坐标通常用固定小数点的整数表示,比如「4 位小数 + 32 位整数」的组合,或用更宽的定点。整数位决定了能表达的最大坐标,小数位决定了覆盖判定的精度——两者都在给 guard band 与光栅稳定性划界。定点位数越多越稳,但也越贵(进位、检溢出成本上升)。视口边界所需的子像素精度在规范里有硬性下限(Vulkan 的 viewportSubPixelBits),可参 Vulkan Specification · Limits;子像素寻址不足引发的共边裂缝(cracking)背景可参 Eric Haines · 实时渲染随记。
| 组成 | 作用 | 影响 |
|---|---|---|
| 整数位 | 坐标上限 | 决定 guard band 能开多大 |
| 小数位 | 覆盖判定精度 | 决定边缘稳定性、避免共边缝 |
这张小表把整数位与小数位各自的职责分开记:guard band 能开多大,看的是整数位撑得起多大的坐标;边缘稳不稳、会不会在共边处冒出一条缝,看的是小数位给不给得起足够的覆盖精度。两者就像一枚硬币的两面,共同决定了子像素坐标这个定点数的表达边界——这也是下一小节「超限三角形」的由来。
5.9 分割(split):超限三角形的处理
当三角形实在超过光栅器子像素定点可表达的范围(guard band 都装不下),硬件要么逐元裁剪,要么用分割(split):把超大的三角形沿某条线切成若干小块,每块单独再做 bounding box 分配。分割让「全屏三角形」这种极端几何也能被正确光栅化,代价是多几次前端开销。
有趣的是,很多「全屏矩形」hack 其实对硬件友好:把一个超过屏幕的大三角形放进来,若不用分割,前端得逐元裁剪;用了分割,硬件能稳当地把它切好吃下。这就是为什么全屏 pass 常常用「一个大三角形 + 一条对角线」而非两个矩形——三角形天然好切。
5.10 多光栅引擎与负载拆分
回到 bounding box 分配,当下一个层面是多光栅引擎(multiple raster engines)的负载拆分。GPU 有多个光栅引擎,同一帧的不同屏幕区块可以由不同光栅引擎并行光栅化。一个巨大的 bounding box 会把它的三角形「切」成若干 screen 区块交给不同引擎,从而并行吞吐上升、但跨引擎协调成本也上升。
5.11 硬件前端成本账:谁贵谁便宜
把第五节硬件侧的成本按「贵/便宜的算子」归一下类:
| 算子 | 成本量级 | 说明 |
|---|---|---|
| 顶点取数 + 缓存 | 带宽 | 依赖内存布局与缓存命中 |
| 装配(拓扑分组) | 每图元固定 | 与小三角形数量成正比 |
| 环绕方向符号判断 | 几乎零 | 一次符号判面积 |
| 子像素固定点除法 | 数次舍入 | 光栅稳定性之源 |
| 逐元裁剪 | 高 | 求交点+重插值+三角化 |
这张成本图能直接指导我们的调优直觉:想降前端压力,减三角形数量最重要;想省三角形裁减,guard band 永远比逐元裁剪划算;想省像素负载,背面剔除永远是第一顺位。 硬件前端的每一步优化,都能在这张图上找到对应的省钱位。
5.12 硅片视角的总结
到这里,第五节的硬件卡片基本凑齐:常驻前端(装配/变换/剔除)→ 分块与 scissor → 子像素定点/分割 → 多光栅引擎并行。这条链把「抽象机制」落到了「硅片上的具体单元与顺序」,也解释了为什么三角形大小、数量、越界情况会真实影响性能。
六、量化账与常见陷阱
好了,机构件都铺完了,账该算了。把几笔「能算出来」的账收一收,再补几个实战里反复踩的坑。
6.1 装配带宽:strip 的账
装配带宽:TriangleStrip 相对 TriangleList,靠共享前缀顶点省掉大量内存往来,一个长 strip 的顶点带宽往往能减半还要多。口径很直接——画 N 个三角形,list 得从顶点缓冲读 3N 个顶点,strip 只要读 N+2 个就够,省下的全靠装配器对前两个顶点的复用白捡。
6.2 guard band 免裁比
guard band 免裁比:视口内场景里,超过 90% 的三角形完全不越界,guard band 让它们零裁剪成本(本系列基于 FGiesen 的机制推演,非实测)。只有极少数跨屏幕或贴相机近处的三角形,才会真的走到逐元裁剪路径。
6.3 剔除省掉的像素
剔除省掉的像素:一个没有开启 backface culling 的场景,一半左右的三角形可能背对相机(取决于相机朝向),等于白白多画了一半。背面剔除在封闭网格上是「白捡一半性能」的正向优化。
| 优化 | 省的东西 | 口径 |
|---|---|---|
| TriangleStrip | 顶点/索引带宽 | N 三角:list 3N vs strip N+2 |
| guard band | 越界三角形的裁剪交点 | 越界三角形才裁,视口内≈0 |
| backface culling | 背面三角形的像素着色 | 背面≈0 贡献,直接扔 |
上图口径说明:
strip 带宽是准确的结构性结论;guard band「90% 免裁」来自机制推演非厂商公布数字;剔除比例为场景相关估计。写进正文都注明了「推演/估计」,不冒充实测。6.4 常见陷阱:X
好了,账都算完了,下面进入排雷环节。这些坑是实战里最容易翻车的。陷阱一:多 viewport 但 scissor 没跟着改。 viewport 变了,scissor 还是旧的,画面就有一块不画。这俩是独立状态,改 viewport 必须同步考虑 scissor。
陷阱二:把 Primitive Restart 索引值读成普通顶点。 strip 的 restart index 若混进图元数据,会被当成一个真实顶点,画出一堆错误的三角形。装配前要确认索引流里没把保留值当顶点藏进去。
陷阱三:winding 约定没对上。 OpenGL 左下角系和 D3D/Vulkan 左上角系下,同一个三角形的「正面」方向是反的,换个 API 忘了翻转 cull 面,三角形就全被剔除,屏幕上只剩一片空白。多 API 引擎通常的做法,是让「顶点顺序 + cullMode」这一对旋钮按目标平台一起翻转,来兜住这条最容易踩空的坑。
陷阱四:半像素偏差在缩放处接缝。 像素中心 +0.5 的约定不一致,多级缩放或 mip 边界常冒半像素接缝,多 Pass、多分辨率合成就更明显。务必在渲染器最外层把坐标系与像素中心语义统一起来,当成一条全工程都得遵守的硬约定写进规范,别让它在某次缩放处偷偷漏出来。
陷阱五:depth clamp 忘关造成投影穿越。 本意只在压近平面时用的 depth clamp,若忘在深度特效收尾处改回 depthClampDisable,近处几何就会被压到近平面上,出现「穿过相机」的虚假穿帮。凡是动态开关它的代码路径,借与还必须成对出现,否则一帧的穿越足以让整个画面出戏。
陷阱六:深度精度没算清——z-fighting 与近平面压缩。 深度缓冲的分辨率沿深度方向并不均匀:离近平面越近,深度值分得越密,越往远处越疏(透视 1/w 分布)。当两个表面深度极其接近、逼近该处精度,就会出现 Z-fighting——两条面疯狂闪断,画面像在被撕裂。它既由投影设置的 near/far 决定,也由深度缓冲自身的分辨率布局决定,是深度类陷阱里最容易「看起来像 bug、其实没算对精度」的一类。下面四张示意图把 Z 缓冲原理、Z-fighting 现象、近远平面对深度分辨率的压缩、以及深度赋值顺序逐一交代清楚。出处:Wikimedia Commons · Z-buffer.svg、Z-fighting.png、Zbmin.svg、Z order.svg(CC BY-SA / Public domain)。
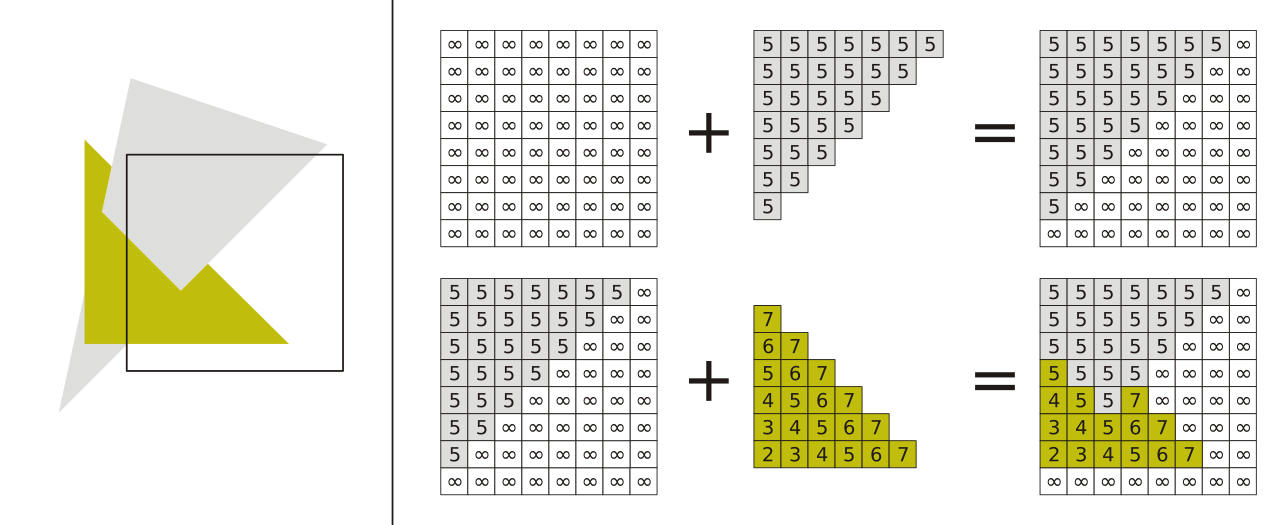
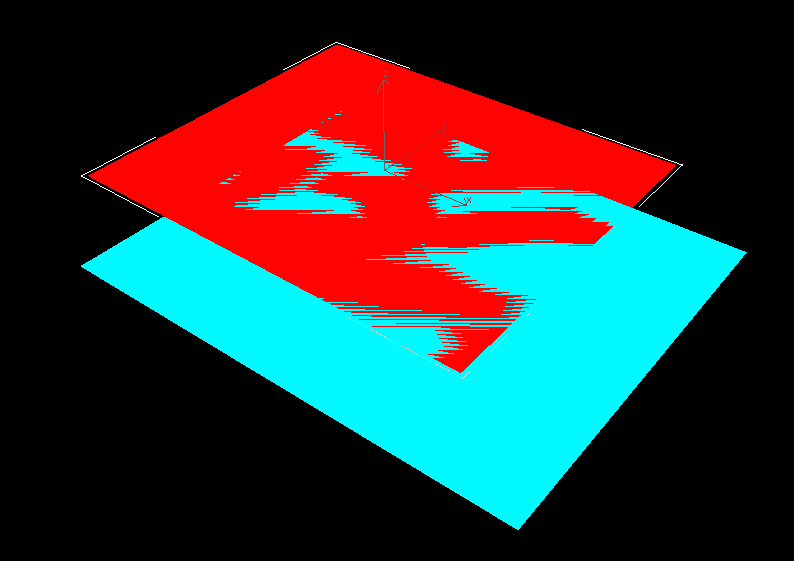
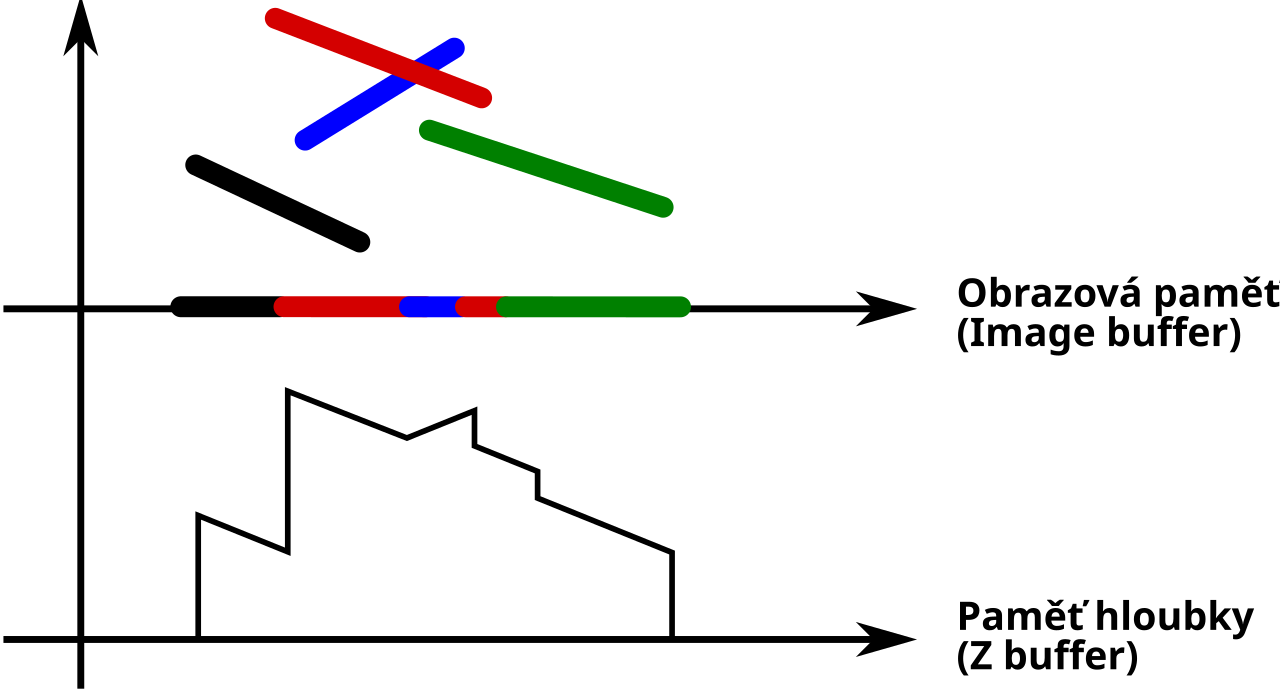
6.5 量化账总表
这一节把全文能算出来的账收拢成一张总表,方便大家对照:每一项优化的名字、它到底省在哪个维度(顶点带宽、越界裁剪的交点计算、还是像素着色)、背后的机理,以及数据口径是什么。看表时请按住一个原则——只有「结构性」的行是准数,其余都是场景化估计:比如 strip 顶点复用 3N vs N+2 是结构决定的准确账,而 guard band 的「视口内约 90% 免裁」、背面剔除的「近一半三角形免画」都随场景浮动,写出来是给你一个数量级,不是承诺:
| 优化 | 省钱维度 | 机理 | 数据口径 |
|---|---|---|---|
| strip 顶点复用 | 顶点带宽 | 复用前缀顶点 | 3N vs N+2 |
| guard band | 越界裁剪交点 | 护栏区免裁 | 视口内≈0 |
| 背面剔除 | 像素着色 | 符号判面积 | 近半三角形免 |
| 退化剔除 | 像素着色 | 面积≈0 丢弃 | 极小量但必剔 |
| depth clamp | 近平面裁剪 | 深度钳位 | 精度换裁剪 |
七、交棒:屏幕坐标定下来,剩下光栅化
正餐到这儿结束,交个棒。这一篇把「clip 坐标变成一组屏幕空间的三角形」讲完了:装配把它们捆好,视口把坐标映射对,guard band 和剔除把该扔的扔、该剪的剪。到这一步,硬件手里是一批合法的、朝向正确的、编号好的屏幕空间三角形,它们接下来要做的事是——决定覆盖哪些像素、按什么顺序插值出每个像素的颜色。 那是下一站光栅化。
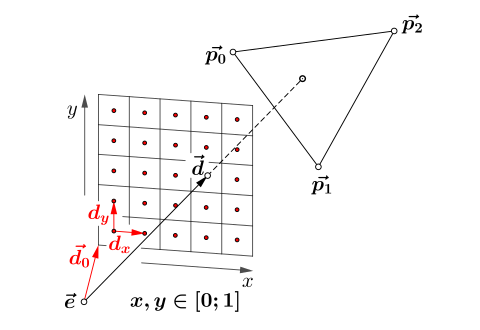
公路上的下一个出口,就是光栅化:三角形的边函数(edge function)、像素覆盖判断、顶点的重心插值。我们从硅片到像素之间,继续往下挖。走到这里,你已经把「顶点算完只有坐标」这个朴素心智升级成了「还有装配、变换、裁剪一整段固定功能在忙」的完整认识——这正是想读懂 GPU 光栅、以及任何「三角形没画对」的排障所必需的那块拼图。
八、参考资料与可回溯出处
本篇的关键数字与机制,绝大部分来自厂商官方文档与公开规格,正文中的引用可直接回溯到出处。按主题归组如下:
一、规范与标准(Khronos / WebGPU / OpenGL) - Vulkan Specification · Fixed-Function Vertex Post-Processing - Vulkan Specification · Rasterization - Vulkan Specification · Pipelines(depth clamp 能力) - Vulkan Specification · Fragment Operations(scissor test) - Vulkan Specification · Coordinate and Window System - Vulkan Specification · Multiview(多视口) - Vulkan Specification · Interface Matching - Vulkan Specification · Limits(viewport 相关限制) - Vulkan Guide · 深度与图元裁剪 - Vulkan Samples 总览 - Vulkan Tutorial · 图形管线固定功能阶段 - WebGPU · 图元装配 - WebGPU · 图元裁剪 - WebGPU · 光栅化 - WebGPU · 视口 - WebGPU · Scissor 矩形 - WebGPU · 深度钳制 - WebGPU · 坐标系 - OpenGL Wiki · 视口变换 - OpenGL Wiki · 背面剔除 - OpenGL Wiki · 裁剪 - docs.gl · glViewport - docs.gl · glScissor - docs.gl · glScissorIndexed - docs.gl · glScissorArray - docs.gl · glDepthRange - LearnOpenGL · 坐标系统 - LearnOpenGL · 面剔除 - Sutherland & Hodgman · Reentrant Polygon Clipping(ACM 1974) - Wikipedia · Sutherland–Hodgman 多边形裁剪 - Wikipedia · 视口 Viewport - Wikipedia · 归一化设备坐标 NDC - Wikipedia · 齐次坐标 - Wikipedia · 透视除法 - Wikipedia · Guard band 护栏区 - Wikipedia · 背面剔除 - Wikipedia · 裁剪算法
二、厂商规范(Microsoft Direct3D / Apple Metal) - Microsoft Learn · D3D11 光栅化阶段(总览) - Microsoft Learn · D3D11 光栅化阶段入门(视口与剪刀矩形) - Microsoft Learn · D3D11 光栅化规则 - Microsoft DirectX-Specs · D3D11.3 功能规格 - Apple · Metal Shading Language 规格 PDF - Apple Metal · MTLViewport - Apple Metal · 渲染 pass 配置(viewport/scissor/cull) - Apple Metal · 单次绘制命令多视口 - Apple Metal · MTL CullMode
三、NVIDIA / AMD 架构手册与工程博客 - NVIDIA · Life of a Triangle - NVIDIA GDC · GeForce 6 系列 GPU 架构 - AMD GPUOpen · 全 GPU 管线漫游 PDF - AMD GPUOpen · 从顶点着色器到网格着色器 - AMD GPUOpen · GPU Performance Counters - AMD GPUOpen · RGP 事件窗口 - AMD GPUOpen · RDNA 架构概览 - AMD GPUOpen · GDC2017:D3D12 + Vulkan 经验教训 PDF - AMD GPUOpen · RPS 教程 Part 1(viewport 状态) - AMD · RDNA3 ISA 参考指南 PDF
四、黄金级工程博客 - Fabian Giesen · A Trip through the Graphics Pipeline(Part 1:命令路径) - Fabian Giesen · Part 2:内存子系统 - Fabian Giesen · Part 3:D3D10/11 管线阶段 - Fabian Giesen · Part 4:纹理与几何前端 - Fabian Giesen · Part 5:装配、裁剪、剔除法与视口变换 - Fabian Giesen · Part 6:光栅化与插值 - Fabian Giesen · Part 系列索引 - Scratchapixel · 投影矩阵与 GPU 中的裁剪 - Scratchapixel · 透视/正交投影矩阵入门 - Scratchapixel · 构造基础透视投影矩阵 - Scratchapixel · OpenGL 透视投影矩阵 - Scratchapixel · 实践中使用透视矩阵(NDC→屏幕) - Themaister · PS2 GS 模拟(Vulkan 计算)
五、学术讲义与经典文献 - UIUC CS418 · 固定功能流水线 - UIUC CS418 · WebGL 图形流水线 - UC Berkeley CS184 · 裁剪讲义 - Chalmers · 图形硬件 TDA361 讲义 PDF - Jim Blinn · 出版物(A Trip Down the Graphics Pipeline) - Real-Time Rendering · 参考资源 - Real-Time Rendering · 经典文献索引 - Eric Haines · 实时渲染随记(子像素寻址 / cracking) - HPG 2011 · GPU 高性能软件光栅化(Laine) - ACM DL · Emerald:SoC 图形建模(分块/binning)
下篇预告:《GPU 架构剖析》系列进度:已完成【一】命令前端、【二】显存与地址空间、【三】着色器核、【四】纹理采样器、【五】图元装配、裁剪与视口变换,接下来是【六】光栅化。我们在硅片到像素之间,继续挖下去。
资源清单 · 参考与延伸:参考文献覆盖本篇全部可回溯出处——规范与标准(Vulkan、WebGPU、OpenGL、Direct3D、Metal)、NVIDIA/AMD 架构手册、黄金级工程博客(Fabian Giesen《A trip through the Graphics Pipeline》、Scratchapixel)与学术讲义。想顺着光栅化这条路线继续读,建议优先看 Fabian Giesen 第 5/6 部分、NVIDIA《Life of a Triangle》和 AMD GPUOpen《All the Pipelines》。
With Best Wishes.