【移动端图形与功耗】第 7 篇 | 系列共 7 篇
站点链接:技术博客页
系列文章前言
1.1 一句话点题:终篇要交的是什么
前六篇把机制讲完了,这一篇只回答一句:凭什么说一个优化真的生效了?
命题就一句:「优化生效了」是可证伪的测量命题,不是感觉命题。 反例要写得出:结果落进某个区间,结论就该被推翻。
1.2 原理与概念:前六篇留下的待验证清单
前六篇每篇留下一句结论;这一篇给每句配上检验它的尺子。
| 篇 | 结论 | 检验量 |
|---|---|---|
| 1 物理约束 | 两条墙:能搬多少、能搬多久 | 帧时间、功耗、频率、温度 |
| 2 分块渲染(TBR) | 中间物留在片上才算省 | 管线时间戳、片上计数器 |
| 3 带宽 | 字节可按「一个屏幕像素」记账 | 字节落点、溢出回写 |
| 4 功耗与热 | 可持续帧率 = 可持续功耗 ÷ 单帧能耗 | 稳态区间、热状态字段 |
| 5 延迟着色 | 一像素只读自己,预算 128 bit/像素 | 逐阶段时间戳、退化路径 |
| 6 现代特性 | 「开了」不等于「生效」 | 对照实验、状态回读、门禁 |
检验这件事一直有人在管,只是各自只管一环:Google Benchmark 文档、FOSDEM 2026 演讲材料、Android 开发者文档 · 在 CI 中做基准测试、AOSP · 性能与电源、Vulkan 规范 · 查询、Arm 学习路径 · 用 Streamline 测性能、CapFrameX · 各性能指标说明。没有一份给出「从改动到结论」的完整链条。
1.3 原理与概念:本篇的边界声明
先把不做的四件事说清楚:PC 与主机的整机评测方法学、具体游戏的帧率横评、AI 辅助调优工具、性能建模与仿真。四者各需另一套前提。
三条口径写在明处:第一,「移动端」指 Mali 与 Immortalis、Adreno、PowerVR 及采用这些架构的 MediaTek 平台,不覆盖 Apple 自研 GPU 的硬件细节;第二,性能以帧时间与功耗为主,不做跑分排名,分数只是方法的例子;第三,厂商宣称值与第三方实测值分列。
1.4 原理与概念:怎么读这一篇
三条读法按目的挑:只想拿结论的,读零章末尾那张总表;要做复现的,从协议字段表起步,接第五章统计与第九章锁频 padho.ai · 性能 A/B 测试;要做判定的,看第十一章的容差窗口与统计检验 Kindatechnical · 发布门禁的统计决策。
测量方法本身就是结论的一部分
2.1 一句话点题:「我觉得快了」为什么不算数
一个优化被声称生效,需要一条完整证据链,五环:改了哪一处 → 哪个量本该跟着变 → 它变了多少 → 这个变化是否大于噪声 → 有没有第三个变量同时在动。
最容易被省掉的是第四环:变化量必须跟噪声比过一次,否则「快了 3%」换台设备就能得出相反答案。
2.2 原理与概念:四个反例——同一台机器,换个条件结论就翻
说白了,测量方法本身不中立,结论就会跟着跑。
最出名的那次是三星的 GOS:把部分应用的包名做伪装后触发限频,3DMark 的 Wild Life Extreme 读数从 2618 掉到 1141 分。数字来自第三方复核,属媒体口径,精确读数与测试机型以原页为准;后续是 Geekbench 把相关机型永久移出榜单,除名范围与公告出处同样以官方公告为准。
其中:2618 分是常规口径下的读数,1141 分是限频口径下的读数,两组读数出自同一台设备。
再看 2014 年那次:华为 P7 被第三方复核认定针对基准测试做了优化,虚高最高达 28%,Futuremark 据此取消其成绩资格;UL 的《Benchmark Rules》把「针对基准测试的特定优化」写成明令禁止项 UL《Benchmark Rules》——方法握在工具手里,被测方就有动机迎合工具。
第四个反例没有厂商,只有版本号:CapFrameX 在 1.5.3 调整了指标算法,同一份原始数据在新旧版本下读数不同 CapFrameX 1.5.3 版本说明。跑分口径与实战口径至少有三处错位:帧率对帧时间、峰值对持续、平均对尾部。
这三处错位,Android 与 Notebookcheck 各从一侧描述过 Android 开发者文档 · 分析并优化游戏性能、Notebookcheck 测试方法。
2.3 原理与概念:四条前提
先来看看四条前提。同机指同一台设备而非同型号——同型号机器的内存频率、闪存批次、固件都可能不同。同场景指同一条可复现的负载;场景一变,GPU 与 CPU 的受限关系可能从一侧翻到另一侧。同热状态是移动端最特殊的一条:设备带着上一轮的温度进场,高负载下十到十五分钟掉到约 70%(口径:媒体实测)Notebookcheck 测试方法。同一采集口径指工具、版本、算法、采样位置全部一致。
2.4 原理与概念:术语清理——帧率 / 帧时间 / 延迟 / 吞吐
帧率(frame rate)是每秒完成多少帧,帧时间(frame time)是相邻两次呈现的间隔,互为倒数——只有帧时间能直接测到,帧率永远是算出来的。延迟(latency)是输入到画面更新的时间,由帧时间、排队深度与显示链路共同决定。吞吐(throughput)是单位时间完成的工作量,可以增长而帧率不动。
「卡顿」在四家文档里指四件事。Android 判实际呈现时间与调度器预测是否一致,超过 700 ms 的 UI 帧叫冻结帧(frozen frame)Android 开发者文档 · 渲染时间;Apple 判实际帧寿命是否超过期望帧寿命,超出的时长叫 hitch duration(帧寿命超出量),以 ms/s 计 Apple 文档 · 理解 hitch;Qualcomm 讲 GPU 时间线与瓶颈定位 Qualcomm · Adreno 图形开发工具;Imagination 的 PVRTune 手册讲驱动与硬件计数器的读法 Imagination · PVRTune 手册。
凡说「卡顿」,先指明是哪一套口径;不指口径的卡顿率不写进结论。
2.5 实现与配置:本篇的验证方式
我们把它写成一份测量协议(measurement protocol):字段先给草稿,后面每章再补一列。
原始数据两条来路:逐帧分阶段时间戳 Android 开发者文档 · dumpsys、系统侧计数器与渲染阶段轨道 Perfetto 文档 · GPU 数据源。两条来路互不替代;后面的对照,靠的就是把两边的时间轴对齐。
下面开始看两条来路的取法。
adb push config.pbtx /data/misc/perfetto-configs/config.pbtx
adb shell dumpsys gfxinfo com.example.game reset
adb shell dumpsys gfxinfo com.example.game framestats > framestats.csv
adb shell perfetto --txt -c /data/misc/perfetto-configs/config.pbtx -o /data/misc/perfetto-traces/trace.perfetto-trace
adb pull /data/misc/perfetto-traces/trace.perfetto-trace
2.6 效果与量化:先给结论表
| 线 | 解决什么 | 代价 | 展开在 |
|---|---|---|---|
| 口径线 | 同一份数据换算法读数就变,先说清用哪把尺子 | 报告要带六项元信息 | 第一、二章 |
| 噪声线 | 移动端的一等噪声来自热与动态电压频率调节(Dynamic Voltage and Frequency Scaling, DVFS) | 测量时长从秒级拉到分钟级 | 第五章 |
| 统计线 | 差异要和噪声比过才算成立 | 同机交替切片加配对差值 | 第五章 |
这张表把三条线收在一处:口径线管读数怎么来,噪声线管差值能不能信,统计线管差值算不算成立。三条线走完,「优化生效」这句话才落到实处;缺任何一条,结论都只是半句话。
噪声线的代价不是时间,是心态:三十秒的测量拉长到三十分钟,结论常常会变小。
2.7 源码与数据链接
- UL《Benchmark Rules》
- CapFrameX 1.5.3 版本说明
- Android 开发者文档 · dumpsys
- Android 开发者文档 · 渲染时间
- Android 开发者文档 · 分析并优化游戏性能
- Perfetto 文档 · GPU 数据源
- Apple 文档 · 理解 hitch
- Notebookcheck 测试方法
- Qualcomm · Adreno 图形开发工具
- Imagination · PVRTune 手册
- Android 站点许可说明 与 AOSP 站点许可说明
好了,最后两条要并排看:Android 站点是文档部分 Apache-2.0、其余内容 CC BY 2.5,AOSP 站点是文档部分 Apache-2.0、其余内容 CC BY 4.0。转载配图前回到目标页面复核许可。
2.8 这一章留下的问题
零章解决了「怎么判」,还没解决「判出来是什么」:下一章先把感知量拿回来。
一、帧时间才是感知量:平均帧率为什么骗人
3.1 一句话点题:一帧从 16 ms 拉到 100 ms,平均值几乎不动
取一个十秒的窗口,60 Hz 下能装下 600 帧,每帧 16.67 ms;把其中一帧拉到 100 ms,总时长变成 10083 ms——平均帧率从 60 掉到 59.5(降幅 0.8%),平均帧时间从 16.67 ms 变成 16.81 ms;那一帧离 16.7 ms 的帧预算(frame budget)差了六倍。这六倍,在平均值里没有位置。
平均值把六百个样本摊薄,一个离群点就看不见了:感知量是帧间隔,不是每秒帧数。
3.2 原理与概念:帧时间的分布形态
一批帧时间不对称:一个是垂直同步(Vertical Synchronization, Vsync)在 16.7 ms 处压出的尖峰,另一个是右侧长尾。尖峰是被刷新周期挤出来的,长尾是逃出去的少数帧,两头要放在一起看;只看尖峰,会以为一切正常。
换成本篇那份构造数据:一千帧里 940 帧贴在 16.7 ms,50 帧约 20 ms,9 帧约 33 ms,1 帧 120 ms。
3.3 原理与概念:平均值、中位数与分位数
先看看三个统计量:平均值是所有帧时间的算术平均,中位数(median)是排序后正中间那一个,分位数(percentile)是排序后某个位置上的值(P99 即第 99 百分位)。三者看的是同一批数据的不同位置,谁也不能替代谁。
| 统计量 | 读数 | 它在说什么 |
|---|---|---|
| 平均帧时间 | 17.1 ms | 长尾摊平之后的总体印象 |
| 中位数 | 16.7 ms | 一半的帧比它快,一半比它慢 |
| P90 | 16.7 ms | 九成的帧不超过它 |
| P99 | 20 ms | 最慢的百分之一 |
| P99.9 | 33 ms | 最慢的千分之一 |
| 最大值 | 120 ms | 一次长卡顿的单点 |
平均值被长尾抬高了 0.4 ms,P99 与 P99.9 之间又隔了 13 ms。
平均 17.1 ms、中位 16.7 ms,差值全由那 10 帧贡献:只看平均值,会以为设备「均匀地慢了 2%」。
3.4 原理与概念:1% low 的两种算法
时间型(time-based)把帧按耗时从长到短累加,累到总测量时长的 1% 就停;百分位型(percentile-based)按帧数取最慢的 1%,再取平均。
总时长 17115 ms,1% 就是 171.2 ms;时间型取最慢的 120 ms 加两个 33 ms,三帧平均得 62 ms(约 16.1 fps);百分位型取最慢的 10 帧,(9×33 + 120) ÷ 10 得 41.7 ms(约 24 fps)——同一份数据差了近 50%。
排序也可能翻。场景 A:一千帧里 1 帧 400 ms,其余 16.7 ms;场景 B:20 帧 60 ms,其余 16.7 ms。时间型判 A(400 ms,约 2.5 fps)远差于 B(60 ms,约 16.7 fps);百分位型判 A(约 55 ms,约 18.2 fps)略好于 B(60 ms)。换算法结论相反。
CapFrameX 在 1.5.3 调整了指标算法,同一份原始数据在新旧版本下读数不同 CapFrameX 1.5.3 版本说明。报 1% low 必须连算法一起报;第三方社区对算法取向也有整理 truebottleneck · 1% low 指南。少了这一项,两个数就不是同一个指标。
其中:171.2 ms 是总时长的 1%,62 ms 是时间型的三帧平均,41.7 ms 是百分位型的十帧平均。
3.5 原理与概念:0.1% low 的代价
下面我们进入更极端的一档。0.1% low 专盯最慢的千分之一,更接近「最难受的那一下」,代价是样本太少——两次运行差出一倍并不罕见。
一千帧里最慢的 0.1% 只有一帧,读数等于极值本身,换一次运行就可能从 60 ms 变成 120 ms;要稳定,样本量得提一个量级——它的帧数得是 1% low 的十倍。样本不够时,这个数测的多半是运气。
分位数越高越接近最大值,也就越不稳定:报 P99.9 不写样本量,就没法被复核。
3.6 实现与配置:可比的帧率报告必带的六项
帧率报告要求六个字段齐全:工具与版本、算法、样本量、场景、热状态、原始数据。
| 字段 | 为什么必须有 | 缺了会怎样 |
|---|---|---|
| 工具与版本 | 同一份数据换版本读数会变 | 别人复不出你的数 |
| 算法 | 1% low 有两套,结果可差一半 | 两个数其实不是同一个指标 |
| 样本量 | 分位数越高对样本量越敏感 | P99.9 变成随机数 |
| 场景 | 帧时间分布随负载形态变 | 两组数据不可比 |
| 热状态 | 移动端一等噪声是热与 DVFS | 峰值与持续混在一起 |
| 原始数据 | 第三方复核的唯一依据 | 结论无法被推翻,也无法被确认 |
落到一份报告里是这样:
{
  "tool_and_version": "<工具名 + 版本>",
  "algorithm": "time-based 1% low",
  "sample_count": 1000,
  "scenario": "十秒窗口",
  "thermal_state": "<冷启动 / 稳态>",
  "raw_data": "framestats.csv"
}
工具各有默认口径:FrameView 的定义写得细 NVIDIA FrameView 用户指南,Godot 的性能监视器只给瞬时值 Godot 文档 · 性能监视器、Godot 文档 · 性能分析总览。
下沉到时间戳那一层:写时间戳走 vkCmdWriteTimestamp Vulkan 参考页 · vkCmdWriteTimestamp,跨 CPU 与 GPU 时间域换算用 vkGetCalibratedTimestampsKHR Vulkan 参考页 · vkGetCalibratedTimestampsKHR,Khronos 另有示例 Khronos Vulkan-Samples · 时间戳查询示例;计数器侧是另一套读法 Android 开发者文档 · AGI 系统分析器、Vulkan 指南 · 性能分析、Android 开发者文档 · AGI 入门。它决定了你手里这个数是软件帧时间还是硬件时间。先来看看实测里的读数。
3.7 效果与量化:三种口径在同一实测上的读数差异
Arm 用 Android GPU Inspector(AGI)给 Crytek 的 Neon Noir 做调优,Mali-G76 上的单帧从 78 ms 降到约 45 ms,约 12 fps 变成约 22 fps(口径:厂商案例实测)Arm 博客 · Mali GPU 驱动与 Android GPU Inspector;按帧时间报降约 42%,按帧率涨约 75%。同一份读数,换个口径呈现,印象就完全不同。
Arm 用 Streamline 分析 Cocos2d-x 的 Demo,把内存拷贝从主线程热点里挪走后,memcpy 的 CPU 占比从 54.62% 降到 9.10%,FPS 从 11.3 涨到 17.2(口径:厂商案例实测)Arm 博客 · 用 Streamline 分析 Cocos2d-x。
3.8 源码与数据链接
- truebottleneck · 1% low 指南
- NVIDIA FrameView 用户指南
- Godot 文档 · 性能监视器
- Godot 文档 · 性能分析总览
- Vulkan 指南 · 性能分析
- Vulkan 参考页 · vkCmdWriteTimestamp
- Vulkan 参考页 · vkGetCalibratedTimestampsKHR
- Khronos Vulkan-Samples · 时间戳查询示例
- Android 开发者文档 · AGI 入门
- Android 开发者文档 · AGI 系统分析器
- Perfetto 计数器与归因边界(第三方整理)
- Arm 博客 · Mali GPU 驱动与 Android GPU Inspector
- Arm 博客 · 用 Streamline 分析 Cocos2d-x
3.9 这一章留下的问题
帧时间的几套口径已经摆开,但「坏帧」怎么定义还没有统一答案:同一段卡顿,Android 叫 janky,Apple 叫 hitch——两个词不能互相换算。下面开始看两套平台口径的分歧。
二、掉帧不等于卡顿:两套平台口径的分歧
4.1 一句话点题:掉帧、卡顿、延迟是三件事
这三个词在平台文档里是三件事。掉帧(dropped frame)是一次主动取舍:这一帧不再按原计划呈现,直接换成更新的那一帧,Android 的 FrameTimeline 把它与卡顿分成两类 Android 开发者文档 · 卡顿检测。卡顿(janky frame)是没赶上:实际呈现时间与预测呈现时间不一致 Perfetto 文档 · FrameTimeline。延迟(latency)则可能一帧都没坏,却依然让人感到操作发黏。
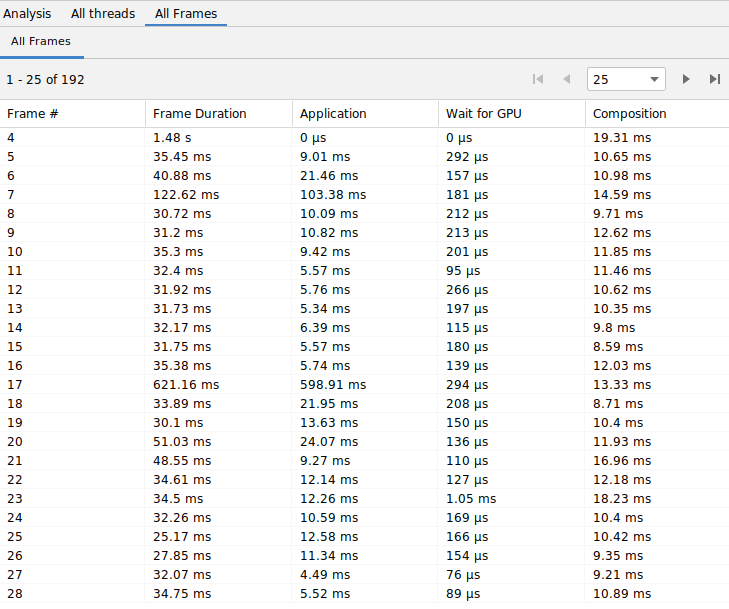
说白了,跳过一帧未必是坏事。
4.2 原理与概念:Android 的判定口径
判定轴只有一条:实际呈现时间与调度器预测是否一致。不一致就是 janky,按断点位置细分成四类:应用没赶上截止时间(AppDeadlineMissed)、系统合成器没赶上(SurfaceFlingerDeadlineMissed)、显示硬件层出问题(DisplayHAL)、预测本身偏了(PredictionError)。
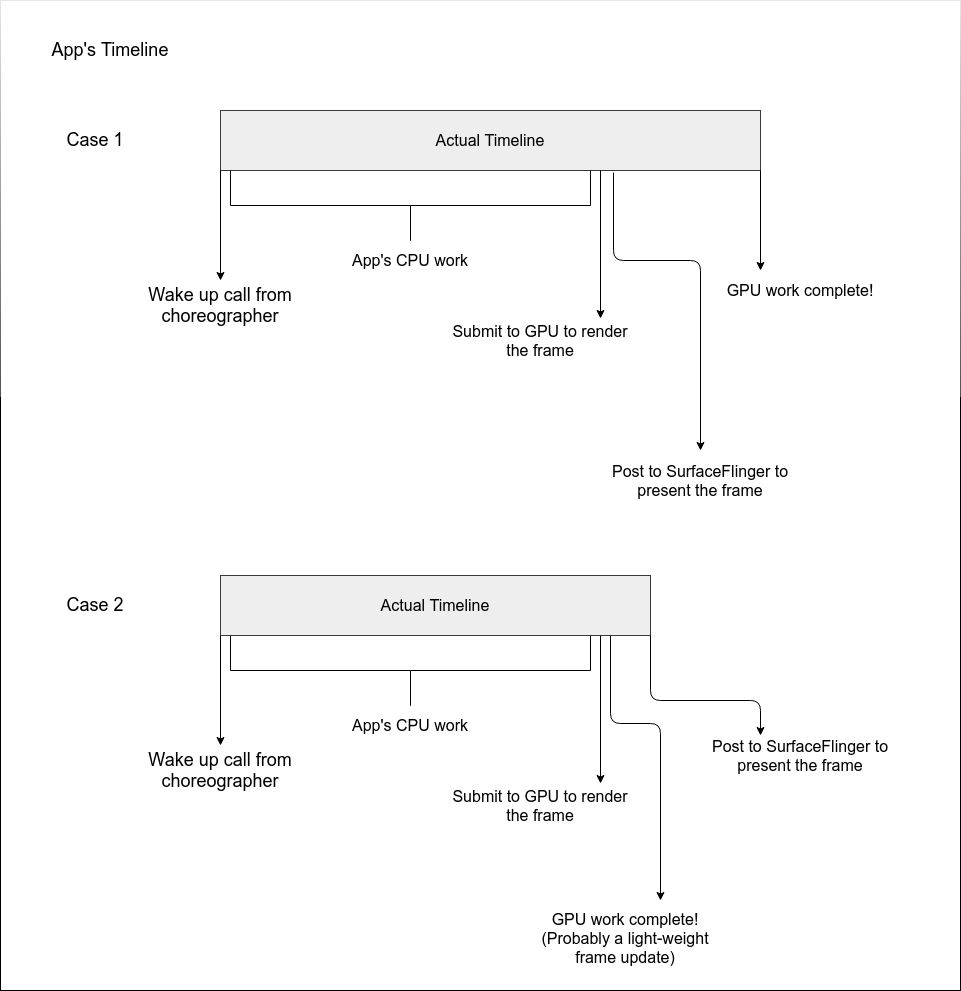
把这四类与轨道图对照,就能判断该去找应用代码、系统合成还是平台侧。
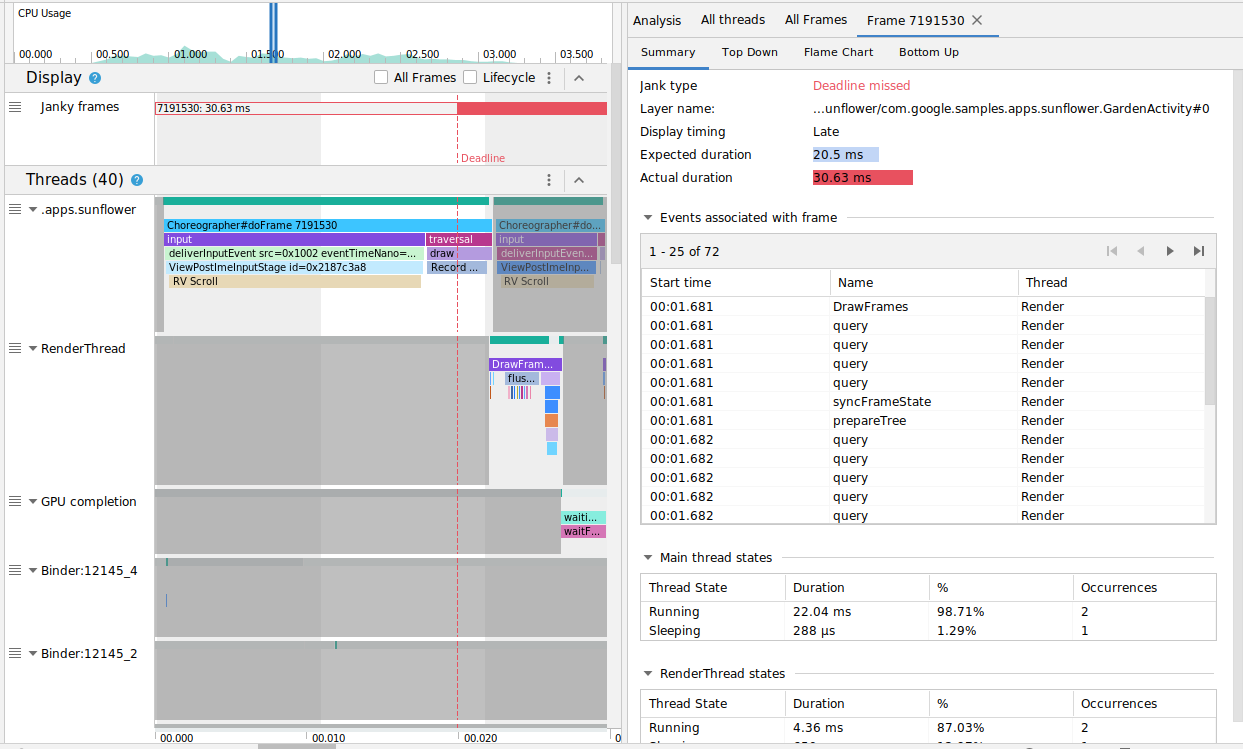
这段 trace 的采集配置:
{
  "buffers": [{ "size_kb": 65536 }],
  "duration_ms": 30000,
  "data_sources": [
    { "config": { "name": "android.surfaceflinger.frametimeline" } }
  ]
}
前两类在应用与系统侧可改,第三类要看平台与驱动,第四类在测量与判定本身。Android 把冻结帧的门槛定在渲染超过 700 ms 的 UI 帧 Android 开发者文档 · 渲染时间。下面我们进入 Apple 那一侧的判法。
4.3 原理与概念:Apple 的 hitch 口径
Apple 换了一根轴:它看帧寿命。期望寿命是 60 Hz 下 16.7 ms、120 Hz 下 8.3 ms,实际寿命超出期望寿命的部分就是一次 hitch,超出的时长叫 hitch duration(帧寿命超出量)Apple 文档 · 理解 hitch。轴换了,同一段画面就可能被判成两样。
它的输出是每秒累计多少毫秒的卡顿时间(ms/s),门禁三档:≤10 为良好、≤25 为警告、≤50 为严重 Apple 文档 · 分析 Metal App 的性能。
4.4 原理与概念:两套口径为什么不能互相换算
这两套数能互相换算吗?不能:一个比时间戳一致性,一个比帧寿命超出量;分母也一个按帧数、一个按时长。硬凑一个系数,只会把两种口径的误差叠在一起。
同一段 30 秒的 trace,前者给出「2% 的帧 janky」,后者给出「12 ms/s 的 hitch」——回答的不是同一个问题。
4.5 原理与概念:帧节奏与垂直同步
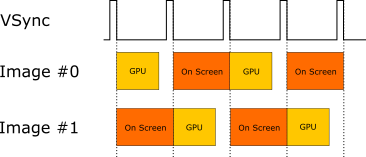
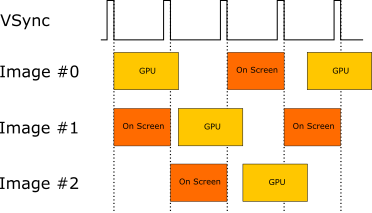
先看看这个例子。Khronos 的 swapchain_images 示例算得很直白:双缓冲(double buffering)下交换周期要等两帧,帧时间约 33.4 ms(约 30 fps);三缓冲(triple buffering)下周期缩到一帧,约 16.7 ms(约 60 fps)Khronos Vulkan-Samples · swapchain_images。
垂直同步解决的是撕裂,代价是把呈现时刻钉在刷新周期上;还有一条路:持续投递新帧把队列塞满,帧率看着平顺,输入延迟却在上升——这叫缓冲区堆叠(BufferStuffing),Android 的帧节奏文档专门讲过 Android 开发者文档 · 帧节奏;Unity 与 Unreal 也各给过口径 Unity 文档 · 时间与帧管理、Unreal 文档 · 移动端帧节奏。
4.6 实现与配置:帧预算 16.7 ms / 8.3 ms 与冻结帧 700 ms
16.7 ms 是 60 Hz 的帧预算,8.3 ms 是 120 Hz 的帧预算,由刷新率直接除出来;700 ms 则是异常线:Android 把渲染超过 700 ms 的 UI 帧归为冻结帧 Android 开发者文档 · 渲染时间。
言归正传,三档阈值放一起看,就能分清「预算」和「异常线」:预算是对每一帧的要求,异常线是放弃这一帧的信号。两者混着讲,报告里就会出现拿异常线当目标的笑话。
4.7 效果与量化:同一份 trace 用两套口径判出的卡顿率
构造一段 30 秒的 trace:130 帧因错过截止时间被判为 janky,占比约 4.2%;同一段数据按 hitch 口径累计,超出帧寿命合计约 1140 ms,折合约 38 ms/s,落在 Apple 门禁的「严重」区间(口径:本篇构造数据)。
一个按帧数计、一个按时长计,两个数因此能同时成立;硬件侧的计数器是第三种视角 Arm 博客 · Mali Bifrost 性能计数器。两套口径各记各的账,并排摆比硬折算更有信息量。
其中:4.2% 是按帧数计的 janky 帧占比,1140 ms 是超出帧寿命的累计,38 ms/s 是按时长计的 hitch 读数。
4.8 源码与数据链接
- Android 开发者文档 · 卡顿检测
- Android 开发者文档 · 渲染时间
- Android 开发者文档 · 帧节奏
- Perfetto 文档 · FrameTimeline
- Apple 文档 · 理解 hitch
- Apple 文档 · 分析 Metal App 的性能
- Khronos Vulkan-Samples · swapchain_images
- Unity 文档 · 时间与帧管理
- Unreal 文档 · 移动端帧节奏
- Arm 博客 · Mali Bifrost 性能计数器
4.9 这一章留下的问题
两套口径的原料来自不同层:帧级、系统级、计数器级、管线级;下一章问这四层各自能回答什么、会在哪里骗人。
三、四层数据源:从帧级到管线级
5.1 一句话点题:四层数据源各自能回答什么
先看看粒度这一维。按最细粒度,能拿到的东西分四层:帧级(frame level)、系统级(system level)、计数器级(counter level)与管线级(pipeline level)。
四层不是「越深越好」的阶梯,而是一张「问题—工具」匹配表:帧级答「这一帧多长、卡在哪一段」,系统级答「CPU 在干什么」,计数器级答「GPU 内哪个单元在忙」,管线级答「这段管线花了多少纳秒」。
5.2 原理与概念:帧级——gfxinfo framestats
Android 上取它最省事的入口是 adb shell dumpsys gfxinfo <包名> framestats,它把最近约 120 多帧的时间戳按环形缓冲存下,每帧拆成十几个阶段、纳秒精度。dumpsys 官方文档
先来看看阶段名的读法。这些阶段名就是一份时序说明书:INTENDED_VSYNC 是系统原本安排的垂直同步(Vertical Synchronization, VSync)时刻,DRAW_START 到 SWAP_BUFFERS 是应用侧干活的那一段,相邻两项相减即常说的那几个耗时。
5.3 原理与概念:系统级——Perfetto
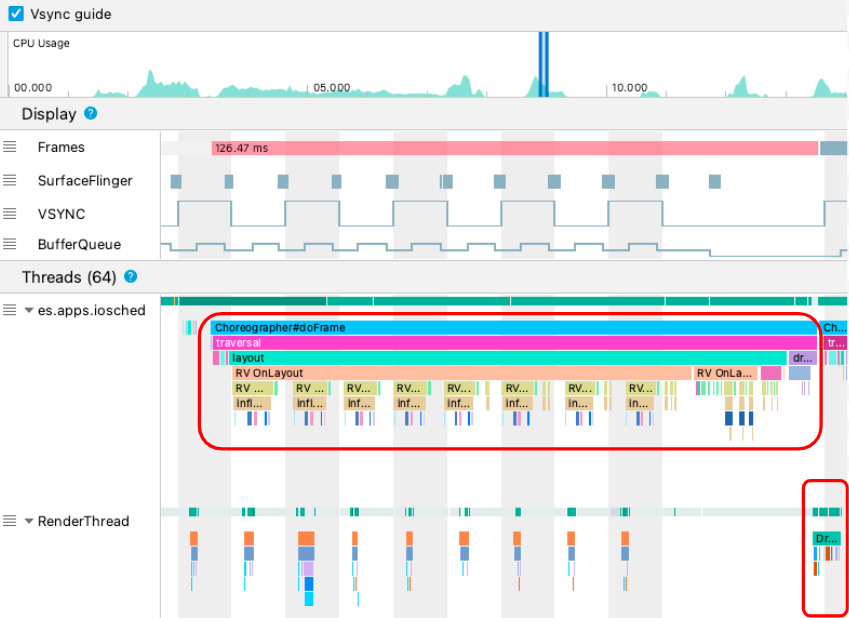
这一层的代表是 Perfetto,它最大的价值不在「能采更多数据」,而在把所有数据放进同一条时间轴:CPU 调度、GPU 提交、显示管线与频率共用一套时钟。Perfetto GPU 数据源 CPU 侧的线程级归因另有 Android Studio · CPU Profiler 可对照。
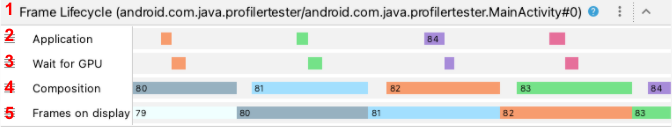
下面开始分类。GPU 数据源可归四类:gpu.counters 是厂商计数器的周期采样;gpu.renderstages 是应用提交到 GPU 的时间线,注意它是提交时间而非执行时间;FrameTimeline 把每帧拆成 Expected 与 Actual 两条线;内存类计数器记带宽与内存压力。Perfetto FrameTimeline
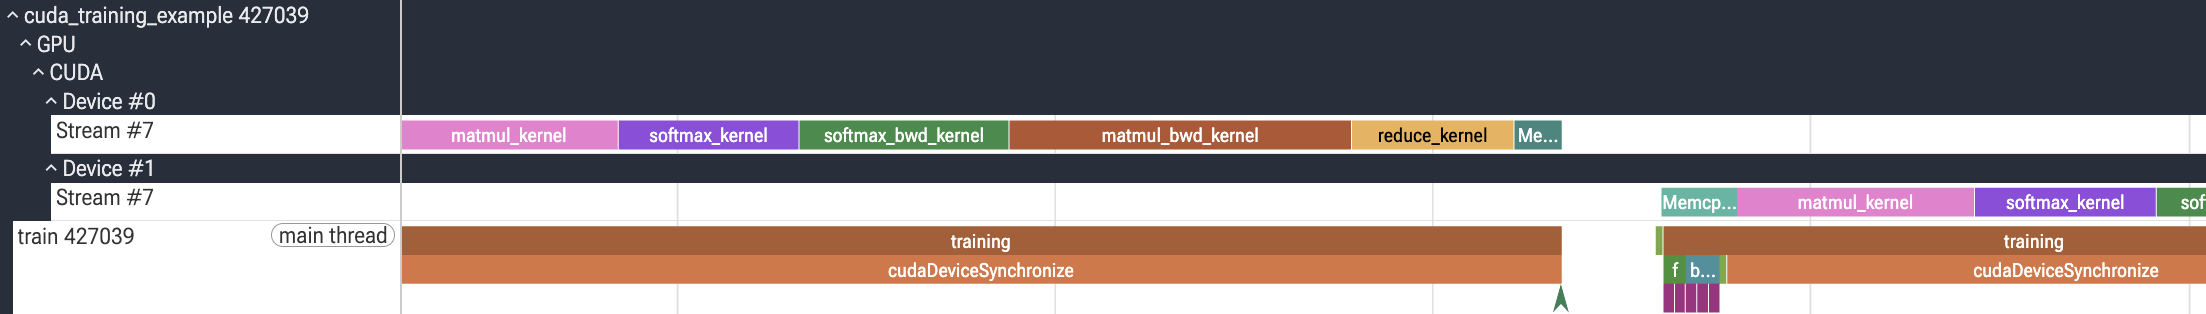
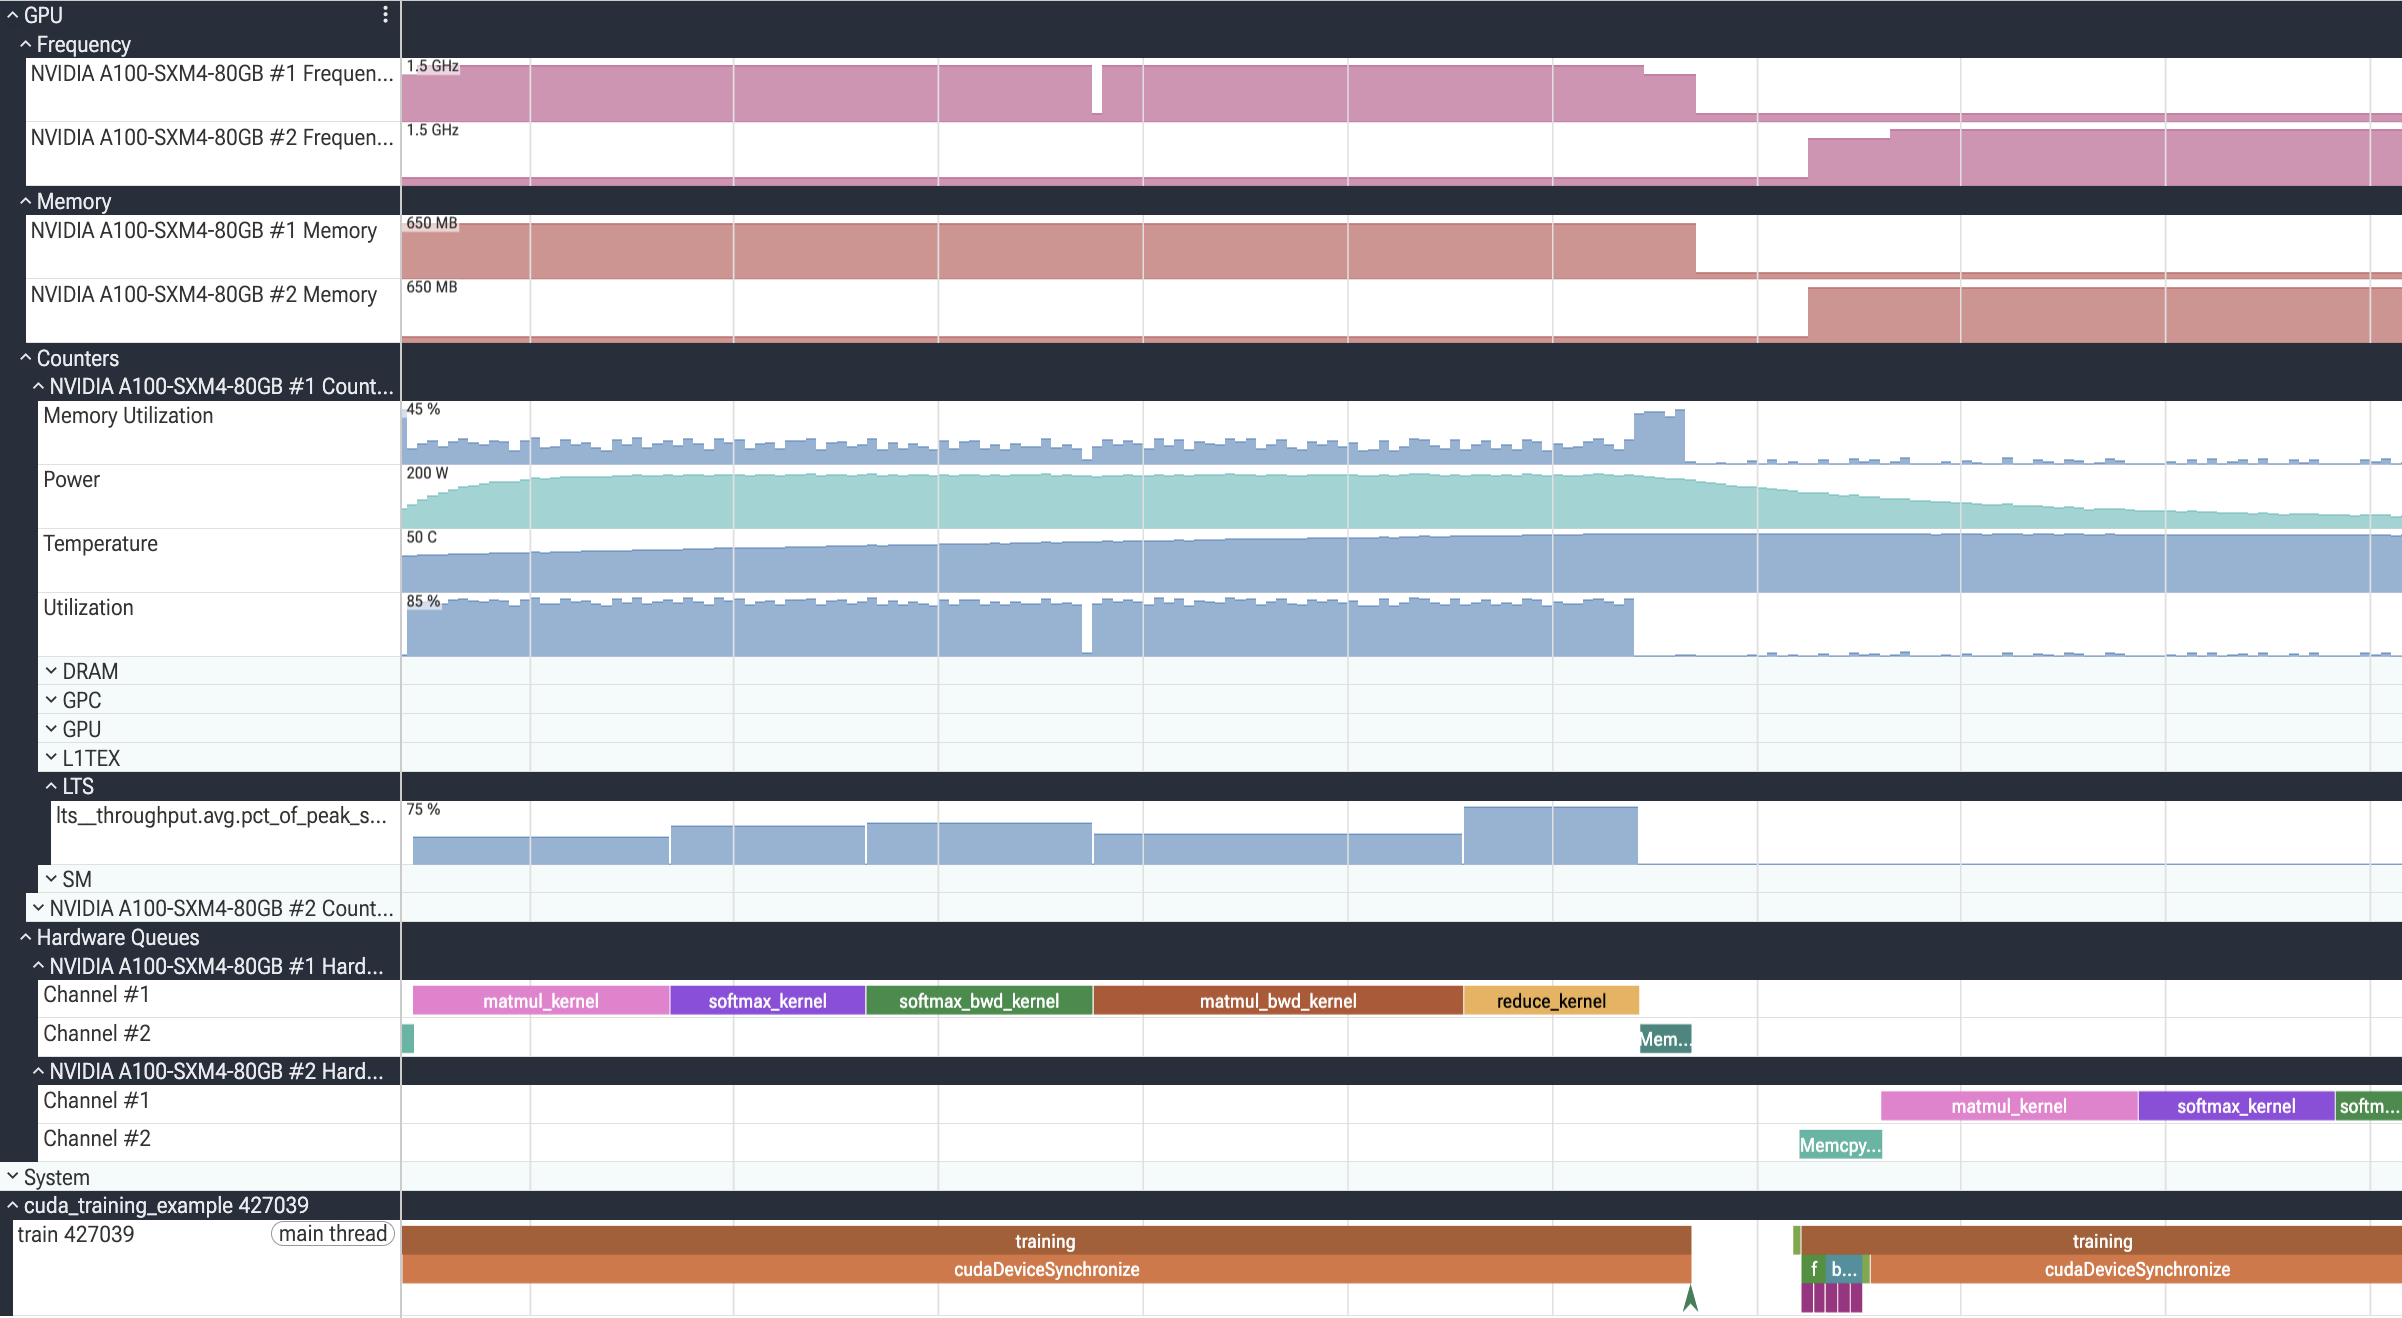
先整体后局部:缩到全局,得到的是各轨道在同一时间轴上的相对位置;顺着 GPU 轨道放大到逐帧,摊在眼前的才是 FrameTimeline 那两条线。前一张帮你决定往哪段放大,后一张把放大后的逐帧摊开对照。

# 采一段带 GPU 计数器与 FrameTimeline 的 trace
adb shell perfetto -c - --txt -o /data/misc/perfetto-traces/gpu.pftrace <<EOF
buffers: { size_kb: 65536 fill_policy: RING_BUFFER }
data_sources: { config { name: "gpu.counters"
  gpu_counter_config { counter_period_ns: 1000000 } } }
data_sources: { config { name: "android.surfaceflinger.frametimeline" } }
duration_ms: 10000
EOF
5.4 原理与概念:计数器级——AGI 与厂商 profiler
Android 侧最好用的入口是 Android GPU Inspector(AGI),它能在真机上读 GPU 与厂商计数器——纹理带宽、纹理 L1 命中与缺失这类指标——再把逐帧 profile 与系统 trace 并排摆出来。它给的是「哪个单元在忙」,答不了「为什么慢」。AGI 入门 逐帧视图另见 AGI · 渲染通道 与 AGI · 帧剖析器。
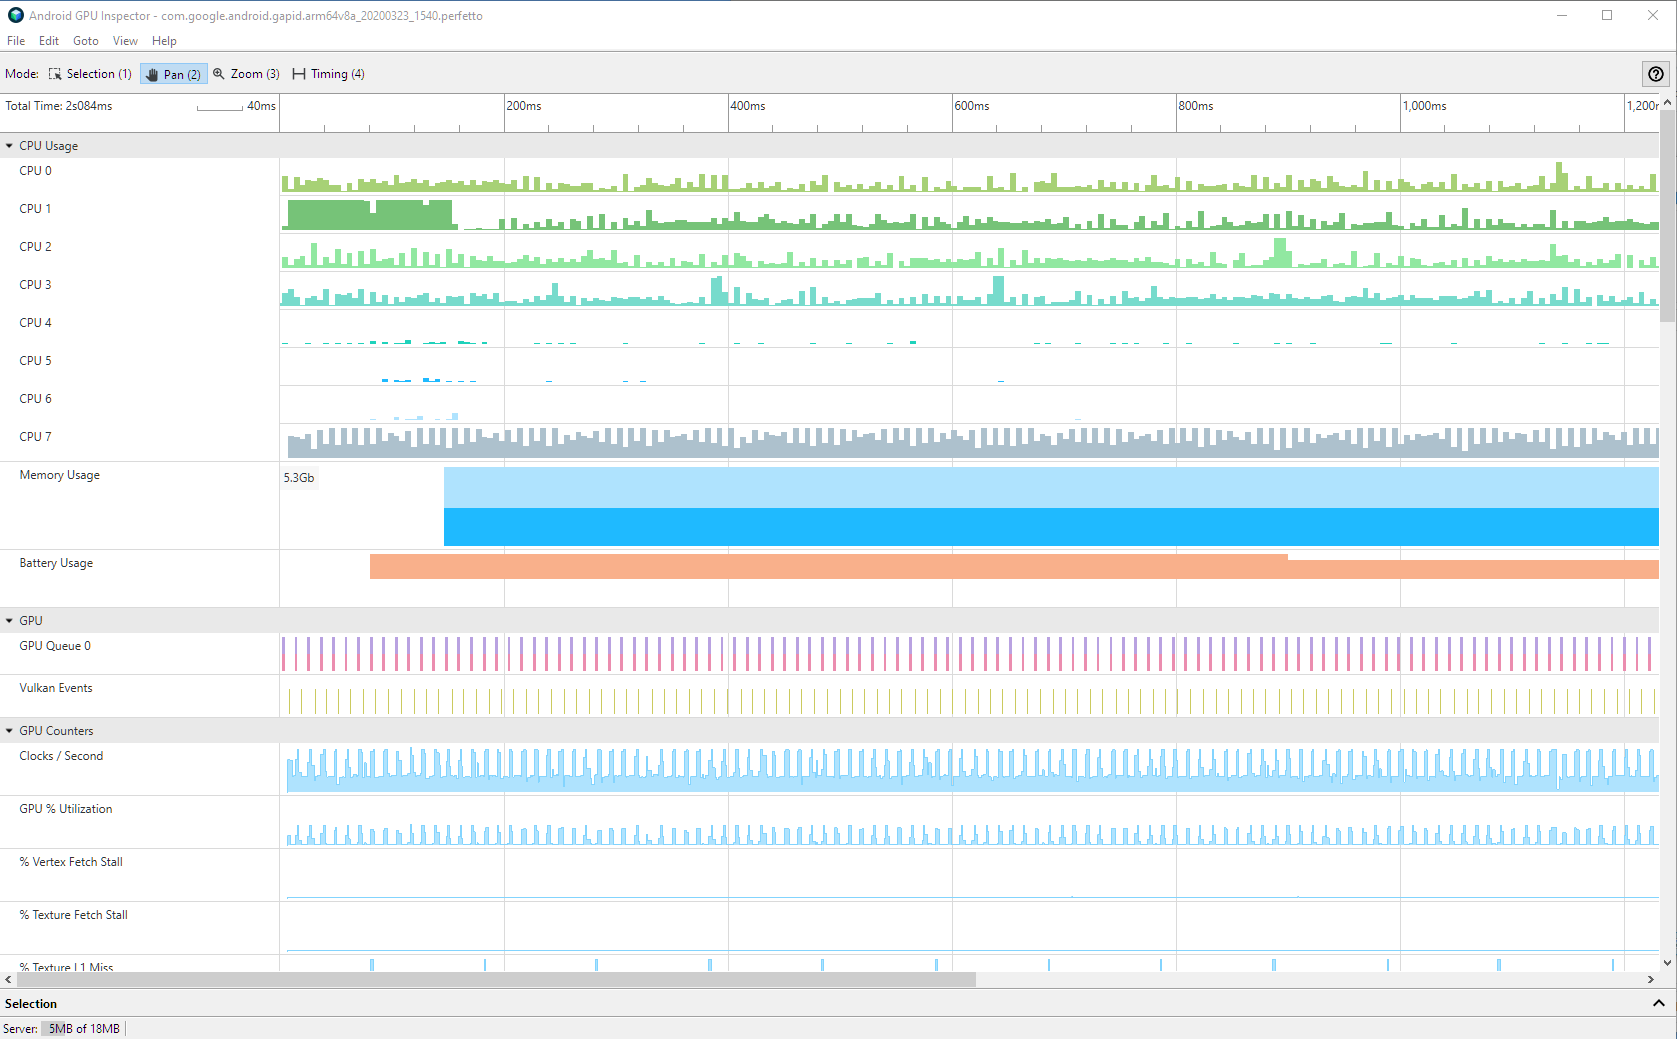
说白了,计数器名称跨代也会变,必须和芯片型号、驱动版本一起记进报告,否则过半年没人知道那串数从哪来。读法可对照 RenderDoc 文档 与 RenderDoc · 性能计数器。
5.5 原理与概念:管线级——时间戳与性能查询
时间戳查询的接口是 vkCmdWriteTimestamp:把当前时间写进查询池(query pool),并指定一个管线阶段作为落点。
$$ t_{ns} = \left((t_2 - t_1)\ \&\ \text{mask}\right) \times timestampPeriod $$
其中 t1 与 t2 是从查询池读回的原始值;mask 按 timestampValidBits 取有效位,该值可能不足 64 位并会回绕;timestampPeriod 是每个 tick 的纳秒数,由设备属性给出,各设备差别不小,换算前先查。跨设备比较之前先把这一步对齐。
5.6 实现与配置:按问题选工具的决策树
规则只有一条:先选能回答问题的最浅一层,上一层给不出方向时才往下走。
好了,回到这张表。最右一列才是重点:每层能力都配着一句「它给不了什么」,记住这几处缺口比记住工具名有用。顺序不能颠倒:先把浅层能排除的方向排除掉,再决定往下走。
5.7 效果与量化:四层数据源的精度与代价对照
| 层 | 典型工具 | 时间精度 | 采集粒度 | 附加开销 | 主要局限 |
|---|---|---|---|---|---|
| 帧级 | gfxinfo framestats / SurfaceFlinger timestats | 纳秒时间戳(软件侧) | 逐帧,环形缓冲约 120 帧 | 极低 | 软件帧时间;缓冲会滚掉历史 |
| 系统级 | Perfetto | 纳秒,统一时间轴 | 逐事件,含插桩 | 低到中,随轨道数与缓冲长度上升 | 数据源须提前配置;写满会丢 |
| 计数器级 | AGI / Arm Streamline / Snapdragon Profiler | 依工具而定,通常毫秒级采样 | 周期采样或逐帧 | 中到高,需 root 的更贵 | 计数器语义厂商私有,跨设备不可比 |
| 管线级 | Vulkan 时间戳 / 性能查询 | tick 级,由 timestampPeriod 换算 | 逐查询,可落在指定阶段 | 高,打断并行、需同步 | 差值只是下界;有效位可能不足 64 位 |
5.8 源码与数据链接
- 帧级与系统级:dumpsys 官方文档、Android 卡顿检测。
- Perfetto:Perfetto GPU 数据源、Perfetto FrameTimeline、归因边界的社区讨论(B 级,作方法参考)见 androidperformance 的 Perfetto 系列。
- 计数器级:AGI 入门、AGI 系统分析器、Arm Mali 性能计数器、Qualcomm 图形开发工具、PVRTune 手册。
- 管线级:vkCmdWriteTimestamp 参考页、Vulkan 查询章节、vkGetCalibratedTimestampsKHR 参考页、Vulkan 时间戳查询示例、Vulkan 性能剖析指南。
- 选型与引擎侧:Android 游戏性能分析、Godot 性能监视器。
5.9 这一章留下的问题
下一章把时间戳、计数器与利用率这三处失真拆开。
四、你以为测到的,可能不是那个
6.1 一句话点题:四类精度陷阱总览
先来看看落差从哪来。按成因分,落差有四类:时间戳失真(写入允许顺延、有效位可能不足 64 位)、采样失真(计数器只是周期采样)、语义失真(频率、利用率、吞吐本是三个量)、归因失真(把工具开销算进被测对象)。
本章处理前三类,第四类留到第五章。
6.2 原理与概念:时间戳的三处失真
第一处是阶段顺延。规范允许把 vkCmdWriteTimestamp 的写入推迟到更晚的阶段,于是落点是一个「不早于」,相邻两个时间戳之差只是下界。Vulkan 查询章节
第二处是有效位不足。timestampValidBits 可能小于 64,超出部分无意义,时间戳在原值上还会回绕。
好了,第三处是跨域未校准。CPU 与 GPU 各有时间域,不校准就把两边的段拼在一条轴上,段与段的相对位置就是错的,且这种错不会以异常形式出现。vkGetCalibratedTimestampsKHR 参考页
6.3 原理与概念:计数器是采样,不是逐 draw
硬件性能计数器(performance counter)本质是寄存器,值反映「读它的那一刻」的状态,不是一段时间的精确累加。
采集方式有两种:周期采样(periodic sampling)按固定间隔读寄存器,Perfetto 的 gpu.counters 轨道即此类;插桩采样在事件前后各读一次。
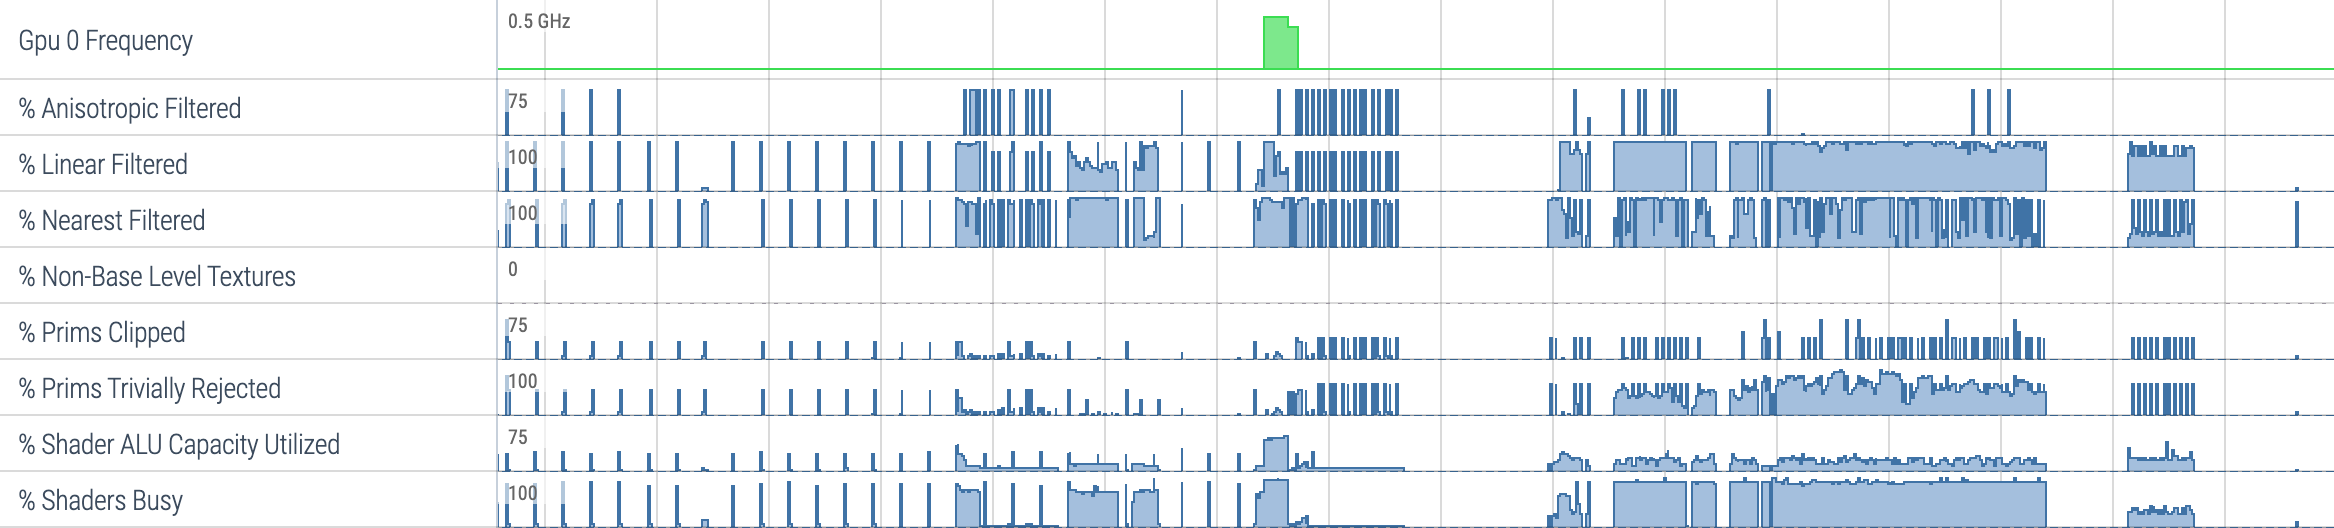
先看看下一个问题。采得到,不等于算得准。上一张说的是间隔与事件时长的匹配,决定一次采样能否覆盖目标事件;这一张往前走一步,假设读数都采到了,再问把瞬时值按周期数累加能不能还原总量。
# 计数器两种取法二选一
data_sources { config { name: "gpu.counters"
  gpu_counter_config {
    counter_ids: 1
    counter_period_ns: 1000000      # 周期采样:固定间隔读
    # instrumented_sampling: true   # 插桩采样:事件边界读
  } } }
其中:counter_period_ns 是两次读寄存器之间的间隔,instrumented_sampling 是插桩采样的开关。
6.4 原理与概念:频率不等于利用率
频率(frequency)、利用率(utilization)、吞吐(throughput)是三个量,可以朝不同方向动。
频率是时钟跑多快;利用率是「多少比例的周期里这个单元手上有活」;吞吐是单位时间完成的工作量。频率降一半,利用率可能升上去而吞吐不变;利用率上到 90%,吞吐也可能不动——不少实现把「忙」算上了等内存的周期。
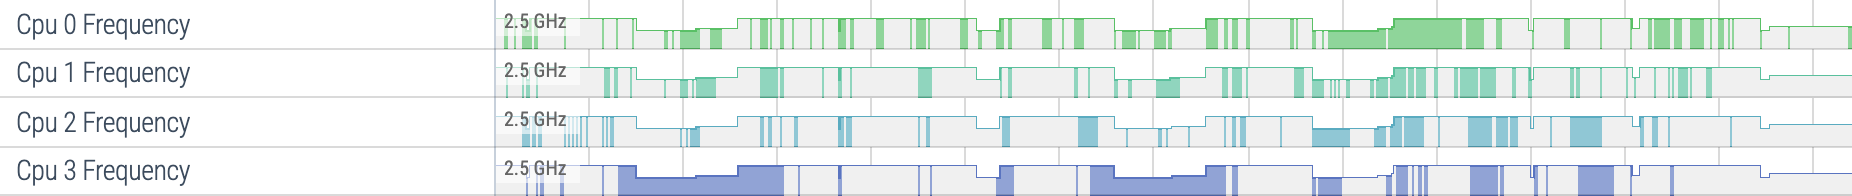
口径的歧义不止「占用」一处。上一张把同一个百分比拆成三种算法,说明一个词可以对应几个量;这一张换到功耗,同一个数字,取自整机与取自模块是两回事。
6.5 实现与配置:三类失真的自检清单与量级
用法是:拿到一组读数先跑一遍清单,再动结论。
计数器侧与语义侧六项:采样方式是周期还是插桩、间隔多少;被观测事件的最短时长与采样间隔比是什么量级;还开着哪些采集器,会否互相打断计数;读的是哪个域的值;「利用率」的 busy 定义含哪些等待;功耗是整机口径还是模块口径。
6.6 效果与量化:同一段代码在两种读数下的归因差异
假设某帧有一段 GPU 工作。管线级时间戳测是若干毫秒;同一时刻计数器看,某单元利用率接近饱和;帧级的软件帧时间看,从 SWAP_BUFFERS 到 FRAME_COMPLETED 又是另一个数。Android 游戏性能分析
下面我们进入本章的落点:这张图要说的是读数粒度决定你能问到第几层问题,而非哪个读数更准。Vulkan 性能剖析指南
6.7 源码与数据链接
- 时间戳失真:vkCmdWriteTimestamp 参考页、Vulkan 查询章节、vkGetCalibratedTimestampsKHR 参考页。
- 采样失真:Perfetto GPU 数据源、Perfetto FrameTimeline、AGI 系统分析器。
- 语义失真:AOSP 性能与功耗、Arm Mali 性能计数器、Qualcomm 图形开发工具。
- 归因边界与工具开销:androidperformance 的 Perfetto 系列、Android 渲染时间指标、Android 游戏性能分析。
- 帧级口径追溯:dumpsys 官方文档、Android 卡顿检测。
6.8 这一章留下的问题
同一台机器同一场景连跑三次,结果能差几个百分点,往往比辛苦优化出来的收益还大。
五、先说清噪声,再谈差异
7.1 一句话点题:有没有差异 vs 差异是否大于噪声
言归正传,「差异是否大于噪声」是统计问题:先说清噪声有多大,再说清差值落在噪声的哪个位置。下面的协议是我们在真机调优时反复用的,七步,顺序不能换,与工具无关。
7.2 原理与概念:样本量与方差
常用指标是变异系数(Coefficient of Variation, CV):标准差除以均值,与量纲无关。
FOSDEM 那份可靠测量的演讲给过一组实测:单轮 N=30 帧时 CV 是 6.95%,提到 N=90 后降到 4.59%;重复 M=5 轮把跨轮 CV 从 11.80% 压到 2.94%。FOSDEM 可靠测量软件性能,CV 数据的采样场景与帧率口径以其原表为准。
样本量由三个量决定:想检出的最小效应(Minimum Detectable Effect, MDE)、置信水平与刚量出的方差。
$$ n \approx \frac{2\,(z_{1-\alpha/2} + z_{1-\beta})^2\,\sigma^2}{\Delta^2} $$
其中 n 是每组所需样本量;Δ 是想检出的最小效应,也就是那个值得报告的收益;σ² 是单次读数的方差,来自第一步的实测;z(1−α/2) 与 z(1−β) 由显著性水平与统计功效决定,常取 0.05 与 0.8。
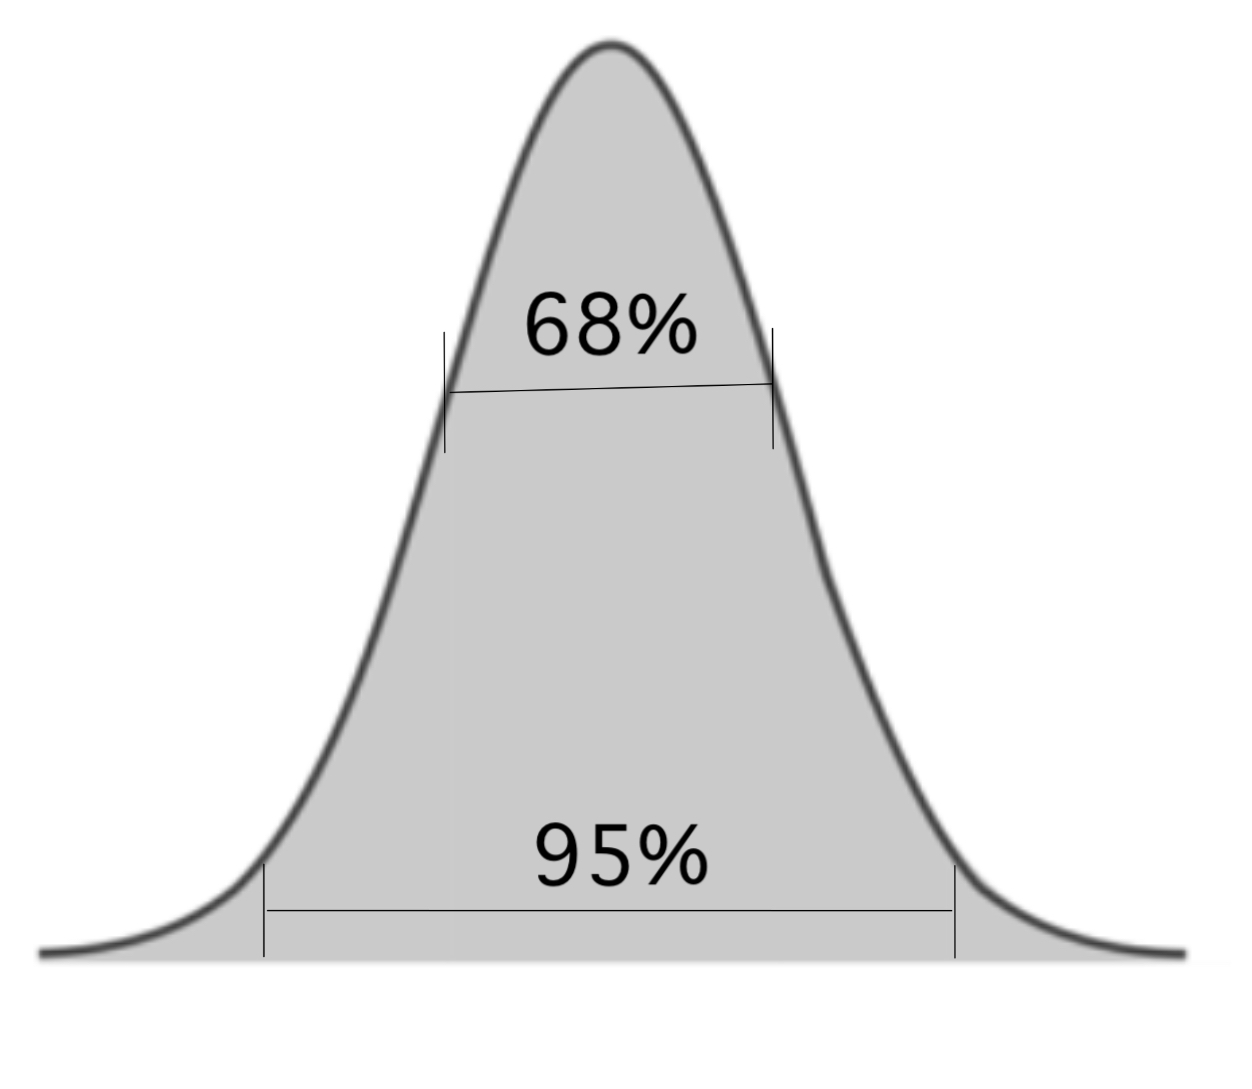
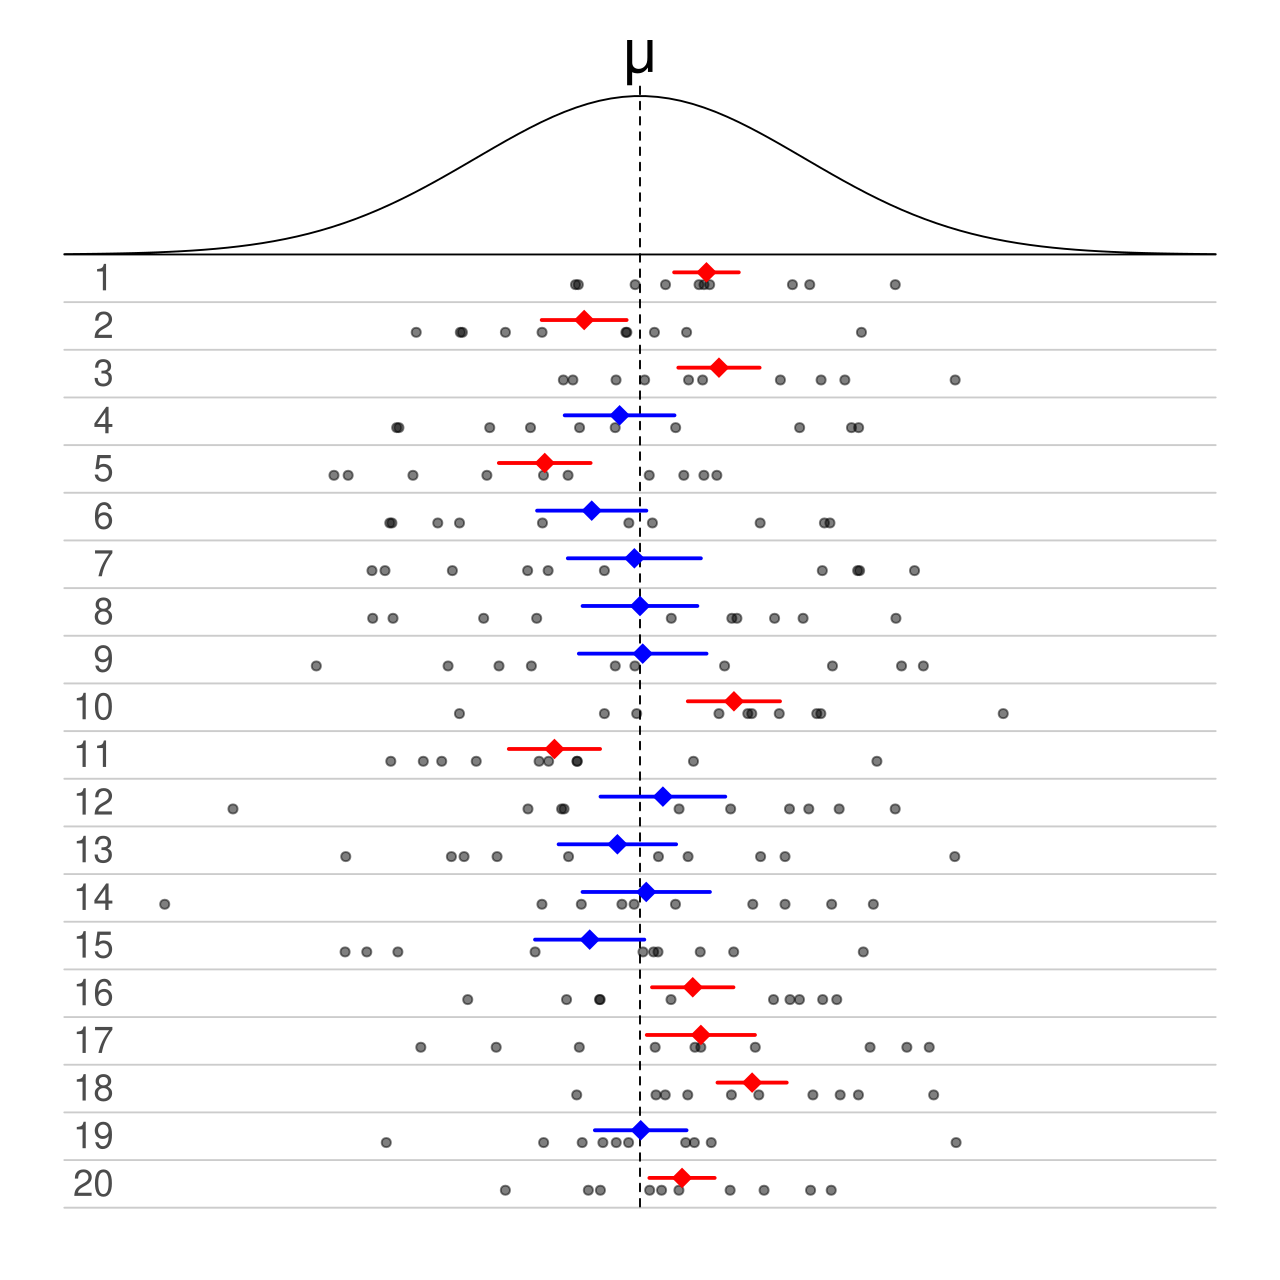
说白了,式子的推论很直白:Δ 减半,样本量变四倍,收益越小越难证明。
7.3 原理与概念:预热与稳态
判断有没有进稳态,看三条线同时走平:帧时间序列不再下行、频率轨道进入平台、温度或热余量进入平台。三条都到位才算进入稳态,只走平其中一条就下结论,容易把预热段当稳态。
丢弃长度在采集之前写死,两组一致,规则也要可复现——同场景重跑,拐点应在相近位置。Android CI 基准测试
7.4 原理与概念:交替配对的 A/B
正确的做法叫交替配对(paired / interleaved A/B):把总时长切成 k 个等长切片,按 A 片、B 片交替采集,每片长度记为 T;然后构造配对差值——第 i 对的差值等于同一对里 B 的读数减去 A 的读数。拿到的是一串 k 个差值,而非两组分开的读数。
下面开始看它为什么成立。热漂移在 T 这个尺度上是慢变量:一对里两片挨着采,热状态与后台状态几乎一致,相减即消掉;快噪声不被消掉也不被放大,留在差值序列里,靠 k 次重复平掉。
切片长度 T 有上下两条约束:下限是频率调节与热控的时间常数,T 比它短,两片取到的是同一响应过程的两个瞬间;上限是漂移显著的时间尺度,T 太长,一对之内不再共享热状态。T 只能实测,片序也要防周期化。
7.5 原理与概念:对差值做置信区间
Bootstrap 最省事也最不挑分布,流程五步:把 k 个差值当成一个样本池;从池子里有放回地随机抽 k 个;算出重抽样本的均值;把重抽与求均值重复 B 次(B 取两千到一万);把这 B 个均值排序,取第 2.5 与第 97.5 百分位,两数之间就是 95% 置信区间。
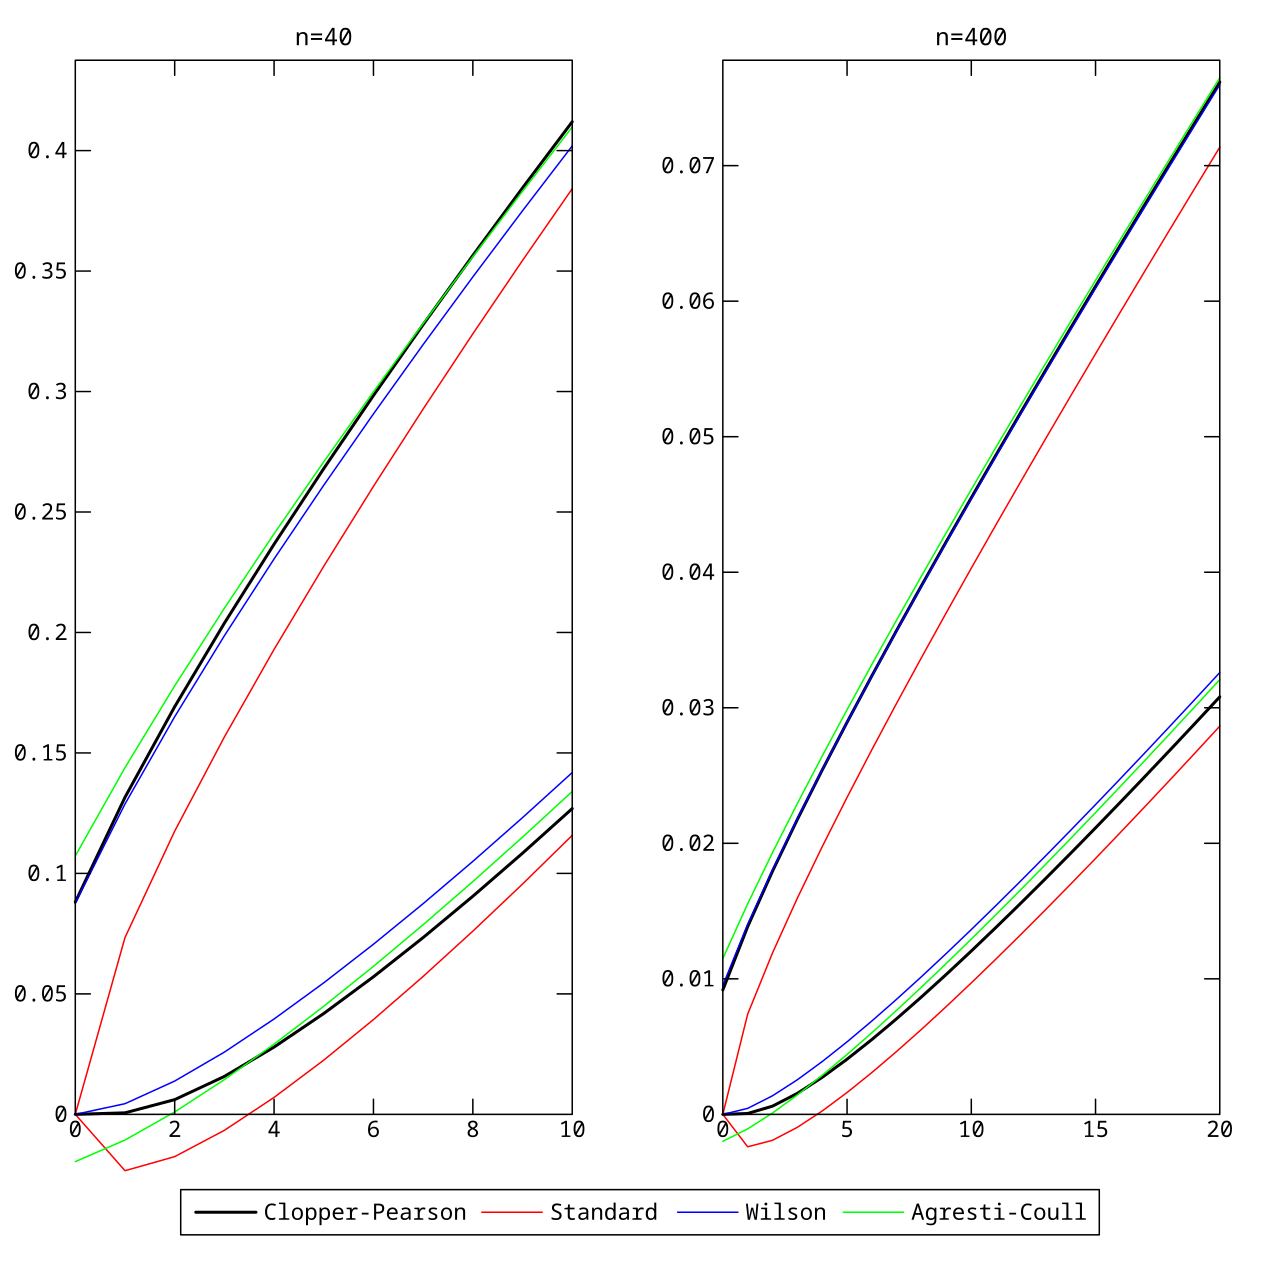
判据只有一句话:区间不含 0,才说差异成立;区间含 0,只能说这次证据不足。 含 0 时写「本次测量未能检出差异」,不写「接近显著」或「趋势上更好」,含糊表述正是下一条谬误的温床。非确定性系统的统计发布门禁
# bootstrap: B in [2000, 10000]
d = [b[i] - a[i] for i in 1..k]    # k paired differences
for b in 1..B:
    s = resample_with_replacement(d, k)
    m[b] = mean(s)
sort(m)
ci = [m[0.025 * B], m[0.975 * B]]   # 2.5 / 97.5 percentiles
其中:k 是配对差值的个数,B 是重抽的次数。
7.6 原理与概念:显著性检验怎么选
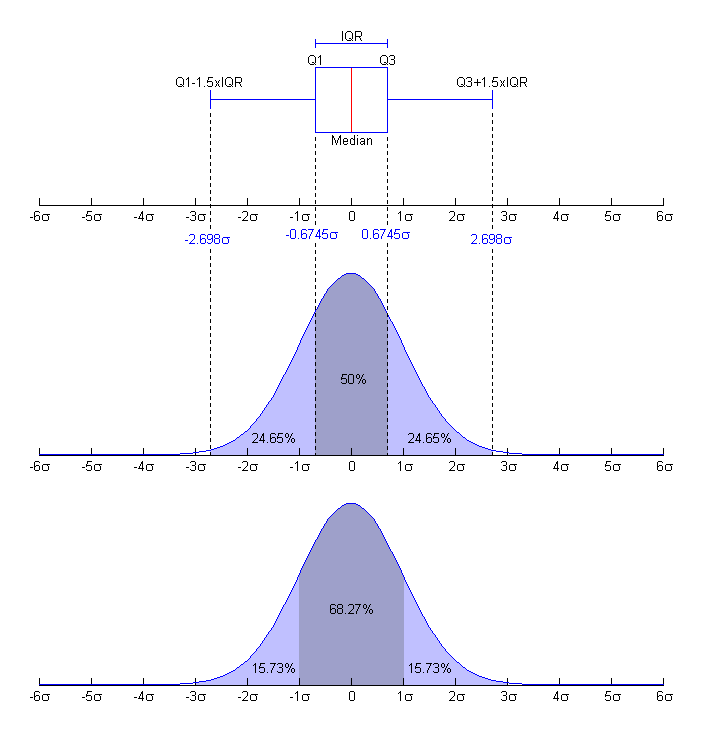
配对 t 检验(paired t-test)假设差值近似对称、无极端离群,临界值来自 t 分布。
选择规则可以压成三句:先画差值直方图,近似对称且没有极端离群就用配对 t 检验;分布明显偏斜或有个别极端值(一次垃圾回收就够造成),改用 Wilcoxon 并同时报中位数差值;两组不独立——两台设备、两个系统版本——才退回 Mann–Whitney U,并写明这不是配对设计。
言归正传,换检验方法只解决「差得可不可信」,不回答「差得值不值得」。上一张管的是分布形状把检验选错,这一张挪到另一头:显著而效应量过小,结论仍不该写。
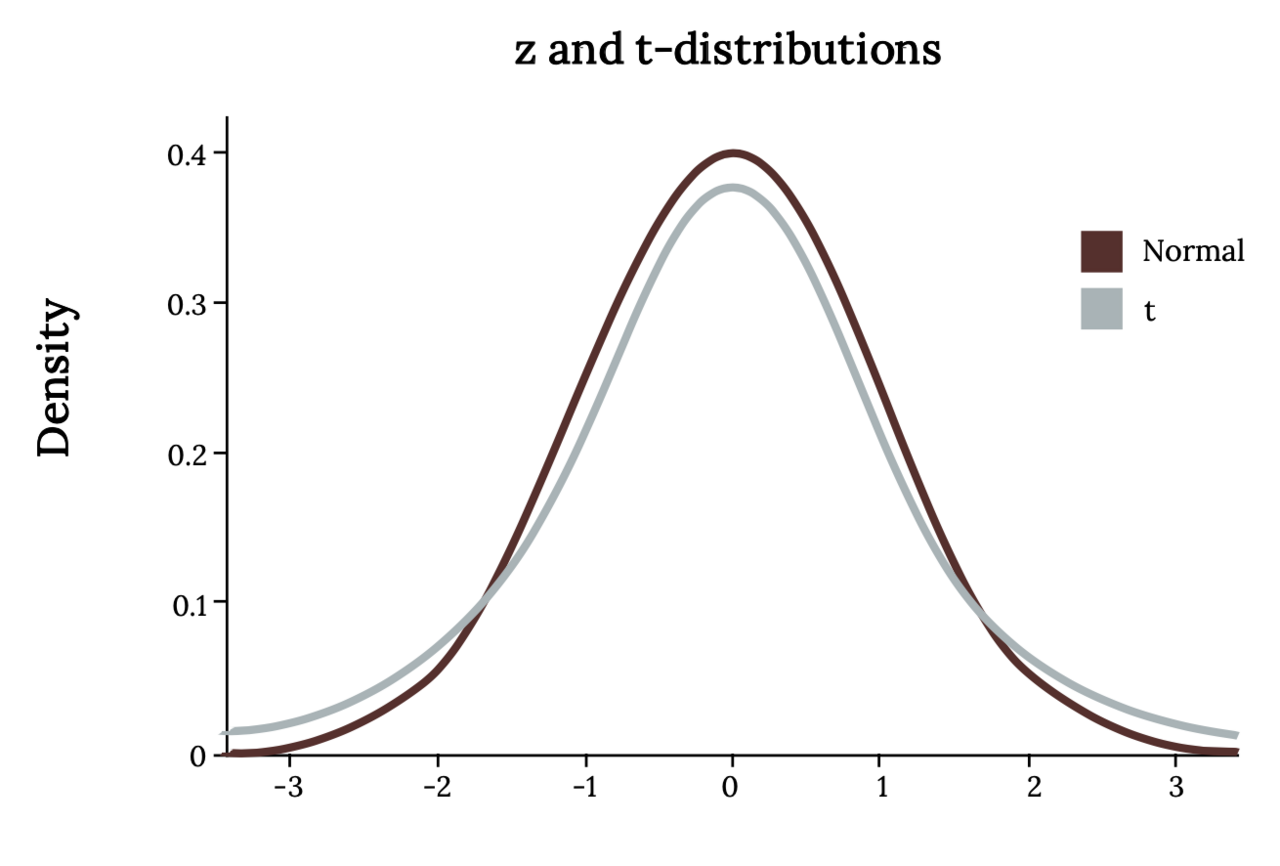
这两张图要串起来读:判定「显著」用的临界值不是固定的,配对数少时这把尺子更宽;前面那张提醒,过了尺子还要看效应量够不够大。两处合读才完整。
正态假设下 95% 的临界值是 1.96;自由度小时 t 分布尾部更厚,配对数 5 时约 2.78。Commons t 分布与正态分布对比

7.7 效果与量化:六条常见谬误与各自的反例
一、用平均值代表快慢。反例:一帧从 16 毫秒拉到 100 毫秒,平均帧率几乎不动。处置:报分位数。
二、只看短测。反例:持续性能通常只有暴发的五成到六成半,Notebookcheck 高负载测试里 10 到 15 分钟掉到约七成(口径须随结果标注)。处置:测量时长与性能目标对齐。Notebookcheck 测试方法
三、顺序跑 A 再跑 B。反例即上一节的漂移偏置。处置:交替配对。
四、把一次结果当基线。处置:重复加置信区间。
五、把工具读数当硬件时间。处置:跨层交叉验证。
六、把工具自身开销算进被测对象。处置:空白对照,全关与全开各跑一遍。
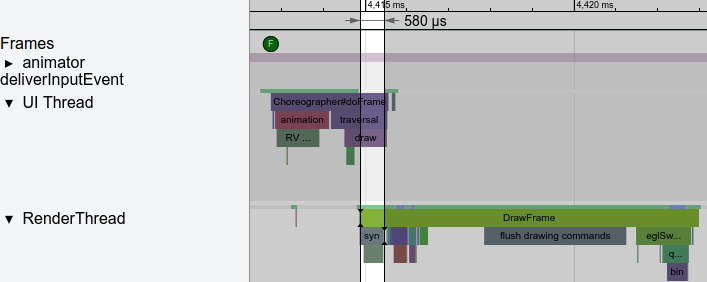
两张图是同一件事的两面:上一张算的是工具自身吃掉的那部分时间,这一张看的是多个工具并行时互相踩到的计数。先看开销,再看打断,归因才站得住。
7.8 源码与数据链接
- 样本量与噪声:FOSDEM 可靠测量软件性能、Google Benchmark 工具文档、性能 A/B 方法页。
- 判定与门禁:非确定性系统的统计发布门禁、Android CI 基准测试、UL Benchmark Rules。
- 外部统计示意图:Commons 区间对比示意、Commons t 分布与正态分布对比、Commons 置信区间示意。
- 指标口径与反例数据:CapFrameX 指标说明、CapFrameX 1.5.3 版本说明、1% low 指南、NVIDIA FrameView 用户指南、Notebookcheck 测试方法。
- 平台口径与工具开销:Android 渲染时间指标、dumpsys 官方文档、Perfetto FrameTimeline、AOSP 性能与功耗。
- 长时测量与判定阈值:Android 游戏性能分析、Android ADPF 热管理、Android 帧节奏、Apple 理解 hitch、Vulkan 性能剖析指南。


7.9 这一章留下的问题
下一章处理:哪些变量须控制住,剩下的怎么记进结果。
六、热决定你测到的是什么
8.1 一句话点题:热与频率在测量中的主导地位
同一台机器、同一段场景、同一套采集口径,只要起始温度不同,我们量到的就不是同一个东西。热状态与频率状态不落进记录,两次读数就失去可比性,这也是本章先讲热的原因。
8.2 原理与概念:DVFS 与热节流
先看看这一节的两个概念。要说清热怎么改写读数,得先看清频率是谁在调。答案是动态电压频率调节(Dynamic Voltage and Frequency Scaling, DVFS):它让频率随负载与温度持续变动。
负载上来,系统里的调节器(governor)抬升工作点;工作点是一对参数——频率(frequency)与供电电压(voltage);瞬时功耗随之上抬,结温跟着上升;热管理介入,也就是常说的热节流(thermal throttling),再把工作点压回去。
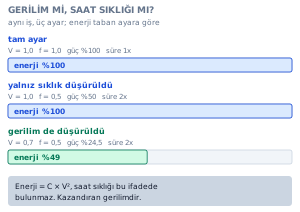
同等工作量下只把频率减半:瞬时功耗减半、耗时翻倍,总能耗不变;只有电压也降到 0.7,能耗才落到原来的 49%。原因在于每次操作的能耗写出来是 E = C × V²,这个式子里根本没有频率。
触发与恢复之间还有迟滞(hysteresis):恢复点通常低于触发点,同一个温度读数可能对应两个不同的频率状态。
三重影响叠起来是这样的:频率改写功耗(P ≈ αCV²f);温度改写漏电(leakage),漏电再回到功耗;功耗推高温度,温度拉低频率。在这个回路里,温度是状态量,不是结果。
8.3 原理与概念:峰值不等于持续
好了,峰值与持续分开看。同一台机器在冷机与热平衡两种状态下,本来就是两个工作点。 行业里把这两个工作点叫作峰值(burst)与持续(sustained):短跑测到的是峰值,热平衡之后测到的是持续。
Notebookcheck 的高负载测试口径下,多数机型在 10 到 15 分钟之间衰减到峰值的约 70%(Notebookcheck 测试方法,第三方实测值)。
下面我们进入实测。同一口径下,红魔 9S Pro 的 60 分钟长时测试给出两个数字:平均帧率从 90 掉到 72 fps,触控延迟从 28 升到 53 ms(同源,第三方实测值)。
常见的宣传口径是「持续性能约为暴发的 50–65%」,它没有给出可追溯的测试方法。一个数字如果说不清是怎么测的,它在协议里就是不合格的,我们的处理是标注出来、不参与判定。
8.4 实现与配置:控制变量清单
- 屏幕亮度与自动亮度:固定亮度并关掉自动亮度。
- 分辨率与渲染缩放:固定输出分辨率与渲染比例。
- 刷新率与帧率上限:固定刷新率,必要时锁帧率上限。
- 电池电量与充电状态:固定电量区间,明确是否边充边跑。
- 后台与网络:清后台,断网或固定网络状态。
- 环境温度与风道:记录环境温度,明确是否垫散热垫、是否有风。
言归正传,说回读数来源。Android 官方的能耗性能分析器读的是设备端电源管理器(On-Device Power Monitor, ODPM)的电源轨(power rail)数据,测的是设备一级的功耗,并不针对某个应用(Android 官方能耗分析器)。
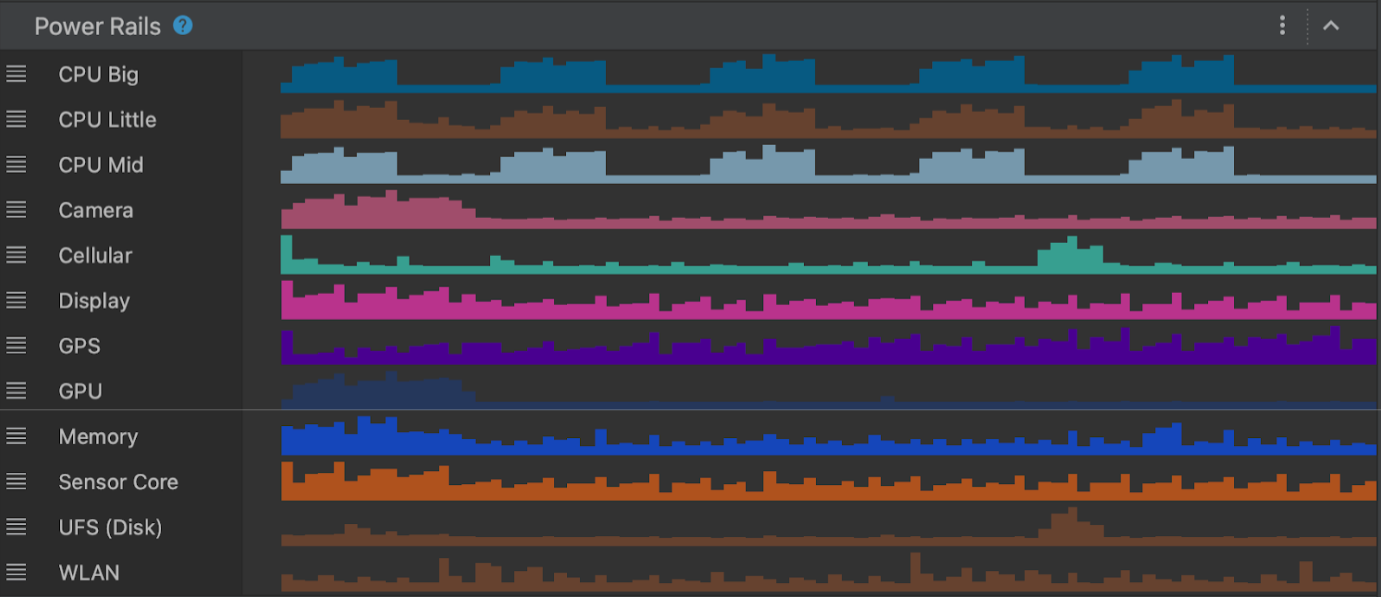
亮度对功耗的影响幅度只有「不同亮度下差异从 42% 缩到 9%」这类没有测试方法的说法,只能算现象举例。
8.5 实现与配置:把热状态记进结果
先来看看落盘字段。读数只有配上环境,才是可比的。
| 字段 | 取值方式 | 为什么必须留 |
|---|---|---|
| 设备型号与个体编号 | 机型 + 序列号后四位 | 区分同型号不同个体 |
| 系统与驱动版本 | 系统 build + GPU 驱动版本 | 驱动版本会改热策略 |
| 环境温度 | 独立温度计 | 散热边界条件 |
| 起始机身温度 | 背面固定点 | 决定起跑线 |
| 采样时刻温度 | CPU / GPU / 电池三处 | 判定是否已进入稳态 |
| 采样时刻频率 | CPU / GPU 频点 | 判定是否已被降档 |
| 热余量读数 | getThermalHeadroom |
平台给出的统一口径 |
| 预热时长与跑测时长 | 秒 | 决定读数落在哪一段 |
| 是否锁频、是否充电 | 布尔 | 影响可比性 |
表里的字段分成四组:设备与环境划出边界,采样时刻的温度与频率说明读数落在哪一段,热余量给出平台刻度,跑测条件决定可比性。缺一组,读数就只能自己跟自己比。
adb shell dumpsys thermalservice
adb shell cat /sys/class/thermal/thermal_zone0/temp
adb shell cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_cur_freq
adb shell dumpsys battery
其中:thermal_zone0/temp 是机身温度采样,scaling_cur_freq 是当前频点。
8.6 效果与量化:同机两次测量的热漂移量级
| 时间窗口 | 读数漂移量级 | 依据 |
|---|---|---|
| 前 10 分钟以内 | 个位百分比 | 尚未进入首次降档,漂移主要来自调节器抖动 |
| 10–15 分钟 | 约 30% | 衰减到峰值约 70%(第三方实测,换算) |
| 60 分钟长时 | 帧率约 20%、触控延迟近 90% | 90 → 72 fps、28 → 53 ms(第三方实测,换算) |
(表内为量级参照,由前文第三方实测的衰减幅度换算而来,不是我们自己的实测;凡要用于具体结论,须在目标机型上自行复测。)
「我们优化了 15%」这句话,如果不写清测了多久、起始温度多少,大家没法判断它是优化还是热漂移。
8.7 源码与数据链接
- AOSP 电源与性能、Android 官方能耗分析器、Android ADPF 热管理、Android 渲染时间。
- Notebookcheck 测试方法。
- Voltage versus frequency scaling energy tr.svg、Perfetto GPU 数据源、Arm Streamline 学习路径、Android 游戏性能优化。

Arm、Qualcomm、Imagination 等厂商的 profiler 界面与实测曲线不可转载,本章用到的温度-频率关系图与漂移曲线都由本系列自绘,数据取自上列公开来源。
8.8 这一章留下的问题
热把「测多久」变成了协议的一部分,但它只回答了读数会变,没回答该以哪一段时间为准。
七、先定位,再优化:判定与对照实验
9.1 一句话点题:定位流程五步
优化之前先证明瓶颈在哪,证明不了就别动代码。 五步是固定的:定现象 → 采数据 → 判阈值 → 做对照 → 分场景结论。
这五步的顺序不能颠倒:先有现象才有数据,先有数据才谈阈值,先有阈值才谈对照,最后才把结论按场景分开陈述;跳过任何一步,后面的判断都会失去依据。
9.2 原理与概念:判定阈值
下面我们进入阈值。Android 官方给出一组分流阈值(Android 游戏优化总览、Android 游戏性能优化,官方口径):
- GPU 受限:渲染硬件接口(Rendering Hardware Interface, RHI)线程耗时持续 > 30 ms;GPU 完成时间 > 25 ms;GPU 利用率 > 90%。
- CPU 受限:CPU 利用率 > 15%,且 GPU 利用率与帧率同时偏低。
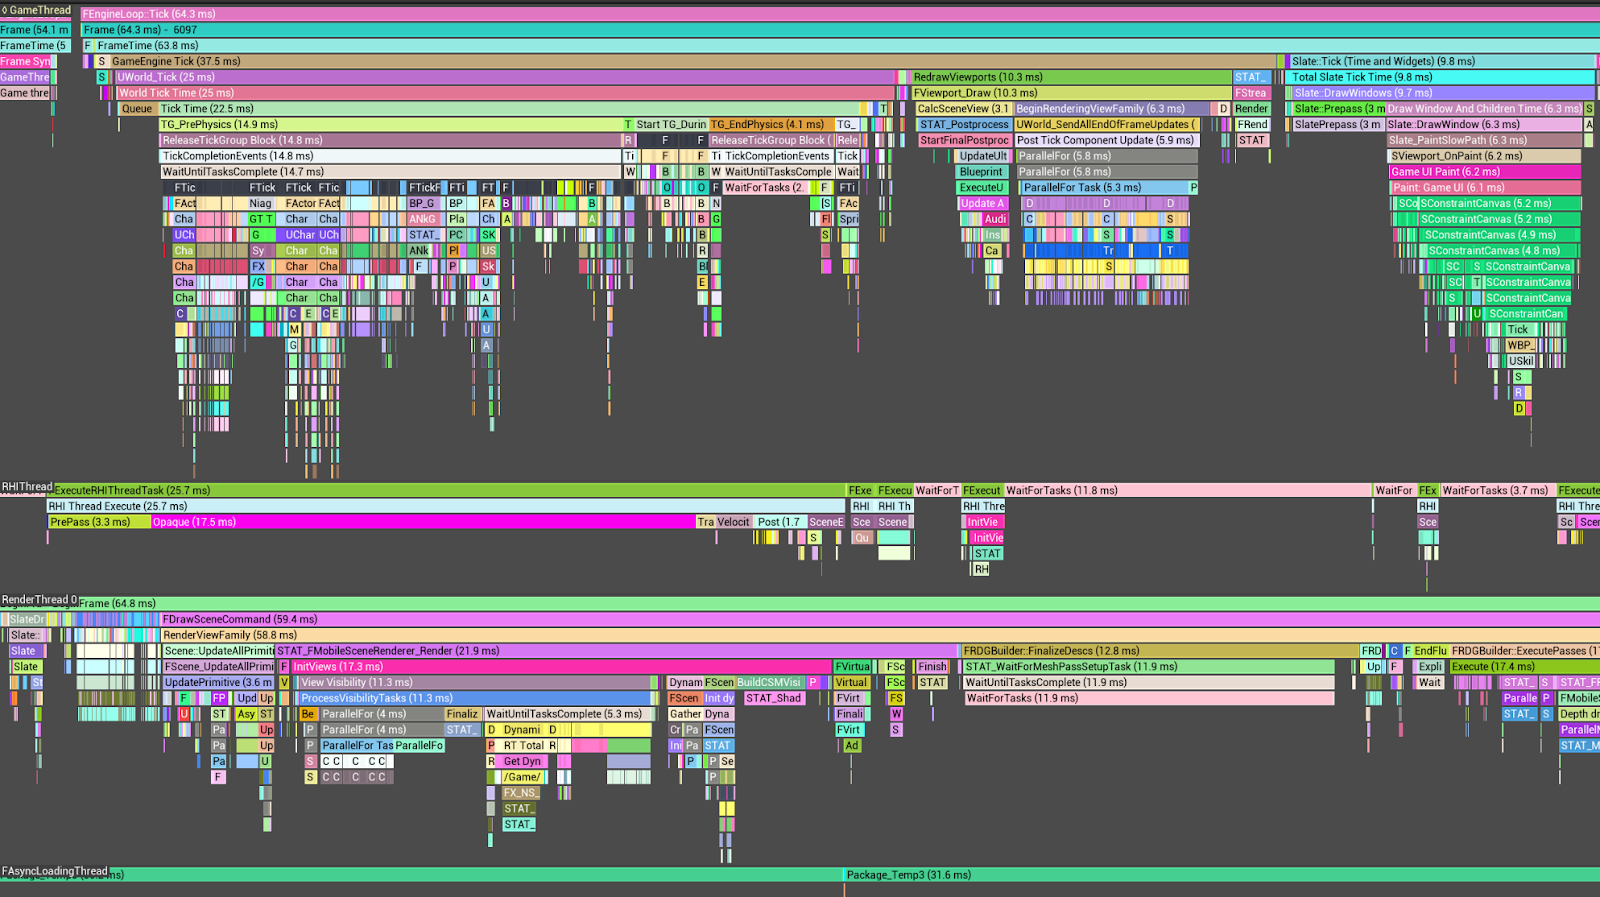
三条线程里 RHI 那一栏最能说明问题,它代表提交之后到 GPU 完成的等待,这就是阈值的定义式依据。这一栏持续超线,瓶颈就已经落在 GPU 侧;反过来,三条线程的耗时都不高而帧率上不去,就该往 CPU 侧去找。
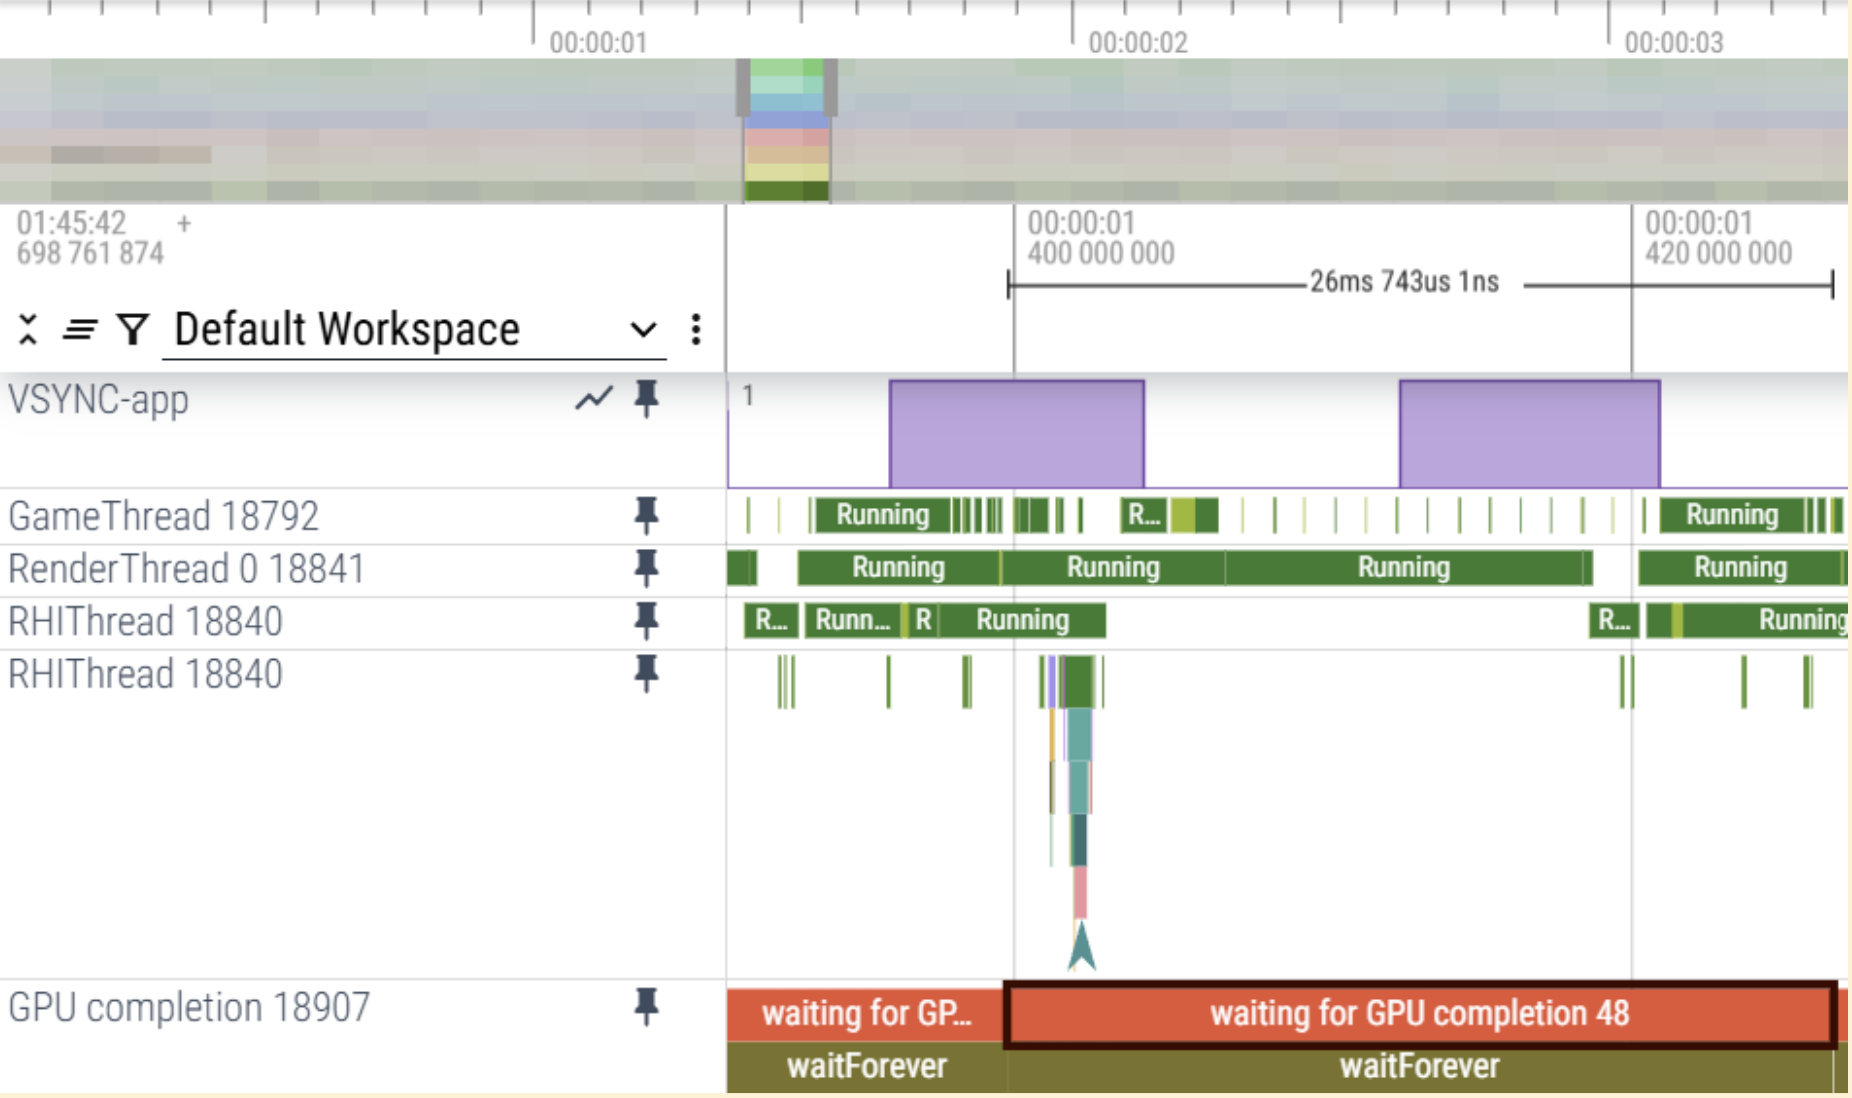
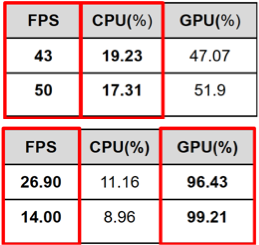
两条都不满足的中间地带最需要小心。
9.3 实现与配置:对照实验法
好了,看对照实验怎么设计。这一步只能靠对照实验,核心是一次只改一个变量,而且改的必须是能放大瓶颈的那个变量。改的变量若没落在瓶颈上,读数不动只能说明这次没碰到真正的成本项。
| 对照 | 自变量 | 预期读数变化 | 能排除什么 |
|---|---|---|---|
| 分辨率减半 | 渲染像素量 | 帧率大涨 → GPU 侧 | 瓶颈不在像素侧 |
| 关后处理 | Bloom / SSAO / 色调映射开关 | 帧时间增量落在这几段 | 后处理链的成本占比 |
| 减 AI 与物理 | 实体与碰撞数量 | 帧率跟随逻辑负载 | CPU 侧的逻辑成本 |
| 换渲染路径 | 前向 / 延迟 | 大改动,仅在上三步同向时用 | 路径级取舍 |
引擎侧的帧时间口径可以直接对表读(Unity 帧时间管理、UE 移动端帧节奏)。
9.4 效果与量化:分场景量化
固定起点与终点、固定镜头路径、固定敌我数量与画质档位。
先来看看分场景怎么切。分场景读数有三条可比性前提:段的边界由可重放的脚本定义(不是人工掐表);每段的样本量足够;段的划分在 A/B 两侧完全一致。用 Perfetto 的 FrameTimeline 判段,比用帧率阈值判段更贴近感知(Perfetto FrameTimeline)。
工具侧的选择按问题走:要逐帧分阶段时间戳用 gfxinfo framestats(dumpsys 用法);要看系统级时间线用 Perfetto(Perfetto GPU 数据源);要看计数器用 AGI(AGI 入门、AGI 系统分析器)。经验值是三到六段。
adb shell dumpsys gfxinfo com.example.app framestats
adb shell dumpsys gfxinfo com.example.app
adb shell dumpsys SurfaceFlinger --list
adb shell perfetto -o /data/misc/perfetto-traces/trace_file.perfetto-trace -t 20s sched freq gfx view
其中:framestats 是逐帧的分阶段时间戳,Perfetto 那条是系统级时间线。
9.5 源码与数据链接
- Android 游戏性能优化
- Android 渲染时间、Android 帧节奏
- dumpsys 用法、Perfetto FrameTimeline、Perfetto GPU 数据源
- AGI 入门、AGI 系统分析器
- Unity 帧时间管理、UE 移动端帧节奏
本章三张截图取自 Android 官方文档(站点其他内容 CC BY 2.5),署名与许可见文末图片版权表。
9.6 这一章留下的问题
定位把瓶颈分成了两类,对照实验把责任落到了具体改动上。
八、目标是稳态而不是峰值:长时测量
10.1 一句话点题:性能目标与热限制的关系
产品要守的是一段时长里的下限,不是峰值。 帧预算封住上限——60 Hz 下一帧 16.7 ms,120 Hz 下一帧 8.3 ms,超过就是 jank(Android 渲染时间,官方口径)。
说白了,两个预算各管一头。峰值与下限是两件事:帧预算管一帧之内的上限,热预算管一段时间里的下限,可持续区间就落在两者之间;测量要回答的,是这段区间有多宽、何时开始收窄。
10.2 原理与概念:热余量 API
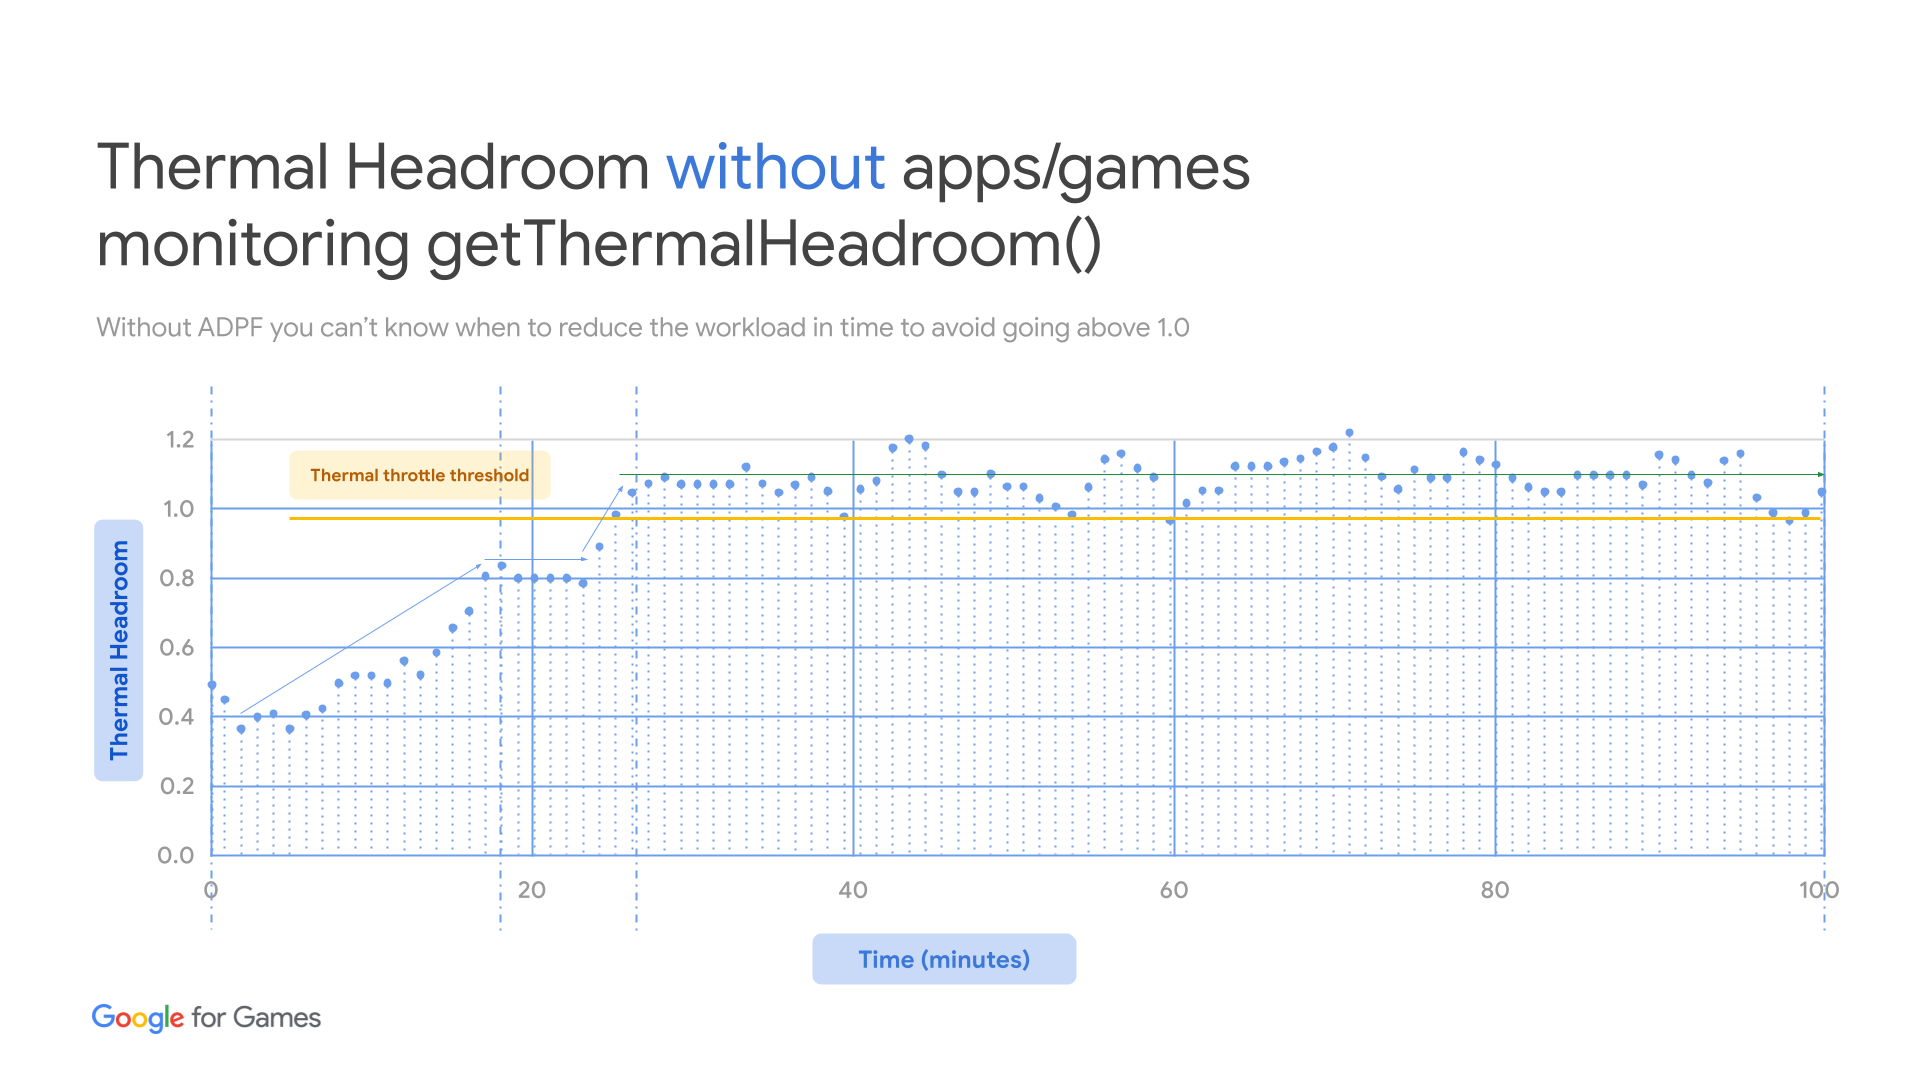
平台给的是 getThermalHeadroom,也就是热余量(thermal headroom):取值从 0.0 到 1.0,1.0 表示还有余量,越接近 0 越接近热极限(Android ADPF 热管理,官方口径)。它属于 Android 动态性能框架(Android Dynamic Performance Framework, ADPF):各家温度传感器的位置、刻度、滤波都不一样,「机身 42 摄氏度」在两台机器上不是同一件事。
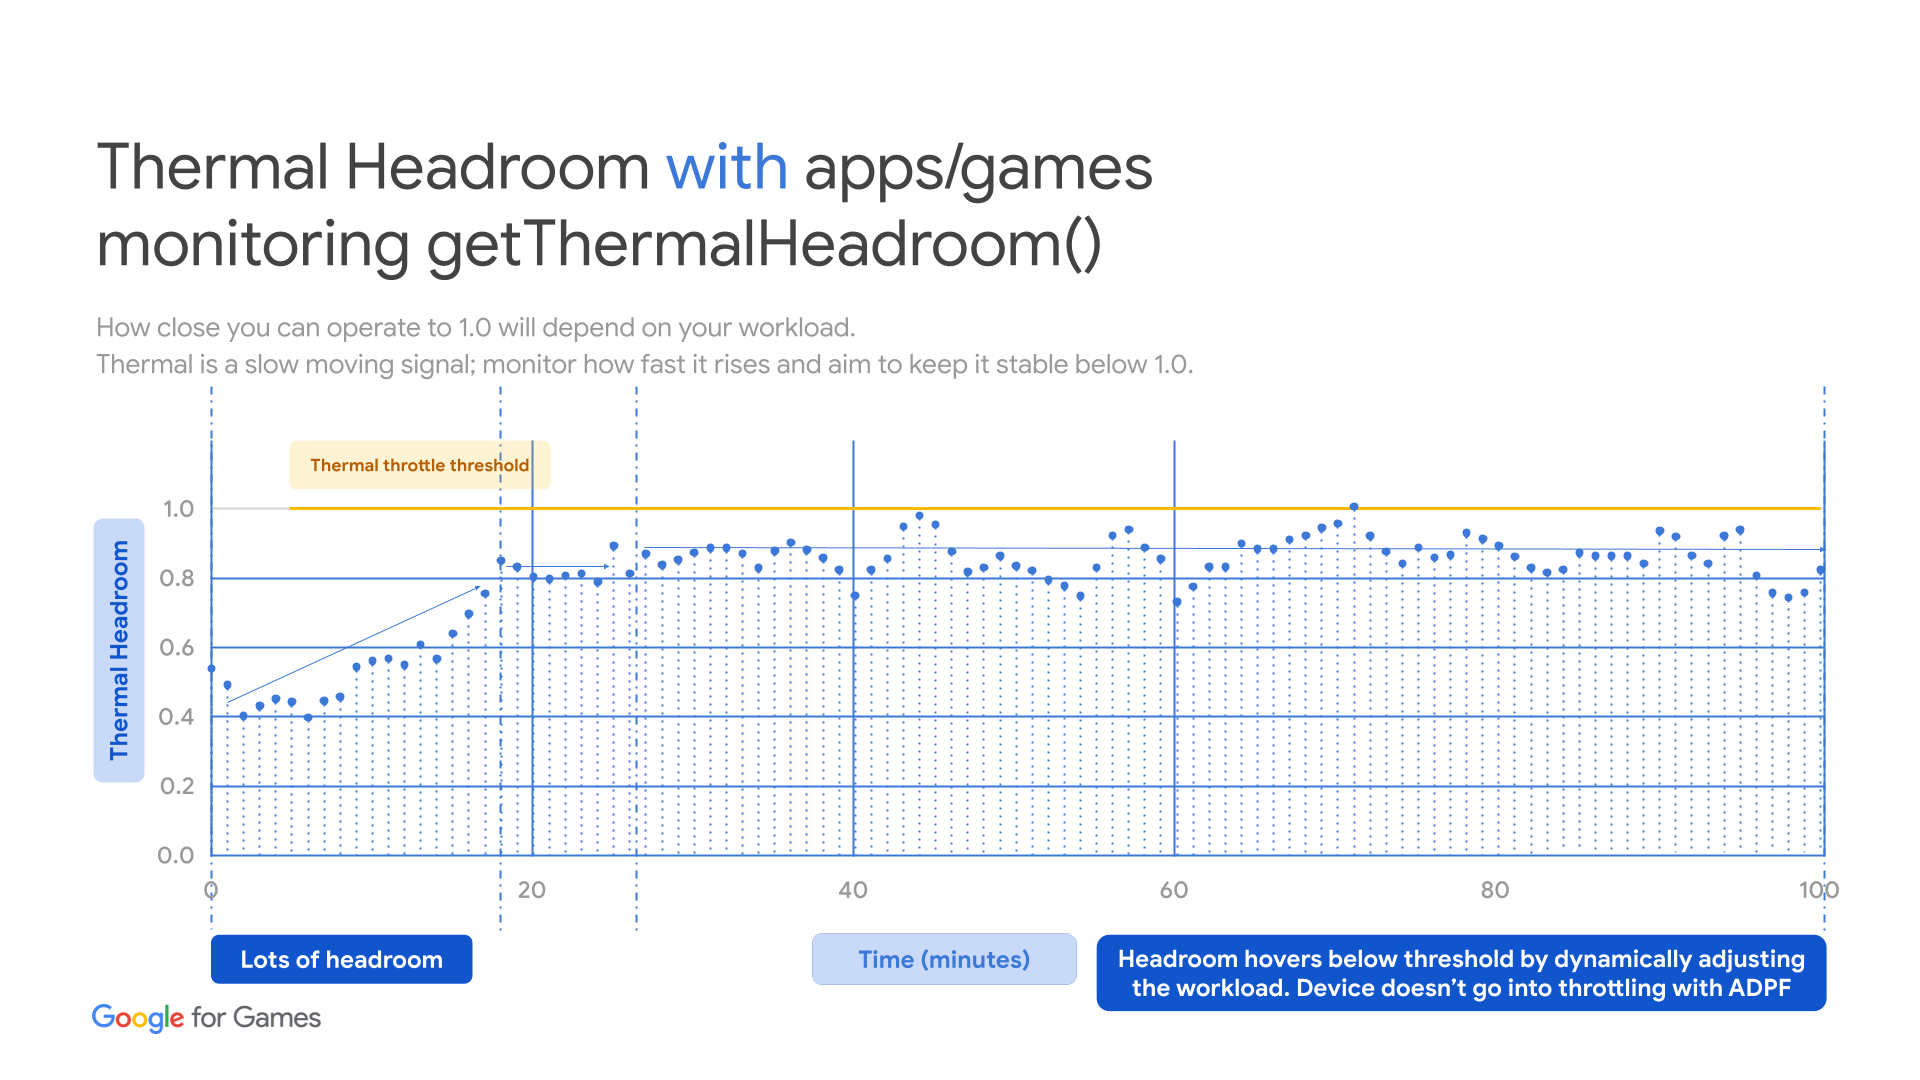
下面开始看这条 API 的用法。用它有一条硬限制:调用频率不得高于每 10 秒一次,超过就返回 NaN(官方原文)。
余量与温度并不同向:温度是瞬时量,余量是滤波后的预测值。
PowerManager pm = getSystemService(PowerManager.class);
float headroom = pm.getThermalHeadroom(10);
int status = pm.getCurrentThermalStatus();
Log.d(TAG, "headroom=" + headroom + " status=" + status);
其中:getThermalHeadroom 是热余量,10 是预报窗口的秒数。
10.3 原理与概念:持续性能模式
平台给出的机制是持续性能模式(sustained performance mode),自 Android 7.0 起在系统侧提供支持(AOSP 电源与性能),代价是峰值被削掉一截。削掉的幅度不写进文档,只能靠长时测试量出来,得自己跑一遍。
另一条路是锁频(frequency locking):好处是去掉调节器抖动;坏处是它与平台的热策略直接冲突。
| 做法 | 抖动 | 峰值 | 与平台的关系 |
|---|---|---|---|
| 不干预 | 大 | 完整 | 完全交给平台 |
| 锁频 | 小 | 完整 | 与热策略冲突,可能被覆盖 |
| 持续性能模式 | 小 | 被削 | 与平台协商 |
10.4 实现与配置:长时测量的设计
| 档位 | 时长 | 用途 | 不能用来做什么 |
|---|---|---|---|
| 冒烟档 | 30 秒 | 确认链路通、口径对、数据能落盘 | 不做任何性能结论 |
| 中长档 | 5 分钟 | 跨过多数机型的首次降档 | 代表不了稳态 |
| 长时档 | 30 分钟 | 观察稳态与二次降档 | 不适合放进每次提交的门禁 |
采样与掉线处理有三条规矩:采样间隔固定;掉线只做标记、不做插值;对齐用时间戳、不用序号。
时长之外还有一条纪律:同一档位内的跑测次数要固定。30 分钟档跑两次与跑五次,中位数本身的稳定性差别很大。跑测次数不固定,这条纪律就落不了地。
10.5 效果与量化:三档时长下的结论差异
好了,把三档差异摆出来。下面这张表是机制性的预期,依据来自前面已经引用过的第三方实测(10–15 分钟衰减到约 70%、60 分钟帧率 90 → 72 fps),不是我们自己的跑测数字。
| 档位 | 假设的 A/B 差异 | 能不能下结论 |
|---|---|---|
| 30 秒(冷机) | 差异落在噪声内 | 不能,冒烟档只验链路 |
| 5 分钟 | 差异小于噪声量级 | 不能,最多算观察 |
| 30 分钟 | 差异大于漂移量级 | 可以,但须附热状态字段 |
10.6 源码与数据链接
- 平台与官方口径:Android ADPF 热管理、AOSP 电源与性能、Android 渲染时间、Android 帧节奏
- 采集工具:Perfetto FrameTimeline、dumpsys 用法、Android 游戏性能优化
- 第三方实测与测试方法:Notebookcheck 测试方法
本章两张热 API 截图取自 Android 官方文档(站点其他内容 CC BY 2.5),署名与许可见文末图片版权表;其余曲线与结构图由本系列自绘。
第三方实测的衰减幅度只用于说明量级,没有参与任何判定。
九、让回归自己冒出来:把测量接进 CI
11.1 一句话点题:人工比对与门禁判定的差别
人工比对与门禁判定的差别不在精度,在可重复性。这套判定的原理是:让阈值与统计替人做判断。门禁判定把这些都交给同一套阈值与统计,跑一次和跑一百次给出同一个答案。同一份曲线换个人看,结论就可能不同。
11.2 实现与配置:真实设备与锁频
下面我们进入设备。第一件事是别用模拟器:模拟器没有真实的 GPU 驱动栈、没有 DVFS、也没有热行为(Android CI 基准测试,官方口径)。
第二件事是靠锁频压噪声:把频率钉住之后,同一个样本的离散度会明显收窄。
第三件事是设备池与热等待:上一轮跑完的机器是热的,如果不等冷却就开下一轮,第 N 轮的起跑温度就是第 N−1 轮的残留。热等待的时长也要写进跑测条件。
设备池的规模也有下限:一台机器跑不出个体差,三台以上才有意义。
11.3 实现与配置:相对基线的容差判定
回归判定的对象是相对基线的变化量。
选中位数是有理由的:均值会被长尾拖走,而移动端的帧时间天生有长尾。容差窗口之外还要加抖动抑制,三条一起用:扔掉每个跑测窗口的首轮样本(预热期);取中位数;连续 N 轮同向才算回归。
先看看这个窗口怎么定。容差窗口的宽度应当由噪声决定:先在同一版本上连跑 N 轮,再把窗口设在分布的 95% 分位附近。
11.4 实现与配置:用统计检验而非肉眼
判定链是固定的四步:先构造配对差值(paired difference)(同一台机器上交替跑 A 与 B,取每对的差),再对差值做置信区间(confidence interval),然后看区间有没有跨过 0,最后看效应量(effect size)。
paired = [a - b for a, b in zip(A, B)]
lo, hi = bootstrap_ci(paired, 0.95)
if lo <= 0 <= hi:
    return "no-diff"
return "regression" if abs(effect_size(paired)) >= gate else "significant-only"
其中:配对差值是同一台机器上 A 与 B 的逐对之差,95% 是区间分位。
第二步是整条链的关键:区间含 0 就不能宣称有差异。
配对差值这一步有个前提:A 与 B 必须交替跑,不能先跑完 A 再跑 B。
显著不等于值得改。样本量足够大时,0.5% 的差异也能被检出为显著,但为它排一次重构未必划算。门禁可以做两档:显著即报警,效应量超过人工设定的门槛才算回归。
11.5 效果与量化:CI 上的六类干扰源
CI 上最常出现的干扰源有六类:设备个体差、系统与驱动更新、后台任务与温控策略、设备热历史、采集工具自身开销、以及把一次跑分当基线。
好了,这一类单独说。第五类值得单独展开:开发者选项里的「GPU 呈现模式」本身也在读 gfxinfo,所以它算一个工具(Android 渲染时间、dumpsys 用法)。测量工具的开销污染结果这件事,在方法学上有专门的经验总结可参考(FOSDEM 测量方法演讲、Google Benchmark 工具说明)。
第六类的后果最隐蔽:一次跑分里含着当时的起始热状态,把它当基线,等于把那一刻的温度固化成了判据。发布门禁的统计判据怎么设,有专门的工程讨论可查(不可确定系统的统计决策、性能 A/B 方法页)。
11.6 源码与数据链接
- CI 与基准测试(官方口径):Android CI 基准测试、AOSP 电源与性能
- 采集与口径:dumpsys 用法、Perfetto GPU 数据源、Perfetto FrameTimeline
- 指标与口径说明(第三方):CapFrameX 指标说明、Notebookcheck 测试方法
- 方法学与门禁判据:FOSDEM 测量方法演讲、Google Benchmark 工具说明、不可确定系统的统计决策、性能 A/B 方法页
- 基准条款(跑分口径的约束):UL Benchmark Rules
先来看看怎么落地。落地顺序建议是「先采集、再判定、后门禁」:第一步只把数据跑出来并落盘,不设任何阈值;第二步在历史数据上离线试算容差与轮数;第三步才把判定接进提交流程。
11.7 这一章留下的问题
六个信号入了门禁,回归能从流水线里自己冒出来了,但门禁只能守住我们量得到的东西。
十、把机制收束成可验证:七篇的账
12.1 一句话点题:哪些结论已被验证、哪些只是解释
说白了,这一章做的是对账。前六篇讲了六层机制,这一章把它们分成两堆:哪些结论已经被独立证据验证过,哪些目前只是解释。 两栏的界限,决定了哪些数字能直接引用、哪些不能。
12.2 全量回收:前六篇的量化结论
| 结论 | 数值 | 来源类型 | 可否独立复核 |
|---|---|---|---|
| 帧预算 | 60 Hz → 16.7 ms;120 Hz → 8.3 ms | 平台官方口径(Android 渲染时间) | 可(定义式,无争议) |
| 延迟着色经典四段账 | 写 4 + 读 ≥4 + 混合 ≥2 ≈ 10 BU | 厂商口径(Khronos 的移动端最佳实践) | 部分(须先复现其 BU 定义) |
| 片上路径下的账 | 约 1 BU | 厂商口径(同上一行来源) | 部分(可用带宽计数器反推) |
| 内存能耗量级 | RAM 约 100 pJ 对片上缓存约 10 pJ | 厂商口径(来源见参考资料第三组) | 部分(只能靠计数器间接验证) |
| 持续性能占暴发的比例 | 50–65% | 无测试方法可追溯,不给出来源 | 不可(本系列不作判据) |
| 长时帧率与触控延迟 | 90 → 72 fps;28 → 53 ms | 第三方实测(Notebookcheck 测试方法) | 可(同一测试方法可复现) |
| 结论 | 数值 | 来源类型 | 可否独立复核 |
|---|---|---|---|
| 隐藏面消除的红利 | 应用提交 4.7 fragments/像素 → 实际着色 1.2(少 75%) | 厂商实测(PowerVR 的 GDC 2020 材料) | 可(同型号硬件上可重复) |
| 分块带来的削减 | tile 数与带宽各约 −55% | 厂商口径(来源见参考资料第三组) | 部分 |
| 片上预算硬线 | 每像素 128 bit(Mali-G72 起 256 bit) | 引擎与厂商官方口径(Khronos 的移动端最佳实践) | 可(引擎文档里写死) |
| 合并失败的指纹 | 片段任务约翻倍(56/s → 113/s) | 官方样例(Khronos 的子通道样例,见本系列第五篇) | 可(样例可下载复现) |
| 结论 | 数值 | 来源类型 | 可否独立复核 |
|---|---|---|---|
| 双缓冲对三缓冲 | 33.4 ms(30 fps)→ 16.7 ms(60 fps) | 官方样例(Vulkan-Samples 的 swapchain_images) | 可(仓库可下载、步骤公开) |
| 移动端光栅优化(Crytek Neon Noir on Mali-G76) | 单帧 78 ms(12 fps)→ 减 33 ms → +43% → 22 fps | 厂商演示(Arm 的 Mali 驱动与 AGI 材料) | 部分(演示场景非公开) |
| memcpy 占比与帧率(Cocos2d-x + Streamline) | 54.62% → 9.10%;11.3 → 17.2 fps | 厂商案例(Arm 的 Cocos2d-x 案例) | 部分(可在自己工程上自测同类改动) |
| GPU 受限判定阈值 | RHI > 30 ms;GPU 完成 > 25 ms;利用率 > 90% | 平台官方口径(Android 游戏性能优化) | 可 |
| CPU 受限判定阈值 | CPU 利用率 > 15%,且 GPU 与帧率双低 | 平台官方口径(同上一行来源) | 可 |
还有两条属于「测量口径」而非性能结论,一并回收。
先看看这两条口径。一条是 Apple 的卡顿门禁:以 ms/s 计,≤10 良好 / ≤25 警告 / ≤50 严重(Apple 官方口径)。另一条是两个跑分判例:三星 GOS 使 Wild Life Extreme 从 2618 掉到 1141,华为 P7 因针对基准优化虚高最高 28%;行业处置是永久除名与取消资格,条款依据写在 UL Benchmark Rules 里。
{
  "gpu_limited": { "rhi_ms": 30, "gpu_finish_ms": 25, "util_pct": 90 },
  "cpu_limited": { "cpu_util_pct": 15, "gpu_low_and_fps_low": true }
}
其中:RHI 是渲染硬件接口线程的耗时,25 是 GPU 完成时间的阈值。
前六篇的结论也能逐条挂到规范与厂商页上:
| 前六篇结论 | 来源 | 可复核程度 |
|---|---|---|
| 网格着色 | VK_EXT_mesh_shader 提案、Vulkan 规范 · VK_EXT_mesh_shader、interplay of light · meshlets、krupitskas · 现代剔除、tmarrec · meshlet 剔除、linebender · 网格着色 | 部分 |
| VRS 与降低精度 | NVIDIA VRS、Godot VRS、Wikipedia VRS、Android · Vulkan 降低精度 | 部分 |
| 移动光追的遍历 | Vulkan 规范 · 光线遍历 | 可 |
| 动态渲染与片上路径 | VK_KHR_dynamic_rendering、VK_KHR_dynamic_rendering_local_read | 可 |
| 子通道合并失败的指纹 | VkSubpassMergeStatusEXT、Vulkan 规范 · 渲染通道 | 可 |
| 移动端光栅优化 | Vulkan 规范 · 图元光栅化 | 可 |
| 内存能耗量级 | PowerVR · 硬件架构概览 | 部分 |
| 分块带来的削减 | Qualcomm · 移动端最佳实践、Arm 开发者文档 101897 | 部分 |
| 引擎侧口径 | Unity · 时间与帧管理、Unreal · 移动端渲染特性 | 可 |
12.3 效果与量化:一份可复现清单
下面开始把协议收成清单。配上第五章的样本量结论(单轮 N=30 时变异系数 6.95%,N=90 降到 4.59%;重复 M=5 把跨轮变异系数从 11.80% 压到 2.94%),这五条就构成完整协议。
字段的价值在于每一项都能落到一次可复跑的采集上。
| 组 | 字段 |
|---|---|
| 设备 | 机型、个体编号、系统 build、GPU 驱动版本 |
| 场景 | 场景脚本、镜头路径、画质档位、分辨率与渲染缩放 |
| 口径 | 帧时间来源、统计量、样本量、重复次数、工具与版本 |
| 热 | 环境温度、起始机身温度、采样时刻温度、频率、热余量、跑测时长 |
| 判定 | 基线指纹、容差窗口、判定方法、连续同向轮数 |
12.4 原理与概念:证明不了的部分
言归正传,说回边界。第一类证明不了的是因果:混杂因素(confounder)与中介变量(mediator)在图上长得很像,但两者的含义完全不同:前者必须被控制,后者恰恰是机制本身。现有工具能指到位置,却替不了这一步。
十一、结语与系列收尾
13.1 效果与量化:系列七篇的索引与阅读路径
| 篇 | 主题 | 一句话价值 |
|---|---|---|
| 一 | 两台不同的机器:移动 GPU 的物理约束 | 先说清约束,后面才谈取舍 |
| 二 | 分块渲染:binning、片上内存与它的代价 | 分块的收益与三笔代价 |
| 三 | 带宽:移动端最硬的那道墙 | 四类手段的收益排序与验证 |
| 四 | 功耗与热:帧率为什么会掉下去 | 可持续帧率与热闭环 |
| 五 | 延迟着色在移动端:能做什么、不能做什么 | 一拆 pass 就前功尽弃 |
| 六 | 现代特性落地:VRS、网格着色与移动光追 | 开了不等于生效 |
| 七 | 测量与调优:怎么证明你真的优化了 | 把结论变成可复核的证据 |
七篇的顺序不是随意的:先立约束、再谈手段、最后讲证法,前面的结论在后面的篇里被当成条件使用。想解决某个具体问题的读者,可以直接跳到对应的一篇。
顺着这份索引回看整条线:第 1 篇立约束、第 2 篇谈机制、第 3、4 篇分别算字节账与焦耳账、第 5 篇拿去审延迟着色、第 6 篇落地新特性,最后这篇把每篇的结论都收到「可复核的证据」上——篇篇独立可翻,但连起来才是一套完整的证法。
13.2 实现与配置:源码与数据链接
- 规范层:Vulkan 规范与 Khronos 样例(Vulkan 时间戳查询样例、Vulkan-Samples 三缓冲样例)。
- 平台层:Android 与 AOSP 的口径页(Android 渲染时间、Android ADPF 热管理、AOSP 电源与性能)。
- 厂商层:Arm 与高通的分析工具文档(Arm Streamline 学习路径、Snapdragon Profiler 文档)。
- 工具层:采集工具(Perfetto GPU 数据源、dumpsys 用法)。
- 素材层:外部图片的许可与署名,见文末图片版权表;Android 站点其他内容按 CC BY 2.5(Android 站点许可),AOSP 站点其他内容按 CC BY 4.0(AOSP 站点许可)。
Android 文档站点的文档内容是 Apache-2.0,但站点其他内容(含配图)是 CC BY 2.5,不是常见的 CC BY 4.0;AOSP 站点才是文档 Apache-2.0、其他内容 CC BY 4.0。
素材检索留痕(Commons):Commons 与本主题(移动端 GPU 的测量与调优)重合度极低,下列类目页与文件页记录的是检索路径,不都是本篇的引用来源。


13.3 效果与量化:写给下一个系列
三个还没答完的问题,留给下一个系列:
一是跨设备的下限。本篇协议都是在单机上立的,换一台机器、换一颗芯片,同一条结论还能不能守住,需要一套跨机型的方法。
二是自动化的边界。回归能自动跑,但「为什么慢了」仍然要人来看;能自动化到哪一步、哪一步必须留给人,还没有答案。
三是能耗与画质的联合判定。本篇把性能和功耗分开量,但产品要的是两者的比值——这个比值怎么定义、怎么进门禁,是下一个系列的第一个问题。
参考资料
本篇正文在每处论点就近给出了出处;以下是完整来源清单,分七组排列,涉及数字与条款的条目都能回溯到原文,便于逐条查证与延伸阅读。
一、平台与官方口径(Android / AOSP / Perfetto / Apple)
- https://developer.android.com/tools/dumpsys
- https://developer.android.com/agi/start
- https://developer.android.com/agi/sys-trace/system-profiler
- https://developer.android.com/agi/frame-trace/renderpasses
- https://developer.android.com/agi/frame-trace/frame-profiler
- https://developer.android.com/studio/profile/jank-detection
- https://developer.android.com/studio/profile/energy-profiler
- https://developer.android.com/studio/profile/cpu-profiler
- https://developer.android.com/games/optimize
- https://developer.android.com/games/optimize/gameperformance
- https://developer.android.com/games/optimize/vulkan-reduced-precision
- https://developer.android.com/games/optimize/adpf/thermal
- https://developer.android.com/games/sdk/frame-pacing
- https://developer.android.com/topic/performance/benchmarking/benchmarking-in-ci
- https://developer.android.com/topic/performance/vitals/render
- https://developer.android.com/license
- https://source.android.com/license
- https://source.android.com/docs/core/power/performance
- https://perfetto.dev/docs/data-sources/gpu
- https://perfetto.dev/docs/data-sources/frametimeline
- https://developer.apple.com/documentation/xcode/understanding-hitches-in-your-app
- https://developer.apple.com/documentation/xcode/analyzing-the-performance-of-your-metal-app/
二、Vulkan 与 Khronos:规范、参考页与官方样例
- https://docs.vulkan.org/guide/latest/profiling.html
- https://docs.vulkan.org/refpages/latest/refpages/source/vkCmdWriteTimestamp.html
- https://docs.vulkan.org/refpages/latest/refpages/source/vkGetCalibratedTimestampsKHR.html
- https://docs.vulkan.org/spec/latest/chapters/queries.html
- https://docs.vulkan.org/samples/latest/samples/api/timestamp_queries/README.html
- https://docs.vulkan.org/spec/latest/chapters/primsrast.html
- https://docs.vulkan.org/spec/latest/chapters/renderpass.html
- https://docs.vulkan.org/spec/latest/chapters/raytraversal.html
- https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- https://docs.vulkan.org/features/latest/features/proposals/VK_EXT_mesh_shader.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_KHR_dynamic_rendering.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_KHR_dynamic_rendering_local_read.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkSubpassMergeStatusEXT.html
- https://registry.khronos.org/vulkan/specs/latest/man/html/VK_EXT_mesh_shader.html
- https://github.com/KhronosGroup/Vulkan-Samples/tree/main/samples/performance/swapchain_images
三、厂商与工具文档(Arm / Qualcomm / Imagination / NVIDIA / RenderDoc)
- https://learn.arm.com/learning-paths/mobile-graphics-and-gaming/voice-assistant/8-performance-with-streamline/
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/mali-bifrost-family-performance-counters
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/mali-gpu-drivers-and-android-gpu-inspector
- https://community.arm.com/arm-community-blogs/b/tools-software-ides-blog/posts/profiling-cocos2d-x-game-engine----ds-5-streamline-case-study
- https://developer.arm.com/documentation/101897/latest
- https://docs.qualcomm.com/doc/80-70018-19SC/topic/graphics_developer_tools.html
- https://docs.qualcomm.com/bundle/publicresource/topics/80-71528-1/snapdragon_profiler.html
- https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- https://docs.imgtec.com/tools-manuals/pvrtune-manual/html/pvrtune-manual/topics/introduction.html
- https://zeux.io/data/gdc2020_pvr.pdf
- https://imagination-technologies-cloudfront-assets.s3.eu-west-1.amazonaws.com/website-files/documents/PowerVR+Hardware.Architecture+Overview+for+Developers.pdf
- https://images.nvidia.com/content/geforce/technologies/frameview/frameview-1-7-user-guide-web-version.pdf
- https://developer.nvidia.com/blog/advanced-api-performance-variable-rate-shading/
- https://renderdoc.org/docs/index.html
- https://renderdoc.org/docs/window/performance_counter_viewer.html
四、引擎侧文档(Unreal / Unity / Godot)
- https://docs.unrealengine.com/5.2/en-US/rendering-features-for-mobile-games-in-unreal-engine/
- https://dev.epicgames.com/documentation/en-us/unreal-engine/frame-pacing-for-mobile-devices-in-unreal-engine
- https://docs.unity3d.com/2023.2/Documentation/Manual/TimeFrameManagement.html
- https://docs.godotengine.org/en/stable/tutorials/scripting/debug/the_profiler.html
- https://docs.godotengine.org/en/stable/engine_details/development/profiling/index.html
- https://docs.godotengine.org/en/latest/tutorials/3d/variable_rate_shading.html
五、测量方法论、统计与第三方实测
- https://www.capframex.com/blog/post/Explanation%20of%20different%20performance%20metrics
- https://www.capframex.com/news/detail/New%20version%201.5.3
- https://truebottleneck.com/guides/1-percent-lows/
- https://learn.padho.ai/wiki/a-b-testing-for-performance
- https://www.fosdem.org/2026/events/attachments/8AS3XD-how-to-reliably-measure-software-performance/slides/267404/presentat_rtufkjn.pdf
- https://google.github.io/benchmark/tools.html
- https://kindatechnical.com/testing-non-deterministic-systems/statistical-decision-making-for-release-gates.html
- https://benchmarks.ul.com/en/support/benchmark-rules
- https://www.notebookcheck.com/Wie-wir-testen.1948.0.html
- https://www.androidperformance.com/2026/05/04/Android-Perfetto-16-GPU-Power-Counters/
- https://interplayoflight.wordpress.com/2025/05/05/meshlets-and-mesh-shaders/
- https://krupitskas.com/posts/modern_culling_techniques/
- https://www.tmarrec.dev/posts/mesh-shaders-and-meshlet-culling.html
- https://linebender.org/wiki/gpu/mesh-shaders/
- https://en.wikipedia.org/wiki/Variable_rate_shading
六、Wikimedia Commons:外部素材逐张溯源
- https://commons.wikimedia.org/wiki/File:Boxplot_vs_PDF.png
- https://commons.wikimedia.org/wiki/File:Beispielboxplot.png
- https://commons.wikimedia.org/wiki/File:2_box_plots_-_fr.jpg
- https://commons.wikimedia.org/wiki/File:Vsync_diagram.svg
- https://commons.wikimedia.org/wiki/File:Confidence_intervals_visual.jpg
- https://commons.wikimedia.org/wiki/File:Normal_distribution_50%25_CI_illustration.svg
- https://commons.wikimedia.org/wiki/File:ComparisonConfidenceIntervals.svg
- https://commons.wikimedia.org/wiki/File:Comparing_the_Standard_Normal_Distribution_and_Student%27s_T_Distribution.png
- https://commons.wikimedia.org/wiki/File:Voltage_versus_frequency_scaling_energy_tr.svg
- https://commons.wikimedia.org/wiki/File:Faktor-mediator-confound.png
- https://commons.wikimedia.org/wiki/File:Confounding.svg
- https://commons.wikimedia.org/wiki/File:Triple_buffering.png
- https://commons.wikimedia.org/wiki/File:Double_buffering.png
- https://commons.wikimedia.org/wiki/File:Comparison_double_triple_buffering.svg
- https://commons.wikimedia.org/wiki/File:Screen_tearing_on_DOSV.png
- https://commons.wikimedia.org/wiki/File:AllanDeviation.svg
- https://commons.wikimedia.org/wiki/File:Confidence_interval_by_Standard_deviation.svg
- https://commons.wikimedia.org/wiki/File:Confidence_intervall_normal_dist.svg
- https://commons.wikimedia.org/wiki/File:P-value_in_statistical_significance_testing.svg
- https://commons.wikimedia.org/wiki/File:Repeated_Measures_ANOVA_Example.png
- https://commons.wikimedia.org/wiki/File:Main-sources-of-Type-B-uncertainty.svg
- https://commons.wikimedia.org/wiki/File:Banakuntza_normala_histograma_01.png
- https://commons.wikimedia.org/wiki/File:Videosignal_vsync.jpg
- https://commons.wikimedia.org/wiki/File:QAS_Sample_Histogram_Chart_of_Gas_Expenses.png
七、Commons 检索路径(类目枚举留痕)
- https://commons.wikimedia.org/wiki/Category:Frame_rate
- https://commons.wikimedia.org/wiki/Category:Benchmarking
- https://commons.wikimedia.org/wiki/Category:Computer_performance
- https://commons.wikimedia.org/wiki/Category:Metrics
- https://commons.wikimedia.org/wiki/Category:Statistics
- https://commons.wikimedia.org/wiki/Category:Statistical_charts
- https://commons.wikimedia.org/wiki/Category:Data_visualization
- https://commons.wikimedia.org/wiki/Category:Box_plots
- https://commons.wikimedia.org/wiki/Category:Normal_distribution
- https://commons.wikimedia.org/wiki/Category:Confounding
- https://commons.wikimedia.org/wiki/Category:Computer_cooling
- https://commons.wikimedia.org/wiki/Category:Display_technology
- https://commons.wikimedia.org/wiki/Category:Graphics_processing_units
- https://commons.wikimedia.org/wiki/Category:Analysis_of_variance
- https://commons.wikimedia.org/wiki/Category:Measurement
- https://commons.wikimedia.org/wiki/Category:Metrology
- https://commons.wikimedia.org/wiki/Category:Video_game_development
- https://commons.wikimedia.org/wiki/Category:Histograms
附录 · 图片版权
本篇共 142 张图:外部真实素材 29 张、自绘示意图 113 张。外部素材逐张核过许可,可按来源页回溯;自绘示意图由本系列按同一份色板生成。
Wikimedia Commons(逐文件许可)
| 文件 | 章 | 作者 | 许可 | 来源页 |
|---|---|---|---|---|
ext_boxplot_vs_pdf.png |
一 | The original uploader was Jhguch at English Wikipedia. | CC BY-SA 2.5 | 来源页 |
ext_boxplot_picture.png |
一 | The Twists and Turns | CC0 | 来源页 |
ext_dvfs_voltage_frequency.svg |
六 | Oğuz Ergin | CC BY-SA 4.0 | 来源页 |
ext_comparison_ci.png |
五 | KurtSchwitters, vector Habitator terrae | CC BY-SA 3.0 | 来源页 |
ext_confidence_intervals.jpg |
五 | Rohanukhade | CC0 | 来源页 |
ext_normal_ci.png |
五 | FRuDIxAFLG | CC BY-SA 4.0 | 来源页 |
ext_t_vs_normal.png |
五 | Kindredgrey | CC BY-SA 4.0 | 来源页 |

Android 开发者文档(站点其他内容 CC BY 2.5)
| 文件 | 章 | 作者 | 许可 | 来源页 |
|---|---|---|---|---|
ext_android_adpf_post.png |
八 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_adpf_pre.png |
八 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_agi_system_profile.png |
三 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_frame_lifecycle_tracks.png |
三 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_gc.png |
五 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_janky_frames_detailed.png |
二 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_jd_all_frames.png |
二 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_opt1.png |
七 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_opt6.png |
七 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_opt7.png |
七 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_power_rails.png |
六 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_trace_events_ui_renderthread.png |
三 | Android Developers | CC BY 2.5 | 来源页 |
ext_android_vitals_thread_sleep.png |
五 | Android Developers | CC BY 2.5 | 来源页 |
Perfetto 项目(Apache-2.0)
| 文件 | 章 | 作者 | 许可 | 来源页 |
|---|---|---|---|---|
ext_perfetto_app_timelines.png |
二 | Perfetto 项目 | Apache-2.0 | 来源页 |
ext_perfetto_cpu_frequency.png |
四 | Perfetto 项目 | Apache-2.0 | 来源页 |
ext_perfetto_gpu_by_process.png |
三 | Perfetto 项目 | Apache-2.0 | 来源页 |
ext_perfetto_gpu_counters.png |
四 | Perfetto 项目 | Apache-2.0 | 来源页 |
ext_perfetto_gpu_tracks.png |
三 | Perfetto 项目 | Apache-2.0 | 来源页 |
ext_perfetto_timeline_tracks.png |
三 | Perfetto 项目 | Apache-2.0 | 来源页 |
Khronos Vulkan-Samples(Apache-2.0)
| 文件 | 章 | 作者 | 许可 | 来源页 |
|---|---|---|---|---|
ext_khronos_swapchain_double.png |
二 | Khronos Group | Apache-2.0 | 来源页 |
ext_khronos_swapchain_triple.png |
二 | Khronos Group | Apache-2.0 | 来源页 |
Godot 引擎文档(CC BY 3.0)
| 文件 | 章 | 作者 | 许可 | 来源页 |
|---|---|---|---|---|
ext_godot_profiler.png |
三 | Godot Engine 文档团队 | CC BY 3.0 | 来源页 |
不可转载声明:Arm、Qualcomm、Apple、Imagination、NVIDIA、Epic、Unity、Microsoft 的图片一律不得转载;其数据可在标注口径后引用,图由本系列自绘。
七篇写到这里,机制、取舍与证法都摆上了桌。把这一路的线索收成最后一张图,这个系列就到这里。
相关链接
- 上一篇:【移动端图形与功耗】(六) 现代特性落地:VRS、网格着色与移动光追
- 下一篇(预告):下一个系列(题名待定,方向为渲染工程的实践与判定)
With Best Wishes.