公众号版文章链接:{发布后回填}
个人博客版文章链接:https://yyy3d.online/blog/cpp-language-foundations-ep01-object-layout/
系列文章前言
系列定位
这个系列只讲一层东西:同一段 C/C++,编译器和链接器对它做了什么、代价落在哪。
它不是语法教程,也不是"面试题速查"。它站在我们已经写过的三卷旁边:
《实时渲染管线探析》讲算法,移动端与 GPU 两卷讲硬件与约束,Godot、Jolt、Skia 三卷讲别人写好的引擎。
而这些引擎里天天出现的 sizeof、对齐、虚表、异常、内存序、编译时间——没有一卷专门讲它们是怎么被决定的。
所以这一卷补的就是这块地基。它跟其他卷的关系是"被引用":Godot 卷讲对象模型时会撞到空基类优化, Jolt 卷讲多核时会撞到内存序,性能剖析卷讲符号表时会撞到名字修饰——那些地方我们只给结论, 把"为什么"留在这里。
系列文章写作风格说明
- 篇幅规划:每篇约 16,000 字,每章约 1,600 字;四波连载,每篇自洽,可以单读。
- 写作顺序:第一波布局与内存(本篇是开篇)→ 第二波编译器与链接器 → 第三波运行时代价 → 第四波跨平台专项。
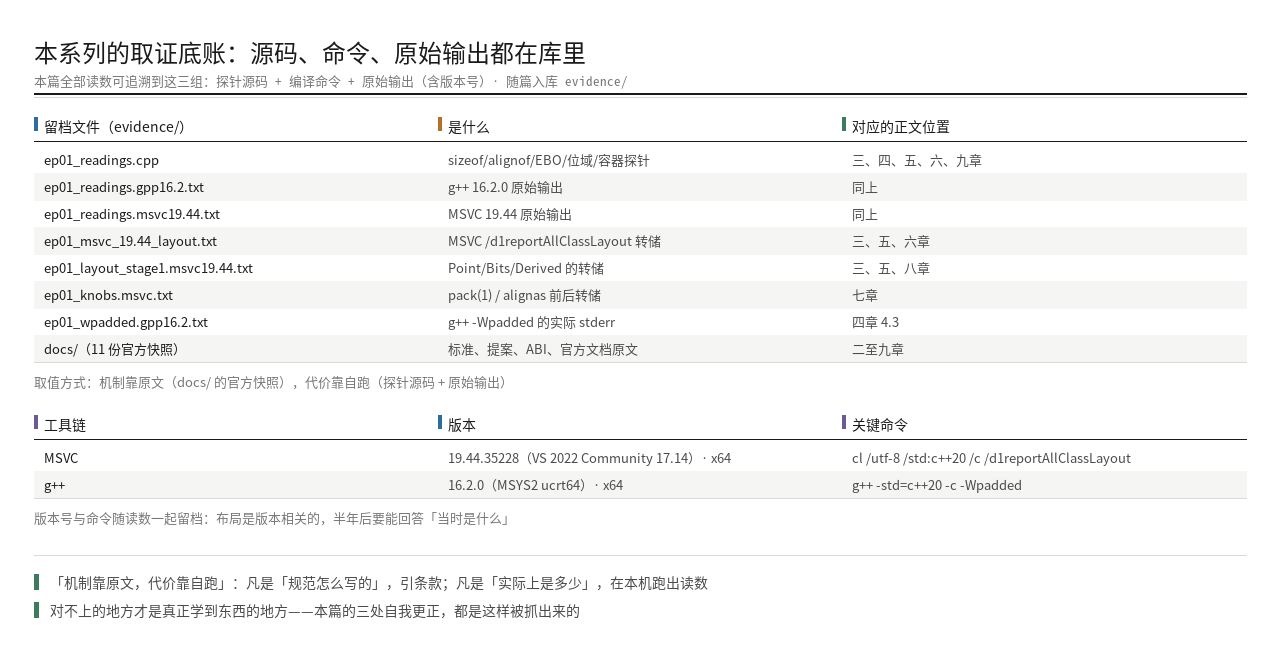
- 证据规矩:机制靠原文,代价靠自跑。 凡是"规范怎么写的",引规范原文(条款标签、ABI 章节、官方文档); 凡是"实际上是多少",一律在本机跑出来给读数,并把转储文本、编译命令、版本号一起留档。
全系列内容总览
- 【C/C++ 现代语言与底层】(一) 对象布局、对齐与 padding:
sizeof的真相 - 【C/C++ 现代语言与底层】(二) 分配器解剖:从
malloc到 jemalloc / mimalloc /pmr - 【C/C++ 现代语言与底层】(三) 值语义的账:移动、拷贝、SSO 与
emplace_back - 【C/C++ 现代语言与底层】(四) 编译期账本:模板实例化与编译时间的去处
- 【C/C++ 现代语言与底层】(五) 优化器的边界:未定义行为、严格别名与向量化报告
- 【C/C++ 现代语言与底层】(六) 名字与符号:ABI、修饰、可见性、PLT 与 IAT
- 【C/C++ 现代语言与底层】(七) 链在一起:LTO 与 PGO 的收益从哪来
- 【C/C++ 现代语言与底层】(八) 分发的代价:虚函数、模板、
variant与类型擦除 - 【C/C++ 现代语言与底层】(九) 异常与 RTTI:零成本到底成不成立
- 【C/C++ 现代语言与底层】(十) 内存序与原子:
seq_cst在 x86 上免费吗 - 【C/C++ 现代语言与底层】(十一) 缓存与布局:AoS/SoA、伪共享与 cache line 的账
- 【C/C++ 现代语言与底层】(十二) SIMD:自动向量化与手写 intrinsic 的分界
相关资源链接
- 本站其他相关专题:《Godot 4 引擎架构》《Jolt Physics 3D》《图形性能剖析工具链》
- 规范入口:Itanium C++ ABI(
itanium-cxx-abi.github.io/cxx-abi/)| C++ 标准草案条款(eel.is/c++draft/) - 本系列的工具链基线:本机 VS 2022(MSVC 19.44)与 msys64 g++ 16.2
背景与边界
0.1 从一行输出说起
好了,先看一行真实的编译产物。把两个字段一模一样的结构体交给编译器,它会告诉你两个不一样的数字:
//-----------------------------------【布局实验·第一个结构体】---------------------------------------
// 描述:两个字段相同、顺序不同的结构体,观察 sizeof 的差别
//------------------------------------------------------------------------------------------
//【1】先放 char 再放 int
//【2】先放 int 再放 char
struct U { char a; int b; };   //【1】
struct S { int a; char b; };   //【2】
sizeof(U) 在本机(MSVC 19.44,x64)上是 8,不是 5——中间那 3 个字节你从来没写过。
把字段加到三个,差别会更明显:struct {char a; int b; char c;} 是 12,
而同样三个字段的 struct {char a; char b; int c;} 是 8。
12 与 8 之间那 4 个字节,没有一个是你主动写的。
再看两个更反直觉的:
struct Empty {};                       // sizeof(Empty) == 1,不是 0
struct E1 { Empty e; };                // sizeof(E1) 也 == 1
struct Base { virtual void f(); };     // sizeof(Base) == 8:一个虚表指针
一个空的类,占 1 字节。可如果把 Empty 改成基类,它又可以在派生对象里一个字节都不占。
"空的也占位"和"空的可以不占"——这两句同时成立,这就是本篇要讲清的第一件事。
0.2 为什么这件事值得认真
因为它是每天都在收费的那种知识,只不过账单不在你名下。
- 它决定了你省不省内存:同一个数据模型,字段顺序换一下,一个数组就能省下 20%–40% 的常驻内存;
反过来,一个不注意的
bool插在中间,就是每个对象多 7 个字节。 - 它决定了你的数据能不能被高速缓存友好地遍历:跨 cache line 落位的问题,源头往往就是这里的填充。 (注意:本篇只讲布局规则本身,缓存侧的实际读数留给第十一篇。)
- 它决定了你的库能不能被别人的二进制安全地链接:给一个已经发布的类加一个成员, 在源码层面是无害的,在二进制层面可能是别人的程序直接崩。第九篇会给出三类真实事故。
- 它决定了你看到的数字是不是"能安全依赖"的数字:标准里哪些是规定的、哪些是"实现定义", 这个界限划不清,就会写出"在我机器上是对的"这种代码。
一句话:sizeof 不是编译器心情好给的数字,是一套规则的输出。 规则学会了,数字就能自己算出来。
0.3 本篇不涉及什么
说白了,按本站的规矩,边界要写在前面,免得后面互相打架:
- 不涉及分配器怎么把这些字节搞到手——那是第二篇《分配器解剖》的事。本篇假设内存已经在手上。
- 不涉及移动与拷贝的语义——那是第三篇。本篇只谈"一个对象在内存里长什么样",不谈它怎么被搬走。
- 不涉及编译期开销——那是第四篇。这里只谈结果,不谈编译器为了算这个结果花了多久。
- 不涉及虚函数调用的开销——那是第八篇《分发的代价》。本篇只谈虚表指针在对象里的位置, 不谈通过它调用一次要几纳秒。
- 不涉及布局对缓存的实际影响——那是第十一篇。本篇只在必要处点到"这里会跨 line",不给读数。
- 不涉及符号修饰与名字 ABI——那是第六篇。本篇提到的 ABI 只到"布局规则"这一层。
- 关键参数的取值范围:本系列的读数默认按 x64 + Windows(MSVC 19.44) 与 x64 + msys64 g++ 16.2
两条工具链给出;32 位、ARM、以及带
/Zp非默认值的场景会单独标注,不会混在一起讲。
OK,言归正传,从那个"不是 5 的 8"开始。
一、sizeof 不是数,是一份契约
1.1 三个数字,三种意外
先看三个数字。
我们先把三个反直觉的数字摆在一起,它们分别是"有填充""零尺寸不能存在""零尺寸可以被消化"三种机制的产物:
| 表达式 | 本机结果(MSVC 19.44,x64) | 为什么 |
|---|---|---|
sizeof(U),U = {char a; int b;} |
8 | 两个字段只占 5 字节,剩下 3 字节是填充(alignment padding)——为了满足 int 的对齐要求 |
sizeof(Empty) |
1 | 空类必须能被"取地址",两个不同对象不能有同一个地址,所以至少要 1 字节 |
| 含一个空基类的派生对象 | 该空基类占 0 字节 | 空基类优化(empty base optimization)把"不占位的空对象"消化掉了(本机转储见第五章) |
这三个数字不是随手挑的。它们分别对应本篇的三个层次:{char,int} 的 8 字节讲的是语言层面的对齐规则,空类的 1 字节讲的是语言为可寻址性留下的最小值,而空基类那不占一格的 0 字节讲的是ABI 允许的例外。三种「意外」背后是三种不同来源的规定——把它们并排摆出来,是为了先建立一个印象:sizeof 的答案,不是一个来源给的。
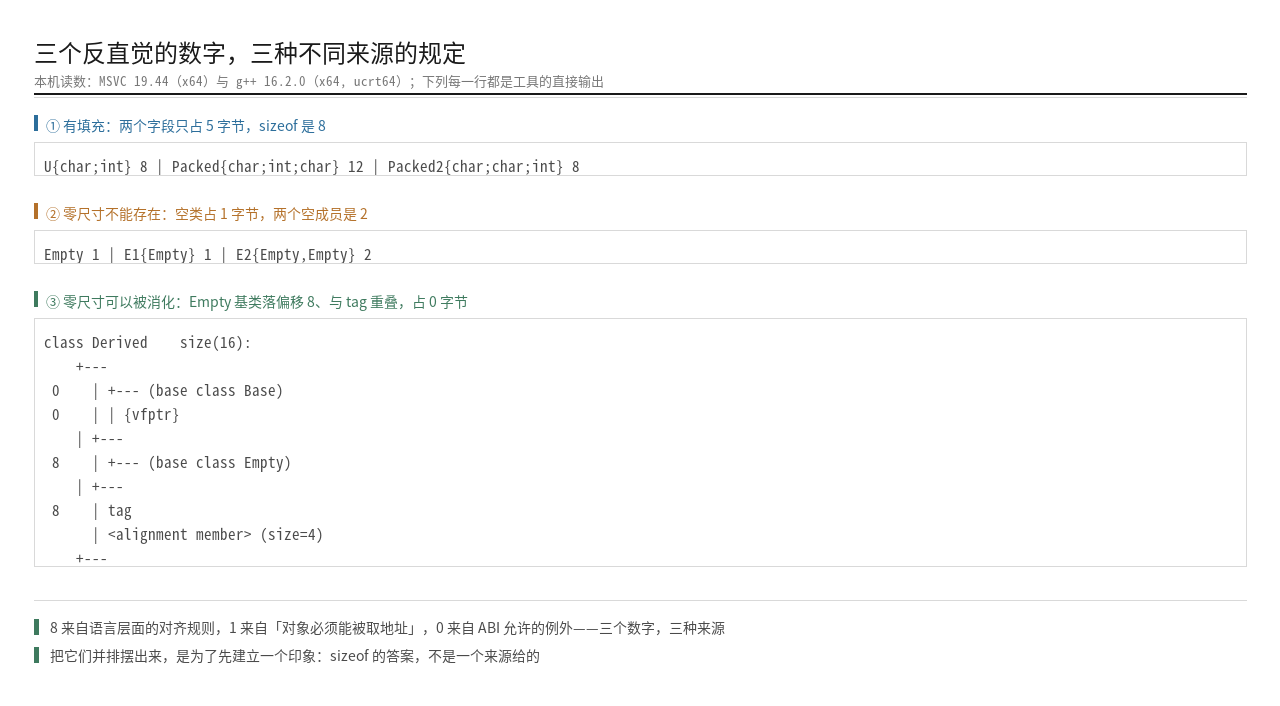
这三个数字值得放在一起看,因为它们不是三个孤立的知识点,而是同一条契约在三种边界情况下的三种表现。
1.2 谁在签字
那么这份"契约"是谁签的?三方:
- 语言标准:规定了哪些是必须的(比如成员按声明顺序排列、非静态数据成员不用空基类优化就不可能重叠), 哪些是实现定义的(比如位域的分配与对齐——是的,标准明说这是实现定义的)。
- 目标平台的 ABI:规定了具体怎么做。x64 Linux/macOS 的主流是 Itanium C++ ABI, Windows 上 MSVC 用的是自己那套(它没有一份完整的公开规范,只有分散的文档)。 两者在"虚表指针放在哪""空基类怎么处理"这些问题上给出的是两套答案。
- 你写的声明:规定了对齐要求的上限(
alignas)、打包粒度(#pragma pack)、以及字段顺序。
三方里最容易被忽略的是第三方。标准与 ABI 你改不了,声明顺序是你唯一随手就能改的东西—— 而它恰好是收益最直接的那个旋钮(第二篇 2.2 会给读数)。
1.3 本篇的取证方式
先看看取证方式。
这一节要交代"本系列凭什么这么说",否则后面每个数字都站不住。
我们的取证只有三种,没有第四种:
- 规范原文:能引条款就引条款。但注意措辞——标准草案的条号会随版本漂移,
所以本篇一律给稳定标签名(例如
[basic.types]、[class.bit]),条号只在必要时附注, 而且每次都标明抓取日期。(规范侧的坑:en.cppreference.com直连会触发反爬, 机制类引用我们改引eel.is/c++draft与open-std.org的原始提案。) - 编译器与工具的真实转储:MSVC 的类布局转储会把它内部插入的填充显式画出来,
形如
<alignment member> (size=3)。这是比"编译器没报警"硬得多的证据。 (要说清一件事:这个开关是未文档化的内部开关,官方只在博客里提过,它不是正式选项, 所以本系列用它取证,但不把它当成稳定契约——换编译器版本要重跑。) - 双编译器对照:同一份代码在 MSVC 与 g++ 下各跑一遍。 标准说"实现定义"的地方,两个编译器给出不同答案,本身就是最好的证据。
一句提醒:本系列的"真实素材"包括这些编译器与工具的真实输出——它们不是示意图, 是有原始文件可核的证据(转储文本、读数 JSON、编译命令与版本号都会随篇留档)。
二、三条规则
三条规则,我们按"谁定起点、谁定中间、谁定收尾"的顺序摆开。先把它们放在一张图里看一眼, 后面每一节再逐条拆开。
这三条规则的排列次序不是随意的,它是一条依次收紧的流水线:第一条(对齐要求)决定每个字段的起点,第二条(声明顺序)在上一层的约束下决定字段之间的空隙,第三条(尾填充)在最后把整体大小补齐到自己的对齐要求。三者叠加之后,sizeof 就唯一确定了——没有任何自由发挥的余地,也没有「编译器心情」这一项。后面第三章的手算与转储对照,走的正是这条流水线。(规则落点在 [class.mem]:非静态数据成员的声明顺序与布局。)
2.1 第一条:对齐要求决定起点
对齐(alignment):一个类型在内存里允许出现的地址必须是它对齐值的整数倍。
int 要求 4 字节对齐,意思是"它的起始偏移必须是 4 的倍数"。
于是布局算法只有一句话:从偏移 0 开始,每放一个字段,先把当前偏移向上取整到该字段的对齐要求; 放完最后一个字段,再把总大小向上取整到"最大成员对齐要求"。
- 当前偏移(offset):下一个字段将被放置的位置。
- 对齐要求(alignment):取该字段自身类型的
alignof。 - 向上取整(round up):
offset = (offset + A - 1) / A * A。
这套算法里没有"最优解"这一说——它是顺序敏感的,这就是第二条规则的来由。
2.2 第二条:声明顺序决定好坏
好了,同样的三个字段,顺序不同,浪费不同。动手改一下顺序:
//-----------------------------------【布局实验·字段顺序】---------------------------------------
// 描述:同一组字段、两种声明顺序,观察编译器插入的填充
//------------------------------------------------------------------------------------------
//【1】三种类型交错:中间补 3、尾部再补 3
//【2】同类大小聚在一起:中间补 2、尾部 0
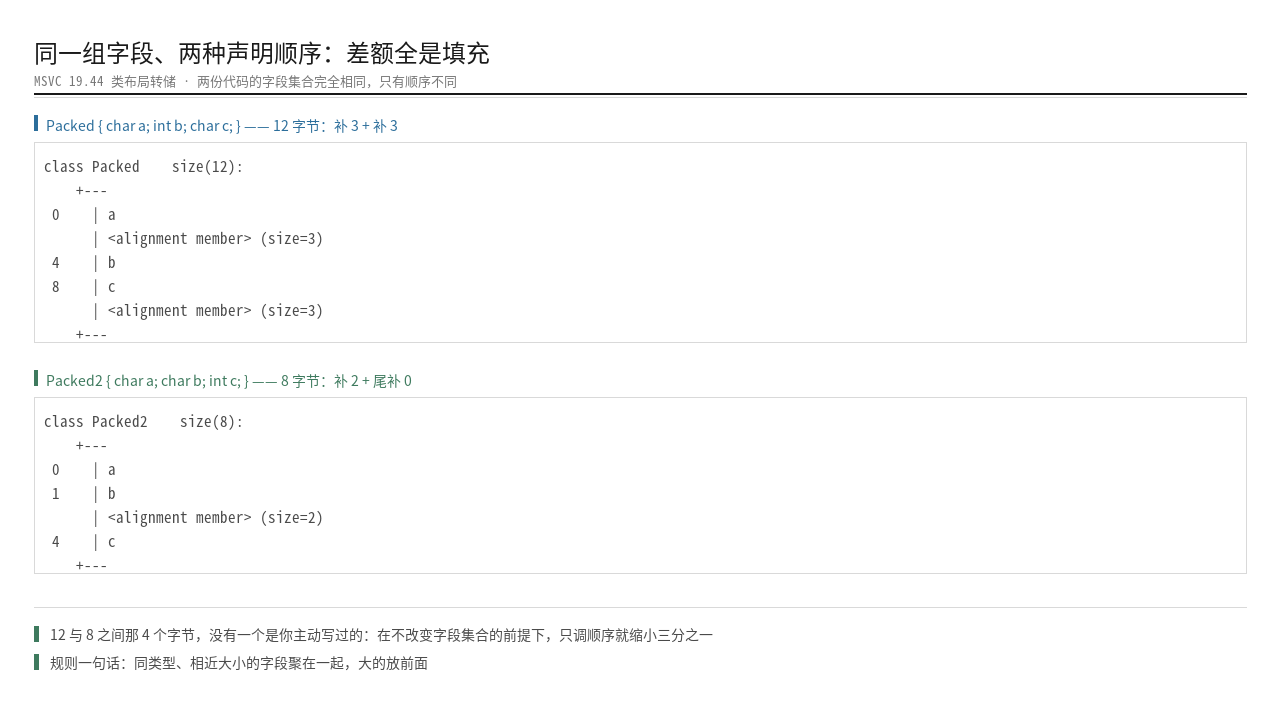
struct Packed  { char a; int b; char c; };   //【1】12 字节
struct Packed2 { char a; char b; int c; };   //【2】8 字节
同样三个字段,一个 12、一个 8。 差出来的 4 个字节全部是填充,所以这条规则可以更狠地说: 在不改变字段集合的前提下,只调顺序,就能把结构体缩小三分之一。
规则本身一句话记住:同类型、相近大小的字段聚在一起,大的放前面。
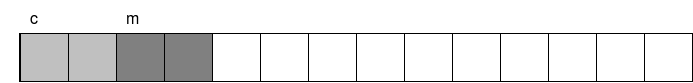
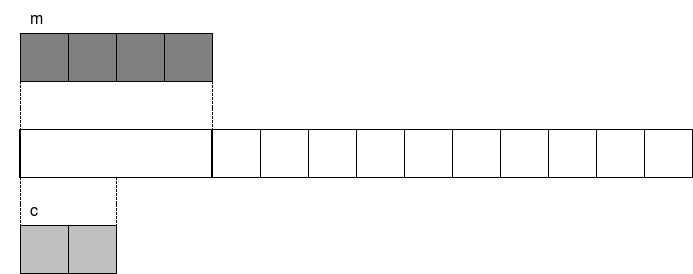
下面这张是外部素材里少见的对位图,把"字段在内存里一个挨一个"这件事画成了方块图—— 我们拿它当本章的对照参考(它是 C 语言侧的原理小图,尺寸 693px,只能当示意图用;本系列真正用来 定论的是本机转储):
2.3 第三条:尾填充决定收尾
说白了,前面两条管"中间",第三条管"结尾":整个结构体的大小必须是它最大成员对齐要求的整数倍。
这条规则存在的理由很实际:如果一个结构体数组的元素大小不是对齐要求的整数倍, 数组里第二个元素就可能落在一个不满足对齐的地址上。所以编译器宁可在尾部补白, 也不允许"数组越界对齐"。
struct Tail { int a; char b; };     // 5 字节的有效内容 → 8 字节(尾部补 3)
struct Tail2 { char a; double b; }; // 9 字节的有效内容 → 16 字节(中间补 7、尾部补 0)
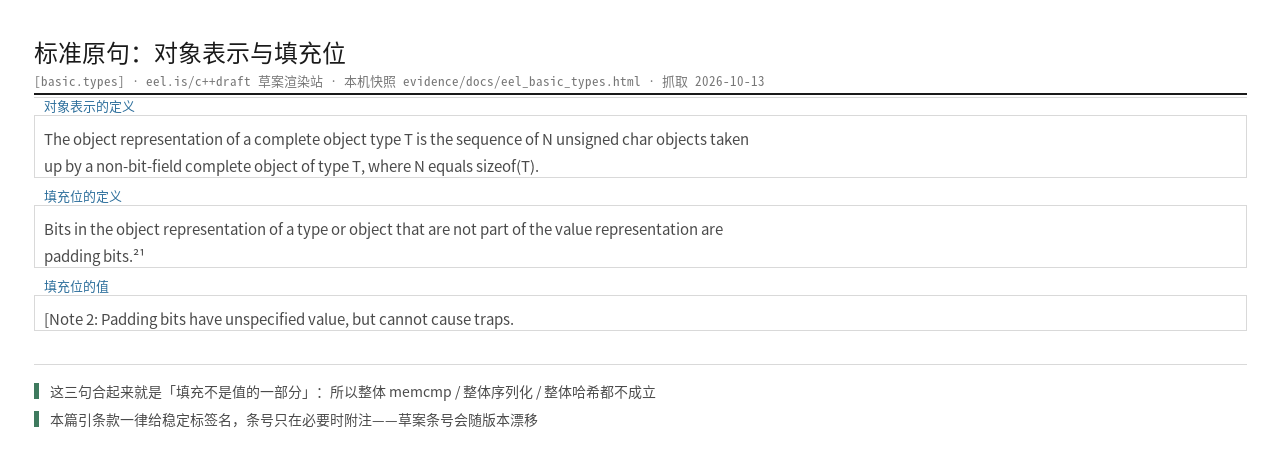
顺带说清一个常被搞混的点:这些填充字节不是"值的一部分"。 标准把它们叫 对象表示(object representation)里的填充位(padding bits), 它们不参与值表示(value representation)。后果有三条,第九篇会展开:
- 用
memcmp比较两个结构体,可能因为填充字节不同而报"不相等",即便每个字段都相等; - 把结构体整体写进文件/网络,等于把编译器的填充策略一起序列化了;
- 用哈希函数对
sizeof字节整体做散列,得到的是不稳定的哈希。
2.4 标准怎么说
先看规则在标准里的原文位置(引稳定标签,并注明抓取日期):
- 对象表示与填充位:
[basic.types]——对象表示是 N 个unsigned char的序列, 其中不属于值表示的位就是填充位。 - 对齐:
[basic.align]——基础对齐不超过alignof(std::max_align_t);超出者是扩展对齐(over-aligned)。 - 布局的顺序保证:
[class.prop](标准布局类)——同一访问控制下的非静态数据成员, 按声明顺序在内存中地址递增。 - 位域:
[class.bit]——位域在类对象内的分配与对齐是实现定义的(这条要记住,第六篇专门实测)。 - 零尺寸子对象:
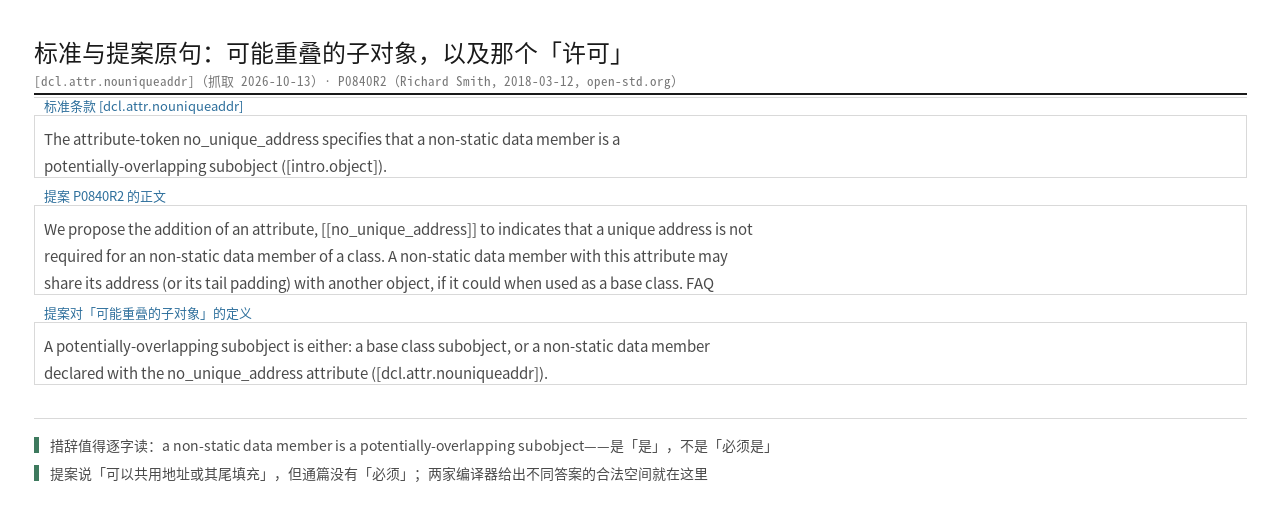
[dcl.attr.nouniqueaddr]——[[no_unique_address]]让非静态数据成员有机会 成为"可能重叠的子对象",从而复用尾填充。
(以上条款抓取日期:2026-10-13;草案渲染站 eel.is/c++draft。)
2.5 规则之外,不保证什么
三条规则给的是保证,但布局这件事上,没被保证的部分比被保证的更多。三处最容易踩:
- 标准不管具体偏移。它保证"顺序",不保证"没有填充",更不保证"不同编译器给出同样的布局"。
- 标准布局(standard-layout)是一个"可移植边界"的标记,不是一个"布局已固定"的承诺。 反过来,非标准布局的类,跨编译器/跨语言边界传递就是自找麻烦。
alignof之外还有 platform 的#pragma pack与/Zp,它们能改掉的正是上面三条规则的输入。 用了它们,就得自己承担后果——第七篇会把三个旋钮摆在一起对照。
顺带把联合体(union)也归位:它是这三条规则的极端情形——所有成员都从偏移 0 开始, 大小取最大的成员,再按最大成员的对齐要求补齐。所以"字段顺序"这条规则在联合体上根本不适用, 它只有"最大者说了算"。
2.6 影响布局的全部因素:先把清单给全,再做归类
先看看全量清单。
三条规则是"主干",但真正能改变一个对象布局的因素不止三条。先把清单给全(宁全勿缺), 这样后面遇到任何"布局跟我算的不一样"的情况,你都能在这张单子上找到是哪一项在动:
- 成员的对齐要求(
alignof)——决定每个字段的起点,也决定结构体的对齐; - 成员的声明顺序——决定填充总量;
- 尾填充规则——决定总大小必须是最大对齐的整数倍;
- 是否有虚函数 / 虚基类——决定虚表指针(可能不止一个)放在哪、占几个字节;
- 基类的排列与 primary base——决定基类子对象怎么摊在日常成员中间;
- 空基类优化(EBO)——决定零尺寸基类是否"消失";
[[no_unique_address]]——决定零尺寸成员是否可能被复用(注意:只被"许可");- 位域——分配与对齐由实现定义;
#pragma pack//Zp——从声明级或模块级压低对齐上限;alignas——抬高某个类型或对象的对齐要求。
十条摆在眼前,接下来这一步才是关键——把它们归类。按"谁说话算数"分,只有三类:
| 类别 | 因素 | 你能否依赖 |
|---|---|---|
| 语言规则定的(两家编译器一致) | 1、2、3、6 | ✅ 可以放心依赖,跨编译器也成立(本批实测 8 行读数全一致) |
| ABI 决定的(同一平台内一致,跨平台不一定) | 4、5、7 的部分 | 🟡 同一 ABI 内一致;跨 ABI(MSVC ↔ Itanium)必须重新核 |
| 实现定义的(标准明说不管) | 7 的效果、8、9、10 的具体值 | ❌ 不能依赖;只能"实测当前工具链 + 锁定版本" |
这张表是整篇的地图。后面五章分别落在三个格子里:第三、五章在语言规则格,
第八章在ABI格,第六章(位域)与第五章的 [[no_unique_address]](第七、九章)都落在实现定义格——
而错误几乎都发生在把第三格的东西当成第一格用。
到这里,规则已经全部摆出来了。但规则这种东西,光看是记不住的——下一章我们手算一遍, 再拿本机的转储逐行对上去。对不上的地方,才是真正学到东西的地方。
三、手算一遍
规则讲完了,我们手算一遍,再拿转储逐行对上去。这一章的全部读数都是本机跑出来的, 命令与编译器版本会跟着读数一起给出——没有"大概是"这种数字。
3.1 逐字段推演
先看看靶子。
拿一个五个字段的结构体当靶子:
//-----------------------------------【布局实验·手算靶子】---------------------------------------
// 描述:用于手算与转储对照的结构体
//------------------------------------------------------------------------------------------
//【1】按三条规则依次落位
struct Target { char a; int b; char c; double d; short e; };
按 2.1 的算法走一遍(a 起于偏移 0):
| 步骤 | 字段 | 对齐要求 | 落位偏移 | 说明 |
|---|---|---|---|---|
| 1 | char a |
1 | 0 | 占 1 字节 |
| 2 | int b |
4 | 4 | 偏移 1 向上取整到 4 → 补 3 字节 |
| 3 | char c |
1 | 8 | 紧跟 b 之后 |
| 4 | double d |
8 | 16 | 偏移 9 向上取整到 16 → 补 7 字节 |
| 5 | short e |
2 | 24 | 偏移 24 已是 2 的倍数,无需补 |
| 尾 | — | 8(最大对齐) | — | 26 向上取整到 32 → 尾补 6 字节 |
手算结果:32 字节。 有效内容 1+4+1+8+2 = 16 字节——一半是填充。
之所以要一字段一字段地走,是因为布局的每一步都依赖上一步的结果:b 落在 4 而不是 1,不是因为 int 喜欢 4,而是因为 a 占掉了 0 号字节。手算的价值就在这里——它能告诉你「为什么是这个偏移」,而不只是「偏移是多少」。下面这张图把五个字段依次落位的过程画了出来:每个字段先补齐到自己的对齐要求,再放下去。
3.2 与转储对上
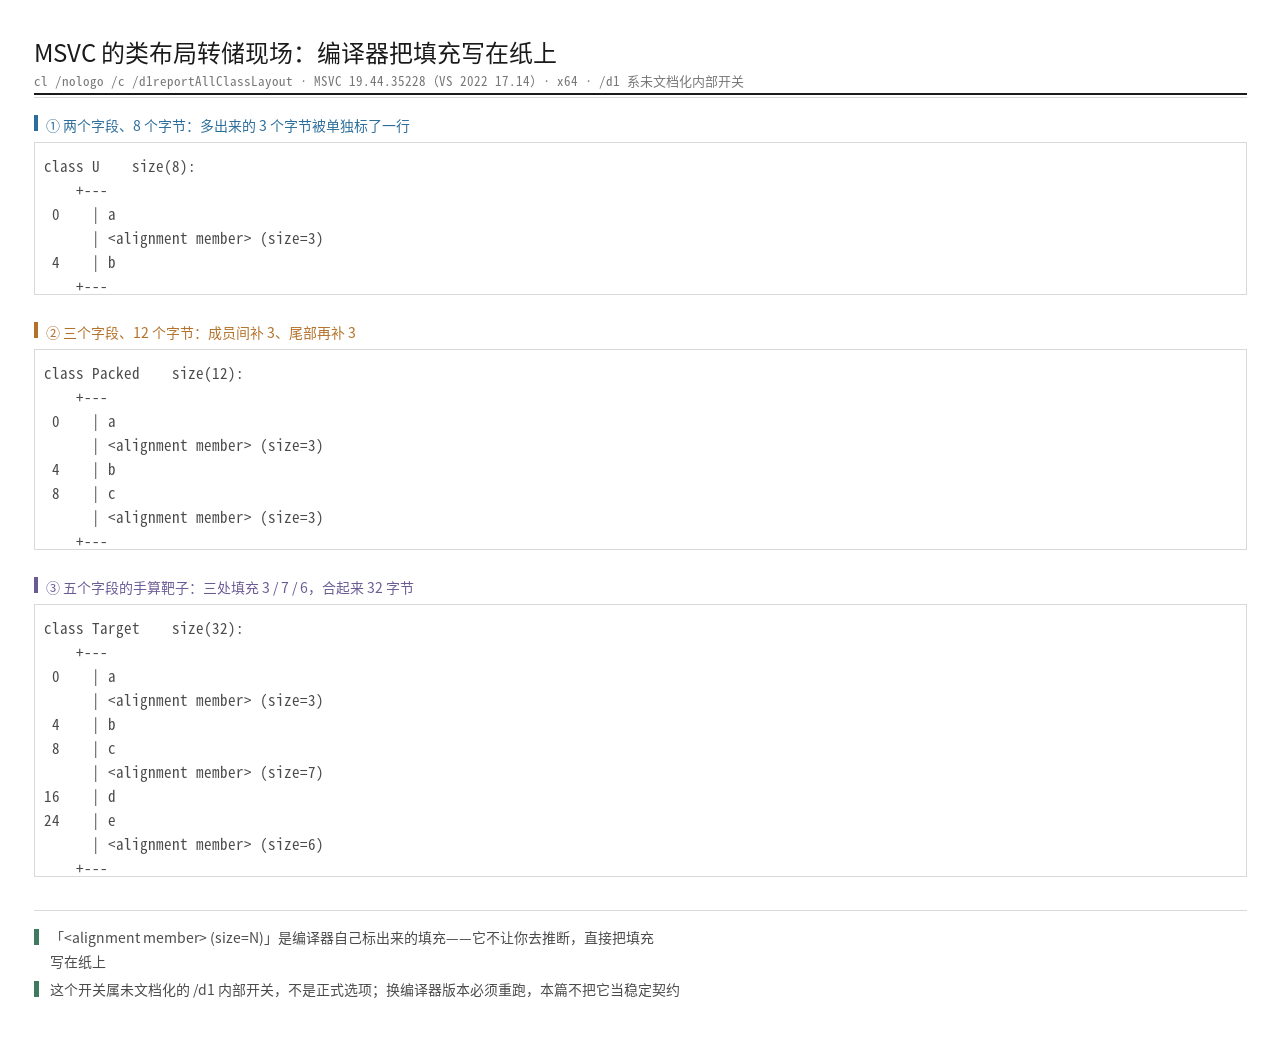
现在让编译器自己说。MSVC 的布局转储会把它内部插入的填充显式标出来:
cl /nologo /c /d1reportAllClassLayout layout.cpp
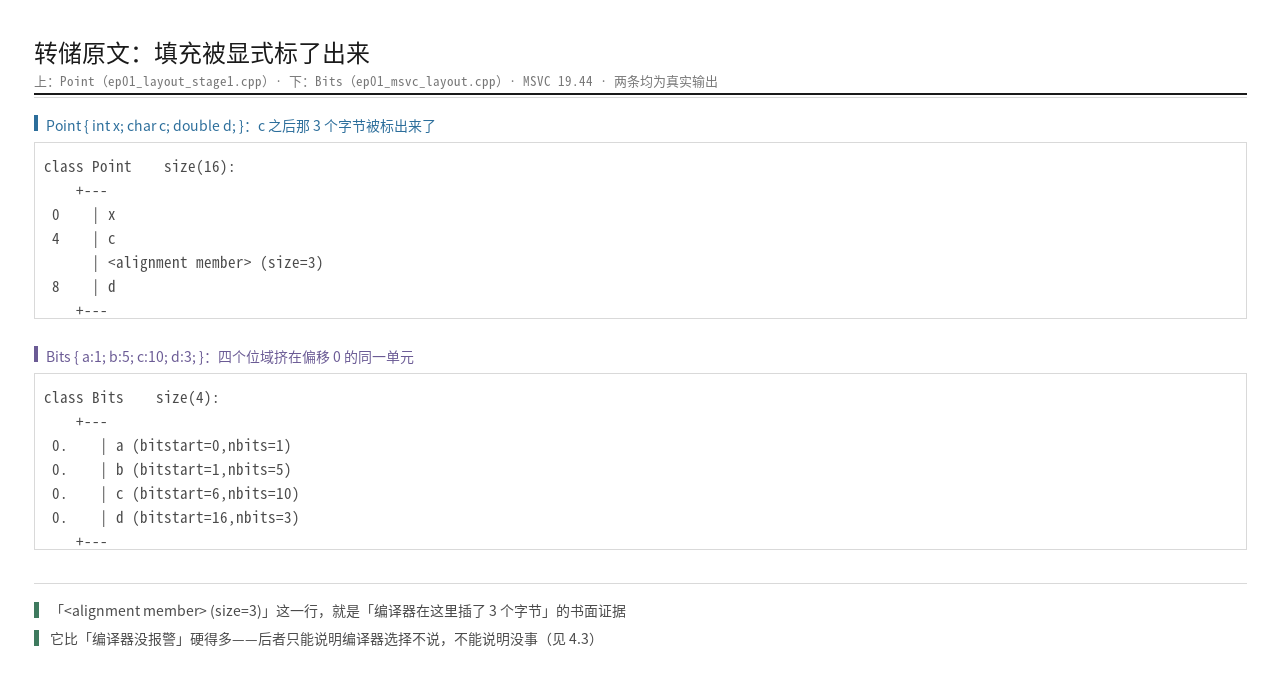
它对本机那组结构体给出的原文(节选,均为真实输出;两段分别来自本机的 ep01_layout_stage1.cpp 与 ep01_msvc_layout.cpp):
class Point     size(16):
 0      | x
 4      | c
        | <alignment member> (size=3)     ← 这就是那 3 个字节
 8      | d

class Bits      size(4):
 0.     | a (bitstart=0,nbits=1)
 0.     | b (bitstart=1,nbits=5)
 0.     | c (bitstart=6,nbits=10)
 0.     | d (bitstart=16,nbits=3)
<alignment member> (size=3) 这一行,就是"编译器在这里插了 3 个字节"的书面证据。
它比"编译器没报警"硬得多——后者只能说明编译器选择不说,不能说明没事(4.3 会证明这一点)。
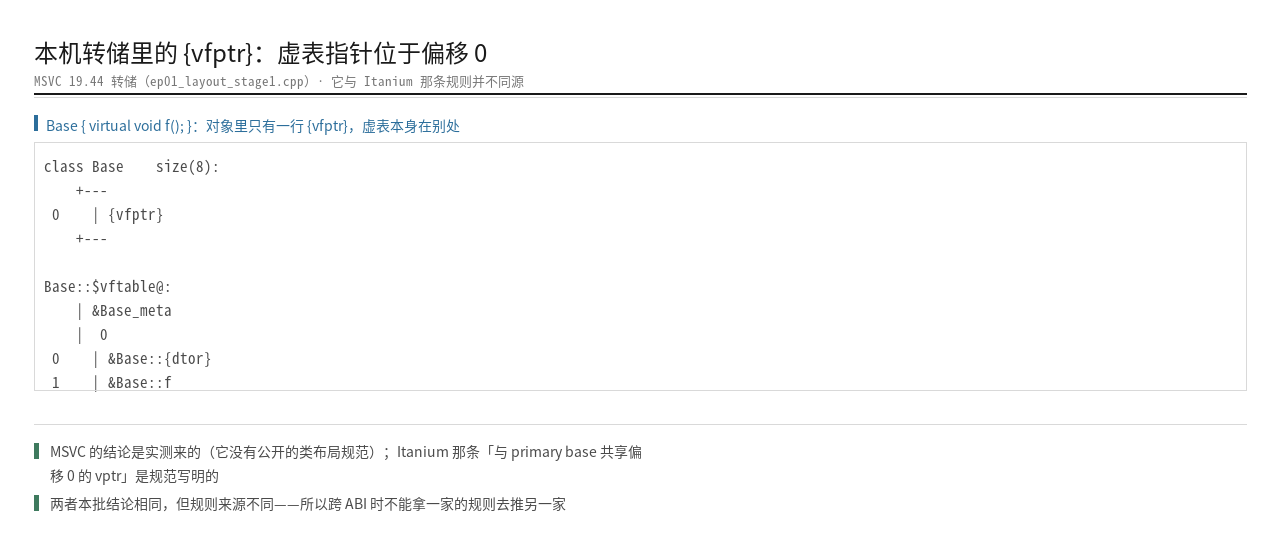
顺带记一笔:class Base size(8) 里只有一行 {vfptr}——一个虚表指针,8 字节。
虚表指针排在对象最前面,这是 MSVC 的做法;Itanium ABI 的规则不同(第八章对照)。
这张转储之所以是整篇的主力证据,在于它的列含义很直白:左边是偏移,右边是落在那个偏移上的东西;而编译器自己插进去的填充,它用 <alignment member> 这一行明确标出来,还带上字节数。它不是让你去推断填充在哪,它直接把填充写在纸上。能把话说到这个程度的证据,比任何「应该是这样」的推理都硬。
3.3 两个编译器各跑一遍
依然是惯例:先给两边都一致的读数。
标准说"实现定义"的地方,最好的证据是两个编译器给出不同的答案。先看一份两边都一致的读数:
| 表达式 | MSVC 19.44 | g++ 16.2.0 | 一致? |
|---|---|---|---|
sizeof(struct{char;int}) |
8 | 8 | ✅ |
sizeof(struct{char;int;char}) |
12 | 12 | ✅ |
sizeof(struct{char;char;int}) |
8 | 8 | ✅ |
sizeof(struct{int;char}) |
8 | 8 | ✅ |
sizeof(Target)(五字段,本章手算靶子) |
32 | 32 | ✅ |
sizeof(Base)(含一个虚函数) |
8 | 8 | ✅ |
sizeof(struct{Bits a:1,b:5,c:10,d:3}) |
4 | 4 | ✅ |
sizeof(struct{a:3; unsigned:0; b:5}) |
8 | 8 | ✅ |
sizeof(struct{[[no_unique_address]] Empty; int}) |
8 | 4 | ❌ 不一致 |
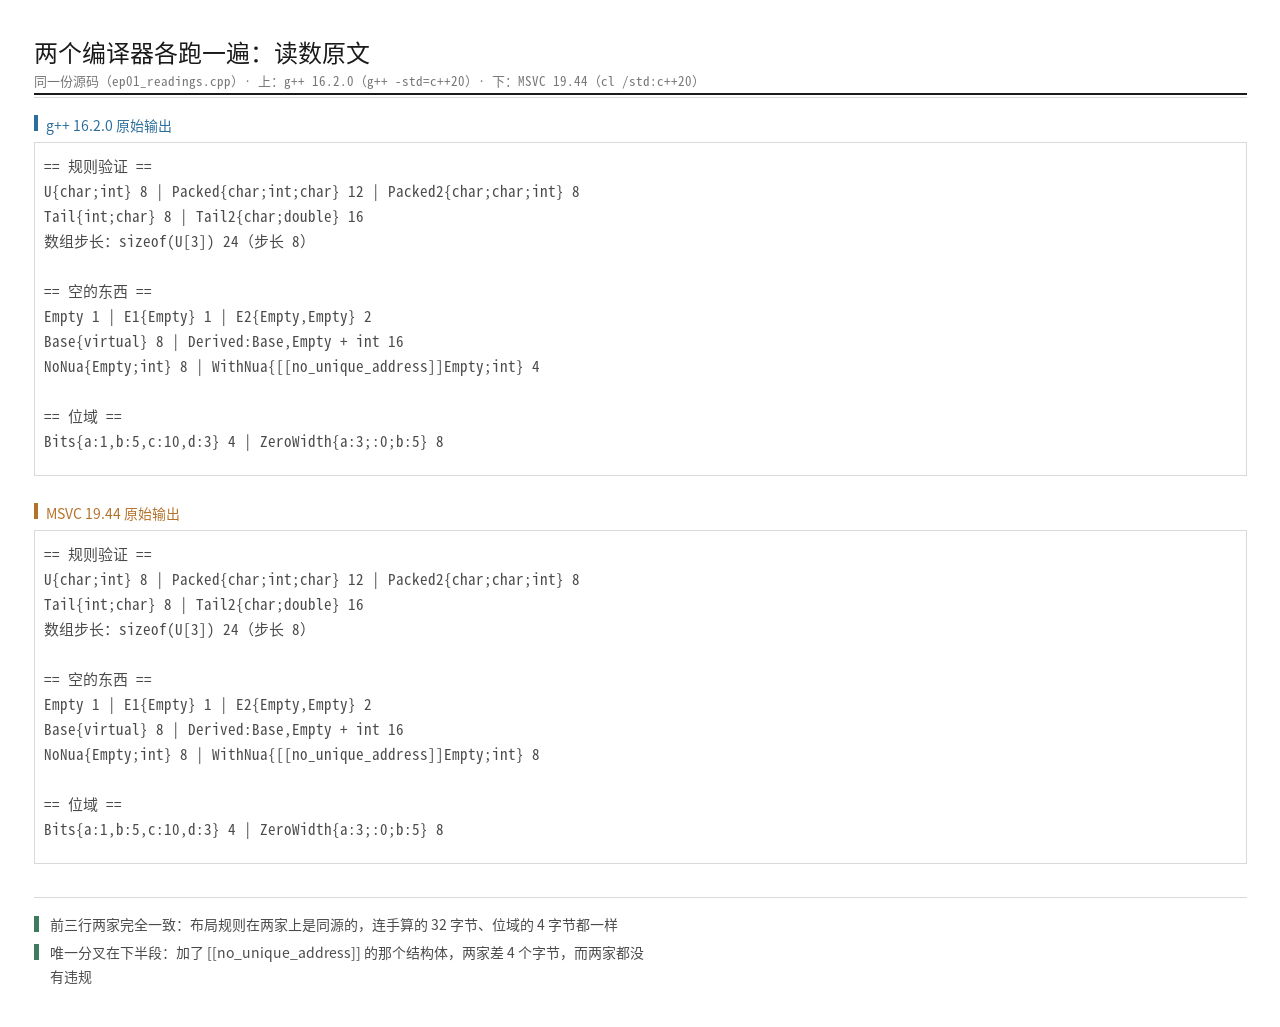
前八行说明布局规则在两家上是同源的:不只"按对齐要求补齐"一致,连手算的 32 字节、 空基类优化的结论、位域本例的 4 字节都一样。最后一行是这一批里唯一一处真正的分歧—— 一个属性,两家差 4 个字节,而两家都没有违规。 这件事放到 5.3 展开, 它是标准里"实现定义"与"许可但不要求"这两种措辞最直观的一次演示。
下面是本机 g++ 16.2.0(x64,ucrt64)的完整读数表,命令是 g++ -std=c++20:
char 1/1 | short 2/2 | int 4/4 | long 4/4 | longlong 8/8
float 4/4 | double 8/8 | long double 16/16 | void* 8/8
max_align_t 32/16 | __STDCPP_DEFAULT_NEW_ALIGNMENT__ 16
注意
long 4/4这一项:Windows 是 LLP64,long是 4 字节而不是 8。 同一台机器上如果换成 Linux 的 LP64,这一格就会变成 8——同一份源码,跨平台布局不一样,从这里就开始了。
3.4 数组步长:为什么还要管收尾
上一章说"尾填充是为了数组不越界",这里给读数把它坐实:
struct U { char a; int b; };   // 有效 5 字节 → sizeof 8
sizeof(U[3]) == 24             // 步长 8,不是 5
如果编译器允许 sizeof 是 5,那么 arr[1] 就会落在地址偏移 5 上——那是个不满足 int 对齐的地址。
所以那 3 个尾填充字节不是浪费,是给数组买的保险。(代价是:内存里多占 37.5% 的位。)
3.5 算不对的时候:五步定位法
说白了,手算和实测总有对不上的一天。对不上的时候,按这五步走,基本能定位到原因,
而且每一步都能落到一个"可验证的东西"上(条款入口:[expr.sizeof]):
- 先对齐工具链的两个参数:编译器版本 + 打包粒度(
/Zp、#pragma pack(show))。 版本不同布局就可能不同(9.2 有一份官方 Breaking Changes 作证),粒度不同则填充规则整体变了。 - 别推理,读转储。同一份代码的转储里,编译器会把每个字段的偏移和它插入的填充都写出来—— 用它对照你的手算,差在哪一行一目了然。
- 检查有没有多态基类。有虚函数、有虚基类、有多继承时,虚表指针(可能不止一个)也要占位置, 而它不在你的字段清单里——这是"凭空多出 8 字节"最常见的原因。
- 检查有没有落在"实现定义"格里的东西。位域、
[[no_unique_address]]的效果、 具体对齐数值都在那一格(第二章 2.6 的三类表)——这些地方两家编译器给出不同答案是正常的。 - 把结论固定下来。用
static_assert写下"这个类型是 N 字节",让下一次变化在编译期就冒出来。
五步的顺序是有讲究的:前两步排除"环境不同",中间两步排除"漏算了东西",最后一步把结论变成护栏。
四、填充从哪来
4.1 对齐阶梯
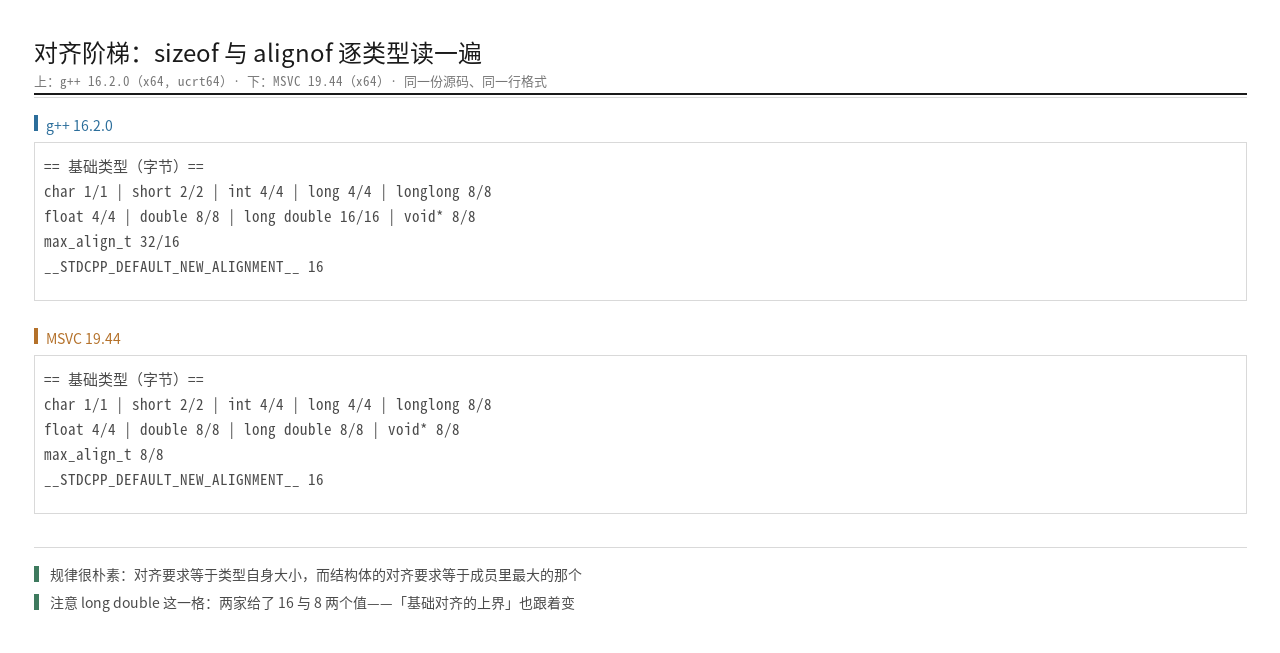
先看看本机的读数。
对齐要求不是某个"全局最优值",而是逐类型给定的。本机读数(g++ 16.2.0,x64):
| 类型 | sizeof |
alignof |
|---|---|---|
char |
1 | 1 |
short |
2 | 2 |
int |
4 | 4 |
long(Windows) |
4 | 4 |
long long |
8 | 8 |
float |
4 | 4 |
double |
8 | 8 |
long double |
16 | 16 |
void* |
8 | 8 |
规律很朴素:对齐要求等于类型自身大小(最大到 16),而"结构体的对齐要求 = 成员里最大的那个"。
于是"一个 char 挨着一个 double"这种排列,就必然要补 7 个字节——不是编译器小气,是硬件那边
对"未对齐访问"的惩罚更大。
4.2 max_align_t 与默认 new 对齐
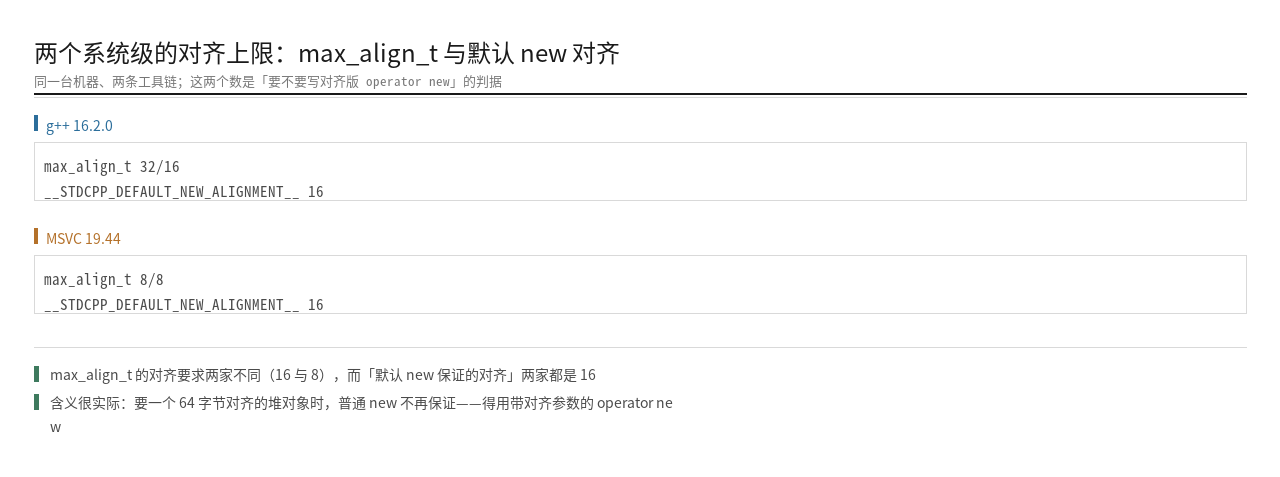
两个系统级的"对齐上限"要分清:
max_align_t:g++ 16.2.0 下sizeof32、alignof16(同一台机器的 MSVC 19.44 给的是 8/8—— 差别来自它把long double定为 8 字节)。它是"基础对齐"的上界—— 标准规定基础对齐不超过alignof(std::max_align_t)。超过它的叫扩展对齐(over-aligned)。__STDCPP_DEFAULT_NEW_ALIGNMENT__:两家都是 16。它是operator new默认保证的对齐。
这两个数字的用处在于:如果你要一个 64 字节对齐的对象,普通的 new 不再保证,
得用带对齐参数的 operator new,或者 alignas(64) 加上配套的对齐分配。
这也是 Eigen 那类库要自己重载 operator new 的原因(第九篇 9.4 会看到它的源码)。
4.3 -Wpadded 的能力边界
好了,这一节是我们自己实测出来的一个结论,中文材料里没见过有人写。
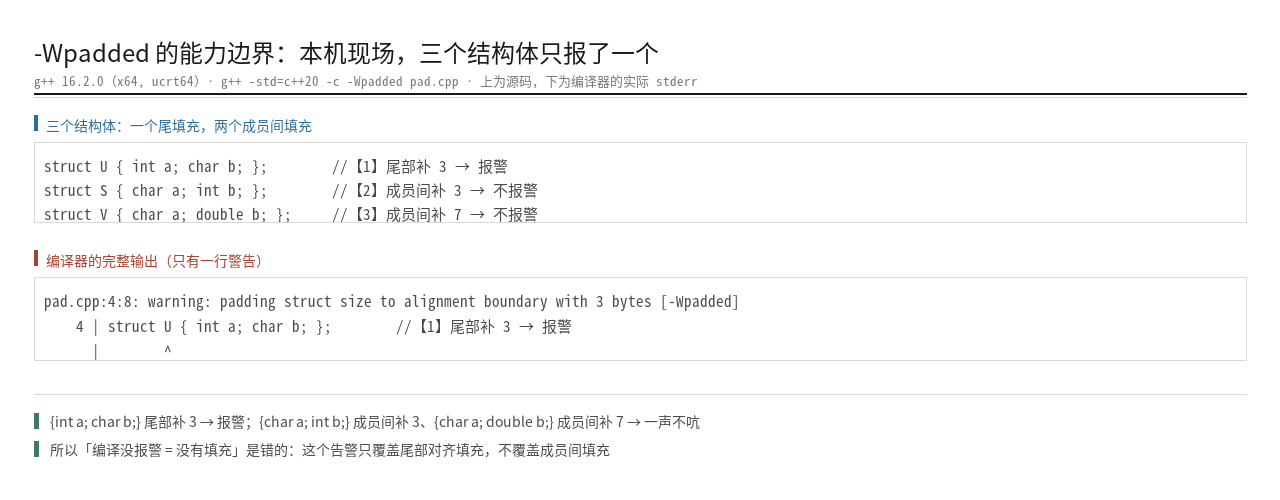
GCC 有个告警 -Wpadded,官方描述是"结构体需要填充时告警"。很自然地,大家会把它当成"填充检测器",
然后推出一个反过来的推论:编译没报警 = 没有填充。
本机实测(g++ 16.2.0)把这条推论打掉了:
g++ -std=c++20 -c -Wpadded -o pad.o pad.cpp
pad.cpp:1:8: warning: padding struct size to alignment boundary with 3 bytes [-Wpadded]
    1 | struct U { int a; char b; };
      |        ^
三种结构体,三种结果:
| 结构体 | 填充位置与字节数 | -Wpadded 是否报警 |
|---|---|---|
{int a; char b;} |
尾部补 3 | ✅ 报警 |
{char a; int b;} |
成员间补 3 | ❌ 不报警 |
{char a; double b;} |
成员间补 7 | ❌ 不报警 |
这个告警只覆盖"尾部对齐填充",不覆盖"成员间填充"。
{char a; double b;} 明明浪费了 7 个字节,编译器一声不吭。
所以正确的姿势是:别用告警判断有没有填充,用转储判断。 这也是本系列把布局转储当主力取证手段的原因。
这一节的价值不在「知道了有这个告警」,而在知道它管什么、不管什么。一个只覆盖部分情形的检查,最危险的用法是把它当成「覆盖全部情形」——于是「编译没报警」被读成「没有填充」,接着这个错误结论被写进容量估算、协议格式和内存预算里。下面这段本机实测,就是为了把这个误读堵死:它在整字节的成员间填充面前是完全沉默的。
(GCC 官方对该告警的描述在 Warning Options 的 -Wpadded 一节——
读它的时候要注意它的措辞只覆盖到"padding struct size to alignment boundary"。)
4.4 填充位到底是什么
先看看标准怎么说。
最后把"填充"这件事的定义说准。标准的说法是([basic.types],抓取日期 2026-10-13):
一个对象的对象表示(object representation)是 N 个
unsigned char的序列; 其中不属于值表示(value representation)的那些位,就是填充位(padding bits)。
这句话有三个直接后果,都值得记住:
memcmp不可靠。两个结构体逐个字段都相等,填充字节却可能是"上次留下的脏数据",memcmp会报不相等。- 整体序列化等于把编译器的策略写进文件。你把
sizeof(T)个字节直接写盘, 写进去的不只是你的数据,还有编译器的填充布局——换个编译器/换个/Zp就读不回来了。 - 整体哈希不稳定。对
sizeof字节做散列,得到的是"跟填充内容有关"的哈希值。
4.5 这笔账到底有多大:推一次给读者看
前面讲的都是"有关系",这一节把账推出来。取一组最常见的字段(一个 double、一个 int、
一个 short、三个 char),按两条相反的思路排:
//-----------------------------------【填充实验·两种排法】---------------------------------------
// 描述:同一组字段,只改声明顺序,按三条规则推算各自的布局
//------------------------------------------------------------------------------------------
//【1】按"想到哪写到哪"的顺序
//【2】按"大的放前面、同类型聚在一起"的顺序
struct Before { char a; double b; char c; int d; char e; short f; };   //【1】
struct After  { double b; int d; short f; char a; char c; char e; };   //【2】
按 2.1 的算法逐项推(每一步都只用到"向上取整到该字段的对齐要求"这一条):
| 字段 | Before 偏移 |
说明 | After 偏移 |
说明 |
|---|---|---|---|---|
b(double,对齐 8) |
8 | 前面被 a 占 1 后补 7 |
0 | 起于 0 |
d(int,对齐 4) |
20 | c 占 1 后补 3 |
8 | 紧接 b |
f(short,对齐 2) |
26 | 紧跟 d |
12 | 紧接 d |
a / c / e(char) |
0 / 16 / 24 | 各自插在中间 | 14 / 15 / 16 | 三个 char 挤在一起 |
| 有效内容合计 | 17 字节 | — | 17 字节 | — |
| 总大小(补齐到 8 的倍数) | 32 | 填充 15 字节 | 24 | 填充 7 字节 |
同一组字段、同一台机器:32 与 24。 省下的 8 个字节全部是填充,占比 25%。 如果这是内存里放了 100 万个的实体(粒子、图元、实体记录都很常见), 这一个动作就是 8 MB 的差别——而它不需要改任何逻辑,只需要把声明的顺序换一下。
这条也是本篇第一个可以量化的结论:填充不是"理论上存在",它是可以按字节算出来的成本。 后面第九章那三类事故,本质上是同一个成本从"浪费"变成"错位"。
4.6 三条规则与标准条款的对应关系
好了,最后把这章的结论接到条款上(均为抓取日期 2026-10-13):
- 对齐的上界与扩展对齐:
[basic.align]; - 对象表示与填充位:
[basic.types]; alignof的语义:[expr.alignof];- 缓存行干扰的对齐建议值(本篇只用它的名字,实测归第十一篇):
[hardware.interference]; - MSVC 侧的默认对齐与结构体填充行为:Alignment (C++)。
五、空的东西也占位
5.1 空类为什么是 1
struct Empty {};
sizeof(Empty) == 1      // 本机读数
为什么不是 0?因为对象必须能被取地址。如果空类的大小是 0,
那么同一个 Empty 数组里的两个元素就会有相同的地址——"这是两个不同的对象"这件事就没法表达了。
标准因此要求:完整对象的大小至少是 1。
顺带一个容易被忽略的读数:两个空成员就是 2 字节。
struct E1 { Empty e; };              // sizeof == 1
struct E2 { Empty e1; Empty e2; };   // sizeof == 2   ← 不是 1
因为 e1 和 e2 是两个不同的子对象,必须有不同的地址,各占 1 字节。
5.2 空基类优化
好了,现在把 Empty 从"成员"改成"基类",规则立刻变了:
struct Base { virtual void f() {} };       // sizeof == 8(一个虚表指针)
struct Derived : Base, Empty { int tag; };

sizeof(Derived) == 16      // 本机读数:Base 8 + Empty 0 + int 4 → 补齐到 16
Empty 基类占了 0 字节。 这就是空基类优化(empty base optimization,EBO):
标准允许零尺寸的基类子对象与其他子对象共用地址,所以它不占空间。
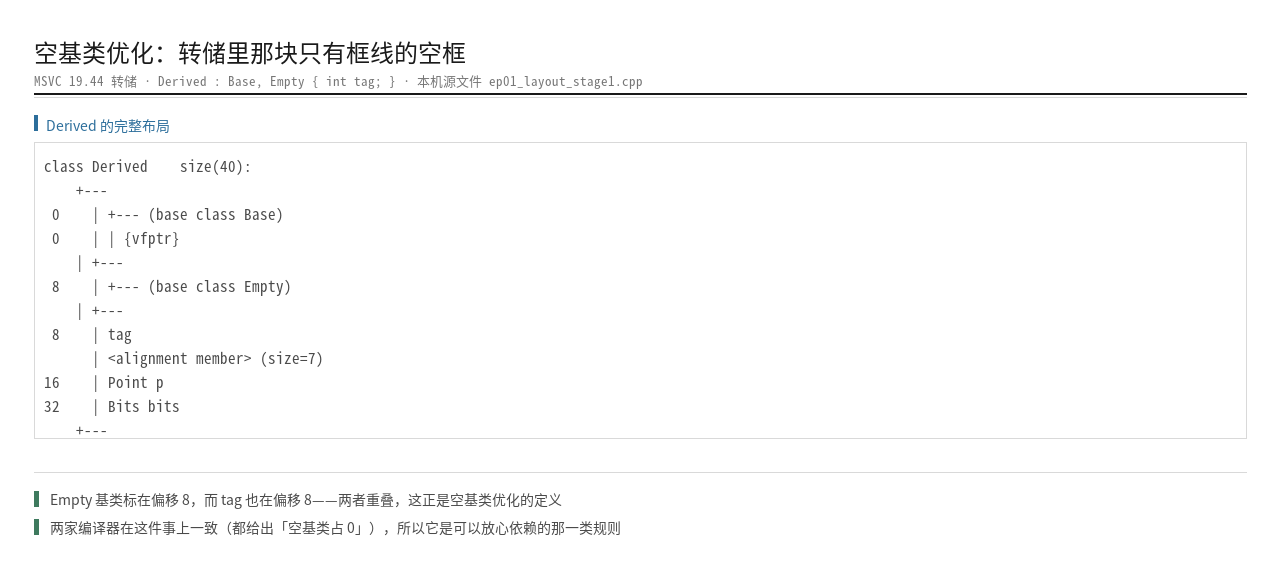
MSVC 的转储把它画得更直白——在派生类里,空基类那一块是空的:
class Derived   size(40):
 0      | +--- (base class Base)
 0      | | {vfptr}
        | +---
 8      | +--- (base class Empty)     ← 只有两行框线,没有成员
        | +---
 8      | tag
注意 Empty 基类标在偏移 8,但 tag 也在偏移 8——两者重叠,这正是 EBO 的定义。
两家编译器在这件事上一致(MSVC 与本机 g++ 都给出"空基类占 0"),所以它是可以放心依赖的。
EBO 有一条边界要记牢:同类型的两个子对象不能共用地址。 所以下面这种写法不省:
//-----------------------------------【空基类实验·同类型不能共用地址】---------------------------------------
// 描述:两个同类型的空基类子对象必须各有地址,EBO 在这里不适用
//------------------------------------------------------------------------------------------
struct E3 : Empty, Empty { };     // 两个同类型的 Empty 基类 —— 布局上不允许重叠
规则的理由是语言层面的:两个同类型的子对象不能有同一个地址(否则 &a == &b 会把它们判成同一个对象),
而 EBO 之所以成立,是因为标准为零尺寸基类单开了一条许可。
[[no_unique_address]] 走的也是这条许可的延伸("可能重叠的子对象"),所以它同样只对零尺寸子对象有意义——
给一个 4 字节的成员加这个属性,一个字节也省不下来。
再看一个只有虚函数、没有数据成员的基类:它叫"近乎空类(nearly-empty class)"—— 尺寸不为 0(有一个虚表指针),但也没有自己的数据。它的存在让"多继承下的布局"开始变得难算: Itanium 规范里用 primary base 这个词指"与派生类共享偏移 0 处虚表指针的那个基类", 非 primary 的多态基类会带自己的虚表指针。这一点与"空基类"叠加时,就是布局开始反直觉的地方。
一个可查证的习惯:这类问题不必靠推。把同一段代码丢进 Compiler Explorer,把 MSVC 与 g++ 的布局输出并排看, 比自己推理快得多——本批的"两家一致/不一致"结论,第一遍筛选就是这么做的。
MSVC 侧的类布局还有一篇值得读的第一手材料:Visual C++ 团队的 Class Layout Insights, 它解释了为什么"编译器会自动插入填充、并可能重排(在允许的地方)"。
5.3 [[no_unique_address]] 的阶梯
C++20 起,这个优化不再只给基类——普通成员也能享受,只要加 [[no_unique_address]]:
struct NoNua   { Empty e; int x; };
struct WithNua { [[no_unique_address]] Empty e; int x; };
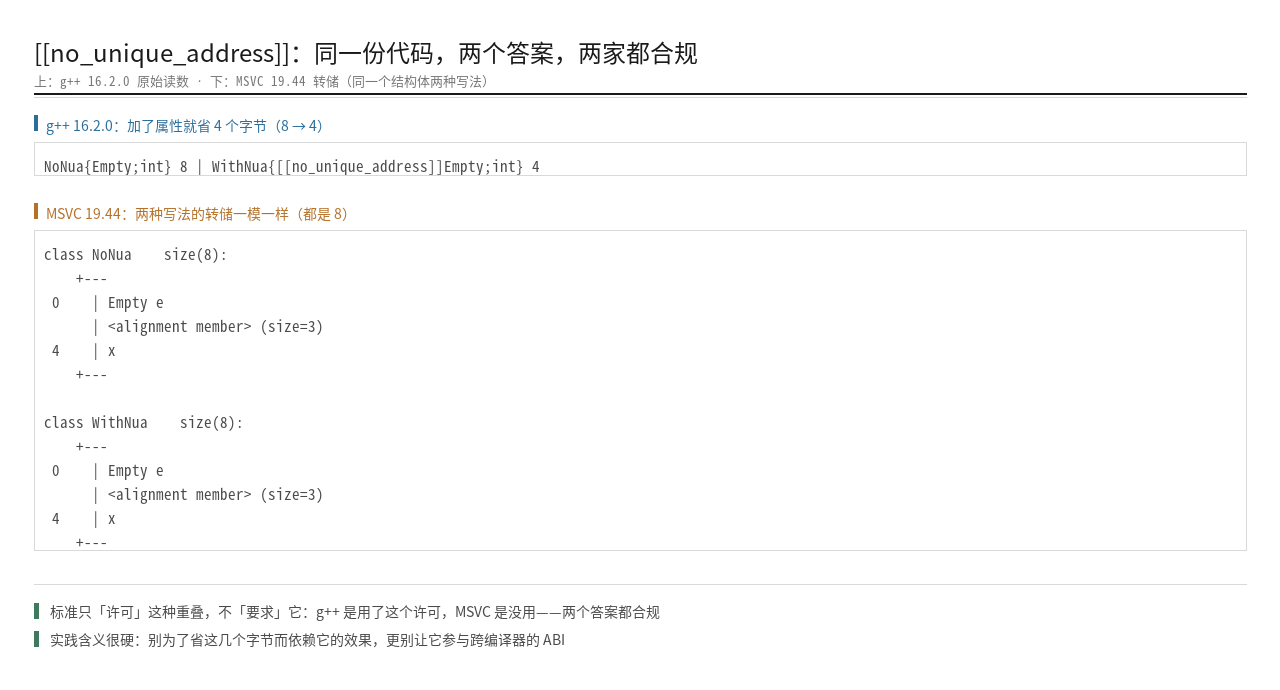
两份代码只差一个属性,两家编译器给出两个不一样的答案:
| 结构体 | g++ 16.2.0 | MSVC 19.44 |
|---|---|---|
NoNua(不加属性) |
8 | 8 |
WithNua(加 [[no_unique_address]]) |
4 | 8 |
g++ 省掉了 4 个字节(e 那 1 字节被 x 的填充吃掉了),MSVC 一个字节没省。
关键在后面这句话:标准只"许可"这种重叠,不"要求"它。 所以两个答案都合规——
g++ 是"用了这个许可",MSVC 是"没用"。
这件事的实践含义很硬:不要为了省这几个字节而依赖 [[no_unique_address]] 的效果,
更别让它参与跨编译器的 ABI——它在自己的工具链里是优化,在别人的工具链里可能是空操作。
(MSVC 侧没有公开的类布局规范,"它为什么没省"我们只记录现象,不做推测。)
代价也要说清楚:一旦真的重叠,取 e 的地址可能与 x 相同,
这个成员就不能再要求"独立地址"的身份了。
5.4 标准与提案怎么说
先看看出处。
这两条优化都有出处,引稳定标签与提案号:
- EBO:由标准里"零尺寸基类子对象可与其他子对象共用地址"的许可支撑,落点在
[class.prop]与[class.mem.general]的相关条款;[intro.object]定义了"可能重叠的子对象"。 [[no_unique_address]]:由提案 P0840R2(Richard Smith,2018-03-12)引入, 现行条款标签为[dcl.attr.nouniqueaddr]。它把"可能重叠"的许可从基类扩到了非静态数据成员。
(提案原文:open-std.org/jtc1/sc22/wg21/docs/papers/2018/p0840r2.html,抓取日期 2026-10-13。)
六、位域:实现定义的打包
6.1 标准原句:这是"实现定义"
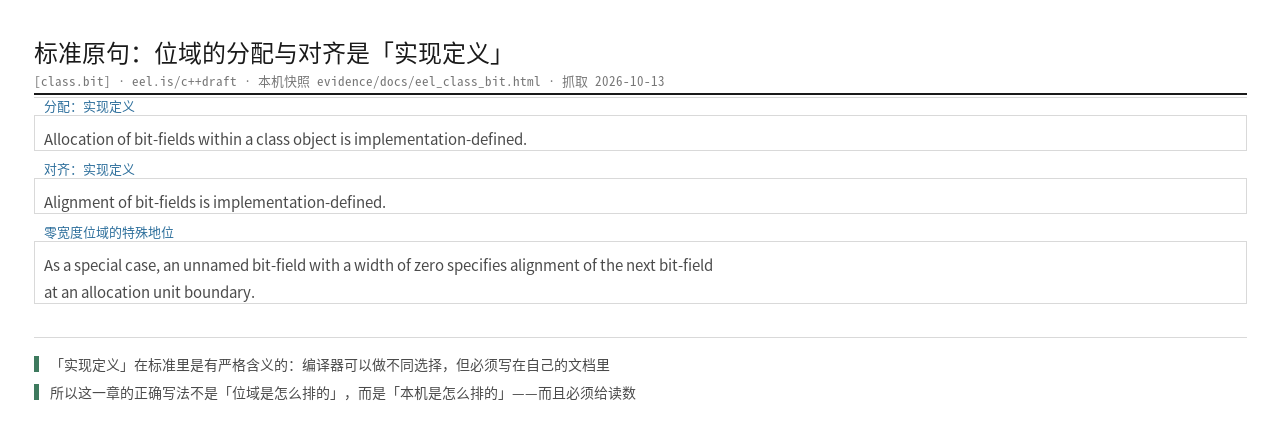
位域是本章唯一一个标准明确不管细节的类型。[class.bit] 的原话是(抓取日期 2026-10-13):
位域在类对象内的分配与对齐是实现定义的。
"实现定义"这四个字在标准里是有严格含义的:编译器可以做不同选择,但必须写在自己的文档里。 所以这一章的正确写法不是"位域是怎么排的",而是"本机是怎么排的"——而且必须给读数。
6.2 本机打包实测
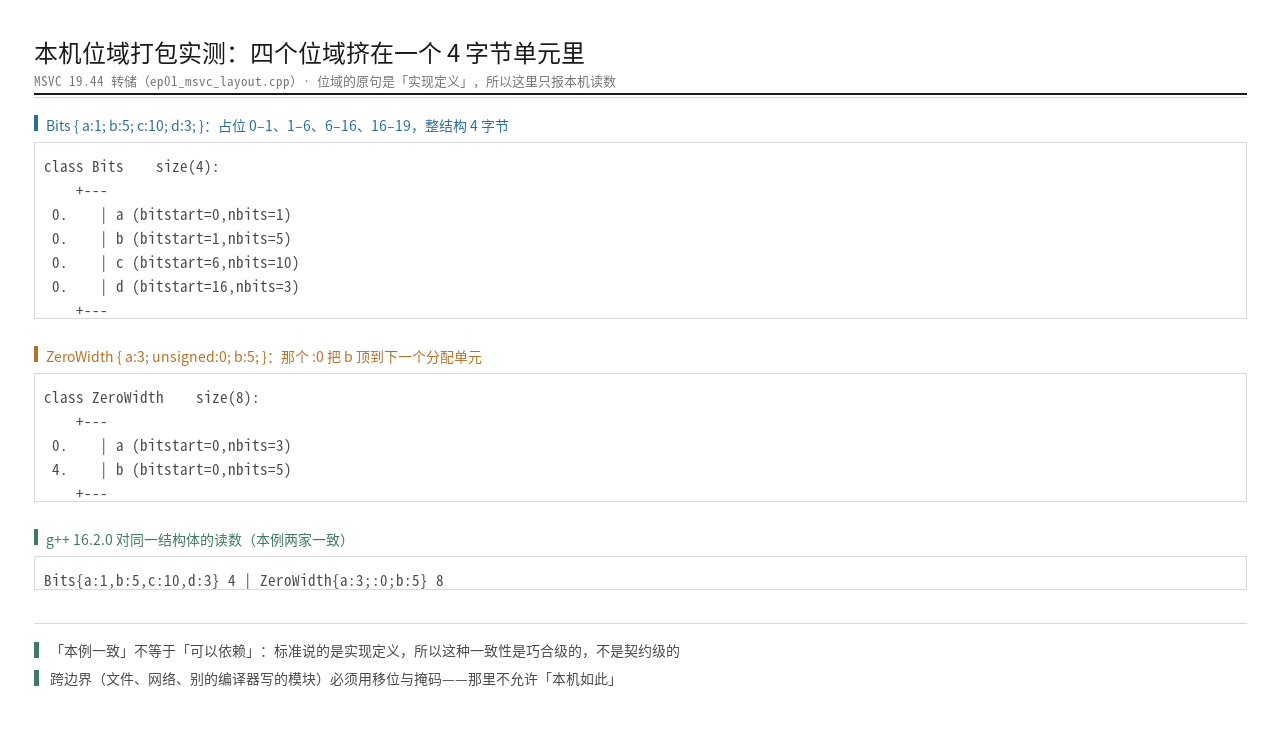
好了,MSVC 的转储把每个位域的起始位与宽度都列了出来:
class Bits      size(4):
 0.     | a (bitstart=0,nbits=1)
 0.     | b (bitstart=1,nbits=5)
 0.     | c (bitstart=6,nbits=10)
 0.     | d (bitstart=16,nbits=3)
读法:a、b、c、d 四个位域被塞进同一个分配单元(偏移 0 的 4 字节)里,
依次占位 0–1、1–6、6–16、16–19。于是整个结构体是 4 字节——
本机 g++ 16.2.0 对同一结构体给出的也是 4 字节,本例两家一致。
但"本例一致"不等于"可以依赖"。 标准说的是"实现定义",所以这种一致性是巧合级的,
不是契约级的:MSVC 侧没有公开的类布局规范(第二、八章都提到过),
而这一批我们在 [[no_unique_address]] 上就抓到了一处真实分歧(5.3)——
同一个属性,一个省 4 字节、一个不省,两家都没违规。
所以位域的正确用法只有一条:要么只用它做位标记且不在乎布局,要么在跨编译器边界处用显式的移位与掩码, 不要依赖位域的具体排布。
6.3 零宽度位域:一把对齐的尺子
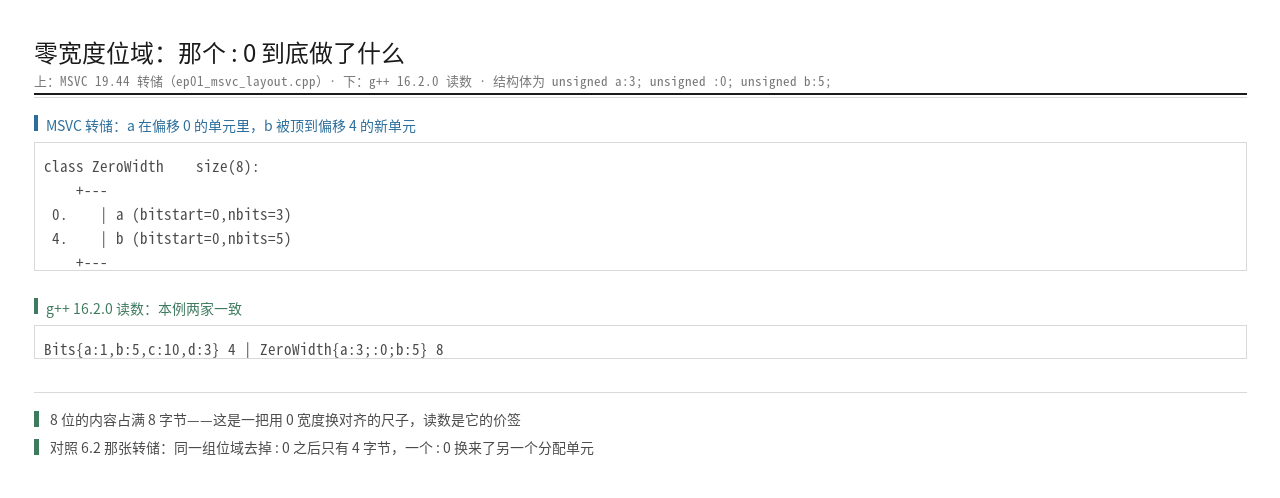
标准里有一个特殊成员——宽度为 0 的匿名位域,它的作用是把下一个字段顶到分配单元的边界:
struct ZeroWidth { unsigned a : 3; unsigned : 0; unsigned b : 5; };
sizeof(ZeroWidth) == 8      // 本机读数
a 占 3 位、b 占 5 位,加起来才 8 位,可 sizeof 是 8 字节——
因为那个 : 0 把 b 推到了下一个分配单元的起点,于是两个分配单元各自为一个字段敞开。
这是一把"用 0 宽度换对齐"的尺子,读数是它的价签。
6.4 那到底该用什么:位域、掩码,还是 std::bitset
说白了,既然位域的排布是实现定义,那"我要在 1 个字节里塞 8 个开关"这种事该怎么做?三条路各有定位:
| 做法 | 大小与排布 | 适用 |
|---|---|---|
位域 unsigned a : 1 |
实现定义,跨编译器不确定 | 单个编译单元内部、不在乎布局 |
手写掩码 (x >> 3) & 1 |
完全由你决定,跨编译器一致 | 跨边界(文件、网络、ABI) |
std::bitset<N> |
标准定义接口,但内部排布仍不对你承诺 | 单个程序内部的位集合运算 |
判据只有一句:只要这段位布局要"跨出去"(写进文件、发给别的进程、给另一个编译器写的模块看), 就必须用掩码或"按字节定义"的格式,不能用位域。 位域留给"只在自己代码里、且不在意具体排布"的场合。
条款入口:[class.bit](位域的分配与对齐是实现定义)。
七、三个旋钮
前面六章讲的都是"规则怎么运行"。这一章讲你能动什么。三个旋钮各有它的价钱, 我们一个一个拧,每一步都给前后对照的读数。
7.1 旋钮一:#pragma pack——把填充挤掉
#pragma pack 是"声明级"的打包粒度控制:它告诉编译器"这个范围内的成员最多按 N 字节对齐"。
//-----------------------------------【旋钮实验·pack(1)】---------------------------------------
// 描述:同一个结构体,包在 pack(1) 里与不包,差多少
//------------------------------------------------------------------------------------------
//【1】默认对齐
//【2】pack(1):成员之间不再补齐
struct Normal  { char a; int b; char c; };          //【1】12 字节
#pragma pack(push, 1)
struct Packed1 { char a; int b; char c; };          //【2】6 字节
#pragma pack(pop)
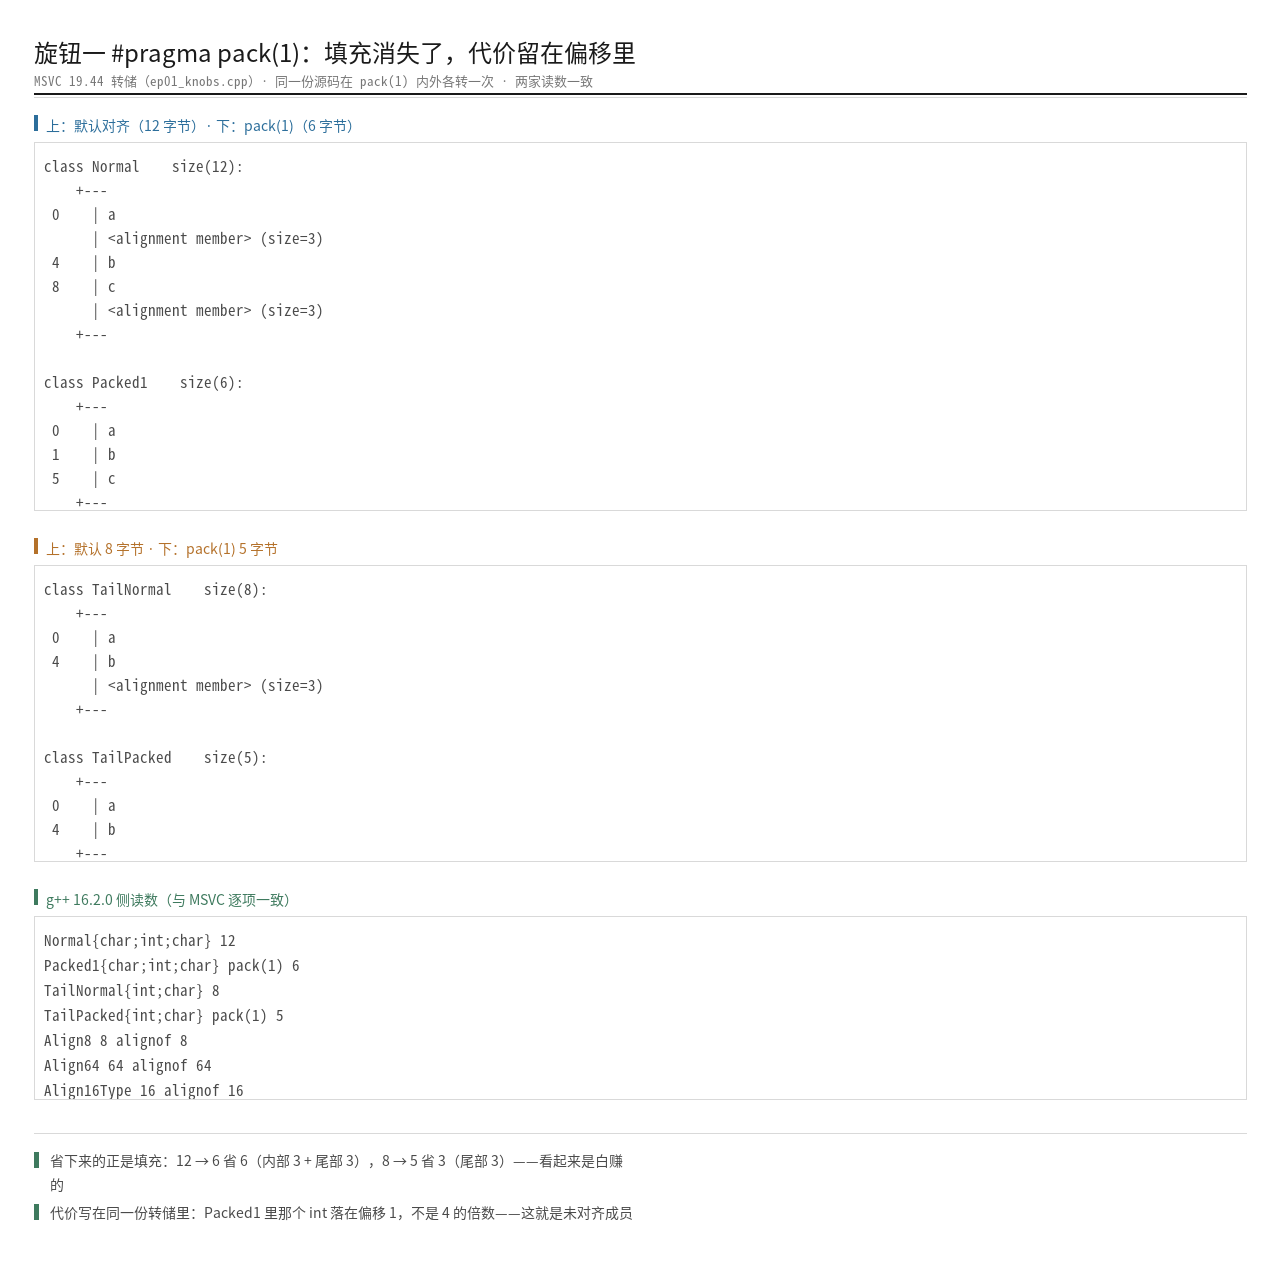
读数(MSVC 19.44 与 g++ 16.2.0 两边一致):
| 结构体 | 默认 | pack(1) |
|---|---|---|
{char a; int b; char c;} |
12 | 6 |
{int a; char b;} |
8 | 5 |
省下来的正是填充:12 → 6 省 6 字节(内部 3 + 尾部 3),8 → 5 省 3 字节(尾部 3)。 看起来是白赚的——但代价就写在 MSVC 的转储里:
class Packed1   size(6):
 0      | a
 1      | b          ← int 落在偏移 1,不是 4 的倍数
 5      | c
b 是个 int,现在落在偏移 1。这就是未对齐访问(misaligned access):
x86 上硬件能容忍(代价是可能跨 cache line、慢一些),但在要求严格对齐的架构上会直接抛异常。
所以 pack(1) 的取舍是:省内存 + 序列化时字节数确定,换"这个结构体不能再被当作普通内存对象直接访问"。
它在"网络包 / 文件格式"这类场景是对的用法,在"频繁访问的内存数据结构"上通常是错的。
这笔代价拆成三条,看得更清楚:
- 未对齐访问会被惩罚。 在 x86 上,硬件通常能容忍未对齐访问,代价是速度——本文不给具体倍数
(那是第十一篇的活)。但在要求严格对齐的架构上,未对齐访问会直接抛异常,而不是"慢一点"。
同一份
pack(1)的代码,在一个平台上只是慢,在另一个平台上会崩。 - 一个成员可能横跨两条缓存行。 偏移 1 上的 4 字节
int落在字节 1–4 上—— 如果它正好压在缓存行边界上,读它就要动两条行。这是"慢"的那一类代价,也是"多线程下更慢"的那一类。 具体数字同样归第十一篇。 - 它不再是"能直接读写的内存对象"。 这一点最容易被忽略:一旦结构体里有未对齐成员,
你不能再把一个字节流
reinterpret_cast成这个类型然后访问成员。 反过来,这恰恰是它正确的用途——在"边界"处 pack、在"内部"解包: 收到网络包时按 packed 结构体切字段,然后拷贝到内部那个按对齐优化的结构体里去用。
要想清楚"要不要压",还有一个更朴素的判据:如果这个结构体会在内存里被高频访问,就不要压; 如果它只是"过路的数据格式",压是合理的。 两种需求用两个类型,是最省事的做法。
(顺带说一个方向相反的旋钮:需要抬高对齐的库——比如为了 SIMD 而要求 16/32 字节对齐的数学库——
会自己重载 operator new。Eigen 就是这么做的,源码在
Eigen/src/Core/util/Memory.h,
它同时用 EIGEN_MAX_ALIGN_BYTES 这个宏来在 SIMD 选项不同的代码之间维持二进制兼容。)
两个旋钮的官方文档都在手边,改之前值得先读一遍:
#pragma pack 与
/Zp。
7.2 旋钮二:alignas——抬高对齐要求
好了,第二个旋钮方向相反:不是把对齐压低,而是把某个对象的对齐要求抬高。
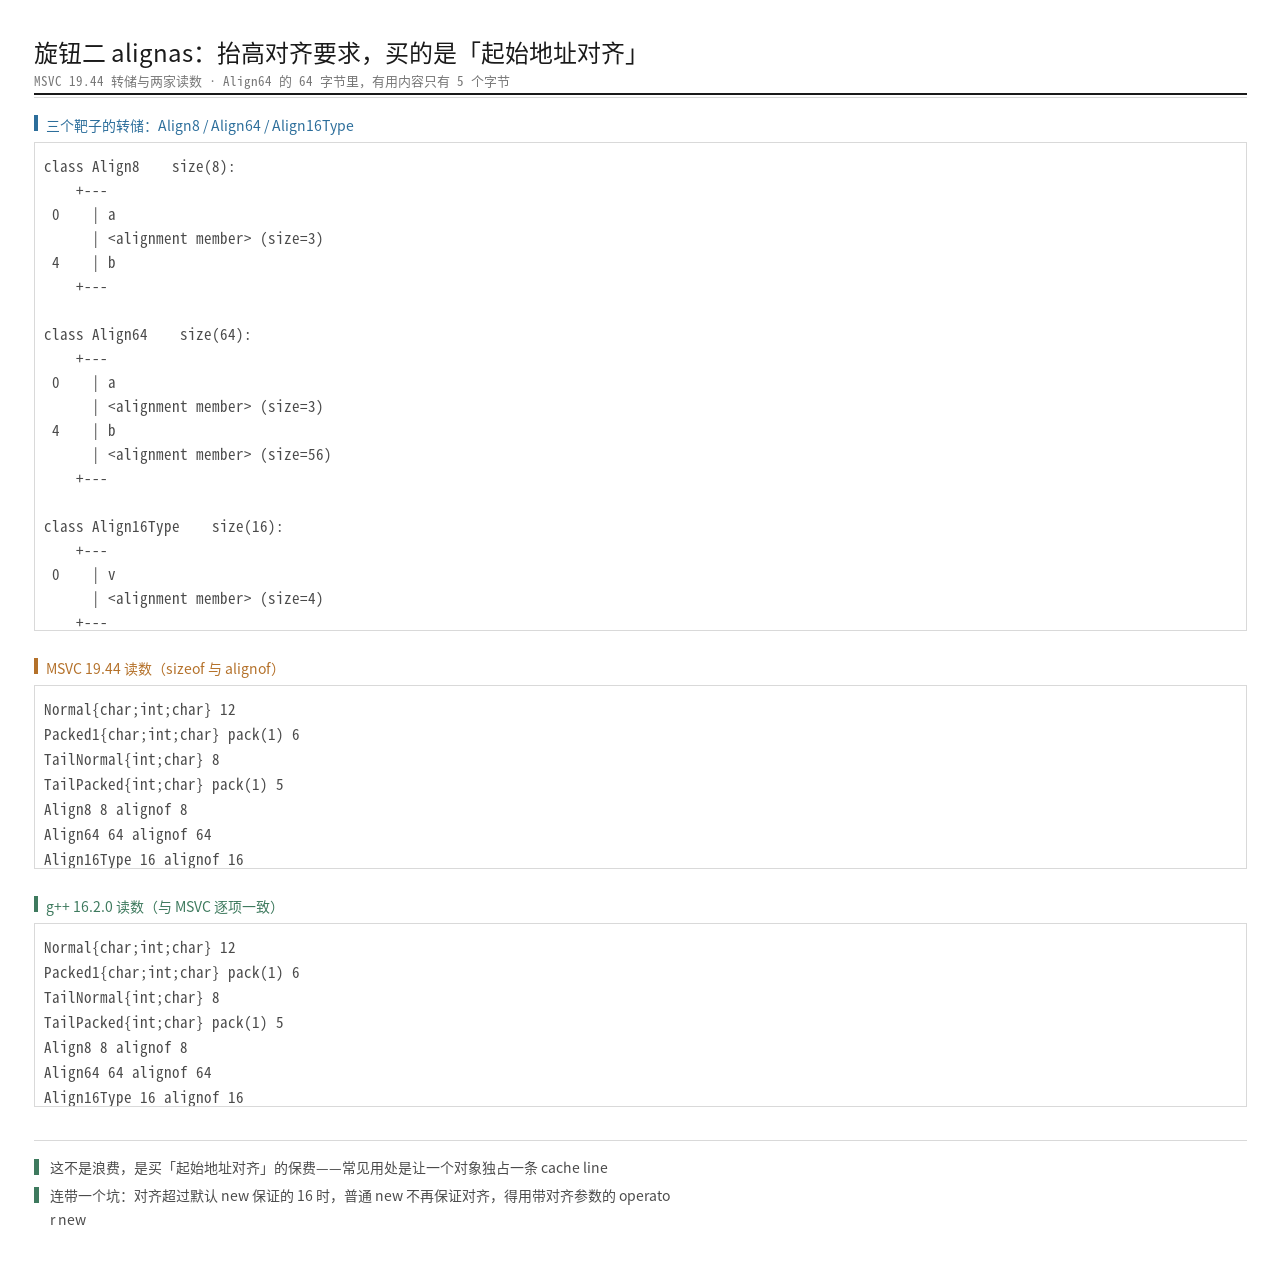
struct Align8      { alignas(8)  char a; int b; };
struct Align64     { alignas(64) char a; int b; };
struct Align16Type { alignas(16) int v[3]; };
读数(两家一致):
| 结构体 | sizeof |
alignof |
|---|---|---|
Align8 |
8 | 8 |
Align64 |
64 | 64 |
Align16Type |
16 | 16 |
Align64 的 64 字节里,有用内容只有 5 个字节,其余 59 个都是为了"让这个对象落在 64 字节边界上"。
这不是浪费,是买"起始地址对齐"的保费——它常见的用处是让一个对象独占 cache line
(alignas(64) 或 alignas(std::hardware_destructive_interference_size):
//-----------------------------------【旋钮实验·防伪共享布局示意】---------------------------------------
// 描述:让两个高频写入的计数器各自独占一条 cache line
//------------------------------------------------------------------------------------------
struct Bad  { std::atomic<long> a, b; };                 // 两个计数器挤在同一条 line 上
struct Good { alignas(64) std::atomic<long> a; alignas(64) std::atomic<long> b; };
注意:这段代码的实际性能影响我们不在本篇给读数——那是第十一篇《缓存与布局》的活。
本篇只负责说清"alignas 改的是对齐要求,因而改的是 sizeof"这一层)。
未对齐/超高对齐还有一个连带的坑:对齐超过 __STDCPP_DEFAULT_NEW_ALIGNMENT__(本机 16)时,
普通的 new 不再保证对齐。想要一个 64 字节对齐的堆对象,你得用带对齐参数的 operator new,
或者像 Eigen 那样自己重载(9.4 会看到它的源码)。
7.3 旋钮三:/Zp 与那个"别碰 SDK 头"的警告
/Zp 是模块级的打包粒度(#pragma pack 是声明级)。它的默认值分平台:
x86 与 ARM 默认 8,x64 与 ARM64EC 默认 16。
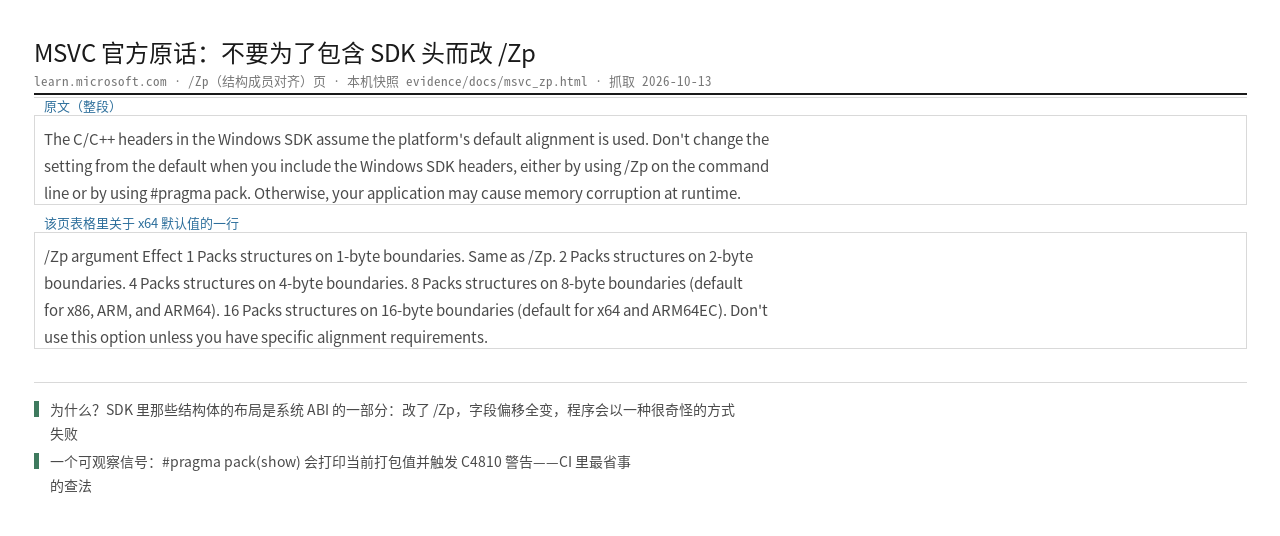
这个旋钮有一句官方原话,值得原样抄下来(MSVC 文档 /Zp 页,抓取日期 2026-10-13):
Windows SDK 头文件假设结构成员使用默认对齐。不要为了包含 Windows SDK 头文件而修改
/Zp设置。
为什么?因为 SDK 里的结构体(WNDCLASS、OVERLAPPED、各种 *_DESCRIPTOR)的布局是系统 ABI 的一部分。
你把 /Zp 改成 1,编译器会按 1 去排这些由操作系统定义的结构体,字段偏移全变——
你的程序调用系统 API 时传进去的就不再是系统期待的那个结构体了。它不会报错,它会以一种很奇怪的方式失败。
顺带一个可观察信号:#pragma pack(show) 会打印当前打包值并触发 C4810 警告。
CI 里想看某个编译单元到底处在什么打包粒度下,这是最省事的办法。
7.4 三个旋钮摆在一起
| 旋钮 | 作用域 | 改了布局的哪一项 | 典型代价 |
|---|---|---|---|
#pragma pack(N) |
声明级 | 成员间的最大对齐(压低) | 出现未对齐成员、跨 cache line |
/Zp |
模块级 | 同上(全局) | 与系统 ABI 打架,SDK 结构体错位 |
alignas(N) |
类型/对象级 | 该类型的对齐要求(抬高) | sizeof 变大、堆分配需要对齐 new |
先看看结论。
三句话总结:压低对齐省内存但换来未对齐;抬高对齐花内存买地址边界;模块级压低是最危险的那一个。
三个旋钮放在一起看,关系就清楚了:它们改的是同一组约束的不同层级——pack 与 /Zp 往下压(减少填充,代价是可能未对齐),alignas 往上抬(增加填充,买到地址边界)。而它们的作用域也不同:一个是声明级,一个是模块级,一个是类型级。作用域越大的旋钮,出问题时波及的范围也越大——这也是为什么 /Zp 那一格,代价栏写的是「与系统 ABI 打架」。
八、两个 ABI 的两套答案
8.1 Itanium:这条路有规范可查
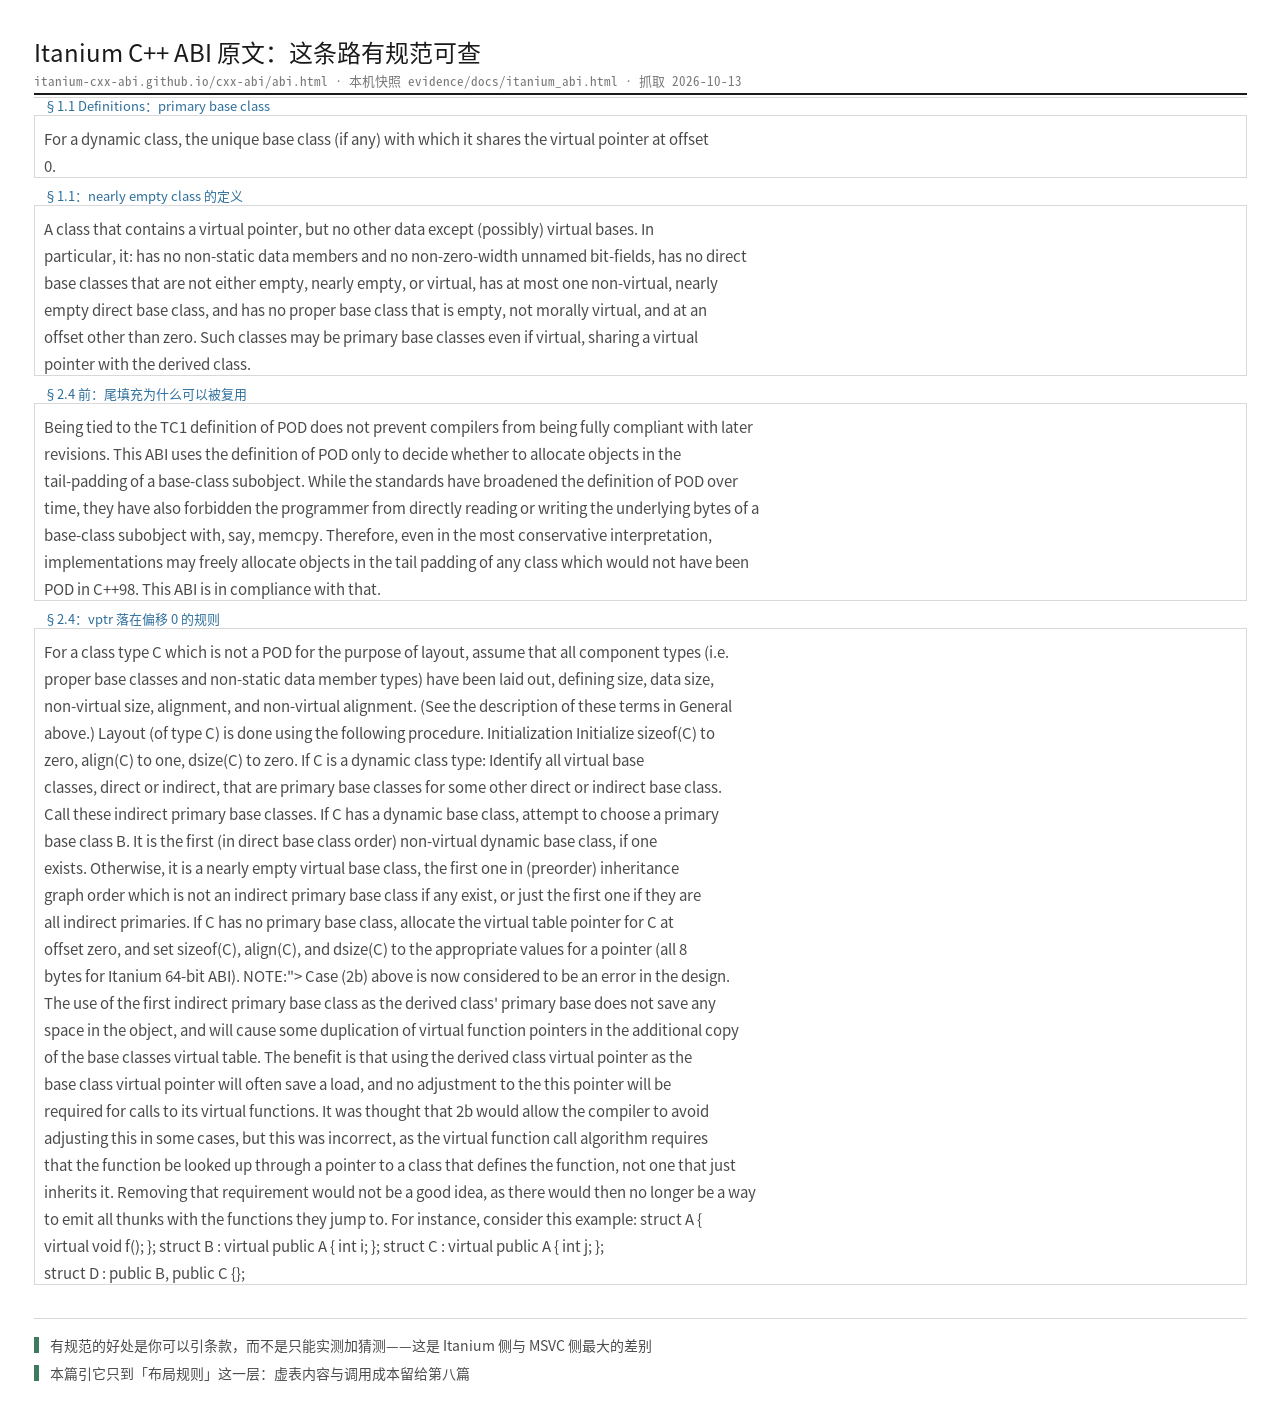
x64 上的 Linux / macOS(以及大多数非 Windows 平台)走的是 Itanium C++ ABI。它有几节是公开规范,
可以逐条引用(抓取日期 2026-10-13):
- §1.1 Definitions 定义了 primary base class:
"the unique base class (if any) with which it shares the virtual pointer at offset 0",
以及
empty class/nearly empty class/potentially-overlapping subobject的定义。 - §2.4 Non-POD Class Types 给出类布局规则:基类子对象可以是零尺寸、primary base 共享 vptr、 尾填充可以复用。
- §2.5 Virtual Table Layout 给出虚表布局:首槽是 offset-to-top,接着是 typeinfo 指针,然后是虚函数槽。
- §2.9 Run-Time Type Information 规定 typeinfo 指针恒存在,且同一类的各虚表条目指向同一 typeinfo。
有规范的好处是:你可以引条款,而不是只能"实测 + 猜测"。 (另有一份 v1.83 的稳定快照可引:refspecs.linuxfoundation.org/cxxabi-1.83.html—— 现行版持续维护,引带版本号的快照更稳。)
8.2 MSVC:这条路只有分散的文档
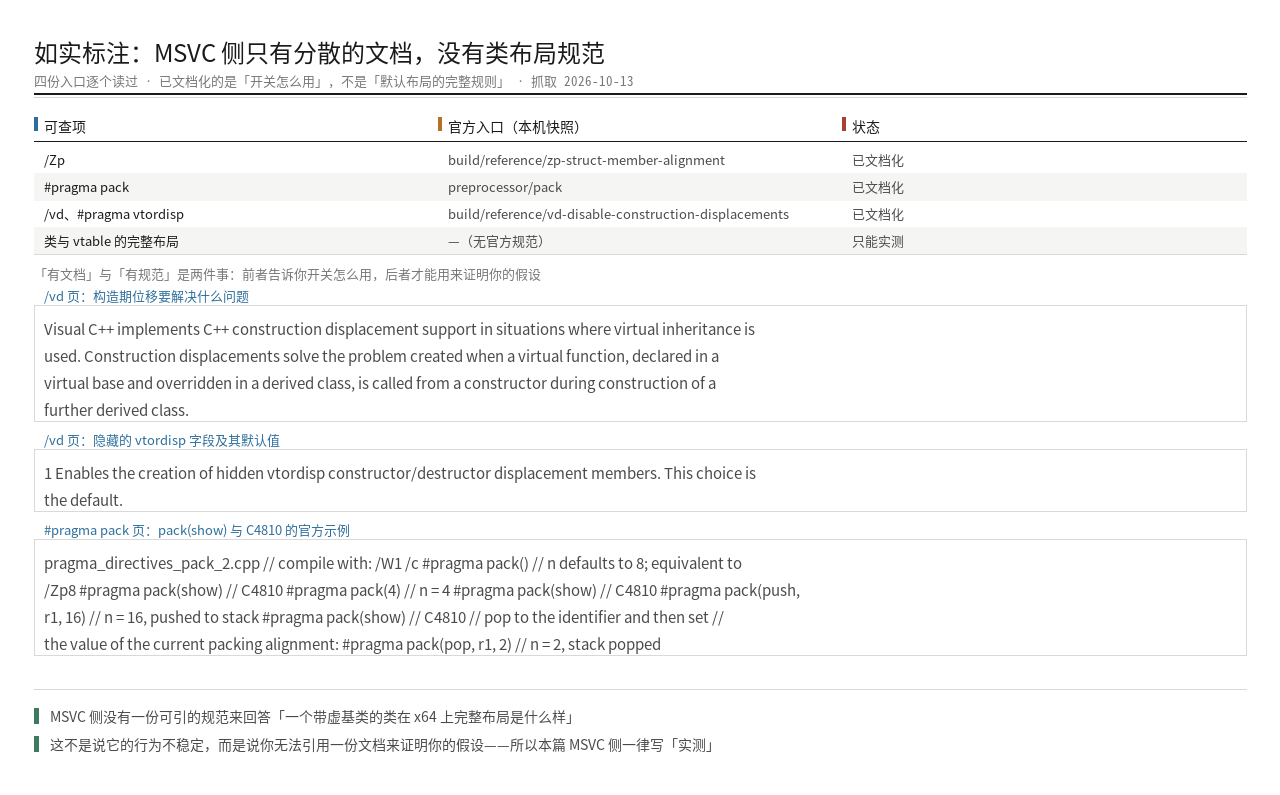
好了,Windows 上 MSVC 用的是另一套,而且没有一份完整的公开规范。可查的只有分散文档:
| 可查项 | 入口 | 说明 |
|---|---|---|
/Zp |
官方选项页(已文档化) | 打包粒度,x64 默认 16 |
#pragma pack |
官方 pragma 页(已文档化) | 声明级打包 |
/vd、#pragma vtordisp |
官方选项页(已文档化) | 控制隐藏的 vtordisp 字段(构造期位移) |
| 类/vtable 完整布局 | 无官方规范 | 只能靠转储实测(本系列的做法) |
"有文档"和"有规范"是两件事:/Zp 的文档告诉你怎么改,不告诉你默认布局的完整规则。
所以本系列的规矩是:MSVC 侧的说法一律标注"实测",不写成"规范规定"。
这里要说清一个容易混淆的区别:「有文档」和「有规范」是两件事。/Zp、#pragma pack、/vd 都有正式文档,但它们各自只回答「这个开关怎么用」;而「一个带虚基类的类在 x64 上完整布局是什么样」这类问题,MSVC 侧没有一份可引的规范。这不是说它的行为不稳定,而是说——你无法引用一份文档来证明你的假设。这件事直接决定了本文在 MSVC 侧的行文方式:一律写「实测」,不写「规定」。
8.3 分叉点对照
两家在哪些地方一致、哪些地方分叉,这一批的实测给了清楚的答案:
| 维度 | Itanium(规范) | MSVC(实测) | 一致? |
|---|---|---|---|
| 成员按声明顺序、按对齐补齐 | 有规范 | 实测一致(本章前面 8 行读数全部相同) | ✅ |
| 空基类优化 | 有规范(基类可零尺寸) | 实测一致(空基类占 0 字节) | ✅ |
| 虚表指针的位置 | 规范:与 primary base 共享,位于偏移 0 | 实测:{vfptr} 在偏移 0 |
🟡 本批同,但规则来源不同 |
| 构造期 vtable 切换 | 规范 §2.6 有定义 | /vd + vtordisp 字段 |
❌ 机制不同 |
[[no_unique_address]] 的重叠复用 |
实测:复用(8→4) | 实测:不复用(8→8) | ❌ 分叉 |
| 位域排布 | 实现定义 | 实现定义(本批两家同值) | 🟡 同值≠同规则 |
| vtable 内容与槽位顺序 | 规范 §2.5 可查 | 无公开规范 | ❌ 不可对照 |
两处 ❌ 是要记住的:[[no_unique_address]] 的重叠复用(5.3)与构造期位移机制。
至于最后一行——MSVC 的 vtable 内容根本没有公开规范,所以任何"MSVC 的 vtable 是这样排的"的说法,
都只能是"某个版本实测如此",不能当成契约。
8.4 逐项展开:这几处分叉具体差在哪
说白了,上一张表是结论,这一节把它摊开——因为"知道哪里会分叉"和"知道差在哪"是两件事。
第一处:虚表指针的位置与数量。 Itanium 的做法写在规范里:
类与它的 primary base 共享位于偏移 0 的虚表指针;而每一个非 primary 的多态基类会带自己的
虚表指针(Itanium C++ ABI §2.4)。
MSVC 侧我们从转储里只看到"{vfptr} 在偏移 0"这一条实测事实——
"多重继承下 MSVC 会有几个 vfptr、分别在哪"我们没有单列读数,
所以正文只给 Itanium 的规范结论 + MSVC 的单继承实测,不把两家的多重继承行为混着讲。
第二处:构造期位移(vtordisp)。 这一处是 MSVC 独有的机制,而它恰好有正式文档:
/vd 与 #pragma vtordisp 控制的就是那个隐藏字段
(MSVC /vd 文档)。
它存在的理由很具体:当基类构造函数/析构函数里发生虚调用、而派生类又用了虚基类时,
需要知道"当前这个 this 相对派生对象的位移",才能把调用重定向到正确的覆盖版本。
Itanium 用另一套办法解决同一件事——构造与析构期切换虚表指针,
这一条也有规范可查(§2.6 Virtual Tables During Object Construction)。
第三处:RTTI 的落地方式。 Itanium 规范 §2.9 规定 typeinfo 指针恒存在,且同一类的各 vtable 条目
指向同一 typeinfo。MSVC 侧的可观察证据出现在转储里:它的内部类型描述结构会跟着一起被打印出来
(本机转储里出现过 pTypeDescriptor、signature 这类条目)——这说明
两家的 RTTI 都"挂在"对象或虚表附近,但挂法不同,而 MSVC 那一侧没有规范可引。
第四处:空基类。 这一处两家一致,是本批实测里少见的"无需分叉"项(空基类占 0 字节,两边都是)。 把它列出来是有意的:不是所有 ABI 相关的东西都会分叉,把"一致的"和"分叉的"分开, 才不会形成"跨 ABI 什么都别信"这种过度恐慌。
最后补一句方法论:这张表里三个 ❌ 中,有两个(构造期位移、RTTI 的挂法)在 MSVC 侧没有规范。 所以面对 Windows 上的布局问题,正确的姿势不是"查文档",而是 "锁一个版本、转一次储、把转储当证据"。
8.5 所以边界怎么划
三条实践规矩,都是从上面那张表直接推出来的:
- 跨编译器的二进制边界,不要传非标准布局的类。要传就退到 C ABI:
只传 POD、
extern "C"函数、明确的对齐与大小。 - 不要假设两个编译器会给出同样的
sizeof。哪怕今天实测一样,那也是"今天、这个版本、这个开关组合下"的一样。 - 把 MSVC 侧的一切当"实测事实",不当"规范承诺"。规范缺失不等于行为不稳定, 但它意味着你无法引用一份文档来证明你的假设——只能锁定版本 + 留转储。
九、误配布局的后果
规则讲完了、旋钮讲完了、两个 ABI 也对照完了。这一章回答那个最实际的问题: 改布局会出什么事? 三类事故,都有公开出处。
9.1 第一类:给已发布的类加一个成员
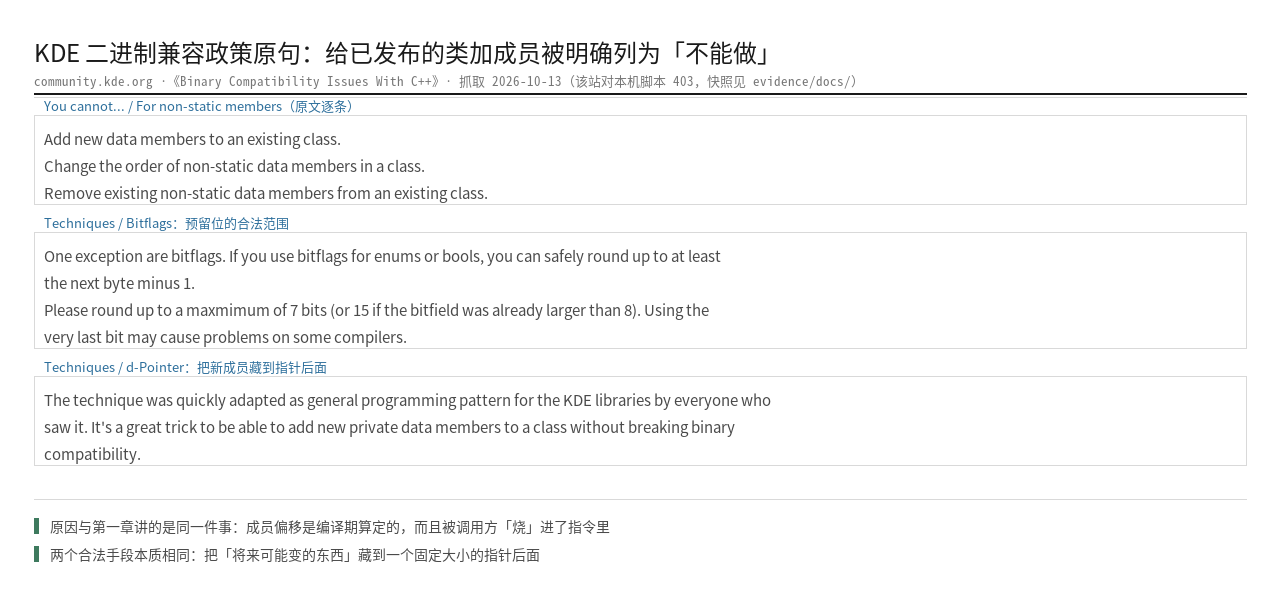
好了,KDE 的《Binary Compatibility Issues With C++》把几条做法明确列进了"不能做"(抓取日期 2026-10-13):
- 不能"Add new data members to an existing class";
- 不能"Change the order of non-static data members"。
原因和本篇第一章讲的是同一件事:成员偏移是编译期算定的,而且被调用方"烧"进了指令里。
你在库里加一个 int,用这个类的每一个已编译程序里的偏移都会错位——
它读到的还是老偏移上的字节,只是那些字节现在属于别的字段了。这种错误不会在编译期暴露,
它只会在运行期表现得像"随机的数据错乱"。
KDE 给的两个合法手段值得记住:预留位(bitflags)/ 用 d-pointer(pimpl)。 本质都是把"将来可能变的东西"藏到一个固定大小的指针后面,让库的使用者看到的类布局永远不变。
同一件事上,Qt 的官方文档给的是同一套禁令:
Shared Library 一节明写"客户端使用的类的内存布局必须与编译时那份库完全一致",
并要求改动公开类时按二进制兼容规则走。两家独立维护的兼容性政策在这一点上完全重合——
这比单一出处更能说明"成员偏移被烧进调用方指令"不是某家的口味。
9.2 第二类:连编译器版本都算数
第二条事故更让人意外:布局是"版本相关"的,换个编译器版本就可能变。
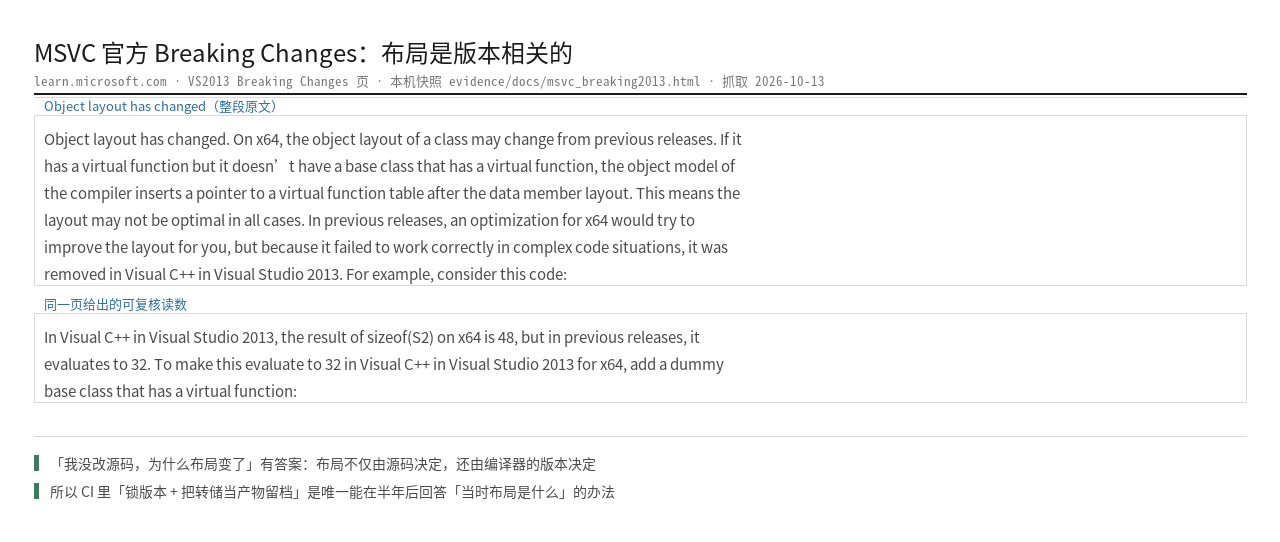
MSVC 官方的《Breaking Changes in Visual C++》记录过一次 x64 对象布局的变化: 在没有"带虚函数的基类"的情况下,编译器会把 vftable 指针插在数据成员布局之后 (而不是像有虚基类时那样放在最前)——这一条与旧版本不同。
所以"我没改源码,为什么布局变了"这个问题有答案:因为布局不仅由源码决定,还由编译器的版本决定。
9.3 第三类:一个宏掀翻整个标准库
说白了,第三类事故最有名:GCC 5 的双 ABI(dual ABI)。
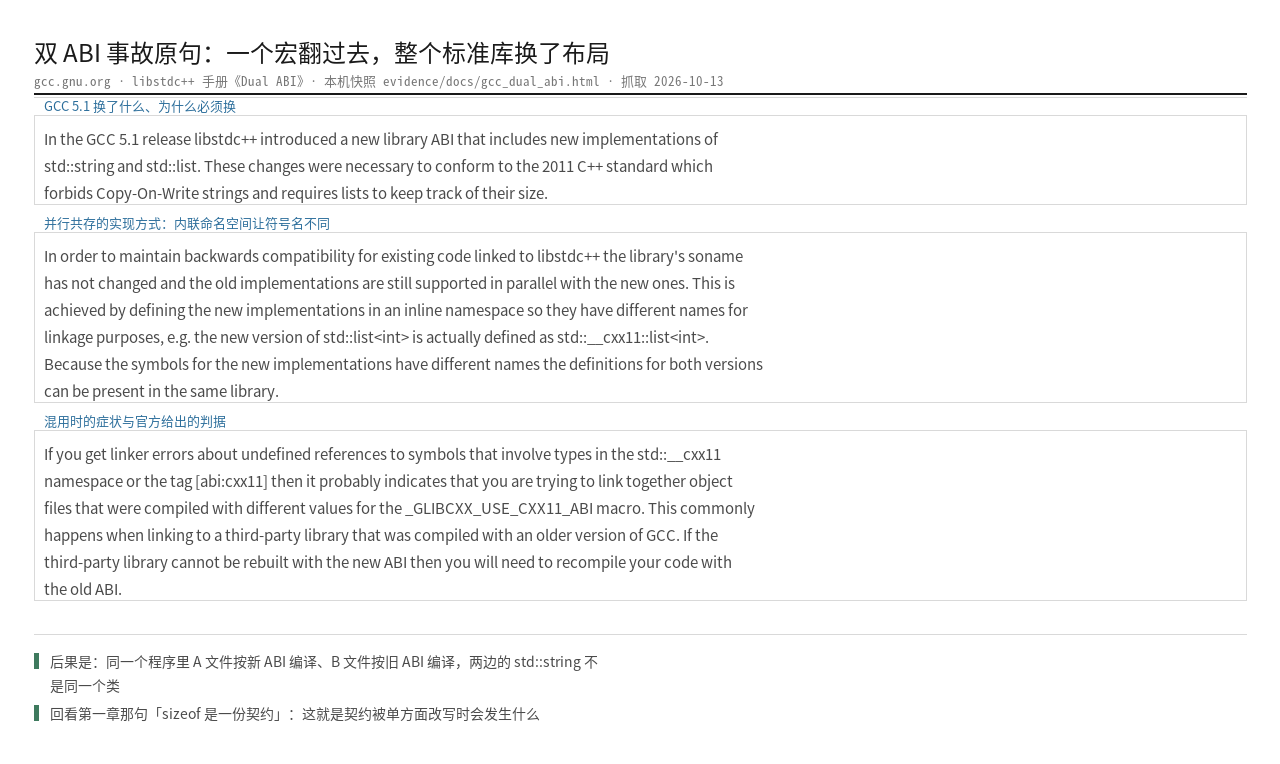
libstdc++ 从 GCC 5 起把 std::string 的实现从 COW(copy-on-write) 换成了 SSO(small string optimization),
std::list 的结构也变了。为了不至于让所有人都重编,它提供了一个开关
_GLIBCXX_USE_CXX11_ABI(官方文档:gcc.gnu.org/onlinedocs/libstdc++/manual/using_dual_abi.html),
而且可以按单个源文件分别设置。
后果是:同一个程序里,A 文件按新 ABI 编译、B 文件按旧 ABI 编译,两边的 std::string 不是同一个类。
它们会链接报 __cxx11 未解析符号;如果侥幸链上了,就是运行期崩溃。
当年 Debian 为了这件事同时提供 libcxx98 与 libcxx11 两份——一次标准库布局变更,上升到了发行版级的工程。
回看本篇第一章那句"sizeof 是一份契约":这就是契约被单方面改写时会发生什么。
9.4 本机的真实容器有多大
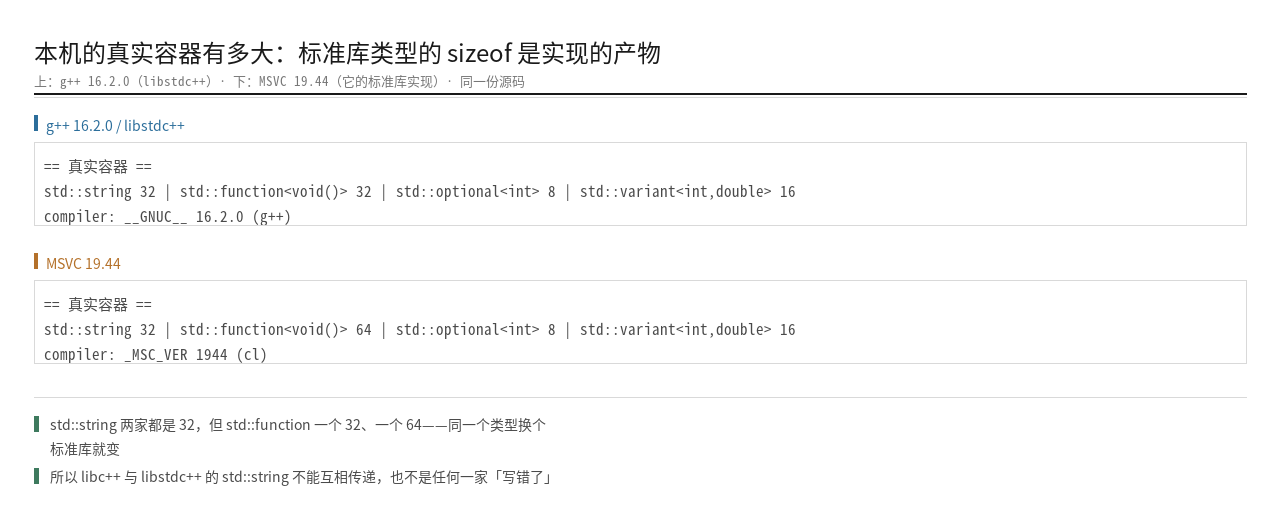
抽象讲了这么多,落回读数。本机 g++ 16.2.0(x64,ucrt64)给出的 sizeof:
| 类型 | sizeof |
说明 |
|---|---|---|
std::string |
32 | libstdc++ 的 SSO 布局:8 指针 + 8 长度 + 16 缓冲 |
std::function<void()> |
32 | 内含一个 16 字节的"小对象缓冲" + 两个指针 |
std::optional<int> |
8 | union + 标记,整体 8 |
std::variant<int, double> |
16 | 按最大成员 + 判别位对齐 |
同一份源码在 MSVC 19.44 上的对照(本批同批实测):std::string 仍是 32,而
std::function<void()> 是 64——多出来的那 32 字节是那个标准库实现自己的选择。
这四个数字说明一件事:标准库类型的 sizeof 是实现的产物,不是标准规定的。
std::string 在 libc++ 上是 24 字节(SSO 容量 22),在 libstdc++ 上是 32(SSO 容量 15)——
同一份代码,换个标准库,sizeof(std::string) 就变了。 这不是 bug,这是"实现定义"。
也正因为如此,libc++ 与 libstdc++ 的 std::string 不能互相传递——
而 Eigen 那类库更直接:它为了对齐自己重载了 operator new,
并用 EIGEN_MAX_ALIGN_BYTES 这个宏来"在 SIMD 选项不同的代码之间强制二进制兼容"
(官方文档原话:typically used to enforce binary compatibility between code/libraries compiled with
different SIMD options,并把它列在"会破坏 API/ABI 的宏"一节)。
9.5 怎么提前发现这类问题
先看看这五个动作。
三类事故的共同点是:它们都不在编译期报错。所以本文最后给五个可以在动笔写代码之前就做完的动作—— 按成本从低到高排:
① 把假设写成 static_assert。 只要你对"这个结构体是 32 字节"有依赖,就写下来:
//-----------------------------------【布局护栏·编译期断言】---------------------------------------
// 描述:把布局假设固定在编译期,换编译器/换开关时立刻报错
//------------------------------------------------------------------------------------------
static_assert(sizeof(Target) == 32, "Target 的布局假设变了:检查字段顺序或 /Zp");
static_assert(alignof(Target) == 8, "对齐假设变了");
成本几乎为零,收益是把"运行期数据错乱"提前成"编译期一行红字"。
② 读一遍你所依赖的库的 ABI 政策。 这一步的价值在于:别人已经把坑标出来了。 本文引过的三份就够用一轮:KDE 的二进制兼容规则、 libc++ 的 Release Notes(ABI 变更一节)、 libstdc++ 的双 ABI 手册。 顺带看看 GCC 5 的变更说明与 Red Hat 那篇双 ABI 的实践说明—— 它们是"布局变了一次,整个发行版跟着动"的完整案例。
③ 用工具读真实布局,而不是靠推理。 除了本文主用的 MSVC 转储,
Linux 侧可以用 pahole(dwarves) 直接从 DWARF/BTF 里读出
结构体的洞与偏移——同一份代码,工具给出的偏移就是编译器真正用的偏移,
比手算可靠(手算能算对规则,但算不出 #pragma pack 与 ABI 细节的叠加)。
④ 引入 ABI 对比工具。 改动库的公开类之前,先用工具比"改前/改后"的 ABI 指纹 (abicheck 的 C++ ABI 系列给出了完整的方法论, 它能解释为什么"vtable 的槽位顺序被烧进调用方指令")。
⑤ 在 CI 里锁版本,并把转储当产物。 本文的全部 MSVC 读数都来自一个明确版本(19.44 / VS 2022 17.14)。 布局是版本相关的(9.2 的 Breaking Changes 就是证据),所以"锁版本 + 把转储文本随构建产物留档" 是唯一能在半年后回答"当时布局是什么"的办法。
五条里,①② 是零成本的纪律,③④ 是工具,⑤ 是流程。它们合起来做一件事:把"看不见的假设"变成"看得见的证据"。
十、收束
10.1 一张可以抄走的清单
好了,把整篇收成十条。每一条后面都标了它出自哪一章,方便回头查:
| # | 清单项 | 判据 | 出自 |
|---|---|---|---|
| 1 | 按对齐要求给字段排序:大的放前面、同类型聚在一起 | 转储里填充最少 | 二 |
| 2 | 别用 -Wpadded 判断"有没有填充" |
它只报尾填充 | 四 |
| 3 | 用转储做定论,不用告警做定论 | <alignment member> 是书面证据 |
三 |
| 4 | 需要"可能重叠"的成员时,先确认两个编译器都真的省了 | [[no_unique_address]] 只被"许可",不被"要求" |
五 |
| 5 | 别对结构体整体 memcmp / 整体序列化 / 整体哈希 |
填充位不是值表示的一部分 | 四 |
| 6 | 位域只用来做位标记;跨边界用移位与掩码 | 它的分配与对齐是实现定义 | 六 |
| 7 | 压低对齐(pack / /Zp)前先问"这个结构体会被当内存对象访问吗" |
会出现未对齐成员 | 七 |
| 8 | 抬高对齐(alignas)超过 16 时,确认堆分配也带对齐 |
默认 new 只保证 16 | 七 |
| 9 | 跨编译器二进制边界只传 C ABI 的 POD | 两套 ABI 在若干点上分叉 | 八 |
| 10 | 已发布的类只加预留位或藏到 pimpl 后面 | 成员偏移被烧进调用方指令 | 九 |
这张清单的用法不是「背下来」,而是当成 review 时逐条过的检查表:打开一份结构体定义,从第 1 条往下走,问「这条在这里成立吗」。十条里真正会踩的通常只有两三条,但是哪两三条取决于代码在做什么——紧凑的内存数据和高频收发的协议包,踩中的条目完全不一样。每条后面的判据与出处章号,是为了让你在不确定时能立刻翻回原文。
10.2 全篇读数总表
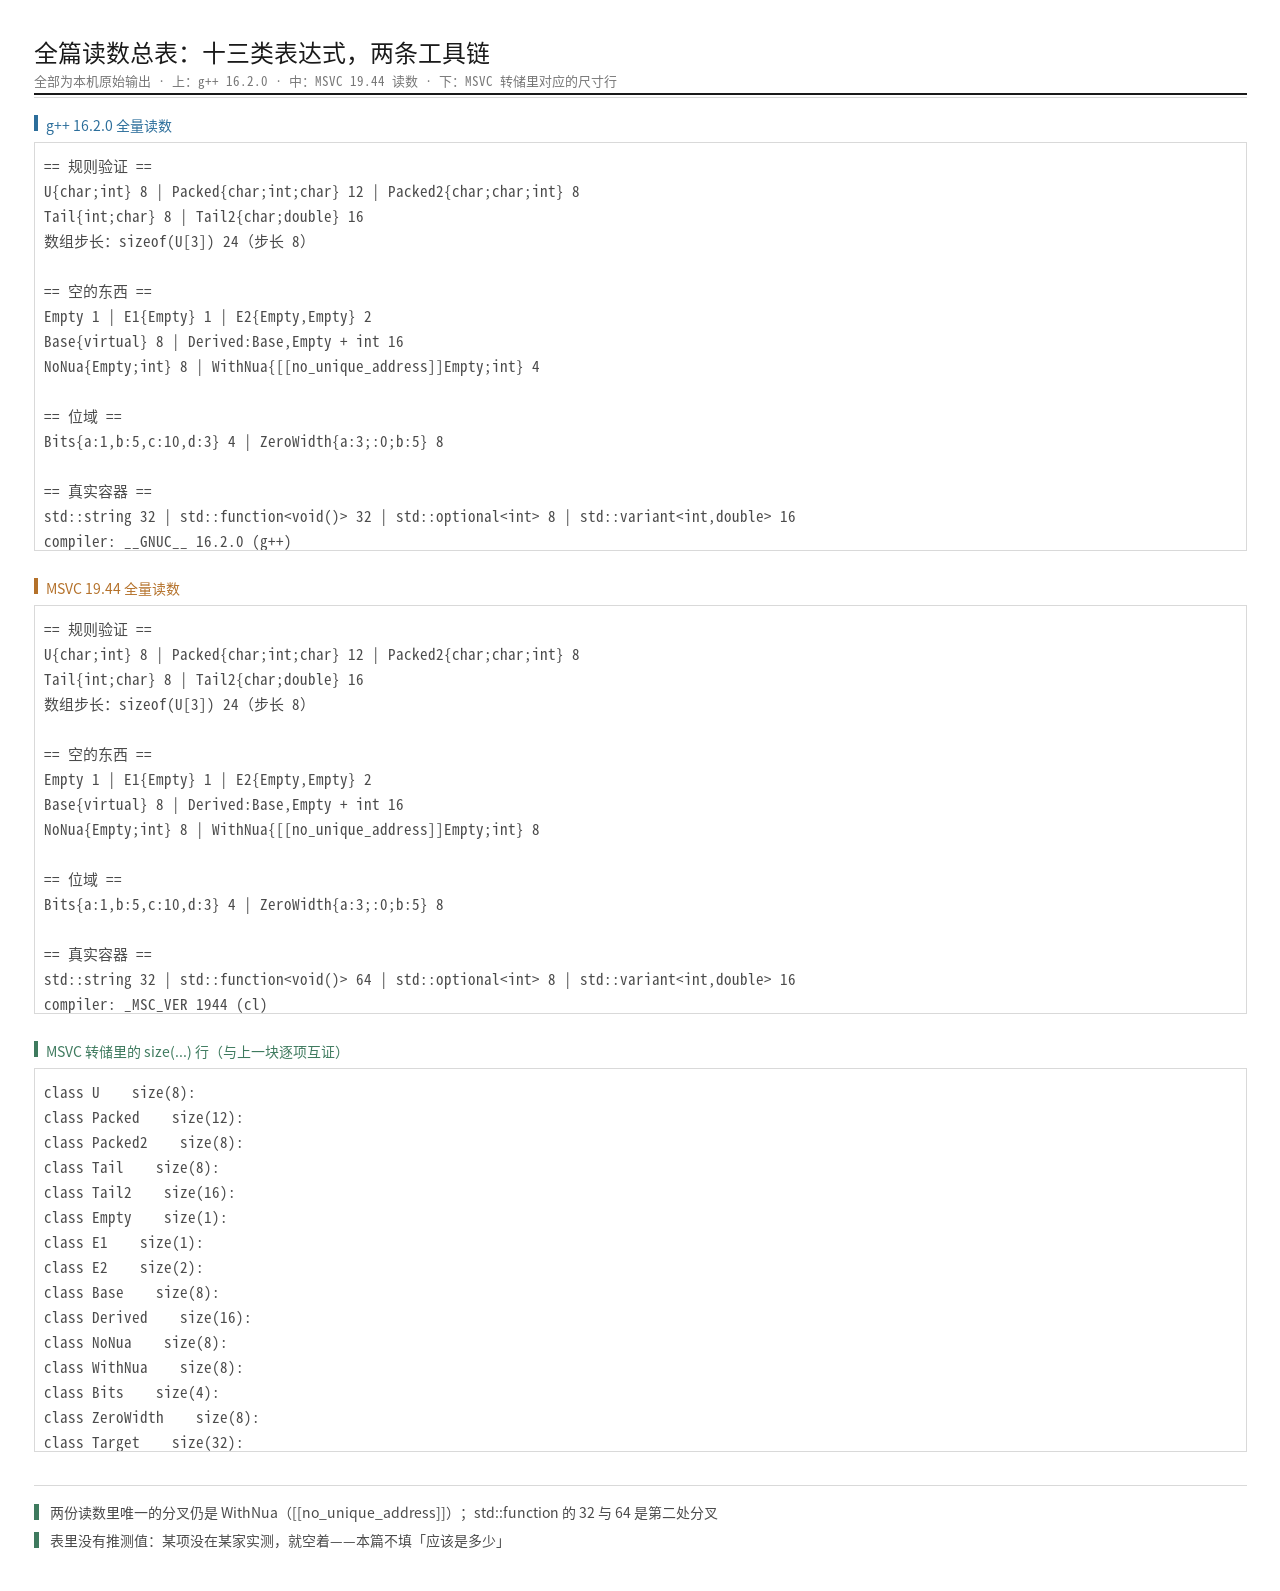
所有读数都是本机跑出来的,两张工具链都给了对照:
| 表达式 | MSVC 19.44 | g++ 16.2.0 | 章 |
|---|---|---|---|
sizeof(struct{char;int}) |
8 | 8 | 一 |
sizeof(struct{char;int;char}) |
12 | 12 | 二 |
sizeof(Target)(五字段手算靶子) |
32 | 32 | 三 |
sizeof(Empty) / sizeof(E1{Empty}) |
1 / 1 | 1 / 1 | 五 |
sizeof(E2{Empty;Empty}) |
2 | 2 | 五 |
| 空基类在派生对象里占 | 0 | 0 | 五 |
WithNua([[no_unique_address]]) |
8 | 4 | 五 |
Bits{a:1,b:5,c:10,d:3} |
4 | 4 | 六 |
struct{a:3; unsigned:0; b:5} |
8 | 8 | 六 |
pack(1) 的 {char;int;char} |
6 | 6 | 七 |
pack(1) 的 {int;char} |
5 | 5 | 七 |
alignas(64) 的结构体 |
64 | 64 | 七 |
sizeof(std::string) |
32 | 32 | 九 |
sizeof(std::function<void()>) |
64 | 32 | 九 |
(表内每一格都是本机实测;某家没跑过的项就留空,不填推测值。两家不一致的两行已加粗—— 第五章那个属性是一处,标准库这两个容器类型是另一处。)
10.3 留给下一篇的问题
说白了,写到这里,有一件事已经很明显:布局规则能告诉你"这些字节排在哪",但它回答不了"这些字节从哪来、什么时候来"。
一个 16 字节的结构体,它不是凭空出现在内存里的。谁在什么时候把它交给你?你连续 new 一万个,
它们落在哪?为什么有的分配器能在多线程下不打架,有的会——而它们表面上的接口一模一样?
下一篇我们就往下一层走:分配器。从 malloc 的公开契约讲到 jemalloc、mimalloc 与 pmr 的三种取舍,
用同一套"机制靠原文、代价靠自跑"的办法,把"每次分配到底花了什么"算清楚。
相关链接
- 下一篇(预告):【C/C++ 现代语言与底层】(二) 分配器解剖:从
malloc到 jemalloc / mimalloc /pmr - 规范入口:Itanium C++ ABI | C++ 标准草案条款
- 本系列工具链基线:MSVC 19.44(VS 2022 17.14)与 msys64 g++ 16.2.0
- 相关专题:Godot 4 引擎架构 | Jolt Physics 3D | 图形性能剖析工具链
With Best Wishes.