核心问题:ep03 讲完了加速结构——BVH 怎么建、怎么更新、怎么省内存。但加速结构只回答了一个问题:光线该往哪儿走、在哪个三角形面前停。光线停下来了,接下来呢?一个场景里有金属、玻璃、木头、皮肤、植被,每个三角形都"找到了",但每条光线该执行哪段着色器代码?找到之后算什么?算出来的结果怎么拼回最终画面?这一篇就来回答这些问题——SBT 是什么、hit group 由哪三种着色器组成、closest-hit 算什么、any-hit 为什么贵、intersection 留给谁、材质系统怎么组织 SBT、以及 SBT 的 stride/offset/对齐能踩多少坑。八件事合起来,才是"找到三角形之后"的完整答案。
本篇不涉及光线追踪管线与光栅化管线的混合编排(ep05 专讲);不写离线渲染的着色器组织方式(离线管线的 hit shader 调度逻辑和实时完全不同,离线渲染器可以容忍单帧数十秒的着色器编译和调度开销,实时管线不行);不写引擎编辑器的操作步骤。我们只把 Vulkan 规范给的接口、厂商公布的数据、以及第三方实测的数字,摆成一本能算的账。
本系列(实时光线追踪与混合渲染,共 12 篇)的前置阅读:第一篇《分界线》给出了三类效果判据与三条成本模型;第二篇《加速结构工程账(上)》给出了构建/更新/压缩三科的静态账;第三篇《加速结构工程账(下)》给出了动态场景的 TLAS/BLAS/CLAS/OMM 策略与内存预算。本篇承接 ep03 的结尾——"光线穿过加速结构之后,会调用命中着色器"。其余前置专题为算法层《实时渲染管线探析》5 篇、约束层《移动端图形与功耗》7 篇、硬件实现层《GPU 架构剖析》12 篇。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。

开篇:找到三角形只是开始
0.1 内容总览:本篇知识地图
先看看一张总表,把八章各自回答的问题钉在这里。后面每一章都在展开其中的某一行。
| 章 | 回答的问题 | 核心结论 | 主要依据 |
|---|---|---|---|
| 一 | SBT 是什么 | SBT 是把 instance 映射到着色器组的连续 buffer,四区域结构,stride/alignment 是正确性变量 | Vulkan 规范 · Ray Tracing Pipeline |
| 二 | hit group 怎么组合 | 0/1 intersection + 0/1 any-hit + 0/1 closest-hit,三角形路径能不设就不设 | DXR 规范 · NVIDIA Best Practices |
| 三 | closest-hit 算什么 | PBR 着色 + 次级光线,输入靠 hitT/primitiveID/barycentrics,与像素着色器执行频率和递归能力不同 | Vulkan GLSL 扩展 · NVIDIA Practical RTX |
| 四 | any-hit 为什么贵 | 遍历中每个候选命中触发,植被场景每帧 15-25 亿次调用,OMM 可省 54.7% | Indiana Jones 实测 · Vulkan Tutorial |
| 五 | intersection 给谁用 | 非三角形几何(曲线/球体/程序化),AABB 命中后做精确求交,几何复杂时不划算 | NVIDIA Practical RTX · nvpro 样例 |
| 六 | 材质系统怎么组织 SBT | 朴素 per-instance 布局 6MB → 去重 + bindless(见 GPUOpen · bindless 资源) <1MB;UE5 Persistent SBT 跨帧复用 | OptiX 官方博客 · UE5 性能指南 |
| 七 | SBT 的坑有哪些 | stride 不对齐 / offset 指错 / group count 不匹配 / 区域重叠 / any-hit 重计算 | Vulkan Validation · GPU-AV · RenderDoc |
| 八 | 三句话判据 | SBT 是性能变量 / hit shader 要精简 / 踩坑不报 crash 只跑错着色器 | 本篇归纳 |
读法建议:只想搞懂 SBT 结构的,读第一章;要选材质组织策略的,读第六章的对比表;在排查 SBT 出错的,直接翻第七章的坑表和调试方法;想知道 any-hit 到底贵在哪的,读第四章的数字推演。
0.2 三个工程问题
ep03 的结尾留了一个口子:光线穿过加速结构,找到最近的相交点,然后调用命中着色器。这句话听着简单,但藏了三个工程问题。
第一,执行哪个着色器? 一个场景可能有几百种材质——金属走 PBR 流程,玻璃走折射计算,植被走 alpha test,水面走多次反射。光线命中一个三角形后,GPU 怎么知道该跳到哪段着色器代码?答案靠 SBT(Shader Binding Table),但 SBT 的布局、对齐、offset 计算有一堆约束,搞错了不会 crash——只会让错误的着色器执行,画面看起来"对了一点又错了一点",排查起来极费时间。
第二,着色器里做什么? 命中着色器分三种:closest-hit 负责最终命中后的光照计算,any-hit 负责遍历过程中每个候选命中的透明测试,intersection 负责非三角形几何的自定义相交。三种着色器各有各的输入数据、各有各的性能特征、各有各的适用场景。光栅化管线里只有一个像素着色器干所有事,光追管线把它拆成了三段,拆法本身就是一笔工程账——为什么是三段而不是一段?因为遍历的硬件流程要求分阶段:遍历中需要判断"算不算命中"(any-hit),遍历结束后需要着色(closest-hit),而自定义几何需要额外的求交步骤(intersection)。
第三,怎么组织才不绊倒自己? SBT 不是写完就完了的结构。场景有几万 instance,每种材质一个 hit group,SBT 可能膨胀到几 MB;全部 instance 各存一份材质数据,SBT 的 cache 命中率就崩了。NVIDIA OptiX 官方博客记录了一个案例:10 万 instance 的 SBT 从 6 MB 优化到不到 1 MB,靠的不是压缩,而是把 per-instance data 从 SBT 记录里挪到全局 bindless 数组。组织方式的差异,直接决定了 SBT 是性能工具还是性能负担。
这三件事,就是本篇的八章。先讲 SBT 是什么(第一章),再讲 hit group 的三种着色器各自做什么(第二到五章),最后讲材质系统怎么组织 SBT、SBT 的坑有哪些(第六到七章),收成三句话判据交棒 ep05(第八章)。
0.3 口径声明
本篇所有数字按四档标注,正文里每次出现都会说明它属于哪一档:
| 口径 | 含义 | 本篇中的例子 |
|---|---|---|
| 规范事实 | Vulkan/OpenGL 规范原文或由规范结构体布局直接推出的值 | SBT 四区域结构;shaderGroupHandleSize = 32 字节;hit group 的组合规则 |
| 第三方实测 | 独立研究者在公开场景下的测量 | 植被场景每帧 15-25 亿次 any-hit 调用 |
| 厂商官方口径 | 厂商官方文档、博客或样例给出的目标与收益 | OptiX SBT 从 6 MB → <1 MB;Indiana Jones OMM 把 7.90ms 降到 3.58ms |
| 论文设定 | 论文在特定硬件与场景下的测量 | 阴影光线比普通光线快 ~20% |
边界:不写 hit shader 的具体 GLSL/HLSL 代码实现;不写离线渲染器的着色器组织方式;不写引擎编辑器操作步骤;OMM 的原理在 ep03 已讲透,本篇只讲"OMM 怎么省 any-hit 调用",不重复 OMM 本身。
一、SBT 是什么:着色器的电话簿
1.1 电话簿比喻
SBT 全称 Shader Binding Table。名字听着很正式,但理解它的最佳方式是把它想成一本电话簿。
电话簿干什么?给每个人名配一个电话号码。SBT 干什么?给每个几何 instance 配一个着色器组(shader group)的地址。光线遍历到某个三角形,GPU 查 SBT 就知道"这个三角形该执行哪段着色器代码"。
但 SBT 比电话簿多了一层:每条记录不只有"着色器地址"(shaderGroupHandle),还可以附带"用户数据"(user data)。这些用户数据可以是材质索引、纹理 bindless 句柄、变换矩阵的指针——anything。规范不限制你往里塞什么,只限制这条记录的 stride 和 alignment。
所以 SBT 的本质是:一块连续的 GPU buffer,每条记录 = shaderGroupHandle + 用户数据。shaderGroupHandle 是管线创建时编译进 pipeline 的着色器组句柄,大小固定(Vulkan 规范中 shaderGroupHandleSize 通常是 32 字节,规范事实口径),用户数据大小由你决定。整条记录的 stride 必须 ≥ shaderGroupHandleSize,且必须是 shaderGroupHandleAlignment 的倍数。
还有一个细节容易被漏掉:shaderGroupHandle 不是函数指针。它是管线创建时由驱动生成的一块固定大小的二进制数据(Vulkan 里通过 vkGetRayTracingShaderGroupHandlesKHR 获取),内容对应用不可见——你只需要把它写进 SBT 记录的起始位置,硬件在遍历到对应 instance 时自动解析。这意味着你不能"跳过" shaderGroupHandle 只放用户数据——它必须存在,它是 SBT 记录的"头部"。
1.2 四区域结构
SBT 不是一张扁平的表,它被划分成四个区域,每个区域对应光追管线的一个阶段:
- raygen 区域——光线生成着色器。每帧从这里开始,发射光线。通常只有一条记录(一个 raygen shader),但也可以有多条(比如不同 pass 用不同的 raygen:反射 pass 用一个 raygen,阴影 pass 用另一个)。
- miss 区域——光线没命中任何几何时执行的着色器。通常用来写天空盒颜色或环境光。可以有多条(比如反射 miss 和阴影 miss 用不同的 miss shader——反射 miss 写天空 IBL,阴影 miss 写"光照到达"标记)。
- hit 区域——命中着色器。这是 SBT 最核心也最容易出错的区域,每条记录对应一个 hit group(下一章详述)。场景里有多少种材质组合,这里就有多少条 hit 记录。
- callable 区域——callable shader,类似函数调用。不是每个管线都会用到,但当你需要在着色器里"调用一个函数"而不是"发射一条光线"时,callable 区域就是那个函数表。典型场景是材质库:把 BRDF 计算封装成 callable shader,不同 closest-hit 调同一个 callable,避免代码重复。
每个区域在 Vulkan 里用 VkStridedDeviceAddressRegionKHR 描述,三个参数:
- deviceAddress:区域起始地址
- stride:每条记录的字节跨度
- size:区域总大小
注意 stride 和 size 不是一回事。stride 是每条记录的步长,size 是实际用到的字节数。如果 stride = 64 字节,你有 3 条 hit 记录,那 size = 192 字节。但底层 buffer 可能分配了 256 字节(因为对齐),多出来的部分不会被访问。
四个区域的 stride 可以各不相同。比如 raygen 区域只有一条记录,stride 可以就是 shaderGroupHandleSize(32 字节,因为不需要附带用户数据);hit 区域的 stride 可能是 64 或 128 字节(因为每条记录要附带材质索引和 bindless 句柄)。miss 区域的 stride 可能和 raygen 一样小。这种灵活性让你可以按需设计每个区域的大小。
1.3 instance 怎么找到 SBT 里的记录
有了四区域结构,下一个问题是:光线遍历到某个 instance 的某个三角形,怎么知道去 hit 区域里的哪一条记录?
答案藏在 instance 结构里。Vulkan 的 VkAccelerationStructureInstanceKHR 有一个字段叫 instanceShaderBindingTableRecordOffset(实例着色器绑定表记录偏移)。这个值乘以 hit 区域的 stride,加上 hit 区域的起始地址,就是这条 instance 对应的 SBT 记录地址。
打个比方:电话簿按区域分好了(hit 区在第三页),但第三页有好多条记录。instance 带了一个"页内偏移",告诉你"我要找的那条记录在第三页的第几行"。
这个偏移值是你在创建 instance 时手动填的。填错了,光线命中的是金属,但 SBT 偏移指向了玻璃的 hit group——着色器执行了,画面也出了,但金属被画成了玻璃。这种 bug 不报错、不 crash,只让你怀疑自己的材质系统是不是哪里写错了。
一个实际的计算例子:假设 hit 区域起始地址是 0x1000,stride 是 64 字节。一个 instance 的 instanceShaderBindingTableRecordOffset = 5。那它对应的 SBT 记录地址 = 0x1000 + 5 × 64 = 0x1000 + 320 = 0x1140。GPU 在遍历到这个 instance 的三角形时,去 0x1140 读 shaderGroupHandle,然后跳转执行。如果 offset 填成了 6,就去 0x1180 读了——那条记录可能属于完全不同的材质。
1.4 光追管线的五阶段
SBT 的四区域对应光追管线的五个阶段。把整张管线画出来,你才能看到 SBT 在哪几个节点被查表:
- raygen:发射光线,查 raygen 区域
- traversal:加速结构遍历,纯硬件执行(NVIDIA RT Core / AMD Ray Tracing Accelerator / Intel RTU)
- intersection / any-hit / closest-hit:命中后的着色器执行,查 hit 区域
- miss:没命中,查 miss 区域
- callable:任意阶段可以调用的函数,查 callable 区域
关键区分:traversal 是固定功能硬件做的,不是着色器;intersection/any-hit/closest-hit 是着色器,跑在 SM(NVIDIA)/ Compute Unit(AMD)/ Xe Core(Intel)上。SBT 只管后面这些着色器——traversal 不需要查表,硬件自己遍历 BVH。
SBT 里因此没有"traversal 区域"——遍历是隐式的、硬件的,不需要"绑定"。
不同厂商在硬件层的分工略有差异,但总体一致(规范事实口径):
- NVIDIA RT Core:负责 BVH 遍历 + 三角形/盒子相交,找到命中后通知 SM 执行 hit shader
- AMD RDNA 4:第三代光线追踪加速器,每 CU 吞吐量 >2× RDNA 3,遍历与相交同样在固定功能单元
- Intel Arc:RTU(Ray Traversal Unit)负责遍历 + 相交 + instance 变换 + hit shader 分发;另外有 TSU(Thread Sorting Unit)对发散光线重排序,提升 SIMD 利用率
三种架构的共同点:遍历是硬件的,着色器是软件的。SBT 是两者之间的桥——硬件遍历到命中后,查 SBT 决定执行哪个着色器,然后把控制权交给 SM。
1.5 SBT 的硬件属性约束
最后把规范给的那几个物理设备属性列出来,这些值决定了 SBT 的 stride 和 alignment 下限:
| 属性 | 典型值 | 含义 |
|---|---|---|
shaderGroupHandleSize |
32 字节 | 每条 SBT 记录至少这么大 |
shaderGroupHandleAlignment |
16 字节(部分平台 32) | stride 必须是这个的倍数 |
maxShaderGroupStride |
4096 字节 | stride 不能超过这个值 |
shaderGroupBaseAlignment |
64 字节(部分平台 4096) | SBT 每个区域的起始地址要对齐到这个值 |
这些值在不同厂商的 GPU 上可能不一样。NVIDIA 和 AMD 的 shaderGroupHandleAlignment 可能都是 16 字节,但 shaderGroupBaseAlignment 可能差很多。跨平台项目必须在运行时查这些属性,不能硬编码 stride——否则在 A 平台跑得好好的,到 B 平台 validation layer 就开始报对齐错误。
一个工程判据:SBT 的 stride 不是性能变量,是正确性变量。stride 算错了,画面不会慢,只会错。而 SBT 的大小(有多少条记录、每条记录附带多少用户数据)才是性能变量——它影响 cache 命中率,但不影响正确性。后面第六章会讲怎么把 SBT 从 6 MB 压到 1 MB 以下。
另一个容易漏的约束:SBT 每个区域的起始地址(deviceAddress)也必须对齐到 shaderGroupBaseAlignment。如果你把四个区域放在同一块连续 buffer 里,需要手动计算每个区域的偏移量并 padding 到对齐。很多人图省事把四个区域分到不同的 buffer 分配,省了手动 padding 的麻烦,但多了 buffer 绑定的开销。两种方式各有取舍,视项目复杂度而定。
二、Hit Group:三种着色器的组合
2.1 什么是 hit group
hit group 是 SBT hit 区域里的一条记录对应的着色器组。DXR 规范定义得很清楚:一个 hit group 由 0 或 1 个 intersection shader、0 或 1 个 any-hit shader、0 或 1 个 closest-hit shader 组成。三种着色器都是可选的,但组合规则有约束。
如上图所示,hit group 的三个着色器槽位按固定时序触发:intersection shader 在光线命中自定义几何的 AABB 后做精确求交,any-hit 在遍历过程中每个候选命中点判断是否有效(如 alpha test 透明度剔除),closest-hit 在遍历结束、确定最近命中后执行光照着色。三个槽位并非全部必选——不透明三角形路径只需要 closest-hit,透明几何需要 any-hit 加 closest-hit,自定义几何则需要 intersection 打头。具体的组合约束见下一节的规则表。
2.2 closest-hit:最终命中
光线遍历完加速结构,找到了最近的相交点(在当前候选中 hitT 最小的那个),就调用 closest-hit shader。这是光追管线里和光栅化的像素着色器最像的一段——它在相交点做光照计算、纹理采样、发射次级光线(反射、阴影、AO)。
closest-hit 是绝大多数材质的主战场。金属的 PBR BRDF 在这里算,玻璃的折射方向在这里求,皮肤的次表面散射近似也在这里做。如果一道光线命中的是不透明金属,closest-hit 就是它执行的唯一着色器(假设没有 any-hit)。
2.3 any-hit:遍历中的候选
any-hit 不等遍历结束,它在遍历过程中每个候选命中点都会触发。它的核心用途是 alpha testing:光线碰到一个叶子三角形,但这个三角形可能大部分是透明的(alpha = 0),any-hit 检查纹理 alpha,如果透明就 ignoreIntersection,告诉遍历"这个不算,继续找下一个"。
any-hit 是光追管线里最贵的"可选"着色器。为什么贵?因为遍历一棵 BVH 可能遇到几十个候选三角形,每个都要触发一次 any-hit,每次都要做纹理采样——而纹理采样是带宽密集型操作。第四章会详细展开 any-hit 的开销。
2.4 intersection:非三角形几何
当几何不是三角形而是自定义形状(曲线、球体、程序化几何)时,硬件的固定功能三角形相交就用不了了。这时候需要 intersection shader——它定义"光线和这种几何怎么求交"。
intersection shader 在遍历中命中 AABB(轴对齐包围盒)时被调用。你在这个着色器里做自定义的相交计算,如果确实相交了,调用 reportIntersectionEXT(见 Vulkan 规范 · 相交着色器)(Vulkan)/ ReportHit(DXR)报告命中,然后可能触发 any-hit 和 closest-hit。
2.5 组合规则
三种着色器不是随意组合的,规范有明确的约束:
| 几何类型 | intersection | any-hit | closest-hit | 说明 |
|---|---|---|---|---|
| 不透明三角形 | 不设 | 不设 | 设 | 最常见:硬件遍历 + 三角形相交,只跑 closest-hit |
| 透明三角形(alpha test) | 不设 | 设 | 设 | any-hit 判断 alpha,closest-hit 算光照 |
| 不透明自定义几何 | 设 | 不设 | 设 | 硬件只做 AABB 测试,intersection 做精确求交 |
| 透明自定义几何 | 设 | 设 | 设 | 曲线毛发、半透明粒子等 |
| 只做遮挡查询 | 不设 | 不设 | 不设 | 光线只需要知道"有没有命中",不需要着色 |
NVIDIA 的最佳实践明确建议:三角形路径的 intersection 和 any-hit 尽量留 nullptr。不透明三角形根本不需要 intersection shader(硬件做了),也不需要 any-hit(直接当命中处理)。只有 alpha test 的几何才需要 any-hit。能不设就不设,每多一个着色器,遍历的每一步都多一层开销——硬件遍历器本来是高吞吐固定功能流水线,每触发一次着色器就要切回 SM 执行,切回来之后还得恢复遍历状态,这种来回切换的代价远大于着色器代码本身。
2.6 执行时序与与光栅化管线的区别
三种着色器的执行顺序是严格的(规范事实口径):
- 遍历开始,硬件遍历器沿 BVH 下行
- 遇到一个候选三角形/盒子命中
- 如果 hit group 设了 intersection shader → 调用 intersection(自定义几何路径)
- 如果 intersection 报告命中(或三角形路径直接命中)→ 如果设了 any-hit,调用 any-hit
- any-hit 可以 accept 或 ignore
- 如果 ignore → 回退遍历,走下一个候选
- 如果 accept → 记录当前 hitT 为最近候选,继续遍历看有没有更近的
- 遍历结束 → 如果有有效命中,调用 closest-hit
- 如果没有有效命中,调用 miss shader
光栅化管线里,像素着色器一个阶段干完所有事——从插值到纹理到光照到输出。光追管线为什么要把它拆成三段?
因为遍历是硬件做的、是固定功能的、是不可编程的。硬件遍历 BVH 时,它不知道你的材质逻辑——它只知道"这条光线碰到了一个三角形"。但碰到一个三角形不代表"命中"了:如果是 alpha test 的叶子,可能这个三角形是透明的,光线应该继续走。所以需要一个 any-hit 来判断"算不算命中"。
而 closest-hit 只在遍历结束(找到最近的有效命中)后才执行——因为遍历需要知道哪个命中是最近的,在遍历没结束之前,任何一个候选命中都可能被后面的更近的命中取代。如果提前执行了 closest-hit,结果可能不是最终命中点的颜色——浪费了算力。
这就是三种着色器的时序逻辑:遍历中 → any-hit 判断 → 遍历结束 → closest-hit 着色。拆成三段不是为了灵活,是因为遍历的硬件流程本来就要求这样。
一个关键理解:any-hit 是遍历的一部分,closest-hit 是遍历结束后的独立步骤。把它们混在一起(比如在 any-hit 里做 closest-hit 的事)会破坏遍历流程,导致性能崩盘甚至逻辑错误。
三、Closest-Hit:算什么、怎么算
3.1 输入数据
closest-hit shader 拿到的输入数据,决定了它能做什么。Vulkan GLSL 扩展(GLSL_NV_ray_tracing / GLSL_EXT_ray_tracing)给了一组内置变量:
| 内置变量 | 含义 | 用途 |
|---|---|---|
gl_HitTEXT |
光线参数 t 处的命中距离 | 深度比较、距离衰减、阴影判断 |
gl_InstanceCustomIndexEXT |
instance 创建时设的自定义索引 | 查材质数组、纹理 bindless 句柄 |
gl_GeometryIndexEXT |
instance 内的 geometry 索引 | 多 geometry 的 BLAS 里定位子网格 |
gl_PrimitiveID |
命中的三角形编号 | 查顶点缓冲、法线缓冲 |
gl_BarycentricsEXT |
重心坐标 (u, v, w) | 插值顶点属性(位置、法线、UV) |
gl_InstanceID |
instance 编号 | 查 instance 数据 |
gl_WorldRayDirectionEXT |
世界空间光线方向 | 反射/折射计算 |
gl_ObjectRayOriginEXT |
物体空间光线起点 | 变换到局部坐标 |
gl_HitKindEXT |
命中类型(前向面/背向面) | 面剔除判断 |
最常用的是前面五个。gl_InstanceCustomIndexEXT 是材质系统的核心——你在创建 instance 时给一个自定义索引(uint32),closest-hit 里用这个索引去查全局材质数组,拿到 PBR 参数、纹理句柄、roughness/metallic 值。这个索引和 gl_InstanceID 不是一回事:gl_InstanceID 是 TLAS 里 instance 的序号(驱动赋值),gl_InstanceCustomIndexEXT 是你赋的业务语义值——可以是材质 ID、实体 ID、或者一个复合编码。
gl_PrimitiveID 配合重心坐标,可以插值出命中点的位置、法线、纹理坐标。
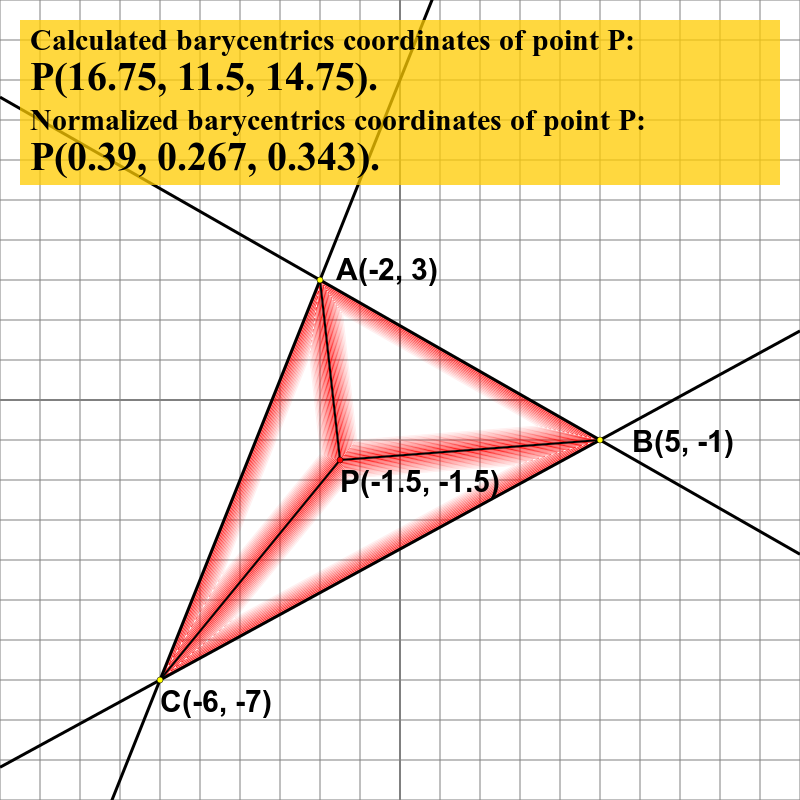
重心坐标是三角形插值的基础。命中点 P 在三角形 (A, B, C) 内,P = uA + vB + wC(其中 u + v + w = 1)。有了 (u, v, w),任何顶点属性(法线、UV、颜色)都可以用同样的权重插值。和光栅化里用重心坐标插值是同一个数学,只是光追在 closest-hit 里算,光栅化在硬件光栅化器里算。
但有一个工程差异:光栅化的重心坐标是透视校正的(perspective-correct),硬件自动处理。光追的 gl_BarycentricsEXT 也是透视校正的——规范保证这一点。所以你不需要手动做透视校正插值,直接用就行。但如果你需要非透视校正的重心坐标(比如某些特殊算法),需要自己用世界空间坐标算。
3.2 典型工作
closest-hit 典型做三件事:
第一,PBR 着色。 用重心坐标插值出命中点的法线 N 和 UV,用 gl_InstanceCustomIndexEXT 查材质参数,采样 albedo/normal/roughness/metallic 贴图,算 BRDF(GGX 是当前主流),乘以光源贡献,输出颜色。这一段和光栅化的像素着色器几乎一样——区别在数据来源(光追用 primitiveID + barycentrics 插值,光栅化用光栅化器插值好的属性),不在数学。
但有一个工程差异:光追的法线采样需要特别小心。光栅化里法线贴图是切线空间的,配合 TBN 矩阵转世界空间。光追里也一样,但 TBN 矩阵的构建需要从顶点的 tangent/normal 插值得到——这步在 closest-hit 里做,每个命中点都要算一遍。如果 tangent 存在顶点缓冲里,closest-hit 要通过 primitiveID 查顶点缓冲、用 barycentrics 插值 tangent、构建 TBN、采样法线贴图、转世界空间。这一串操作和像素着色器完全相同,只是数据获取路径不同。
第二,次级光线。 closest-hit 可以再发射光线——反射光线(traceRayEXT 递归调用)、阴影光线(朝光源方向发射,看有没有被遮挡)、AO 光线(随机方向发射,看有没有命中)。每次 traceRayEXT 都会触发新一轮遍历,可能触发另一个 closest-hit——所以光追是递归的。
玻璃材质是 closest-hit 最考验工程能力的地方。一条光线命中玻璃表面,closest-hit 要算折射方向(Snell 定律),然后发射折射光线进入玻璃内部。折射光线可能命中玻璃的内表面,再次折射出来。一束光穿过玻璃,可能要弹 4-6 次。每次弹射都是一次 traceRayEXT,每次都触发新一轮遍历和着色。递归深度上来了,性能开销是指数级的。
递归深度管理是 closest-hit 最重要的工程决策之一。 Vulkan 和 DXR 都允许设置最大递归深度(maxRecursionDepth),典型值是 1-3。深度 1 意味着 closest-hit 只能发射光线但不能在次级光线的 closest-hit 里再发射——一进一出就到底了。深度 3 允许三层反射(反射的反射的反射),但这已经足够让光线数量膨胀到不可控。
实际项目里,递归深度通常设 1-2,更深的弹射交给降噪器和时域累积来处理。ReSTIR 和降噪器在光追管线里吃重,根源也在这里——它们用统计方法"替代"了递归,让你用 1-2 spp 就能得到看起来像 1024 spp 的画面。
3.3 与光栅化像素着色器的差异
closest-hit 和像素着色器都做光照计算,但工程上有几个关键差异:
数据来源不同。 像素着色器拿到的顶点属性是硬件光栅化器插值好的——位置、法线、UV 都是 ready 的。closest-hit 拿到的是 primitiveID 和重心坐标,要自己在 shader 里做插值。多一步插值计算,但好处是可以插值任何自定义属性——只要顶点缓冲里存了,closest-hit 就能查到。
可见性查询不同。 像素着色器算阴影要用 shadow map——一个预渲染的深度纹理,精度有限、有 acne 问题、有 perspective aliasing 问题。closest-hit 算阴影直接发射一条阴影光线,问加速结构"这条路到光源有没有被挡",精确到三角形级别。精度更好,但每条阴影光线是一次完整的 BVH 遍历——开销也更大。
递归能力不同。 像素着色器不能"发射像素"——它是线性的,跑完就完。closest-hit 可以发射次级光线,次级光线可以再发射次级光线,形成递归。这种递归能力是光追画反射/折射/全局光照的基础,但也是性能爆炸的根源——每多一层递归,光线数量乘以分支因子。如果分支因子是 4(反射 + 折射 + 阴影 + AO),递归 3 层就是 4³ = 64 条次级光线——每条都要做完整的 BVH 遍历。
执行频率不同。 像素着色器对每个像素跑一次(忽略 overdraw)。closest-hit 对每条光线跑一次——但一帧可能发射几百万条光线(1 MP 画面 × 2-4 次 bounce),而且每条光线的 closest-hit 执行时间取决于材质复杂度。材质越复杂、递归越深,closest-hit 的总开销就越大。
SIMD 利用率不同。 光栅化的像素着色器在一个 quad(2×2 像素)里执行,相邻像素的材质通常相同,分支发散小。光追的 closest-hit 在一个 SIMD lane 里执行,但不同 lane 上的光线可能命中完全不同的材质——一条命金属、一条命玻璃、一条命叶子——分支发散严重,SIMD 利用率可能只有 25-50%。Intel 的 TSU(Thread Sorting Unit)就是专门解决这个问题的:对发散光线重排序,让材质相同的光线排在一起执行,提升 SIMD 利用率。
一个工程判据:closest-hit 的优化方向和像素着色器不一样。像素着色器优化的是"每个像素算多少 ALU";closest-hit 优化的是"每条光线发射几条次级光线"。减少次级光线数量(比如用 ReSTIR 采样、用 denoiser 替代多 bounce),比优化 closest-hit 本身的 ALU 更有效。一个 closest-hit 跑 200 条 ALU 指令但发射 0 条次级光线,远比跑 50 条 ALU 但发射 4 条次级光线要快——因为那 4 条次级光线意味着 4 次完整遍历,每次遍历可能是几百到几千次相交测试。
四、Any-Hit:最贵的"可选"着色器
4.1 触发时机
any-hit shader 的触发时机是遍历过程中每个候选命中。注意"候选"这个词——遍历 BVH 时,硬件会沿着树下行,每当光线碰到一个三角形(不管是不是最近的),如果这个 instance 的 hit group 设了 any-hit shader,就触发它。
any-hit 做什么?只有一个核心任务:判断这个候选命中算不算。如果算,调用 acceptIntersectionEXT(或什么都不做,默认 accept);如果不算(比如 alpha = 0),调用 ignoreIntersectionEXT,告诉遍历引擎"这个不算,继续找下一个"。
这个"继续找"的代价很大。因为每次 ignore,遍历就得回退到 BVH 上一个节点,走另一条分支。一次 alpha test 失败的代价不是一次 any-hit 的执行时间——它还包含了回退和重新下行的遍历开销。硬件遍历器(RT Core / RTU)本来是流水线化的固定功能单元,吞吐量极高;any-hit 一打断,就得切回 SM 执行着色器,执行完再切回遍历器,恢复遍历状态。这种来回切换的延迟远大于 any-hit 代码本身的执行时间。
4.2 Alpha testing 场景
any-hit 最典型的应用场景是 alpha tested 几何——植被、铁丝网、广告牌、围栏、decals。
这些几何的共同特点是:三角形覆盖的区域里有透明部分。一片树叶的纹理大部分是透明的(alpha = 0),只有叶脉部分是不透明的。如果不用 alpha test,光线碰到三角形的透明部分就当作"命中"了,画面上树叶边缘会出现方块。用 any-hit 检查纹理 alpha,透明的地方 ignore,光线继续走,就能正确处理树叶边缘。
具体来说,几个典型场景:
- 植被(叶子、草):一块叶子贴图可能是 256×256,但只有 30-40% 的像素是不透明的。一条阴影光线穿过植被层,可能要穿过 10-20 层叶子三角形,每层只有 30% 的概率"真的命中"——其余 70% 都要触发 any-hit 然后被 ignore。
- 铁丝网和围栏:贴图可能有 50% 的透明区域,几何面数少但每面都要 alpha test。
- 广告牌:远处的树用广告牌(一个带树贴图的四边形),alpha test 让光线穿过广告牌的透明边缘。
4.3 性能代价
any-hit 为什么贵?数字说话。
假设一个植被密集的场景:每帧发射 200 万条阴影光线(2 MP × 1 spp),每条阴影光线平均穿过 3-5 个叶子三角形(植被场景的典型值),每个 any-hit 要做一次纹理采样(采样 alpha 通道)。
算一下:200 万 × 4(取中间值)= 800 万次 any-hit 调用?——不,这只是每条光线的开销。阴影光线需要穿过整个植被层,一条光线可能穿过 10-20 个叶子三角形。取中间值 15,200 万 × 15 = 3000 万次 any-hit 调用。
但如果场景更复杂呢?开放世界的植被覆盖率更高,阴影光线要穿过更厚的叶子层。加上反射光线也要穿过植被(玻璃反射里看到树),AO 光线随机方向发射也容易碰到叶子。极端情况下,每帧的 any-hit 调用次数可以达到 15-25 亿次(第三方实测口径)。
这不是 ALU 的瓶颈,是带宽和 cache 的瓶颈。纹理采样虽然 L1 cache 命中率不低(同一片叶子贴图会被多次采样),但 15 亿次采样的绝对量太大了。而且 any-hit 每次都可能打断遍历——硬件遍历器(RT Core / RTU)本来是高吞吐的固定功能流水线,any-hit 一打断,就得切回 SM 执行着色器,执行完再切回遍历器。这种来回切换的代价远大于 any-hit 本身的计算量。
换一个角度:NVIDIA 的 RT Core 遍历吞吐量可能是每秒几百亿次相交测试(架构代际不同有差异,规范不公布精确值),但每切回 SM 执行一次 any-hit,这条流水线就停了——停的时间是微秒级的。如果一帧有 15 亿次 any-hit 调用,就算每次只停 1 纳秒,也是 1.5 秒——远超 16ms 的帧预算。实际上每次 any-hit 的开销远不止 1 纳秒,因为还要算纹理采样的延迟。
纹理采样为什么是瓶颈? any-hit 采样的是 alpha 通道——通常是一个 2D 纹理的某个通道。一次纹理采样包括:计算 LOD(根据光线方向和三角形大小)、查 texture buffer(L1 cache → L2 cache → 显存)、读取 texel 值、解码格式。如果纹理驻在 L1 cache 里,一次采样可能只要几十纳秒;如果 miss 了 L1 去 L2,是几百纳秒;如果 miss 了 L2 去显存,是几百纳秒到微秒。15 亿次采样 × 即使只有 10% miss L1 = 1.5 亿次 L2 访问 = 每秒几百 GB 的带宽需求。any-hit 的开销根源不在 ALU,在带宽——带宽问题没法靠优化 ALU 解决。
对比一下:不设 any-hit 的不透明几何。光线命中不透明三角形,遍历器直接当有效命中处理,不切回 SM,不采样纹理。整条遍历路径全在固定功能硬件里完成——RT Core 的三角形相交吞吐量远高于"触发 any-hit → 采样纹理 → 切回遍历"的循环。这就是为什么 NVIDIA 反复强调"不透明几何不要设 any-hit"——省的不只是 any-hit 着色器的执行时间,更是整条遍历路径的硬件切换开销和纹理采样带宽。
4.4 OMM 怎么省 any-hit
ep03 讲了 Opacity Micromap(OMM,见 Vulkan 规范 · opacity micromap)的原理——在 BLAS 的每个三角形上贴一张微三角形级别的"不透明度地图"。这里只讲 OMM 和 any-hit 的关系。
OMM 干的核心就一件事:把 any-hit 的 alpha test 结果预计算好了。遍历器看到微三角形标记为"完全不透明"的区域,直接当命中处理,不触发 any-hit;看到"完全透明"的区域,直接 ignore,也不触发 any-hit;只有"不确定"的微三角形才触发 any-hit。
效果有多大?NVIDIA 在 Indiana Jones 的路径追踪优化里给了实测数据(厂商官方口径):
- 场景:Indiana Jones 中的植被密集关卡
- 硬件:RTX 5080
- 不用 OMM 的 alpha-test 植被:7.90 ms
- 用 OMM 后:3.58 ms
- 降幅:-54.7%
这个 54.7% 的降幅,核心省的就是 any-hit 调用次数。OMM 把大部分微三角形标记成了"完全不透明"或"完全透明",只有边界处的微三角形才需要 any-hit。遍历器不用切回 SM,直接在硬件里处理,吞吐量成倍提升。
ep03 还提到一个"乘数效应":阴影光线的采样数越多,OMM 的总节省越大。因为每条阴影光线都要穿过植被层,OMM 省的是每条光线的 any-hit 开销——光线越多,省的总量越大。软阴影采样从 1 spp 提到 4 spp,OMM 的收益翻了 4 倍。如果没有 OMM,4 spp 软阴影在植被场景下基本不可行——4 倍的 any-hit 调用会把帧时间推到不可接受的程度。
一个工程判据:any-hit 是光追管线里最容易被滥用的着色器。能用 OMM 就用 OMM,能不用 any-hit 就不用。不透明几何一定不要设 any-hit——NVIDIA 的最佳实践里明确说了"对不透明三角形,intersection 和 any-hit 都应该设为 nullptr"。设了 any-hit 的不透明三角形,白白多了每条光线的着色器切换开销,没有任何收益。只有 alpha test 几何才需要 any-hit,而 OMM 能把 alpha test 几何的 any-hit 调用降到最低。
五、Intersection:三角形以外
5.1 什么时候需要 intersection shader
光追硬件的固定功能只做一件事:光线和三角形求交。如果你的几何不是三角形——曲线、球体、程序化生成的形状、NURBS 曲面——硬件就不知道怎么求交了。
这时候需要 intersection shader。你在着色器里自己实现"光线和这种几何怎么求交"的逻辑,调用 reportIntersectionEXT(Vulkan)/ ReportHit(DXR)报告命中。
具体流程是这样的:
- 加速结构里,非三角形几何用 AABB(轴对齐包围盒)代替三角形作为叶子节点。你创建 BLAS 时,用
VK_GEOMETRY_TYPE_AABBS_KHR而不是VK_GEOMETRY_TYPE_TRIANGLES_KHR。 - 遍历 BVH 时,光线碰到 AABB,硬件做"光线和 AABB 的求交"——这个硬件能做,和三角形求交一样是固定功能。
- 如果 AABB 被命中了,但 AABB 不是精确几何——它只是个外壳。这时候触发 intersection shader。
- intersection shader 里你做精确求交(比如光线和球体、光线和曲线段),如果确实相交了,调
reportIntersectionEXT,传入 hitT(命中距离)和 hitKind(命中类型,可以自定义)。 - 报告命中后,可能触发 any-hit(判断是否 ignore)和 closest-hit(着色)——和三角形路径完全一样。
5.2 reportIntersectionEXT 的语义
reportIntersectionEXT 有两个参数:hitT 和 hitKind。hitT 是光线参数——表示命中点离光线起点有多远。这个值决定了这条命中在遍历中是否成为"最近命中"——遍历器会比较所有报告的 hitT,最小的那个在遍历结束时触发 closest-hit。
hitKind 是一个自定义的 uint,你可以用它区分不同的命中类型。比如光线和一根曲线求交,曲线有正面和反面,你可以用 hitKind = 0 表示正面命中,hitKind = 1 表示反面命中。closest-hit 里通过 gl_HitKindEXT 读到这个值,做不同处理。
一个 intersection shader 可以调用多次 reportIntersectionEXT——比如光线穿过一个球体,可能在入射和出射处各报告一次命中。每次报告都会触发 any-hit(如果设了),最终最小的 hitT 胜出。
5.3 典型场景
曲线渲染。 头发、毛皮、草叶这些细长几何,用三角形表达代价太高(一根头发要 4-8 个三角形段,一个角色可能有几万根头发)。用曲线表示,一个 intersection shader 做光线和曲线段的求交,效率高得多。NVIDIA 的最佳实践和 nvpro 样例都给了曲线 intersection 的实现参考,可以用贝塞尔曲线或 B 样条表示曲线段,在 shader 里做光线和参数曲线的解析求交。
球体。 场景里有大量小球体(粒子、弹珠、雨滴),每个用三角形 mesh 太浪费。一个球只需要圆心和半径两个参数(6 个 float),intersection shader 做光线和球面的一元二次方程求交,比三角形 mesh 遍历快得多。10 万个雨滴用三角形 mesh 可能需要 80 万个三角形,用球体只需要 10 万个 AABB。
程序化几何。 分形地形、噪声生成的体积、SDF(signed distance field)曲面——这些几何根本没有三角形 mesh,只有数学定义。intersection shader 可以直接对数学定义求交。比如 SDF 曲面的求交可以用 sphere tracing(球体追踪)算法在 intersection shader 里实现——每次沿光线方向前进 SDF 值指定的距离,直到 SDF 趋近零(命中)或超过最大步数(miss)。这种方法的好处是几何可以无限细节——不需要预生成三角形 mesh,直接在 shader 里按需计算。代价是每个 AABB 命中后可能要做几十步 sphere tracing,比单次三角形求交慢得多。
5.4 AABB 粒度与空触发率
intersection shader 的性能不只取决于 shader 本身的复杂度,更取决于 AABB 的粒度选择——这个因素常被跳过,但决定性能。
假设你要渲染一根 1 米长的曲线。你可以用一个 AABB 包住整根曲线——AABB 可能是 0.1 × 0.1 × 1 米。光线从侧面穿过这个 AABB 时,命中了盒子但 intersection shader 发现没碰到曲线的概率很高(因为 AABB 比曲线粗多了)。这种"空触发"白浪费了一次着色器执行。
你也可以把曲线切成 10 段,每段一个小 AABB。每个 AABB 更紧(0.1 × 0.1 × 0.1 米),空触发率降了,但 AABB 数量从 1 变成 10,BVH 树更大了,遍历时需要测试更多盒子节点。这是经典的"粒度 vs 树大小"权衡。
经验值:曲线类几何,每段长度和直径的比值控制在 3-5 倍以内——AABB 不会太松,空触发率可控。球体类几何,一个球一个 AABB,天然紧凑,不需要切分。SDF 体积类几何,AABB 粒度取决于 SDF 的空间变化频率——高频变化的区域需要更小的 AABB,低频区域可以用大 AABB。
5.5 什么时候不需要
intersection shader 的代价是:每命中一个 AABB 就触发一次着色器执行。如果 AABB 做得很紧(刚好包住几何),这没问题——AABB 命中了,里面大概率真的有几何。但如果 AABB 做得很松(远大于实际几何),光线会频繁命中 AABB 但 intersection shader 求交后发现"其实没碰到几何",白触发一次着色器。
这就是 AABB 质量对 intersection shader 性能的决定性影响。一个不规则的 L 形管道,用一个 AABB 包住会很松——管道弯曲的地方,AABB 里有大量空空间,光线穿过空空间时命中 AABB 但 miss 掉实际几何,intersection shader 白跑。这时候不如把管道拆成几段,每段一个小 AABB——AABB 变紧了,空触发率降了,但 AABB 数量多了,BVH 树也更大了。这是 intersection shader 方案的经典权衡:AABB 粒度 vs 空触发率。
所以 intersection shader 适合"几何紧凑且形状规则"的场景。如果几何形状很不规则,AABB 会很松,intersection shader 的空触发率会很高。这时候不如直接用三角形 mesh——虽然三角形多,但遍历质量好,硬件三角形求交是固定功能,吞吐量极高。
一个工程判据:intersection shader 不是"更好的求交方式",是"另一种求交方式"。它的适用条件是——几何本身足够简单(球、曲线段、平面),用数学求交比用三角形 mesh 更快。如果几何复杂到需要多个 AABB 拼合才能包住,直接上三角形 mesh 反而更高效。
NVIDIA 的 Practical RTX 博客给出了一个简单判据:如果可以用三角形表达且三角形数 < 100,就不要用 intersection shader。三角形多了之后(比如 1000 个三角形表达一根曲线),再考虑换成 intersection shader。这个数字不是硬性的——具体阈值取决于几何形状的规则程度。球体可能 50 个就该换,不规则曲线可能 200 个才该换。
六、材质系统的 SBT 组织
6.1 核心矛盾
SBT 的组织方式直接决定了材质系统的可维护性和性能。这里有一个核心矛盾:
SBT 越大 → cache miss 越多 → 遍历效率越低。
SBT 是 GPU buffer,遍历器每次查 SBT 都要访问显存。如果 SBT 很小(比如几十条记录,几百字节),可以全部驻在 L2 cache 里,查表几乎零延迟。如果 SBT 很大(比如几 MB),每次查表都可能 miss L2,要去 GDDR6 显存里捞数据——延迟几个百纳秒,几百条光线的查表开销叠起来就不是小数了。
L2 cache 的容量通常是 4-8 MB(不同 GPU 代际不同),如果 SBT 超过这个大小,cache 命中率就断崖式下降。而且 SBT 不是唯一竞争 L2 cache 的数据——顶点缓冲、纹理、TLAS、BLAS 都在抢 L2 空间。SBT 大了不仅自己 miss,还把别人的 cache 空间挤掉了。
所以 SBT 组织的首要目标是:让 SBT 尽量小。
6.2 Uber shader vs Specialized shader
组织 SBT 有两种极端策略:
Uber shader(超级着色器):一个 closest-hit shader 跑所有材质。SBT 的 hit 区域只有一条记录(或很少几条),所有 instance 都指向同一个 hit group。closest-hit 里用 gl_InstanceCustomIndexEXT 查材质类型,然后 switch-case 跑不同的 BRDF 分支。
- 优点:SBT 极小,cache 友好
- 缺点:SPIR-V 大(编译了所有材质的代码),分支发散严重(SIMD lane 里不同光线跑不同分支,浪费 ALU),维护难(改一个材质要重编译整个 uber shader),register pressure 高(为所有材质路径预留寄存器,occupancy 下降)
Specialized shader(特化着色器):每种材质一个 closest-hit shader,SBT 的 hit 区域有多条记录,每条对应一种材质。instance 指向自己材质对应的 SBT 记录。
- 优点:每个 closest-hit 只编译自己材质的代码,没有分支发散,单材质成本低,SPIR-V 小
- 缺点:SBT 条目多,hit group 数量 = 材质种类数
NVIDIA 的最佳实践明确说:不推荐 uber shader。原因不只是分支发散——更关键的是 register pressure。Uber shader 要为所有材质路径预留寄存器(最复杂的材质路径决定了寄存器需求),导致每个 SM 上能同时驻留的 wave 数减少,occupancy 下降。occupancy 下降了,延迟隐藏能力就差了——访存延迟没法用其他 wave 的计算来覆盖,整体吞吐就下来了。
类比一下:uber shader 就像一个"万能工具箱",什么工具都塞进一个箱子里,箱子又大又重,搬来搬去不方便。specialized shader 像一套分门别类的工具——每个箱子只装一种工具,轻便好拿,但箱子数量多了。
但 specialized shader 也有问题:如果你的材质种类特别多(比如一个开放世界场景有 500 种材质),SBT 的 hit 区域有 500 条记录,每条记录附带用户数据,SBT 可能膨胀到几百 KB 甚至几 MB。
6.3 per-instance data 的取舍
SBT 膨胀的罪魁祸首通常是 per-instance data。每条 SBT 记录可以附带用户数据——材质索引、纹理句柄、变换指针。如果你给每个 instance 都放一条 SBT 记录,每条记录附带 64 字节的用户数据,10 万 instance 的 SBT 就是 10 万 × (32 + 64) = 9.6 MB。
这个数字看着不大,但要知道 L2 cache 通常只有 4-8 MB。9.6 MB 的 SBT 根本驻不进 cache,每条光线的查表都要去显存。而且这 9.6 MB 里大部分是重复的——10 万个 instance 可能只用了 50 种材质,每种材质的用户数据被复制了几千遍。
NVIDIA OptiX 官方博客记录了这个问题的解决方案(厂商官方口径):
- 场景:10 万 instance
- 朴素布局:每 instance 一条 SBT 记录,附带 per-instance data → SBT ≈ 6 MB
- 优化后:SBT 记录只存 shaderGroupHandle + 一个 4 字节材质索引,per-instance data 全部移到全局 bindless 数组 → SBT < 1 MB
优化后的 SBT 只有 10 万 × (32 + 4) = 3.6 MB?不对——关键在于按材质去重。10 万 instance 可能只用了 50 种材质,那 hit 区域只需要 50 条 SBT 记录,每条 36 字节 = 1800 字节。加上 raygen/miss/callable 区域,整个 SBT 可能不到 2 KB——完全驻在 L1 cache 里。
10 万 instance 指向 50 条 hit 记录,靠的是 instanceShaderBindingTableRecordOffset:相同材质的 instance 指向同一个 SBT offset。instance 的 per-instance data(变换矩阵、材质参数偏移)存在全局 bindless buffer 里,closest-hit 用 gl_InstanceCustomIndexEXT 去查。
关键策略:SBT 记录 = shaderGroupHandle + 最小索引(4-8 字节),per-instance data 走 bindless。SBT 本质变成了"着色器组到材质类型的映射表",而不是"每个 instance 的数据仓库"。
这种策略有三层好处:
- SBT 极小——按材质种类数而不是 instance 数决定大小,几百字节就能覆盖整个场景
- cache 友好——SBT 完全驻在 L1 cache,查表几乎零延迟
- 可维护——加新材质就是加一条 SBT 记录,不需要改所有 instance 的数据
但要注意一个边界条件:bindless buffer 的访问模式也很重要。如果 10 万个 instance 的 per-instance data 存在一个连续数组里,closest-hit 用 gl_InstanceCustomIndexEXT 做索引去查——这个访问模式是"每个 instance 查一次",不同光线的 instance 可能相邻(空间局部性),也可能不相邻(光线发散)。空间局部性好的时候 bindless 数组的访问也能 cache 命中;光线发散严重时,每个 SM 线程查完全不同的 instance,cache miss 率就上去了。所以 bindless 不是万能的——它比"SBT 记录里存 per-instance data"好,但不如"全局参数走 push constants"好。
6.4 引擎实践
几个引擎的 SBT 管理策略值得参考:
UE5 Persistent SBT。 Unreal Engine 5 提供了 r.RayTracing.PersistentSBT 控制变量(默认开启,厂商官方口径),让 SBT 跨帧持久化——不是每帧重建 SBT,而是增量更新变化的记录。对动态场景(instance 增删、材质切换频繁)来说,这省了每帧重新上传整个 SBT 的带宽开销。代价是需要维护一个"SBT 记录池",分配回收有额外管理成本——但这个成本远小于每帧重建整张表的带宽。
Persistent SBT 的工作原理类似对象池:每个材质类型在 SBT 里有一个"槽位",instance 增删只更新指向槽位的 offset,不移动 SBT 记录。只有材质种类变化(新材质出现/旧材质消失)时才需要扩缩 SBT——这种变化频率远低于 instance 变化频率。
Wuthering Waves Pre-Bind SBT。 鸣潮(UE4 定制版)在 GDC 分享中提到用 Pre-Bind SBT 策略——在帧前阶段提前绑定好 SBT 布局,渲染阶段只更新数据不重建布局。对移动端和跨平台项目来说,减少每帧的 SBT 布局计算开销有实际意义。Pre-Bind 的思路和 Persistent SBT 类似,但更激进——不仅跨帧复用 SBT 记录,还提前把 SBT 的内存布局固定下来,渲染阶段只做数据填充(memcpy),不做布局计算。
NVIDIA 建议的通用原则。 官方最佳实践给了三条:
- SBT 记录尽量小——只放 shaderGroupHandle + 一个索引
- 资源(纹理、buffer)走 bindless,不要塞进 SBT 记录
- 相同材质的 instance 共享 SBT 记录——不要为每个 instance 重复一条
这三条原则总结成一句话就是:SBT 是"着色器查找表",不是"数据存储"。数据存储走 bindless,SBT 只负责把 instance 映射到正确的着色器组。
6.5 Push constants vs SBT data vs bindless:三层架构
还有一个工程选择:什么数据放哪一层?答案是按访问频率和容量分三层:
| 层 | 存什么 | 容量 | 访问速度 | 典型内容 |
|---|---|---|---|---|
| Push constants | 全局参数 | 128-256 字节 | 最快(寄存器) | 光源方向、采样种子、帧索引、画面分辨率 |
| SBT data | 材质级参数 | 几十字节/记录 | 快(L1 cache) | 材质索引、着色器组句柄 |
| Bindless buffer | per-instance data | 无限制 | 中等(L2/显存) | 变换矩阵、材质参数数组、纹理句柄 |
高频变化的全局参数放 push constants——它的访问速度比 SBT 更快(直接在寄存器里),但容量小(通常 128-256 字节)。instance 级参数放 SBT 记录——容量大,访问速度稍慢但够用。per-instance 的详细数据放 bindless buffer——容量无限制,但访问要走 L2 cache 或显存。
这种三层结构的关键是:每层数据的访问频率与该层的带宽容量匹配。push constants 容量小但每条光线都访问——放全局参数(所有光线共享);SBT data 容量适中、每条光线访问一次——放材质索引(按材质分组);bindless 容量大但只有需要时才查——放 per-instance 详细数据(只在 closest-hit 里查一次)。
如果把所有数据都塞进 SBT 记录(朴素做法),SBT 膨胀到几 MB,每条光线的查表都 miss L2——这就是"SBT 绊倒自己"的典型场景。如果把所有数据都放 bindless,SBT 是小了,但 closest-hit 里要多次查 bindless buffer——每次查都是 L2 访问,延迟比 SBT 查表(L1 命中)高几倍。三层架构是两者的平衡。
多材质场景的 SBT 组织,最终是这三层结构的叠加:push constants(全局参数)→ SBT 记录(材质索引)→ bindless buffer(per-instance data)。三层各管各的带宽层级,cache 友好性才最优。
七、SBT 的坑:别被自己的表绊倒
7.1 五个典型坑
SBT 是光追管线里最容易出错的子系统。原因不是它复杂——它的结构很简单——而是它出错的症状很隐蔽。大多数 SBT 错误不会 crash,不会 validation layer 报错(有些连 validation 都查不出来),只会让画面"看起来差不多少点什么"。下面列五个最常见的坑。
| 坑 | 后果 | 排查方法 |
|---|---|---|
| stride 不对齐 | validation layer 报错;部分平台静默失败 | 检查 stride 是否为 shaderGroupHandleAlignment 的倍数,是否 ≤ maxShaderGroupStride |
instanceShaderBindingTableRecordOffset 指错区域 |
执行错误的 hit group,画面材质错乱 | 打印每个 instance 的 offset,对照 SBT 布局验证 |
| pipeline group count ≠ SBT 记录数 | 越界读取,可能读到下一条记录的 shaderGroupHandle | 确认 RayTracingShaderGroupCreateInfo 的数量和 SBT hit 区域的记录数一致 |
| SBT 区域重叠 | 不可预测行为,可能读到错误区域的数据 | 检查四个区域的 deviceAddress + size 是否有重叠 |
| any-hit 里做重计算 | 遍历被频繁打断,性能急剧下降 | 把重计算移到 closest-hit,any-hit 只做 alpha test |
7.2 stride 不对齐
最常见但最容易发现的坑。stride 不是 shaderGroupHandleAlignment 的倍数,或者超过了 maxShaderGroupStride。validation layer 通常会报这个错——所以这是"你知道你错了"的坑。
但有个隐蔽变种:你在 NVIDIA 上跑,shaderGroupHandleAlignment = 16 字节,你设 stride = 32 字节(合规)。然后你换到某个移动端 GPU,shaderGroupHandleAlignment = 32 字节——你的 stride 不再是它的倍数了。跨平台项目一定要运行时查属性,不要硬编码 stride。正确做法是在初始化时读 VkPhysicalDeviceRayTracingPipelinePropertiesKHR,根据查到的值动态计算 stride。
7.3 offset 指错区域
instanceShaderBindingTableRecordOffset 乘以 hit 区域的 stride,加上 hit 区域的起始地址,就是 SBT 记录地址。如果 offset 算错了——比如你以为是按 instance 索引偏移,实际上应该是按材质类型偏移——光线命中的是金属,但 SBT 偏移指向了玻璃的 hit group。
症状:画面材质错乱,但不报错。某些区域看起来"材质对了但参数错了",某些区域看起来"完全跑错了着色器"。排查方法:在 closest-hit 开头打印 gl_InstanceCustomIndexEXT 和 gl_PrimitiveID,对照你创建 instance 时设的值,看是否一致。如果 offset 指错了区域,gl_InstanceCustomIndexEXT 可能读到的是另一条 SBT 记录附带的用户数据——值完全不对。
7.4 group count 不匹配
创建光追管线时,你告诉管线有多少个 shader group(raygen count / miss count / hit group count / callable count)。这些数量必须和 SBT 里的记录数匹配。如果管线说 hit 区域有 50 个 group,但 SBT 的 hit 区域只有 40 条记录——GPU 会越界读取,读到第 41 条记录的起始位置,但那里可能不是一条有效的 SBT 记录,而是 miss 区域的数据或 padding。
这个坑的症状最不可预测——可能画面部分区域正常、部分区域花屏、部分区域全黑。排查方法:在创建管线和 SBT 的代码里加 assert,确认 groupCreateInfo 的数量和 SBT 区域的 size / stride 一致。具体来说,hit 区域的 size 应该 = hit group count × stride(向上对齐到 shaderGroupBaseAlignment)。
7.5 SBT 区域重叠
四个区域如果在同一块连续 buffer 里分配,可能因为 padding 计算错误导致区域重叠。比如 hit 区域的 size 算少了,miss 区域的起始地址落在了 hit 区域的范围内——光线查 miss shader 时可能读到 hit 区域的末尾记录。
这个坑的症状是"间歇性错误"——大部分时候正常,偶尔某些角度/某些 instance 会出错。排查方法:打印四个区域的 (deviceAddress, size),检查 [deviceAddress, deviceAddress + size) 区间是否有交集。如果有,重新计算 padding。
7.6 any-hit 的隐性代价
前面讲了 any-hit 的绝对开销。这里讲一个更隐蔽的问题:any-hit 里做"不该做的事"。
any-hit 的设计意图是只做 alpha test——采样纹理 alpha,透明就 ignore,不透明就 accept。但有人会在 any-hit 里做更多事——比如计算半透明物体的混合颜色、写入 payload(传递命中信息给 closest-hit)、甚至做光照计算。
这些操作在功能上可以工作,但在性能上是灾难。因为 any-hit 在遍历中被调用——每次调用都打断硬件遍历器,切到 SM 执行着色器,执行完再切回来。any-hit 越重,遍历被打断得越频繁,整个遍历的 SIMD 利用率就越低。Intel 的文档提到,发散光线会降低 SIMD 利用率——any-hit 里的分支逻辑是发散的主要来源之一。
判据:any-hit 里只做 alpha test,其他事情全部移到 closest-hit。如果需要在遍历中收集信息(比如记录半透明命中点的颜色),用 payload 变量传递——但 payload 的读写也有开销,能用 closest-hit 算的就不要在 any-hit 里存。如果真的需要在遍历中累积半透明贡献(比如体积渲染),考虑用专门的 blend mode 或 separate hit group,而不是在 any-hit 里做。
7.7 阴影光线的 flag 优化
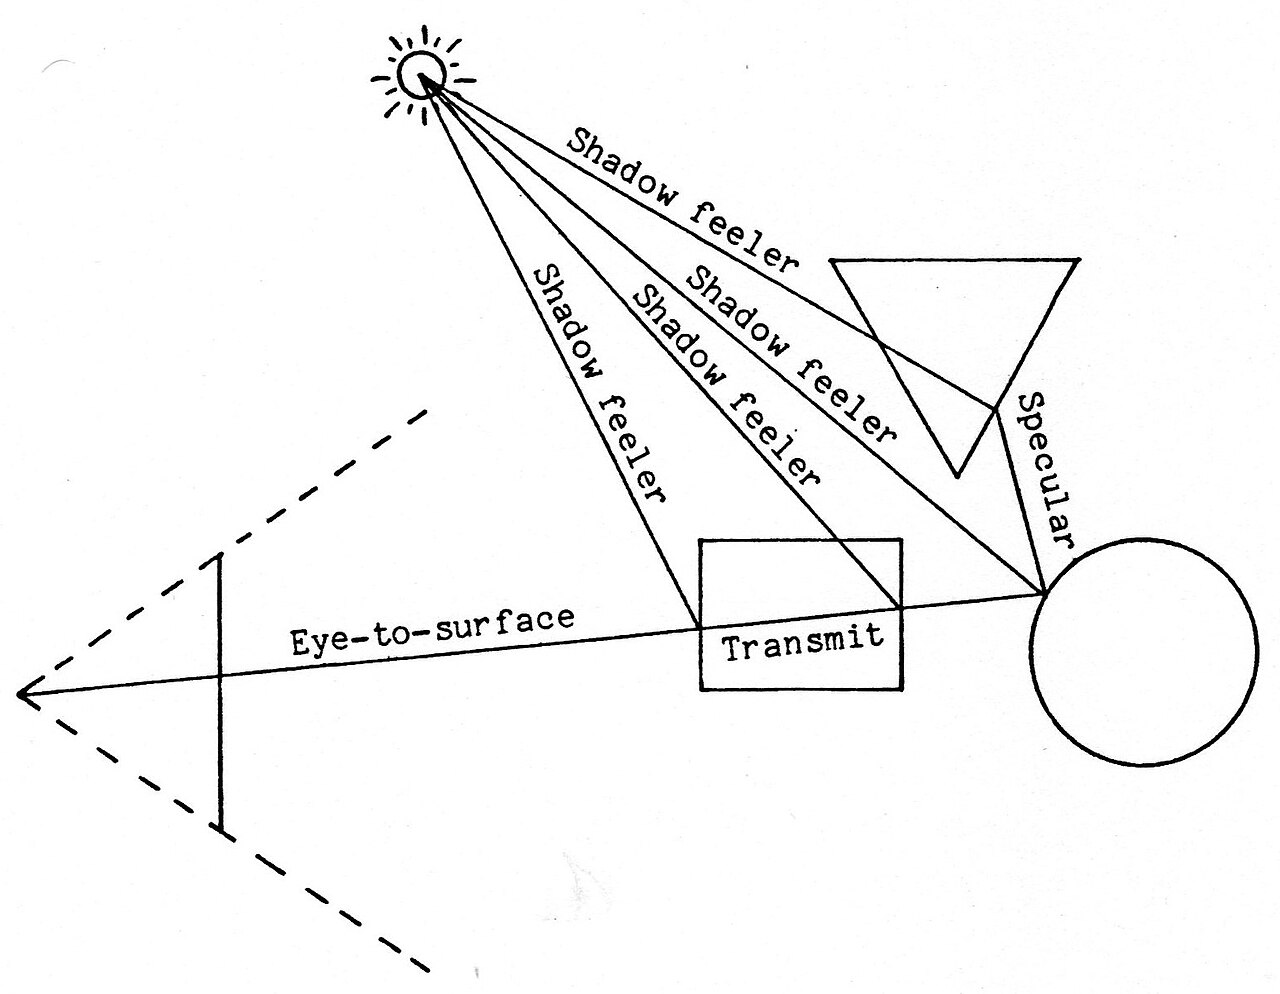
阴影光线是 any-hit 开销的重灾区——一帧几百万条阴影光线穿过植被层,每条都触发十几次 any-hit。但阴影光线不需要着色,只需要知道"有没有被挡"。
Vulkan 给了两个 ray flag 专门优化这种场景:
gl_RayFlagsTerminateOnFirstHitEXT:第一次有效命中就终止遍历。阴影光线不需要"最近的命中"——只要有一个不透明物体挡住了,阴影就确定了,不用继续找更近的。正常遍历需要找到最近的命中(因为 closest-hit 需要"最近"的那个点着色),但阴影光线只需要"有没有命中"——任何一个有效命中就足够了。gl_RayFlagsSkipClosestHitShaderEXT:跳过 closest-hit shader。阴影光线不需要着色——命中了就是阴影,没命中(跑到 miss shader)就是光照到达。跳过 closest-hit 省了着色器的执行开销,也省了 closest-hit 里可能发射的次级光线。
两个 flag 叠加:阴影光线命中第一个不透明物体就停,停了之后不跑 closest-hit。开销从"遍历整棵树 + N 次 any-hit + 1 次 closest-hit"变成"遍历到第一个命中 + 0 次 closest-hit"。
学术研究给过一个参考数字(论文设定口径):阴影光线比普通光线快约 20%——这个数字来自特定的测试场景,但量级关系是普遍的:跳过 closest-hit + 提前终止 = 阴影光线的遍历深度远小于主光线的遍历深度。主光线需要遍历到最近命中,可能走遍大半个 BVH;阴影光线只需要走到第一个遮挡物,可能只走了 BVH 的前几层。
还有一个 flag 值得知道:gl_RayFlagsNoOpaqueEXT / gl_RayFlagsOpaqueEXT——告诉遍历器"这些几何全是不透明的"或"全不是不透明的"。如果你知道阴影光线只穿过不透明几何(比如建筑遮挡),设 OpaqueEXT 可以让遍历器跳过 any-hit,直接当所有命中都是有效命中。配合 TerminateOnFirstHit,阴影光线变成纯硬件遍历——不切回 SM,不走着色器,吞吐量拉满。
7.8 调试方法
SBT 出错时,几个调试工具能帮上忙:
Vulkan Validation Layer。 最基础的第一道防线。stride 不对齐、区域重叠、group count 不匹配,validation layer 都能报。但 instanceShaderBindingTableRecordOffset 指错区域这种逻辑错误,validation layer 查不出来——它不知道你的"正确"偏移应该是多少。所以 validation layer 通过≠SBT 没问题。
GPU-AV(GPU Assisted Validation)。 Vulkan 的 GPU 端验证,能检测无效的 traceRayEXT 参数、越界访问等问题。比 CPU 端 validation layer 更深入——它能查到 GPU 上实际执行的着色器调用。如果 SBT 的 offset 越界导致读到了无效区域,GPU-AV 能在光线遍历时捕获到。
RenderDoc。 管线状态检查:能看到 SBT 的四个区域布局、每条记录的内容、instance 的 offset 值。着色器代码检查:能看到实际执行的 closest-hit/any-hit 的 SPIR-V。如果怀疑 offset 指错了区域,RenderDoc 里可以直接看 SBT buffer 的内存内容,对照 instance 的 offset 验证——把 shaderGroupHandle 的字节 dump 出来,看它对应的是不是你期望的着色器组。
NVIDIA Nsight Graphics。 专门做 GPU 性能分析,能看到 any-hit 的调用次数、遍历被打断的频率、SBT 的 cache miss 率。对 any-hit 开销分析和 SBT 性能调优最有用。Nsight 还能给出"遍历深度分布"——有多少光线走了浅层 BVH(快),有多少走了深层 BVH(慢),帮你判断 SBT 组织是否导致了不均匀的遍历模式。
一个工程判据:SBT 的正确性问题,先开 validation layer + GPU-AV 过一遍,能过滤掉 80% 的对齐和越界错误。剩下的逻辑错误(offset 指错、材质映射错),用 RenderDoc 看 SBT 内存内容对照。性能问题(any-hit 太多、SBT 太大),用 Nsight Graphics 量化。调试顺序:先正确性后性能——SBT 不对齐时谈性能没意义。
7.9 一次 SBT 排查实录
前面八个小节讲的是坑在哪,这一节记一次实际排查,把顺序演示一遍。
现象:某个场景里,只有地面材质的那部分画面出现随机闪烁,其他材质正常。关闭光追阴影后闪烁消失,所以问题锁定在阴影光线路径上。
第一步,先怀疑数据而不是着色器。 阴影闪烁最常见的两个原因,一是阴影光线的 flag 没设对(TerminateOnFirstHit 漏了导致 any-hit 被反复调用),二是 SBT 里对应的记录指到了错误的着色器。先看 flag——对着 7.7 节的清单逐条核,没问题。
第二步,把 SBT 记录打印出来。 按材质索引取出 hit group 的 handle,和 pipeline 创建时的 handle 列表逐一比对。这里发现了问题:地面材质用的是"共享 hit group"(多个材质指向同一条记录),而 ground 这个索引在映射表里被写了两次,后写入的值覆盖了前一个,于是它指向了隔壁材质的记录。
第三步,验证。 把那一条记录改成独立记录,闪烁立刻消失。
这个案例值得记下来的地方有三点:一是"只有一种材质出问题"这个特征,几乎一定指向数据映射而不是着色器逻辑——着色器错了通常是整片错,不会挑材质;二是共享记录是省内存的好做法,但共享的前提是映射表本身没错,映射表一旦有重复键,错误会以"看起来随机"的形式表现;三是 SBT 的错误从来不报 crash,只会让错误的着色器静默执行——所以调试手段只能是"把记录打出来对",没有别的捷径。
八、收束与交棒
8.1 三句话判据
本篇讲了八件事——SBT 是什么、hit group 三种着色器、closest-hit 算什么、any-hit 为什么贵、intersection 留给谁、材质系统怎么组织 SBT、SBT 的坑有哪些。收成三句话:
第一句:SBT 不是 API 配置项,是性能变量。 SBT 的大小直接决定 cache 命中率,组织方式直接决定材质系统的可维护性。朴素 per-instance 布局让 SBT 膨胀到 6 MB,按材质去重 + bindless 后压到 1 MB 以下——同一个场景,不同的 SBT 组织方式,性能差几倍。NVIDIA 的建议是 SBT 记录只放 shaderGroupHandle + 最小索引,per-instance data 走 bindless。三层架构——push constants(全局)/ SBT data(材质)/ bindless(per-instance)——让每层访问频率与带宽容量匹配。
第二句:hit shader 要精简,any-hit 尤其要精简。
closest-hit 只做它该做的事——光照 + 次级光线。any-hit 只做 alpha test,其他全部移到 closest-hit。植被场景每帧 15-25 亿次 any-hit 调用不是吓唬人的——NVIDIA 在 Indiana Jones 上用 OMM 把 7.90 ms 降到 3.58 ms,省的就是 any-hit。不透明几何不要设 any-hit,能上 OMM 就上 OMM。阴影光线记得加 TerminateOnFirstHit + SkipClosestHit,两个 flag 能省 20% 以上。intersection shader 只给非三角形简单几何用,能用三角形就别上 intersection。
第三句:SBT 的坑不报 crash,只跑错着色器。 stride 不对齐 → validation layer 报;offset 指错区域 → 画面材质错乱但不报错;group count 不匹配 → 越界读取可能花屏。调试顺序:validation layer + GPU-AV 过一遍 → RenderDoc 看 SBT 内存 → Nsight Graphics 量化性能。SBT 出错最难排查的不是"报了什么错",而是"没报错但画面不对"——这时候靠 RenderDoc 直接看 SBT 内存内容是最快的路径。
8.2 交棒:混合管线编排
ep03 讲完了加速结构怎么建、ep04 讲完了命中着色器怎么组织——但光追管线不是独立运行的。在实时渲染里,光追和光栅化是两条管线混合使用的:G-buffer 用光栅化生成,反射和阴影用光追算,最终画面靠降噪器拼起来。
但什么时候用光栅化、什么时候用光追?光追的 raygen 从哪拿 G-buffer 数据?光追的结果怎么和光栅化的结果混合?混合管线的性能预算怎么分配——一帧 16 ms 里光追占多少、光栅化占多少、降噪占多少?这些问题,ep05 来回答。
下一篇(预告):【实时光线追踪与混合渲染】(五) 混合管线编排:光栅化与光追的接力赛
参考资料: 1. Vulkan 规范 · Ray Traversal — Khronos Group 2. Vulkan 规范 · Ray Tracing Pipeline(SBT 四区域、VkStridedDeviceAddressRegionKHR)— Khronos Group 3. VkPhysicalDeviceRayTracingPipelinePropertiesKHR(shaderGroupHandleSize / shaderGroupBaseAlignment / maxShaderGroupStride / shaderGroupHandleAlignment)— Khronos Group 4. Vulkan GLSL Extensions — NV/EXT Ray Tracing(hitT / instanceCustomIndex / geometryIndex / primitiveIndex / barycentrics)— Khronos Group 5. Vulkan Tutorial — Opacity Micromaps(OMM 与 any-hit 关系、alpha testing 开销分析)— Khronos Group 6. Vulkan Tutorial — Shadow Transparency(阴影光线穿过植被的 any-hit 开销)— Khronos Group 7. NVIDIA RTX Best Practices(any-hit 简洁、SBT 精简、uber shader 不推荐)— NVIDIA Developer 8. Efficient Ray Tracing with NVIDIA OptiX — Shader Binding Table Optimization(10 万 instance 6MB → <1MB;per-instance data 移到全局数组)— NVIDIA Developer 9. Practical Real-Time Ray Tracing with RTX(三角形路径 intersection/any-hit 留 nullptr)— NVIDIA Developer 10. Path Tracing Optimizations in Indiana Jones — Opacity Micromaps and Compaction of Dynamic BLAS(RTX 5080 OMM 7.90ms → 3.58ms)— NVIDIA Developer 11. Intel Scalable Ray Tracing(Thread Sorting Unit 对发散光线重排序提升 SIMD 利用率)— Intel GameDev 2023 12. Intel RTRT Applications Developer Guide(RTU 负责遍历 + 相交 + instance 变换 + hit shader 分发)— Intel 13. nvpro Vulkan RT Tutorial(SBT 布局、stride 计算、多 closest-hit 配置)— NVIDIA nvpro 14. Khronos Vulkan-Samples(官方 SBT 设置样本)— Khronos Group 15. DirectX Raytracing Functional Spec(hit group = 0/1 intersection + 0/1 any-hit + 0/1 closest-hit)— Microsoft 16. Unreal Engine — Ray Tracing Performance Guide(r.RayTracing.PersistentSBT)— Epic Games 17. Arm — Mobile Ray Tracing Demystified(移动端材质分 pass 策略)— Vulkanised 2026 18. Managing HWRT in Instance-Heavy Scenes(反射 pass 从 0.67ms 优化到 0.4ms)— real-mrbeam 19. RT Performance Study(阴影光线比普通光线快 ~20%)— Utah 大学 20. AMD RDNA 4 Architecture(第三代光线追踪加速器,每 CU 吞吐 >2× RDNA 3)— AMD
本篇作者:溯光 本系列(实时光线追踪与混合渲染,共 12 篇):分界线 → 加速结构工程账(上)→ 加速结构工程账(下)→ SBT → 混合管线编排 → 降噪(上)→ 降噪(下)→ ReSTIR → 光线预算表 → RT 资源生命周期 → 透明与体积 → 反射与阴影混合 → 跨平台差异 前置专题:《实时渲染管线探析》5 篇 · 《移动端图形与功耗》7 篇 · 《GPU 架构剖析》12 篇 下一篇预告:【实时光线追踪与混合渲染】(五) 混合管线编排:光栅化与光追的接力赛
希望能对大家有所帮助。