站点链接:技术博客页 | 公众号:溯光的图形笔记
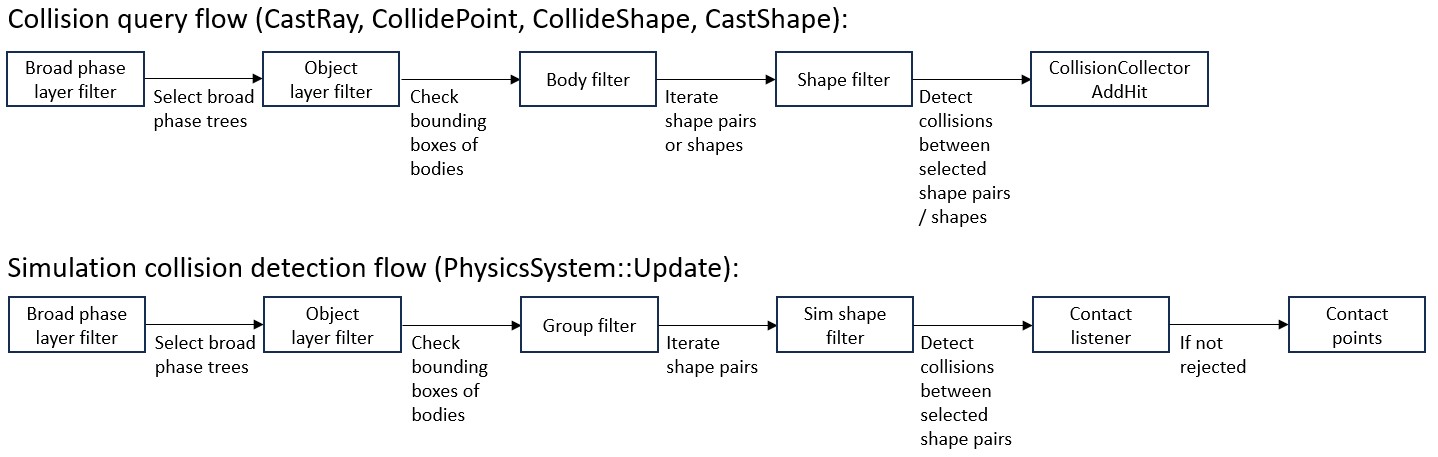
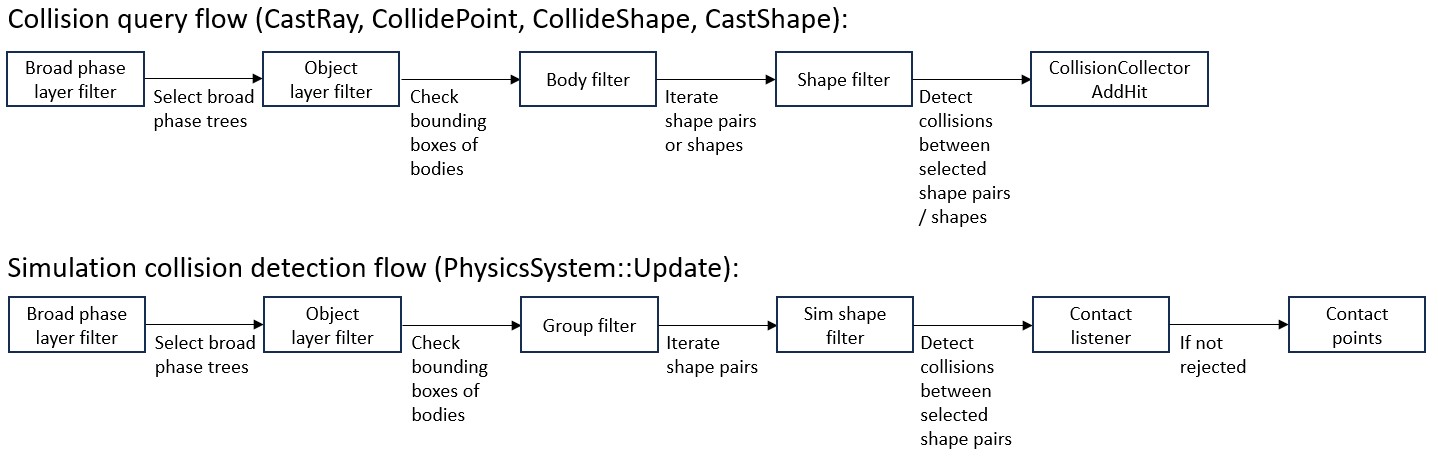
Docs/Images/CollisionFlow.jpg(MIT)上一篇把宽相那棵树拆开了:四叉、无锁、双根、退化。但还有一件事没交代,树里到底该放谁。 上一篇结尾留了一句:配错一个映射,轻则白跑一堆查询,重则该撞的不撞。这一篇就把这句话拆开。
OK,先说两个症状,它们看起来毫不相干,根因却是同一个:
// 症状 A:碎片穿过了玩家,两个人像不在一个世界
settings.mObjectLayer = Layers::DEBRIS;      // 碎片
player.mObjectLayer   = Layers::MOVING;     // 玩家
// → 碎片检查自己的配对表,发现「DEBRIS 只碰静态」,玩家在它眼里不存在

// 症状 B:传感器(触发区)一次都没触发过
trigger.mObjectLayer = Layers::SENSOR;      // 触发区
// → 触发区被放进了错误的宽相层,或者它所在的那一层与角色层之间根本没打开配对
A 是「该碰没碰」,B 是「碰了但没反应」。 两者的成因都在同一处:物理引擎里没有「碰不碰」这一个开关, 只有一条从「还没配对」走到「已经算出接触点」的漏斗,而漏斗每一级的价格不同。 把过滤写在便宜的一级,省下的是整片计算;写在贵的一级,等于先做完了活再扔掉。 本篇要回答的就是这三件事:这条漏斗有哪几级、每一级怎么配、以及配错一级的代价到底是多大。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、源码怎么实现、本机跑出来是什么,这三层在文中分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(版本、场景、规模、编译选项、日期);
- 自跑优先:本专题的图以本机编译运行 Jolt 得到的真图与官方一手图为主,自绘为辅;
- 不写没有落点的说法:凡是官方文档与源码里找不到对应命名的说法,文中会明确指出查无落点;
- 本篇的知识地图:三条主线贯穿全篇,定位的代价(对象层映射到哪一棵宽相树)、 过滤的代价(六级漏斗从上到下越来越贵)、配置的代价(两条落地路线怎么选、写错会怎样)。 三条线各自的落点见 §0.4,全篇内容总览也在此处给出;
- 本篇不涉及:宽相树的内部结构(第四篇已写)、候选配对怎么变成接触点(第六篇)、 形状与质量属性(Shape 篇)、约束怎么迭代求解(第九篇)、岛与睡眠(第十篇)、 GPU 宽相(Jolt 没有这条路)。
入口:一次「本该不碰却碰了」
0.1 漏斗总览:六级过滤器
好了,先看官方怎么把这条链讲完的。Docs/Architecture.md 的 ## Collision Filtering 一节,
在讲完三个必需接口之后,用一小节列出了碰撞检测管线穿过各级过滤器的顺序,并在那一段下面挂了这张图:
官方给的这个顺序是(Architecture.md 第 650 至 655 行,逐条照抄其定位):
- Broadphase layer:在这一级,对象层被拿来与「相关的宽相树」比对,靠的是
ObjectVsBroadPhaseLayerFilter; - Object layer:宽相层那一关过了之后,才是对象层对对象层,模拟期用
ObjectLayerPairFilter, 查询期用ObjectLayerFilter; - GroupFilter:只在模拟期用,而且在包围盒已经被判定为重叠之后才跑;
- BodyFilter:做
CastRay这类查询时,用它替代 group filter; - Shape filter:查询期(
ShapeFilter)与模拟期(SimShapeFilter)都用,可以过滤掉复合形状里的单个子形状; - ContactListener:模拟期里所有碰撞检测都做完了之后,你仍然可以丢弃一个接触点。
然后官方用一句话给这六级定了调(第 657 行):
To avoid work, try to filter out collisions as early as possible.
原理上,这句话就是全篇的判据:过滤本身很便宜,但「在什么时候过滤」决定了它省下多少。
最便宜的过滤是「连配对都不生成」,最贵的过滤是「接触点都算出来了,再扔掉」。
这一节与六级顺序的完整原文见 Docs/Architecture.md 的 ## Collision Filtering 一节(第 603 至 657 行)。
但在讲代价之前,得先把边界说清。
0.2 本篇的边界(本篇不涉及什么、为什么)
好了,边界说三条。
讲什么:三个必需接口怎么装、ObjectLayer 与 BroadPhaseLayer 的多对一映射、
ShouldCollide 在模拟期与查询期的两副面孔、两条落地路线(表驱动与掩码)的取舍、
碰撞组与它的存储、查询期的另外三层过滤器、以及配错一级的代价。
只给指针、不展开什么:宽相树为什么是四叉、无锁与双根怎么实现(第四篇)、
候选配对怎么变成接触点(第六篇)、形状本身与质量属性(Shape 篇)、
约束怎么迭代、岛怎么切分、睡眠判据(第九、十篇)。
本篇提到 Samples/Layers.h 里的 SENSOR 层,只讲它「为什么要独立成层」,不讲触发器的事件接口。
为什么不写 GPU 宽相:Jolt 没有这条路。v5.6 的 compute 通路只服务发束头发仿真, 刚体求解与宽相全在 CPU 的 job-system 上。拿 PhysX 或 Havok 的 GPU 实现来填 Jolt 的机制位, 是这一系列明确划掉的做法。
0.3 本机环境与读数口径
好了,最后交代读数的来源。本篇有三类数据:官方文档与源码原文(行号可复核)、
本机原创基准(bench_layers.exe,四组实验 E0–E3)、以及上一类推导出的账。
本机环境:Jolt Physics v5.6.0、MSVC 14.44(VS 2022 BuildTools)、Release、/O2 /MT、
JPH_OBJECT_LAYER_BITS = 16、JPH_TRACK_BROADPHASE_STATS 打开、精度为默认双精度关闭(单精度)配置。
场景是六万体的交错网格:2 米间距,偶数索引是 MOVING、奇数索引是 DEBRIS,
两类混在同一片区域,这一点很关键,后面 §5 会解释为什么把碎片放到远处会让对比消失。
探针查询盒是中心 ±20 米的 AABB。稳态跑 200 步。日期 2026-10-02。
第一,为什么是「交错」而不是「分区」。 宽相查询靠 AABB 剪枝:把碎片放到离动态物体很远的地方, 那么围绕碎片的小盒子本来就只会碰到碎片,两种映射的差会被剪枝吃掉。 要让「同一棵树里住了别人」这件事显形,就得让两类住在同一片区域。 这也正是真实项目里的样子:碎片就散落在动态物体中间。
第二,「共享」与「独占」只差一个映射。 两种配置的对象层、配对规则、
体数、初始位置完全相同,唯一差别是 DEBRIS 映射到哪一层的宽相树:
// 共享:DEBRIS 与 MOVING 进同一棵树(宽相层共 2 个)
BroadPhaseLayer GetBroadPhaseLayer(ObjectLayer l) const override {
    if (l == Layers::NON_MOVING) return BroadPhaseLayer(0);   // BP_STATIC
    return BroadPhaseLayer(1);                                // MOVING 与 DEBRIS 都到这里
}

// 独占:DEBRIS 单独一棵树(宽相层共 3 个)
BroadPhaseLayer GetBroadPhaseLayer(ObjectLayer l) const override {
    if (l == Layers::NON_MOVING) return BroadPhaseLayer(0);
    if (l == Layers::MOVING)     return BroadPhaseLayer(1);
    return BroadPhaseLayer(2);                                // BP_DEBRIS
}
这段是实测里真正改掉的那一处。换句话说,§5 里所有「共享」与「独占」的差距, 都不是因为体数变了、也不是因为规则变了,只是因为这一行返回了不同的值。
0.4 本篇的知识地图:三条主线
主线一,定位的代价:对象层映射到哪一棵树。 一个对象层只能映射到一个宽相层,但多个对象层可以挤进同一个宽相层。 挤进去之后它们共享同一棵树,于是一次查询会先走遍「AABB 与之重叠」的所有对象, 等重叠被判定出来了,才去查真正的对象层。所以「映射写在哪」直接决定了查询要白走多少东西。 本机实测的差距是 2.0 倍的访问节点、2.1 倍的访问刚体(§2.5),而结果集一模一样。
主线二,过滤的代价:六级漏斗从上到下越来越贵。 宽相层那一级能省掉「进错树」的全部工作;
对象层那一级是两个整数的一次比较;GroupFilter 要等到包围盒已经重叠;ContactListener 最贵。
接触点都算完了。越早过滤越省,而「早」这个位置各家引擎放在不同地方(§8.4)。
主线三,配置的代价:两条落地路线怎么选、写错会怎样。 表驱动(ObjectLayerPairFilterTable 三件套)
与掩码(ObjectLayerPairFilterMask 三件套)表达同一套规则的能力是等价的(本机逐条比对 9 组全一致),
但在「最后一层」上有一个真实分歧(2 组不一致,§4.5),而这条分歧会让层序设计改样。
「双向命中」是通行规则,可手写 ShouldCollide 能写出单向(§3.3),两种内置实现都写不出来。
0.5 本机实验设计:四组实验
这四组实验都跑在同一个可执行文件里(evidence/bench_layers.cpp),口径在 §0.3。
- E0 · 表驱动的对称性:不建场景,只构造一个三层的
ObjectLayerPairFilterTable, 从一个方向调用EnableCollision与DisableCollision,看反方向读出来是什么; - E1 · 官方计数:同一个探针查询,在两种映射下读官方 instrumentation 的
Nodes Visited/Bodies Visited/Hits Reported,并同时跑「只找 DEBRIS」与「不过滤对象层」两遍; - E2 · 稳态代价:两种映射各跑 200 步,量首步与稳态每步耗时;
- E3 · 两条路线比对:把「表驱动」与「掩码」两套实现放在同一套配对规则下, 逐条比对对象层配对 9 组与「对象层 × 宽相层」9 组。
其中:E1 与 E2 共用同一份场景构造代码,这是「只差一个映射」这句话成立的前提; 两组的对象层、配对规则、体数、初始位置逐项相同。
0.6 先归类:过滤器只有四种形状
OK,在往下走之前,先把全篇要出现的过滤器归一次类。官方的六级是按「执行的先后」列的, 但按「判定的粒度」看,它们只有四种形状,这个归类后面每一章都会用到。
| 形状 | 刻度 | 判定依据 | 有哪些 | 配在哪 |
|---|---|---|---|---|
| 类级 · 定位 | 「类住哪儿」 | 对象层 → 宽相层 | BroadPhaseLayerInterface(表驱动版 / 掩码版) |
Init 参数 |
| 类级 · 配对 | 「哪两类碰」 | 两个对象层 | ObjectLayerPairFilter(表驱动 / 掩码 / 手写),查询期对应 ObjectLayerFilter |
Init 参数 |
| 实例级 | 「这两个实例碰不碰」 | 两个 CollisionGroup |
GroupFilter / GroupFilterTable |
建体时逐体给 |
| 查询级 | 「这次查询要不要看它」 | 体 / 形状 | BodyFilter / ShapeFilter / SimShapeFilter |
查询调用点 / SetSimShapeFilter |
这四种形状的代价是递增的:类级定位最便宜(进树之前)、类级配对次之(两个整数比较)、
实例级要等 AABB 重叠、查询级要等体或形状已经被选中。
而它们的配置位置也是不同的,前两种装进 Init 的三个参数,第三种随建体给,
第四种挂在查询调用点上。「配在哪」和「多贵」是同一件事的两面。
这张归类表是后面所有取舍的地图:§2 讲第一种,§3 与 §4 讲第二种, §6 讲第三种,§7 讲第四种。
一、三个接口:Init 为什么非要这三样
1.1 三个接口是必需参数,不是可选配置
好了,任何 Jolt 程序都躲不过这一段:建 PhysicsSystem 的时候,Init 的签名里明明白白写着三个过滤接口。
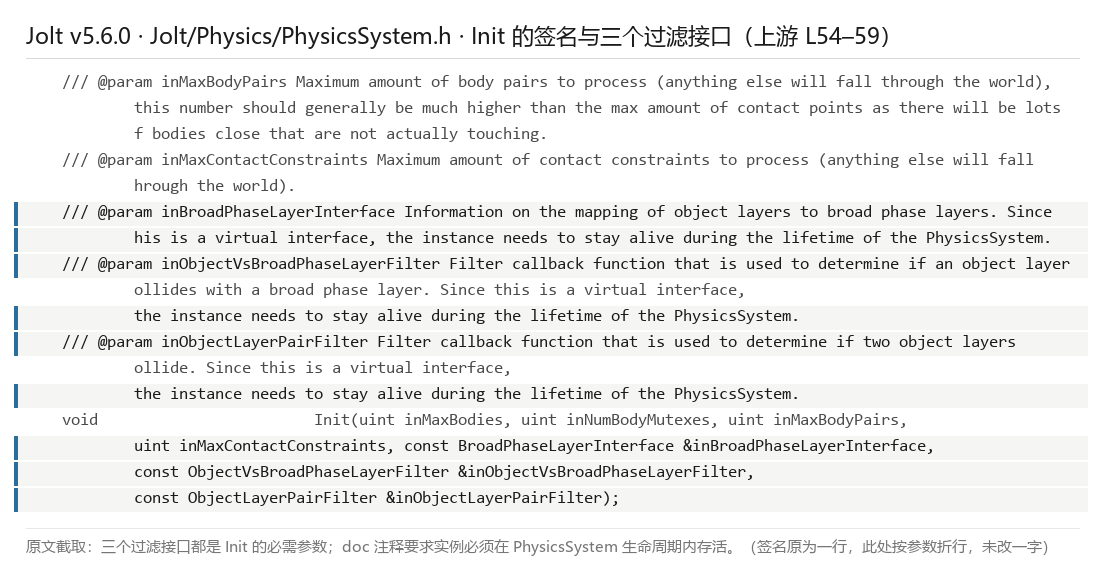
//【初始化:三个过滤接口是必需参数】,摘自 PhysicsSystem.h 的 Init 声明
void Init(uint inMaxBodies, uint inNumBodyMutexes, uint inMaxBodyPairs, uint inMaxContactConstraints,
          const BroadPhaseLayerInterface &inBroadPhaseLayerInterface,        // 对象层 → 宽相层
          const ObjectVsBroadPhaseLayerFilter &inObjectVsBroadPhaseLayerFilter, // 对象层 × 宽相层
          const ObjectLayerPairFilter &inObjectLayerPairFilter);             // 对象层 两两
下面对这三个参数特别说明两处。
第一,它们全是引用,而且注释里明写了寿命要求。 官方在 PhysicsSystem.h 第 56 至 58 行给每个参数的
doc 注释都补了一句同样的话:实例必须在 PhysicsSystem 的整个生命周期内存活。
也就是说这三个对象是「借给」物理系统的,不是拷贝进去的。这条约束在真实项目里最容易被踩:
把三个实现类写成某个场景类的局部变量,场景一析构,物理系统还留着悬空引用。
它不会立刻崩,而是在下一次配对时才咬人。
第二,第二个接口管的是「对象层 × 宽相层」,不是「宽相层 × 宽相层」。 这个命名很容易被读岔。
它的名字是 ObjectVsBroadPhaseLayerFilter,而历史上它叫过 BroadPhaseLayerPairFilter
(Docs/APIChanges.md 第 161 行记的这次改名)。改名的原因正是语义:宽相层两两之间不存在配对,
被问的永远是「某个对象层,要不要和某个宽相层里的东西碰」。
1.2 三个接口各管什么
三者的分工可以一句话说完,但要知道谁在什么时候被问。
原理上,这三个接口回答的是三个不同粒度的问题:
| 接口 | 被问的问题 | 返回什么 | 调用时机 |
|---|---|---|---|
BroadPhaseLayerInterface |
这个对象层该住在哪棵树? | 一个 BroadPhaseLayer |
体入世界时 |
ObjectVsBroadPhaseLayerFilter |
这个对象层要不要走那棵树? | 真 / 假 | 每次配对与查询,每棵树问一次 |
ObjectLayerPairFilter |
这两个对象层要不要碰? | 真 / 假 | 宽相层那一关过了之后 |
其中:第一行是「定位」,后两行是「过滤」。这也是为什么本篇的三条主线要把「定位的代价」单列。 映射做错,后面两级过滤器再便宜也补不回来,因为它们拦不住「多走的那棵树」。
1.3 谁持有它、谁调用它
把这三个接口塞进去之后,它们到底存在哪、谁在用?
//【存引用与转发:三个接口在 Init 里的去向】,摘自 PhysicsSystem.cpp 的 Init
mObjectVsBroadPhaseLayerFilter = &inObjectVsBroadPhaseLayerFilter;   // 第 85 行:存指针
mObjectLayerPairFilter         = &inObjectLayerPairFilter;           // 第 86 行:存指针
mBodyManager.Init(..., inBroadPhaseLayerInterface, ...);              // 第 89 行:转给 BodyManager
mBroadPhase->Init(..., inBroadPhaseLayerInterface, ...);              // 第 93 行:转给宽相
而这两个 filter 真正被用上,是在 PhysicsSystem.cpp 第 967 行:
//【唯一的使用点:找配对时把两个 filter 一起传下去】,摘自 PhysicsSystem.cpp
mBroadPhase->FindCollidingPairs(..., *mObjectVsBroadPhaseLayerFilter, *mObjectLayerPairFilter, add_pair);
这一行值得单独看一眼:它说明「过滤」不是 PhysicsSystem 自己做的,
而是被传进宽相、由宽相在遍历时调用的。理解了这一点,§2.5 那个「白走一倍」的读数就顺理成章了。
过滤器在树的内部被调用,而树已经走到了那一层。
三个接口的完整定义与全部调用点见
PhysicsSystem.h 与
PhysicsSystem.cpp;
官方的最小装配例子在
HelloWorld/HelloWorld.cpp 第 278 行。
二、ObjectLayer 与 BroadPhaseLayer:多对一的映射
2.1 对象层的位宽与「零开销」这句
先来看看对象层本身。官方文档第 605 行有一段话,两句话加起来才完整:
Each Body is in an ObjectLayer. If two object layers don't collide, the bodies inside those layers cannot collide. …you're free to define as many as you like as they don't incur any overhead in the system.
第一句是语义:体属于一个对象层,层之间不碰,层里的体就不碰。 第二句是关键:层数零开销,所以「层多不好」这个直觉在 Jolt 这里是错的。 真正贵的是下面的宽相层数,跟层数多少没关系。
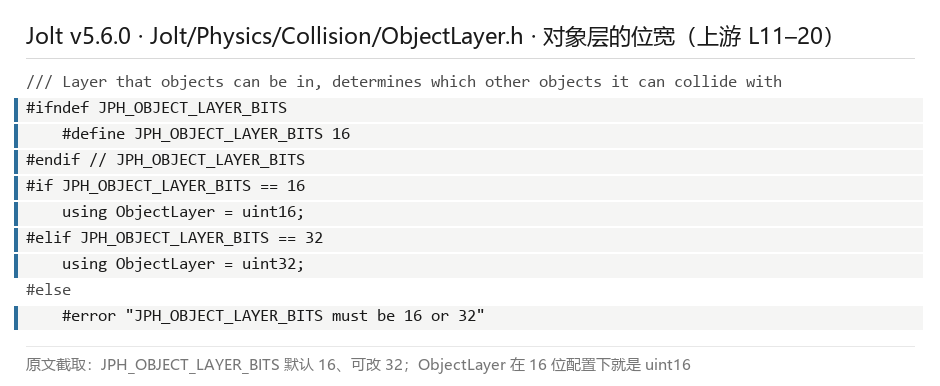
//【对象层的位宽】,摘自 ObjectLayer.h
#ifndef JPH_OBJECT_LAYER_BITS
    #define JPH_OBJECT_LAYER_BITS 16      // 默认 16 位;官方允许改成 32
#endif
using ObjectLayer = uint16;                // 16 位配置下的实际类型
其中:16 这个位数不是随便定的,它决定了掩码路线里 group 与 mask 各能分到几位(§4.2),
也决定了「最多多少个分组」这个上限。把它改成 32 的开关与代价同样写在官方文档里。
2.2 宽相层只有 8 位
好了,对象层是 16 位,但宽相层不是。
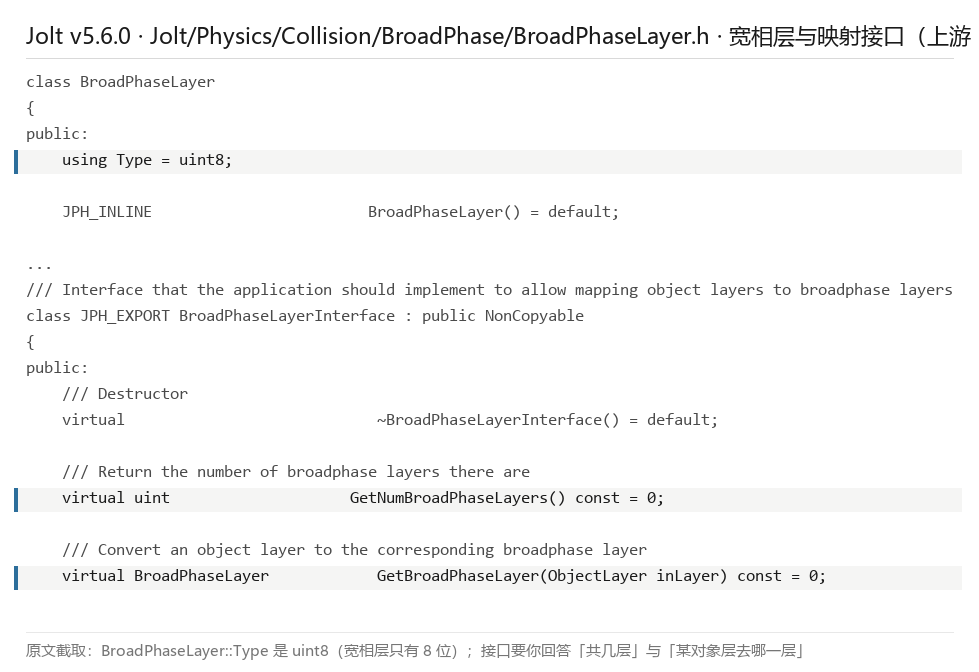
//【宽相层的位宽与接口】,摘自 BroadPhaseLayer.h
class BroadPhaseLayer {
    using Type = uint8;                    // 只有 8 位
};

class BroadPhaseLayerInterface {
public:
    virtual uint GetNumBroadPhaseLayers() const = 0;                 // 一共有几层
    virtual BroadPhaseLayer GetBroadPhaseLayer(ObjectLayer inLayer) const = 0;  // 映射
};
这里有个值得记住的不对称:对象层 16 位、宽相层 8 位。 官方在文档里给了原因,每个宽相层都是一棵树,都要花钱("because each broad phase layer comes at a cost")。 所以一边是「层随便加、零开销」,另一边是「层要省着用、每层一棵树」。 这就是多对一映射存在的理由,也是下一节要讲的取舍点。
2.3 多对一:为什么值得多一层
OK,现在到了本篇最核心的一句官方原文。Architecture.md 第 608 行:
Each Body can only be in 1 BroadPhaseLayer so an ObjectLayer maps to 1 BroadphaseLayer. In general there will be multiple ObjectLayers mapping to the same BroadPhaseLayer … If there are multiple object layers in a single broad phase layer, they are stored in the same tree. When a query visits the tree it will visit all objects whose AABB overlaps with the query and only when the overlap is detected, the actual object layer will be checked.
原理上,这段话说的是「过滤放在哪一级」这件事的物理形态:
顺序是「先走树、后查层」,不是「先查层、后走树」。 这句话听起来只是表述差异,但它决定了代价的量级: 被树走到的对象,在对象层那一关之前就已经付出了一次 AABB 判定。 如果把两个不相干的对象层塞进同一棵树,那么针对其中一个的查询,会顺带走遍另一个的所有 AABB 重叠对象, 到最后一刻才把它们剔掉。
同一段末尾,官方把取舍点也写出来了:
you should carefully design which object layers end up in which broad phase layer, balancing the requirement of having few broad phase layers with the number of needless objects that are visited.
「要少」和「要多走的对象数」,这句话定性地给了取舍,但没给数字。 §2.5 就把它量出来。
2.4 官方自己怎么配层
说白了,官方在文档里给了一套完整的示例(对象层五个、宽相层三个),而真正在跑的代码在 Samples/Layers.h 里。
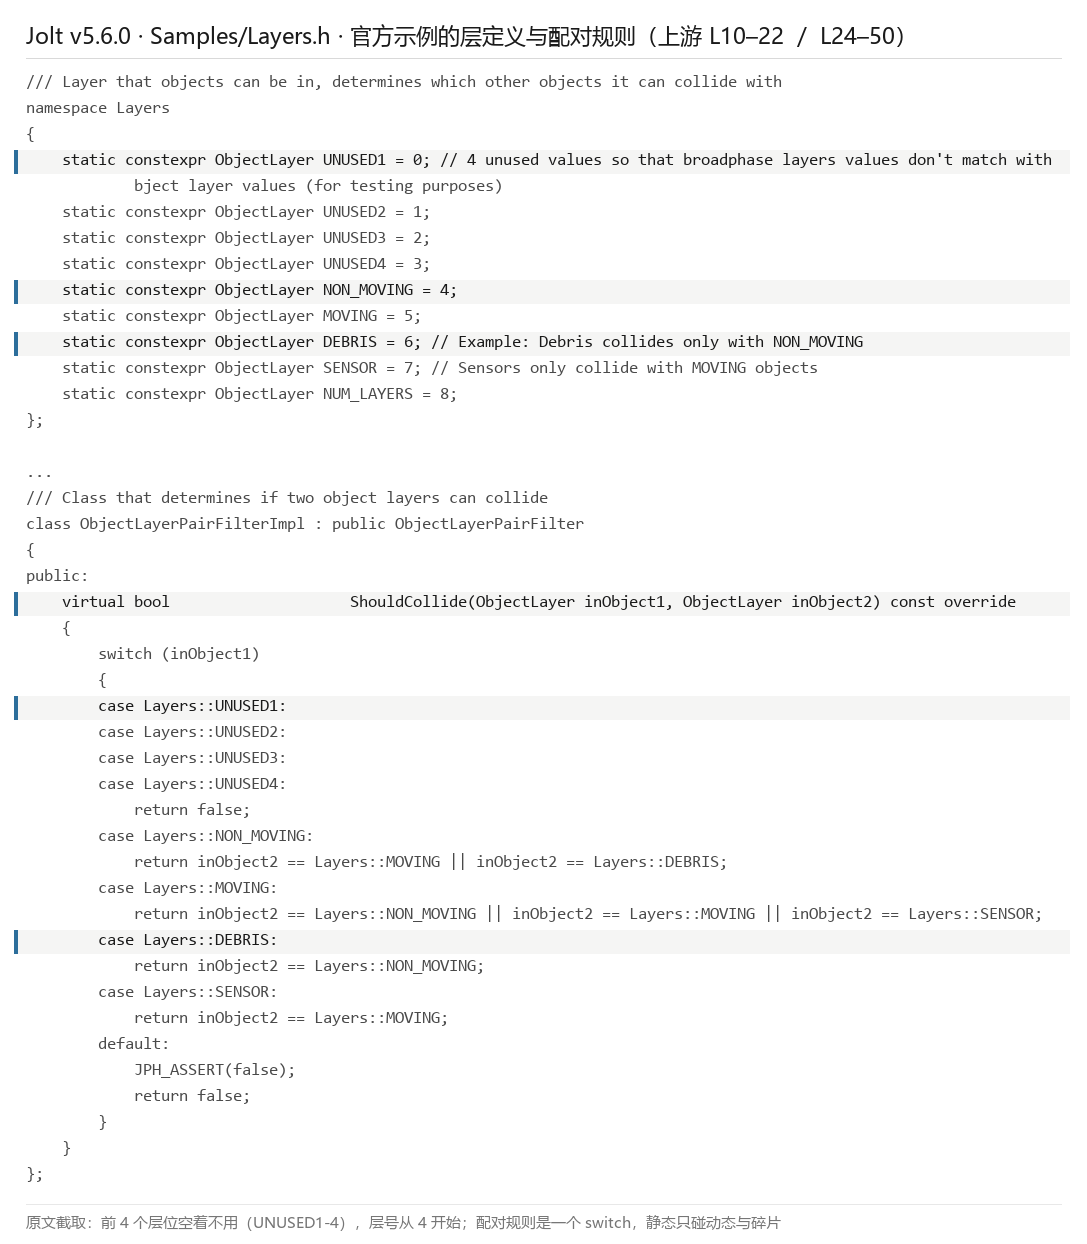
//【官方示例的层定义】,摘自 Samples/Layers.h
namespace Layers {
    UNUSED1, UNUSED2, UNUSED3, UNUSED4,     // 前 4 个位空着
    NON_MOVING, MOVING, DEBRIS, SENSOR,     // 4 / 5 / 6 / 7
    NUM_LAYERS
};

// 配对规则:静态只碰动态;动态碰一切;碎片只碰静态
virtual bool ShouldCollide(ObjectLayer inObject1, ObjectLayer inObject2) const override {
    switch (inObject1) {
        case Layers::NON_MOVING: return inObject2 == Layers::MOVING;
        case Layers::MOVING:     return true;
        case Layers::DEBRIS:     return inObject2 == Layers::NON_MOVING;
        default:                 return false;
    }
}
有两处细节值得抄走。 第一,前四个位宽官方空着不用(UNUSED1…4),
层号从 4 开始,空出来的低位留给「调试用层」或者未来的扩展,这是个便宜的好习惯。
第二,DEBRIS 那条规则让碎片只碰静态地面,官方在文档第 640 行给了理由:
碎片通常有上千个,ObjectVsBroadPhaseLayerFilter 把它们限制在「只需要访问一棵宽相树」,
查询能有多快就多快。
官方示例的宽相层映射是:NON_MOVING → BP_NON_MOVING、MOVING 与 BULLET → BP_MOVING、
DEBRIS → BP_DEBRIS。注意 MOVING 与 BULLET 是共享一层的,这就是多对一。
2.5 本机实测:共享一层要多走多少
好了,把 §2.3 那句「会走遍所有 AABB 重叠的对象」量出来,只要构造一个「两类混住」的场景就够。
本节口径见 §0.3:六万体交错网格(MOVING 与 DEBRIS 混在同一片区域)、
对象层、配对规则、体数、位置完全一致,唯一差别是 DEBRIS 映射到哪一层。
同一个探针查询(只找 DEBRIS)在两种映射下的官方计数:
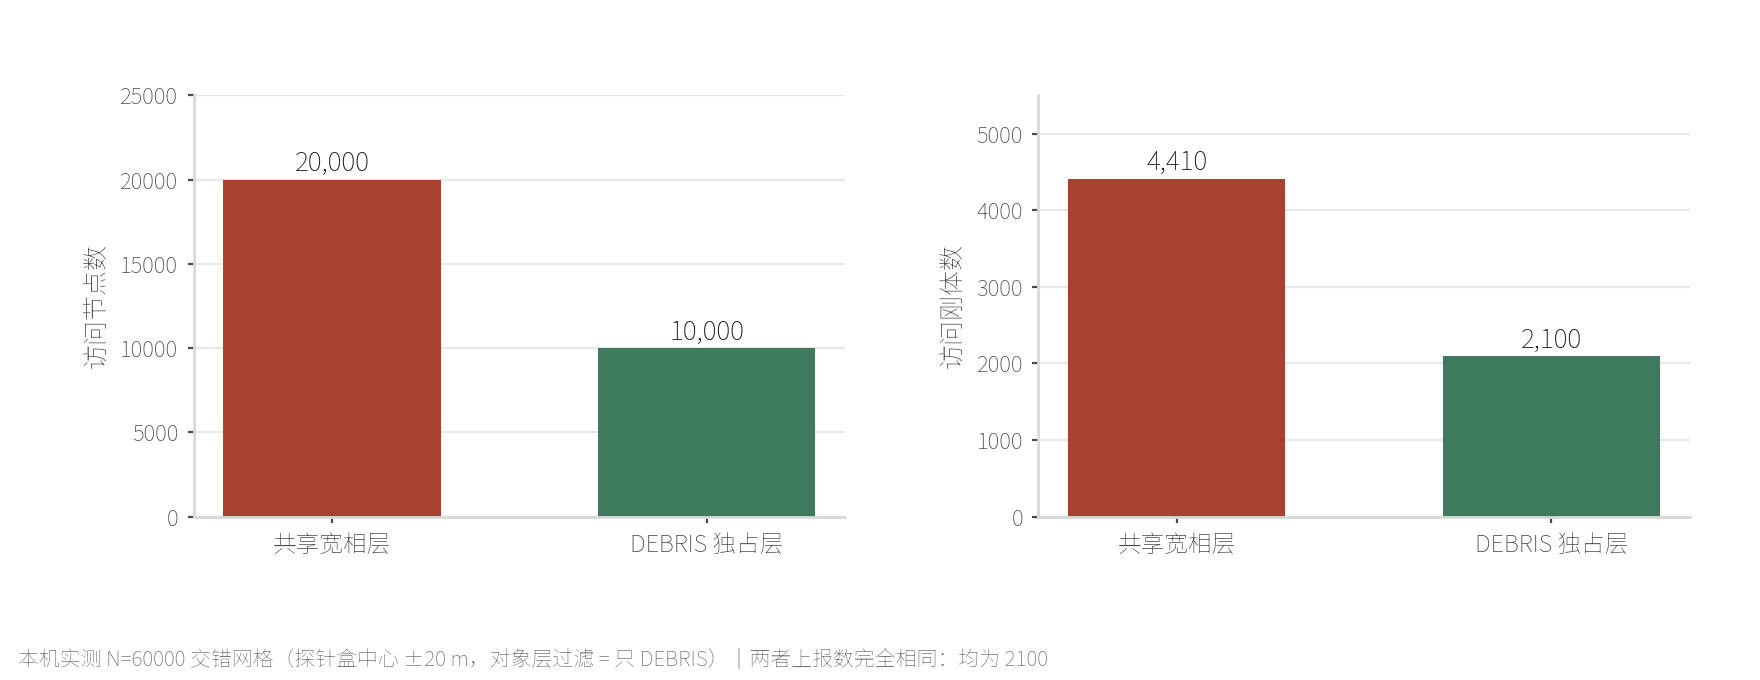
读数(口径:Jolt v5.6.0 本机 Release、N=60000 交错网格、探针盒中心 ±20 米、单次查询):
| 配置 | 宽相层过滤 | 对象层过滤 | 访问节点数 | 访问刚体数 | 上报数 | 其中 DEBRIS |
|---|---|---|---|---|---|---|
| 共享宽相层 | BP_MOVING |
只 DEBRIS |
20000 | 4410 | 2100 | 2100 |
DEBRIS 独占层 |
BP_DEBRIS |
只 DEBRIS |
10000 | 2100 | 2100 | 2100 |
这张表要说三件事。
第一,结果完全一样。 两种配置上报的都是 2100 个 DEBRIS,因为对象层过滤确实生效了,
「谁能撞谁」的行为没有变。第二,代价差一倍。 共享配置下,同一个查询多走了一万个节点、多访问了两千三百一十个刚体
(访问刚体 4410 对 2100,倍数 2.1;访问节点 20000 对 10000,倍数 2.0)。
第三,多出来的那部分是「别人的」,把它们是谁看清楚了,就知道代价落在哪。
如果去掉对象层过滤,那棵树里到底住着谁就一目了然了。
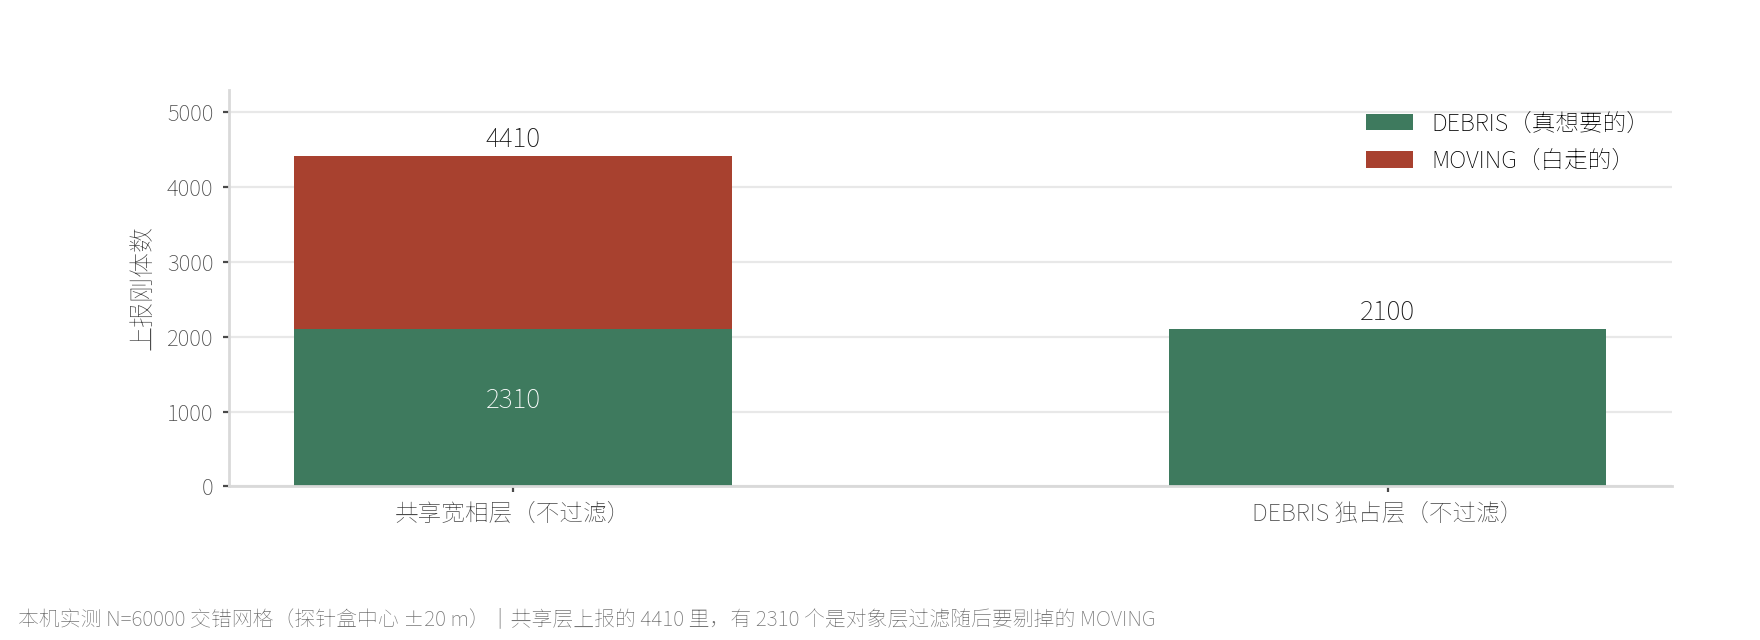
| 配置 | 对象层过滤 | 上报总数 | 其中 MOVING |
其中 DEBRIS |
命中率 |
|---|---|---|---|---|---|
| 共享宽相层 | 无 | 4410 | 2310 | 2100 | 47.6% |
DEBRIS 独占层 |
无 | 2100 | 0 | 2100 | 100% |
2310 个 MOVING 刚体,就是「共享一层」的账单:它们的存在只是让宽相白走一遍 AABB 判定,
然后在对象层那一关被一个个剔掉。官方那句 "needless objects that are visited",
本机的数字是两千三百一十个。
这条结论的适用边界要说清:它量的是「两个对象层混住时,针对其中一个的查询」。如果两个对象层的 空间分布本来就不重叠(比如碎片都在远处、动态物体都在近处),AABB 剪枝会把这份代价吃掉, 两者就难分高下,这也是为什么本机的场景特意做成「交错」。
三个宽相层与两个宽相层的取法、以及 JPH_TRACK_BROADPHASE_STATS 的读法,见
Docs/Architecture.md 与
Samples/Layers.h。
三、配对表:ShouldCollide 的两副面孔
3.1 模拟期与查询期不是同一个函数
OK,名字很像,但确实是两个基类。
//【两副面孔:一个比两个层,一个只比一个层】,摘自 ObjectLayer.h
class ObjectLayerFilter {                                   // 查询期
    virtual bool ShouldCollide(ObjectLayer inLayer) const;  // 只问「这一个层行不行」
};

class ObjectLayerPairFilter {                               // 模拟期
    virtual bool ShouldCollide(ObjectLayer inLayer1, ObjectLayer inLayer2) const;  // 问「这两个层行不行」
};
为什么查询期只需要一个层? 因为查询本身自带一个「提问者」: 射线属于某个对象层、探针盒也属于某个对象层。所以查询期的问题是 「我这个层,要不要看那一层的东西」,这已经隐含了配对, 只不过把提问者固定住了。而模拟期是两个体在互相看,没有固定的提问者,所以必须传两个层。
官方文档第 651 行把两个名字的用法并列写了出来,并加了一句很关键的说明:
查询期的默认实现 DefaultObjectLayerFilter 用的就是 ObjectLayerPairFilter,
所以「仿真与查询的行为天然一致」("so the behavior is consistent between simulation and collision queries")。
3.2 默认实现为什么能复用配对表
说白了,这句话值得展开,因为它解释了一个常见困惑:为什么改了 ObjectLayerPairFilter,查询也跟着变了。
//【默认查询过滤器:把「一个层」当成「与自己配对」】,摘自 ObjectLayer.h
class DefaultObjectLayerFilter : public ObjectLayerFilter {
public:
    DefaultObjectLayerFilter(const ObjectLayerPairFilter &inFilter, ObjectLayer inLayer)
        : mObjectLayerPairFilter(inFilter), mLayer(inLayer) { }

    virtual bool ShouldCollide(ObjectLayer inLayer) const override {
        return mObjectLayerPairFilter.ShouldCollide(mLayer, inLayer);   // 复用模拟期的配对表
    }
};
其中:mLayer 是「提问者自己的对象层」。于是查询期的判定退化成
「我这一层,和它那一层,配对表里写着能碰吗」,一份规则,两处使用。
这带来一个直接的好处:你不用为射线单独维护一张过滤表;
也带来一个直接的坑:如果你的规则写得不对称,查询与仿真会各自按不同的方向读它(§3.3)。
3.3 表驱动的对称性是结构性的
好了,现在讲「双向命中」这条通行规则,以及 Jolt 的两条内置路线各自怎么保证它。
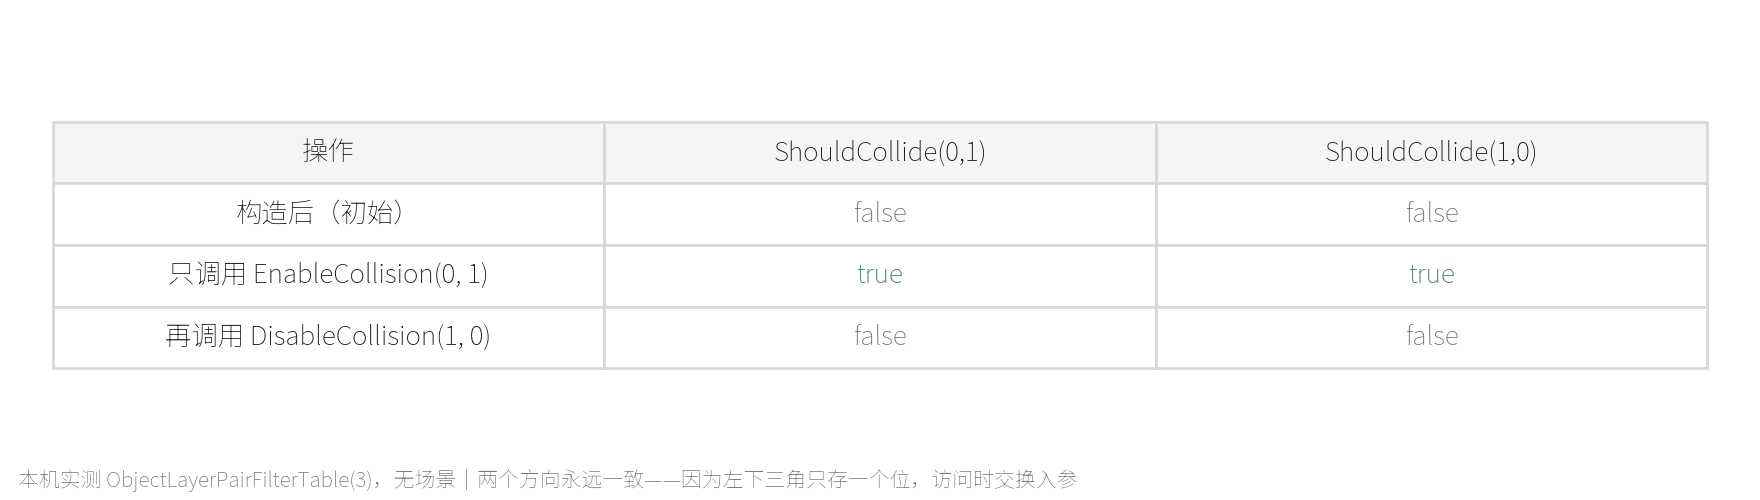
先看本机实测(E0,纯过滤器、不建场景):
| 操作 | ShouldCollide(0,1) |
ShouldCollide(1,0) |
|---|---|---|
| 构造后(初始) | false | false |
只调用 EnableCollision(0, 1) |
true | true |
再调用 DisableCollision(1, 0) |
false | false |
读数(口径:ObjectLayerPairFilterTable(3)、无场景、代码见 evidence/bench_layers.cpp 的 E0):
两个方向永远一致。原因在存储方式上,源码注释写得明白:
//【只存左下三角:访问时交换入参】,摘自 ObjectLayerPairFilterTable.h
uint GetBit(ObjectLayer inLayer1, ObjectLayer inLayer2) const {
    // We store the lower left half only, so swap the inputs when trying to access the top right half
    if (inLayer1 > inLayer2)
        std::swap(inLayer1, inLayer2);
    return (inLayer2 * (inLayer2 + 1)) / 2 + inLayer1;
}
原理上,(A,B) 与 (B,A) 算出来是同一个位下标,所以「只配一边」这件事
在这条路线上根本不是一种选择,它没有被表达出来的机会。
官方文档第 624 行那句「若 ShouldCollide(A,B) 为真,则 ShouldCollide(B,A) 也应为真」,
这句是给手写实现准备的契约:内置的两条路线都用结构保证了它,而你自己写的 switch 不会。
手写实现能写出单向,而且后果不轻。 本机 E4 用一个只有一行的手写过滤器验证了这一点:
//【手写实现可以只配一边】,摘自 evidence/bench_layers.cpp 的 E4
struct Asym : public ObjectLayerPairFilter {
    virtual bool ShouldCollide(ObjectLayer a, ObjectLayer b) const override {
        return a == Layers::NON_MOVING && b == Layers::MOVING;   // 只认这一个方向
    }
};
// 实测:ShouldCollide(0,1) = true,而 ShouldCollide(1,0) = false
读数(口径:同上,纯过滤器):手写实现下 (0,1) 为真、(1,0) 为假。
而 FindCollidingPairs 传入的 (对象层1, 对象层2) 顺序取决于体的遍历次序。
于是这个过滤器会让配对结果依赖于遍历顺序:同一对体,谁先被走到就决定它们碰不碰。
这是本篇最该记住的一条:内置路线做不到这件事,不是运气,是存储方式。
两个基类与两个默认实现的完整定义见
ObjectLayer.h。
四、两条落地路线:表驱动 vs 掩码
4.1 两条路线总览
OK,官方文档第 642 至 644 行给了两条现成的落地路线,各有三件套。它们是两种表达方式,谈不上「新旧」。
| 表驱动三件套 | 掩码三件套 | |
|---|---|---|
| 配对 | ObjectLayerPairFilterTable |
ObjectLayerPairFilterMask |
| 对象层 × 宽相层 | ObjectVsBroadPhaseLayerFilterTable |
ObjectVsBroadPhaseLayerFilterMask |
| 映射 | BroadPhaseLayerInterfaceTable |
BroadPhaseLayerInterfaceMask |
| 配置方式 | EnableCollision(A,B) / DisableCollision(A,B) |
构造时给 group 与 mask 位 |
| 判定 | 查一个三角形位表 | (g1&m2)!=0 && (g2&m1)!=0 |
| 层数上限 | 由构造时的 inNumObjectLayers 决定 |
受 JPH_OBJECT_LAYER_BITS 限制 |
| 适合 | 层少、组合固定、要能逐对开关 | 分组多、组合有规律、要和已有掩码体系对接 |
官方给掩码路线的定位写得很直白:这套行为「similar to e.g. Bullet」。
Docs/ReleaseNotes.md 第 321 至 322 行记着这两条路线都是 v5.0.0 才加的:
「Created an object layer filter implementation that is similar to Bullet's group & mask filtering」
与「Created implementations … that use a bit table internally」。
掩码路线为什么会被加进来,社区里有一条很直接的诉求。
issue #744 的提问者指出:
Jolt 里每个体只挂一个 ObjectLayer,而 PhysX 与 Bullet 的风格是
「源掩码 + 目标掩码」两个 16 位字段(他抄的 PhysX 判定是
(filterData.word0 & shape->getQueryFilterData().word1) && (shape->getQueryFilterData().word0 & filterData.word1))。
ObjectLayerPairFilterMask 正是对这条诉求的回应,把 16 位切成两半,一半当 group、一半当 mask(§4.2)。
两条路线的实现分别在
BroadPhaseLayerInterfaceTable.h /
ObjectVsBroadPhaseLayerFilterTable.h
与 BroadPhaseLayerInterfaceMask.h /
ObjectVsBroadPhaseLayerFilterMask.h。
4.2 掩码的位宽与打包
先来看看掩码路线最需要弄清的东西:位怎么分。
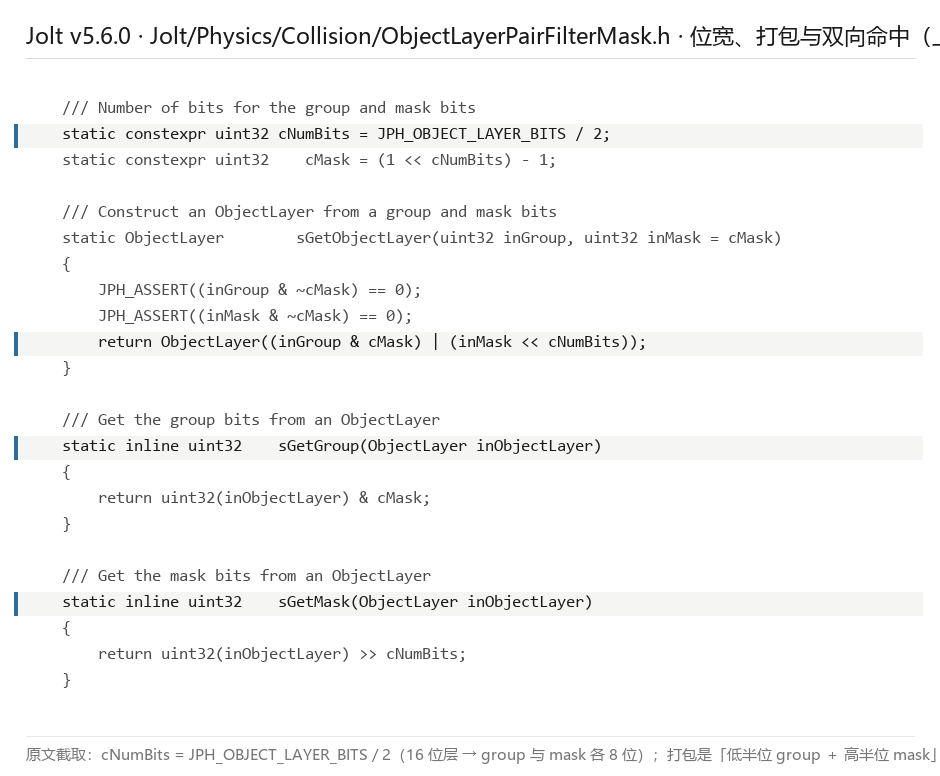
//【掩码路线:位宽与打包】,摘自 ObjectLayerPairFilterMask.h
static constexpr uint32 cNumBits = JPH_OBJECT_LAYER_BITS / 2;      // 16 位层 → 各 8 位
static constexpr uint32 cMask    = (1 << cNumBits) - 1;

static ObjectLayer sGetObjectLayer(uint32 inGroup, uint32 inMask = cMask) {
    JPH_ASSERT((inGroup & ~cMask) == 0);
    JPH_ASSERT((inMask  & ~cMask) == 0);
    return ObjectLayer((inGroup & cMask) | (inMask << cNumBits));   // 低 8 位 group,高 8 位 mask
}

virtual bool ShouldCollide(ObjectLayer inObject1, ObjectLayer inObject2) const override {
    return (sGetGroup(inObject1) & sGetMask(inObject2)) != 0
        && (sGetGroup(inObject2) & sGetMask(inObject1)) != 0;       // 两个方向都要命中
}
其中:cNumBits 是 JPH_OBJECT_LAYER_BITS / 2,默认 16 位层下,group 与 mask 各 8 位,
也就是每边最多 256 个分组。本机实测把打包结果打了出来(E3):
STATIC = 1537、MOVING = 770、DEBRIS = 260,三个数都小于 65536,说明它们确实挤在一个 16 位里。
官方在同一段给了一条升级建议:如果要用这套实现,考虑把 cmake 选项 OBJECT_LAYER_BITS 设成 32,
这样 group 与 mask 各 16 位(各 65536 个分组)。这句话的含义很直接:
掩码路线是用位宽换表达力,而位宽的上限由对象层的位数决定(§2.1)。
4.3 双向命中的位运算
好了,把那个判定式子画开,就是四次与运算加两次非零判断。
原理上,这个式子有一个很值得注意的性质:它是对称的。
把 inObject1 与 inObject2 交换,两个与项只是换了位置,结果完全一样。
所以掩码路线和表驱动一样,结构上写不出单向,本机 E4 也验证了这一点:
构造一对互为目标的 group/mask 之后,ShouldCollide(g0,g1) 与 ShouldCollide(g1,g0) 同时为真。
这条性质还带来一个实用的推论:你可以只写「谁能看见我」,不必写「我能看见谁」。 而反过来,如果你的某个 group 忘了在别人的 mask 里出现,那就真的碰不上。 这正是 §8.2 要讲的「只配一边」的经典写法。
4.4 最后一层是兜底层
OK,掩码路线的第三个接口 BroadPhaseLayerInterfaceMask 与表驱动那一个,语义上有一个真实差异。
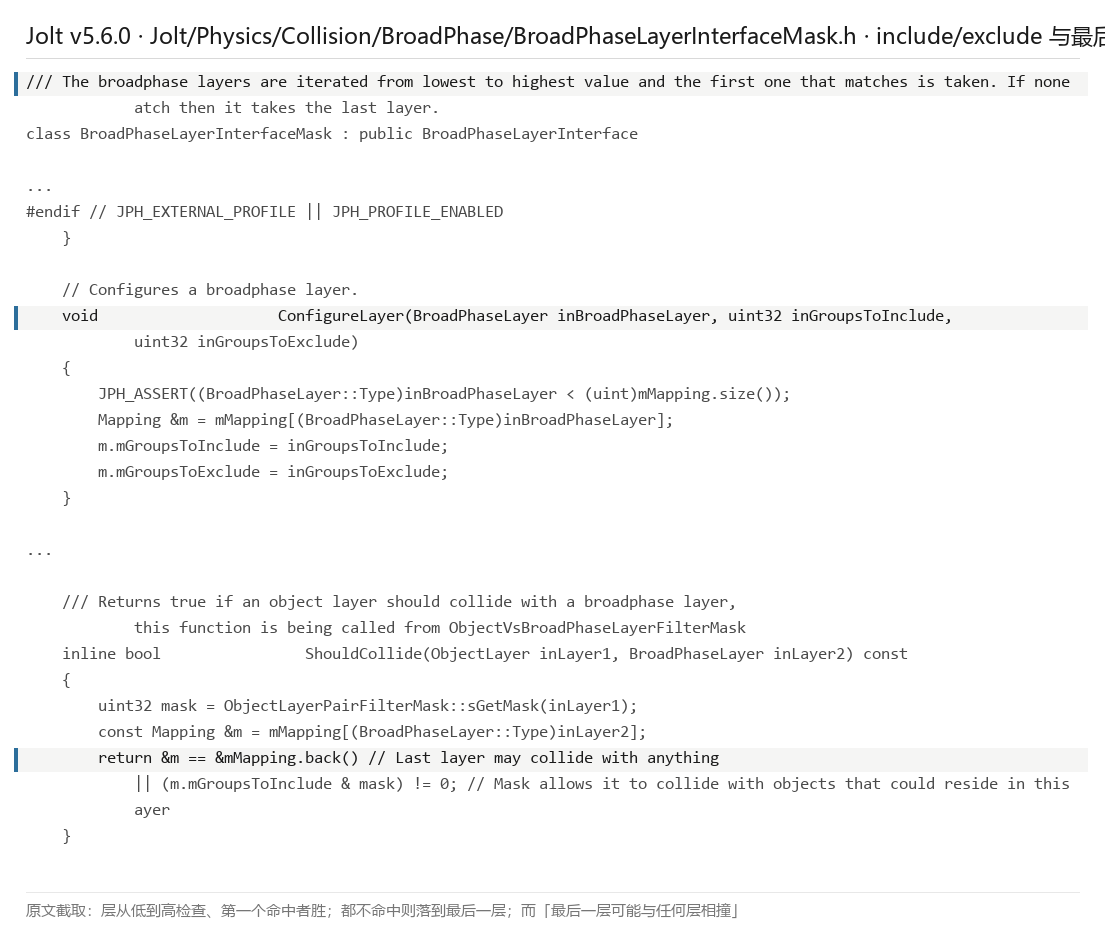
//【掩码路线的映射:include / exclude 与「先命中者胜」】,摘自 BroadPhaseLayerInterfaceMask.h
void ConfigureLayer(BroadPhaseLayer inBroadPhaseLayer, uint32 inGroupsToInclude, uint32 inGroupsToExclude);

virtual BroadPhaseLayer GetBroadPhaseLayer(ObjectLayer inLayer) const override {
    uint32 group = ObjectLayerPairFilterMask::sGetGroup(inLayer);
    for (const Mapping &m : mMapping)
        if ((group & m.mGroupsToInclude) != 0 && (group & m.mGroupsToExclude) == 0)
            return BroadPhaseLayer(...);           // 从低到高,第一个命中的就是它
    return BroadPhaseLayer(...);                   // 都不命中 → 落到最后一层
}
源码注释把两句话都写明了:「最后一层可能与任何层相撞」(Last layer may collide with anything),
以及层从低到高检查、第一个命中的被选中。
这两条加起来有一个不显然的后果:最后一层是兜底层,所以它不能用来装一个 「应当被排除在外的层」。如果你把「只与静态碰」的碎片层放在层序的最后一位, 那么它对任何层的判定都会返回真,兜底语义会盖掉你的排除意图。§4.5 用实测给出了这条分歧。
4.5 本机实测:两条路线逐条比对
好了,同一套配对规则,用两条路线各实现一遍,然后逐条比对,9 组对象层配对 + 9 组「对象层 × 宽相层」。
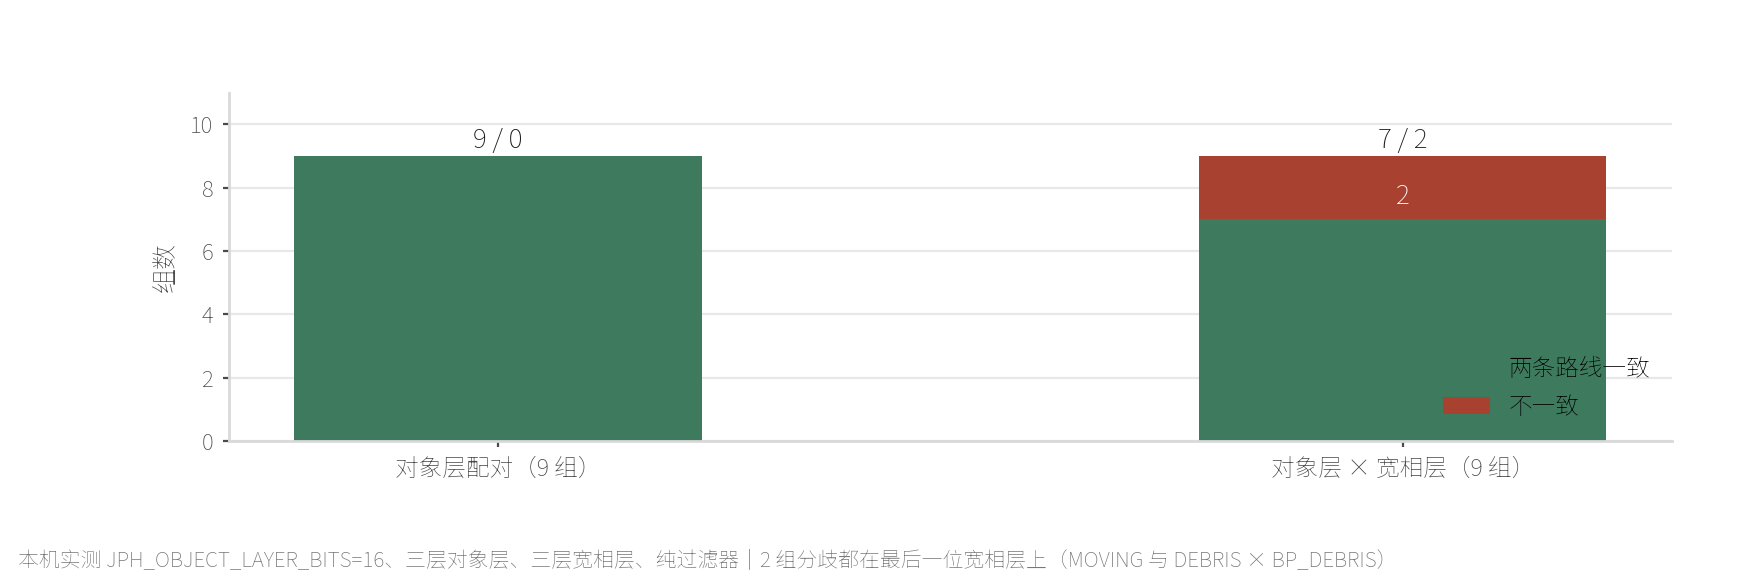
读数(口径:JPH_OBJECT_LAYER_BITS = 16、三层对象层、三层宽相层、纯过滤器无场景):
| 比对项 | 一致 | 不一致 |
|---|---|---|
| 对象层配对(9 组) | 9 | 0 |
| 对象层 × 宽相层(9 组) | 7 | 2 |
两组分歧都在最后一层上:MOVING × BP_DEBRIS 与 DEBRIS × BP_DEBRIS。
表驱动路线给的是假(规则里这两个组合本来就不碰),掩码路线给的是真。
因为 BP_DEBRIS 是最后一层,而「最后一层可能与任何层相撞」。
这张表要说两件事。
第一,表达同一套配对规则的能力是等价的(9 组全一致)。所以「选哪条路线」不是能力问题, 而是表达方式与层序设计的问题。
第二,层序在这条路线上是有语义的。表驱动路线的判定与层序无关, 而掩码路线的最后一层被赋予了兜底含义,同一条映射规则,换个层序就换了行为。 官方那句 "The broad phase layers are checked one by one and the first one that meets the condition is the one that the body will be put in",读的时候容易只注意「第一个」,而漏掉末尾那条兜底。
处置建议(本机结论,非官方文档):用掩码路线时,把最宽松的层放在最后一位, 把需要排除语义的层放在前面。这条建议的代价是「层序变成了一种约定」。 一旦有人重排层序,行为就变,而且不会有报错。
掩码路线还有一处社区踩过的坑,与这条兜底直接相关。
issue #2016 的作者照抄 HelloWorld,
换成 BroadPhaseLayerInterfaceMask + ObjectVsBroadPhaseLayerFilterMask + ObjectLayerPairFilterMask
这三件套之后崩溃,原因是他在非主线程重建示例。
这条 issue 的形状值得记一下:三件套必须成套使用,
而且它们内部持有的是引用(ObjectVsBroadPhaseLayerFilterMask 的构造函数就是
「把 BroadPhaseLayerInterfaceMask 引用进来」),所以三个对象的寿命与线程归属都要与物理系统一致。
两条路线的完整实现见
ObjectLayerPairFilterMask.h、
BroadPhaseLayerInterfaceMask.h
与 ObjectLayerPairFilterTable.h。
五、本机实测:映射改一个,代价差多少
5.1 六级的代价链
OK,先把「越早越省」这句话变成一条链。六级过滤器是一条越来越贵的流水线,虽然看起来像六个并列的开关:越靠前的判定手上信息越少,但能省下的工作越多;越靠后的判定信息越全,可惜那时候活已经干完了,没什么可省的。
原理上,这条链上每一级的输入都不同,这就是它便宜或贵的原因:
| 级 | 输入 | 省掉的工作 | 相对代价 |
|---|---|---|---|
| 宽相层 | 对象层 + 宽相层号 | 整棵树都不用走 | 最便宜 |
| 对象层 | 两个 16 位整数 | 这对不生成 | 便宜 |
GroupFilter |
两个 CollisionGroup |
已重叠的这对丢弃 | 中(AABB 已判定) |
BodyFilter / ShapeFilter |
体 ID 或形状指针 | 查询里的这个体/子形状 | 中 |
ContactListener |
已经算出的接触点 | 丢弃它 | 最贵(活都干完了) |
官方那句 "To avoid work, try to filter out collisions as early as possible" 的完整含义就在这里: 这六级是「同一件事在六个不同时刻做」,谈不上「六个开关」;而每个时刻的价码差着数量级。
5.2 读数口径
好了,在给数字之前,把这份基准的口径单独列出来,因为下面每个数都只在这个口径下成立。
//【两种映射的唯一差别:DEBRIS 返回哪一层】,摘自 evidence/bench_layers.cpp
// 共享:DEBRIS 与 MOVING 同层,宽相层共 2 个
if (l == Layers::NON_MOVING) return BroadPhaseLayer(0);
return BroadPhaseLayer(1);

// 独占:DEBRIS 单独一层,宽相层共 3 个
if (l == Layers::NON_MOVING) return BroadPhaseLayer(0);
if (l == Layers::MOVING)     return BroadPhaseLayer(1);
return BroadPhaseLayer(2);
其中:N = 60000、交错网格 2 米间距、探针盒 ±20 米、稳态 200 步、
JPH_TRACK_BROADPHASE_STATS 打开、单精度、MSVC Release。
三条适用边界:① 单机型(绝对值会变,倍数关系相对稳定);
② 单场景(交错混住是最有利于显形的布局,空间分离会让差变小);
③ 关睡眠(mAllowSleeping = false,量的是每步都在动的上界)。
5.3 只差一个映射的稳态代价
OK,现在把「配置的代价」这条主线量到底。两种配置体数相同、规则相同、初始位置相同, 唯一差别是 §5.2 那段代码返回了不同的宽相层号。
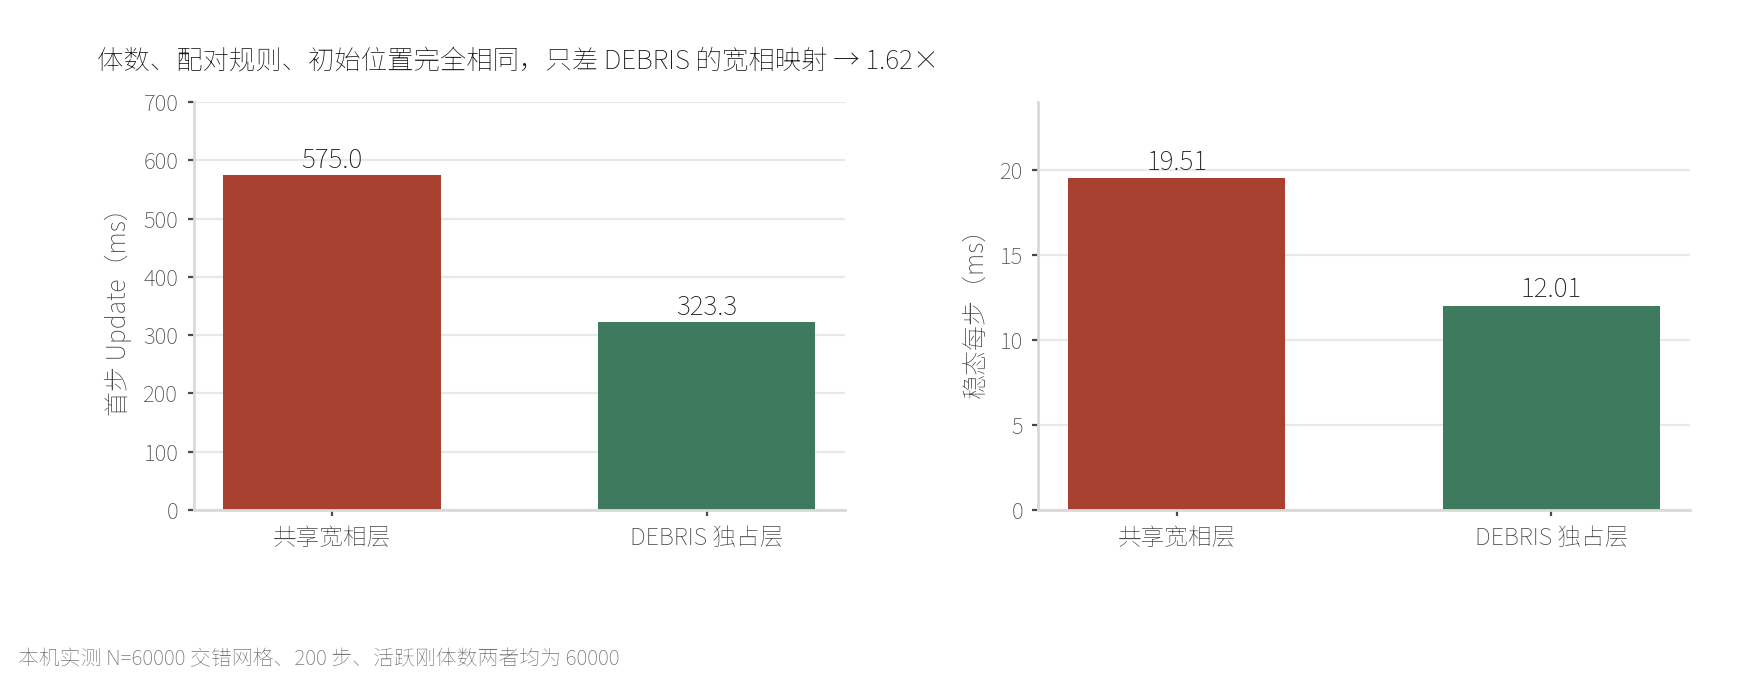
读数(口径见 §5.2,N=60000,200 步):
| 映射 | 首步耗时 | 稳态每步 | 活跃刚体数 |
|---|---|---|---|
| 共享宽相层(2 棵树) | 575.0 ms | 19.51 ms | 60000 |
DEBRIS 独占层(3 棵树) |
323.3 ms | 12.01 ms | 60000 |
这张表的三个要点。
第一,仅仅改了一个映射的函数体,稳态就快了 1.62 倍(19.51 → 12.01 毫秒/步), 首步快了 1.78 倍(575.0 → 323.3 毫秒)。活跃刚体数完全相同。 同样的体被组织进了更合适的树,而不是「体变少了所以更快」。
第二,为什么「多一棵树」反而更快。 这看起来反直觉:树的数目从 2 个变成 3 个,
总节点数还多了(多了一棵树的根与内部节点)。但每棵树自己的规模小了:
MOVING 那棵树从「三万个动态 + 三万个碎片」变成「三万个动态」,
而 DEBRIS 有自己的紧凑树。配对与查询的代价主要随树内与查询相关的规模增长,
所以拆分是净赚。这正是官方那句 "balancing … few broad phase layers with the number of needless
objects that are visited" 的定量版本:层数要少,但不能少到把无关的东西塞进同一棵树。
第三,这条收益与 §2.5 的查询收益是同一件事的两面。 §2.5 量的是「一次查询白走多少」, 本节量的是「每步所有配对加起来白走多少」。前者 2.0 倍节点、后者 1.62 倍耗时。 量级一致,方向一致。
这条结论的适用边界同样要说清:如果把 DEBRIS 的数量压到很小(比如一千个),
拆出一棵树带来的收益会被「多一层固定开销」吃掉一部分,甚至可能逆转。
本机这一组是 3 万对 3 万,属于占便宜的那一侧。
5.4 这条账怎么用在项目里
好了,本机实测给出的账很直白,但落到项目里要做三次判断。
判断一:两个对象层会不会「混住」。 如果它们的空间分布本来就不重叠(碎片都在远处), 拆树几乎无收益,AABB 剪枝已经替你省了(§2.3 的边界)。先看空间分布,再决定拆不拆。
判断二:被共享的那一层里,有多少是「别人」。 §2.5 的答案是 2310 / 4410 ≈ 52%。 这个比值越高,拆树的收益越大。
判断三:树的数量本身也有成本。 每一层都要维护自己的树(更新、重建、内存), 而且层多了以后「层序」这件事在掩码路线上还带着语义(§4.5)。 所以这件事的尽头是「拆到不再混住为止」,谈不上「越拆越好」。
JPH_TRACK_BROADPHASE_STATS 是这条判断的入手点:它按查询类型与层打印
Nodes Visited / Bodies Visited / Hits Reported,
这三个数就是「有没有白走」的直接证据,不需要自己插桩。
上一篇用它量了树的退化,这一篇用它量映射,同一把尺子,两个用途。
完整列表见
Docs/Build/README.md 与
Docs/Architecture.md。
六、碰撞组:GroupFilterTable 与它的存储
6.1 层解决不了的第三种问题
OK,前五章讲的都是「哪些类之间碰」。但有一类需求,层表达不了: 同一层里的某几个实例不碰。最典型的例子是布娃娃,一具布娃娃的各个部件如果互相碰撞, 它会自己把自己弹开;可它们又都和世界里的其它物体照常碰。
官方的处置是第三级 GroupFilter,而它的时机与前两级完全不同:在包围盒已经被判定为重叠之后才跑
(Architecture.md 第 652 行)。
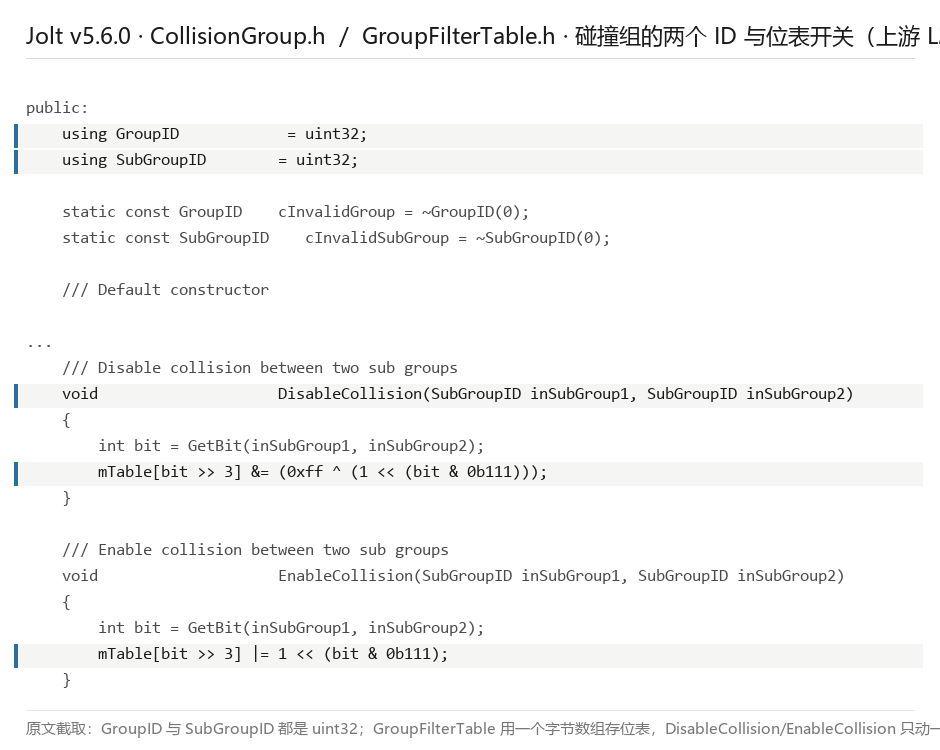
//【碰撞组:两个 32 位 ID 加一个过滤器】,摘自 CollisionGroup.h 与 GroupFilterTable.h
using GroupID    = uint32;
using SubGroupID = uint32;

class CollisionGroup {
    bool CanCollide(const CollisionGroup &inOther) const;   // 取首个非空的 GroupFilter 来裁决
};

class GroupFilterTable final : public GroupFilter {
    void DisableCollision(SubGroupID inSubGroup1, SubGroupID inSubGroup2);
};
其中:GroupID 回答「这一组是谁」,SubGroupID 回答「这一组里的哪一个」。
一具布娃娃给一个 GroupID,每个部件给一个 SubGroupID。
于是「同组的部件互不碰撞、但对组外照常碰」这件事,一个 GroupFilterTable 就表达完了。
6.2 存储是对称三角位表
好了,GroupFilterTable 的存储方式与 §3.3 的配对表是同一个思路,而且更省。
原理上,N 个子组两两组合有 N·(N−1)/2 对(去掉自反与顺序),而每一对只需要一个位。
所以一个 8 部件的布娃娃只要 28 位,一个 uint32 就装得下。
访问时同样把 (i,j) 归一成无序对,所以「关掉 i 与 j 的碰撞」和「关掉 j 与 i 的碰撞」
是同一个位,与配对表一样,结构上写不出单向。
这也解释了为什么它要放在第三级:它的存储与判定都比前两级贵一点点(要算下标、要查位), 但真正的成本在于它必须等到 AABB 判定重叠之后才能用,因为在这之前, 根本不知道哪一对需要裁决。前两级能省掉「整棵树 / 整对配对」,而这一级只能省掉「这一对」。
6.3 布娃娃案例与一个真实的误用
说白了,官方文档把这一级的用途说得很具体:「丢弃被约束连接的体之间的碰撞」 ("allows you fine tune collision e.g. by discarding collisions between bodies connected by a constraint")。
但这一级有一个真实项目里踩过的坑,写在 Jolt 的 issue 里。
issue #907 的复现代码用
GroupFilterTable(2) + DisableCollision(0, 1) 给两个刚体设了 CollisionGroup,
而在限定自由度(EAllowedDOFs::RotationY)的体上接触时触发了断言。
这条 issue 的价值不在断言本身,而在它暴露的耦合:碰撞组的效果要等到真的产生接触时才体现。 也就是说,如果你用约束或自由度限制去「人为避免」某个方向上的接触, 而碰撞组那边又假定会有接触,两者会在断言处相遇。 处置是:用碰撞组表达「不该碰」,就不要再用约束去绕开它,两条路走同一件事,容易互相打脸。
6.4 组与层不是一回事
OK,到这一节可以把「组」和「层」摆在一起了。它们在文档里经常被混着叫,实际上是两把尺子。
| 对象层 / 宽相层 | 碰撞组 | |
|---|---|---|
| 刻度 | 「类」,按种类划 | 「实例」,按具体对象划 |
| 配置位置 | Init 的三个接口 |
建体时的 CollisionGroup 字段 |
| 判定时机 | 进树前 / 配对时 | AABB 已重叠之后 |
| 存储 | 配对表(三角位表)或掩码位 | 每组的三角位表,可被多体共享 |
| 典型用途 | 静态 / 动态 / 碎片 / 传感器 / 查询层 | 布娃娃自碰、载具零件、被约束连接的体 |
| 一个体能有几个 | 一个对象层、一个宽相层 | 一个 GroupID + 一个 SubGroupID |
「层」是一次性的、装进接口里的静态配置;「组」是逐体的、随建体一起给的动态配置。 这条区分也解释了 §8 那些反模式里出现频率最高的一条: Cocos 官方文档特意写过「分不清刚体组件上的分组和节点上的层」。 概念相似但使用者不同(分组给物理模块、层给渲染模块)。Jolt 这边是「层给配对表、组给单个实例」, 误用的形状不同,根子是同一个。
CollisionGroup / GroupFilterTable 的完整定义见
CollisionGroup.h
与 GroupFilterTable.h。
七、查询期:三层之外还有三层
7.1 查询期过滤器的三个签名
好了,仿真期的两级(宽相层、对象层)是共用的,但查询期在它们之后还有自己的三层。
第一层 BroadPhaseLayerFilter 与 ObjectLayerFilter 前面讲过(§1.2 / §3.1),
再往后是 BodyFilter 与 ShapeFilter。
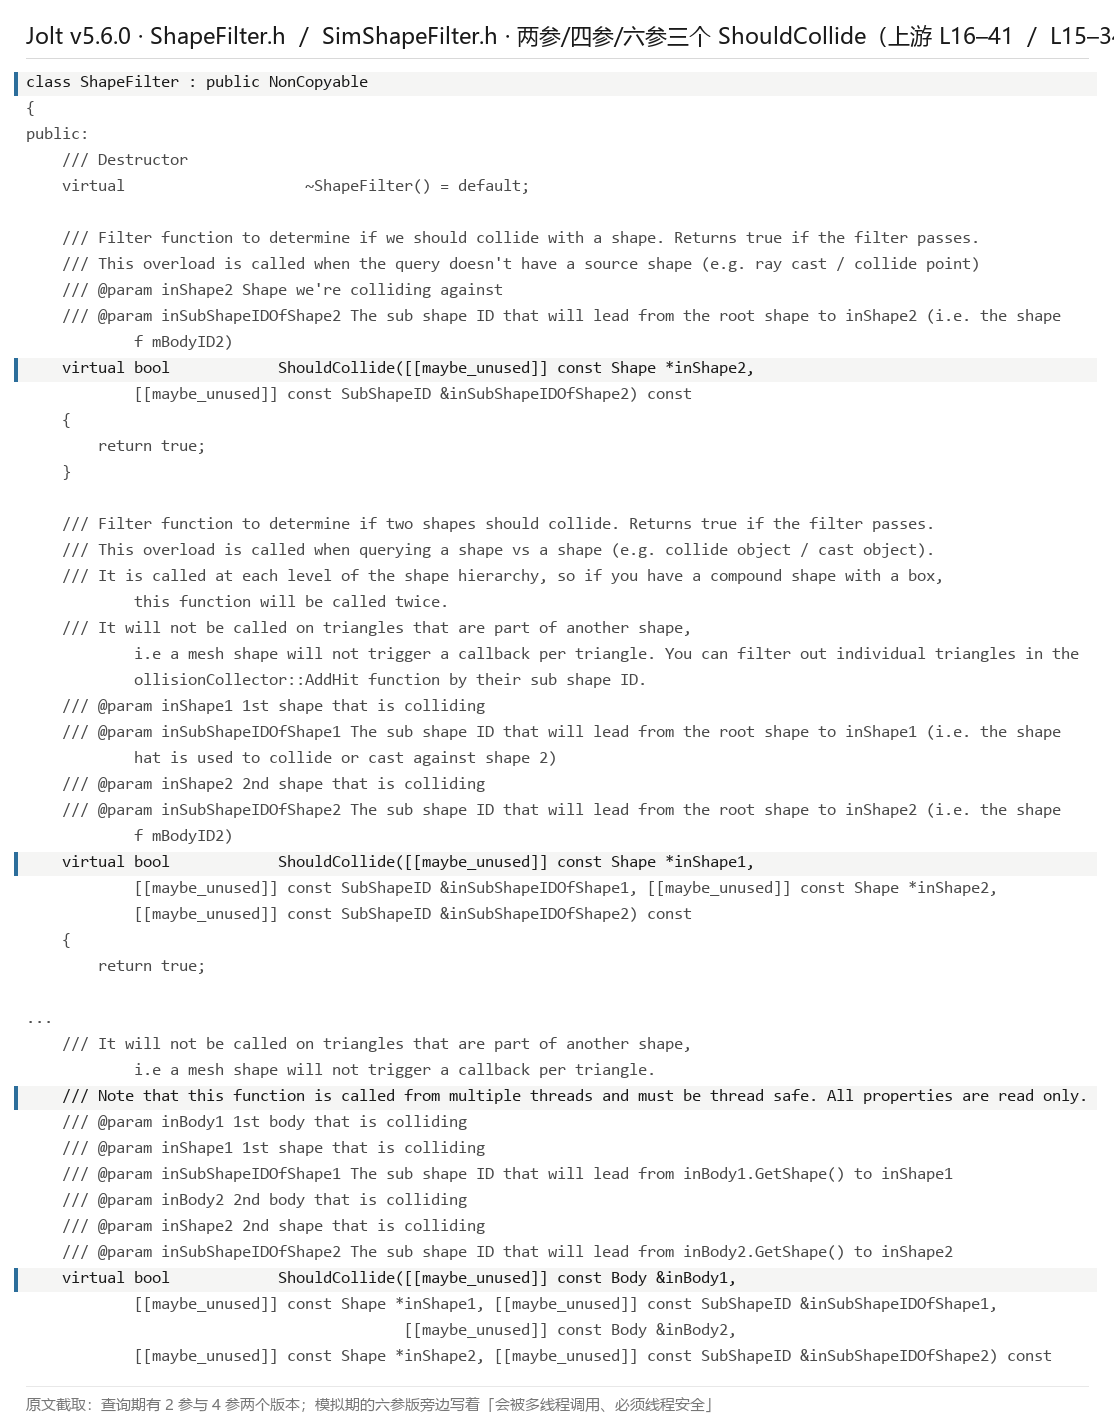
//【查询期与模拟期的形状过滤器】,摘自 ShapeFilter.h 与 SimShapeFilter.h
class ShapeFilter {
    virtual bool ShouldCollide(const Shape *inShape2, const SubShapeID &inSubShapeID2) const;   // 查询期三参
    virtual bool ShouldCollide(const Shape *inShape1, const SubShapeID &inSubShapeID1,
                               const Shape *inShape2, const SubShapeID &inSubShapeID2) const;   // 四参
};

class SimShapeFilter {
    // 模拟期六参:两侧各拿到体 + 形状 + 子形状 ID
    virtual bool ShouldCollide(const Body &inBody1, const Shape *inShape1, const SubShapeID &inSubShapeID1,
                               const Body &inBody2, const Shape *inShape2, const SubShapeID &inSubShapeID2) const;
};
这一文件里有一条极容易被忽略的注释:SimShapeFilter 的声明旁边写着
「会被多个线程调用,必须线程安全」("called from multiple threads and must be thread safe")。
仿真期的 shape 过滤跑在物理作业里,所以你的实现不能有可变状态。
这一点在写「按帧累计统计」这类调试代码时最容易踩。
其中:SimShapeFilter 是 v5.3.0 才加的(Docs/ReleaseNotes.md 第 132 行),
用途是过滤掉一个体内部的子形状之间的碰撞,比如一个复合形状自己跟自己碰。
它的注册口是 PhysicsSystem::SetSimShapeFilter,而不是 Init 的三个参数之一。
v5.4.0 还修过一个与它有关的 UBSAN 误报(同文件第 95 行)。
7.2 一次查询要穿过的过滤链
先来看看把查询期的过滤器串起来之后是什么样:一次射线查询要过四关。
//【查询期的四关:前三关可以用默认值】,摘自 BroadPhaseQuery.h 的查询签名
virtual void CollideAABox(const AABox &inBox, CollideShapeBodyCollector &ioCollector,
                          const BroadPhaseLayerFilter &inBroadPhaseLayerFilter = { },   // 第一关:进哪棵树
                          const ObjectLayerFilter &inObjectLayerFilter = { }) const = 0; // 第二关:哪个层
// 再往后(不在这条签名里)还有 BodyFilter 与 ShapeFilter
原理上,这四关的「省」是不同的量级:第一关省掉整棵树, 第二关省掉这一对配对,第三关省掉这个体(但树已经走过了), 第四关省掉这个子形状(但体已经被选中了)。所以:
| 关 | 过滤器 | 省掉 | 位置 |
|---|---|---|---|
| 一 | BroadPhaseLayerFilter |
整棵树 | 进树之前 |
| 二 | ObjectLayerFilter |
这一对 | AABB 重叠之后 |
| 三 | BodyFilter |
这个体 | 体已被选中 |
| 四 | ShapeFilter |
这个子形状 | 形状已展开 |
「越早越省」在查询期同样成立:把条件写进第一关和第二关,
比写进第三关和第四关便宜得多。而 SpecifiedObjectLayerFilter 与 SpecifiedBroadPhaseLayerFilter
这两个现成实现,正是「只想看某一层/某一棵树」的写法(本机 §2.5 用的就是它们)。
7.3 射线打不到东西的四种原因
OK,「射线打不到东西」是这类配置出错后最常见的症状,而它有四种彼此独立的成因。
| 症状 | 成因 | 定位方法 |
|---|---|---|
| 什么都打不到 | layerMask / 对象层过滤器写成了空集 |
layerMask = 0 这类写法在 Unity 官方文档里有明确语义:没有任何碰撞 |
| 该打到的打不到 | 掩码/分组只配了一边 | 把两个方向的判定都打出来(§3.3 的 E0 表) |
| 仿真正常、查询落空 | 查询与仿真用的是两套过滤 | 查 DefaultObjectLayerFilter 有没有被换掉(§3.2) |
| 只在某些位置上落空 | 目标体在另一个宽相层里,而第一关没放行 | 打印 GetBroadPhaseLayer() 的返回值(§2.3) |
第一条值得单独说:Unity 官方文档把 layerMask = 0 的语义写得很直白。
「If the layerMask = 0, there are no collisions」。这条语义在所有引擎里都成立,
因为它就是「与零做与运算」的必然结果。
第二条则是本篇反复强调的那一条:Jolt 的两条内置路线都写不出单向,
所以如果你用的是手写实现,你就有机会踩到它,issue #1554
就是这个形状:作者用 GetDefaultBroadPhaseLayerFilter + GetDefaultLayerFilter + 自定义 BodyFilter
做射线查询,在一个重载上触发了断言,换另一个重载才绕开。
同一件事在两个重载上行为不同,通常说明过滤器的组合被用错了。
官方对「查询期过滤不共享仿真过滤」这件事写得很清楚:BodyFilter 是
「used instead of the group filter if you do collision queries like CastRay」。
查询不跑 group filter(因为查询没有「配对」),所以要用 BodyFilter 顶上。
三个形状过滤器的完整签名见
ShapeFilter.h 与
SimShapeFilter.h。
八、横向对照:七家的「谁能撞谁」
8.1 七家的过滤机制
言归正传,「谁能撞谁」是每家物理引擎都有的一层,而且术语与位运算规则高度可比。 这正是本篇做横向对照的底气。下面这张表的每一行都取自官方文档,不是二手转述。 按本系列一贯的读法:先给全量清单,再做二次归类,清单是「面」,归类是「骨」。 这里先铺七家的全量对照,再在 §8.2 与 §8.4 收成两条交叉结论。
| 引擎 | 机制 | 判定规则(官方原文) | 执行时机 | 查询是否独立 |
|---|---|---|---|---|
| Jolt | 对象层 → 宽相层 → 组 | 表驱动逐对开关;或掩码 (g1&m2)!=0 && (g2&m1)!=0 |
宽相层最先(决定进哪棵树),组最晚(AABB 之后) | 是(BodyFilter / ShapeFilter) |
| Bullet | collision group + filter mask | 组/掩码进入配对缓存前判定(needsBroadphaseCollision) |
广相阶段 | 另有查询掩码 |
| PhysX | PxFilterData(4×32 位)+ filter shader |
(f0.word0 & f1.word1) && (f1.word0 & f0.word1) |
AABB 首次相交之后;官方定性「particularly performance sensitive」 | 是(PxQueryFilterData) |
| PhysX(查询) | PxQueryFlag::ePREFILTER / ePOSTFILTER |
前者在中/窄相之前剔除,后者在窄相之后 | 查询链分 broad / mid / narrow | — |
| Rapier | collision_groups(membership / filter)+ solver_groups |
(A.membership & B.filter)!=0 && (B.membership & A.filter)!=0 |
前者在广相之后、窄相之前;后者在窄相之后、求解器之前 | 是(独立 QueryFilter) |
| Box2D | categoryBits / maskBits / groupIndex |
「Non-zero group filtering always wins against the mask bits」 | groupIndex 非 0 时先于掩码生效 |
是(b2QueryFilter) |
| Unity | Layer Collision Matrix(勾选式) | 未勾选的两层「no callbacks, no physics response」 | 碰撞检测阶段 | 是(Raycast 用独立 LayerMask) |
| Cocos | 分组 + 掩码 | (GroupA & MaskB) && (GroupB & MaskA) |
碰撞检测阶段 | 有独立查询过滤 |
这张表右下角那一列值得单独看一眼:七家里的七家,查询过滤都是独立的一套。 这不是巧合,查询没有「配对」这个概念,所以仿真层过滤表的形状根本套不上去。
8.2 双向命中是通行规则
好了,把上表里四家的判定式子并排放,会看到一个高度一致的东西。
Jolt(官方文档第 644 行):(object1.group & object2.mask) != 0 && (object2.group & object1.mask) != 0
Rapier(官方文档):(A.membership & B.filter) != 0 && (B.membership & A.filter) != 0
Cocos(官方文档):(GroupA & MaskB) && (GroupB & MaskA)
PhysX(官方 shader 示例):(filterData0.word0 & filterData1.word1) && (filterData1.word0 & filterData0.word1)
四家、四个团队、四种命名,判定式子是同一个形状。 这就是「双向命中」。 A 的组要在 B 的掩码里,并且 B 的组也要在 A 的掩码里。
为什么必须双向? 因为只有双向才能保证对称性,而对称性是「配对」这件事的物理前提。
两个物体碰不碰,不该取决于谁先被遍历到(§3.3 的教训)。
官方文档第 624 行那句「若 ShouldCollide(A,B) 为真,则 ShouldCollide(B,A) 也应为真」,
是 Jolt 把这条隐含要求写成了契约。
把这四家的式子写成同一个函数,形状就更清楚了:
//【四家的判定式子可以写成同一行】,按各家官方文档原文整理
bool CanCollide(uint32 g1, uint32 m1, uint32 g2, uint32 m2) {
    return (g1 & m2) != 0 && (g2 & m1) != 0;   // Jolt 掩码版 / Rapier / Cocos / PhysX 都是这一行
}
其中:两个与项的分工是「A 的组在不在 B 的掩码里」与「B 的组在不在 A 的掩码里」, 两个都必须非零。
「只配一边」的后果:如果 A 的组没进 B 的掩码,那么即使 B 的组在 A 的掩码里, 判定式子的第二个与项为 0,整式仍为假。所以症状是「我明明把 A 的掩码打开了,为什么还是不碰」。 A 打开的是「A 能看见谁」,不是「谁能看见 A」。
8.3 幽灵体与触发体为什么值得一层
说白了,官方文档列的五个示例对象层里有一个 SENSOR,本机没有用到它;但它是「为什么值得多切一层」的好例子。
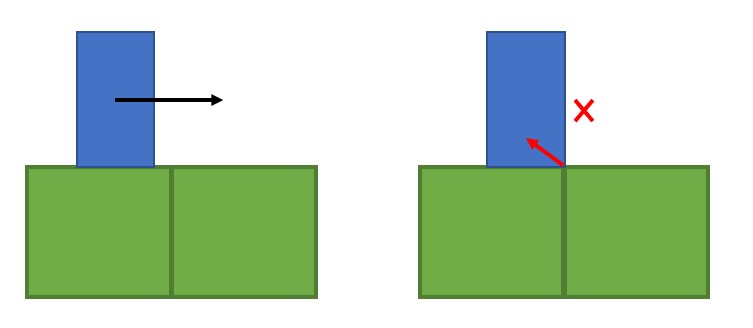
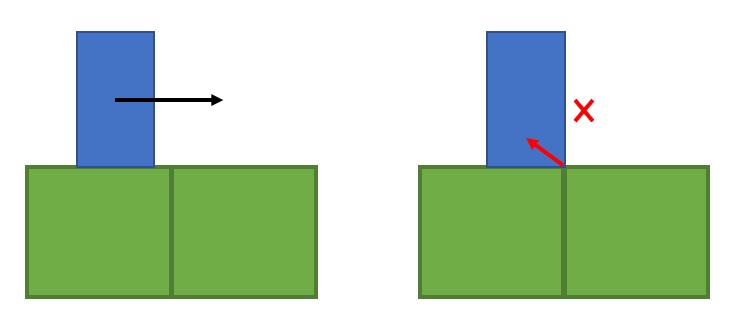
Docs/Images/GhostCollision.jpg(MIT)幽灵体(ghost / sensor)的语义是「只报接触、不给响应」。它带来一个很特别的过滤需求: 传感器通常数量不少、而且每次只需要被少数几个层看见。如果把它塞进动态物体那一层, 那么每次针对动态物体的查询都会顺带走一遍传感器,又是 §2.3 那个形状。
官方在这里还留了一条版本变更:Docs/APIChanges.md 第 107 行(20230212)记着
「Sensors are now able to detect other Sensors, make sure you put sensors in an ObjectLayer that
doesn't collide with other sensors…」。升级期会变行为,这是「层配置不是一次性工作」的一个实例:
引擎版本变了,层配置要跟着复核。
8.4 「早」的位置各家不同
OK,最后一条交叉结论,也是本篇最有信息量的一条。
| 引擎 | 最便宜的过滤放在哪 |
|---|---|
| Bullet | 广相阶段(靠 needsBroadphaseCollision 决定进不进配对缓存) |
| PhysX | 广相之后(filter shader 在两个形状的 AABB 首次相交时被调用) |
| Rapier | 广相之后、窄相之前(官方明说这一档「skips more computations」,并建议优先用它,而不是求解前的那一档) |
| Jolt | 宽相层,在「配对」这件事发生之前,先决定进哪棵树 |
这就是 Jolt 多一层 BroadPhaseLayer 的完整理由。 其余几家最便宜的过滤都要等到
「两个形状的 AABB 相交」这个事实成立;而 Jolt 把一层过滤挪到了这个事实之前,
代价是你要为它设计一套映射(§2.3 与 §2.5 的全部内容就是这套映射的收益与账单)。
物理上的界限也好理解:在 AABB 相交之前,引擎手上只有「层」这一个信息, 所以能做的过滤只有一种,按类丢弃。Jolt 把这个唯一能做的过滤做到了最早的位置。 官方那句 "To avoid work, try to filter out collisions as early as possible", 在 Jolt 这里的落点就是宽相层。
七家的判定规则与执行时机原文,分别见 Box2D 官方文档、 Rapier 官方文档、 PhysX 官方指南、 Unity 官方文档、 Cocos 官方文档 与 Bullet 用户手册。
九、边界、演进与处方
9.1 一次配对要过几道判定
好了,把全篇的六级串成一张判定流程图。
原理上,这张图的价值在于「每一道判定的失败,省掉的东西不一样」:
在宽相层失败,省掉整棵树的遍历;在对象层失败,省掉这一对配对;
在碰撞组失败,省掉已经做完的 AABB 判定;在 ContactListener 上失败,什么也没省。
所以「把过滤往上挪」这件事的收益是指数级的,而它的成本是配置复杂度。
这就是全篇的取舍。
9.2 十条层配置反模式
OK,社区与官方文档里反复出现的坑,收成一张表。每一条都给出「后果」与「对位处方」。这一层有个很别扭的特点:配错往往不报错,只是行为或性能悄悄变了;没有崩溃、没有断言,只能靠对照表回头排查。
| # | 反模式 | 后果 | 对位处方 |
|---|---|---|---|
| 1 | 层数爆炸(几十个对象层) | 配对表失控、无人敢改 | 对象层本身零开销,但要能被人读懂:按更新频率与空间分布切 |
| 2 | 静态与动态混装同一层 | 静态物体的查询走遍动态树 | 至少两层宽相层(官方建议 2 层起步) |
| 3 | 查询绕过过滤 | 射线扫全场景、随规模线性变慢 | 查询期四关都要给(§7.2) |
| 4 | 掩码只配一边 | 「该碰的不碰」 | 两个方向都打出来(§8.2) |
| 5 | 组与层混淆 | 配了层却管不住单个实例 | 分层管「类」,组管「实例」(§6.4) |
| 6 | 矩阵默认不连通 | 新增层后什么都不碰 | Cocos 官方原话:新增分组默认不与其它组碰撞 |
| 7 | 矩阵未勾选 | 彻底无碰撞、无回调 | Unity 官方:未勾选即 "no callbacks, no physics response" |
| 8 | 把过滤塞进最贵的一级 | 活干完了才丢 | ContactListener 是"a very expensive way of rejecting collisions" |
| 9 | 忽略特殊语义(如 groupIndex) |
反直觉结果 | Box2D:非 0 的 groupIndex 覆盖掩码 |
| 10 | 运行时才想起过滤 | 查询开销随场景增长 | 把过滤写进配置,不要写进回调(§5.4) |
//【反模式 2 的对位处方:至少两层宽相层】,本机实测的两种映射(§5.2)
// 好:静态与动态分开 → BP_STATIC / BP_MOVING
// 更好(若还有大量碎片):再加一层 → 本机实测稳态每步 19.51 → 12.01 毫秒
其中:第 8 条那句官方原文最值得记住: 「a very expensive way of rejecting collisions as most of the work is already done」。 已经做完的工作不会因为你的丢弃而退还。
9.3 演进:与过滤有关的版本变更
言归正传,过滤这一层不是一次成型的,迭代集中在近五个版本。
//【v5.0 之前:过滤器是函数指针】,摘自 Docs/APIChanges.md 第 109 行(20221231)
// ObjectLayerPairFilter and ObjectVsBroadPhaseLayerFilter are now objects instead of function pointers.
读这条时间线要注意口径:Docs/ReleaseNotes.md 顶端是 ## Unreleased changes,
v5.6.0 没有单独成节,所以 v5.6 相关的过滤条目会落在 v5.4.0 区段或 Unreleased 区。
引用版本时务必写清「落在哪个版本区段」,上一篇已经踩过一次类似的口径问题。
- v3.0.0(
ReleaseNotes.md第 449 行):支持 32 位对象层,「allow easier integration with existing collision filtering systems」,即为了对接别家的掩码体系。这也解释了为什么JPH_OBJECT_LAYER_BITS是个可配的宏(§2.1)。 - v5.0.0(第 321 至 322 行):两条落地路线都是这个版本加进来的。 掩码路线官方标注「similar to Bullet's group & mask filtering」。
- v5.2.0 前后(
APIChanges.md第 109 行):三个过滤器从函数指针变成对象, 顺带解决了「函数指针没有状态」的老问题。 - v5.3.0(
ReleaseNotes.md第 132 行):新增SetSimShapeFilter,可以过滤体内部的子形状。 - v5.4.0(第 95 行):修
SimShapeFilter的一处 UBSAN 误报。
上述条目的原文见 Docs/ReleaseNotes.md 与 Docs/APIChanges.md。
9.4 三条处方
好了,把全篇收成三条能直接落地的做法。
处方一,宽相层按「更新频率 + 空间分布」切,切到不再混住为止。 官方建议两层起步
(静态、动态);本机补上第三条判据,当一层里「别人」的占比超过一半时,再切一刀
(§5.4 的 52%)。切完用 JPH_TRACK_BROADPHASE_STATS 复核 Nodes Visited 是否降下来。
处方二,路线选择看「表达方式」而不是能力。 两条路线表达配对规则的能力等价(§4.5 的 9 组全一致)。
要逐对开关就选表驱动;要和已有掩码体系对接、或分组有规律就选掩码,
并记得把 OBJECT_LAYER_BITS 考虑成 32。用掩码路线时,最宽松的层放最后一位(§4.4)。
处方三,过滤一律往上游写,越早越好。 这在 Jolt 里有一个便利:
查询期的 DefaultObjectLayerFilter 会自动复用你的配对表(§3.2),
所以你只需要维护一份规则;而把它写进 ContactListener 是最贵的一种做法。
9.5 六条可被检验的命题
说白了,本篇的结论都可以自己验,不需要相信本文。下面六条都给了「检验入口」:左列是命题,右列是一条读源码或跑本机程序的路径;其中四条只要读一个头文件或一段官方文档就能确认,两条需要跑一次本机的 bench_layers。
| # | 命题 | 检验入口 |
|---|---|---|
| 1 | 对象层映射到宽相层是多对一,同层即同树 | 读 Architecture.md 第 608 行,或打印 GetBroadPhaseLayer() 的返回值 |
| 2 | 共享宽相层会让同一个查询多走一倍的节点 | 打开 JPH_TRACK_BROADPHASE_STATS,跑 bench_layers 看 Nodes Visited(20000 对 10000) |
| 3 | 只改一个映射,稳态每步快 1.62 倍 | 同上,跑 E2(19.51 对 12.01 毫秒) |
| 4 | 表驱动结构上写不出单向配对 | 读 ObjectLayerPairFilterTable.h 的 GetBit,或跑 E0 |
| 5 | 掩码路线的最后一层是兜底层 | 读 BroadPhaseLayerInterfaceMask.h 的注释,或跑 E3 的 9 组比对 |
| 6 | 七家引擎的查询过滤都是独立的一套 | 读 §8.1 那张表里每一行的官方文档 |
9.6 本篇的边界(已给出的结论与不展开的部分)
好了,按本系列的惯例,边界要写两遍:开头写一次「本篇不涉及什么」,收口时再写一次「已经给出了什么、剩下什么归别人」。这一节是收口那一遍,六条边界一一对应,也顺便标出哪一条已经在第四篇写完了。
| 本篇给出的 | 不展开的部分 | 归属篇目 |
|---|---|---|
| 三个必需接口的分工与生命周期契约 | 宽相树为什么是四叉、无锁与双根怎么实现 | 第四篇(已写) |
ObjectLayer 与 BroadPhaseLayer 的多对一映射与代价 |
候选配对怎么变成接触点(GJK / EPA / 流形裁剪) | 第六篇 |
| 表驱动与掩码两条路线的取舍与分歧 | 每个形状自身的质量属性与包围盒怎么算 | Shape 篇 |
| 碰撞组与它的三角位表存储 | 约束怎么迭代、岛怎么切分、睡眠判据 | 第九、十篇 |
| 查询期四关与射线落空的四种成因 | 触发器(SENSOR)的事件接口与生命周期 |
第十二篇(上层模块) |
| 过滤完全在 CPU 上(本系列边界) | GPU compute 通路(只服务发束头发,不是 GPU 刚体) | 收官篇(反误区) |
9.7 本篇的三层证据,与它们的分工
OK,最后交底:这一篇的每一条结论,出自哪一层。这三层的分工是这一层本身的形状,不是写作技巧,官方文档管设计意图、源码管实现方式、本机实测管真实代价;三者能对上,结论才站得住;对不上,多半是有一层被我读岔了。
| 层 | 它在本篇说的话 | 本篇用到的材料 |
|---|---|---|
| 官方层 | 六级漏斗的顺序与「越早越省」;多对一的取舍;两条路线的存在与定位;七家的判定规则 | Architecture.md 第 603 至 657 行;各引擎官方文档;ReleaseNotes.md / APIChanges.md |
| 源码层 | 映射怎么返回;配对表怎么存;掩码怎么打包;最后一层怎么兜底;查询期有几个签名 | ObjectLayer.h / BroadPhaseLayer.h / ObjectLayerPairFilterTable.h / ObjectLayerPairFilterMask.h / BroadPhaseLayerInterfaceMask.h / CollisionGroup.h / ShapeFilter.h / SimShapeFilter.h / Samples/Layers.h |
| 实测层 | 共享一层要多走一倍;只改映射快 1.62 倍;两条路线差在哪 2 组 | bench_layers.exe 的 E0–E3(evidence/bench_layers_run_20261002.txt) |
这套分工也就是本系列的写作纪律:每一句结论都要能指到它出自哪一层。 如果一句话既像官方口径又像实测结论,那它通常两边都不牢。
资源清单
官方文档(v5.6.0)
Docs/Architecture.md,## Collision Filtering全节(第 603 至 657 行,含六级过滤的原理与顺序)/## Level of Detail(第 659 至 661 行)/宽相一节(第 577 至 593 行)Docs/ReleaseNotes.md, v3.0 的 32 位对象层(第 449 行)/v5.0 的两条路线(第 321 至 322 行)/v5.3 的SetSimShapeFilter(第 132 行)/ v5.4 的 UBSAN 修复(第 95 行)Docs/APIChanges.md, 过滤器由函数指针变为对象(第 109 行)/sensor 检测 sensor(第 107 行)/ShapeFilter签名变更(第 105 行)/BroadPhaseLayerInterface改名(第 143 行)/ObjectVsBroadPhaseLayerFilter改名(第 161 行)Build/README.md,JPH_TRACK_BROADPHASE_STATS的官方说明- 官方配图:
CollisionFlow.jpg(1438×457,题图)/GhostCollision.jpg
官方源码(v5.6.0)
Jolt/Physics/PhysicsSystem.h,Init的签名与三个接口参数的寿命约定(第 56 至 59 行)/SetSimShapeFilter(第 89 至 90 行)Jolt/Physics/PhysicsSystem.cpp, 接口去向(第 85 至 93 行)/唯一使用点(第 967 行)Jolt/Physics/Collision/ObjectLayer.h,JPH_OBJECT_LAYER_BITS与using ObjectLayer(第 12 至 16 行)/两个过滤器基类与两个默认实现(第 27 至 105 行)Jolt/Physics/Collision/BroadPhase/BroadPhaseLayer.h,BroadPhaseLayer::Type(第 17 至 20 行)/BroadPhaseLayerInterface(第 60 至 70 行)/ObjectVsBroadPhaseLayerFilter(第 79 至 90 行)Jolt/Physics/Collision/ObjectLayerPairFilterTable.h, 左下三角位表与GetBit的交换逻辑Jolt/Physics/Collision/ObjectLayerPairFilterMask.h,cNumBits/sGetObjectLayer/ 双向命中Jolt/Physics/Collision/BroadPhase/BroadPhaseLayerInterfaceMask.h,ConfigureLayer的 include/exclude 与「最后一层兜底」Jolt/Physics/Collision/CollisionGroup.h/GroupFilterTable.h,GroupID/SubGroupID与DisableCollisionJolt/Physics/Collision/ShapeFilter.h/SimShapeFilter.h, 三个签名与「必须线程安全」Jolt/Physics/Collision/BroadPhase/BroadPhaseQuery.h, 六类查询与两个过滤器参数Samples/Layers.h, 官方示例的层枚举、配对规则与三个实现(注:v5.6.0 里Layers.cpp不存在,实现全部内联在本头文件)
本机产物(原创)
evidence/bench_layers.cpp+evidence/build_bench.ps1, 四组实验源码与编译脚本evidence/bench_layers_run_20261002.txt, 完整原始输出(E0–E4)
其中:四组实验的原始输出与编译脚本都在 evidence/ 下,可直接复跑核对每一个读数;
场景构造代码只有一份,两种映射共用。
好了,下一篇往漏斗的下一位走:窄相(narrow phase)。 宽相交出来的只是一堆「包围盒重叠」的候选对,它们绝大多数并没有真的相碰; 把候选变成接触点要过 GJK 与 EPA 两道算法,而接触点还要再裁成一个稳定的流形。 那条路径上有它自己的代价故事:一次再细的包围盒也代替不了形状本身。
With Best Wishes.