本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
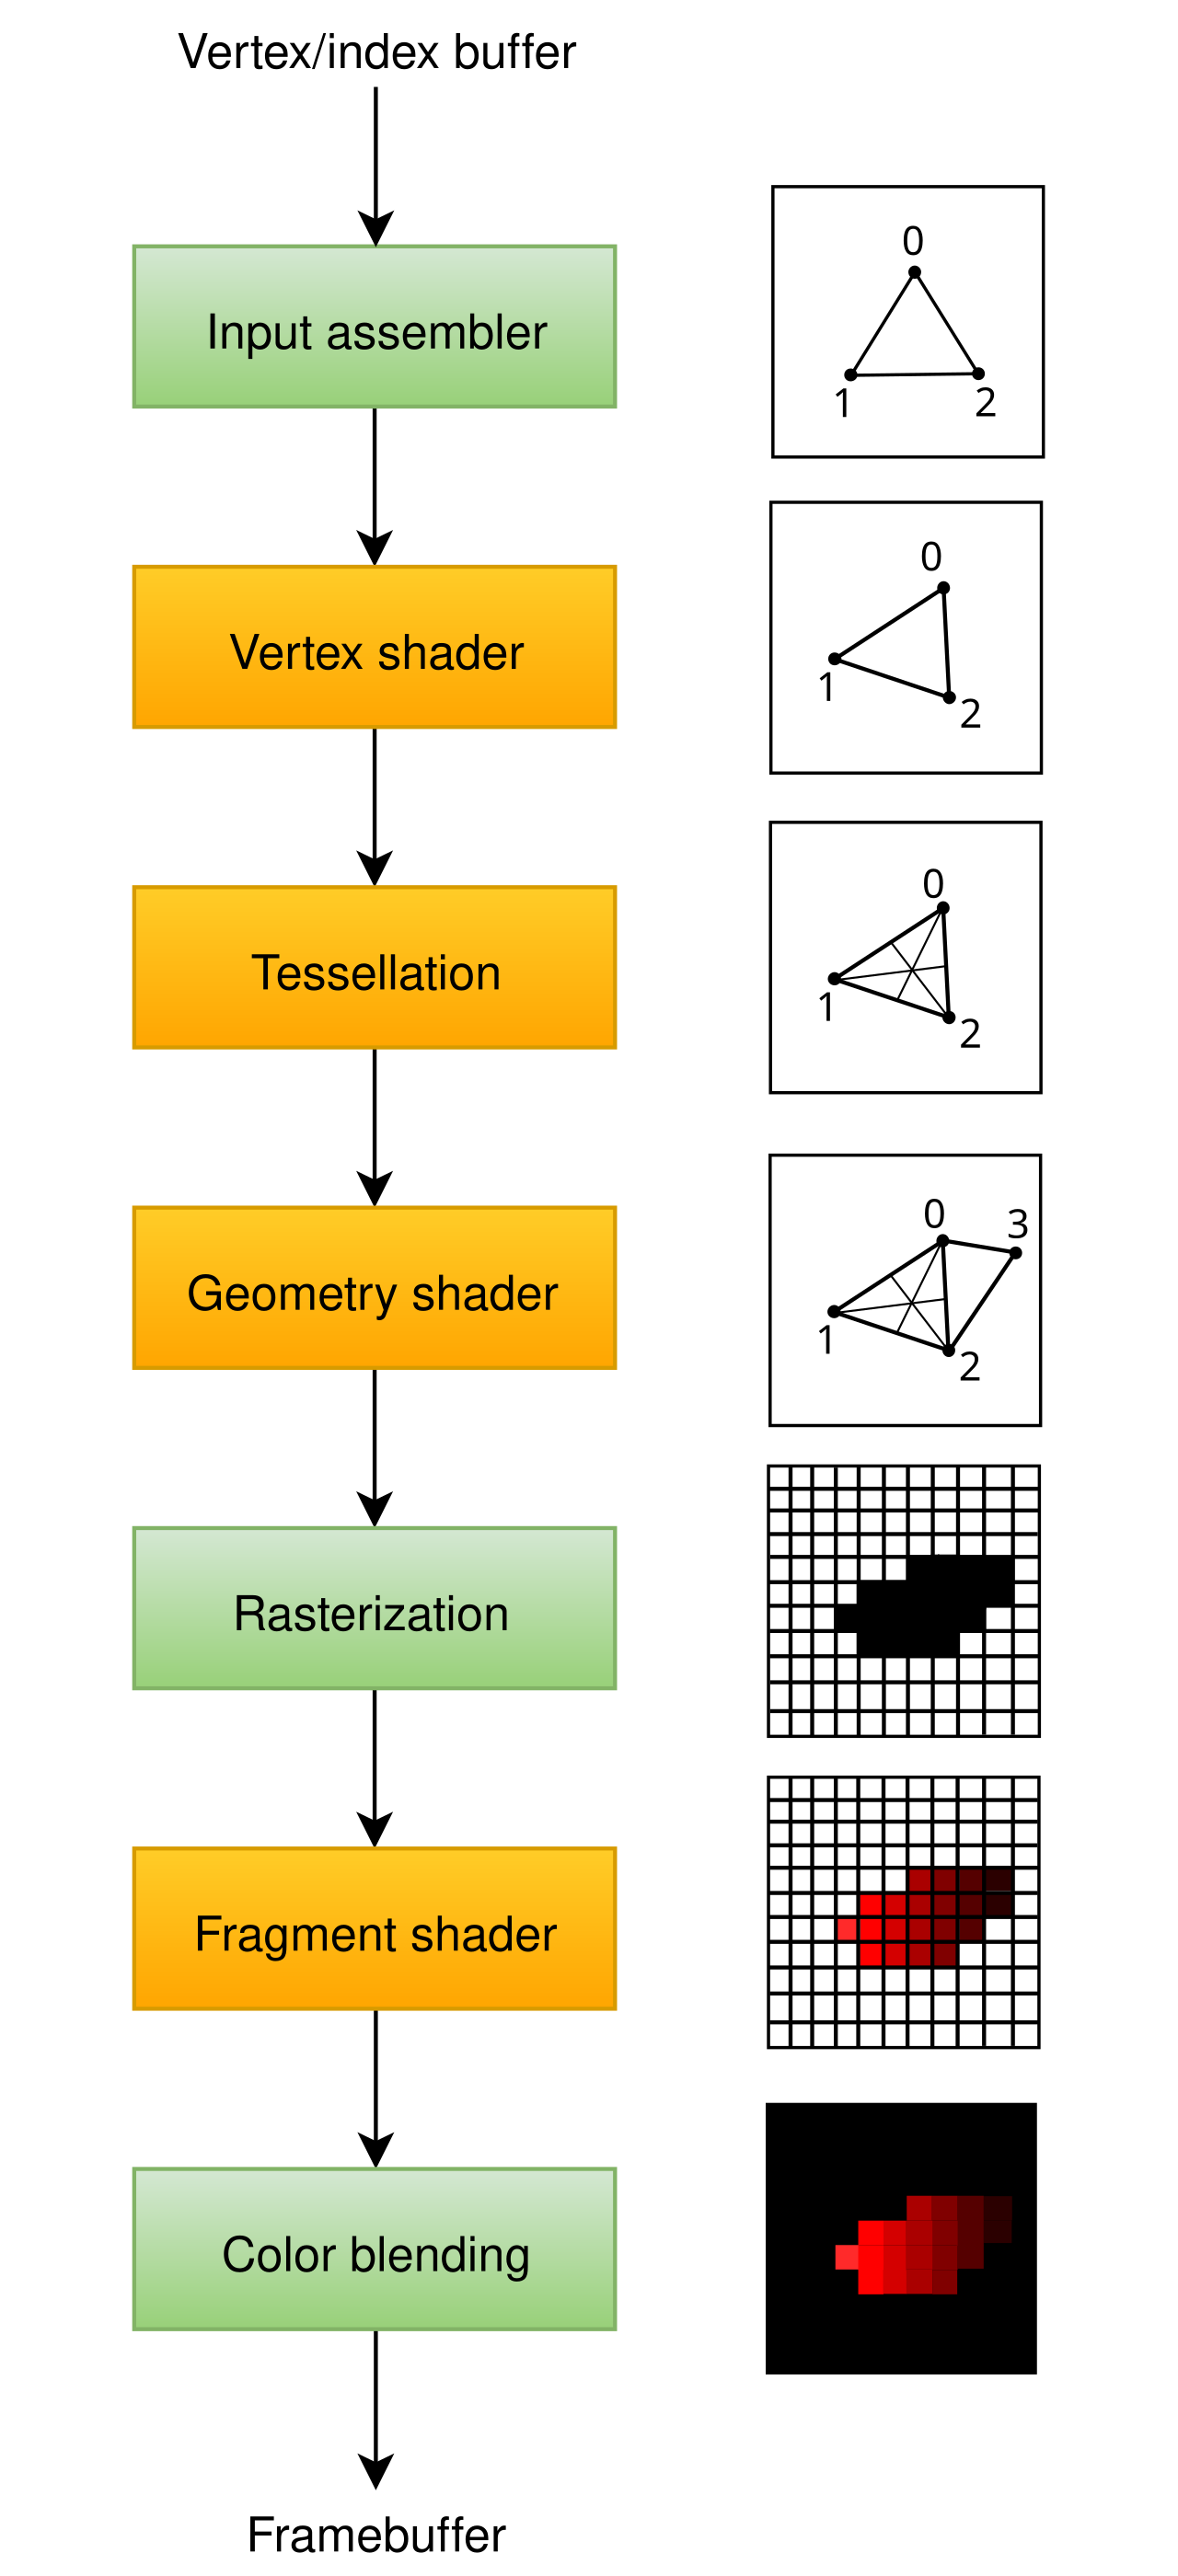
核心问题:上一篇结尾欠的是"缓冲传往哪、谁来决定",这一篇要问的更靠前一件事是:在 Android 上,一个应用到底走哪条"入口"来接上 GPU?
一个具体的问题就能把它逼出来:本机的默认渲染后端是 OpenGL 还是 Vulkan? 抓帧工具的说明文档暗示"默认走 Vulkan",可我在这台设备上两次读到
Pipeline=Skia (OpenGL)。是谁在说谎?都不是。答案藏在一个没人摆到台面上的矛盾里:"通用默认"和"本机默认"是两件事,而本机的默认不是我改的,是模拟器在内核命令行上钉死的。
承接上一篇。ep04 讲的是缓冲队列怎么记账,ep03 讲的是缓冲怎么被申请、被画、被交出去,ep02 讲的是节拍怎么打在帧上。这三篇都默认了一件事:命令最终要交给 GPU,而总得有个"入口"把它接进去。 这个入口,在 Android 上主要就是 Vulkan,而它恰恰是前三篇各欠下的一笔账。
这件事不是我临时起意补的。前几篇正文里共有两处把"Vulkan 后端路径"指向本篇:
| 出处 | 原话 |
|---|---|
| ep03 §0.3 | 把 Vulkan 后端路径列为 ep05 的正题 |
| ep04 §0.3 | 把「Vulkan 后端路径」与 BufferQueue 的桥接列为 ep05 |
所以这一篇是来还债的:把"应用怎么接上 Vulkan、系统怎么把它加载起来、渲染后端怎么被选中"一次讲清。它回答的不是"Vulkan 怎么用"(那是《实时渲染管线探析》),也不是"GPU 怎么算"(那是《GPU 架构剖析》),而是入口本身:谁加载、谁被选中、谁在跑。
三篇共用同一条链路,各篇量的东西各不相同:
| 维度 | ep03《RenderThread》 | ep04《BufferQueue》 | ep05(本篇) |
|---|---|---|---|
| 关心的对象 | 交接:活与缓冲怎么交出去 | 记账:队列自己怎么记这一笔 | 入口:命令从哪条门进 GPU |
| 量什么 | 时间与占比 | 数量与状态 | 加载路径与后端身份:加载链、Pipeline=、版本号 |
| 主要命令 | framestats + 双线程轨 |
SurfaceFlinger 的队列段 |
getprop + dumpsys gpu + cmd gpu vkjson + logcat |
| 典型结论 | dequeueBuffer 的双峰 |
公式值 2、实打 slot 2、已分配 3 | 本机默认 GL,且切到 Vulkan 会启动即崩(设备建成但走不通),同一台机器六个版本号 |
本篇也不涉及:应用/引擎能画多少与功耗带宽取舍(《移动端图形与功耗》已写)、渲染算法与画面技术(《实时渲染管线探析》《实时光线追踪与混合渲染》已写)、具体渲染器内部的光栅化实现(《2D 矢量引擎深挖》已写)、GPU 硬件内部(《GPU 架构剖析》已写)、Perfetto 与 RenderDoc 自身的原理(《图形性能剖析工具链》已写)、队列与栅栏(ep03/ep04 已写)、合成决策与送屏(ep06 展开)、HWC 叠加层与合成模式(ep08 展开)。为什么不涉及:这一篇的价值集中在"入口"这一个点,把加载链、后端选择、版本门槛三样讲透,掺进别的题域,这件事就讲不透了。完整边界见 §0.3。
系列文章写作风格说明(沿用前四篇,不再重复解释)
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、AOSP 源码怎么做、本机跑出来是什么,这三层分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(机型、Android 版本、命令、采样时刻);
- 模拟器与真机分开写:本机走 gfxstream + SwiftShader 软实现,凡是性能类结论一律不外推为真机;HWC overlay 与 ARR 这类拿不到的东西如实标"需真机"。
系列主要内容总览
- 【Android 图形显示系统】(一) 总览:从 App 到屏幕的图形管线
- 【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 【Android 图形显示系统】(三) RenderThread 与帧提交:从显示列表到一块缓冲
- 【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局
- 【Android 图形显示系统】(五) Vulkan on Android:低开销渲染入口(本篇)
- 【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么
- 【Android 图形显示系统】(七) ASurfaceControl:Android 10 的透明事务
- 【Android 图形显示系统】(八) HWC:GPU 合成之外的硬件叠加
- 【Android 图形显示系统】(九) HWC2:Vsync 回调和虚拟显示路径
- 【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞
- 【Android 图形显示系统】(十一) 三缓冲、多刷新率与 ARR
- 【Android 图形显示系统】(十二) 虚拟显示与屏幕录制
- 【Android 图形显示系统】(十三) 剖帧实战:Perfetto FrameTimeline 抓 jank
相关资源链接
- 官方一手来源:使用 Vulkan 处理图形 | 实现 Vulkan | Vulkan 架构 | 原生引擎支持 | Vulkan 设计指南 | Vulkan 验证层
- 源码入口:
frameworks/native/vulkan/|frameworks/native/vulkan/libvulkan/|hardware/include/hardware/hardware.h| Khronos Vulkan 基础样本 - 与本文强绑定的前置:ep01《总览》| ep02《Choreographer》| ep03《RenderThread 与帧提交》| ep04《BufferQueue》
这一篇回答什么,不回答什么
OK,先把坐标系挪正。前四篇给了地图、给了一条叫醒链、给了一次交接、给了一本账;这一篇要给的是一个门,也就是命令进入 GPU 的那条入口,以及这条入口在 Android 上是谁加载的、谁被选中、谁在跑。
0.0 内容总览:本篇知识地图
好了,先把十章各自回答的问题钉在一张表上。它同时也是本篇的目录总览。如果时间紧,第二章(加载链)与第五章(后端怎么被选中)是这篇最不可替代的两章,前者把"命令怎么进来"讲清,后者把它变成这台设备上可以复现的实验。
| 章 | 回答的问题 | 关键结论 |
|---|---|---|
| 零 | 这一篇补哪一段 | 一个入口的三层坐标;前三篇欠的账 |
| 一 | 为什么 Android 要另开一个入口 | 它取代 GLES;ANGLE 跑在它之上而不是之下 |
| 二 | 加载链是几步 | loader → ICD → HAL;层怎么被搜到 |
| 三 | 低开销到底省的是谁 | 省的是 CPU 侧的组织开销,不是 GPU 干活的量 |
| 四 | 版本与门槛 | 六台阶时间线;apiVersion 与 Android 版本两项都要对 |
| 五 | 后端怎么被选中 | RenderPipelineType 两条 pipeline;切换实验可复现 |
| 六 | 验证层与调试开关 | 只讲开关,不讲内部 |
| 七 | 实测:本机这台设备的入口 | 驱动上报、加载器、后端、六版本号、模拟器三处限制 |
| 八 | 五处流传很广的说法 | 逐条核对,不立空靶 |
| 九 | 四项可执行动作 | 每条都给命令与判据 |
0.1 一个入口,三层坐标
好,先立框架。说"Vulkan 是 Android 的底层图形 API",这句话里其实藏着三个不同的角色,懒懒地混着一说就乱。把它们拆成三个问题,就是本篇的一条主线:
第一层,谁加载它。 应用链接的 libvulkan.so 是一个加载器(loader),它负责找到真正的驱动。这一层对应本篇第二章。
第二层,谁被选中。 加载器从系统里挑出一个驱动(ICD),也就是某个 vulkan.<厂商>.so。这一层是入口的"实体",对应第二章的加载结果。
第三层,谁在跑。 即便驱动被加载了,具体到渲染管线,还有一层"后端选择":Android 的界面渲染(HWUI)到底用 OpenGL 后端还是 Vulkan 后端,是另有一个属性决定的。这一层对应本篇第五章。
三层各司其职,缺一不可,也正是本篇标题里"入口"二字的全部含义。
0.1.1 入口的三层坐标图
0.1.2 本篇与前几篇的量纲分工图
好了,还是那句老话:几篇共用同一条链路,但量的东西不一样。上面开头那张表划了边界,这里再补一个量纲上的区分图。前几篇量的多是"时间"与"数量",本篇量的主要是"身份"与"路径":本机默认后端是 OpenGL 还是 Vulkan、驱动自报是 1.4 还是 1.2、层从哪个目录被搜到、Pipeline= 在什么条件下有一行什么条件下连那行都不存在。这些不是性能数字,读的是"这条路走通了没有、走的是哪条岔路"。
0.2 本篇不涉及什么(边界声明)
开篇把边界说死,是这几篇的统一约定。本篇:
- 不讲 Vulkan 怎么用:不着色器、不写 render pass、不排命令缓冲,这些给指针(§三尾部资源链接)。
- 不讲 GPU 怎么算:不展开管线各阶段、不讲光栅化实现(《实时渲染管线探析》《GPU 架构剖析》《2D 矢量引擎深挖》已写)。
- 不讲迁移的性能结论:本机是模拟器软实现,"Vulkan 起不来"是环境产物,不是 API 结论,不写成 Android 通例(§7.4 展开)。
- 不搬运厂商配图、不使用任何 logo 文件:Commons 上 Vulkan/Khronos/OpenGL 的 logo 全是注册商标,且对技术论证无贡献(§8.4)。
- 不假装读到读不到的东西:真机厂商 ICD 名、Vulkan APEX、验证层的"被加载"演示、以及合成侧的 Vulkan 路径,本机都拿不到,如实标注(§7.3)。
这五条边界不是客套,它们直接决定了本篇的证据类型。原理上,一篇技术文章的结论强度受限于它的取证手段:能用命令读出来的(属性、计数、日志)是一手证据;官方文档写明的规则是权威依据;社区文章与教程只能作旁证。本篇把这三类出处逐处标出来,凡属"模拟器环境产物"的结论一律不外推。作为对照,官方 Vulkan 总览页与 AOSP 的实现 Vulkan 文档是本篇回引最多的两处权威依据——凡是它们已经写明的事,本篇尽量引原话,而不是转述成自己的说法。
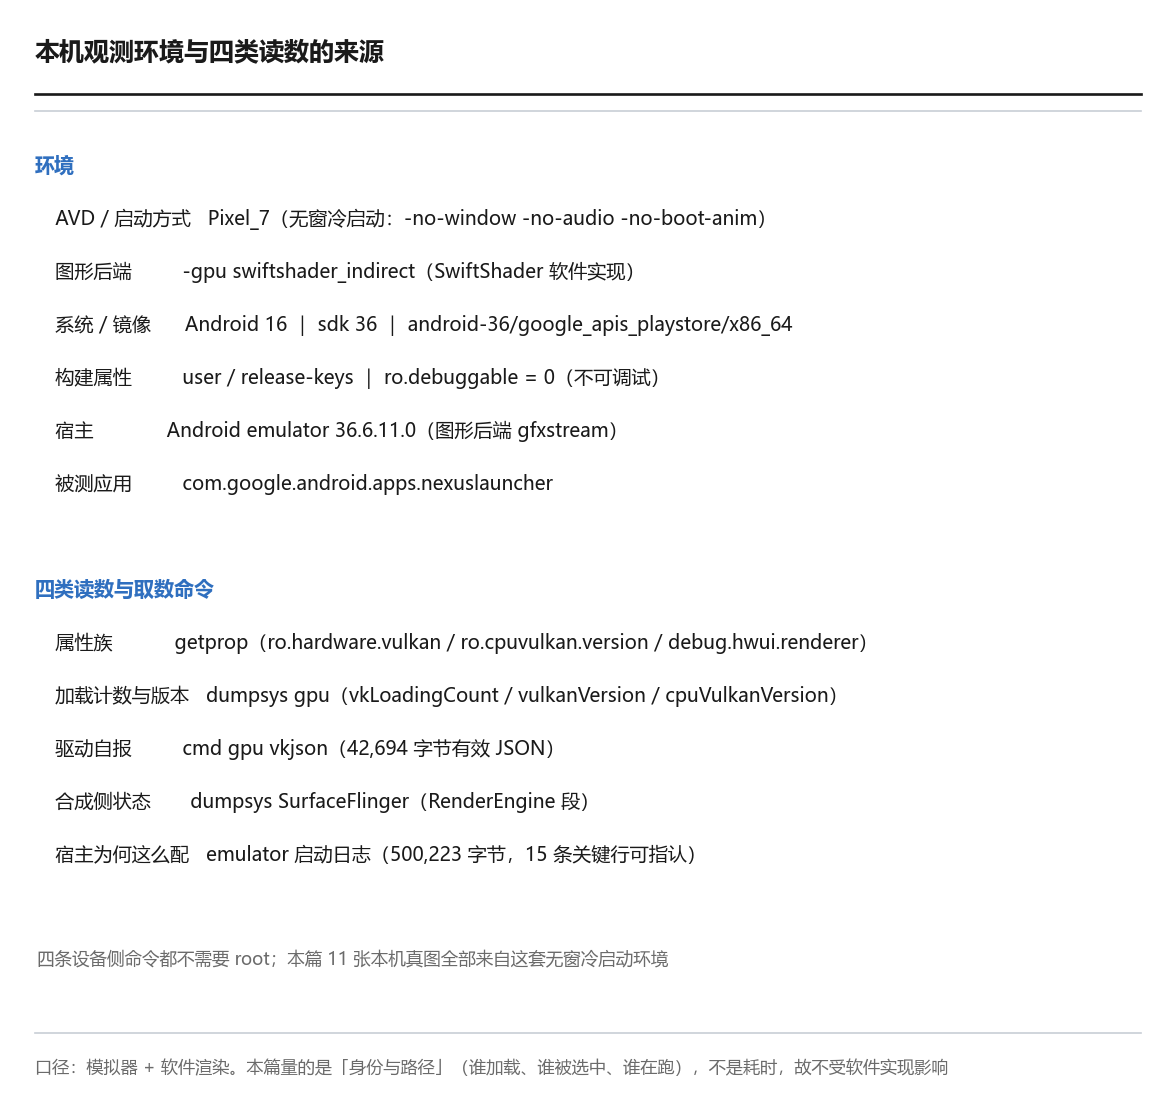
本机观测环境(本篇 11 张本机真图的来源,先交代清楚):无物理设备,统一用 Pixel_7 无窗冷启动(-no-window -no-audio -no-boot-anim -gpu swiftshader_indirect -no-snapshot);宿主 Android emulator 36.6.11.0,图形后端 gfxstream;系统镜像 android-36/google_apis_playstore/x86_64;设备侧 ro.build.version.release = 16、sdk = 36、user / release-keys、ro.debuggable = 0。
0.2.1 本机观测环境与四类读数来源面板
一、为什么 Android 要另开一个入口
在拆加载链之前,先回答一个更"为什么"的问题:既然 Android 一直有 OpenGL ES,为什么还要一个 Vulkan? 这一个问题,牵扯出三个概念的位置关系:GLES、Vulkan、还有夹在中间的 ANGLE。
1.1 官方给的一句话定位
开发者文档里《使用 Vulkan 处理图形》的原话是这么说的:
Vulkan 是 Android 主要的底层图形 API,取代(supersedes)OpenGL ES。OpenGL ES 仍受支持,但不再为它开发新功能。
言归正传,这一句里最关键、也最容易被读偏的词是"取代"。它不指"OpenGL ES 立刻消失",而指"新功能不再往 GLES 上加,未来属于 Vulkan"。这就像系统里同时有新旧两条路:旧的还通车,但新工程默认走新的那条。
要理解这三个概念谁在上谁在下,一张层次图最清楚:
1.1.1 GLES / Vulkan / ANGLE 的层次关系
这一层最容易读反的地方在这里:ANGLE 不在 Vulkan 下面撑着它,恰恰相反,ANGLE 跑在 Vulkan 之上,把 OpenGL ES 的调用翻译成 Vulkan。真正的驱动仍是 GPU 厂商(IHV,Independent Hardware Vendor)提供的。这一点在 §1.3 会再钉一次,因为中文侧最容易把 ANGLE 读成"驱动"。
好了,趁着"谁在上谁在下"还热乎,把 GLES 与 Vulkan 的机制差别摊成一张表,后面几章反复回看都方便。这张表只列机制层的六处差别,不含任何性能结论:
| 维度 | OpenGL ES | Vulkan |
|---|---|---|
| 状态处理 | 全局状态机,改一处即影响全局 | 状态打包成对象(PSO),绘制时只切换对象 |
| 命令提交 | 单线程命令流,调用即录制 | 命令缓冲可多线程录制,再一次性提交队列 |
| 着色器 | 文本源码(GLSL / ESSL),运行期编译 | 二进制中间表示(SPIR-V),可离线编译 |
| 内存 | 驱动代管,应用少操心 | 应用显式选择内存类型与堆(memory type / heap) |
| 同步 | 多为隐式,驱动替你插等待 | 显式:栅栏(fence)、信号量(semaphore)、管线屏障(barrier) |
| 错误检查 | 驱动用启发式猜,行为依厂商 | 多数校验移出运行期,改由可选的验证层承担 |
这张表的读法是责任转移,不是"谁做得多谁做得少":右列不是"Vulkan 省掉了这些事",而是"Vulkan 把这些决定权交还应用,同时把责任一起交了过去"。上表里被省下的每一个隐式动作,都会在应用侧变成一个必须显式安排的动作——这也是为什么第三章要说清"低开销"是一把双刃剑:它省的是驱动替你猜的成本,不是省掉工作本身。
顺带把 ANGLE 的开启方式说全,因为它常被误当成"默认就在跑"。官方口径是它按应用启用,靠一组 angle_gl_driver_selection_pkgs 与 angle_gl_driver_selection_values 这类开关指名哪些包走 ANGLE、走哪条后端。对本篇的主角没有影响:一个直接用 Vulkan 的应用根本不经过 ANGLE,ANGLE 存在与否都不改变它的加载链。把它读成"Android 图形栈的地基"是错的,它只是 GLES 这条旧路旁边的一条可选的翻译车道。
1.2 Vulkan 长什么形状
"底层图形 API"到底长什么样?为了立起这个形状,我用一张 Wikimedia Commons 上的 Vulkan 简化管线图作题图(见文首题图,此处不再重复贴同一张)。为什么取它而不自绘?因为本系列纪律要求:能用外部真实素材就不用自绘示意,而这篇图带的许可(CC BY-SA 4.0)允许原样引用。边界必须说清:这张图展示的"render pass 里跑什么"属于《实时渲染管线探析》的题域,本篇只借它的形状告诉你"Vulkan 的应用侧动作大致是:往命令缓冲里录指令、提交队列、然后由管线逐阶段算出图像"。
回到那张题图,能读出的只有三件与"入口"有关的事:命令从应用侧录进命令缓冲(这是入口的输入端)、提交到队列(这是交接点)、由管线算出图像(这是出口)。至于管线内部每个阶段怎么算,本系列不在这篇展开,留一句指针即可。
1.3 官方定位的拆解:"取代"指什么、不指什么
回到官方那一句,它值得逐词拆一遍,因为拆完你会发现它能带出整个系列的地图。
"主要的底层图形 API":底层(low-level)是说它离硬件更近、暴露更多控制权。对显示链路而言,这意味着一张帧从命令到上屏,中间系统给你的"自动"更少,你要自己安排的部分更多。
"取代 OpenGL ES":取代的是新功能开发的方向,不是存量兼容。所以一门新引擎学图形 API 该学什么,答案很明确。
"不再为它开发新功能":这是给 GLES 判的"维护态",不是"死刑"。它解释了为什么我们会在本机上看到 GLES 还在跑、还跑得动。
关于 ANGLE 的定位,再钉三个钉子,直接引用官方页的最新口径:ANGLE 自 Android 15 起作为可选层(optional layer),在 Vulkan 之上运行 OpenGL ES,用来标准化 OpenGL 实现、提升兼容性;它不是驱动,真正的驱动仍由 GPU 厂商提供;它不是默认全量启用,要通过开关按应用启用(angle_gl_driver_selection_pkgs 一类)。
1.3.1 官方定位一句的拆解图
好了,这一章把"为什么另开入口"和"三个概念谁在上谁在下"立住了。下一章,我们进入本篇最硬的一手来源,看这条入口到底是怎么被加载起来的。
二、加载链:loader → ICD → HAL
OK,言归正传。这一章回答"谁加载它、谁被选中"。AOSP 的《实现 Vulkan》是把这条链写得很具体的一手来源,它把加载链拆成三个环节:加载器(loader)、驱动(ICD)、以及封装驱动的 HAL 机制。
2.1 加载链三步:loader → ICD → HAL
先把三步画出来。
第一步,加载器(loader)。 源码在 platform/frameworks/native/vulkan,安装为 /system/lib[64]/libvulkan.so。它是应用链接的那个库,你的应用调 vkCreateInstance,先落在这里。Android 用的是自己的加载器,不是 LunarG 的,这是官方原生引擎支持页专门强调的一句,而且它提醒:构建期直接链接系统库会多一层 dispatch 开销。
第二步,驱动(ICD)。 加载器按规则去找真正的驱动:首选 /vendor/lib[64]/hw/vulkan.<ro.hardware.vulkan>.so,另有 vulkan.<ro.product.platform>.so 等备选。这句话有个直接后果:ICD 文件里有厂商名:真机上是 vulkan.adreno.so(高通)、vulkan.mali.so(Arm)一类的名字。
第三步,HAL 封装。 Android 7.0 起用 hw_module_t / hw_device_t 这套 HAL 机制去封装驱动,open() 时传入常量 HWVULKAN_DEVICE_0。驱动不裸奔,它被包在硬件抽象层里,系统通过 HAL 找到它、打开它。
2.1.1 加载链三步图
open() 传 HWVULKAN_DEVICE_0,驱动经硬件抽象层被打开@ 本系列绘制老一点的中文资料里,《Android N 中的 Vulkan 支持》把这条链拆得最细:vkCreateInstance → EnsureInitialized → OpenHAL → hw_get_module("vulkan") → hwvulkan_module_t/hwvulkan_device_t。它的价值是"形状",局限是版本偏旧(基于 Android 7 / Vulkan 1.0,没有 Android 15 的 APEX)。本篇引用它的形状,不引用它的版本号。
下面把这条链落到能读的代码层级。这段伪代码只保留"谁调谁",略去错误分支与 dispatch 细节:
// 1) 应用侧:入口只有一个调用
vkCreateInstance(&createInfo, NULL, &instance);

// 2) loader 侧:第一次调用触发初始化(源码路径 frameworks/native/vulkan/libvulkan)
EnsureInitialized();                        // 决定加载哪个 ICD、挂哪些 layer
OpenHAL();                                  // 打开 HAL
hw_get_module("vulkan", &module);           // 走 hardware.h 的模块查找
module->open(HWVULKAN_DEVICE_0, &device);   // 拿到封装后的设备句柄

// 3) ICD 侧:真正实现 vk* 的是这个 .so(本机为 vulkan.ranchu.so)
这段代码里藏着三个要点。第一,"一个调用"是表象:应用只写了一次 vkCreateInstance,但 loader 在它背后做了"读属性拼出 ICD 名 → dlopen → 取符号 → 建 dispatch 表"这一整套动作,代价压在第一次调用上。第二,hw_get_module 这一步说明了驱动为什么要包一层 HAL:Android 不希望图形驱动完全裸奔,硬件抽象层负责找到它、打开它,打开时用常量指定设备序号。第三,loader 是 Android 自己的,不是 LunarG 的通用 loader。这一点的实际后果在构建期:如果构建配置里直接链接系统库,调用会多绕一层 dispatch 转发,这是官方专门提醒过的一条开销。
好了,加载链讲完,顺手把"层从哪儿被搜到"的来源也收全,因为这决定了第六章那张开关树能不能落地。全部来源只有三类,彼此不重叠:
| 来源 | 怎么生效 | 谁适用 |
|---|---|---|
| 系统 native 库目录 | 自动搜 /system/lib64 与 /system_ext/lib64 |
所有应用 |
| 开发目录 | 自动搜 /data/local/debug/vulkan |
仅可调试应用 |
| 显式指定 | VK_LAYER_PATH 环境变量 / debug.vulkan.layers 属性 |
按需,调试场景 |
三类的排序不是随意的:前两类是"系统替你搜",第三类是"你自己指路"。本机的 logcat 只打出前两类,第三类一次都没出现——原因在 §2.4 交代。
2.2 实测:本机这台设备的加载器与 ICD 文件
好了,前面是"文档怎么写"与"源码怎么做",现在落到"本机跑出来是什么"。在本机的文件系统里,这套加载链是实打实的一对文件:
-rw-r--r-- 1 root root   223616  …  /system/lib64/libvulkan.so          # loader,约 218 KB
-rw-r--r-- 1 root root  1373184  …  /vendor/lib64/hw/vulkan.ranchu.so    # ICD,约 1.3 MB
2.2.1 本机加载器与 ICD 文件的路径与体积
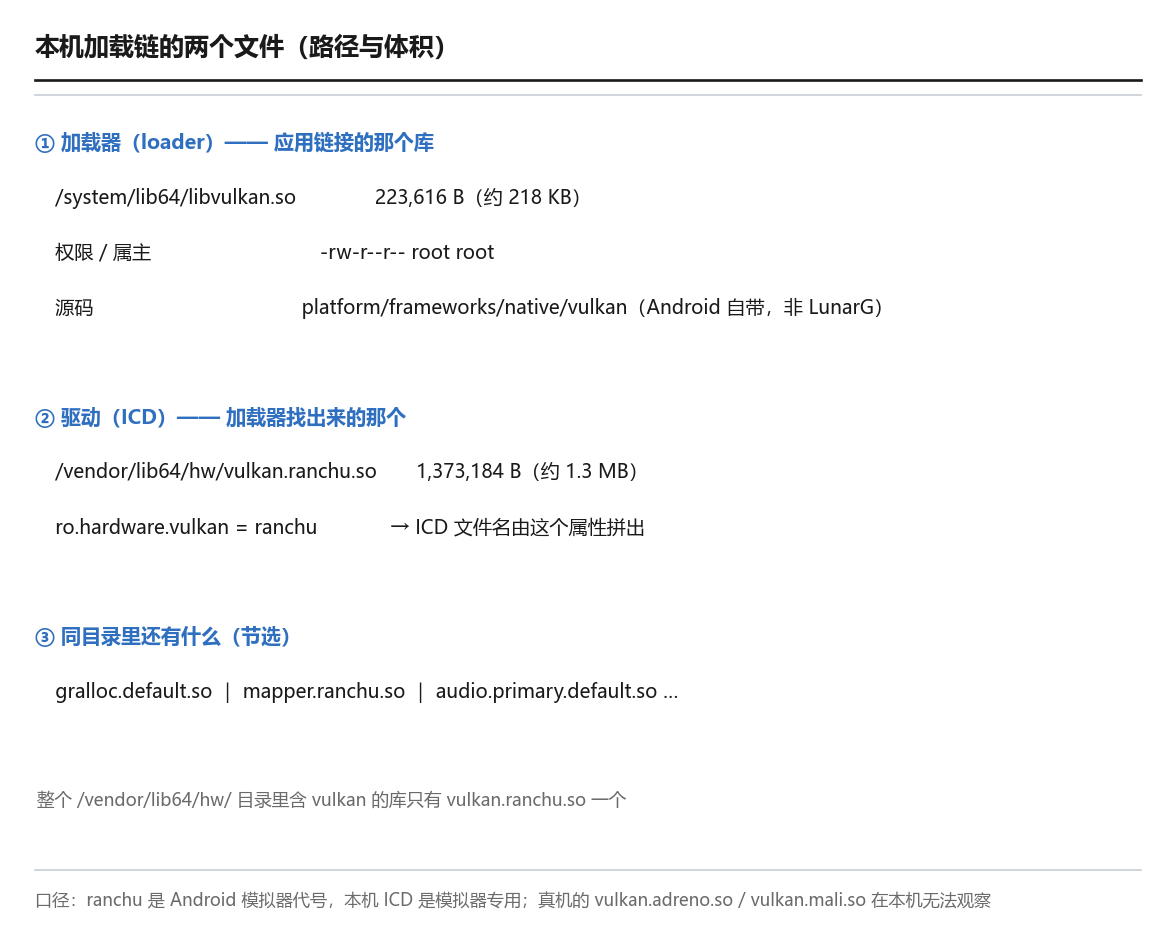
/system/lib64/libvulkan.so(223,616 B)与 /vendor/lib64/hw/vulkan.ranchu.so(1,373,184 B),ranchu 正是模拟器代号@ 本机实测(Pixel_7 AVD,Android 16)两个信息要留意。第一,vulkan.ranchu.so 里的 ranchu 是 Android 模拟器的代号,说明这台机器用的是模拟器专用 ICD(ro.hardware.vulkan = ranchu),不是真机的 Adreno/Mali 驱动。第二,这条链的形状(加载器 + ICD + HAL)是通用的,但具体文件名不能代表真机,正文只把通用画法给全,不用本机名去顶真机名。
口径警示 ①:本机 ICD 是
ranchu,真机厂商 ICD 的命名与路径在本机无法观察。凡用到vulkan.ranchu.so的地方,说的都是"这台模拟器",不是 Android 通例。
2.3 层(layer)怎么被搜索到
加载链还有一个常被忽略的分支:层(layer)。验证层是一类特殊的库,用于调试;加载器要按规则去"搜索"它们。AOSP 文档给出的规则是:不可调试应用只搜 native 库 libVKLayer_*.so;可调试应用另搜 /data/local/debug/vulkan。
为什么会有"可调试/不可调试"两种搜索范围?因为层是额外的库,加载它意味着信任它、也意味着可能的注入风险,所以系统对不可调试应用(普通发布 App)只搜系统的 public 路径,对可调试应用才放宽到开发目录。
2.3.1 层的发现路径分叉图
2.4 实测:logcat 里加载器正在找层的现场
这条"不可调试应用只搜 native 库"的规则,能不能在本机上看到活的现场?能。在本机 logcat 里,加载器启动时会直接打出它正在搜索的层目录:
D/vulkan: searching for layers in '/system/lib64'
D/vulkan: searching for layers in '/system_ext/lib64'
2.4.1 层搜索的 logcat 现场
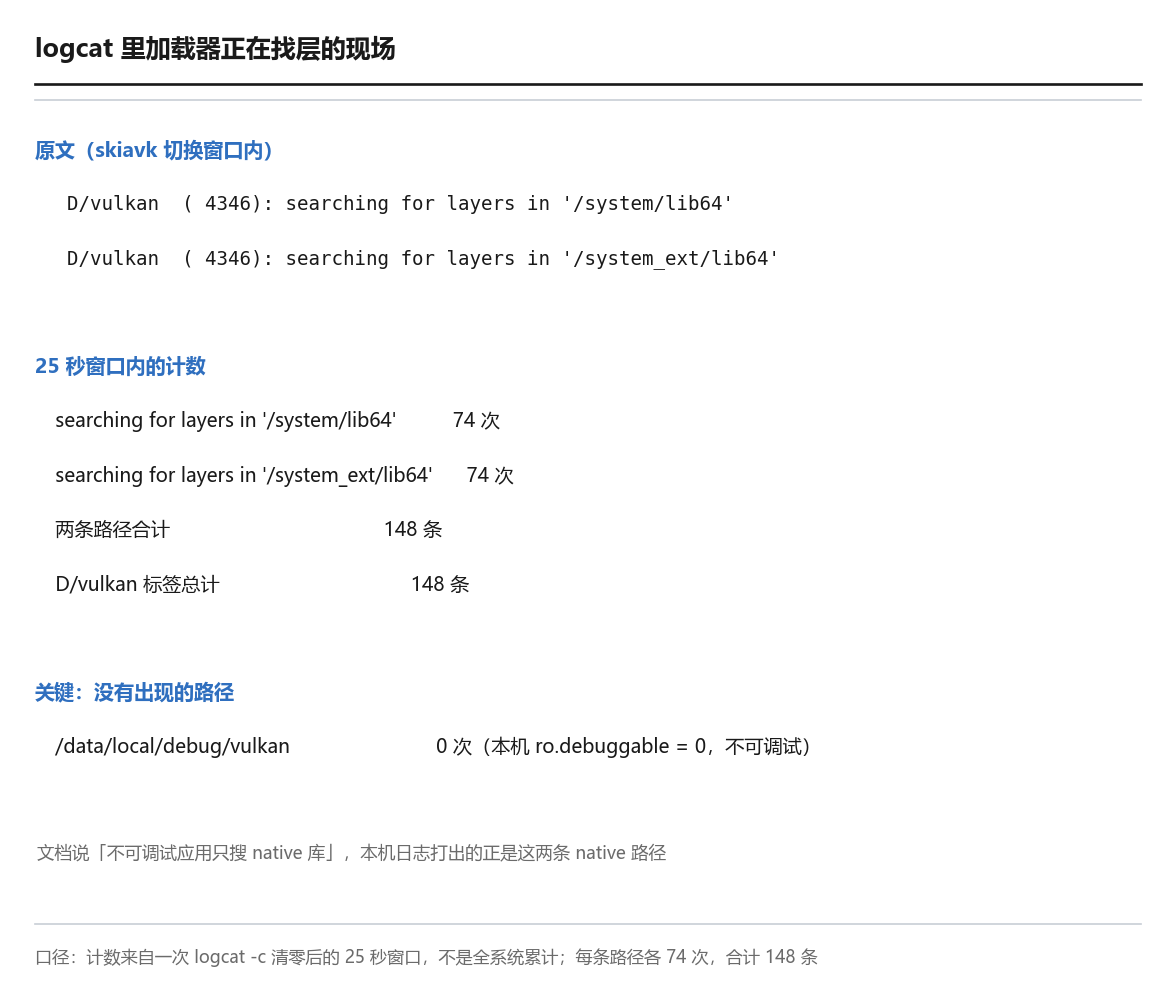
D/vulkan: searching for layers in '/system/lib64' 与 '/system_ext/lib64',25 秒窗口内合计 148 条、每条路径各 74 次,而 /data/local/debug/vulkan 一次都没出现@ 本机实测(Pixel_7 AVD,Android 16)这一屏特别漂亮,因为它是官方文档的规则在设备上现形:文档说"不可调试应用只搜 native 库",本机日志直接打出它搜的正是 /system/lib64 与 /system_ext/lib64 这两条 native 路径,而没有 /data/local/debug/vulkan,因为它不是可调试应用(ro.debuggable = 0)。规则与现场对上了。
顺便交代一个本篇尾部的伏笔:宿主启动日志第 43 行写着 Disabling implicit Vulkan layers to avoid compatibility issues,等于说本机的隐式验证层被人为掐掉。这导致第六章只能讲"开关树与属性可读性",无法演示"层真的被加载"。这是本机的限制,如实登记(§7.3)。
三、低开销到底省的是谁
好了,"Vulkan 是低开销(low-overhead)的渲染 API"。这句话几乎人人都背得,但要问它到底省的是谁的开销,很多人会答成"省 GPU 的活"。这一章要把这个"谁"说清。
3.1 省的是 CPU 侧的组织开销
好了,先说结论:Vulkan 省的是 CPU 侧"组织绘制"的开销,不是 GPU"干渲染"的开销。
一张帧从 App 到屏幕上,CPU 要做一堆"组织"工作:把命令录下来、把状态设好、把资源绑上、把对象创建好。Vulkan 的思路是:把很多原本在每次 draw 时重复的钱,提前一次性付掉,然后绘制时只需切换对象。
3.1.1 省的是谁:CPU 组织开销 vs GPU 干活的量
3.2 CPU 与 GPU 的分工:一张外部对照图
"CPU 管组织、GPU 管算"这个分工,用 Wikimedia Commons 上的一张CPU 与 GPU 分工图(CC0)做对照最直观。它把 CPU 的控制流与命令组织职责、GPU 的大规模并行计算职责画在左右两侧,中间的 API 层是两侧的调度入口。我们说"低开销",落点就是左侧这条 CPU 组织链上省事。它是通用对照图,不是 Android 专属,所以本篇只借它承担"分工"这一处的示意,不引申到具体驱动栈。

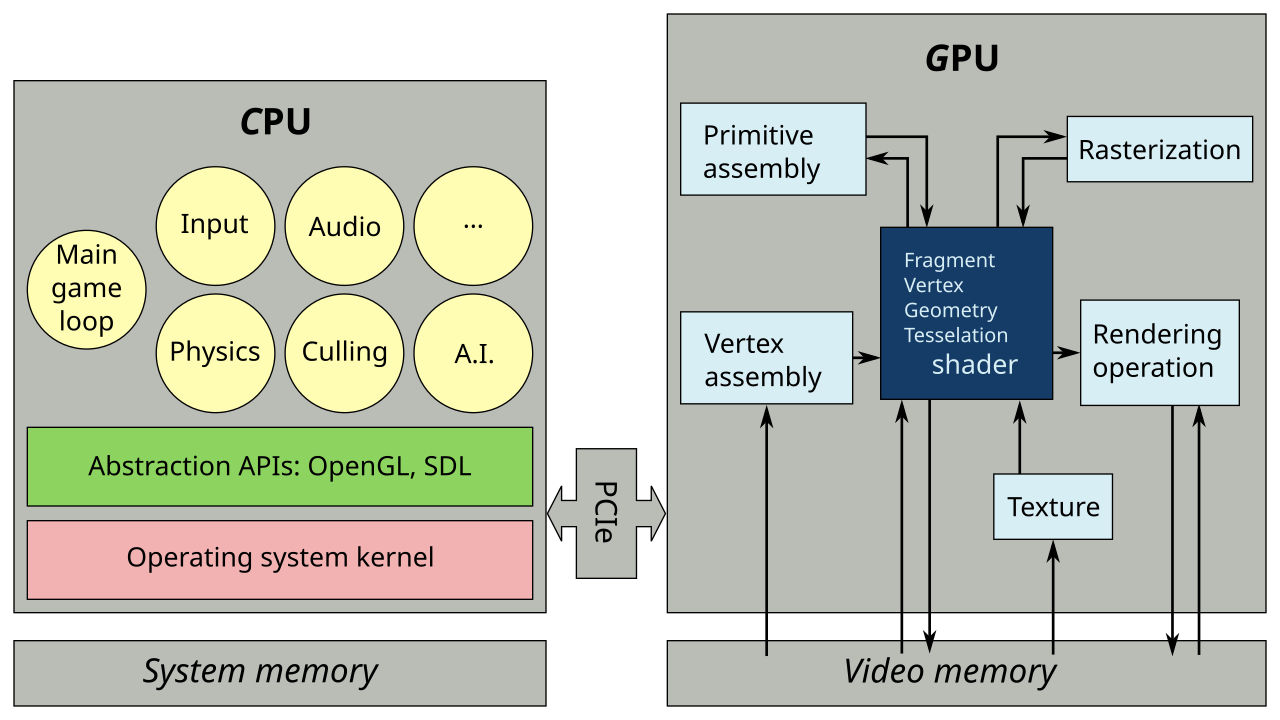
需要提醒一句:这是通用对照图,不是 Android 专属。它讲的是"两类处理器的分工"这条普适结论,本篇只借它承担「省的是左侧那条链」这一处的示意,不引申到具体的驱动栈或 Android 加载链。
3.3 "低开销"的完整含义:三条合起来
那么"省"到底是省在哪几步?把几条官方与教程的表述合起来,可以拆成三条,而且三条都指向 CPU:
- 状态打包成 PSO,绘制时只切换对象,每次 draw 不再重建状态;
- 命令缓冲可以多线程录制:不再只有一条串行的命令队列,多线程各自录,最后提交;
- 驱动侧变薄:框架侧能自己安排的都自己安排了,驱动需要"猜、补、修"的动作少了。
再补一个从应用侧看的视角。Vulkan 设计指南列了应用侧"必须自己做"的事:避免软件模拟(VK_PHYSICAL_DEVICE_TYPE_CPU)、渲染期做旋转(preTransform)、减少 render pass 数量、选合适的内存类型、按更新频率分组 descriptor。"必须自己做"反过来读,就是"Vulkan 把这些负担从驱动搬到了应用",你获得了控制权,也接过了责任。
三条里最容易被一句"状态提前打包"糊过去的是第一条,值得把"打包"这个词拆开看。PSO(Pipeline State Object,管线状态对象)打包的不是某一个状态,而是一组在绘制前就固定下来的状态。按 Vulkan 规范的分段,一份图形管线对象大致覆盖下面这些段——逐段释义,这也是读任何 Vulkan 代码时最先要对上的清单:
- 顶点输入(vertex input):顶点缓冲的绑定与属性格式,哪个缓冲出哪几个分量、步长多少;
- 输入装配(input assembly):图元拓扑是三角形、三角形扇还是线段,是否带索引;
- 视口与裁剪(viewport / scissor):画到画面哪一块(这一项常被声明为动态状态,录制时再改);
- 光栅化(rasterization):填充模式、面剔除方向、深度偏置等;
- 多重采样(multisample):采样数与采样遮罩;
- 深度与模板(depth-stencil):是否开深度测试、比较函数、模板操作;
- 颜色混合(color blend):每个颜色附件的写掩码与混合因子——这里正是取代
glBlendFunc那一族调用的位置; - 动态状态(dynamic states):显式声明"这几项我要在录制时改",剩下的就被对象锁死。
于是"提前打包"的原理就清楚了:上列这些项只要在绘制中途被改一次,GLES 侧就得重设一遍并触发驱动的状态重算;Vulkan 侧则把它们做成一个不可变对象,绘制时切换的只是对象引用。切换引用比重新设置一整套状态便宜得多,省下来的正是驱动的比较、校验与推导。
第二条"多线程录制"有个容易踩的实现细节:VkCommandPool 不是线程安全的,所以正确做法是"每线程一个池",各自录各自的命令缓冲,最后统一提交到队列。要注意"多线程"省的不是 GPU 的时间,而是把 CPU 侧串行的录制工作摊到多个核上——如果录制量本来就很小,这条的收益近乎为零。
第三条"驱动侧变薄"听着最抽象,落到可指认的表现上其实就三件事:隐式同步变成显式栅栏(驱动不再替你在合适位置插等待)、状态跟踪变成对象校验(不再逐次比较全局状态的差异)、内存管理变成显式选择(应用按用途挑 memory type,驱动不再替所有资源猜最优位置)。这三件事合起来才是"驱动变薄"的完整含义——它薄掉的是替应用做决定的那些逻辑,不是薄掉功能。
3.3.1 PSO vs 全局状态机对照图
3.4 反鸡汤:Vulkan 不保证"自动更快"
写到这里必须踩一脚刹车,因为这一章最容易滑向宣传。《Vulkan 教程 18 · 阶段性总结》 的原话:
有些场景 OpenGL 与 Vulkan 性能没有任何差别……不需要多线程或非 CPU 密集时,用 OpenGL 即可。
这句是反鸡汤的好句。它说明"低开销"是指当你确实吃到了 CPU 组织开销这块瓶颈时,Vulkan 给了你把它砍薄的工具(多线程录制、PSO、薄驱动),但砍工具 ≠ 一定更快。如果你根本没到那个瓶颈,或没用好那些工具,两者可以没有差别,甚至 Vulkan 因为状态更复杂会更慢。
同理,《理解 Vulkan 的核心优势》自己也有一段"Vulkan 不是自动更快"的免责段,本篇把它正面引用。本篇全篇不引用任何"单核开销降低 XX%""同步开销降低 XX%"这类带精确百分比的无源数字,因为不可核对,一律改为定性表述。这是§8 那条"五处流传说法"的地基之一。
四、版本与门槛:六台阶时间线
OK,入口除了"怎么加载",还有一个"够不够用"的问题,也就是版本。这一章把版本谱系理清,并演示本机上同一时刻能读到多少个互相打架的号。
4.1 六个台阶:从 1.0 到 1.4 与 Android 版本的对应
把官方原生引擎支持页的映射与 AOSP 侧的要求整理成一条干净的时间线:
| 时间点 | 事件 |
|---|---|
| Android 7(API 24) | 首次引入 Vulkan 1.0,入口出现 |
| Android 9(API 28) | 支持实现 Vulkan 1.1 |
| Android 10(API 29) | AOSP 要求新 64 位设备最低支持 Vulkan 1.1 |
| Android 13(API 33) | 起始设备须支持 Vulkan 1.3 |
| Android 14 及以后 | CDD 要求所有支持 Vulkan 的设备必须带 1.1 驱动 |
| Android 16 | 起始设备须支持 Vulkan 1.4 |
4.1.1 六台阶版本时间线图
这条时间线的用法:它把"我这台设备能不能用 Vulkan 的某个特性"变成一个两步可查的问题,第一步看 Android 版本(决定"该不该有"),第二步看驱动报的 apiVersion(决定"实际有没有")。两项都对上,才谈得上用。这个"两步核对"正是下一章的核心判据。
这里得补两条容易混的口径。第一条是"要求"的主语不同:CDD 里那些"须支持 1.3 / 1.4"的条款,主语是起始设备——也就是某个 Android 版本之后新上市的设备;它并不回头要求存量设备升级驱动。第二条是"驱动门槛"另有单独一条:从 Android 14 起,所有支持 Vulkan 的设备必须带 1.1 驱动。两条合起来才解释得通一个常见现象:同一代 Android 上,新机和旧机的 Vulkan 版本可以差出两个台阶。
那官方为什么要逐级抬升?因为它撬动的是厂商必须实现的特性集合。Vulkan 每抬一个大版本,都会把一批扩展收进核心,变成"可以假定存在"的必需项。于是"设备报 1.3"这句话的实际含义不是"数字更大",而是"有一批特性你有权假定它存在"。这也是本篇要花整章讲版本的原因:它决定了你写代码时能假定什么、必须探测什么。
至于那个大整数怎么读,写成参数式更清楚:
apiVersion = major<<22 | minor<<12 | patch
其中:major 占最高位段、minor 占中段、patch 占最低 12 位
      判定时先看 major/minor,patch 一般只影响补丁级差异
读取顺序也有讲究:应用可以先调 vkEnumerateInstanceVersion 问"loader 支持到哪一版",再在创建实例时声明自己要用哪一版,最后从物理设备属性里读"设备实际报哪一版"。三次询问问的是三个不同的对象,所以三个答案可以合法地互不相同——这正是 §4.2 那六个版本号并存的技术根据。
4.2 一个重要的现实:同一台机器上会同时读出六个版本号
好了,讲了半天时间线,落回现实就会撞上一件非常反直觉的事:同一台机器的同一个时刻,你能读到六个彼此不一致的 Vulkan 版本号,而且它们各自都"没说谎"。
它们的来源不同,报的是六件不同的事:
| 报数来源 | 读取位置 | 数值 | 解码 |
|---|---|---|---|
| 宿主声明的 CPU Vulkan 版本 | ro.cpuvulkan.version |
4210688 | 1.4.0 |
dumpsys gpu 的 cpuVulkanVersion |
同上同源 | 4210688 | 1.4.0 |
dumpsys gpu 的 vulkanVersion |
guest 侧实际加载到的 | 4206592 | 1.3.0 |
cmd gpu vkjson 顶层 apiVersion |
加载器实例自报 | 4210688 | 1.4.0 |
cmd gpu vkjson 设备侧 apiVersion |
SwiftShader ICD 自报 | 4202496 | 1.2.0 |
宿主启动日志 guestVulkanMaxApiVersion |
模拟器给 guest 设的上限 | — | 1.3.0(并明说 "Vulkan 1.4 不启用") |
六个号,1.4.0 出现了三次、1.3.0 两次、1.2.0 一次,外加日志里一句"1.4 不启用"。它们不是在吵架,而是在报六件不同的事:宿主声明、guest 上限、加载器实例、设备自身。把它们当"版本就该是一个数"来看,就会晕;把它们当成"每个组件报自己的",反而一秒就顺了。
4.2.1 同一台机器上的六版本号实测面板
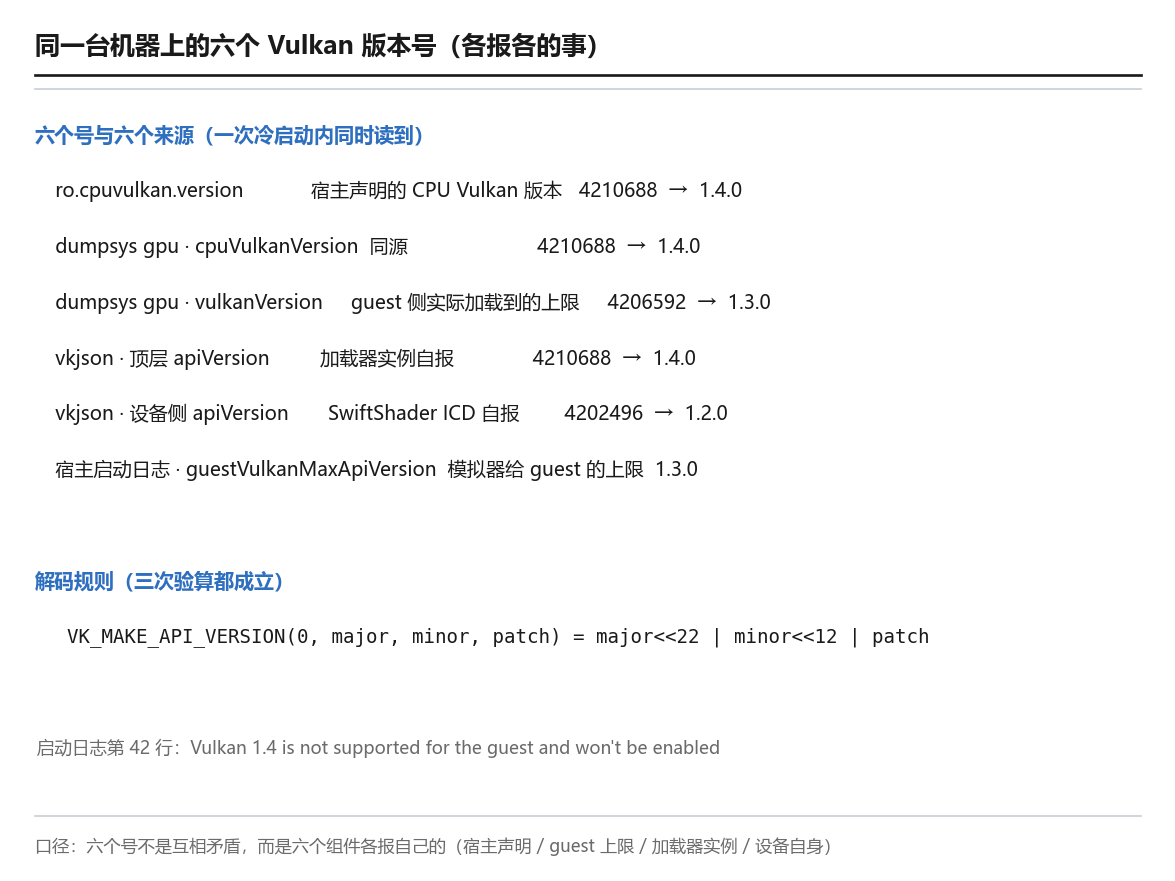
ro.cpuvulkan.version=1.4.0、dumpsys gpu 的 vulkanVersion=1.3.0、vkjson 设备侧=1.2.0、guest 上限=1.3.0 并存,六个号各报各的事@ 本机实测(Pixel_7 AVD,Android 16)4.3 apiVersion 的编码与判定顺序
OK,要读懂上面那串数字,先要知道 Vulkan 版本号是怎么编码成一个大整数的。官方规则:
encoding(major, minor, patch) = VK_MAKE_API_VERSION(0, major, minor, patch)
                              = major<<22 | minor<<12 | patch
用这条规则把三个数各验算一次:
4210688 = 1<<22 + 4<<12(1<<22=4194304,4<<12=16384,相加正好 4210688)→ 1.4.0;4206592 = 1<<22 + 3<<12(3<<12=12288)→ 1.3.0;4202496 = 1<<22 + 2<<12(2<<12=8192)→ 1.2.0。
三次都成立,这套编码不是摆设,是真能反推的。
4.3.1 apiVersion 编码结构图
apiVersion 的编码:major<<22 | minor<<12 | patch,高位 major、中位 minor、低位 patch;读取时先对 Android 版本门槛,再对驱动 apiVersion@ 本系列绘制判定顺序也就清楚了:先看 Android 版本门槛(该不该有),再看驱动 apiVersion 的 major/minor(有没有),两项核对后才决定能不能用某个特性。本机那个"1.4.0 与 1.3.0 并存"的现象,离开这段编码解释是没法圆回来的。
口径警示 ⑤:六个版本号各说各话,是本系列至今最典型的"多个来源对不上"案例。本篇不把它们合并成一个数,也不外推,而是用上面那张表把"谁报的哪个号"分开列,这正是研究阶段那条"没人说清默认是谁"的答案面。
五、后端怎么被选中:切换实验
OK,这是本篇最核心、也最可能出硬证据的一章。前面讲的是"加载链"这种偏静态的东西;这一章讲"渲染后端怎么被选中",并且亲手做一次能复现的切换实验。
5.1 后端选择:RenderPipelineType 与两条 pipeline
Android 的界面渲染(HWUI)在初始化时,会按一个属性决定用哪条渲染管线。源码路径在 CanvasContext::create,它按 Properties::getRenderPipelineType() 在两条 pipeline 里选一条:SkiaVulkanPipeline 或 SkiaOpenGLPipeline。这个判断来自《Android 渲染——重温硬件加速下 Vulkan 篇》(已读全文,基于 Android 12 源码)。
5.1.1 后端选择流程分叉图
getRenderPipelineType() 判定后分叉成 SkiaVulkanPipeline / SkiaOpenGLPipeline 两条,最终都交手给 Surface 与 BufferQueue@ 本系列绘制驱动这条选择的开关,就是一个调试属性:debug.hwui.renderer。可取值如 skiagl(Skia + OpenGL)与 skiavk(Skia + Vulkan)。这也是社区里"改个属性切后端"传说的源头。
5.2 实验:把后端从 OpenGL 切到 Vulkan,读同一字段
实验设计:用一个字段做判据,就是 dumpsys gfxinfo 里的 Pipeline= 那一行。切换前读一次、切换后读一次、再切回读一次,三态对照。
先在默认态(skiagl)读:
Pipeline=Skia (OpenGL)
(gfxinfo 全文 12,398 字节,含完整 GPU 缓存段、View 树)
执行 setprop debug.hwui.renderer skiavk,读回属性确认写进去了,然后强制停止并重新拉起目标应用,再读同一字段,结果:
(gfxinfo 全文只剩 146 字节,连 Pipeline= 那一行都不存在)
看到吗?Pipeline= 那一行消失了。 但先别急着下"切换失败"的结论,因为"字段读不到"有个必须排除的可能:它可能不是没生效,而是被测对象根本没走到那一步。这就需要一个关键的旁证:dumpsys gpu 里的 Vulkan 计数。
5.2.1 后端切换实验的三态对照
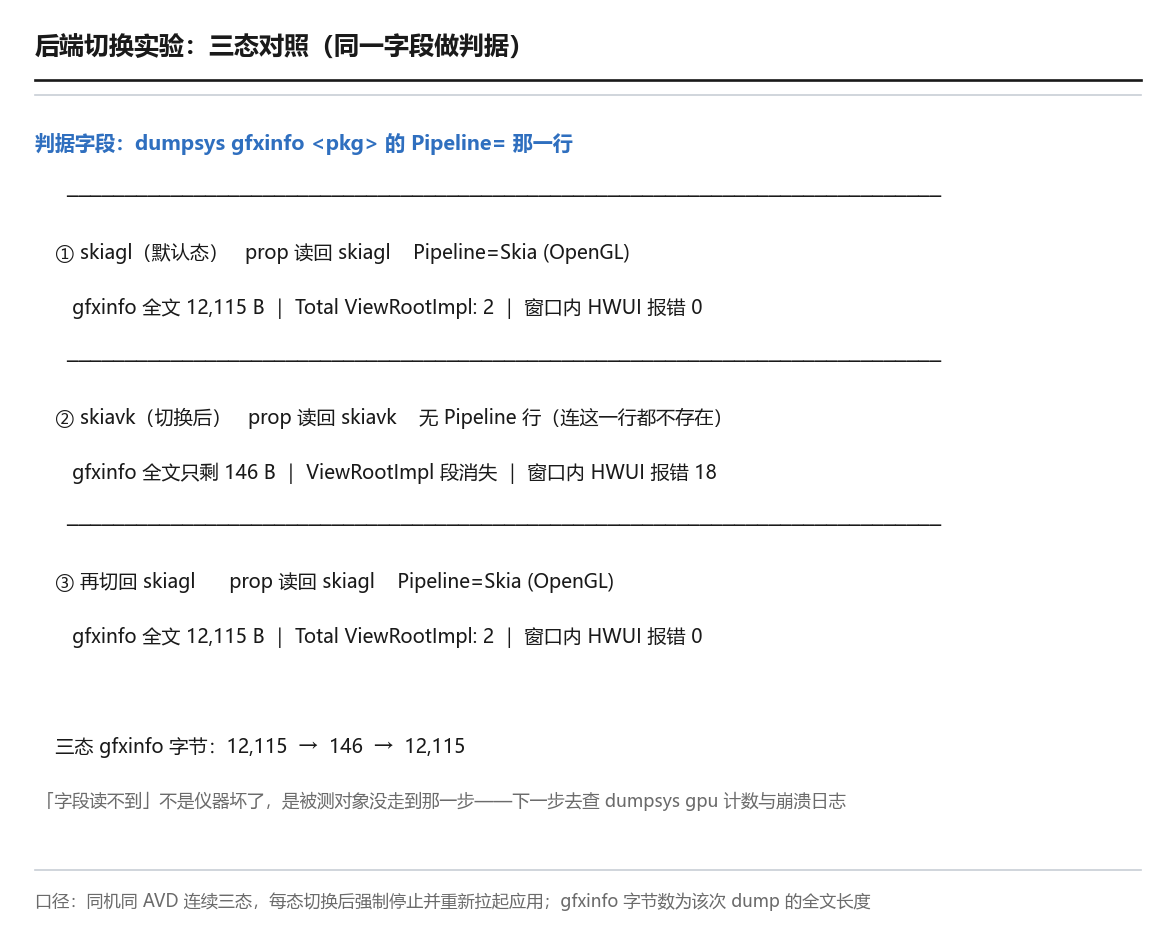
skiagl → Pipeline=Skia (OpenGL)(12,398 B);skiavk → 无 Pipeline 行(146 B);再切回 skiagl → 恢复@ 本机实测(Pixel_7 AVD,Android 16)5.3 最关键的一处证据:Vulkan 设备其实建起来了
OK,排除了"属性没写进去"(读回 skiavk,rc=0)之后,真正让结论翻转的是同一个采样窗口里 dumpsys gpu 的计数:
| 计数项 | 切换前(skiagl) | 切换后(skiavk) |
|---|---|---|
app_createdVulkanDevice |
0 | 1 |
app_cpuVulkanInUse |
0 | 1 |
vkLoadingCount |
0 | 33 |
5.3.1 dumpsys gpu 的 Vulkan 计数对照
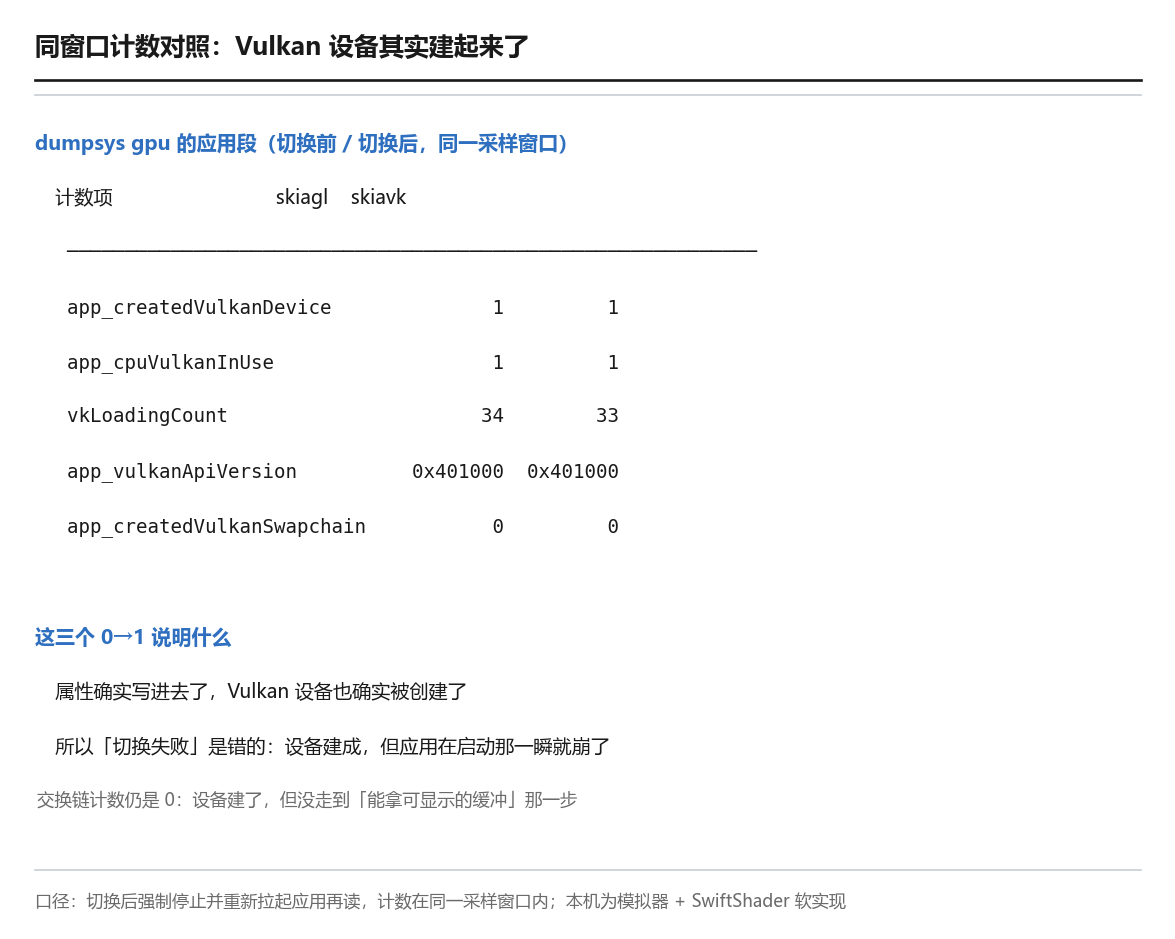
dumpsys gpu 同窗口计数对照:切到 skiavk 后 app_createdVulkanDevice 0→1、app_cpuVulkanInUse 0→1、vkLoadingCount 0→33,证明 Vulkan 设备确实被创建了,不是属性没写进去@ 本机实测(Pixel_7 AVD,Android 16)这三个 0→1 是本章最硬的一句读数,它们证明:属性确实写进去了,Vulkan 设备也确实被创建了(app_createdVulkanDevice 从 0 变成 1)。所以"切换失败"这个说法是错的。真相是:切换是"生效"的,Vulkan 设备也真的建起来了,但应用在启动那一瞬就崩溃了,所以 Pipeline= 那一行根本没来得及被打出来。
5.4 崩溃的因果链:五层,每一层都有句子作证
于是"为什么 Pipeline= 读不到"的答案,落进一条完整的五层因果链,每一层都能在 logcat 里指认:
第 1 层,属性写入。 setprop debug.hwui.renderer skiavk,读回 skiavk,rc=0,写进去了。
第 2 层,Vulkan 设备建成。 dumpsys gpu 计数 0→1,设备真建了。
第 3 层,取图失败。 W/HWUI: Error reading image: -30001!(25 秒窗口内 ×74)。
第 4 层,surface 包装失败。 E/HWUI: SkSurfaces::WrapAndroidHardwareBuffer failed(×74)、E/HWUI: VulkanSurface::dequeueNativeBuffer called with an invalid surface!(×74)——两行合计 148 条,即每轮崩溃各出一次。
第 5 层,应用侧空指针崩溃。 java.lang.NullPointerException: Attempt to invoke virtual method 'int android.graphics.Bitmap.getHeight()' on a null object reference,栈顶 at com.android.launcher3.icons.DotRenderer.<init> → FATAL EXCEPTION: main → signal 9 (Killed)。
5.4.1 skiavk 崩溃的五层因果链 logcat
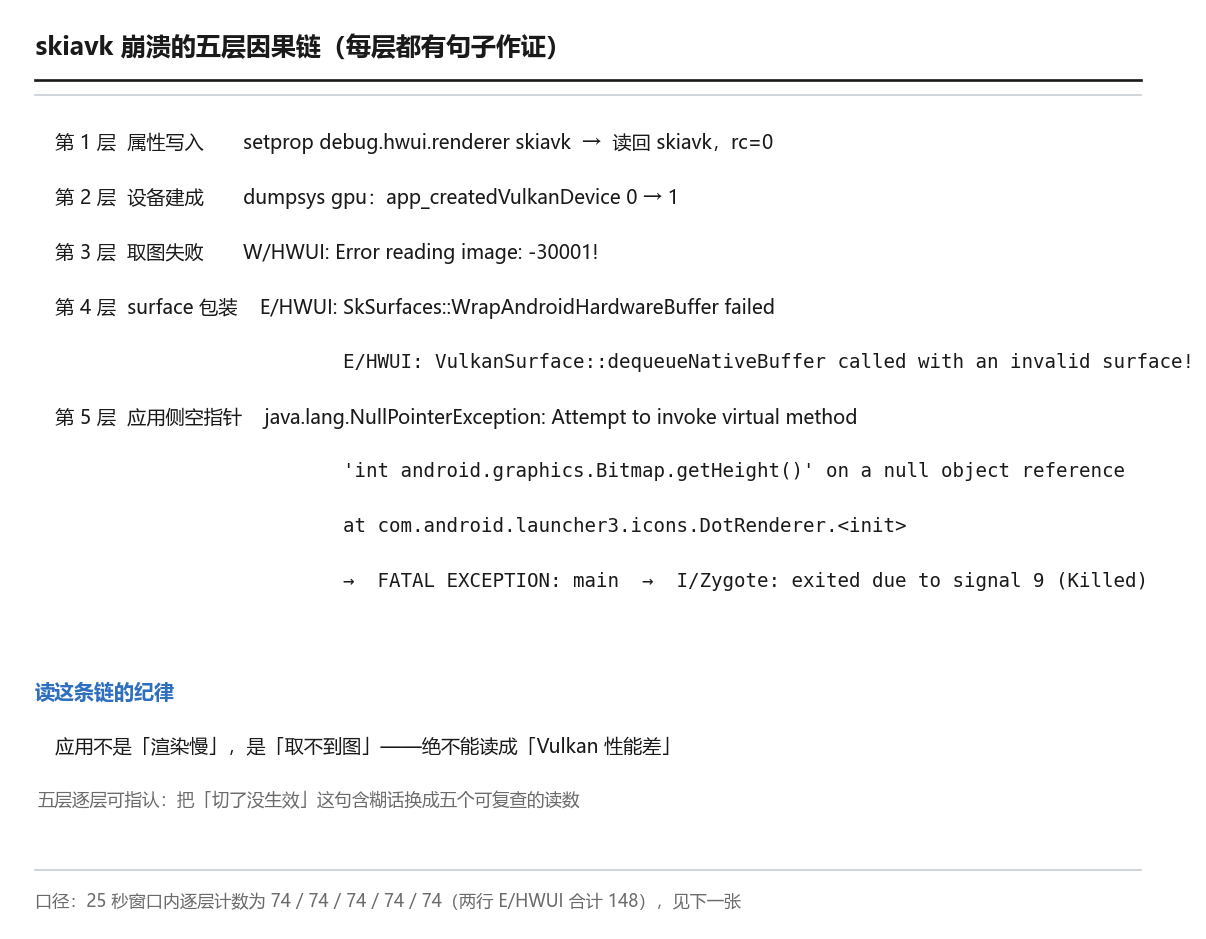
Bitmap.getHeight() on null → DotRenderer.<init> 抛 NPE → 进程被杀,五层逐层可指认@ 本机实测(Pixel_7 AVD,Android 16)5.4.2 skiavk 崩溃循环计数
这个循环有多频繁?用 logcat -c 清零后开一个 25 秒窗口统计:FATAL EXCEPTION: main ×74、has died: fg TOP ×74、signal 9 (Killed) ×74、E/HWUI ×148、D/vulkan ×148。约每 0.34 秒一轮:拉起、一瞬崩溃、被杀、再拉起。
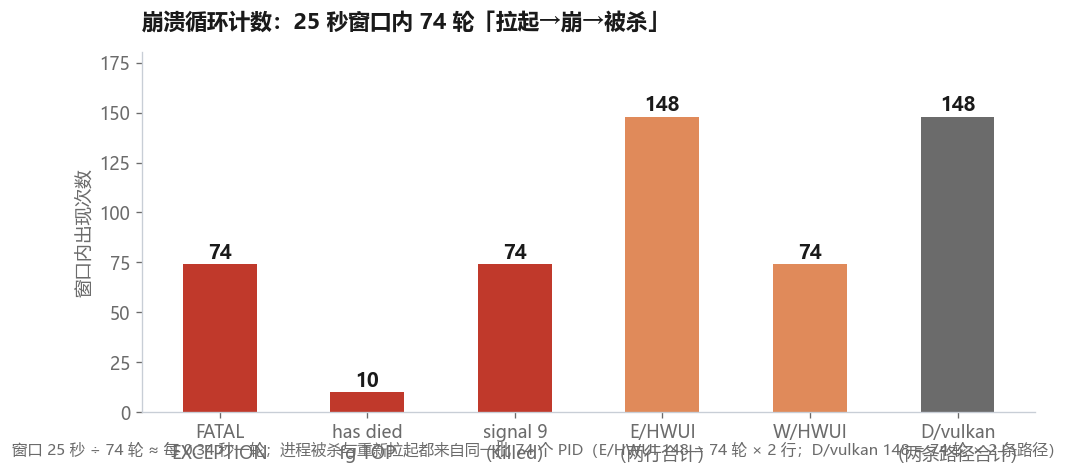
FATAL EXCEPTION ×74、has died: fg TOP ×74、signal 9 ×74、E/HWUI 148 条(两行各 74),约每 0.34 秒一轮崩溃重启@ 本机实测(Pixel_7 AVD,Android 16)这段因果链是本篇最硬的一处证据,它把"切了没生效"这句含糊话,换成五个可指认的读数。同时必须说清两件事:
一是应用不是"渲染慢",是"取不到图"。所以这条链绝不能读成"Vulkan 性能差",它读的是"这条路在本机走不通"。走不通的根因与本机环境吻合:guest 版本上限 1.3、SwiftShader 软实现、合成不走 Vulkan(§7.2)。
二是它不能外推为真机结论。本机是模拟器;真机上 skiavk 可能是正常工作的(抓帧工具甚至要主动 setprop debug.hwui.renderer skiagl 把 HWUI 的 Vulkan 关掉,见 §8.3 旁证)。"本机启动即崩"是这台模拟器的产物。
5.5 驱动在栈里的位置:一张外部对照图
还差一张位置图,给"驱动侧变薄"补上。用 Wikimedia Commons 的Linux AMD 图形驱动栈图(1280×720,CC BY-SA 4.0),它含 Vulkan 层,用来回答"驱动到底在哪一层"。沿着图从上往下,应用在最上,Vulkan/GL 中间 API 居中,Mesa 与内核驱动依次往下,最下面是硬件。我们说"驱动侧变薄",指的就是这张图中间靠下的那一段:框架与 Mesa 把原本驱动要"猜、补、修"的动作替了,应用侧接手更多。它是通用驱动栈,不是 Android 专属,所以本篇只借它承担位置示意,不当作 Android 栈的全貌。

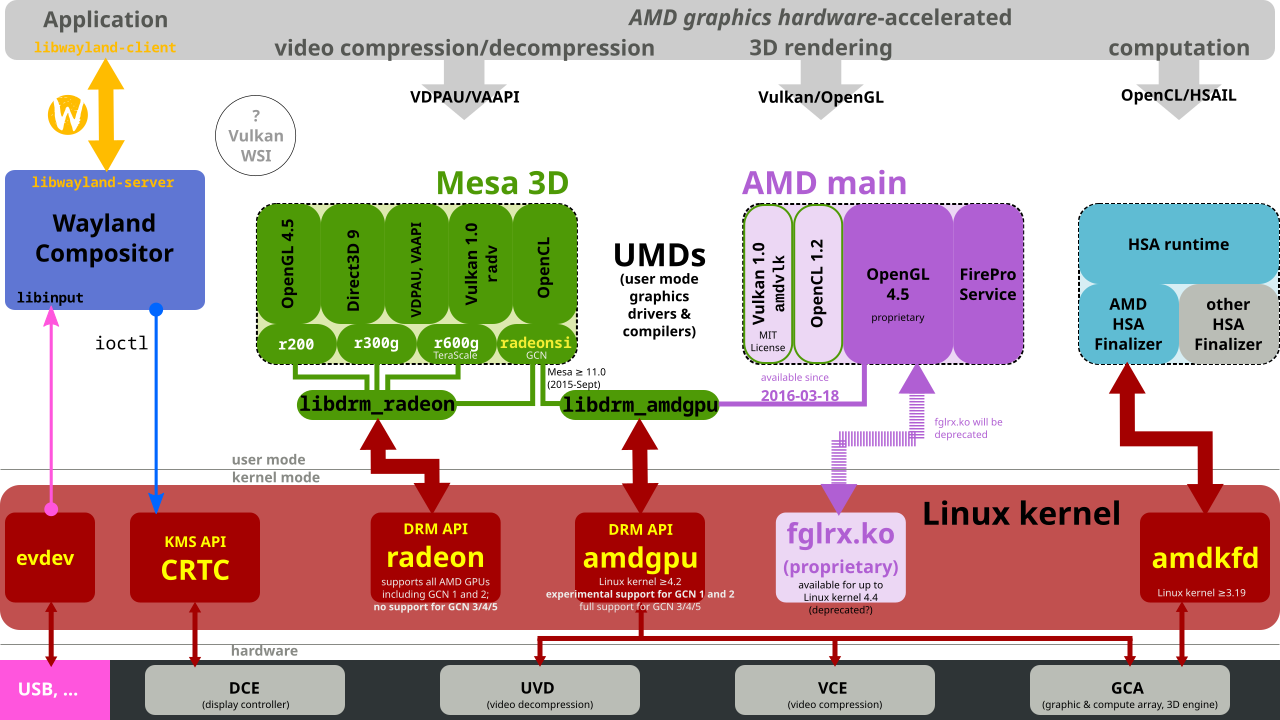
这张图也有边界要说清:它是通用 Linux 驱动栈,不是 Android 专属。Android 的对应关系要换几个名字——内核驱动这一层在 Android 上由厂商 GPU 内核模块(KGSL / Mali kbase 一类)承担,Mesa 的位置由厂商 HAL 与 ICD 库顶上,而"应用"那一格在本篇讲的场景里是 HWUI 的 Skia 后端。形状可借,名字不可套,这是本篇引用外部对照图的一贯口径。
六、验证层与调试开关
先来看看这一章:它很短,只讲"入口怎么开调试的绿灯",不讲验证层内部怎么实现(那是《图形性能剖析工具链》的题域)。
6.1 验证层的开关树
验证层(validation layer)是挂在加载链上的额外库,用于在开发期抓 API 用错。它有三种部署方式:打包进 APK、改全局属性、按应用指定,各自的打开位置不同。我把 NDK 的《Vulkan 验证层》给出的可操作路径,整理成下方这张开关树,按部署方式分叉,读者照着自己的调试场景走对应分支即可。
- 打包进 APK:把
libVkLayer_khronos_validation.so放进jniLibs/<abi>/; - 外部加载:全局走
setprop debug.vulkan.layers; - 按应用:
settings put global enable_gpu_debug_layers 1+gpu_debug_app+gpu_debug_layers; - 单一层名:统一用
VK_LAYER_KHRONOS_validation。
再多说两句"它能查什么、代价是什么",因为这两点决定了它只能待在开发期。
能力上,VK_LAYER_KHRONOS_validation 主要管四类事:参数与用法校验(枚举值越界、结构体链写错、必需项没填)、对象生命周期(谁在谁之前销毁、句柄用完有没有释放)、同步校验(读写同一资源时的栅栏是否缺失,这一项开销最大、通常要单独打开)、以及最佳实践提示(不是错,但是会让你的应用在真机上吃亏的写法)。这四类校验如果自己做,等于在驱动里重写一遍;交给验证层,代价就被移出了日常运行期。
代价上,它只该用于开发期。验证层要拦下每一次 API 调用再做检查,还要跟踪对象与同步,开销可观(具体幅度取决于开了哪几项校验)。更要紧的是它默认不随应用分发:把层库打包进 APK 会撑大包体,而在不受信任的设备上加载额外库本身就带风险——这也正是宿主会在启动日志里明写"禁掉隐式层"的原因(第 43 行,见 §7.2)。
6.1.1 验证层开关树图
6.2 实测:debug 属性的可写性自查
上面这些开关大多是 debug.* / global 属性。一个现实问题是:shell 身份到底能不能写这些属性? 拿本机自查一下(所有权属检查,不属于"层被加载"演示):
$ setprop debug.test.zz 1; getprop debug.test.zz
1
$ setprop debug.hwui.renderer skiavk; getprop debug.hwui.renderer
skiavk
6.2.1 debug 属性可写性自查面板
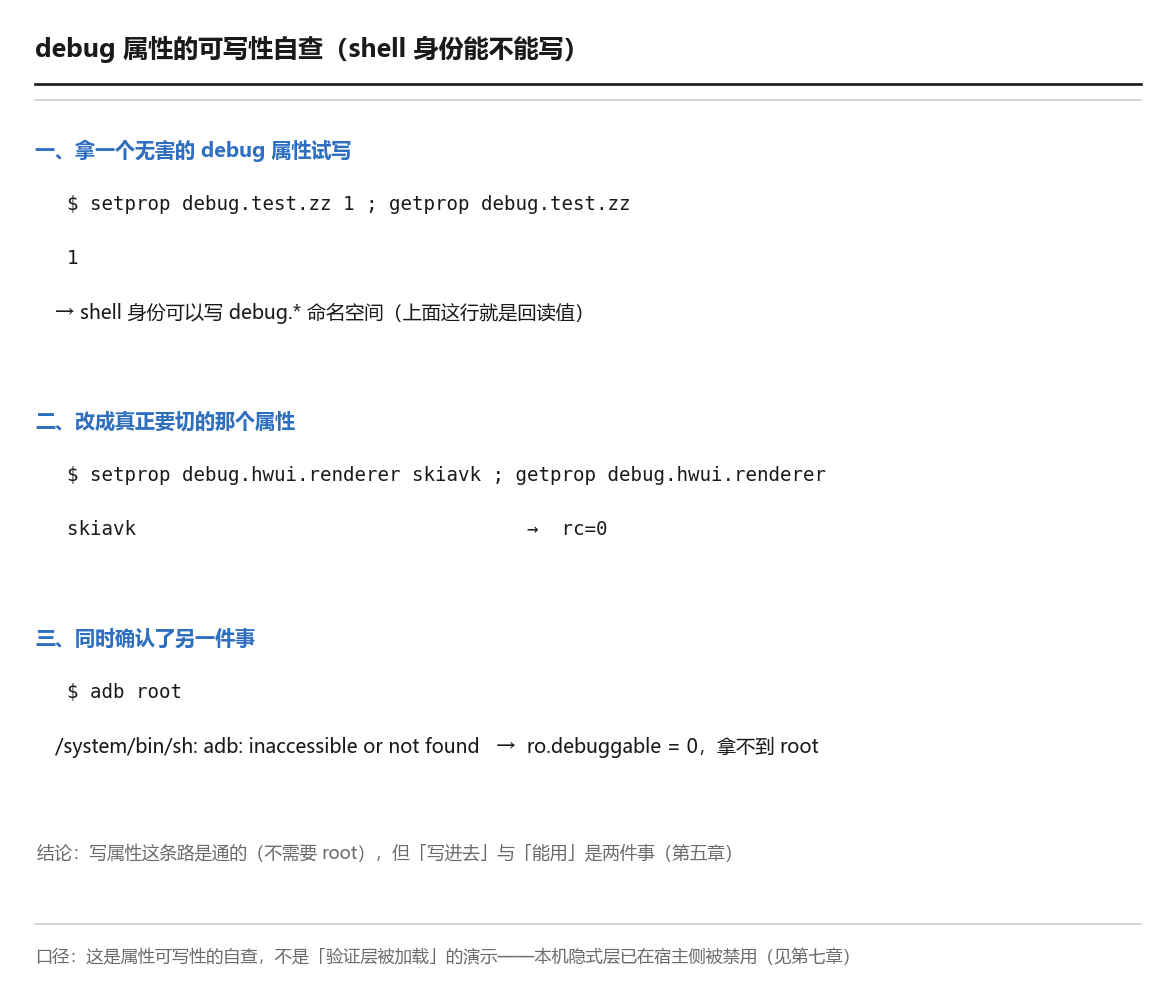
debug.test.zz 与 debug.hwui.renderer 都能读回(rc=0);同时 adb root 拿不到(ro.debuggable = 0)@ 本机实测(Pixel_7 AVD,Android 16)这个自查其实回答了第五章实验的一个前置疑问:如果 setprop 被权限挡住,第五章那个实验根本做不了。本机 debug.* 在 shell 下可写,所以切换能落进去。注意这里只查了"属性可写",没有演示"层被加载",因为宿主日志第 43 行明写隐式层被禁用,如实登记。
七、实测:本机这台设备的 Vulkan 入口
好了,把前面几章讲的概念,落回本机这台设备上一次读净。这一章全部是本机真图(cmd gpu vkjson、模拟器限制、RenderEngine 段),是十一章里真图密度最高的一章。
7.1 cmd gpu vkjson:设备上报了什么
OK,本机有一条命令能一次性拿到驱动自报的设备信息:cmd gpu vkjson。它输出的有效 JSON 有 42,694 字节,关键字段:
"apiVersion": 4210688                       # loader 实例自报 = 1.4.0
"device": {
    "apiVersion": 4202496                   # SwiftShader ICD 自报 = 1.2.0
    "driverName": "SwiftShader driver"
    "deviceName": "SwiftShader Device (LLVM 10.0.0)"
    "deviceType": 4                          # VK_PHYSICAL_DEVICE_TYPE_CPU
    "vendorID": 6880
    "deviceID": 49374
}
7.1.1 vkjson 设备上报面板
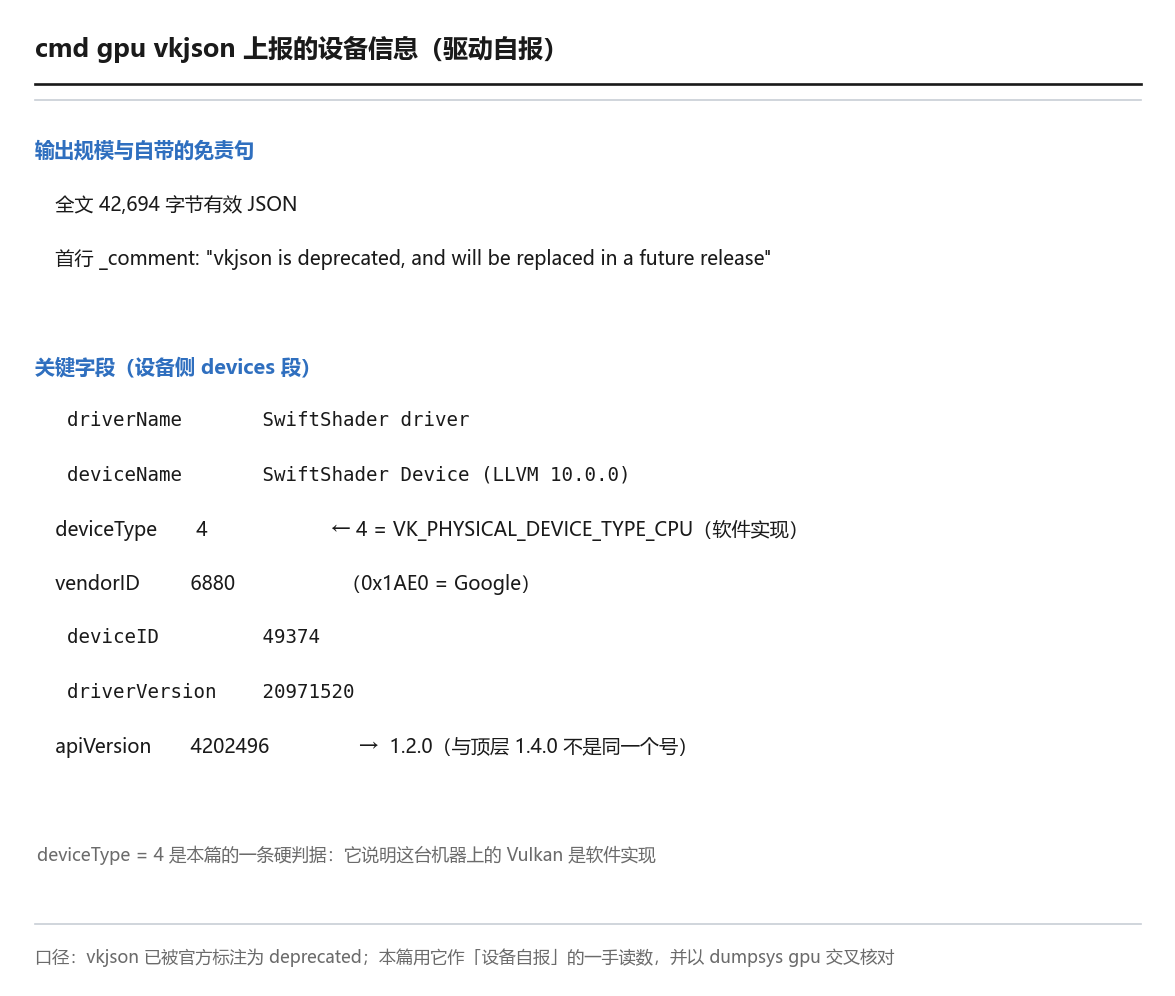
cmd gpu vkjson 上报的设备信息:driverName: SwiftShader driver、deviceType: 4(CPU 类型)、vendorID: 6880;顶层 apiVersion 1.4.0 与设备侧 1.2.0 不是同一个号@ 本机实测(Pixel_7 AVD,Android 16)留意三点。第一,deviceType: 4 是 VK_PHYSICAL_DEVICE_TYPE_CPU,正是设计指南里警告要避免的"软件模拟"类型。第二,工具输出里自带一句 vkjson is deprecated, and will be replaced in a future release,说明命令本身在弃用路上,但它现在是能用的。第三,这正好和 §4.2 那张六个版本号表对上:顶层 1.4.0(loader 报的)、设备侧 1.2.0(ICD 报的),是同一份 JSON 里就存在的两个号。
既然拿到了这份 JSON,就顺手把几个字段逐项读一遍——它们各自的读法并不一样:
deviceType是枚举不是自由值:0 = 其他、1 = 集成 GPU、2 = 独立 GPU、3 = 虚拟 GPU、4 = CPU。只有 0 到 3 才谈得上"有 GPU";读到 4,说明这条 Vulkan 路径全部由软件实现,任何性能类结论都不适用。driverName/deviceName是给人看的字符串,不承担判据。它们随厂商实现变化,不能拿来做if driverName == ...这类判断;要判就用vendorID/deviceID这类数字。apiVersion出现两次,含义不同:顶层是 loader 实例自报的,设备段里是 ICD 自报的。1.4.0 与 1.2.0 并存,根因就在这。driverVersion是厂商自己的编码,规范没有规定它的位域——它只在同一厂商内部可比,跨设备比较没有意义。
再看 dumpsys gpu 那组加载计数,它们的语义也各不相同,值得分清:
| 字段 | 读的是谁 | 本机默认态 |
|---|---|---|
glLoadingCount |
OpenGL ES 驱动被加载的次数 | 1 |
angleLoadingCount |
ANGLE 被加载的次数 | 0 |
vkLoadingCount |
Vulkan 驱动被加载的次数 | 0 |
driverVersionCode |
驱动包版本号 | 0 |
默认态下 vkLoadingCount = 0 是个关键读数:它说明这台机器在没被要求走 Vulkan 之前,连 Vulkan 驱动都还没加载过。这与第五章"切到 skiavk 之后 vkLoadingCount 变成 33"构成了完整的前后对照——那个 0→33 不是随机波动,而是"驱动真的被拉起来了"的直接证据。
7.2 模拟器的三处硬限制
先来看看这台设备为什么 Vulkan 被"关小了"?答案不在设备里,在宿主启动日志里。抓出三处硬限制:
第42行  INFO | Vulkan 1.4 is not supported for the guest and won't be enabled
第63行  INFO |     guestVulkanMaxApiVersion: 1.3.0
第55行  INFO |     useVulkanComposition: false
第56行  INFO |     useVulkanNativeSwapchain: false
7.2.1 模拟器硬限制面板
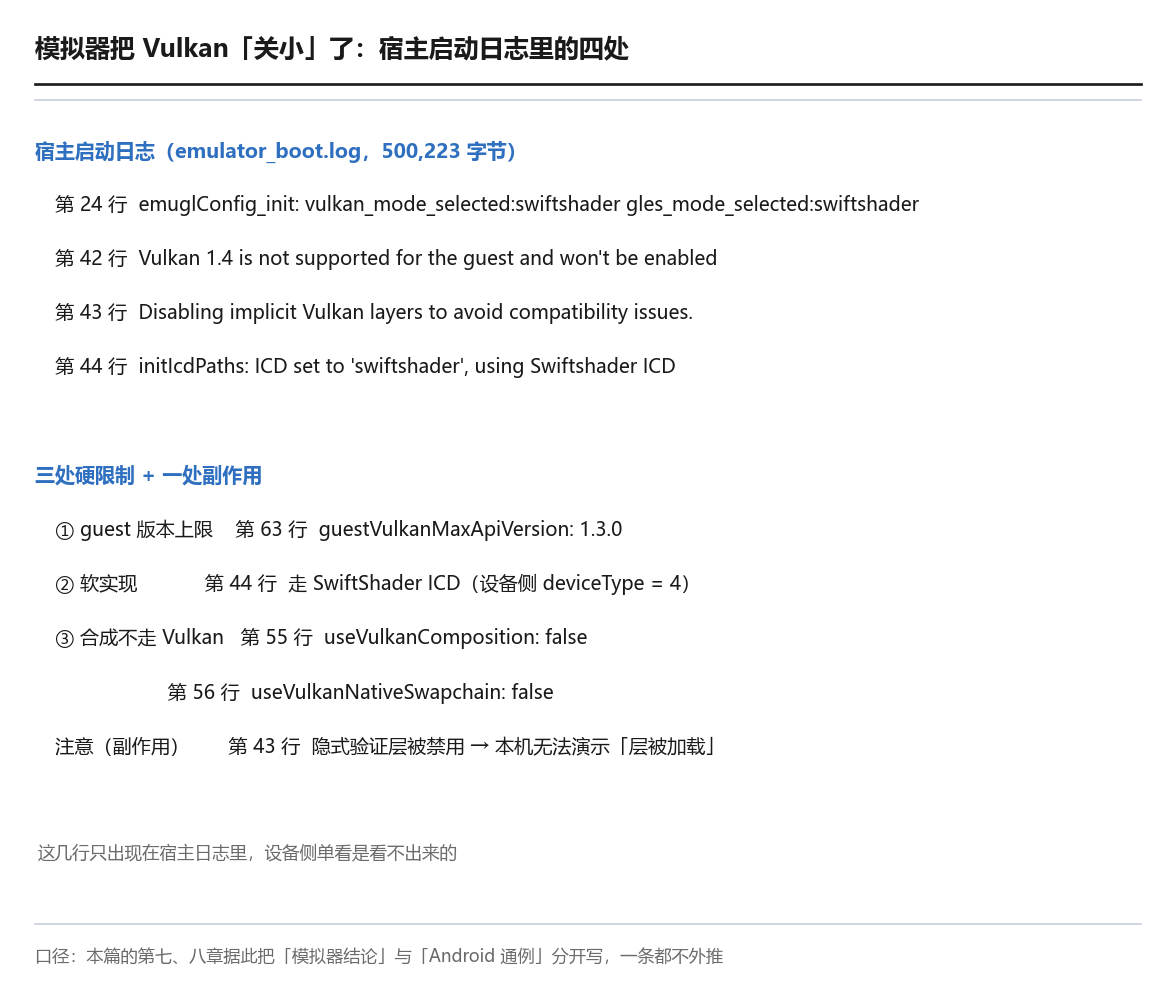
这三行解释了本篇几乎所有"反直觉"的读数:版本上限 1.3 解释了为什么驱动自报 1.2、guest 侧加载到 1.3;useVulkanComposition: false 解释了为什么合成侧不走 Vulkan(下节再对一次)。模拟器把 Vulkan 关小了这件事,只写在宿主日志里,设备侧单看是看不出来的,这正是它值得警惕的地方。
7.3 SurfaceFlinger 的 RenderEngine 段
好了,合成侧也没有放掉,要确认 SurfaceFlinger 有没有 Vulkan 路径,直接读它自己吐出来的 dumpsys SurfaceFlinger 的 RenderEngine 段。这一段会把合成器内部是否启用 Vulkan 渲染、缓存了多少纹理缓冲、编译了多少个着色器、运行时挂了几个特效一次列清,是我们判断"合成侧走不走 Vulkan"的第一手读卡:
vulkan_renderengine: false
RenderEngine tracked buffers: 18
RenderEngine shaders cached since last dump: 134
RenderEngine runtime effects: 5
7.3.1 RenderEngine 的 Vulkan 段面板
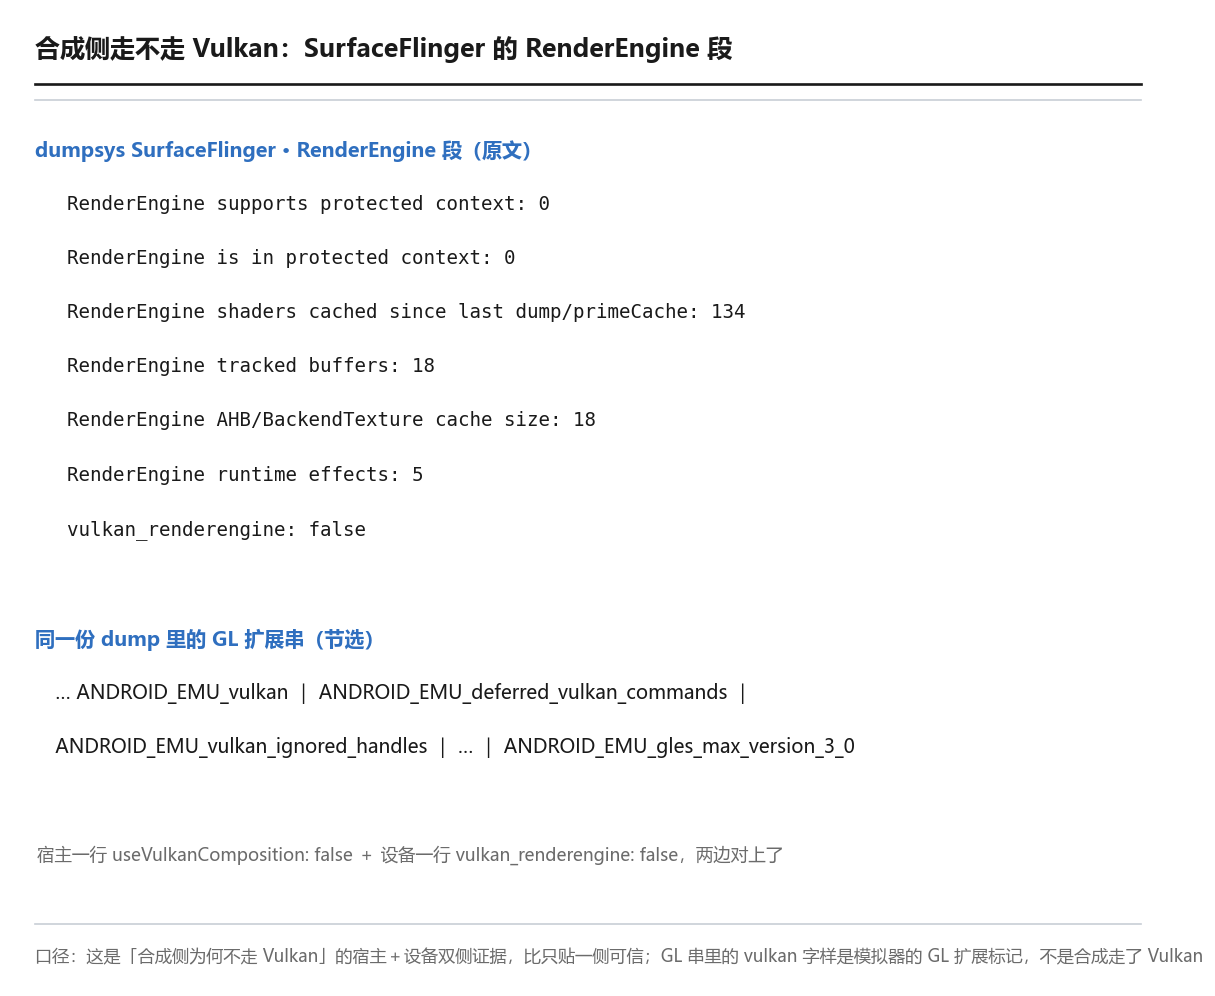
vulkan_renderengine: false,与宿主侧的 useVulkanComposition: false 对齐,合成侧不走 Vulkan@ 本机实测(Pixel_7 AVD,Android 16)这是"合成侧为何不走 Vulkan"的宿主+设备双侧证据:宿主日志一行 useVulkanComposition: false,设备 dumpsys 一行 vulkan_renderengine: false,两边对上了,比只贴一侧可信。
7.4 一处必须写进正文的口径警示:为什么本篇不做性能对比
OK,看完上面这些,你会理解为什么本篇刻意不做 Vulkan vs OpenGL 的性能对比:因为本机上一个对照实验只会得到"Vulkan 起不来"(§5.4),那是模拟器环境产物,不是 API 结论。把"软实现、版本上限 1.3、合成不走 Vulkan"这台机器的表现,写成"Vulkan 比 OpenGL 慢/快",等于用一台报废的靶子替整个 API 下结论。
模拟器结论一律不得写成 Android 通例。 这是本系列红线;凡是需要真实 GPU 路径、真实 overlay、真实性能数字的结论,如实标"需真机"(HWC overlay → ep08,多刷新率/ARR → ep11,都需真机)。
八、五处流传很广的说法,逐条核
OK,收集资料时遇到不少流传很广的说法,本篇把它们逐条拿到本机或官方文字上核一遍。口径:每条都给"流传说法 → 出错处 → 实证/官方依据 → 本篇结论"。
8.1 五条说法一览
先把收集过程中遇到的五条流传说法汇总成一张对照表:每条都给"流传说法原文、它到底错在哪一步、拿什么实证或官方文字去核、本篇最终怎么落笔"四列。这样读者不用翻正文也能一眼看到五处结论各自站哪、依据是什么;逐条独立核验,不把几条说法含糊捏成一段。
8.2 说法的分辨
说法一:「Vulkan 一定比 OpenGL 快」。 出错在把"API 更现代"直接等同"更快",忽略场景。正面两条反证:教程那句"有些场景两者没有任何差别"(§3.4 已引),以及"不是自动更快"的免责段。本篇结论:Vulkan 提供的是减 CPU 组织开销的工具,不是自动的加速包。
说法三:「改个属性就白嫖性能」。 出错在把后端切换说成性能提升,且该路径可能需 root。本篇用一个实验把这个说法拆穿了一半:改属性确实能切(§5.3 设备 0→1 为证),但"切换生效"和"能用"是两件事,本机切完是启动即崩。切换成功 ≠ 变快,收益依设备与驱动而定。
说法四:「ANGLE 就是驱动」/「ANGLE 已是默认的 ES 实现」。 出错在把翻译层当驱动、把"可选"当"默认"。本篇按官方口径写:ANGLE 是跑在 Vulkan 之上的可选层、不是驱动(§1.3 已钉死)。
关于说法五「Vulkan 不需要驱动」,诚实说明:本轮没有找到把它写明文的中文文章,所以本篇不为它单独立靶。只在术语处把话说全:驱动仍由 GPU 厂商提供并做硬件映射,Vulkan 变的只是框架侧变薄(§3.3、§5.5)。
说法二(一串精确收益百分比):Vulkan 单核开销降低 30%–50% 这类数字无出处、不可核对。本篇一律不引用,改为定性表述(§3.4 已贯彻)。
把这五条的正确写法各收成一句,可以直接拿去对照。Vulkan 比 OpenGL 快这条,正确写法是"Vulkan 把削减 CPU 组织开销的工具交给你,用不用得上取决于场景与实现";单核开销降三到五成这类数字,正确写法是"无源数字不引用,要论证请给出可复现的机型、场景与采样方法";改个属性就白嫖性能这条,正确写法是"属性只决定哪条路被选中,选中不等于走得通,更不等于变快";ANGLE 就是驱动这条,正确写法是"ANGLE 是运行在 Vulkan 之上的可选翻译层,驱动仍由 GPU 厂商提供";Vulkan 不需要驱动这条,正确写法是"驱动仍由厂商提供并做硬件映射,变的是框架侧把更多决定权交给了应用"。
原理上讲,这五条错的是同一件事:把"机制层的替换"读成"结果层的提升"。一个 API 换了模型,与"你的应用在你这台机器上更快了"之间,隔着场景、实现与环境三重大门。§8.3 那条抓帧工具的旁证是同一机制的另一面:它暗示的默认后端不是本机的默认后端,因为"默认值由谁写下"这件事本身就跟环境绑定。
8.3 一个值得单独摆出来的旁证:抓帧工具主动切回 GL
收集资料时挖到一条特别值得写的旁证:LunarG 的抓帧指南为了抓帧,要求先 setprop debug.hwui.renderer skiagl 把 UI 的 Vulkan 关掉。这说明:在它面对的机型上,HWUI 默认走的是 Vulkan。而本机实测默认是 Skia (OpenGL)。
这不矛盾,而是"三层不一致"的又一例:工具文档暗示的真机默认(Vulkan)≠ 本机默认(GL)。结合第四章,我们得到一条完整的不一致链:文档写主导底层 API 是 Vulkan、抓帧工具暗示 HWUI 默认走 Vulkan、本机却钉成 GL,而且同一个驱动栈里同时有六个版本号。 本篇把这些不一致全部摆上台面,而不是抹平。
8.4 商标与素材边界
与"说法"关系不大,但属于素材纪律:Commons 上 Vulkan/Khronos/OpenGL 的 logo 全是注册商标(标 PD 只因为低于原创性门槛,商标权没放弃),所以本篇不使用任何 logo 文件。logo 对技术论证没有贡献,反而挤掉一张机制图,还有商标风险。
8.5 本机后端结论:默认 GL,且切换启动即崩
OK,把上面几条说法编成本机这一台设备的后端结论:本机默认 renderer 是 skiagl(OpenGL 后端),且冷启动后读 debug.hwui.renderer 仍是 skiagl;根因在宿主启动日志第 75 行 androidboot.debug.hwui.renderer=skiagl,是模拟器在内核命令行上钉死的。 强行切到 skiavk 会启动即崩(§5.4 五层链)。
8.5.1 本机冷启动默认后端结论面板
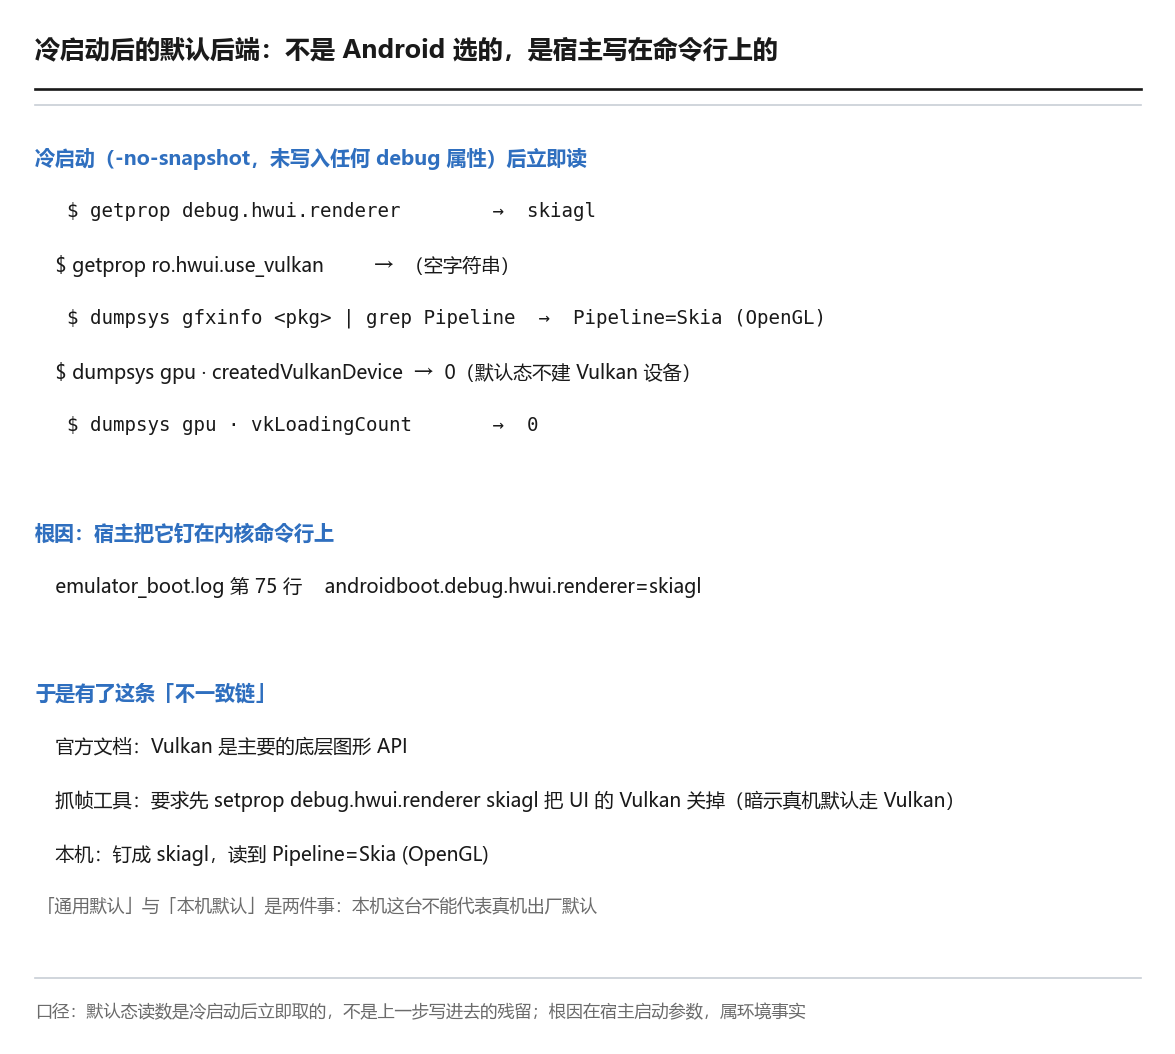
debug.hwui.renderer 读到 skiagl,根因在宿主启动日志第 75 行 androidboot.debug.hwui.renderer=skiagl@ 本机实测(Pixel_7 AVD,Android 16)这里的"通用默认"与"本机默认"必须分开写:真机出厂多按 Vulkan 走(§8.3 旁证),本机是 GL,是因为模拟器在 boot args 上把 HWUI 后端钉成了 skiagl。本机这一台不能代表真机出厂默认。
九、四项可执行动作 + 下一篇
好了,把理论收进可操作的命令上。给四项动作,每条都给命令与判定阈值。
9.1 四项动作与判据
动作一:查本机 Vulkan 版本与驱动。
getprop ro.hardware.vulkan          # 查 ICD 名
getprop ro.cpuvulkan.version        # 宿主声明版本(需解码)
cmd gpu vkjson                      # 驱动自报(注意 deviceType 可能是 CPU)
dumpsys gpu | grep -i vulkan        # 加载计数与版本
判据:deviceType != 4(不是 CPU 软实现)时,版本号才谈得上有"硬件性能"的含义。
动作二:查本机默认渲染后端。
dumpsys gfxinfo <pkg> | grep Pipeline
判据:在有界面的应用上应能读到一行 Pipeline=<后端>。读不到=被测对象没走到那一步,先别断言"没生效",去查崩溃日志。
动作三:想做后端切换实验。 先确认 shell 能否写 debug.*(§6.2 的自查法),再 setprop debug.hwui.renderer skiavk,改完必须读同字段对照(§5.2),并且成功与失败都要记录,失败也要能写出因果链。
动作四:需要验证层时,走正确的开关树。 jniLibs 打包 / debug.vulkan.layers 全局 / enable_gpu_debug_layers + gpu_debug_layers 按应用。判据:确认层真的被加载了再宣称"层生效",被禁用的环境要如实标注。
9.1.1 四项可执行动作与判据面板
9.2 本篇的结论
好了,把十章收成三句。
第一句:Vulkan 是一条"入口",问"我的设备走哪条入口"比背"Vulkan 更现代"更有用。 加载链、版本门槛、后端选择,这三样决定了本机到底是什么在跑。
第二句:入口的"生效"和"能用"是两件事。 本机用实验证明了这一点:属性写进去了、Vulkan 设备也真建起来了(app_createdVulkanDevice 0→1),但应用启动即崩。凡是从文档/社区/真机给出的结论,落到本机都要用一个可复现的读数去对。
第三句:模拟器与真机分开写。 本机的 Vulkan 是被"关小"的模拟层,六个版本号并存、合成不走 Vulkan、切到 skiavk 启动即崩,这些全是这台环境的事,一条都不能外推成 Android 通例。
未解的挑战也留一句:HWUI 默认到底走哪个后端、"走通"的条件是什么,在本机只能答到"设备建成但走不通",真正要答清需要一台走 Vulkan 后端正常的真机,并配合 §8.3 那种"抓帧工具主动切回 GL"的旁证。这部分留给需要真机的 ep11/ep13 与后续自跑篇。
9.3 下一篇预告
OK,下一篇回到链路的主线,讲缓冲交出去之后,系统侧在 Vsync 之后到底做了什么:SurfaceFlinger 怎么决定每一层要不要合成、用 GPU 还是用硬件叠加,以及它是怎么在刷新率对齐的时间里把一帧送上屏幕的。
参考资料
- 使用 Vulkan 处理图形
- 实现 Vulkan
- Vulkan(Android 架构入口)
- 图形总览
- NDK 图形入门
- 原生引擎支持
- Vulkan 设计指南
- Vulkan 验证层
frameworks/native/vulkan/(源码入口)frameworks/native/vulkan/libvulkan/hardware/include/hardware/hardware.h- Khronos Vulkan 基础样本
- Android N 中的 Vulkan 支持
- Android 渲染——重温硬件加速下 Vulkan 篇
- Vulkan 教程 18 · 阶段性总结
- 理解 Vulkan 的核心优势
- AOSP 课程 · Vulkan
- SurfaceFlinger 系列 · RenderEngine
- ANGLE 与 Android 11
- Qualcomm · 移动端 Vulkan
- Skia 讨论组 · 后端切换
- 某第三方实操帖 · 在 Galaxy 上启用 Vulkan
- LunarG · GFXR Android 抓帧指南
- 某魔改包站点
- open-awesome · ANGLE
- Wikimedia Commons · Vulkan 简化管线图
- Wikimedia Commons · Linux AMD 图形驱动栈图
- Wikimedia Commons · CPU 与 GPU 分工图

相关链接 - 上一篇:【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局 - 下一篇(预告):【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么 - 相关系列:实时渲染管线探析 | 移动端图形与功耗 | GPU 架构剖析 | 图形性能剖析工具链 | 2D 矢量引擎深挖
With Best Wishes.