站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:前十篇走了一条链,这一篇把链翻过来看
前十篇我们沿着同一条链往下游走:对象模型(第二篇)→ 服务层接口(第三篇)→ 画布剔除与排序(第四篇)→ 画布渲染抽象(第五篇)→ 批处理(第六篇)→ RenderingDevice 与渲染依赖图(第七篇)→ 后端分叉(第八篇)→ 主循环与多线程(第九篇)→ 资源侧(第十篇)。每一篇都在回答同一个句式的后半截:这一层是怎么做的。
好了,收官这一篇问的是前半截:这一层为什么这么做,后来为什么又改了。
言归正传,这不是一句客套话。前十篇里我们反复遇到同一种情形——某个设计看起来是「理所当然的工程选择」,但把版本线拉开一看,它在不同的年份被官方改过三次口径。本篇最重要的一次发现就属于这一类:「2D 要不要走 GPU 批处理」这件事,官方先判定「不太需要」,四年后又把它铺到所有后端,再过一年多又回头重写渲染器把代价压回去。 一条弧线,三段口径,全在官方自己的文档与发布说明里。
0.1 全系列目录总览(十一篇)
整个系列按这条链铺开,目录如下(本篇即最后一行):
| # | 篇目 | 这一篇落点链上的位置 |
|---|---|---|
| 一 | 全景与边界 | 链的形状:一次绘制有四个落点 |
| 二 | 对象模型 | 命令可以随便下发,但下发之后不能改 |
| 三 | 服务层接口 | 命令先攒下来、再统一处理 |
| 四 | 画布剔除与排序 | 顺序就是可见性;每帧重算 |
| 五 | 画布渲染抽象 | 绘制项只写一次,改属性等于清空重加 |
| 六 | 批处理 | 按状态切批;批的边界一丢,代价按数量线性回来 |
| 七 | RenderingDevice 与渲染依赖图 |
命令列表变成一张依赖图 |
| 八 | 后端分叉 | 四条驱动、七种组合;换来统一,交出特例 |
| 九 | 主循环与多线程 | 一个同步入口 + 三个线程入口,共用一个任务体 |
| 十 | 资源侧:一张纹理从盘上到显存 | 一张纹理三个身份;导入是一次会回环的链 |
| 十一 | 收官:这套架构的取舍,以及 Godot 为什么让 2D 也吃 GPU(本篇) | 把整条链的取舍与版本定价合起来读 |
0.2 这一篇不做什么
OK,先把边界钉死,免得读成一堂复习课。本篇不重复讲机制:前十篇已经逐层讲过的源码细节,这里只引用结论与图,绝不再抄一遍源码——那既会让收官篇变成第十一遍复习,也必然与前九篇的面板区间重复。本篇不做新机制的原创断言:文中出现的新事实只有三类,一是版本线事实(官方发布说明写着什么),二是文档口径差(同一份官方文档的不同版本各自说什么),三是本机新跑的一次读数(第十篇那次探针留下的工具,这一篇再跑一次 2D 批处理的对照)。除此之外,本文一律引用前十篇的既有结论。
再往上一层,本篇不给选型建议。收官篇最容易被写坏的地方,就是结尾来一段「所以 2D 项目应该用哪个渲染器」。官方文档里确实有一句现成的答案(后面 1.1 节会引到),但把这句话当成结论,等于把一整条链的账目换成一个选项框。我们要做的是把账摊开,把判断留给大家。
0.3 四条读法约定(沿用本系列体例)
依然是惯例,四条读法约定也一并写清:
| 约定 | 为什么 |
|---|---|
| 行号属于某个提交,不属于版本号 | 前十篇的行号一律按各自的 master 快照,不做算术平移;本篇不新引任何源码行号区间,只引官方文档页与发布说明 |
| 官方文档要连同版本一起读 | 本篇有三处关键引文来自同一页官方文档的不同版本——4.3 的中文页与 4.7/stable 的英文页说法不同(见第六章)。凡引官方话,必带版本 |
| 文档 / 源码 / 本机三层不能混说 | 文档说「设计上是这样」,源码说「代码里确实这样」,本机说「这台机器上跑出来是这样」。三层结论不一致时并列给读者,不替任何一层圆场 |
| 本机读数的前提 | 引擎为自建版本 4.8.dev.custom_build.7177493c1(2026-07-03 构建)、Windows、RTX 3060 Laptop;本篇探针读的是墙钟帧时间,不是 GPU 时间——本机没有 GPU 侧读数工具(第十篇已登记同一限制) |
0.4 先把账本摊开
其中:这一篇的骨架其实是一本账。左栏记「买到」,右栏记「付出」;前十篇各自记了一行,本篇要补上最末那一行。
说白了,翻开账本之前,先看一眼底账。下面这张面板是本篇新跑的一次探针——同一份 2D 场景,只改精灵的排布方式,横跨三档渲染方法,一共十二格:
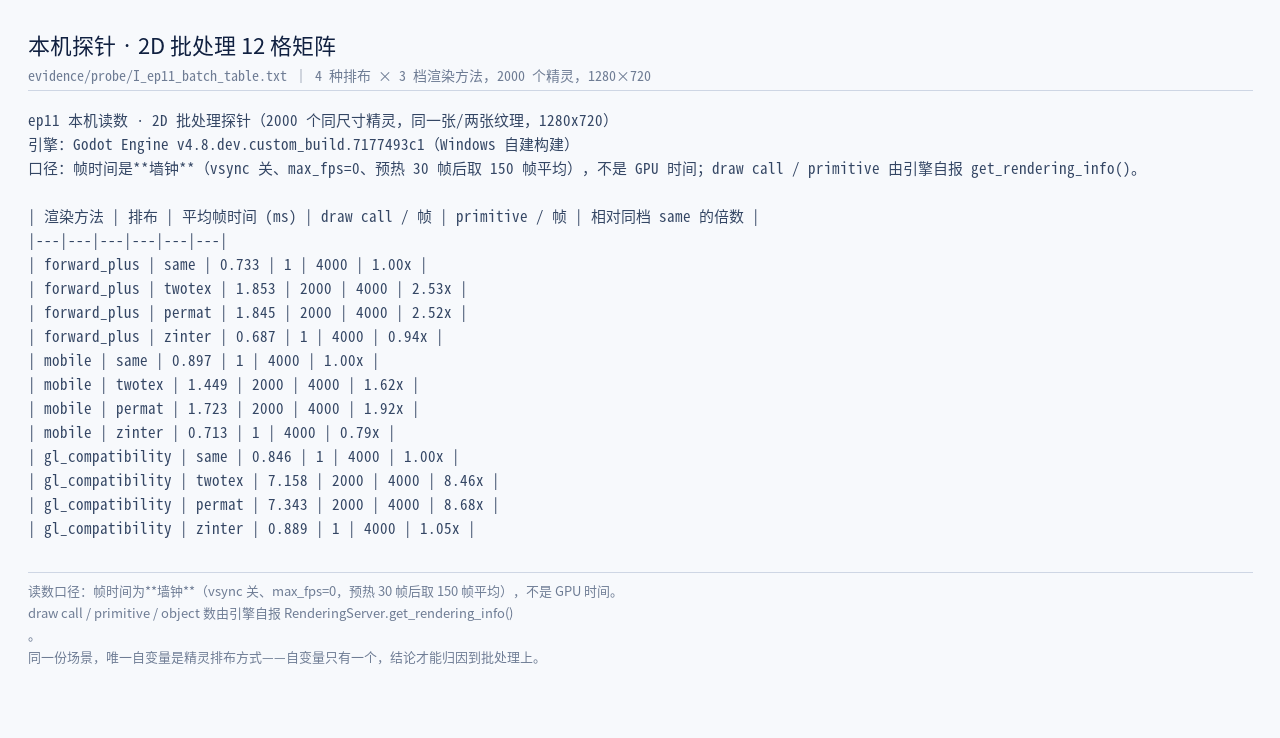
evidence/probe/I_ep11_batch_table.txt 逐行)。突出两格:same 在三档渲染方法上都是 1 个 draw call;twotex/permat 在三档上都是 2000 个 draw call@ 本机探针(Godot 4.8.dev.custom_build.7177493c1,一键复跑 ep11_run_probe.py)好了,这张面板是机读底账:它给出的不是意见,是每格里的 draw call 数与帧时间。整篇后面的讨论都会回到它。之所以把它放在零章而不是第六章,是因为它同时说明了本篇的两个关键词——批处理买到了什么(same 那一列:三档渲染方法上都是 1 个 draw call),以及这笔账有多容易被抹掉(twotex 与 permat 两列:三档上都退化成 2000 个 draw call)。
OK,这场探针的原理说起来只有一条:同一份场景,唯一自变量是排布方式。 自变量只有一个,结论才能归因到批处理上,而不是归因到精灵数量或屏幕大小。具体怎么跑,命令行也一并留在这里,方便大家自己复核:
【本篇 2D 批处理探针 · 一键复跑(原文照录)】

python evidence/probe/ep11_make_probe.py     # 生成最小工程(幂等)
python evidence/probe/ep11_run_probe.py      # 4 排布 × 3 渲染方法 = 12 次运行

godot --path evidence/probe/godot_2d_batch_probe \
      --rendering-method forward_plus --resolution 1280x720 \
      -- --mode=same --count=2000 --tag=forward_plus/same

# 每次运行落一份 I_ep11_batch_<排布>__<渲染方法>.txt,
# 汇总表在 I_ep11_batch_table.txt,机读清单在 I_ep11_batch_manifest.json。
本章出处:本机探针 evidence/probe/I_ep11_batch_table.txt 与 Godot 官方文档 · Internal rendering architecture。
一、总表:四层落点链 × 每层的「买到」与「付出」
言归正传,这一章先把总表立起来。四层落点链讲过一次又一次的「怎么做」,这里换一种读法:每一层分别换到了什么、又交出了什么。
1.1 官方表格里那句「2D 用 Compatibility 通常就够」
先来看看先说一个容易被略过的细节。官方 renderers.rst 有一张三行对照表,逐行列三种渲染方法对各平台与体裁的支持情况。其中 2D Games 那一行,Forward+ 一栏写的是支持,而 Mobile 与 Compatibility 两栏写的是同一句话:
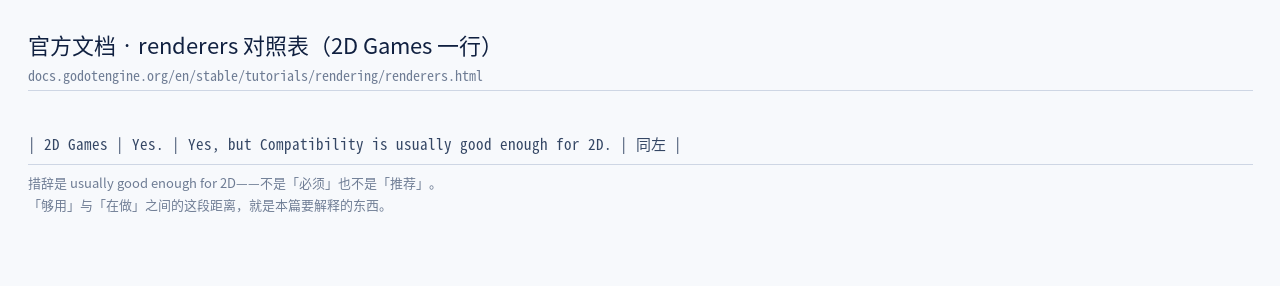
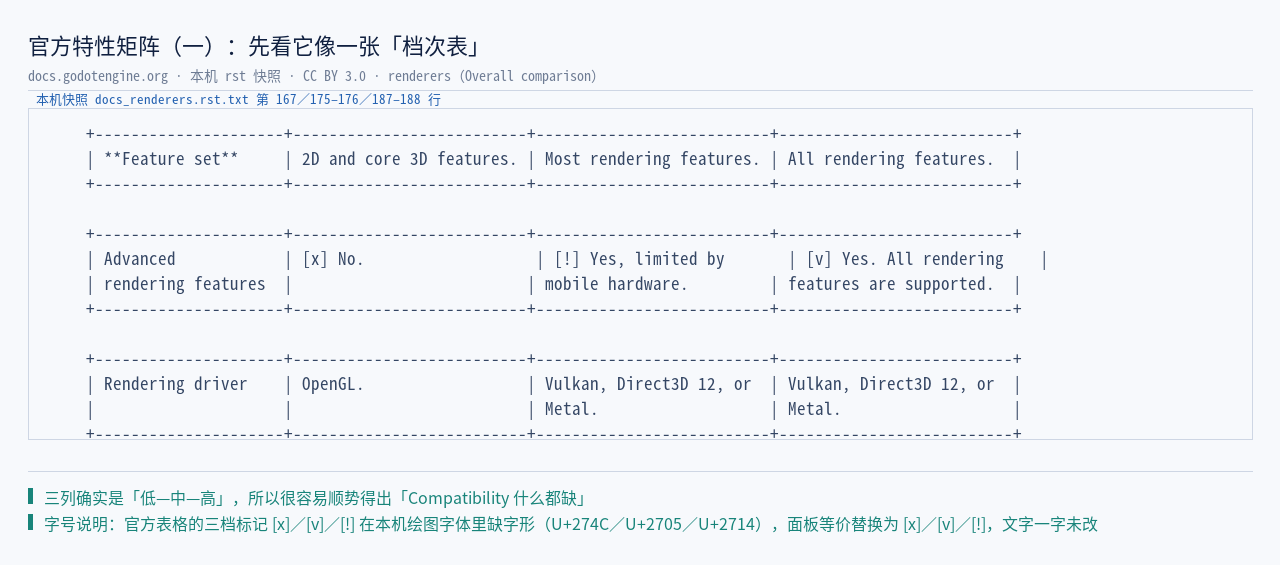
renderers.rst 对照表逐字(三行渲染方法 × 各平台与体裁的支持情况),重点框出 2D Games 那一行:Forward+ 是 yes,而 Mobile 与 Compatibility 两栏都写着 Compatibility is usually good enough for 2D@ Godot 官方文档/发布说明(版本见图注与正文出处)其中:请注意这句话的位置。它出现在官方自己的对照表里,用的是「usually good enough」这种留有余地的措辞——不是「必须」,也不是「推荐」,而是「通常够用」。而我们知道(第十篇刚查过)引擎在导入侧为 2D 与 3D 准备了不同的默认预设,批处理这条线也在不同版本里被反复调整。
「够用」与「在做」之间的这段距离,就是本篇要解释的东西。 官方表格里的建议是面向使用者的,引擎里的持续投入是面向架构的,两件事并不矛盾,但把它们摆在一起看,就能看出这套架构真正的取舍姿态。 把那一行的原文抄下来,大家可以看得更清楚——它的措辞本身就是这份账的口径:
【官方 renderers.rst 对照表的 2D Games 一行(逐字)】

| 2D Games | Yes. | Yes, but Compatibility is usually good enough for 2D. | 同左 |
这里有必要先给「渲染方法」下一个定义,免得后面几章混淆:渲染方法是一套渲染管线的组织方式(怎么分组光源、用什么缓冲格式、能不能上 compute),而渲染驱动是底下那套图形 API——两者是正交的两层。官方表格给出的判断落在「方法」这一层,而本篇第七章要量的差别,也正好落在这一层。
1.2 四层链的结构总表
说白了,这张表是本篇的结构图:每一层的名字、它买到的能力、它付出的代价,以及它在系列里对应的篇目。请把它和后面各章对读——各章做的事情,就是逐行给这张表的「付出」列补上证据。
其中:表格里有一个反复出现的句式值得先点出来:「换来可预测性,交出自由度」。对象模型换来「命令可以随便下发」,交出的是「下发之后不能改」;批处理换来「一次提交装很多相似项」,交出的是「相似必须真的相似」。这不是巧合,是同一套设计哲学在不同层的投影。
把上面那张表逐行读完之后,还可以按代价落在谁身上再归一次类——清单回答「有哪些取舍」,归类回答「这些取舍是同一类东西吗」。分下来是三组:
| 组别 | 代价落在谁身上 | 包含的取舍 | 这一组的共同点 |
|---|---|---|---|
| 甲组:可预测性 | 落在使用者身上 | 对象模型的图元不可变、画布渲染抽象的绘制项只写一次 | 换来的是「行为可预测」,付出的是「改一下要重来」 |
| 乙组:规模效益 | 落在引擎的批处理逻辑身上 | 批处理按状态切批、服务层把命令先攒下来 | 换来的是「数量越多越赚」,付出的是「必须真的相似」 |
| 丙组:可移植性 | 落在驱动特性身上 | RenderingDevice 的窄接口、后端分叉的七种组合 |
换来的是「一套代码多后端」,付出的是「特例不可达」 |
三组之间不是并列关系,而是递进关系:甲组把行为固定下来,乙组才敢在这个固定行为上做批量合并,丙组才能把批量合并的结果抽象成一份可移植的接口。换句话说,前面几层付的那些代价,是后面几层能收益的前提。 这也是为什么本篇第六章那笔「2D 的账」要放到最后算——它是这三组取舍在同一个具体场景上叠起来之后的总和。
1.3 官方对 2D 的三句裁定
官方 internal_rendering_architecture 里有一段专门讲 2D 渲染技术,只有三句,但这三句是本篇第六章的引子,也是第八章分界线的来源:
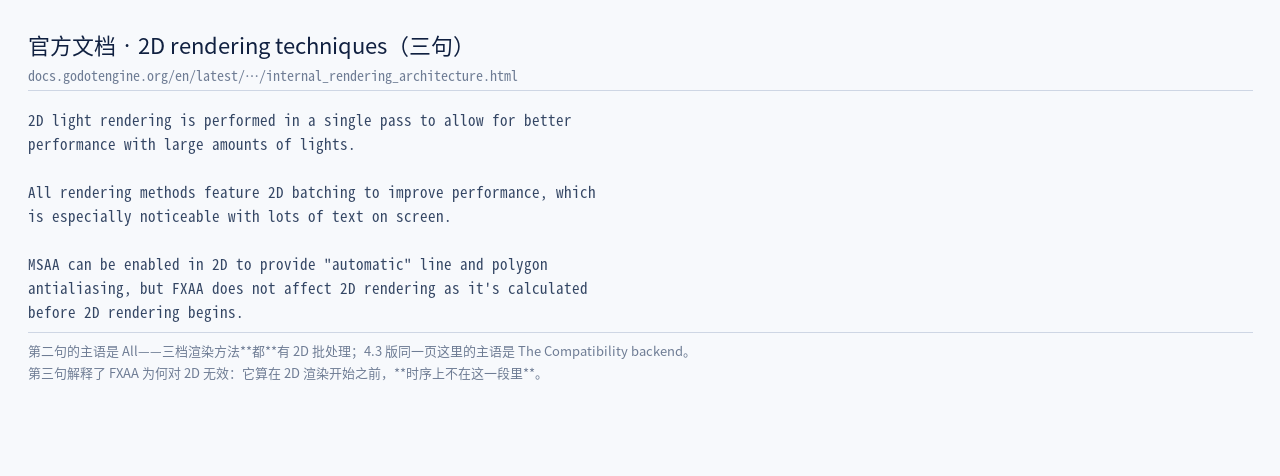
internal_rendering_architecture 的 2D rendering techniques 段逐字三句:2D 光照在单趟里做完 / All rendering methods feature 2D batching(尤其明显于屏幕上大量文字)/ MSAA 在 2D 管线与多边形边缘,而 FXAA does not affect 2D rendering@ Godot 官方文档/发布说明(版本见图注与正文出处)其中:三句里的第二句是关键——All rendering methods feature 2D batching。注意它的主语是「All」,即三档渲染方法都有 2D 批处理。而这句话并不是一开始就长这样:在 4.3 版的同一份文档里,主语是「The Compatibility backend」(见第六章)。一句主语的改动,背后是四年。
依然是惯例,第三句同样值得记住:FXAA does not affect 2D rendering as it's calculated before 2D rendering begins。FXAA 对 2D 无效,不是因为不好用,而是因为它在时序上根本不在 2D 这一段里——它算在 2D 渲染开始之前。这一句会在第八章变成与 T03 那条路的分界线。
1.4 本系列自证:这条链的形状
这条链的形状不是本篇总结出来的,是第一篇就定下来的:
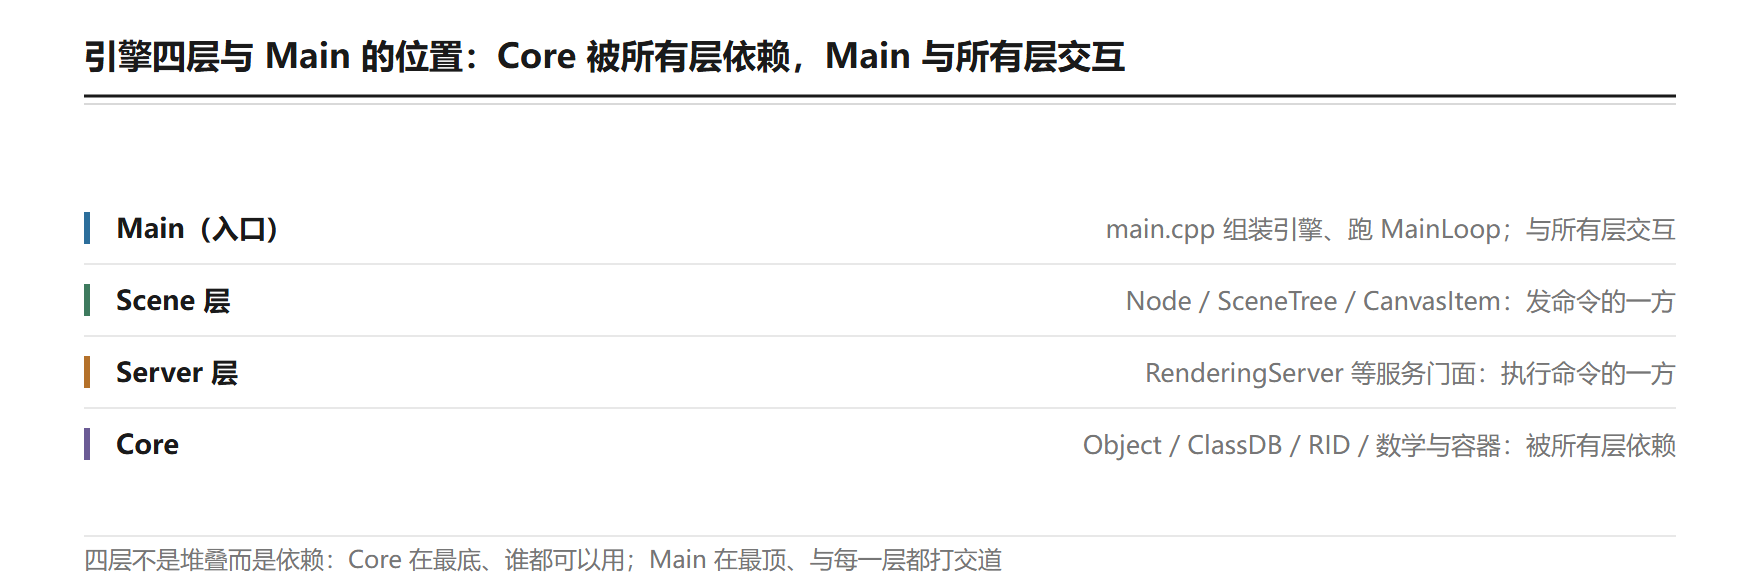
其中:引用自己前一篇的图,需要说明一句:同一张图在不同论证里的角色不同。在第一个篇章里它是「这条链长什么样」的结论图示;在本篇里它是「这一层买到什么」的凭证。这不是重复使用,是收官篇的立论方式决定的——收官篇的证据库就是前九篇,它要做的是重新排列,而不是重新取证。
本章出处:官方文档 Overview of renderers(三行对照表与 2D Games 那一行);官方文档 Internal rendering architecture(2D rendering techniques 三句);本系列第一篇《全景与边界》的四层落点总览;类参考 CanvasItem 与 RenderingServer;绘制顺序见 画布层文档。
二、第一二层:对象模型与服务层接口买到了什么
账本从最上游开始记。第一层是对象模型,第二层是服务层接口,这两层加起来只做了一件事:把「我要画一个东西」和「GPU 上真的去画」拆成两半。
2.1 第一层:命令的下发与执行解耦
CanvasItem 一侧:谁在什么时候把命令层下发)@ 本系列第二篇(复用)这一层买到的是一个命令的中间态。场景树里的节点并不知道 GPU 上发生了什么,它只知道「我要在下一次重绘时画这样一批图元」。这个中间态的存在,让引擎可以在两者之间插进任意多的东西——剔除、排序、合并、延迟——而节点侧一行代码都不用改。
其中:这个设计有一个不太起眼但影响深远的结果:命令是可以被推迟的,因此也可以被重排。 前面第四篇讲的剔除与排序、第六篇讲的批处理,前提都是「命令先攒下来、再统一处理」。而反过来,只要命令还在中间态里,它就还没有成为 GPU 上的一条指令——这句话会在下一节变成代价。
2.2 第二层:服务层接口的形状
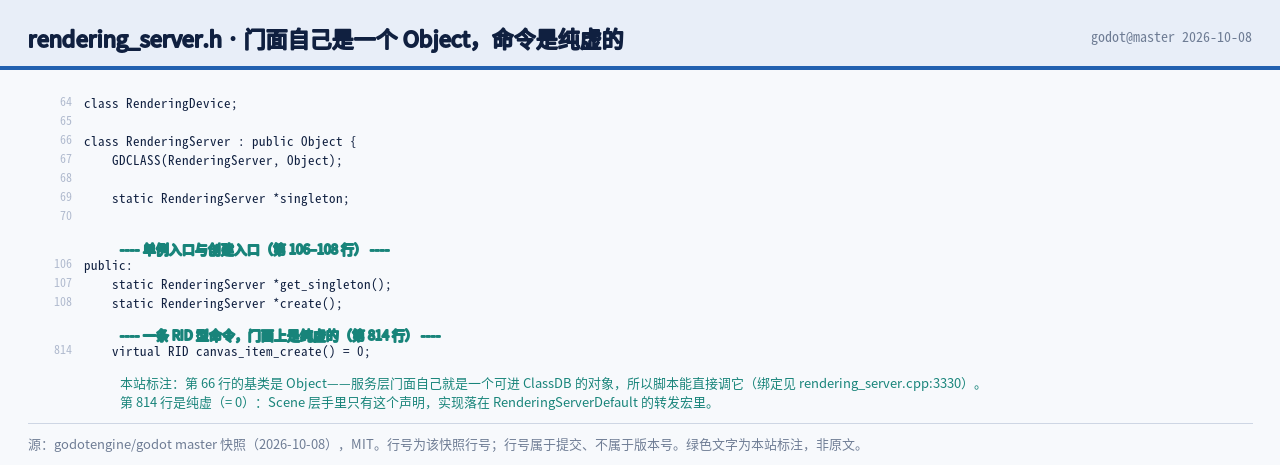
RenderingServer 一侧:命令长什么样、怎么被排队)@ 本系列第三篇(复用)服务层买到的是一个稳定的窄接口。场景系统挂在这个接口上;接口背面是哪个渲染方法、哪条驱动,前面完全不用管。这一层的价值在后面第五层(RenderingDevice)会被复制一次,属于同一种手法。
其中:这一层还有一个与章节标题直接相关的参数:缓存模式。同一份命令,同步加载与线程加载走的是同一套接口,只多一个参数决定「谁等谁」。这一点在第九篇已经展开,此处只记结论。
2.3 代价:图元加进去就不能改
好了,账本的右栏来了。上面两层换来了命令的中间态与稳定接口,代价写在官方文档的一句注意事项里:
【CanvasItem 服务器接口的约束 · 官方 using_servers 逐字】

The Canvas Item API in the server allows you to add draw primitives to it.
Once added, they can't be modified. The Item needs to be cleared and the
primitives re-added (this is not the case for setting the transform, which
can be done as many times as desired).
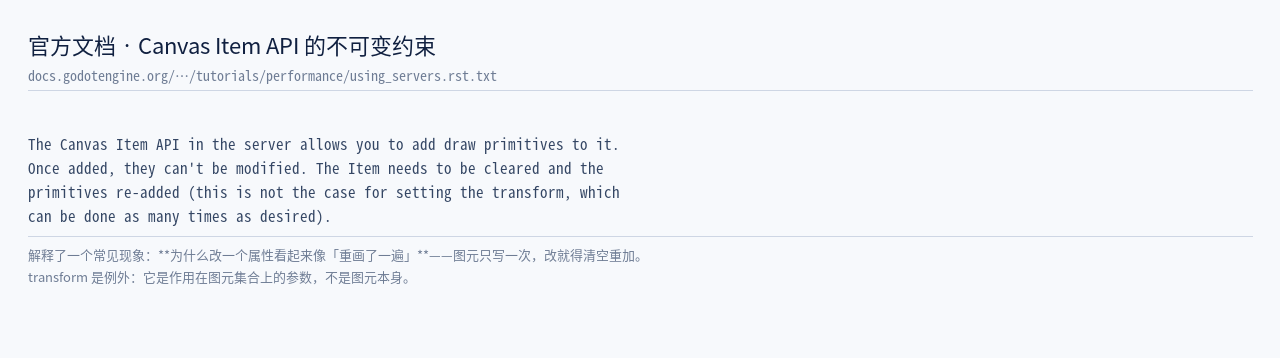
using_servers 逐字:Canvas Item API 加进去的图元不可修改——The Item needs to be cleared and the primitives re-added(transform 是例外,可反复设置)。这就是「改一个属性为什么要重画」的接口层原因@ Godot 官方文档/发布说明(版本见图注与正文出处)下面对这段特别说明:它解释了一个大家天天遇到、但很少追究的现象——为什么改一个属性看起来像「重画了一遍」。
【1】图元不可变。加进服务器的绘制图元(矩形、多边形、线段、文字)是只写一次的;想改,就得把整个 Item 清空,再把图元重新加一遍。这不是实现偷懒,而是为了让「命令的中间态」能被安全地重排与批处理——如果图元可以在重排之后再被修改,那么每一次批处理都得重新验证一遍假设。
【2】transform 是例外。位置/旋转/缩放可以反复设置,因为它是作用在图元集合上的一个参数,不是图元本身。改它不影响批处理对图元内容的判断。这个例外很省事:动画里最常见的正是「位置在变、形状不变」。
【3】于是「属性变更」天然是昂贵的。改个颜色、换个纹理、调个可见性,都可能意味着清空重加。这也解释了第六篇里那个结论的另一面:批处理省下来的是提交次数,而每一次真正的状态变更都在暗中标好了价格——它要么打断批,要么触发重建。
其中:把这一节的结论与第十篇的接口约束对照着看会更有意思:第十篇讲导入侧时说过,「一次导入的产物有多个文件」在接口层就是允许的;这里讲的是同一件事的另一面——接口给了你能力,就一定在别处收走一点自由。 再往深一层看,这条约束背后是一个可以写成公式的取舍:一帧的提交成本 ≈ 状态切换次数 × 每次切换的固定代价 + 图元数量 × 每图元的边际代价。 图元不可变,等于把「每次切换的固定代价」压到最低——因为状态一旦确定,整批图元的处理就可以走同一条最快路径;而代价是任何状态变更都得从头再走一遍这条路径。这条公式在第四章会直接决定批处理能省下多少。
本章出处:官方文档 Using servers for optimization(Canvas Item API 的不可变约束);本系列第二篇《对象模型》、第三篇《服务层接口》的既有结论与面板。
三、第三四层:剔除、排序、画布渲染抽象买到了什么
好了,账本继续往下记。第三层决定「画什么、按什么顺序」,第四层决定「一条绘制命令在引擎里长什么样」。这两层的收益最直观,代价也最隐形。
3.1 第三层:先筛一遍,再排一遍
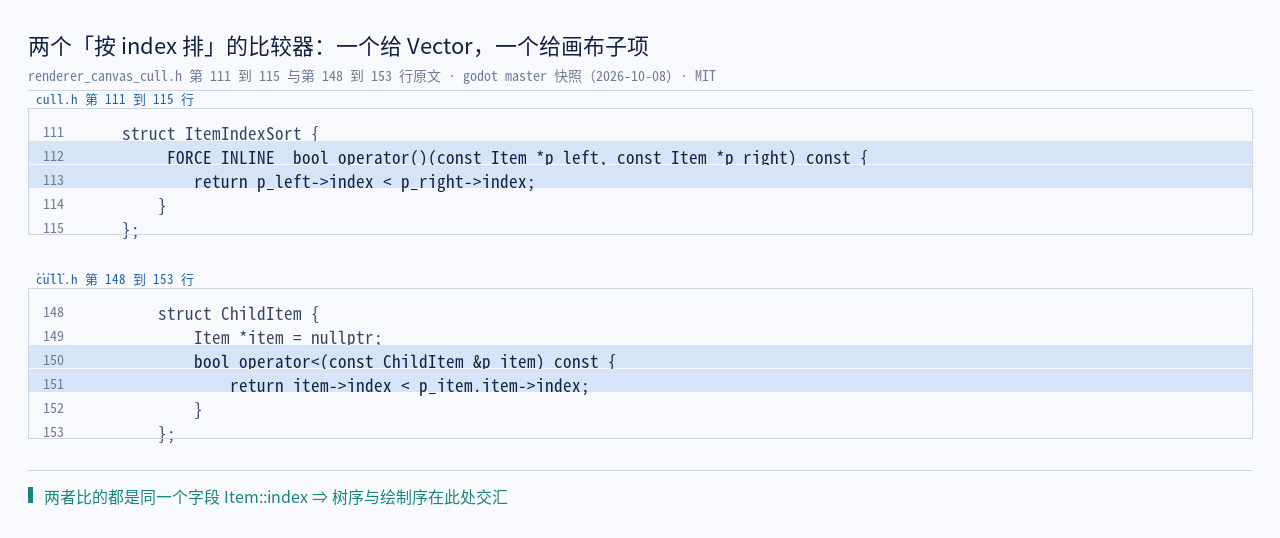
言归正传,这一层买到的是可预测的绘制顺序。屏幕外的、被裁掉的先筛掉,剩下的按一套确定规则排队。顺序为什么重要?因为在同一块画布上,顺序就是可见性——谁盖住谁,完全由「谁先被画」决定。
其中:这一层还有一个数字口径值得记住:剔除与排序都是逐帧做的。也就是说,只要场景内容变了,这套筛选与排序就要重来一遍。它不是一次性的预处理,而是每帧的固定开销。
3.2 第四层:把「一条绘制命令」变成引擎内部的结构
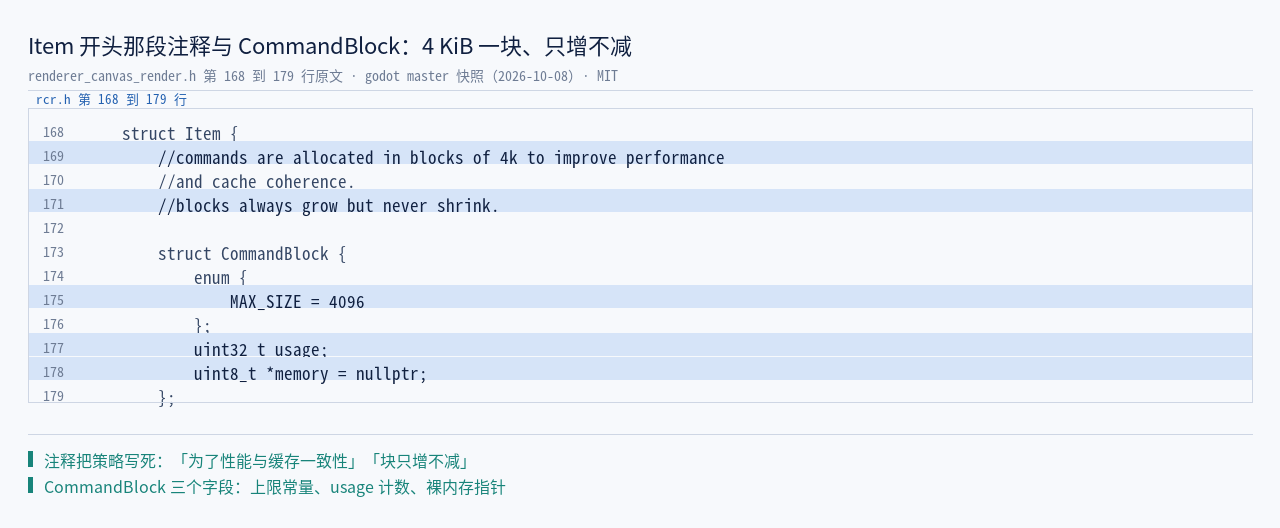
先来看看这一层买到的是绘制项(draw item) 这个中间结构。节点说要画什么,到这一层被翻译成一组带状态的绘制项:图元在哪、用哪张纹理、哪种混合模式。翻译完成之后,它就进入了前一节说的那个「只写一次」的世界。
3.3 三层各自买到了什么,以及它们的共同前提
下面这张对照表把前三层的收益与代价摆在一起:
| 层 | 买到的 | 付出的 | 这一层的关键参数 |
|---|---|---|---|
| 对象模型 | 命令的中间态,可推迟、可重排 | 图元不可变,改属性等于清空重加 | CanvasItem 的可见性与调制 |
| 剔除与排序 | 可预测的绘制顺序 | 每帧重算,内容一变就全重来 | z 分层与绘制顺序规则 |
| 画布渲染抽象 | 统一的绘制项结构 | 翻译成本,且翻译结果只写一次 | 纹理与材质的绑定 |
其中:请注意三者的共同前提:它们都建立在「命令先攒下来」这件事上。 攒下来才能筛、才能排、才能翻译成统一结构。而「攒下来」这个动作,恰好也是下一章批处理能成立的全部原因——没有中间态,就没有批。 说白了,三层分工说到底是一个定义问题:谁有权决定「画什么」,谁有权决定「按什么顺序画」。 第一层只决定「画什么」(内容),第三层才决定顺序(次序),第四层决定「怎么表述」(形式)。把这三件事拆给三个地方,收益是每一处都能独立优化,代价是三处之间必须靠一份中间结构来通信:
【三层的职责与各自的输入输出(本篇的结构拆解,非引文)】

对象模型     输入:节点的属性与可见性
             输出:一批「要画的图元 + 它的状态描述」
剔除与排序   输入:上面那批图元 + 摄像机范围
             输出:同一批图元,但已按确定顺序排好、范围外的已摘掉
画布渲染抽象 输入:排好序的图元
             输出:引擎内部统一的绘制项(只写一次,之后不可改)
本章出处:本系列第四篇《画布剔除与排序》、第五篇《画布渲染抽象》的既有结论与面板;官方文档 Internal rendering architecture 的 2D 与 3D 渲染分离小节(绘制项与缓冲的关系,本篇第九章再展开)。
四、批处理:买到 draw call 数,付出「批的边界」
OK,这一章是账本上最厚的一行。批处理(batching)在系列第六篇已经讲过「按什么切、代价在哪」,这里补上另外两笔:它的收益到底有多硬,以及它的代价是怎么被官方自己承认的。
4.1 官方清单:什么会让批断掉
官方 optimization/batching 一页写得很直白——批处理是中间层,它按能力把图元分组;而有几种变更必然打断批:
这三条听起来像三条规定,其实衡量的是同一件事:批的边界画在哪里。 官方把「相似」这件事定死在纹理、材质、图元类型三项上,是因为底层提交只认这三样状态;换句话说,只要这三样里的任一样在相邻两条命令之间发生了变化,提交路径就必须重新走一遍准备流程。所谓「断批」,本质上是「准备流程被重复走了一遍」。
这也是为什么本系列第六篇讲批处理时,第一句话是「按什么切」,而不是「怎么开」——切法决定了批能有多长,而批的收益与它的长度成正比。 下一节的实测会把这件事量化成一组很扎眼的数字。
【批处理与断批 · 官方 optimization/batching 逐字】

To match Godot's general-purpose nature with the batching preferences of
GPUs, Godot features an intermediate layer which can automatically group
together primitives wherever possible and send these batches on to the GPU.

Certain changes (or techniques), by necessity, prevent the formation of a
contiguous batch, this is referred to as "breaking batching". Batching will
be broken by (amongst other things):
  - Change of texture.
  - Change of material.
  - Change of primitive type (say, going from rectangles to lines).
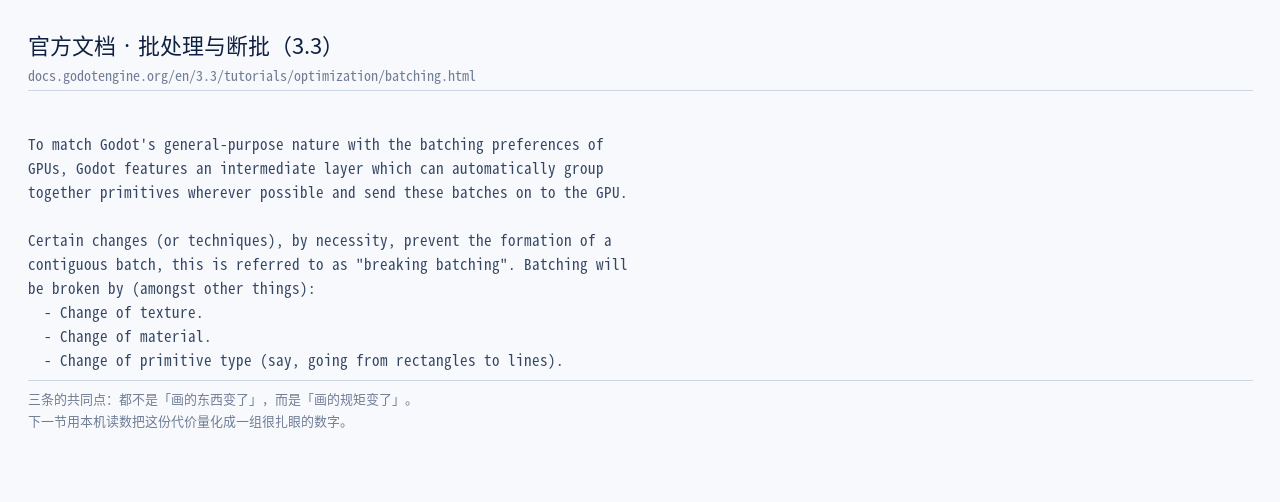
optimization/batching(3.3)逐字:批处理是「an intermediate layer which can automatically group together primitives」;以及 Breaking batching 三条——Change of texture / Change of material / Change of primitive type@ Godot 官方文档/发布说明(版本见图注与正文出处)好了,下面对这三条特别说明:它们有一个共同点——都不是「画的东西变了」,而是「画的规矩变了」。
【1】换纹理。批处理的单位是「同一条状态下的多个图元」;纹理是状态的一部分,所以两张纹理交替,等于把一条批切成两段。
【2】换材质。材质比纹理更重:它可能带自己的着色器与混合模式。逐节点各给一个材质,等价于让每个图元都处于不同的状态。
【3】换图元类型。矩形与线段在底层是不同的绘制方式,混在一起无法合并成一次提交。
4.2 本机实测:断批的代价是 2000 倍
OK,上一节是文档说的。文档说得对不对、代价有多大,得自己量。下面是同一份 2000 个精灵的场景,只改排布方式:
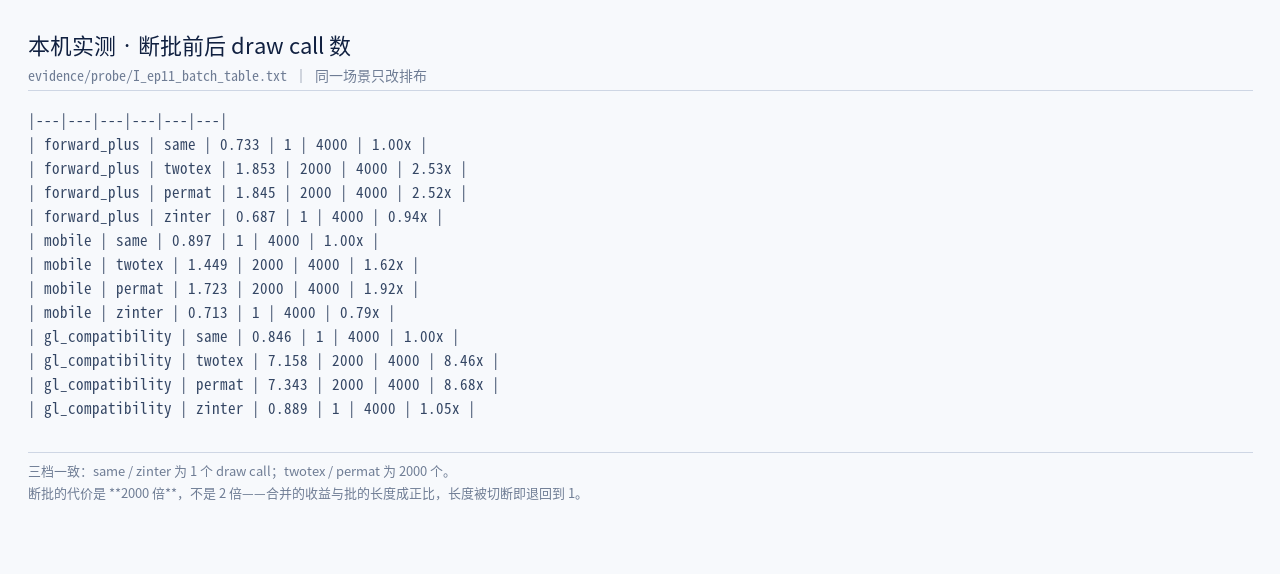
same 1 / twotex 2000 / permat 2000 / zinter 1,三档渲染方法上一致——断批的代价是 2000 倍,不是 2 倍@ 本机探针(Godot 4.8.dev.custom_build.7177493c1,一键复跑 ep11_run_probe.py)其中:这张表里有两个数字需要并排看。same 排布下,2000 个精灵、4000 个图元,在三档渲染方法上都是 1 个 draw call——这就是批处理「买到」的东西,而且是三档都买到了。而 twotex(两张纹理交替)与 permat(每个精灵各自一个材质)两列,三档上都退化成 2000 个 draw call。
代价是 2000 倍,不是 2 倍。 这句话值得反复念一遍:只要批断了,批处理从「合并 2000 个」变成「一个都没合并」,中间没有平滑过渡。这不是引擎的小气,而是「批」这个概念的数学性质——合并的收益与批的长度成正比,而批的长度一旦被切断,长度就退回到 1。
4.3 两支清单并列,以及一处本机未能复现
官方有三条,社区还有一张更长的清单。把两支并排放,并逐一标注本机复现情况:
| 断批原因 | 出处 | 本机复现 |
|---|---|---|
| 换纹理 | 官方 optimization/batching |
复现(twotex:2000 draw call) |
| 换材质 | 官方 optimization/batching |
复现(permat:2000 draw call) |
| 换图元类型 | 官方 optimization/batching |
未单独构造该场景,不作结论 |
| Z-index 交错 | 社区清单 | 未复现(zinter:仍是 1 个 draw call) |
| 逐节点各给材质 | 社区清单 | 复现(同「换材质」) |
| 中间插入别的节点 | 社区清单 | 未单独构造该场景,不作结论 |
其中:最后一列是这一节的重点,尤其是第四行。社区那份清单把「Mixing Z-index values between sprites sharing a texture」列为断批原因,而本机用最小复现(z_index 在 0 与 1 之间交替)跑出来仍然是 1 个 draw call。
言归正传,按本系列的规矩,这一处并列给读者:本机事实是「未复现」,社区说法是「会断批」。两者都写出来,并注明本探针是该说法的最小复现,可能与社区当时的场景不同(例如他们场景里还叠了别的状态变更)。不替任何一方圆场——既不因为官方在线就默认社区错,也不因为本机没复现就宣布那条说法是错的。
4.4 批的那个环
其中:把这一章收成一句话:批处理买到的是「一次提交装很多项」,付出的是「这些项必须真的相似」。 相似这件事没有任何弹性——要么全进一条批,要么各自单飞。这就是为什么本系列第六篇讲批处理时,第一句话是「按什么切」,而不是「怎么开」。
本章出处:官方文档 Optimization using batching(3.3)(Breaking batching 三条);官方文档 GPU optimization(2D batching 小节);官方博客 GLES2 renderer optimization - 2D batching 与对应改动 PR #37349;本机探针 evidence/probe/I_ep11_batch_table.txt(12 格矩阵,一键复跑 ep11_run_probe.py);社区原帖另有 Spine 中文同题帖 与 纹理图集视角的整理。
社区那两支说法也把原帖留在这里,方便大家自己去看语境:Godot on Mobile(断批清单)、Spine 官方论坛:Godot 不对 2D 三角形网格做批处理、Godot Q&A #38213:2500 个精灵把 CPU 压到 100%、一份 2D 游戏移植到安卓的记录:换回 Compatibility 后快约 30%。这四条的图一律不入单(C 级),文字只作「社区说法」引用。
五、RenderingDevice 与后端分叉:窄接口换掉了什么
好了,账本翻到第五层。这一层的名字有点长,但它记的账很短:用一层自己造的窄接口,换掉四条驱动的差异。
5.1 第五层:把命令列表变成一张依赖图
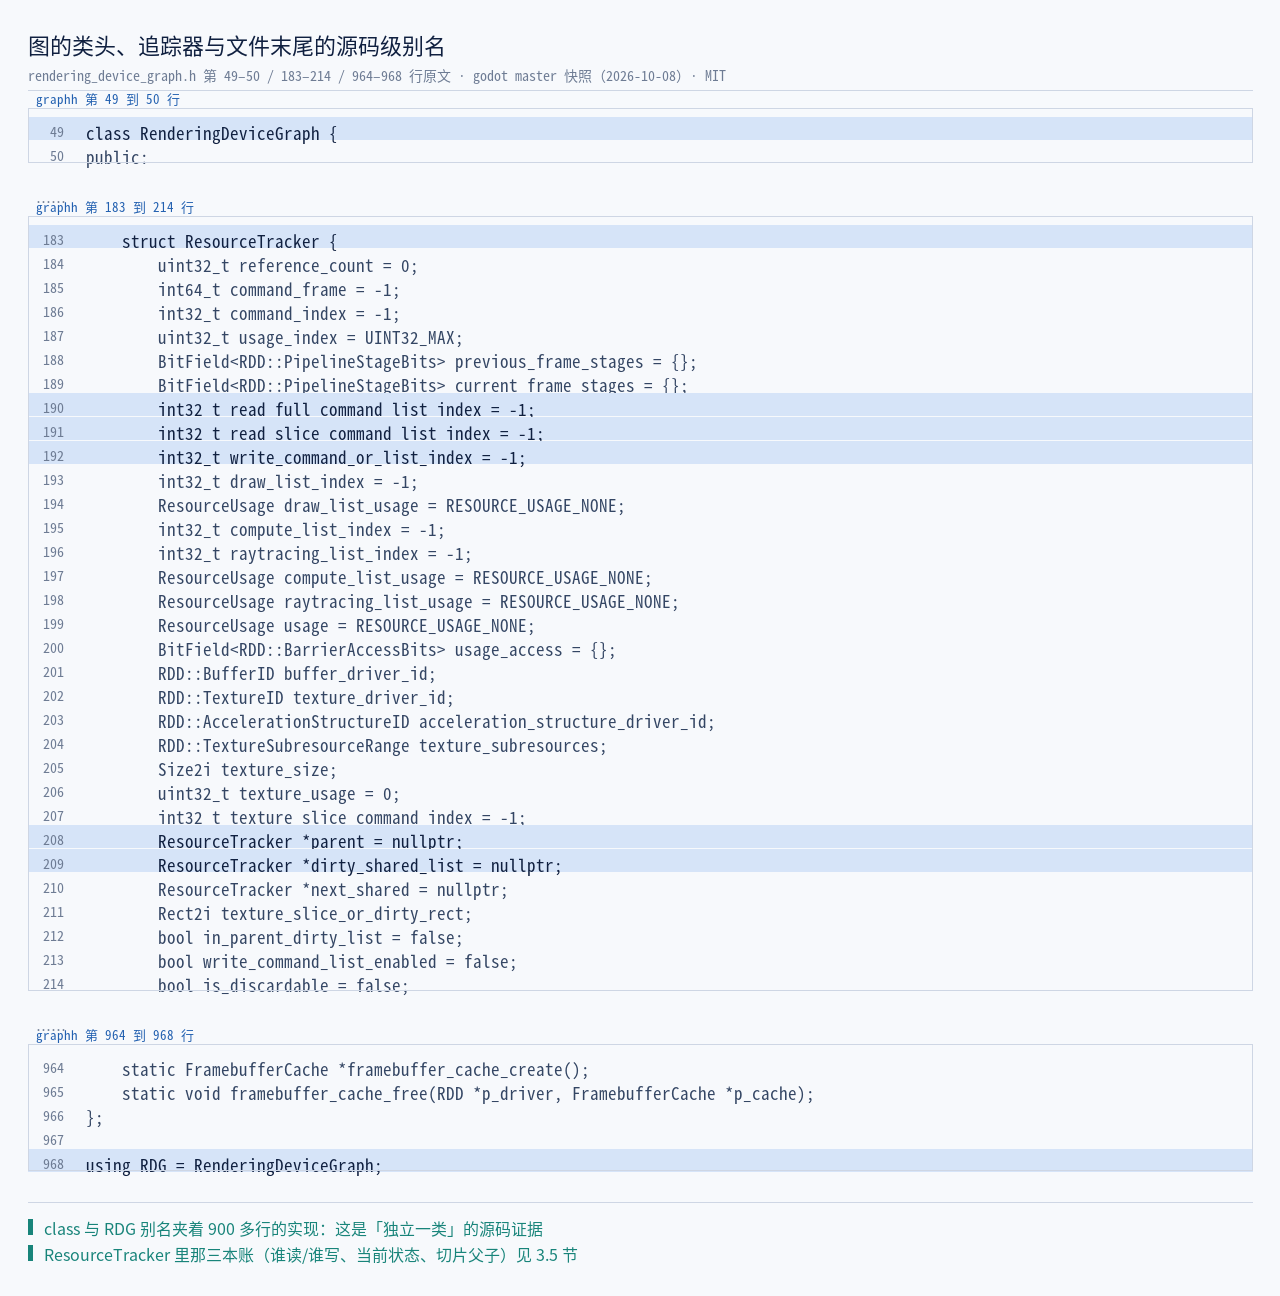
RenderingDevice 面板(命令列表怎么变成一张依赖图)@ 本系列第七篇(复用)这一层买到的是可移植的提交模型。命令不再直接对应某条图形 API 的调用,而是先被编进一张有依赖关系的图里,再由后端翻译出去。
「依赖图」这个词要按字面理解:图上每个节点是一次资源操作(写缓冲、跑计算、上传纹理),每条边是一次真实的数据依赖。编图的收益不在于图本身,而在于它可被重排——两条互不相邻的支路谁先谁后都行,调度器就能把它们并行发出去;而一旦某条边被标上依赖,顺序就被钉死了。
这里有个容易被忽略的推论:图能表达的依赖是有限的,表达不了的关系只能由调用方自己保证。 这正是后面第五章那句「换来统一,交出特例」在图上最具体的形态——窄接口替你管住了公共依赖,管不到的部分就得自己负责。
5.2 后端分叉:四条驱动,七种可用组合
其中:这里的账要算清楚:不是「一套代码跑所有后端」,而是「一套代码 + 四个后端实现」跑七种可用组合。收益是可移植性,成本是每个后端都要各自维护一遍——这一点在下一篇(也就是最后一章)会变成一条具体的版本线更新。
5.3 窄接口的两面
RenderingDevice 这层窄接口的两面:向上买到一套代码跑四个后端,向下付出驱动特性不可达;并标出本机三档渲染器在批处理探针里的读数差@ 本系列绘制其中:这一层是本篇最有意思的一处对称设计。它的窄接口向上提供的是同一份代码,向下交出的是驱动特性的可达性——绕过窄接口去用某个后端独有的能力,等于放弃可移植性本身。这与第四章批处理的句式完全相同:换来统一,交出特例。 说白了,「窄接口」这个词需要落到具体定义上:它指的是一组刻意做小、只暴露公共能力的抽象。小到什么程度,官方给了可用的组合清单:
【渲染驱动 + 渲染方法的可用组合(本机 4.8-dev 实测可用)】

Vulkan   + Forward+          Vulkan   + Mobile
D3D12    + Forward+          D3D12    + Mobile
Metal    + Forward+          Metal    + Mobile
OpenGL   + Compatibility
七种组合,四套后端实现。接口的宽度就是这样被定出来的:它必须窄到七种组合都能实现,于是任何只有一两种组合才有的特性,就只能留在窄接口之外。
本章出处:官方文档 Internal rendering architecture · Rendering drivers。
本章出处:本系列第七篇《RenderingDevice 抽象》、第八篇《后端分叉》的既有结论与面板;官方文档 Internal rendering architecture 的渲染驱动与渲染方法汇总小节。
六、★★ 2D 为什么也吃 GPU:官方三段弧
前面五章把账本上的每一层都记了一行。这一章记的是本篇最厚、也最有意思的一笔——2D 要不要走 GPU 批处理。
言归正传,说它有意思,是因为这件事在官方口径里出现过三种答案,而且三种答案各自都很有道理。这不是官方前后矛盾,而是同一笔账在不同年份用不同的参数重算了一遍。
6.1 起点:一个为 3D 造的路径,2D 顺带被提速
4.0 那次重写是为 3D 造的:新的低层图形 API、新的抽象层、新的一套资源去向。2D 在这件事里的位置,官方在一份 2020 年的进度报告里说得很轻松:
【2D 为什么一起受益 · 官方 4.0 进度报告逐字(页面自带「内容可能已过时」声明)】

Thanks to Vulkan (which has a much lower draw-call cost than OpenGL),
2D itself in Godot 4.0 will see a speedup for free.

Changes in memory allocation strategy and internal simplification in
draw call logic make it much more efficient to manually call thousands of
draw() functions from a node's _draw() callback.
先来看看注意那句 a speedup for free。既然新的低层 API 让绘制调用便宜得多,2D 就顺带拿到了提速——这是「2D 也吃 GPU」的第一层含义:不是把 2D 搬到 GPU 上算,而是让 2D 走的那条提交路径变便宜了。
而在同一时期,官方文档对「2D 批处理」这件事给出了一个明确的判断:
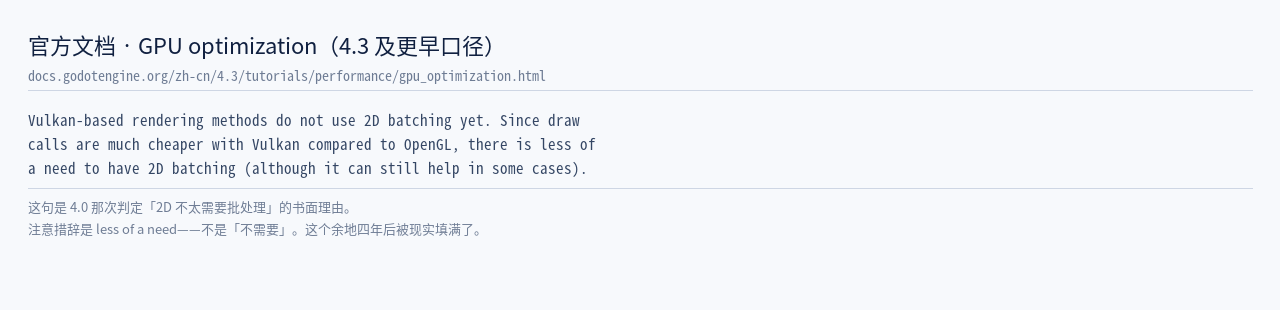
gpu_optimization(4.3 及更早口径)逐字:Vulkan-based rendering methods do not use 2D batching yet;Since draw calls are much cheaper with Vulkan compared to OpenGL, there is less of a need to have 2D batching@ Godot 官方文档/发布说明(版本见图注与正文出处)其中:把这两段放在一起读,就能看出当时的逻辑链条:低层 API 的绘制调用变便宜 ⇒ 2D 通路上最贵的那一环不再是最贵 ⇒ 所以「合并绘制调用」这件优化,必要性下降了。文档用的词是 less of a need——不是「不需要」,而是「没那么需要」。这个措辞留了余地,四年后正是这个余地被现实填满了。
6.2 同一页文档的两个版本
OK,现在看一处更深的东西。上面那张面板里的那句话,在同一页官方文档的新版里已经不见了:
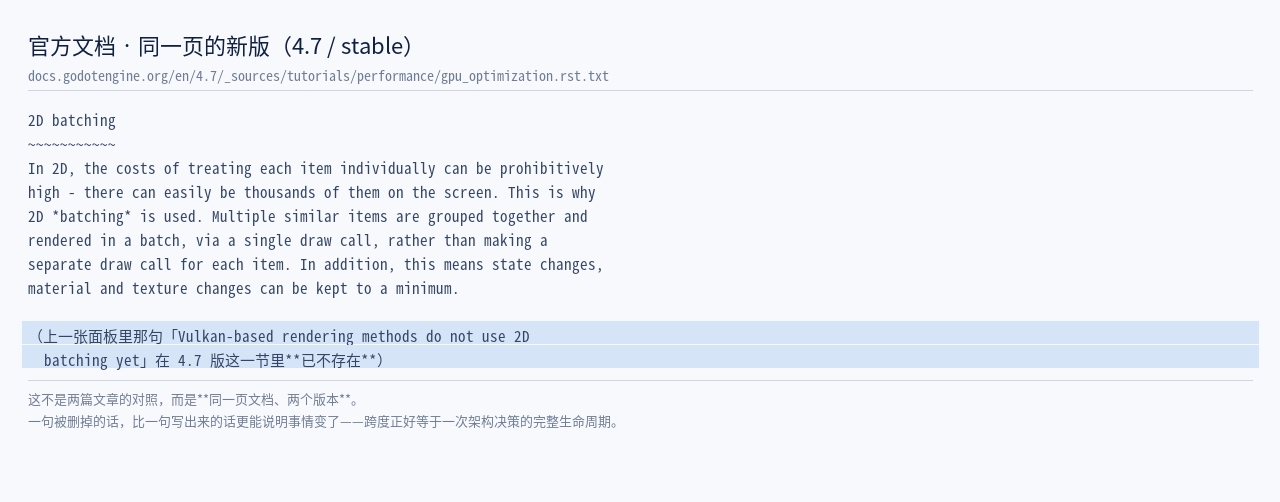
其中:这不是我从两篇文章里凑出来的对照,而是同一页文档、两个版本。旧版写着「基于 Vulkan 的渲染方法尚不使用 2D 批处理」;新版把这一句删掉了,只留下通用描述。一句被删掉的话,比一句写出来的话更能说明事情变了。 这里顺便把「批处理」在本文里的定义固定下来,后面各章都按这个口径用:把若干条状态相同的绘制命令合并成一次提交。 它的判据只有一条——状态是否相同;而状态由纹理、材质、图元类型三项共同决定(官方清单见第四章)。搞清楚这个定义,第六章这三段弧就不是「官方反复改主意」,而是同一个定义在不同后端上的收益被重新计算了三遍。
依然是惯例,按本系列「官方文档要连同版本一起读」这条约定,正文凡引官方话都带版本号。这一处的版本号差得有点大——4.3 与 4.7/stable——跨度正好等于一次架构决策的完整生命周期。
6.3 第二段:4.4 把批处理铺到所有后端
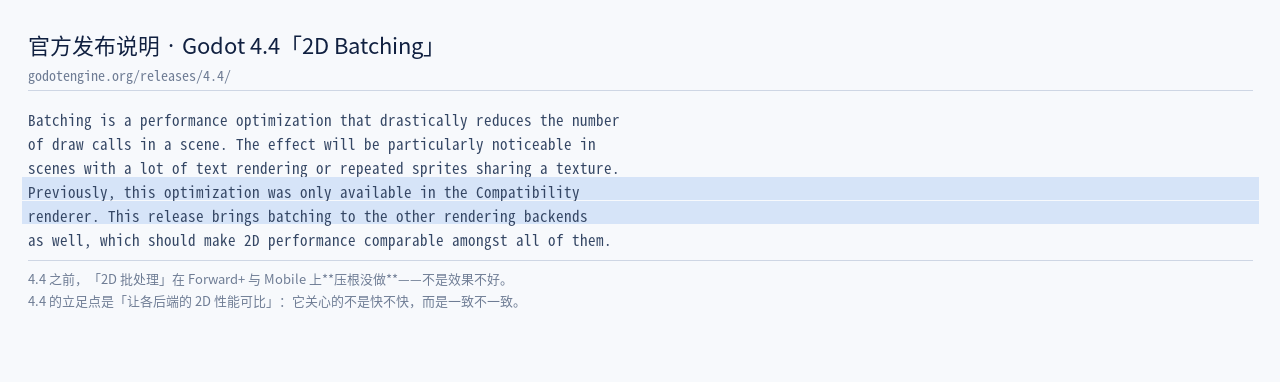
其中:这段发布说明里最关键的是第一句:Previously, this optimization was only available in the Compatibility renderer. 也就是说,在 4.4 之前,「2D 批处理」这四个字在 Forward+ 与 Mobile 上是不存在的——不是效果不好,是压根没做。而我们 6.1 节引的那句「less of a need」,正是这段空白的书面理由。
4.4 把这块空白填上了,理由是「让各后端的 2D 性能可比」。请注意这个理由的立足点:它关心的不是「快不快」,而是「一致不一致」。 这是本篇反复出现的第二种取舍——换来一致,交出的是「按需开特例」的自由。
6.4 第三段:4.6 回头重写 2D 渲染器
好了,批处理铺开之后一年多,官方发了一篇把这件事讲得最透的发布说明:
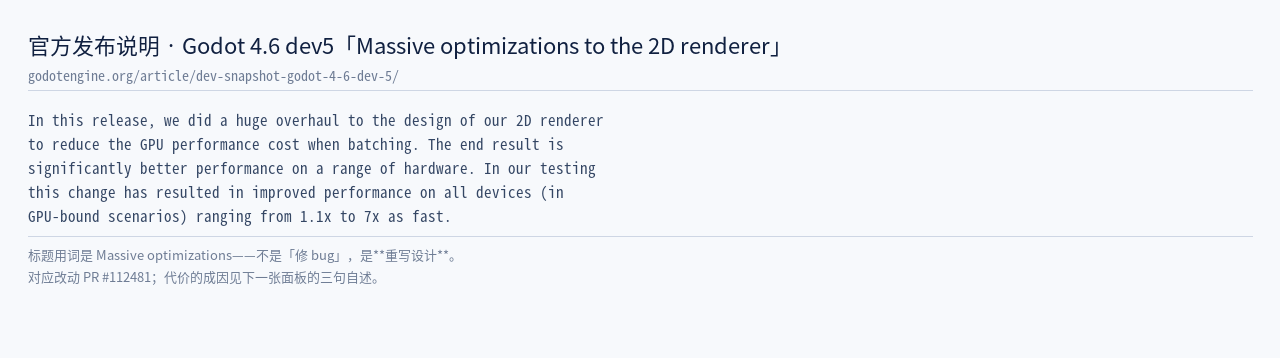
GH-112481@ Godot 官方文档/发布说明(版本见图注与正文出处)其中:请注意这条发布说明的标题用词:Massive optimizations to the 2D renderer——不是「修 bug」,是重写设计。而它给出的动因(下一章逐句引)是「批处理让渲染在 GPU 上略微更贵」,且在低端设备上出现了回归。
于是整条弧线闭合了:先因为绘制调用变便宜而判定不必批;四年后为了后端一致而铺开批;再过一年多,为了把批的 GPU 代价压回去而重写 2D 渲染器。 三段都在同一件事上,三段都不是错的——因为它们各自优化的目标不同。
6.5 把三段弧画成一条线
其中:这一节是本篇的转折点。前面五章记的是结构上的取舍(每一层换来什么、交出什么),这一章记的是时间上的取舍——同一层在不同年份被反复重新定价。两者合起来才是完整的账本:结构决定了有哪些账可算,版本决定了这些账每一次被算成多少。
本章出处:官方博客 Godot's 2D engine gets several improvements for upcoming 4.0(含页面自带的「内容可能已过时」声明);官方文档 GPU optimization(4.3 zh) 与 同一页(4.7);官方发布说明 Godot 4.4(2D Batching 段);官方发布说明 Dev snapshot: Godot 4.6 dev 5 与 4.6 beta 1(Massive optimizations to the 2D renderer 段);对应改动 PR #112481;官方文档 Internal rendering architecture(All rendering methods feature 2D batching 一句);同一页在更早版本下的写法见 4.3 版 与 4.4 版。
七、★ 这笔账的代价面:批处理为什么会让 GPU 更贵
上一章说「批处理让渲染在 GPU 上略微更贵」。这一章要把这句话拆开:贵在哪一步,谁最先感觉到,以及本机能不能看到。
7.1 先把本机的账摆上:同一份断批,三档差价一个数量级
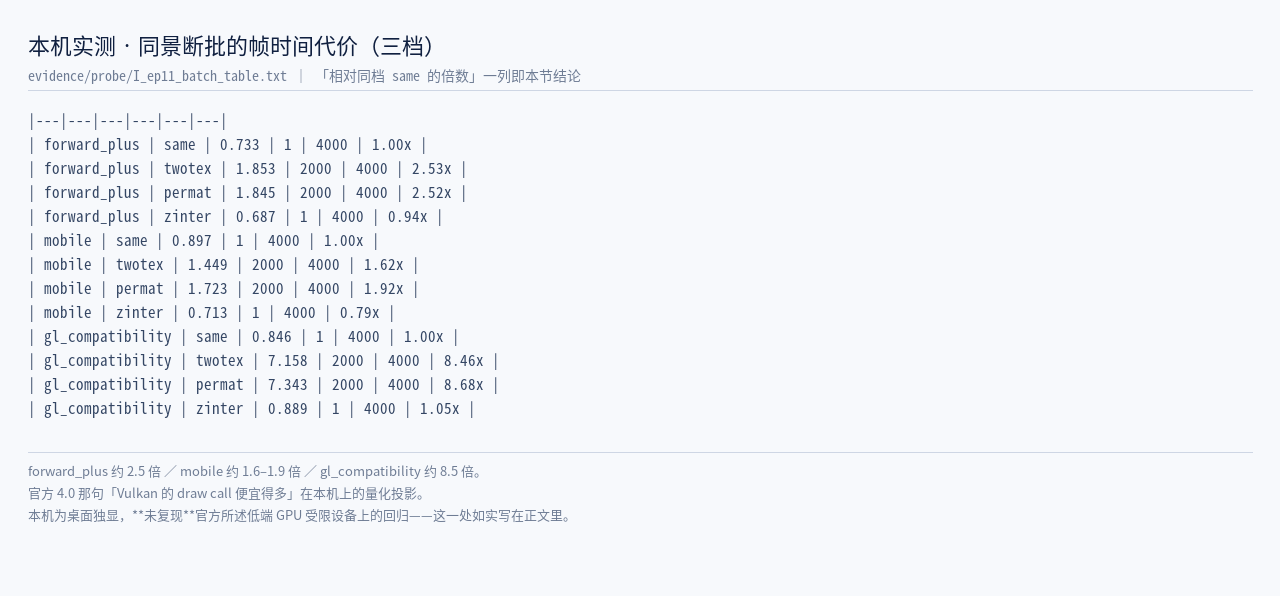
forward_plus 上约 2.5 倍、mobile 上约 1.6 到 1.9 倍、gl_compatibility 上约 8.5 倍——官方那句「Vulkan 的 draw call 便宜得多」在本机的量化投影@ 本机探针(Godot 4.8.dev.custom_build.7177493c1,一键复跑 ep11_run_probe.py)这张表是第四章那张 draw call 表的另一半。draw call 数告诉我们批有没有断,帧时间告诉我们断了之后谁买单:
| 渲染方法 | same 帧时间 |
twotex 帧时间 |
相对倍数 | 断批的 draw call |
|---|---|---|---|---|
| forward_plus | 0.733 ms | 1.853 ms | 约 2.5 倍 | 1 → 2000 |
| mobile | 0.897 ms | 1.449 ms | 约 1.6 倍 | 1 → 2000 |
| gl_compatibility | 0.846 ms | 7.158 ms | 约 8.5 倍 | 1 → 2000 |
其中:三档的 draw call 退化完全相同(都是 1 → 2000),但帧时间的代价差了一个数量级。这正是 6.1 节那句「Vulkan 的 draw call 便宜得多」在本机上的量化投影。 也就是说,官方在 4.0 判定「2D 不太需要批处理」并不是拍脑袋——在桌面低层 API 上,这份代价确实比在 OpenGL 上小得多。 说白了,要把这处差别说清楚,得先明确「GPU 受限」与「CPU 受限」这两个常用的定义:一帧的耗时被谁占满,就叫被谁受限。 断批之后,CPU 侧的提交次数从 1 涨到 2000,GPU 侧则多了 2000 次状态切换的开销。官方测试的多数场景里前者先占满,于是后者的增加看不见;而在低端移动设备上,GPU 侧本来就接近占满,那点增加就会直接顶破帧预算。同一笔开销,在两种瓶颈下是完全不同的两件事。
本章出处:官方发布说明 Godot 4.6 dev 5;本机探针 I_ep11_batch_manifest.json。
反过来说,同一份数据也解释了 4.4 为什么还是把批处理铺开了:只要还有一档渲染方法上这份代价是 8.5 倍,就不能说这件事不重要。
7.2 官方自己的代价自述
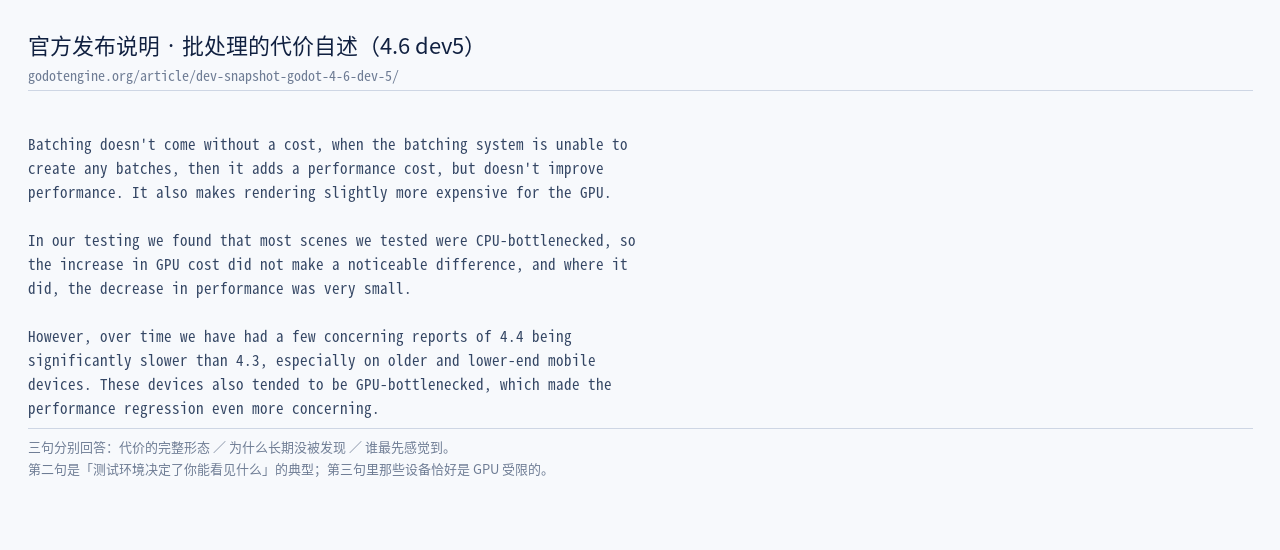
下面是官方在 4.6 发布说明里对这件事的完整交代,一共三句,句句都值得读两遍:
【批处理的代价 · 官方 4.6 dev5 逐字】

Batching doesn't come without a cost, when the batching system is unable to
create any batches, then it adds a performance cost, but doesn't improve
performance. It also makes rendering slightly more expensive for the GPU.

In our testing we found that most scenes we tested were CPU-bottlenecked, so
the increase in GPU cost did not make a noticeable difference, and where it
did, the decrease in performance was very small.

However, over time we have had a few concerning reports of 4.4 being
significantly slower than 4.3, especially on older and lower-end mobile
devices. These devices also tended to be GPU-bottlenecked, which made the
performance regression even more concerning.
下面对这三句特别说明:
【1】第一句是代价的完整形态。批处理有两种不利情形:一是批不成(白花成本,且性能不改善),二是批成了也想让 GPU 多花点(因为批的组装与状态提交让渲染侧变复杂)。这两件事方向不同,但都记在同一个账本上。
【2】第二句解释了为什么这个代价长期没被发现。官方自己的测试场景大多是 CPU 受限的——在 CPU 受限的场景里,GPU 上多出来的那点成本被 CPU 的等待吞掉了,看不见。这是「测试环境决定了你能看见什么」的典型例子。
【3】第三句是被用户报上来的。4.4 being significantly slower than 4.3, especially on older and lower-end mobile devices——报告来自更老、更低端的移动设备,而这些设备恰好是 GPU 受限的。请注意这里的因果:不是因为移动设备特殊,而是因为它们的瓶颈位置不同。
7.3 本机不复现那条回归——如实写下来
OK,必须在这里说清楚一件事:本机没有复现官方所说的那条回归。
按 7.1 节的读数,same 排布下三档渲染方法的帧时间都在 0.7 到 0.9 ms 的同量级,没有哪一档出现「显著更慢」。原因不神秘——本机是桌面独显(RTX 3060 Laptop),既不属于官方所指的「更老、更低端的移动设备」,也不处在 GPU 受限的状态。用本机去否定官方的报告是不成立的,把本机读数说成「复现了回归」更是不诚实的。
这处「本机不复现」按系列规矩留在正文里,不作删改。第十篇登记的「显存侧读数拿不到」是同一类事:本体查得清、外围查不清的时候,就把查不清的部分明写出来。
7.4 边缘质量:另一件必须落到 GPU 上的事
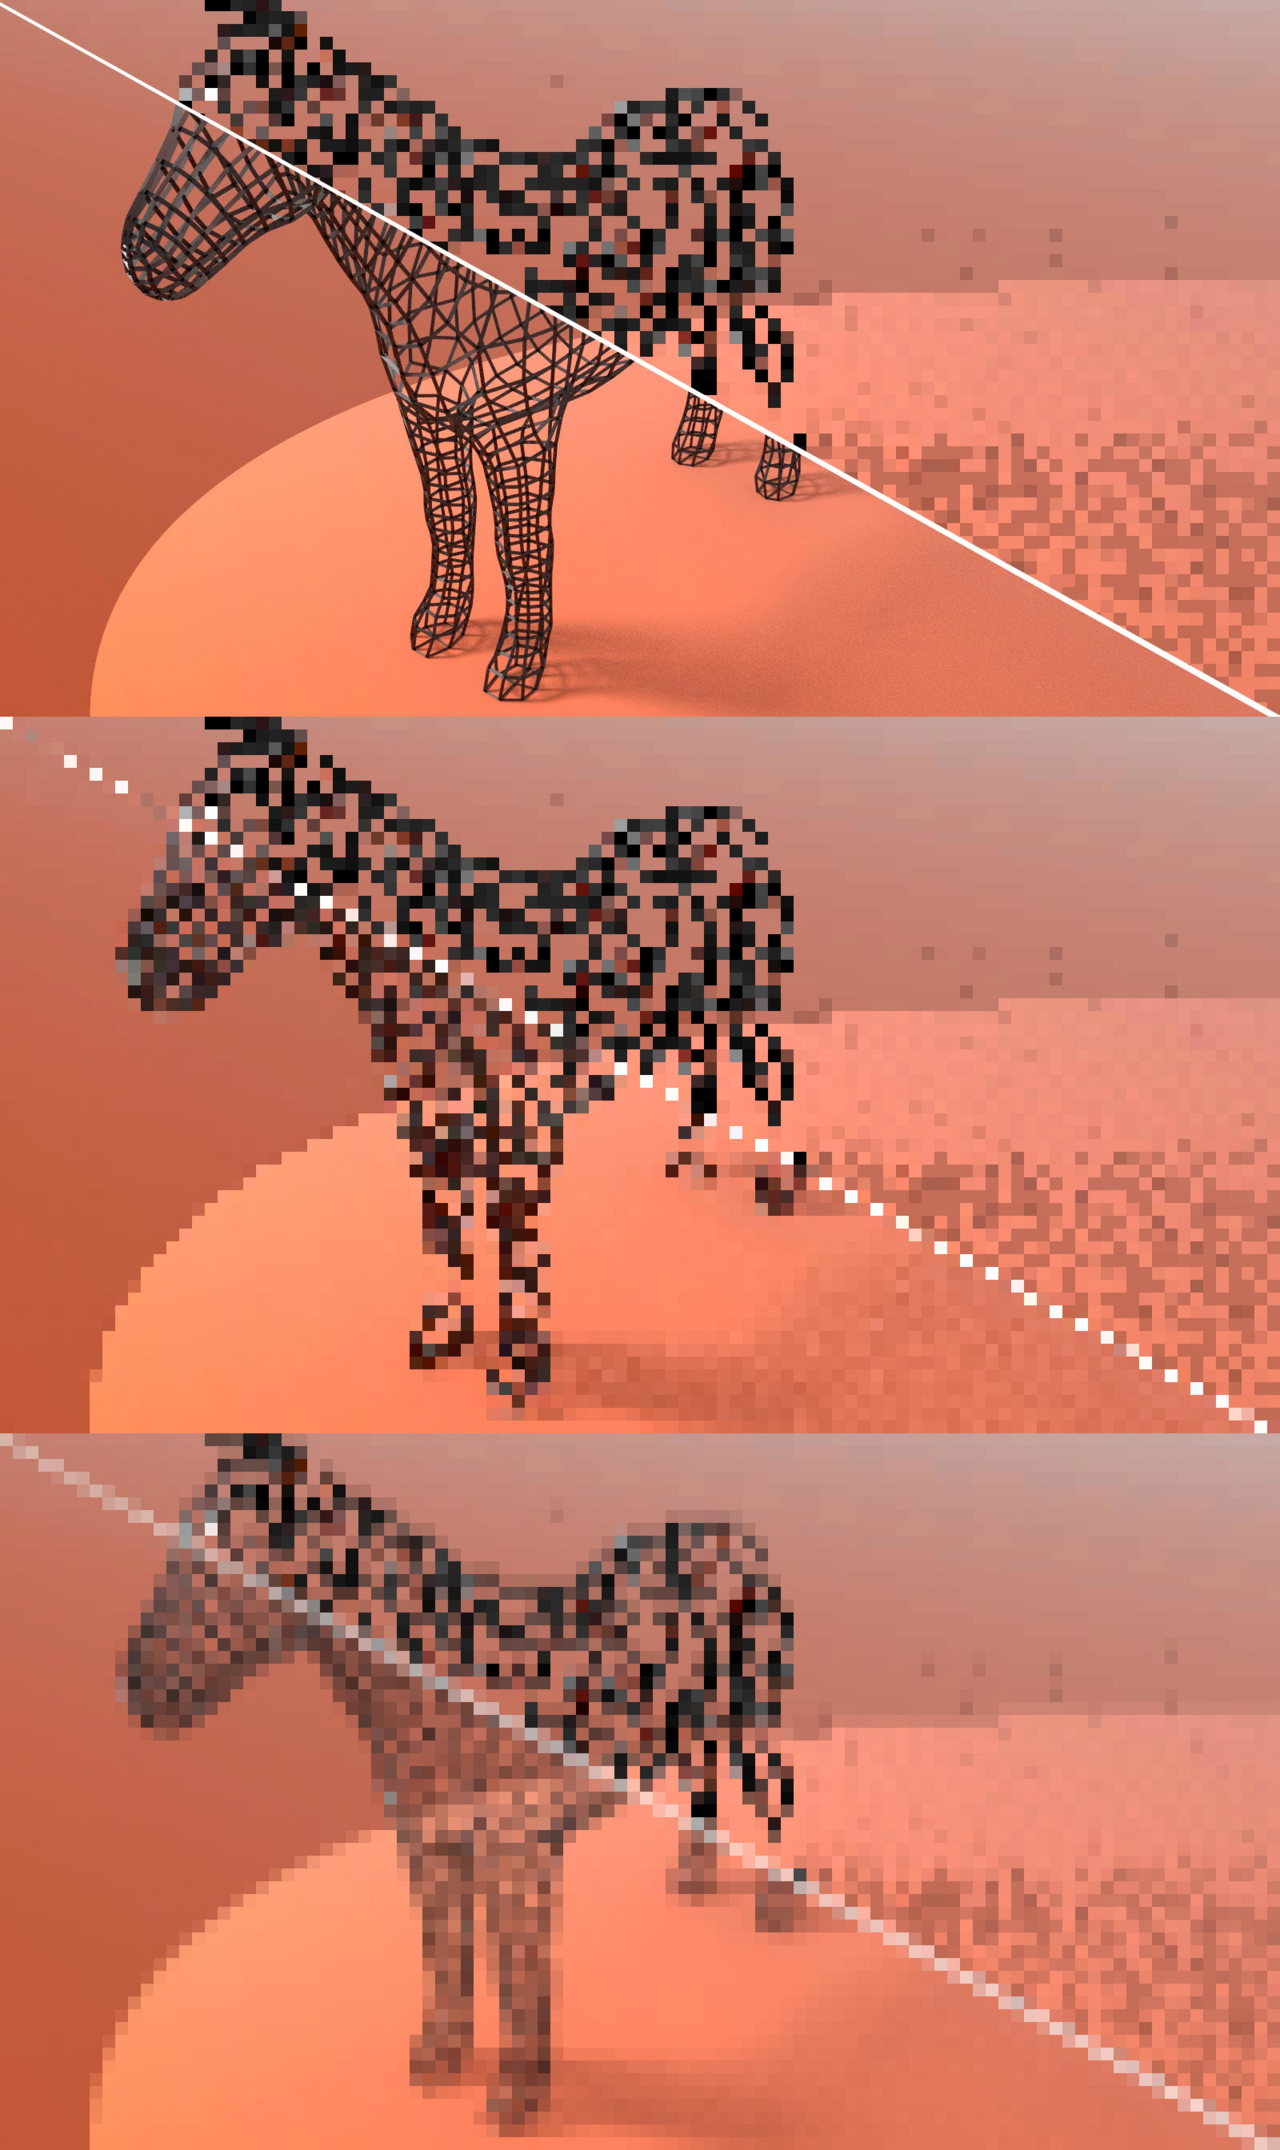
Anti-Aliasing in CGI revision example.png,1600×2688,CC BY-SA 4.0,作者 DanTDM)——用来说明「边缘锯齿」这件事本身长什么样,为下一节的分界做铺垫@ DanTDM / Wikimedia Commons / CC BY-SA 4.0先来看看这张外部真图是随手补的一处铺垫。它说的是另一件从 CPU 时代就存在、但同样在 GPU 上被重新解决的问题——边缘怎么变平滑。下一章会看到,这件事恰好是与另一条技术路线(2D 矢量引擎)的分界点。
本章出处:官方发布说明 Dev snapshot: Godot 4.6 dev 5(代价自述三句与 1.1x–7x 结论);官方库 PR GH-112481;本机探针 evidence/probe/I_ep11_batch_table.txt;外部图 Wikimedia Commons Anti-Aliasing in CGI revision example.png。

八、★ 与 T03 的分界:MSAA 而不是 analytic coverage
先来看看本系列有一篇平行的专题,讲的是 2D 矢量引擎——那条路关心「一个像素应该被涂多少比例」,这条链关心「这条命令怎么落到 GPU」。 分界线在抗锯齿这件事上最清楚。
8.1 官方给 MSAA 划的范围
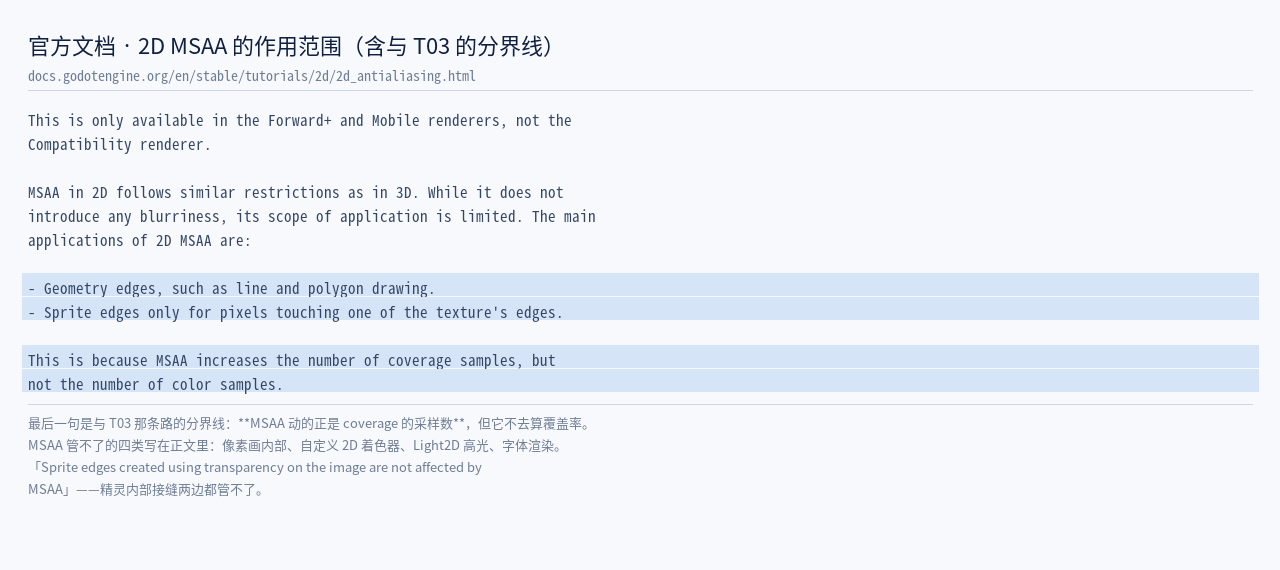
2d_antialiasing 逐字:MSAA in 2D follows similar restrictions as in 3D / 主要应用是 Geometry edges(线与多边形绘制)/ 精灵边缘 *only for pixels touching one of the texture's edges*——作用范围是被明确限定的@ Godot 官方文档/发布说明(版本见图注与正文出处)其中:官方这一段括号里的限定词很关键——only for pixels touching one of the texture's edges。这句话的意思是:精灵内部的接缝,MSAA 管不了。 精灵是一张纹理,纹理内部相邻像素之间的硬边,采样再多遍也还是硬边。 两条路各自能管到哪一段,列成一张清单比反复描述清楚得多:
【两条抗锯齿路径的作用范围(本篇归纳,依据官方 2d_antialiasing 与 T03 既有结论)】

MSAA(多采样,本系列这条链)
  能管:线与多边形的几何边缘
  能管:精灵边缘——但仅限贴图边缘所在的那一圈像素
  管不了:精灵内部的相邻像素硬边

analytic coverage(逐像素算覆盖率,T03 那条路)
  能管:任意曲线、贝塞尔细分后的轮廓
  能管:细笔画与字形(采样数不足时也不糊)
  管不了:精灵内部的相邻像素硬边
本章出处:官方文档 2D antialiasing。
8.2 把两条路放回硬件背景上
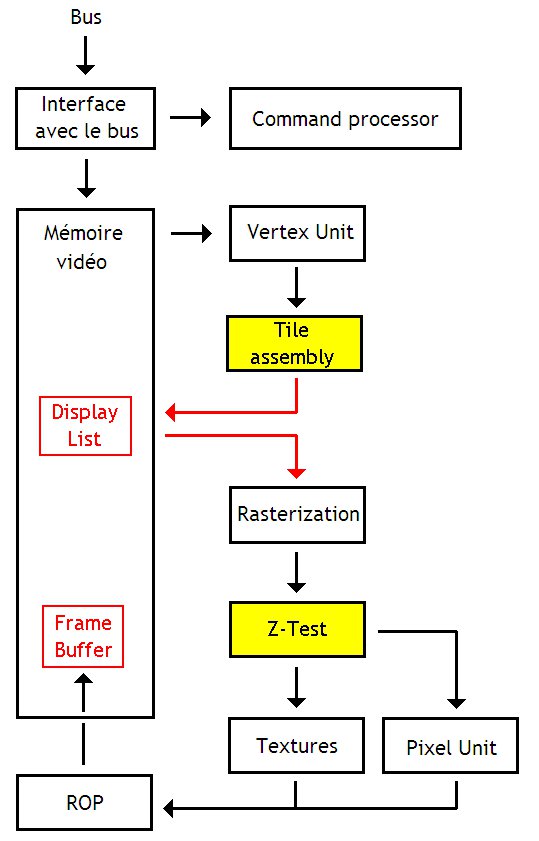
Tiled rendering architecture.jpg,539×841,CC BY-SA 4.0,作者 Mewtow)。尺寸不达标(长边 841 小于 1280)⇒ 只作原理小图,不做大幅效果图@ Mewtow / Wikimedia Commons / CC BY-SA 4.0这张图讲的是移动 GPU 的分块渲染(tile-based rendering,TBR)架构。放到本篇的上下文中,它的作用是回答一个前面留下的问题:为什么第七节里那条回归最先出现在低端移动设备上。
因为移动 GPU 的架构约束不同——受电池、发热与带宽限制,它把画面切成小块、在片内缓存里渲染完再写出去。这套架构对带宽极其敏感,而批处理带来的额外 GPU 成本正好压在带宽与状态开销上。换句话说,同一份架构决策,在不同硬件上被定价成不同的数目——这又是账本上那句老话的第三种说法。
8.3 分界与共同缺口
下面这张表把两条路的分界摆清楚:
| 维度 | 本系列这条链 | T03 那条路 |
|---|---|---|
| 核心问题 | 这条命令怎么落到 GPU | 一个像素应该被算成多少 |
| 抗锯齿手段 | MSAA(多采样,作用于几何边缘) | analytic coverage(逐像素算覆盖率) |
| 谁能受益 | 线与多边形边缘、贴图边缘所在像素 | 任意曲线与字形,包括细笔画 |
| 共同缺口 | 精灵内部接缝——两条路都管不了 | 同左 |
其中:这张表的最后一行是本节的落点。两条路都各自解决了一大类问题,也各自留下同一处空白。把两条路的边界画到一起,比争论哪条路更好有用得多。
本章出处:官方文档 2D antialiasing(MSAA 在 2D 的作用范围);官方文档 Internal rendering architecture(2D rendering techniques 的 MSAA 与 FXAA 两句);外部图 Wikimedia Commons Tiled rendering architecture.jpg(长边 841,尺寸不达标,仅作原理小图)。

九、2D/3D 分家的边界条件
账本快记完了。这一章要处理一处最容易被含糊过去的地方:2D 与 3D 到底是不是同一套东西。 官方给的答案很明确——分家,但有一条边界条件。
9.1 三项分家
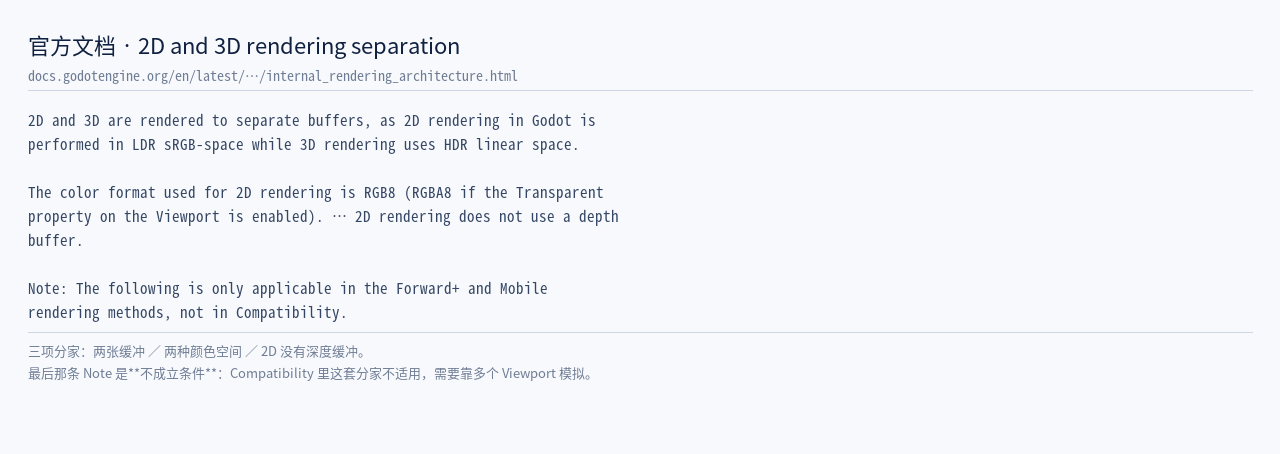
internal_rendering_architecture 的 2D and 3D rendering separation 段逐字:separate buffers / 2D 在 LDR sRGB-space、3D 在 HDR linear space / 2D 用 RGB8(Viewport 开 Transparent 时 RGBA8)/ 2D rendering does not use a depth buffer@ Godot 官方文档/发布说明(版本见图注与正文出处)其中:官方这段一共分了三件事,每一件都值得单独记:
【1】两张缓冲。2D 与 3D 分别渲染到各自的缓冲,不是画在同一张上再分图层。
【2】两种颜色空间。2D 在 LDR 的 sRGB 空间,3D 在 HDR 的线性空间。这一条决定了「2D 的东西不能直接当 3D 的输入」,也解释了为什么某些跨 2D/3D 的效果需要显式转换。
【3】2D 没有深度缓冲。这一条最容易被忽略,但它对 2D 意味着:可见性完全由绘制顺序决定——回到第三章那句「顺序就是可见性」。2D 没有深度可以依赖,全靠排队。
把这三项放在一起看,会发现它们共同指向一件事:2D 这条通路是为「可预测」优化的,不是为「可组合」优化的。 没有深度缓冲意味着顺序必须显式排好;走 LDR 的 sRGB 空间意味着颜色不必等到最后才定;用 RGB8 意味着每像素的开销被压到最低。这些选择单看都很划算,代价是 2D 与 3D 的产物之间不能直接互塞——想把 3D 的渲染结果当 2D 素材用,中间必须过一次显式转换。
顺带记一个参数口径:2D 用的颜色格式是 RGB8,Viewport 开启 Transparent 时改成 RGBA8。
9.2 资源侧留下的遗迹
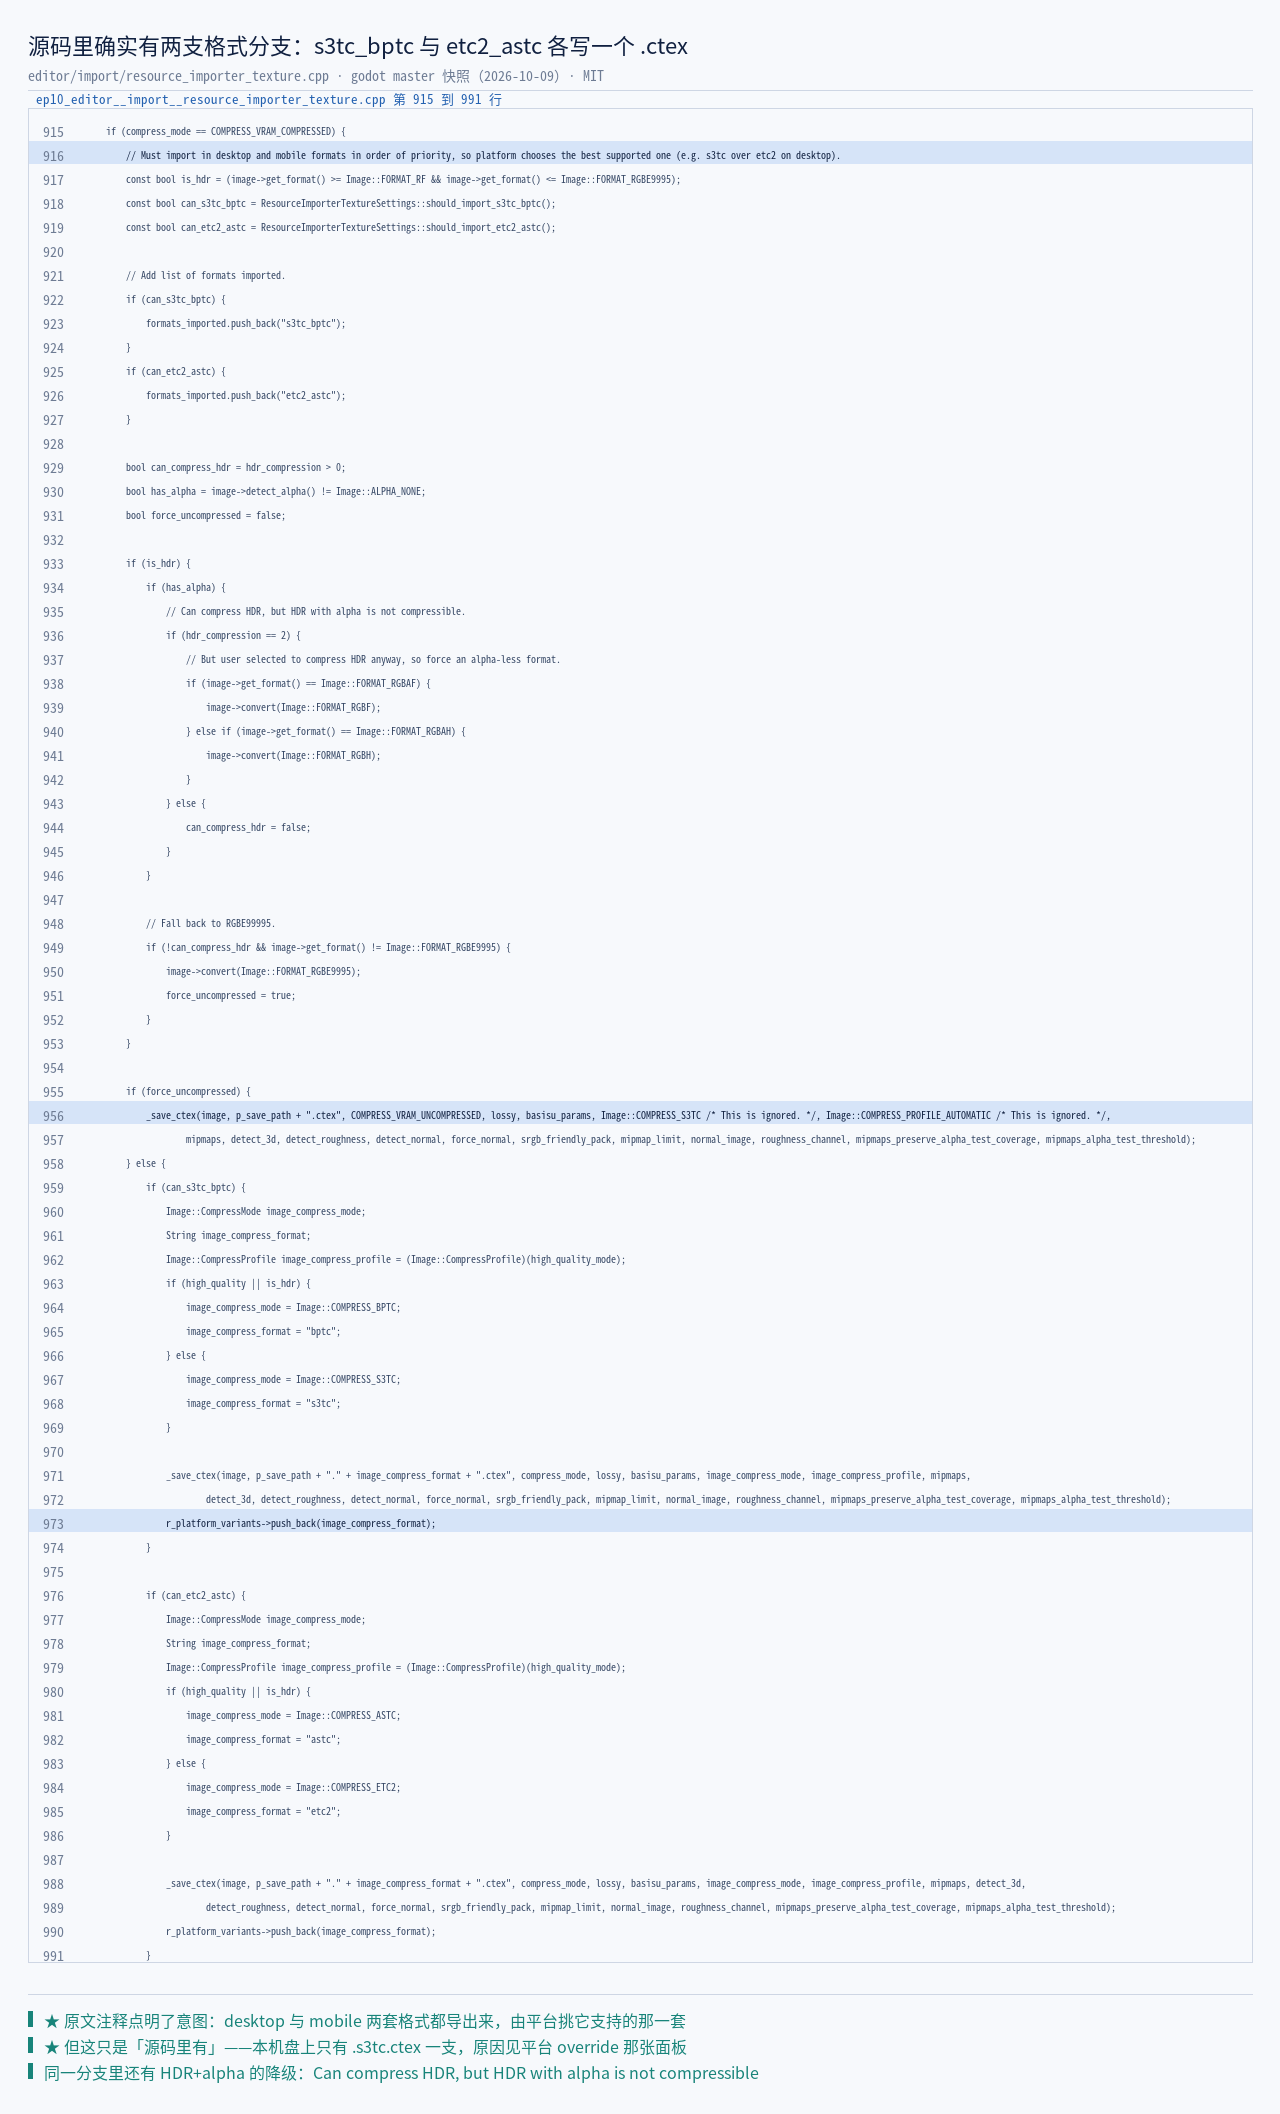
_validate_texture_format() 与 FORMAT_RGB8 面板——那条 if (false && …) 的长年死支,正是「2D 走独立 LDR 缓冲」在资源侧留下的遗迹@ 本系列第十篇(复用)先来看看这一张是第十篇的面板。它出现在这里,是因为那条 if (false && …) 的长年死支,正是 9.1 节那三项分家在资源侧留下的遗迹:纹理导入侧默认早就走 RGBA8,而格式校验里那条 RGB8 分支写着恒假的判断。
其中:同一个架构事实,在渲染侧写在文档里(9.1 节那三项),在资源侧写在一行恒假的条件里。两处相隔两千多行代码、隔着两个子系统,说的却是同一件事。 这类「跨子系统的呼应」是读架构时最值钱的线索之一。
9.3 那条不成立条件
OK,官方那段话里藏着一个容易被读漏的从句:only applicable in the Forward+ and Mobile rendering methods, not in Compatibility. 也就是说,前面说的三项分家在 Compatibility 渲染方法里并不成立;在那一档里,需要靠多个 Viewport 去模拟。
其中:这一条把本篇的两个话题接上了。第三章到第五章讲的是结构上的取舍,第六章到第七章讲的是版本上的定价,而这一条说的是同一份结构在不同档位上的成立范围。三者叠起来才是完整的账:结构决定了有哪些账,版本决定了每一次算成多少,而档位决定了这笔账在你这台机器上成不成立。 把三项分家写成结构定义会更清楚——它不是「2D 排在 3D 前面」这种顺序问题,而是两张格式不同的画面:
【2D 与 3D 两张缓冲的结构定义(依据官方 2D and 3D rendering separation 小节)】

2D 缓冲   颜色空间:LDR sRGB        格式:RGB8(Transparent 时 RGBA8)   深度:无
3D 缓冲   颜色空间:HDR linear      格式:随渲染方法与设备而定           深度:24 位或 32 位浮点

成立范围:仅 Forward+ 与 Mobile;Compatibility 里不成立(需多个 Viewport 模拟)
本章出处:官方文档 Internal rendering architecture(2D and 3D rendering separation 小节与其 Note);官方文档 Overview of renderers(七种驱动组合表);本系列第十篇《资源侧:一张纹理从盘上到显存》的 _validate_texture_format() 面板。
十、本系列自证:十篇的「测不了」与「未闭环」
说白了,收官篇最容易写坏的地方在结尾:一路顺下来,把前面所有的不确定都悄悄抹平,最后给出一个漂亮的结论。这一章专门用来挡住这件事。
10.1 十篇的总账
下面这张表把前十篇里明确登记在册的「测不了」与「未闭环」逐条列出来。它们不是缺陷列表,而是这套架构的可观测边界:
| 类别 | 条目 | 出处 |
|---|---|---|
| 测不了 | 线程级「谁在哪个线程」——读数拿得到,线程归属看不到 | 第九篇 |
| 测不了 | 物理螺旋本机无稳定复现手段,只转述官方定义 | 第九篇 |
| 待回源 | 某一档的插值分数恒定,因本机构建与源码快照不是同一提交而推不出机制 | 第九篇 |
| 口径边界 | 显存侧读数本机拿不到,全篇凡涉字节一律写「被上传的压缩块字节数」 | 第十篇 |
| 口径边界 | texture streaming 两个键在本机构建里读不到 |
第十篇 |
| 口径边界 | 本篇探针读的是墙钟帧时间,不是 GPU 时间 | 本篇 |
| 未复现 | 官方所述「低端设备上的性能回归」,本机不复现(本机非 GPU 受限) | 本篇 |
| 未复现 | 社区所述「Z-index 交错断批」,本机最小复现未能复现 | 本篇 |
| 既有遗留 | 第一篇与第五篇的封面来自同一张源图,属同池撞脸 | 系列登记 |
| 既有遗留 | 术语表未覆盖本系列题域,术语侧分母偏小 | 系列登记 |
其中:请特别注意最后两行。它们与架构无关,是系列自己的工程遗留,本来完全可以不出现在一篇讲架构的文章里。放在这里,是因为「未闭环」这件事不该按类别挑着写——为了好看而只保留技术性的未知、把工程性的遗留删掉,与直接篡改结论没有本质区别。 依然是惯例,这张总账同时也是自查清单的机读版,把「哪一类缺口该往哪儿查」固定下来,后续篇目可以直接复用:
【本系列的读数缺口分类与自查口径(本篇归纳)】

测不了       本机没有对应工具 —— 例:显存侧读数
               处置:换口径写(写成「被上传的压缩块字节数」),并在正文声明
读不到       接口没暴露该字段 —— 例:texture streaming 两个键、线程归属
               处置:只作版本线观察,不给任何本机读数
未复现       官方或社区所述现象本机跑不出来 —— 例:低端设备回归、Z-index 断批
               处置:并列给出,注明本机环境,不替任何一方圆场
既有遗留     与架构无关的工程债 —— 例:封面同池撞脸、术语表未覆盖题域
               处置:照实登记,不以「与本文无关」为由删掉
本章出处:本系列第九篇、第十篇各自的「测不了」登记,以及本仓库 README 里的系列遗留条目。
10.2 一处具体例证
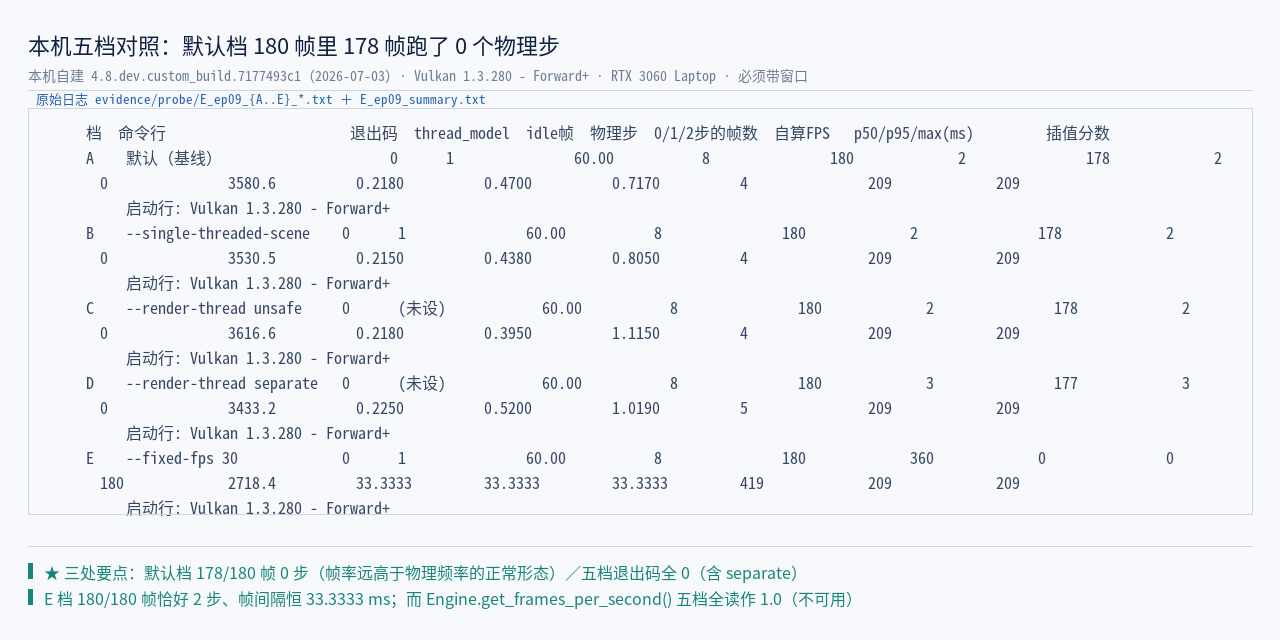
其中:这张图是第九篇的探针面板。它同时展示了「测得到」和「测不到」:面板上的数字都是真的,而「哪个线程在跑哪一段」这件事,探针里根本没有对应的行。读数与读不到的边界,最好用同一张图来讲。
十一、版本节奏的两处更新
言归正传,写到这里,本篇还有一个必须完成的动作:前十篇里有两处说法已经过期了,要明写更新。
11.1 第一处:Windows 上的默认驱动换了
第八篇讲后端分叉时,本系列的表述是「Direct3D 12 是实验性的、且不是默认」。这个说法在当时是对的。但现在不是了:
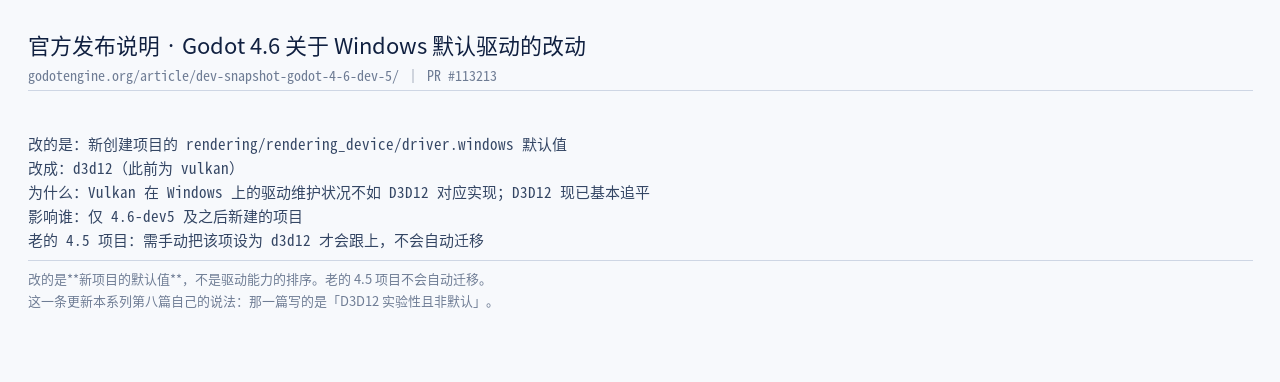
GH-113213。这一条更新本系列 ep08 自己的说法(ep08 当时写的是实验性且不是默认)@ Godot 官方文档/发布说明(版本见图注与正文出处)官方 4.6 发布说明写得很清楚:Direct3D 12 as the new default on Windows,新项目默认使用 D3D12,理由是它「pretty much on par with Vulkan」,且驱动支持更稳定、平台怪癖更少(对应改动 GH-113213)。
其中:按本系列的规矩,这种更新不能默默改,要写出来。所以这一节的写法是:「本篇更新第八篇的这一条」——老结论在这里失效,原因与出处一并给出。 这条更新的定义要写清楚,免得读成「D3D12 取代 Vulkan」:它改的是新项目的默认值,不是驱动能力的排序。
【4.6 关于 Windows 默认驱动的改动(依据官方发布说明与 GH-113213)】

改的是:新创建项目的 rendering/rendering_device/driver.windows 默认值
改成:d3d12(此前为 vulkan)
为什么:Vulkan 在 Windows 上的驱动维护状况不如 D3D12 对应实现;D3D12 现已基本追平
影响谁:仅 4.6-dev5 及之后新建的项目
老的 4.5 项目:需手动把该项设为 d3d12 才会跟上,不会自动迁移
11.2 第二处:一条「文档口径滞后于版本」的通用规律
前面第六章已经出现过一次:同一页官方文档的 4.3 版与 stable 版说法不同。这一节把它上升为一条通用规律:
官方这张「核心渲染类架构」图,是本篇这条链的静态形状。它的问题不在于准不准,而在于官方文档的不同页面、不同语言版本、不同版次,更新节奏并不一致——有的页跟着版本走,有的页停在两三个版本之前。
其中:这条规律对读者的实用价值是:凡是拿官方文档当依据做判断,先确认那一页是哪个版本的。
那张官方「核心渲染类架构」图(本节原本要嵌的一张)没有嵌进来——本机三轮直取都没能拿到它(latest / stable / engine_details 三个路径都返回 404)。按本系列的规矩,这种情形不拿自绘图去顶:需要看图的朋友请直接翻官方页面的 Core rendering classes architecture 一节,正文这里只留一句读法——那张图是这条链的静态形状;而静态形状本身不会告诉你它在哪个版本上成立。
本篇第六章那句「不太需要 2D 批处理」就是最好的例子——它在 4.3 的页面里成立,在 stable 的页面里已经被删掉了。
本章出处:官方发布说明 Godot 4.6 与 Dev snapshot: Godot 4.6 dev 5(D3D12 成为 Windows 默认,对应改动 PR #113213);官方文档 Internal rendering architecture(核心渲染类架构图);本系列第八篇《后端分叉》的既有结论。
十二、收官:架构读法三条 + 跨系列对照
最后一章,把这一路的东西收成三句话。
12.1 三条读法
【1】先找「谁在哪里等谁」。 这条链上每一个设计决策,都能翻译成一个等待关系:命令攒在哪里等处理、线程在哪里等依赖、执行与提交在哪里等对方。把等待关系画出来,结构自己就显形了——本篇第七章那两个章节甚至不需要源码,只看「谁等谁」就能读通。
【2】每个数都问「它是在哪一档、哪个版本上算出来的」。 本机那 12 格矩阵里,同一份断批在 Compatibility 上是 8.5 倍、在 Forward+ 上是 2.5 倍;官方那份「不太需要批处理」的判断在 4.3 的页面上成立、在 stable 上被删掉。数不是错的,只有脱离档位与版本的数是错的。
【3】官方文档要连同版本一起读。 这一条是前一条的必然推论,也是本系列做得最较真的一条:凡引官方话必带版本。原因很简单——引擎在动,文档跟着动,而两者的速度不一样。
12.2 把本篇放回系列里
下面这张表是本系列与另外三个专题的对照。四个专题都在讲「图形怎么落到屏幕上」,但切口各在不同的一段:
| 专题 | 切口 | 与本篇的关系 |
|---|---|---|
| 本系列(Godot 4 引擎架构) | 一次绘制的四层落点:命令怎么下发、怎么攒批、怎么变成 GPU 命令、怎么分叉到四条驱动 | 本篇是它的收官:把这条链的取舍与版本定价合起来看一遍 |
| 《2D 矢量引擎深挖》 | 一个像素应该被算成多少:贝塞尔细分、覆盖率、字形光栅化 | 第八章的分界线:MSAA 与 analytic coverage 两条路,共同缺口是精灵内部接缝 |
| 《Android 图形显示系统》 | App 到合成器的系统级链路 | 本系列到低层图形接口与驱动交界为止,不下探到系统合成 |
| 《Jolt Physics 3D》 | 物理引擎的机制与自跑读数 | 第九篇做过一次对照:两边的任务调度与线程模型互不相同 |
其中:四个专题加起来,覆盖了一次绘制从「谁说要画」到「屏幕上真的亮了」的整段路。它们之间没有覆盖关系,只有接缝——而接缝处往往才是读起来最费劲、也最有收获的地方。 先来看看本系列十一篇各自的一句话结论,也列成文本速查表,方便回头检索(图形版见上一张图):
【T02《Godot 4 引擎架构》全十一篇一句话速查】

01 全景与边界        链的形状:一次绘制有四个落点
02 对象模型          命令可以随便下发,但下发之后不能改
03 服务层接口        命令先攒下来、再统一处理(这也是批的前提)
04 画布剔除与排序    顺序就是可见性;每帧重算
05 画布渲染抽象      绘制项只写一次,改属性等于清空重加
06 批处理            按状态切批;批的边界一丢,代价按数量线性回来
07 RenderingDevice   命令列表变成一张依赖图
08 后端分叉          四条驱动、七种组合;换来统一,交出特例
09 主循环与多线程    一个同步入口 + 三个线程入口,共用一个任务体
10 资源侧            一张纹理三个身份;导入是一次会回环的链
11 收官(本篇)      结构决定有哪些账,版本决定算成多少,档位决定成不成立
本章出处:本系列 ep01–ep10 各篇的既有结论。
12.3 最后一句
好了,写到这里,本系列十一篇走完了。回头看,这条链最值得记住的不是任何一层实现,而是它每一次都在做同一件事:把一类东西标准化换取规模效益,然后承认标准化带来的例外,再把例外单独处理。
对象模型把命令标准化了,例外是「图元不可变」;批处理把提交标准化了,例外是「批的边界」;窄接口把驱动标准化了,例外是「驱动特性不可达」;2D 复用了 3D 的路径,例外是「批处理让 GPU 更贵」。
所以这套架构真正的产出,不是它的分层图,而是它处理例外的固定姿态:先标准化,再给例外留一个明确的出口,然后把出口的成本记在账上、并且允许它被重新定价。 这大概也是读任何一套成熟引擎时最可迁移的一条经验——看它怎么处理例外,比看它怎么分层信息量大得多。
相关链接
- 上一篇:资源侧:一张纹理从盘上到显存
- 系列总览:Godot 4 引擎架构(全十一篇,本篇收官)
- 参考资源:Overview of renderers · Internal rendering architecture · GPU optimization · Optimization using batching · 2D antialiasing · Using servers for optimization · Godot 4.4 发布说明 · Godot 4.6 发布说明 · Dev snapshot: Godot 4.6 dev 5 · PR GH-112481 · PR GH-113213
- 素材来源:Wikimedia Commons(CC0 / CC BY-SA,逐图署名见图注)
- 本机探针:evidence/probe/I_ep11_batch_table.txt(12 格矩阵,一键复跑 ep11_run_probe.py)
With Best Wishes.