本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
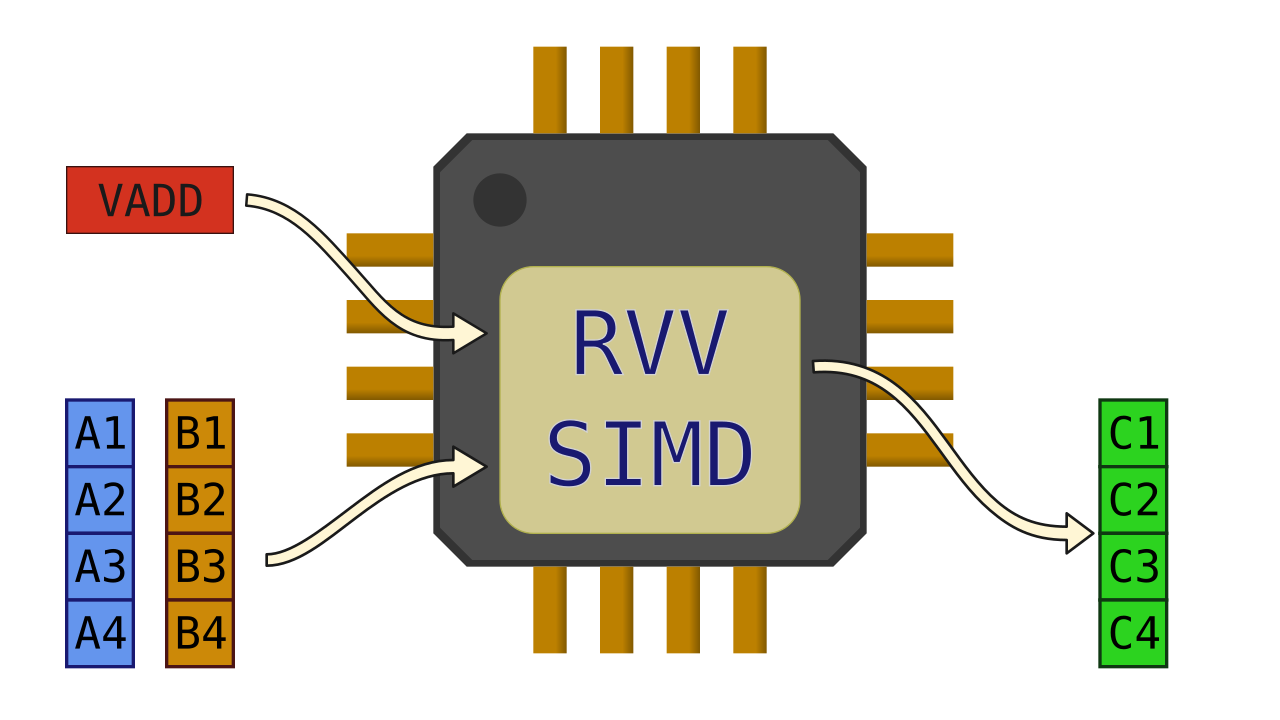
题图 同一个加法循环的两条数据通路:标量通路一次一个元素、打包通路一条指令八个元素,走不走第二条路由语义与数据决定 @ 本系列绘制
本系列已发表篇目(全系列共 12 篇,分四波连载,本篇为收官):
- ep01 对象布局、对齐与 padding:sizeof 的真相——第一波·布局与内存
- ep02 分配器解剖:malloc → jemalloc/mimalloc → pmr arena——第一波·布局与内存
- ep03 值语义的账:move/拷贝/SSO/emplace_back——第一波·布局与内存
- ep04 编译期账本:模板实例化与 -ftime-trace——第二波·编译器与链接器
- ep05 优化器的边界:UB、严格别名与向量化报告——第二波·编译器与链接器
- ep06 名字与符号:ABI、修饰、可见性、PLT 与 IAT——第二波·编译器与链接器
- ep07 链在一起:LTO 与 PGO 的收益从哪来——第二波·编译器与链接器
- ep08 分发的代价:虚函数、模板、variant 与类型擦除——第三波·运行时代价
- ep09 异常与 RTTI:零成本到底成不成立——第三波·运行时代价
- ep10 内存序与原子:seq_cst 在 x86 上免费吗——第三波·运行时代价
- ep11 缓存与布局:AoS/SoA、伪共享与 cache line 的账——第四波·跨平台与专项
- 本篇 · ep12 SIMD:自动向量化与手写 intrinsic 的分界——第四波·跨平台与专项(全系列收官)
背景与边界:一句「加 -O3 就自动向量化」的账
全系列十二篇的最后一篇,主题是并行。
好了,前面十一篇算的分别是「字节怎么摆」「编译器怎么翻」「代价从哪来」「跨核看见什么」。这一篇换一个轴:一条指令怎么同时处理八个数据。它不是语言特性,也不是库——是硬件给了 256 位的寄存器和一批打包指令,然后由编译器决定要不要用、由你决定要不要自己动手。
而这一篇要处理的第一件事,是一句在中文技术圈流传极广、也极容易被当成结论的话:「开 -O3 就会自动向量化,所以不用手写 SIMD。」
0.1 一句话结论先放这里
先把五条结论放前面,逐条都在本篇给出了本机读数:
- 「报告说向量化了」和「真的变快了」是两件事。 GCC 在
-O3 -march=native下对那个浮点归约循环的报告原文是optimized: loop vectorized using 32 byte vectors and unroll factor 8;把同一个循环用no-tree-vectorize关掉之后,读数是 3.296 ms 对 3.274 ms——收益是 0。四个构建全部如此。 - 真正解锁浮点归约的不是
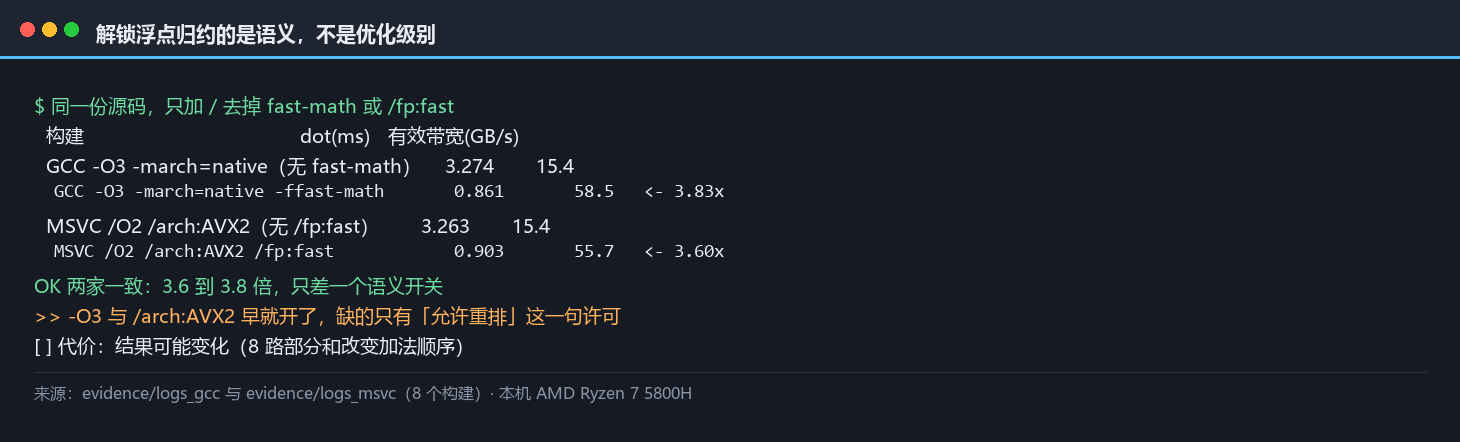
-O3,是放弃严格语义。 同一份源码,加上-ffast-math//fp:fast之后:GCC 3.274 → 0.861 ms(3.83 倍),MSVC 3.263 → 0.903 ms(3.60 倍)。因为浮点加法不满足结合律,编译器必须保序,除非你允许它不保序。 - 分支可预测性值 7.5 倍,而无分支的 SIMD 只值 1.6 倍。 同一份 MSVC 二进制、同一个分支循环:随机符号 17.256 ms、块状符号 2.292 ms;手写无分支版分别是 1.823 与 1.421 ms。手写的优势从 9.47 倍掉到 1.61 倍,全程只换了数据。
- 开了 fast-math 之后,编译器赢了手写 intrinsic。 GCC:自动 0.861 ms vs 手写 FMA 0.928 ms(自动快 7.2%);MSVC:0.903 vs 0.972(自动快 7.1%)。
saxpy更悬殊——MSVC 自动 1.332 ms vs 手写 1.929 ms,自动快 31%。 - 对齐在一笔越来越小的账上。 把数组基址故意错开 1 个 float,与 32 字节对齐的读数差落在噪声内(最好与最差相差不到 8%,方向还不一致)。
_mm256_load_ps的真实风险不是慢,是一旦对齐不成立就段错误。
0.2 实测环境
- CPU:AMD Ryzen 7 5800H(Zen 3),8 核 16 线程。
CPUID.7.0.EBX = 219c97a9⇒ AVX2 有(bit5)、AVX-512 没有(bit16 = 0);CPUID.1.ECX = 7ed8320b⇒ AVX(bit28)与 FMA(bit12)都有。 - ABI:
alignof(__m256) = 32、sizeof(__m256) = 32;但alignof(max_align_t)两家不同——GCC 16、MSVC 8(与 ep01 同一处差异)。 - 工具链:MSVC 19.44(VS 2022,
/std:c++17 /O2)与 GCC 16.2.0(MSYS2 ucrt64,-std=c++17)。 - 构建矩阵:MSVC 三个(默认 SSE2 /
/arch:AVX2//arch:AVX2 /fp:fast),GCC 四个(-O2/-O3/-O3 -march=native/-O3 -march=native -ffast-math),另加一个-msse2 -mno-avx的窄宽度对照。一共 8 个构建,每个都把全部子命令跑一遍。 - 用例:
evidence/src/simd_lab.cpp,7 个内核(逐元素加、saxpy、点积归约、跨步访存、分支取值、前缀和、对齐对照),4 万余行读数来自同一批日志。
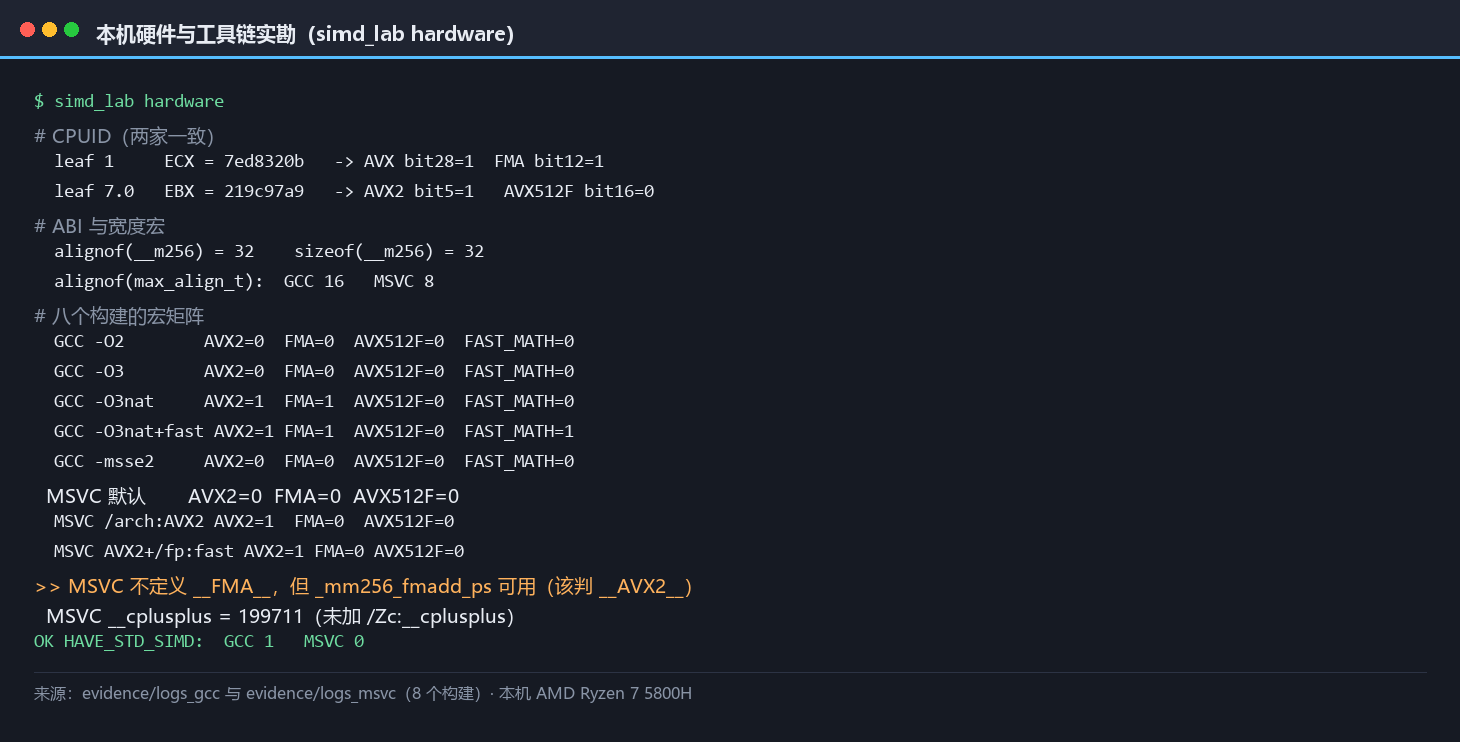
0.3 本篇不涉及什么(边界声明)
说白了,四条边界,逐条都是本机拿不到或不该做,而不是「不重要」:
- 不做 AVX-512 实测。 本机 Zen 3 没有 AVX-512(
bit16 = 0),而且消费级平台上 512 位指令还有降频的争议。这一章只引官方规格与第三方实测口径,不给本机读数。 - 不做 Clang 实测。 本机不存在
clang/clang-cl(VS 自带的 LLVM 只有 clang-format 与 clang-tidy,msys64 只有 gcc)。Clang 的-Rpass=loop-vectorize与-fsave-optimization-record只作引用;本篇「报告 vs 读数」的对照全部落在 MSVC 与 GCC 两家。 - 不给微架构事件。 本机 HAL 暴露了 17 个 PMC 源(
xperf -pmcsources实跑可列),但采集需要管理员权限的内核日志器,本轮拿不到。所以没有 IPC、没有端口压力、没有 cache-miss 计数——「为什么 fast-math 之后自动版反超手写」只能给结构与读数解释,给不出事件级证据。(这条边界与 ep11 同源。) std::experimental::simd只有单侧实测。 GCC 16.2 的 libstdc++ 有(HAVE_STD_SIMD = 1),MSVC 19.44 的 STL 没有(HAVE_STD_SIMD = 0)。所以「标准 SIMD 抽象能不能用」这一章是单侧实测 + 官方资料,不是双工具链结论。
0.4 按需跳读
- 只想知道「我该不该手写 SIMD」:读 §0.1、§七(规模与算术强度)、§九(判据六条)——这三节就能回答,其余是证据。
- 想搞清「为什么我的循环明明向量化了却没变快」:读 §二(四种卡点与报告怎么读)、§三(浮点归约与 fast-math)、§四(分支与数据)。
- 想学 AVX2 intrinsic 的写法:读 §五,那里有六个典型指令的用法与逐位正确性核对。
- 想知道「编译器和手写谁更强」:读 §五与 §八——本机读数给了一个和流行说法相反的答案。
- 只关心可移植性:读 §八(标准 SIMD 的三家现状)与 §六(对齐与
loadu的风险)。
0.5 这一篇与系列其他篇的接续
- 接 ep11《缓存与布局》:ep11 给的是 AoS/SoA 的 k-扫描结论——只读 1 个字段时 SoA 快 2.35 倍、读满 8 个字段两家打平。本篇的 SoA 是它的前置条件:访存不连续,向量化第一道门就过不去(§二会量这件事)。
- 接 ep05《优化器的边界》:ep05 量的是 UB、严格别名与向量化报告在两家编译器上的可见性;本篇把它推进到浮点结合律与分支这两处更硬的语义卡点——ep05 说「编译器看见什么才敢动」,本篇说「编译器看见但不允许动时怎么办」。
- 接 ep07《LTO 与 PGO》与 ep10《内存序》:三篇是同一条方法论——同一份源码、只换开关、量差异。ep07 换的是链接期视野,ep10 换的是内存序,本篇换的是 ISA 宽度与浮点语义。
- 全系列收官:ep01 到 ep12 十二篇的账在 §十一次列全,含篇幅、图量、一句结论各一列。
0.6 为什么这一篇要按「问题类型」拆,而不是按指令族拆
市面上多数 SIMD 材料是按指令族组织的:MMX 一节、SSE 一节、AVX 一节、AVX-512 一节。这个结构适合查手册,不适合回答工程问题——因为「用哪一族指令」是结论,不是起点。
本篇按问题类型拆,一次问一件事:编译器为什么不向量化(§二)、为什么报告说向量化了却没变快(§三)、数据为什么能决定快慢(§四)、手写什么时候赢(§五)、哪一笔账被夸大了(§六)、收益为什么随规模衰减(§七)。
OK,这样拆的好处是每一节都能独立回答一个问题,代价是同一批读数会在不同章节里以不同角度出现两次——所以 §十 的汇总表会把全部读数集中一遍,便于对照与复核。
0.7 证据形态与读法
本篇的证据有三类,读的时候要分清它们各自能证什么。
第一类是本机实测:向量化报告原文、端到端读数、逐位正确性核对。它能证代价区间与变化方向,不能证「为什么」——因为拿不到事件计数,机理解释只能落在结构与读数的一致性上。
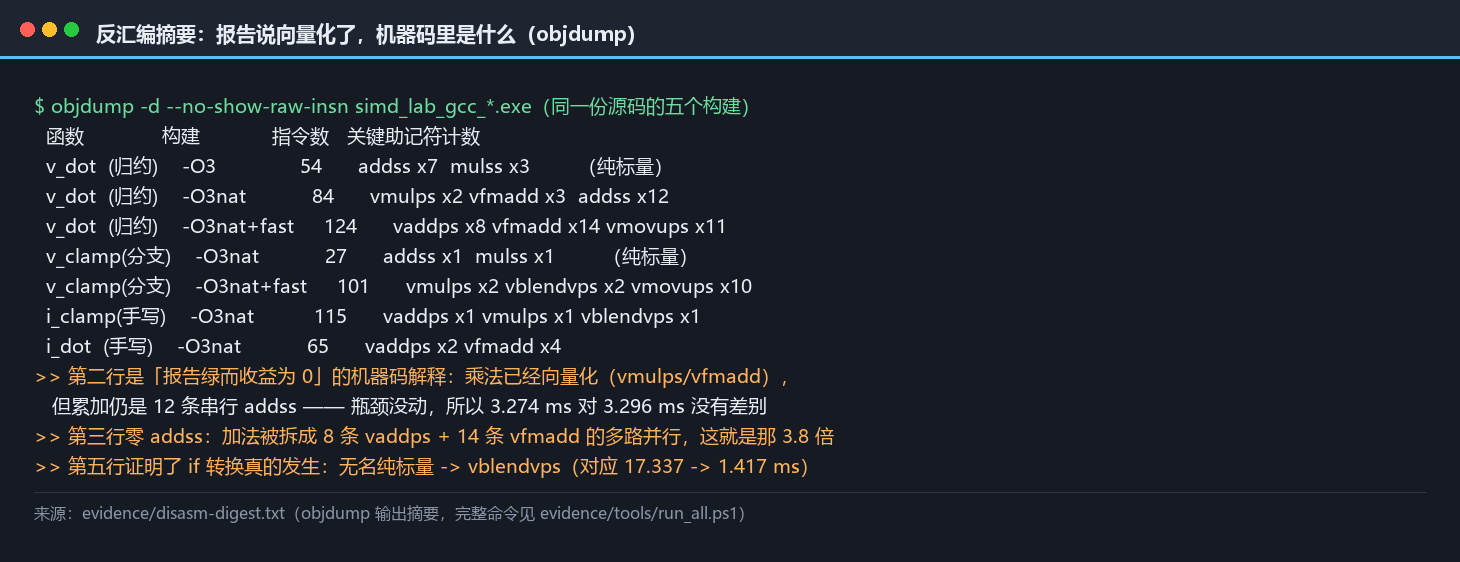
第二类是本机反汇编:报告说向量化了,机器码里到底有没有 vaddps / vfmadd。它是「报告」与「读数」之间的中间凭证——报告可信不可信,靠它核。
第三类最特殊:本机拿不到的那部分。 AVX-512、Clang 的优化报告、微架构事件——这三样都只能引外部资料。所以本篇凡涉及它们的地方都标了出处,且不写成实测结论。
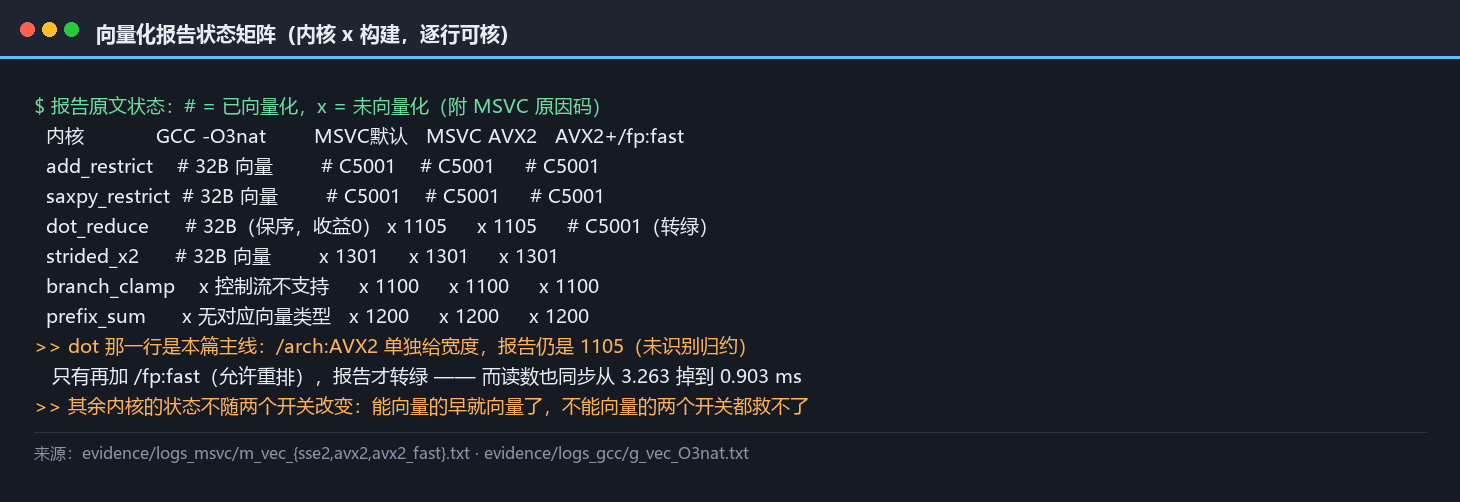
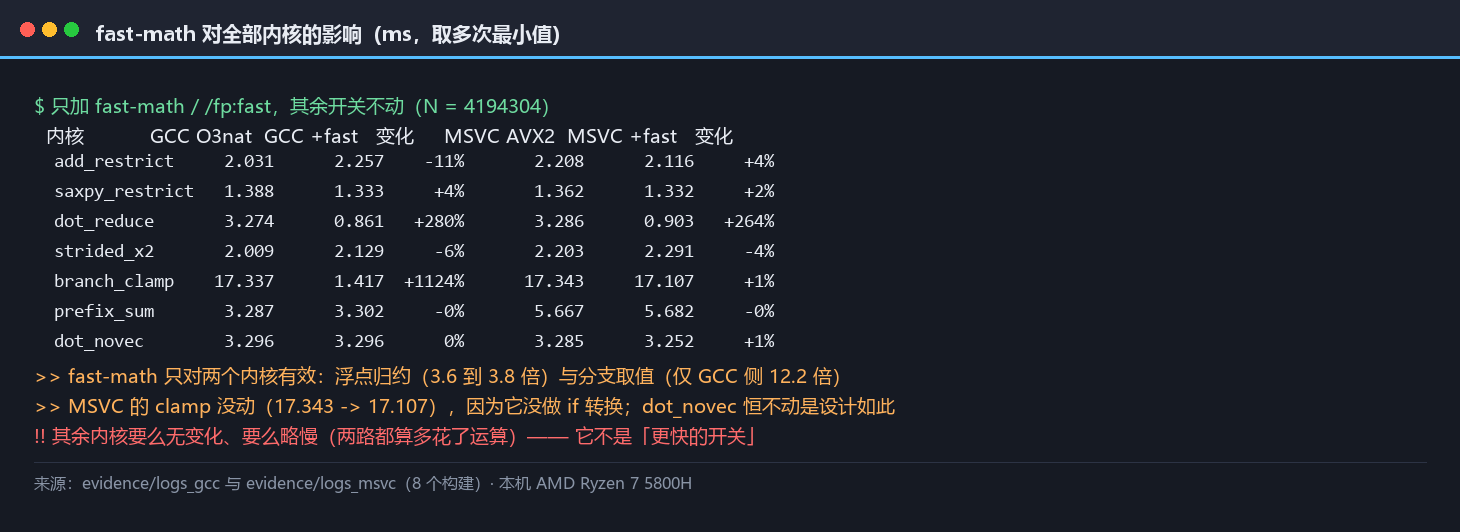
读法上有一个反复出现的坑要提前说:本机读数全部是「同一台机器、同一份源码、只换一个开关」。这种对照能排除机器差异,但也会把「开关之间互相作用」藏起来——比如 /arch:AVX2 对逐元素加法几乎无感(+1.7%)、对 dot 恰好 0%、对 saxpy 却是 +23%。同一个开关,三种结果,差别全在「这个循环到底向不向量化」。
一、向量化到底发生了什么:从标量循环到 256 位寄存器
言归正传,机制部分从最小的一层说起:一条指令一次能干几件事。
1.1 标量通路与打包通路
先看两条数据通路。标量通路里,一条加法指令从两个寄存器各取一个 32 位浮点、相加、写回一个——一次一个元素。打包通路里,同一个加法指令作用在两个 256 位寄存器上,每个寄存器装着 8 个浮点,一条指令出 8 个结果。
这就是 SIMD(Single Instruction, Multiple Data,单指令多数据)的全部含义。它不改变计算的总量,只改变每次搬运与每次运算打包多少个元素。
好了,但真正决定这一篇所有实验的,是三个容易被忽略的前提:
- 数据必须已经在寄存器里排队。 要把内存里的 8 个连续浮点装进一个 256 位寄存器,它们得连续——这就是 ep11 的 SoA 结论为什么会在这里出现(跨步访存装不满一个寄存器,得靠 gather,代价立刻上去)。
- 指令是「宽度固定」的。 256 位寄存器里放 float 是 8 个、放 double 是 4 个、放
int16是 16 个——同一个指令,元素数随类型变。所以「向量化能快几倍」这个问题本身没有统一答案。 - 一次指令的延迟没有变短。
vaddps与addss的延迟几乎一样(都是几个周期);快的是吞吐——每周期能出 8 个结果而不是 1 个。这一点决定了后面「多累加器为什么赢」。
1.2 寄存器族的宽度演进(以及本篇为什么不测 AVX-512)
x86 上的向量寄存器宽度换过四代,每一代都把「一条指令能装多少」翻一倍:
| 代号 | 年份 | 寄存器 | 宽度 | 一条 float 加法出几个结果 |
|---|---|---|---|---|
| MMX | 1996 | MM0–MM7 | 64 位 | 2 |
| SSE / SSE2 | 1999 / 2000 | XMM0–XMM15 | 128 位 | 4 |
| AVX / AVX2 | 2011 / 2013 | YMM0–YMM15 | 256 位 | 8 |
| AVX-512 | 2015+ | ZMM0–ZMM31 | 512 位 | 16 |
说白了,本机落在第三代:__AVX2__ = 1、__AVX512F__ = 0。所以本篇的所有实测读数都止步于 256 位,AVX-512 那 16 个结果只作为规格对照出现在这张表里,不给本机数字——这是 §0.3 的第一条边界。
一个容易踩的细节:新寄存器的低半部分就是旧寄存器。YMM0 的低 128 位就是 XMM0,往 XMM0 写会把 YMM0 的高 128 位清零(AVX 的 VEX 编码语义)。这条别名关系既是兼容性的来源,也是「混用旧指令导致性能意外」的常见原因。
1.3 换一代寄存器,不是换一条指令那么简单
既然宽度翻倍,为什么不能「编译一下就好了」?因为每一代都伴随新的编码格式与语义约束:
- AVX 引入了 VEX 编码(三操作数形式,
vaddps ymm0, ymm1, ymm2不再毁掉源操作数); - AVX2 把整数运算补齐到 256 位(AVX 的 256 位只覆盖浮点,整数还是 128 位)——这是「AVX 与 AVX2 差在哪」的标准答案;
- FMA 引入了融合乘加:
a*b + c一次算出、只舍入一次,精度与吞吐都更好; - AVX-512 又引入掩码寄存器与新的编码形式。
OK,这些约束直接落到编译开关上。MSVC 侧 /arch 的值域是 SSE2 | SSE4.2 | AVX | AVX2 | AVX512,不指定时默认 SSE2;GCC 侧对应的是 -mavx2 / -mfma / -march=native。而这不等于「用哪一代由开关决定」——下一节就量这件事。
1.4 开关的语义:是「最低要求」,不是「上限」
有一条官方口径必须先说清,否则后面的读数会被误读。MSVC 文档关于 /arch 的原话是:自动向量化可能生成与 /arch 指定不同的指令,这些指令由运行期检查保护——例如按 /arch:SSE2 编译时,可能生成 SSE4.2 指令。
/arch 是「保证能跑的最低要求」,不是「能用的最宽宽度」。这个语义与 GCC 的 -march 一致(-march 设定目标 CPU,编译器可以生成该 CPU 支持的一切)。
本机读数里能直接看到这条语义的后果:MSVC 默认构建(SSE2 基线)与 /arch:AVX2 构建,在逐元素加法上几乎一样快(23.4 vs 23.8 GB/s,+1.7%)——因为加法那个循环在两种构建里都已经向量化,差异只在宽度,而它有更硬的瓶颈(§七会量)。
1.5 官方口径对得上
言归正传,把三处官方表述放在一起,本节的结构结论就有据可依:
- MSVC
/arch(x64) 文档:不指定时默认 SSE2;/arch:AVX2把多数整数运算扩展到 256 位并启用 FMA;/arch:AVX512引入 512 位向量、掩码与嵌入舍入。 - GCC 的
-ftree-vectorize与-fvect-cost-model:-ftree-loop-vectorize在-O3下默认启用;代价模型取值为unlimited | dynamic | cheap | very-cheap,新一代 GCC 在-O2下默认走very-cheap——这就是为什么-O2也可能向量化,只是更保守。 - LLVM 的 Auto-Vectorization 文档:Loop 与 SLP 两个向量化器默认开启;复杂控制流、不可向量化类型与函数调用会导致失败,而浮点归约只有在
-fassociative-math那一族选项下才会向量化。
最后那条是下面两章的主线:浮点归约的开关不在「优化级别」,在「浮点语义」。
1.6 本章判据(第一条)
- 判据:动手之前先问「这条循环的瓶颈是宽度还是别的东西」。宽度问题(算力受限、数据在缓存里)值得换更宽的 ISA;不是宽度问题(带宽受限、依赖链受限、压根没向量化)换 ISA 没有用。
- 反判据:如果一段代码的算术强度很低(每搬一个字节只算一两次),任何向量化都不会有收益——本机读数:
add在 64 MB 规模上只有 22.7 GB/s,而 16 KB 时是 122.9 GB/s(§七)。 - 本机依据:同一个
/arch:AVX2开关,对saxpy是 +23%、对add是 +1.7%、对未向量化的dot是 0%(§八)。
下一章先把「编译器到底怎么看一个循环」拆开——因为它决定后面所有的读数高低。
二、编译器看不看得见:四种卡点与它们的报告
好了,上一章讲的是硬件给了什么。这一章讲编译器敢不敢用——以及它愿不愿意告诉你。
好在两家编译器都愿意说。这是本篇的第一件工具。
2.1 两家的向量化报告长什么样
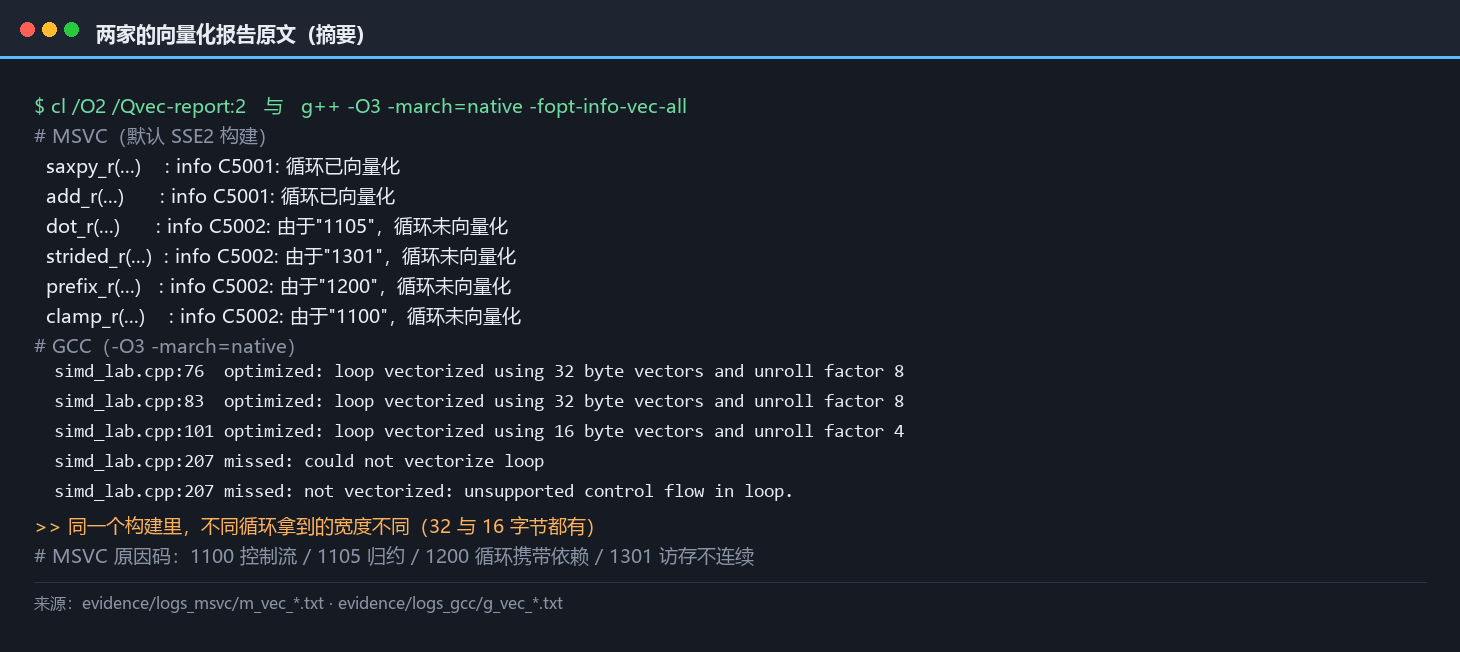
MSVC 与 GCC 各有一个开关,把「这个循环向量化了没有、没向量化是因为什么」直接打印出来:
- MSVC
/Qvec-report:2:向量化成功打info C5001: 循环已向量化;失败打info C5002: 由于"NNNN",循环未向量化,NNNN是原因码。 - GCC
-fopt-info-vec-all:成功打optimized: loop vectorized using 32 byte vectors and unroll factor 8;失败打missed: not vectorized: <原因>。-all会同时输出optimized、missed与note三类消息。
说白了,本机的报告原文可以直接读。MSVC 侧(默认 SSE2 构建):
--- 正在分析函数: void __cdecl saxpy_r(...)
simd_probe.cpp(35) : info C5001: 循环已向量化
--- 正在分析函数: float __cdecl dot_r(...)
simd_probe.cpp(40) : info C5002: 由于"1105",循环未向量化
--- 正在分析函数: void __cdecl strided_r(...)
simd_probe.cpp(45) : info C5002: 由于"1301",循环未向量化
--- 正在分析函数: void __cdecl prefix_r(...)
simd_probe.cpp(53) : info C5002: 由于"1200",循环未向量化
--- 正在分析函数: void __cdecl clamp_r(...)
simd_probe.cpp(49) : info C5002: 由于"1100",循环未向量化
GCC 侧(-O3 -march=native):
simd_lab.cpp:76:23: optimized: loop vectorized using 32 byte vectors and unroll factor 8
simd_lab.cpp:83:23: optimized: loop vectorized using 32 byte vectors and unroll factor 8
simd_lab.cpp:101:14: optimized: loop vectorized using 16 byte vectors and unroll factor 4
simd_lab.cpp:207:23: missed: could not vectorize loop
simd_lab.cpp:207:23: missed: not vectorized: unsupported control flow in loop.
注意最后两行的落差:GCC 报告的宽度是 32 字节(-march=native 给了 AVX2),但在另一个循环上报的是 16 字节向量——同一个构建里,不同的循环拿到了不同的宽度。所以「我开了 AVX2」这句话,只能说明上限,不能说明每个循环都用上了。
2.2 四种卡点,以及它们怎么落到原因码上
把本机八份报告里的失败条目归一下类,只有四种卡点:
| 卡点 | 本质 | 本机报告原文 | MSVC 原因码 |
|---|---|---|---|
| 别名 | 编译器无法证明两个指针不重叠 | (带 restrict 时通过;不带时退回保守分析) |
— |
| 不可数 | 循环次数在进入时未知,或退出依赖数据 | not vectorized: ... |
1200 系列 |
| 控制流 | 循环体里有分支/条件,无法 if 转换 | not vectorized: unsupported control flow in loop. |
1100 |
| 归约 | 浮点归约改变结合序,语义不允许 | missed: ...(保序版本) |
1105 |
另外两个本机实录的原因码值得单独记:1301(本机出现在跨步访存 strided_x2,即访存不连续)与 503(出现在非循环的代码块,不属向量化范畴)。
OK,这张表本身就是一篇材料的目录。下面三节各处理一种。
这四种卡点的分工值得说清,因为它决定后面三章的处置顺序。前三种都属于「编译器缺一条信息」:别名缺的是「这两个指针不重叠」的承诺,可以用 restrict 或者让它插入运行期检查来补;不可数缺的是「循环次数确定」的结构,只能改代码;控制流缺的是「两路都算也无妨」的许可,取决于浮点模型。只有浮点归约是「语义不许动」——即使编译器把整个循环看得一清二楚,语言规则也不允许它改变加法顺序。所以处置顺序是:能给承诺的先给承诺,给不了再动手写。
2.3 别名与 restrict:一次「承诺」而不是一次「开关」
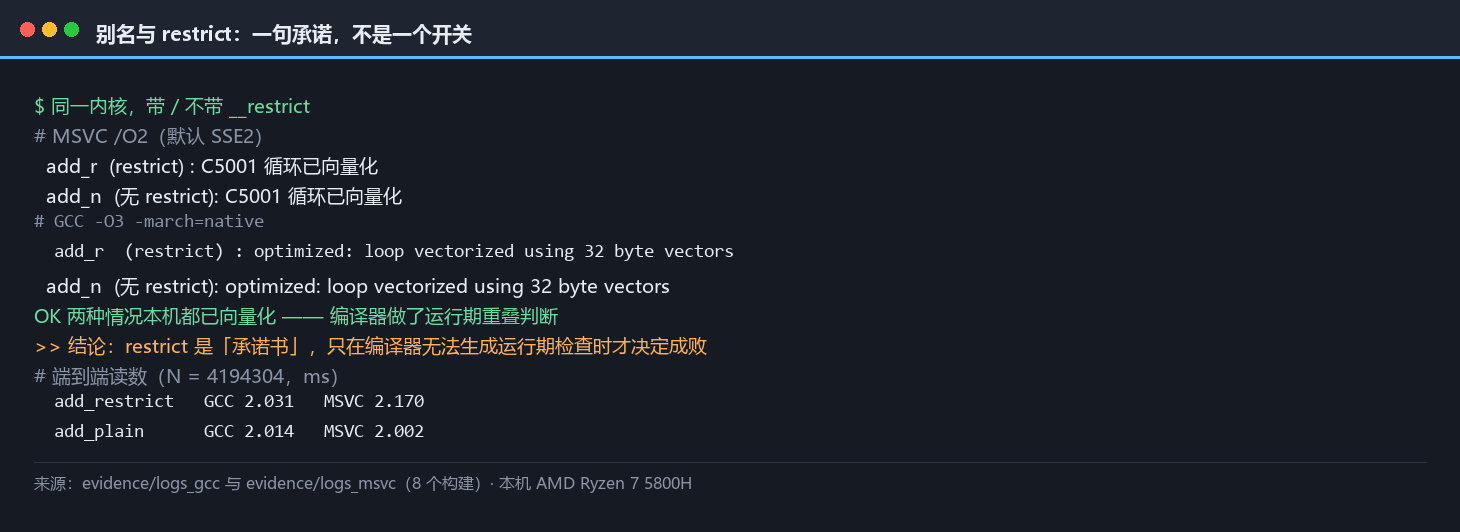
别名是四种卡点里最容易被当成开关的一种。restrict(C99)/ __restrict(各家扩展)的语义是承诺:通过这个指针访问的对象,在当前作用域内不会被其他指针访问。编译器拿到这个承诺,就敢把「先读后写」排成向量化的顺序。
言归正传,但它只是承诺,不是开关。本机读数里能直接看到两件事:带 restrict 的逐元素加法与把它去掉之后,本机都向量化了(MSVC 在两种情况下都报 C5001)——因为编译器在这个规模上做了运行期重叠测试,或者干脆把两个分支都生成了。所以「加 restrict 就能向量化」这句话在本机不成立,它只是让编译器少一层顾虑。
真正需要 restrict 的场景是编译器无法生成运行期检查的时候(比如指针来自不同模块、或者循环体太复杂)。这类情况下报告会告诉你「可能重叠所以不向量化」,而 restrict 是你能给的最有力的信息。
2.4 不可数与依赖:两种「编译器不敢动」
不可数指循环次数在进入时算不出来。官方口径很直白(Intel 编译器文档):可向量化的循环必须是 countable(trip count 进入循环时已知,且退出不依赖数据)、最内层、无函数调用。while (*p != NULL) { *q++ = *p++; } 就是官方列的不可数反例——它每轮的退出条件依赖数据。
依赖指循环的某一轮依赖前一轮的结果。本机最干净的一个例子是前缀和:
for (int i = 1; i < n; ++i) a[i] = a[i] + a[i - 1];
MSVC 报 C5002 由于"1200",GCC 报 missed: not vectorized。这条循环在本机八份报告里一次都没有被向量化,读数也印证了这一点:GCC 3.279 ms、MSVC 5.682 ms,全程 10 GB/s 上下——而逐元素加法是 22–24 GB/s。同样的访存字节数,差在依赖链上。
好了,值得记住的是:前缀和这类「看起来只能串行」的循环,确实有并行算法(成对求和、对数步移位),但那不是编译器的职责——编译器只能拒绝向量化,不能替你换算法。这是 §九 判据里的一条。
2.5 报告 → 机器码 → 读数:三段核对链
有了报告还不够,本篇所有关键结论都过一条三段核对链:
- 报告:编译器说这个循环向量化了没有(§2.1)。
- 机器码:反汇编里到底有没有 256 位指令与打包运算(
vaddps/vfmadd/ymm)。 - 读数:端到端时间有没有真的变化。
三段全绿才算数。 本篇最有价值的一条结论恰恰来自「第一段绿、第三段没动」——那个浮点归约循环的报告写着 loop vectorized using 32 byte vectors and unroll factor 8,而读数与「明确关掉向量化」的版本一模一样(3.296 对 3.274 ms)。只读报告会得出错误结论,这就是下一章。
2.6 官方口径对得上
- Intel 编译器文档:可向量化的循环必须 countable、最内层、无函数调用(例外是数学库 intrinsic 与可内联函数);并列出数据依赖的 RAW / WAR / WAW 三类。
- LLVM Vectorizers:
-Rpass=loop-vectorize报成功、-Rpass-missed报失败、-Rpass-analysis指到导致失败的语句。 - MSVC 文档:
/Qvec-report:1只报已向量化的循环,/Qvec-report:2连未向量化的原因码一起报。 - GCC 文档:
-fopt-info-vec-missed与-fopt-info-missed-vec等价,-fsave-optimization-record写一份机器可读的.opt-record.json.gz(官方标注该格式为实验性)。
说白了,最后一条对写工具的人有意义:GCC 把报告也做成了机器可读格式,意味着向量化报告可以被 CI 当成断言来用——这一条在 §9.5 的判据里会用到。
2.7 本章判据(第二条)
- 判据:改性能之前,先开报告跑一遍。两家各一条命令:MSVC
/Qvec-report:2、GCC-fopt-info-vec-all。报告的条目数就是「有多少个循环没进去」的清单。 - 反判据:报告全绿也不等于快了——§三点名的那条归约就是反例。报告的绿只说明「编译器的向量化器接受了这个循环」,不说明「收益为正」。
- 本机依据:本机 8 份报告里,
dot在 GCC-O3 -march=native下报绿而收益 0;prefix_sum在全部 8 份里报红且确实没有收益。
下一章开始处理第一种「报告绿但收益 0」的卡点——它也是最常见的一种。
三、浮点归约:报告说向量化,收益是 0
上一章留下了一个悬案:那个浮点归约循环的报告写着 loop vectorized using 32 byte vectors and unroll factor 8,读数却没动。这一章把它拆开。
3.1 先把悬案坐实:关掉向量化,读数一样
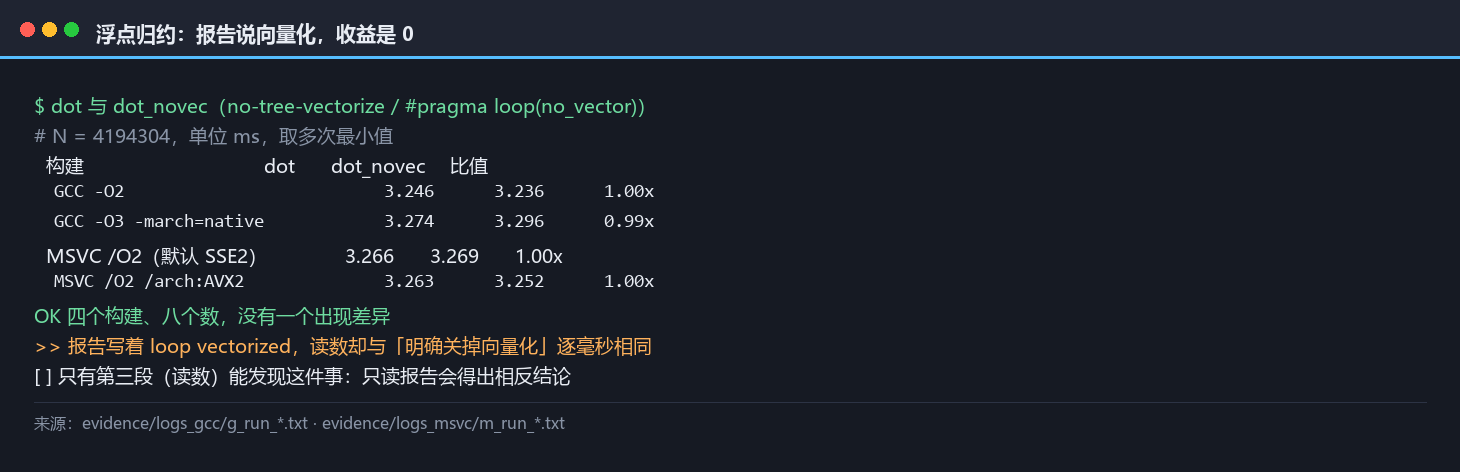
OK,要证明「收益是 0」,最干净的做法是同一个循环、同一份源码、只差一个「不许向量化」的属性。本机用例里两份都在:一份是普通的 float 累加点积,一份加了「不要向量化」的函数属性(GCC 用 optimize("no-tree-vectorize"),MSVC 用 #pragma loop(no_vector))。
N = 4,194,304(16 MB 数组 ×3),单位毫秒:
| 构建 | dot(报告:已向量化) |
dot_novec(明确关掉) |
比值 |
|---|---|---|---|
GCC -O2 |
3.246 | 3.236 | 1.00× |
GCC -O3 -march=native |
3.274 | 3.296 | 0.99× |
MSVC /O2(默认 SSE2) |
3.266 | 3.269 | 1.00× |
MSVC /O2 /arch:AVX2 |
3.263 | 3.252 | 1.00× |
四个构建、八个数,没有一个出现差异。报告写着向量化了,读数却与「明确关掉向量化」逐毫秒相同。
这就是本篇最该记住的一条:编译器报告的「已向量化」,说的是「向量化器接受了这个循环」,不是「收益为正」。 只读报告就下结论,会得到相反答案。
3.2 为什么:浮点加法不满足结合律
言归正传,原因只有一句话:浮点加法不满足结合律((a+b)+c 与 a+(b+c) 在浮点里可能不等)。
向量化的本质是把顺序打散——8 个元素同时算,再合并。对于整数这是合法的(整数加法满足结合律);对于浮点,打散顺序就意味着允许结果与顺序执行不同,而 C/C++ 默认不允许编译器这么干。
所以编译器面对一个浮点归约时只有两条路:要么不向量化,要么保序地部分向量化——把乘法向量化、加法仍按顺序串起来。GCC 选了后者(报告于是打了「已向量化」),MSVC 在默认档位干脆报 C5002 由于"1105"(无法识别的 reduction)直接拒绝。
好了,两条路的读数是一样的:瓶颈在加法链上,不在乘法上。乘法本来就不慢。
3.3 解锁它的是一个语义开关,不是优化级别
真正有效的开关是放弃严格浮点语义。本机读数:
| 构建 | dot |
相对 dot_novec |
有效带宽 |
|---|---|---|---|
GCC -O3 -march:native(无 fast-math) |
3.274 ms | 0.99× | 15.4 GB/s |
GCC -O3 -march:native -ffast-math |
0.861 ms | 3.83× | 58.5 GB/s |
MSVC /O2 /arch:AVX2(无 fast-math) |
3.263 ms | 1.00× | 15.4 GB/s |
MSVC /O2 /arch:AVX2 /fp:fast |
0.903 ms | 3.60× | 55.7 GB/s |
两家一致:3.6 到 3.8 倍,只差一个语义开关。 注意这不是「调高优化级别」——-O3 早就开了,/arch:AVX2 也早就给了宽度;缺的只有「允许重排」这一句许可。
而 -ffast-math / /fp:fast 在 MSVC 文档与 GCC 文档里的定位都是浮点模型,不是性能开关。它做的三件事在下一节列。
说白了,这里要做一次严格的对照,因为两种开关很容易混为一谈。优化级别是「允不允许做优化」,浮点模型是「允不允许改变结果」——本机这四个构建里,-O3 与 /arch:AVX2 早就开了,缺的只有浮点模型那一句许可。核对方法也很直接:先看同一个循环在两个构建里的向量化报告条目是否相同(都报绿),再看读数是否相同(差 3.6 倍)。报告相同、读数不同的那一格,才是语义开关的净效果;只看其中一边,都会把归因搞错。
3.4 -ffast-math 到底改了什么,代价是什么
它不是「更快的开关」,是一揽子语义放宽。主要三条:
- 允许重排(
-fassociative-math):浮点加减乘可以按数学结合律重新结合。这条带来上面那 3.6 倍。 - 假设没有 NaN 与 Inf(
-ffinite-math-only):于是x != x可以优化成常量假、a + b不需要处理 Inf 传播。 - 忽略符号零与 denormal(
-fno-signed-zeros、-fno-trapping-math、denormal 置零):极小数不再走慢速路径。
代价是结果可能变。本机给了一条量化证据:手写 AVX2 的 8 路部分和版与「标量顺序版」的结果相对偏差是 1.06e-05(GCC)/ 1.33e-05(MSVC)——量级正好符合「八个数相加顺序变了」的误差预期。对性能计数没有影响,对需要逐位可复现的场合(校验和、确定性物理仿真、回归比对)是硬约束。
OK,所以正确的一句话是:-ffast-math 买的不是速度,是「编译器可以重排」这件事;速度是它的副产品。
3.5 保序的代价:一条加法链的账
把 3.3 的两列数字换算成每元素时间,能看清瓶颈在哪。
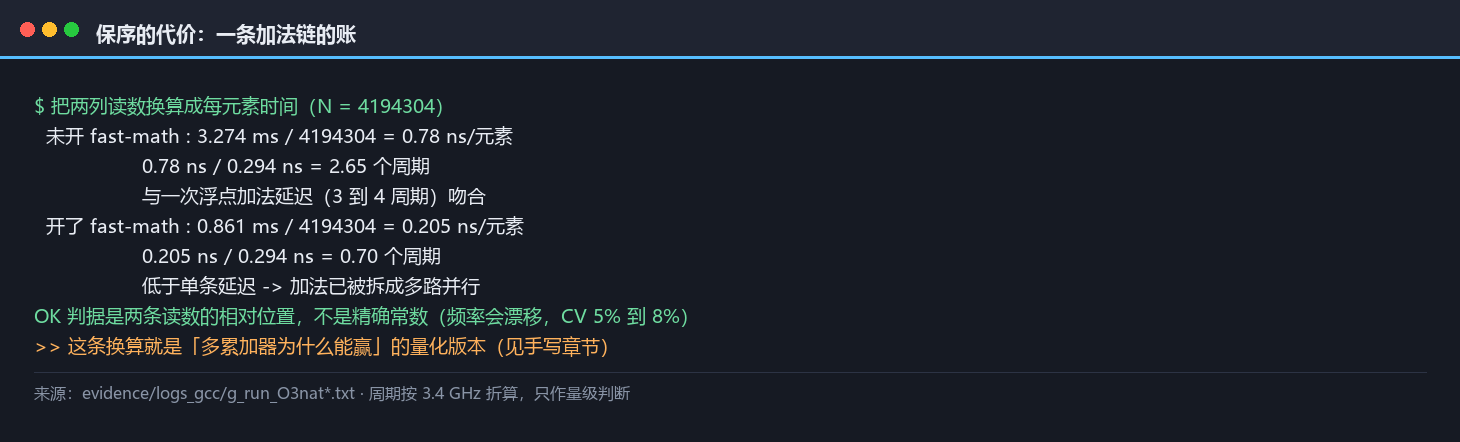
未开 fast-math 时:3.274 ms / 4,194,304 元素 ≈ 0.78 ns/元素。本机 3.4 GHz 上下,0.78 ns ≈ 2.65 个周期。一次浮点加法延迟大约 3 到 4 个周期——读数与「每轮等一次加法」完全吻合。
开了 fast-math 后:0.861 ms / 4,194,304 ≈ 0.205 ns/元素 ≈ 0.7 个周期。这已经低于单条加法延迟,说明加法被拆成了多路并行(编译器展开了循环、用了多累加器),吞吐才顶得上来。
言归正传,这条换算就是「为什么多累加器能赢」的量化版本——§五 会用手写版再验一次。
这条换算有个前提要讲清:它给的是量级判断,不是精确常数。本机是笔记本,频率在长跑中会漂移(ep11 量过:同一用例连跑五次的变异系数是 5% 到 8%),所以「2.65 个周期」只能读成「接近一次加法延迟」,不能当成测量结果。真正站得住的判据是两条读数的相对位置:未开 fast-math 时落在单次延迟那一档、开启后掉到明显低于它——这个跨越本身就说明累加被拆成了多路并行,而不需要知道确切频率。
3.6 官方口径对得上
- LLVM 的向量化文档明确写着:浮点归约只有在
-fassociative-math -fno-signed-zeros -fno-trapping-math这一族(即-ffast-math)下才向量化,因为浮点不满足结合律。 - GCC 的项目页同样把浮点归约列在需要
-ffast-math或-fassociative-math的一类里。 - MSVC 的原因码 1105 的官方解释正是「无法识别的 reduction」,并注明浮点 reduction 需要
/fp:fast。
三家的说法与本机四组读数完全对上。这一条是本篇"报告 vs 读数"的第一处完整闭环。
3.7 本章判据(第三条)
- 判据:循环里如果有浮点累加(求和、点积、求最值的
min/max也算一类),先问语义允不允许重排。允许 → 开 fast-math,收益 3 到 4 倍;不允许 → 别指望编译器,去改算法(分层归约、分块累加)。 - 反判据:不要为了这个开关去改全局编译选项。本机读数是收益 3.6 倍,但代价是全部浮点代码的语义都放宽了。正确做法是给单个函数加属性(GCC
__attribute__((optimize("fast-math"))))或给单个文件加开关。 - 本机依据:
dot3.274 → 0.861 ms(GCC)、3.263 → 0.903 ms(MSVC);而dot_novec全程恒在 15.4 GB/s。
四、分支与 if-conversion:数据决定贵不贵
好了,上一章处理的是「语义不许动」。这一章处理另一种更隐蔽的情形:语义允许,但编译器不肯消掉那个分支——于是性能由你的数据分布说了算。
4.1 一个循环,两种数据,差 7.5 倍
本机用例里有一段再普通不过的取值:
a[i] = (b[i] > 0.f) ? (b[i] * 2.f) : (b[i] * 0.5f);
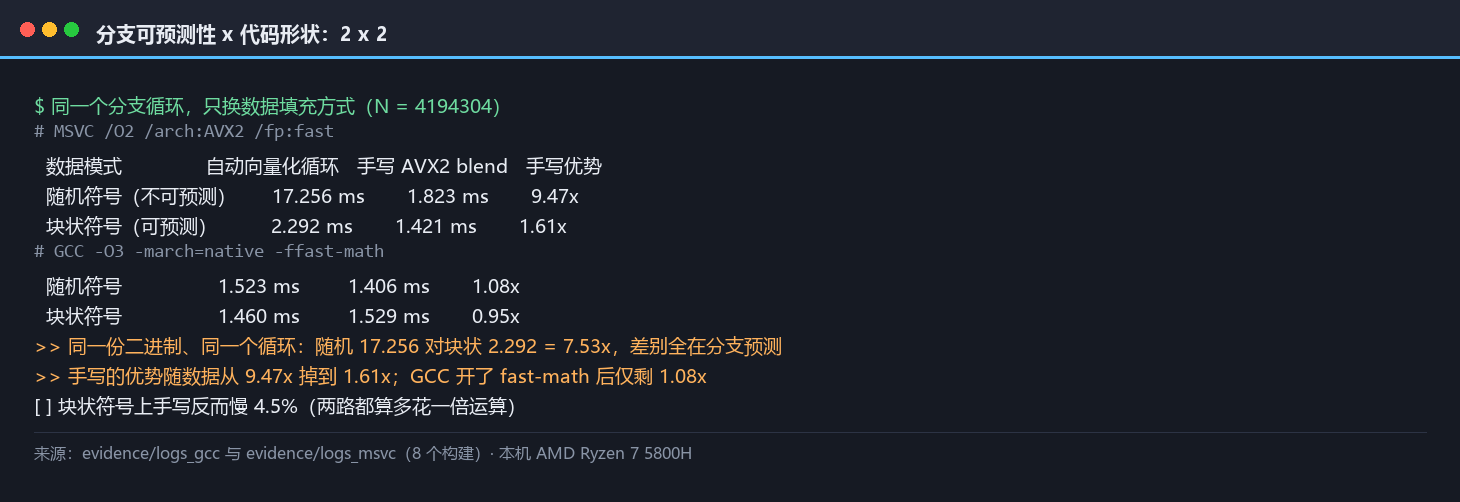
它把 b 里的正数乘 2、非正数乘 0.5。同一份 MSVC 二进制(/O2 /arch:AVX2 /fp:fast),只换 b 的填充方式:
| 数据模式 | 读数 | 每元素 |
|---|---|---|
| 随机符号(不可预测) | 17.256 ms | 4.11 ns |
| 块状符号(每 64 个一组同号,可预测) | 2.292 ms | 0.55 ns |
7.53 倍,差别全在数据。这不是「缓存」也不是「向量化」,是分支预测:随机符号下那个三元表达式的跳转每两次猜错一次,一次猜错约十几到二十个周期;块状符号下预测器几乎全中。
说白了,第零章把这条写成结论时用的是同一对数字——它们可信,靠的是同一份二进制、同一台机器、同一个循环,只换了输入。
4.2 手写 SIMD 在这里做的是「消掉分支」
手写版把三元表达式换成无分支的掩码选择:比较生成掩码、两个结果都算出来、用掩码混合。
同一份数据、同一个 MSVC 构建,加上手写 AVX2 blend 版:
| 数据模式 | 自动向量化循环 | 手写 AVX2 blend | 手写优势 |
|---|---|---|---|
| 随机符号 | 17.256 ms | 1.823 ms | 9.47× |
| 块状符号 | 2.292 ms | 1.421 ms | 1.61× |
手写的优势从 9.47 倍掉到 1.61 倍——同一份手写代码,优势随数据的可预测性变化 5.9 倍。
OK,所以「手写 SIMD 快 5 倍」这种说法本身不成立:它没有说清对照的是哪种数据。在随机数据上,手写的真实价值是消掉分支;在可预测数据上,分支本来就便宜,手写的价值只剩下宽度。
4.3 编译器愿不愿意消分支:if 转换
编译器把分支消掉这件事有个名字:if 转换(if-conversion,把控制依赖转成数据依赖)。它把 if 变成谓词执行或掩码选择,于是循环体变成直线代码,可以向量化。
但编译器不总是敢做。本机读数正好把这条边界量出来了——GCC 同一份源码、两个构建:
| 构建 | 随机符号 | 块状符号 | 说明 |
|---|---|---|---|
GCC -O3 -march:native(无 fast-math) |
17.753 ms | —— | 报告 missed: unsupported control flow in loop. |
GCC -O3 -march:native -ffast-math |
1.523 ms | 1.460 ms | 已经做了 if 转换,数据不再影响 |
同一个分支循环,-ffast-math 一开,从 17.753 ms 掉到 1.523 ms(11.7 倍),而且两种数据模式几乎一样快(1.523 对 1.460)——分支消失了,数据自然不再影响。
言归正传,为什么 if 转换需要 -ffast-math?因为它要「两路都算出来再选」,而两路都算意味着算了本不该算的值——比如把负数也拿去取对数。在严格浮点语义下,这可能有副作用(异常、超范围);-ffast-math 一并把这类顾虑放掉了,编译器才敢动手。
4.4 什么时候分支本来就不贵
反过来也要说清:不是所有分支都值得消。判据是「可预测性」。
- 可预测分支:循环边界判断、单调扫描、块状数据。预测器几乎全中,代价接近 0。本机读数里块状符号的 2.292 ms 就是这一类。
- 不可预测分支:随机数据上的阈值判断、哈希命中、分支概率接近 50% 的二分。代价由误预测率决定,最坏可达十几倍。本机读数里随机的 17.256 ms 就是这一类。
- 无分支写法不总是更快:两路都算意味着多做一倍的运算。当运算本身很贵(比如一次开方)而分支其实可预测时,无分支版会更慢——本机读数里 GCC fast-math 下
i_clamp1.406 ms 对自动版 1.523 ms 是 1.08 倍,而块状符号上i_clamp1.529 ms 反而比自动版 1.460 ms 慢 4.5%。
最后那一格是本篇里少见的「手写略慢」实例,它比「手写快 9 倍」更有信息量:手写不是免费的正确做法。
4.5 一把更省事的工具:#pragma omp simd 与 loop hint
好了,如果只是想让编译器相信「这个循环没有依赖」,比起手写 intrinsic,有几把轻量得多的工具:
- OpenMP 的
simd指令:#pragma omp simd直接告诉编译器「这是可向量化的循环」,还可带aligned/safelen/simdlen/reduction子句描述对齐、最大无依赖距离、目标宽度与归约类型。 - Clang 的 loop hint:
#pragma clang loop vectorize(enable) interleave(enable),还能用vectorize_width(4)直接指定宽度。(本机无 Clang,只作引用。) - Intel 编译器的
#pragma ivdep:忽略潜在的依赖假设——注意官方措辞是「不会忽略已证明的依赖」,只忽略「可能」的。
它们的共同点是:你给编译器一句它自己推不出来的知识。这正是本篇的核心主题从另一个方向的表述——手写的分界不在「写不写指令」,而在「你能不能给出编译器缺的那条信息」。
4.6 本章判据(第四条)
- 判据:循环体里有
if或三元表达式时,先看数据的可预测性。可预测 → 不用管;不可预测(接近 50% 命中)→ 这是收益最大的一处,两条路都试:让编译器 if 转换(开 fast-math)、或自己写无分支版。 - 反判据:无分支版不是无条件更优。本机有一条手写略慢的读数(块状符号上 1.529 对 1.460 ms,慢 4.5%),原因就是两路都算多花了一倍运算。
- 本机依据:随机符号 17.256 → 手写 1.823 ms(9.47 倍);块状符号 2.292 → 1.421 ms(1.61 倍);GCC 开 fast-math 后自动版 17.753 → 1.523 ms(11.7 倍)且两种数据同价。
下一章离开「让编译器做」,进入「自己做」——手写 intrinsic 到底是哪六个指令在干活,以及它凭什么赢、又凭什么输。
五、手写 intrinsic:它到底什么时候赢
到这里为止,主动权都在编译器手上。这一章把主动权拿回来:手写 AVX2。目标不是「手写更快」——本机读数恰好相反——而是搞清楚它相对编译器赢在哪、输在哪。
5.1 六个指令就够写一个内核
说白了,AVX2 的 intrinsic 有几百个,但本机用例里真正用到的只有六个。按数据流排一遍:
| 阶段 | intrinsic | 对应的机器码 | 说明 |
|---|---|---|---|
| 装数据 | _mm256_loadu_ps |
vmovups |
从内存装 8 个 float,不要求对齐 |
| 装数据(对齐版) | _mm256_load_ps |
vmovaps |
同上,但要求 32 字节对齐,否则可能 GP fault |
| 广播标量 | _mm256_set1_ps |
vbroadcastss |
把一个标量复制到 8 个通道(saxpy 的系数) |
| 运算 | _mm256_add_ps / _mm256_mul_ps |
vaddps / vmulps |
逐通道加/乘 |
| 融合乘加 | _mm256_fmadd_ps(a,b,c) |
vfmadd213ps |
算 a*b + c,一次舍入 |
| 比较与选择 | _mm256_cmp_ps + _mm256_blendv_ps |
vcmpps + vblendvps |
生成掩码、按掩码混合两路结果 |
| 取回标量 | _mm256_extractf128_ps + _mm_movehl_ps / _mm_add_ss |
vextractf128 等 |
水平归约:8 → 4 → 2 → 1 |
写一个逐元素加法内核,代码量是:
for (; i + 8 <= n; i += 8) {
    __m256 vb = _mm256_loadu_ps(b + i), vc = _mm256_loadu_ps(c + i);
    _mm256_storeu_ps(a + i, _mm256_add_ps(vb, vc));
}
for (; i < n; ++i) a[i] = b[i] + c[i];   // 余数:必须自己收尾
两个细节必须自己管,编译器替你管了:一是余数(n 不是 8 的倍数时的尾巴循环),二是对齐(用 loadu 就完全避开,代价见 §六)。
余数与对齐这两处必须自己管,因为编译器替你管的时候是隐式的,而手写时它们是显式的。余数处理写错会漏掉最后几个元素(这类 bug 在小数组上测不出来);对齐用错会直接崩(§六)。此外还有一件事必须自己核:intrinsic 的名字与语义以 Intel Intrinsics Guide 为唯一权威索引——它给出每个指令的 CPUID 标志、对应的机器码与伪代码级操作,是核对手写版本行为的第一手依据,比任何二手博客都可靠。
5.2 逐位正确性:手写必须自己证明自己
OK,写手写 SIMD 的第一件事不是量速度,是证明结果没错。本机用例把三条核对都做了:
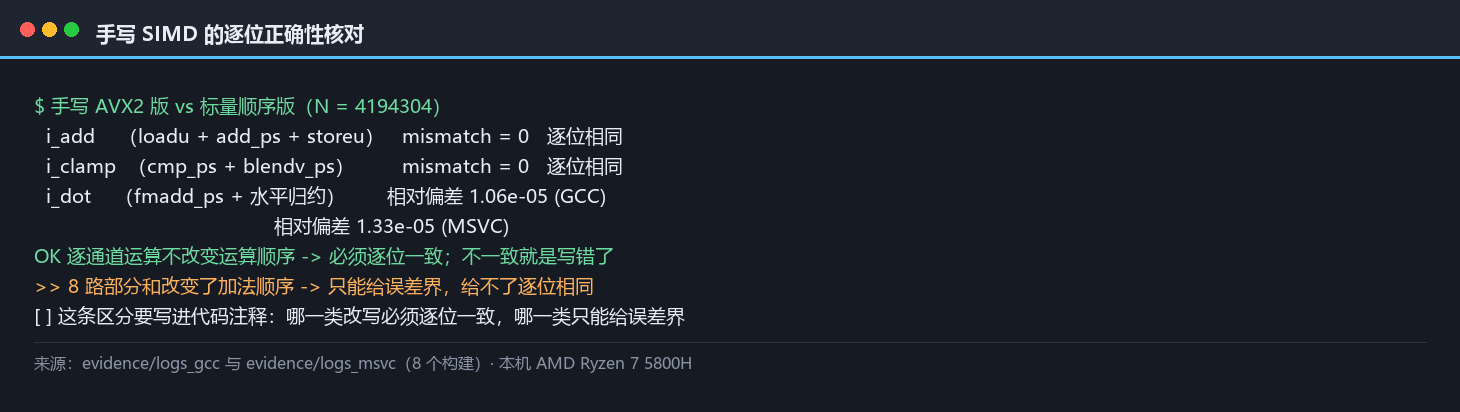
i_add与标量逐元素加法:3.5 亿次比较,逐位相同(mismatch 0)。i_clamp(cmp+blendv)与三元表达式:同上,逐位相同(mismatch 0)。i_dot(fmadd+ 水平归约)与顺序加法:相对偏差 1.06e-05(GCC)/ 1.33e-05(MSVC)。
前两条的「逐位相同」是应该的:逐通道的加、乘、选择都不改变运算顺序,所以结果必须一致;不一致就是写错了。第三条的 1e-05 是必然的:8 路部分和改变了加法顺序,与前缀和那类改写同源——所以它只能给相对偏差,不能要求逐位相同。
这条区分很重要:写 SIMD 的时候要能说清「哪一类改写必须逐位一致,哪一类只能给误差界」。前者的不一致是 bug,后者的不一致是数学。
5.3 反直觉的读数:开了 fast-math 后,编译器赢了
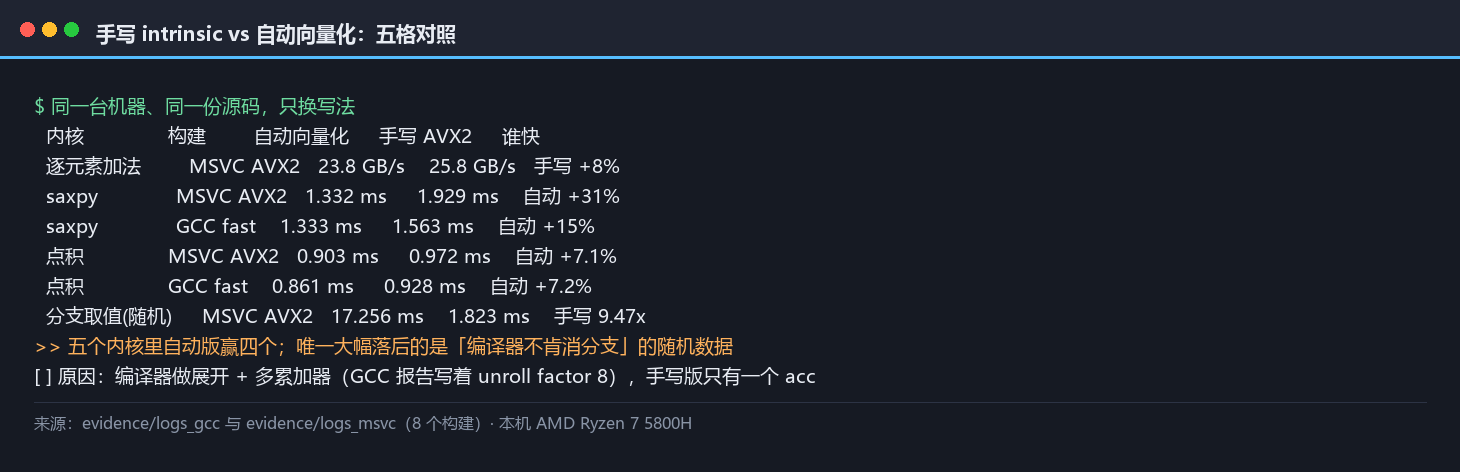
现在量速度。四组「手写 vs 自动」,同一台机器、同一份源码:
| 内核 | 构建 | 自动向量化 | 手写 AVX2 | 谁快 |
|---|---|---|---|---|
| 逐元素加法 | MSVC /arch:AVX2 /fp:fast |
23.8 GB/s | 25.8 GB/s | 手写快 8% |
| saxpy | MSVC /arch:AVX2 /fp:fast |
1.332 ms | 1.929 ms | 自动快 31% |
| saxpy | GCC -O3 -march:native -ffast-math |
1.333 ms | 1.563 ms | 自动快 15% |
| 点积 | MSVC /arch:AVX2 /fp:fast |
0.903 ms | 0.972 ms | 自动快 7.1% |
| 点积 | GCC -O3 -march:native -ffast-math |
0.861 ms | 0.928 ms | 自动快 7.2% |
| 分支取值(随机数据) | MSVC /arch:AVX2 /fp:fast |
17.256 ms | 1.823 ms | 手写快 9.47× |
| 分支取值(可预测数据) | MSVC /arch:AVX2 /fp:fast |
2.292 ms | 1.421 ms | 手写快 1.61× |
五个内核里,自动版赢了四个。 只有在「编译器不肯消掉分支」的随机数据上,手写才大幅领先。
言归正传,这与中文侧「手写 intrinsic 提升近 5 倍」的说法方向相反——原因不在结论错,而在对照条件不同:那句说法对照的是「未调优的自动向量化」(很可能没开 fast-math、没开更宽的 /arch)。本机把条件摆齐之后,答案是编译器赢。
5.4 为什么自动版能赢:多累加器与展开
手写版输在哪里,报告里写得很直接:GCC 的原文是 loop vectorized using 32 byte vectors and **unroll factor 8**——展开 8 倍。
展开 8 倍的意义在多累加器上。看两个写法的数据依赖:
- 单累加器手写版:
acc = fmadd(vb, vc, acc),每一轮都依赖上一轮的acc。vfmadd的延迟约 4 个周期,所以每轮至少等 4 个周期——吞吐被延迟锁死。 - 多累加器版:
acc0..acc3各自累加,四条链并行。每轮的 4 个fmadd互相独立,吞吐可以打满(本机一代的 FMA 吞吐约每周期 1 到 2 条)。
同一批指令、同一个总数,只差「累加到几个寄存器上」。 这就是为什么自动版快 7%:编译器替我做了这件事,而我没做。
好了,修法很直接——手写版也要多累加器。但要注意:那已经不是「手写 SIMD」,而是「手写编译器已经会做的优化」。这条界线正是本篇要划的那条。
5.5 fmadd 与精确性:为什么它不只是「合并两条指令」
_mm256_fmadd_ps(a,b,c) 算 a*b + c,只舍入一次。相比先 mul 再 add(两次舍入),它既省一条指令又更精确——这是 -mfma / /arch:AVX2 的实质收益之一。
但有一个坑:FMA 的存在会改变数值结果。同一个公式,开不开 FMA 可能给出不同的最低位。这与 §3 的 1e-05 是同一种账:精度与可复现性是一对矛盾,FMA 站在精度那边。
还有一处容易漏的平台差异:MSVC 不定义 __FMA__ 宏。本机 __FMA__ = 0(MSVC)而 = 1(GCC 在 -march=native 下),但 MSVC 的 _mm256_fmadd_ps 照常可用(/arch:AVX2 已启用 FMA)。所以用 #if defined(__FMA__) 判条件编译在 MSVC 侧会走错分支——该判的是 __AVX2__。
说白了,宏定义这处差异有实际的坑。本机实测:__FMA__ 在 GCC 的 -march=native 下是 1、在 MSVC 的 /arch:AVX2 下是 0,但 MSVC 的 _mm256_fmadd_ps 照常编译可用。所以 #if defined(__FMA__) 这种写法在 MSVC 侧会把 FMA 分支整段跳过——该判的是 __AVX2__。判据很简单:用「指令族」判条件编译,不用「单条指令」判;任何与具体指令绑定的宏,都要先在两家实测一遍再写进代码。
5.6 水平归约:唯一手写「明显更啰嗦」的地方
点积的最后一步是把 8 个通道加起来(水平归约)。手写版是三步:
__m128 lo = _mm256_castps256_ps128(acc);      // 低 128 位
__m128 hi = _mm256_extractf128_ps(acc, 1);    // 高 128 位
__m128 s4 = _mm_add_ps(lo, hi);               // 8 -> 4
__m128 s2 = _mm_add_ps(s4, _mm_movehl_ps(s4, s4));   // 4 -> 2
__m128 s1 = _mm_add_ss(s2, _mm_shuffle_ps(s2, s2, 1)); // 2 -> 1
三步走完才拿到一个标量。这一步没有捷径:x86 的向量指令都是「通道对通道」,没有单指令把所有通道求和(haddps 也是两两合并、且延迟不低)。
OK,所以「点积手写版」的瓶颈往往不在乘法,而在最后这三步——这也是为什么自动版能在点积上赢:它把归约插进了展开的循环里,减少了水平归约的次数。
5.7 本章判据(第五条)
- 判据:手写之前,先量一遍自动版。本机读数:五个内核里自动版赢四个,唯一大幅落后的是「编译器不肯 if 转换的随机数据分支」。
- 反判据:如果手写版只用单个累加器、没做展开,它在归约类内核上一定输给开了 fast-math 的编译器(本机 7%)。手写要与编译器打平,得先做它做的事。
- 本机依据:saxpy 自动 1.332 ms vs 手写 1.929 ms(自动快 31%);点积自动 0.861 vs 手写 0.928(自动快 7.2%);唯有随机数据上的
clamp手写快 9.47 倍。
六、对齐与 loadu:一笔被夸大的账
写 SIMD 的材料里,「对齐」几乎总是被列在第一条注意事项。这一章量一下它到底值多少。
6.1 把基址故意错开 1 个 float
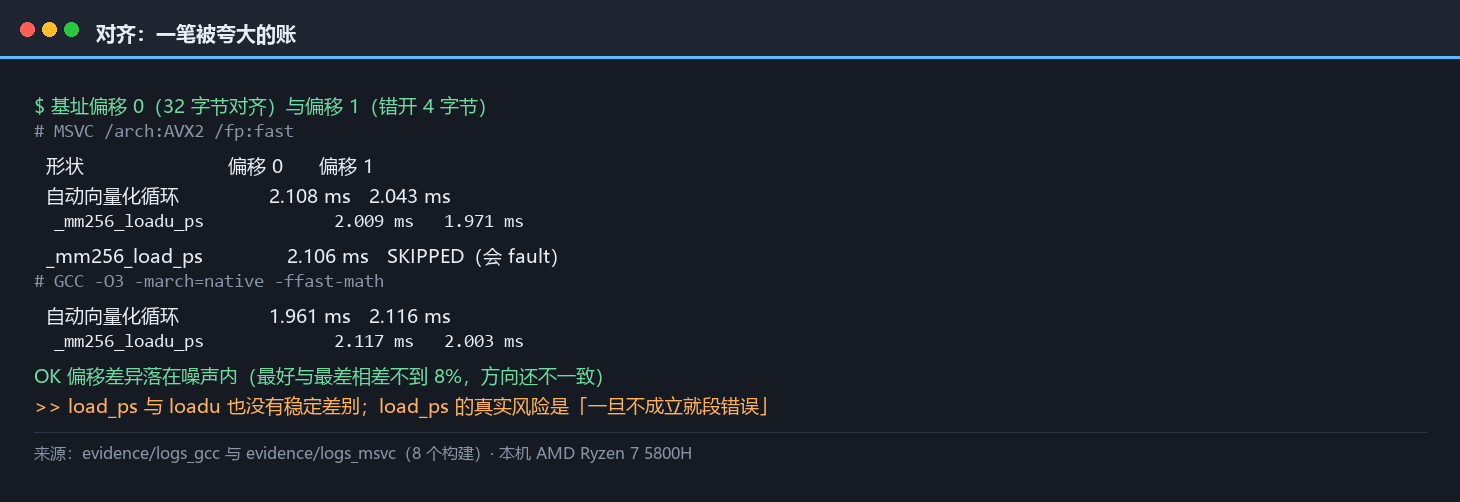
做法很直接:把三个数组多分配 64 个元素,然后取基址偏移 0(32 字节对齐)与偏移 1(错开 4 字节,不再对齐),跑同一个内核。
MSVC /arch:AVX2 /fp:fast:
| 形状 | 偏移 0 | 偏移 1 |
|---|---|---|
| 自动向量化循环 | 2.108 ms | 2.043 ms |
_mm256_loadu_ps |
2.009 ms | 1.971 ms |
_mm256_load_ps(要求对齐) |
2.106 ms | 不跑(会 fault) |
GCC -O3 -march=native -ffast-math:
| 形状 | 偏移 0 | 偏移 1 |
|---|---|---|
| 自动向量化循环 | 1.961 ms | 2.116 ms |
_mm256_loadu_ps |
2.117 ms | 2.003 ms |
读法:偏移 0 与偏移 1 的差异落在噪声内(最好与最差相差不到 8%,而且方向不一致——MSVC 侧错位反而略快、GCC 侧对齐反而略慢)。loadu 与 load_ps 之间也没有稳定差别(MSVC 2.106 vs 2.009、GCC 2.096 vs 2.117)。
言归正传,结论很清楚:在本机这种带宽受限的循环上,对齐不是一个值得为之改数据结构的代价项。 这与「对齐很重要」的流行说法方向不一致,但读数是这样。
6.2 为什么对齐的钱越来越小
有三个原因叠加。
- 硬件替我们做了。 现代 x86 的
vmovups(未对齐装载)在没有跨缓存行的情况下与对齐装载同速;只有在跨界时才付一两个周期的额外代价。ep11 量过:行宽 64 字节,一个 32 字节的未对齐装载只有约一半概率跨行。 - 循环是带宽受限的。 §七 会量到:这批内核在 16 MB 规模上只有 20 到 50 GB/s,早就撞上内存带宽。带宽是瓶颈时,几个周期的装载惩罚被完全掩盖。
- 编译器自己会处理。 GCC 与 MSVC 都会为「可能不对齐」的循环生成前导(peel)循环或运行期对齐分支,把不对齐的部分单独处理掉——手工写这些,正是「重写编译器已经会做的事」。
所以对齐这笔账的正确读法是:它在算力受限(数据在 L1/L2 里)的循环里才有意义,在带宽受限的循环里几乎不存在。
6.3 load_ps 的真实风险:不是慢,是会 fault
好了,真正需要注意的是另一件事:对齐版装载指令在对齐不成立时的行为是未定义/陷阱,不是「慢一点」。Intel 的 intrinsic 文档措辞是:地址必须 32 字节对齐,否则可能产生 general-protection 异常。
本机用例里那一格写的是「不跑(会 fault)」——这是故意不跑:让它跑就崩了。下表把两版的取舍说明白:
| 指令 | 对齐要求 | 对齐不成立时 | 适合什么场合 |
|---|---|---|---|
_mm256_loadu_ps |
无 | 照常工作 | 默认选择。所有来源不确定的数据 |
_mm256_load_ps |
32 字节 | 可能 GP fault | 只在你自己分配并对齐过的内存上 |
判据因此很简单:能证明对齐就用对齐版,不能证明就别用。 而「能证明」通常意味着你自己 _mm_malloc / aligned_alloc 出来的内存——一旦数据来自别人(第三方库、序列化缓冲、切片),loadu 是唯一安全的选择。
6.4 那 assume_aligned 是干什么的
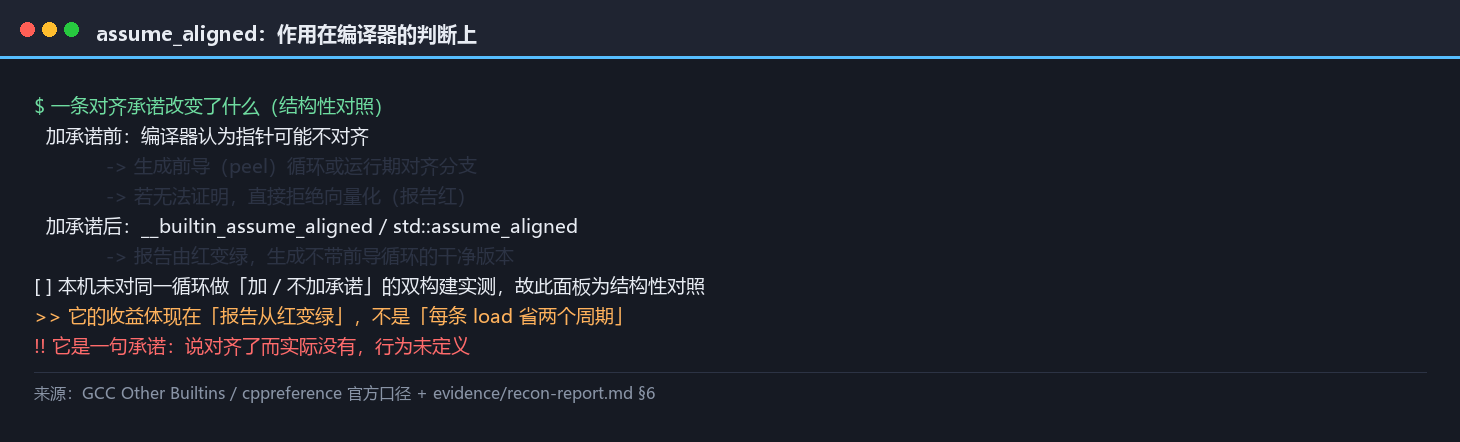
说白了,既然对齐不值钱,为什么还有 __builtin_assume_aligned(GCC)与 std::assume_aligned(C++20)?因为它的作用对象不是运行时,是编译器的判断:
- 它让编译器敢向量化那些它原本因为「可能不对齐」而拒绝的循环;
- 它让编译器生成不带前导循环的干净版本(省掉分支与重复代码)。
assume_aligned 的收益体现在向量化报告从红变绿,而不是「每条 load 省两个周期」。这与 §5.7 的判据是同一条:多数性能开关的真实价值是「让编译器敢动」,不是「让指令更快」。
需要注意的是它是个承诺:你说对齐了但实际没有,行为是未定义的(与 load_ps 同类风险,只是不会立刻崩)。
6.5 本章判据(第六条)
- 判据:默认用
loadu。只有在「内存是你自己对齐分配」且「这个循环确实算力受限」两个条件同时成立时,才考虑对齐版。 - 反判据:把「对齐」当成 SIMD 的第一注意事项是错位的重点。本机读数:对齐偏移带来的差异落在噪声内(< 8%,方向不一致),而「循环没被向量化」带来的差异是数倍到十倍。
- 本机依据:偏移 0 / 1 在两种形状下四个数对,最好与最差相差 < 8%;
load_ps与loadu的差别同样在噪声内(MSVC 2.106 对 2.009 ms)。
七、规模与算术强度:收益为什么随 N 衰减
前六章都在讲「编译器敢不敢、值不值」,有一个变量一直被固定着:数据规模。这一章把它放开。
7.1 N 扫描:从 L1 到主存
OK,同一份内核,只改数组大小,从 16 KB 扫到 64 MB(MSVC /arch:AVX2 /fp:fast):
| 数组大小 | add |
add 有效带宽 |
dot |
dot 有效带宽 |
|---|---|---|---|---|
| 16 KB | 0.0004 ms | 122.9 GB/s | 0.0003 ms | 163.9 GB/s |
| 64 KB | 0.0016 ms | 122.9 GB/s | 0.0011 ms | 178.7 GB/s |
| 256 KB | 0.0100 ms | 78.6 GB/s | 0.0046 ms | 171.0 GB/s |
| 1 MB | 0.0627 ms | 50.2 GB/s | 0.0309 ms | 101.8 GB/s |
| 4 MB | 0.3100 ms | 40.6 GB/s | 0.0830 ms | 151.6 GB/s |
| 16 MB | 2.5436 ms | 19.8 GB/s | 1.4105 ms | 35.7 GB/s |
| 64 MB | 8.8540 ms | 22.7 GB/s | 4.0837 ms | 49.3 GB/s |
两个拐点很清楚:256 KB 以后 add 开始掉(本机每核 L2 是 512 KB,三个数组共 768 KB 已经装不下),16 MB 处同时触底(L3 共 16 MB)。从 122.9 掉到 22.7 GB/s,跌了 5.4 倍。
同一个内核、同一个 ISA、同一份向量化报告,只因为数据放大了 4000 倍,收益就没了 5 倍。 这就是「向量化收益随规模衰减」的实测版本。
这条扫描的口径要说清三点。第一,三个数组同时驻留:a、b、c 各占一份,所以「数组 16 MB」实际占用三倍内存,拐点会比只算一张表推算得更早。第二,每个点取多次最小值,避免把偶发抢占读成趋势。第三,小规模那一档只作对照——16 KB 时单次只有零点几毫秒,计时精度已接近噪声下限,所以它给的是「算力顶天时能到多少」,而不是可长期复现的常数。
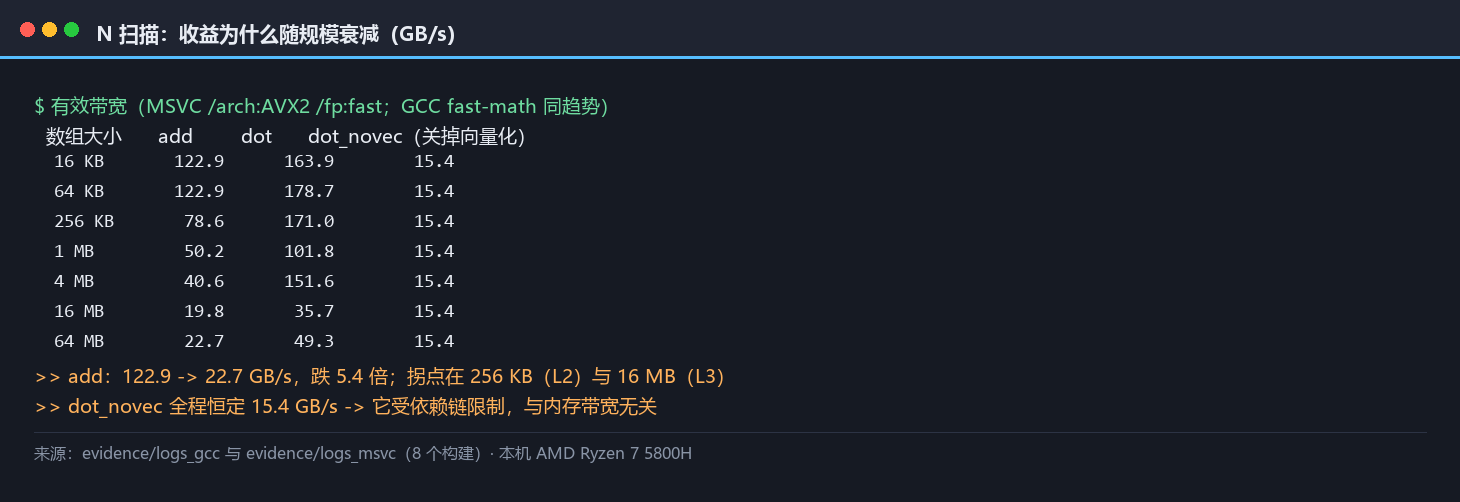
7.2 两条天花板:算力与带宽
言归正传,把上面两条曲线放在一起,能看出两种不同的瓶颈:
add是小算力内核:每个元素 1 次加法、搬 12 字节(读 8 写 4)。小规模时 122.9 GB/s(算力顶天),大规模时 22.7 GB/s(带宽顶天)。它两头都撞。dot是较大算力内核:每个元素 1 次乘加、搬 8 字节。大规模时 49.3 GB/s,比add的 22.7 高一倍——因为它的算术强度(每字节的运算次数)更高。dot_novec(关掉向量化)全程恒为 15.4 GB/s:不管数据在 L3 里还是主存里都是 15.4——说明它一直依赖链受限,跟内存带宽根本没关系。
三行对照就是一张缩小的 roofline 图:add 落在带宽墙上,dot 在两者之间,dot_novec 落在延迟墙上。有了这张图,「该不该手写 SIMD」这个问题才有一个可判定的答案。
7.3 算术强度:先算这一项,再决定写不写
把上面的结构抽成一条可操作的判据:算术强度 = 每搬运一个字节做多少次浮点运算。
- 强度很低(每字节不到 1 次):例如
add(12 字节 1 次加)。向量化只在数据装得下缓存时有用;一旦出缓存,加宽寄存器完全无感。 - 强度中等(每字节 1 到 3 次):例如
dot(8 字节 1 次乘加)。向量化在缓存外仍有效(本机 49.3 GB/s),但会随规模递减。 - 强度很高(每字节 5 次以上):例如矩阵乘的分块内核。向量化收益与规模无关,这才值得手写、值得调 tile。
本机读数给这三档各提供了一个实例(add / dot / 前缀和的反例),这一章的分区图就是它们的实测版本。
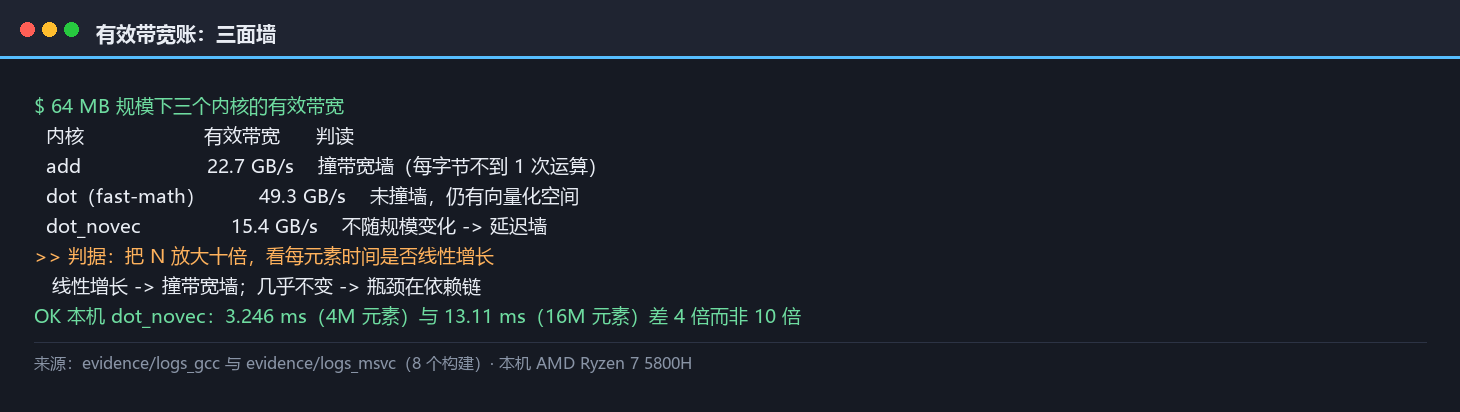
7.4 有效带宽账:把「搬了多少」摆出来
好了,换个角度读同一批数据更容易看清。逐元素加法的有效带宽按「读 2 写 1」算,dot 按「读 2、标量出 1」算:
| 内核 | 大规模(64 MB)有效带宽 | 判断 |
|---|---|---|
add |
22.7 GB/s | 撞带宽墙 |
dot(fast-math) |
49.3 GB/s | 未撞墙,仍有向量化空间 |
dot_novec |
15.4 GB/s | 不随规模变化 ⇒ 延迟墙 |
这一列的作用是把「是不是带宽受限」变成一个可测的量,而不是靠猜。判据是:把 N 放大十倍,看每元素时间是否线性增长——线性增长说明撞墙了,几乎不变说明瓶颈在别处(依赖链)。
本机 dot_novec 正是后者:3.246 ms(4 M 元素)与 13.11 ms(16 M 元素)差不多是 4 倍而不是 10 倍——它压根不受带宽支配。
7.5 本章判据(第七条)
- 判据:动手前先做两件事——估算术强度、量数据规模。三个数就能定位:每元素运算次数、每元素搬入字节数、数据是否装得下 L2/L3。
- 反判据:如果数据装得下 L2 而算术强度又低,把寄存器从 128 位换到 256 位几乎没有意义——本机读数:
add在 64 KB 时 122.9 GB/s、在 64 MB 时 22.7 GB/s,5.4 倍的全在规模上,不在宽度上。 - 本机依据:
add122.9 → 22.7 GB/s;dot178.7 → 49.3 GB/s;dot_novec全程 15.4 GB/s。
下一章离开「怎么做」,去问「用哪套接口做」——标准库给了什么,以及它能不能跨编译器。
八、标准 SIMD:std::experimental::simd 与 C++26 std::simd
前两章都在讲「怎么写」。还有一个更根本的问题:要不要写 intrinsic——标准库其实给了一套可移植的向量抽象。这一章量它。
8.1 三家的支持现状
说白了,标准 SIMD 走过两个阶段:std::experimental::simd(P0214R9,目标 Parallelism TS v2)与 C++26 的 std::simd(P1928 系列)。
本机的实测结果是:
| 实现 | <experimental/simd>(TS) |
本机实测 |
|---|---|---|
| libstdc++(GCC 16.2) | 完整实现,自 GCC 11 起 | HAVE_STD_SIMD = 1,simd<float>::size() = 4 |
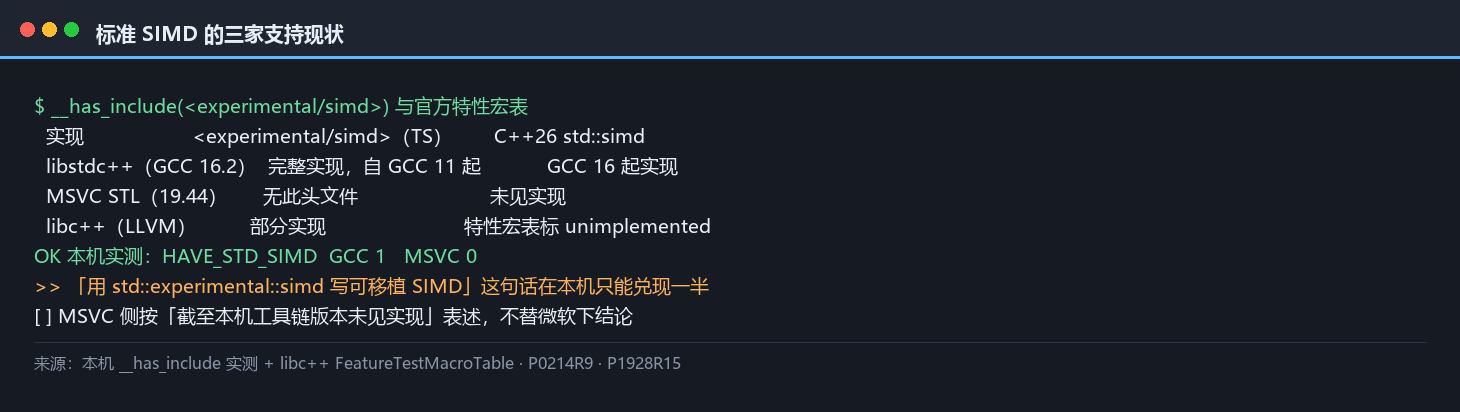
| MSVC STL(19.44) | 无此头文件 | HAVE_STD_SIMD = 0(__has_include 判假) |
| libc++(LLVM) | 部分实现,特性宏表把 __cpp_lib_simd 标为 unimplemented |
本机无 Clang,未能实测,只引官方特性宏表 |
所以「用 std::experimental::simd 写可移植 SIMD」这句话在本机只能兑现一半:GCC 侧能编译能跑,MSVC 侧连头文件都没有。 这条不是小差异——它意味着这套接口在 2026 年还不能作为跨编译器的默认选择。
8.2 一个意外的读数:size() 是 4,不是 8
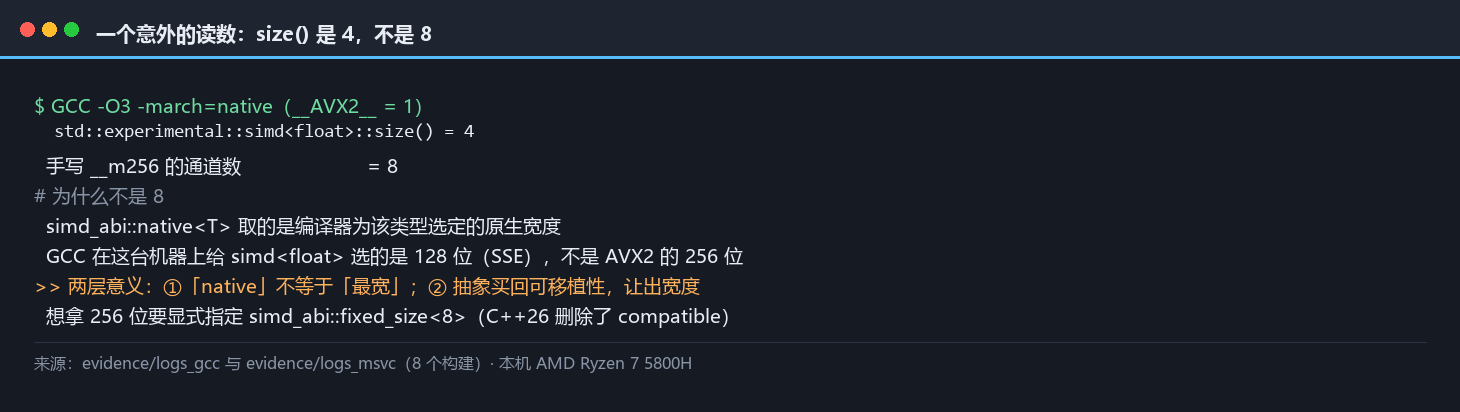
本机在 -O3 -march=native 下实测:std::experimental::simd<float>::size() = 4。
为什么不是 8? 因为 TS 的默认 ABI 标签 simd_abi::native<T> 取的是编译器为该类型选定的原生宽度,而 GCC 在这台机器上给 simd<float> 选的是 128 位(4 个 float)——不是 AVX2 的 256 位。
这条读数有两层意义:
- 「native」不等于「最宽」。想要 256 位得显式指定 ABI(
simd<float, simd_abi::fixed_size<8>>),或者依赖编译器版本的具体行为。 - 这正是抽象层的代价:标准接口为了可移植,只能给一个「保守的 native」;而手写 intrinsic 的宽度是你自己指定的。抽象把可移植性买回来了,把宽度让出去了。
OK,(在 C++26 的 std::simd 里,simd::size 改成了 integral_constant<size_t, N> 静态成员,simd_abi::compatible 被删除,最小支持宽度提到 64——这些变化的方向是「让宽度更显式」。)
8.3 where 不是 select:一次踩过的接口坑
TS 版的 where 不是三参数选择函数。本机实测的编译错误原话是:
error: no matching function for call to 'where(simd<float>::mask_type, simd<float>, simd<float>)'
candidate expects 2 arguments, 3 provided
where 的真实语义是掩码赋值:where(mask, lvalue) = value;。要写「按掩码在两条路里选一个」,得先算出一个中间量、再用 where 覆盖它:
simd<float> x(&b[i], element_aligned);
simd<float> r = x * 0.5f;              // 先假设走 else 分支
where(x > 0.f, r) = x * 2.f;           // 再用掩码覆盖成 if 分支
C++26 的 std::simd 把这件事改掉了:where 设施被替换成掩码版的 load/store 重载加 simd_select——那才是三参数的 select。同时 hmin/hmax 改名 reduce_min/reduce_max、split/concat 改名 simd_split/simd_cat。
这条差异对写代码的人有直接影响:照着 C++26 的示例写 TS 版一定编译不过,而网上两版示例混在一起。
言归正传,迁移路径值得单独记一笔,因为两版 API 的示例在网上混在一起。从 TS 到 C++26,除了 where 换成 simd_select,还有一批改名:hmin/hmax 变成 reduce_min/reduce_max,split/concat 变成 simd_split/simd_cat,simd_abi::compatible 被删除,simd::size 从函数改成静态成员。实测方法很直接:用 __has_include(<experimental/simd>) 判可得性、用 simd<float>::size() 判宽度——两个数就能定位当前实现落在哪一代,不必去猜编译器版本与标准的关系。
8.4 三方读数:标准版没有赢
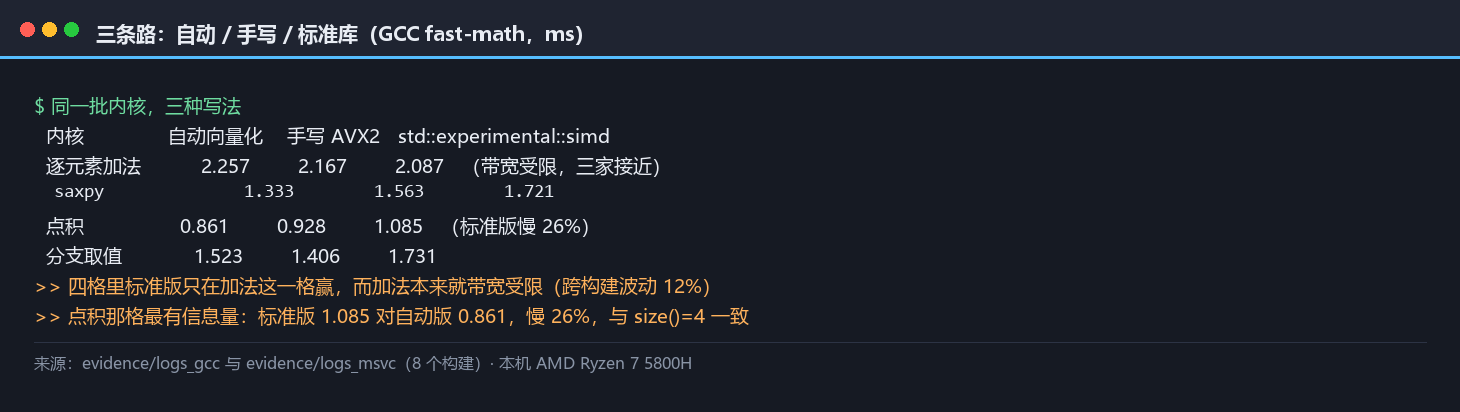
三条路写同一个点积与同一个逐元素加法,同一台机器(GCC -O3 -march:native -ffast-math):
| 内核 | 自动向量化 | 手写 AVX2 | std::experimental::simd |
|---|---|---|---|
| 逐元素加法 | 2.257 ms / 22.3 GB/s | 2.167 ms / 23.2 GB/s | 2.087 ms / 24.1 GB/s |
| saxpy | 1.333 ms / 37.8 GB/s | 1.563 ms / 32.2 GB/s | 1.721 ms / 29.3 GB/s |
| 点积 | 0.861 ms / 58.5 GB/s | 0.928 ms / 54.2 GB/s | 1.085 ms / 46.4 GB/s |
| 分支取值 | 1.523 ms / 35.5 GB/s | 1.406 ms / 32.5 GB/s | 1.731 ms / 29.1 GB/s |
四个内核里,标准版只在「逐元素加法」这一格赢了,其余三格都是最慢的。 加法那一格赢在它本来就带宽受限——三家的代码都被内存卡住,差异落在噪声里(2.087 对 2.257 ms 是 7.5%,而加法的跨构建波动本来就有 12%)。
真正有信息量的是点积那一格:标准版 1.085 ms,比自动版的 0.861 ms 慢 26%。 这与 §8.2 的宽度读数一致——size() = 4 意味着它只用了 128 位,一半的宽度。
8.5 官方口径对得上
- P0214R9(TS 提案)定义了
simd<T, Abi>、simd_mask<T, Abi>、where、reduce,以及 ABI 标签native/fixed_size/compatible(最后这个在 C++26 被删除)。 - P1928R15(C++26)的改动清单确认了 §8.3 的几处改名与语义替换。
- libc++ 的特性宏表把
__cpp_lib_simd标为未实现——这是「libc++ 还没做」最权威的凭据。 - libstdc++ 的状态页把 Parallelism TS v2 列为已实现。
- MSVC 侧没有官方声明说「我们不提供」,但 STL 特性宏表里没有它;本机
__has_include判假是更直接的证据。文章里按「截至本机工具链版本,未见实现」表述,不替微软下结论。
8.6 本章判据(第八条)
- 判据:需要跨编译器的可移植 SIMD 时,先确认目标编译器有没有这套接口——本机读数:GCC 有、MSVC 无。没有就别指望标准库,退回「自动向量化 + 少量 intrinsic」。
- 反判据:不要假设标准抽象与手写等速。本机读数:点积上标准版比自动版慢 26%(1.085 对 0.861 ms),原因是它只用了 128 位。
- 本机依据:
simd<float>::size() = 4(开启 AVX2 的构建下);四格读数里标准版三格最慢、一格在噪声内。
九、选型判据:按顺序问的六条
好了,把全篇收成一串问题。顺序本身就是结论的一部分——只有前一条不构成瓶颈,后面的权衡才有意义。倒过来问(先挑 SIMD 指令再看规模)会踩出「给小数组手写 AVX2」这类误用。
9.1 六条判据
| # | 问什么 | 通过 | 回落 |
|---|---|---|---|
| 1 | 规模:数据装得下 L2 吗? | 装不下 → 继续 | 装得下 → 布局与向量化都不影响它(本机 add 在 64 KB 时 122.9 GB/s,撞的是算力不是带宽) |
| 2 | 算术强度:每搬一个字节算几次? | 1 次以上 → 继续 | 不足 1 次 → 先解决带宽(改布局、分块、减少搬运),加宽寄存器无用 |
| 3 | 卡点诊断:报告说向量化了没有? | 报告绿且读数也涨 → 不用手写 | 报告红 → 按四种卡点分别处置(§二) |
| 4 | 给许可:这条卡点能不能靠「给编译器一条信息」解决? | 能 → 改开关或加属性(restrict、assume_aligned、-ffast-math、#pragma omp simd) |
不能 → 进入第 5 条 |
| 5 | 手写:剩下的收益是否值得维护代价? | 值得 → 写,且必须做多累加器 + 展开 | 不值得 → 放弃,记入结论 |
| 6 | 复核:改完之后重跑报告与读数了吗? | 报告与读数都看 → 结束 | 只看了报告 → 回去看读数(§三的反例) |
第 3 与第 4 条是本篇的核心:多数情况下,手写不是第一选择,「给编译器一条它缺的信息」才是。 本机读数支撑这一点——五个内核里自动版赢四个。
第 5 条里的「必须做多累加器 + 展开」是有读数支撑的硬要求:本机单累加器的手写点积版输给编译器 7.2%(0.928 对 0.861 ms),原因就是编译器展开了 8 倍。
说白了,这六条有一个特点:每一条都能落到本机的一个读数上,不是凭空列的清单。第 1 条落在 add 在 64 KB 与 64 MB 之间的 5.4 倍差上;第 2 条落在 add 与 dot 的有效带宽差上(22.7 对 49.3 GB/s);第 3 条落在八份报告条目上;第 4 条落在 fast-math 的 3.6 到 3.8 倍上;第 5 条落在手写与自动的五格对照上(自动赢四格);第 6 条落在「报绿而收益为 0」那一格上。判据能追溯到读数,才可以被证伪。
9.2 一条容易被跳过的前提:先确认瓶颈在算力
第 1、2 两条排在最前,因为它们能直接否掉整个向量化议题。本机有一个干净的实例:add 这个内核在内核内规模是 122.9 GB/s、在主存规模是 22.7 GB/s——5.4 倍的差距全在数据规模上,与用不用 AVX2 无关。
反过来说:如果你手上的代码数据量不大(装得下 L2/L3),那么无论自动向量化、手写 intrinsic 还是 std::simd,测出来的差异都会落在噪声里。本机四格读数里最"平"的一格正是逐元素加法——三家差 7.5%,而加法跨构建的波动本来就有 12%。
9.3 三步复现流程
OK,复现这一篇不需要任何私有环境,需要三样东西:
- 两套工具链:MSVC 19.44(VS 2022,
/O2与/arch:AVX2、/fp:fast)与 g++ 16.2(MSYS2 ucrt64,-O2/-O3/-march=native/-ffast-math)。共 8 个构建。 - 一份源码:
evidence/src/simd_lab.cpp(单文件、C++17、Windows 与 MSYS2 都能编)。 - 一个脚本:
evidence/tools/run_all.ps1,一次跑完 8 个构建的全部分支,报告与读数分别落到evidence/logs_gcc/与evidence/logs_msvc/。
核验方法:本篇正文里的每一个读数都能在 evidence/logs_* 里逐行找到;面板图由同一批日志生成(evidence/recon-report.md 是它们的中介)。
复现时有三个容易踩的地方。第一,别在跑基准时占着机器:本机取的是多次最小值,但如果同时编译或跑别的负载,最小值会被抬高。第二,规模要走完整条曲线:只测一个大数组会把「算力受限」与「带宽受限」两种情形混淆——同一份代码在小规模上的相对收益可能是大规模的两倍。第三,两家读数的绝对值不能互换比较:本机 MSVC 的 prefix_sum 是 5.682 ms、GCC 是 3.279 ms,比值才是可比的量。
9.4 自检清单与五条常见误用
写完代码、准备提交之前,逐条核对:
言归正传,1. 热点循环的报告看过了吗(两家各一条命令)?
2. 报绿之后,读数也核过了吗?(§三:报绿收益为 0 是真实存在的)
3. 循环里有浮点累加吗?如果有,语义允不允许重排?
4. 有不可预测的分支吗?数据分布是什么样的?
5. 数据装得下 L2 吗?算术强度够吗?(先答这两条再谈 SIMD)
6. 手写版做了多累加器与展开吗?(否则一定输给开了 fast-math 的编译器)
7. 有余数处理吗?n 不是向量宽度的整数倍时,尾巴循环写对了吗?
8. 对齐是承诺还是保证?load_ps 的前提成立吗?
9. 手写版的正确性逐位核对过了吗?哪一类改写必须逐位一致?
10. -ffast-math 是加在单个文件/函数上,还是全局?
11. 结论有没有越过证据边界(说「未命中几次」「哪个端口满」)?
五条最常见的误用:
- 「开
-O3就向量化了」——报告要看,读数也要看。 - 「加
restrict就能向量化」——它是一句承诺,不是开关。 - 「对齐是第一条注意事项」——本机读数里它的差异落在噪声内。
- 「手写一定比编译器快」——本机五个内核里自动版赢四个。
- 「AVX-512 一定更快」——本机没有 AVX-512,不给结论;而第三方实测有反例会低于 AVX2。
十、收束:全系列十二篇的账
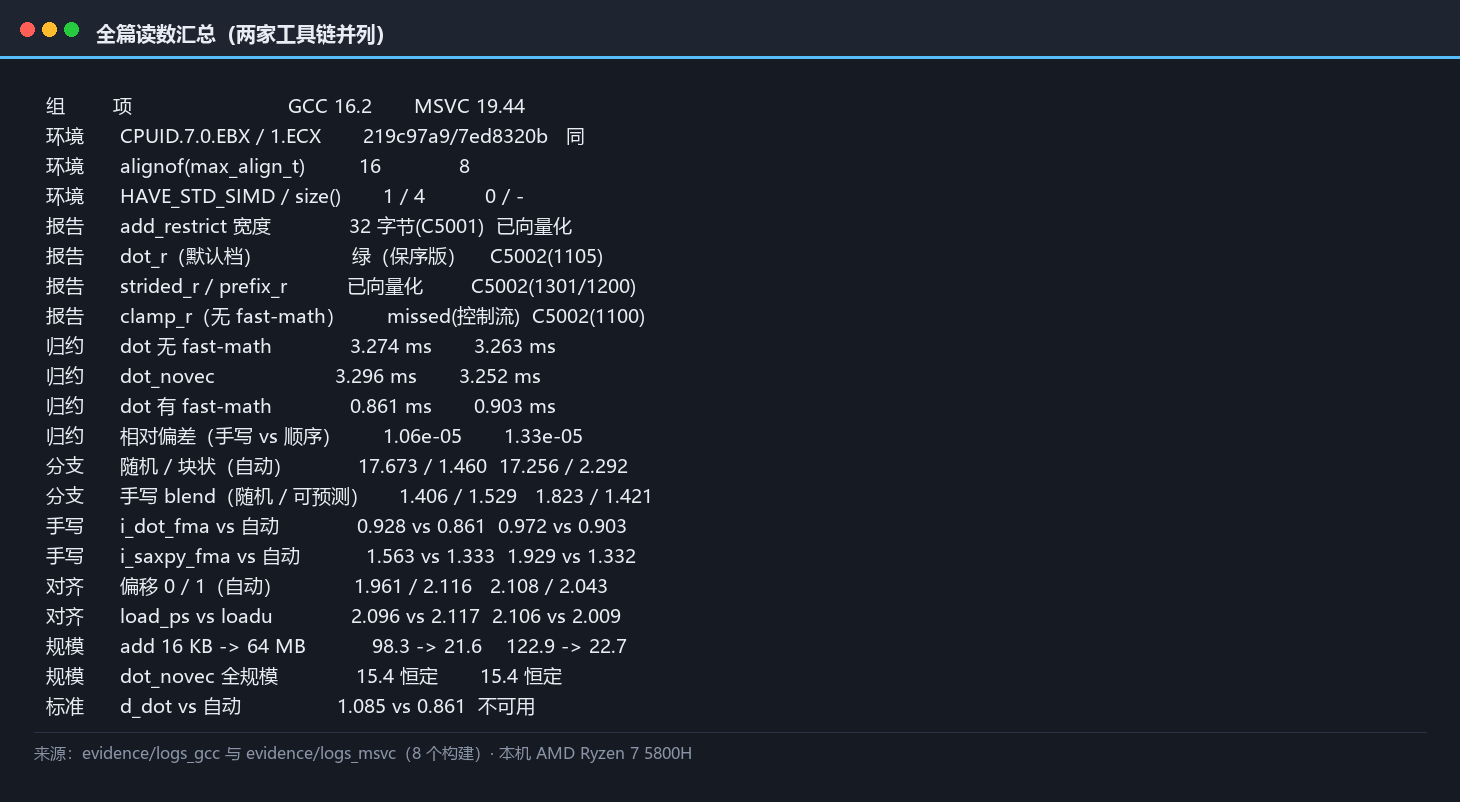
10.1 全篇读数汇总
把本篇测出的全部关键读数集中在一张表里,便于对照与复核。每一档的原始日志都随篇留档在 evidence/。
| 组 | 项 | GCC 16.2 | MSVC 19.44 | 说明 |
|---|---|---|---|---|
| 环境 | CPUID.7.0.EBX / CPUID.1.ECX | 219c97a9 / 7ed8320b | 同 | AVX2 有、AVX-512 无、FMA 有 |
| 环境 | alignof(max_align_t) |
16 | 8 | 两家不同 |
| 环境 | HAVE_STD_SIMD |
1 | 0 | 标准 SIMD 单侧可用 |
| 环境 | simd<float>::size() |
4 | — | native ABI 取 128 位 |
| 报告 | add_restrict 宽度 |
32 字节 | (C5001) | GCC 报 unroll factor 8 |
| 报告 | add_restrict 宽度(另一构建) |
16 字节 | — | 同构建里宽度也会不同 |
| 报告 | dot_r(默认档) |
绿(保序版) | C5002 由于 1105 | 未识别的 reduction |
| 报告 | strided_r |
— | C5002 由于 1301 | 访存不连续 |
| 报告 | prefix_r |
missed | C5002 由于 1200 | 循环携带依赖 |
| 报告 | clamp_r(无 fast-math) |
missed:unsupported control flow | C5002 由于 1100 | 控制流 |
| 归约 | dot 无 fast-math |
3.274 ms | 3.263 ms | 15.4 GB/s |
| 归约 | dot_novec |
3.296 ms | 3.252 ms | 与上一行同价 |
| 归约 | dot 有 fast-math |
0.861 ms | 0.903 ms | 3.83× / 3.60× |
| 归约 | 相对偏差(手写 vs 顺序) | 1.06e-05 | 1.33e-05 | 顺序改写必然的误差 |
| 分支 | 随机符号(自动) | 17.753 ms | 17.256 ms | 不可预测 |
| 分支 | 块状符号(自动) | 1.460 ms(fast) | 2.292 ms | 可预测 |
| 分支 | 手写 blend(随机 / 可预测) | 1.406 / 1.529 ms | 1.823 / 1.421 ms | 手写优势 9.47× → 1.61× |
| 手写 | i_add / i_clamp 正确性 |
mismatch 0 | mismatch 0 | 逐位相同 |
| 手写 | i_dot_fma vs 自动 |
0.928 vs 0.861 | 0.972 vs 0.903 | 自动快 7.2% / 7.1% |
| 手写 | i_saxpy_fma vs 自动 |
1.563 vs 1.333 | 1.929 vs 1.332 | 自动快 15% / 31% |
| 对齐 | 偏移 0 / 1(自动) | 1.961 / 2.116 ms | 2.108 / 2.043 ms | 差异落在噪声内 |
| 对齐 | load_ps vs loadu |
2.096 vs 2.117 ms | 2.106 vs 2.009 ms | 无稳定差别 |
| 规模 | add 16 KB → 64 MB |
98.3 → 21.6 GB/s | 122.9 → 22.7 GB/s | 5.4 倍跌幅 |
| 规模 | dot_novec 全规模 |
15.4 GB/s 恒定 | 15.4 GB/s 恒定 | 依赖链受限 |
| 标准 | d_dot vs 自动 |
1.085 vs 0.861 | 不可用 | 标准版慢 26% |
这张表的读法有一处要注意:同一组读数在正文与这里出现过两次(第一次在它所属的章节、第二次在汇总表里),两处必须一致。这是本篇的核对设计——两处对不上,说明搬运时改错了数。另外,表中每一行的原始日志都在 evidence/logs_gcc/ 或 evidence/logs_msvc/ 里可逐行回溯,构建参数写在 evidence/tools/run_all.ps1 里,不存在「某个数字只在正文里出现过」的情形。
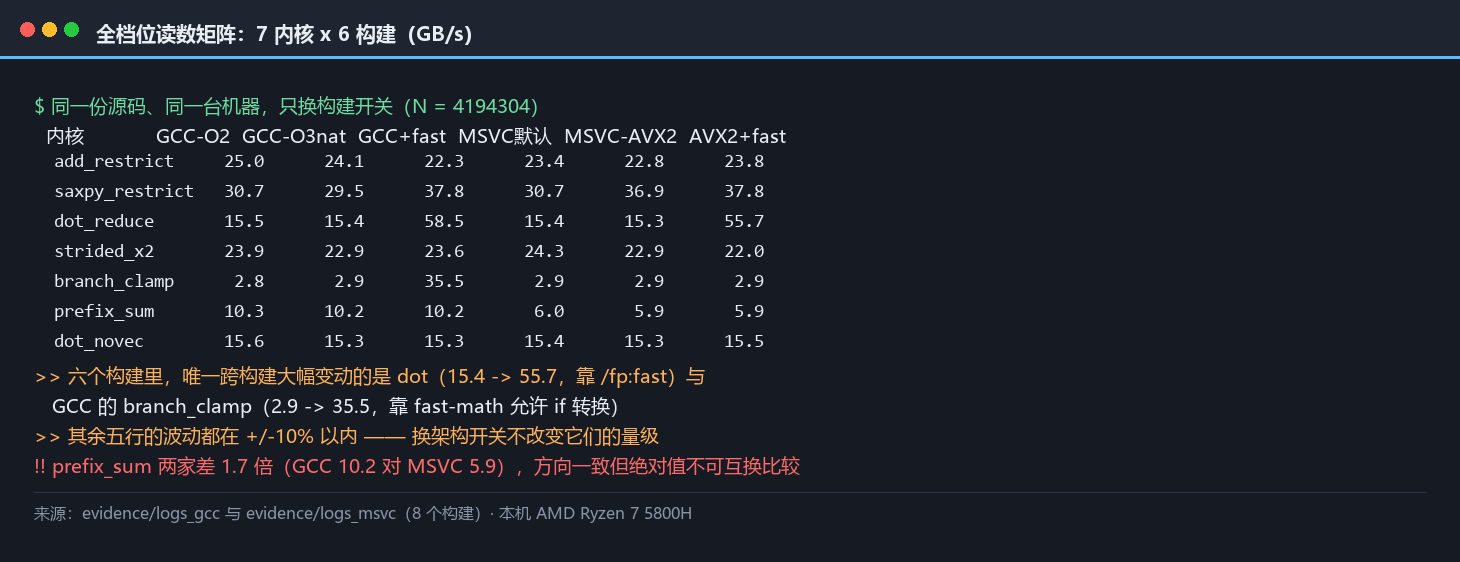
10.2 证据形态与读法(一句话版)
好了,三类证据:编译器报告(能证「它接受了这个循环」)、端到端读数(能证代价区间与方向)、反汇编与逐位核对(能证报告与读数之间那一步是不是真的)。四样里少一样,结论都有缺口——而本机拿不到的微架构事件(IPC、端口、cache-miss)在正文里一律不加推测。
10.3 复现流程
见 §9.3。核心是:八个构建、一份源码、一个脚本;evidence/recon-report.md 是读数与面板图之间的中介。
10.4 自检清单与五条常见误用
见 §9.4。第 2 条和第 6 条是最容易踩的:第 2 条(报绿不等于收益),第 6 条(手写不做多累加器必输)。
说白了,这份清单的用法是逐条核对、不留「大概没问题」。十一条里前四条是「先看再动」(报告、读数、浮点语义、数据分布),中间四条是写法要求(多累加器、余数、对齐、逐位核对),最后三条是报告纪律(fast-math 的作用域、结论的证据边界)。最容易跳过的是第 2 条与第 6 条:第 2 条是因为「报告已经绿了」看起来就完事了;第 6 条是因为单累加器的手写版在简单用例上看着也对——它只是慢,不是错。
10.5 与系列其他篇目的交叉点
- 与 ep13 无关——本系列到此收束。 下面是与已交付十一篇的接续。
- 与 ep05《优化器的边界》:ep05 讲的是「编译器看见什么才敢动」(UB、严格别名),本篇讲「编译器看见了但不许动时怎么办」(浮点结合律、分支)。两篇合起来才是「优化器的边界」的完整图景。
- 与 ep11《缓存与布局》:ep11 的 SoA 结论是本篇的前置——访存不连续,向量化第一道门就过不去。两篇是同一条链上的两环:位置决定能不能装进寄存器,宽度决定一次装几个。
- 与 ep01《对象布局》:
alignof(max_align_t)两家之差(16 / 8)在本篇复现,与本系列首篇同一处读数。 - 与 ep10《内存序》:ep10 的结论是「跨核看见什么」,本篇是「一条指令算几个」——同属「代价从哪来」的第四波。
10.6 一条可以搬走的方法
把本篇的做法抽象成三步:
- 先问「这条循环值不值得动」,再问「怎么动」。 规模与算术强度能直接否掉多数议题;本机读数是这一条的证明(加法 5.4 倍的差距全在规模上)。
- 把「编译器说」与「读数说」分开记。 报告与读数必须分两栏;两者不一致时,不一致本身就是结论(§三)。
- 手写之前,先做编译器会做的事。 多累加器、展开、余数处理——本机读数里手写输给编译器的那几格,输的全是这些。
这三步与 ep07 到 ep11 是同一条。这一篇多了一件工具:编译器自己的报告(/Qvec-report:2 与 -fopt-info-vec-all),它把「编译器到底怎么想的」从猜测变成了打印——与 ep11 的布局转储是同一类东西。
10.7 参考资料(含源码与证据)
- 编译器报告通道:GCC Developer Options|GCC Dump output verbosity|GCC Optimize Options|MSVC /Qvec-report|MSVC 向量化消息与原因码|LLVM Auto-Vectorization|Clang Users Manual
- ISA 与开关:MSVC /arch (x64)|GCC x86 Options|GCC x86 Function Attributes|Intel Intrinsics Guide|Intel 装载类 intrinsic
- 向量化前提与「给编译器一条信息」:GCC
__builtin_assume_aligned|cppreferencestd::assume_aligned|WG21 P1007R1|OpenMP 5.0 SIMD Directives|Intel Use Automatic Vectorization|Intel Vectorization and Loops - 标准 SIMD:WG21 P0214R9|Parallelism TS v2 · N4742|WG21 P1928R15(C++26 std::simd)|libc++ 特性宏表|libstdc++ Data parallel extensions
- 权威手册:Agner Fog · VCL 手册|Agner Fog · 优化资源索引|Agner Fog · Optimizing software in C++
- 本机源码与证据:
evidence/src/simd_lab.cpp(用例)|evidence/tools/run_all.ps1(8 构建一次跑完)|evidence/logs_gcc/与evidence/logs_msvc/(原始日志与向量化报告)|evidence/recon-report.md(读数汇总) - 延伸阅读(文中有引用、本机未实测):Intel · ISPC 的手写 intrinsic 实测|Intel · 向量化指南(PDF)|Intel · LLVM 与 GCC 的向量化对比|Clang · loop hint 扩展
- 延伸阅读(续):OpenMP 5.1 速查卡(PDF)|WG21 · P0820R4 对 P0214 的反馈|GCC · 自动向量化项目页|Intel · 向量化编程指引
- 延伸阅读(续二):MSVC ·
/arch(x86)|__restrict__的可移植性代价|AVX-512 未必更快的第三方实测|SIMD 向量化方法综述(《软件学报》)
10.8 全系列十二篇的账
OK,最后收一次全系列的账。十二篇、四波、同一条方法论:同一份源码、只换一个开关、量差异。
| 篇 | 一句话结论 | 图量 |
|---|---|---|
| ep01 对象布局、对齐与 padding | sizeof 的真相藏在填充里;-Wpadded 只报尾填充、不报成员间填充 |
39 |
| ep02 分配器解剖 | malloc → jemalloc/mimalloc → pmr arena,代价在分配粒度与 thread cache | 40 |
| ep03 值语义的账 | move/拷贝/SSO/emplace_back 的账要按「省了几次分配」算 | 40 |
| ep04 编译期账本 | -ftime-trace 是 Clang 专属,Windows 侧要换 ETW 路线 |
40 |
| ep05 优化器的边界 | UB、严格别名与向量化报告:编译器看见什么才敢动 | 40 |
| ep06 名字与符号 | ABI、修饰、可见性、PLT 与 IAT:链接期的账 | 40 |
| ep07 链在一起 | LTO 与 PGO 的收益来自跨 TU 内联与画像,不是"打开就更快" | 40 |
| ep08 分发的代价 | 虚函数/模板/variant/类型擦除四条路的代价分四层 | 41 |
| ep09 异常与 RTTI | 「零成本」要拆成时间与空间两笔账,空间侧不免费 | 40 |
| ep10 内存序与原子 | seq_cst 在 x86 上:load 与 RMW 免费,store 不免费 |
40 |
| ep11 缓存与布局 | 对齐 ≠ 隔离;SoA 的答案是「看 k」;padding 买并行正确性、付单线程容量 | 45 |
| ep12 SIMD(本篇) | 报告说向量化了 ≠ 有收益;解锁归约的是语义不是优化级别;开了 fast-math 编译器赢手写 | 41 |
十二篇一路读下来,能看到同一条线:语言层面的写法(ep01–ep03)→ 编译与链接期的选择(ep04–ep07)→ 运行时的代价(ep08–ep10)→ 与硬件对话的两端:位置(ep11)与宽度(ep12)。
全系列到此完结。 严格说,本篇没有「下一篇」——十二篇到此收束;但同一条方法论在站内还有下一站:GPU 架构(从命令提交到光栅化)、引擎架构(Godot / Jolt)、图形性能分析,各自都有独立专题,读法仍是同一条:先量规模,再问开关,最后才动手写指令。
以上。希望能对大家有所帮助。十二篇见。