核心问题:前面九期我们把 GPU 的硬件环节一个个拆完了——命令提交、显存、着色核、纹理、装配裁剪、光栅化、深度、像素后端、几何、计算着色器。可很多第一次写完一帧的人都会撞上同一个怪现象:命令明明提交了、API 也没报错,屏幕上却"看起来没画出来"。这不是渲染错了,而是同步与资源生命周期的问题——CPU 和 GPU 之间隔着一个巨大的异步鸿沟,而资源从"被上一个用途用"切到"被下一个用途用",中间那道转换没有被正确声明。本篇把「规范怎么写」和「硬件实际怎么做」分开讲:fence、semaphore、barrier、event 这些同步对象只是正确性规则的"遥控器",硬件真正执行的是 cache flush、pipeline drain、fence register 写标记、跨队列一致性切换。全篇收在"跨命令、跨队列、CPU-GPU 的同步全图,是理解 2011 之后一切异步机制的地基"这句交棒给 ep12 的预告上。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
一句话点题:visible-after-submit 是一个错觉(set-context)
先来把最磨人的那个困惑摆上台面:"我把 Draw 提交了,API 返回了,为什么下一帧还是空的?"
答案不在哪一次绘制本身,而在两个字——异步(asynchronous)。你 vkQueueSubmit / ID3D12CommandQueue::ExecuteCommandLists 调用返回的那一刻,命令并没有执行完,甚至可能压根还没开始执行。它只是被推进了 GPU 那条深不见底的命令队列里,GPU 在后面按自己的节奏慢慢消化。API 返回只保证"提交这件事成功了",绝不保证"画出来了"。
这个"提交 ≠ 执行 ≠ 可见"的落差,正是本系列硬件实现层最后一篇的地盘。前面十期我们把一个个硬件单元的内部读透了,而同步讲的是这些单元之间的边界——谁在写、谁在读、什么时候数据才算"真正就绪可以被消费",以及硬件在边界上到底做了什么物理动作。
本篇不涉及什么、为什么: - 不重复 ep10 已经讲透的 CS 工作项内部那一层屏障(
__syncthreads/ 工作组屏障)——那是"一群线程一起重聚",范围到 block 为止。 - 不展开 mesh shader 与 work graphs 的完整实现——那是 ep12"2011 之后"的内容,本篇只做方向性交棒。 - 不重复应用层用同步 API 写一帧 demo 的具体接线——本篇关心的是"每个同步对象在硬件上到底买了什么"。
本系列属硬件机制文,凡涉及精确耗时一律不虚构:公开资料没有统一的"同步要花多少 ns"数字,正文对任何量级都显式标注"推测 / 需实测",并给出可核对的观察方法(RGP 的 barrier duration / drain time)。
全系列知识地图:整个系列分四段在走——上游(ep01–04)命令排队、显存寻址、着色核调度、纹理采样;装配(ep05–08)图元装配裁剪、光栅化、Z 与 early-Z、像素后端;从几何到计算(ep09–10)几何着色器与计算着色器;收束与未来(ep11–12,本篇所在)同步与资源生命周期,以及 2011 之后哪些机制变了。本篇站在第四段的开头:ep10 的 CS 工作项内屏障刚划出"到 block 为止"的边界,本篇把这个边界一路推到命令、队列、CPU-GPU 的全程。
出处参考:Fabian Giesen《A trip through the Graphics Pipeline 2011》(CC0)——硬件管线异步结构的背景。
读法提示:这一篇我们把"画一帧"的视角暂时放一放,换成"排队、可见、资源身份"的思维。核心混乱来自三个经常被混为一谈的问题:
- 提交问题(CPU 把命令递给 GPU,什么时候算递到?)→ fence
- 可见性问题(GPU 的哪个阶段写的数据,能被哪个阶段读?)→ barrier / memory dependency
- 生命周期问题(同一块资源当 UAV 写完,当顶点缓冲读,中间那道"身份切换"谁管?)→ layout transition / resource state
我们逐个把它们的硬件账摊开,最后用"误用代码段 + 修复"收拢,再用 RGP 这类可观察工具回答"同步到底花多少钱"。
为什么这一篇是硬件实现层的收官:前面十期讲的是"某个单元内部怎么工作",这一期讲的是"这些单元之间怎么交接"。两者的难度不同——单元内部的机制有明确边界(读寄存器、看流水线图就能对上),而交接的边界是协议性的:它由 API 规范、驱动实现和硬件行为三方共同定义,任何一方偷懒,现象就变成"偶发花屏"。所以本篇不追求给你一张"同步开销表",而是给你一套能自己下判断的框架:先分清 when 与 where,再按范围与对象选同步手段,最后用工具量一次。
一、为什么「提交了却看不到」:CPU 与 GPU 是两台松耦合的机器(explain-structure)
先说结论:CPU 和 GPU 之间没有"同时处于同一时刻"的握手。 它们共享显存和命令打包的内存,但执行节奏完全独立——CPU 以微秒级时钟跑指令,GPU 以毫秒级的批次处理一大包工作,中间隔着一根带宽极高、延迟也极高的总线(PCIe / 内部互连)。
1.1 命令队列:CPU 只做"推进指针"这一件事
CPU 侧提交命令的物理动作,比你想象的要小得多。当应用调用提交 API 时,驱动干的事大致是:
- 把命令打包成 GPU 能懂的二进制描述(铁引擎说得上话的 command buffer / command list);
- 把它挂到某条命令队列(queue)上,写一批登记信息——起始地址、结束地址、涉及的资源;
- 写一个门铃(doorbell / kick)寄存器,告诉 GPU"有活干了"。
关键在于第 3 步之后 CPU 就返回了。从提交到 GPU 真正跑到你那条命令,中间隔着:前面排队的命令、驱动批处理策略、GPU 的调度延迟。所以"API 返回"只是"命令进入队列"的信号,不是"执行完成"的更不是"画面可见"的信号。
1.2 没有 fence,你怎么知道画完了?
既然提交是异步的,自然就有一个问题:CPU 什么时候才能安全地读 GPU 写出来的结果? 回答它需要一个"完成信号"——GPU 执行到某个点,写一个 CPU 能查的标志。这个标志在 Vulkan / D3D12 里叫 fence(围栏)。
fence 的操作模型非常简单,两个动作:
- signal(发信号):GPU 跑完某批命令后,把一个整数寄存器写成某个值;
- wait(等待):CPU 侧调
vkWaitForFences/ID3D12Fence::SetEventOnCompletion,查到那个值到了就解除阻塞。
fence 的本质是一个跨 CPU 与 GPU 的单向完成信号。它不关心数据在哪、被谁读写,它只回答一个问题:"GPU 有没有跑到某个时间点?" 你要读 GPU 写的 buffer,正确的姿势是"先 fence.wait,再读 buffer"——fence 是 CPU 与 GPU 之间唯一合法的"对齐点"。
等待的"姿势"也值得说清,因为这一层直接决定 CPU 那侧的代价:最省事的是自旋(循环调一次非阻塞查询),延迟最低但会白烧一个核;稍好的是阻塞等待(带超时的 wait,把线程挂起,由驱动在 GPU 写寄存器时唤醒);最省 CPU 的是回调 / 事件通知(把后续动作挂在完成事件上,主线程根本不进等待)。三者的选择权在应用侧,与 GPU 无关——但选择会显著影响"CPU 到底被同步拖住多少",这也是第 7 章量化时容易被忽略的一块。
最容易踩的坑:把返回的 API 当成"画完了"。驱动可以提前返回、命令可以延迟执行,只有 fence wait 成功才代表 GPU 真的推进到了那个点。任何"直接读刚写完的 buffer"的做法,在驱动的运气好时能跑,但迟早会在某台机器、某次驱动更新后变成闪烁、花屏、甚至是安全洞。
1.3 CPU-GPU 记忆一致性:谁把 cache 里的东西倒出去?
这里还有一层比"执行顺序"更隐蔽的东西:数据可见性。fence 保证"GPU 执行到了某点",但 CPU 看到的数据是它自己 cache 里的,GPU 看到的数据是显存里的——如果 GPU 写的是显存、而 CPU 读的是它 L2 cache 里同一块物理地址的旧副本,那即使 fence wait 成功了,你也读到脏数据。
现代桌面 GPU 依赖显存一致性协议(coherent 总线)来让 CPU mmap 的 buffer 读写可见,但"可见"的范围由驱动声明的资源用途决定。一致性协议的世界里有个经典对照图景:同一地址在 CPU cache 与 GPU cache 里各放一份副本,谁改写了都不知道对方——必须靠一套协议去裁决、去刷新。桌面 PCIe 场景下,CPU 映射的可写 buffer 通常是"写传递"(write-through)或配一个主动刷新的命令来实现可见;但对真正被 GPU 大量写、又要被 GPU 另一阶段读的纹理/缓冲,靠总线 snoop 是撑不住的,必须走显式的 resource barrier。
于是这把我们引向本章下一节、也是整个同步体系的核心概念:数据不是自动就位的,谁写的、谁读、在哪一步之间切用途,都要显式声明,硬件才知道该不该刷 cache、要不要停流水线。 硬件不会替你猜——它默认你的 buffer 是"死的"数据,除非你用同步原语明确告诉它"这里有个边界,你给我处理一下 cache 与可见性"。
1.4 统一内存与分离显存:同一份规范,两种物理
上面这套说法在两类机器上的代价完全不同,写代码时若不分清,很容易在移动端或集显上踩到"桌面跑得好好的、换台机器就花屏"。
统一内存(UMA):CPU 与 GPU 在同一颗芯片上,共用一套 DRAM 与地址空间。手机 SoC、游戏主机、桌面 APU 都属这一类。物理上只有一份内存,所以"搬运"这件事基本不存在——同步的花销主要落在缓存刷新与失效上:GPU 写完的脏行还在它自己的 L1/L2 里,CPU 或另一个引擎要读,就得先让这些行落回共享的下一级。
分离显存:独立显卡自带 VRAM,CPU 通过 PCIe 访问,两侧各有自己的缓存与地址空间。跨域的每一次读写都要显式搬运(staging buffer、拷贝队列、映射的 coherent 标志),所以"能少搬就少搬"是第一原则,而同步点往往就挂在搬运路径的两端——这解释了为什么桌面上的同步开销常常比移动端更"贵"。
判据只有一句:先确认你的目标平台是 UMA 还是分离显存,再决定"这次交接是刷缓存的事,还是搬数据的事"。第 4 章的 swapchain、第 6 章的跨队列一致性交接,在两类平台上的实现与代价差着一个量级。
出处:Khronos Vulkan 规范 §VkFence/D3D12 · Fence-Based Resource Management。
这一段的账先钉下:fence 只解决"GPU 推进到哪了",不解决"看到的数据新不新"——可见性是另一类同步(barrier / memory dependency)的地盘,下一章给出全景。
二、同步对象全景表:fence / semaphore / event / barrier / subpass dependency(compare-options)
GPU 生态把"同步"拆成了 5 个名字各异的对象。初学者最容易把它们混成一团,其实每个解决一个特定坐标上的问题。先用一张分类表把全景摊开,再逐一说透。
| 同步对象 | 作用域 | 解决什么问题 | 谁是发起/等待方 |
|---|---|---|---|
| fence | CPU ↔ GPU | "GPU 推进到某点了没" | GPU signal,CPU wait |
| semaphore | GPU ↔ GPU / queue 间 | "这条队列的活能不能被另条队列消费" | GPU signal,GPU wait |
| event(Vulkan)/ event(D3D12) | 设备 / 命令内 | "命令流中某个更细的同步点" | 命令内 signal/wait |
| pipeline barrier | 同一 queue 命令流 | "执行依赖 + 内存可见性" | 命令内前/后依赖 |
| memory barrier | 同一 queue 命令流 | "数据可见性(写后读等)" | 命令内 |
| subpass dependency | render pass 内 attachment | "attachment 在子pass间读写依赖" | 命令内 |
2.1 fence 与 semaphore:差在"谁是等待方"
很多人把 fence 和 semaphore 记成双胞胎,错。判据只有一条:等待方在 CPU 还是 GPU。
- fence = GPU signal,CPU wait。CPU 想读 GPU 的结果,用 fence。
- semaphore = GPU signal,GPU wait。两条 queue 之间要串行化(比如"图形队列算完,计算队列才能读那张图"),用 semaphore,因为 CPU 不该、也不需要在中间被唤醒——让 GPU 自己在设备内部等,省掉一次 CPU-GPU 往返。
Vulkan 里 semaphore 挂在 vkQueueSubmit 的 pSignalSemaphores / pWaitSemaphores 上,D3D12 里用 ID3D12Fence 配 Acquire/Release 或 timeline semaphore 实现类似语义。一句话记:fence 把 CPU 拉进来,semaphore 让 GPU 自己排队。
D3D12 侧的表达方式值得单独补一句,因为它的词汇很容易把人绕进去:DX 只有 ID3D12Fence 这一个原语,跨队列协作靠 Acquire / Release 语义——Release 表示"我这个队列对这块资源的写入告一段落",Acquire 表示"我这个队列准备接管它"。所以它并不是"没有 semaphore",而是把 semaphore 的语义编码进等待值与资源状态里:同一个 fence 对象既能给 CPU 等(SetEventOnCompletion),也能给另一个队列等(Signal + Wait)。理解这一点,就能明白为什么跨 API 迁移时"对象对不上"而不是"能力对不上"。
另外要点破一个高频混淆:fence 不是 barrier。 fence 只回答"GPU 推进到哪了",它不建立任何内存可见性——你在 DX 里用 fence 等到了 GPU 完成,读回的数据仍可能是旧的;反过来,barrier 也替代不了 fence,因为它不通知 CPU。两者管的是两条完全不同的账(§1.3),混用是后面第 8 章好几类误用的共同源头。
2.2 event:一堵墙,还是一枚路标?
分类表里那个最容易被跳过的是 event。它的定位很特别:既不是 CPU 等 GPU(那是 fence),也不是两条队列互相等(那是 semaphore),而是在同一条命令流内部造一个更细的同步点。三个动作就能说清:vkCmdSetEvent 打标、vkCmdWaitEvent 等标、vkCmdResetEvent 清标。
要理解它,得先看清 barrier 的"贵"在哪儿:barrier 是一堵墙。 它前后的命令被严格切开,墙这一侧的工作必须全部到达指定阶段,墙那一侧才准进场——中间没有缝,也没法让无关的工作继续跑。event 换了一个思路:它是一枚路标。 你可以在写完之后随手打个标,然后让一堆与结果无关的工作继续往下跑;等到真要消费那份结果时,再让那一条命令停下来等标。
差别就出来了:
- barrier:切断流水线换取"确定可见"——范围大、代价高,但语义最强;
- event:允许流水线在"打标"和"等标"之间继续运行——范围小、代价低,但要求你自己算清楚"谁是那个真要读的人"。
典型用法是"一次分派只写完一半,另一半的消费者可以提前开跑":比如计算着色器分两批输出,第一批结果先交给拷贝引擎下载,第二批还要等图形队列来读——如果中间插一堵全局 barrier,拷贝引擎得白等第二批;改成打标 + 等标,两段就重叠起来了。
D3D12 侧有同一思想的两种写法:老版的 split barrier(在同一个资源屏障上分别声明"开始段"和"结束段"),以及 Enhanced Barriers 里把一次转换拆成 BEGIN_ONLY / END_ONLY 的写法——都是把"墙"拆成"前半段声明 + 后半段兑现"。
代价与坑也很明确:event 不触发全局排空,但它要求驱动记住半程状态;一旦你等的那个 event 永远不会被 set(写错对象、漏了 reset、提前 reset),整条队列会挂死——设备侧没有超时,这类问题只能靠校验层或抓帧工具定位。另外 D3D12 没有与 Vulkan event 完全对等的对象,常见的逼近方式是用 fence 配信号值,或用 alias barrier 把"半程状态"表达出来。
2.3 一句被反复敲打的误区
这里必须敲打一句最常见的错误说法:"反正同一 queue 里的命令本来就是串行执行的,用不着 barrier。" 这句话一半对、一半错:
- 对的部分:同一条 queue 里,命令的执行顺序是有保证的——第 2 条命令不会在第 1 条之前开始,这是提交顺序(submission order)保证的。
- 错的部分:执行顺序 ≠ 内存可见性。GPU 里的各执行单元各自有 cache,第 1 条命令"写"了数据,第 2 条命令不一定"读得到"——跨 cache 的写如果没被刷新/失效,第 2 条读到的是旧值。所以即使同在一条 queue,只要第 1 条命令的结果要被第 2 条读,就需要 barrier 来建立"内存可见性"。 顺序保证给了"谁先谁后",barrier 给了"读得到写的结果"。
把"顺序"和"可见性"分开,是理解 GPU 同步最关键的单一认知。它也正是下一章的主题。
2.4 timeline semaphore:把 fence 的计数值搬到 GPU 侧
前面 §2.1 的判据(谁是等待方)在 Vulkan 1.2 之后被一个对象打通了一半——timeline semaphore。它值得单独讲,因为多帧在飞的现代渲染器里,它几乎取代了半池 binary semaphore。
先说 binary semaphore 的局限:它只有"已 signal / 未 signal"两个状态,一次交接用一次,用完就得重建。于是三条队列、三帧在飞的时候,你要维护的是一池子对象,还得逐个算清楚谁和谁配对——这是纯粹的记账负担。
timeline semaphore 换成了一个64 位单调递增的计数值:signal 的时候带一个值,wait 的时候说"等到值不小于 N 为止"。由此多出三件很实用的能力:
- 按值等待,而不是按对象等待:一个值就能表达"第 N 帧的全部工作完成",不用为每帧每队列各建一个对象;
- CPU 与 GPU 两侧都能等:CPU 侧
vkWaitSemaphores等一个值(这就覆盖了 fence 的用法),GPU 侧在提交时声明等某个值;还能随时用vkGetSemaphoreCounterValue查当前推进到哪; - 天然贴合帧号:帧号本身就是那个递增值,多帧在飞的记账从"配对"退化成"比较大小"。
对照 D3D12:ID3D12Fence 本来就是计数值语义,所以"CPU 按值等待"这一半 DX 早就有;DX 缺的是"GPU 命令直接等一个值"的那一半,通常靠 fence 轮询或 alias barrier 逼近。
三个坑要记住:值必须严格递增,回退即未定义行为;signal 与 wait 写反会死锁,而设备侧不会超时——排查时第一个要看的就是"等的是不是那个还没被 signal 的值";最后,CPU 侧等一个很高的值等价于 DeviceWaitIdle,别把它当成"我先歇一会儿"的通用手段(理由见 §6.3)。
2.5 Vulkan 推荐的操作路径
碰到实际的同步需求,别一上来就想叠最复杂的对象。Vulkan 官方的判定顺序大致是:
- 读写都在 GPU、且只是"同一资源换用途" → pipeline barrier + image layout transition;
- 涉及 CPU 要读 GPU 结果 → fence;
- 涉及两条 queue 协作 → semaphore(多帧在飞、要按帧号记账时换 timeline semaphore,见 §2.4);
- render pass 内部 attachment 依赖 → subpass dependency;
- 同一条命令流里只想"提前打个标、稍后再等" → event(见 §2.2),别为了让一小段结果可见就砌一堵全局墙。
选错的三种典型:该用 semaphore 的地方用了 fence(把 CPU 拉进设备内部的交接,白白多一次往返);该用 event 的地方用了 ALL_COMMANDS barrier(为一份局部结果把整条流水线排空);该按帧号记账的地方用了一池 binary semaphore(对象越攒越多,配对越写越乱)。
优先级永远先想"最简单的能不能解决",而不是"最精确的是哪个"——因为每个同步对象都自带开销,见第 7 章。
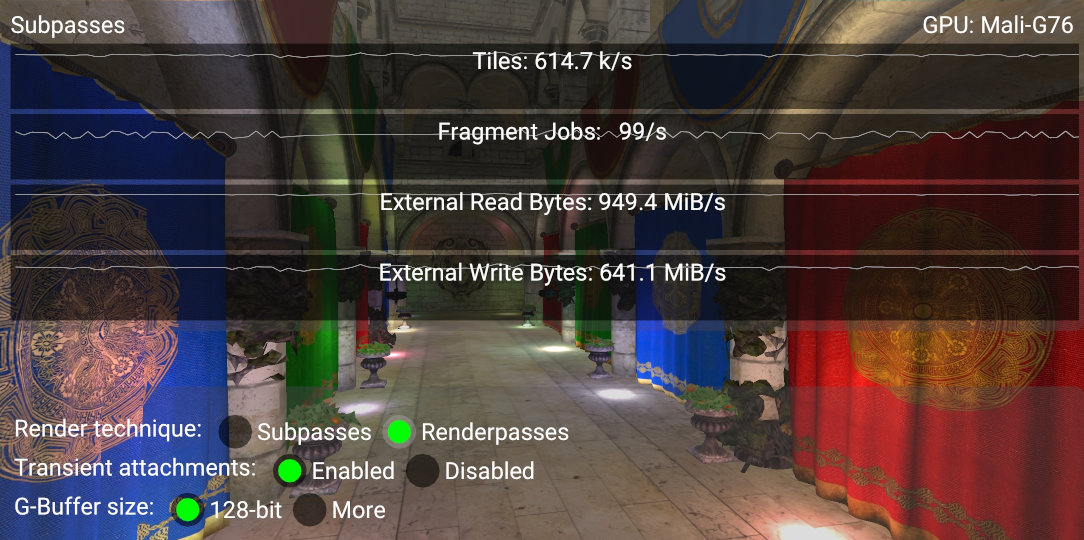
其中第 4 档(subpass dependency)是五个对象里最特别的一个:它不靠 barrier 显式插入,而是在 render pass 创建时把依赖声明出去,由驱动决定要不要真的切一刀。真机上两种接法的差别是可测的——同一场景用两次 render pass 接,attachment 必须落回显存再被读;合成一个 render pass + 两个 subpass,交接就发生在 pass 内部:
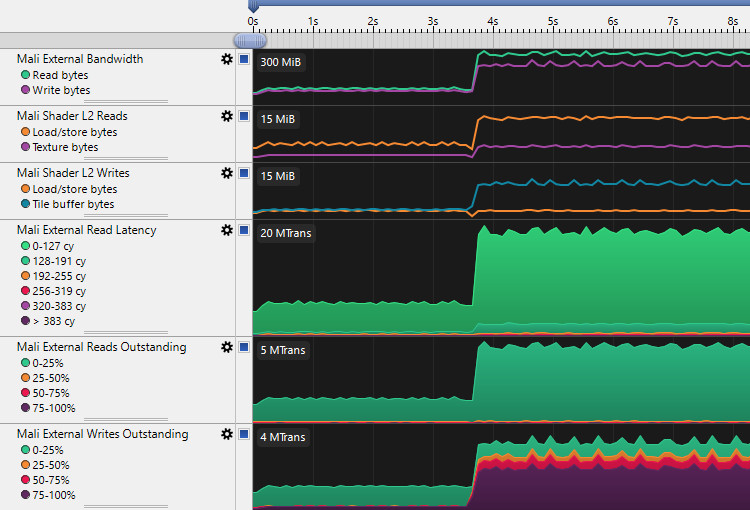
出处:Khronos Vulkan 规范 §Synchronization and Cache Control/Sebastian Castor · Vulkan synchronization。
三、执行依赖 vs 内存依赖:when 与 where(explain-structure)
Vulkan 把 barrier 分成两层概念,这是新手最大的门——执行依赖(execution dependency) 和 内存依赖(memory dependency)。可以这样记:
- 执行依赖回答 when(什么时候):前面哪些 stage 必须在后面哪些 stage 之前完成。
- 内存依赖回答 where(哪里):前面 stage 写的哪些内存位置,要对后面 stage 可见。
PDF 式的讲法很绕,我们用一句人话:执行依赖让 GPU 把"时间上靠前的事干完",内存依赖让 GPU 把"干完的结果真的落到指定的地方"。 缺执行依赖,可能顺序错;缺内存依赖,顺序对但读到的还是旧数据。
3.1 src/dst stage mask 到底在说什么
Vulkan 的 vkCmdPipelineBarrier 有四个关键参数:srcStageMask、dstStageMask、srcAccessMask、dstAccessMask。四个 mask 里藏着上面那两个层次:
srcStageMask/dstStageMask→ 执行依赖的 when:声明"我 src 里的这些 stage 干完,dst 里的这些 stage 才能开始";srcAccessMask/dstAccessMask→ 内存依赖的 where:声明"src 的这些访问(写 texture / 写 buffer / 读 depth),要对 dst 的这些访问可见"。
stage mask 是按整个管线阶段切的粗粒度:VERTEX_SHADER_BIT、FRAGMENT_SHADER_BIT、COMPUTE_SHADER_BIT、TRANSFER_BIT…你没法说"这个 shader 的第 3 行指令要在第 5 行前执行",只能把"整个 vertex stage"作为同步的最小单位。这是显卡异步执行模型决定的:硬件只在阶段边界做 drain/恢复,粒度太细驱动也没法保证。
3.2 三类 barrier:memory / buffer / image
vkCmdPipelineBarrier 一次调用可以同时捎上三种 barrier,粒度依次变细:
| barrier 类型 | 覆盖范围 | 什么时候用 | 代价 |
|---|---|---|---|
VkMemoryBarrier |
全局:不指向具体资源,声明"这一批访问整体对后面可见" | 说不清具体是谁、或一次要覆盖多份资源 | 最高:驱动只能保守处理整片可见域 |
VkBufferMemoryBarrier |
定向到某个 buffer(可带 offset / size) | 某块 UBO / SSBO / 顶点缓冲写完要被读 | 中:范围锁在该 buffer 的区间内 |
VkImageMemoryBarrier |
定向到某个 image,且必须带 oldLayout / newLayout 与子资源范围(mip、array layer) |
纹理、渲染目标、深度附件换用途 | 低到中:粒度最细,layout transition 也只能挂在这里 |
选择原则一句话:粒度越细,驱动要维护的可见性集合越小,flush / invalidate 的范围越窄。 但代价是把语义责任交给了写代码的人——漏声明一份访问,校验层不一定会报错,现场表现为"偶尔花屏、换个驱动就好",属于最难查的一类问题。
顺带钉一下一处容易混的说法:这里的"三类"指的是 barrier 对象的三种粒度(memory / buffer / image);而 ep10 讲"三种屏障"指的是作用域三档(工作项内 / 工作组内 / 跨命令)。两个轴互不替代——对象决定"这次声明覆盖哪些资源",作用域决定"谁必须到达会合点",写代码时两个维度都要各选一次。
D3D12 侧的演进是同源的:老版只有 resource barrier(天然定向)和一个 UAV barrier(全局语义,近似 memory barrier);Enhanced Barriers 把"同步掩码"和"访问掩码"拆开,并补上 GLOBAL 一类——等于把 Vulkan 这套三档粒度用另一套拼写重新讲了一遍。
3.3 availability 与 visibility:规范把"内存依赖"拆成了两步
规范里有一个容易被跳过的细节:一次写要被后面的读看见,中间其实是两个动作,不是一步。
- make available(使其可用):把这次写的结果推到"对设备域可见"的位置——写回、刷出缓存,保证结果不再只待在某级私有缓存里;
- make visible(使其可见):让后续的访问能读到新值——失效旧副本,保证读的人不会拿到陈旧数据。
顺序不能反,也缺一不可。barrier 的 access mask 恰好就是这两个动作的开关:srcAccessMask 声明"哪些写需要 make available",dstAccessMask 声明"哪些读需要 make visible"。把这两句代回 §3.1 的四参数模型,三件此前"知道该这么写、但说不清为什么"的事就都通了:
- 为什么只写 stage mask、漏了 access mask 会读到旧值——执行顺序建立了,可见性根本没建立;
- 为什么 layout transition 必须带 access mask——它本身就是一次"让写端 available、让读端 visible"的声明,少了这半句,硬件不知道要刷哪一段;
- 为什么
ALL_COMMANDS/ 全量 access 那么贵——你把整片可见域里的每一个可能位置都刷了一遍,而其中绝大多数与本次交接毫无关系。
更妙的是,这套规范语言与第 5 章的硬件语言是同一件事的两种说法:make available ≈ flush(写回),make visible ≈ invalidate(失效)。规范用"可见性"这类抽象词描述它,硬件用"刷哪些 cache 行"来实现它——中间那层翻译由驱动完成。
所以 when 与 where 的分工可以再收紧一句:when 只是排队,where 才是让数据真的到那儿。
3.4 最省心的实践坑
实践中最常见的坑是把 stage mask 和 access mask 配错档位。许多入门代码图省事,srcStageMask = ALL_COMMANDS_BIT(等于"前所有指令都干完"),性能立刻崩——因为 ALL_COMMANDS 会触发一次全局 pipeline drain + cache flush,把前面所有 stage 都刷一遍,代价极大。正确做法是只声明真正有依赖的那两个 stage,让驱动有最小的工作范围。
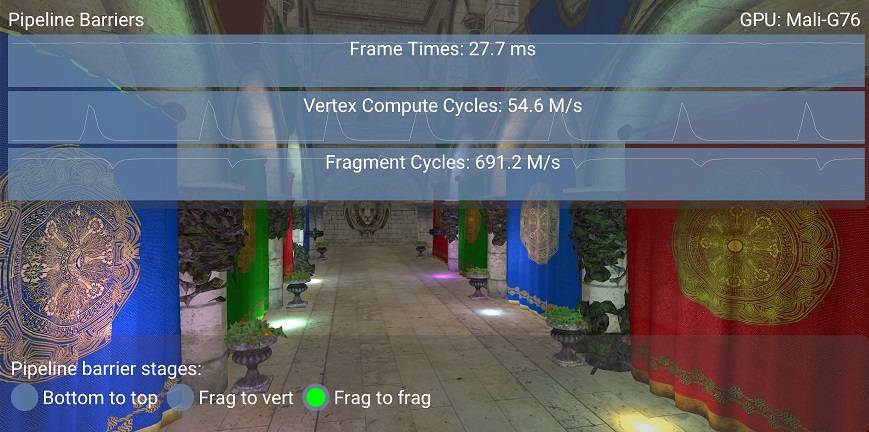
范围写宽到底有多"崩",真机波形给得很直白。下面是 Arm 官方 pipeline_barriers 样例里最保守档(BOTTOM_OF_PIPE → TOP_OF_PIPE,等于把范围拉满)的一次实测:顶点与片元工作被完全串行化,波形上永远看不到两者重叠——
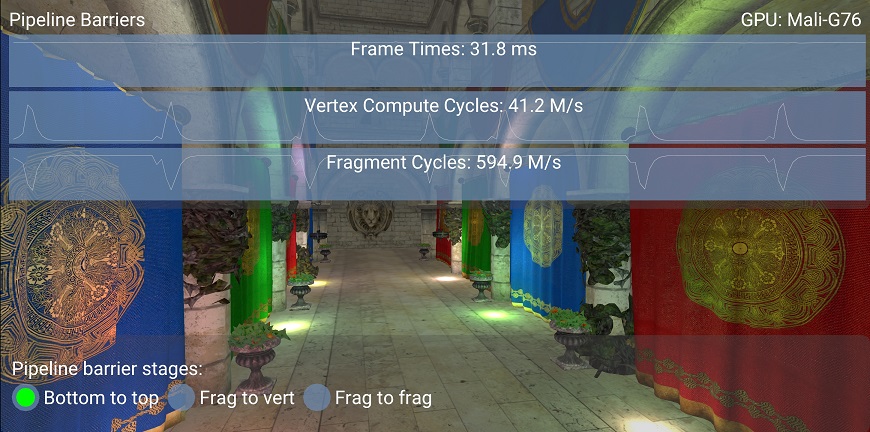
一句话:stage mask 往宽里配 = 让 GPU 多干活,往窄里配 = 依赖没声明全会读到脏数据。这中间的平衡点,就是本章的"优化"所在,也是第 7 章讲 cost 时反复出现的主题。
3.5 barrier 的一生:从四个 mask 到硬件命令
收尾之前,把本章的三个概念串成一条时间线——你写下的一行 barrier,中间经历了什么:
- 你写的:一次
vkCmdPipelineBarrier,带四个 mask 和(可选的)具体资源; - 校验层替你查的:mask 组合是否自相矛盾(比如 src stage 被声明在 dst stage 之后)、资源是否被同时声明成读写冲突;
- 驱动翻译成的:一组硬件命令——"某个引擎到达此点"的标记、一批需要 flush / invalidate 的地址区间、以及 layout 相关的元数据改写;
- 硬件执行的:执行依赖部分让前段到达指定阶段(必要时排空),内存依赖部分让写端 available、读端 visible(§3.3);
- 放行的:后段 stage 这时才准进场。
这条链路解释了一件常被忽略的事:同一个 barrier 在不同驱动上会翻译成完全不同的命令——有的驱动能把它压成一条标记,有的驱动保守地刷一大片。所以"我的 barrier 写法和他一样,为什么我的更慢"是个真问题,答案往往在第 3、4 步里。结论与第 7 章一致:量一次,永远比抄一份配置靠谱。
出处:Vulkan Tutorial · Anatomy of an Execution Boundary/AMD GPUOpen · Vulkan Barriers Explained。
执行层面的账顺一遍:"我什么时候回来看你(when)+ 我从哪里读你最新的(where)"——把这句刻在脑子里,后面 layout transition 和硬件动作都只是它的实例。
为了再压实这个模型,我们把 D3D12 的世界也套进 when/where 看一遍。DX12 的 transition barrier(D3D12_RESOURCE_TRANSITION_BARRIER)用 stateBefore / stateAfter 声明资源的两个身份,另配一个 syncBefore / syncAfter(在 enhanced barrier 里细化为 D3D12_BARRIER_SYNC)来管执行次序——stateBefore/stateAfter 近似 where(可见性),syncBefore/syncAfter 近似 when(执行次序)。可见不管 API 的拼写是 layout 还是 resource state、旧版还是 enhanced,底下始终是同一个二元:先保证"何时能交接"(when),再保证"交接时数据是真新的"(where)。有了这个统一视角,你在两套 API 间跳来跳去时就不会被名词吓住。
四、资源生命周期:同一块内存在不同"身份"之间切换(show-flow)
前面几章讲"同步发生在命令之间",但 GPU 编程里最麻烦的一类同步其实是资源自身的生命周期:同一块显存,这一帧被当作 UAV 让 CS 写,下一帧要被当作顶点缓冲让光栅化读——中间那句"我改当什么用了"就是 layout transition / resource state transition。
4.1 Vulkan 的 ImageLayout:资源的状态机
Vulkan 给图像(image)定义了一个状态枚举,叫 ImageLayout:UNDEFINED、GENERAL、COLOR_ATTACHMENT_OPTIMAL、DEPTH_STENCIL_ATTACHMENT_OPTIMAL、SHADER_READ_ONLY_OPTIMAL、TRANSFER_SRC_OPTIMAL、TRANSFER_DST_OPTIMAL…资源在任意时刻处于其中一个 layout,而切换必须经 vkCmdPipelineBarrier 的 oldLayout/newLayout 显式声明——layout 就是资源生命周期的状态机变量。
之所以要"显式切换"而不是"驱动自动猜",是因为不同用法在硬件上对数据有不同的 cache 处置要求:渲染目标写完后,cache 里可能还留着尚未落回显存的数据;而把它当 shader 只读纹理读时,希望先 invalidate 掉陈旧缓存。layout 切换就是告诉硬件"下面我要换一套 cache 策略了"。
规范文字 vs 硬件动作:Vulkan 规范和显存说"把 layout 从 A 切到 B",但硬件上实际做的是——flush 掉渲染目标的写缓存(writeback)、invalidate 掉只读路径的旧缓存、必要时停掉依赖的 pipeline。layout 只是"遥控器的旋钮",真正的动作在第 5 章。
还要补一个容易误解的点:layout 的合法迁移图不是全连通的。 UNDEFINED 与 GENERAL 通常是"万能中转站"(前者表示内容无效,后者表示未指定用途),但两个具体用途之间往往不能直接跳——比如从 PRESENT_SRC_KHR 直接切到 DEPTH_STENCIL_ATTACHMENT_OPTIMAL 就没有意义,规范与校验层都会拦下。真正写起来才发现的约束有两条:一是有些迁移必须绕 GENERAL,二是带子资源范围时(某些 mip 或 layer 单独迁移)要保证整体状态一致。这两条都属于"校验层会报、但报的话看不懂"的类型,先把迁移图当作状态机读一遍,比事后猜要省事得多。
"只要切到目标 layout 就行、oldLayout 随便填"是另一个常见误解:写 UNDEFINED 语义上一定安全,但它等于告诉硬件"这块数据我不认了",于是本可以省下的那趟显存往返省不掉。Arm 的 layout_transitions 样例把两种写法各测了一遍——同一场景、同一张 G-buffer,只有 oldLayout 不同:
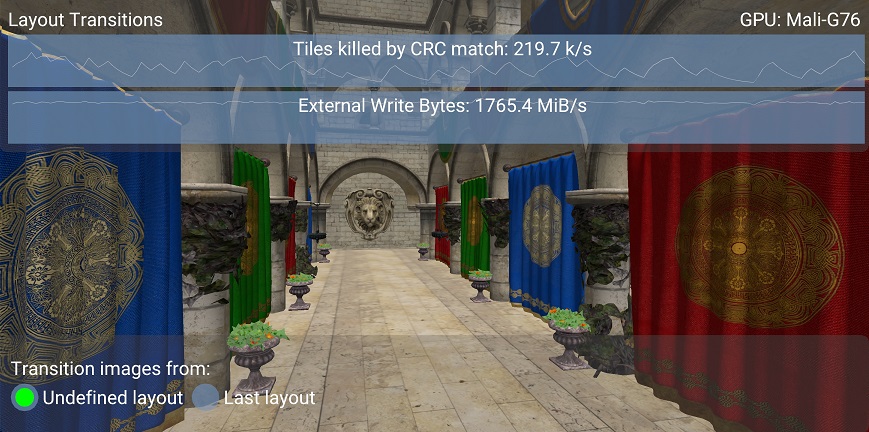
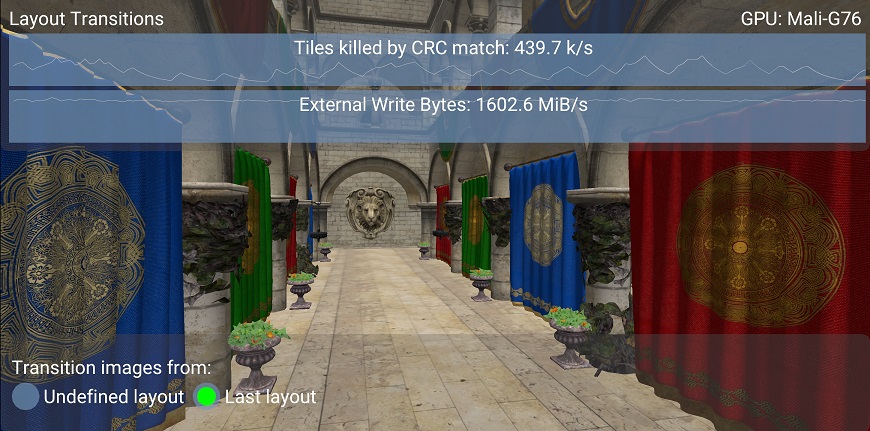
4.2 D3D12 的 Resource State:同一个思想的另一套拼写
DX12 不用 layout 枚举,改用 resource state + resource barrier:D3D12_RESOURCE_STATE_RENDER_TARGET、UNORDERED_ACCESS、VERTEX_AND_CONSTANT_BUFFER、GENERIC_READ、COPY_DEST…切换用 D3D12_RESOURCE_BARRIER_TYPE_TRANSITION,语义与 layout transition 一一对应。两者只是 API 的词汇表不同,底下是同一套硬件逻辑:声明资源身份的转换,让驱动决定要不要刷 cache、停哪段 pipeline。
DX12 还多一个版本演化:老版 barrier(Transition / Aliasing)粗粒度,新版的 Enhanced Barriers 把 single-state barrier 换成更细的 BEGIN/END 与可批量的 barrier 声明,让驱动能做全局的重排优化、减少中间的 pipeline stall——这是"同步在 API 侧变聪明"的一个实例,也预告了第 5 章要讲的"驱动能合并什么"。
两版到底差在哪,值得摊开对照一次。老版 barrier 是隐式的、单点的:你声明"这个资源从 A 变 B",驱动在命令流里就地插入一次转换,既不知道前后有没有别的 barrier,也不知道你后面真正要用它干什么阶段。新版做了三件事:
- 把同步掩码与访问掩码显式拆开:
D3D12_BARRIER_SYNC管"哪些阶段要排队",D3D12_BARRIER_ACCESS管"哪些访问要可见",正好对应 §3.1 的 when / where; - 允许把一个转换拆成
BEGIN_ONLY与END_ONLY:等于 D3D12 也给了一次 event 式的"打标 / 等标"能力,可以在两段之间塞进与这份资源无关的工作; - 给驱动全局视野:一段命令流里的所有 barrier 一起交上去,驱动能在合法前提下重排、合并,把多次小停顿攒成一次。
代价是写起来更啰嗦:要自己算 sync / access 掩码,写错就是校验层报错或行为未定义。所以实践口径是——先用老版 barrier 把功能做对,再用 Enhanced Barriers 压平停顿,而不是一上来就手搓掩码。
4.3 双缓冲与 swapchain:资源生命周期的收尾动作
最后把"同一块内存多身份"收束到一个最日常的场景:swapchain(交换链)与双缓冲/三缓冲。
显示器逐帧刷新,GPU 不能在显示器正读着某张 image 时去改它,否则会出现撕裂(tearing)。所以 swapchain 准备了两到三个 back buffer,轮流当 front:GPU 往 back 画,画完翻转(flip) 让它变 front,显示器从那读;同时下一帧轮到另一张。这张"我画完的,能不能交给显示"的同步,Vulkan 用 acquire / present semaphore(获取的是该 image 的 semaphore),DX12 用 swapchain 的 fence/event——本质都是让 CPU-GPU 的帧节奏与显示刷新节奏对齐。
双缓冲的意义有三:一是让 CPU 不必等上一帧 end——上一帧在显示、这一帧在画,CPU 和 GPU 各忙各的,吞吐上去了;二是防止撕裂;三是留出 swapchain 允许的帧间重叠。代价是帧延迟变成 2–3 帧(latency),这对交互式应用很要命,才催生后面 low-latency 系列的技巧。
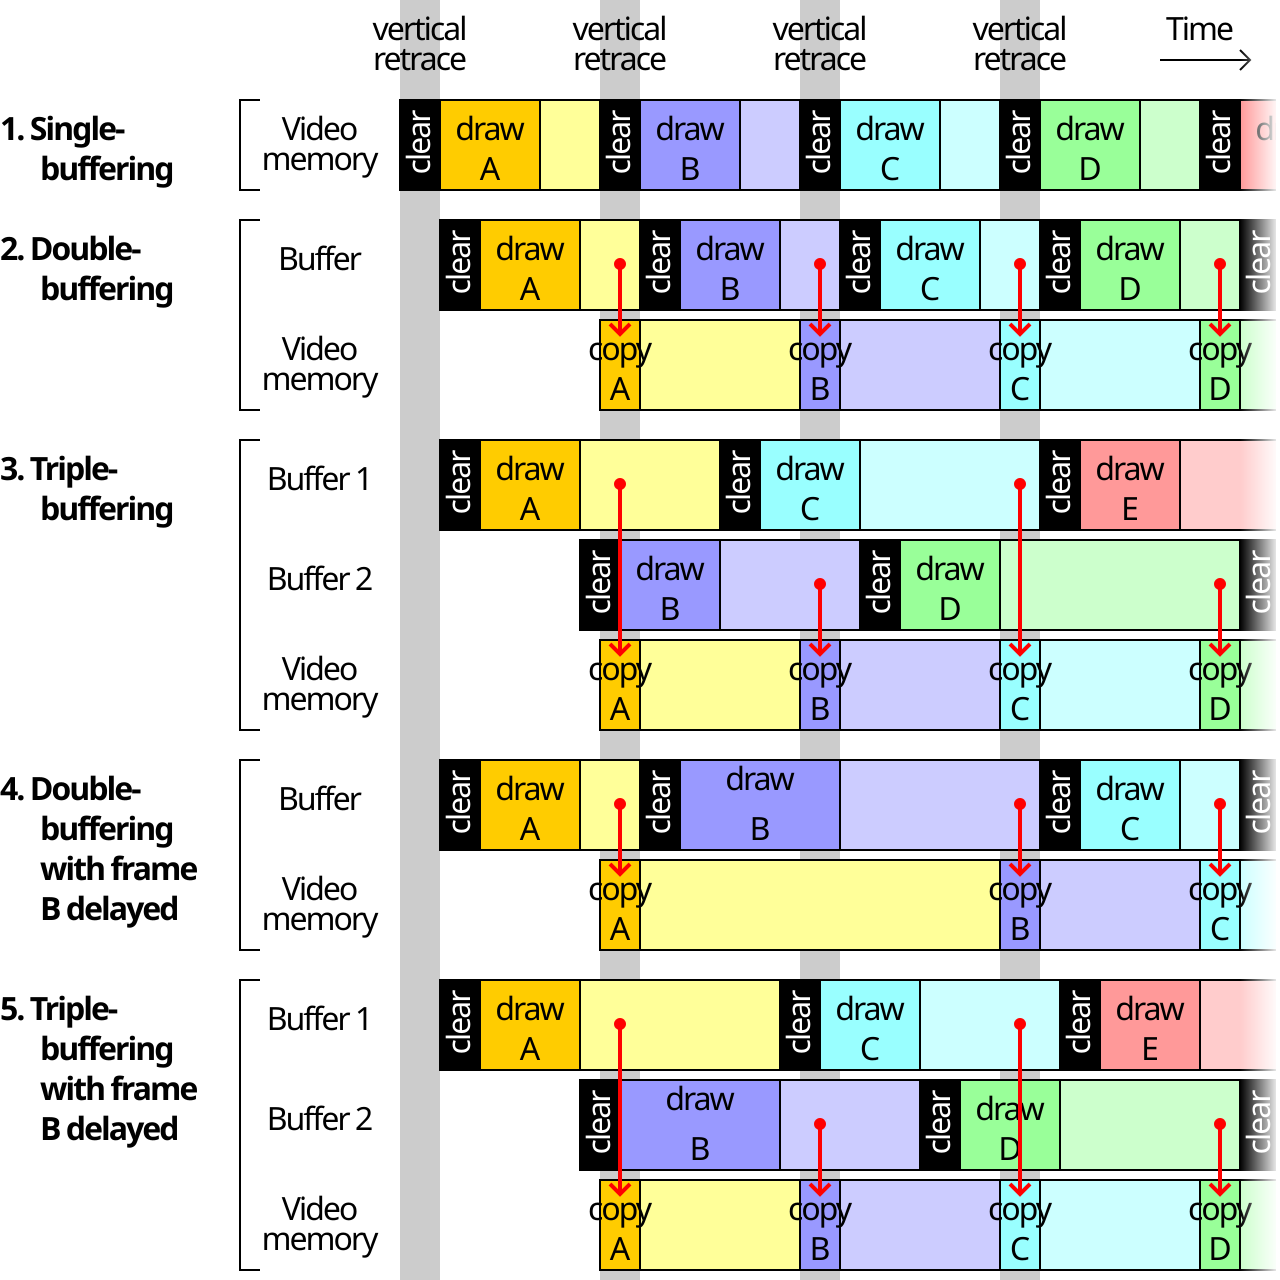
反过来看:为什么交互应用宁愿牺牲一点吞吐也要降延迟——因为"手到画面"的端到端延迟由这 2–3 帧顶着。桌面 vs 电竞 FPS 的差异常有很大一块就出在 swapchain 缓冲策略上,而不在渲染本身够不够快。
4.4 多帧在飞:swapchain 图像数不等于在飞帧数
这一节要拆开两个天天被混着说的数量。
- swapchain 图像数:屏幕那侧有几张图可以轮换,通常 2 到 3 张,由 surface 的能力上下限决定;
- frames in flight(在飞帧数):CPU 已经录好命令、GPU 还没跑完的帧有几帧,通常也是 2 到 3。
两者不必相等。3 张 swapchain 图像配 2 帧在飞,是很常见的组合。为什么至少要有 2 帧在飞?因为 CPU 录一帧命令要几毫秒,GPU 跑一帧也要几毫秒——如果只有 1 帧在飞,CPU 录完就必须等 GPU 跑完才能开始录下一帧,两边严格串行,帧率被硬生生扼住。两帧在飞,才能让"CPU 录第 N+1 帧"与"GPU 跑第 N 帧"重叠起来。
代价是记账。每一帧在飞都需要自己的一整套会变的资源:命令缓冲、常量缓冲、描述符集、查询对象,外加上一个 fence(或 timeline semaphore 的一个值)。CPU 在复用第 N 帧那一套之前,必须先确认第 N 帧的 GPU 工作已经完成——这个 fence 的唯一职责就是这个。
于是帧循环里有三本账必须对齐:
| 账 | 管什么 | 由谁管 |
|---|---|---|
| swapchain image | 哪张在显示、哪张在画、哪张空闲 | acquire / present semaphore |
| 帧内资源 | 这套 UBO / 命令缓冲能不能被 CPU 覆写 | 按帧 fence(或 timeline semaphore 的值) |
| 帧号 | 把前两本账串起来的那个数 | timeline semaphore 的计数值(§2.4) |
配置上的经验值:2 帧在飞 + 3 张 swapchain 图像是最常见的起点;把在飞帧数提到 3,能再压掉一点 GPU 的空隙,代价是输入延迟与显存占用同步上升。所以判据是——在飞帧数就是你愿意为吞吐付出的延迟预算,不是越大越好。
两个高频 bug 的根因都在这本账上:一是把"2 帧在飞"的资源按 3 帧复用,CPU 覆写了 GPU 还在读的常量缓冲,表现为随机的批次性花屏;二是每帧都 DeviceWaitIdle(把在飞帧数强行压回 1),CPU-GPU 重叠全被砍掉——见 §6.3。
出处:Khronos · Image Layout Transition/Microsoft · D3D12 Resource Barriers/Microsoft · D3D12 Enhanced Barriers。
生命周期的账顺一遍:资源不是一块"死的显存",而是一个带着"当前身份"的活对象——每次换用途,都要经 barrier 显式声明,硬件才决定要不要刷 cache、停 pipeline。 而"刷 cache、停 pipeline"具体是什么物理动作,正是下一章。
五、硬件层:barrier 触发的真实动作(explain-why)
前面三章都在"规范层"打转:fence 改个整数、barrier 改个枚举、layout 切一下状态。现在把盖子掀开:这些"遥控器"按下时,GPU 硬件上到底发生了什么? 只有看懂了这一层,才理解为什么同步这么贵。
5.1 cache flush 与 invalidate
GPU 内部有多级 cache(L1 per-SM/LSU、L2 共享、以及显存)。当一张纹理被"写"(比如当 UAV/CopyDest)后再被"读"(当采样器只读),正确的数据可能还停在某个 SM 的 L1 里,没落回 L2/显存。
- flush(刷出 / writeback):把写缓存里脏的数据写回下一级(L2 / 显存)。这是"写端"要做的,确保新值真的出去了。
- invalidate(失效):把读缓存里旧的副本作废,下次读强制重新拿。这是"读端"要做的,确保不吞旧值。
一个 layout transition 往往是先 flush 写端、再 invalidate 读端的成对动作。这就是为什么"只改个枚举"的说法是错的——枚举背后是真实的内存层次运维。
5.2 pipeline drain 与 stall
当依赖跨越管线的两个阶段(比如"compute 写完 buffer,graphics 当 vertex 读"),硬件可能要让前一段管线跑到一个完全对齐的点才能交接——这就是 pipeline drain(排空) 或 pipeline stall(停顿):前面所有 wave 都执行完、退出,执行单元空出来,新的 stage 才进场。这等于在一根高速流水线里插了一脚急刹车,吞吐立刻掉。
具体到一个例子:假设计算队列里的 CS 刚把一张图当 UAV 写完,紧接着图形队列要用它当反锯齿的 resolve target。这两个阶段分别跑在不同的执行引擎上,而反锯齿 resolve 又要求"写已经完全落定"。为了满足这一条,驱动必须在两个阶段之间插入一次排空——把计算引擎里所有在飞的 wave 全部赶到终点,确保没有任何一条还握着那张图的一部分在写补丁。这趟排队期间,计算引擎一整段空转,就是 pipeline drain 的真实成本。
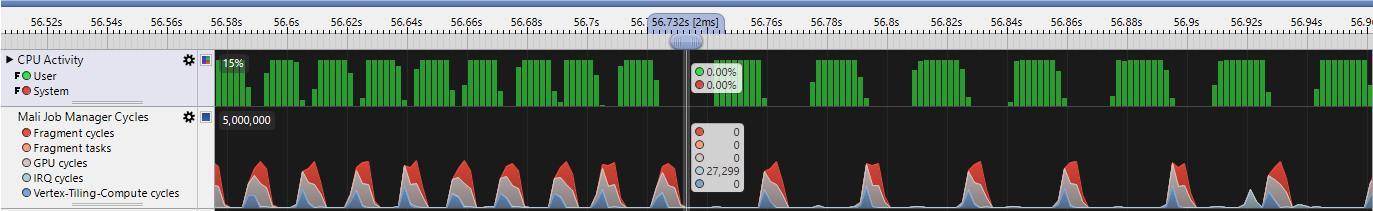
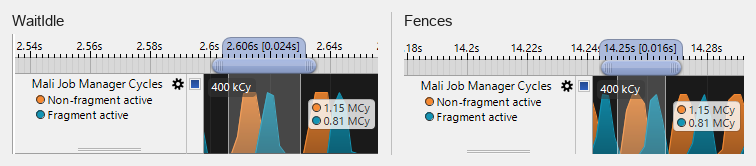
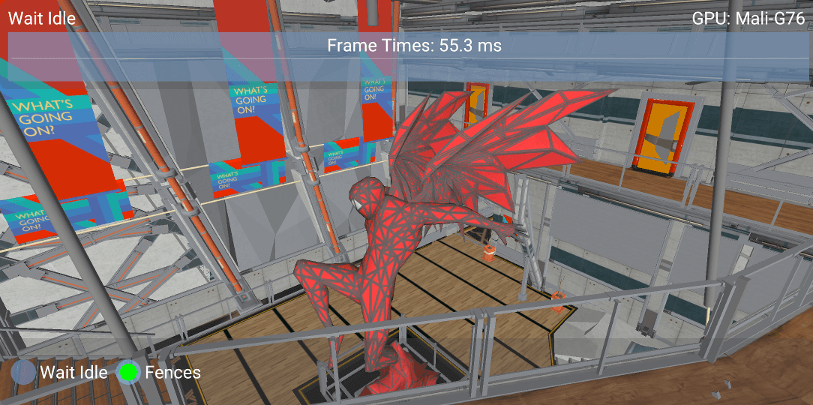
"排空"不是纸上推演,它在真机波形上是能直接看见的。同一场景、同一段命令,只把同步改成最粗暴的那种——每帧开头 vkDeviceWaitIdle——Job Manager 的波形立刻出现大段空闲:驱动必须把所有在飞的活全排空才放行,执行槽空着等下一帧的命令。改用 Fence 只等"那一个点",同一波形就被工作填满:
D3D12 的 barrier 里 D3D12_RESOURCE_BARRIER_TYPE_* 会对驱动声明:这个资源要被几种用途在几个 queue 间共享,驱动据此决定 drain 的范围。而 "Enhanced Barriers" 的关键卖点之一,就是让驱动能看到一段命令流里所有 barrier 的总集合,从而把多次小 drain 合并成一次干事情,尽可能少踩刹车。
5.3 fence register 与跨队列一致性
fence 在硬件上落点的是一个寄存器(fence register / completion register):GPU 的参数单元执行完命令,把一个递增计数器写成寄存器值。CPU 侧 waitFence 本质就是在这块内存上自旋/挂中断,直到计数器到目标值。这部分延迟极低(微秒级),但它只负责推进信号,不负责刷任何 cache——这也再次印证第 1.3 节的结论:fence 不等于内存同步,fence + barrier 合起来才是完整正确性。
跨队列时(比如计算队列写、图形队列读),还涉及一个所有权与一致性交接:要么做一次真正的 cache 同步(flush+invalidate),要么通过硬件语义保证跨 queue 的 cache 共享。这引出第 6 章的 queue family ownership transfer。
5.4 驱动能合并什么:barrier 不是每条都要独自花钱
前面说的成本是"一次 barrier 触发的动作",但驱动很聪明:同一段命令流里相邻、且无冲突依赖的多个 barrier,可以合并成一次执行。Vulkan 的 vkCmdPipelineBarrier 本来就接受一组 barrier;D3D12 Enhanced Barriers 更进一步让驱动拿到全局视野做合并。所以"barrier 很多 = 每次都很贵"不完全对——贵的是那些无法合并、真正打断流水线的孤立 barrier,以及 ALL_COMMANDS 这种把范围拉满的写法。
教训只有一句话:别把 barrier 当免费,也别慌着数次数,重点看有没有把范围写宽、把该合并的写成孤立的。
验证方法就藏在第 3 章与第 8 章那两张真机波形里:把 barrier 收窄前后各抓一帧,看两段图形流水线有没有开始重叠——重叠起来了,说明合并与收窄都生效;仍旧完全串行,说明范围还是写宽了,或者驱动的合并被你的依赖形状挡住了。
5.5 flush 与 invalidate 的粒度:范围越小越便宜
§5.1 说 flush 与 invalidate 是写端与读端各自要做的动作,这里补上代价的那一半——这两个动作不是按"整片 cache"执行的,而是按地址区间与资源范围执行的。
GPU 的内存层次至少三层:L1(贴着 SM/LSU 的私有缓存)、L2(全芯片共享)、显存。写端的 flush 要沿着这条链把脏数据往下推,读端的 invalidate 要把链上所有层级的旧副本作废。现代硬件允许把这两件事约束在一个范围内:buffer 的 offset/size、image 的 mip / array layer / 区域。这正是 §3.2 里"定向 barrier 更便宜"的物理原因——你告诉驱动范围越窄,它要推、要作废的 cache 行就越少。
粒度也有它自己的约束。不少架构的刷新以 cache line 或 tile 为最小单位,所以你写一个 4 字节的范围,实际代价可能是一整行;同理,一份资源被切成很多碎片频繁同步,每次都带上固定开销,反而不如攒在一起。两条经验由此而来:范围尽量对齐、别把一份大资源拆成十次小同步。
把三节连起来看,同步的代价其实是三个旋钮共同决定的:范围(全局还是定向)、次数(孤立还是可合并)、时机(早打标还是砌墙)。第 7 章给出的观察方法,就是让你在自己的机器上分别拧这三个旋钮,看波形怎么变。
5.6 两条一致性路线:硬件 snoop 与软件管理
还有一个更底层的问题没交代:既然"写端要刷、读端要失效",那为什么有些平台上你什么都不做也能读到新值?答案在于一致性是由谁负责的——业界有两条路线。
- 硬件一致性(snoop / probe):缓存控制器之间互相监听,谁改了哪一行,其他缓存立刻知道。这类机器上,可见性由硬件兜住,软件"不写 barrier 也能跑";
- 软件管理:硬件不做全程监听,可见性由显式的 flush / invalidate 完成——谁写谁负责把数据"推出去",谁读谁负责把旧副本"作废"。
真实产品大多数是混合的,而且分界线画在不同地方:桌面独显常常在"CPU 映射的那部分内存"上走一致性协议(所以你 memcpy 进去马上就能看到),但 GPU 内部各级缓存之间依旧靠显式 barrier;移动与嵌入式则更偏软件管理——让 GPU 的私有缓存全程 snoop 系统内存,功耗与设计复杂度都不划算,于是"该刷就刷"的责任落回驱动与 API 的 barrier 上。
这条分界的实际意义是一条警告:在同一台机器上"能跑",不能证明你的同步写对了。 一致性协议可能替你兜住了一部分错误,换架构、换驱动、甚至同架构换驱动版本,兜不住了就崩。这正是校验层与跨平台测试存在的意义,也是把 §1.4 那句话再收紧一次——统一内存只是"内存只有一份",不等于"缓存自动一致"。
出处:AMD GPUOpen · RDNA Performance Guide/AMD RGP Manual · Overview(barrier duration / drain time 的可视化观察)。
硬件账顺一遍:同步的"遥控器"按下,硬件在背后做 flush / invalidate / drain / fence 写标记——这些动作本身就吃带宽、吃吞吐,"多个孤立的 barrier"和"一个范围拉满的 barrier"都是昂贵的写法。 所以才有下一章讲的、有时能避开的跨队列同步。
六、队列所有权转移与跨 queue 同步(show-flow)
现代 GPU 设备通常不止一条命令队列——有图形队列、计算队列、拷贝队列,有时它们能并行执行(这就是异步计算 async compute 省时间的基础)。可是资源要在不同队列间流转时,"谁拥有这块资源"就变成了一个问题。
6.1 为什么需要队列所有权转移
Vulkan 规定一个资源在同一时刻只能被一个队列族(queue family)拥有(所有权)。当图形队列写完一张图、想让计算队列读它做后处理时,必须先做一次 queue family ownership transfer:在图形队列上用一个 barrier(srcQueueFamilyIndex != dstQueueFamilyIndex)把资源"让渡"出去,再在计算队列上接一个 barrier"接收"。这中间涉及一次跨队列的 cache 同步,确保图形队列看到的写,计算队列也能看到。
DX12 没有 queue family 概念,但等价物是跨队列共享时的 D3D12_RESOURCE_BARRIER_TYPE_* + 必要的 fence/semaphore——用资源在当前 queue 的状态声明 + 完成信号,处理同一块资源被多个执行上下文使用的正确性。
"要不要做所有权转移"其实是建资源时就能选掉的。 Vulkan 在创建 buffer / image 时要求声明 sharing mode:选 exclusive(独占),资源在同一时刻只归一个队列族所有,跨队列使用就必须做 transfer;选 concurrent(并发共享),则允许被多个队列族同时访问,省掉 transfer 的那对 barrier,代价是驱动要在内部替你做更多的一致性维护,某些实现上还会影响资源的排布与带宽效率。
所以 §6.2 那句"有时能不加同步就并行"在 API 层面对应两个开关:资源建的时候就声明成共享,或者让两条队列碰的是完全不同的资源。前者是"我愿意长期付一点内部开销,换取不用写 transfer",后者是"根本不共享,所以什么都没欠"。判断哪种更划算,回到 §6.2 的规则上——它们共享同一块资源吗?
顺带交代第三条队列:拷贝队列(transfer queue)在同步账本上是最省事的一类。 它的工作只有搬运,不参与着色,因此通常不涉及"写端 flush 一批渲染结果"这类动作——它要的只是"源数据写完了(一次交接)、搬完了源可复用(再一次交接)"。这也是为什么把 CPU→显存的上传、显存→CPU 的回读放进拷贝队列往往比塞进图形队列更划算:既避开了图形侧的依赖链,也少一层 cache 运维。代价是多一次队列间的交接记账,所以要不要分队列,仍然回到那条判据上——省下的停顿,值不值这次交接。
6.2 为什么有时能"不加同步就并行"
"跨 queue 同步要花钱"的另一面是:如果两块资源完全不同,两条队列同时跑不同工作,是不需要任何同步的——各画各的,cache 也不冲突。异步计算的价值就在这里:把"后处理"这种与主渲染无关的工作丢给计算队列,主渲染不停顿,靠 semaphore 只在真正该交接的点对齐一次。这就是 NVIDIA 强调的 async compute overlap。
判断规则:只有共享同一块资源、且读写时序相关时,才需要跨队列同步;纯独立的并行工作,白赚并发,不加任何 barrier。 这条能省掉大量无效同步。
举个让"独立就并发"落地的场景:一帧里既有主渲染(画 shadow map、画 G-buffer、画主视图、提交到交换链),又有一些跟主视图无依赖的活——比如游戏刚加载完一批地形 LOD,要做一次异步的 re-vertex、或给上一帧的 CPU 侧做了些遮挡剔除。这些活和当前主视图完全不碰同一张资源,就能丢到计算队列/拷贝队列上并行跑,主渲染不停顿,等真正需要结果时才用 semaphore 接一次头。这就是 async compute 的主流用法。
但要注意反面:如果你把"依赖主渲染结果"的活也丢进计算队列,那就两头不讨好——时序上没有真正并行(还是要等主渲染),却又多了一次跨队列的 cache 交接开销。所以 async compute 的正确开法不是"把能挪的都挪出去",而是"只把真正无依赖的那部分挪出去",中间用一次 semaphore 精确对齐。
落到真实项目里,值得挪出去的活基本是三种形态:
- 趁固定功能的空档:某一趟极吃固定功能单元(大面积阴影贴图、超采样 resolve),着色核大半闲着——计算队列正好趁这个空档跑后处理。这类收益最稳,也最容易量到;
- 把独立子系统整体外包:GPU 剔除、地形 LOD 重整、粒子模拟这些与主视图互不依赖的活,整段丢给计算或拷贝队列,主渲染完全不感知;
- 前置计算:在渲染之前先把数据算好(比如每帧初的骨架变换、聚类),收益来自"把原本 CPU 侧的准备工作搬到 GPU",而不是来自并行。
三种形态共用一个前提:两边不碰同一份资源。一旦碰了,就得退回 semaphore + 所有权转移(或者建资源时就声明共享模式),前面省下的时间立刻被同步开销吃回去——这也是为什么"能不能挪"要先问"碰不碰同一份资源",而不是先问"这段代码耗不耗时"。
6.3 常见误用:无脑 await 提交
一个很常见的低效写法是:每提交一次命令,就 vkDeviceWaitIdle() / ID3D12CommandQueue::Signal+Wait 一把。这等于把 GPU 完全清空一次——排队中的命令全跑完,独占等待。单帧 demo 没事,生产管线里会把 GPU 的吞吐压成零:CPU 每帧都在等 GPU idle,两代流水完全串行,帧间重叠一点不剩。正确做法是用 fence 只等真正需要的那一帧的那一个点,绝不用 DeviceWaitIdle 当通用同步。
改起来其实只有三步:第一,每个在飞帧槽位配一个 fence(或 timeline semaphore 的一个值);第二,CPU 准备复用第 N 个槽位的资源之前,只 wait 那个槽位的 fence,而不是等整条队列;第三,把 wait 放在真正需要结果的位置(读回数据、覆写上传缓冲),其余地方让帧自己流动。三步做完,在飞帧数就从 1 恢复到 2 到 3,帧间重叠自然回来了。
DeviceWaitIdle 唯一该出现的场景是生命周期节点:销毁设备前、退出时、以及调试时想把状态钉死的那一次——它不是一个"同步原语",是一把"清场"的开关。
一句话:async compute 是"让 GPU 自己排队的同步",DeviceWaitIdle 是"把 GPU 彻底清空"的回避——前者降延迟,后者毁吞吐,别混用。
6.4 一个可核对的 async compute 实测
上面全是判据,这一节给一个能自己去核对的实测,把"async compute 到底值多少"落到实处。
Khronos 的 Vulkan-Samples 里有一个 async_compute 样例,做法很典型:画一张 8K 方向光阴影贴图、一张 4K HDR 图,把 HDR 与 Bloom 后处理整段丢到异步计算队列,最后在交换链那一趟做色调映射与 UI。样例作者在移动 GPU 上量到的结果是 21.8 ms 对 22.9 ms——大约 5% 的收益,并明确写过"不要期待它会大幅扩展"。
这个数字比很多宣传口吻诚实得多,也点出了 async compute 的本质:它改善的是占用率,不是算术吞吐。 阴影贴图那一趟极吃固定功能光栅化,计算队列趁这个空档干活,把原本浪费掉的执行槽填上;一旦两边开始争同一批着色核资源,收益就不再线性增长。
样例里还有一处更值得记:作者指出某一版配置下"片元周期远低于 GPU 周期"——这是片元队列在挨饿的直接证据,根因就是 barrier 写得过头,把计算与图形在该交接的地方硬生生隔开。换句话说,async compute 的收益常常不是靠"多开一条队列"赚来的,而是靠"少写几堵不必要的墙"捡回来的,这与第 3、5 章的结论完全一致。
要自己复现,三个条件缺一不可:被挪出去的活真的无依赖、交接点用 semaphore / timeline 值精确对齐(而不是 DeviceWaitIdle)、以及给队列配上合理的优先级(一帧里靠后的工作比靠前的工作更值钱,所以图形队列通常拿高优先级)。
出处:Khronos · Queue Family Ownership Transfer/NVIDIA · Async Compute and Overlap/Khronos Vulkan-Samples · async_compute(21.8 ms vs 22.9 ms 实测与屏障分析)。
队列这章的账顺一遍:跨队列同步才有 cache 交接,纯独立工作白赚并发不加 barrier;最忌讳用 DeviceWaitIdle 当通用同步把 GPU 吞吐清零。
七、量化账:同步到底花多少钱(prove-claim)
前面反复说"同步很贵""别乱用",那它到底多贵?诚恳的回答是:公开资料没有统一数字。 它依赖一长串现实:什么架构、什么 memory 类型、走不走 PCIe、驱动怎么合并、跑的是哪个 stage。所以这一章我们不给一个假装的精确值,而是给可核对的观察方法 + 量级区间 + 承认推测的诚实态度。
7.1 量级直觉(需实测)
基于学界社区与厂商工具的经验,给一个带强不确定性的感性量级(务必当"推测"看,别当常数用):
- 纯 fence 寄存器写读:微秒级(µs)。一次性状态推进,极便宜,是"对齐点"的最小代价。
- 一次完整 pipeline drain / ALL_COMMANDS 全局同步:比 fence 贵一到两个数量级,因为它触发整条管线的排空与多级 cache 运维——这是"每次提交都 DeviceWaitIdle"会毁吞吐的根本原因。
- 跨 PCIe 的同步 / 跨队列一致性交接:涉及总线往返,往往最贵,且随传输量非线性上涨——能避免就避免。
这里要给第二条一个直觉锚点:为什么"排空一次"能贵到两个数量级?在于它把你正在流水化的一切逼停——不只是你要等的那一段,而是所有可能依赖它的执行前端。GPU 高吞吐的本质就是"很多 wave 交错着填满执行槽",一旦要排空,这些交错全部倒退成串行,损失的是整条流水线的占用率,而不是一条指令的延迟。所以真正贵的不是"检查一个寄存器",而是"让一大片并行工作先退化成串行,再重新铺回并行"。
量级表里最容易被质疑的是第二条——"排空一次能贵到一两个数量级"。这一条有现成的实测可核对:同一场景、同一硬件,只把每帧开头的 vkDeviceWaitIdle 换成 vkWaitForFences,平均帧时间就从 72ms 掉到 56ms(降幅 22%):
再次强调诚实边界:上图数字是"工程经验量级",不是可引用的规范常数。任何要对外宣称的精确 ns 数,必须用你自己的硬件 + RGP/DCGM 实测后落地。本系列在量化上守这条规矩:不给假装的精确,只给可核对的量级与方法。
7.2 用 RGP 观察 barrier 的真实代价
要量化,最实用的工具是 AMD Radeon GPU Profiler(RGP) 与 NVIDIA Nsight Graphics。它们把一次提交摊在时间轴上,每次 barrier 的 duration / drain time / stalls 都能直接看出来——你不必相信任何"经验常数",只要在自己的硬件上抓一帧,就知道这一次同步到底花掉多少。具体的读法就三问:
- 看 barrier 拉出多长一条停顿带;
- 看它有没有把前后两段工作完全隔开(说明没能合并);
- 对比"合并后的 barrier"和"孤立 barrier"的 gap 长度。
这三问合起来就是一条判据:停顿带越长,说明这次同步把越多本可以重叠的工作逼成了串行。 把同一帧里几条 barrier 的停顿带长度排个序,优化目标自己就浮出来了——先啃最长的那几条,而不是均匀地"少写几个 barrier"。
不过时间轴只回答"贵在哪一段",不回答"这条依赖是不是真的必要"。后半个问题归抓帧工具(RenderDoc 这一类)管:它把一次提交摊成一棵树——每一条绘制、每一次分派、每一处资源状态转换都记在案,你可以顺着"这块纹理被谁写过、这条 barrier 前后是谁"逐条核对依赖链。它的强项不是时序,而是结构:你怀疑某条 barrier 是抄来的、根本没必要时,抓一帧就能看见它挡住的到底是谁。
三类工具的分工可以这样记:
| 工具 | 看什么 | 什么时候用 |
|---|---|---|
| RGP / Nsight Graphics | 时间轴:barrier duration、drain time、stall | 已经知道哪一帧慢,要定位到哪一条同步 |
| 抓帧器(RenderDoc 等) | 结构:命令树、资源状态转换、依赖链 | 怀疑某条依赖是多余的,要核对它挡了谁 |
| 平台计数器(HWCPipe / Streamline / Perfetto) | 汇总指标:GPU cycles、带宽、tile 数 | 先找出"哪一帧/哪一段变差了" |
用法上有个顺序别弄反:先用计数器定位到帧或段,再用时间轴定位到具体的 barrier,最后用抓帧器确认这条依赖是否必要。 反过来做,很容易拿着一堆数字却不知道该改哪一行。
7.3 真机计数器:把同步代价读成数字
时间轴看形状,计数器看数字。真机上都有一组计数器能把同步的后果直接读出来,最常用的三个:
- 外部读写带宽:同步范围写宽,最直接的后果就是"多跑了几趟显存"——§4.1 那两张 layout 计数器的差别,本质就是这个指标;
- 片元周期对 GPU 周期的比值:两者差得越远,说明某个队列在挨饿(§6.4 的判据就是这个),而挨饿的常见根因是 barrier 把该重叠的两段隔开了;
- GPU 空闲周期:
DeviceWaitIdle与强制排空会在这里留下痕迹——§5.2 那张 WaitIdle 波形里的"大段空闲",在计数器上就是这些周期。
这三个指标的好处是它们不撒谎:带宽、周期、空闲,都是硬件自己数的。所以调优的可靠顺序是:先在计数器上确认"确实存在浪费",再去时间轴上找"是哪条同步造成的",最后回代码里改。
一个提醒:计数器是汇总值,它告诉你哪里不对,不告诉你为什么不对。看到带宽偏高,可能是一次范围拉满的 barrier,也可能是 layout 选择不当,甚至只是纹理格式选错了——所以它适合用来开始排查,不适合用来下结论。
7.4 自测清单:六个十分钟量得完的实验
把前面七章所有判据压成一张可执行清单。六个实验都能在本地小 demo 上做完,关键不是复现某个具体数值(数值因硬件而异,这里给的是方向,不是常数),而是确认"改动方向 → 指标变化方向"这一对关系在你的机器上成立:
| # | 实验 | 怎么改 | 盯哪个指标 | 预期方向 |
|---|---|---|---|---|
| 1 | barrier 范围 | ALL_COMMANDS → 收窄到两个 stage |
停顿带长度、两段流水线是否重叠 | 变短、开始重叠 |
| 2 | barrier 合并 | 三条孤立 barrier → 一次 vkCmdPipelineBarrier |
停顿带条数与总长 | 条数变少、总长变短 |
| 3 | 同步对象选择 | 跨队列的 fence → semaphore | CPU 唤醒次数、帧时间 | 唤醒变少 |
| 4 | 等待方式 | 每帧 DeviceWaitIdle → per-frame fence |
帧时间、GPU 空闲周期 | 帧时间下降、空闲减少 |
| 5 | layout 选择 | UNDEFINED → 上次已知 layout |
外部写带宽 | 带宽下降 |
| 6 | 在飞帧数 | 2 → 3 | GPU 空隙、输入延迟 | 空隙减少、延迟上升 |
第 6 个实验是这张表里唯一"两头都动"的:在飞帧数提高会换来更少的 GPU 空隙,代价是端到端延迟变大(§4.4)。所以它没有标准答案——先决定你要的是吞吐还是延迟,再调这个数。其余五个的预期方向都很干脆,做完对照一遍,你对"同步花多少钱"就从"听说很贵"变成了"我在自己的机器上量过"。
出处:AMD RGP Manual · Overview/NVIDIA · Advanced API Performance/Khronos Vulkan-Samples · performance 组样例(计数器与波形实测)。
八、同步之恶:误用代码段 + 修复(compare-options)
理论讲透了,最后用几段"错误代码 + 修复"把最容易踩的坑钉死。这些不是完整 demo,是指出 '为什么错、怎么改、诚实标注'的最小片段。
8.1 误区一:fence 当通用同步、每次都 idle
【错误】
【fence_wait_idle】每次提交后无脑清空 GPU —— 单帧能跑,生产吞吐归零
for frame in frames:
    submit_queue(command_buffer)      # 提交当前帧
    queue_wait_idle()                 # 把 GPU 彻底清空,独占等待
为什么错:queue_wait_idle 等于是"把命令流完全清空再继续",CPU 每帧都被迫等 GPU 全跑完,帧间重叠一点不剩,吞吐塌成串行。修复:改用 fence 只等当前帧需要的那点,保留帧间流水。
【修复】
【fence_frame_pipeline】用 per-frame fence 只等真正依赖的那一帧
frame_fences = [create_fence(initial=signaled)...]
for i in cycle(range(3)):
    wait_fence(frame_fences[i])       # 只等这张 back 帧的上一轮画完(撞上双缓冲重叠)
    reset_fence(frame_fences[i])
    record_and_submit(command_buffer, signal=frame_fences[i])
修复说明:靠交换链双缓冲的天然 2–3 帧重叠,fence 只卡住"同一张 back buffer 被复用时"的那一点,CPU 与 GPU 各忙各的。
8.2 误区二:同一 queue 以为不用 barrier、直接读刚写的纹理
【错误】
【no_barrier_same_queue】同一 queue 里写完纹理立刻采样 —— 顺序对,但读的是 cache 旧值
render_pass_color_attach(tex)   # 作为颜色缓冲写 tex
sample_tex(tex)                 # 作为采样器立即读 tex —— 缺可见性,写的新值未落回前可能读到旧值
为什么错:提交顺序保证"写命令先执行",但不保证"写的结果对采样器的 cache 可见"。tex 作为渲染目标写完后,数据可能还在渲染单元的 L2 里没充分回写;采样路径没被 invalidate,读到旧值。修复:在写与读之间插一个 COLOR_ATTACHMENT → SHADER_READ_ONLY 的 layout transition barrier,让硬件做 flush+invalidate。
【修复】
【layout_transition】写→读之间显式切 layout,硬件 flush+invalidate
cmdPipelineBarrier(
    srcStage=COLOR_ATTACHMENT_OUTPUT, dstStage=FRAGMENT_SHADER,
    srcAccess=COLOR_ATTACHMENT_WRITE, dstAccess=SHADER_READ,
    oldLayout=COLOR_ATTACHMENT_OPTIMAL, newLayout=SHADER_READ_ONLY_OPTIMAL,
    image=tex)
修复说明:这一极极小的一对 barrier,就是"同一 queue 也要同步"的正解——解决的是 where(可见性),不是 when(顺序)。
8.3 误区三:fence 当 semaphore 用、CPU 被频繁唤醒
【错误】
【fence_as_semaphore】两条 GPU queue 之间用 fence —— CPU 被无谓拉进循环,白付 CPU-GPU 往返
wait_fence(gfx_done)      # CPU 自旋等图形队列写完后处理
submit_compute(read=gfx_result)   # 再提交计算队列 —— 中间 CPU 白白醒来一次
为什么错:跨 GPU queue 的交接本来可以让 GPU 内部自己排队(semaphore),用 fence 硬是把 CPU 拉进每次交接,一次 CPU-GPU 往返白费。修复:用 semaphore 让 GPU 内部等。
【修复】
【semaphore_queue】跨队列依赖用 semaphore,GPU 内部自行排队,不惊动 CPU
submit_queue(gfx_queue, signal=sem, work=gfx_result)      # 图形队列写完,发信号
submit_queue(compute_queue, wait=sem, work=read(gfx_result))  # 计算队列内部等信号后接活
修复说明:semaphore 让 GPU 在设备内部完成跨队列交接,省掉一次 CPU-GPU 往返,也是 async compute 能省时间的底层原因。
8.4 误区四:把 barrier 范围拉满、破坏并行
【错误】
【all_commands_everywhere】每个 barrier 都 ALL_COMMANDS —— 等于频繁触发全局 pipeline drain
cmdPipelineBarrier(srcStage=ALL_COMMANDS, dstStage=ALL_COMMANDS, srcAccess=ALL, dstAccess=ALL)
为什么错:ALL_COMMANDS 逼驱动做全局 drain + 全 cache 运维,把毫无冲突的 stage 也一起排空,吞吐被反复拉停。修复:只声明真正有依赖的那两个 stage 与那一份访问。
【修复】
【narrow_stage_mask】只声明有依赖的 stage,让驱动最小化 drain 范围
cmdPipelineBarrier(
    srcStage=COMPUTE_SHADER, dstStage=VERTEX_SHADER,
    srcAccess=UNORDERED_ACCESS_WRITE, dstAccess=VERTEX_BUFFER_READ,
    oldLayout=GENERAL, newLayout=GENERAL, image=buffer_as_uav)
修复说明:链路里最常用的一条优化——把要同步的范围压到最小的两个 stage + 最少的一份访问,硬件 drain 的范围随之变小。
这条修复在真机波形上是可验证的:把 barrier 从最保守档收窄到 COLOR_ATTACHMENT_OUTPUT → FRAGMENT_SHADER 之后,片元工作全程不停、顶点工作与它并行推进,pipeline bubble 消失,帧时间改善 13%——
出处:Vulkan · Synchronization Examples/Vulkan Tutorial · Barrier Batching。
8.5 误区五:layout 一律从 UNDEFINED 开始
【错误】
【undefined_everywhere】每次 barrier 都写 oldLayout = UNDEFINED —— 语义上一定安全,代价是白扔一趟回写
cmdPipelineBarrier(image=gbuffer, oldLayout=UNDEFINED,
                   newLayout=COLOR_ATTACHMENT_OPTIMAL, ...)
为什么错:UNDEFINED 的字面意思是"这块数据我不认了"。于是上一帧好不容易留在 cache 里的内容被判作废,必须重新回写一遍;写带宽上去了,而"内容没变、本可以整块省掉"的优化也一并失效。第 4.1 节那两张真机计数器把它量化得很直白:同样一帧,只有 oldLayout 不同,写带宽差约 10%、判为重复的 tile 数差一倍。修复:把 oldLayout 写成上次已知的 layout——只有资源第一次使用、或数据确实已无效时,才该写 UNDEFINED。
【修复】
【tracked_layout】自己维护资源当前 layout,barrier 里如实声明
cmdPipelineBarrier(image=gbuffer, oldLayout=tracked[gbuffer],
                   newLayout=COLOR_ATTACHMENT_OPTIMAL, ...)
tracked[gbuffer] = COLOR_ATTACHMENT_OPTIMAL        # 用后更新状态
修复说明:这是"状态机得自己记"的典型——API 允许你偷懒写 UNDEFINED,硬件就照字面意思执行。D3D12 侧对应的坑是"拿 D3D12_RESOURCE_STATE_COMMON 当万能起点"。
8.6 一张表收束:同步对象该怎么选
把第 2 章的五个对象压成一张对照表,选对象就是在选"谁等谁、等多久":
| 对象 | 等待方 | 代价量级 | 该用在哪 | 别用在哪 |
|---|---|---|---|---|
| event | 命令流内部(打标 / 等标) | 低(不排空) | 局部结果先交付、其余工作继续 | 需要跨队列或 CPU 参与时 |
| 定向 barrier(buffer / image) | 命令流内部 | 低到中 | 同一资源换用途、layout transition | 要覆盖多份说不清的资源时 |
全局 barrier(memory / ALL_COMMANDS) |
命令流内部 | 高(可能触发排空) | 兜底、调试、确实需要全局时 | 日常默认值 |
| subpass dependency | render pass 内部 | 低(声明式) | attachment 在子 pass 间交接 | 跨 render pass 或跨队列 |
| semaphore / timeline | GPU(队列间/按值) | 中(设备内部往返) | 两条队列协作、按帧号记账 | 只为了给 CPU 一个完成信号 |
| fence | CPU | 极低(寄存器推进) | CPU 要读 GPU 结果 | 每帧无脑 wait(=清空 GPU) |
一条经验排序:event 与定向 barrier 最轻,全局 barrier 次之,强制排空更贵,跨队列 / 跨 PCIe 交接最贵;而 fence 这个对象本身极便宜——贵的是"用它把 GPU 等空"这件事。 所以整篇的结论可以收成一句话:不是"少用同步",而是"用最小的范围、最合身的对象"。
8.7 排查路线:四类症状各自先看哪儿
误区讲完,给一张"症状 → 先查什么"的对照表。同步类问题的难处在于现象千奇百怪、根因只有那么几个,按症状分流能省掉大量乱试:
| 症状 | 最可能的根因 | 先查什么 |
|---|---|---|
| 花屏、随机条纹、局部脏块 | 读到了旧数据;或 CPU 覆写了 GPU 还在读的资源 | 先看 layout / state 是否如实声明(§8.5),再看在飞帧资源有没有复用错位(§4.4) |
| 偶发闪烁、有时整帧黑 | "提交了但没等到" | 看 fence 的重置时机与被复用次数,确认 wait 真的发生在读之前 |
| 帧率不稳、周期性卡顿 | 同步写得太宽 | 计数器找周期(§7.3)→ 时间轴找停顿带(§7.2)→ 抓帧器确认依赖是否必要 |
| 彻底不动(挂死,不是变慢) | 在等一个永远不会到的信号 | 查 semaphore / timeline 的值有没有写反或回退、event 是否 set 过、reset 顺序(§2.2 / §2.4) |
分成"脏"与"慢"两个大类来看会更清楚:脏(花屏、闪烁)几乎总是"可见性没建立或建立错了",属于正确性;慢(卡顿、挂死)几乎总是"范围写宽了或信号等错了",属于代价与语义。 前者用校验层 + 抓帧器最有效——校验层能直接指出"这里缺一次 barrier / layout 声明错了";后者用计数器 + 时间轴最有效——它们能把"贵在哪一条"变成可见的停顿带。
最后一条经验:排查顺序永远从"能不能复现"开始。 同步问题的坏消息是它常常偶发,好消息是它非常依赖时序——固定帧率、关掉后台负载、尽量把在飞帧数与工作负载钉住,一旦能稳定复现,上面这张表基本就能定位到章节。
五个误区的共同教训只有两个词:范围(scope)与对象(fence vs semaphore vs barrier)——把一个边界问题用一个对象、一个最小范围的同步解决,而不是图省事上全局清空。
九、这一章留下的问题:从 queue 走到整个设备(bridge-to-next)
把这一期的坐标收束一下。我们把同步从 CS 工作项内(ep10,__syncthreads)一路提到了命令/队列/CPU-GPU:fence 解决"推进到哪",barrier 解决"谁的数据对谁可见",layout 管理资源身份,semaphore 让 GPU 自行跨队排列队。到这一步,本系列的"硬件机制账"基本收清了。
但它不是终点,而是一个坐标系的地基。ep12《2011 之后》要讲的 mesh shader、work graphs、异步计算的下沉,全部建立在这套"同步与资源生命周期"上——因为它们的卖点恰恰是"让 GPU 在运行时自己决定更多调度",而"自己决定"的前提,就是这套 fence/semaphore/barrier 能精确表达跨命令、跨队列的依赖边界。
交棒的最后一笔账:"同步"听起来是正确性的事,但在硬件层它同时是一笔性能账——正确性靠它撑住(flush/invalidate/pipeline drain),性能也往往被它拖住(孤立 barrier、ALL_COMMANDS、DeviceWaitIdle)。读 ep12 之前,先记得这套"范围与对象"的判据:一个边界问题,用一个对象、一个最小范围的同步解决。
合上这一篇之前,留三件可以立刻动手的事,它们都不依赖新硬件、也不需要重写引擎:
- 把资源状态记起来:自己维护图像 / 缓冲的当前 layout 或 state,别再让
UNDEFINED/COMMON当万能起点——这是投入最小、回报最直接的一项(§8.5)。 - 把等待收窄:把每帧的
DeviceWaitIdle换成按帧 fence 或 timeline 值,同时把ALL_COMMANDS换成本次真正有依赖的两个 stage(§7.4 的 1、4 号实验)。 - 量一次再改:在计数器上先确认浪费真实存在,再去时间轴定位到具体那一条同步;不要凭感觉批量删 barrier——删错方向买到的是"偶发花屏",那比慢更难查。
本篇的边界也一并说清:不涉及 mesh shader 与 work graphs 的完整实现(交 ep12)、不重复 CS 工作项内部那一层屏障(ep10 已讲透)、不展开应用层帧循环的完整接线(那是工程实践,不是硬件机制)。
待续:2011 之后(ep12)——mesh shader 完整实现、work graphs 把调度次数交给 GPU、硬件细分器的演化,以及这些机制如何在"GPU 自己排队"的同步地基上长出来。
出处:NVIDIA · Work Graphs(预告)/fgiesen · A trip through the Graphics Pipeline 2011 索引(CC0,背景)。
技术资源清单
- Khronos Vulkan 规范 · Synchronization and Cache Control
- Khronos Vulkan 规范 · VkFence/VkSemaphore
- Khronos Vulkan 规范 · Pipeline Barrier/Memory Barrier
- Khronos Vulkan 规范 · Image Layout Transition/Queue Family Ownership Transfer
- Khronos Vulkan 规范 · Timeline Semaphore/Resource Sharing Mode
- Khronos Vulkan-Samples · pipeline_barriers/layout_transitions/wait_idle/subpasses/async_compute/swapchain_images(本文全部真机实测图与计数器数据来源,Apache-2.0)
- Khronos · Vulkan Synchronization Examples
- Vulkan Tutorial · Execution vs Memory Dependencies/Barrier Batching
- AMD GPUOpen · Vulkan Barriers Explained/RDNA Performance Guide
- AMD · RGP Manual(barrier duration / drain time 观察)
- NVIDIA · Async Compute and Overlap
- NVIDIA · CUDA Memory Fence(
__threadfence_*类比) - Microsoft · D3D12 Resource Barriers/D3D12 Enhanced Barriers
- Sebastian Castor · Vulkan synchronization(叙事参考)
下篇预告《【GPU 架构剖析】(十二)2011 之后:哪些机制变了,哪些没有》—— mesh shader 完整实现、work graphs 的动态调度、硬件细分器的演化,以及这些"GPU 自己排队"的现代机制如何长在同步的地基上。
相关链接 - 上一篇:【GPU 架构剖析】(十)计算着色器:波前、共享内存与三种屏障 - 下一篇(预告):【GPU 架构剖析】(十二)2011 之后:哪些机制变了,哪些没有 - 核心参考:Fabian Giesen《A trip through the Graphics Pipeline 2011》——硬件管线异步结构的总背景 - 官方文档:Khronos Vulkan 规范 · Synchronization/Microsoft D3D12 Resource Barriers
With Best Wishes. 本文由@溯光 出品,转载请注明出处。我们在"提交、可见、资源身份"之间,继续挖下去。
(本篇完)