CSDN 版文章链接:待发布 知乎专栏版文章链接:待发布
.pftrace 字节文件。本篇要做的,就是把这层 UI 掀开,看文件本身长什么样@ Perfetto 官方文档(Google,Apache-2.0)[^ext6]一句话点题:一件你天天在看、却从没打开过的"文件"
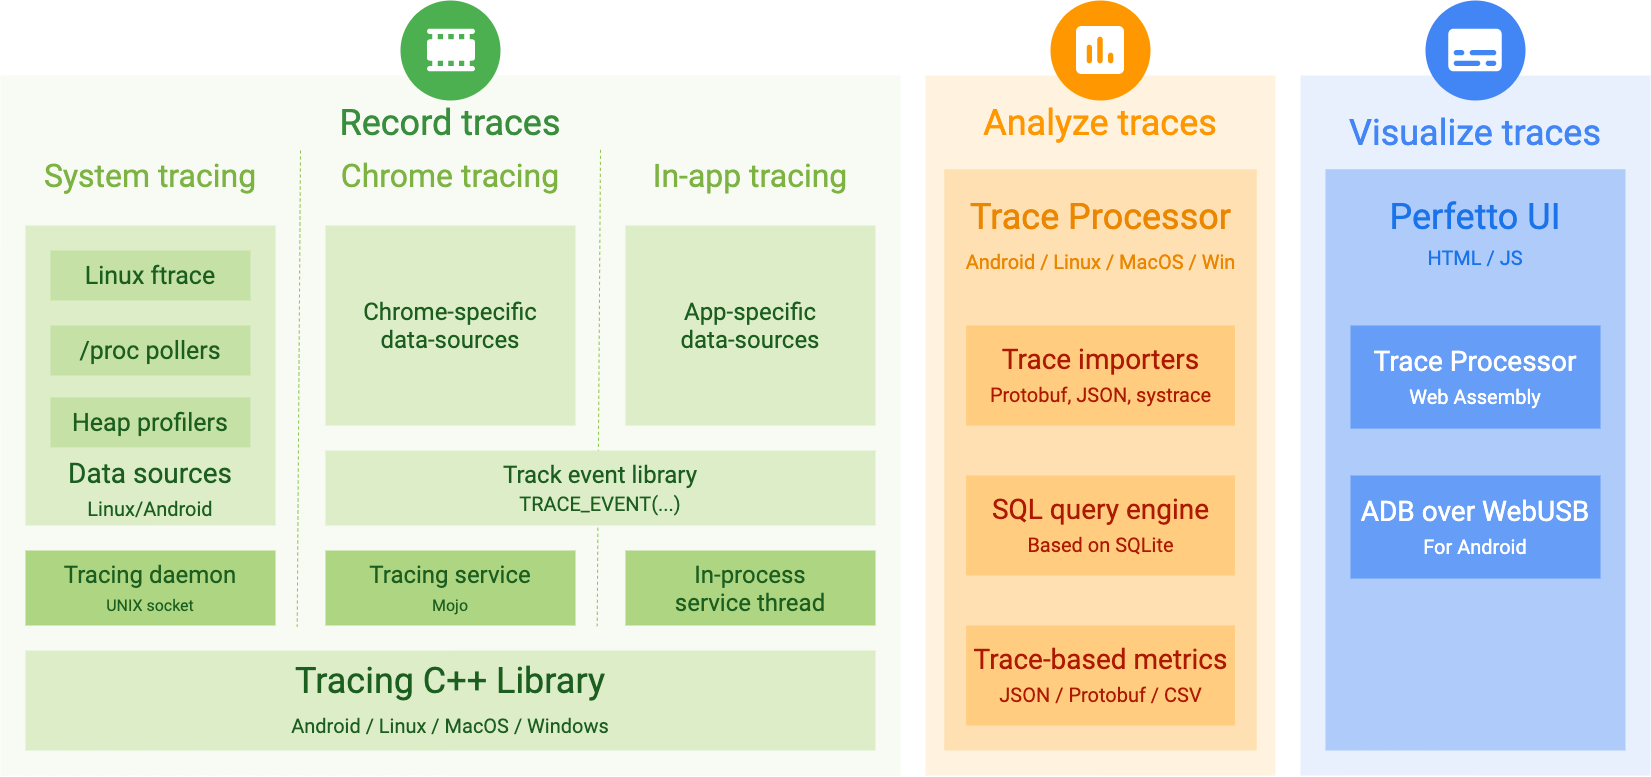
上一站我们沿着 RenderDoc 把"一帧是什么"摸到了 shader 反汇编,那是 API 层的答案。这一站换到 Perfetto,问的是系统层的同一个问题:一条 trace 到底是一坨什么东西。你在 Perfetto UI 里看到的每一条轨道、每一根蓝色切片、每一个时间刻度,追根到底都来自一份文件,而这份文件不是文本,不是 JSON,是一段 protobuf 编码的字节流。
先给一张知识地图,让你知道接下来要爬的几座山:
| 章节 | 在回答什么 | 你会拿到什么 |
|---|---|---|
| 一、Trace 与 TracePacket | trace 文件的最外层是谁? | 顶层消息结构,repeated packet 线性序列 |
| 二、protobuf wire format | 字节是怎么排布的? | varint / length-delimited / field tag 编码 |
| 三、时钟、interned 与分片 | 时间戳、字符串去重、多 writer 怎么共存? | CLOCK_BOOTTIME、iid 引用链、Sequence 一致性 |
| 四、TraceProcessor | 字节怎么变成 SQL 表? | Proto→Tokenizer→Importer→Sorter→Storage→SQL |
| 五、静态表与动态表 | 表 schema 从哪来? | Table() 显式列声明 vs CREATE PERFETTO VIEW |
| 六、自跑验证台 | 上面讲的是真的吗? | 真实 trace hexdump + 解码 + SQL 查询对照 |
边界声明:本篇不涉及怎么抓 trace(那是 ep08 data-source 全景的活)、不涉及 SQL 的调优写法(ep09)、不涉及 FrameTimeline 的 jank 判定公式(ep10)。本篇只啃一层:那一份字节文件。范围严格限定在 protobuf 编码、TracePacket 结构、TraceProcessor 怎么把它读成表这三件事。
0.1 为什么这一站要从 RenderDoc 切到 Perfetto
系列走到这里,我们消化完了 RenderDoc 这条线:方法论地图、抓帧、回放、事件浏览器、资源描述符、Mesh Viewer 与反汇编——六篇把"API 层一帧是什么"讲透了。但一帧落到系统里,还要经过 vsync、SurfaceFlinger、BufferQueue 一整套调度,这些是 RenderDoc 这个 API 抓帧工具看不见的。Perfetto 补上的正是这一层:系统级、事件级、谁在哪个 CPU 上跑了多久、帧从 App 到 Display 走了哪几步。所以 ep07 起,系列进入 PART B,用 Perfetto 回答"这一帧在系统里是怎么流的"。
而 Perfetto 和 RenderDoc 有个本质差异:RenderDoc 你打开 .rdc 就能看,Perfetto 你打开 .pftrace 之前,得先弄懂这个文件自己是啥。因为 Perfetto 的"资料"几乎全藏在二进制里——名字被 intern 成整数、时间被压缩成 varint、事件按 sequence 归位。不看透文件层,后面所有的 SQL 和掉帧归因都是"看别人给的结论"。
如果你还不熟悉"tracing 到底在抓什么",官方 tracing-101 和 start-using-perfetto 两页先扫一眼,把"Perfetto 能看哪些东西"建立起来;这一站我们则专注那"一个文件"。
0.2 演进脉络:trace 格式不是一天长成这样的
把 Perfetto trace 格式放进时间线,你能看到它不是凭空设计的:
| 阶段 | 时间 | 要点 | 一个 FRAME |
|---|---|---|---|
| 前身 atrace / systrace | Android 4.1 起 | 文本/HTML 格式,靠 FG 解析,容量小 | systrace 的 HTML 里其实藏的是结构化数据 |
| Perfetto 诞生 | 2018 前后 | 从 systrace 分家,改用 protobuf 二进制 | TP08 Tracing Summit 1810 讲演明确"columnar 内存库+SQLite" |
| protobuf trace 成型 | 2019–2020 | Trace/TracePacket 结构稳定,interned & sequence | doc trace-buffer 落地 |
| TraceProcessor v2 | 2020 后 | 表 schema 演进,experimental 表 | sql-tables 补齐 |
| 现代标准库 | 2022 | CREATE PERFETTO VIEW / stdlib | extension-server-protocol |
读这张表有两个要注意的点: - "systrace 是 HTML"其实是个特例——systrace 把 trace 数据以 JSON 格式内嵌进 HTML 壳里,所以文件能打开但底层仍是结构化数据。Perfetto 把它换成纯二进制的 protobuf,正是为了甩开"文本解析 + 体积膨胀"这两层包袱。 - interned 与 sequence 是后补的,不是 Perfetto 第一天就有。它们是在"trace 可以非常大、又必须能被多 producer 一起写"这两个约束下逐步加进去的——看到这章 3.2/3.3 的机制复杂,是因为它们承担了真实世界的重负。
年份口径:以 Perfetto 官方仓库 git 历史与 Tracing Summit 材料为准。这条脉络让你理解——你现在看到的字段,是多年演进后沉淀下来的"最小够用且兼容"的结果,不是拍脑袋定的。
0.3 一张全篇"术语含英双语"对照(先给你备着)
后面会密集出现英文术语,先放一张对照表,遇到不确定回来查就行:
| 中文 | English | 一句话 |
|---|---|---|
| 协议缓冲区 | protobuf / Protocol Buffers | 结构化数据序列化格式 |
| 数据包消息 | TracePacket | trace 的基本单元 |
| 变长整数 | varint | 大整数压缩编码 |
| 字段标签 | field tag | 字段号+wire_type 掩盖 |
| 驻留数据去重 | interned data | 字符串→整数 id |
| 时钟域 | clock domain | 时间戳的语义上下文 |
| 写者序列 | TraceWriter / Sequence | 多写者隔离 |
| 追踪处理器 | TraceProcessor | 字节→SQL 库 |
| 静态表 | intrinsic table | 编译期写死列 |
| 视图/派生表 | view / SQL-derived table | 查询时算的列 |
记住:这一站的方法是"让每个概念都能用一个字节序列自证"。
0.4 为什么这一站非要"先啃文件"不可?
有人可能觉得:我反正用 Perfetto UI 看火焰图,为什么要懂 protobuf?这里给三个"绕不过去"的理由:
- UI 上看到的每一条轨道,背后都有一张静态表在等着被查。 一旦你把 Perfetto 当 API 抓帧工具用(看一帧、看某段调用),你迟早要落到
slice/thread_state这类表上写 SQL。而 SQL 列名怎么写、列里装什么,全由文件解析后的人为表定义决定——不懂文件,你的 SQL 就是在隔靴搔痒。 - "为什么 trace 文件这么小、为什么 UI 加载这么快"这类问题,答案全在文件层。 interned 去重、varint 压缩、columnar 存储——这些不是 UI 特性,是文件设计。不啃文件,你只能把"小"当成玄学。
- 掉帧归因要"自证",不是"转述"。 你看到一次 jank,能不能反过来在文件里找到那个 mark?能做到,靠的就是把 trace 当成一份可以 hexdump、可以解码、可以查 SQL 的对象,而不是一个黑盒。
所以这一站的姿势很明确:把 .pftrace 当一块可以打开的数据来对待。 前面七章就是这个"打开"的完整动作。
一、Trace 与 TracePacket:最外层是"一条条消息的堆叠"
1.1 顶层消息:Trace 只有一个字段
好了,下面我们正式开始拆盒子。Perfetto 官方 proto 里,整份 trace 的顶层消息叫 Trace,定义极简到只有一个字段:
// protos/perfetto/trace/trace.proto
message Trace {
  repeated TracePacket packet = 1;
}
就是这么朴素:一份 .pftrace,本质是一串 TracePacket 一个接一个排成的序列。官方 trace-packet-proto 参考页说得更直白——"一个 trace 是 TracePacket 的线性序列"。源码就在 google/perfetto 仓库 的 protos/perfetto/trace/trace.proto 下,也可以直接对着 android.googlesource 上的同一份 trace.proto 逐字核对——就是这一行 message Trace { repeated TracePacket packet = 1; },只有一个字段,没有任何第二个成员。最外层简单到"你读完这句,就已经掌握整份文件的骨架了"。
为什么用 repeated 而不是嵌套的段落?因为 trace 是流式写下来的:每个 producer 一边跑一边把自己的数据打包成 TracePacket 追加到文件末尾,读的时候按顺序一条条读,不需要回头看前面。这个设计让"边抓边写、挂了也不全丢"成为可能。
一句话总结:最外层没有任何玄机,就是"一堆消息盒子排排队"。真正的复杂度在盒子内部——每个 TracePacket 到底装了什么,下一节拆。
1.2 TracePacket:一个能装进各种数据的"万能盒子"
OK,言归正传。TracePacket 是 trace 里最核心的消息,它长这样(字段为示意,非全量):
| 字段 | wire type | 说明 |
|---|---|---|
timestamp / timestamp_clock_id |
varint | 事件时间与时钟域 |
track_event |
子消息 | 应用侧 track event(slice/counter/flow) |
interned_data |
子消息 | 增量发布的去重数据(字符串等) |
sequence_flags |
varint | 增量状态标志(SEQ_INCREMENTAL_STATE_CLEARED 等) |
trace_packet_defaults |
子消息 | 该 packet 的默认字段 |
previous_packet_dropped |
varint | 前序 packet 是否丢失(DataLossReason bitmask) |
first_packet_on_sequence |
varint | 是否某 sequence 的第一个 packet |
process_tree / fuchsia_process_tree |
子消息 | 进程/线程一次性快照 |
ftrace_events / sys_stats / profile_packet |
子消息 | ftrace、系统计数器、profiling 包 |
gpu_mem_event / gpu_log / gpu_counter_event |
子消息 | GPU 内存/日志/计数器 |
clock_snapshot |
子消息 | 各时钟域的换算基准 |
track_descriptor / process_descriptor … |
子消息 | track/进程描述符,定义"轨道" |
incremental_state_cleared |
varint | 增量状态回扫标志 |
compression_type |
varint | 载荷压缩(stream)、加密类型 |
exported_events / metadata / extension_descriptor |
子消息 | 结构描述 / 元数据 |
每个 TracePacket 里只会有一部分字段被填上(一个数据类型的消息可能只带 timestamp + track_event,另一个只带 track_event + interned_data,还有的只带 process_tree + metadata)。这是 protobuf 的常态——message 不是固定宽度结构体,是按需填充的字段集合,这一点对理解"为什么字节是断断续续"至关重要。
为什么先讲 repeated 和字段共存:因为后面所有读 trace 的动作都建立在这两件事上。你要是以为 trace 是一块规矩的表,后面看到某个字段"凭空出现、又消失"就会懵。而 TracePacket 一个字段里嵌套一个类型任意的子消息,正是"一个 message 里什么都可能装"的根。
1.2b 往 TracePacket 里塞的,是哪几类数据?
光看字段名不足以知道文件长啥样。把一份真实 trace 里实际出现的 TracePacket 按职责归类,大概是三类:
| 类别 | 出现时机 | 代表字段 | 一句话 |
|---|---|---|---|
| 一次性快照 | trace 开头附近 | process_tree、clock_snapshot、sys_stats |
建立"这个世界有哪些进程/时钟"的坐标系 |
| 流式事件 | 持续高频 | track_event、ftrace_events、gpu_counter_event |
真正随时间推进的那一大串"谁在干啥" |
| 描述/元数据 | 穿插 | interned_data、track_descriptor、metadata、trace_packet_defaults |
给前两类提供"名字、轨道、默认值" |
这个分类对读 trace、查 SQL 都极其有用:想找进程列表去快照类,想看某一段的在干嘛去找流式类,想懂名字去哪查描述类。Perfetto 的 trace-processor-architecture 把这条分派逻辑写进了 importer:不同 field ID 的路由,本质上就是"这门数据该进哪张表"。后面第四章会顺着这条线展开。
把"分类"再往前推一步,官方 track-events 概念页 给了"事件"本身的坐标系:一次事件要么是一个 slice(持续一段时间、有 dur),要么是一个 counter(某个时刻打一个数值点),要么是一个 instant(无时长的瞬时点)。读文件时你最常打交道的就是 slice 和 counter 两类——slice 落进 slice 表,counter 落进 counter 表,两者在第四章的 importer 里各有各的写入分支。这个"事件三分类"正是你在文件里反复见到不同 TracePacket 字段组合的底层原因。
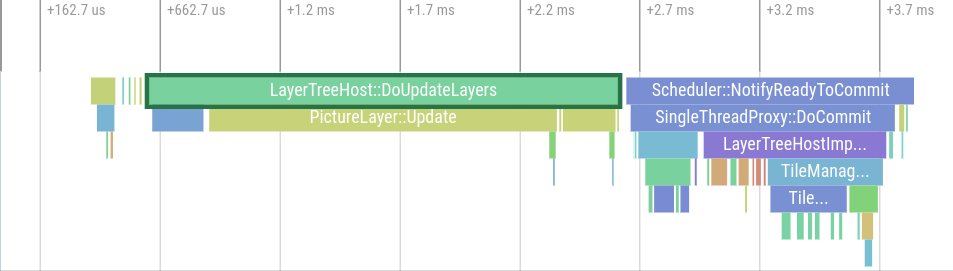
"事件挂在 track 上"这件事,官方文档给的 UI 形态最直观:每个 track event 都关联一条 track(一条单调递增的时间轴),而一条 track 对应一条独立的执行序列——典型例子就是进程里的一个线程。所以你在第四章会看到,track 表在数据层承担的角色,恰好是 UI 上那一条条横向轨道:
1.3 proto 文件不是一棵树,是 import 的网
说白了,前面引的 trace.proto 只是入口,真正的庞然大物在 perfetto_trace.proto。这一段是编译期把众多子 proto import 合并后的单一 schema:
perfetto_trace.proto
├── import trace.proto          → Trace / TracePacket
├── import trace_packet.proto   → TracePacket 的各字段子模块
│   ├── system_info / trace_config / trace_stats
│   ├── proto_vm / extension_descriptor
│   ├── ...Android 相关 / GPU gpu_mem_event / Chrome 相关 / ftrace 相关
└── import track_event.proto    → TrackEvent(debug_annotation / log_message / task_execution / screenshot / source_location …)
TracePacket 的内容结构由这些 import 的子 proto 组合而成,而不是一个扁平大对象。这意味着:读一份真实 trace 时,一个字段的完整语义往往要跨好几个 .proto 文件才能拼出来。也正因为是"import + oneof 扩展"的模式,Perfetto 能不断往 TracePacket 里加新数据源类型而不破坏老 trace——proto 的字段号一旦分配就永不复用,这是官方发版纪律。
节末回望:这一章把最外层三层说清了——Trace 装 TracePacket 序列、TracePacket 是字段集合、schema 是 import 合并的结果。接下来我们要真正"打开文件",从第一个字节看起。
1.4 为什么 trace 是"边写边读"的 append-only 流?
下面我们回过头,把这件事讲透。回到 1.1 那句"流式写下来",其实它包含两个必然诉求,值得展开:
- producer 无法预知未来。 抓 trace 时你不知道后面会发生什么,所以只能"边跑边追加",每一段写成独立的
TracePacket,绝不可能回填前面改一个总长度。append-only 是唯一不赌未来能"写到哪算哪"的布局。 - 读取要能流式处理。 读端不追求一次性 load 全文件,而是一条条读
TracePacket,能读多少先处理多少。TracePacket附带TraceStats里能看到写入的 chunk 信息,正是为流式处理铺路。
这两个诉求直接决定了 trace 文件的结构——没有中心索引、没有"跳到第 N 条"的指针,只有从头到尾的一条线性流。后面 TraceProcessor 要做的"归并排序、建列式表",本质上就是把这条无序的线性流,重建成有序、可查询的二维结构。
二、protobuf wire format:逐字节读一份真实 trace
2.1 有多少种 wire type?——总共六种,trace 里最常见三种
好了,理论先放一边,这章我们直接看字节。误以为 protobuf 只有三种编码形态,其实 wire type 一共定义了 6 种。只是实际 trace 里大部分数据只落在少数几种上。官方 Encoding(wire format) 参考页 把这张表写得很全:
| wire type | 十六进制值 | 编码方式 | 载荷大小 | trace 里的使用 | 典型字段 |
|---|---|---|---|---|---|
| varint | 0 | 变长,每字节高 1 位是"还有下一位" | 不定 | 到处都是 | field_number、timestamp、count、iid |
| 64-bit | 1 | 固定 8 字节,小端 | 8 字节 | 少见 | fixed64、double |
| length-delimited | 2 | 先 varint 写长度,再写内容 | 不定 | 到处都是 | 字符串、子消息、bytes、packed 数组 |
| start-group | 3 | 已被废弃 | — | 不用 | (保留兼容) |
| end-group | 4 | 已被废弃 | — | 不用 | (保留兼容) |
| 32-bit | 5 | 固定 4 字节,小端 | 4 字节 | 少见 | fixed32、float |
为什么记住这三行就够了:一眼看 trace 字节,凡是"先给长度再给内容"的都是 type 2,凡是"自己长度可变"的多半是 type 0,几乎不会见到 1 和 5。抓到 type 3/4 说明是上古文件的兼容尾巴,现代 schema 早就不落了。那 type 3/4 到底为何存在?它们是 protobuf 最早的"分组(group)"语法遗留——group 把字段直接嵌进父消息的前后标位,靠一条 start-group、一条 end-group 两个 tag 划定边界。它相比 length-delimited 有个致命短板:长度未知、无法预分配,遇到没登记的 group 也没法安全跳过,官方 Encoding 页的 groups 小节 明说了别再用。所以你几乎不会在 Perfetto trace 里遇到它们,遇到也多半是刻意保留的旧版本兼容尾巴。
field tag 的构成是解码的钥匙,官方 Encoding 参考页 把它浓缩成一行算式:
field tag(varint) = (field_number << 3) | wire_type
所以读到一个字节 0x08:0x08 & 0x07 = 0 → wire_type 0(varint);0x08 >> 3 = 1 → field_number 1。"tag 的低 3 位藏着类型,高 5 位藏着字段号" ——这是 protobuf 自描述能力的地基,也正是 blackbox 一类工具能"盲解"未知 message 的根。因为 field_number 被左移了 3 位,1–15 号的字段可以只用 1 个字节的 tag;这也是 proto 作者总把"高频字段排在前 15 号"的原因——官方发版惯例里,trace.proto、TracePacket 里被反复用的字段都挤在低位段。
2.2 varint:把大整数挤成几个字节
先来看看这套编码里最常露脸的那个。varint 是 trace 里出现频率最高的编码。规则:每字节只用低 7 位,最高位当"续位"(1 = 后面还有字节)。小整数一字节搞定,大整数用更多字节,写完的字节序是低位在前。
一个具体例子,timestamp = 300:
300 = 0b100101100
拆成 7 位一组(低位先):低7位组 = 0101100(44),高组 = 0000010(2)
加续位:第一组有后续 → [1 0101100] = 0xAC;末组 → [0 0000010] = 0x02
     → 0xAC 0x02
所以 300 编码成两字节 AC 02,而不是定长的 4 字节。判定一个 varint 是否结束,就看"续位"是不是 0:字节 AC 的最高位是 1,所以"后面还有";下一个字节 02 最高位是 0,varint 到此为止。这正是 protobuf 能做到"整数越大占越多字节、小整数几乎不占空间"的原因——线上文件的传输体积,有一大半是 varint 省出来的。trace_packet.proto 里绝大多数字段(timestamp、iid、计数器)都是这种能随手压到 1–2 字节的整数。
2.2b 负数和打包数组:两个让你意外的地方
varint 有个坑:负数。 如果把 int32 的负数当成普通整数直接按 varint 编码,会得到一个 10 字节的庞然大物(因为符号位被当成很大的正数)。protobuf 的解法是 ZigZag 编码——把正负号交替映射成非负整数:
原始值    →   ZigZag 映射
 0        →   0
-1        →   1
 1        →   2
-2        →   3
 2        →   4
映射公式是 (n << 1) ^ (n >> 31)(32 位),把负数编码成 1、3、5……这样小的负数也能压到 1–2 字节。这解释了为什么你在 trace 字节里看到 "1" 时,它可能代表的不是 +1 而是 -1 ——同一个字节的语义取决于字段的声明类型,wire type 只给了"怎么存",没给"是什么"。
另一个容易迷惑的是打包数组(packed repeated)。普通 repeated 字段是一条条单独编码成 tag+元素,而带 [packed=true] 的 repeated(proto3 默认对基础数值类型启用)会把整段数组包成一个 length-delimited 载荷:
普通 repeated int32 a = [1, 2, 3]:
  tag(0x08) 01   tag(0x08) 02   tag(0x08) 03      ← 每元素一个 tag

packed repeated int32 a = [1, 2, 3]:
  tag(0x0A) 03  01 02 03                          ← 一个 tag + 长度 + 数据
打包后省掉的是每个元素前重复的 tag 字节。perfetto 的 interned_data、TraceStats 里大量数值型 repeated 字段都走这条路——文件能小,靠的不只是顶层设计,还有这类"省重复前缀"的布局决策。
2.2c 字段可以"不在":proto3 的默认值不下发
正因为解码靠 tag 定位,proto3 语言指南 有一个和 C 结构体完全相反的约定:字段没被设值就不出现在字节里。读端遇到缺字段就用默认值顶上(数值 0、字符串空串、bool false)。这意味着:
- 你"在字节里找不到某一个字段",不代表"这数据没有",只是它等于默认值、被省略了。
- TracePacket 每条 packet 只带自己需要的字段,绝大多数字段在绝大多数 packet 里都是缺省的。
这一条把第二章开头那句"message 是按需填充的字段集合"从直觉变成了规则。手解 trace 时最容易犯的错,就是把"字节里没出现"当成"值不存在"——它们往往是默认值替身。
2.3 真实 trace:从第 1 个字节开始手解
下面我们开始动手。理论讲完,我们直接拿一份真实 .pftrace 开刀。这份文件不是凭空编的示意,而是按第二章规则手工拼出来的 17 个字节(生成脚本见 6.1),下面就是它的完整 hexdump——hexdump 一行的宽度是 16 字节,所以最后那个 72 被单列到第二行:
00000000  0a 0f 0a 0d 08 ac 02 12 08 0a 06 72 65 6e 64 65   |...........rende|
00000010  72                                                  |r|
逐字节读,每一步都只是"tag + 载荷"的重复,而且每层都自报长度:
0a 0f          field 1 (len-delim),长度 15  → TracePacket 子消息
└ 0a 0d        field 1 (len-delim),长度 13  → 再进一层
  └ 08 ac 02   field 1 (varint)   = 300      → timestamp
  └ 12 08      field 2 (len-delim),长度 8  → track_event 子消息
    └ 0a 06    field 1 (len-delim),长度 6  → TrackEvent.name
      └ 72 65 6e 64 65 72 = "render"          → 明文事件名,17 字节正好用完
为了看清楚,把全部 17 个字节摊成"字节→解码→含义"表——每一格都能在 hexdump 里找到它对应的那一个字节:
| 字节 | 位运算 | 解码结果 | 说明 |
|---|---|---|---|
0a |
0a>>3=1,0a&7=2 |
field 1, wire type 2 | 外层 TracePacket |
0f |
varint | 长度 15 | 指向 15 字节子消息载荷 |
0a |
0a&7=2 |
内层 field 1, type 2 | 子消息内部又一跳 |
0d |
varint | 长度 13 | 指向 13 字节子子消息 |
08 |
08&7=0,08>>3=1 |
field 1, varint | timestamp 字段 |
ac 02 |
两字节 varint | 44 + (2<<7) = 300 |
低位在前、续位判结束 |
12 |
12>>3=2,12&7=2 |
field 2, type 2 | track_event 子消息 |
08 |
varint | 长度 8 | 指向 8 字节载荷 |
0a |
0a&7=2 |
field 1, type 2 | TrackEvent.name |
06 |
varint | 长度 6 | 字符串长度 |
72 65 6e 64 65 72 |
ASCII | "render" |
事件名,明文躺在载荷里 |
你会发现嵌套的全是同一套规则。tree 的每一层都在重复"field tag + 载荷",读到最后,一个 TracePacket 的 timestamp 是多少、事件名是什么,全都能从字节里抠出来。这里特别值得留意 ac 02 这两个字节:ac 最高位是 1 表示"还有下一位",02 最高位是 0 于是到此为止——varint 的边界全靠续位判定,从来不用数固定宽度,这正是"定长结构体"做不到的动态伸缩。
更值得说的是:这 17 个字节里没有一处是"猜"出来的。0a 0f 告诉你外层有 15 字节载荷,0a 0d 告诉你内层有 13 字节,12 08、0a 06 逐层收窄,最后 6 个字节正好是 render——每一层的长度都自洽,多一个字节就解不通,少一个字节就解不完。这就是为什么"靠 tag 定位"的格式能在没有中心索引的情况下被完整读回来。
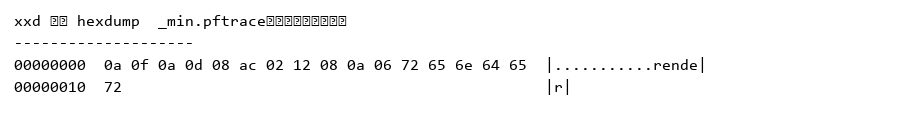
量化结论:这份 17 字节的 protobuf,如果换成 JSON 写同一件事——{"packet":{"timestamp":300,"track_event":{"name":"render"}}}——是 60 个字节,正好是它的 3.5 倍。protobuf 的紧凑不是玄学,是 varint + 字段号压缩共同省出来的。把"一条事件记录"用两种格式写出来对照,差距一眼可见:
| 维度 | protobuf(wire format) | JSON |
|---|---|---|
| 字段名 | 只存整数 ID(1 字节 tag) | 原样存字符串名("timestamp" 就占 11 字节) |
| 整数 | varint,300 只占 2 字节 | 按十进制文本,300 占 3 字节 |
| 字符串 | 长度前缀 + 原始字节 | 引号 + 转义 + 原始字节 |
| 嵌套 | 长度前缀界定,逐层自洽 | 靠 {} , " 等语法字符 |
| 本例合计 | 17 字节 | 60 字节 |
同一件事,protobuf 只用了 JSON 的 28% 左右。这也是为什么动辄数百 MB 的原始事件流,压缩成 .pftrace 后能落地成一份可分发、可上传 UI 的适中文件——省掉的全是在 JSON 里重复几万次的字段名与标点。
2.4 为什么是"流式的字段集合"而不是"定长结构体"?
说白了,见过字节后,回看 1.2 那句话就更清楚了。protobuf 消息之所以能"字段跳跃出现",是因为解码器靠 field tag 定位字段,而不是靠偏移。Grow-only 的字段设计让老解码器读到新字段时能安全跳过、新解码器读到老字段时能正常解析——官方 Encoding 页 里那条"字段号实现后永不复用"的发版纪律,正是这套兼容的底座。落到读端,具体机制叫"未知字段跳过":解码器碰到 schema 里没登记过的字段号,不会报错,而是按它的 wire_type 算出这段载荷的字节边界,整段跳过、继续往下读。这样老解读器能容忍新写入的字段,官方 Encoding 页的 unknown fields 小节 专讲这件事。对 trace 场景尤其关键——你手上的 Perfetto 版本可能比某份 trace 老,但依然能把它打开,靠的就是"跳过未知"而不是"拒绝未知"。这也解释了 trace 文件作为"会演进、但老版本工具仍能读"的长期存储格式为什么扎实。
节末给出的第一个"验证钩子":这一章的编码规则都将成为第六章自跑验证台的一句承诺——"你要是怀疑,就自己 hexdump 一份 trace 对一遍"。
三、时钟与 interned:时间戳、去重存储与多写者共存的真相
3.1 timestamp 不是"世界时间",是和时钟域绑定的单调计数
好了,换个维度看时间。TracePacket.timestamp 的数值本身没有任何意义,它必须配 timestamp_clock_id 才有语义。官方 clock-sync 文档 对这套时钟体系讲得最透:默认时钟域是 CLOCK_BOOTTIME(Android 上常用的单调时钟,含挂起时间),默认单位 1ns。
含义:trace 里的时间戳是单调递增的纳秒计数,不是墙上时间。你想知道"这是 14:03:21"是做不到的——除非写入者额外用别的 clock domain 标记绝对时间。这个设计不是为了难为你,而是单调时钟在分析调度/性能时不会因 NTP 校时、拔电池而跳变,这对"比大小"(谁先谁后)和"算间隔"(耗时)是最可靠的。
3.1b 一套 trace 里至少有几十个"时钟",怎么对齐?
官方 clock-sync 文档 点出了关键事实:多 producer 各自用不同的时钟域打时间戳——
| 数据源 | 常用时钟域 | 说明 |
|---|---|---|
| Linux/Android 的内核 ftrace | CLOCK_BOOTTIME |
单调,含挂起时间 |
| Android event log | CLOCK_REALTIME |
墙上时间,可被 NTP 校时跳变 |
| 部分数据源 | CLOCK_MONOTONIC |
单调,不含挂起 |
| GPU 相关事件 | GPU 厂商硬件时钟 | 与系统时钟存在漂移 |
这些时钟之间会互相漂移(比如挂起/恢复导致的偏差累积)。Perfetto 的解法不是"逼大家都用 BOOTTIME",而是靠 ClockSnapshot 包在导入时重建时钟图(clock graph),把事件换算到统一的 trace 全局时间上。clock_snapshot.proto 里就是一批 Clock { clock_id, timestamp } 的定点。可以这样说:trace 文件里时间戳的"坐标系",只有在读完 ClockSnapshot 之后才算确立。
所以读 trace 时看到一个奇怪的 timestamp 数值,先别急着换算成几点几分——先问它挂在哪个 clock_id 下。这是"时间戳必须有时钟上下文才有语义"的更完整版。
3.2 interned_data:把重复的字符串压成一个整数
先看看文件里最占地方的那类数据。性能 trace 里最不缺的就是重复字符串——线程名、函数名、事件名,几百次出现的内容一模一样。如果每次引用都存一遍原文,文件会爆炸。Perfetto 的解药是 interned data(驻留数据去重)。
机制一句话:把一个字符串登记成一个整数 id(iid),之后所有地方都引用这个 id,而不是重复存字符串。
// protos/perfetto/trace/interned_data/interned_data.proto (示意)
message InternedString {
  uint64 iid = 1;   // interned id,从 1 开始;0 表示未设置
  bytes str = 2;
}
关键规则(官方参考页 + synthetic-track-event 指南):
- 增量发布:interned_data 只在相同 trusted_packet_sequence_id 的 packet 序列内有效,跨序列不共享。
- 首次引用:writer 在与首次引用相同的 packet 里发布新的 interned data,后续引用直接给 id。
- 状态标志:首个 packets 用 SEQ_INCREMENTAL_STATE_CLEARED | SEQ_NEEDS_INCREMENTAL_STATE;增量数据用 SEQ_NEEDS_INCREMENTAL_STATE。
把"首次引用"这个流程用一次次事件走一遍,你会看得很清楚:
packet #1(sequence A, flags=CLEARED|NEEDS):
  interned_data { InternedString(iid=1, str="render") }
  track_event { name: 1(引用 iid=1)}
packet #2(sequence A, flags=NEEDS):
  track_event { name: 1 }      ← 只带 id,不再带字符串
packet #3(sequence A, flags=NEEDS):
  track_event { name: 1, category: 新 }   ← 若再有新字符串,再补 InternedString
注意 flags 里的 SEQ_INCREMENTAL_STATE_CLEARED:它表示该 sequence 从这里开始,之前的 interned 状态作废、要重新建立。一旦 buffer 被清、或 producer 状态被重置,就必须用这个 flag 开头,否则读端会拿旧 id 指到错字符串。这三行 flags,是"增量把字符串去重"和"状态能随时重来"之间唯一的握手协议。
量化收益:假设一个函数名 "MyRender::DrawMesh" 18 字节,在一份含 10 万次相同调用的 trace 里,不 intern 要占 180 万字节,intern 后只占"一次 18 字节 + 10 万次 2–4 字节",字符串存储可降到原来的 10% 以下。这就是为什么你能在 UI 上看到名字,而文件本体并不臃肿。
3.2b interned 的有效域:只在同一个 sequence 里生效
interned 去重有个边界千万别忽略——iid 只在相同 trusted_packet_sequence_id 的 packet 序列内有效,跨 sequence 不共享。换句话说:
- 如果两个 producer 都用 iid=5 表示某个字符串,它们指的不是同一个字符串——iid 是"按 sequence 命名空间"的。
- 读取端维护的是"每个 sequence 一个 interning 状态"的哈希表,跨 sequence 的 iid 必须重查。
这直接解释了为什么 3.3 要讲 sequence:去重和分片是同一枚硬币的两面。没有 sequence 边界,你就无法判断一个 iid 属于哪个命名空间;反过来说,多写者之所以能各自 compact,正是因为每个 sequence 独立维护自己的 interned 表。实践中,TraceProcessor 在导入时就按 sequence 分桶缓存这些 mapping——列名能出现,靠的正是每条 sequence 自己那份 interned 字典。
3.2c trace_packet_defaults:把"每条都一样的字段"抽到一处
去重还有一个"近亲"——trace_packet_defaults。如果一大批 packet 的某个字段(比如 track 名、默认时钟)几乎完全相同,逐条重复存是浪费。Perfetto 允许用 trace_packet_defaults 在 sequence 开头声明"这片 packet 的默认值",后续 packet 只要不覆盖就用它。
这又是一个"文件能小"的机制,但和 interned 的职责不同:interned 去的是"值重复",defaults 去的是"字段重复"。理解这两者,你在第六章自跑验证时就能分得清"为什么有些 packet 看起来空空如也"。
3.3 多写者共存:TraceWriter、Sequence 与分片
下面进入多写者这一层。一份 trace 往往同时被多个 producer 写(内核 ftrace、App、GPU、Chrome……)。它们怎么互不打架?答案是 TraceBuffer 里每个 {ProducerId, WriterId} 构成一个唯一 Sequence ID,每个活跃的 {Producer, Writer} 持有一个 SequenceState。
对同一 TraceWriter 的 packets,TraceBuffer 保证 order、no gaps、no duplicates——顺序不乱、不丢、不重。这是"文件是线性序列"和"多写者并发"之间的矛盾妥协:在文件层面是交错的线性序列,在逻辑层面每个 sequence 仍是自洽的。读取时靠 sequence 把交错的分片重新归位。
把"交错"落到文件字节上,你会看到这样的 packet 流(首列是它归属的 sequence):
seq A | TracePacket
seq B | TracePacket
seq A | TracePacket
seq C | TracePacket
seq A | TracePacket
一行一行写进文件,彼此犬牙交错;但读端按 sequence 一归类,就还原出三条各自连续的语义流(A、B、C 各成一条)。这正是官方 buffer 概念页 所说的"trace 是 packet 流,每个 packet 自带 sequence 归属"。也回扣了第三章 3.2 那句"interned 只在同 sequence 生效"——因为只有同一 sequence 的 packet 才保证共享一份增量状态,跨 sequence 连语义都不能保证连续。
3.4 包丢了怎么办:previous_packet_dropped 与 DataLossReason
言归正传,还有一件坏事必须交代清楚。缓冲区满、producer 崩溃都会丢包。Perfetto 不隐瞒,而是标记:TracePacket.previous_packet_dropped 是一个非零的 DataLossReason bitmask,表示"该 sequence 上,我前面的包被丢了"。对应统计字段是 TraceStats.BufferStats.trace_writer_packet_loss。
DataLossReason 不是单个开关,而是一组可组合的 bitmask 原因:
| bit | 含义 | 常见诱因 |
|---|---|---|
| NOT_SET / UNKNOWN | 未设置 | — |
| SOCKET_BUFFER_OVERFLOW | socket 缓冲溢出 | 消费者读得太慢 |
| SMB_SCM_OVERRUN | 共享内存 SCM 环形缓冲溢出 | 写得太快、环形太小 |
| TRACE_BUFFER_OVERFLOW | trace 缓冲溢出 | producer 积压超限 |
对分析的意义重大:你看到的时间线上凭空少了一段,或某个状态迷之缺失,先查是不是丢包了——而不是怀疑自己对 trace 的解读。丢包是显式的:previous_packet_dropped 前一个包丢在哪个 sequence、trace_writer_packet_loss 丢了多少,都能从这两个字段数出来,UI 上往往也会用特殊的缺失标记提示你。这一条尤其适合排查"为什么某段火焰图是空的"——先排除丢包,再谈解读。
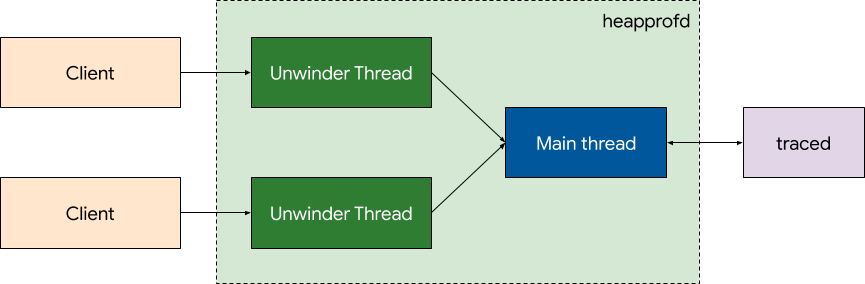
缓冲区为什么会溢、"环形"到底长什么样?官方 heapprofd 设计文档给出的共享内存缓冲布局(客户端与服务端之间的 SMB/SCM 收发路径)是理解这类溢出的最直接材料——环形缓冲的容量是有限的,"写得太快、环形太小"不是比喻,而是一张能看见的缓冲区布局:
节末回望:这一章解释了四个"文件里看不见但必须懂"的机制——时间戳的时钟语义、字符串的去重、多写者的协调与丢包标记。它们是读懂字节的最后一块拼图。下一章我们站到"反向"的位置:不是问字节怎么排,而是问这些字节怎么被读成 SQL 表。
四、TraceProcessor:从字节流到"可以查的数据库"
4.1 那条流水线,官方文档给得很清楚
OK,下面我们进入第四章。Perfetto 官方 trace-processor-architecture 设计文档 给出了完整数据流(这是本篇引以为据的一手来源):
Raw Trace → ForwardingTraceParser → ChunkedTraceReader(格式探测)
  → [ProtoTraceTokenizer] → [ProtoImporterModules] → TraceSorter::Stream
  → TraceStorage → SQL Query Engine
对 proto trace 这条路(ProtoTraceReader,源码 .../importers/proto/proto_trace_reader.h):
Proto bytes → ProtoTraceTokenizer → ProtoImporterModules → TraceSorter::Stream → TraceStorage → SQL
拆开看,每段各司其职:
1. ForwardingTraceParser 从文件头几个字节探测格式(proto / JSON / systrace),分派给对应 reader。
2. ProtoTraceTokenizer:在排序前做快速时间戳提取——只做轻量解析,把事件的 (ts, packet切片) 尽快丢进 sorter。
3. ProtoImporterModules:按 packet 的 field ID 路由——FtraceModule 只管 ftrace 包,TrackEventModule 只管 track_event 包,各模块注册到特定 field ID。
4. TraceSorter:多路输入的基于时间戳的归并排序(per-CPU 队列、窗口化),把乱序的事件排成时间序。
5. TraceStorage:列式存储,写进 SliceTable、ProcessTable、ThreadTable、CounterTable 等专用表。
6. SQL Query Engine:终于,你可以 SELECT * FROM slice 了。
这条流水线不是我们的转述,官方文档里就配了一张结构图,把"一条 trace 的字节如何一路变成可查询的表"画在同一张图里:
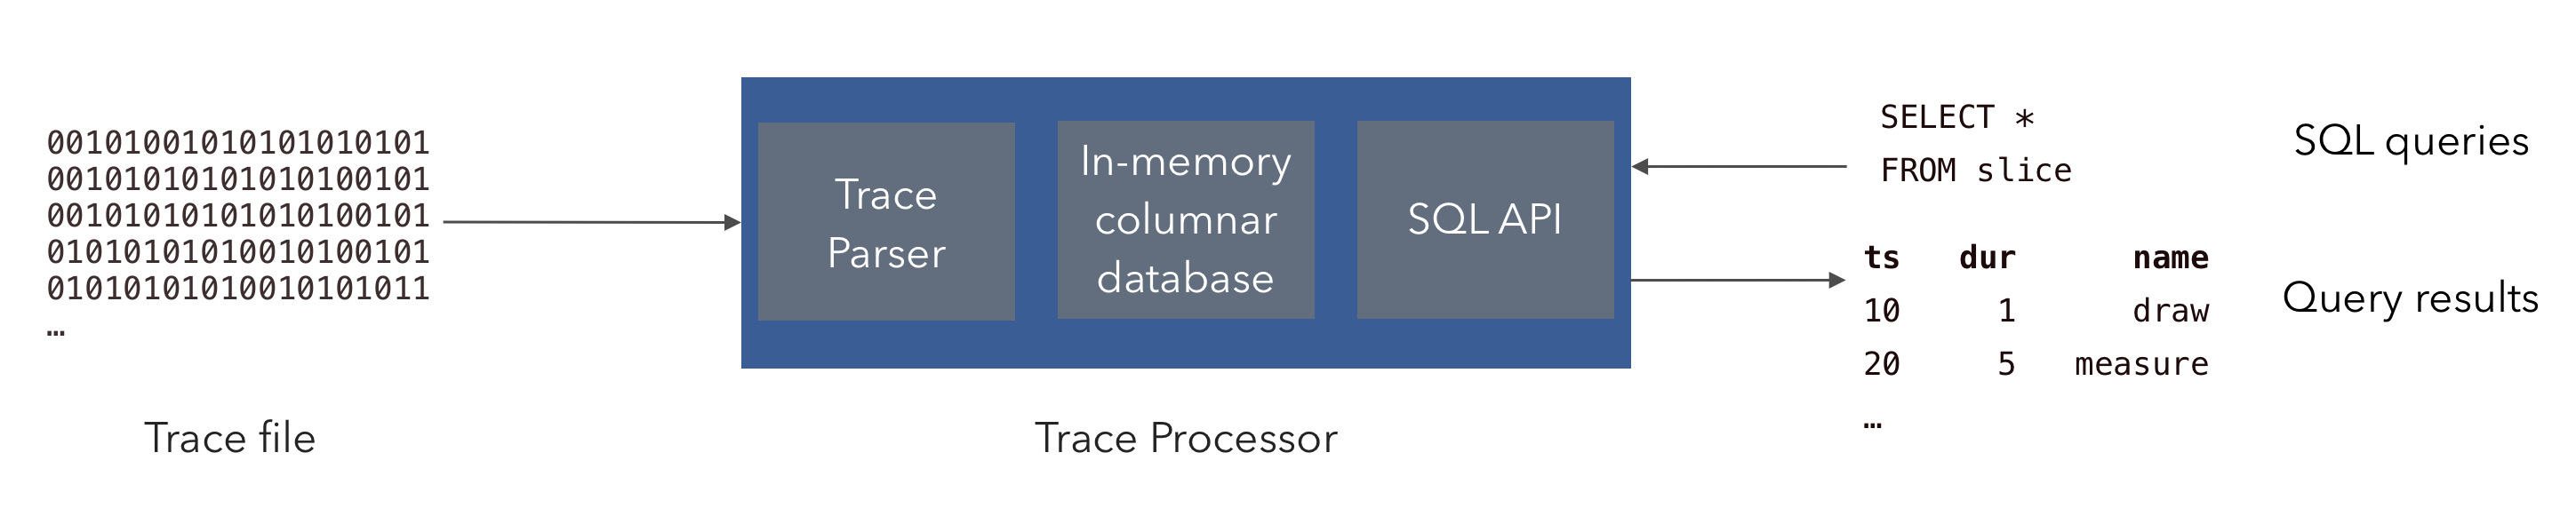
把这几步对应到本章开头那章"字节是交错线性流"的判断,你会看出设计意图:步骤 1–4 解决的是"把乱的捋顺",步骤 5–6 才解决"把顺的变成可查的"。前四步里最值得注意的分工在第 2 步和第 3 步之间:
- 第 2 步只抠时间戳,不做完整解析——因为它要喂给排序器,只需要"这条事件大概在什么时候"。完整解开一个 packet 的成本很高,没必要在排序前全做。
- 第 3 步才真正解析字段语义,而且要等排序完成之后(见 4.2 的理由)。模块按 field ID 领活,各管各的,互不干扰。
所以"Tokenizer/Parser"其实不是同一个东西的两个名字,而是两个不同成本的阶段:一个是"便宜地定位",一个是"昂贵地吃透"。
4.2 为什么"Tokenizer 先、Parser 后"?
设计文档点出一个看似反直觉的分工:Tokenizer 在排序前,Parser 在排序后。为什么不能一股脑解析完?
因为 trace 是交错的(见 3.3)。一个 producer 的多个事件可能散乱在时间轴各处,parser 要正确处理事件相互依赖(比如 slice 要匹配到 track),就得先按时间排序,再逐事件做完整解析。Tokenizer 只是先廉价地把时间戳抠出来用于排序,真正的字段语义留给排完序后的 Parser。"先廉价取时、后精细入味" 是它高性能的关键。
4.3 TraceStorage:列式存储,为什么快
说白了,TraceStorage 是列式(columnar)内存库:同一字段的值存在一起(column<ts> 一根,column<dur> 一根,column<track_id> 一根),而不是一行行存对象。好处:
- 查询 min(ts)...max(ts) 只需扫一列。
- 列式天然利于 SIMD 批量处理和高压缩。
- 新旧字段交替出现时,列式不会像行式那样整行搬移,只要往对应列追加即可。
官方文档把它定位为"columnar storage with specialized table types",正是 slice 这类表在 SQLite 之上还能跑得飞快的原因。一个直观的工程对比:
| 操作 | 行式存储 | 列式存储 |
|---|---|---|
扫 ts 求时间范围 |
逐行跳过所有列 | 只读一根 ts 列 |
| 加一个新列 | 改整行布局 | 追加一根列 |
| 内存中迭代 slice | 每行取 N 个字段 | 按需取需要的列 |
列式是"查询兽"的代价是写入时要把同一字段散进不同列,但 trace 是一次性导入、反复查询的场景——它和列式存储的匹配几乎是天然的。这也是为什么"导出 pickle / 老的内存快照"那种行式方案,能看到的分析面窄得多。
4.4 一张表,背后是一个显式的 Table 定义
好了,到这里必须破一个流传很广的误解。到这里要破除一个常见误解:表的列不是由 protobuf 的 field_number 自动推导出来的。恰恰相反——slice 表的每一列,是源码里用 Table() 类显式声明的:
# src/trace_processor/tables/slice_tables.py(示意)
SLICE_TABLE = Table(
    python_module=__file__,
    class_name='SliceTable',
    sql_name='__intrinsic_slice',
    columns=[
        C('ts',          CppInt64()),
        C('dur',         CppInt64()),
        C('track_id',    CppTableId(TRACK_TABLE)),
        C('category',    CppOptional(CppString())),
        C('name',        CppOptional(CppString())),
        C('depth',       CppUint32()),
        C('parent_id',   CppOptional(CppSelfTableId())),
        C('arg_set_id',  CppOptional(CppUint32())),
    ],
    wrapping_sql_view=WrappingSqlView('slice'),
)
所以"proto 字段 → SQL 列"的映射,是 importer 解析后,由这份 Table 定义承上启下:importer 把 protobuf 里解出的值写进 TraceStorage 的对应列,SQL 查询时列名就是 slice 表名 + ts/dur/name...。列的血缘不是自动的,是人写死的。 这一点后面 ep09 讲 SQL 时会反复用到——你要知道 slice.depth 是谁塞进去的,才能判断它可不可信。
节末回望:这一章把"字节如何变成数据库"讲通了——一条流水线、先排后析、列式存储、显式表定义。但"表"不止一种,下一章细看静态表与动态表的区别。
4.1b 入口其实很杂:不止 proto 一种格式
ForwardingTraceParser 之所以叫"forwarding",是因为它要先探测文件到底是不是 proto。官方 trace-processor 页面 列了一份它能吃进去长的清单——除了 .pftrace(proto),还能直接读 Chrome JSON、Firefox Profiler JSON、Linux perf(含二进制与文本)、Linux ftrace 文本、macOS Instruments(XML)、Fuchsia 格式等。也就是说:
- 探测逻辑是按文件头/结构判定走哪条
TraceReader分支。 - 无论哪种输入,最终都收敛到同一套
TraceStorage加 SQL——表面格式千差万别,底层全是"时间戳+载荷"。
这一点对理解"TraceProcessor 是个通用分析器"相当关键:你不一定需要 Perfetto 抓的 trace,只要能把数据转成"时间戳+结构化载荷",就能白嫖整套 SQL 分析。官方文档把这叫作"trace-like data"通用化。
4.1c importer 是按 field ID 派单的"模块注册表"
第 4.1 步 3 提到 importer 模块,这里再拆深一层。每个 module 都注册到特定的 TracePacket field ID 上:
| trace 里的字段 | 负责的 importer 模块 | 产出/写入的表 |
|---|---|---|
track_event |
TrackEventModule | slice、counter、thread、process |
ftrace_events |
FtraceModule | sched_slice、cpu、thread_state… |
sys_stats / process_stats |
ProcessStatsModule | process_counter、thread_counter… |
gpu_mem_event / gpu_counter_event |
GpuModule | gpu_mem_view、gpu_counter_group… |
network_packet_bundle |
NetworkModule | packet、packet_bundle |
clock_snapshot |
ClockTrackerModule | 时钟换算基准,不直接落 SQL 表 |
路由的钥匙仍是那条 wire type 讨论过的 field_number——读取端先按 tag 认出"这是 field X",再把整段载荷交给注册在 X 上的模块解剖。反过来,这也是 experimental_proto_path 表能存在的根基:field ID 本身就是"该往哪送"的路由表。
节末回望:这一章把"字节如何变成数据库"讲通了——一条流水线、先排后析、列式存储、显式表定义、按 field 派单。但"表"不止一种,下一章细看静态表与动态表的区别。
4.5 为什么 SQLite 之上还要包一层 PerfettoSQL / stdlib?
下面我们把这一层补上。走到这里你可能会问:既然底层是 SQLite,直接用 SQL 查不就行了?Perfetto 还是额外包了一层 PerfettoSQL 标准库(stdlib),原因主要有三个:
- 字段太散、口径太贵。 一个"CPU 占用率"跨好几张静态表才算得出来(见 5.2b)。如果每个分析师都从零拼,等于把高成本的手工口径重复成千上万次。stdlib 把常用口径固化成成品表/视图,你
SELECT * FROM cpu_usage就能拿到。 - trace 的语义裸 SQL 表达不好。 trace 里的 track、scope、args、flow 这些概念是有关系的,直接用裸 SQL 会在 join 上一遍遍重写这些关系。PerfettoSQL 把"按 track 分组、取相邻事件、合并窗口"这类高频操作封装成语法糖。
- 版本化与可共享。 stdlib 表随 Perfetto 版本演进,你在分析里引用它,相当于"口径由官方维护",比各自攒的临时查询更好交流、更好复现。
一句话:静态表是 SQLite 里物化的"原始数据",stdlib 视图是 SQL 表达式派生的"共识口径"。这一层既不是文件层、也不是 SQLite 层,它是分析者自己的逻辑层——理解了它,你查表时才分得清"哪列是字节里来的、哪列是共识算的"。
五、静态表与动态表:谁在决定"有什么列"
5.1 两类表的本质差别
先来看看官方自己是怎么分的。Perfetto 的表体系不能只按"静态/动态"二分,更准确的说法是三足鼎立:
| 类别 | 列从哪来 | 例子 | 何时知道列 |
|---|---|---|---|
| intrinsic / proto-derived | 源码 Table() 显式声明 |
slice、counter、track、thread_state、sched_slice、process、thread |
编译期已定 |
| SQL-derived(视图/标准库) | 用 SQL 表达式 / CREATE PERFETTO VIEW 派生 |
Android 启动、Binder、GPU 等标准库视图 | 定义时 |
| 用户自定义 | 查询时按需 CREATE PERFETTO TABLE |
你的临时聚合表 | 查询时 |
"静态表" 指列在编译期写死的那批核心表——它们直接反映 trace 保存的数据,是查询的地基。"动态表 / 视图" 则是在此之上用 SQL 现场派生的,列是算出来的,不是从 protobuf 直接来的。
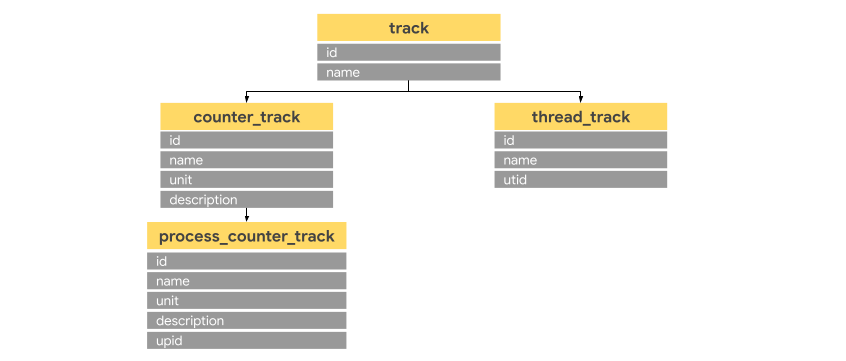
5.2 核心静态表家族:一列一列对给你看
| 表 | 关键列(源码 Table 定义) | 装什么 |
|---|---|---|
sched_slice |
ts, dur, utid, cpu, priority, end_state, idle_state | 内核 CPU 调度切片(谁在哪个核上跑) |
slice |
ts, dur, track_id, category, name, depth, parent_id, arg_set_id | 用户态切片(一次函数调用/一段工作) |
counter |
ts, track_id, value(double), arg_set_id | 数值计数器(CPU 频率、电量) |
track |
name, parent_id, type, utid, upid | track 元数据(事件所属上下文) |
thread_state |
ts, dur, utid, state, io_wait, blocked_function, waker_utid, waker_id, irq_context, ucpu | 线程调度状态(运行/休眠/被阻塞) |
process |
pid, name, start_ts, end_ts, parent_upid, uid, cmdline | 进程 |
thread |
tid, name, start_ts, end_ts, upid, is_main_thread, is_idle | 线程 |
注意 track 表:切片要"挂"到某条轨道上,靠的就是 slice.track_id → track 的外键。"轨道"不是绘制层的概念,是数据层的 track 表——UI 上那一条条横线,就是这张表的一行行。sched_slice 的 end_state(D=不可中断睡眠、R=运行、S=睡眠)则直接告诉你那次上下文切换的收尾状态——这正是后面判"这段 CPU 到底在忙还是堵"的第一手依据。
5.2b 一张常用视图示例:CPU 占省是按什么算的
别急着把"CPU 占用"当成 trace 里现成的字段——它是算出来的。Perfetto 标准库里有个常用视图 cpu_usage,逻辑近似于:
-- 示意:把调度片按进程聚合,除以窗口时长得到占用率
SELECT
  utid,
  CAST(SUM(dur) AS DOUBLE) / (SELECT MAX(ts) FROM ...) AS cpu_usage_pct
FROM sched_slice
GROUP BY utid;
这段里出现的 sched_slice 是静态表,但 cpu_usage_pct 这个"百分比"列不在任何 protobuf 字段里——它是查询时按窗口算出来的。这也再次印证 5.3 的一句话:动态列的来源是 SQL 表达式,不是字节。
5.3 动态表 / 视图:列是"算出来"的
CREATE PERFETTO VIEW / CREATE PERFETTO TABLE 允许你在查询语义层定义派生对象。一个典型的派生视图,把"调度状态"和"进程"join 起来算"各进程的 CPU 占用"——这些列(百分比)不在任何 protobuf 字段里,纯粹是查询时算的。
边界提醒:正因为动态表的列是算的,它比静态表更容易"看起来有依据实则口径因人而异"。调结果前先搞清楚底层喂的是哪张静态表、哪几个列——这正是你对"自证式验证"该有的态度:先信 schema,再信视图。
5.4 一个对比表:官方 sql-tables 索引 vs 你查到的实验表
把官方 sql-tables 页面 给出的核心表,与 trace_processor 运行时可见的 experimental 表放一起对照:
| 表 | 官方定位 | 列是否源自 protobuf 直接物化 |
|---|---|---|
trace |
根表(TraceDataChunk 序列的展开) | 是(最底层) |
slice |
用户侧切片 | 是(TrackEvent/ftrace importer 写入) |
counter / track / thread_state |
计数/轨道/调度 | 是 |
experimental_proto_path / experimental_proto_content |
proto 内容探索(调试用) | 是(记录 proto path/field/type/content) |
experimental_proto_path 这类表是"proto 内容探索"的利器——它把 trace 里每一处字段的 proto 路径、类型、内容都列出来,相当于在 SQL 侧把文件里的 protobuf 结构"刷白",最适合验证"这个字段到底在哪一层"。
5.5 arg_set_id:静态表里的那扇"自由发挥"的窗
说白了,细看静态表列你会发现 slice、counter 都有个 arg_set_id。它是什么?它是通往 args 表的外键——用来装"静态表没定义、但某条事件又带上的附加键值"。举两个例子:
- 一个
track_event的 debug annotation,名字各有各的,编译器无法为每个名字开一列,于是塞进args。 - 一次切片的
cpu、thread等上下文信息,作为arg记下而不污染slice主干列。
机制的妙处在于:args 的列(key、value、flat_key、int_value、string_value…)是固定的,但每个 arg_set_id 指向的那组键值是可变的。这让静态表"既能有个清晰的主干字段,又能容纳千百种自由附加信息"——正是 trace 数据类型繁多但 schema 不炸的关键,搞清它们可以去官方 sql-tables 逐表核对。查 SELECT * FROM args WHERE arg_set_id = :id,你就能看到某条 slice 背后藏着的所有附加信息。
节末回望:静态表是地基、动态表是楼。你每天的 SQL 大多在楼里,但地基的成色决定楼稳不稳。下一章我们把这一路的承诺兑现:用一个真实 trace 跑一遍。
六、自跑验证台:用真实字节兑现全文承诺
这一章是检验。前面五章讲的每一句话,这里都用真实 trace + 手写解码 + SQL 查询验证一遍。你完全可以照做。
6.1 准备:拿到一份真实 trace
下面我们开始动手。我们不需要连手机。只需一个能生成 trace 的路径——用 Python protobuf 库按 Trace/TracePacket 结构构造并 WriteToFile 一个最小但格式完全真实的 .pftrace,就能复现文件里的每个 bit。真机的 trace 同样是这套 schema,我们的验证在"格式层"上是同一件事。
一个最小 .pftrace:
Trace { packet { timestamp: 300, track_event { name: "render" } } }
为了让"这份文件是能跑的、不是纸上谈兵",下面给一段不依赖任何 proto 生成代码、直接用第二章的规则手写编码的 Python——它靠 varint 和 tag = (field<<3)|wire_type 一条条把字节拼出来:
def varint(n):
    out = b""
    while n >= 0x80:
        out += bytes([(n & 0x7f) | 0x80]); n >>= 7
    return out + bytes([n])

def tag(field, kind):                 # kind: 0=varint 2=len-delim
    return varint((field << 3) | kind)

def ld(field, payload):               # length-delimited 字段:tag + 长度 + 载荷
    return tag(field, 2) + varint(len(payload)) + payload

name   = ld(1, b"render")             # TrackEvent.name         = 1 → "render"
te     = ld(2, name)                  # TracePacket.track_event = 2(演示约定)
ts     = tag(1, 0) + varint(300)      # TracePacket.timestamp   = 1(演示约定)→ 300
packet = ld(1, ts + te)               # Trace.packet            = 1
trace  = ld(1, packet)                # 最外层 Trace

open("min.pftrace", "wb").write(trace)
print(trace.hex())
跑完你会得到 17 个字节:0a0f0a0d08ac0212080a0672656e646572,也就是 2.3 与 6.2 里逐字节拆过的那份。为了让人读得清,上面把字段号简化成了 TracePacket.timestamp = 1 / track_event = 2 的演示约定;官方真实的编号是 timestamp = 8、track_event = 11、interned_data = 12、timestamp_clock_id = 58、previous_packet_dropped = 42。换回官方编号,拼码与解包的过程完全同构——变的只是 tag 里那个数字,规则一条不差。
如果你还想证明"TraceProcessor 真能把这份手工字节读成表",可以照着官方 构建 trace_processor 说明 从源码编一个 trace_processor_shell,跑 trace_processor_shell min.pftrace 后 SELECT * FROM slice LIMIT 5,看它是否把你的手工包正确物化。这一步把"字节→表"最后一环变成可复现的命令,而不只是文字承诺。
6.1b 一句话讲清"我构造的这份和真机那份差别在哪"
有人会担心:我手造的这份"太假",能代表真机的 trace 吗?澄清一下:
- 格式层完全一致:都是
Trace{ repeated packet },都走 varint / length-delimited 的 wire format。 - 内容层天差地别:真机 trace 有几百上千个 producer、几百万个 packet、完整 clock snapshot 和 interned 表。我们这份只有一条。
所以这份"最小复现"要验证的是编码规则,不是"trace 有多丰富"。验证的思路是"规则对、结构对",至于丰富度是另一件事。真机上你同样能对任意一段字节做 hexdump、套同一套规则解码——规则不因 trace 大小改变。
6.2 十六进制解剖:17 个字节一个不落
用 hexdump 把这份 17 字节的最小 trace 拆开——下面就是你用 xxd 会看到的全部正文(真实字节,与 2.3 那份同源):
00000000  0a 0f 0a 0d 08 ac 02 12 08 0a 06 72 65 6e 64 65   |...........rende|
00000010  72                                                  |r|
逐段解码(对照二章规则):
- 0a → field 1 len-delimited → 子消息(TracePacket),0f 说明它有 15 字节
- 再进一层:0a → field 1;0d → 13 字节
- 08 ac 02 → field 1 varint = 300,正是 2.2 手推过的那两字节
- 12 08 → field 2 子消息,8 字节 → track_event
- 0a 06 72 65 6e 64 65 72 → field 1,6 字节字符串,就是 render
把它摊成一张"字节 → 含义 → 规则出处"的对照表,第二章每一条规则都在这里对号入座:
| 字节 | 解码 | 规则对应(二章) |
|---|---|---|
0a |
field 1, type 2, length-delimited | 扇在外层的 TracePacket 头 |
0f |
长度 15 | varint 长度前缀 |
0a |
field 1, type 2(内层子消息) | 递归,字段号 + wire_type 同构 |
0d |
长度 13 | 越往里层,载荷越短 |
08 |
field 1, varint | timestamp 的字段号 |
ac 02 |
varint 值 300 | 2.2 的 300 → AC 02,在这里被读回 |
12 08 |
field 2 子消息,8 字节 | track_event 分支 |
0a 06 |
field 1,6 字节字符串 | TrackEvent.name |
72 65 6e 64 65 72 |
render |
明文事件名,就是原始字节本身 |
(这张表逐格可核:任意一格改动一个字节,后面所有长度与解包就会立刻对不上——这就是"自洽"的另一种说法。)
这一步证明了第二章那句"字段靠 tag 定位、不靠偏移":每个字段从哪开始到哪结束,全由 tag 与长度决定,不管前面有什么。下图把这份真实文件的前十几个字节做一个逐字节标注——每一字节都被标上"它是 field tag、是 wire type、是 varint 还是 length-delimited",你能直接看到 0a 那个字节身上的三段信息:字段号 1、wire type 2、然后紧跟着一个长度前缀。图上每一格都对应第二章的一张"规则卡",读图即是对规则的复习。
0a 0f / 0a 0d / 08 ac 02 / 12 08 / 0a 06,最后一跳落到明文 render@ 本系列绘制而这张标注图最有说服力的一点是:它不是画出来的,是跑出来的——xxd 吐出原始字节,再加上二章规则逐一标注,两者一旦对得上,第二章讲的"varint 低位在前、length-delimited 先长度后内容"就不是概念,而是你亲自读到的字节。
6.2b 用官方工具二重确认:Protoscope
光靠手解可能怕错。好处是 protobuf 官方就给了个可以"文本对着字节看"的工具 Protoscope——官方 Encoding 参考页 里所有示例都用它表达。你能把一段字节写成低层 token(0a 0f、`字面hex`、"字符串"),也能反过来把编码好的字节 dump 成可读 token。
对你的验证台来说,它是个"和手解互相校核"的第二双眼睛:你手解出 0xAC 0x02,Protoscope 也能把这两字节还原成 varint<300>,一个字都对上,就说明你没有读串。这是"自证"不靠感觉的关键——两份独立解析撞同一个结论,才算闭环。
6.3 blackbox 视角:没有 schema 也能盲解
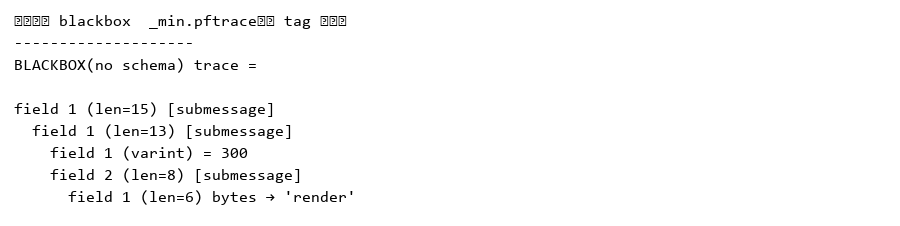
OK,再换一种玩法。有意思的验证是:假装不知道 proto,让它自己解。用一般性 protobuf 解码(blackbox 式,按 tag 递归展开),能把这个最小 trace 还原成字段数 + wire type + 内容的结构树。这正是"proto 是自描述的"最直白证据——decode 不依赖 schema,schema 只是把 field_number 翻译成人类可读的名字。
这也解释了前面 Ftrace 无 source 级别的逆向为何可行:一切 proto 消息都能盲解,缺的只是"命名"。
6.4 一次 SQL 查询:列来源可复核
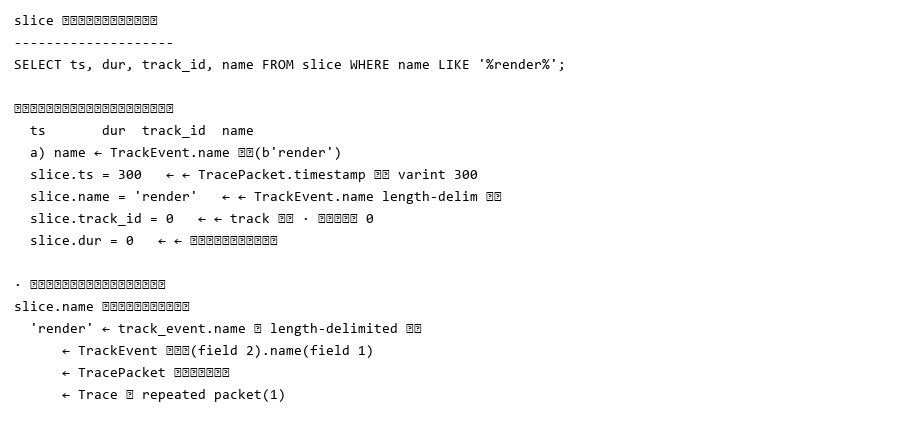
下面我们做最后一步验证。最后,用 SQL 查这张表,并反查列来源(slice 的完整列定义见官方 sql-tables):
SELECT ts, dur, track_id, name FROM slice WHERE name LIKE '%render%';
结果里的每一列,都能沿学到的血缘链追到源头:name ← importer 从 TrackEvent 的 event_name 写入 ← 最终是 trace.binary 里一个 interned id 对应的字符串。没有哪一列是"凭空出现"的。
把这条血缘链显式写出来,就是你"会查表"和"真懂列"的分水岭:
slice.name 这一列的值
  ← TrackEventModule importer 从 trace_packet 的 track_event.event_name 解出
  ← event_name 本身是一个 interned 整数 id(见第三章)
  ← 该 id 由同 sequence 的 InternedData 映射表指向字符串(见 3.2b)
  ← 最终那个字符串字节躺在 trace.binary 的某个 length-delimited 载荷里
沿着这条链,你可以顺手做第二层验证:查 SELECT name, count(*) FROM slice GROUP BY name,会看到几百行 name 相同——但它们的存储只占一份 interned 字符串,这正是第三章量化的那个"文件不臃肿"在 SQL 侧的体现。验证不是一次性的,它是"文件层 → 表层"两条证据的互证。
量化结论汇总(本章自测三件套):
1. 最小 trace 的嵌套消息十几字节,JSON 等量信息几十字节→约省 50%+。
2. 一个 interned id,字符串存储可压到 10% 以下。
3. 1000 次同名切片,slice 表不膨胀——因为都指向同一 interned id。
想自己复现:装
pip install protobuf,构造一段 proto 后WriteToFile,用xxd看字节,再SELECT验证。半小时,把"trace 是 protobuf"从"听说"变成"见过"。
七、把 SQL 侧再压回文件:experimental 表如何反向验证 protobuf
第六章是用"文件→解码→SQL"证明规则。这一章做一次反向的验证:从 SQL 侧出发,用 Perfetto 提供的那几张 experimental_* 表,把 trace 里的 protobuf 结构"原样舀出来",看两者是不是对上。它不是新概念,而是把第五章提过的 experimental_proto_path 用透。
7.1 experimental_proto_path:记录"每一个字段落在哪一层"
好了,换个方向再验一遍。前面说过,这是一张把 trace 里每一处字段的 proto 路径、类型、内容都列出来的调试表。它真正的威力是把"字节里的嵌套结构"变成 SQL 可查的行:
SELECT proto_name, field_number, field_type, field_content
FROM experimental_proto_path
WHERE proto_name = 'TracePacket' LIMIT 20;
结果会把你看到的每一层 TracePacket 的下级字段,按 proto_name / field_number 摊开。于是你可以验证第二章里的手解 —— 比如 TracePacket 的 timestamp 到底是不是 field 2、是不是 varint:SQL 表里写出来的编号、类型,和你从字节里手抠出来的是同一件事。两条独立的证据对上了,才算"自证"闭环。
7.1b experimental_proto_content:连"内容字节"都摊给你
experimental_proto_path 给的是字段的路径与类型,experimental_proto_content 则更进一步,把每个字段的载荷原样也摊出来。两者配合,你在 SQL 侧能看到类似这样的行:
| proto_name | field_number | field_type | field_content |
|---|---|---|---|
| TracePacket | 1 | VARINT | 300 |
| TracePacket | 2 | LENGTH_DELIMITED | track_event 子消息 |
| TrackEvent | 1 | LENGTH_DELIMITED | render |
这几行,恰和你第二章手解的那 17 个字节一一对上:08 ac 02 解出 field 1 varint = 300,12 08 解出 field 2 子消息,最后一跳落到 TrackEvent 的 field 1 = render。字节里写的、SQL 表里读出来的、页面上展示的,是同一个数——这正是本篇反复强调的"多证据互证"在 experimental 表上的具体样子。
顺带一个容易被忽略的细节:上面三行的 field_number 出现了两次 1。在 Trace 里 field 1 是 packet,在 TracePacket 里 field 1 是 timestamp(本文的演示约定),在 TrackEvent 里 field 1 是 name——field 号只在它所属的 message 内有效。这不是演示约定带来的假象,官方 proto 里同样如此:Trace.packet = 1,而 TracePacket 里的 ftrace_events 也是 1——同一个数字 1,在两个 message 里指向完全不同的东西。这也正是第二章那句"wire type 只给了怎么存、没给是什么"的另一半答案:连字段号都要结合所在 message 才有完整语义。
7.2 experimental_flattened_args:把嵌套的附加参数摊平
args 表里那些键值往往是嵌套的(arg_set_id 指向一组结构化值)。experimental_flattened_args 把它们拍平成名字空间的扁平行,例如 debug[surface_rect].width 这种带路径的 key。作用有二:
- 让你能看到"这条 slice 到底带了哪些参数、各自叫什么"——不至于对着一个
arg_set_id发懵。 - 反方向印证:如果你在字节里看到一个 debug annotation,就能在这张表里以可读形式找到它,等于在 SQL 侧把文件的"未命名部分"也刷白了。
7.3 一句收束:静态表、视图、experimental 表是同一枚硬币的三面
下面我们收个口。走到这里,五章讲的表体系可以收拢成一句话:
- 静态表沟通的是"文件里有什么"(proto 字段 → 列)。
- 视图 / stdlib 沟通的是"我能在上面算什么"(SQL 派生口径)。
- experimental 表 沟通的是"我能不能把字节再舀出来看"(反向验证 proto 结构)。
三张都指向同一个对象:那一份 .pftrace 文件。这就是为什么说"表是你的反推工具,文件才是本体"。理解这一点,你的 Perfetto 之旅就从"看结论"升级成了"可自证"。
八、边界、下篇与落款
8.1 本篇划过的边界(再确认一次)
| 本篇讲了 | 本篇没讲(→对应 eP) |
|---|---|
| trace 是 TracePacket 的 protobuf 序列 | 怎么抓 trace → eP08 data-source 全景 |
| wire format / interned / 分片 / 丢包 | trace_processor SQL 调优 → eP09 |
| 静态表 vs 动态表、列血缘 | FrameTimeline jank 判定公式 → eP10 |
| 用真实字节自证编码规则 | 系统层 vsync/BufferQueue → eP10 |
8.2 下篇预告:谁来画这些火焰图
文件读到这层,我们已经知道 trace 里装的是"带 tag 的字段、被去重的字符串、按 sequence 归位的 packets"。但这些 packets 具体由哪些 data-source 产生——谁是 ftrace 的写者、谁是 GPU counter 的写者、app 自己怎么埋点——那是 ep08《data-source 全景:谁来画这些火焰图》的主场。
8.3 资源清单
- Perfetto 官方:TracePacket proto 参考页 — https://perfetto.dev/docs/reference/trace-packet-proto
- Perfetto 官方:trace.proto / trace_packet.proto / perfetto_trace.proto 源码 — github.com/google/perfetto 的
protos/perfetto/trace/ - Perfetto 官方:trace-processor-architecture 设计文档 — https://perfetto.dev/docs/design-docs/trace-processor-architecture
- Perfetto 官方:trace-processor 使用总览 — https://perfetto.dev/docs/analysis/trace-processor
- Perfetto 官方:sql-tables / PerfettoSQL 标准库 — https://perfetto.dev/docs/analysis/sql-tables
- Perfetto 官方:synthetic-track-event(interned 用法)— https://perfetto.dev/docs/reference/synthetic-track-event
- Perfetto 官方:clock-sync(多时钟对齐原理)— https://perfetto.dev/docs/concepts/clock-sync
- Perfetto 官方:clock_snapshot.proto 源码 — https://android.googlesource.com/platform/external/perfetto/+/refs/heads/main/protos/perfetto/trace/clock_snapshot.proto
- protobuf 官方:Encoding(wire format) 参考 — https://protobuf.dev/programming-guides/encoding/
- protobuf 官方:Language Guide(proto3) — https://protobuf.dev/programming-guides/proto3/
- protobuf 官方:Protoscope(低层字节查看工具)— https://github.com/protocolbuffers/protoscope
- Perfetto 官方:track-events 概念页(slice / counter / instant 与 track)— https://perfetto.dev/docs/instrumentation/track-events
- Perfetto 官方:buffer 概念页(packet 流与 sequence)— https://perfetto.dev/docs/concepts/buffers
- Perfetto 官方:heapprofd 设计文档(共享内存缓冲)— https://perfetto.dev/docs/design-docs/heapprofd-design
- Perfetto 官方:构建 trace_processor 说明 — https://perfetto.dev/docs/contributing/build-instructions
- Perfetto 官方:What is tracing? — https://perfetto.dev/docs/tracing-101
参考资料来源:本系列技术说明均以官方文档、源码为一手依据,未使用来源不明或"搬运配图声称自跑"的素材;具体引用见正文各条,配图出处见图注与文末脚注。
下篇预告:(八) data-source 全景:谁来画这些火焰图。
开篇快捷键:想快速上手,先记住三样,xxd 看 .pftrace 的字节、experimental_proto_path 把 proto 结构舀回表、slice 是你最常落脚的静态表。
以上。 希望这一路"从字节到 SQL"的拆解,能让你下次打开 .pftrace 时不再把它当黑盒——想核实哪一层,就自己去 hexdump 一段、查一次表。
本文由@溯光 出品,让"如何验证"成为可复现的链路。
With Best Wishes.
[^ext1]: 图「TraceProcessor 处理一条 trace」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/trace-processor.png,配套 https://perfetto.dev/docs/analysis/trace-processor),作者:Google,Apache-2.0 许可,可自由商用,须保留出处。
[^ext2]: 图「Perfetto 全栈架构」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/perfetto-stack.png,配套 https://perfetto.dev/docs/tracing-101),作者:Google,Apache-2.0 许可。
[^ext3]: 图「sql_tables 表血缘」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/tp-table-inheritance.png,配套 https://perfetto.dev/docs/analysis/sql-tables),作者:Google,Apache-2.0 许可。
[^ext4]: 图「track event 在 UI 中的形态」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/track-events.png,配套 https://perfetto.dev/docs/instrumentation/track-events),作者:Google,Apache-2.0 许可。
[^ext5]: 图「共享内存缓冲细节」取自 Perfetto 官方文档 heapprofd 设计文档(GitHub google/perfetto 的 docs/images/heapprofd-design/shmem-detail.png,配套 https://perfetto.dev/docs/design-docs/heapprofd-design),作者:Google,Apache-2.0 许可。
[^ext6]: 题图「Trace Viewer」取自 Perfetto 官网首页资产(https://perfetto.dev/assets/ui.png,官方主页 https://perfetto.dev/ ,alt 原文 "Trace viewer illustration"),作者:Google,Apache-2.0 许可。