本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
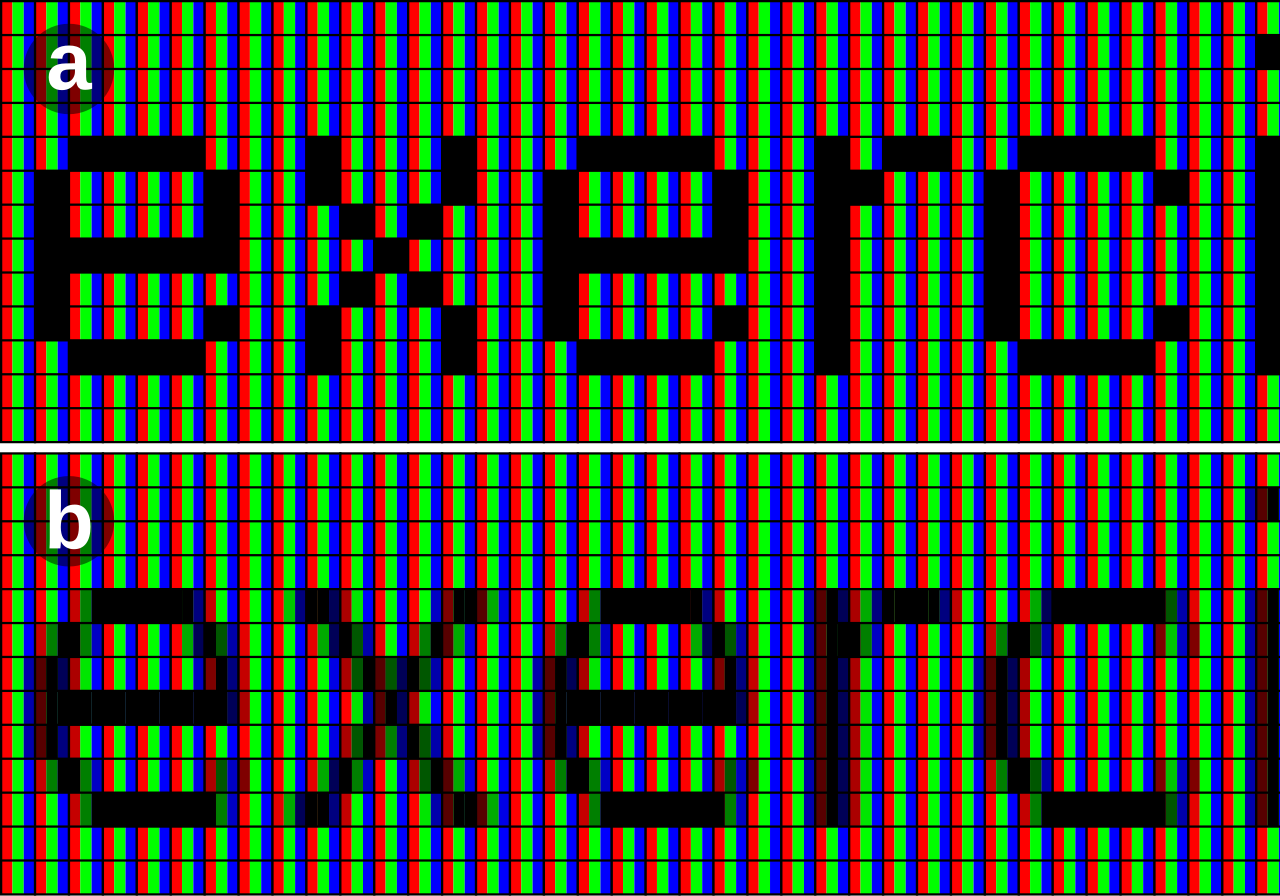
上一篇换的是后端。同一段场景代码,CPU 光栅跑一遍、GPU 后端跑一遍,然后把两条路的输出差、耗时口径与 overdraw 触达数逐条量出来。这一篇不换后端了,换输入。
输入有两样,都在 Skia 的「谁来画」与「画什么」之间那条缝上。第一样是 SKP——一份把绘制命令录下来、可以存成文件、可以在别的时候放出来重放的东西。它回答的是「录下来的到底是什么」:是像素,还是命令?如果只录命令,那录一份带中文的图,文件该有多大?第二样是文字——同一串字,交给同一个光栅器,只是把 hinting(提示)、edging(边缘处理)、亚像素(subpixel)这几个开关拨一下,画出来的像素会变多少?
这两样凑在一起,是因为它们共用同一个落点:「一份内容」从「被记下来」到「被画成像素」之间,到底有多少东西是你没写在代码里、却实实在在决定了结果的。SKP 那一侧,答案是环境里的字体;字体那一侧,答案是三个开关背后的那套机制。
这是「自跑」系列的第二篇。上一篇的读数全部来自一台机器——Windows 10.0.26200 | Python 3.10.11 | skia-python 144.0.post2 | GLFW 3.4.0(Win32 WGL)| NVIDIA 驱动 560.70 | GeForce RTX 3060 Laptop GPU。这一篇一模一样,环境、绑定、口径都不换,方便两篇的读数对着看。也正因为是同一台机器,边界也和上一篇一样必须写在最前面(见 0.4):这一篇里有两个实验的结果是零,还有一个章节的结论只能靠改字节而不是靠真文件来支撑——这两件事我都会照实写,不修饰。
先看看这一篇要回答的三个问题。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 结论带读数:凡是「更快/更差/更大」的说法,绑定本机读数并写明口径与条件;
- 凡引必注:官方定义给链接,本机读数给环境、命令与脚本口径;
- 本篇不涉及(边界见 0.3):Graphite 的运行(本机跑不了,见第六篇)、overdraw 触达计数与两条后端的耗时口径(已在第七篇做完)、 Vello 与 sparse strips(ep09/ep10)、GPU 抓帧与片元计数(本机无工具)、跨机型与跨平台的结论;
- 篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,400 到 2,300 字。
本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真跑/真算的读数图由本篇的测量脚本产出(图注写明口径);
自绘图为本系列绘制,走 styles/qianmo/palette.json 色板单源。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(第一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 上一篇(两条后端与 overdraw 的读数):【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 本次用的绑定:skia-python 发行页 | skia.Picture 参考 | skia.Font 参考
- 官方 SKP 工具:Skia Web Debugger | Chromium:如何保存 .skp 文件
- 上一篇的姊妹篇主题(字形数据组织与 blob):【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
本篇只回答三件事
先从三个问题入手。它们不是三个并列的知识点,而是一条从「输入」到「像素」的动线:先把录下来的东西拆开看它装了什么,再看这份东西换一条路放出来会不会变形,最后把镜头推到最小的那一格——一个字形在像素网格上是怎么落地的。
0.1 全篇知识地图:三个问题,一条动线
好了,先把两份输入摆开。
第一件:一份 SKP 里到底存了什么? 这件事最容易被「文件格式」四个字糊过去。我们要盯住的是一个具体的选择:Skia 在录制的时候,存的是像素还是命令?官方对 SkPicture 的第一句定义就把答案给了——「SkPicture records drawing commands made to SkCanvas.」。存命令,就意味着这份文件的大小跟画面复杂度无关、跟画面里有没有字高度相关。这一章要把这件反直觉的事量出来:同一张 256×256 的画面,画一个矩形和画四个中文字,文件能差四个数量级。
接着看第二件。
第二件:同一份 SKP 换一条后端回放,结果会一样吗? 上一篇量过「同一段代码在两条后端上有 1.58% 的像素不一样」。这一篇的问题更刁一点:如果代码不是重跑一遍,而是从文件里读回来再放,那还能不能保证一样?换句话说,序列化(serialization)与反序列化(deserialization)这一段本身有没有损耗?如果有,那「SKP 是一份可靠的交付格式」这句话就不成立了。
OK,第三件换个方向。
第三件:那几个字体开关,各自在像素上改了什么? 这一件是第二件的放大镜。SKP 里存的字体信息,最终要落到 SkFont 的几个开关上——hinting 四档、edging 三档、亚像素定位开关。官方对它们的说明都很短,短到看不出代价。这一章要把「代价」量成数字:开一个开关,同一个字形在缓存里要多存几份?关一个开关,四个不同位置会不会塌成同一张图?
这三个问题说完了。
OK,把这套做法先定义清楚,再压成一句话。
0.2 一句话说清这篇换了什么做法
上一篇问「同一段代码交给两条路会怎样」,这一篇问「同一份内容交给两份输入会怎样」。
前一句里,「同一段代码」是活的——每次运行都重新走一遍绘制命令。后一句里,「同一份内容」是死的——它先被写成字节,再从字节被读回来。这中间多出来的一段路,就是这一篇要检查的东西。
所以这一篇的诚实标准又多了一条。上一篇的诚实是「这个数字是在什么环境、什么口径下测出来的」;这一篇要加上一条:「这个数字是在这份文件、这个版本、这套绑定上测出来的」。因为 SKP 自带版本号,读取方对版本是有闸门的;而字体是不是随文件走,又决定了这份文件能不能在另一台机器上还原出同一张图。
还有一件事得提前说清:自跑篇最容易犯的错,不是数算错了,而是把「本机这一版」当成了「Skia 的规矩」。这一篇里几乎所有结论都挂着版本号或绑定版本——skia-python 144.0.post2、头部版本号 109、Python 绑定没暴露的那几个接口。数字一旦离开这一层,就只剩「好不好看」这一个属性了;本篇会反复回到这句话。
先把不做的那部分定义清楚,直接让出去。
0.3 边界:本篇不涉及什么
把话说在前面,避免把精力花在别处:
- Graphite 的运行:本机绑定里没有
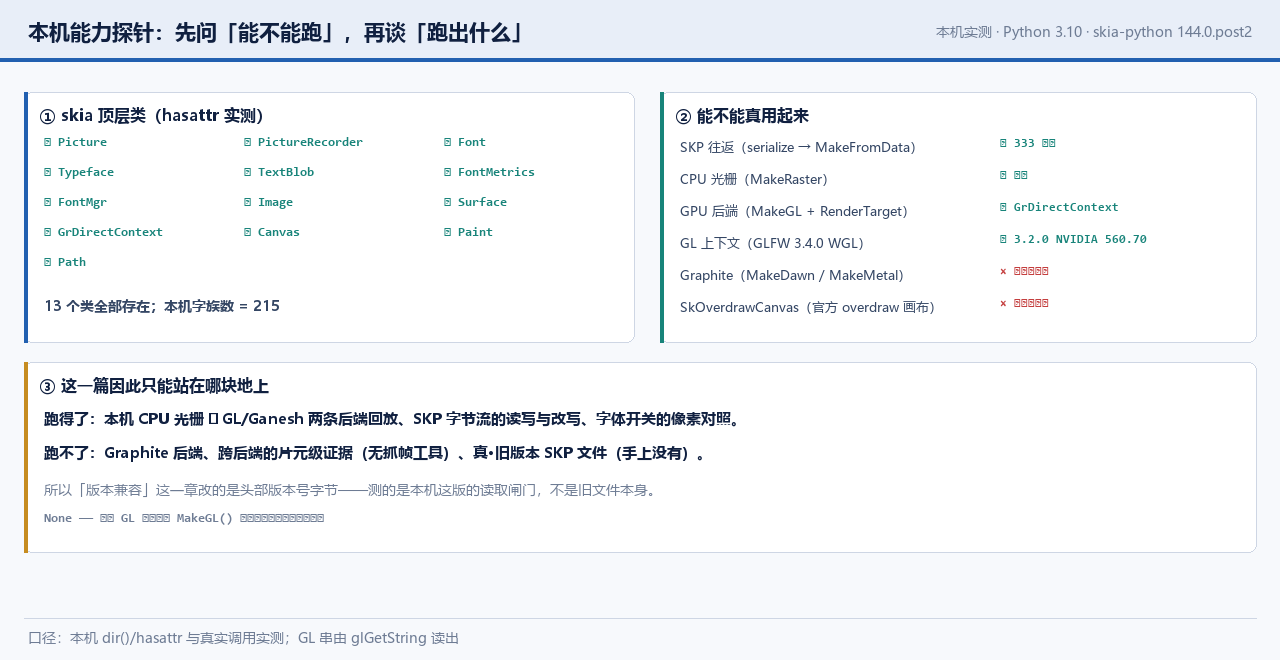
MakeDawn,所以第六篇讲的那套结构在本篇依旧跑不起来——本篇的 GPU 侧一律指 GL/Ganesh 那条路; - 两条后端的耗时口径与 overdraw 触达计数:这两件事在上一篇已经做完了,本篇不重复,只在需要对照时引用它的结论;
- GPU 抓帧与片元计数:本机没有 RenderDoc、AGI 这类工具。跨后端的差异本篇只能停在「像素级」,停不到「片元级」;
- 真·旧版本 SKP 文件:本机手上没有旧版本 Skia 产出的真实 SKP。第三章测的是读取闸门,不是旧文件本身(详见 §3.2);
- Vello / sparse strips / prefix-scan:属 ep09/ep10;跨机型与跨平台的结论:本篇只报本机读数,不外推。
关键参数的取值范围(本篇反复用到的几个数,先立在这里):实验画布 256×256 与 512×256;
字形实验统一用 Microsoft YaHei 28px 的字串「字形Ag」(拉丁对照用 Arial 40px 的「Graphite」);
字号扫描取 8 / 12 / 16 / 24 / 32 / 48 / 64 七档;亚像素位置序列取 0 到 0.875、步长 0.125 共八档。
0.4 证据口径与能力边界
这一节要放在最前面,因为它决定了大家怎么读后面的每一个数字。
第一类:本机真跑。 所有读数取自同一份测量脚本,环境是:Windows 10.0.26200 | Python 3.10.11 |
skia-python 144.0.post2 | GLFW 3.4.0(Win32 WGL)| NVIDIA 驱动 560.70 | GeForce RTX 3060 Laptop GPU。
GL 侧读回的是 GL_VERSION = 3.2.0 NVIDIA 560.70、GL_RENDERER = NVIDIA GeForce RTX 3060 Laptop GPU/PCIe/SSE2。
本机字族数 215。这是一台机器的读数。
第二类:本机真算。 「落墨像素」(与底色通道差大于 6 的像素总数)是自己算的,不是引擎给的统计接口。 它包含抗锯齿边缘那些半透明的像素,所以它量的是「这次绘制碰到的像素规模」,不等于「填充率」,也不等于「GPU 片元着色调用数」。 这两件事相关,但不等同——这条界线在上一篇已经划过,这里照旧。
本机明确拿不到的四样东西(逐条给原因):
- 真·旧版本 SKP 文件:手上没有旧版 Skia 产出的样本,也没有现成的跨版本语料;本机这一版只能写出当前版本的文件;
- strike cache 的实际条目数:Python 绑定没有暴露字形缓存的统计接口,本篇第十章给的键位数是推算,不是实测;
- 跨后端的片元级证据:需要抓帧工具,本机没有;本篇只能给到逐像素;
- Graphite 上的回放行为:绑定里没有
MakeDawn,跑不起来。
一条额外的自我约束:本篇把零结果当结果写。实验里有两次「本该有差别、实际没有」:hinting 的 kSlight / kNormal / kFull
三档在本机落在同一张图上;setLinearMetrics 在本机对像素的影响是 0。这两条不会因为「看起来不漂亮」被删掉,
也不会被换成「理论上应该有差别」——它们就是这台机器上的实测。
0.5 本章收在哪里
下面我们进入第一阶段。 本篇的线索是「两份输入」:一份是录下来的绘制内容(SKP),一份是当场排的字。先从第一份开始,把它从「一个文件」拆成「一串字节」。
官方依据:
SkPicture的定义与「records drawing commands」的原话见 api.skia.org · SkPicture; 录制与回放的入口见 api.skia.org · SkPictureRecorder; Python 绑定侧的 API 见 skia-python · skia.Picture; 本篇的绑定版本与建面方式见参考资料第 25–27 条。
一、一份 SKP 到底是什么、有多大
这一章不写测量方法,只做一件准备工作:把「一份 SKP」这句话,落到「一串字节」和「一次往返」上。做完这件事,后面几章才有东西可拆。
1.1 录下来的是命令,不是像素
言归正传,从官方定义开始。
先看这一步的官方定义。SkPicture 的第一句是:
"SkPicture records drawing commands made to SkCanvas." —— api.skia.org · SkPicture
紧接着的第二句是「The command stream may be played in whole or in part at a later time.」——命令流可以在之后的某个时间被整体或部分地放出来。
两句连起来读,「录命令、放命令」这条链就完整了。录制的入口是 SkPictureRecorder::beginRecording,
官方说它「Returns the canvas that records the drawing commands.」——它返回的是一个 Canvas,也就是说录制过程里你面对的还是平时那套绘制 API;
收口的是 finishRecordingAsPicture,官方注明「The returned picture is immutable.」;回放则是 SkPicture::playback,
「Replays the drawing commands on the specified canvas.」。
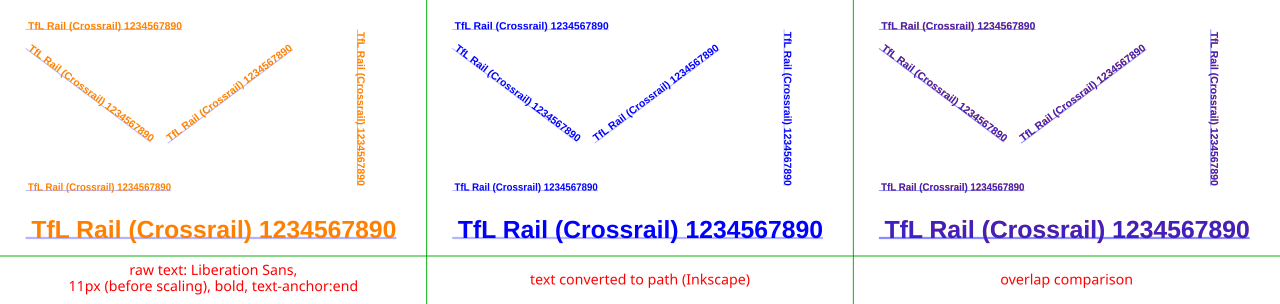
这里有个细节值得停下来看一眼:录制的对象是命令,不是像素。这意味着文字在录制的那一刻会被转成什么,是有讲究的。 文字在 Skia 里有两副面孔:一副是 text blob(一段可绘制的文本),另一副是轮廓路径(glyph outline)。 画文字时用前者,引擎会记下「在哪儿画了哪串字、用了哪个字体」;如果开发者自己先把字形转成路径再画,引擎记下的就是一堆路径。
这两种记法,最终会落到两个数量级完全不同的文件上(§2.2 会把数字给出来)。这也是「文字光栅化」这条线与「SKP 回放」这条线能接上的地方: 第四篇讲字形数据怎么组织、blob 怎么走,本篇讲这些数据在录制时被怎么对待。
一条容易被忽略的边界:beginRecording 接受一个 bounds 参数,但它是 cull rect(裁剪提示),不是硬边界。
官方原文是「Any drawing that falls outside of this rect is undefined, and may be drawn or it may not.」——
画到框外的内容,画不画是不确定的。这句话解释了为什么有的 SKP 回放出来会缺内容:录的时候框给小了,
放的时候引擎没有义务补齐。§3.2 会拿一次改字节的实验去验证这句话——把 cull rect 改到任意值,文件照样能被读进来。
1.2 一次往返:333 字节,进出像素一致
下面我们开始动手,让文件真的走一遍。
先看定义不够,得让文件真的走一遍。
下面这段是本篇测量脚本里的往返核心,完整的脚本在 .scratch/ep08_run.py:
rec = skia.PictureRecorder()
canvas = rec.beginRecording(skia.Rect.MakeWH(256, 256))
canvas.clear(skia.Color(247, 249, 252))
canvas.drawRect(skia.Rect.MakeXYWH(24, 24, 100, 100), paint_a)
canvas.drawPath(circle_path, paint_b)              # 一条描边圆弧
canvas.drawRect(skia.Rect.MakeXYWH(60, 150, 140, 60), paint_c)   # 半透明
picture = rec.finishRecordingAsPicture()

blob = bytes(picture.serialize())            # 写出去
back = skia.Picture.MakeFromData(blob)       # 读回来
四个 op(一次清屏 + 三笔绘制)写完,序列化出来的字节数是 333,文件开头的八个字节是 skia + pict。
把 blob 交给 MakeFromData 读回来,再在 CPU 光栅表面上回放一遍,与「录制后直接回放」的那张图逐像素比对:
不同的像素是 0 个,最大通道差 0。再把读回来的 picture 重新序列化一遍,还是 333 字节。
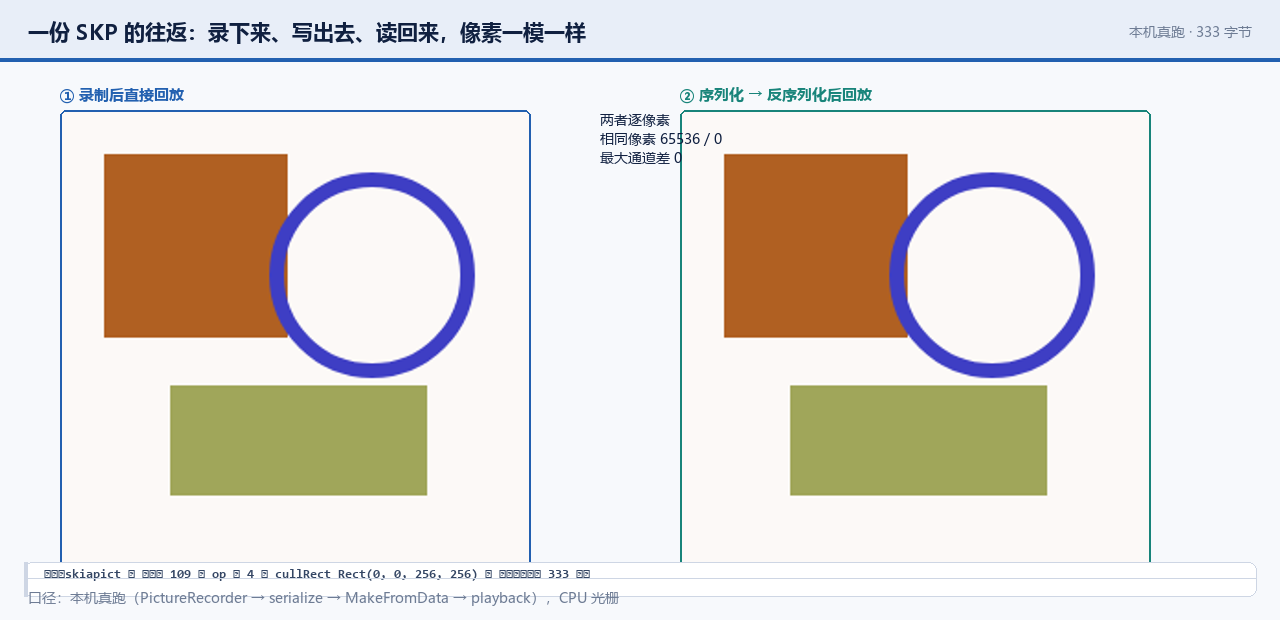
这三个数放一起看,说明了一件对后面很要紧的事:序列化这一段本身是无损的。文件里有的东西,读回来一模一样;文件里没有的东西,读回来也不会有。 所以后面第三章问「为什么旧文件打不开」、第四章问「换后端会不会变」,问题的位置就清楚了——它们都不在这段路上。 换一句话说:SKP 的保真度不是本篇的疑点,它的体积与它对环境的依赖才是。
顺手还能读出一件事:blob 的第 9 到第 12 个字节,按小端整数读出来是 109。这是这份文件自己声明的版本号,
而 kCurrent_Version = kWorkingColorSpaceOutput = 109 正是本机这一版 Skia 的当前版本。写入方盖了个章,读取方要验章——
第三章就是围绕着这个 109 与它下面的那个下界展开的。
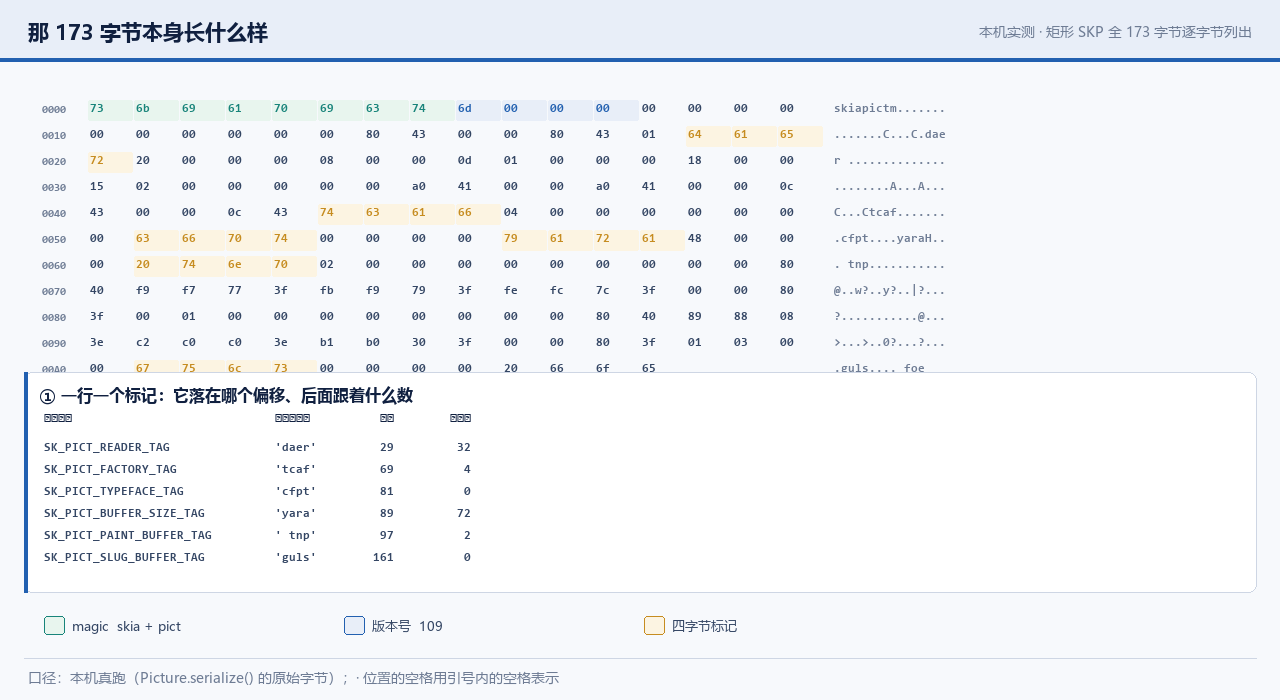
这张图把前文的三个说法一次落了地:头 8 个字节是 skia 加 pict(magic),紧接着 4 个字节是小端版本号 109,
再往后就是那一串带标记的分块。标记不是从源码里抄来的名字,是在这份文件的字节里扫出来的——
它们的偏移与「后面跟着的那个数」都列在图的右半部分,下一章会逐条解释这些数各自是什么意思。
1.3 本章收在哪里
下面我们进入下一章。 现在我们知道「一份 SKP」是一串带版本号的字节,也知道这一段路是无损的。 接下来要把这串字节切开看:它里面按什么分块、每块装什么。
官方依据:
SkPicture/SkPictureRecorder/playback的定义与bounds是 cull rect 的那句,见 SkPicture、SkPictureRecorder 与 Skia 用户文档;序列化与反序列化在绑定侧的接口见参考资料第 19–20 条。
二、SKP 里面分了哪些块
上一章知道了一串字节的总长与版本号,这一章要把它切开。切法很简单也很硬:跟着源码里那些四字节标记走。
2.1 一套带 tag 的分块
Skia 的序列化代码用一组四字节标记(tag)把内容分类存放。源码里的写法是 write_tag_size(buffer, TAG, count)——
先写标记、再写这个块的长度或条目数。SkPictureData::flattenToBuffer 里逐条写着这些块:扁平的 paint、path、文本 blob、slug、vertices、image 引用;
顶层还写出 op 流、工厂表、typeface、子 picture。
光有宏名不够,得看文件里到底有没有。本机做了一次扫描:对每个候选标记,取它的四字节反转形式,在一份份 SKP 里找, 再读它后面那四个字节的小端整数,看是不是一个像样的长度或计数。判定标准只有一条——内容增减,标记随之出现或消失。 四条用例分别是:只有矩形、矩形 + 一条路径、矩形 + 路径 + 一个圆、以及在前者基础上再加一段文字。
扫出来的结果很干净,逐条都对得上:
SK_PICT_PAINT_BUFFER_TAG后面那个数是 2 / 2 / 3 / 4,正好等于四份 SKP 里各自的 paint 数(清屏也算一笔);SK_PICT_PATH_BUFFER_TAG只在画了 path 的那三份里出现,纯矩形那份里没有它;出现了就是 1;SK_PICT_TEXTBLOB_BUFFER_TAG只在画了文字的那一份里出现,别的三份里都找不到;SK_PICT_TYPEFACE_TAG在没画字的三个里都是 0,画了字的那份变成 1;SK_PICT_READER_TAG后面那个数从 32 涨到 64,跟着命令数一起长;SK_PICT_BUFFER_SIZE_TAG从 72 涨到 276,跟着内容一起长;SK_PICT_SLUG_BUFFER_TAG四份里全是 0。这不是 bug——slug 是 GPU 侧的文本表示,CPU 录制不产生它。
其中:「内容增减 → 标记出现或消失」这条判据,比「在文件里搜到某四个字节」强得多。因为字体二进制里到处都是可打印的四字节窗口, 单看「有没有出现」,误判率很高;只有让它跟着内容一起进退,才算把标记坐实。
2.2 字节账:同一张 256×256,差四个数量级
先看看这笔账有多大。
块分清了,接着量每一块撞上字体之后会膨胀到什么程度。同样是 256×256 的画布,同样一次 serialize(),五种内容:
# 五次调用,只有画的东西不同;画布、底色、序列化方式完全一致
draw_rect_only(canvas)                      # 只有矩形
draw_string(canvas, "Graphite", arial_40)   # 拉丁文,Arial 40px
draw_glyph_paths(canvas, "Graphite", arial_40)   # 同一串字,先转轮廓路径再画
draw_string(canvas, "字形缓存", yahei_40)    # 中文,Microsoft YaHei 40px
draw_glyph_paths(canvas, "字形缓存", yahei_40)   # 同一串字,先转轮廓路径再画
读数是:只有矩形 173 字节;拉丁文画字 1,046,075 字节;拉丁文画轮廓 3,073 字节; 中文画字 19,704,677 字节;中文画轮廓 2,521 字节。
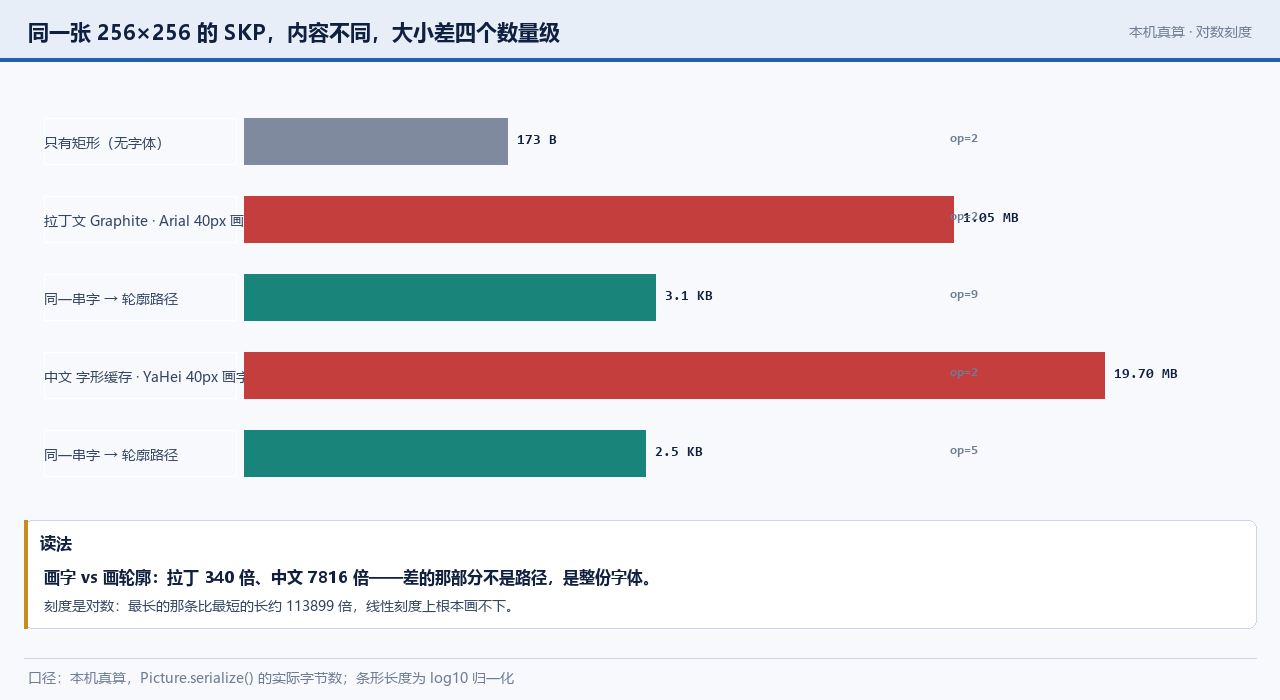
这组数把两件事同时说完了。
第一件:画字和画轮廓不是一个量级。拉丁文差 340 倍,中文差 7,816 倍。 注意方向——不是因为画字慢,而是因为画字把整份字体打进了文件。同一串「字形缓存」, 用 text blob 记录是 19.7 MB,用四条轮廓路径记录是 2.5 KB。差的那 19.7 MB 里没有一个是多余的像素。
第二件:中文字体的体量是拉丁字体的近二十倍。Arial 40px 那一份是 1.05 MB,YaHei 40px 那一份是 19.70 MB。
而 Category:Font hinting 这类「字体原理图」在素材库里全是几十像素的小位图(见素材清单),二者放在一起看很有意思:
原理图很小,原理本身很大。
2.3 那几十兆是什么:字体连同数据一起走
OK,查一下这几十兆到底是什么。
上一节的负数(19.7 MB)看着不像字节账,倒像有人在文件里塞了别的东西。查起来只差一步:把 SKP 的字节数与字体文件本身对一下。
本机 Windows 上,arial.ttf 是 1,045,720 字节,msyh.ttc 是 19,704,352 字节。两份画字的 SKP 分别是 1,046,075 与 19,704,677。
差值:+355 与 +325。
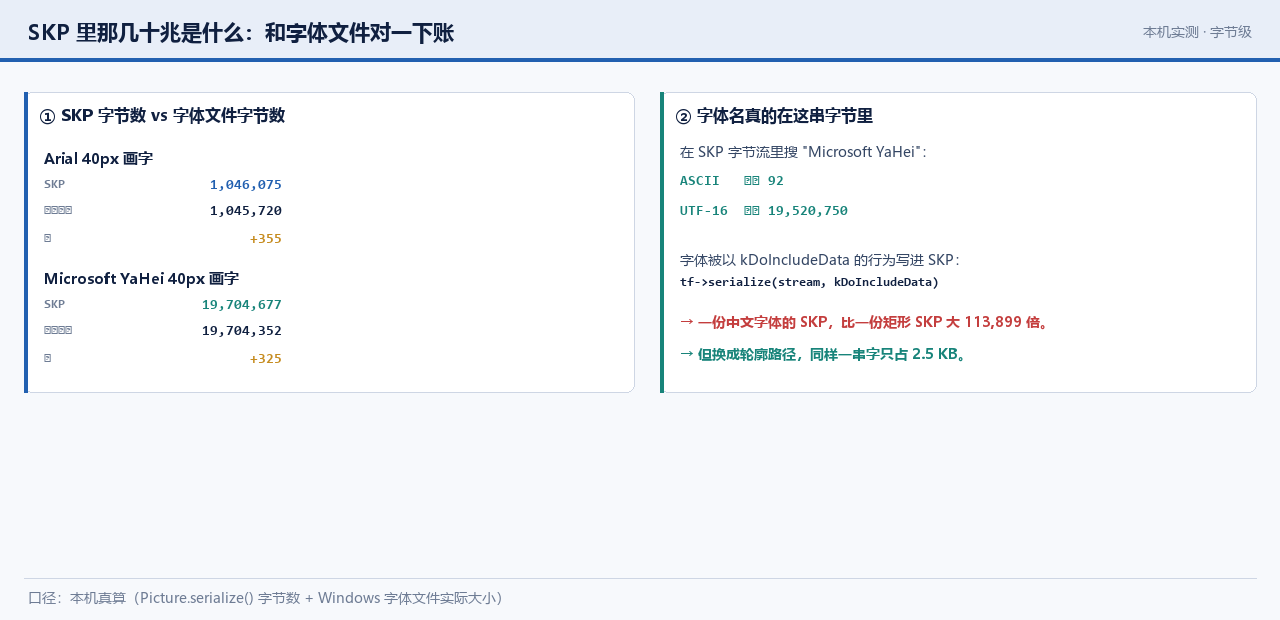
三百多个字节,就是一份 SKP 除了字体数据之外的全部开销(头部、op 流、paint 表、typeface 记录)。 换句话说:一份画了中文的 SKP,99.998% 的体积是字体文件本身。
源码那边有对应的写法。序列化 typeface 时用的是:
tf->serialize(stream, SkTypeface::SerializeBehavior::kDoIncludeData);
kDoIncludeData 这四个字就是字面意思:把字体数据一起写进去。本机还做了一步交叉验证——在这份 19.7 MB 的字节流里搜字体名,
ASCII 形式能在偏移 92 处找到,UTF-16 形式能在偏移 19,520,750 处找到。名字都在里面,数据当然也在。
顺手记一条源码注释里写明的坑:「With the default serialization and deserialization behavior,
kIncludeDataIfLocal does not always work because there is no default fontmgr to pass into SkTypeface::MakeDeserialize。」
——只带描述符、不带数据时,反序列化可能因为找不到字体管理器而失败。这解释了为什么默认行为选了 kDoIncludeData 这条更重的路:
重,但是自洽;文件拿到别的机器上也能还原出同一张图,不依赖对方的字体库。
其中:这一节的结论不是「Skia 浪费空间」。它是一笔明确的取舍——用体积换可移植性。 反过来看也成立:如果一份 SKP 里没有字体数据(比如录的时候字形已经转成了路径),那它拿到别的机器上就不依赖字体, 但画出来的就不是「字」,而是「一串轮廓」。两条路各有各的代价,本篇把它们各自的代价都量成了字节数。
2.4 本章收在哪里
下面我们进入下一章。 现在这串字节里有什么、最重的那块是什么,都清楚了。再说一件它自带的东西:版本号。 它决定了这份文件在别的机器上还能不能被读进来。
官方依据:分块与
kDoIncludeData的写法见 Skia 的SkPictureData.cpp、SkPicturePriv.h; 「没有默认字体管理器时kIncludeDataIfLocal不总能工作」见SkTypeface序列化相关注释; 序列化行为的定义见参考资料第 28 条,字体管理器与反序列化的关系见第 15 条。
三、为什么旧 SKP 会打不开
第二章把那串字节拆成了块,也找到了最重的一块。这一章换一个角度:这串字节自己带着一个版本号, 而读取方对这个号是有闸门的。闸门在哪、边界多严,就是这一章要量的事。
3.1 版本区间 82–109,以及字体那一次搬家
先把官方那句话说完整:
"Only SKPs within the min/current picture version range (inclusive) can be read." —— Skia 源码中关于 picture version 的注释
区间是闭区间,两个端点各有一个常量:kMin_Version = kPictureShaderFilterParam_Version(82)、
kCurrent_Version = kWorkingColorSpaceOutput(109)。官方 Debugger 页面上也直接把下界印出来了——「Minimum version this build can open: 82」。
而「字体」这条线,正好在这个版本轴上搬过一次家。版本注释里有两条相邻的记录:
// V67: Blobs serialize fonts instead of paints
// V68: Paint doesn't serialize font-related stuff
其中:读法是这样的——从 V67 起,文本 blob 开始自己序列化字体;到 V68,paint 里不再带字体相关的东西。 所以「同一份带文字的 SKP 在不同版本上能不能打开」这件事,取决于字体信息当时住在哪儿。 如果在 V67 之前录的,字体信息挂在 paint 上;之后则挂在 blob 上。这不是兼容性问题,而是存放位置迁移带来的读取路径变化。
那 82 与 109 之间隔着 27 个版本号。本机这一版写出来的文件,头部声明的正是 109。写入方永远盖当前版本这个章; 读取方要认的,是这个区间。这一节到这里只是读源码。下面把它变成一次可以重复的实验。
3.2 把版本号改掉,看闸门在哪一格
言归正传,先把手上的条件说清。
手上的问题是:本机没有旧版本产出的真实 SKP,怎么验证这个区间?
有一条不需要旧文件的验证路径:改字节。SKP 的头部是自描述的,本机从字节流里读出来的布局是:
偏移 0..4   'skia'            偏移 4..8   'pict'
偏移 8..12  uint32 版本号      偏移 12..16 保留
偏移 16..   float cullRect
一份 173 字节的矩形 SKP,前 24 字节的十六进制是 736b6961706963746d000000000000000000000000008043:
6d000000 就是小端整数 109。既然版本号是一个写在固定偏移上的整数,那就可以只改这 4 个字节,
其余部分一个不动,看读取方还认不认:
import struct
blob = bytearray(open("rect.skp", "rb").read())
for v in (60, 81, 82, 108, 109, 110, 200):
    b = bytearray(blob)
    struct.pack_into("<I", b, 8, v)          # 只动偏移 8 上的 4 字节
    try:
        pic = skia.Picture.MakeFromData(bytes(b))
    except ValueError:
        print(v, "拒收")
读数是:60 拒收、81 拒收、82 通过、108 通过、109 通过、110 拒收、200 拒收。
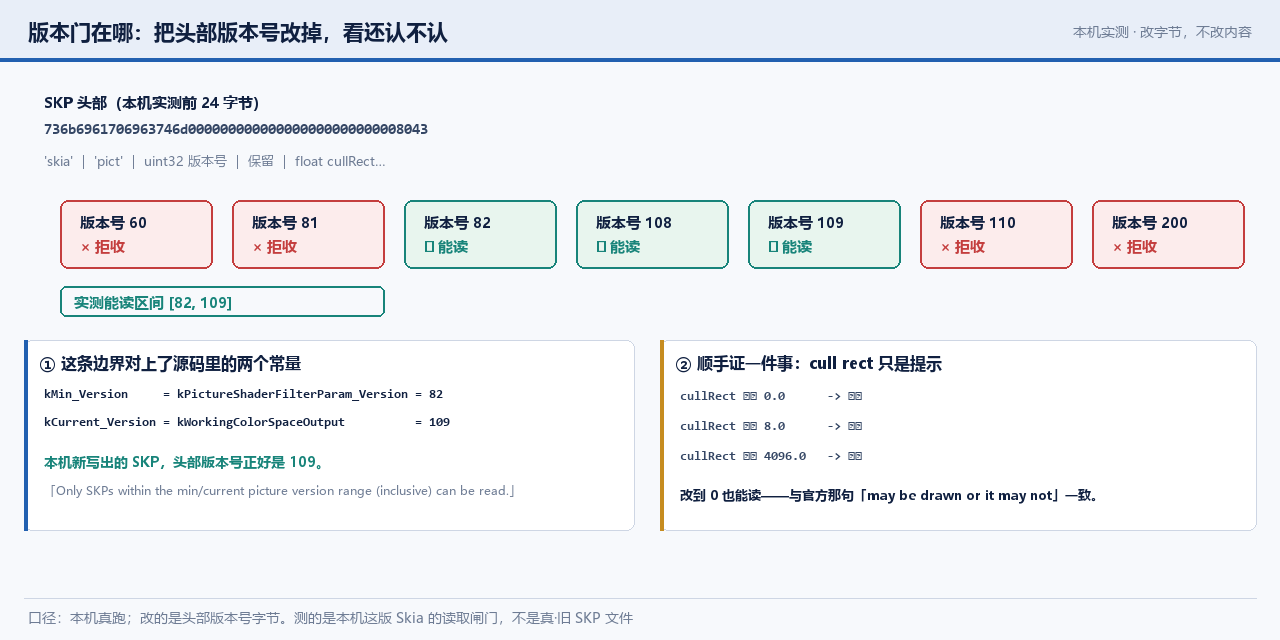
这一组读数把源码里那两个常量从「注释里的数字」变成了「行为上的端点」。82 是能读的最小值,109 是能读的最大值,两个端点都是闭的。
再往下改、再往上改,都会拿到同一个结果——绑定抛 ValueError: Invalid data,也就是读取方连内容都没来得及看就退回了。
作为对照,把最前面的 skia 四个字节改坏,结果一样,所以这个异常本身没有区分「版本不对」与「文件坏了」——它只负责拒收。
同一个实验里还顺手验了另一件事:cull rect 真的只是提示。把偏移 16 起的那两个 float 分别改成 0、8、4096, 三份文件的读取结果全部通过。回看 1.1 里那句「may be drawn or it may not」——录的时候框小了,读取方不会因此拒收, 它只是不保证把框外的内容补回来。
一条必须写死的边界:这次测的是本机这一版 Skia 的读取闸门,不是「一份真实的旧版本 SKP 文件能不能读」。 两者相关但不重合:前者只动了 4 个字节,文件其余部分的编码方式仍是 109 这一版写出来的;真实的旧文件, 它的 op 流编码、块布局都可能不一样。所以本章的结论只说到「闸门端点在 82 与 109」为止, 不往下推「旧文件一定能/不能被完整还原」。
3.3 本章收在哪里
下面我们进入下一章。 版本号这道闸门看清了,接下来回到那份能读进来的文件身上,问一个更实际的问题: 同一份读回来的 picture,交给不同的后端去放,结果会不会变。
官方依据:版本区间与两个常量的注释见 Skia 源码的
SkPicturePriv.h/SkPictureData.cpp; Debugger 页面上的下界提示见 Skia Web Debugger; 版本历史中 V67 / V68 两条注释见参考资料第 7–8 条。
四、同一份 SKP 给两条后端回放,会一样吗
上一章那份文件能读回来了。这一章把它交给两条路去放:一条 CPU 光栅,一条 GPU(GL/Ganesh)。 问三件事——读写这一段有没有损耗、跨后端会不会变、如果会变,变在哪儿。
4.1 同一份反序列化出来的 picture,交给两条后端
先看看被试是什么。
被试是一份 512×256 的 picture:一串 64px 的中文(「字体渲染」)、一条描边的圆弧、一块半透明矩形。
它序列化出来是 19,704,893 字节,op 数 4——体积的大头依旧是那份字体(第二章的账)。
实验有三份产物,分别在三种条件下回放同一份从字节读回来的 picture:
back  = skia.Picture.MakeFromData(blob)        # 从字节读回来
cpu_b = play(back, backend="cpu")              # ① CPU 光栅
gpu_b = play(back, backend="gpu")              # ② GPU:MakeRenderTarget + GL
cpu_o = play(picture, backend="cpu")           # ③ 对照:录制后直接回放
第一组对照是「③ 录制后直接回放」对「① 读回来再回放」:不同的像素 0 个。这和第一章 §1.2 的结论一致—— 序列化这一段是无损的,字体数据一起走,读回来还是同一份东西。 第二组对照是「① CPU」对「② GPU」:131,072 个像素里有 2,070 个不一样,占 1.58%,最大通道差 77。
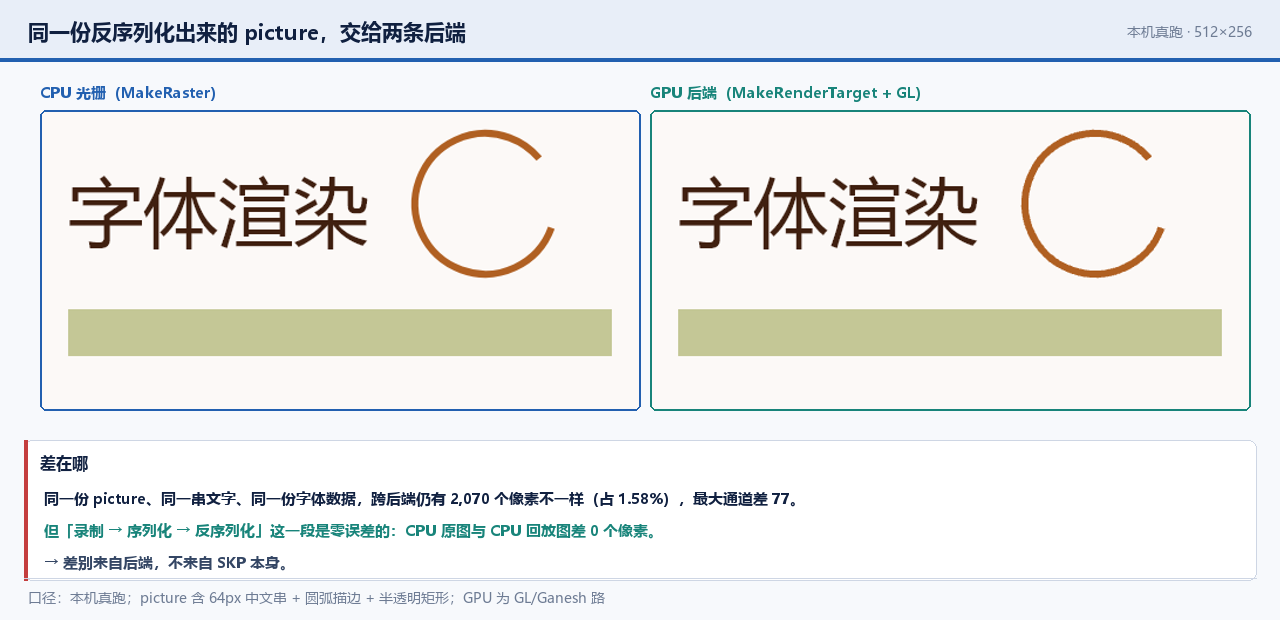
把两组数放在一起,这一章的主结论就出来了:差别来自后端,不来自 SKP。 同一个文件在两条路上放出来的像素有 1.58% 不同,但同一份文件在读写一圈之后像素完全一致—— 所以如果你遇到「同一份录好的内容在两台机器上画得不一样」,问题的位置在后端,不在文件。
这个结论和上一篇量到的「同一段代码在两条后端上 1.58% 不同」是同一个量。两次测量的图不同、路径不同, 但比例落在同一个位置。这不是巧合,它说明这 1.58% 的量级是这两条后端之间稳定的一个差—— 差异的量级比差异的具体形态更值得记住。
4.2 差在哪些像素上
好了,再往下看一层。
比例只是第一层,第二层是位置。
本机对这两张图做了逐像素差分:取每个像素的 R、G、B 三个通道与基准的最大差,得到一张热图。
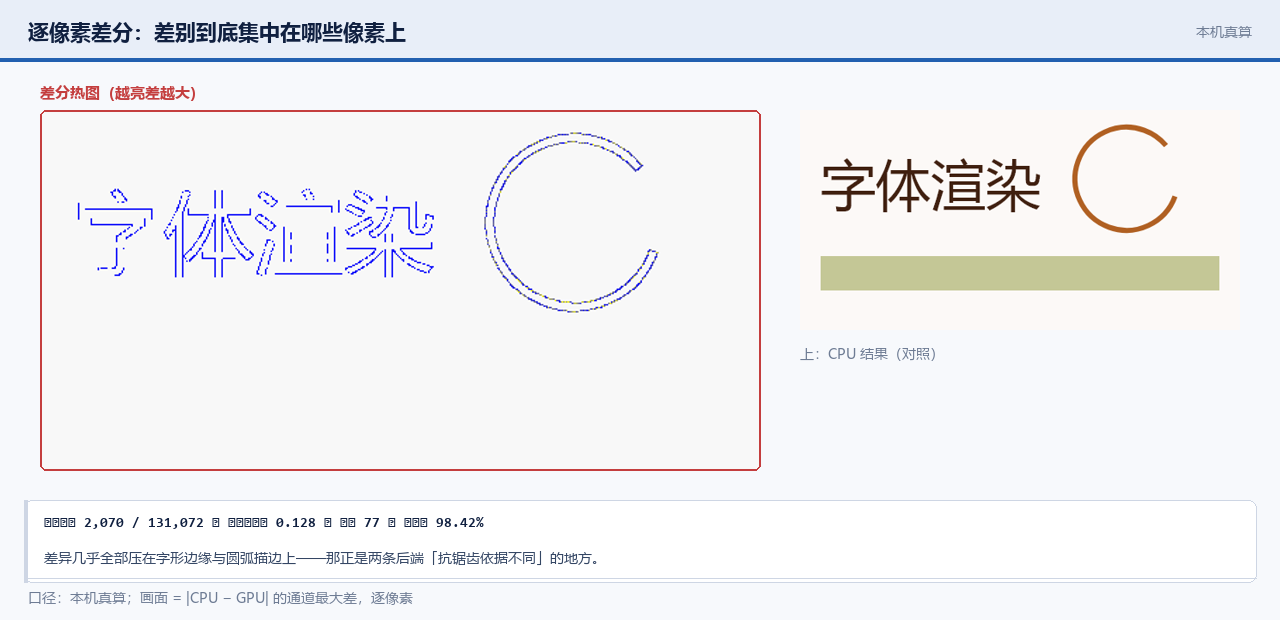
热图上的亮区不散,全部压在字形边缘与圆弧描边上。画面内部(字形的笔画中心、矩形的实心区)是干净的: 那些位置的像素值在两条后端上完全相同。这印证了上一篇那条结论的同源机制—— 差异不来自「算错了」,来自「边缘那半个像素该给多少灰度」这件事上,两条路援引的依据不同。
其中:这里要区分两件事。像素级差异是能测的(本机能算,读数就是上面那 2,070 个像素); 片元级证据是测不了的(需要抓帧工具,本机没有)。所以这一节只能说到「差在字形边缘」, 说不出「差的是哪一次片元着色调用」。这条界线在 §0.4 已经划过了,这里照旧。
4.3 为什么两条后端的抗锯齿依据不同
OK,机制还得补一句。
差异的位置有了,机制还得补一句。Skia 官方邮件列表里有一段回帖把 GPU 侧的做法写得很清楚:
"The GPU implementation uses a few different AA techniques, depending on your surface configuration & the type of primitive being drawn. ... 1. MSAA ... 2. Geometric / analytic ..." —— skia-discuss 官方回帖
也就是说,GPU 侧的抗锯齿(anti-aliasing)不是一个机制,而是「MSAA / 几何解析」这几套里的某一套, 用哪一套要看 surface 的配置与被画的东西是什么;近年还加了 CCPR 这一条。而 CPU 侧走的是解析式的覆盖率计算—— 一套从头到尾一贯的算法。
同一串文字,一边的依据是「这个像素被覆盖了多少比例」,另一边的依据可能是「这个像素上叠了几个样本」。 两边都在回答「边缘该给多少灰度」,但问的不是同一句话。这就是那 1.58% 的来路。
4.4 本章收在哪里
下面我们进入下一章。 到这里,「录下来的那一侧」算讲完了:文件是无损的、自带版本号、 换后端会变但只在边缘变。镜头现在推到最小的一格——那些字本身。下一章就从字体的三个开关开始。
官方依据:GPU 侧抗锯齿的多种机制见 skia-discuss 回帖; 两条后端的建法与
MakeRenderTarget的用法见 SkCanvas Creation; surface 配置如何影响 AA 的选择见参考资料第 17 条。
五、字体那侧有哪三个开关
先换到另一侧。
现在换输入。SKP 那一侧讲的是「录下来的内容」,这一侧讲的是「当场排的字」。这一章先把三个开关的官方定义列清楚, 再往下两章逐个量它们各自的像素代价。
5.1 hinting、edging、subpixel
先看看这三个地方分别是什么。
字体在像素上落地时,有三个地方可以拨。它们的官方定义都很短。
第一个是 hinting(提示),四档:
kNone,   //!< glyph outlines unchanged
kSlight, //!< minimal modification to improve constrast
kNormal, //!< glyph outlines modified to improve constrast
kFull,   //!< modifies glyph outlines for maximum constrast
(原文里 "contrast" 拼成了 "constrast",照录。)这四行注释里最要紧的是「glyph outlines」这个词——
hinting 改的是轮廓本身,不是给已经画好的图加一层滤波。kNone 那行写的是 "unchanged",也就是不动轮廓。
第二个是 edging(边缘处理),三档:kAlias(字形边缘没有透明像素)、kAntiAlias、kSubpixelAntiAlias。
官方对第二档的描述是「glyph positioned in pixel using transparency」——用透明度来表达亚像素位置。
而 setEdging 的措辞比取值本身更重要:
"Requests, but does not require, that edge pixels draw opaque or with partial transparency."
它只是请求,不是要求——后端可以不满足。这一句解释了后面两章为什么会出现「我明明设了,但看起来没变」的情况: 设的是意图,不是结果。
第三个是 subpixel(亚像素) 开关。它管的是「字形落在像素内部的哪个位置」—— 一支笔画的位置是 10.0 还是 10.375,落在亚像素这一层。这个开关表面上看只是精度问题,代价却在第十章才显影。
5.2 一个像素里的三个子像素
说白了,得先看一个像素在物理上长什么样。
要理解第三个开关在做什么,得先看一个像素在物理上是什么。液晶屏的一个「像素」其实由红、绿、蓝三个并排的子像素组成; 当渲染器知道自己面对的是这样的屏幕时,它可以把一个像素内部的水平分辨率用满——这就是亚像素渲染的物理前提。
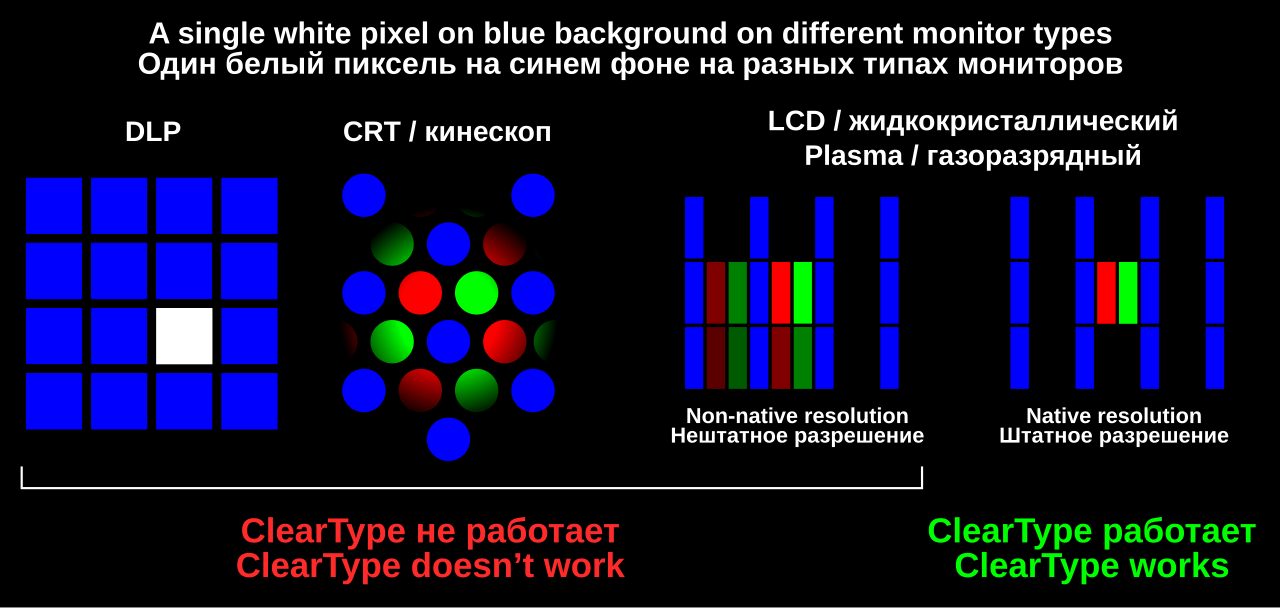
官方对 edging 的描述「glyph positioned in pixel using transparency」正是建立在这件事上: 字形不是只能落在整数像素边界,它可以落在某个像素内部的偏移上,代价是这个像素要按比例分配给左右的笔画。 本机测到了这个代价(§7.1),也测到了它的来路(§7.3)。
5.3 还有两件相关的事:blob 不做回退,也不做复杂排版
好了,顺带说清两件容易踩的事。
顺手把两件容易踩的事说清楚,它们和「字为什么画得和想象的不一样」直接相关。
第一件:SkTextBlob::MakeFromText 的官方注释把两件事说死了——
"It does not perform typeface fallback for characters not found in the SkTypeface. It does not perform kerning or other complex shaping; glyphs are positioned based on their default advances."
不替你把缺字的字符换个字体,也不做 kerning 或复杂排版;字形位置一律按默认推进宽度排。 所以在 Skia 这一层,一段带中文的文本如果没有指定中文字体,缺字的部分不会被自动补上—— 这和操作系统里那种「自动挑一个字体顶上」的行为是两回事。
第二件:SkTextBlob 本身是「immutable container」,并且源码注明它可以作为缓存条目的键,blob 被删掉时相关的缓存可以随之清理。
这让「文本」在 Skia 里有了一个和「一串字符」不同的身份——它是一段已经定好位置、可以被引用计数的东西。
SKP 里那块 SK_PICT_TEXTBLOB_BUFFER_TAG,装的就是它。
5.4 本章收在哪里
下面我们进入下一章。 三个开关的定义到这里就齐了,但定义看不出代价。下一章从最容易被误读的那个开始——hinting。
官方依据:hinting 四档的逐字注释见
SkFontTypes.h;setEdging的「Requests, but does not require」见SkFont.h;SkTextBlob不做字体回退与复杂排版的原文见 api.skia.org · SkTextBlob; 本篇引用的头文件版本见参考资料第 11–16 条。
六、hinting 到底改了多少像素
先看看它到底改了多少。
第五章说 hinting 改的是轮廓。这一章要把它量出来:改了多少、改在哪里、以及一个本机上出现的意外结果。
6.1 四档并置
先看看这次实验怎么设。
实验的设定尽量干净:同一台机器、同一个字体(Microsoft YaHei)、同一个字号(28px)、同一串字(「字形Ag」)、
抗锯齿一律打开、位置一律落在整数像素上,只改 hinting 这一档。
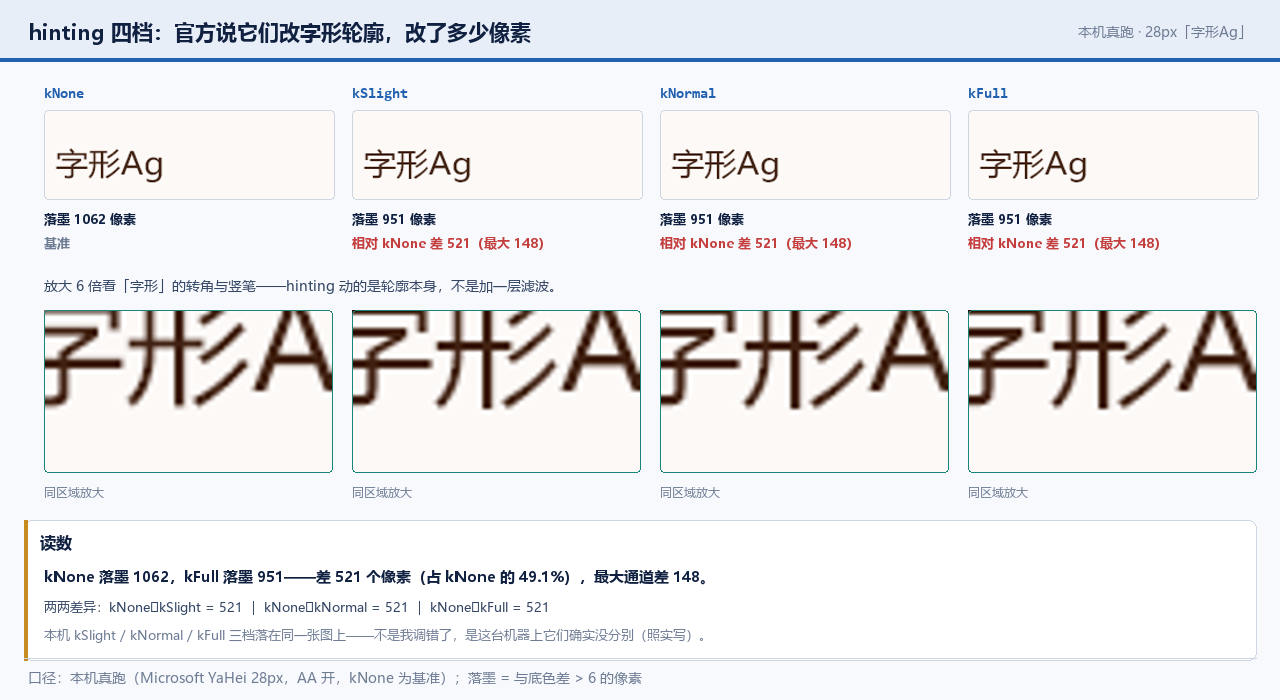
读数如下:
| hinting | 落墨像素 | 相对 kNone 不同的像素 | 最大通道差 |
|---|---|---|---|
kNone |
1,062 | 0(基准) | 0 |
kSlight |
951 | 521 | 148 |
kNormal |
951 | 521 | 148 |
kFull |
951 | 521 | 148 |
两两差异矩阵更直白:kNone 对另外三档分别是 521 / 521 / 521,而 kSlight、kNormal、kFull 三档彼此之间全是 0。
其中:kSlight、kNormal、kFull 三档落在同一张图上——这不是我调错了,也不是实验没做对。
它说的是:在这台机器、这个字体、这个字号下,官方那三档描述里的「minimal / modified / maximum」并没有落到不同的像素上。
本机只能报出「改与不改差 521 个像素」,报不出「改多少档差多少像素」。这条零结果照实写在这里,不修饰。
6.2 差异落在哪、量级多大
OK,把这两个数放进上下文里读。
521 个像素、最大通道差 148,这两个数需要放进上下文才有意义。
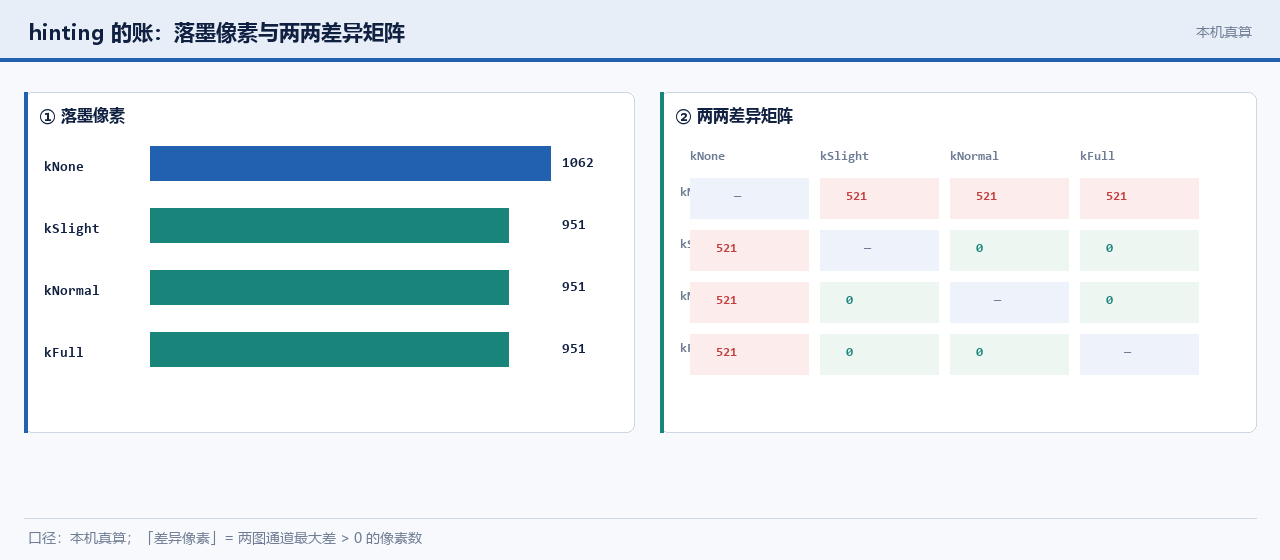
先看分母。kNone 的落墨像素是 1,062,改成 hinting 之后是 951。落墨像素少了 111 个,减了 10.4%。
这个方向是对的:hinting 会把笔画对齐到像素网格,边缘那些「只盖住一点点」的像素更容易被抹掉——
字形会变得更结实、更细。这与社区里那些「换后端之后字变细了」的报告方向一致:
Mozilla 的 Bug 1230366 就是一个例子——macOS 上换用 Skia 后端之后,字形被报告为明显偏细,当作渲染回归处理。
再看分子。521 个像素对 1,062 个落墨像素,相当于基准图上一半的落墨像素都变了;最大通道差 148(满值 255 的 58%)说明这不是浮点误差, 而是实打实的灰度重排。所以「hinting 是个微调」这个印象是错的——它是在轮廓层面动刀。 官方那句 "glyph outlines modified" 在这里有了数字。
至于「多大字号以下 hinting 才明显」——官方没有给阈值。本机也不敢给:一台机器、一个字体、一档字号推不出这条线。 唯一的相近表述出自 SkiaSharp(不是 Skia 本体),按取材规矩不能当官方口径引用,所以本篇不给这个阈值。
6.3 本章收在哪里
下面我们进入下一章。 hinting 动的是轮廓,代价是「字形不再严格线性」。下一章换到亚像素那一侧—— 那个开关看起来只管精度,但它买的和花的都得算。
官方依据:hinting 四档注释见
SkFontTypes.h;Typeface.getBounds里「不考虑任何 hinting 或其它逐字号调整」的表述见 api.skia.org · SkFont;「换后端后字形变细」的社区报告见 Mozilla Bug 1230366。
七、亚像素定位买到的是什么、代价是什么
第六章量的是「改轮廓」的代价,这一章量的是「改位置」的代价。这两件事经常被混为一谈,但它们动的是完全不同的东西。
7.1 八个位置,开关两态
先看看这次怎么设计。
实验设计得比上一章狠一点:把同一个字形放在八个只差 0.125 像素的位置上,分别在「亚像素关」和「亚像素开」两种状态下渲染, 然后数一件事——八个位置到底落出了几种互不相同的图。
for sub in (False, True):
    font = skia.Font(typeface, 28)
    font.setHinting(skia.FontHinting.kNone)
    font.setSubpixel(sub)
    imgs = [render(font, x=10.0 + i / 8) for i in range(8)]   # 0, 0.125, ..., 0.875
    distinct = count_distinct(imgs)                          # 互不相同的图有几张
读数是:亚像素关——八个位置只落出 3 种图,八档里只有 2 档真的动了(其余六档落在同一张图上), 动的两档是整格的跳变,最大通道差 231;亚像素开——八个位置落出 8 种图,八档里 7 档都动了, 最大通道差只有 100。
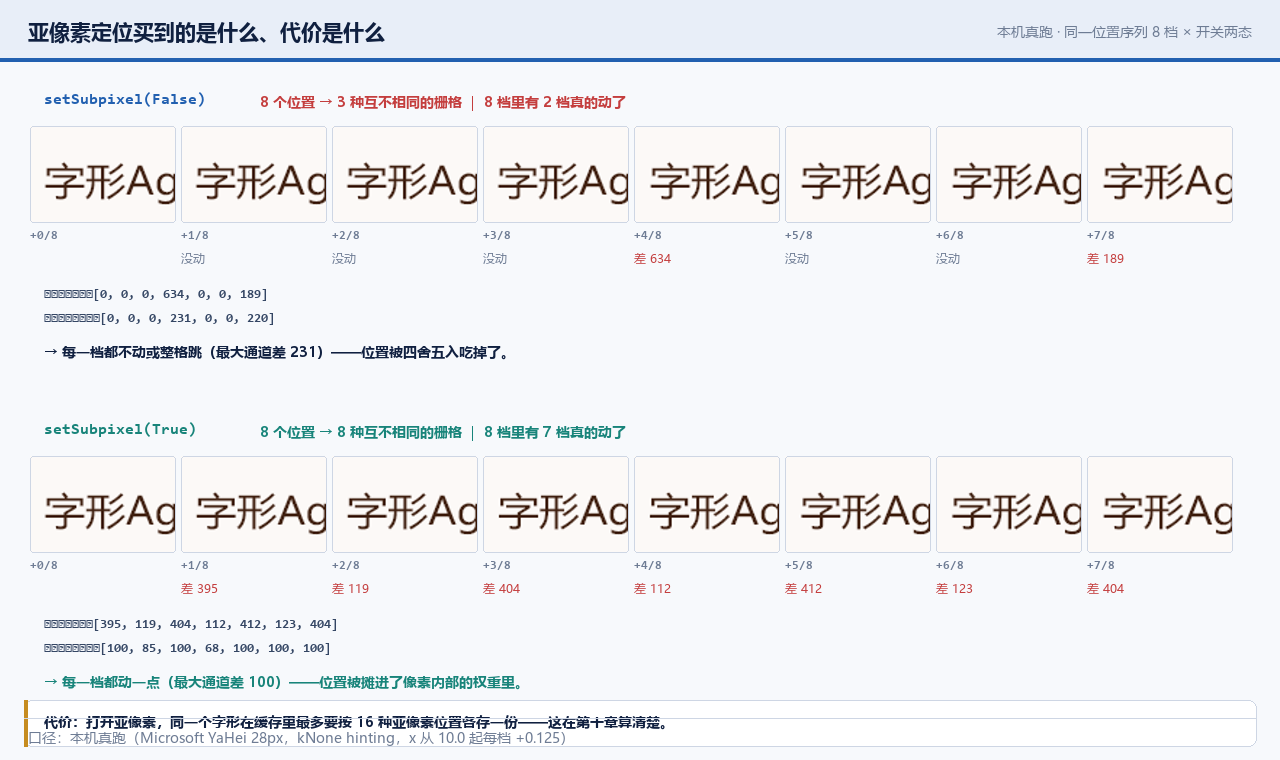
这组对照是这一章最值得看的一张。它把两个开关的差别说成了一句人话:
- 关掉亚像素,位置信息被四舍五入吃掉了。0.0 到 0.875 这八个值,落到像素上只剩两三个不同的结果, 而且要么不动、要么整格跳(最大通道差 231,几乎是黑与白之间的一跳)。
- 打开亚像素,位置信息被摊进了像素内部的权重里。八档各不相同,但每一次变化都是小步的(最大通道差 100), 也就是「相邻位置之间只挪一点点灰度」。
其中:注意「3 种」这个数在别的条件下会变。研究阶段用 24px 字串试的时候得到过 4 个位置落出 3 种的结果, 现在用 28px 得到 8 个位置落 3 种——具体数字取决于字号与字串里各个字形的推进宽度加起来落在哪儿。 所以本篇报的是「在这个设定下,关掉亚像素把八档压成三档」,而不是「关掉亚像素一定压成三档」。 这条自我约束在本篇反复出现,原因只有一个:这台机器上量到的数,只能替这台机器说话。
7.2 亚像素排布的两种方向
好了,它还有一个前提。
亚像素渲染还有一个前提条件被经常忽略:它要知道屏幕的子像素是按什么顺序排的。 常见的两种是 RGB(红绿蓝,从左到右)与 BGR(蓝绿红)。排列方向搞反了,字形边缘会出现彩色镶边, 而画面本身看起来是「对的」,只是颜色不对——这类问题最难查。
这也解释了一件事:亚像素渲染是一种与设备绑定的优化。它不是「把字画得更好」,而是「把字按这块屏的物理结构画」。 所以它只在知道屏幕排布时才有意义——本机这个实验是在 CPU 光栅表面上做的, 用的是一个抽象的像素模型,没有真实屏幕的排布信息。这也是本机读数必须带条件的原因之一。
7.3 代价在哪:键位变多
言归正传,代价在哪。
买到了「八个位置八种结果」,代价是什么?
代价藏在字形缓存(glyph cache)的键里。Skia 的缓存不是按「字形」来存的,而是按「键」来存的;
键的构造方式决定了同一份字形数据在缓存里能被切成几份。SkGlyph.h 里有一行注释加一行常量,专门讲这件事:
// A combination of SkGlyphID and sub-pixel position information.
kSubPixelPosLen = 2u,
其中:SkPackedGlyphID 把「字形 ID」与「亚像素位置」拼在一起当键。每个轴用 2 位来存位置,也就是每轴 4 档;
两个轴合起来,同一个字形最多能对应 16 种不同的键。键不一样,缓存里的条目就不一样,同一份轮廓数据会被重复存上多份。
这一句话把亚像素的代价说透了:打开亚像素买到的「位置精度」,付的钱是「键空间乘 16」。 关掉亚像素的时候,一个字形在缓存里通常只有一种形态;打开之后,它可能以十六种不同的键各占一格。 而且这笔账不是一次性的——它不是「多存一份就完了」,而是每多一个字形、每多一个字号、每多一个变体,都要再乘一次。 第十章会把这个乘数和缓存的总量上限放在一起,算清楚一段普通中文能在多快的时间里把它顶满。
7.4 本章收在哪里
下面我们进入下一章。 到这里,「位置」这条线量完了:关掉它会把位置吃掉,打开它要按 16 份来存。 下一章回到「字号」这条更常见的线上——字号变了,度量和像素各怎么变。
官方依据:
SkPackedGlyphID与kSubPixelPosLen = 2u的注释见SkGlyph.h;setSubpixel/setHinting的取值见 api.skia.org · SkFont; Python 绑定侧的字体接口见 skia-python · skia.Font。
八、字号变了,度量与像素各怎么变
前两章拨的是开关,这一章拨的是字号。这是最普通的一个参数,也是误会最多的一个:「字号翻倍,字就大了一倍」—— 这句话在度量上成立,在像素上不成立。这一章把两条线分开量。
8.1 度量那条线:严格线性
先看看度量这条线。
先量度量。用 Font.measureText 拿同一串字在不同字号下的推进宽度,再除以字号:
for size in (8, 12, 16, 24, 32, 48, 64):
    font = skia.Font(typeface, size)
    w = font.measureText("字形Ag")
    print(size, w, w / size)          # 第三列是关键
第三列在七档字号上全是一样的:3.3433。
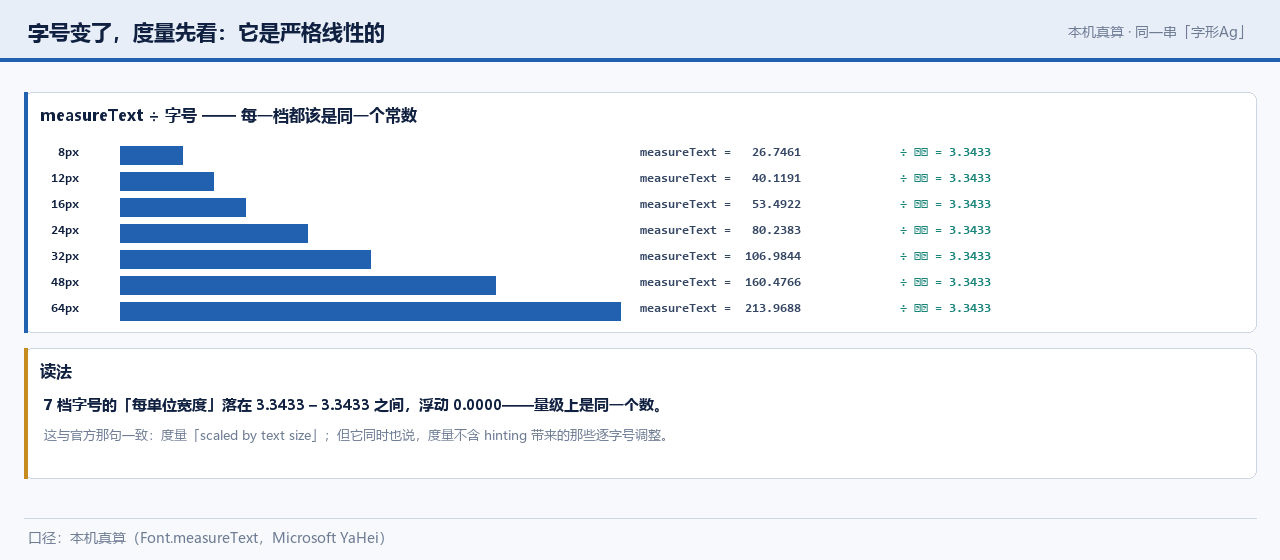
这个数的意义在于「恒定」。8px 的宽度是 26.7461,64px 是 213.9688——比值 8.0,两边严格成比例。
官方对度量的说明和这个读数对得上:「Results are scaled by text size but does not take into account dimensions required by
text scale, text skew, fake bold, style stroke, and SkPathEffect.」——按字号缩放,同时明确不管倾斜、假粗、描边这些变形。
换句话说,度量是一条干净的直线。
其中:3.3433 这个常数只对「这个字体 + 这串字」成立,换成别的字串当然会变。 它要证的不是「有一个普适常数」,而是「同一串字、同一个字体下,度量随字号严格线性」—— 以及,后文要拿它当一个「本该如此」的参照,去对照像素那条线。
8.2 像素那条线:放大一次,就要重新算一次
好了,再看像素那条线。
度量是线性的,像素却不是。原因不在字号,在放大这件事本身怎么实现。
位图放大和矢量放大是两种完全不同的操作。位图放大是插值:新像素是从邻近的老像素加权算出来的, 信息量不增加,所以放得越大越糊。矢量放大是重新光栅化:轮廓是数学曲线,放大之后重新在更大的网格上算覆盖率, 新像素是算出来的,不是插出来的。
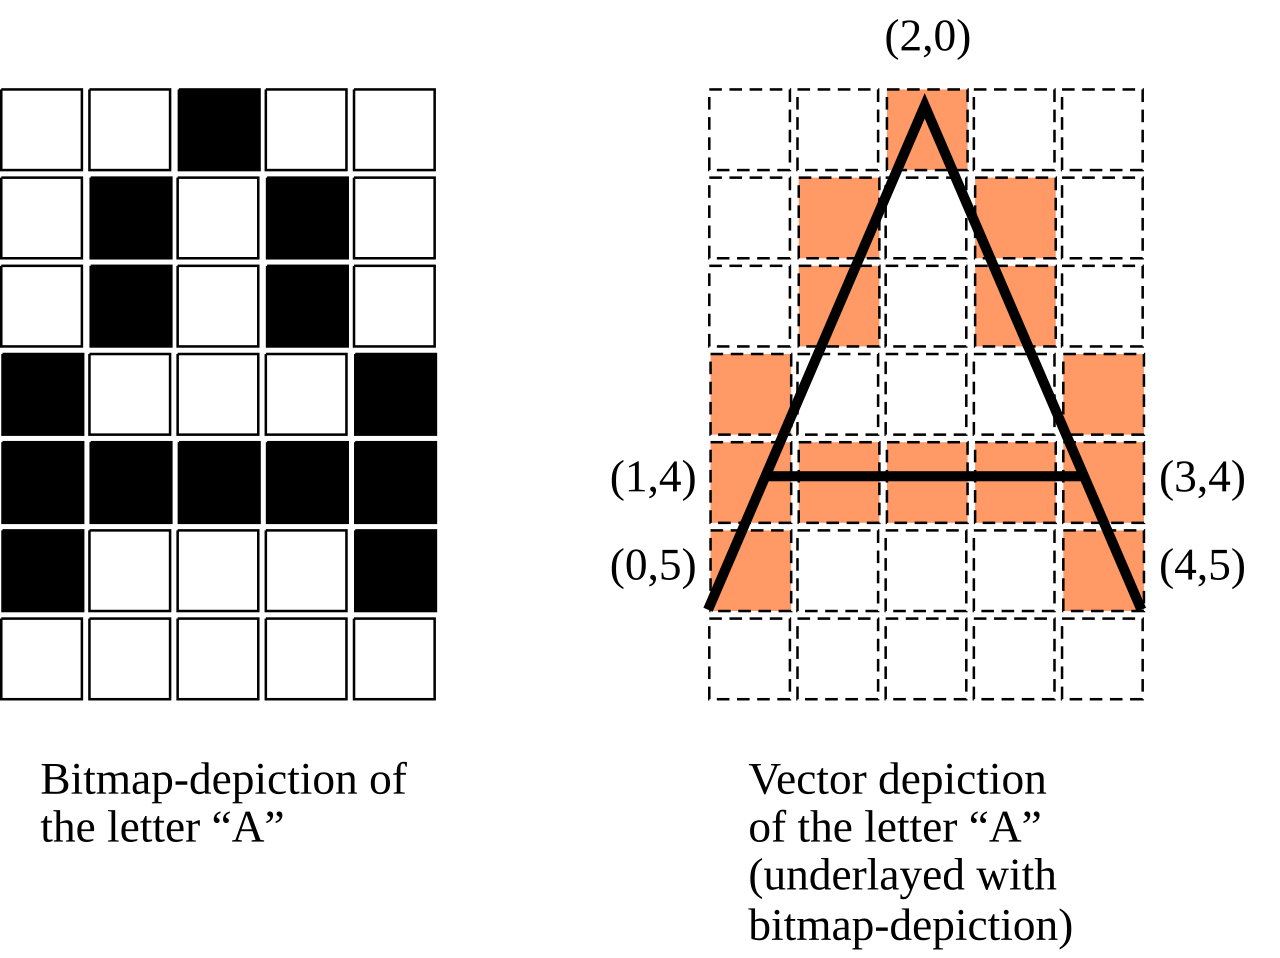
这条区别决定了一件很实际的事:字号变化在 Skia 里不是一个「缩放」操作,而是一次完整的重新光栅化。 把 16px 的字改成 64px,不是把一张小图拉大,而是拿同一份轮廓在一个四倍大的网格上重走一遍覆盖率计算。 所以它不会变糊——但它要重算的东西,比「把小图放大」多得多。
官方的 Typeface.getBounds 里还有一句可以直接接上:「This may be conservatively large, and will not take into account any
hinting or other size-specific adjustments.」——逐字号的调整这件事是被明写出来的。
这句话就是前一章 hinting 的伏笔:hinting 不是一个全局开关,它是按字号做的一套调整。
8.3 本章收在哪里
下面我们进入下一章。 到这里,度量线性、像素不线性,两条线都摆出来了。下一章把这两条线和 hinting 放在一起, 回答一个更刁的问题:hinting 为什么会让「缩放」这件事变得不可靠。
官方依据:
getMetrics的「scaled by text size」与getBounds的「不考虑任何 hinting 或其它逐字号调整」见 api.skia.org · SkFont;逐字号调整与 SurfaceProps 的关系见 SkSurfaceProps.h; 度量接口在绑定侧的对应物见 skia-python · skia.FontMetrics。
九、hinting 与「线性性」到底是什么关系
先看看问题的形式。
这一章要把第八章那两条线合起来用。问题的形式是这样的:如果我有一张 12px 的图,把它放大一倍,能不能当作 24px 的图用? 如果能,引擎就省掉了重新光栅化的开销;如果不能,那「缓存一张小图、需要时拉大」这条优化路线在字体上就走不通。
9.1 半缩对齐:一个能区分两种说法的实验
说白了,就是把两张图叠起来比。
实验的做法很直接:12px 直接渲染一张图;24px 也渲染一张,然后把它缩回一半。两张图逐像素比—— 如果线性成立,二者应该几乎重合;如果不成立,差异像素数就会冒出来。
a12 = render(font_12px, w=260, h=48)                       # 12px 直接画
a24 = render(font_24px, w=520, h=96)                       # 24px 画
small = bilinear_resize(a24, (260, 48))                    # 缩一半
diff = count_pixels(|a12 - small| > 8)                     # 差异像素数
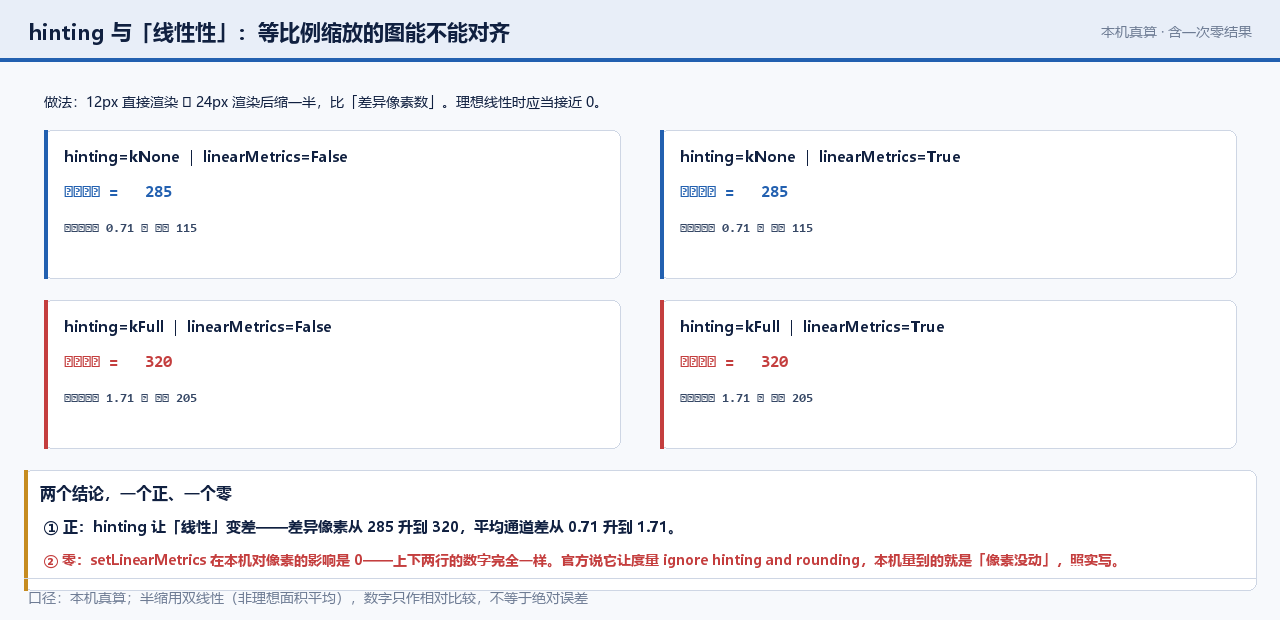
读数是:hinting = kNone 时 285 个差异像素(平均通道差 0.71,最大 115);hinting = kFull 时 320 个(平均 1.71,最大 205)。
OK,两个方向都能读出来。
两个方向都能读出来。差异像素数从 285 涨到 320——涨的不多,只有 12%;但平均通道差从 0.71 涨到 1.71, 涨了 1.4 倍,最大通道差从 115 涨到 205。也就是说,hinting 让「差得不多的像素」变成了「差得挺多的像素」: 它把差异从「边缘上的细碎抖动」推成了「整片灰度重排」。
这正是社区那篇「为什么 Android 上缩放时文字会抖」文章在讲的事——hinting 破坏了文本的线性性, 于是缩放动画里字形会一跳一跳。那篇文章的可信度不错(Wear OS 团队内部的调研,致谢了 HarfBuzz 与 Skia 团队), 但它完全没有 SKP、没有跨后端、也没有缓存机制,只有症状。本篇在这里把它量化了。
其中:这条读数有一个方法学前提必须写明——半缩用的是双线性插值,不是理想的面积平均。 所以 285 与 320 这两个数只能相对比较(同一个缩放口径下,hinting 开与关谁更差),不能当绝对误差读。 换一种缩放算法,两个数都会变,但「hinting 让差异变大」这个方向仍然是可复核的。
9.2 一个零结果:setLinearMetrics 对像素没影响
先看看官方是怎么说的。
官方对 setLinearMetrics 的说明是:「For outline fonts 'true' means font and glyph metrics should ignore hinting and rounding.」
——听起来像是「打开它就能拿到不受 hinting 干扰的度量」,很容易被读成「打开它渲染会更规整」。
本机把四种组合都跑了一遍:hinting(kNone / kFull)× linearMetrics(False / True)。读数:
| hinting | linearMetrics | 差异像素 | 平均通道差 | 最大通道差 |
|---|---|---|---|---|
kNone |
False | 285 | 0.71 | 115 |
kNone |
True | 285 | 0.71 | 115 |
kFull |
False | 320 | 1.71 | 205 |
kFull |
True | 320 | 1.71 | 205 |
上下两行的数字完全一样。也就是说:在这台机器上,setLinearMetrics 对渲染出来的像素影响是 0。
其中:这是一个零结果,它照样是结果。它说的是:setLinearMetrics 管的是度量侧的行为(让度量忽略 hinting 与舍入),
不是像素侧的行为(不改轮廓怎么画)。所以不能把它写成「改善了渲染」——
这句话不是谦虚,是本机量到的。要拿到「不受 hinting 影响的渲染」,得改的是 hinting 那一档,不是这个开关。
9.3 度量线性了,像素却不线性
好了,再换个角度检查一遍。
第九章开头那个问题——「小图拉大能不能顶替重绘」——还可以从另一个角度检查。第九章 9.1 是从「缩」的方向看; 其实从「放」的方向看会更清楚:字号变大时,落墨像素按什么规律涨?
本机把七档字号的落墨像素也记了下来:8px 130 个、12px 254 个、16px 395 个、24px 798 个、32px 1,320 个、48px 2,648 个、64px 4,419 个。
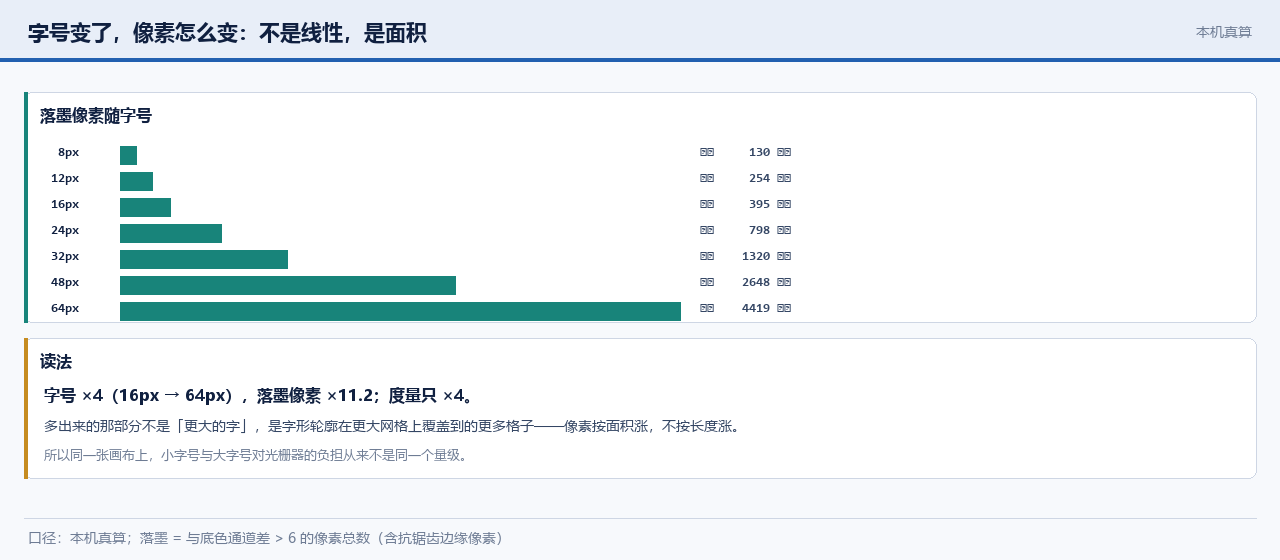
取两头看:字号从 16px 到 64px 是 4 倍,落墨像素从 395 到 4,419 是 11.2 倍。 而同一个区间里,度量只老老实实乘了 4(3.3433 × 16 到 3.3433 × 64)。
这就把「两条线」说死了:
- 度量按长度涨(一维),所以随字号线性;
- 落墨像素按面积涨(二维),所以涨得更快——而且实际比 4² = 16 倍还低一点,因为笔画有粗细下限、 边缘的覆盖率也有取整,大字号下这些「折扣」占比更小。
所以「字号翻倍,字就大了一倍」这句话,对度量成立,对要画的像素数不成立。 同一张画布上,小字号与大字号给光栅器的负担从来不是同一个量级——这一点在移动端排版里是实打实的开销。
9.4 本章收在哪里
下面我们进入下一章。 「位置」和「字号」两条线都量过了,它们最后都汇到同一个地方:字形缓存。 下一章把这个账算清楚——上限是多少、一段文字能产生多少键。
官方依据:
setLinearMetrics的「ignore hinting and rounding」见SkFont.h; 「缩放时文本抖动」的社区调研见 halilibo · Why text gets jittery when scaled on Android; 另一个方向的同类症状(换后端后字形偏细)见 Mozilla Bug 1230366。
十、字形缓存为什么会被撑爆
言归正传,把前面几章的账合成一本。
前九章攒下的东西,这一章要合成一个账。因为「亚像素」和「字号」这两条线,最后都会落到同一张表上:缓存条目的键。
10.1 两个上限,和一条乘法
言归正传,先把两个上限摆出来。
缓存这一侧,官方给的是硬上限,逐字可查(SkStrikeCache.h):
SK_DEFAULT_FONT_CACHE_COUNT_LIMIT  =  2048        // 条数上限
SK_DEFAULT_FONT_CACHE_LIMIT        =  2 * 1024 * 1024   // 字节上限(2 MB)
然后接上一台乘法。§7.3 已经拿到了乘数:SkPackedGlyphID 的 kSubPixelPosLen = 2u,
每个轴用 2 位存亚像素位置,也就是每轴 4 档;两个轴合起来,同一个字形最多对应 16 种键。
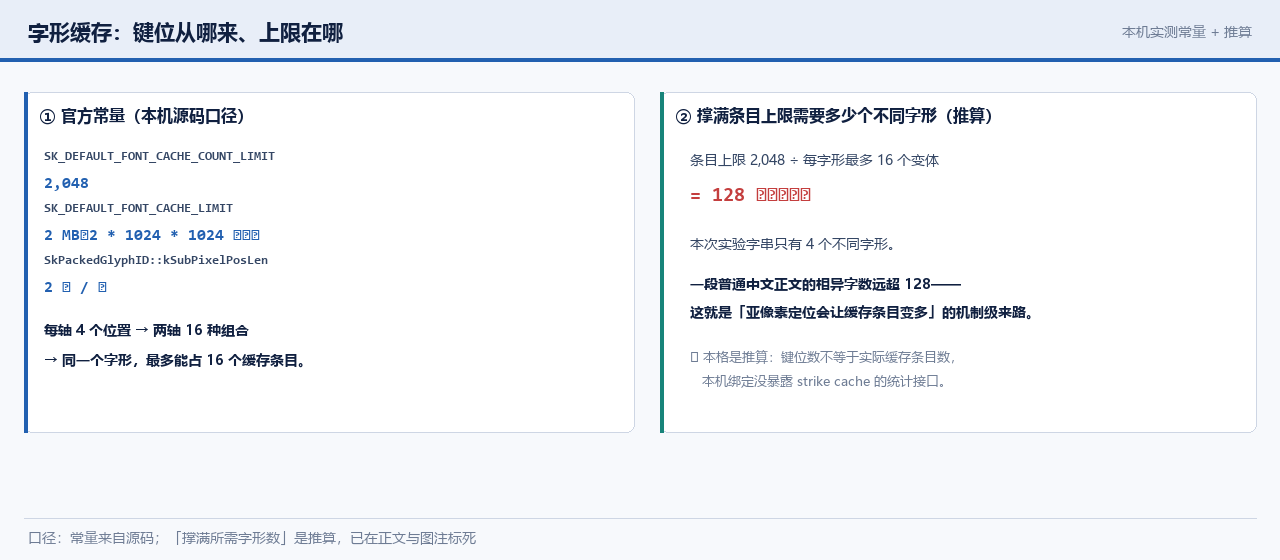
两个数一除,结论就出来了:
其中:2048 ÷ 16 = 128。也就是说,只要一段文字里有 128 个不同的字形,光靠「同一个字形在不同亚像素位置上的变体」,就能把缓存的条数上限占满。 而 128 个不同汉字,在中文里大约是一两句话的量。这就是「亚像素定位会让缓存条目变多」的机制级来路—— 不是感觉上变多,是键空间直接乘了 16。
这一格是推算,不是实测。本机绑定没有暴露 strike cache 的统计接口,所以「实际条目数」这个量本篇拿不到。 能坐实的只有两件事:乘数(2 位每轴,来自源码)与上限(2048 / 2 MB,来自源码),中间那一步乘法是本篇自己做的。 把它标成推算而不含糊过去,是因为这两个数的量级差太悬殊——一个说「一两句话就能顶满」,一个可能说「其实还早」, 不该让读者以为这是量出来的。
顺带说清一件事:缓存的清理粒度比条目本身大。源码里 SkTextBlob 被注明可以作为缓存条目的键,
blob 被删掉时相关的缓存可以随之清理(§5.3)。也就是说,缓存的寿命不完全由「用了多久」决定,
也由「引用它的那段文本还在不在」决定。这条线索在本篇只记下来,不展开——它需要另一套实验才能量。
10.2 本章收在哪里
下面我们进入下一章。 到这里,本篇想量的事基本量完了:SKP 的字节账、往返的无损性、换后端的 1.58%、三个开关的像素代价、 字号两条线、以及缓存那一笔乘法。最后一章要把镜头拉开,逐条交代这套方法测不了什么。
官方依据:两个缓存上限见
SkStrikeCache.h;SkPackedGlyphID与kSubPixelPosLen见SkGlyph.h; strike 规格与键的构成见 SkStrikeSpec.cpp; blob 作为缓存键的说法见 api.skia.org · SkTextBlob。
十一、这套方法测不了什么
先看看这一章的规矩。
这一章是「自跑」类文章的固定收尾:把给不出数字的量逐条列出来,并给原因。 理由很简单——不用能测的量去近似不能测的量,是这类文章唯一值得坚持的纪律。
11.1 能测与测不了
本机能测的(都在前文出现过):
- SKP 的字节账与往返一致性:§1.2 的 333 字节、§2.2 的五个数量级、§2.3 的 ±355 字节差值;
- 同一份 picture 的两条后端回放差:§4.1 的 2,070 / 131,072 = 1.58%,以及 §4.2 的差异位置;
- hinting 与亚像素的像素级对照:§6.1 的 521 个差异像素、§7.1 的「八档塌成三档」;
- 头部版本号的读取闸门:§3.2 的 [82, 109] 闭区间,以及 cull rect 可任意改写。
本机测不了的(逐条给原因):
- 真·旧版本 SKP 文件能不能读:手上没有旧版本 Skia 产出的真实样本。§3.2 测的是闸门端点,不是旧文件本身;
- strike cache 的实际条目数:Python 绑定没有暴露统计接口。§10.1 给的是推算;
- 跨后端的片元级证据:没有抓帧工具。差异只能停到「哪些像素」,停不到「哪一次着色调用」;
- Graphite 上的回放行为:绑定里没有
MakeDawn,跑不起来; - 跨机型、跨驱动、跨平台的结论:全篇读数来自一台机器、一块显卡、一个驱动版本。
为什么不做这五件事,比「测不了」本身更重要。前四件都有一条共同的性质:它们能测的量与想测的量之间隔着一个不可忽略的近似。 比如,「用 CPU 侧的光栅化种类数去代表缓存条目数」听起来顺,但 §7.1 已经量到了这个数会随字号和字串浮动; 「用像素差去代表片元差」听起来顺,但 §4.2 已经说了前者是能算的、后者是要抓帧的。 把它们混起来,读数就会变成「看起来很硬的软数字」——这才是自跑类文章最该防的错。
其中:这里有一条判断可以带走——当一个量给不出数字时,给原因,不给估算。 估算不是不能给,但必须像 §10.1 那样标死「这是推算」,并且把推算用的两个输入项(乘数与上限)都摆出来让人复核。
11.2 本章收在哪里
下面我们进入下一章。 能测的、测不了的,都摆在桌面上了。最后用三句话把这一篇收住,再把题域让出去。
官方依据:Python 绑定未暴露的接口可由 skia-python · skia.Picture 与 skia.Font 两个参考页逐个核对; GPU 侧「用哪一套 AA 要看 surface 配置」的原文见 skia-discuss 回帖; 本节引用的打包工具与调试器见参考资料第 30–32 条。
十二、边界回指与预告
好了,用三句话收住这一篇。
这一篇只做了三件事,用三句话收住。
第一句给 SKP:它录的是命令,所以它是无损的;但它把字体一起带走了,所以它是重的。 一份中文字串的 19.7 MB 与一份矩形的 173 字节,差的不是画面复杂度,是那台机器上的那份字体。 这条账把「SKP 是不是一个好的交付格式」这个问题拆成了两半——保真度不是问题,体积与字体依赖才是。
第二句给回放:同一份文件换后端会变,变的那 1.58% 全在边缘。 两篇「自跑」量到的比例落在同一个量级上,说明这个差是两条后端之间稳定的差异,而不是某次运行的噪声。 再往回追一层,差异的根在抗锯齿的依据不同:一条路算覆盖率,一条路可能叠样本。
第三句给字体:几个开关的代价都不在「画得快不快」,在「同一份结果要不要重算」。 hinting 动轮廓(§6.1 的 521 个像素),亚像素动位置(§7.1 的「八档塌成三档」),字号动的是「要重算多少格」(§9.3 的 11.2 倍)。 这三件事共同解释了同一个现象:在字体这一层,「把一张图缩放着用」是一条走不通的路。
把题域让出去之前,先标清这篇的两条自我约束。其一,零结果也是结果:§6.1 的三档重合、§9.2 的 zero 影响, 都照实写了,没有换成「理论上应该有差别」。其二,同一个数必须能追溯到它的来源: 本篇所有读数都落在同一份读数文件里,正文与图注里的数字都以它为准——这样任何一条读数对不上时, 能立刻知道是正文写错了还是图注写错了。
下面我们进入下一篇。
下篇预告:第九篇换一个引擎——Vello。它走的是另一条路:GPU compute 加 sparse strips 与 prefix-scan, 把「哪些像素要填」变成一份可以直接并行处理的条带清单。第八篇量到的那些「边缘上必然对不齐」的差, 在 Vello 那条路上会变成什么样,是下一篇要看的事。
官方依据:本篇所有机制性结论的出处见参考资料第 1–18 条;本机读数所依赖的绑定与建面方式见第 25–27 条; 外部示意图的来源与许可见第 38–47 条。
参考资料
- api.skia.org · SkPicture(records drawing commands 与 playback)
- api.skia.org · SkPictureRecorder(beginRecording 与 finishRecordingAsPicture)
- Skia 用户文档(SkCanvas 与后端相关章节)
- Skia 开发者提示(dm / skpbench 的逐字命令)
- Skia 官方调试工具文档(Debugger 支持 .skp 与 .mskp)
- skpbench README(回放 SKP 的基准工具)
- Skia 源码 · SkPictureData.cpp(分块与 flattenToBuffer)
- Skia 源码 · SkPicturePriv.h(tag 宏与版本区间常量)
- api.skia.org · SkFont(setEdging / setSubpixel / getMetrics)
- api.skia.org · SkTextBlob(immutable container 与不做回退)
- Skia 源码 · SkFontTypes.h(hinting 四档逐字注释)
- Skia 源码 · SkFont.h(setEdging 的 Requests, but does not require)
- Skia 源码 · SkGlyph.h(SkPackedGlyphID 与 kSubPixelPosLen)
- Skia 源码 · SkStrikeCache.h(2048 条与 2 MB 两个上限)
- Skia 源码 · SkFontMgr.h(字体管理器与反序列化)
- Skia 源码 · SkTextBlob.h(blob 的官方注释)
- Skia 源码 · SkSurfaceProps.h(surface 配置与 AA 选择的关系)
- skia-discuss · GPU 侧抗锯齿的多种机制(官方回帖)
- skia-python · skia.Picture(serialize 与 MakeFromData)
- skia-python · skia.PictureRecorder
- skia-python · skia.Font
- skia-python · skia.Typeface
- skia-python · skia.TextBlob
- skia-python · skia.FontMetrics
- skia-python 发行页(本篇绑定版本 144.0.post2)
- skia-python 教程 · Canvas Creation(建面与建上下文)
- GLFW 官网(本机建 GL 上下文用的库)
- Skia 源码 · SkSerialProcs.h(序列化行为与字体数据)
- Skia 源码 · SkStrikeSpec.cpp(strike 规格与缓存键)
- Skia Web Debugger(在线打开 SKP 逐条看 op)
- Skia Fiddle(只能导出 SKP,不能载入回放)
- Chromium · 如何保存 .skp 文件
- halilibo · Why text gets jittery when scaled on Android(hinting 与线性性)
- Mozilla Bug 1230366 · Skia Text is thin on OS X(换后端后字形偏细)
- Flutter CanvasKit 字体渲染不一致(社区报告)
- CSDN · 一次字体渲染差异的排查(中文梳理,二手参考)
- deepwiki · Skia 的 dm 测试运行器与 nanobench
- Commons · Category:Font rasterization(本篇 EXT 的主类目)
- Commons · Category:Subpixel rendering(亚像素排列与 LCD 原理)
- Commons · Category:Font hinting(hinting 对照样张,尺寸偏小)
- Commons · Comparison raw text converted path.svg(文本与轮廓路径的对照)
- Commons · ClearTypePixels.svg(题图:亚像素渲染的像素级放大)
- Commons · ClearType white pixel.svg(一个像素的三个子像素)
- Commons · Subpixel arrangement-RG-B-GR.svg(子像素排列方向)
- Commons · Bitmap vs vector.svg(位图与矢量放大)
- Commons · Aliasing 2.svg(有不抗锯齿对照)
- Commons · Category:ClearType(真 ClearType 样张,多数长边不足 1280)


本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真跑/真算的读数图由本篇测量脚本产出(图注写明口径); 自绘图为本系列绘制,走
styles/qianmo/palette.json色板单源。站点链接:技术博客页
下篇预告:下一篇换一个引擎——Vello 走的是 GPU compute 加 sparse strips 与 prefix-scan,把「哪些像素要填」变成一份可并行处理的条带清单。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。
With Best Wishes.