站点链接:技术博客页
【移动端图形与功耗】第 2 篇 | 系列共 7 篇
- 上一篇:【移动端图形与功耗】(一) 两台不同的机器:移动 GPU 的物理约束
- 下一篇(预告):【移动端图形与功耗】(三) 带宽:移动端最硬的那道墙
系列文章前言
1.1 系列定位
上一篇把两条墙立起来了:带宽决定一帧能搬多少字节,功耗与散热决定这些字节能持续搬多久。但那里留了一个没有拆开的盒子——我们说移动 GPU 靠"尽量不画"取胜,可它究竟是怎么做到的?
这个盒子就是分块渲染(tile-based rendering,TBR)与它的进阶形态分块延迟渲染(tile-based deferred rendering,TBDR)。上一篇给的是结论:移动端把深度、混合与瞬态附件留在片上。这一篇给机制:那块片上内存到底有多大、几何是怎么被分到块里的、装不下的时候会发生什么、以及为此要在别处还哪几笔账。
所以本篇在系列里的位置是机制篇——上接前提,下启账本。它不替你算带宽总账(那是第 3 篇),也不解释限频与温度墙(那是第 4 篇),只把"分块这台机器怎么运转"讲透。
本篇的边界:不涉及带宽的完整账本与四类降带宽手段(第 3 篇),不讨论 DVFS、温度墙与持续性能(第 4 篇),不给"照抄即最优"的配置模板;第 4 步按变体 B 以配置清单与伪代码呈现,理由见 1.5。
1.2 本篇要回答的三个问题
先给本篇在系列里定个坐标:它只拆机制,把带宽账与功耗账留给后续篇章。三个问题,正好对应本篇的三条主线:
- 几何是怎么被分到块里的? 分桶(binning)阶段把屏幕切成小块、把每个图元登记进它覆盖的块。这里藏着一笔固定开销,而且它有个反直觉的放大效应——一个三角形可能被登记进远多于它实际覆盖的块数。
- 片上内存装不下会怎样? 颜色、深度、模板、多重采样都要占这块内存。它的容量在移动端是几十 KB 到 1 MB 量级,附件一多就会溢出(spill)。溢出的代价不是"慢一点",而是这套架构最核心的前提被打破。
- 分块自己的代价在哪几处、各有多大? 三笔账:binning 的固定开销、溢出的 flush 代价、resolve 的带宽代价。第三笔里有一个数字值得记住——用错一次 resolve API,1080p 60 帧下的代价约 500 mW,占一台 2.5 W 设备功耗预算的 20%。
1.3 全系列内容总览
七篇的递进关系是先立前提、再拆子系统、最后回到实践。第 1 篇把带宽与功耗两道墙立起来,第 2 到第 4 篇分别拆分块机制、带宽账本与持续性能,第 5、6 篇回到取舍与前沿,第 7 篇收在方法论上。
把系列位置一句话标记:第 1 篇立前提,第 2~4 篇拆机制、账本与持续性能,第 5~6 篇回到取舍与前沿,第 7 篇收方法论;本篇就落在这条主线的「机制」一环。下面用一张表把每篇的定位列清楚。
| 篇 | 主题 | 它回答的问题 | 与前一篇的关系 |
|---|---|---|---|
| 1 | 两台不同的机器:移动 GPU 的物理约束 | 移动端到底被什么约束? | 立前提 |
| 2 | 分块渲染:binning、片上内存与它的代价 | 分块是怎么做到的?代价在哪? | 前提 → 机制(本篇) |
| 3 | 带宽:移动端最硬的那道墙 | 每帧的字节都花在哪了? | 机制 → 账本 |
| 4 | 功耗与热:帧率为什么会掉下去 | 为什么持续性能只有爆发的一半? | 账本 → 持续性能 |
| 5 | 延迟着色在移动端:能做什么、不能做什么 | 哪些桌面上成立的做法在这里不成立? | 前四篇 → 取舍 |
| 6 | 现代特性落地:VRS、网格着色与移动光追 | 新特性在移动端的真实收益与前提是什么? | 取舍 → 前沿 |
| 7 | 测量与调优:怎么证明你真的优化了 | 怎么量化、怎么验收? | 全部 → 方法论 |
1.4 与已有中文解析的差异
移动 GPU 的中文资料里,讲分块渲染的其实不少。但读完常有一个感觉:流程图画得很清楚,可"代价"始终是定性的。
我们把已有的中文写作分成三类,并说明本篇补的是哪一块:
| 类型 | 典型内容 | 已经讲得很好的部分 | 缺口 |
|---|---|---|---|
| 架构科普笔记 | IMR 与 TBR 数据流图、两个 Defer 的区分、各厂 HSR 名号 | 概念与流程的入门理解 | 几乎没有量化:省了多少、什么时候不省、代价多大 |
| 引擎配置清单 | "关掉 HDR""用 memoryless""设 storeOp" | 可执行的操作项 | 不解释每一项省的是哪笔账、量级多少 |
| 厂商白皮书翻译 | Arm / Imagination / Qualcomm 的架构文档 | 架构的权威表述 | 缺少横向对照与工程取舍,且配图不可引用 |
本篇的差异点是一句话:把分块的每一项收益与代价绑到可核对的数字上。 每个"所以你应该……"的结论,前面必须有一个"因为量级是……"的依据。
具体说,本篇会补上中文资料里最空的四块:片上内存溢出(spill)的机制级代价;subpass 合并的反直觉结论(省带宽但不保证更快);binning 的包围盒高估效应;以及把三笔账合成一张可核算的表。
1.5 阅读建议与边界声明
阅读建议:如果你只知道"移动 GPU 是分块的",这一篇是从概念走到工程判据的那一段。已经清楚分块流程、只想看代价的,可以直接跳到第 4 节。
边界声明(这篇不涉及什么,以及为什么):
- 不涉及带宽的完整账本与四类降带宽手段——那是第 3 篇的主线,本篇只点出与 tile 直接相关的那几项流量。
- 不涉及 DVFS、温度墙与持续性能——那是第 4 篇。
- 不涉及具体机型的跑分与排名。型号迭代快,排名半年就过期;机制与约束不会过期。
- 不给"照抄即最优"的配置模板。分块的正确配置取决于附件数量、位深、多重采样与引擎的 render pass 结构,脱离这些谈最优配置是伪命题。
- 本篇第 4 步按变体 B 呈现(见 1.6 末)。移动端图形以硬件约束与工程取舍为主线,代码密度天然偏低,硬凑长代码段只会稀释信息密度;因此关键做法以配置清单 + 伪代码给出,凡涉及具体实现仍给可复现的做法。
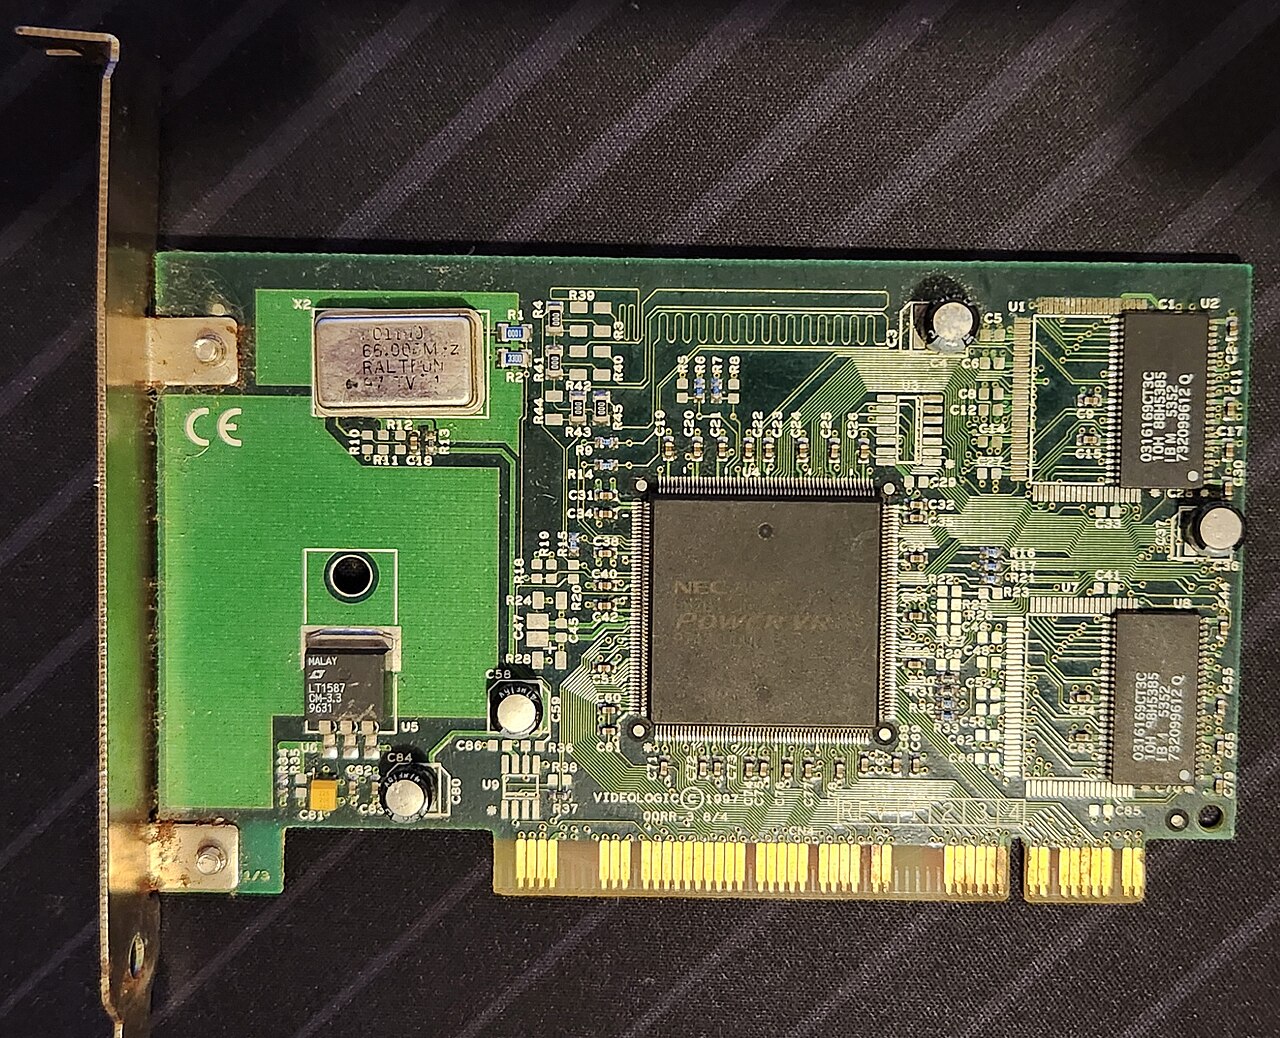
顺带把这张主板的意义说清楚:分块渲染所有机制,最终都落在这条窄板上。 片上内存就在 SoC 里,tile list 要落到旁边那颗 LPDDR 颗粒上;两者之间的距离以毫米计——这既是优势(延迟低),也是限制(位宽和散热互相牵制)。
1.6 术语对齐
术语先对齐,免得后面反复解释。分块渲染(tile-based rendering, TBR)指把渲染面切成小块、逐块处理;bin 是分桶阶段产出的图元列表,tile 是实际着色的小块;binning 是"把图元分到 tile"这个动作;tile list 是分桶的结果,通常会落到 LPDDR 里;GMEM / tile RAM / tile memory / imageblock 是同一件事在四家厂商口中的四种叫法,指 GPU 上那块放 tile 数据的片上内存;resolve 是把多重采样的结果合并成单采样并写回系统内存的那一次搬运;HSR(hidden surface removal,隐藏面消除) 是"先决定可见性、再着色"这一步的统称。
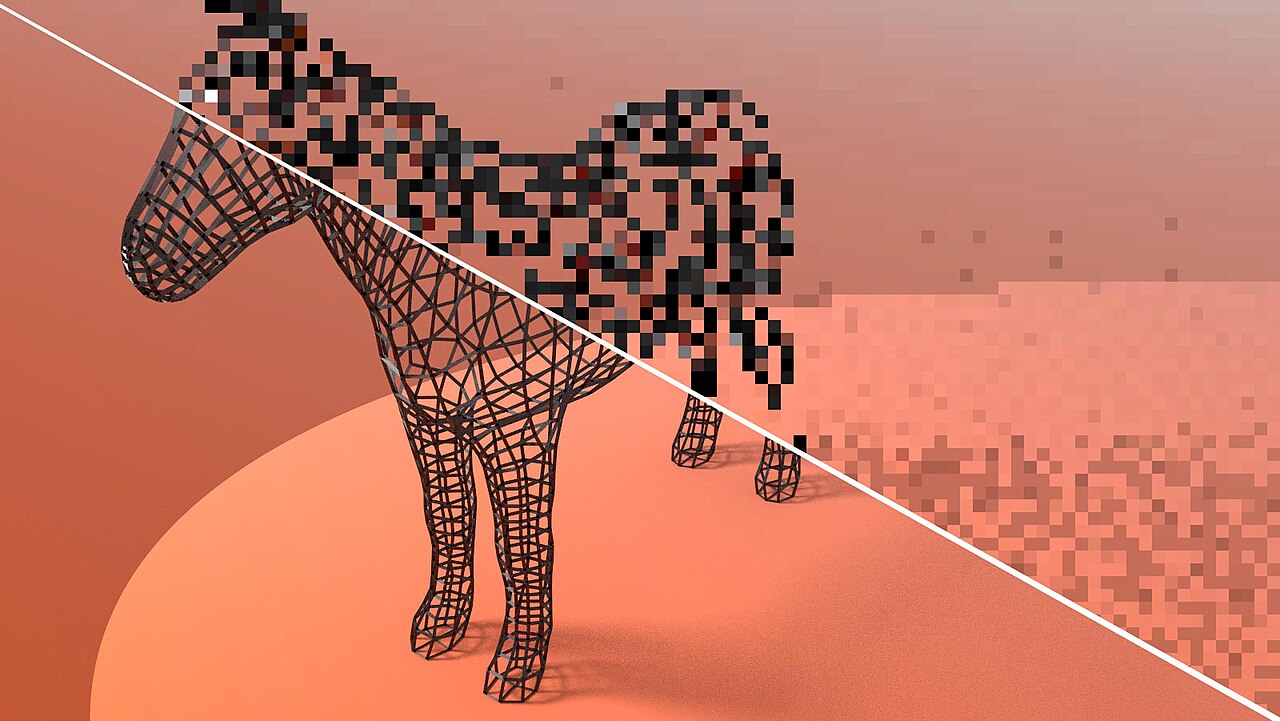
还有一处最容易混:延迟渲染(deferred rendering)在移动端语境里特指"先决定可见性、再着色",与桌面上的延迟着色(deferred shading)不是一回事。 本篇只讨论前者;后者是第 5 篇的主题。
六步闭环的变体说明:本系列按变体 B 执行——六步的顺序与完整性不变,第 4 步「实现与配置」允许以配置清单与伪代码替代长代码段落,并在每篇的边界声明中写明理由。本篇的理由是:这张清单上的每一项(loadOp / storeOp / transient / resolve 附件)本身就是一到两行的声明式配置,写成代码反而看不清"省的是哪笔账"。
从「两台机器」到「一台机器怎么运转」
2.1 一句话点题
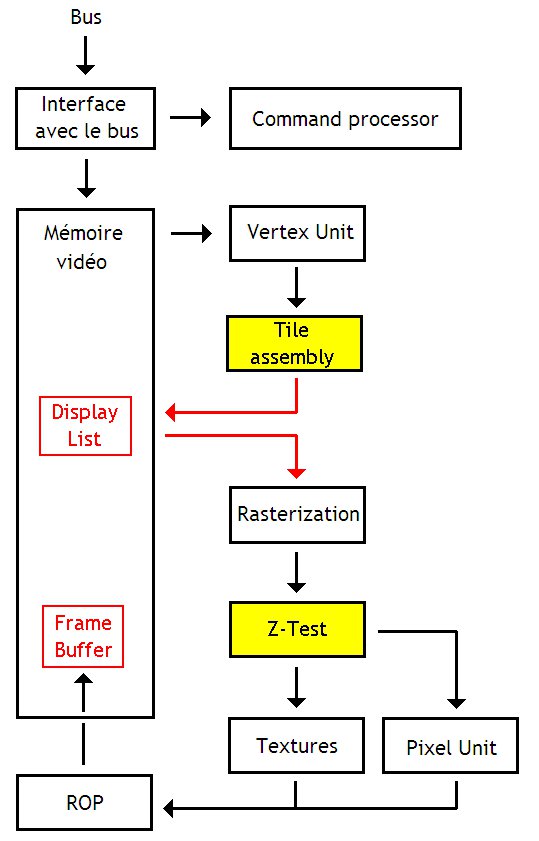
这一章要做的事只有一件:把上一篇那句"尽量不画"翻译成机制。 分块渲染之所以能省带宽,是因为它改变了"framebuffer 放在哪"——从系统内存搬到了片上;而它全部的代价,都来自这次搬运带来的几条新动线。
2.2 原理与概念:两阶段与多出来的一步
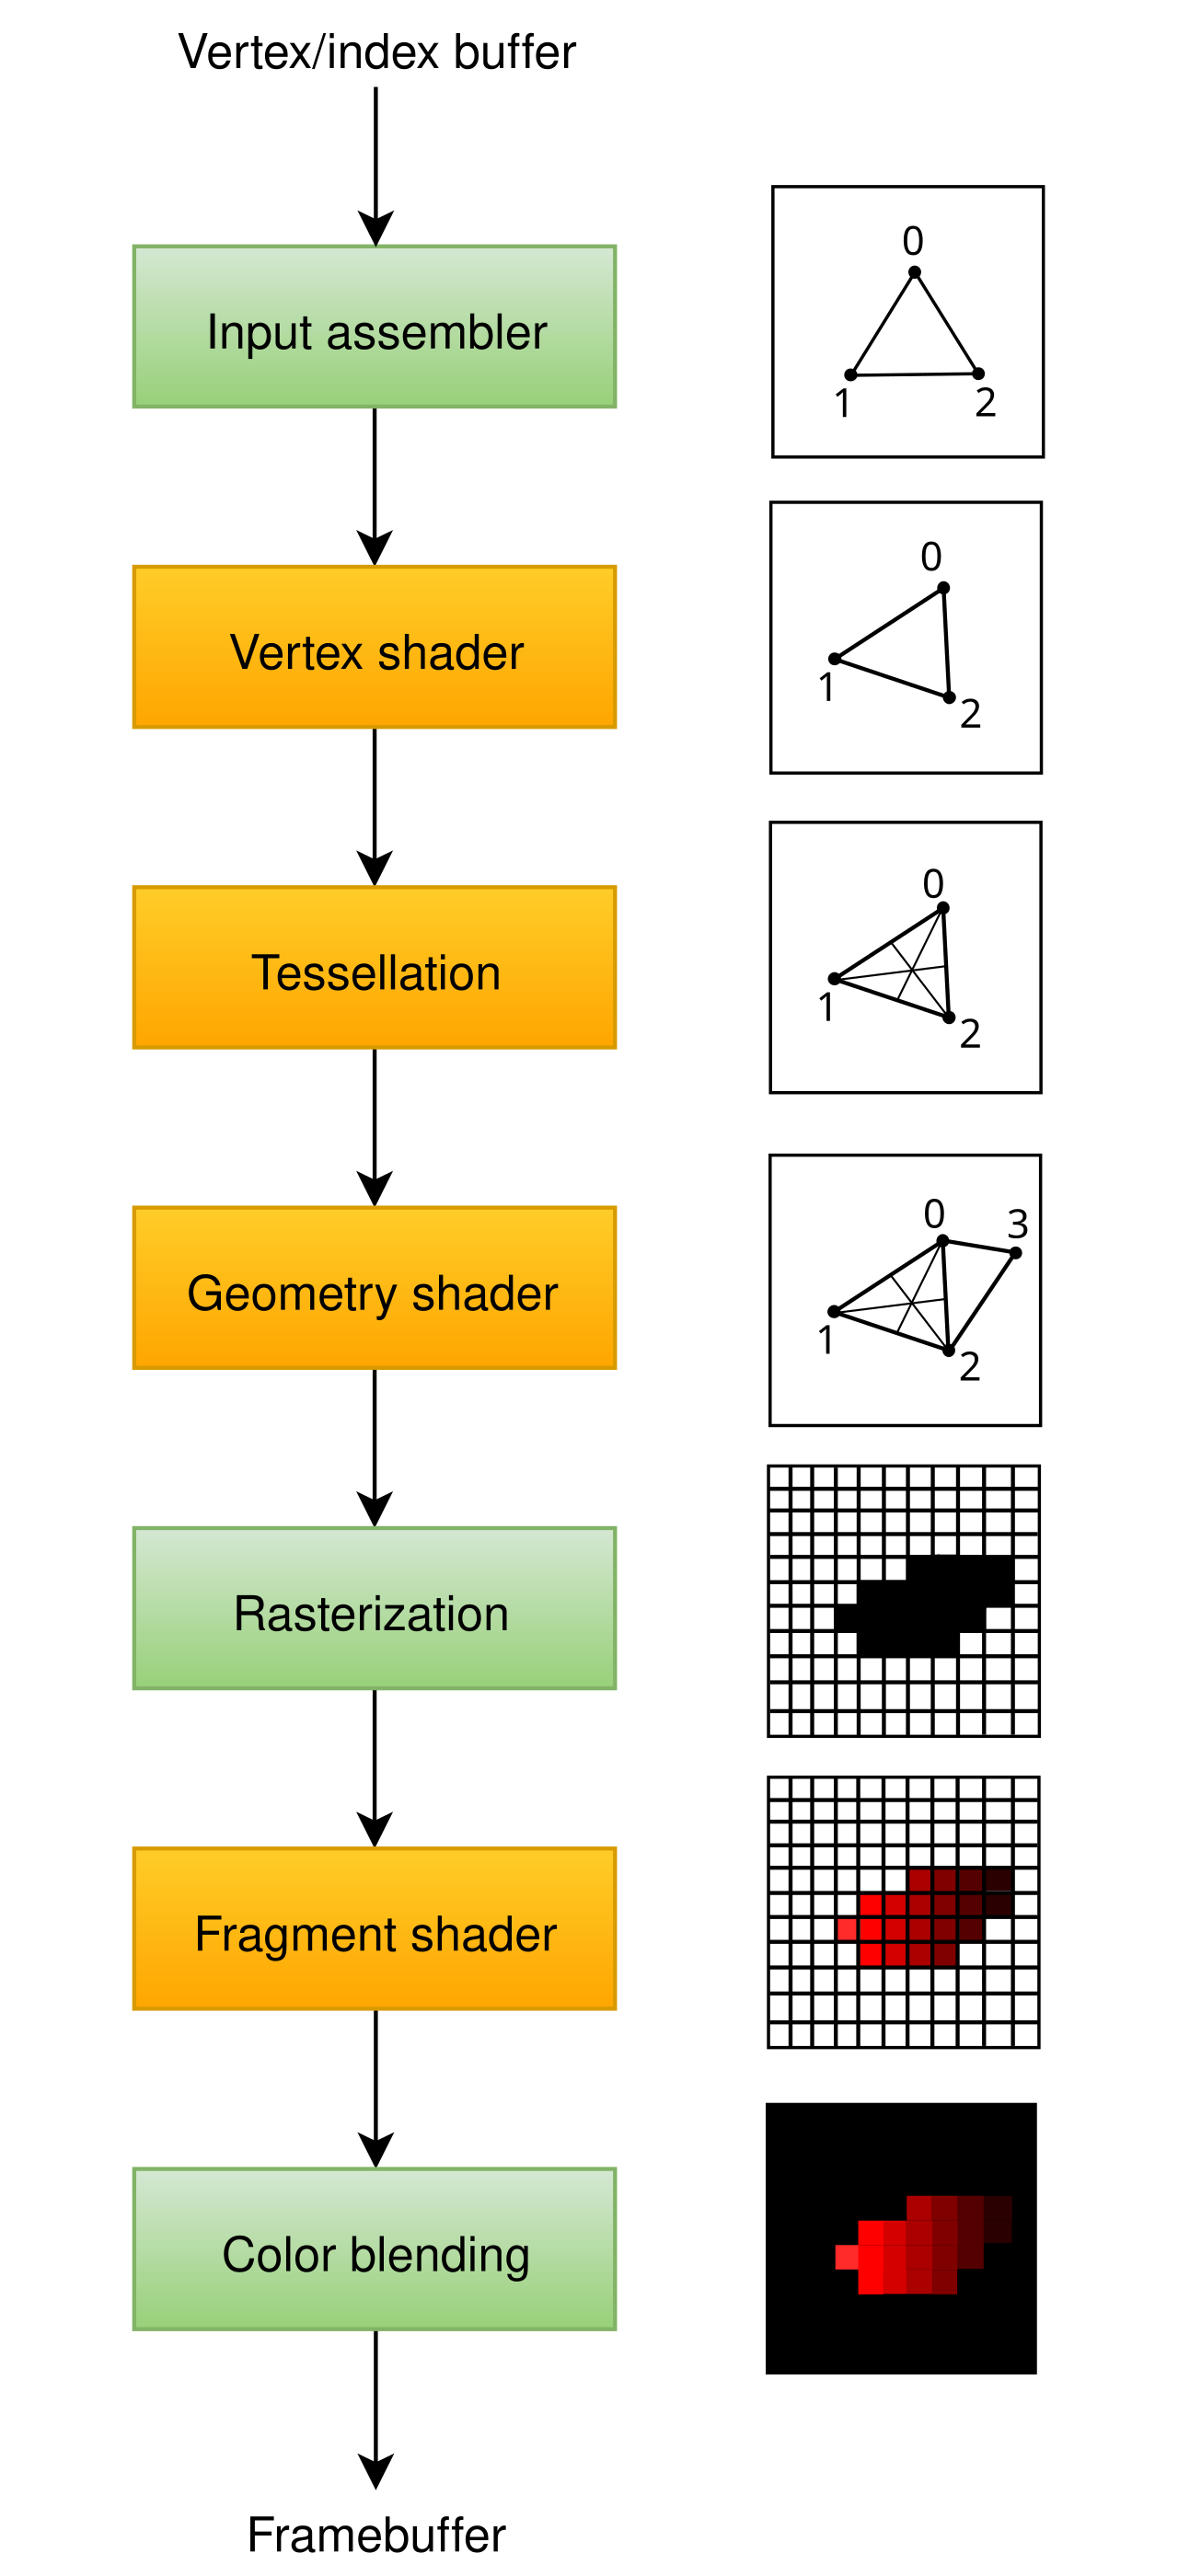
先说 TBR 的骨架。它把一帧拆成两趟:
第一趟是几何处理与分桶。顶点着色、裁剪、投影都在这趟完成,然后 GPU 判断每个图元覆盖了哪些屏幕小块,把它的引用登记进对应的列表。Arm 对其 Mali 架构的描述是:把屏幕切成小的 16×16 像素 tile,并构建"每个 tile 里有哪些图元"的列表 [Arm 抽象机系列]。
第二趟是逐块着色。GPU 一次取一个 tile,把它涉及的图元拿出来光栅化、着色。关键就在于这一步:因为一个 16×16 的小块面积足够小,颜色、深度、模板这些工作集可以整块留在与着色核心紧耦合的快速 RAM 里 [Arm 抽象机系列]。
TBDR 在这个骨架上多了一步。Imagination 的 PowerVR 是这条路线最早的商业实现:它把对物体的纹理与着色推迟到所有物体的可见性都判定完之后,官方文档给出的效果是——对完全不透明的渲染,overdraw 可以被完全消除 [Imagination PowerVR 架构指南]。
2.3 原理与概念:这次搬运带来了什么
把两趟结构画成时间线,就能看出三类新动线:
一是几何数据要先攒一遍。分桶需要全部几何,所以几何阶段的输出(逐顶点 varying 与分桶中间状态)必须写回主存、再由片元阶段读回——Arm 明确把这列为分块渲染固有的额外带宽 [Arm 抽象机系列]。
二是片上内存会被占满。附件越多、位深越高、开了多重采样,每像素占用就越大;而片上内存的容量是固定的。
三是结果最终仍然要写回。resolve 也好、附件 store 也好,这一次搬运跑不掉。
三个动线对应三笔账,本篇的第四、五章就是逐笔去算它们。 这里先记住一句话:分块不是让流量消失,而是把流量从"反复读写整张 framebuffer"换成了"一次性攒几何 + 一次性写回"。
2.4 公式或参数逐项释义:五个必须先记住的数
把这五个数放在一起看,分块机制的全部取舍几乎都能从它们推出来:tile 尺寸决定块数与单块面积,每像素位宽与附件数共同决定片上内存够不够用,而这三项又一起决定了溢出与回写的次数。
| 参数 | 典型取值 | 谁在决定 | 说明 |
|---|---|---|---|
| tile 尺寸 | Arm 16×16(早期)/ 32×32(Valhall 起);PowerVR 32×32;自适应机型 64×64 起可缩 | GPU 架构(软件不可直接设定) | core Vulkan 无法查询或控制,硬件选"能装进片上内存预算"的尺寸 [Vulkan Guide] |
| 每像素附件占用 | 由附件数量、格式位深、是否 MSAA 决定 | 开发者(通过 render pass 结构) | 这是开发者唯一能直接影响的变量 [Vulkan Guide] |
| 片上内存容量 | Adreno GMEM 512 kB(642L/643/623)、1.5 MB(663);Apple A11 单 tile 最大 32 KB | 芯片设计 | 数值来自各厂商官方规格 [Qualcomm / Apple] |
| 位置数据精度 | 顶点位置可用 unorm16 | 开发者 | 官方给出的换算:10 米量级模型下量化精度约 0.15 mm [Vulkan Guide] |
| 片上内存能效 | 外部 DRAM 每 GB/s 约 120 mW;片上访问能耗约为其十分之一 | 芯片设计 | Arm 给的量级,用来解释"为什么值得把数据留在片上" [Arm 抽象机系列] |
这张表要读出的东西是:tile 尺寸不由你定,附件预算由你定。 所以工程上能做的那一半,全在"怎么把附件塞进固定预算里"。
2.5 原理与概念:分块机制的演进
分块不是一次性设计出来的,而是一轮轮被约束逼出来的:从早期照搬桌面管线,到分块架构普及,再到带宽成为首要瓶颈、片上内存开始被显式管理。下面这条时间线按该认知在公开文档里被写出来的时间排序。
分块不是一次成型的。把它的关键节点排开,能看到一条很清晰的线:从"把 framebuffer 搬进片上",一路走到"连几何和可见性也一起提前处理"。
| 时期 | 节点 | 变化 |
|---|---|---|
| 1990 年代中后期 | PowerVR 以 TBDR 路线进入市场 | 首次用"先判定可见性再着色"消除 overdraw |
| 2000 年代 | Arm Mali 确立两阶段结构 | 16×16 tile,颜色/深度/模板留在与着色核心紧耦合的 RAM |
| 2010 年代 | 移动端全面转向分块 | 分块成为移动 GPU 的默认形态;桌面仍以 IMR 为主 |
| Valhall 起(Mali-G77 之后) | tile 改为 32×32 | 并引入更强的前端处理;纹理采样速度达到片上内存访问的 2 倍 |
| Immortalis-G920 / G925 | 硬件 fragment pre-pass + 自适应 tile | 128 bpp 阈值时 tile 从 64×64 缩到 64×32;256 bpp 时缩到 32×32 |
| Qualcomm | FlexRender | Adreno 可在分块与直接模式间切换,由驱动按负载自动选择 |
| 2020s | Apple 的 imageblock 与 memoryless 存储 | G-buffer 这类中间附件可以完全不分配系统内存 |
年份口径说明:上表以该能力在公开技术文档中被明确表述的时间为准,不是技术首次出现的时间。
第一代与第二代 TBDR 的实现路线并不相同:前者靠硬件隐藏面消除一次性确定可见性,后者把这一层做得更彻底,并去掉了传统的 Z-buffer 存储——无 Z-buffer 时代的分块就是从这里开始的。
2.6 实现与配置:四种口径的横向对照
四家厂商的口径差异,本质上是对同一个预算的不同切法:有的把片上内存当作可配置的附件预算,有的把它做成必须显式声明的生命周期。对照它们的表述方式,比记住某个数字更有用。
同一个机制,四家厂商的实现与口径差别不小。这张表是后面所有章节的索引——每一项差异都会在具体章节里变成一笔不同的账:
| 维度 | Arm Mali / Immortalis | Imagination PowerVR | Qualcomm Adreno | Apple GPU |
|---|---|---|---|---|
| 结构 | TBR(两阶段)+ 硬件 pre-pass | TBDR(可见性先行) | TBDR 为主,可切 IMR | TBDR |
| tile 尺寸 | 16×16 → 32×32 → 自适应 64×64 起 | 32×32(硬件设计时定) | 未公布固定像素尺寸 | 可配三种尺寸,A11 单 tile 最大 32 KB |
| 片上内存口径 | tile RAM(与着色核心紧耦合) | 片上内存(chip memory) | GMEM(512 kB / 1.5 MB) | tile memory / imageblock |
| 可见性 | 硬件 fragment pre-pass(G925 起) | HSR,官方称可完全消除 opaque overdraw | visibility pass + 每 tile 一次渲染 pass | 延迟到几何评估之后渲染 |
| 模式切换 | 固定分块 | 固定分块 | FlexRender:可在两种模式间切换 | 固定分块 |
| 中间附件能力 | Pixel Local Storage(T760 起,每像素 16 字节) | 应用选择保留哪些附件 | tile memory heap 可绑定 buffer | imageblock / memoryless 存储 |
把当时的桌面图形卡放在一起看,可以清楚看到另一条路线的硬件形态:走线与散热结构复杂得多,供电规模也远大于移动端,而这一切都是用更大的板面换来的带宽与算力余量。
2.7 效果与量化:三项固有成本概览
先说结论:分块换来的是"把 framebuffer 搬进片上",付出的代价集中在三处。
第一处是 binning 的固定开销。几何必须全部过一遍分桶,这段串行过程必须完成后才能开始片元着色;Arm 明确说,合并 subpass 会增加初始几何负载并推迟片元着色的启动,而这段串行分桶可能无法被掩盖 [Arm subpass 博客]。
第二处是溢出。附件所需位宽超过 tile 尺寸对应的片上内存时,驱动可能被迫使用更小的 tile,效率随之降低 [Vulkan Guide]。更硬的代价来自机制层面:在任何 tiler 上,读取 framebuffer 会导致整个 framebuffer flush,flush 后要把全部元数据(所有采样、深度、模板)写回内存,而这些数据可能比 framebuffer 本身还大 [Garrard, SIGGRAPH 2015]。
第三处是 resolve。多重采样的正确做法是把 resolve 留在片上完成(4× MSAA 只增加约 3% 带宽);用错 API 则要走主存往返,代价是 +5 GB/s,约 500 mW [Vulkan-Samples MSAA 实测]。
2.8 源码与数据链接
这一章引用的机制描述与规格,全部来自四家厂商的官方文档与公共规范:
- Arm,《The Mali GPU: An Abstract Machine, Part 2 — Tile-based Rendering》:https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/the-mali-gpu-an-abstract-machine-part-2---tile-based-rendering
- Imagination,《Tile-Based Deferred Rendering (TBDR)》:https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/tile-based-deferred-rendering-index.html
- Qualcomm,《Adreno GPU 图形概述(含 GMEM 规格)》:https://docs.qualcomm.com/bundle/publicresource/topics/80-70020-19SC/graphics-overview.html
- Apple,《Tailor your apps for Apple GPUs and tile-based deferred rendering》:https://developer.apple.com/documentation/metal/tailor-your-apps-for-apple-gpus-and-tile-based-deferred-rendering
- Khronos,《Tile Based Rendering (TBR) Best Practices》:https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
2.9 这一章留下的问题
到这里,机制的形状清楚了:分桶 → 逐块着色 → 写回。但每一步都还只是轮廓——分桶到底怎么分?一块 tile 里放得下什么、放不下什么?
下一章从分桶这一趟开始拆。那里有一个反直觉的放大效应:一个三角形被登记进的 tile 数,可能远多于它实际覆盖的块数,而这个误差在几何密集的场景里会被放大成真实的开销。
一、binning:几何是怎么被分到桶里的
3.1 一句话点题
这一章回答一件很具体的事:几何从顶点着色出来之后,是怎么被"分到屏幕小块里"的,以及这个动作本身要花多少代价。
答案的第一层是流程(变换后的图元 → 覆盖判定 → 写进 tile list)。第二层才是关键:覆盖判定通常不做完整的保守光栅化,而是取图元变换后的坐标包围盒。这一个近似,就是分桶开销的主要来源。
3.2 原理与概念:分桶这一趟在做什么
把这一趟拆开,是四步:
第一步,顶点变换与裁剪。顶点着色、投影、视锥体裁剪都在这里完成。输出是屏幕空间的位置数据。
第二步,覆盖判定。对每个图元,判断它落在哪些 tile 上。这里就是近似发生的地方——GPU 取变换后三角形的坐标包围盒与 tile 网格求交,而不是做精确的保守光栅化 [Garrard, SIGGRAPH 2015]。
第三步,写 tile list。把图元引用按 tile 归类,形成"每个 tile 要画哪些图元"的列表。这份列表通常会落到系统内存(LPDDR)里——它不小,尤其是几何密集的场景。
第四步,交接。几何阶段的输出(逐顶点 varying 与分桶中间状态)必须写回主存,第二趟再读回来 [Arm 抽象机系列]。
四步里有两步是纯开销:覆盖判定的近似误差,和第三、四步的额外往返流量。 后面的三小节分别把这两笔账量出来。
3.3 公式或参数逐项释义:tile 尺寸与每像素位宽
这张表是本章的账本基础:
| 参数 | 典型取值 | 谁在决定 | 说明 |
|---|---|---|---|
| tile 边长 | 16、32、64 像素 | GPU 架构 | core Vulkan 无法查询或控制;硬件选"能装进内部内存预算"的尺寸 [Vulkan Guide] |
| Arm 默认 tile | 64×64(G925 系列) | 硬件 + bpp | 默认 64×64,按每像素位宽自适应收缩 [Arm G925 博客] |
| 自适应阈值一 | 128 bits-per-pixel | 硬件 | 超过后 tile 从 64×64 缩到 64×32 [Arm G925 博客] |
| 自适应阈值二 | 256 bits-per-pixel | 硬件 | 超过后缩到 32×32 [Arm G925 博客] |
| 颜色附件预算(合并 subpass) | ≤128 bit/像素;Mali-G72 起放宽到 ≤256 bit | 开发者(决定附件组合) | 超出预算必须用更小 tile → 吞吐下降 + 读 tile list 带宽上升 [Vulkan-Samples subpasses] |
| 位置数据精度 | unorm16 | 开发者 | 10 米量级模型下约 0.15 mm 量化精度 [Vulkan Guide] |
这张表的读法是从下往上读:先看你打算开几张附件、每张多少位,加出每像素总位宽;再看这个位宽会不会触发 tile 收缩。收缩的代价是双重的——tile 变小意味着同样的画面要切更多块,块调度开销上升,同时 tile list 也更大、读它的带宽也上升。
3.4 原理与概念:包围盒高估与几何局部性
这是本章最值得记住的一处机制。因为覆盖判定取的是包围盒,一个细长的大三角形会被登记进远多于它实际覆盖的 tile 数。SIGGRAPH 2015 的移动图形课程里给了一个具体例子:某个 tile 实际只被 4 个三角形覆盖,却要处理 8 个 [Garrard, SIGGRAPH 2015]。
浪费的形式是"多遍历":分桶阶段多做一次登记,第二趟在那个 tile 里还要多做一次剔除。单个 tile 上是小浪费,但几何密集时会被放大。
放大效应的第二个来源是几何提交的顺序。分桶会做图元压缩——跳过那些整体落在 tile 之外的图元。这项优化依赖局部性:如果相邻图元的位置也相邻,压缩效果好;如果顺序随机,压缩基本失效,每个 tile 都要遍历几乎整个几何列表。
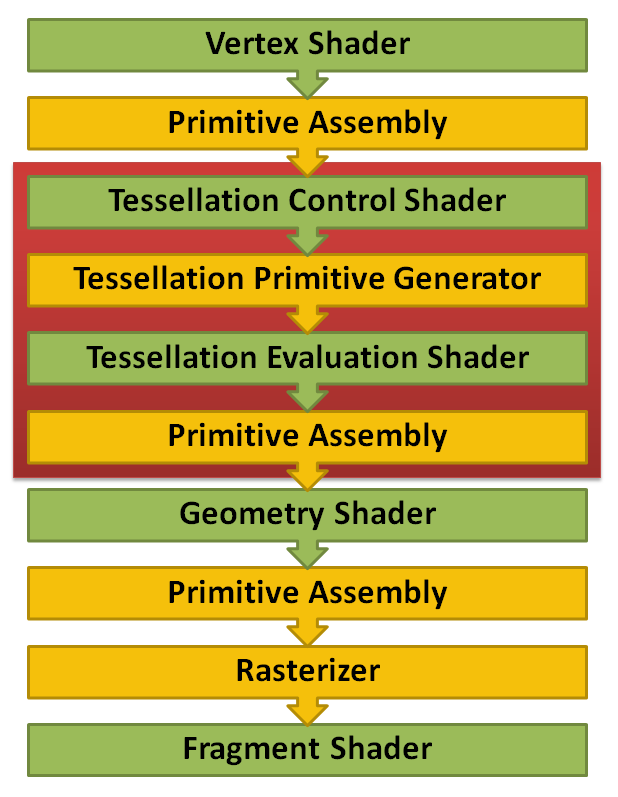
粒子系统是典型受害者:一次提交几万个位置分散的小图元,压缩失效,分桶开销按图元总数走。几何着色器与曲面细分生成的几何同理——它们让"提交顺序"与"屏幕位置"彻底解耦。
还有一层是层次化分桶:为了加速大范围判定,GPU 可能先在更高层级(甚至整个 framebuffer 范围)做粗判。这会让"非常精细但很小的几何"也被纳入更大范围的考虑中 [Garrard, SIGGRAPH 2015]。换句话说,几何越小越碎,这套判定的相对开销越高。
3.5 实现与配置:位置数据的压缩与提交顺序
这一章的"实现"不是写代码,而是两条可以在引擎侧落地的约束:
第一,让顶点位置数据尽量窄。 分桶阶段读的是位置数据,官方建议把顶点位置单独存到一个 buffer 里以减少分桶带宽,并用 unorm16 量化——10 米量级的模型上仍能保持约 0.15 mm 精度 [Vulkan Guide]。这是典型的"用精度换带宽",代价可控。
第二,让提交顺序有局部性。 分桶的图元压缩依赖位置相邻。工程上的做法是按空间结构(网格分区、四叉树)组织提交顺序,而不是按资源加载顺序。官方还提了一条:如果必须做二维网格划分,让网格边界对齐到 2 的幂,这样与 tile 网格的对齐关系最友好 [Garrard, SIGGRAPH 2015]。
如果确实要细分大形状,官方给的对策是让细分轴对齐(比如用水平三角带构建曲线),但明确说"细分到 tile 级别不太可能有帮助" [Garrard, SIGGRAPH 2015]。
这里还有一条容易被忽略的结构性事实:binning 必须完成后才能开始片元着色。好处是它天然可以流水——第 N 帧的分桶可以和第 N−1 帧的逐块着色并行,形成一种隐式的多缓冲;代价是多帧延迟 [Garrard, SIGGRAPH 2015]。但在单帧内部,这段串行是躲不掉的,而滥用 pipeline barrier 会破坏上面那种跨帧重叠 [Vulkan Guide]。
3.6 效果与量化:分桶的开销构成
| 流量项 | 来源 | 量级特征 | 能否优化 |
|---|---|---|---|
| 几何数据读取 | 变换后的顶点与其属性 | 与图元数成正比 | 位置数据量化、属性裁剪 |
| tile list 写入 + 读回 | 每个图元的引用与覆盖信息 | 与"图元 × 覆盖 tile 数"成正比;包围盒高估会放大它 | 提升局部性、减少跨块大三角形 |
| 阶段交接数据 | 逐顶点 varying 与分桶中间状态 | 分块渲染的固有成本 | 减少 varying 数量与位宽 |
三行合起来是本章的结论:分桶的开销不是常数,它随"几何数量 × 覆盖块数"增长。 这也解释了为什么移动端对几何放大(曲面细分、网格着色、几何着色器)格外谨慎——Arm 在其移动图形课程里把"几何放大"直接列为分块的劣势之一,措辞是"尤其糟糕" [Arm SIGGRAPH 2024]。
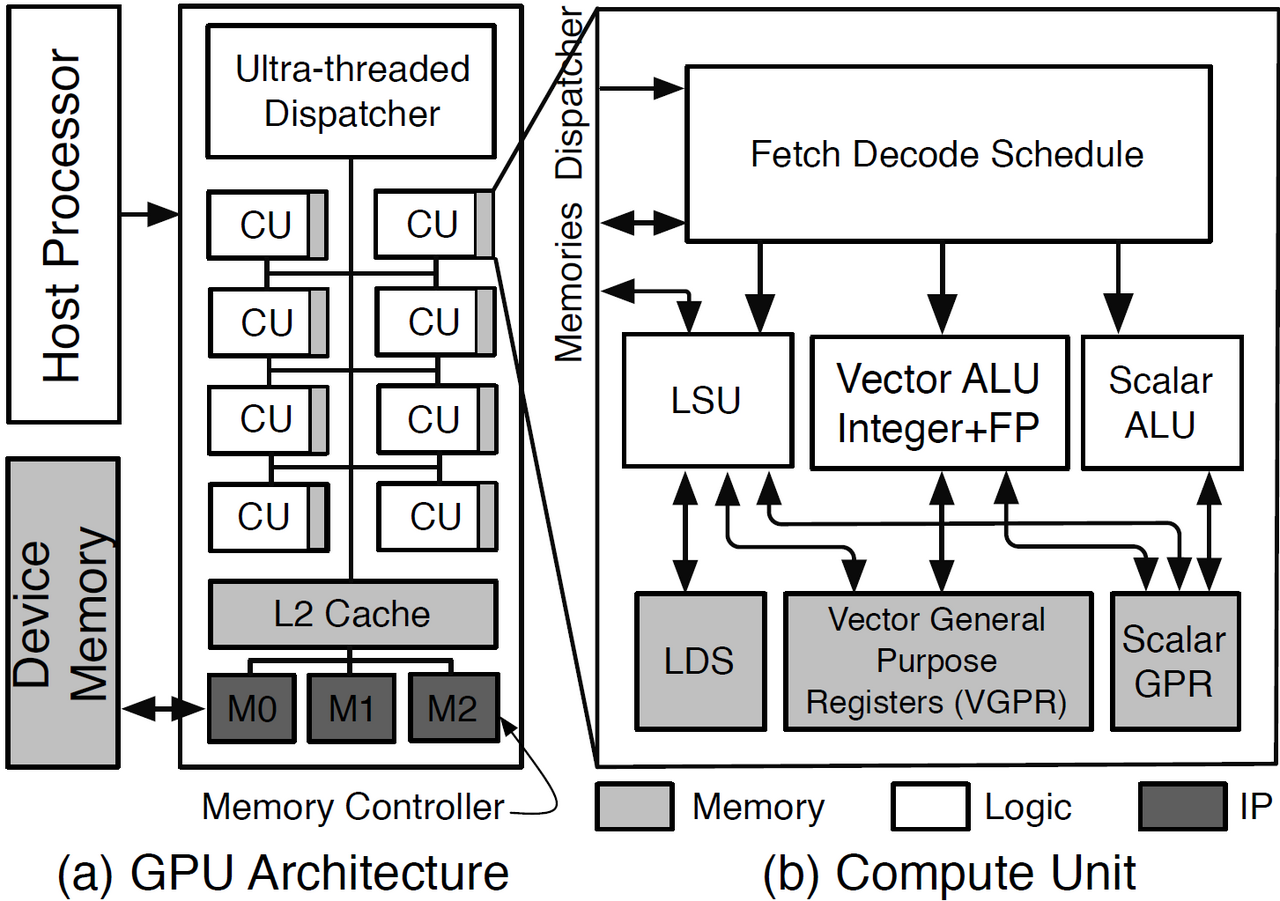
这几张实物照有一个共同点:它们都是存储阵列与几何前端在硅片上的占位证据——分桶的中间产物最终要落到这些阵列里,几何前端的规模也直接决定了分桶能并行到多宽。
3.7 原理与概念:tile list 长什么样
前面几节反复提到 tile list,但没交代它的形态。这一节补上,因为它的大小直接决定了分桶的流量。
tile list 的本质是"每个 tile 对应一份图元引用列表"。它不存图元本身,只存引用与少量覆盖信息——因为同一份几何会被多个 tile 引用,存本体就太重了。这份列表通常落在系统内存(LPDDR)里,而不是片上 [soo:bak 机制笔记]:片上内存要留给附件,装不下这种随几何量增长的数据结构。
它的大小可以粗算:
tile 总数 = 渲染宽 ÷ tile 宽 × 渲染高 ÷ tile 高
列表规模 ∝ tile 总数 × 每 tile 平均图元引用数
代入一个真实规模就直观了:2220×1080 分辨率配 16×16 的 tile,每帧约 9k 个 tile [Vulkan-Samples subpasses]。如果几何把一个 tile 平均填 200 个引用,这一项就是百万量级的引用条目。这也是为什么位宽阈值触发 tile 收缩时,除了块调度变重,读 tile list 的带宽也会上升——tile 变小意味着 tile 总数变多,列表按比例增大。
压缩手段有三类,都在前面的机制里出现过:
- 引用索引化:图元用固定位宽的索引表示,而不是完整数据。
- 跳过未命中的压缩:整体落在 tile 之外的图元直接不写进列表。这也是前面"几何局部性"那一节的主角——这项压缩对提交顺序敏感,顺序随机时基本失效 [Garrard, SIGGRAPH 2015]。
- 位置数据量化:顶点位置用 unorm16,既省几何带宽,也省判定时的读取量 [Vulkan Guide]。
三者的共同点是:都在减少"每帧要过多少条引用"。 这也再一次指向本章的结论——分桶开销随"几何数量 × 覆盖块数"增长,优化它的方向只有两个:减少几何,或者让几何的屏幕位置更集中。
3.8 源码与数据链接
- Arm,《Vulkan subpasses: the good, the bad, and the ugly》(binning 串行性与几何负载): https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/vulkan-subpasses-the-good-the-bad-and-the-ugly
- Garrard(Samsung),《Cramming Software onto Mobile GPUs》SIGGRAPH 2015(包围盒高估、几何局部性、层次化分桶): https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/siggraph2015_2D00_mmg_2D00_andrew_2D00_notes.pdf
- Khronos,《Tile Based Rendering (TBR) Best Practices》(tile 尺寸不可控、位置数据量化): https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- Arm,《Immortalis-G925: The Fragment Prepass》(自适应 tile 阈值): https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/immortalis-g925-the-fragment-prepass
3.9 这一章留下的问题
分桶这一趟的账算清了:开销随"几何数量 × 覆盖块数"增长,而包围盒高估与几何局部性是两个放大器。
但分桶的产物——tile list 与后续的附件数据——都要有地方放。那块片上内存究竟有多大?装不下的时候,代价为什么不是"慢一点"而是"机制失效"? 下一章算这笔账。
二、片上内存:容量账与溢出
4.1 一句话点题
这一章回答:分块渲染的核心资产——片上内存——到底有多大,以及装不下会发生什么。
答案的前半段是规格:它是几十 KB 到 1 MB 量级,具体数值各家公开程度不一。后半段是代价:溢出不是"变慢一点",而是分块的前提被打破——framebuffer 又要回到系统内存里去。
4.2 原理与概念:三种叫法,一份预算
同一样东西在不同厂商的文档里有三个名字:GMEM、tile memory、on-chip memory。名字不同不代表机制不同,但各家给出的容量与配置方式确实不同,而这正是「能不能同时开 HDR 与 MSAA」的分界线。
同一块内存,四家厂商的叫法不同,公开程度也不同:
| 厂商 | 叫法 | 公开规格 | 备注 |
|---|---|---|---|
| Arm | tile RAM(与着色核心紧耦合的片内 RAM) | 未按机型公布字节数;PLS 自 T760 起提供每像素 16 字节本地存储 | PLS 用的是原本给多重采样预留的片上内存 [Arm PLS 博客] |
| Imagination | 片上内存(chip memory) | 未公布字节数 | 官方只说明"tile 足够小,使所有数据可保存在片上内存中" [Imagination] |
| Qualcomm | GMEM | 512 kB(Adreno 642L / 643 / 623);1.5 MB(Adreno 663) | 官方规格页直接给出容量 [Qualcomm] |
| Apple | tile memory / imageblock | A11 上单个 tile 最大 32 KB | 官方 Tech Talk 给出;并提示应选能装下 imageblock 的最大 tile [Apple Tech Talk] |
这张表有一个必须点破的差异:Qualcomm 公布了容量,但没公布固定的 bin 像素尺寸;Apple 公布了 A11 的 32 KB,之后各代未逐一公布;Arm 与 Imagination 都只给机制不给字节数。
这意味着开发者在写代码前很难精确预判"我的附件组合会不会溢出"——这正是本篇列入的未解问题之一。
把桌面侧的内存模组放在旁边对照,差异一目了然:桌面用可插拔模组换来容量与升级能力,移动端把颗粒直接焊在 SoC 旁边,用不可升级换取更短的走线与更低的每比特能耗。
4.3 公式或参数逐项释义:每像素位宽的算法
虽然容量不透明,但预算的算法是公开的、可手算的。官方表述是:附件数量、格式、是否开启多重采样决定每像素需要存多少数据;因为片上内存总量固定,使用更小位深的像素格式常能让硬件使用更大的 tile,或避免数据溢出到外部内存 [Vulkan Guide]。
把它写成算式:
每像素占用 = Σ(颜色附件位深) + 深度位深 + 模板位深
单块占用   = 每像素占用 × tile 宽 × tile 高 ÷ 8      (单位:字节)
是否溢出   = 单块占用 > 该架构的片上内存预算
代入两组常见配置,就能直观看到差别:单张 RGBA8 颜色附件加 24 位深度,每像素 56 位;四张 RGBA8 加 4× 多重采样的深度,每像素 32×4 + 96 = 224 位——后者是前者的四倍。按上表 Arm 的阈值,128 bpp 就已经触发一次 tile 收缩,224 bpp 会触发第二次 [Arm G925 博客]。
这就是工程上最该记住的一句:附件预算是你唯一能直接调的变量。 tile 尺寸不由你定,但"开几张附件、每张多少位"完全由 render pass 的结构决定。
4.4 原理与概念:溢出的完整路径
溢出不只有一种后果,而是两级:
第一级是"换更小的 tile"。 官方表述是:附件所需位数超过该 tile 尺寸对应的片上内存时,驱动可能被迫使用更小的 tile,效率随之降低 [Vulkan Guide]。这一级是性能损失:块更多、调度更重、tile list 更大。
第二级是"机制失效"。 当附件需求超过硬件能提供的任何 tile 尺寸时,数据就必须经外部内存中转,分块的核心收益(framebuffer 留在片上)当场消失。技术侧的描述是:多张颜色附件或极宽的像素格式会让单个 tile 的工作集超容量,惩罚是"重新取更小的 tile",或"片上放不下、经外部内存中转,TBDR 的前提被打破" [Tech-TLDR 机制综述]。
还有一个比"换小 tile"更硬的代价,来自机制层面:在任何 tiler 上,读取 framebuffer 会导致整个 framebuffer flush。 flush 之后,后续渲染必须把全部元数据(所有采样点、深度、模板)写回内存,而这些数据可能比 framebuffer 本身还大——结果是烧带宽、掉性能 [Garrard, SIGGRAPH 2015]。
工程结论很直接:把一次 framebuffer 的渲染尽量收在同一个 pass 里做完。 反射、阴影贴图这些中间产物要先渲染好,不要在它们与其他 pass 之间来回切换。同理,如果用 occlusion query 决定是否继续渲染,要把"做这个决定本身的代价"一起算进去 [Garrard, SIGGRAPH 2015]。
4.5 实现与配置:把附件压进预算
这一章的可落地部分,是四类声明式配置。每一项都对应"省下哪一笔":
| 配置项 | 写法 | 省的是哪一笔 |
|---|---|---|
| 新帧初始化 | loadOp 用 CLEAR,而不是先手动清屏 |
让硬件直接在片上内存初始化,不产生外部内存流量 [Vulkan Guide] |
| 会被完整覆盖 | loadOp 用 DONT_CARE |
不必载入上一帧数据,也不必清 [Vulkan Guide] |
| pass 之后不用 | storeOp 用 DONT_CARE(要显式不写回但不逻辑丢弃用 STORE_OP_NONE) |
省掉整块附件的写回;深度/模板与多重采样颜色附件是最常见候选 [Vulkan Guide] |
| 只在 pass 内存在的中间数据 | TRANSIENT_ATTACHMENT + LAZILY_ALLOCATED |
某些 GPU 可完全不分配物理系统内存,数据只活在片上 [Vulkan Guide] |
| 多重采样 | 同 subpass 提供 resolve 附件 + 多采样附件 storeOp 设 DONT_CARE |
resolve 完全在片上完成;避免 vkCmdResolveImage(它强制走主存往返)[Vulkan Guide] |
这五项合起来就是"把附件压进预算"的全部手法。它们不是优化技巧,而是对预算的正确使用方式——不写这些,等于把片上内存省下来的带宽又原样还回去。
4.6 效果与量化:溢出的代价有多大
| 情形 | 实测/官方数字 | 来源 |
|---|---|---|
| 未给附件设 transient + lazily-allocated | GPU 会把附件写回外部内存,fragment job 约翻倍(56/s → 113/s) | Vulkan-Samples subpasses |
| 超出颜色附件预算 → 用更小 tile | 示例中 tile 数近乎翻倍到 409.6k/s | Vulkan-Samples subpasses |
| 合并 subpass 后(正确配置) | 物理 tile 数 约降 55%(262.2k/s vs 614.7k/s,Mali-G76) | Vulkan-Samples subpasses |
| 静态场景下的 tile 级写入消除 | framebuffer 带宽节省可达 99%(Transaction Elimination,16×16 tile) | Arm 官方技术页 |
| 片上内存 vs 外部内存能效 | 外部 DRAM 每 GB/s 约 120 mW;片上访问能耗约为其十分之一 | Arm 抽象机系列 |
最后一行是理解"为什么值得省"的钥匙:片上访问的能耗只有外部访问的十分之一量级。 所以片上内存省下的不只是带宽,更是功耗——而功耗才是移动端真正的稀缺资源。
下面这几张是片上存储与外部存储在硅片层面的对照。SRAM 单元面积大、密度低,但访问能耗比 DRAM 低一个量级——这正是分块架构宁可把附件留在片上、也不愿意回写的原因。
转到外部存储一侧,形态就完全不同了:颗粒紧挨着 SoC 焊接,位宽受走线数量限制,任何一次跨芯片往返都要付出延迟与能耗的双重代价。溢出之所以昂贵,根子就在这里。
4.7 原理与概念:片上内存的另外三种用法
前面几节把片上内存当成"放附件的地方"。但在最近的架构里,它已经不只是附件缓冲——它被部分暴露给开发者,当成一块可编程的片上存储。 这个变化值得单独说,因为它把"省带宽"从被动变成了主动。
Arm 的 Pixel Local Storage(PLS)。 自 Mali-T760 起提供,每像素 16 字节;它用的正是原本给多重采样预留的那块片上内存。开发者可以把中间结果写在里面、在同一 tile 内多次读写,而且 PLS 在 tile 处理完成后自动丢弃,对外部内存带宽没有影响。官方给出的对比是:相比多渲染目标(MRT),PLS 的带宽消耗约低 8 倍 [Arm PLS 博客]。
Apple 的 imageblock。 可以定义一个自定义的逐像素结构,存在 imageblock memory 里,并且在 tile 的生命周期内跨 draw 与 dispatch 持续存在;宽度、高度、像素深度都可定义,还支持多个 image slice。Metal 在 Apple 芯片上一直渲染到 imageblock,自 A11 起开放完整控制 [Apple Tailor 指南]。
Qualcomm 的 tile memory heap。 VK_QCOM_tile_memory_heap 允许把 image 或 buffer 直接绑定到 tile memory 上,用同样的思路把中间数据留在片上。但官方也明确划了边界:tile memory 是瞬态的,作用域默认只限单个 command buffer submission batch(部分设备可通过 queueSubmitBoundary 查询扩展范围),而且"容量因设备而异,通常小到只能容纳少量资源" [Qualcomm tile memory heap 博客]。
三种用法合起来说明一件事:片上内存的价值不只是"少搬一趟附件",而是"可以在片上做中间计算"。 但它有一条硬边界——容量小、且瞬态。把大块中间结果放进去是不可能的;能放进去的,只有那些本来就要在一个 tile 内反复读写的量。
4.8 源码与数据链接
- Khronos,《Tile Based Rendering (TBR) Best Practices》(附件预算、loadOp/storeOp、瞬态附件): https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- Qualcomm,《Adreno GPU 图形概述》(GMEM 容量规格): https://docs.qualcomm.com/bundle/publicresource/topics/80-70020-19SC/graphics-overview.html
- Apple,《Metal 2 on A11 — Tile Shading》(tile memory 容量与 imageblock 维度): https://developer.apple.com/videos/play/tech-talks/604/
- Arm,《Introducing Pixel Local Storage》(PLS 每像素 16 字节、带宽约低 8 倍): https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/introducing-pixel-local-storage
- Arm,《Transaction Elimination》官方技术页: https://www.arm.com/technologies/graphics-technologies/transaction-elimination
4.9 这一章留下的问题
到这里,容量账与溢出账都算清了:预算是固定的,附件是你唯一能调的变量;溢出的第一级代价是换小 tile,第二级代价是机制失效加上一次 frame buffer flush。
还差一步:分块之所以能省,是因为它在着色之前就知道"谁可见"。这一步(HSR)是怎么做的,代价又是什么? 下一章拆它。
三、可见性先行:HSR 与 fragment pre-pass
5.1 一句话点题
这一章回答:分块渲染为什么能在着色之前就知道"谁可见",以及这一步的代价是什么。
在桌面侧的立即模式渲染(IMR)里,不透明物体如果按由远及近的顺序绘制,靠近相机的物体会把远处已经画好、已经写回显存的像素再覆盖一遍——那次写入是纯浪费。分块架构把这一步提前,用硬件把不可见的片元剔掉,这个机制统称隐藏面消除(hidden surface removal,HSR)。Imagination 的说法是:对完全不透明的渲染,overdraw 可以被完全消除 [Imagination PowerVR 架构指南]。
5.2 原理与概念:四条实现路径
HSR 不是一种技术,而是一类目标。四家厂商的实现路径差别不小:
| 厂商 | 机制 | 做法 |
|---|---|---|
| Arm Mali / Immortalis | Forward Pixel Kill(早期)+ 硬件 fragment pre-pass(G925 起) | 逐 tile 先跑一遍预通道,记录覆盖样本并填满 ZS buffer;主通道只着色活下来的片元 |
| Imagination PowerVR | HSR + 参数缓冲(parameter buffer) | 顶点变换结果写入参数缓冲;只有通过可见性测试的像素才真正着色 |
| Qualcomm Adreno | visibility pass + 逐 tile 渲染 pass | 一次可见性通道处理几何、剔除被遮挡图元,之后每个 tile 各发一次渲染 pass |
| Apple | 延迟到几何全部评估之后 | 官方表述是"延迟到所有几何评估完再渲染",配合 imageblock 做片元级操作 |
四种做法共享同一个前提:几何先全部过一遍,可见性判定必须在着色之前完成。 这也是它区别于桌面 Z pre-pass 的地方——应用侧的 Z pre-pass 要把几何渲染两遍,而硬件的做法不需要重复提交与分块几何,中间数据结构留在片上,且预通道与主通道还能部分重叠 [Arm G925 博客]。
5.3 公式或参数逐项释义:pre-pass 的两遍流程
官方给了一个 4×4 tile、3 个图元的例子,把它摊开最能看清机制 [Arm G925 博客]:
预通道逐图元推进:
- 橙色图元先来,判定为"兼容",光栅化到覆盖信息确定为止,硬件记下它覆盖了样本 (1,2)。
- 蓝色图元接着来,同样兼容,记下它覆盖 (2,1)、(2,2)、(3,1)。
- 绿色图元最后来,记下它覆盖 (0,1)、(1,1)、(2,1)、(1,2)——注意 (1,2) 的记录被绿色覆盖了。
主通道再走一遍:
- 橙色图元:兼容,但没有任何样本记在它名下,直接丢弃。
- 蓝色图元:只剩 (2,2) 与 (3,1) 两个样本,只为这两个样本启动片元着色。
- 绿色图元:四个样本都在,为四个样本着色。
这一个例子省下的是:橙色图元的全部 varying 与片元着色开销,以及蓝色图元在 (2,1) 上的片元着色开销。 这就是 HSR 的收益形式——不是让正确的结果更快算出来,而是让错误的候选项根本不进入着色。
反过来看失效的情形也很清楚:如果蓝色图元是"不兼容"的,预通道在它那里直接终止,后面的绿色图元也不再被纳入预通道。结果是预通道一点都省不下来 [Arm G925 博客]。
5.4 实现与配置:让 pre-pass 生效的前提
这是本章工程价值最高的一张表。Arm 的文档把"不兼容"的情形列得很细,而不兼容的绘制调用一旦出现,它以及它之后的所有图元都会退出预通道:
| 会让绘制调用不兼容的情形 | 为什么 |
|---|---|
| 非不透明绘制且写入深度或模板 | 它依赖读取颜色缓冲,前面的图元必须着色完成;且后续绘制可能已改动 ZS 值 |
| 只写 ZS 的绘制紧跟在兼容的非不透明绘制之后 | 它更新了 ZS 缓冲,却未被记为不透明,会改变前面非不透明图元的测试结果 |
| 片元着色器对同一目标既读又写 | 只写可以、只读可以,读写同一目标不行;原子操作仅在用到返回值时不兼容 |
| 片元着色器需要光栅化覆盖信息 | 包括质心 varying、读取覆盖掩码、判断 helper lane |
| 在图元未覆盖的样本位置读取 tile buffer | 包括用子组操作跨线程传值、把读到的值当纹理坐标算 LOD |
| 多重采样或可变着色率下的 tile buffer 读取 | 被明确列为不兼容 |
| 片元着色器修改覆盖但显式要求 ZS 提前测试更新 | 会产生"样本被丢弃却更新了 ZS"的情形,干扰后续非不透明绘制 |
由此得到三条工程规则:
第一,把不兼容的绘制调用排到兼容的之后。 官方原话是要尽量把不兼容的图元放在兼容的图元之后,而不是之前——因为预通道是在第一个不兼容调用处终止的 [Arm G925 博客]。
第二,别在片元着色器里既读又写同一个 render target。 这条在延迟着色里最容易踩:可编程混合(programmable blending)确实允许在片元着色器里读 G-buffer,但如果同一个 target 又被写,预通道就失效。
第三,多重采样与可变着色率会与预通道冲突。 文档明确把"在多重采样或可变着色率下读取 tile buffer"列为不兼容 [Arm G925 博客]。这一条与第 4 节的 MSAA 账要连起来看。
5.5 效果与量化:收益与三条代价
Arm 在一台内部定频平台上开关预通道做了对照实测,结果很有代表性 [Arm G925 博客]:
| 内容 | 整体 GPU 周期 | 片元读带宽 | 浮点算术指令 | 纹理操作 |
|---|---|---|---|---|
| Fortnite:跳伞场景 | 6.5% | 10.7% | 16.1% | 13.9% |
| Fortnite:山地/城镇场景 | 5.4% | 8.6% | 11.4% | 9.6% |
| 某在线竞技手游 | 4.6% | 6.0% | 15.9% | 11.1% |
| 3DMark Steel Nomad Light | 3.6% | 3.9% | 2.7% | 3.4% |
| 某开放世界动作游戏 | 1.6% | 2.0% | 2.4% | 1.8% |
| 某回合制 RPG | 0.6% | 0.8% | 1.2% | 0.8% |
两点值得注意。一是收益强烈依赖内容:从 0.6% 到 6.5% 都有,取决于场景的遮挡关系有多复杂。二是降幅最大的是浮点算术与纹理操作(最高 16.1% 与 13.9%),而不是整体周期——因为这些正是最耗电的部分,所以这类优化的价值主要体现在功耗上。
注意这组数据只关掉了预通道,Mali 的其他 HSR 技术(例如 Forward Pixel Kill)依然开着 [Arm G925 博客]。也就是说,这是增量收益,不是 HSR 的全部收益。
预通道本身的代价有三条,都在官方文档里写明:
代价一:顶点着色器里的位置计算最多要跑三遍。 一个简单的 Early-Z 绘制调用,位置计算会跑在:判断覆盖哪些 tile 并做背面剔除时一遍;预通道光栅化确定覆盖样本时一遍;主通道有可见样本时跑完整顶点着色器再一遍 [Arm G925 博客]。官方的建议很直接:优化顶点着色器里的位置计算,回报率最高。
代价二:胖 G-buffer 的代价被预通道放大。 前面说过位宽超过阈值会触发 tile 收缩。官方列了三条具体坏处,其中第一条最值得记:跨多个 tile 的图元要为它所在的每个 tile 各跑一遍延迟顶点着色;而预通道会放大这个代价——因为延迟顶点着色在预通道和主通道里都要跑 [Arm G925 博客]。第二条是 tile 变小后,预通道与主通道之间的依赖更难掩盖——主通道必须等预通道完成才能开始。
代价三:late-Z 与 discard 会让预通道被迫跑一部分片元着色器。 而为了确定覆盖所跑的那部分,之后在有可见样本时还要再跑一遍——总体可能反而做了更多工作 [Arm G925 博客]。
5.6 源码与数据链接
- Arm,《Hidden Surface Removal in Immortalis-G925: The Fragment Prepass》(两遍流程、兼容性条件、收益表、三条代价): https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/immortalis-g925-the-fragment-prepass
- Imagination,《Tile-Based Deferred Rendering (TBDR)》: https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/tile-based-deferred-rendering-index.html
- Khronos,《TBR Best Practices》(HSR 相关建议:一致深度比较函数、尽量开深度写、少用 discard 与 gl_FragDepth): https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- Qualcomm,《VK_QCOM_tile_shading》(visibility pass 与逐 tile 渲染 pass): https://docs.vulkan.org/refpages/latest/refpages/source/VK_QCOM_tile_shading.html
5.7 这一章留下的问题
机制到这里就齐了:分桶、片上内存、可见性先行。三件事各自都带来收益,但收益不是白拿的——分桶有固定开销、片上内存会溢出、可见性先行让顶点位置算三遍。
下一章把这三处的代价合成一张可核算的表。
四、代价:分块不是免费午餐
6.1 一句话点题
这一章是三笔账的合计。前两章讲的是"分块省了什么",这一章只讲"分块花了什么"。
分块换来的东西很明确:把 framebuffer 从系统内存搬到片上片内,于是深度、混合、多重采样这些操作不再产生外部流量。而付出的代价集中在三处:分桶这一趟的固定开销、片上内存溢出的 flush、以及结果写回时的 resolve。
6.2 第一笔账:binning 的固定开销
第一笔账是分桶本身的固定开销:每个三角形都要被判一次覆盖,每个块都要维护一份几何列表。这份开销与屏幕上画了什么无关,只与几何数量与块数有关——它不会因为「画得少」消失。
第一笔账的构成是三项,前两项在第 1 章算过:
| 项 | 来源 | 量级特征 |
|---|---|---|
| 几何重复遍历 | 包围盒高估:实际 4 个三角形却处理 8 个 | 与"图元 × 覆盖块数"成正比,几何密集时放大 |
| 阶段交接流量 | 逐顶点 varying 与分桶中间状态要写回主存再读回 | 分块渲染固有;与 varying 数量与位宽成正比 |
| 串行等待 | binning 完成后才能开始片元着色 | 单帧内不可消除;跨帧可重叠,代价是多帧延迟 |
第二笔账是溢出:当单块附件字节数越过片上内存上限,硬件只能把块中途回写到系统内存,随后再读回来。收益在这一刻直接反转——分块从「省流量」变成「多一趟往返」。
6.3 第二笔账:溢出的 flush 代价
这笔账的量级不是"多一点带宽",而是"整个 framebuffer 的量"。 机制层面的表述是:在任何 tiler 上,读取 framebuffer 会导致整个 framebuffer flush;flush 后要把全部元数据(所有采样、深度、模板)写回内存,而这些数据可能比 framebuffer 本身还大 [Garrard, SIGGRAPH 2015]。
实测侧的对应数字是:未给附件设 transient 与 lazily-allocated 时,GPU 会把附件写回外部内存,fragment job 从 56/s 涨到 113/s——约翻倍 [Vulkan-Samples subpasses]。
工程后果很简单:尽量把一次 framebuffer 的渲染收在同一个 pass 里完成,不要在中间产物与其他 pass 之间来回切换 [Garrard, SIGGRAPH 2015]。
6.4 第三笔账:resolve 的带宽账
第三笔账是 resolve:每帧把片上结果写回系统内存的那一次写入。它的量级由附件总字节数决定,而 MSAA 是最容易把它放大的一项——采样数越高,片上要解析的数据越多。
这笔账最能说明"用对 API"值多少钱。以 2168×1080、RGBA8、60 帧为口径 [Vulkan-Samples MSAA 实测]:
| 处置方式 | 单帧数据量 | 代价 |
|---|---|---|
| 1× 附件(基线) | 562 MiB/s | — |
| 4× 附件(仅附件本身) | 2247 MiB/s | — |
| 正确做法:内联 resolve(提供 resolve 附件 + 多采样附件 storeOp 设 DONT_CARE) | 相对 1× 仅 +3% 带宽 | 画质显著改善,几乎免费 |
坏做法:单独调 vkCmdResolveImage |
+5 GB/s | 按移动端 DDR 约 100 mW/GB/s 换算,约 500 mW,占 2.5 W 设备功耗预算的 20% |
| 最坏情形:MSAA 的颜色与深度都被写出 | +6.3 GB/s | 相对最佳实践 +302%,约 630 mW,占预算 25% |
同一个画面、同一个画质目标,只因为 resolve 的写法不同,1080p60 的 4× MSAA 表面从约 500 MB/s 涨到 3.9 GB/s。
这一笔账最终要靠仪器确认,而不是靠估算。示波器与电流探头抓的是瞬时电流波形,用来判断 resolve 集中发生的那一小段时间里,功耗有没有出现尖峰。
6.5 公式或参数逐项释义:三笔账的合计
把三笔账加起来才能得到分块的真实成本。只报收益、不报这三笔,是分块机制最常见的误读——尤其在附件挂得多、或者几何放大做得重的时候,三笔账很容易吃掉全部收益。
| 账目 | 触发条件 | 量级 | 可避免性 |
|---|---|---|---|
| binning 固定开销 | 总是发生 | 与几何数量 × 覆盖块数成正比 | 部分:提升局部性、减少跨块大三角形、位置数据量化 |
| 溢出 flush | 附件预算超出片上内存 | 整个 framebuffer 的量级(元数据可能更大) | 可以:控制附件数量与位深、用 transient / lazily-allocated |
| resolve | 用了多重采样 | 正确做法 +3%;错误做法 +5~6.3 GB/s | 可以:resolve 留在片上,避免 vkCmdResolveImage |
三笔账合起来的结论是:分块的代价不是"一定发生",而是"配置错了就一定会发生"。 这三项里只有 binning 是架构固有成本,另两笔都是写法的函数。
合并 render pass 会改变这三笔账的结构:把多次回写收成一次,第一笔与第三笔因此下降,但第二笔的风险反而上升,因为同一时刻要挂的附件变多了。
6.6 实现与配置:subpass 合并的收益与一个反直觉结论
收益侧:在 Mali-G76(三星 S10,2220×1080,16×16 tile,每帧约 9k tile)上合并 subpass 后,物理 tile 数从 614.7k/s 降到 262.2k/s,约降 55%,带宽随之约降 55% [Vulkan-Samples subpasses]。
边界:Mali 上合并要求每像素 tile buffer 颜色 ≤128 bit,较新 GPU(Mali-G72 起)放宽到 ≤256 bit;超出预算就必须用更小 tile,示例中 tile 数近乎翻倍到 409.6k/s [Vulkan-Samples subpasses]。这正好与第 5 章那张"位宽 → tile 尺寸"的阈值表对上。
反直觉结论(这一段是中文资料里基本没覆盖的):
- subpass 省带宽,但不保证更快。 Arm 的说法是:在 Arm GPU 上"峰值纹理性能始终不低于 tile memory 访问性能",把纹理采样换成片上读取本身没有收益;好的结果是"性能持平、带宽大降",很多情况下性能还略降——因为调度更难 [Arm subpass 博客]。
- 合并可能连带关掉其他优化。 合并会让 COLOR0 被重映射到 COLOR1 插槽,而只有 COLOR0 支持事务消除(transaction elimination),于是合并可能同时关闭 empty tile elimination 与 transaction elimination [Arm subpass 博客]。
- 部分 OEM 在老 GPU 上直接关闭了 subpass 合并 [Arm subpass 博客]。所以同一份代码在不同设备上可能被合并、也可能不被合并。
- 平台提供了检查手段:
VK_EXT_subpass_merge_feedback可以查询合并是否真的发生 [Vulkan Guide]。
这条结论的工程含义值得单独说一句:省带宽的优化,要先确认它换来的东西是当前瓶颈。 如果应用卡在算力而不是带宽上,合并 subpass 可能白做甚至倒亏。
6.7 效果与量化:几何放大与延迟代价
几何放大是分块最吃亏的地方。 Arm 在其移动图形课程里把"几何的带宽与存储成本上升"和"几何放大(曲面细分、网格着色)尤其糟糕"直接列为分块的劣势 [Arm SIGGRAPH 2024]。原因在第 1 章已经拆过:几何越多,分桶的固定开销与包围盒高估的浪费都被放大。
官方给的缓解办法是让细分轴对齐(比如用水平三角带构建曲线),但同时明确否定了"细分到 tile 级别"这个方向 [Garrard, SIGGRAPH 2015]。
延迟是另一个常被忽略的代价。 分桶必须先于片元着色完成,所以相比直接模式,分块天然多出一段前置延迟;跨帧重叠能掩盖它,但代价是多帧缓冲 [Garrard, SIGGRAPH 2015]。官方也提醒,滥用 pipeline barrier 会破坏这种跨帧重叠 [Vulkan Guide]。
6.8 源码与数据链接
- Vulkan-Samples,《Subpasses》(物理 tile 数 −55%、transient 缺省时 fragment job 翻倍): https://docs.vulkan.org/samples/latest/samples/performance/subpasses/README.html
- Vulkan-Samples,《MSAA》(内联 resolve +3%、vkCmdResolveImage +5 GB/s ≈ 500 mW、最坏情形 +6.3 GB/s): https://gpx1000.github.io/Vulkan-Samples/samples/latest/samples/performance/msaa/README.html
- Arm,《Vulkan subpasses: the good, the bad, and the ugly》(反直觉结论、连带关闭、OEM 差异): https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/vulkan-subpasses-the-good-the-bad-and-the-ugly
- Arm(SIGGRAPH 2024,Mobile GPU 101)(几何放大列为劣势): https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/3858.siggraph_5F00_mmg_5F00_2024_5F00_Mobile101.pdf
6.9 这一章留下的问题
三笔账算完了:一笔架构固有(binning),两笔取决于写法(溢出与 resolve)。 这个结论把问题从"分块快不快"变成了"你的 render pass 结构对不对"。
下一章就把这个"对不对"落成可执行的配置清单与测量协议。
五、工程实践:把机制换成配置与判据
7.1 一句话点题
这一章把前三章的机制翻译成两样东西:一张配置清单,和一套能验证它的测量协议。
清单解决"该怎么写",协议解决"怎么证明写对了"。移动端没有测量就没有优化——这句话在第 1 篇里说过,在这里它有了具体形态:你要能说清楚自己的 tile 数、有没有溢出、resolve 走的是片上还是主存。
7.2 原理与概念:Vulkan 侧的配置清单
落到配置层,Vulkan 侧需要显式声明的其实只有三件事:附件的加载与存储语义、依赖与屏障、以及渲染通道的划分方式。这三件事决定了硬件能不能把附件留在片上。
这份清单只有六行,但每一行都对应前一章三笔账里的一笔:
| # | 配置项 | 推荐写法 | 对应哪笔账 |
|---|---|---|---|
| 1 | 新帧的颜色/深度初始化 | loadOp = CLEAR |
避免手动清屏的外部流量:硬件直接在片上初始化 |
| 2 | 会被完全覆盖的附件 | loadOp = DONT_CARE |
不必载入上一帧,也不必清 |
| 3 | pass 之后不再使用的附件(深度、模板、多重采样颜色) | storeOp = DONT_CARE(需显式不写回但保留逻辑值时用 STORE_OP_NONE) |
省掉整块附件的写回 |
| 4 | 只在单个 render pass 内存在的中间数据 | USAGE_TRANSIENT_ATTACHMENT + LAZILY_ALLOCATED 内存 |
某些 GPU 可完全不分配系统内存,数据只活在片上 |
| 5 | 多重采样 | 同 subpass 提供 resolve 附件 + 多采样附件 storeOp = DONT_CARE |
resolve 留在片上;不要调 vkCmdResolveImage |
| 6 | 深度比较 | 整个 render pass 用一致的 VkCompareOp(LESS 或 LESS_OR_EQUAL),尽量开深度写 |
让 early depth test 与 HSR 生效 |
这六项全部来自 Khronos 官方的最佳实践页面 [Vulkan Guide]。
7.3 参数逐项释义:每一项省的是哪一笔
把清单再翻译一层,变成"不写会怎样":
| 配置项 | 不写的后果 | 量级参考 |
|---|---|---|
loadOp = CLEAR |
用手动清屏,产生一次全屏外部流量 | 官方:CLEAR 比 vkCmdClearAttachments 更快 |
storeOp = DONT_CARE |
附件被写回外部内存 | 实测:fragment job 约翻倍(56/s → 113/s) |
| transient + lazily-allocated | 物理内存照分配、附件照写回 | 同上 |
| 内联 resolve | 走主存往返 | 实测:+5 GB/s ≈ 500 mW(占 2.5 W 预算 20%) |
| 一致的深度比较 + 开深度写 | early depth test 退化,HSR 收益下降 | 官方列为 HSR 建议项 |
避免 discard / 写 gl_FragDepth |
预通道被迫跑部分片元着色器 | 官方:可能总体做了更多工作 |
这张表的用法是反过来用的:先看自己的 profiler 显示哪笔账重,再回头检查对应的那一行配置。带宽重就看 1–4 行,功耗重就看第 4 行,帧率上不去而计算量不高就看第 5、6 行。
7.4 实现与配置:Metal 侧对应配置与关键片段
Apple 侧的概念一一对应,只是名字不同:load action 对应 loadOp,store action 对应 storeOp,MTLStorageModeMemoryless 对应 LAZILY_ALLOCATED。
| Vulkan | Metal | 作用 |
|---|---|---|
loadOp = DONT_CARE |
load action = MTL_LOAD_ACTION_DONT_CARE |
跳过把纹理旧内容拷进 tile memory |
storeOp = DONT_CARE |
store action = MTL_STORE_ACTION_DONT_CARE |
跳过把 tile 内容写回内存 |
LAZILY_ALLOCATED + transient |
MTLStorageModeMemoryless |
系统内存不为该纹理分配 |
| 内联 resolve 附件 | 多重采样纹理设为 memoryless | resolve 始终在 tile memory 内发生 |
苹果对这件事的官方表述很直白:load action 决定 GPU 是否把纹理既有内容拷进 tile memory,store action 决定是否把 tile 内容写回内存;任一设为 don't care,GPU 就跳过这些内存操作 [Apple Porting 指南]。同时它也指出了反面:只画少量图元的 render pass 很低效,因为 GPU 必须反复在 tile memory 与系统内存之间拷贝像素数据 [Apple Porting 指南]——这与第 4 节的"把渲染收进单个 pass"是同一件事的两面。
一段最小可用的伪代码,把前四项串起来:
【render pass 定义】
  color   : format=RGBA8,  loadOp=CLEAR,    storeOp=STORE      # 最终结果要保留
  depth   : format=D24,    loadOp=CLEAR,    storeOp=DONT_CARE  # 【1】pass 之后不再读
  gbuffer : format=RGBA8×3,loadOp=DONT_CARE,storeOp=DONT_CARE  # 【2】中间产物,只在片上
  msaa    : samples=4,     loadOp=CLEAR,    storeOp=DONT_CARE  # 【3】resolve 在片上完成
  resolve : 作为 color 的 resolve 目标,随 pass 一起提交

【内存声明】
  gbuffer / msaa 附件 → LAZILY_ALLOCATED      # 【4】不分配物理系统内存
下面对这四行特别说明:
- 【1】深度为什么可以 DONT_CARE:如果后面的 pass 不需要读回深度(比如不做屏幕空间反射、不做深度相关的后处理),这次写回就是纯浪费。
- 【2】G-buffer 三张附件是最容易溢出的地方:三张 RGBA8 就是 96 位/像素,加上深度与多重采样很容易越过 128 bpp 的收缩阈值。它们恰恰也是最适合设成 transient 的——生命周期只在单个 pass 内。
- 【3】多重采样附件的 storeOp 必须与 resolve 配套:留着它写回等于把 resolve 的收益全部还回去。
- 【4】lazily allocated 是"声明意图",不是"强制不分配":官方措辞是"某些 GPU 可完全不分配物理系统内存",具体行为依硬件。
7.5 测量协议:怎么确认 tile 数、溢出与 resolve 代价
有三个量必须是可观测的,否则前面的配置无从验证:
| 要确认的事 | 观测手段 | 判定标准 |
|---|---|---|
| 有没有触发 tile 收缩 | 厂商 profiler 的 tile 数 / 每帧 tile 请求速率 | 与"理论 tile 数 = 分辨率 ÷ tile 面积"对比;明显偏高即说明 tile 变小了 |
| 有没有溢出或多余的附件写回 | profiler 的片元作业数、外部读写带宽 | 实测参照:未设 transient 时 fragment job 约翻倍 |
| resolve 走没走片上 | 带宽曲线在 MSAA 开关前后的差值 | 正确做法应接近 +3%;若出现 GB/s 级跳变,说明走了主存往返 |
测量口径要固定:分辨率、附件格式、多重采样设置、帧率上限、测量时长,四项都要写进报告。原因是这三笔账全都对这些参数敏感——换个分辨率,位宽阈值就可能跨过去;换个帧率上限,功耗行为也不同。
做对照实验时,一次只改一个变量。最容易犯的错是同时改附件格式与 setuppass 结构,结果不知道是哪一项带来的变化。
协议里还有两项容易被忽略的设置:环境温度必须记录或恒定,机型至少覆盖低中高三档。前者决定结论能不能复现,后者决定结论能不能外推——两者缺一项,测量就只是一次性的经验。
7.6 效果与量化:三处常见误用
前面几章的账,落到工程上就是三类高频误用。它们都不是"写错了",而是"用了但对当前瓶颈没帮助"或者"以为写了就有效"。
误用一:以为合并了 subpass,就一定更快。 前面说过,Arm 官方的结论是省带宽但不保证更快,好结果是性能持平、带宽大降,很多情况还略降 [Arm subpass 博客]。判断标准应该是"带宽是不是当前瓶颈",而不是"有没有合并"。
误用二:把多重采样附件留着写回。 这是 resolve 那笔账里最贵的一种写法:+6.3 GB/s、相对最佳实践 +302%、约 630 mW [Vulkan-Samples MSAA]。只要多采样附件的 storeOp 设成 DONT_CARE 并在同一 subpass 提供 resolve 附件,这笔钱就不用花。
误用三:在片元着色器里既读又写同一个 render target。 这在做延迟着色时很自然——G-buffer 挂在 pass 上,光照 pass 里读它,同时又往光照附件写。只要读写的是同一个目标,预通道就判为不兼容,它以及它之后的所有图元都会退出预通道 [Arm G925 博客]。正确的做法是把读写分开到不同附件上。
还有一条容易省掉、但代价很高的步骤:分档验证。 本篇讲的所有阈值都依机型而变——128 bpp 与 256 bpp 的 tile 收缩阈值出自一个特定架构系列 [Arm G925 博客],GMEM 容量在不同 Adreno 上从 512 kB 到 1.5 MB 不等 [Qualcomm],而 subpass 合并的支持度连同一厂商的不同代都可能不同 [Arm subpass 博客]。
这意味着同一份配置在三档机型上可能落在三个不同的分支上:低端机型可能因为附件预算不足直接换了更小的 tile,中端机型刚好卡在阈值附近,高端机型则完全不触发。只在旗舰机上验证,得到的结论无法外推;只在低端机上验证,会误判成"这个优化没用"。
所以测量协议里要加一条:至少覆盖低、中、高三档机型,并且把每档的"tile 数、fragment job 数、外部读写带宽"三项都记下来。这三项正好对应本篇的三笔账——哪一档在哪一项上异常,就说明它在哪一笔账上出了问题。
7.7 源码与数据链接
- Khronos,《TBR Best Practices》(完整配置清单与理由): https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- Apple,《Porting your Metal code to Apple silicon》(load/store action 与 memoryless): https://developer.apple.com/documentation/Apple-Silicon/porting-your-metal-code-to-apple-silicon
- Apple,《Tailor your apps for Apple GPUs and tile-based deferred rendering》: https://developer.apple.com/documentation/metal/tailor-your-apps-for-apple-gpus-and-tile-based-deferred-rendering
- Qualcomm,《Adreno GPU on Mobile: Best Practices》(无效化附件、惰性分配、子通道合并): https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- Vulkan-Samples,《Subpasses》与《MSAA》两个可运行样例(本文的实测数字即出自它们): https://docs.vulkan.org/samples/latest/samples/performance/subpasses/README.html
7.8 这一章留下的问题
配置清单与测量协议都给了,三笔账也有了对应的检查项。但有一个问题始终悬着:这套机制在不同设备上的行为差异有多大?
VK_EXT_subpass_merge_feedback 能查合并是否发生,但它不是所有平台都支持;Qualcomm 公布了 GMEM 容量却没公布 bin 像素尺寸;Apple 只公布了 A11 的 32 KB。开发者在写代码前,很难预判自己的附件组合会不会溢出。 这属于本篇列出的未解问题,也是结语要交代的三件事之一。
六、结语:把机制的账结清
8.1 回到那条主线
七篇大体顺着「前提→机制→账本→持续性能→取舍→方法论」推进,每一环都站在前面某一两篇之上,跳读时留意前置即可。把这一篇压成一句话:分块渲染的意义不是"画得快",而是"把 framebuffer 搬到了片上"。
这条搬运动线带来了三个收益:深度、混合、多重采样不再产生外部流量;不透明的 overdraw 可以被消除;静态区域的整块 tile 写入可以被跳过。而它的全部代价都来自这条动线的四个断点——几何要先过一遍分桶、tile 装不下会溢出、可见性要提前算、结果最终还是要写回。
第 1 篇说"移动 GPU 靠'尽量不画'取胜",到这里这句话有了机制层面的落点:"尽量不画"不是一种风格,而是三套硬件机制(分桶、片上内存、可见性先行)合起来的效果。
8.2 本篇的量化结论汇总
把本篇的量化结论集中列在这里。凡标「机制上如此」的是架构层面的必然差异,凡给数字区间与实测值的都标注了来源与条件,两者不混用,便于逐条复核。
| 结论 | 数值 | 来源类型 |
|---|---|---|
| 合并 subpass 后物理 tile 数 | −55%(262.2k/s vs 614.7k/s) | 官方样例实测 |
| 未设 transient + lazily-allocated | fragment job 约翻倍(56/s → 113/s) | 官方样例实测 |
| 4× MSAA 内联 resolve | 带宽仅 +3% | 官方样例实测 |
误用 vkCmdResolveImage |
+5 GB/s ≈ 500 mW(2.5 W 预算的 20%) | 官方样例实测 |
| MSAA 最坏情形(颜色与深度都写回) | +6.3 GB/s、+302%、约 630 mW | 官方样例实测 |
| binning 包围盒高估 | 某 tile 实际 4 个三角形却处理 8 个 | 会议课程 |
| 预通道收益(多内容区间) | 整体 GPU 周期 0.6%–6.5%;浮点算术最高 16.1% | 厂商官方实测 |
| 顶点位置计算重复次数 | 最多 3 遍(覆盖判定 / 预通道 / 主通道) | 厂商官方文档 |
| Arm 自适应 tile 阈值 | 128 bpp → 64×32;256 bpp → 32×32 | 厂商官方文档 |
| 片上内存能效 | 外部 DRAM 约 120 mW 每 GB/s;片上访问约为其 1/10 | 厂商官方文档 |
| Transaction Elimination | 静态场景 framebuffer 带宽 −99% | 厂商官方技术页 |
8.3 三个还没解决的问题
第一,溢出无法在编码前预判。 Qualcomm 公布了 GMEM 容量但未公布固定 bin 像素尺寸;Apple 只公布了 A11 的 32 KB;Arm 与 Imagination 只给机制不给字节数。开发者只能靠 profiler 事后发现,而不是在设计时避免。
第二,subpass 合并的收益不可预期。 同一份代码在不同驱动/OEM 上可能被合并、也可能被关闭,部分 OEM 在老 GPU 上直接关掉了这个能力 [Arm subpass 博客]。检查手段 VK_EXT_subpass_merge_feedback 并非所有平台都支持 [Vulkan Guide]。
第三,几何密度与分桶开销的最优点没有工程判据。 包围盒高估、几何局部性、层次化分桶三者叠加之后,"多少三角形就该放弃分块转向直接模式"这件事,目前没有可用的量化标准。Qualcomm 给过一条经验值——理想三角形至少覆盖 4 像素、且不要远大于一个 bin [Qualcomm Best Practices],但这只是单条启发式,不是判据。
8.4 系列进度与下一篇
进度上,机制篇至此讲完,下一篇就该把每帧的带宽账本摊开了。
本篇是《移动端图形与功耗》的第 2 篇。机制讲完了,但每帧的字节账还没摊开——分桶的流量、tile list 的流量、resolve 的流量,各自在一帧总流量里占多少,哪一项最值得动,那是第 3 篇《带宽:移动端最硬的那道墙》要回答的。
如果你只关心"这周该改哪几行",第 5 节的配置清单可以直接用;如果你想先把账算清楚再动手,建议先读第 3 篇。
8.5 一点点题外话
写这篇时最费劲的地方,不是找机制,而是找代价。
机制很好找——四家厂商的架构文档讲得都比中文资料详细。但代价几乎只存在于两个地方:厂商自己的实测样例,和十几年前的会议课程里的那几页笔记。中文资料里,"分块会掉性能"这样的句子很多,"分块在什么条件下掉多少性能"几乎没有。
这大概也是这个系列想做的事:把"知道"和"能算"之间的那段距离补上。 机制决定你能不能看懂 profiler,账本决定你能不能判断该不该动手。
8.6 落款
本篇是《移动端图形与功耗》系列的第 2 篇。文中凡是引用第三方数据的地方都给了出处,凡是"机制上如此"的判断都注明了依据来源;两处存在版本差异的官方数字(自适应 tile 阈值与预通道收益区间)已按原文口径给出。
如果你在自己的项目里量到过与本文不一致的数字,欢迎对照本文第 7 节的测量协议复现一遍——测量口径不同,结论不同,这是移动端最常见的一类分歧。
参考文献
官方文档与架构指南(1–24)
- Arm,The Mali GPU: An Abstract Machine, Part 2 — Tile-based Rendering — https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/the-mali-gpu-an-abstract-machine-part-2---tile-based-rendering
- Arm,Transaction Elimination(官方技术页)— https://www.arm.com/technologies/graphics-technologies/transaction-elimination
- Arm,Introducing Pixel Local Storage — https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/introducing-pixel-local-storage
- Arm,Hidden Surface Removal in Immortalis-G925: The Fragment Prepass — https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/immortalis-g925-the-fragment-prepass
- Arm,Vulkan subpasses: the good, the bad, and the ugly — https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/vulkan-subpasses-the-good-the-bad-and-the-ugly
- Imagination,Tile-Based Deferred Rendering (TBDR) — https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/tile-based-deferred-rendering-index.html
- Imagination,PowerVR Architecture Glossary(tile 尺寸 32×32)— https://docs.imgtec.com/starter-guides/powervr-architecture/html/glossary.html
- Imagination,Further TBDR Details — https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/further-tbdr-details.html
- Imagination,PowerVR Hardware Architecture Overview for Developers(PDF)— https://imagination-technologies-cloudfront-assets.s3.eu-west-1.amazonaws.com/website-files/documents/PowerVR+Hardware.Architecture+Overview+for+Developers.pdf
- Qualcomm,Adreno GPU 图形概述(GMEM 容量规格)— https://docs.qualcomm.com/bundle/publicresource/topics/80-70020-19SC/graphics-overview.html
- Qualcomm,Adreno GPU on Mobile: Best Practices — https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- Qualcomm,Improving memory bandwidth with the Tile Memory Heap extension for Vulkan — https://www.qualcomm.com/developer/blog/2026/05/high-performance-memory-extension-optimize-memory
- Apple,Tailor your apps for Apple GPUs and tile-based deferred rendering — https://developer.apple.com/documentation/metal/tailor-your-apps-for-apple-gpus-and-tile-based-deferred-rendering
- Apple,Porting your Metal code to Apple silicon(load/store action、memoryless)— https://developer.apple.com/documentation/Apple-Silicon/porting-your-metal-code-to-apple-silicon
- Apple,Rendering a scene with deferred lighting(programmable blending 与 memoryless G-buffer)— https://developer.apple.com/documentation/Metal/rendering-a-scene-with-deferred-lighting-in-objective-c
- Apple,Metal 2 on A11 — Tile Shading(tile memory 32 KB,Tech Talk 604)— https://developer.apple.com/videos/play/tech-talks/604/
- Apple,Implementing order-independent transparency with image blocks — https://developer.apple.com/documentation/Metal/implementing-order-independent-transparency-with-image-blocks
- Apple,Harness Apple GPUs with Metal(WWDC 2020,Tiling Phase 官方讲解)— https://developer.apple.com/videos/play/wwdc2020/10602
- Khronos,Tile Based Rendering (TBR) Best Practices — https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- Khronos,VK_QCOM_tile_shading 扩展规范(FlexRender 与 visibility pass)— https://docs.vulkan.org/refpages/latest/refpages/source/VK_QCOM_tile_shading.html
- Khronos,VK_EXT_shader_tile_image 扩展规范 — https://docs.vulkan.org/refpages/latest/refpages/source/VK_EXT_shader_tile_image.html
- Khronos,Appropriate use of render pass attachments(Vulkan Samples)— https://docs.vulkan.org/samples/latest/samples/performance/render_passes/README.html
- Khronos,Mobile Development: Rendering Approaches — https://docs.vulkan.org/tutorial/latest/Building_a_Simple_Engine/Mobile_Development/04_rendering_approaches.html
- Khronos,Mobile Development: Vulkan Extensions(dynamic rendering local read)— https://docs.vulkan.org/tutorial/latest/Building_a_Simple_Engine/Mobile_Development/05_vulkan_extensions.html
实测与会议材料(25–36)
- Vulkan-Samples,Subpasses 性能样例(物理 tile 数 −55%、fragment job 翻倍)— https://docs.vulkan.org/samples/latest/samples/performance/subpasses/README.html
- Vulkan-Samples,MSAA 性能样例(内联 resolve +3%、+5 GB/s ≈ 500 mW、+6.3 GB/s)— https://gpx1000.github.io/Vulkan-Samples/samples/latest/samples/performance/msaa/README.html
- Garrard(Samsung),Cramming Software onto Mobile GPUs,SIGGRAPH 2015 课程笔记 — https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/siggraph2015_2D00_mmg_2D00_andrew_2D00_notes.pdf
- Potter(Arm),Mobile GPU 101,SIGGRAPH 2024 — https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/3858.siggraph_5F00_mmg_5F00_2024_5F00_Mobile101.pdf
- Arm,Vulkan Multipass — mobile deferred done right,GDC 2017 — https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/GDC2017/Vulkan-Multipass-Final.pdf
- Arm,Mobile Graphics 101,SIGGRAPH 2020 — https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/1_2D00_mmg2020_2D00_mobile_2D00_graphics_2D00_101_2D00_jesse.pdf
- LIBRA: Memory Bandwidth- and Locality-Aware Parallel Tile Rendering,MICRO 2024 — https://webs.um.es/jlaragon/papers/tomas_MICRO24.pdf
- Rendering Elimination(arXiv:1807.09449)— https://arxiv.org/pdf/1807.09449v1
- Triangle Dropping: An Occluded-geometry Predictor for Energy-efficient Mobile GPUs — https://dl.acm.org/doi/fullHtml/10.1145/3527861
- Epic,Nanite GPU Driven Materials,GDC 2024(per-material tile 分类 pass 开销 <2%)— https://media.gdcvault.com/gdc2024/Slides/GDC+slide+presentations/Nanite+GPU+Driven+Materials.pdf
- Silva,GPU-Driven Rendering in the Quest 2 and 3,Vulkanised 2026 — https://vulkan.org/user/pages/09.events/vulkanised-2026/1415-Lucas-Silva-DevshGraphicsProgramming.pptx.pdf
- Collabora,Re-thinking framebuffers in PanVK — https://www.collabora.com/news-and-blog/blog/2026/03/23/re-thinking-framebuffers-in-panvk/
工程讨论与中文解析(37–46)
- Tech-TLDR,モバイルGPUとタイルベース描画(溢出触发条件与后果)— https://www.tech-tldr.com/mobile-development/mobile-gpu-tile-based-rendering/
- soo:bak,GPU 아키텍처 (2) — 모바일 GPU와 TBDR(tile list 与 binning 阶段图解)— https://soo-bak.github.io/dev/unity/GPUArchitecture-2/
- CSDN,移动端GPU的TB(D)R架构(中文解析代表,覆盖范围与缺口分析对象)— https://blog.csdn.net/qq_53352162/article/details/141563720
- CSDN,基于移动端渲染 Tile-Based Rendering — https://blog.csdn.net/Kaitiren/article/details/140371914
- CSDN,GPU 帧缓冲内存:理解平铺技术 — https://blog.csdn.net/qq_33060405/article/details/143959346
- CSDN,GPU 渲染管线漫谈 — https://blog.csdn.net/qq_33060405/article/details/143958515
- CSDN,Metal memoryless 与 MSAA resolve 配置 — https://blog.csdn.net/qq_33060405/article/details/143958775
- CSDN,通过适用于 Vulkan 的 Tile Memory Heap 扩展提升内存带宽 — https://www.csdn.net/article/2026-06-11/161881500
- CSDN,Deferred shading on mobile: An API overview(带宽下降量级)— https://blog.csdn.net/cubesky/article/details/122842784
- Unity 中文(与 Arm 合作),移动端游戏性能分析工具实践 — https://developer.unity.cn/projects/62300227edbc2a098b339b62
延伸资源与工具(47–56)
- Arm,Getting started on mobile and best practices for Arm GPUs(Vulkanised 2023)— https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_2023_getting_started_on_mobile_and_best_practices_for_arm_gpus.pdf
- Arm,Mobile HW and Bandwidth(SIGGRAPH 2015 讲义)— https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/siggraph2015_2D00_mmg_2D00_andy_2D00_slides.pdf
- Arm,Vulkan on mobile(SIGGRAPH 2020 讲义)— https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2_2D00_mmg2020_2D00_vulkan_2D00_emilio.pdf
- Arm,Performance Studio(性能分析工具套件)— https://www.arm.com/products/development-tools/graphics/arm-performance-studio
- Imagination,PowerVR 架构文档总入口 — https://docs.imgtec.com/
- Qualcomm,Snapdragon Profiler(Adreno 性能分析工具)— https://developer.qualcomm.com/software/snapdragon-profiler
- Apple,Metal 框架文档总入口 — https://developer.apple.com/documentation/metal
- Khronos,Vulkan 规范(render pass 与附件语义)— https://registry.khronos.org/vulkan/specs/latest/html/vkspec.html
- Khronos,Vulkan Guide 总入口 — https://docs.vulkan.org/guide/latest/index.html
- Unity,Universal Render Pipeline 性能文档 — https://docs.unity3d.com/Packages/com.unity.render-pipelines.universal@latest
图片版权
本篇共使用 28 张外部图片,全部来自 Wikimedia Commons,遵循各文件标注的开放许可使用,逐张署名如下:
| 文件 | 作者 | 许可 |
|---|---|---|
src_board_dreamcast.jpg |
Evan-Amos | Public domain |
src_board_pcfx.jpg |
Evan-Amos | Public domain |
src_chip_kyro2.png |
Trio3D | CC BY-SA 3.0 |
src_chip_powervr_pcx2.jpg |
Marco123456789~enwiki | CC BY-SA 4.0 |
src_die_powervr2.png |
User:ZyMOS | CC BY-SA 4.0 |
src_dram_kindle.jpg |
Raimond Spekking | CC BY-SA 4.0 |
ext_gpu_diagram.png |
MIAOW Project | BSD-3-Clause |
ext_gpu_r200_diagram.png |
Appaloosa | Public domain |
src_gpucard_ibmvga.jpg |
Vlask | CC BY-SA 4.0 |
src_gpucard_voodoo.jpg |
Hades2k | CC BY-SA 2.0 |
src_hero_dreamcast_gpu.jpg |
Fritzchens Fritz | CC0 |
ext_igpu_cache.png |
Mewtow | CC0 |
ext_mem_hierarchy.png |
Oferyardeni | CC BY-SA 4.0 |
ext_mrt.png |
Faldrian | CC BY-SA 4.0 |
src_multimeter.jpg |
Retired electrician | CC0 |
src_multimeter_2.jpg |
OliCol11 | CC BY-SA 4.0 |
src_pkg_cross.jpg |
TubeTimeUS | CC BY-SA 4.0 |
ext_post_transform_cache.png |
Mewtow | CC0 |
src_power_analyzer.jpg |
Tiia Monto | CC BY-SA 3.0 |
src_power_analyzer2.jpg |
dfrolov | CC BY-SA 4.0 |
src_scope_tektronix.jpg |
File:Tektronix TPS 2014B cropped.jpg: * File:Tektronix TPS 2014B.jpg: Marcin Łukasz Kiejzik derivative work: TeKaBe File:Tektronix Oscilloscope 475A.jpg: Pittigrilli derivative work: Pittigrilli | CC BY-SA 3.0 |
src_scope_wave.jpg |
User:Xato | CC0 |
ext_scratchpad.jpg |
Skamecrazy123 | CC BY-SA 4.0 |
ext_supertiling.png |
Herf | CC BY-SA 3.0 |
ext_tbr_arch.jpg |
ScotXW | CC BY-SA 4.0 |
ext_tess_pipeline.png |
Davi.trip | CC BY-SA 4.0 |
src_thermal_device.jpg |
CharlesMJames | CC BY-SA 4.0 |
ext_vulkan_pipeline.png |
Alexander Overvoorde | CC BY-SA 4.0 |


相关链接 - 上一篇:【移动端图形与功耗】(一) 两台不同的机器:移动 GPU 的物理约束 - 下一篇(预告):【移动端图形与功耗】(三) 带宽:移动端最硬的那道墙 - 参考资料:本篇引用的规范条款、厂商文档与量化材料见上文「参考文献」;图片素材的来源与许可见「图片版权」 - 系列总览:移动端图形与功耗(全七篇)
With Best Wishes.