站点链接:技术博客页
系列文章前言
系列定位
这个系列只回答一个问题:当渲染管线里的某一环,它的先验从"人手写的启发式"换成"训练出来的网络",代价到底转移到了哪里?
它面向的是已经能读懂渲染管线、也大致知道神经网络是什么,但没亲手把学习式环节接进过真实管线的图形程序员。所以我们不推导反向传播,也不复述算法综述——我们要算的是那笔账:算力、带宽、显存、训练成本、以及最容易被忽略的"泛化边界"。
系列文章写作风格说明
- 每条结论都落到"代价换到了哪里":显存、算力、训练成本,还是画质与稳定性。
- 把"论文里的设定"与"项目里的现实"分开写——尤其训练数据规模与泛化范围。
- 对厂商宣传的倍数标注口径,不转述为定论,也不搬运其配图。
- 明确写出"这一环换成网络不划算"的反例场景,不写成推销。
全系列内容总览
本篇是已发布篇目之一。至此为止本系列共发布五篇,后续规划暂缓,以系列现状为准。全系列目录(仅列已发布篇目):
| 序号 | 篇目 | 主题 |
|---|---|---|
| 一 | 神经渲染的分界线 | 哪一环该换成网络 |
| 二 | 神经降噪(上) | 当先验从人手写变成学出来 |
| 三 | 神经降噪(下) | 训练数据、泛化与失效模式(本篇) |
| 四 | 神经纹理压缩 | 把纹理解码交给网络 |
| 五 | 神经外观 | 从解析 BRDF 到学习式材质 |
系列结构
本系列目前已发布到第五篇(判据、降噪上/下、纹理压缩、外观),后续篇目因需要真实硬件/训练环境而暂缓,不再续写尚不能真实实验的篇目。
本篇在系列里的位置
上篇《神经降噪(上):当先验从人手写变成学出来》写清了分界:手写先验(SVGF、A-SVGF、BMFR)与学习式先验(核预测、端到端重建)在数学形式上的距离,比它们在概念上的距离小得多;也给出了三道判据与三类鬼影的判别方法。
但那篇把一件事留到了现在——它只说了"先验被换成学出来的之后,多了一本账",没有说清这本账具体怎么付。本篇就付这本账:训练数据从哪来、它在哪里失效、你怎么知道它失效了。
三问的答案都不在渲染论文里,而散落在厂商技术长文、公开数据集的许可条款、官方集成指南、以及一堆 issue 的定位过程里。把它们串起来,就是本篇的活。
上篇留下的一本账
先来看看,上篇结束时我们得到一个结论:这一环该不该换成网络,取决于你能不能接受"先验的形状不再由你写定"。这句话在纸面上很轻,落到项目里却很重——因为它把一件原本不存在的工作,变成了每周都要做的事情。
先把手写时代的工作流摆出来对照。写一个 SVGF,你要决定的是:滤波带宽多少、三个 σ 取什么值、邻域半径开多大。这些东西都在你自己手里,改一个常数就能改行为,而且改完即刻见效——不需要等任何人。上篇讲过,这三样恰恰也是它的天花板:带宽是全局常数、假设是固定的、每换一个项目都要重新调参。
换成学出来的方案之后,你的控制面变了。你不再调常数,你调的是数据:收集什么、标注什么、覆盖哪些场景、怎么保证训练集里有部署时会遇到的东西。判断一个环节能不能换,本质上就是判断你手里有没有那批数据,以及它能不能覆盖你的内容。
有个反直觉的地方,也是本篇要说清的第一件事:"数据"不是"算力"的另一个名字。 算力可以买,数据不行——要么你自己产,要么你去用别人的,而别人的那批往往带着许可限制。这是本篇第一章。
这三件事合起来就是本篇的骨架:
第二件事更刺人。上篇提到过一句官方自述,当时只当它是"厂商承认自己也有做不到的事"。认真读原文会发现它说的是一件更具体、也更值得记住的事:为了提升泛化去扩大训练集,先撞上的不是新能力,而是新的失效模式。 这句话来自 NVIDIA 自己的 DLSS 4 技术长文,而且就写在降噪那一章里。这是本篇第二章,也是全篇的题眼。
第三件事是方法问题。失效之后要归因,但"降噪器坏了"这句话没有信息量——它可能是输入没喂对,可能是训练集里没那一类东西,也可能是模型容量真的不够。这三件事的修法完全不同,而公开材料里没有人给过分类。本篇第三章到第六章把这套分类建起来,并明确标注它是本文归纳,不是厂商既有标准。
最后一件事最容易被忽略:你怎么知道它失效了。 如果你的验收指标是 PSNR,那你大概率会在指标变好的同时把画面变糊。这是第七章。
一、训练数据的三条通道
下面进入,先给结论:能拿到训练数据的路只有三条,而且它们不是"三个选项",是三种完全不同的成本结构。厂商走第一条,学术界常走第二条,小团队往往被逼到第三条。
1.1 通道一:离线渲染自产——真值是免费的
好了,NVIDIA 公开的 DLSS Ray Reconstruction 训练口径是这样的:模型用离线渲染的图像训练,官方原话是这类渲染"所需算力远超实时游戏能给的水平";规模上,它"比 DLSS 3 多用 5 倍训练数据",由 NVIDIA 的超级计算机喂入"数十亿数据点"。(口径:官方技术新闻稿,NVIDIA DLSS 3.5 Ray Reconstruction)
有一个细节比数字更重要。DLSS 的官方集成文档里写明,训练数据是"该游戏自己的最终渲染帧 + 渲染管线中间 buffer 的混合",经过预处理累积成所谓的 perfect frames,然后在 Saturn V DGX 集群上训练。(口径:官方开发者博客,How to integrate NVIDIA DLSS 4 into your game)
把这两句放一起,就能读出这条通道的两个特征。
第一个特征:真值是免费的。 离线渲染想跑多久就跑多久,跑到收敛为止——那批收敛结果就是标准答案。相机数据不行:真实场景的"干净图"不存在,你只能用长曝光或堆栈去逼近,而长曝光本身会引入别的问题。这是渲染侧相比图像处理侧的一大优势,也是为什么渲染降噪的学习式方案能这么快落地。代价是你得先有一个可离线渲染的场景与渲染器——对自研引擎的团队来说这不是问题,对用第三方引擎的团队来说,这句话就变成了"你得能出命令行渲染"。
第二个特征:训练集与内容强绑定。 既然训练数据来自"这款游戏自己的帧",那么换一款游戏就是换一个数据集。这不是厂商偷懒,而是这个方案的泛化方式决定的:网络学的是"这款游戏的光照与材质大概长什么样",然后据此重建。它在自己的内容上很强,这份强度不可直接搬运。
对读者的启示很直接:如果你的内容很独特(自研材质体系、非写实美术风格、特殊后处理链),那么走厂商预训练模型这条路,你等于在赌"你的内容落在别人的训练分布内"。 没有公开材料能替你回答这个赌博的胜率。
1.2 通道二:公开数据集——先看许可,再看规模
说白了,第二条路是用现成的公开数据集。这条路上有个必须先说清的坑:最常用的那几个,恰恰是不能商用的那几个。
| 数据集 | 规模(官方页面口径) | 许可(官方页面口径) | 商用 |
|---|---|---|---|
| Vimeo-90K | 9 万视频片段级 | 分发声明"仅限非商业用途"(non-commercial usage only) | 否 |
| DND(Darmstadt) | 50 对真实噪声/真值图 | "免费提供给学术与非学术实体,用于非商业目的" | 否 |
| SIDD | 约 30,000 张;Small 160 对 / Medium 320 对 / Benchmark 40 张 | "数据集与相关代码仓库采用 MIT 许可" | 可 |
| UCF101 | 13,320 个视频 / 101 类 / 25 组 | 页面只要求引用,未给出许可条款 | 不明 |
| Middlebury | —— | 许可正文未取得 | 未明确 |
这张表值得多看两眼。第一眼看到的是规模差:DND 只有 50 对,SIDD 有三万张。第二眼才看到真正的问题:DND 和 Vimeo-90K 明确写着非商业用途,而它们恰好是很多论文默认的基准。第三眼是最麻烦的一格——UCF101 的官方页面没有许可条款,只有一句"请引用技术报告"。这意味着它的可用性不是技术问题,是法务问题。
四个数据集的官方页面分别在这里,落地前建议自己打开核一遍许可原文:DND、SIDD、UCF101、Vimeo-90K 分发页。
这也是为什么 NVIDIA 在技术长文里点名的三个"自然视频基准"(Vimeo-90k、Middlebury、UCF101)会被同时批评两件事:一是低分辨率低帧率,二是没有 UI 元素。前者是技术缺陷,后者是内容缺陷——但它没说的是,这三个里有两个的许可本身就限制了商用。
顺带一提,数据集来源平台的规则会向上传导。有一篇关于视频压缩数据集的论文解释过为什么选 Vimeo 而不是 YouTube:YouTube 的服务条款明确禁止下载任何视频,所以只能选可再分发的来源。(论文原文)数据集的许可收紧,根子常常在它上游的平台。
真到项目里落地,这件事可以机检。下面这段是我在项目里用的一小段脚本,作用是把候选数据集的许可条款扫一遍,把带 non-commercial、NC、ND 这些标记的项直接标红,免得"先下了再说":
import re
from pathlib import Path

BANNED = re.compile(r"non[\s-]?commercial|仅限非商业|\bNC\b|\bND\b|NoDeriv", re.I)

def audit(csv_path: str):
    """csv 每行:name,url,license_text"""
    rows = [l.split(",", 2) for l in Path(csv_path).read_text(encoding="utf-8").splitlines()[1:]]
    for name, url, lic in rows:
        hit = BANNED.search(lic)
        # 三种结论分开输出:明确禁商用 / 未标许可 / 可用
        if hit:
            print(f"[禁用] {name:<18} 命中「{hit.group(0)}」")
        elif not lic.strip() or "unspecified" in lic.lower():
            print(f"[待确认] {name:<18} 未标许可 —— 按不可用处理,先去问法务")
        else:
            print(f"[可用] {name:<18} {lic.strip()[:40]}")
下面对这段特别说明:它的价值不在正则写得多好,而在它把"未标许可"单独判成一类。工程上最常见的翻车不是"用了明确禁商用的数据集",而是用了一个页面上没写许可的数据集——没人拦,就一直用下去了。
至于数据集本身长什么样,看本篇题图就够了——"数据集"这三个字的实际形态,就是"一堆被整理过、被归过类的样本"。而它是怎么来的?看它的工具:
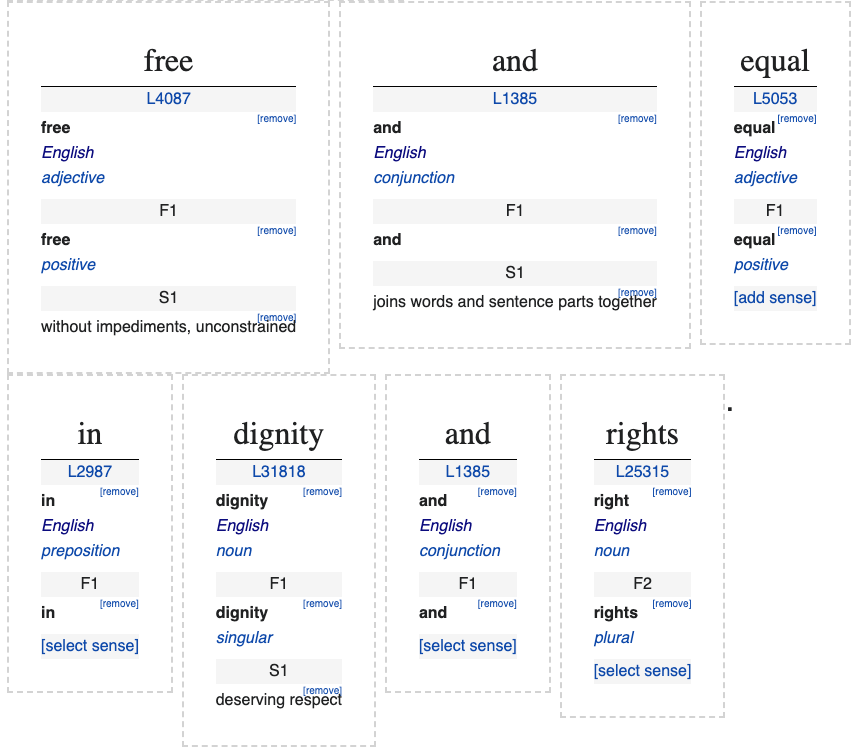
上表里那些"成对图""带标签数据"不是自动产生的——它们是在这个界面里一条条做出来的。口径要说清:这张取自词条标注的工具,工序同族但领域不同(不是图像标注),此处只用来说明"标注要一条条做"这件事。
这就是第一章的成本提示:数据集的规模是结果,标注是过程,而过程要人。这解释了为什么"用别人的数据集"在账面上那么划算:你已经把人力成本转嫁给别人了。 代价就是许可。
1.3 通道三:自建自训——小团队真正能走的那条
下面进入,第三条路是自己训。Intel 的 Open Image Denoise(OIDN)把这条路的门槛降得很低,官方文档的说法是:库自带一组预训练模型,但不强制使用——它同时附带训练工具链,可以用用户自己提供的图像数据集重新训练,针对特定渲染器、特定采样数、特定内容类型去调。(口径:OIDN 官方文档)
训练范式也不复杂。Intel 的技术文章里写明,他们用"含噪图与完全收敛无噪图"成对来训练。(口径:Intel 官方技术文章)对渲染侧来说,这意味着生成训练数据就是跑两次渲染:一次低 spp,一次高 spp 到收敛。这是可以自己做的,不需要超算。
还有一条更省事的路子:有时候连干净图都不需要。Noise2Noise 这条方法论线证明了用噪声数据对训练也能收敛——它给出的启示是"训练数据的形式比我们以为的宽松",代价是需要更多数据量来补偿监督信号的噪声。
OIDN 的另一个细节值得注意:它的官方文档明确提示,如果辅助特征(albedo、normal)有锯齿而 beauty 已经抗锯齿,会在边缘引入伪影,需要用 cleanAux 处理。这条提示说明自训练不是"把数据喂进去就行"——输入表征的匹配程度会直接决定结果,这一点第三章会展开。
1.4 三条通道怎么选
把三条通道摊开对照,选型其实是三个问题:
下面我们开始,第一条问的是内容独特性:如果你的内容在公开数据里找不到同类,前两条通道都帮不了你——厂商模型不认识你的内容,公开数据集更没有。这时唯一的路是自产。第二条问的是法律约束:能不能商用,决定了你能不能碰 DND 与 Vimeo-90K 这一类;能做商业项目却拿非商用数据集训练,是这条路上最容易犯的错。第三条问的是工程量:离线渲染要不要出命令行、标注要不要自建流程、训练要不要机器——这些不是钱的问题,是排期的问题。
有一条容易被忽略的事实:这三条通道的时间成本差别非常大。用公开数据集是"今天下午就能开始训",自建流程通常以周计,而训练一个能用的模型还要再加一轮迭代。项目里真正稀缺的往往不是算力,是这个排期。
本节的边界:具体网络结构与训练超参不在本篇范围(这一侧面未在当前已发布篇目里展开)。本节只回答"数据从哪来"这个更前置的问题——因为如果数据这一步没定,后面的结构讨论都是空转。
二、数据不是越多越好
言归正传,这一章要讲的是全篇最关键、也最容易被忽略的一条官方自述。它推翻了一个很自然的直觉——"效果不好就加数据"。
2.1 官方自己说:扩数据先撞上来的是新失效
先看看,DLSS 4 的技术长文在降噪那一章(不是在讲帧生成的部分)里写了这么两句。第一句是:
Initially, convolutional neural networks (CNNs) were used as the backbone for Ray Reconstruction, but they quickly reached their limits.
第二句紧接着第一句,而且信息量更大:
As we scaled up the training dataset to improve generalization, we encountered issues like ghosting, painterly artifacts, and a lack of temporal coherence. To overcome these limitations, we had to invent a novel transformer-based architecture specifically tailored for NVIDIA's GPU architecture.
把这两句连起来读,官方的因果链是这样的:CNN 骨干先碰到了极限;然后为了提升泛化去扩大训练集,结果碰上了鬼影、油画感伪影、时域不一致——他们最后靠换架构(Transformer)才解决。
注意改的是什么:遇到问题时他们动的不是数据,是模型。 这个动作顺序值得记下来,因为它和大多数人的本能相反。
口径要说清:以上两句均为原文引用,出处是 NVIDIA《Technical Insights into DLSS 4》第 3 节(Transformer based Ray Reconstruction)。该长文另有一段讲"经验空白 / UI 元素缺失"的话,那段在第 2.1 节、讲的是帧生成,不是降噪——两段不可混用。
2.2 为什么加数据会先变"坏"
先来看看,这条官方自述看起来反直觉,但机制并不神秘。关键在于训练集扩的是什么类别的东西。
上篇说过,学习式降噪的网络容量是有限的。当训练集从"一种光照、一套材质"扩到"多种光照、多套材质混合"时,你要求同一个网络在更宽的分布上都拟合得好。在容量不变的前提下,每一项都会学得更松——原来在窄分布上被压得很紧的时域复用策略,在宽分布上必然要放松,而一放松,鬼影就回来了。官方点名的三种新失效(鬼影、油画感、时域不一致)恰好都是"时域策略放松"的表现,这个对应关系很说明问题。
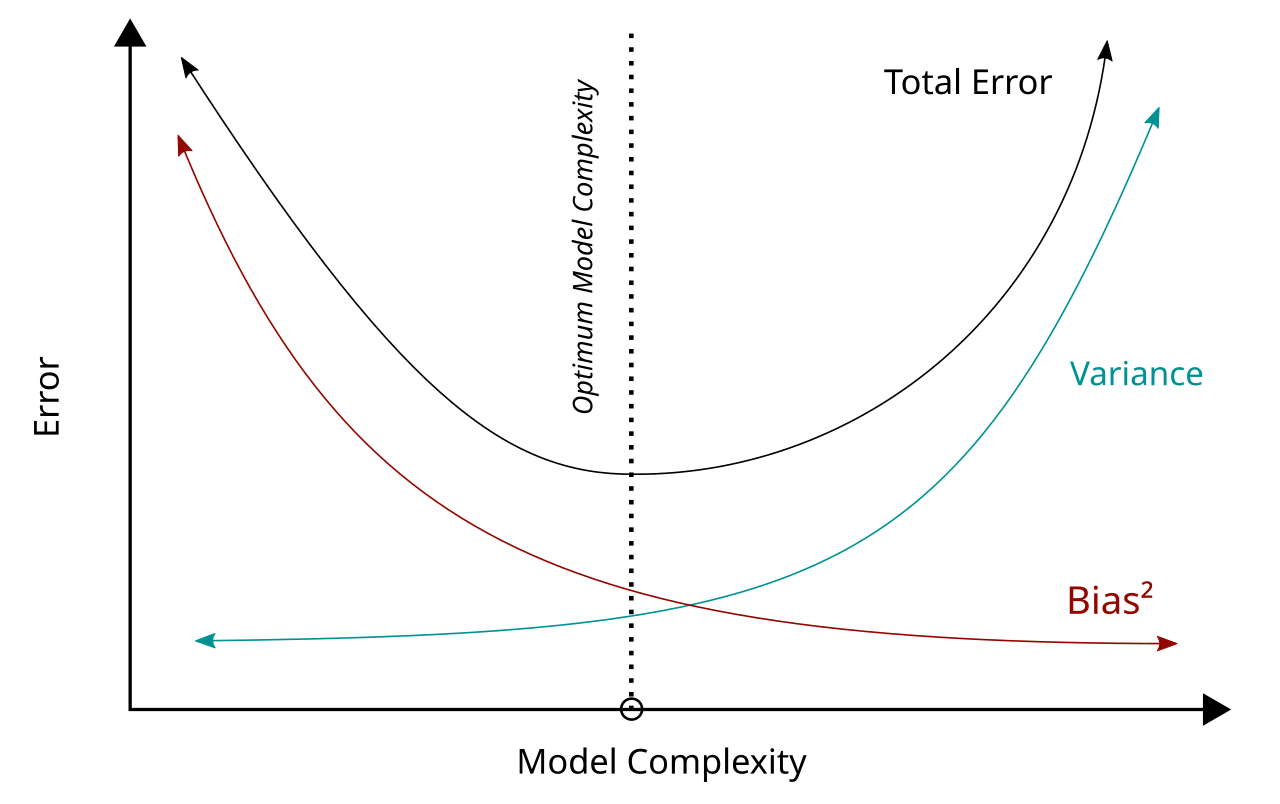
用统计的语言说,加数据降的是方差那一项,降不了偏差那一项。如果你的误差里主要是偏差(模型的表达形式就不够用),那加再多数据也只是让"拟合得更平均",而不是"拟合得更准"。所以"加数据"这件事本身带着一个前提:你的瓶颈在方差那一侧。 这个前提不成立时,加数据只会把问题从"不够准"变成"不稳定"。
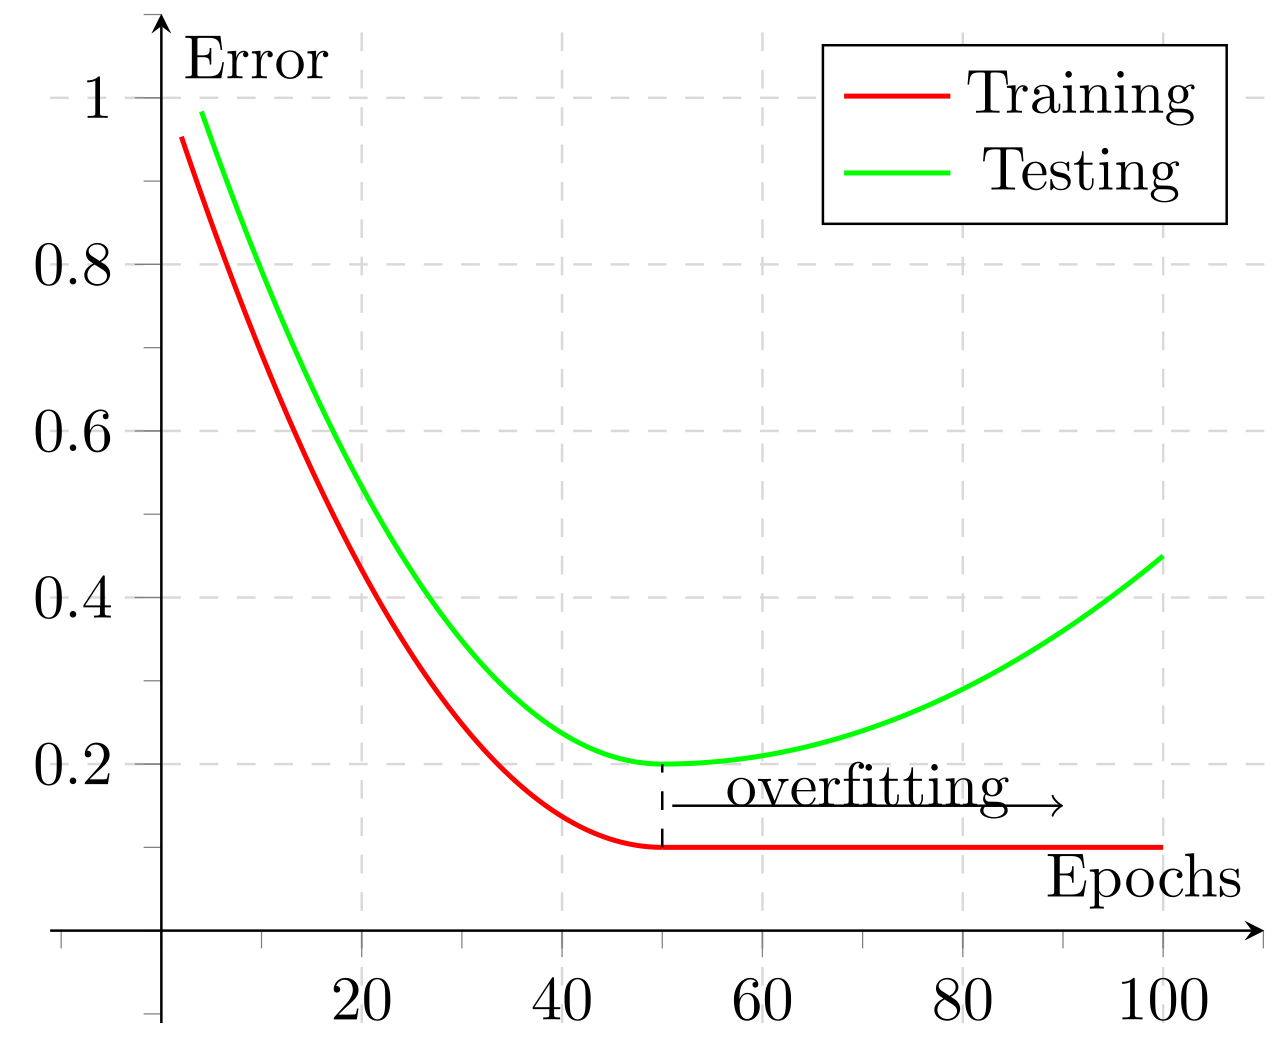
上面这张是机器学习里最常规的一类曲线:误差随训练轮次一路下降,但到某个点之后,在训练时没见过的数据上误差会转而上升——那个转折就是过拟合的起点。它的意义在降噪这一环上会被放大——因为渲染侧的验证集通常比训练集更"窄":训练用的是这款游戏的帧,验证往也还是这款游戏的帧。于是这条曲线会显得很好看,而它看不到的真实间隙,要等到玩家换了一个场景才暴露。
2.3 一个更隐蔽的绑定
下面进入,第一章提到过 DLSS 的训练数据来自"该游戏自己的帧与中间 buffer"。这句话除了说明成本,还说明一件事:官方在自己的内容上做验证时,天然是 in-distribution 的。
这不是说厂商在作弊,而是这类方案的结构性特征。它带来一个对开发者的直接后果:厂商给出的画质对比图,衡量的是"在他们的训练分布内"的表现。 如果你的场景在他们分布外——自研材质、特殊后处理、非写实风格——那么两张图之间的差距不能直接搬到你身上。
判断自己是否在分布外,有个便宜的探法:拿一段你自己最有代表性的、最容易出问题的场景去跑,把它和厂商演示里的典型场景并排看。如果你只在厂商演示的那个类型里看着好,而在你的主力场景里发糊,那大概率不是参数问题。
把第二章收成一句可执行的话:扩数据不是免费动作,它会在你观察到收益之前先交付新的失效模式。 因此扩数据的正确姿势不是"一把梭",而是先把失效模式的监测做起来——先用小样本训练一轮,看清在你的主力场景上会不会冒出新的伪影,再决定要不要把训练集推大。这套监测方法,是第七章的主题。
三、失效归因一:输入锅
好了,从这一章起进入本篇的核心:当降噪器表现不对时,怎么归因。 我把可归因的成因压成三类——输入锅、数据锅、容量锅。按修法成本从低到高排,先讲最容易排除、也最常被冤枉的那一类。
3.1 为什么输入锅要第一个排
说白了,理由很实际:只有这一类是你能自己修的,而且不需要重训。 输入错、参数没给对、buffer 格式不对,改配置就能验证;而数据锅要重训,容量锅要换模型——两件事都以周为计。
更实际的理由是:输入锅最常被误判成另外两锅。 官方在集成文档里自己承认了这件事。DLSS 4 的集成指南里有一句提醒:开 Ray Reconstruction 必须设好 mip-map bias、必须提供线性深度这一路 buffer,否则"纹理会显得模糊、糊成一团、像低分辨率"。
请体会这句话的分量:它描述的症状(模糊、糊成一团)恰好就是人们看到"降噪器效果不好"时最先说的那句话。也就是说,一个纯粹的集成配置问题,会被自然地读成"这个模型不行"——然后你会去考虑换方案或者重训,而真正该做的是改两行配置。
3.2 输入是一份契约,不是一堆可选 buffer
先看看,Ray Reconstruction 的输入清单是硬的。官方集成指南要求提供:diffuse albedo、roughness、normal、线性深度、密集的运动矢量、以及镜面命中距离(specHitDist)。而且有一条容易踩的限制:sRGB 格式的 albedo 不被支持。
这些细节合起来说明一件事:学习式降噪器的输入不是"随便给几张图",而是一份有语义约定的契约。 每一路 buffer 都在替模型回答一个具体问题——albedo 回答"这个像素的固有色是什么"(用来把光照与材质分开),roughness 回答"这里是镜面还是漫反射",深度与法线回答"上一帧那个像素是不是同一个表面"。少一路,模型就要靠猜;格式不对,模型学到的东西就对不上。
OIDN 那边有一条同族但更容易被忽略的提示:如果辅助特征(albedo、normal)有锯齿而 beauty 已经抗锯齿,会在边缘引入伪影,需要用 cleanAux 处理。(口径:OIDN 官方文档)这说的是同一件事的另一面——输入之间的一致性问题。纹理边缘被抗锯齿磨平了,但辅助通道还带着锯齿,模型就会在那些像素上做出矛盾的判断。
3.3 缺省值与聚合方式:两个真实的翻车记录
下面我们开始,输入锅最典型的形态不是"少给了一路 buffer",而是给了、但给的值在边界情况下没有意义。 这有个教科书级的例子。
NRD 的仓库里有个 issue 记录过这样一件事:当某个像素没有有效深度时,如果按"无深度"的直觉把 viewZ 直接设成 NRD_FP16_MAX,相机一移动就会在地平线附近突然出现随机颜色的像素块——看着就像读了未初始化的内存。把 viewZ 改成一个"落在降噪范围内的值"(而不是一个代表"无穷远"的极值),问题就消失了。(口径:官方仓库 NRD issue #90)
这条值得记住,因为它说的不是"你少给了一路输入",而是"你给的值超出了降噪器的定义域"。降噪算法内部会做加权与归一化,一个数量级离谱的输入会把权重分配带偏——而它的表现不是报错,是画面局部冒出随机颜色。
同类的第二条更贴近渲染实践。NRD 的另一个 issue 里,开发者按官方文档用"镜面命中距离聚合"这套接口去做镜面反射的降噪,结果出现严重拖影:车后的倒影被放大、相机移动时倒影明显滞后。最后他把聚合方式换成最朴素的"求和 ÷ 命中数",画面反而稳定了。(口径:官方仓库 NRD issue #110)
这条的方向恰好也和直觉相反:按文档给的"更讲究"的聚合方式,结果更差。 它提醒的是,输入这一层不存在"越精确越好"——只有"和降噪器的内部假设相匹配才好"。
3.4 运动矢量在哪些对象上不可信
言归正传,上面反复出现同一类问题:某一路输入在某个对象上失去语义。把它列成一张表就是上图。本节只补一条可复现的判据。
有篇专门做间接光照时域降噪的论文,给出了运动矢量失效的两个具体触发条件:一是被遮挡区域靠近画面边界,二是前景物体在明暗交界处高速运动。(口径:论文,ICCV 2022 相关论文)这两条可以直接拿来做测试用例——不用等美术在正式关卡里撞见,自己造一个就能复现。
官方的表述更概括一些:在按现代引擎方式计算的运动矢量里,它在镜面高光、反射、UI 运动上是不准的;而深度在激光这类不透明特效、以及在几何光栅化之后才绘制到帧上的元素(比如 UI)上也常常是错的。注意后半句的措辞——"在几何光栅化之后才绘制"。这句话解释了一个很多人疑惑的现象:屏幕空间 UI 明明在屏幕上、明明有像素,为什么它的深度不可信。答案是它的深度不来自几何,而来自"画在最后"这个事实。
3.5 为什么运动矢量的失效是结构性的
先看看,上面那张表列的是"哪些对象上不可信"。但更该问的是:为什么偏偏是这些对象? 答案和运动矢量的产生方式有关,而这件事值得单独说一段。
渲染器里的运动矢量不是猜出来的:它把每个顶点用上一帧的视图投影矩阵再变换一次,得到它上一帧的屏幕位置,与当前位置相减,就是该顶点的位移,三角形内部按插值给出。这个过程精确到顶点——代价是它只说明"这块几何自己动了多少",不说明"这个像素看到的东西动了多少"。
把这句话套到反射上,问题立刻显形:一个镜面像素的位移,按上面的算法等于镜面自己的位移;而它看到的画面内容是反射物的位移。两者可以完全无关。所以镜面反射上的运动矢量不是"估得不准",而是它答的根本是另一个问题。这就是为什么反射上的鬼影特别难修——不是参数问题,是输入答非所问。
同样的道理适用于一整套对象,而且每一种的失效理由都不同。半透明表面的像素混合了前后两层几何的贡献,运动矢量只描述了其中一层。粒子是屏幕空间公告板,它的几何位移与它在画面上表现出的运动不是一回事。屏幕空间 UI 在几何光栅化之后才绘制,它的"位移"来自界面的布局变化,和三维几何没有关系。这三种可以归成一句话:凡是"一个像素对应哪块几何"这件事本身不成立的地方,运动矢量都会失效。
这一点对工程实践有个直接推论:遇到反射/半透明/粒子/UI 上的伪影时,先别调降噪参数。 这些位置的输入在定义上就是错的,降噪器只是忠实地把这些错误放大成画面上的痕迹。上篇给出的那条处置办法——把前提不成立的那部分从滤波输入里拿掉——在这个框架下就很好理解了:不是为了"简化",而是为了让剩下那部分的运动矢量重新变得诚实。
把这一章收成一句:输入锅的排查不需要看懂网络,只需要逐路核对 buffer 的语义、格式、取值范围与缺省值。 这是唯一一类你可以今天就动手排掉的成因。
四、失效归因二:数据锅
排掉输入之后,第二锅是数据。这一锅的形态和多数人想的不一样。
4.1 不是"不够多",是"那一类根本没有"
先来看看,官方在长文里承认了这样一件事:
This bias has left a gap in experience with the kind of diverse, high-resolution, high-frame-rate data prevalent in gaming. User interface elements, so ubiquitous in gaming content, are absent in natural videos, making existing models and datasets perform quite poorly on an important component of gaming content. Consequently, no existing model or training dataset did well enough on image quality to meet our standards.
口径必须写清:这一段在长文的第 2.1 节,讲的是帧生成(multi frame generation)那一章,不是降噪章。它说的是视频插值模型的数据集偏差。但它描述的现象——"训练数据里没有那一类东西"——在降噪侧同样存在,而且它把这件事说得比任何二手转述都直接:现有模型和数据集在游戏内容的一个重要组成部分上表现很差,以至于"没有任何现成的模型或数据集达到我们的质量门槛"。
这句话里最该记住的是"absent"这个词。不是"少",是"没有"。少可以补,没有就补不上——你再怎么扩大视频数据集,只要那批数据本身不包含游戏 UI,模型对 UI 的处理就不会变好。 这是加数据这条路上真正的墙,也是第二章那条官方自述的另一面。
下面这张图把两种缺口放在一起对照:左边是"数量不够"(缺口随规模扩大而收窄),右边是"那一类根本没有"(规模翻倍缺口也不会合上)。
而这两种缺口在画面上长得很像。要分清它们,先得把"域间隙"这个更基础的概念摆正:训练分布与部署分布是两个圆,交集以外的地方就是模型没见过的东西。多数人对这个概念的理解停在"合成数据训练、真实场景部署";本篇要补的是它在降噪这一环上的另一种形态——两边都是真实内容,但一边有游戏 UI,另一边没有。
真正麻烦的是,"数据里没有那一类东西"和"数据不够多"在画面上长得几乎一样:都表现为某个局部处理不好。区别只在修法——前者加数据没用,后者加数据有用。所以下面要先给出一线报告里的具体对象清单。
4.2 一线报告里,坏掉的都是同一类对象
下面进入,把社区与官方 issue 里的记录排一排,会发现失效对象高度集中:
第一类是 UI 与 HUD。 有报告记录了在特定档位组合下出现大面积黑屏;也有记录指出超分与降噪开启后,游戏内特效的边缘轮廓会出现错位缩放;第三方工具修 FSR 在旧卡上的拖影时,问题也集中在细部、角色边缘、HUD 邻近元素、高对比场景切换这几处。还有一份来自开发者的记录更值得看:一个自研路径追踪器把所有 RR 输入 buffer 都给全了、采样数提到 16,相机一动仍然出现"液态流动"伪影,最后判定问题出在时域重投影与运动矢量的集成上,不是噪声。(口径:官方论坛用户报告与开发者记录)
第二类是粒子、烟、透明表面。 一份旧卡强开超分方案(含降噪)的实测里列得很清楚:烟、粒子、透明表面"并不总能干净重建",镜面高光出现噪点闪烁,边缘(电线、栏杆、草、远处建筑线脚)运动时抖动。(口径:第三方媒体实测)
第三类是次表面散射这类"渲染特性"。 这是一条很值得记的记录:Digital Foundry 在逐帧分析里指出,CNN 时代的模型下次表面散射(皮肤)几乎不可见、直线都解不出来,画面还有一种"风格化/油画感";换成更大模型后这些问题才消失。(口径:Digital Foundry 逐帧技术分析)
这三类有个共同点:它们都不是噪声问题,而是"内容类型"问题。 它们的处理质量取决于模型有没有见过这一类东西,而不取决于输入多干净、参数多合适。这就是数据锅的特征。
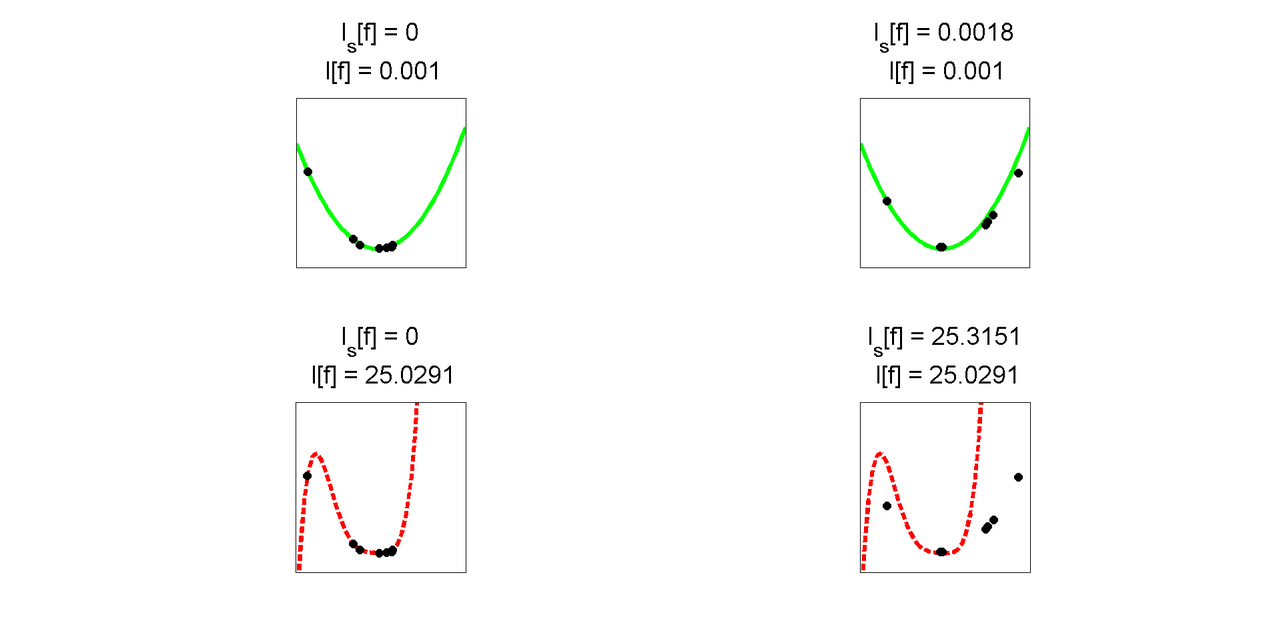
上图是过拟合与泛化的经典对照:同一批点,一条曲线拟合得又紧又抖,另一条平滑但更接近真实规律。在渲染侧,这个对照会以更具体的方式出现——"拟合过紧"对应的是模型把训练集里某种光照/材质的处理方式硬套到新内容上,表现为"在训练内容上很锐、换个场景就出伪影"。
4.3 合成数据能不能替代真实数据:公开材料里的对照
好了,数据锅最实际的一个问题是:既然真实数据难拿(还常常不可商用),那用合成数据训练行不行?
公开材料里有一组少见的直接对照实验:研究者程序化生成了约 17.5 万对合成数据,与真实图像数据集分别训练、在同一测试集上评测,给出定性与定量的比较。(口径:论文,FSID)结论的大方向是:合成数据能顶上一部分,但在真实噪声特性上仍有落差。另一个典型的实验骨架是"用高清图 + 合成噪声生成三万张带噪图,再去真实噪声上评测"——这类配置在图像降噪界的论文里很常见。(口径:论文)
对渲染侧来说,这组实验的意义比它的结论更重要:渲染侧恰好是"合成数据"最有优势的领域——我们的"真实数据"本身就是渲染出来的,只要把 spp 拉高就有干净真值。所以渲染降噪不需要纠结"合成能不能替代真实",它需要纠结的是"合成数据有没有覆盖到那一类内容"——也就是上面那三类对象。
要把两件事分开:仿真度与覆盖度。仿真度问的是"这批合成数据像不像真实数据",覆盖度问的是"这批数据里有没有那一类东西"。图像降噪界讨论得多的是前者——合成噪声的分布与真实传感器噪声的分布不完全一致,这是那个领域的核心难题之一。而渲染降噪的难题主要在后者的那一侧:因为渲染侧的真值本来就来自渲染,仿真度问题天然较小。 把两者混为一谈的代价是具体的——你会花力气去提升"像不像"(改噪声模型、调参数),却漏掉"有没有"(UI、粒子、次表面散射压根不在数据里)。前者是可以优化的,后者只能靠补数据。
4.4 数据锅的排查动作
数据锅没法靠改配置解决,但它可以靠看错的方式来判:
- 错法是"脑补"(模型生成了画面里不存在的东西、或是把某个局部抹成一片)→ 偏向数据锅或容量锅;
- 错法是"噪声残留"(该消的没消掉)→ 更可能是输入或参数;
- 错法集中在特定对象上(UI、粒子、透明、皮肤)→ 强烈指向数据锅,因为这些对象在自然视频里本来就稀缺。
说白了,判断出是数据锅之后,处置只有两条:要么把那一类内容补进训练集(自建数据集,成本以周计),要么把那一类内容从滤波输入里摘出去(工程规避)。上篇讲过的那条经验在这里同样适用——把前提不成立的那部分拿掉,剩下的部分才符合假设。
五、失效归因三:容量锅
下面我们开始,第三锅最容易被误当成数据锅,因为两者的表象都是"这一类内容处理不好"。区别在于:数据锅是没见过,容量锅是见过了也装不下。
5.1 容量锅长什么样
下面我们开始,第二章引过的那条官方自述,前半句其实就在讲容量锅:CNN 骨干"很快就碰到了极限"。到了极限之后,再怎么喂数据,模型也表达不出更复杂的关系——这就是容量锅。
Digital Foundry 那条记录里有一个几乎可以当判决书的细节:在 CNN 模型下,次表面散射(皮肤)几乎不可见。皮肤次表面散射是一个典型的"长程、低频、需要跨区域推断"的现象——它不是靠邻域加权能算出来的。所以这个症状不是"训练得不够",而是模型的表达形式承载不了这类现象。同一份记录里提到的"直线都解不出来""风格化/油画感",也都是表达力不足的表现,而不是数据问题。
上图是一个简化的网络结构示例——把它读成"输入 → 逐级抽象 → 输出判断"这条链就够了。层数决定能组合多少级抽象,每一级的宽度决定能携带多少种特征;容量锅的修法只有一条:把这些数字加上去。
5.2 加容量的官方口径与代价
言归正传,官方给出的容量增量是有数字的。DLSS 4.5 的第二代模型,公开口径是算力 +35%、参数量 +20%,而"性能与旧模型基本持平"。(口径:中文媒体转述官方数据,IT之家——这一条我没有找到一手英文原文,按二手口径标注)
官方对这笔收益的描述是"更强的降噪器、空间感知更深",同时给开发者新增了时域累积的精细控制。这两句放在一起看,说明官方自己认定的改进杠杆有两个:模型容量与时域累积策略。注意第二个杠杆——它是策略而非容量,说明官方并不认为所有问题都能靠加参数解决。
加容量的代价却不是线性的,这一点有实测数据。同一份逐帧分析里给出了换装更大模型后的帧率代价,4K quality 档下:
| 显卡 | 换更大模型后的帧率代价 |
|---|---|
| RTX 5090 | 约 −7% |
| RTX 4090 | 约 −5% |
| RTX 3090 | 约 −31% |
| RTX 2080 Ti | 约 −35% |
(口径:Digital Foundry 实测基准)这张表的形状比它的数值更重要:同样的模型升级,在最新卡上几乎免费,在旧卡上要付三成以上。 这条对做发行决策的人比对做渲染的人更有用——如果你的用户里旧卡占多数,"换更大的模型"就成了要用户买单的体验下修。
5.3 两锅最难切割的地方
先看看,必须承认一件事:数据锅与容量锅在真实案例里常常同时存在,而且难以分离。
第二章那条官方自述就是最好的例子——他们把 CNN 换成 Transformer,同时也在扩大训练集。官方没有公布"换架构后如果数据不变会怎样"的对照实验,所以"这份收益里多少来自容量、多少来自数据"在公开材料里无法拆分。(口径:官方未公布)这是我必须留在这里的一处空白,而不是可以绕过去的细节。
可以确定的是两者的分工方向,也就是上图那张偏差-方差分解:加数据主要降方差那一项,加容量才能降偏差那一项。 如果误差的主要来源是模型表达形式的局限(偏差),那加数据只会让"拟合得更平均";反过来,如果误差主要来自见过的样本太少(方差),那把模型做大只是让它更有能力去记住那些样本——这正好解释了为什么"更大的模型 + 更少的数据"会比"小模型 + 更多数据"更糟。
把第五章收成一句:容量锅的判别看的是"错的方式有没有可能是表达力问题"——如果失败集中在需要长程推断的现象上(多次表面散射、长反射链、复杂遮挡关系),并且补数据无效,那答案是加容量。代价按第五章那张表算。
六、三锅怎么区分
三章分别讲了三类成因,但实战里没人会先告诉你"这是输入锅"。这一章给一套能照着做的判别顺序。
6.1 判别顺序:按修法成本从低到高
判别顺序按修法成本排,不按"可能性大小":
第一步,先排输入。 理由前面说过:这是唯一不需要重训、不需要换模型就能验证的一类。而且它有一个很好用的排除法——只要把某一项怀疑的输入换掉以后现象变了,因果就成立。 比如怀疑运动矢量,就把那块内容临时关掉时域复用;怀疑视图深度,就把无深度像素的缺省值改成一个落在定义域内的值。这类动作当天就能做完。
第二步,再看数据覆盖。 如果输入逐项核过没问题,就看失效对象有没有集中性。第 4.2 节列的三类对象(UI/HUD、粒子与透明、次表面散射)是强信号——因为它们在自然视频数据里原本就稀缺。这一步的验证动作是"覆盖测试":拿一段故意包含这类对象的相机路径去跑,看失效是否只在那些对象上出现。
第三步,最后才怀疑容量。 只有在下面两个条件同时成立时,才把账算到容量上:一是失效集中在需要长程推断的现象上;二是补数据之后现象没有改善。这一步最贵,所以放最后。
上图把这三步画成了一条决策路径。它和大多数人直觉的顺序恰好相反——直觉总是先怀疑"模型不行",因为换模型看起来最像"解决问题"。 但换模型最贵,而且如果病根在输入,换完还是同一个症状,只是又花了一轮时间。
6.2 三个能自己做的验证动作
上面三步对应三个具体动作,都是能在项目里当场做的:
动作一:造输入故障。 逐一篡改可疑输入(把运动矢量清零、把深度设成极值、把 albedo 换成 sRGB),看症状是否复现。如果"故意把它弄坏"能复现玩家报的现象,那病根大概率在这条线上。这一步的价值在于它把"猜测"变成了"对照"。
动作二:造覆盖缺口。 按第 3.4 节给出的两个可复现条件(被遮挡区域靠近画面边界、前景物体在明暗交界处高速运动)造测试用例;再补一段包含 UI 与粒子的相机路径。这套用例跑下来,能把"数据锅"和"参数问题"分开。
动作三:容量对照。 如果条件允许,用同一个训练集训两个不同规模的模型做对照——这一步是唯一能把容量锅与数据锅分开的实验。它贵,但它是"补数据无效"这个判据的唯一硬证据来源。
6.3 症状对照表
把三锅的可观察差异压成一张表:
这张表最有用的一列是最后两列——"改配置是否见效"与"补数据是否见效"。它们不需要你看懂网络,只需要你做两次对照实验。
有一个反直觉的提醒:同一症状可能同时挂着两锅。 比如 UI 发糊,既可能是 UI 没进训练集(数据锅),也可能是 UI 的深度不可信导致输入错(输入锅)——后者反而是更常见的原因,因为屏幕空间 UI 的深度确实不来自几何。先排输入的意义就在这里:它会先替你把"看起来像数据问题"的那批案子摘掉。
6.4 走一遍完整案例:一次"反射里的车影糊了"
把三锅串起来看一遍,会更容易记住顺序。假设美术报了一个问题:赛道旁的车窗反射里,经过的车影是糊的、而且移动时拖着一层。
第一步,别动降噪参数。 先按第三章的框架问一句:这块像素的输入可信吗?车窗反射恰好落在那张"语义失效表"上——镜面像素的运动矢量等于镜面自己的位移,而它看到的是反射物的位移。这一条几乎可以直接结案在输入锅上。
第二步,做一次排除实验。 把车窗那部分内容临时从滤波输入里摘出去(上篇讲的"把前提不成立的部分拿掉"),再看一次:如果糊与拖影一起消失,因果成立,根本不需要进入数据与容量讨论。如果问题还在(比如整片反射区域都发灰),那说明还有别的成因叠着,继续往下排。
第三步,只有在前两步都干净时,才去看数据覆盖。 检查你的用例里有没有"高速运动的强反射物体"这类内容——很多项目的美术测试场景都是静止机位,这类内容压根没进过验收集。如果没进过,那你不知道它是"训练不足"还是"根本没测"。先补用例,再谈补数据。
第四步,容量是最后一步,也是唯一需要重训的一步。 到这一步你至少已经有两次对照实验的记录,可以拿着它们去和预算讨论,而不是凭感觉说"模型不够强"。
这个顺序的价值在于它把最贵的动作放到了最后,而且每一步都留下可复核的记录。我见过的大多数"降噪效果不好"的讨论,卡在第一步——大家直接从"要不要换方案"开始,而没先花半天把输入核对一遍。
七、怎么知道它失效了
最后一章讲方法论。前面所有归因都建立在一个前提上:你能看见失效。 而这件事比想象的难——如果你用的是 PSNR 这类指标,你大概率会看不见。
7.1 PSNR 在量什么,以及它量不到什么
先讲机制,不讲立场。PSNR 是建立在均方误差(MSE)之上的,而 MSE 有一个性质:它把所有位置的误差等同看待。 这条性质在压缩与降噪里会带来两个具体的盲区。
盲区一:它分不出"误差在哪"。 同等的 MSE 下,一个整体亮度轻微位移的画面几乎不可察觉,而一个分块量化的画面非常难看——但两者的分数可以一样。有作者为此写了一篇交互式文章专门演示这件事,结论写得很直白:"当一篇论文只报 PSNR 时,别信那个对比。"(原文)关于"把所有误差等同看待"这条性质的更多例子,也可以看这份指标说明。
盲区二:它奖励"抹平"。 这正好命中降噪这一环。一个把所有高频细节(包括真实的纹理与颗粒)一并抹掉的降噪器,在 PSNR 上会得到高分——因为它把"难算的误差"换成了"零误差的平坦区"。而观众看到的是糊。这就是上篇第六章讲"看起来干净是坏指标"时的机制来源。
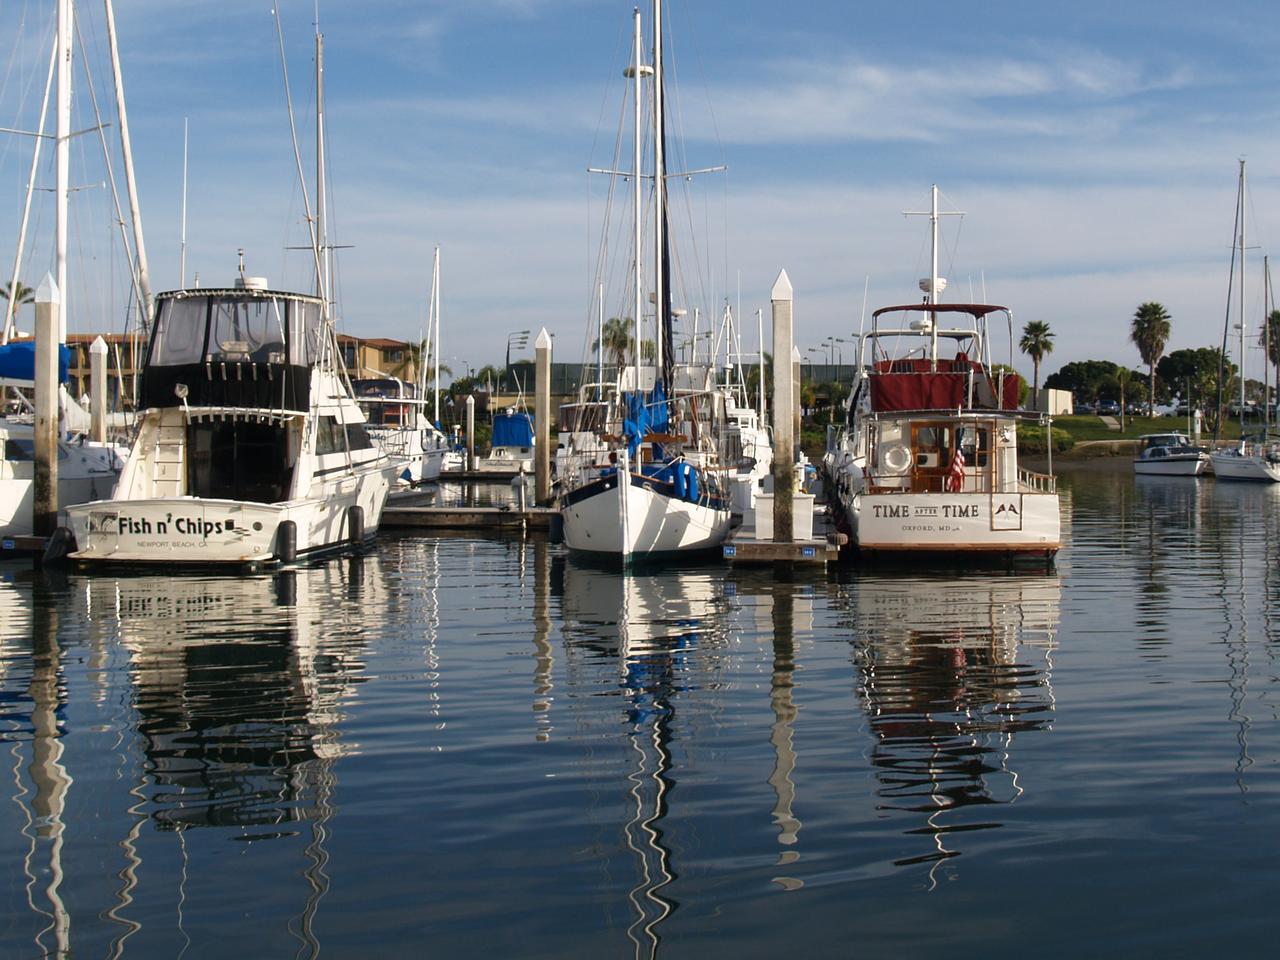
下面用同一张原图压出的两档来说明。两档出自同一位作者的同一套 PSNR 演示图,官方描述写明是 cjpeg 的质量 30 与质量 10 两档。按 Commons 原始档(三档同为 2028×1521)实测,两档相对原图的 PSNR 分别是 33.33 dB 与 28.88 dB(本篇实测,不是官方给出的数值)。
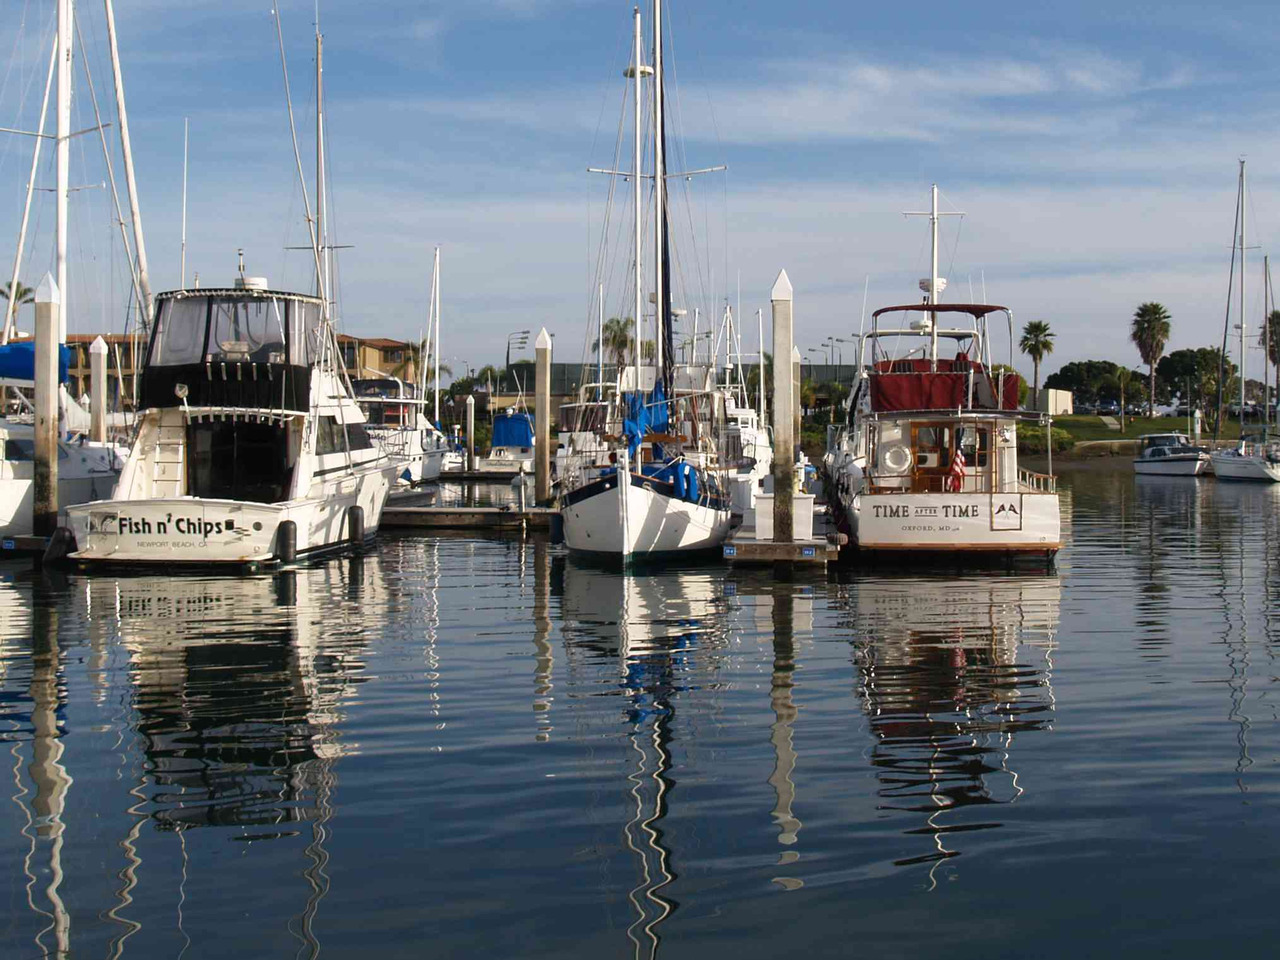
先看较轻的这一档。到这一档为止,指标和肉眼是同一个方向——分数掉下来了,画面也确实不如原图(两张图可以直接上下比)。
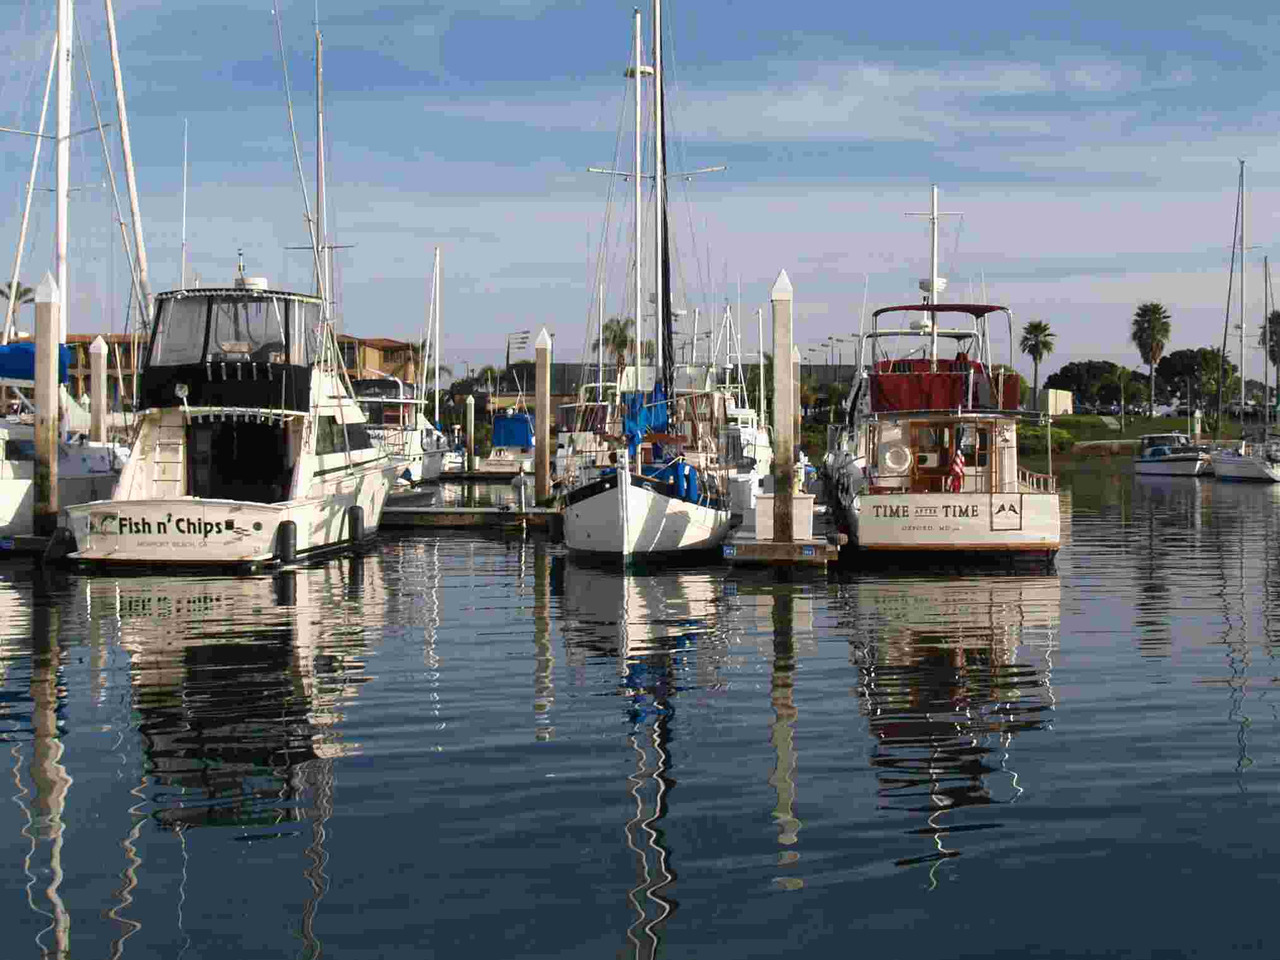
再压一档,分数继续往下掉,方向仍然一致。
三档摆在一起,结论才出来:在这条"压得越狠、画面越差"的直线上,PSNR 表现得完全正确。 这正是它危险的地方——绝大多数评测就落在这条直线上,于是"指标好 = 画面好"的经验被反复验证、最后写进流程。真正的麻烦在于,一旦离开这条直线(换一种误差分布),它就开始失灵。这就是下一节要展示的。
7.2 指标之间也会打架
比"PSNR 不完美"更值得知道的,是不同指标给出的排序本身就不一致。下面这张图把同一张原图做十几种不同失真(亮度位移、对比拉伸、缩放、旋转、零阶保持、量化、高斯噪声、椒盐噪声等),再用 MSE、SSIM、CWSSIM 三种指标分别排名:
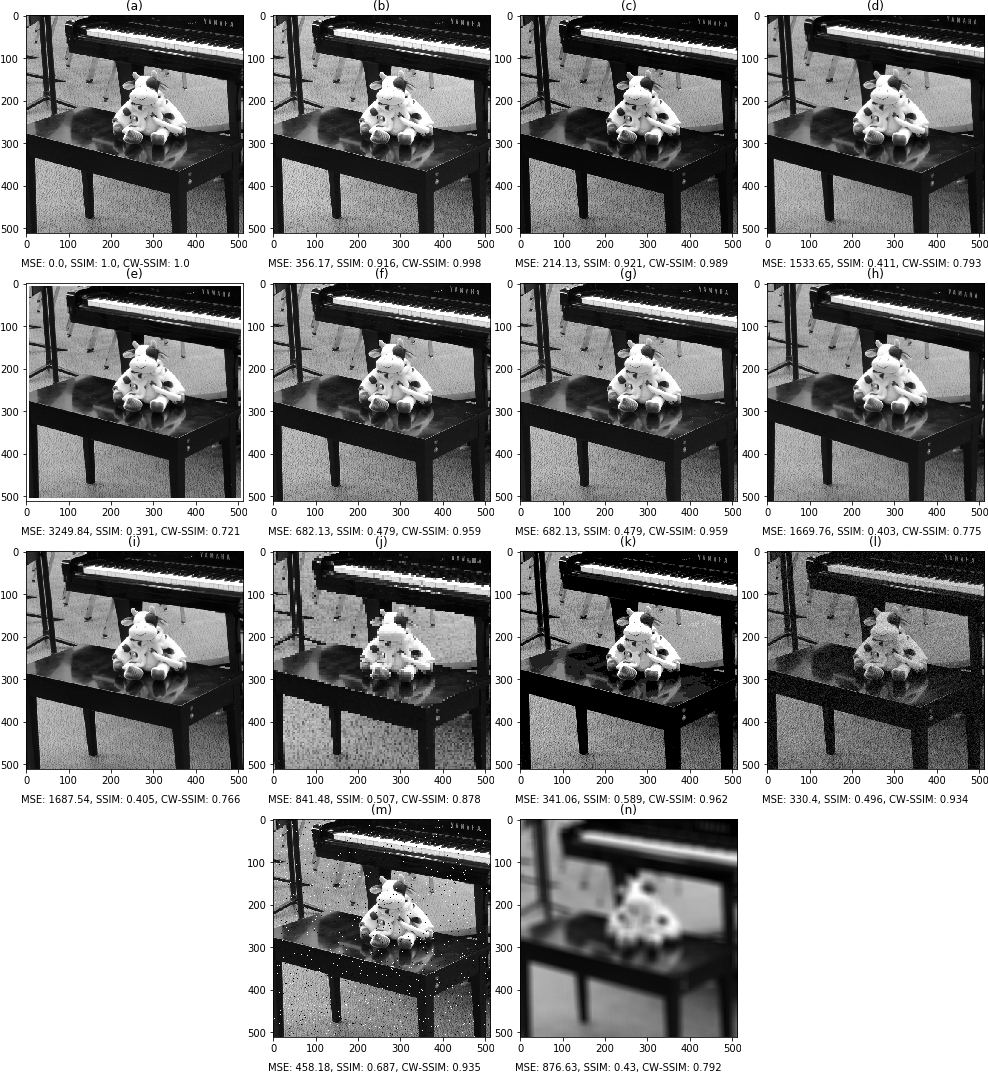
这张图值得停下来看:它是"选哪个指标"这个问题的直接证据——既然三个指标自己都排不出同一个顺序,那"用某一个指标做验收"这件事本身就需要说明理由。对降噪尤其致命的是上面那三种失真的位置:亮度位移与量化在 PSNR 上表现差异巨大,而在观感上差异相反。
7.3 学界已经在为"神经重建"单列失真类
有一个进展值得写进来,因为它说明这件事不只我们在意。面向计算机图形的质量指标体系里,已经出现同时覆盖 neural supersampling、neural denoising 与 path tracing 的数据集与指标,它的失真分类里显式包含:时空锯齿(spatio-temporal aliasing)、flicker、ghosting、摩尔纹、fireflies、模糊、tiling,以及一项值得注意的——hallucinations(神经重建错误)。(口径:CGVQM+D 论文)
"hallucinations"被单列成一类失真,这句话本身就是一个结论:当一个重建系统可能生成画面里原本不存在的东西时,传统的保真度指标在定义上就覆盖不了它——因为指标衡量的是"与原图的差异",而"脑补出不存在的东西"在某些情况下差异并不大。这是这一环的特殊性。
同时要说清它的地位:这是一个研究性的数据集与指标,不是行业标准。 我检索到的公开材料里,没有厂商给出的游戏降噪质量指标定义,也没有公开的、被广泛采用的"游戏内容降噪"标准指标。
7.4 项目内自测的四个做法
把这一章收成可执行的四条:
第一,验收必须与干净参考图对比。 这一点上篇已经给过,本节补它的原因:只有成对比较才能把"抹平"和"降噪"分开。这也是为什么学习式方案要花那么大力气产成对数据——不只是为了训练,也是为了验收。
第二,指标只当回归护栏,不当验收标准。 合适的用法是:把当前版本在固定用例集上的指标存成基线,只用来发现"这一版比上一版明显变差"。它的价值在"变化检测",不在"绝对判断"。指望它回答"这个降噪器好不好看"是设计目标就错了。
第三,必须建逐帧观感的用例集。 前面三章反复出现的失效(鬼影、拖影、抹平、脑补)在单帧上很多是看不出来的——它们都是时间维度的现象。所以用例集必须以视频为单位,并且包含三类内容:快速运动、去遮挡、以及 UI/粒子这类高危对象。它的成本是明确的:它是工时成本,不是金钱成本,所以别指望它能被采购解决。
第四,给失效对象建清单。 每个项目的内容特征不同——你的 UI 是什么样的、粒子和透明用得多不多、有没有大量次表面散射。把你自己项目里"用了这类东西"的清单列出来,再逐项在高危相机路径上过一遍。这份清单是这个项目自己的资产,公开材料里没有。
7.5 人眼验收怎么做才不自欺
上面四条说完,还剩一个最实际的问题:观感这件事怎么"验"而不流于主观。 一线评测的做法其实有可循的套路,把它整理成四条可执行的规则:
第一,并排、同帧、同步动。 单独看一个版本容易适应——看久了连鬼影都会被大脑当成"细节"。评测同一段内容时,把两个版本并排放在同一帧上、以相同速度播放,差异才会显形。这也是为什么一线评测的结论都建立在逐帧视频上,而不是单帧截图。
第二,先不给指标。 顺序很重要:先让人眼给结论,再去查指标。 反过来做会污染判断——一旦知道某个版本 PSNR 更高,人会不自觉地去为它找理由。这个顺序就是一次廉价的盲测。
第三,把"发现的失效"转成固定用例。 每发现一次失效(某个机位下的 UI 拖影、某段快速运动下的抹平),就把它固化成用例集里的一条。这一步是把"观感"变成"资产"的关键——不然下一次版本更新时,你只能靠"感觉好像变差了"来讨论。
第四,验收样本必须来自你的内容分布。 这是本篇第二章的结论在验收环节的落地:如果验收用的场景都是静止机位、没有 UI、没有粒子,那么即使指标全绿、观感全好,它证明的也只是"在你的验收集上没问题"。而玩家会在你的游戏里跑最坏的那条相机路径。
把这四条和前面的指标用法合起来,就是一个完整的验收策略:指标做回归护栏(防退步),人眼做验收判断(定好坏),用例集做资产沉淀(防遗忘)。 三者缺一都不是"验收",只是"看过了"。
八、反例、边界与结论
三锅讲完,这一章把话说回来:"必须有训练数据"这件事本身有反例,而且反例不止一个。
8.1 反例一:有一条路根本不用训练数据
上篇提过 NVIDIA 的 NRD 是非 AI 方案,这一章要把它当成一个更硬的论据来用。
NRD 是纯手写的时空滤波库,没有任何训练环节——也就没有训练数据、没有泛化边界、没有重训成本这几本账。按照常理,它应该在质量上明显落后于学习式方案。但官方的 README 里写着:它的现代 "SH" 模式质量"可与 DLSS-RR 相比",并自称是"在 AI 主导的时代仍然是站得住的强力非 AI 替代方案"。(口径:官方仓库 NRD README)
这条反例的价值不在"谁更好",而在它划出了边界:这一环的收益并不必然来自学习。 如果你的内容极度过不了"数据"这一关——内容独特、数据拿不到、非商用数据集又不能用——那么放弃学习式路线、改用一套官方维护的非 AI 方案,是一个正经选项,不是妥协。
这也解释了为什么前面三章的归因框架有意义:它不只服务于学习式方案。输入锅与容量锅的排查方法(第 3、5 章)对非 AI 方案同样适用——视图深度的缺省值、镜面命中距离的聚合方式,都是 NRD 自己的 issue 里记录的问题。
8.2 反例二:可以自己训,也可以不用监督对
第二条反例是关于"没有数据"这件事本身。前面说"数据拿不到",其实有两级解法。
第一级:自己训。 第 1.3 节讲过,OIDN 提供了配套的训练工具链,可以用用户自己的数据集重训。这条路的前提只是"你有可离线渲染的场景",门槛比想象的低。
第二级:不用成对数据。 上面两个办法都建立在"有监督对"上,但这件事也不是必须的。Noise2Noise 那条线证明了用噪声数据对可以训练(论文);而下面这张图展示的是更早的一条思路——自编码器重建与线性降维的对照:
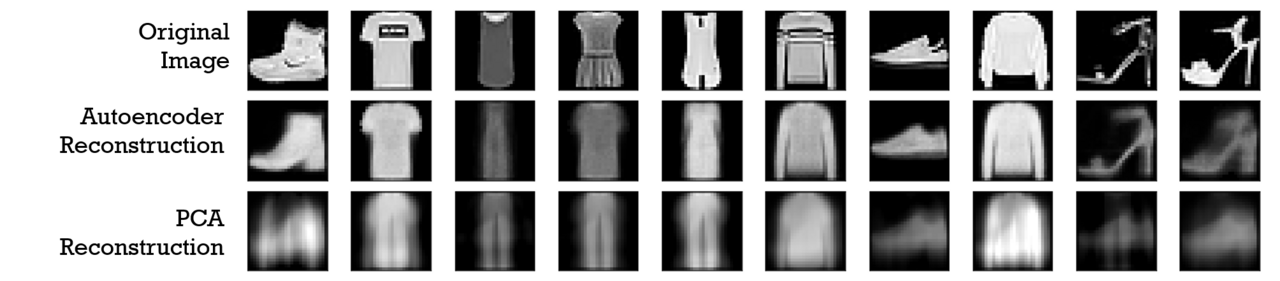
它在渲染侧的意义:如果你连"配对的干净图"都不好产,那么以"压缩表示、再重建"为目标的路线仍然可用——它的监督信号来自数据自身的结构,而不是外部标注。代价是它学到的表示未必对齐你关心的画质目标。上篇讲"学出来这一侧的最小可解释形态"时提过这条路,本节补的是它的数据前提:它对数据的要求比监督式低。
8.3 边界:有一家完全无法评估
讲完了能走的路,得说一条走不了的路。
AMD 的 FSR Ray Regeneration 是机器学习的解耦式降噪方案,官方手册把它定位为"面向光追工作负载的机器学习降噪器"。但这份手册全篇没有披露任何训练数据来源、数据集或训练规模的信息。(口径:官方手册)产品页对它的描述只有一句功能性的——"从稀疏采样中推断并恢复完整质量的光追细节"。
这不构成任何指控,但它造成一个实际后果:你无法评估它的泛化边界。 数据从哪来、覆盖了什么内容、有没有包含 UI 与粒子——这三问都答不上来,那么"它在我这个项目上表现如何"就只能靠实测,没有任何先验可以借。对做技术选型的人来说,"无法评估"本身就是一条要记下来的信息。
8.4 三件"没有这个数"的事
本篇写到这里,有三处数字是查不到的。我把它们单独列出来,因为知道"没有"和"以为有"是两种完全不同的决策状态:
- 重训成本与周期:没有任何一家公布过重训所需的人时、GPU 小时、或费用;也没有官方的"多久必须重训一次"。驱动侧只说了模型"定期改进"。
- 自建 benchmark 的规模与指标:官方承认"We had to develop our own benchmark, training, and testing pipeline",但没有公布场景数、评测集规模、评测指标。
- 失效归因的分类:本篇第三到第六章那套"输入锅/数据锅/容量锅",是我归纳的,不是任何厂商或论文的既有标准。检索确认:公开材料里只有逐条的失真描述(鬼影、反射未解决、对 fireflies 敏感),没有成套的归因分类。最接近的是前面提过的 CGVQM+D 里那项 "hallucinations",但它给的是失真类,不是归因方法。
第 3 条尤其要说清,因为它是本篇的核心结构——如果你在别处看到类似的三分法,那是别人独立得出的;如果你要引用它,请引这里并注明它是归纳而非标准。
8.5 结论:一张"数据与失效"判据表
依然是惯例,收尾不复述:把全篇压成一张可查的表。
用法和上篇那张判据表一样:按行排查,遇到第一个能对上号的症状就停在那里修,不要跳步。 顺序本身是这张表最重要的信息——它按修法成本排,不按可能性排。
相关链接
- Technical Insights into DLSS 4(降噪与帧生成两章原文,含"扩数据撞上新失效"那段)
- NVIDIA DLSS 3.5 Ray Reconstruction 技术新闻稿(训练数据口径:5 倍数据量 / 离线渲染)
- DLSS-RR Integration Guide(输入表征契约:albedo / roughness / normal / 线性深度 / 命中距离)
- NVIDIA RTX NRD 仓库(非 AI 方案;issue #90 与 #110 是本章两处翻车记录)
- Intel Open Image Denoise(预训练权重 + 自训练工具链 + cleanAux 说明)
- AMD FSR Ray Regeneration 官方手册(训练数据未披露的对照样本)
- SIDD 数据集(MIT 许可)|DND 数据集(非商业用途)|UCF101(未标许可)
- CGVQM+D:面向计算机图形的质量指标与数据集(失真类含 hallucinations)
- Noise2Noise(不依赖干净真值的训练)|FSID(合成 vs 真实训练数据的对照实验)
下篇预告
到这里,最成熟、也最早落地的那一环(降噪)讲完了两篇。它的账算下来是这样一个形状:收益是真实的,但它要求你拥有对得上内容的训练数据,并且在你验收时得看得见时间维度上的失效。
从下一篇开始换一环:神经纹理压缩——把纹理解码交给网络。它会带来一个和降噪不太一样的局面:这里要替换的不是一条时域链路,而是一段带宽与解码的账;而且它的"训练数据"来自贴图本身,不来自渲染帧——数据这一关的难度会低很多,但另一关会变高:运行时要在着色器里把网络跑起来。
With Best Wishes.