站点链接:技术博客页 | 公众号:溯光的图形笔记
上一篇我们把一次 Update 的作业图读开了。但那张图里有一个东西始终没有被打开:作业们究竟在摆弄什么?
OK,答案听起来很朴素,刚体。可一旦你开始写代码把它塞进物理世界,问题就来了:
BodyCreationSettings settings(shape, position, rotation, EMotionType::Dynamic, Layers::MOVING);
Body *body = new Body(settings);        // ← 编译能过吗?
physics.AddBody(body);                  // ← 这样对吗?
delete body;                            // ← 谁来负责释放?
这三行,一行都不对。 而且每一行为什么都不对,答案都不一样:
第一行错在 Body 的分配方式,第二行错在参数类型,第三行错在释放时机。
本篇要讲的,就是这三行背后的那套设计:物理世界里的"对象"到底是怎么被表示、怎么进来、怎么出去的。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、源码怎么实现、本机跑出来是什么,这三层在文中分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(版本、场景、规模、编译选项、日期);
- 自跑优先:本专题的图以本机编译运行 Jolt 得到的真图与官方一手图为主,自绘为辅;
- 不写没有落点的说法:凡是官方文档与源码里找不到对应命名的说法,文中会明确指出查无落点;
-
篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,300 到 2,200 字。
-
本篇的知识地图:三条主线贯穿全篇,存储分层(可变与不变分开)、身份分治(句柄与对象分开)、 批量优于单条(接口粒度匹配数据规模)。三条线各自的落点见 §0.4,全篇内容总览也在此处给出。
-
本篇不涉及:宽相树的内部结构(第四篇)、形状与质量属性的具体计算(Shape 篇)、 约束与迭代求解(第九篇)、运动质量与 CCD(第十一篇)、岛与睡眠(第十篇)。 本篇只讲"对象怎么被表示、怎么进来、怎么出去",不打开宽相与形状的内部。 理由与上一篇一致:本篇交付的是对象层的形状,提前深入会让后面几篇无题可写。
本篇的图分三类:本机自产真图(源码原文截取、环境面板、原创基准实测数据,版权自有)、
外部真实素材(本篇为 0,Commons 检索无对位素材,理由见 §6.3)、
自绘示意图(走 styles/qianmo/palette.json 色板单源)。
入口:物理世界里的「对象」是什么
0.1 从一个朴素的问题开始
好了,物理引擎要回答的问题,上一篇已经说清:这个世界里的东西,下一刻应该在哪、朝哪个方向、转多快。 那么"东西"是什么?
答案是刚体(rigid body),形状不会变形的物体。注意定语:不会变形。 这意味着它只需要记录两件事:位置与朝向(它现在在哪、朝着哪), 以及描述变化率的线速度与角速度。形状本身、质量、摩擦这些"属性"另外存。
这张图要先记住一个分界:左边是数据,右边是操作。
Body 是数据;BodyInterface 是唯一被推荐用来操作它的入口(下一篇会看到为什么"唯一"很重要)。
Shape 与 Constraint 各占一边,本篇都不打开,它们只作为"Body 依赖什么"出现。
官方对对象模型的完整描述见
Docs/Architecture.md
的 Types 与 Creating Bodies 两节。
其中:Body 是数据(位置、朝向、形状引用),BodyInterface 是操作(增删改查),
Shape 与 Constraint 是它依赖的两类外部对象。本篇只把后两者当作"依赖"提及,不打开它们。
0.2 本篇的边界(本篇不涉及什么、为什么)
好了,边界说三条。
讲什么:刚体的三种运动状态、为什么只有会动的刚体带一份额外的 MotionProperties、
刚体的标识符 BodyID 是怎么设计的、Body 为什么不能 new、访问接口为什么有加锁与非加锁两副面孔,
以及官方那句"必须批量添加"的警告,代价到底有多大。
只给指针、不展开什么:宽相树怎么建(第四篇)、形状怎么算质量属性(Shape 篇)、 约束怎么迭代(第九篇)、CCD 怎么偷时间(第十一篇)。
为什么这个顺序:物理世界的一切都建立在"对象"之上。 把对象层讲清楚,后面的宽相、窄相、约束、岛才有共同的立足点: 否则每一篇都要重新解释一次"这个 Body 是干嘛的"。
0.3 本机环境与读数口径
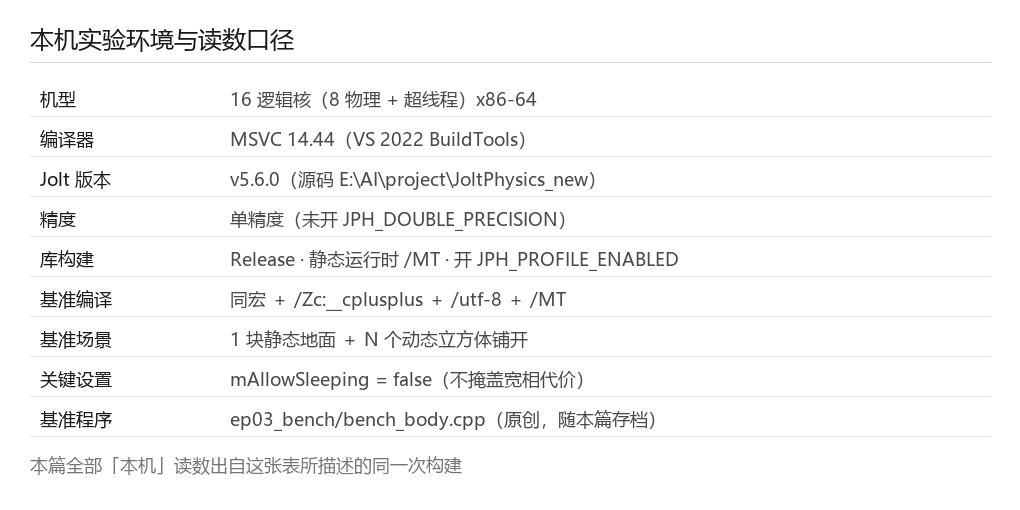
最后交代读数的来源。言归正传,本篇有两类本机数据:源码原文截取(行号可复核)与原创基准实测。
| 项 | 值 |
|---|---|
| 机型 | 16 逻辑核(8 物理核 + 超线程)x86-64 |
| 系统 / 编译器 | Windows · MSVC 14.44(VS 2022 BuildTools) |
| Jolt 版本 | v5.6.0(源码在 E:\AI\project\JoltPhysics_new) |
| 精度 | 单精度(JPH_DOUBLE_PRECISION 关) |
| 库构建 | Release · 静态运行时(/MT) · 开了 JPH_PROFILE_ENABLED |
| 基准编译 | 与库同宏 + /Zc:__cplusplus + /utf-8 |
| 基准场景 | 1 块静态地面 + N 个动态立方体铺开(mAllowSleeping = false) |
| 基准程序 | ep03_bench/bench_body.cpp(原创,随本篇存档) |
这些参数在本文开头那张题图里已经集中呈现过,这里不再重复贴一遍: 题图那张环境面板与上面这张表是同一份口径,读者可对照复核(面板上的每一项都能在表里找到对应行)。
三点口径要说明,其中每一条都影响到读数的可比性:
第一,mAllowSleeping = false 是有意关掉的。 睡眠(sleeping)会让静止的刚体退出仿真,
从而把宽相的代价掩盖掉。本篇要量的是宽相,所以必须让所有刚体全程保持活跃。
第二,sizeof 是编译期读数,不是运行期估算。 它由编译选项决定(尤其是精度),
换双精度或换编译器都会变。文中给的是本机单精度 Release 的值。
第三,"逐个插入更慢"要拆成三段看。 插入本身、插入后首次 Update、后续稳态 Update: 这三段的量级差得很远,混在一起报一个总数会把结论带偏(§5 会看到这个拆分有多重要)。
0.4 本篇的知识地图:三条主线
在进入正文之前,先把三条主线摆出来,大家读的时候可以对照着看。
主线一,存储分层:可变部分与不变部分要分开。
刚体身上有两类信息,"现在在哪、转多快"这类每帧都在变的状态,
和"是什么形状、多重的"这类建好就不再变的属性。Jolt 把第一类中只属于运动体的部分切出去,
单独放成 MotionProperties。这条线解释了 §1 的三态与内存账。
主线二,身份分治:句柄与对象要分开。
你手上拿到的是一个 32 位的 BodyID,Body* 只在建体的那一瞬间存在。
这条线解释了 §2 的位布局、§3 的所有权规则,以及 §4 的两副面孔:
"我引用的是谁"和"我能不能碰它"是同一个设计的两面。
其中三条主线的分工是:一、二两条管"数据怎么放、引用怎么指",第三条管"一次来一大批怎么办"。
主线三,批量优于单条:接口的粒度要匹配数据的规模。 宽相是一棵树,而树的形状对插入顺序极其敏感。 单条插入把这件事暴露给了调用者,批量接口则把它收进内部。 这条线解释了 §5 的全部实测。
三条线共同指向同一件事:对象层怎么设计,决定了上面各层能怎么做。§8 会把它们收成四条原则。
一、三态与「半个对象」
1.1 三种运动状态
OK,先说最基础的一件事:刚体有三种运动状态(motion type)。
- 静态(Static):永远不动。地面、墙壁、地形。它不参与积分,也不受重力;
- 运动学(Kinematic):按你设定的速度移动,但不受力影响。 适合"我让你怎么动你就怎么动"的东西,移动平台、电梯、被脚本驱动的机关;
- 动态(Dynamic):受力影响,自由模拟。箱子、布娃娃、被撞飞的碎片。
三者更像是一条能力阶梯,而非"三个开关":静态体完全被动,运动学体主动移动但不响应力, 动态体两者都接。理解这条阶梯,后面所有的内存与接口设计都能顺下来。
1.2 只有会动的刚体带 MotionProperties
好了,现在看这一节最关键的一处设计。Docs/Architecture.md 第 22 行原文:
Moving bodies have a
MotionPropertiesobject that contains information about the movement of the object. Static bodies do not have this to save space (but they can be configured to have it if a static body needs to become dynamic during its lifetime by settingBodyCreationSettings::mAllowDynamicOrKinematic).
(原文见 Docs/Architecture.md。)
翻译过来:会动的刚体带一个 MotionProperties 对象,装着与"运动"有关的信息;
静态体不带它,为的是省空间。
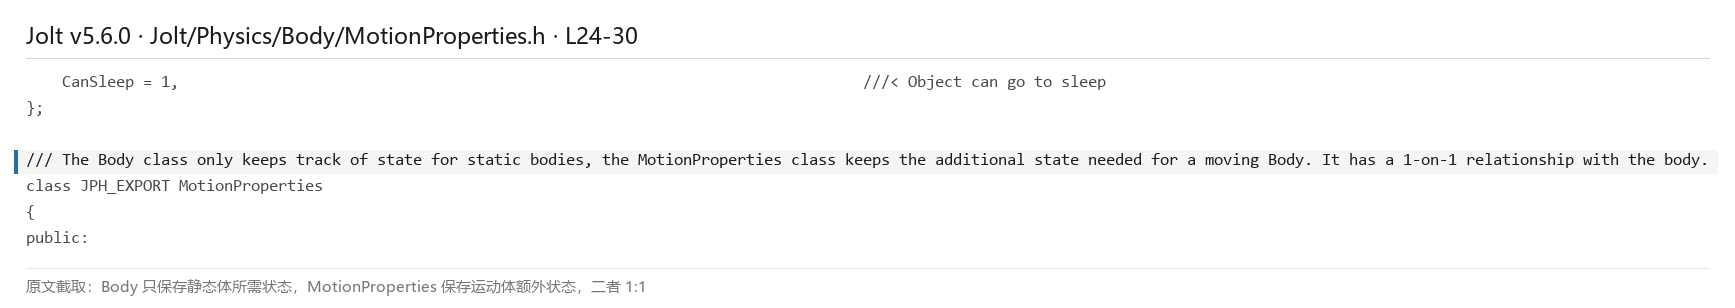
MotionProperties.h 第 27 行的类头注释把这层关系说得更直白:
The Body class only keeps track of state for static bodies, the MotionProperties class keeps the additional state needed for a moving Body. It has a 1-on-1 relationship with the body.
这是个很典型的可选部分(optional part)设计:把"只有动态体才需要"的字段从主体里切出去, 让静态体不为它们付内存。地面往往比动态刚体多得多,这个取舍很划算。
1.3 省了多少:本机 sizeof 实测
说白了,"省空间"是个定性说法。省了多少?本机实测:
sizeof(Body)             = 128 bytes
sizeof(MotionProperties) = 192 bytes
sizeof(BodyID)           = 4 bytes
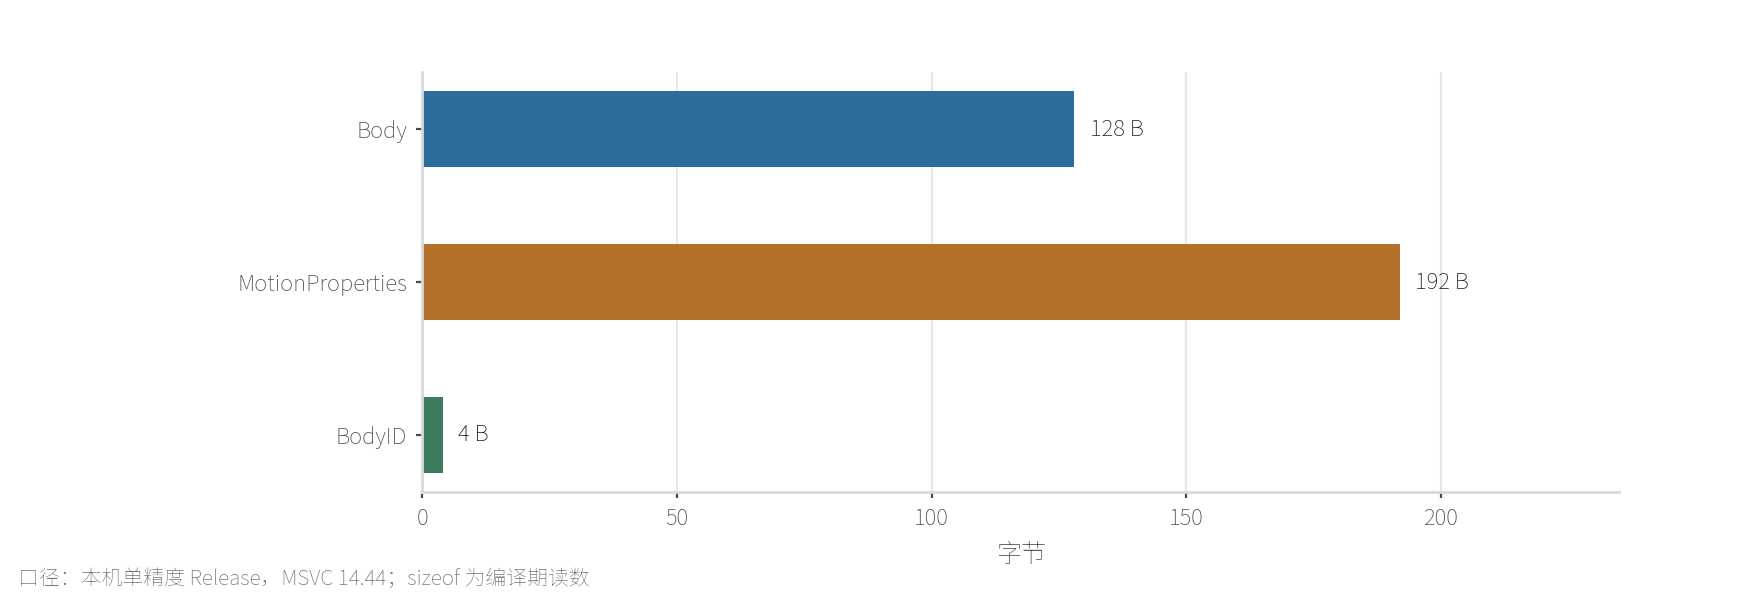
算一下账:
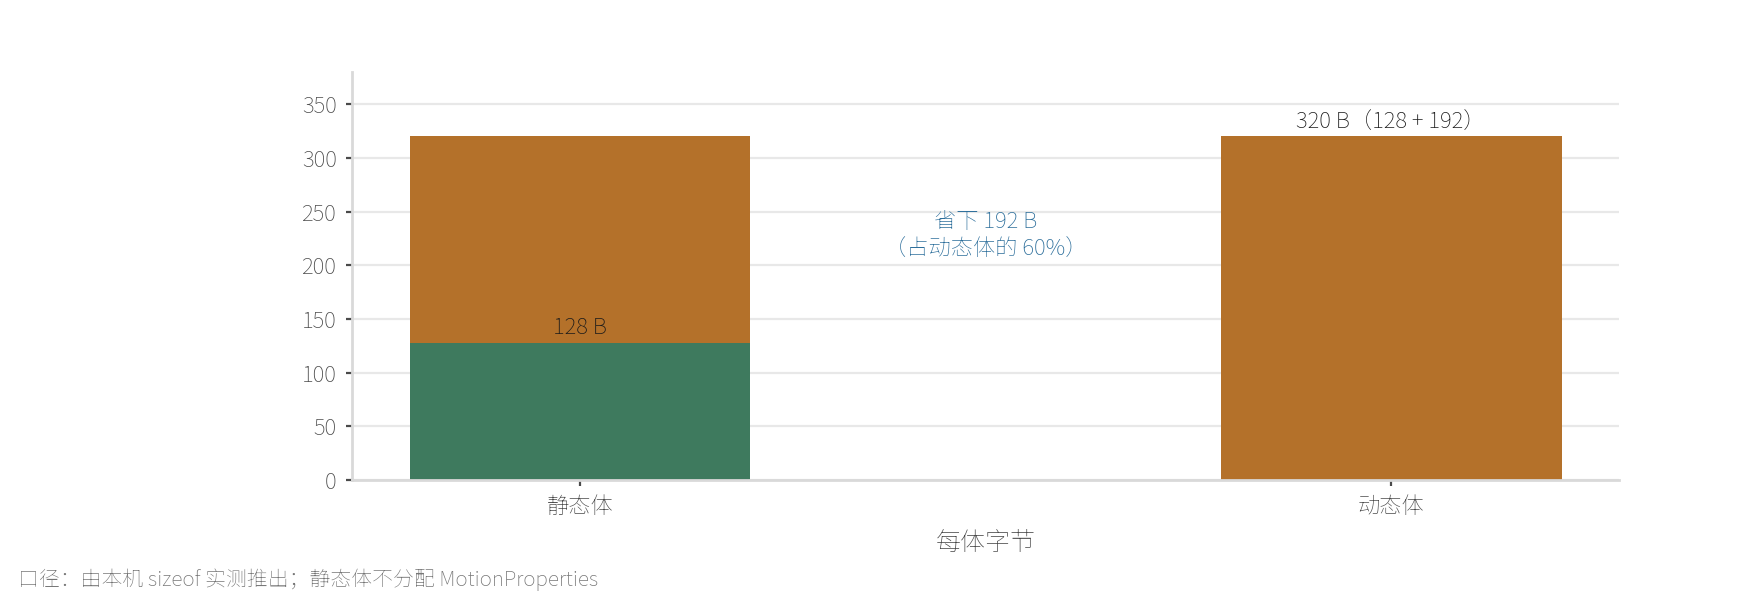
| 刚体类型 | Body | MotionProperties | 每体合计 |
|---|---|---|---|
| 静态(Static) | 128 B | 不分配 | 128 B |
| 动态(Dynamic) | 128 B | 192 B | 320 B |
其中:Body 的 128 字节在所有运动状态下相同,差别全在那 192 字节上。
静态体少付的是 192 字节,占动态体总量的 60%。 一万块地面砖,这个差别就是约 1.9 MB; 十万块就是约 19 MB。对一块"每帧都要遍历"的数据结构来说,这不是可以忽略的数字。
1.4 破例开关:mAllowDynamicOrKinematic
OK,任何"省"都有代价。静态体不带 MotionProperties,那它还能不能改成动态?
默认不能。但官方给了破例开关,BodyCreationSettings.h 第 99 行:
bool mAllowDynamicOrKinematic = false;   ///< When this body is created as static, this setting tells the system to
                                         ///< create a MotionProperties object so that the object can be switched to
                                         ///< kinematic or dynamic
同文件第 56 行给出它如何参与判定:
bool HasMassProperties() const { return mAllowDynamicOrKinematic || mMotionType != EMotionType::Static; }
读法:这个开关买的是"可能性"。一块将来可能要动的地面(升降平台、被撞开的门), 建体时把它打开,就能在运行期切到 dynamic 或 kinematic;代价是这块"地面"要付动态体那份内存。
一句话总结这一节:Jolt 把"会不会动"从运行期状态,前移成了创建期的一次分配决策。
1.5 「能不能动」判的是指针,不是标志位
先来看看这里有个容易看漏、但很有信息量的细节。Body.h 里三个状态判定看着很平常(第 61 / 64 / 67 行):
inline bool IsStatic()    const { return mMotionType == EMotionType::Static; }
inline bool IsKinematic() const { return mMotionType == EMotionType::Kinematic; }
inline bool IsDynamic()   const { return mMotionType == EMotionType::Dynamic; }
但紧接着第 69–70 行的那个判定,实现方式完全不同:
/// Check if a body could be made kinematic or dynamic (if it was created dynamic or with mAllowDynamicOrKinematic set to true)
inline bool CanBeKinematicOrDynamic() const { return mMotionProperties != nullptr; }
它判的是指针是否为空,而非标志位。
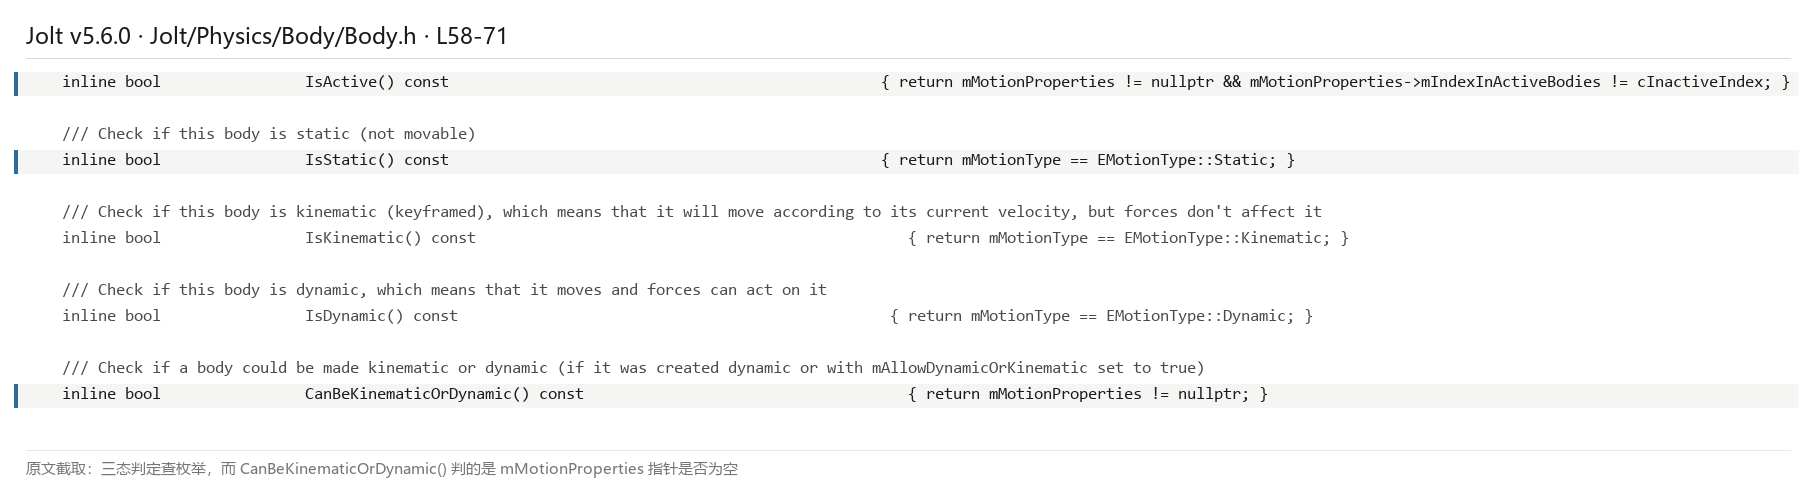
这一行的意义在于:「能不能动」这件事,Jolt 是用「有没有那半个对象」来表达的, 不是再用一个 bool 去记一遍。同一份信息只存一处,就没有"标志位与实体不一致"的可能。
这个手法在取值接口上继续延伸(Body.h 第 150 / 163 / 176 行等):
inline Vec3 GetLinearVelocity() const { return !IsStatic()? mMotionProperties->GetLinearVelocity() : Vec3::sZero(); }
静态体问速度时会直接短路返回零向量,连指针都不解,压根不给"存在但为零"这种中间答案。 在每帧要被调用几十万次的热路径上,这种"先判空、再解引用"的写法是刻意为之。
1.6 三态之间能不能切换
说白了,读完 §1.4,很自然会追问:已经建好的刚体,能不能改运动状态?
答案分两种情况,而且差别正好落在"有没有 MotionProperties"上:
| 起点 → 终点 | 能否切换 | 原因 |
|---|---|---|
| Dynamic ↔ Kinematic | ✅ 可以 | 两者都带 MotionProperties,只是受力与否不同 |
| 静态(未开破例)→ Dynamic/Kinematic | ❌ 不能 | 建体时没分配 MotionProperties,没有存速度的地方 |
| 静态(开了破例)→ Dynamic/Kinematic | ✅ 可以 | 建体时为"可能性"付了内存 |
所以 §1.4 那个开关真正回答的是"有没有为未来的动预留存储",跟"允不允许动"没关系。 这也解释了一个常见困惑:为什么有的引擎里"把地面改成动态"是一行代码,而在 Jolt 里要先在创建时决定。
这是一处典型的"创建期决策换运行期性能"的取舍。 单看这条规则会显得别扭, 但把它和 §1.3 的内存账放在一起看就成立了:静态体在场景里通常是数量最多的一类, 让它们统一不为"可能永远用不到的动态字段"付内存,省下的是可观且稳定的开销。
1.7 横向对比:四种引擎怎么组织"刚体对象"
好了,Jolt 这套"主体 + 可选部件 + 句柄"的做法不是唯一解。把主流做法并排放一下, 本篇「对象层」的形状会更清楚。
| 维度 | Jolt | PhysX 5 | Rapier | Bullet |
|---|---|---|---|---|
| 主体类型 | Body(单一类型) |
PxRigidBody 派生 PxRigidStatic / PxRigidDynamic |
RigidBody(配 RigidBodyDesc) |
btRigidBody 派生自 btCollisionObject |
| 运动状态怎么表达 | 一个 mMotionType 枚举 + 有无 MotionProperties |
类继承(静态与动态是不同类型) | RigidBodyType 枚举 |
标志位(CF_STATIC_OBJECT / CF_KINEMATIC_OBJECT) |
| 运动数据存哪 | 切出去的 MotionProperties(静态体不分配) |
在 PxRigidDynamic 内(静态类没有) |
在 RigidBody 内 |
在 btRigidBody 内 |
| 外部引用方式 | BodyID(32 位,含序号) |
PxRigidActor* 指针 |
RigidBodyHandle(含世代号) |
btRigidBody* 指针 |
| 能不能运行期改类型 | 可以(前提是建体时开了破例) | 静态体与动态体是不同类型,通常要重建 | 可以(改 RigidBodyType) |
可以(改标志位) |
三条可以带走的判断:
第一,"用枚举还是用继承"决定了能不能运行期切换。 PhysX 把静态与动态做成两个不同的类,换了类型就不能原地改(因为对象大小都可能不同); Jolt 与 Bullet 用一个标志/枚举,保留了原地切换的可能,代价是每个对象都要为"可能是动态的"留一句判断。
第二,"数据切不切出去"决定了静态体的内存下限。 Jolt 与 PhysX 都把运动数据单独放置(PhysX 靠继承,Jolt 靠可选部件), Bullet 则把两者放在一个类里,静态体也要付这份内存。
第三,"用指针还是用句柄"决定了跨线程能有多安全。 Jolt 与 Rapier 都选了带世代/序号的句柄,Bullet 与(部分用法下的)PhysX 直接用裸指针。 §2 会看到,句柄多出的那 32 位里藏着防呆机制。
(表格里 Bullet 与 PhysX 的几格,可对照 Bullet 仓库 与 PhysX 刚体总览 复核。)
口径提醒:这张表的每一格都来自各家官方文档对公开 API 的描述, 不是性能对比,它只回答"对象是怎么组织的",不回答"谁更快"。 本系列不做没有控制变量的跨引擎性能比较。
1.8 一个具体场景的内存预算
先来看看把 §1.3 的数字放进一个真实场景是什么样。假设我们要做一个"开放世界的一小片":
| 对象 | 数量 | 类型 | 每体字节 | 小计 |
|---|---|---|---|---|
| 地形砖块 | 100,000 | 静态 | 128 B | 12.8 MB |
| 建筑与道具 | 20,000 | 静态 | 128 B | 2.56 MB |
| 可推动的箱子/桶 | 5,000 | 动态 | 320 B | 1.60 MB |
| 布娃娃(每个约 15 体) | 200 | 动态 | 320 B | 0.96 MB |
| 合计 | 125,200 | — | — | 约 17.9 MB |
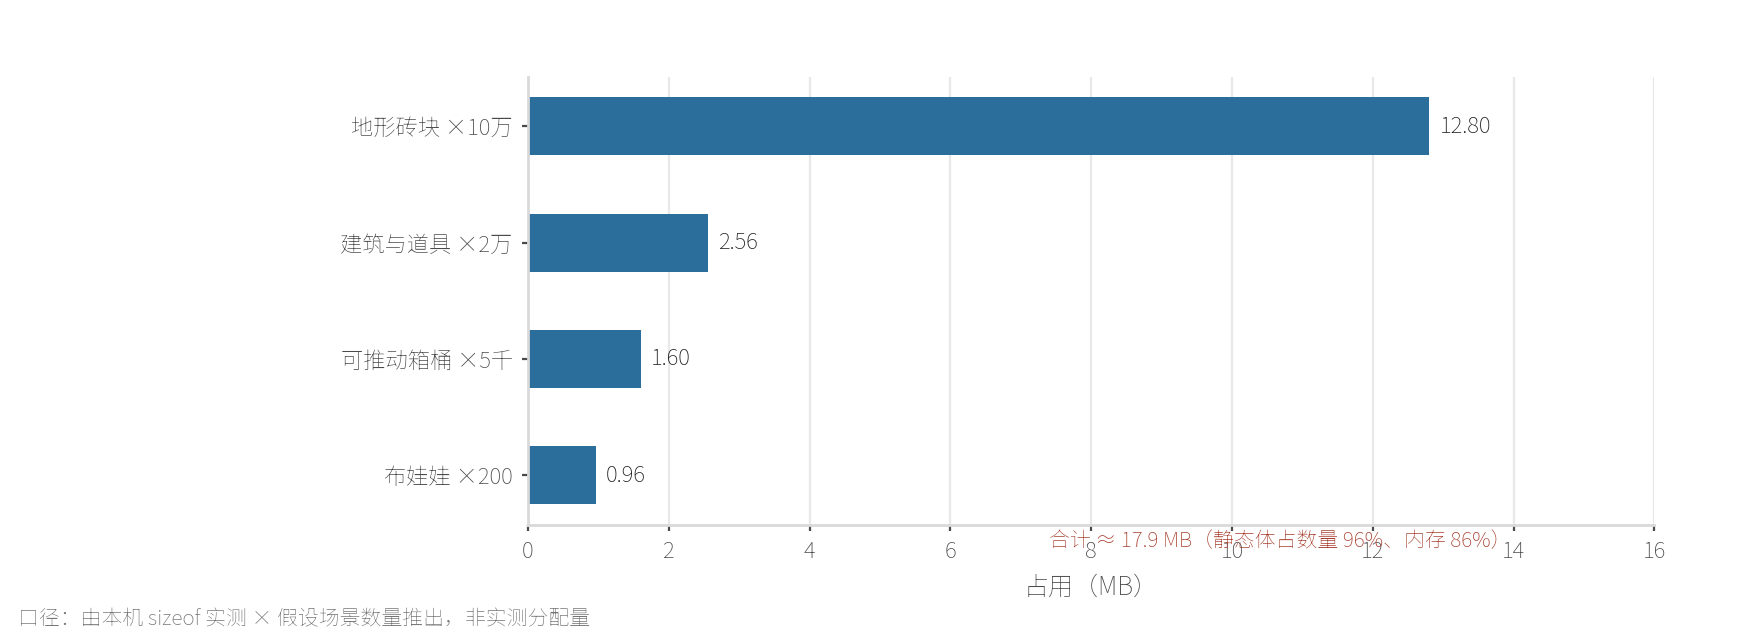
这张表里能读出两件事。
第一,静态体的数量压倒性地多。 12 万个静态体占了总量的 96%,但只占内存的 86%:
因为动态体每体要多付 192 字节。如果静态体也带 MotionProperties,这块内存会从 17.9 MB 涨到约 40 MB
(12 万 × 192 B ≈ 23 MB 的额外开销)。这就是 §1.2 那个"省空间"决策的具体价值。
第二,真正决定"能不能跑得动"的是宽相,跟这份内存没关系。 17.9 MB 对现代机器不算什么, 但 12 万个刚体每帧都要在宽相里被筛一遍,那是 §5 要量的问题。 对象层管的是"每个对象多少钱",宽相管的是"查一次多少钱",两者要分开算账。
1.9 三则常见误解
说白了,这一节把容易混淆的地方集中澄清一下,都是读源码时真实会卡住的点。
误解一:"静态体更便宜,所以把能做成静态的都做成静态。" 不对。静态体的确省内存(§1.3),但"该不该是静态"首先是个语义问题: 它会不会被移动、会不会被推。为了省 192 字节把一块该被撞开的门做成静态, 换来的是玩法上的错误。先按语义定三态,再享受它带来的内存收益,顺序不能反。
误解二:"mAllowDynamicOrKinematic 开了就更灵活,干脆都开。"
不对。这个开关买的是"事后可切换"的可能性,代价是每体多付 192 字节(§1.4)。
如果你的场景里静态体有 12 万个,全开就是约 23 MB 的额外开销:
而这 23 MB 买到的能力,绝大多数对象一辈子都用不上。
误解三:"用 ID 就等于安全,随便跨线程访问也没事。"
不对。BodyID 解决的是"引用会不会指向错误的对象",不解决"同时访问会不会读到中间态"。
跨线程访问的正确做法是用 §4 的加锁版接口或 RAII 锁:
ID 防的是"错对象",锁防的是"半成品"。 两者是两件事。
二、BodyID:一个 uint32 里的两样东西
2.1 23 位索引 + 8 位序号
BodyInterface 的绝大多数接口不接收 Body*,而接收 BodyID。
原因在上一篇已经埋了伏笔:在主线程之外改刚体是不安全的(§4 会展开)。
用一个 32 位整数当句柄,就能在"持有者"与"实际对象"之间插一层间接。
BodyID.h 第 19–21 行给出它的位布局:
static constexpr uint32 cMaxBodyIndex = 0x7fffff;      ///< Maximum value for body index (also the maximum amount of bodies supported - 1)
static constexpr uint8  cMaxSequenceNumber = 0xff;     ///< Maximum value for the sequence number
static constexpr uint    cSequenceNumberShift = 23;    ///< Number of bits to shift to get the sequence number
第 44–46 行的取值也印证了布局:
inline uint32 GetIndex() const { return mID & cMaxBodyIndex; }
0x7fffff 就是低 23 位全 1。所以一个 BodyID 是这样切的:
| 位段 | 宽度 | 含义 | 上限 |
|---|---|---|---|
| 低 23 位 | 23 | 索引(index) | 2^23 = 8,388,608 个刚体 |
| 高 8 位 | 8 | 序号(sequence number) | 0–255 |
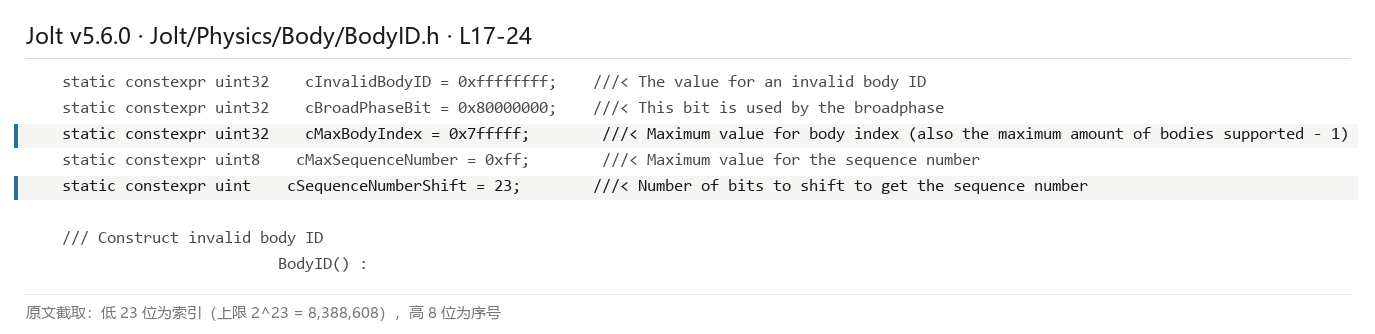
位布局的原文见 Jolt/Physics/Body/BodyID.h。
其中:低 23 位是索引、高 8 位是序号,两者拼在同一个 uint32 里;
838 万这个上限是硬性的,它由 23 个比特决定,不是配置项。
超过这个数量的刚体,BodyID 就表达不了了。
2.2 序号位防的是什么
OK,索引位好理解,序号位是干嘛的?
答案:防止 ID 复用被误用。刚体被销毁后,它在句柄表里的位置会被后来的刚体占用。
如果 BodyID 里只有索引,那么"一个指向旧刚体的 ID"在旧刚体销毁后,
就会静默地指向一个完全不同的新刚体,这是最难查的一类 bug:不崩、不报错,只是行为诡异。
序号位解决的正是这件事:每复用一次索引,序号加一。旧 ID 的序号已经过期,用它去访问就会失败, 而不是拿到错误的物体。
这和第上一篇说的"加锁接口在 ID 过期时会失败而不是死等"是同一条设计线: Jolt 倾向于让错误尽早、显式地暴露出来,而不是让它变成一个难以定位的行为异常。
2.3 为什么用 ID 而不是指针
好了,到这里可以正面回答一个设计问题了:为什么不直接用 Body*?
理由一,指针不携带"过期"信息。 一个 Body* 只说明内存地址,不说明这个对象是否还活着。
对象被释放后,指针指向的地址可能被别的对象占用,这就是"悬垂指针",
C++ 里最难查的 bug 之一。BodyID 的序号位把"还活着吗"编码进了句柄本身。
理由二,指针不利于紧凑存储。 64 位系统上一个指针是 8 字节,而 BodyID 只有 4 字节(本机实测)。
宽相里每个刚体一个节点、接触缓存里每个接触引用两个刚体,这类结构数量极大,
把 8 字节压到 4 字节的收益会随规模放大。
理由三,指针不能当"弱引用"用。 引擎里有大量"临时记住某个刚体,但不拥有它"的场景 (比如"上一帧撞到我的那块地板")。用指针表达这种关系必须自己管生命周期; 用带序号的 ID,则过期访问天然失败。
2.4 序号到期之后
说白了,还有一个细节值得交代:序号是 8 位,上限 255。也就是说,同一个索引位在被复用 256 次之后, 序号会绕回原点,旧的 ID 又"看起来有效"了。
这属于在有限位数下的必然取舍,谈不上漏洞。官方在 BodyID.h 里给出的注释也很直白:
"Body ID's will only be reused after many add/remove cycles"(要经过很多次增删循环,体 ID 才会被复用)。
工程上怎么用这条信息:不要把 BodyID 当长期凭证保存(比如存进存档文件或跨会话复用)。
它的设计目标是"在引擎运行期内可靠地指向一个刚体",不是"永久身份"。
需要长期引用时,应该在需要时重新解析。
这个判断也可以反推到别处,凡是"位数有限 + 会绕回"的句柄,都只适合短周期持有。
三、生命周期:为什么不能用 new
3.1 四步,一步都不能少
OK,回看开篇那三行错误代码,问题出在刚体的生命周期上。
Docs/Architecture.md 的 "Creating Bodies" 章节给出官方规定的四步:
The general life cycle of a body is: -
BodyInterface::CreateBody- Construct a Body object and initialize it. You cannot usenewto create a Body. -BodyInterface::AddBody- Add the body to the PhysicsSystem and make it participate in the simulation. -BodyInterface::RemoveBody- Remove it from the PhysicsSystem. -BodyInterface::DestroyBody- Deinitialize and destruct the Body. You cannot usedeleteto delete a Body. This function will not automatically remove the Body from the PhysicsSystem.
注意加粗的两处:不能 new,不能 delete。而且第三、四步的顺序不能颠倒:
(见 BodyInterface.h。)
官方在 DestroyBody 的注释里又强调了一遍:
"Make sure that you remove the body from the physics system using BodyInterface::RemoveBody before calling this function."
上面四步与这两处禁令,在 Docs/Architecture.md 的 Creating Bodies 一节里就是下面这一段(原文照录,高亮处即那两句禁令):
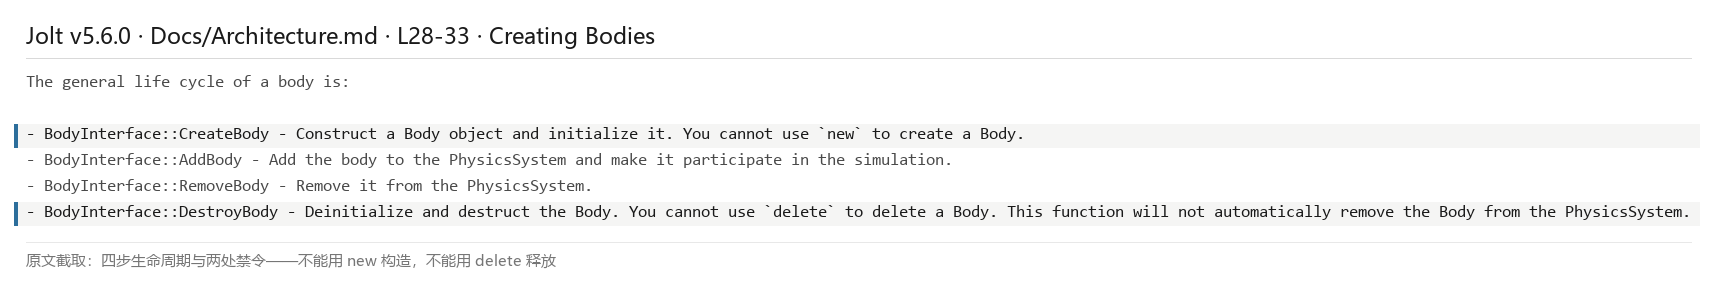
原文把 CreateBody 与 DestroyBody 这两条单独强调,正是它们把所有权钉死在了 BodyManager 上;而四步之间还夹着三个不能跳过的前置条件。把每一步的状态与转移画出来,是这样:
这张图的重点是每两步之间的前置条件。注意 CreateBody 之后的刚体处于一个"已构造但未入世界"的中间态,它占着内存、能被查询,但不参与任何仿真。这个状态既是批量插入流程的基础(§5 会用到),也是很多"刚体加了却没反应"问题的根源:东西建好了,但没 AddBody。
3.2 为什么不能 new
好了,原因不复杂,但要说清。刚体不是一个"孤立的堆对象",它同时被好几处引用:
BodyManager用一张按索引排布的表持有它,BodyID的索引位指向的就是这张表的位置;- 宽相(broadphase) 里有一个代表它的 AABB 节点;
- 接触缓存里可能有它参与的接触点;
- 岛构建器在分岛时会记录它属于哪个岛。
这四处的引用都是"按索引/按位置"建立的。如果你用 new 造一个 Body,
它不在 BodyManager 的表里,BodyID 也就无从指向它;
如果你用 delete 释放它,BodyManager 的表里还留着悬空项,
其他三处引用也一起悬空。
生命周期四步的原文见 Docs/Architecture.md 的 Creating Bodies 一节。
其中:CreateBody 与 AddBody 是两个独立动作,前者只分配、后者才入世界;RemoveBody 与 DestroyBody 亦然。四步的顺序构成了对象的所有权规则。
这里有一处最容易读岔的地方,得提前点出来:BodyInterface::CreateBody 的实现里确实调了一个同名的 BodyManager::AddBody:
但那个 AddBody 只做「登记进表、分配 ID」,完全不碰宽相;真正把刚体放进宽相、让它参与仿真的是 BodyInterface::AddBody(BodyID)。
两个函数同名,做的却是四步里的不同两步。源码见
BodyInterface.cpp 第 30–39 行。
所以正确的做法只有一条:构造走 CreateBody(由 BodyManager 分配位置),
析构走 DestroyBody(由它负责把各处引用一并清干净)。
这也是为什么第二行代码 physics.AddBody(body) 也不对:AddBody 接收的是 BodyID,不是 Body*。
3.3 四处常见误用
先来看看把这些规矩整理成一张表。
| 误用 | 后果 |
|---|---|
用 new 造 Body |
不在 BodyManager 的表里,拿不到有效 BodyID,无法参与仿真 |
AddBody 之前没 AddBodiesFinalize |
刚体停在"已构造未入世界"的中间态,不参与仿真也不报错 |
直接 DestroyBody 而不先 RemoveBody |
官方明确要求先移除;跳步会破坏 BodyManager 与仿真的一致性 |
从非主线程用 Body* 直接读写 |
与 Update 内部作业竞争,行为未定义 |
这四条里,前三条是顺序问题,第四条是并发问题。顺序问题的表现往往是"静默失效",不崩溃、不报错,只是刚体不参与仿真;并发问题则可能时好时坏地复现。所以排查刚体相关问题时,先按这张表核对顺序,再去查线程。
其中最后一条是下一篇(第四篇讲宽相)与第四节的共同前提: "谁可以碰这个对象"和"这个对象怎么进来"是同一个问题的两面。
四、接口全貌与便捷路径
4.1 全量清单:BodyInterface 到底给了哪些操作
OK,讲完生命周期,把接口的全貌摆出来会更清楚。BodyInterface 的方法可以按"它动的是什么"分成五类。
先给全量清单,再做二次归类:清单是"面",归类是"骨"。
| 类别 | 代表方法 | 作用 |
|---|---|---|
| 生命周期 | CreateBody / CreateAndAddBody / AddBody / RemoveBody / DestroyBody |
对象的生与死 |
| 批量生命周期 | AddBodiesPrepare / AddBodiesFinalize / AddBodiesAbort / RemoveBodies / DestroyBodies |
与上同类,但按批处理(§5 的主题) |
| 状态设置 | SetPosition / SetRotation / SetLinearVelocity / SetAngularVelocity |
改对象自身的状态量 |
| 运动状态 | SetMotionType / SetObjectLayer / ActivateBody / DeactivateBody |
改对象"属于哪一类、现在活不活跃" |
| 查询与力 | GetPosition / GetCenterOfMassPosition / AddForce / AddTorque |
读状态、施加外力 |
这五类方法的完整定义见 Jolt/Physics/Body/BodyInterface.h。
这张表有两处值得留意,其中第一处是结构性的:
第一,"批量"是一等公民,不是补充接口。 生命周期里的每一个单条操作,几乎都有一组批量对应
(AddBody ↔ AddBodies*、RemoveBody ↔ RemoveBodies、DestroyBody ↔ DestroyBodies)。
这不是 API 冗余。它承认了"单条与批量是两种不同规模的操作,值得两套实现"(§5 会给数据)。
第二,"读"和"写"的接口没有分开成两个对象。 同一个 BodyInterface 既能读也能写,
线程安全靠 §4 的两副面孔来区分。这与很多现代引擎(把读写分离成不同接口)的做法不同:
Jolt 选择了"一个接口、两副面孔",把选择权交给调用者。
4.2 与上一篇的呼应:为什么 Update 期间不能加删
说白了,把本节与上一篇接起来看,有一条因果链值得单独点出。
上一篇讲过:Update 内部会把刚体的加删锁住,位置在宽相收尾前是"冻结"的。
本节讲了:刚体被 BodyManager、宽相、接触缓存、岛构建器多处按索引引用。
两条合起来,就解释了那条规则为什么必须存在:
Update 内部的所有作业都是"按索引读句柄表"工作的。
如果允许在 Update 期间插入一个刚体,句柄表会被重新分配、索引可能移动,
那么正在跑的作业读到的引用就全部失效了,而且是在多线程下随机失效,几乎不可能调试。
所以那条规则是对象层的引用方式决定的硬约束,而非"为了简单而禁掉的便利"。
想在新场景里批量加刚体?要么在两次 Update 之间完成,要么走 §5 的批量接口。
4.3 三条便捷路径,以及它们各自的适用面
好了,官方在四步生命周期之外,还给了几条"合起来做"的便捷路径。它们的差别只在"替你省了哪几步":
| 路径 | 等价于 | 何时用 |
|---|---|---|
CreateBody |
只构造,不入世界 | 需要先拿 ID 做别的事(如建约束)再入世界 |
CreateAndAddBody |
CreateBody + AddBody |
最常见:建完立刻入世界 |
CreateBodyWithID |
自带指定 ID 的构造 | 需要 ID 可预测(如按索引寻址的网格) |
CreateBodyWithoutID |
构造但暂不分配 ID | 批量插入前的准备阶段 |
两条值得注意的:
CreateBodyWithoutID 是 §5 批量插入的前置。 批量流程里,
AddBodiesPrepare 需要一批已构造、但还没分配 ID 的刚体。这也解释了为什么
批量接口的签名是 AddBodiesPrepare(BodyID *ioBodies, int inNumber):
它在 Prepare 阶段才把 ID 填进去,并顺手把这个数组重排(§6.2 提到的 "may be shuffled around")。
CreateBodyWithID 买的是"可预测性",不是性能。 当你想用"索引 = 网格坐标"这种映射去寻址时,
可预测的 ID 会省掉一层查找表。但它不解决 §5 的宽相问题:
病态宽相来自插入顺序与方式,不是 ID 的取值方式。
一句话选型:日常用 CreateAndAddBody;需要两步走时用 CreateBody;
要做批量插入时用 CreateBodyWithoutID + 批量接口;只有真的需要可预测 ID 时才用 CreateBodyWithID。
4.4 一次完整的增删:正确写法长什么样
把 §3.1 到 §4.3 的规矩落到一段完整代码上,对照开篇那三行错误写法:
//-----------------------------------【单条增删的正确顺序】---------------------------------------
// 描述:构造 → 入世界 → (使用)→ 出世界 → 析构;四步顺序不可颠倒
//------------------------------------------------------------------------------------------
BodyInterface &bi = physics.GetBodyInterface();

//【1】构造:不能用 new;BodyCreationSettings 里给出形状、位姿、运动类型与对象层
BodyCreationSettings settings(new BoxShape(Vec3(0.5f, 0.5f, 0.5f)),
                              RVec3(0, 5, 0), Quat::sIdentity(),
                              EMotionType::Dynamic, Layers::MOVING);
BodyID id = bi.CreateBody(settings)->GetID();   // 返回的是 Body* 临时指针,但我们只留 ID

//【2】入世界:接收的是 BodyID,不是 Body*
bi.AddBody(id, EActivation::Activate);

//【3】(使用:读状态要用 RAII 锁,或确认单线程)
if (bi.IsAdded(id)) { /* ... */ }

//【4】出世界 →【5】析构:顺序不可颠倒
bi.RemoveBody(id);
bi.DestroyBody(id);                             // 不能用 delete
下面对这段代码特别说明两处。
第一,CreateBody 返回的是 Body* 临时指针,但我们只留 BodyID。
这是很常见的一个混淆点。返回指针是为了让你能立刻读几次刚体信息(如拿到 ID),
但不要把它存起来,理由是 §2.3 说的那三条:不携带过期信息、占 8 字节、不能当弱引用。
第二,RemoveBody 与 DestroyBody 必须分开且按序。 官方在 DestroyBody 的注释里
明确要求先移除。合并成一次调用看起来更方便,但会丢掉一个中间态:
"已移出仿真、但仍可查询"这个状态在对象池与流式加载里是有用的。
批量版则是把【1】与【2】换成三段:
//-----------------------------------【批量增删】---------------------------------------
// 描述:先准备(可在后台线程)→ 一次性原子加入;反悔则 Abort
//------------------------------------------------------------------------------------------
BodyID ids[N];
for (int i = 0; i < N; ++i) ids[i] = CreateBodyWithoutID(settings_i);   //【1】只构造,不分配 ID
BodyInterface::AddState st = bi.AddBodiesPrepare(ids, N);               //【2】准备(可后台)
bi.AddBodiesFinalize(ids, N, st, EActivation::Activate);                //【3】一次性加入
// 若中途决定不加:bi.AddBodiesAbort(ids, N, st);
到这为止,对象层的"怎么用"已经完整。§4 讲的是"谁能用",§5 讲的是"一次来一大批怎么办"。
五、两副面孔的接口
5.1 加锁版与非加锁版
上一篇讲过:Update 内部会把刚体的加删锁起来,位置在宽相收尾前是"冻结"的。
那么问题来了:如果我要在别的线程里读一个刚体,该怎么办?
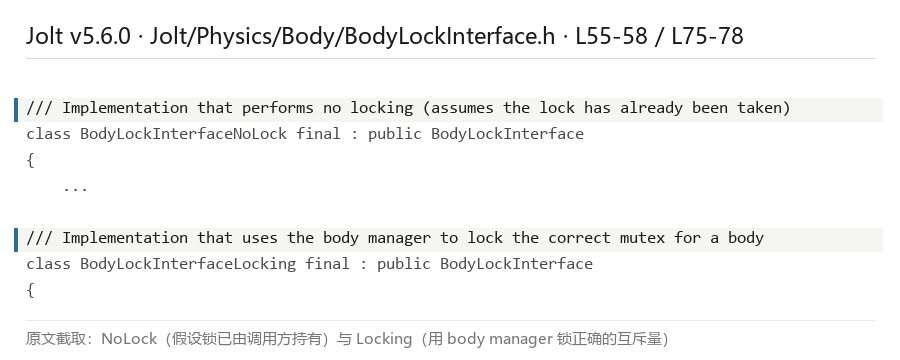
Jolt 的答案是:同一个接口,提供两副面孔。
BodyLockInterface.h 第 16 / 57 / 77 行:
class BodyLockInterface : public NonCopyable { ... };
/// Implementation that performs no locking (assumes the lock has already been taken)
class BodyLockInterfaceNoLock final : public BodyLockInterface { ... };
/// Implementation that uses the body manager to lock the correct mutex for a body
class BodyLockInterfaceLocking final : public BodyLockInterface { ... };
怎么选,官方文档(Docs/Architecture.md 的 Multithreaded Access 一节)给的原则很直接:
"locking 版用互斥量数组防止对同一刚体的并发访问;non-locking 版不加锁,所以需要你自己小心。"
换句话说:默认用加锁版;只有你能证明"此刻没有别人在碰它"时才用非加锁版。
5.2 固定大小的锁数组
OK,现在看加锁版的实现方式。这里有一个反直觉的选择:它不是每个刚体一把锁。
BodyManager.h 第 181–182 行:
/// Bodies are protected using an array of mutexes (so a fixed number, not 1 per body). Each bit in this mask indicates a locked mutex.
using MutexMask = uint64;
第 179 行给出"哪个刚体用哪把锁":
SharedMutex & GetMutexForBody(const BodyID &inID) const { return mBodyMutexes.GetMutexByObjectIndex(inID.GetIndex()); }
而 MutexArray.h 第 11–12 行说明了这套机制的定位:
A mutex array protects a number of resources with a limited amount of mutexes. It uses hashing to find the mutex of a particular object.
为什么不是每体一把锁? 两个理由:
锁数组的实现见 Jolt/Core/MutexArray.h 与 Jolt/Physics/PhysicsLock.h。
其中:MutexArray 负责"对象 → 锁槽"的哈希映射,PhysicsLock 负责实际的加解锁;
理由一,省内存。 每体一把锁,一万个刚体就是一万个互斥量。用固定数组则与刚体数量无关。
MutexMask 是 uint64,它同时说明了一个隐含上限:一次最多能锁 64 把(每一位对应一把锁)。
理由二,避免了锁的"数量爆炸"。 固定数组 + 哈希的代价是多个刚体会共享同一把锁: 这带来一点虚假争用(本可并行的两个刚体若哈希到同一槽,就会互相等待), 但换来了可控的内存与实现复杂度。
5.3 到底几把锁
"固定数量"是多少?BodyManager.cpp 的 Init 给出了算式(本机已核):
uint num_body_mutexes = Clamp<uint>(GetNextPowerOf2(inNumBodyMutexes == 0? 2 * thread::hardware_concurrency() : inNumBodyMutexes), 1, sizeof(MutexMask) * 8);
拆开读,三个动作各有出处:默认值取「2 × 硬件线程数」(本机 16 逻辑核 → 32), 向上取到 2 的幂(哈希要靠位掩码取模,不是 2 的幂就没法用位运算), 再夹到 [1, 64] 的区间(下限 1 保证至少有一把锁可用,上限 64 的原因稍后给)。 三个动作写在同一行、顺序不能换,先按线程数定基数,再取幂,最后才夹取。
本机 16 个硬件线程 → 2 × 16 = 32 → 已经是 2 的幂 → 夹取后仍是 32 把。
而上限 64 来自 sizeof(MutexMask) * 8,MutexMask 是 uint64,8 字节 64 位。
这个数量在公开接口上就是 PhysicsSystem::Init 的 inNumBodyMutexes 参数,官方注释原话是
「Should be a power of 2 in the range [1, 64], use 0 to auto detect」:
官方层的一句话与本机读到的那个算式,说的是同一件事(见
PhysicsSystem.h 第 53 行)。
加解锁的实现落在 Jolt/Physics/PhysicsLock.h
与 Jolt/Core/MutexArray.h。
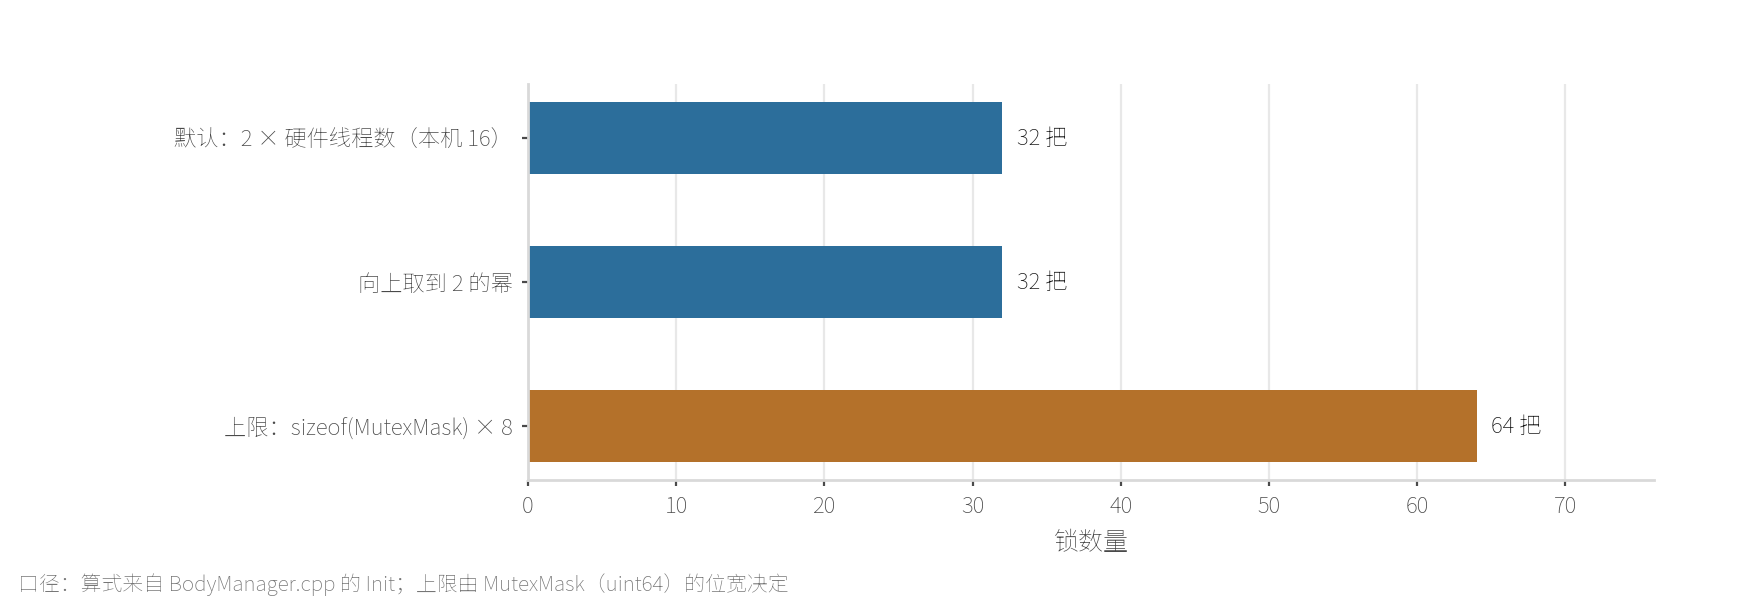
这里可以带走一个判断方法:看到"固定大小数组 + 哈希"的设计,先去它的类型定义里找上限。
本例的上限(64)由 MutexMask 的位宽决定,并非拍脑袋定的。
5.4 RAII 用法:不要手写加解锁
基类注释里还有一句实用提示:通常你不需要直接用 BodyLockInterface,
而是用 BodyLockRead / BodyLockWrite / BodyLockMultiRead / BodyLockMultiWrite:
它们是 RAII 包装,构造即加锁、析构即解锁。
为什么推荐批量版本? 官方文档在别处解释过一个死锁场景: 如果你用两次单对象读锁去锁同一对刚体,两个线程以相反顺序锁同一对刚体就会死锁。 批量版本按一致的顺序加锁,从根上避开这个问题。
这条规则和上一篇的"不能只等最后一个作业"是同一类经验: 并发问题的解法往往是让危险的操作在结构上不可表达,而不是靠更小心。
5.5 ID 过期时会发生什么
BodyLockRead 这类 RAII 锁在实现上还依赖一个细节,值得单独讲:它拿到的是"锁 + 校验"两样东西,不止一把锁。
回忆 §2 的 BodyID:低 23 位索引 + 高 8 位序号。加锁流程是:
用索引找到该刚体应属的锁槽 → 加锁 → 再核对该刚体的序号是否与 ID 里的一致。
如果在这两次操作之间,刚体已经被别的线程删除、索引被新刚体占用,那么序号必然不匹配: 锁会失败返回,而不是继续操作一个错误的物体。官方文档对这个场景的措辞是: "When another thread has removed the body between the time the body ID was obtained and the lock, the lock will fail."
为什么"失败"比"成功但锁错"好? 因为它把竞态变成了一个可处理的返回值。 调用者拿到失败可以重试、可以跳过、可以记录日志;如果锁成功了却拿到了别的刚体, 那就变成一个不崩不报错的静默错误。
这一条和第上一篇"不能只等最后一个作业(会死锁)"合起来看,能看出 Jolt 在并发上的一贯选择: 宁可显式失败,也不要静默地做错。
5.6 锁的粒度:一种"可控的争用"
§5.2 说固定锁数组会带来虚假争用,多个不相关的刚体若哈希到同一槽,就会互相等待。 这一节的末尾把它量化一下,因为这是选型时常被问到的问题。
本机默认 32 把锁(§5.3)。这意味着在最坏情况下,同时"想锁刚体"的线程数超过 32 时, 必有线程要排队。但要注意两点:
第一,锁的持有时间极短。 典型的 BodyLockRead 只覆盖"读几个字段"这一段,
不是整个逻辑处理过程。所以 32 把锁的吞吐上限,远高于"32 个线程同时干活"给人的直觉。
第二,争用是否真实发生,取决于刚体访问模式。 如果多个线程访问的是空间上分散的刚体, 哈希到同一槽的概率低;如果它们集中处理同一个小区域的刚体(比如同一堆箱子), 争用就会明显,因为它们的索引往往相邻,容易落到同一槽。
工程上的推论:如果你在做一个"多线程分块处理世界"的系统,让每个线程处理空间上成块的区域, 而不是"每个线程按索引轮流取刚体",前者会让索引分散,后者会让索引聚集。 这也解释了为什么 Jolt 内部分岛(island)而不是简单地按索引分段: 分岛的边界是按接触关系切的,天然会把"互相碰得到的刚体"分给同一段。
5.7 什么时候真的需要非加锁版
好了,读到这里,一个自然的疑问是:既然加锁版更安全,非加锁版存在的意义是什么?
三个真实场景:
场景一,单线程程序。 如果你的游戏就在主线程里跑物理,Update 之外根本没有别的线程会碰刚体,
那么加锁纯粹是白付成本。此时用非加锁版是合理的,前提是你能保证"就一个线程"这件事长期成立。
场景二,已经持有更高的锁。 比如你已经拿到了整个物理系统的写锁(或自己维护了一把粗粒度锁), 此时再去取刚体级别的锁就是重复保护,还可能引入锁序问题。
场景三,在 Update 内部。 这一点与上一篇呼应:Update 期间刚体位置是"冻结"的、
刚体加删是被禁止的,所以作业内部访问刚体时,不需要也不能再加一层刚体锁。
Jolt 内部的作业用的正是非加锁路径。
反面:如果你的程序是多线程的、且访问刚体的时机分散在任意地方,用加锁版。 加锁版多出的那点开销,远比一个随机复现的数据竞争便宜。
六、批量增删:官方那句话与三件套
6.1 官方的那句话
说白了,这一节是本篇的核心。Docs/Architecture.md 第 42 行,原文逐字:
Always use the batch adding functions when possible! Adding many bodies, one at a time, results in a really inefficient broadphase (a trace will notify when this happens) and in extreme cases may lead to the broadphase running out of internal nodes (
std::abortwill be called in that case). If you cannot avoid adding many bodies one at a time, usePhysicsSystem::OptimizeBroadPhaseto rebuild the tree.
同义句在 BodyInterface.h 第 96–97 行:
Note that if you need to add multiple bodies, use the AddBodiesPrepare/AddBodiesFinalize function. Adding many bodies, one at a time, results in a really inefficient broadphase until
PhysicsSystem::OptimizeBroadPhaseis called or whenPhysicsSystem::Updaterebuilds the tree!

注意这段话里其实有三层信息:结论(要批量)、后果(低效宽相、极端下 std::abort)、补救(OptimizeBroadPhase)。官方把这三层压在一段里,读的时候容易只看第一层。本篇 §7.1 到 §7.4 就是逐层把这三点量出来。
官方的措辞很重("极端情况下会调用 std::abort"),但全是定性的:
"低效的宽相":低效多少?"直到 Update 重建树":要等几次 Update?
研究阶段查过:这个数字公开渠道不存在。 官方没给,社区拆解文章也只是复述官方那句话, 中文侧更没有系统解读。所以这一节我们自己量。
6.2 批量三件套
OK,先看官方给的批量接口。BodyInterface.h 第 116–133 行:
using AddState = void *;
/// Prepare adding inNumber bodies at ioBodies to the PhysicsSystem, returns a handle that should be used in AddBodiesFinalize/Abort.
/// ioBodies may be shuffled around by this function and should be kept that way until AddBodiesFinalize/Abort is called.
AddState AddBodiesPrepare(BodyID *ioBodies, int inNumber);
/// Finalize adding bodies to the PhysicsSystem, supply the return value of AddBodiesPrepare in inAddState.
void     AddBodiesFinalize(BodyID *ioBodies, int inNumber, AddState inAddState, EActivation inActivationMode);
/// Abort adding bodies to the PhysicsSystem, supply the return value of AddBodiesPrepare in inAddState.
void     AddBodiesAbort(BodyID *ioBodies, int inNumber, AddState inAddState);
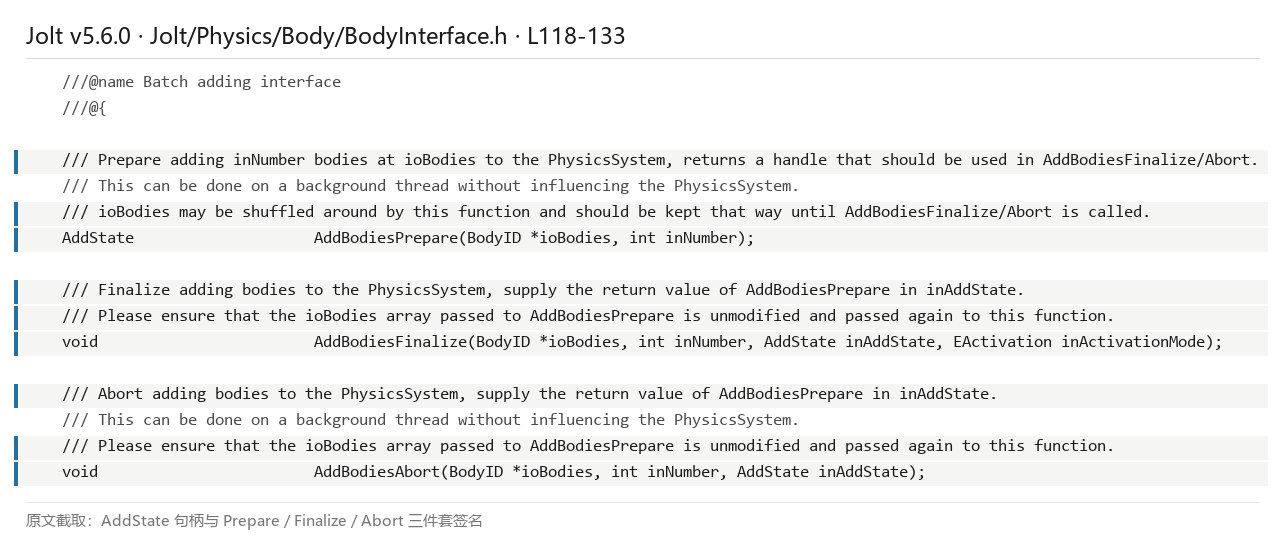
这三个签名里有几处信息量很大的细节。返回值 AddState 是一个不透明句柄(void *),调用方不需要知道它是什么。
ioBodies 是输入输出参数,会被重排。而 inActivationMode 说明:加进来之后要不要激活,由调用方说了算。
签名原文见 Jolt/Physics/Body/BodyInterface.h 第 116–133 行。
其中:AddState 是不透明句柄、ioBodies 是输入输出参数、inActivationMode 决定加入后是否唤醒。
三处细节值得单独点出来:
第一,AddBodiesPrepare 可以在后台线程做。 官方文档写得很明确:
"Doesn't affect simulation and can be done from a background thread."
这是"流式载入关卡"的关键,大块地图可以提前在后台备好,只把 Finalize 留到需要时。
第二,ioBodies 会被打乱顺序。 注释原文是 "may be shuffled around by this function
and should be kept that way until AddBodiesFinalize/Abort is called":
它故意重排这个数组(为了内部打包效率),你必须原样留着,不能在中途动它。
第三,AddBodiesAbort 存在的意义是"准备完又不加了"。 官方举的例子很生动:
玩家在原路返回,那一块地图就不用加载了。
两条路径的差别不在"快或慢",而在什么时候接触宽相树。单条插入是每个刚体立刻插进树里,插入顺序就等于建树顺序;批量则是先在旁边准备好一整批,再一次性交给树。这也是为什么批量的准备阶段可以放到后台线程,它还没碰树。
6.3 基准怎么设计的
好了,要量代价,先要把"代价"拆开。这里有个陷阱: 如果只测"插入耗时",你会得到与官方警告相反的结论(§7.2 会看到)。 所以基准把时间拆成三段:
| 段 | 含义 | 为什么单列 |
|---|---|---|
add |
插入调用本身 | 单条插入 vs 批量的直接开销 |
update1 |
插入后首次 Update |
宽相质量的代价最可能在这里爆出来 |
steady |
后续 K 次 Update 的平均 |
官方说的"直到 Update 重建树"到底要多久 |
其中:add 量的是接口自身的开销,update1 量的是宽相质量的代价,steady 量的是它会不会自愈。
基准源码见 evidence/bench_body.cpp(随本篇存档)。
三种插入方式对照:
- 逐个:循环调用
AddBody(id, EActivation::Activate); - 批量:
AddBodiesPrepare→AddBodiesFinalize; - 逐个 + 补救:逐个插入后,显式调用
PhysicsSystem::OptimizeBroadPhase()。
为什么一定要拆成三段?因为"逐个插入更慢"这个结论在不同段上方向是相反的,插入那一段批量更慢,首次 Update 那一段逐个慢两个数量级。若把三段合并成"从开始插到跑完若干帧"的总数,你会因为批量的准备开销被摊薄而低估差距。
场景统一为一块静态地面 + N 个动态立方体在空间里铺开,
mAllowSleeping = false 让它们全程保持活跃。N 取 10,000 / 50,000 / 100,000,
每个配置重复 3 次取平均。
关于外部素材的一处说明:本篇的外部真实素材为 0。 检索阶段用 6 组关键词在 Wikimedia Commons 共得 69 条候选,全部与刚体对象组织方式无关; 3 个直系类目(
Rigid body dynamics/Physics engines/Concurrency control)全部为空。 所以"证明类"素材只能来自源码原文与本机自跑,这也正是这段基准存在的原因。
七、把代价量出来:本机三段计时实测
7.1 首次 Update:差距随规模放大到 185 倍
先来看看最惊人的一段。插入后首次 Update 的耗时(毫秒):
| 规模 | 逐个 | 批量 | 逐个 + Optimize |
|---|---|---|---|
| 10,000 | 35.5 | 1.4 | 1.2 |
| 50,000 | 896.8 | 10.1 | 7.5 |
| 100,000 | 3821.1 | 20.7 | 17.2 |
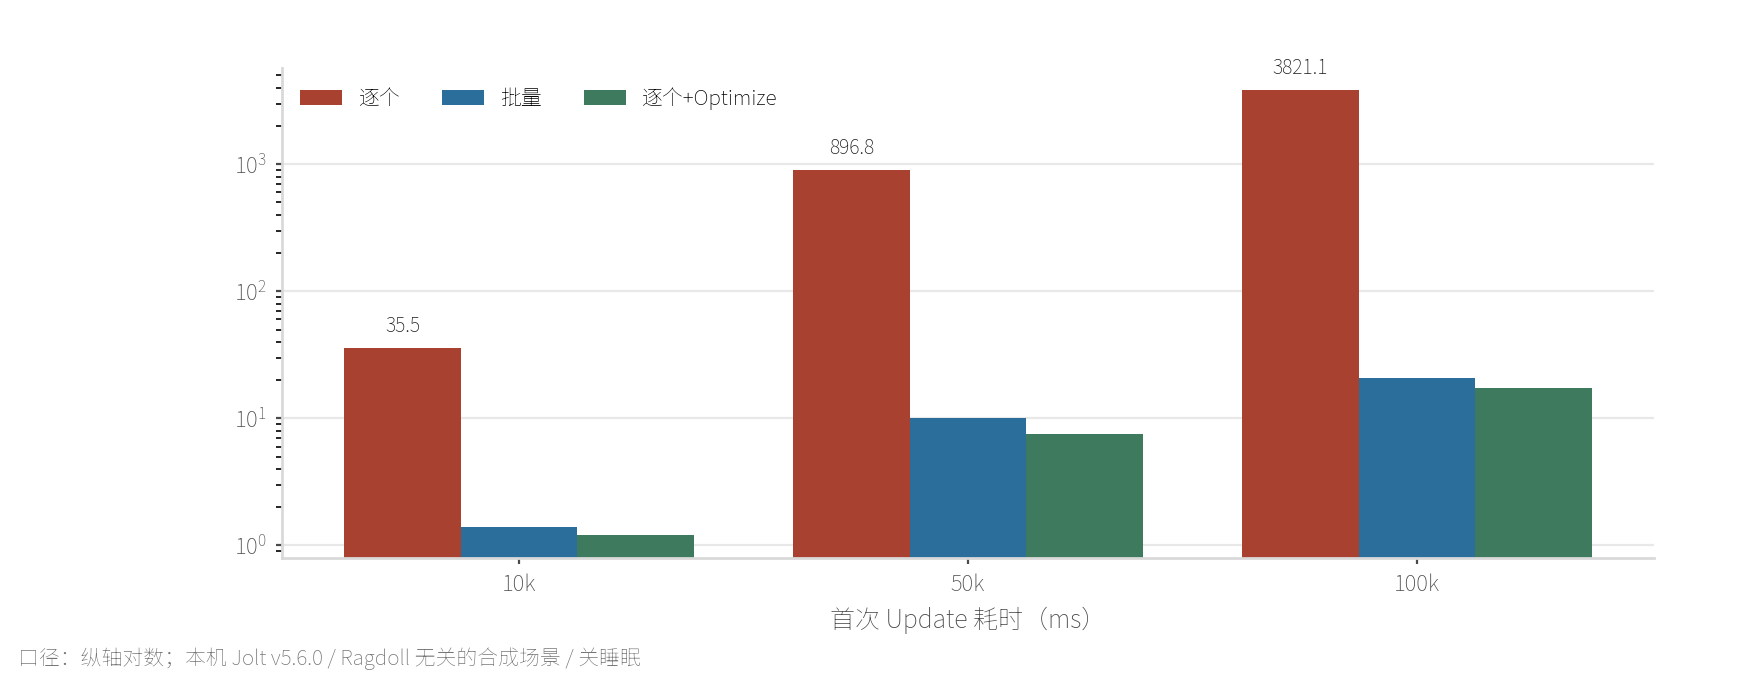
这组数字的读法是看两列的走势差,而不是看某一格的绝对值。批量那一列从 1.4 ms 到 20.7 ms,随规模大致线性增长,符合宽相查询成本的预期;逐个那一列从 35.5 ms 到 3821 ms,增长速度远超线性。两条线的分岔,就是"病态宽相"的量化形状。
把它换成倍数:
| 规模 | 逐个 ÷ 批量 |
|---|---|
| 10,000 | 25× |
| 50,000 | 89× |
| 100,000 | 185× |
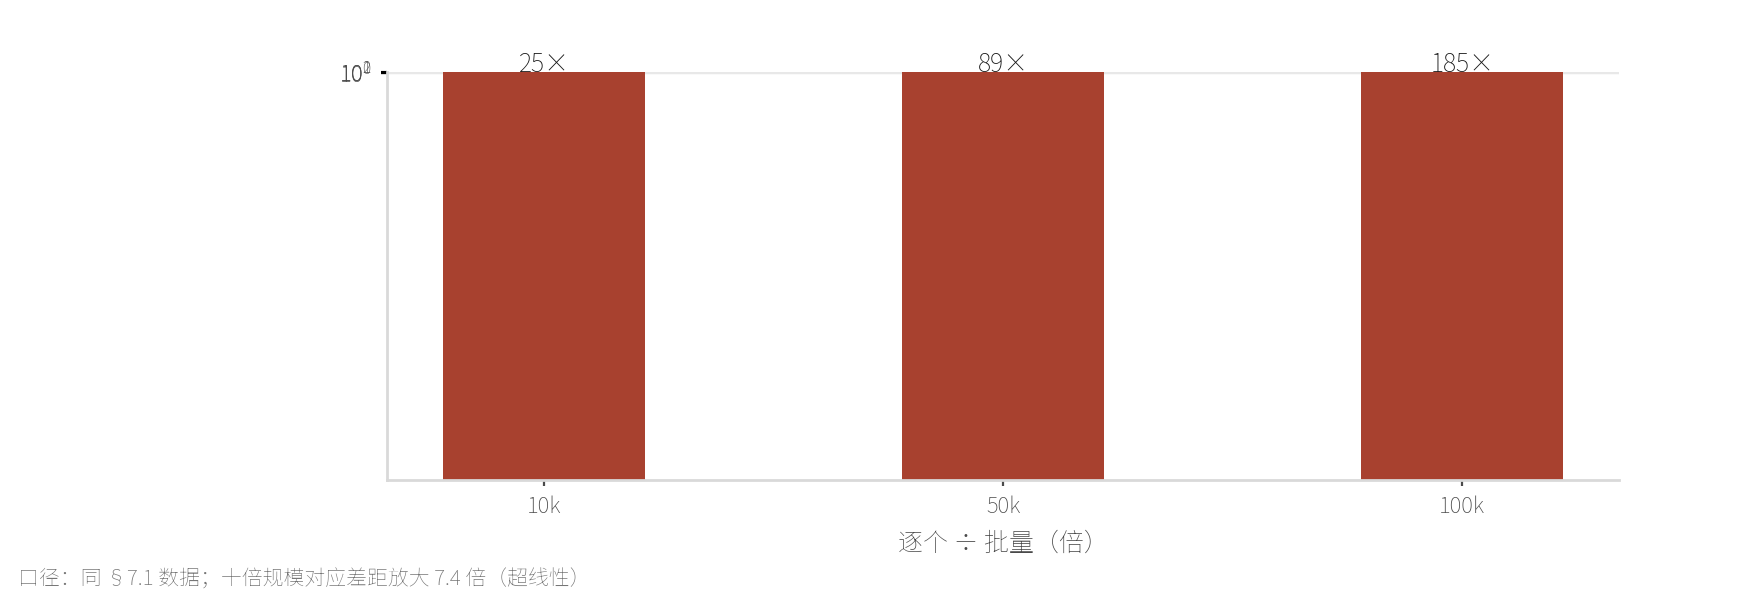
把倍数单独列出来,是因为它比绝对毫秒更稳。换机器、换编译器,两组绝对值都会变,但"逐个的代价随规模超线性放大"这个形状不会变。这也是本篇最值得带走的一条结论:宽相质量的代价不是常数,它会随规模一起变大。
十倍的规模(1 万到 10 万),差距放大了 7.4 倍。 这不是"慢一点",是量级差异: 10 万个刚体逐个插入后,光第一次 Update 就要 3.8 秒,在 60 帧的游戏里,这一帧直接卡死。
原因在官方的原话里:逐个插入会让宽相树长成病态形状(深度大、不平衡), 而宽相每帧要遍历这棵树,于是代价转嫁到了后续每一次查询上。
7.2 插入本身:批量反而更慢
OK,如果只看插入那一步,结论完全相反:
| 规模 | 逐个 | 批量 |
|---|---|---|
| 10,000 | 3.3 | 4.4 |
| 50,000 | 18.4 | 23.8 |
| 100,000 | 35.1 | 46.1 |
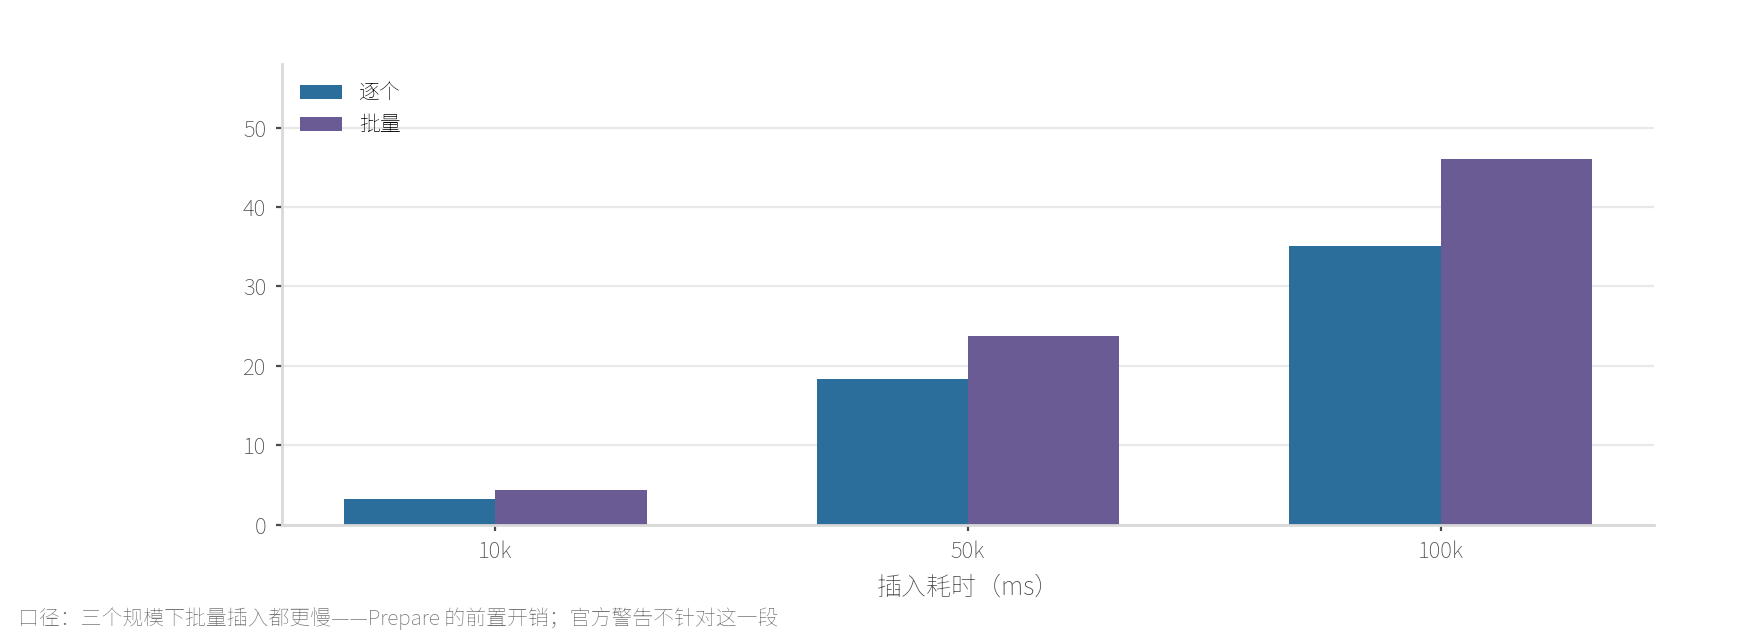
逐个插入比批量插入更快。 这不是测错,批量接口要先做一遍 Prepare(把刚体排序、打包成连续的插入批次),
这份前置工作本身要花钱,而单条插入是"来一个塞一个",省掉了这次遍历。
这条读数的价值在于它澄清了官方警告的指向:官方警告针对的是宽相质量, 不是"插入那一下的耗时"。把两者混为一谈,就会得出"批量更慢所以不该用"的错误结论。 真正的账要算总账,见 §7.4。
7.3 稳态会自己收敛吗
说白了,官方说病态宽相会持续"直到 Update 重建树"。那重建需要多久?本机把稳态 Update 拆成不同步数观察(50,000 刚体):
| 稳态步数 | 逐个(ms/步) | 批量(ms/步) |
|---|---|---|
| 20 | 56.69 | 15.46 |
| 100 | 24.85 | 16.10 |
| 200 | 20.16 | 17.15 |
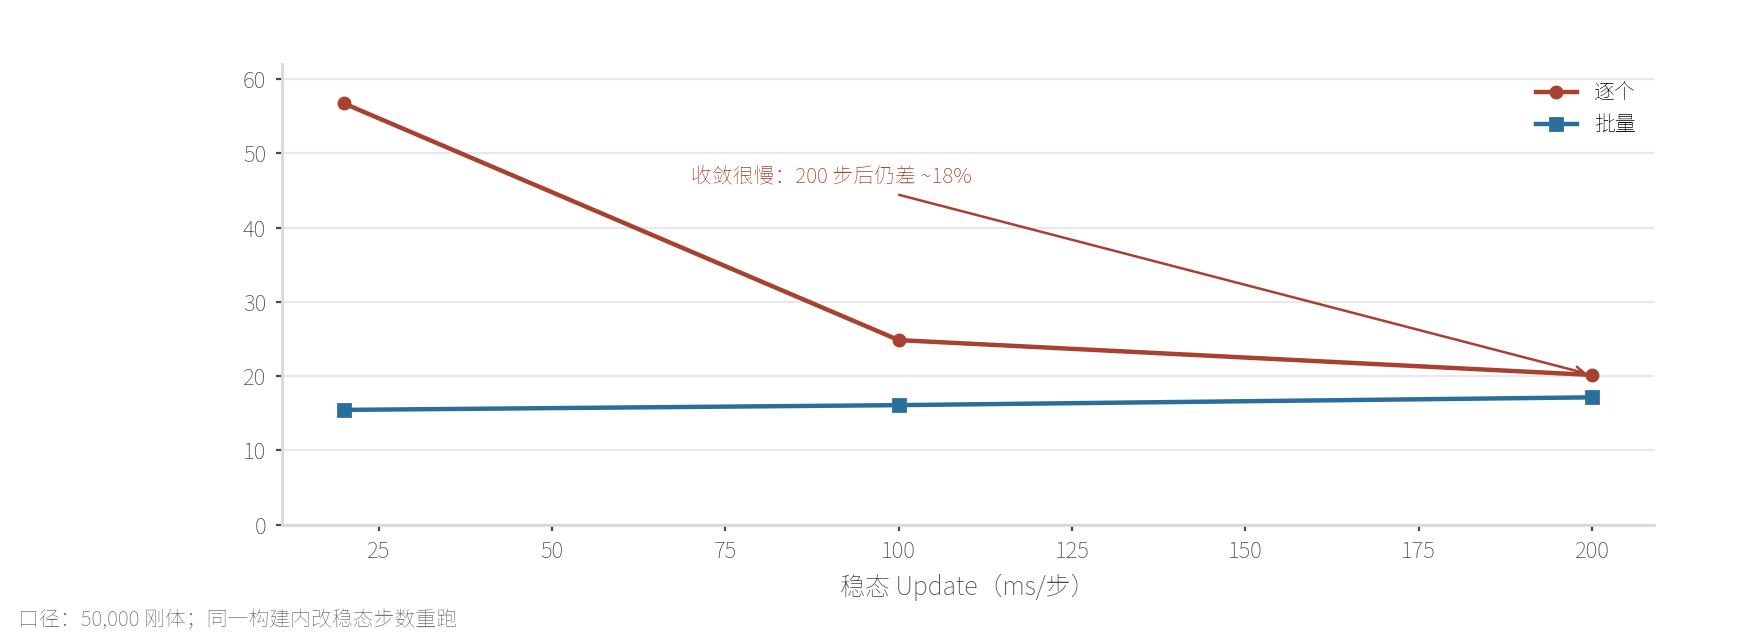
结论有三层:
第一,确实在收敛,官方的说法是成立的。逐个模式的稳态耗时从 56.7 ms 一路降到 20.2 ms,
说明树在后续 Update 中逐步被改善。
第二,收敛得很慢。 200 步、按 60 Hz 算就是 3.3 秒的仿真时间,仍比批量档慢约 18%。 在一块需要立即流畅的场景里,这 3.3 秒就是玩家能感知的卡顿。
第三,批量档的稳态也有轻微上升(15.46 → 17.15 ms)。这不是宽相的问题, 而是刚体下落过程中接触数量增加导致的正常负载变化,把它和"收敛"分开看,才不会被误导。
7.4 总账:OptimizeBroadPhase 的性价比
好了,把三段加起来看总账。
| 插入方式 | add | optim | update1 | steady | 合计 |
|---|---|---|---|---|---|
| 逐个 | 35.1 | — | 3821.1 | 152.2 | 4008.4 ms |
| 批量 | 46.1 | — | 20.7 | 31.9 | 98.8 ms |
| 逐个 + Optimize | 37.3 | 25.2 | 17.2 | 34.1 | 113.8 ms |
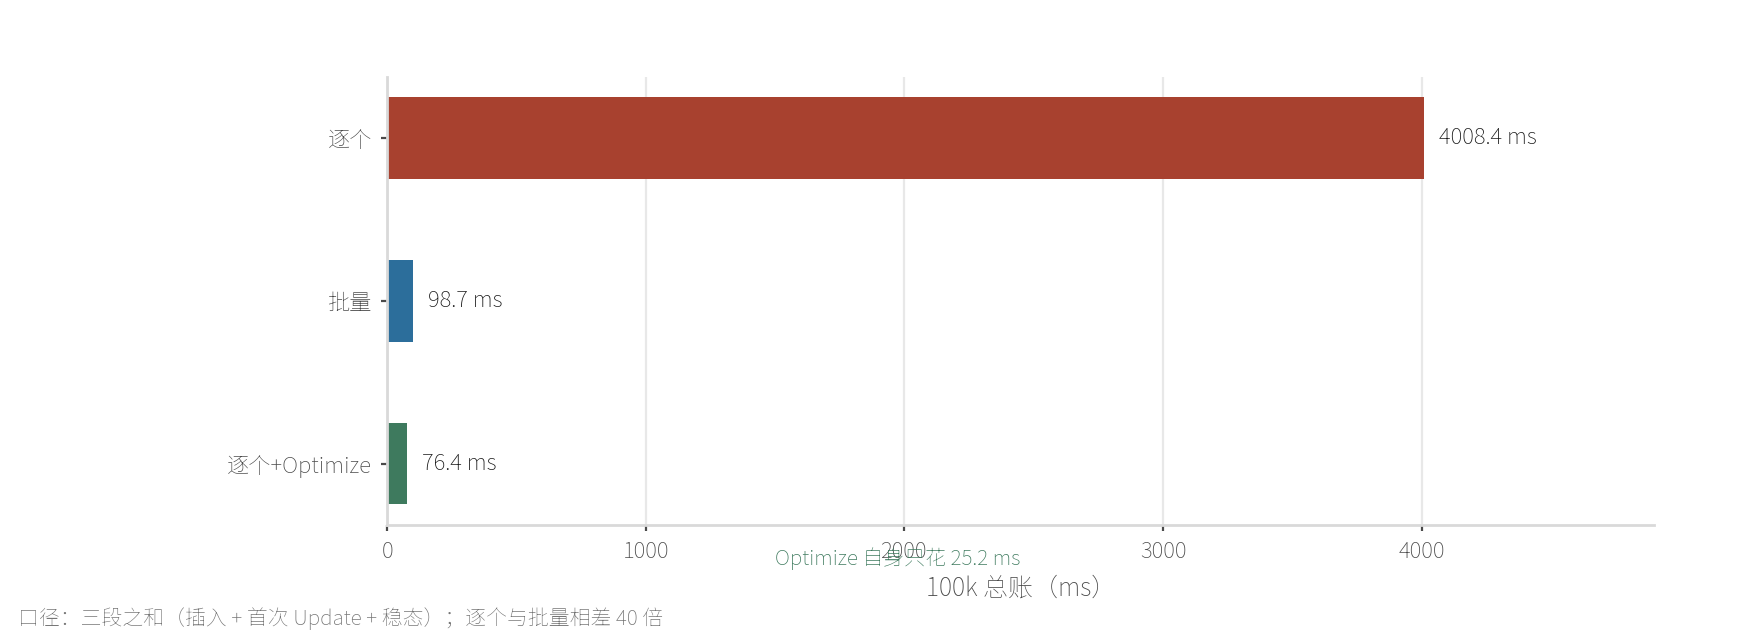
总账差距是 40 倍(4008 ms vs 98.8 ms)。
而更值得注意的是第三行:OptimizeBroadPhase 花了 25.2 毫秒,
就把首次 Update 从 3821 ms 拉回到 17.2 ms,代价不到收益的 1/200。
这给出一条很实用的工程结论:
- 新场景加载,一律走批量接口,这是官方的建议,本机数据支持它(40 倍总账差距);
- 如果代码里已经存在"逐个添加"的老路径(比如动态生成的关卡、玩家建造的系统),
不必重写整套流程,在插入完成后补一次
OptimizeBroadPhase(), 就能用极低的代价把宽相质量拉回正常水平; - 别只看插入耗时做优化决策。§7.2 那组读数会把你带向反方向。
7.5 自己跑一遍:基准的核心代码
OK,上面所有读数都出自一个不到两百行的程序。核心就三段,摘出来供大家复核: 这个基准的设计原理很朴素,把「插入」与「插入造成的后果」拆成两笔账, 因为官方那句警告指向的恰恰是后者,只量插入就会得出§7.2 那个反向结论。
//-----------------------------------【插入】---------------------------------------
// 描述:三种插入方式的对照(逐个 / 批量 / 逐个+OptimizeBroadPhase)
//------------------------------------------------------------------------------------------
double t0 = NowMs();
if (inMode == 1)
{
    //【1】批量:先准备,再一次性原子加入
    BodyInterface::AddState st = bi.AddBodiesPrepare(ids, inNumBodies);
    bi.AddBodiesFinalize(ids, inNumBodies, st, EActivation::Activate);
}
else
{
    //【2】逐个:来一个塞一个
    for (int i = 0; i < inNumBodies; ++i)
        bi.AddBody(ids[i], EActivation::Activate);
}
r.add = NowMs() - t0;

//-----------------------------------【首次与稳态 Update】---------------------------------------
// 描述:把"宽相质量的代价"从"插入本身的代价"里分离出来
//------------------------------------------------------------------------------------------
r.up1 = NowMs();
phys.Update(1.0f / 60.0f, 1, &temp, &jobs);      //【3】首次 Update:病态宽相最可能在这里爆出来
r.up1 = NowMs() - r.up1;

t0 = NowMs();
for (int i = 0; i < inSteadySteps; ++i)
    phys.Update(1.0f / 60.0f, 1, &temp, &jobs);  //【4】稳态:官方说"直到 Update 重建树",用这里量它
r.steady = (NowMs() - t0) / inSteadySteps;
下面对这段代码特别说明三处。
第一,EActivation::Activate 不能省。 作者第一版写的是 DontActivate,
结果所有 update1 读数都是 0.0 毫秒,因为未激活的刚体不施重力、也不参与碰撞检测,
整个仿真等于空转。读数全零时先怀疑"仿真有没有真的跑起来",而不是"机器太快"。
第二,mAllowSleeping = false 是有意的。 睡眠会让静止刚体退出仿真,
把宽相代价掩盖掉;本篇要量宽相,所以必须让它们全程活跃。这个开关的默认值其实是 true
(见 PhysicsSettings.h 第 123 行),
是我们在基准里显式关掉的,§7.6 说读数是"上界",根子就在这一行。
其中:三个场景参数的口径分别是,inNumBodies 是本次插入的刚体数(1 万 / 5 万 / 10 万),
inSteadySteps 是首次 Update 之后继续跑的步数(本篇取 200 步,用来观察宽相会不会自愈),
EActivation::Activate 决定新体是否立刻进入仿真。三者正交,改任何一个都不影响另外两个的口径。
第三,三段计时是分开计的。 如果把三段合成一个总数,就无法看到 §7.2 那条反直觉的读数 (插入本身批量更慢),而那条读数恰恰是理解官方警告指向的关键。
编译口径(本机实测):对着官方库编译时要注意三件事:
Jolt 需要 /Zc:__cplusplus(否则 MSVC 报 __cplusplus = 199711L,C++17 分支失效);
源文件含中文注释时要加 /utf-8(否则按本地代码页解析,可能破坏行结构);
官方库是静态运行时,链接方也要用 /MT 而不是 /MD。
完整复现步骤:
#【1】配置与构建官方库(PerformanceTest 目标即可,它会一并产出 Jolt.lib)
cmake -S <repo>\Build -B <repo>\Build\VS2022_CL_v2 -G "Visual Studio 17 2022" -A x64
cmake --build <repo>\Build\VS2022_CL_v2 --config Release --target PerformanceTest

#【2】编译本基准(宏与库一致)并运行
cl /std:c++17 /O2 /EHsc /MT /Zc:__cplusplus /utf-8 /I<repo> bench_body.cpp /Fe:bench_body.exe /link <repo>\...\Release\Jolt.lib
.\bench_body.exe 100000 30 3        # 规模 100000 / 稳态 30 步 / 重复 3 次
源码与四份原始输出已随本篇存档(见文末资源清单),结论不是让你信,是让你能复现。
7.6 这份数据的适用边界
说白了,这份数据还要划三条边界,免得被过度外推。
边界一,单机型。 全部读数出自本机(16 逻辑核 / MSVC 14.44 / 单精度 Release)。 换机器、换编译器、换精度,绝对毫秒数都会变。相对倍数(如 185×)比绝对值更稳,但也不是普适常数。
边界二,单场景。 场景是"一块地面 + N 个立方体铺开"。如果换成"逐步流式加载"的真实关卡 (每次只加几百个、分很多批),逐次插入的病态累积会温和得多: 因为树在被反复重建。本机这组数据量的是"一次猛插一大批"的最坏情形。
边界三,mAllowSleeping = false。 真实游戏里大部分刚体迟早会睡着,
睡着之后宽相查询量会大幅下降。本机全程保持活跃,量的是上界。
怎么用:把它当数量级证据,不当精确基准。 "逐个插入的代价在首次 Update 上、且随规模超线性放大",这条结论是稳的; "100k 就是 3821 毫秒",这条只在本文口径下成立。
7.7 三条可以直接落地的处方
好了,把这一章的全部读数收成三条可执行建议。
处方一,新场景加载:一律走批量接口。
这不是"更优雅",是 40 倍的总账差距(100k 规模:98.8 ms vs 4008.4 ms)。
如果加载流程现在是"读一个物体列表、循环 AddBody",把它改成
"先全部 CreateBodyWithoutID、再 AddBodiesPrepare/Finalize",这是本篇最值钱的一条改动。
处方二,已有逐个路径:补一次 OptimizeBroadPhase() 就能救回来。
很多项目的逐个插入藏在不好动的地方(动态生成的关卡、玩家建造系统、网络同步的增量物体)。
不必为了这条建议重写整条流程,在插入结束后补一次 OptimizeBroadPhase(),
本机实测 100k 时只花 25.2 ms,就把首次 Update 从 3821 ms 拉回 17.2 ms。
处方三,别用"插入耗时"为这条决策买单。 §7.2 那组读数(批量插入反而更慢)很容易被误读成"批量不划算"。 衡量方式应该是"从插入开始,到场景稳定后的总耗时",本篇把它拆成三段正是为了避免这个误判。
最后补一句适用提醒:这三条处方针对的是"一次插入一大批"的场景。
如果你本来就是"每次只加几个、分散在很多帧里",那 §7.6 的边界二已经说了:
病态累积会温和得多,OptimizeBroadPhase 也不必每帧都调(它本身有代价)。
先量自己的场景,再决定要不要改。
八、边界、演进与六条命题
8.1 六条可被检验的命题
OK,照例把本篇结论写成可被检验的命题,每条给出检验入口。
| # | 命题 | 检验入口 |
|---|---|---|
| 1 | 静态体不分配 MotionProperties,每体少付 192 字节 |
本机 sizeof,或读 Architecture.md L22 |
| 2 | 「能不能动」由 mMotionProperties != nullptr 决定,不是标志位 |
读 Body.h L69–70 |
| 3 | BodyID 是 23 位索引 + 8 位序号,上限 8,388,608 个刚体 |
读 BodyID.h L19–21 |
| 4 | 锁数组默认 2 × 硬件线程数,取 2 的幂后夹到 [1, 64] | 读 BodyManager.cpp 的 Init,或看 MutexMask 位宽 |
| 5 | 逐个插入后首次 Update 慢 185×(100k 规模) | 跑 ep03_bench,或按 §6.3 自建基准 |
| 6 | OptimizeBroadPhase 用约 25 ms 抹平 3.8 秒的代价 |
同上,对比第 1 与第 3 行 |
这六条覆盖了本篇的三层证据:第 1 到第 4 条是源码层的,读文件即可验证;第 5、6 条是实测层的,需要按 §7.5 跑一遍基准。没有一条需要相信本文,这是本系列从 ep01 起就定下的规矩。
其中:第 1、2、3、4 条只需读源码,第 5、6 条需要跑一遍基准。 把它们列出来的意思和前两篇一样:这篇讲的是"你可以这样去查",而非"Jolt 大概是这样"。
8.2 本篇不涉及什么(边界声明)
| 本篇给出的 | 不展开的部分 | 归属篇目 |
|---|---|---|
| Body 与 MotionProperties 的分离与内存账 | 形状如何算质量与惯量张量 | Shape 篇 |
| BodyID 的位布局与复用防护 | 宽相树的数据结构与遍历 | 第四篇 |
| 生命周期四步与所有权规则 | 约束的迭代求解 | 第九篇 |
| 批量插入的实测代价与补救 | 运动质量、CCD 的"偷时间" | 第十一篇 |
这张表的每一行都是一条"本篇到此为止"的界线。之所以要写这么细,是因为对象层与后面几篇的交界特别容易模糊。三态牵涉到 CCD 的运动质量,BodyID 牵涉到宽相的节点索引,批量插入牵涉到宽相树的形状。本篇只走到"接口把什么交给宽相",不走进宽相内部。
8.3 演进:与 Body 相关的版本变更
好了,对象层不是一夜之间长成现在这样的。把与 Body 相关的官方变更按版本排一下, 能看到这条设计线在往哪个方向走(年份口径:以官方 Release Notes / APIChanges 的分组为准)。
| 版本 | 与 Body 相关的变更 | 说明了什么 |
|---|---|---|
| v5.0.0 | 刚体可覆盖默认求解迭代次数;新增 SetUseManifoldReduction |
对象层开始承接"逐体可调"的求解参数 |
| v5.1.0 | AddForce / AddTorque 增加可选的激活参数 |
力接口与"是否唤醒"解耦 |
| v5.3.0 | 新增 MotionProperties::ScaleToMass(创建后改质量与惯量张量);修掉"逐个插入大量刚体导致树深 > 128、析构时栈溢出" |
记忆点的雏形:官方开始正面处理"逐个插入"的极端后果 |
| v5.4.0 | 新增 SetIsSensor / IsSensor;修 MoveKinematic 等在体未入系统时的行为 |
运动学刚体的接口被补齐 |
| v5.5.0 | 新增 JPH_TRACK_SIMULATION_STATS(逐刚体统计,可选编译) |
对象层开始提供可观测性 |
| v5.6.0 | 新增 Body::ApplyBodyCreationSettings(创建后改参数);修正运动学刚体被并入同一模拟岛导致岛偏大的问题 |
创建期与运行期的边界在松动 |
三处值得点出来的趋势:
第一,创建期的决策在变少。 v5.3 的 ScaleToMass 与 v5.6 的 ApplyBodyCreationSettings
都在把"原先必须在建体时定好的东西"挪到运行期。
但注意:本篇讲的 mAllowDynamicOrKinematic 没有被这条趋势覆盖:
因为它是"内存布局"层面的决策,不是"参数值"层面的。这条界线大概会长期存在。
第二,官方确实在意"逐个插入"这个坑。 v5.3 那条修复(树深 > 128 会栈溢出)与
Architecture.md 里那句"极端情况下会 std::abort"是同一件事的两个版本。
说明 §5 量的是官方修过、还在文档里反复警告的真实风险,并非假想问题。
第三,可观测性在增加。 v5.5 的逐体统计开关意味着官方承认: "哪个刚体在吃性能"这个问题,光靠总览数据答不了。 这与本系列"自跑优先"的做法是同一个逻辑。
8.4 小结:对象层的四条设计原则
说白了,把本篇读到的零散结论收成四条可以直接搬走的原则。
原则一,把"只有一部分对象需要的字段"切出去。
Jolt 用 MotionProperties 做到这一点,代价是"能不能动"这件事变成了创建期的决策(§1.6)。
判断标准很简单:这类字段在目标场景里的覆盖率是多少? 覆盖率低(如静态体)就切出去;
覆盖率接近 100% 就不值得切,多一次解引用换不来内存收益。
原则二,用句柄而不是裸指针来引用对象。
BodyID 的 32 位里,23 位定位、8 位防呆(§2)。这条原则不只适用于物理引擎:
任何"对象会被销毁、而引用可能残留"的系统,都值得考虑带世代号的句柄。
原则三,让危险的用法在结构上不可表达。
不能 new/delete、必须走四步生命周期、Update 期间不能加删:
这些限制看起来繁琐,但它们把"用错"的空间压到了最小(§3)。
对照本节 §4.2 的因果链:这些限制不是教条,是从"对象被多处按索引引用"推出来的。
原则四,接口的粒度要匹配数据的规模。 单条与批量两套接口并存,是在承认"这两种规模的代价结构完全不同"(§5),谈不上冗余。 判断标准:你的操作频率是不是集中在"一次来一大批"? 是的话,一定要有批量路径。
这四条原则,下一篇就会用上第一条与第二条的对立面:宽相那棵树: 它恰好是一个"字段无法切出去、访问模式又极度密集"的结构, 所以它必须用完全不同的手法来解决(双树、无锁扩张、后台重建)。
8.5 本篇的三层证据,与它们的分工
OK,最后交代一下本篇的证据结构,这套分工从 ep01 起就固定了下来。
| 层 | 回答什么 | 本篇用到的 |
|---|---|---|
| 官方层 | 作者说这个设计是做什么的 | Architecture.md 的三态、生命周期、批量警告;源码头注释 |
| 源码层 | 代码实际怎么实现的 | Body.h 的指针判空、BodyID 的位掩码、BodyManager.cpp 的锁数量算式 |
| 实测层 | 在真机上跑出来是什么 | sizeof 内存账 + 原创基准的三段耗时 |
(Architecture.md 与源码的对应关系见 Jolt/Core/JobSystem.h。)
这套分工也是本系列的写作纪律:每一句结论都要能指到它出自哪一层。如果一句话既像官方口径又像实测结论,那它通常两边都不牢,要么是转述走了样,要么是数字没有口径。
三层分开说,是为了避免把三者混成一句。 举个本篇的具体例子:
官方说:"逐个添加会导致低效的宽相。" 源码说:逐个添加走的是"单条插入"路径,批量走的是"先准备再一次性加入"。 实测说:100k 规模下,代价差在首次 Update 的 185 倍上,而不是插入本身(批量插入反而慢 11 ms)。
如果只保留官方那半句,读者拿不到量级;只保留实测数字,读者不知道官方为什么这么建议。 三层合起来,才是完整的一句。
8.6 下篇预告
下一篇我们跟着宽相走:几十万个刚体的 AABB 怎么在每帧被快速筛掉。
QuadTreeExample.png 那张官方图我们会正面打开,讲清 Jolt 那棵"无锁双树"为什么要那么设计:
以及本篇 §5 里反复出现的"病态宽相",到底病在哪里。
相关链接
- 上一篇:【Jolt Physics 3D】(二) 一次 step 的流水:Update 里到底排了哪些活 https://yyy3d.online/blog/jolt-physics-ep02-step-pipeline/
- 下一篇(预告):【Jolt Physics 3D】(四) 宽相:QuadTree 的无锁双树
- Jolt Physics 仓库:https://github.com/jrouwe/JoltPhysics
- 本机实测数据与基准源码:https://yyy3d.online/blog/jolt-physics-ep03-body-motionproperties/
资源清单
官方源码与文档(Jolt 仓库,MIT;以下均给出 v5.6.0 的 raw 地址,行号已从本机源码逐条核对)
- Docs/Architecture.md , 三态/生命周期/批量警告/锁数组(L22、L37–42)
- Jolt/Physics/Body/Body.h , 三态判定与 CanBeKinematicOrDynamic()(L61–70)
- Jolt/Physics/Body/MotionProperties.h , 「1-on-1 relationship」(L27)
- Jolt/Physics/Body/BodyInterface.h , 批量三件套与警告(L96–133)
- Jolt/Physics/Body/BodyManager.h , 锁数组与 MutexMask(L179–189)
- Jolt/Physics/Body/BodyManager.cpp , 锁数量的算式
- Jolt/Physics/Body/BodyLockInterface.h , 两副面孔(L16/57/77)
- Jolt/Physics/Body/BodyLock.h , RAII 锁族
- Jolt/Physics/Body/BodyID.h , 位布局(L19–21、L44–46)
- Jolt/Physics/Body/BodyCreationSettings.h , mAllowDynamicOrKinematic(L56/L99)
- Jolt/Core/MutexArray.h , 哈希锁数组(L11–12)
- Jolt/Physics/Body/MotionType.h , EMotionType 枚举
- Jolt/Physics/PhysicsSystem.cpp , OptimizeBroadPhase 与 Init
- Docs/ReleaseNotes.md / Docs/APIChanges.md , 与 Body 相关的版本变更
- 仓库主页 | v5.6.0 版本页 | Doxygen 文档
社区与对照(用于判断本篇的差异化空间)
- 官方文档镜像站 · BodyInterface 参考页
- 社区拆解:Working with bodies · 线程安全与锁
- NVIDIA PhysX 刚体类层次 , 对照:PxRigidBody 的继承式设计
- Rapier 的句柄式设计 · Rapier 刚体创建 , 对照:与我们本篇的 BodyID 同思路
- Jolt / PhysX / Bullet 综合对照
- 百万级碰撞体的 broadphase profiling , 旁证:批量增删是 broadphase 成本集中处
本机产物(原创)
- evidence/bench_body.cpp + evidence/build_bench.ps1 , 基准源码与编译脚本
- evidence/bench_body_n{10000,50000,100000}_20261001.txt , 三档规模原始输出
- evidence/bench_body_n50000_steady200_20261001.txt , 收敛观测原始输出
With Best Wishes.