本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
题图 一条 64 字节的行的三种命运:同一行里两个热变量(伪共享)、各自独占一条行(隔离)、被填充撑成 128 字节(容量代价) @ 本系列绘制
本系列已发表篇目(全系列共 12 篇,分四波连载):
- ep01 对象布局、对齐与 padding:sizeof 的真相——第一波·布局与内存
- ep02 分配器解剖:malloc → jemalloc/mimalloc → pmr arena——第一波·布局与内存
- ep03 值语义的账:move/拷贝/SSO/emplace_back——第一波·布局与内存
- ep04 编译期账本:模板实例化与 -ftime-trace——第二波·编译器与链接器
- ep05 优化器的边界:UB、严格别名与向量化报告——第二波·编译器与链接器
- ep06 名字与符号:ABI、修饰、可见性、PLT 与 IAT——第二波·编译器与链接器
- ep07 链在一起:LTO 与 PGO 的收益从哪来——第二波·编译器与链接器
- ep08 分发的代价:虚函数、模板、variant 与类型擦除——第三波·运行时代价
- ep09 异常与 RTTI:零成本到底成不成立——第三波·运行时代价
- ep10 内存序与原子:seq_cst 在 x86 上免费吗——第三波·运行时代价
背景与边界:一条 128 字节的争论
好了,第四波的第一篇,主题是空间。
上一篇量的是"跨核看见什么"——内存序管的是可见性。这一篇换一个轴:管的是位置。同一个缓存行里坐着谁、谁需要独占一条行、把一个结构体拆成几个数组到底是赚是赔——这些问题的答案全落在字节的排布上,与指令无关,与线程同步也无关。
说白了,而这一篇要处理的第一件事,是中文技术圈里流传最广、也最容易被照抄的一组数字。
0.1 一句话结论先放这里
先把五条结论放前面,逐条都在本篇给出了本机读数:
- 「对齐」与「隔离」是两件事。
alignas(64)只保证起点落在 64 的倍数上,不保证两个变量不在同一条行里——本机实测:alignas(64)加在类型上,与完全不加对齐一样慢(4.61 对 4.20 ns/op,GCC);只有把alignas加到每个字段上才掉到 0.39 ns/op,差10.8 倍(MSVC 侧 16.9 倍)。 - 「填多少」不是教条,是硬件参数。 流传的三个数值——56 字节、64 字节、128 字节——分别出自 LMAX 的 7 个
long、标准常量的取值、以及 JVM 的@Contended。本机的读数是:代价在间距从 32 跨到 64 字节时骤降,再往上(128 / 256 / 512)没有任何进一步收益。 - 「SoA 比 AoS 快」只在特定访问模式下成立。 只读 1 个字段时 SoA 快 2.35×(GCC)与 2.49×(MSVC);但读满 8 个字段时,两者没有差别(比值 1.000 与 1.001)。交叉点在"访问 6 到 8 个字段之间"移动。
- padding 不是免费的。 为隔离 8 字节的计数器而把步长从 32 字节抬到 128 字节,单线程遍历慢 3.59×(GCC)/ 3.36×(MSVC),触及的字节从 128 MB 涨到 512 MB。填充买的是并行正确性,付的是单线程容量。
- 线程越多,伪共享的相对代价越大。 2 线程时同行与隔离差 9.2×,4 线程 31.0×,8 线程 46.9×——两条曲线方向相反地张开。
0.2 实测环境
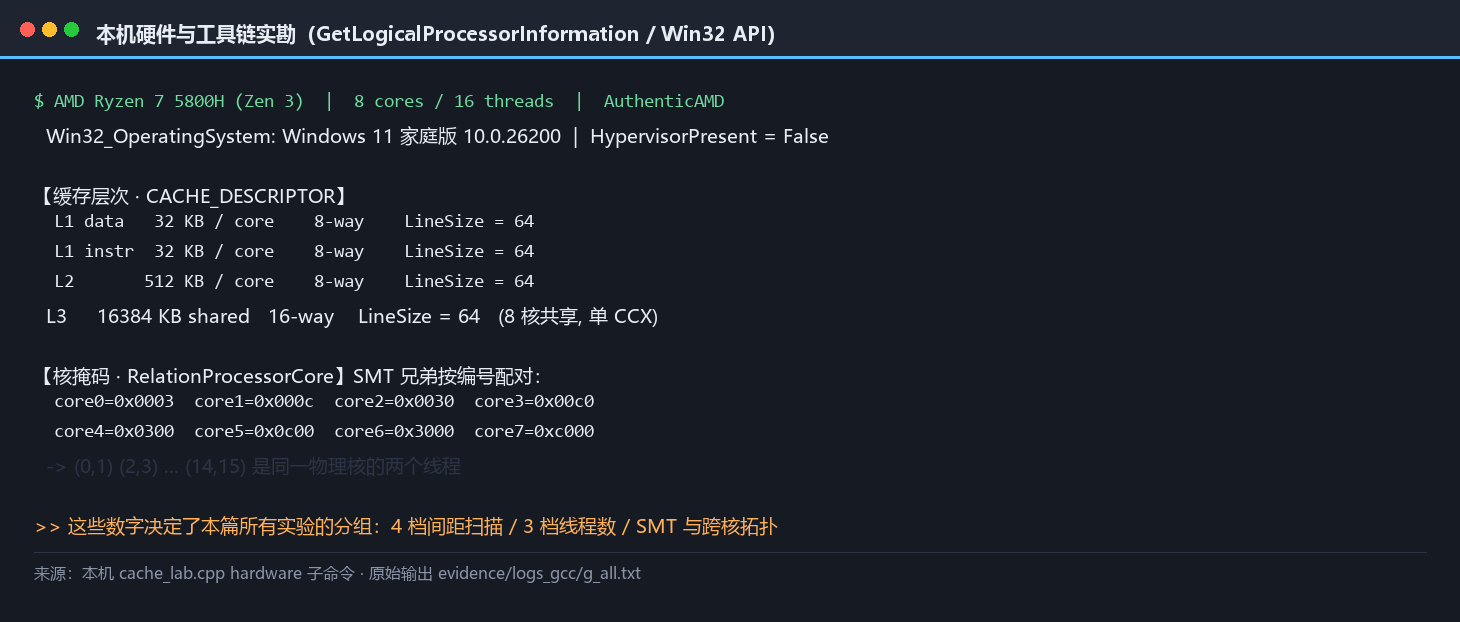
本机是一台笔记本:
- CPU:AMD Ryzen 7 5800H(Zen 3),8 核 16 线程
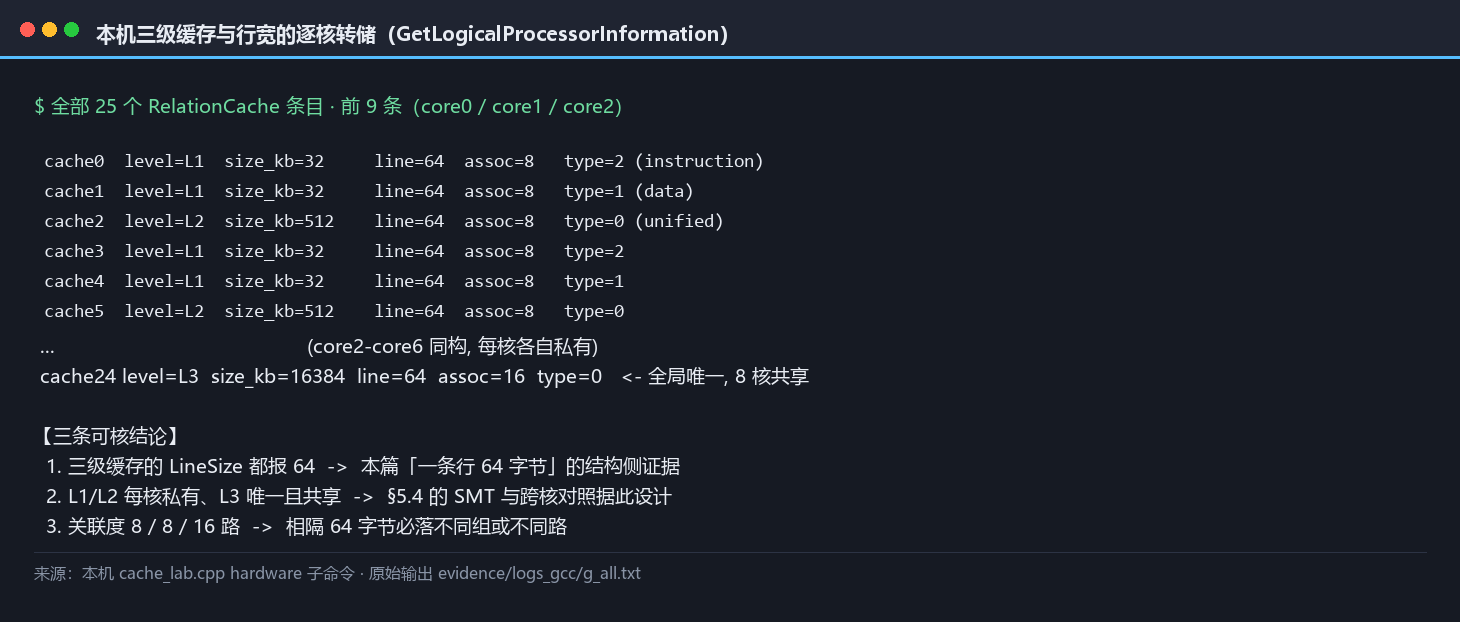
- 缓存:L1 数据 32 KB/核、L1 指令 32 KB/核、L2 512 KB/核、L3 16 MB(8 核共享),关联度 8/8/16 路
- 行宽:
CACHE_DESCRIPTOR.LineSize = 64(三级缓存都报 64) - 工具链:MSVC 19.44.35228 + GCC 16.2.0(MSYS2 ucrt64)
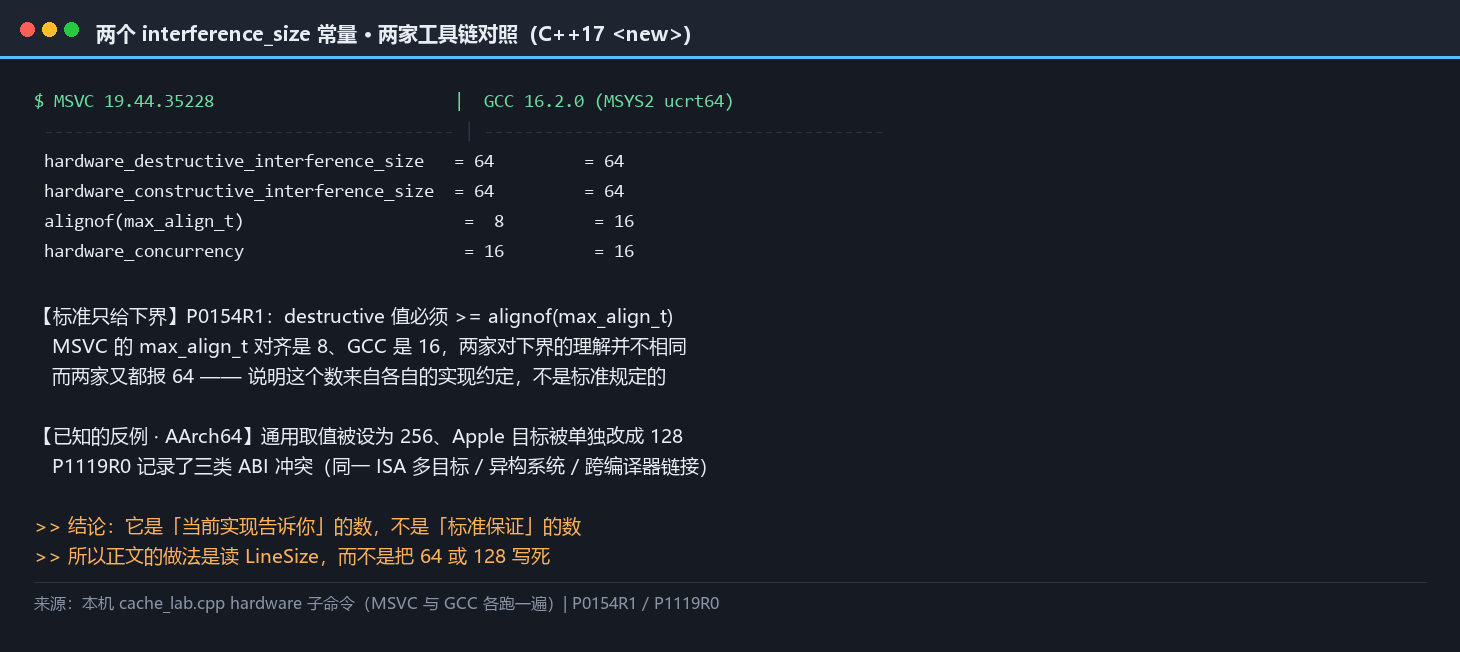
- 两个标准常量:两家的
hardware_destructive_interference_size与hardware_constructive_interference_size都是 64 - 一个容易被忽略的差异:
alignof(max_align_t)在 MSVC 上是 8、在 GCC 上是 16
最后那一条不是花边。它是"这个值该取多少"的争议源头之一——hardware_destructive_interference_size 按标准必须 ≥ alignof(max_align_t),而两家对这个下界的理解本身就不一样。
这张表里有两件事值得先记住:一是三级缓存的关联度与行宽(8 / 8 / 16 路,三级都报 64 字节),后面所有关于"行"的推演都建立在这个数上;二是 alignof(max_align_t) 的差异(8 对 16)——它不是细节,而是 §1.2 里那个"标准只给了下界"的争议来源。
0.3 本篇不涉及什么(边界声明)
这是本篇最硬的一条边界,先说清楚:
- 不给 cache-miss 事件计数。 本机的 Windows 确实暴露了硬件计数器——
xperf -pmcsources列出 17 个源,包含DcacheMisses、CacheMisses、DcacheAccesses、TotalCycles、InstructionRetired、BranchMispredictions。但采集需要管理员权限的内核日志器,本篇的会话是非管理员,起不来。所以本篇的界面只到端到端时间 + 布局转储,给不出"每条指令摊到几次未命中"。实验台写成了带可选硬件计数器开关的形式,通道一旦打通,同一批用例可以原样补采。 - 不给伪共享的地址级定位。 教科书上的证据是
perf c2c的 HITM 计数("跨核命中了被修改的行"),本机没有;而且perf-c2c(1)的手册明确写了 Zen 3 上不受支持(AMD 走的是 IBS)。所以本篇只能证明"填充前后时间差多少",不能给出"是哪条行、哪个变量"。 - 不做数据竞争检测。 MSYS2 的 g++ 16.2.0 没有
libtsan(实测链接期报cannot find -ltsan),本机也没有 Clang。数据竞争只能靠设计约束,不靠工具。 - 不讨论 NUMA。 Ryzen 7 5800H 是 8 核单 CCX、16 MB L3 共享,不存在跨 CCD 或跨 socket 的远端内存效应。所以本篇不做 NUMA,也不采用任何讲 NUMA 的外部图。
0.4 按需跳读
- 只想知道"我该不该 padding":读 §0.1、§三(对齐 ≠ 隔离)、§五(填多少)、§六(padding 的反击)、§九(判据)。
- 只想知道"AoS 还是 SoA":读 §四(交叉点),再回 §一 补层级与行的背景。
- 只关心并行正确性:读 §二(两种共享)、§三、§五,外带 §八(端到端能证到什么)。
- 想复核读数:§七(布局转储)、§八(测量口径)、§十(复现流程)给出了全部命令与原始日志位置。
0.5 这一篇与系列其他篇的接续
- 接 ep10:ep10 算的是"跨核看见什么"(内存序与可见性),本篇算的是"bytes 怎么摆"(位置与容量)。两篇合起来才是"多核代价"的完整两半。ep10 §8.3 曾用端到端时间间接观察到"缓存行争抢约 13 ns",当时只能标注"这是间接观察"——本篇要把它拆开:那笔钱里有多少来自行归属的迁移,有多少来自容量损失。
- 接 ep01:ep01 给了
sizeof/ 对齐 /-Wpadded的工具链口径,量的是"对齐的事实";本篇在同一批工具上量"对齐的收益"——而结论是:收益并不像传说中那样自动到手。 - 接 ep12:本篇 §四 的 SoA 结论是 ep12(自动向量化与手写 intrinsic)的前置——向量化能不能生效,第一道门就是访存连不连续。
0.6 为什么这一篇要按"访问模式"拆
言归正传,上一篇的写法是:把一个单词的答案("免费吗")拆成可分类的问题(load / store / RMW 三类操作)。这一篇沿用同一条方法,但拆的轴换成了访问模式。
因为"SoA 比 AoS 快"这句话和"seq_cst 免费"一样,是一个适用于一部分情况的答案:
- 如果代码只访问结构体里的少数字段,SoA 把不用的字段留在内存里,赢的是带宽;
- 如果代码要遍历所有字段,AoS 与 SoA 搬进来的字节数完全一样,这时比的是流数——AoS 一个连续流,SoA 八个并发流。
不拆开,就只能得到一个"适用于一半情况"的答案。§四 会把这句话变成一张 k = 1…8 的扫描表。
0.7 证据形态与读法
本篇的证据有三类,读的时候要分清它们各自能证什么。
第一类是本机实测:布局转储(sizeof / alignof / 成员偏移、MSVC 的 /d1reportAllClassLayout)、硬件信息转储、时序读数与扫描表。原始日志在 evidence/logs_gcc/ 与 evidence/logs_msvc/ 下,表里任何一个数字都能逐行回溯。这一类能证"在这台机器、这两套工具链上,代价是多少"。
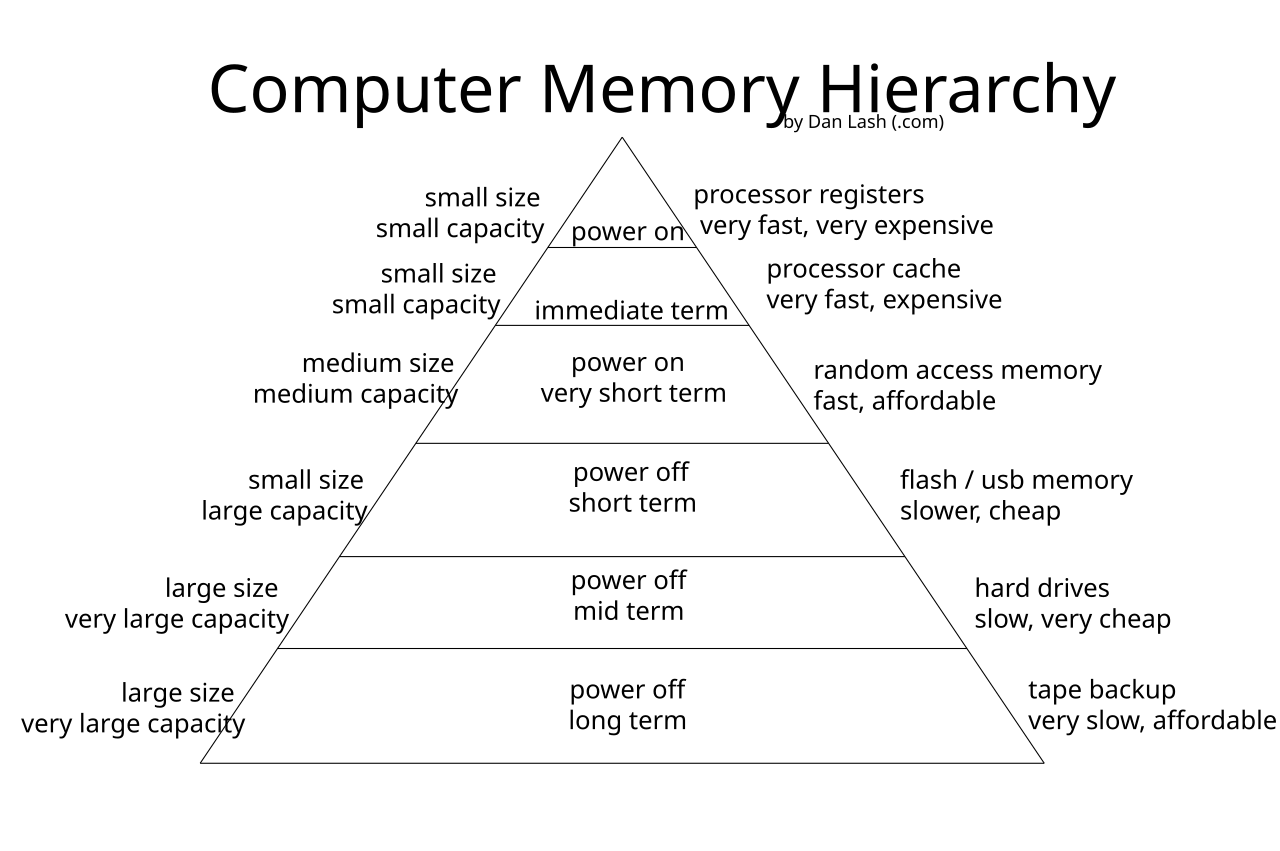
第二类是本机的外部图示:内存层级、组相联结构、多级缓存实例三张,用来把"行"落到具体硬件结构上。它证的是结构,不是代价。
第三类最特殊:本机拿不到的那部分。 硬件计数器、HITM 定位、TSan——这三样本篇都声明为不可得,并且不用"引用别人的数字"来填补。这是本系列从 ep07 起就定下的口径:宁可少一个维度,也不把别人的读数写成自己的。这一节不配图:证据边界是一条读法约定,写清楚就够了,配张图反而占掉一个本该给读数的图位。
一、层级与行:硬件到底给了什么
好了,机制部分从最小的一层说起:byte 是怎么被搬动的。
1.1 三级缓存与 64 字节的行
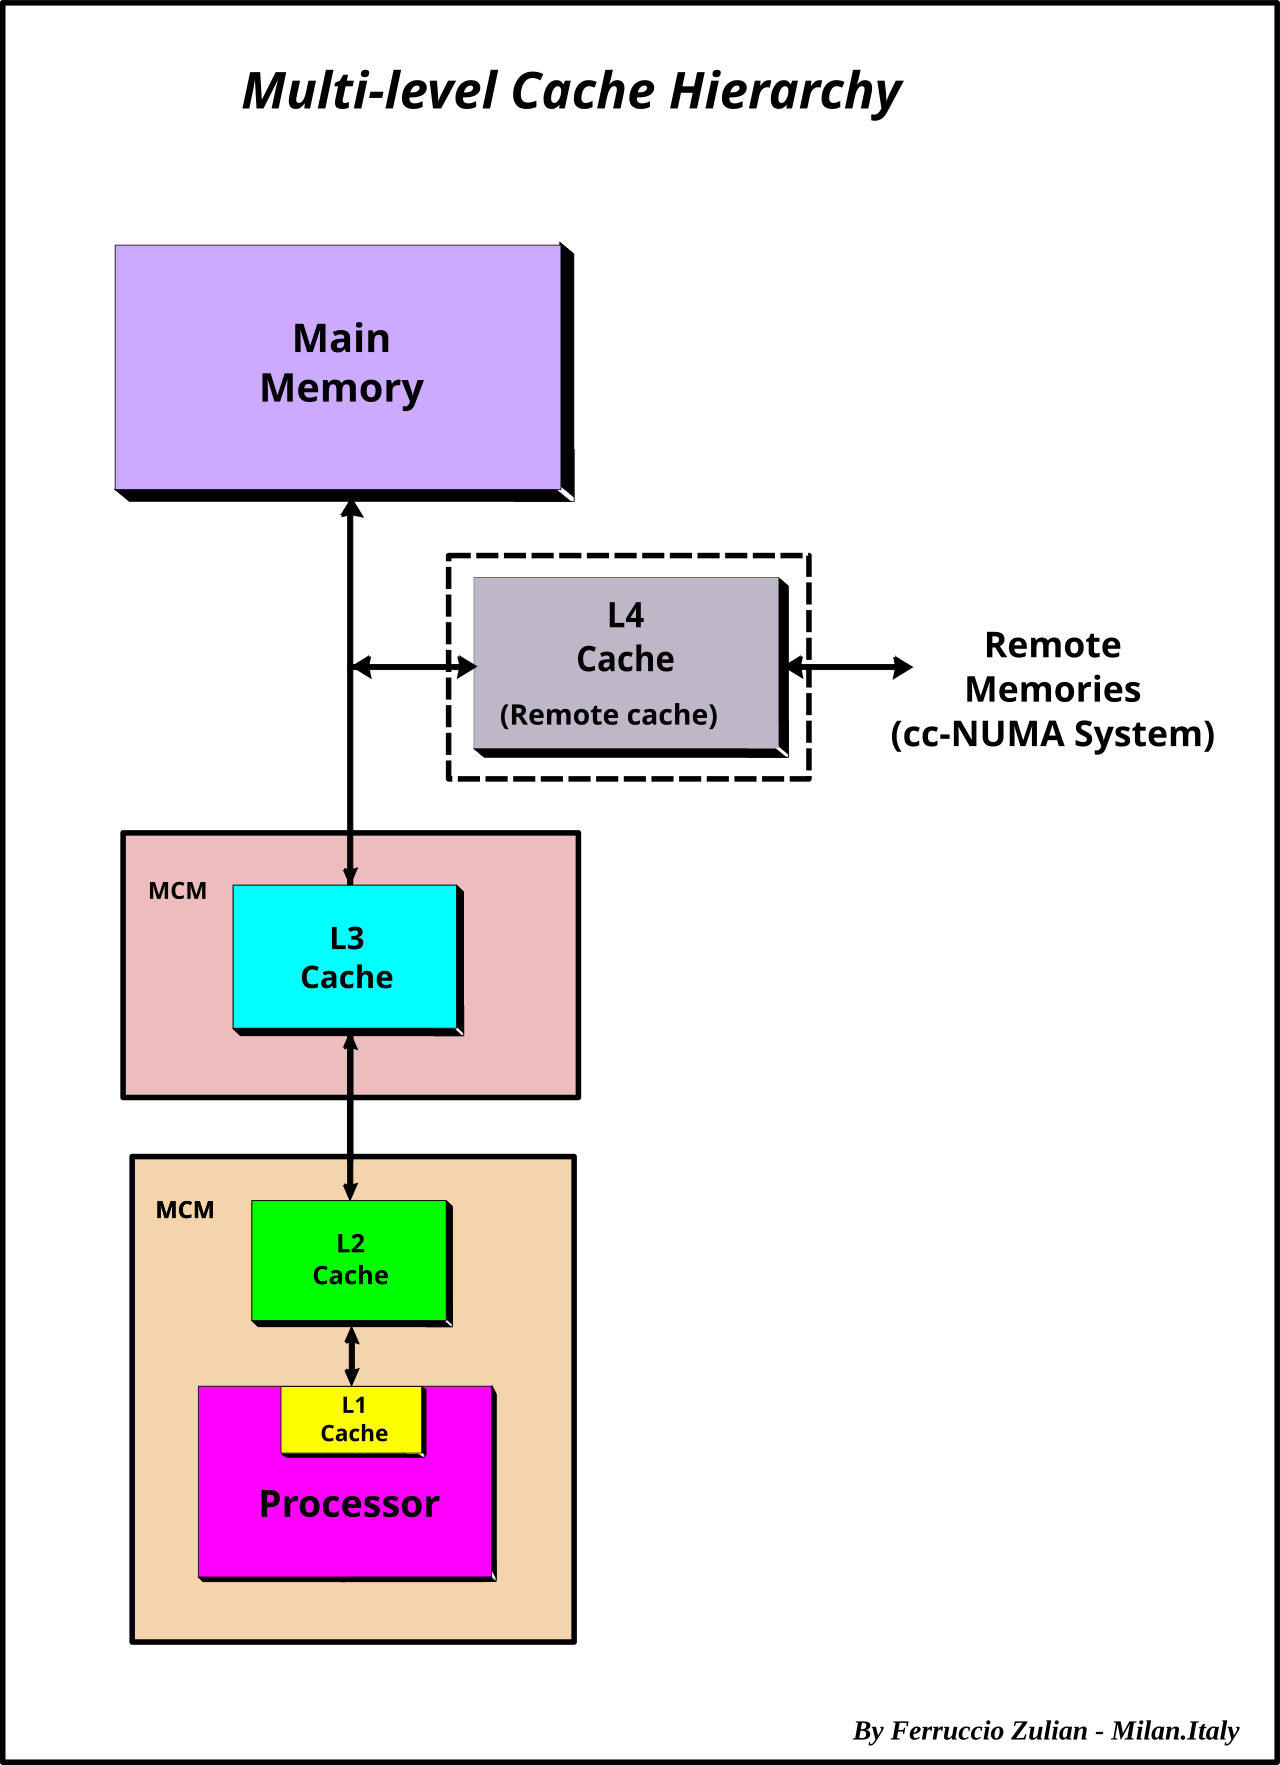
先从数据说起。现代 x86 的访存代价跨了四个数量级:L1 命中大约 4 个周期,L2 大约 12 到 14 个,L3 大约 40 个,到主存就是 200 个以上。这个梯度不是"越靠上越快"这么一句废话——它决定了优化该往哪个方向使劲。
说白了,但真正决定这一篇所有实验的,是搬运的最小单位。
CPU 不会一个字节一个字节地从内存取数。 它按缓存行搬:本机三级缓存的 LineSize 都报 64 字节。这意味着两件后果:
- 你只要 4 个字节,可能连带搬进来 64 个。 一条行里剩下的 60 个字节对这次访问毫无用处,但它占着带宽、占着容量。
- 一条行里两个变量,在硬件眼里是同一个东西的一部分。 硬件不知道它们是两个变量——它按行维护状态、按行做无效化与迁移。
第 2 条就是伪共享的全部根因。而破解它的办法,看上去很简单:把两个变量放到不同的行里去。
1.2 两个常量:标准给了两个名字,两家实现都是 64
OK,C++17 在 <new> 里加了两个常量,看上去正是为这件事准备的:
std::hardware_destructive_interference_size——"破坏性干扰尺寸"。用于隔离:把两个变量推开到这个距离,就不该落在同一行里。std::hardware_constructive_interference_size——"建设性干扰尺寸"。用于打包:希望被一起访问的数据放进这个尺寸里。
它们的来历是 P0154R1。标准同时给了一条约束:破坏性尺寸必须 ≥ alignof(max_align_t)。
说白了,本机实测:MSVC 19.44 与 GCC 16.2 两家,两个常量都是 64。
但请注意——"两家都是 64"不等于"标准保证了 64"。这两个常量从提案阶段起就背着 ABI 争议(P1119R0 记录了委员会的讨论:同一 ISA 不同目标、异构系统、跨编译器链接三类冲突都可能让取值不同;Clang/GCC 维护者当时明确 push back 过)。已知的反例就摆在台面上:AArch64 上通用取值被设成 256,Apple 目标被单独改成 128。
所以正确的读法是:它是一个"当前实现告诉你"的数,不是一个"标准保证"的数。 依赖它做跨平台的数据布局,等于把 ABI 兼容性押在编译器的默认值上——这也是为什么现实里更常见的写法是直接写死 alignas(64)。
1.3 组相联:一行落在哪一段
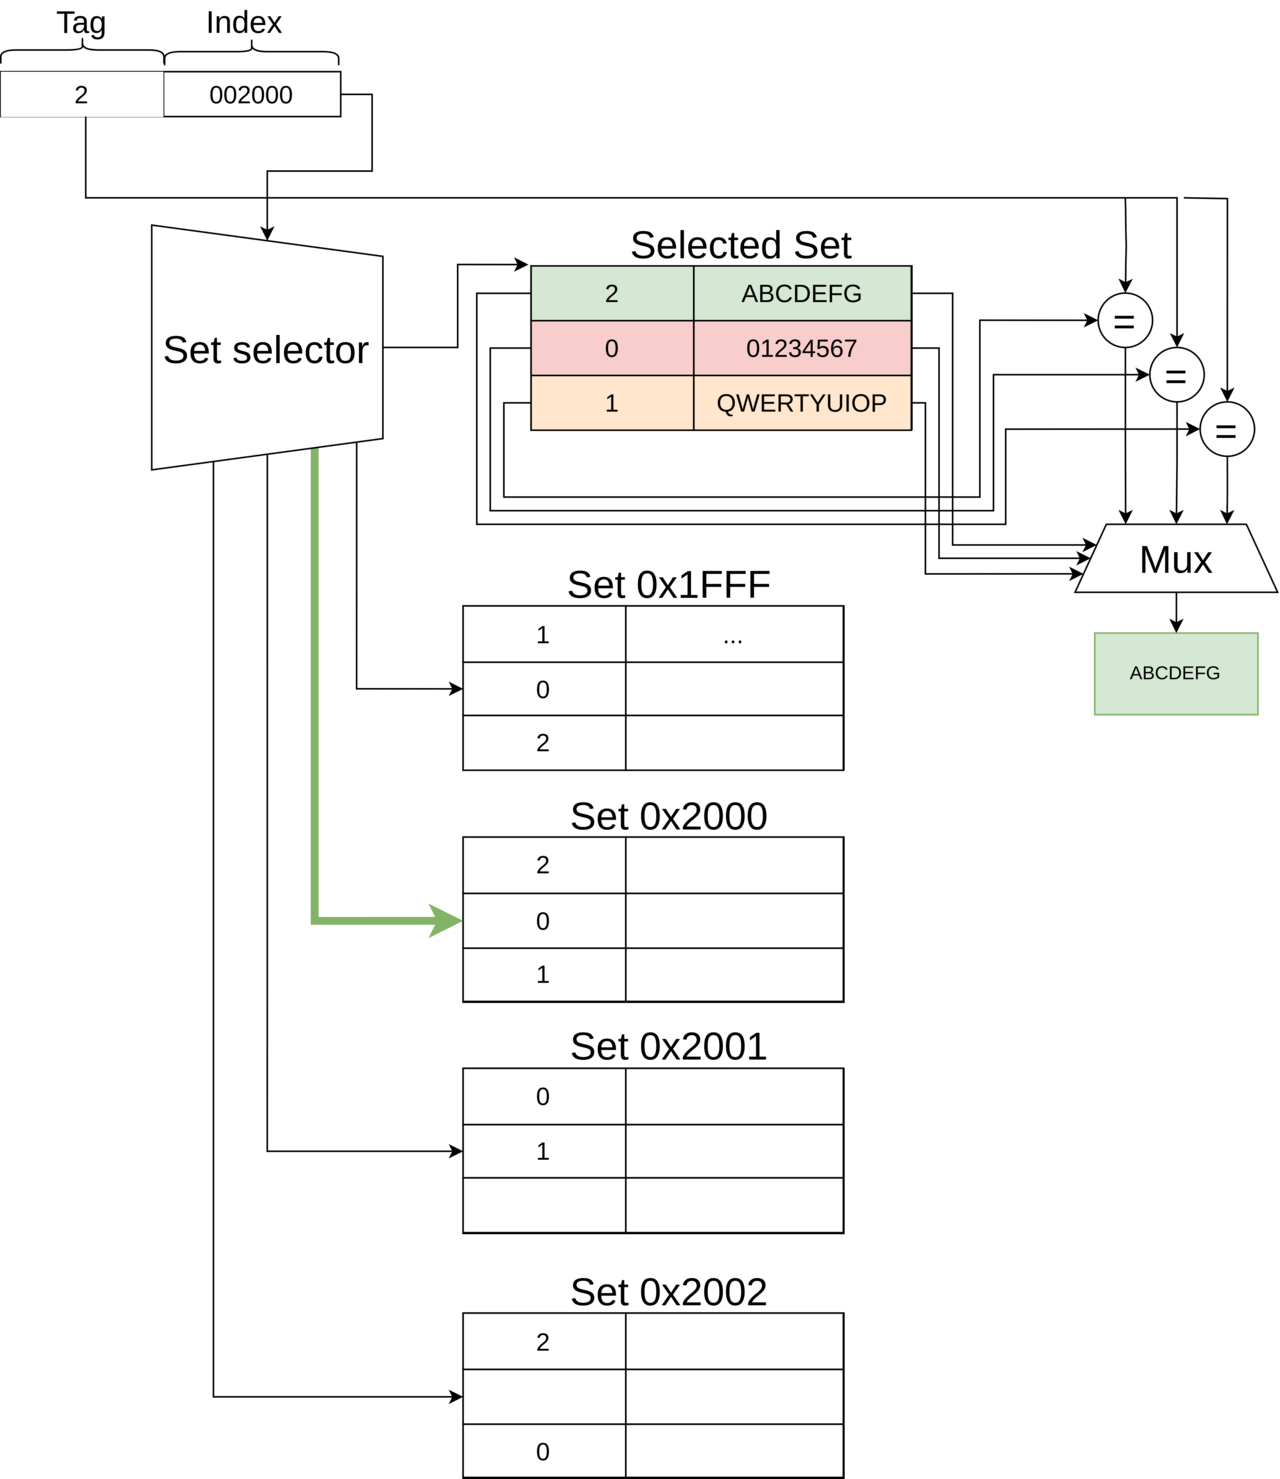
上面说的"行"在缓存内部并不是随便放的。现代缓存是组相联的:地址先按位切成三段——块内偏移(低 6 位,64 字节)、组索引、标记。低 6 位决定在行内的位置,中间的位决定去哪一个"组",组内几条"路"里哪一条被选中由替换策略定,高位标记用来确认命中。
这件事对本篇的实验有一个直接后果:两个地址相隔 64 字节,就一定落在不同的组(或同组的不同路),不会再共享一条行。§三 的间距扫描正是把这条结构性质测出来——间距从 32 跨到 64 的那一步,代价骤降 11 到 14 倍。
1.4 一次访存的下落路径
把上面两条串起来,一次 x[i].v[0] 的读取会发生什么:
先按地址算出它落在哪一行,去 L1 找;没中就去 L2;还没中就去 L3(本机是 8 核共享的 16 MB);再没中才去主存。每一次失败都会把整条行搬上来,而不只是那 4 个字节。
同时,如果这行是"被别的核改过的",本机还要走一致性协议把归属收回来——这一步就是"伪共享"付钱的地方,也是 §五 要量的东西。
写成一句话:你付的钱按"行"计,不按"字节"计。 这句话既是本篇所有优化的出发点,也是所有 padding 代价的来源(把步长从 32 抬到 128,就是让每次访问多买三行)。
这条路径还有一个容易被忽略的特点:每一级失败都按整条行结算。所以哪怕你只要 4 个字节,一次未命中也会把 64 字节搬上来——这个"按行计价"的规则,既解释了 §四 里 AoS 为什么白搬字节(拉进 32 字节只用 4 个),也解释了 §五 里填充为什么能起作用(把两个热变量分到两条行上)。
1.5 官方与厂商口径对得上
把三处官方表述放在一起,本节的结构结论就有据可依:
- Intel SDM 卷 3 第 11 章 "Memory Cache Control" 讲缓存管理与一致性(11.1 是"内部缓存、TLB 与缓冲区");
- AMD 的 EPYC 7003 调优指南给了 Zen 3 的组织方式:CCX(Core Complex)最多 8 个 Zen 3 核共享一个 L3,单 CCX 最多 16 个硬件线程、最多 4 MB 的 L2(即每核 512 KB)——这正是本机 8 核单 CCX、16 MB L3 的来源;
- Linux 内核的 False Sharing 文档给了最直接的方法论口径:用
perf c2c按 cacheline 报Load Local/Remote HITM,并且诚实地记了一句"修完之后热点可能转移,甚至没有提升"。
最后那句值得单独抄下来。它是官方的一句话:修伪共享不保证变快。§六 会从另一个方向补上这句——不修,也可能更快;乱修,一定更慢。
1.6 为什么正好是 64 字节
前面两次转储说的都是"这台机器"。动手之前先把一个容易被当成常识的问题问清楚:64 这个数是从哪来的?
标准里找不到它。C++ 标准只给了两个常量(§1.2),取值由实现决定;Linux 内核侧的 L1_CACHE_BYTES 同样是各架构自己配(P0154R1 的附录专门列了这件事)。所以 64 不是"规定的",是"当前这几家的约定"。
本机确认它生效的地方只有一个办法:量。§五 的间距扫描给出了时间侧的回答——两个计数器的间距从 32 跨到 64 的那一步,代价降了 11 到 14 倍;而再往上(128 / 256 / 512)没有任何进一步收益。这条阶梯的形状本身就说明了:本机生效的行宽界就在 64,不在 128。
换个平台这个数会变。AArch64 上通常报 128——Apple 目标的 hardware_destructive_interference_size 就是 128,Clang 的改动记录里能看到这个取值是按目标分开设的。
所以这一篇反复要用到的那句结论,写法应该是一个动作而不是一个数字:行宽要读出来(CACHE_DESCRIPTOR.LineSize),不要背下来。
1.7 本章判据(第一条)
- 判据:动手改布局之前,先问"这次访问按行要付多少钱"。如果一次循环只用到 4 个字节却跨了 32 字节的记录,那么你已经在为不用的字节付费了——这是 §四 的入口。
- 反判据:如果一段代码的数据量小到装得下 L2,布局基本不影响它。本机读数:8,192 个元素(256 KB)时,AoS 与 SoA 的比值是 1.000。
下一章先把"共享"这个词拆开——因为"两个线程碰了同一个东西"和"两个线程碰了同一条行上不同的东西",是两码事。
二、两种"共享":同一个变量 vs 同一条行
好了,上一章把"行"讲清楚了,这一章把"共享"这个词拆开。因为两个线程碰了同一个东西和两个线程碰了同一条行上不同的东西,在硬件眼里是同一件事,在逻辑上却是两码事。
2.1 真共享与伪共享:只差一个字,差在"行"上
- 真共享(true sharing):两个线程访问同一个变量。
- 伪共享(false sharing):两个线程访问同一条行上不同的变量。
说白了,前者的开销是必须付的——两个线程真要改同一个对象,就必须靠同步、靠一致性协议把顺序定下来,这笔钱买的是正确性。
后者的开销一分钱都不该付:两个变量在逻辑上毫无关系,甚至可能属于两个不相干的功能模块,只是碰巧成了邻居。硬件不知道它们是两个变量,它只按行维护状态——于是两个线程的写操作被硬件当成"抢同一条行",反复把归属从一边迁到另一边。
OK,判断方法简单到一句话:问这两个地址是不是同一个变量。不是,就是伪共享。
而伪共享最阴的地方在于它不出错。没有数据竞争、没有未定义行为、单线程测试全绿——只是慢。而且慢多少完全取决于两个变量在内存里的距离,这一点在源码里看不出来。
2.2 行归属的迁移:这笔钱到底花在哪
写操作要求独占。所以当核 A 写过行 X 之后,核 B 要写同一条行 X 时,硬件必须做一串动作:把 A 的副本作废、把行 X 的归属迁到 B、让 B 拿到可写状态。如果两个核交替写,这条行就在两个核之间来回搬——每一次搬动都要经过共享层(本机是 8 核共享的 16 MB L3)。
本机读数说得很清楚:
- 两个
long挤在同一条行里(偏移 0 与 4):4.2021 ns/op(GCC) - 两个
long各自独占一条行:0.3902 ns/op
差的 3.81 ns/op 就是"行归属反复迁移"的账单。而这个代价不是按访问次数计的,是按归属变更次数计——两个核各写各的计数器,逻辑上零交互,硬件看到的却是同一条行反复易主。
也正因为如此,线程数一多,情况会急转直下:§五 的扫描里,2 线程时同行与隔离差 9.2 倍,8 线程时差 46.9 倍。
2.3 从"哪条行"到"字节偏移"
言归正传,后面的实验全部建立在一个等式上:地址的低 6 位是行内偏移。
行号   = addr >> 6
行内位 = addr & 63
两个地址同行  ⟺  (a >> 6) == (b >> 6)
所以"两个变量是不是邻居"这个问题,在字节层面是可以直接算出来的。padding 的全部作用就是一件事:让两个热变量的行号不相等。
这段代码不复杂,但它解释了一个反直觉的现象——为什么"改了 8 个字节的对齐方式"能带来一个数量级的差别:因为在它之前,两个地址的 addr >> 6 相同。
它也把"邻居"这件事从直觉变成了可计算的对象:同一结构体里的两个字段是不是邻居,不再取决于你"感觉它们挨着",而取决于 (a >> 6) 与 (b >> 6) 是否相等。§三 的全部实验,本质上就是在改这两个数之间的关系。
2.4 判据(第二条)
- 判据:这段代码里有没有"两个线程各自高频写、且这两个变量地址相邻"的形态?有,就是伪共享的嫌疑对象。
- 反判据:如果两个线程读或写的是同一个变量,padding 一点用都没有——那是真共享,那笔钱必须付。给真共享加填充,只会白占内存(§六 会量出这笔白账)。
好了,判据有了,接下来看那个最容易被照抄的动作:加对齐。
三、对齐 ≠ 隔离:第一个元素的坑
好了,如果"伪共享"这一节让你记住了一个动作——把那两个变量推开——那这一节要告诉你,最常用的那个动作是错的。
3.1 对齐只保证起点,不保证独占
alignas(64) 的语义只有一句话:让对象的起始地址是 64 的倍数。它不承诺对象有多大,更不承诺这个对象独占一条行。
说白了,于是有两个长得很像、结果完全不同的写法:
写法一:对齐加在类型上。
// ASCII 注释:declared type is 64-byte aligned, but its fields are not isolated
struct alignas(64) TwoAlignedType {
    long a;
    long b;
};
OK,这个类型的 sizeof 是 64(对齐要求会强制 sizeof 是对齐的倍数),所以数组形式的实例确实是隔离的。但 a 和 b 的偏移是 0 和 4——它们在同一条行里。填充被放到了结构体的末尾,不是两个字段之间。
写法二:对齐加在每个字段上。
// ASCII 注释:each hot field gets its own cache line
struct TwoIsolated {
    alignas(64) long a;
    alignas(64) long b;
};
这时 sizeof 是 128,b 的偏移是 64——两个字段各自独占一条行。
差别的落点只有一处——你对齐的是"起点",还是"归属"。前者只影响第一个字节落在哪,后者才决定两个热变量会不会在同一行里抢。
言归正传,把这两种写法各摆三个实例出来,差别会变得很直观:类型对齐的那一列,三个结构体的起点都整齐地落在 64 的倍数上,但每个结构体内部的两个字段仍然挤在同一条行里;字段对齐的那一列,起点同样整齐,而每个字段各自占满一条行——两者在"起点"上完全一样,在"归属"上完全不同。
3.2 布局转储:填充跑到哪儿去了
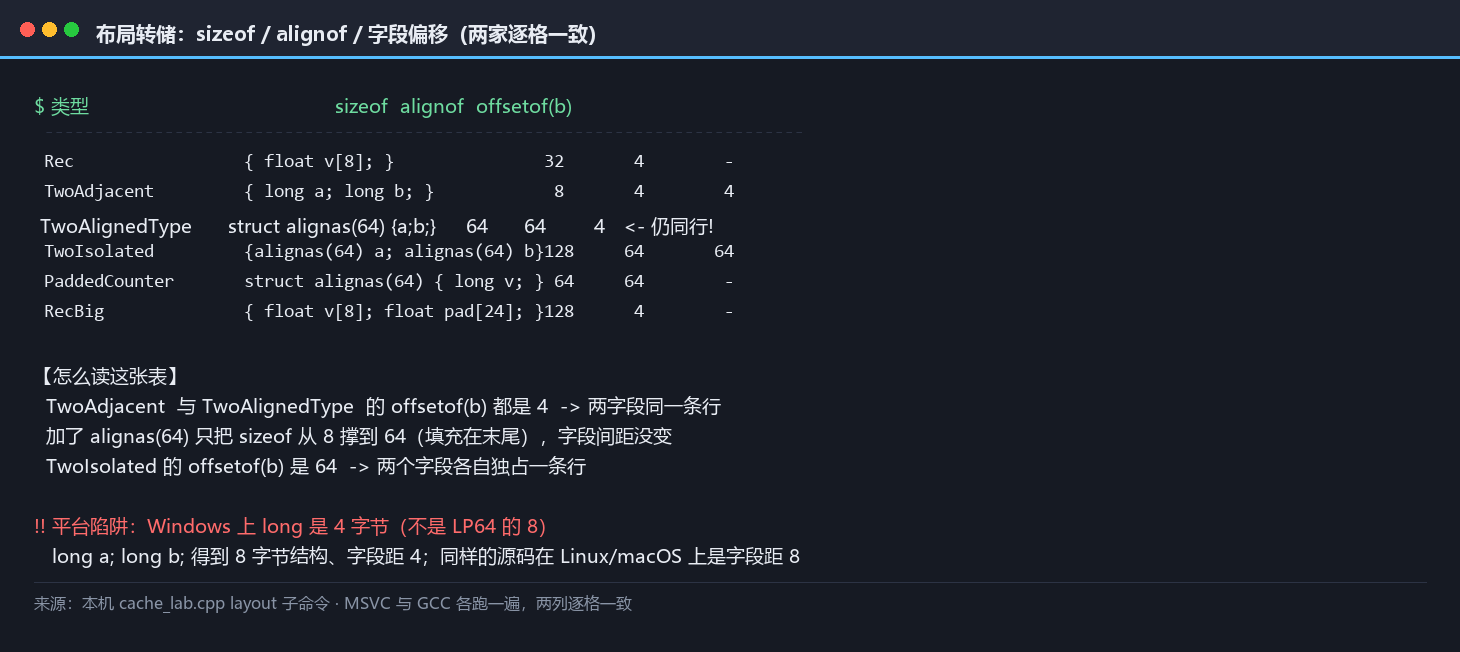
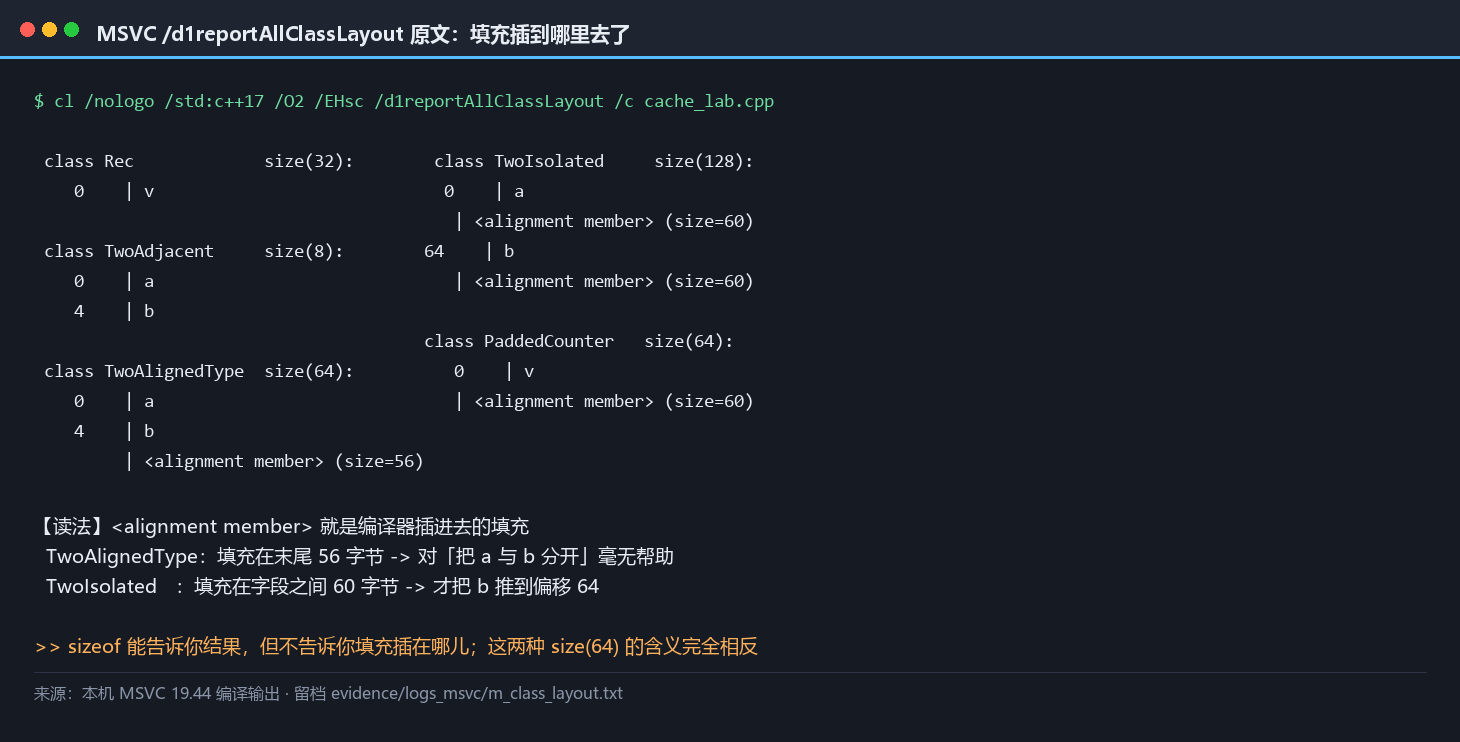
这件事用编译器的转储看最直接。MSVC 的 /d1reportAllClassLayout 把两个写法并排打出来(原文照抄):
class TwoAlignedType  size(64):
   0    | a
   4    | b
        | <alignment member> (size=56)      <-- 填充在末尾

class TwoIsolated     size(128):
   0    | a
        | <alignment member> (size=60)
  64    | b
        | <alignment member> (size=60)      <-- 填充在字段之间
<alignment member> 这一行是 MSVC 的用词:它把编译器插进去的填充显式标出来。第一张里那 56 个字节的填充待在末尾,对"把 a 和 b 分开"这件事毫无帮助——它只是把结构体的体积撑到了 64。
GCC 侧没有等价的可视化,但 sizeof 与 offsetof 的数字完全一致(off_b = 4 vs 64),两家在 ABI 层面是同一件事。
3.3 三档吞吐对照:对齐类型帮不上忙
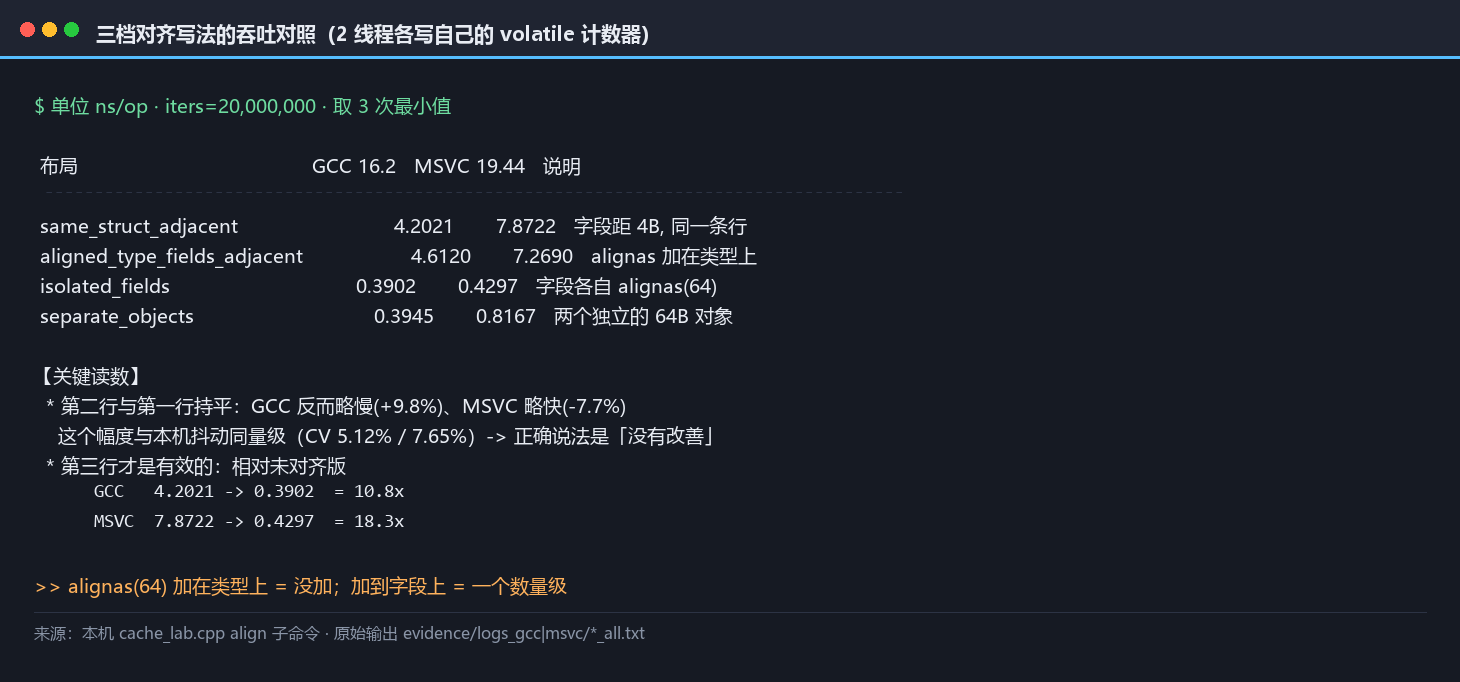
OK,把三种写法放进同一个用例:两个线程各自反复自增一个 volatile long(隔离用例则放到两条行里),单位 ns/op。
| 布局 | GCC 16.2 | MSVC 19.44 |
|---|---|---|
| 同结构、字段距 4 字节 | 4.2021 | 7.8722 |
| 类型对齐、字段距仍 4 字节 | 4.6120 | 7.2690 |
| 字段各自对齐、距 64 字节 | 0.3902 | 0.4297 |
| 两个独立的 64 字节对齐对象 | 0.3945 | 0.8167 |
看第二行。alignas(64) 加了,但两个字段的距离还是 4 字节——读数与"完全不加对齐"持平:GCC 上甚至略慢(4.6120 对 4.2021),MSVC 上略快(7.2690 对 7.8722)。这个 7% 到 10% 的差异与本机抖动同量级(同一用例连跑 5 次的变异系数是 5.12% 与 7.65%),所以正确的说法是"没有改善",不能读成"略有改善"。
第三行才是有效的做法:0.3902 / 0.4297。相对未对齐版:
- GCC:4.2021 → 0.3902,10.8 倍
- MSVC:7.8722 → 0.4297,18.3 倍
3.4 三种写法与它们的后果
把这一章缩成三个写法:
- 什么都不做:能不能撞上,靠运气。热点变量的位置由声明顺序和分配器决定。
alignas加在类型上:起点好看了,字段还是邻居。这一档在本机读数上与第 1 种没有区别——它是本篇最想让人记住的那一格。alignas加在字段上,或让每个对象整体独占一条行(struct alignas(64) { long v; },sizeof恰好 64):真隔离,快一个数量级。
而第 3 种不是免费的——它把每个对象从 8 字节撑到 64 或 128 字节。这笔账在 §六 单独算。
3.5 判据(第三条)
- 判据:写下
alignas(...)之后,回头核一遍被推开的是谁——是对象的起点,还是两个热字段的间距?只有后者能防伪共享。 - 反判据:如果一个结构体本来就是独占使用的(每个线程有自己的实例、且这个结构体只被一个线程碰),给它加对齐是纯粹的浪费。这句话在 §六 有读数支撑。
言归正传,位置讲完了,接下来换一个更常见的问题:数据该按行摆,还是按列摆。
四、AoS 与 SoA:交叉点在哪
位置这一半讲完了,接下来换一个每天都有人问的问题:数据该按"行"摆,还是按"列"摆。
4.1 两种布局的形状
同一个粒子集合,两种摆法:
AoS(Array of Structures)——一个结构体装下所有字段,结构体排成数组:
// ASCII comments only
struct Rec { float v[8]; };   // 32 bytes: 8 floats
Rec data[N];                  // AoS: one contiguous stream
SoA(Structure of Arrays)——每个字段自己一个数组:
float v0[N], v1[N], ..., v7[N]; // SoA: eight contiguous streams
好了,两边的总字节数完全相同(都是 32 字节一个元素)。差别只在"同一元素的 8 个字段"是挨在一起还是分散在 8 条流里。
4.2 访问模式 × 布局:把它拆成可分类的问题
说白了,「SoA 更快吗」这个问句本身缺一个变量。补上它,问题就分成两格:
| 只访问少数字段 | 访问全部字段 | |
|---|---|---|
| AoS | 拉进整条 32 字节记录,但只用其中 8 个字节 | 拉进 32 字节,8 个字节全用上 |
| SoA | 只拉需要的数组,不多搬一个字节 | 拉 8 条流,字节数与 AoS 相同,但流数从 1 变成 8 |
左列是 SoA 的主场:带宽赢了。右列是 AoS 的主场:流数赢了(硬件预取器最爱一个连续流;8 条并发流会挤压预取与 TLB)。
所以这一节的答案不是"SoA 快",而是"看 k"——k 是每轮循环真正命中的字段数。§4.4 会把 k 从 1 扫到 8,把交叉点找出来。
OK,这张表还有一句话要说清楚:两格的共同前提是"数据装不下缓存"。数据装得下的时候,左列的带宽优势与右列的流数优势都无从体现——§4.3 的读数会证明这一点(GCC 侧的比值是 1.000,两家布局一模一样)。
4.3 装得下 L2 时,两家布局完全一样
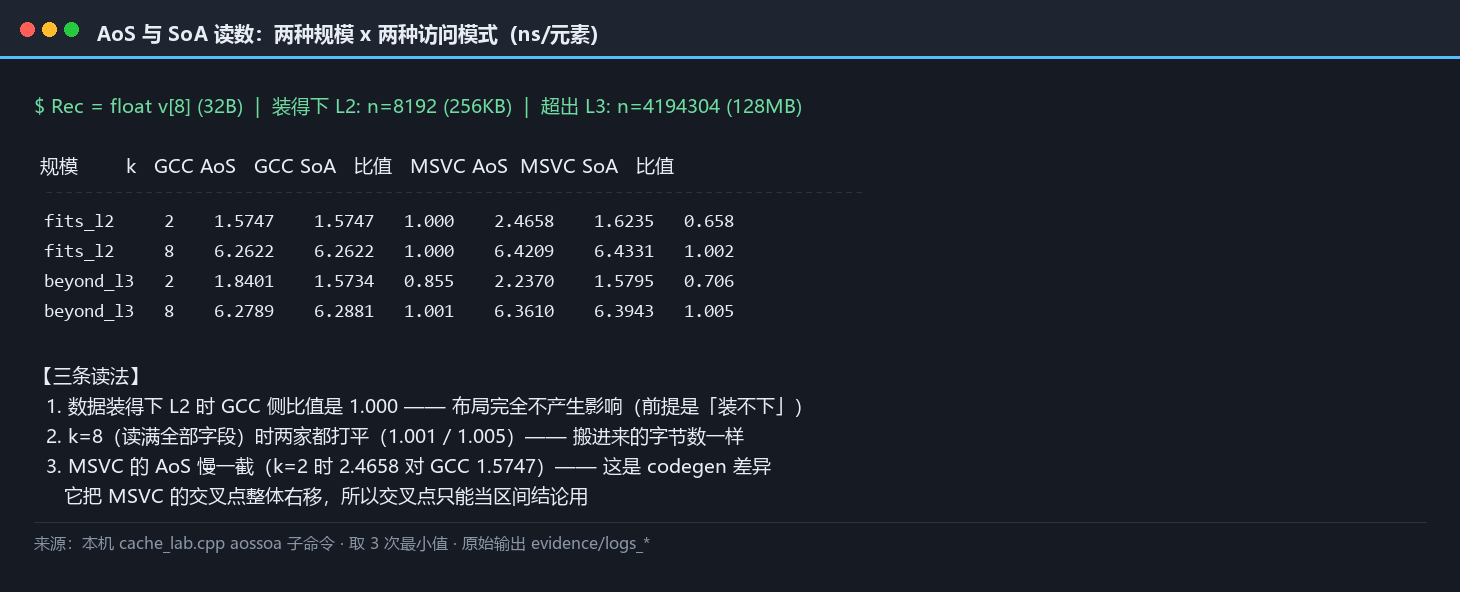
先说结论的边界。把元素数降到 8,192(32 字节一个,共 256 KB,装得进本机每核 512 KB 的 L2):
| 规模 | k | GCC AoS / SoA | MSVC AoS / SoA |
|---|---|---|---|
| 256 KB | 2 | 1.5747 / 1.5747(1.000) | 2.4658 / 1.6235(0.658) |
| 256 KB | 8 | 6.2622 / 6.2622(1.000) | 6.4209 / 6.4331(1.002) |
GCC 侧两个比值是 1.000——一模一样。
言归正传,这是一条很值得单独拎出来的读数:当数据装得下 L2 时,"布局"这个词根本不影响速度。 因为这时没有"搬多少字节"的问题,全都已经在上层缓存里了。所有关于 AoS/SoA 的说法,前提都是数据装不下。
MSVC 侧左边那格是 0.658(SoA 快 1.5 倍),因为 MSVC 的 AoS 循环本身生成得慢一截——这一点在 §4.4 会作为"读数里混着 codegen 差异"的证据专门交代。
4.4 交叉点扫描:k 从 1 扫到 8
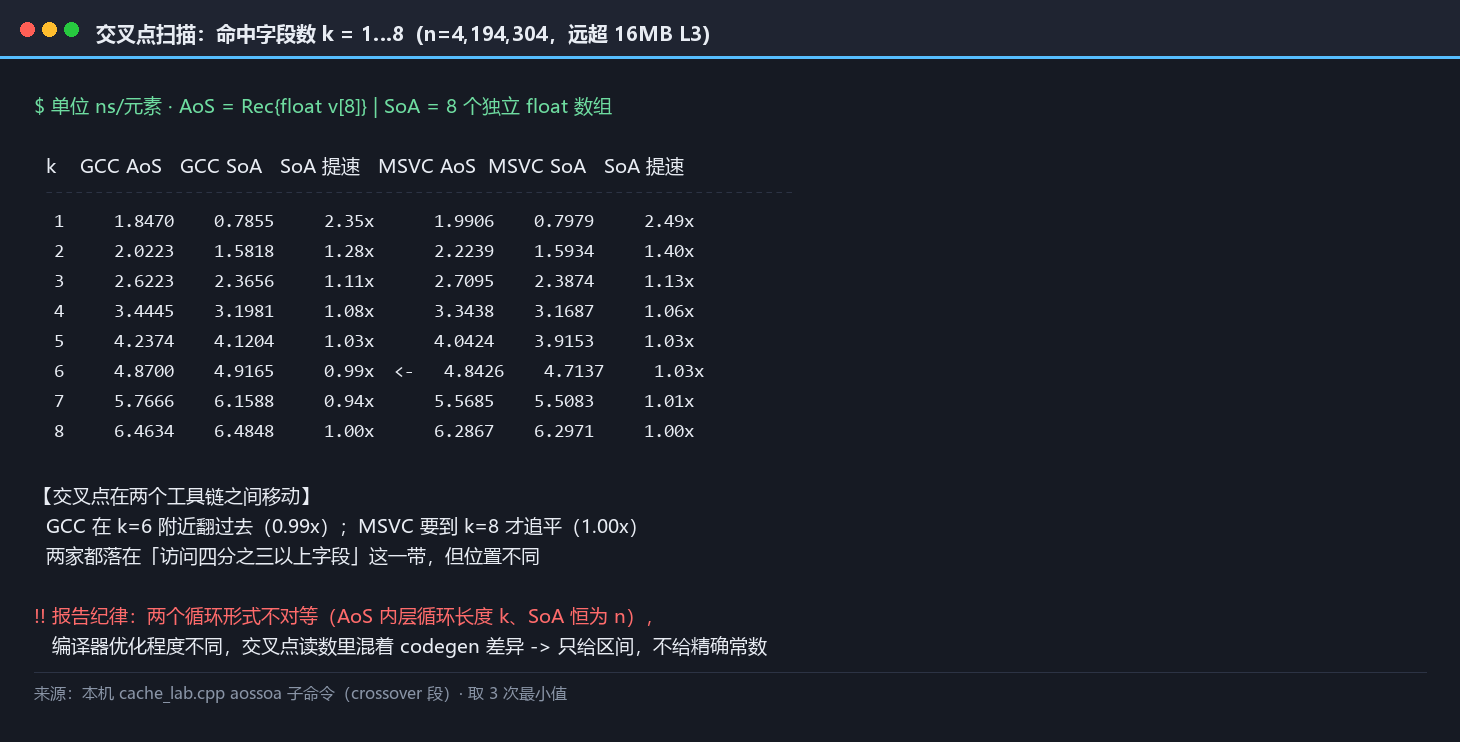
把元素数抬到 4,194,304(128 MB,远超 16 MB 的 L3),按命中字段数 k 扫描。单位 ns/元素:
| k | GCC AoS | GCC SoA | SoA 提速 | MSVC AoS | MSVC SoA | SoA 提速 |
|---|---|---|---|---|---|---|
| 1 | 1.8470 | 0.7855 | 2.35× | 1.9906 | 0.7979 | 2.49× |
| 2 | 2.0223 | 1.5818 | 1.28× | 2.2239 | 1.5934 | 1.40× |
| 3 | 2.6223 | 2.3656 | 1.11× | 2.7095 | 2.3874 | 1.13× |
| 4 | 3.4445 | 3.1981 | 1.08× | 3.3438 | 3.1687 | 1.06× |
| 5 | 4.2374 | 4.1204 | 1.03× | 4.0424 | 3.9153 | 1.03× |
| 6 | 4.8700 | 4.9165 | 0.99×(已交叉) | 4.8426 | 4.7137 | 1.03× |
| 7 | 5.7666 | 6.1588 | 0.94× | 5.5685 | 5.5083 | 1.01× |
| 8 | 6.4634 | 6.4848 | 1.00× | 6.2867 | 6.2971 | 1.00× |
三条读法:
- k = 1 时最悬殊:SoA 快 2.35×(GCC)与 2.49×(MSVC)。这时 AoS 每轮搬 32 字节只用 4 个,浪费了 87.5%。
- k = 8 时打平:1.000 与 1.00。搬进来的字节数一样、每字节都用上,没有可省的了。
- 交叉点夹在两个工具链之间:GCC 在 k = 6 附近翻过去(0.99×),MSVC 要到 k = 8 才追平(1.00×)。两家都落在"访问四分之三以上字段"这一带——方向一致、位置不同。
OK,第 3 条要加一句报告纪律:这两个比值不是纯内存效应。AoS 侧的内层循环长度是 k、SoA 侧的内层循环恒为 n,两个循环形式不对等,编译器优化程度不同(MSVC 的 AoS 在 k = 2 时是 2.22 ns,GCC 是 2.02 ns)。所以交叉点只能当区间结论用:"只访问少数字段时 SoA 明显赢;访问大部分字段时两者没有差别"——不要把它读成"第 5.7 个字段是分界线"。
4.5 有效带宽账
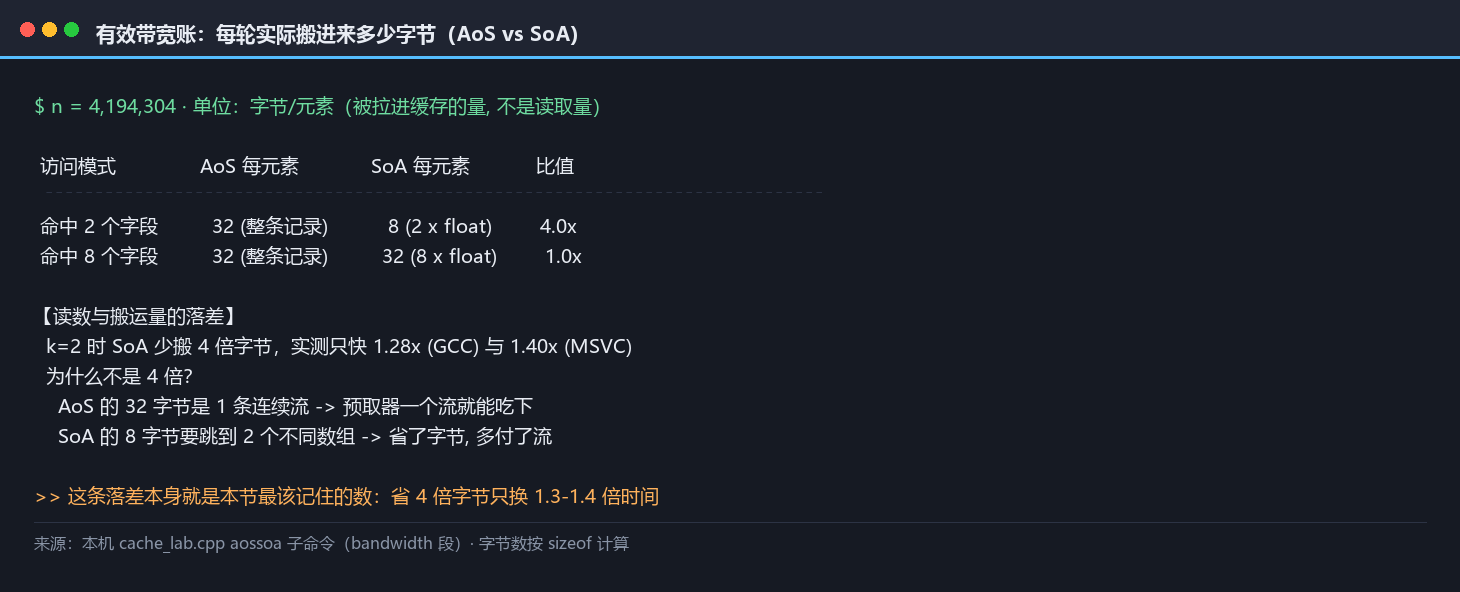
把上面的差别还原成"每轮搬了多少字节",就很好懂了:
| 访问模式 | AoS 每元素 | SoA 每元素 |
|---|---|---|
| 命中 2 个字段 | 32 字节(整条记录) | 8 字节(2 个 float) |
| 命中 8 个字段 | 32 字节 | 32 字节 |
k = 2 时 SoA 只搬 8 字节,AoS 搬 32 字节——4 倍的搬运量。而实测的提速是 1.28×(GCC)到 1.40×(MSVC),小于 4 倍。为什么?
因为省下的字节并不等比例换成时间:带宽是共享的、延迟是隐藏式的。AoS 那 32 字节是一次连续读,预取器一个流就能吃下;SoA 那 8 字节虽然少,却要分两次跳到不同数组——省了字节,多付了流。所以"少搬 4 倍字节"最终只换来 1.3 到 1.4 倍的时间——这条落差本身就是本节最该记住的数。
4.6 第三种摆法:块化 SoA
§4.4 的扫描表里,k = 1 与 k = 8 是两种极端。现实代码往往落在中间——一部分循环只碰位置,另一部分循环要碰全部字段。这时 AoS 与 SoA 都不理想:前者让位置循环白搬 28 个字节,后者让全字段循环开 8 条流。
说白了,第三种摆法叫 AoSoA(Array of Structures of Arrays,也叫 blocked SoA / tiled SoA):先把元素按固定大小分块,块内再按字段分列。
// ASCII comments only: blocked SoA, B elements per block
constexpr int B = 8;
struct Block { float v0[B], v1[B], /* ... */ v7[B]; };   // 8 * 8 * 4 = 256 bytes
Block blocks[N / B];
块大小 B 是新的调节参数:B = 1 退化成 AoS,B = N 退化成纯 SoA。
它买到的是两头的好处:位置循环只读块内那 8 个 v0(32 字节,而不是整块的 256 字节);全字段循环则在一个 256 字节的块内顺序走完——流数从 8 条降到 1 条,只是每条流变成"8 个元素一轮"。
代价也实在:结构体定义复杂一截;B 成为新的调参维度(取多少要看 L1 容量与向量宽度);插入删除变麻烦(块内要么留空位、要么移位);序列化格式跟着改。
值得单独记一句的是:在中文与英文的公开材料里,AoSoA 几乎是缺位的一档——多数文章在"SoA 更快"与"AoS 更适合面向对象"之间二选一,很少给出这个中间态与它的大小参数。本篇把它列出来不是因为它总是更好,而是因为只给两个极端选项、不给中间态,本身就是一种信息缺失。
4.7 改造的代价
改 SoA 不是免费的。要动的清单:结构体定义、所有读写该结构体的地方、序列化格式、以及跨模块的接口;如果这个结构体是公开 API 的一部分,改动还会外溢到调用方。
所以 §4.6 之后的判据要加一条前提检查:改布局值得的前提是——数据装不下缓存(§4.3)、命中字段数 k 稳定且小(§4.4)、且这段代码在剖析里确实是热点。三条缺一条就不该动。
反过来有一条更常见的结论:如果 k 会随需求增长(今天只算位置,明年加质量、后年加寿命),那 AoS 是更稳的选择——SoA 的收益随 k 变大而消失(§4.4 的 k = 8 彻底打平),而改造的复杂度是一次性付清的。
4.8 判据(第四条)
- 判据:先数 k——每轮循环真正用到几个字段。k 小(1 到 2)且数据装不下缓存 → SoA 值得改;k 接近字段总数 → 改布局没有收益,别动。
- 反判据:如果整块数据装得下 L2,任何布局改动都不会有收益(本机读数 1.000)。先量规模,再谈布局。
- 前提:改 SoA 是有代价的——代码结构、缓存友好性、以及"以后加一个字段"的成本都要重算。省下 1.3 倍时间是否值这个改动,是工程判断,不是性能问题。
好了,布局这一半告一段落。下一章回到并行侧,把"到底该填多少"这个问题量成一张表。
五、伪共享的代价标尺:填多少才够
好了,这一章要给三个数字:伪共享占多少、真共享占多少、填充填到什么档为止。
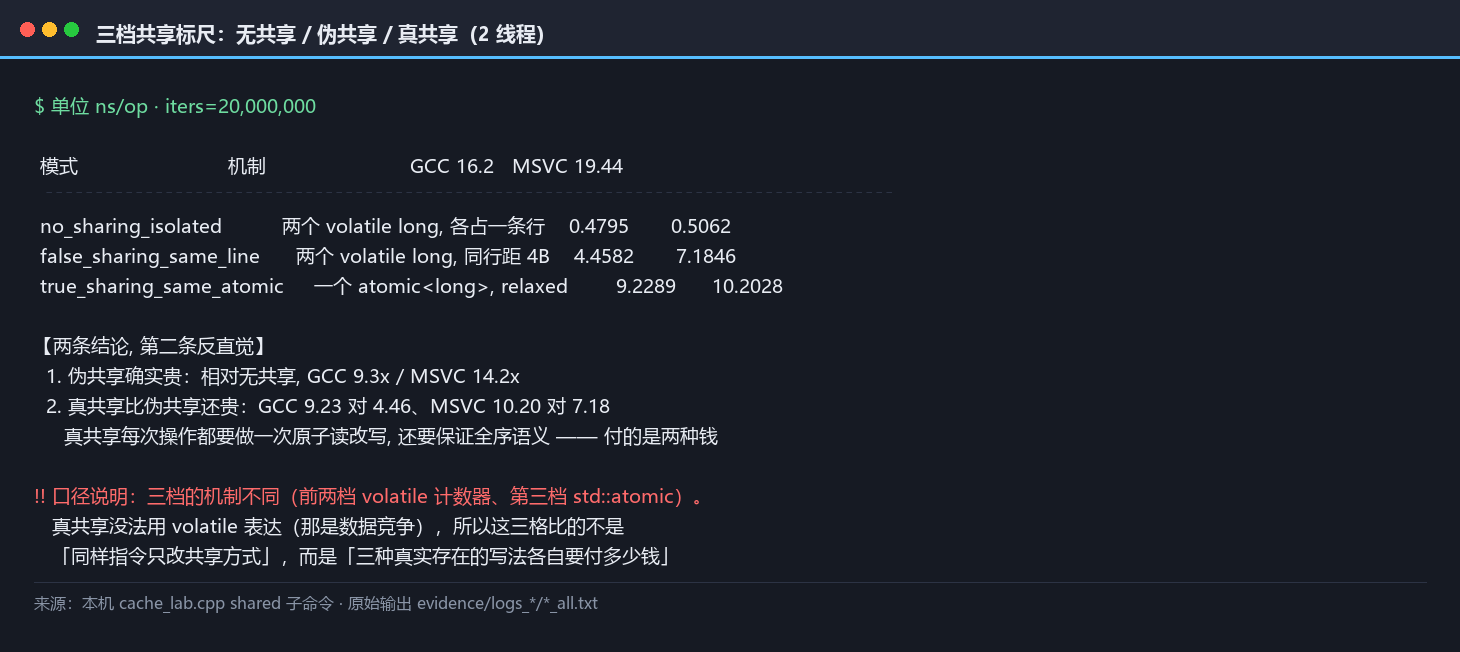
5.1 三档标尺:真共享比伪共享更贵
说白了,先立参照系。同一个"两个线程各自反复增加一个计数器"的形态,三种共享模式:
| 模式 | 机制 | GCC 16.2 | MSVC 19.44 |
|---|---|---|---|
| 无共享(两个计数器各在一条行) | 两个 volatile long |
0.4795 | 0.5062 |
| 伪共享(两个计数器同行、距 4 字节) | 两个 volatile long |
4.4582 | 7.1846 |
真共享(同一个 atomic,两线程 fetch_add) |
一个 std::atomic<long>,relaxed |
9.2289 | 10.2028 |
两个结论,第二个是反直觉的:
- 伪共享确实贵:相对无共享,GCC 9.3 倍、MSVC 14.2 倍。
- 真共享比伪共享还贵:GCC 9.23 对 4.46,MSVC 10.20 对 7.18——贵一倍上下。
OK,第 2 条值得停下来想一下。伪共享贵在"行归属来回搬",而真共享每一次操作都要做一次原子的读改写,还要保证全序语义——所以它付的是两种钱。这也解释了一个常见的误判:看到多线程代码慢,第一反应是"肯定伪共享",于是加一堆 padding——但如果两个线程真的在改同一个变量,padding 一点用都没有,该改的是算法(分片累加、每线程一个计数器最后再合并)。
口径说明:三档的机制不同(前两档是 volatile 计数器,第三档是 std::atomic)——真共享没法用 volatile 表达,那是数据竞争。所以这三格比的不是"同样的指令、只改共享方式",而是"三种真实存在的写法各自要付多少钱"。这一点必须写明,否则 9.23 与 4.46 会被误读成纯粹的共享模式差异。
5.2 填充档位扫描:56 字节就够了
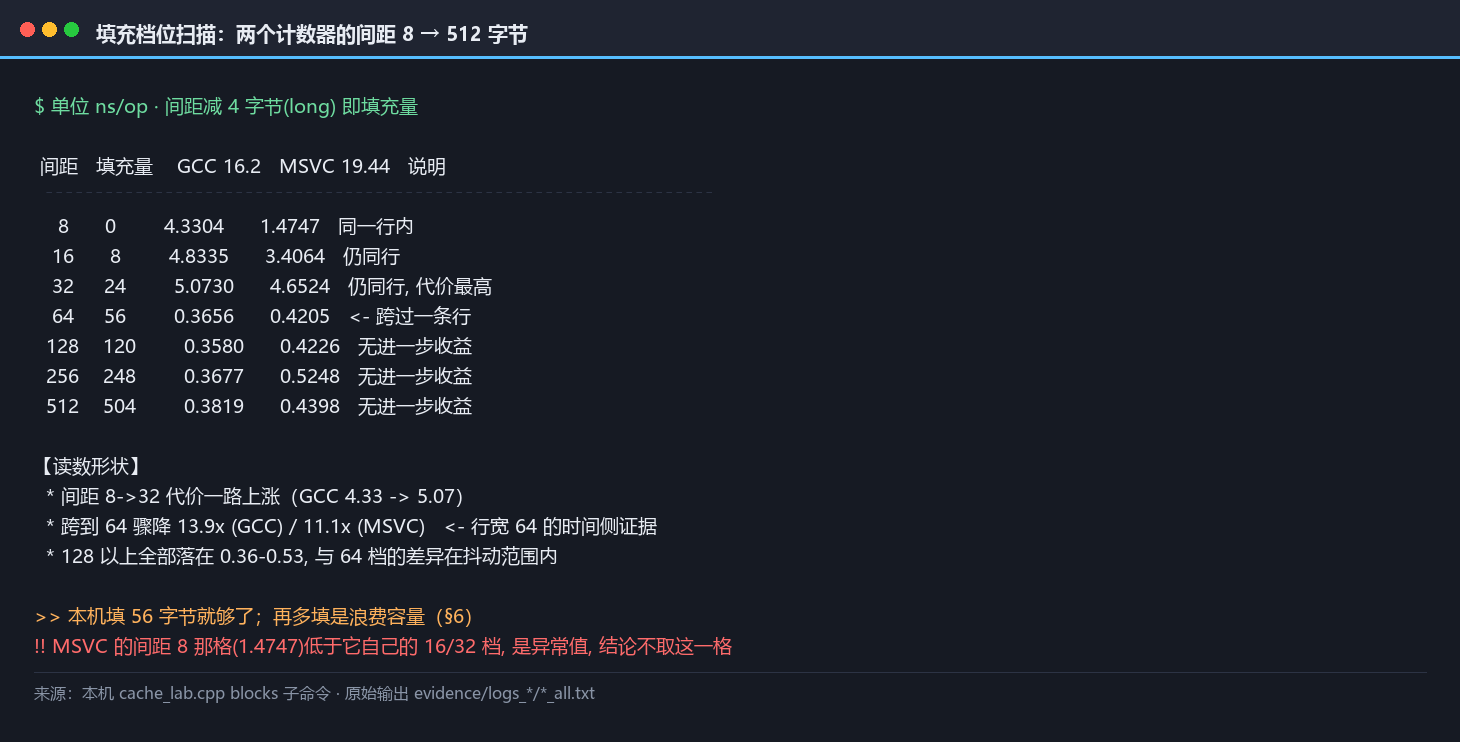
既然要填充,填多少?把两个计数器的间距从 8 字节扫到 512 字节(间距减 4 字节的 long 就是填充量):
| 间距 | 填充量 | GCC | MSVC |
|---|---|---|---|
| 8 | 0(同行) | 4.3304 | 1.4747 |
| 16 | 8 | 4.8335 | 3.4064 |
| 32 | 24 | 5.0730 | 4.6524 |
| 64 | 56 | 0.3656 | 0.4205 |
| 128 | 120 | 0.3580 | 0.4226 |
| 256 | 248 | 0.3677 | 0.5248 |
| 512 | 504 | 0.3819 | 0.4398 |
读数极其干净:
- 间距 8 到 32 字节之间,代价一直在涨(GCC 4.33 → 5.07),因为两个计数器越挨越近仍然同行;
- 跨到 64 字节那一步骤降 11 到 14 倍(GCC 5.0730 → 0.3656,13.9×;MSVC 4.6524 → 0.4205,11.1×);
- 再往上没有任何进一步收益:128 / 256 / 512 三档全落在 0.36 到 0.53 之间,与 64 字节档的差异在抖动范围内。
言归正传,所以本机的答案是:填 56 字节(把间距做到 64)就够了,多填是浪费。
这同时解释了流传的三个数值为什么各不相同:LMAX 的 7 个 long(56 字节)正好是为 64 字节行设计的;标准常量报 64(间距);而 JVM 的 @Contended 填到 128 是另一套口径——它防的是"相邻扇区预取把冲突扩到两条行",那是另一件事(预取器行为),不是行宽。
这条 64 字节的阶梯,是本机"行宽 = 64"的第二个独立证据(第一个是 §一 的 LineSize 转储),而且它是时间侧的:结构性质说的话,时间读数也说了。
MSVC 那格的 1.4747(间距 8)是个异常值——比它自己的间距 16/32 还低,大概率是两次自增落进了同一个 8 字节区域的某种合并行为。这一格单独看不成立,结论只取"64 字节处骤降、再往上无收益"这两条(两家都在这两条上一致)。
5.3 线程数放大伪共享
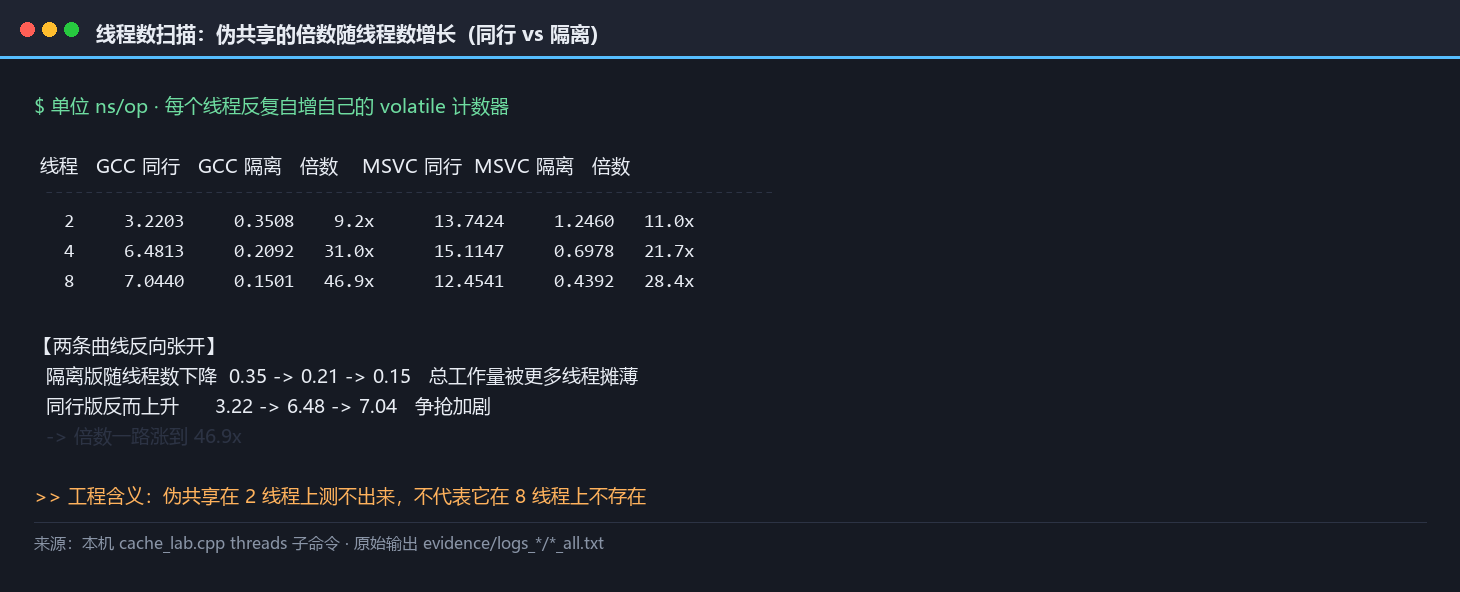
把线程数从 2 加到 8,两个版本(同行 / 隔离)的单位成本:
| 线程 | GCC 同行 / 隔离 | 倍数 | MSVC 同行 / 隔离 | 倍数 |
|---|---|---|---|---|
| 2 | 3.2203 / 0.3508 | 9.2× | 13.7424 / 1.2460 | 11.0× |
| 4 | 6.4813 / 0.2092 | 31.0× | 15.1147 / 0.6978 | 21.7× |
| 8 | 7.0440 / 0.1501 | 46.9× | 12.4541 / 0.4392 | 28.4× |
说白了,看两列的走向:隔离版随线程数下降(0.35 → 0.21 → 0.15),因为总工作量被更多线程摊薄;同行版反而上升(3.22 → 6.48 → 7.04),因为争抢加剧。两条曲线反向张开,所以倍数一路涨到 46.9 倍。
这条读数有一个工程含义:伪共享在 2 线程上测不出来,不代表它在 8 线程上不存在。 本机 2 线程的差距是 9 倍,8 线程是 47 倍——如果你的用例只在 2 线程下调过,你看到的只是问题的一小部分。
5.4 SMT 兄弟核 vs 跨物理核
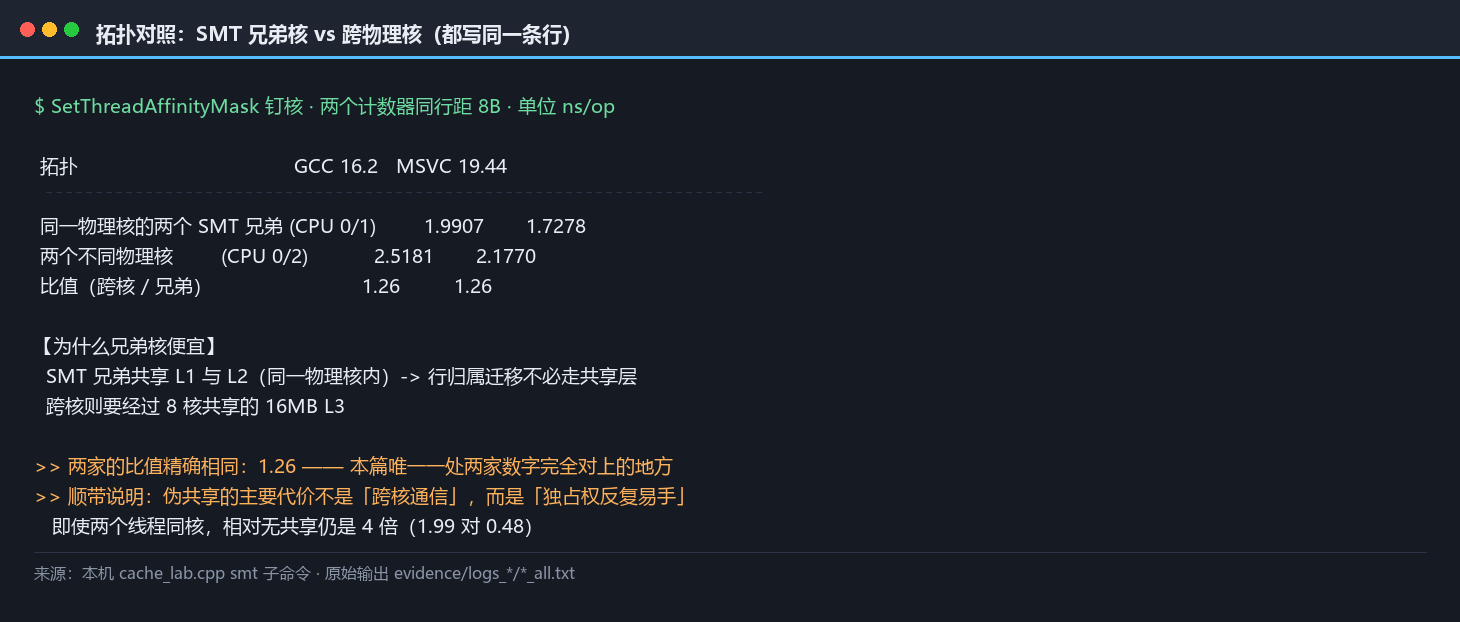
本机的 8 核各有 2 个 SMT 线程,逻辑处理器按核配对编号(0/1 是 0 号核的两个兄弟)。把两个线程钉到不同拓扑上,都写同一条行:
| 拓扑 | GCC | MSVC |
|---|---|---|
| 同一物理核的两个 SMT 兄弟(CPU 0 / 1) | 1.9907 | 1.7278 |
| 两个不同物理核(CPU 0 / 2) | 2.5181 | 2.1770 |
| 比值(跨核 / 兄弟) | 1.26 | 1.26 |
两家的比值精确相同:1.26。 这是本篇唯一一处两家数字完全对上的地方,可信度高。
原因不难推:SMT 兄弟共享 L1 与 L2(都在同一个物理核里),行归属在两个兄弟之间迁移时不必走共享层;跨核则要经过 8 核共享的 16 MB L3。所以跨核的伪共享比同核的贵约 26%。
这个 26% 也顺带说明:伪共享的主要代价不是"跨核通信",而是"独占权反复易手"——即使两个线程在同一个核上,代价仍然有 1.99 ns/op(相对无共享的 0.48 是 4 倍)。
5.5 填多少才够:一条判据
把这一章收成一条:
填充量 = 行宽 − 热字段大小,且只需要做到"跨过一条行"。 本机行宽 64 字节,计数器 4 字节,所以填 56 字节;再往上(128/256/512)没有任何收益——那些数字防的是预取把相邻行一起拉进来,是另一件事,值不值得要按场景量。
而"行宽"这个数不要写死。 本机是 64,AArch64 上常见 128(Apple 的 hardware_destructive_interference_size 就是 128)——把 64 硬编码进代码,换平台就失效。可移植的写法是用标准常量(§1.2 说过它的 ABI 风险,但至少在同一个 ABI 内是对的):
// ASCII comments only
struct alignas(std::hardware_destructive_interference_size) Counter {
    alignas(std::hardware_destructive_interference_size) long v;
};
5.6 填充之外的三条路
说白了,§5.5 给的答案是加填充。但动手之前,有三条路往往更划算——而且它们治的是根,不是症状。
第一条:把两个热变量分到不同的对象里。 伪共享的前提是"两个变量在内存里相邻"。如果它们本来就分属两个对象(比如两个线程各自的上下文结构体),那么距离由分配器决定,一行 alignas 都不用写。反过来说,如果你发现两个热变量住在同一个结构体里,先问一句"它们为什么必须住在一起"——多数时候答案是"因为当初图方便"。
第二条:每线程一个累加器,最后再合并。 这条治的是真共享(§5.1 的第三档)。两个线程都要更新同一个总数时,把它改成"每线程各写各的、结束时求和",两个热变量立刻各自独占一条行——同样不需要填充。这是无锁计数器的标准做法,也是 §5.1 那个"真共享比伪共享更贵"的读数最直接的用法。
第三条:换数据结构。 把"一个共享计数器"换成"每线程一个槽位的数组",按线程索引写入。这时隔离是结构自带的,不是靠 padding 挤出来的。
还有一条反方向的技巧值得知道。hardware_constructive_interference_size 说的是"希望被一起访问的数据放进同一条行"。如果一段只读数据总是一起被读(比如一张查找表里相邻的两项),把它们打包到同一条行里是有益的——填充不是只有"推开"一个方向。
5.7 判据(第五条)
- 判据:先分清真共享还是伪共享。同一个变量 → 改算法(分片、每线程一个累加器);相邻的不同变量 → 填充,填到跨过一条行为止。
- 反判据:如果这段代码只用 1 到 2 个线程,或者写频率很低(每次循环几十纳秒才写一次),伪共享的账可能被别的开销盖住。测,别猜。
言归正传,填充能解决问题——但它同时要收钱。下一章算这笔账。
六、padding 的反击:什么时候填充更慢
好了,第五章给了填充一个漂亮的读数阶梯。这一章要说的是它的另一半:填充买的是并行正确性,付的是单线程容量。
6.1 容量账:把步长从 32 抬到 128 会发生什么
填充的本质是让每个元素占更大的地方。为了让一个 4 字节的计数器独占一条 64 字节的行,你把它的"位置成本"抬了 16 倍。
说白了,这件事在单线程上的后果是直接的:缓存是按行装的,行里装的元素少了,能装下的元素就少了。
拿一个具体的例子——一个 32 字节的记录,只读每个记录的第一个 float(4 字节):
- 步长 32 字节:每 2 个元素占一条 64 字节行 → 4,194,304 个元素共触 128 MB;
- 步长 128 字节:每个元素占两条行 → 同样 4,194,304 个元素共触 512 MB。
OK,元素数没变、读取的字节数没变(都只读 4 字节),但被拉进缓存的字节数翻了 4 倍。
这笔账的口径要说明:这里比的不是读取字节数,而是被拉进缓存的字节数。两次实验的元素数与读取的字段宽度完全一样,唯一的变量是元素之间的步长——所以差异全部来自"每一条行里能装几个元素"。
6.2 实测:单线程慢 3.4 到 3.6 倍
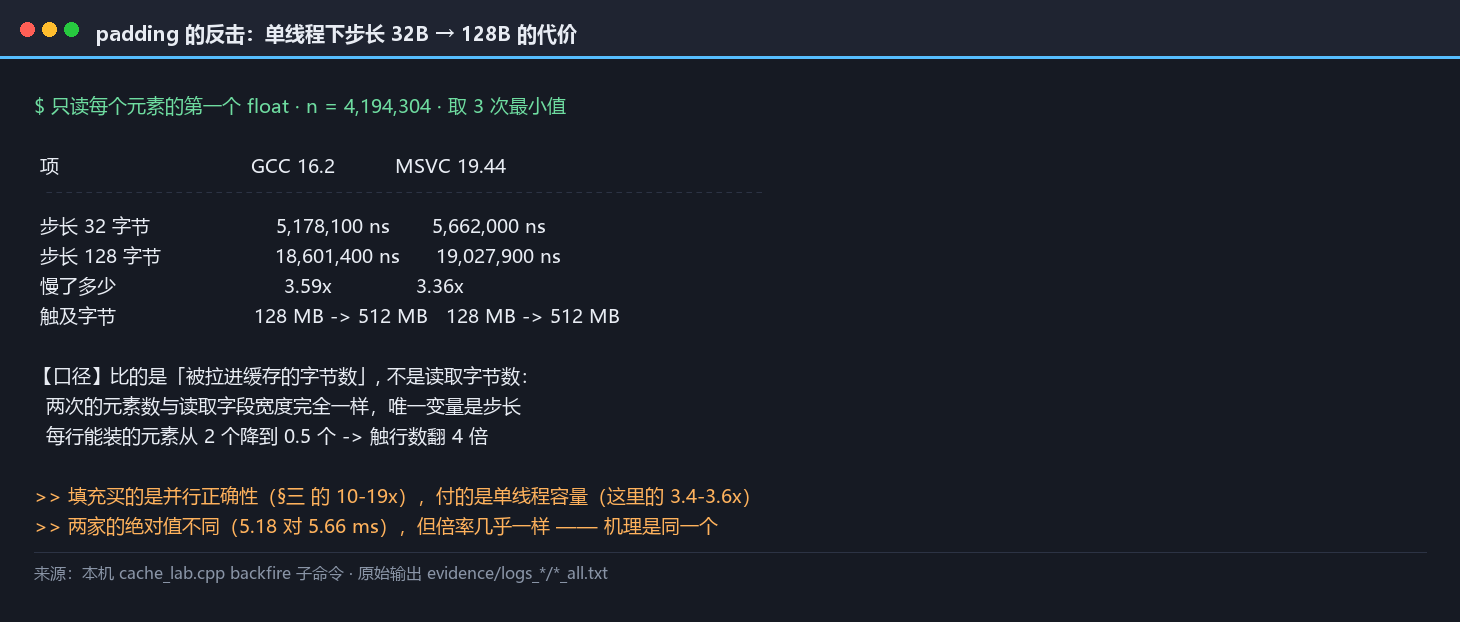
| 项 | GCC 16.2 | MSVC 19.44 |
|---|---|---|
| 步长 32 字节(4,194,304 个元素) | 5,178,100 ns | 5,662,000 ns |
| 步长 128 字节(同元素数、同读取量) | 18,601,400 ns | 19,027,900 ns |
| 慢了多少 | 3.59× | 3.36× |
| 触及字节 | 128 MB → 512 MB | 128 MB → 512 MB |
单线程、同一个算法、只把步长从 32 改成 128,慢 3.4 到 3.6 倍。 两家工具链方向与幅度都一致。
这条读数与第五章的结论放在一起,才是完整的判据:
- 有争用(多线程高频写相邻变量)→ 填充买到的是 10 到 19 倍的收益(§三),值。
- 没有争用(单线程,或者写频率很低)→ 填充付的是 3.4 到 3.6 倍的代价,纯亏。
而现实里最常见的错误是第三种:给一个单线程独占的结构体加 alignas(64),只因为"看到别人这么写"。
读数里还有一处细节:两家的绝对时间不同(GCC 5.18 毫秒对 MSVC 5.66 毫秒),但倍率几乎一样(3.59 对 3.36)。这说明变慢的机理是同一个——触行的数量翻倍——而不是某一家的代码生成出了问题。这一点与 §4.4 那个"MSVC 的 AoS 循环本身慢一截"形成了对照:同一个现象,一个来自内存,一个来自代码生成,读数里必须分得开。
6.3 填充要生效,分配出来的内存必须真的对齐
言归正传,一个容易漏掉的环节:alignas 管的是对象的对齐要求,而内存是分配器给的。两边对不上,填充就白写。
MSVC 的文档把这件事写得最直白:普通的 malloc 与 new 不保证返回按 align 对齐的内存,需要 _aligned_malloc。C++17 起有标准做法:
// ASCII comments only
struct alignas(64) Counter { long v; };

Counter* p = static_cast<Counter*>(
    ::operator new(sizeof(Counter), std::align_val_t{64}));   // aligned new
本机读数里有一格可以直接印证:struct alignas(64) { long v; } 的 sizeof 恰好是 64(见 §7.2 的转储),所以数组形式的实例天然是隔离的——每个元素占满一条行、起点按 64 对齐。这是最省事的一种隔离写法,连字段级的 alignas 都不用。
但有两件事要一起算:
- 对齐到 64 会让分配器多占。 对齐分配需要额外簿记,而且 64 字节对齐的请求常常落进更大的 size class。给小对象加对齐,摊销到整体占用上未必划算——这与 §6.1 的容量账是同一笔钱的两处支出。
- 容器只看
sizeof。std::vector<Counter>会按sizeof(Counter) = 64排布,所以是隔离的;如果放进去的是struct { long a; long b; }(sizeof是 8),容器会老老实实按 8 字节步长排——一条行里坐 8 个元素。
6.4 判据(第六条):一张该不该填充的判据树
OK,把前面五章收成一棵树,按顺序问:
- 这个变量会同时被两个以上线程高频写吗? 不会 → 不填(单线程填充纯亏,§6.2)。
- 两个线程写的是同一个变量吗? 是 → 改算法,不要填(真共享比伪共享更贵,§5.1)。
- 两个变量在内存里相邻(同一行)吗? 用
(a >> 6) == (b >> 6)核一遍。不相邻 → 不填。 - 填充的收益覆盖得了容量代价吗? 有争用就覆盖得了(§三 的 10 到 19 倍 vs §6.2 的 3.4 倍)。但要把整体数据结构的大小增幅算进来:如果这个结构体在别处还有十万个实例,把它们全部撑到 128 字节就是在用容量换一个你并不存在的争用。
- 填到多少? 跨过一条行为止(本机 56 字节到 64 间距),再往上无收益(§5.2)。
- 这一档填完,核过归属了吗? 用 §三 的判据:被推开的是热字段的间距,不是对象的起点。
七、布局转储:把抽象落回字节
说白了,前面几章的结论都建立在"几个字节的偏移差"上。这一章把那些数字摊开,让每一个都能自己核。
7.1 MSVC 的 alignment member 现场
MSVC 的 /d1reportAllClassLayout 会把编译器插进去的填充显式打印出来,这是本篇最有用的一件工具:
class Rec             size(32):
   0    | v
class TwoAdjacent     size(8):
   0    | a
   4    | b
class TwoAlignedType  size(64):
   0    | a
   4    | b
        | <alignment member> (size=56)
class TwoIsolated     size(128):
   0    | a
        | <alignment member> (size=60)
  64    | b
        | <alignment member> (size=60)
class PaddedCounter   size(64):
   0    | v
        | <alignment member> (size=60)
读法:<alignment member> 就是填充。TwoAlignedType 的填充是末尾 56 字节(对齐要求把 sizeof 撑到 64 的倍数),对"把 a 与 b 分开"毫无帮助;TwoIsolated 的填充插在字段之间(60 字节),才把 b 推到偏移 64。
说白了,GCC 侧没有等价的"填充插在哪"可视化,但 sizeof 与 offsetof 的数字与 MSVC 完全一致——两家在 ABI 层面是同一件事。GCC 自己的类布局转储(-fdump-lang-class)给的是 size 与 align,不含填充位置,见 §7.2 末尾。
顺带说一句为什么值得用这个开关:sizeof 与 offsetof 能告诉你结果,但它不告诉你填充插在哪儿。上面那两个 size(64) 的类型,"填充在末尾"与"填充在字段之间"这两种情况,只从 sizeof 是看不出来的——而它们的运行时含义完全相反(一个没用,一个有用)。
7.2 两家的 sizeof / offsetof 对照
| 类型 | 声明 | sizeof |
alignof |
b 偏移 |
|---|---|---|---|---|
Rec |
float v[8] |
32 | 4 | — |
TwoAdjacent |
long a; long b; |
8 | 4 | 4 |
TwoAlignedType |
struct alignas(64) { long a; long b; } |
64 | 64 | 4 |
TwoIsolated |
struct { alignas(64) long a; alignas(64) long b; } |
128 | 64 | 64 |
PaddedCounter / Line |
struct alignas(64) { long v; } |
64 | 64 | — |
OK,两家工具链在这张表上逐格一致。
⚠️ 一处平台陷阱必须标注:Windows 上 long 是 4 字节(不是 LP64 平台的 8 字节)。所以 long a; long b; 得到的是 8 字节结构、字段距 4。同样的源码拿到 Linux 或 macOS 上编译,两个字段的间距会变成 8 字节——所有涉及"偏移多少"的结论都必须标平台,这是 ep01 就立下的规矩。
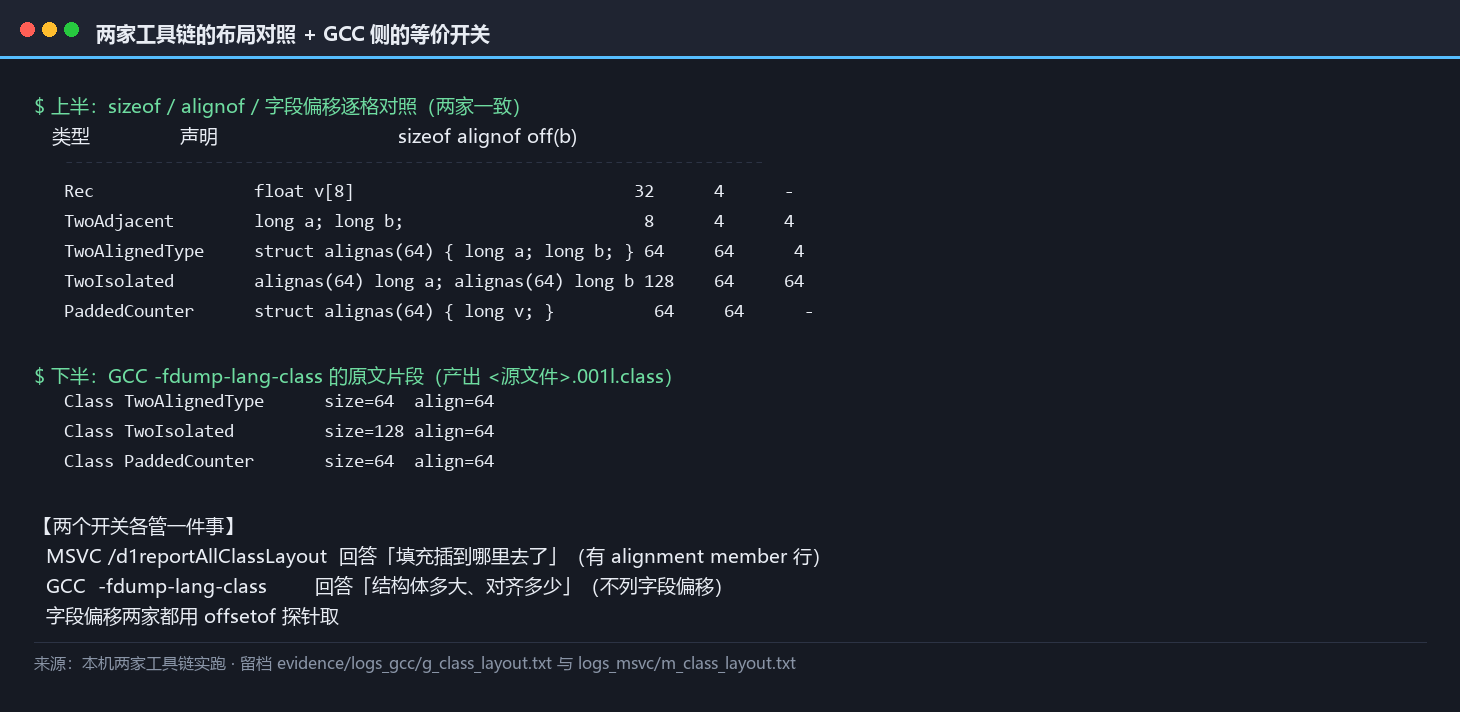
GCC 侧同样有等价开关:-fdump-lang-class 会产出 <源文件名>.001l.class 文本转储。本机的输出片段:
Class TwoAlignedType
     size=64 align=64
     base size=64 base align=64
Class TwoIsolated
     size=128 align=64
     base size=128 base align=64
Class PaddedCounter
     size=64 align=64
     base size=64 base align=64
它给的是 size 与 align(以及带基类时的继承布局),不逐字段列偏移——所以"偏移多少"那一路仍然要靠 offsetof 探针。两个开关合起来覆盖两件事:MSVC 的 /d1reportAllClassLayout 回答"填充插到哪里去了",GCC 的 -fdump-lang-class 与探针一起回答"结构体多大、字段在第几个字节"。
7.3 从声明到地址:把抽象落回字节
言归正传,把整条链串起来看,一个 C++ 声明是怎么变成内存里的位置的:
声明顺序 → 字段偏移(受对齐约束)→ 结构体大小(受最大对齐约束)→ 数组步长 → 每个元素的地址 → 行号(addr >> 6)→ 会不会与邻居同行。
这条链上每一步都是确定的、可打印的、可复核的。这也是为什么本篇的所有结论都能被单独验证:没有一个结论依赖于"我以为编译器会这么做"。
这一节的结论可以直接当核对清单用:任何一条关于"某个变量在内存里的位置"的断言,都应该能落到这条链的某一环上,而且那一环能被打印出来。落不到链上的位置断言,多半是把"编译器大概会这样"当成了"就是这样"——而 §三 那个 alignas 反例正好说明,这种默认推断错起来是一整个数量级。
八、测量方法论:端到端能证到什么
好了,这一章交代口径。本篇的所有数字都是端到端时间,它有一个明确的证明边界。
8.1 抖动与口径
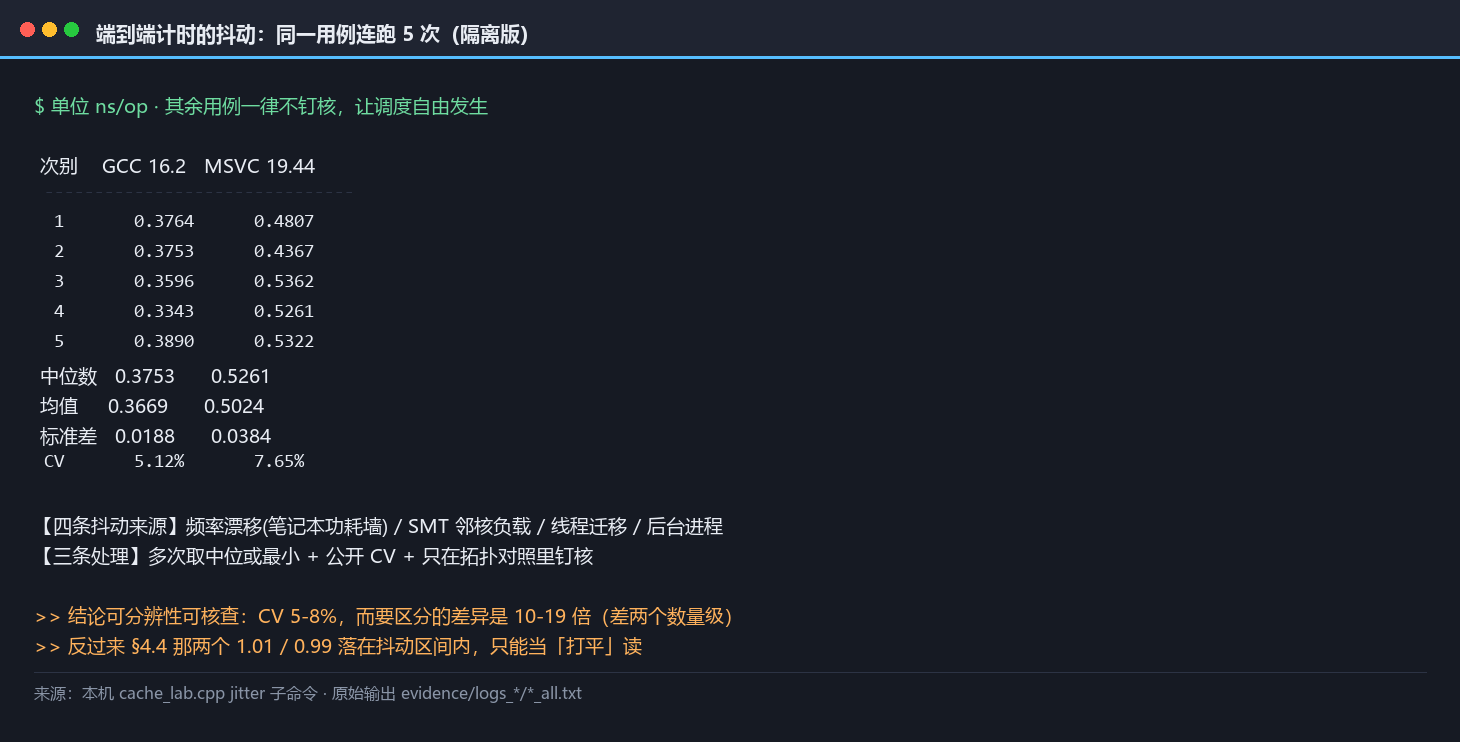
同一个用例连跑 5 次(隔离版):
| 项 | GCC | MSVC |
|---|---|---|
| 5 次读数(ns/op) | 0.3764 / 0.3753 / 0.3596 / 0.3343 / 0.3890 | 0.4807 / 0.4367 / 0.5362 / 0.5261 / 0.5322 |
| 中位数 | 0.3753 | 0.5261 |
| 标准差 | 0.0188 | 0.0384 |
| 变异系数 CV | 5.12% | 7.65% |
单次读数不能用。 本机同一用例的抖动是 5% 到 8%,而 turbo 频率、SMT 邻核的负载、以及操作系统的调度都会进到这个区间里。本篇的所有读数一律取 3 次最小值或 5 次中位数,并公开 CV。
好消息是:本篇要区分的量级差异(伪共享 4.5 ns vs 隔离 0.48 ns,10 倍量级)远大于抖动(5% 到 8%),所以方向性结论不受影响。而 §4.4 里那两个 1.01 与 0.99 的比值就在抖动范围内——这也是我把交叉点写成"区间结论"的原因。
8.2 那 5% 到 8% 的抖动是从哪来的
四类来源,本机都真实存在:
- 频率漂移。 本机是笔记本,长跑时功耗与温度都会让频率往下走。同一个隔离用例连跑五次(§8.1),读数整体在 0.33 到 0.39 之间漂——一部分就是这件事。
- SMT 邻核的负载。 每个物理核有两个线程,邻核在跑别的东西时,L1 与 L2 的容量是被分掉的。
- 线程在核之间迁移。 操作系统会在核之间挪线程,缓存归属跟着搬——这条对伪共享的读数影响最大,因为"行在哪一边"正是被测量的东西。
- 操作系统与后台进程。 本机跑的是普通 Windows 桌面,不是实时系统。
说白了,处理办法只有三条,都很朴素:每个用例跑多次取最小值或中位数(本篇取 3 次最小值或 5 次中位数)、把原始读数与 CV 一起公开、以及不去钉核。
最后一条是个反直觉的选择,值得多说一句。钉核(SetThreadAffinityMask)能显著降低抖动,很多基准测试都这么做。但本篇只在 §5.4 的拓扑对照里钉核——因为那一节测的就是拓扑,必须把两个线程固定在指定的核上;其余用例一律不钉,让调度自由发生。这样读到的数字更接近真实程序会遇到的场景,代价是 CV 偏高(5% 到 8%),而那个 CV 也一并写出来。
换来的好处是:结论的可分辨性可以被核查。§8.1 的 CV 是 5% 到 8%,而本篇要区分的量级差异是 10 倍(4.46 对 0.48)到 19 倍(7.87 对 0.43)——差了两个数量级,所以方向性结论不依赖运气。反过来,§4.4 里那两个 1.01 与 0.99 的比值就落在抖动区间内,只能当"打平"读。
8.3 端到端能证什么、不能证什么
能证:
- 两种写法的代价差(同一台机器、同一份用例、同一套编译选项);
- 代价随参数(间距、线程数、命中字段数)的变化方向与幅度;
- 结构与代价的对应关系(行宽 64 这条,转储与时间两侧互证)。
不能证:
- 每一条指令摊到几次未命中(需要硬件计数器,本机因权限不可得);
- 是哪一条行、哪个变量在争(需要 HITM 地址级定位,本机不可得);
- 跨平台的绝对值(AArch64 的行宽常见 128,本机 64;两家的
alignof(max_align_t)也不同); - 别的机器上的最优填充量(那是硬件参数,不是常数)。
OK,这四条边界合起来是一句话:端到端时间能给"多少",给不了"哪里"。 而"哪里"恰恰是 perf c2c 那一类工具的活——本机拿不到,就如实说拿不到,不用二手数字补。
九、选型判据:按顺序问的六条
OK,把全篇收成一串问题。顺序本身就是结论的一部分——只有前一条不构成瓶颈,后面的权衡才有意义。如果反过来问(先挑填充量、再看有没有争用),就会出现"给一个单线程独占的结构体加 alignas(64)"这种典型误用:§6.2 量过它,白付 3.4 到 3.6 倍。
六条按"代价的分母"从大到小排:规模 → 访问模式 → 争用前提 → 共享类型 → 填充量 → 归属核对。前一条答"不值得动",后面五条就不用问了。
- 判据一(规模):这块数据装得下 L2 吗?装得下 → 布局改动没有收益(§4.3 读数 1.000),到此为止。
- 判据二(访问模式):每轮真正命中几个字段?k 小且装不下 → 考虑 SoA;k 接近字段总数 → 别动(§4.4)。
- 判据三(共享):有多个线程高频写相邻变量吗?没有 → 不做填充(§6.2 单线程填充分明会慢 3.4 到 3.6 倍)。
- 判据四(真共享还是伪共享):是同一个变量吗?是 → 改算法(分片累加),填充无用(§5.1:真共享 9.23 比伪共享 4.46 更贵)。
- 判据五(填充量):填到跨过一条行(本机 56 字节到 64 间距),再往上无收益(§5.2);行宽不要硬编码。
- 判据六(核对归属):最后用
sizeof/offsetof/ 类布局转储核一遍——被推开的是热字段的间距,还是只有对象的起点(§三)。
十、收束与下一篇钩子
好了,第四波的第一篇写完了。这一篇把"多核代价"里位置那一半算清了;最后一篇要算的是指令那一半。
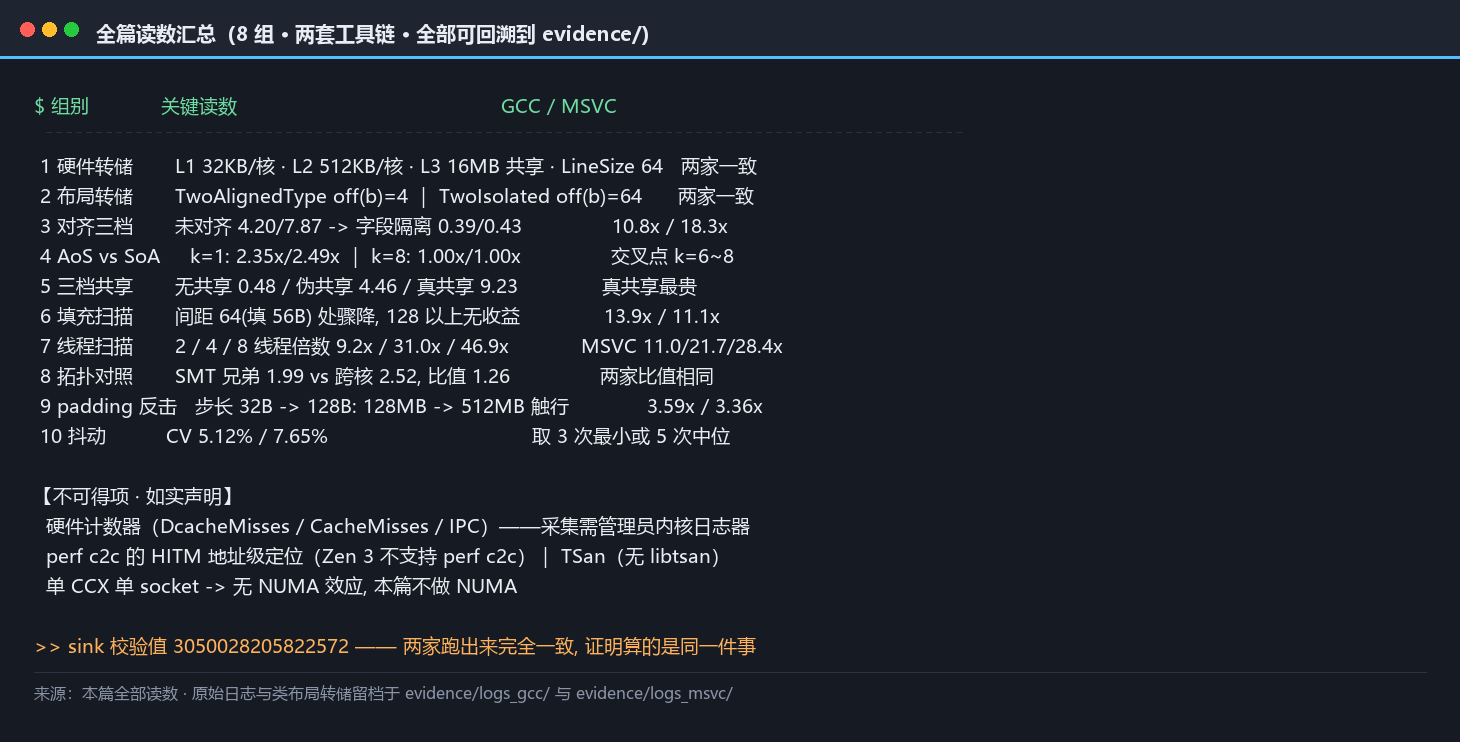
10.1 全篇读数汇总
把本篇测出的全部读数集中在一张表里,便于对照与复核。每一档的原始日志都随篇留档在 evidence/ 下,任何一个数字都可以逐行回溯。
汇总表里的每一组读数在本篇都出现过两次:一次在它所属的章节里,一次在这张表里。两张表如果对不上,就说明搬运时抄错了——这既是我把原始日志随篇留档的原因,也是这本系列一贯的复核方式。
10.2 证据形态与读法(一句话版)
说白了,三类证据:本机实测(能证代价区间)、外部图示(能证结构)、本机不可得(硬件计数器、HITM、TSan——声明为不可得,不用二手数字补)。
10.3 复现流程
复现这一篇不需要任何私有环境,需要三样东西:
- 两套工具链:MSVC 19.44 与 g++ 16.2(都要 C++17),共用一个
cache_lab.cpp; - 一组参数:
iters = 20,000,000(时序用例)、n = 4,194,304(布局用例); - 一个信息转储:
GetLogicalProcessorInformation取三级缓存与行宽(CACHE_DESCRIPTOR.LineSize)。
命令与原始输出见 evidence/tools/run_all.ps1 与 evidence/logs_gcc/g_all.txt / evidence/logs_msvc/m_all.txt。两家跑出来的 sink 校验值完全一致(3050028205822572)——这是"两边算的是同一件事"的证据。
10.4 自检清单与五条常见误用
OK,写完代码、准备提交之前,逐条核对:
- 热点变量之间,用
(a >> 6) == (b >> 6)核过归属了吗? - 对齐是加在字段上,还是只加在类型上?(后者等于没加)
- 填充量是跨一条行,还是照抄了别人的 128?
- 这段代码真的有多个线程高频写相邻变量吗?没有就别填。
- 两个线程写的是同一个变量吗?是 → 改算法,不是 → 才考虑填充。
- 填充之后,整个数据结构的大小涨了多少?有没有别处十万个实例被一起撑大?
- 行宽是读出来的(
LineSize),还是硬编码的 64? - 所有涉及偏移的结论,标平台了吗(Windows 上
long是 4 字节)? - 读数取的是中位数或最小值,并公开了 CV 吗?
- 单线程下测过填充的反面代价吗(3.4 到 3.6×)?
- 结论有没有越过证据边界(说"未命中几次"、"哪条行在争")?
五条常见误用(都是本篇量过的,按代价从大到小):
| # | 误用 | 本机读数 | 该怎么写 |
|---|---|---|---|
| 1 | 给单线程独占的结构体加 alignas(64) |
白付 3.4 到 3.6 倍(§6.2) | 有争用才填;没争用别碰 |
| 2 | alignas 加在类型上就以为隔离了 |
与完全不对齐持平(§三:4.61 对 4.20) | alignas 加到每个热字段上 |
| 3 | 给真共享(同一个变量)加 padding | 一点用没有;真共享 9.23 比伪共享 4.46 更贵(§5.1) | 改算法:每线程一个累加器 |
| 4 | 照抄 128 字节填充 | 本机 56 字节就够了,多填的是容量(§5.2) | 填到跨过一条行;行宽要量 |
| 5 | 在 2 线程上调优伪共享就收工 | 2 线程差 9.2 倍,8 线程差 46.9 倍(§5.3) | 在目标线程数上测 |
第 3 条是最容易踩的:它的症状(多线程计数器慢)与伪共享一模一样,而解法相反——伪共享要拉开距离,真共享要换掉共享。分不清这两者,padding 就会从"解法"变成"安慰剂"。
10.5 与系列其他篇目的交叉点
- 与 ep01《对象布局、对齐与 padding》:§7.2 那张表接着 ep01 的口径——
sizeof/offsetof/alignof三家数字、以及"Windows 上long是 4 字节"这条平台陷阱,两篇共用。 - 与 ep10《内存序与原子》:ep10 的 §8.3 用端到端时间间接看到"缓存行争抢约 13 ns",本篇把它拆成了两笔:行归属迁移(§2.2,3.81 ns)与容量损失(§6.2,3.4 到 3.6 倍)。
- 与 ep02《分配器解剖》:填充会改变分配器的实际占用与碎片形态——本篇只算容量账(§6.1),碎片那一侧在 ep02。
- 与 ep12《SIMD》:§4 的 SoA 结论是向量化的前置条件——访存不连续,向量化第一道门就过不去。
10.6 一条可以搬走的方法
把本篇的做法抽象成三步:
- 先把一句口号拆成可分类的问题。 "SoA 更快吗" → 拆成"命中几个字段"(§4.2 的 2×2);"要填充吗" → 拆成"真共享还是伪共享"(§5.1)。
- 把结构性质与时间读数两边对上。 行宽 64 这条结论有两个独立来源:
CACHE_DESCRIPTOR.LineSize的转储,与间距扫描在 64 字节处的骤降(§5.2)。两边都对上,结论才立得住。 - 给代价配一个反面。 填充的收益(10 到 19 倍)与它的代价(3.4 到 3.6 倍)必须一起给——只给收益的那一半,读者就会把它当成免费的正确答案。
这三步与 ep07 到 ep10 是同一条。这一篇多了一件工具:编译器的布局转储(/d1reportAllClassLayout 的 <alignment member>),它把"填到哪里去了"从推理变成了打印。
10.7 参考资料(含源码与证据)
- 标准与 ABI:P0154R1(两个 interference_size 的提案)|P1119R0(ABI 争议)|libstdc++ 源码实现|Clang 19.1.0 Release Notes
- 编译器与平台:GCC 变量属性(aligned)|MSVC align 说明|Linux 内核 False Sharing 文档|JEP 142(Java 的 Contended)|JDK-8003985(128 字节的由来)
- 处理器手册:AMD EPYC 7003 HPC 调优指南(CCX 与 L3 共享)|AMD EPYC 7003 设计与配置最佳实践|AMD Zen 架构官方页|Intel SDM 文档库(卷 3 第 11 章 Memory Cache Control)
- 工具与测量:perf-c2c(1) 手册(HITM 语义、Zen 3 不受支持)|Windows 记录 PMU 事件|Windows PMU 采集示例|Google Benchmark:降低方差|Red Hat:用 perf c2c 检测伪共享|Arm SPE 与伪共享
- 数据布局与 DOD:Agner Fog 优化手册|Mike Acton: Data-Oriented Design and C++(CppCon 2014)|同演讲幻灯片|CppCon 2025 主题演讲:Practical Data-Oriented Design|Unity DOTS:Data design
- 中文对照:华为开发者联盟:伪共享原理与性能影响|CPU 缓存一致性以及伪共享问题|倚天710 性能监控:perf arm-SPE 检测 cacheline 竞争|京东云:从代码到设计的性能优化指南|掘金:缓存友好的数据结构设计
- 实测与反例:Martin Thompson: False Sharing|同上:Java 7 之后|Joe Duffy: False sharing is no fun|CoffeeBeforeArch: False Sharing tutorial|HFT 模式的复现与证伪|Measuring the impact of false sharing|SoA vs AoS 逐字节拆解|padding 的反例|CPU Cache: What Every Programmer Should Know
- 外部示意图:Computer Memory Hierarchy.svg(Public domain)|Set-associative cache.png(CC BY-SA 4.0, Chop0)|Intel486 cache.png(CC BY-SA 3.0, Mixabest)
- 本篇证据:用例源码
evidence/src/cache_lab.cpp、构建与运行脚本evidence/tools/、两套工具链的原始日志与 MSVC 类布局转储(evidence/logs_gcc/、evidence/logs_msvc/)、以及实验台与读数的完整报告evidence/recon-report.md


10.8 下一篇:SIMD——自动向量化与手写 intrinsic 的分界
言归正传,这一篇算完了"位置"。第四波还剩最后一篇,也是全系列的收官:SIMD。
它和本篇是一对。本篇的 SoA 结论是它的前置条件——访存不连续,向量化第一道门就过不去;而向量化能不能生效,又要看编译器愿不愿意把循环变成连续访存指令。所以下一篇要问的是:同一段循环,编译器自动向量化到哪一步,手写 intrinsic 又能多拿到多少。
它的证据边界会比本篇更硬:本机没有 Clang(-Rpass=loop-vectorize 那种逐条向量化报告拿不到),只能用 MSVC 的 /Qvec-report:2 报告加反汇编;而微架构侧的事件计数同样因权限不可得。所以下一篇照样只给"时间 + 指令"两类证据,不给"每次向量化省了几个周期"的硬件解释。
以上。希望能对大家有所帮助。下一篇见。