站点链接:技术博客页
【实时渲染管线探析】姊妹系列 · 《移动端图形与功耗》第 1 篇 | 系列共 7 篇
- 上一篇:(本系列首篇)
- 下一篇(预告):【移动端图形与功耗】(二) 分块渲染:binning、片上内存与它的代价
系列文章前言
1.1 系列定位
OK,言归正传。写这个系列的起因很具体:我们在桌面端调好的渲染方案,搬到手机上往往不是"变慢一点",而是画风都变了——帧率掉到个位数,机身发烫,十几分钟后又莫名其妙恢复。
这类现象通常被归为"优化没做好"。但更准确的说法是:移动 GPU 和桌面 GPU 不是同一种机器的小型化版本,而是被不同物理约束塑造出来的两种设计。同样一句采样、同样一次混合,在两台机器上的代价可以差一个数量级。这不是实现的锅,是前提不同。
把边界划在前面:本篇不涉及具体机型与芯片型号的性能排名(排名半年就过期,约束不会),不涉及着色器语言与引擎的完整配置手册(那属于各引擎文档),也不给"最佳设置"(脱离机型与画质目标谈最佳是伪命题)——这一篇只立前提。
所以本系列的目标不是给一份"移动端优化清单"——那样的清单网上已经很多了,而且往往只写了"关掉什么",没写"为什么关、关掉能省多少"。我们要做的是另一件事:把移动端图形的物理前提讲清楚,再把工程后果一项项接上去。前提清楚了,清单就能自己推出来;前提不清楚,清单背下来也会用错地方。
1.2 这个系列要讲清的一件事
先把立论摆出来。一句话:移动端图形的每一个工程选择,背后都对应一份明确的物理账。这份账只有两页——带宽与功耗。凡是省带宽、省功耗的做法,在移动端就可能划算;凡是不省这两样的"高级效果",在移动端就得先证明自己值这个价。
这听起来像正确的废话,但把它落到具体决策上,就会立刻变得尖锐。举三个本系列会反复遇到的例子:
- 为什么移动端倾向把渲染拆成"先建几何列表、再逐块着色"两趟,而不是像桌面那样一路画到底?
- 为什么同一张阴影贴图,桌面可以 4K,移动端 1K 就要掂量?
- 为什么"跑分 60 帧"的机器,玩二十分钟只剩 40 帧,而另一台跑分只有 45 帧的机器却稳在 42 帧?
这三个问题的答案,都要回到那两页账上。
1.3 全系列内容总览
七篇的递进关系是这样安排的——先立前提、再拆子系统、最后回到实践。第 1 篇立两道墙,第 2 到第 4 篇拆机制、账本与持续性能,第 5、6 篇回到取舍与前沿,第 7 篇收在方法论上。这条主线也决定了阅读顺序:跳读可以,跳过的环节会在后面变成看不懂的结论。
一句话记住全系列的位置:第 1 篇立前提,第 2~4 篇依次拆机制、带宽账本与持续性能,第 5~6 篇回到取舍与前沿,第 7 篇收在方法论。下面用一张表把每篇的位置、回答的问题和与前一篇的关系列清楚。
| 篇 | 主题 | 它回答的问题 | 与前一篇的关系 |
|---|---|---|---|
| 1 | 两台不同的机器:移动 GPU 的物理约束 | 移动端到底被什么约束?为什么这些约束无法绕过? | 立前提(本篇) |
| 2 | 分块渲染:binning、片上内存与它的代价 | 分块到底省了什么?代价是什么? | 前提 → 机制 |
| 3 | 带宽:移动端最硬的那道墙 | 每帧的字节都花在哪了?怎么省? | 机制 → 账本 |
| 4 | 功耗与热:帧率为什么会掉下去 | 为什么持续性能只有爆发的一半? | 账本 → 持续性能 |
| 5 | 延迟着色在移动端:能做什么、不能做什么 | 哪些桌面上成立的做法在这里不成立? | 前四篇 → 取舍 |
| 6 | 现代特性落地:VRS、网格着色与移动光追 | 新特性在移动端的真实收益与前提是什么? | 取舍 → 前沿 |
| 7 | 测量与调优:怎么证明你真的优化了 | 怎么量化、怎么验收? | 全部 → 方法论 |
1.4 与已有中文文章的差异
先看看已有的中文资料。移动 GPU 的中文资料其实不少,但读完常有一个感觉:知道了很多名词,仍然做不好决定。我们把已有的中文写作分成三类,并说明本系列的取舍:
| 类型 | 典型内容 | 已经讲得很好的部分 | 缺口 |
|---|---|---|---|
| 架构科普 | TBDR 是什么、binning 两阶段、片上内存 | 名词与流程的入门理解 | 几乎没有量化:省了多少、什么时候不省 |
| 引擎操作清单 | "关掉 HDR""禁用 Opaque Texture" | 可执行的操作项 | 不解释为什么关、代价与收益的量级 |
| 厂商白皮书翻译 | Arm / Imagination / Qualcomm 的架构文档 | 架构的权威表述 | 面向开发者,缺少横向对照与工程落地取舍 |
本系列的差异点只有一句话:把架构事实与工程后果用可核对的数字连起来。每个"所以你应该……"的结论,前面必须有一个"因为量级是……"的依据;拿不到依据的地方,我们会明说"这里只有经验,没有数据",而不是拿"一般来说"糊过去。
数据口径也说一句:第三方数字都给出处,"我们实测"的数字都给机型与测试条件,两者不混用。
1.5 相关资源与阅读建议
- 官方与权威:Arm、Imagination、Qualcomm、Apple 的移动 GPU 文档;学术与量化:SIGGRAPH 移动 GPU 课程、HPG 能效论文、移动热管理系统级研究。
- 阅读建议:如果只读一篇,读这一篇——后面六篇的技巧都建立在这一篇的前提上;已经清楚"带宽与功耗是硬约束"的,可以直接跳到第 2 篇。
术语先对齐,免得后面反复解释(速查表见下,逐条定义见 2.6 节)。
背景铺垫
2.1 从一次"同一份代码,两种命运"说起
下面我们开始正文。先看现象。同一份渲染代码、同样的资源规格,在桌面显卡上跑 1440p 高画质稳定 120 帧,换到手机上:
- 画面能出,但平均帧率掉到 10–20 帧;
- 机身背部迅速升温,能明显感觉到热;
- 持续十几分钟后,帧率进一步下降,然后在一个更低的水平上稳定下来。
如果这是第一次遇到,通常会怀疑三件事:驱动没适配好、代码里有什么移动端不支持的坏习惯、或者这台手机性能就是不行。这三件事都可能有,但它们解释不了最反常的那一点:为什么同一台手机,同样的场景,跑分能到 60 帧,玩二十分钟却只有 40 帧?
答案是:移动设备上,"能跑多快"和"能跑多久"是两个独立的问题,由两套不同的机制决定。前者取决于算力,后者取决于散热能力与功耗预算。
2.2 两台机器:先看它们长什么样
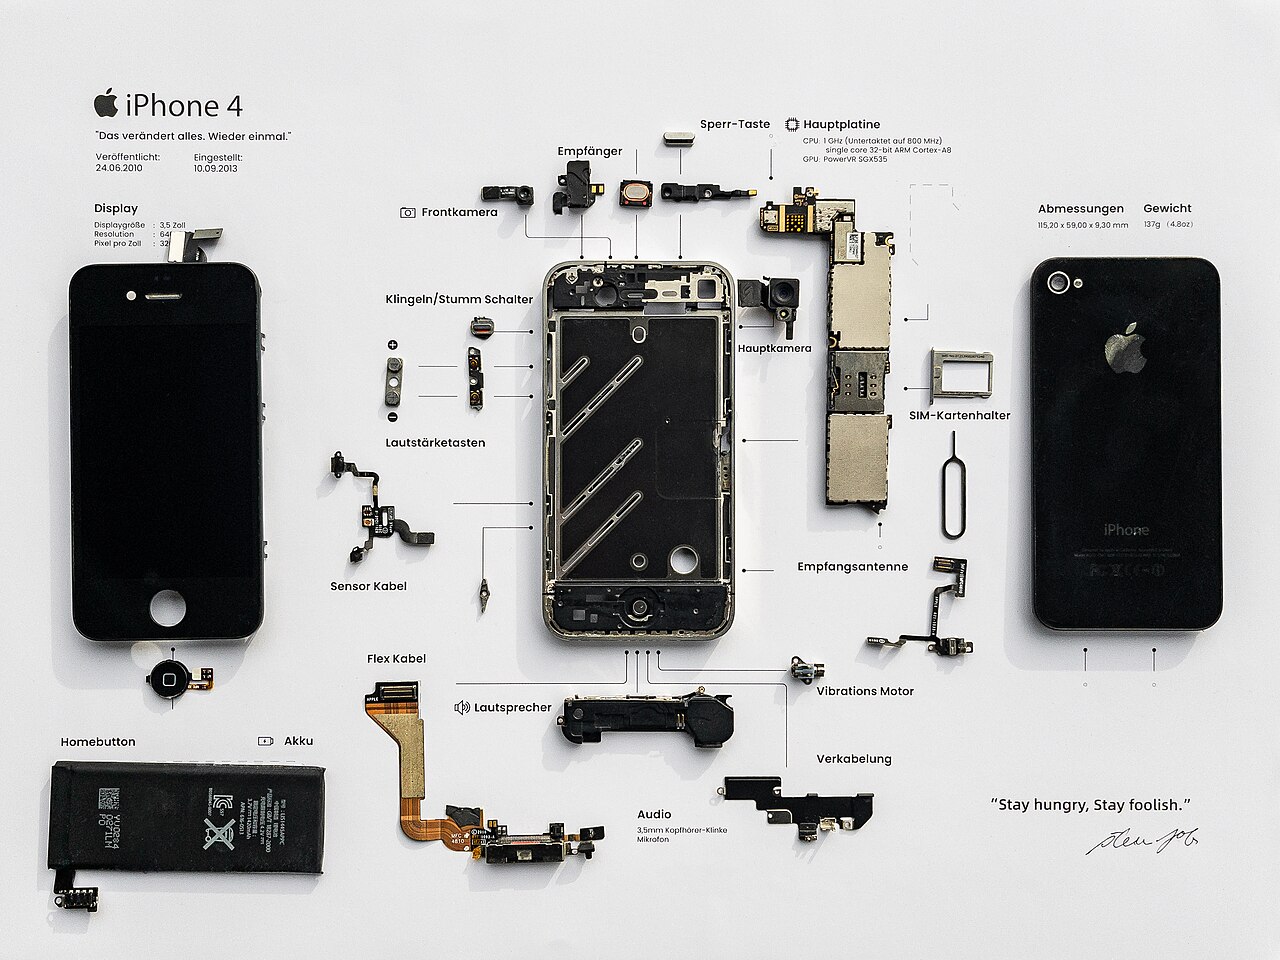
先看移动端。下面这一组是同类设备从外壳一路拆到硅片的几个层面——顺序刚好是拆机的顺序。
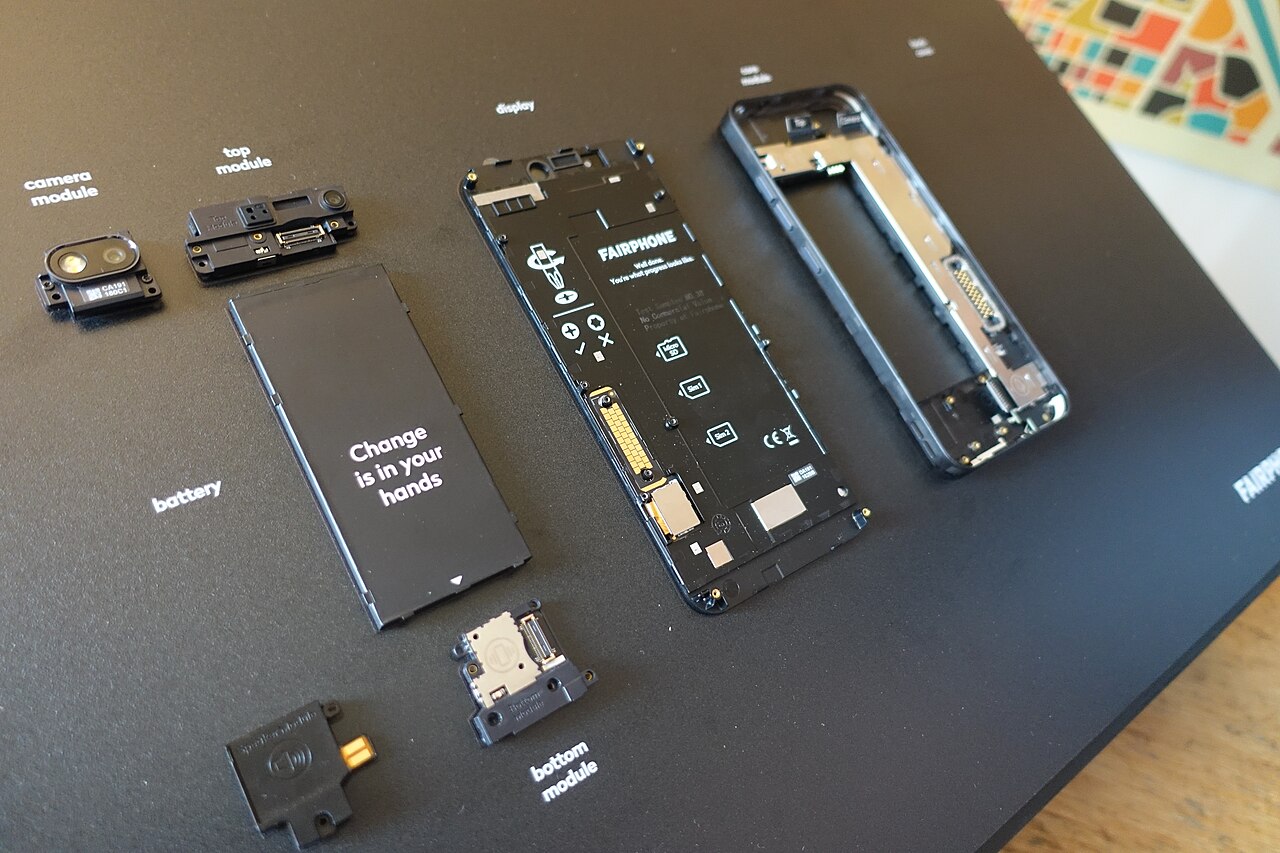
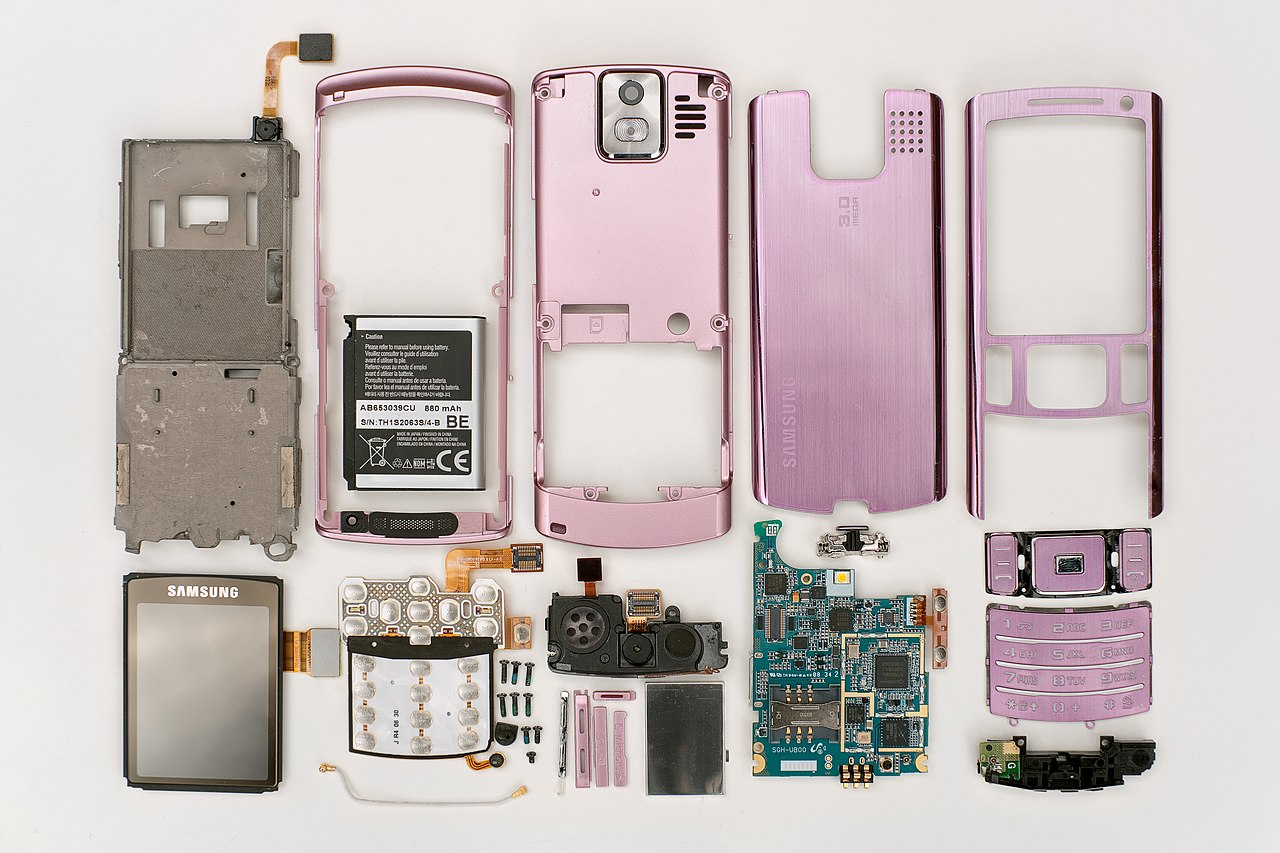
请注意三件事:电池占了绝大部分面积、主板只有一条窄长区域、没有任何主动散热部件。这三件事决定了移动 GPU 的全部处境——它的功耗预算来自电池,它的散热上限来自被动散热,它的体积上限来自这条窄长的主板。
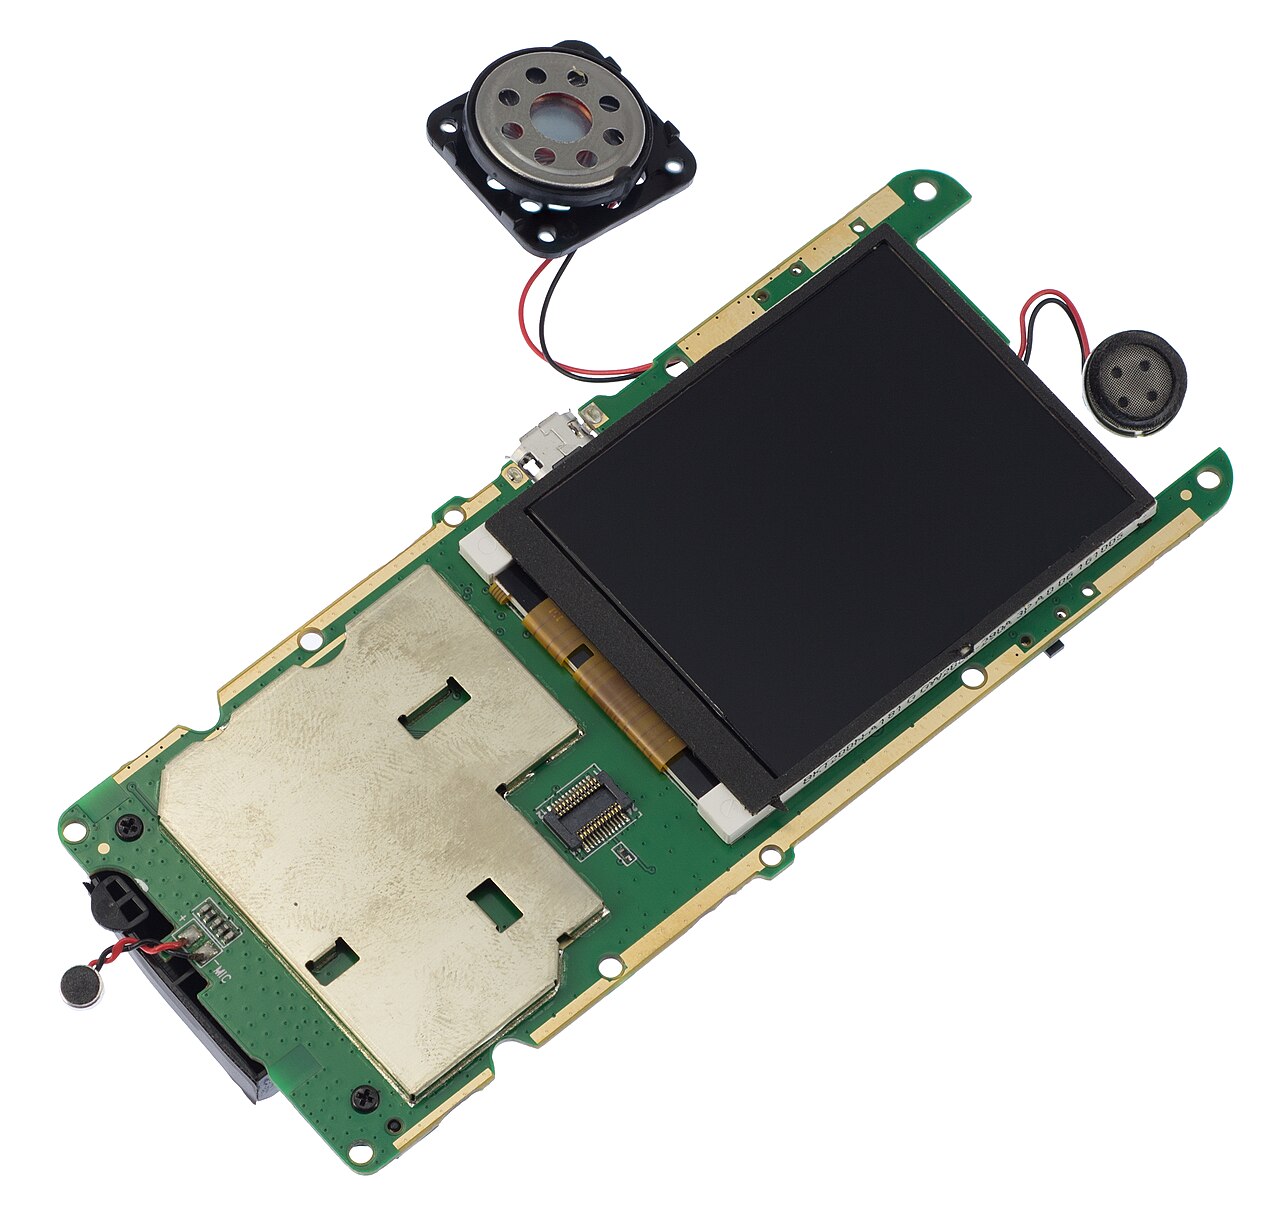
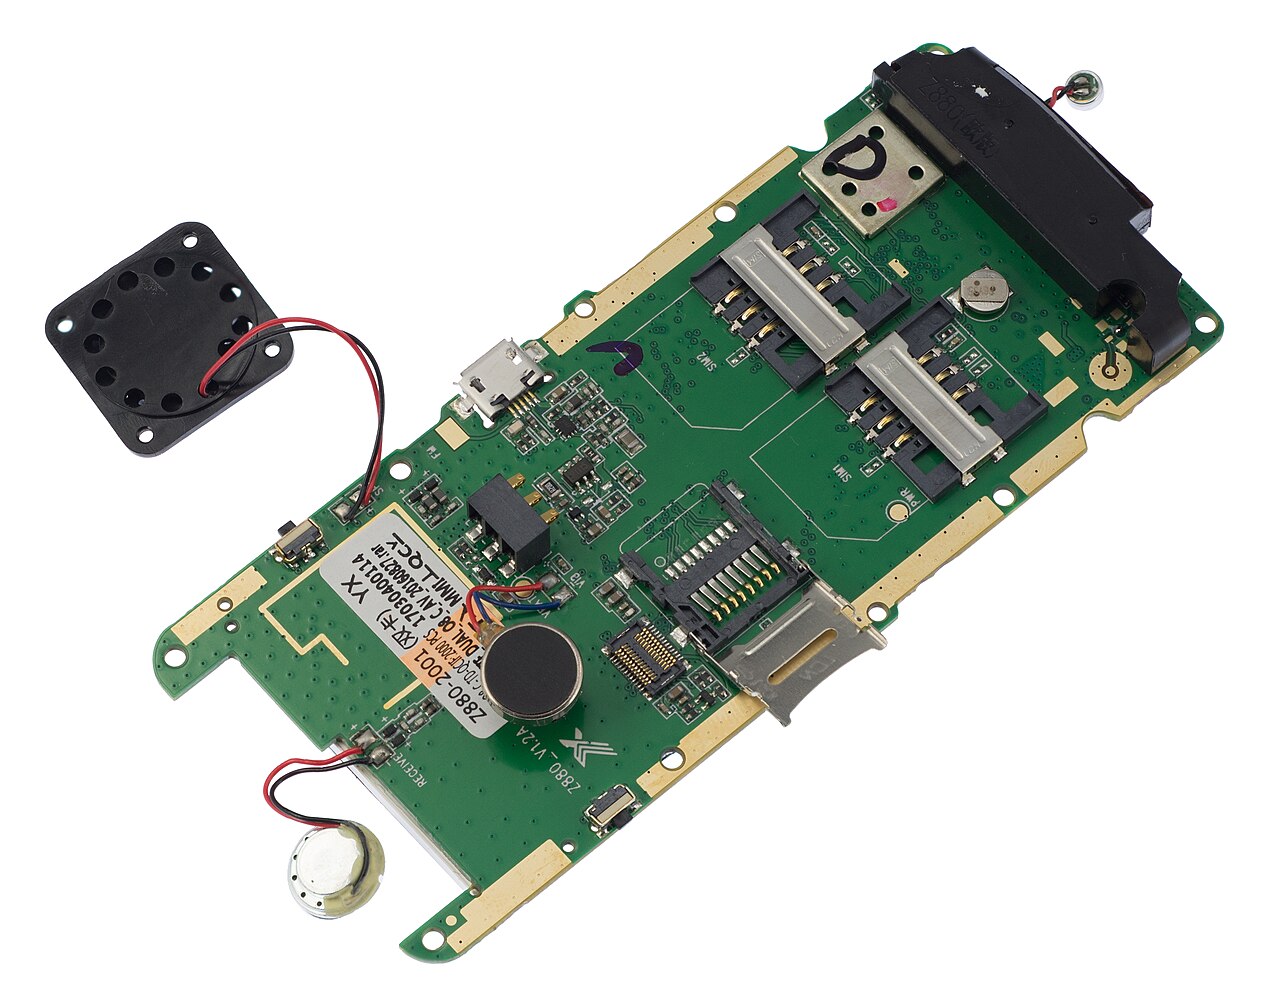
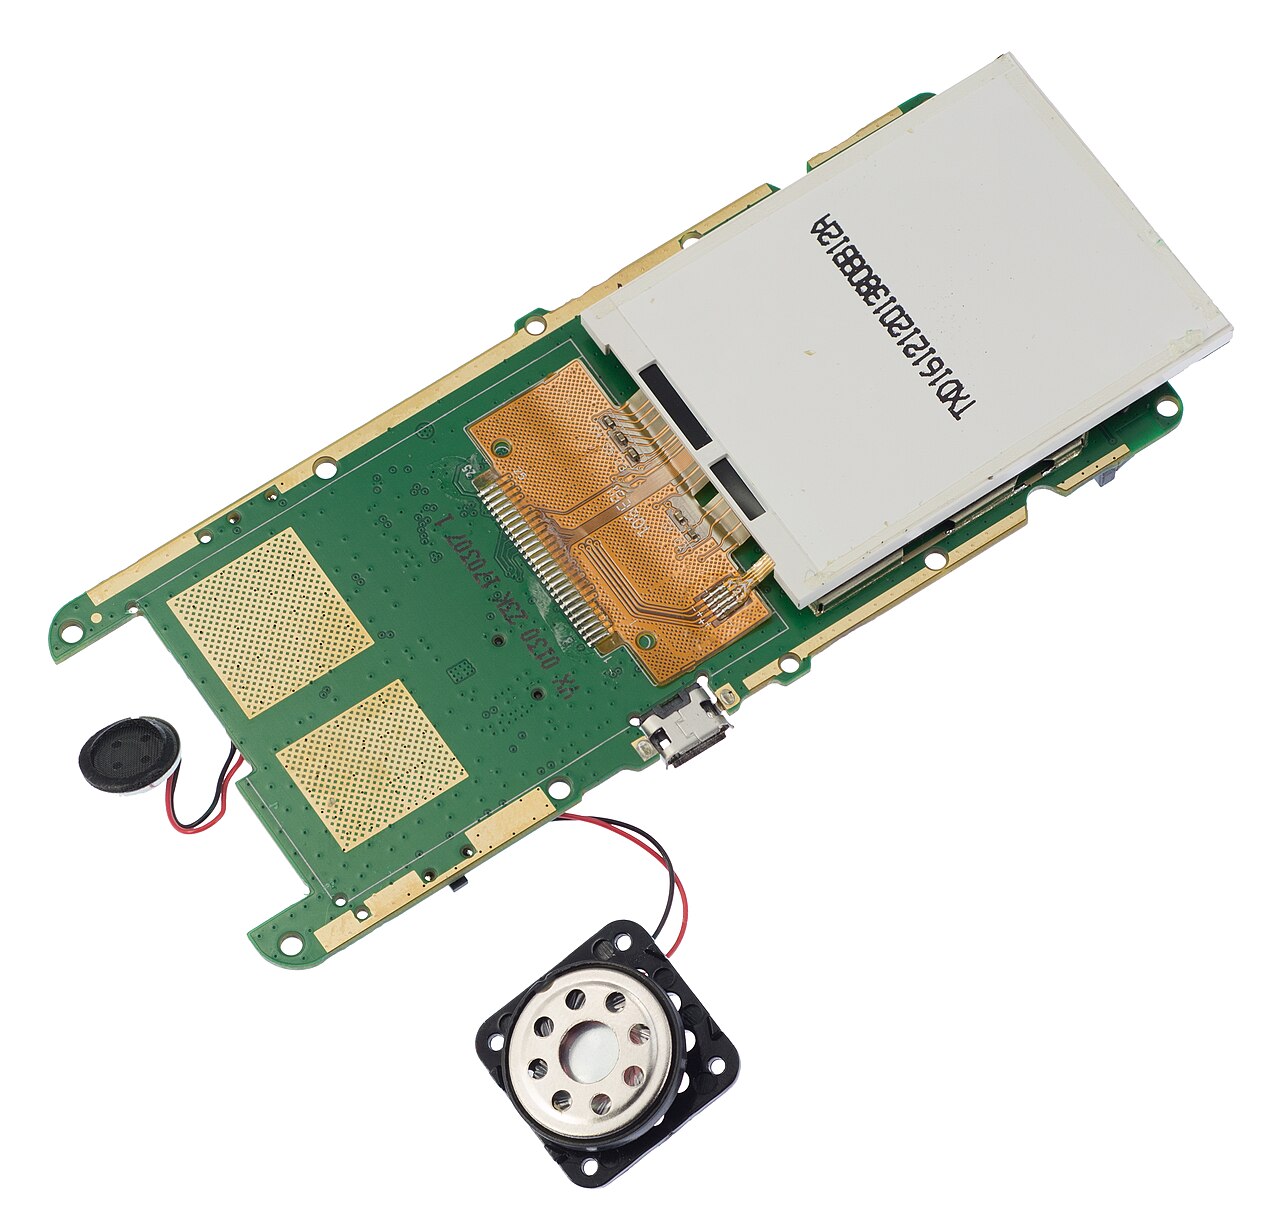
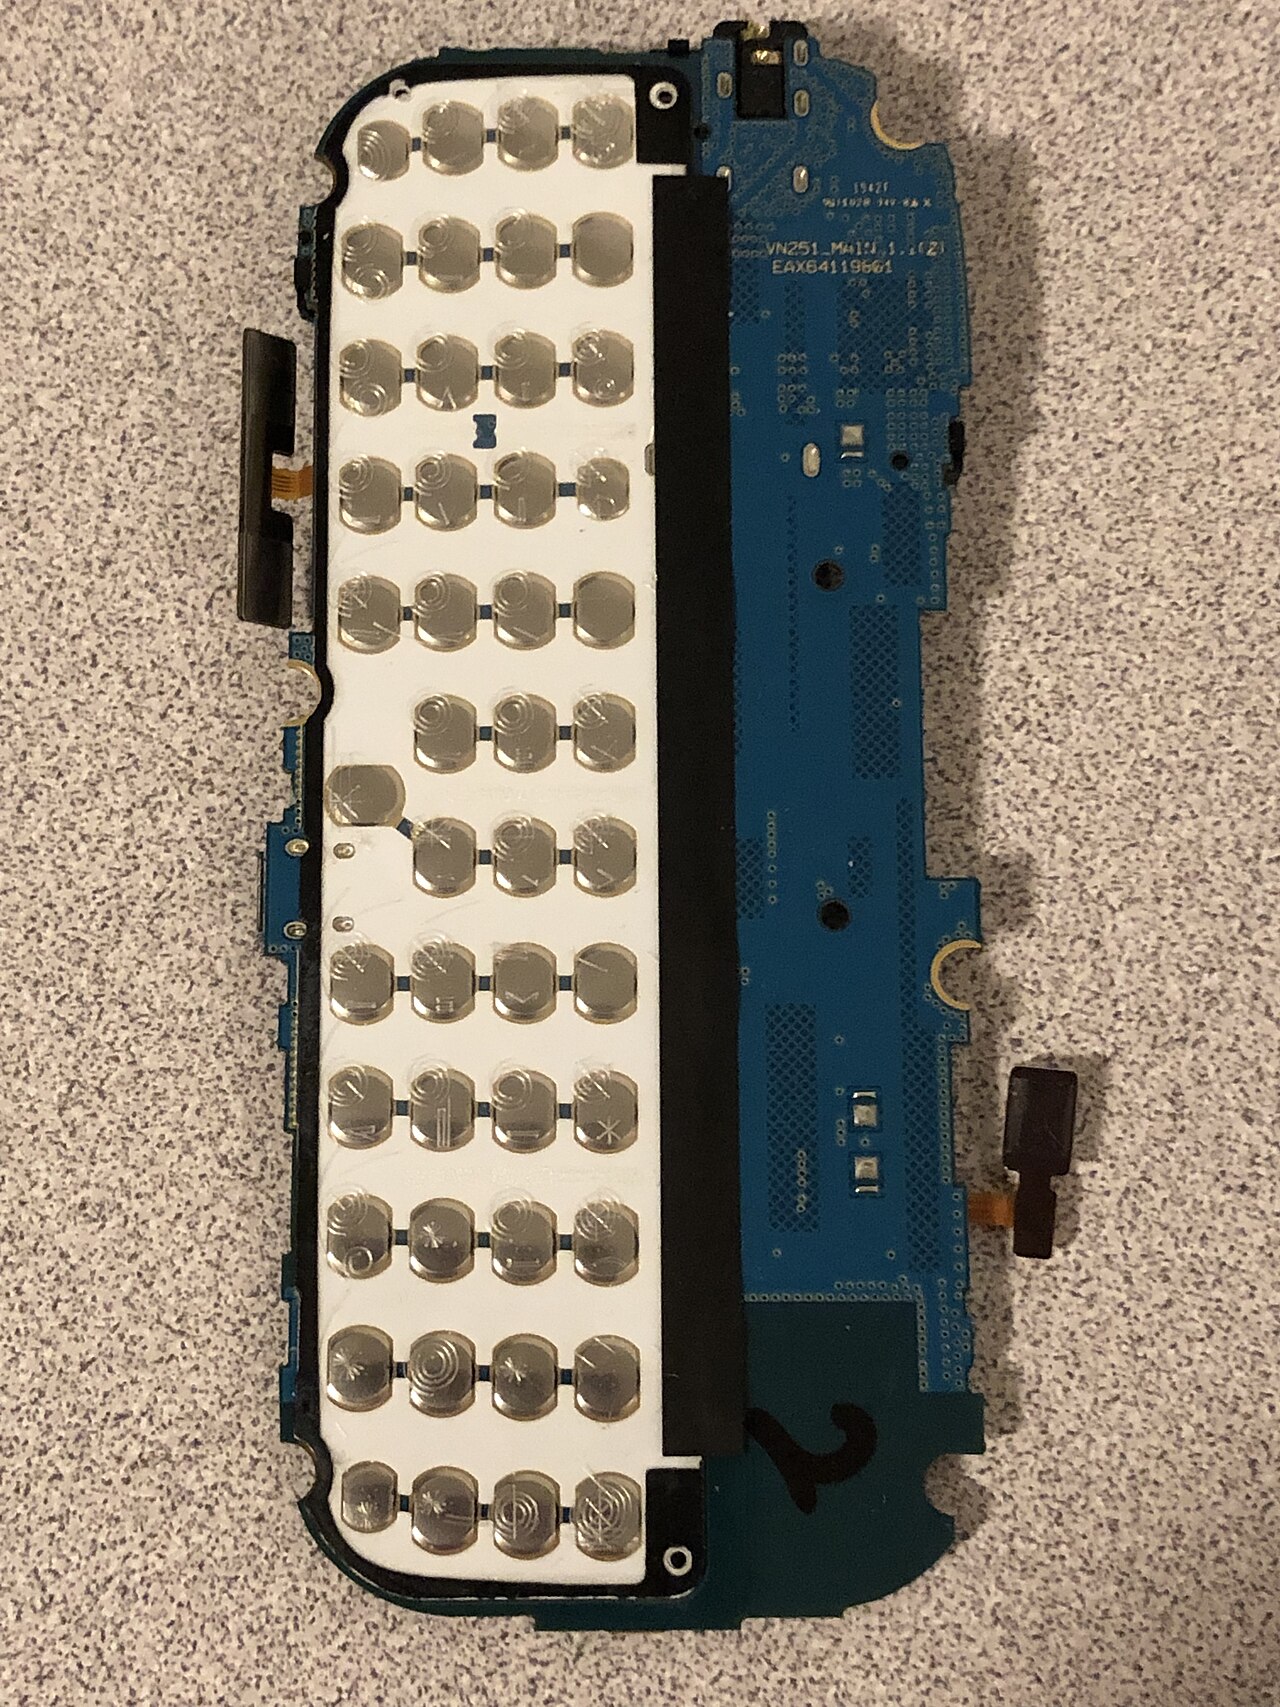
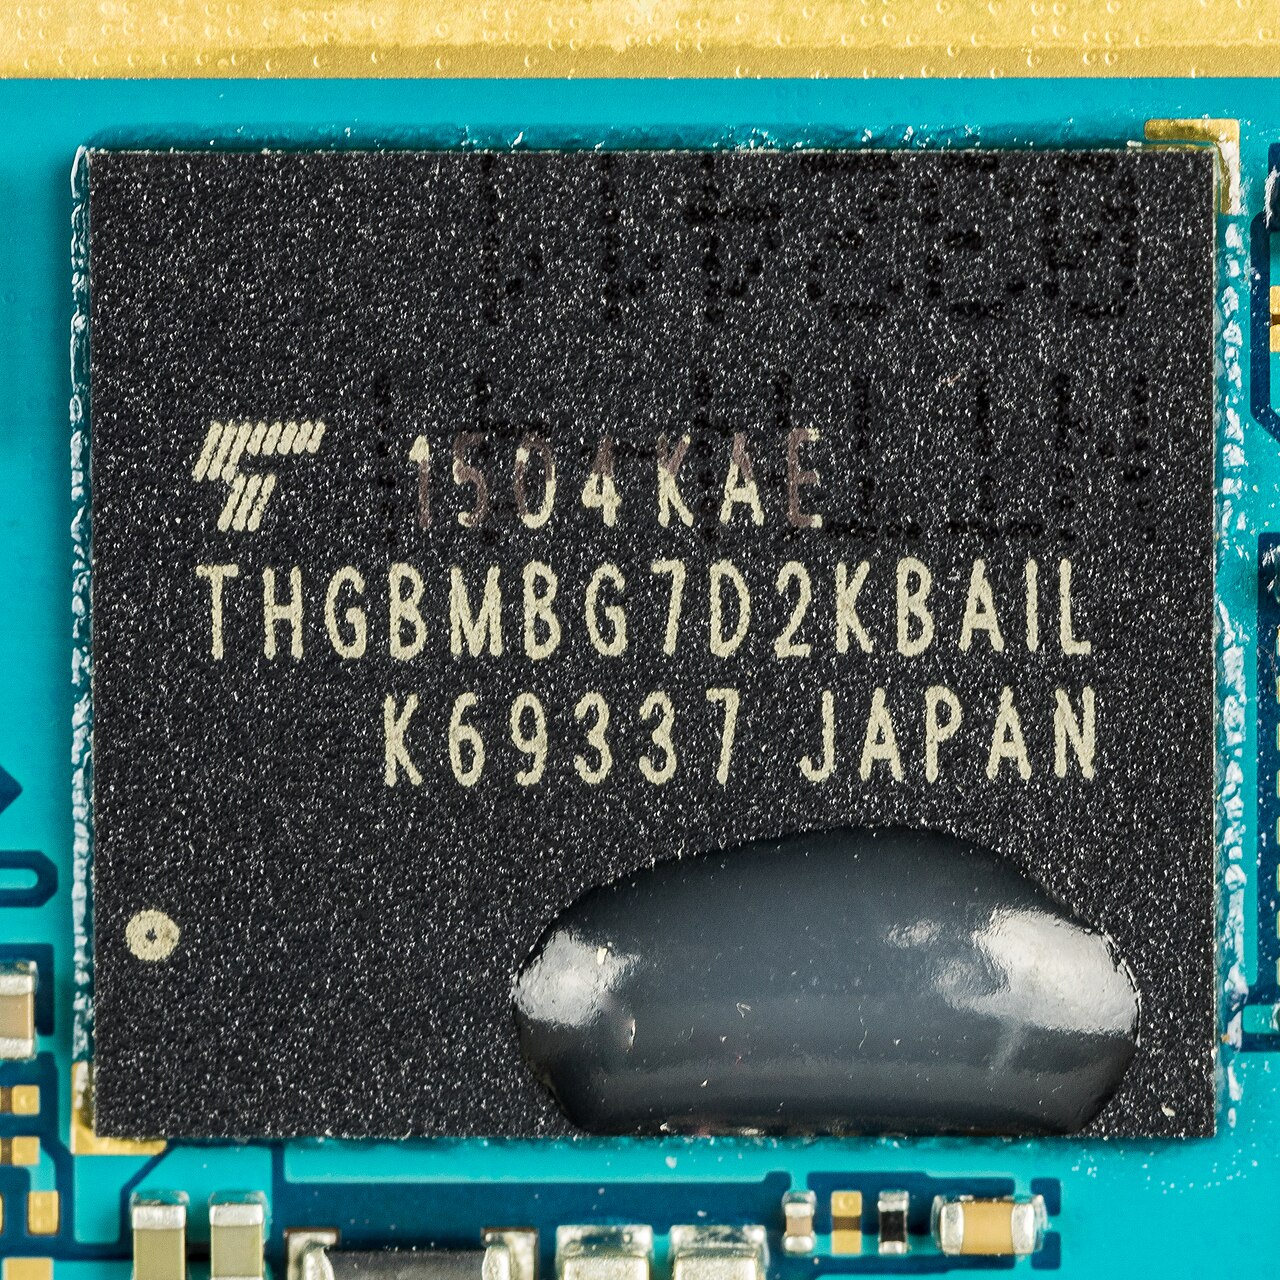
先看看主板这一级。把主板放大看,SoC 与内存是紧挨着焊在同一块板上的。这个距离在桌面端是几厘米的走线,在手机上被压缩到毫米级——这既带来好处(延迟低),也带来麻烦(散热互相影响、可选封装形式受限)。
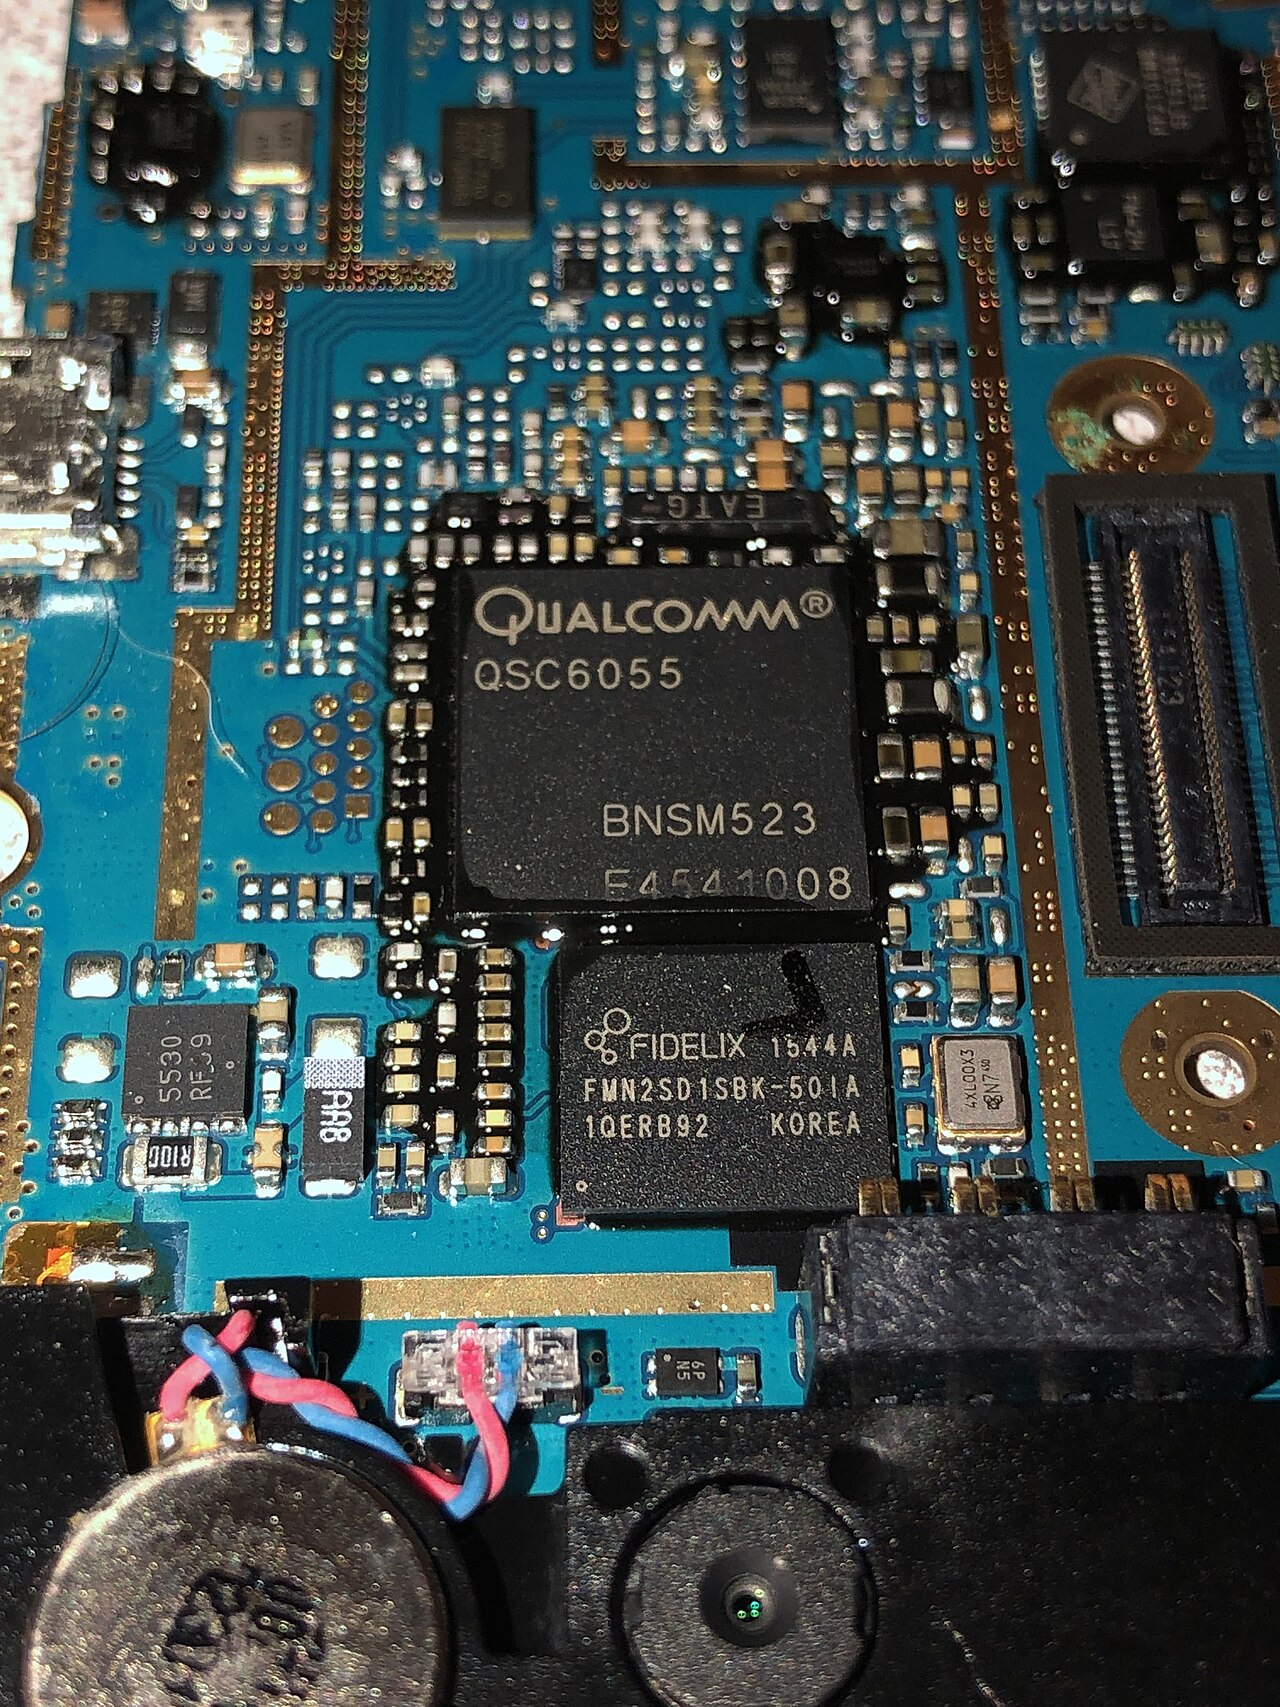
再往里一层是封装与硅片。移动端最常见的做法是把内存直接摞在 SoC 上方(叠层封装),用垂直方向换平面面积——元件不是变少了,而是被摞起来了。下面几张按封装由外到内的顺序看:
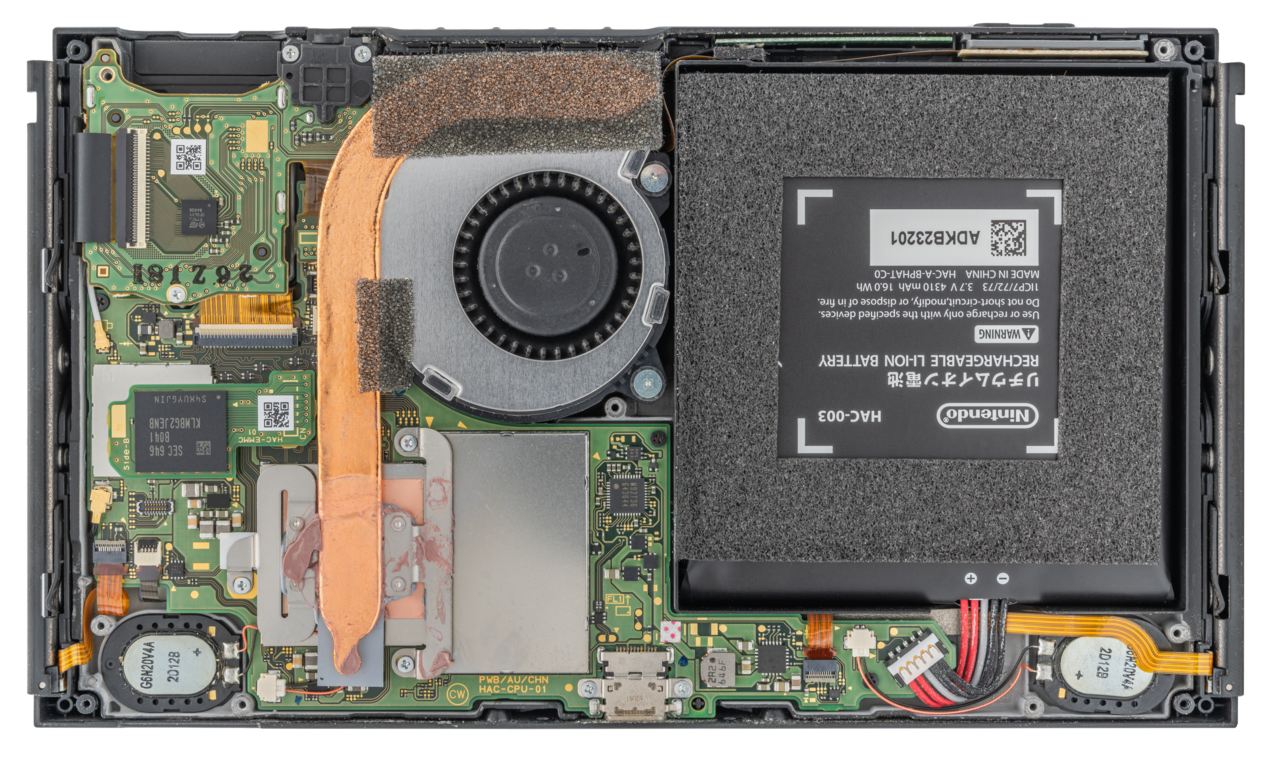
桌面对照一下就很明显了。差异不是「性能差一点」,而是设计前提根本不同:桌面可以靠风扇和更大的板面散热,移动端只能靠一块被电池与屏幕夹住的窄板把热量散出去。
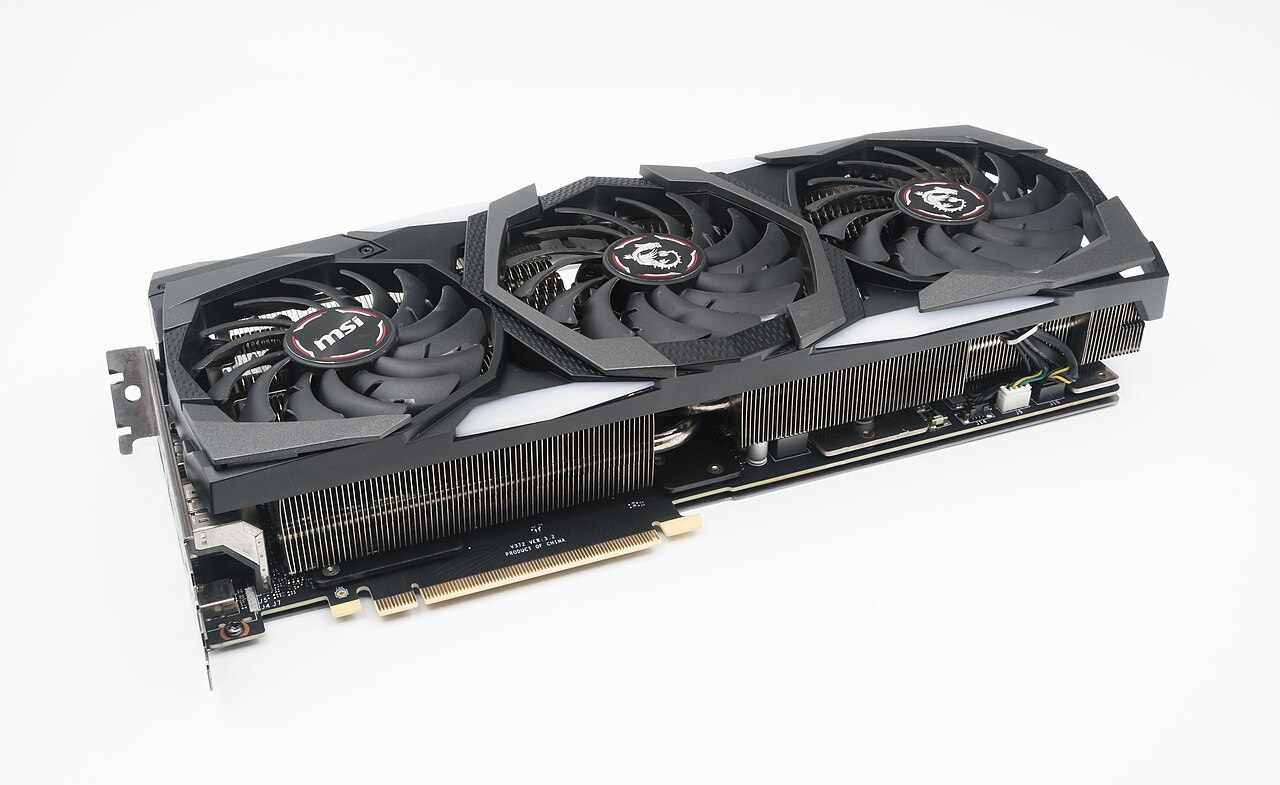
结论先行:移动端不是"性能弱一点的桌面",而是"功率被锁死、散热被锁死、面积被锁死"的另一台机器。后面所有的设计差异,都是这三条锁死的推论。
2.3 两份约束的物理来源
说白了,约束只有两条。
第一道是带宽。 GPU 计算所需的操作数、纹理、渲染目标都放在系统内存(LPDDR)里,而 LPDDR 的功耗与带宽特性与桌面的 GDDR 完全不同:
这张对照图的结论要读两遍:移动端不是"带宽略低",而是"每 pin 带宽与总位宽都被手机形态限制住"。一颗手机 SoC 的内存位宽通常是 64 位或 128 位,桌面显卡是 256–384 位。位宽决定了同一时刻能并行搬运多少数据,这是物理走线数决定的,不是软件能改的。
第二道是功耗。这里最常见的误解是"功耗高就是费电"。真正的机制是:功耗直接变成热量,热量必须散发出去,而手机的散热面积只有几平方厘米、且没有风扇。
所以移动端真正稀缺的资源不是"电"(电池容量在毫安时级别,够跑几小时),而是「持续散热的功率上限」——通常只有几瓦。这个上限一旦被突破,系统就会限频,而限频是不可谈判的。
2.4 全量清单:移动端图形的全部约束手段
在展开之前,先把"移动端能用的手段"穷举一遍,免得后面每讲一个都像是新发现。从减算什么、少搬什么、少耗什么三个阶段归类,清单是:
| 维度 | 手段 | 主要收益 | 主要代价 |
|---|---|---|---|
| 减算 | 视锥剔除、遮挡剔除、背面剔除、LOD | 减少顶点/像素着色次数 | CPU 或带宽开销、实现复杂度 |
| 减算 | 着色率控制(VRS)、分辨率缩放 | 直接减少像素着色量 | 局部画质下降 |
| 少搬 | 分块渲染 + 片上内存 | 深度/混合/附件不回写显存 | 几何阶段需缓存、bin 构建开销 |
| 少搬 | 纹理压缩(ASTC/ETC2) | 纹理带宽降 4–8 倍 | 压缩伪影、编码时间 |
| 少搬 | Render Target 格式精简、MSAA 替代方案 | 附件带宽成比例下降 | 精度或边缘质量下降 |
| 少搬 | 只加载 LoadOp/StoreOp 必要的部分 | 省掉整块附件的读写 | 需要正确的依赖声明 |
| 少耗 | 降低频率/电压(DVFS)、帧率上限 | 功耗与温度下降 | 性能下降(交换) |
| 少耗 | 减少空转与同步等待 | 单位功耗产出提高 | 需要重构提交结构 |
| 散热 | 均热板、石墨片、机身结构散热 | 提高可持续功率上限 | 重量、成本、设计复杂度 |
四大类之中,"减算"与"少搬"是渲染开发者能直接控制的,"少耗"一半可控(帧率与同步结构)、一半交给系统(DVFS),"散热"完全属于硬件设计。按可控性再看一遍这张表,优先级就出来了:
| 减算类手段 | 触发条件 | 失效场景 | 代价落在哪 |
|---|---|---|---|
| 视锥剔除 | 物体在相机视锥外 | 物体横跨视锥边界 | CPU 遍历开销 |
| 遮挡剔除 | 物体被完全遮挡 | 半透明、粒子、动态遮挡者 | 预处理与查询开销 |
| 背面剔除 | 面朝向背对相机 | 双面材质、薄片物体 | 几乎没有 |
| LOD 切换 | 物体屏幕占比小 | 切换处的跳变 | 显存(多套模型) |
| 着色率控制(VRS) | 局部区域对比度低 | 高频细节区域(UI、文字) | 局部画质 |
| 分辨率缩放 | 整帧或中间过程 | 依赖像素精度的效果(如细线) | 全局锐度 |
| 少搬类手段 | 省下的流量 | 前置条件 | 风险 |
|---|---|---|---|
| 分块片上处理 | 深度/混合/瞬态附件的片外读写 | 平台为分块架构 | 附件超容量则溢出 |
| 纹理压缩 | 纹理带宽降 4–8 倍 | 目标平台支持该格式 | 压缩伪影、编码时间 |
| 附件格式精简 | 与字节数成正比 | 非 HDR 中间结果 | 色带、精度不足 |
| 附件语义(不读不写) | 整块附件的往返 | 正确声明依赖 | 声明错误导致画面异常 |
| 通道合并打包 | 少一张 RT | 各通道数据可以共享分辨率 | 解包与位运算开销 |
| 少耗/散热类手段 | 谁在做 | 对开发者的意义 |
|---|---|---|
| DVFS 调频调压 | 系统固件 | 只能通过"降低负载"影响它,不能直接控制 |
| 帧率上限 | 开发者 | 最直接有效的一项:直接设定功耗目标 |
| 减少 CPU/GPU 同步与空转 | 开发者 | 提高单位功耗的性能产出 |
| 读取热余量并主动降档 | 开发者(需平台支持) | 把被动掉帧变成主动取舍 |
| 均热板 / 石墨片 / 机身结构 | 设备厂 | 决定"可持续功率"这个上限值 |
一句话总结这四张表:移动端的所有手段,最终都指向"减少进入内存的字节数"或"减少单位时间的能量消耗",没有第三种。
2.5 演进时间线:约束是怎么被逐步认识到的
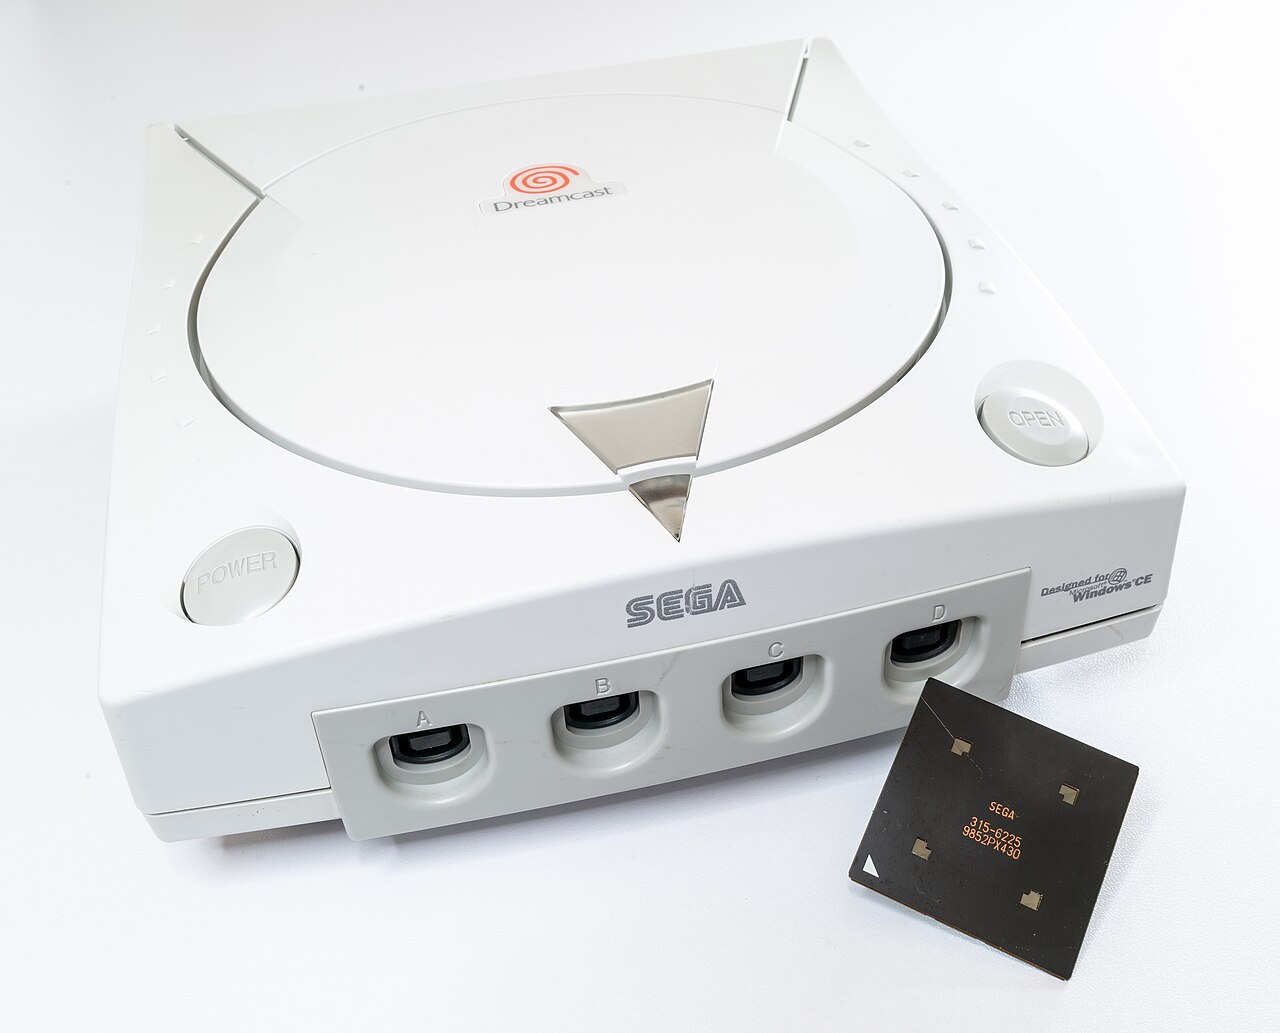
这二十多年里被「发现」的其实不是新硬件,而是旧做法在新约束下不成立这个事实。下表按该认知在公开文档里被写出来的时间排序,而不是按技术首次出现的时间——第一台 TBDR 商用主机出现在 1998 年,比它被写成共识早了将近十年。
| 时期 | 标志 | 认知上的变化 |
|---|---|---|
| 2000 年代中期 | 移动 GPU 出现,直接照搬桌面管线 | 认为移动只是"慢" |
| 2008–2012 | PowerVR 的分块与隐藏面消除(HSR)被广泛采用 [Imagination 架构文档] | 认识到"少搬字节"比"算得快"更值钱 |
| 2013–2016 | Metal / Vulkan 等显式 API 出现,附件与依赖可显式声明 [Khronos 规范] | 引擎开始主动利用片上内存 |
| 2017–2020 | 持续性能与热设计被系统厂商正式纳入指标 [移动热管理研究] | 认识到"跑分"与"可持续"是两件事 |
| 2021 至今 | 可变着色率、网格着色、移动光追进入移动平台 [Arm / Qualcomm 文档] | 新特性的收益必须按"每瓦"重新评估 |
年份口径说明:上表以该认知在公开技术文档中被明确表述的时间为准,不是技术首次出现的时间。
2.6 术语对齐
| 中文 | 英文 | 一句话定义 |
|---|---|---|
| 立即模式渲染 | immediate mode rendering, IMR | 几何处理完立刻光栅化着色,直接读写显存 |
| 分块渲染 | tile-based rendering, TBR | 先按屏幕分块收集几何,再逐块着色 |
| 分块延迟渲染 | tile-based deferred rendering, TBDR | 分块 + 先确定可见性再着色,消除 overdraw |
| 分桶 | binning | 把三角形分配到覆盖的屏幕块,产出每块的几何列表 |
| 分块 | tile / bin | 实际着色的屏幕小块,尺寸由 GPU 与开发者共同决定 |
| 片上内存 | GMEM / tile RAM / on-chip memory | GPU 内部用于放当前块及其附件的高速内存 |
| 回写 | resolve | 把片上结果一次性写回系统内存的动作 |
| 重复着色 | overdraw | 同一像素在一帧内被着色多次 |
| 动态调频调压 | DVFS | 按负载与温度调整频率与电压 |
| 持续性能 | sustained performance | 长时间稳定运行时的性能,通常显著低于峰值 |
2.7 边界声明
边界与前面开篇说的一致,这里只补一条:六步闭环的第 4 步允许以「配置清单 + 伪代码」呈现(本系列按变体 B)。移动端题材以硬件约束与工程取舍为主线,代码密度天然偏低,硬凑长代码段只会稀释信息密度;但凡涉及具体实现,仍给可复现的做法,不接受"一般来说应该……"。
关键参数的取值范围(本篇会反复用到):
| 参数 | 典型范围 | 说明 |
|---|---|---|
| 移动 SoC 内存位宽 | 64 / 128 位 | 由走线数决定,软件不可改 |
| 可持续散热功率 | 数瓦量级 | 依机身尺寸与散热设计浮动 |
| 持续性能 / 爆发性能 | 50%–65% | 见第 3 节引用的实测区间 |
| 典型触发限频的温度点 | 70°C 上下 | 具体阈值依厂商策略 |
2.8 三个常见误判
在立起前提之前,先把三个最常见的误判摆出来。它们都源于同一种思维习惯:把桌面端的经验直接搬到移动端,而没有检查前提是否变了。
| 误判 | 表述 | 为什么错 | 正确理解 |
|---|---|---|---|
| 误判一 | "手机慢,是因为算力不够" | 移动端的瓶颈通常是带宽与功耗,不是 ALU 吞吐 | 先定位瓶颈,再决定优化方向 |
| 误判二 | "按最佳实践清单逐条关掉就行" | 清单是"结果",前提不同则结果不同 | 理解每个开关省的资源,再判断是否命中当前瓶颈 |
| 误判三 | "跑分高就是性能好" | 跑分测的是爆发性能,与持续性能可以差一倍 | 以"连续 20 分钟稳定帧率"为验收指标 |
第一个误判最值得展开一点。"算力有余、带宽已满"是可以直接观察到的:把着色器复杂度减半,如果帧率几乎不动,说明瓶颈不在算术上;把渲染分辨率降低一档,如果帧率立刻上升,说明瓶颈在像素与带宽侧。这两次试验加起来不到一小时,却比读十篇优化清单更能定位问题所在。
第二个误判的危害不在"关了不该关的",而在"关了该关的却没效果,于是得出结论:优化没用"。清单上的每一项都对应一个具体资源,如果当前场景不消耗那个资源,关掉它自然没有收益。这也是本系列坚持"每个开关都要说清它省的是什么"的原因。
2.9 贯穿全篇的问题
把这一篇要立的前提压缩成一句话,就是这篇文章要反复回答的:
在带宽与功耗两道墙的约束下,哪些桌面上的做法可以照搬,哪些必须换一种做法,换法背后的账又该怎么算?
后面六篇,每一篇都在回答这个问题的某一个侧面。这一篇负责把问题问清楚——以及说明,为什么它不是一个"优化技巧"层面的问题,而是一个物理前提层面的问题。
(本篇正文续见下节写入)
一、两台不同的机器:IMR 与 TBR/TBDR
3.1 一句话点题
先看看这一章的落点。这一章回答一个问题:为什么底层架构不同,会导致"同一句采样"在两台机器上代价不同?
答案在于数据在哪、什么时候被写回。桌面 GPU 采用立即模式渲染(IMR),几何与像素一路推进,随时读写显存;移动 GPU 采用分块渲染(TBR),先把几何按屏幕分块收集起来,再逐块着色,块内的深度、颜色、附件都留在片上内存里。这个差别看似只是"顺序不同",但它决定了一帧里有多少字节需要跨芯片搬运——而带宽正是移动端最贵的资源。
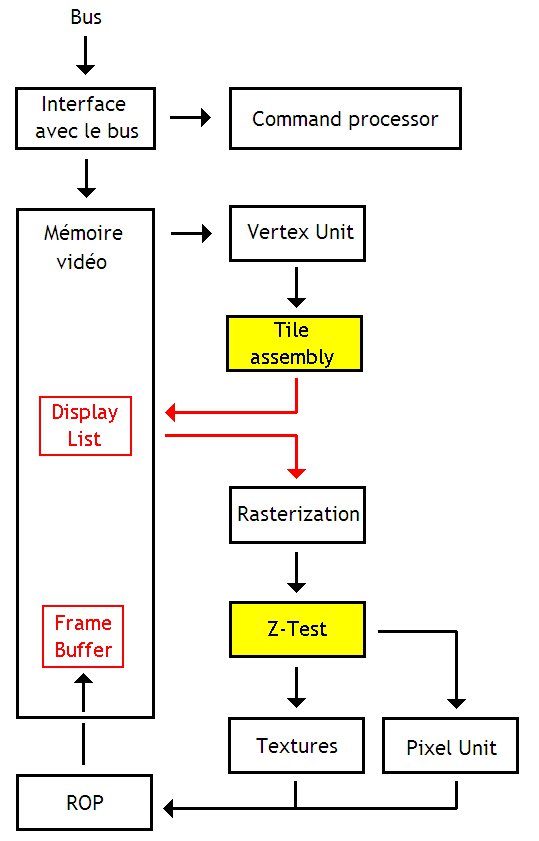
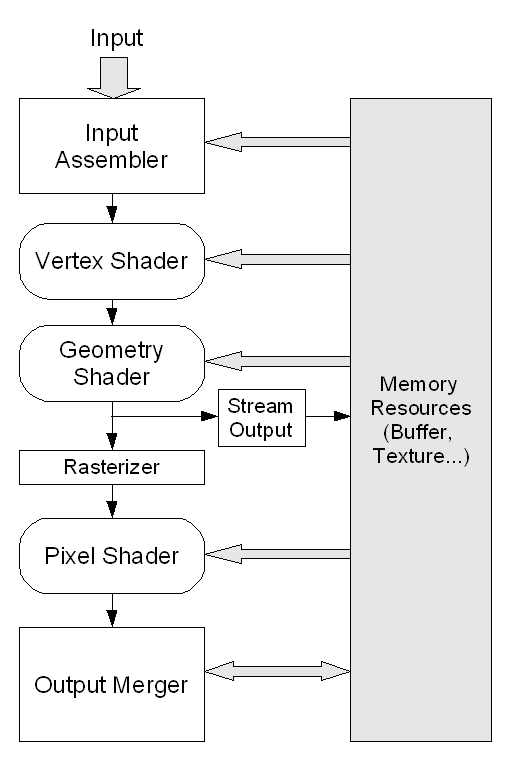
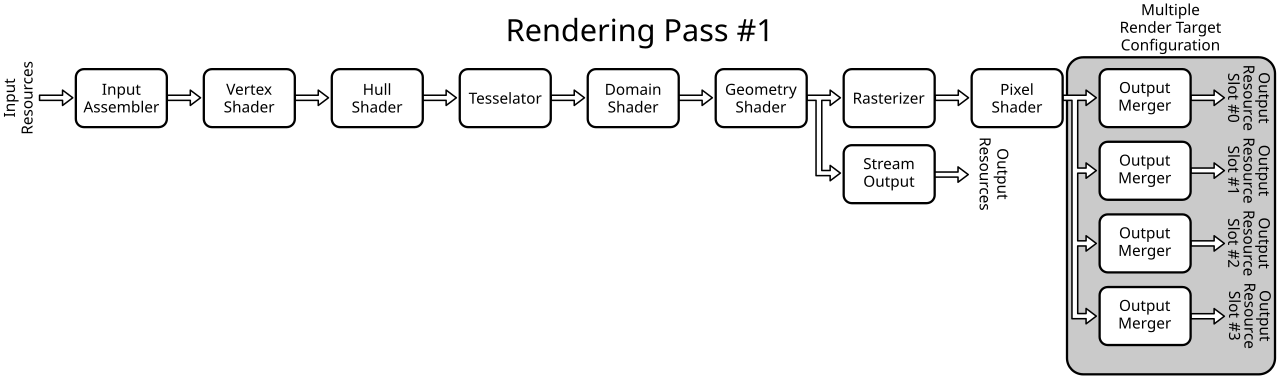
3.2 原理与概念:IMR 是怎么工作的
IMR 的流程很直白:顶点着色器处理顶点,光栅化把三角形变成像素片段,像素着色器逐片段着色,然后做深度测试与混合,结果写回显存中的渲染目标。整个过程没有全局的重新排序,谁先到谁先画。
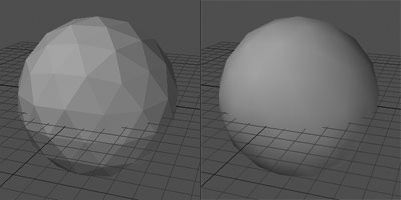
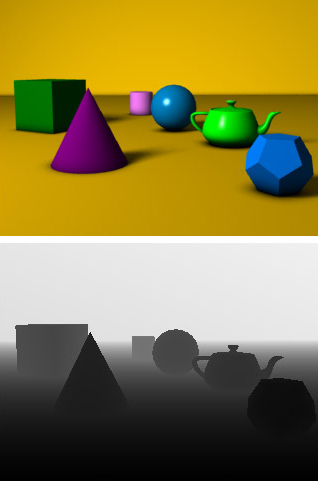
这种设计的优点是把复杂度交给硬件与驱动程序,开发者不用关心顺序;代价是同一像素可能被反复读写。举个最典型的例子:不透明物体如果按由远及近的顺序绘制,靠近相机的物体会把远处已经画好并写回显存的像素再覆盖一遍——那次写入是纯浪费。桌面 GPU 用 Early-Z 之类的技术缓解,但缓解的前提是绘制顺序合理,而顺序由应用决定,不是硬件能改的。
3.3 原理与概念:TBR 的两阶段与 TBDR 的可见性先行
这一节讲分块在硬件上怎么落地。先看一张权威管线示意图,再看 TBDR 最早的两代商业实现——它不是近年才有的优化技巧,1998 年就作为一颗独立图形芯片的架构卖到了消费市场。
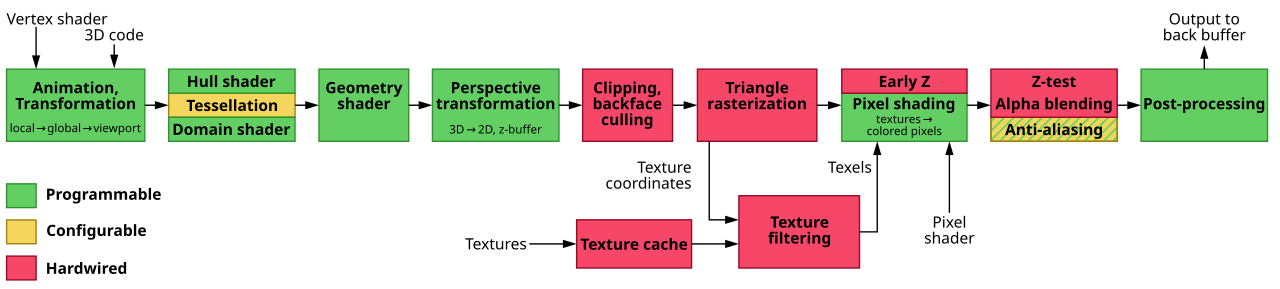
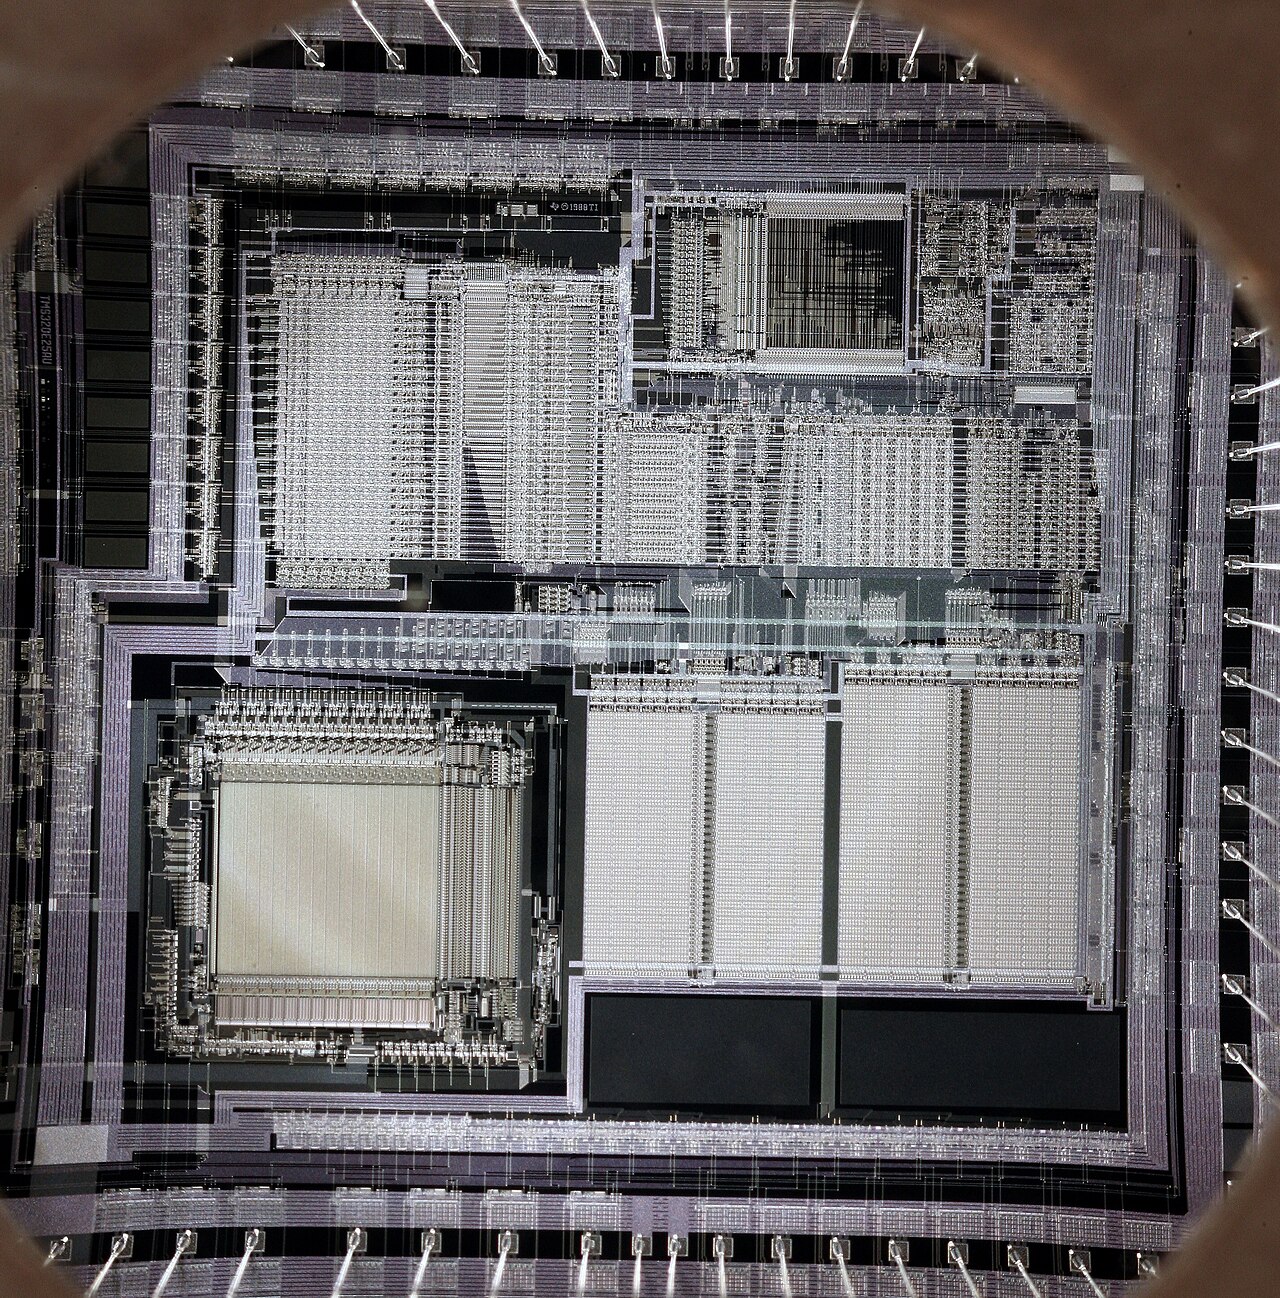
下面两颗芯片分别是第一代与第二代 TBDR 的商业实现。「先确定可见性、再着色」这条路径的硬件证据就在这里——不是从论文推出来的,而是卖过几百万台的图形芯片。
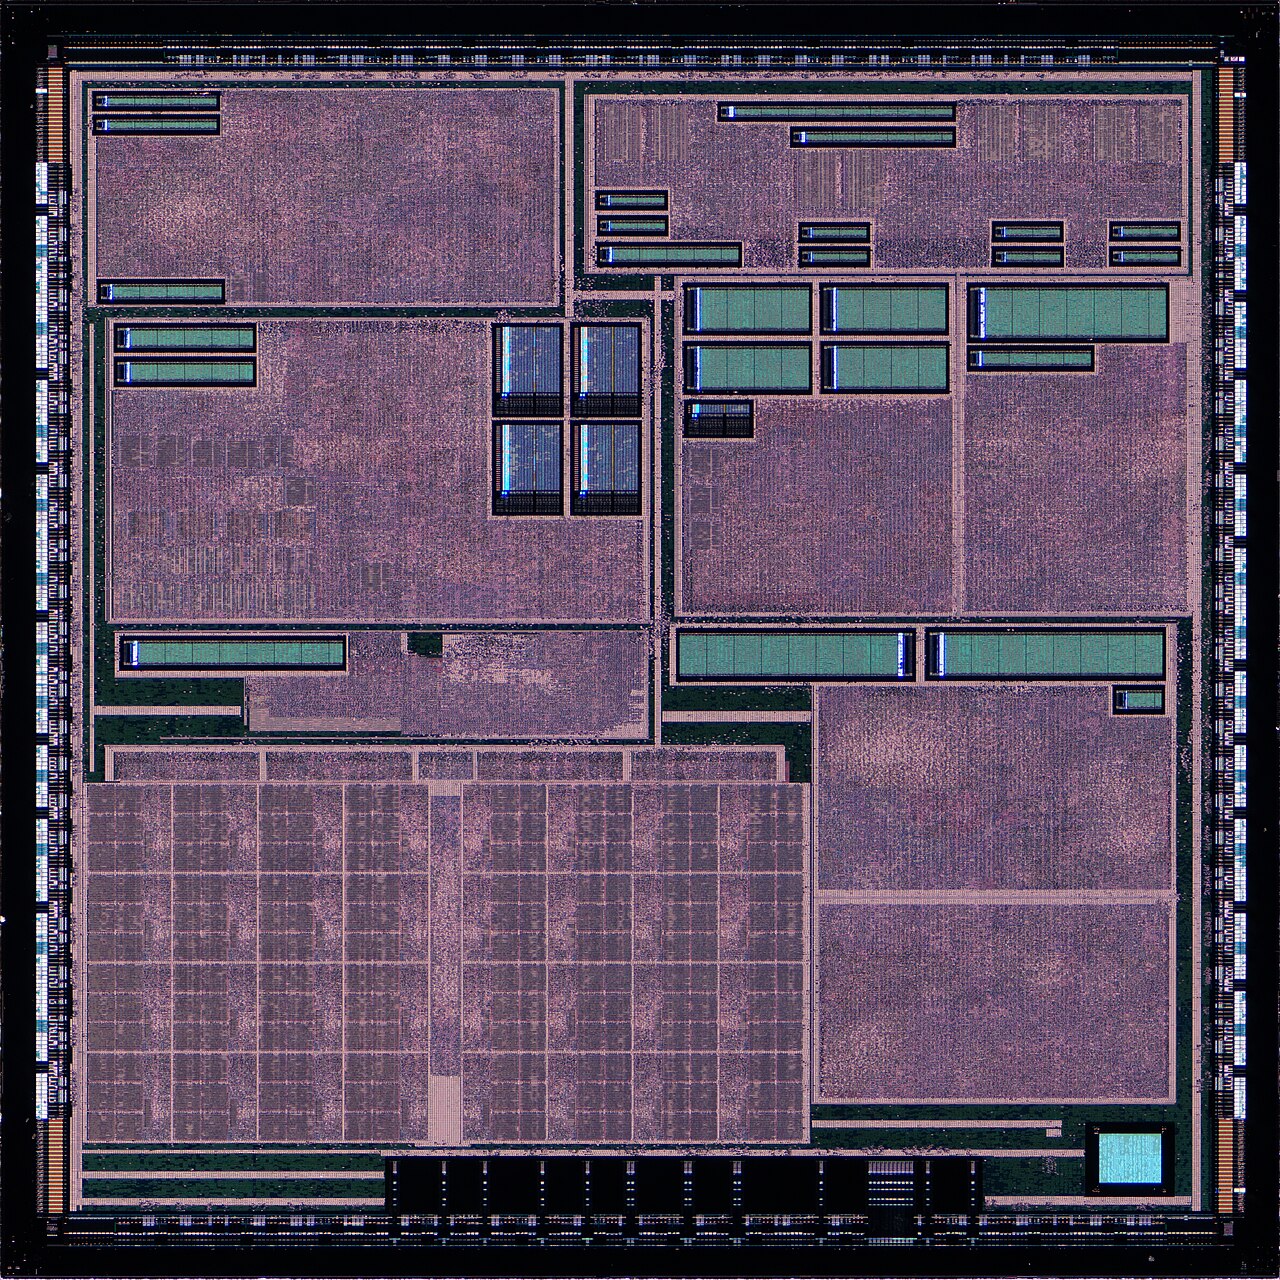
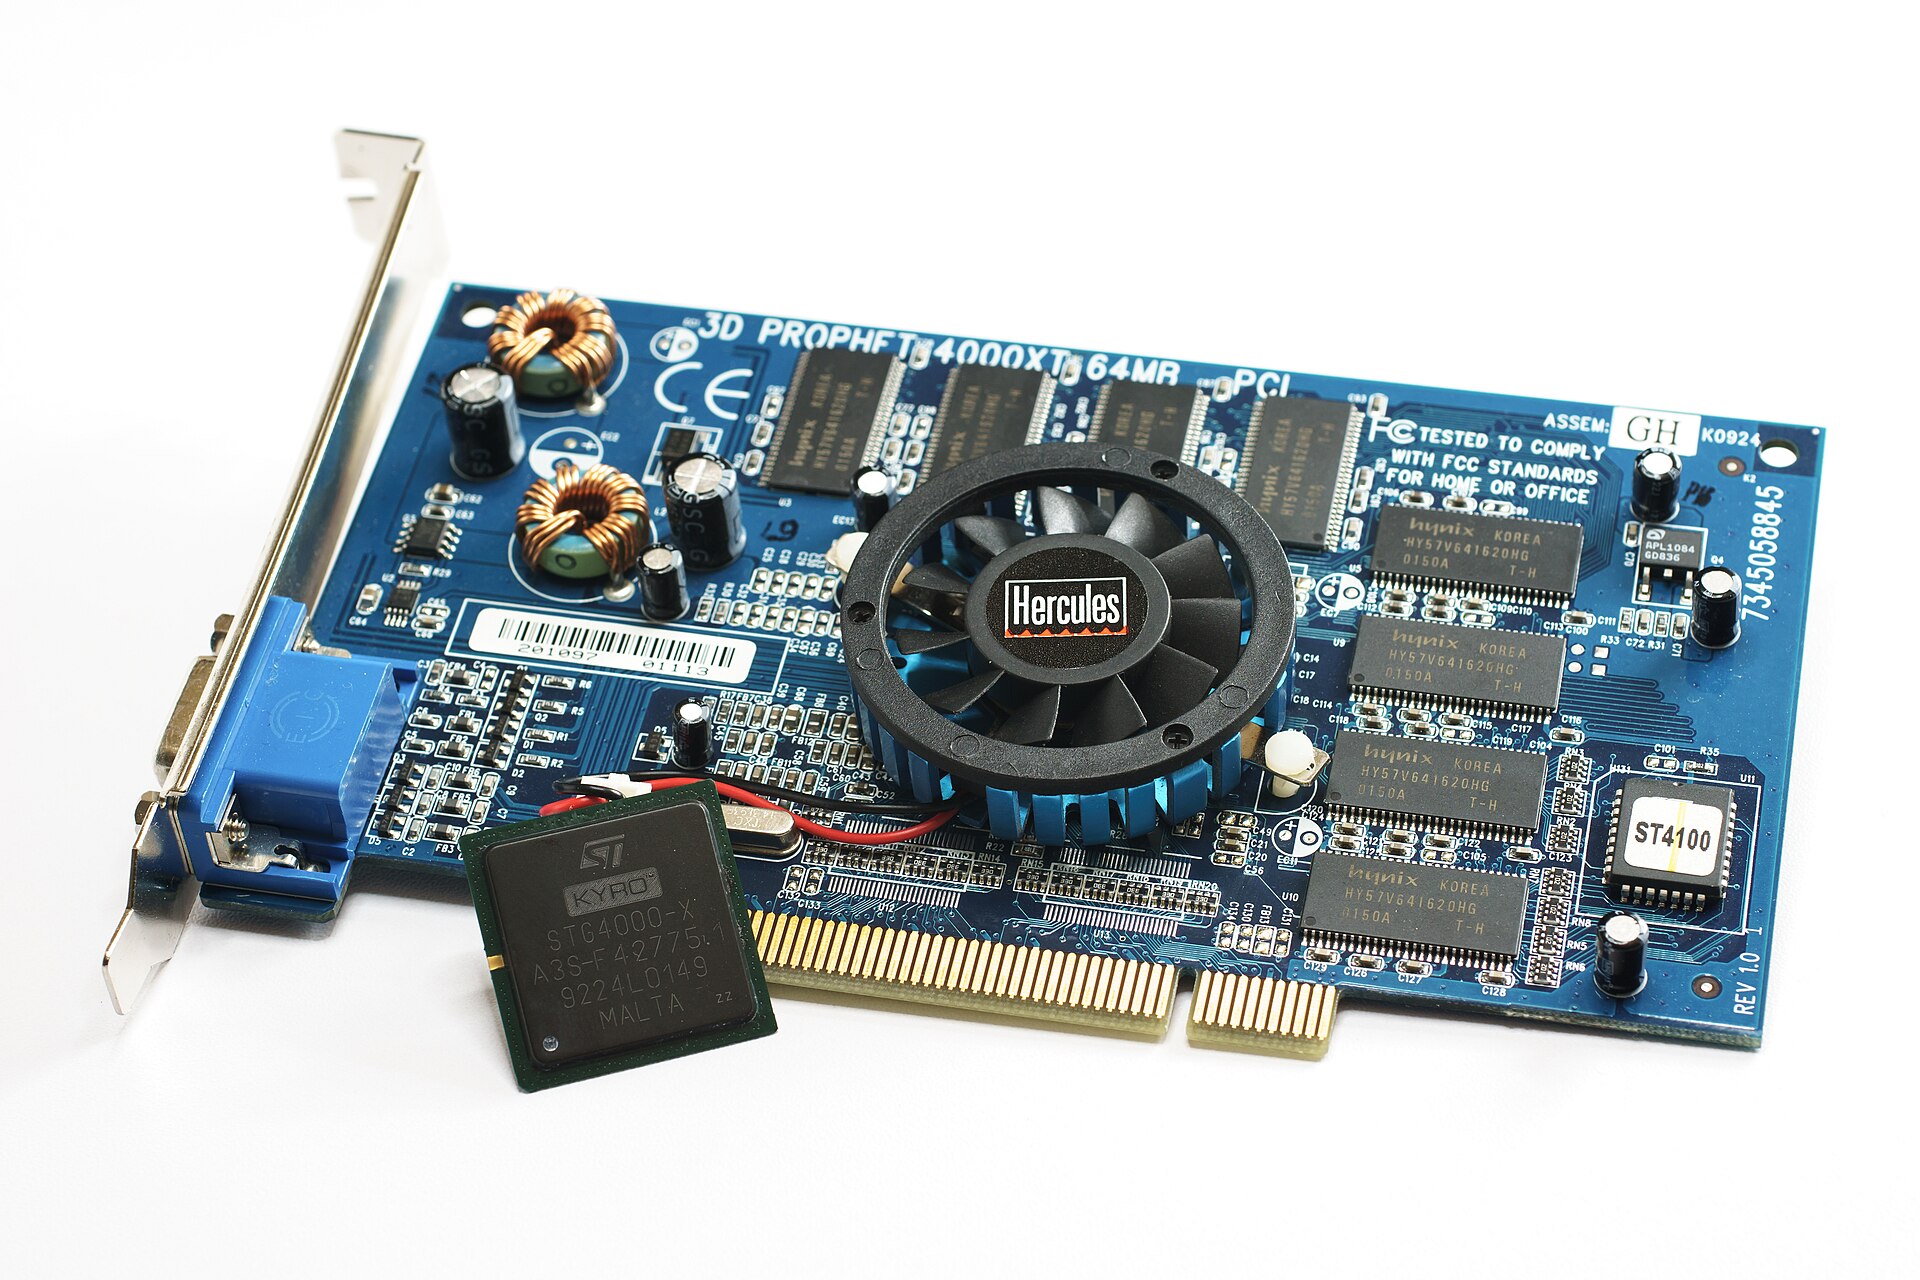
TBR 把一帧拆成两趟。第一趟是几何阶段(binning):所有顶点变换完成后,光栅化只做"这个三角形覆盖了哪些块"的判断,把结果记进每个块的三角形列表——这一步不产生任何像素。第二趟是瓦片处理阶段:逐块取出它的三角形列表,着色这一块的所有像素,块内数据全放在片上内存里,最后一次性回写(resolve)到系统内存。
TBDR 在此基础上多了一层:先决定可见性,再着色。同一块里,硬件先做隐藏面消除(hidden surface removal, HSR),确定每个像素最终可见的是哪个片元,然后只对它执行纹理采样与着色。这一点很关键——它把 overdraw 从"尽量缓解"变成了"基本消除",而且与绘制顺序无关。Imagination 在文档里把这个机制称为其架构的核心特征,并明确描述了它的效果:只有最终会被看到的像素才消耗着色资源 [Imagination 架构文档]。
这也是"两台机器"这个说法最扎实的地方:桌面 GPU 靠"画得快"取胜,移动 GPU 靠"尽量不画"取胜。
3.4 公式或参数逐项释义:块大小、桶数与片上内存
分块的具体参数决定了收益与代价,逐项说清:
| 参数 | 含义 | 取值影响 | 谁决定 |
|---|---|---|---|
| 块尺寸(tile size) | 每次着色的屏幕小块边长 | 越大越省管理开销,但片上内存需求越大 | GPU 架构固定(常见 16×16 到 32×32 像素量级) |
| 桶数(bin count) | 几何阶段把屏幕切成的块数 | 桶越多,单桶几何越少、但每帧的块调度开销越大;部分平台允许开发者影响 | 驱动/开发者可影响 |
| 片上内存容量(tile RAM / GMEM) | 存放当前块颜色、深度、附件的空间 | 决定能同时挂多少个渲染目标、能否开 MSAA | 硬件固定 |
| 单块附件字节数 | 颜色 + 深度 + 模板 + 其他附件的总字节 | 直接决定片上内存占用与是否溢出到显存 | 开发者可设计 |
| 回写次数 | 每帧把片上结果写回几次 | 越少越省带宽;多渲染目标切换会打断 | 开发者可设计 |
这里有一条容易踩的边界:片上内存是有限的。如果附件太多(比如同时挂颜色 + 深度 + 多张自定义 RT),或者 MSAA 采样数太高,块内数据放不下,硬件就必须溢出到系统内存——这时候"零带宽"的收益直接消失,甚至比 IMR 更差,因为多了分桶与调度的开销。
把这个边界拆到每一个参数上,就能看出各自的"可行区间"在哪里:
| 参数 | 取值偏小会怎样 | 取值偏大会怎样 | 现实中的选择 |
|---|---|---|---|
| 块尺寸 | 每帧块数多、调度开销上升 | 片上内存需求上升,易溢出 | 由 GPU 架构固定,开发者无法改 |
| 桶数(bin count) | 单桶几何过多,缓存压力大 | 每块几何太少,桶管理开销占比高 | 部分平台可让开发者影响 |
| 片上内存容量 | 可挂附件少,被迫多趟渲染 | — | 硬件固定,是"能不能开 HDR+MSAA"的硬门槛 |
| 单块附件字节数 | 省,但功能受限 | 溢出到系统内存,收益反转 | 开发者最该精打细算的一项 |
| 回写次数 | 收益最大 | 过度合并会限制管线灵活性 | 开发者可设计,需权衡 |
从这张表能得到一条很实用的判据:当有人问"移动端能不能开 HDR + 4×MSAA + 多渲染目标"时,正确的回答不是"能"或"不能",而是"要看单块附件字节数是否越过该平台的片上内存上限"——而这三项会相乘放大,很容易越线。
| 平台 | 架构取向 | 可见性处理 | 对开发者的可见差异 |
|---|---|---|---|
| Arm(Mali / Immortalis) | 分块渲染 | 逐块处理,深度在片上 | 附件语义与 tile 尺寸对性能影响显著 |
| Imagination(PowerVR) | 分块延迟(TBDR) | 硬件 HSR,与绘制顺序无关 | overdraw 主要由硬件消除,无需应用排序 |
| Qualcomm(Adreno) | 分块 + GMEM | 片上附件与快速解析 | GMEM 容量决定可否合并通道 |
| Apple(GPU 家族) | TBDR | 片上完成可见性与附件 | 显式 API 直接暴露 tile 语义 |
还有一件容易被忽略的事:片上处理会被某些操作打断。下面这张图说明哪些操作会迫使硬件提前把块回写——它对应上表里的「回写次数」,也是开发者真正能控制的一项。
从「逻辑上限」到「物理上限」还有一步:分块逻辑与存储阵列都落在同一片硅上,集成度决定了片上内存能给多少。下面这张显微照里,逻辑区与存储阵列的分区看得一清二楚。

读法是看哪一列差异最大:对渲染开发者影响最直接的是"可见性处理"那一列——在 Imagination 的架构上纠结绘制顺序通常是白费力气,而在别的平台上它仍然有意义。这也解释了为什么很多"排序优化"的经验在不同手机上效果差异巨大。
3.5 实现与配置:从几何到 resolve,可以做和不能做的
按变体 B,这一步用配置清单 + 伪代码说明,不给长代码段落。
(1)声明附件不需要回读——这是最直接的收益点。
【渲染通道配置示意 · 伪代码】

render_pass:
    颜色附件:
        format:   RGBA8            # 不要无脑上 RGBA16F
        load_op:  CLEAR            # 上一帧内容不需要
        store_op: DONT_CARE        # 这一帧画完没人读它
    深度附件:
        format:   D24S8
        load_op:  CLEAR
        store_op: DONT_CARE
上面这几行里真正省钱的是 store_op: DONT_CARE 与 load_op: CLEAR——它们明确告诉硬件"这块附件的旧内容不用读、新内容不用写回"。桌面端这么写只是省一点,移动端这么做能直接省掉整块附件的往返流量。Arm 的移动端实践讲义把这类"零带宽"附件(深度、混合、瞬态附件)列为移动 GPU 的核心收益来源之一 [Arm Vulkanised 2023 讲义]。
(2)把多个渲染步骤合并进同一个渲染通道。
【合并渲染通道示意 · 伪代码】

before:  通道A(写 G-Buffer) → 回写 → 通道B(读 G-Buffer 做光照)
after:   通道A + 通道B 合并为同一通道(借助 tile 内的读写)

收益:    G-Buffer 不再往返系统内存
代价:    片上内存占用上升,可能触碰容量上限
(3)不要在块内混用会打断 resolve 的操作。例如在同一个通道内反复切换渲染目标、或者对同一附件既要写又要读(除非平台支持块内读写)。
(4)不要指望它替你做剔除。分块只解决"同一像素被重复着色"的问题;看不见的东西(视锥外、被完全遮挡)仍然要经过几何阶段,那是另一个问题,第 5 篇会讲。
3.6 效果与量化:省下的到底是多少
先看看量化落在哪。这一章的量化要落到三处具体的字节账上(第 4 节会给出完整的每帧账本,这里先给结论方向):
| 环节 | IMR 的典型流量 | TBR/TBDR 的典型流量 | 差异来源 |
|---|---|---|---|
| 深度读写 | 每个像素多次读 + 写回 | 块内完成,通常不产生片外深度流量 | 片上深度测试 |
| 混合(blending) | 每层混合一次读 + 写 | 块内混合,最后一次写回 | 片内累积 |
| 瞬态附件 | 写回 + 读回 | 声明 DONT_CARE 后完全不产生 | 附件语义 |
| MSAA | 采样数成倍放大附件流量 | 块内解析(resolve)后再写回一份 | 采样在片上完成 |
需要强调一句口径:表中"典型流量"是架构层面的机制性差异,不是某一台设备上的实测值。本系列凡给机制性结论,一定标明"机制上如此";凡给数字区间,一定标注来源。混着说会让人误以为机制差异就是实测收益,而实测收益还要看具体场景是否真的触发这些路径。
顺带给出 overdraw 的可测量定义,因为它经常被当成一个模糊的词用:Apple 在其 GPU 计数器的官方讲解中给出的定义是——overdraw = 片元着色器调用次数 ÷ 实际存储的像素数,并建议用 GPU 计数器分别测量光栅化像素数、片元着色调用数、存储像素数与 Pre-Z 测试失败数,以此评估隐藏面消除的效率 [Apple GPU Counters]。有了这个定义,"overdraw 是 4.2 倍"才有确切含义(每写入 1 个像素平均执行了 4.2 次片元着色),也才能作为优化验收的指标。
3.7 源码与数据链接
- Imagination,PowerVR 图形架构说明(延迟着色与隐藏面消除的机制描述):https://www.imaginationtech.com/products/gpu/graphics-architecture/
- Imagination,Hidden Surface Removal 效率(overdraw 与逐 draw 排序的局限):https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/hidden-surface-removal-efficiency.html
- Arm,Getting started on mobile and best practices for Arm GPUs(Vulkanised 2023):https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_2023_getting_started_on_mobile_and_best_practices_for_arm_gpus.pdf
- Apple,Tailor your apps for Apple GPUs and tile-based deferred rendering:https://developer.apple.com/documentation/Metal/tailor-your-apps-for-apple-gpus-and-tile-based-deferred-rendering
- Qualcomm,Adreno GPU Game Developer Guide · Overview(分块渲染与 GMEM):https://docs.qualcomm.com/doc/80-78185-2/topic/overview.html
3.8 这一章留下的问题
架构层面的收益已经清楚了:分块的真正价值在于把深度、混合与瞬态附件留在片上。但还有一个更基础的问题没有回答——一帧到底有多少字节必须跨芯片搬运?带宽账本里,除了附件还有纹理、还有缓冲、还有各种被忽略的隐式流量。下一章把这张账摊开算。
二、带宽:移动端最硬的那道墙
4.1 一句话点题
先看看这一章的落点。这一章回答:每帧的字节都花在哪了,以及为什么带宽比算力更值得优先看。
先给结论:在移动端,算力通常还有余量,带宽才是最先撞上的墙。这不只是因为带宽小,更因为"碰内存"这件事本身的代价被严重低估——它既贵在字节,也贵在延迟与能量。Arm 在其移动 GPU 课程里给过一句总结式的判断:算力的缩放速度快于内存带宽的缩放速度,而碰内存是昂贵的 [Arm SIGGRAPH 2024 讲义]。
4.2 原理与概念:内存层级与"碰内存是贵的"
说白了,现代 GPU 的存储层级从里到外是:寄存器、片上内存与各级缓存、系统内存。层级之间的差别不是线性的,而是数量级级别的:
| 层级 | 容量量级 | 延迟量级 | 每次访问的单位能耗 |
|---|---|---|---|
| 寄存器 | 每线程几十个 | 1 个周期 | 最低 |
| 片上内存 / 缓存 | 数十 KB 到数 MB | 数十周期 | 低 |
| 系统内存(LPDDR) | GB 级 | 数百周期 | 高(跨芯片往返) |
一个反直觉但很关键的事实是:DRAM 即使不被访问也在耗电。它需要周期性刷新来维持数据 [带宽优化实践]。"不访问就不耗电"是错的,但"访问一次代价高昂"更是被低估的那一半——一次缓存未命中的代价不只是那几十个字节,还包括跨芯片往返的延迟与能量。
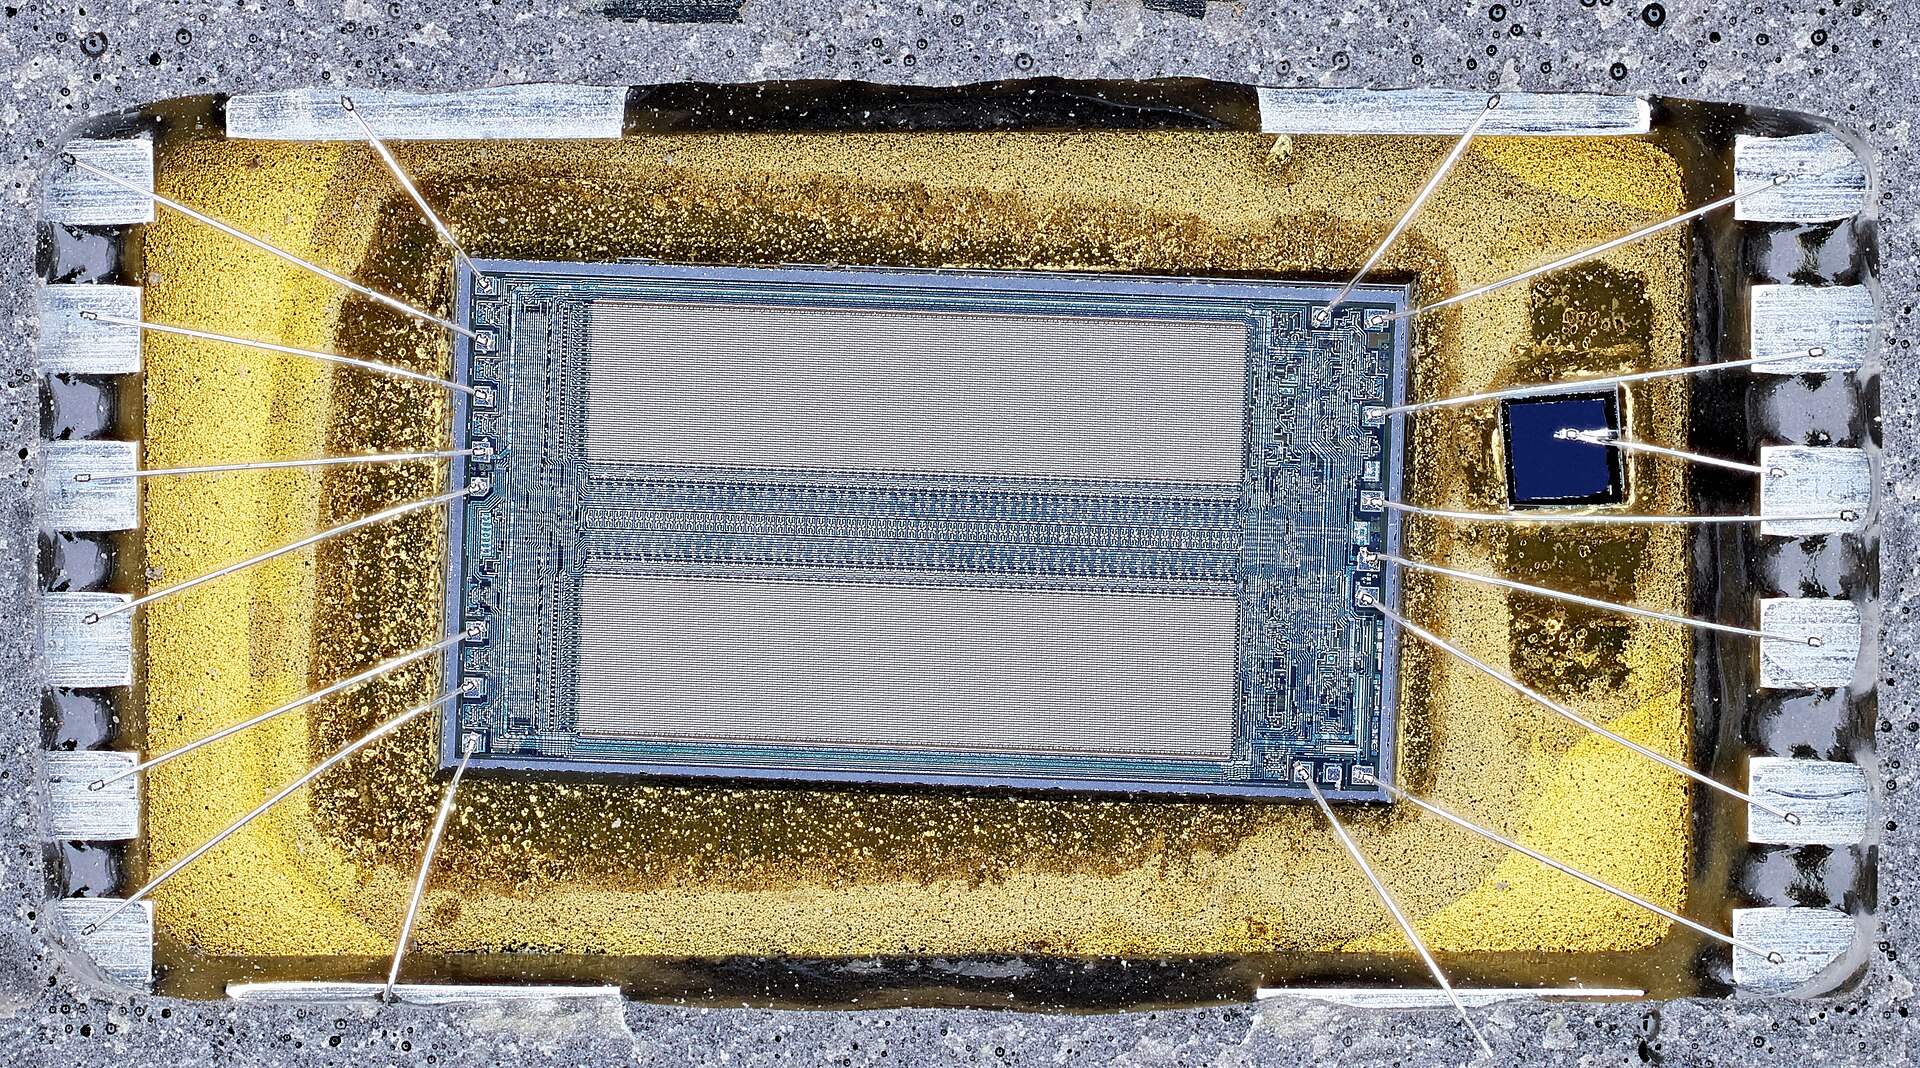
「碰内存是贵的」里的那个「内存」长什么样?下面是一颗 DRAM 的裸片实拍——存储阵列是整片硅上最规整、占比最大的部分。这种规则性正是它便宜到能做成 GB 级、又慢到必须靠多级缓存遮住延迟的原因。
4.3 原理与概念:LPDDR 的物理特性
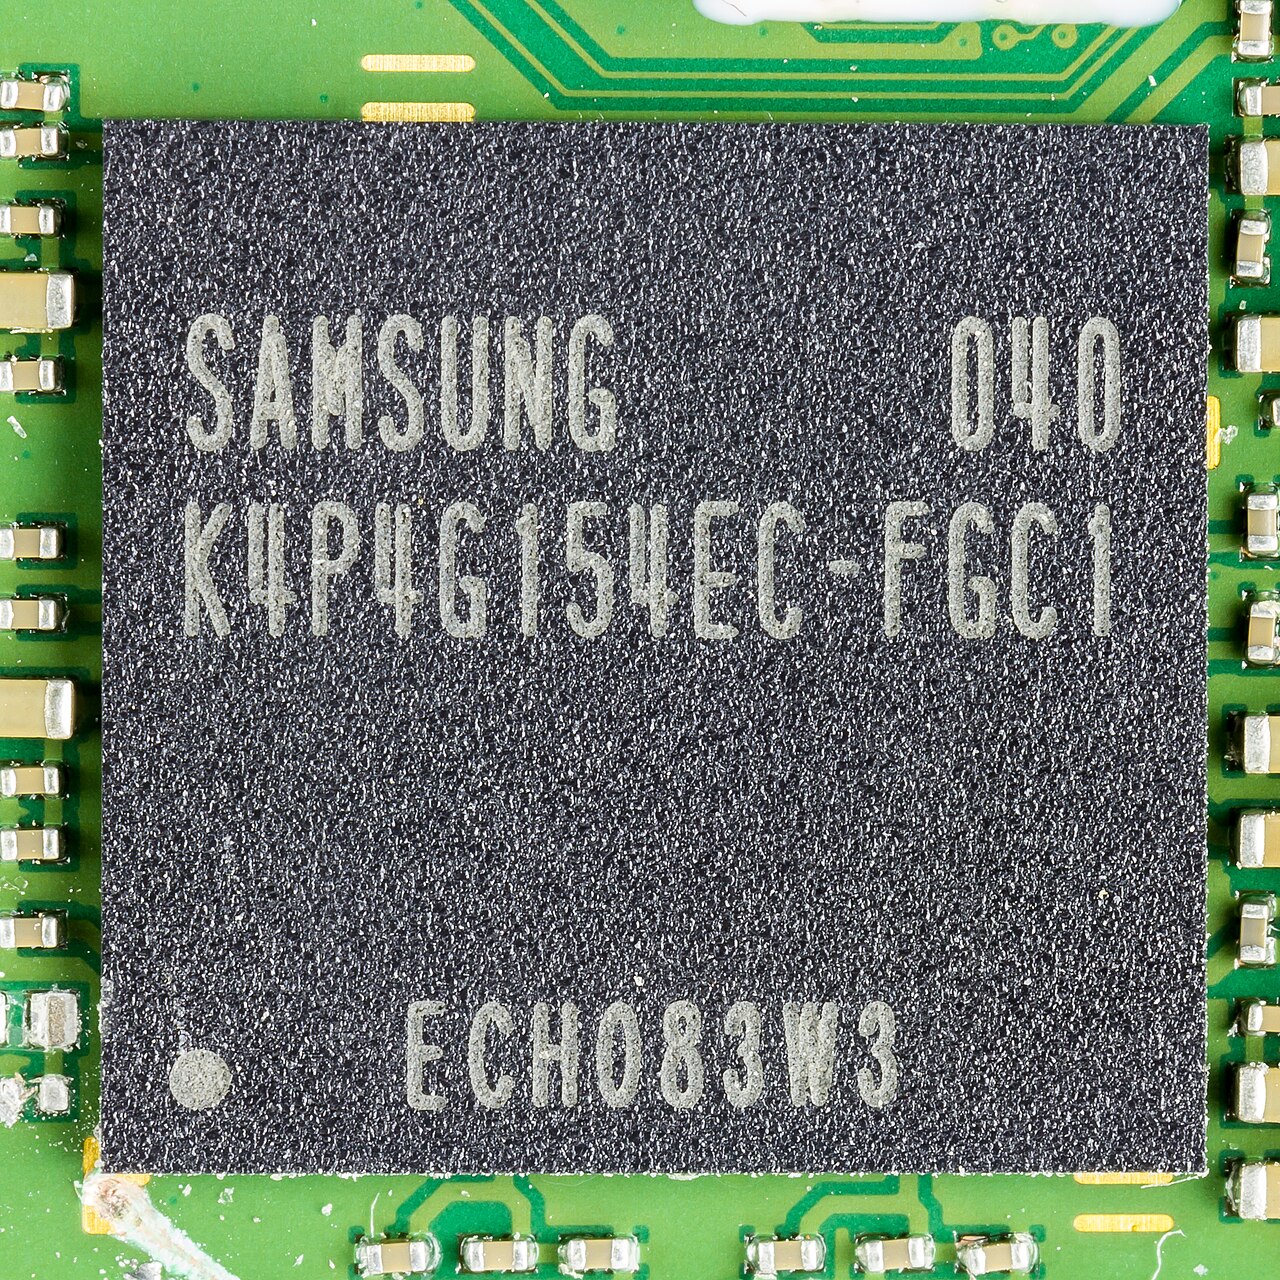
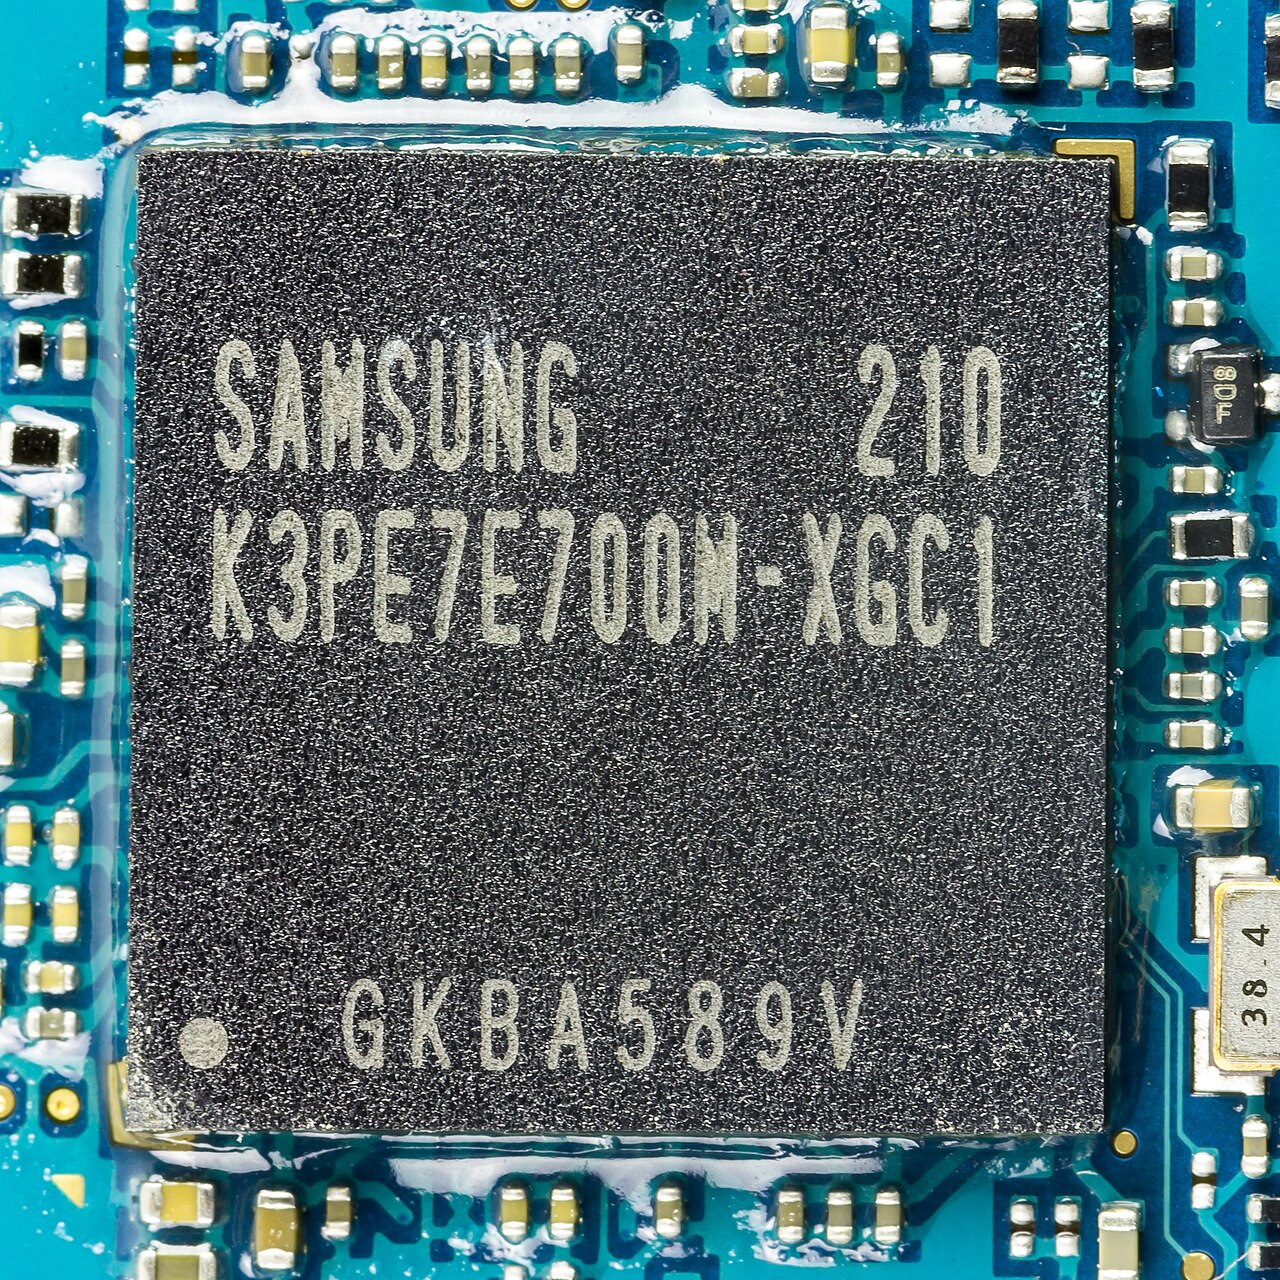
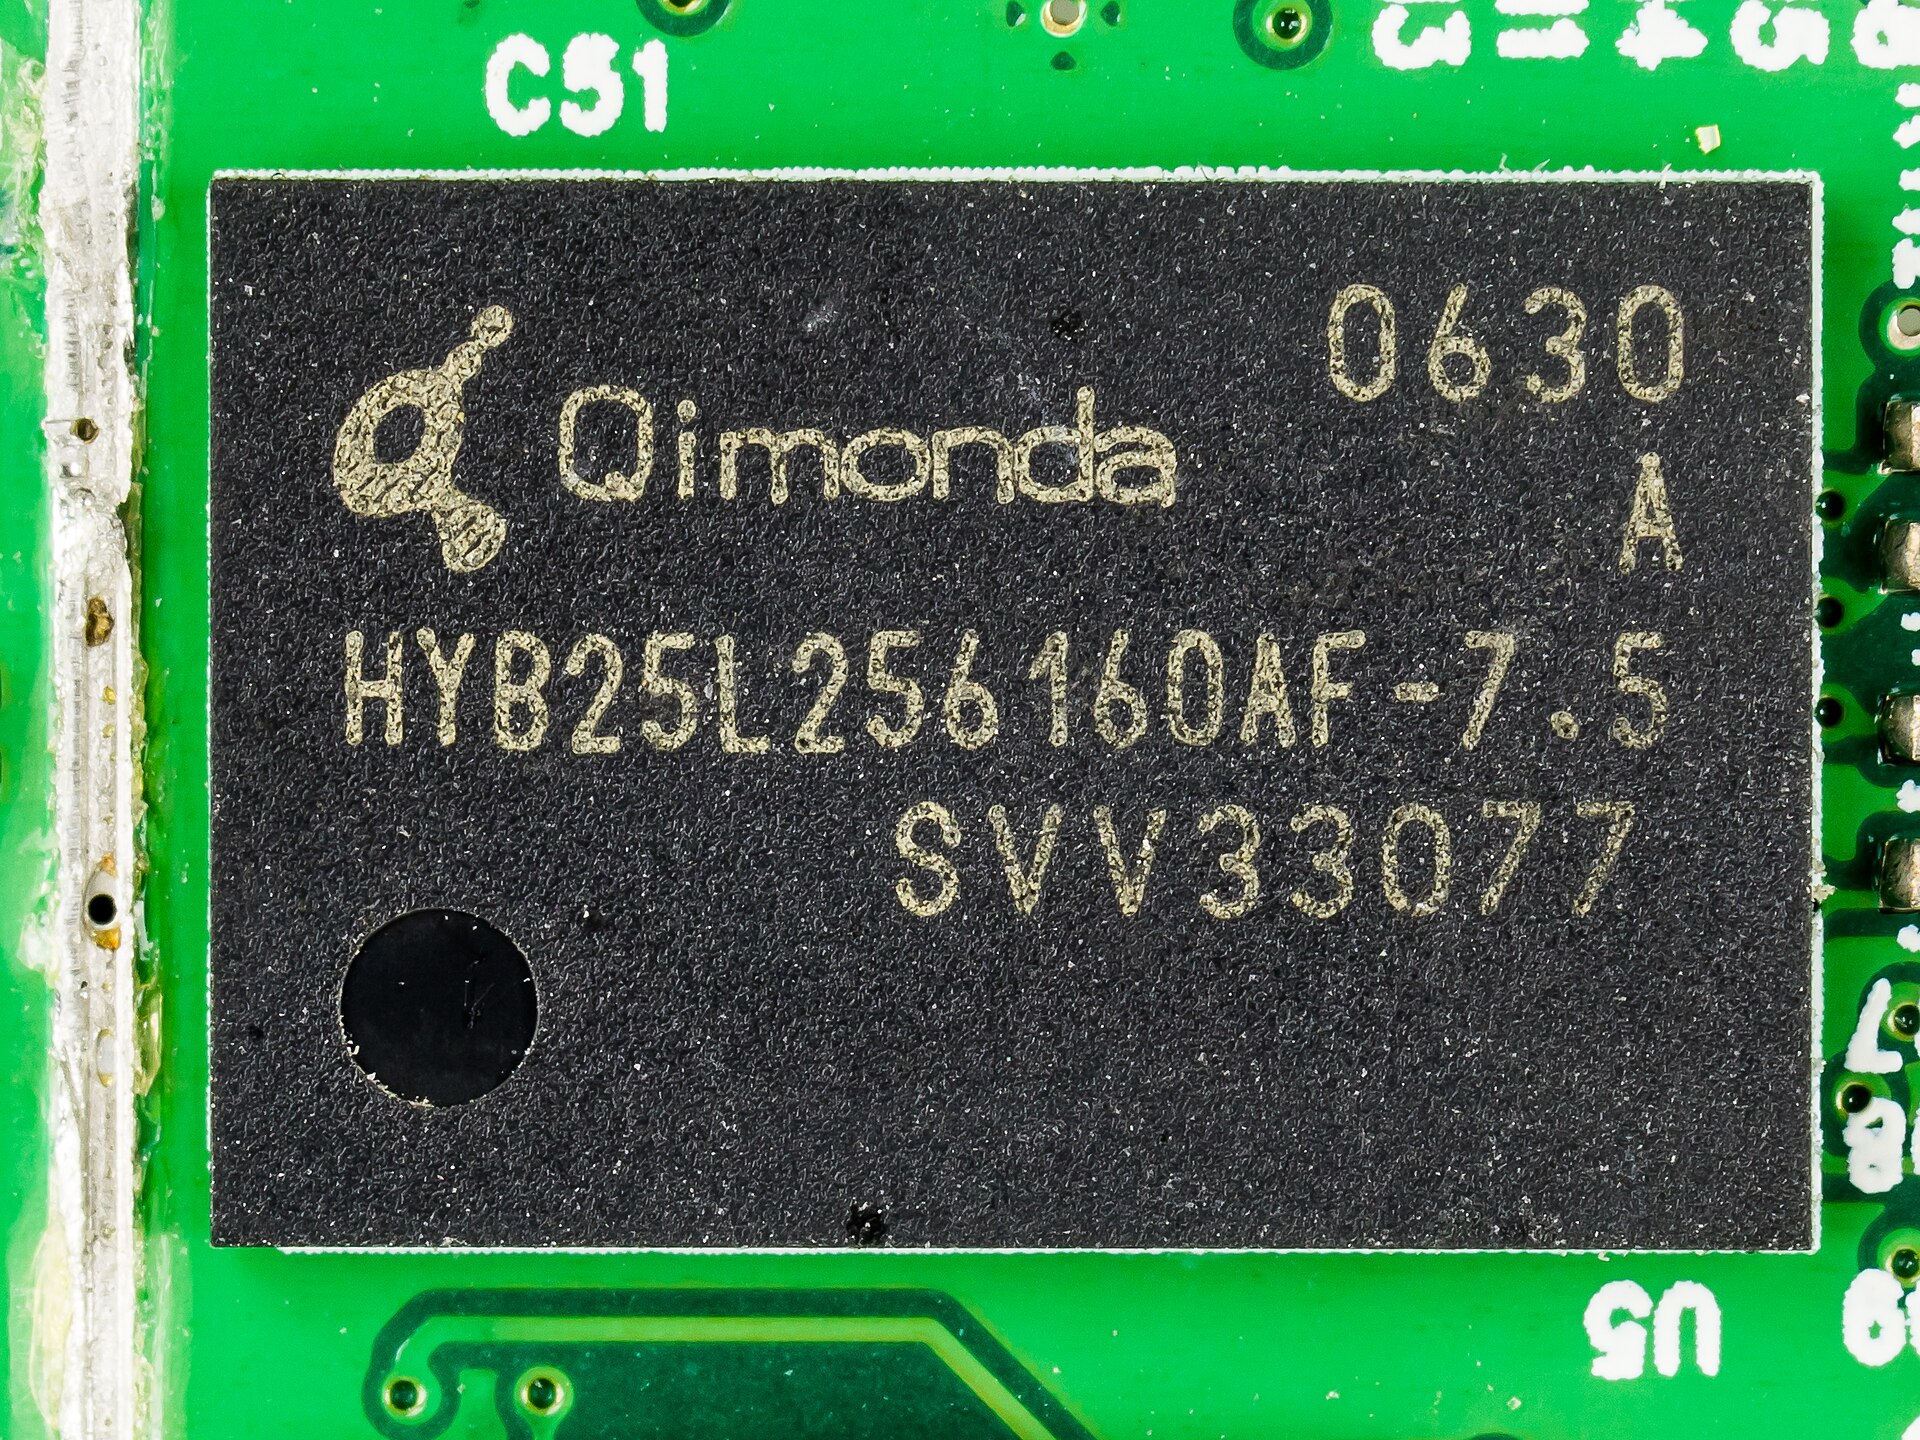
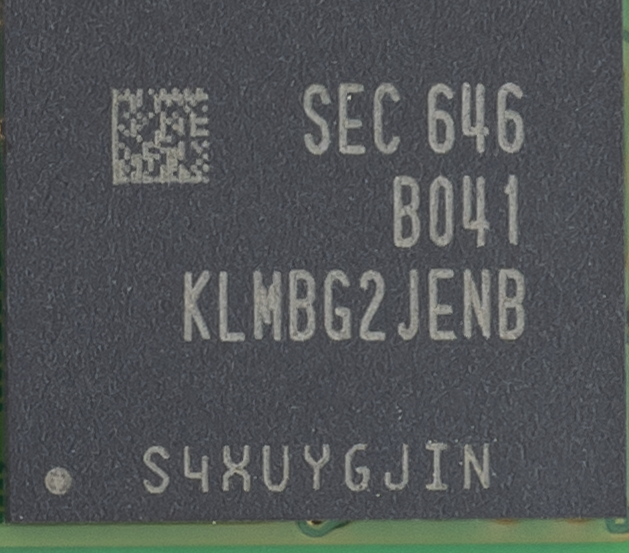
移动端用的是 LPDDR(低功耗双倍数据率内存),它的设计目标与桌面的 GDDR 不同——LPDDR 优先低功耗与低引脚数,GDDR 优先高带宽。代价是每 pin 带宽明显更低:按 HPG(High Performance Graphics)会议的材料,LPDDR 的每 pin 带宽不到 GDDR 的一半,但在峰值频率下的能效高出约 10% [HPG 2019 移动 GPU 能效材料]。
| 维度 | LPDDR(移动) | GDDR(桌面显卡) |
|---|---|---|
| 优化目标 | 低功耗、低引脚数 | 高带宽 |
| 每 pin 带宽 | 相对较低 | 约为 LPDDR 的两倍以上 |
| 总线位宽 | 64 / 128 位 | 256 / 384 位 |
| 能效(每 GB/s 的功耗) | 更好 | 较差 |
| 封装 | 直接焊在主板上(或叠在 SoC 上) | 显存颗粒 + 独立走线 |
这两行合起来才是完整的结论:移动端不仅每 pin 慢,而且总位宽小,两个因素相乘,理论带宽比桌面显卡低一个数量级——而这是硬件设计决定的,软件无法绕过。
Arm 在 SIGGRAPH 2018 的移动图形课程里给过一个更直观的量级描述:移动端的渲染性能相比中端桌面低 10–20 倍,且这个差距在渲染结构(rendering structures)上比普通渲染更大 [Arm SIGGRAPH 2018]。这个数字比"低一个数量级"更有用,因为它区分了"普通渲染"与"结构复杂的渲染"——后者才是移动端真正吃力的地方。
4.4 公式或参数逐项释义:一帧的字节账
现在把账摊开。一帧的片外流量大致由这几项构成:
| 项目 | 付费次数 | 说明 | 压缩手段 |
|---|---|---|---|
| 纹理采样 | 每个像素 × 采样次数 | 最大的一项,取决于材质复杂度与 mip 覆盖 | 纹理压缩(ASTC / ETC2) |
| 颜色附件(RT) | 写 1 次 + 可能的读 | 与 RT 数量、格式、分辨率成正比 | 降格式、降分辨率、合并通道 |
| 深度/模板 | 读 + 写 | 依赖深度测试的时机 | 片上完成(分块架构) |
| 顶点/索引缓冲 | 每个顶点 1 次 | 与三角形数量成正比 | 索引复用、几何压缩 |
| Uniform / 常量 | 每次绘制 | 通常很小但同步敏感 | 合并更新、常量缓冲 |
| 阴影贴图等中间产物 | 写 1 次 + 读多次 | 分辨率的平方关系 | 降分辨率、级联、复用 |
再叠加分辨率的平方关系,就能看出为什么移动端对分辨率如此敏感:
【分辨率与带宽的关系 · 伪代码】

带宽 ≈ 像素数 × 每像素字节 × 读写次数
像素数 = 宽 × 高

例:从 1080p 提到 1440p
    像素数 × 1.78   →   带宽需求 × 1.78
    若同时把亮度精度从 8bit 提到 16bit(RT 格式变化)
    每像素字节 × 2  →   总带宽 × 3.56
要记住的判据只有一条:先看哪一项的"付费次数 × 像素数"最大,先动它。
把六项逐一拆开,每一项的节省空间与手段就清楚了:
| 项目 | 付费次数 | 主要放大因素 | 最有效的手段 |
|---|---|---|---|
| 纹理采样 | 每像素 × 采样次数 | mip 未生效、各向异性过度、采样点过多 | 纹理压缩 + 正确的 mip 与过滤设置 |
| 颜色附件 | 写 1 + 可能读 | 分辨率、格式字节数、RT 数量 | 降格式、中间过程降分辨率、少开 RT |
| 深度/模板 | 读 + 写 | 是否在片上完成 | 分块架构 + 附件语义声明 |
| 顶点/索引 | 每顶点 1 次 | 三角形数量、索引是否复用 | 索引复用、几何压缩、LOD |
| Uniform/常量 | 每次绘制 | 绘制调用数量 | 合批、常量缓冲、减少状态切换 |
| 中间产物 | 写 1 + 读多次 | 分辨率的平方 | 降分辨率、级联、按需重算 |
把"每帧可用字节"这个上限落成一个具体的数,账就变得可算了:按公开的移动 GPU 功耗建模结果,DRAM 访问的代价约为每 GB/s 80–100mW,而在典型的内存功率预算(约 650mW)下,60fps 每秒能搬的等价值约为每帧 100MB [移动 GPU 功耗建模]。这意味着"每帧 100MB"量级可以作为移动端字节预算的起点——一张 1080p 的 RGBA8 颜色附件就是约 8.3MB,写一次读一次是 16.6MB,占掉预算的六分之一。
| 附件(1080p,约 207 万像素) | 每像素字节 | 单帧字节 | 占 100MB 预算 |
|---|---|---|---|
| 颜色 RGBA8 | 4 B | 约 8.3 MB | 8.3%(读写各一次则 16.6%) |
| 颜色 RGBA16F(HDR) | 8 B | 约 16.6 MB | 16.6% |
| 深度 24/32 位 | 3–4 B | 约 6.2–8.3 MB | 6–8% |
| 深度 + 颜色(读写各一次) | — | 约 29–33 MB | 近三分之一 |
| 4×MSAA 颜色(未解析) | 16 B | 约 33.2 MB | 三分之一 |
用法很直接:下次有人问"移动端为什么不能随便开 HDR 和 MSAA",可以直接把这张表贴出来——不是"性能不够",是预算不够:颜色 + 深度 + HDR + 4×MSAA 叠起来,光附件就把每帧的字节预算吃掉大半,纹理采样还没开始算。
4.4.1 移动内存技术的演进
| 代际 | 每 pin 速率量级 | 相对前代的关注点 |
|---|---|---|
| LPDDR3 | 800–2133 MT/s | 普及低功耗内存 |
| LPDDR4 / 4X | 1600–4266 MT/s | 速率提升,电压下调 |
| LPDDR5 | 3200–6400 MT/s | 更高带宽 + 链路能效优化 |
| LPDDR5X 及之后 | 6400–8533 MT/s 及以上 | 带宽继续提升,能效与热成为主要约束 |
演进表要读出的不是"越来越快",而是"能效提升慢于带宽提升"——这正是本系列反复强调的那句话:算力与带宽的缩放不同步,而移动端的散热能力几乎没变。第 6 篇会展开这个趋势带来的后果。
4.5 实现与配置:降带宽的四类手段
移动 SoC 还有另一种存在形态——开发板与评估板。它们的带宽条件与手机不同(散热与供电充足),但内存子系统的结构与手机同源,因此常被用来做量化实验:
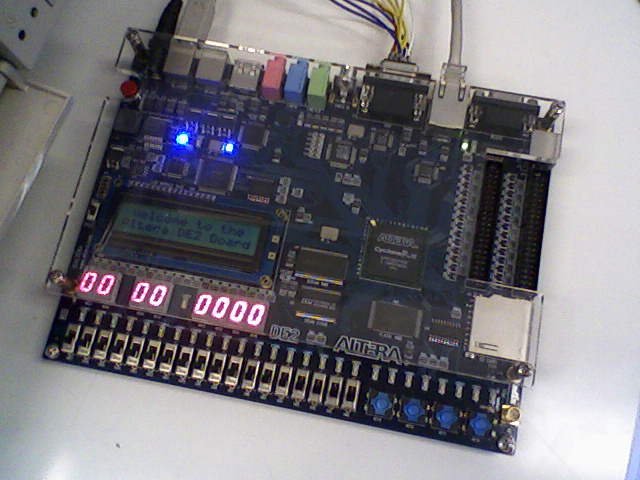
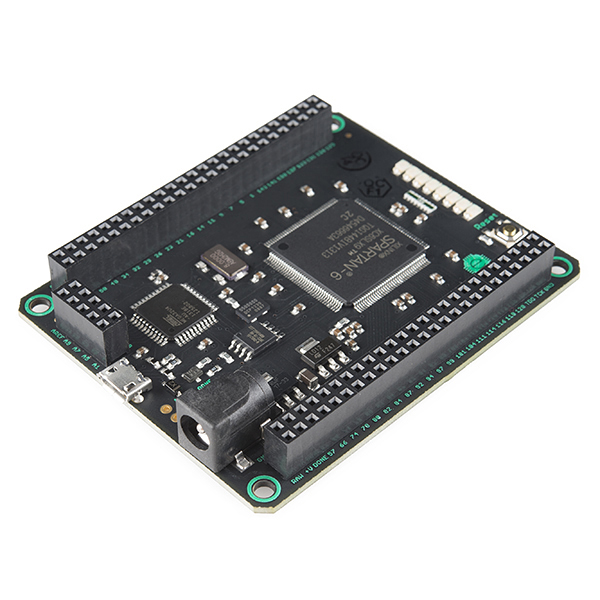
【纹理压缩格式选择 · 配置清单】

移动端首选:      ASTC      # 可变块尺寸(4x4 ~ 12x12),同一张图可按区域取不同压缩率
保守兼容:        ETC2      # 覆盖广,压缩率固定 4bpp
桌面移植:        BCn       # 移动端普遍不支持,跨平台项目需准备两套
未压缩:          仅用于特殊数据(如查找表)

典型压缩率收益:  压缩前 32bpp → 压缩后 4bpp,纹理带宽降为 1/8
【附件配置精简 · 配置清单】

1) RT 格式按需下调:      RGBA16F → RGBA8(仅在需要 HDR 中间结果时保留高精度)
2) RT 分辨率与显示分辨率解耦: 中间过程半分辨率(后处理链路常见)
3) MSAA 替代:            MSAA 2x/4x 换 FXAA/SMAA 类后处理 AA(代价是边缘质量的实现复杂度)
4) 附件语义:              load_op=CLEAR / store_op=DONT_CARE(不读不写)
5) 通道合并:              把多个中间结果打包进一张 RT 的不同通道
4.6 效果与量化:各项手段的收益量级
| 手段 | 收益量级 | 代价 | 适用条件 |
|---|---|---|---|
| 纹理压缩(ASTC 4bpp) | 纹理带宽降至约 1/8 | 压缩伪影、编码时间 | 几乎所有纹理 |
| 附件语义精简 | 省掉整块附件的读写 | 需正确声明依赖 | 中间产物与瞬态附件 |
| 附件格式下调 | 与字节数成正比 | 精度/色带 | 非 HDR 中间结果 |
| 中间过程降分辨率 | 与像素数成正比(常见 1/4) | 边缘质量 | 后处理链路 |
| 分块片上处理 | 深度/混合/瞬态附件不产生片外流量 | 片上内存容量限制 | 分块架构平台 |
| 减少 overdraw(HSR) | 与重复着色比例成正比 | 无(硬件侧) | TBDR 平台 |
这里有一项必须单独标注口径的数字:学术研究中给出过"并行帧渲染(PFR)平均节省 23.8% 带宽,带来 12% 提速与 20.1% 省电"的实测结果 [Energy-Efficient Mobile GPU Systems]。这个数字很有价值,但它是特定机制在特定测试集上的结果,不能直接外推成"随便做点带宽优化就能省 20%"。本系列引用这类数字时会连同它的适用条件一起给出。
4.7 源码与数据链接
- HPG,Mobile GPU approaches to power efficiency:https://highperformancegraphics.org/wp-content/uploads/2019/hot3d/mobile_gpu_power_and_performance.pdf
- Arm,Mobile GPUs: Architecture, Constraints, and Optimization(SIGGRAPH 2024):https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/3858.siggraph_5F00_mmg_5F00_2024_5F00_Mobile101.pdf
- Arm,Mobile HW and Bandwidth(SIGGRAPH 2015):https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/siggraph2015_2D00_mmg_2D00_andy_2D00_slides.pdf
- Qualcomm,Adreno GPU on Mobile: Best Practices:https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
4.8 这一章留下的问题
带宽账摊开了,但还有一笔更硬的账没算:即使你把带宽压到很低,功耗也可能照样撞墙。因为功耗不只来自内存访问,还来自频率、电压、以及那些看起来"没在干活"的空转与等待。下一章算这笔账,并解释一个现象:为什么同一台手机,跑分能到 60 帧,玩二十分钟却只有 40 帧。
三、功耗与热:帧率为什么会掉下去
5.1 一句话点题
先看看那个反常现象。这一章回答开篇那个反常的现象:为什么同一台手机,跑分能到 60 帧,玩二十分钟却只有 40 帧?
因为"能跑多快"由算力决定,"能跑多久"由散热能力与功耗预算决定。移动设备没有风扇,散热面积以平方厘米计,可持续散发的功率只有数瓦量级。一旦产生的热量超过这个上限,系统必然限频——而这与代码写得好不好无关。
5.2 原理与概念:整机的功耗预算
手机的功率预算不是一个数,而是一份分配方案。屏幕常常是最大的一项,SoC(含 CPU、GPU、NPU、内存控制器)是第二项,射频与摄像头瞬时功率也相当可观。这带来一个常被忽略的结论:优化渲染并不等于优化整机功耗——如果屏幕亮度拉满,渲染省下来的那点功率占比很小。
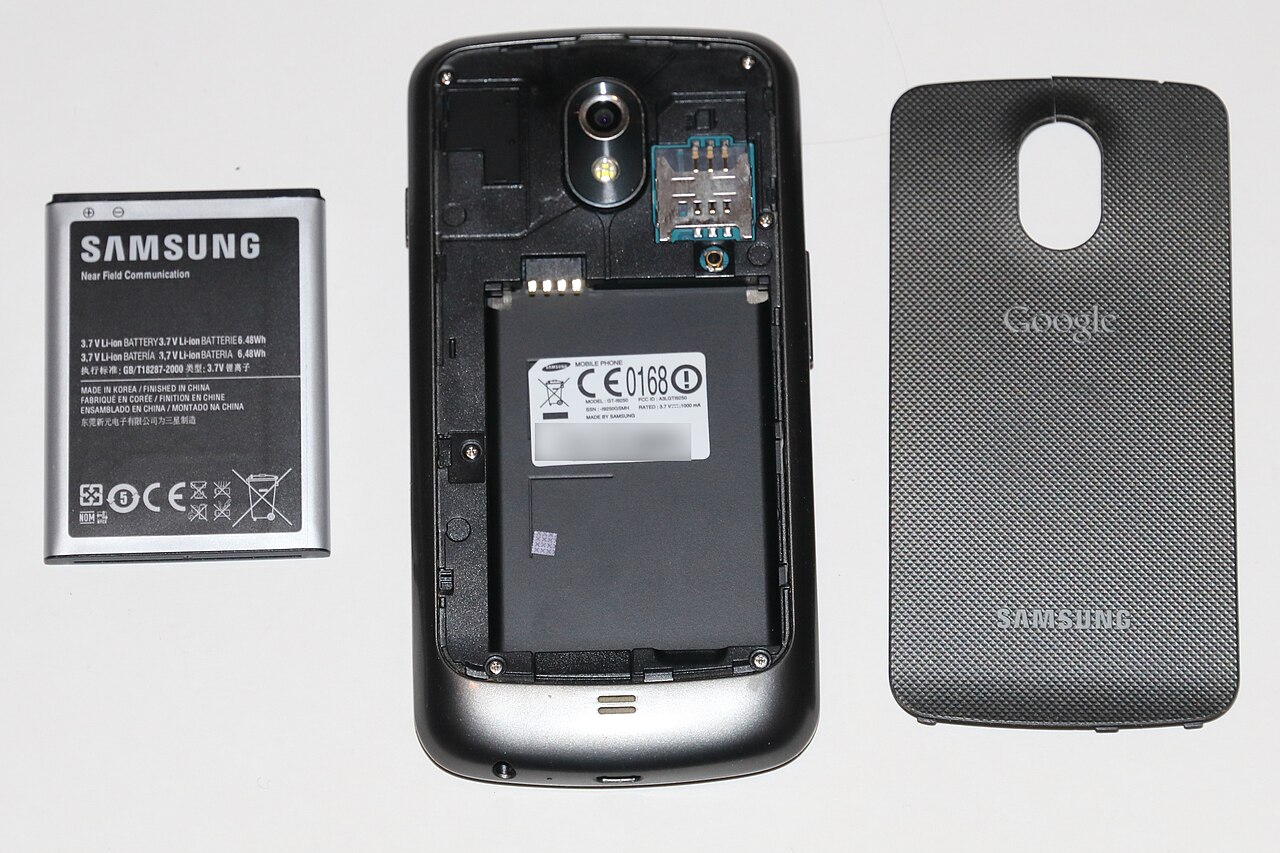
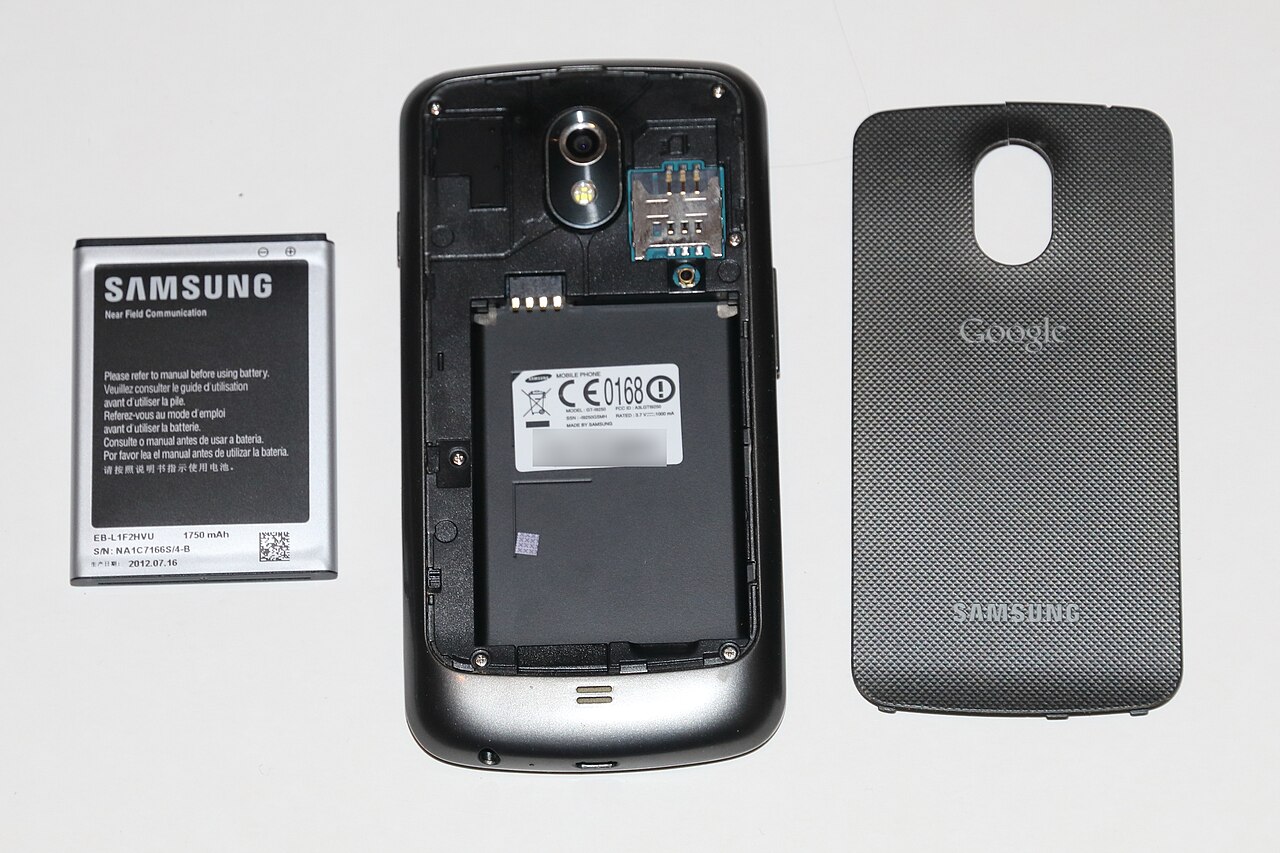
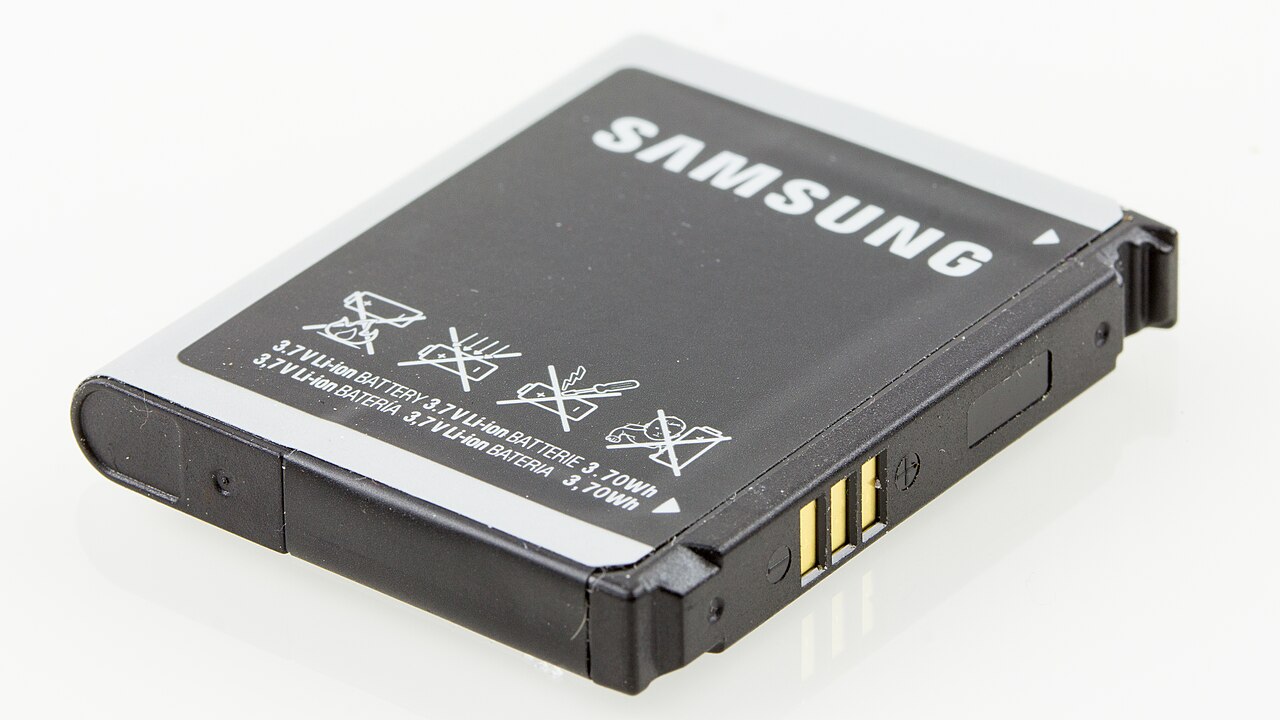
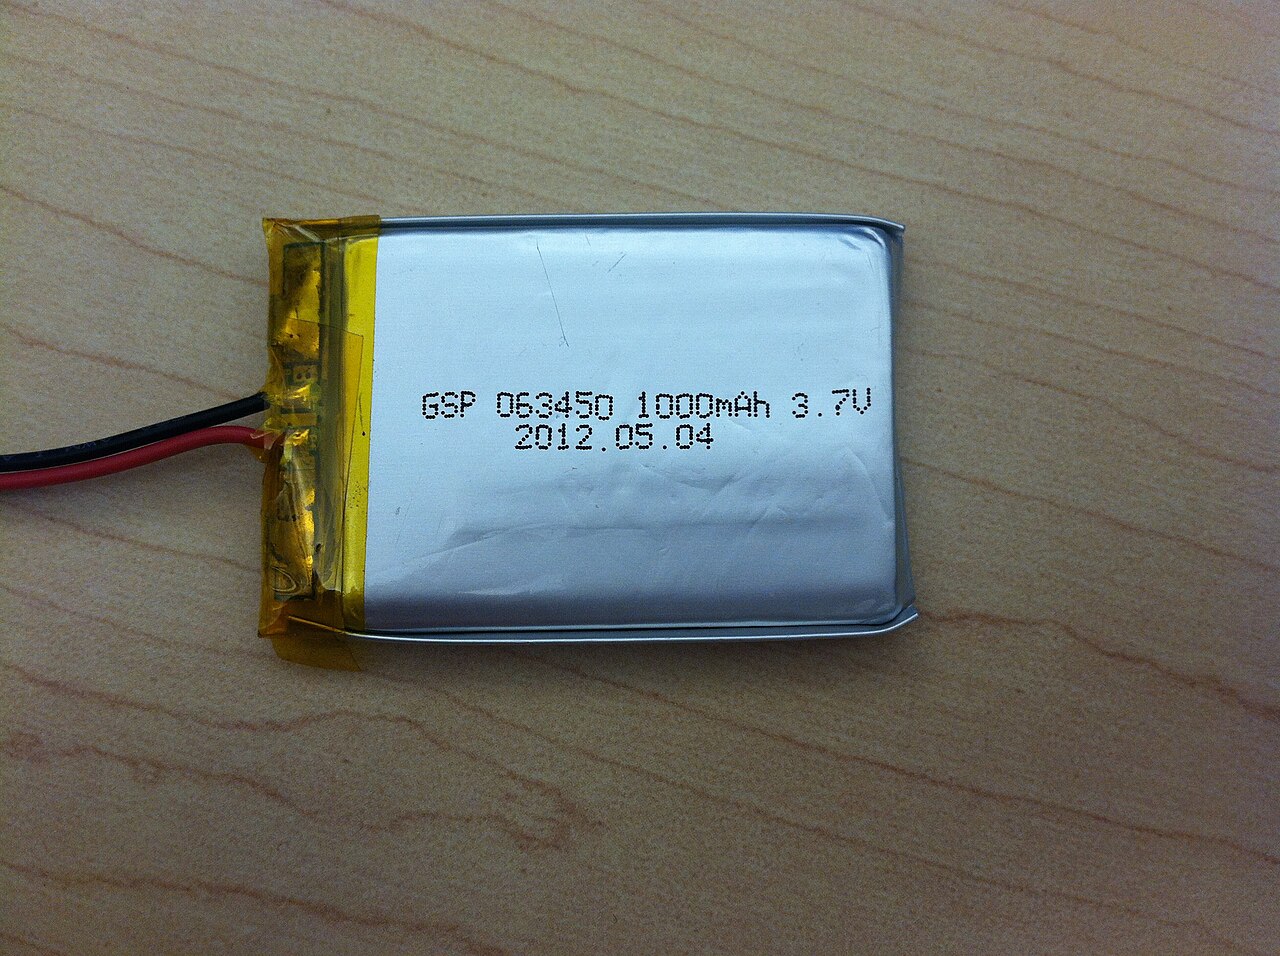
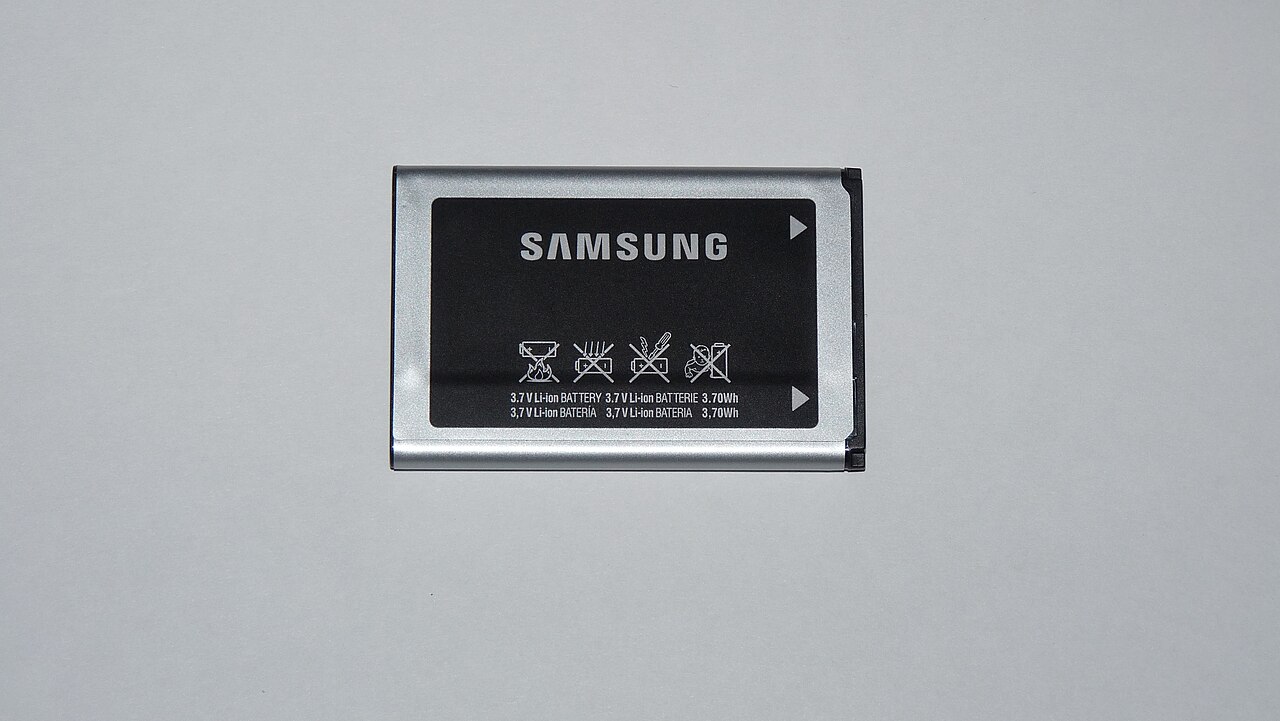
用电池反推一次功率上限就很直观:
【整机平均功率的粗算 · 伪代码】

电池能量 ≈ 容量(Ah) × 标称电压(V)     # 例如 4.5Ah × 3.85V ≈ 17.3 Wh
目标续航 = 6 小时
→ 整机平均功率 ≈ 17.3 Wh / 6 h ≈ 2.9 W

若游戏场景允许续航 2 小时:
→ 平均功率上限 ≈ 8.6 W(且这是整机,不是 SoC)
这个粗算解释了两件事:第一,为什么移动端的功耗预算这么紧——它由"电池容量 ÷ 期望续航"直接决定;第二,为什么持续性能必然低于峰值性能——峰值是"短时间借来的功率",而平均功率由散热与电池共同锁死。
关于这个落差,公开的实测统计给出的区间是:持续 GPU 性能大约只有短时峰值分数的 50%–65%(CPU 约 64%–78%),并且"5 分钟跑分赢的机器可能在 30 分钟持续负载里输给更慢的对手" [Smartphone Performance 实测统计]。这是本系列最该被记住的一个数字区间。
5.3 原理与概念:DVFS 与温度墙
限频的机制叫动态频率电压调节(dynamic voltage and frequency scaling, DVFS)。它的逻辑是:芯片的动态功耗近似正比于频率乘以电压的平方,而高频需要更高电压,所以频率提高带来的功耗增长远快于性能增长。反过来,当温度逼近阈值时,降低频率是最有效的降温手段。
温度墙触发之后会发生什么,有一份可引用的实测记录:在一台具体机型上,持续负载约 4 分钟后 GPU 温度达到 48°C 并触发系统的图形限频机制(GPU_MITIGATION),频率从 900MHz 被直接降到 315MHz,同一任务的单次延迟从 130ms 升到 410ms [端侧推理功耗与热管理实测]。频率掉了约 65%,延迟涨了约 3.15 倍——性能的下降幅度比频率的下降幅度还大,因为降频同时降低了访存吞吐。
这里还有一个工程上很容易被忽略的细节:CPU 与 GPU 的降频通常不协同。移动热管理的研究记录过这样的过程:CPU 在 70°C 先触发限频,GPU 的频率"稍后才被驱动降低",两者不同步;受热惯性影响,CPU 降频之后温度仍继续爬到约 79°C [Cooperative CPU-GPU Thermal Management]。后果是性能下降的曲线不是平滑的,而是台阶式的、且带有滞后——这解释了玩家常说的"卡一下、好一点、又卡一下"。
5.4 参数逐项释义:与功耗相关的参数
| 参数 | 含义 | 典型取值/区间 | 谁在控制 |
|---|---|---|---|
| 频率(clock) | GPU 的工作频率 | 数百 MHz 到 1.5GHz 量级 | 驱动/系统策略 |
| 电压(voltage) | 与频率配套的供电电压 | 随频率档位变化 | 驱动/PMIC |
| 温度阈值(thermal threshold) | 触发限频的温度点 | 70°C 上下(依厂商策略) | 系统固件 |
| 可持续功率(sustained power) | 长时间可散发的功率 | 数瓦量级 | 机身设计与散热 |
| 爆发功率(burst power) | 短时可借的功率 | 显著高于可持续 | 电池与供电 |
| 帧率上限 | 应用主动设定的上限 | 30 / 45 / 60 fps | 开发者 |
| 热惯性(thermal inertia) | 温度变化的滞后 | 秒到分钟级 | 物理(材料与结构) |
把这些参数逐项拆开,每一项对开发者的"可影响程度"差异很大:
| 参数 | 谁在控制 | 开发者能做什么 | 不能做什么 |
|---|---|---|---|
| 频率 | 系统 DVFS 策略 | 通过降低负载间接影响 | 直接设定频率 |
| 电压 | 与频率档位配套 | 无 | 无 |
| 温度阈值 | 厂商固件 | 无 | 无(可查询热余量) |
| 可持续功率 | 机身散热设计 | 通过降低持续功耗需求来"适应" | 提高它 |
| 爆发功率 | 电池与供电设计 | 决定是否使用(不要依赖它) | 延长它 |
| 帧率上限 | 开发者 | 直接设定功耗目标 | — |
| 热惯性 | 物理(材料与结构) | 通过提前降档规避 | 消除它 |
表里只有一行是"开发者直接可控",就是帧率上限。这不是说其他手段无效,而是说:移动端的功耗优化本质上是"在给定的硬件与系统策略下,把负载曲线调到系统能长期承载的形状"——帧率上限是最直接的那个旋钮,附件与纹理的精简是间接降低单帧成本,而散热结构不由应用决定。
5.4.1 三条热设计经验法则
| 法则 | 内容 | 为什么 |
|---|---|---|
| 法则一 | 先设帧率上限,再谈画质 | 上限即功耗目标;不设上限等于把稳定性交给温控策略 |
| 法则二 | 画质档 = 功耗档,按机型分级 | 热量由功率决定,而不同机型的可持续功率差一个档位 |
| 法则三 | 把"连续 20 分钟不掉帧"写成验收指标 | 首次进入场景的帧率无法反映持续性 |
三条法则里最反直觉的是第一条:设上限会让"最高帧率"变低,却会让"长期体验"变好。原因在于,超过可持续功率的那部分性能只能维持很短时间,之后必然以更低的水平偿还——而用户对"从 60 掉到 35"的感受,远差于"始终 45"。
5.4.2 不同机型的持续性能差异
| 机型档位 | 峰值表现 | 持续表现 | 落差特征 | 优化重点 |
|---|---|---|---|---|
| 低端 | 低 | 低但稳定 | 落差小 | 减负:先把画质降到可持续水平 |
| 中端 | 中 | 约为峰值的六成 | 落差中等 | 平衡:分级画质档 + 帧率上限 |
| 高端 | 高 | 约为峰值的一半 | 落差最大 | 收着用:避免"峰值思维"导致的后期崩落 |
这张表解释了一个常见的产品现象:高端机型在长时间游戏中的"掉帧感"往往比中端机型更明显——不是因为它更差,而是因为它前段借了更多功率,后段要还得更多。这也提醒我们:性能测试必须覆盖持续态,否则会系统性地偏向高端机型。
5.5 实现与配置:把"可持续"当成设计目标
按变体 B,这里给配置清单与决策规则,而不是长代码。
【以可持续为目标的三条配置规则 · 配置清单】

规则 1: 主动设帧率上限,而不是"能跑多高跑多高"
        reasoning: 帧率上限直接设定功耗目标;跑满峰值 = 提前撞温度墙
        例: 目标 45fps 稳定,优于 60fps 掉到 35fps(体验与发热都更好)

规则 2: 按机型区间分级设置(画质档 = 功耗档)
        低端: 降分辨率 + 关 HDR + 简化后处理
        中端: 保持分辨率 + 精简后处理链
        高端: 完整链路,但仍设帧率上限

规则 3: 把"连续 20 分钟不掉帧"写成验收指标
        而不是"首次进入场景的帧率"
这三种取向没有绝对优劣,取决于产品定位。但"不设上限、期待它自己稳"一定是最差的选择:它把稳定性交给了温控策略,而策略的抖动是用户能直接感觉到的。
【散热侧的可做与不可做 · 配置清单】

开发者可直接做:   降低持续功率需求(帧率上限、画质档分级)
                  避免"无意义的高负载"(空转的渲染、过度提交)
设备侧决定:       均热板 / 石墨片 / 机身结构散热 / 温度阈值
应用可感知:       系统温度状态(部分平台可读)→ 提前降档而不是被动掉帧
5.6 效果与量化:功耗优化的收益与代价
| 手段 | 收益 | 代价 | 备注 |
|---|---|---|---|
| 设帧率上限(60 → 45) | 持续功率显著下降,稳定性提升 | 直接损失流畅度上限 | 换取长时稳定,通常划算 |
| 降低渲染分辨率 | 功耗近似随像素数下降 | 画质下降 | 与带宽收益叠加 |
| 减少 CPU/GPU 同步等待 | 单位功耗产出提高 | 需要重构提交结构 | 常被忽略的一项 |
| 分级画质档 | 覆盖不同散热能力的机型 | 需要多套配置与测试 | 工程量大但收效稳 |
| 主动读取温度状态并降档 | 避免被动掉帧的抖动 | 需要平台支持 | 体验提升明显 |
两个公开的工程案例可以佐证这套做法确实有效:
案例一(自适应降档):Kakao Games 在其手游上接入 Android 自适应功能(含 ADPF 热 API 与 Unity Adaptive Performance)之后,FPS 稳定性提升到 96%——注意这个指标不是"平均帧率提高",而是"帧率更稳",正符合本节主张的以稳定性为目标的思路 [Android Developer Stories]。
案例二(定位发热源):一个 Unity 手游项目在骁龙 888 机型上跑 8 分钟后触发限频,GPU 频率从 840MHz 掉到 520MHz;用帧调试器与 Snapdragon Profiler 定位后发现三个主要热源,其中透明的粒子系统带来 4.2 倍的 overdraw,减少 60% 粒子并改用 GPU 实例化后缓解 [移动端散热限频实测案例]。这个案例里有两点值得记住:一是"8 分钟"而不是"立刻",说明短测发现不了问题;二是热源是透明粒子,而不是"渲染太复杂"这种笼统判断。
散热结构本身属于设备侧,但理解它对开发者的意义在于:它决定了"可持续功率"这个上限值,而你的任务是让功耗需求低于这个上限。
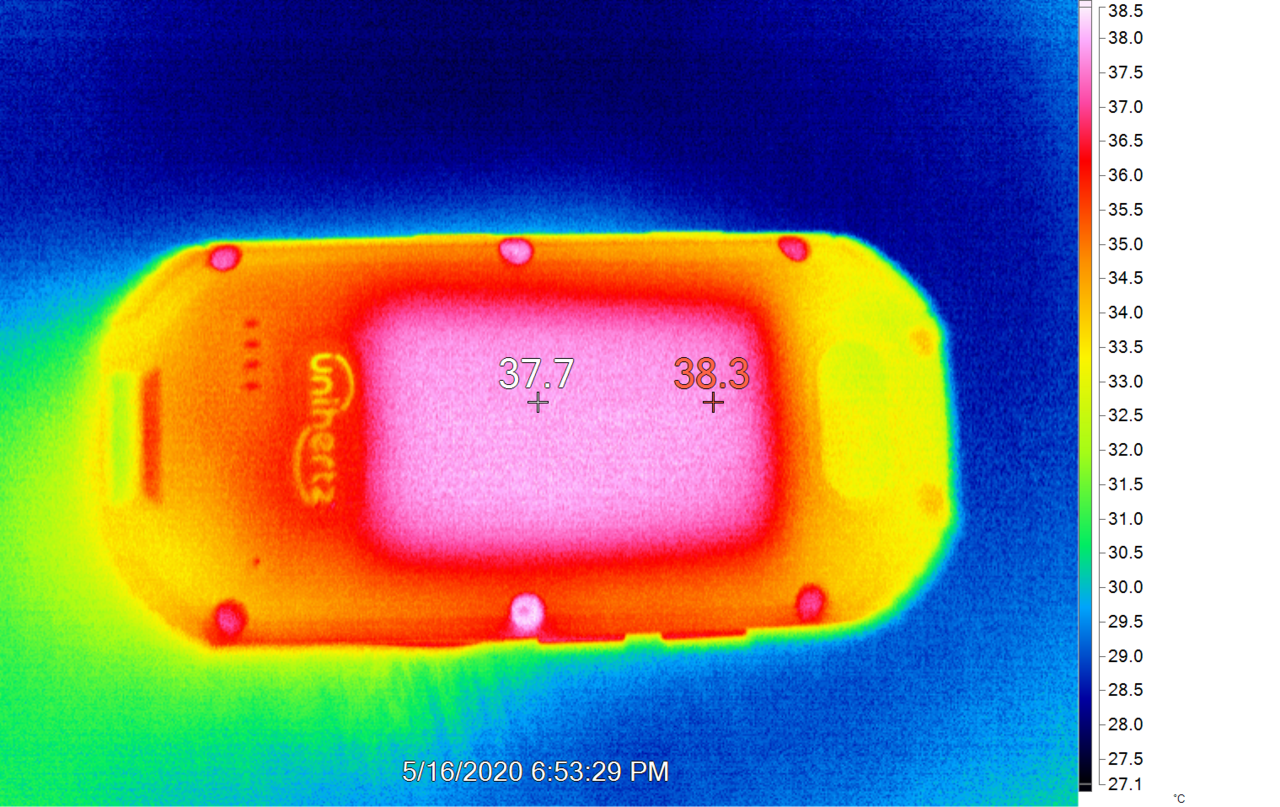
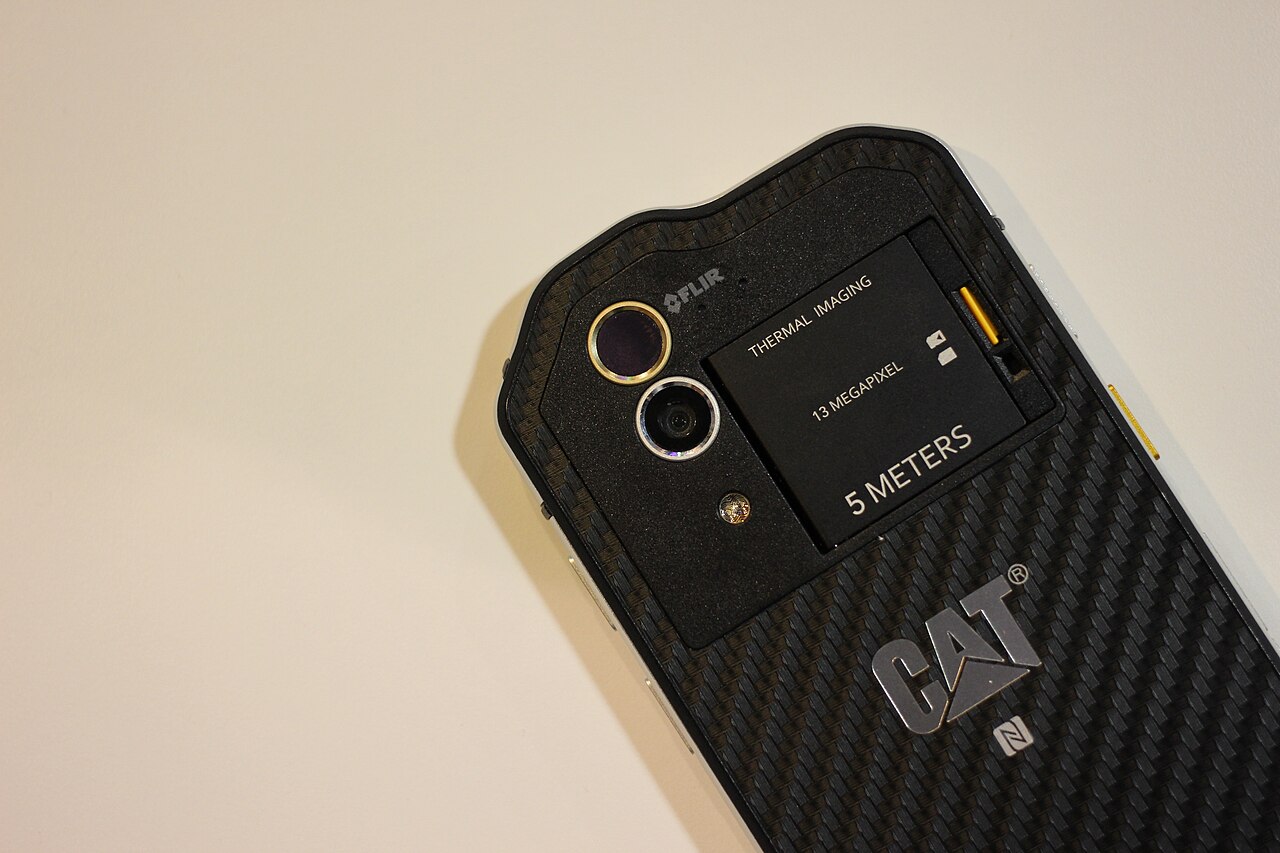
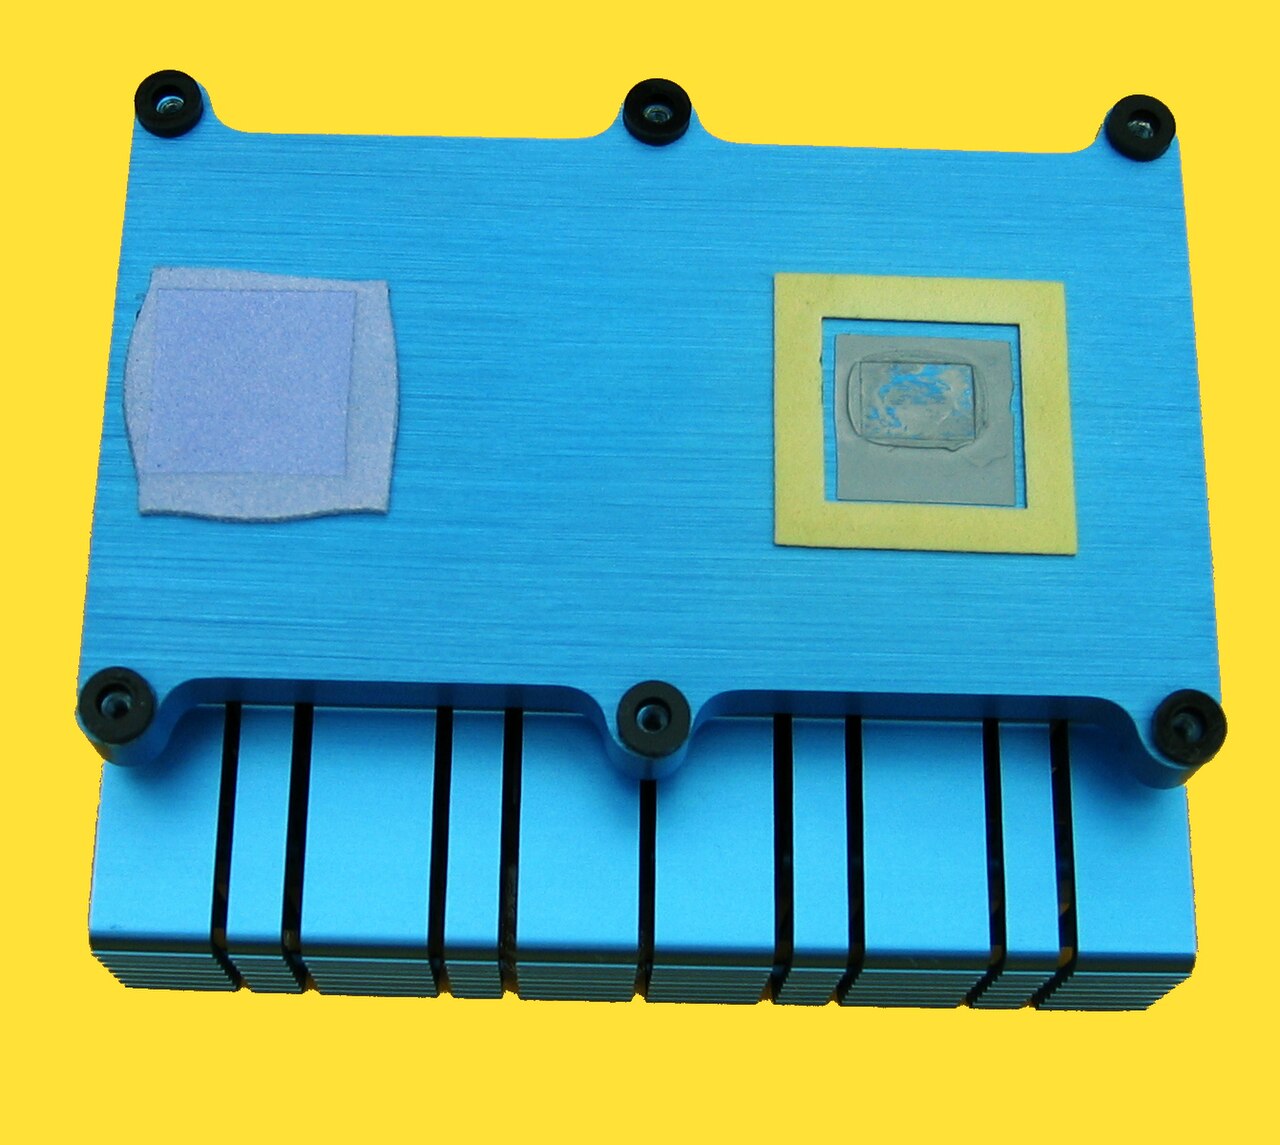
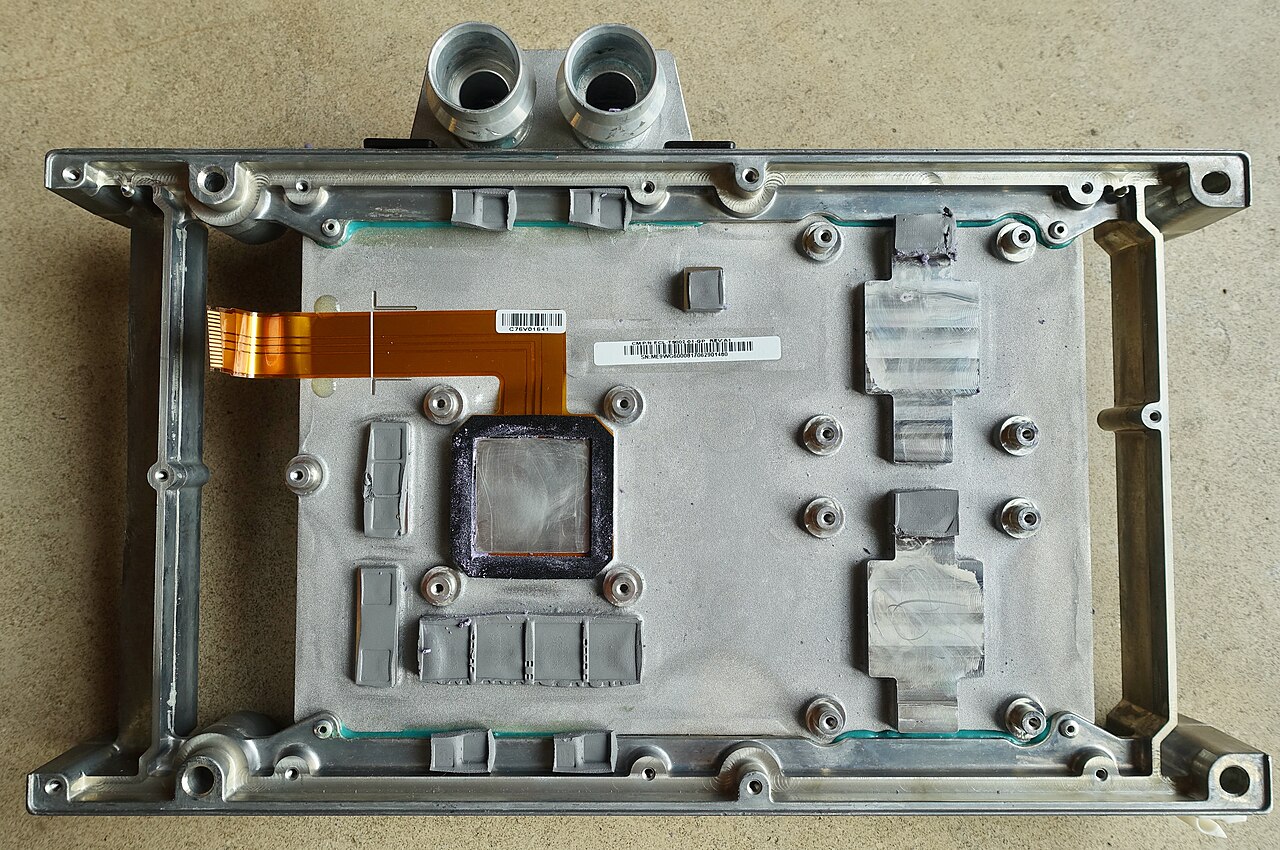
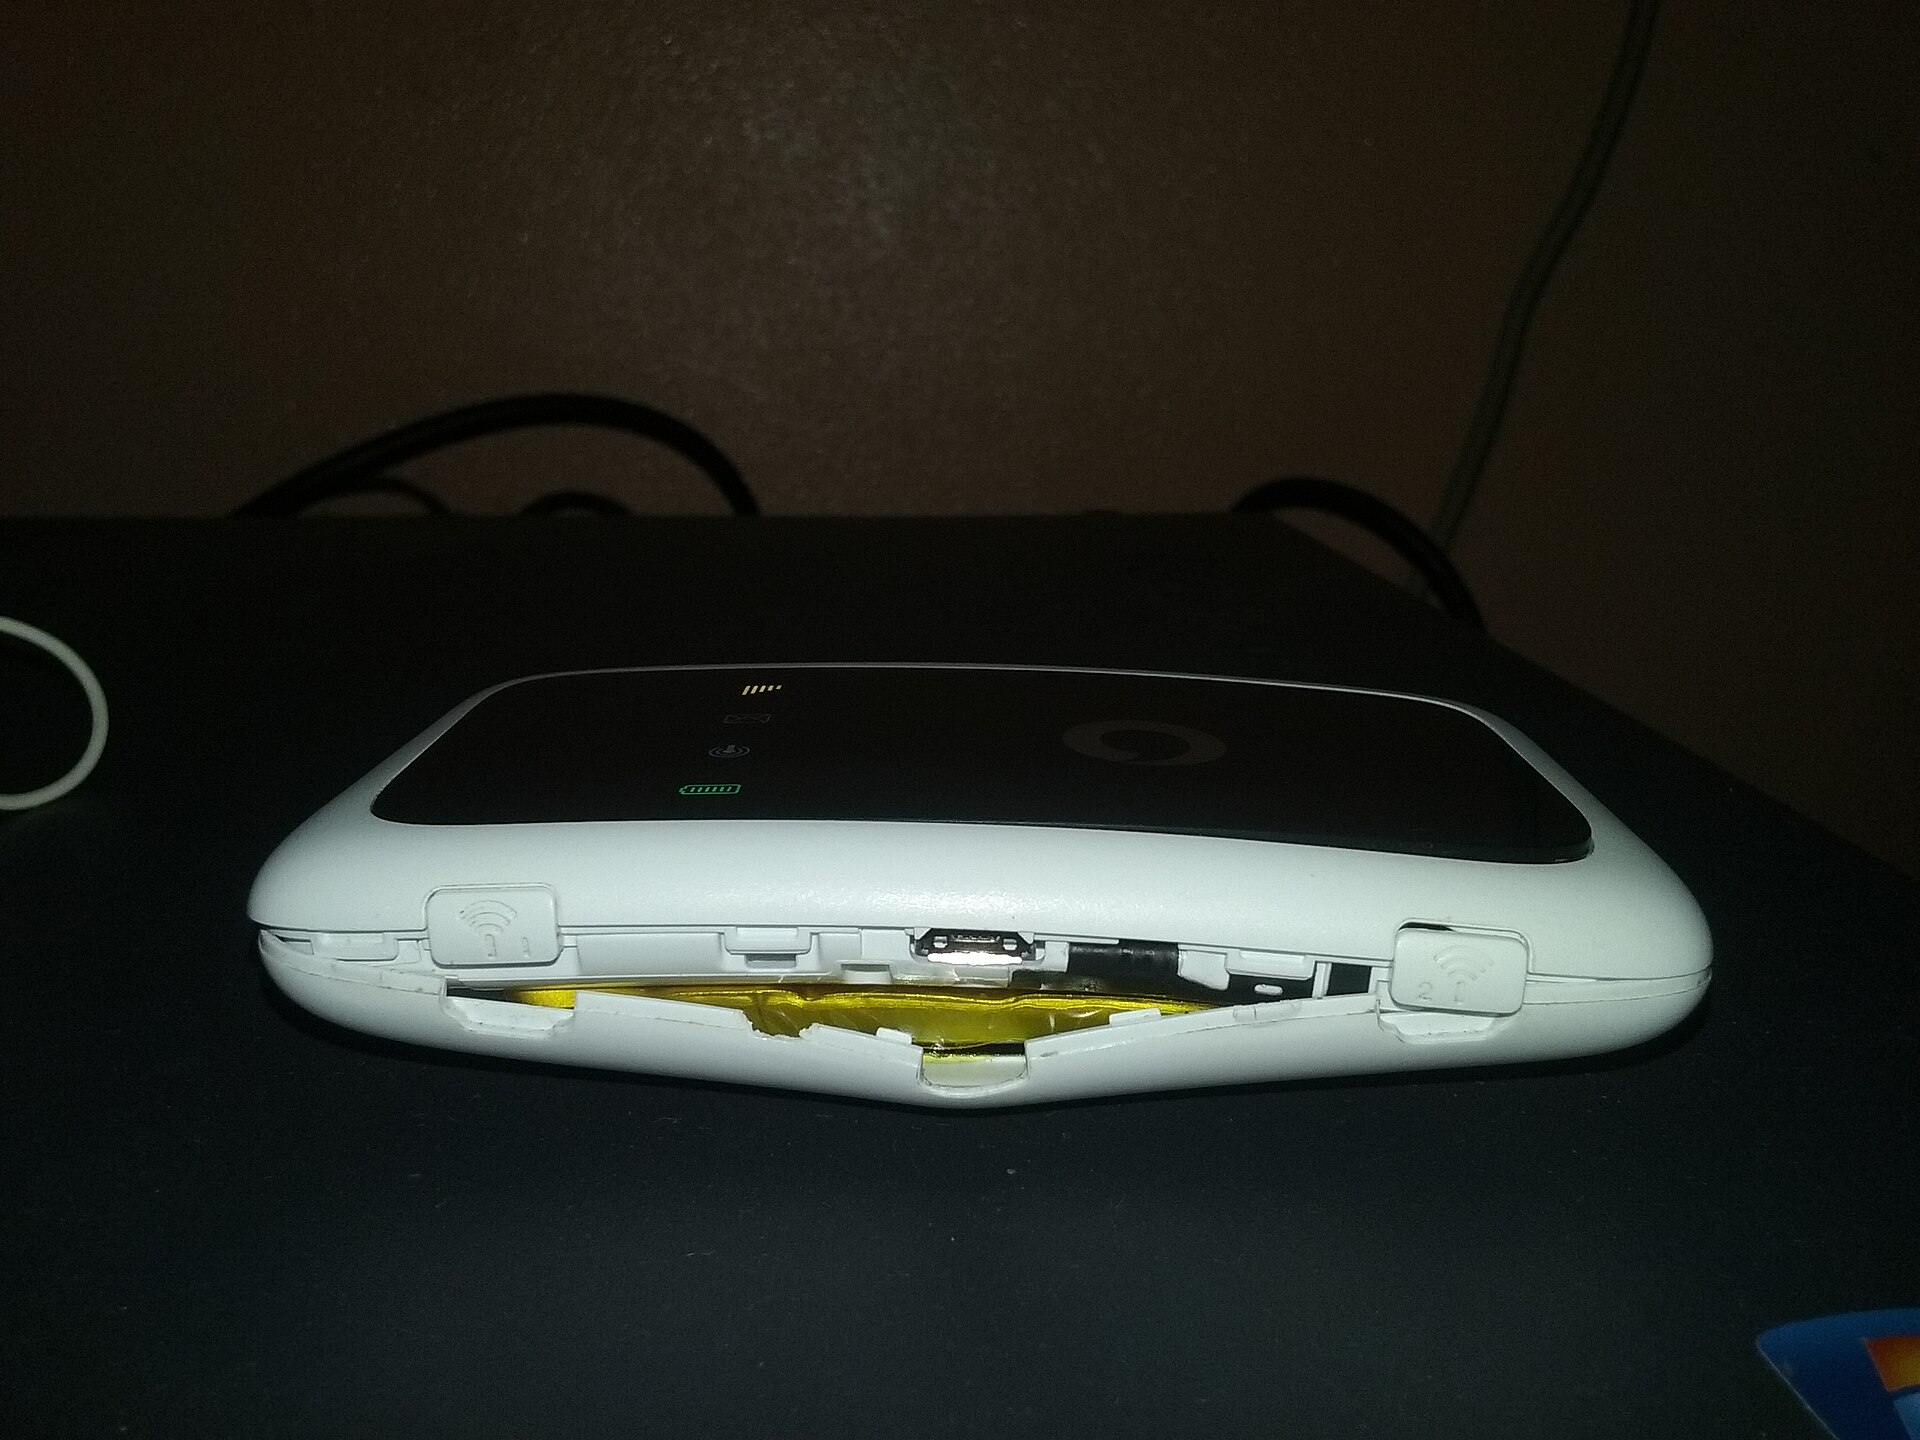
把这四张放在一起看,热量路径就很具体了:从 SoC 结温出发,经封装与导热界面材料传到均热板或冷却板,再通过中框扩散到机身表面。任何一个环节热阻偏高,可持续功率都会提前撞墙。代价也不只是掉帧——下面这块鼓包的锂聚合物电池,留下的是不可逆的物理损伤。
5.7 源码与数据链接
- Improving Mobile Gaming Performance through Cooperative CPU-GPU Thermal Management(热管理协同与温度阈值实测):https://ces.itec.kit.edu/img/Improving_Mobile_Gaming_Performance_through_Cooperative_CPU_GPU_Thermal_Management.pdf
- 端侧推理的功耗与热管理全链路(限频实测:900→315MHz):https://xckevin.com/blog/2025-11-21-%E6%B7%B1%E5%85%A5_android_%E7%AB%AF%E4%BE%A7_ai_%E6%8E%A8%E7%90%86%E7%9A%84%E5%8A%9F%E8%80%97%E4%B8%8E%E7%83%AD%E7%AE%A1%E7%90%86%E5%85%A8%E9%93%BE%E8%B7%AF_%E4%BB%8E_soc_dvfs_%E8%B0%83%E5%BA%A6%E5%88%B0_therm/
- Smartphone Performance: The Complete Physics Guide(持续性能区间统计):https://product.ai/truth-graph/smartphones/performance/
- LLM Inference at the Edge(DVFS 与结温阈值的机制说明):https://arxiv.org/html/2603.23640v1
- Energy-Efficient Mobile GPU Systems(并行帧渲染的带宽/能耗收益):https://pdfs.semanticscholar.org/d9a1/8a89784bb60aee829866853b502c2872000c.pdf
5.8 这一章留下的问题
到这里,两道墙都立起来了:带宽决定"一帧能搬多少字节",功耗与散热决定"这些字节能以多快的速度、持续多久被搬"。但还有一个问题没有回答——知道约束之后,具体该怎么做?下一章把约束转成可执行的判断规则与测量方法,并说明怎么证明你的优化真的有效。
四、工程实践与测量:怎么证明你真的优化了
6.1 一句话点题
先看看工程侧要回答什么。这一章回答:知道约束是一回事,怎么把它落到工程决策上、又怎么证明自己没白干,是另一回事。
这一章给三层内容:引擎侧的第一层配置、约束转成判据的几条规则、以及一套可复现的测量协议。最后一项最重要——移动端没有测量就没有优化,"感觉变快了"在温控抖动面前毫无意义。
6.2 原理与概念:引擎侧的第一层应对
引擎的官方文档其实已经给了一份清单,只是没解释为什么。以 Unity 的 URP 文档为例:关掉 Depth Texture、Opaque Texture、Use Rendering Layers、HDR 与 LOD Cross Fade,Additional Lights 降到 Per Vertex [Unity URP 性能配置文档]。放回前两章的账本里看,每一项都对应一笔具体的流量或算力开销——它不是「经验之谈」,而是物理约束在配置项上的投影。
把每个开关翻译成物理原因,就能理解为什么这份清单长这样:
| 开关 | 省的是什么 | 为什么 |
|---|---|---|
| 关闭 Depth Texture | 一张全分辨率深度附件的读写 | 不用就不该生成 |
| 关闭 Opaque Texture | 一次全场景快照的拷贝 | 这是典型的"多出来的一趟全屏流量" |
| 关闭 HDR | 附件每像素字节数减半 | RGBA16F → RGBA8 |
| 关闭 Rendering Layers | 少一张渲染目标 | 额外的附件 = 额外的带宽 |
| 关闭 LOD Cross Fade | 过渡期的额外混合与采样 | alpha 混合与阴影采样都变贵 |
| Additional Lights 设 Per Vertex | 逐像素光照次数下降 | 光照是逐像素的成倍开销 |
6.3 约束转成判据:四条判断规则
这一节把前面立下的约束收成四条判断规则。用法是反过来的:不是先挑手段,而是先从现象判断瓶颈在哪,再决定动哪一层——顺序错了,优化就会做在最不该做的地方。
| 现象 | 大概率瓶颈 | 首选手段 | 不应先做 |
|---|---|---|---|
| 降低分辨率后帧率显著上升 | 带宽或像素填充率 | 降中间过程分辨率、精简附件 | 先优化着色器算法 |
| 着色器复杂度减半但帧率几乎不动 | 带宽 | 纹理压缩、附件语义、减少 RT | 继续优化算力 |
| 前 5 分钟稳、之后掉帧 | 热与功耗 | 设帧率上限、分级画质档 | 继续加效果 |
| 帧率方差大、偶发卡顿 | CPU/GPU 同步与提交 | 减少状态切换与同步点 | 只看平均帧率 |
6.4 参数逐项释义:测量协议里的参数
测量协议里的每一个参数都对应一类会污染结论的误差来源,所以它们不是随手定的。下表先给一份可以直接照用的取值,随后逐项说明每个取值背后的用意,以及它对应的是哪一类误差。
| 参数 | 含义 | 建议取值 | 为什么 |
|---|---|---|---|
| 预热时长 | 开始计时前先跑多久 | ≥3 分钟(或至温度稳定) | 避开爆发性能,测的是可持续性能 |
| 测量时长 | 正式取样时长 | ≥10 分钟 | 覆盖限频发生与再平衡 |
| 取样间隔 | 多久记一次数据 | 1 秒或更细 | 捕捉台阶式下降 |
| 记录指标 | 除平均帧率外还记什么 | 帧时间分布、1% low、SoC 温度 | 平均值会掩盖卡顿 |
| 环境温度 | 测试环境 | 恒温或记录实测 | 温度结论强依赖环境温度 |
| 机型分级 | 覆盖哪些区间 | 至少低/中/高三档 | 单机型结论不可外推 |
逐项拆开,每个取值背后都有具体的用意:
| 参数 | 取值偏小的后果 | 取值偏大的代价 | 建议 |
|---|---|---|---|
| 预热时长 | 测到爆发性能,高估 | 测试时间变长 | ≥3 分钟或至温度稳定 |
| 测量时长 | 未覆盖限频与再平衡 | 同上 | ≥10 分钟 |
| 取样间隔 | 漏掉台阶式下降 | 数据量膨胀 | 1 秒或更细 |
| 记录指标 | 平均值掩盖卡顿 | 分析复杂度上升 | 加记帧时间分布与 1% low |
| 环境温度 | 结论不可复现 | 需恒温设备 | 恒温或明确记录 |
| 机型分级 | 结论无法外推 | 机型数量增加 | 至少低/中/高三档 |
6.4.1 测量数据怎么读
拿到数据之后,最常犯的三个解读错误:
| 解读错误 | 表现 | 正确的读法 |
|---|---|---|
| 只看平均帧率 | 两台设备平均值相同,体验差别大 | 同看 1% low 与帧时间标准差 |
| 把"稳定"当"平" | 曲线平但有周期性尖峰 | 看帧时间的分布形状,而不只是走势 |
| 把首段数据当结论 | 前 30 秒最亮眼 | 以稳定态区间为结论,首段只作参考 |
"稳定态帧率 / 峰值帧率"这个比值,才是衡量移动端性能最该写进报告的指标。它同时反映了散热设计、温控策略与应用负载三者的匹配程度,而这三个因素恰好是移动端性能的全部。
6.5 实现与配置:一套可复现的测量流程
【可持续性能测试协议 · 伪代码】

阶段 1  冷机 → 记录起始温度
阶段 2  预热 3 分钟(同一场景、同一画质档)→ 丢弃这段数据
阶段 3  正式取样 10 分钟
        每次记录: 帧时间 / SoC 温度 / GPU 频率 / 内存占用
阶段 4  计算:
        平均帧率、1% low、帧时间标准差
        达到稳定态的时间(从开始到帧率曲线变平)
        稳定态帧率 / 峰值帧率  ← 这个比值才是"持续性"指标
阶段 5  同一协议在低/中/高三档机型各跑一遍
【测量工具的分工 · 配置清单】

抓帧分析:   逐 draw 的耗时与状态(定位单帧问题)
系统级监测: 帧率、温度、频率的时间序列(定位持续性问题)
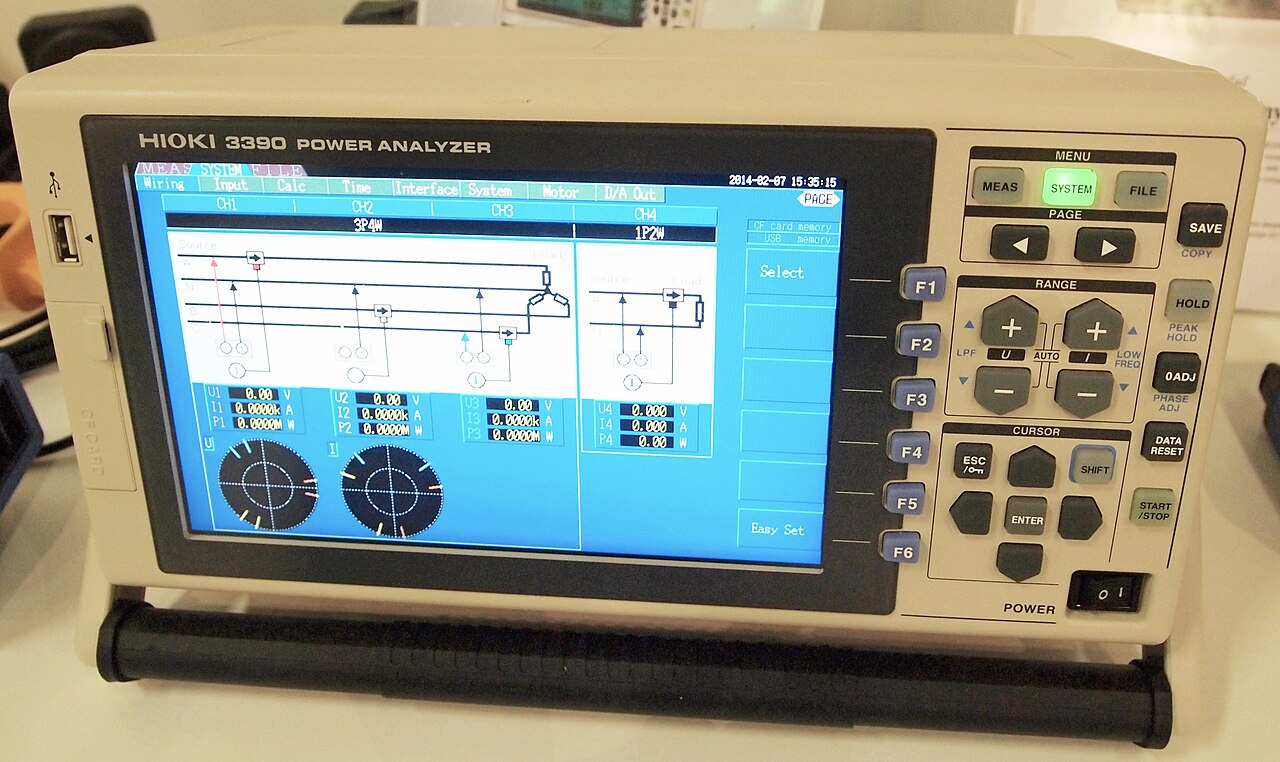
功耗测量:   外接功率分析仪(整机功率,最可信)
            注意: 设备自报功耗通常不含屏幕与供电损耗

6.6 效果与量化:常见测量错误与代价
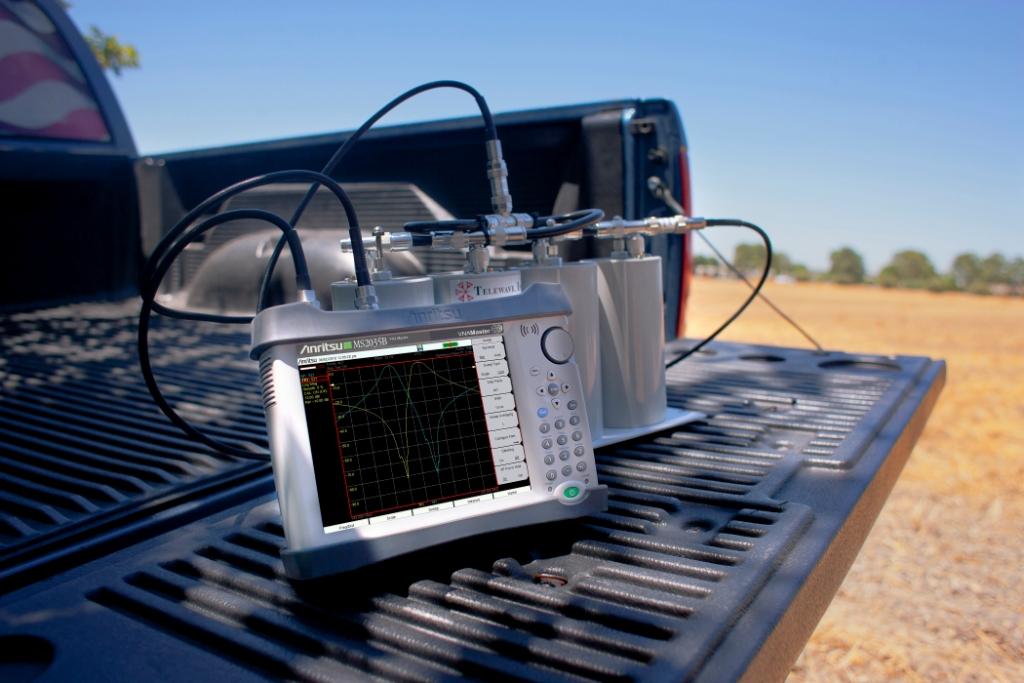
测量这件事,错法往往比正法多,而且每种错法都给出一个「看起来很有道理」的错结论。下表把五种常见错误、导致的错结论与正确做法并排列出;后三张图对应最容易踩的三处。
| 错误做法 | 会得出什么错结论 | 正确做法 |
|---|---|---|
| 冷机跑 1 分钟取平均 | 高估 40%–100%(取决于机型) | 预热后测,或明确标注"爆发性能" |
| 只看平均帧率 | 忽略卡顿(1% low 可能很差) | 同时看帧时间分布与 1% low |
| 在室温波动大的环境测 | 温度结论不可复现 | 恒温环境或记录环境温度 |
| 单机型得出"优化有效" | 无法外推到其他档位 | 至少三档机型 |
| 用设备自报功耗 | 低估真实整机功耗 | 外接功率分析仪校准 |
6.7 源码与数据链接
- Unity URP,Configure for better performance:https://docs.unity3d.com/6/Documentation/Manual/urp/configure-for-better-performance.html
- Unity URP 中文版(同上,术语对照):https://docs.unity.cn/cn/Packages-cn/com.unity.render-pipelines.universal@14.1/manual/configure-for-better-performance.html
- Qualcomm,Adreno GPU on Mobile: Best Practices:https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- Arm,Getting started on mobile and best practices for Arm GPUs:https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_2023_getting_started_on_mobile_and_best_practices_for_arm_gpus.pdf
6.8 这一章留下的问题
言归正传,约束、机制、账本、测量都讲完了,但这一篇始终没有回答一个更尖锐的问题:在这两道墙之下,哪些"高级效果"仍然值得做?延迟着色、屏幕空间反射、体积光这些桌面上的常客,在移动端是"换个做法就能用"还是"根本不该用"?这是第 5 篇的主题,也是本系列从"前提"转向"取舍"的转折点。
五、结语:把前提立住,把问题交出去
7.1 回到那条主线
依然是先来看看七篇怎么互相关联。把知识地图展开成一张依赖关系表,大家按自己的需要跳读:
七篇的依赖并不重:除第 1 篇人人可读外,其余各篇几乎只依赖前面的某一两篇,跳读也没问题。下面用一张表把每篇的前置依赖标清楚。
| 篇 | 前置依赖 | 可独立阅读 | 适合大家 |
|---|---|---|---|
| 1 物理约束(本篇) | 无 | 是 | 所有人 |
| 2 分块渲染 | 第 1 篇 | 部分 | 引擎与底层开发者 |
| 3 带宽 | 第 1、2 篇 | 部分 | 性能优化工程师 |
| 4 功耗与热 | 第 1 篇 | 部分 | 产品与性能负责人 |
| 5 延迟着色取舍 | 第 1–4 篇 | 否 | 渲染架构与美术技术 |
| 6 现代特性 | 第 1–5 篇 | 否 | 追赶前沿的开发者 |
| 7 测量与调优 | 第 1 篇 | 是 | 所有人(尤其是测试) |
这一篇通篇只在做一件事:把移动端图形的物理前提立起来。我们会得出一条主线:现象(同一份代码两种命运)→ 约束(带宽墙与功耗墙)→ 机制(分块架构为什么这样设计)→ 账本(每帧字节与每瓦产出)→ 判据(怎么选手段)→ 验证(怎么证明有效)。
本篇的量化结论汇总(每条都标注了出处,方便核对):
| 结论 | 数值 | 来源类型 |
|---|---|---|
| 持续 GPU 性能 / 爆发性能 | 50%–65% | 公开实测统计 |
| CPU 持续性能 / 爆发性能 | 64%–78% | 同上 |
| 一次限频实测:频率下降 | 900MHz → 315MHz(约 −65%) | 单机型实测记录 |
| 同一次限频:单次任务延迟 | 130ms → 410ms(约 3.15×) | 同上 |
| CPU 触发限频的典型温度 | 70°C 上下,GPU 随后且不协同 | 学术研究 |
| LPDDR vs GDDR 每 pin 带宽 | 不到一半 | HPG 会议材料 |
| LPDDR 峰值能效优势 | 约 10% | 同上 |
| DRAM 访问功耗代价 | 约 80–100mW per GB/s | 移动 GPU 功耗建模论文 |
| 典型内存功率预算下的每帧可搬字节 | 约 100MB(60fps、650mW 预算) | 同上 |
| 并行帧渲染的收益 | 带宽 −23.8% → 提速 12%、省电 20.1% | 学位论文实测 |
| 三角形丢弃(遮挡几何预测)的收益 | 平均省电 14.5%(其中 11.7% 来自内存系统) | ACM 论文 |
| VRS 在移动端的实测收益 | 平均帧率提升约 12%–13% | 厂商开发者文档 |
这里面有两条数字值得单独记住,因为它们把"约束"从形容词变成了可算的量:
第一条:DRAM 访问的功耗代价约为每 GB/s 80–100mW,而在典型的内存功率预算(约 650mW)下,60fps 每秒只能搬运约 100MB/帧的等价值 [移动 GPU 功耗建模]。这意味着"每帧能用多少字节"是可以算出来的——不是感觉上的"带宽紧张"。
第二条:持续性能只有峰值的 50%–65%。这条决定了移动端的性能设计必须以"持续"为目标,而不是以"峰值"为目标。
7.2 三个还没解决的问题
按惯例,讲结束时要把仍然敞开的口子列清楚,而不是假装都解决了。
- 限频策略不可见、不可预测。厂商温控策略不公开,开发者只能拿到"已经降频了"这个结果。Android 的动态性能框架(ADPF)给出热余量查询接口,让应用能在不可持续之前主动降负载,这是目前最接近"提前知道"的手段 [Android ADPF 文档];但它给的是余量,不是曲线。
- 跨机型外推依然困难。同一个优化在中端机上收益 20%、在高端机上可能只有 3%(因为它本来就不在带宽瓶颈上)。"优化收益取决于当前瓶颈在哪"这件事,目前只能逐机型实测。
- 功耗与画质的最优点依赖产品定位。竞技类游戏与叙事类游戏的取舍完全不同,这不是技术问题,是产品问题——技术能做的是把取舍曲线画清楚,让人知道每个选择的代价。
7.3 选型建议:什么时候该为移动端单独设计
给一条可操作的判断路径。入口是四个维度:目标机型区间、画质要求、续航要求、团队能力——任何一个落在下半个区间,共用一套管线都会在持续性能上付代价。
| 判断条件 | 若成立 | 建议 |
|---|---|---|
| 目标机型覆盖中低端 | 是 | 必须单独设计:带宽与散热上限差一个档位 |
| 要求连续 30 分钟不掉帧 | 是 | 必须单独设计:峰值优化在这里无效 |
| 画质目标是"接近主机/PC" | 是 | 单独立项:需要另一条画质档链路 |
| 只面向少数高端机型 | 是 | 可以先共用管线,但必须单独做持续性能验收 |
| 团队无法维护两套配置 | — | 至少做"分级画质档 + 帧率上限"两条最小干预 |
7.4 下一篇预告与系列进度
系列刚从首篇起步,立完前提,下一篇就该进入机制层了。
下一篇是【移动端图形与功耗】(二)分块渲染:binning、片上内存与它的代价。它会把这一篇立下的第一道墙(带宽)拆到机制层:binning 阶段到底在做什么、片上内存能挂多少附件、什么时候会溢出到系统内存、"零带宽"的成立条件与失效条件各是什么,以及这些机制在三个平台上(Arm / Imagination / Qualcomm / Apple)的具体差异。
如果你只想知道"该怎么配",第 2 篇与第 4 篇是最实用的两篇;如果你在做架构选型,第 5 篇(延迟着色取舍)与第 6 篇(现代特性)更相关。
7.5 一点点题外话
移动端图形这个方向的写作有个尴尬之处:它的结论往往不如桌面端"漂亮"。很多取舍的答案是"看情况"——看机型、看画质目标、看续航要求。但这不是含糊,而是这个领域真实的样子:约束越多的地方,最优解越依赖上下文。
我们能做的是把上下文写清楚:哪些量是硬的(位宽、热阻、温度阈值),哪些是软的(画质偏好、帧率目标),以及每个选择的代价落在哪。把这件事做到位,比给一份"最佳实践清单"更有用——因为清单会过期,而约束不会。
7.6 落款
本篇是《移动端图形与功耗》系列的第 1 篇。写作过程中,凡是引用第三方数据的地方都给了出处,凡是"机制上如此"的判断都没有伪装成实测结论;拿不到数据的地方,我们选择留白而不是填空。如果大家发现任何一处口径不一致或引用错误,欢迎指出——技术文章的信誉就建立在"数字能核对"这一点上。
参考文献
官方文档与权威资料(1–34)
- Arm,Getting started on mobile and best practices for Arm GPUs(Vulkanised 2023)— https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_2023_getting_started_on_mobile_and_best_practices_for_arm_gpus.pdf
- Arm,Mobile HW and Bandwidth(SIGGRAPH 2015)— https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/siggraph2015_2D00_mmg_2D00_andy_2D00_slides.pdf
- Arm,Vulkan on mobile(SIGGRAPH 2020)— https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2_2D00_mmg2020_2D00_vulkan_2D00_emilio.pdf
- Arm,Mobile GPUs: Architecture, Constraints, and Optimization(SIGGRAPH 2024)— https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/3858.siggraph_5F00_mmg_5F00_2024_5F00_Mobile101.pdf
- Arm,Performance Studio(性能分析工具套件)— https://www.arm.com/products/development-tools/graphics/arm-performance-studio
- Imagination,PowerVR Graphics Architecture — https://www.imaginationtech.com/products/gpu/graphics-architecture/
- Imagination,Hidden Surface Removal Efficiency — https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/hidden-surface-removal-efficiency.html
- Qualcomm,Adreno GPU Game Developer Guide · Overview — https://docs.qualcomm.com/doc/80-78185-2/topic/overview.html
- Qualcomm,Adreno GPU on Mobile: Best Practices — https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- Qualcomm,Snapdragon Profiler — https://www.qualcomm.com/developer/software/snapdragon-profiler
- Qualcomm,Snapdragon Profiler User Guide — https://developer.qualcomm.com/qfile/71530/snapdragon_profiler_user_guide.pdf
- Apple,Tailor your apps for Apple GPUs and tile-based deferred rendering — https://developer.apple.com/documentation/Metal/tailor-your-apps-for-apple-gpus-and-tile-based-deferred-rendering
- Apple,Rendering a scene with deferred lighting in Swift — https://developer.apple.com/documentation/metal/rendering-a-scene-with-deferred-lighting-in-swift
- Apple,Capturing a Metal workload in Xcode — https://developer.apple.com/documentation/Xcode/Capturing-a-Metal-workload-in-Xcode
- Apple,Modern Rendering with Metal(WWDC19)— https://devstreaming-cdn.apple.com/videos/wwdc/2019/601fthb9otw94fg/601/601_modern_rendering_with_metal.pdf
- Khronos,Tile Based Rendering (TBR) Best Practices(Vulkan Guide)— https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- Khronos,Mobile Development: Rendering Approaches(Vulkan Tutorial)— https://docs.vulkan.org/tutorial/latest/Building_a_Simple_Engine/Mobile_Development/04_rendering_approaches.html
- Khronos,VK_EXT_multisampled_render_to_single_sampled — https://docs.vulkan.org/features/latest/features/proposals/VK_EXT_multisampled_render_to_single_sampled.html
- Khronos 社区,Tile Based Rendering Best Practices 讨论 — https://community.khronos.org/t/tile-based-rendering-best-practices/112538
- Khronos,Vulkan Spec 深度相关章节(Vulkan Guide · Depth)— https://docs.vulkan.org/guide/latest/depth.html
- Godot,Internal rendering architecture — https://docs.godotengine.org/en/4.3/contributing/development/core_and_modules/internal_rendering_architecture.html
- Godot,GPU optimization(tile renderer 与带宽)— https://docs.godotengine.org/ru/4.5/_sources/tutorials/performance/gpu_optimization.rst.txt
- Godot,Mobile rendering limitations(移动端逐顶点光照等)— https://godot-ru.readthedocs.io/ru/3.x/_sources/tutorials/platform/mobile_rendering_limitations.rst.txt
- Godot,4.5 Release Notes(Fragment Density Map 与 Vulkan Mobile 的注视点渲染)— https://godotengine.org/releases/4.5/
- Godot QA,移动端性能优化经验讨论 — https://godotengine.org/qa/57294/looking-for-some-tips-to-speed-up-my-game
- Unity,Configure for better performance(URP)— https://docs.unity3d.com/6/Documentation/Manual/urp/configure-for-better-performance.html
- Unity(中文),配置 URP 以获得更好的性能 — https://docs.unity.cn/cn/Packages-cn/com.unity.render-pipelines.universal@14.1/manual/configure-for-better-performance.html
- Android,Thermal API(ADPF 热余量查询)— https://developer.android.com/games/optimize/adpf/thermal
- Android,Adaptive Performance Framework 总览 — https://developer.android.google.cn/games/optimize/adpf
- Android,Slow sessions(可持续性能监测)— https://developer.android.google.cn/games/optimize/vitals/slow-session
- Samsung,Adaptive Performance in Call of Duty Mobile(热状态 API 实践)— https://developer.samsung.com/galaxy-gamedev/gamedev-blog/cod.html
- Samsung,Using Variable Rate Shading to Improve Performance on Mobile Games — https://developer.samsung.com/galaxy-gamedev/blog/en-us/2022/11/22/using-variable-rate-shading-to-improve-performance-on-mobile-games
- MediaTek,VRS 开发示例(移动端实测帧率)— https://developer.mediatek.com/VariableRateShading/642428c3f55b040d6989a991.html
- NVIDIA,VRWorks – Variable Rate Shading — https://developer.nvidia.com/vrworks/graphics/variablerateshading
学术研究与量化材料(35–46)
- Improving Mobile Gaming Performance through Cooperative CPU-GPU Thermal Management(KIT)— https://ces.itec.kit.edu/img/Improving_Mobile_Gaming_Performance_through_Cooperative_CPU_GPU_Thermal_Management.pdf
- Mobile GPU approaches to power efficiency(HPG 2019)— https://highperformancegraphics.org/wp-content/uploads/2019/hot3d/mobile_gpu_power_and_performance.pdf
- Energy-Efficient Mobile GPU Systems(学位论文,并行帧渲染的带宽与能耗收益)— https://core.ac.uk/download/33348056.pdf
- Automated PMC-based Power Modeling Methodology for Modern Mobile GPUs(DRAM 每 GB/s 功耗与内存功率预算)— https://arxiv.org/pdf/2408.04886v1
- Triangle Dropping: An Occluded-geometry Predictor for Energy-efficient Mobile GPUs(ACM)— https://dl.acm.org/doi/fullHtml/10.1145/3527861
- Perceptual Model for Adaptive Local Shading and Refresh Rate(ACM,VRS 的 16×16 分块)— https://dl.acm.org/doi/pdf/10.1145/3478513.3480514
- A QoS-Aware Memory Controller for Dynamically Balancing GPU and CPU Bandwidth Use in an MPSoC(分块渲染的片上缓存机制)— http://lph.ece.utexas.edu/users/mjeong/pubs/cpugpumc_dac12.pdf
- LLM Inference at the Edge: Mobile, NPU, and GPU Performance Efficiency Trade-offs Under Sustained Load(DVFS 与结温阈值)— https://arxiv.org/html/2603.23640v1
- RTGS: Enabling Real-Time Gaussian Splatting on Mobile Devices Using Efficiency-Guided Pruning and Foveated Rendering — https://arxiv.org/html/2407.00435v2
- Resource utilization of different mobile platforms under sustained inference — https://arxiv.org/html/2410.05315
- OpenCL Optimization and Best Practices for Qualcomm Adreno GPUs(SP 内部结构)— https://dl.acm.org/doi/pdf/10.1145/3204919.3204935
- Smartphone Performance: The Complete Physics Guide(持续性能区间统计)— https://product.ai/truth-graph/smartphones/performance/
工程实践与社区讨论(47–62)
- 端侧推理的功耗与热管理全链路:从 SoC DVFS 调度到 Thermal Throttling(限频实测 900→315MHz)— https://xckevin.com/blog/2025-11-21-
- Mobile Performance Deep Dive(移动端分析工具分工)— https://getperfguard.com/tutorials/mobile-performance
- Foveated Rendering Strategies for Power-Constrained Mobile XR(VRS 与注视点渲染的工程取舍)— https://beefed.ai/en/foveated-rendering-mobile-xr-best-practices
- Arm Mali GPU 最佳实践(中文翻译)— https://blog.csdn.net/ZJU_fish1996/article/details/129095365
- 解密手机 GPU:硬件架构、渲染机制与手游开发的性能突围 — https://blog.csdn.net/qq_33060405/article/details/151753314
- 技术美术百人计划 · 3.7 移动端 GPU 的 TB(D)R 架构(笔记)— https://blog.csdn.net/qq_53352162/article/details/141563720
- 揭秘 TBR 渲染架构:移动图形的心脏(Imgtec 社区)— https://imgtec.eetrend.com/blog/2026/100598386.html
- 带宽:GPU 的粮道在哪里堵住了(DRAM 维持功耗与未命中代价)— https://blog.csdn.net/qq_45370022/article/details/164295496
- GPU 性能优化全指南:从诊断到实战(纹理压缩格式对照)— https://blog.csdn.net/qq_33060405/article/details/148148889
- Metal2 剖析(二):传统延迟渲染和 TBDR — https://blog.csdn.net/cordova/article/details/102944905
- Vulkan 入门(7):渲染过程与附件描述 — https://blog.csdn.net/u014535072/article/details/115278337
- TBDR ってなんだ?〜Apple GPU の心臓部「タイルベース遅延レンダリング」を完全理解〜 — https://qiita.com/GeneLab_999/items/af98cd50e9e117a29ed7
- Apple Silicon TBDR: What App Developers Actually Get — https://blakecrosley.com/blog/apple-silicon-tbdr
- 分块延迟渲染架构能否在桌面领域立足(几何压缩与剔除策略)— https://blog.csdn.net/weixin_49393016/article/details/155230945
- TBDR 架构为什么特别适合手机 GPU(片上内存与两阶段流程)— https://wenku.csdn.net/answer/3xp49m0nshg2
- POWERVR GPU IP core family(TA / ISP / TSP 三段流水)— http://cs.nju.edu.cn/swang/CompArchOrg_11F/project/P1/P3-PowerVR.pdf
硬件媒体与拆解报告(63–68)
- 3nm 芯片们,亮剑(骁龙 8 Elite 裸片与版图分析)— https://www.icviews.cn/news/14907/7
- 三款 3nm 旗舰手机,深度拆解 — http://news.qq.com/rain/a/20260226A062PN00
- 天玑 9000 die shot 分析 — https://ask.zol.com.cn/x/33329964.html
- 拆解小米 15s Pro:玄戒 O1 的 GPU 面积与缓存配置 — https://www.eet-china.com/news/202505233807.html
- 日机构拆解中国最新智能手机发现的自研芯片 — https://www.eet-china.com/news/202302026677.html
- AMD Radeon RX 6650M Mobile Graphics(移动独显的功耗与带宽规格对照)— https://www.amd.com/en/products/graphics/amd-radeon-rx-6650m
素材来源(69–78,逐张登记见「图片版权」一节)
- Wikimedia Commons,Category:Thermal imaging cameras — https://commons.wikimedia.org/wiki/Category:Thermal_imaging_cameras
- Wikimedia Commons,Category:System on a chip — https://commons.wikimedia.org/wiki/Category:System_on_a_chip
- Wikimedia Commons,Category:Graphics processing units — https://commons.wikimedia.org/wiki/Category:Graphics_processing_units
- Wikimedia Commons,CAT-B25 主板四视图(主板实拍)— https://commons.wikimedia.org/wiki/File:CAT-B25-Motherboard-Front-FL.jpg
- Wikimedia Commons,LG VN251S Motherboard Front — https://commons.wikimedia.org/wiki/File:LG_VN251S_Motherboard_Front.jpg
- Wikimedia Commons,SIP integrated circuits package — https://commons.wikimedia.org/wiki/File:SIP_integrated_circuits_package.jpg
- Wikimedia Commons,SN76489AN die shot(CC0 裸片)— https://commons.wikimedia.org/wiki/File:SN76489AN_die_shot.png
- Wikimedia Commons,Samsung Galaxy Nexus battery(电池实拍)— https://commons.wikimedia.org/wiki/File:Samsung_Galaxy_Nexus_battery_1.JPG
- Wikimedia Commons,Hioki 3390 Power analyzer(功率分析仪)— https://commons.wikimedia.org/wiki/File:Hioki_3390_Power_analyzer.jpg
- Wikimedia Commons,3D-Pipeline.svg(CC0 图形管线图)— https://commons.wikimedia.org/wiki/File:3D-Pipeline.svg
工程案例与测量方法(79–90)
- Android Developer Stories,Kakao Games 通过自适应功能将 FPS 稳定性提升至 96% — https://developer.android.com/stories/games/kakaogames-adaptability
- Unity Blog,Higher fidelity and smoother frame rates with Adaptive Performance(Megacity / Galaxy S10 对照)— https://blog.unity.com/technology/higher-fidelity-and-smoother-frame-rates-with-adaptive-performance
- Unity,Adaptive Performance 示例指南(热状态事件难以触发的原因)— https://docs.unity.cn/Packages/com.unity.adaptiveperformance@4.0/manual/samples-guide.html
- Ocean View Games,Managing Thermal Throttling in Unity Mobile Games — https://oceanviewgames.co.uk/blog/posts/managing-thermal-throttling-unity-mobile
- 移动端实测案例:散热限频与 Overdraw 排查(840MHz → 520MHz,粒子 4.2× overdraw)— https://dredyson.com/the-hidden-truth-about-hardware-control-patterns-from-a-12v-heater-thread-what-every-senior-game-developer-needs-to-know-for-aaa-performance-optimization-in-unreal-engine-and-unity/
- Unity 移动端 Overdraw 优化指南:从 GPU 原理到发热掉帧排查 — https://blog.csdn.net/weixin_29007135/article/details/164386353
- Apple,Optimize Metal apps and games with GPU counters(overdraw 的计数器定义)— https://developer.apple.com/videos/play/wwdc2020/10603
- J. Arnau 等,Eliminating Redundant Fragment Shader Executions on a Mobile GPU via Hardware Memoization(ISCA 2014,TBDR 的 tile 尺寸与几何列表构建)— https://people.ac.upc.edu/jarnau/isca14-arnau.pdf
- Arm,Rendering Structures: Analyzing modern rendering on mobile(SIGGRAPH 2018,移动与中端桌面的差距量级)— https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/5127.siggraph_2D00_2018_2D00_mmg_2D00_3_2D00_rendering_2D00_hanskristian.pdf
- Impeller 渲染引擎的分块与重绘策略(tile 约 256×256)— https://differ.blog/p/advanced-performance-optimization-with-the-impeller-rendering-engine-d3b2c5c
- Arm,Mali GPU 最佳实践(开发者文档入口)— https://developer.arm.com/documentation/101897/latest/
- Android,游戏开发性能与热管理专题(ADPF 与游戏模式)— https://developer.android.com/games/optimize
图片版权
外部实拍素材全部来自 Wikimedia Commons,逐张登记如下(正文图注亦已标注作者与许可); 自绘示意图版权归本系列所有。
| 文件 | 作者 | 许可 |
|---|---|---|
src_analyzer_anritsu.jpg |
Dtwitkowski | CC BY-SA 3.0 |
src_battery_gt5230.jpg |
Raimond Spekking | CC BY-SA 4.0 |
src_battery_label.jpg |
Dmitry G | CC BY-SA 3.0 |
src_battery_nexus.jpg |
MKFI | Public domain |
src_battery_nexus2.jpg |
MKFI | Public domain |
src_battery_swollen.jpg |
Stemoc | CC0 |
src_board_back.jpg |
MarcoTangerino | Public domain |
src_board_front.jpg |
MarcoTangerino | Public domain |
src_board_lcd_lifted.jpg |
MarcoTangerino | Public domain |
src_board_lg.jpg |
Mbrickn | CC BY 4.0 |
src_board_samsung.jpg |
Raimond Spekking | CC BY-SA 4.0 |
src_camera_module.jpg |
Bautsch | CC0 |
src_cell_pouch.jpg |
Shagett | CC BY-SA 4.0 |
src_chip_qualcomm.jpg |
Mbrickn | CC BY 4.0 |
src_cooling_plate.jpg |
Steve Jurvetson from Los Altos, USA | CC BY 2.0 |
src_devboard_altera.jpg |
Thotypous (Paulo Matias) | CC BY-SA 3.0 |
src_devboard_mojo.jpg |
SparkFun Electronics from Boulder, USA | CC BY 2.0 |
src_die_broadwell.jpg |
cole8888 | CC BY-SA 2.0 |
src_die_sn76489.png |
BirdbrainEngineer | CC0 |
src_die_tms320.jpg |
Mister rf | CC BY-SA 4.0 |
src_die_voodoo.jpg |
Fritzchens Fritz from Berlin | CC0 |
src_disassembled.jpg |
Medvedev | CC BY-SA 3.0 |
src_display_assembly.jpg |
Peddy https://www.ifixit.com/User/167584/Peddy | CC BY-SA 3.0 |
src_dram_die_mmn.jpg |
Mister rf | CC BY-SA 4.0 |
src_dram_samsung.jpg |
Raimond Spekking | CC BY-SA 4.0 |
src_dram_tab2.jpg |
Raimond Spekking | CC BY-SA 4.0 |
src_dreamcast_console.jpg |
Fritzchens Fritz | CC0 |
src_fairphone_modules.jpg |
PKFP | CC BY-SA 4.0 |
src_flir_phone.jpg |
Maurizio Pesce from Milan, Italia | CC BY 2.0 |
src_godot_editor.png |
AfterCadaver | CC BY-SA 4.0 |
src_gpu_datacolor.jpg |
Agnes Andersson | CC BY 4.0 |
src_gpu_rtx2080.jpg |
Jacek Halicki | CC BY-SA 4.0 |
src_heatsink.jpg |
Hans Haase | CC BY-SA 4.0 |
src_hero_components.jpg |
DYVER | CC BY-SA 4.0 |
src_mcu_die_micro.png |
Zom-B | CC BY-SA 4.0 |
src_package_open.jpg |
(公有领域作品,见来源页) | Public domain |
ext_pipeline.png |
Original: Martin Wantke Vector: AntiCompositeNumber | CC0 |
ext_pipeline_async.png |
Mewtow | CC0 |
ext_pipeline_sync.png |
Mewtow | CC0 |
src_pmic_ic.jpg |
Raimond Spekking | CC BY-SA 4.0 |
src_power_analyzer.jpg |
Tiia Monto | CC BY-SA 3.0 |
src_power_analyzer2.jpg |
dfrolov | CC BY-SA 4.0 |
src_powervr2_die.jpg |
Fritzchens Fritz | CC0 |
src_powervr3_die.jpg |
Fritzchens Fritz | CC0 |
src_rf_shield.jpg |
Raimond Spekking | CC BY-SA 4.0 |
src_scope_gwinstek.jpg |
BekundaOff | CC BY 4.0 |
src_sip_package.jpg |
Mister rf | CC BY-SA 4.0 |
src_switch_inside.png |
PantheraLeo1359531 | CC BY 4.0 |
src_switch_ram.png |
PantheraLeo1359531 | CC BY 4.0 |
src_thermal_phone.png |
Srnec media | CC BY-SA 4.0 |
src_wlcsp.jpg |
Phiarc | CC BY-SA 4.0 |
src_xoom_lpddr2.jpg |
Raimond Spekking | CC BY-SA 4.0 |


相关链接 - 上一篇:(本系列首篇) - 下一篇(预告):【移动端图形与功耗】(二) 分块渲染:binning、片上内存与它的代价
With Best Wishes.