站点链接:技术博客页
系列文章前言
系列定位
本系列逐层拆解实时渲染管线(Real-Time Rendering Pipeline)的关键环节,面向有一定图形学基础、想真正读懂引擎实现细节的开发者。写作初衷很直接:国内缺少一套既能讲清原理、又能落到代码与数据的渲染管线长文,而散落的英文教程与会议 PPT 门槛偏高。把零散笔记整理成体系,既是给读者一条捷径,也是对我自己知识结构的一次清算。
系列文章写作风格说明
- 篇幅规划:每篇约 8,000 字,每个技术章节约 900 字。
- 写作顺序:按真实管线的执行顺序推进——几何处理 → 光栅化 → 着色 → 后处理。
- 全部结论尽量绑定数据;凡引用他人成果,均给出可点击出处。
全系列知识体系
全系列内容总览
- 【实时渲染管线探析】(一) 延迟渲染:从原理到实现的性能权衡
- 【实时渲染管线探析】(二) 阴影贴图:从 PCF 到 VSM 的演进
- 【实时渲染管线探析】(三) 后处理链:Bloom、色调映射与抗锯齿
- 【实时渲染管线探析】(四) PBR 与 IBL:从渲染方程到工业实践
- 【实时渲染管线探析】(五) 可见性与剔除:从视锥到 GPU-Driven
背景铺垫
实时渲染(Real-Time Rendering)中,光照计算(Lighting)几乎总是性能开销的头号来源。当场景里的动态光源从十几盏涨到上百盏,传统的前向渲染(Forward Rendering)会迅速撞上性能墙——而这,正是延迟渲染(Deferred Shading)要解决的问题。
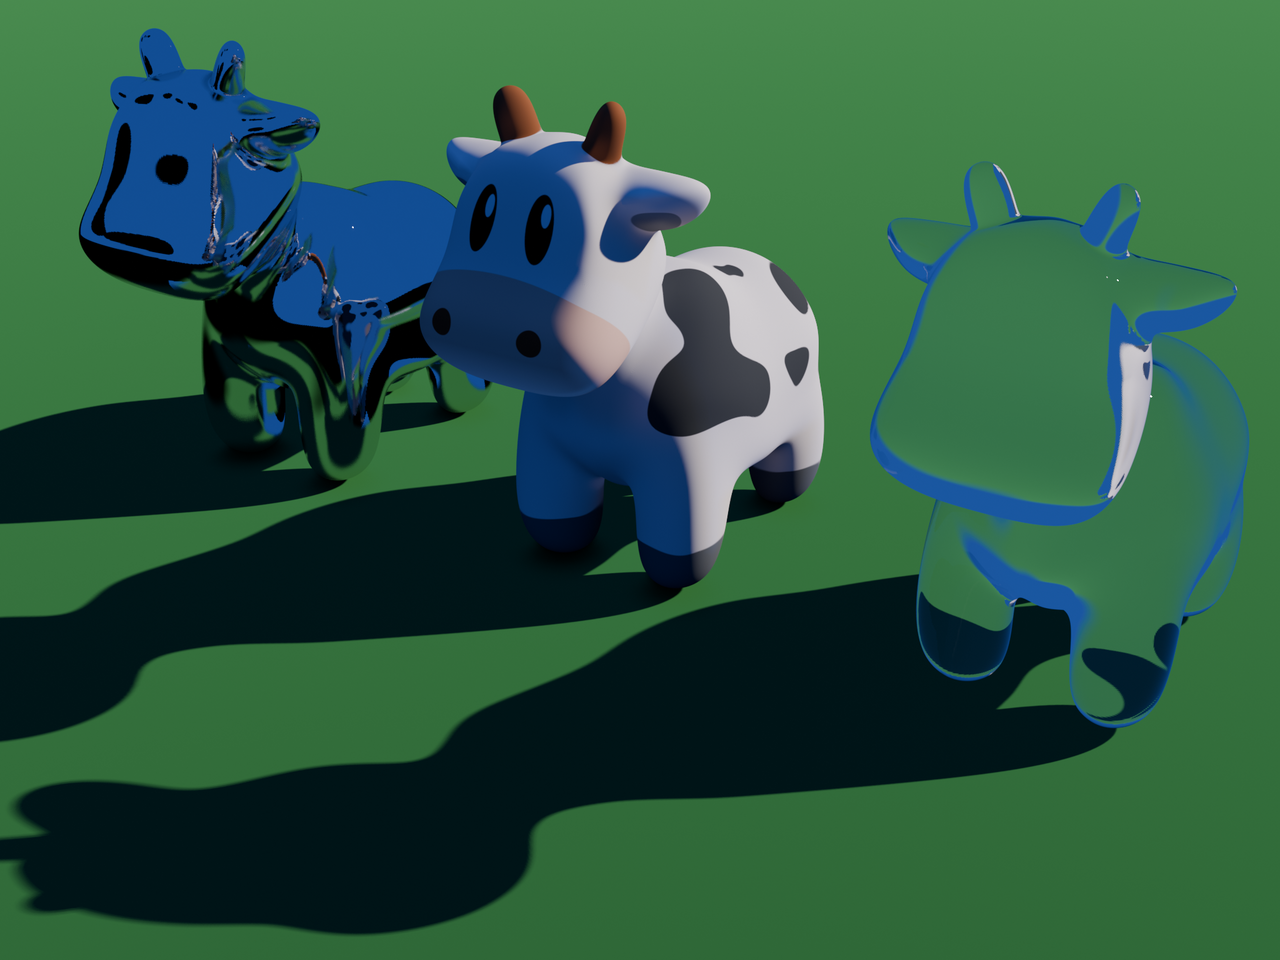
先给出"效果"这一层的直观印象——本系列讨论的所有管线优化,最终都是为了让这类画面在可控的性能预算内稳定跑起来。离开效果谈管线,容易陷入参数堆砌;而只看效果不问管线,又会在美术需求变更时无从下手。
本文的范围边界需要先说清楚:只讨论不透明几何的延迟着色主链路,不涉及移动端 Tile-Based GPU 的片上内存细节,也不展开光线追踪与全局光照(那是另一个系列的话题)。参数取值范围会随结论一并给出,不做无依据的推荐。
术语层面先做一次对齐,后文统一使用简称,避免中英混用造成歧义:
预判一个常见疑问:既然延迟渲染听起来处处占优,为什么不是所有引擎都改用它?答案在第六、七章——它有"三座大山",且优势只在特定规模区间成立。带着这个问题读下去,会比带着"新技术必胜"的预设更有收获。
为了便于随时对照,这里先给出一张总表——后文各章会逐项展开其中的每一行:
有了这张表作为索引,后面遇到任何一项差异,都可以回到这里确认它在整体结构中的位置。技术文章常见的困境是"细节记住了、结构没建立",这张表就是用来解决这个问题的。
OK,言归正传,下面我们开始正文。
一、前向渲染的复杂度瓶颈
1.1 执行模型
好了,我们先从执行模型说起。前向渲染的模型可以一句话概括:逐物体、逐光源(per-object, per-light)。对场景中每个物体,都要把它受到影响的每一盏光源完整算一遍。
这套模型的代价随"物体数 × 光源数"增长。说白了,一盏光源哪怕只照到屏幕上一个像素,也会参与该物体的整个着色计算——大量算力被浪费在几乎不可见的贡献上。
图 逐盏布光的动态演示:主光→辅光→轮廓光逐盏点亮,直观对应"逐光源"思想 @ Wikimedia Commons · GDallimore(Public domain,H.264 MP4 全浏览器兼容)
这种双层循环带来的浪费,最直观的体现是重复着色(Overdraw):同一屏幕像素被多层几何反复覆盖,每次覆盖都要完整跑一遍片元着色器,而只有最后一遍的结果留在屏幕上。
在深度复杂度高的场景(森林、城市街道)里,Overdraw 系数常达到 2–3 倍——这意味着前向渲染有近半的片元着色被白白丢弃。延迟渲染天然规避了这个问题:几何阶段不跑光照,光照阶段每像素只跑一次。
不同场景的浪费率差异很大,下面这组估算值可以帮你判断自己项目的处境:
可以看到,场景越复杂,前向渲染浪费得越多——这恰好也是延迟渲染收益最大的场合。反过来说,如果你的场景以平坦地面、天空盒为主,前向渲染的浪费率接近零,此时上延迟渲染就是纯粹的额外开销。
1.2 三大具体痛点
前向渲染的瓶颈不止"次数多"这一条,实际工程中它表现为三种具体形态:
- 重复着色:同一屏幕像素被多层几何反复覆盖,片元着色器(Fragment Shader)跑了多遍,只有最后一遍留在屏幕上。
- 光源浪费:光源的影响范围与会话几何不一致时,被照不到的物体也要参与循环。
- 状态切换:为每个光源单独设置 uniform 或常量缓冲,CPU 侧提交开销随光源数线性上升。
官方管线文档把这套流程拆成顶点着色 → 光栅化 → 像素着色 → 输出合并四个阶段,前向渲染把光照全部压在"像素着色"这一步里:https://learn.microsoft.com/en-us/windows/win32/direct3d11/overviews-direct3d-11-graphics-pipeline
1.3 复杂度对比
下面我们开始把上面的直觉写成公式。前向渲染的片元着色次数可以写成:
$$ \text{ShadingCount}_{forward} = \sum_{o \in Objects} \sum_{l \in Lights(o)} \text{Fragments}(o) $$
其中: - $Objects$ 是场景中的物体集合。 - $Lights(o)$ 是影响物体 o 的光源集合。 - $\text{Fragments}(o)$ 是物体 o 覆盖的屏幕片元数。
延迟渲染把公式换成:
$$ \text{ShadingCount}_{deferred} = \sum_{p \in Pixels} |Lights(p)| $$
其中: - $Pixels$ 是屏幕像素集合(每个像素只着色一次)。 - $|Lights(p)|$ 是影响该像素的光源数。
关键差异:前向的求和项里带着"物体数",延迟把它彻底消掉了——这就是后者的结构性优势。复杂度对比可参考 ogldev 延迟着色系列第一篇对 G-Buffer 与 MRT 的推导:https://ogldev.org/www/tutorial35/tutorial35.html
值得展开的是这个"消掉"到底意味着什么。前向渲染的代价随场景复杂度双向增长:物体变多要涨,光源变多也要涨;而延迟渲染的代价与物体数完全无关,只随屏幕分辨率与光源数变化。这个性质带来一个很实际的工程好处——性能可预测性。做前向渲染时,美术往场景里加一批道具就可能让某个区域掉帧,且难以提前预估;做延迟渲染时,只要分辨率和光源数不变,开销基本恒定,优化目标非常明确。
反过来说,这个性质也正是延迟渲染的局限所在:它对"屏幕像素"敏感,因此分辨率提升的代价是平方级放大的(详见第六章带宽部分);而在这一点上,前向渲染反而更有弹性。
1.4 什么时候它其实够用
必须承认,前向渲染并非"过时技术"。当光源数少(<10)、场景深度复杂度低、或需要大量透明与多样材质时,前向渲染的实现简单性与灵活性反而是优势。这也是后来的 Forward+ 方案能在工业界站稳脚跟的原因——它保留了前向的材质灵活性,只把"光源列表"这一步做得更聪明。
换句话说,选型的正确问法不是"哪个更先进",而是"我的约束落在哪个区间"。这个问题会在第八章给出完整的判断顺序。
好了,我们正式开始 G-Buffer 部分的讲解。
二、G-Buffer:延迟渲染的数据中枢
2.1 核心思路
延迟渲染(Deferred Shading)的思路,是把"几何"和"光照"彻底拆成两个阶段:
- 几何阶段(Geometry Pass):只做光栅化,把每个像素的材质信息写入一组渲染目标,这组目标合称 G-Buffer(Geometry Buffer)。
- 光照阶段(Lighting Pass):以屏幕空间的全屏四边形为画布,逐像素读取 G-Buffer,再做光照积分。
这样一来,光照计算量只与"屏幕像素数 × 光源数"相关,与场景物体数彻底解耦。
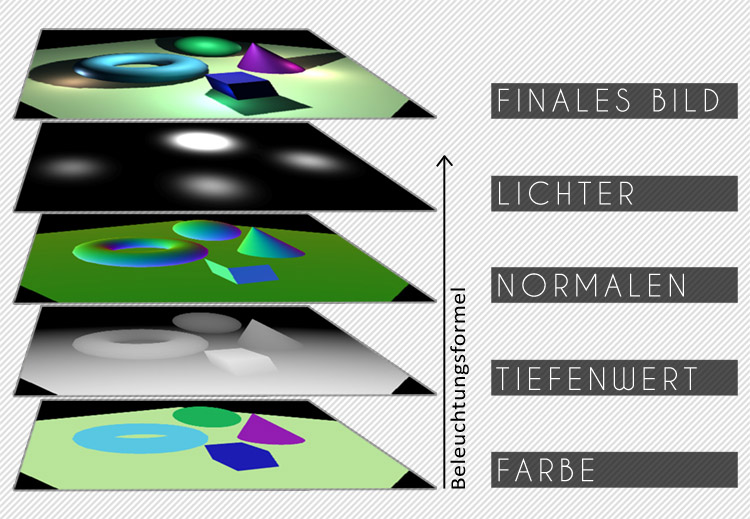
理论讲完,先看一张真实的可视化素材——延迟着色被拆成各阶段之后,实际呈现是什么样子:
延迟着色的整体流程,一张图就能交代清楚:
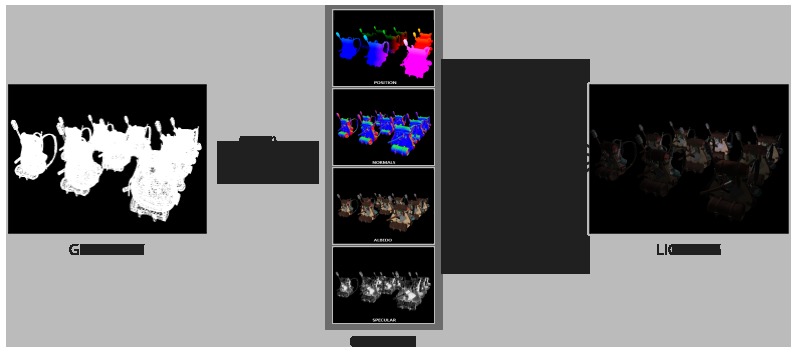
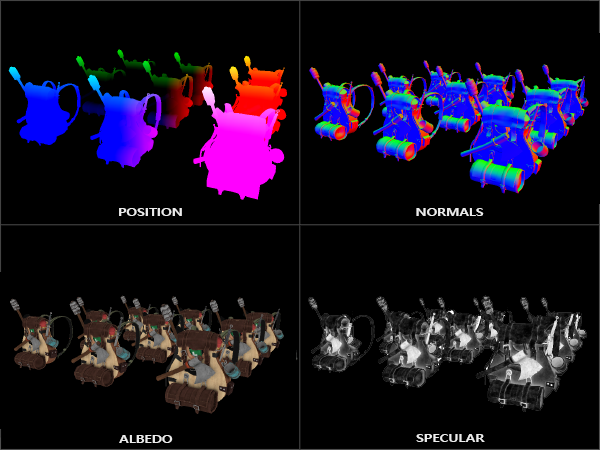
G-Buffer 里到底存了什么,可以直接看这张多通道可视化:
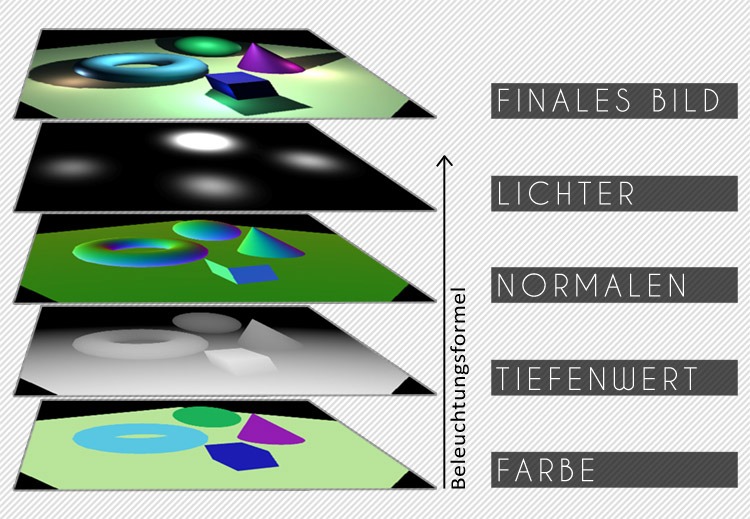
这张图把延迟着色的各个阶段并列展示了出来——从几何阶段的原始输出,到 G-Buffer 的各个通道,再到光照合成后的结果。对照它来读后面的通道布局章节,会比只看示意图直观得多。
这个思路并非新近发明,GPU Gems 3 第 19 章就记录过 Tabula Rasa 项目的完整实践:https://developer.nvidia.com/gpugems/gpugems3/part-iii-rendering/chapter-19-deferred-shading-tabula-rasa
2.2 通道布局设计
OK,言归正传,先看通道该怎么分配。G-Buffer 的通道分配是第一个要拍板的决策,它直接决定了显存占用与带宽(Bandwidth)成本。
一个常见的紧凑布局(约 20 字节/像素):
| 渲染目标 | 通道分配 | 内容 |
|---|---|---|
| RT0 | RGB / A | 基础色(baseColor)/ 环境光遮蔽(AO) |
| RT1 | RGB / A | 世界空间法线(World Normal)/ 粗糙度(roughness) |
| RT2 | RGB / A | 自发光(emissive)/ 金属度(metallic)/ 标志位 |
这套"多渲染目标(Multiple Render Targets, MRT)"的写法,是把几何数据一次写完的关键。LearnOpenGL 的延迟渲染章节给出了完整的 OpenGL 实现,可作为对照:https://learnopengl.com/Advanced-Lighting/Deferred-Shading
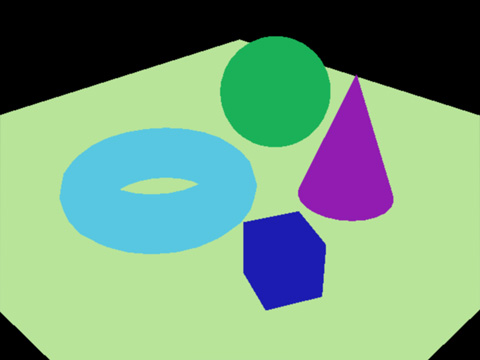
真实项目里,几何阶段单独输出的 Color Pass 是这个样子:
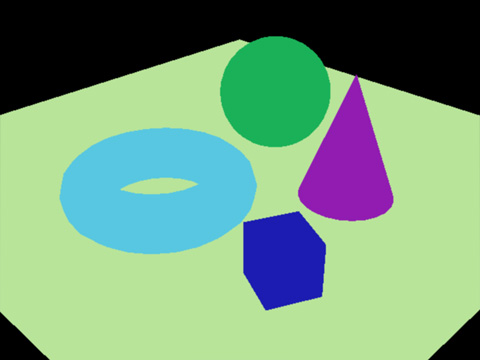
注意它与最终画面之间的差别——Color Pass 里还没有任何光照信息,只有材质本身的颜色。光照是在后续的光照阶段才叠加进去的,这正是"延迟"二字的由来。
布局的字节数直接决定带宽成本,几种常见布局的对比:
从 8 B/px 到 32 B/px 差了 4 倍——在 4K 分辨率下,这个差异会被放大到每帧数百 MB 的显存流量。
通道数量的抉择本质是一次权衡:
通道布局的具体排布是这样的:
单看颜色通道,就是一张“没有光照”的画面:
法线通道里存的究竟是什么数据,可以看一张法线贴图——法线被编码成颜色:
这里没有普适最优解:桌面端通常倾向"通道多、信息全",移动端则必须优先压缩通道数。同一款游戏在两端采用不同的 G-Buffer 布局,是相当常见的工程实践。
2.3 精度分配:为什么法线必须高精度
通道布局里最容易踩的坑,是精度分配。不同数据的精度需求差异极大:
- 世界空间法线(World Normal):必须用 16 位或 32 位浮点。8 位量化会带来可见的法线台阶,光照高光直接出现色块。
- 基础色(baseColor):8 位足够,人眼对漫反射色彩的量化不敏感。
- 粗糙度(roughness):8 位一般够用,但与金属度共用通道时要注意取值范围划分。
法线的存储方案,则是精度与带宽之间最典型的权衡:
除了编码方式,法线还存在一个"存哪个空间"的选择,它直接影响光照阶段的实现复杂度:
本系列后续统一采用世界空间法线:它能在光照阶段直接使用,代价是精度要求更高、通道更难压缩。这同样是取舍,而非对错。
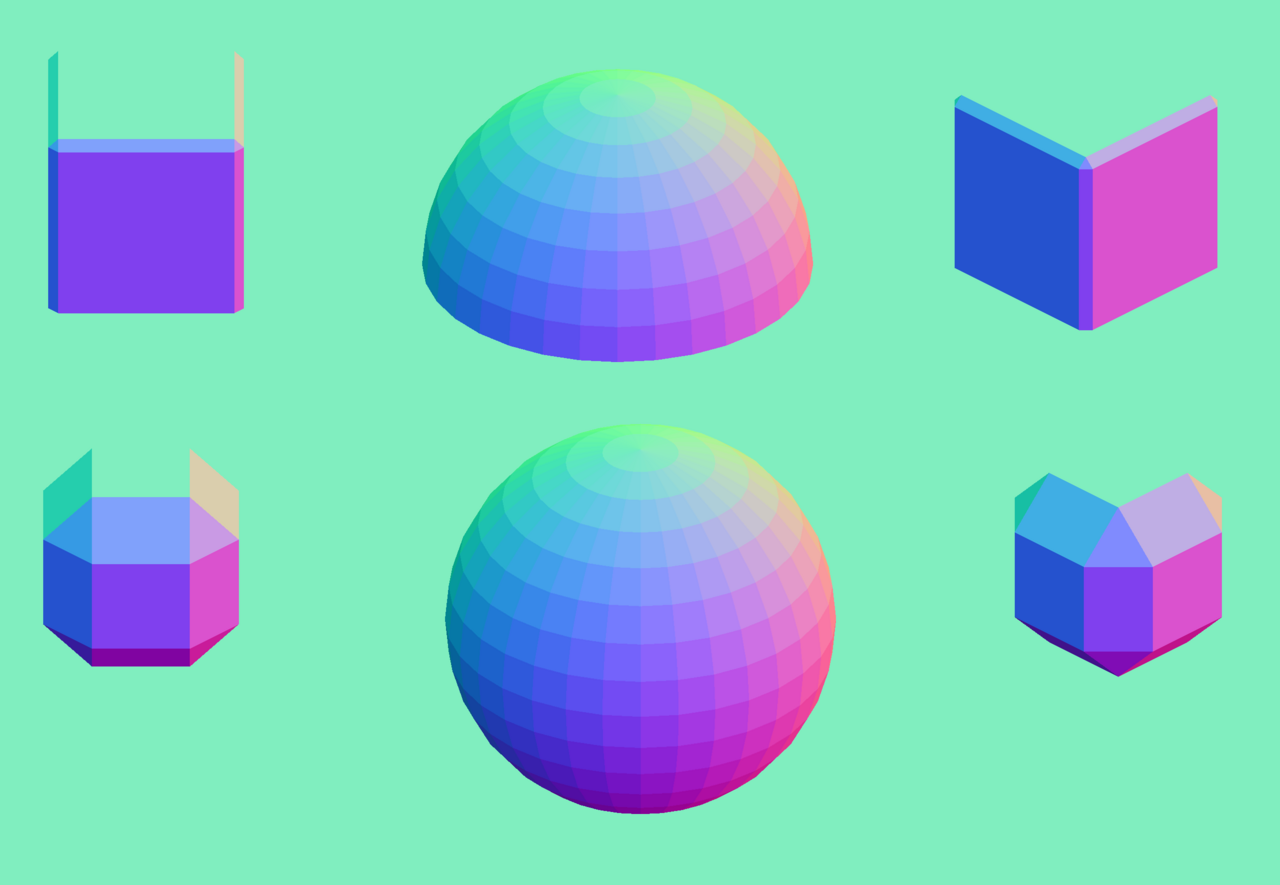
把法线数据直接可视化出来,是排查 G-Buffer 问题最常用的手段——不同朝向的几何体会映射为不同颜色,一眼就能看出法线是否正确:
精度不足的后果,Godot 官方文档给了一张很直观的实例——位深不够时,渐变会被量化成可见的台阶:
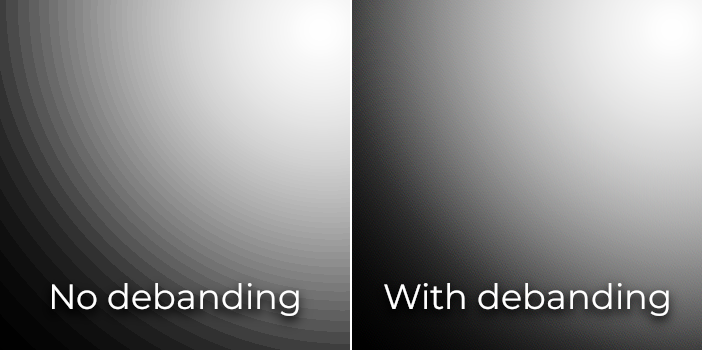
顺带提醒一个容易被忽略的细节:法线写入前必须归一化。插值后的法线长度会偏离单位长度,直接写入会让光照阶段的 N·L 计算出现偏差。相关细节可参考透视校正插值的原理:https://www.scratchapixel.com/lessons/3d-basic-rendering/rasterization-practical-implementation/perspective-correct-interpolation-vertex-attributes.html
2.4 几何阶段:写入 G-Buffer
先看看几何阶段具体要做什么。几何阶段的像素着色器只负责"打包"材质信息,不做任何光照计算:
//-----------------------------------【G-Buffer 写入】---------------------------------------
// 描述:几何阶段的像素着色器,把材质信息打包进三张渲染目标
//------------------------------------------------------------------------------------------
struct GBufferOutput {
    float4 rt0 : SV_Target0;   // baseColor.rgb + AO
    float4 rt1 : SV_Target1;   // worldNormal.rgb + roughness
    float4 rt2 : SV_Target2;   // emissive + metallic
};

GBufferOutput GeometryPass(Varyings input) {
    GBufferOutput o;
    //【1】基础色与环境光遮蔽打包到 RT0
    o.rt0 = float4(SampleBaseColor(input), SampleAO(input));
    //【2】法线必须归一化后写入 RT1,否则光照阶段方向会失真
    o.rt1 = float4(normalize(input.worldNormal), SampleRoughness(input));
    //【3】自发光与金属度打包到 RT2
    o.rt2 = float4(SampleEmissive(input), SampleMetallic(input), 1.0);
    return o;
}
上面代码中,法线归一化是最容易被忽略的一步。
MRT 的绑定与 glDrawBuffers 调用顺序,ogldev 的教程讲得比官方文档更直观:https://ogldev.org/www/tutorial35/tutorial35.html
注意最后一步"显式声明绘制缓冲":省略它会让附件静默失效,G-Buffer 全是空白却不报错——这是 MRT 最常见的调试陷阱。
三、光照阶段:从数据到画面
3.1 渲染方程
下面进入光照阶段。它真正求解的,是经典的渲染方程(Rendering Equation):
$$ L_o(p, \omega_o) = \int_{\Omega} f_r(p, \omega_i, \omega_o) L_i(p, \omega_i) \cos\theta_i \, d\omega_i $$
其中: - $L_o$ 是 p 点沿出射方向 $\omega_o$ 的出射光亮度。 - $f_r$ 是双向反射分布函数(BRDF),描述入射到出射的反射比例。 - $L_i$ 是沿入射方向 $\omega_i$ 的入射光亮度。 - $\cos\theta_i$ 是入射方向与表面法线的夹角余弦。
工程实现里,这个积分通常被离散成对每盏光源的累加——也正因如此,光源数量才成为延迟渲染的主战场。
这里有个容易混淆的点值得强调:光照计算本身与前向渲染完全一致,变的只是"输入从哪来"——前向从顶点着色器插值得到,延迟则从 G-Buffer 采样得到。理解这一点,就不会把延迟渲染当成"另一套光照算法"。
3.2 逐像素累加
下面我们看这个积分在代码里怎么落地。光照阶段用全屏 Pass 遍历每个像素,读取 G-Buffer 后累加所有光源:
//-----------------------------------【延迟光照】---------------------------------------
// 描述:光照阶段逐像素读取 G-Buffer,累加所有光源的贡献
//------------------------------------------------------------------------------------------
float3 DeferredLighting(float2 uv) {
    //【1】从 G-Buffer 反解材质参数
    float4 rt0 = GBuffer0.Sample(sampler, uv);
    float4 rt1 = GBuffer1.Sample(sampler, uv);
    float3 albedo    = rt0.rgb;
    float3 N         = normalize(rt1.xyz);
    float  roughness = rt1.a;

    //【2】逐光源累加(迭代次数只由光源数决定,与物体数无关)
    float3 color = 0;
    for (uint i = 0; i < lightCount; ++i) {
        color += EvaluateBRDF(albedo, N, roughness, lights[i], uv);
    }
    return color;
}
上述代码实现了延迟渲染的核心收益:光照循环的迭代次数只由光源数决定,与屏幕上有多少物体无关。
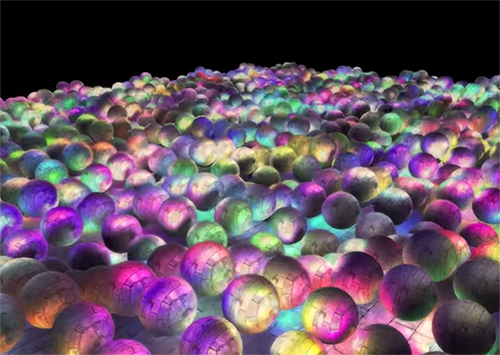
这段循环的产物,就是下面这张多光源场景的最终画面——每个像素把若干光源的贡献用加法混合累加,形成立体的局部光照:
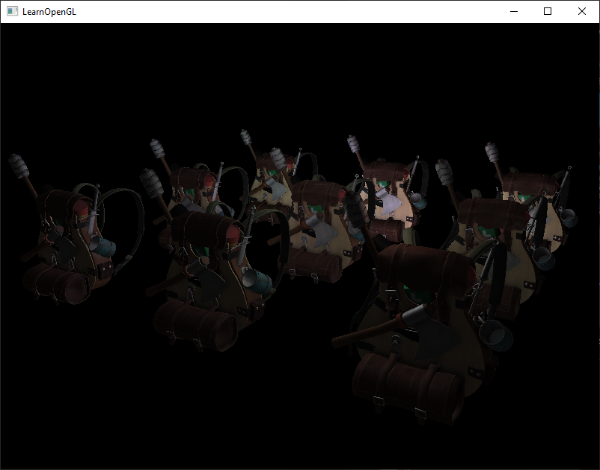
逐光源累加的执行层次可以用一张图概括:
不同光源类型在延迟渲染里的适配方式并不相同——这直接决定了剔除策略能做多细:
光照 Pass 逐像素累加的结果长这样:
平行光是个特例:它影响范围无限大,无法用包围体剔除,只能在光照阶段全屏处理。这也是"一个平行光 + 大量点光源"的组合在延迟渲染里特别常见的原因——前者负责整体基调,后者承担局部细节。
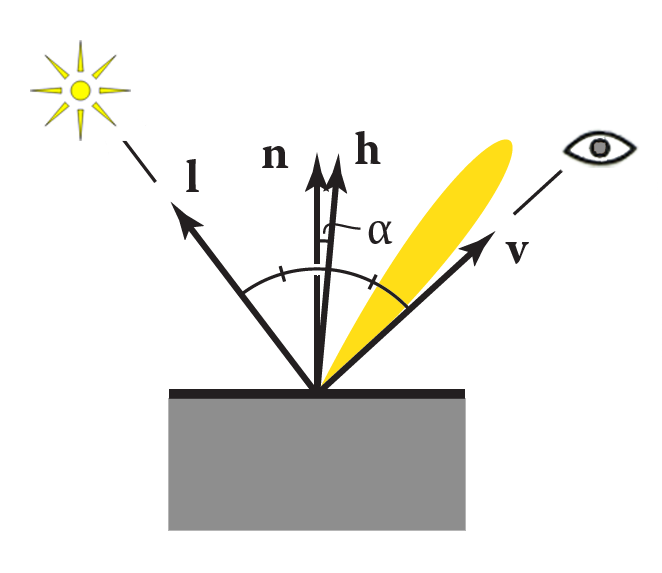
3.3 从 Blinn-Phong 到 PBR
OK,下面我们看真正在工业里跑的东西。真实的工业实现不会停在 Blinn-Phong。光照项 EvaluateBRDF 通常被替换为基于物理的 BRDF(Cook-Torrance):
$$ f_r = \frac{F \cdot D \cdot G}{4 (\omega_o \cdot n)(\omega_i \cdot n)} $$
其中: - $F$ 是菲涅尔项(Fresnel),描述掠射角反射增强。 - $D$ 是法线分布函数(NDF),决定高光形状。 - $G$ 是几何遮蔽项(Geometry),处理微表面自遮挡。
三项的具体形式与取舍,LearnOpenGL 的 PBR 章节与 selfshadow 的 SIGGRAPH 着色课程是两套互补的资料:https://learnopengl.com/PBR/Theory 与 https://blog.selfshadow.com/publications/s2013-shading-course/
三项的分工可以这样理解:D 决定高光"长什么样",G 决定微表面"遮掉多少",F 决定掠射角"反多少"。工业实现里最常用的组合是 GGX 分布 + Smith 遮蔽 + Schlick 菲涅尔。
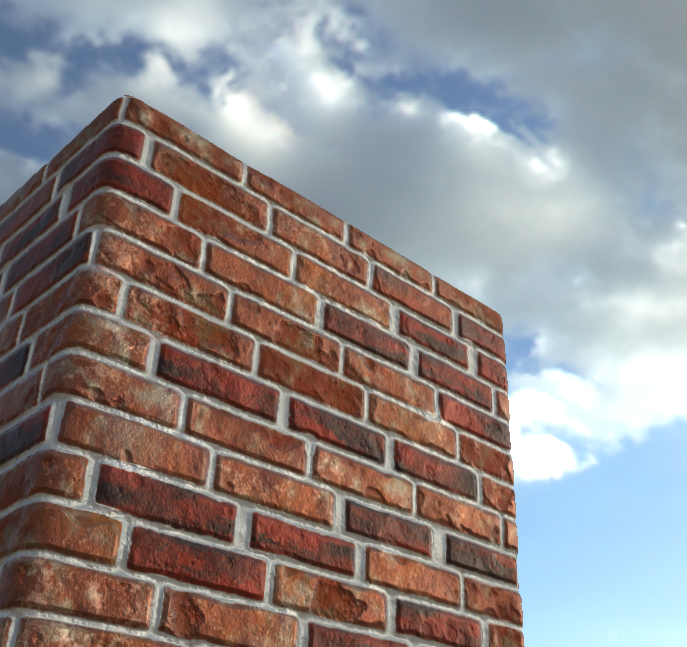
PBR 的实际效果是这样的——同一材质在环境光下呈现出的反射与粗糙度表现:
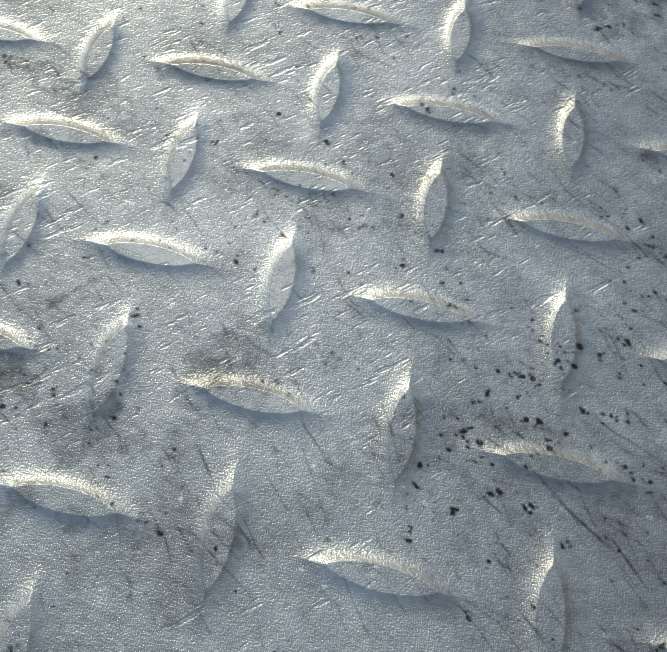
放大到微表面尺度,PBR 的价值更加明显——金属表面的划痕与磨损在掠射角下会被正确增强:
顺带给一个方向指引:面积光(Area Light)的实时近似目前在工业界取得良好效果,LTC(Linearly Transformed Cosines)是其中代表,项目页有完整论文与 WebGL 演示:https://eheitzresearch.wordpress.com/757-2/
实际项目里怎么选这三项的搭配?主流组合的对照如下:
在跨到 PBR 之前,先把传统模型看准——Phong 与 Blinn-Phong 的高光形状差异是这样的:
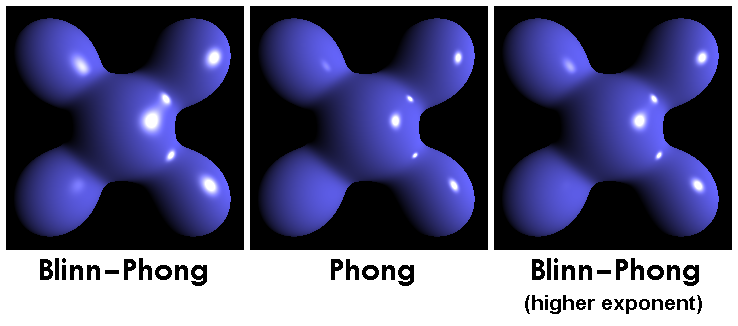
Blinn-Phong 单独渲染出来是这样:
一句实操建议:除非有明确的美术风格需求,直接用 GGX + Smith + Schlick 即可——它是被验证最多、公开资料最全、美术工具链支持最好的组合。HLSL 侧的算子写法可参照官方语言说明:https://learn.microsoft.com/en-us/windows/win32/direct3dhlsl/dx-graphics-hlsl
四、光源剔除与模板缓冲
4.1 为什么必须剔除
光照阶段的朴素实现是对每个像素遍历全部光源。但屏幕大部分区域只被少数光源照到,无差别遍历会浪费巨量算力。
剔除(Culling)的目标很明确:只对真正受影响的像素执行光照计算。主流做法有三类:
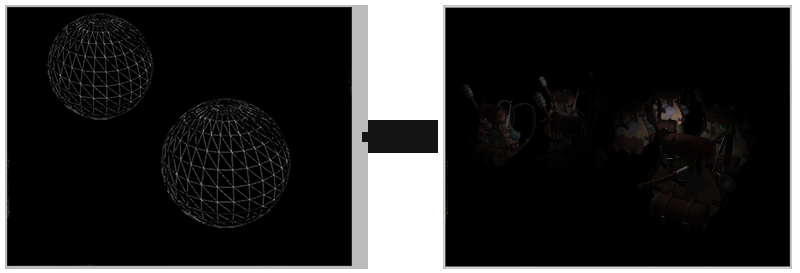
- 光源体积(Light Volume):把点光源当成球体渲染,只处理球体覆盖的像素。
- 模板缓冲(Stencil Buffer):用深度测试结果标记"真正在光体积内"的像素。
- 分块列表(Tiled / Clustered):把屏幕分块,预先算出每块的光源列表。
光源体积的大小不是拍脑袋定的,它由"衰减到可忽略"的阈值反推:
$$ r = \sqrt{\frac{I}{I_{\min}}} $$
其中: - $r$ 是光源包围球的半径。 - $I$ 是光源在单位距离上的强度。 - $I_{\min}$ 是可接受的最小照度阈值——低于它的区域直接不参与光照计算。
这个阈值取得越大,包围球越小、剔除越激进;但取得过大,远处会出现肉眼可见的光照"断层"。工程上一般从 1/256 的衰减比例起步调参。
三种策略的核心差异在于"筛选粒度",各自由此带来不同的收益与成本:
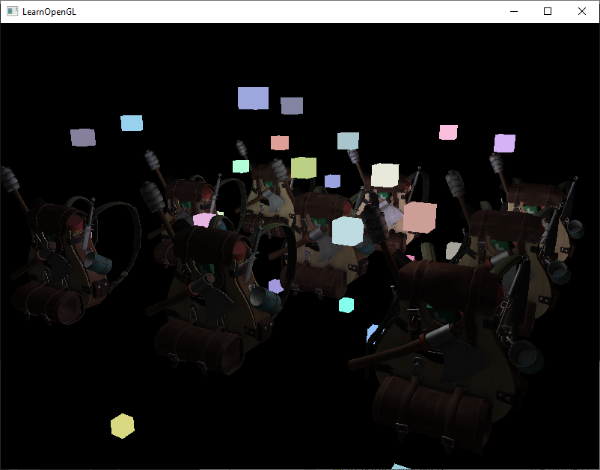
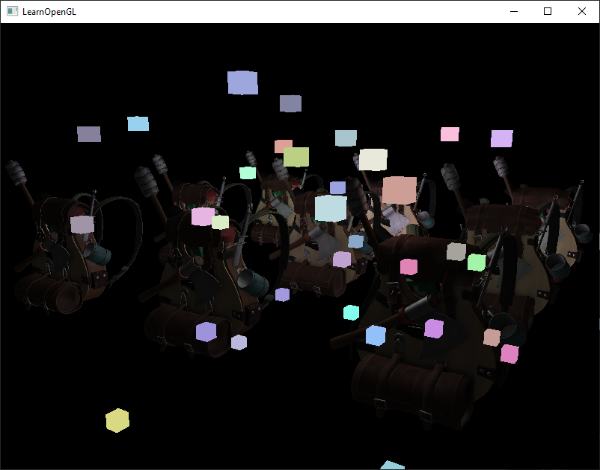
光源体积之所以有效,关键在深度测试。下面是同一场景的两张对比:左边开启深度测试,光体积被几何正确遮挡,只有受光照的可见表面执行计算;右边关掉 GL_DEPTH_TEST,所有光体积穿透模型、相互叠加,画面立刻混乱——这直观回答了"为什么必须做剔除":
Tiled 与 Clustered 则进一步把"逐光源筛选"变成"预先分配光源列表":
光源体积(light volume)本身也可以被可视化出来:
4.2 模板缓冲的妙用
好了,来聊聊模板缓冲这个更精细的做法。模板缓冲(Stencil Buffer)方案的巧妙之处,在于用一次"前后面深度测试差异"就完成了像素筛选。ogldev 的第三篇教程给出了完整实现,其核心是:对光源包围球,背面深度测试失败时自增、正面深度测试失败时自减,最终模板值大于零的像素,就是真正处在光体积内的像素。
完整实现在此:https://ogldev.org/www/tutorial37/tutorial37.html
四个步骤的执行顺序如下:
这套方案的代价是需要额外的模板 Pass,且在光源稀疏时收益有限——它最适合"光源密集、互相重叠"的场景。
两种剔除方式的成本对比:
而 Clustered 方案在实现上要多走几步,这四步也解释了它为什么更难调试:
模板缓冲这套判定之所以成立,靠的是“阴影体”这个几何构造:
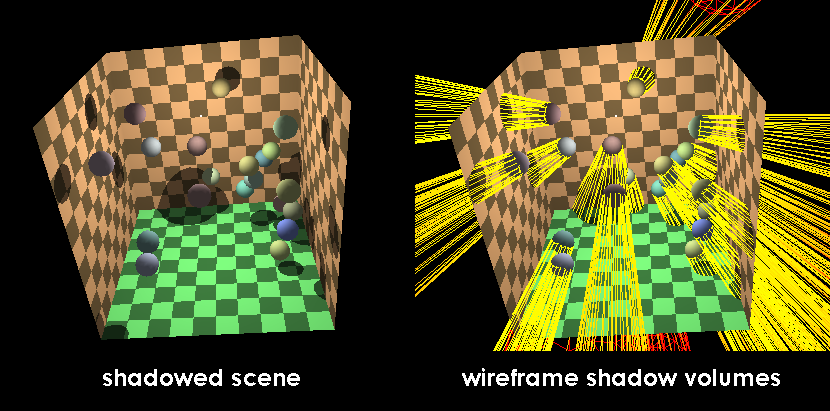
depth-fail 是它的关键变体,模板值的增减规则正是正文描述的那样:
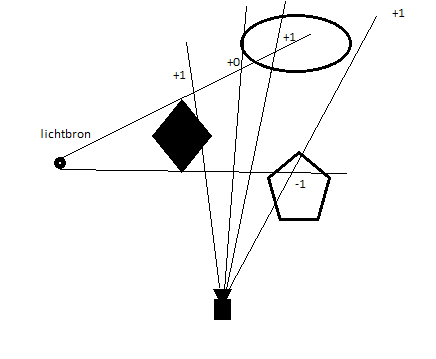
模板缓冲的典型用法,可以先用一个简单例子建立直觉:
4.3 光照阶段的两条路径
工程上前向与延迟的对照,可以看 ogldev 第二篇对光照 Pass 的拆解(含稠密光源场景的性能对比):https://ogldev.org/www/tutorial36/tutorial36.html
而更彻底的解法是把剔除搬到 GPU——GPU-Driven Rendering Pipelines 的思路就是让 GPU 自主生成与剔除绘制指令,CPU 只做提交。这是本系列第五篇的主题,此处先埋个伏笔。
五、技术演进与方案对比
5.1 演进脉络
先来看看这条路是怎么一步步走过来的。把延迟渲染放回历史坐标里看,它的每一次转折都由"硬件约束"推动:
时间线(年份为"该方案被广泛采用/公开"的时间点,非首次提出时间):
- 1970s–1980s:Catmull 等人提出深度缓冲(Z-Buffer)与可见性算法,为"先把几何存下来"奠定基础。[Catmull 1974]
- 2004:[Hargreaves & Harris 2004] 在 GPU Gems 中系统提出延迟着色,用于解决多光源开销。
- 2007:[Tabula Rasa 2007] 首次在商业项目中大规模落地,写入 GPU Gems 3 第 19 章。
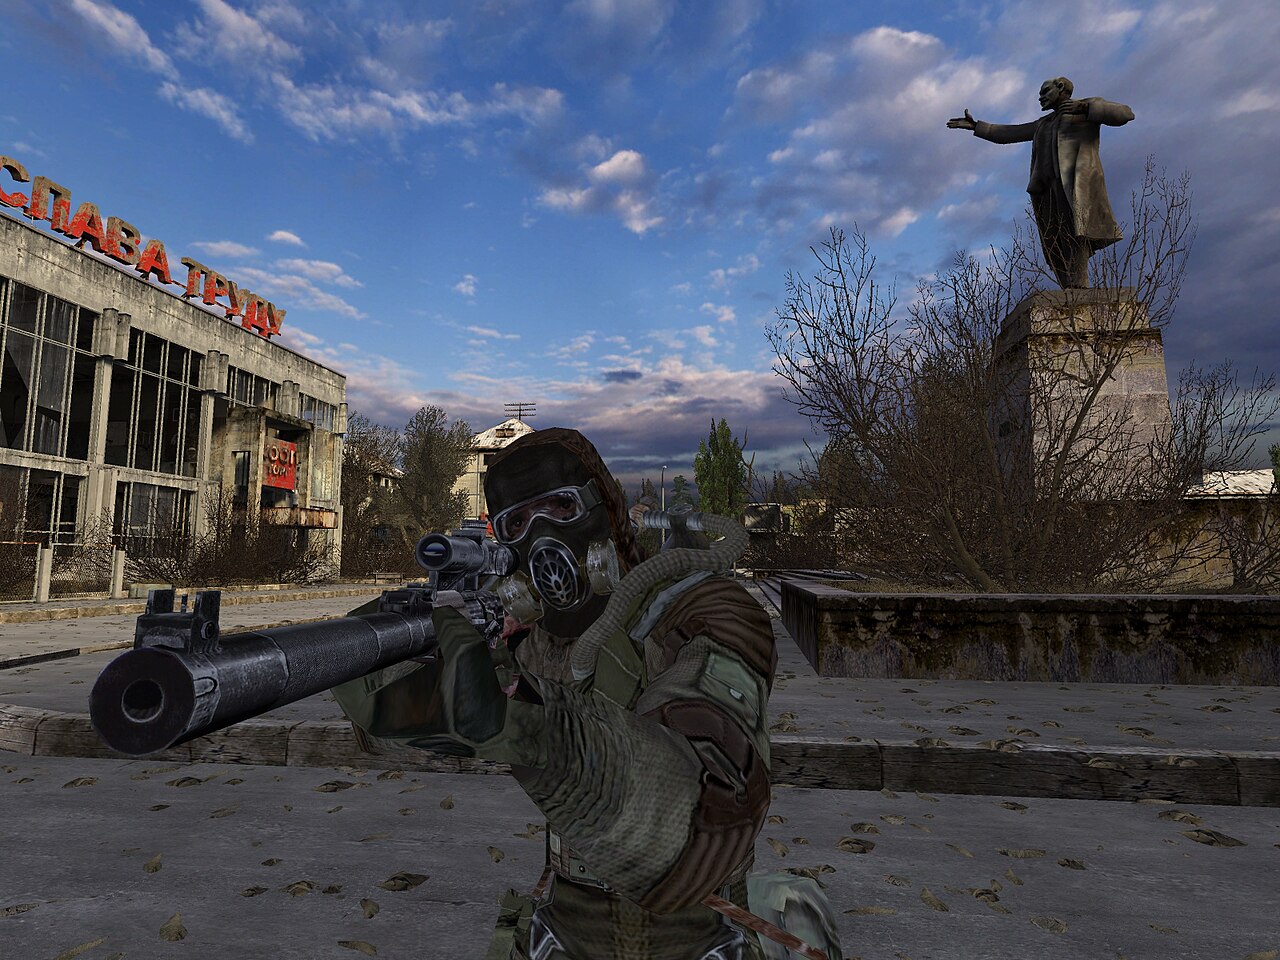
- 2009:[S.T.A.L.K.E.R. 2009] 在东欧引擎中把延迟着色与太阳阴影结合,成为一时范式。
- 2012–2013:[Persson & Olsson 2013] 提出 Clustered Deferred and Forward Shading,把"分块"升级为"三维簇"。
- 2016:[Uncharted 4 2016] 在 SIGGRAPH 课程中公开其延迟光照与 TAA 方案,《神秘海域 4》成为质量标杆。
- 2018:实时光线追踪商用元年,行业开始讨论"延迟着色是否会被取代"。[NVIDIA 2018]
上面几个里程碑里,有两个是真正跑在当时的商业游戏里的。下面这张是东欧工作室在《S.T.A.L.K.E.R.》中把延迟光照与太阳阴影结合的画面——多光源场景能被高效点亮,正是延迟渲染在那个年代最有说服力的实证:
从这条时间线里,可以提炼出三条对技术判断有用的结论:
这三条不止适用于延迟渲染——后处理链、阴影方案、抗锯齿技术的演进,几乎都遵循同样的模式:硬件约束变化触发方案迁移,旧方案以混合形态长期共存。相关一手资料可查 SIGGRAPH 2018 课程页:https://advances.realtimerendering.com/s2018/
5.2 全量方案清单
下面我们开始把方案列全。延迟渲染不是单一方案,而是一个方案族。把主流方案一次列全:
- 经典延迟着色(Deferred Shading):G-Buffer + 全屏光照 Pass。
- 延迟光照(Deferred Lighting,又称 Light Pre-Pass):只把法线与深度写入,光照在更晚阶段算。
- 延迟着色 + 光源体积剔除:用球体包围光源,减少无效像素。
- 延迟着色 + 模板缓冲剔除:用深度/模板测试精确筛像素。
- Tiled Deferred(分块延迟):屏幕切成二维 Tile,每块先算光源列表。
- Clustered Deferred(分簇延迟):把视锥切成三维簇,解决深度方向的光源分配不均。
- Forward+(前向增强):保留前向的材质路径,只把光源列表做成 Tiled/Clustered。
- Visibility Buffer(可见性缓冲):只存 primitive ID + 重心坐标,片元阶段重建属性,缓解带宽。
- Hybrid / 混合管线:不透明走延迟、透明走前向,工业界主流形态。
这张清单还可以按"演进层次"重排成一张族谱,四个层次对应四代思路:
5.3 二次归类
上面 9 种方案,按剔除粒度归为三大流派:
- 流派一 · 像素级剔除:方案 1–4。以单像素为单位决定是否光照,实现简单,但缺乏空间加速结构。
- 流派二 · 分块/分簇级剔除:方案 5–7。以屏幕空间块或视锥簇为单位预计算光源列表,是目前的主流范式。
- 流派三 · 几何信息压缩:方案 8–9。不在"剔除"上做文章,转而压缩几何信息的存储与带宽。
三个流派对应三种"省算力"的哲学——像素级靠精确判断,分块级靠空间预分配,压缩级靠少存少读:
5.4 横向对比
评价维度需要提前声明:材质灵活性、光源扩展性、带宽开销、透明支持、实现复杂度。五维打分如下(●优 / ◐中 / ○差):
| 方案 | 材质灵活性 | 光源扩展性 | 带宽开销 | 透明支持 | 实现复杂度 |
|---|---|---|---|---|---|
| 经典延迟着色 | ◐ | ● | ○ | ○ | ◐ |
| 延迟光照 | ◐ | ● | ◐ | ○ | ◐ |
| 光源体积剔除 | ◐ | ● | ○ | ○ | ● |
| 模板缓冲剔除 | ◐ | ● | ○ | ○ | ○ |
| Tiled Deferred | ◐ | ● | ◐ | ○ | ◐ |
| Clustered Deferred | ◐ | ● | ◐ | ○ | ○ |
| Forward+ | ● | ● | ● | ● | ◐ |
| Visibility Buffer | ● | ◐ | ● | ◐ | ○ |
| Hybrid 混合 | ● | ◐ | ◐ | ● | ○ |
两条结论:想兼顾材质灵活性与透明支持,Forward+ 与 Hybrid 是两个现实解;想在纯不透明重光源场景榨性能,Clustered Deferred 目前仍是效率上限。
评分口径汇总如下,便于对照查找:
需要提醒的是,这张表是定性判断,具体项目的权重会因约束而异——如果你的项目里透明物体占比极高,那么"透明支持"这一列的权重应被显著上调。
5.5 复杂度与量级
把前面几代方案的复杂度并排写成公式,差距一眼可见:
$$ \text{Cost}_{Forward} = \sum_{o}\sum_{l} F(o), \quad \text{Cost}_{Deferred} = \sum_{p} |L(p)|, \quad \text{Cost}_{Clustered} = \sum_{c}\sum_{p \in c} |L(c)| $$
其中: - $F(o)$ 是物体 o 在屏幕上覆盖的片元数——它让前向渲染的代价与场景复杂度绑定。 - $|L(p)|$ 是影响像素 p 的光源数。 - $|L(c)|$ 是分配到簇 c 的光源数,通常远小于 $|L(p)|$——这一项正是 Clustered 的收益来源。
从实现成本看,各方案的代码量级差异同样显著:
一句话总结这段演进史:延迟渲染的每一次迭代,都在用更细的剔除粒度换更少的无效计算。相关工程细节可参考 SIGGRAPH 2013 的 Advances in Real-Time Rendering 课程页:https://advances.realtimerendering.com/s2013/
六、三大难题:透明、抗锯齿、带宽
延迟渲染并非没有代价。工业界的共识是它有"三座大山",绕不开,只能各想办法。
6.1 难题一:透明物体
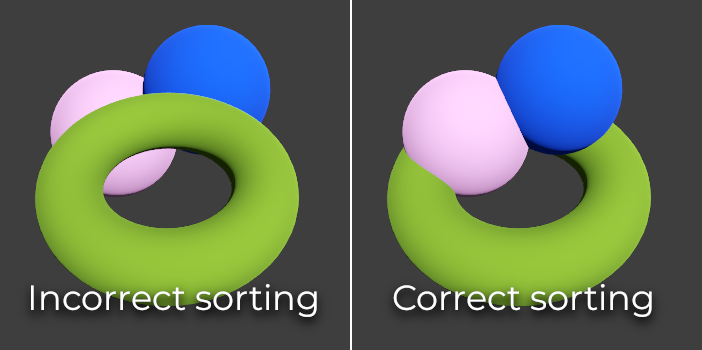
问题:延迟渲染的核心假设是"每个像素只保留最前一层几何",而透明(Transparency)的本质是多层叠加。混合需要按深度顺序逐层累加,这与"单层 G-Buffer"直接冲突。
主流解法:
- 双 Pass 分离:不透明走延迟,透明走前向(Forward)。这是最常用也最稳的做法,代价是维护两套着色路径。
- 深度剥离(Depth Peeling):逐层剥离并累计,层数越多开销越大,实时场景一般不超 4 层。
- 加权混合(OIT,Order-Independent Transparency):用加权平均近似无序混合,牺牲物理正确性换性能。
三种解法的成本与效果差异明显,选哪种取决于你的透明物体占比:
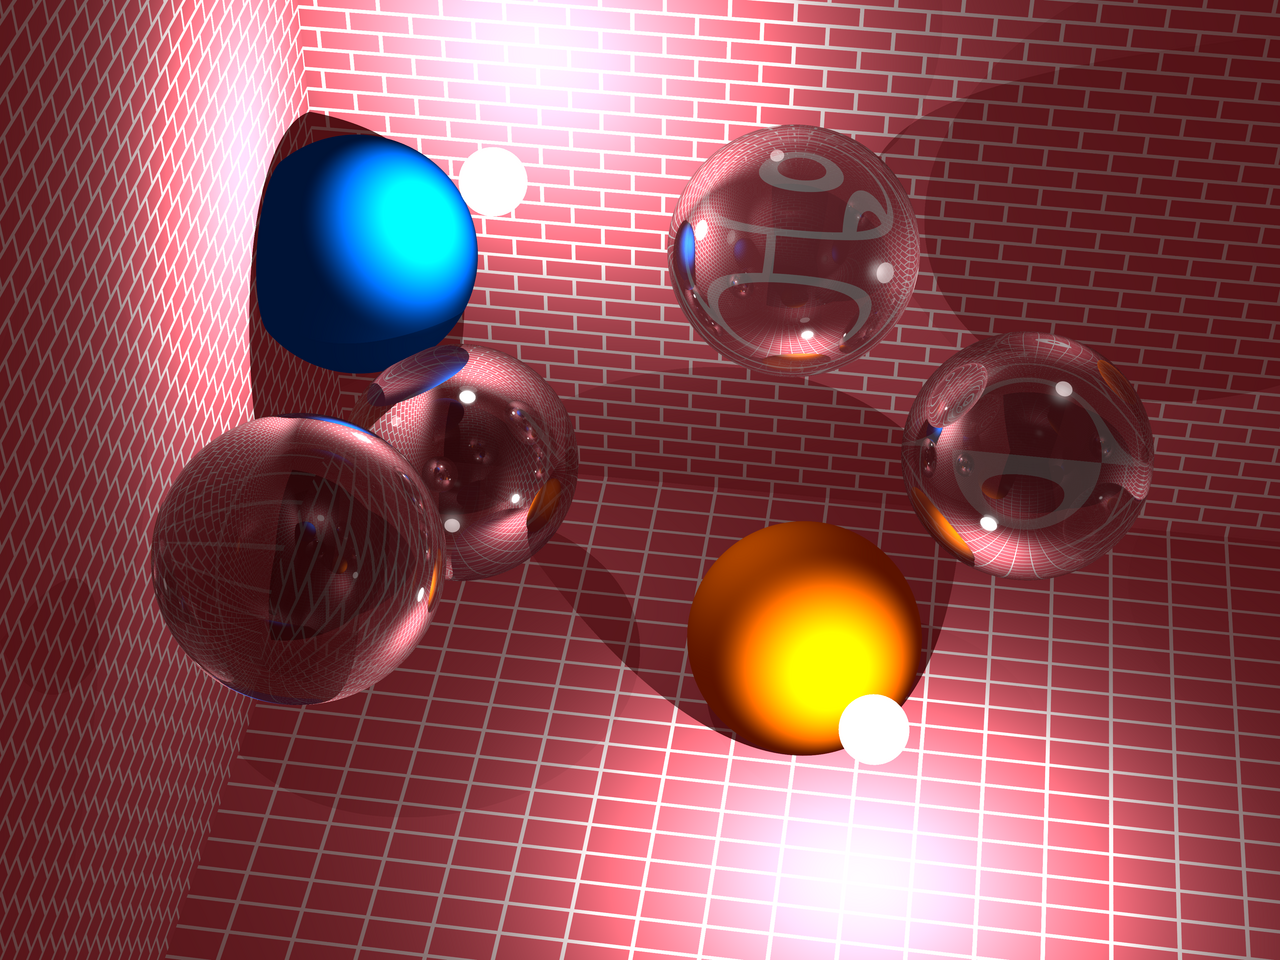
透明的视觉效果有多难做,看这张玻璃渲染就明白了——折射、反射与色彩偏移同时发生,任何一个环节出错都会露馅:
透明排序出错的典型表现,Godot 官方文档给了一张实例:
6.2 难题二:抗锯齿
OK,言归正传,说第二个难题。问题:多重采样抗锯齿(MSAA)依赖"每像素保存多个采样点的深度与颜色"。G-Buffer 一旦按采样点存储,显存占用与带宽立刻乘以采样数——4× MSAA 意味着 4 倍的 G-Buffer 开销。这也是延迟渲染长期"不爱 MSAA"的根因。
主流解法:
- 后处理抗锯齿(TAA / FXAA):在图像空间做抗锯齿,与 G-Buffer 采样数解耦。TAA 复用历史帧,效果好但会引入拖影。
- 几何抗锯齿(FXAA / SMAA):纯图像空间,开销低,细节损失换性能。
- 混合 MSAA:只对边缘做多采样,成本可控但实现复杂。
掌握深度测试与模板测试的语义是理解抗锯齿方案的前提,LearnOpenGL 的对应章节讲得比规范更易读:https://learnopengl.com/Advanced-OpenGL/Depth-testing 与 https://learnopengl.com/Advanced-OpenGL/Anti-Aliasing
MSAA 采样数对 G-Buffer 开销的放大关系如下:
这组数据解释了一个行业现象:延迟渲染流行的那些年,恰恰也是 TAA 等后处理抗锯齿方案快速普及的时期——两者是配套出现的,而非巧合。
超采样(Supersampling)的抗锯齿原理可以这样理解——用更多采样点换取边缘平滑,代价是成倍的开销:
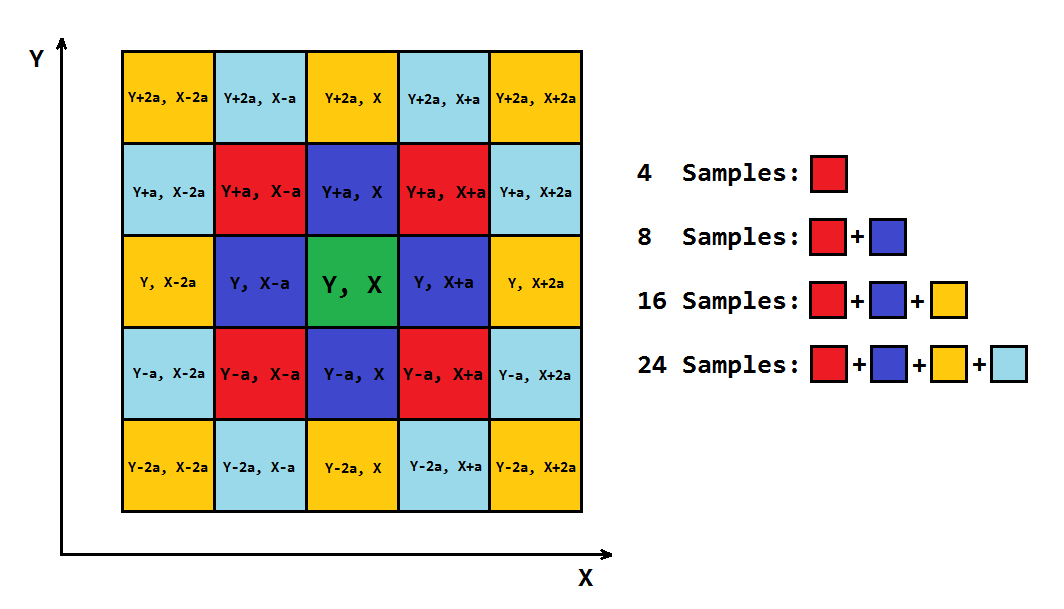
而质量设置对最终画面的影响,可以从这张同场景的低质量渲染中直观看到——边缘与细节会明显粗糙:
6.3 难题三:带宽
好了,最后一座山是带宽。问题:延迟渲染省下了重复着色,却付出了 G-Buffer 的读写带宽。单帧的显存流量可以这样估算:
$$ \text{Bandwidth} = W \times H \times \text{BytesPerPixel} \times \text{FPS} $$
其中: - $W$、$H$ 是渲染分辨率的宽与高。 - $\text{BytesPerPixel}$ 是 G-Buffer 每像素字节数,本例为 20。 - $\text{FPS}$ 是目标帧率。
代入 1920×1080、60 FPS:单帧写入约 40 MB,读写合计约 79 MB,每秒流量超过 4.7 GB。这已经接近部分中端显卡显存带宽的可观比例。
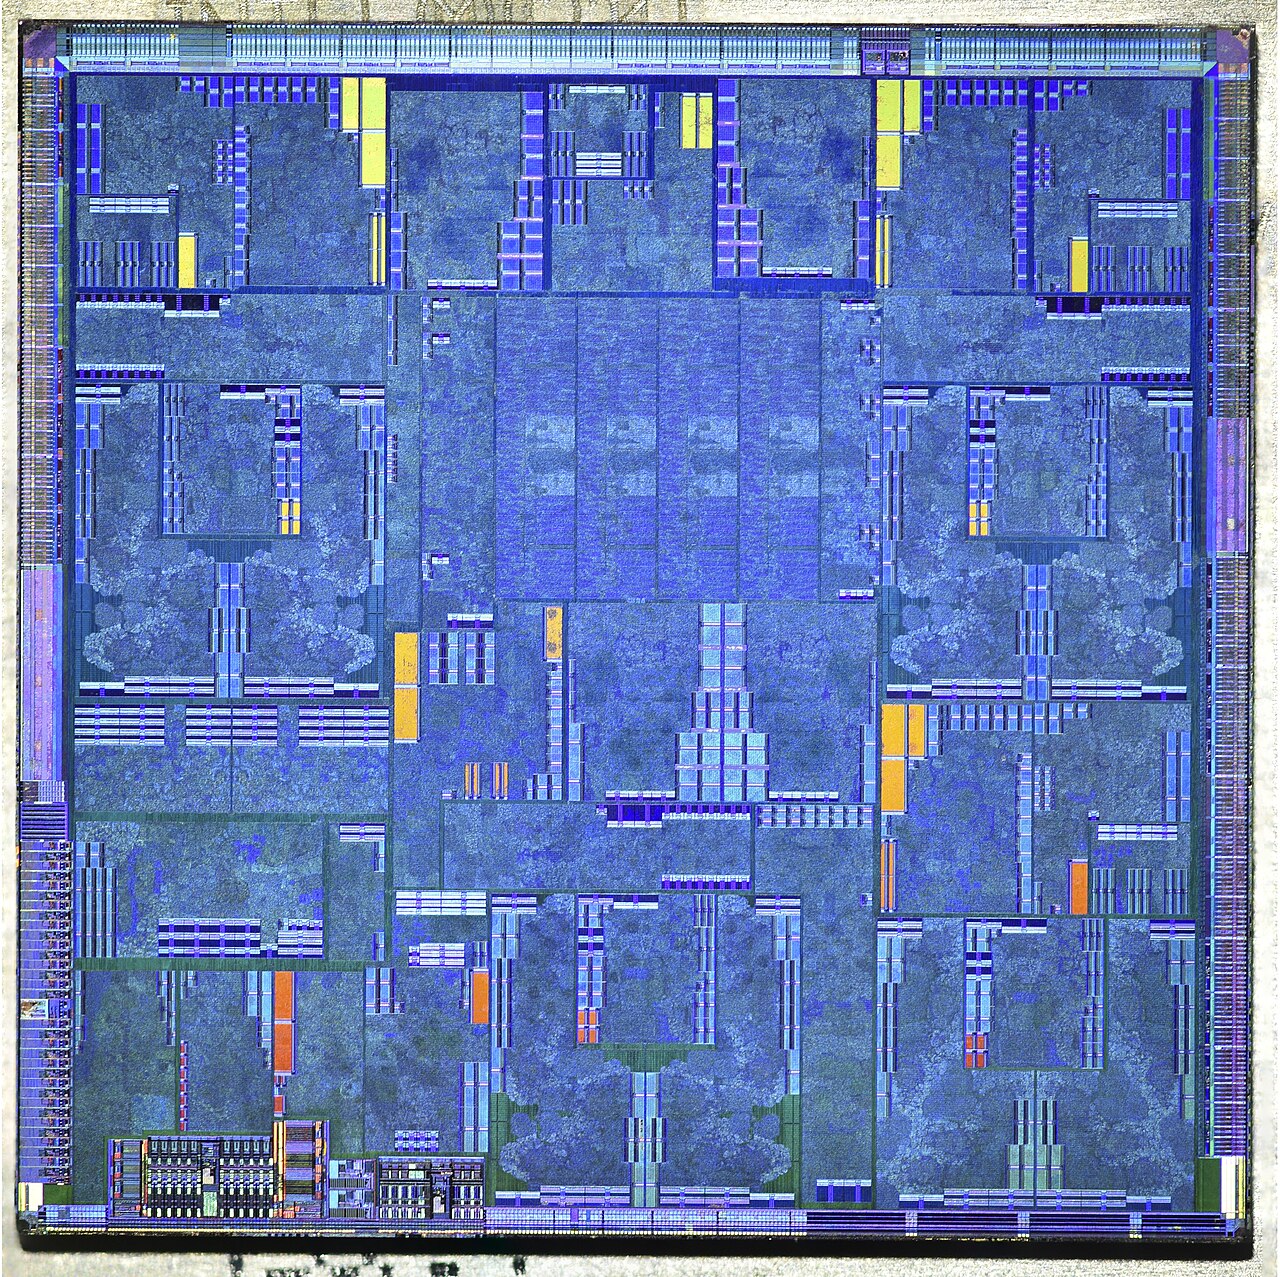
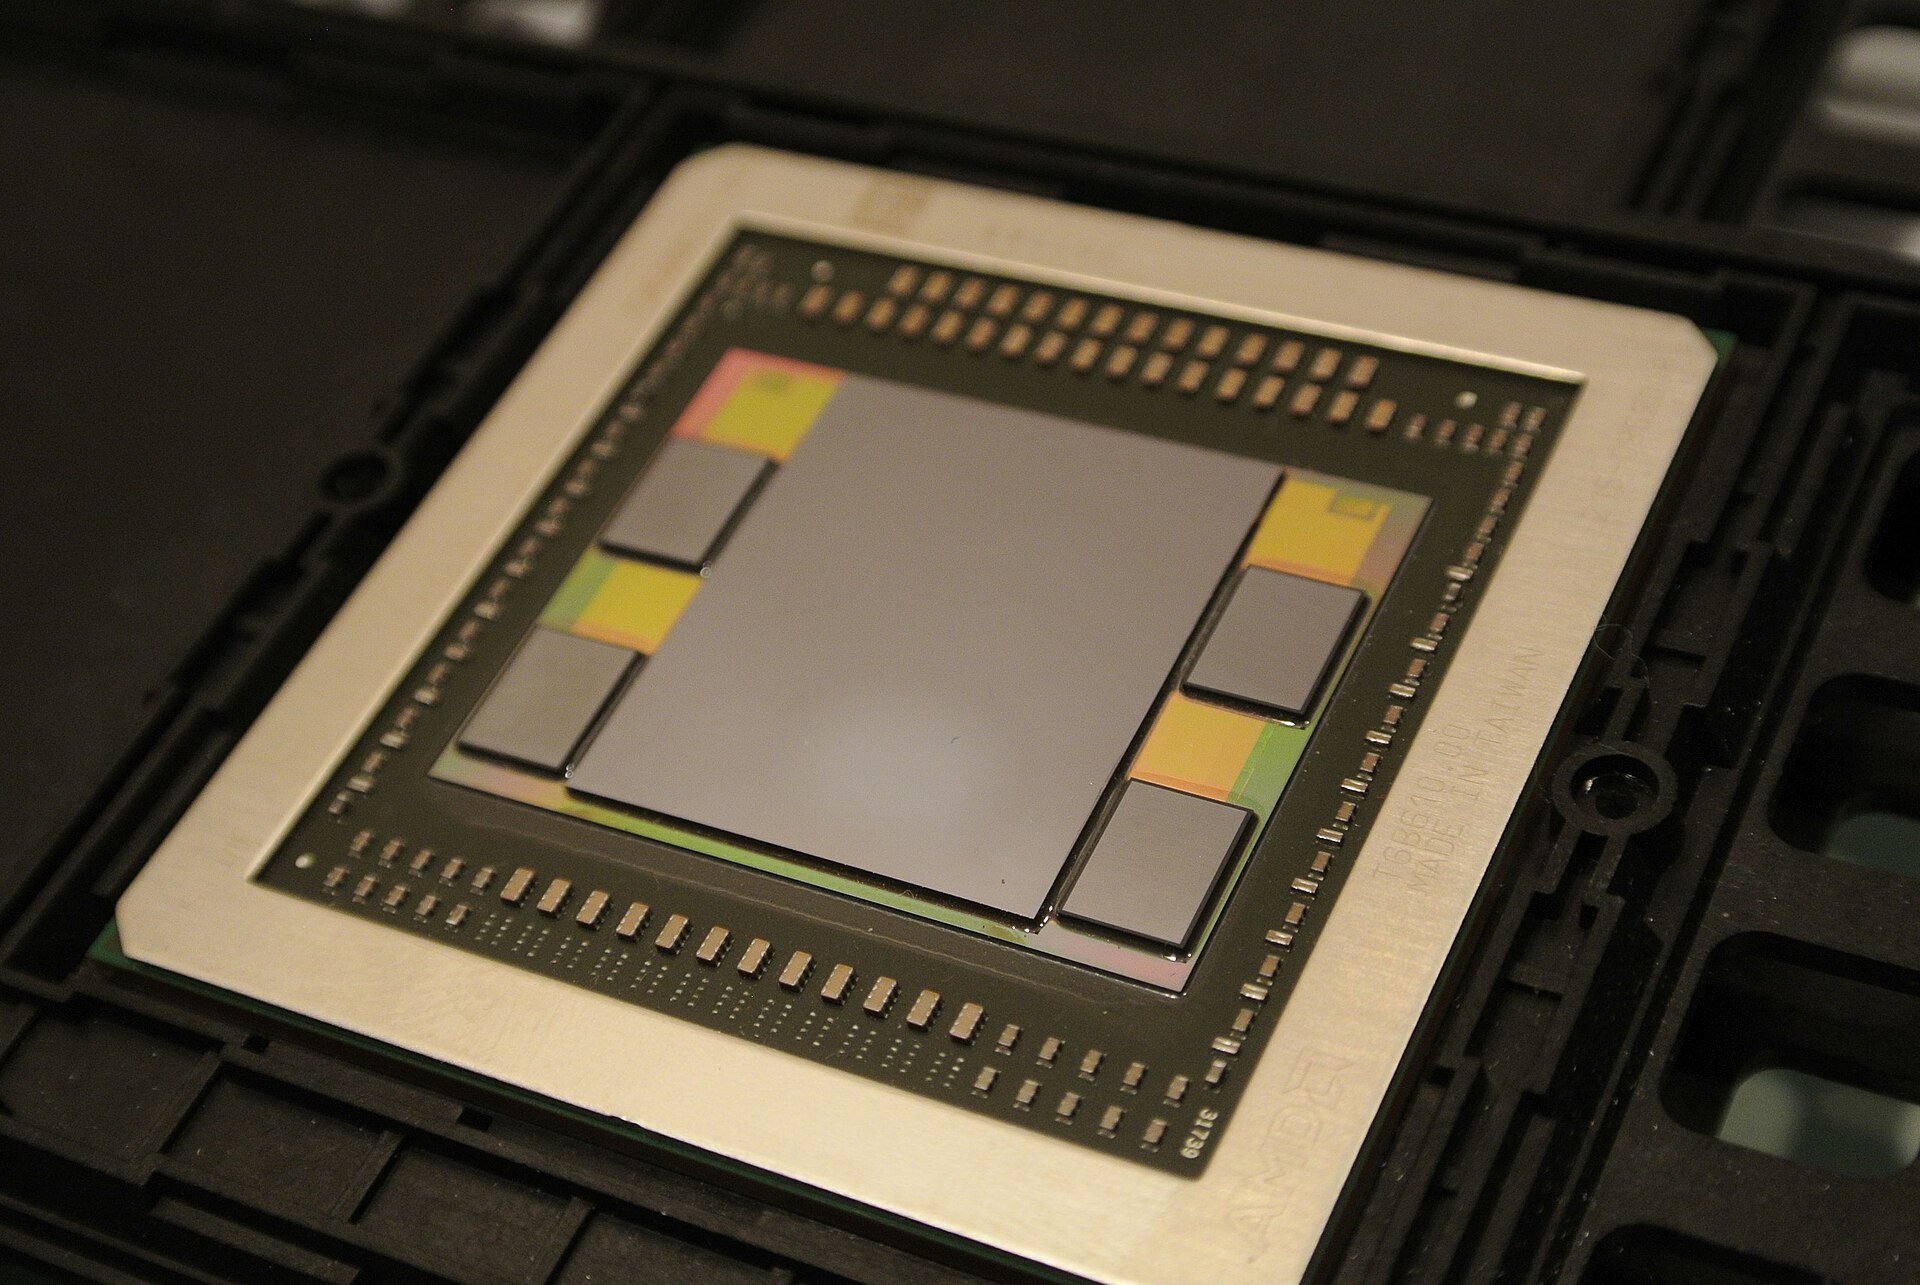
带宽之所以是硬约束,根源在硬件本身——G-Buffer 的每一次读写都要经过显存,而显存控制器与计算单元被集成在同一块裸片上:
主流解法:
- 通道压缩:法线用八面体映射(Octahedral Mapping)压到 2 通道,粗糙度与金属度合包,可把 20 字节压到 12–16 字节。
- 写入合并(MRT 一次写完):避免多次 Pass 重复读写。
- 可见性缓冲(Visibility Buffer):只存 primitive ID,把材质还原推迟到需要时。
压缩的收益可以量化:
从 20 B 压到 14 B 意味着带宽直接下降 30%——在 4K/120Hz 这类高负载目标下,这往往是"能不能跑满"的分界线。
分辨率对带宽的影响比很多人预想的更剧烈,它是平方级关系:
正因为带宽是硬约束,厂商干脆把显存搬到离计算单元最近的地方——HBM 就是为带宽而生的封装:
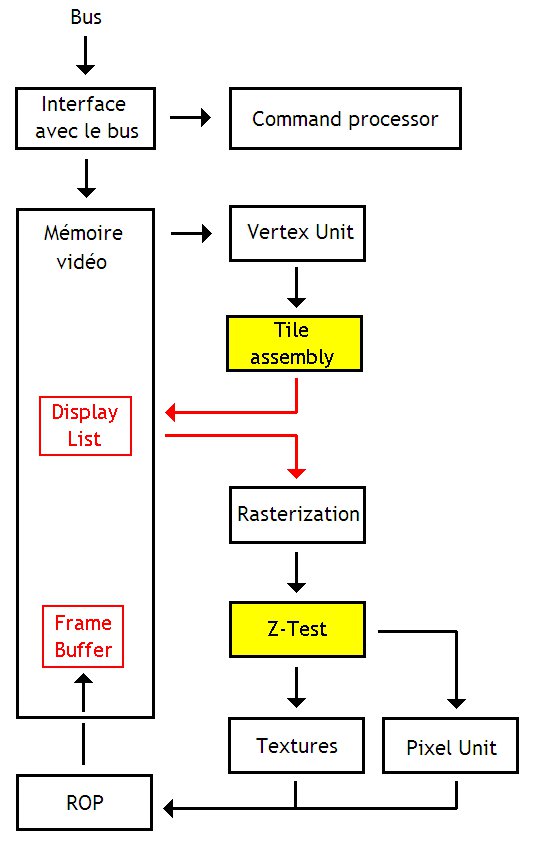
移动端的思路相反:把 G-Buffer 留在片上,避免往返显存——这就是分块渲染:
从 1080p 到 4K,单帧 G-Buffer 写入量涨了 4 倍。这也是为什么 4K 游戏在延迟渲染管线上往往需要额外做分辨率缩放或分块渲染——不这么做,带宽会成为第一瓶颈。
八面体法线映射与帧缓冲对象的实现细节,可参考:https://www.scratchapixel.com/lessons/3d-basic-rendering/rasterization-practical-implementation/rasterization-stage.html 与 https://learnopengl.com/Advanced-OpenGL/Framebuffers
好了,我们正式开始工程实践部分的讲解。
七、工程实践与性能实测
7.1 基准数据
先说结论:延迟渲染的收益只在光源数足够多时才显著。以 1920×1080、G-Buffer 20 B/px 为基准,不同光源规模下的相对开销如下(相对值,1.0 表示前向渲染在 8 光源时的开销):
可以看到:光源数在 8 以下时,前向渲染更快(延迟的固定开销——G-Buffer 读写——压不过收益);约 32 光源后延迟才开始明显占优;到 256 光源时差距拉大到数倍。这也解释了为什么早期 3A 项目要等到"多光源成为常态"才大规模转向延迟。
这里的"32 光源"只是一个量级参考,实际拐点会随分辨率、G-Buffer 布局、GPU 架构而移动。给出这个数字的意义不在于精确套用,而在于建立一种判断意识:延迟渲染有一笔固定的"入场成本",光源规模必须超过它才划算。
如果你的项目正处在拐点附近(20–40 光源),最务实的做法是两种管线各做一个最小实现,用真实场景各测一遍——这个决定会贯穿整个项目的优化路径,值得花两天时间实测,而不是靠估算拍板。
7.2 优化手段清单
工程上可用的优化手段,按收益排序:
- 光源剔除:最直接的收益来源,通常能砍掉 60% 以上的无效光照计算。
- 通道压缩:把 20 B/px 压到 14 B/px,带宽直接下降 30%。
- 半分辨率光照:光照 Pass 在 1/2 分辨率执行再上采样,画质损失可控时收益接近翻倍。
- MRT 合并:减少 Render Target 数量,降低 MRT 切换与合并开销。
- 模板剔除:对密集小光源场景,可把光体积内的像素筛到 10% 以下。
半分辨率光照与降采样的取舍,可参考 SSAO 章节里"半分辨率计算 + 模糊重建"的通用思路:https://learnopengl.com/Advanced-Lighting/SSAO
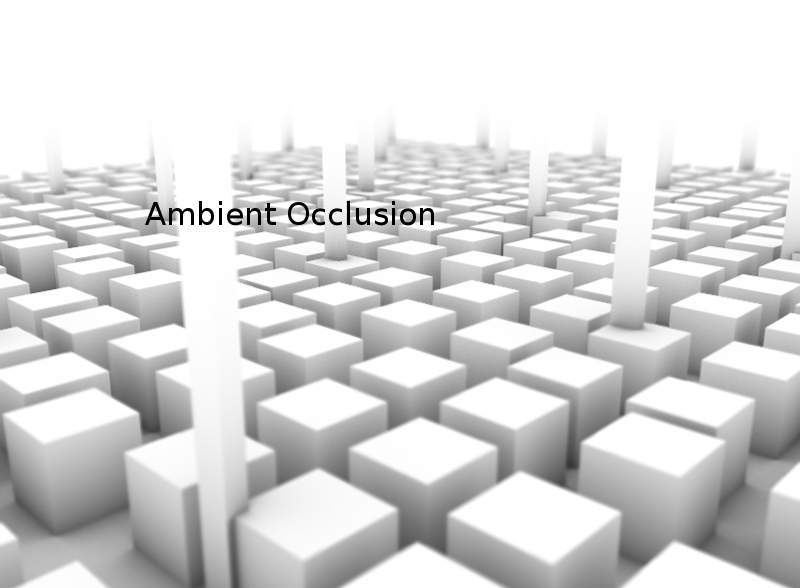
环境光遮蔽(Ambient Occlusion, AO)是 G-Buffer 里最"省力"的一项——它用廉价的近似换来明显的立体感,且只需占用一个通道:
在没有全局光照的实时管线下,AO 几乎是"廉价立体感"的唯一来源:
优化的推荐执行顺序(按收益/成本比排序):
7.3 常见坑清单
延迟渲染的坑集中在"数据一致性"与"平台差异"两类:
- 法线未归一化 → 光照方向失真,高光位置偏移。
- 坐标系混用 → 世界空间与观察空间的法线混写,光照结果整体偏暗或偏亮。
- 线性空间与 sRGB 混用 → 基础色写入前未转线性空间,画面发灰或过曝。参考:https://learnopengl.com/Advanced-Lighting/Gamma-Correction
- 深度精度不足 → 远近平面比例失调导致 Z-Fighting,G-Buffer 里出现条纹噪点。参考:https://learnopengl.com/Advanced-OpenGL/Depth-testing
- 移动端 Tile 内存溢出 → G-Buffer 通道数超过片上内存容量,被迫回落主存,性能断崖。参考 Tile 架构下的可见性算法说明:https://www.scratchapixel.com/lessons/3d-basic-rendering/rasterization-practical-implementation/visibility-problem-depth-buffer-depth-interpolation.html
- HDR 与色调映射顺序错误 → 在延迟 Pass 里做了色调映射,后续叠加的透明物体无法正确合入。参考:https://learnopengl.com/Advanced-Lighting/HDR
这六个坑有一个共同特征:都不会报错,只会让画面"看起来不对"。这也是延迟渲染调试难度普遍高于前向渲染的根本原因——数据分散在多张渲染目标里,出错时往往要逐张 RT 单独可视化排查。
针对这些坑,推荐一套固定的排查顺序——按"数据 → 空间 → 公式"逐层排除,比直接盯光照代码效率高得多:
这套顺序的道理在于:延迟渲染的绝大多数"画面不对",根源都在数据本身,而非光照公式。先确认 G-Buffer 里存的东西是对的,再去怀疑后面的计算——顺序反了,会在错误的代码区域里绕很久。
7.4 一个最小可跑的实现路径
如果要亲手实现一遍,最小路径是:
- 建帧缓冲对象(FBO),挂 3 个颜色附件 + 1 个深度模板附件。参考:https://learnopengl.com/Advanced-OpenGL/Framebuffers
- 几何 Pass 写入 G-Buffer,确认每张 RT 的内容正确。
- 光照 Pass 用全屏四边形读取 G-Buffer,先实现单光源,再扩到多光源。
- 加光源体积剔除,最后加模板剔除。
- 用 SSAO 或 Bloom 验证 G-Buffer 数据的可用性。参考:https://learnopengl.com/Advanced-Lighting/Bloom 与 https://ogldev.org/www/tutorial45/tutorial45.html
八、选型建议与未来展望
8.1 决策建议
下面我们开始讲怎么选。选型不该凭"哪种更先进",而该看约束。给出一个可执行的判断顺序:
- 光源数是否长期 > 32 且以不透明几何为主? 是 → 考虑延迟;否 → 留在前向。
- 材质种类是否高度多样(皮肤、布料、次表面)? 是 → Forward+ 或 Hybrid;否 → 经典延迟。
- 是否需要大量透明与粒子? 是 → 必须保留前向路径;否 → 可纯延迟。
- 目标平台是否移动端 Tile 架构? 是 → 严格控制 G-Buffer 通道数,或直接放弃纯延迟。
- 是否追求 GPU 驱动的大规模剔除? 是 → 关注 Visibility Buffer 与 GPU-Driven 方案。
把上面五步串起来,就是一条可直接照做的决策流:
8.2 未解挑战
延迟渲染仍有三件事没有让人满意的答案:
- 带宽墙:分辨率越高,G-Buffer 带宽越贵。4K 下 20 B/px 的代价已经是很多方案的瓶颈。可见性缓冲是当前最有希望的缓解路径之一。
- 材质多样性:G-Buffer 的固定通道布局天然偏向"统一材质模型"。异质材质(毛发、布料、次表面散射)要么塞进统一 BRDF,要么退回前向。
- 与光线追踪的共存:硬件光追商用后,"光栅化 G-Buffer + 光追阴影/反射"的混合管线成为新常态,但两者的几何表示并不统一,数据要在两套管线间来回搬运。
光追能带来什么,对比最直观。先看叠加了辐射度与光子映射的高质量结果:
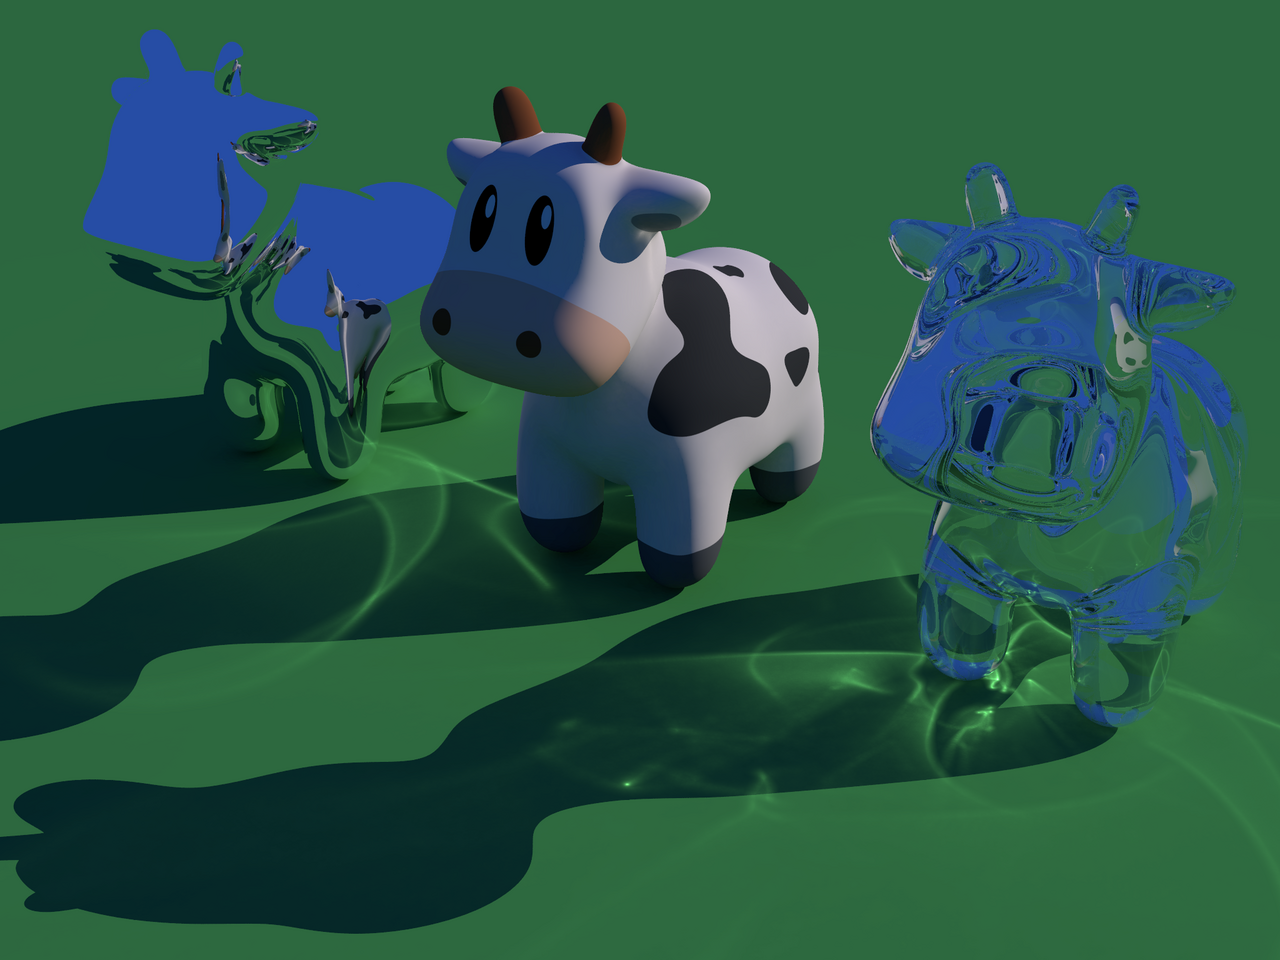
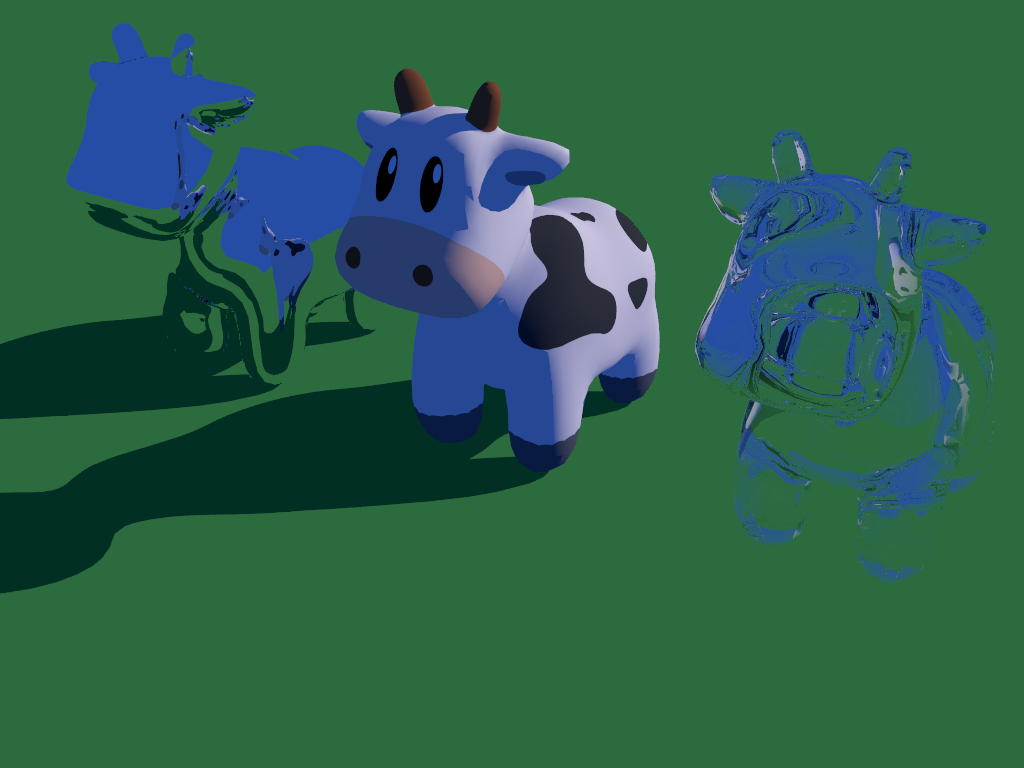
再对照只使用简单光照的版本,差异主要体现在间接光与软阴影上:
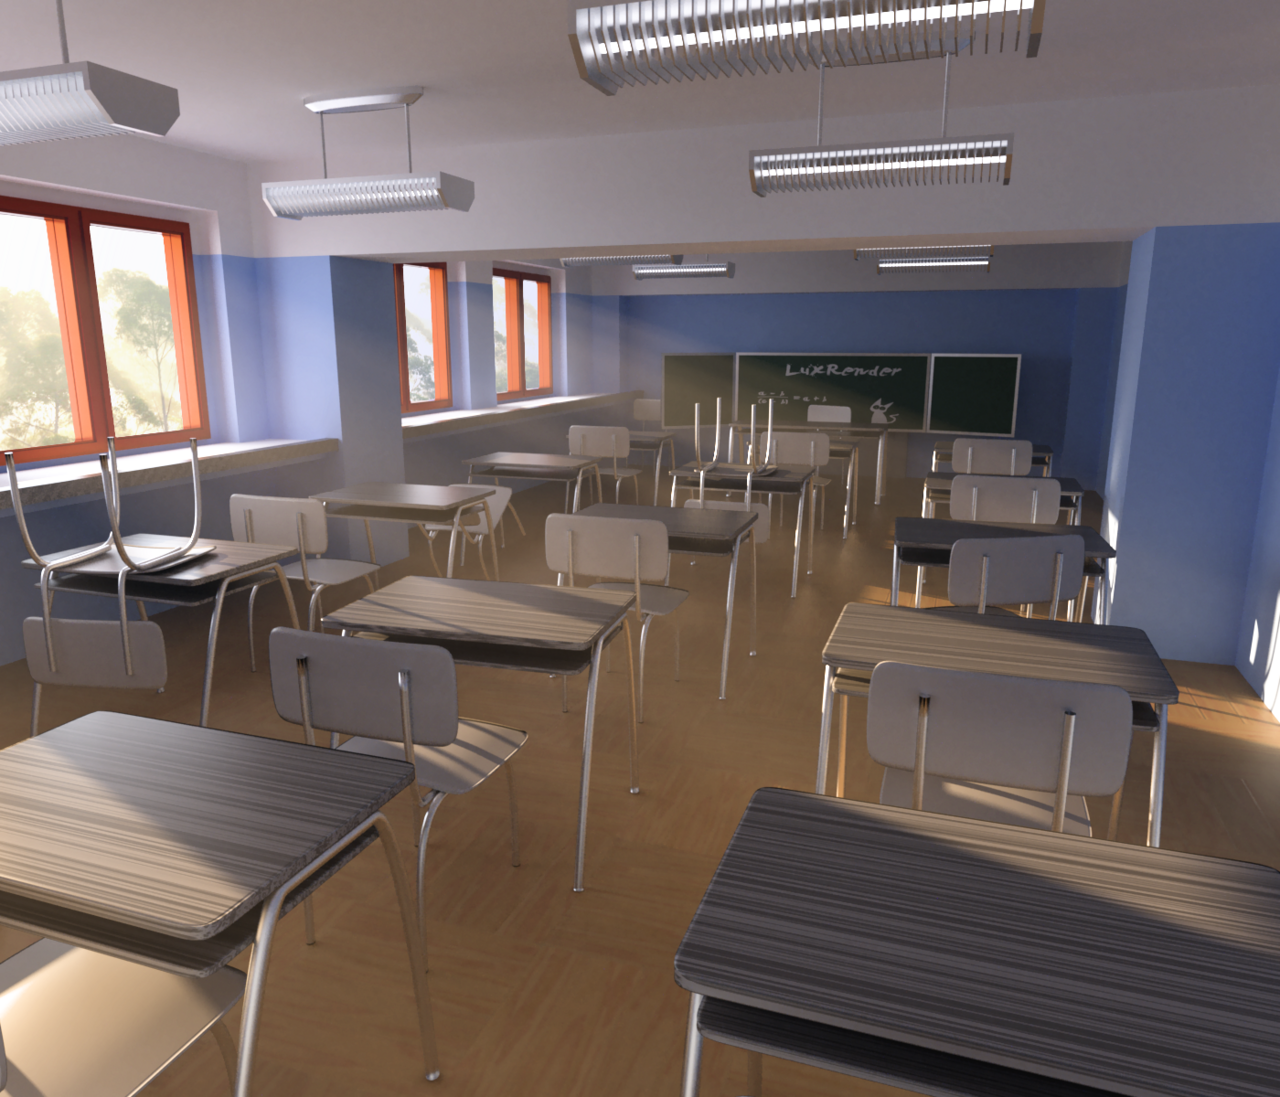
而全局光照(Global Illumination)正是补上"间接光"的那一环,下面这张室内场景是它的典型应用:
面对这三重挑战,工业界当前的实际选择是"混合"而非"二选一":
这也是本系列的基本判断:未来不会存在"唯一的正确管线",而是按几何类型、材质类型、性能预算分层组合。理解每一层的边界,比记住某个方案的优劣更重要。
把视角再拉高一点,不同方向的工业实践其实已经给出了各自的答案:
这张表没有优劣之分,只有约束之别——主机 3A 要兼顾多光源与高画质,移动端受 Tile 内存与带宽限制,独立项目追求实现成本,开放世界则要处理光源与几何的规模问题。选型的本质,始终是在约束下找最优解。
如果你想更深入,这条线索值得顺着往下走:GPU Gems 3 第三部分的渲染章节合集 https://developer.nvidia.com/gpugems/gpugems3/part-iii-rendering、SIGGRAPH 2016 的 Advances in Real-Time Rendering 课程页 https://advances.realtimerendering.com/s2016/、以及 selfshadow 逐年更新的基于物理着色课程 https://blog.selfshadow.com/publications/s2016-shading-course/。这三处是当前最密集的一手资料。
参考与延伸
- 图形管线总览:https://learn.microsoft.com/en-us/windows/win32/direct3d11/overviews-direct3d-11-graphics-pipeline
- 顶点/几何/像素着色阶段:https://learn.microsoft.com/en-us/windows/win32/direct3d11/vertex-shader-stage 与 https://learn.microsoft.com/en-us/windows/win32/direct3d11/pixel-shader-stage
- 光栅化器与输出合并阶段:https://learn.microsoft.com/en-us/windows/win32/direct3d11/d3d10-graphics-programming-guide-rasterizer-stage 与 https://learn.microsoft.com/en-us/windows/win32/direct3d11/d3d10-graphics-programming-guide-output-merger-stage
- 曲面细分与计算着色器:https://learn.microsoft.com/en-us/windows/win32/direct3d11/direct3d-11-advanced-stages-tessellation 与 https://learn.microsoft.com/en-us/windows/win32/direct3d11/direct3d-11-advanced-stages-compute-shader
- D3D11 渲染技术总览与 D3D12 图形:https://learn.microsoft.com/en-us/windows/win32/direct3d11/overviews-direct3d-11-render 与 https://learn.microsoft.com/en-us/windows/win32/direct3d12/direct3d-12-graphics
- HLSL 语言总览:https://learn.microsoft.com/en-us/windows/win32/direct3dhlsl/dx-graphics-hlsl
- 延迟着色入门(LearnOpenGL):https://learnopengl.com/Advanced-Lighting/Deferred-Shading
- 帧缓冲对象:https://learnopengl.com/Advanced-OpenGL/Framebuffers
- 模板测试与混合:https://learnopengl.com/Advanced-OpenGL/Stencil-testing 与 https://learnopengl.com/Advanced-OpenGL/Blending
- 实例化渲染与立方体贴图:https://learnopengl.com/Advanced-OpenGL/Instancing 与 https://learnopengl.com/Advanced-OpenGL/Cubemaps
- 法线映射与基础光照:https://learnopengl.com/Advanced-Lighting/Normal-Mapping 与 https://learnopengl.com/Lighting/Basic-lighting
- 着色器基础:https://learnopengl.com/Getting-started/Shaders
- 阴影贴图与级联阴影:https://learnopengl.com/Advanced-Lighting/Shadows/Shadow-Mapping 与 https://learnopengl.com/Guest-Articles/2021/CSM
- PBR 直接光照与 IBL:https://learnopengl.com/PBR/Lighting 与 https://learnopengl.com/PBR/IBL/Diffuse-irradiance
- 延迟着色实现三部曲(ogldev):https://ogldev.org/www/tutorial35/tutorial35.html、https://ogldev.org/www/tutorial36/tutorial36.html、https://ogldev.org/www/tutorial37/tutorial37.html
- 阴影与 SSAO 教程:https://ogldev.org/www/tutorial23/tutorial23.html、https://ogldev.org/www/tutorial46/tutorial46.html、https://ogldev.org/www/tutorial47/tutorial47.html
- 几何着色阶段与 D3D12 编程指南:https://learn.microsoft.com/en-us/windows/win32/direct3d11/geometry-shader-stage 与 https://learn.microsoft.com/en-us/windows/win32/direct3d12/directx-12-programming-guide
- 光栅化与着色原理(Scratchapixel):https://www.scratchapixel.com/lessons/3d-basic-rendering/rasterization-practical-implementation/overview-rasterization-algorithm.html 与 https://www.scratchapixel.com/lessons/3d-basic-rendering/introduction-to-shading/diffuse-lambertian-shading.html
- 投影阶段与法线着色:https://www.scratchapixel.com/lessons/3d-basic-rendering/rasterization-practical-implementation/projection-stage.html 与 https://www.scratchapixel.com/lessons/3d-basic-rendering/introduction-to-shading/shading-normals.html
- GPU Gems 3 延迟着色专章:https://developer.nvidia.com/gpugems/gpugems3/part-iii-rendering/chapter-19-deferred-shading-tabula-rasa
- SIGGRAPH 课程:https://advances.realtimerendering.com/s2013/、https://advances.realtimerendering.com/s2016/、https://advances.realtimerendering.com/s2018/
- selfshadow 基于物理着色课程:https://blog.selfshadow.com/publications/s2012-shading-course/、https://blog.selfshadow.com/publications/s2014-shading-course/、https://blog.selfshadow.com/publications/s2015-shading-course/、https://blog.selfshadow.com/publications/s2017-shading-course/
- 面积光着色(LTC)项目页:https://eheitzresearch.wordpress.com/757-2/
图片素材来源与许可
本篇共使用 37 张真实素材图(渲染结果 / 硬件实拍 / 官方文档配图)+ 54 张自绘示意图。素材图均标注来源(Wikimedia Commons / GitHub),许可与署名如下:
| 用途 | 作者 | 许可 | 来源页 |
|---|---|---|---|
| 题图 / Sponza 宫殿场景 | Khronos Group (glTF Sample Models) | 未标注明确许可(历史性场景,作者原始声明 donated to public / 学术使用);因用于技术说明引用,已尽力标注来源 | Sponza atrium |
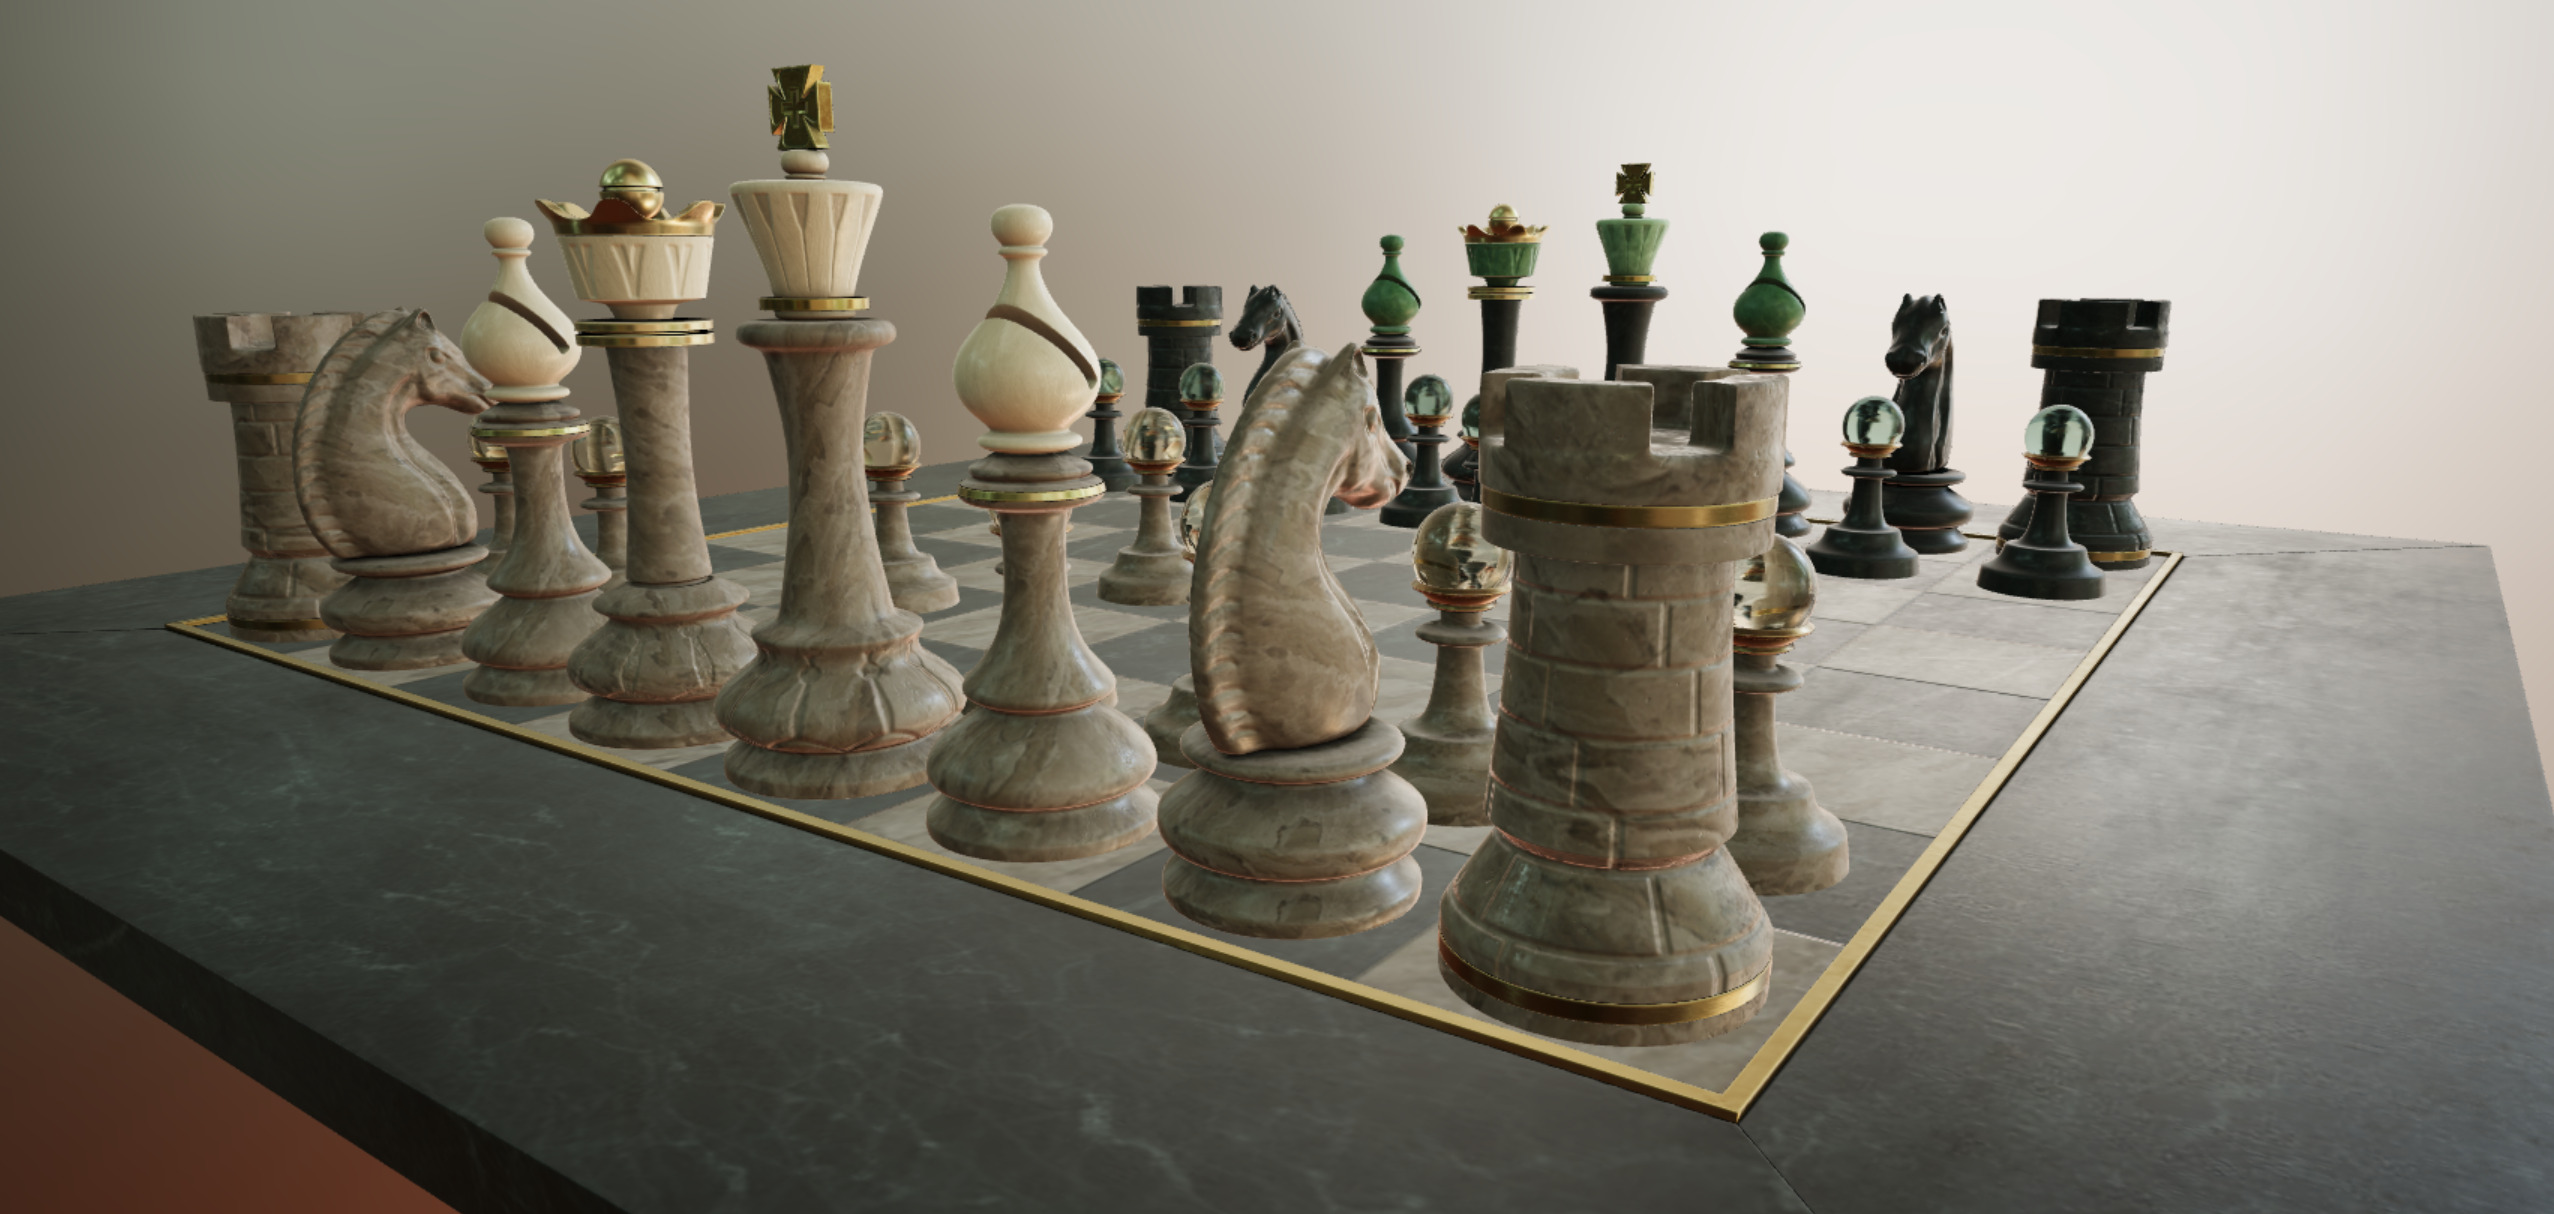
| 收尾图 / 棋盘场景实时渲染 | Academy Software Foundation / MaterialX Project(Ed Mackey 转换) | CC BY 4.0 | A Beautiful Game |
| 带宽章节 / GPU 裸片 | Martijn Boer | 公有领域 | R580+ 方幅 |
| 光栅化渲染(高/低质量) | KaiaVintr | CC BY-SA 4.0 | Blender EEVEE |
| 光追渲染(高/低质量) | KaiaVintr | CC BY-SA 4.0 | POV-Ray |
| 延迟着色各阶段可视化 | Wikimedia Commons | CC BY-SA 3.0 | Deferred Shading FBOs |
| 延迟渲染 Color Pass | Wikimedia Commons | CC BY-SA 4.0 | Deferred rendering pass |
| 法线可视化 | Wikimedia Commons | CC0 | Normals |
| PBR 材质(砖墙 / 微表面) | Wikimedia Commons | CC BY 4.0 | PBR Sample 1 |
| 玻璃折射渲染 | Morn | CC0 | Glass scene |
| 超采样原理 | Hrkalona | CC BY-SA 4.0 | Supersampling |
| 环境光遮蔽 | Philip Rideout | CC BY-SA 3.0 | Ambient Occlusion |
| 环境光遮蔽应用 | Wikimedia Commons | CC BY-SA 3.0 | Ambient occlusion |
| 全局光照室内场景 | Niabot | CC BY-SA 3.0 | LuxRender |
| 法线通道数据形态 | JPBotelho | CC BY-SA 4.0 | File:Normal Map.png |
| 精度不足的色阶表现 | Godot Engine documentation | CC BY 4.0 | 3d rendering limitations.html |
| Phong 与 Blinn-Phong 高光对比 | Wikimedia Commons | CC BY-SA 3.0 | File:Blinn phong comparison.png |
| Blinn-Phong 着色实效 | Davi.trip | CC BY-SA 4.0 | File:Blinn-phong shading.png |
| 阴影体几何示意 | Wikimedia Commons | CC BY-SA 3.0 | File:Shadow volume illustration.png |
| depth-fail 阴影体判定 | SamVandenBerghe | Public domain | File:Depth fail shadow volume.png |
| 模板缓冲的典型应用 | Beuc | CC BY-SA 3.0 | File:OpenGL Tutorial Stencil.png |
| 透明排序伪影 | Godot Engine documentation | CC BY 4.0 | 3d rendering limitations.html |
| HBM 封装(GPU + 显存同置) | C. Spille / pcgameshardware.de | CC BY-SA 4.0 | File:AMD Fiji GPU package with GPU, HBM memo |
| 分块渲染架构(TBDR) | Mewtow | CC BY-SA 4.0 | File:Tiled rendering architecture.jpg |
| lo deferred overview(按文件登记) | Joey de Vries | CC BY 4.0 | lo deferred overview |
| deferred fbos passes(按文件登记) | McMalloc | CC BY-SA 3.0 | deferred fbos passes |
| lo gbuffer(按文件登记) | Joey de Vries | CC BY 4.0 | lo gbuffer |
| deferred pass col(按文件登记) | astrofra | CC BY-SA 4.0 | deferred pass col |
| lo deferred example(按文件登记) | Joey de Vries | CC BY 4.0 | lo deferred example |
| lo light volume(按文件登记) | Joey de Vries | CC BY 4.0 | lo light volume |


许可合规说明:留用素材均允许商业使用,但 CC BY / CC BY-SA 系列要求保留署名,CC BY-SA 还要求对素材本身的修改以相同许可发布。本文字体不改动素材原图,仅在等比缩放后嵌入正文并完整署名,符合上述条款。若你需要更宽松的使用条件,可优先选用其中的 CC0 / 公有领域素材(法线、玻璃、GPU 裸片等)。其中题图 Sponza 场景为历史性基准测试场景,来源未标注明确商用许可,本处仅作为技术说明引用并尽力标注出处,商用前请另行向权利方确认。
- 示意图:本系列自绘(
ep01_*.svg)
相关链接 - 上一篇:{无(系列首篇)} - 下一篇(预告):【实时渲染管线探析】(二) 阴影贴图:从 PCF 到 VSM 的演进
With Best Wishes.