站点链接:技术博客页

系列文章前言
系列定位
这个系列只回答一个问题:当渲染管线里的某一环,它的先验从"人手写的启发式"换成"训练出来的网络",代价到底转移到了哪里?
它面向的是已经能读懂渲染管线、也大致知道神经网络是什么,但没亲手把学习式环节接进过真实管线的图形程序员。所以我们不推导反向传播,也不复述算法综述——我们要算的是那笔账:算力、带宽、显存、训练成本、以及最容易被忽略的"泛化边界"。
系列文章写作风格说明
- 篇幅规划:每篇约 16,000 字,10 章左右;每章 1,500–2,000 字。
- 写作顺序:先立判据(本篇),再从最成熟的落地(神经降噪)写起,把已经进入生产管线的降噪与纹理/外观讲透;后续更前沿的着色器内推理等篇目,因缺少可真实实验的硬件/训练环境而暂缓,本系列止步于此五篇。
- 每篇都给出可核对的量化结论与出处;凡是厂商自述的数字,一律标注口径,不转述为定论。
- 本系列不搬运厂商官方配图(NVIDIA / AMD / Intel / Apple 的图片受站点条款与商标指南约束)。需要图示时,我们用自己运行、自己计算、自己绘制出来的图。
全系列内容总览
- 【神经渲染与神经着色器】(一) 神经渲染的分界线:哪一环该换成网络
- 【神经渲染与神经着色器】(二) 神经降噪(上):当先验从人手写变成学出来
- 【神经渲染与神经着色器】(三) 神经降噪(下):训练数据、泛化与失效模式
- 【神经渲染与神经着色器】(四) 神经纹理压缩:把纹理解码交给网络
- 【神经渲染与神经着色器】(五) 神经外观:从解析 BRDF 到学习式材质
系列结构
上面这份目录收录的是已经发布的五篇:先立判据,再把已经进入生产管线的降噪与纹理/外观落地讲透。后续篇目(着色器内推理、学习式采样、辐射场、帧生成、训练侧工程与总账)因缺少可真实实验的硬件/训练环境而暂缓,不再续写尚不能真实实验的篇目,本系列止步于此五篇。
而这条线在整个技术栈里的位置是:它换掉的是先验的来源——即前四个系列覆盖之外的那一层。
相关资源链接
- 本系列前三系列(可用于对照阅读):【实时渲染管线探析】算法层、【移动端图形与功耗】约束层、【GPU 架构剖析】硬件实现层、【实时光线追踪与混合渲染】工程取舍层
- Khronos 的 ML Inference 教程(射线级学习式采样的规范依据背景参考):Vulkan ML Inference 教程
- Microsoft DirectX Developer Blog(本系列第一篇的核心论据来源之一):DirectX Cooperative Vector
背景铺垫:手写先验的三十年
我们先从一个容易被忽略的事实说起:渲染管线里的每一个"公式",其实都是一条被人写死的先验。
先看几个例子。Phong 光照模型里那个 $(\mathbf{R}\cdot\mathbf{V})^n$ 的高光项,是 1975 年选定的一个近似——它并不物理,但它便宜、可控、够像。PCF 阴影里那个固定半径的采样核,是"阴影该有多软"这条先验被人为固定下来的结果。再到 SVGF 的时域方差引导滤波:它用"方差越大越该多滤"这条启发式去指挥滤波强度,权重函数里的三个 $\sigma$ 是手调的。
这些先验有一个共同特征:它们的能力上限,就是写下它们的人当时的表达能力上限。 你想要更准,就得写更复杂的解析式;而更复杂的解析式意味着更长的着色器、更难调的参数、以及更多"这条是不是特例"的判断。
这里有个值得记住的对照实验。我们用同一个目标函数(一个各向异性、带高频细节的着色项)去比较两条路线:一条是手写先验——用低阶多项式做最小二乘拟合,10 个系数,这就是"手写解析式"的真实能力上限;另一条是一个 409 参数的小网络,在 8000 个稀疏样本上训练。
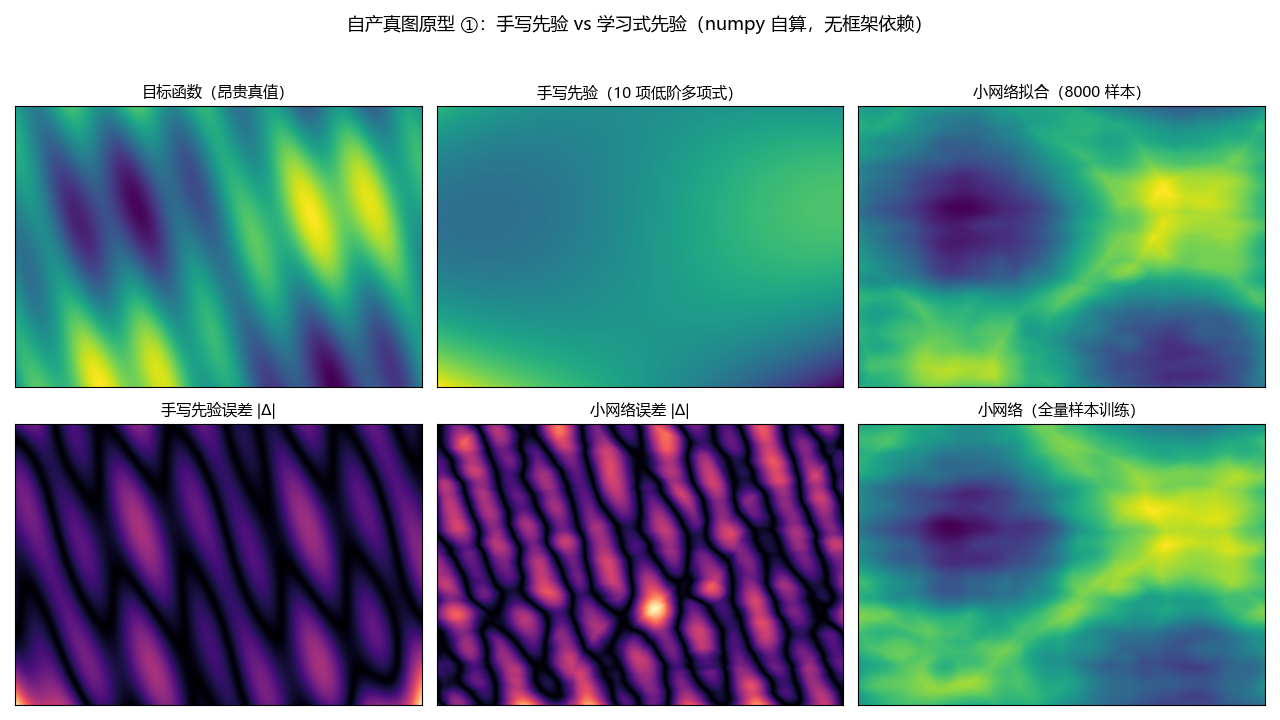
结果是:手写先验的平均误差 0.1466、最大误差 0.8897;小网络的平均误差 0.1017、最大误差 0.4007——平均改善 1.4 倍、最坏情况改善 2.2 倍。
但这个结果有边界:改善是真实的,只有 1.4 倍,不是数量级。而这个"1.4 倍"恰恰是整篇系列要讨论的核心——换成网络带来的好处,往往不是"更快",而是"用同样的算力买到更少的误差",或者"用更少的人力买到同样的画质"。
顺带说一句,这个对照实验本身就藏着一个坑。我们第一版跑出来的结论是反过来的——小网络比手写先验更差(平均误差 0.145 对 0.096)。查下去才发现,那一版的"手写先验"直接用了目标函数的低频项,等于让对照组开了外挂。基线怎么定,决定了结论是什么——这一点我们在后续篇目里会反复遇到。
0.1 一条时间线:先验被换掉的历史
好了,为了让"分界线"这件事有个时间坐标,我们把历史上几次典型的"先验替换"排一条线出来。这条线有个规律:每一次替换,都不是因为新方法更"正确",而是因为它能覆盖旧方法覆盖不了的那部分输入。
| 年份 | 替换事件 | 被替换的手写先验 | 换来的能力 |
|---|---|---|---|
| 1975 | Phong 光照模型 [Phong Bui-Tuong] | 无(此前是平坦着色) | 第一次让高光成为可计算项 |
| 1977 | Blinn-Phong 改写 [James Blinn] | Phong 的镜面项 | 同样的观感、更少的计算 |
| 2007 | 级联阴影贴图(CSM)[Engel] | 单一阴影贴图的分辨率分配 | 让方向光的阴影在远景可用 |
| 2017 | SVGF 时域方差引导滤波 [Schied 等, HPG] | 固定核的空间滤波 | 让 1–2 spp 的光追 GI 可看 |
| 2018 | 学习式重要性采样(NIS)[Müller 等] | 手工设计的采样 PDF | 让样本分布贴合被积函数 |
| 2021 | 神经辐射缓存(NRC)[Müller 等] | 预训练的辐射缓存 | 运行时自适应、不假设场景 |
| 2023 | 神经纹理压缩(NTC)[Vaidyanathan 等] | 块压缩(BC/ETC 一族) | 额外两级 LOD,即 16× 细节 |
| 2023 | 3D 高斯泼溅(3DGS)[Kerbl 等] | 三角网格 + 体渲染混合 | 实时辐射场渲染的新表示 |
| 2025 | Cooperative Vector 提案 [NVIDIA → Vulkan/HLSL] | 手工展开的向量运算 | 让每调用独立跑小网络成为标准能力 |
| 2026 | SM 6.9 零售版 + VK_ARM_data_graph 落地 |
手写的算子树 | 让"整图执行"成为管线类型 |
年份口径:论文年份取正式发表年(会议或期刊),规范与扩展取公开提案或零售版的年份。表内的年份只用于定位演进顺序,不作为版本依赖依据。
大家可以从表里看出两件事。第一,替换的密度在加快:1970–2000 年三十年只发生两次,而 2017 年之后几乎每两年一次。第二,被替换的"先验"形态在变化:早期换掉的是公式里的一个项(Phong 的镜面项、阴影的分辨率分配),而近年换掉的是整条函数(整个辐射缓存、整个纹理解码)。这个变化正是本系列要讨论的对象。
说到底,"神经渲染"并不是一夜之间冒出来的东西,它只是这条线上的最近一段。所以当我们问"哪一环该换成网络"的时候,其实是在问:这条线上的下一段该划在哪里。
OK,历史坐标有了。接下来这个问题更实际:它为什么在 2026 年突然变成了一道"现在就得决定"的题?
0.2 2026 年:三条线同时到位
换成网络这件事,到 2026 年已经从"研究者的玩具"变成了"规范里的条款"。三条线同时到位:Vulkan 侧有了 GLSL_NV_cooperative_vector(让每个着色器调用独立跑自己的小网络)与 VK_ARM_data_graph(把整个数据流图编译成一种新的管线类型);DirectX 侧在 Shader Model 6.9 里把 Cooperative Vector 与 16/64 位运算一起变成了可用能力(SM 6.9 零售版公告);而 GDC 2026 上微软直接把"Evolving DirectX for the ML Era"开成了专场。这场专场的公开页在这里。
言归正传。铺垫到此为止,下面进正文。
一、先把"换成网络"拆成四个动作
"神经渲染"这个词最大的问题,是它把四件完全不同的事混成了一个词。这四件事在管线上的落点不同、代价结构不同、判断"该不该换"的依据也不同。我们在本篇的第一件事,就是把这个词拆开。
1.1 四类替换
第一类是替换着色计算。 管线上原来算 BRDF、算法线、算阴影的那几行数学,换成一次小网络推理。它的落点在像素级——四类替换里最靠近帧输出的那一级。输入输出维度都很小(法线、粗糙度、观察方向进,辐射亮度出),因此对"每次调用独立算"这种粒度最友好。官方在 D3D12 Cooperative Vector 的动机段里点名了这类负载:用神经网络替换单个 shader 线程里的光照计算,且不改变渲染管线其它部分。 这条界定的原文见 DirectX 官方博客的 Cooperative Vector 篇。
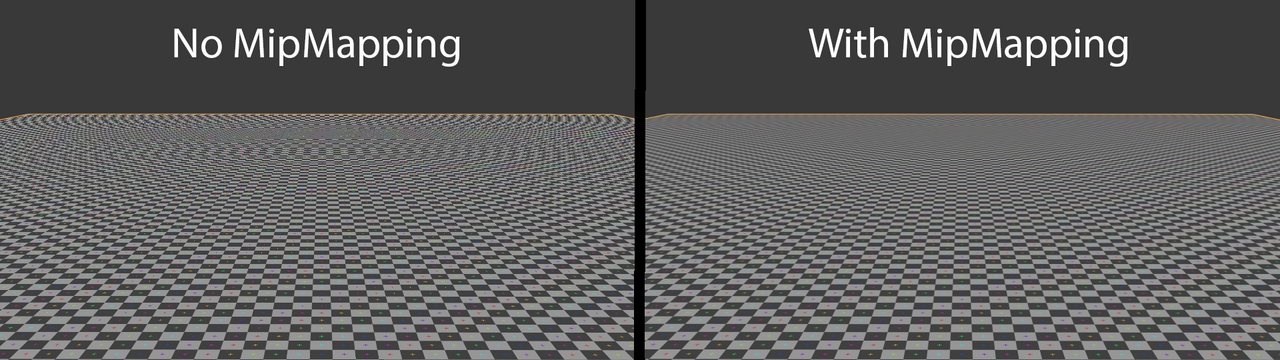
第二类是替换表示。 纹理、几何、乃至整条光传输函数,用网络编码后的形式来存与读。它的落点是资产与采样,改的不是"怎么算",而是"算什么"。神经纹理压缩(Neural Texture Compression, NTC)就是典型:它把材质纹理编码成网络权重加特征金字塔,"额外两级 LOD"到底意味着什么,一张对照就够了——mip 链本身就是逐级降分辨率的 LOD,采样时选错层级,画面立刻出问题:
第三类是替换采样分布。 光线往哪打、往哪采样,原本由手工设计的概率密度函数(PDF)决定;现在让网络学一个更贴合被积函数的分布(代表工作见 NIS 论文)。这类替换不动像素、不动资产,动的是方差——用同样多的样本拿到更低的噪声。
第四类是替换时间轴。 把帧与帧之间的信息,从"复用历史"改成"生成新帧"。它的落点横跨一帧之外,代价结构也最特别:省的是渲染帧,花的是生成帧。
好了,落点摆清楚了。接下来要问的是:它们的账本长得一样不一样——下一张对照表是后面三章的地基。
1.2 代价类型对照
拆开之后你会发现,四类替换的"账"长得很不一样。我们先把这张对照表立起来,后面三章的三道判据就是往这张表里填数据。
| 替换类别 | 改动的对象 | 主要代价 | 能否离线摊销 | 典型方案 |
|---|---|---|---|---|
| 着色计算 | 像素级的数学 | 每次调用的推理算力 + 权重带宽 | 权重可离线训练,推理不可 | Cooperative Vector、神经着色器 |
| 表示 | 资产的存储形式 | 显存占用 + 解码算力 | 可以(编码可离线) | NTC、NTBC、神经外观 |
| 采样分布 | 光线/样本的去向 | 训练成本 + 方差的稳定性 | 部分(可预训练,也可运行时适应) | 神经重要性抽样、路径引导 |
| 时间轴 | 帧间信息 | 生成算力 + 延迟 + 伪影风险 | 不可以(与帧率强耦合) | 帧生成类方案 |
这张表里最有信息量的一列是"能否离线摊销"。它解释了一个现象:为什么表示类(NTC)是四类里最早大规模落地的——编码可以离线做、解码是一次固定开销、而省下的是显存和带宽这两样最硬的资源。反过来,时间轴类最难:它与帧率强耦合,任何一点额外延迟都会直接吃掉生成帧带来的收益。
至于"改动的对象"这一列,它对应着四类替换对人力的不同要求。着色计算类要重写的是着色器,工程量最小;表示类要重建的是整条资产管线,工程量最大。也就是说,收益与工程量在四类之间是错配的——这也解释了为什么很多团队先做降噪(着色计算类的近亲),最后才碰神经纹理。
而要看清"工程量最大"这件事,得先看清它换掉的旧方案长什么样。块压缩把纹理切成固定大小的块、逐块编码,代价在放大时最明显——块边界与色阶会露出来:
神经纹理压缩替换的正是这一层:它不再逐块编码,而是把整张纹理编码成网络权重加特征金字塔。
先来看一个直觉性的例子,说明"材质多样性"这件事为什么是自绘和手写公式都挡不住的。同一批球体、同一套光照,只是把着色器换成不同的模型,画面的复杂度就上一个台阶:
这张图想说的其实是一件朴素的事:材质与着色模型的多样性,本身就是手写公式覆盖不了的成本。 下面开始把方案清单列全。
1.3 全量清单与二次归类
先看看这个方向的完整清单。做技术选型最怕的是"只知道三个方案",所以我们把四类替换底下已经能查到公开资料的具体方案尽量列全,再按机制归一次类。
| 类别 | 具体方案(可公开查证) | 归类(按机制) |
|---|---|---|
| 着色计算 | 神经着色器(Neural Shaders)、Cooperative Vector 光照替换、神经辐射缓存(NRC)、神经可见性缓存 | 逐像素函数置换:输入输出维度小、每调用独立 |
| 表示 | 神经纹理压缩(NTC)、神经块纹理压缩(NTBC)、神经外观模型(Neural Appearance)、学习式材质(Block-Compressed Features) | 资产编码置换:编码可离线、解码在片元侧 |
| 采样分布 | 神经重要性抽样(NIS)、路径引导(Path Guiding)、多光源神经采样、ReSTIR 类与学习式候选分布的结合 | 分布置换:改的是样本去向,改的是方差 |
| 时间轴 | 帧生成类方案(DLSS 多帧生成、FSR 帧生成)、时域升采样、光流与重投影的学习式替代 | 帧间信息置换:与帧率强耦合、引入延迟 |
二次归类之后,"四类替换"这张表就有了三层结构:最外层是四类替换(我们的框架)→ 中间是机制归类(上表的第三列)→ 最内层是具体方案。同属于"资产编码置换"的方案可以横向比(NTC 与 NTBC 的区别在于是否改动着色器),而跨机制的两个方案通常没法直接比——它们的代价落在不同的账上。
再说一条清单本身的信息:"着色计算"与"表示"这两类的方案数量最多,也正是本系列要用四篇篇幅去写的部分;而"采样分布"与"时间轴"两类的公开方案数量明显更少,原因不在没人做,而在于它们的落地更依赖具体场景——这也印证了第五章速查表里那两格"观望"与"谨慎"的判断。
好了,四个动作拆完了,清单也列全了,代价表也立起来了。接下来三章,我们给这道分界线装上三道判据。
二、判据一:粒度——是每像素独立,还是跨线程一起算
第一道判据问的是执行粒度:这个环节换成网络之后,每一次推理是"一个像素自己算自己的",还是"一堆线程凑在一起算一个大矩阵"?这个问题之所以排在第一位,是因为它决定了一件很现实的事——你能不能用上硬件专门为此做的那条路。
2.1 两种执行形态
先说清两种形态的本质差别。
形态甲:每次调用独立。 每个像素(更准确地说,每个着色器调用)拿着自己的输入,跑一遍完整的小网络,产出一个结果。它不需要和其它线程交换数据,也就不要求子组内的线程走同一条控制流。这条路的硬件支持是 Cooperative Vector。
形态乙:跨线程协作。 一堆线程把数据凑成矩阵,一起做矩阵乘法。这就是 Cooperative Matrix / Tensor Core 那条路。它的吞吐高得多,但代价是要求参与协作的线程在同一个子组里、且控制流一致,还需要线程间共享数据。
GLSL_NV_cooperative_vector 的规范文本把形态甲说得很清楚:新增的 coopvecNV 类型"逻辑上存于所属 invocation",可以"机会性协作"完成矩阵-向量乘,而且不要求满子组、不要求统一控制流。规范里写明它的用途是"加速小型神经网络求值,每个 invocation 独立跑自己的网络"。
这两句话合起来就是形态甲的适用边界:小网络 + 每像素独立 + 允许发散。
两种形态的差别摆清了。先看看官方自己怎么划分这两类负载——这条边界不必我们猜。
2.2 官方怎么划分这两类负载
我们不必自己猜边界,官方给过一条相当明确的划法。在 GDC 2026 的 DirectX 场次里,微软把负载分成了两类:Cooperative Vector 适合"per-pixel 推断"类负载(官方点名的例子是神经纹理压缩里的解码、以及神经辐射缓存);而超分、降噪、时域升采样、通用大模型推断这些,需要的是"矩阵-矩阵相乘 + 跨线程共享数据 + batch 执行",向量-矩阵原语不足以高效表达。
注意这条划分不是"新旧"之分,而是形状之分:向量-矩阵(矩阵乘一个向量)天然适合"每像素一个输入向量";而超分和降噪要处理的是整张图的空间邻域,本质是卷积——卷积在实现上要跨线程取邻居数据,落在形态乙那一侧。
划分本身够用了,但判据要能落地,还得有量级。下面我们开始算第一笔开销。
这也解释了一个常见误解:很多人以为"降噪归网络管"和"神经着色是一回事",其实它们是形态甲和形态乙两边的东西。前者要跨线程取邻域,后者每像素独立算。这条区分在后面几篇里会反复用到。
2.3 维度与开销的第一笔估算
判据一最后要落到量级上。形态甲的每次推理开销可以这样粗算:
$$ \text{FLOPs}_{\text{per-pixel}} = 2 \times \frac{\text{参数量}}{1} \times \text{像素数} $$
其中: - 系数 $2$ 是"一次乘加算两次浮点运算"这一惯例折算。 - 参数量是网络可训练参数的总数;注意它同时决定权重带宽——每个像素都要把权重读一遍(或从常量缓存/共享内存里复用)。 - 像素数是每帧要处理的着色器调用次数,$1920\times1080$ 就是约 207 万。
拿我们那个 409 参数的小网络算一下:$2 \times 409 \times 2{,}073{,}600 \approx 1.70\times10^{9}$,也就是每帧 17 亿次浮点运算——对于一个只替换了一行光照计算的小网络来说,这已经不算可以忽略的量。参数量每涨 10 倍,这笔记账就涨 10 倍,这也是为什么"小网络"三个字在形态甲里不是修辞,而是硬约束。
实拍与实测的对照也得摆上来。超分这类"形态乙"负载的效果,恰好可以用公开可核的真实图片来看——它是"跨线程批处理"这一侧最容易被读者直观感受到的例子:
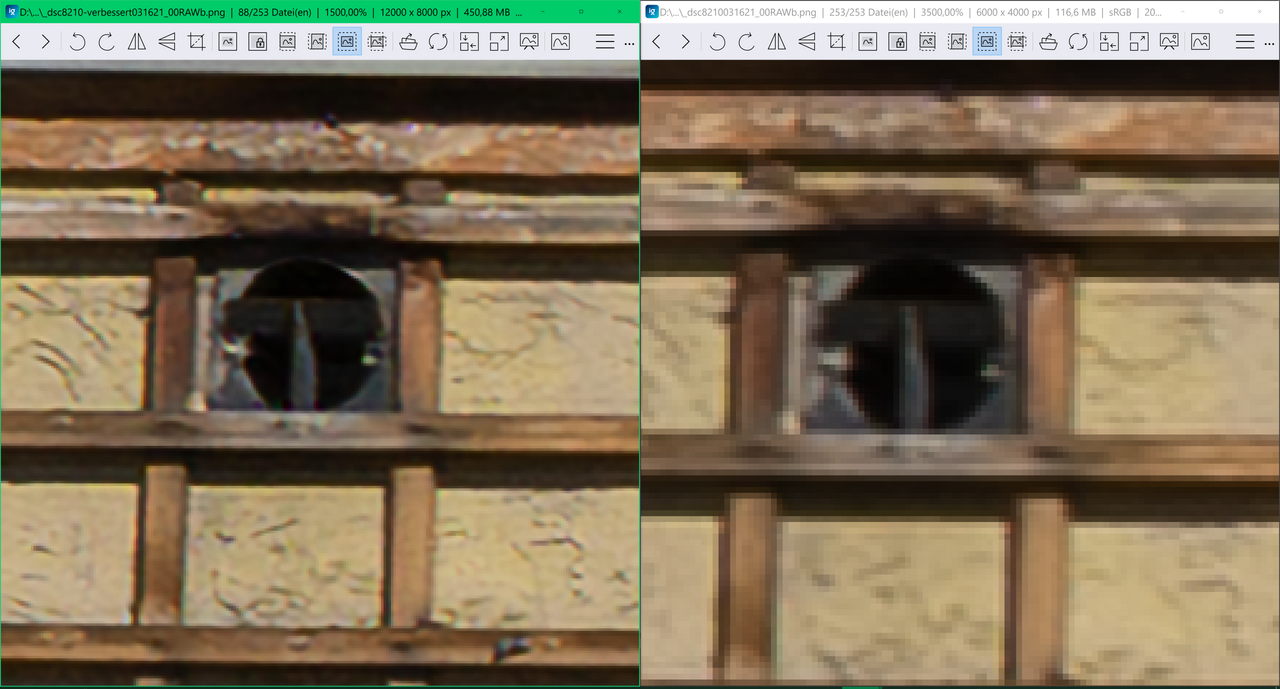
再看一张做成"原图 vs AI 放大"并排的对照。它更适合用来说明形态乙的两个特征:处理的是空间邻域(所以必须跨线程),而且输出的信息有一部分是"补"出来的——这既是它的价值,也是它会被质疑的地方。

形态乙这一侧的直观例子看到这里就够了。先来看看判据一能收成哪几个可以直接自问的问题。
2.4 判据一的小结:三条自问
把粒度这条判据收成三个可以直接自问的问题:
第一问:这个环节的输入,是"每个像素自己的一组数",还是"需要看邻居"? 如果是后者(卷积类、需要空间邻域),它天然落在形态乙,别指望向量-矩阵那条路能救它。
第二问:权重能不能小到"每个调用各读一遍"还不心疼? 这个"心疼"的阈值由 4.1 节的带宽公式给。形态甲的前提是权重小,而"多小算小"取决于你的目标分辨率与帧率——1080p60 与 4K120 是两回事。
第三问:这个环节的控制流会不会发散? 形态甲允许发散,但发散是有代价的(在并发跑同样的替换单元时,发散的控制流可能带来 25%–52% 的例程差距)。如果一个环节天生高度发散(比如逐材质分支很多),那么它换成网络之后,浪费可能比省下的还多。
这三个问题怎么连起来用?它们其实是一个漏斗:第一问筛掉一半(需要邻域的走形态乙),第二问再筛掉一批(权重太大的形态甲撑不住带宽),第三问留下的是真正适合"每调用独立小网络"的环节。(这个漏斗在实现层怎么落地——元素级网络内的矩阵乘法该映射到 coopVecMatMulNV → OpCooperativeVectorMatrixMulNV 这类硬件指令、以及对齐约束在代码里怎么体现——属于着色器内推理这条线,本会在后续暂缓篇目中展开。)
好了,判据一讲完了。但它只回答了"能不能算得动",没回答"算出来的东西对不对"——那要看判据二。
三、判据二:数据的可得性——训练数据从哪来、泛化到哪
第二道判据问的是数据。渲染器是确定的:给它同样的输入,它给你同样的输出。而网络不是——它的正确性由训练数据定义。所以"换成网络"这句承诺的背后,其实是一道选择题:你打算用哪一批数据,来定义"正确"。
3.1 三条数据来源与各自的代价
行业里能用的数据来源基本只有三条,它们的代价结构完全不同。
第一条:自产渲染。 用自己的渲染器(或用离线渲染器)把"昂贵函数"跑出来当标签。这条路最大的好处是版权干净、可无限生成、标签绝对准确——标签就是那个昂贵函数本身的值,不存在标注误差。缺点是分布单一:你能生成什么分布,网络就只见过什么分布。用它训练一个"替换光照计算"的小网络是最合适的,因为训练分布就是你自己的着色模型。
第二条:真实拍摄与扫描。 照片、扫描件、捕获设备采集。它带来的是真实的分布,尤其是那些你在合成数据里想不到的角落(真实的噪声、真实的材质瑕疵)。代价是许可与标注成本:素材要能商用,标签往往要靠人工或者更昂贵的设备(比如用高精度扫描仪给出参考值)。
第三条:程序化合成。 用过程化生成器造数据,可控、可参数化、能覆盖长尾。它的问题是一个老问题——域间隙(domain gap):合成分布与真实分布之间的差,会在推理时变成你解释不了的误差。
| 数据来源 | 版权风险 | 标签准确性 | 分布覆盖 | 主要代价 |
|---|---|---|---|---|
| 自产渲染 | 无(自有) | 极高 | 窄(跟随你写的着色模型) | 生成算力 + 分布设计 |
| 真实拍摄/扫描 | 需逐项核许可 | 中(依赖设备与标注) | 宽(含长尾) | 采集设备 + 标注人力 |
| 程序化合成 | 无 | 高 | 可调但存在域间隙 | 生成器开发 + 域间隙调参 |
这张表里最容易被低估的是第一行的"分布窄"。自产渲染的训练集里没有你不知道的东西——这句话听起来像优点,实际是最大的风险:如果真实场景里出现一个你的渲染器不表达的效应,网络既没有学过它,也没有机制告诉你"这里我不熟"。
说白了,"数据多不多"只是第一层;第二层是这个矛盾——数据再多,也未必覆盖得到明天会遇到的东西。业界给出的两条解法正好相反。
3.2 泛化边界:预训练,还是运行时适应
面对"分布窄"这个问题,有两条相反的解法。
解法一:把数据准备得更足。 训练时覆盖尽量多的场景、材质、光照条件,上线后只做推理。神经纹理压缩走的就是这条路:编码阶段离线完成,运行时只付解码。这也是绝大多数方案的做法,代价是训练数据要跟上现实世界的长尾,而长尾往往贵得离谱。
解法二:把学习搬到运行时。 这条路有一个很干净的代表:神经辐射缓存(Neural Radiance Caching, NRC)。它的做法是不做预训练,改为在运行时做自适应,并且不假设光照、几何与材质(NRC 论文)——也就是说,它把"泛化"这件事从"训练数据的覆盖度"换成了"每个场景上线后自己学"。
这两种解法的取舍很清楚:解法一省运行时的算力,但训练数据要一次性准备到位、且上线后遇到没见过的分布就退化;解法二省下准备数据的力气,代价是每个场景都要付出在线学习的时间与算力,而且在线学习的稳定性需要额外保障。
判据二到这里可以给出一句可操作的判断:如果一个环节的输入分布是你自己能完全控制的(比如你自己写的着色模型),自产渲染就够;如果它的输入分布包含现实世界的长尾,你只有两条路——要么准备昂贵的数据,要么付在线学习的成本。没有第三条。
路线选完了,接下来要看这条路的失败长什么样。下面进入判据二里最容易被低估的一节。
3.3 失效模式:数据不平衡会静默地毁掉模型
数据问题最危险的地方,不是"数据不够",而是数据不平衡。
一个已经被明确记录下来的现象是:数据驱动的方法需要大量训练数据才能泛化,而当训练数据不平衡时,模型会忽略异常的光照条件(相关研究)——典型的例子是暗场景。原因是那类样本在训练集里占比太低,模型为了降低整体损失,学出了"忽略它"这个策略。
这类失效有两个特征:第一,训练时的指标是好的——因为暗场景样本少,忽略它对总体损失的影响很小;第二,推理时的错误不报错——它只是给出一张偏亮的图,而没有任何机制提醒你"这里我不确定"。这也是为什么本系列的第三章会专门写"训练数据、泛化与失效模式":这一类问题的排查成本,远高于写一个更好的损失函数。
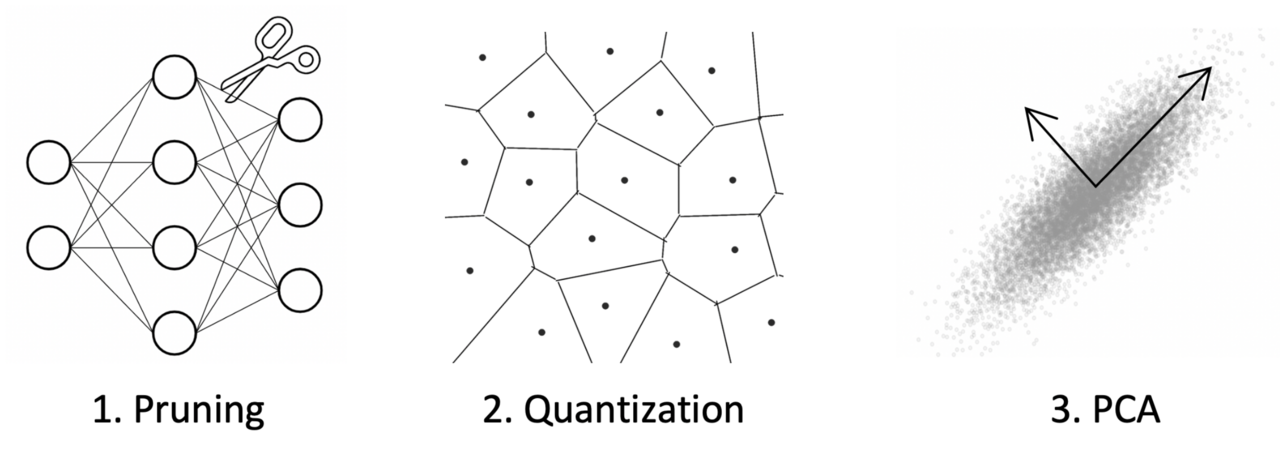
网络上还有一个相关的技术方向值得提前知道:参数是可以被压掉的。 剪枝、量化、降维、蒸馏这几类手段,目的都是把"网络规模"这个数字降下来——而由判据一的公式可知,参数量同时决定算力与带宽,所以压缩是同时省两本账的手段。
说到数据类型对泛化的影响,一个很直观的对照是同一类模型在照片与文本上的表现差异。文本是高频、强结构、低冗余的内容,网络在它上面"补细节"时更容易露出破绽——这也是"用哪批数据"会直接影响你能拿到什么结果的一个现实注脚。
3.4 判据二的小结:数据是"一次投入"还是"持续投入"
判据二最容易被简化成"数据够不够",但它真正的分岔在投入的形态上。
自产渲染是一次投入:写一遍生成器,之后要多少数据有多少,边际成本接近零。代价是分布固化——生成器写成什么样,你就只能见过什么样。
真实数据是持续投入:采集、清洗、标注、核许可,每一批都要重新来一遍。好处是分布真实,长尾也在里面。
运行时适应是把投入搬到线上:省下了准备数据的力气,但每个场景都要重新学一次,而且它的稳定性要在运行时现场保障。
这三条路在什么情况下会合流?答案有点反直觉。当你的渲染器本身就是权威(比如你要替换的就是自己写的着色模型),自产渲染不仅够,而且是最优解——标签的准确性没有对手。而当目标里包含现实世界的长尾,三条路会同时变得昂贵,这时候通常的工程选择是缩窄问题范围:不去替换整条函数,只替换其中最贵的那一段。这也正是"小网络"这个约束的来处——它不是技术限制,是数据成本的限制。
数据的账讲到这里。不过,即使粒度合适、数据也够,还有一个问题绕不过去:这套东西每帧要花多少。这就是第三道判据。
四、判据三:推理开销落在哪
第三道判据问的是代价落在哪本账上。渲染工程师习惯把开销分成三本:算力、带宽、显存。学习式环节的特别之处在于,它的开销不随场景复杂度增长,而随分辨率和帧率线性增长——这一点和传统渲染的直觉正好相反。
4.1 第一本账与第二本账:算力与带宽
算力那笔账在判据一里算过了($\text{FLOPs} = 2 \times \text{参数量} \times \text{像素数}$)。这里补上更常被忽略的带宽那笔:
$$ \text{BW}_{\text{weights}} = \text{参数量} \times \text{每参数字节} \times \text{像素数} \times \text{帧率} $$
其中: - 参数量与前面的口径一致;注意这里是"每像素都要把权重读一遍"的保守估计。 - 每参数字节由精度决定:fp32 是 $4$、fp16 是 $2$、fp8 类格式是 $1$。 - 像素数 × 帧率就是每秒的着色器调用次数,$1920\times1080@60$ 是约 $1.24\times10^{8}$。
还是拿那个 409 参数的小网络、fp16 精度算:$409 \times 2 \times 1.24\times10^{8} \approx 1.01\times10^{11}$ 字节/秒,也就是约 101 GB/s 的权重带宽。
这个数字的含义必须放到设备上才有意义:桌面独显的显存带宽在数百 GB/s 量级,看上去还撑得住;但移动端 SoC 的整机带宽往往只有几十 GB/s 量级,而这 101 GB/s 是只为了读一个替换单行光照计算的小网络的权重。这也正好解释了为什么某些学习式方案在移动端是负收益——一个看似轻量的替换,先被带宽这本账压垮。
第三本账是显存:权重常驻(409 参数 × 2 字节不到 1 KB,可忽略)+ 中间张量(与批次和精度相关)。小网络这一侧显存压力很小,真正的显存压力在表示类替换上——神经纹理压缩那类方案的显存账要按 MB 甚至数十 MB 计。
这三本账都是"显式成本"。先来看看一类更隐蔽的:它不在你的估算表里,却会在带宽缺口出现之后被追溯到。
4.2 隐性成本:对齐与步长
这里有一类成本,是渲染程序员以外的人最容易漏掉的:内存对齐。
GLSL_NV_cooperative_vector 的规范文本给出了一组硬约束:矩阵偏移 matrixOffset 需要 64 字节对齐、偏置偏移 biasOffset 需要 16 字节对齐、矩阵与偏置的加载/存储偏移必须是 16 的倍数、而 matrixStride 必须是 16 字节的倍数。
为什么硬件要卡这些?因为一次访存的粒度是固定的。如果一个矩阵的起始地址没有对齐到访存粒度的边界上,硬件要么把一次访问拆成两次(浪费吞吐),要么要求你把数据补齐到边界(浪费显存)。规范把这件事写成硬约束,等于把选择权交回给你:要么按对齐排布权重,要么承担拆访存的代价。
这类成本在"参数量很小"的时候看不出来,在参数量上去之后会以"莫名其妙的带宽缺口"的形式出现。所以我们把它单列一节:它不是算法问题,是布局问题,而且它不会在功能测试里暴露。
4.3 精度与误差:1 字节的诱惑
由带宽公式直接可以推出一个诱人的结论:把精度从 fp32 换成 fp16,带宽立刻减半;换成 8 位格式,再减半。但精度换来的误差,落在输出上是什么样子?
我们用同一个训练好的小网络,模拟了三种精度下的量化误差(fp32 作为基准,fp16 走半精度往返,fp8 用 3 位有效尾数近似)。结论很直接:fp16 的量化误差在输出上几乎不可见(误差量级在 $10^{-4}$ 以下),而 fp8 级格式的误差开始进入肉眼与后处理都可能放大的区间。规范里之所以把 FloatE4M3、FloatE5M2 这些格式单列出来(gl_ComponentTypeFloatE4M3NV = 1000491002),正是因为这个区间的选择需要按场景定。
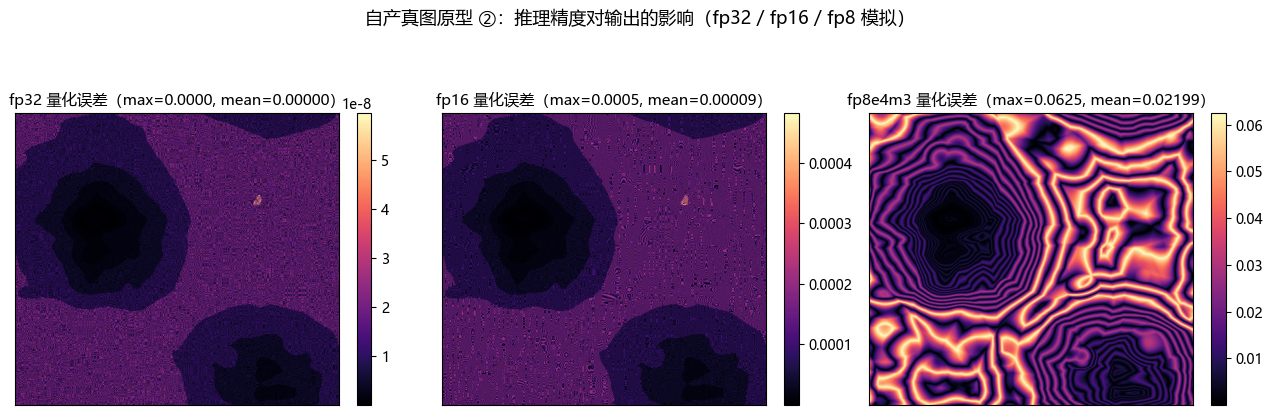
顺带看一眼小网络的非线性来源——激活函数。它是"网络能拟合非线性"这件事的最小图解,也是你在压参数时最先该动的地方(换个更省算力的激活,往往比砍宽度划算):
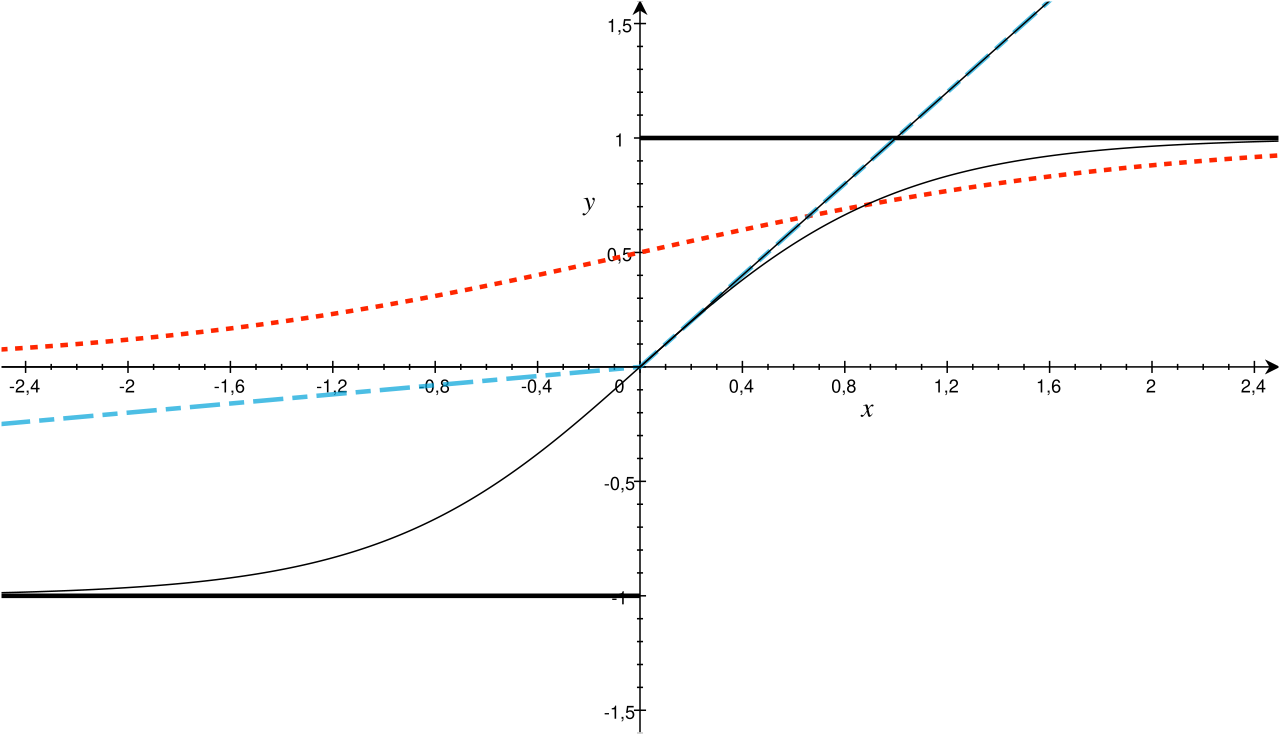
三本账的三块内容(算力与带宽、对齐步长、精度误差)都拆开了。下面我们开始把它们合进一个能直接跑的脚本。
4.4 把三本账算一遍
下面这段脚本把上面三本账合到一起,给定参数量、精度、分辨率与帧率,直接算出每秒算力与带宽需求。它也是我们做本篇那两张自产真图时用的同一套估算逻辑。
#-----------------------------------【推理开销三本账估算】-----------------------------------
# 描述:给定网络规模与目标分辨率/帧率,估算每帧算力、权重带宽与显存占用
# 用途:判断一个学习式环节的代价落在哪本账上(判据三的可执行形式)
#------------------------------------------------------------------------------------------
#【1】规模与目标:参数量、精度字节数、分辨率、帧率
#【2】算力本账:FLOPs = 2 × 参数量 × 像素数(乘加各算一次浮点运算)
#【3】带宽本账:BW = 参数量 × 字节数 × 像素数 × 帧率(每像素读一遍权重的保守估计)
#【4】显存本账:权重常驻 + 中间张量的量级
def budget(params, bytes_per_param, w, h, fps, flops_per_pixel_factor=2):
    pixels = w * h
    flops_per_frame = flops_per_pixel_factor * params * pixels
    bw = params * bytes_per_param * pixels * fps          # 字节/秒
    vram_weights = params * bytes_per_param               # 字节
    return {
        "每帧算力(GFLOP)": flops_per_frame / 1e9,
        "每秒算力(GFLOP/s)": flops_per_frame * fps / 1e9,
        "权重带宽(GB/s)": bw / 1e9,
        "权重常驻(KB)": vram_weights / 1024,
    }

for tag, p, bpp, w, h, fps in [
    ("409 参数 / fp16 / 1080p60", 409, 2, 1920, 1080, 60),
    ("4K 参数 / fp16 / 1080p60", 4096, 2, 1920, 1080, 60),
    ("409 参数 / fp8  / 1080p120", 409, 1, 1920, 1080, 120),
]:
    r = budget(p, bpp, w, h, fps)
    print(f"{tag:28s} " + " | ".join(f"{k}={v:.2f}" for k, v in r.items()))
- 第一个参数
params是可训练参数总数。它同时进三本账,是唯一一个"一改就全面变动"的量。 - 第二个参数
bytes_per_param是每参数字节数,由精度决定。它是唯一一个"改了不影响正确性上限、只影响误差"的量。 - 第三、四个参数
w、h与fps是目标条件。它们决定了这套开销的绝对值,也是学习式环节与传统渲染最不同的一点:它的开销不随场景复杂度走,只随分辨率和帧率走。
上述脚本实现了三本账的合并估算,关键在把"每像素读一遍权重"当成保守前提——真实实现会用常量缓存或共享内存复用权重,实际带宽会低于这个上界。完整脚本我们随本篇的素材一起留档在博客仓库里。
4.5 判据三的小结:先看落点,再谈优化
三本账讲完了,判据三的使用顺序如下——顺序本身比结论重要。
第一步,先定位落点。 用 4.4 节那段脚本算出三本账的量级,看哪一本明显偏高。带宽超了就别去优化算力,算力超了也别去压精度——优化错的那本账是最常见的浪费。
第二步,再看精度的空间。 如果落点是带宽,精度是最直接的杠杆:fp32 → fp16 立刻减半,而由 4.3 节的实测,fp16 的误差在输出上几乎不可见。这一步的性价比最高。
第三步,最后才考虑压参数量。 因为参数量同时进三本账,动它会全面变动,代价最大也最难回退——通常需要重新训练。
至于"为什么不早点压参数量",原因在判据二:压参数量往往意味着重新训练,而重新训练的成本不在运行时三本账里,它落在人力与时间上——那笔账要到第十一篇才讲得清。
三道判据到这里都立起来了。下一章把它们合成一张可以直接查的表。
五、一页速查判据表
这一章是本篇最应该被收藏的一页。我们把四类替换与三道判据交叉,做成一张可以直接查的矩阵。先说清一件事:这张表是我们综合本篇所引规范、官方表述与实测数据整理的判断框架,不是任何官方标准——它是一张工作用的速查表,不是规范条款。
5.1 四类替换 × 三道判据
判据的读法:粒度看"这个环节能不能让每次调用独立算";数据看"输入分布是否由你自己控制";开销看"代价落在算力、带宽还是显存"。
| 替换类别 | 判据一·粒度 | 判据二·数据 | 判据三·开销主要落点 | 结论 |
|---|---|---|---|---|
| 着色计算 | 形态甲(每调用独立) | 可控(自产渲染即可) | 算力 + 权重带宽 | 该换(先小网络试点) |
| 表示(纹理/外观) | 形态甲为主(解码在片元侧) | 可控(自产渲染 + 捕获) | 显存 + 解码算力 | 该换(可离线摊销,优先) |
| 采样分布 | 看实现:样本级可独立,路径级要跨线程 | 较难(分布随场景变化) | 训练成本 + 稳定性风险 | 观望(先做预训练版) |
| 时间轴(帧生成) | 形态乙(必须跨线程) | 不可控(需要真实运动数据) | 生成算力 + 延迟 | 谨慎(延迟吃掉收益) |
表本身是静态的。把它放进四个真实场景会读出什么——一张表的价值,最终取决于它能不能替你做决定。
这张速查表的每一格都能回溯到公开文本,这也是它敢叫"判据"而不是"经验"的原因:粒度一列的原理来自 GLSL_NV_cooperative_vector 规范,数据一列来自 GDC 2026 的负载划分,开销一列来自 hlsl-specs 的 Cooperative Vector 提案。
5.2 怎么用这张表:四个场景走查
光有表不够,我们走四个真实场景。
场景一:想给一个复杂材质的光照计算提速。 粒度上它是形态甲(每像素独立),数据上训练分布就是你自己的着色模型(可控),开销上落在算力与带宽。表里三格全绿——该换,而且应该先做最小试点:把置换前的函数与置换后的小网络放在同一张对照图上比较误差,就像我们在第零章做的那样。
场景二:想省显存与带宽。 表示类替换的"能否离线摊销"这一列是关键——编码可以离线做,上线只付解码。该换,而且是四类里优先级最高的,因为它同时省下两样最硬的资源。
场景三:想降低光追的噪声。 这里要分两层看:降噪本身(形态乙,需要空间邻域)与采样分布(第三类替换)。前者已经是生产方案(下一章与后续两篇展开),后者仍是"观望"——它的收益上限很高,但稳定性与训练数据的代价也高。
场景四:想让帧率翻倍。 时间轴类替换看起来最诱人,但它要过延迟这一关。只要你的目标帧预算里塞不下那点额外延迟,收益就是负的——这是"谨慎"那一格的真正含义。
5.3 当三道判据互相冲突时
四个场景走的都是"三格一致"的理想情况,但真实项目里更常见的是它们互相打架。下面这三种冲突形态覆盖了绝大多数情形。
| 冲突形态 | 典型场景 | 处理原则 |
|---|---|---|
| 粒度通过、数据不通过 | 想替换的环节,输入分布里混着大量现实长尾 | 缩窄范围:只替换分布可控的那一段函数,不整体替换 |
| 数据通过、开销不通过 | 训练数据非常充足,但目标平台带宽撑不住 | 先降精度,再压参数;两者都撑不住就退回非学习式方案 |
| 开销通过、粒度不通过 | 想把一条卷积式的方案直接搬进像素着色器 | 换落点:把它从像素级移到独立 pass,或改走形态乙的路径 |
这三条原则背后其实是同一个取舍顺序:先看粒度能不能落到硬件路径上,再看数据能不能一次说清,最后才谈怎么优化开销。 反过来做——先把开销算到达标、再回头补数据——是返工率最高的一条路,因为数据侧的返工意味着重训,而重训的成本不在这三本账里。
说白了,冲突本身不是坏消息。三道判据会打架,恰恰说明它们量的是三件不同的事;如果它们永远一致,那留一条判据就够了。 真正该警惕的是"三格全绿就无脑上"这种读表方式——第 6 章那五类反例里,有好几类正是在三格全绿的情况下踩的坑。
5.4 这张表不包含什么
5.3 这张表不包含什么
边界声明是本系列的规矩,本篇也不例外。这张表不包含:
- 不包含"换到什么精度"的选择。精度与带宽、误差的三角关系在 4.3 节,但它与具体场景强相关,不适合压进一张通用表。
- 不包含训练侧工程(数据集构建、损失函数设计、渲染器闭环)。那是第十一篇的主题。
- 不包含许可与合规。哪些材料能用、哪些不能搬,是工程决策的一部分,但它是流程问题而非技术判据,我们在第九篇会专门讲"许可坑"。
- 不包含硬件代际差异。本篇的所有规范事实以 2026 年 9 月的公开文本为准;尤其是
VK_NV_cooperative_vector这类新扩展,各厂商的支持情况会随时间变化。
表立起来了,判据也走完了。但如果我们只讲"什么时候该换",这篇就有推销的嫌疑。所以下一章我们专门讲换了不划算的情形——而且多数例子来自一线踩坑记录。
六、反例:哪些环节换了不划算
这一章的材料大多来自公开的踩坑记录、官方 panel 纪要与 GitHub issue。我们按"代价类型"分成五类反例,每一类都对应判据里的一个格子。
6.1 反例一:移动端的带宽墙
回到第三道判据的那个数字:101 GB/s 的权重带宽,只为了每像素读一遍 409 参数、fp16 的小网络。
桌面独显的显存带宽在数百 GB/s 量级,这个数字还撑得住。但移动端 SoC 的整机带宽往往只有几十 GB/s——也就是说,单这一项就吃掉了整机可用带宽的一大块。更麻烦的是功耗:移动端省带宽之所以重要,是因为每字节的搬运都要付焦耳。在移动端,一个"看起来很小"的网络很可能在带宽与功耗两本账上同时亏本。
这也解释了为什么移动端的学习式方案走的路线与桌面很不一样:行业里更倾向于把网络编译成单个 dispatch 的管线(VK_ARM_tensors / data_graph 就是这个思路,见 Vulkanised 2026 的 Arm 演讲),并追求"接近寄存器"的访问模式,而不是"每次调用读一遍大权重"。
带宽这本账算清了。下一类反例不在显存里,而在执行模型里——它甚至不是"搬不搬得动"的问题。先看看形态甲那个被高估的优势。
6.2 反例二:发散——lane 空转,而驱动不给救
第二类反例来自执行粒度。形态甲的优势是"允许发散",但允许发散不等于发散的代价是零:控制流一散,子组里没走这条路的 lane 就空转。
有一个专门的学术工作针对神经纹理压缩里的线程发散提出解法(共享解码器 + 纹理聚类),报告的数字是减少 25%–52% 的线程发散(该工作的论文)——也就是说,在这个方案的原型里,发散造成的浪费高达四分之一到一半。
更值得注意的是它的"不可自救性":neural.slang 的技术报告明确指出,恢复这些空转的 lane 属于驱动层控制,着色器语言本身做不到(neural.slang 技术报告);官方给出的建议是"在平台支持时改用 Cooperative Vector",因为向量-矩阵这条路是在 API 之下处理发散的。换句话说,这个代价你写代码绕不过去,只能换硬件路径。
前两类反例都发生在运行时。先看看第三类——它发生在你写第一行代码之前,成本比训练本身还高。
6.3 反例三:工具链——授权循环比训练更慢
第三类反例不在运行时而在于开发期。一个很具体的说法来自图形程序的行业 panel 纪要:当前主流框架对微小 MLP的训练效率很低,以至于有从业者建议自己在 compute shader 里重写 MLP 训练来获得可靠加速,否则"授权(authoring)循环感觉超级慢"。
同一份纪要里还有一条判断值得记住:行业正"进入新一轮数据烘焙时代,只是层次更高、技能门槛更高"。"烘焙"这个词用得很准——学习式环节的离线部分,在工程形态上和光照贴图烘焙是同一类东西:都是拿离线算力换运行时开销。
工具链的不成熟还有更细的证据:SlangPy 直到 0.35.0(2025-09-18)才加入对光追管线的初步支持(变更日志)。对一个想把训练与推理串进图形管线的团队来说,这意味着可依赖的工具面每年都在变。
带宽、发散、工具链这三类反例,分别来自显存、执行模型与开发期流程。下面进入本篇唯一一个"我们自己踩的坑"。
6.4 反例四:基线选得不公平,结论就会反过来
第四类反例是方法论的,也是我们自己踩的坑,所以讲得细一点。
在第零章我们提过:这个对照实验的第一版跑出来,小网络比手写先验更差(平均误差 0.145 对 0.096)。当时如果就此收工,结论会是"神经网络不划算"。
查下去的原因很简单:那一版的"手写先验"里,我直接写进了目标函数的低频项。等于让对照组拿着答案来考试。换成真正公平的基线(低阶多项式最小二乘,10 个系数——这才是手写解析式的能力上限)之后,结论才反转成"小网络平均改善 1.4 倍"。
请记住这条:在"该不该换成网络"的讨论里,绝大多数争议其实不是技术争议,而是基线争议。 一个被喂了答案的手写实现、或者一个被故意调差的学习式实现,都能让结论指向任何一方。这也是为什么本系列每一篇都会明确写出对照的设置。
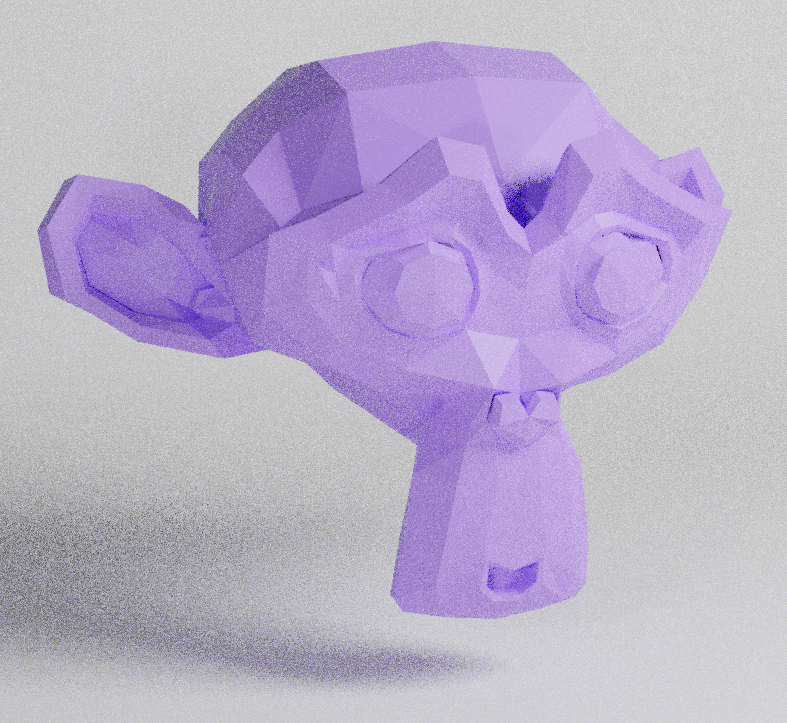
而"采样不足"正是"该换网络"这个念头最常见的起点。同一场景、同一采样数,不开启降噪时画面是这样:
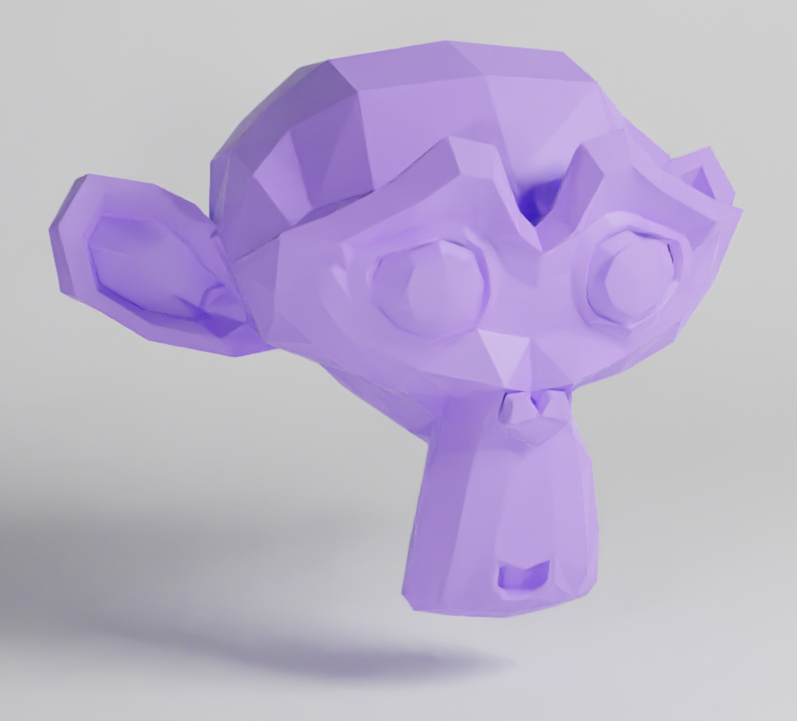
开启降噪之后,同一场景变成这样——这一对图的差别,就是后面两篇要拆开的那笔账:
好了,第四类反例是方法论层面的。它提醒我们,"结论对不对"先取决于"实验设计对不对"。最后一类比它更难受——在你的测试里根本不会亮红灯。
6.5 反例五:静默失效——错了却不报错
最后一类反例最危险,因为它在功能测试里不会暴露。
公开的 issue 记录里有这样两个例子:一是某个平台的默认 target 缺失,导致压缩结果静默输出全零(RTXNTC 仓库 issue)——不报错、不崩溃,只是结果全错;二是4 位打包格式的线性过滤采样返回无关数据,跨多个驱动版本仍未修复。
这两个例子的共同点是:错误的表现形式是"数据不对",而不是"程序出错"。 传统的渲染 bug 往往会以可见的伪影暴露自己(一个黑块、一条裂缝),而学习式环节的 bug 可能只是一张"看起来还行、但细节是编的"图。
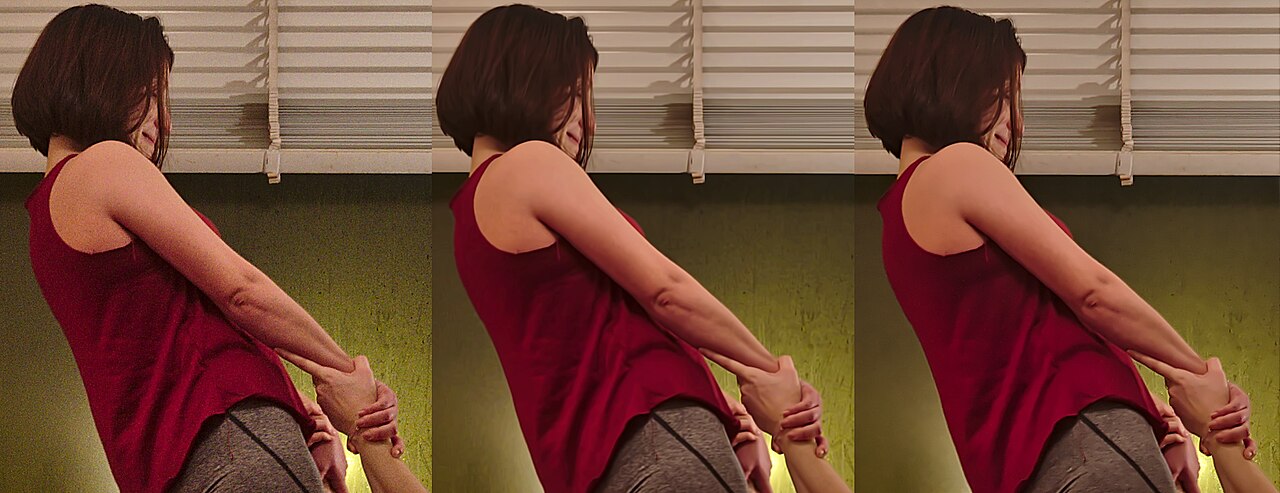
至于"传统方法"这一侧能提供什么参照,降噪是个好例子——因为它是传统方法谱系最完整的一个领域,从非局部均值、小波到 BM3D 都有可核的对照图:
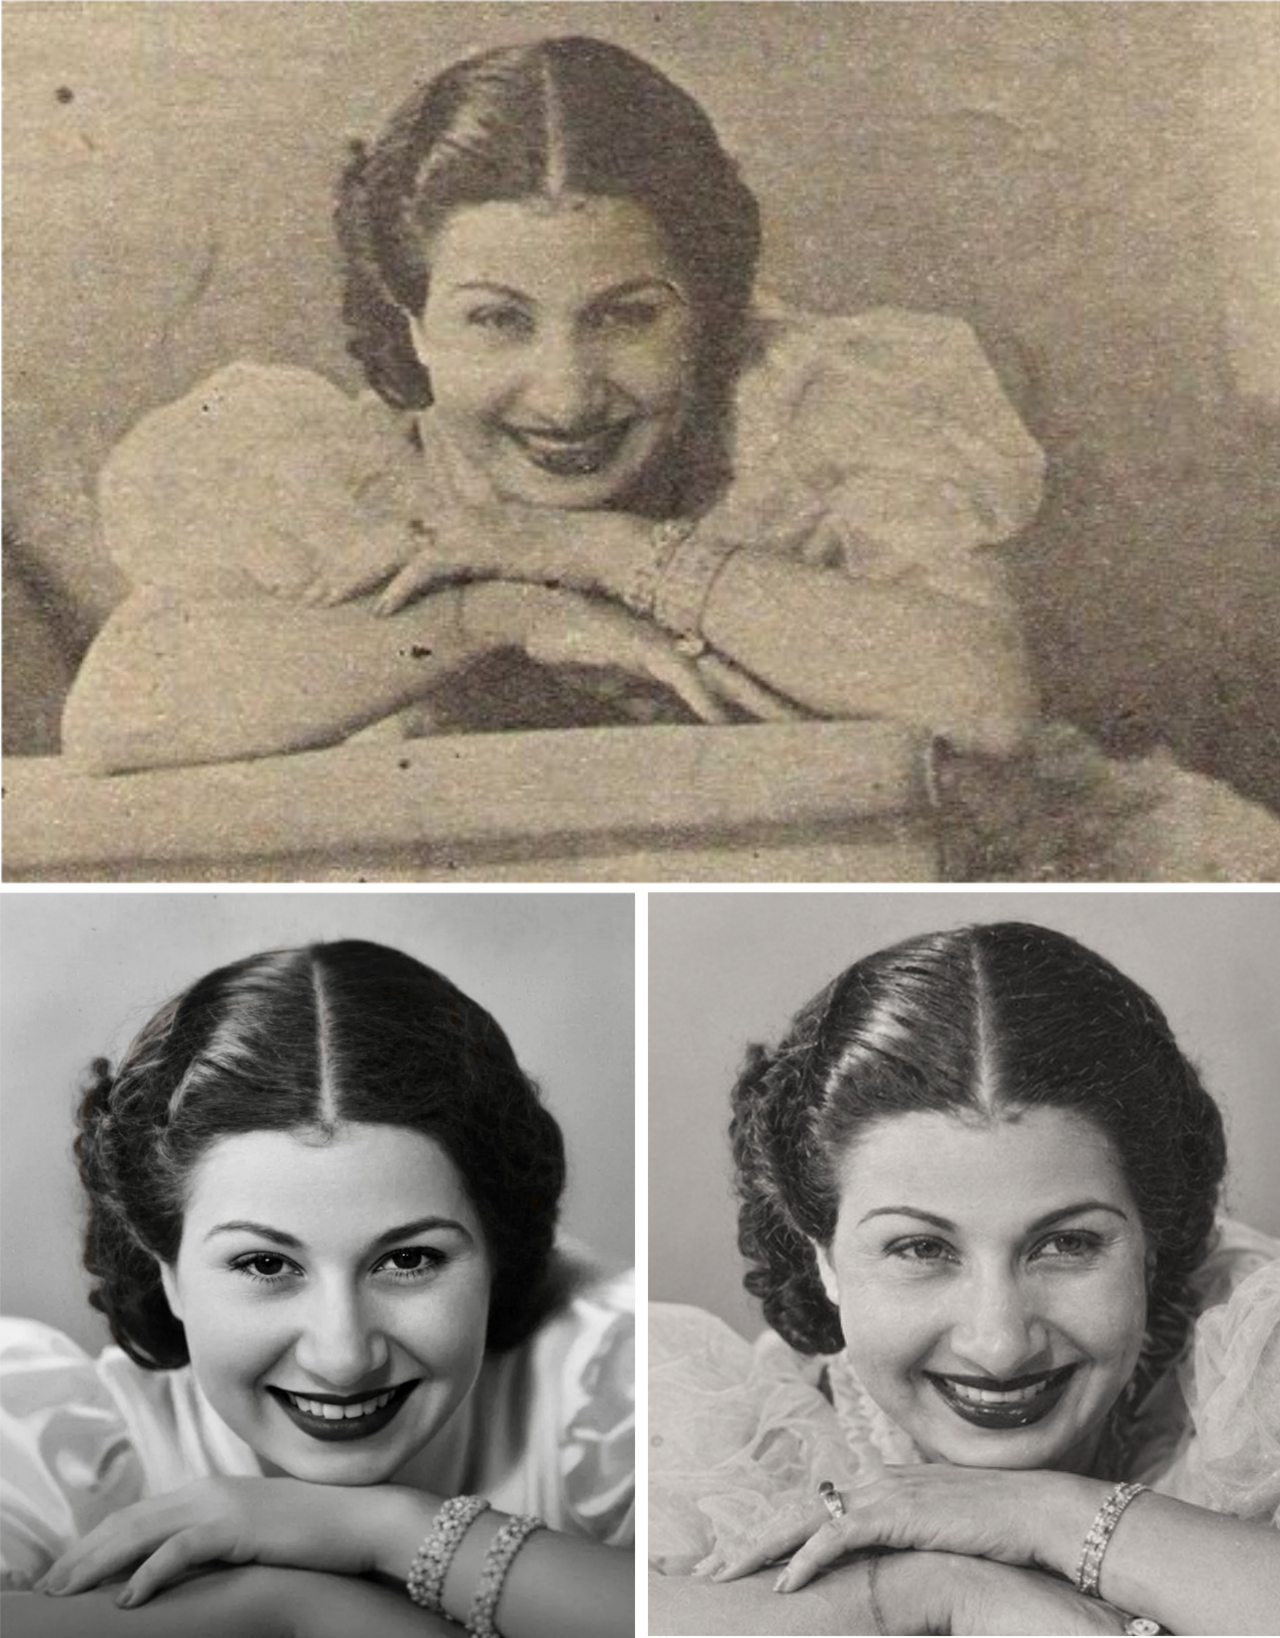
最后,关于"放大"这件事还有一种容易被忽略的形态:同一份旧照片,交给两款不同的 AI 工具去"修复",补出来的东西差别很大。这类图在讨论"该不该用学习式方案"时,比任何指标都直观:
6.6 五类反例的共性
把这五类反例摆在一起,会发现它们共享三个特征——而这三个特征的原理并不相同,它们分别对应判据里三个不同的格子。
第一,反例的成因几乎都不是"网络不够好"。 移动端的问题是带宽与功耗(账本问题),发散的问题是执行模型(粒度问题),工具链的问题是开发期效率(流程问题),静默失效的问题是测试方法(验证问题)。真正因为"模型能力不足"而失败的情形,一个都没有。
第二,"换之前没算账"是最贵的错误。 移动端那 101 GB/s 是可以在写第一行代码之前算出来的;对齐与补齐的浪费也是可以提前算出来的。可实际操作里,绝大多数团队是先接了、跑了、发现不对,才回头算账。
第三,也是最重要的一条:反例的证据往往比正例更容易拿到。 正例通常来自厂商博客或论文(口径需要标注),而反例大量存在于 issue 跟踪器、panel 纪要与开发者自述里。如果你在评估一个学习式方案,先去找它的反例——这比再去读一遍它的效果宣传更有信息量。
说了这么多"不该换",容易给人一个印象:这个方向不成熟。事实恰恰相反——五类反例的存在恰恰说明它已经进入工程阶段:只有在真正被使用的地方,才会有这种养分级别的踩坑记录。
五类反例讲完了。它们和前三章的判据合在一起,就是本篇的完整答案。
七、本系列的路线图
判据立住了,反例也讲清了,剩下的问题就是:如果你信了这张表,接下来该按什么顺序动手? 这一章给出本系列已发布五篇的阅读路线,并明确它与前四个系列的边界。
7.1 已发布五篇的推进顺序
本系列目前收录已发布的五篇,对应"从最成熟到最实验"里当前能真实实验的那一段。
判据与最成熟的落地(第一篇至第五篇)。 先立判据(本篇),再写四类替换里已经进入生产的两类——降噪(第二、三篇)与纹理/外观(第四、五篇)。这一段的特点是每一篇都有可核的论文与规范,而且结论相对稳定。
更实验的部分(着色器内推理、学习式采样、辐射场、帧生成、训练工程与总账)暂缓。 它们需要真实硬件/训练环境才能写出"能跑还是不能"的现状,写作条件暂不具备,故不列为待续承诺——本系列就以这五篇收束。
路线摆完了。先来看看一个必须提前讲清的问题——这条路和前面四个系列有没有重叠?不划清,读者会以为我们要重写一遍。
7.2 与已交付四个系列的边界
本系列是第五个专题。前面四个系列已经写了四层,边界必须写清,否则读者会以为我们要重写一遍:
| 已交付系列 | 写的是哪一层 | 本系列与它的关系 |
|---|---|---|
| 【实时渲染管线探析】 | 算法层 | 本系列只在必要处引用算法结论,不重写算法 |
| 【移动端图形与功耗】 | 约束层 | 本系列的"移动端反例"引用其带宽与功耗结论 |
| 【GPU 架构剖析】 | 硬件实现层 | 本系列不重写硬件机制(占用率、波前、张量单元内部) |
| 【实时光线追踪与混合渲染】 | 工程取舍层 | 边界最需要注意:其第六、七篇已讲透降噪的机制(时域重投影、à-trous、方差驱动),本系列的第二、三篇只写"先把验换成学出来的之后多了什么" |
这条边界值得多说一句。光追系列的降噪两篇写的是机制:怎么重投影、怎么滤波、参数怎么调。本系列要写的是先验来源的替换:训练数据从哪来、泛化到哪、失效是什么样子。同一个主题、两个角度,不重复——这也是我们在立项时最花力气划清的一条线。
这一节的组织原理很简单:先按你的目的分类,再决定读哪几篇——所以下面按"目的"列,而不按篇号列。
7.3 怎么读这个系列
- 想快速判断"我手上这个环节该不该换":读本篇第五章的速查表。
- 想动手做第一个落地:按第二、三篇(降噪)或第四、五篇(纹理压缩/外观)走——这两条路的资料最完整、量化结论最容易复现。
- 关注硬件与规范动向:着色器内推理这条线(cooperative vector 等扩展)的规范原文尚未在本系列展开,感兴趣的可直接读 Khronos 的 ML Inference 教程 与 hlsl-specs 提案。
路线图讲完了,最后把整篇收一下。
八、收束与交棒
依然是惯例,收尾不复述:只留下能当判据用的那条原理。
本篇要说清的其实只有一句话:"要不要用神经网络"不是先进性问题,而是代价类型换没换的问题。 四个动作(改写着色计算、替换表示、替换采样分布、替换时间轴)各有各的账;三道判据(粒度、数据、开销)各有各的格子;而五类反例说明了——在某些格子里,换了确实不划算。
如果你只从这篇带走一样东西,我们希望是这一句:在讨论"该不该换成网络"时,先把对照基线写清楚。 因为本篇里最能说明问题的那个例子,不是任何一张规范条款,而是我们自己那个被喂了答案的基线——它差点让结论完全反过来。
不过话说回来,判据只能告诉你"该不该换"。真要落地,还得看最成熟的那条路是怎么走通的。四类替换里,哪一类最早进入生产管线?
答案很清楚:降噪(Denoising)。 它已经是每一款光追作品的标准配置,传统方法的谱系完整、学习式方案的论文与实现都有,而且它的账本最容易核对——噪声降了多少、代价花了多少、伪影出现在哪。
所以下一篇,我们从这里开始:当降噪的先验,从人手写的启发式变成学出来的网络,究竟多了什么、少了什么。
相关链接
- 本系列:第五专题《神经渲染与神经着色器》(系列现收录至第五篇、后续暂缓,本篇为第一篇)
- 下一篇(预告):【神经渲染与神经着色器】(二) 神经降噪(上):当先验从人手写变成学出来 —— 技术博客页
- 前序系列对照阅读:【实时光线追踪与混合渲染】(七) 降噪(下):从 SVGF 到神经降噪的取舍 —— 技术博客页
- 主要规范依据:Khronos Vulkan ML Inference 教程 —— Khronos Vulkan-Site
- 主要论据来源:Microsoft DirectX Developer Blog · Cooperative Vector —— DirectX 官方博客
With Best Wishes.