CSDN 版文章链接:待发布 知乎专栏版文章链接:待发布
点题、总览与边界:把"验证"本身当成交付物
先说说这一篇要干什么。 前十二篇给了大家一堆判据:怎么分责任方、怎么读 FrameTimeline、怎么判 GPU 忙不忙、怎么用反汇编做排除。可真正让人卡住的往往不是某条判据本身,而是顺序——手上有一个新项目、一个新 bug,先做哪一步,做到什么程度算够,什么时候该停手说"数据不够"。
这一篇不新增判据,它交付的是顺序。 我们要把散落在前十二篇里的"判据 / 边界 / 工具能力与缺口"收成一套可复用的 SOP(Standard Operating Procedure,标准作业流程),让一个刚接手新项目的图形或性能工程师能照着走。凡前面讲过的机制,本篇只引用、不重讲:需要的时候一句话带过,并给出篇号。
本篇的骨架叫"验证阶梯"。 它有一条常被跳过的第 0 条,加六步,再加一个出口:
第 0 条(先确认文档对应哪一代实现)→ 0 定症状与帧预算 → 1 分责任方 → 2 取 API 层证据 → 3 交叉印证能到什么粒度 → 4 落基线 / 防回归 → 5 四类必须停手。
这条阶梯有两个东西挂在上面,但它们不单独成章:"工具箱台账"是第 4 步的一个实例,"证据可信度分级"是第 3 步里的一张表。阶梯的主体靠自绘的阶梯图、分级表、矩阵与判定树讲清顺序;外部依据来自两个官方文档站的实景图;而本篇最硬的证据,是本仓库那套真在跑的验证工具链——它们真拦过东西,本轮也逐件实跑并留下了原始输出。
0.1 全篇知识地图:九章的顺序与产出
下面这张表不是并列的知识点,而是一条排查动线——顺序不能颠倒:先确认文档代际,才谈得上引用;先定症状与预算,才有"超没超"这把尺子;先分责任方,才谈得上取证据。
| 章节 | 在回答什么 | 你会拿到什么 |
|---|---|---|
| 零、点题与边界 | 这一篇讲什么、不讲什么? | 十二篇索引 + 不复述清单 + 术语双语表 + 边界与量化锚点 |
| 一、第 0 条:文档代际 | 手上的文档,对应哪一代实现? | v1 legacy 与 metrics-v2 的并存判据 + 本机版本兜底 |
| 二、第 0 步:症状与帧预算 | 症状怎么变成可复现的采集? | 1000 ÷ 目标 FPS 换算 + "结果不是 pass/fail" + 自动化边界 |
| 三、第 1 步:分责任方 | 这件事该记在谁头上? | app / SF / HAL / 预测漂移 / 未定 五出口 + "未定"的可算条件 |
| 四、第 2 步:取 API 层证据 | 不打开界面能取到哪三样? | 三条取数路径 + 绘制量、管线状态、反汇编原文 |
| 五、第 3 步:交叉印证与分级 | 两层证据能印证到什么粒度? | 六级证据可信度表 + "分层 + 方向 + 量级自洽"口径 |
| 六、第 4 步:落基线防回归 | 这次结论怎么固化成下次能复跑的? | 官方 diff test 范式 + 工具箱台账 + 故障注入实证 |
| 七、第 5 步:四类必须停手 | 什么时候该说"数据不够"? | 四类停止条件判定树 + 十三条款欠账看板 |
| 八、收口清单与结语 | 下次遇到同类问题怎么办? | 症状 / 责任方 / 取什么 / 印证粒度 / 基线 五列清单 |
这张表里最该记住的是第一章。 多数教程把它跳过去了——拿到官方页就直接抄命令。可本系列本轮就撞上一个干净的例子:官方那页 metrics 文档,自己顶着一行"这是 legacy (v1),仅作历史参考"的黄框。把"文档写了 X"当成"当前版本就是 X",后面每一步都会建在过期的地基上。
0.2 前十二篇一句话索引
下面这张表只用文字承载,不做成图——它是"找篇号用"的索引,不是本篇的论点。大家读到后面某一步,需要回看机制时按这张表回跳即可。
| 篇号 | 一句话 |
|---|---|
| ep01 方法论全景 | 全系列的坐标系:CAP 三层与工具坐标,以及"为什么这样验" |
| ep02 抓帧 | 一帧怎么被抓下来,事件树与资源视图怎么读 |
| ep03 回放 | .rdc 如何被回放引擎重放,帧注入与重放机制 |
| ep04 事件浏览器 | 事件浏览器与区域标注的读法 |
| ep05 资源与描述符 | 资源 / 描述符视图:绑定长什么样 |
| ep06 网格与反汇编 | Mesh Viewer 与反汇编面板、IR 形态与源码映射 |
| ep07 trace 结构 | trace 文件的 protobuf 结构——"文件里有什么" |
| ep08 data source | data source 全景——"这些数据谁写的" |
| ep09 PerfettoSQL | 表该怎么问:EXPLAIN 调优与一次真机证伪 |
| ep10 FrameTimeline | 一帧到底有没有掉:overrun、双轨、8 类 jank 与归因 |
| ep11 GPU 瓶颈 | GPU 忙不忙:GPU 受限 / CPU 受限两组证据与"本机拿不到什么" |
| ep12 jank vs shader | 这帧该记在谁头上:判别链、反汇编当排除性证据、四种"数据不足" |
0.3 本篇不复述什么:四张已经占领的题域
既然索引列全了,就得把边界划清。"收口篇"最容易翻的车,就是写成前面各篇的复述。 所以下面这张表把四块题域显式让出去:
| 已被占领的题域 | 属哪篇 | 本篇只用它做什么 |
|---|---|---|
| 反汇编面板与 IR 读法 | ep01 到 ep06 | 只在第 2 步里把反汇编当排除性证据用一次 |
| FrameTimeline 判据与 8 条目归因 | ep10 | 只在第 1 步里问一句"换个项目还成立吗" |
| GPU 忙闲判定与"本机拿不到什么" | ep11 | 只在证据分级表里给它定一个档位 |
| jank 与 shader 的判别链 | ep12 | 只在第 3 步里引用它的"分层 + 方向 + 量级"口径 |
一句话说清本篇与它们的关系: 前十二篇教大家怎么判,这一篇教大家按什么顺序判、拿什么证据判、以及什么时候不许判。
0.4 边界声明与量化锚点
边界在开篇说一次,第七章再确认一次:
- 不涉及任何新的剖析机制:本篇不解释
overrun怎么算、反汇编四个坑为什么发生、GPU 计数器为什么拿不到——它们分别属 ep10、ep12、ep11; - 不覆盖"怎么搭一整套 CI 基础设施":本篇只给最小可复现验证,不教大家配自托管 runner、不教容器编排;
- 不在本篇承诺跨工具同帧结论:印证口径只有"分层 + 方向 + 量级自洽",理由 5.3 节给三条实测;
- 不把本仓库的工具链当普适工具推荐:那套工具验的是"我们的站点产物",它是方法论实例,不是使用说明;
- 本机可用面:Perfetto
trace_processor_shellv58.2-add693d8b、RenderDoc v1.29、六份 trace 仍在、adb devices为空;所有数字只取阶段 1/2 实测过的值。
本篇要拿下的可核对数字有六个,全部来自本轮实测或官方原文:故障注入后硬失败 2 项、退出码 1,且 deploy_site.ps1 在"建立 SSH 会话"之前就中止;audit_site.py --no-net 一轮扫到 105 个 HTML / 3,828 条图片引用 / 硬失败 0 / 退出码 0;旧实现漏报223 条 = 5.8%(历史口径 231 条 = 6.1%);断点帧里只有 16 个(3.3%)能挂上线程;反汇编 VS 32 条 / PS 3 条、无循环无动态分支;jank_type GLOB '*GPU*' 六份 trace 恒为 0 行。
本篇与前三篇的题域切分图决定了一件事——后面每一章能讲什么:
图上最宽的那几条都不是本篇。 本篇占的是最上面那一条细线——一个后来者按什么顺序走,走到哪一步该停。正因为它是"顺序",它才可以不带任何新机制独立成篇。
0.5 验证阶梯总览:一条常被跳过的第 0 条
先来看看这条阶梯的全貌。把它画出来,就是本篇的主线图。图上每一级都要标两件事:这一步要什么证据,以及什么条件下必须停。
图上最下面那道出口就是本篇的诚实边界。 它不在最底层,而是从第 3 步与第 4 步各引一条线出来——"数据不够"不是失败,是阶梯的一个正常出口。第七章会把这条出口拆成四类可判定的条件。
0.6 术语双语对照(先备着)
后面几章会密集出现官方术语原名,中文侧译法并不统一,这里一次钉死:
| 中文 | English | 一句话 |
|---|---|---|
| 验证阶梯 | verification ladder | 本篇的顺序骨架:六步与一个第 0 条 |
| 责任方 | blame | 这次超期该记在谁头上 |
| 帧预算 | frame budget | 1000 ÷ 目标 FPS,60 FPS 是 16.67 ms |
| 证据分级 | evidence grading | 按"能支持什么结论"给证据定档,不是按好坏 |
| 基线 | baseline | 一次固定输入 + 期望输出,用来 diff 出变化 |
| 门禁 | gate | 判据可核、硬失败即中止的自动检查 |
| 豁免 | waiver | 阈值显式下调并留检索痕迹,不是改口径 |
| 停止条件 | stop condition | 达到即必须说"数据不够"的可判定条件 |
一句话记住本篇的方法:先确认文档是哪一代,再把症状换成帧预算;分完责任方才取证据,取到证据先分级;能落基线就落基线,落不了就按四类条件停手。
一、第 0 条:先确认"文档对应哪一代实现"
这一条不产生任何帧数据,却排在最前——它决定后面每一句引用是否落在当前实现上。它的判据只有一句话:"官方页写了 X" ≠ "当前版本就是 X"。文档会过期,接口会换代,而两者的时间差往往藏在页面自己的角落里。
1.1 一个干净的例子:官方那页 metrics 自标 legacy
先来看看本系列撞上的那个最干净的例子。Perfetto 官方的 metrics 页面,正文一开头就顶着一行黄框:
「WARNING: This page describes the legacy (v1) metric system. For all new use cases, please refer to the Trace Summarization documentation, which is the successor to this system. This page is only kept around as a historical reference.」
它的接班人叫 Trace Summarization,即 metrics-v2。 新系统的用法是 trace_processor_shell summarize --metrics-v2 METRIC_ID_1,METRIC_ID_2 TRACE_FILE YOUR_SPEC_FILE——注意它多了一个位置参数(spec 文件)。而旧系统那套 RUN_METRIC 机制,页面里虽然还在讲全套,但它自己已经声明只作历史参考了。
| 项 | 旧(metrics v1) | 新(metrics-v2) |
|---|---|---|
| 页面状态 | 官方自标 legacy / 历史参考 | 官方指定的接班人 |
| 入口 | metrics 子命令(ep09 记:必须带 --run) |
summarize --metrics-v2 |
| 额外参数 | 无 | 需要一份 spec 文件 |
| 用它的前提 | 只在维护老脚本时 | 所有新用例 |
先看看这张图——它把两代接口的并存关系画成了一张对照,判据就写在图上:
先盯住"历史参考"四个字。 它意味着:这页内容不是错的,但它描述的是另一代接口。照它写脚本,在新版本上可能语法能过、语义早已变味——这正是"第 0 条"要挡的坑。
1.2 本机兜底:版本号比文档更硬
既然文档会过期,兜底只能落在本机读数上。 这是本系列从 ep09 起就固化的一条纪律:凡涉及版本相关的能力,必须由本机实跑或版本号兜底,不能只引文档。本轮复核的环境是这样:
-----------------------------------【第 0 条:本机版本兜底】----------------------------------------
# 描述:确认剖析工具的实际版本,与官方文档所述的代际对齐
# 实测:本机 Windows / 16 核 / RTX 3060 Laptop 6144 MiB
#------------------------------------------------------------------------------------------------
.\bin\trace_processor_shell.exe --version      #【1】trace 处理器版本
(Get-Item 'C:\Program Files\RenderDoc\qrenderdoc.exe').VersionInfo.ProductVersion   #【2】RenderDoc 版本
下面对【1】【2】特别说明。【1】的输出是 v58.2-add693d8b,同时打印 Trace Processor RPC API version: 14——版本号与 RPC API 号是两件事,前者是构建版本,后者是远程调用的协议代次,跨版本升级时两者不一定同步变。【2】读出 v1.29,且 Test-Path 为真。→ "本机是这一代、文档讲的是哪一代"这两个问题,靠这两行代码就能分开回答。
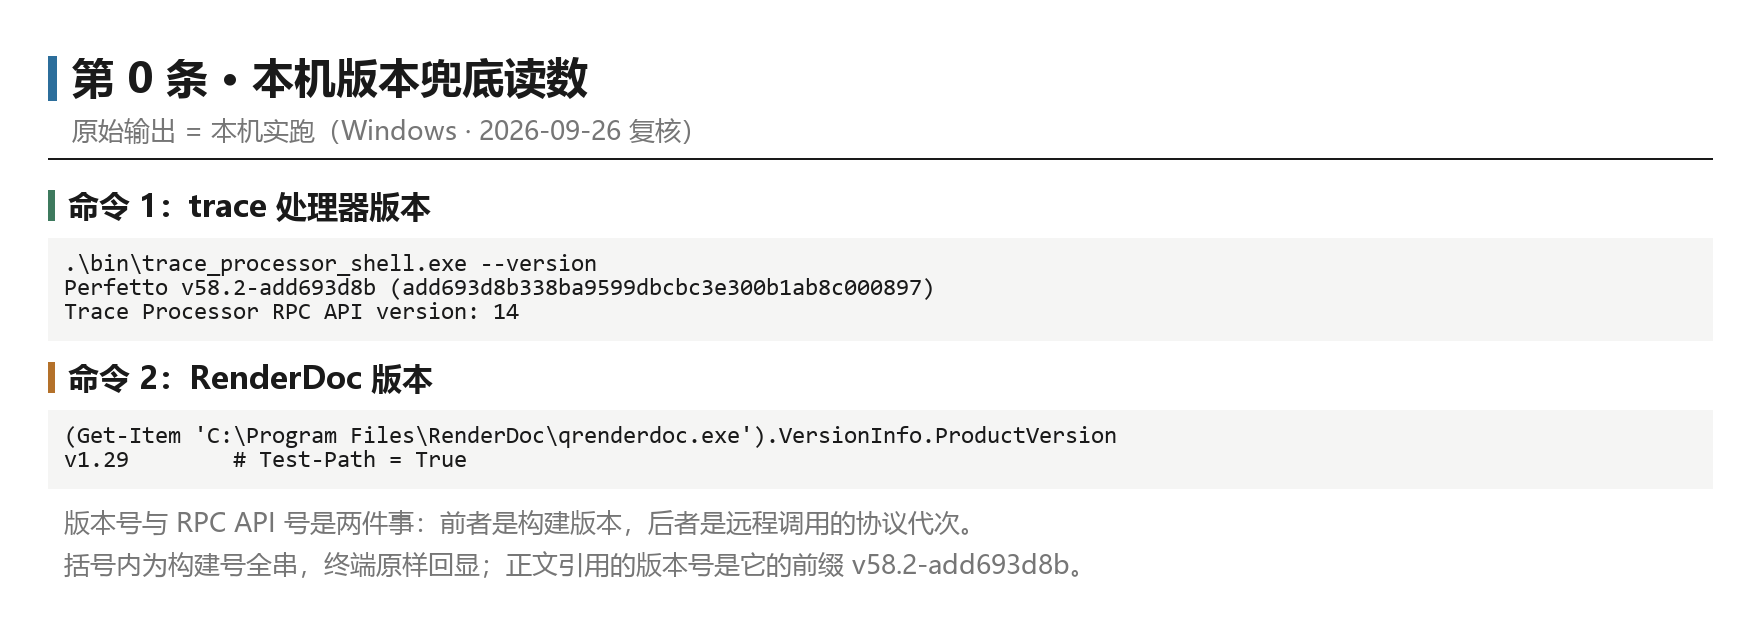
trace_processor_shell v58.2-add693d8b(--version 同时打印 RPC API version 14)与 RenderDoc v1.29@ 本机自跑(Windows,2026-09-26 复核)真正要盯住的是 RPC API 那一行。 它提醒我们:文档里说的"接口"可能指构建版本,也可能指协议版本。分不清的时候,两行都读出来。
1.3 官方实景:一整份 trace 打开后的样子
第 0 条之后全部步骤的"观测面"是这样——一整份 trace 打开后,证据长在哪一栏:
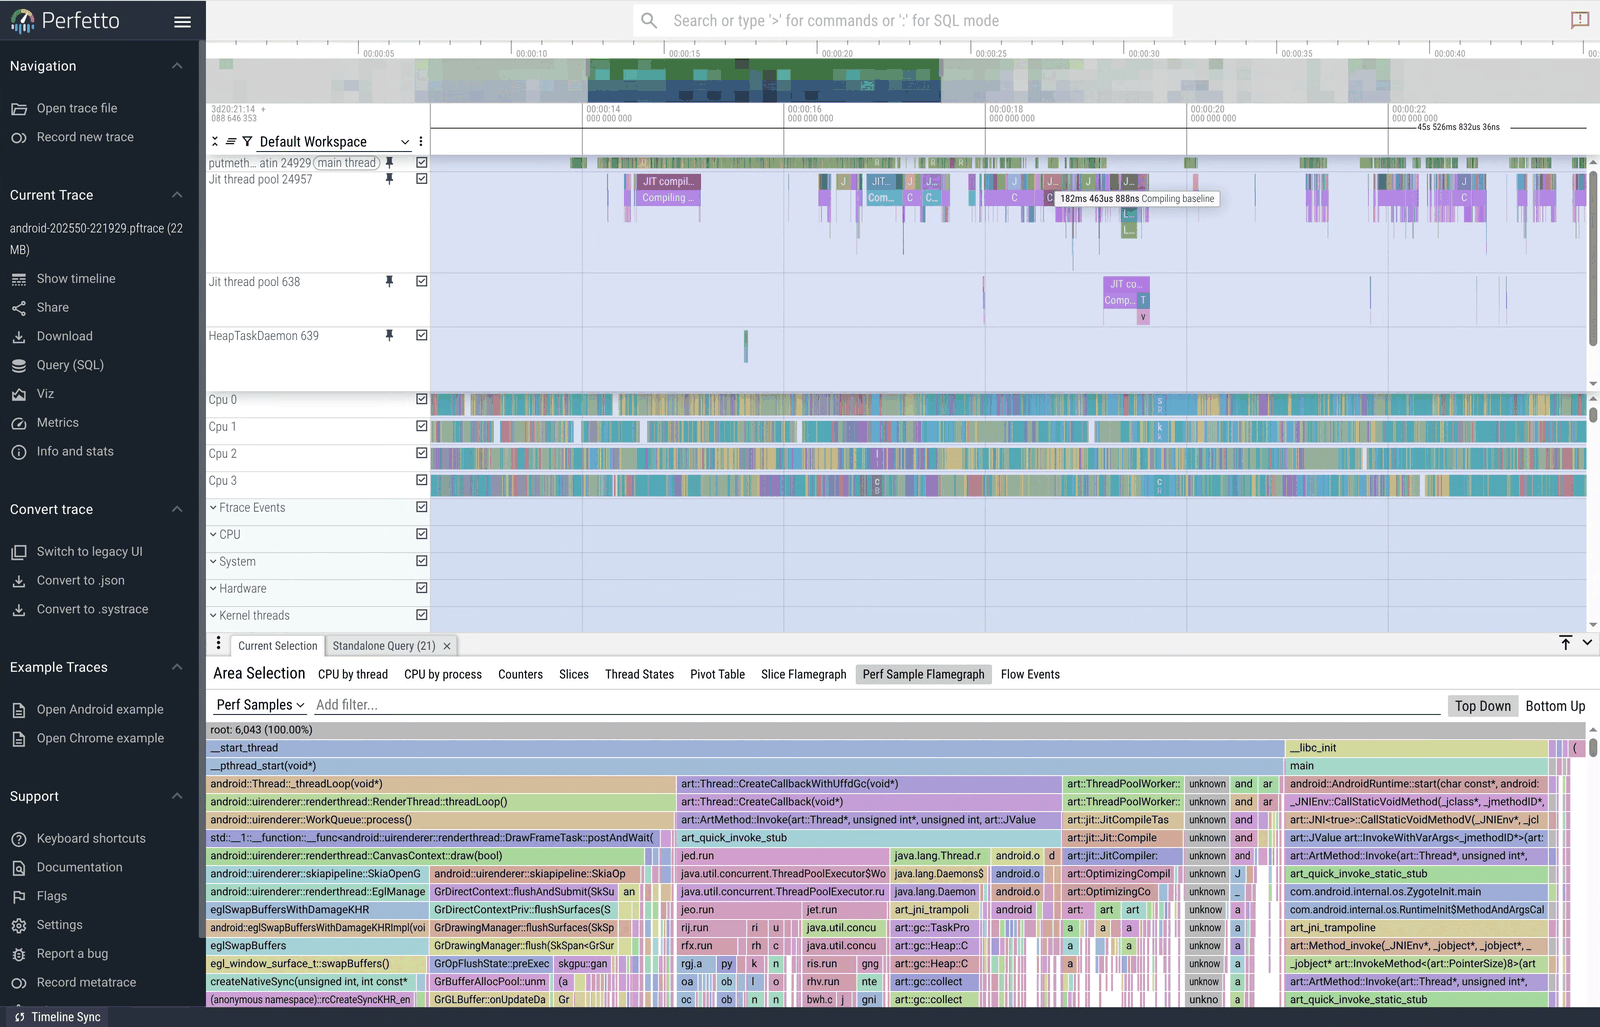
这张图不承担判据,它只交代"观测面"。 后面三章里那些命令行查询,换到界面上就是在这张图的某条轨道里点一下;本篇走命令行只是为了让结论可复现、可进脚本(与 ep12 同一口径)。
1.4 为什么这一条排在最前
因为它是一个前置条件,而不是一个步骤。 后面的第 1 步到第 4 步,全部建立在"引用的是当前实现"这个假设上:分责任方引的是 FrameTimeline 的判据,取 API 层证据引的是 RenderDoc 的接口签名。这两套东西都在换代中——Perfetto 的 metrics 从 v1 走到 v2,是一条清晰的接口演进线;RenderDoc 官方也从 v1.29 走到 v1.46(ep12 记)。文档是 A 代、机器是 B 代时,一切看起来都对,结论却可能指向两件不同的事。
收口: 第 0 条要回答的只有"这一代是哪一代",它不给任何帧数据,却决定后面每一步的证据算不算数。
1.5 本章收在哪里
第一章走完,手里该有三件事:一份"文档 vs 实现"的对照表、一套本机版本兜底的命令、一张"整份 trace 长什么样"的观测面。下一章把症状换成一把尺子:帧预算。
本章对应的官方依据:旧 metrics 自标 legacy 与新系统入口见 Perfetto metrics 页 与 Trace Summarization 页;命令行子命令全集见 Trace Processor CLI 参考;RenderDoc 版本与构建入口见 RenderDoc builds。
二、第 0 步:把症状换成帧预算,并确认它能不能自动跑
上一章确认了"文档是哪一代",这一章我们做两件事: 把一句模糊的症状("一卡一卡的")换成一把可算的尺子;再确认这一次验证能不能进自动化。顺序不能反:先有尺子,才谈得上"这次算不算慢"。
2.1 帧预算:一句抱怨,换算成一个毫秒数
先来看看这把尺子怎么造。它的算式只有一行:
帧预算(frame budget) = 1000 ÷ 目标 FPS

其中:
- 目标 60 FPS  → 1000 ÷ 60  = 16.67 ms
- 目标 30 FPS  → 1000 ÷ 30  = 33.3  ms
- 目标 120 FPS → 1000 ÷ 120 = 8.33  ms
这把尺子的用法,是把它当成所有"超没超"判据的分母。 说"这一帧 20 毫秒",在 60 FPS 语境下是超期,在 30 FPS 语境下却是达标——不写目标帧率就说"慢了",等于没写单位。
先看看下面这张图:它把三档换算与官方那条"不是 pass/fail"的口径并排放,判据与边界一起看:
1000 ÷ 目标 FPS,并置官方"基准测试的结果不是简单的通过或失败"@ 本系列绘制(官方原文见 Android 官方 CI 基准测试页)图右边那句话,是第 4 步的种子。 官方明说性能结果不是简单的"通过"或"失败"——要"监控变化情况和观察噪声"。这句话决定了后面的"回归门禁"必须长成"趋势 + 阈值 + 噪声"三件,而不是"拿一个数判红绿"。
2.2 性能数字不是 pass/fail:官方给的一整套配套纪律
既然数字不是二值,就得配一套纪律。 Android 官方在"CI 中的基准测试"这一页里,把配套条件列得很清楚,我们逐条搬进 SOP:
| 官方要点 | 原话 / 事实 | 落到本篇的哪一步 |
|---|---|---|
| 结果模糊 | 「提供的结果不是简单的"通过"或"失败"……监控变化情况和观察噪声」 | 第 4 步:门禁做成趋势 + 阈值 |
| 必须真机 | 「强烈建议您不要在模拟器上运行……结果并不代表真实的用户体验」 | 第 0 步:样本必须来自目标设备 |
| 快门禁分层 | 用 dryRunMode 在拉取请求验证流程里只跑单循环,验证"基准本身能跑" |
第 4 步:快门禁只验能跑,慢门禁留夜间 |
| 锁时钟 | ./gradlew lockClocks(需 root),只有 Microbenchmark 需要 |
第 5 步:噪声源前置排除 |
| 产物成对 | 每次运行输出 JSON + 性能分析轨迹(Macrobenchmark 每个迭代各一份 trace) | 第 4 步:数字要和 trace 一起留 |
最容易被跳掉的是第四行。 官方把噪声来源也列全了:移动设备上的时钟会动态地从高频降到低频("这些变化的时钟可能会使您的基准数据大幅变化"),此外还有温控降频、AOT 编译,以及「尽量避免只测量缓存」。→ "变了 3%"在排除这几类噪声之前,根本不是证据。
2.3 自动化边界:RenderDoc 与 Perfetto 的答案完全不同
先来看看这一节——它是第 0 步里最该问清楚、也最容易被默认掉的一件事:手上的工具,到底能不能进 CI?
答案因工具而截然不同。 本机把 RenderDoc 的命令行子命令全清单跑了一遍,结果是:
-----------------------------------【RenderDoc 命令行子命令全清单】----------------------------------
 capture  convert  embed  extract  help  inject  remoteserver  replay  test  thumb  version
下面对这份清单一句话说明。 它里面没有任何 shader 或反汇编相关的子命令——反汇编只能从 qrenderdoc --python 的内嵌解释器里取,而那件事有一个额外的坑:进程不自己退出(ep12 四次实跑,每次都靠 Stop-Process 收尾)。→ "能不能进 CI"这一步,RenderDoc 与 Perfetto 的答案是相反的。
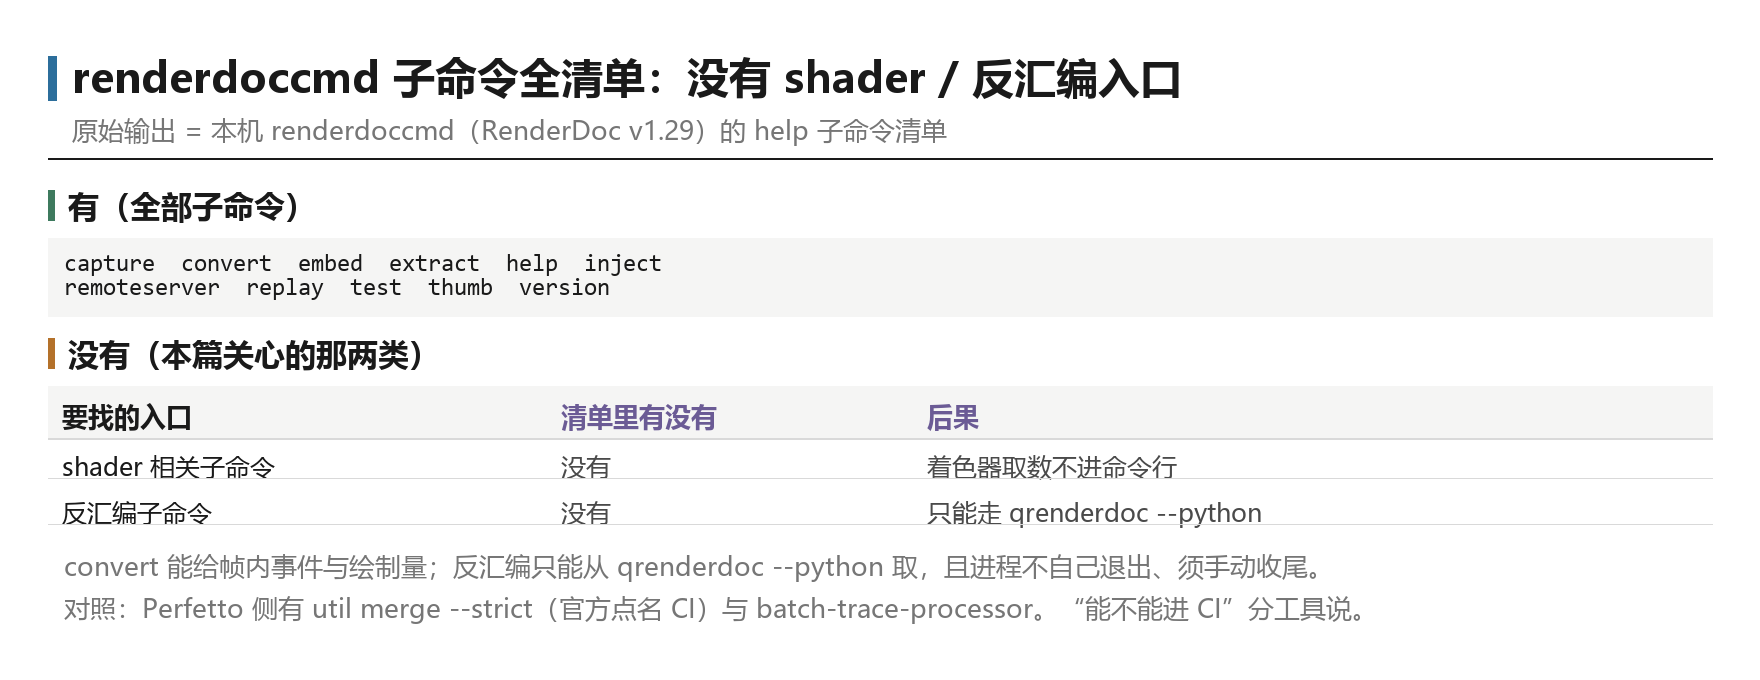
renderdoccmd 的子命令清单里没有 shader / 反汇编入口,而 Perfetto 侧有严格合并与批量 Python——"能不能进 CI",两个工具的答案完全不同@ 本机自跑(RenderDoc v1.29)Perfetto 那一侧则是另一番景象。 官方不仅给了"能脚本化"的自然形态(query -f - 从标准输入读,"the natural form for scripts"),还把严格模式直接点名给 CI 用:trace_processor util merge --strict 会把"合不干净"从警告升级为硬错误,官方注明「handy in CI」。再加上 batch-trace-processor——它是 Trace Processor 的 Python 包装,能在最多约 1000 份 trace 上做秒级以内的交互查询,query(...) 返回每份 trace 一个 Pandas DataFrame。
| 能力 | Perfetto | RenderDoc v1.29 |
|---|---|---|
| 命令行可脚本化 | 有(query -f -) |
有(子命令一批) |
| 严格模式 | util merge --strict,官方点名 CI |
无对应入口 |
| 批量跑语料 | batch-trace-processor(约 1000 份) |
无 |
| 反汇编 / 着色器取数 | 不适用 | 只能走 qrenderdoc --python,且不自动退出 |
这张表决定了后面第 4 步的写法: 防回归那一章,Perfetto 侧可以写成"语料级批跑 + 严格合并",而 RenderDoc 侧只能写成"脚本 + 手动收尾"。"能不能自动跑"这句话,必须分工具说。
2.4 官方实景:症状先落到一次可复现的采集
先来看看第 0 步在界面上的起点——一次可复现的抓帧:
这张图提醒一件事:采集是可以被"标准化"的。 同一串操作、同一个场景、同一个目标帧率,重复三次——这三次里只有一次是"证据",另两次是"它的复现条件"。第 0 步要的正是这三样齐备。
2.5 本章收在哪里
第二章走完,第 0 步该有能力了:一把换算好的帧预算尺子、一套"数字不是 pass/fail"的配套纪律、一张分工具的自动化边界表、一次可复现的采集。下一章开始分流:这件事该记在谁头上。
本章对应的官方依据:结果模糊 / 真机 / 干跑 / 锁时钟 / JSON + trace 见 Android 官方 CI 基准测试页;噪声来源与一致性手段见 Microbenchmark 总览;命令行会话 / 合并 / 导出语义见 Perfetto 命令行分析 cookbook;语料级批跑见 Batch Trace Processor。
三、第 1 步:分责任方,以及"未定"怎么算
这一步只回答一个问题:这件事该记在谁头上? 把责任方分错,后面所有深挖都会敲错门——把合成侧的迟到记到应用的着色器上,是最昂贵的一种走错。判据本身在 ep10 已经讲透,本篇不复述,只问一句:换一个新项目,这套出口还成不成立?
3.1 五个出口:分流的原料
先来看看分流的原料。FrameTimeline 给出的是一张归因清单,经三个分类函数收敛成五个出口:
| 出口 | 含义 | 下一步该做什么 |
|---|---|---|
| 应用侧 | 应用自己的主线程 / 渲染线程迟到 | 进第 2 步,问"哪条线程吃时间" |
| 合成侧 | 合成器(SurfaceFlinger)迟到 | 查合成与显示链路,不要翻应用的着色器 |
| 显示链路 | HAL 或上屏时序 | 查硬件抽象层 |
| 预测漂移 | 调度器自我纠正的偏差 | 单列,不当锅 |
| 未定 | 数据不足以判定 | 见 3.3 节的可算条件 |
合成侧那一行的注脚最该记住。 全部归因条目里,只有一个名字带 GPU——SurfaceFlinger GPU Deadline Missed,而它属于合成侧。它的判据是"CPU 时间没超,但 GPU 合成没按时完成,于是被推到下一个 vsync"。→ 一帧因为 GPU 而迟到时,FrameTimeline 会把它记在合成器名下,而不是应用的着色器名下。 这一条决定了"先分流再取证据"的顺序不能反。
先看看这张分流图——五个出口与它们的判据:
SurfaceFlinger GPU Deadline Missed 是唯一名字带 GPU 的一类,而它在合成侧@ 本系列绘制(判据回指 ep10)图上要盯住的是最下面那个"未定"出口。 它容易被当成"我们没查出来"的托词,但它其实是一个可算的条件——3.3 节给算法。
3.2 真值:六份 trace 上"带 GPU 名字"的条目从未出现
先来看看真值。分流要落地就得有数字。本机在六份官方 Android 测试 trace 上,把含 GPU 字样的归因条目完整检索了一遍:
-------------------------------------【GPU 归因:它有名字,但没有数据】-----------------------------------
-- 描述:在 jank_type 里检索含 GPU 字样的条目,再在 args 全表里检索关键词
-- 实测:六份 trace 上两问全部为 0 行;真值分布里从未出现 SurfaceFlinger GPU Deadline Missed
--------------------------------------------------------------------------------------------------------
SELECT count() AS gpu_jank_rows FROM actual_frame_timeline_slice WHERE jank_type GLOB '*GPU*'; --【1】
SELECT count() AS n FROM args WHERE display_value GLOB '*GPU Deadline Missed*'
                                 OR key GLOB '*GPU Deadline Missed*';                        --【2】
下面对【1】【2】特别说明。【1】用 GLOB 而不是等值比较,因为 jank_type 可能是逗号拼接的多值形态,等值比较会漏。【2】换一个入口再问一次:args 是参数全表,连键名带值一起搜。两问在六份 trace 上都是 0 行。
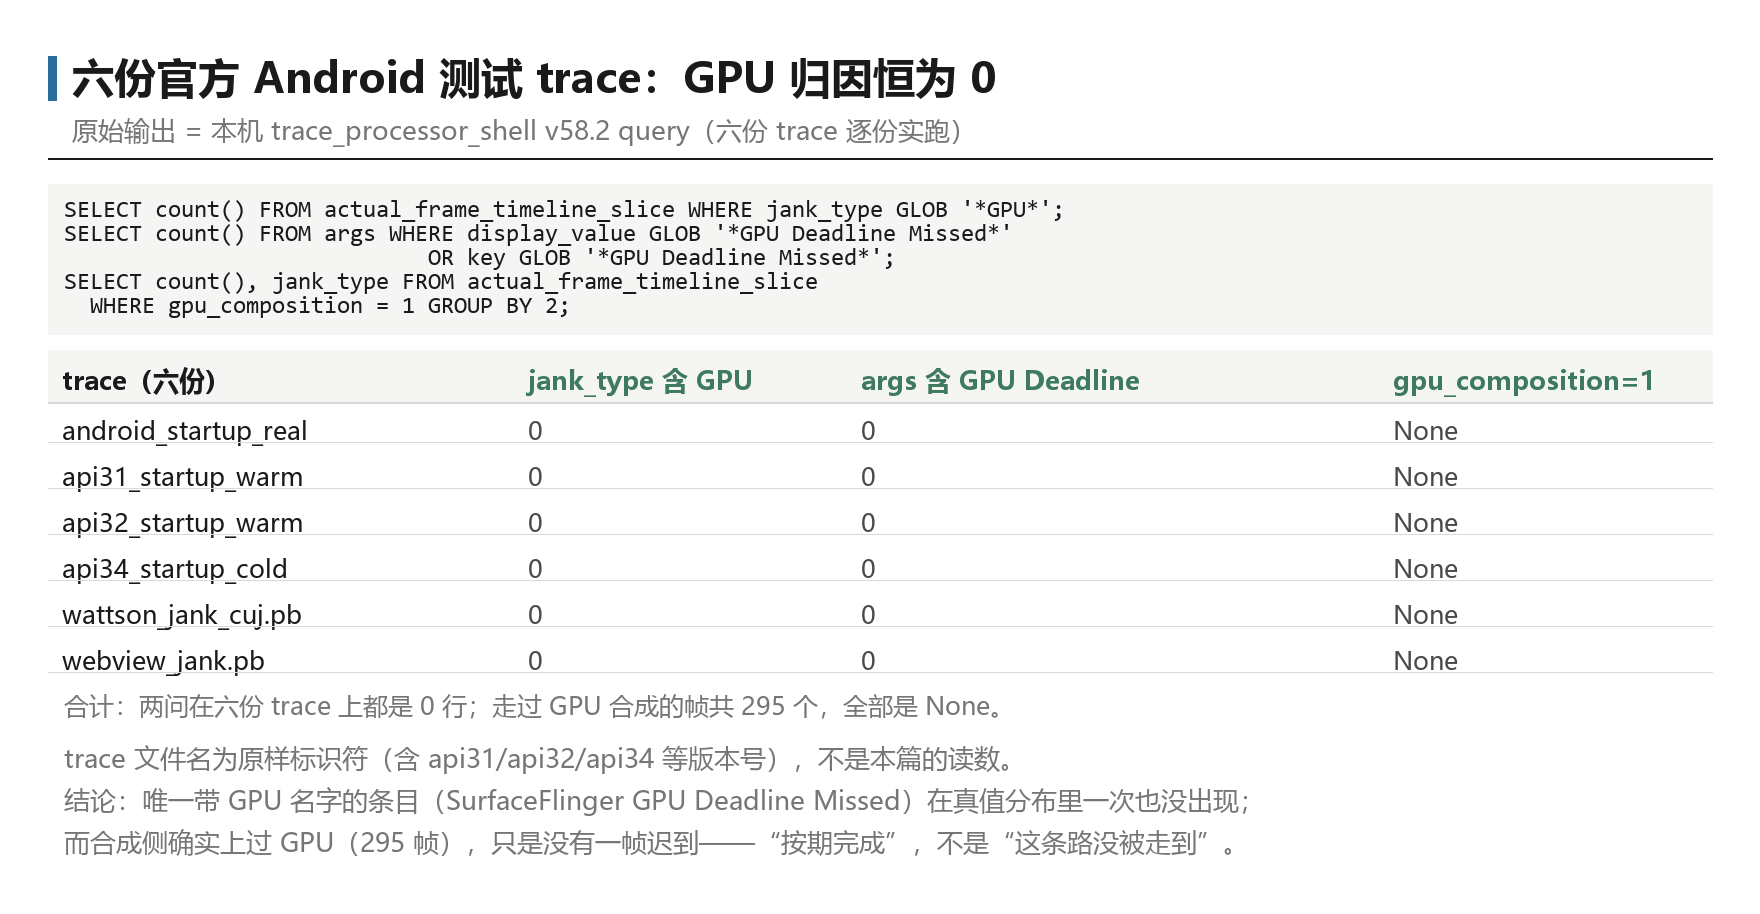
jank_type GLOB '*GPU*' 六份全部 0 行,args 里检索同样是 0 行@ 本机自跑(trace_processor v58.2 + 官方测试 trace 六份)这张图有两层结论。 一,SurfaceFlinger GPU Deadline Missed 在真值分布里一次也没出现;二,就算它出现了也属于合成侧(3.1 节)。它为什么零出现?本机查到官方定义与一条反证:六份 trace 里走过 GPU 合成的帧行共 295 个,全部是 None——合成侧确实上过 GPU,只是没有一帧迟到。→ 是"GPU 合成的帧都按期完成",不是"这条路没被走到"。
3.3 "未定"不是情绪判断,是可算的条件
先来看看本篇对"未定"的处理。第 1 步的结论不是非黑即白的三档之一,而是先算一个联结率:把正超期帧与线程切片(Choreographer#doFrame / DrawFrame)做联结,看能挂上多少。
本机的读数是:487 个正超期帧里,只有 16 个(3.3%)能挂上线程。 → 剩下的 471 帧,系统层给不出"哪条线程吃时间",责任方只能写"未定"。这不是放弃,是把"未定"从主观判断变成了可复现的算术:联结率低于一个阈值,就该写未定,并且写清缺的是哪一块。
先看看这张判定图——它把"未定"的条件钉在图上:
Choreographer#doFrame / DrawFrame,责任方只能写"未定"@ 本系列绘制这张图,把"未定"写成了一条条件。 团队里最容易发生的争执是"你觉得是应用、我觉得是系统"——有了这张图,争执变成一次联结查询:能挂上的比例是多少、缺的是线程还是时标。数字不够,就不是"谁赢谁输",而是补数据的任务单。
3.4 本章收在哪里
第三章走完,第 1 步该有能力了:一张五出口分流表、一个"带 GPU 名字的条目在合成侧"的判据、一条"GPU 归因恒为 0"的真值、一套把"未定"变成可算条件的口令。下一章换腿:系统层问不到的地方,去 API 层取。
本章对应的官方依据:FrameTimeline 的设计目标与归因清单见 Perfetto FrameTimeline 数据源页;
jank_type的 GLOB 判据与分类函数见 Perfetto SQL 表参考;判据推导的完整过程回指 ep10。
四、第 2 步:取 API 层证据,以及反汇编的四个坑
当系统层把责任方指到应用侧,或者干脆"未定"时,就得换一条腿:不打开界面,从 API 层把证据抽成可进脚本的产物。 这一步的关键不在"能取到什么",而在"取到的到底是不是那件东西"——反汇编那一腿,有四个坑会让脚本"看起来跑通了"。
4.1 三条取数路径:输入、产物与能力边界
先来看看 API 层一共有哪几条腿可走。它们各有各的产物,也各有各的能力边界:
| 路径 | 输入 | 产物 | 能力边界 |
|---|---|---|---|
renderdoccmd convert -c chrome.json |
一份 .rdc |
帧内事件与绘制量的 JSON | 给绘制量、帧内 API 耗时,不给 GPU 周期 |
qrenderdoc --python 管线探针 |
.rdc + 一段脚本 |
输出目标 / VB 与 IB / cbuffer / 纹理 | 进程不自己退出,须手动收尾 |
DisassembleShader() |
ResourceId + 目标 ISA |
反汇编文本 | 只能作排除性证据,不是耗时测量 |
先看看这张路径图——三条腿的输入、产物与边界画在一张上:
renderdoccmd convert、qrenderdoc --python 管线探针、DisassembleShader();只画取数动作,不讲面板读法(面板属 ep02 到 ep06)@ 本系列绘制每条腿右边那句"不给什么"最要紧。 三条腿合起来能回答"绘制量 × 指令量级是多少",但三条腿都回答不了"这一帧花了多少纳秒"——那句在证据分级表里只能落到中间档。
4.2 绘制量与管线状态:一次探针的真值
先来看看这条腿的产物。本机用 qrenderdoc --python 跑了一次管线探针,结果是:
-----------------------------------【API 层管线探针:绘制量 / 输出目标 / 顶点布局】-------------------
# 描述:不打开界面,把帧内动作、绘制量与管线状态抽成 JSON
# 实测:本机 RenderDoc v1.29;产物 pipe_probe2.json
#------------------------------------------------------------------------------------------------
actions = controller.GetRootActions()                     #【1】取动作树
draws   = [a for a in actions if a.flags & rd.ActionFlags.Drawcall]   #【2】只要绘制类
rt      = controller.GetPipelineState().GetOutputTargets()[0]         #【3】输出目标
vb      = controller.GetPipelineState().GetVBuffers()[0]              #【4】顶点缓冲
下面对【1】到【4】特别说明。 探针跑出来的真值是:5 个 action / 2 个 draw——DrawIndexed 在事件 22 上 numIndices = 6、在事件 30 上 288,合计 294 个索引;图元拓扑是 Topology.TriangleList;输出目标 ResourceId::35 是 1264×681 的 B8G8R8A8_UNORM,深度模板是 D24S8;顶点缓冲 stride 44 字节(属性偏移 0 / 12 / 24 / 32),常量缓冲 cb0 144 字节。
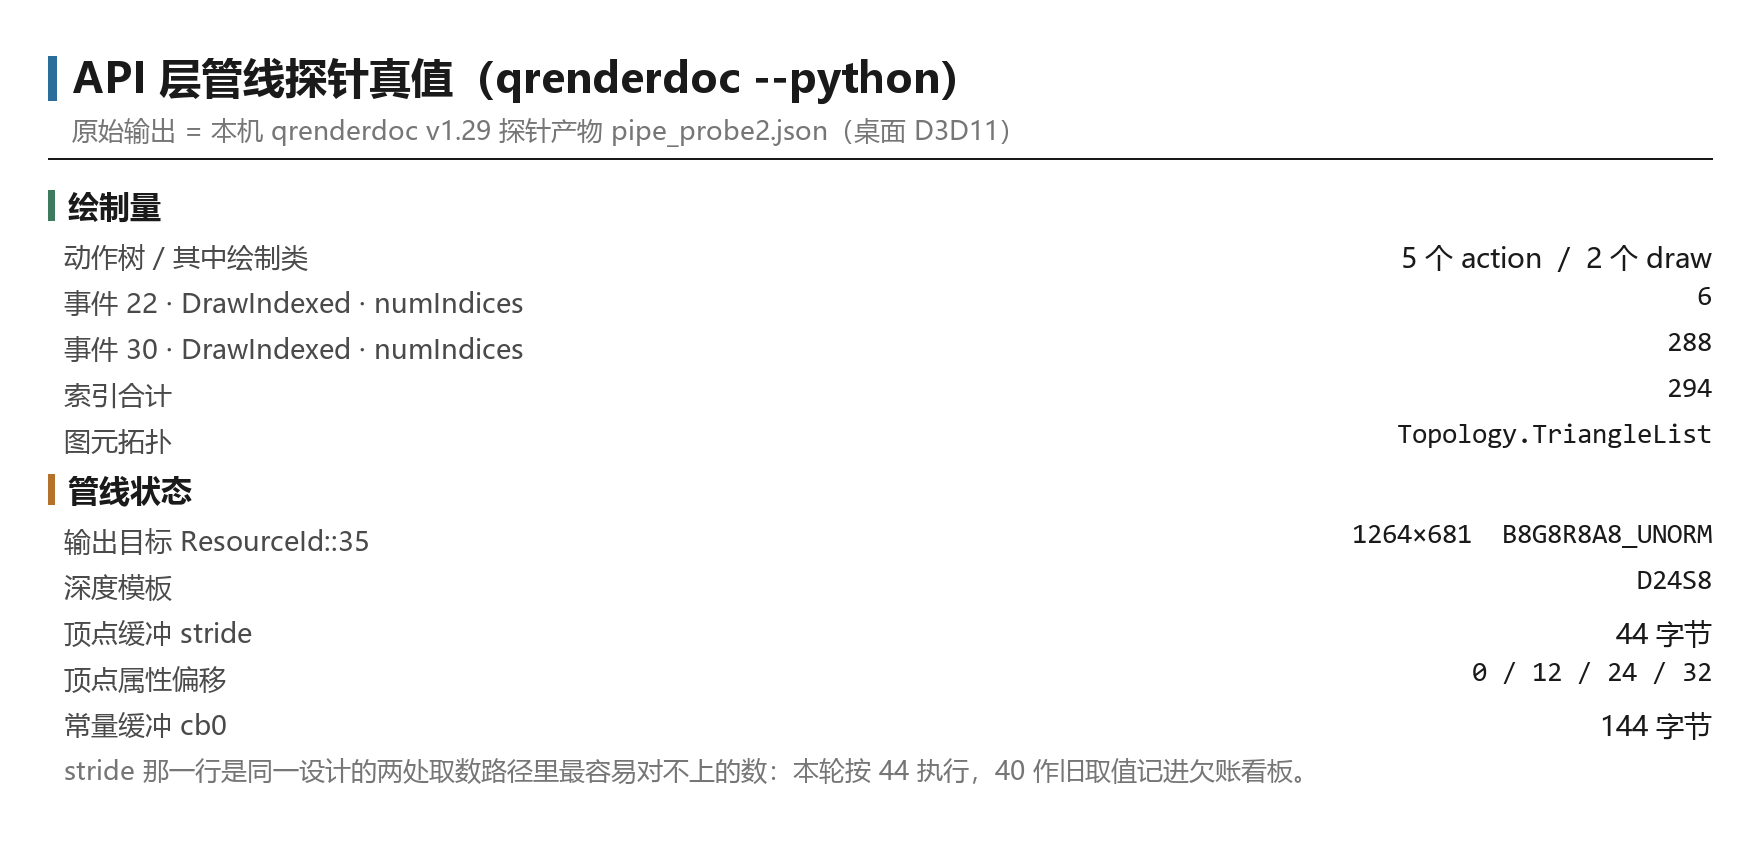
numIndices 分别 6 与 288,合计 294 索引)、Topology.TriangleList、RT 1264×681 B8G8R8A8_UNORM、DS D24S8、VB stride 44 字节、cb0 144 字节@ 本机自跑(RenderDoc v1.29,桌面 D3D11)stride 那一行最该盯住。 它是同一设计的两处取数路径里容易对不上的一个数:ep11 的内部分析笔记里曾记 vertexByteStride = 40,而 ep12 复核认为 44 才自洽(属性偏移 0 / 12 / 24 / 32 撑到 44)。本篇按 44 执行,并把 40 作为旧取值记录进第七章的欠账看板。
4.3 反汇编的四个坑:三次不报错,一次报得不像错
先来看看这条腿的坑。反汇编是"看起来最容易跑通"的一腿——四个坑里有三个不报错,脚本会正常退出,产物却是空的或错的:
| 坑 | 现象 | 性质 |
|---|---|---|
① GetDisassemblyTargets() 必须带 1 个参数 |
不带 → TypeError |
报错,好查 |
② DisassembleShader 第 1 参是 ResourceId |
传 PipeState → TypeError |
报错,好查 |
③ ShaderReflection 没有 disassembly 属性 |
取属性拿到空 | 不报错 |
④ 目标 'AMD GCN ISA' 返回说明文本 |
返回 ; Error loading atidxx64.dll. |
不报错 |
-------------------------------------【反汇编取数:先问目标,再取文本】-----------------------------------
# 描述:先取反汇编目标列表,再对指定着色器取文本
# 实测:本机 RenderDoc v1.29;目标列表 = ['DXBC', 'AMD GCN ISA']
#--------------------------------------------------------------------------------------------------------
targets = controller.GetDisassemblyTargets(True)          #【1】必须带 1 个参数
text    = controller.DisassembleShader(pipeline, refl, target)   #【2】第 1 参是 ResourceId
下面对【1】【2】特别说明。【1】的参数不是可选的——不带就抛 TypeError。【2】的返回值按官方文档定义是"the disassembly text, or an error message if something went wrong"——返回说明文本是这份接口的既定行为,不是异常。→ "返回了字符串" ≠ "拿到了反汇编",这是第四个坑最阴的地方。
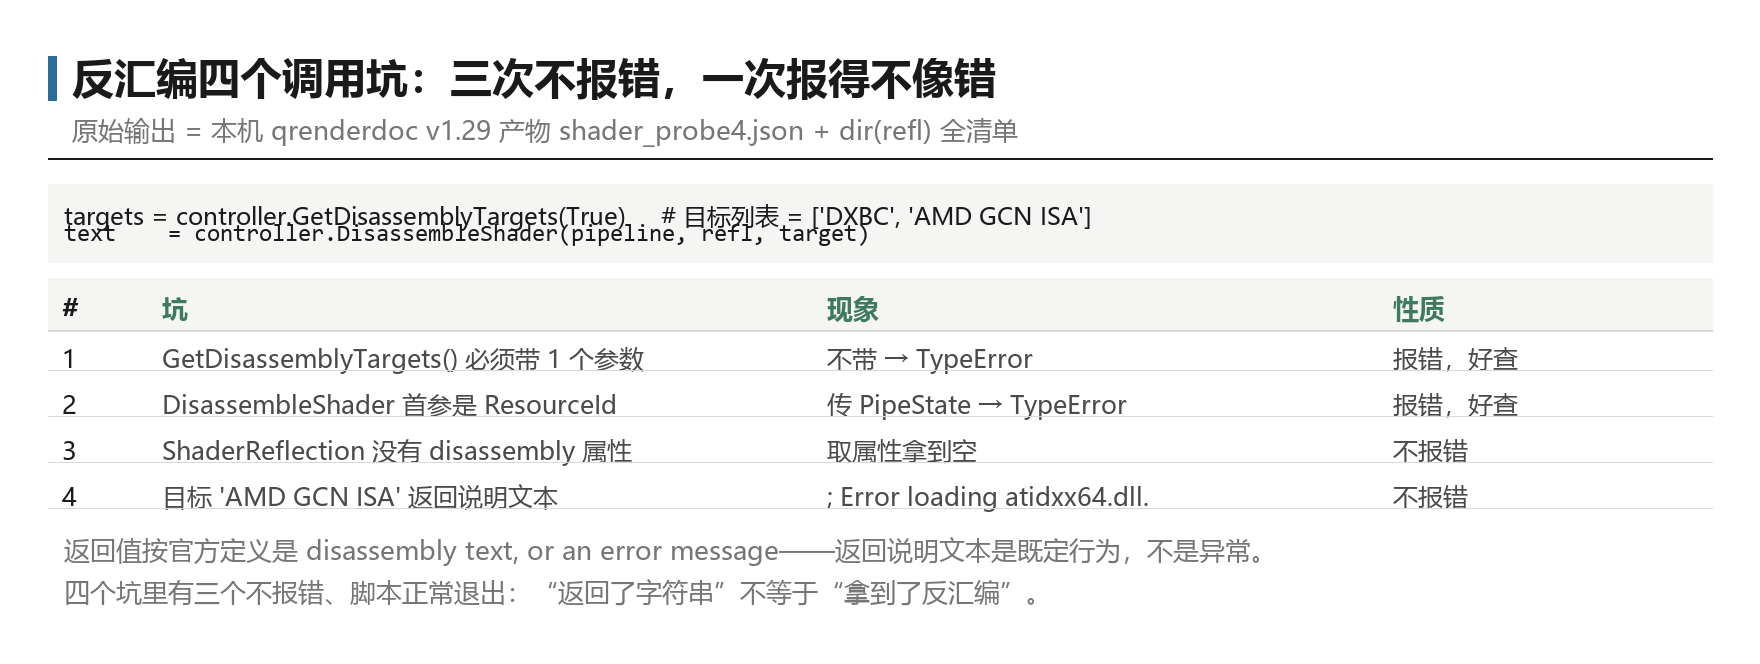
GetDisassemblyTargets 必须带参数、DisassembleShader 首参是 ResourceId、ShaderReflection 无 disassembly 属性、'AMD GCN ISA' 返回说明文本而非异常——"返回了字符串不等于拿到了反汇编"@ 本机自跑(RenderDoc v1.29)这张图示范了"判据的边界条件"本身也要被验证。 脚本能跑完、能返回字符串、退出码为 0——三件事同时成立,产物却可能是一句加载失败说明。
4.4 反汇编原文:VS 32 条、PS 3 条,以及它能排除什么
先来看看把坑绕过去之后拿到的东西。本机导出的两份反汇编文本是:vs_5_0 共 32 条指令(其中 20 条是 mul / mad 的矩阵展开,归一化用 dp3 + rsq + mul;无循环、无动态分支),ps_5_0 共 3 条指令(1 条 sample_indexable + 1 条 mul + ret)。
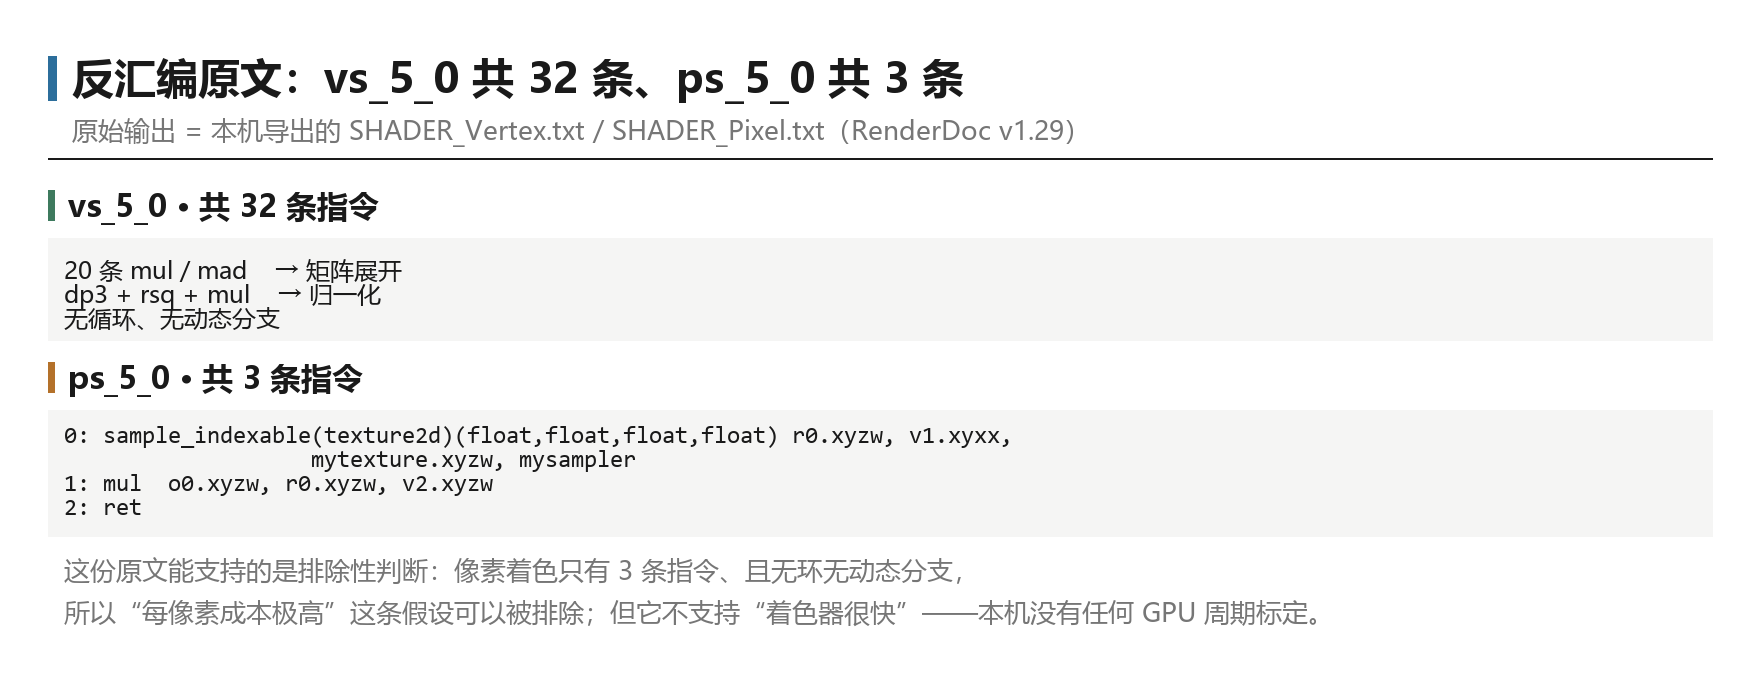
vs_5_0 32 条指令(20 条 mul / mad 矩阵展开、dp3 + rsq + mul 归一化,无循环无分支)与 ps_5_0 3 条指令(sample_indexable + mul + ret)@ 本机自跑(RenderDoc v1.29,产物 SHADER_Vertex.txt / SHADER_Pixel.txt)这张图能支持什么结论,必须说清。 它支持的是排除性判断:像素着色器只有 3 条指令、且没有环与动态分支,所以"每像素成本极高"这条假设可以被排除。它不支持"着色器很快"——本篇手上没有任何 GPU 周期标定,反汇编在这里的合法身份只有排除性证据(与 ep12 同一口径)。
4.5 本章收在哪里
第四章走完,第 2 步该有能力了:三条取数路径的输入与产物、一次管线探针的真值、反汇编四个坑、能排除什么的边界。下一章要问的是:两条腿的证据,能印证到什么粒度?
本章对应的官方依据:
DisassembleShader的返回约定与ReplayController接口见 RenderDoc Python API 的 replay 页;Python API 总入口见 RenderDoc Python API 索引;RGP 与 RenderDoc 的联动与"事件编号不同"自陈见 RenderDoc 与 RGP 联动页。
五、第 3 步:交叉印证能到什么粒度,以及给证据分级
前两步拿到的证据分住两层:系统层给的是"谁超时 / 哪条线程吃时间",API 层给的是"绘制量 × 指令量级"。这一章我们要回答的是:这两层能印证到什么粒度——是能拼出"同一帧的因果链",还是只能比"方向"?这个问题答错,后面的结论就会被读得比它实际更强。
5.1 证据可信度分级:先给证据定档,再谈结论
先来看看这一节——它是本篇第 3 步的核心,也是"别人给的性能结论可不可信"这个问题的答案。分级不是按"好不好",而是按"每一级能支持什么结论"。
| 级别 | 证据形态 | 本机能不能拿到 | 能支持什么结论 |
|---|---|---|---|
| ① 厂商硬件 counter | GPU 周期 / 带宽 count | 拿不到 | 可直接给"耗时归谁",是唯一能标定周期的档 |
| ② 官方文档自陈的边界 | 如"RenderDoc 的 timing 不含 pipeline overlap" | 能读到 | 能划定"这个数不能证明什么" |
| ③ 本机自跑真值 | trace / .rdc 产物 |
能拿到 | 能给"真值 + 复现命令",但仍是单侧 |
| ④ 静态对照 | 反汇编 / 管线状态 | 能拿到 | 只能排除,不能测量 |
| ⑤ 文档转述 | 二手复述 | 能读到 | 只能作背景,不能作判据 |
| ⑥ 博客捷径 | 如"按 Duration 排序取最贵" | 能读到 | 有前提,前提不成立即失效 |
先看看这张分级图——每一档的"能支持什么"写在格子里:
④与⑥两档最该记住。 ④(静态对照)是本机 API 层证据的真实身份——它只能排除;⑥(博客捷径)不是不能用,而是它有前提:让它成立的"per-draw GPU 时间"在本机 FetchCounters 全 0 的条件下根本不存在。→ 分级表的作用,是让每句话都说得出"它站在第几档上"。
5.2 印证口径:分层 + 方向 + 量级自洽,不是"同一帧"
先来看看理想形态与真实形态的差距。理想形态是"同一帧因果链":一份数据里同时含系统层的帧切片与 API 层的提交记录,再用帧号或时间戳连起来——"这一帧超期,是因为第 22 个 draw 的着色器太重",就是一条等值关系。这个形态在本机做不到,而且不能靠配置调好。
退到第二档,判据只有一行:
印证:方向(系统层看到的"谁超时 / 哪条线程吃时间")
      == 方向(API 层看到的"绘制量 × 指令成本上界"的量级)

其中:
- 左侧取值:超期帧落在 app 侧还是 SF 侧;cpu_time 与帧预算的位置关系
- 右侧取值:绘制量(draw 数 / 索引数 / 目标尺寸)与指令量级(条数 / 有无循环 / 采样次数)
- 两侧指向同一个方向 → "量级自洽",结论可按三档落地
- 两侧任一侧缺数据 → 直接进"数据不足",不许用另一侧单独下结论
最要紧的是"量级自洽"四个字,而不是"数值相等"。 系统层看到"这条线程吃掉 N 毫秒",API 层看到"这一帧只有 2 个 draw、294 个索引、像素着色 3 条指令"——这两个数在量纲上不可比,只可比"它们指向的方向冲不冲突"。想看数值相等,先得标定每指令周期数,而这件事本机做不到。
图上那句官方自陈很关键。 RenderDoc 与 RGP 的联动页写明,两个工具对帧的作用域、目的与视图都不同,「the numbering of events will not be the same between the two tools」。→ 连厂商自家两个工具的事件编号都对不齐,跨工具"对准同一帧"更不是配置问题。
5.3 为什么同帧因果链在本机做不到
三条实测依据都在本机,不是推测:
| # | 实测事实 | 后果 |
|---|---|---|
| 1 | 六份 trace 全是官方 Android 测试数据(Mali / Exynos 平台) | 与桌面抓帧不是同一台设备 |
| 2 | 桌面 .rdc 是 RTX 3060 上的 D3D11 |
与 trace 不是同一套 API |
| 3 | adb devices 为空 |
做不到"在真机上同时采两层" |
三条合起来只剩一个结论:本机拿不到"同设备 + 同时在采 + 一个共同的等值键"这三个条件。→ 本篇因此不再承诺任何跨工具同帧结论,而是把它降级成第 3 步的一条停止条件——"如果你拿不到同帧的两层证据,就只能给方向,不能给因果"。这正是第七章四类停止条件里的第一类。
5.4 门禁的真实读数:一次自证
先来看看"验证"这件事在本仓库里长什么样。它不只验文章,也验站点产物。本轮把写作流程的四道门禁与两个内容 lint 全部实跑了一遍,读数如下:
| 门禁 | 对象 | 读数 | 判定 |
|---|---|---|---|
stage-gate research |
研究笔记 | 7/7 PASS(唯一 URL 78 条,下限 20) | 通过 |
content-lint |
ep12 正文 | 汉字 17,188 / 图 26 / 引 31 / 13/13 PASS(含 C13 水位) | 通过 |
style-lint |
ep12 正文 | 8/8 PASS | 通过 |
stage-gate draft |
ep12 产物 | 8/9,唯一阻断 = D:外部示意图配额(32/148 = 21.6%) |
挂一项 |
stage-gate visual |
ep12 图片 | 3/4,唯一阻断同为外部示意图配额 | 挂一项 |
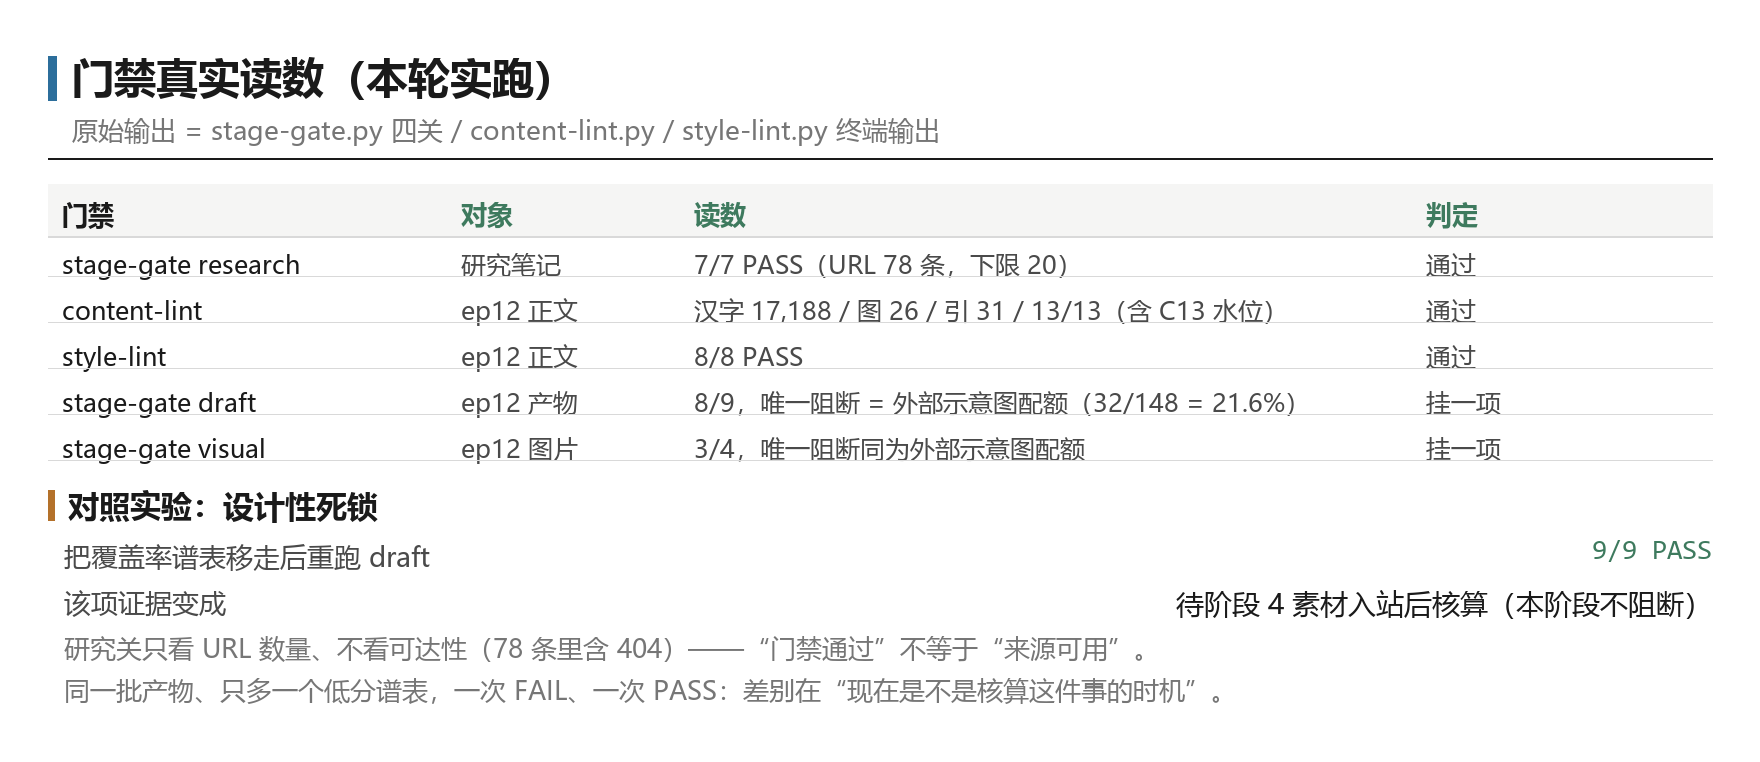
这张表里还有三条"人话翻译"。 一,research 的"来源数量"只看 URL 数量、不看可达性(78 条里包含 404 条目)→ 门禁通过不等于来源可用。二,图位侧配额早已降级为参考值,权威口径只剩两条:术语侧主体占比与外部示意图配额。三,下面这条最精妙。
5.5 设计性死锁:为什么"谱表不存在就不阻断"
那张覆盖率谱表带来的两难是这样的。stage-gate draft 在 ep12 上是 8/9,唯一挂的是"外部示意图配额"——因为该配额的分母要等草稿出来才存在,而图要等阶段 4 才入站。这就形成一个死结:draft 若因此判 FAIL,就进不了阶段 4;进不了阶段 4,图就不入站;图不入站,覆盖率谱表就永远不存在;谱表不存在,draft 就永远过不了。
本仓库的解法是"让它在谱表不存在时不阻断"。 本轮做了对照实验:把覆盖率谱表移走后重跑 draft,结果是 9/9 PASS,而 D:外部示意图配额 那一项的证据变成了 "待阶段 4 素材入站后核算(本阶段不阻断)"。
这不是自相矛盾,是防死锁的设计。 同一批产物、只多一个低分谱表,一次判 FAIL、一次判 PASS——差别不在产物质量,而在"现在是不是核算这件事的时机"。→ 门禁的判据里,时间维度也是判据的一部分。
5.6 判据本身也会错:6.1% 漏报的复现
本篇最好的一个"反面教材"在这里。本仓库有个图片引用检查器 check_image_refs.py,它是站点自检 C4 的薄封装。它的旧实现只有两条正则:
-----------------------------------【图片引用检查:旧实现的两条正则】-----------------------------------
# 描述:旧实现只认两种形态,不认 ../ 相对路径,也不认其它目录与语法
# 实测:同一棵树上,旧实现漏检 223 条 = 5.8%
#------------------------------------------------------------------------------------------------
r'src="(/blog/[^"]+/images/[^"]+)"'      #【1】站内绝对路径
r'src="(images/[^"]+)"'                  #【2】相对本页的 images/
下面对【1】【2】特别说明。 这两条正则漏掉了 ../ 相对路径(导航图大量使用)、assets / figs 等其它目录、单引号与无引号形态、以及内联 css 里的 url(...)。→ 它当年报"0 缺失",是结论碰巧正确,不是机制正确。
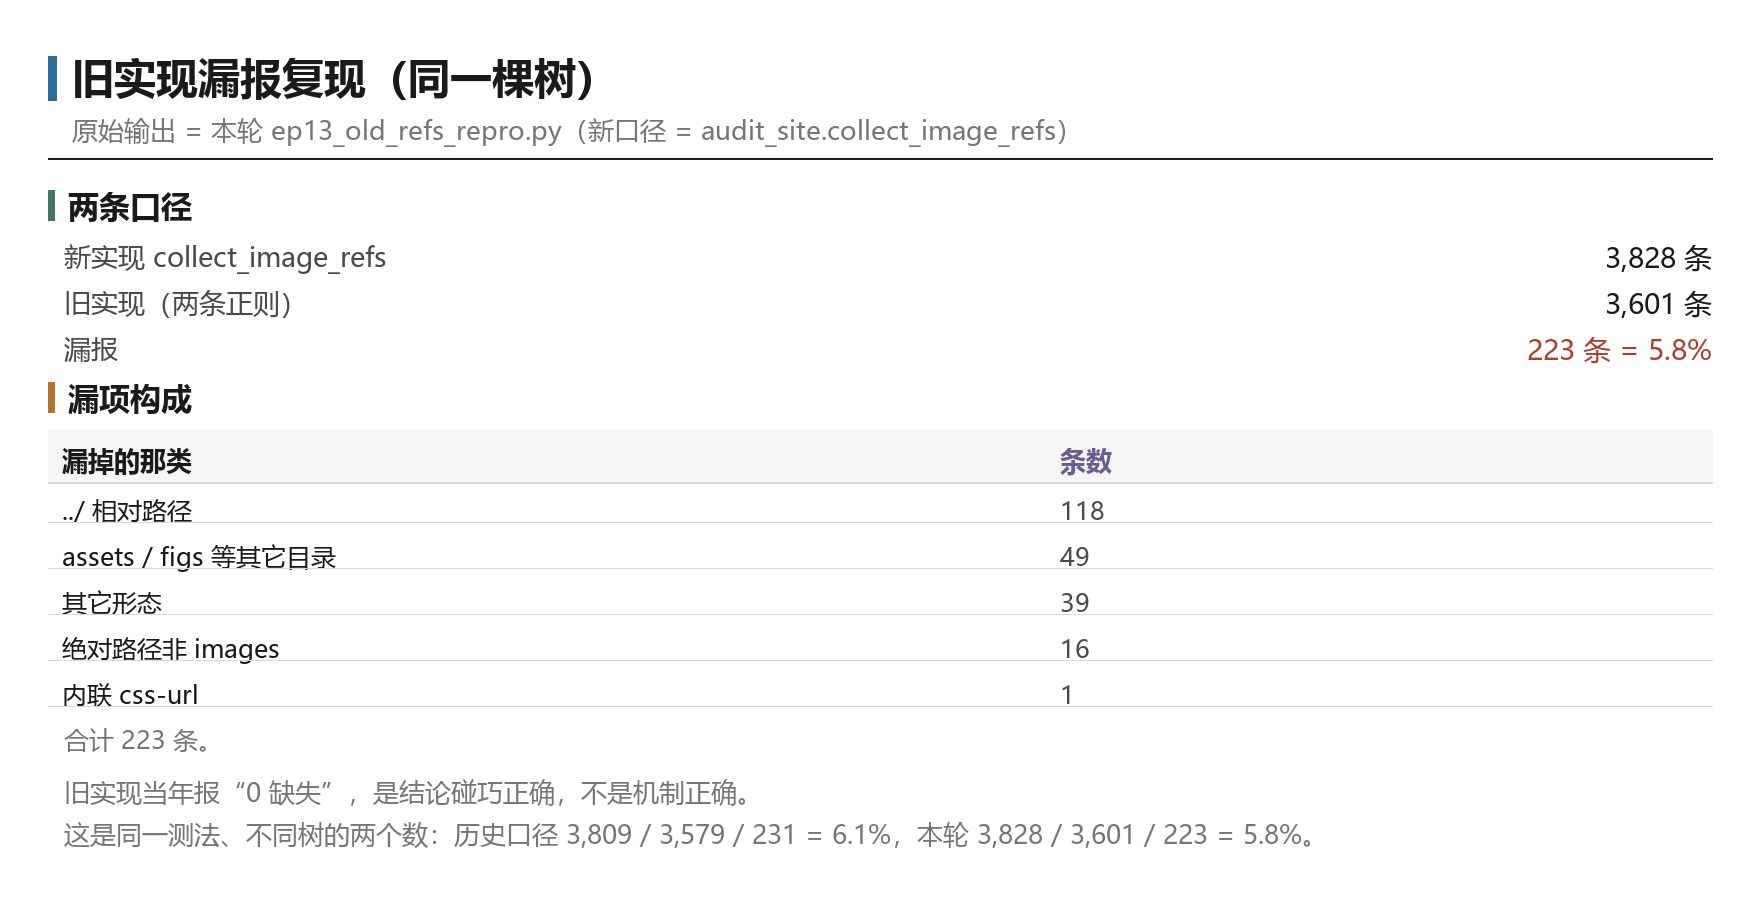
../ 相对 118 条、assets 与 figs 49 条、其它 39 条、绝对路径非 images 16 条、css-url 1 条@ 本机自跑(check_image_refs.py 旧正则 vs audit_site.collect_image_refs)这张图有两处必须写清的口径。 第一,漏项构成:../ 相对 118 条、assets|figs 49 条、其它 39 条、绝对路径非 images 16 条、css-url 1 条,合计 223。第二,这是"同一测法、不同树"的两个数:历史口径是 3,809 / 3,579 / 231 = 6.1%,本轮是 3,828 / 3,601 / 223 = 5.8%——机制一致,数字随树变。→ 正文引用这个比例时,必须写清是哪一棵树的哪一个口径。
还有一层更细的口径要交代:树在动。 本轮同一天两次读数是不同的——audit_site.py --no-net 首跑读到 105 个 HTML / 3,828 条引用(09:20),而 deploy_site.ps1 -WhatIf 里那次审计读到 106 个 HTML / 3,829 条引用(09:56);事后直接数 web/**/*.html 是 106 个。→ 期间有别的会话新增了一个页面(本仓库多会话共用)。两个数都不是错,是不同时刻——所以本篇引用任何读数,都带上时间戳口径。
5.7 本章收在哪里
第五章走完,第 3 步该有能力了:一张六级证据分级表、一条"分层 + 方向 + 量级自洽"的印证口径、一套门禁真实读数与设计性死锁的判据、一个"判据本身会错"的复现。下一章做这件"验证"里最难也最有价值的事:把结论固化成下次能自动复跑的东西。
本章对应的官方依据:RGP 与 RenderDoc 的事件编号差异与联动条件见 RenderDoc 与 RGP 联动页;Vulkan 官方指南关于"逐 draw timing 不含 pipeline overlap"的自陈见 Vulkan 指南 Profiling 页(脚本直连返回 403,经抓取复核可达);trace 真值查询口径见 Perfetto SQL 表参考。
六、第 4 步:落基线 / 防回归,以及工具箱台账
到第 4 步了。 前五步都在回答"这一次是怎么回事";这一步我们要回答的是另一个问题:这一次的结论,怎么固化成下次能自动复跑的检查? 这一章是本篇最"重"的一章,因为它要把"验证"从一次性动作,变成一条能反复跑、能拦住回归的链。
6.1 官方范式:diff test 是"可复现验证"的标准形态
先来看看官方怎么定义"可复现的验证"。Perfetto 的测试页给了一个干净的定义:
Trace Processor 「is mainly tested using so called "diff tests" rather than unit tests」——「parses a known trace and executes a query string or file. The output of these queries is then compared (i.e. "diff"ed) against an expected output file」。
它的三件套是:固定输入 trace + 固定查询 + 期望输出文件。 官方还解释了为什么不用 unit test:「Unit tests have proven too brittle when dealing with code that parses traces」——选哪种验证形态,本身是有理由的。度量也做 diff:拿度量名替代查询,期望输出里放的是该 metric 的计算结果。
| 官方机制 | 形态 | 对本篇的用途 |
|---|---|---|
| diff test | 固定 trace + 查询 + 期望输出 | "可复现验证"的标准形态 |
| metric diff | 同一 trace + 同一 metric 的数值对比 | 度量级回归 |
| golden screenshot | headless chrome 逐像素比对 | 视觉产物也要有 golden |
| CI 定位 | 「on-top of (not in replacement of) Android 的 TreeHugger」 | CI 是叠加信号,不替代人工 |
| CI 边界 | 「only … functional and performance testing and doesn't deal with any sort of continuous deployment」 | 验证与发布是两条链 |
| 可复现环境 | 无状态 VM + 只读镜像 + docker sandbox | 不可复现就不算验证 |
最后两行最要紧。 "验证与发布是两条链"这条官方边界,正好对上本仓库的设计:审计只读、部署另走;而"不可复现就不算验证"这条,解释了为什么本篇每一步都要给可复现命令,而不只给结论。
6.2 本仓库范式:工具箱台账
先来看看本仓库自己那套真在跑的验证工具链。它是"门禁长什么样、盲区在哪"的活样本——本篇把它当方法论实例,而不是当工具使用说明。下面按"站点侧"与"写作侧"两张表摊开,每件工具给三列:判据 / 能拦什么(硬) / 已知盲区与证据。
| 工具 | 判据 | 能拦什么(硬) | 已知盲区与证据 |
|---|---|---|---|
audit_site C1 |
扫 HTML 命中 narrative_arc / visual_assets / key_decisions / _meta: |
内部元数据泄漏 → 阻断部署 | 首页只按警告;只认这 4 个 token |
audit_site C2 |
扫 HTML 命中 VISUAL 占位符(方括号形态) |
占位符残留 → 阻断 | 只认这一种字面,其它占位符形态不查 |
audit_site C3 |
文末导航块与源稿现算邻篇逐字比对 | 导航陈旧 → 阻断 + 给重建命令 | 只覆盖 web/blog/*;靠正则解析 |
audit_site C4 |
扫 img src / srcset / source / 内联 url(...),含 ../,URL 解码 + 大小写敏感 |
本地碎图引用 → 阻断;线上不可达 → 警告 | 只看图片,link href / script src / 字体未纳入;页面未上线则 SKIP |
deploy_site 前置审计 |
建立 SSH 之前调审计,硬失败即 throw |
把 C1–C4 挡在上传之前 | 逃生口 -SkipAudit(有文档化的适用边界) |
deploy_site 部署锁 |
锁文件 + 归属校验 + 存活判定 + 360 分钟兜底 | 并发上线 | 锁在共享目录,多机不适用 |
check_image_refs |
薄封装 C4 | 与 C4 同结论 | 旧实现只两条正则,漏 6.1%(5.6 节) |
| 工具 | 判据 | 能拦什么(硬) | 已知盲区与证据 |
|---|---|---|---|
stage-gate research / material / draft / visual |
四关,各查板块、盘点、描述回扫、图量 | 阶段产物缺项 / 术语太水 / 图量不足 | research 只看 URL 数量;真实素材配额已降级为参考值 |
content-lint C1–C13 |
体量 / 密度 / 深度 / 素材;C13 永不可降级 | 篇幅、密度跌破下限 → 阻断 | C7/C9/C10/C11 是启发式;图注写方括号会让图片正则失配 |
style-lint L1–L8 |
结构骨架 8 项(含结尾三件套) | 结构缺项 → 阻断 | L4/L8 是启发式;L7 要求含"预告" |
palette-audit |
用色合规(覆盖上限 / 单块上限 / 描边白名单) | 配色越界 → 阻断 | 只管用色,越界归 svg-lint |
svg-lint |
越界 / 重叠 / 超画布 / 列对齐 / 行距比 | 排版缺陷 → 阻断 | 字宽是启发式估算,不能替代真实渲染 |
material-verify |
可解码 / ≥2048 B / dhash 重复 / 长边 / 比例 | 坏图、重复、过低分辨率 → 阻断 | dhash 是场景级判据,同场景会撞哈希 |
material-assess |
五判据(色彩 / 明暗 / 细节 / 变化 / 曝光) | 低分丢弃(--strict) |
对纯图表天然低分:反汇编文本截图被判低 |
term-asset-coverage |
外部示意图配额(分母 = 复合技术名按章计次) | 外部示意图不足 → 在 visual 阶段阻断 | 设计性死锁(5.5 节);图注写法两种都要收 |
selfdrawn_meta_gate |
SVG 标题命中泛化图号 / 导览 / 空洞 Q-map | 废话卡占图位 → 阻断 | 判据是枚举子串;新造词会漏 |
cover_gate |
封面必须是 ext_ 前缀外部真图 |
封面不合规 | 存量 16/40 篇缺 cover,且未接入部署阻断链 |
先看看这张台账矩阵——它把"判据 / 硬拦 / 盲区"三列并成一图,逐条带本轮实跑标记:
这张表里长出了三条"方法论公理"。 一,判据可以"结论正确"而"机制错误"——check_image_refs 的 6.1% 漏报就是最好的例子。二,门禁的盲区必须写进门禁自己——本仓库把这批盲区全写在源码 docstring 与"未处理 / 存疑"节里,这是可以照抄的做法。三,"降级为参考值"也是一种设计——把盘点侧配额降级、只让术语侧权威,正是为了避免两条闸门互相打架。
6.3 全站门禁一轮的真实报告
先来看看台账里最大的一件——audit_site.py 一轮全站自检到底扫出了什么。本轮跑了离线与联网两版:
============================================ contentfactory 站点自检门禁(只读) ============================================
仓库 <repo> | 扫描 web/**/*.html 105 个 | 博客详情页 54 个
--------------------------------------------------------------------------------------------------------------
[C1] 内部元数据泄漏(硬)  通过 105 / 失败 0
[C2] 占位符残留(硬)   通过 105 / 失败 0
[C3] 导航陈旧(硬)        通过 54 / 失败 0 / 末篇 off 6 / 无源稿 0
[C4] 图片引用完整性(本地硬 / 线上警告)  引用 3828 条 | 本地通过 3828 / 失败 0
[H1] 从未纳管(git 未跟踪,提示)  目录 0 个
--------------------------------------------------------------------------------------------------------------
结论:硬失败 0 项 —— 通过    退出码:0    (耗时 9.5s)
这份报告里有两点要分开说。 一,离线版(--no-net)扫到 105 个 HTML / 54 个详情页 / C4 引用 3,828 条 / H1 未纳管 0 / 硬失败 0 / 退出码 0;二,联网版多出线上核查:线上页面 57 个 / 图片 URL 3,623 条 → 不可达 0 条,H2 字节比对 一致 54 / 漂移 0,耗时 132.5 s。
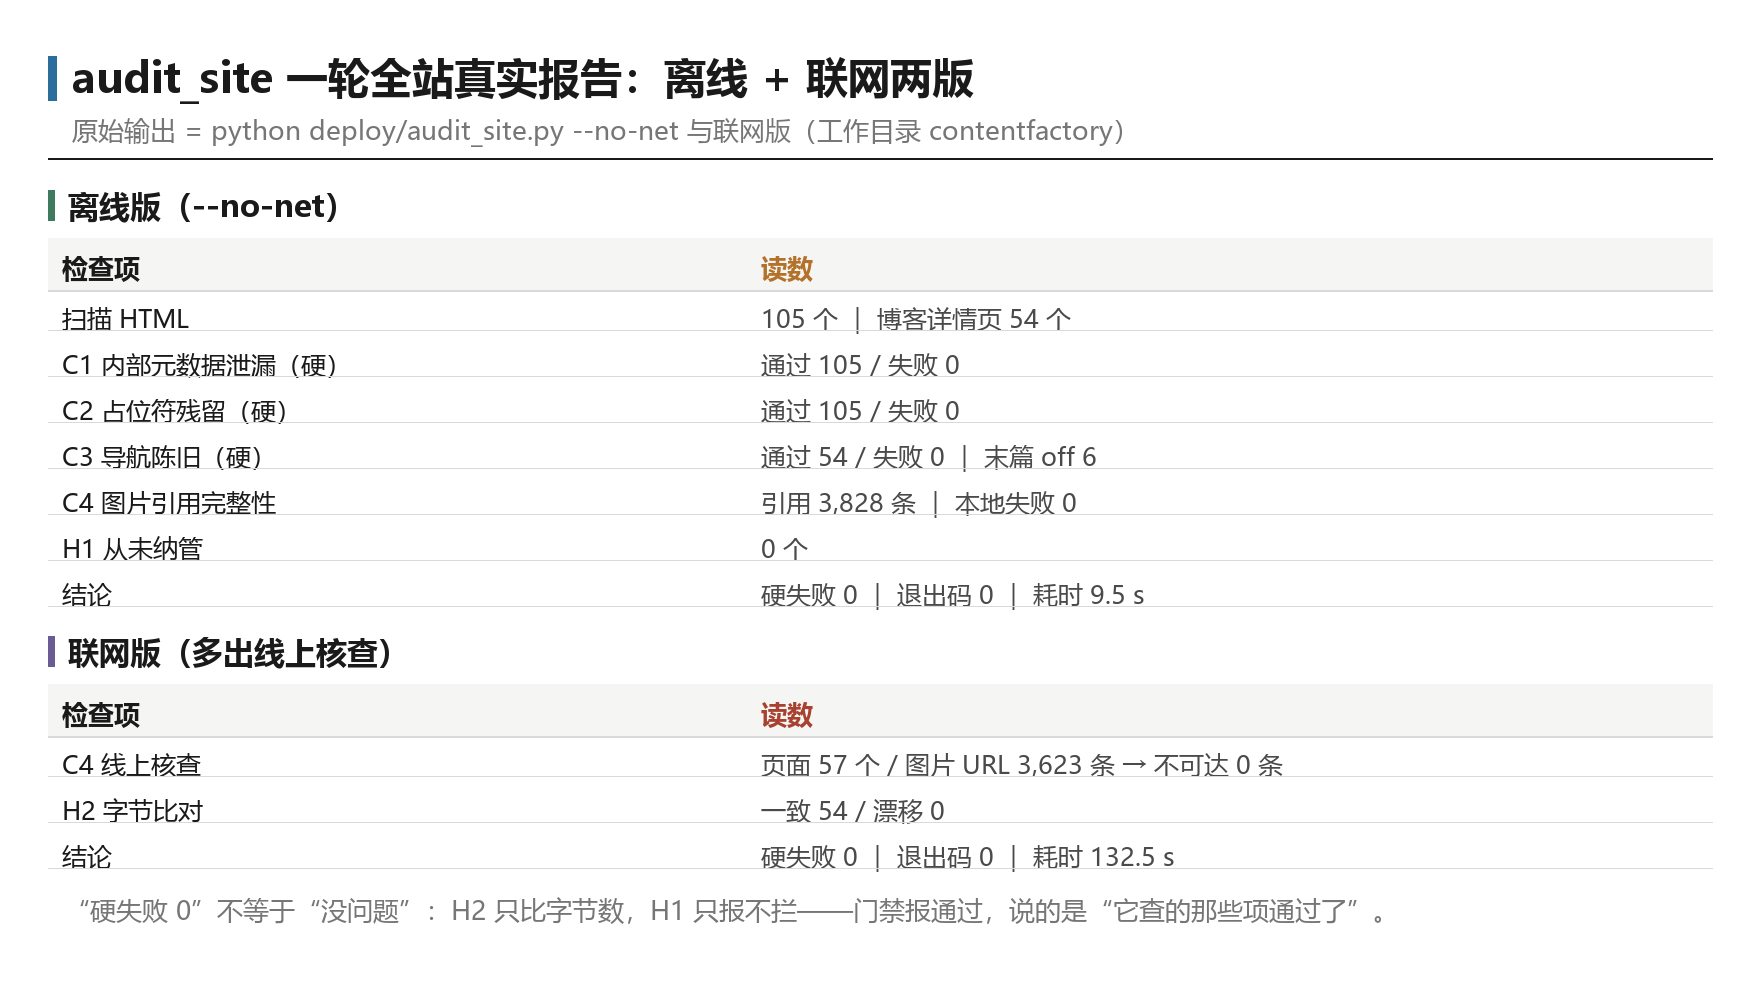
audit_site.py 一轮全站的真实报告:离线(105 个 HTML / 3,828 条引用 / 硬失败 0 / 退出码 0)与联网(线上 57 页 / 3,623 条图片 URL、不可达 0;H2 一致 54 / 漂移 0)两版并置@ 本机自跑(工作目录 E:\AI\test\contentfactory)这段报告里最该记住的是"硬失败 0 不等于没问题"。 H2 只比字节数——"没漂移"不等于"内容对";H1 只报不拦。→ 门禁报"通过",说的是"它查的那些项通过了",不是"这份产物没问题"。
6.4 故障注入实验:门禁真的会拦
本篇最硬的一块证据——"门禁真的能拦"怎么证明? 光看它"报 0"不够;要看它遇到坏东西时会不会拦。为此做了一次故障注入(fault injection)实验,过程按 STAR 四段记下来。
情境(Situation): 需要一个"门禁拦不拦得住"的实证,且不能碰线上仓库。做法是在沙箱仓库 ep13_fault\faultrepo\ 里造一份干净页做基线。
任务(Task): 往页面里注入两类典型故障——内部元数据泄漏(narrative_arc)与占位符残留(带方括号的 VISUAL 标记),再跑一次审计与一次部署演练,看拦在哪一步。
行动(Action): 注入后重跑 audit_site.py --no-net,再在故障页仍在位时跑 deploy_site.ps1 -WhatIf(沙箱演练,不带批次号)。
结果(Result): 三段输出可逐条对照——
【注入后 · audit_site.py --no-net】
[C1] 内部元数据泄漏(硬)  通过 1 / 失败 1   FAIL  …命中「narrative_arc」
[C2] 占位符残留(硬)   通过 1 / 失败 1   FAIL  …命中 VISUAL 标记
结论:硬失败 2 项 —— 未通过    退出码:1

【沙箱 · 故障页在位 · deploy_site.ps1 -WhatIf】
=== 0/6 本地门禁 selfdrawn_meta_gate(限定本批次范围)===  ✓ 通过
=== 0b/6 本地站点自检 audit_site ===  硬失败 2 项
throw:「站点自检未通过(硬失败 0 不成立),拒绝上线。」   ← 从未打印“=== 0/5 建立 SSH 会话 ===”

【删掉故障页 · 恢复复核】
[C1] 通过 2 / 失败 0 | [C2] 通过 2 / 失败 0 | 硬失败 0 项 —— 通过 | 退出码:0
下面对这三段特别说明。 第一段说明审计能报(C1、C2 各失败 1、硬失败 2、退出码 1)。第二段才是关键:deploy_site.ps1 在 0b/6 就抛异常中止,一次都没打印"建立 SSH 会话"——部署在 SSH 之前被拦下了,沙箱侧的锁文件也没生成(这一步全程在沙箱仓库;批次号 20260926ep12 属真仓库只读演练)。第三段说明删掉故障页后复核回 0,即拦的是那份故障,不是环境本身。
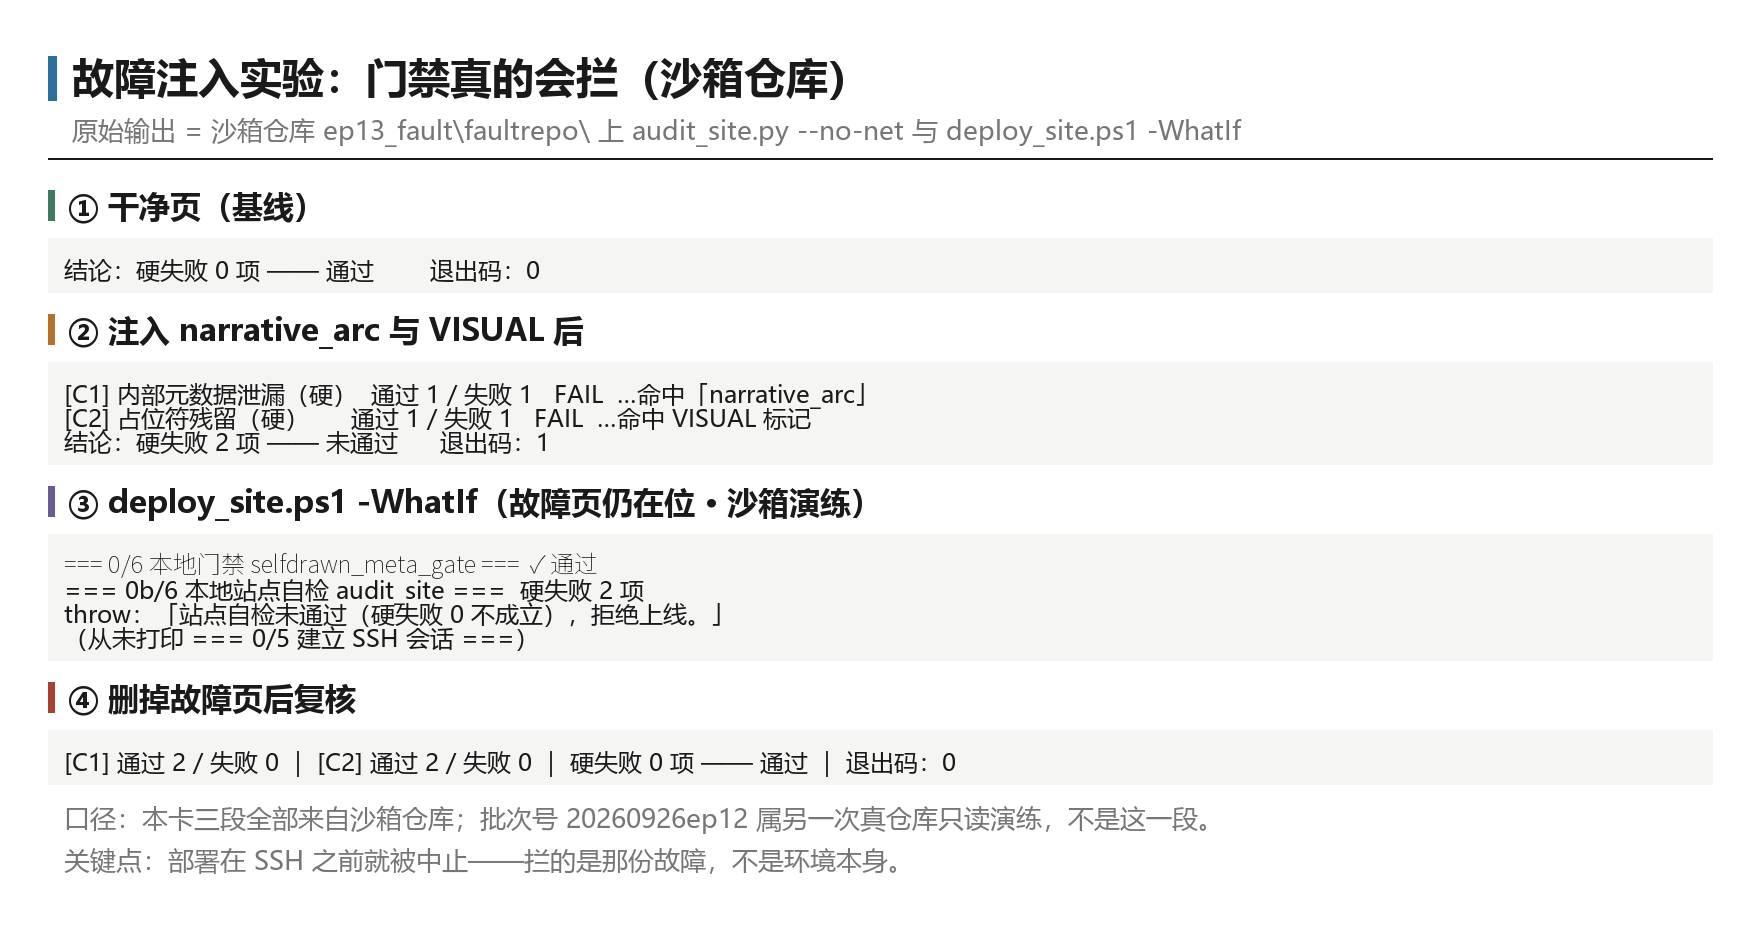
deploy_site.ps1 -WhatIf 在 0b/6 抛异常中止、从未走到建立 SSH 会话 → 删掉故障页后复核恢复硬失败 0 / 退出码 0@ 本机自跑(沙箱仓库 ep13_fault\faultrepo\)这张图是第 4 步这一章的骨。 它把"门禁能拦"变成了一次可回放的演示:干净 → 注入 → 拦下 → 恢复。任何一段门禁,都该有这么一次演示——只报 0 不算。
6.5 门禁判据会被自己的说明文字污染
本轮踩到一个自伤实例,它示范了"判据的边界条件"本身也需要被验证。
本仓库有一条门禁,专门数 render-assets-plan.md 里的图位分类标记。它的正则是 ·\s*EXT\b 与 ·\s*DIY\b——它不区分"表格单元格里的标记"与"正文里提到这两个标记"。写这张盘点表时,我们为了解释口径,在正文里写了一句含裸标记的说明;结果这句话被一并计入,把原本的 3/16 = 18.8% 数成了 4/18 = 22.2%。
修正方式很笨但很关键:正文提到这两个标记时,不带中点。 → 这条与 5.6 节的漏报同源:门禁的判据不是"真理",它是"一段可以被自己的输入污染的规则"。凡有新写法(新目录、新标记、新说明文字),都该先问一句:这会不会把门禁的读数算歪?
6.6 本章收在哪里
第六章走完,第 4 步该有能力了:一套官方 diff test 范式、一张分两侧的工具箱台账、一次全站审计的真实报告、一次故障注入的完整演示、一个"判据被自己污染"的自伤实例。下一章处理最后一件事:什么时候该停手说"数据不够"。
本章对应的官方依据:diff tests / golden screenshot / CI 矩阵见 Perfetto contributing 测试页;CI 的目的与边界(只做功能与性能、不做 CD、不可复现即不算验证)见 Perfetto CI 设计文档;CI 站点入口见 ci.perfetto.dev;语料级批跑见 Batch Trace Processor;基准测试体系总览见 Android 基准测试总览。
七、第 5 步:四类必须停手,以及十三条款欠账
这一步对应阶梯上那道出口。"数据不够"不是失败,是阶梯的一个正常出口——但前提是它能被判定,而不是被拿来当挡箭牌。这一章先把"必须停手"拆成四类可判定的条件,再把本系列的十三条款欠账逐条结案或留档。
7.1 四类必须停手:每一类都给两条出口
先来看看这四类条件。它们的共同点是:达成就必须说"数据不够";不同点是,每一类都还有一条"降级后可继续"的路——不是停在"所以做不了"。
| # | 停手条件 | 判据 | 停手后给什么 | 降级后可继续的路 |
|---|---|---|---|---|
| ① | 拿不到同帧的两层证据 | 同设备 / 同时在采 / 一个共同等值键,三者缺一 | 只能给方向,不给因果 | 退到"分层 + 方向 + 量级自洽"(5.2 节) |
| ② | 样本量不足以压过噪声 | 时钟 / 温控 / 缓存 / AOT 四类噪声源未排除 | 给"变了多少",不给"是否回归" | 跑锁时钟 + 多轮取分布,再判显著性 |
| ③ | 判据本身不可靠 | 判据的漏检率未测、或写法会污染读数 | 先修判据,不给结论 | 用新旧两套口径同跑一次做对照(5.6 节) |
| ④ | 文档与实现不一致 | 文档代际与本机版本对不上 | 先确认用哪一代,不给引用 | 用本机版本号兜底后重引(1.2 节) |
先看看这张判定树——四类条件的入口与两条出口:
这张图的用法,是把"吵起来"换成"查一下"。 团队里最常见的分歧是"我觉得是回归""我觉得只是噪声"——按这张树走一遍,问题就变成:四类噪声源排除了没有、样本够不够压过分布、判据的漏检率是多少。答不上来,就该写"数据不够"。
7.2 "数据不够"怎么写才是有用的
先来看看这句话的正确写法。"数据不够"如果只写这四个字,它就是托词;写清"缺什么、怎么补",它才是结论。
- 缺的是哪一块:是缺 GPU 时长、缺线程切片,还是缺"同设备同帧"的等值键?
- 补它需要什么条件:要一台能访问 AOSP 的机器?要一个真机抓帧?要一批而不是一份 trace?
- 补上之后能回答什么:能回答"归谁",还是只能回答"量级对不对"?
一个合格的"数据不够",本身就是一份任务单——它把"没查出来"变成了"下一步采什么"。
7.3 十三条款"还欠什么":可收口 6 / 只能留档 4 / 存疑 2 / 已裁定 1
全系列的欠账如下:它是本篇"回填底座"的实质内容——能核到证据的才写,核不到的标存疑。十三条款按四档处置:
| # | 事项 | 现状证据(本轮实测) | 处置 |
|---|---|---|---|
| 1 | ep01 配图水位缺口 | 站点源 md chars: 14011 / figures: 14,images/ 实测 14 个文件;绝对下限 = ceil(14027 ÷ 1000 × 1.5 × 0.9) = 19,差 8 张,配图密度 0.994 < 1.35(全系列唯一跌破密度线的一篇) |
① 写进正文,不返工 ep01 |
| 2 | 首页未挂该系列各篇 | web/index.html 全文只有 2 处 graphics-profiling(ep01 / ep02);ep03–ep12 一个都没挂 |
① 走首页改版会话的具名锁 |
| 3 | ep11 的 stride 40 → 44 旧值 | ep11 的研究笔记记 vertexByteStride = 40;ep12 复核认为 44 才自洽;ep11 正文里没有 stride 字样(本轮 grep 0 命中)→ 错值只活在内部分析笔记里 |
① 勘误留痕 |
| 8 | 字形机检 | ep12 正文命中 U+22C8(连接符)1 次(三款字体全缺)、U+00B5(微符号)2 次、U+2212(减号)3 次(仅 SimHei 缺);U+21D2(双线右箭头)已由 10 处归零 |
① 写进 SOP + 本篇执行 |
| 11 | 篇目目录内过程产物未纳管 | git ls-files --others 命中 ep02–ep06 篇目目录内的 research-notes / desc-audit 等文件(站点源 md 本身已跟踪) |
① 本篇示范 + ② 老篇目留档 |
| 12 | 正文中间非 _meta 内部块未全量扫描 |
README 记"同口味的风险面本轮未全量扫描" | ① 补扫 + 写进 SOP |
| 5 | index.v2-home-13px.waitingcheck.html 前缀错 |
本轮 grep 到 7 处 ../../contentfactory/web/blog/…(README 记的是 6 条)→ 差 1 处是内联 url(...) 算不算的口径分歧;文件 git 未跟踪 |
② 留档(属在途产物) |
| 7 | 两个系列源稿未纳管 | git ls-files --others 命中 12 个 .md(mobile-graphics-power × 7、realtime-rendering × 5) |
② 留档(跨系列整理任务) |
| 9 | AOSP 逐字枚举未完成 | ep12 记 android.googlesource.com 三次不同路径全部超时 → "8 类 jank"只能写成"官方页列 8 条目,真数据另有取值" |
② 留档(需能访问 AOSP 的机器) |
| 10 | cover_gate 存量欠账 |
合计 16/40 篇缺 cover 字段;该门禁未接入部署阻断链 |
② 留档(当"没接入链就等于没有"的实例) |
| 6 | shipping-dynamic-gi 现状 |
README 记"整目录未部署";本轮 Test-Path = False,全仓只找到 _drafts/shipping-dynamic-gi.txt |
③ 存疑(须复核再写) |
| 13 | ep07 的 forward link 与规划不一致 | README 记"仍指向'像素历史与帧剖析'";但本轮 audit_site C3 导航检查 54/54 通过 |
③ 存疑(先确认指正文还是 nav) |
| 4 | ep12 的 23 条悬空脚注 | ep12 正文内联引用 0 处,却有 23 条脚注定义;构建后渲染成 23 个无样式段落、共 4,687 字符,落在落款之后 | ④ 已裁定:本轮不改 ep12,改为写进本篇 SOP |
第一行要单独说。 ep01 是本系列的基线篇,而它自己就欠着 8 张图、密度跌破 1.35 的下限线。→ 这说明一件事:水位是下限不是目标,这一篇欠着。本轮不返工 ep01——把这条"底座债"照实写进正文,比事后把数字补漂亮更有价值。
这张看板的读法是"谁欠谁还"。 可收口的 6 条这一轮就收(含本篇自己的过程产物纳管);只能留档的 4 条属跨系列或在途产物;存疑的 2 条先复核再写,不照抄旧结论;已裁定的 1 条不改已发布正文,只把规则写进 SOP——这正是下一章收口清单里的第一条检查项。
7.4 本章收在哪里
第七章走完,第 5 步该有能力了:一张四类停手判定树、一套"数据不够"的正确写法、一张十三条款的欠账看板。下一章把全篇压成一张可截图的清单,并把结尾三件套交代清楚。
本章对应的官方依据:噪声来源与一致性手段(时钟 / 温控 / 缓存 / AOT)见 Android Microbenchmark 总览 与 Macrobenchmark 总览;"结果不是 pass/fail"见 Android CI 基准测试页;jank 判据回指 ep10 与 jank 检测页。
八、收口清单与结语
好了,最后一章做三件事: 把全篇压成一张可截图的清单,把这一轮新立的 SOP 检查项钉死,把系列之后的去向交代清楚。
8.1 收口清单:症状 / 责任方 / 取什么 / 印证粒度 / 基线
先来看看这张"随身卡"。左边是症状,后面四列是每一步该拿的证据与口径。
| 症状 | 该用哪层工具 | 要什么证据 | 印证到什么粒度 | 什么时候必须停手 |
|---|---|---|---|---|
| "一卡一卡的" | 先系统层,再 API 层 | 可复现采集 + 帧预算换算 | — | 症状落不成可复现采集 |
| "不知记谁头上" | 系统层 FrameTimeline | 五出口分流 + jank_type / jank_tag |
两侧同指非应用侧 | 联结率不足 → 写"未定" |
| "怀疑着色器太重" | API 层 RenderDoc | 绘制量 + 反汇编指令清单 | 量级自洽 → 可排除 | 排除 ≠ 证明,无周期标定 |
| "拿不到 GPU 时长" | — | FetchCounters 全 0、无厂商 ISA |
数据不足是正常出口 | 接口在、库不在 |
| "想对上同一帧" | 两层 | 帧切片 + 帧内事件序号 | 只比方向与量级 | 同设备 / 同时在采 / 等值键缺一 |
| "这次结论怎么防回归" | 基线 + 门禁 | 固定输入 + 期望输出 + 故障注入演示 | diff 出变化,而非"0 就不管" | 判据漏检率未测 |
再压一层,本篇只有五个动作: 先确认文档代际、再把症状换成帧预算、分完责任方才取证据、取到证据先分级、能落基线就落基线;落不了就按四类条件停手,并写成任务单。五条都做到,这套流程就不会给出反向结论。
8.2 本轮新立的 SOP 检查项
先来看看这一轮从欠账里"长出来"的规则。它们不是口号,是写在流程里的检查项:
| 检查项 | 来源 | 判据 |
|---|---|---|
| 脚注必须有内联引用 | 欠账 ④(ep12 的 23 条悬空定义) | 写了脚注定义,正文就得有对应的内联引用;否则改为可见的资料小节 |
| 文档代际先确认 | 第 0 条 | 引用前先确认"文档讲的是哪一代、本机是哪一代" |
| 门禁盲区写进门禁自己 | 6.2 节 | 每条门禁的已知盲区写在源码 / 文档里,不能只写"能拦什么" |
| 豁免必须留检索痕迹 | 6.2 / 7.3 节 | 阈值下调要留检索轮次与理由,不得把需素材位改判为自绘 |
| 字形先机检 | 欠账 ⑧ | 成稿前跑一次字形检查,U+21D2 一律用 → 替代 |
| 读数带时间戳 | 5.6 节 | 多会话共用的仓库里,任何读数都要写清时刻 |
第一条是"用自己踩过的坑换来的"。 ep12 那 23 条脚注定义读者可见却无样式,恰恰是因为写的人只写了定义、没写引用。→ 本篇因此不用悬空脚注,并在清单里把这条钉死。
8.3 降级表:环境缺了 X 怎么办
先来看看"照抄命令但环境不同"这种最常见的情况。每一步都给输入 / 输出 / 判据,命令只作本仓库实例;环境缺件时按下表降级,并留痕:
| 缺什么 | 降级怎么做 | 影响 |
|---|---|---|
| 没有厂商硬件 counter | 退到本机自跑真值 + 静态对照,结论降级为"可排除" | 不能给周期归因 |
| 没有厂商 ISA 反汇编 | 用字节码级反汇编做排除,标注目标不可用 | 不能给指令级成本 |
| 没有真机抓帧 | 用桌面抓帧做量级对照,不承诺同帧 | 只比方向与量级 |
| 没有真机 trace | 用官方测试语料 + batch 批跑 | 结论只对语料成立 |
| 外部示意图拿不到 | 走检索留痕 + 显式下调阈值豁免 | 需在豁免节写明理由 |
这张表的口径跟 ep10 到 ep12 一脉相承:降级要留痕,不能把"降级"写成"等价"。
8.4 资源清单与参考资料来源
- Perfetto 命令行分析 cookbook —— https://perfetto.dev/docs/getting-started/command-line-analysis
- Perfetto 旧 metrics 页(自标 legacy v1)—— https://perfetto.dev/docs/analysis/metrics
- Perfetto Trace Summarization(metrics-v2)—— https://perfetto.dev/docs/analysis/trace-summary
- Perfetto contributing/testing(diff tests)—— https://perfetto.dev/docs/contributing/testing
- Perfetto CI 设计文档 —— https://perfetto.dev/docs/design-docs/continuous-integration
- Perfetto Batch Trace Processor —— https://perfetto.dev/docs/analysis/batch-trace-processor
- Perfetto Trace Processor CLI 参考 —— https://perfetto.dev/docs/reference/trace-processor-cli
- Perfetto FrameTimeline 数据源页 —— https://perfetto.dev/docs/data-sources/frametimeline
- Perfetto GPU 数据源页 —— https://perfetto.dev/docs/data-sources/gpu
- Perfetto SQL 表参考 —— https://perfetto.dev/docs/analysis/sql-tables
- Perfetto CI 站点 —— https://ci.perfetto.dev/
- Trace Processor 下载入口 —— https://get.perfetto.dev/trace_processor
- RenderDoc Python API 索引 —— https://renderdoc.org/docs/python_api/index.html
- RenderDoc Python API 的 replay 页 —— https://renderdoc.org/docs/python_api/renderdoc/replay.html
- RenderDoc 快速上手页 —— https://renderdoc.org/docs/getting_started/quick_start.html
- RenderDoc 与 RGP 联动页 —— https://renderdoc.org/docs/how/how_rgp_profile.html
- RenderDoc 构建入口 —— https://renderdoc.org/builds
- Android 官方《在 CI 中使用基准测试》—— https://developer.android.google.cn/topic/performance/benchmarking/benchmarking-in-ci
- Android 官方基准测试总览 —— https://developer.android.google.cn/topic/performance/benchmarking/benchmarking-overview
- Android 官方 Microbenchmark 总览 —— https://developer.android.google.cn/topic/performance/benchmarking/microbenchmark-overview
- Android 官方 Macrobenchmark 总览 —— https://developer.android.google.cn/topic/performance/benchmarking/macrobenchmark-overview
- Android 官方 jank 检测页 —— https://developer.android.google.cn/studio/profile/jank-detection
- Vulkan 官方指南 Profiling 页 —— https://docs.vulkan.org/guide/latest/profiling.html
- 早期性能回归检测(Wilcoxon 5% 显著性)—— https://arxiv.org/html/2408.08148
- 性能基线测试实践(Welch 单尾)—— https://oneuptime.com/blog/post/2026-01-30-performance-baseline-testing/view
- CI 性能回归检测实践(滚动基线 mean + 2σ)—— https://www.appxiom.com/blogs/continuous-integration-for-ios-apps-automating-performance-regression-detection/
- 回归门禁阈值管理实践 —— https://pratikdhanave.com/blog/posts/eval-agents-go-07-ci-regression-gating.html
- CI/CD 显著性加效应量实践 —— https://futureagi.com/blog/ci-cd-llm-eval-github-actions-2026/
参考资料来源:系统层真值来自本机对六份官方 Android 测试 trace 的实跑(trace_processor_shell v58.2-add693d8b);API 层真值来自本机自跑(RenderDoc v1.29,桌面 D3D11);"验证能拦什么"的证据来自本仓库工具链的本轮实跑(audit_site / deploy_site / stage-gate / content-lint / style-lint / check_image_refs);机制与判据取自官方一手文档,回归检测实践类文章仅作旁证。
8.5 系列之后的去向(预告)与落款
预告,写给这个系列本身。 这一篇是《性能剖析工具链》十三篇的收口,到此全系列已交付 13 篇:从 ep01 的方法论全景,到 ep02–ep06 的 RenderDoc 本体,到 ep07–ep09 的 trace 结构与 SQL,再到 ep10–ep13 的四步实战与这套闭环手册。这里不预告"下一篇讲什么",因为本系列没有下一篇;要说的是这一套还能往哪儿长:把这条阶梯用到一个真实项目上——它会先在"责任方分流"还是"同帧拿不到"上撞墙?把 batch-trace-processor 真接到一份自有语料上,语料级回归长什么样?以及那条一直欠着的"厂商硬件 counter",换一台能拿到它的机器之后,分级表的第一档会被填成什么样。
以上。 希望这一套"从症状到基线"的梳理,能让大家下次接到一个新问题时不再直接翻源码,而是先问一句:文档是哪一代、症状换成帧预算是多少、这件事记在谁头上、证据站在分级表第几档——以及,现在的数据到底够不够回答问题。
本文由@溯光 出品,让"如何验证"变成一条可照抄、可复跑、也能诚实停手的流程。
With Best Wishes.