按领域

Ray Tracing Gems

CC BY-NC-ND 4.0
Apress · 2019Part VI · 第 23–26 章 · p.399–508原图 67 张
ReSTIR 用于次表面散射

非 CC · 待逐件许可
ACM TOG · 2023单篇论文 · 19 页 · 10 图
Neural Temporal Adaptive Sampling & Denoising

非 CC · 待逐件许可
NVIDIA · EUROGRAPHICS 2020单篇论文 · CGF 39(2) · 11 图
AAA-Gaussians

CC BY · arXiv
arXiv 2504.12811v2 · ICCV 2025单篇论文 · 12 章 · 5 图
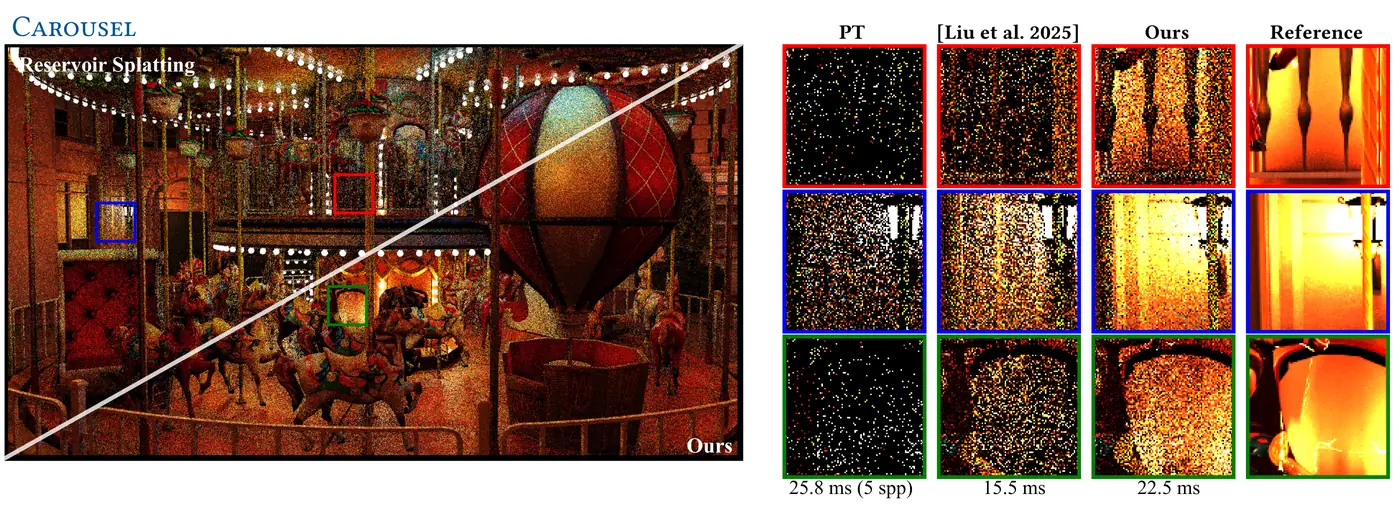
Multi-Layer Reservoir Splatting

CC BY 4.0
论文 figure + 讲座材料单篇论文精读 · 13 章 · 11 图
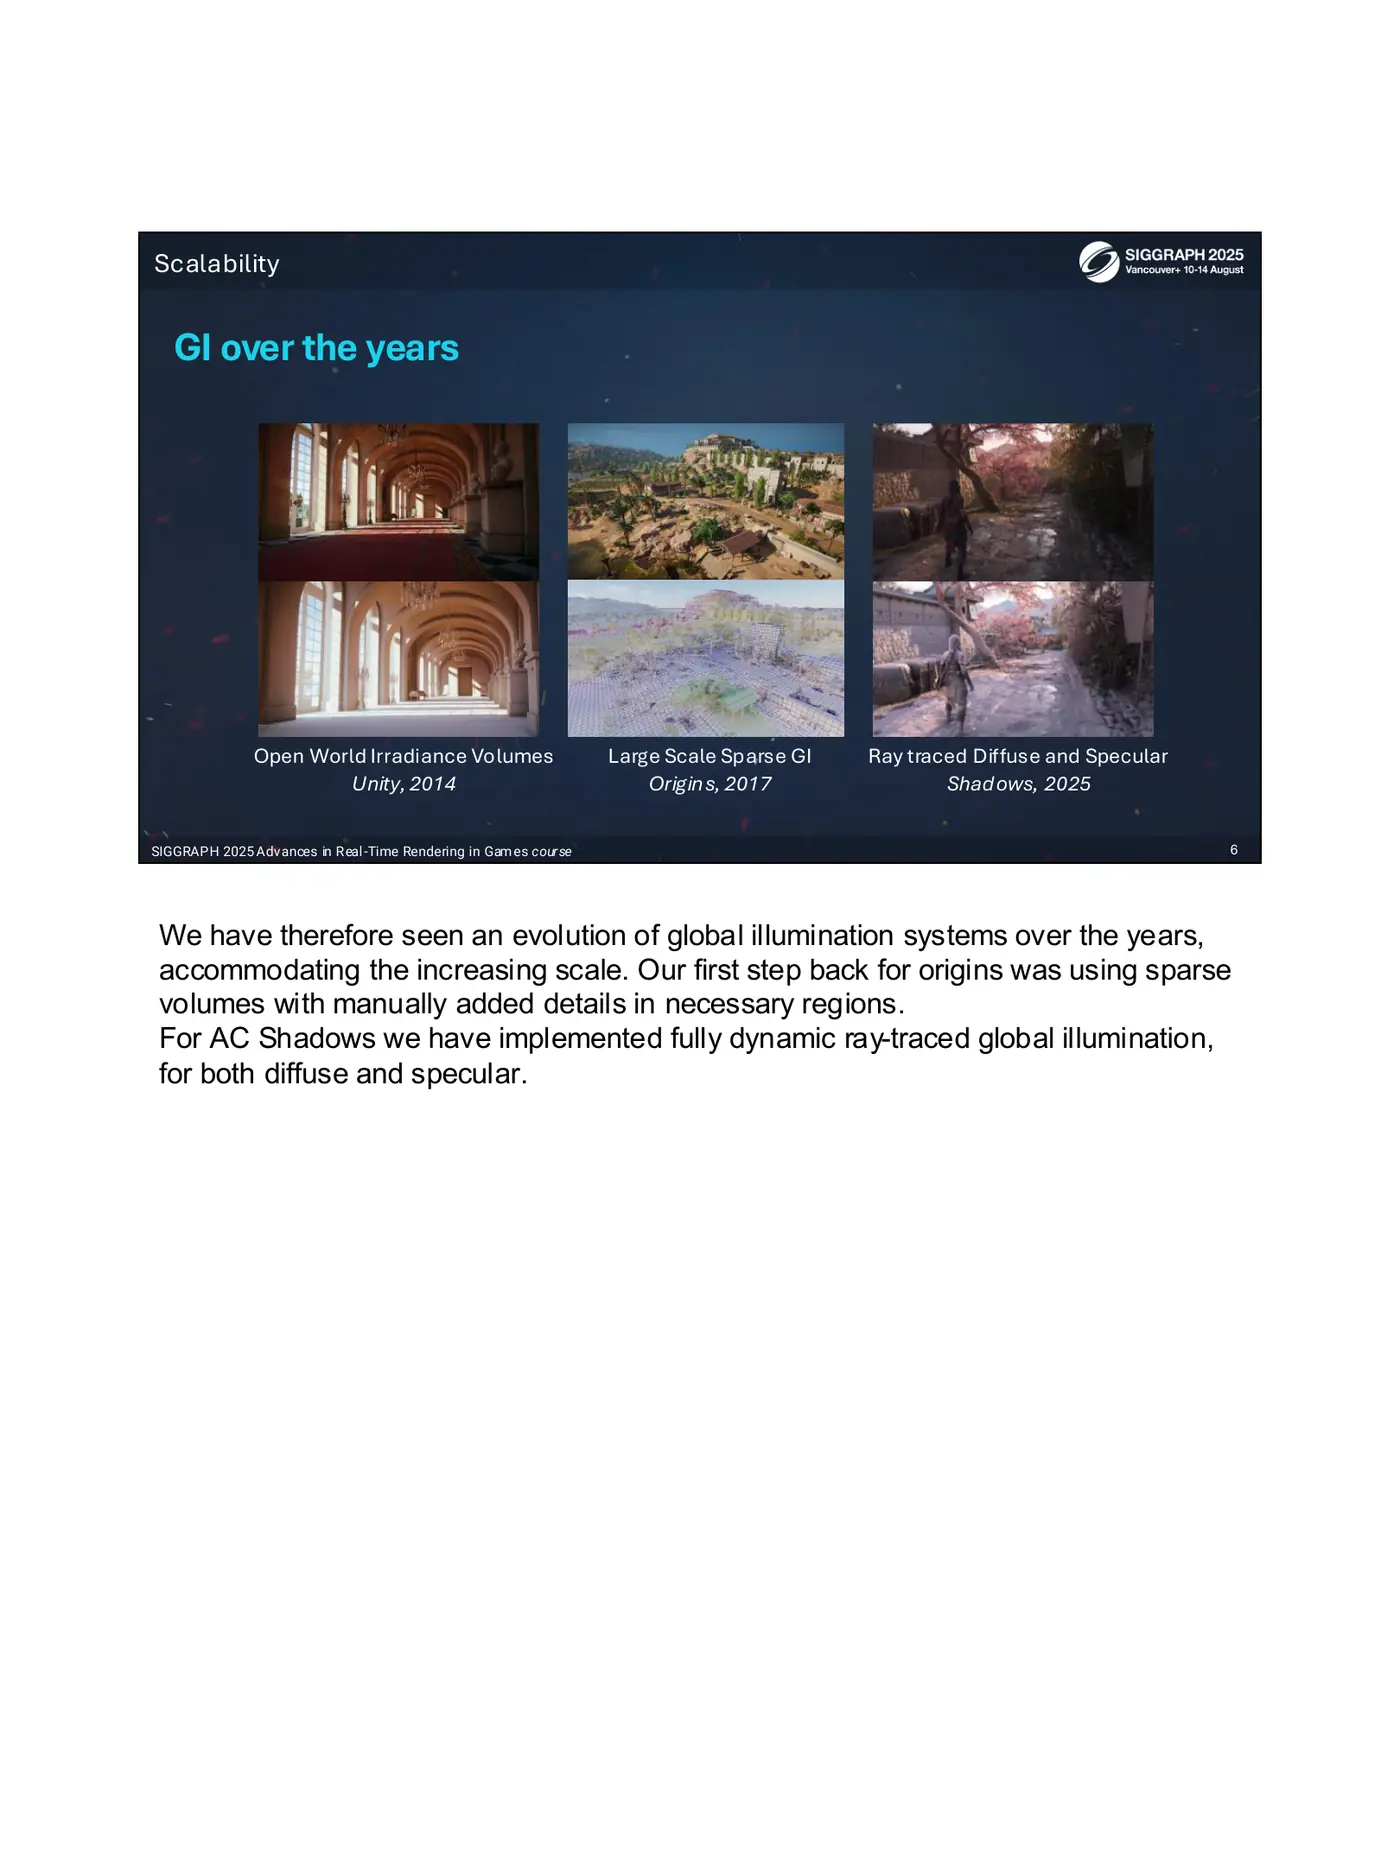
Raytracing the World of AC Shadows

Ubisoft 授权
SIGGRAPH 2025 · Advances in Real-Time Rendering单篇讲座深读 · 13 章 · 12 图
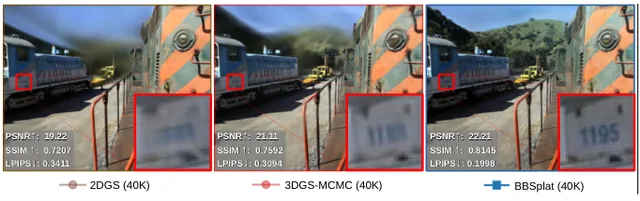
BBSplat

CC BY · arXiv
arXiv 2411.08508v4 · ICCV 2025单篇论文 · 12 章 · 9 图
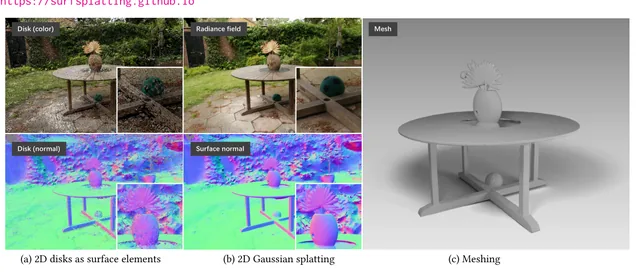
2DGS

CC BY 4.0
arXiv 2403.17888v3 · SIGGRAPH 2024单篇论文 · 14 章 · 12 图
SSS Hybrid ReSTIR

非 CC · 逐图署名引用
NVIDIA · SIGGRAPH 2025 · Advances in Real-Time Rendering单篇讲座精读 · 13 章 · 20 图
MegaLights

非 CC · 逐图署名引用
Epic Games · SIGGRAPH 2025 · Advances in Real-Time Rendering单篇讲座精读 · 14 章 · 18 图
DDGI

非 CC · 逐图署名引用
I3D 2019 · ACM I3DG单篇论文精读 · 14 章 · 18 图
StopThePop

CC BY-NC-ND 4.0
arXiv 2402.00525v3 · SIGGRAPH 2024单篇论文精读 · 14 章 · 13 图
UE5 Raytracing Guideline

官方文档 · 整页渲染署名引用
Epic Games 官方技术文档 · v5.4(2024-07)单篇论文体 · 14 章 · 16 图
CoMoGaussian

CC BY 4.0
arXiv 2503.05332v2 · ICCV 2025单篇论文精读 · 14 章 · 11 图
CL-Splats

非 CC · 逐图署名引用
arXiv 2506.21117v2 · ICCV 2025单篇论文精读 · 14 章 · 13 图
Gaussian Opacity Fields

非 CC · 逐图署名引用
arXiv 2404.10772v2 · SIGGRAPH 2024单篇论文精读 · 14 章 · 14 图
Ada GPU Artistry

非 CC · 逐图署名引用
NVIDIA 官方技术文档 · V1.0(2022)26 页 · 16 张编号配图 + 1 张技术表原图 16 张
LightGaussian

非 CC · 逐图署名引用
arXiv 2311.17245v6 · NeurIPS 2024单篇论文精读 · 14 章 · 9 图
PowerVR Hardware Architecture

非 CC · 逐图署名引用
Imagination Technologies · Revision PowerVR SDK REL_18.216 页 · 10 张编号配图原图 10 张
Mip-Splatting

非 CC · 逐图署名引用
arXiv 2311.16493v1 · CVPR 2024(Oral)单篇论文精读 · 14 章 · 9 图
Forward+(CGF 2012)

非 CC · 逐图署名引用
Computer Graphics Forum · Eurographics 2012 · AMD单篇论文精读 · 14 章 · 5 件
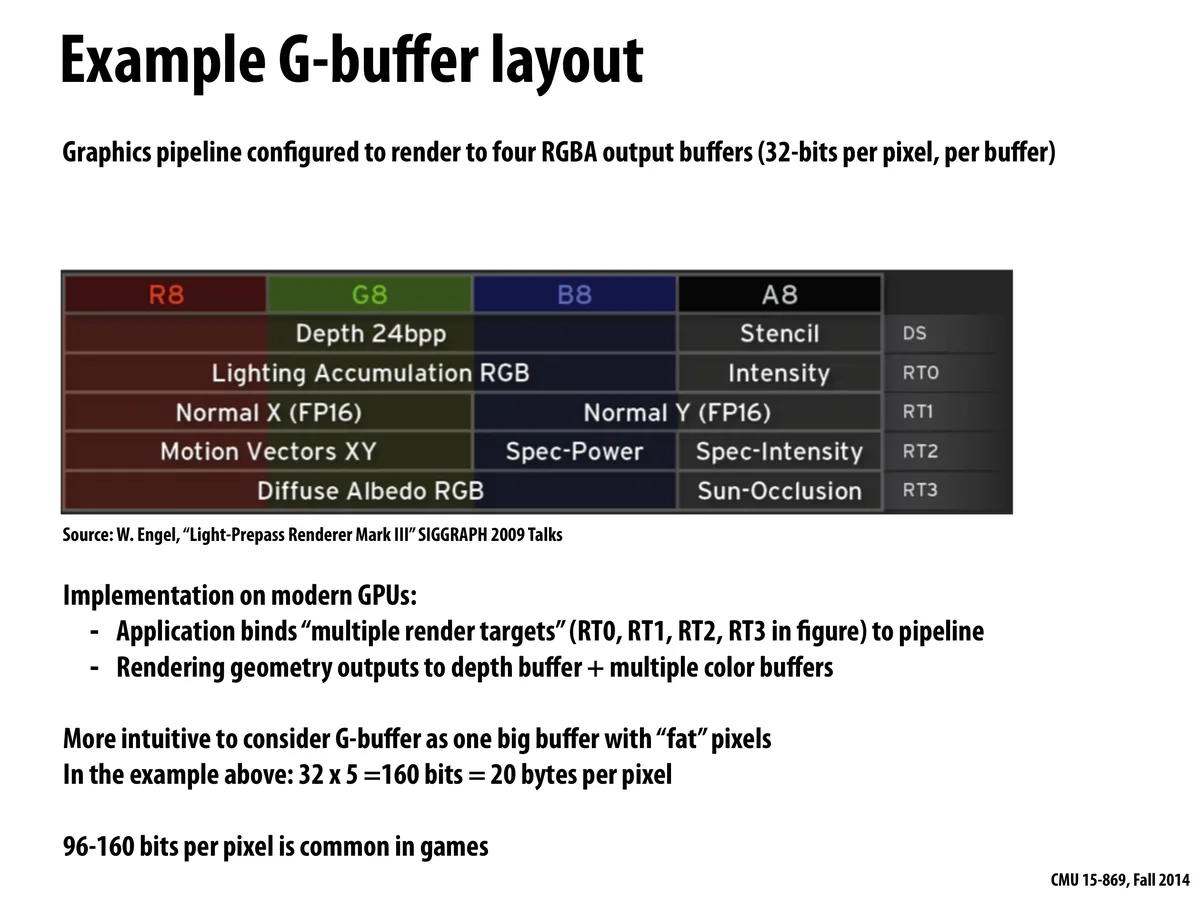
CMU 15-869 · Deferred Shading

非 CC · 逐图署名引用
Carnegie Mellon University · Fall 2014 课程讲义 · 50 页单篇论文精读 · 14 章 · 16 图
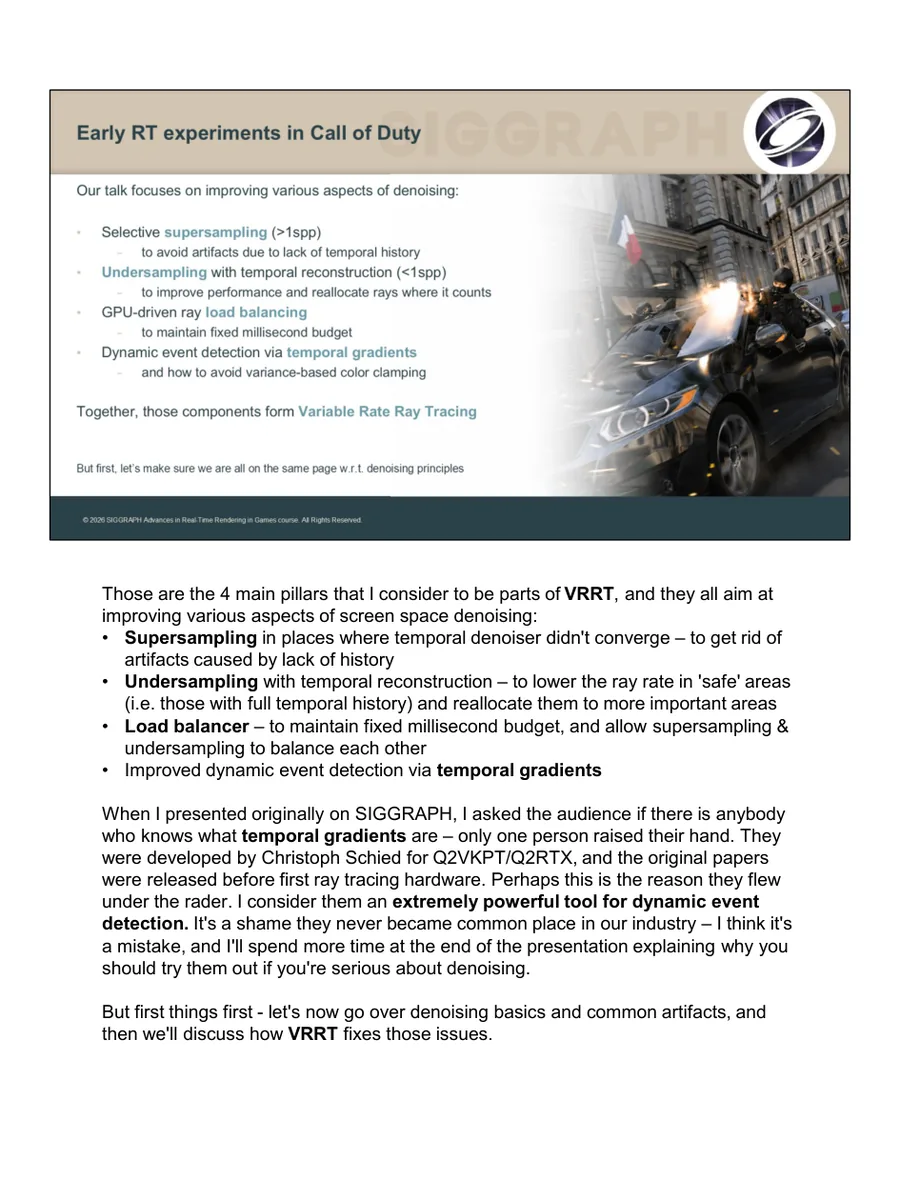
VRRT in CoD: MW4

非 CC · 逐图署名引用
SIGGRAPH 2026 · Advances in Real-Time Rendering in Games · 70 页讲义单篇论文精读 · 14 章 · 16 图
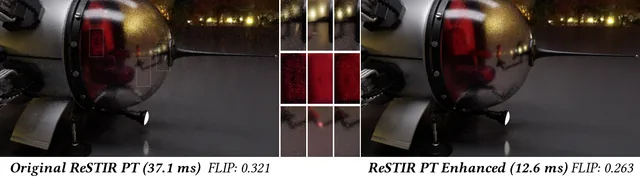
ReSTIR PT Enhanced

CC BY 4.0 · 可原样引用
I3D 2026 · Best Paper · 19 页论文单篇论文精读 · 14 章 · 15 图
Neural Shading Variance

CC BY 4.0 · 可原样引用
SIGGRAPH 2026 · Conference Papers · 9 页论文单篇论文精读 · 14 章 · 12 图
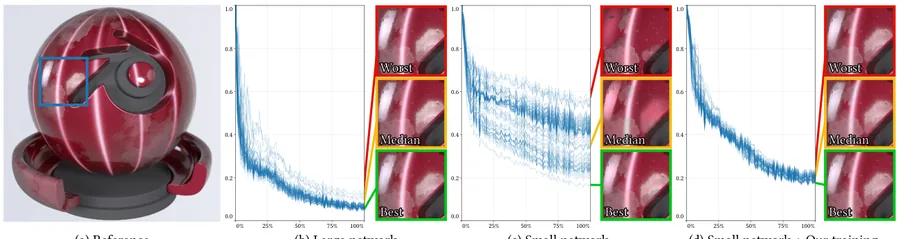
Upgrading PSSR on PS5 Pro

非 CC · 逐图署名引用
SIGGRAPH 2026 · Advances in Real-Time Rendering in Games · 84 页讲义讲座体精读 · 14 章 · 20 图
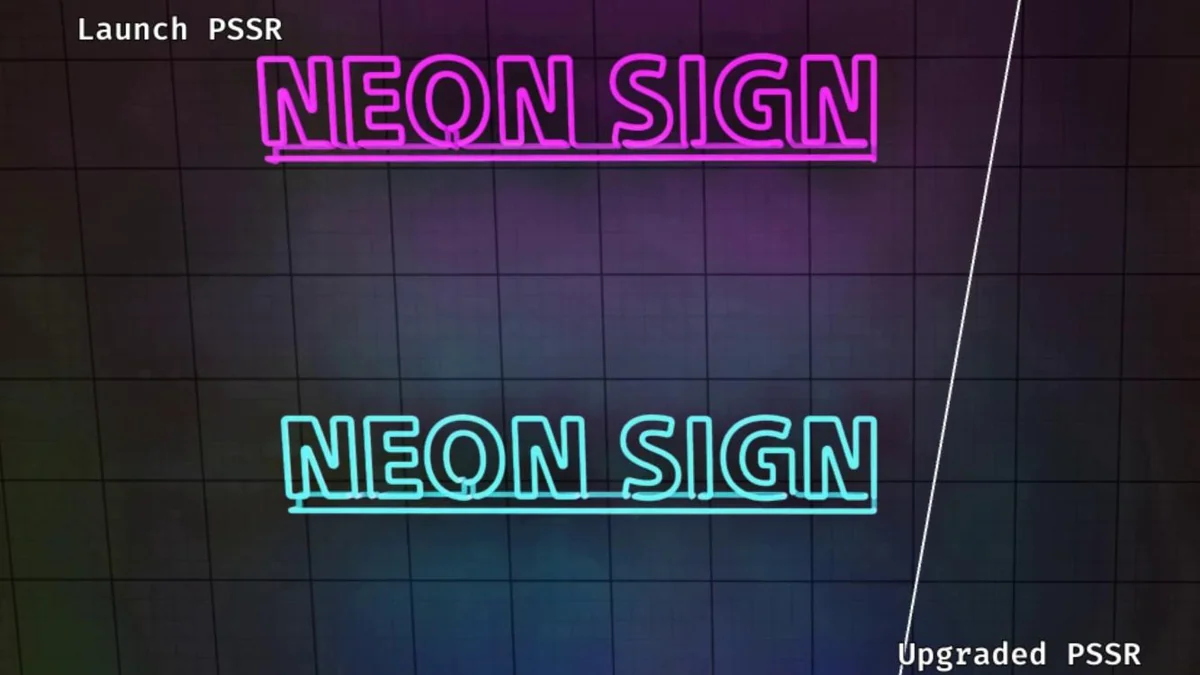
ORCA: Online Radiance Cache Acceleration

非 CC · 逐图署名引用
SIGGRAPH 2026 · Advances in Real-Time Rendering in Games · 59 页讲义讲座体精读 · 14 章 · 21 图
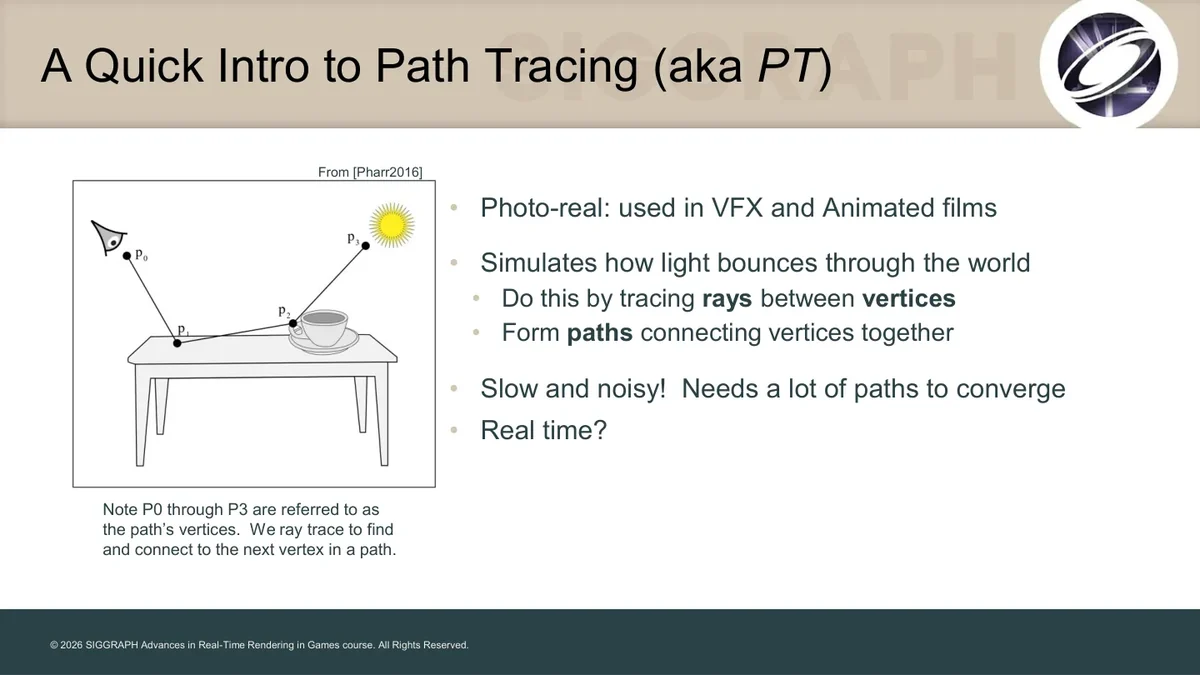
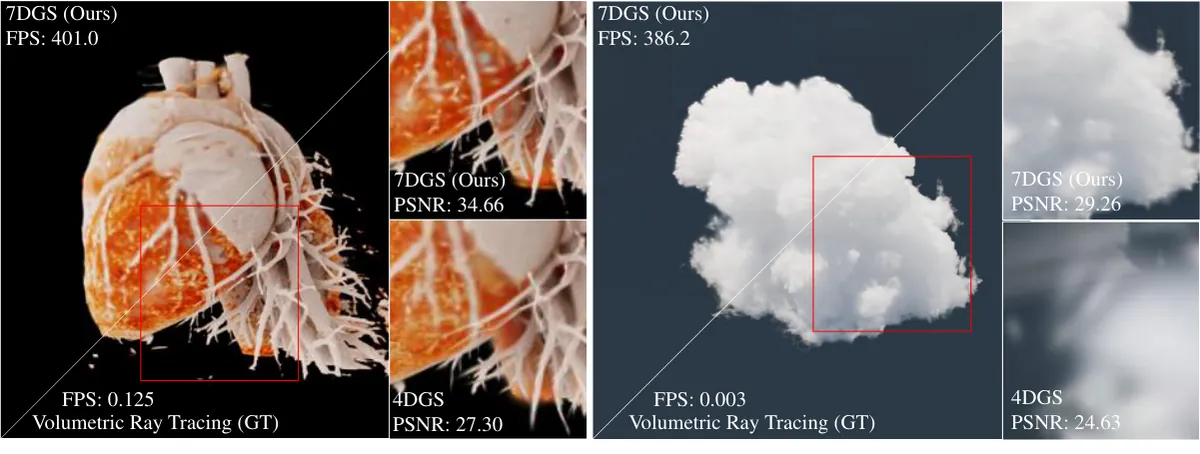
7DGS: Unified Spatial-Temporal-Angular Gaussian Splatting

非 CC · 逐图署名引用
arXiv:2503.07946v1 · 预印本 · 10 页单篇论文体精读 · 14 章 · 5 图
Smolder: Real-Time Volumetric Effect Rendering in Glacier and 007 First Light

非 CC · 逐图署名引用
SIGGRAPH 2026 · Advances in Real-Time Rendering in Games · 113 页讲义讲座体精读 · 14 章 · 21 图
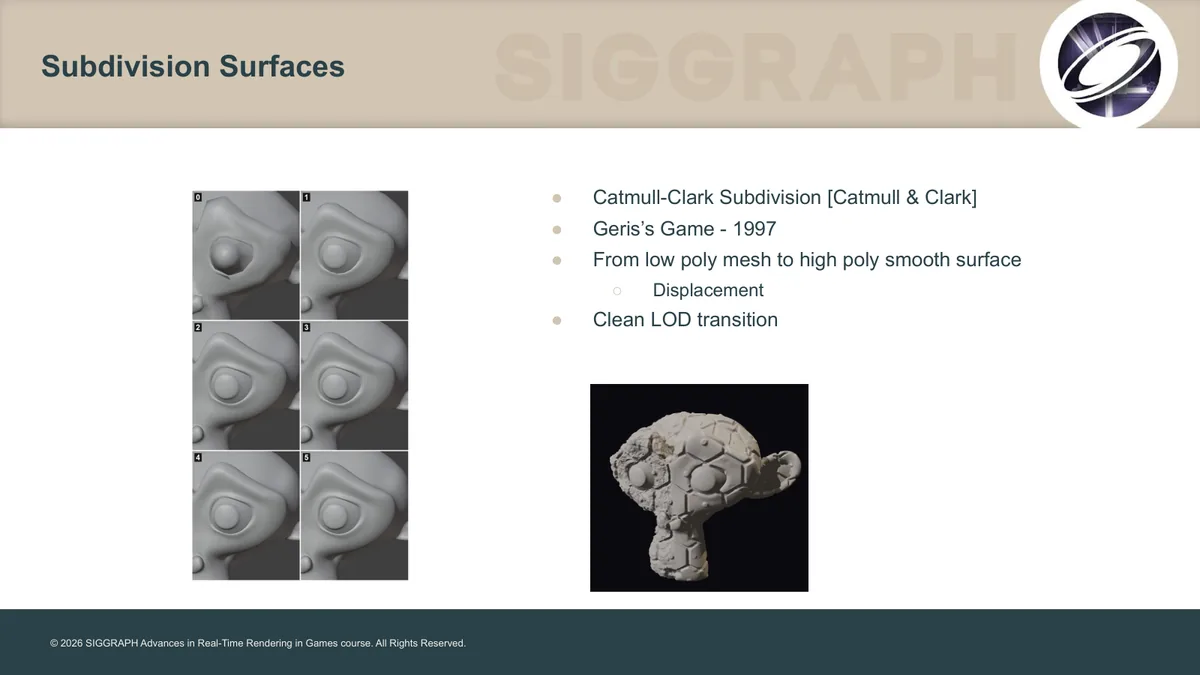
Adaptive Tessellation and Subdivision

非 CC · 逐图署名引用
SIGGRAPH 2026 · Advances in Real-Time Rendering in Games · 87 页讲义讲座体精读 · 14 章 · 21 图
SLIM: Scaling User-Generated 3D Worlds on Roblox

非 CC · 逐图署名引用
SIGGRAPH 2026 · Advances in Real-Time Rendering in Games · 64 页讲义讲座体精读 · 14 章 · 21 图
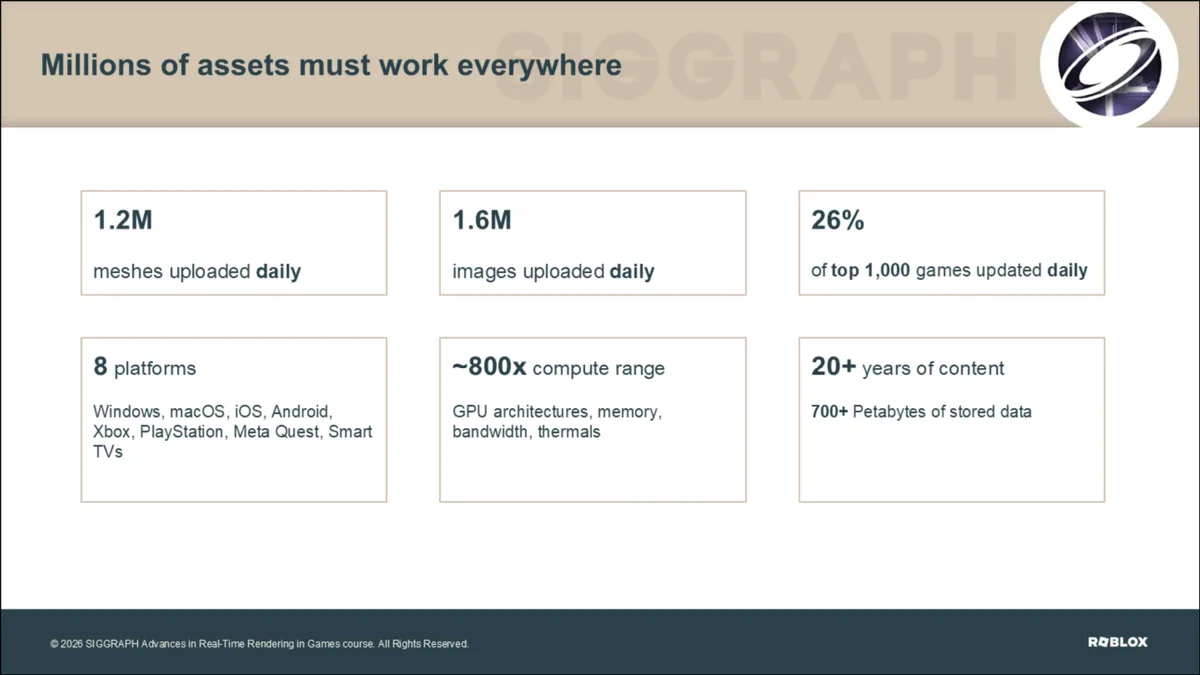
SLIM 讲义首图:平台体量页,每天 120 万网格 / 160 万图片上传,8 平台间算力相差约 800 倍(原文 slide 5)
篇目 31 内容管线世界转码 已完成 14 章17,228 字21 图

同一片 UGC 世界要在八档设备上跑:把 cook 搬进云端,让优化单元从一块资产长到整片世界

要解的是规模差与持续变化:同一份引擎、同一批用户生成内容要跑八个平台,高端算力约是低端的 800 倍,世界还一直在变,「离线 cook 再冻住」这条路走不通。讲者的三步建立在一套转码契约上。先把离线 cook 搬进内容平台:源版本不可变、运行时形态按需派生,ACR 内容寻址自动去重,缓存未命中就入队转码。再把优化单元从一块资产放大到整片世界:SLIM 描述符只带引用不带字节,归一化后哈希让等价模型落到同一源地址;世界转码器按材质聚合、去内部面、建多级 LOD,示例里 60 个源网格收成 1 个几何块、13 个源材质收成 1 个运行时材质。最后运行时按双预算挑档:三角形目标加一笔固定 GPU 字节池,按「每加一字节消除的可见误差」做率失真打分。同一场景同一相机下实例 −97%(172,531→5,213)、三角形 −98%(59.4M→1.1M)、draw call −74%(3,526→917)、显存 −33%。末章四条边界:结构频繁变动会回退传统渲染、一次性唯一几何去重无收益、高延迟场景尚不适用;平台级指标为讲者所述、不可复现,讲义 64 页带讲者备注。

原文 SIGGRAPH 2026 Advances in Real-Time Rendering · 64 页讲义引用 21 页整页渲染非 CC · 逐图署名引用

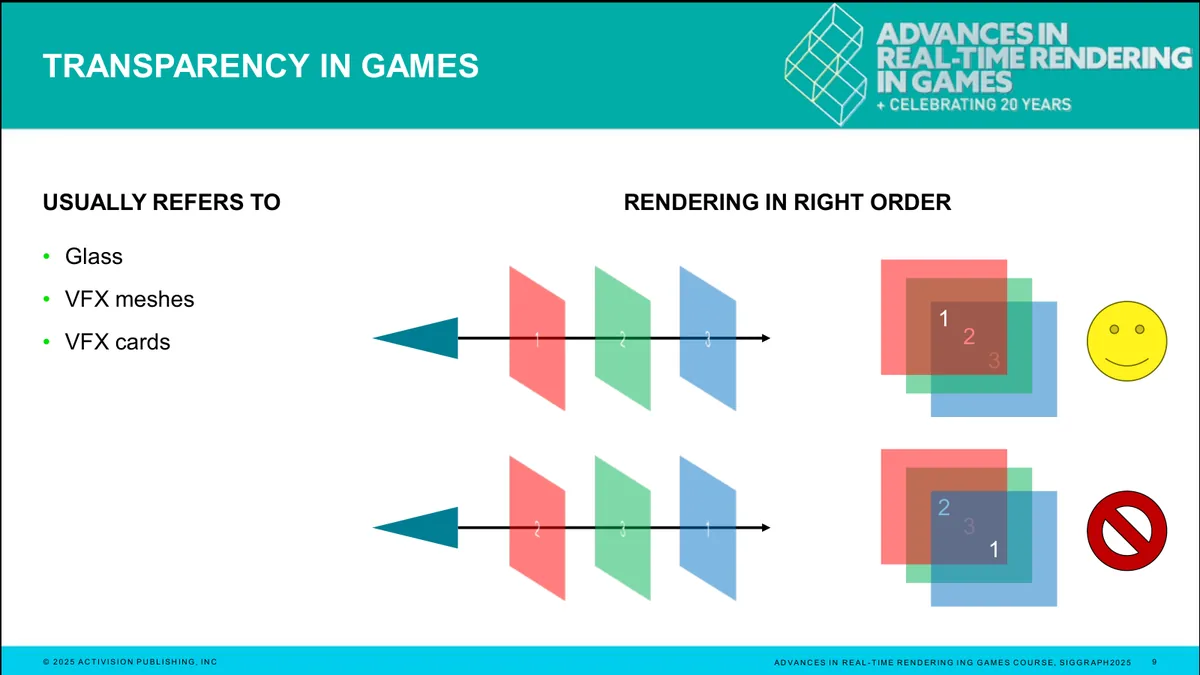
Adaptive Voxel-Based Order-Independent Transparency

非 CC · 逐图署名引用
SIGGRAPH 2025 · Advances in Real-Time Rendering in Games(Part I)· 136 页讲义讲座体精读 · 14 章 · 23 图
Strand-based hair and fur in "Indiana Jones and the Great Circle"

非 CC · 逐图署名引用
SIGGRAPH 2025 · Advances in Real-Time Rendering in Games(Part I)· 87 页讲义讲座体精读 · 14 章 · 21 图
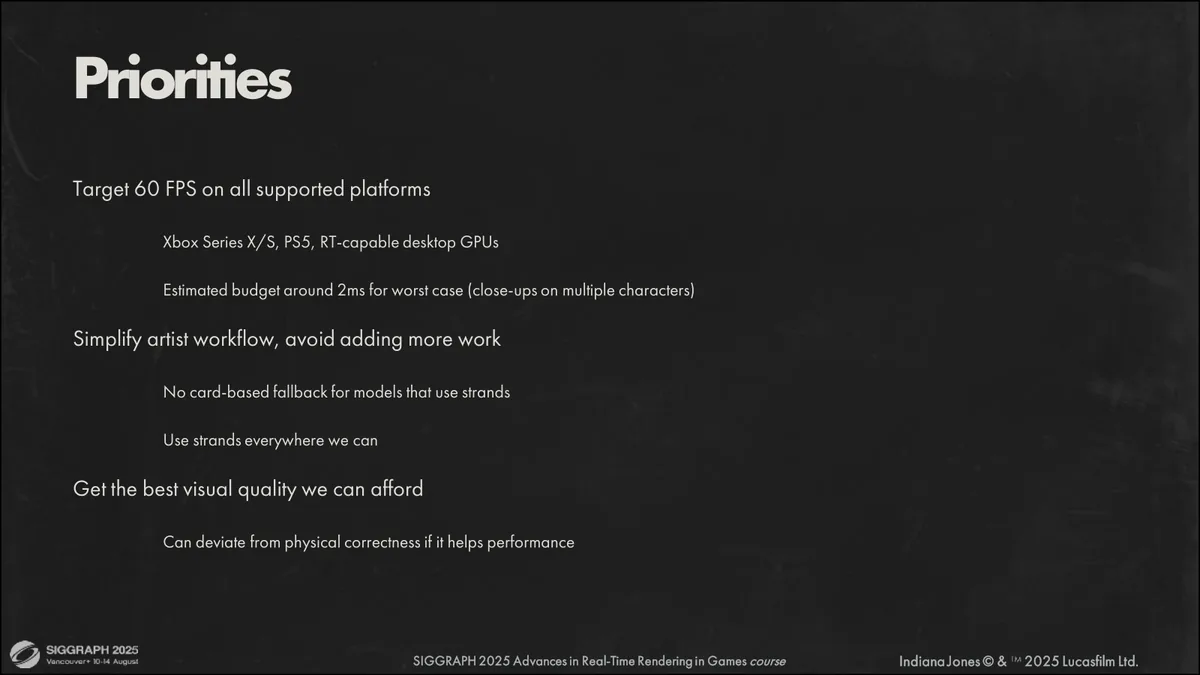
发丝渲染讲义首图:硬指标一页,全平台 60 FPS、最坏情形约 2 毫秒 GPU 预算、不做卡片回退(原文 slide 4)
篇目 33 发丝渲染GPU 工程 已完成 14 章18,351 字21 图

头发从卡片贴片换成真发丝,再用「处处设上界」压进 60 FPS

要解的是一笔硬约束:这是一款叙事驱动的第一人称游戏,约 4 小时过场、玩家几乎总在近距离看脸,角色必须尽量好看;而指标是全平台锁 60 FPS、最低规格最坏情形约 2 毫秒 GPU 预算、不做卡片回退,还允许为性能偏离物理正确。讲者的答案不是某个新算法,而是一套「处处设上界」的工程:LOD 用随机化发丝顺序后截取并按比例加粗,把每屏段数用三层上限钉死(每 64×64 贴片 2000 段、合计 200 万段);自写保守软件光栅器,把可见性缓冲从 64 位砍到 32 位载荷并换成 64×64 贴片图集,放不下就逐贴片降分辨率;用循环扁平化与像素请求栈把 GPU 分歧从 45% 压到 20%、活跃 lane 升到约 80%,再用一次不到 100 微秒的全局计数排序把缓存命中率找回来。自阴影试过深透明度图、密度体 raymarch 与随机球面探针三条路都不成,最终改用离线软件光追预计算可见性函数,并把平均散射事件数编进 L1 球谐、给未命中射线加负偏置。末章八条边界:计时表是关闭 async 的口径、内存账绑定 Series S 低配、三条被否方案不得写成发货方案、动物毛与墙地影子两处例外、与 LOD 的「幽灵遮挡」未解。

原文 SIGGRAPH 2025 Advances in Real-Time Rendering(Part I)· 87 页讲义引用 21 页整页渲染非 CC · 逐图署名引用

Neural Light Grid: Modernizing Irradiance Volumes with Machine Learning

非 CC · 逐图署名引用
SIGGRAPH 2024 · Advances in Real-Time Rendering in Games(Part I)· 98 页讲义讲座体精读 · 13 章 · 21 图
Seamless Rendering on Mobile: The Magic of Adaptive LOD Pipeline

非 CC · 逐图署名引用
SIGGRAPH 2024 · Advances in Real-Time Rendering in Games(Part I)· 36 页讲义讲座体精读 · 13 章 · 20 图
Fast as Hell: idTech8 Global Illumination

非 CC · 逐图署名引用
SIGGRAPH 2025 · Advances in Real-Time Rendering in Games(Part II)· 38 页讲义讲座体精读 · 14 章 · 22 图
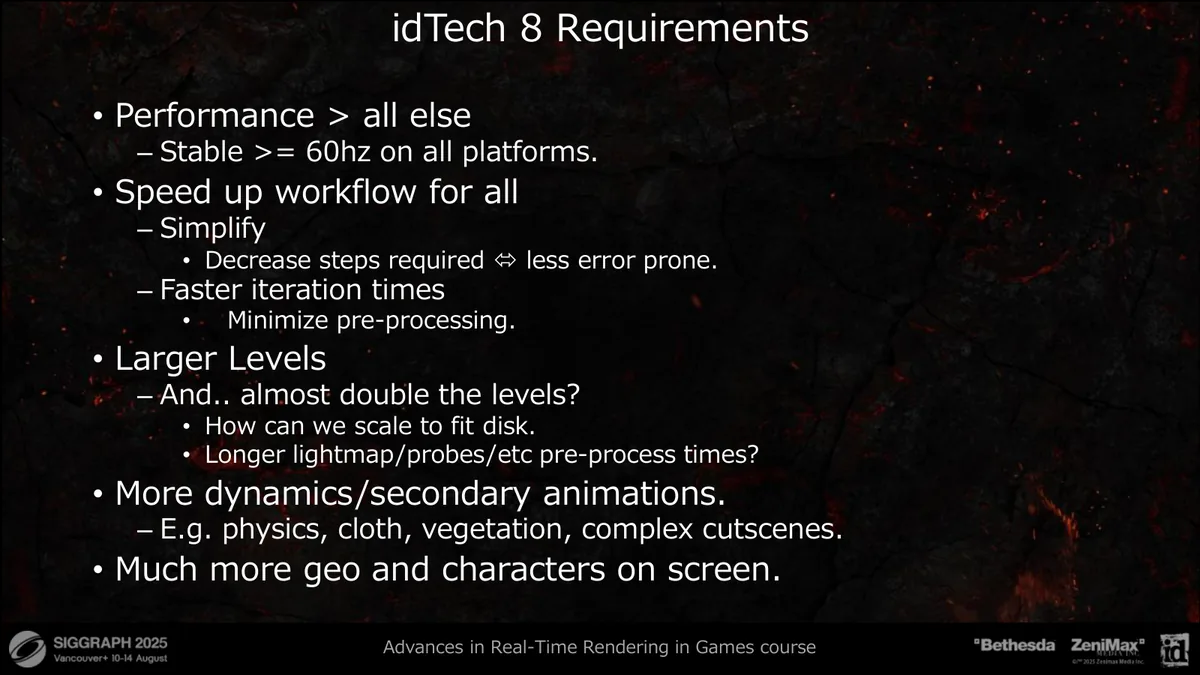
idTech8 GI 讲义首图:要求一页,性能压倒一切、全平台稳定 60 Hz(原文 slide 2)
篇目 36 全局光照光追 已完成 14 章18,618 字22 图

把路径追踪 lightmap 整套换掉:世界空间的级联光网格加空间哈希,把全局光照搬到帧内

要解的是一笔规模账:DOOM The Dark Ages 的可行走面积合计约 5000 平方公里(上一代的 4–10 倍、单人关卡 22 张对 13 张),而按这个规模照搬上一代的路径追踪 lightmap,推算下来是单关 16–100 小时预处理、磁盘 44–110 GB、周期 27–68 天。讲者的做法是把整套预计算搬进帧内:视锥绑定的分箱换成世界空间的级联光网格(16×16×16×8、约 30 MB、点亮约 0.2 毫秒,同时服务灯、反射探针、贴花、粒子与玻璃);探针每帧只更新 1 个级联加 1 个体积,而且这一遍只追可见性,命中记录压进 128 位;写进用空间哈希组织的世界辐射缓存(约 14 MB)后按活跃列表着色、更新成八面体映射的辐照度体积图集(64 MB);末级收集每像素一条射线,依次查屏幕空间、世界辐射缓存与体积,结果存 2 波段 SH。半透明顺手分享体积雾的 froxel 辐照度体积。读数分三类且都带条件:上一代实测、slide 9 的假设推算、slide 31 的发货值(async 在 Series X 与 PS5 省约 0.5 毫秒);未竟项也写在明面上:镜面的光追这一支在控制台上因性能被关掉。

原文 SIGGRAPH 2025 Advances in Real-Time Rendering(Part II)· 38 页讲义引用 22 页整页渲染非 CC · 逐图署名引用

Stochastic Tile-Based Lighting in HypeHype

非 CC · 逐图署名引用
SIGGRAPH 2025 · Advances in Real-Time Rendering in Games · 64 页讲义讲座体精读 · 14 章 · 26 图
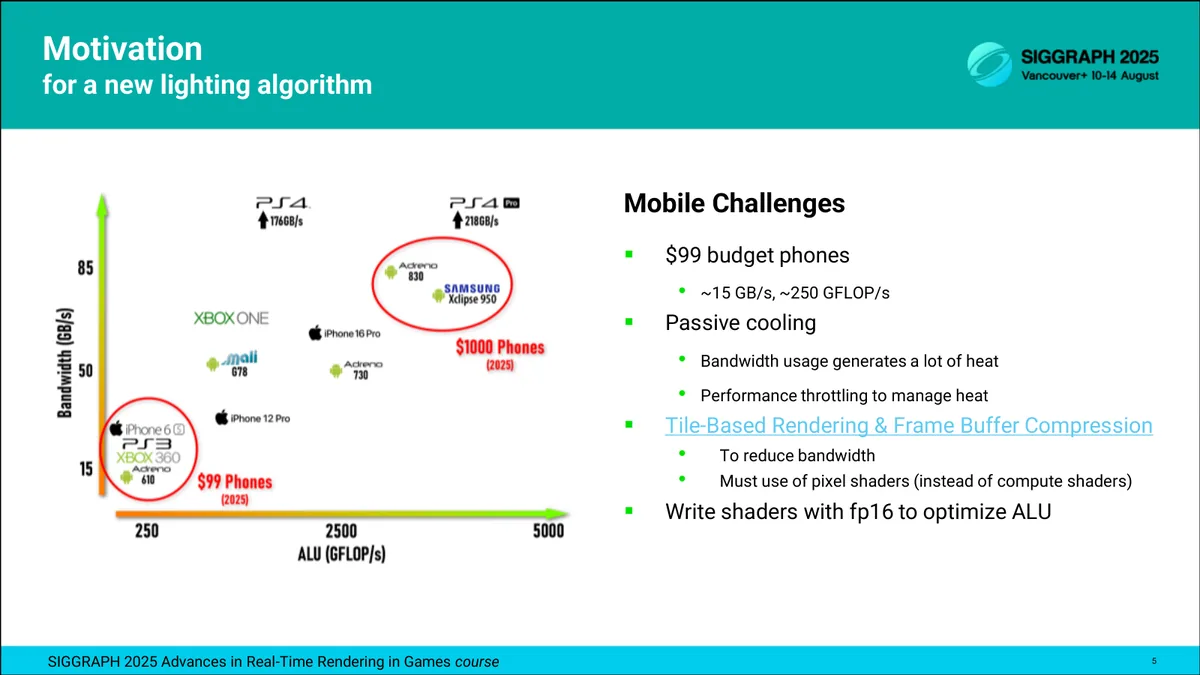
HypeHype STB 讲义首图:手机端照明要过的五道约束页(原文 slide 4)
篇目 37 采样算法移动端 已完成 14 章19,710 字26 图

$99 手机也要跑得动任意多盏动态灯:把光源采样从逐像素搬到逐 tile

要解的是两头同时收紧的账。一头是设备:$99 手机的峰值带宽只有约 15 GB/s、算力约 250 GFLOP/s(约等于二十年前的 Xbox360 与 PS3),高端机也只到约 85 GB/s,而移动端被动散热意味着吃带宽的操作直接转成发热降频、搬一个字节的功耗是简单 ALU 的上百倍。另一头是用户:平台面向休闲创作者,他们不做性能调优,而灯会被敌人死亡随机生成、也可能被一次塞满一间屋子。两条现成路都不合用:Tiled Deferred 只随每块 tile 的灯数线性增长、tile 剔除本身很贵;ReSTIR 逐像素采样访存不友好吃带宽,还要再做一次高带宽的时空重采样,逐像素的光源类型差异又带来代码发散。讲者的解法是把采样的单位从像素搬到 tile —— 一块 tile 只存一组共享样本,访存、带宽与 wave 发散一起降,并且每一趟都能用像素着色器写,为的是吃到移动端基于 tile 的渲染与帧缓冲压缩。两级精度不同的 PDF 接力:第一级 128×128 像素一块、每块 16 盏互不重复的灯,用一条由 MinMax 深度上下界构成的「中心线段」上的全向光标量照度做粗略 PDF(处处为正,故不引入偏置);第二级每块 256 像素、重采样 1 到 4 盏,换成在 64 个 quad 样本点里随机取 4 个、含可见性与 BRDF 的随机求值。样本在画面上先交错采样(4 个相邻 tile 铺在 32×32 像素、每块 64 个 2×2 像素 quad、高斯–泊松分布)破掉小 tile 的采样相关性,再用随机双线性抹掉 big-tile 的方块伪影;阴影被拆出去单独跑一趟,每 2×2 像素求一次,阴影项按 8×8 像素块存放、只存 8 位加 1 位时序噪声(1080p 下约 0.5 MB 起),换回更简单的照明着色器与可替换的阴影技术。代价与偏差都写在明面上:small-tile 的 PDF 做不到处处非零,4 个样本点可能全落在阴影里,由此产生带偏向的照明边缘噪声;为性能放弃了在 RGB 乘积之后加权,材质与光源被假定为单色;减少 big-tile 蓄水池会让画面整体变暗,是裁光权重压萤火虫的偏置;去噪尚未定案(讲者称当前最大的挑战),半透明与体积光照尚未支持。成本读数只含直接光:1spp 在 Adreno 610($99 机、3W)上只增 0.66 毫秒、在高端机与笔记本上约增 0.35 毫秒,50 盏相机视锥内局部光源的场景下弱机上再增约 1.5 毫秒。

原文 SIGGRAPH 2025 Advances in Real-Time Rendering · 64 页讲义引用 26 页整页渲染非 CC · 逐图署名引用

Hemispherical Lighting Insights from the Call of Duty Production Lessons

非 CC · 逐图署名引用
SIGGRAPH 2024 · Advances in Real-Time Rendering in Games course · 66 页讲义讲座体精读 · 14 章 · 24 图 · 14 式
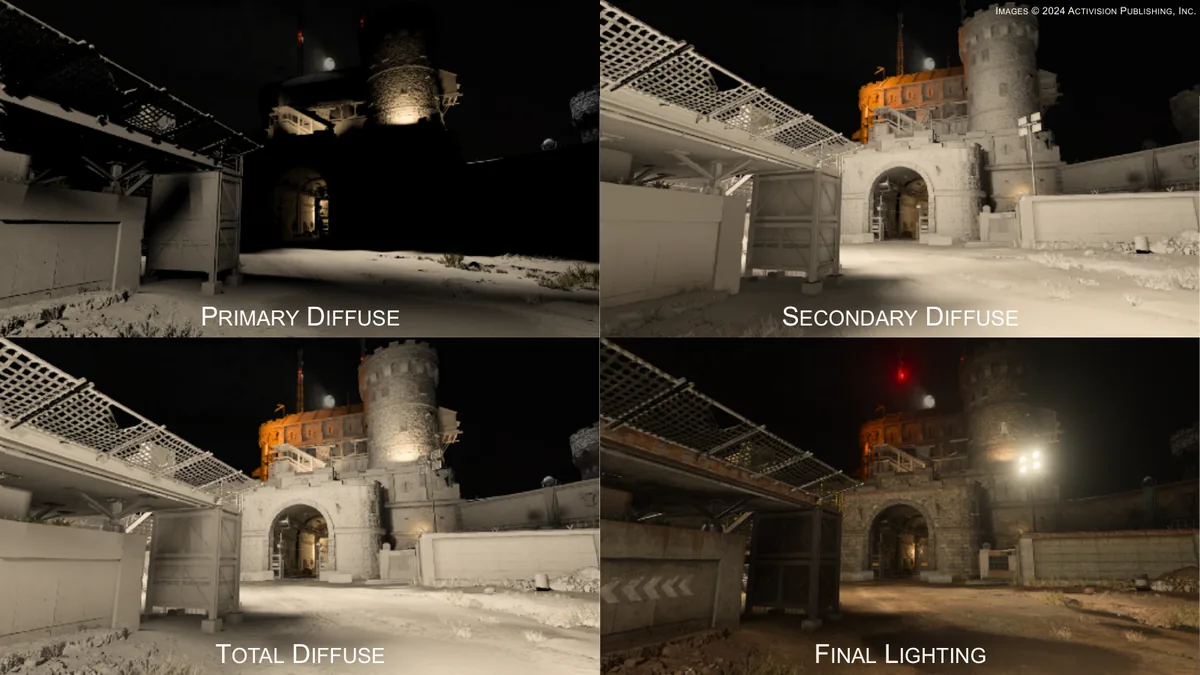
CoD 半球光照讲义首图:烘焙光照的四段分解(原文 slide 4)
篇目 38 全局光照光照贴图 已完成 14 章19,114 字24 图

让方向性 lightmap 不再漏光:把环境项换成一盏半球光,把遮挡做成一次矩阵乘法

要解的是两处具体的画面缺陷。一处是方向性 lightmap 的混合:AHD(环境色加一盏方向光)简单好用,从 Quake III 一直用到 The Last of Us,但它是非线性模型,直接把系数存进 lightmap 再在 texel 之间插值会出过滤伪影与过冲 —— 页内的现象是混合后的半球法线方向辐照度比两端都亮。2018 年的 IrradZ 编码改为存并插值标量辐照度 Iz 与环境权重 wa,重建时解回 AHD 参数并保持 Iz 不变,整套只占 2.5 字节/texel。另一处是归一化法线贴图的漏光。讲者的正题从「常数环境光该编成什么」开始:直觉的答案与真实辐照度不符,因为半球遮挡让辐照度越靠边缘越暗,最优化解出来恰好是一盏半球光(Ca = 1/2、Cd = 1/2、d = nv);再叠一盏方向光就根本没有精确解(页内明写 No exact solution!),于是把重建式里的环境项整体换掉,得到 HHD。求解分两条路:Iz 可烘焙时采样或由辐照度 SH 重建,wa 是线性参数用最小二乘,d 是非线性参数必须搜索(θ 上黄金分割、外层再搜 φ)。两处容易被忽略的细节决定了这套求解是对的还是错的:算 wa 必须用半球 Gram 矩阵,用球面 Gram 等于把质量浪费在永远看不到的下半球(页内直觉:只看天的话,地面是绿的与你无关),RMSE 从 0.0473464 降到 0.0165971;高光方向不能取解析的「最优线性方向」,因为把 HHD 投影进线性 SH 后线性带的 z 分量被半球光污染,方向被拉向半球法线、侧倾不够。三组 RGB 重建误差随之从 3.795/4.874/5.159 降到 1.514/1.805/1.597。但讲者同时指出:六个场景的逐场景表显示 AHD 与 HHD 的质量差别相当小、甚至能构造出让任一方赢的场景,所以换 HHD 的理由在混合 —— CoD 里会有可关的动态灯光组,而 HHD 作为合法的半球光照表述可以直接从线性 SH 廉价解回。最后把遮挡也写成一次矩阵乘法:半球乘法要在 radiance 上先把下半球乘掉,把半球的积分上限换成锥角就得到锥形乘法,分量与半球乘法完全相同、只是系数变成 cos(α) 的多项式,于是运行时 AO 给的可见性锥能复用同一套数学(讲义特意对比了过去常用的弯曲法线是相当粗糙的近似)。

原文 SIGGRAPH 2024 Advances in Real-Time Rendering · 66 页讲义引用 24 页整页渲染非 CC · 逐图署名引用

Shipping Dynamic Global Illumination in Frostbite

非 CC · 全文无声明
SIGGRAPH 2024 · Advances in Real-Time Rendering in Games course · 67 页讲义讲座体精读 · 14 章 · 24 图 · 0 式
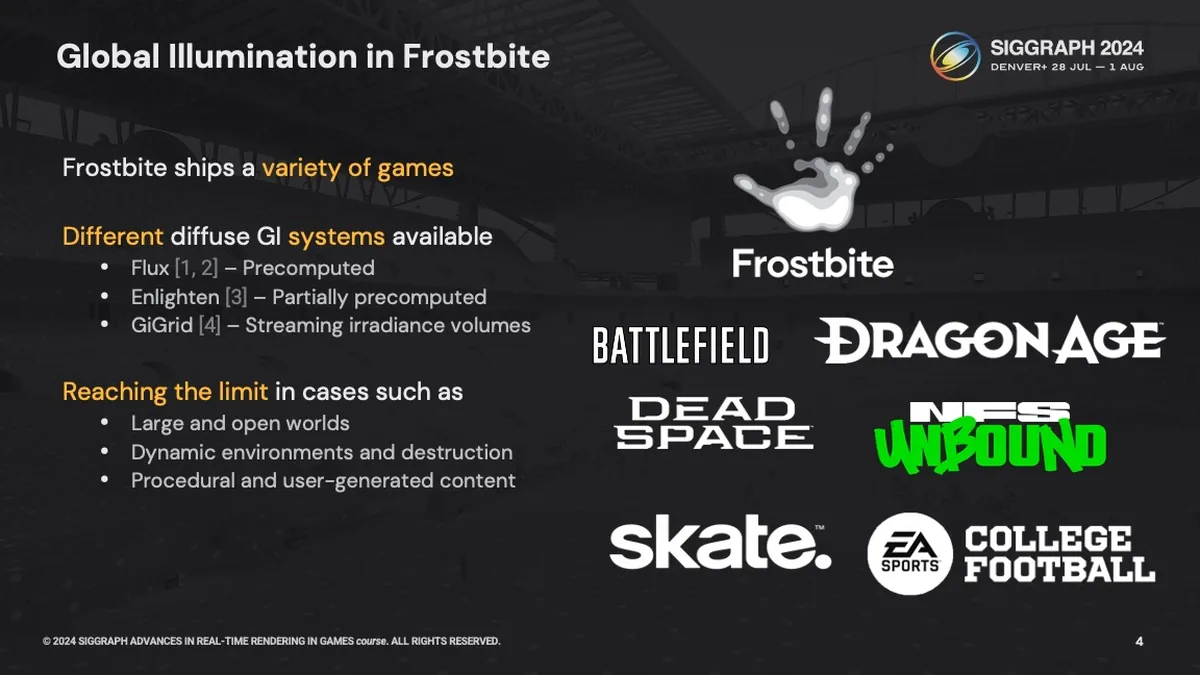
Frostbite GIBS 讲义首图:引擎里同时带着的几套 GI 系统(原文 slide 3)
篇目 39 全局光照引擎 已完成 14 章19,285 字24 图

三年不加新系统,只把这 6 到 7 毫秒压到 2.5 毫秒:Frostbite 的 GIBS 是怎么在主机上解锁 60 帧的

要解的是一笔很具体的账。2021 年那场讲完整套系统时,内容已经发行、GIBS 自己还没出货,而总平均 GPU 时间要 6 到 7 毫秒,Frostbite 的游戏普遍按 60 帧发行、一般没有 6 毫秒可让。这三年的做法是少见的:没有引入任何新系统,仍然是光追、surfel 与探针三件事,做的是增量改进,其中大量优化对间接光本身的质量没有影响、另有少数是为了减少求交次数而刻意引入偏差的。探针侧从球谐的硬件三线性插值换成八面体表示与软件插值(与 DDGI 很接近),在「最多 3 个 clip、上限约 10 万探针、总预算 100 MB」的框里把每探针约 1 KB 分配掉 —— 两个图集里深度分辨率更重要,最终 variance depth 用 14×14(含 2×2 边界)、irradiance 用 6×6,剩下 96 字节;射线预算上,每帧可派发 10 万条、每探针每帧只够 1 条,但行内卷积至少需要 16 条,于是把更新摊成每帧约 6 千个探针,靠每帧一个 clipmap 层级加层内优先级排序来挑。surfel 侧修掉三个坑:法线切线基准不一致会过量 spawn(最后改成在 GBuffer 落盘时导出顶点插值法线),射线起点偏移过于保守会让射线漏到室外造成漏光(误差界逐 surfel 不同,所以按 surfel 存下来),覆盖缺失时改为用探针给初值。光追侧把加速结构做进离线管线(离线 BLAS 让静态几何遍历改善 15%、选择性 rebraid 再加 5%),代价是加速结构里只放不透明非 alpha 测试几何、材质简化成每个网格材质子集一色、光追视野里植被整体缺席;再把主射线从 1000 米限到 20 米并用辐照度体积兜底(讲者承认这肯定有偏,但收敛速度反而明显变好),次级射线则是「有阴影贴图就直接取贴图」。两张表把账收尾:均值从 6 毫秒档降到 2.5 毫秒、整趟不超过 3 毫秒 —— 而且讲者同时写明,2021 年的 6 毫秒是 PS5 上另一款游戏、不可直接横比,CFB25 的 60 帧是靠把辐照度更新整个停掉换来的。

原文 SIGGRAPH 2024 Advances in Real-Time Rendering · 67 页讲义引用 24 页原生图流非 CC · 全文无声明

Achieving Scalable Performances for Large Scale Game Components with CBTs

非 CC · 逐图署名引用
SIGGRAPH 2024 · Advances in Real-Time Rendering in Games course · 159 页讲义讲座体精读 · 14 章 · 26 图 · 0 式
CBT 讲义首图:本场标题页(原文 slide 0)
篇目 40 LODGPU 工程 已完成 14 章19,831 字26 图

全分辨率要 exabytes,他们只用一套表示:把满二叉树当内存池,做任意网格的无裂缝自适应二分

要解的是一道被数字堵死的问题。他们的地球模型若不做任何 LOD,全分辨率网格需要 exabytes 的数据(页内注明 1 exabyte = 1,000,000 terabytes),这直接挡住了 Nanite 那一类要求把全分辨率网格作为输入的 LOD 系统;UE5.3 里还有一条路,把近处一套与远处一套表示耦合起来,但讲者说混合表示很难用,尤其是自由飞行的相机,因为两套表示之间那个过渡位置很难定。他们的做法是只用一套表示:把一个满二叉树当成 GPU 上可分配的内存池 —— 树最底层一个位域,其余每个节点存它对应子树里绿位的个数,于是根给出绿位总数,也能遍历并不连续的绿位;容量等于位域的容量,绿位记已分配、红位记可用。网格侧再把这口池子接到任意多边形网格上:输入半边界网格、输出每条半边界一个三角形,代价是要自带邻接信息,否则朴素二分会出 T 形接缝、最终表面上出现裂缝。后半是重做后的实现细节:128k 的 CBT 节点数是位域的两倍(2 × (128 × 1024) = 262144),朴素表示约 1 MB,而 DX12 的组共享内存上限是 32 KB,于是树被按访问约束拆成原子友好子树、线程子树、虚拟层级与原始位域四类,本体落到约 3 KB;一帧跑十二段管线,多数是间接派发,Classify 把每条平分线判成 Keep、Merge 或 Split,Split 的第一件事是算出这次分裂最坏情况要预留多少内存,拿不到就不做。最实在的优化在 Evaluate LEB:最终位置由 heapID 位串经一串矩阵乘法给出,乘法必须在 double 空间做,按层级最多 64 次 3×3,先拆成两段各 32 次 float 夹一次 double,仍不够好,再用一张深度 5 的矩阵缓存降到两组各 6 次 float 加一次 double。在 1920×1080、CBT 128K 下,讲者点名的结论是始终在合理成本内、在相当于 PS5 的硬件上低于 0.2 毫秒;演示的完整代码开源在讲义 slide 158 给出的地址上。

原文 SIGGRAPH 2024 Advances in Real-Time Rendering · 159 页讲义引用 26 页整页渲染非 CC · 逐图署名引用

Variable Rate Shading with Visibility Buffer Rendering

非 CC · 逐图署名引用
SIGGRAPH 2024 · Advances in Real-Time Rendering in Games course · 185 页讲义讲座体精读 · 14 章 · 27 图 · 0 式
VRS + VBuffer 讲义首图:key idea 那一页(原文 slide 4)
篇目 41 可变速率着色可见性缓冲 已完成 14 章19,249 字27 图

一像素三角形要付 4 倍,quad 又甩不掉:用可见性缓冲把着色率从几何率里拆出来

要解的是一笔藏在像素着色器调度里的固定开销。像素着色器以 2×2 的 quad 全速运行,quad 没填满时空出的像素仍然要跑 —— 跑在屏幕上的是 active lane,即将被丢弃的是 helper lane,结果会被丢掉;于是大三角形付 1 倍、典型约 10 像素的三角形付 2 倍、只覆盖一个像素的三角形付 4 倍。硬件 VRS 把 quad 放大成 4×4,把大三角形拉到 0.25 倍、约 10 像素拉到 1 倍,但一像素三角形仍是 4 倍;讲者由此提出软件 VRS,目标是到处都拿 0.25 倍,代价是额外的开销。要落地得先把三条路径的账算清:Forward 整趟 4 倍,Deferred 只有 GBuffer 写那趟 4 倍、光照 1 倍,VBuffer 一律 1 倍而且容易套软件 VRS。VBuffer 结构上只是多一趟的 GBuffer,实践上复杂得多,要解四件事:Primitive ID、取插值量、材质求值、VRS 重建。Primitive ID 有六种取法,能当统一路径的只有 SV_PrimitiveID、NonIndexed 与 Leading Vertex 三种,Mesh Shaders、Software Rasterizer 与 Geometry Shader 能作后续优化、不能作统一路径;选型标准是「到处都够好」与「没有大的性能悬崖」。Leading Vertex 胜出靠的是一份公开实测,三平台读数出自 Sebastian Aaltonen 的推文;它的原理只有一行 —— flat 插值只取第一个顶点 —— 难点在给每个三角形排到一个空闲起点:先贪心定起点,再旋转顶点补上剩下的,簇固定 64 个三角形配 64 个顶点,最后落到每三角形两个 6 位索引、32 位索引下 5.5 字节。后三件事都带让步:quad 为了导数而存在,导数得自己算并改用 SampleGrad;重建放弃洪泛填充、改用一条硬编码搜索路径与位掩码表达式,那一趟页内自评 TODO: Optimize;完全可变速率在光照变化时有鬼影、需要不断调参。两套账收尾:一像素三角形上 Forward 10.55、Deferred 7.01、VBuffer 4.72 毫秒;Monkeys 场景里 Forward 2.47、Deferred 1.94、Vis 1x 1.67、2x 1.44、4x 1.35、4x 可变 1.47 毫秒。结论带一句限定:密集三角形加复杂材质再加强 GPU 才划算,其余场景要等硬件把这份开销盖过去 —— 「VBuffer 是更好的做法……终将如此;但『终将』可能很长」。

原文 SIGGRAPH 2024 Advances in Real-Time Rendering · 185 页讲义引用 27 页整页渲染非 CC · 逐图署名引用

Dynamic Novel View Synthesis in High Dynamic Range

CC BY-NC-ND 4.0
arXiv:2509.21853v3 · ICLR 2026 会议论文 · 22 页单篇论文精读 · 14 章 · 17 图 · 9 表 · 8 式
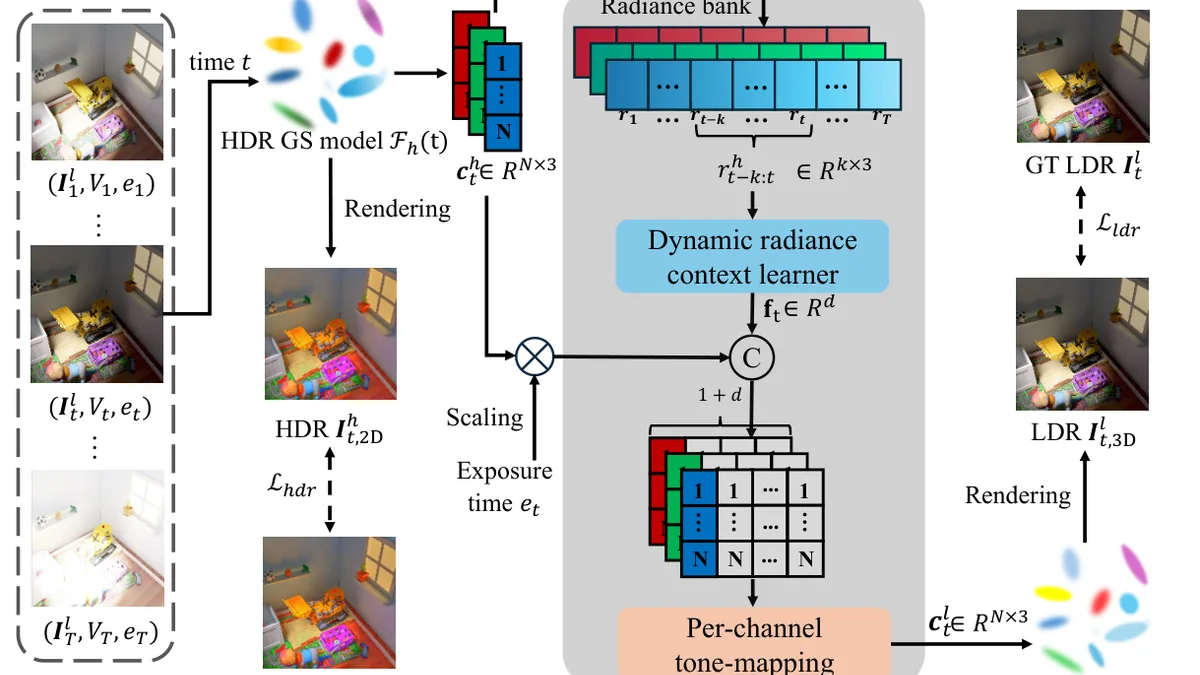
HDR-4DGS 方法总览:输入与场景表示、动态色调映射器、联合优化的损失(原文 Fig. 1)
篇目 42 高动态范围动态新视角合成4D 高斯 已完成 14 章19,590 字17 图

要 HDR、要动态、训练数据却只有 LDR:给 4D 高斯配一个跟着时间走的色调映射器

前人的两条线各缺一半:新视角合成默认场景静止、输入还是低动态范围;HDR 新视角合成敢跨动态范围,却把场景当成不动的。这篇把两边合起来立了一个新任务 HDR DNVS —— 从稀疏、随时间变化的 LDR 输入,学出时间上连贯的 HDR 辐射场与动态几何。作者给的理由落在成像本身:人眼能跨十个数量级以上的亮度,典型 LDR 传感器只覆盖很窄一段,还要经相机响应函数非线性压缩,把局部对比、亮度梯度与色彩保真一起压掉。解法 HDR-4DGS 的底座是 4DGS,只把颜色空间从 LDR 扩到 HDR;核心新增件是动态色调映射器 DTM,它先用辐射库把每个时间戳的平均 HDR 颜色统计下来,用一段滑窗取过去 k 帧的签名喂给上下文学习器(默认 GRU、维度取 2),再把取对数并乘上曝光时间的 HDR 颜色与这个嵌入拼起来,送进逐通道色调映射函数。作者说这个设计的来路是生物视觉的自适应:视网膜感光细胞会随环境亮度调整。训练上加了一条像素级监督,用来压住直接对 HDR 高斯场做三维色调映射带来的过拟合,消融给它的定价是 1.03 dB。两套数据集的分工是「真值怎么来」:合成集八个场景的 HDR 真值是重新合成的,真实集四段序列用六台同步 iPhone 14 Pro、三种曝光拍摄,HDR 真值由 UltraFusion 生成 —— 二维方法生成的真值缺乏多视角一致性,这正是 4DGS 在真实集上仅用 HDR 监督时重建失败的原因。账要分开算:合成集上 HDR 侧本文是 11 行里最好的,30.40 对 HDR-HexPlane† 的 29.30;真实集上 PSNR 最高的是对手的 33.03,本文 25.13,作者归因于真值噪声与 PSNR 偏好过平滑或模糊的重建,并专门画了一张图作证。效率侧是本文赢:推理 48.63 fps,比 HDR-HexPlane 快约 36× 与 200×;作者还解释了一条反直觉的现象 —— 加上 HDR 监督反而让推理更快,因为 HDR 信号会压缩模型。本站在文里把九张原表按文字层逐格取出来重排并复算,同时标出两处原文疑点:表 2 末行的 LDR 三列与两个耗时与表 1 末行完全相同,以及表 6(k=20)的 SSIM 与表 4、表 5 同配置差 0.009。

原文 arXiv:2509.21853v3 · ICLR 2026 · 22 页引用原文图 17 张 · 表 9 张CC BY-NC-ND 4.0 · 可站内托管

Mono4DGS-HDR: High Dynamic Range 4D Gaussian Splatting from Alternating-exposure Monocular Videos

arXiv:2510.18489v2 · ICLR 2026 会议论文 · 24 页单篇论文精读 · 14 章 · 15 图 · 8 表 · 11 式
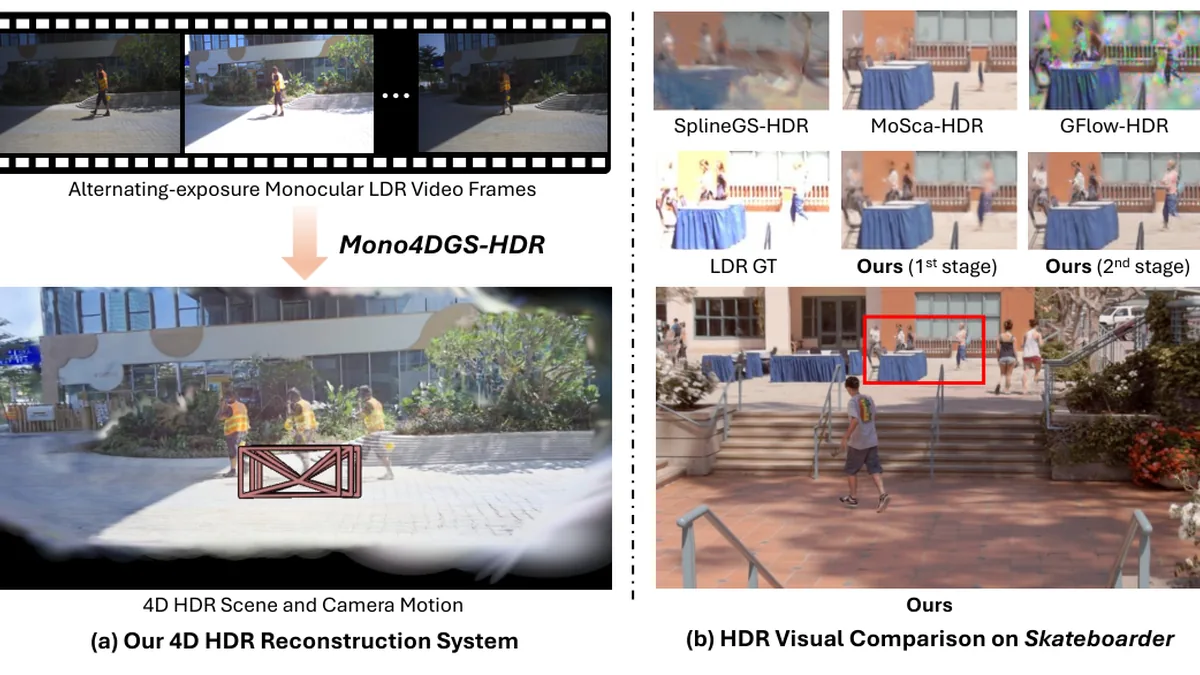
Mono4DGS-HDR 的系统总览与 Skateboarder 上的 HDR 对比(原文 Fig. 1)
篇目 43 高动态范围单目视频4D 高斯 已完成 14 章21,031 字15 图

没有位姿、曝光还在逐帧交替:把相机运动吸收进高斯,再用 2D 不变性把尺度搬回世界空间

相机位姿未知、只有一台手持相机、视频帧的曝光还一帧一变,三条约束撞在一起时,用光度重投影误差优化位姿这条常规路直接断了。这篇做的是从这样的单目 LDR 视频里恢复可渲染的 4D HDR 场景:第一阶段在正交相机坐标系里学一组视频 HDR 高斯,把相机运动和物体运动统一收进高斯的轨迹,相机参数被彻底绕开,训练视频的亮度先对齐;第二阶段把这组高斯搬到世界空间,与相机位姿一起精调。搬的过程有两处硬骨头。判动静这一步不能只看高斯有没有落进动态区域,还要用一个指示量把它当时被挡住的那些时刻剔掉,再按 N_d / N_f 是否超过 0.1 投票;尺度这一步不能继承,要按「投影出的 2D 高斯在变换前后形状尺寸一致」这条不变性重解一个最小二乘,作者的做法是用梯度下降,1000 步以内、1 分钟以内收敛。训练上还补了一条时间亮度正则:监督在曝光正常的时刻有效、在过曝或欠曝的时刻很弱,动态高斯于是会在物体表面上方留下飘点,用光流把相邻帧的 HDR 渲染互相 warp 过来对齐逐像素亮度,就能把有效时刻的信息传下去。评测集是从公开数据集拼出来的 25 个场景,另造了一个 HDR-TAE 指标量时间稳定性。账面上,合成集测试帧 HDR 侧 37.64 / 0.959 / 0.042、真实集 27.65 / 0.876 / 0.081,两处都是最好的;推理 161 fps,对 HDR-HexPlane 的 1 fps 是 161 倍。本站在文里把八张表按文字层逐格取出来重排,并核出三处:被采用的控制点采样间隔 Ns=4 在四个指标列上都不如 Ns=1(作者给的理由是显存折中);完整模型那一行读数在六张表里逐格一致;GFlow-HDR 在合成集上 LDR-OE 有 30.08 而 HDR 只有 18.70,落差 11.38 dB,本文则是反向的。

原文 arXiv:2510.18489v2 · ICLR 2026 · 24 页引用原文图 15 张 · 表 8 张非 CC · 逐图署名引用

MoE-GS: Mixture of Experts for Dynamic Gaussian Splatting

arXiv:2510.19210v2 · ICLR 2026 会议论文 · 23 页单篇论文精读 · 14 章 · 11 图 · 13 表 · 16 式
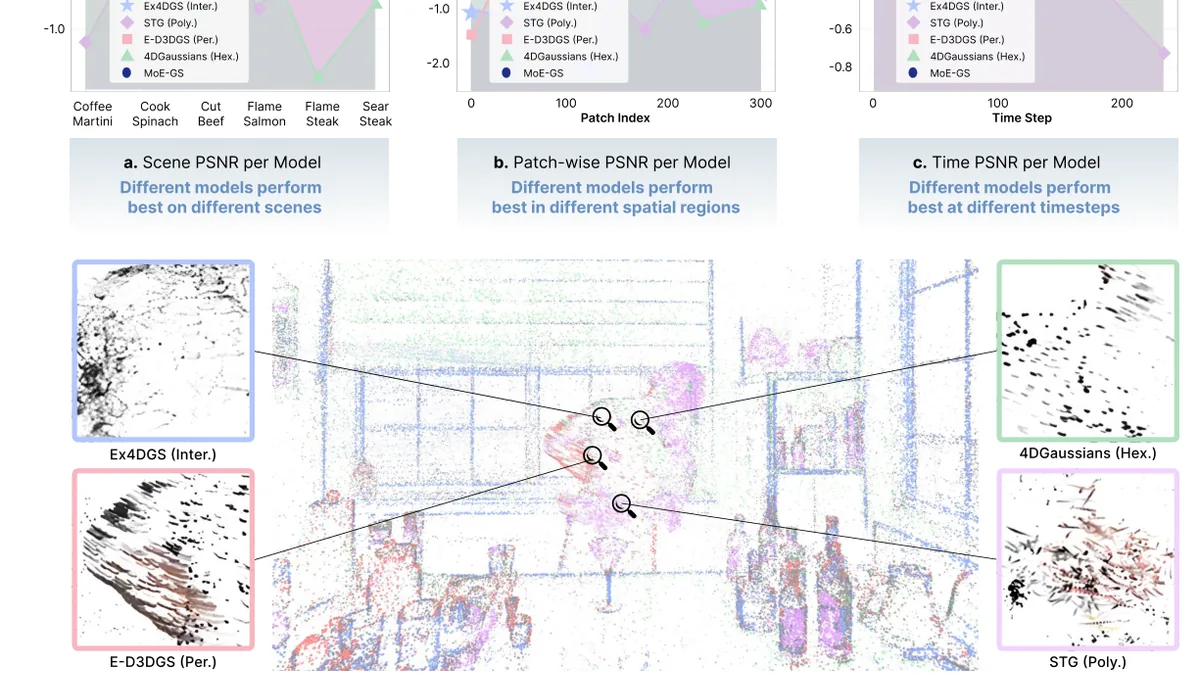
MoE-GS 立题的三组证据:跨场景、同场景内跨空间块、同视频内跨时刻,最优方法都在换人(原文 Fig. 1)
篇目 44 动态重建混合专家3D 高斯 已完成 14 章20,176 字11 图

没有单一方法能通吃所有动态场景:让专家各训各的,再把 3D 权重泼溅进像素空间做路由

动态场景重建这条线上方法已经不少,麻烦在于没有哪一个能一直好:换个场景、同一场景里换个空间块、同一段视频里换个时刻,最优方法都在换人 —— 原文用图 1 的三组证据把这句话立起来。作者的对策是把「选一个」换成「混几个」:让形变先验互不相同的三个专家(4DGaussians 的 MLP 形变场、E-D3DGS 的显式控制点、STG 的多项式运动)同时重建同一段场景,再训一个路由器决定每个像素上各专家的话语权。路由器是这篇最吃工的地方,两头的好都要:不在 2D 图像空间直接学权重(结果会过度平滑、抓不住锐利边界),也不在 3D 里改高斯不透明度(细节保不住),而是给每个高斯算一组逐高斯权重(不透明度、方向权重、时间加权的轨迹权重),把它可微地泼溅进像素空间拼成路由特征,再过一个轻量 MLP 出残差、过 softmax 得到融合权重。作者特意说明这与大语言模型里的 MoE 不是一回事:那边的 MoE 以稀疏化省算力为目的,这边是为了把异质的形变先验合起来把画质做上去。代价也是承认下来的 —— 容量上去、帧率下来,是 MoE 架构本身带来的;于是补两条路:框架内用单遍多专家渲染加门控感知剪枝把成本压回去,框架外用蒸馏把 MoE 的画质搬回单个专家、部署不必改架构。账面上 N3V 平均 33.23 dB;效率侧 N=2 是 32.82 dB/44 FPS,剪掉 55% 之后 32.80 dB/83 FPS,PSNR 只掉 0.02 dB。本站把十三张原表按文字层逐格取出来重排(465 个数値格),标出五处跨表读数不一致,并如实并列一处原文自身不自洽:表 8-2 的 MoE-GS (N=3) Average 写 34.55,而该行五个场景值的均值是 34.584、同一配置在表 10-2 里写 34.58。

原文 arXiv:2510.19210v2 · ICLR 2026 · 23 页引用原文图 11 张 · 表 13 张非 CC · 逐图署名引用

Uncertainty Matters in Dynamic Gaussian Splatting for Monocular 4D Reconstruction

CC BY 4.0
arXiv:2510.12768v3 · ICLR 2026 会议论文 · 27 页单篇论文精读 · 14 章 · 7 图 · 3 表 · 12 式
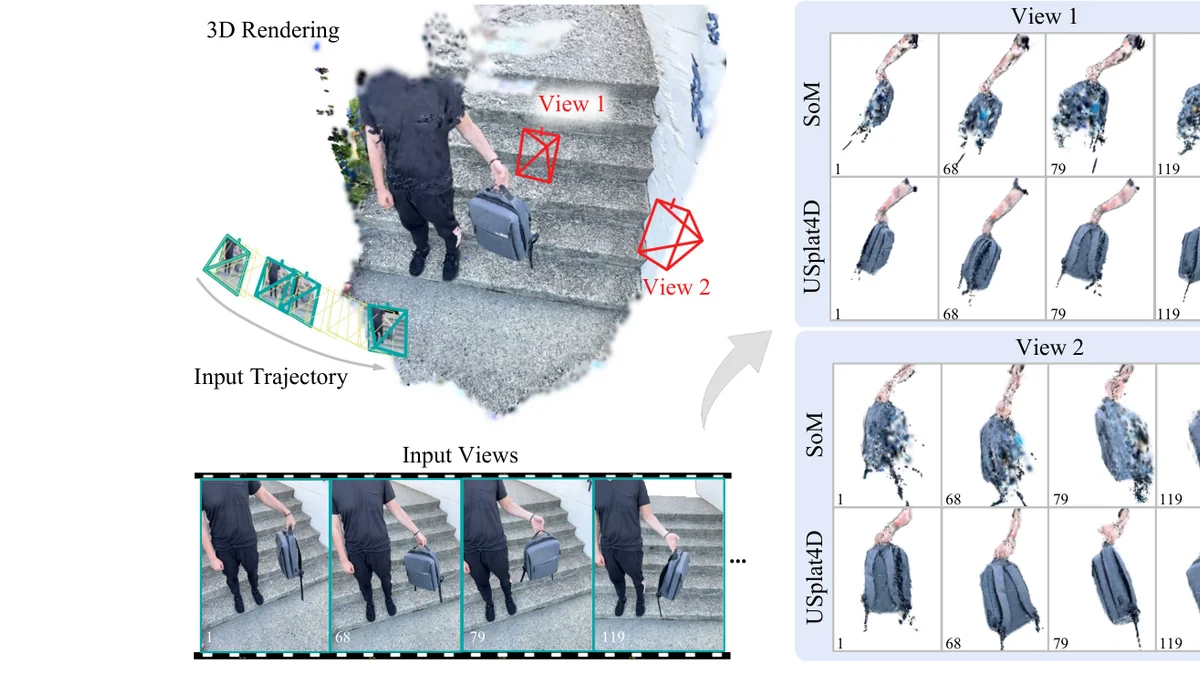
USPLAT4D 的立题案例:移动单目相机前随手转动的背包,以及两个极端新视角下与 SoM 的合成对照(原文 Fig. 1)
篇目 45 动态重建不确定性3D 高斯 已完成 14 章18,454 字7 图

一视同仁地优化会让不可信的高斯把运动带偏:把不确定性做成锚点,再沿时空图把可靠的运动传出去

单目 4D 重建的卡点不在表示够不够强,而在「哪些高斯的话可以信」。单目输入本身欠约束:遮挡背后看不见、极端新视角下的表面从未被观测,而 vanilla 动态高斯对所有基元一视同仁地优化 —— 一个整段序列里被反复看到的高斯,和一个只在两三帧里露过一面的高斯,在损失里占同样的分量,于是遮挡处出现运动漂移、外推到没见过的视角时画质塌下去。作者把不确定性当一等公民:先由光度损失的闭式方差估出逐高斯、随时间变化的不确定性,再把标量掰成沿相机轴的各向异性矩阵;据分数把高斯划成关键与非关键两类,用不确定性感知的 k 近邻连成一张时空图,非关键节点跨整段序列挂到时间上一直离它最近的关键节点;损失侧把 U 的逆加权写进关键项与非关键项,非关键节点同时贴预训练位置与 DQB 插值轨迹。账面三处:DyCheck 的 7 scenes 2× 上 19.63 dB / mSSIM 0.716 / mLPIPS 0.25,对 MoSca 是 +0.31 dB;Objaverse 上对 MoSca 的三档视角偏移增益 0.04 / 0.24 / 0.42 dB(单调递增);消融里去掉不确定性那一环掉 0.77 dB,是四个档里最大的一笔。本站把三张原表按文字层逐格取出来重排(87 个数値格 + 18 个同格连写增益格),并用页面几何独立重抽核对到零差异,同时标出三处读数问题:表 8-1 的表注称「across all metrics」领先,但按表现算 5 scenes 1× 的 mLPIPS 上 MoBlender 的 0.37 优于本篇的 0.38;表 8-2 的增益与读数连写在同一格,18 格里 6 格与「读数 − 同行基线」算不平;表 8-2 与附录表 S4 的六场景均值有 7 格差 0.008–0.175。

原文 arXiv:2510.12768v3 · ICLR 2026 · 27 页引用原文图 7 张 · 表 3 张CC BY 4.0 · 可站内托管

Learning Physics-Grounded 4D Dynamics with Neural Gaussian Force Fields

CC BY-NC-SA 4.0
arXiv:2602.00148v2 · ICLR 2026 会议论文 · 43 页单篇论文精读 · 14 章 · 7 图 · 2 表 · 5 式
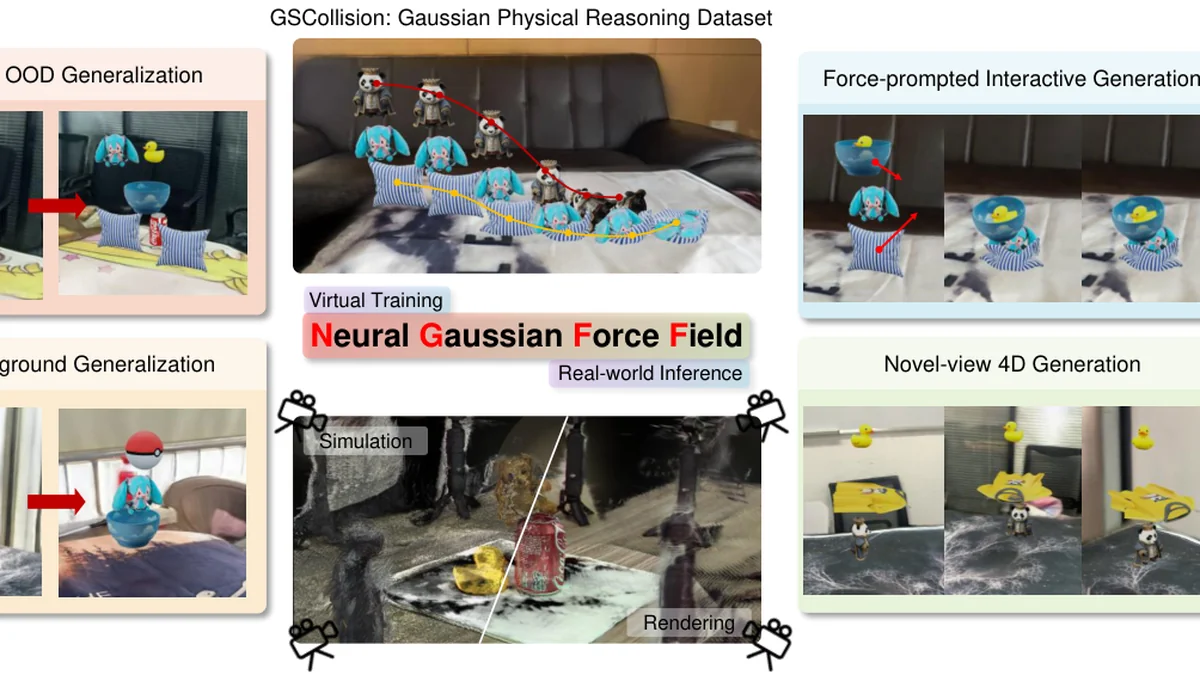
NGFF 的能力总览:四块能力面板拼成的立题 teaser(原文 Fig. 1)
篇目 46 动态重建物理接地3D 高斯 已完成 14 章18,645 字7 图

视频生成画得出重力却守不住重力:把力场学进网络、让轨迹靠积分算出来,比外挂物理引擎快两个数量级

视频生成模型能画出好看的重力,却经常违反重力本身。原文把缺口立在「显式物理」四个字上:视频生成模型视觉质量已经很能看,但没有显式物理建模,会违反重力、物体恒存这类最基本的规律;把 3D 高斯泼溅接上传统物理引擎那条路物理上是自洽的,代价却是算得极慢、也难处理复杂的多物体交互。作者要的是第三条 —— 从视觉观测里直接学出一个显式力场。做法分三段接:用冻结的视觉基础模型(Point Encoder/π3/SAM 2/DiffSplat 这条链)把多视图 RGB 变成可分实例的 3D 高斯,再从高斯的接触关系图上用神经算子学出全局变换力场与局部逐点应力场,合成统一力场后交给二阶 ODE 求解器积分出轨迹 —— 位移是物理量积分出来的,不是网络凭画面记忆拼出来的,这就是它能谈「空间/时间/组合三种泛化」的底气。力场是显式的,外力因此可以当「力提示」直接注入,交互生成在同一套表示里就能做。账面三处:动态预测上对最强对照 Pointformer,空间、时间、组合三个泛化维度全部占优(RMSE 0.082 对 0.096、0.107 对 0.129、0.104 对 0.162,FPE 与 R 同向);比先前的高斯仿真器快两个数量级(表 9-1 上 0.363s 对 VLM-MPM 的 39.29s 约 108 倍,附表 A5 上对 PhysGen3D 是 37s 对 400s、72s 对 590s,但同一列对 Pointformer 的 0.183s 本篇并不占优);可控生成上人类评测的物理合理性 0.56 对 Cosmos 的 0.29 大幅领先,视觉真实感则让位 —— 表 10-1 里 Veo3 的 PhotoR 0.64 高于 NGFF-V 的 0.55,作者写在明面上这是取舍。数据集 GSCollision 是自己造的(10 类刚柔物体、3,200 场景、640k 段渲染视频;训练 8×H100、1001 epochs、48 小时),体量在原文里有 4TB/4.25 TB/216K clips 等多套口径。本站把两张原表按文字层逐格取出来重排(共 106 格),并用页面几何独立重抽核到零差异,同时标出三处:表 9-1 的 Compositional 列与附表 A4 的两个拆分行都不吻合(而 Spatial/Temporal 两段逐格吻合);Time 列三套口径并存(0.363s/2.5s per sequence/37s)而原文未标;附表 A5 里三行耗时完全相同(37s/72s),该列不采信。

原文 arXiv:2602.00148v2 · ICLR 2026 · 43 页引用原文图 7 张 · 表 2 张CC BY-NC-SA 4.0(依据 arXiv 摘要页)· 可站内托管

3DGEER: 3D Gaussian Rendering Made Exact and Efficient for Generic Cameras

CC BY 4.0
arXiv:2505.24053v3 · ICLR 2026 会议论文 · 35 页单篇论文精读 · 14 章 · 8 图 · 6 表 · 11 式
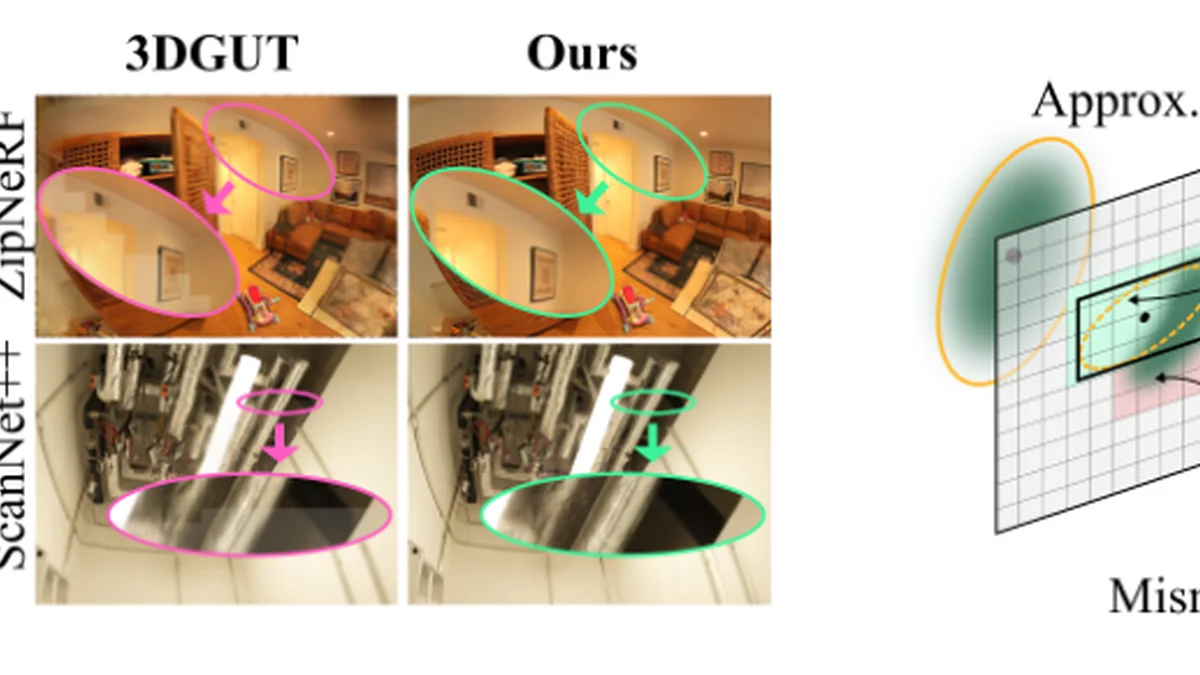
3DGEER 首图:投影近似的两种错法 —— UT 关联的栅格线伪影,与本文从真实 3D 协方差直接算的精确包围(原文 Fig. 1)
篇目 47 3D 高斯实时渲染相机模型 已完成 14 章19,624 字8 图

大视场相机下靠近似投出来的高斯不算数:把投影近似换成沿射线的闭式积分,精确还能保实时

3DGS 的看家效率来自 EWA splatting 的一次局部仿射近似:把 3D 高斯投成图像平面上的 2D 高斯。窄视场下这一步几乎无感,换到鱼眼、全向这类大视场(机器人、自动驾驶的日常输入),非线性畸变让真实投影偏离对称 2D 高斯,误差就显形了。原文把缺口立在文首:先前工作要么把可微渲染扩到特定鱼眼模型(FisheyeGS 那条线)或更一般的相机模型(GS++ 那条线)、却仍靠一阶泰勒展开,要么走几何精确的 ray-based(EVER、3DGRT)被场景级 BVH 拖慢,或者用 Unscented Transform 提速却把关联阶段的投影近似一并继承(3DGUT)—— 没有一篇同时做到投影精确与实时高效。3DGEER 的答案是把近似换成闭式积分:从第一性原理推导高斯密度沿射线的闭式表达式(先做规范变换,让所有高斯退化到同一个各向同性密度,再沿规范射线积出累积透射率与平方马氏距离),保留 3DGS/3DGUT 为简化而省掉的 det(Σ)^½ 一项,测度换元才守恒;再配两件效率机制 —— Particle Bounding Frustum(PBF)用四张切平面给出紧的射线-高斯关联、不做 BVH 遍历,由球面角 θ/φ 的二次方程直接解出角度界;Bipolar Equiangular Projection(BEAP)把不同视场的相机统一成一套图像参数化。账面三笔:ScanNet++ 分区、ZipNeRF 跨相机、MipNeRF360 窄视场三套协议各指标全面占优(ScanNet++ 全视场 PSNR 31.50 对 3DGUT 的 30.64、对 EVER 的 29.47、对 FisheyeGS 的 27.81;边缘区对 FisheyeGS 拉开 5.66,而中心区只有 0.20 —— 增益随视场变宽而变大);比既有的投影精确 ray-based 基线快 5 倍(表 7-3 上对 EVER 约 9.1 倍、对 3DGRT 约 6.3 倍,但对 3DGS 的 343 只有 327,并不更快 —— 5 倍只对 ray-based 成立);并能泛化到训练时没见过的更宽视场。本站把 6 张表按文字层逐格取出重排(共 284 格),用独立路径复核到零差异,并把四处跨表读数摆上台面:同一配置在表 7-1/8-1/9-1 三表里 7 个数值逐格相同而行名写法不统一(Projective-Exact (Ours) 对 3DGEER (Ours))、FisheyeGS 与 3DGS 跨两表读数一致偏高 0.05–0.09 而原文未标口径、表 9-1 行 1 与行 3 的 Central PSNR 打平在 32.21(SSIM 0.951 对 0.952)、附录 K.1/K.2/K.7/K.8/K.9 是这 6 张表的逐序列版;另外记下作者的自我划界 —— 本篇的「精确」只到投影几何,不含完整物理体积正确性。

原文 arXiv:2505.24053v3 · ICLR 2026 · 35 页引用原文图 8 张 · 表 6 张CC BY 4.0(依据 arXiv 摘要页)· 可站内托管

4D Gaussian Splatting SLAM

CC BY 4.0
arXiv:2503.16710v1 · ICCV 2025 会议论文 · 11 页单篇论文精读 · 14 章 · 7 图 · 5 表 · 10 式
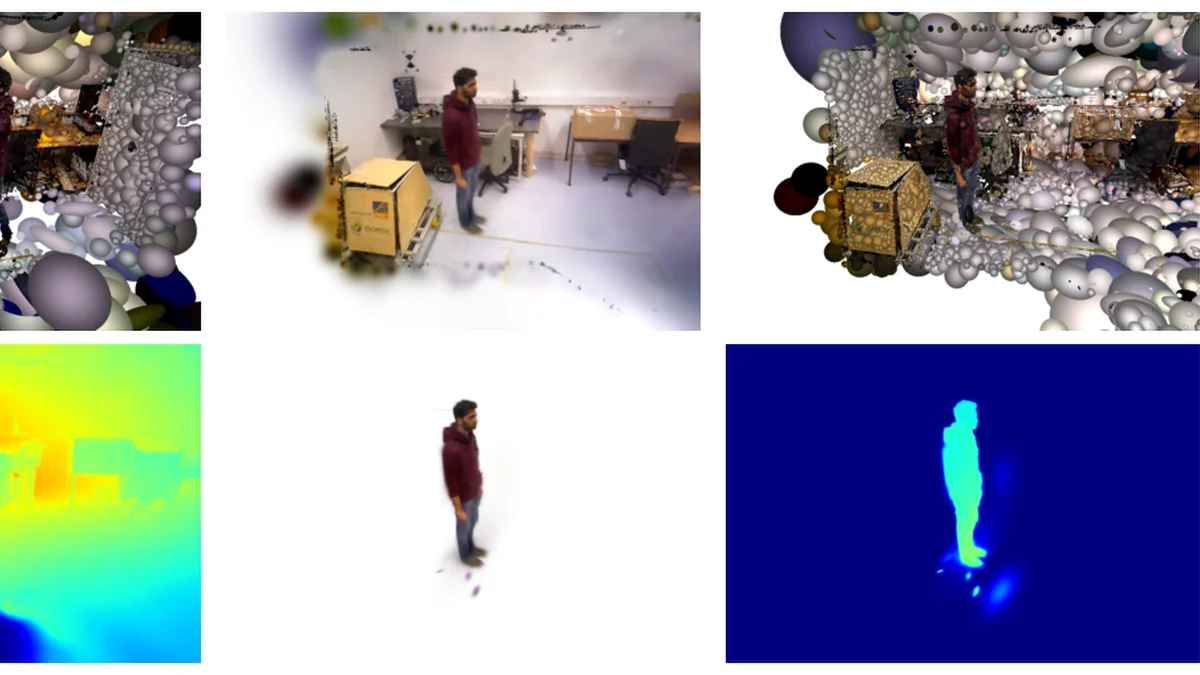
4DGS-SLAM 首图:上排新视角合成与高斯可视化,下排静态与动态的外观与几何(原文 Fig. 1)
篇目 48 4D 高斯动态场景SLAM 已完成 14 章19,520 字7 图

别把走过去的人擦掉:动态场景里一边定位相机,一边把动态物体也建进高斯场

动态场景里的 GS-SLAM,主流做法是「检测出动态像素就剔掉」:位姿稳了,代价是剔完之后重建回落成静态高斯辐射场,动态物体本身没被建出来。这篇不丢:给每个高斯多挂一个「动态与否」的标记,把基元分成静态 Gst 与动态 Gdy 两拨;跟踪期只让静态那拨参与渲染,位姿由渲出的颜色与深度约束,输入侧再用运动掩膜把动态区域从残差里剔掉;动态那拨的形变不逐高斯存轨迹,而是用少数稀疏控制点各带一个 6 自由度时变变换(MLP 块 Ψ),再由 LBS 配 KNN 与高斯 RBF 的局部插值摊到每个动态高斯上。监督上加了一路原文自认的新东西 —— 把光流也当成一种可以渲出来的图:把动态高斯在当前关键帧与上一关键帧之间迁移、投到当前帧相机平面,两点坐标之差按渲颜色同一套 alpha 混合渲成光流图,再与 RAFT 估的真值光流在掩膜区域内做 L1;原文称自己是第一个提供这一策略的 4D 高斯泼溅 SLAM 系统。建图那份损失分两步付:先只放开位姿、曝光与形变网(掩膜区域内颜色/深度权重加倍),再把高斯参数放进来,最后用 1500 次以颜色为主的迭代收外观。账面上:BONN 九列序列里八列最优、Avg 3.6 对 RoDyn-SLAM 的 7.9;TUM 六列全优于它、Avg 1.8 对 5.1;画质上 TUM 三项指标的均值全取(PSNR 22.46/SSIM 0.786/LPIPS 0.228),BONN 的 SSIM 十列全取。本站把 5 张表按文字层逐格取出重排(共 426 格、加粗 74 格),并核出四处:表 10-2 里 Ours 的 LPIPS 整行加粗、而该行十列只有三列最优(其余七列 SplaTAM 更低,SplaTAM 的 LPIPS 行反而不加粗);表 9-1 的 sync2 列 0.56 打平、只给 Ours 加粗;表 10-2 的 MonoGS 行三处位数不齐(20.764/780/0.5210),照录不改;表 11-1 末行与表 10-2 的 sync/sync2 逐格相同。另记两处原文侧的指代不齐(§4.5 把架构图 Figure 2 当画质证据;结论句在逐序列口径上有两格不成立),以及三条作者自我划界:新动态高斯不再添加、中途出现的动态物体需人工预指定初始帧、曝光参数影响部分序列指标。

原文 arXiv:2503.16710v1 · ICCV 2025 · 11 页引用原文图 7 张 · 表 5 张CC BY 4.0(依据 arXiv 摘要页)· 可站内托管

VIST3A: Text-to-3D by Stitching a Multi-view Reconstruction Network to a Video Generator

CC BY 4.0
arXiv:2510.13454v2 · ICLR 2026 (Oral) · 31 页单篇论文精读 · 14 章 · 16 图 · 7 表 · 7 式
VIST3A 首图:上排文本到 3DGS 的生成与高斯可视化,下排文本到点图的结果(原文 Fig. 1)
篇目 49 Text-to-3D高斯泼溅模型拼接 已完成 14 章16,860 字16 图

别从零训那个解码器:把现成的前馈 3D 模型接上去,再把生成器对齐过来

端到端 text-to-3D 的瓶颈不在生成端,而在那个从零训的 3D 解码器 —— 原文点名它是 Achilles heel,并指出既有的「生成器↔解码器」对齐只做单步采样、忽略去噪轨迹。这篇的解法不是换一个更强的生成器,而是把一个已经训好的前馈 3D 模型整段拿来当解码器:先用闭式最小二乘扫层,找出与视频潜表示线性关系最强的那一层,切在它前面并拟合一个线性拼接层(这一步只需要一个小数据集、不需要标签),再在整条去噪轨迹上加奖励做直接奖励微调,把生成器对齐到拼接后的解码器。奖励由三样组成:多视图图像质量、3D 表征质量、3D 一致性,且只在两个采样解码视图上计算以省算力。账面上:T3Bench 与 SceneBench 的 12 个指标格全部由两个变体拿下;DPG-Bench 五个子项从 69.70/68.43/66.89/50.49/40.91 抬到 81.82/85.58/86.13/76.70/54.55(最大一项 +26.21);用户研究里在 >68% 的样本上被评为文本对齐最好、>87% 为视觉质量最好;VBench 上质量分与总分上升(0.8143 对 0.7827、0.7943 对 0.7716),语义分轻微下降(0.7143 对 0.7275)。另一支支点是「拼接不掉精度」:点图与位姿精度拼接前后几乎不变,而把 AnySplat 接到任一视频生成器上都优于单用 AnySplat(20.85 → 21.17/21.29/21.32/21.48)。本站把 7 张表按文字层逐格取出重排(共 363 格,其中数值格 315、加粗格 31),并核出五处:表 8-1 整表 0 处加粗(原文未标任何最优值);表 10-1 的 Ours 行与表 7-1 的「VIST3A: Wan + AnySplat」行在 SceneBench 上六格逐格相同(64.87/56.96/30.18/3.667/3.862/3.400);表 7-3 的三格加粗全落在「SVD + AnySplat」行,而正文把「Wan + AnySplat」当主配置;表 10-1 与表 7-1 的同一组子指标两种写法(Alignment/Coherent/Style 对 Align./Coher./Style);表 8-1 下部嵌着一条累计误差曲线(不是表格数据)。另记三处原文侧的写法不齐:图 15 图注把方法名写成 VISTA(漏数字 3)、图 16 图注把 by 误拼为 bt、同一方法名篇内四种写法,均照录不改;以及三条作者自我划界:输入必须是有序序列、最优拼接层必须逐「VAE–3D 模型」对分别确定、文本到点图没有基准可依只做定性。

原文 arXiv:2510.13454v2 · ICLR 2026 (Oral) · 31 页引用原文图 16 张 · 表 7 张CC BY 4.0(依据 arXiv 摘要页)· 可站内托管

Augmented Radiance Field: A General Framework for Enhanced Gaussian Splatting

非 CC · 逐图署名引用
arXiv:2602.19916v1 · ICLR 2026 · 22 页单篇论文精读 · 14 章 · 10 图 · 15 表 · 6 式
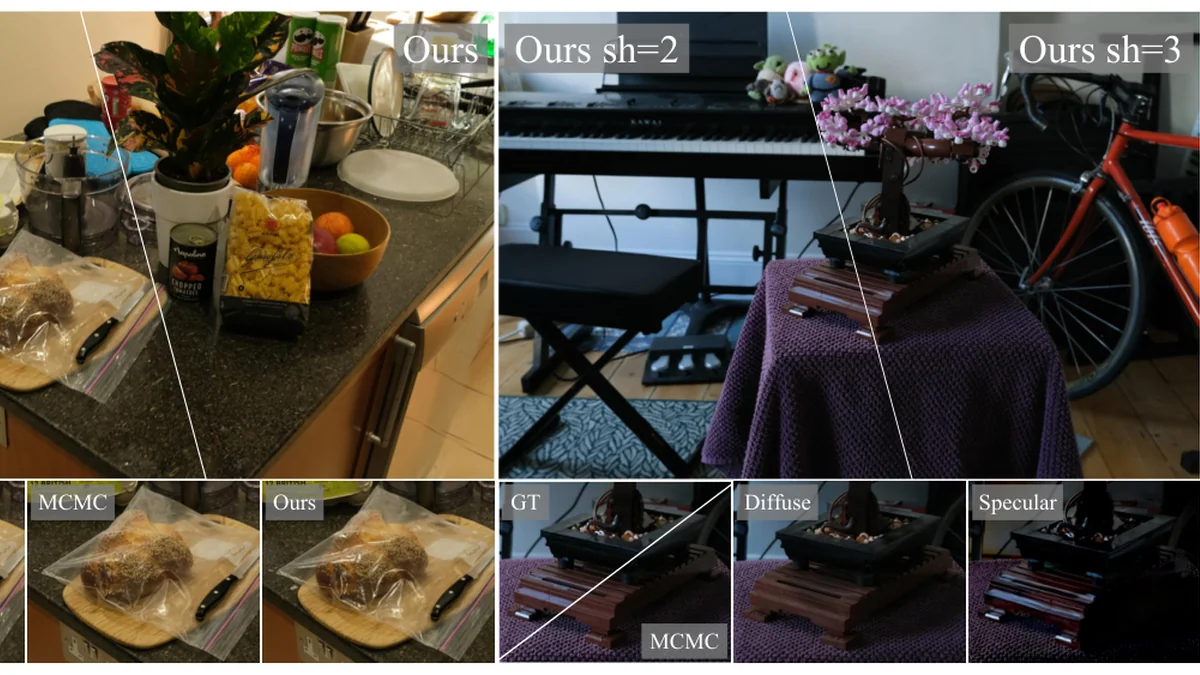
Augmented Radiance Field 首图:增强前后的镜面表达对比(原文 Fig. 1)
篇目 50 高斯泼溅镜面分解球谐 已完成 14 章16,184 字10 图

把方向性挪个位置:不往球谐阶数上堆,改挂在每个高斯核的不透明度上

3DGS 用三阶球谐建模视角相关辐亮度,这一步内在地限制了它表达辐射场的能力 —— 球谐是视角的函数,它记不住「同一处反射里哪一部分是漫反射、哪一部分是镜面」,于是复杂反射表达不出来。这篇不往阶数上加,而是给每个高斯核加一个视角相关的不透明度 lobe(改写自经典 Phong shading),把镜面显式放在不透明度上;每个补充核只多 5 个可学参数。流程三步走:先在图像空间用一批 2D 高斯拟合当前渲染的残差,再经逆高斯泼溅反投影回世界空间(以 Frobenius 范数最小化协方差之差,最优缩放系数有闭式解),最后冻结原高斯多数参数、联合精修新增核,因此它是个可对多数 3DGS 框架即插即用的后增强。账面上:四个数据集上无论二阶还是三阶球谐都优于 SOTA NeRF(Zip-NeRF)与 DBS,Mip-NeRF 360 上 28.96/0.849/0.170,对 28.54/0.828/0.189 与 28.60/0.844/0.182 分别高 +0.42 dB 与 +0.36 dB;加阶数不值得这一条被量了出来 —— 3→4 阶 PSNR 只 27.47→27.55,内存却从 608 MB 涨到 887 MB。消融把功劳分清(基线 28.33 dB):去掉 lobe 只 +0.12 dB、固定覆盖率 π/2 +0.27 dB、完整模型 +0.63 dB;开销那一笔是正的:27.9(纯后处理 15.0)分钟、691 MB、110 FPS,对比 Spec-Gaussian 的 44.8 分钟、882 MB、43 FPS。本站把 15 张表按文字层逐格取出重排(共 969 个数值格,机器校验零差异),并核出四处:15 张表里只有表 9-4 有加粗格(6 格),其中两处 SSIM 打平、原文两格都加粗,其余 14 张整表 0 格;插入比例三处口径不一致(§3.2 写 20%、§4.1 写 10%、表 9-1 的结论是 10% 最优);表 8-1 与表 9-2 的同一配置基线不同(28.29 对 28.33);表 10-1 的 Total(Post-proc.) 把总时长与纯后处理时长写在一格(27.9(15.0) min)。另记两处原文侧的不齐:p16 的 Table 7. 是交叉引用而非表注;表 9-2 的行名写 T = 0.5、正文写「覆盖率固定到 π/2」。本篇许可为 arXiv 非独占分发(非 CC),故不站内托管原文 PDF,图与表按非 CC 惯例逐件署名并标注残留风险。

原文 arXiv:2602.19916v1 · ICLR 2026 · 22 页引用原文图 10 张 · 表 15 张非 CC(arXiv 非独占分发)· 不托管原文 PDF · 逐图署名

Universal Beta Splatting

非 CC · 逐图署名引用
arXiv:2510.03312v3 · ICLR 2026 · 20 页单篇论文精读 · 14 章 · 4 图 · 10 表 · 13 式
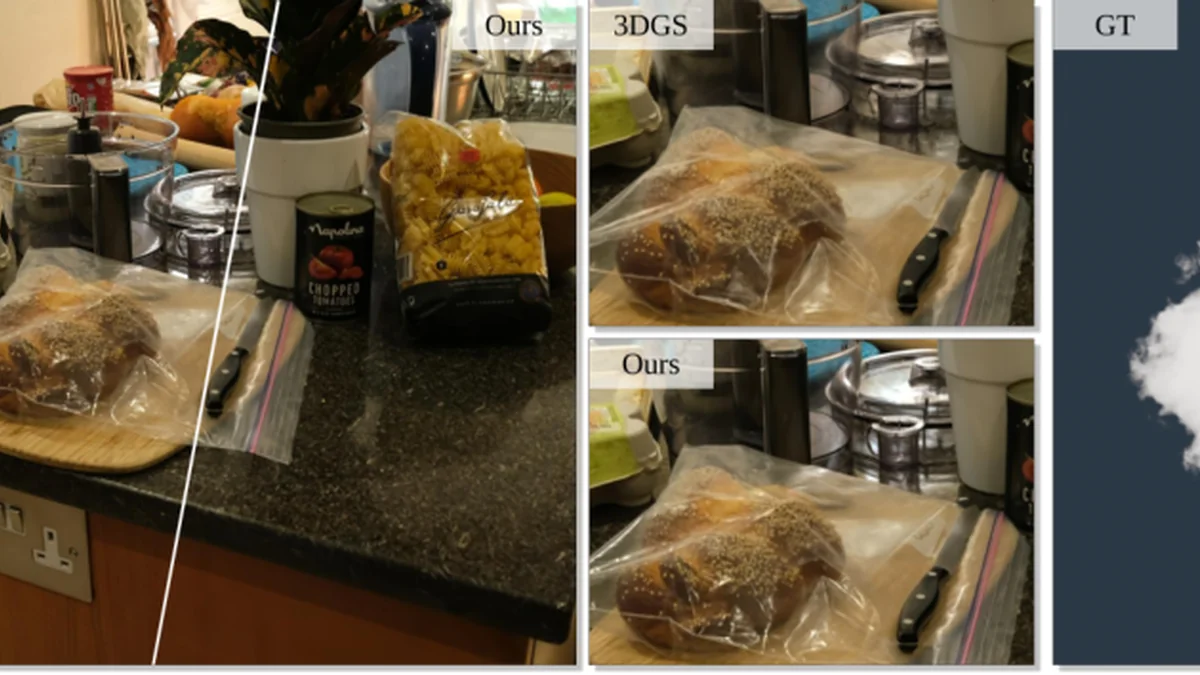
Universal Beta Splatting 首图:静态真实场景的反射与镜面、动态体积场景的时空保真(原文 Fig. 1)
篇目 51 高斯泼溅Beta 核无监督分解 已完成 14 章16,366 字4 图

把核从钟形换成可逐维调形的 Beta 核,让它一次管住空间、角度、时间

3DGS 把「视角相关外观」交给球谐、把「动态」交给形变网络,可核函数本身始终是那个高斯钟形。这篇既不换编码也不加网络,直接把核从高斯换成可逐维调形的 Beta 核,并让它一次管住空间、角度、时间三个维度。形状参数 β = 4exp(b) 逐维可学:b 为负更平、b = 0 退回高斯、b 为正更尖;两处工程分别是空间正交 Cholesky(空间子空间保住 SO(3) 的旋转-尺度结构,跨维相关性交给非对角块)与Beta 调制的条件切片(均值、协方差、不透明度各加调制,不透明度走门控乘积 o·∏(1−d i)^4β qi)。收益最直白的是参数账:免掉球谐编码后每基元从 3DGS 的 59 降到 35(−41%)、从 4DGS 的 161 降到 44(−73%),画质反而上升 —— NeRF Synthetic 34.92、Mip-NeRF 360 28.66、6DGS-PBR 40.10(对 6DGS 高 3.42 dB),动态 7DGS-PBR 33.00、D-NeRF 33.35。消融把功劳分清:去掉空间正交 −0.29 dB、用完整 Cholesky −0.56 dB、去掉 Beta 调制 −0.53 dB、去掉 Beta 调制不透明度 −3.52 dB(最重);CUDA 把训练时间压掉 58%、渲染帧率提 26%。效率账不是一边倒:多数基准更快(8.7 vs 12.7 分钟、25.2 vs 81.9、59.9 vs 116.7),但 6DGS-PBR 上 27.7 分钟长于 6DGS 的 22.2(基元数 300K vs 68K),动态几格的帧率也不占优。本站把 10 张表按文字层逐格取出重排(1,618 个数值格,机器校验零差异),并核出四处:β 的定义三处口径不一(§4.1 的 4exp(b)/§4.3 的 exp(b)/式 6-3 用 4β);表 15-1 的动态帧率并非全面占优;表 7-1 的 7DGS-PBR/UBS-7D/PSNR 均值按表现算是 33.0117 而表内写 33.00(§5.2 的叙述也用 33.00);表 14-1 的 6DGS/PSNR 均值按表现算 36.6857 而表内写 36.68(属截断)。本篇许可为 arXiv 非独占分发(非 CC),故不站内托管原文 PDF,图与表按非 CC 惯例逐件署名并标注残留风险。

原文 arXiv:2510.03312v3 · ICLR 2026 · 20 页引用原文图 4 张 · 表 10 张非 CC(arXiv 非独占分发)· 不托管原文 PDF · 逐图署名

Deformable Beta Splatting

非 CC · 逐图署名引用
arXiv:2501.18630v2 · SIGGRAPH 2025 · 15 页单篇论文精读 · 14 章 · 8 图 · 7 表 · 15 式
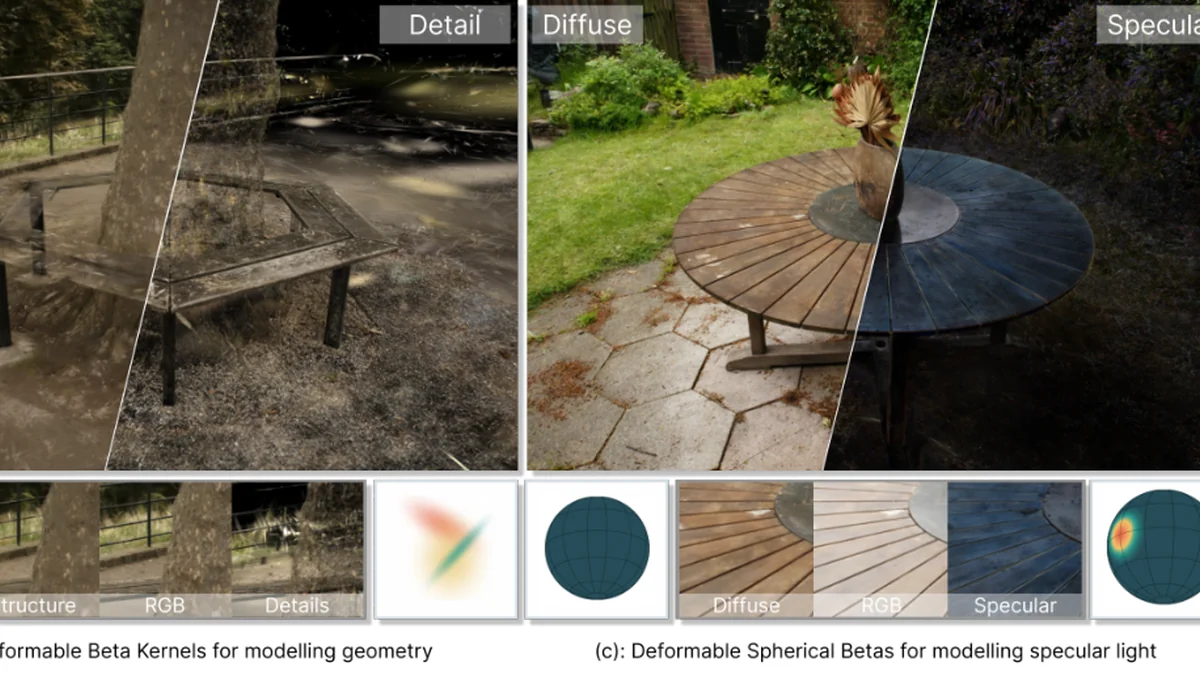
Deformable Beta Splatting 首图:几何与外观重建、几何/纹理解耦、镜面与漫反射分离(原文 Fig. 1)
篇目 52 高斯泼溅Beta 核保分布致密化 已完成 14 章17,638 字8 图

核与颜色两件一起换:致密化那套为高斯量身定的尺度重算可以整块删掉

3DGS 卡在两件固定件上:高斯核无界、必然平滑,上机前还得硬截断;低阶球谐参数随阶数平方涨(3(N+1)²),只能给出平滑的视角相关色。这篇两件一起换。核换成有界的 Beta 核 B(x;b) = (1−x)^{4e^b},一个标量 b 管形状:负 b 更平、b = 0 退回高斯、正 b 更尖,常数 4 由「b = 0 时核近似高斯」的积分近似定出。颜色换成 Spherical Beta,把 Phong 的漫反射与镜面分离写成可学的高光瓣,维度从 3(N+1)² 的平方增长改成 3 + 6M 的线性增长。第三条贡献是这篇唯一的证明型工作:Kernel-Agnostic MCMC —— 在「不透明度被正则化得很小」的前提下,只调不透明度就能保持分布不变,与克隆次数和核形状都无关,于是 3DGS-MCMC 里那套为高斯量身定的尺度重算可以整块删掉。账面上四套数据集几乎全赢(Mip-NeRF360 28.75、Tanks&Temples 24.85、Deep Blending 30.12、NeRF Synthetic 34.66),只用 45% 的参数,比 3DGS-MCMC 快 1.5×,显存从 733.19 MB 降到 356.04 MB。本站把 7 张表按文字层逐格取出重排,并记下三处版式待核(表 8-1 的 implicit/explicit 行组归属、表 12-1 的四个竖排组名被字层切碎、表 8-2 表头粘连)与一处原文侧不齐(表 12-2 的 bonsai 步数读出 84.5 而缺 K)。本篇许可为 arXiv 非独占分发(非 CC),故不站内托管原文 PDF,图与表按非 CC 惯例逐件署名并标注残留风险。

原文 arXiv:2501.18630v2 · SIGGRAPH 2025 · 15 页引用原文图 8 张 · 表 7 张非 CC(arXiv 非独占分发)· 不托管原文 PDF · 逐图署名

SpotLessSplats

CC BY 4.0
arXiv:2406.20055v2 · ACM TOG 44(2) · 12 页单篇论文精读 · 14 章 · 12 图 · 1 表 · 12 式
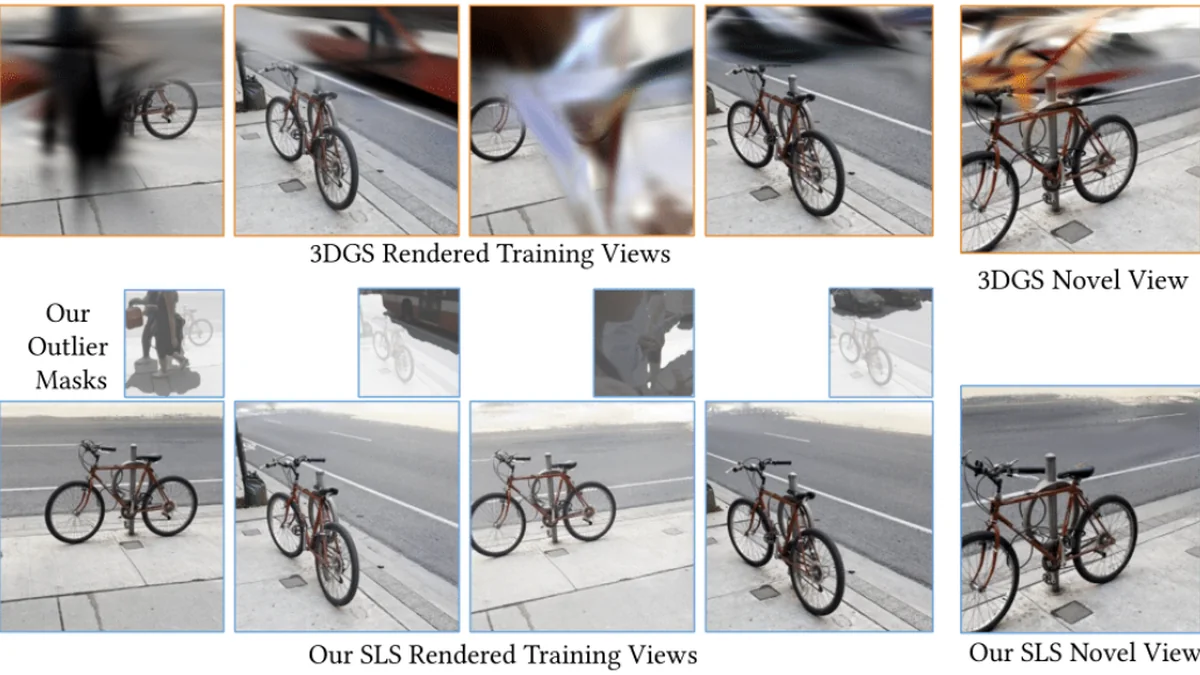
SpotLessSplats 首图:多干扰物场景的掩膜、重建与细节对照(原文 Fig. 1)
篇目 53 高斯泼溅抗干扰重建语义特征 已完成 14 章18,792 字12 图

把「谁在动」的判据从颜色残差搬到文生图特征空间

3DGS 默认两件事:世界是静止的、光照是一致的。休闲拍摄两件都不满足 —— 走过的人、风里的物件、自动曝光与白平衡。前人把「谁在动」的判据放在 RGB 颜色残差上,于是撞上一个具体死角:干扰物与背景同色时,颜色残差里两者是同一件事(原文图 2 的气球)。这篇把判据换了个空间:用预训练文生图扩散模型(Stable Diffusion)的特征图,在语义特征空间里找离群区域。两条检测路线分别是按空间块投票的 SLS-agg(特征图聚成 100 个连通簇、按簇投票内点/外点,快且不需额外训练)与与 3DGS 交替优化的 SLS-mlp(MLP 只对残差能明确判定的像素直接监督,其余交给特征相似度,外加 Lipschitz 正则)。把鲁棒掩膜搬进 3DGS 会坏在三处(掩膜扑向早期噪声、小批即整图导致分位数偏斜、致密化搅乱残差分布),对应三处修法:伯努利采样 + 阶梯退火的热启动、直方图追踪分位数、用「对屏幕坐标的梯度」定义的利用率剪枝(UBP)替掉 opacity reset。UBP 在含干扰数据上把高斯数减到 1/4–1/6、训练时间至少减半、推理快 3 倍;在干净的 MipNeRF360 上也能减 2–4.5× 而不掉画质。三层消融把功劳分清:判据换空间约值 +1.2 dB,而关掉 UBP 指标反而更高(29.27 对 28.72)却会漏出干扰物 —— 这一格把「PSNR 这类指标能在多大程度上代表观感」量化了一次。本篇许可为 CC BY 4.0,站内托管原文 PDF,图与表原样零加工引用并逐图署名。

原文 arXiv:2406.20055v2 · ACM TOG 44(2) · 12 页引用原文图 12 张 · 表 1 张CC BY 4.0(依据 arXiv 摘要页与 Crossref)· 可站内托管

3DGS2

CC BY-NC-SA 4.0
arXiv:2501.13975v2 · 11 页单篇论文精读 · 14 章 · 6 图 · 1 表 · 14 式
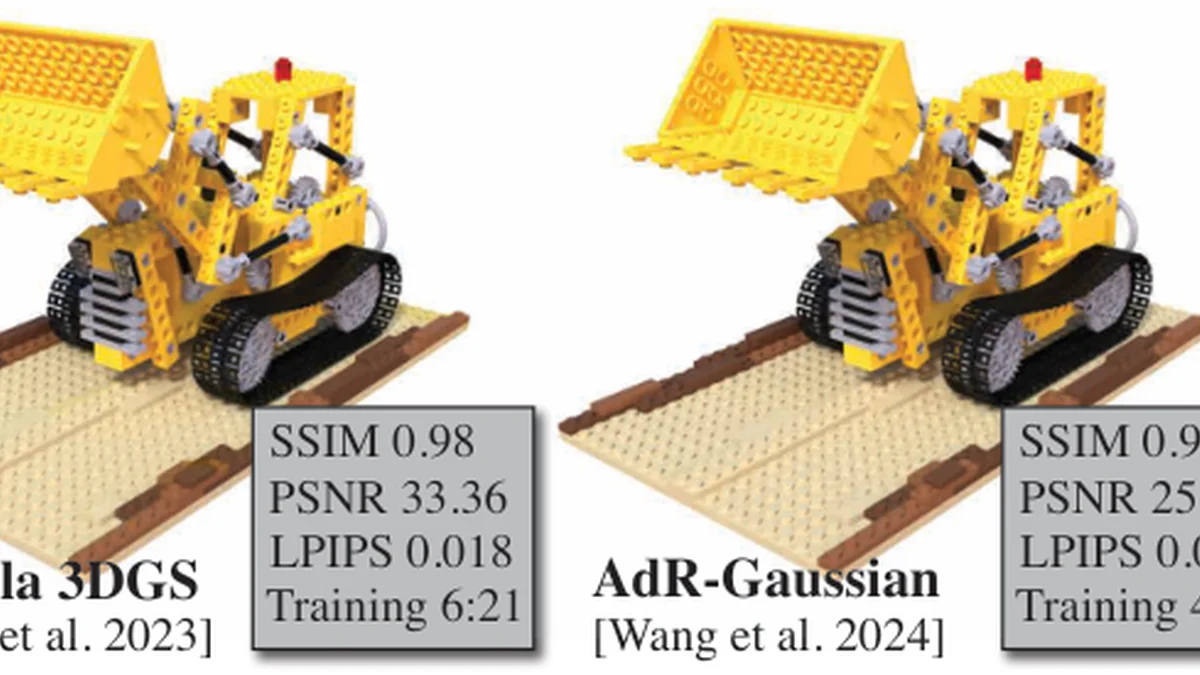
3DGS2 首图:同一场景上五个训练算法的重建结果与四项读数(原文 Fig. 1)
篇目 54 高斯泼溅二阶优化局部牛顿 已完成 14 章21,899 字6 图

把训练从「一阶走一步」换成「每个参数组解一个小牛顿」

3DGS 一直按通用深度学习的办法训练:把全部基元的全部参数拼成一条长向量,用 SGD 走一阶小步,学习率还得按阶段手调。本篇的主张是这条路子放错了层。理由有两条:神经网络里的参数在计算图上强双向耦合,动一个就牵动全部;而 3DGS 的基元参数是弱耦合的 —— 想让一个基元取到好的尺度,先沿 x 调到最好、再去调 y 与 z 就行,这本身就是一串串行的局部贪心。第二条证据来自 Hessian:非零值呈稀疏的局部尖峰而不是全局弥散,「解整个牛顿系统」的收益与代价不成比例。于是本篇按参数组切开,每组解一个小规模牛顿系统,在 GPU 线程上解析地组装局部 Hessian 与梯度:学习率退化成默认的 1.0,线搜索也不需要了。五块参数各有一处必须处理的退化 —— 位置不满秩要投影到视线的垂面、尺度与朝向冗余要降到特征值空间、旋转走乘性更新、不透明度用内点法、颜色要先把位置解耦。代价立刻出现:二阶方法对过冲更敏感,而牛顿法想省掉的恰恰就是学习率这层保护。第二块工程接在这里:把相机位姿投到一个包住全场景的球面上,用球面距离取 K 近邻,把近邻图像的损失当作自调节预条件。账面口径:摘要称「超过 10 倍更少的迭代」,而表 1 的墙钟加速比是 5.1×/5.3×/6.4×;表 1 在 Mip-NeRF360 上 SSIM 与 PSNR 实际低于 Taming 3DGS,只在 LPIPS 上更好。本篇许可为 CC BY-NC-SA 4.0,站内托管原文 PDF,图与表原样零加工引用并逐图署名。

原文 arXiv:2501.13975v2 · 11 页引用原文图 6 张 · 表 1 张CC BY-NC-SA 4.0(依据 arXiv 摘要页与 OpenAlex)· 可站内托管

Virtualized 3D Gaussians

CC BY 4.0
arXiv:2505.06523v1 · SIGGRAPH Conference Papers '25 · 16 页单篇论文精读 · 14 章 · 21 图 · 5 表
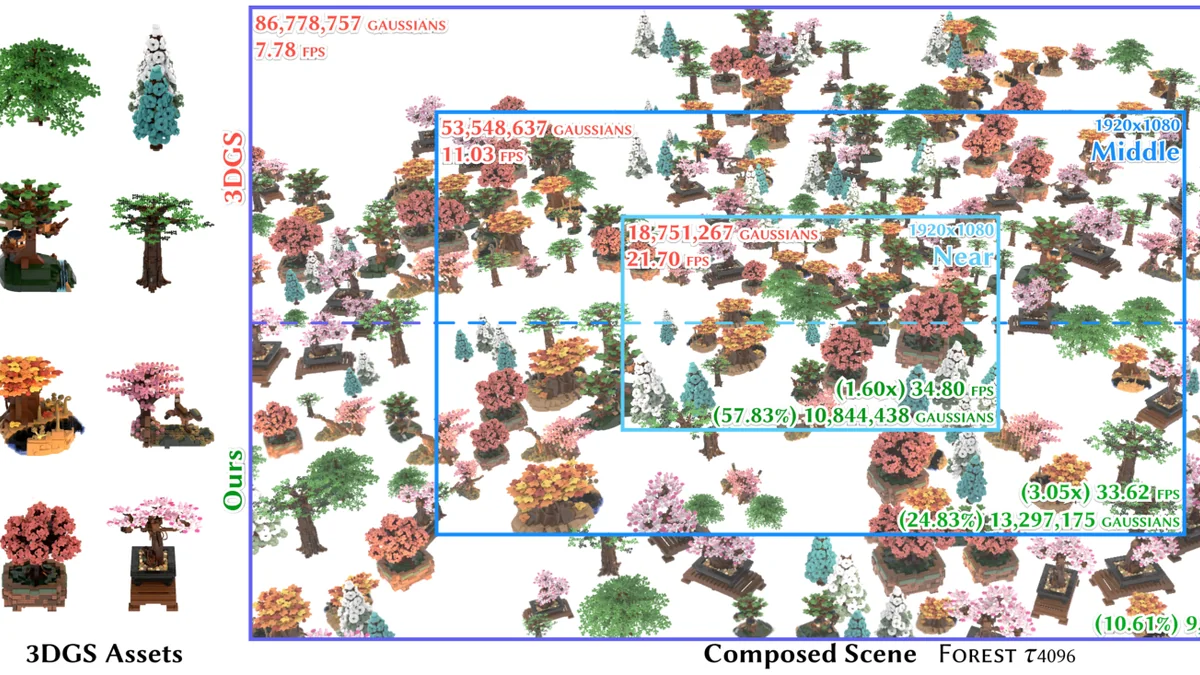
Virtualized 3D Gaussians 首图:左侧一批数字资产,右侧组合场景 Forest 里按距离/分辨率/容差自适应选出的结果(原文 Fig. 1)
篇目 55 高斯泼溅LOD虚拟几何簇 已完成 14 章26,011 字21 图

资产能实时,世界不能:给 3DGS 装一套以簇为单位的 LOD

3DGS 把单个资产的实时渲染做成了常态,但成千上万个资产拼成的数字世界跑不动。本篇把原因归到一处被默认的假设:3DGS 只做基于可见性的裁剪,等于假定视锥里的基元同等重要。解法借自 UE5 的 Nanite 虚拟几何:把 4096 个相邻基元打包成簇、逐层减半排成一棵树,渲染前用足迹(簇组包围球投影椭圆的面积)度量「该看多细」,只渲染「子簇过了容差检查、父簇没过」的那些簇。两处关键处理:离线用局部泼溅(簇组周围撒 640 个伪视角)把每对相邻簇蒸馏成一个新簇;在线用子簇与父簇一起判的并行选择一步到位。最大的产品性质是 τ 由用户在线给定 —— 画质与速度的取舍从训练时的超参变成渲染时的旋钮。账面口径:Forest 在 near/middle/far 三档视距下 3DGS 要渲染 41M/67M/96M 个基元,本系统只选 25M/29M/27M;四个组合场景在「far」距离的加速比是 1.86×/3.48×/5.28×/2.94×,最远相对距离处的平均是 6.19×。三条自陈局限要一起读:存储近乎翻倍、名字里的「虚拟化」目前只在内存里做、评测场景还比较简单。另有三处口径边界:FLIP 的参照是 4K+SSAA 造的 1080p 真值,不是原图;与 H3DG 对比时移除了对方脚本里的 alpha mask 乘法;「每场景约 1 亿基元」是显存限制下的规模,不是方法上限。本篇许可为 CC BY 4.0(arXiv 存缴版),站内托管原文 PDF,图与表原样零加工引用并逐图署名。

原文 arXiv:2505.06523v1 · SIGGRAPH Conference Papers '25 · 16 页引用原文图 21 张 · 表 5 张CC BY 4.0(arXiv 存缴版)· 可站内托管

Don't Splat your Gaussians

非 CC · 逐图署名引用
arXiv:2405.15425v3 · ACM TOG 44(1), Article 10 · 18 页单篇论文精读 · 14 章 · 17 图 · 2 表 · 18 式
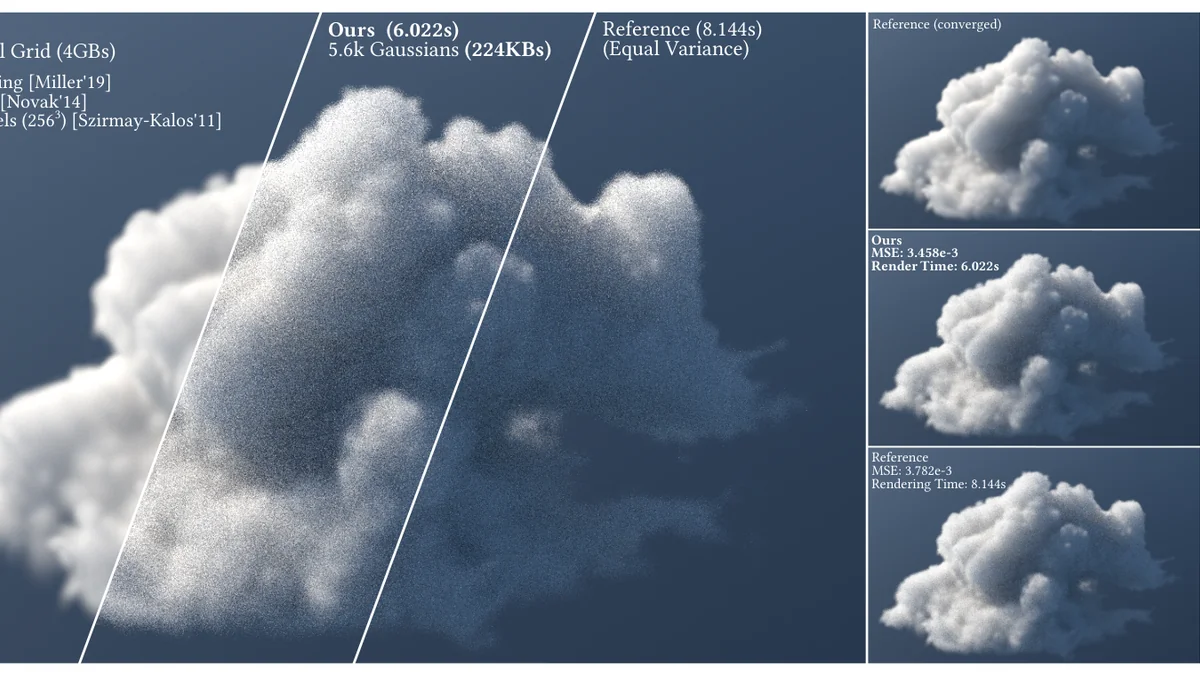
Don't Splat your Gaussians 首图:同一朵云的三种表示 —— 左右为 10,243 体素网格(4GB),中间为本篇的 5.6k 个高斯基元(224KB)(原文 Fig. 1)
篇目 56 体渲染射线追踪核混合逆渲染 已完成 14 章26,643 字17 图

3DGS 把三维压成了二维;体介质要的是另一条路

3DGS 这条线一直在把表示做得更省、把渲染做得更快,但有一处它从没打算改:成像模型。它的每个基元在渲染时变成一张朝向相机的 billboard,沿射线的密度于是退化成 delta 函数之和 —— 这一步是为光栅化速度付的账,代价是离开了物理运输过程:不保互易性,而且必须按视角排序基元。本篇把方向反过来:三维密度留在原地,用「三维核的混合」表示介质,在辐射传输框架里推出闭式的透射率与自由飞行距离采样,再用硬件射线追踪查基元边界、沿射线分段积分。得到的是一个能进物理渲染器的体介质表示:同一组基元既做云与烟的前向渲染,也做逆层析与逆散射,还能当 radiance field 用。除高斯核之外,还引入并实测了 Epanechnikov 核。账面口径:同一朵云,4GB 的 10,243 体素网格 对 5.6k 个基元的 224KB(约 ×5251 压缩,OpenVDB 为 ×6.823);烟用 900 个高斯(37KB) 对 512³ 网格(550.4MB),单样本零方差且每样本开销最小;同画质(PSNR 38.05dB)下 Epanechnikov 比高斯 快 3.26×。而 radiance field 那一节要分两面读:画质上落后于光栅化的 3DGS(MipNeRF-360 上 22.07/0.536 对 25.25/0.771),但在射线追踪这一类里它最快(复杂场景平均 40–50 FPS),也是表里唯一「复杂相机模型 = Yes 而框架 = Ray-tracing」的解。三条自陈局限要一起读:逆渲染训练时间明显更长、绝对画质略逊于 3DGS、资产目前只支持「只有密度非均匀」。另有一句必须写在正文里,否则标题会被读反:「不 Splat」指的是不把三维压成 billboard,核用的恰恰就是高斯。本篇许可为 非 CC(arXiv 存缴版),图与表原样零加工引用并逐图署名,本站不托管原文 PDF。

原文 arXiv:2405.15425v3 · ACM TOG 44(1) · 18 页引用原文图 17 张 · 表 2 张非 CC · 逐图署名引用(不托管原文)

When Gaussian Meets Surfel

非 CC · 逐图署名引用
arXiv:2504.17545v2 · ACM TOG 44(4) · 18 页单篇论文精读 · 14 章 · 21 图 · 7 表 · 14 式
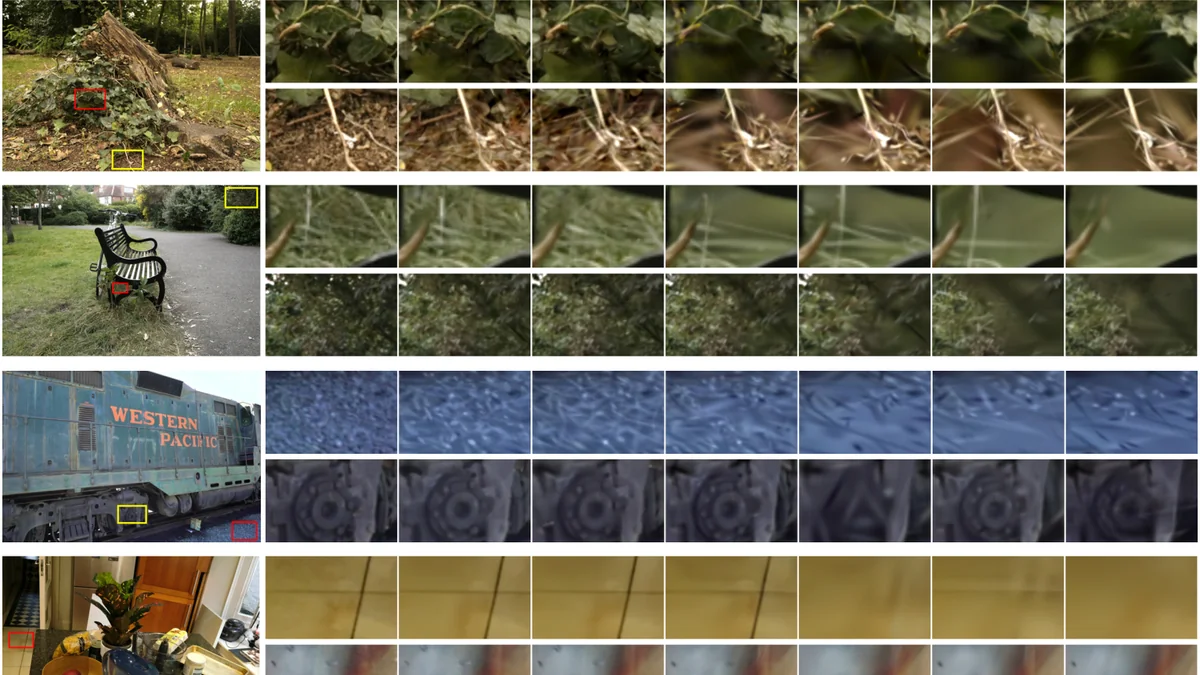
When Gaussian Meets Surfel 配图:五个场景(Stump/Bicycle/Train/Counter/Treehill)的画质定性对照(原文 Fig. 5)
篇目 57 实时渲染辐射场面片表示排序无关 已完成 14 章23,749 字21 图

3DGS 卡住的环节是排序,不是画质

3DGS 把单个资产的实时渲染做成了常态,但它有一处从没打算改:α 混合要求按深度排序。逐像素精确排序太贵,3DGS 改用整幅图一次性的 tile 级预排序近似它,代价是视角变化时的跳变伪影(popping)。本篇不去改高斯、也不去改 α 混合,而是把排序这件事本身拿掉:用一组 2D 不透明 surfel 走标准图形管线光栅化出颜色图与深度图(Pass 1),再用一个 ε 修正过的深度测试把 3D 高斯泼溅上去、按权重归一化累加(Pass 2),最后两层按权重线性合成。因为高斯的颜色本身已被权重归一化,整条管线完全不排序。副作用比主效应还值钱:不排序 ⇒ 没有跳变 ⇒ 视角一致;surfel 层天然给出显式几何与粗尺度深度。四个扩展把这条基础表示推向实用:Mip-GES(抗锯齿)、Speedy-GES(剪枝加速)、Compact-GES(紧凑存储)、2D-GES(更好几何)。账面口径:3D-GES 1080p 平均 675 fps、2160p 233 fps,Speedy-GES 1135 fps / 348 fps;存储 366MB 对 3DGS 的 734MB(不到一半),Compact-GES 压到 47MB(对 C3DGS 的 49MB,原文称 20 倍以上压缩);代价是训练时间比 3DGS 长 1.3×–1.6×,且不透明 surfel 抓不住镜面反射(3DGS 可以靠大量低不透明度高斯把反射「糊」出来,它不能)。三条作者自陈局限要一起读:训练变长、镜面吃亏、与 3DGS 共享初始化敏感性。另有九条口径边界,其中最要紧的一条是:「合」不等于「融合」—— 两层是两次渲染后按权重线性合成,不是把两类基元塞进同一次 α 混合。本篇许可为 非 CC(arXiv 与 ACM 两处互相印证),图与表原样零加工引用并逐图署名,本站不托管原文 PDF。

原文 arXiv:2504.17545v2 · ACM TOG 44(4) · 18 页引用原文图 21 张 · 表 7 张非 CC · 逐图署名引用(不托管原文)

FLoD: Integrating Flexible Level of Detail into 3D Gaussian Splatting for Customizable Rendering

CC BY-NC-ND 4.0
arXiv:2408.12894v2 · ACM TOG 44(4) · 16 页单篇论文精读 · 14 章 · 19 图 · 9 表 · 8 式
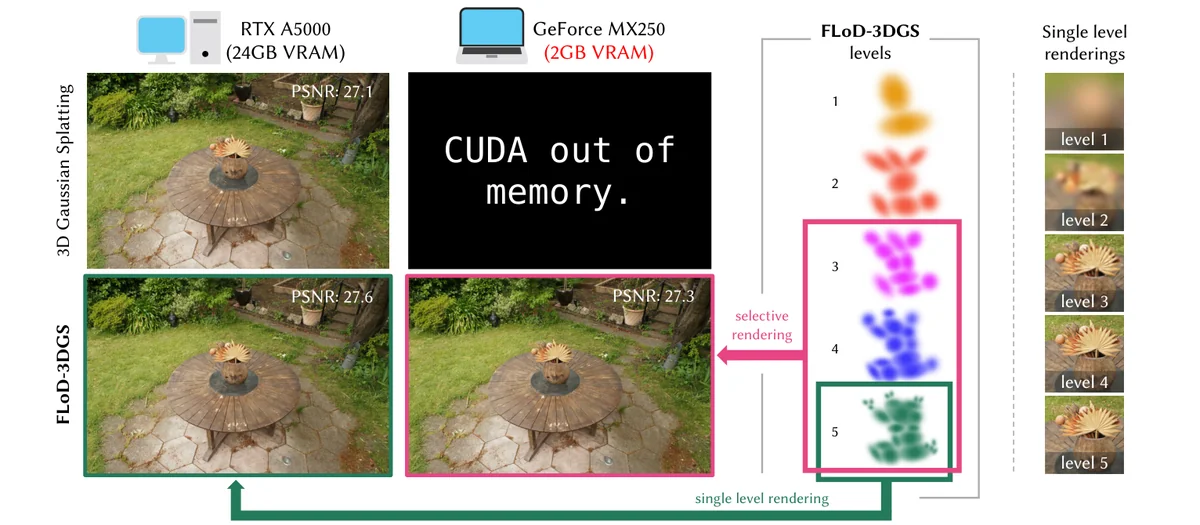
FLoD 首图:同一份模型在两台机器上的三种跑法——24GB 服务器满级渲染、2GB 笔记本上原版 3DGS 直接 OOM、以及笔记本上的分级/选择性渲染(原文 Fig. 1)
篇目 58 实时渲染辐射场层次细节显存自适应 已完成 14 章30,875 字19 图

3DGS 的短板不是画质,是它只认一种硬件

3DGS 把「一个场景、一台机器」的实时渲染做成了常态,但它一直带着一处没打算解决的前提:同一份模型只服务一种硬件。往上走的路(原版 3DGS、AbsGS、FreGS、Mip-Splatting)要海量高斯换画质,显存一紧就崩;往下走的路(LightGaussian、Compact3D、EAGLES)把高斯砍掉,画质跟着掉,而且只给一个压缩档。本篇把图形学里最成熟的 LoD(Level of Detail) 搬进 3DGS:训出 L_max = 5 级表示,每一级用一条随级别变化的 3D 尺度下限 s_min^(l) = λ·ρ^(1−l)(λ = 0.2、ρ = 4,最高级取 0 不加约束)把高斯「在第 l 级不许小于某个尺寸」——于是第 1 级用少量大高斯扛粗结构、第 5 级用大量小高斯补细节,每一级都能独立把整个场景渲出来。再用逐级训练(上一级训完克隆一份当下一级初值,并把尺度参数调成 s^(l+1) = s^(l),消掉初值处的尺度断层)保证各级结构一致,用重叠剪枝(三个最近邻平均距离低于 d_OP^(l) = s_min^(l)/2 的高斯删掉)压掉交叠伪影。用法有两种:选一级(照显存挑档),或者选择性渲染(按屏幕尺寸阈值 γ 把远处的像素分给低级别,只把 [L_start, L_end] 这一段的高斯子集 G_sel 留在显存里)。账面口径:2GB 的 MX250 笔记本上「只用第 5 级」直接 OOM,改成「5+4+3」或降一级就跑得起来(bonsai 上 7.48 fps);满级渲染与五条基线在三个数据集上比九格,FLoD 拿下五格(DL3DV-10K 三项全拿);第 1/2/3 级只用满级 0.7%/2%/22% 的高斯数;选择性渲染用 5+4+3 相对只用第 5 级显存少约一半、PSNR 掉不到 1。代价照写:per-view 的 G_sel 为了维持帧率必须把整段高斯留在显存里,作者自己把它列进局限;γ 调到 2、3 时级别交界处会出现可见接缝(附录 E 是这条的证据);以及原文正文写重叠剪枝在第 1 级降 90%,与表 6 的 38K → 10K(−73.7%)对不上——这三条都写进了正文。本篇许可为 CC BY-NC-ND 4.0(原文两处互相印证),图与表原样零加工引用并逐图署名,站内托管原文 PDF。

原文 arXiv:2408.12894v2 · ACM TOG 44(4) · 16 页引用原文图 19 张 · 表 9 张CC BY-NC-ND 4.0 · 原样引用(托管原文)

Learning View-Dependent Splatting Kernels

CC BY-NC-ND 4.0 · 站内托管原文 PDF
arXiv:2605.25426v1 · SIGGRAPH Conference Papers '26 · 10 页单篇论文精读 · 14 章 · 8 图 · 5 表 · 8 式
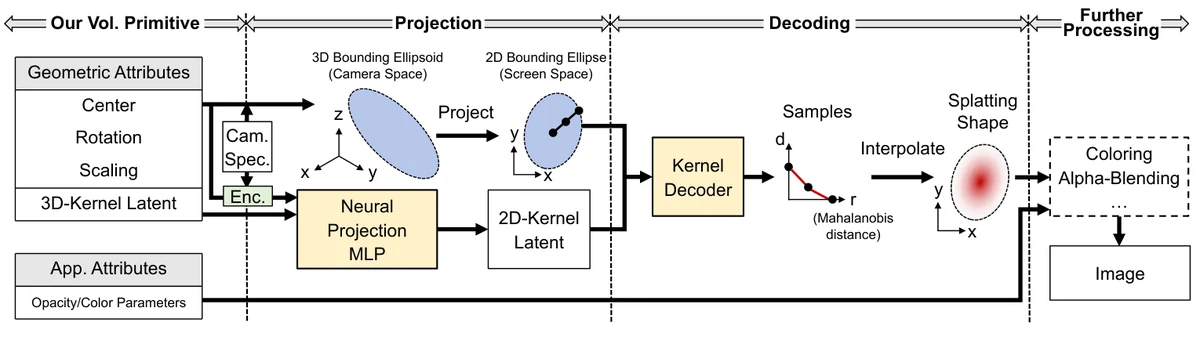
LVDK 方法总览:包围椭球先投成 2D 包围椭圆,神经投影 MLP 把 3D 核隐码换成 2D 核隐码,核解码器再输出一条按马氏距离表述的径向对称剖面(原文 Fig. 2)
篇目 59 实时渲染辐射场泼溅核视角相关 已完成 14 章19,814 字8 图

换掉高斯核:让网络自己学出泼溅的形状

3DGS 一系把画质与效率的账全都算在核的形状上,可这个形状一直由人写死:广义指数、Student’s t、可变形 Beta,式子一改就换一种核,表达力被式子封顶。想从数据里学,又撞上另一堵墙:通用 3D 基元沿视线的线积分没有闭式解,绕不过去就只能做「切片」近似,或者把基元限制成平面、限制成某类网络。本篇换了一个位置下手:不算线积分,直接学积分的结果,把投影之后的 2D 核本身当成要学的东西。基元 = 一个包围椭球(管位置/朝向/尺度)+ 一个 5 维隐码(管形状);投影由全局 MLP Φproj 完成,它除了吃隐码,还额外吃相机空间下的椭球中心、尺度 s 与旋转 Rcam 三样;解码由另一个全局 MLP Φdec 完成,输入只有马氏距离的平方 r2 与投影后的隐码,输出一条隐式的 1D 剖面。输出被限定为径向对称,理由不是省事,而是一条拓扑结论:任意 3D 视角映到 2D 坐标架的映射存在不连续(hairy ball 定理),作者试过平滑手法,结果动画里核会绕某些视线突转。渲染时把剖面在 k 个 r 采样点上预先求值、其余靠插值,把「基元内像素数」与「网络调用数」解耦,而且内存不随 k 变。4 个基准 21 个场景上,3D/2D 两侧全部画质指标最好或次好;约 100MB 预算里用最少的原语数拿到最高 PSNR(1.32M 原语 / 25.22,对比 DBS 的 1.67M / 24.24)。代价照写:帧率明显低于同代方法(同档 42 对 178 fps),作者的耗时分解是 Φproj : Φdec : 光栅化 ≈ 9 : 2 : 1;另有三处限定跟着写:没做抗锯齿、没用位置/频率编码、以及颜色视角相关与几何视角相关不等价(它们在 RGB 与 alpha 两个通道上工作)。本篇许可为 CC BY-NC-ND 4.0(依据所据 PDF 内的权利块;arXiv 摘要页为非独占分发,两处不一致),图与表原样零加工引用并逐图署名,站内托管原文 PDF;因 ND 禁演绎,封面与图件一律等比缩放、不裁切、不加标注、不施滤镜。

原文 arXiv:2605.25426v1 · SIGGRAPH Conference Papers '26 · 10 页引用原文图 8 张 · 表 5 张CC BY-NC-ND 4.0 · 站内托管原文 PDF

A LoD of Gaussians

CC BY-NC-ND 4.0
arXiv:2507.01110v4 · SIGGRAPH 2026 · 19 页单篇论文精读 · 14 章 · 21 图 · 8 表 · 7 式
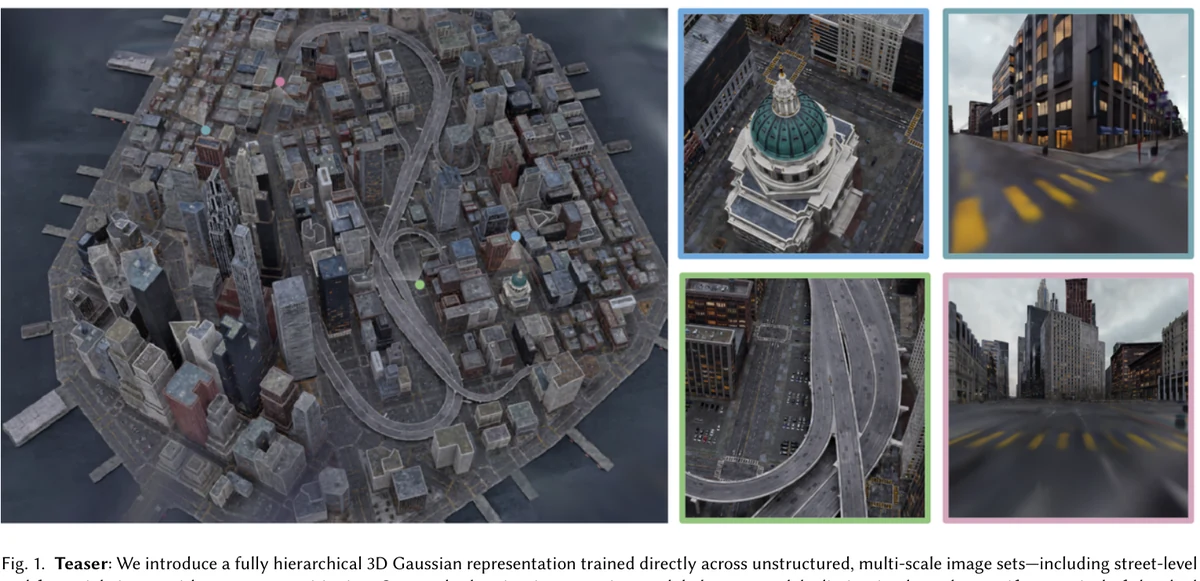
ALoD teaser:同一城市场景从高空俯视到街区近景,细节随视角连续变密,全场景没有块边界(原文 Fig. 1)
篇目 60 实时渲染辐射场细节层次外存流式 已完成 14 章22,000 字21 图

不切块:让上亿高斯住在内存,按视角只搬那几包

3DGS 想往城市尺度走,撞上的第一堵墙不是画质、也不是速度,而是显存:每个高斯连同优化器状态与前向/反向的临时分配,实测约 800 字节,于是每 GB 显存只放得下约 50 万个高斯,城市要的是这个量的成百上千倍。前人两条路各有代价:切块会在块边界留下接缝与鬼影,只靠外存、不管 LoD 又省不下训练期的内存。本篇的路子是外存 + 不切块:全部高斯属性留在 CPU 内存,只把树结构放进显存,按视角把当前要用的那几个流式搬进来;大子树压成 SPT,与上层的高斯层级拼成混合结构 HSPT,缓存按整块 SPT 切存、按距离比容差命中。有一处改动是这篇的地基:致密化不再等训练完再做,而是在训练中让层级持续长大 —— 于是前人并行切法依赖的那条堆条件会被训练破坏,HSPT 正是为解这个才被造出来的。账面:MC-small-city+ 上 21.59,而 H-3DGS 与 OctreeGS 在 141GB 卡上直接 OOM;Uni10k 上 21.32,略低于 HorizonGS 的 21.72,而后者每帧要 10 秒。代价照写:单次迭代比标准 3DGS 慢,渲染帧率也未到全在核内 3DGS 的峰值。许可为 CC BY-NC-ND 4.0,站内托管原文 PDF,封面不裁切。

原文 arXiv:2507.01110v4 · SIGGRAPH 2026 · 19 页引用原文图 21 张 · 表 8 张CC BY-NC-ND 4.0 · 站内托管原文 PDF

AD-GS: Alternating Densification for Sparse-Input 3D Gaussian Splatting

非 CC · 逐图署名引用
arXiv:2509.11003v2 · SIGGRAPH Asia 2025 · 19 页单篇论文精读 · 14 章 · 15 图 · 18 表 · 9 式
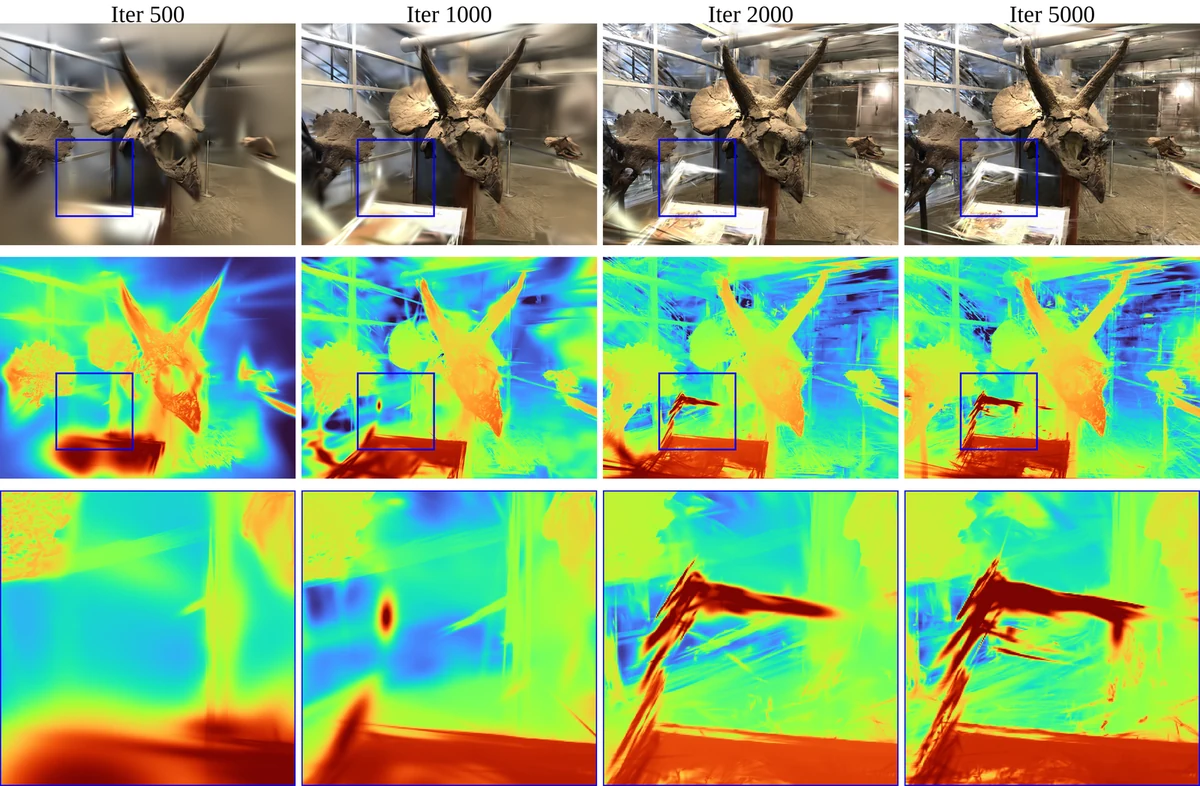
AD-GS 的失控时间线:稀疏视角下随训练推进,画面里逐步冒出悬空的碎屑(floater)与不一致的几何(原文 Fig. 2)
篇目 61 3D 高斯泼溅稀疏视角致密化新视角合成 已完成 14 章22,373 字15 图

放闸与清淤:稀疏视角下把致密化切成两种节奏

3DGS 在视角很少的时候会坏,而且坏得有规律:画面上先冒出一片悬空的碎屑(floater),几何跟着糊,模型对着那几张照片越训越过拟合。成因追到一个很具体的位置:致密化没人管 —— 稀疏输入下初始点云本来就少,而分裂是从父高斯的分布里采样、没有任何位置约束;采歪了的高斯又会招来周围更多的克隆与分裂,光度损失只会把它们染成训练视角里的颜色,不会把它们挪走,按低不透明度做的剪枝在稀疏输入下又太弱。本篇的办法是把训练过程切成两种节奏轮流来:高致密化段用低阈值猛涨高斯、且只吃光度损失,专门把细节捞回来;低致密化段把不透明度阈值抬高 20 倍、梯度阈值收紧 2.5 倍,同时用伪视角一致性与边缘感知深度平滑两套约束把几何拉回正轨。账面:三个数据集(LLFF/Mip-NeRF360/Tanks & Temples)五个视角档(3/6/9/12/24)上全部指标领先,且输入视角越少提升越大(LLFF 3 视角 SSIM 由 CoR-GS 的 0.674 提到 0.699,LPIPS 由 DropGaussian 的 0.266 降到 0.237);随视角数增加它收敛到稠密 3DGS 的水平且不退化。代价照写:要为伪视角一致性同时训两个 3DGS 模型(训练峰值显存 89%,3DGS 是 72%;时长约 15 分钟,3DGS 约 10),而推理仍只用其中一个;两模型同时犯错时这条一致性就失效;以及它是「先出错后纠正」而不是预先避免。许可为非 CC,本站不托管原文 PDF,图件逐图署名引用。

原文 arXiv:2509.11003v2 · SIGGRAPH Asia 2025 · 19 页引用原文图 15 张 · 表 18 张非 CC · 不托管原文 PDF · 逐图署名引用

Neural Texture Splatting: Expressive 3D Gaussian Splatting for View Synthesis, Geometry, and Dynamic Reconstruction

CC BY 4.0 · 站内托管原文 PDF
arXiv:2511.18873v1 · SIGGRAPH Asia 2025 · 16 页单篇论文精读 · 14 章 · 10 图 · 21 表 · 11 式
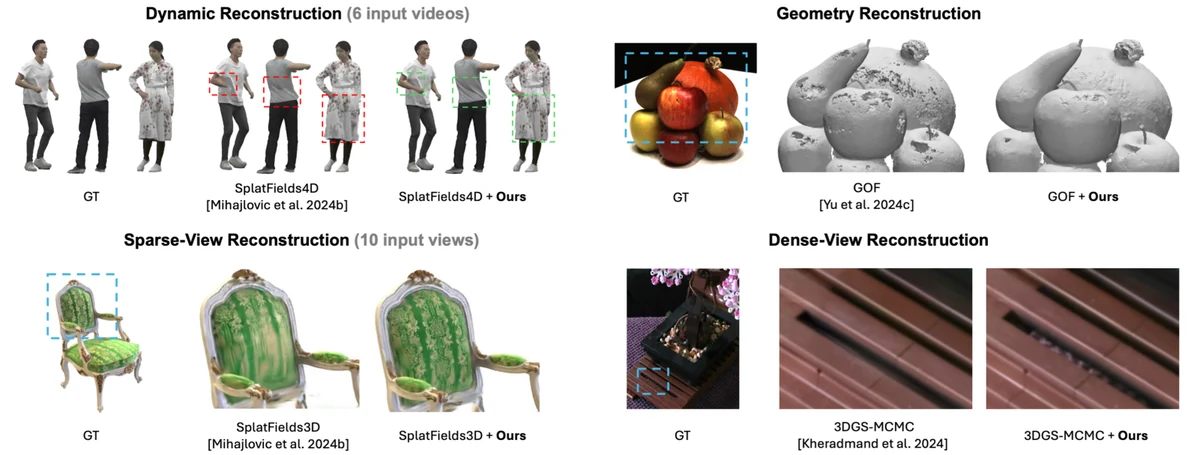
NTS 的 teaser:同一套 per-primitive 神经纹理场模块挂在静态稀疏、动态稀疏、几何重建与稠密新视角合成四个任务上的一致提升(原文 Fig. 1)
篇目 62 3D 高斯泼溅稀疏视角纹理场动态重建 已完成 14 章23,391 字10 图

不逐张发贴纸,改查一本公共字典:让每个高斯自己去算纹理

3DGS 的表达力卡在一个高斯只有一个核。前人给每个高斯挂一张小贴图,可这条路只在「视角稠密 + 高斯数量被压得很低」的新视角合成上被验证过,换到稀疏视角、表面重建、动态场景就缩水:贴图是印死的(从哪个角度看都一样、也不随时间变),而且各写各的(相邻两张接不上、容量冗余、训练时容易背答案;表 1 里那条「训练 PSNR 更高、测试几何更差」就是证据)。本篇把它换成一本公共字典:一个全局神经场(三张平面 + 神经解码器)按每个高斯的位置、朝向、视角方向与时间,现场算出它的局部 RGBA 纹理场;再用CP 分解与外积把三张 τ×τ 的平面压成两列 4τ 维向量,模型体积因此降下来。账面:Blender 稀疏视角 4/6/8/10 视角平均 PSNR 由 SplatFields3D 的 22.58 提到 23.05,Owlii 动态由 27.87 提到 29.25(4 视角那一档单档 +3.10 dB);DTU 表面重建的 Chamfer Distance 由 GOF 的 0.74 降到 0.67;与 per-primitive 纹理的 SOTA(Textured-GS)相比,PSNR 更高而纹理存储小 3.4 倍(Blender)到 56.9 倍(MipNeRF360)。代价照写:推理多出 ray-Gaussian 求交与一次网络前向(表 6 有逐项时长),训练显存与时长成倍上涨(表 5/11);作者另陈两条局限,户外场景提升不明显(有界的 tri-plane 编码抓不住大范围变化),以及那两笔额外计算。许可为CC BY 4.0(依据所据 PDF 内的权利块),本站站内托管原文 PDF,图件逐图署名引用。

原文 arXiv:2511.18873v1 · SIGGRAPH Asia 2025 · 16 页引用原文图 10 张 · 表 21 张CC BY 4.0 · 站内托管原文 PDF · 逐图署名引用

Graphical X Splatting (GraphiXS): A Graphical Model for 4D Gaussian Splatting under Uncertainty

CC BY 4.0 · 托管原文 PDF
arXiv:2601.19843v3 · SIGGRAPH 2026 · 23 页单篇论文精读 · 14 章 · 14 图 · 19 表 · 28 式
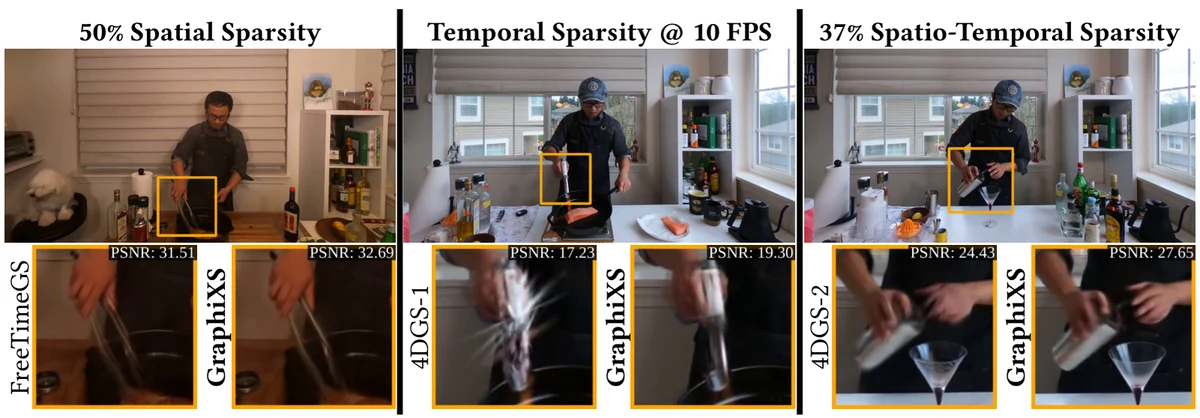
GraphiXS 的 teaser:缺 50% 相机、10 FPS 慢速相机、缺 37% 随机帧三种数据不确定性下都优于现有 4DGS 方法(原文 Fig. 1)
篇目 63 3D 高斯泼溅数据不确定性概率建模四维重建 已完成 14 章24,732 字14 图

相机没到齐,重建照样做:把数据缺失写成四维高斯泼溅的一个变量

四维高斯泼溅这两年只有一条路:确定性优化;而这条路默认「相机够多、姿态够准、帧率够高、设备都好」,真实采集里这四条一条都不保准 —— 相机少了、帧缺了、机位之间没同步、还有一台干脆坏了。这四种「数据不确定性」在文献里各自被零散处理过,却没有一件工作把它们放进同一个框架。本篇把整件事换成概率建模:先把 4DGS 认成无权重的混合模型,再画一张图模型,把渲染拆成四步生成过程,并把相机位姿 C 与帧时刻 T 也提成随机变量(前人只把图像当观测)。全贝叶斯在百万级参数上跑不动,于是退到 MAP:似然按图模型分成四个因子,其中三步由光传输决定、照旧确定性实现,只把剩下那一步改成随机,并配一个「组件自信度」——一个组件被越多相机、越多时刻看见,它的软可见度占比就越高。先验侧给组件配一本行车记录:位置按布朗运动走、运动由四阶导数驱动;不透明度、协方差、运动量各有一条先验,运动量那条按体积代理 |det Σ| 加权(大块头要走得慢而稳)。账面:标准设置下 N3DV 的 PSNR 由最强基线 Ex4DGS 的 31.71 提到 32.02(GraphiTS)/31.78(GraphiGS),GI 上由 FTGS 的 28.01 提到 29.08/28.84;缺 30%/50% 相机时领先幅度反而拉大;它还能把别的 4DGS 方法「升级」——FTGS 换零件后标准 31.55→31.61、Faulty Cam 1 由 30.46→30.80。代价照写:训练时长 ×1.8、训练显存 +25%、推理 FPS −10%;消融里最要紧的一处是去掉随机性会掉 2 dB 以上(30.90→28.64)。作者另陈三条边界:C 与 T 用的是无信息先验、做的不是全贝叶斯、只支持由共同隐变量参数化的分布族。许可为 CC BY 4.0,本站托管原文 PDF。

原文 arXiv:2601.19843v3 · SIGGRAPH 2026 · 23 页引用原文图 14 张 · 表 19 张CC BY 4.0 · 托管原文 PDF

Generative 3D Gaussians with Learned Density Control

CC BY 4.0 · 托管原文 PDF
arXiv:2605.16355v1 · SIGGRAPH 2026 · 19 页单篇论文精读 · 14 章 · 16 图 · 6 表 · 29 式
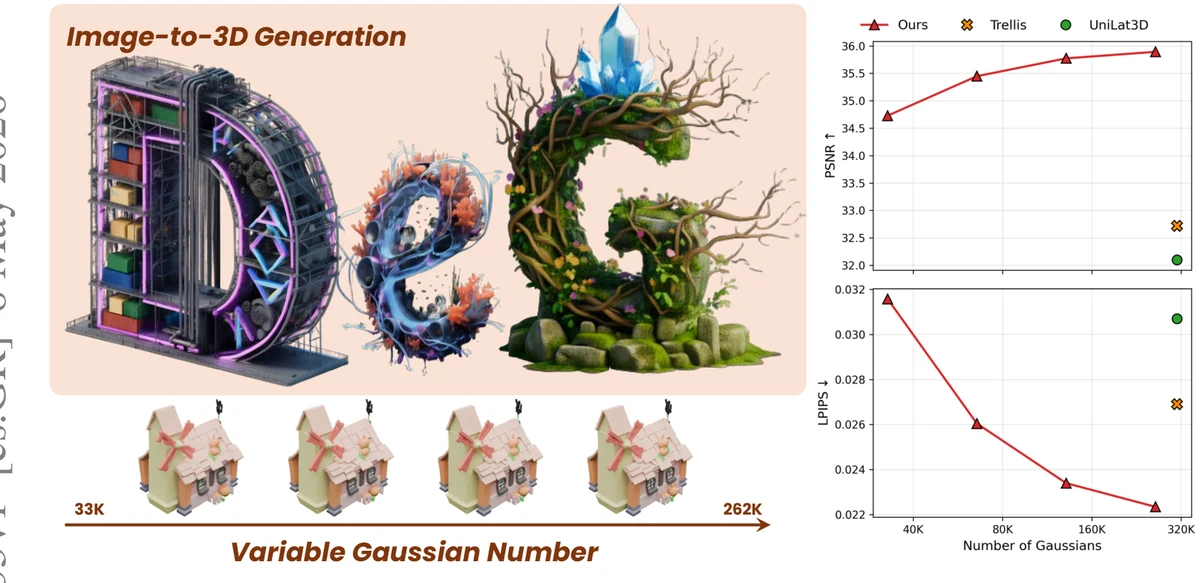
DeG 的 teaser:同一份隐表示在 33K 与 262K 两种高斯数下都能解码出三维高斯(原文 Fig. 1)
篇目 64 3D 高斯泼溅生成式建模可微密度控制单图到三维 已完成 14 章30,548 字16 图

不学坐标,学一张密度:把 3DGS 的加密剪枝做成可微的一步

三维高斯泼溅之所以好看,靠的是一套密度控制:欠拟合的地方加密,贡献小的剪掉。可加密与剪枝天生不可微、也难向量化,于是它进不了任何「学一个模型、一次生成一堆资产」的设定,现有生成式高斯全都退回固定结构:GaussianCube 固定 N³ 个高斯、结构化隐变量给每个体素分固定个数、像素对齐法给每个像素分固定个数。结构一固定,按局部复杂度自适应分配算力这条性质就没了。原文的解法是换掉被优化的对象:不学坐标,学一张三维概率密度,高斯中心是从密度里采出来的样本,「在哪里」与「长什么样」解耦,采多少在推理时随便调(同一个隐表示,33K 轻量资产与 262K 密资产都能出)。但采样不可微,渲染误差传不回去,于是推了一条 render loss contribution gradient:借差奖励把「拿掉这个锚点之后渲染损失涨了多少」当作它的边际贡献,回传到 log qθ;数学上它等价于可微版的加密与剪枝,工程上却在同一个 CUDA 反向 pass 里顺手做完。第三块用 VecSeq 把无序集合对到固定的 3D Sobol 序列上,把集合生成拧成序列生成。账面:Toys4K 重建 PSNR 由最强基线 TRELLIS 的 32.72 提到 35.89、LPIPS 由 0.0269 压到 0.0223,而高斯数比基线少约 15.5%;单图生成 CLIP-I 拿到全表最高的 92.26,用户研究 Elo 1137 领先最强基线 141 分。代价照写:VAE 训了约 10 天 × 32 张 A800,解码 0.10 秒是三者里最慢的一档,而贡献梯度只从 L1 项导出,作者自陈这会让它在高预算区间欠拟合感知误差。许可为 CC BY 4.0,本站托管原文 PDF。

原文 arXiv:2605.16355v1 · SIGGRAPH 2026 · 19 页引用原文图 16 张 · 表 6 张CC BY 4.0 · 托管原文 PDF

TransparentGS: Fast Inverse Rendering of Transparent Objects with Gaussians

非 CC · 逐图署名引用
arXiv:2504.18768v2 · SIGGRAPH 2025 · 16 页单篇论文精读 · 14 章 · 19 图 · 6 表 · 23 式
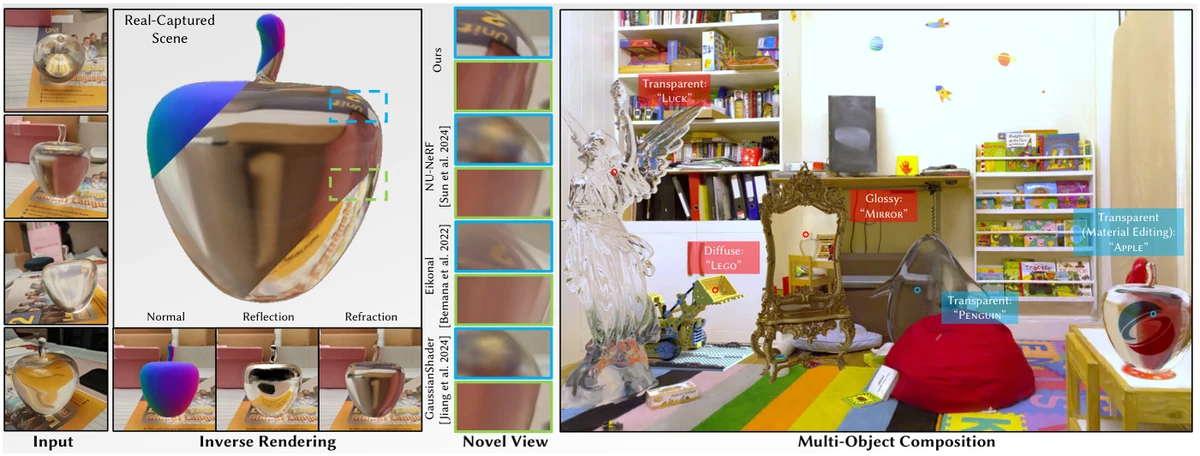
TransparentGS 的 teaser:真实捕获场景上的透明物体重建,蓝框标出高频折射、绿框标出含邻近物体的反射(原文 Fig. 1)
篇目 65 3D 高斯泼溅逆渲染透明物体光线探针 已完成 14 章29,432 字19 图

把透明写进基元:一小时内做完带二次光线的逆渲染

三维高斯泼溅把场景表示成一堆各向异性高斯,靠光栅化活着,而光栅化天生只支持理想针孔相机、没有二次光线:折射与互反射这两件事在 3DGS 里无处安放,球谐表达不了高频折射,硬拟合不是过拟合视角、就是把细节糊平。原文的解法是把「透明」写进基元本身:给每个高斯加上法向与材质参数(粗糙度、金属度、透明度、折射率),再用延迟折射先把所有基元的法向与命中点做 α-加权积分,只用一条折射光线去采样环境,而不是让每个基元各自采样再平均(α-blending 是线性的、而折射对法向不线性,顺序一换结果就变)。环境那一侧用 GaussProbe:把不透明环境烘焙成一组带颜色与深度全景的探针,既能装无限远的环境光,也能装近处的桌面与窗户。探针的代价是视差,于是第三块是 IterQuery:用深度信息迭代地掰正每个探针的查询方向,几次迭代就收敛到正确交点。账面:无色真实场景 PSNR 27.12/28.07/23.05、LPIPS 0.044/0.084/0.047;有色真实场景 Average PSNR 21.55、LPIPS 0.172(GShader 0.200、NU-NeRF 0.308);合成集上法向 MAE° 5.53(NU-NeRF 16.02、GShader 26.51),折射 22.87 与基色 21.51 两列 GShader 直接报 N/A。训练一小时内(Eikonal 22–24 h、NU-NeRF 8–9 h),渲染 31–51 FPS(Eikonal 0.03 FPS、NU-NeRF 0.016 FPS)。代价照写:光路只允许两次折射 + 最多一次全内反射,空心与复杂自遮挡几何难重建,高度异质透明物的材质估计有歧义,且流形约束被破坏时 IterQuery 会失败(图 18;作者用它解释了探针数 K=1 的失败)。许可为 非 CC(PDF 首页印 ACM 标准版权块),本站不托管原文 PDF,图件逐图署名。

原文 arXiv:2504.18768v2 · SIGGRAPH 2025 · 16 页引用原文图 19 张 · 表 6 张非 CC · 不托管原文 PDF · 逐图署名

Radiance Surfaces: Optimizing Surface Representations with a 5D Radiance Field Loss

非 CC · 逐图署名引用
arXiv:2501.18627v2 · SIGGRAPH 2025 · 17 页单篇论文精读 · 14 章 · 20 图 · 7 表 · 17 式
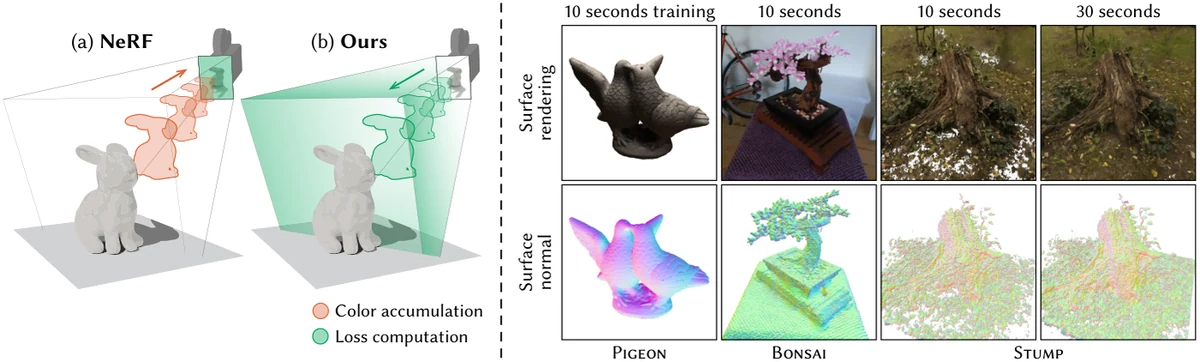
Radiance Surfaces 的 teaser:左侧并排对比体渲染与本篇的成像模型(color accumulation 对 loss computation),右侧是 Stump、Bonsai、Pigeon 三个场景的表面渲染与法向(原文 Fig. 1)
篇目 66 辐照度场表面重建损失函数Instant NGP 已完成 14 章29,082 字20 图

只改一个位置:把训练图像投进场景,让辐照度场自己长出表面

这篇论文只动了一个位置:把「算损失」从图像空间搬进场景里。NeRF 那一族的做法是先沿光线把辐照度场积分成一张图、再拿这张图跟训练照片比;本篇把它翻过来,把训练照片投进场景,直接在 5D 辐照度场上监督。这一步换来的东西比看上去多:alpha 混合与光线步进从成像模型里彻底消失,被搬进了损失计算;辐照度场的 2D 子集因此获得明确语义,成为一个个辐照度面;从表示里提面不再需要任何启发式,取一个水平集就行。代价小得不像话:原文自陈改动可以塞进几行代码(p3 右栏那张 NeRF/Ours 伪码对照就是证据),Instant NGP 变体的平均 PSNR 只比体渲染基线低 0.1 dB。账面:MipNeRF360 室内 29.02/0.888/0.275、室外 22.41/0.679/0.563(NeRF 29.19/0.893/0.303 与 22.47/0.683/0.638),LPIPS 两组都更低;DTU 平均 Chamfer 0.80(NeuS2 0.68、NeuS 0.77),而训练时间从 8 小时/5 分钟压到 1 分钟;改成表面渲染即得平均 2.4 倍帧率,再换成网格光栅化可再 2 倍。代价照写:与依赖图像空间邻域的损失不兼容,观测不足时轻量 Laplacian 正则会失效,高频颜色变化在面上比在体里更难表达,且这套损失依赖「光线到最近相交面」的 1:1 映射,不能平移到带全局光照的嵌套积分渲染器。许可为 非 CC(arXiv 摘要页为非独占分发许可、PDF 首页印 ACM 标准版权块,两处证据同向),本站不托管原文 PDF,图件逐图署名。

原文 arXiv:2501.18627v2 · SIGGRAPH 2025 · 17 页引用原文图 20 张 · 表 7 张 · 无编号伪码 1 件非 CC · 不托管原文 PDF · 逐图署名

A Generalizable Light Transport 3D Embedding for Global Illumination

CC BY 4.0 · 托管原文 PDF
arXiv:2510.18189v2 · SIGGRAPH 2026 · 18 页单篇论文精读 · 14 章 · 20 图 · 7 表 · 12 式
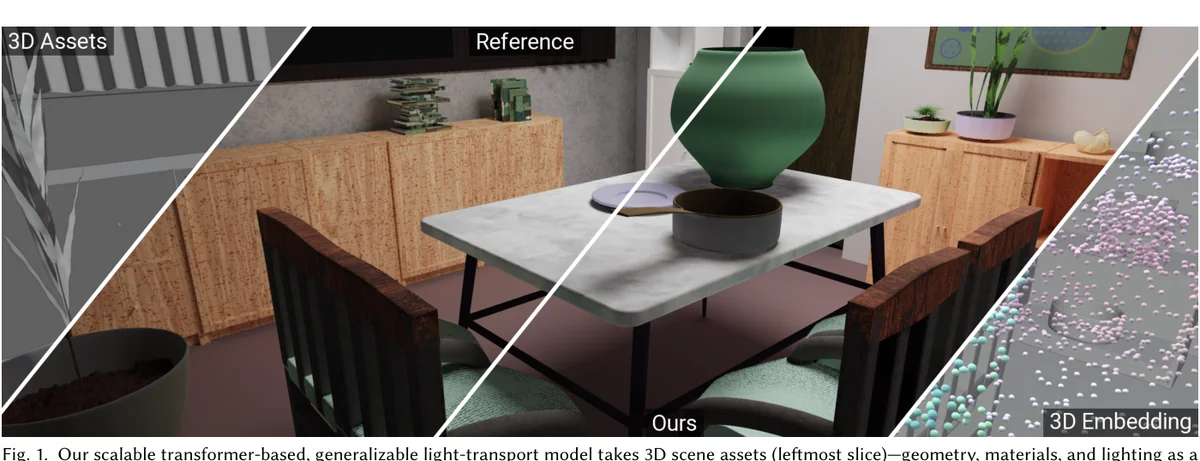
A Generalizable Light Transport 3D Embedding 的 teaser:左端是输入的 3D 场景资产(几何、材质与光照以点云形式给出),右端是把全局光传输编码成的一份 3D 嵌入(锚在场景点上的潜码),中间两格是同一未见场景在 2688×1152 分辨率下本篇预测与参考的全局光照对照(原文 Fig. 1)
篇目 67 全局光照光传输嵌入点云Transformer 已完成 14 章29,717 字20 图

把全局光照从「算」变成「查」:一份能跨场景复用的 3D 光传输嵌入

这一篇要回答的问题是「能不能不跑光追,也把全局光照直接猜出来」。前人给过三种答案,各有天花板:逐场景拟合的那一类学不会通用,换个场景就废;屏幕空间的那一类看不到屏幕外的光,一转头就闪;直接在 3D 里学的那一类走对了路,却卡在显存上 —— 全局注意力的平方复杂度把它们锁在「约 4k 三角面」的物体级网格里。本篇把三处一起换掉:网格换成点云(把光照分辨率与原始拓扑解耦)、全局注意力换成线性复杂度的 PTV3 点云 transformer、解码改成每条渲染光线只查自己那 32 个邻居(每像素成本与场景规模无关);再补一条世界空间里的 3D 监督,于是「换个视角」与「换个分辨率」都不再需要重训。账面:参数量 42M(RenderFormer 205M/483M),评估场景平均 320 万三角面(对方上限约 4k),主结果表在 105 个测试场景上 MSE 0.048(最优基线 0.051)、SSIM 0.912(0.425)。代价照写:编码一次 208 ms、512×512 出图 368 ms 尚未实时,高频镜面反射的保真度低于「直接预测出射辐射度」的对手,方向辐射场是 32×32 的离散低分辨率表示。许可为 CC BY 4.0(以所据 PDF 首页的权利块为准;arXiv 摘要页另登记 CC BY-NC-SA 4.0,两处分叉照录),本站托管原文 PDF,图件逐图署名。

原文 arXiv:2510.18189v2 · SIGGRAPH 2026 · 18 页引用原文图 20 张 · 表 7 张CC BY 4.0 · 托管原文 PDF · 逐图署名

Neural BRDF Importance Sampling by Reparameterization

CC BY 4.0 · 托管原文 PDF
arXiv:2505.08998v1 · 15 页单篇论文精读 · 14 章 · 20 图 · 4 表 · 16 式 · 另 3 块伪码
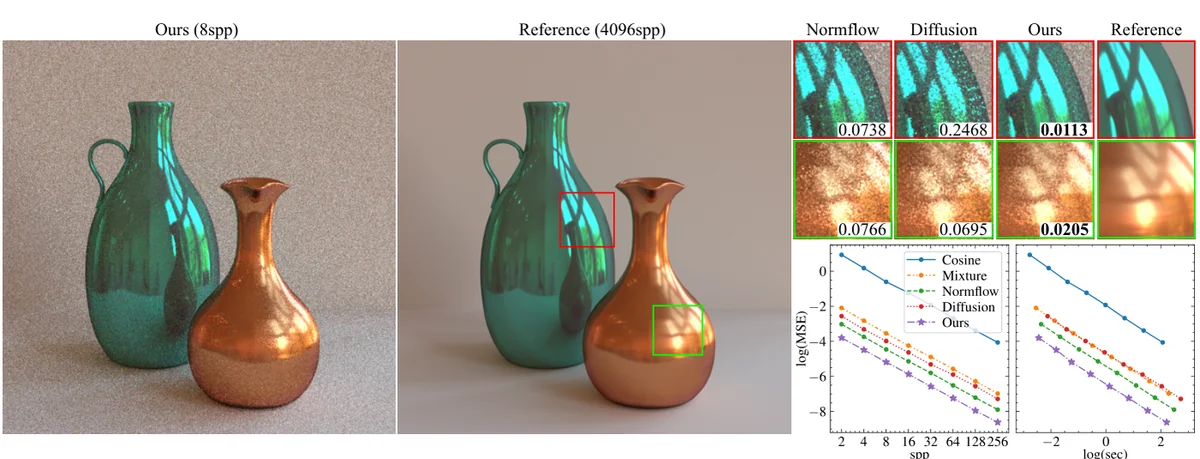
Neural BRDF Importance Sampling 的 teaser:左端是同一场景的渲染结果对比(本篇 8 spp 与 4096 spp 参考),中间是三条基线(Normflow/Diffusion 等)与本篇、参考的并排对照,右端是 MSE 随 spp 与 MSE 随渲染时间的 log-log 曲线(原文 Fig. 1)
篇目 68 采样算法神经 BRDF重参数化重要性采样 已完成 14 章28,519 字24 图

把重要性采样从「凑解析式」改成「学换元」:一次前向,就采出神经 BRDF 的分布

这一篇要回答的问题是「神经 BRDF 好用了,可它的分布怎么采」。前人给过答案,代价都写在约束上:可逆网络那一族能把 pdf 直接推出来,但为此要把变换设计成多步的、结构受限的,多步推断在渲染时就成了瓶颈;扩散模型同理;解析混合采样最快,却只能给出高斯团那样的形状。本篇把这道约束拆掉:概率变换本来就是 pdf 积分里的换元法则,于是「让采样分布贴近 BRDF 分布」可以改写成「给 BRDF 积分找一个换元」;换元不要求可逆,采样一次前向就出方向;pdf 缺失的坑用一个轻量近似 pdf 网络补上(它的不精确不影响无偏性,只影响方差),单步采样与 MIS 因此可以同时成立。账面:等 spp 下方差少 2–5 倍、推断耗时少 1–1.6 倍;等方差渲染下比解析混合快 2.32–7.14 倍、比第二好的方法快 1.39–3.78 倍;网络只有 T 约 1.0k + p̂ 约 0.7k 参数,训一种材质 45 分钟;与「表格化采样」这条近似最优的对手比,方差相当、耗时只差 6%–8%,存储小三个数量级(1.7 KB 对 4.4 MB)。代价照写:掠射角下 pdf 重建质量略降、强断开的多模态分布会模态塌缩、高维分布上雅可比算不动。许可为 CC BY 4.0(PDF 内权利块 0 命中,以 arXiv 摘要页为准),本站托管原文 PDF,图件逐图署名。

原文 arXiv:2505.08998v1 · 15 页引用原文图 20 张 · 表 4 张 · 伪码 3 块CC BY 4.0 · 托管原文 PDF · 逐图署名

Neural Importance Sampling of Many Lights

非 CC · 逐图署名引用
arXiv:2505.11729v1 · 11 页单篇论文精读 · 14 章 · 11 图 · 3 表 · 12 式 · 无伪码
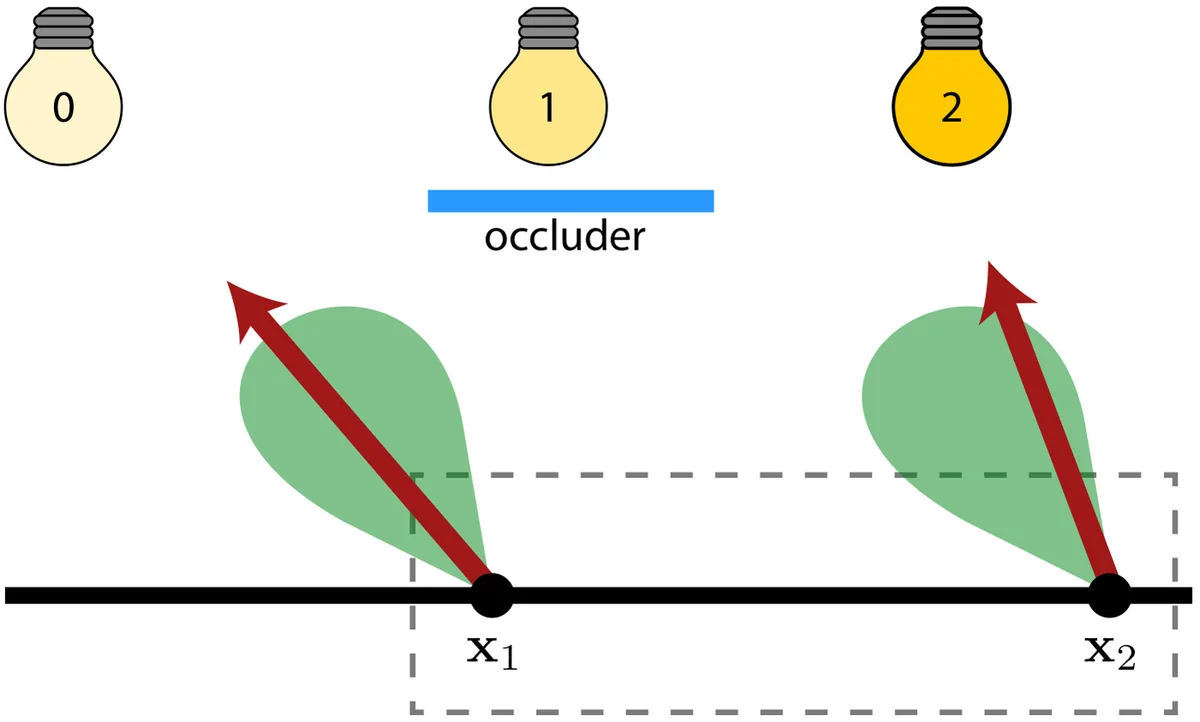
Neural Importance Sampling of Many Lights 的 teaser:三盏灯与两个相邻的着色点 x1、x2,红色箭头标出各自贡献最大的那盏灯;右侧灰色虚线框点出「学习类方法只对一片着色点算一份分布」的尺度问题,图里 x1 由 0 号灯主导、相邻的 x2 却由 2 号灯主导(原文 Fig. 1)
篇目 69 采样算法多光源神经重要性采样光层次树 已完成 14 章30,148 字14 图

一千盏灯里该采哪一盏:交给一个只答到「簇」的小网络,而它开局就等于别人的答案

这一篇要回答的问题是「一千盏灯里,这一根光线该采哪一盏」。前人给过两条路,各自缺一块:光层次树那一族能把簇概率算得很细,但算重要性时不看可见性,于是会反复去采被遮挡的灯;在线的学习类方法把可见性吃了进去,代价是对一小片空间只优化一份分布,抓不住子区域内部的差异(而相邻两点的主导灯本来就可以不是同一盏)。本篇让一个 3 层 × 64 神经元的小网络按着色点的局部信息逐点输出簇上的概率,损失取与目标分布的 KL 散度,而目标分布就是各盏灯在总量里占的那一份;为了不被上千盏灯撑爆,网络只答到「簇」这一层,簇内部那一盏仍旧交给既有的树;而为了让在线训练从第一帧就能用,它学的是在既有方法算好的簇概率之上的修正量(对数域相加 + 归一化,网络随机初始化时输出近似零)。账面:等时间与等样本两栏里,八个场景的 FLIP 全部最低(相对最好的基线分别降 16.5%–53.6% 与 16.5%–48.0%);等时间栏里它在六个场景上采到的样本数还比最快的树方法少;训练预算只占样本的 15%。代价照写:激进优化会带来离群飞点、割是全局固定的、簇内采样与灯内采点都不归它管。许可为非 CC(PDF 首页权利块明写 Not for redistribution),本站不托管原文 PDF,图件逐图署名。

原文 arXiv:2505.11729v1 · 11 页引用原文图 11 张 · 表 3 张非 CC · 不托管原文 PDF · 逐图署名

Neural Visibility of Point Sets

非 CC · 逐图署名引用
arXiv:2509.24150v1 · 11 页单篇论文精读 · 14 章 · 18 图 · 9 表 · 3 式 · 无伪码
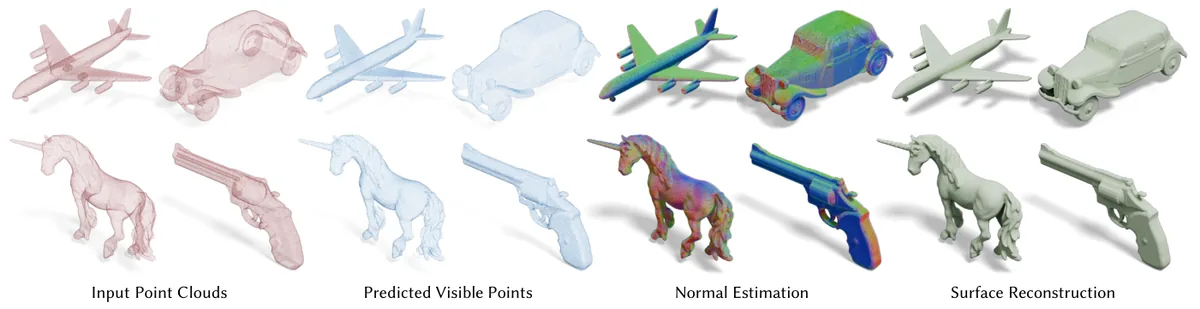
Neural Visibility of Point Sets 的 teaser:从左到右四格 —— 输入点云、给定视点下预测出的可见点(被挡住的点不再画出)、由可见性估计出的法向、以及泊松重建得到的网格,整条链说明「可见性错一点,法向与网格就跟着歪」(原文 Fig. 1)
篇目 70 可见性预测点云八叉树 U-Net神经渲染 已完成 14 章28,932 字27 图

点云上「谁挡着谁」没有标准答案:把它当一道二分类题,一份特征就能喂给任意多个视角

这一篇要回答的问题是「一朵点云上,这个点到底被挡住了没有」。这个问题严格说没有答案:点没有大小,被另一个点精确遮挡的概率近乎零;人眼能分出前后,靠的是它背后那张曲面的先验,而这份先验得从别处借。前人借过三种:先重建表面再做可见性测试(代价是重建本身还是开放问题)、HPR 那套球变换加凸包(代价是手写先验,且凸包最坏 O(n²))、投到像素平面再用二维网络判(代价是精度被分辨率锁死)。本篇换的是「这个判断怎么产生」:用八叉树 U-Net 抽出与视角无关的逐点特征,再用一个两层 MLP 把视角方向吃进去,输出「可见/不可见」两个通道 —— 关键在于两个部件是分开的:特征抽一次,可以给任意多个视角复用,于是「换一个视角」几乎不额外花钱。账面:81k 点平均 97.4%、2k 点平均 93.0%(比最好的基线分别高 1.2 与 3.7 个百分点,复杂类别上高 5 个百分点以上);20 万点以上快 126 倍;不重训就能接住 130k 点的输入;喂进法向还能再涨。代价照写:要真值标签(而标签本身比训练还贵)、只面向单物体且视点在视觉外壳之外、输出是硬二值的。许可为非 CC(所据 PDF 内权利块 0 命中,以 arXiv 摘要页为唯一证据源),本站不托管原文 PDF,图件逐图署名。

原文 arXiv:2509.24150v1 · 11 页引用原文图 18 张 · 表 9 张非 CC · 不托管原文 PDF · 逐图署名

ArtiFixer: Enhancing and Extending 3D Reconstruction with Auto-Regressive Diffusion Models

非 CC · 逐图署名引用
SIGGRAPH Conference Papers '26 · Article No. 114 · Pages 1–12单篇论文精读 · 13 章 · 11 图 · 11 表 · 4 式 · 伪码 1 块
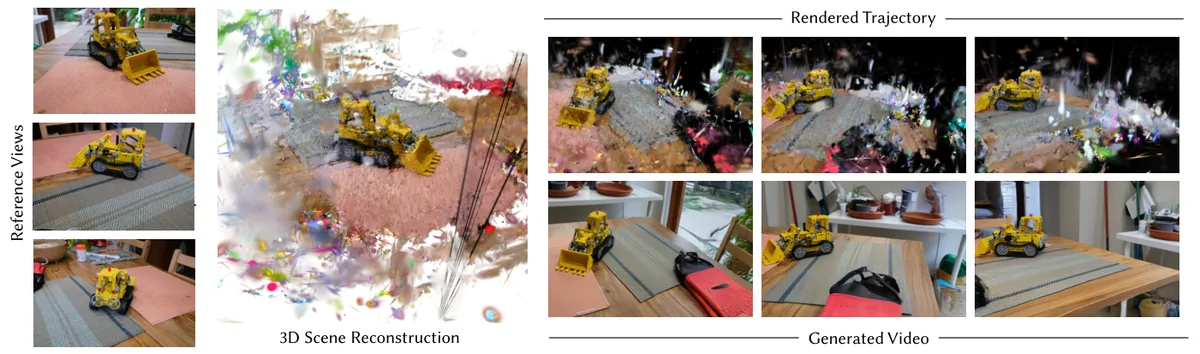
ArtiFixer 的 teaser:给定一张初始重建与可选的参考视图、文本提示,模型自回归地生成与既有观测高度一致的新内容,一次推理可直接产出几百张新视图,也可当作伪监督回灌以改进底层三维重建(原文 Fig. 1)
篇目 71 三维重建自回归视频扩散不透明度混合蒸馏 已完成 13 章29,292 字22 图

重建没扫到的地方补不上内容:按不透明度把噪声与脏图混起来,再压成一个能一次推几百帧的自回归模型

这一篇要补的是「初始重建没观测到的那些地方」。逐场景优化的三维重建(NeRF/3DGS 一系)在没人去过的区域只能给空洞、糊面与说不通的几何,而生成模型那一侧虽然能画,却不受任何东西约束。前人两条路各修一半:把生成结果灌回三维的那一拨,一次只能出少量新视图,为了前后一致得反复「生成—蒸馏」;把三维当条件直接生成的那一拨,画面好看但会改动已经对的内容。本篇换的是「源分布从哪里出发」:起点既不是纯噪声、也不是那张脏渲染图,而是按渲染出的不透明度把两者逐像素混起来 ——看得见的地方保住一致性,完全没看见的地方退回生成先验;再把这个双向教师蒸馏成一个少步数的因果自回归学生,一次推理能出几百帧,既可直接出图,也可当伪监督回灌三维。账面:Nerfbusters 与 DL3DV 上 PSNR 比前最好方法高约 2 dB(20.24/20.14 对 18.51/17.99);Mip-NeRF 360 三档视角每一格都赢(3-view 17.51 对 CAT3D 16.62);空区生成比次好的 GenFusion 高 3.12 dB;推理 8.36 FPS,1.3B 变体 34.38 FPS,而双向基座只有 0.12 FPS。代价照写:仍明显慢于直接渲染(268 FPS)、按时间块解码有首帧延迟、两个变体被骨干锁在 720p、偶尔糊掉细节与文字并可能有轻微色偏。

原文 arXiv:2603.00492v2 · 16 页(正文 12 + 补充 4)引用原文图 11 张 · 表 11 张非 CC · 不托管原文 PDF · 逐图署名

CoherentRaster: Efficient 3D Gaussian Splatting for Light Field Displays

CC BY 4.0 · 托管原文 PDF
SIGGRAPH Conference Papers '26 · 14 pages · DOI 10.1145/3799902.3811217单篇论文精读 · 13 章 · 6 图 · 6 表 · 11 式 · 伪码 2 块
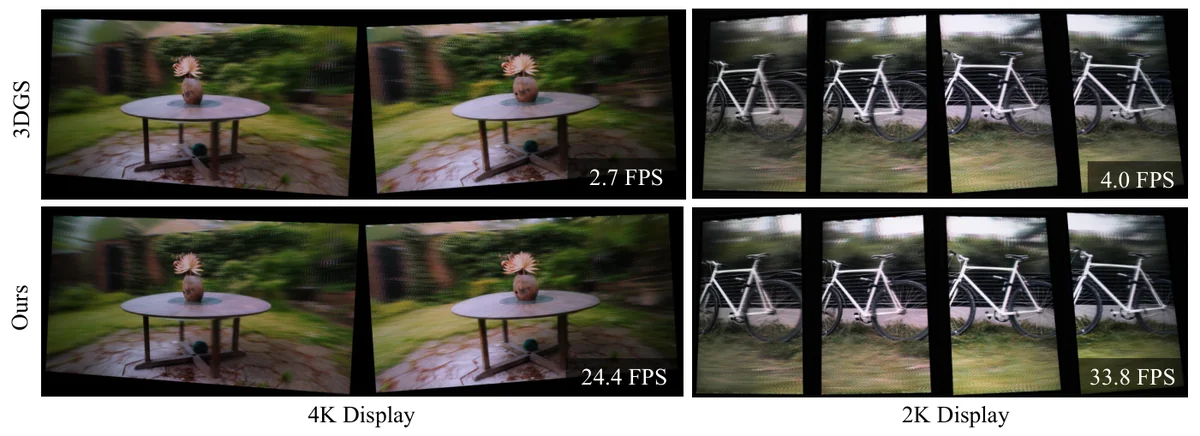
CoherentRaster 的 teaser:透过镜头实拍同一块光场屏,左右两侧分别是 4K 与 2K 的对照,每侧上下两幅为全帧 3DGS 与本篇的渲染结果,并各标出帧率(左侧全帧 3DGS 2.7 FPS 对本篇 24.4 FPS、右侧 4.0 对 33.8 FPS)(原文 Fig. 1)
篇目 72 光场显示高斯泼溅视点复用访存优化 已完成 13 章30,001 字12 图

一块屏要同时喂几十只眼睛:把视点之间重复算的那部分省下来,再把同一束线程排到同一只眼睛上

这一篇要解决的是光场显示器一帧要同时喂几十只眼睛这件事。普通屏一帧只有一个视点,3DGS 那句「实时」正是踩着这个前提换来的;光场屏一帧要出 71 个视点,前提当场没了,于是撞上两堵性质完全不同的墙。第一堵是算力:投影、生成排序键、排序这几段的工作量随视点数线性膨胀,而其中很大一部分在不同视点之间是重复的;第二堵更隐蔽:屏把不同视点的画面交错到同一个像素网格里,相邻子像素往往属于两个视点,GPU 赖以为生的「相邻线程读连续地址」随之失效。前人两条路各拆一堵:子像素级渲染(DirectL 一系、Ji 等人接到 3DGS)省了无用像素,却让第二堵更疼;多平面图像(Kim 等人的 MPI 路线)用相邻视点共享中间结果绕开重复计算,代价是要几百张深度平面、开销随分辨率暴涨。本篇两堵一起拆:跨视角相干属性复用把四件属性分两类,变化快的 2D 均值逐视点算、变化慢的协方差/深度/颜色每个视点簇只算一次;视角相干重映射把子像素按视点重新排队,让同一个线程束里的线程去读同一只或邻近的眼睛。账面:4K 真实场景跑到 23 FPS,对全帧 3DGS 提速 7.6 倍,画质只有可忽略的下降;缓存只有 6MB 的 RTX 3090 上 4K 仍有 6.0 FPS。代价照写:高镜面表面会露出破绽、动态场景目前不支持、换一块屏就得重算全部预计算表。

原文 arXiv:2605.04509v1 · 14 页(正文 11 + 补充 3)引用原文图 6 张 · 表 6 张CC BY 4.0 · 托管原文 PDF · 逐图署名

GigaSLAM: Large-Scale Monocular SLAM with Hierarchical Gaussian Splats

CC BY 4.0 · 托管原文 PDF
arXiv:2503.08071v2 [cs.RO] · 纯预印本 · 20 页单篇论文精读 · 14 章 · 14 图 · 6 表 · 32 式 · 伪码 0 块
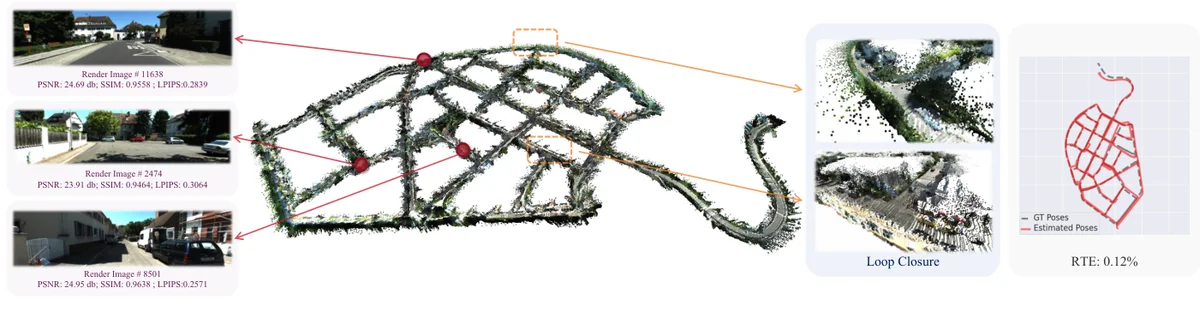
GigaSLAM 的 teaser:一段多公里级室外序列上若干帧的渲染结果,三帧各带一行 PSNR/SSIM/LPIPS(Render Image # 2474 = 23.91 dB/0.9464/0.3064、# 8501 = 24.95/0.9638/0.2571、# 11638 = 24.69/0.9558/0.2839),另标注 Loop Closure 与 RTE 0.12%(原文 Fig. 1)
篇目 73 单目 SLAM高斯泼溅层次体素回环修正 已完成 14 章33,879 字20 图

一段单目视频在一座城市里开出去十几公里:地图要按需取用才省,回环之后还得能整体扳回来

这一篇要解决的是只用一段单目视频、把一座城市走十几公里这件事。室内那套高斯泼溅 SLAM 之所以能跑,靠的是场景小、边界已知;一到室外,两笔账同时找上门。第一笔是地图要多大:NeRF 那一类表示常常要预先框死场景边界,稠密体素网格又是立方复杂度,几千立方米以上就铺不开;显式高斯不设边界,但体量随场景线性涨,长序列下显存与算力一起崩。第二笔更麻烦:漂了怎么扳回来。室外长序列必然累积漂移,检测出一个回环之后,要动的是整张地图,而不是几个位姿;而既有的增量式梯度配准只适合「一帧一帧往前推」。前人两条路各撞一头:DROID-SLAM 那条链把 SLAM 做成全可微的联合优化,但因子图靠光流建边,室外长序列上共视矩阵退化成「每帧只连最近四五个邻居」,优化窗口被压得极小;MonoGS 那条链把 3DGS 的实时渲染搬进 SLAM,代价是跟踪直接由渲染损失驱动,位姿与渲染互为因果,室外尺度下这个正反馈环会自激。本篇换的是地图的组织方式:用层次稀疏体素当骨架,每个体素由一个小网络解码出 k 个高斯,并按相机距离分配细节层级(LoD),近处细、远处粗,于是「一帧要加载上亿个高斯」这件事从源头被掐掉;前端把尺度交给度量深度模型、把位姿交给几何(对极几何 + PnP + GRIC),后端补上 BoW 回环与 Sim(3) 优化,并为高斯地图专门设计了一套分批的整图刚体更新(省显存)。账面:KITTI 十一个序列的平均 ATE 从 16.440 m 压到 15.576 m,渲染侧 PSNR 24.22 dB / SSIM 0.95,显存从 22.46 GiB 压到 8.62 GiB。代价照写:回环在纹理稀薄处会漏、LoD 阈值靠手调、动态场景不支持。

原文 arXiv:2503.08071v2 · 20 页(主文 10 + 参考 2 + 补充 8)引用原文图 14 张 · 表 6 张CC BY 4.0 · 托管原文 PDF · 逐图署名